

CoreWeaveは、サンフランシスコで開催されたFully Connected 2026カンファレンスで、NVIDIA Vera Rubin NVL72を本番環境に投入し、Cognitionが最初の顧客としてライブワークロードを実行しました。Cognitionのエンジニアは、SWE-2推論において、インタラクティビティを一致させた場合、GPUあたりの総トークンスループットがGB200 NVL72ベースラインの最大4.8倍、強化学習におけるGPUあたりの出力トークンスループットが3.8倍になったと報告しています。これらはどちらもCoreWeave Cloud上でCognitionが独自に実施したベンチマークであり、本番環境のエージェントワークロードで実行され、モデルサイズ、コンテキスト長、バッチ設定は公開されていません。
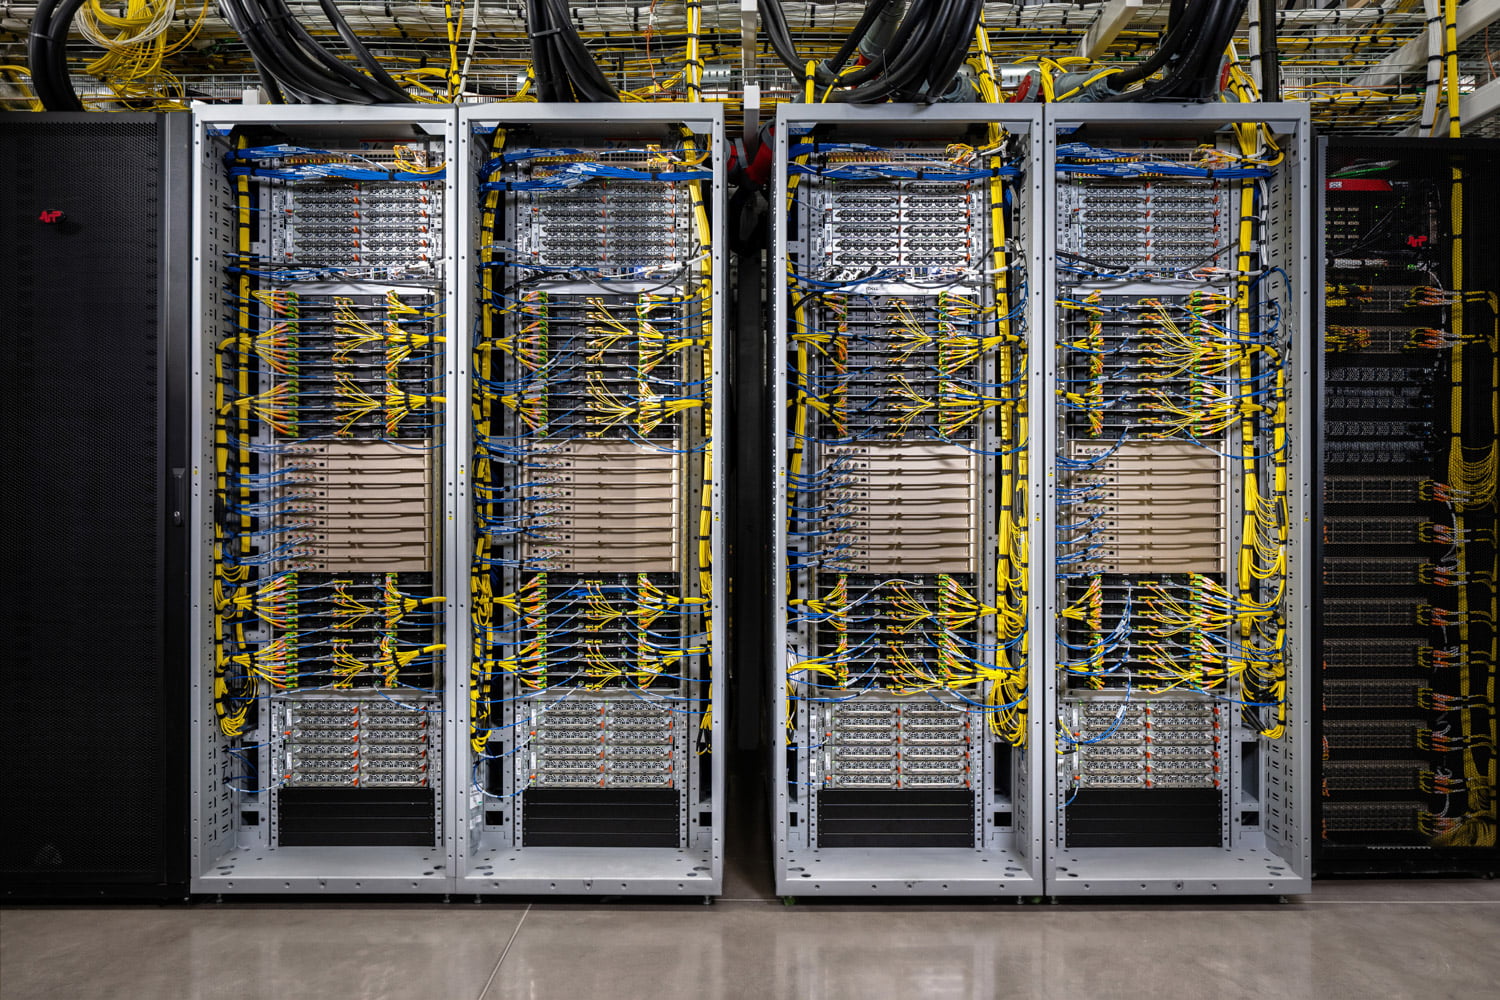
Vera Rubin NVL72がCoreWeaveの生産を開始
Cognitionは、CoreWeave上でDevinのトレーニング、強化学習、および本番推論を実行しています。CoreWeaveによると、Vera Rubin NVL72クラスターは9月上旬に立ち上げられ、ラックの引き渡しから数日以内にCognitionのワークロードが稼働し、Cognitionの実行は顧客が実行した初のVera Rubin推論ベンチマークであるとしています。Cognitionは、SWE-2の結果はGPUあたりの同時Devinセッション数の増加と研究の高速化を意味すると説明しています。
CoreWeaveのプレスリリースによると、Vera Rubin NVL72は現在利用可能とのことですが、Cognitionの導入に関する同社のブログ記事では、利用可能台数が限られているため、当面は割り当てが制限されると予想されます。顧客は、CoreWeaveのGB200 NVL72およびGB300 NVL72フリートと同じソフトウェアと運用モデル(CoreWeave Kubernetes Service、SUNK、Mission Control、Sandboxes、サーバーレス推論)を通じて運用します。
ラック本体、つまりGPUごとに2つのConnectX-9 SuperNICを搭載したDell製のNVL72ラック、そしてラックが製品化される前にCoreWeaveが実行する段階的な検証については、9月のマルチラック立ち上げ記事で解説しました。今回の新しい点は、有料顧客がこれらのラックを利用するようになったことです。
NVIDIA Vera CPU はエージェントサンドボックス密度をターゲットにしています
CoreWeaveは、エージェント処理(サンドボックス実行、強化学習環境、ツール呼び出し、コード実行、GPUトレーニングおよび推論ジョブに関連するデータ処理など)向けのスタンドアロンコンピューティング層として、 NVIDIA Vera CPUを製品ポートフォリオに追加する予定です。具体的なリリース日は「近日公開」とだけ発表されています。
CoreWeave 上の Vera ノードは、88 コアの Vera CPU 2 基と 1.5TB の RAM、15.36TB のローカル NVMe、および 800Gbps の BlueField-4 DPU をペアにしています。フル ラックには、BlueField-4 DPU と Spectrum-X Ethernet スイッチングを備えた 128 個の CPU と 11,264 個のコアが搭載されており、CoreWeave によれば、11,000 を超える同時接続の独立した環境をサポートします。CoreWeave は独自のテストで、名前を明かしていない x86 CPU と比較して、Vera 上でのエージェント サンドボックスの起動が 3 倍以上高速であると報告しています。Vera は、スポット容量を含む、GPU フリートと同じプラットフォームと消費モデルの下でベア メタルで実行されます。
CoreWeave Forgeは開発と生産を繋ぐ
展示会で発表されたCoreWeave Forgeは、Weights & Biases Models、OpenPipeのポストトレーニング機能、そしてオープンソースのmarimoノートブックプロジェクトを統合し、モデルとエージェントのための単一の開発レイヤーとして機能します。実験の追跡、評価、エージェントのトレース、チェックポイント、サンドボックス実行、ポストトレーニング、推論の展開を網羅しており、CoreWeaveは、モデル、フレームワーク、その他のクラウド環境を問わず利用できると述べています。MasterClassとCanvaは既にこのプラットフォームを活用しています。
Forgeには、無料版、プロ版、エンタープライズ版があり、プロ版は月額60ドルからで、30日間の無料トライアルが利用できます。現在一般提供されている機能は、ARIA、サンドボックス、重みとバイアスモデル、サーバーレスSFT、サーバーレスRL、レジストリ、ノートブック、およびサーバーレス推論と専用推論の両方です。プレビュー版として、エージェントレンズ、モデル蒸留、およびRLロールアウト機能があります。RLロールアウト機能を使用すると、トレーニングループを実行しながら、チェックポイントをライブ環境にロードできます。
CoreWeaveのリリースによると、Agent Lensは、名前が明かされていない汎用的な最先端のLLMと比較して、20%多くの重大な障害を検出し、10分の1のコストで問題を修正するとのことです。ただし、同社のブログ記事ではコストは半分とされているため、この数字は鵜呑みにしない方が良いでしょう。Serverless RLは、自己管理型のセットアップよりも1.4倍速く、40%低いコストでトレーニングできるとされています。どちらの場合も、ワークロード、モデル、ハードウェア、および方法論は提供されていません。
パートナーネットワークと臨床推論の展開
本日より提供開始となる CoreWeave パートナー ネットワークは、インフラストラクチャ、データ サービス、ISV、セキュリティ、モデルおよび推論など、CoreWeave が本番負荷でテストし、顧客の要望に基づいて認定した統合をグループ化したものです。パートナーとして、CrowdStrike、VAST Data、Reflection、ClickHouse、LanceDB、Inferact、RadixArk、IBM、Red Hat が名を連ねています。Exa、Parallel Web Systems、You.com は、CoreWeave 上でホストされるエージェント向けの共有検索統合を通じて参加し、発表後数週間以内に展開される予定です。この取り組みのポイントは、ワークロードをクラウドに移行しても、顧客は既存のサービング レイヤー、オブザーバビリティ、ランブック、セキュリティ ツールを維持できるということです。
15州で年間約50,000万人の患者に在宅プライマリケア、緩和ケア、ホスピスケアを提供しているEnnoble Careは、臨床AI推論にCoreWeave Cloudを採用した。このデプロイメントは、CoreWeave Kubernetes Serviceを介して予約済みのNVIDIA RTX PRO 6000 Blackwell Server Editionノード上で実行され、ハードウェアによる隔離と臨床データに対するゼロトラスト制御、および直接的なエンジニアリングサポートが含まれている。CoreWeaveは、プラットフォーム、ワークロード、テスト構成を明示せずに、CKSは汎用クラウドの代替手段よりも8~10倍速くコンテナを起動できると主張している。


 Amazon