

NVIDIAはGTCベルリンでMinervaを発表した。Minervaは、GPU、ネットワーク、ストレージ、スケジューラ、およびそれら上で実行されるAIワークロードからテレメトリを取得し、機械学習を適用して、トレーニングジョブの速度低下を引き起こす前に劣化しているコンポーネントを検出するAIOpsプラットフォームである。Dell Technologies、Lenovo、Supermicroは、AIファクトリーオペレーションポートフォリオにMinervaを導入する予定で、IRENは既に導入済み、IBM、Jio、Lambda、Quake AI、Tesla、Aolani、Bitdeer AIも導入を計画している。NVIDIAは価格や一般提供開始日を公表していない。
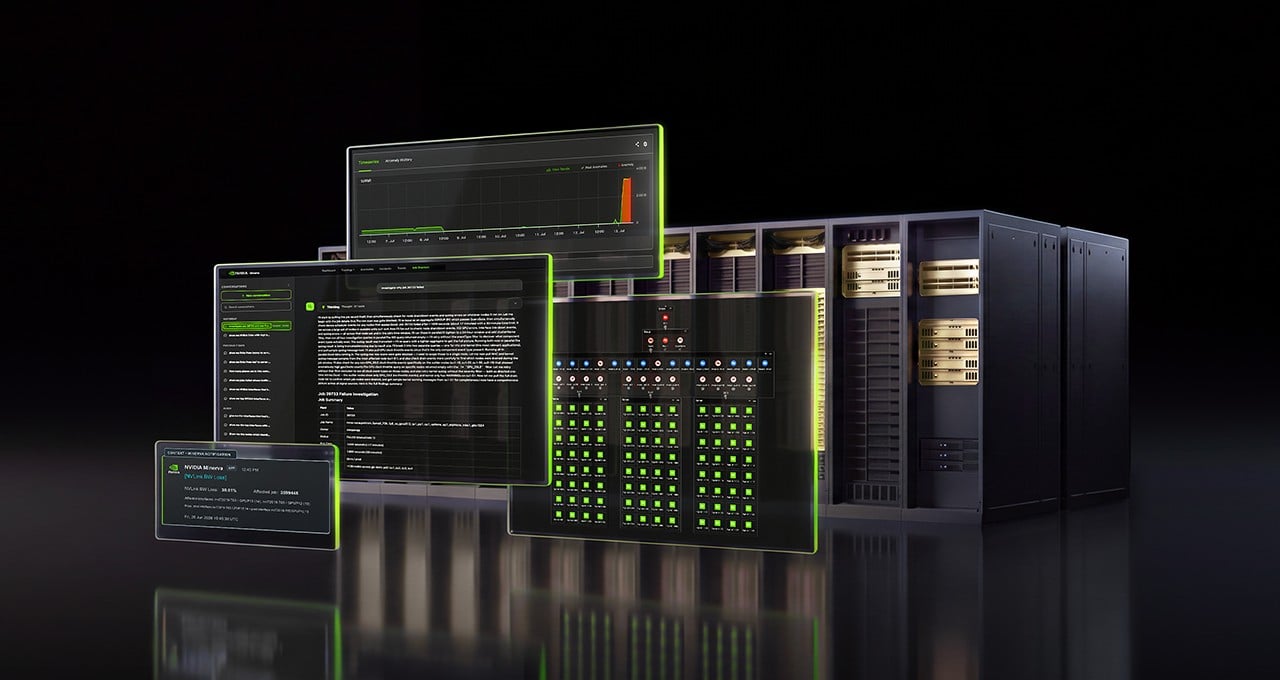
Minervaが解決しようとしている問題は、大規模クラスタの運用者なら誰もが知っているものです。高速ファブリック上の数千個のGPUは1台のマシンとして動作するため、1つの部品が仕様を満たさなくなると、処理全体が停止してしまいます。NVIDIAが挙げている例としては、周囲のGPUよりも高温になるGPUや、負荷がかかるとパフォーマンスが低下するNVMeドライブなどが挙げられます。こうしたデータ信号は、現在ではネットワークツール、コンピューティングツール、機械学習チームのダッシュボードなど、それぞれが同じクラスタを別々の視点から表示する形で存在します。
ミネルバの時計
Minervaは、GPU、SuperNIC、スイッチ、ケーブル、およびそれらにスケジュールされたジョブをマッピングする動的な知識グラフを構築し、NVIDIAが「1時間あたり数十億のデータポイント」と表現するデータを、教師あり学習と教師なし学習を用いて分析します。このモデルは、工場の正常な動作を学習し、これまで見たことのない異常を検出し、発生しつつある障害を予測し、トポロジーを使用して関連するイベントを相関付けます。これにより、NVIDIAが数十万個のGPUを擁する工場全体で、遅いトレーニングジョブの原因となっているコンポーネントを特定できます。
出力はインシデントとして整理され、関連するイベントは単一の項目にまとめられ、考えられる根本原因が添付されます。NVIDIAによると、これにより大量のアラートが1つの対応可能な項目に置き換えられるとのことです。内蔵のアシスタントは、ライブテレメトリに対して自然言語による質問に答え、修正を推奨します。また、プラットフォームは外部のエージェントツールに接続します。オペレーターは、修復を人間が行うか、MinervaがインフラストラクチャAPIと外部システムを介して自動化に任せるかを選択できます。
NVIDIAは、その成果をAIファクトリーの生産性と位置づけており、GPU稼働時間、処理能力、クラスタ稼働時間、トークン生成量で測定している。同社が主張する成果は、中断間隔の延長、修復時間の短縮、トリアージ対象となるアラートの減少であり、運用チームは事後対応型メンテナンスから事前対応型メンテナンスへと移行できるという。ただし、これらはベンダー側の主張であり、具体的な数値は示されていない。NVIDIAは、Minervaの平均修復時間や稼働時間に関する数値を公表していない。
スタック内の位置
NVIDIAは既にリファレンスデザイン向けの運用ソフトウェアを販売している。 2025年3月に発表されたMission Controlは、Base Command Managerによるクラスタプロビジョニング、Run:aiによるワークロード管理、テレメトリ、およびDGX SuperPODシステムの自律的なジョブリカバリを処理する。Minervaと同じ週に、NVIDIAはAIファクトリーのライフサイクル管理のために、3つのオープンソースDSX OSコンポーネントを開発者プレビューとして公開した。ネットワーク構成用のConfig Manager、ラックレベルの電力、在庫、ファームウェア、およびスイッチ管理用のRack Management Service、分散ワークロードでGPUクラスタを検証するためのCluster Readiness Engineである。
Minervaが対象とする問題の規模は、先週Metaが発表したPrometheusに関する記事で明らかになった。Metaは各NVL72ドメインを64個のGPUで構成されたスライスとして運用し、残りの8個のGPUはラック内の予備として保管している。また、ラックの約2%を予備として確保し、修理されたシステムはすべて検証に合格するまで隔離している。NVIDIAのエンジニアと現場で1年間かけて根本原因究明に取り組んだ結果、中断回数は99%削減され、中断間隔の平均時間は54,000 GPU時間を超え、目標は100,000時間となった。
これは、専用のテレメトリパイプラインとNVIDIAとの共同トリアージチームを運用するハイパースケーラーです。Minervaは、この手法をパッケージ化したもので、GPU、ファブリック、ストレージの状態に関するハイパースケーラーレベルの可視性と、それに伴う予備機の投入と再起動のワークフローを必要とする企業やネオクラウド向けに、すぐに使える形で提供され、ラックを販売するのと同じOEMを通じて提供されます。
NVIDIAは、MinervaがMission ControlやDSX OSとどのように関連しているのか、ソフトウェア、アプライアンス、ホスト型サービスとして提供されるのか、またDell、Lenovo、SupermicroのOEMパッケージがどのようなものになるのかについては明らかにしていない。製品のドキュメントページでは、ユーザーガイドについてはNVIDIAのアカウントチームに問い合わせるよう案内している。顧客事例としてはIRENが挙げられており、NVIDIAによると、IRENは現在、AIファクトリーの最適化にMinervaを使用しているという。
「NVIDIA Minervaのおかげで、運用チームはネットワーク、GPU、そしてそれら上で実行されているジョブ全体を俯瞰的に把握できるようになりました」と、IRENの最高技術責任者であるデニス・スクリニコフ氏は述べ、これによりチームの時間を予防保守に振り向けられるようになったと評価した。
ストレージ側で注目すべき点は、負荷時のドライブの動作がGPUやファブリックのテレメトリと並んで入力されるという点です。NVMeデバイスの速度低下は、チェックポイントやデータロード段階で停止するまでGPUの使用率にほとんど反映されないためです。このストレージテレメトリがどの程度詳細に分析されるのか、またどのOEMやアレイプラットフォームがデータを提供しているのかといった点が、このソリューションが市場に投入される際に注目すべきポイントとなるでしょう。



 Amazon