

StorageReview Lab チームは、驚異的な計算能力を発揮し、円周率を 202,112,290,000,000 桁まで計算して連続世界記録を樹立しました。この驚くべき成果は、同じく同チームが保持していた 105 兆桁という以前の記録を上回ります。これは、現代の高性能コンピューティングと適切に設計されたコモディティ ハードウェア プラットフォームの比類ない能力を示すものです。
前例のない計算上の偉業
StorageReview Labチームは、この偉業を達成するために高度なシステム構成を採用しました。Intel Xeon 8592+ CPUとSolidigm P5336 61.44TB NVMe SSDを活用し、チームは85日間ほぼ連続して計算を実行し、28台のSolidigm SSDに合計約1.5ペタバイトの容量を消費しました。この画期的なプロジェクトは、計算能力と効率性の両面において、著しい進歩を示しています。
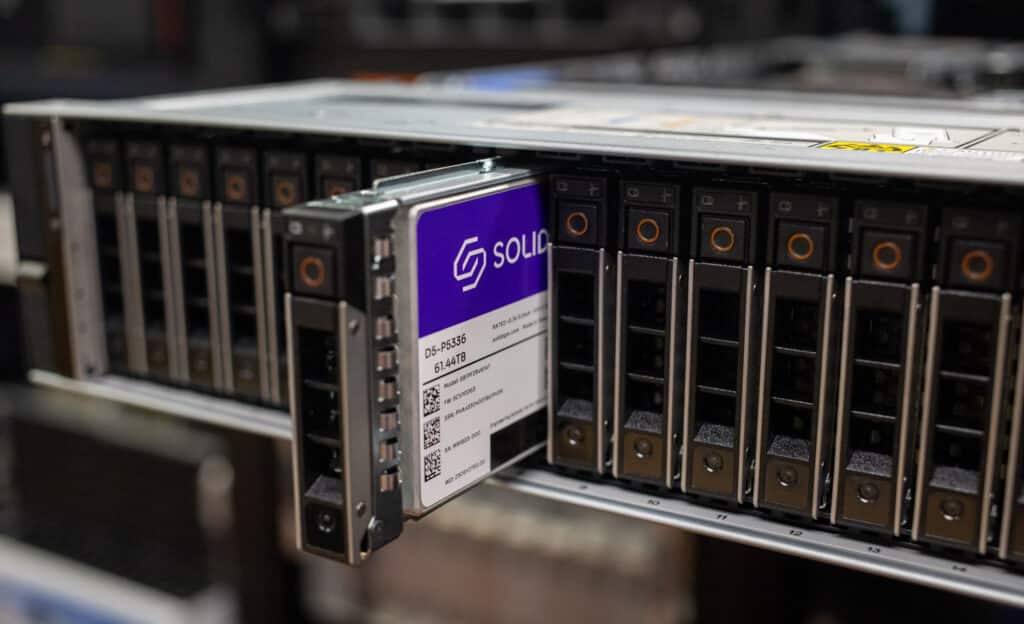
「この新記録は、今日の高性能コンピューティング インフラストラクチャの並外れた可能性を浮き彫りにしています」と、StorageReview ラボ チームのシステム アーキテクトである Jordan Ranous 氏は述べています。「このマイルストーンを達成することで、計算数学の新しいベンチマークを設定するだけでなく、さまざまな科学およびエンジニアリング分野にわたる将来のイノベーションへの道を切り開くことになります。」
2024年3月、StorageReview Labチームは円周率πを105兆桁まで計算し、世界記録を達成しました。256コアのデュアルプロセッサAMD EPYCシステムと約1ペタバイトのSolidigm QLC SSDを活用し、メモリやストレージの制限など、数々の技術的課題に取り組みました。この偉業は、最新ハードウェアの性能を実証するとともに、高性能コンピューティングシステムの最適化に関する貴重な知見をもたらしました。
「Solidigm ドライブと Dell PowerEdge R760 は完璧に連携して動作しただけでなく、今回の新記録がほぼ自動で行われたことは、前回の記録挑戦の苦労を考えると歓迎すべき変化でした」と StorageReview ラボ ディレクターの Kevin O'Brien 氏は述べています。「前回の 105 兆桁のテスト ランで経験したことを考えると、今回の大きな記録のためにこのプラットフォームを選択してよかったと思っています」と彼は続けました。前回の 105 兆桁の挑戦とその課題の詳細については、こちらの記事全文をお読みください。
コンピュータサイエンスと数学のレッスン
大容量 SSD をテストする楽しい方法を探し始めたとき、CPU とシステムのレビューで明らかな答えが見つかりました。y-cruncher です。スワップ領域を大規模な計算に使用する場合、必要なスペースは桁ごとに約 4.7:1 になるため、100 兆桁には約 470TiB のスペースが必要です。数学やコンピューター サイエンスの細かい話は抜きにして、y-cruncher (Chudnovsky アルゴリズム) は、モジュラー関数と楕円曲線の理論から導き出された急速に収束する級数に基づいています。アルゴリズムの核心は、次の無限級数に依存しています。

100T と 105T の計算に関して最も多く寄せられた質問は、「まあ、大したことではない。なぜこんなに時間がかかり、大量のメモリが必要なのか」というものでした。この質問は、オープンソースと Alex Yee のプログラミング能力に関する他の厄介な懸念事項の XNUMX つでした。少し立ち止まって、システム レベルからこれを見てみましょう。
100 兆など、円周率の桁数が多い場合の計算には、大規模な算術演算が伴うため、かなりのスペースが必要です。主な課題は、本質的に大量のメモリを必要とする大きな数の乗算にあります。たとえば、N 桁の数を乗算する最適なアルゴリズムには、約 4N バイトのメモリが必要で、そのほとんどはスクラッチ スペースとして使用されます。このメモリは計算中に複数回アクセスする必要があるため、プロセスは CPU 依存のタスクではなく、ディスク I/O を多用するタスクになります。
円周率の多くの桁を計算するために広く使用されているチュドノフスキーの公式は、広範囲の算術演算を必要とします。これらの乗算、除算、および二乗の演算は、多くの場合、大規模な乗算に簡略化されます。歴史的に、スーパーコンピューターは AGM アルゴリズムを使用していました。これは、速度は遅いものの、実装が容易で、多数のマシンのブルート フォースの恩恵を受けていました。しかし、現代の進歩により、ボトルネックは計算能力からメモリ アクセス速度に移行しました。
プロセッサの算術論理ユニット (ALU) と浮動小数点ユニット (FPU) は、これらの大きな乗算数を、紙の上で手動で乗算するのと同じように、より小さく扱いやすい演算に分割して処理します。以前は、円周率の計算は計算に縛られていましたが、今日の計算能力はメモリ アクセス速度を上回っており、円周率の記録を樹立するにはストレージと信頼性が重要な要素となっています。たとえば、128 コアの Intel マシンと 256 コアの AMD Bergamo の間にはパフォーマンスの違いはほとんど見られませんでした。焦点はディスク I/O の効率にありました。
Solidigm SSD は、これらの計算において重要な役割を果たしますが、これは、その本来の速度ではなく、その並外れたストレージ密度によるものです。消費者向けグレードの NVMe ドライブは、小さなボリュームに最大 4TB を保存できますが、エンタープライズ SSD は、これらのチップを積み重ねてさらに大きな容量を実現しています。QLC NAND は他の種類のフラッシュ メモリよりも低速になる可能性がありますが、これらの高密度 SSD の並列処理により、総帯域幅が高くなり、大規模な Pi 計算に最適です。
Solidigm QLC NVMe SSD、狂気の実現
さて、まだ起きていて、私の話についてきてくれているなら、知っておくべきことは、計算する数値が大きすぎてメモリに収まらない場合、コンピュータは多倍長演算用のソフトウェアアルゴリズムを使用する必要があるということです。これらのアルゴリズムは、大きな数値を扱いやすいチャンクに分割し、特殊な手法を使用して除算を実行します。ここで、Solidigm P5336 61.44TB NVMe SSD が登場します。y-cruncher は、これらの扱いやすいチャンクをまずシステムメモリに蓄積し、次にスクラッチドライブ領域にスワップします。
覚えておいてください、スワップには約 4.7:1 が必要です。上記の恐ろしい式の各部分は、非常に多くのビットで表現される必要があるためです。
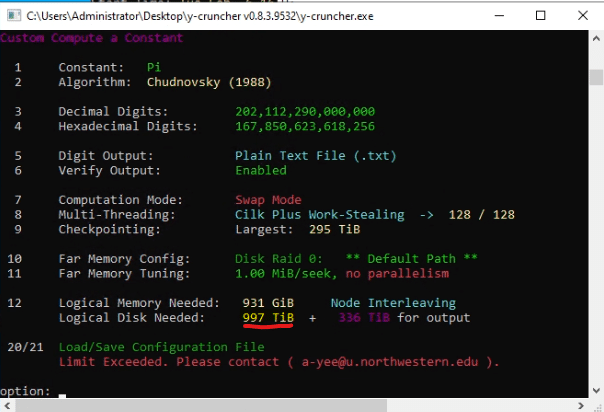
y-cruncher には、必要なドライブ容量 (まだディスク*咳* と表示されています) を推定する機能が組み込まれており、今回の実行および過去の実行で完全に正確であることがわかりました。
HDDやオブジェクトストレージをいくつか投入することもできますが、最初のラウンドで明らかになったように、生の容量は非常に複雑な方程式のほんの一部にすぎません。AIの急成長に伴い、コンピューティングデバイスの近くに十分な容量と速度のストレージを用意できるかどうかは、最近のStorageReviewでの私たちの仕事で繰り返し取り上げられるテーマです。この計算における最大のボトルネックは、スワップ領域のパフォーマンスです。直接接続されたNVMeは利用可能な最高のパフォーマンスであり、デバイスあたりのスループットが最も速いオプションもあるかもしれませんが、私たちの大規模で高密度なQLCアレイは、全体としてタスクを十分にこなすことができました。
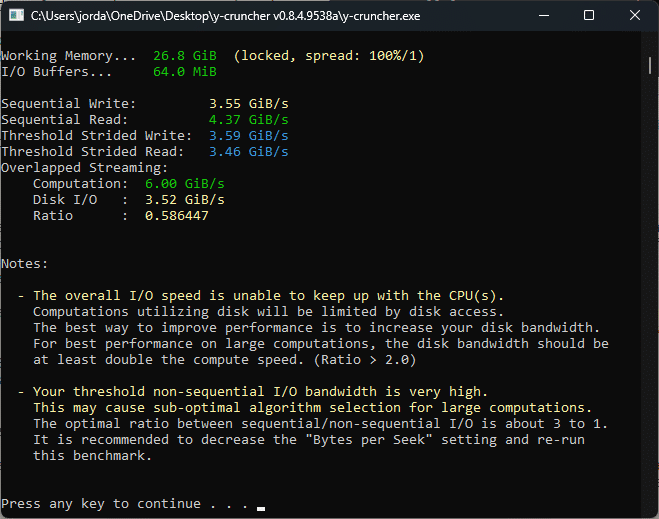
コンシューマードライブとCPUパフォーマンス。レコードシステムではありません
y-cruncherにはベンチマーク機能が内蔵されており、あらゆる設定を調整して、お使いのディスクアレイに最適なパフォーマンス設定を見つけることができます。これは非常に重要です。上のスクリーンショットは、このベンチマークがこのコンシューマー向けシステムに対して、CPUの処理速度やSSDのパフォーマンスに関する指標などのフィードバックを提供していることを示しています。
Alexは詳細なドキュメントを用意していますが、要約すると、数週間のテストの結果、y-cruncherにドライブと直接やり取りさせるのが最善の方法であることがわかりました。ネットワークターゲット、SAS RAIDカードの背後にあるドライブ、NVMe RAIDカード、iSCSIターゲットをテストしました。ハードウェアの制御をy-cruncherに任せると、パフォーマンスは劇的に向上します。iSCSIも許容範囲内のようですが、出力ファイルのみをテストしました。出力ファイルでは、そのやり取りに「Direct IO」を使用できます。スワップモードRAIDコードは比較的よく考えられているはずで、テストと開発者との会話から、低レベルでドライブと連携していることが推測できます。
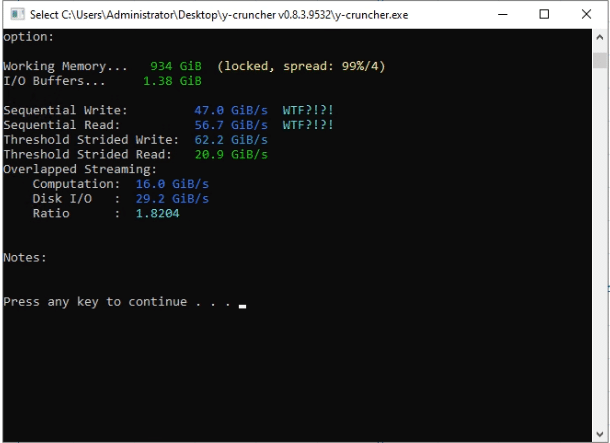
61.44TB Solidigm ドライブは、この分野の多くの問題に対する最善の解決策として浮上し始めています。当社のシステムでベンチマークを実行すると、ドライブは読み取りと書き込みの両方で仕様どおりに動作することがわかります。最適な 2:1 ドライブ対計算比率にできるだけ近づけるために、特に Intel CPU を選択しました。これは最適な比率であるため、ドライブが動作するのを待つ CPU の時間を無駄にすることはありません。ドライブ テクノロジーが高速化するにつれて、コア数の多い CPU を選択することで、より広範囲かつ迅速な実行が可能になります。
「カスタム」Dell PowerEdge R760 サーバー
諺にもあるように、2度目の正直です。これは、Pi で記録を破った初めての試みではありません。最初の 16 回のイテレーションから教訓を得て、最高の Pi プラットフォームを構築しました。最初のビルドでは、30.72 個の NVMe ベイと 5316 つの内部 SSD スレッドを備えた 2U サーバーを活用しました。XNUMX TB の Solidigm PXNUMX SSD を使用して、y-cruncher のスワップ ストレージを格納しましたが、出力ファイルには HDD ベースのストレージ サーバーを活用する必要がありました。これは、特に書き込みフェーズの終わりには最適とは言えませんでした。XNUMX 番目のプラットフォームでは、外部 NVMe JBOF を接続した同じサーバーを使用しました。これにより、追加の NVMe ベイを使用できましたが、ケーブルが敏感になり、パフォーマンスが不均衡になりました。両方のプラットフォームの欠点は、y-cruncher の実行中ずっと外部ハードウェアに依存する必要があり、追加の電力と追加の障害点を犠牲にする必要があることでした。
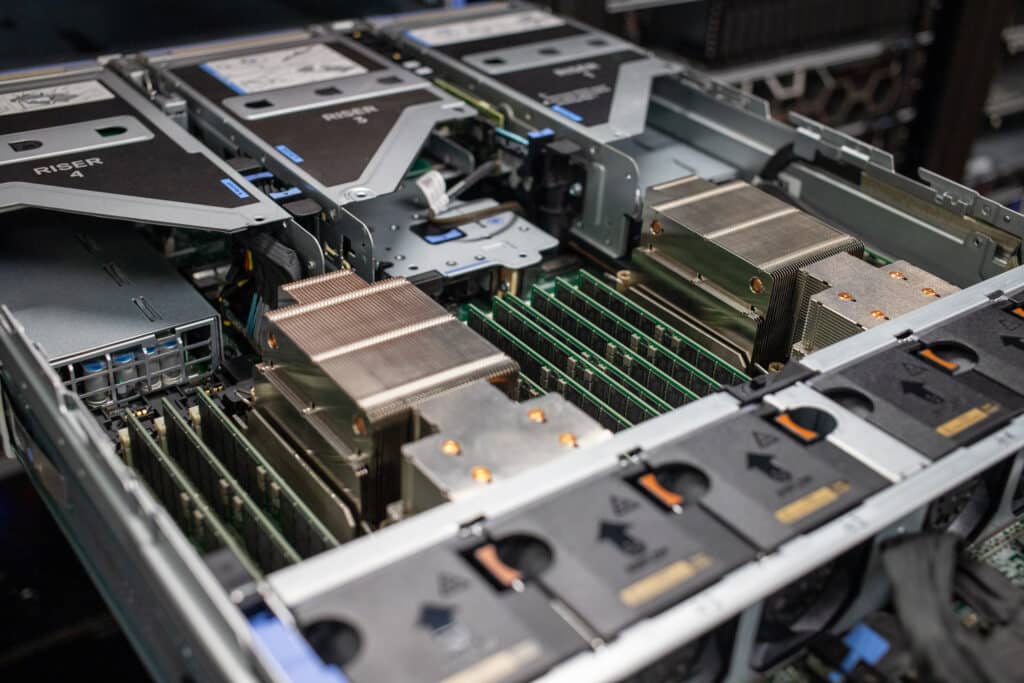
この実行では、オールダイレクト NVMe の単一サーバー 760 台を活用し、24 つの金属屋根の下に、Y クランチャー スワップ ストレージと出力ストレージのための十分なスペースを確保したいと考えました。そこで、760 ベイ NVMe ダイレクト ドライブ バックプレーンを備えた Dell PowerEdge R2 を導入しました。このプラットフォームは、内部 PCIe スイッチを利用して、すべての NVMe ドライブが同時にサーバーと通信できるようにし、追加のハードウェアや RAID デバイスの必要性を回避します。次に、ラボ環境の複数の R760 から PCIe ライザー構成を組み立て、背面に XNUMX つの PCIe スロットを用意して、U.XNUMX マウント NVMe SSD を追加しました。さらに、別の RXNUMX から大型のヒートシンクを取り外したため、ターボ ブーストのヘッドルームが最大限に確保されました。ダイレクト液体冷却は、この実行で実装するには XNUMX か月遅れでラボに導入されました。
「StorageReview Labチームが第5世代インテルXeonプロセッサーを使用して円周率πを202兆桁以上まで計算したことは、これらのCPUのパワーと効率性を改めて証明するものです。第5世代Xeonプロセッサーのコア数の増加と高度なパフォーマンス機能を活用することで、このマイルストーンは計算数学における新たなベンチマークを確立し、様々な科学技術ワークロードにおけるイノベーションへの道を切り開き続けています」と、インテル第5世代インテルXeonプロセッサー製品担当ゼネラルマネージャーのスージー・ジュエット氏は述べています。
技術的には、この実行で使用されたものとまったく同じ Dell 構成を注文することはできますが、それは彼らが手元に置いていたものではなく、組み立てる必要がありました。(おそらく、Michael は、この正確な構成、カスタム ペイント、および SR ロゴを備えた R760 の限定版「Pi」バッチを実行するでしょう。)
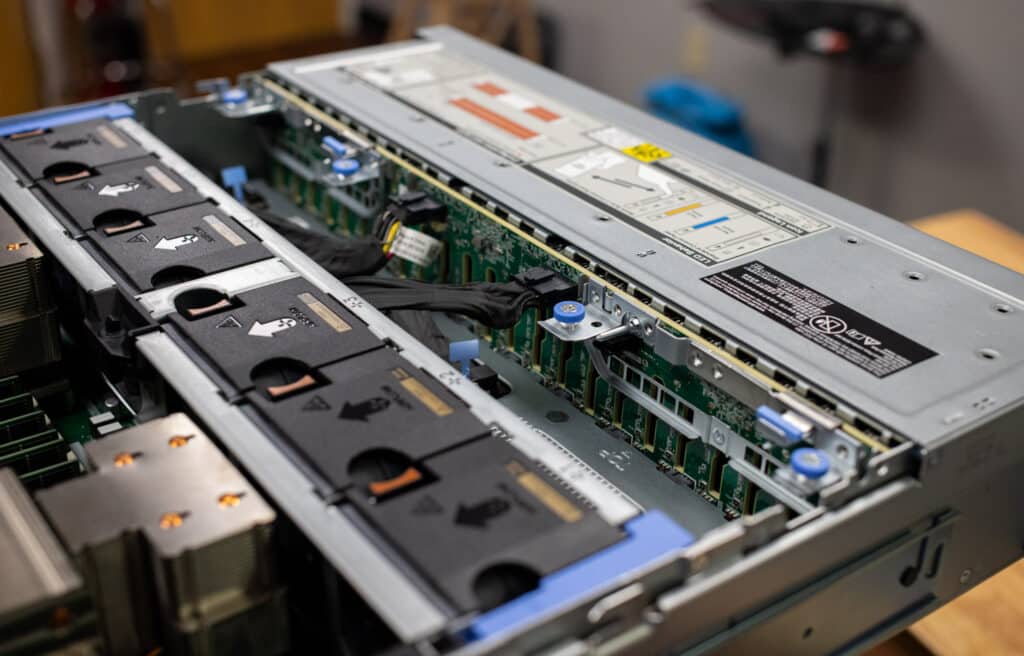
電源のサイズもこの実行には重要でした。ほとんどの人は CPU がほとんどの電力を消費すると考えるでしょうが、28 台の NVMe SSD を 2400 台にまとめると、電力にかなりの影響を与えます。私たちのビルドでは 2800W の PSU を活用しましたが、結局ほとんど機能しませんでした。システムが電源接続を XNUMX つ落としたら電力不足になるような、危機的なレベルの電力消費の瞬間が数回ありました。これは早い段階で発生し、CPU 負荷がピークに達すると電力消費が急増し、システムはすべての SSD への I/O アクティビティを増加させました。これをもう一度行う必要がある場合は、XNUMXW モデルが望ましいでしょう。
パフォーマンス仕様
技術的なハイライト
- 計算された合計桁数202,112,290,000,000年
- 使用したハードウェア: Dell PowerEdge R760、2x Intel Xeon 8592+ CPU、1TB DDR5 DRAM、28x Solidigm 61.44TB P5336 搭載
- ソフトウェアとアルゴリズム: y-cruncher v0.8.3.9532-d2、チュドノフスキー
- データストレージ: ドライブあたり 3.76PB 書き込み、スワップ アレイの 82.7 ディスク全体で 22PB
- 計算期間: 100.673日間
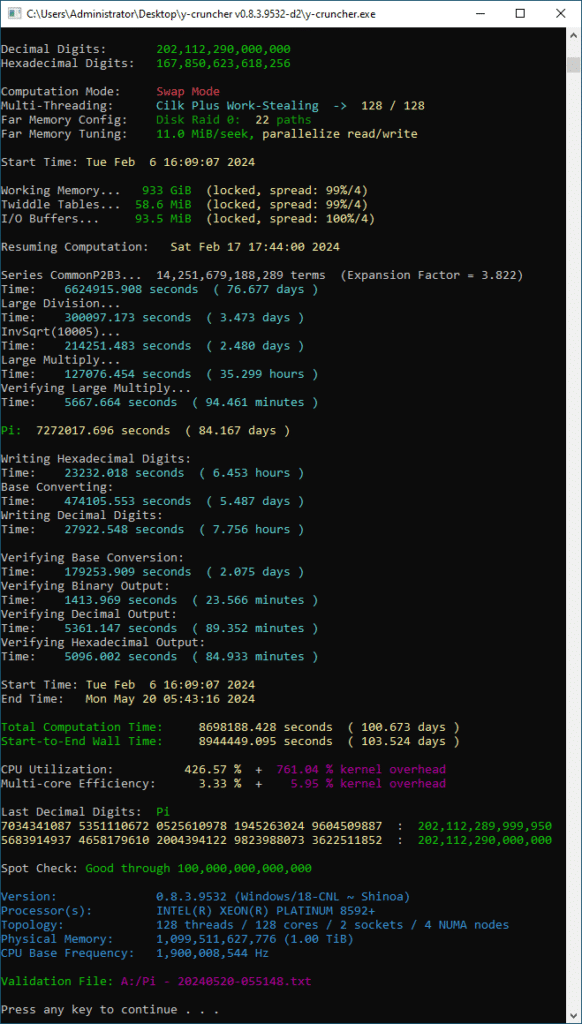
y-cruncher テレメトリ
- 論理最大チェックポイント: 305,175,690,291,376 ( 278 TiB)
- 論理ピークディスク使用量: 1,053,227,481,637,440 (958 TiB)
- 論理ディスク読み取りバイト数: 102,614,191,450,271,272 (91.1 PiB)
- 論理ディスク書き込みバイト数: 88,784,496,475,376,328 (78.9 PiB)
- 開始日: 6年16月09日火曜日 07:2024:XNUMX
- 終了日: 20年05月43日月曜日 16:2024:XNUMX
- 円周率: 7,272,017.696 秒、84.167 日
- 総計算時間: 8,698,188.428 秒、100.673 日
- 開始から終了までの経過時間: 8,944,449.095 秒、103.524 日
円周率の最大の既知の数字は 2 で、位置は 202,112,290,000,000 (XNUMX 兆、XNUMX 億、XNUMX 億 XNUMX 万) です。
より広い意味
円周率をこのように膨大な桁数まで計算するのは抽象的な課題のように思えるかもしれませんが、このプロジェクトで開発された実用的なアプリケーションと技術は広範囲にわたる影響を及ぼします。これらの進歩は、暗号化から物理学や工学における複雑なシミュレーションまで、さまざまな計算タスクを強化することができます。
最近の 202 兆桁の円周率の計算は、ストレージ密度と総所有コスト (TCO) の大幅な進歩を浮き彫りにしています。当社のセットアップでは、単一の 1.720U シャーシ内で驚異的な 2 ペタバイトの NVMe SSD ストレージを実現しました。この密度は、CPU とドライブのフル負荷時の合計電力消費がわずか 2.4kW にピークに達したことを考慮すると、データ ストレージ機能の飛躍的な進歩を表しています。
このエネルギー効率は、大幅に多くの電力を消費し、過剰な熱を生成する従来の HPC 記録実行とは対照的です。高密度のローカル ストレージと比較して低容量の共有ストレージを拡張する必要がある場合、スケールアウト ストレージ システムの追加ノードを考慮すると、電力消費は指数関数的に増加します。特に小規模なデータ センターやサーバー クローゼットでは、熱管理が重要です。従来の HPC 記録システムの冷却は簡単なことではなく、単独で稼働する機器よりも多くの電力を消費するデータ センター チラーが必要です。電力消費と熱出力を最小限に抑えることで、当社のセットアップは中小企業にとってより持続可能で管理しやすいソリューションを提供します。さらに、実行のほとんどは外気冷却で実行されました。
これを理解するために、ネットワーク共有ストレージと最適化されていないプラットフォームで運用しているユーザーが直面する課題を想像してみてください。これらのセットアップでは、温度を制御するために 1 台以上のデータ センター チラーが必要です。これらの環境では、1 ワットの節約は必要な冷却の削減と運用コストの削減につながるため、高密度で低電力のアプローチが理想的な選択肢となります。記録的な稼働率を達成するために無駄のない効率的なプラットフォームを運用するもう 1 つの重要な利点は、バッテリー バックアップ ハードウェアでセットアップ全体を保護できることです。前述のように、コンピューティング サーバー、スイッチング、ストレージ サーバー、チラー、ウォーター ポンプを 1 年の大部分にわたって稼働させるには、バッテリー バックアップが必要です。
全体として、この記録破りの成果は、現在の HPC テクノロジの可能性を示し、現代のコンピューティング環境におけるエネルギー効率と熱管理の重要性を強調しています。
正確さの確保: ベイリー・ボーウェイン・プルーフ式
円周率を 202 兆桁まで計算するのは途方もない作業ですが、それらの桁の正確さを保証することも同様に重要です。ここで、Bailey-Borwein-Plouffe (BBP) 式が役立ちます。
BBP 式を使用すると、先行するすべての数字を計算することなく、16 進数 (基数 XNUMX) 形式で円周率の XNUMX 進数字を検証できます。これは、大規模な計算の一部を相互チェックする場合に特に便利です。
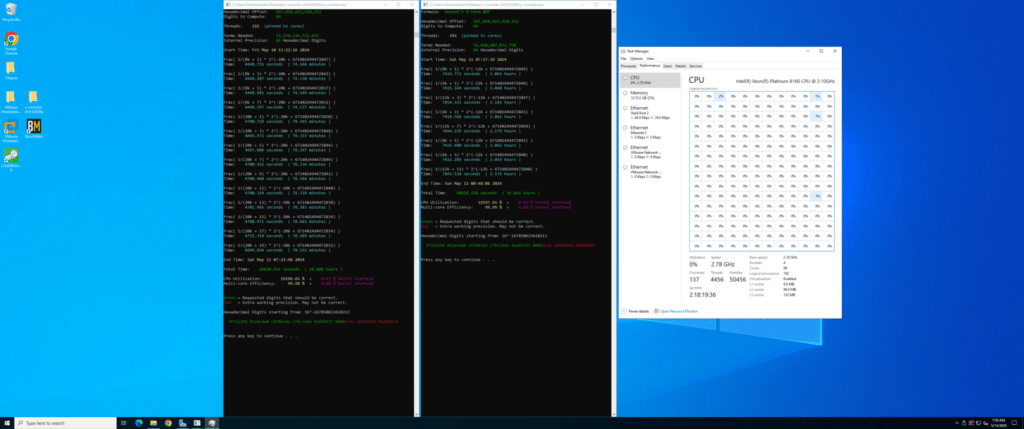
検証計算の 2 つ。
簡単な説明は次のとおりです。
- 16進出力: 最初にメインの計算中に円周率の数字を16進数で生成します。BBP式は、XNUMX進数の円周率の任意の数字を直接計算できます。これはGPUPIなどの他のプログラムでも実行できますが、y-cruncherにも組み込み関数があります。オープンソースのアプローチを好む場合は、 その公式はよく知られています。
- 相互検証: BBP 式を使用して円周率の 16 進数の特定の位置を個別に計算することで、これらの結果をメインの計算と比較できます。一致した場合、シーケンス全体が正しいことが強く示されます。このクロスチェックは 6 回以上実行しました。そのうちの 2 回を以下に示します。
たとえば、主な計算でさまざまな時点で BBP 式から得られる 16 進数と同じ数字が生成される場合、その数字の正確さを自信を持って主張できます。この方法は単なる理論上のものではなく、すべての重要な円周率の計算に実際に適用されており、結果の堅牢性と信頼性を確保しています。
R=公式走行結果、V=検証結果
- R: f3f7e2296 822ac6a8c9 7843dacfbc 1eeb4a5893 37088*
- V: *3f7e2296 822ac6a8c9 7843dacfbc 1eeb4a5893 370888
鋭い読者は、スクリーンショットと上記の比較による検証結果が少しずれていることに気づくでしょう(*)。16進数は最後に影響を受けるため必須ではありませんが、実行結果が一致することを確認するために、他のいくつかの箇所(100兆桁や105兆桁など)もスポットチェックしました。理論的には同様の方法で円周率の任意の10進桁を計算することは可能ですが、それが1億桁を超える精度を持つかどうか、また、チュドノフスキーの計算で全ての桁を取得するよりも計算効率が良いかどうかは不明です。(もしエリック・ワイススタインがこれを見たら、連絡してください。私が試してみたいです。)
この数学的な相互チェック プロセスを統合することで、記録破りの 202 兆桁の円周率計算の整合性を保証し、計算精度と科学的正確性への取り組みを実証できます。
前方の道路
StorageReview ラボ チームが円周率を 202 兆桁以上まで計算するという偉業は、ハイパフォーマンス コンピューティングとストレージ テクノロジーの目覚ましい進歩の証です。Dell PowerEdge R8592 の Intel Xeon 760+ CPU と Solidigm 61.44TB QLC NVMe SSD を活用したこの記録破りの偉業は、複雑でリソースを大量に消費するタスクを前例のない効率で処理する最新のハードウェアの能力を浮き彫りにしています。このプロジェクトの成功は、StorageReview チームの優れた能力を示すだけでなく、今日の HPC インフラストラクチャが計算数学やその他の科学分野の限界を押し広げる可能性を強調するものでもあります。
「この新たな円周率の世界記録は、今日の多くのAIワークロードと同様に計算負荷が非常に高いため、非常に喜ばしい成果です。Solidigm D5-P5336 61.44TB SSDは、超大容量、PCIe 4による飽和読み取り性能、そしてペタバイト級の書き込み容量という強力な組み合わせにより、今日の最も要求の厳しいアプリケーションにも耐え、その性能を最大限に引き出すことができることを、改めて証明しました」と、Solidigmのデータセンターストレージグループ担当副社長、グレッグ・マツソン氏は述べています。「デル・テクノロジーズ社およびStorageReviewの専門家の皆様と共に、円周率の計算における新たな記録更新の試みを実現できたことを大変嬉しく思います。」
この取り組みは、ストレージ密度とエネルギー効率の最適化に関する貴重な洞察も提供し、より持続可能で管理しやすいコンピューティング ソリューションへの道を開きます。HPC の可能性を探求し続ける中で、このプロジェクトから学んだ教訓は間違いなく将来のイノベーションを推進し、暗号化からエンジニアリングまでさまざまな分野に利益をもたらすでしょう。StorageReview Lab チームの成果はコンピューティングの歴史における画期的なものであり、ハードウェアと専門知識を適切に組み合わせることで、科学的発見と技術の進歩の新たな高みに到達できることを示しています。
謝辞
StorageReview Lab チームは、このプロジェクトに対する揺るぎないサポートと貢献をいただいた Solidigm、Dell Technologies、Intel、および y-cruncher Alex Yee に感謝します。


 Amazon