

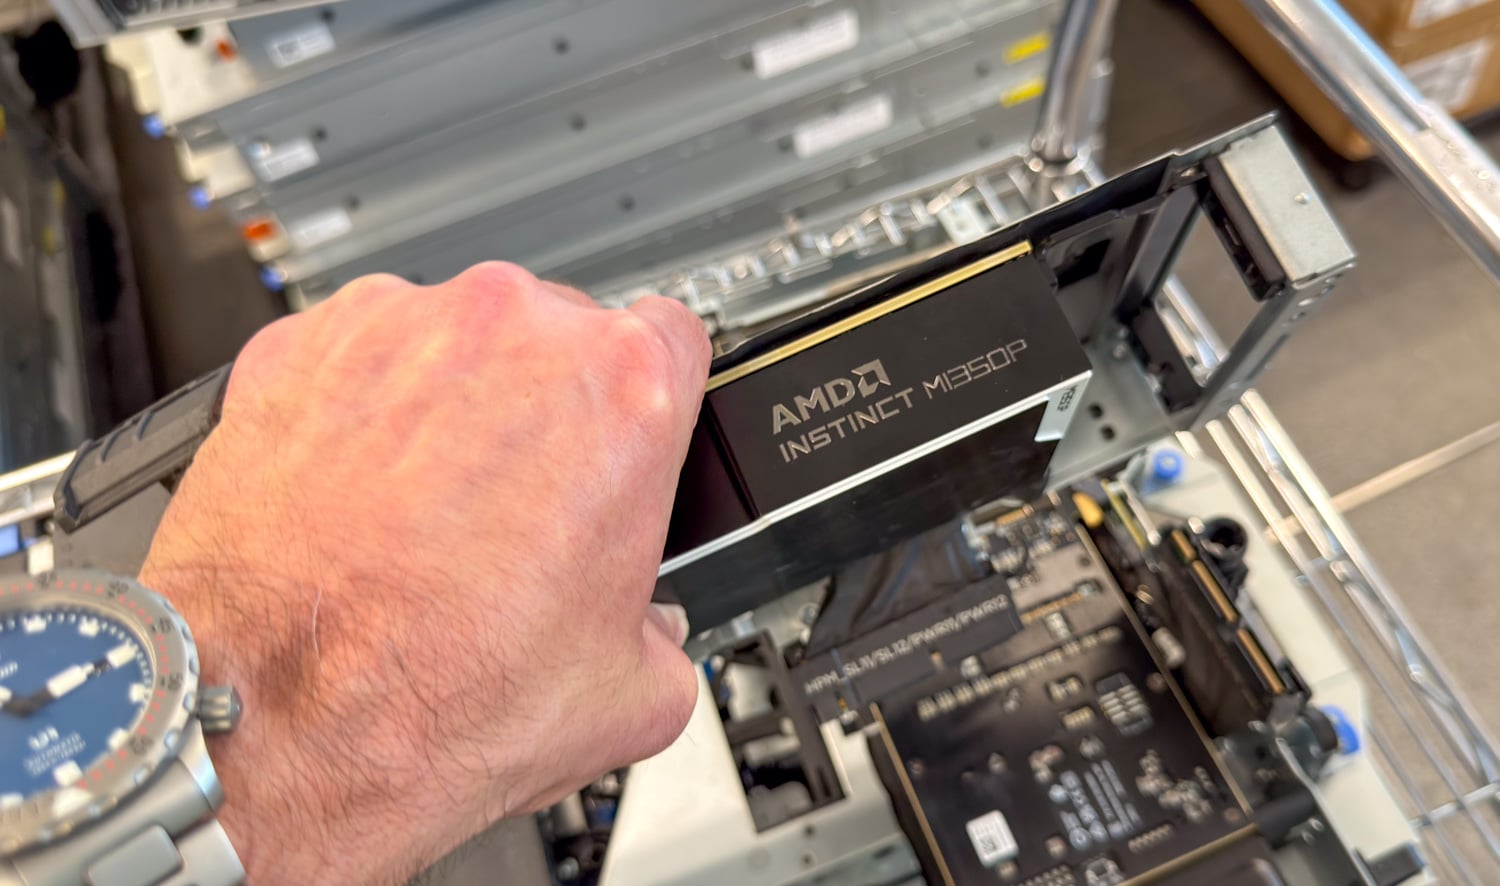
AMD Instinct MI350Pは、2022年のMI210以来、4年ぶりに登場したAMDの新型PCIe Instinct GPUです。同社のCDNA 4アーキテクチャを従来の拡張カードに搭載し、最大4.6 PFLOPSのMXFP4性能、144GBのHBM3Eメモリ、4TB/sのメモリ帯域幅を実現しています。これらすべてがデュアルスロット、600Wの空冷式カードに収められており、より大型の8GPU搭載OAMプラットフォームMI350/5Xに移行することなく、Instinct GPUを導入できる新たな選択肢を顧客に提供します。
主要なポイント(要点)
- PCIeスロットに144GBのメモリを搭載できるのが最大の特長だ。 MI350Pは、現行のPCIeアクセラレータの中で最も多くのメモリを搭載しており、H200 NVLより3GB、RTX PRO 6000 Blackwellより48GB多く、4TB/sのHBM3Eを搭載しています。今回のレビューで対象とした14種類のモデルと精度の組み合わせのうち、10種類が1枚のカードで動作しました。
- 計測された演算領域は、2枚のNVIDIAカードの間にある。 450WのMAMFは、BF16で580TFLOPS、FP8で1,120TFLOPS、ブロックスケールFP4で2,228TFLOPSを達成し、600WのRTX PRO 6000をあらゆる精度で36~38%上回り、FP4パスを持たないH200 NVLのBF16とFP8には及ばなかった。
- GPT-OSSはMI350Pの最も優れた結果である。 AMDGPU 31.60、ROCm 10.1.0、vLLM 0.32.0 において、GPT-OSS-120B はチャットワークロードで 128 ストリーム時に毎秒 5,057 個の出力トークンを達成し、RTX PRO 6000 を 65%、H200 NVL を 50% 上回りました。また、プロンプト形状が 128 ストリームの場合、両方のプロンプト形状でパフォーマンス曲線は上昇し続けています。
- チャットサイズのプロンプトではMI350Pが有利だが、長いプロンプトでは結果がまちまちだ。 512トークンのプロンプトでは、このカードは128ストリームで、すべてのFP8、BF16、およびGPT-OSSモデルでRTX PRO 6000を35~65パーセント上回り、2つのFP4対NVFP4のマッチアップでは5パーセントと21パーセントの差に収まります。一方、8,192トークンのプロンプトでは、GPT-OSSとMistral Smallでリードし、Llama、Qwen FP8、およびMiniMax-M2.7では劣勢となり、その曲線は早い段階で平坦化します。
- 2枚のカードの結果はROCm 7.2.3に掲載されています。 DeepSeek-V4-Flash、MiniMax-M3、GLM-5.2、およびGLM-5.3 Flashは、そのスタックでの実行から報告されています。これは、これらのモデルに対するROCm 10.1のパスがCPUエキスパートオフロードを使用し、DeepSeekでは投機的デコーダーが使用されたのに対し、NVIDIAの実行では使用されなかったためです。
- 600Wについては、まだ未解決の問題だ。 DellはPowerEdge XE7745に8台のMI350Pを600Wで搭載した際のテスト結果を公表しており、フルパワーでのテストも計画されている。
AMDはIFA 2026で、Threadripper Halo Stationプロトタイプに搭載されたMI350Pも展示した。このプロトタイプでは、同じアクセラレータが液冷式で動作していた。ワークステーションのコンセプトでは、最大4つのMI350Pと96コアのThreadripper PROプロセッサを搭載し、1台のマシンで合計576GBのHBM3E容量を実現している。10月に更新されたAMDの製品ページには、このシステムが2027年に発売予定と記載されている。これにより、MI350Pをサーバー向けのPCIeアクセラレータとして、またGB300 DGX Stationのようなマシンと競合する、より大規模なデスクトップAIシステムの構成要素として捉えることができる。
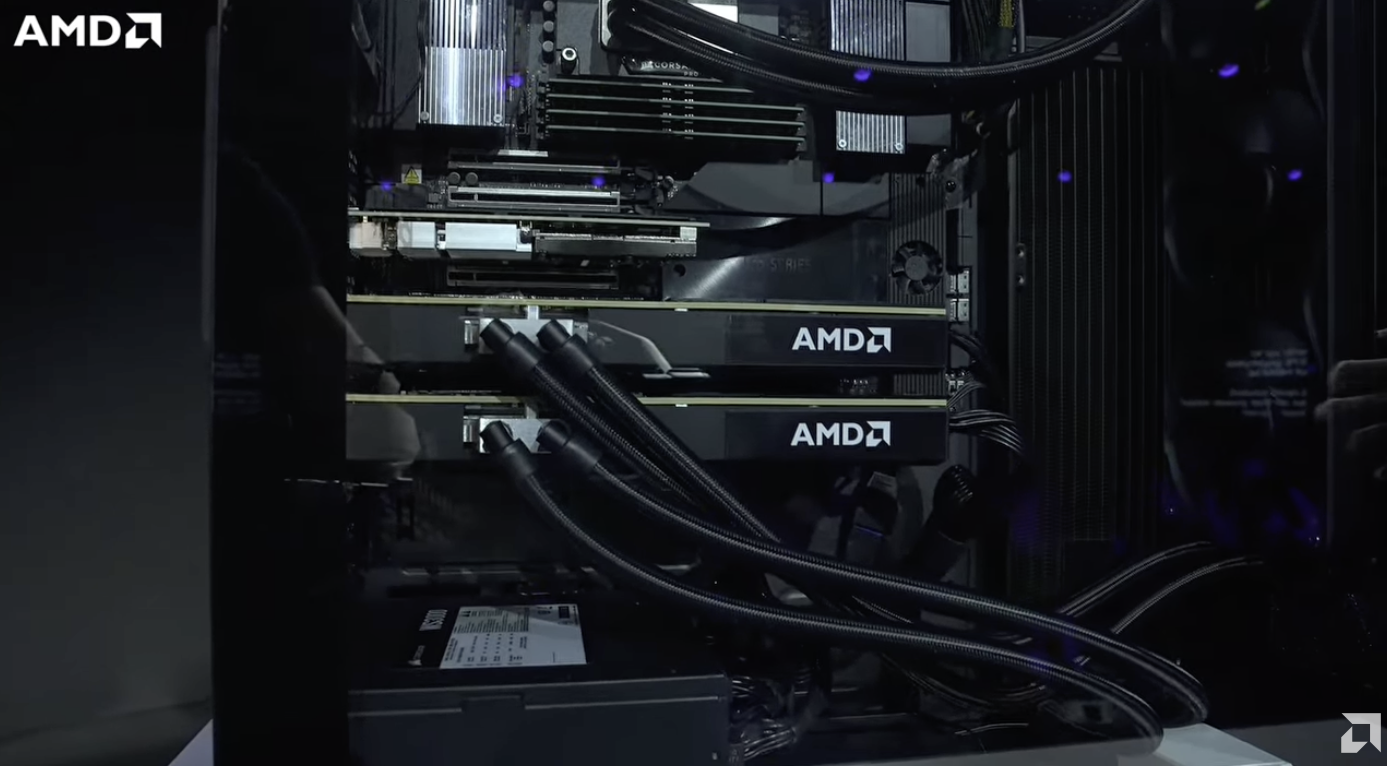
この最初のレビューはサーバー視点で行われるため、PCIeアクセラレータを指定する購入者にとって重要な比較対象は、同じ電力クラスとスロットに属するNVIDIA RTX PRO 6000 Blackwellカードです。また、H200 NVLは、メモリ帯域幅が結果を左右するワークロードにおいて、最も高性能なNVIDIAアドインカードとしてチャートに登場します。デスクトップ視点では、GB300 DGX Stationが1台使用されています。これは価格帯の異なるマシンですが、フル機能のBlackwell Ultra GPUがPCIeカードよりもどれほど優れているかを示すために使用されています。
AMD Instinct MI350Pの仕様
AMDが公表した数値によると、MI350Pは低精度演算に重点を置いており、MXFP4とMXFP6で4.6 PFLOPS、FP8で2.3 PFLOPS、FP16またはBF16で1.15 PFLOPSという高密度な数値を実現している。もう一方の主要部分はメモリシステムで、4TB/sの4,096ビットインターフェースを備えた144GBのHBM3Eメモリと、128MBのInfinity Cacheを搭載しており、以下のシングルストリームの結果はこのキャッシュに依存している。ボードの消費電力は600Wで、450W構成モードも用意されている。レビュー機は450Wで動作した。
MI350Pは、より大型で高出力のMI350/5X GPUと同じCDNA 4アーキテクチャを採用しています。MI350Pは、実質的にMI350Xの半分と考えることができます。その理由を理解するには、大型GPUの組み立て方法を見ていくと良いでしょう。
MI350Xは、TSMCのCoWoS(Chip-on-Wafer-on-Substrate)パッケージングを採用した3D積層チップレット設計で、単一のモノリシックダイは使用されていません。8つのアクセラレータ複合ダイ(XCD)が2つのI/Oダイの上に配置され、各I/Oダイには4つのXCDが搭載されています。AMDのInfinity Fabricがチップレットを接続し、8つのHBM3EスタックがGPUのメモリを提供します。CoWoSはパッケージレベルの統合を表し、I/O上で演算処理を行う構成が、この設計の垂直方向の3D積層コンポーネントとなっています。

MI350Pは、その構成の半分を採用しています。つまり、4つのXCD、1つのI/Oダイ、および4つのHBM3Eスタックで構成されています。各XCDには32個のアクティブな演算ユニットが搭載されており、MI350Xの256個に対し、MI350Pの演算ユニット数は128個となっています。メモリリソースも半分に削減されており、HBM3Eは288GBに対し144GB、帯域幅は8TB/sに対し4TB/s、Infinity Cacheは256MBに対し128MBとなっています。

| 製品仕様 | AMD Instinct MI350P |
|---|---|
| プラットフォームの概要 | |
| アーキテクチャ | CDNA4 |
| 計算単位 | 128 |
| ストリームプロセッサ | 8,192 |
| マトリックスコア | 512 |
| プロセス | TSMC 3nmおよび6nm |
| トランジスタ | 73億 |
| ピークエンジンクロック | 2,200MHz |
| メモリ | |
| 容量 | 144GB HBM3E |
| インタフェース | 4,096ビット |
| 帯域幅 | 4TB /秒 |
| 最終レベルのキャッシュ | 128MB |
| ECC | フルチップ |
| 最高のパフォーマンス(AMD発表) | |
| MXFP4 | 4.6PFLOPS |
| MXFP6 | 4.6PFLOPS |
| MXFP8 | 2.3PFLOPS |
| OCP FP8 | 2.3 PFLOPS、構造的スパース性を用いた場合4.6 PFLOPS |
| FP16 | 1.15 PFLOPS、スパース性ありの場合は2.3 PFLOPS |
| BF16 | 1.15 PFLOPS、スパース性ありの場合は2.3 PFLOPS |
| FP32 | 72 TFLOPS |
| FP64 | 36 TFLOPS |
| 電力、冷却、およびフォームファクター | |
| 標準的なボード電源 | 最大600W、設定可能450W |
| 電源コネクタ | 12V-2×6 |
| 冷却 | パッシブ |
| フォームファクター | PCIe拡張カード、フルハイト、ダブルスロット |
| ボードの長さ | 10.5インチ(267mm) |
| ホストインターフェース | PCIe 5.0 x16 |
| 特長 | |
| SR-IOV | はい |
| インフィニティキャッシュ | はい |
| RAS | はい |
| ページ 退職と回避 | はい |
600W という数値は最大値であり、AMD ではカードを 450W まで構成できるようにしており、これは 2U ホストで動作した値です。H200 NVL は R770 で 450W で同等でしたが、RTX PRO 6000 は XE7740 で最大 600W で動作したため、NVIDIA カードは比較対象として 150W 多く使用できました。最大電力での結果は、600W のパッシブカードを冷却できるシャーシを待つ必要があります。Dell の XE7745 テクニカル ガイドには、600W の MI350P が 8 台記載されています。
もう一つ注目すべき点は、12V-2×6コネクタが1つと、10.5インチのダブルスロット基板を採用していることです。これにより、このカードは現在RTX PRO 6000やH200 NVLを搭載しているものと同じライザーに取り付けることができます。

以下の表では、MI350Pを、チャートに掲載されている3つのNVIDIAシステム(スロット、電力範囲、PCIe 5.0 x16ホストリンクを共有するRTX PRO 6000 Blackwell Server Edition、メモリ帯域幅が同等のHopperカードであるH200 NVL、NVLink-C2Cを介してGrace CPUとペアリングされたシングルBlackwell Ultra GPUであるGB300 DGX Station)と並べて示しています。
まず最初に確認すべき行はメモリ容量で、MI350Pの144GBは3つのPCIeカードの中で最大であり、H200 NVLより3GB、RTX PRO 6000より48GB大きい。次にメモリ帯域幅で、4TB/sは両者の中間に位置する。そしてFP4の行では、AMDは高密度な数値を提示しているのに対し、NVIDIAは疎な数値を提示している。
| 製品仕様 | AMD Instinct MI350P | NVIDIA RTX PRO 6000 ブラックウェル サーバー エディション | NVIDIA H200 NVL PCIe | NVIDIA GB300 DGXステーション |
|---|---|---|---|---|
| GPUアーキテクチャ | CDNA4 | ブラックウェル | ホッパー | ブラックウェル ウルトラ |
| フォームファクター | PCIeアクセラレータ | PCIeアクセラレータ | PCIeアクセラレータ | Blackwell Ultra GPU 1基と72コアのGrace CPUの組み合わせ |
| GPU メモリ | 144GB HBM3E | 96GB GDDR7 ECC | 141GB HBM3E | 252GB HBM3E |
| GPUメモリ帯域幅 | 4TB /秒 | 1.6TB /秒 | 4.8TB /秒 | 7.1TB /秒 |
| FP4 | 4.6 PFLOPS MXFP4 (高密度) | 4 PFLOPS NVFP4 (スパース) | ネイティブFP4なし | 20 PFLOPS NVFP4 (スパース) |
| FP8 | 2.3 PFLOPS (高密度) | 2 PFLOPS (スパース) | 3.3 PFLOPS (スパース) | 10 PFLOPS (スパース) |
| BF16 | 1.15 PFLOPS (高密度) | 1 PFLOPS (スパース) | 1.6 PFLOPS (スパース) | 5 PFLOPS (スパース) |
| FP32 | 72 TFLOPS (高密度) | 120 TFLOPS(スパース) | 60 TFLOPS(スパース) | 80 TFLOPS(スパース) |
| ホスト接続 | PCIe 5.0 x16 | PCIe 5.0 x16 | PCIe 5.0 x16 | GraceとGPU間のNVLink-C2C、900GB/s(BiDi) |
| マルチGPU接続 | PCIeベース | PCIeベース | 2ウェイまたは4ウェイのNVLink、GPUあたり最大900GB/s(BiDi) | ステーション間は800Gb/sのConnectX-8ネットワークで接続されます。 |
| 出力 | 450~600Wまで設定可能 | 300~600Wまで設定可能 | 450~600Wまで設定可能 | 最大1200WのGPU(電力スロッシング機能付き) |
RTX PRO 6000と比較した場合、MI350Pのメモリサブシステムが最も顕著な違いです。GPUメモリ容量は50%増加し、メモリ帯域幅は約2.5倍になっています。96GBでは容量が足りなくなるモデルにとって、この追加容量は、1つのGPUで動作させるか、複数のGPUに分散させるかを左右する可能性があります。
しかし、RTX PRO 6000は、グラフィックス、レイトレーシング、ビデオ処理のためのハードウェアに加え、AI機能も備えており、より幅広いワークロードに対応します。選択の決め手は、2つのピーク演算性能だけではなく、システムが他にどのような処理を必要とするかにも左右されます。
H200 NVLは、大容量メモリ搭載のPCIeアクセラレータの中でMI350Pと直接比較できる製品です。より大型のBlackwellデータセンターGPUは、別のクラスに属します。メモリ容量は、どちらもHBM3Eを使用し、MI350Pの144GBとH200の141GBとほぼ同じですが、H200は4.8TB/sと20%高いメモリ帯域幅を提供します。また、両者の拡張性も異なります。3つのPCIeカードはすべてPCIe経由でホストに接続しますが、H200 NVLはNVLinkブリッジを介して最大4つのGPUを接続する専用のGPU間接続機能を追加しています。
より大型のMI350XとMI355XはBlackwellに対抗するために開発されましたが、MI350Pはハードウェア構成を半分に削減しています。これにより、メモリ特性や全体的な位置付けにおいてH200 NVLに近づきました。MI350Pが依然として他社製品と差別化できる点の1つは、ネイティブのMXFP4およびMXFP6サポートです。これは、推論精度が低くなるにつれて重要性が増します。
メモリサブシステムの小型化もまた妥協点の一つです。AMDはHBMスタックの削減を高速なHBM3Eで補っていないため、MI350Pの帯域幅は4TB/sにとどまり、この点ではH200 NVLに劣ります。そのため、利用可能な演算能力に関わらず、メモリ帯域幅がボトルネックとなるワークロードではパフォーマンスが制限される可能性があります。この点については、レビュー後半で示すメモリ帯域幅と長時間の推論結果がそれを物語っています。
DGX Station との比較は逆で、GB300 Station は HBM スタックが 1 つ無効化されたフル B300 GPU を搭載しており、データセンター向けの電力予算でデータセンター向けチップとして機能します。一方、MI350P は、データセンター向けチップの半分を PCIe 拡張カードの 600W の枠に収めたものです。AMD は、この 1 つの GPU に対応するために MI350P を 2 つまたは 4 つ必要とし、理論上は 2 つで対応できます。Station の 252GB と 7.1TB/s に対し、MI350P は 288GB と 8TB/s です。ただし、これらのリソースは 2 枚のカードに搭載されており、両方のカードにまたがるワークロードは PCIe ピアツーピアでデータをやり取りするため、2 枚目のカードがどれだけの性能向上に貢献できるかは制限されます。
パフォーマンス
テストプラットフォーム
MI350P のレビューユニットは Dell PowerEdge R7725 で、2 つの AMD EPYC 9555 プロセッサ (それぞれ 64 コア)、24 DIMM にわたる 1.5TB の DDR5-6400、および 2U サーバーの上限である 450W に設定された 2 枚の MI350P カードが搭載されています。RTX PRO 6000 Blackwell Server Edition カード (600W) は、 4 枚のカードによる推論ビルドを搭載したDell PowerEdge XE7740で動作し、1 台の H200 NVL (450W) は、レビューしたDell PowerEdge R770で動作し、GB300 の数値は、 9 月にレビューしたASUS ExpertCenter Pro ET900N G3 DGX Station から取得されています。

以下の iDRAC インベントリは、2 枚のカードがどのように装着されているかを示しています。これらは PCIe スロット 2 と 7 に装着されており、どちらも Gen5 x16 で、どちらも正常と報告されています。デバイス キー 0-139-0 と 1-199-0 は、各 EPYC ソケットの背後に 1 枚のカードが配置されていることを示しています。そのため、2 台の MI350P 間のテンソル並列トラフィックは、ルート コンプレックス間を移動する際にソケット リンクを経由します。これは、2U サーバーに 2 枚のカードを導入した場合のデフォルトのレイアウトであり、後ほど 2 枚のカードを使用した結果を説明する際に留意しておく価値があります。

メモリビューには、ホストの残りの部分が表示されます。64GB DDR5-6400デュアルランクのDIMMが24枚搭載されており、最大6TBのサーバーで合計1,536GB、すべてマルチビットECCに対応しています。この余裕はGLM-5.2の実行において重要です。MXFP4チェックポイントは2枚のカードの288GBに収まらないため、vLLMはエキスパートウェイトの一部をホストメモリにオフロードします。

最大達成可能 Matmul FLOPS (MAMF)
MI350Pの演算性能をより正確に把握するために、4つのシステムでMAMFを実行しました。MAMF(Maximum Achievable Matmul FLOPS)は、行列乗算中にアクセラレータが到達する現実的なピーク浮動小数点演算回数(1秒あたり)を測定するために設計された実用的な性能指標であり、仕様書に記載されている理論上のピークFLOPSよりも有用なベンチマークです。各システムをBF16、FP8、およびブロックスケールFP4でスイープし、精度ごとの最良の持続的な高密度結果を報告します。斜線部分は、大規模モデル処理実行で使用されたカード数で各PCIeカードの結果を乗算したもので、測定値ではなく計算値です。

450Wの消費電力で、MI350PはBF16で580TFLOPS、FP8で1,120TFLOPS、FP4で2,228TFLOPSの性能を発揮します。RTX PRO 6000 Blackwellはそれぞれ419TFLOPS、820TFLOPS、1,634TFLOPSで、MI350PはNVIDIAカードよりも150W低い消費電力で、あらゆる精度において36~38%の優位性を維持しています。BF16では38.4%という最大の差が生まれています。
H200 NVL の BF16 での 652 TFLOPS と FP8 での 1,205 TFLOPS は、MI350P を両方とも上回っており、FP4 パスはありません。GB300 DGX Station は、1,924、3,802、6,024 で 3 つの PCIe カードすべてを上回っており、BF16 では MI350P の約 3.3 倍、FP4 では 2.7 倍です。MI350P 2 枚は、理論上は 1,160 と 4,456 に近い値ですが、Station のシングル GPU には及びません。このレビューの NVIDIA MAMF の数値は、各カードでの最新の実行結果であり、以前のテスト結果を置き換えたものです。
GPU メモリ帯域幅
生の演算スループットは、アクセラレータが実行ユニットにデータを供給し続けられる場合にのみ有効です。これは推論において特に重要であり、デコードフェーズでのトークン生成は、利用可能なFLOPSよりもメモリ帯域幅によって制限されます。帯域幅テストでは、演算カーネルとコピーエンジンを介してGPUメモリの読み書きとコピーを行い、各GPUの定格値に対する利用可能な帯域幅を示します。

MI350Pは、HBM3Eの読み出し速度が3,291GB/s、書き込み速度が3,204GB/sで、定格4TB/sの約80%に相当します。コピー速度は1,276~1,283GB/sで、コピー処理では帯域幅が2回消費されます。1回目はソースの読み出し、2回目は宛先への書き込みです。RTX PRO 6000のGDDR7は、読み出し速度が1,540GB/s、書き込み速度が1,483GB/sなので、MI350Pはカード1枚あたり約2.1倍の帯域幅を備えていることになります。
H200 NVLの読み取り速度4,472GB/s、書き込み速度4,156GB/sは、MI350Pをそれぞれ36%と30%上回っており、4TB/sに対する4.8TB/sという定格値と一致しています。また、GB300 DGX Stationは6,869GB/sに達します。2台のMI350Pを一緒に測定すると、読み取り速度は6,529GB/sに達し、Stationに近い値になりますが、この帯域幅は2つのPCIeスロットに収まっており、両方のスロットにまたがるモデルでは、PCIeを介したすべてのデータ交換に対して料金が発生します。
推論
低レベルのテストが完了したので、LLM推論に移ります。vLLMオンラインサービングテストでは、OpenAI互換エンドポイントを固定数の同時ストリームで駆動し、実行中に1秒あたりの出力トークンを記録します。2つの形状を報告します。1つは入力512トークン、出力512トークンで、チャットサイズでデコード負荷が高いもの、もう1つは入力8,192トークン、出力1,024トークンで、RAGおよびドキュメントサイズでプリフィルに頼っているものです。同時実行数は1ストリームごとに2倍になり、各グラフは、その中のすべてのカードが完了した最高の同時実行数で停止します。各ポイントはストリームごとに2つのリクエストなので、単一ストリームの数値は2つのリクエストに基づいており、同時実行数が高いポイントよりも実行ごとのばらつきが大きくなります。
各モデルは、それを収容できる最小限のカードで実行されました。GPT-OSS-120B および MiniMax-M2.7 までのすべての処理には MI350P が 1 枚、DeepSeek-V4-Flash、MiniMax-M3、GLM-5.2、および GLM-5.3 Flash には 2 枚です。RTX PRO 6000 の実行も同じルールに従い、MiniMax-M2.7 では RTX カード 2 枚と MI350P 1 枚、MiniMax-M3 および GLM-5.2 では RTX カード 4 枚と 2 枚が使用されています。低精度ビルドはベンダーによって異なり、AMD は Quark まで MXFP4、NVIDIA は NVFP4 で、FP4 ペアリングは全体を通してそのようにラベル付けされています。GPT-OSS は MXFP4 として出荷され、すべてのカードで同じ重みが実行されます。H200 NVFP4 ビルドは含まれていません。
| モデル | MI350P | RTX PRO 6000 ブラックウェル | H200NVL | GB300 DGXステーション |
|---|---|---|---|---|
| GLM-5.3 フラッシュ | カード2枚、MXFP4 | 実行しない | 実行しない | NVFP4 |
| GLM-5.2 | 2枚のカード、MXFP4(ホストメモリにオフロード) | カード4枚、NVFP4 | 実行しない | NVFP4(Graceメモリに約215GBのエキスパートを搭載) |
| ミニマックス-M3 | カード2枚、MXFP4 | カード4枚、NVFP4 | 実行しない | NVFP4(グレース・メモリアルの専門家グループ) |
| DeepSeek-V4-Flash | カード2枚、FP8 | カード2枚、FP8 | 実行しない | FP8 |
| ミニマックス-M2.7 | カード1枚、MXFP4 | カード2枚、NVFP4 | 実行しない | NVFP4 |
| GPT-OSS-120B | カード1枚、MXFP4 | カード1枚、MXFP4 | カード1枚、MXFP4 | MXFP4 |
| GPT-OSS-20B | カード1枚、MXFP4 | カード1枚、MXFP4 | カード1枚、MXFP4 | MXFP4 |
| Qwen3-コーダー-30B-A3B | カード1枚、FP8、BF16 | カード1枚、FP8、BF16 | カード1枚、FP8、BF16 | FP8とBF16 |
| ミストラル スモール 3.1 24V | カード1枚、FP8、BF16 | カード1枚、FP8、BF16 | カード1枚、FP8、BF16 | FP8とBF16 |
| ラマ3.1 8B | カード1枚、MXFP4、FP8、およびBF16 | カード1枚、NVFP4、FP8、およびBF16 | カード1枚、FP8、BF16 | NVFP4、FP8、およびBF16 |
MI350P の列を読み進めると、まず 144GB のメモリで利用できるカードの枚数が表示されます。10 個のモデルのうち 6 個は 1 枚の MI350P で動作しますが、RTX PRO 6000 の 96GB では MiniMax-M2.7 用に 2 枚目のカードが必要となり、2 枚の MI350P で実行される 2 つの MXFP4 チェックポイント、MiniMax-M3 と GLM-5.2 には 4 枚の RTX PRO 6000 が必要です。GLM-5.2 は 288GB を超えても容量が不足するため、vLLM はその実行時にエキスパート ウェイトの一部を R7725 のホスト メモリにオフロードします。GB300 も、Grace メモリ内の約 215GB のエキスパートで同様の処理を行います。
MI350Pのシングルカードモデルの数値は、10月27日にAMDGPU 31.60、ROCm 10.1.0、vLLM 0.32.0で実行されました。Dellが検証した組み合わせは、ROCm 10.0とAMDGPU 31.5でvLLM 0.27ですが、私たちはさらに一歩進んで、10月5日にリリースされたROCm 10.1を使用しました。NVIDIAカードは、CUDA 13.4.1上でvLLM 26.08コンテナを実行しました。表には、各実行の背後にあるビルドが示されています。
| モデル | vLLMイメージ |
|---|---|
| AMD Instinct MI350P | |
| DeepSeek-V4-Flash-0731 | vllm/vllm-openai-rocm@sha256:a78d3e91404e7875aa650a61dea580a9e26d72553bee9ae5b93dbdef7107594d (ROCm 7.2.3) |
| GLM-5.2 MXFP4 | vllm/vllm-openai-rocm:v0.27.1 (ROCm 7.2.3) |
| GLM-5.3 フラッシュ MXFP4 | vllm/vllm-openai-rocm@sha256:a78d3e91404e7875aa650a61dea580a9e26d72553bee9ae5b93dbdef7107594d (ROCm 7.2.3) |
| GPT-OSS-120B MXFP4 | vLLM 0.32.0 (ROCm 10.1.0、AMDGPU 31.60 上) (10月27日) |
| GPT-OSS-20B MXFP4 | vLLM 0.32.0 (ROCm 10.1.0、AMDGPU 31.60 上) (10月27日) |
| ラマ 3.1 8B BF16 | vLLM 0.32.0 (ROCm 10.1.0、AMDGPU 31.60 上) (10月27日) |
| ラマ 3.1 8B FP8 | vLLM 0.32.0 (ROCm 10.1.0、AMDGPU 31.60 上) (10月27日) |
| Llama 3.1 8B MXFP4 | vLLM 0.32.0 (ROCm 10.1.0、AMDGPU 31.60 上) (10月27日) |
| MiniMax-M2.7 MXFP4 | vLLM 0.32.0 (ROCm 10.1.0、AMDGPU 31.60 上) (10月27日) |
| MiniMax-M3 MXFP4 | vllm/vllm-openai-rocm:nightly-2a02f6efe319c885e3ccbcecde402e0028f9ec1e (ROCm 7.2.3) |
| ミストラル・スモール 3.1 24B BF16 | vLLM 0.32.0 (ROCm 10.1.0、AMDGPU 31.60 上) (10月27日) |
| ミストラル・スモール3.1 24B FP8 | vLLM 0.32.0 (ROCm 10.1.0、AMDGPU 31.60 上) (10月27日) |
| Qwen3-Coder-30B BF16 | vLLM 0.32.0 (ROCm 10.1.0、AMDGPU 31.60 上) (10月27日) |
| Qwen3-Coder-30B FP8 | vLLM 0.32.0 (ROCm 10.1.0、AMDGPU 31.60 上) (10月27日) |
| NVIDIA RTX PRO 6000 Blackwell Server Edition (CUDA 13.4.1.012) | |
| DeepSeek-V4-Flash-0731 | nvcr.io/nvidia/vllm:26.08-py3 |
| GLM-5.2 NVFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| GPT-OSS-120B MXFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| GPT-OSS-20B MXFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| ラマ 3.1 8B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| ラマ 3.1 8B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
| ラマ 3.1 8B NVFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| MiniMax-M2.7 NVFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| MiniMax-M3 NVFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| ミストラル・スモール 3.1 24B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| ミストラル・スモール3.1 24B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
| Qwen3-Coder-30B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Qwen3-Coder-30B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
| NVIDIA H200 NVL (CUDA 13.4.1.012) | |
| GPT-OSS-120B MXFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| GPT-OSS-20B MXFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| ラマ 3.1 8B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| ラマ 3.1 8B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
| ミストラル・スモール 3.1 24B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| ミストラル・スモール3.1 24B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
| Qwen3-Coder-30B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Qwen3-Coder-30B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
DeepSeek-V4-Flash、MiniMax-M3、GLM-5.2、GLM-5.3 Flashの4つの2枚カードモデルは、ROCm 7.2.3での実行結果が報告されています。これらのモデルに対するROCm 10.1のパスでは、CPUエキスパートオフロードが全体を通して使用され、DeepSeek-V4-FlashではNVIDIAの実行では使用されなかった投機的デコーダが使用されたため、これらは異なるテストとなり、現在のスタックでクリーンパスするまで保留され、テーブルにはMI350Pの各行にスタックがラベル付けされています。
AMDがこれらのモデル向けに推奨するパスはAIMコンテナです。10月9日にリリースされたEnterprise AI Suite 2.5はROCm 10で検証済みで、GPT-OSS-120B、Llama 3.3 70B、Gemma 3 27B用のAIMが含まれていますが、AMDのアクセラレータテーブルには、今のところWan2.2用の最適化されたMI350Pプロファイルしか記載されていません。そのため、MI350Pの購入者が現在も選択しているのは標準のvLLMであり、今回もそれを測定しました。
推論結果の概要
以下に 28 個のチャートがありますが、ここでは要約版を 2 つの表にまとめました。各モデルについて、カードが完了する最高同時接続数での 1 秒あたりの出力トークン数を示し、最初にチャットサイズの 512 入力、512 出力ワークロードを示します。MI350P の数値は、行に特に記載がない限り 1 枚のカードで 450W の場合で、各行のスタックを示す列があります。GB300 DGX Station は単一の B300 です。
| モデル | グラフィックカード(MI350P / RTX PRO 6000) | MI350Pスタック | Streams | MI350P | RTXプロ6000 | H200NVL | GB300 DGXステーション |
|---|---|---|---|---|---|---|---|
| GLM-5.3フラッシュメモリ(MXFP4とNVFP4の比較) | 2 / なし | ROCm7.2.3 | 32 | 1,462 | 実行しない | 実行しない | 828 |
| GLM-5.2(MXFP4対NVFP4) | 2 / 4 | ROCm7.2.3 | 32 | 59 | 40 | 実行しない | 139 |
| MiniMax-M3(MXFP4 vs NVFP4) | 2 / 4 | ROCm7.2.3 | 32 | 1,509 | 759 | 実行しない | 1,041 |
| DeepSeek-V4-Flash | 2 / 2 | ROCm7.2.3 | 32 | 1,081 | 829 | 実行しない | 1,766 |
| MiniMax-M2.7(MXFP4 vs NVFP4) | 1 / 2 | ROCm10.1 | 128 | 1,524 | 1,932 | 実行しない | 4,793 |
| GPT-OSS-120B MXFP4 | 1 / 1 | ROCm10.1 | 128 | 5,057 | 3,064 | 3,376 | 9,280 |
| GPT-OSS-20B MXFP4 | 1 / 1 | ROCm10.1 | 128 | 10,726 | 7,937 | 6,022 | 22,041 |
| Qwen3-Coder-30B FP8 | 1 / 1 | ROCm10.1 | 128 | 6,451 | 3,995 | 7,459 | 12,439 |
| Qwen3-Coder-30B BF16 | 1 / 1 | ROCm10.1 | 128 | 4,696 | 2,881 | 5,240 | 10,000 |
| ミストラル・スモール24B FP8 | 1 / 1 | ROCm10.1 | 128 | 4,458 | 3,242 | 4,624 | 11,075 |
| ミストラル スモール 24B BF16 | 1 / 1 | ROCm10.1 | 128 | 3,065 | 2,026 | 3,373 | 7,861 |
| Llama 3.1 8B (MXFP4 vs NVFP4) | 1 / 1 | ROCm10.1 | 128 | 8,383 | 8,869 | 実行しない | 28,400 |
| ラマ 3.1 8B FP8 | 1 / 1 | ROCm10.1 | 128 | 11,045 | 8,073 | 11,054 | 25,602 |
| ラマ 3.1 8B BF16 | 1 / 1 | ROCm10.1 | 128 | 6,819 | 4,740 | 8,069 | 17,074 |
チャットテーブルでは、2つの結果が際立っています。MI350Pは、すべてのFP8、BF16、およびGPT-OSSモデルでRTX PRO 6000を上回り、128ストリームで35~65パーセントの差をつけています。NVIDIAのNVFP4ビルドにはLlamaとMiniMax-M2.7カーブの最高値でのみ劣りますが、Llama 3.1 8BとMistral Small 24Bのシングルストリームでは、4TB/sのHBM3Eが処理を担当し、NVIDIAカードの約2倍の性能を発揮します。
帯域幅が20%多いH200 NVLは、128ストリームの高密度FP8およびBF16モデルで4~18%の優位性を維持し、Llama 3.1 8B FP8では同率となる。2つのGPT-OSSモデルでは順位が逆転し、MI350Pが50%および78%の優位性を示す。
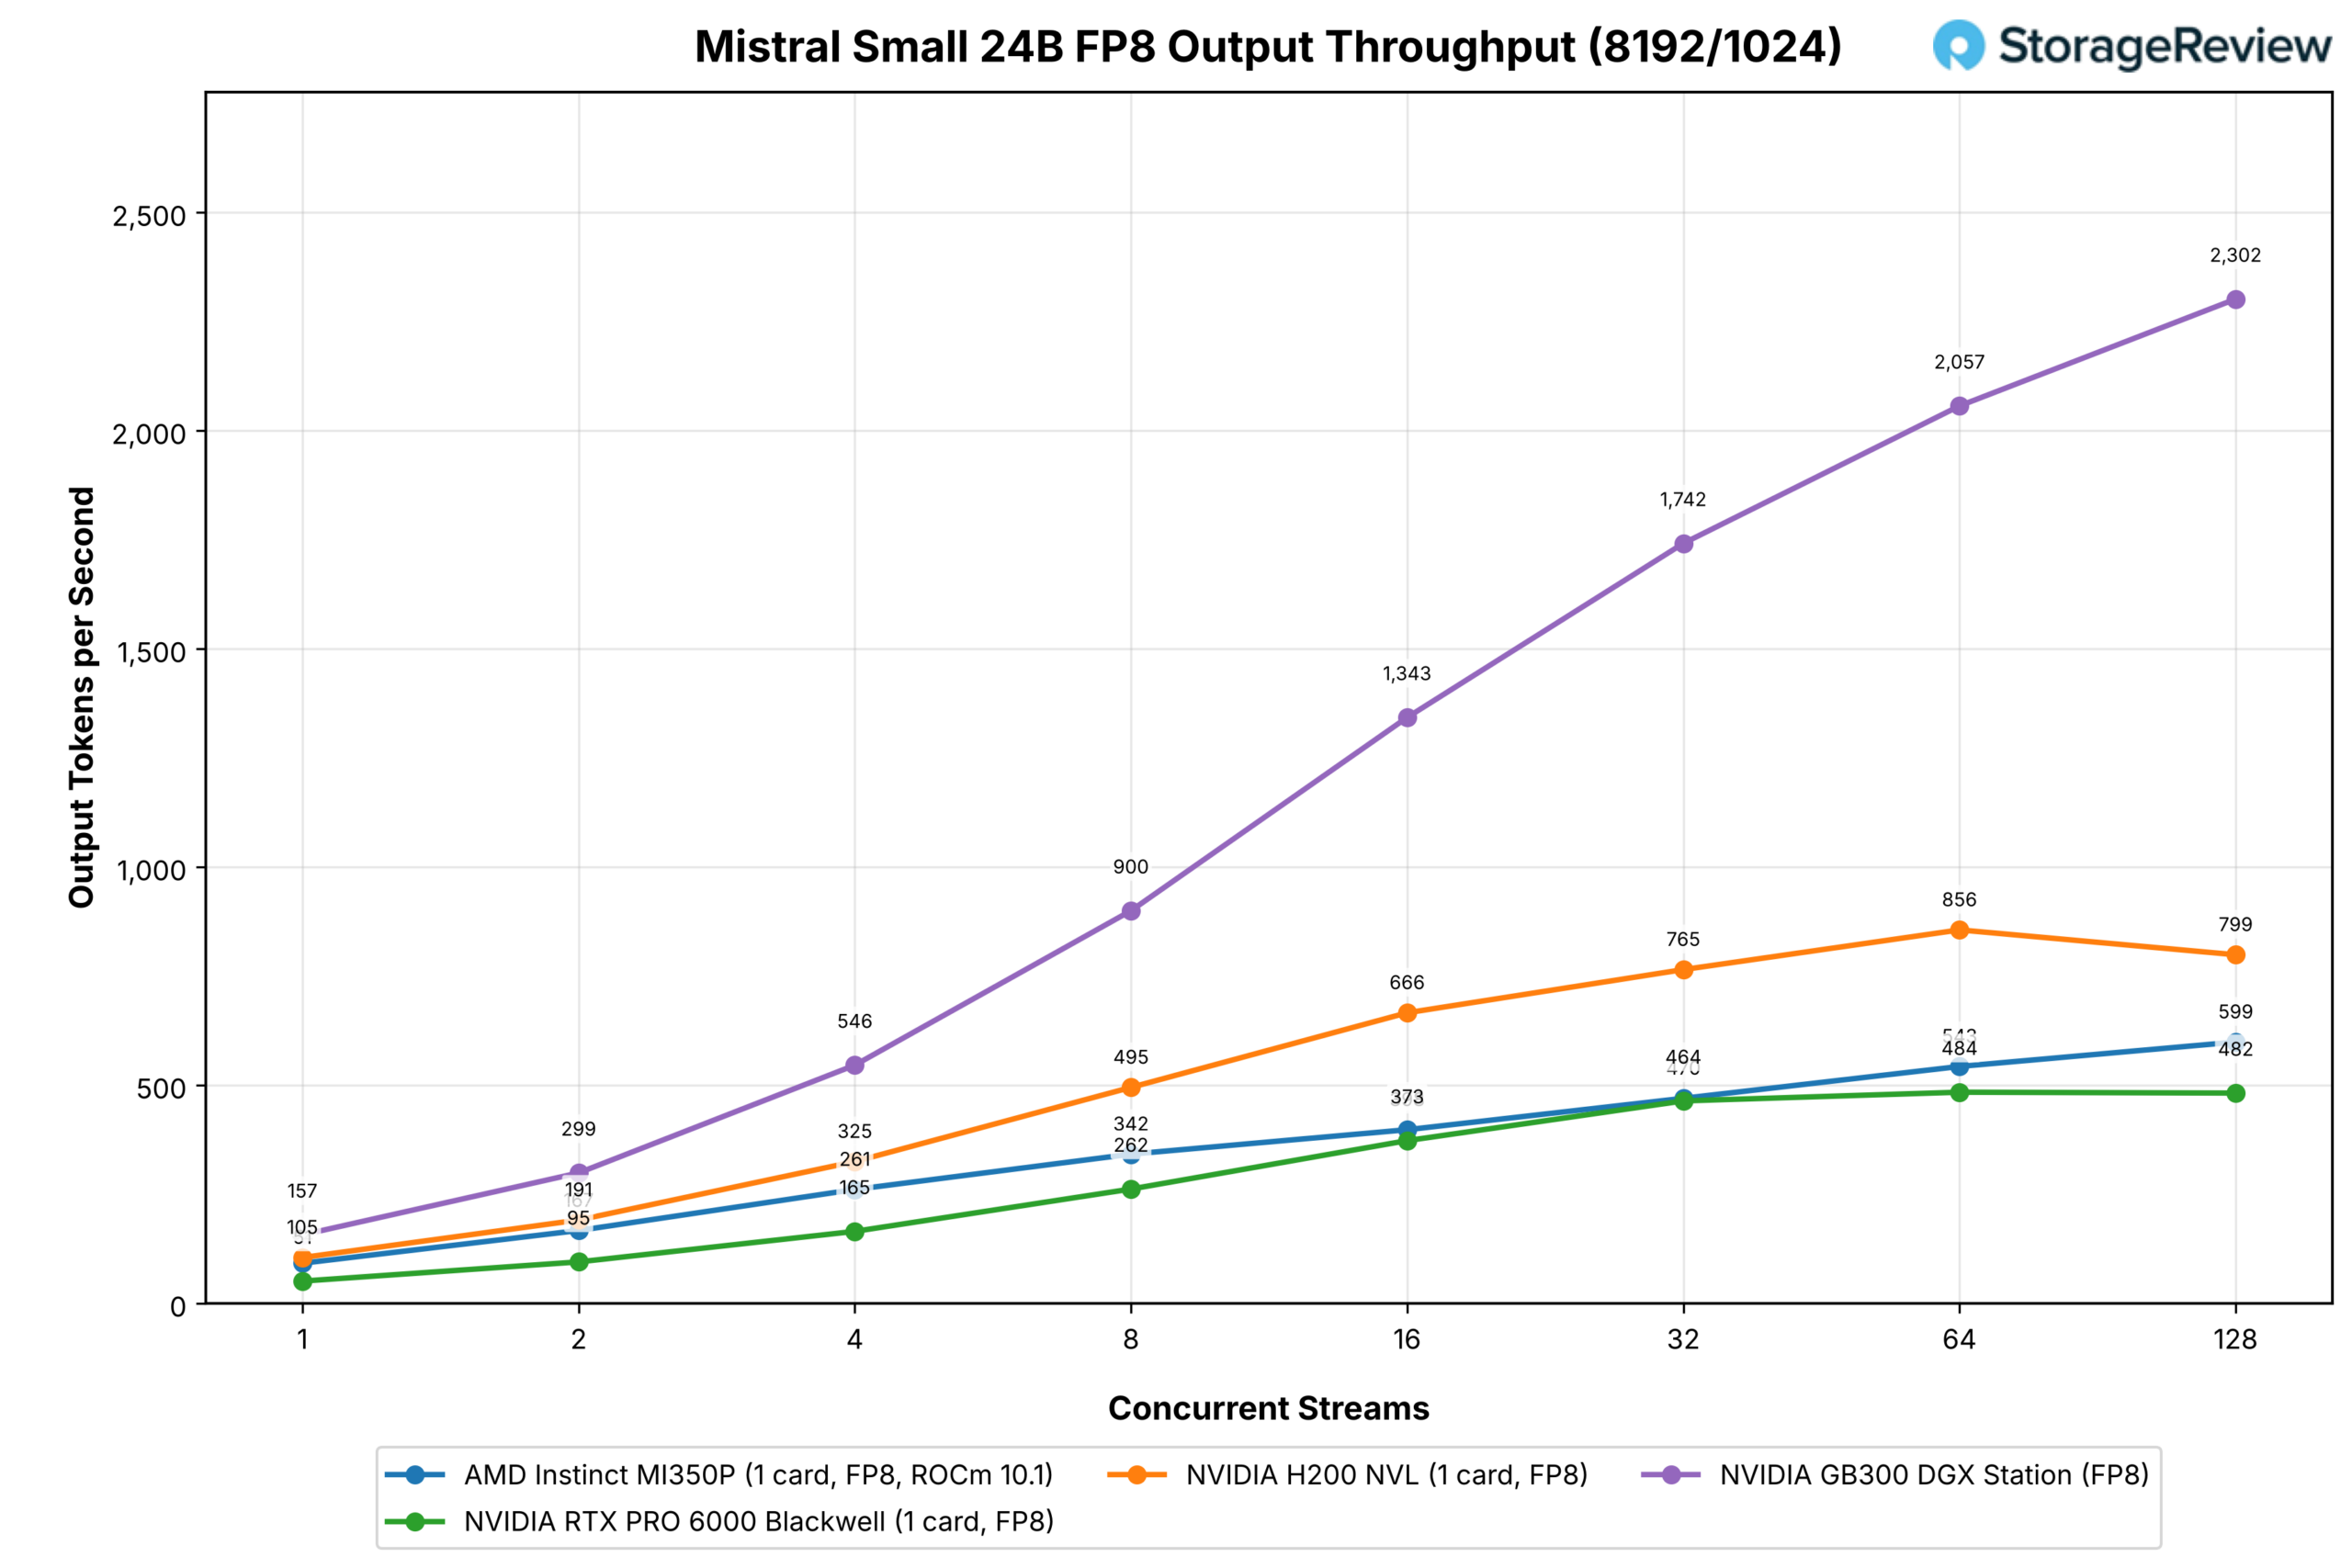
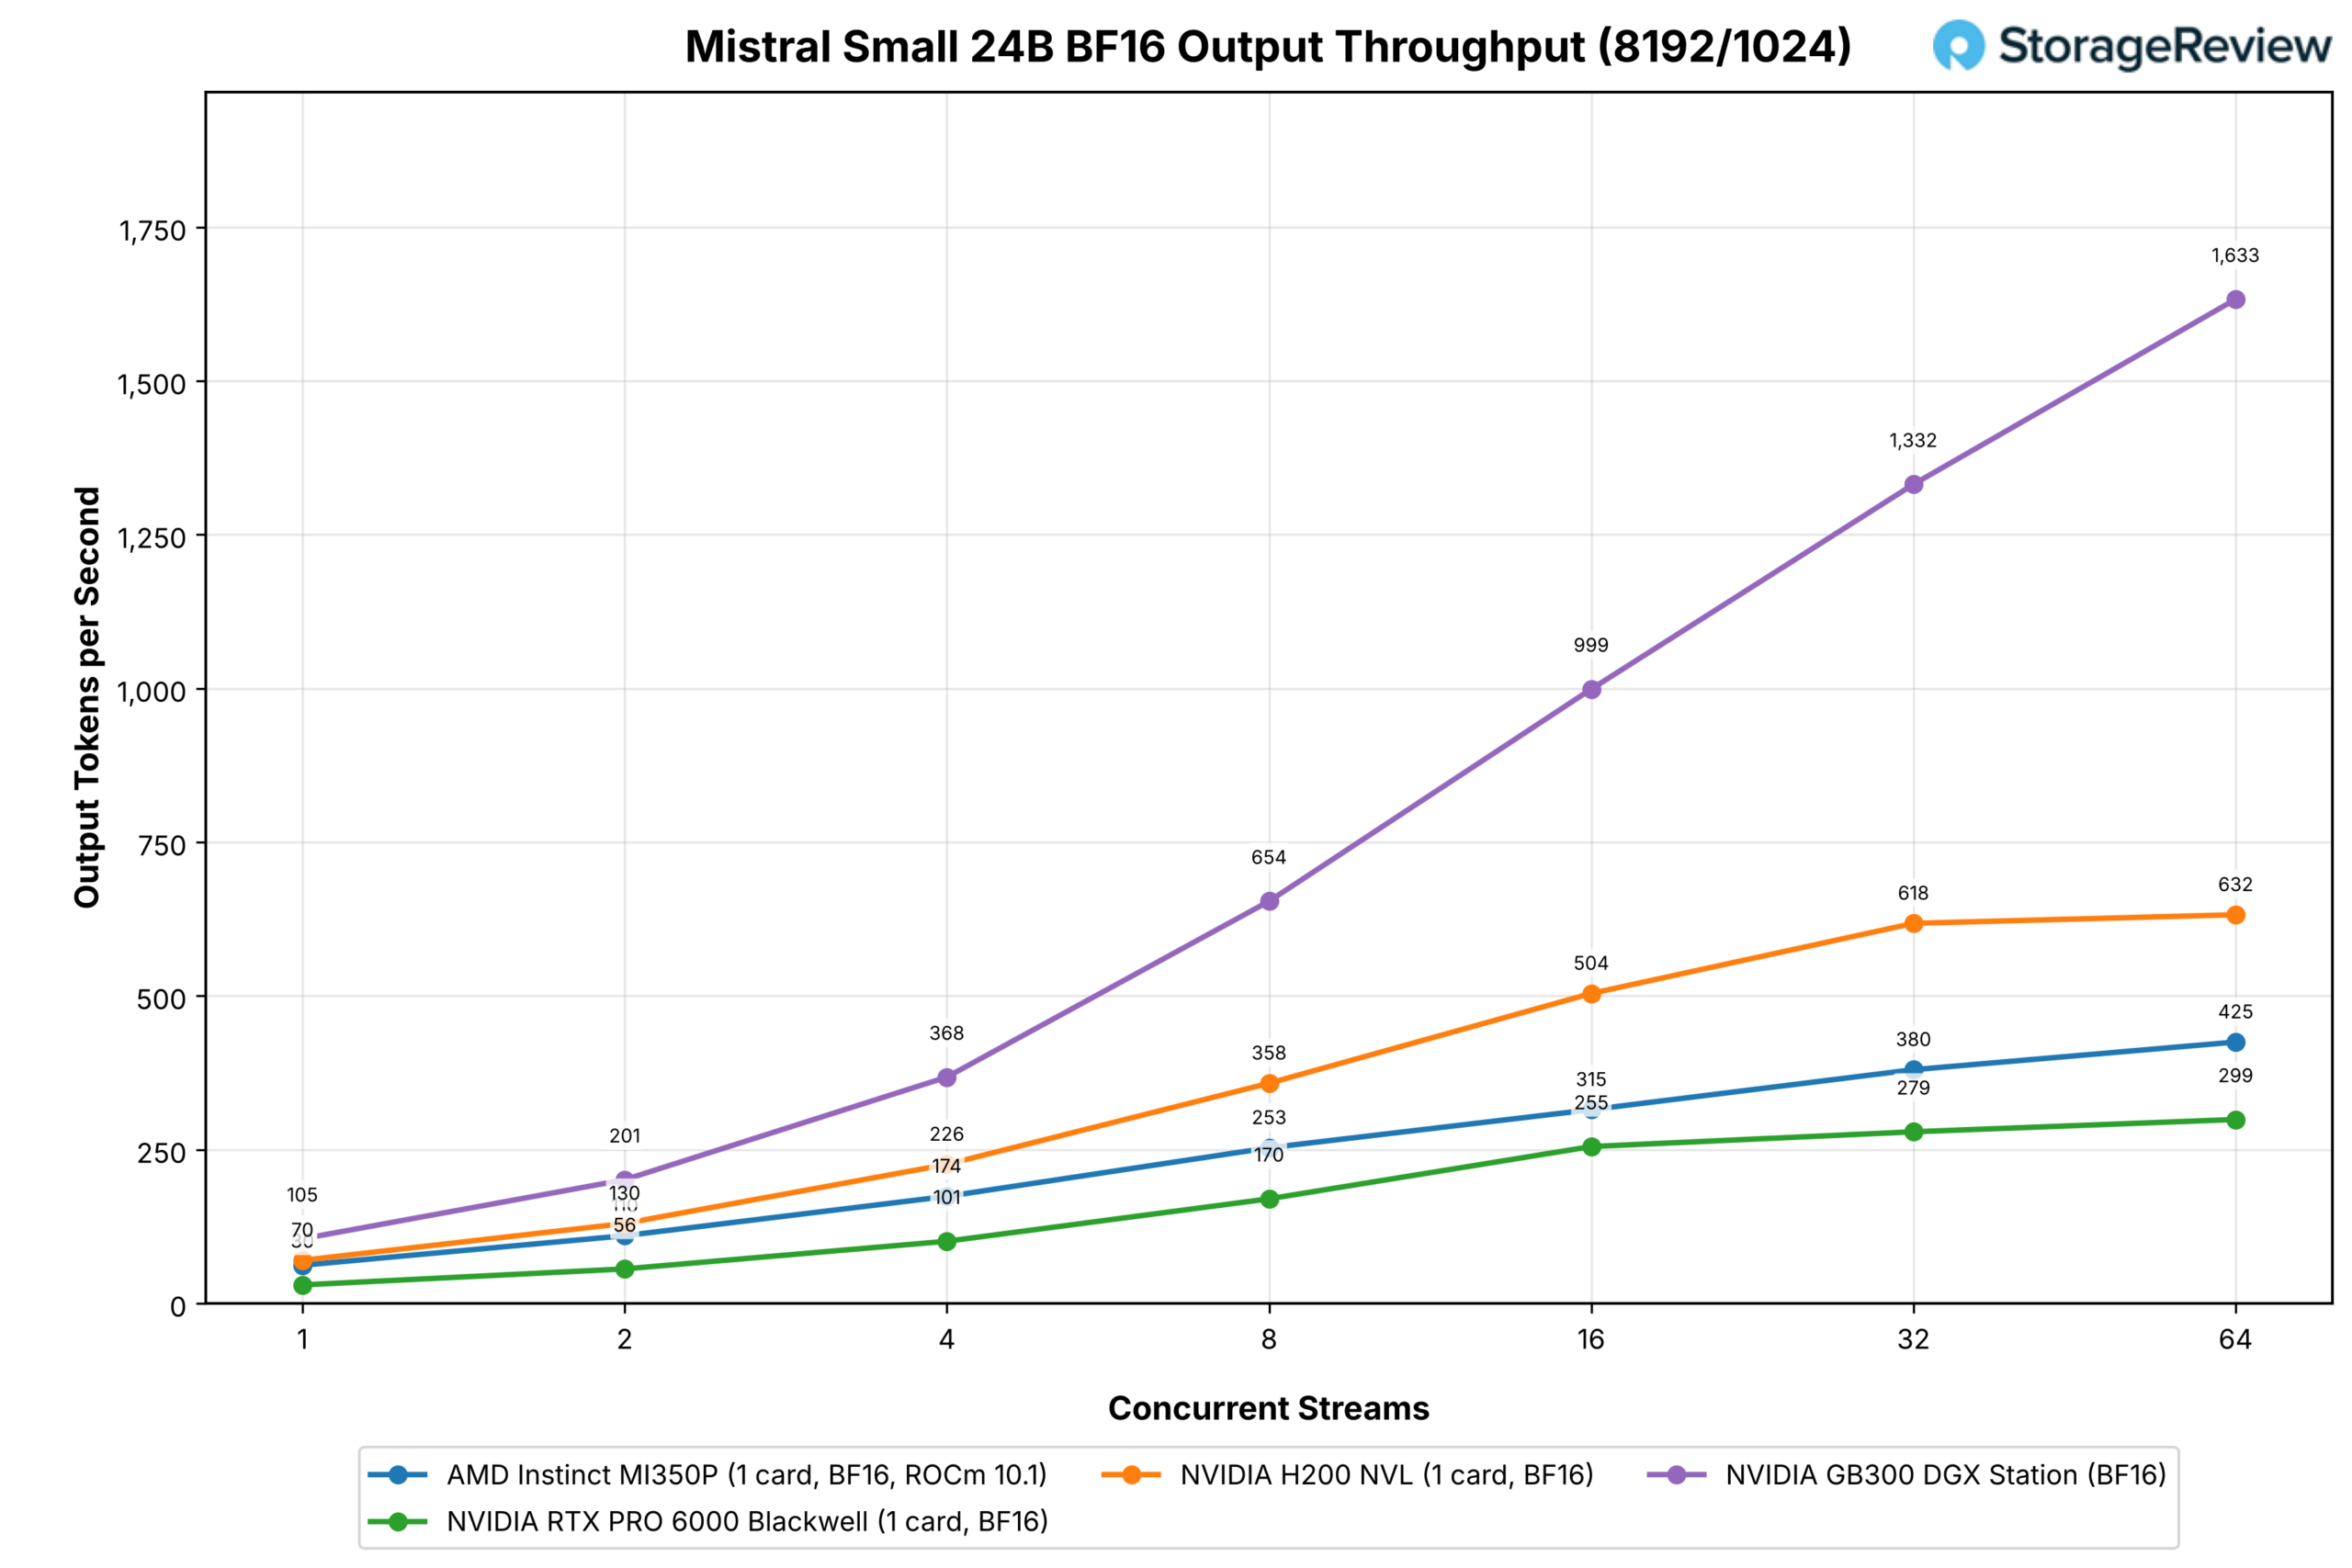
2番目の表は、8,192トークンのプロンプトで同様の処理を繰り返したものであり、プリフィル処理が実行の大部分を占め、コンピューティングとメモリ帯域幅のバランスがNVIDIAカード側にシフトしていることを示しています。
| モデル | グラフィックカード(MI350P / RTX PRO 6000) | MI350Pスタック | Streams | MI350P | RTXプロ6000 | H200NVL | GB300 DGXステーション |
|---|---|---|---|---|---|---|---|
| GLM-5.3フラッシュメモリ(MXFP4とNVFP4の比較) | 2 / なし | ROCm7.2.3 | 32 | 760 | 実行しない | 実行しない | 1,219 |
| GLM-5.2(MXFP4対NVFP4) | 2 / 4 | ROCm7.2.3 | 16 | 6 | 9 | 実行しない | 87 |
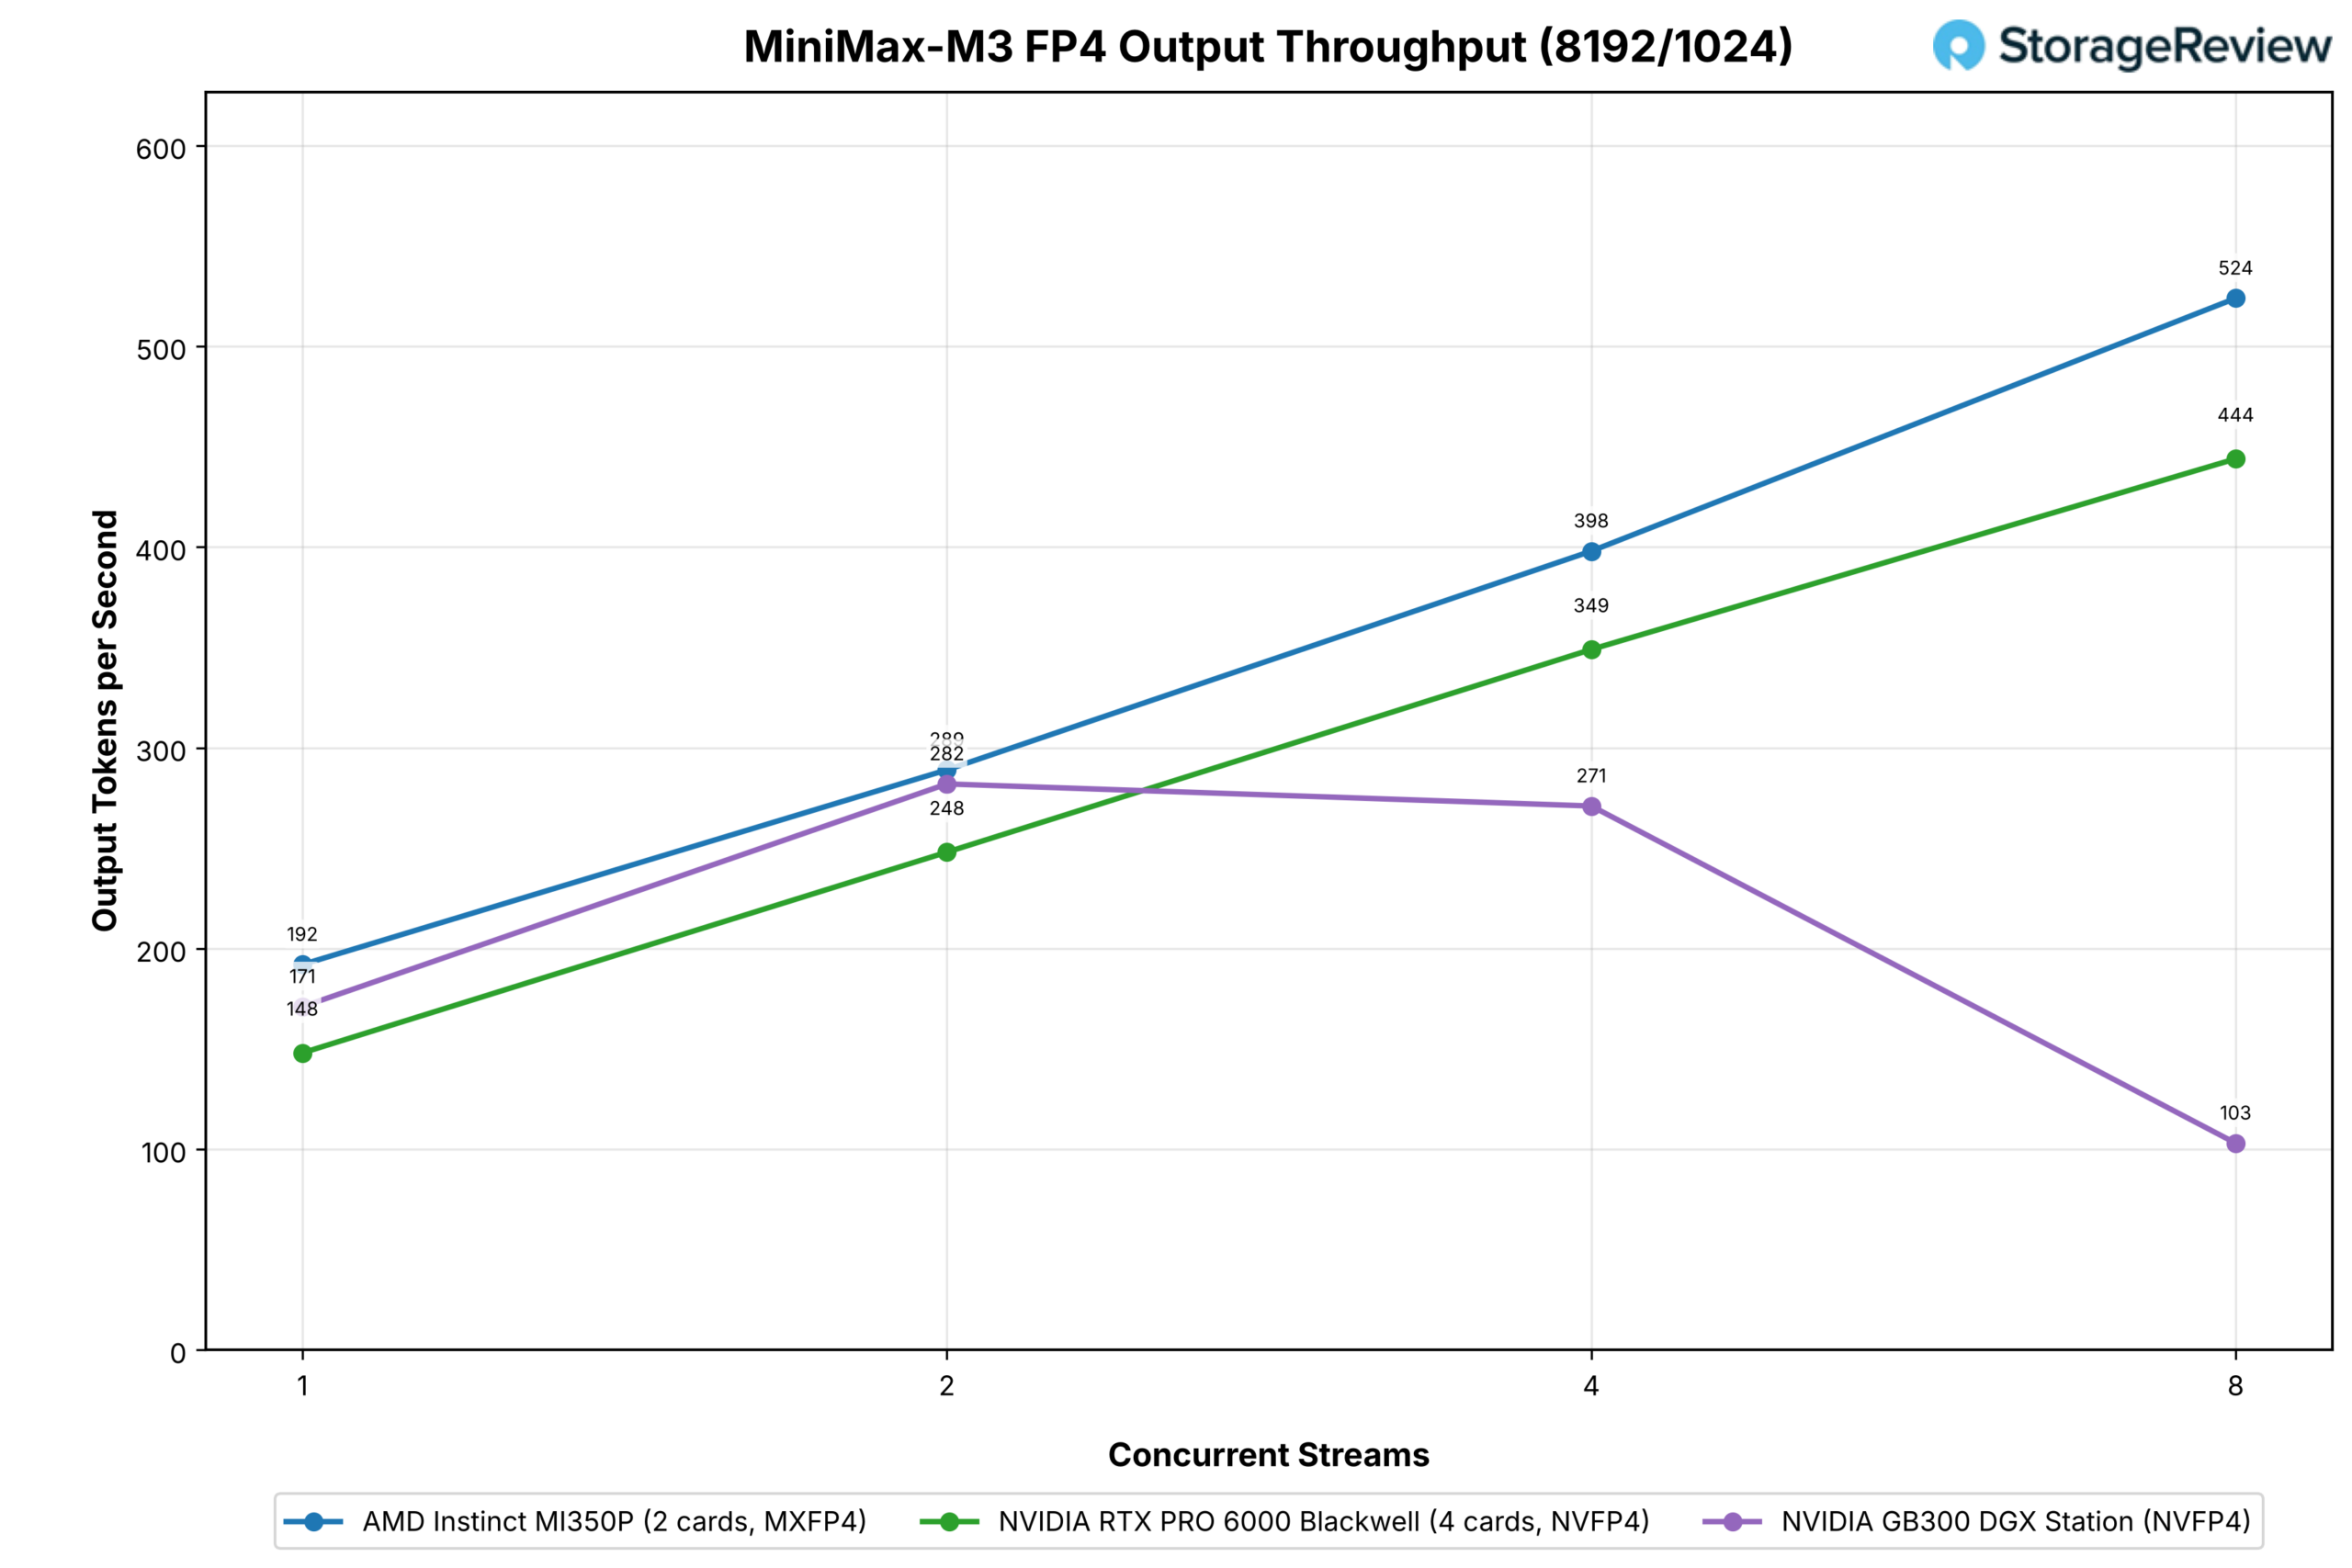
| MiniMax-M3(MXFP4 vs NVFP4) | 2 / 4 | ROCm7.2.3 | 8 | 524 | 444 | 実行しない | 103 |
| DeepSeek-V4-Flash | 2 / 2 | ROCm7.2.3 | 32 | 621 | 345 | 実行しない | 954 |
| MiniMax-M2.7(MXFP4 vs NVFP4) | 1 / 2 | ROCm10.1 | 64 | 331 | 501 | 実行しない | 1,744 |
| GPT-OSS-120B MXFP4 | 1 / 1 | ROCm10.1 | 128 | 2,101 | 1,169 | 1,825 | 5,023 |
| GPT-OSS-20B MXFP4 | 1 / 1 | ROCm10.1 | 128 | 3,603 | 2,482 | 3,419 | 9,555 |
| Qwen3-Coder-30B FP8 | 1 / 1 | ROCm10.1 | 128 | 759 | 823 | 1,820 | 3,837 |
| Qwen3-Coder-30B BF16 | 1 / 1 | ROCm10.1 | 128 | 728 | 588 | 1,592 | 3,749 |
| ミストラル・スモール24B FP8 | 1 / 1 | ROCm10.1 | 128 | 599 | 482 | 799 | 2,302 |
| ミストラル スモール 24B BF16 | 1 / 1 | ROCm10.1 | 64 | 425 | 299 | 632 | 1,633 |
| Llama 3.1 8B (MXFP4 vs NVFP4) | 1 / 1 | ROCm10.1 | 128 | 964 | 1,644 | 実行しない | 6,737 |
| ラマ 3.1 8B FP8 | 1 / 1 | ROCm10.1 | 128 | 1,211 | 1,481 | 2,045 | 6,164 |
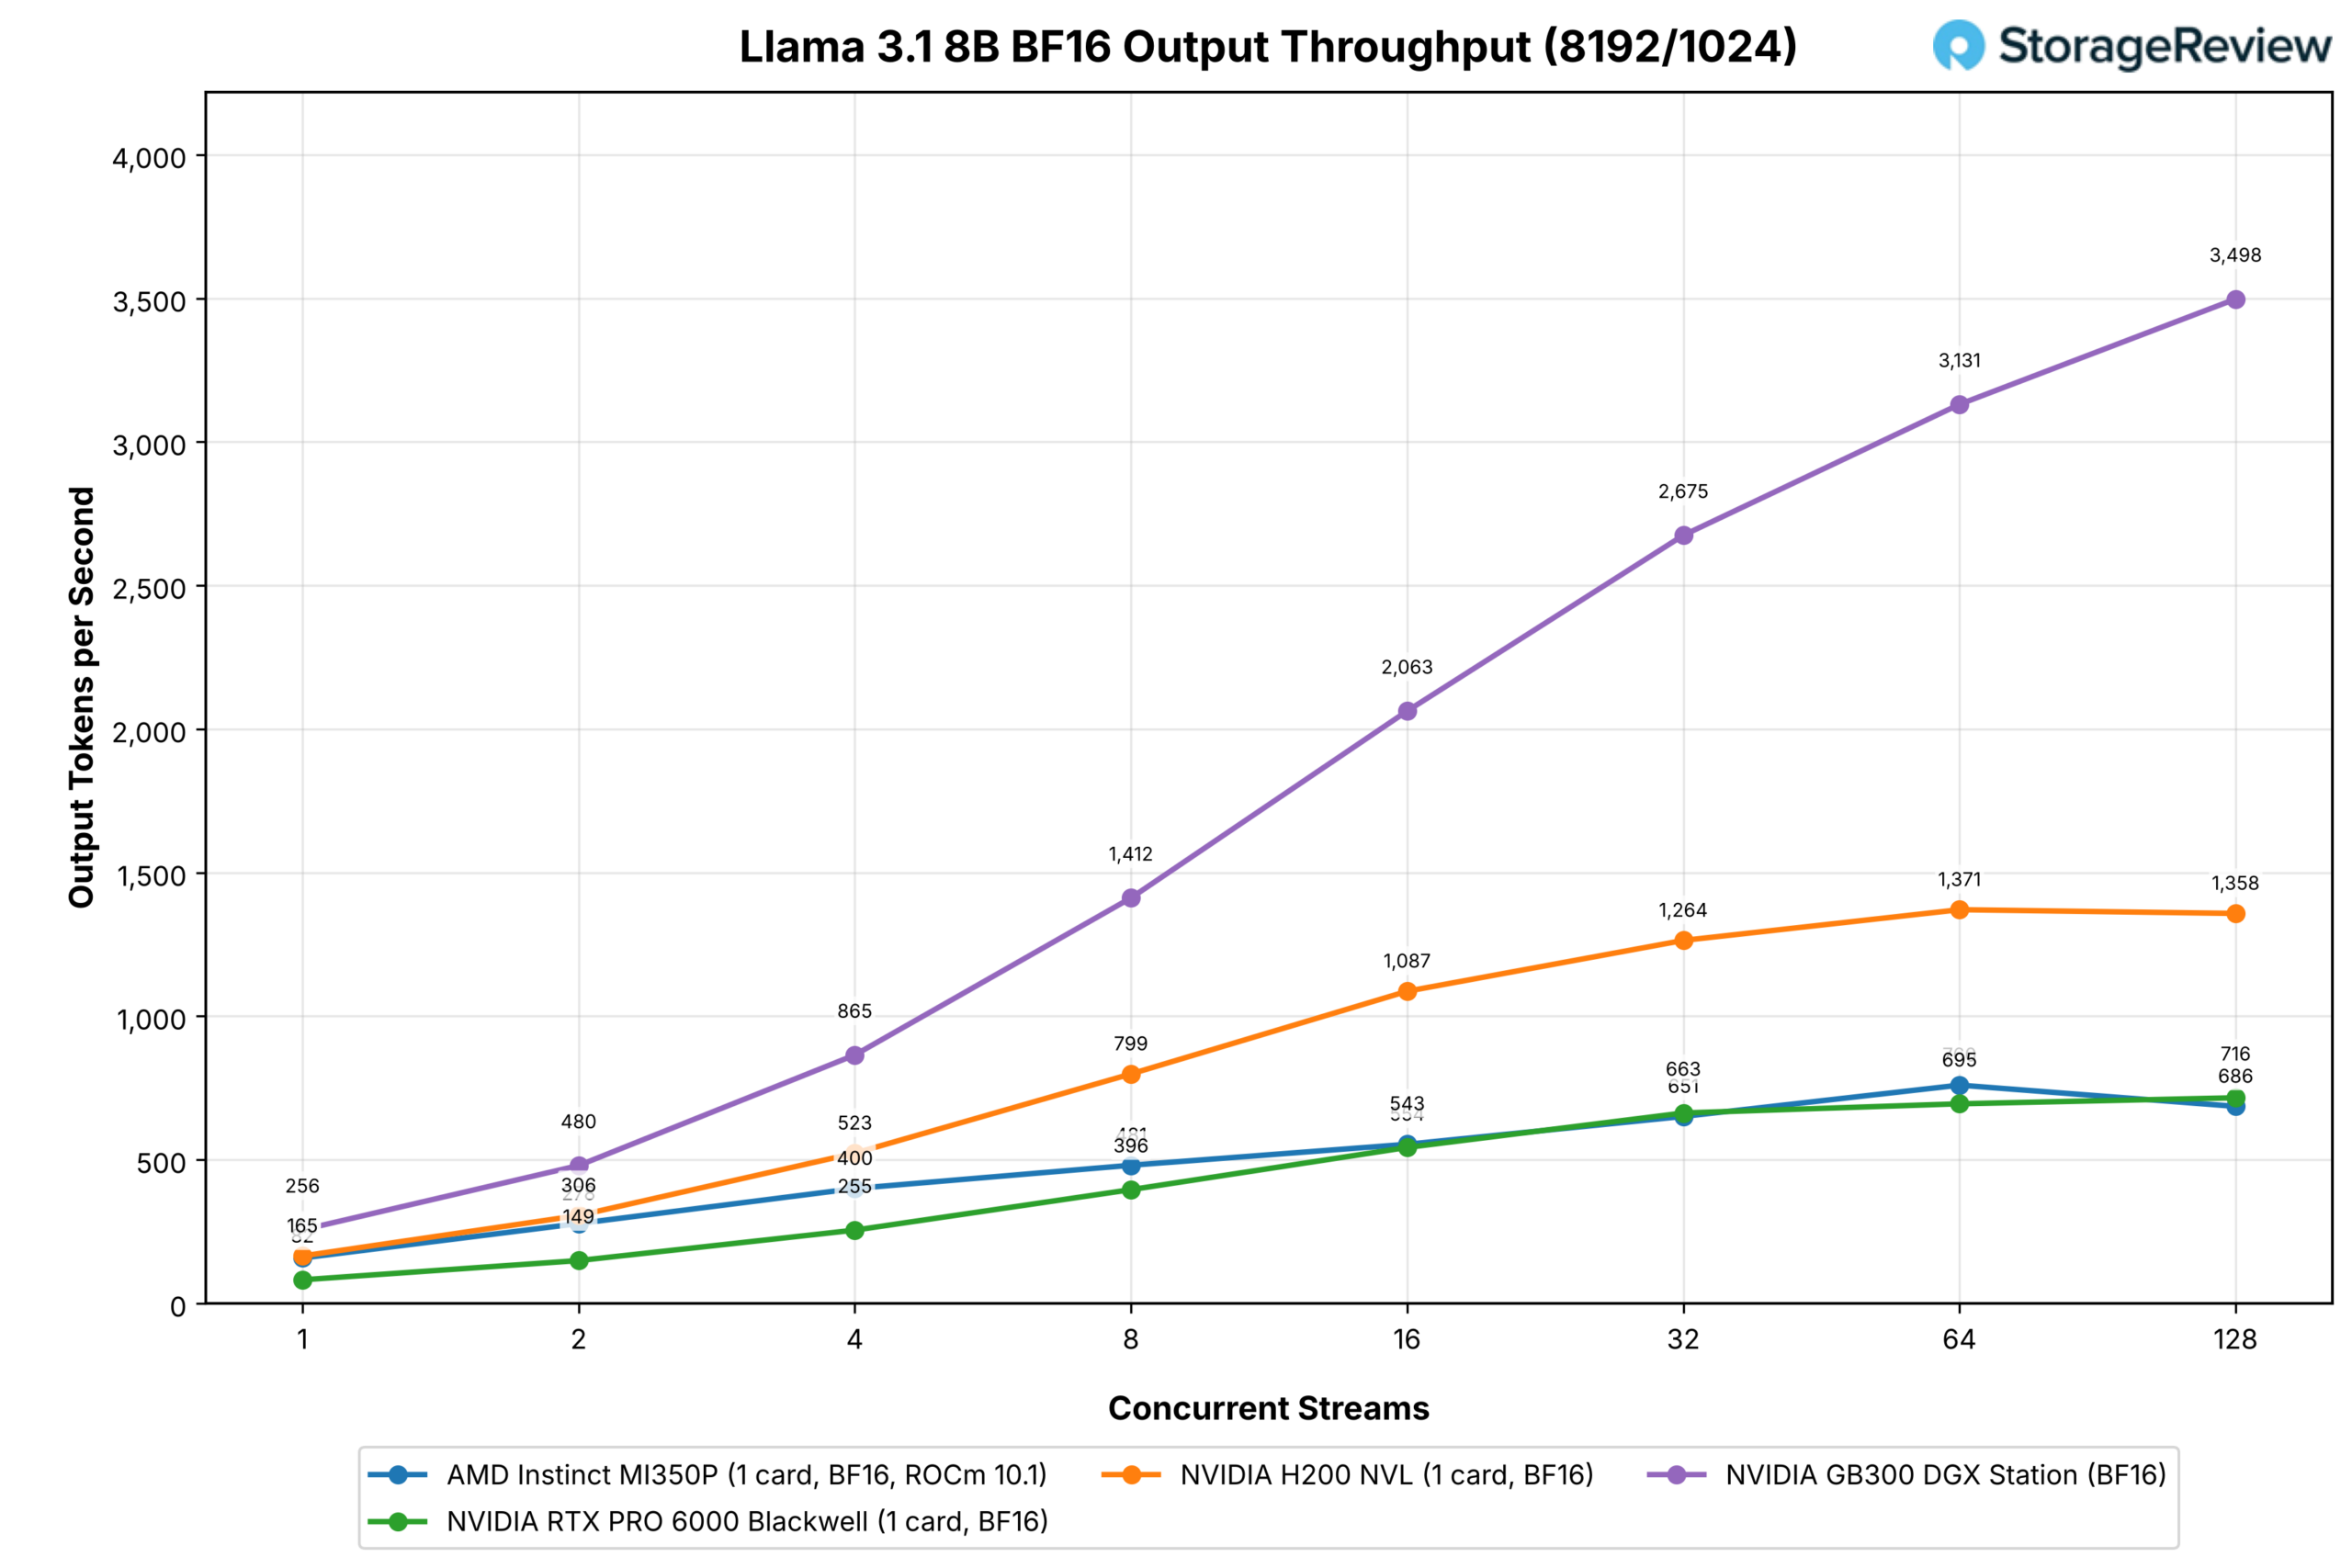
| ラマ 3.1 8B BF16 | 1 / 1 | ROCm10.1 | 128 | 686 | 716 | 1,358 | 3,498 |
プリフィルが多いプロンプトでは、結果はまちまちです。MI350P は、すべてのストリーム数と Mistral Small の両方の GPT-OSS モデルで RTX PRO 6000 をリードし、128 ストリームで Qwen3-Coder と拮抗し (BF16 で 24% リード、FP8 で 8% ダウン)、Llama と MiniMax-M2.7 では 16 ストリームで横ばいとなり、NVIDIA カードに後れを取っています。H200 と比較すると、128 ストリームの 120B モデルでは GPT-OSS で 15%、20B モデルでは 5% リードしていますが、高密度モデルでは 25% から 58% ダウンしています。
最大モデルでは、2つのMI350Pが4つのRTX PRO 6000と対峙し、NVIDIAセットは384GBのGDDR7と288GBのHBM3Eで、チャットワークロードの16ストリームでGLM-5.2をリードします。一方、MiniMax-M3では、3つの構成すべてが8ストリームまでは10パーセント以内の差に収まり、16ストリームでRTXクアッドがリードします。シングルGB300は、252GBに収まるものなら何でも、すべてのPCIe構成を大差で上回ります。
GLM-5.3 フラッシュ
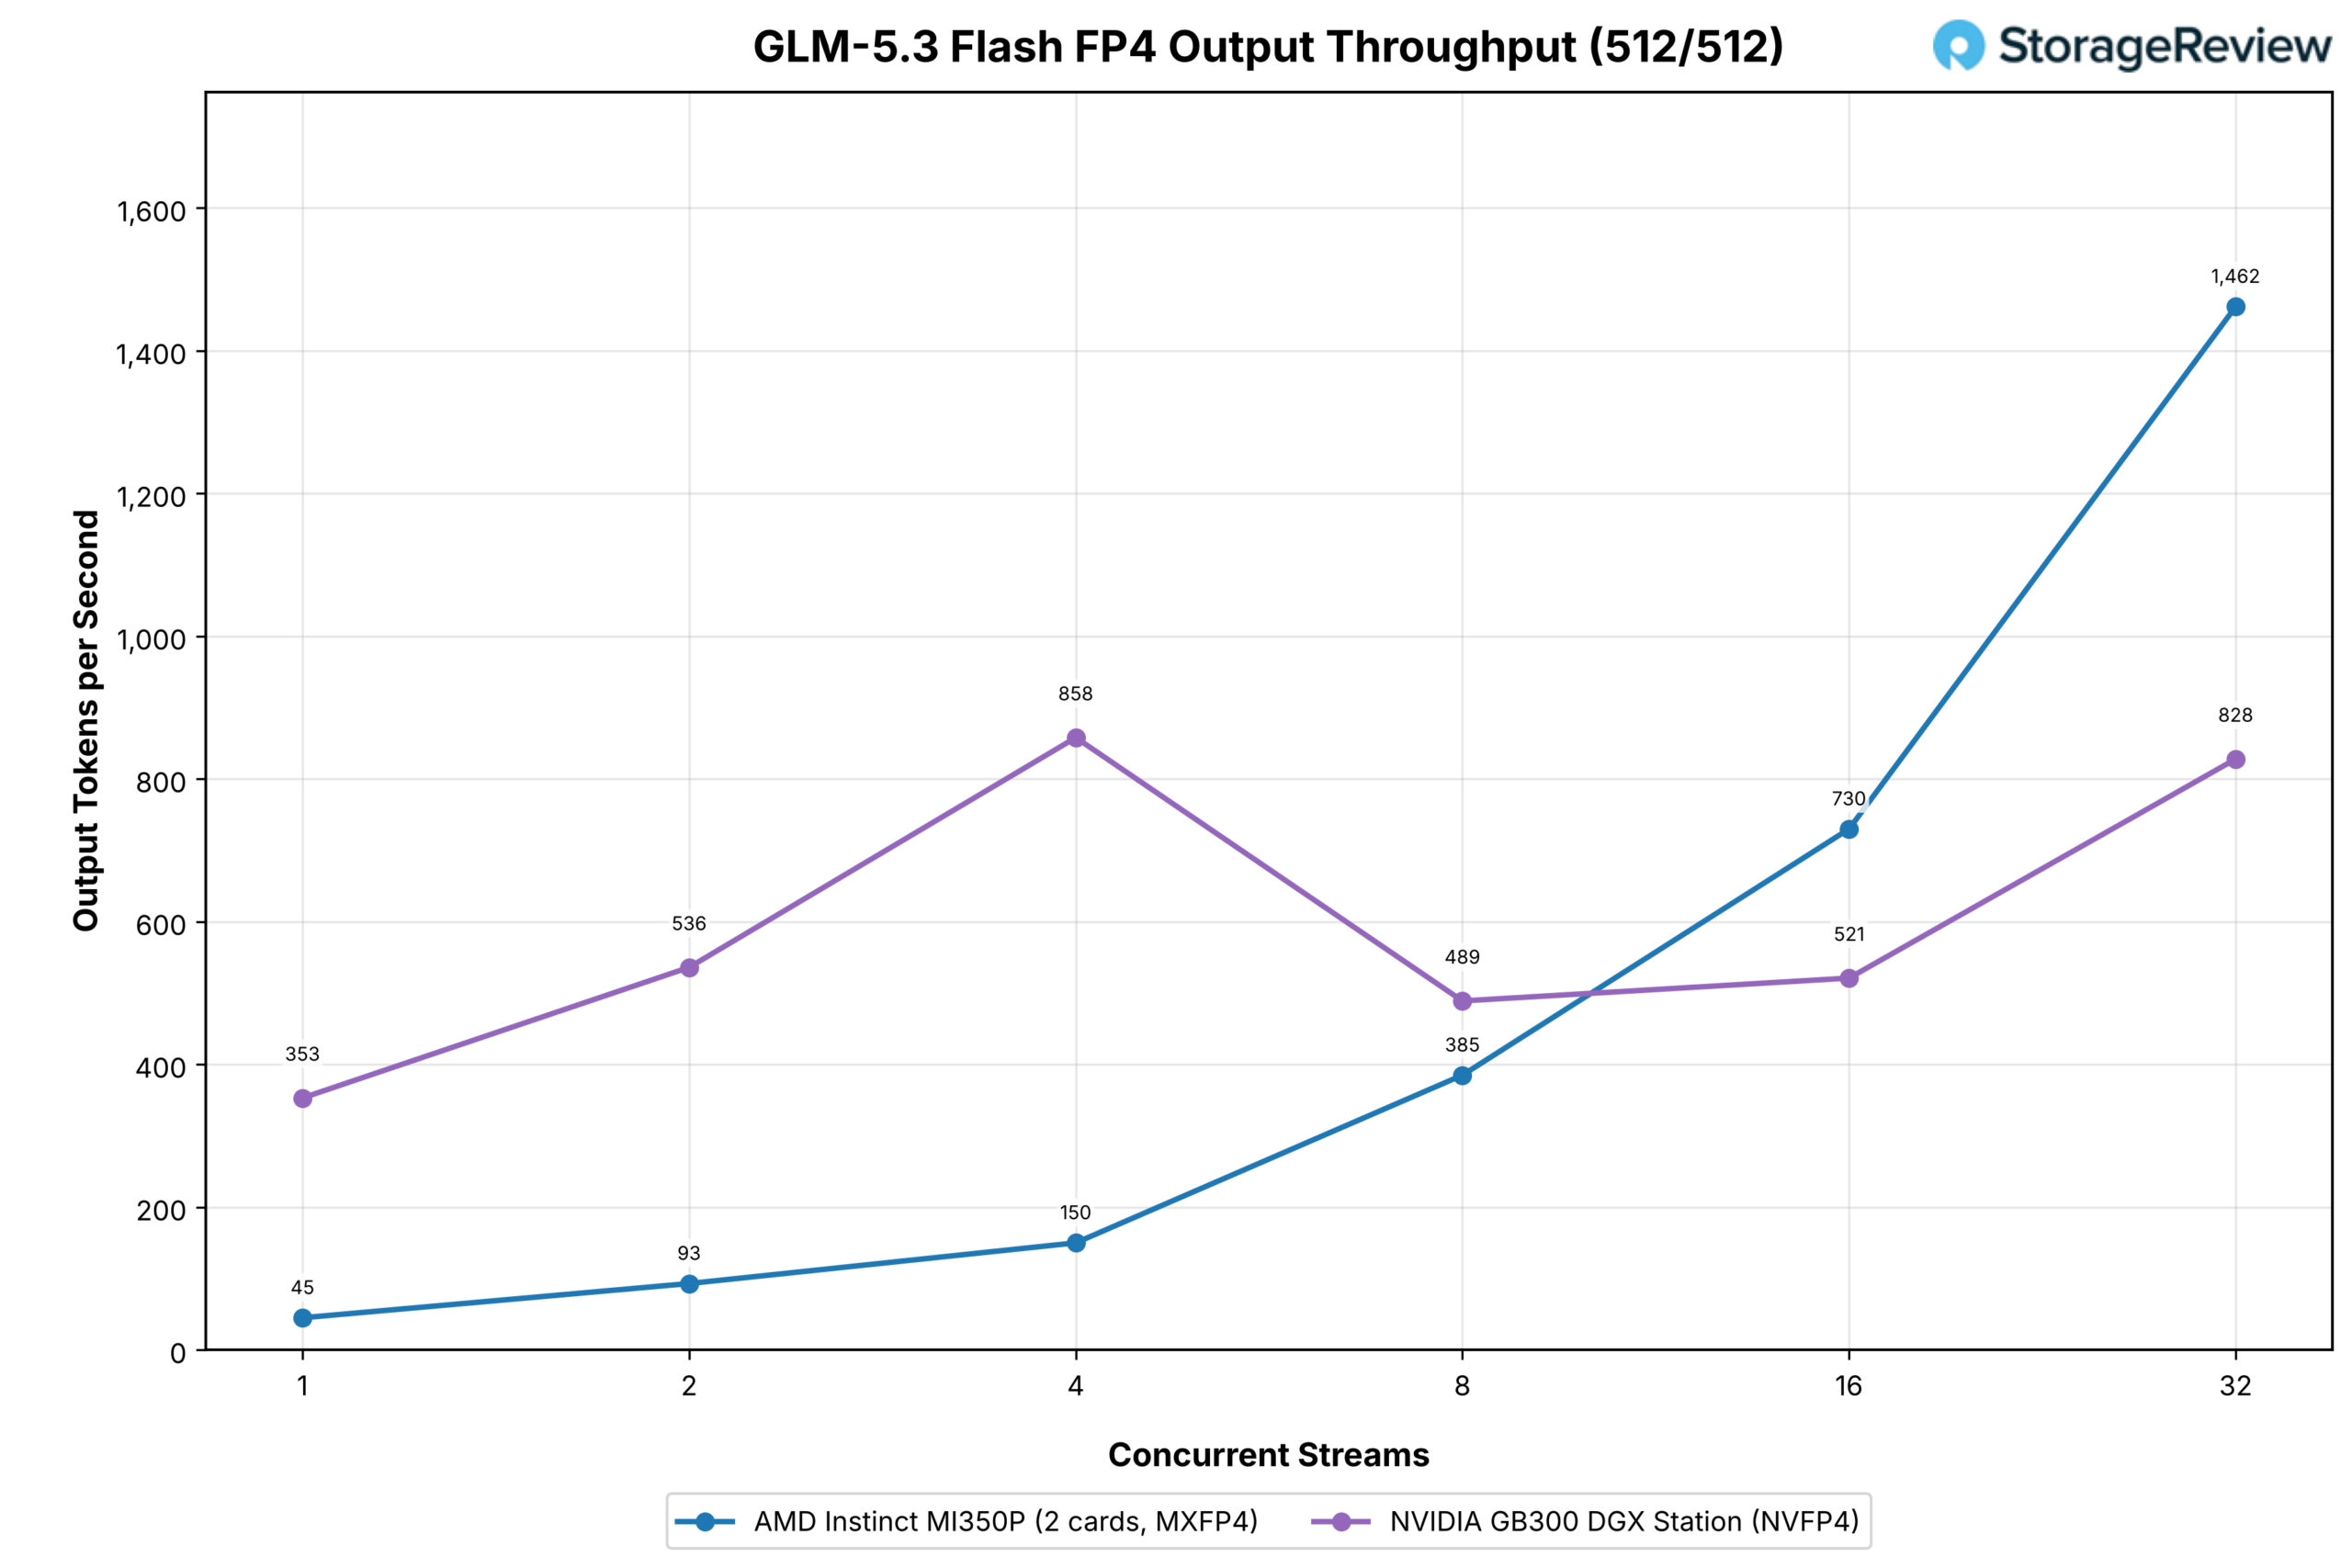
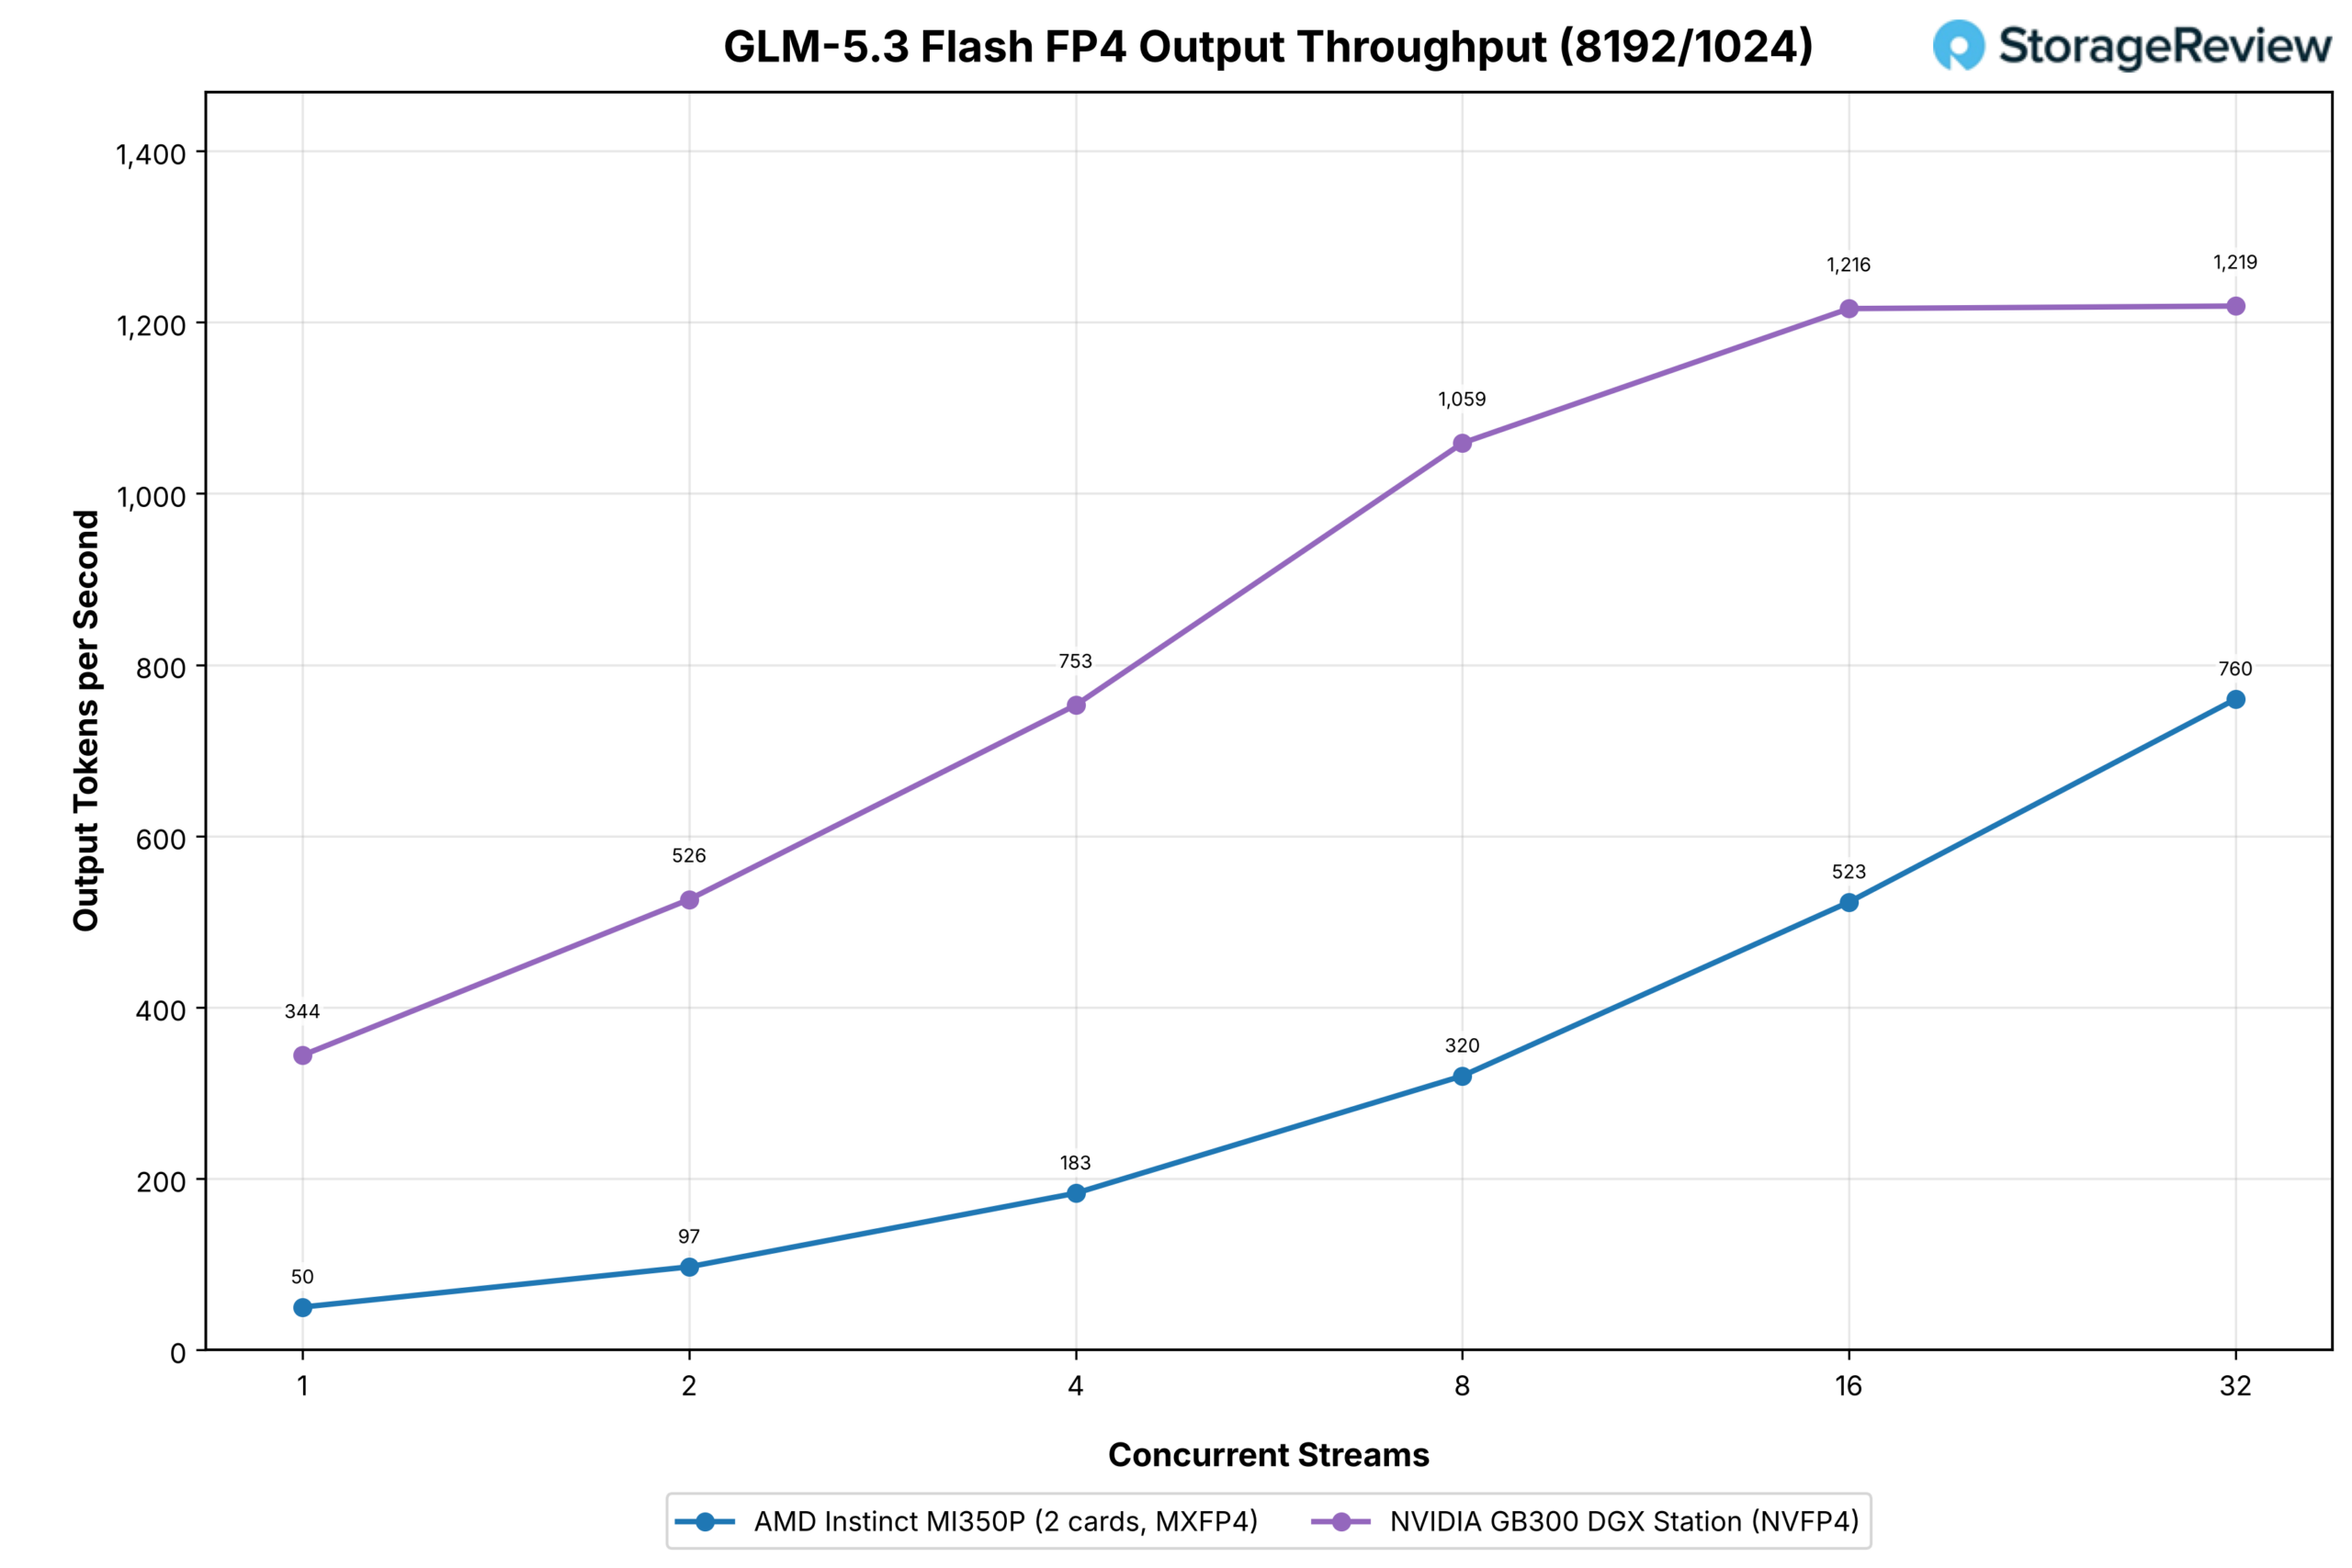
GLM-5.3 Flash は RTX PRO 6000 では実行されなかったため、比較対象は 32 ストリームでの 2 枚の MI350P カードと 1 枚の GB300 Station です。チャットワークロードでは、MI350P ペアは 1 ストリームで毎秒 45 対 353 の出力トークンで遅れをとりますが、8 ストリームで Station を上回り、32 ストリームでは 1,462、Station は 828 になります。プリフィルが多用されるワークロードでは、Station が常にリードし、32 ストリームで 760 対 1,219 となります。これは、ペアのプリフィルが 2 枚のカード間で PCIe を横断する必要があるのに対し、B300 は 1 つの HBM ですべてを実行するためです。
GLM-5.2
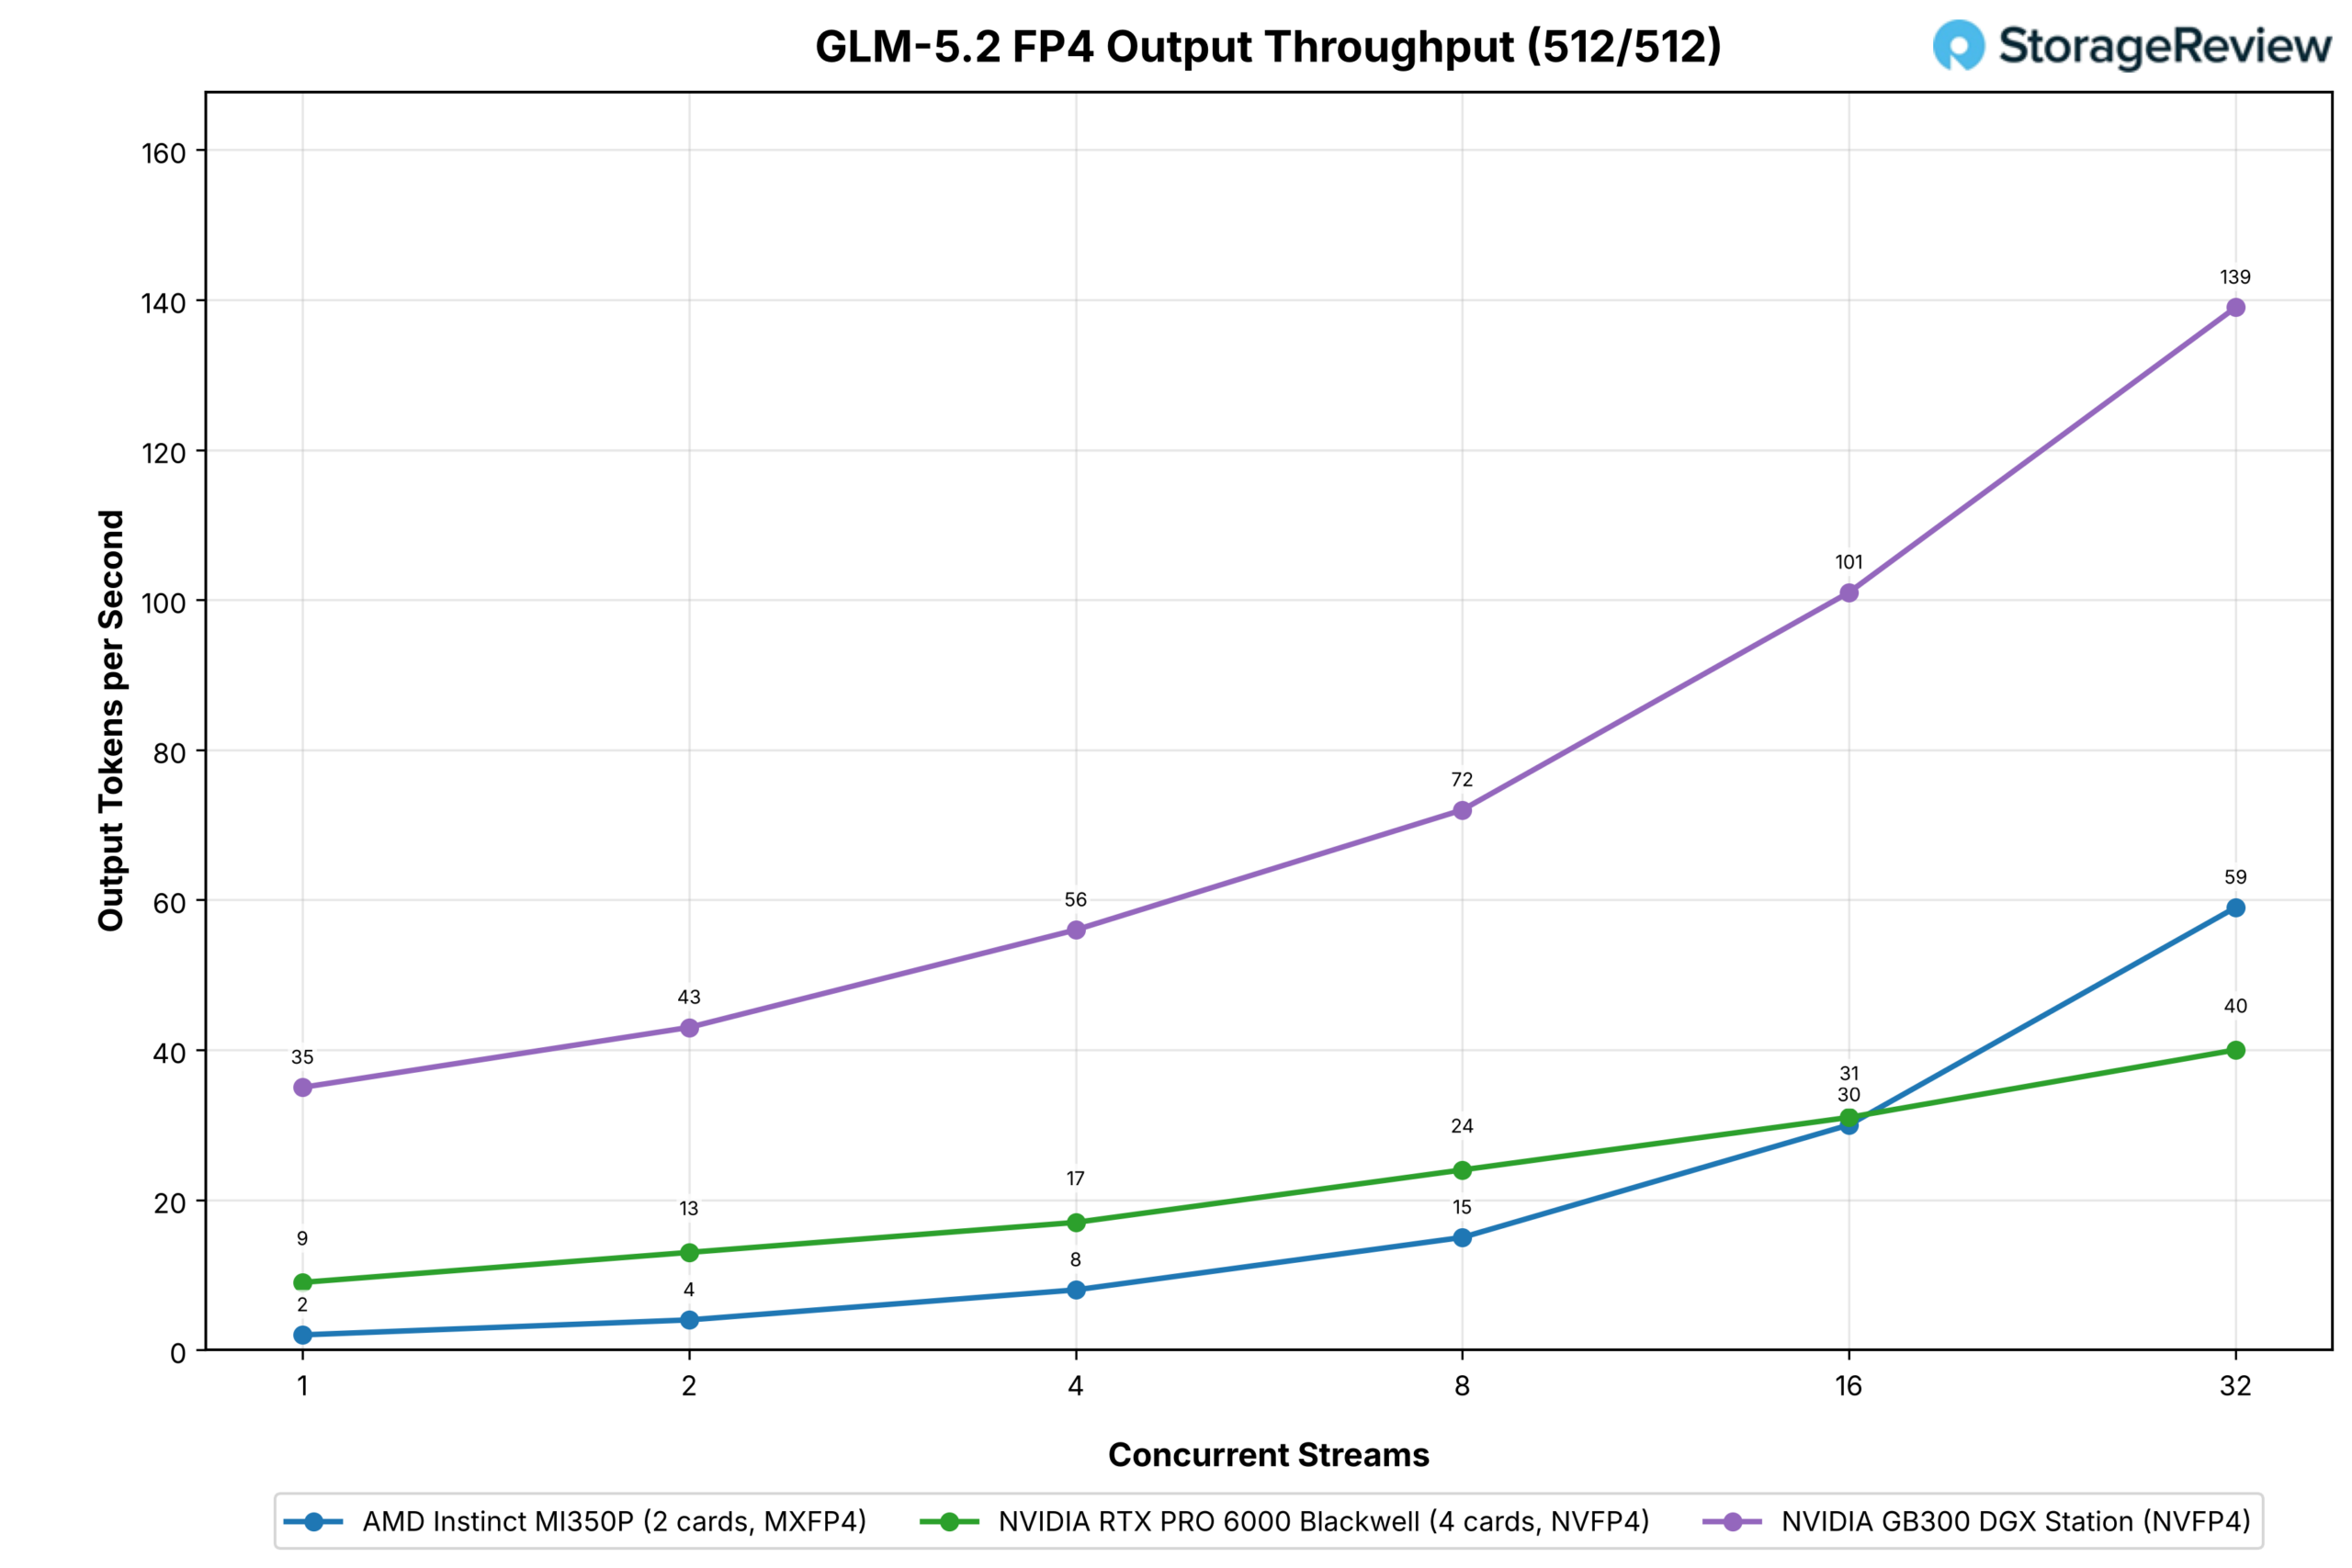
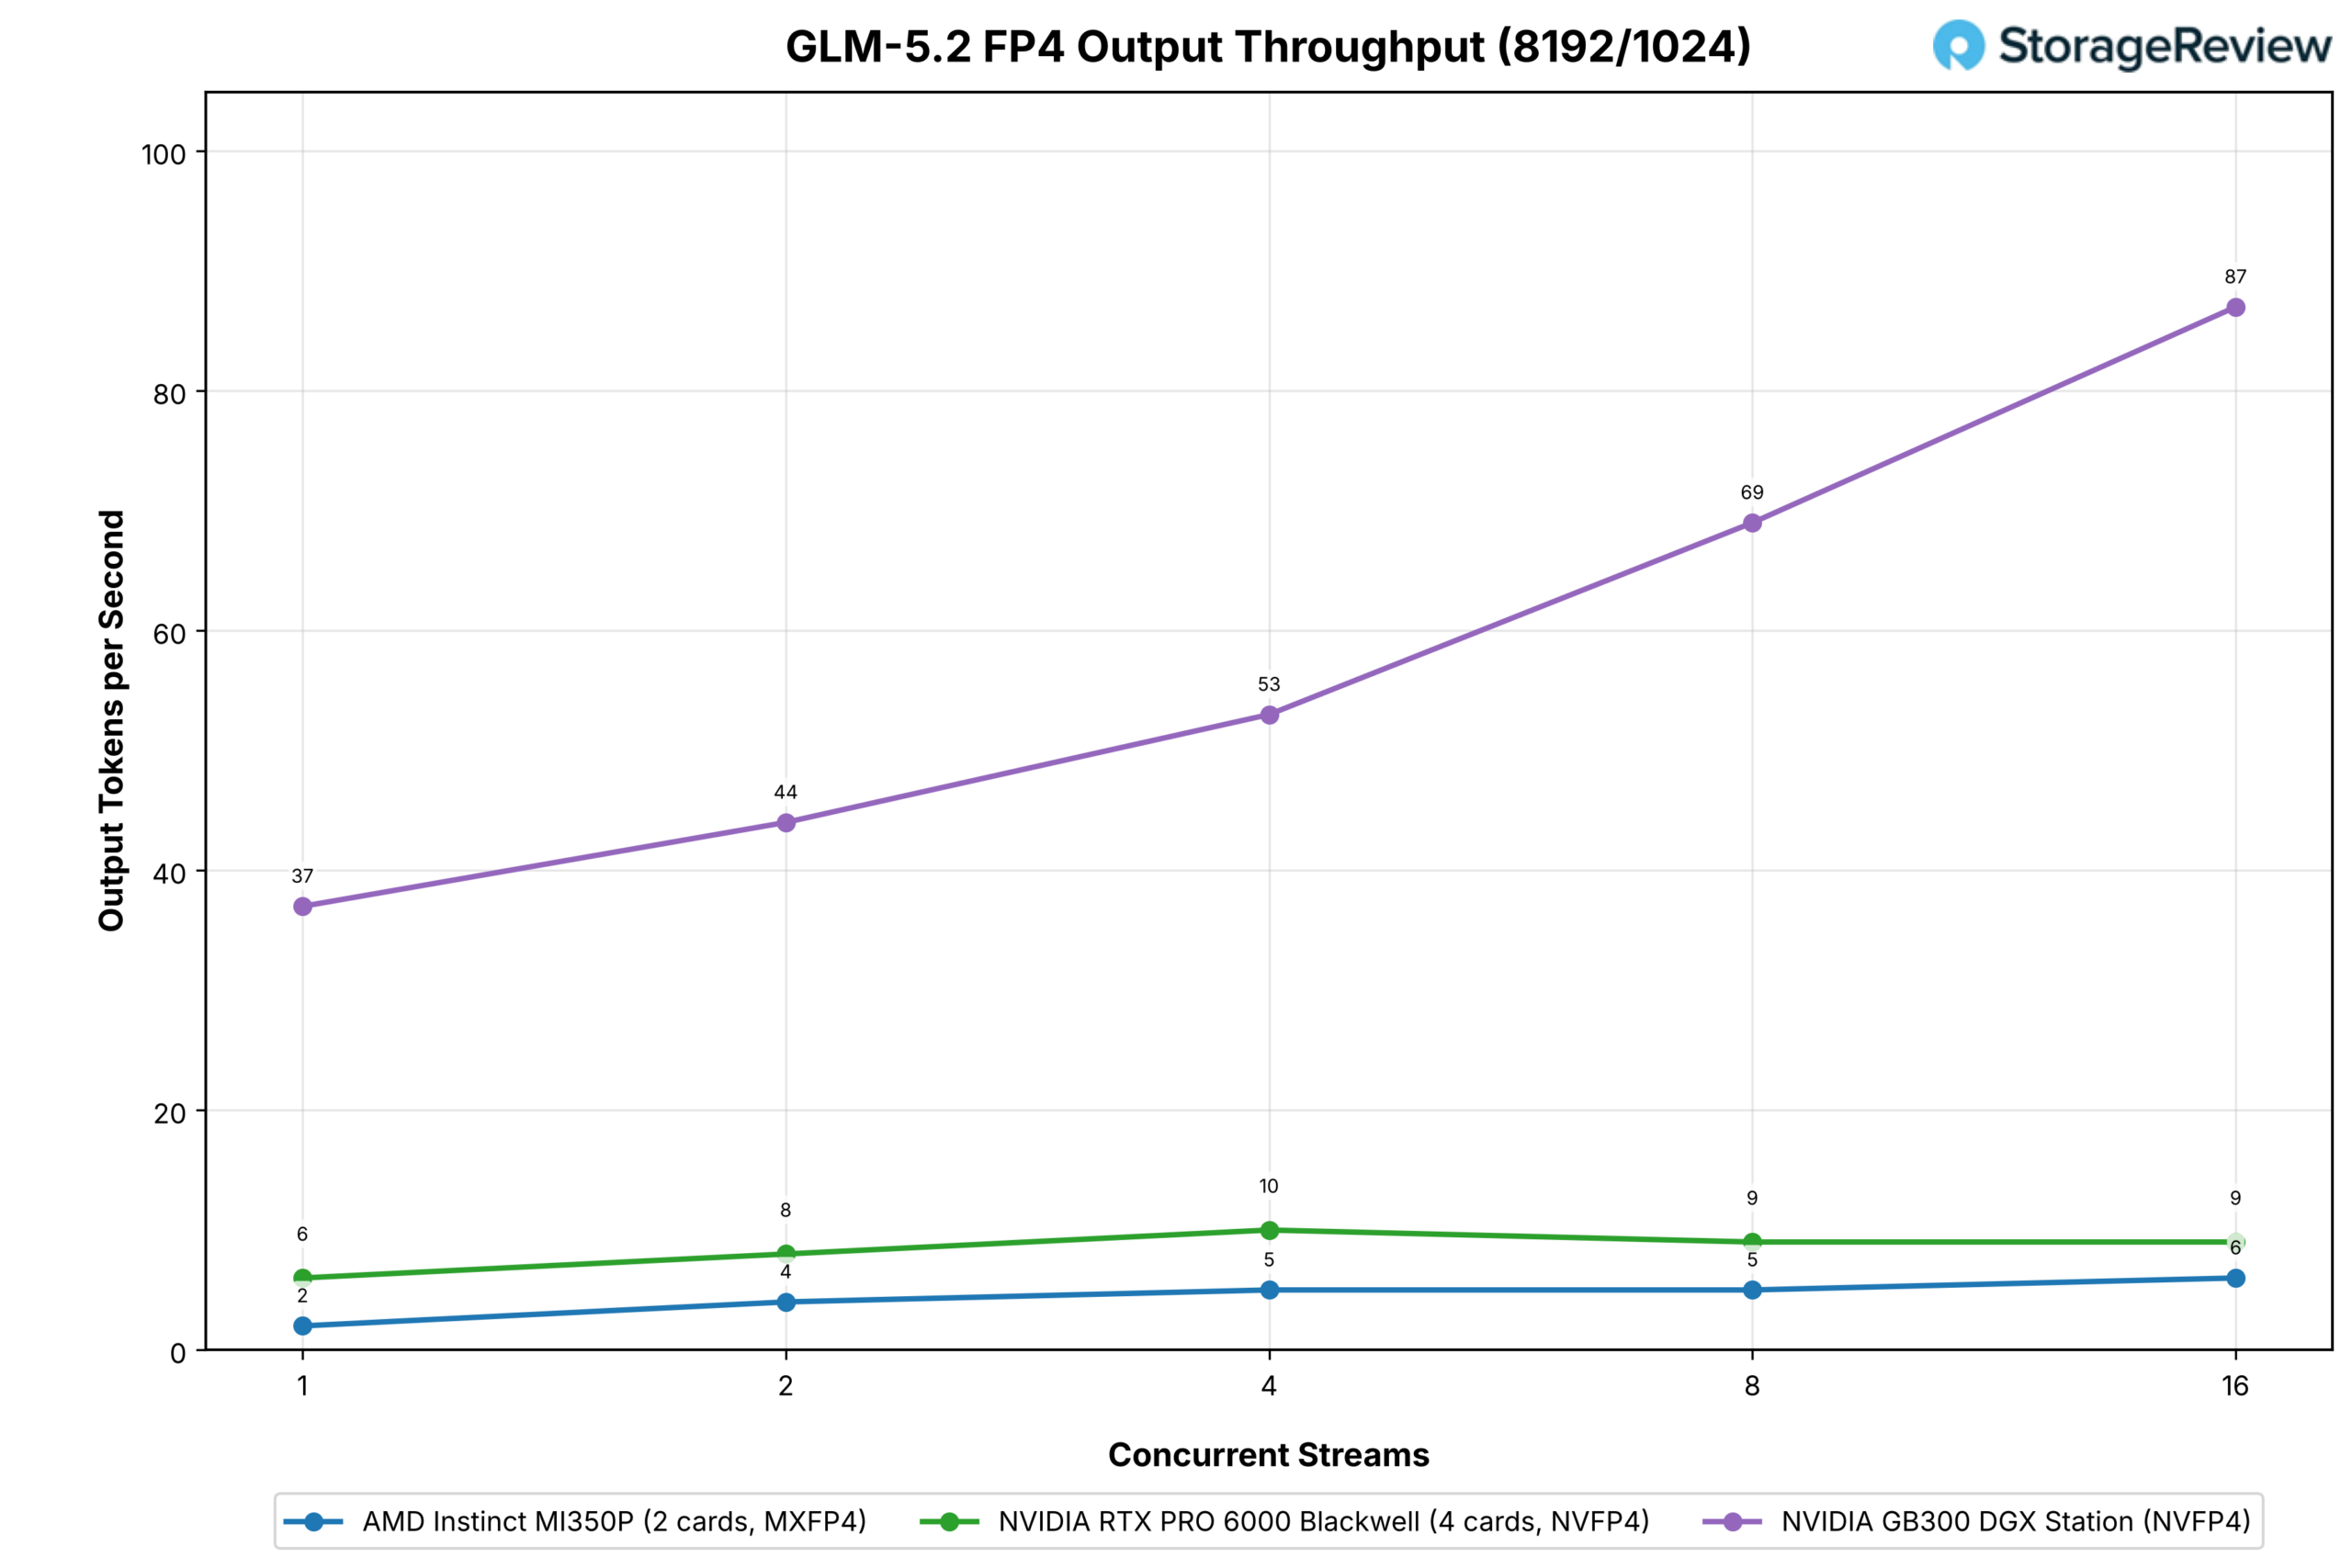
GLM-5.2 はこのセットのメモリの話です。MXFP4 チェックポイントは 2 枚の MI350P カードの 288GB を超えてホスト メモリに漏れるため、シングル ストリーム スループットは、ペアでは毎秒 2 出力トークンですが、384GB の GDDR7 を内蔵した NVFP4 を搭載した 4 枚の RTX PRO 6000 カードでは 9、約 215GB のエキスパート ウェイトを Grace メモリにオフロードする Station では 35 になります。チャット ワークロードでは、RTX クアッドが 16 ストリームでリードします。32 では MI350P ペアが 40 に対して 59 に達し、Station は 139 に達します。プリフィルが多いプロンプトでは、どちらの PCIe 構成も 16 ストリームで一桁を超えませんが、Station は 87 に達します。
ミニマックス-M3
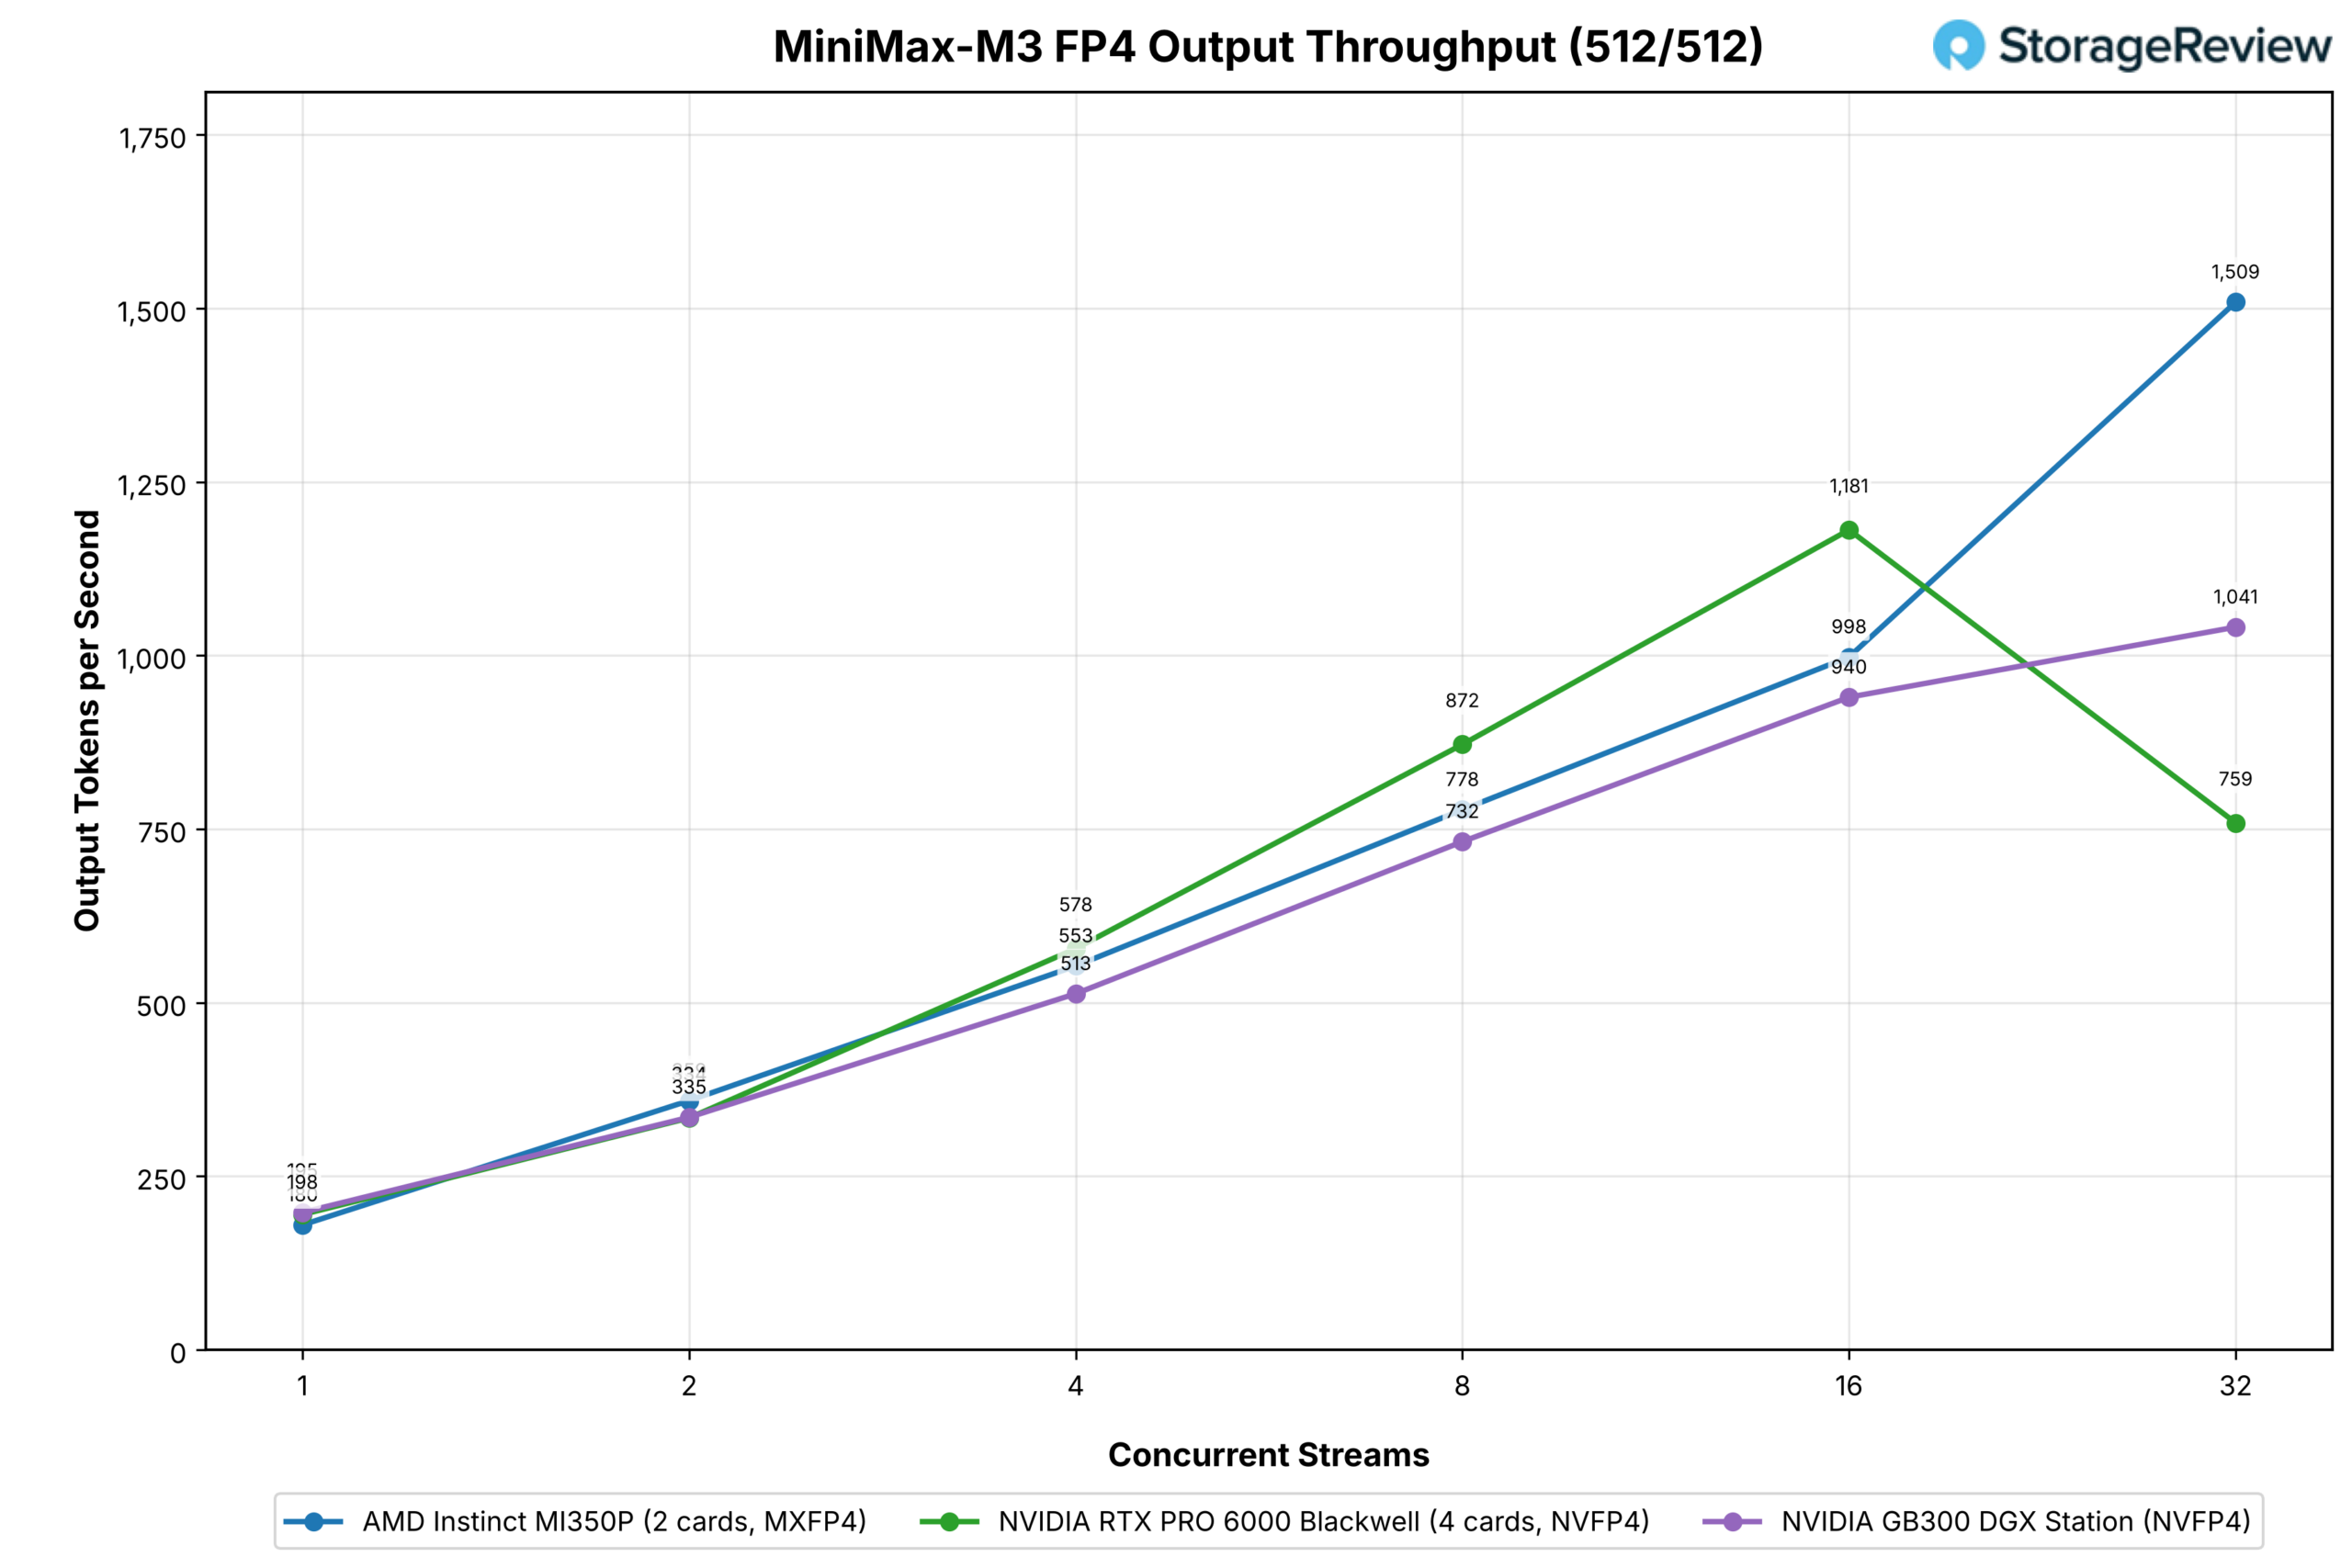
MI350P 2 台で MiniMax-M3 の MXFP4 ビルドを 288GB に格納し、NVIDIA 側には RTX PRO 6000 カード 4 枚が必要です。3 つの構成は、チャットワークロードで 8 つのストリームを通して互いに 10 パーセント以内の差で動作します。RTX クアッドは 16 でリードし (1,181 対 2 台で 998、Station で 940)、MI350P 2 台では 1,509 対 4 台で 759、Station で 1,041 となっています。
事前入力が多いプロンプトでは、MI350P ペアが 8 つのストリームすべてでリードし、4 台の MI350P ペアは 444 に対して 524 を記録しました。一方、このモデルの専門家の一部を Grace メモリに保持している Station は 103 に低下しました。
DeepSeek-V4-Flash
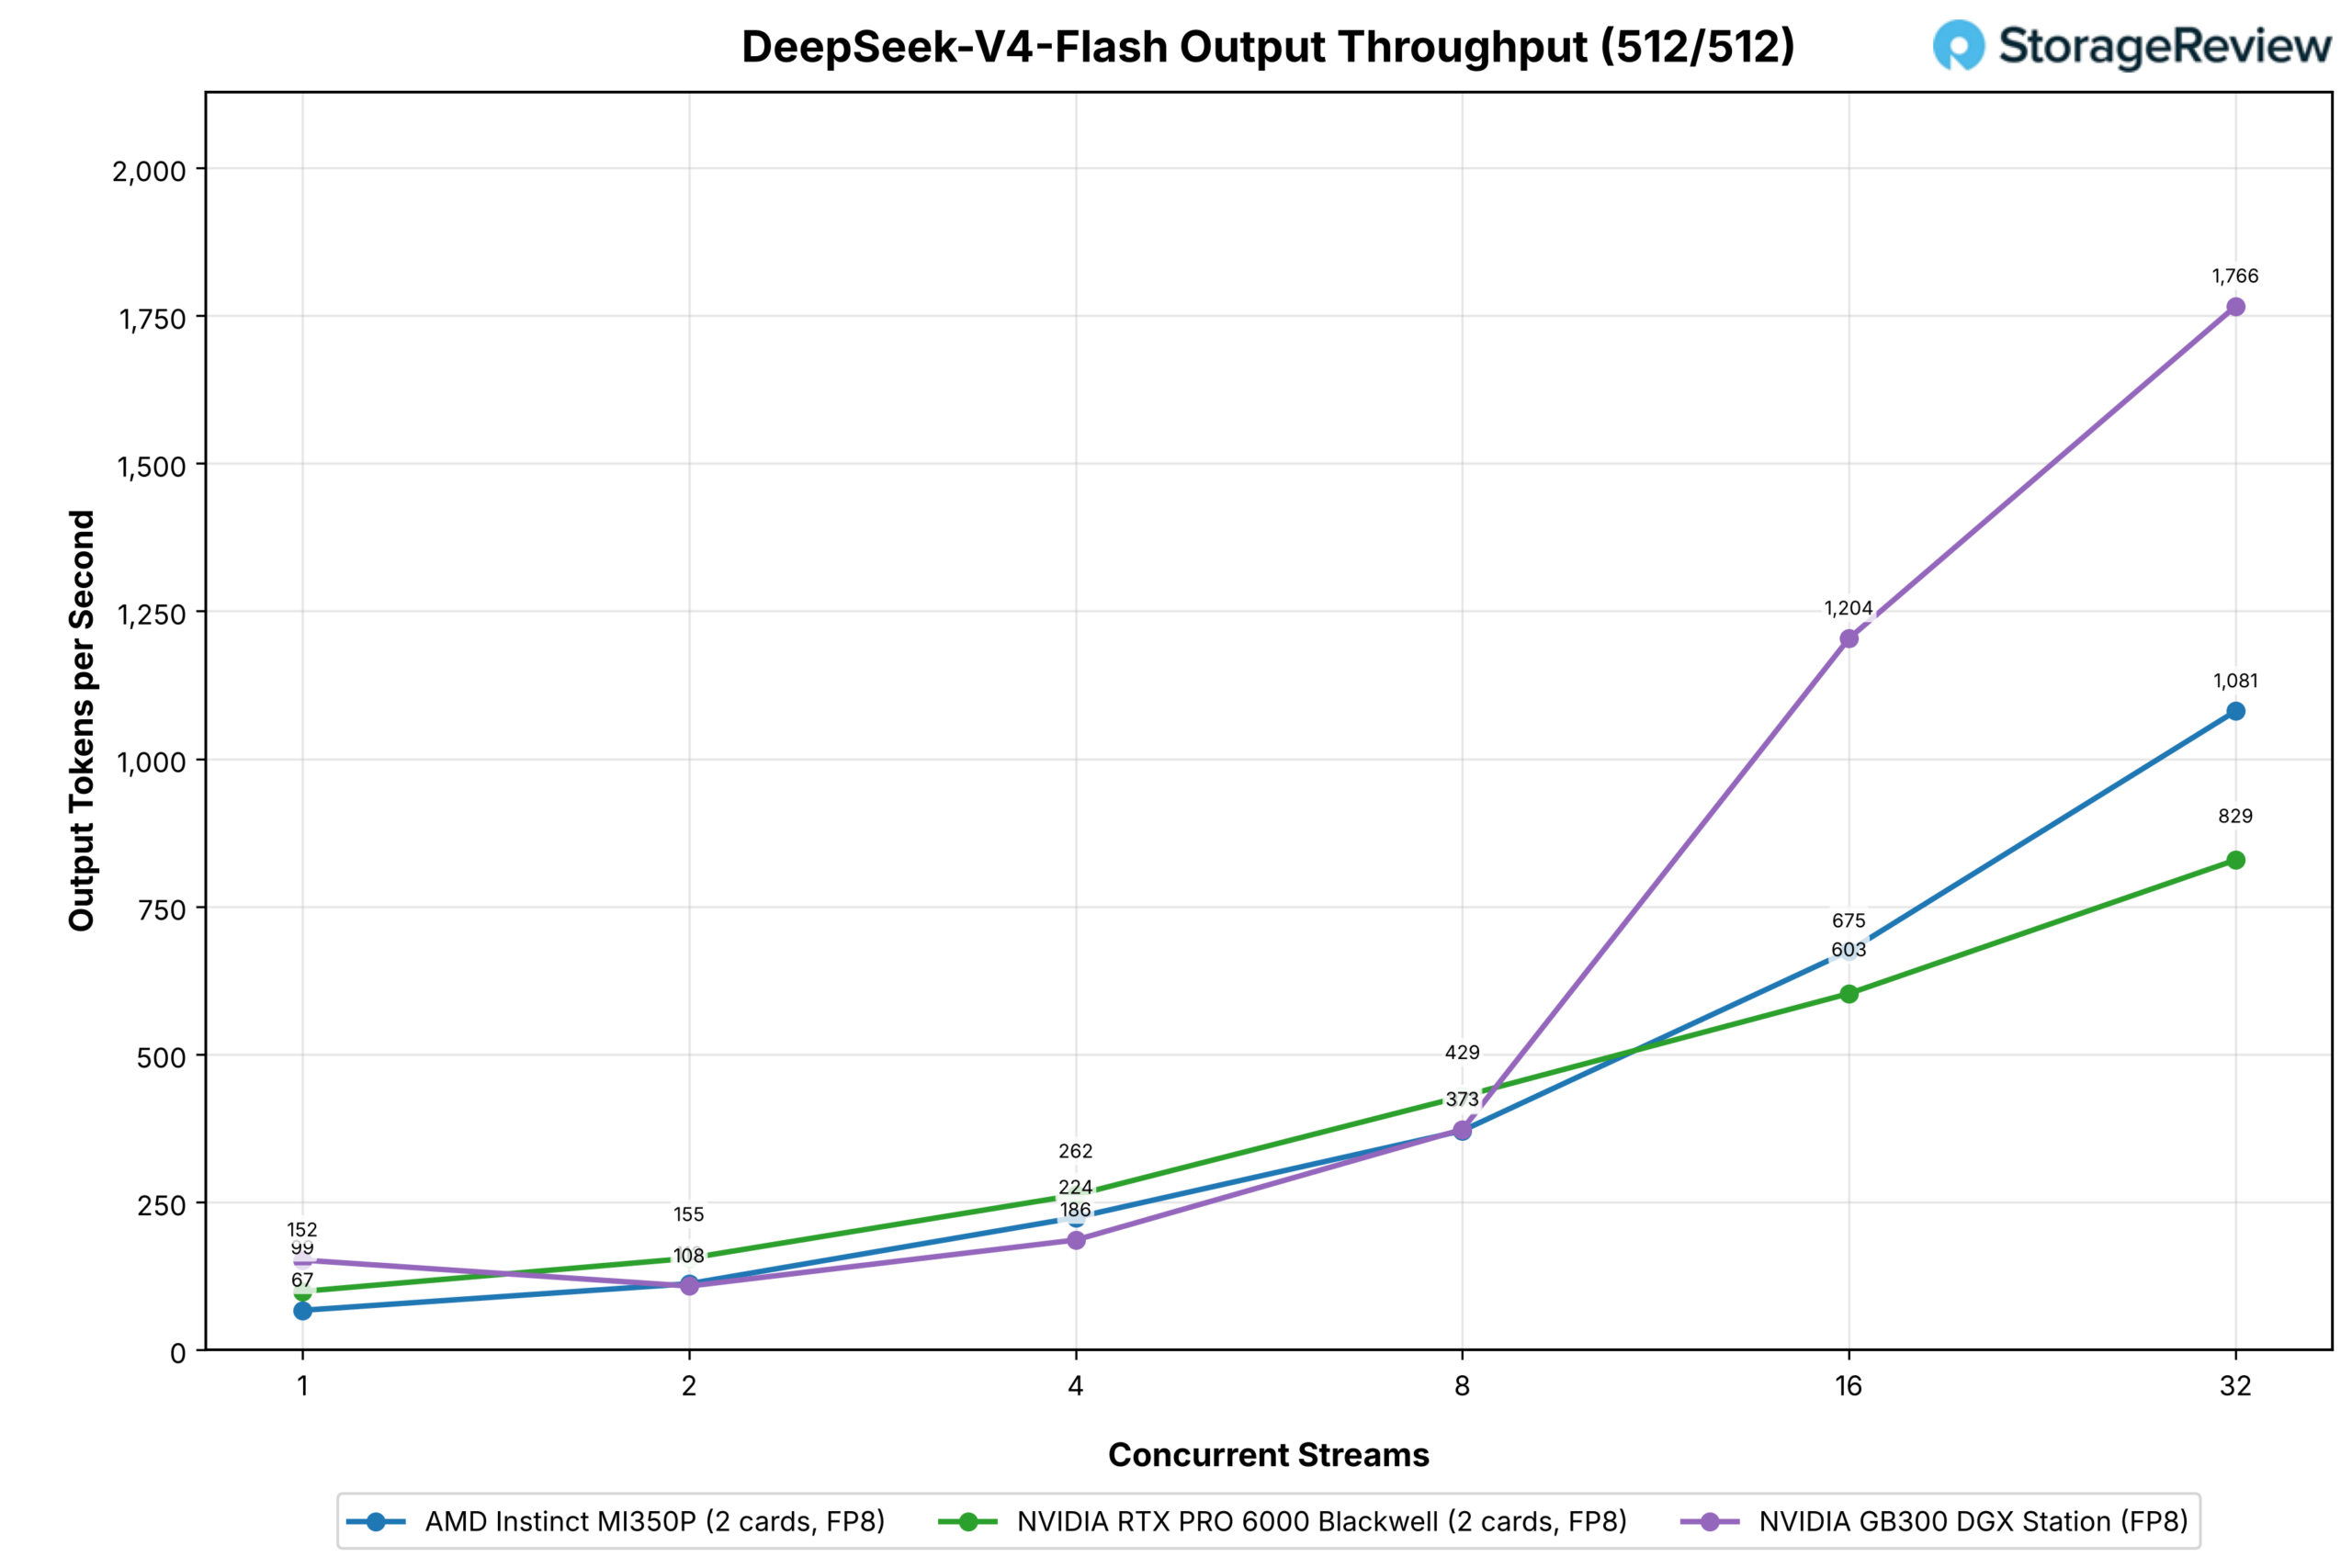
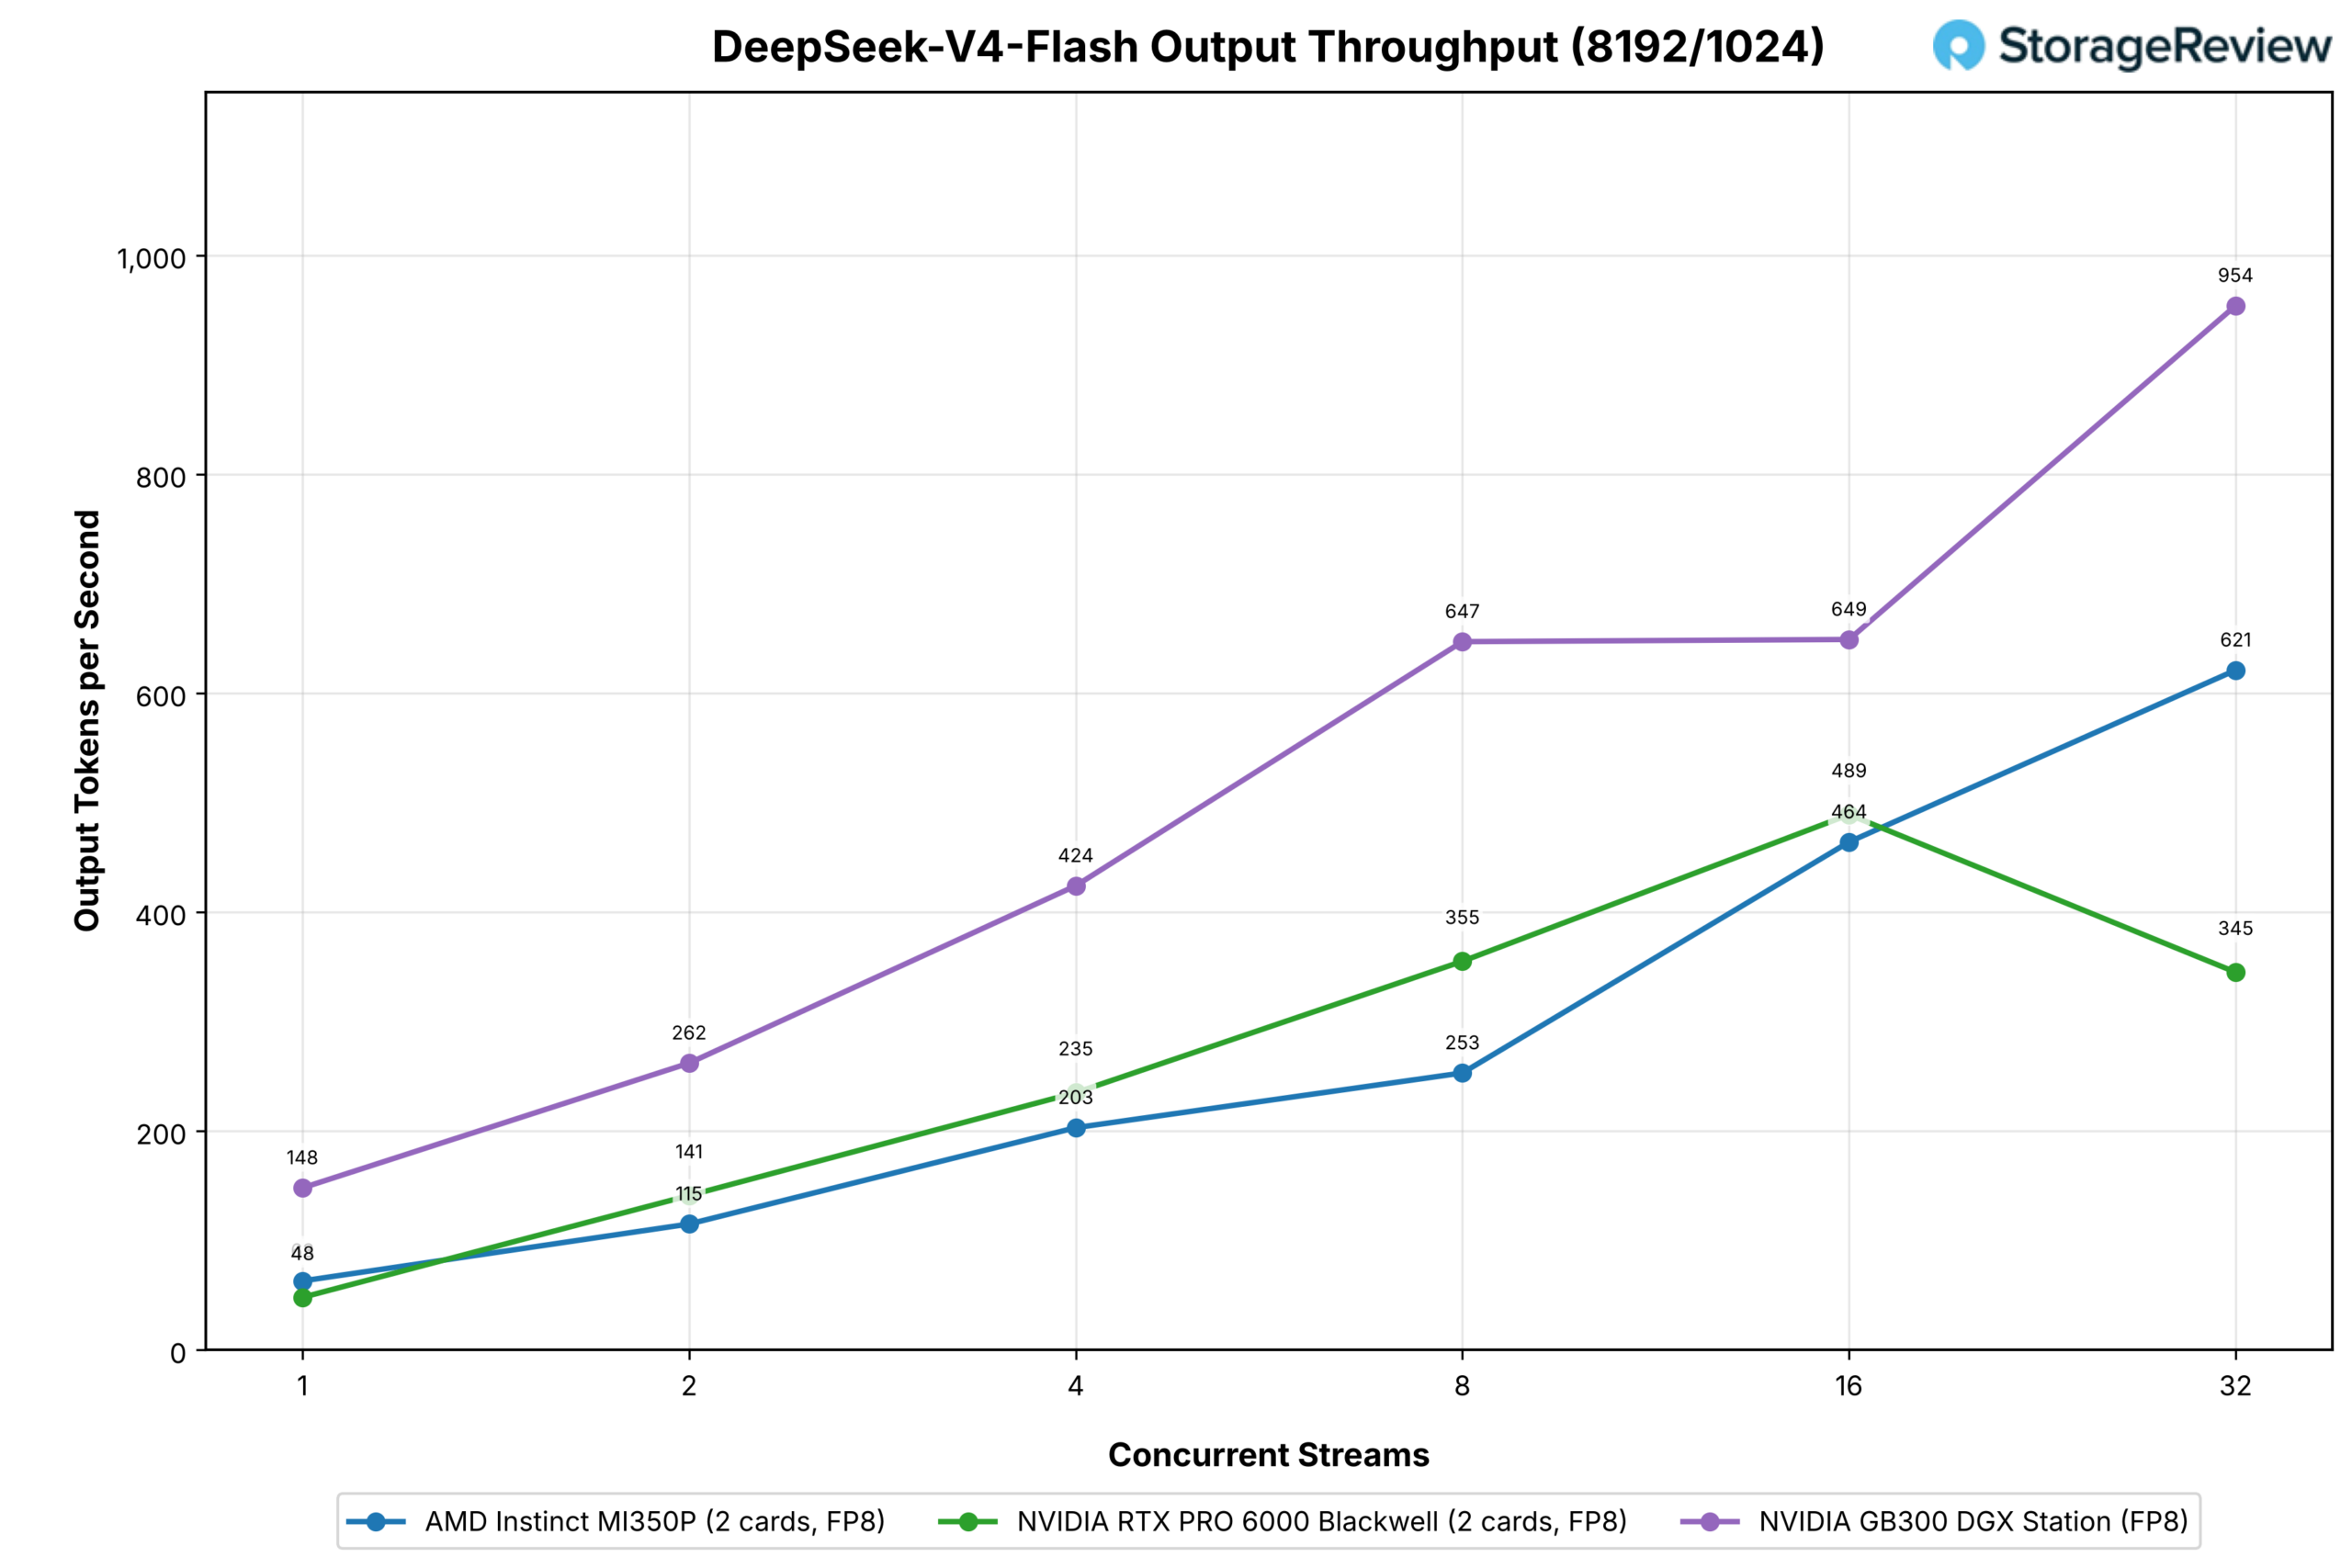
各サイドに 2 枚のカードとネイティブ FP8 チェックポイントを使用すると、RTX PRO 6000 ペアがチャットワークロードで 8 ストリームまでリードし、MI350P ペアが 16 ストリームから引き継ぎ、32 ストリームで 829 に対して 1,081 で終了しました。同じ時点で、単一の Station は 1,766 に達しました。プリフィルが多用された実行も同様の傾向を示し、32 ストリームで MI350P ペアが 345 に対して 321 、Station が 954 でした。
ミニマックス-M2.7
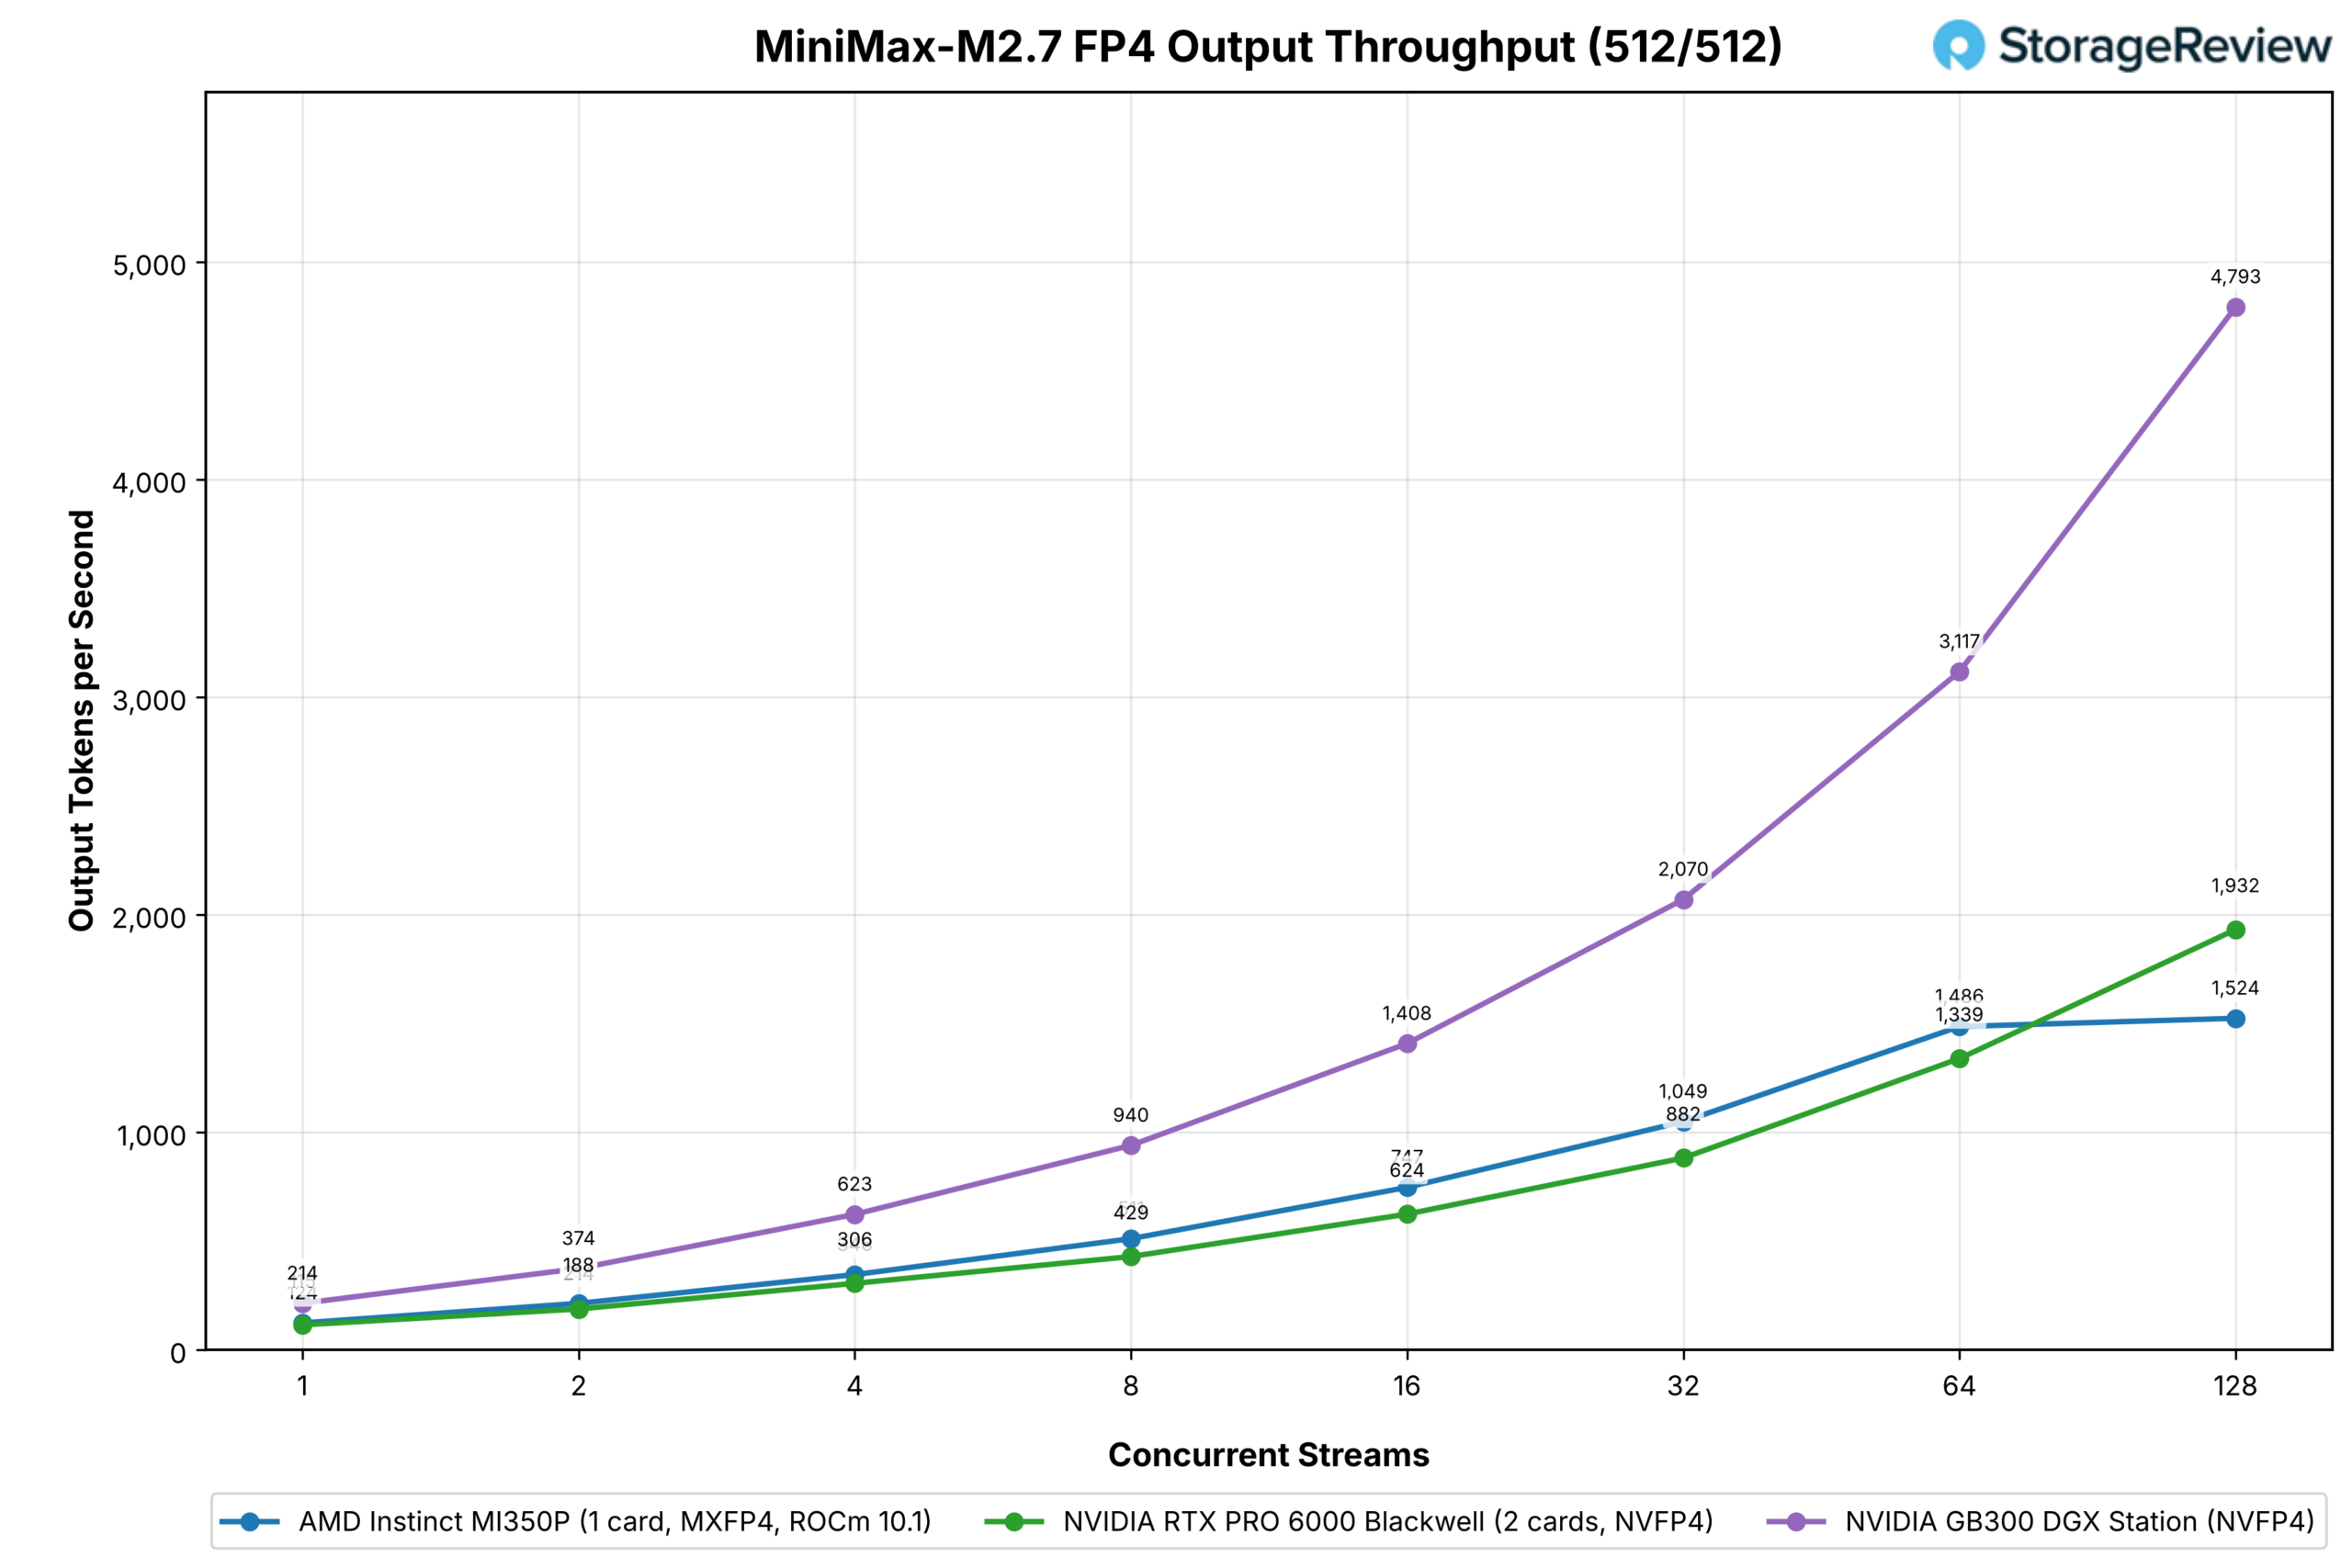
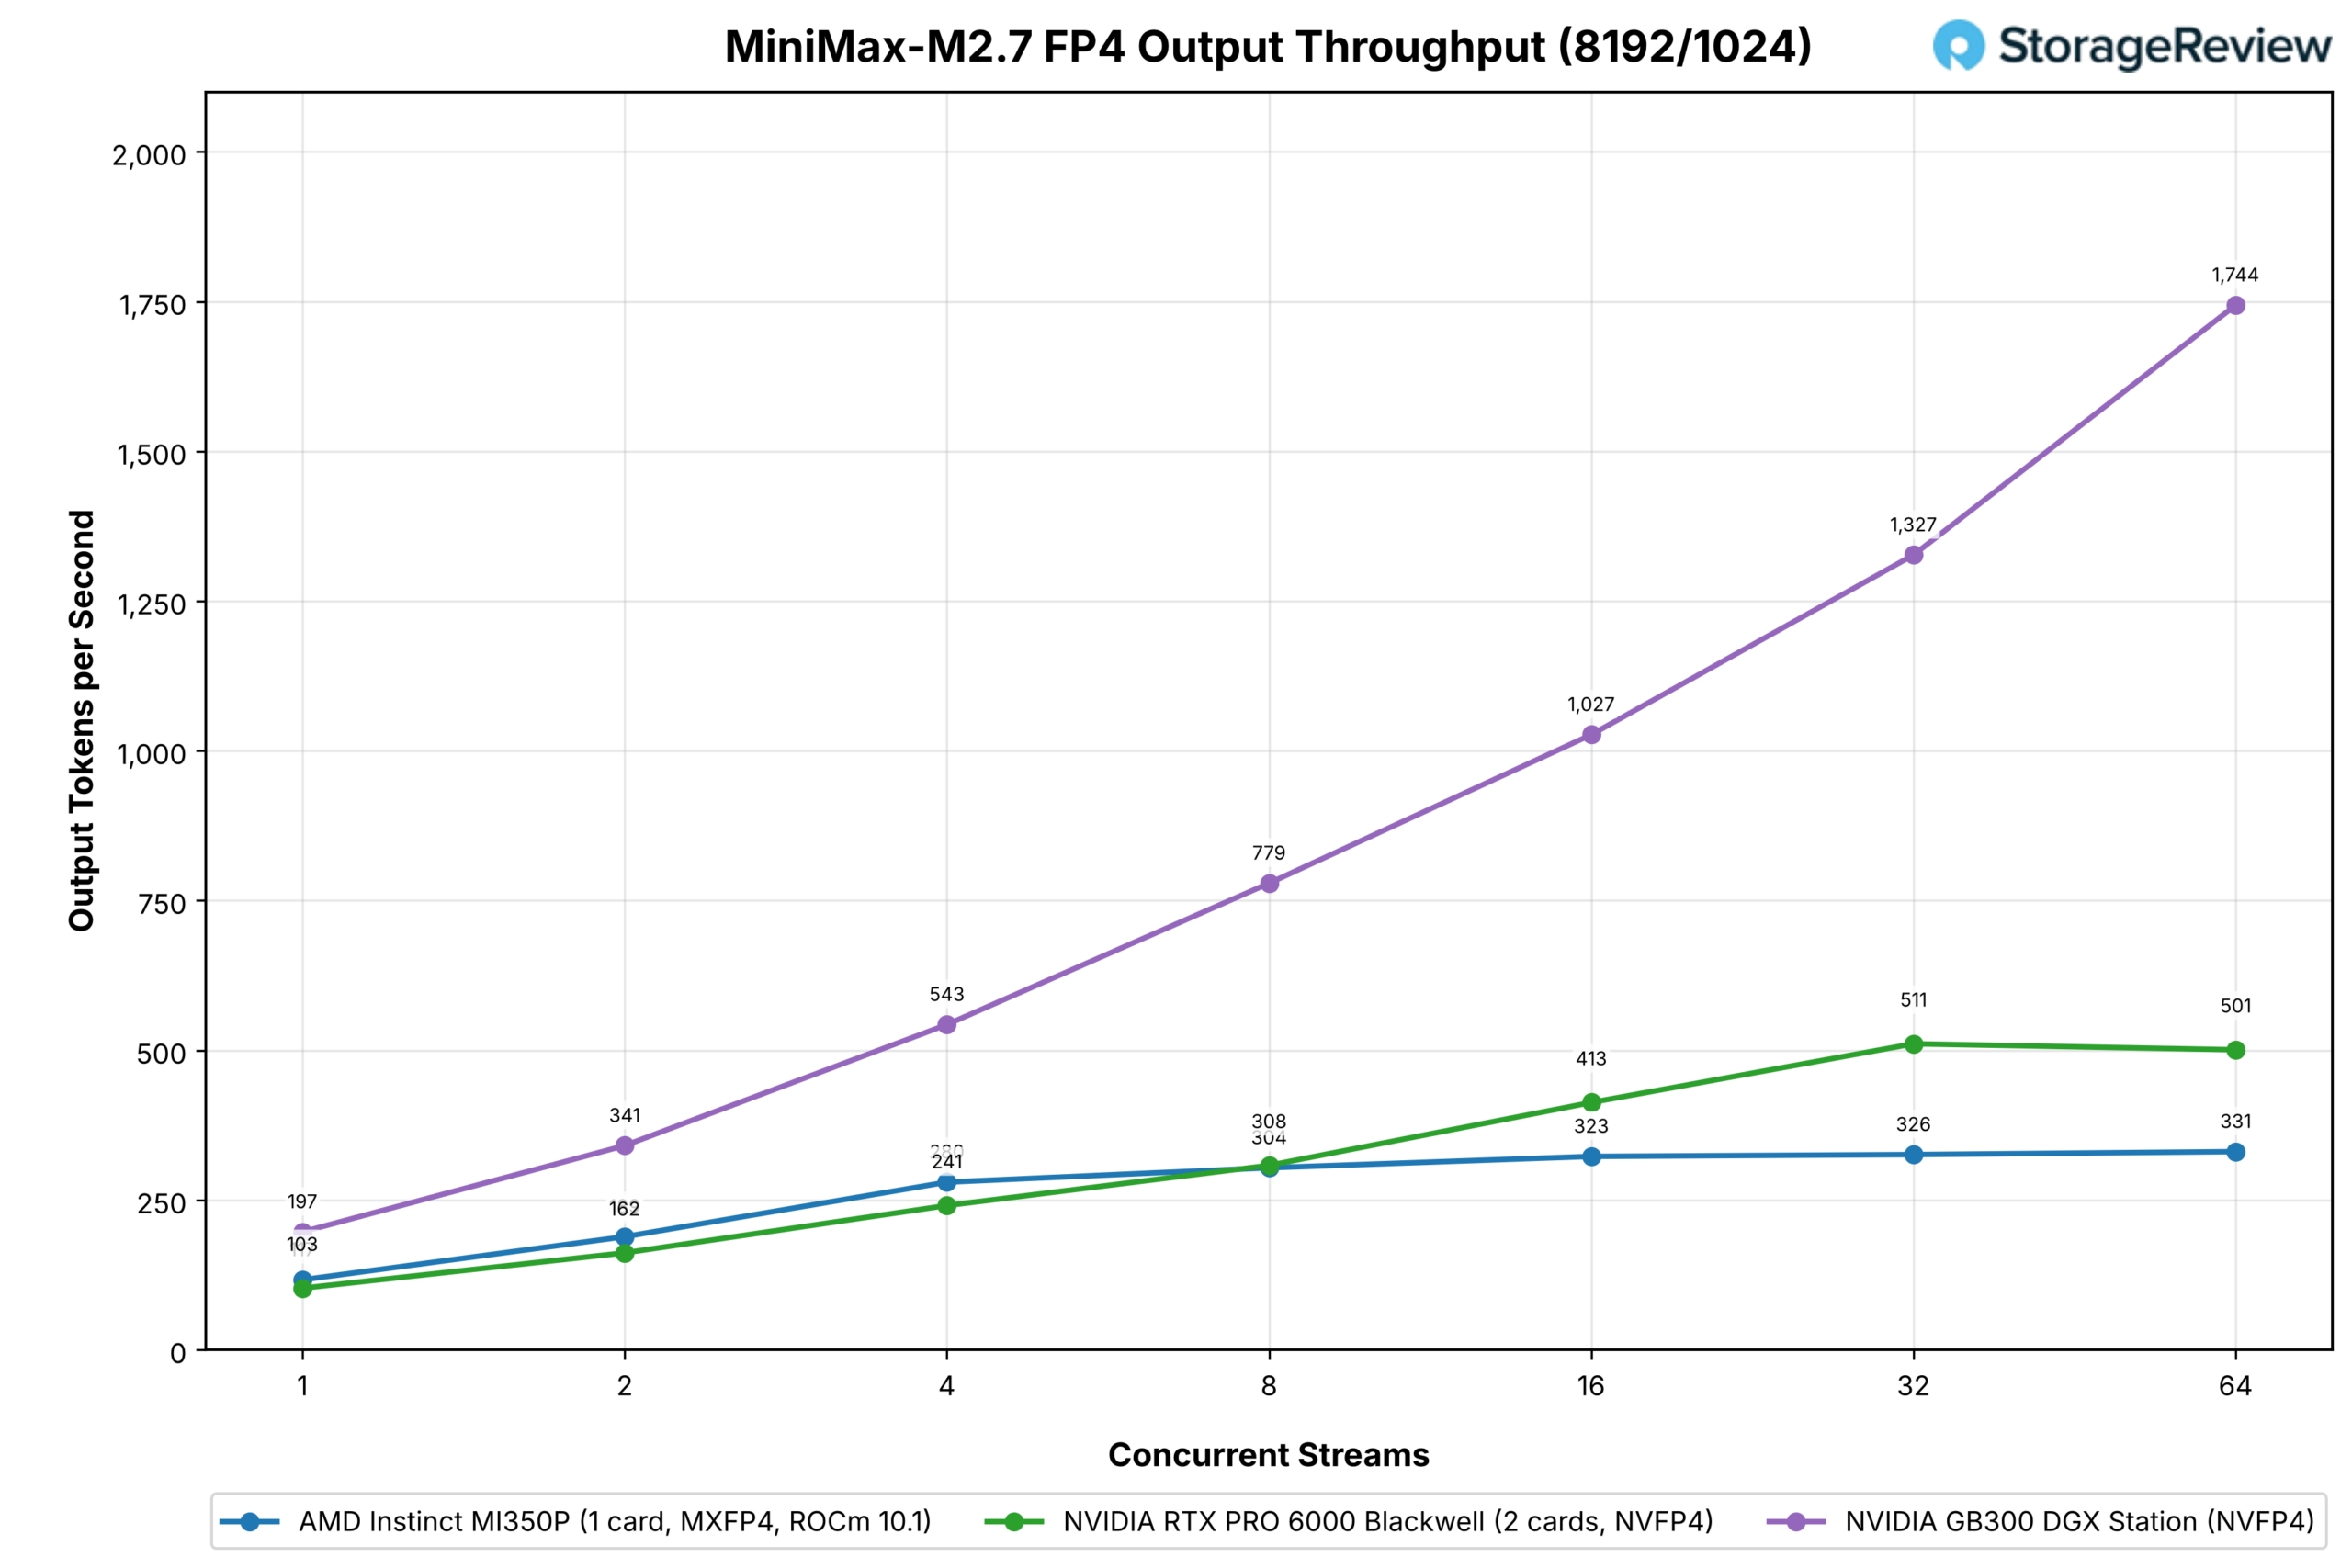
MI350P 1 枚で MiniMax-M2.7 の MXFP4 ビルドを実行し、NVFP4 で動作する RTX PRO 6000 カード 2 枚と比較しました。MI350P 1 枚は、1 つのストリームでリードし (124 対 115)、64 ストリームで 1,486 対 1,339 と 8 ~ 20 パーセントのリードを維持した後、128 ストリームで 1,524、256 ストリームで 1,557 で横ばいになります。一方、RTX ペアは 1,932 と 2,842 まで実行を続け、Station は 4,793 に達しました。
事前充填負荷の高いワークロードでは、MI350Pは8ストリームから64ストリームで毎秒304~331個の出力トークンを維持するのに対し、RTXペアは毎秒501個、Stationは毎秒1,744個となる。
GPT-OSS-120B
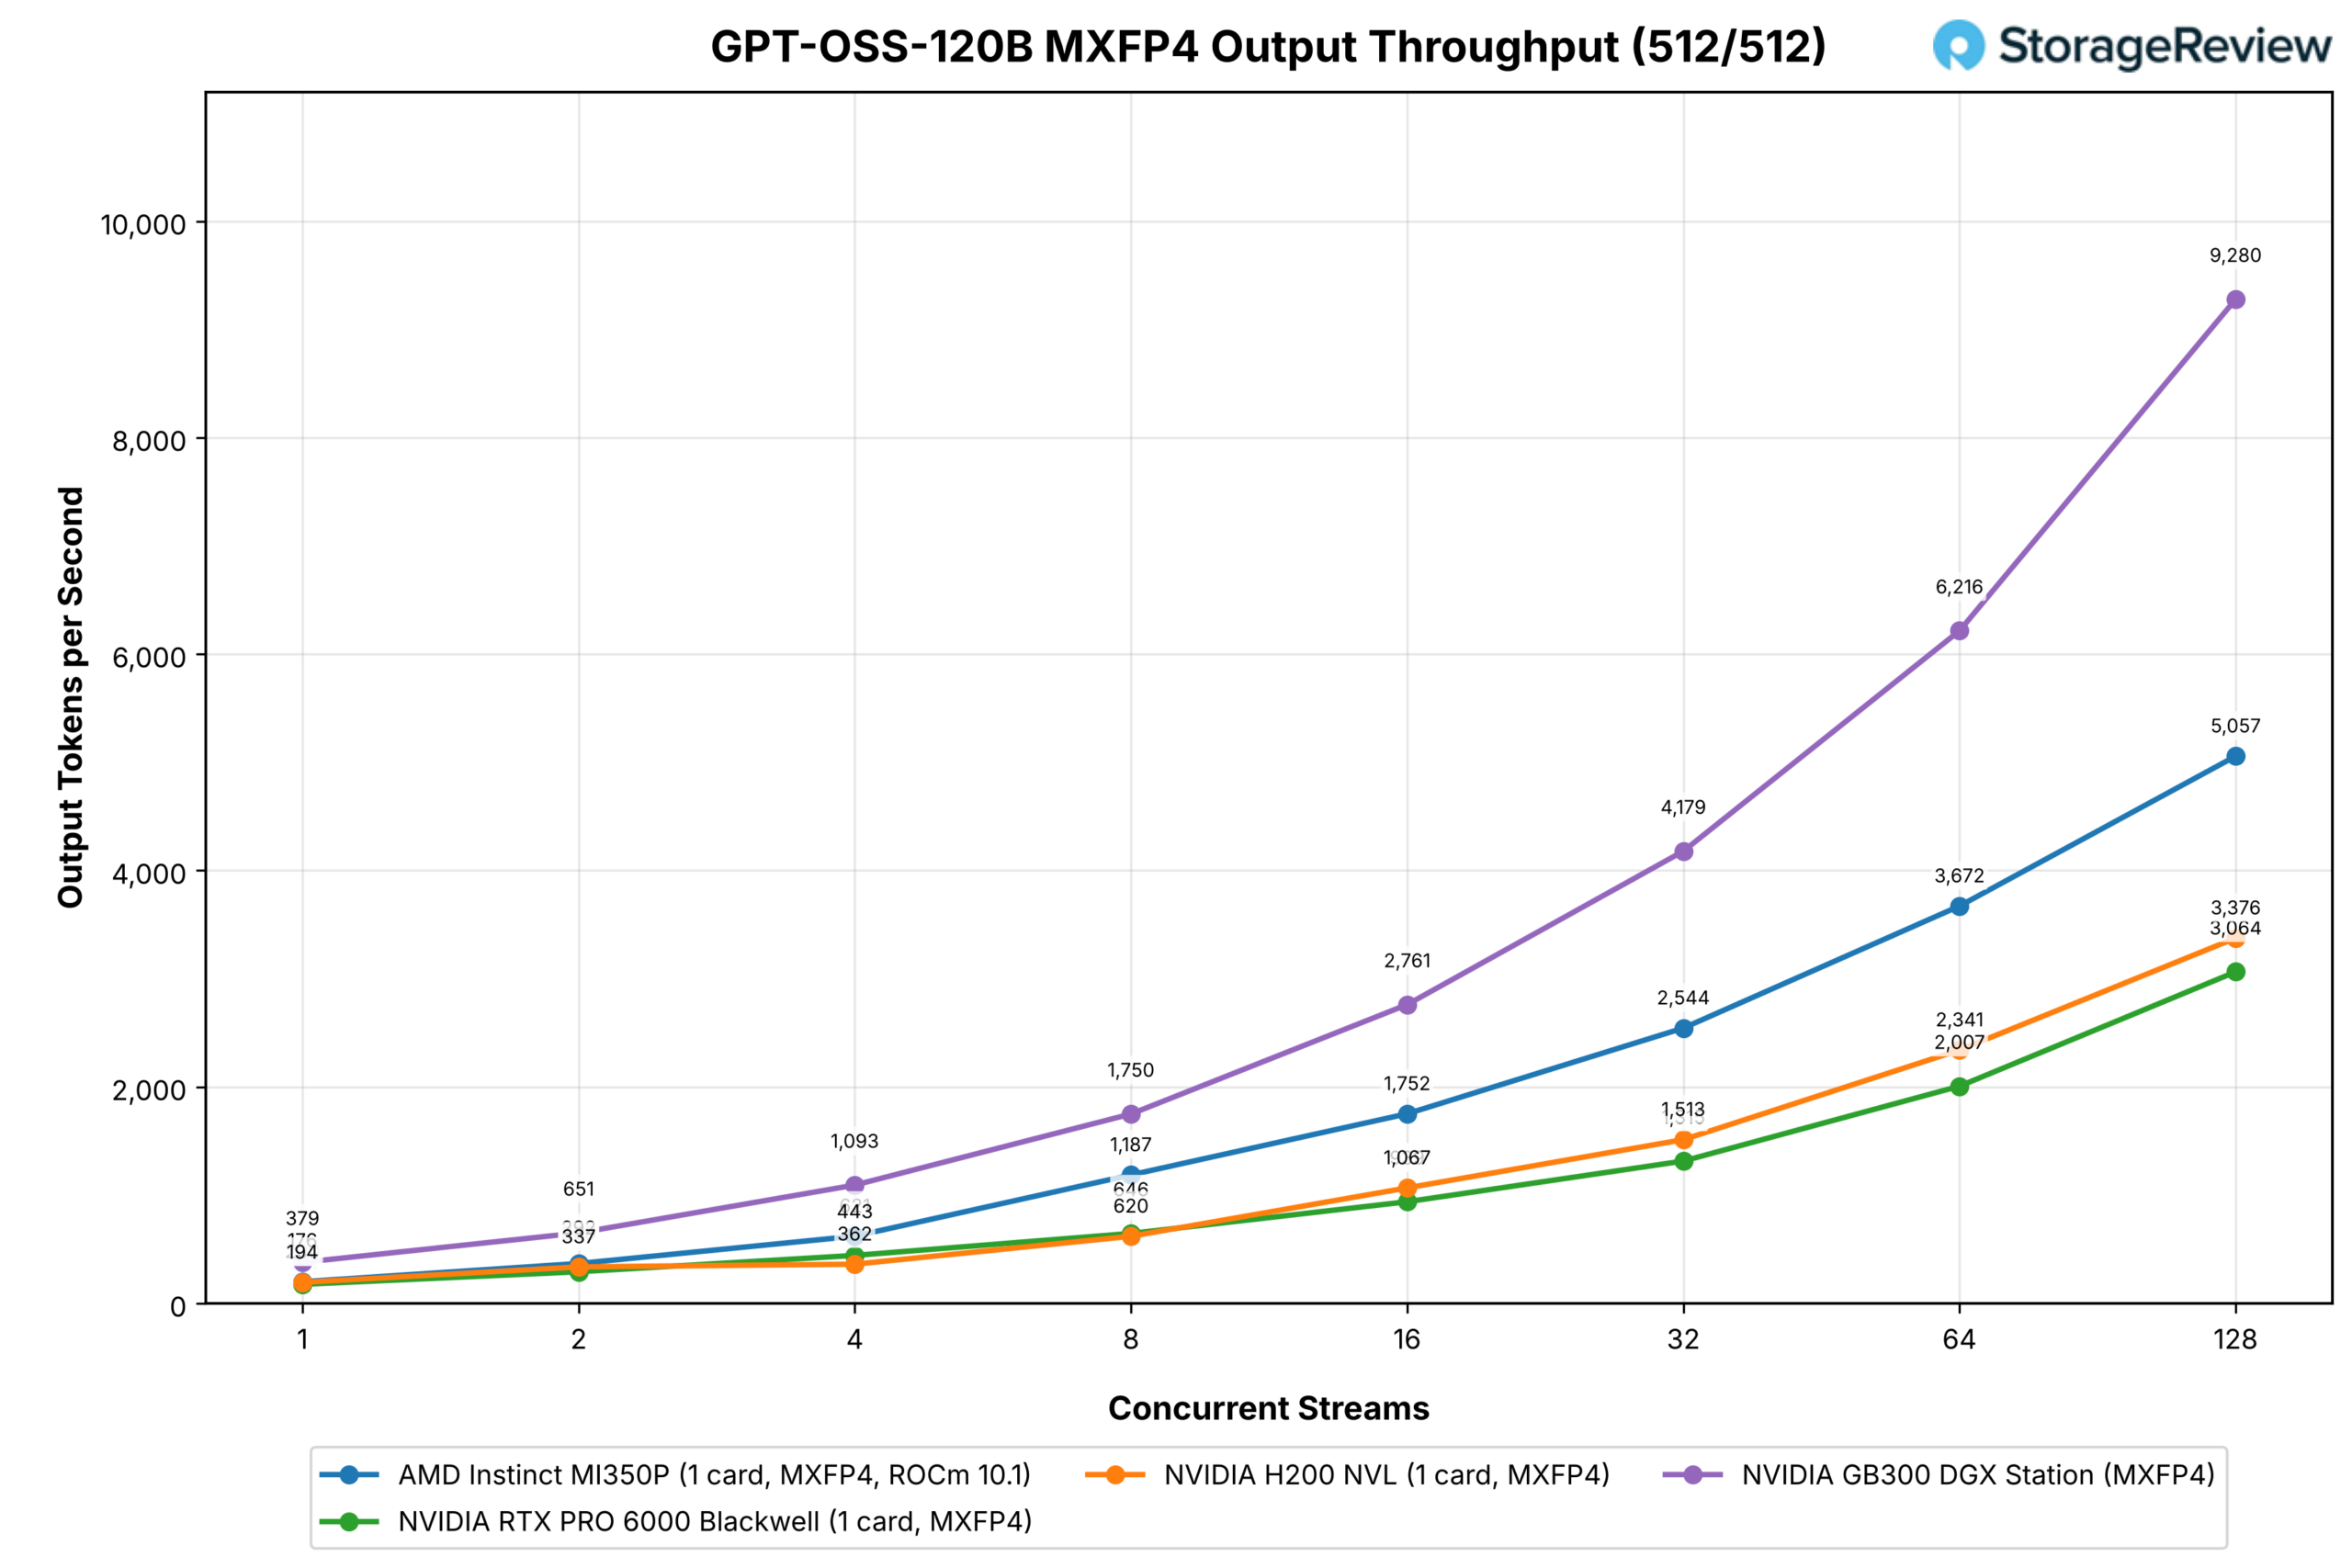
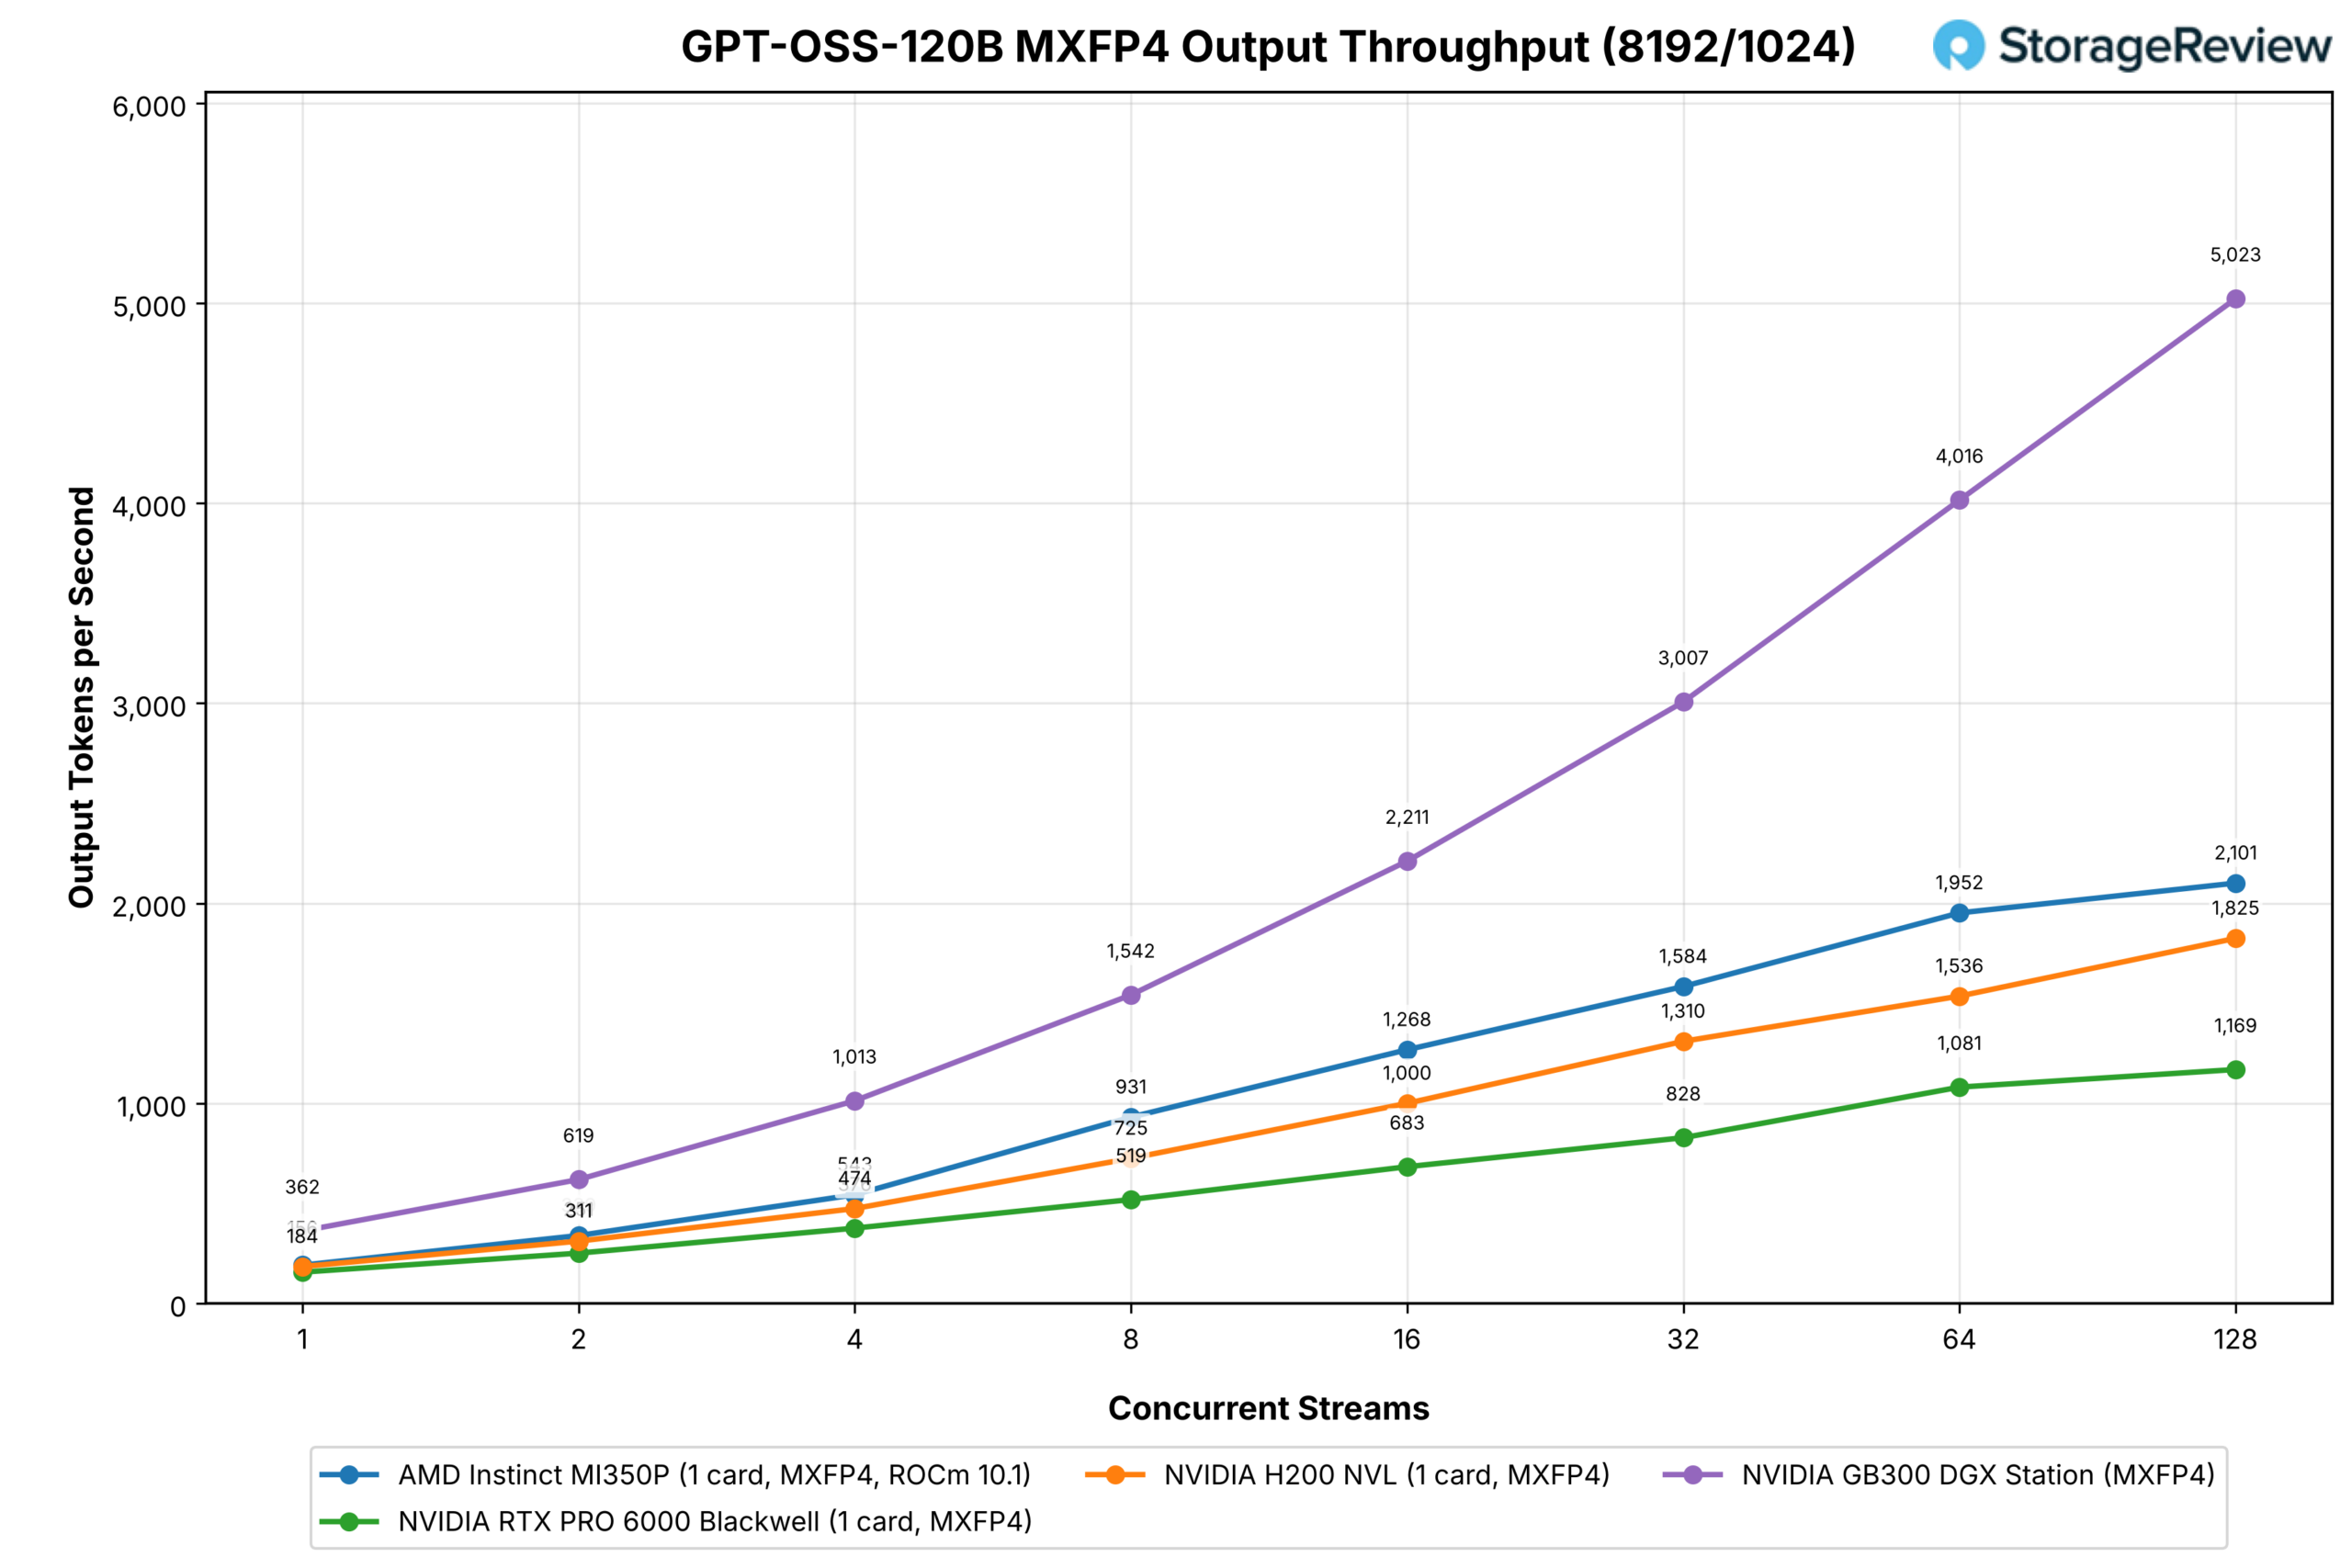
GPT-OSSはMXFP4として出荷されるため、すべてのカードで同じウェイトが実行されます。MI350Pは、両方のワークロードのすべてのストリーム数でRTX PRO 6000を上回り、4ストリーム以上では40~93パーセントの差をつけ、チャットワークロードでは毎秒5,057出力トークン、128ストリームでのプリフィルが多いプロンプトでは毎秒2,101出力トークンを達成しました。これに対し、RTX PRO 6000は毎秒3,064と1,169、H200 NVLは毎秒3,376と1,825でした。Stationは毎秒9,280と5,023に達しました。
AMDとDellが9月16日に提出したMLPerf Inference v6.1では、同じモデルで上限が設定されています。PowerEdge XE7745に搭載された8つのMI350Pは、GPT-OSS-120B上でオフラインで毎秒48,971トークン、サーバーシナリオで毎秒40,868トークンを生成しました。これは、調整された提出スタック上で、GPUあたり6,121と5,108に相当します。このハーネスと私たちのハーネスは完全に同じではありませんが、標準のvLLMで128ストリームで測定した5,057は、この範囲の下限に位置します。
GPT-OSS-20B
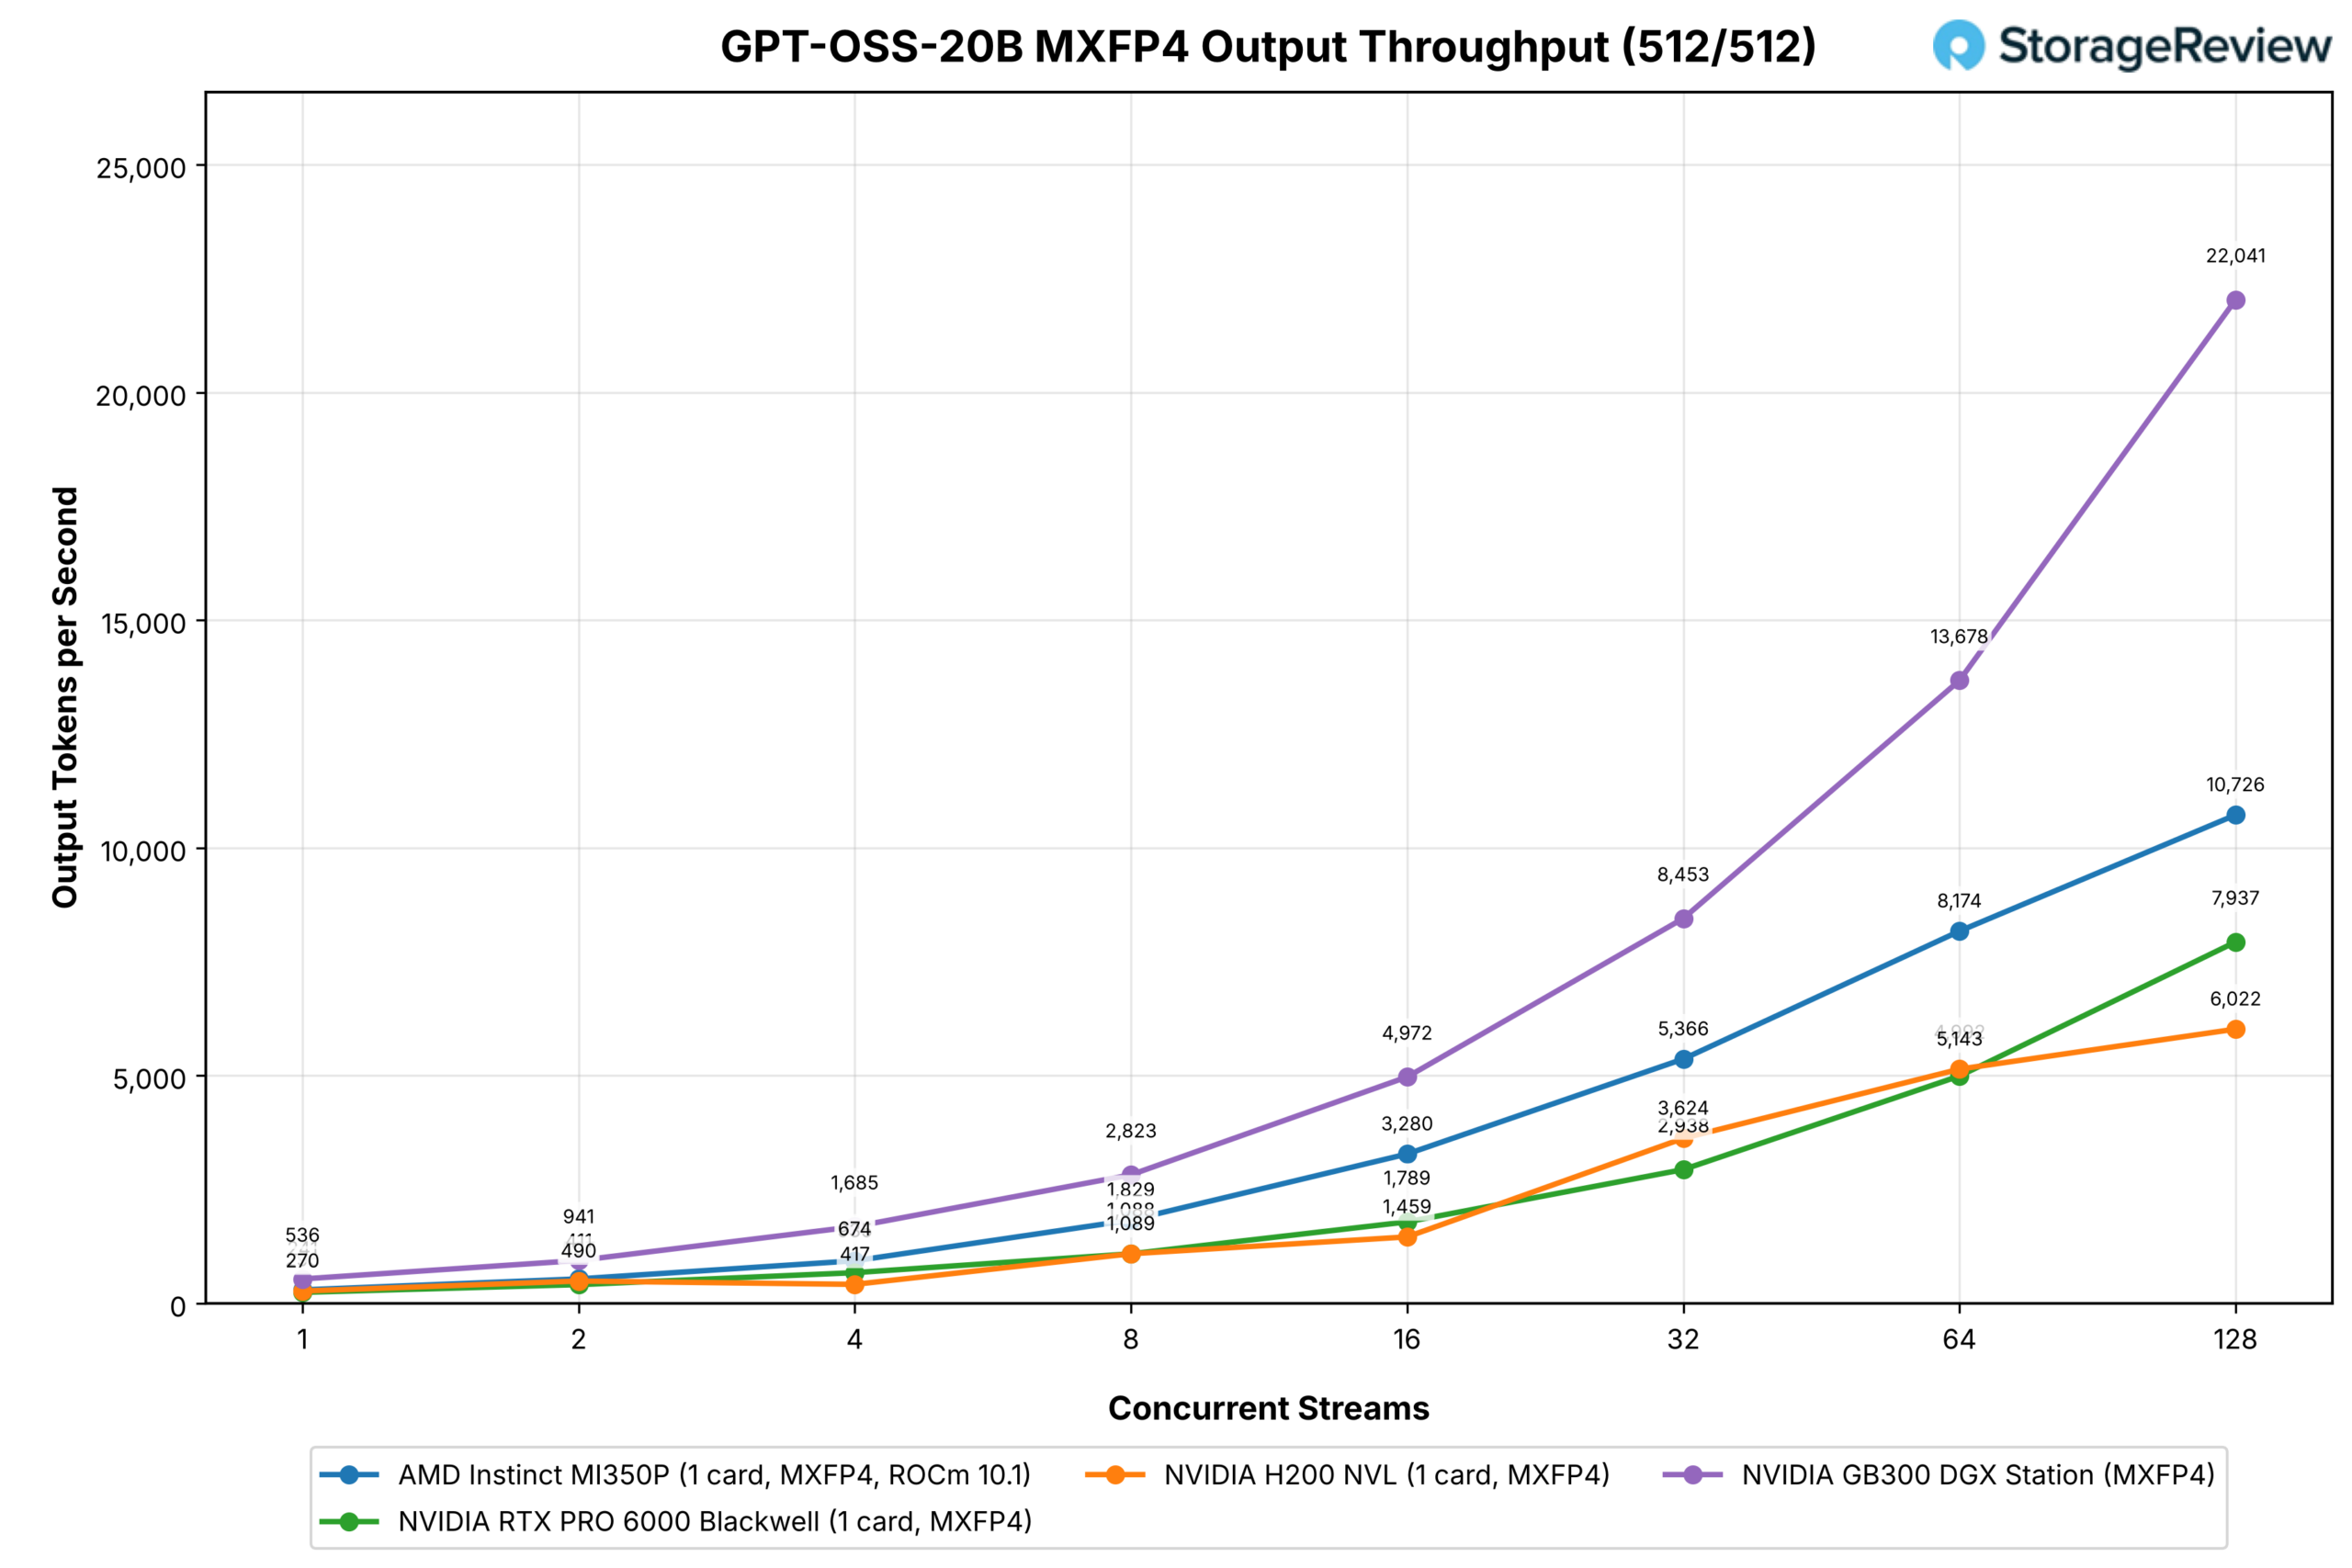
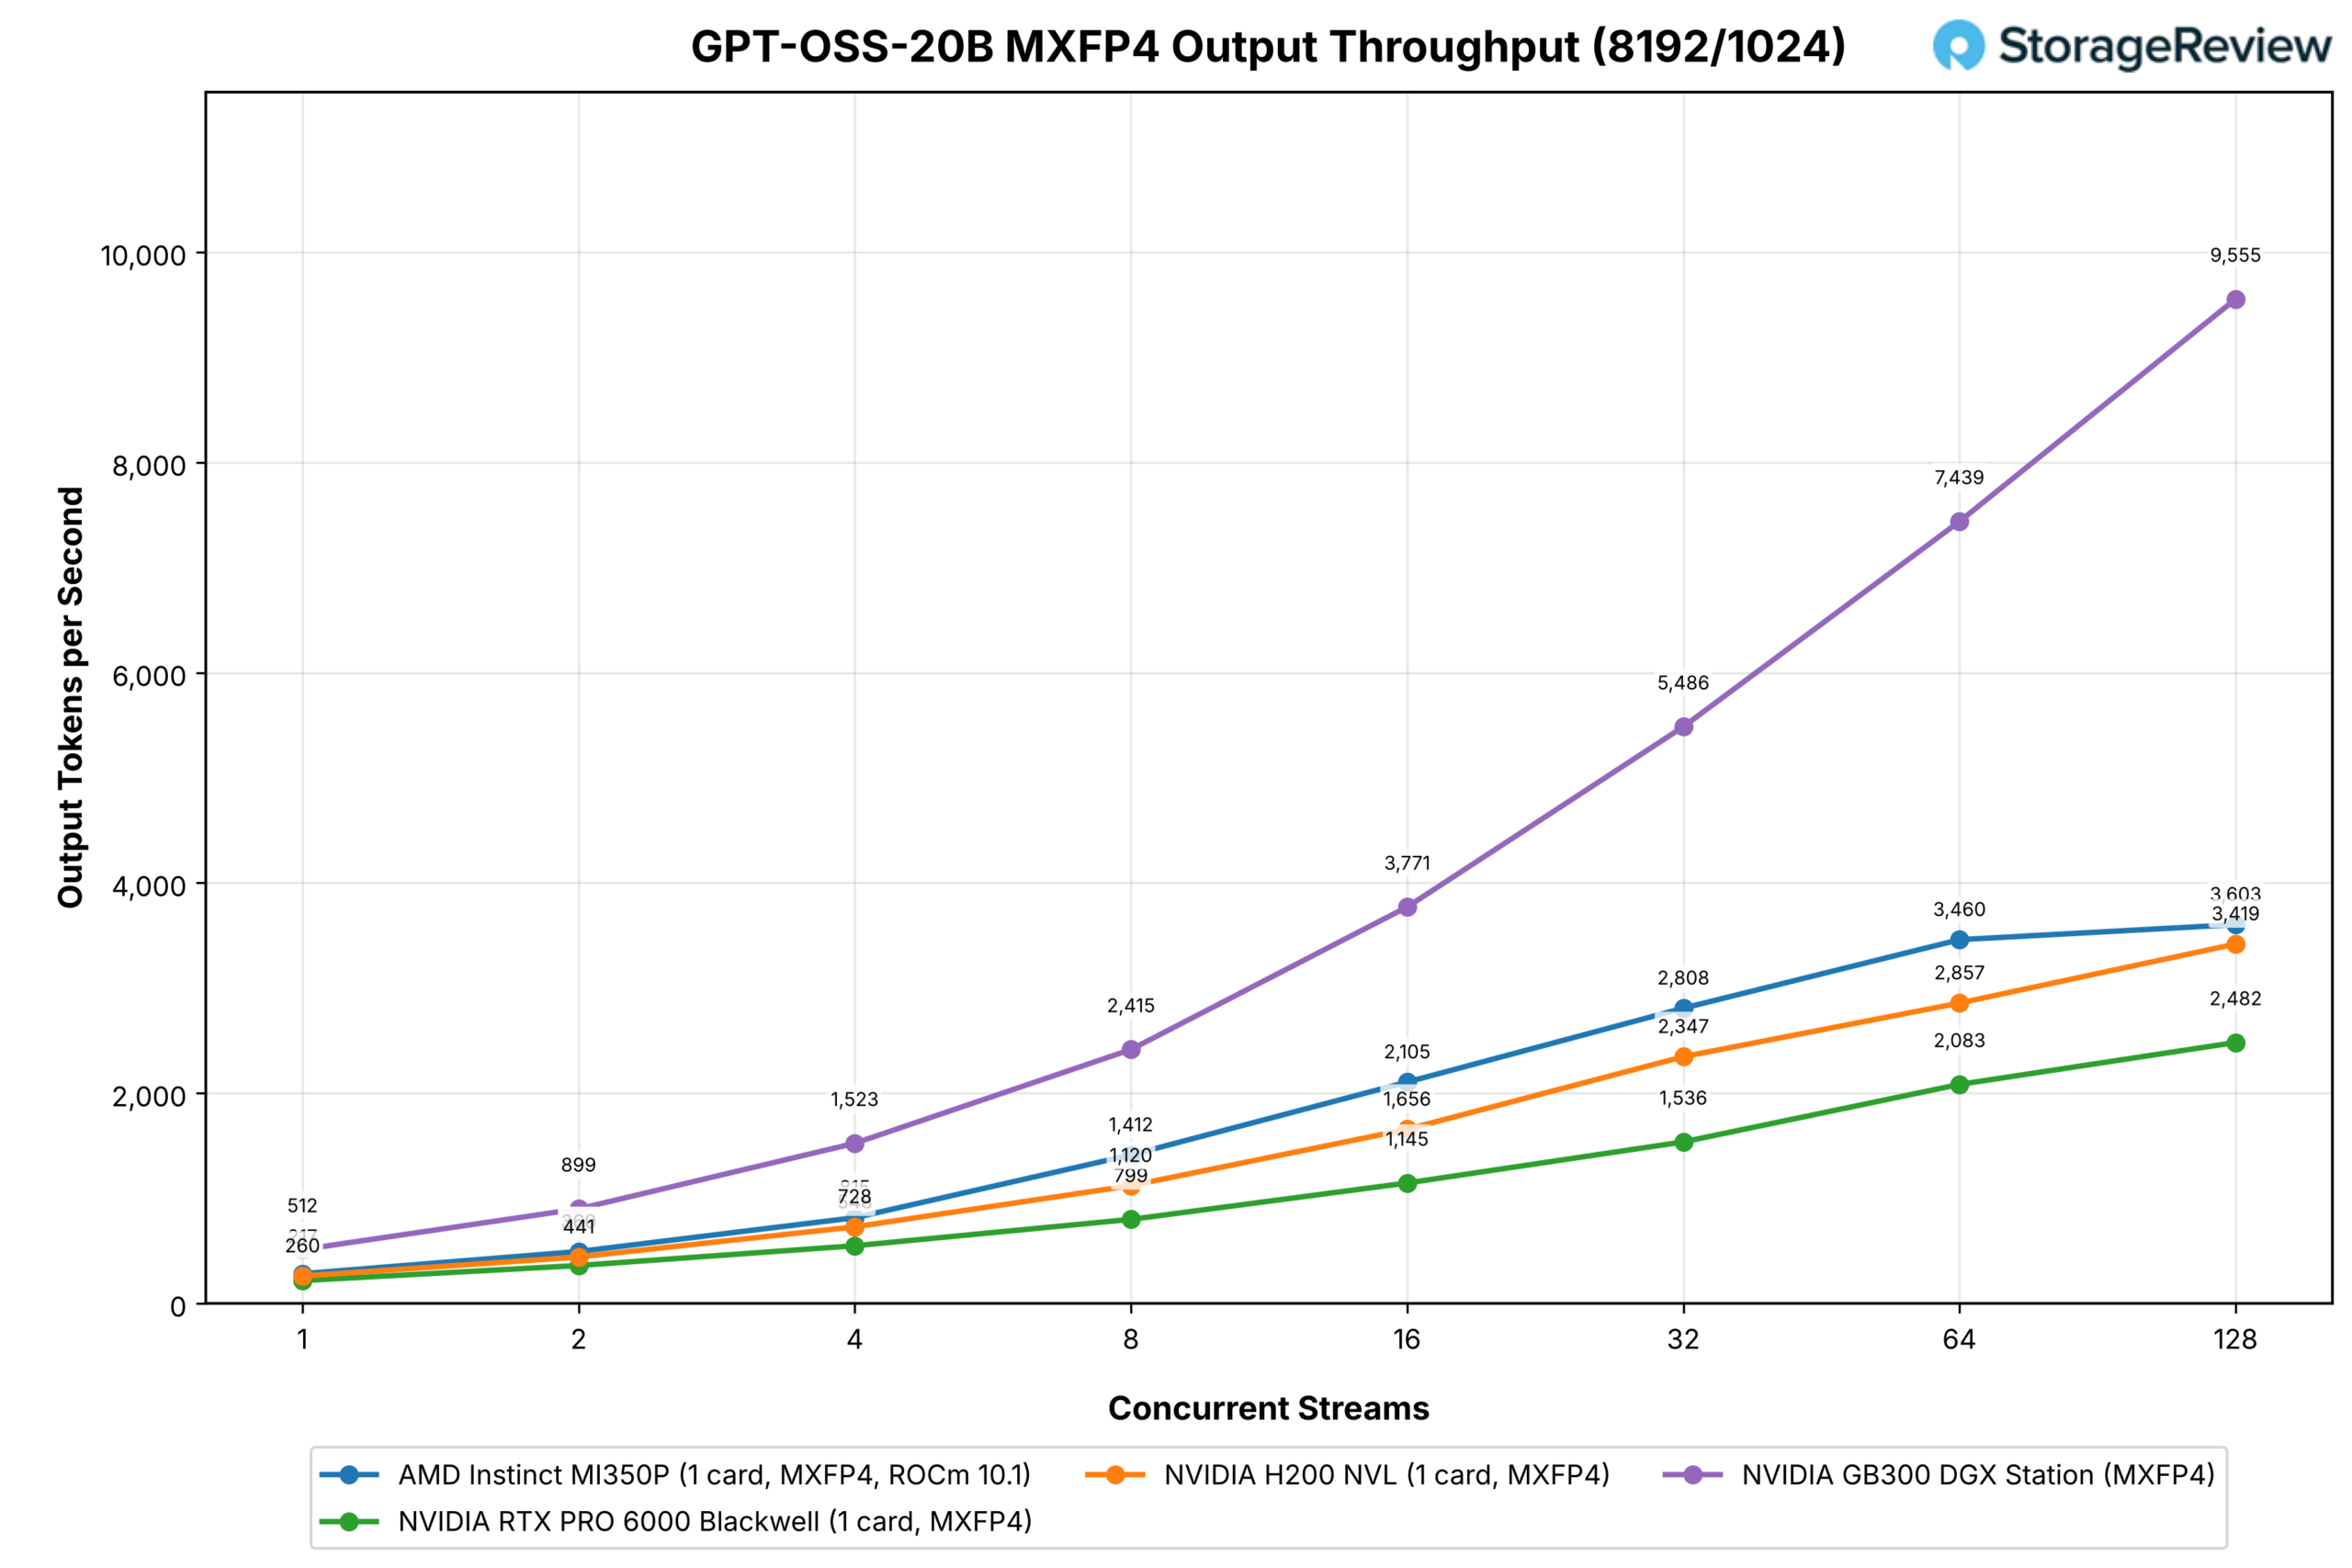
より小型の OpenAI モデルも同様の曲線を描きます。MI350P は、チャットワークロードで 64 ストリームで 8,174 対 4,992、128 ストリームで 10,726 対 7,937、プリフィルが多いプロンプトで 3,460 対 2,083、3,603 対 2,482 と、あらゆる点で RTX PRO 6000 を上回り、256 ストリームでは 16,406 に達し、RTX PRO 6000 は 11,077 を記録します。H200 NVL は、128 ストリームで 6,022 と 3,419 で、両方の形状で MI350P に劣り、Station は 22,041 と 9,555 となっています。
Qwen3-コーダー-30B-A3B
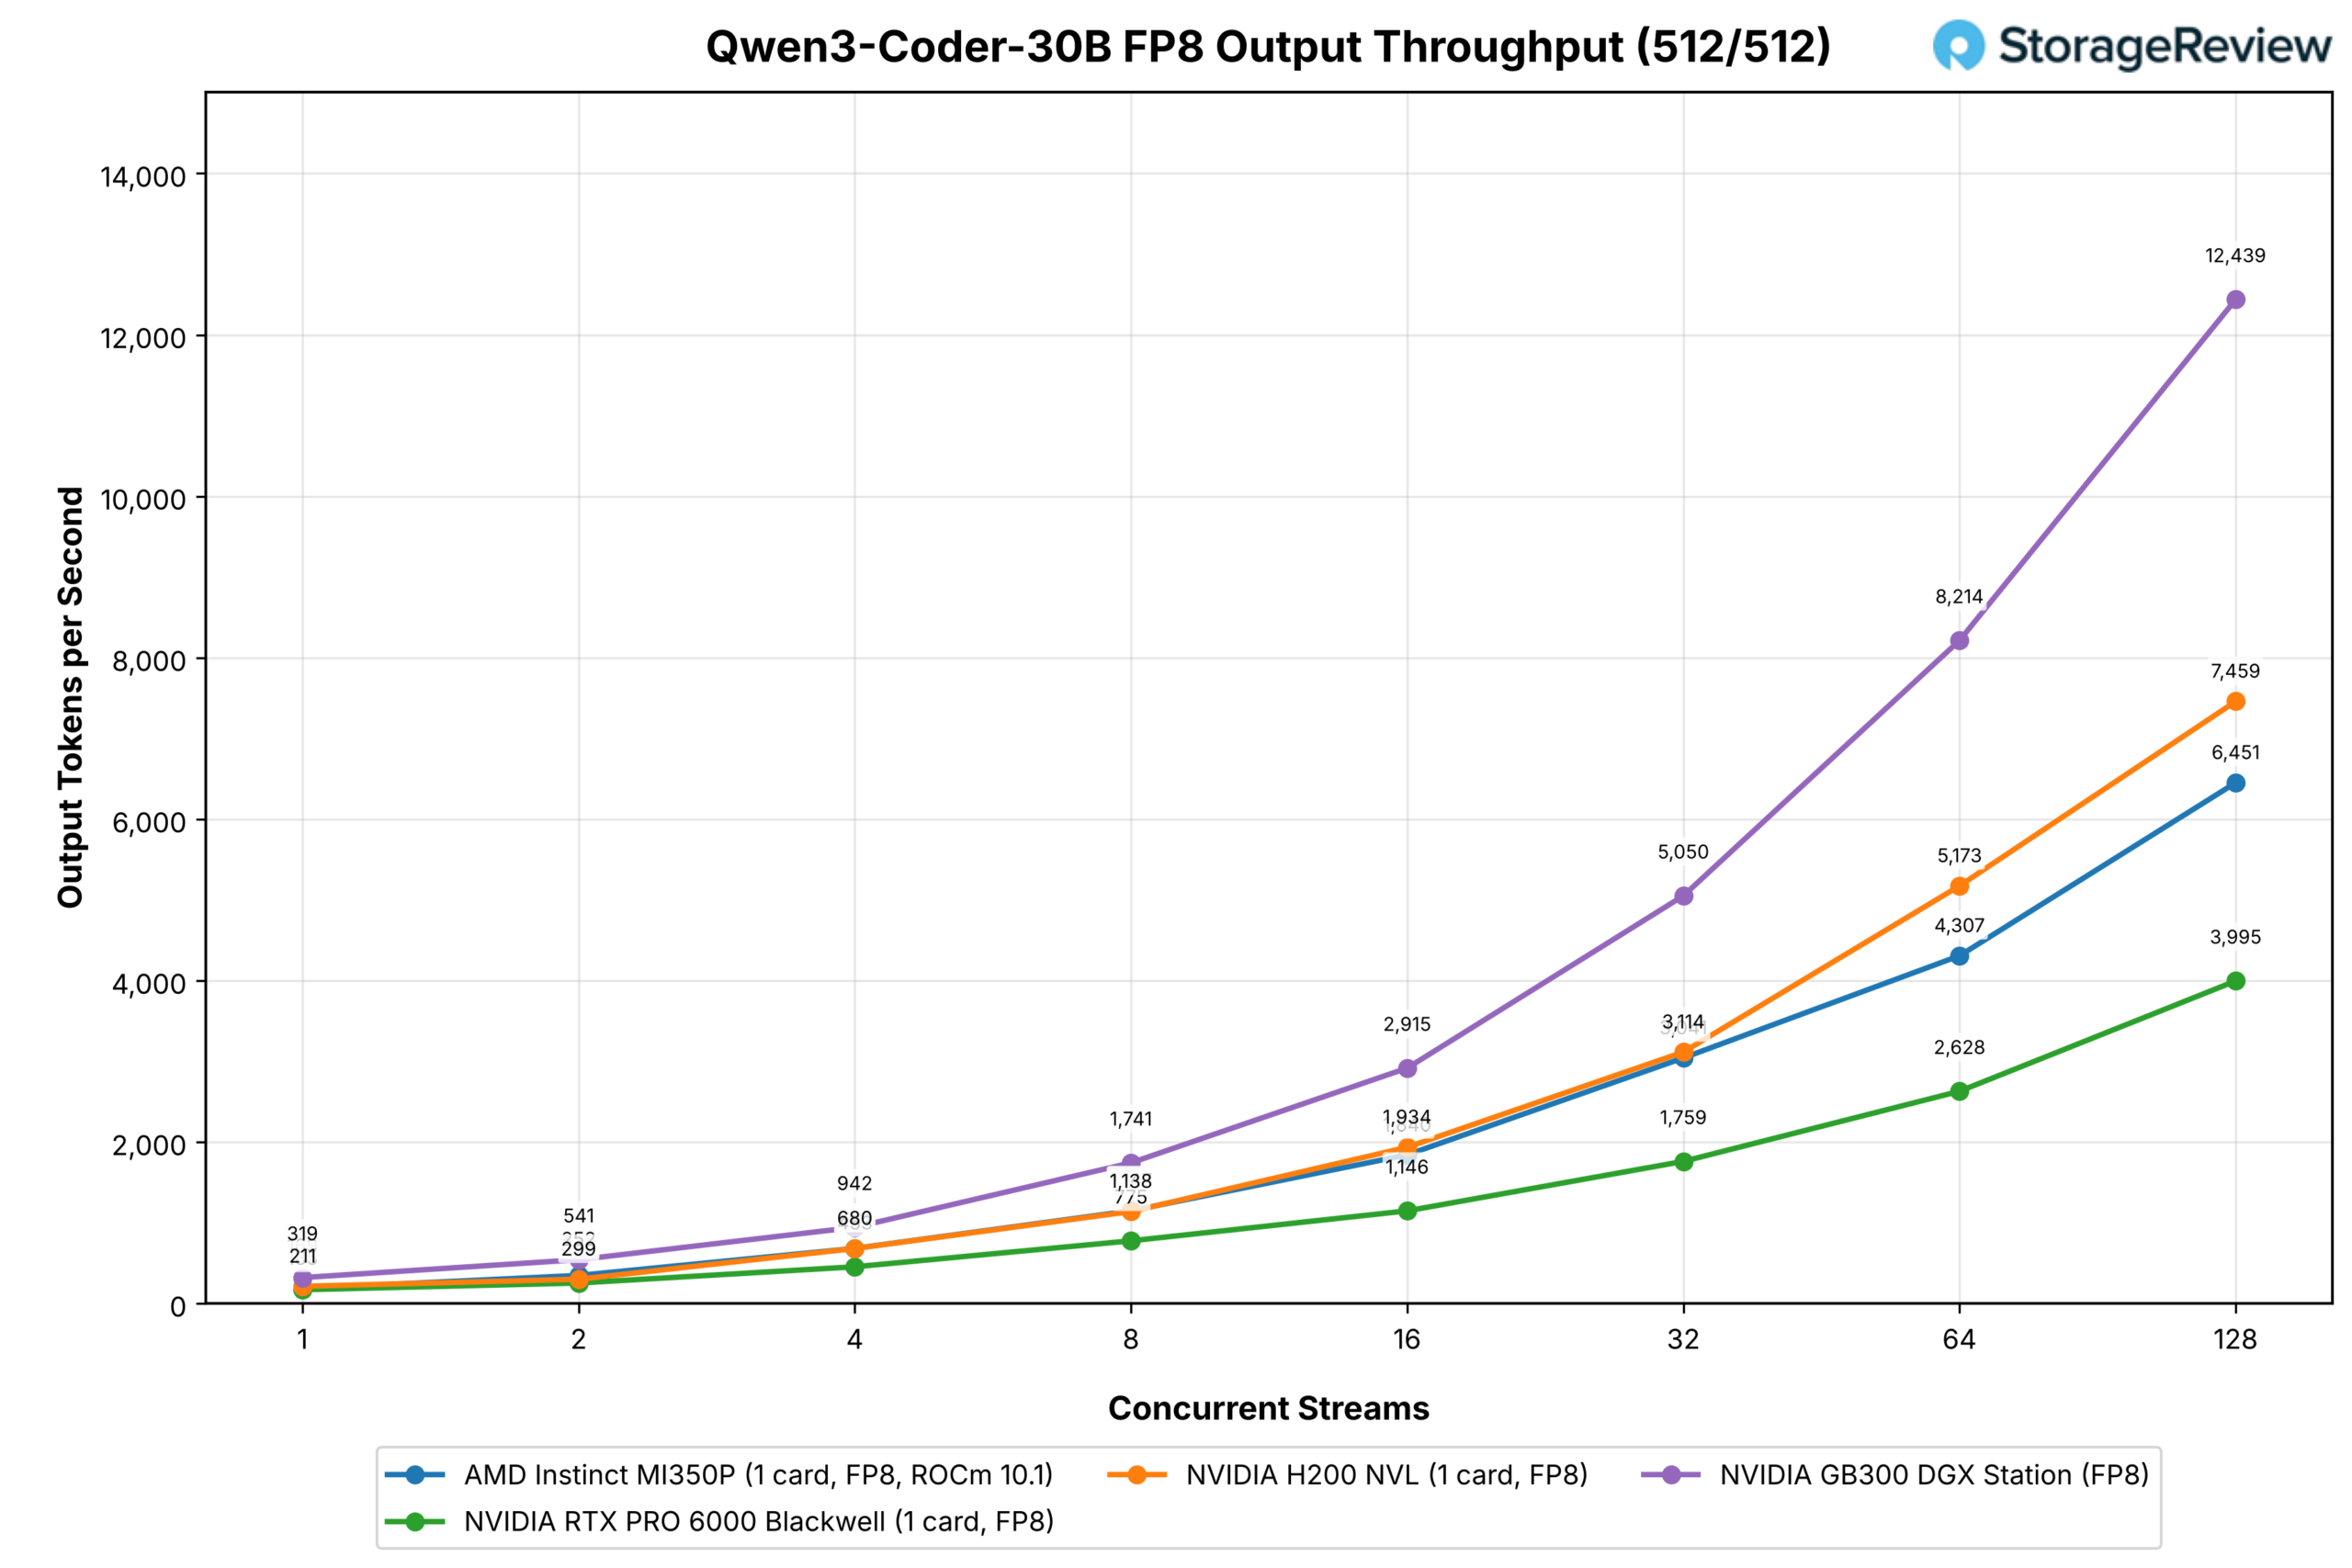
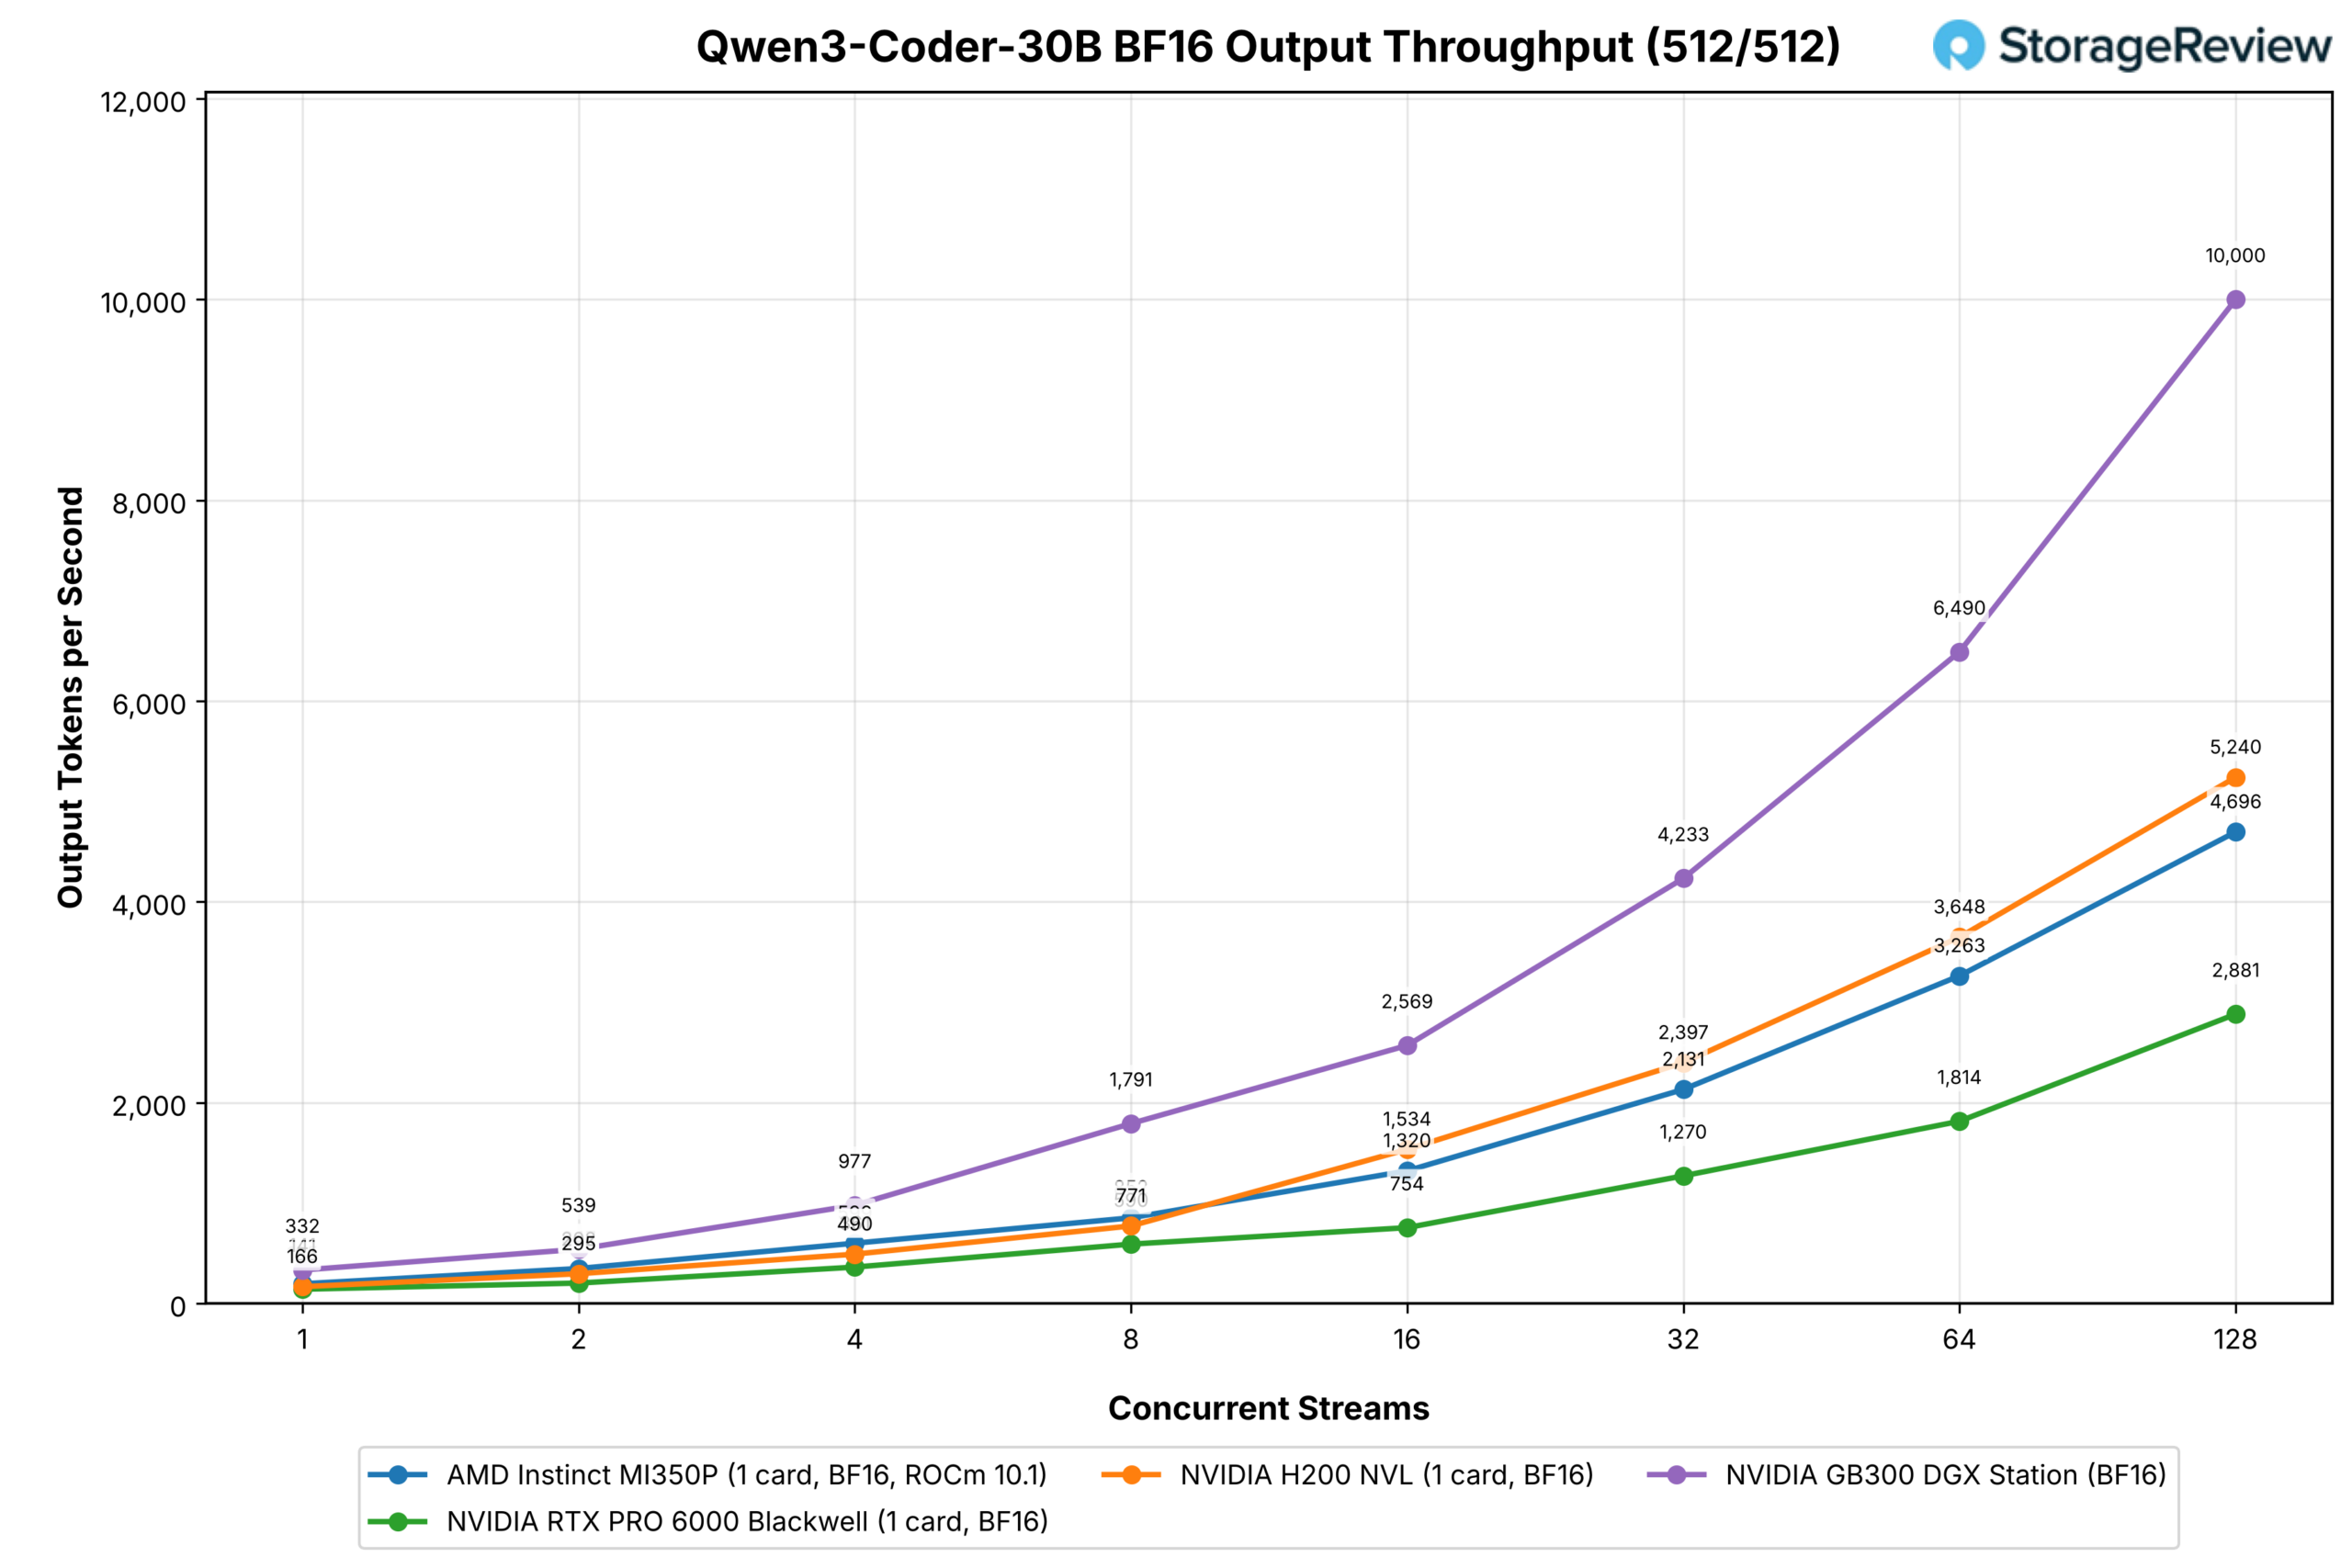
30B MoEと3Bのアクティブパラメータにより、MI350Pはチャットワークロードのあらゆる同時実行数でRTX PRO 6000を上回り、128ストリームでFP8では6,451対3,995、BF16では4,696対2,881という結果を残し、H200は7,459と5,240でした。
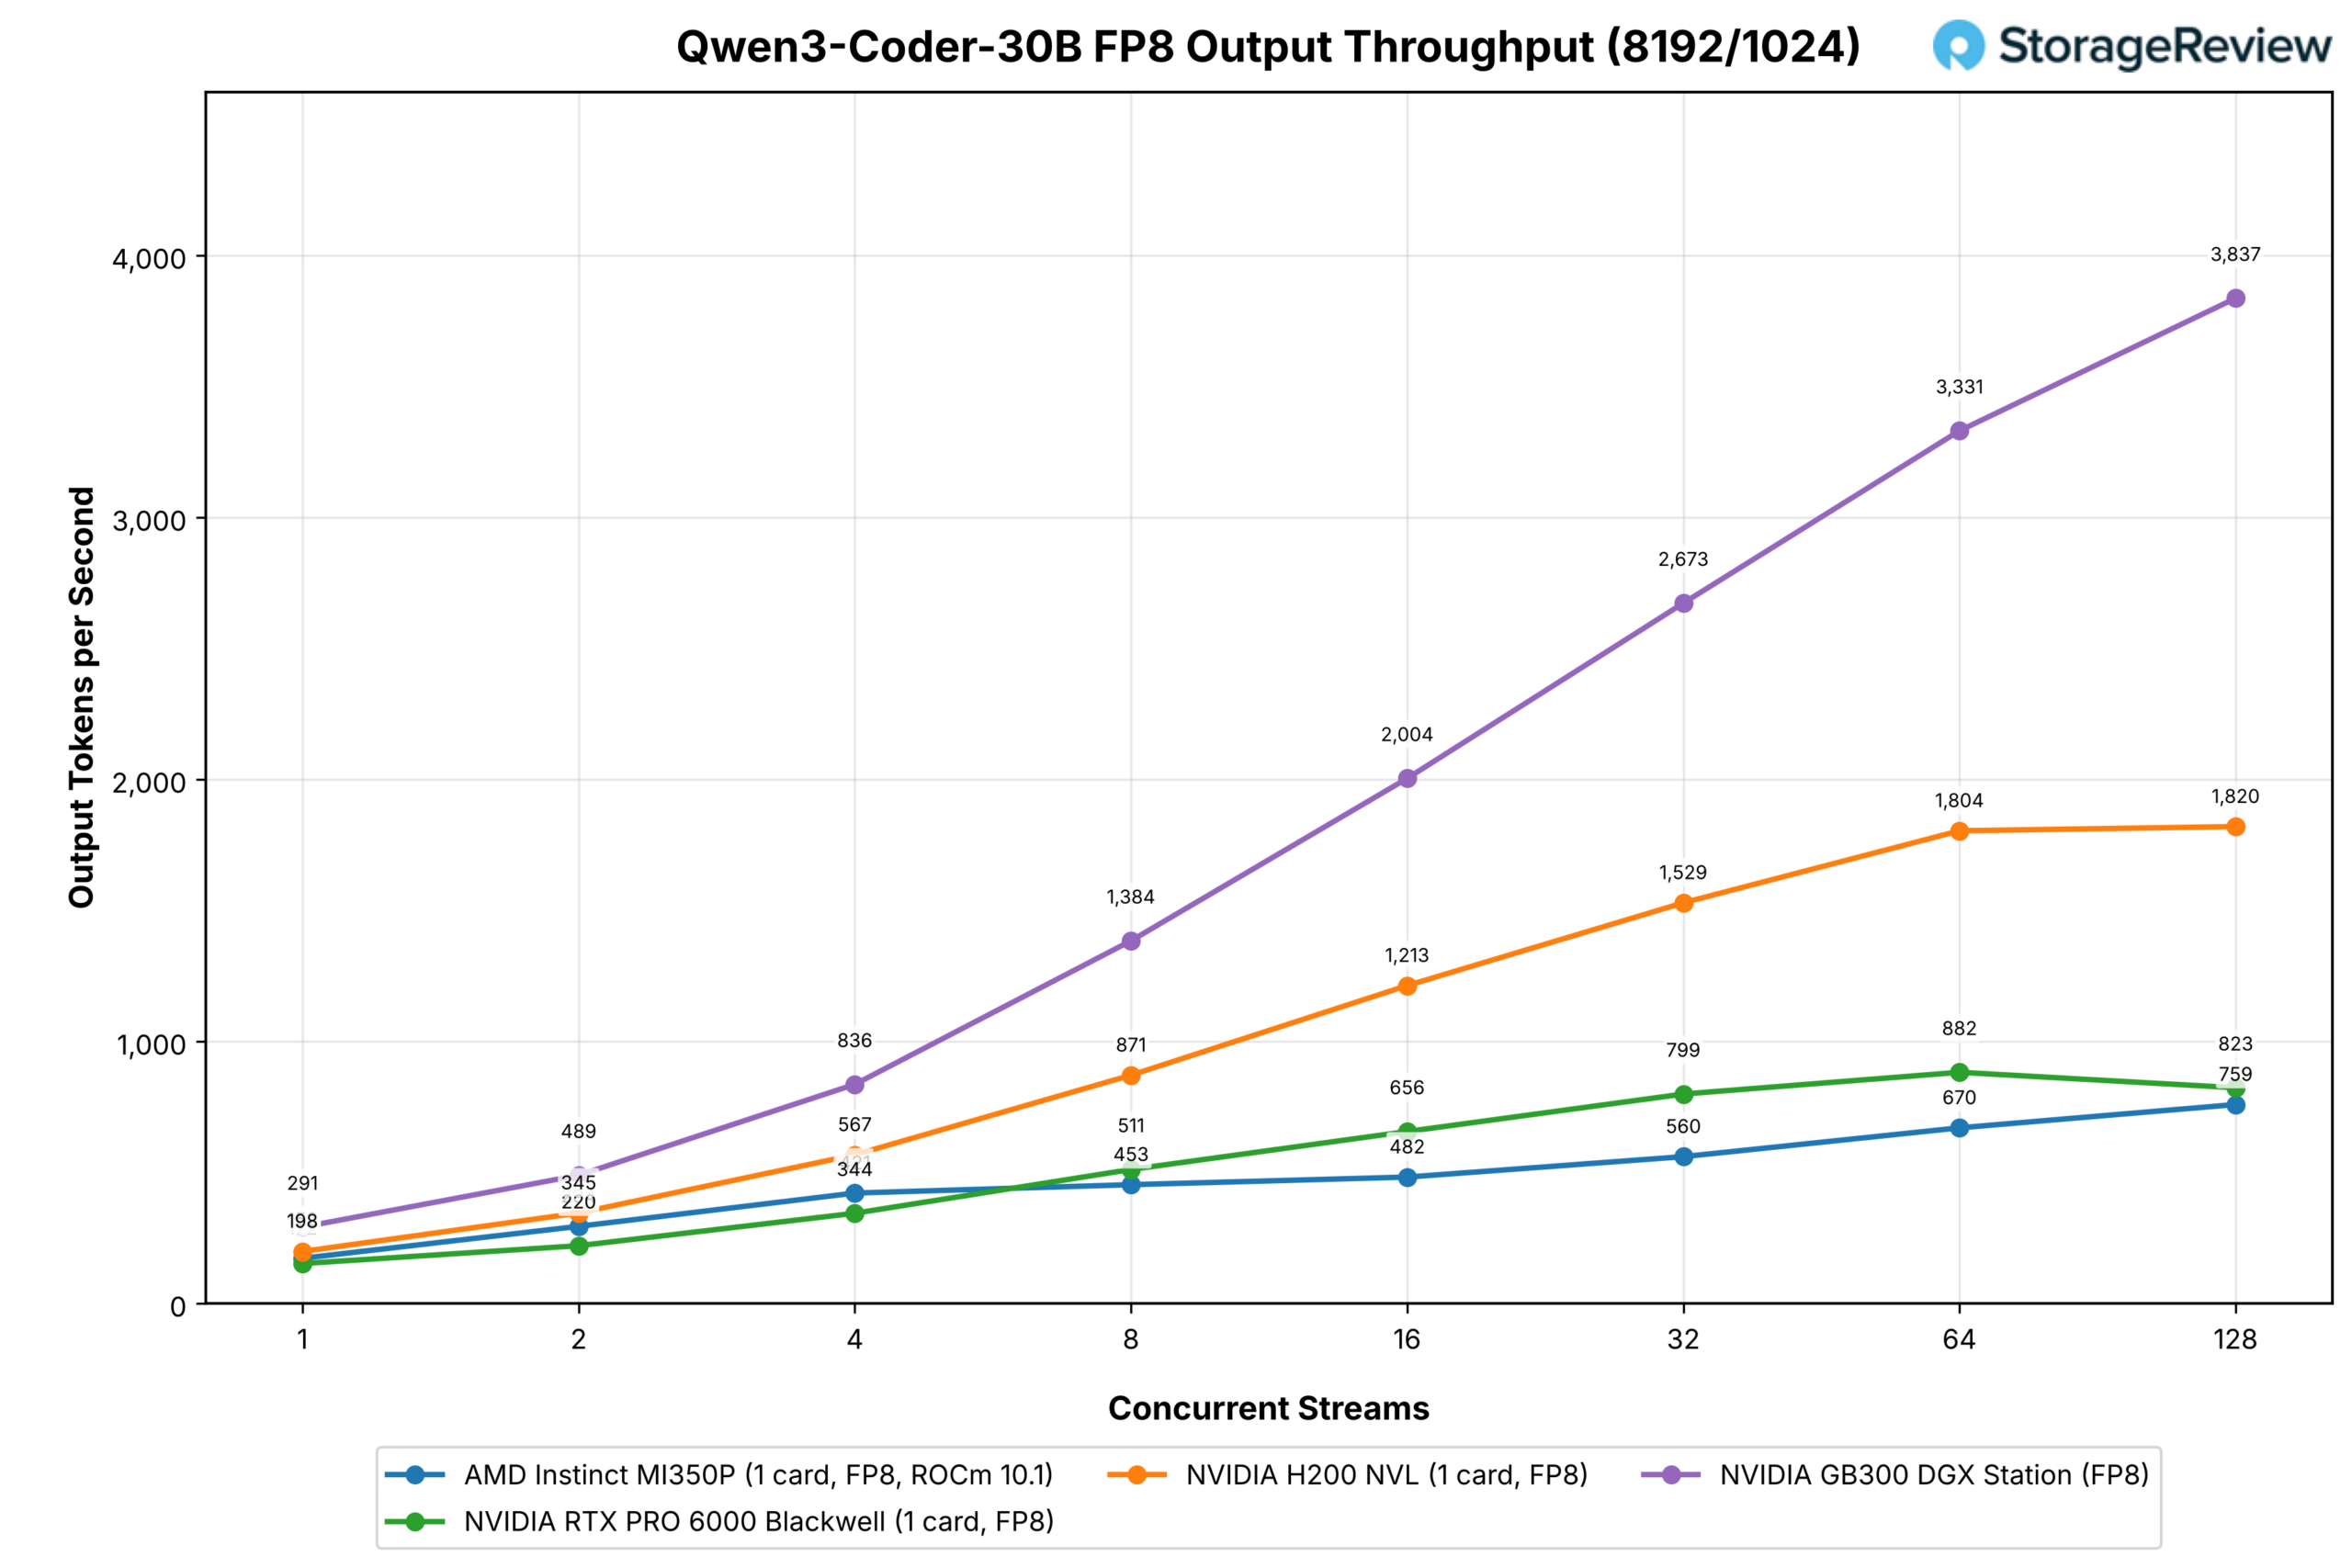
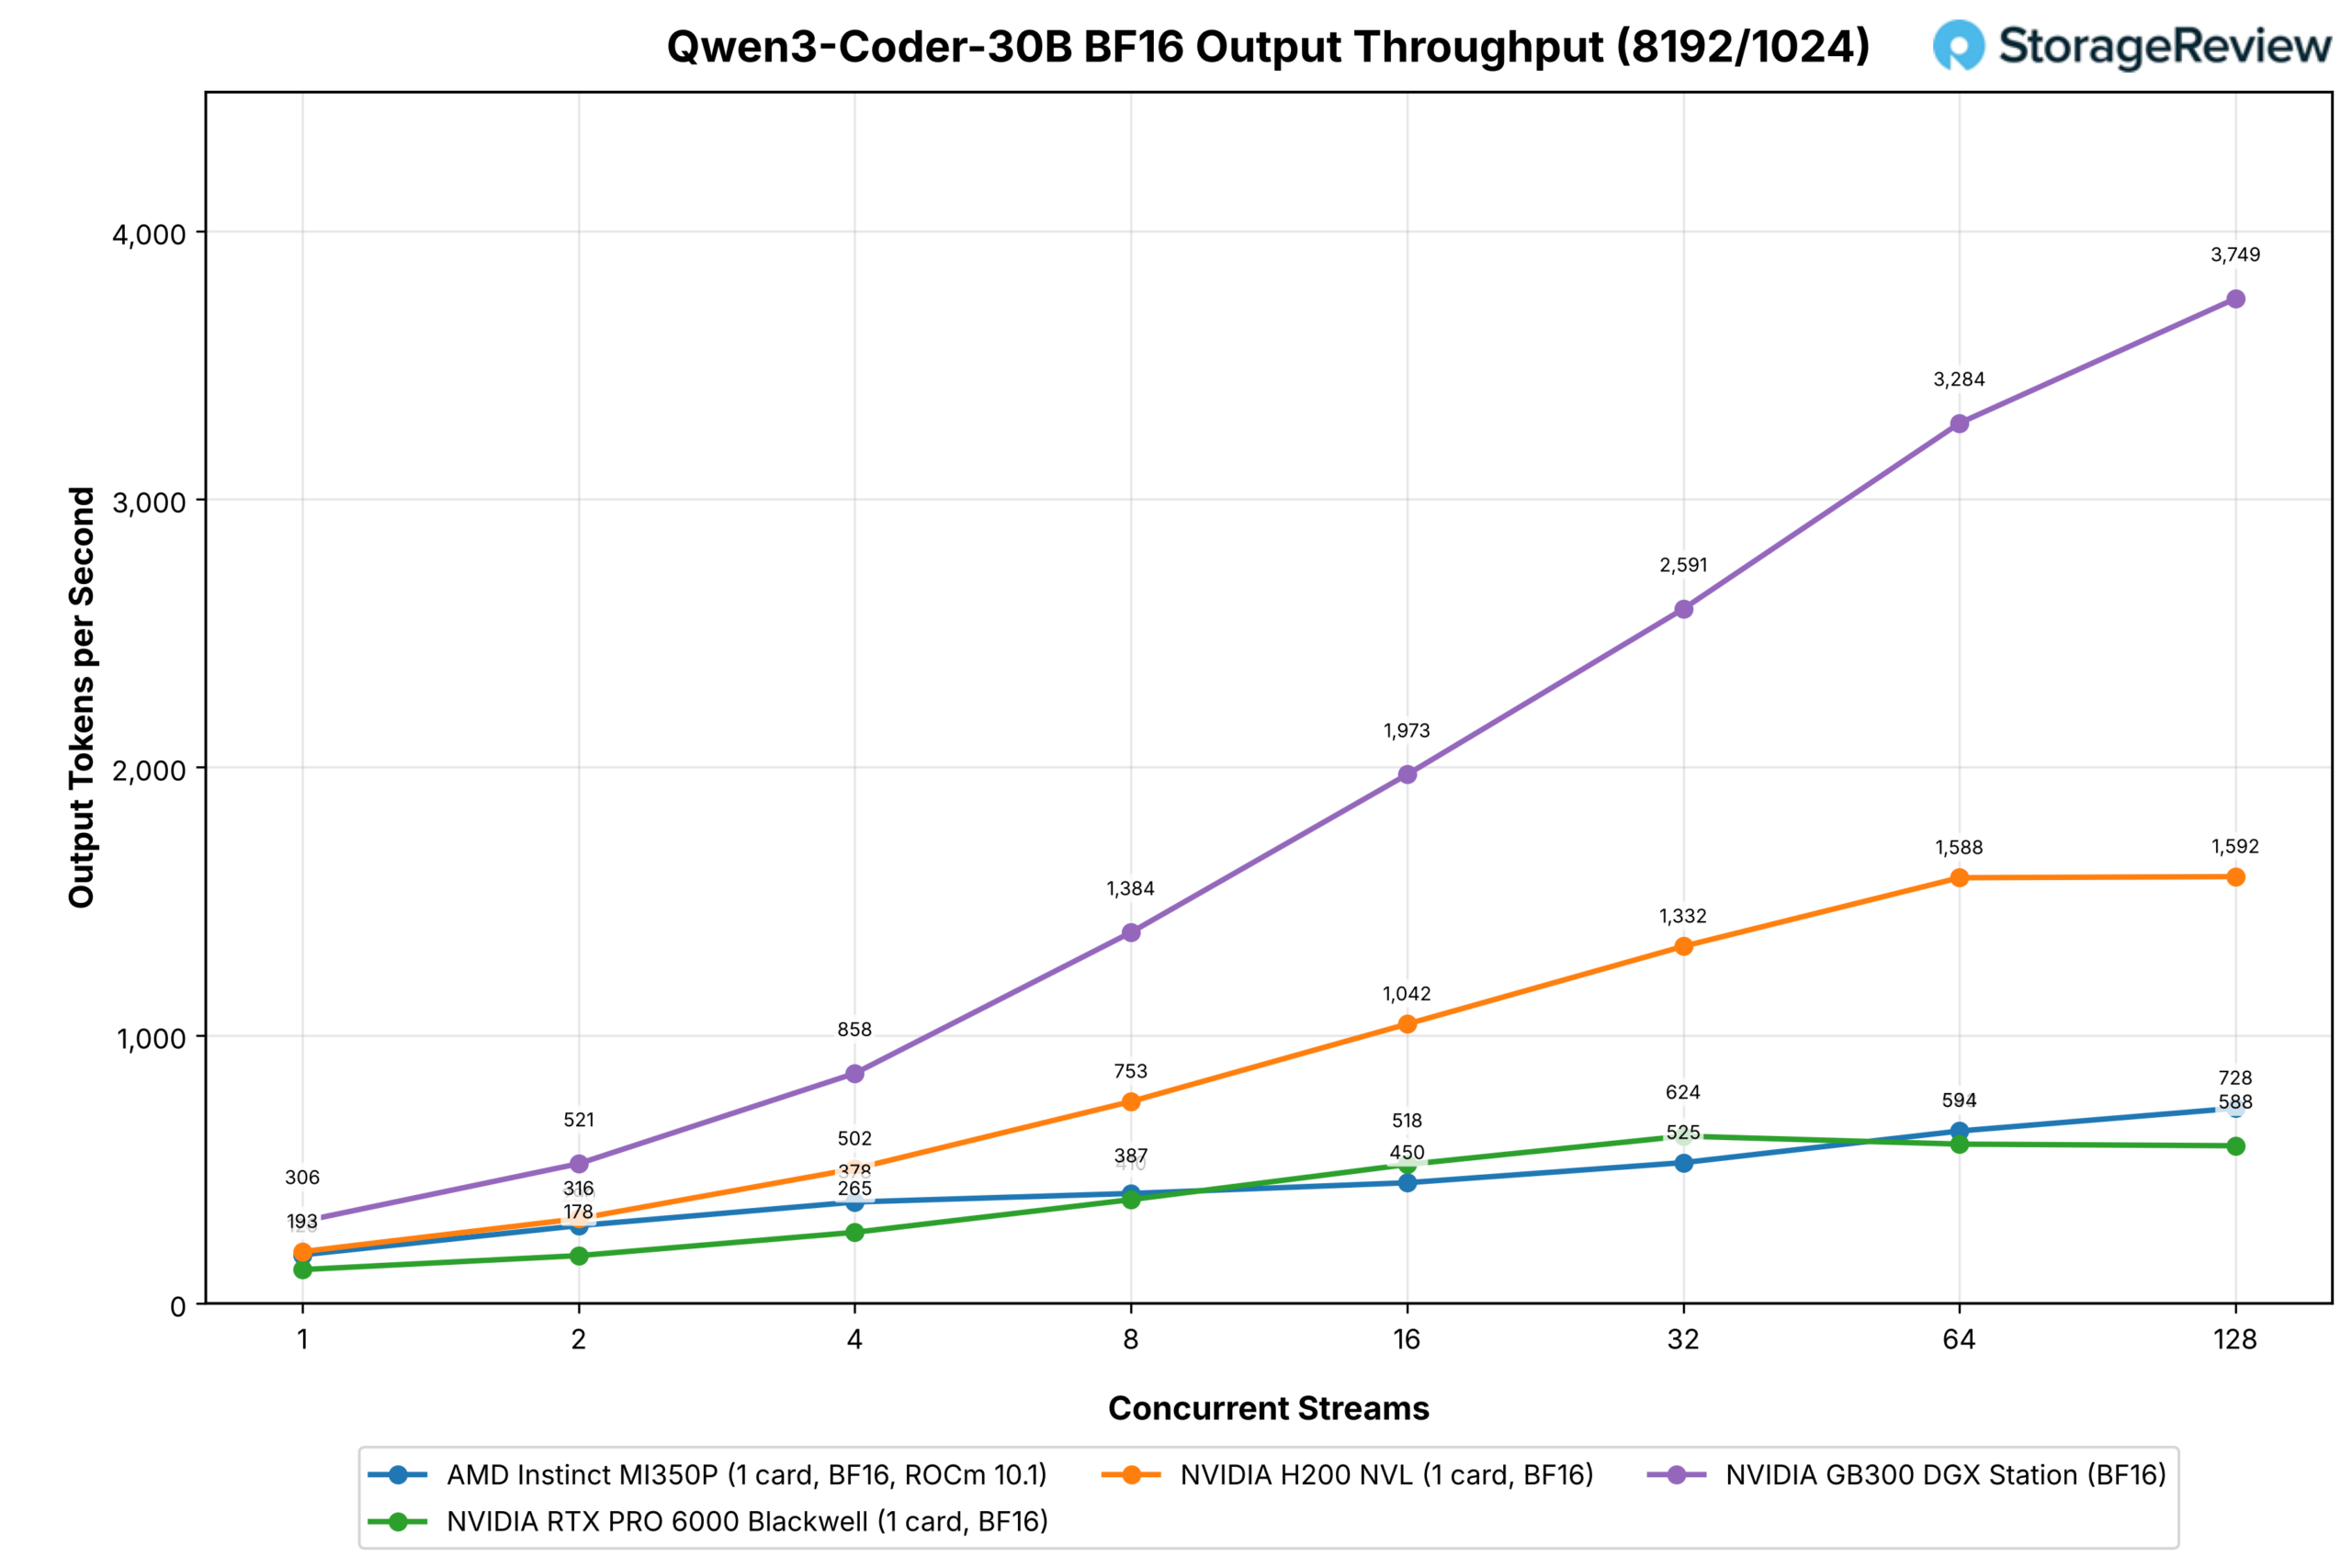
事前入力が多いプロンプトでは、FP8 の実行は 4 つのストリームまでしかリードせず、その後 8 から 128 までは RTX PRO 6000 に後れを取り、トップでは 759 対 823、H200 は 1,820 となっています。BF16 の実行は 128 ストリームで 728 まで上昇し、588 と 1,592 を上回ります。
ミストラル スモール 3.1 24V
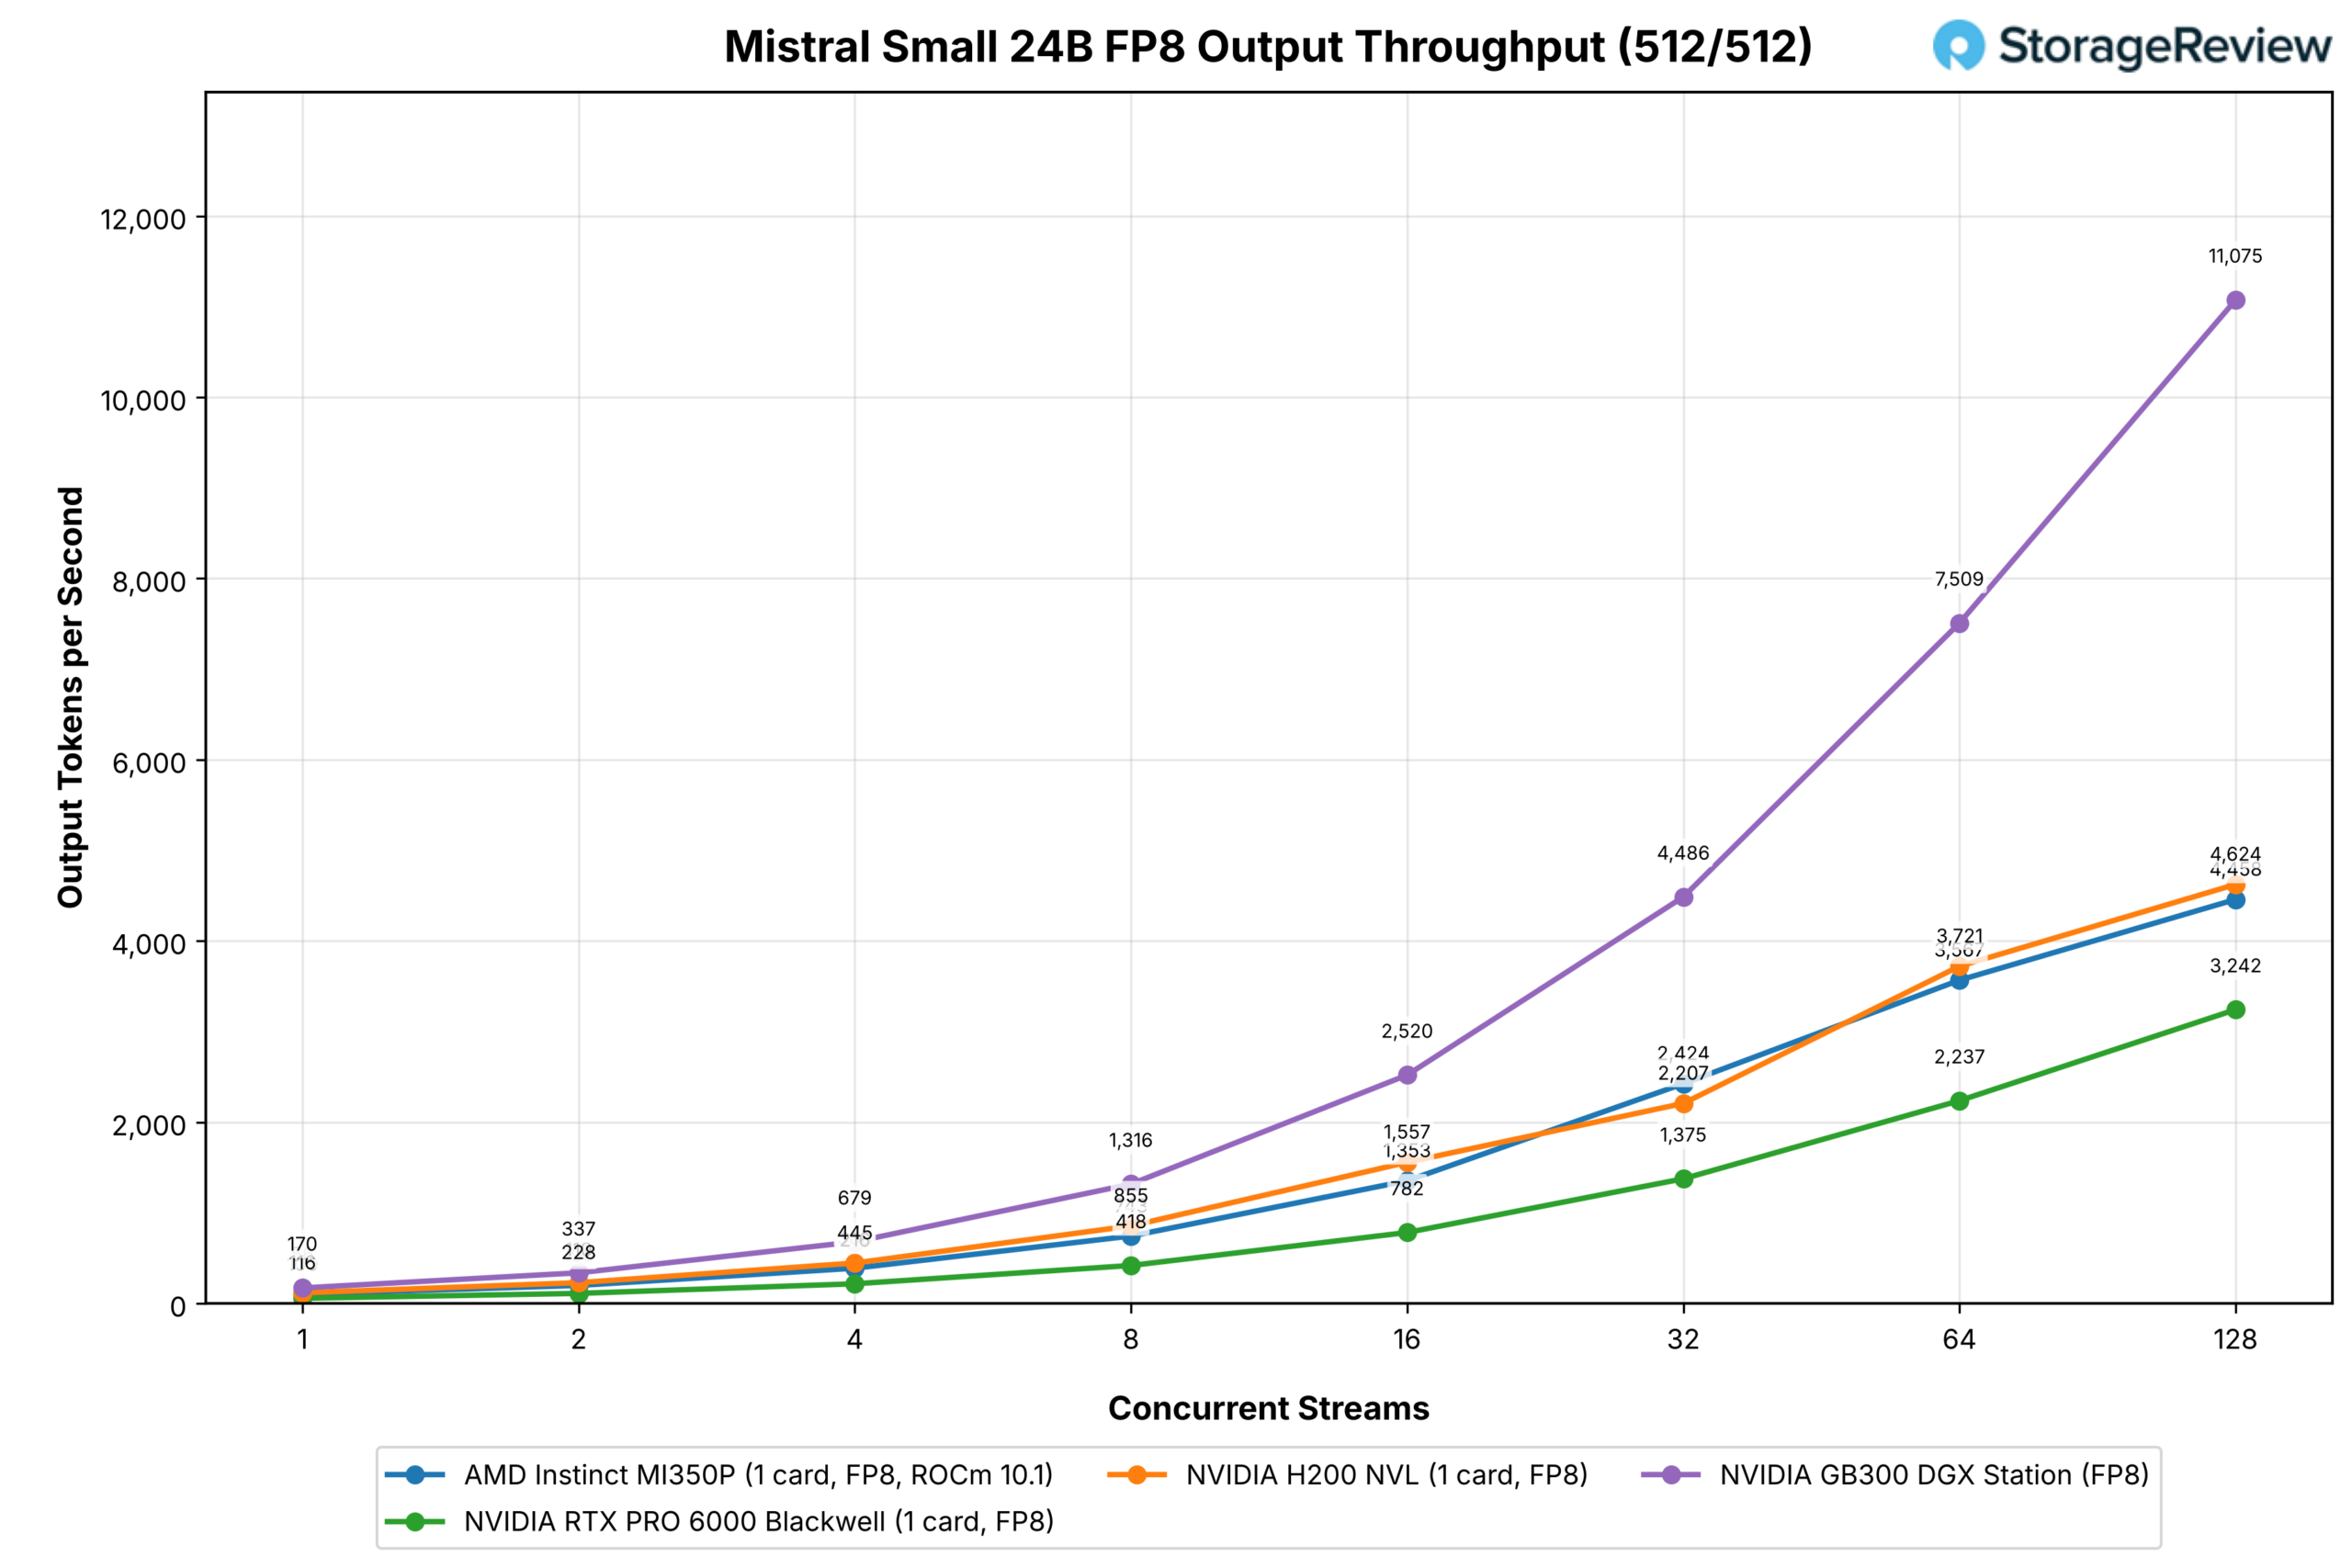
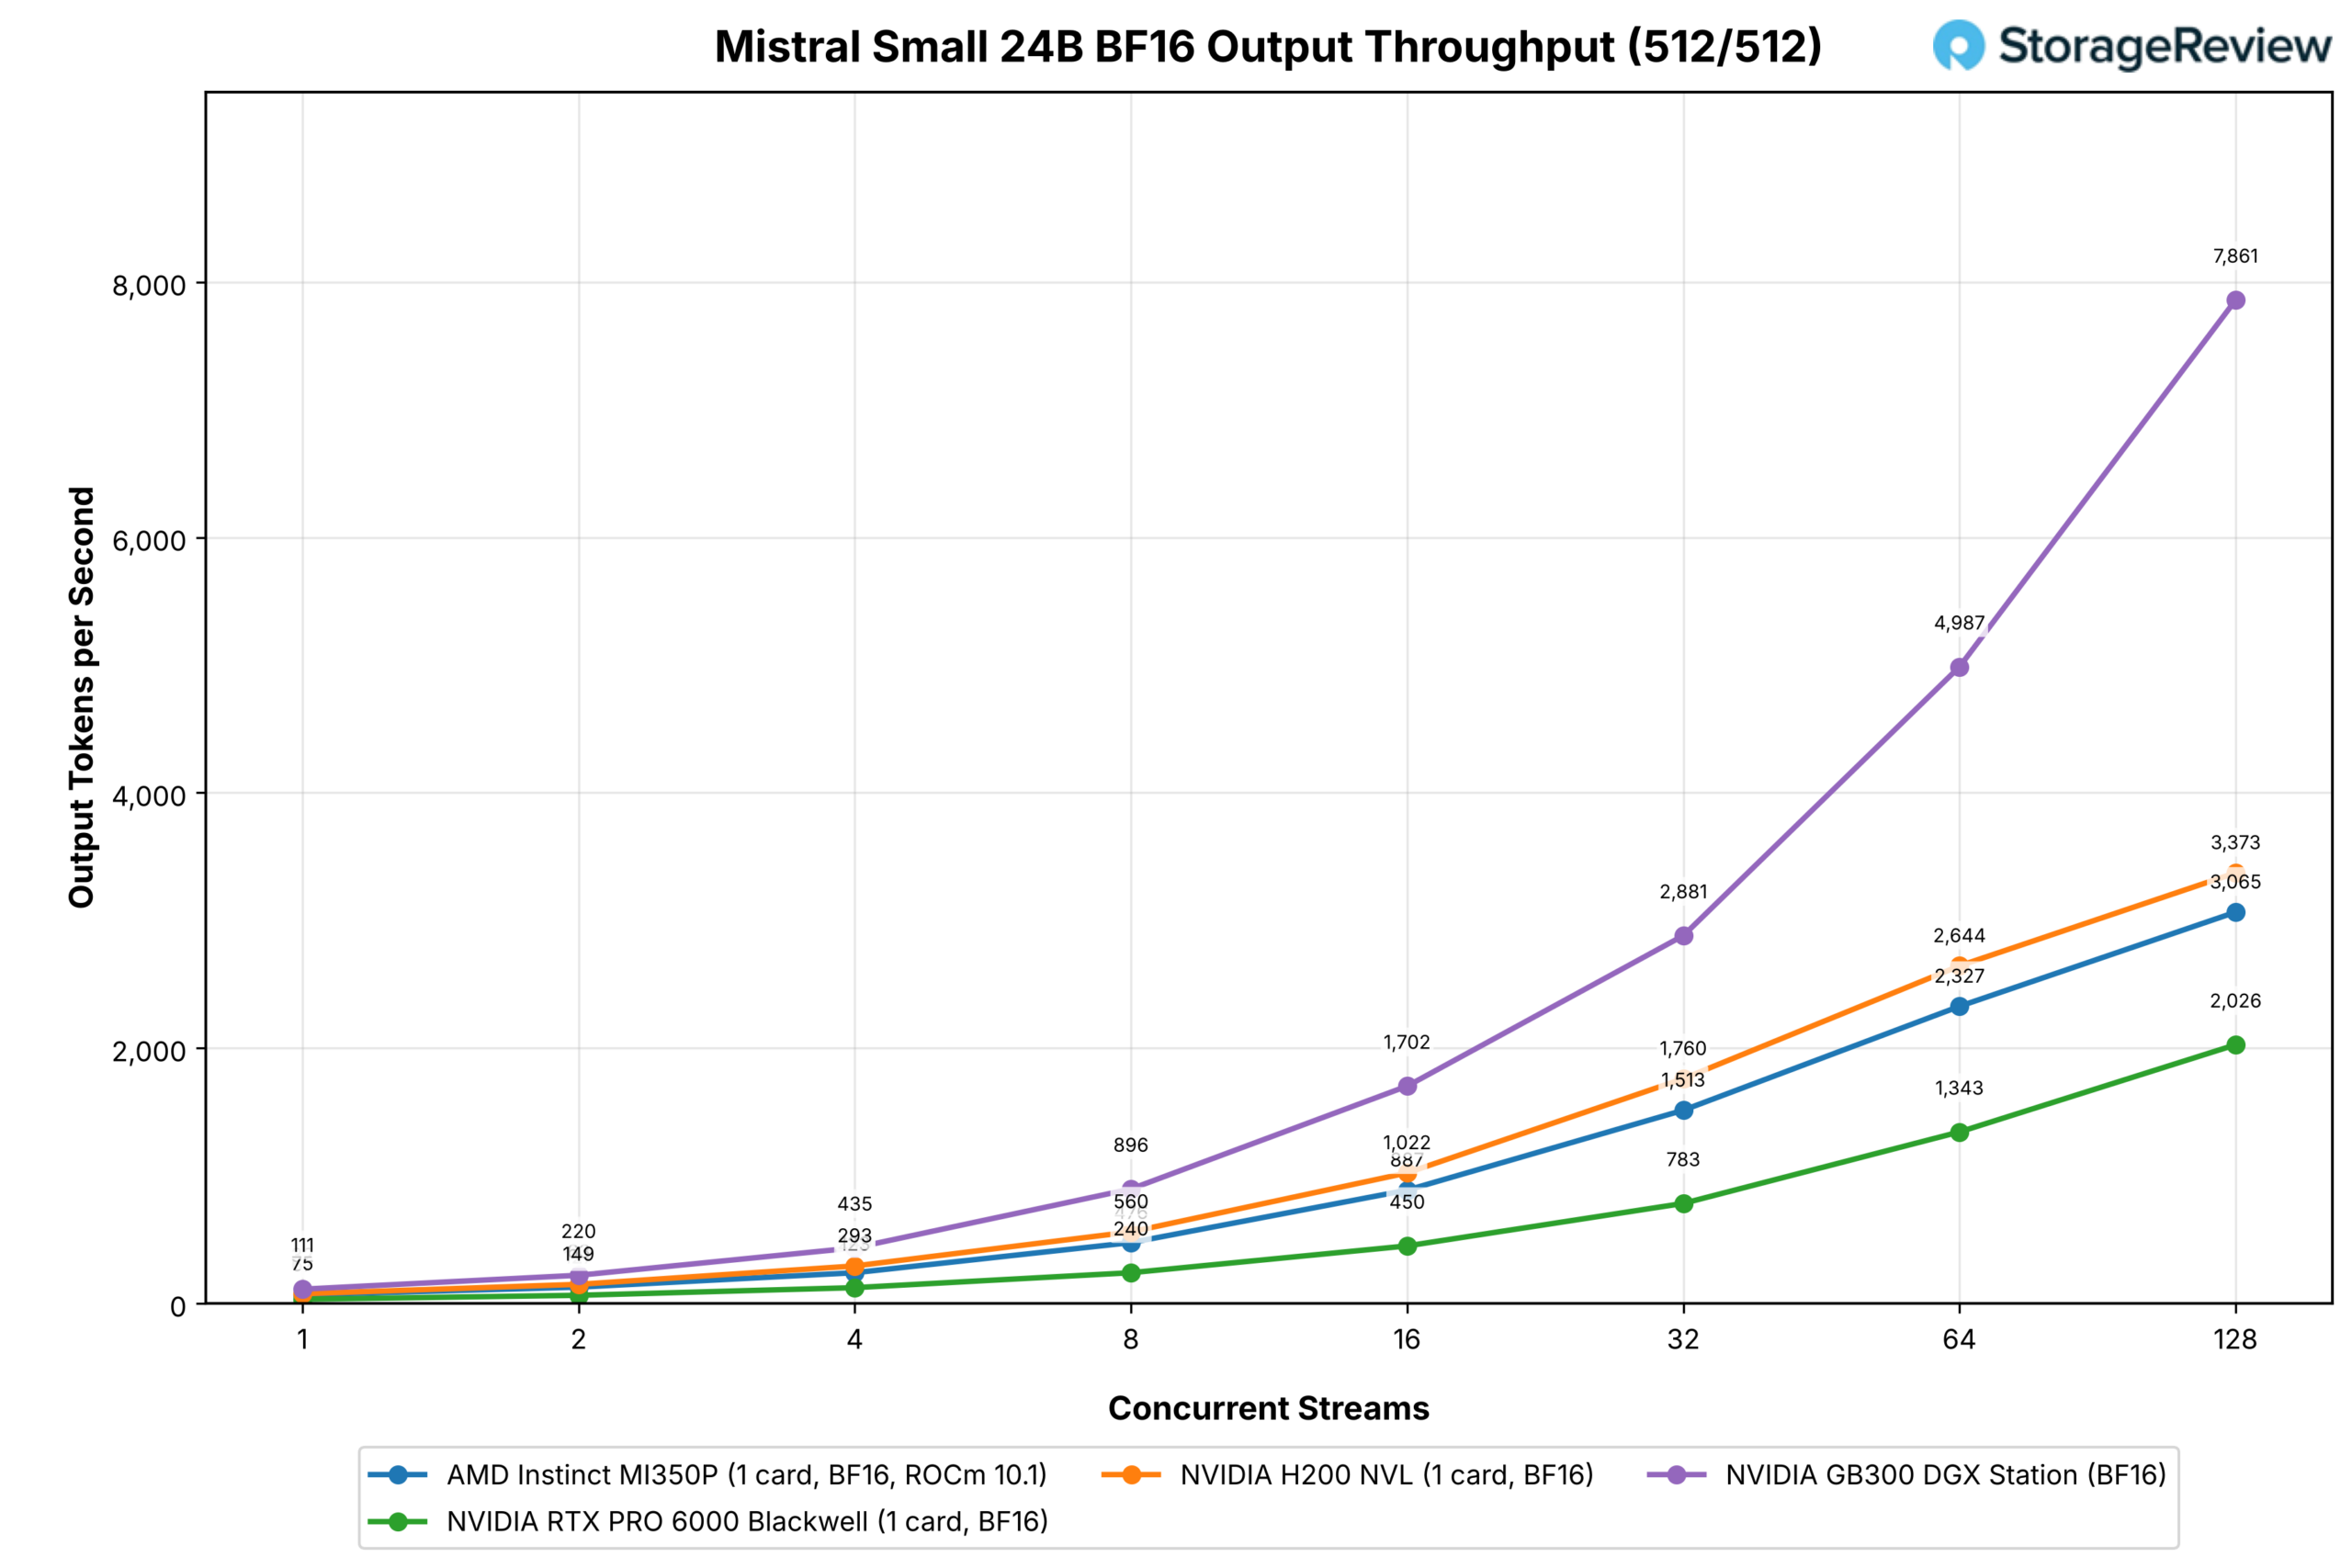
MI350Pの最も強力な高密度結果は、RTX PRO 6000に対するもので、チャットワークロードで128ストリームの場合、FP8で4,458対3,242、BF16で3,065対2,026であり、1ストリームの場合、MI350PはNVIDIAカードのほぼ2倍の性能を発揮します(FP8で100対56、BF16で67対32)。
また、MI350Pは、プリフィルが多いプロンプトにおいて、高密度モデルで優位に立っています。128ストリームのFP8では599対482、64ストリームのBF16では425対299ですが、H200は同じポイントで799と632に達します。
ラマ3.1 8B
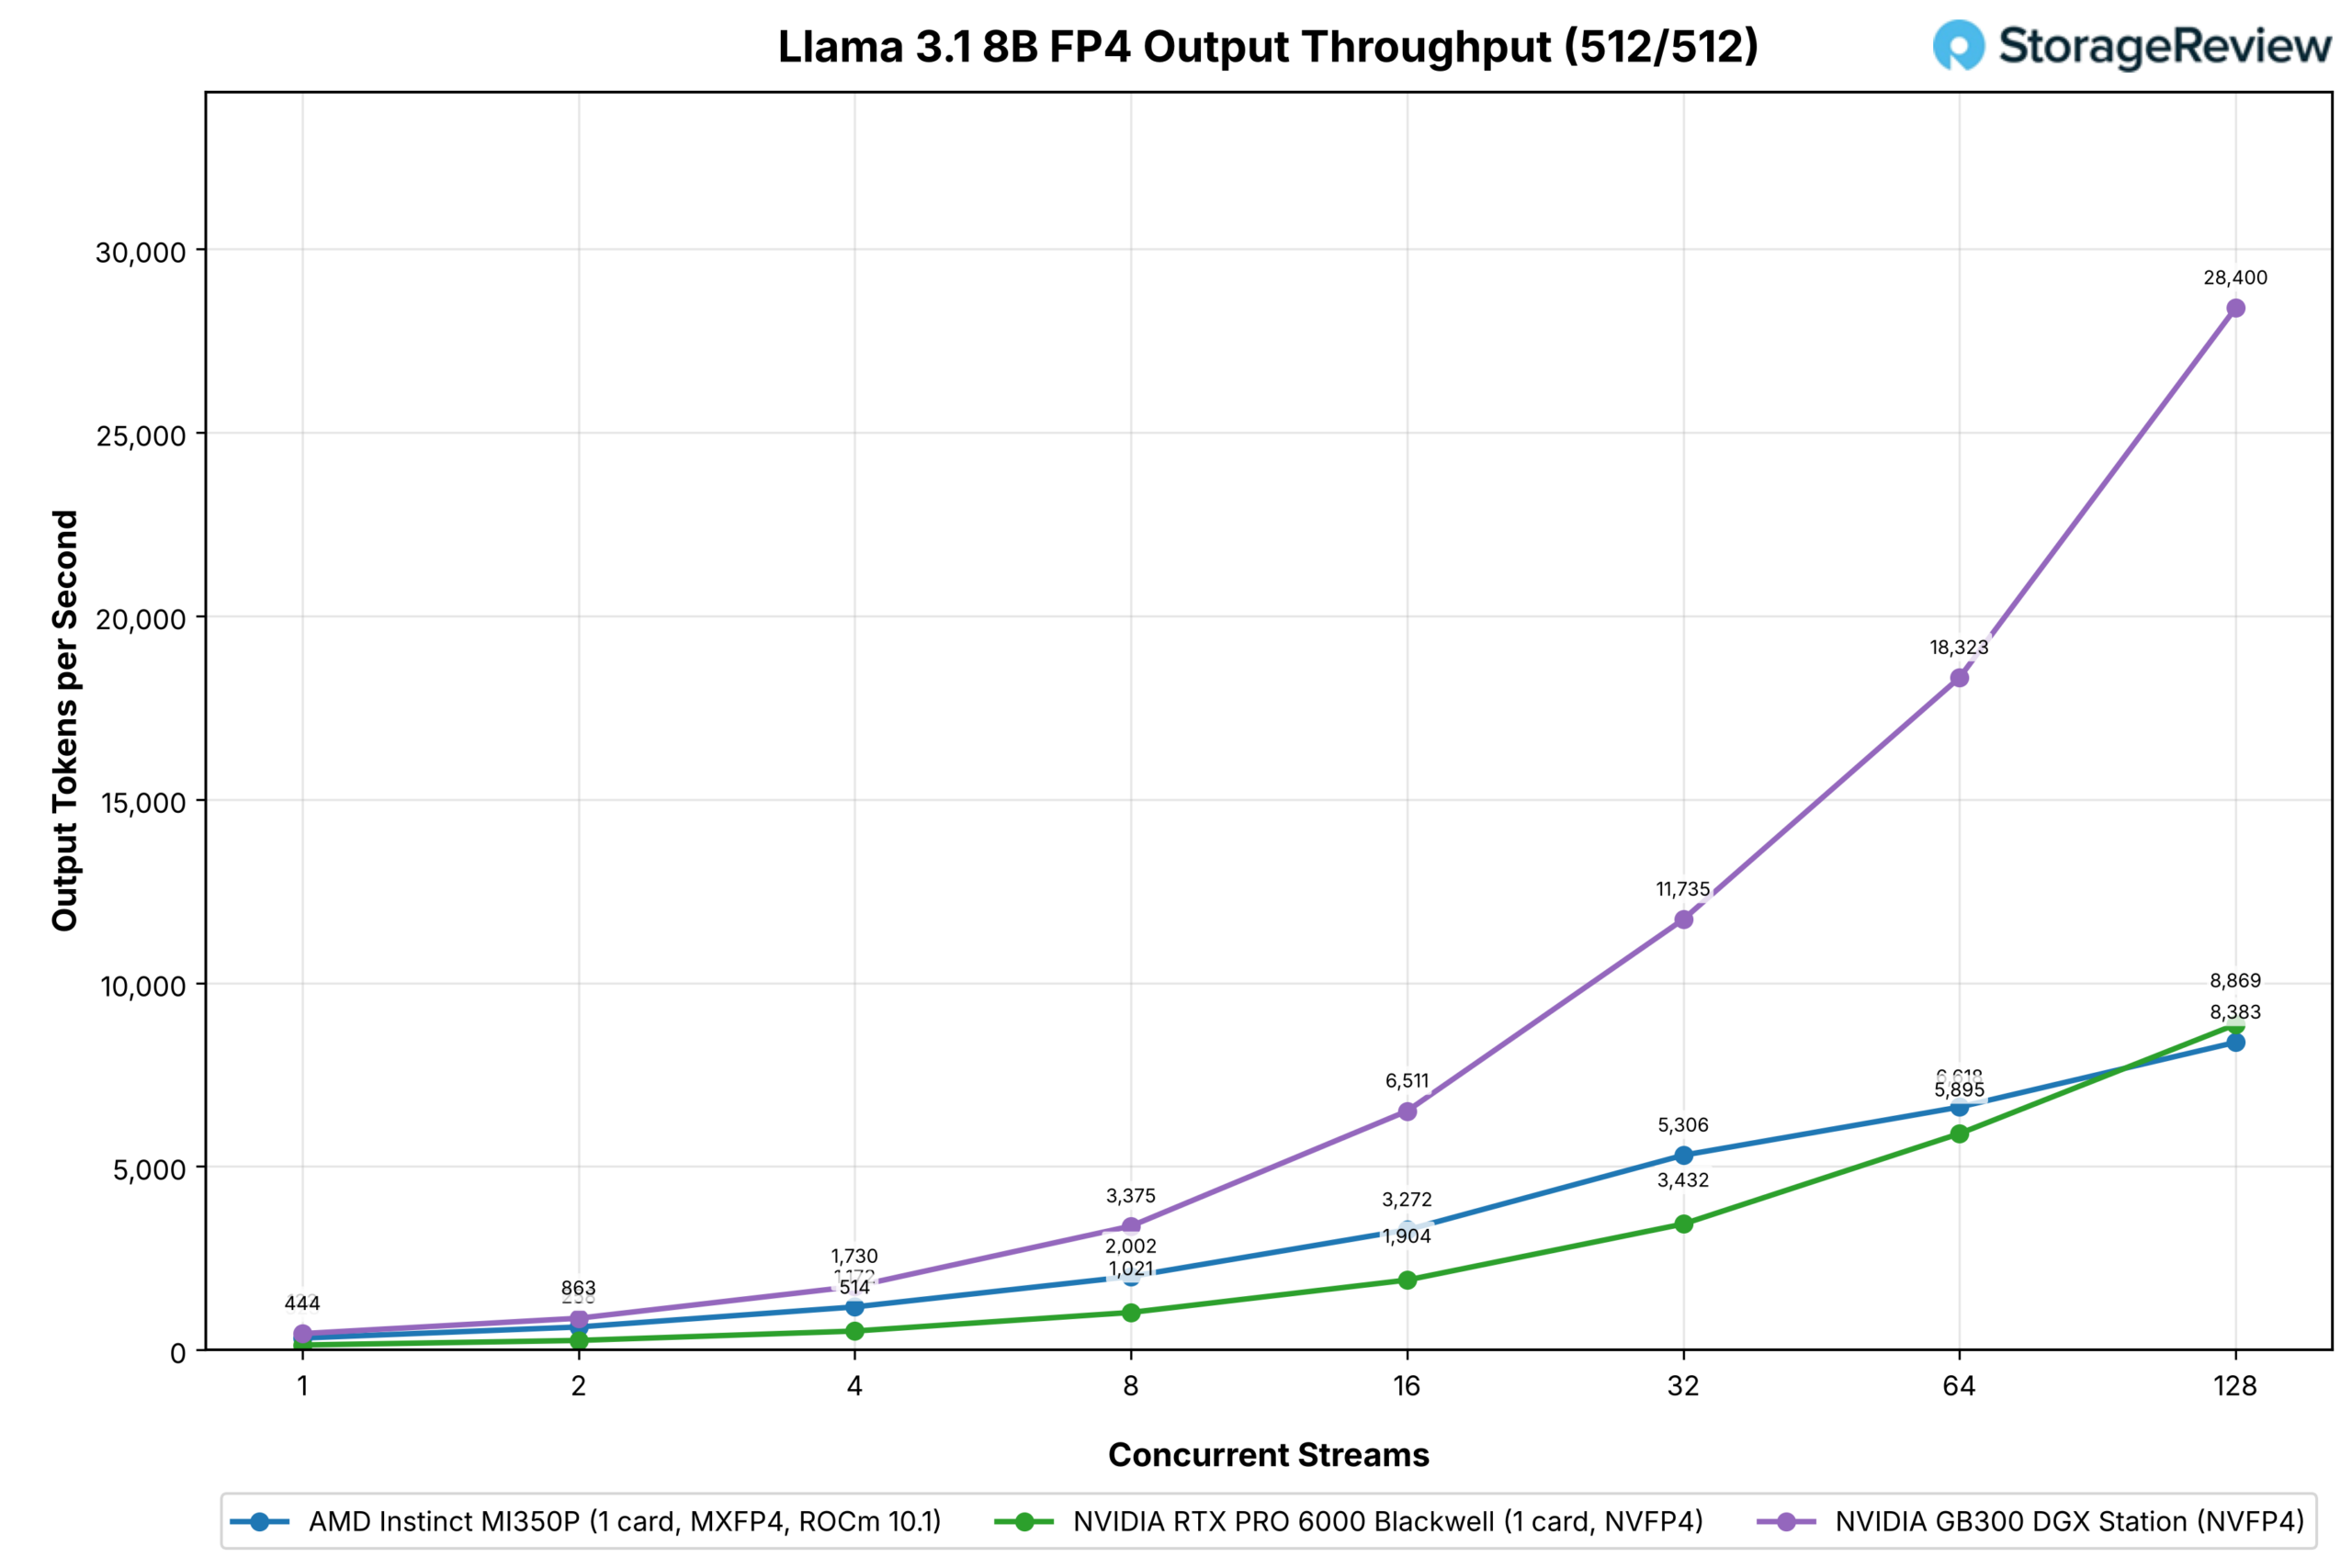
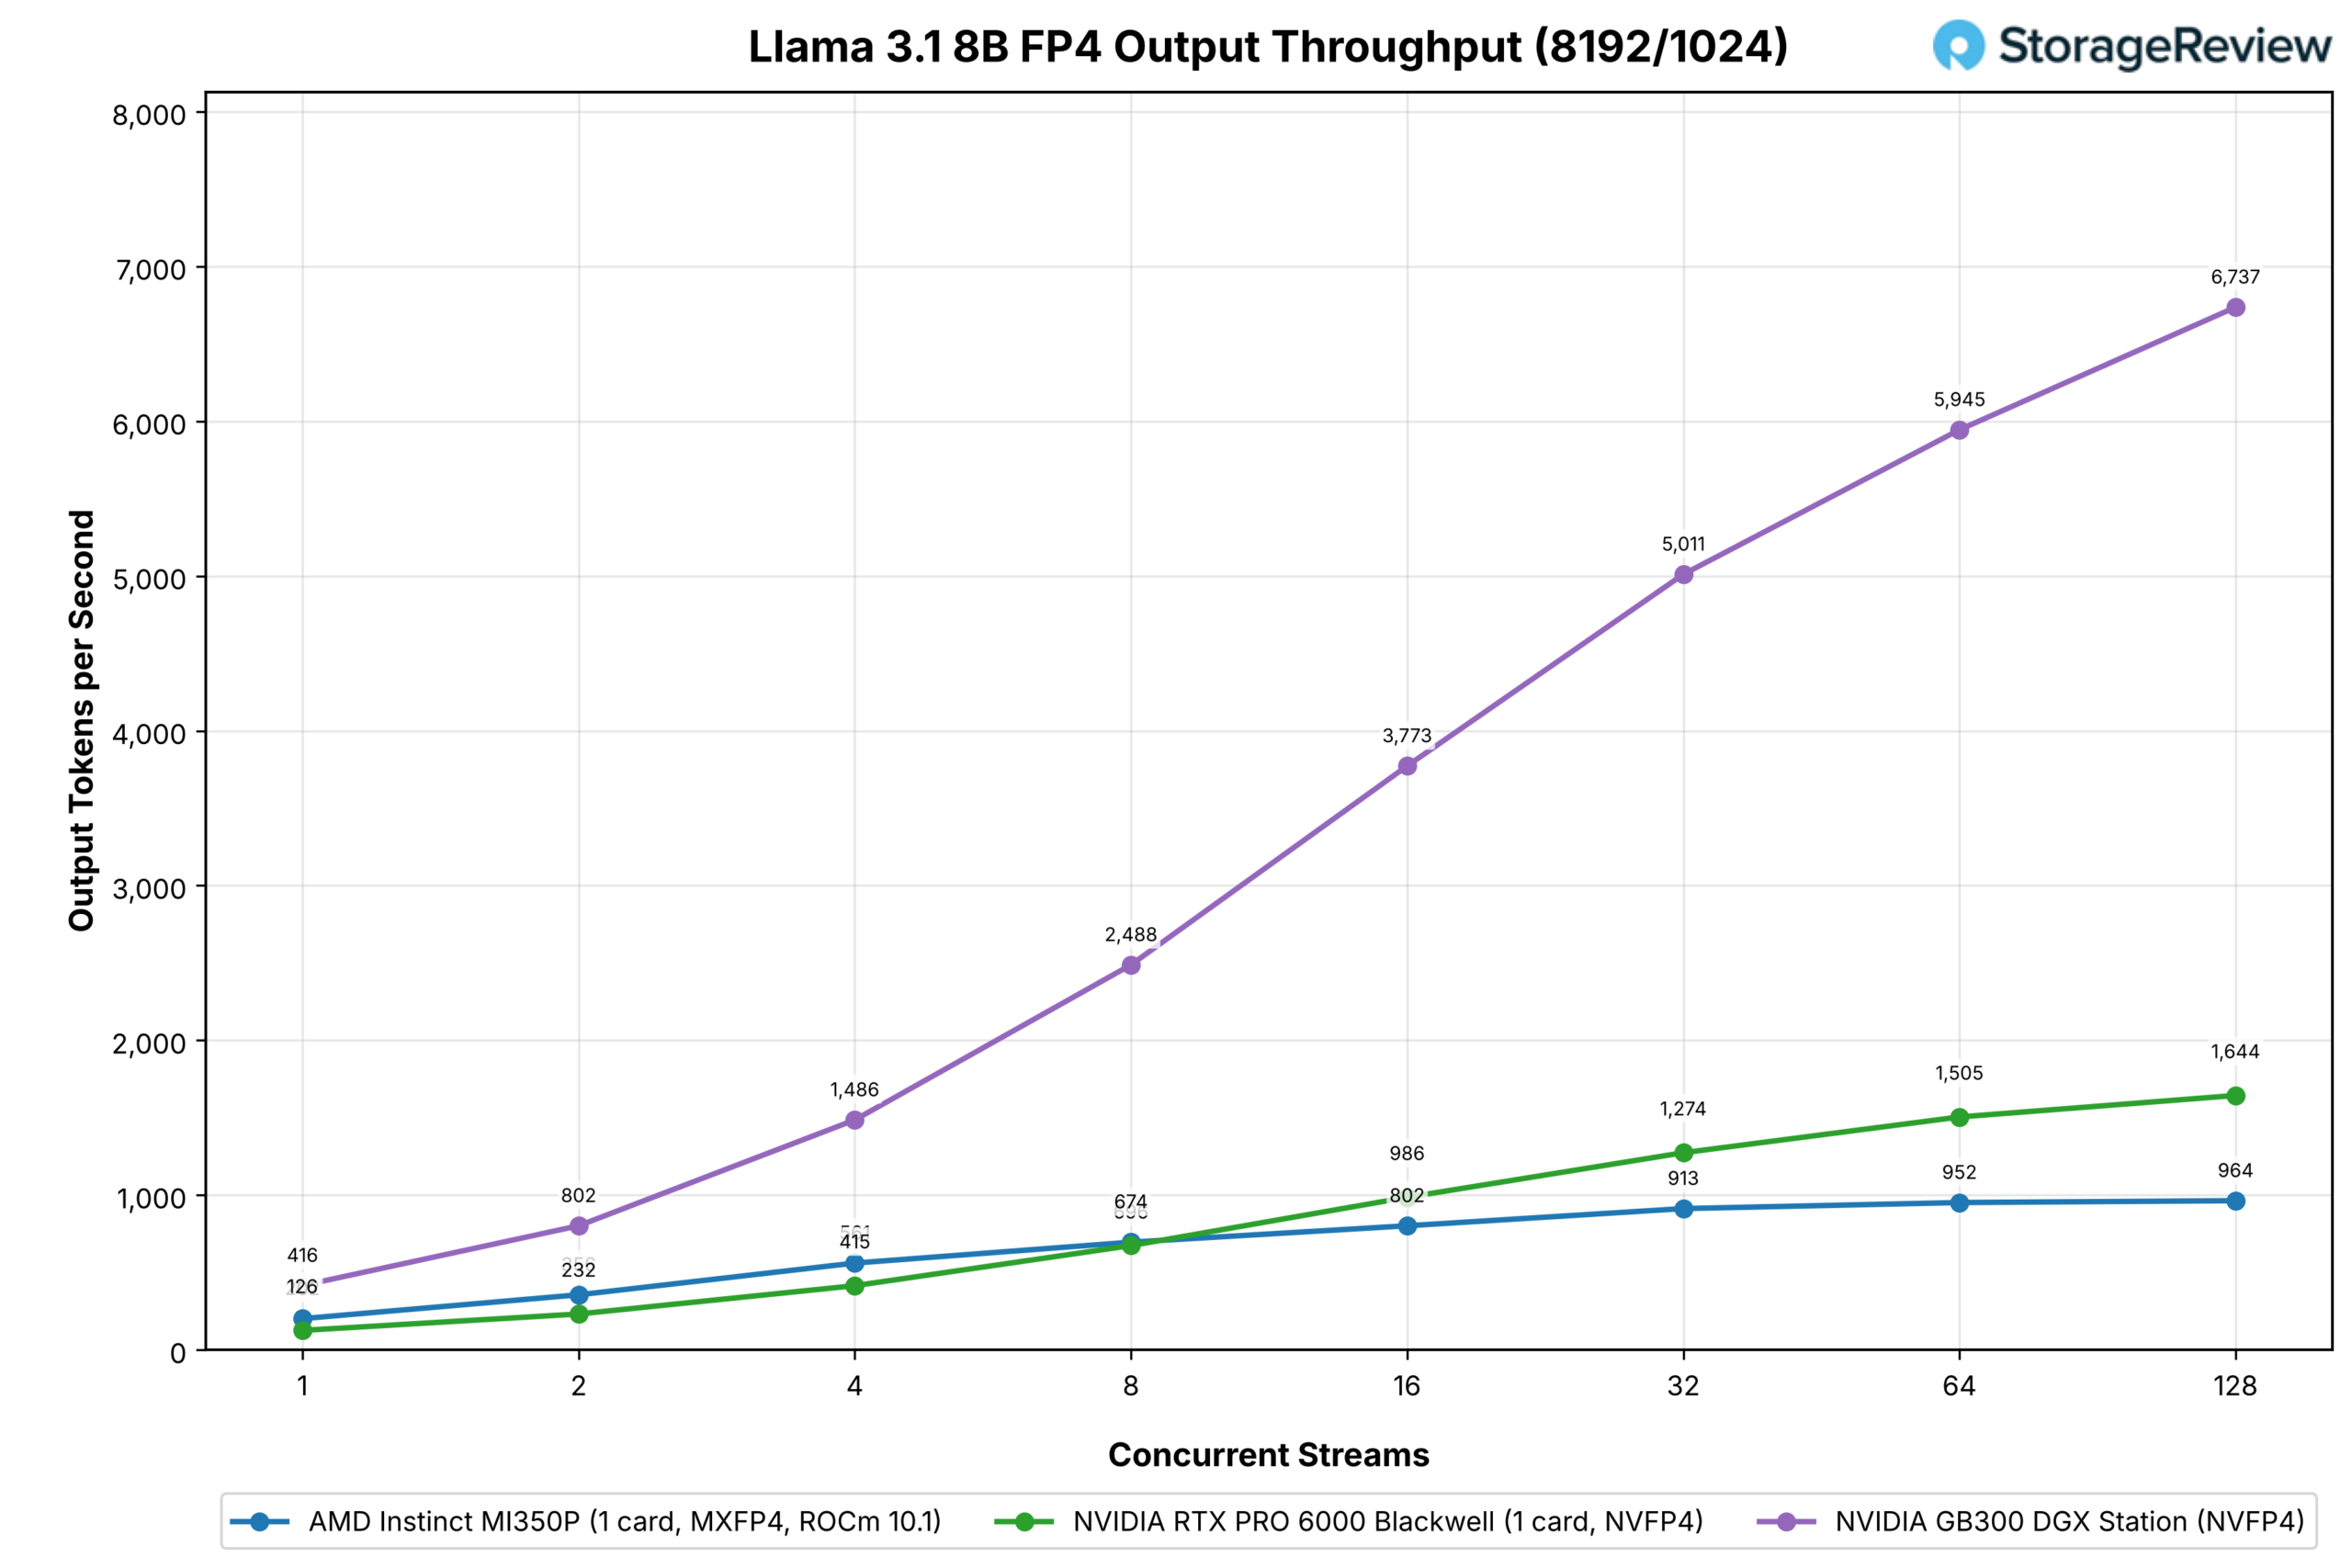
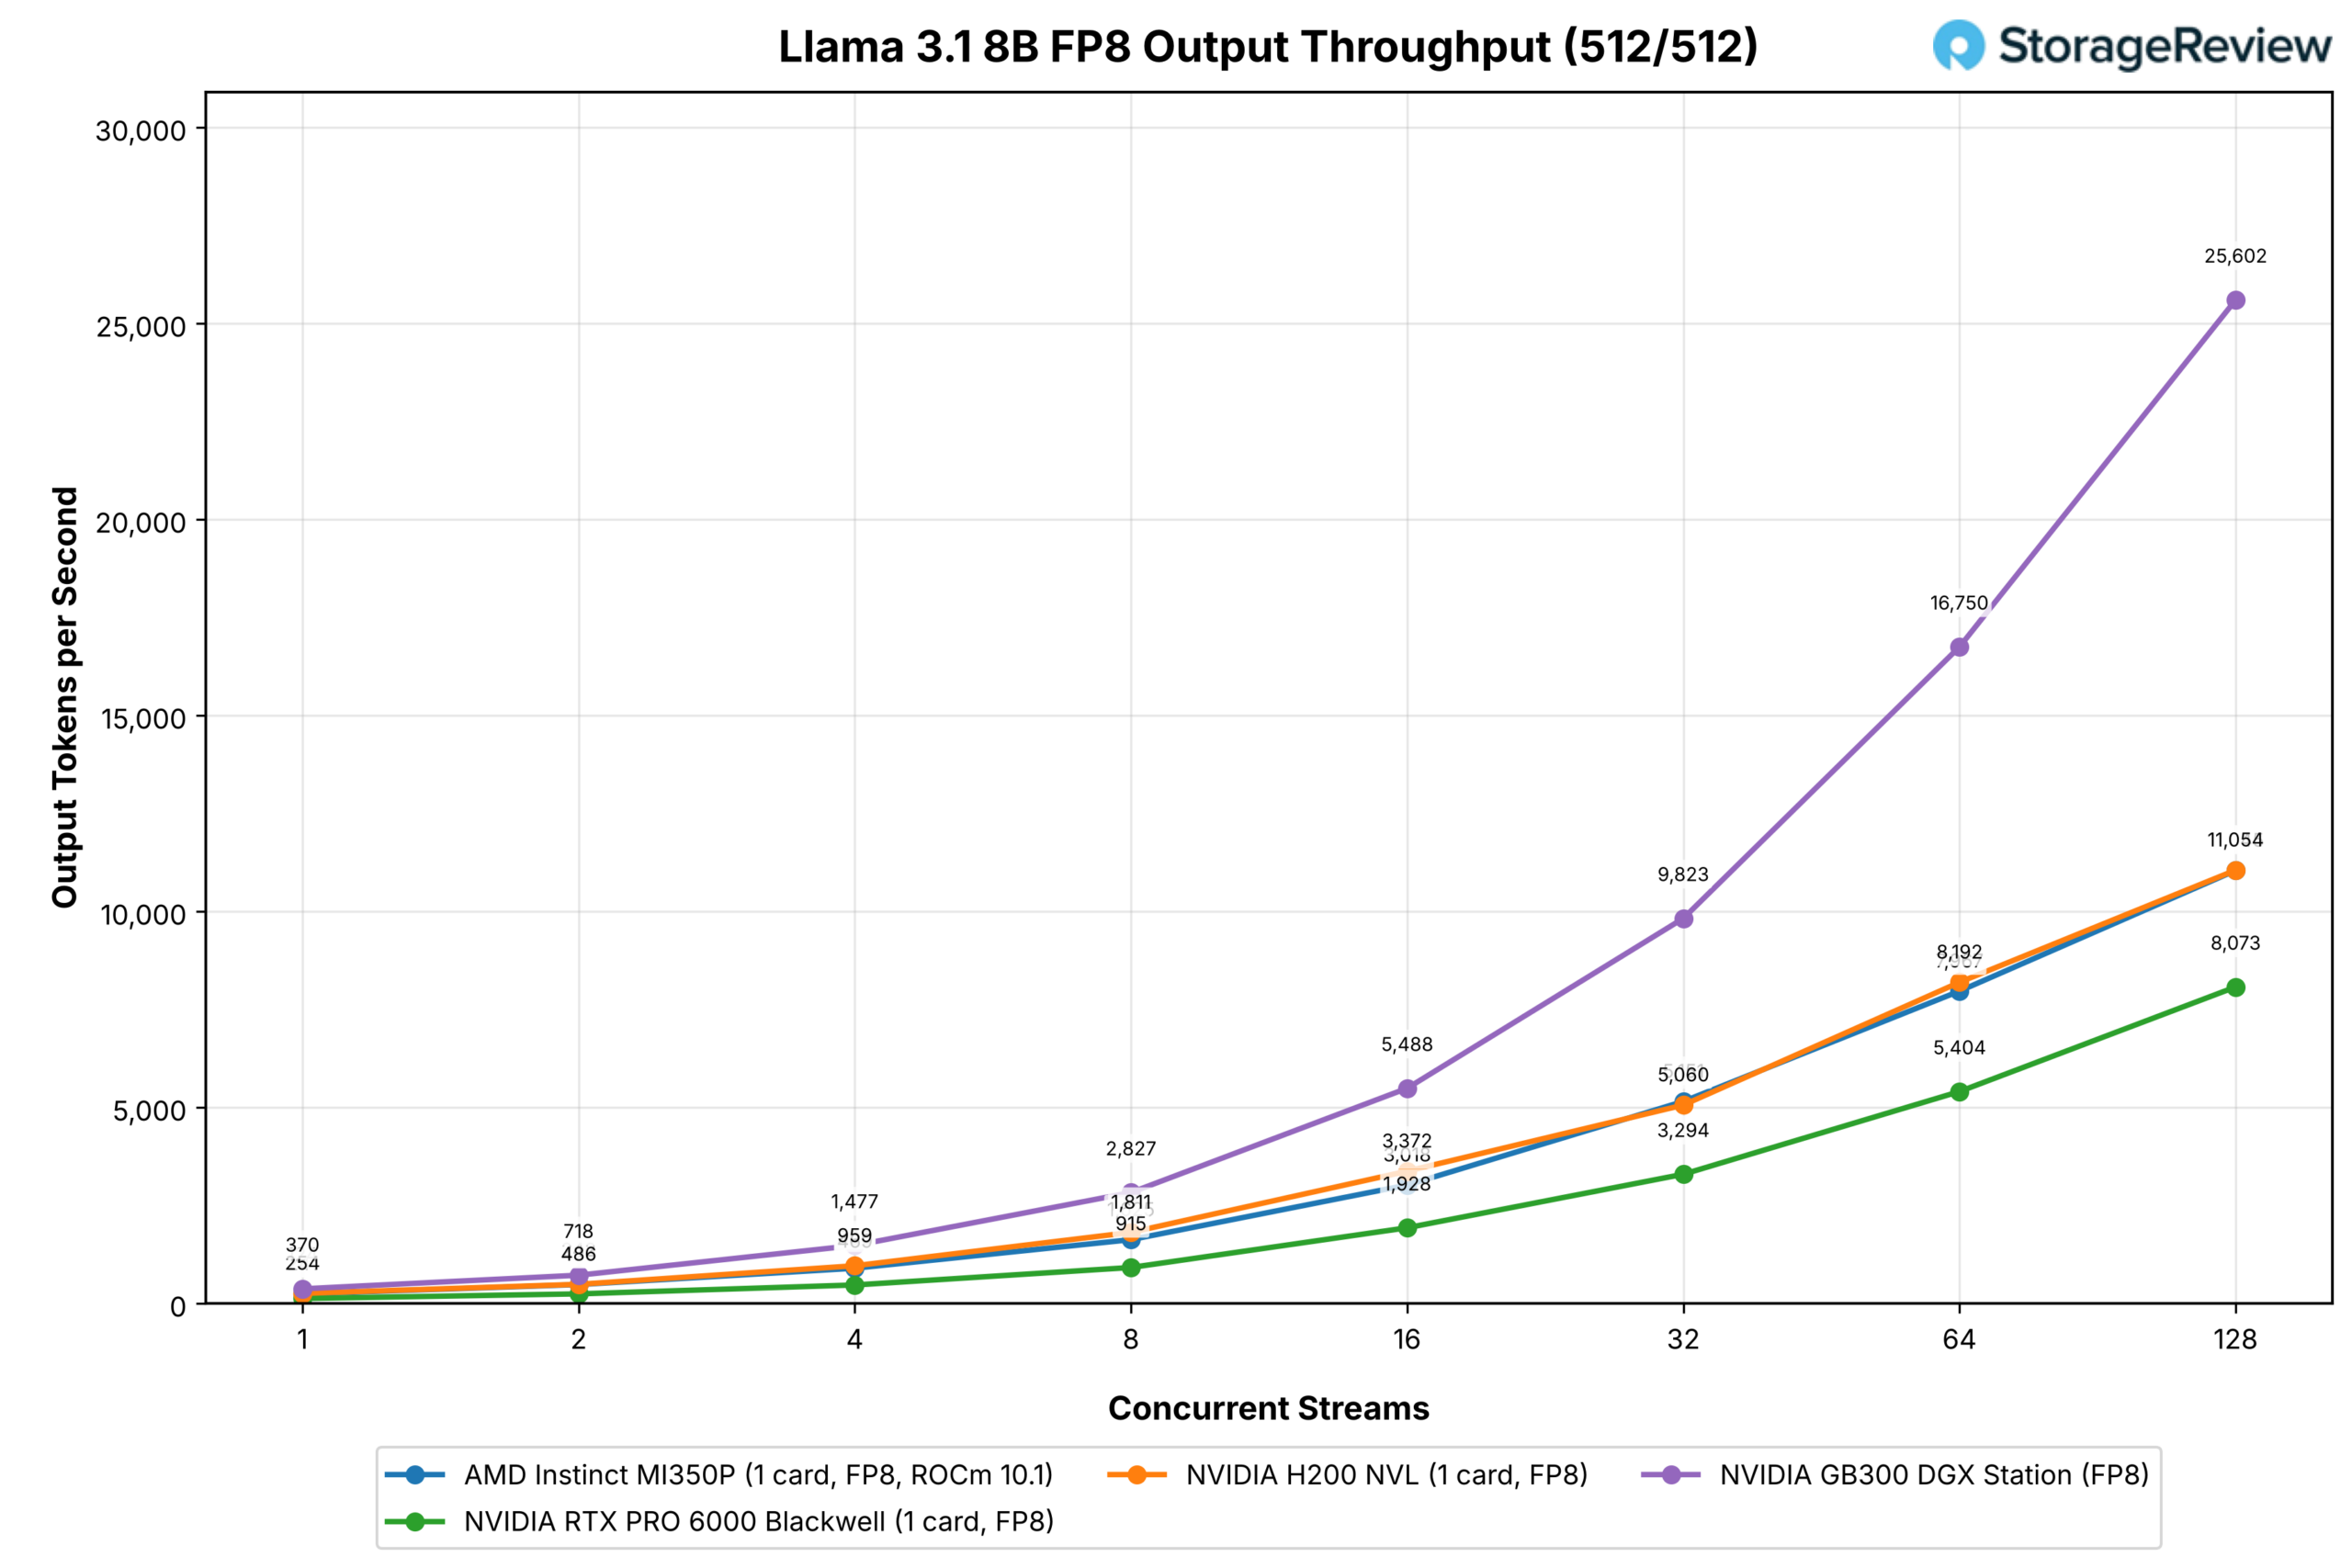
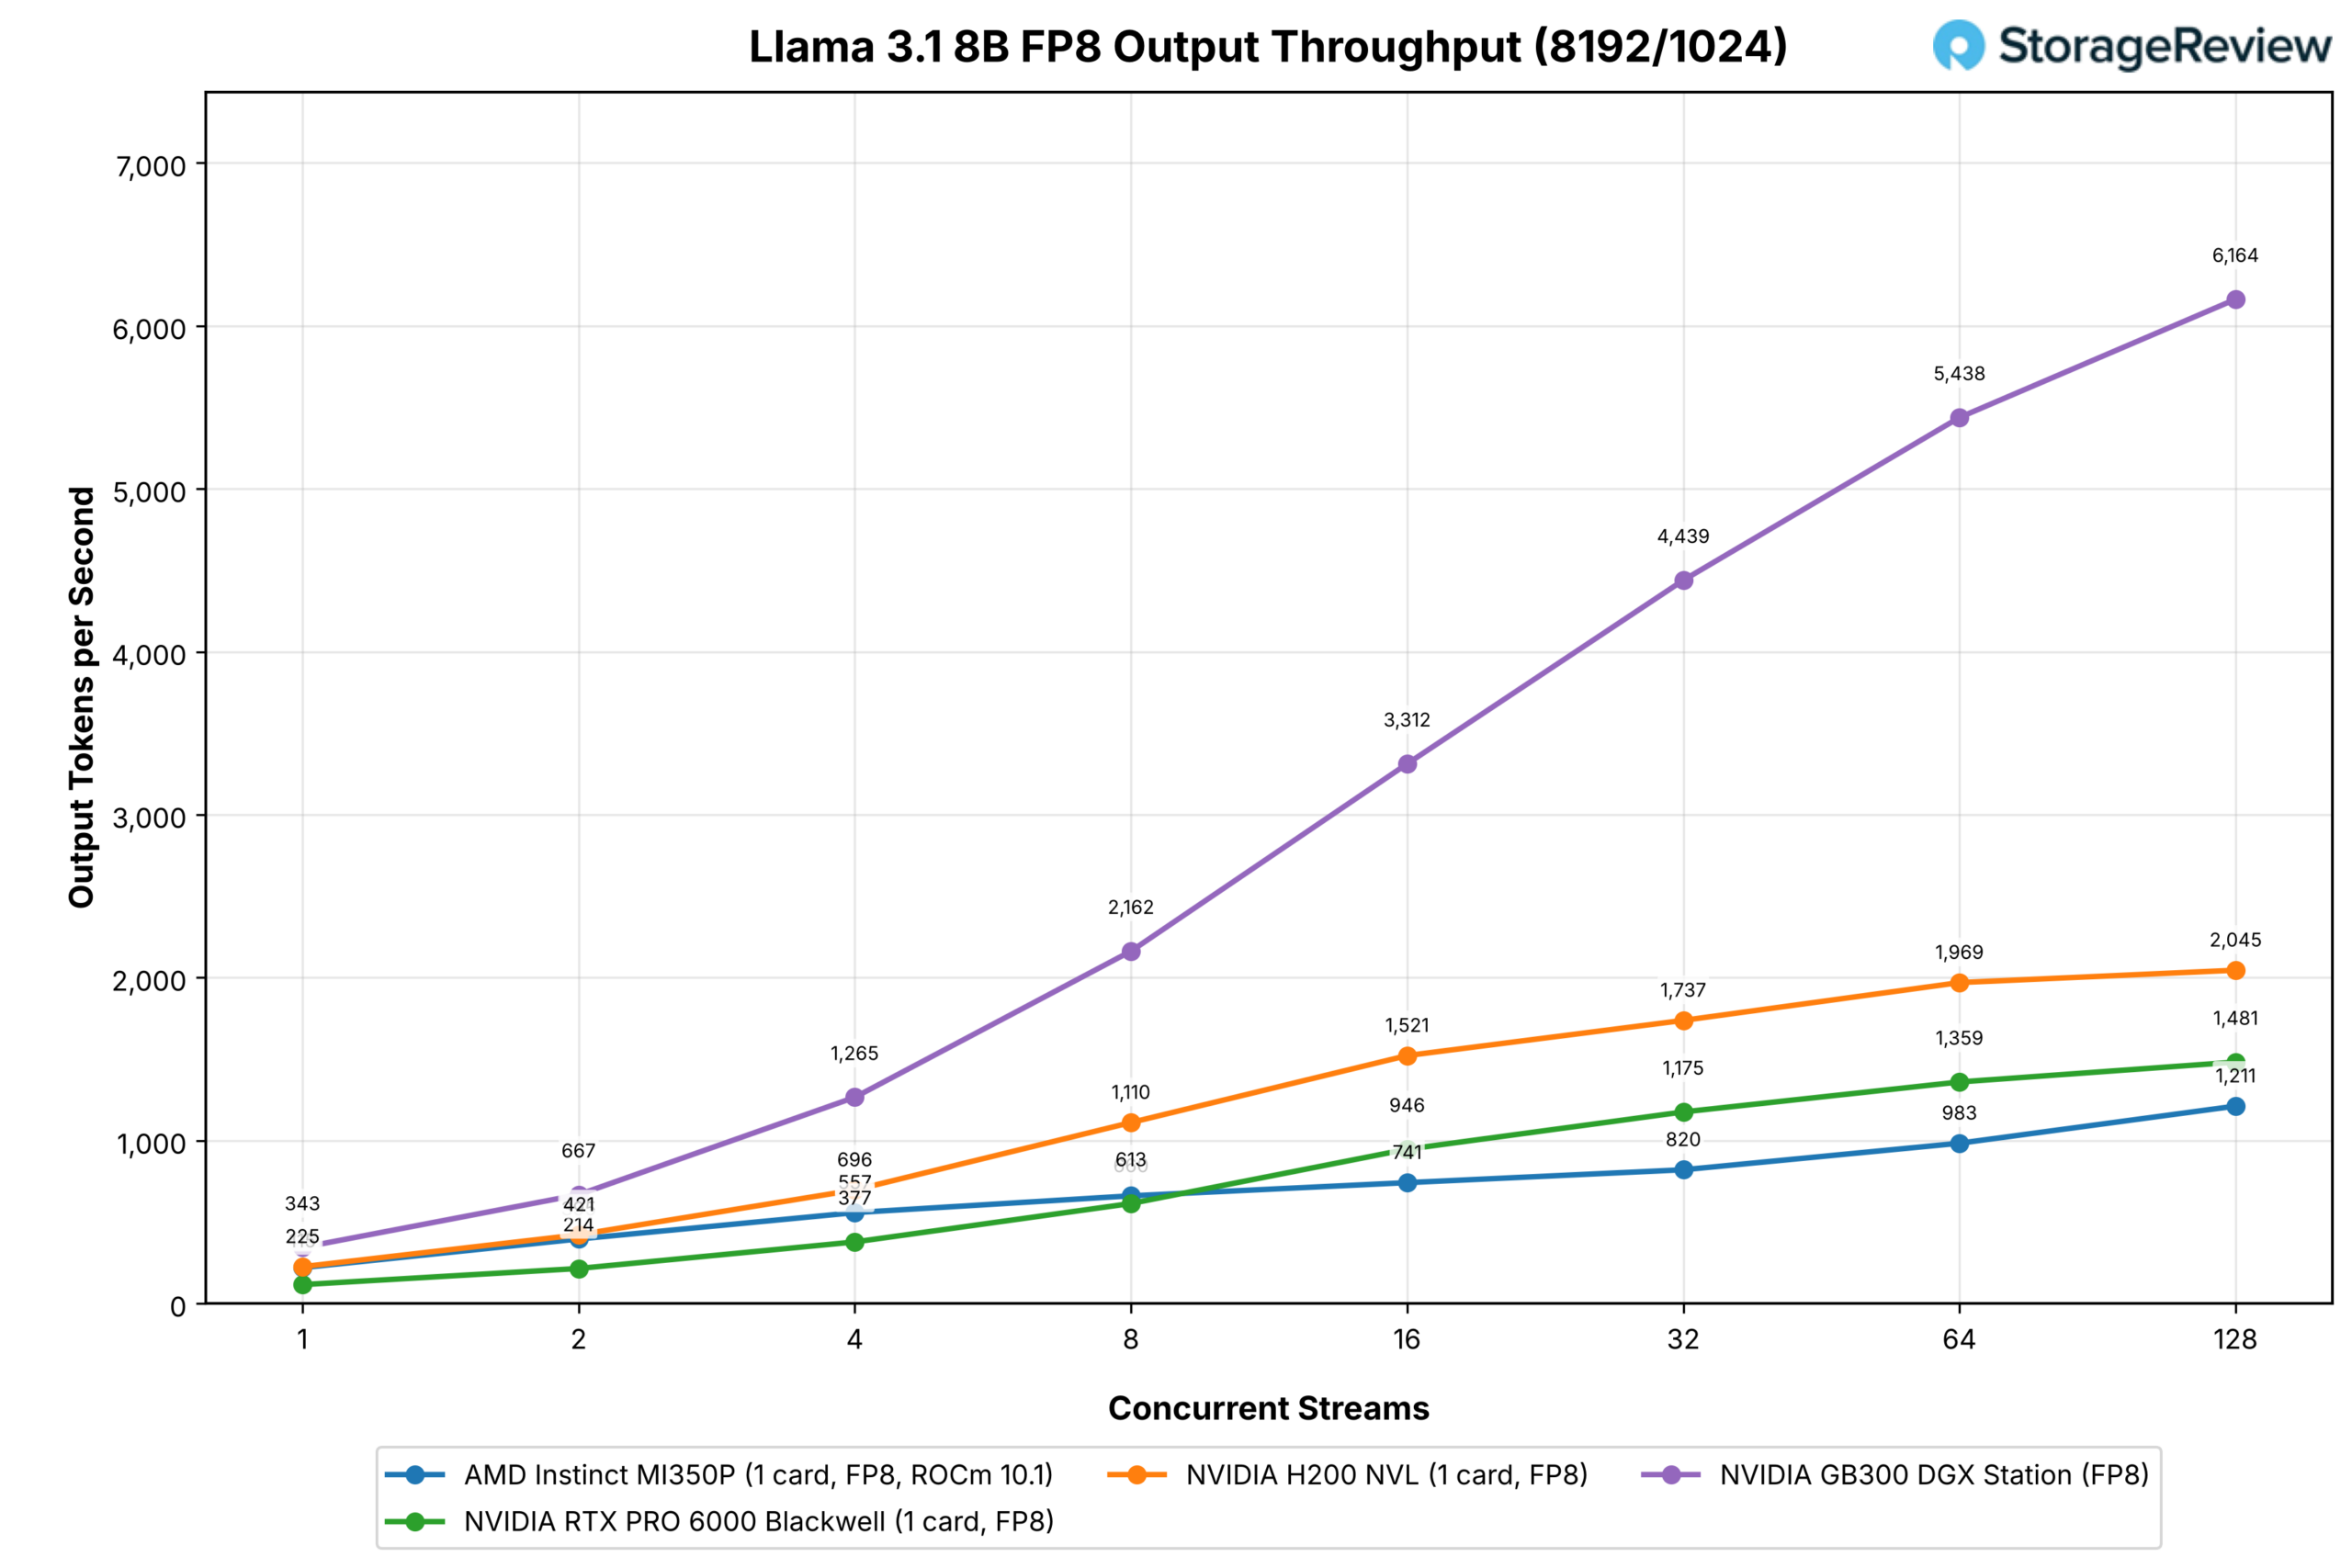
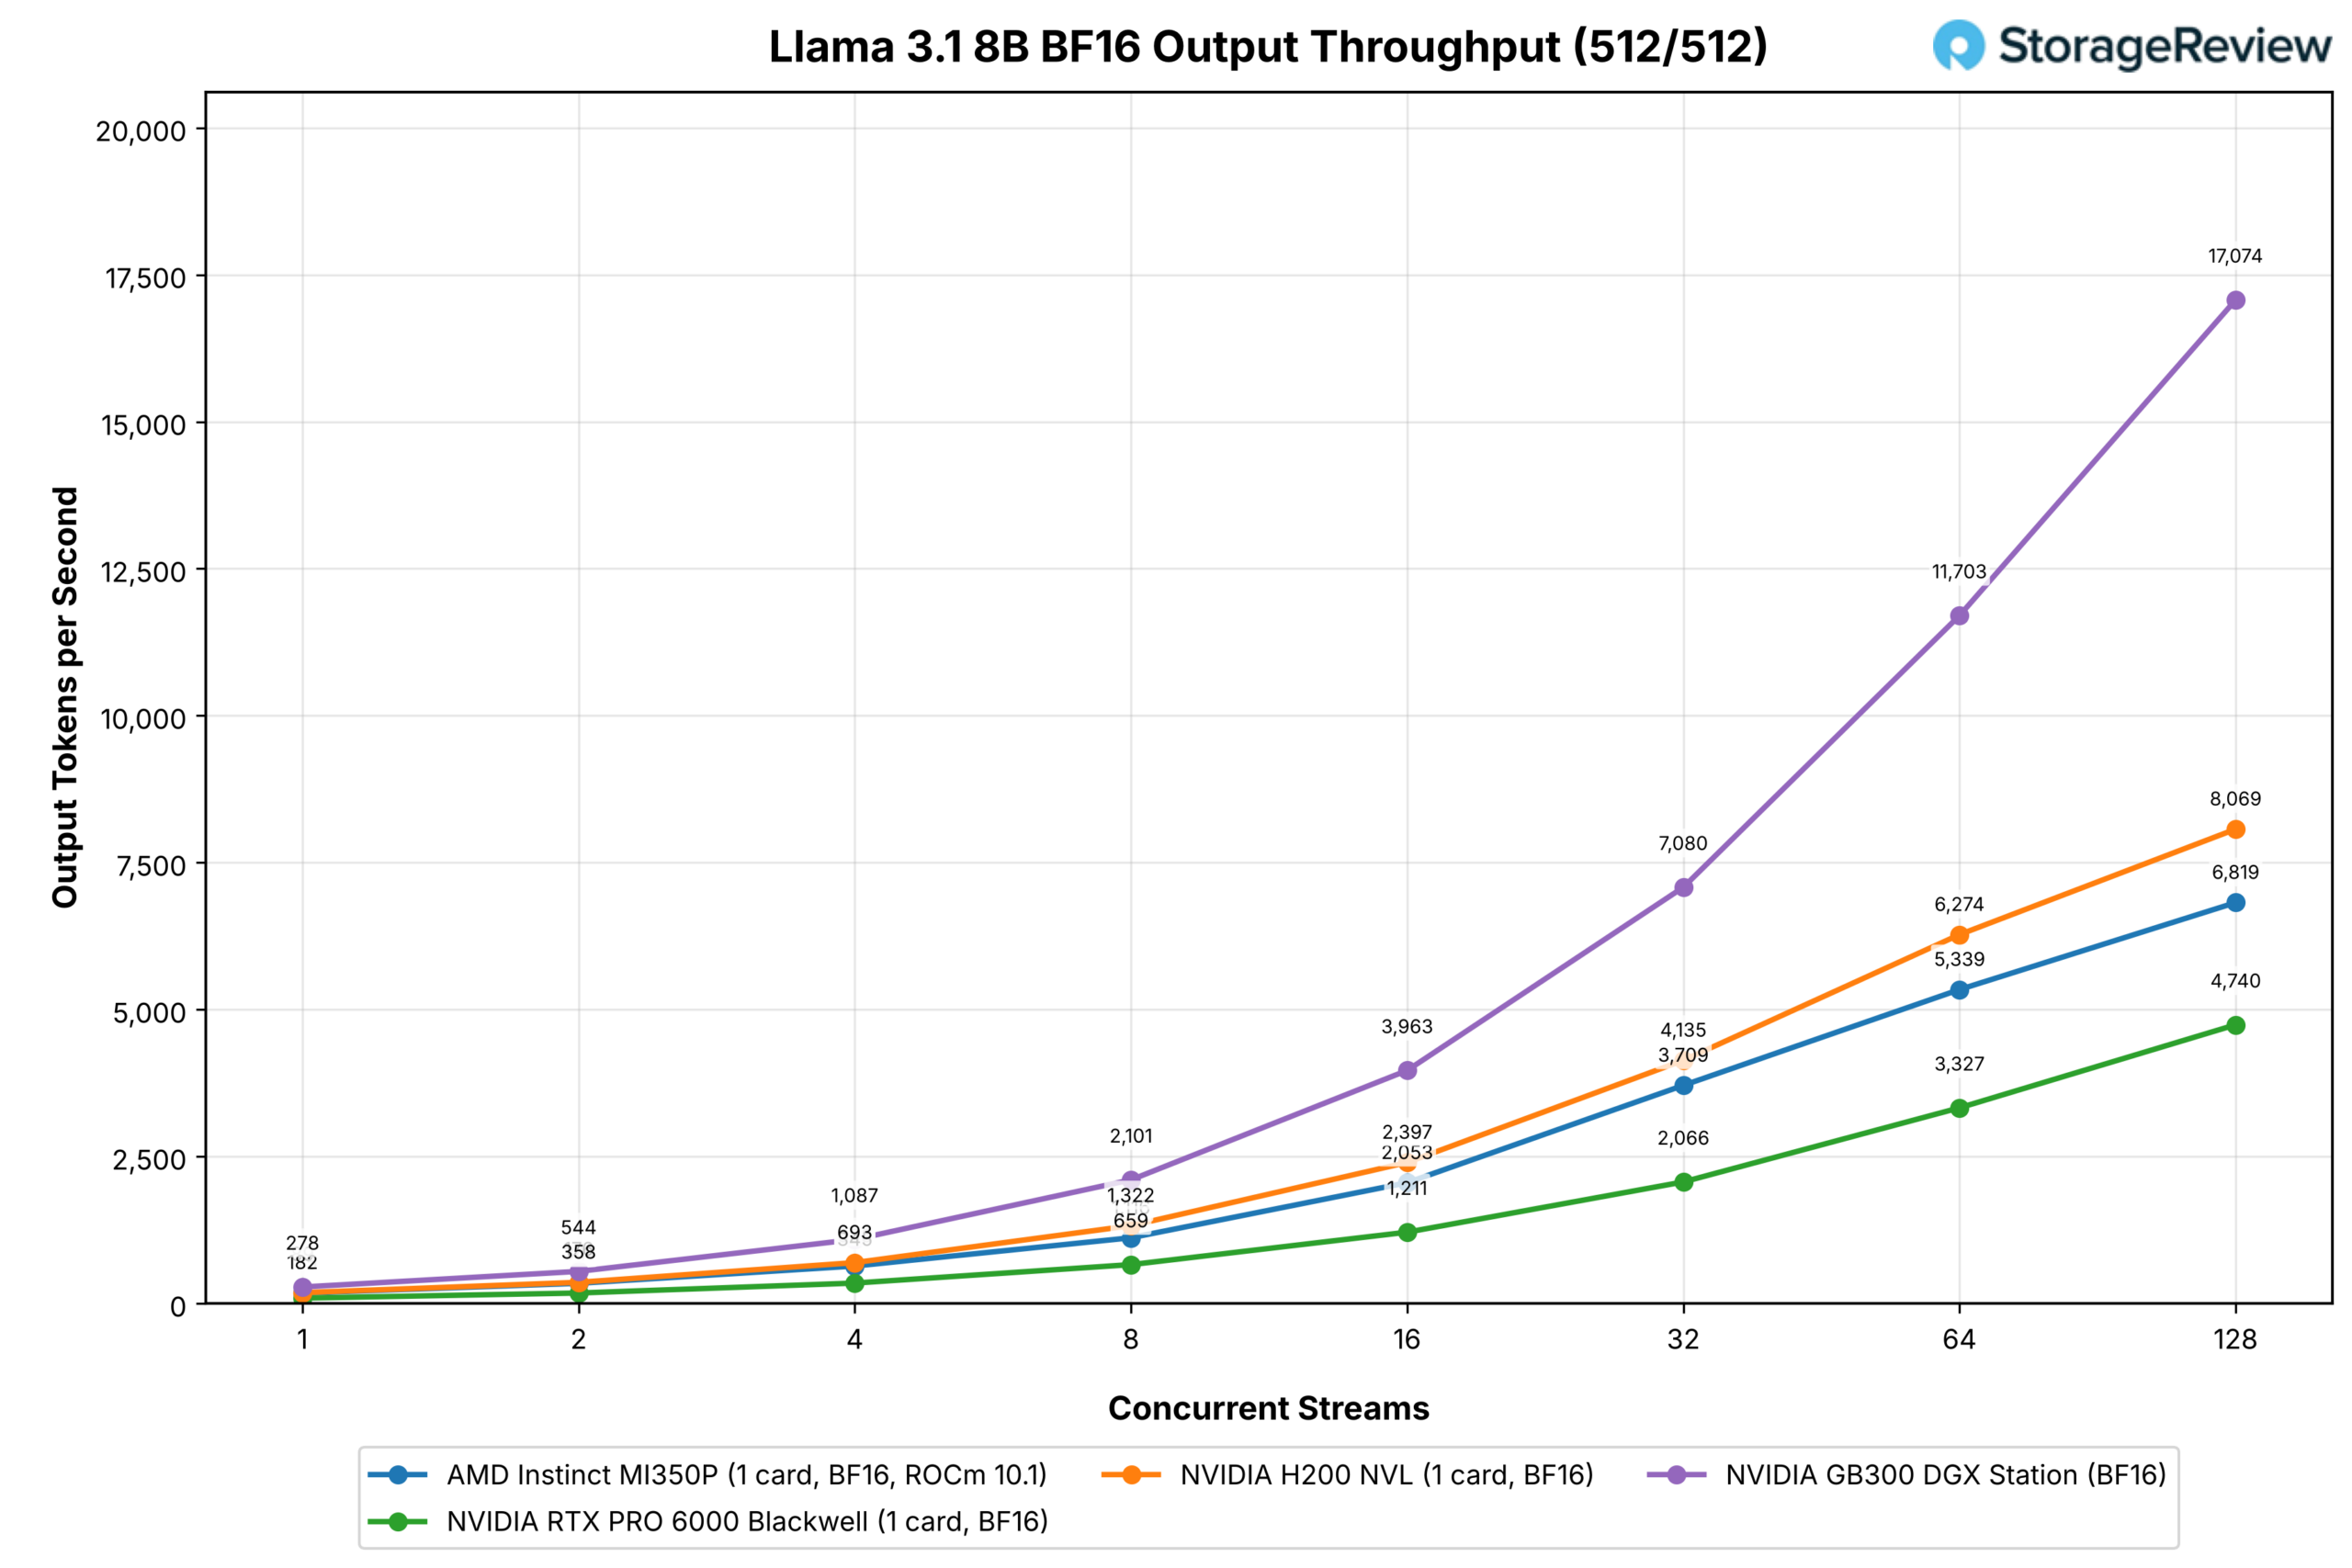
Llama 3.1 8B は、以前の GPU の解説との継続性のためにここにあります。チャットワークロードで 128 ストリームの場合、MI350P は FP8 で毎秒 11,045 個の出力トークンを生成し、RTX PRO 6000 の 8,073 個、H200 の 11,054 個を上回り、Hopper カードと同値です。また、BF16 では 6,819 個を生成し、4,740 個と 8,069 個を上回ります。AMD の MXFP4 ビルドは 128 ストリームで 8,383 個に達し、RTX PRO 6000 の NVIDIA の NVFP4 ビルド (8,869 個) より 5 % 低い値ですが、それより少ないストリーム数では 12 ~ 143 % 上回っていました。シングル ストリームでは、MXFP4 の実行結果は 323 個に対し 133 個でした。
プリフィルを多用した実行では結果が逆転します。MI350P FP8 は 16 ストリームで平坦化され、1,211 で終了します。これは、RTX PRO 6000 の 1,481、H200 の 2,045 と比較して低い値です。ただし、MI350P は 1 ストリームで RTX PRO 6000 より 90% 高い値からスタートし、MXFP4 ビルドは 128 ストリームで NVFP4 より 41% 低い値となっています。
結論
MI350Pは、4年ぶりに標準サーバーに搭載できるInstinctカードであり、2Uサイズの筐体で450Wの消費電力ながら、PCIeアクセラレータとして十分な性能を発揮します。144GBのHBM3Eメモリを4TB/sで搭載し、MAMF構成ではFP8が1,120TFLOPS、ブロックスケールFP4が2,228TFLOPS(RTX PRO 6000 Blackwellはそれぞれ820TFLOPSと1,634TFLOPS)で、NVIDIAカードの約2.1倍のメモリ帯域幅を実現しています。

RTX PRO 6000と比較すると、MI350Pはチャットサイズのプロンプトにおいて、FP8、BF16、GPT-OSSの各モデルで35~65%高速であり、128ストリームではHBM3Eの帯域幅と容量が96GB GDDR7カードを上回り、GPT-OSSモデルでは両方のプロンプト形状のすべてのストリーム数で優位に立っています。
H200 NVLは、FP8とBF16の高密度テストで依然としてHopperを上回り、チャットプロンプトの128ストリームで4~18%、長いプロンプトではさらに上回り、帯域幅が20%多く、FP4パスはありません。GPT-OSSでは、MI350PはHopperカードを50%と78%上回りました。より大きなモデルでは、350つのRTX PRO 6000がGLM-5.2で16ストリームをリードしており、384GB対288GBで、より多くの総帯域幅と演算能力を投入できるため、結果はまだ確定していません。
MiniMax-M3 はより近い値を示しています。3 つの構成は、チャット プロンプトの 8 つのストリーム全体で 10 パーセント以内に収まり、RTX クアッドは 16 でリードし、MI350P ペアは 8 つのストリーム全体で長いプロンプトでリードしています。カード 1 枚あたりの MI350P の測定された FP4 レートは RTX PRO 6000 より 36 パーセント高いため、利点はカードの枚数です。これらの 2 枚のカードの結果は ROCm 7.2.3 スタックで取得され、600W テストと並行して ROCm 10.1 でも再度実行されます。
MI350Pの最終的な評価は、600Wでフルパワーでのテストを実施しない限り、現時点では不可能です。弊社ではPowerEdge XE7745でテストを実施する予定です。Dellはこのシャーシで600WのMI350Pを8台までサポートしています。AMDは、追加の150Wで約10%のパフォーマンス向上を見込んでいると聞いています。
AMDは大きな進歩を遂げており、MI350/5Xシリーズはそのアーキテクチャの能力の高さを証明しています。当社では開発用にMI300Xを搭載したマシンをラボで運用していますが、ソフトウェアスタックのスピードは、標準のvLLM上で多くのアプリケーションが問題なく動作したことからも明らかです。
この構成で確認できた限りでは、MI350Pは、リードタイム、価格、あるいは特定のメーカーへの依存を避けたいという理由でNVIDIA製GPUの代替品を探している購入者向けであり、PowerEdgeシリーズにおけるDellのMI350Pのサポートは、こうしたニーズを満たす主流サーバーにシリコンの多様性をもたらす。
公平を期すために、私たちの仕事はまだ終わっていません。多くの購入者はこれらのカードを2Uサーバーに搭載するかもしれませんが、600Wカード用に設計されたより大きなシャーシに搭載すると、さらに高いパフォーマンスが得られます。どのように展開されるにせよ、これはAMDがアドインカードサーバー市場に復帰したことを示す素晴らしい第一歩であり、ソフトウェアスタックが成熟し続けるにつれて、MI350Pとその後の製品には有望な未来が待っています。現在、96GBから144GBの範囲のモデルを使用している購入者にとって、MI350PはシングルGPUで済む2つのPCIeカードのうちの1つであり、141GBを超える唯一のカードです。
リーダーボード: AMD Instinct MI350Pは、当社の「ベストエンタープライズGPU」リーダーボードの「テスト済み」セクションに掲載されており、2枚のカードを使用した結果は「スケールアウト構成」セクションに記載されています。



 Amazon