

NVIDIAのGB10をベースにしたデスクトップAIシステムには、128GBの統合メモリと1ペタフロップの演算能力を、使用者のすぐ近くのデスクに搭載し、瞬時に反復処理を行うという、たった一つの目的があり、それをうまくこなしています。しかし、組織が既に運用しているストレージとの接続機能がありません。DGX SparkとそのOEM版には、短いM.2スロットが1つしか搭載されておらず、ローカル容量は約4TBに制限され、そのマシン上のすべてのデータセット、モデル、チェックポイントは、データセンターに存在するガバナンス、アクセス制御、バックアップ、監査証跡の対象外となります。これを研究室、部署、キャンパスに当てはめると、結果として数十個の独立した4TBの島ができあがり、それぞれが同じモデルとデータセットのコピーを保持し、それぞれのセキュリティは、それが置かれているデスクのセキュリティレベルに左右されます。
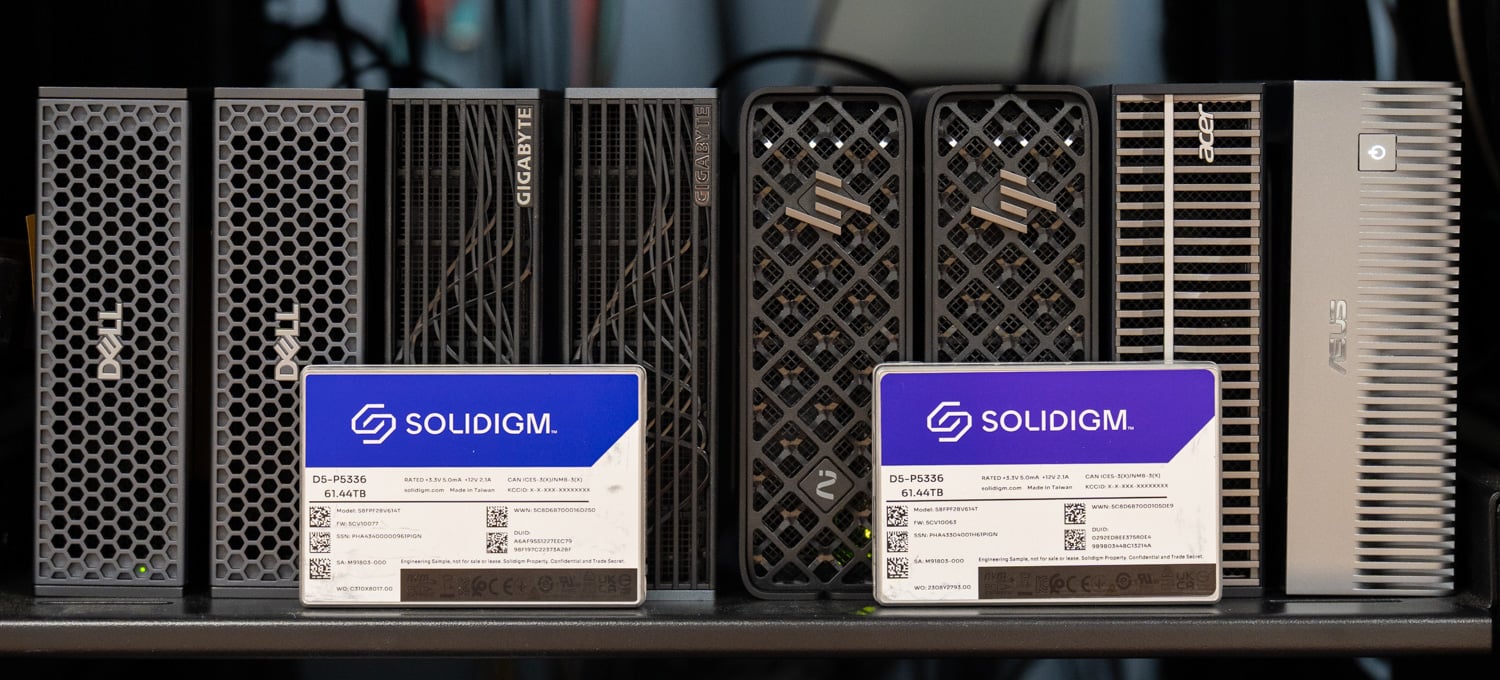
このプロジェクトでは、ストレージの問題をデータセンターにまで遡って解決します。Dell PowerEdge R770AP、Graid SupremeRAID RAID 5構成のSolidigm D5-P5336 QLC SSD 8台、Broadcom 400GbEネットワーク、Tuxera FusionによるNFS over RDMAを基盤としたDGX Spark共有ストレージホストを構築し、その100GbEポートにSparkを8台接続しました。ファブリック上のすべてのSparkは、同じ管理されたパリティ保護ストレージプールを1本の回線でマウントします。各モデルとデータセットの単一コピーがすべてのSparkに提供され、ワークステーションは出荷時のストレージ容量以上の容量を必要とせず、Spark自体はアレイの隣のラックに設置できるため、セキュリティ、冷却、共有が容易になります。この構築のポイントはデータが存在する場所であり、高速NICを備えたNVMeサーバーであればどれでもその役割を果たすことができます。オレゴン州立大学は、AI学習のための大規模なSparkラボを検討しており、数十テラバイト規模の研究データセットへのアクセスを学生に提供したいと考えています。同大学は、構築設計の際にその考えを私たちと共有してくれましたが、その規模のデータに対しては、共有ストレージが今回の評価に適したアプローチでした。
主要なポイント(要点)
- アレイ1つ、Spark8個、クライアントソフトウェアなし: 5社のOEMから提供された8台のDGX Sparkは、Graid SupremeRAIDとTuxera Fusionの背後にある単一のSolidigm D5-P5336 QLCアレイからNFS/RDMA共有を、既存の100GbEポート経由でマウントし、標準のUbuntu上で1行のマウント操作で実行します。
- ホストされたモデルはローカルモデルと同様に読み込まれます。 78GBのQwen3.5-122B-A10B-NVFP4モデルを1台のSparkで共有アレイからロードしたところ、269.6秒で完了しました。これは、同じSparkが内蔵NVMeからロードするのに要した239.6秒の13%以内の時間です。また、8台のSparkで同じ単一コピーを同時にロードした場合、完了まで232.8秒から326.5秒かかりました。
- 各机の上のサイロを1つ置き換える: 管理されパリティ保護されたデータセンターストレージ上のモデルとデータセットは、ワークステーションごとに4TBのM.2ドライブにコピーされていたものを置き換えるため、利用率が向上し、コピーデータ量が減り、Sparkのストレージアップグレードやデスク上の設置場所も不要になります。オレゴン州立大学が検討しているような、研究データセットが数十テラバイトにも及ぶ大規模なAI学習ラボでは、このアプローチが評価対象のユースケースに最適でした。
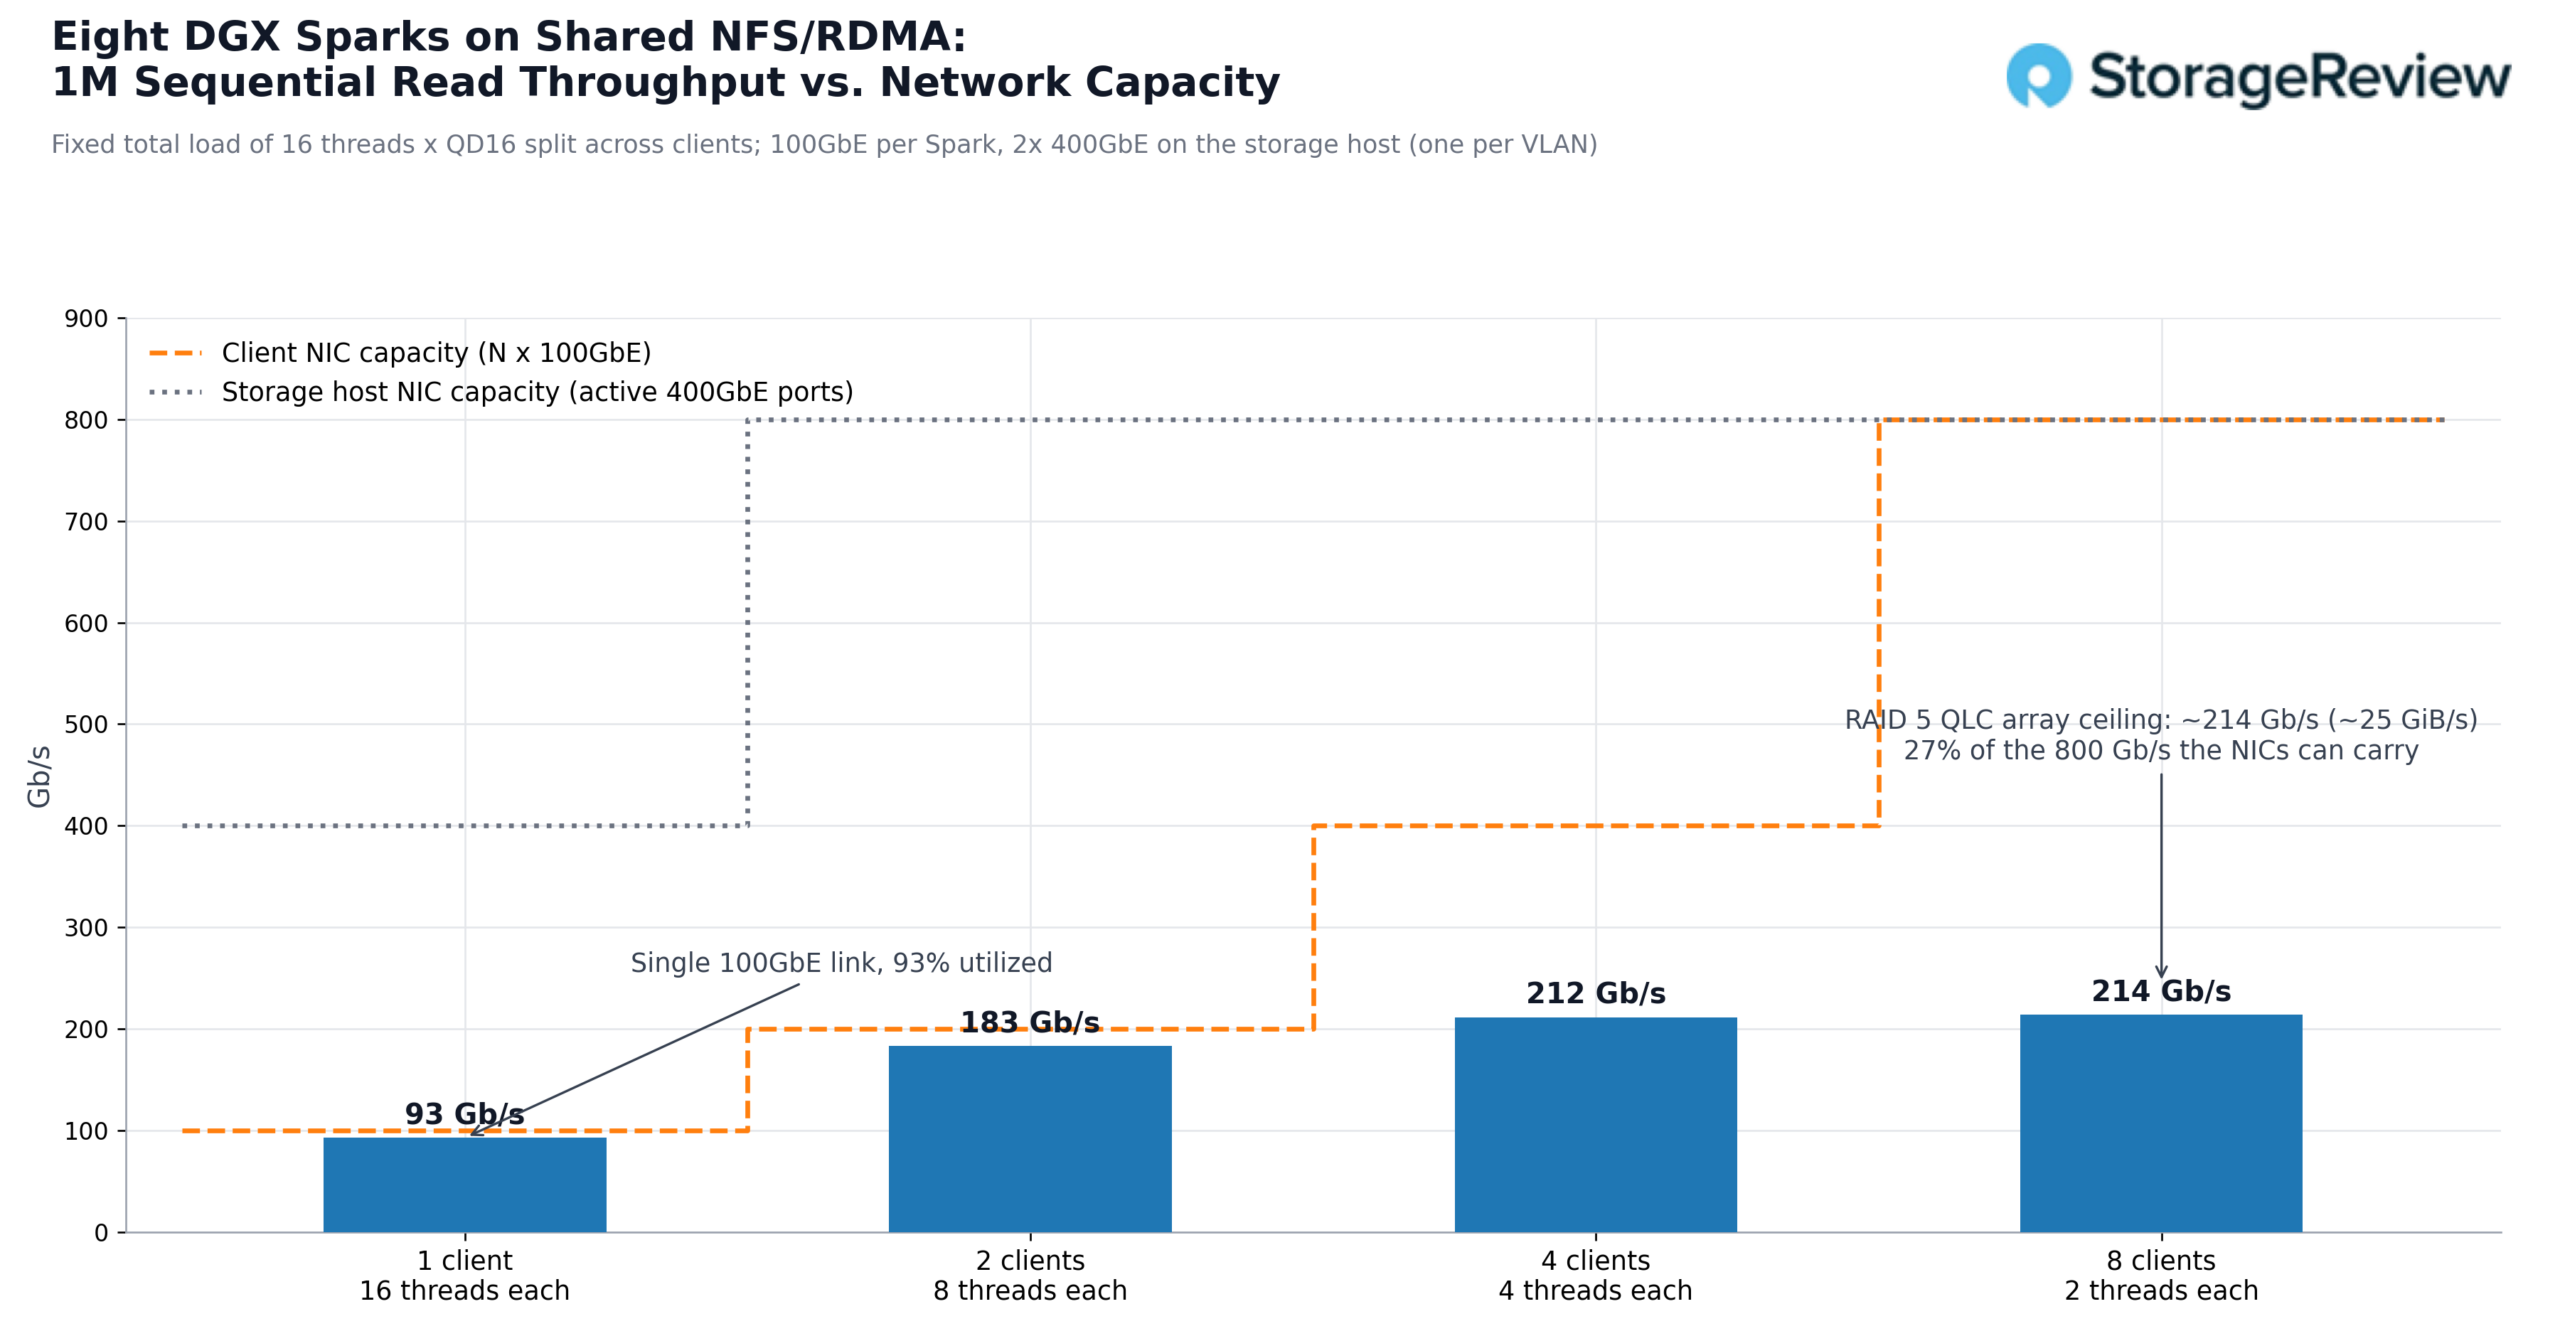
- ドライブが性能の上限を決定づけ、ネットワークには余裕がある。 8台のSparkすべてが同時に読み取りを行うと、8台のドライブで構成されるRAID 5アレイは最大で約25GiB/s(約214Gb/s)に達し、ホストに搭載されている2つのBroadcom BCM57608 NICが処理できる800Gb/sの27%を使用しました。1台のSparkがアレイから10.8GiB/sで読み取りを行った場合、GB10システムで測定した最速の内部M.2に匹敵します。
- ガバナンスにはプロトコルが伴う。 RDMA を使用した NFS では、ユーザーごとのフォルダ、共有データセット、ホスト型モデルが Active Directory、Kerberos、LDAP フックを備えた単一の名前空間に配置されます。これにより、Spark がラックに移動しても、データはデータセンターの管理下に置かれたままになります。
すべての机にAIアイランドを置くことの問題点
DGX SparkとそのOEM版であるDell、GIGABYTE、HP、Acer、ASUSの製品はすべてGB10プラットフォームを共有しており、ストレージ容量の上限も同じです。DGX Sparkの最初のレビューでは、ストレージ容量がこのプラットフォームの最も明確な制限事項でした。内部スロットは短いM.2ドライブしか使用できないため、2280フォームファクタで出荷される8TBクライアントSSDは物理的に収まりません。 8月にレビューしたLuisuantech GP Sparkは、1つの100GbEポートに接続された4ベイM.2エンクロージャでこの問題を解決しており、1台のSparkを1台のデスクに置くためのすっきりとした解決策であり、ラボ規模では、各デスクにさらに大きなサイロを置くことができます。
容量の問題は半分に過ぎず、残りの半分はデータがデスクトップマシンに転送された後にどうなるかという問題です。Sparkにダウンロードされた78GBのモデルは、IT部門の誰も見ることができないコピーです。ローカルフラッシュにステージングされた研究データセットは、バックアップスケジュール、アクセス ポリシー、および組織監査の対象外のコピーです。ラボに10台のSparkがあると、同じ重みの10個のコピーが、他の用途に使用できる780GBのフラッシュを消費し、データセットがマシンと一緒に持ち出される可能性のある場所が10箇所になります。GB10システムであろうと、デスクトップAIインフラストラクチャであろうと、数が増えるにつれて問題は悪化します。ラップトップのフリートを管理したことのあるすべての組織はこのパターンを知っており、その解決策は当時も同じでした。データをデータセンターの共有ストレージに保持し、エンドポイントはエンドポイントとして扱うことです。
ありがたいことに、NVIDIA は Spark にそれを実現するポートを設計しました。各ユニットには、統合された ConnectX-7 上に 2 つの QSFP56 ケージが搭載されており、2 つの PCIe Gen5 x4 リンクの背後で使用可能な帯域幅が最大 200Gb になります。DGX Spark クラスタのレビューでは、一方のケージをピア Spark に、もう一方をストレージに接続する役割分割構成について説明しました。このプロジェクトでは、1 つのケージを Spark ごとに 100GbE のストレージに使用し、もう 1 つのケージをクラスタリングまたは追加の帯域幅用に空けています。100GbE では、各 Spark はストレージ ホストに対して約 12.5GB/s の理論上の帯域幅を持ち、これはこれらのシステムのほとんどで内部 M.2 スロットによって提供される帯域幅を超えています。
データがリンクの反対側に移動すると、Sparkの役割は変わります。ブートドライブとローカルキャッシュドライブを備えたコンピューティングエンドポイントとなり、容量はワークステーションごとに購入する必要がなくなります。モデルやデータセットは一度書き込まれ、すべてのクライアントで読み込まれるため、ストレージの利用率が向上し、コピー回数が減少します。データ保護は、サーバーシャーシ内のパリティ保護されたアレイに移行し、アクセス制御、保存時の暗号化、バックアップ、監査は、他のすべての処理と同様に、既存の場所で実行されます。また、Sparkは電源と100GbEリンク以外何も必要としないため、デスク上に置く必要は全くありません。ストレージホストの隣にラックマウントすることで、冷却効果が高く、静音性にも優れ、物理的に安全に保護され、必要な人がいつでも利用できるようになります。
ストレージホスト
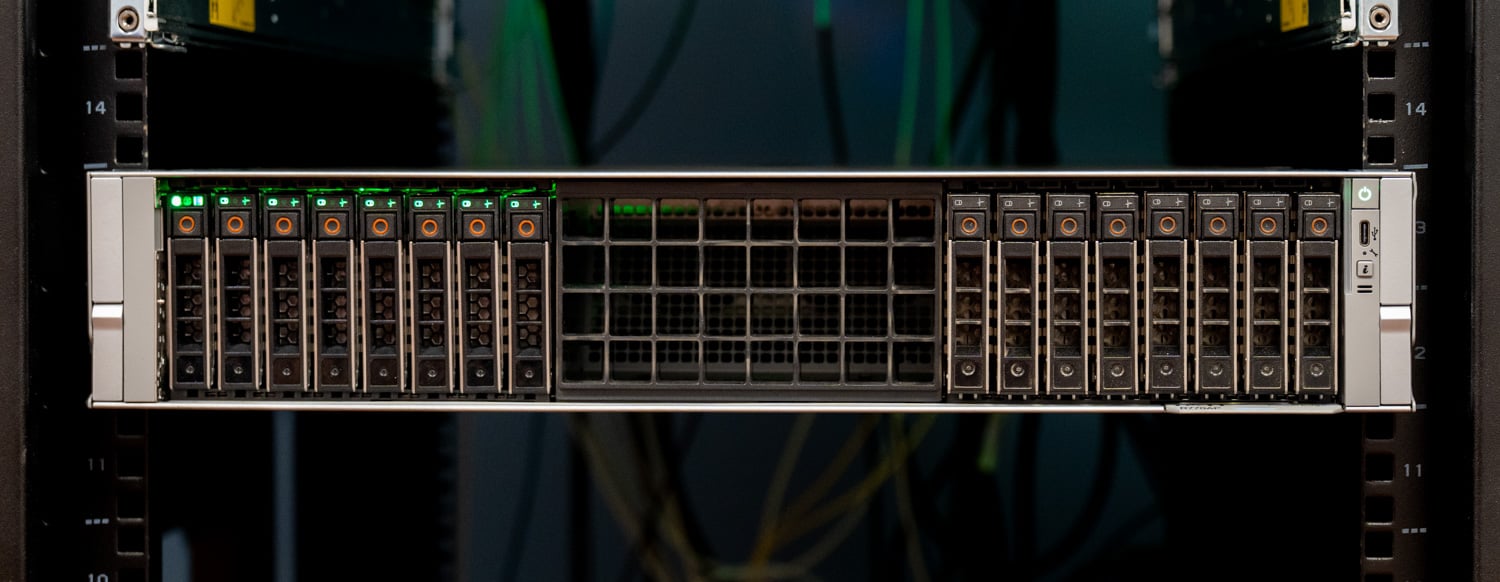
ストレージホストは、今年初めにレビューしたのと同じ 2U Xeon 6 プラットフォームであるDell PowerEdge R770APです。プロジェクト開始時にラボで空いていたため、これを使用しました。高速 NIC と小型 GPU を搭載できるスペースのある NVMe サーバーであればどれでもこの役割を担うことができますが、R770AP は、多少オーバースペックではあるものの、構築方法の 1 つです。このサーバーは、2 つの Xeon 6 6978P プロセッサと 24 DIMM にわたる 1.5TB の DDR5 メモリを搭載し、8 つの Gen5 NVMe ベイの 2 つのバンクのうちの 1 つを使用し、ドライブと Graid GPU を CPU 0 に接続し、2 つの 400GbE アダプタを CPU 1 に接続しています。サーバーは Ubuntu 24.04 で動作します。
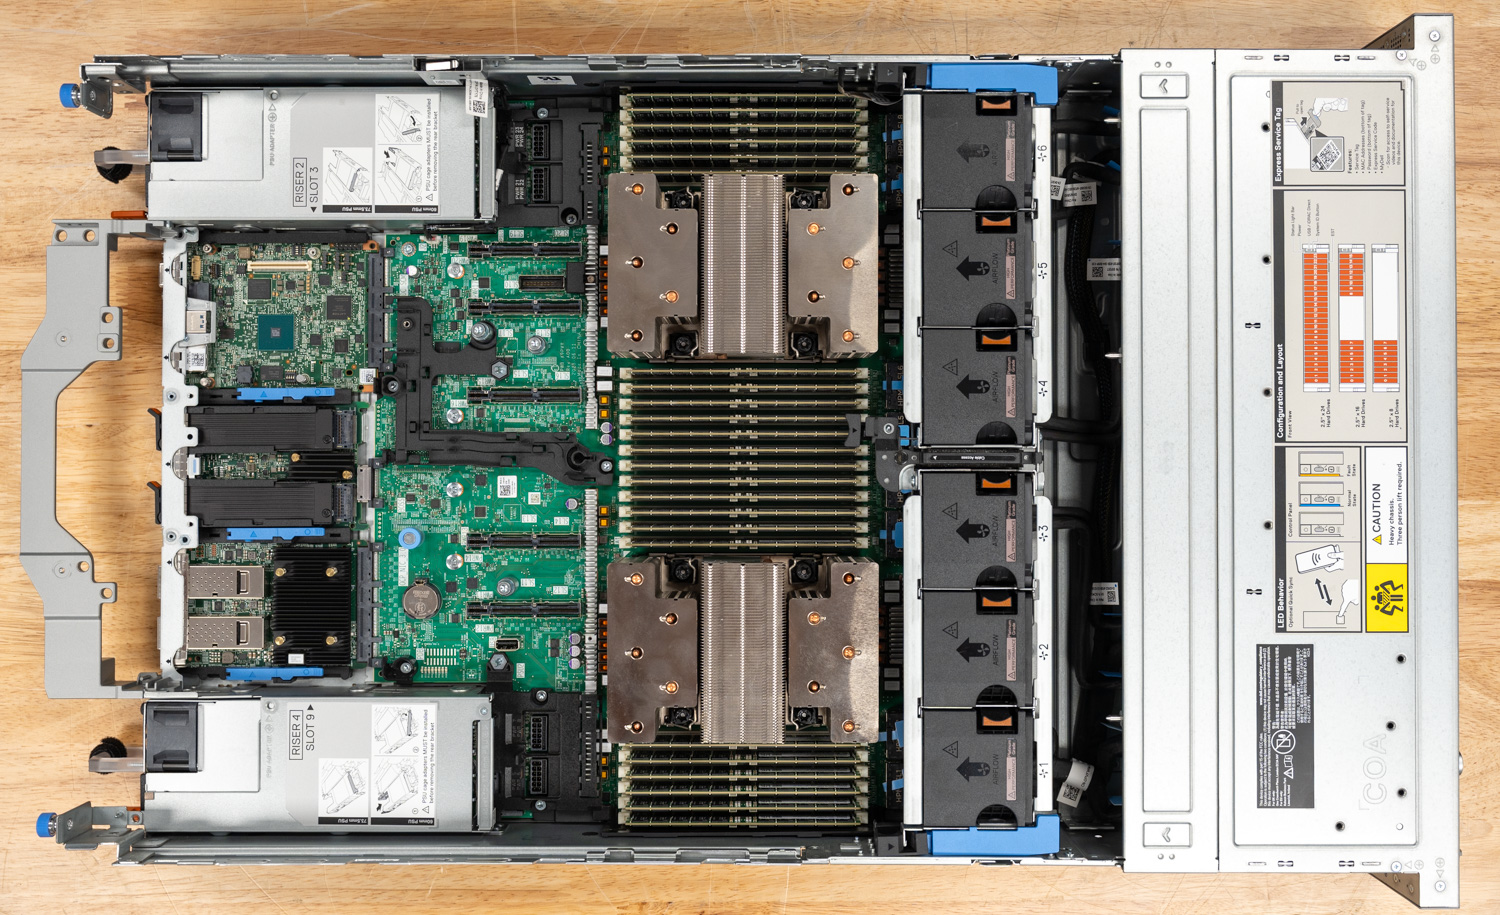
| 成分 | ストレージホスト構成 |
|---|---|
| サーバー | Dell PowerEdge R770AP、2U、2.5インチGen5 NVMeベイ×16 |
| CPU | Intel Xeon 6 6978P x2 |
| メモリ | 1.5TB DDR5 (64GB×24枚) |
| Storage | 8x Solidigm D5-P5336 61.44TB U.2 PCIe 4.0 QLC (491.52TB raw) |
| RAID | Graid SupremeRAID、全8台のドライブでRAID 5構成、CPU 0にNVIDIA RTX A2000 GPU搭載 |
| ファイルシステム | SupremeRAID仮想ドライブ上のXFS |
| ファイルサーバー | Tuxera Fusion(Fusion NFS、プライベートプレビュービルド)、NFS 4.1 over RDMA(ポート20049のRPC-RDMA)、ユーザーモード |
| Networking | Broadcom BCM57608 (Thor 2) シングルポート 400GbE 2基、CPU 1 上の PCIe Gen5 x16、RoCEv2 |
| スイッチ | Dell PowerSwitch Z9864F-ON、64x 800GbE OSFP112、エンタープライズSONiC |
| クライアントリンク | 800G光ファイバーを8x100GbEに分割し、Sparkごとに1リンク、ストレージNICごとに4つのSparkを別々のVLANに接続。 |
| 取引実績 | Dell Pro Max (GB10搭載) 2台、GIGABYTE AI TOP ATOM 2台、HP ZGX Nano G1n 2台、Acer Veriton GN100、ASUS Ascent GX10 |
| OS | Ubuntu 24.04, XNUMX, XNUMX LTS |
QLCを選ぶ理由、そしてD5-P5336を選ぶ理由
オレゴン州立大学とSparkラボのコンセプトについて話し合った際、まず最初に容量が要件となりました。これは、研究データセットが大規模であるためです。このサーバーの役割は、Sparkラボの部屋いっぱいのユーザーが必要とするすべてのデータを格納し、多数のクライアントが同時に読み取れる形式で提供することです。これは、読み取り負荷が高く、ブロックサイズが大きく、容量が大きいプロファイルであり、QLCが設計されたプロファイルです。D5 -P5336ファミリーは7.68TBから122.88TBまで展開されています。ここで使用されている61.44TBのU.2ドライブは、Solidigmによって、最大7,000MB/sのシーケンシャル読み取り、3,000MB/sのシーケンシャル書き込み、1.005Mのランダム4K読み取りIOPS、および65.2PBWの耐久性(5年間で1日あたり0.58回のドライブ書き込み)と評価されており、16KBの間接参照ユニットを備えた192層のQLC NANDを使用しています。
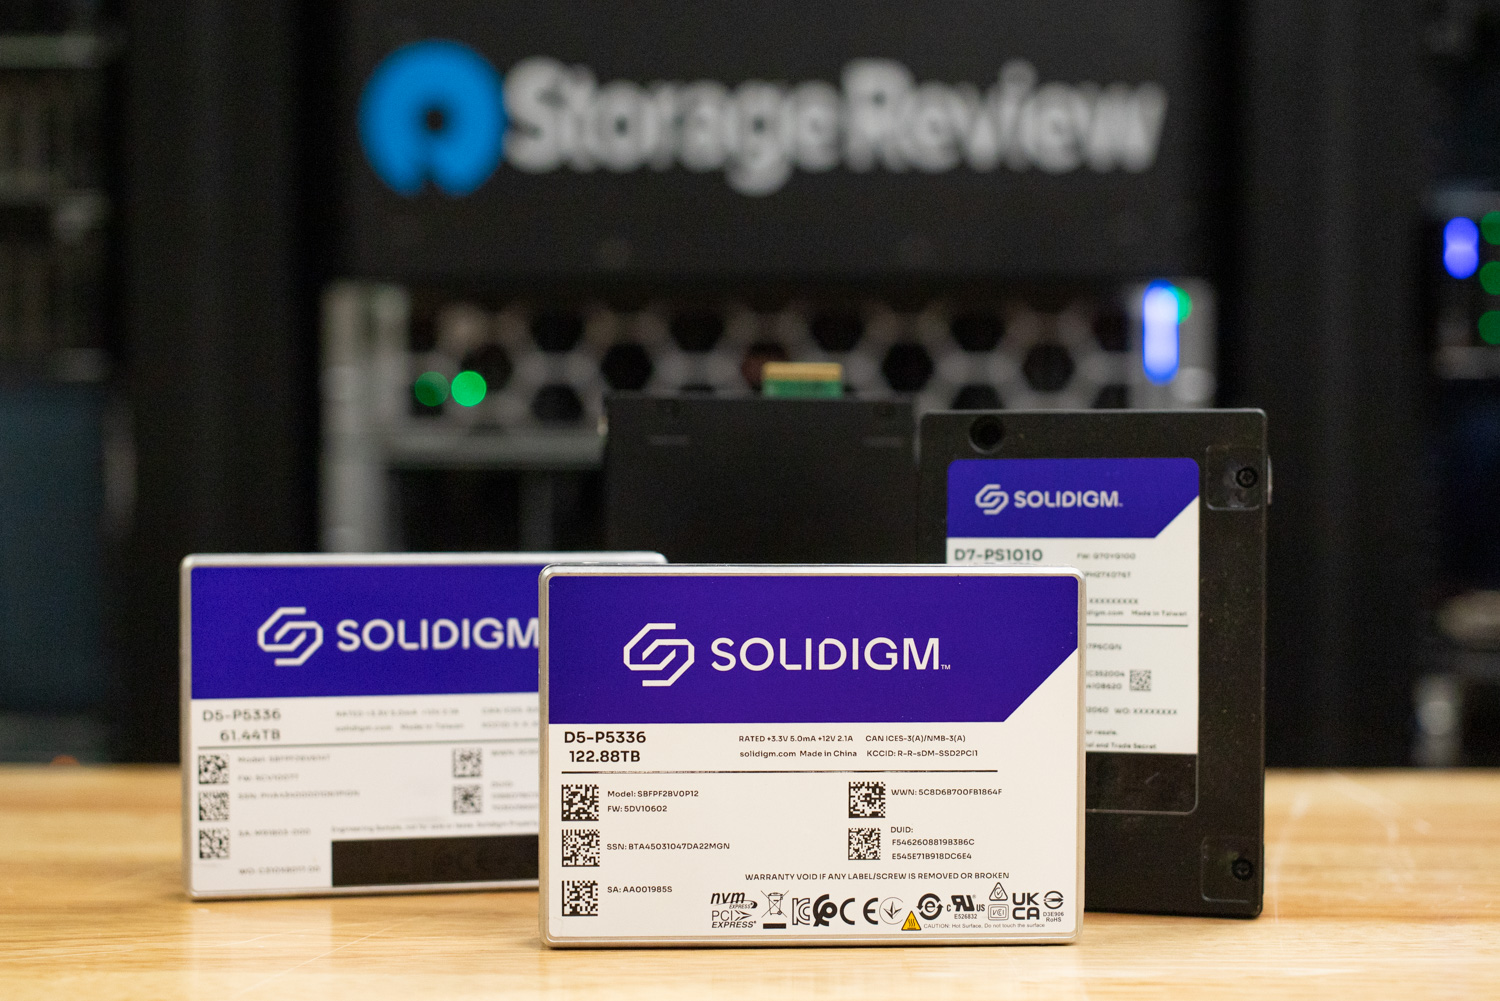
8台の61.44TBドライブはR770APの前面ベイの半分を占めており、製品版ではこのシリーズの任意の容量と任意のベイ数を選択できます。それでも、8台のドライブをRAID 5で構成すると、シングルドライブ障害耐性を備えた約430TBの使用可能な容量が得られます。これはSparkのM.2スロットの容量の100倍以上であり、学科のモデルライブラリ、学生が使用する共有データセット、およびユーザーごとのホームディレクトリに十分な容量です。残りの8つのベイを埋めると、ネットワーク設計を変更することなく容量が2倍になり、このレビューの後半で説明するサイズに関する数値は、ドライブが拡張すべき部分である理由を示しています。
このワークロードでは、16KBの間接参照ユニットが重要になります。なぜなら、Solidigmのより大きなIUは、小さなランダム書き込みの効率を犠牲にして密度とコストを優先しており、モデルとデータセットを扱う共有では、小さなランダム書き込みは少数派だからです。モデルの読み込みは大きなシーケンシャル読み取りです。データセットのストリーミングも大きなシーケンシャル読み取りです。チェックポイントと学生ファイルは一度書き込まれ、頻繁に読み込まれます。このことから生じる分業は、Sparkラボにとって適切なものです。共有QLCアレイには多くのユーザーが読み取るすべてのデータが保持され、Spark独自のM.2は、1つのユーザーが書き込むスクラッチとスワップのトラフィックを処理します。
GPU 上の RAID: Graid SupremeRAID
8 台の Gen4 ドライブで NVMe RAID を実行すると、各ドライブが 7,000MB/s の読み取り速度でデータを取り込むことができ、従来のハードウェア RAID カードがボトルネックになります。これは、すべてのバイトがカードの PCIe スロットを通過する必要があるためです。ソフトウェア RAID は、異なるリソースの課題に直面します。Graid SupremeRAID はパリティ計算を GPU にオフロードし、データ パスをホストの PCIe レーン上に維持します。そのため、 16 台のドライブを使用した SupremeRAID AE テストでは 180GB/s を超えるスケーラビリティを実現しました。このホストでは、小型ワークステーション GPU である NVIDIA RTX A2000 で SupremeRAID を実行しました。
8台のD5-P5336ドライブは、Graidに渡される前にセキュア消去され、順次データが格納され、単一のRAID 5アレイとして構成されました。作成された仮想ドライブはXFSでフォーマットされ、Tuxeraによって管理されます。RAID 5は、このような共有には最適なレベルです。ドライブ障害が発生してもアレイはオンライン状態を維持し、再構築時にユーザーデータがオフラインになることなく実行され、容量の損失は8台に1台分です。容量よりも再構築ウィンドウの保護を重視する本番環境では、RAID 6またはRAID 10が妥当な選択肢となり、SupremeRAIDは両方をサポートしています。
ネットワーク:Broadcom 400GbEと800Gコア
ファブリックのストレージ側は、R770AP に搭載された 2 つの Broadcom BCM57608 Thor 2 アダプタで、それぞれ PCIe Gen5 x16 インターフェイス上のシングルポート 400GbE NIC です。Broadcom は BCM57608 を業界で最も低消費電力の 400G NIC と位置付けており、その機能セットは最適です。拡張 DCQCN 輻輳制御を備えた RoCEv2、適応ルーティング、シリコン ルート オブ トラストによるセキュア ブート、インライン kTLS 暗号化オフロードなどです。この設計では RoCEv2 が RDMA 上で NFS を伝送し、輻輳制御により、複数のクライアントが同時にプルを開始したときに互いに干渉するのを防ぎます。構築中、bnxt_en ドライバは、持続的な負荷の下で 400G ポートの光モジュールが 70℃ の警告しきい値に達していると報告しました。R770AP でファン プロファイルを少しオフセットすることでこれに対処し、その後 NIC は問題なく動作しました。
両方のNICは、当社のラボの800GコアスイッチであるDell PowerSwitch Z9864F-ONに接続され、Enterprise SONiCが稼働しています。Z9864F-ONは800GbEのOSFP112ポートを64個搭載しており、それらのポートを2x400G、4x200G、または8x100Gに分割できます。8x100Gに分割された1つの800G光ケーブルは、8台のSparkをそれぞれ1リンクずつ、2つの400Gストレージリンクを終端する同じスイッチに接続します。各400G NICは独自のVLAN上にあり、4台のSparkにサービスを提供しているため、ストレージホストは2つのRDMAターゲットを提示し、設計上、負荷はそれらに均等に分散されます。実際には、これはフルレートのトポロジーです。片側に8x100Gのクライアント帯域幅、もう片側に2x400Gのストレージ帯域幅、そして中央に102.4Tbpsの容量を持つスイッチが配置されています。
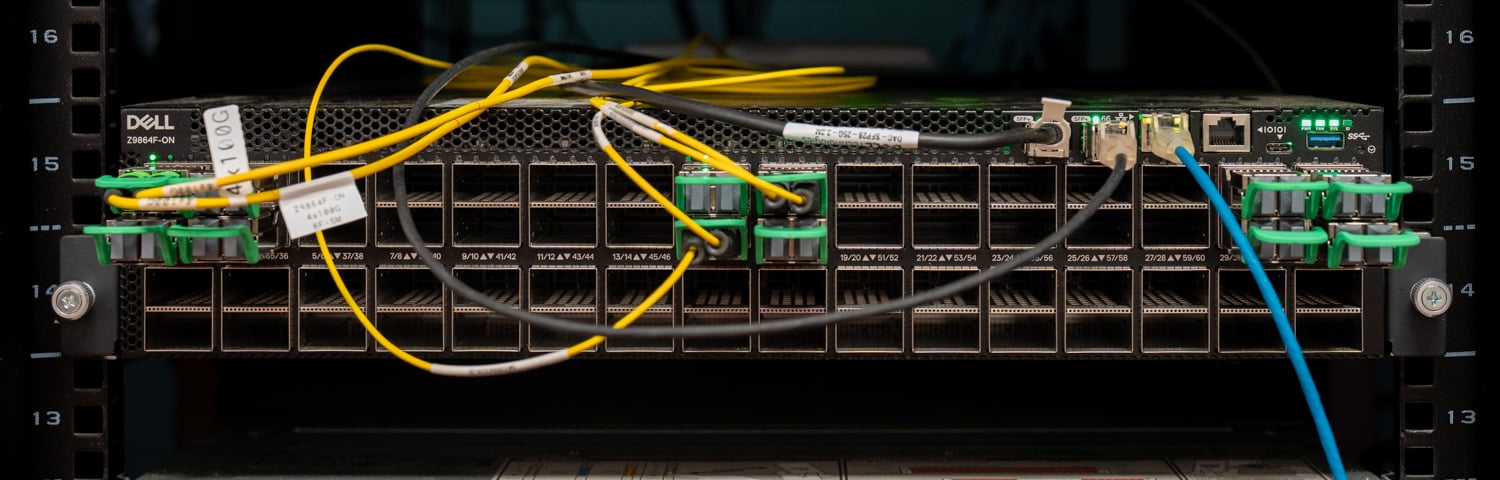
ストレージソフトウェアがファブリックに手を加える前に、ファブリックの検証を行いました。R770APと2台目のホスト間の400Gリンクを介したサーバー間テストは双方向でラインレートで実行され、SparkからのRDMAトラフィックは100Gブレークアウトポートがフルスピードで動作していることを確認できました。TuxeraのエンジニアがNFS共有を立ち上げた後、SparkからそれぞれのNICへのiperf3テストでは、4つの並列ストリームと再送信ゼロで99Gbpsの安定した速度が維持されていることが示されました。
なぜNFSなのか、そしてなぜTuxeraなのか
Graid が高速ブロック デバイスを提供することで、ストレージ ホストは Spark を NVMe-oF ブロック ターゲットまたはファイル 共有として提供できます。 GP Spark のレビューでブロック パスをテストしましたが、1 つのクライアントではうまく機能します。多くの Spark があるラボでは、別のものが必要でした。ブロック ボリュームは 1 対 1 です。各ユーザーには LUN が必要で、2 人のユーザーが同じデータセットを要求した瞬間に、それをコピーすることになります。これは、この設計全体が解消しようとしている問題です。NFS はベン図の中央に位置します。単一の名前空間に、共有データセット、ホスト モデル、およびユーザーごとのフォルダーが格納されます。すべての Spark マウントは、Ubuntu に既に含まれている NFS クライアントを使用し、大学が Spark ラボの上に構築する Kubernetes および Slurm ツールはすべて NFS に対応しています。
Fusion NFSは、マルチプロトコル ファイル サーバーである Tuxera Fusion の NFS 部分で、単一のユーザー モード、マルチスレッド コアで SMB と NFS をカバーします。Fusion SMB は、 2024 年にSolidigm と Tuxera のメディア ワークフロー プロジェクトで初めて取り上げられました。Tuxera は、RDMA を使用した単一の 200GbE 接続で最大 22.7GB/s の速度を実現し、同社独自のテストではカーネル NFSD および Ganesha を上回ると主張しています。また、NFS 4.1、アクティブ アクティブ スケールアウト クラスタリング、透過的フェイルオーバー、Active Directory、Kerberos、LDAP 統合をサポートしています。最後のセットはガバナンス フックです。Spark にログインできるユーザーを制御するのと同じディレクトリで、共有上の表示内容も制御できます。この記事の Tuxera の数値にはすべて注意が必要です。私たちが実行したビルドは、Tuxera によるとパフォーマンスが完全に最適化されていない Fusion NFS のプライベート プレビューであり、ソフトウェアはまだ商用販売されていません。一般提供は SC'26 の後、11 月に予定されています。
TuxeraはR770APにFusionをインストールし、GraidボリュームをXFSでフォーマットし、標準ポートでNFS、ポート20049でRPC-RDMAを使用してサーバーを構成しました。このプロジェクトはNFSのみを使用するため、SMBリスナーは除外しました。初期のスレッド構成は4つのプロトコルスレッドで、それぞれトランスポートの送受信、VFSデータ、VFSメタデータ用に8つのスレッドがあり、Tuxeraはこれをチューニングの出発点としています。ディレクトリサービスはラボ構築から意図的に除外しました。大学での展開では、その上に独自のIDサービスが重ねられることになります。Spark側では、共有をマウントするには1つのコマンドを使用します。
sudo mount -t nfs -o proto=rdma,port=20049 :/mnt/shares/smbnfs1/ /localnfs
その1行だけでクライアント統合が完了します。ドライバも、イニシエータの設定も、Spark上のベンダーソフトウェアも一切必要ありません。明日別のSparkにログインするユーザーも同じ行を実行し、同じファイルを見ることができます。
構成の証明:1つのデータセット上で8つのSparkを実行
モデル作業を行う前に、各 Spark に対して個別に健全性チェックを実行しました。16 ジョブ、キュー深度 16 で、アレイ上の自身のフォルダに対して 1M シーケンシャル fio 読み取りを実行しました。8 つのユニットは 10.0 ~ 11.2GiB/s の値を返し、それぞれの 100GbE リンクを飽和させました。次に、8 個すべてが負荷のシェアを保持できることを証明するためにスイープを実行しました。各実行では、合計で固定 16 スレッドをキュー深度 16 で保持し、1、2、4、8 つの Spark に分散させ、1M シーケンシャル、64K ランダム、16K シーケンシャル、4K ランダムのワークロードに対して、読み取りと書き込み、直接 I/O、テストごとに 60 秒を実行します。各 Spark は、ストレージ NIC ごとに 4 つの自身のフォルダに書き込み、スタックのどこにも QoS はありません。 8台すべてを同時にロードした場合、公平性を適用しない2つのVLAN上の5つのOEM製品において、ユニットあたりの1Mシーケンシャル読み取り速度は3.09~3.13GiB/s、64Kランダム読み取り速度は6,648~6,779IOPS、4Kランダム書き込み速度は2,136~2,155IOPSでした。すべてのSparkがアレイにアクセスし、すべてのSparkが均等にデータを共有し、重要なワークロードに対応できる構成となりました。
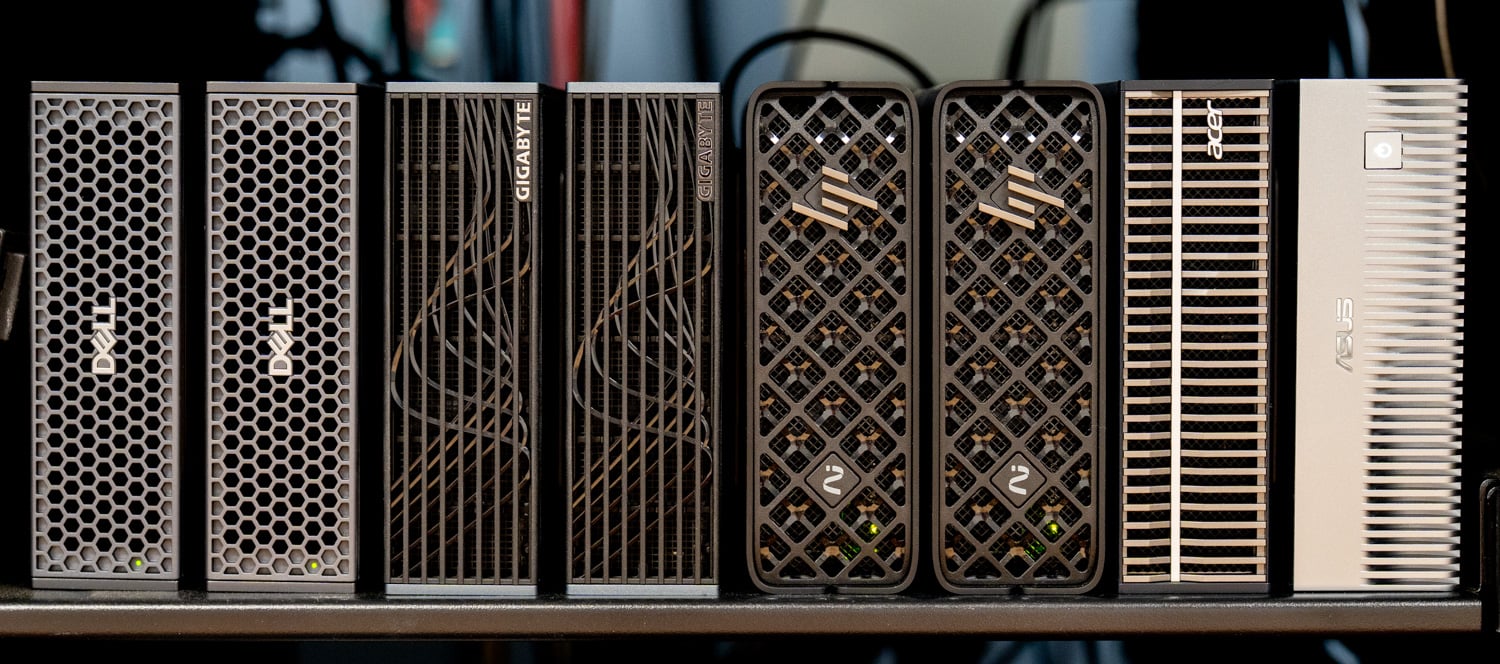
| Spark(クライアント8台、各クライアントにつき2スレッド×QD16) | ストレージNIC | 1Mシーケンシャルリード | 64K ランダム読み取り IOPS | 4K ランダム読み取り IOPS | 4K ランダム書き込み IOPS |
|---|---|---|---|---|---|
| Dell Pro Max(GB10搭載)(1) | 1 | 3,176MiB/秒 | 6,648 | 10,000 | 2,150 |
| GIGABYTE AI TOP ATOM (1) | 1 | 3,195MiB/秒 | 6,779 | 10,300 | 2,142 |
| HP ZGX Nano G1n (1) | 1 | 3,201MiB/秒 | 6,696 | 10,100 | 2,136 |
| エイサー ベリトン GN100 | 1 | 3,194MiB/秒 | 6,670 | 10,100 | 2,149 |
| Dell Pro Max(GB10搭載)(2) | 2 | 3,184MiB/秒 | 6,694 | 10,200 | 2,155 |
| GIGABYTE AI TOP ATOM (2) | 2 | 3,187MiB/秒 | 6,667 | 10,100 | 2,141 |
| HP ZGX Nano G1n (2) | 2 | 3,189MiB/秒 | 6,678 | 10,100 | 2,151 |
| ASUS アセント GX10 | 2 | 3,163MiB/秒 | 6,734 | 10,300 | 2,145 |
ホストのサイジング:2つのNICと十分な余裕
同様の分析によって、ラボや企業が購入前に解決しなければならない疑問、つまり「上限はどこにあるのか、そしてホストのどの部分がそれを決定するのか」という疑問に答えることができます。下の4つのパネルは、固定負荷が1つのSparkから8つに拡大したときの、4つのワークロードすべてにおける読み取りスループットを示しています。書き込み側については、さらに下のテキストと表で説明しています。
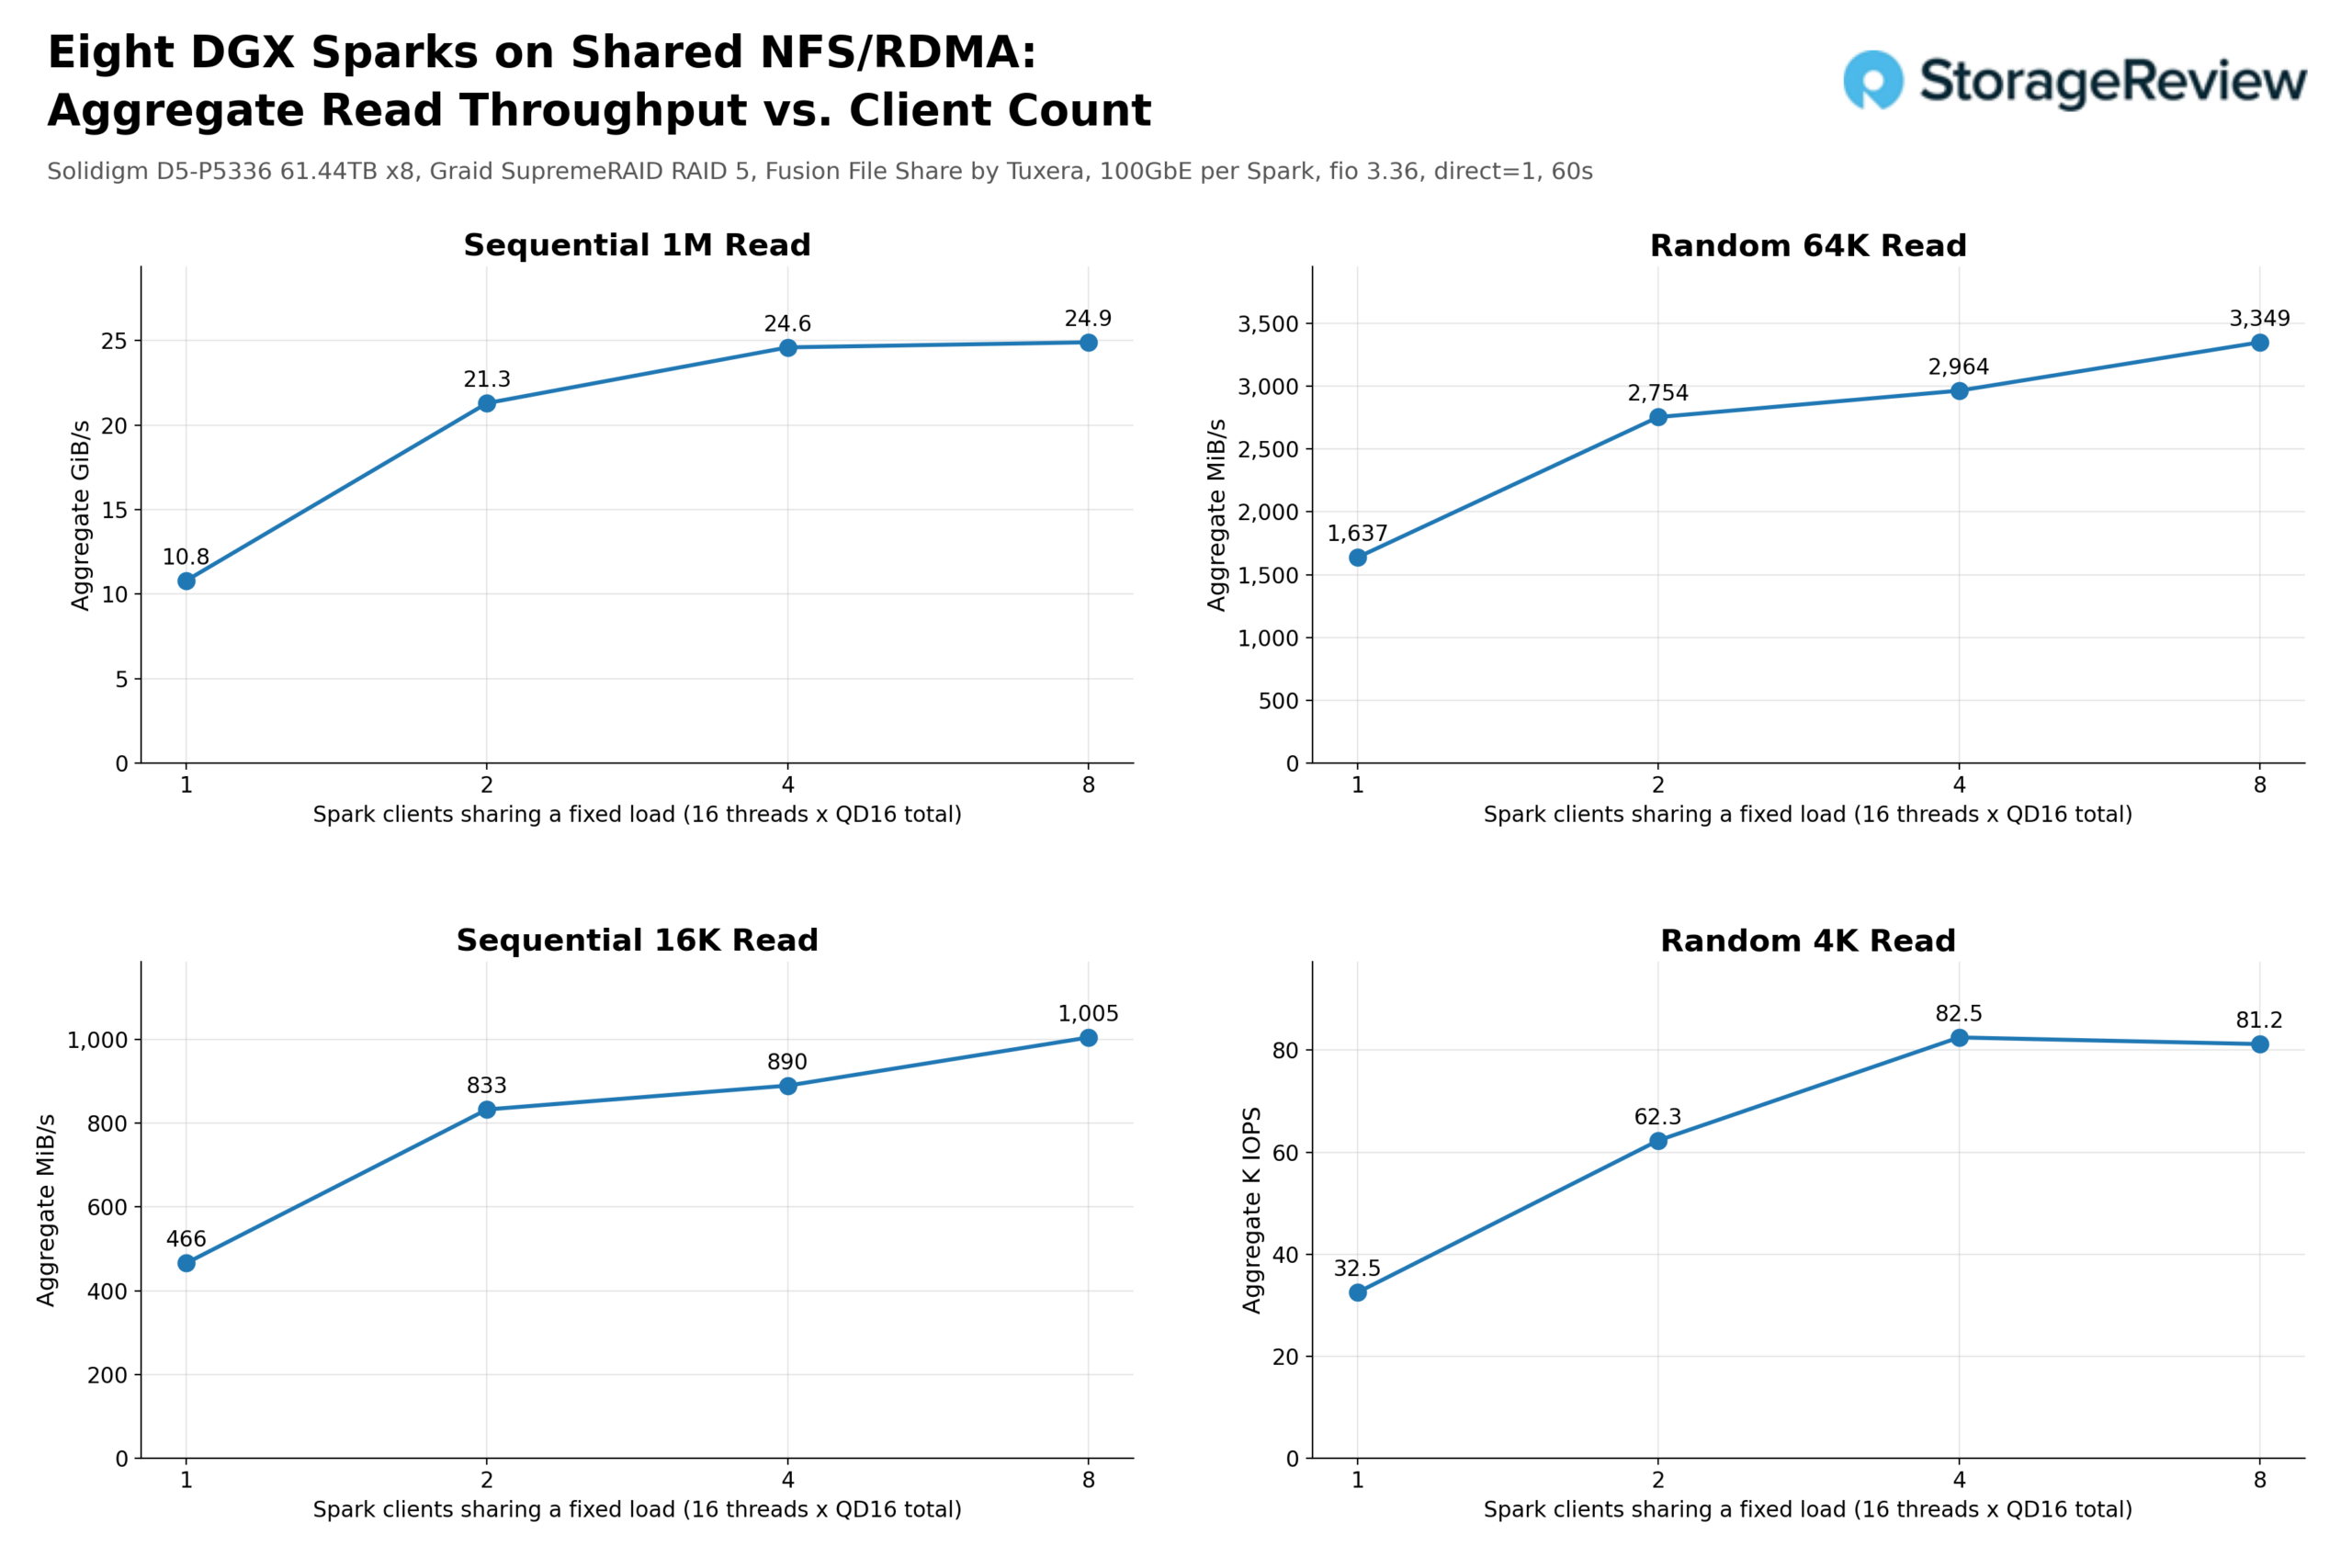
合計 1M シーケンシャル読み取りは、Spark 1 台で 10.8GiB/s から、2 台で 21.3GiB/s、4 台で 24.6GiB/s、8 台で 24.9GiB/s に上昇しました。ネットワークの観点からは、2 個の Broadcom 400GbE NIC が処理できる 800Gb/s に対して、それぞれ 93Gb/s、183Gb/s、212Gb/s、214Gb/s であり、8 台のクライアントがフルにロードされたとき、アレイはホストのネットワーク容量の 27% を使用しました。25GiB/s 付近のプラトーは、8 台のドライブによる RAID 5 QLC アレイのものであり、NIC、スイッチ、および Spark 自身の 100GbE リンクが制限になることはありませんでした。
サーバー側の 2 つの NIC は既に 8 つの Spark をライン レートでカバーしており、R770AP の他の 8 つのベイもカバーします。ドライブ数を 2 倍にすると、2 つ目のアレイとしてでも、より広い RAID セットとしてでも、同じ 2 つのポートの背後に読み取り帯域幅が増え、余裕があります。I/O についても同様です。4K ランダム読み取りは、1 つのクライアントで 32.5K IOPS から、4 つのクライアント以上で約 81K IOPS のプラトーにスケールし、各クライアントのキューが浅くなるにつれて I/O ごとのレイテンシは 7.9ms から 3.1ms に低下し、64K ランダム読み取りは 1,637 から 3,349MiB/s に上昇し、どちらの場合もネットワークは制限をはるかに下回っていました。
もう一つ重要な比較対象は、Spark が既に搭載しているストレージです。GB10 の個別レビューでは、Acer Veriton GN100 と GIGABYTE AI TOP ATOM の内部 M.2 からの GDSIO 1M 読み取りは、最大で 11.2GiB/s 近くに達しました。GB10 を搭載した Dell Pro Max と HP ZGX Nano G1n は約 5.5GiB/s に達し、ASUS Ascent GX10 は 5GiB/s に近づきました。これに対し、Luisuantech GP Spark の外付け NVMe-oF ボックスは、同じ 100GbE ポートで 9.5GB/s を実現しました。共有 QLC アレイからの単一の Spark の読み取りは 10.8GiB/s で、このグループで最速の内部ドライブに匹敵し、他のすべての Spark が読み取ることができるデータから、1 本のケーブルを介して最も遅いドライブの約 2 倍の速度です。ツールが異なります。内部ドライブでは GDSIO、ここでは NFS 上の fio を使用しているため、これは範囲の比較です。
以下に、各クライアント数における4つのワークロード全体の集計値を含む詳細な分析結果を示します。読み取り行は、アレイの余裕がなくなるまでクライアント数の増加とともに上昇し、書き込み行は、RAID 5パリティパスによって、共有クライアント数に関わらずアレイの書き込み上限が固定されるため、Sparkが1台から8台まで横ばいを維持します。多数のクライアントが読み取り、取り込み時に一度だけ書き込みを行う共有ストレージにとって、これはまさに設計上の想定プロファイルです。
| 集約(合計16スレッド) | 1 Spark | 2 スパークス | 4 スパークス | 8 スパークス |
|---|---|---|---|---|
| 1Mシーケンシャルリード | 10.8GiB/秒 | 21.3GiB/秒 | 24.6GiB/秒 | 24.9GiB/秒 |
| 1Mシーケンシャルライト | 2.4GiB/秒 | 2.4GiB/秒 | 2.4GiB/秒 | 2.4GiB/秒 |
| 64Kランダム読み取り | 1,637MiB/秒 | 2,754MiB/秒 | 2,964MiB/秒 | 3,349MiB/秒 |
| 64Kランダム書き込み | 722MiB/秒 | 719MiB/秒 | 723MiB/秒 | 703MiB/秒 |
| 16K シーケンシャル読み取り | 466MiB/秒 | 833MiB/秒 | 890MiB/秒 | 1,005MiB/秒 |
| 16K シーケンシャル書き込み | 57MiB/秒 | 60MiB/秒 | 62MiB/秒 | 28MiB/秒 |
| 4Kランダム読み取り | 32.5K IOPS | 62.3K IOPS | 82.5K IOPS | 81.2K IOPS |
| 4Kランダム書き込み | 17.8K IOPS | 17.7K IOPS | 17.5K IOPS | 17.2K IOPS |
共有ストレージにおけるホスティングモデル
fio スイープにより、アレイとネットワークが十分な能力を備えていることが証明されました。ユースケースにとって重要な次のテストは、共有アレイ上に存在するモデルが Spark 自身の NVMe 上に存在するモデルと同じようにロードされるかどうかです。これは、設計全体が依存するワークフロー、つまり中央でホストされ、誰でもロードできる 1 つのコピーだからです。NVFP4 の Qwen3.5-122B-A10B を選択しました。これは、ディスク上で 78GB を占め、単一の Spark の 128GB の統合メモリに収まる 1220 億パラメータのエキスパート混合モデルです。推論サーバーの起動からサーバーが正常であると報告するまでの時間、およびその期間の平均ストレージ帯域幅を、次の 3 つのシナリオで測定しました。1 つの Spark が内部 NVMe からロードする場合、同じ Spark が共有アレイから NFS/RDMA 経由でロードする場合、および 8 つの Spark すべてがアレイから同じ単一のコピーを同時にロードする場合。
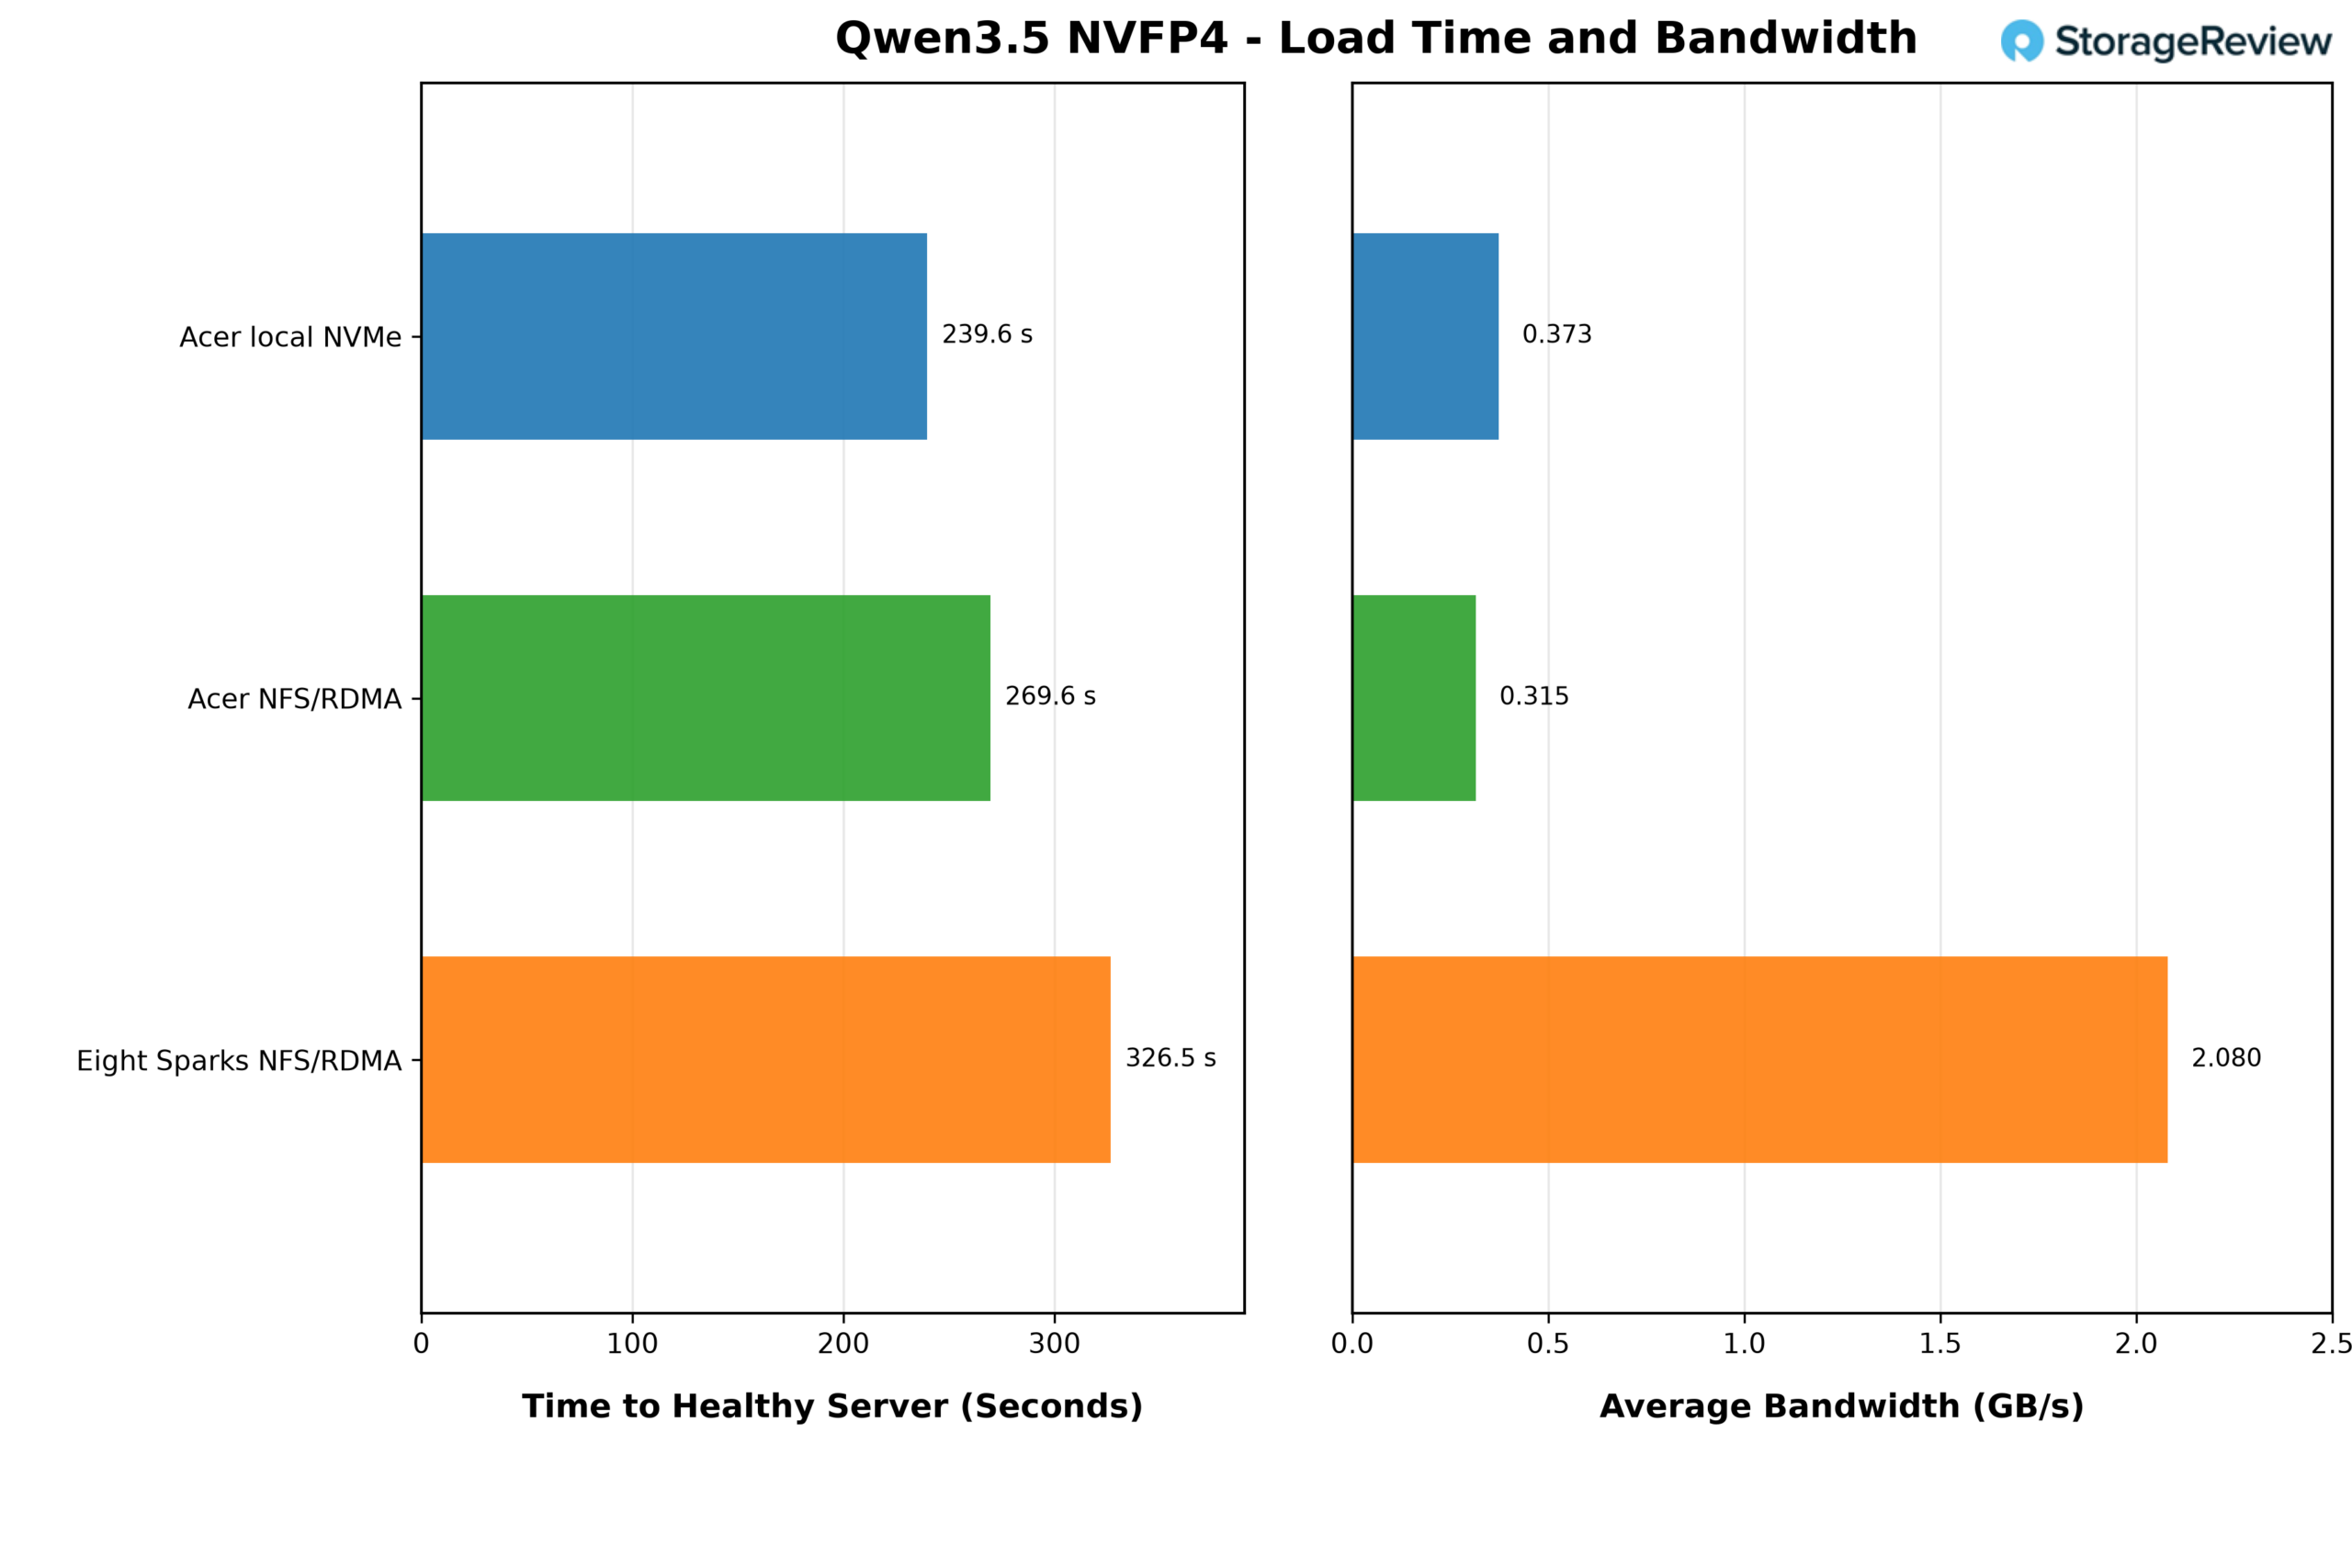
内蔵NVMeから、Acer Veriton GN100は平均0.373GB/sで239.6秒で正常なサーバーに到達しました。NFS/RDMA経由の共有アレイから、同じSparkは0.315GB/sで269.6秒かかり、約30秒、つまり13%長くなりました。平均値から、4分で78GBのモデルをロードする場合、どちらの場合もSparkのモデルロードはストレージのボトルネックにはならないことがわかります。GB10自身の重み処理がペースを決定し、ストレージはウィンドウのほとんどを待機に費やしています。
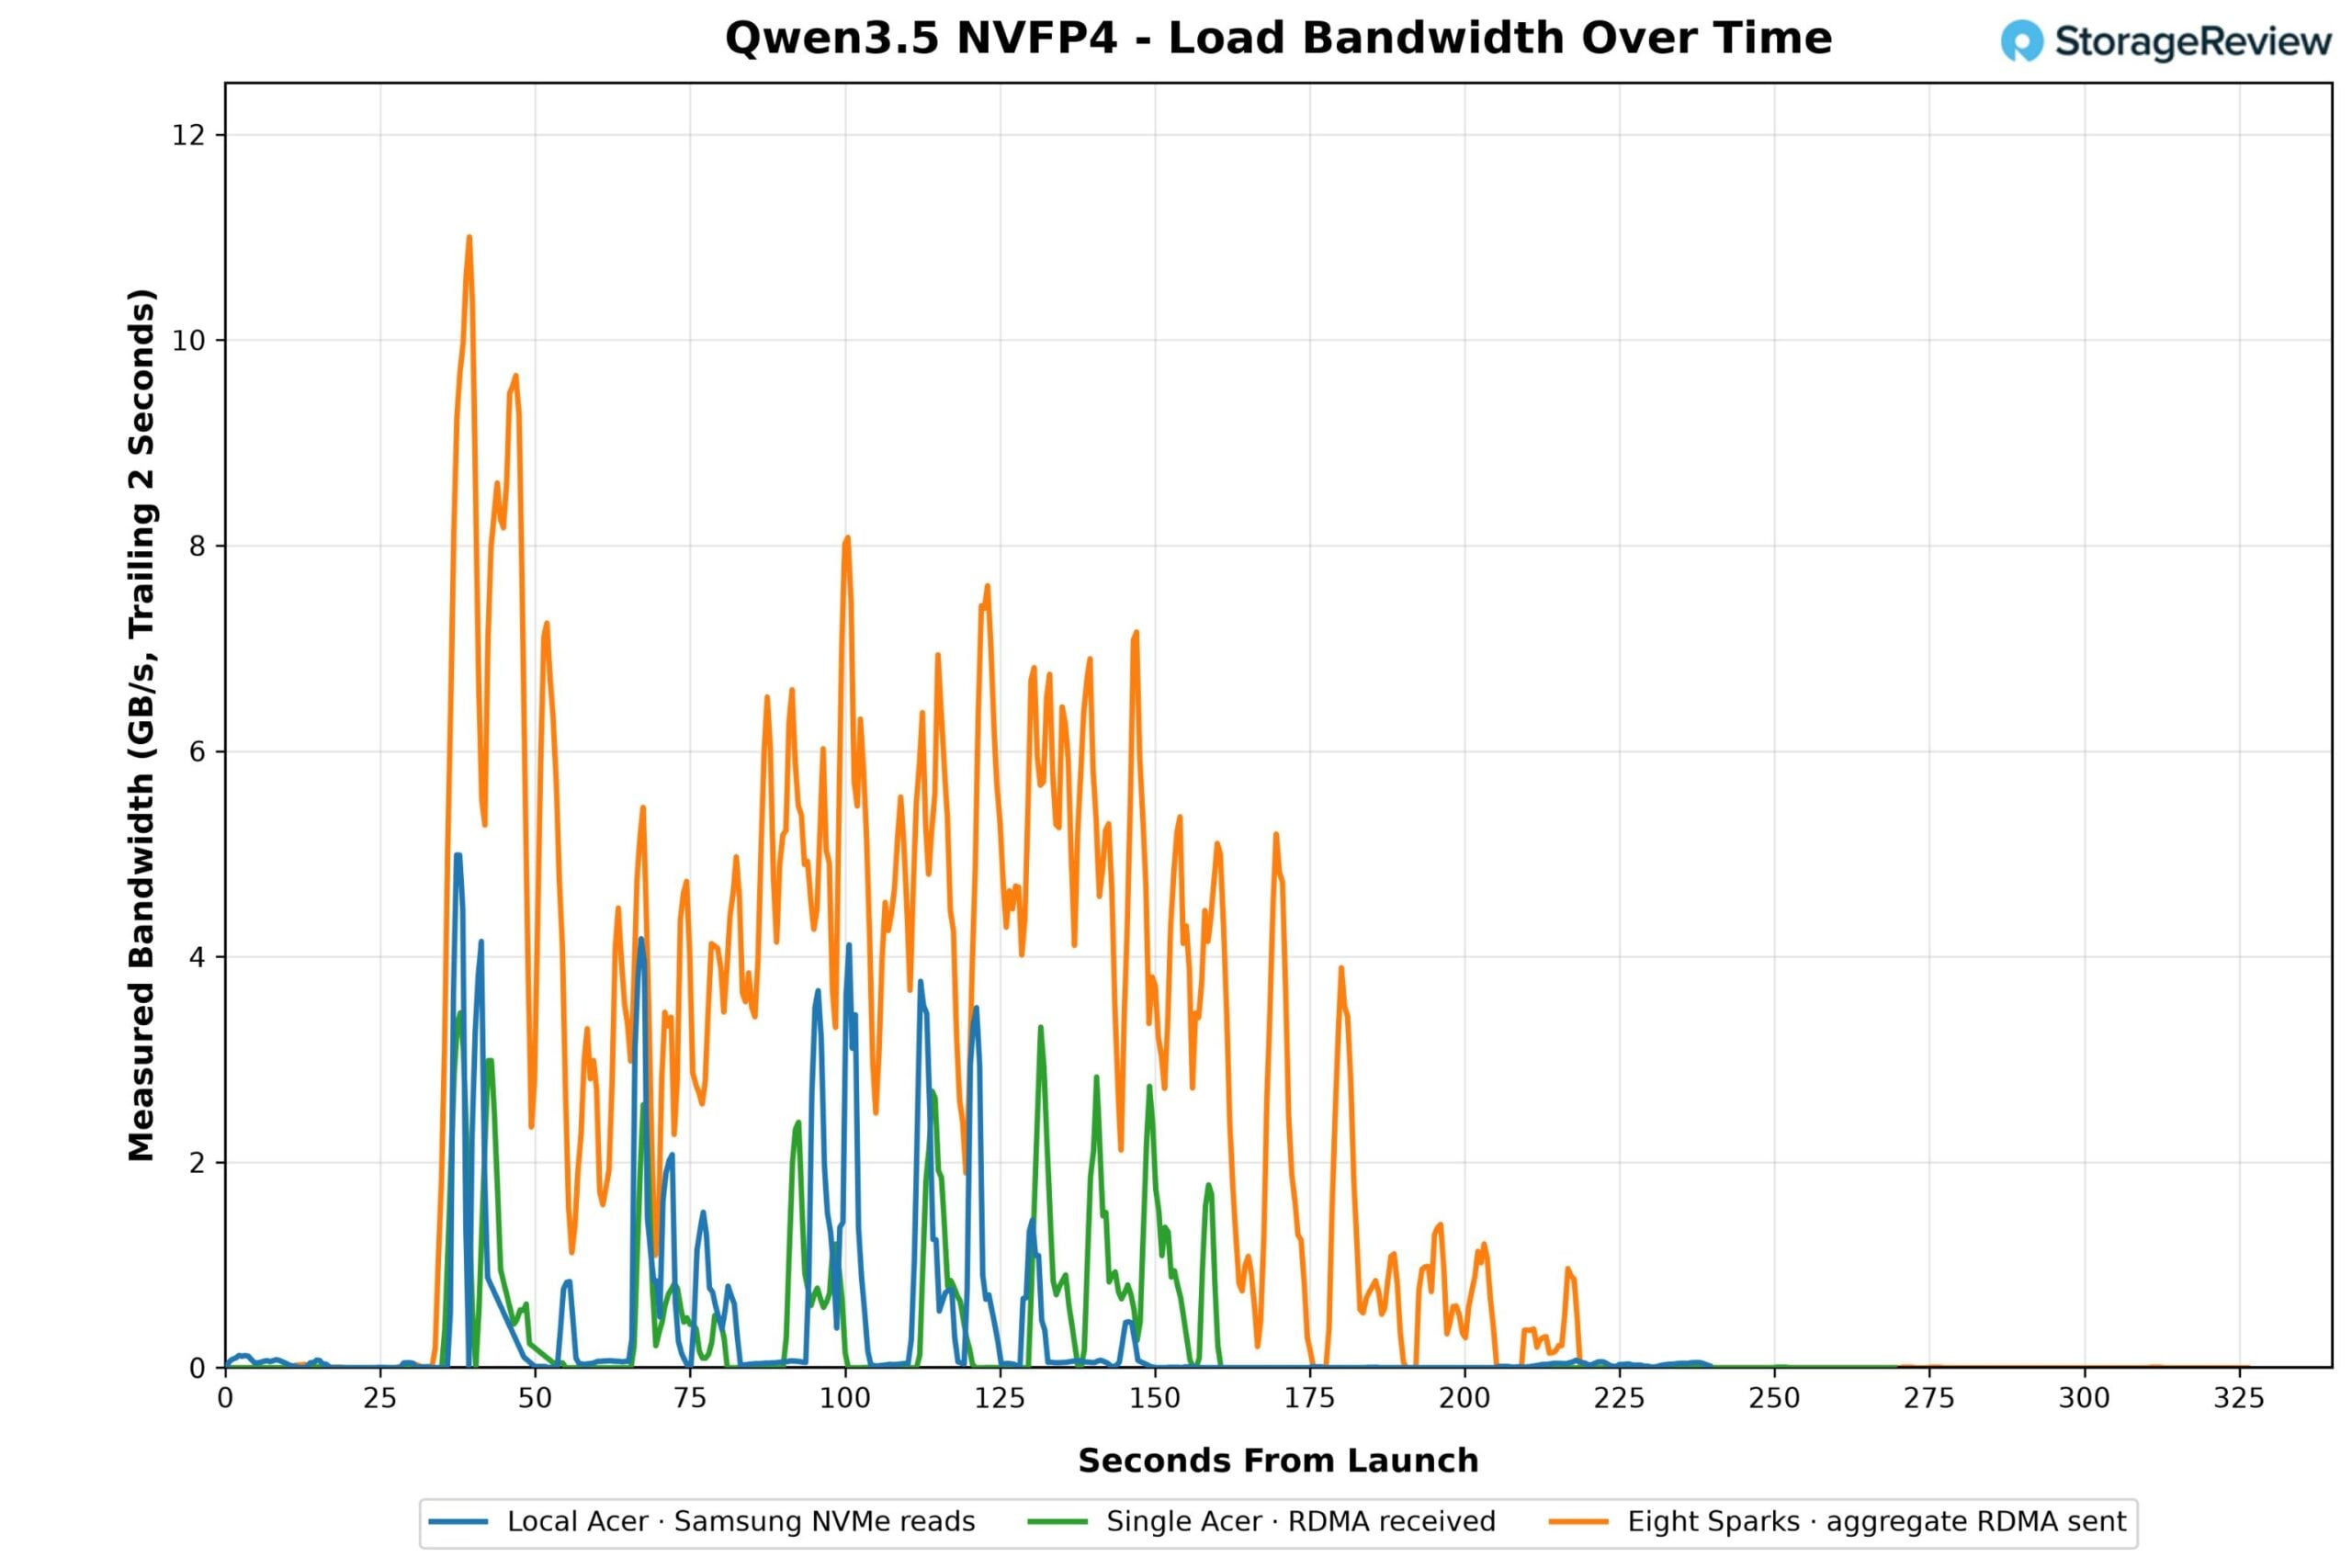
帯域幅トレースは、そのパターンを示しています。ローカル NVMe 読み取りは、5GB/s 付近でピークに達するバーストで到着し、その間に長い間隔があります。単一の NFS クライアントは、わずかに低いピークで同じバースト形状を示しています。8 つの Spark の集計ラインは、同時要求時のアレイを示しています。8 個すべてが同時に 78GB をプルすると、アレイは最初の 1 分で合計 11GB/s のピークを達成し、その後、Spark が重みを処理する間、次の 2 分間はおよそ 4~8GB/s の間で安定し、全ウィンドウの平均は 2.08GB/s でした。fio スイープでアレイが提供できる 25GiB/s と比較すると、8 つの Spark が同時にモデルをロードすると、利用可能な量のほんの一部しか使用されません。
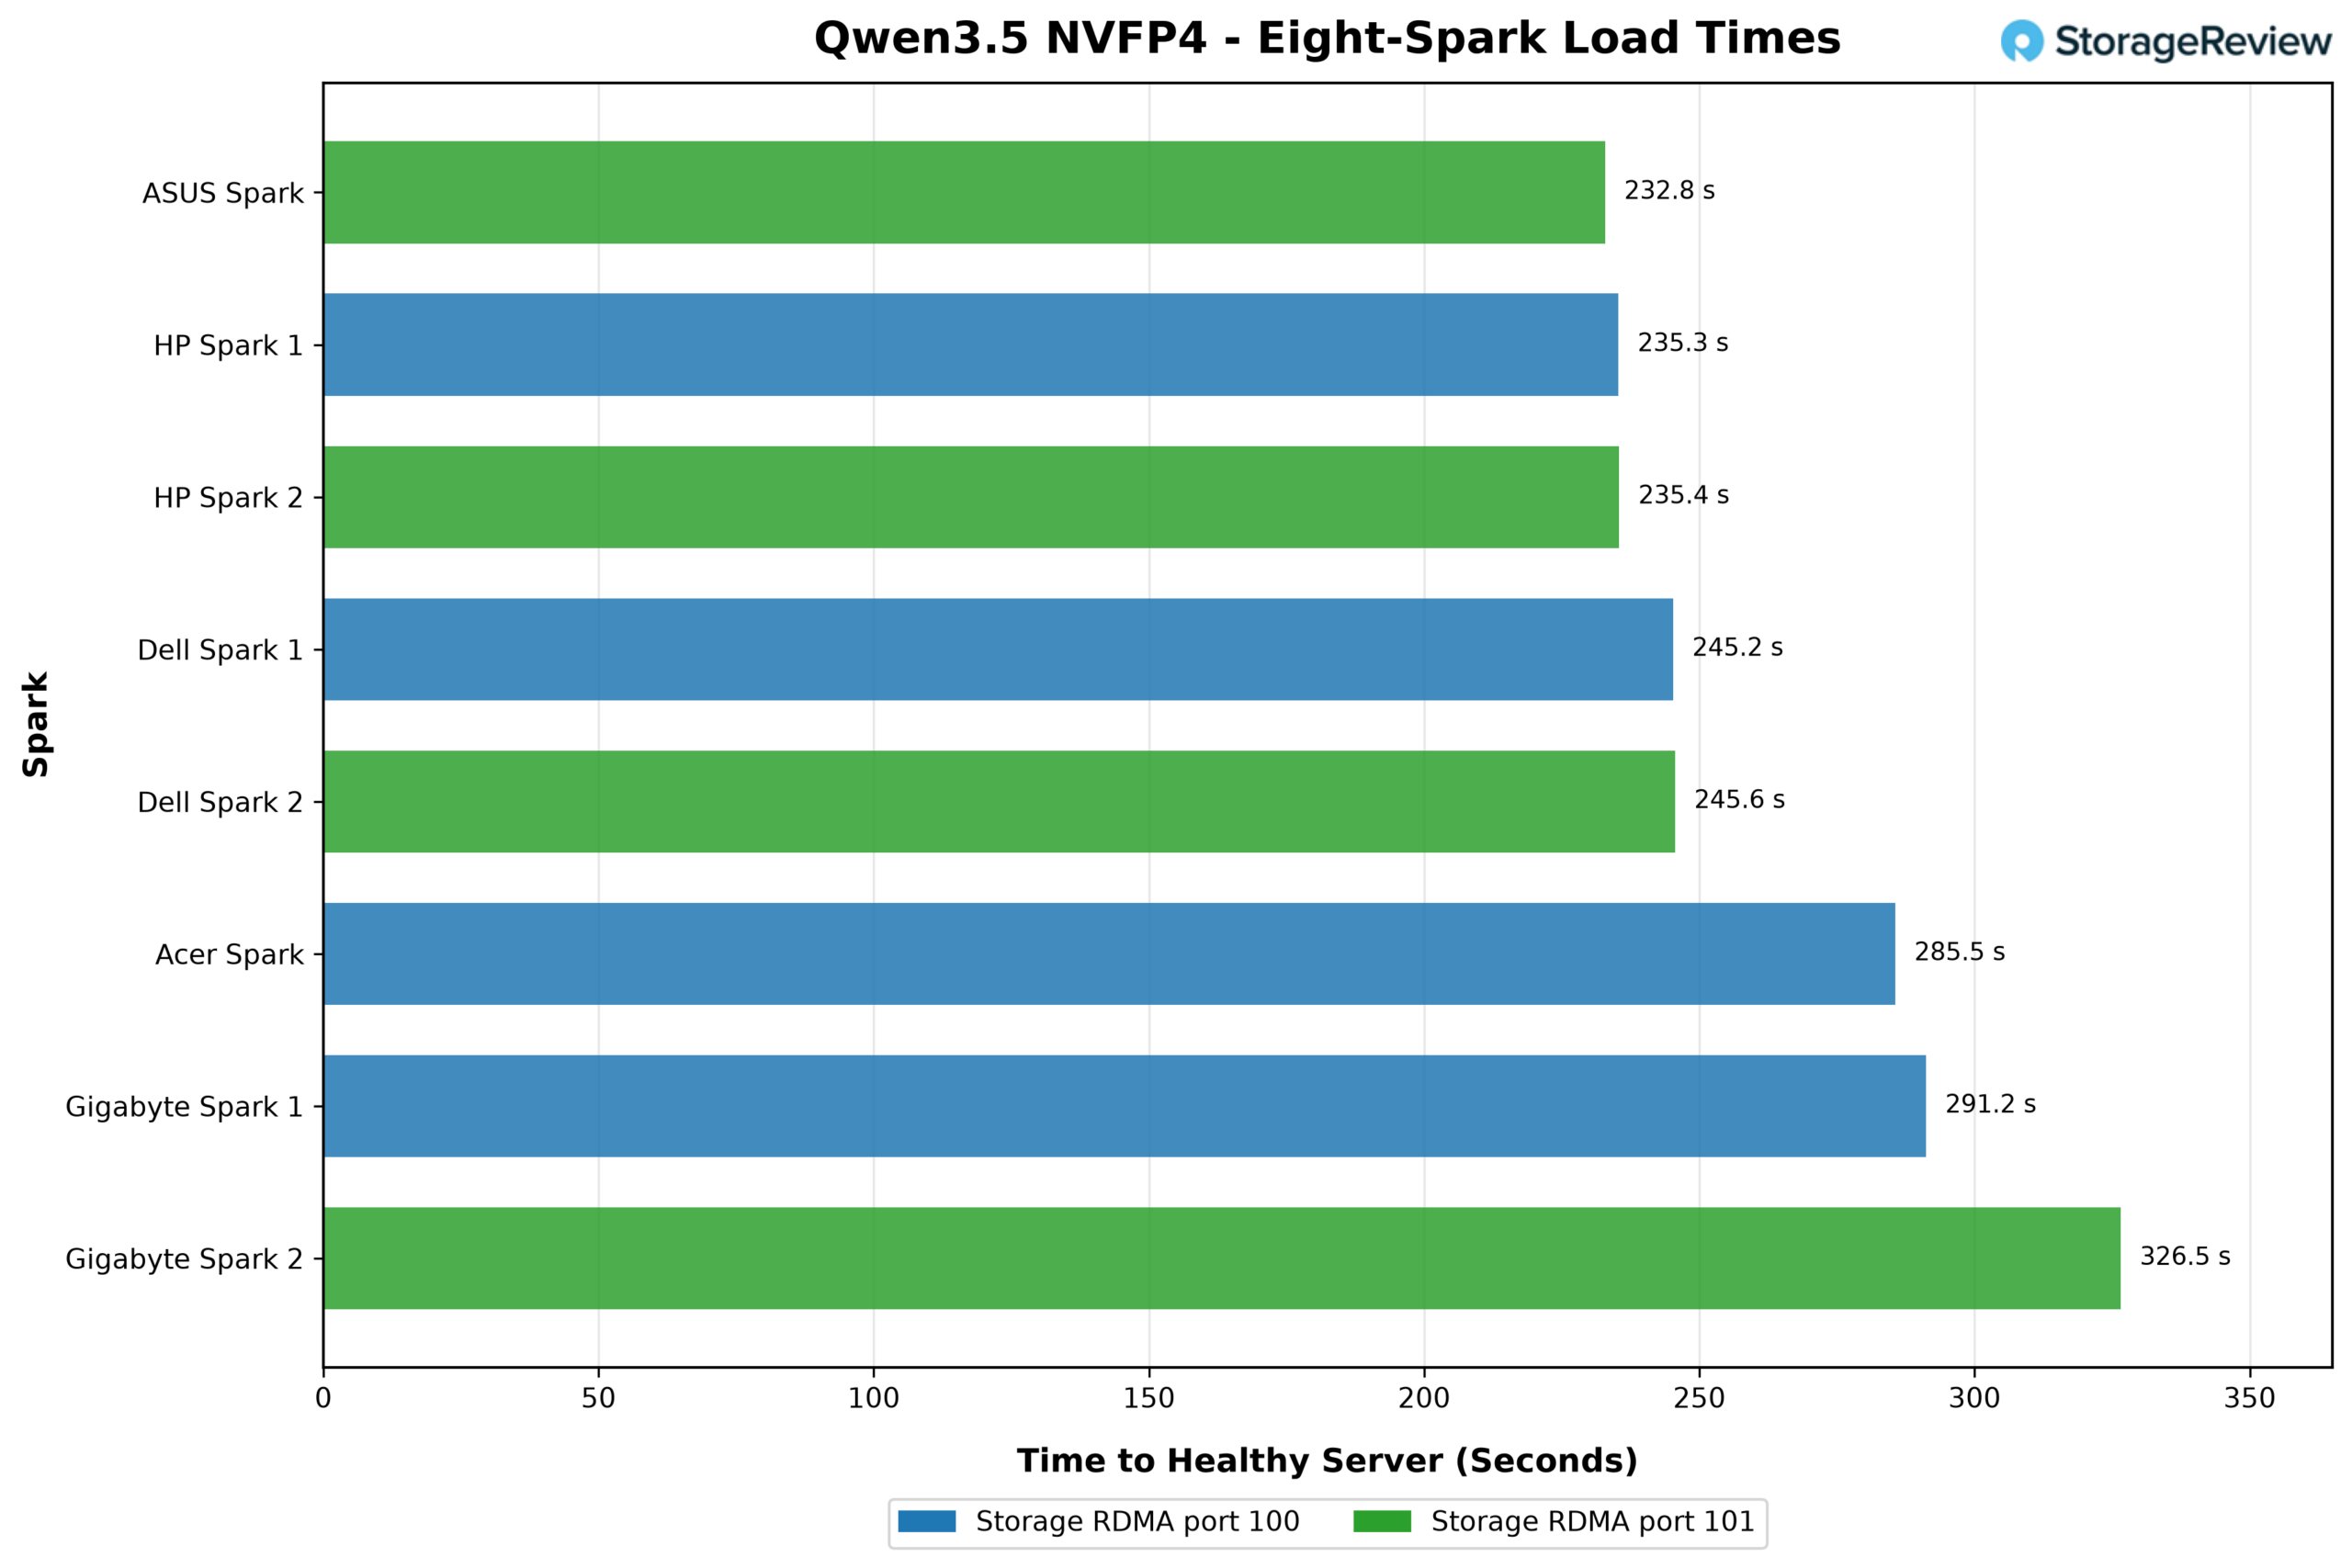
8 つのテストにおけるユニットごとのロード時間は、ASUS Ascent GX10 の 232.8 秒から GIGABYTE AI TOP ATOM ユニットの 1 台の 326.5 秒まで幅があり、2 台の HP ZGX Nano G1n システムは 235.3 秒と 235.4 秒、2 台の Dell Pro Max with GB10 ユニットは 245.2 秒と 245.6 秒でした。共有アレイから同時にロードする 8 つの Spark のうち 5 台は、NFS/RDMA 経由で単独でロードする 1 つの Spark を上回り、そのうち 3 台はローカル NVMe 実行を上回りました。このばらつきはベンダーの話ではありません。スタックに QoS がないため、どのユニットがどの時点でアレイを待機するかは実行ごとに変わり、各ストレージ NIC 上の 2 つのユニットはチャートの高速側と低速側に均等に分かれています。
研究室にとってのメリットは、各モデルのコピーを1つずつアレイ上に保持でき、どのSparkでも、あるいはすべてのSparkが、ローカルコピーを読み込むのとほぼ同じ時間でそれを読み込むことができる点です。ダウンロード手順も、ローカル容量の消費も、机の上に重みのコピーを置く必要もありません。
オレゴン州のユースケース
オレゴン州立大学の地球・海洋・大気科学部は、研究船上でのリアルタイム海洋調査から、 Metrum AI を使用した AI 支援型学術評価まで、当社の AI インフラストラクチャ関連の取り組みにおいて、繰り返し協力してくださっています。OSU の研究・学術コンピューティング担当ディレクターであるクリス・サリバン氏と、同氏の設計者であるトーマス・オルソン氏は、最大 100 ユニットまで拡張可能な大規模な Spark ラボを AI 学習用に検討しており、ストレージに関する彼らの考え方は、特に 2 つの点で当社の設計に影響を与えました。
まず、ストレージは Spark とは独立している必要があります。OSU は Spark 自体にまたがるファイルシステムを検討しましたが、教室での使用には不向きであると判断しました。なぜなら、単一のノードを追加または削除すると、全員のストレージ サービスが中断されるからです。どの Spark もマウントできる中央アレイであれば、Spark を追加、削除、再イメージ化、または別の学生に渡す際に、他のユーザーのデータに影響を与えることはありません。次に、ストレージはユーザーに追随する必要があります。OSU の要件は、AI 用途向けの強化版ファイル共有と表現できます。学生はシステム間を移動しながら、永続的な情報を保存します。NFS では、学生ごとにフォルダが用意されます。どの Spark にログインしても、共有をマウントすれば、作業内容にアクセスできます。
データセットこそが、OSUにとってこれがホームディレクトリサーバーよりも重要な理由です。地球・海洋・大気科学部は、数十テラバイトに及ぶ海洋学および大気学の研究データを、学生が自身の研究に利用できるようにしたいと考えています。デスクトップストレージでは、このようなことは不可能です。4TBのM.2スロットでは、これらのコレクションを1つも保存できませんし、外部エンクロージャーでいっぱいの研究室であっても、各デスク用にコピーを購入してデータを保存し、すべてのコピーを最新の状態に保つ必要があり、どの学部もそのような費用を負担できません。データをアレイに一度ホストし、100GbE経由でマウントするというアプローチが、評価の結果、この要件を満たすことがわかりました。同じアレイがモデルライブラリもホストしているため、学生はダウンロードの手順なしに、Qwen、Llama、またはその他のモデルを実行するだけで済みます。デスクトップAIシステムを開発者ワークステーションとして導入する企業にも、同じ原則が適用されます。高速ネットワーク経由で本番データセットをマウントし、システムにその場で処理させることで、デスクトップマシンが読み取るためのデータレイクを別途構築する必要がなくなります。データはデータセンター内に保持され、既存のアクセス制御、暗号化、バックアップ体制の下で管理されます。また、Sparkが外部に持ち出される際には、重要なデータは一切保持されません。
結論
デスクサイドAIハードウェアは多くの点で優れていますが、組織のデータ資産の一部としては最適とは言えません。GB10システムにはM.2スロットが1つしかないため、ユーザーが必要とするものはすべてローカルフラッシュにコピーされ、IT部門からは見えず、保護もされず、同じものを必要とする他のすべてのデスクにも複製されてしまいます。Sparkが1台だけなら、外部のローカルストレージボックスが妥当な解決策です。しかし、数十台も導入する研究室、部署、企業では、独自のデータを持つ各デスクがサイロ化されてしまい、データセンターが何年も前にたどり着いた解決策、つまり高速ネットワークの背後に容量を配置し、一度管理して共有するという方法が有効です。Sparkは既に高速ネットワークを備えています。このプロジェクトは、そのデータを保存する場所を与えた場合に何が起こるかを示しており、Spark自体がネットワークラックの隣に置かれるべきであることを証明しています。
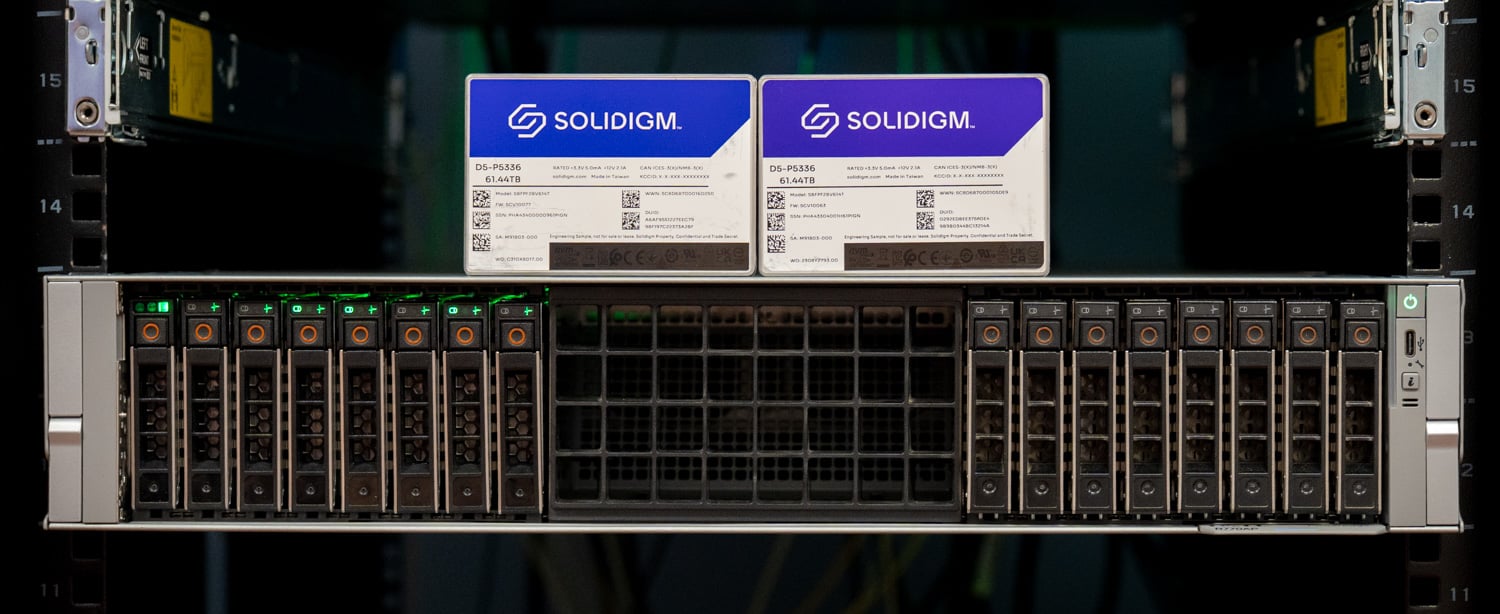
Dellサーバーに搭載されたGraid RAID 5構成のSolidigm D5-P5336 QLCドライブ8台により、8台のSparkに単一のパリティ保護データセットが提供されました。Broadcom 400GbE NIC 2枚と800Gブレークアウトを備えたDell Z9864F-ONにより、8台のSparkそれぞれに100GbEが提供されました。TuxeraのFusion NFS over RDMAにより、この容量は標準Ubuntu上でディレクトリサービスフックによるアクセス制御を備えた1行のマウントで実現されました。8台すべてに固定負荷を分散させた場合、このアレイはQoSなしで均等に分割された合計シーケンシャル読み取りで24.9GiB/sを達成し、1台のSparkだけでもリンクを10.8GiB/sで飽和させました。これは、テストしたGB10システムの最高の内蔵ドライブと同じ速度です。この上限は、2つのサーバー側NICが処理できる容量の27%を使用しているため、ネットワークはこれよりも負荷の高いサーバー向けに設計されています。モデルテストによりワークフローが確認されました。共有アレイ上に一度ホストされた78GBのモデルは、ローカルNVMeと比較して13%以内の速度で1台のSparkにロードされ、同時に8台のSparkにロードされた場合、8台のうち5台は単独のNFS実行よりも高速に完了しました。
QLC フラッシュは、ワークロードが容量重視かつ読み取り重視であり、D5-P5336 の強みであるため、このような経済性を実現しています。また、1 つのサーバーで、100 台の Spark ではローカルに処理できないデータを格納でき、すべてのデータの 1 つのコピーがデータ センターの管理下に置かれます。オレゴン州立大学には、待てない作業のための本番研究用ストレージがあります。クリス サリバンとトーマス オルソンが検討しているコンセプトは、現在大学にはない教育用階層です。サーバーと少数の大容量ドライブから構築された、ラック 1 つまたはそれ以上の Spark を収容できる管理された共有プールで、Spark が使用するのと同じファブリック上に、数十テラバイトの実際の海洋学および大気データを大規模な AI 学習ラボの前に配置できます。
このレポートは Solidigm によって後援されています。このレポートで表明されているすべての見解や意見は、検討中の製品に対する当社の公平な見解に基づいています。
この記事における市販製品への言及は情報提供のみを目的としており、オレゴン州立大学による推奨を意味するものではありません。



 Amazon