

Fungible は、Fungible Storage Cluster、FSC 1600 高性能ストレージ ノードのリリースにより、既存のストレージ アーキテクチャの制限を取り除き、ストレージ プラットフォームの設計方法を変えています。 Fungible Storage Cluster は、高レベルのアプリケーションに対して完全に透過的な、高性能、低遅延の NVMe/TCP 分散ストレージ ソリューションを提供します。 Fungible DPU™ を搭載した Fungible Storage Cluster (FSC) は、高性能で安全なスケールアウト型の分散型オールフラッシュ ストレージ プラットフォームです。
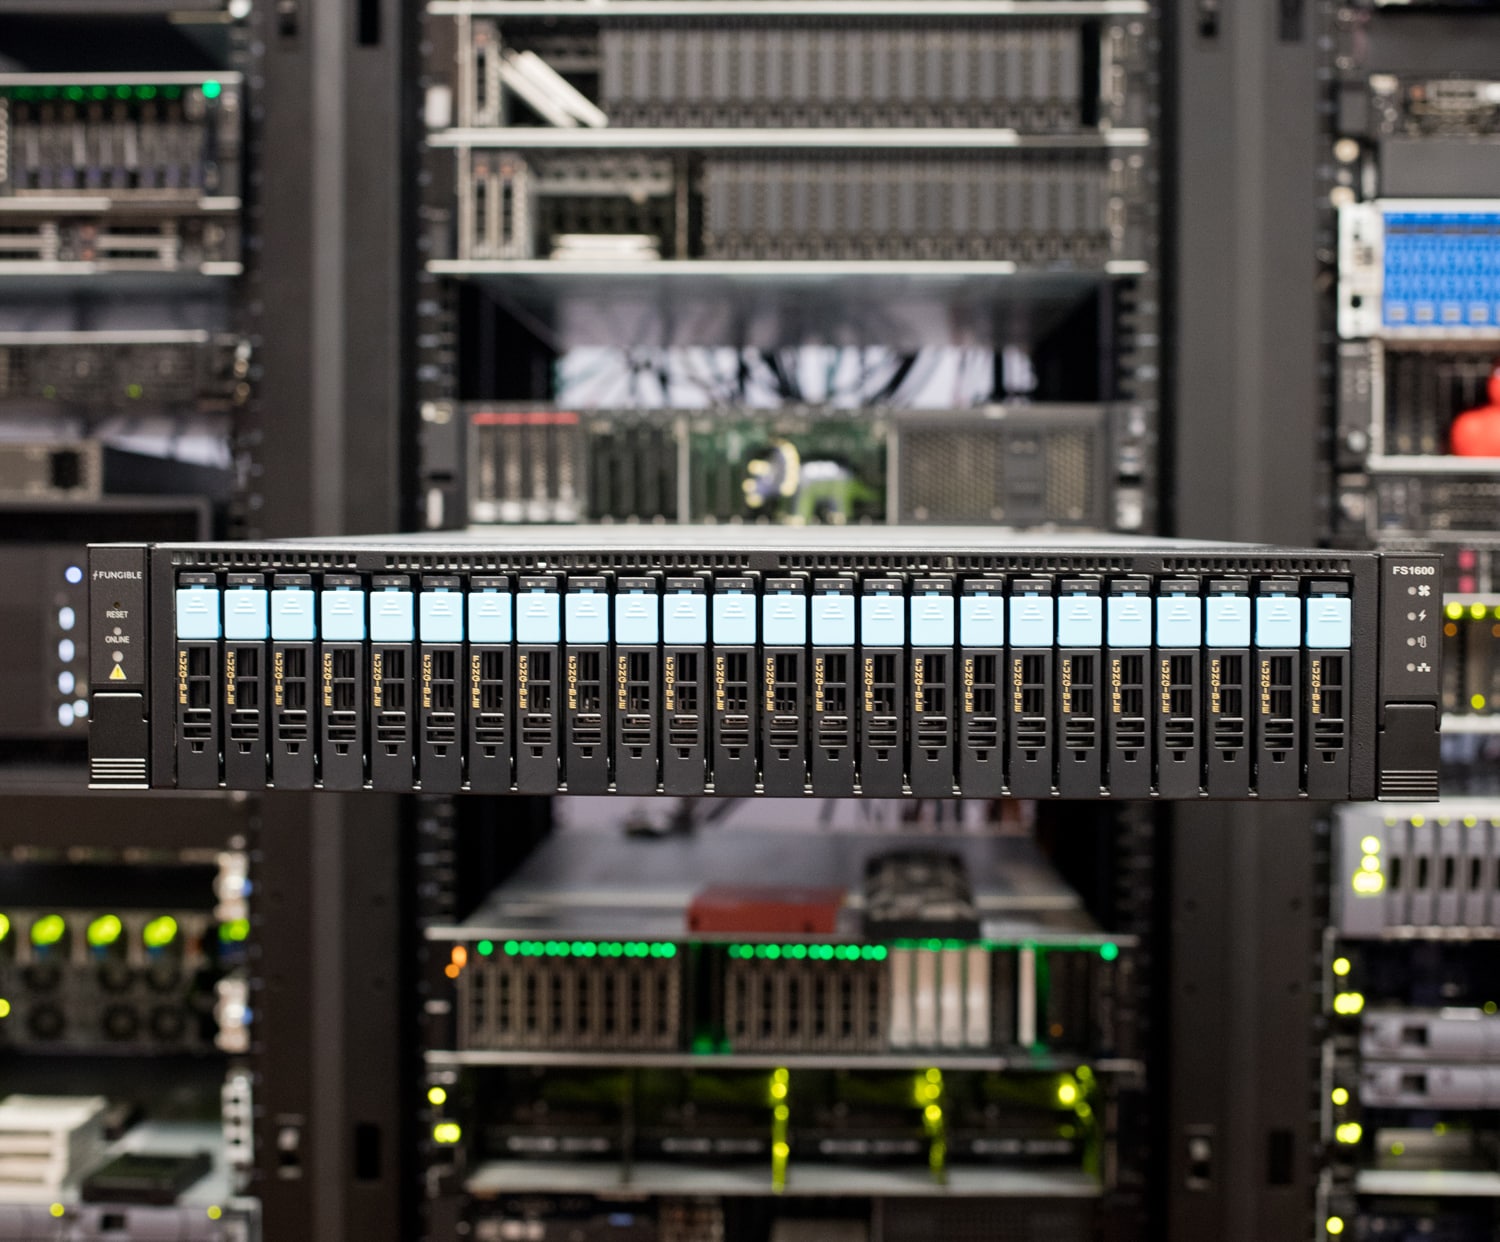
代替可能な FS1600 フラッシュ アレイ
データ処理ユニット (DPU) は、本質的にはチップ上のシステムです。通常、DPU は、マルチコア マイクロプロセッサ、ネットワーク インターフェイス、およびネットワーク、ストレージ、仮想化、セキュリティ、分析機能などのデータ中心のタスクをオフロードするアクセラレーション エンジンで構成されます。 DPU と SmartNIC は、エンタープライズおよびクラウド プロバイダーのデータ センターで引き続き人気が高まっています。
その 代替可能なFSC1600 ストレージクラスター
FS1600 は XNUMX つの代替データ処理ユニットを搭載しています。独自の Fungible イノベーションである DPU は、インフラストラクチャ サービスの実行において比類のないパフォーマンスと効率を実現するためにゼロから設計された新しいクラスのマイクロプロセッサを表します。
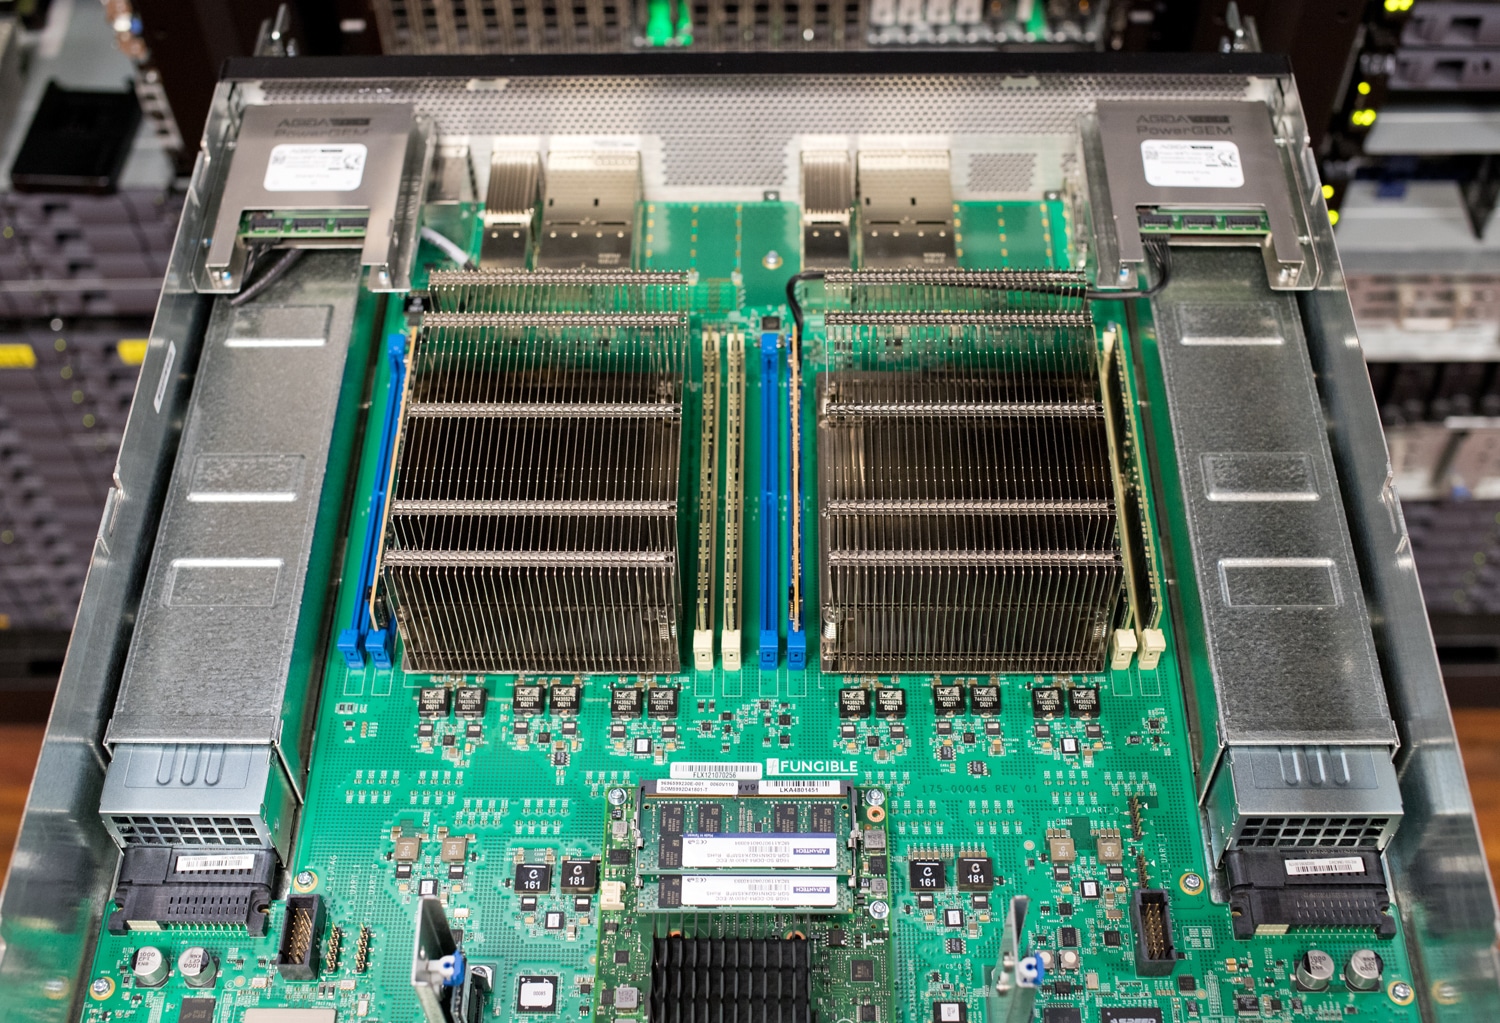
代替可能な FS1600 内部構造
ほとんどのストレージ プラットフォームは x86 ベースですが、FS1600 は基本的な Fungible DPU テクノロジーに根ざしています。データ中心のワークロードを CPU よりも効率的に実行するように特別に設計された DPU により、FS1600 はより高いパフォーマンスを実現できます。 FS1600 は、13M IOPS のランダム読み取りレート、Raw ブロック読み取りパフォーマンス (4KB)、ノードあたり 75 GB/秒のスループット、+10μs の読み取りレイテンシーを備えており、直接接続ストレージ (DAS) システムよりもはるかに効率的なパフォーマンスを実現します。 96.5% のパフォーマンス効率パーセンテージ (PEP)。
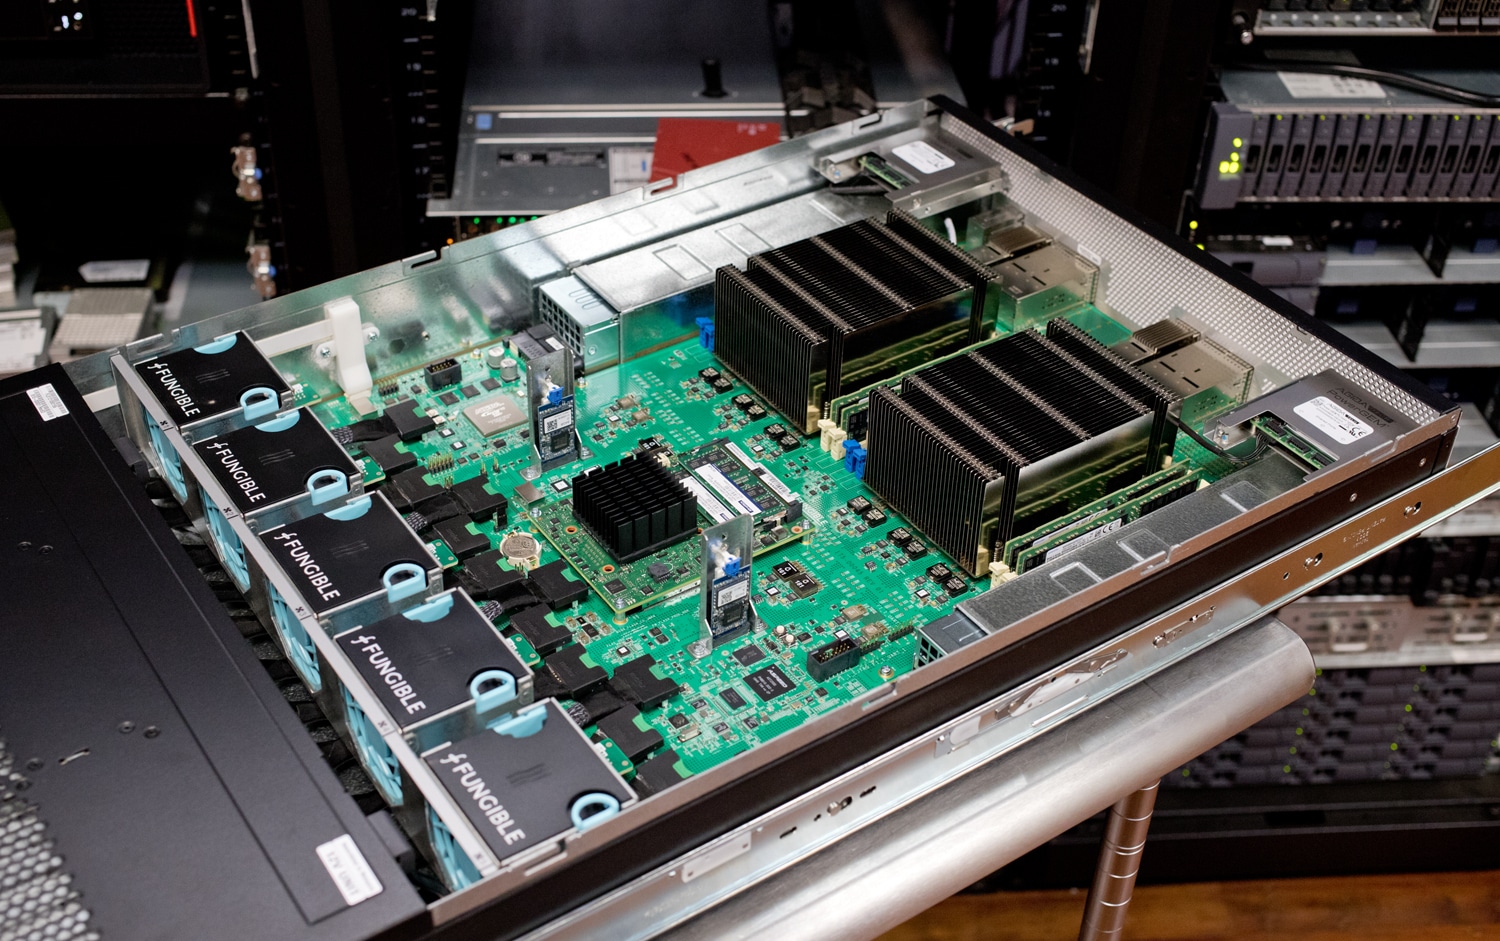
DPU ハードウェア アクセラレータには、圧縮、消去コーディング、暗号化、正規表現、ディープ パケット インスペクション、および DMA が含まれており、800 Gb/s のライン レートで動作します。イレイジャーコーディングでは、ノードに障害が発生した場合、他のノードからのパリティとデータチャンクを使用してデータが再構築され、ホストはマルチパスを通じてデータにアクセスするための代替パスを提供します。 FS1600 は、NVMe/TCP と、Kubernetes 用の Container Storage Interface (CSI) および VM 用の Openstack を介した管理ソフトウェアに準拠しており、既存のストレージ システムのドロップイン代替品として使用できます。ホストの CPU リソースを使用する特別なエージェントには要件はありません。標準の NVMe/TCP ドライバーのみが必要です。また、既存のアプリケーションを変更する必要はありません。
S1 および F1 DPU モデル
Fungible DPU モデルには、S1 DPU と F1 DPU の 1 つがあります。 Fungible ファミリのプロセッサは、同じハードウェアとソフトウェアの共同設計を活用し、同じプログラミング モデルを共有します。ただし、F1 DPU はストレージ、セキュリティ、AI、分析サーバーなどの高性能スタンドアロン アプライアンス向けに設計されているのに対し、SXNUMX DPU は標準の PCIe アダプターの設置面積と電力エンベロープ内でパフォーマンスを最大化します。
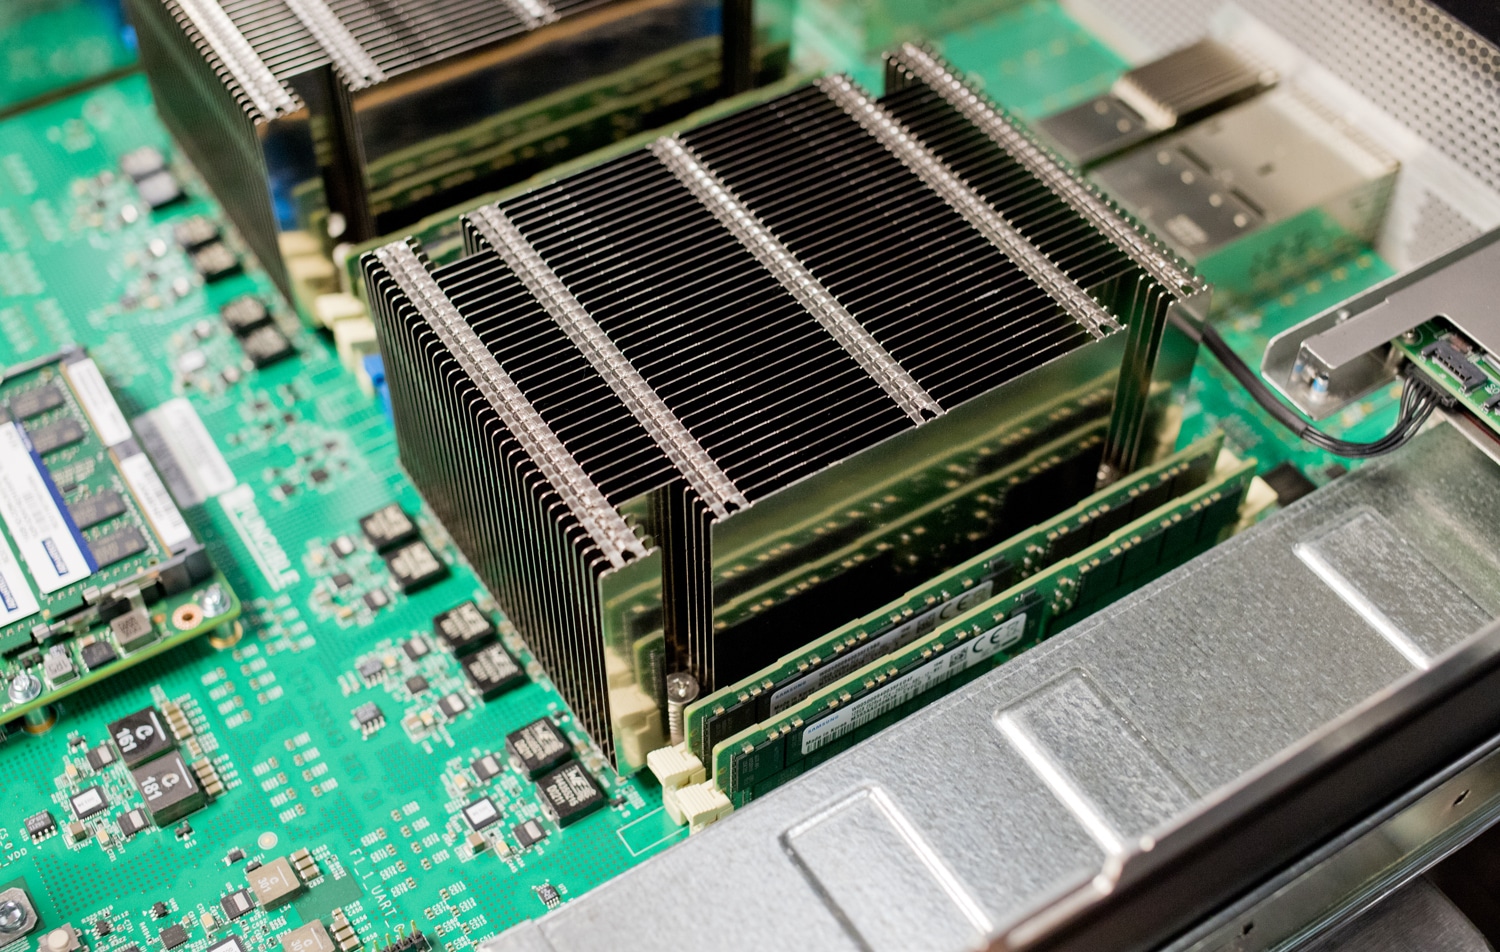
Fungible S1 DPU は、サーバー ノード内でデータ中心の計算を組み合わせ、ノード間でデータを効率的に移動できるように最適化されています。データ中心の計算は、通常はネットワーク、セキュリティ、ストレージ スタックによる、高速でのデータ ストリームのステートフル処理によって特徴付けられます。
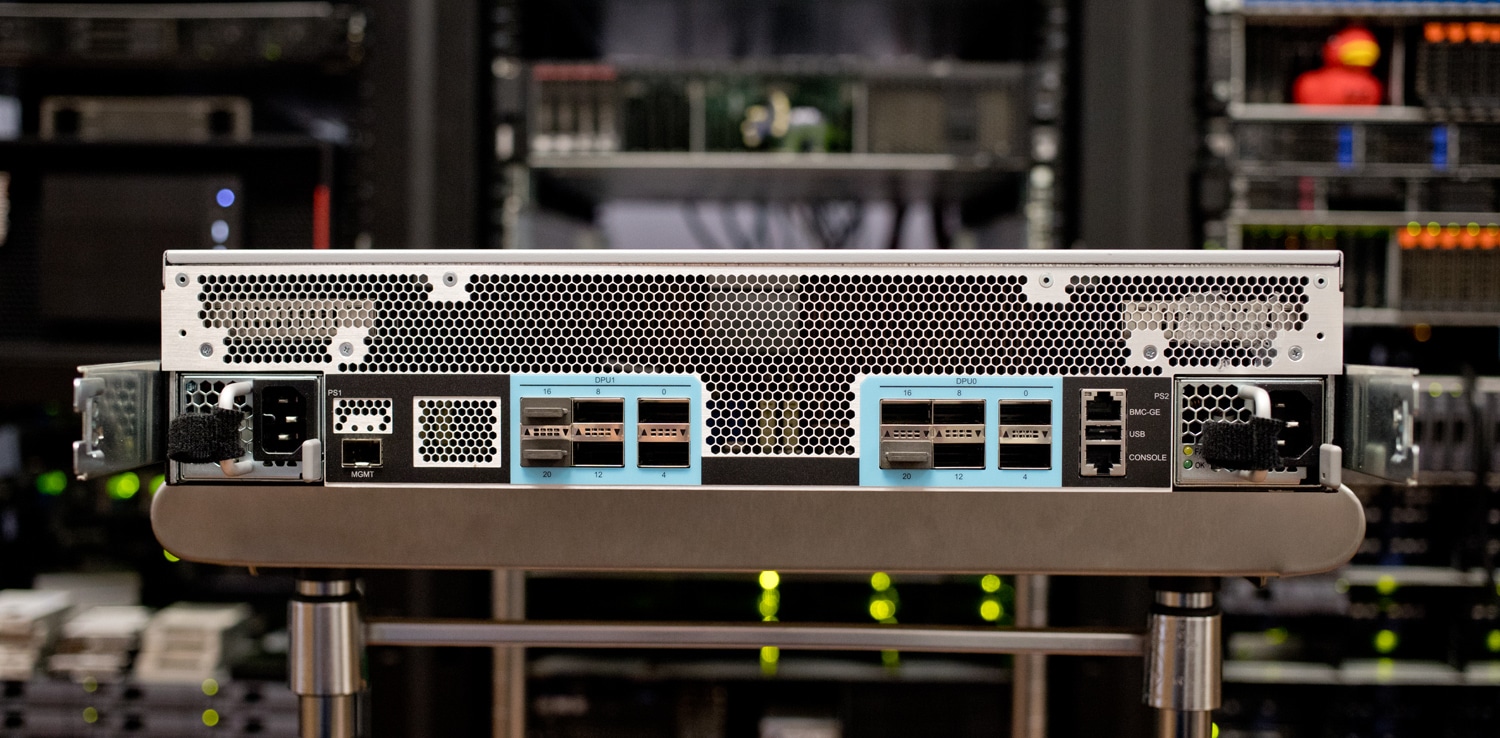
代替可能な FS1600 背面ポート
S1 DPU は、TrueFabric™ テクノロジーを通じてサーバー ノード間のデータ交換を容易にします。 TrueFabric は、大規模な IP-over-Ethernet ファブリック プロトコルであり、平均遅延とテール遅延が低く、エンドツーエンドの QoS、輻輳のない接続、およびサーバー ノード間のセキュリティを備えたネットワーク全体のクロスセクション帯域幅を提供します。 TrueFabric プロトコルは完全に標準に準拠しており、TCP/IP over Ethernet と相互運用できるため、データセンターのスパインリーフ ネットワークを標準の既製イーサネット スイッチで構築できることが保証されます。
FunOS
S1 と F1 DPU の両方のデータ プレーンは、高級プログラミング言語 (ANSI-C) で書かれた専用オペレーティング システムである FunOS™ を実行します。 FunOS は、ネットワーク、ストレージ、セキュリティ、仮想化、分析スタックを実行します。コントロール プレーンは標準 OS (Linux など) を実行し、一連の REST API によって S1 と F1 DPU の両方のクラスターを管理、制御、監視できるようにするエージェントが含まれています。これらの REST API は、Kubernetes CSI プラグイン、OpenStack、OpenShift などの標準またはサードパーティのオーケストレーション システムに統合できます。
これらの主要な機能を 1 つのソリューションに組み合わせることで、Fungible DPU ファミリのプロセッサは、コンピューティング リソースとストレージ リソースの超分割とプールを可能にし、次世代のデータ センターに高性能で非常に拡張性の高いコンポーザブル インフラストラクチャを提供します。
クラスターを構成するもの
FSC™ は、1600 つ以上の Fungible FSXNUMX ストレージ ターゲット ノードと XNUMX つの Fungible Composer ノードのクラスタで構成されます。 Fungible Composer ソフトウェアは、Fungible Storage Cluster を構成、管理、調整、制御、展開する集中管理ソリューションであるコントロール プレーンを管理します。 Composer ノードは、ストレージ、ネットワーク管理、テレメトリ、ログ収集のためのノード管理、Fungible Composer が提供するサービスへの外部アクセスを提供する API ゲートウェイなどのサービスを提供します。
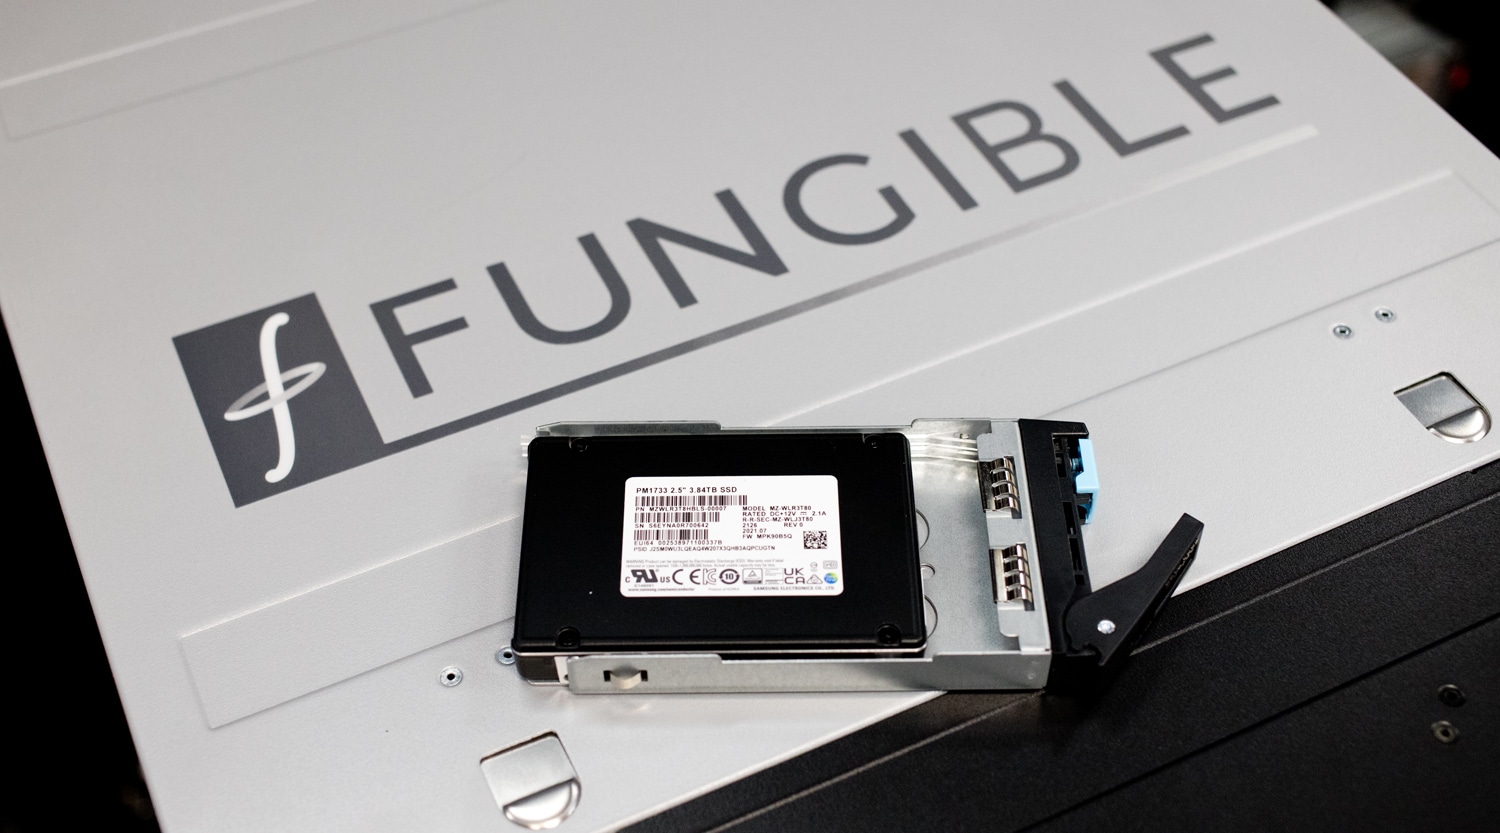
Fungible Storage Cluster は、高レベルのアプリケーションに対して完全に透過的な、高性能、低遅延の NVMe/TCP 分散ストレージ ソリューションを提供します。各 FS1600 は最大 24 個の U.2 NVMe/TCP SSD をサポートし、パフォーマンスは 70TB の小型から複数 PB まで直線的に拡張します。
適用例
ハイパーディスアグリゲーションを実現するクラウドネイティブストレージ:FSCは、クラウドプロバイダーに従来のストレージに代わる選択肢を提供します。ストレージをディスアグリゲーションすることで、FSCはコンピューティングとストレージの独立したスケーリング、利用率の向上、サーバーSKUの削減、管理の複雑さの軽減、そして俊敏性の向上を実現します。
人工知能/機械学習:現代のAI/MLワークロードは、一般的に、パフォーマンスにおける大規模な並列処理、低遅延、および大容量を必要とします。FSCは、高度にスケーラブルな並列ファイルシステムと組み合わせることで、ストレージのボトルネックを解消し、これらの最新ワークロードにおいて、これまでにないパフォーマンス、低遅延、および効率性を実現します。
クラウドネイティブな高性能データベース:今日の高性能スケールアウトデータベースの多くは、レイテンシ要件を満たすためにDAS(分散アレイ)を採用しています。これらのデータベースは通常、レプリカセットやプライマリ/セカンダリ構成などのクラスタ化された冗長性スキームによって耐久性を提供します。サーバーが故障しても、データは別のサーバーに保持されます。FSC(ファイルシステム制御)は、DASと同様のレイテンシを維持しながら、ストレージ利用率の向上とクラスタ化された冗長性を提供し、容量オーバーヘッドを低減します。
シンプルなIT管理
FS1600 および Fungible DPU によってもたらされるすべてのパフォーマンス上の利点に加えて、簡素化された管理アプローチもあります。 Fungible は、単一画面でマルチテナントの安全なデータセンターの管理ツールを提供します。 Fungible Composer ダッシュボードは、IT 管理者の一日の生産性を高め、日々のデータセンター機能を効果的に管理するために必要な情報を提供します。
代替可能な作曲家
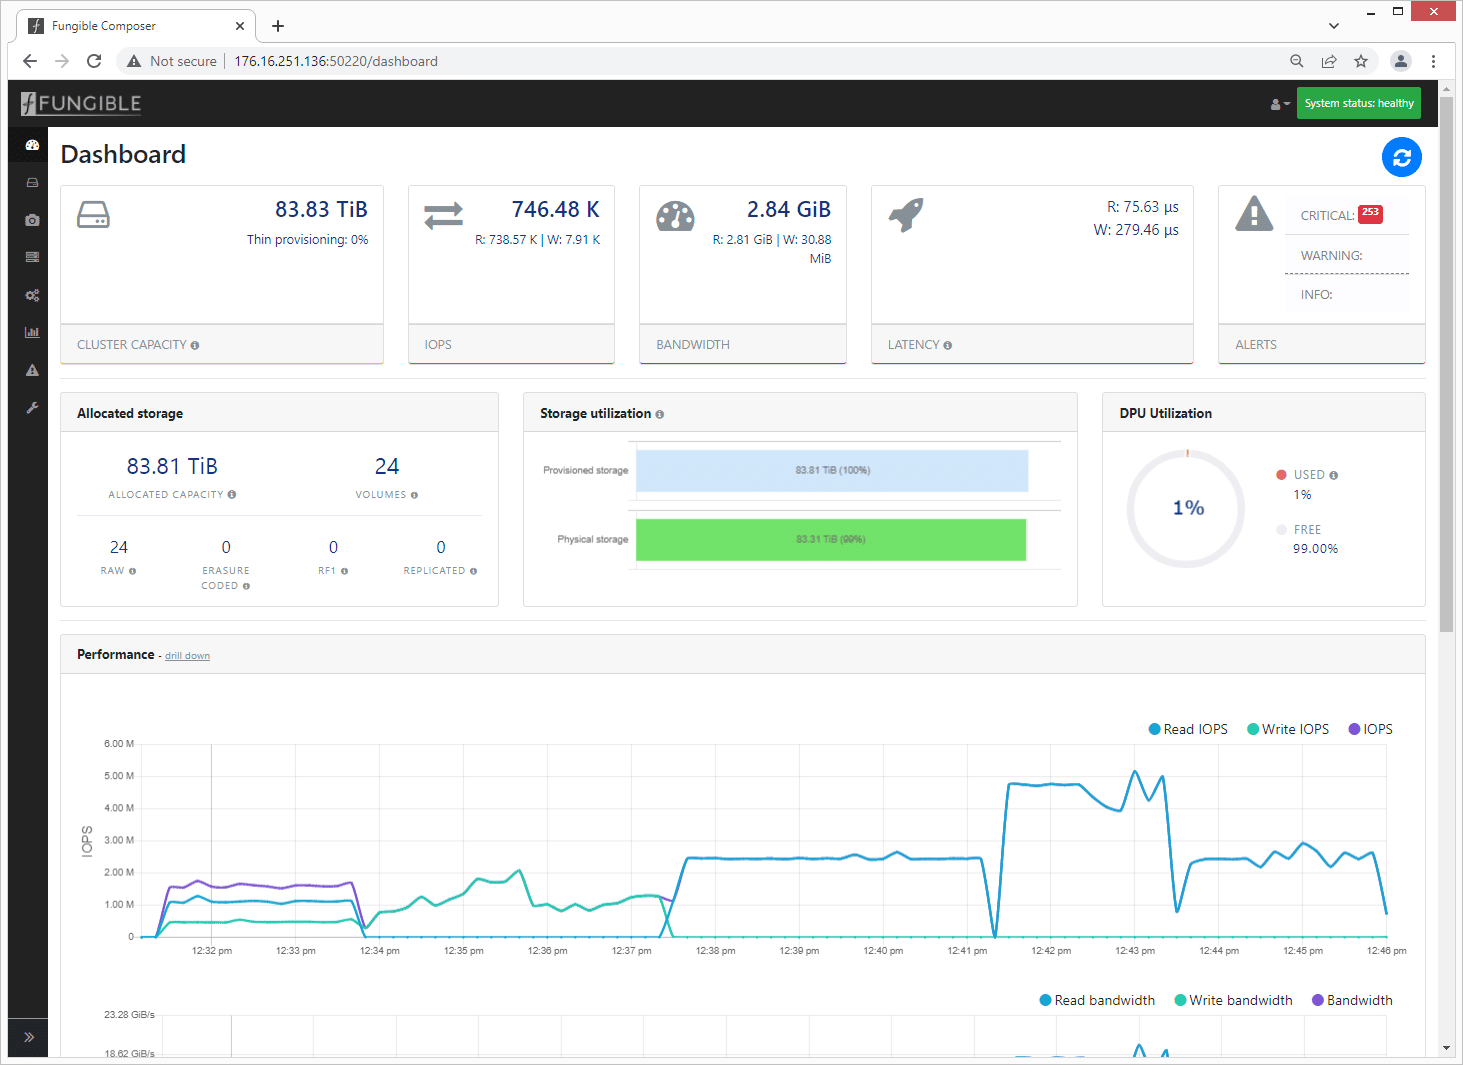
Fungible Composer ダッシュボードは使いやすく、追跡、管理、構成、パフォーマンス監視に関する詳細が豊富に揃っています。上部のタブには、接続されているシステムが表示され、クラスターの詳細、IOPS、ストレージの詳細、および注意が必要なアラームがすべて表示されます。
ディスプレイの左側にあるアイコンを使用すると、特定の管理ツールにすぐにアクセスできます。
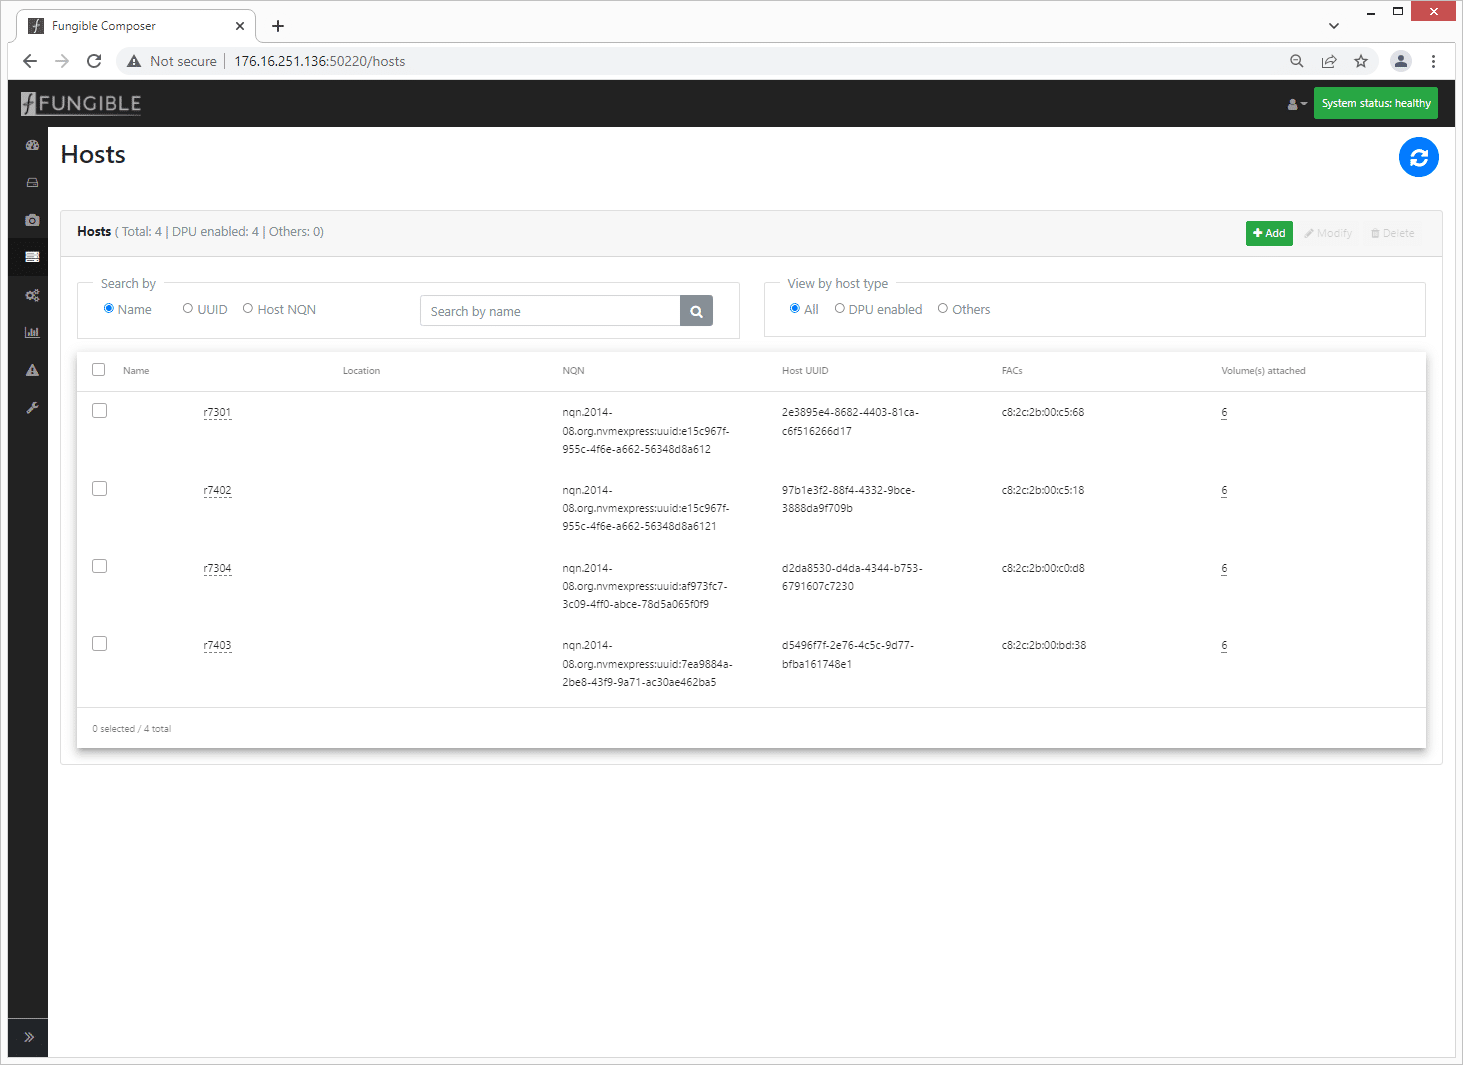
代替デバイスの展開時に指定された詳細に応じて、ホスト テーブルにより、管理者は接続されているホストを簡単に表示でき、特定のホストにドリルダウンするオプションも提供されます。
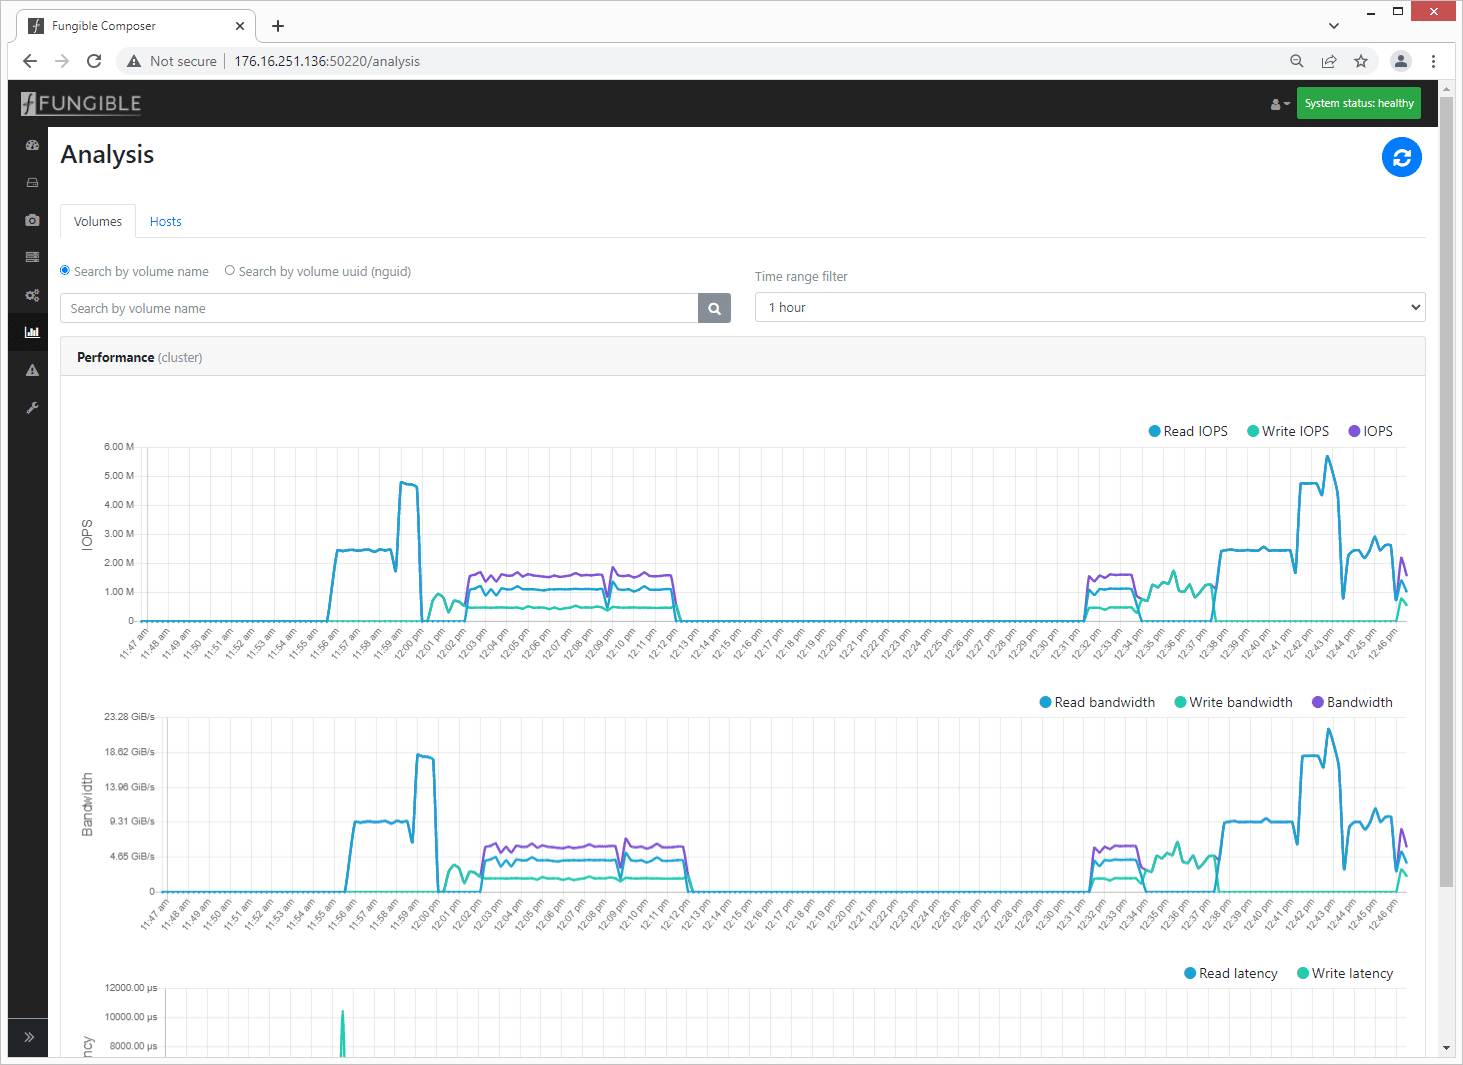
パフォーマンス データの場合、分析アイコンを選択すると、クラスター パフォーマンスの詳細が画面に表示され、IOPS、帯域幅、遅延が一目でわかります。
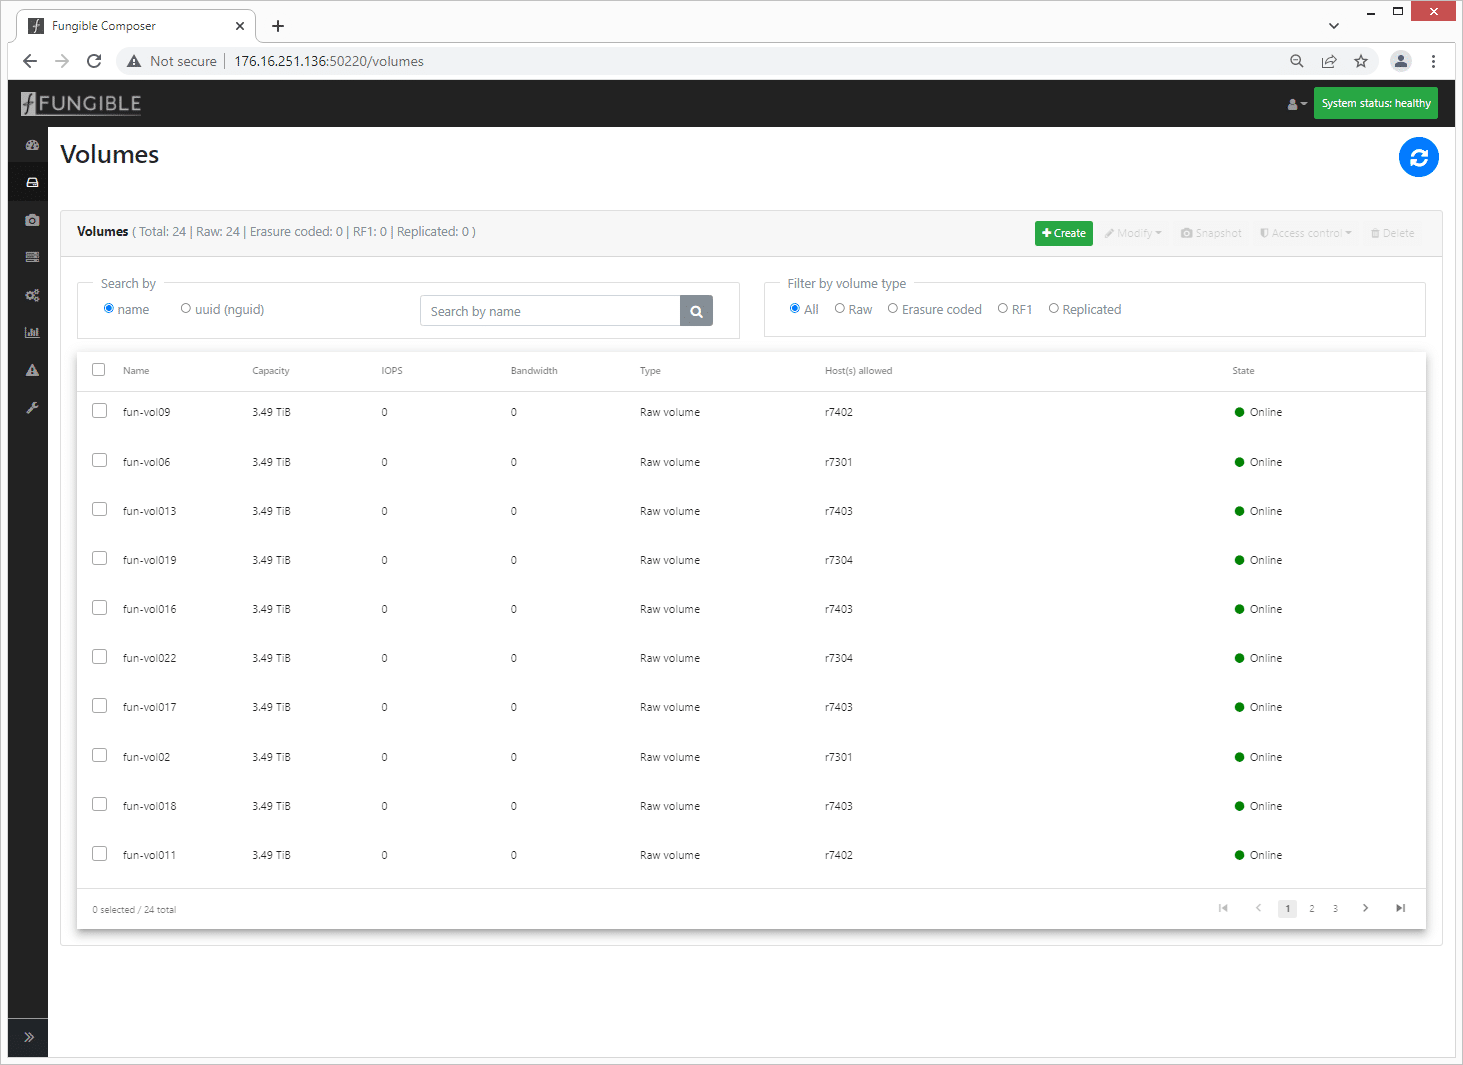
ボリュームの詳細では、各ボリュームの健全性の概要が簡単にわかります。ここから、個々のボリュームにドリルダウンして詳細を確認できます。
展開の詳細
1×代替可能なFSC1600
- 8 x 100GbE 接続
- 24 x 3.84TB NVME デバイス
4×デルR740xd
- 1×代替可能なFC200
- 1×100GbE接続
- 1×NVIDIA ConnectX-5
- 1×100GbE接続
- 2 x Intel Xeon Gold 6130 CPU @ 2.10GHz
- 1 256GB ドラム
ボリューム
- 合計 192 の 100G RAW ボリューム
- ホストごとに 16 x 4K RAW ボリューム
- ホストごとに 16 x 8K RAW ボリューム
- ホストごとに 16 x 16K RAW ボリューム
試験プロセス
テストの準備には、テスト ワークロードを開始する前に、書き込みワークロードですべてのボリュームをプリコンディショニングし、ボリュームを埋めることが含まれます。ボリュームのサイズは、適用されるワークロードのブロック サイズに合わせて調整されました。テストでは、4K、8K、および 16K ボリュームが、それぞれ 4K ランダム、8K ランダム、および 64K シーケンシャル ワークロードに使用されました。 NVMe over TCP プロトコルを利用し、単一ノードで、保護スキームなしでストレージをテストしました。
Fungible DPU または 100GbE NIC 間の各 FIO 反復は、同様の遅延プロファイルを提供するようにバランスがとられています。その後、パフォーマンスを向上させるために 100GbE NIC のワークロードが増加し、その結果、遅延と CPU 使用率が増加しました。
初期テスト段階では、FIO ジョブはカードがインストールされている NUMA ノードにリンクされました。 DPU または NIC は、各テスト間で交換され、同じ PCIe スロットに配置されました。サーバー BIOS プロファイルをサーバー レベルでパフォーマンスに設定する以外に特別な調整は必要ありません。各loadgenに対して、Ubuntu 20.04.2 Live Serverをインストールしました。
代替可能 FS1600 パフォーマンス結果の概要
代替可能な FC200 IOPS
| ワークロード | ホスト1 | ホスト2 | ホスト3 | ホスト4 |
| 4k 読み取り | 2019k | 2015k | 2016k | 2012k |
| 4K書き込み | 2244k | 2020k | 2280k | 2203k |
| 64読み取り | 167k | 166k | 166k | 166k |
| 64K書き込み | 161k | 168k | 164k | 186k |
| 8k 70r/30w | 1118k / 479k | 1105k / 474k | 1075k / 461k | 1117k / 479k |
代替可能な FC200 帯域幅
| ワークロード | ホスト1 | ホスト2 | ホスト3 | ホスト4 |
| 4k 読み取り | 7886MiB/秒 | 7871MiB/秒 | 7873MiB/秒 | 7858MiB/秒 |
| 4K書き込み | 8766MiB/秒 | 7890MiB/秒 | 8905MiB/秒 | 8606MiB/秒 |
| 64読み取り | 9.80GiB/秒 | 10.1GiB/秒 | 10.2GiB/秒 | 10.1GiB/秒 |
| 64K書き込み | 8732MiB/秒 | 10.2GiB/秒 | 11.3GiB/秒 | 11.4GiB/秒 |
| 8k 70r/30w | 8732MiB /3743MiB/秒 | 8632MiB/3699MiB/秒 | 8395MiB/3598MiB/秒 | 8729MiB /3741MiB/秒 |
100GbE NIC IOPS
| ワークロード | ホスト1 | ホスト 1 のランプ化 | ホスト2 | ホスト3 | ホスト4 |
| 4k 読み取り | 980k | 2019k | 1108k | 1102k | 1120k |
| 4K書き込み | 968k | 2776k | 494k | 1025k | 1011k |
| 64読み取り | 140k | 118k | 125k | 141k | 140k |
| 64K書き込み | 72.5k | 179k | 40.1k | 100k | 47.0k |
| 8k 70r/30w | 498k / 213k | 1147k / 491k | 597k / 256k | 567k / 243k | 595k / 255k |
100GbE NIC 帯域幅
| ワークロード | ホスト1 | ホスト 1 のランプ化 | ホスト2 | ホスト3 | ホスト4 |
| 4K読み取り |
3828MiB/秒 | 7887MiB/秒 | 4330MiB/秒 | 4303MiB/秒 | 4374MiB/秒 |
| 4K書き込み |
3783MiB/秒 | 10.6GiB/秒 | 1931MiB/秒 | 4005MiB/秒 | 3950MiB/秒 |
| 64K読み取り | 8761MiB/秒 | 7269MiB/秒 | 7804MiB/秒 | 8832MiB/秒 | 8753MiB/秒 |
| 64K書き込み |
4529MiB/秒 | 10.9GiB/秒 | 2505MiB/秒 | 6251MiB/秒 | 3000MiB/秒 |
| 8K 70R/30W | 3889MiB/1667MiB/秒 | 8958MiB/3839MiB/秒 | 4663MiB/1998MiB/秒 | 4427MiB/1897MiB/秒 | 4646MiB/1991MiB/秒 |
その 代替可能 FS1600 パフォーマーです
このレビューを始めた時点で、Fungible FS1600 が高速であることはわかっていました。それは疑いの余地がありませんでした。 DPU や NIC を含め、各ホストの単一カードは飽和していましたが、アレイにはまだ余裕のあるパフォーマンスがありました。主な焦点は、同様のテスト シナリオで同じストレージ アレイを利用する NVMe/TCP ワークロードに関して NIC と DPU をどのように比較するかでした。 DPU はストレージ市場に信じられないほどのメリットをもたらしました。 CPU からアクティビティをオフロードし、その I/O または帯域幅を使用してアプリケーション ワークロードなどの他のタスクを処理できるようにします。単一のホストに焦点を絞ることで、これらの利点がわかります。
代替可能な DPU
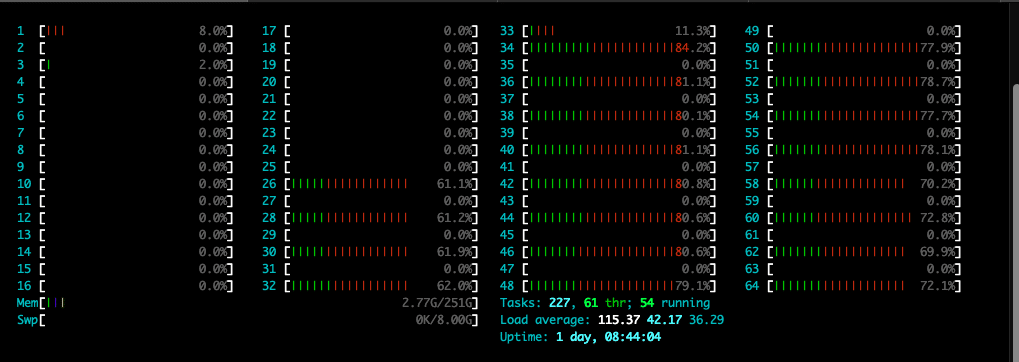
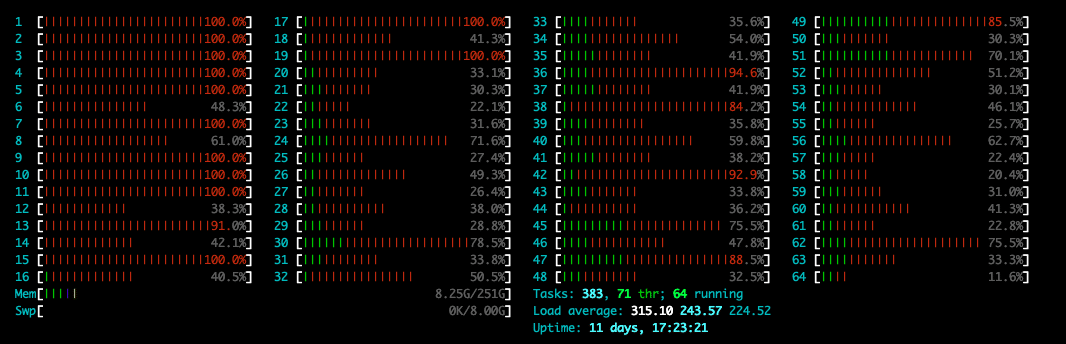
まず、各ワークロードの平均遅延を同様に維持すると、DPU が NIC の約 2.02 倍のパフォーマンスを発揮できることがわかります。ここでは、Fungible DPU からの 4 万 IOPS 0.474K ランダム読み取りを測定し、平均遅延は XNUMX ミリ秒でした。このワークロード中のリアルタイムの CPU 使用率を見ると、ワークロードが FIO ワークロードで指定された CPU コアに含まれていることがわかります。
fio –group_reporting –time_based –runtime=10m –rw=randread –bs=4k –io Depth=5 –numjobs=12 –ioengine=libaio –direct=1 –prio=0 –cpus_allowed_policy=split –cpus_allowed=25,27,29,31,33,35,37,39,41,43,45,47,49,51,53,55,57,59,61,63, 0 –randrepeat=XNUMX
100GbE NIC
次に、平均遅延 100 ミリ秒で 980k IOPS を駆動できる 0.39GbE NIC に移行しました。遅延を抑えるために DPU の IO 深度とジョブ数が削減されましたが、CPU 使用率を見ると、DPU の利点がどこにあるのかがすぐにわかります。FIO ジョブでは NIC に同じ CPU コアが割り当てられていましたが、 、システムの利用範囲がはるかに広範でした。実稼働サーバーのバックエンド プロセス (NIC、アダプターなど) に利用される CPU と、アプリケーション ワークロードなどのフロントエンド プロセスの間にはトレードオフがあります。ここでは、DPU が内部化されたままになっている間に、NIC ドライバーが CPU サイクルを消費していることがわかります。
fio –group_reporting –time_based –runtime=10m –rw=randread –bs=4k –io Depth=4 –numjobs=6 –ioengine=libaio –direct=1 –prio=0 –cpus_allowed_policy=split –cpus_allowed=25,27,29,31,33,35,37,39,41,43,45,47,49,51,53,55,57,59,61,63, 0 –randrepeat=XNUMX
100GbE NIC のランプ化
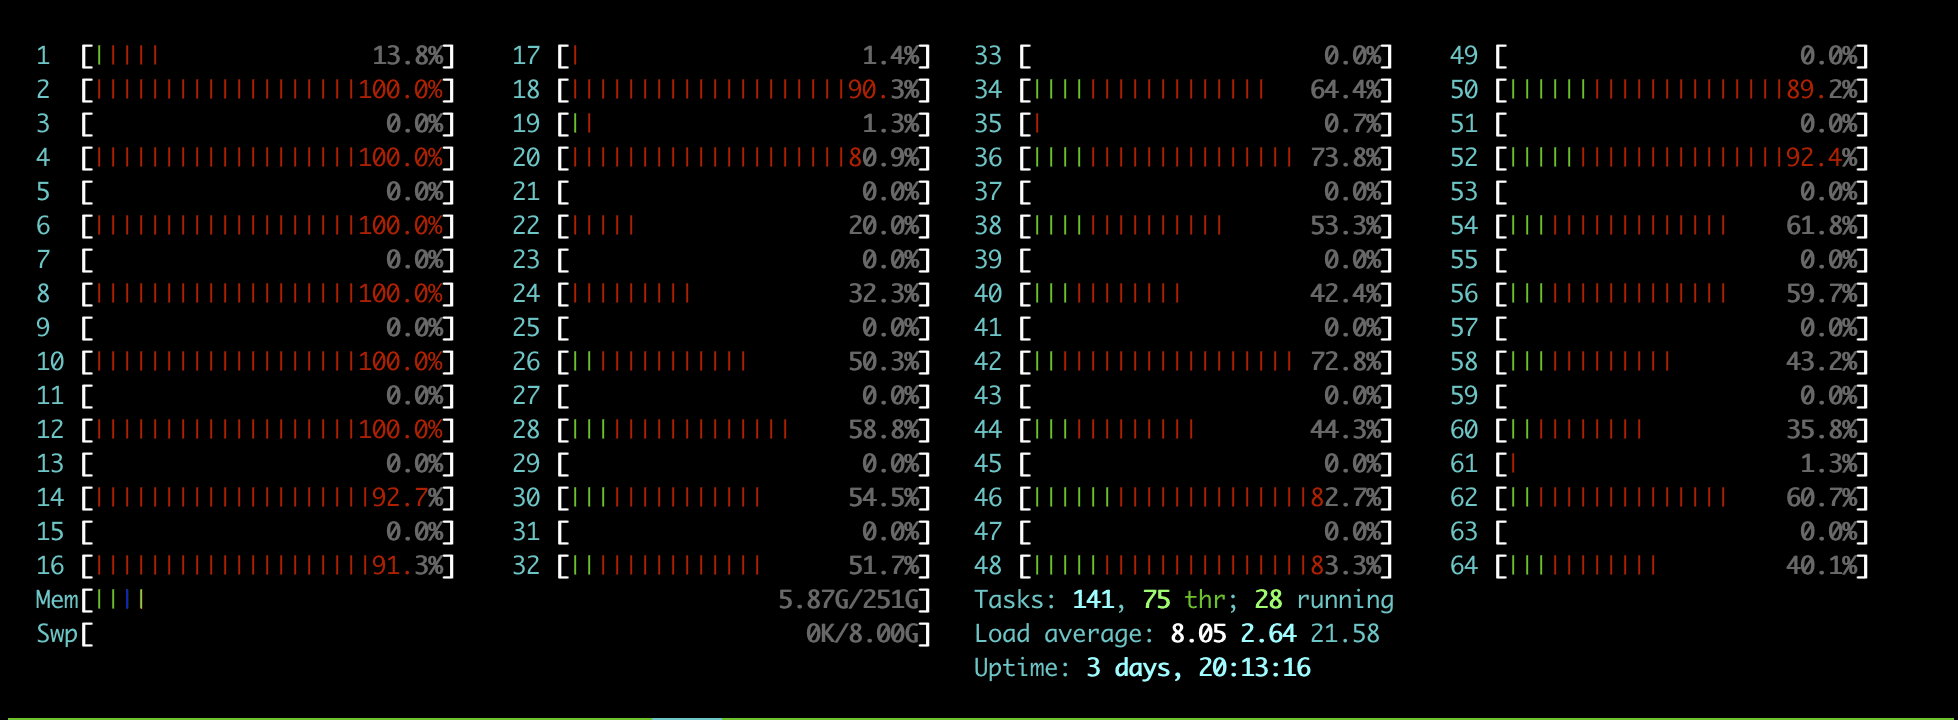
最後に、調整された 100GbE NIC ワークロードに移行しました。これにより、DPU と同じパフォーマンス レベル (約 2.02 万 IOPS) まで到達できるようになりました。ただし、高速化の代償として遅延が発生し、ピーク遅延は 2.6 ミリ秒以上に大幅に増加しました。これは、io Depth を 4 から 16 に、ジョブ数を 6 から 20 にスケーリングしたものです。注目は遅延の増加に集中しているかもしれませんが、CPU 使用率を見ると、ほぼすべてのシステム リソースが重視されていることがわかります。 I/O アクティビティは、他のプロセスにあまり残されません。サーバーの導入をより高密度かつ効率的にしようとしている企業にとって、すべての I/O が同じように作成されるわけではないこと、および DPU がストレージ市場を急速に変えていることは簡単にわかります。
fio –group_reporting –time_based –runtime=10m –rw=randread –bs=4k –io Depth=16 –numjobs=20 –ioengine=libaio –direct=1 –prio=0 –cpus_allowed_policy=split –cpus_allowed=14-63 –randrepeat= 0
最後の言葉
私たちはここ数週間、Fungible FS1600 とその DPU に取り組んできました。アレイ自体には特別なケーブル接続や変更は必要ありませんが、DPU の影響を深く理解するために分析を徹底的に行う必要がありました。 DPU 自体が真新しいというわけではありませんが、ようやく科学プロジェクトだけでなく、エンタープライズ グレードのソリューションでも市販されるようになりました。誤解のないように、DPU の実装はすべて同じではないため、設計上の決定においてインフラストラクチャとパフォーマンスへの影響を理解することが重要です。
この DPU の世界では、Fungible は非常にユニークなものとして際立っています。同社が 2015 年に創業したとき、彼らはカスタム ソリューションを追求し、2016 年後半に会社を設立するために多額の資金を投入しました。これは、Mellanox が BlueField と呼ばれる DPU の最初のバージョンを発表したときとほぼ同じでした。 Fungible が BlueField を採用したのは良かったという意見もあるかもしれませんが、独自のやり方を貫いた結果、テクノロジーとリーダーシップにおいて実質的な優位性が生まれました。 Fungible はスタックを完全に制御でき、クライアントとターゲットの両方で DPU を簡単に活用できます。否かは顧客の判断にあります。しかし、私たちのテストでは、Fungible をエンドツーエンドで使用することに大きな利点があることがわかりました。
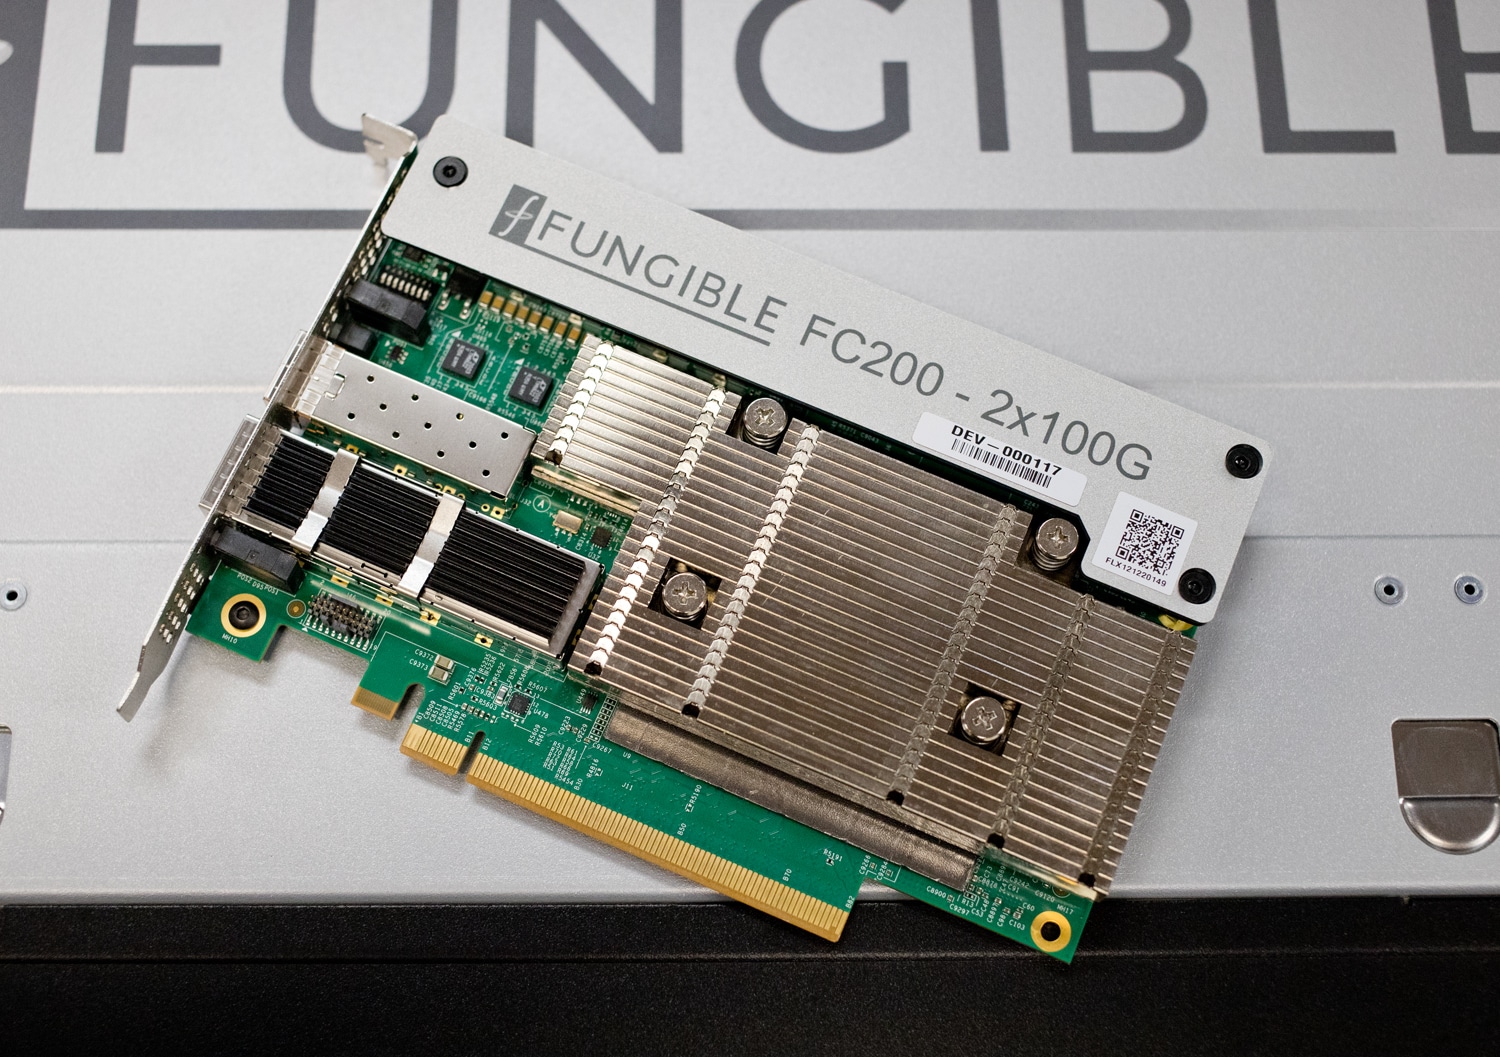
ストレージ アレイとホストで活用される DPU を備えた Fungible により、パフォーマンスの面で大きなメリットをもたらす全体像が完成します。 DPU は、システム プロセッサに割り当てられるリソースをオフロードします。これは、方程式の両側で使用すると興味深い組み合わせになります。従来の NIC の代わりに Fungible FC200 を利用できる場合、I/O 速度が大幅に向上し、CPU 使用率も低下します。 4K ランダム読み取り転送だけを見ると、FC200 は 2 ミリ秒の遅延で 0.474 万 IOPS を超えることができましたが、NIC は 1 ミリ秒で約 0.39 万 IOPS を実現できました。 NIC を増強して 2M IOPS を実現することは可能でしたが、遅延とシステム リソースに多大なコストがかかりました。
代替可能な FC200 DPU
クラスとしての DPU は、フラッシュ ストレージで利用可能なネイティブ パフォーマンスを引き出すという点で、非常に大きな可能性を秘めています。これは現在でもすでに真実ですが、Gen5 SSD やより高速な相互接続などのテクノロジーが市場に登場するにつれて、計算は DPU にとってさらに有利になります。 PCIe レーンを管理するために x86 プレミアムを支払うことは、これらのコンポーネントを利用できるアプリケーションに関してはまったく意味がなく、従来のアーキテクチャはそれほど拡張性がありません。
Fungibleは、FS1600ストレージノードとアクセラレータカードという魅力的なハードウェアとソフトウェアを提供しています。さらに最近では、GPUの分離にも注力し、HPCやAIワークロード向けに、より包括的なスタックを顧客に提供しようとしています。急速に成長しているDPU分野では複数の企業が成功を収めるでしょうが、Fungibleは間違いなく注目すべき企業の1つです。ストレージを最大限に活用したい企業は、ぜひFS1600を試してみるべきです。


 Amazon