

ここ数年で、大規模な言語モデルをローカルで実行することは格段に容易になったものの、モデルをダウンロードしてから、それを活用できる便利なデスクトップ環境を手に入れるまでには、依然としてギャップが存在する。Janは、ChatGPTの代替となることを自称しており、使い慣れたチャットスタイルのインターフェースを備えたオープンソースのデスクトップアプリを提供し、ほとんどの設定作業をアプリケーション内で完結させる。llama.cppを介してダウンロードしたモデルをローカルで実行できるだけでなく、ホストされているAIサービスにも接続できるため、ローカルモデルとクラウドベースモデルを同じインターフェースから利用できる。
この実践ガイドは、当社の「最高のローカルLLMツール」ランキングに連動した最初のガイドでもあります。ランキングに掲載されているプラットフォームを検証していく中で、当社独自のテストハードウェアで得られた再現可能なパフォーマンス結果を随時追加していきます。
Janには、基本的なローカルチャット機能に加え、組み込みのモデルハブ、ウェブ検索とページ取得機能、画像入力機能、MCPとの連携機能、そしてOpenAI互換のローカルAPIが搭載されています。
今回の実地検証では、 Intel Xeon w5-2465X、128GBのRAM、32GBのVRAMを搭載したNVIDIA RTX 5000 Ada Generation GPUを搭載したWindows 11 Pro for Workstations搭載のHP Z4 Rack G5ワークステーションにJanを新規インストールし、セットアッププロセスの動作、Janによるローカルモデルの管理方法、GPUアクセラレーションの自動動作、そしてすべてが稼働した後の主要機能の動作を確認しました。
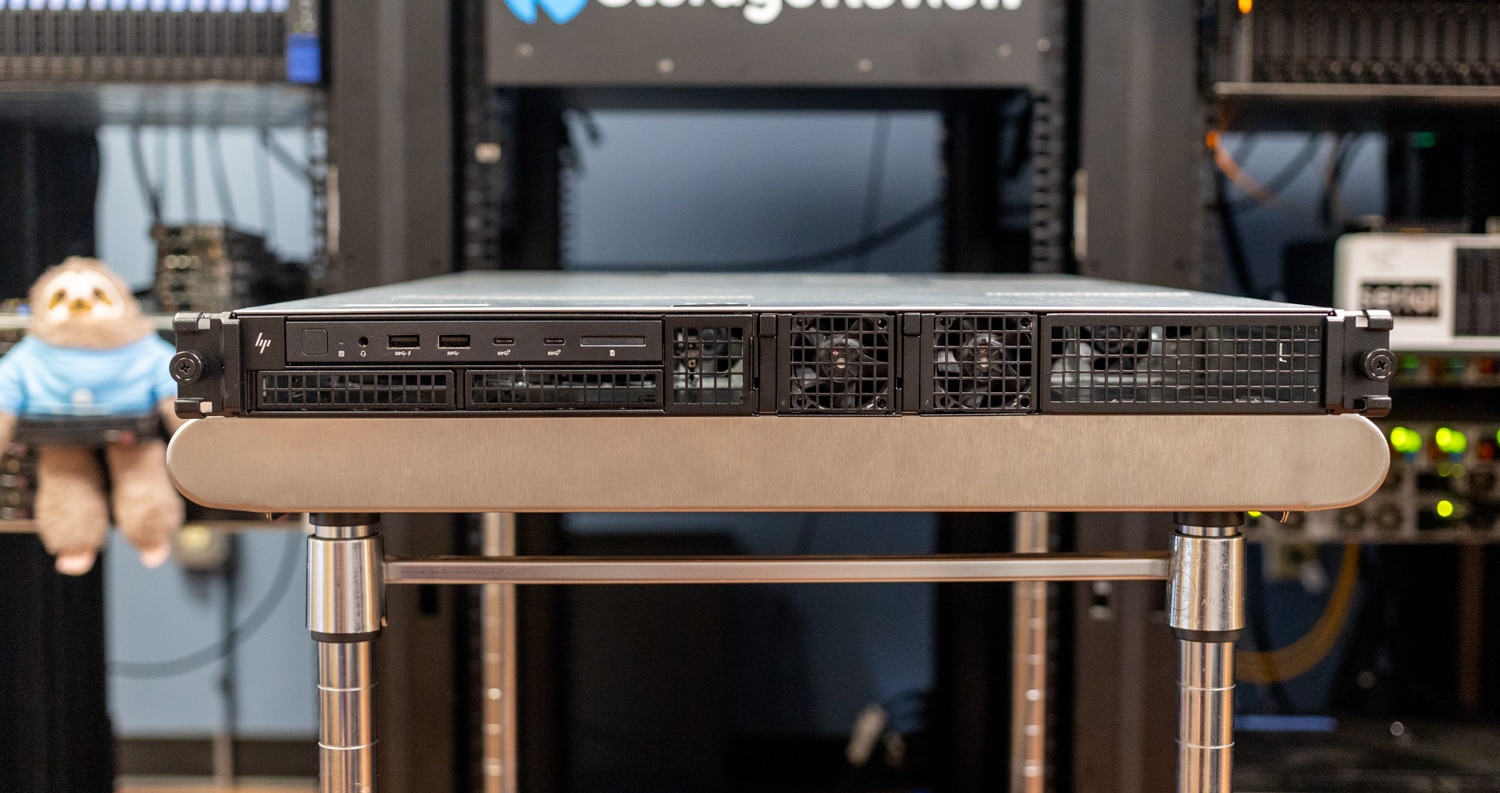
Janは、最初のテストから公開までの間に変更され、v0.8.5とv0.8.6が本レビュー公開直前にリリースされました。新しいリリースでは、以前のビルドのいくつかの領域が修正されており、llama.cppをJanに直接バンドルしたり、GPUオフロードの設定方法を変更したり、並列シーケンスのデフォルト値を調整したり、会話プロンプトのキャッシュ機能を追加したりしています。これらの変更はローカル推論に影響するため、公開前にv0.8.6にアップデートし、すべてのパフォーマンス テストを再実行しました。
テストシステム
| 成分 | |
|---|---|
| オペレーティングシステム | ワークステーション用のWindows11 Pro |
| CPU | Intel Xeon w5-2465X、16コア |
| メモリ | 128GB |
| GPU | NVIDIA RTX 5000 Ada 世代 |
| VRAM | 32GB |
| NVIDIAドライバ | 597.06 |
| CUDA互換性 | 13.2 (nvidia-smi) |
| XNUMX月 | v0.8.6 |
| ラマ.cpp | 0.5.0、ビルドb11146 |
Janは、ハードウェア設定ページを通じて、CPU、システムメモリ、RTX 5000 Adaを含むシステムハードウェアを正しく検出しました。NVIDIAドライバーが既にインストールされていたこのシステムでは、モデルを読み込む前にアプリケーション内で追加のCUDA設定を行うことなく、GPUアクセラレーションを有効にできました。
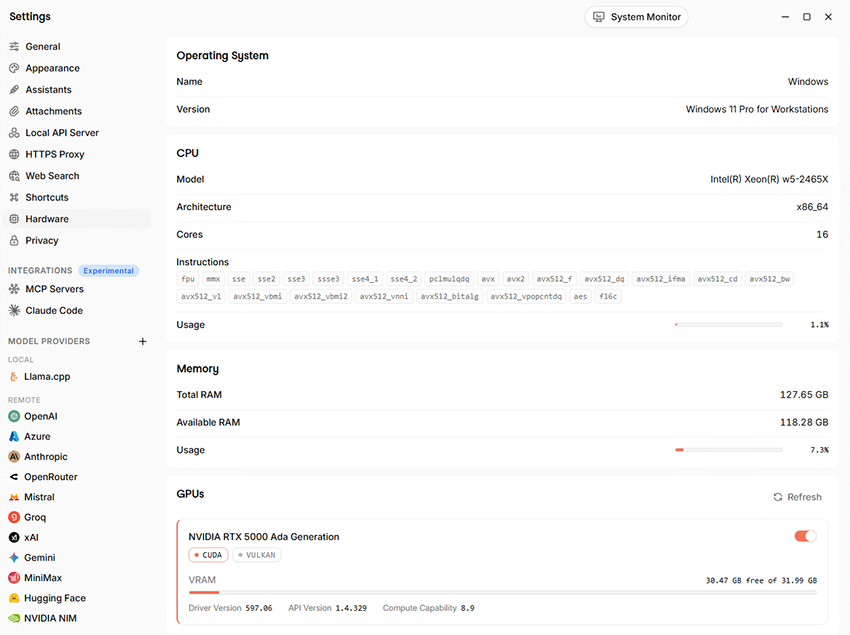
Jan v0.8.6 は、Xeon w5-2465X、127.65GB の RAM、および 31.99GB の VRAM を搭載した NVIDIA RTX 5000 Ada Generation を検出しました。
Janのインストールと使用開始方法
Windows版のインストールには標準の.exeインストーラーが使用され、初回起動時にはJanのメインチャットインターフェースに直接アクセスします。Janはローカルモデルを使用するためにアカウントを必要としませんでした。初回起動時には、匿名での使用データを共有するかどうかを尋ねられ、その後、推奨ローカルモデルであるJan V3.5のダウンロードを促されました。
Jan V3.5の初期ダウンロードサイズは2.8GBでした。ダウンロードをクリックするとアプリ内で処理が開始され、完了するとJanに成功通知が表示されました。インストールが完了すると、チャットウィンドウ上部のセレクターからモデルを選択できるようになりました。
Janは初回リリース時に、推奨版であるJan V3.5ローカルモデルを2.8GBのダウンロードファイルとして提供する。
モデルの閲覧とダウンロード
Jan's Hubは、モデルの検出とインストールをアプリケーション内で完結させ、Hugging Faceのモデルに直接アクセスできるだけでなく、ダウンロード開始前に役立つ情報も提供します。各エントリには、ダウンロードサイズ、量子化、機能タグ、ハードウェア適合性インジケーターが含まれており、利用可能なメモリとGPUに適したモデルを絞り込むのに役立ちます。
RTX 5000 Adaシステムでは、いくつかのモデルに緑色のFitsラベルが付いていました。ハブには、Jan V3.5 4B用の2.5GB Q4_K_Mオプションが表示され、Jan V2 VL Highは4.7GBで、マルチモーダルとツールのサポートが含まれていました。同じモデルのカードから、別のバリエーションも利用可能でした。
Janは、llama.cppを介してローカルで実行されるモデルに加え、OpenAI、Anthropic、Gemini、Groq、Mistralなどのプロバイダーが提供するホスト型モデルも利用できます。これにより、ダウンロードしたモデルとクラウドベースのモデルを1つのインターフェースで管理できるだけでなく、HubによってGGUFファイルの検索やインストール前のメモリ要件の確認といった手作業が大幅に削減されます。
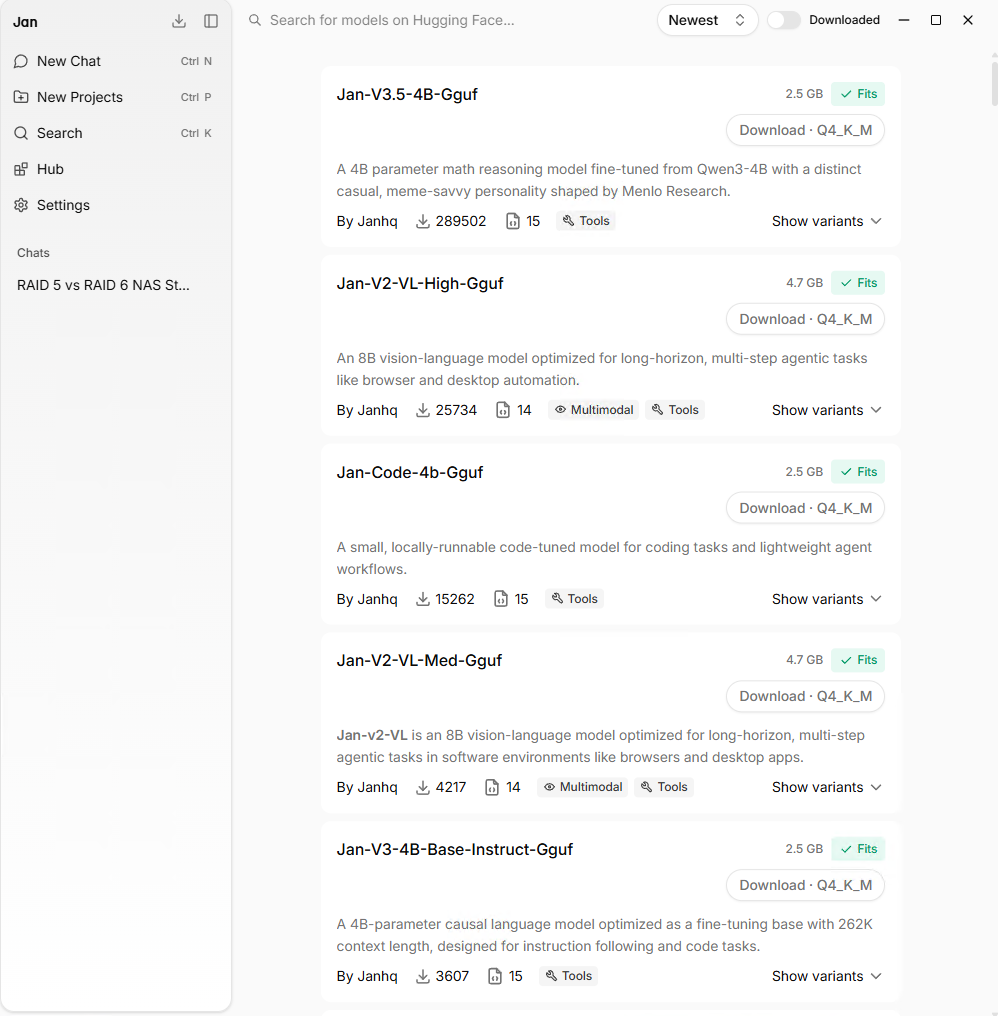
インストール前に、ハブにはダウンロードサイズ、量子化、モデル機能、ハードウェア適合状況が表示されます。
2番目のモデルとしてJan V2 VL Highをダウンロードしたのは、RTX 5000 Adaの32GBのフレームバッファに簡単に収まりつつ、画像サポートが追加されていたためです。
モデル設定とGPUの使用状況
v0.8.5とv0.8.6のアップデートサイクルで導入された大きな変更点の1つは、llama.cppがアプリケーションにバンドルされるようになったことです。以前のビルドではllama.cppは個別に管理されていました。インストール環境では、llama.cpp 0.5.0、ビルドb11146が表示され、並列シーケンスは0に設定されていたため、llama.cppはデフォルトの動作を使用できました。また、セッション間の会話を記憶する機能が有効になっており、各会話のプロンプトキャッシュがディスク上に保持されていました。
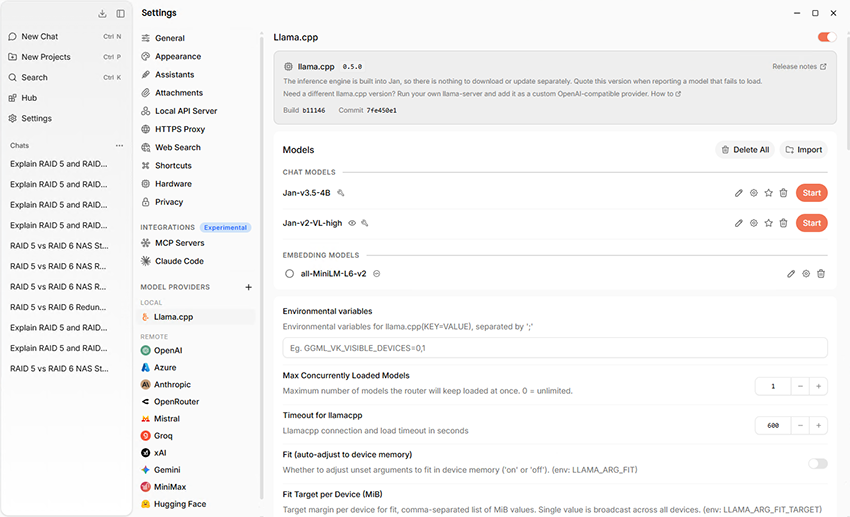
Jan v0.8.6では、llama.cpp 0.5.0がアプリケーションに直接含まれており、ローカルモデルプロバイダ設定にはビルドb11146が表示されます。
Jan V3.5 4Bをインストールすると、アクティブなモデルの横にある歯車アイコンから、サンプリングと実行時設定にアクセスできます。私たちの環境では、Janは温度0.8、最高P値0.95、最高K値40、最低P値0.05、繰り返しペナルティ1を示しました。
最近のランタイム変更によりデフォルトのGPUオフロード動作は変更されましたが、アップグレードされたJan V3.5 4BおよびJan V2 VL Highプロファイルではv0.8.6でも100個のGPUレイヤーが表示されていたため、再実行のためにこれらの保存値は変更せずに残しました。その他の制御項目には、8,192トークンのコンテキストサイズ、Mixture of Experts重みのCPU設定、KVキャッシュオフロード、およびバッチサイズ2,048が含まれます。これらのオプションを使用すると、コマンドラインや個別の設定ファイルを編集することなく、Janでメモリ使用量と推論動作を直接調整できます。
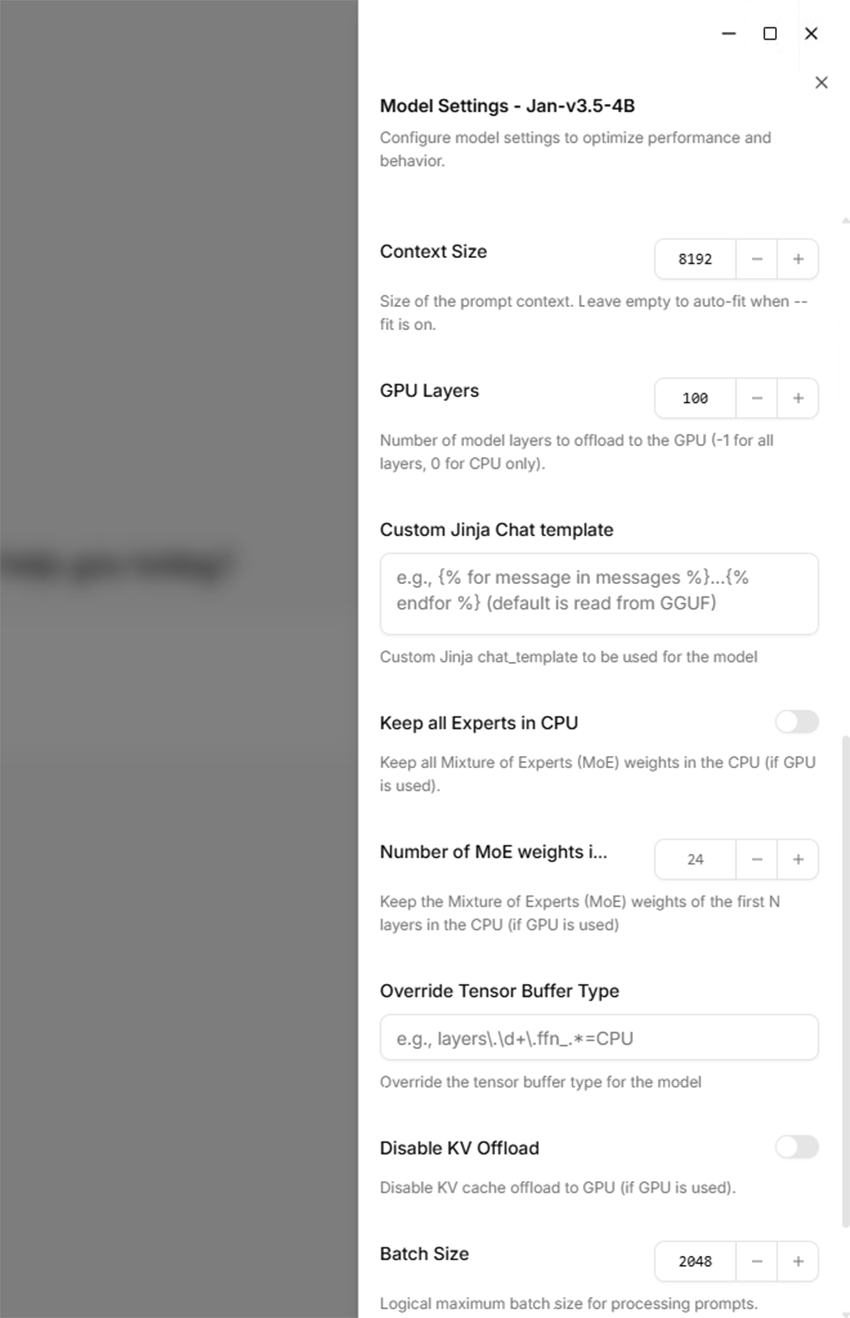
アップグレードされた Jan V3.5 4B プロファイルは、v0.8.6 と同様に、8,192 トークンのコンテキスト サイズ、100 の GPU レイヤー、および 2,048 のバッチ サイズを維持しています。
地域発電性能
両方のモデルをRTX 5000 Ada上で実行し、更新されたランタイムでのデコード速度を測定するために、Jan v0.8.6でテキスト生成テストを繰り返しました。Web検索を無効にし、コンテキストサイズを8,192トークンに、GPUレイヤーをアップグレードしたモデルプロファイルで保持されている100の値に、バッチサイズを2,048に維持しました。
実行ごとに同じテキストのみのプロンプトを使用しました。「初めてNASを構築する人にRAID 5とRAID 6について説明してください。それぞれの主な利点と欠点を含めて、約400語で記述してください。」各モデルを読み込んだ後の最初の回答はウォームアップとして破棄し、その後、3つの新しいスレッドで3回の計測実行を行いました。
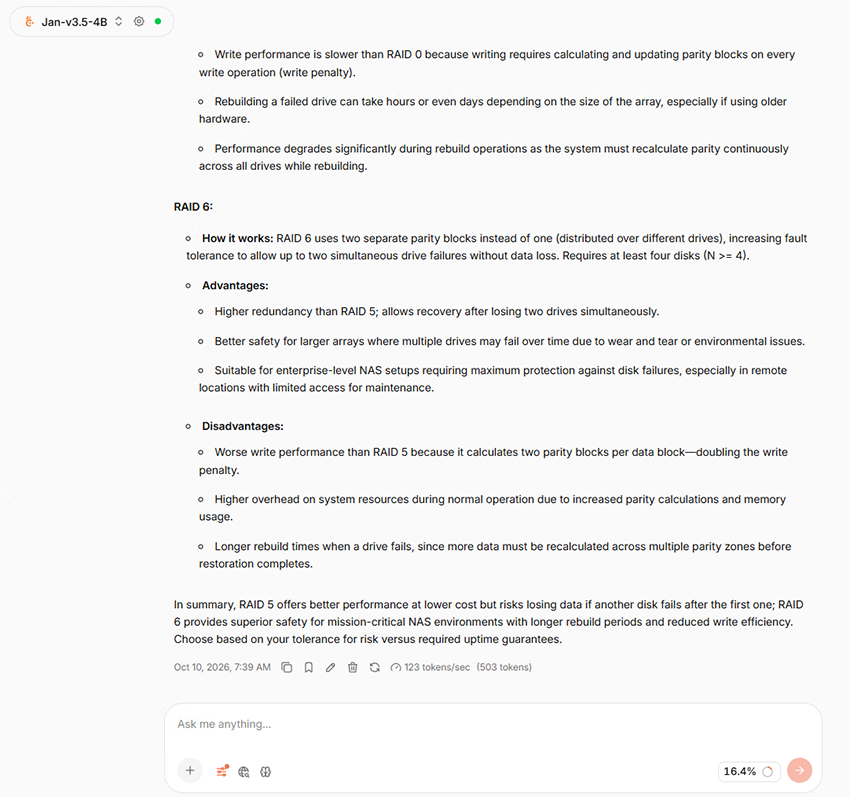
Jan V3.5 4Bは、今回の測定実行において1秒あたり123トークン、Janが報告した出力トークン数は503に達し、3回の実行テストの中央値と一致しました。
Jan V3.5 4B Q4_K_XL は、3 つの測定実行全体で平均デコード速度が 123 トークン/秒を記録し、Jan が報告した出力トークンの平均は 503、GPU メモリ使用量のピークの平均は 4,839 MiB でした。Jan V2 VL High Q4_K_M は平均 82 トークン/秒に達し、Jan が報告した出力トークンは 1,728、GPU メモリ使用量のピークの平均は 8,197 MiB でした。
llama.cpp のタイミング行も Jan の画面上のデコード値とほぼ一致しており、評価レートの中央値は Jan V3.5 4B で 122.55 トークン/秒、Jan V2 VL High で 82.30 トークン/秒でした。v0.8.6 で会話プロンプトのキャッシュが有効になり、複数回実行した結果、評価されたプロンプトトークンが 1 つだけであったため、プリフィルの中央値は報告していません。これらのキャッシュされた値は、フルプロンプト処理のパフォーマンスを比較するのに役立たないからです。
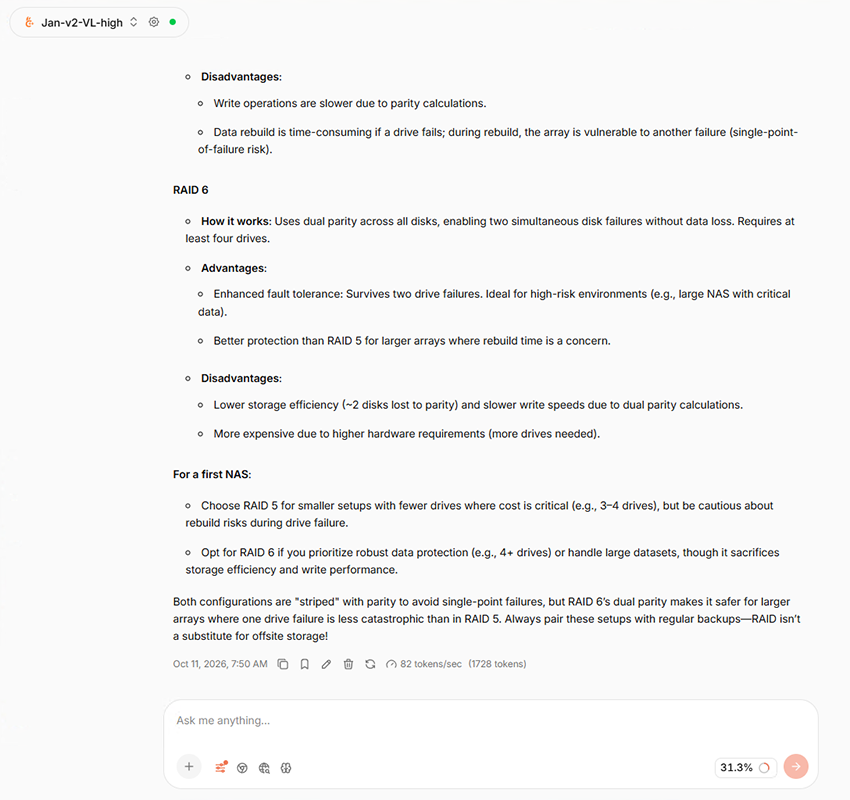
Jan V2 VL Highは、今回の測定実行において、1秒あたり82トークン、Janが報告した出力トークン数は1,728に達し、3回の実行テストの中央値と一致しました。
| モデル | 量子化 | 出力トークン | デコード速度 | GPUメモリ |
|---|---|---|---|---|
| Jan V3.5 4B | Q4_K_XL | 503 | 123 トーク/秒 | 4,839 MB |
| 1月 V2 VL 高 | 翻訳元 | 1,728 | 82 トーク/秒 | 8,197 MB |
注:出力トークン数、デコード率、およびGPUメモリの数値は、破棄されたウォームアップ実行後の3回の測定実行の中央値です。GPUメモリは、各測定実行中に観測されたピークメモリ使用量の中央値です。Jan V2 VL Highの出力数には推論トークンが含まれているようです。これは、表示された回答が約400語であったのに対し、Janが報告したトークン総数ははるかに多かったためです。したがって、その出力トークン数はJan V3.5 4Bと直接比較すべきではありません。
Janをローカルチャットに使用
Janのメインインターフェースは、モデルがインストールされれば簡単に操作できます。最近の会話は左側のサイドバーに表示され、アクティブなモデルは上部に常に表示され、添付ファイルとツールは入力欄のすぐ下に配置されます。
インストール済みのモデルを切り替えるには、数回クリックするだけです。Janは応答の最後に、トークン数や生成速度などの情報も表示します。推論モデルは生成中に思考活動を表示できますが、詳細度は使用するモデルによって異なります。
最初のローカルテストでは、NASを構築しようとしているユーザー向けに、RAID 5とRAID 6の違いをJanに説明してもらいました。ダウンロードした2つのモデルはどちらもリクエストを完了しましたが、Jan V2 VL Highの方がより長い回答を生成し、GPUメモリを8,197 MiB使用しました。一方、4Bモデルは4,839 MiBでした。
ウェブ検索
Janには、チャットインターフェースに直接Web検索とページ取得機能が組み込まれており、これらのツールが有効になっている場合、対応モデルは最新のオンライン情報を会話に取り込むことができます。Jan v0.8.6にアップデートした後、この機能を有効にして、ローカルテストで使用したのと同じRAID 5とRAID 6に関する質問をJan V2 VL Highに投げかけ、以前のWeb検索テストを再度実施しました。
Janは今回も、現在の情報が役立つ可能性があると独自に判断し、プロンプトでオンライン検索を指示されていないにもかかわらず、Web検索を実行しようとしました。推論ビューでは、モデルが検索クエリを送信する前に、現在のNAS推奨事項を確認することを決定したことが示されました。今回の実行では、設定されたExaサービスが無料のMCPレート制限に達したため、検索自体は完了できませんでしたが、Jan V2 VL Highは外部情報が役立つ可能性があると判断した場合、引き続き自動的にWeb検索を呼び出すことがテストで確認されました。
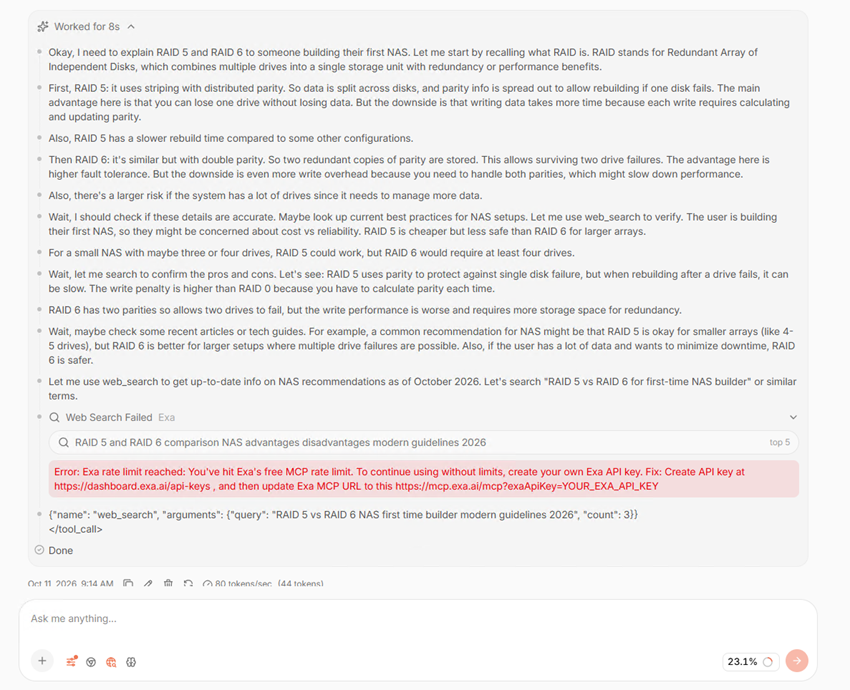
Jan v0.8.6でWeb検索が有効になった場合、Jan V2 VL HighはRAIDクエリ中に自動的にオンライン検索を試みましたが、Exaの無料MCPレート制限によりリクエストは停止されました。
JanはMCPもサポートしており、ブラウザとの連携やその他の統合など、互換性のある外部ツールやサービスをアプリケーションに接続できます。今回のセッションではMCPのテストは行いませんでしたが、MCPが組み込まれていることで、ユーザーはローカルで実行中のモデルが標準のチャットインターフェースを超えてアクセスおよび実行できる機能を拡張する別の方法を得ることができます。
マルチモーダル入力
Jan v0.8.6にアップデートした後、画像入力を再テストするために、新しいnvidia-smiのスクリーンショットをJan V2 VL Highに添付し、画像に表示されているGPUモデル、NVIDIAドライバーバージョン、合計VRAM、GPU使用率、GPU温度、および消費電力を識別するように要求しました。モデルは、NVIDIA RTX 5000 Ada Generation、ドライバー597.06、32,760 MiBのVRAM、1%のGPU使用率、35℃の温度、および4W / 250Wの消費電力という6つの値をすべて正しく識別しました。
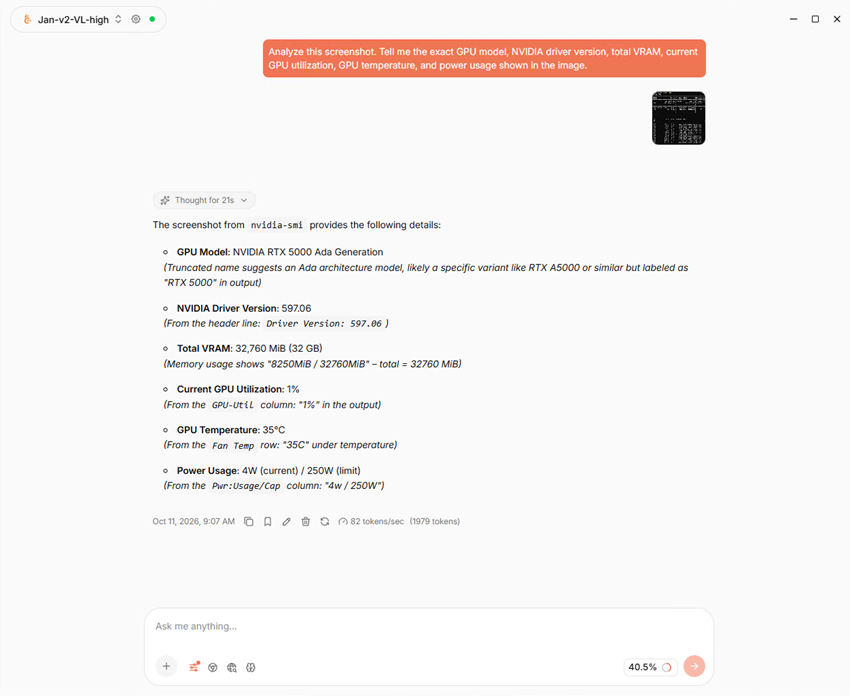
Jan V2 VL Highは、Jan v0.8.6の最新のnvidia-smiスクリーンショットから、要求された6つのハードウェア値をすべて正しく識別しました。
これは、以前のJanビルドで行った最初のマルチモーダルテストよりも優れています。以前のビルドでは、応答の大部分が端末レイアウトの処理に費やされていました。モデルは応答するまでに21秒の推論時間を要し、Janは1,979個の出力トークンを報告しましたが、表示される応答は簡潔で、リクエストに直接答えていました。
ローカルAPIサーバー
Janには、設定メニューからアクセスできるOpenAI互換のローカルAPIサーバーも含まれています。デフォルトのローカルAPIモデルとしてJan V3.5 4Bを選択し、インターフェースから直接サーバーを起動しました。
Janは、サーバーが稼働していると報告した。
http://127.0.0.1:1337/v1
内蔵のサーバーログで起動が成功したことが確認され、さらにJanはインタラクティブなAPIドキュメントへのアクセスも提供した。
PowerShell を使用して、ローカル API が期待どおりに動作することを確認しました。まず /v1/models へのクエリを実行し、インストールされているモデル( Jan V2 VL High を含む)を取得しました。次に、Jan-v3.5-4B-Q4_K_XL に対してチャット完了リクエストを送信し、RAID 6 について一文で説明を求めました。すると、Jan は PowerShell で直接応答を返しました。
「RAID 6は、データブロックごとに2つの独立したパリティブロックを使用することでデータの冗長性を提供するディスクアレイ構成であり、最大2台のディスクが故障してもデータ損失なくアレイが稼働し続けることを可能にします。」
回答には事実誤認が1つ含まれていました。RAID 6は、データブロックごとに2つのパリティブロックを使用するのではなく、ストライプごとに2つのパリティブロックを使用します。
両方のリクエストが正常に動作したことから、OpenAI互換エンドポイントをサポートするソフトウェアは、デスクトップチャットインターフェースを介してすべてのプロンプトを送信することなく、Janがダウンロードしたモデルと直接通信できることが確認できました。
何が悪かったのか
初期テストで主な問題となったのはマルチモーダルテストで、Jan V2 VL Highがnvidia-smiのスクリーンショットは認識したものの、単純な抽出リクエストの処理に時間がかかりすぎたことでした。上記で説明したv0.8.6の再テストでは、6つの値すべてを簡潔な応答で返しましたが、21秒の推論時間と1,979個の出力トークンから、モデルが応答するまでにまだ多くの処理を行っていることがわかります。
v0.8.6でのWeb検索の再テストは、1月以降に限界に達しました。設定済みのExaサービスが無料のMCPレート制限に達したため、RAIDに関する質問中にモデルが試みた自動検索が完了できませんでした。Web検索を頻繁に利用するユーザーは、通常の使用に十分な余裕のある検索プロバイダを設定することをお勧めします。
上記以外の点では、v0.8.6のテストは順調に進みました。6回のローカル生成実行はすべて、クラッシュ、モデル読み込みエラー、GPU検出の問題なく完了しました。
結論
Windows上でローカルLLMを実行することに興味のある方にとって、Jan v0.8.6はセットアップ作業を大幅に削減しつつ、モデルの実行方法を調整できる余地を十分に残しています。テストシステムでは、RTX 5000 Adaが自動的に検出され、ダウンロードした2つのモデルはどちらもGPUアクセラレーションを使用し、ダウンロードを実行する前にHubでモデルサイズとハードウェア適合情報が表示されました。初心者には十分なガイダンスを提供しつつ、より詳細な制御が必要な場合には、コンテキストサイズ、GPUレイヤー、メモリオプションなどの設定も用意されています。
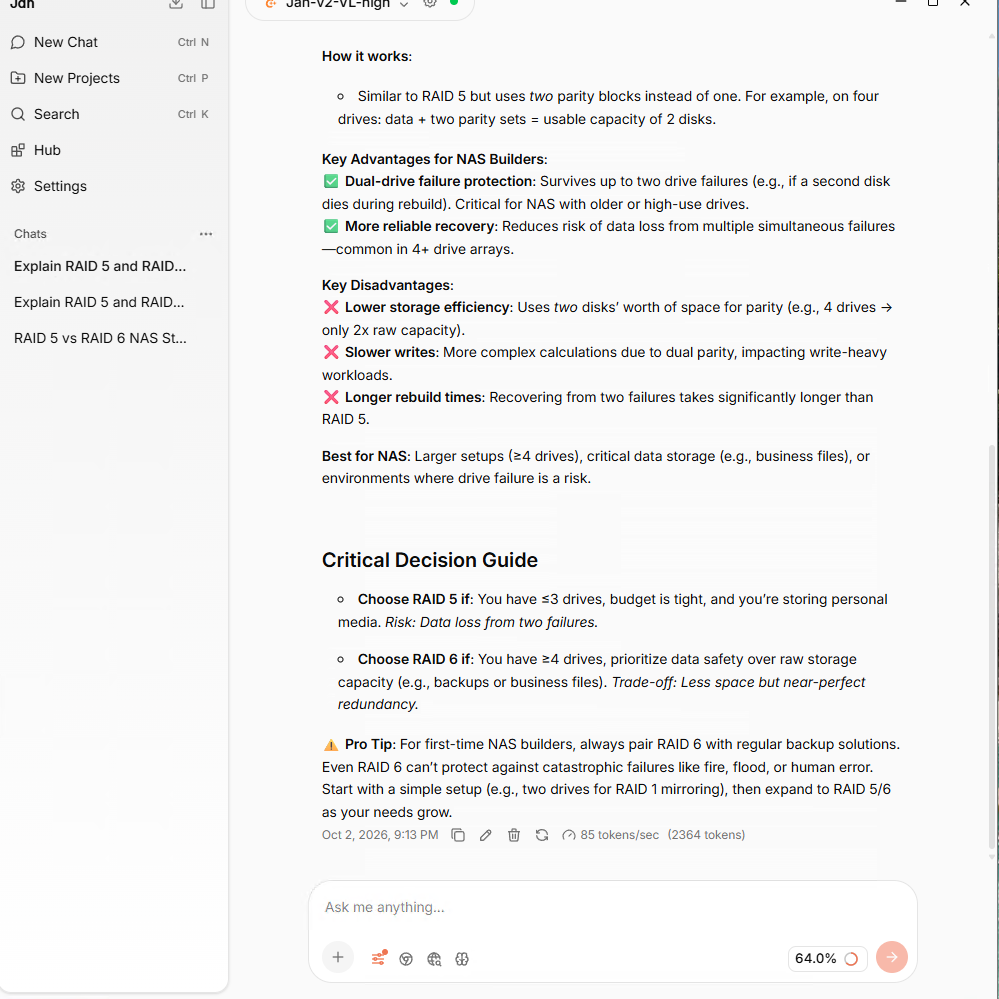
Jan V2 VL Highは、応答の下に世代情報を表示しながら、ローカルRAID比較を完了しました。
Janは、ローカルモデルの実行やチャットウィンドウの提供にとどまらず、同じインターフェースに多くの機能を追加しています。私たちは、会話から直接Web検索をテストしたり、Jan V2 VL Highで画像入力をテストしたり、ローカルのllama.cppモデルと並行してリモートAIプロバイダーが利用できることを確認したり、PowerShellからOpenAI互換APIにリクエストを送信したりしました。
RTX 5000 Adaシステムにおいて、Jan V3.5 4Bは更新されたテキスト生成テストで平均123トークン/秒を達成し、Jan V2 VL Highは82トークン/秒でした。また、Jan V2 VL Highはv0.8.6アップデート後のマルチモーダルテストにおいて、より簡潔な応答を生成し、nvidia-smiのスクリーンショットから要求された6つの値をすべて正しく識別しました。
Janはセッション全体を通して安定して動作し、新規インストールからGPU上でローカルモデルを実行するまでには、インストーラー1つ、モデルのダウンロード1つ、そして数回のクリックだけで済みました。
今後、当サイトの「ベストローカルLLMツール」ランキングに掲載する追加製品についても、同様のテスト方法を用いて検証していきます。これにより、読者の皆様には、同じハードウェアを使用した際のパフォーマンス結果と、機能や日常的な使用における違いを併せてご提示します。


 Amazon