

NVIDIA RTX PRO 4500 Blackwell Server Editionは、多くの企業が既に所有しているサーバー向けにNVIDIAが開発したカードです。シングルスロット、パッシブ冷却、165Wのボードで、32GBのGDDR7メモリを搭載し、Blackwellの全機能を備えています。第5世代Tensorコア(FP4対応)、第4世代RTコア、3つのエンコーダーと3つのデコーダー、そして2つの独立した16GBパーティションに分割できるマルチインスタンスGPUサポートを搭載しています。NVIDIAのRTX PROサーバー製品ラインアップのエントリーポイントとしてL4の後継となり、2U PowerEdge、ProLiant、ThinkSystemなどのサーバーに、電力や冷却の問題を気にすることなく搭載できます。

NVIDIAがこのカードを売り込む理由は、適切な規模への最適化にある。ほとんどの企業はAIファクトリーを構築しているわけではなく、ラックの電力に厳しい制限がある空冷式の既存データセンターを運用しており、新しいサーバークラスを必要としない、最初の高速コンピューティング段階を求めている。あるいは、エッジコンピューティング環境で作業している場合、RTX PRO 4500は、導入可能なシステムを決定づけるワークロードと電力制約により適している。
RTX PRO 6000 Blackwellは、 96GBのメモリと最大600Wの電力供給能力で、この市場の最上位をカバーしています。4500は同じアーキテクチャを維持しつつ、その他の仕様をほぼ半分に削減しているため、小型モデル、多数の小規模タスク、または1ワットあたりのコストパフォーマンスを重視する顧客は、不要な余裕費用をかけずにBlackwellを利用できます。
このクラスのGPUのワークロードはよく理解されています。小規模言語モデルの推論、ビジョンAIとビデオ分析、ベクトル検索と埋め込み生成、トランスコーディング、vGPU 20の仮想ワークステーションなどです。小規模および中規模のモデル推論ではL4の5倍以上、Nemotronモデルでは最大10倍の性能を発揮すると謳われており、ローンチパートナーには、エッジビデオ向けのNTTデータ、シーケンシング向けのパシフィックバイオサイエンス、AI-RAN基地局向けのノキアなどが名を連ねています。AWSは、G6の後継として、このGPUをベースに新しいG7インスタンスを構築しました。
RTX PRO 4500 edgeのレビューでは、HPE ProLiant DL145 Gen11に搭載されているL4プロセッサとの比較テストを実施し、L4プロセッサの2.7倍のスループットを実現しました。今回のレビューでは、過去2年間メインストリームの推論カードの標準となっていた350WのデュアルスロットL40Sにどれだけ近い性能を発揮するのか、また、上位機種のRTX PRO 6000がメモリと電力面でどのような追加性能をもたらすのかを検証します。
それを確認するために、4500をDell PowerEdge R770に搭載し、L40SおよびL4と比較しました。さらに、 Dell Pro Max Tower T2のRTX PRO 6000 Blackwellのデータを、デフォルトの600Wと、R770のGPUスロットで許容される450Wの上限の両方で追加し、2つのコンテキスト長で4つのモデルにわたってvLLMオンラインサービスを実行しました。
簡単に説明すると、一般的なチャットやエージェントのコンテキストの長さでは、4500はFP8およびBF16モデルにおいて、半分以下の消費電力でL40Sと同等の性能を発揮します。8K入力では、32GBのフレームバッファの限界が露呈します。また、NVIDIAがBlackwellの売り文句として掲げる高精度プロセッサNVFP4は、このvLLMビルドにおいて、他の製品ラインナップと同等の性能を発揮します。
主要なポイント(要点)
- L40Sのスループット(1スロットあたり165W): 512トークンの入出力において、4500は、私たちが実行したすべてのFP8およびBF16モデルでL40Sと同等かそれ以上の性能を発揮しました。Ministral 3 14B FP8では1,107対995トークン/秒、Ministral 3 3Bでは2,006対1,988トークン/秒でした。これは、L40Sの47%のパワーと半分のスロット数で設計されたカードによる結果です。
- 交換対象となるL4の約3倍の性能: 短いコンテキストではL4の出力スループットの2.8倍から3.6倍、ボード電力はL4の2.3倍。
- 32GBには上限がある。 8K入力時、4500はL40Sに17~33%劣り、同時実行数8で性能曲線が平坦化したのに対し、L40Sは16まで上昇し続けた。この平坦化はKVキャッシュの容量不足によるもので、32GBがその限界値となる。
- NVFP4は、すべてのカードにソフトウェアの物語が詰まっている。 Qwen3.8-27B NVFP4では、4500は同時実行数32で320トークン/秒、L40SはFP4ハードウェアがまったくない状態で480トークン/秒、RTX PRO 6000は621トークン/秒を生成しました。このvLLMビルドのNVFP4パスは、いずれのプロセッサでもメモリ帯域幅に応じてスケーリングしませんが、MAMFスイープでは、4500のFP4ハードウェアがFP8の280.1TFLOPSに対して568.6TFLOPSに達することが示されています。
- より大きなカードで得られるメリット: Dell R770 GPUスロットの上限である450Wに制限されたRTX PRO 6000は、ショートコンテキストでは4500の約2倍、8Kでは2.5倍から3.2倍の性能を発揮しました。定格出力600Wでは、ショートコンテキストで1~2%、ロングコンテキストで4~9%の性能向上が見られたため、6000が4500を上回る性能の大部分はメモリによるものです。
NVIDIA RTX PRO 4500 Blackwell Server Edition の仕様
RTX PRO 4500 Blackwellという名称のカードは2種類あり、似ているものの全く同じ製品ではありません。GTC 2025で発表されたワークステーションエディションは、200W、デュアルスロット、アクティブ冷却方式のカードで、DisplayPort出力が4つ、メモリ帯域幅は896GB/sです。今回レビューするサーバーエディションは、GTC 2026で発表された165W、シングルスロット、パッシブ冷却方式のヘッドレスボードで、メモリ帯域幅は800GB/sです。データセンター向けの機能セット(MIG、機密コンピューティング、3つ目のNVENCとNVDEC、vGPU 20サポート)と引き換えに、ディスプレイ出力とクロック周波数の余裕が若干減っています。内部的には、どちらも同じ10,496コアのGPUと32GBのECC対応GDDR7を搭載しています。
NVIDIAのデータによると、このダイは378 mm²のTSMC 4nmカスタムシリコン上に45.6億個のトランジスタを搭載し、82個の第4世代RTコア(82個のSMと328個のTensorコアに相当)を備えています。これらはGB203の数値で、RTX 5080と同じダイファミリーですが、若干縮小されています。以下のTensorの数値は、疎な構成でのNVIDIAのピーク値です。密な構成では半分の性能となり、NVIDIA独自のpeakTOPSバイナリでは、このカードで測定されたFP8が805 TFLOPS、FP16が403 TFLOPSであることが確認されています。
| 製品仕様 | RTX PRO 4500 Blackwell SE | L4 | L40S | RTX PRO 6000 Blackwell SE |
|---|---|---|---|---|
| プラットフォームの概要 | ||||
| アーキテクチャ | NVIDIA ブラックウェル | NVIDIA エイダ・ラブレース | NVIDIA エイダ・ラブレース | NVIDIA ブラックウェル |
| CUDAコア | 10,496 | 7,424 | 18,176 | 24,064 |
| RTコア | 82(第4世代) | 58(第3世代) | 142(第3世代) | 188(第4世代) |
| GPUメモリ | ECC付き32GB GDDR7 | 24GB GDDR6 | ECC付き48GB GDDR6 | ECC付き96GB GDDR7 |
| メモリインターフェイス | 256ビット | 192ビット | 384ビット | 512ビット |
| メモリ帯域幅 | 800GB /秒 | 300GB /秒 | 864GB /秒 | 1,597GB /秒 |
| パフォーマンス(NVIDIAのピーク値、スパース性を考慮したテンソルレート) | ||||
| FP32 | 51 TFLOPS | 30.3 TFLOPS | 91.6 TFLOPS | 120 TFLOPS |
| FP16 / BF16 テンソル | 406 TFLOPS | 242 TFLOPS | 733 TFLOPS | 1PFLOPS |
| FP8テンソル | 811 TFLOPS | 485 TFLOPS | 1,466 TFLOPS | 2PFLOPS |
| FP4テンソル | 1.6PFLOPS | サポートされていません | サポートされていません | 4PFLOPS |
| RTコアパフォーマンス | 154 TFLOPS | 記載されていない | 209 TFLOPS | 355 TFLOPS |
| 電力とフォームファクター | ||||
| 最大ボード電力 | 165W | 72W | 350W | 最大 600W (設定可能) |
| フォームファクター | シングルスロット、FHFL 4.4「X 10.5」 |
シングルスロット、HHHL | デュアルスロット、FHFL 4.4「X 10.5」 |
デュアルスロット、FHFL(エア) シングルスロット、FHXL(液体) |
| サーマル | パッシブ | パッシブ | パッシブ | 受動的(空気)または液体 |
| 電源コネクタ | 1x PCIe CEM5 16ピン | スロットマシン搭載 | 1x 16ピン | 1x PCIe CEM5 16ピン |
| インターコネクト | PCIe 5.0 x16 | PCIe 4.0 x16 | PCIe 4.0 x16 | PCIe 5.0 x16 |
| 重量 | 1,055g | 記載されていない | 記載されていない | 記載されていない |
| 特長 | ||||
| マルチインスタンスGPU | 最大2x 16GB | いいえ | いいえ | 最大4x 24GB |
| NVENC / NVDEC | 3x / 3x | 2x / 4x | 3x / 3x | 4x / 4x |
| 機密コンピューティング | サポート | いいえ | いいえ | サポート |
| vGPU サポート | はい(vGPU 20) | はい | はい | はい |
設計と構築
4500 Server Editionは、高さ4.4インチ、長さ10.5インチのフルハイト・フルレングスのボードで、1スロットを占有します。これは、ハーフハイト・ハーフレングスのカードだったL4からの重要な変更点です。ベンチマークの比較対象は依然としてL4ですが、メモリ、16ピン電源入力、シャーシのエアフローだけで165Wの熱を放散できるヒートシンクのためのスペースを確保するために、フォームファクタはFHFLに変更されました。

そのフォームファクターは、L4とは大きく異なる点です。L4はHHHLスロットに適合し、72Wの電力をスロットから供給していたため、1Uサーバーや小型エッジボックスに搭載されていました。一方、4500はフルハイト、フルレングスで、16ピンケーブルが必要です。私たちが扱う1Uメインストリームサーバー(Dellの現行1U PowerEdgeシリーズなど)は、このコネクタなしではHHHLまたはFHHLカードが最大搭載されています。
実際には、これは2Uサイズのカード、あるいはFHFLスロットを中心に構築された少数のホワイトボックス1Uシャーシ用のカードであるため、1Uまたはエッジボックス用にL4を購入したショップは、そのまま交換できるカードを入手することはできません。
4500は、上にL4、下にL40Sと横向きに積み重ねられるため、L40Sが2つのスロットを必要とするのに対し、1つのスロットで済みます。そのため、ダブルワイドカードを4枚搭載できる2Uサーバーには、このカードを8枚搭載でき、AWSのG7インスタンスではホストあたり最大8枚まで搭載できるのです。
電源は、RTX PRO 6000と同じ16ピンのPCIe CEM5コネクタ1つを通して供給され、8ピンの補助オプションはありません。冷却は完全にパッシブ方式なので、カードはサーバーのファンに依存し、空気を循環させることができないシャーシではスロットリングが発生します。これはこのクラスのカードとしては一般的であり、他のすべてのGPUも同様の要件を持っています。
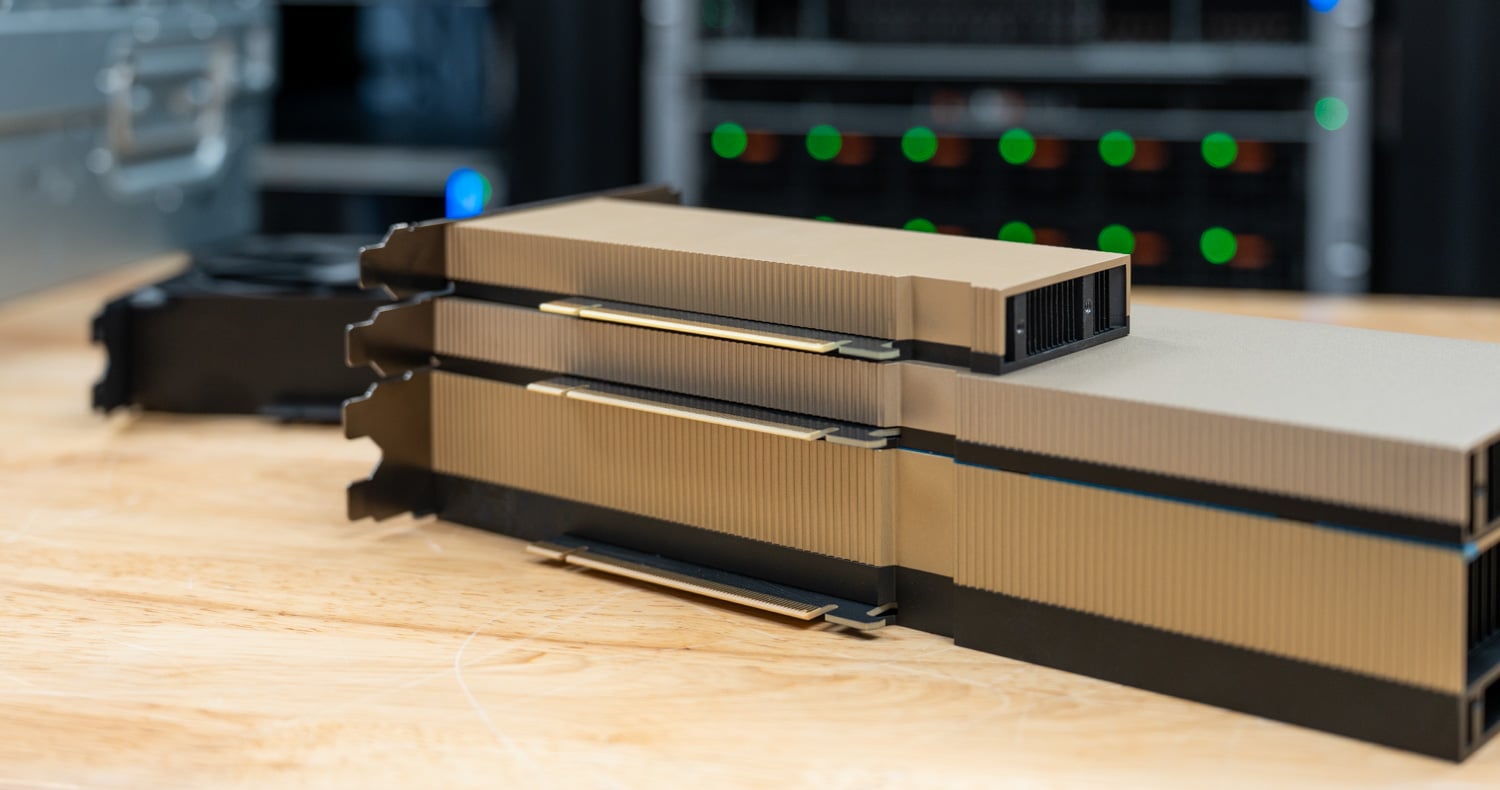
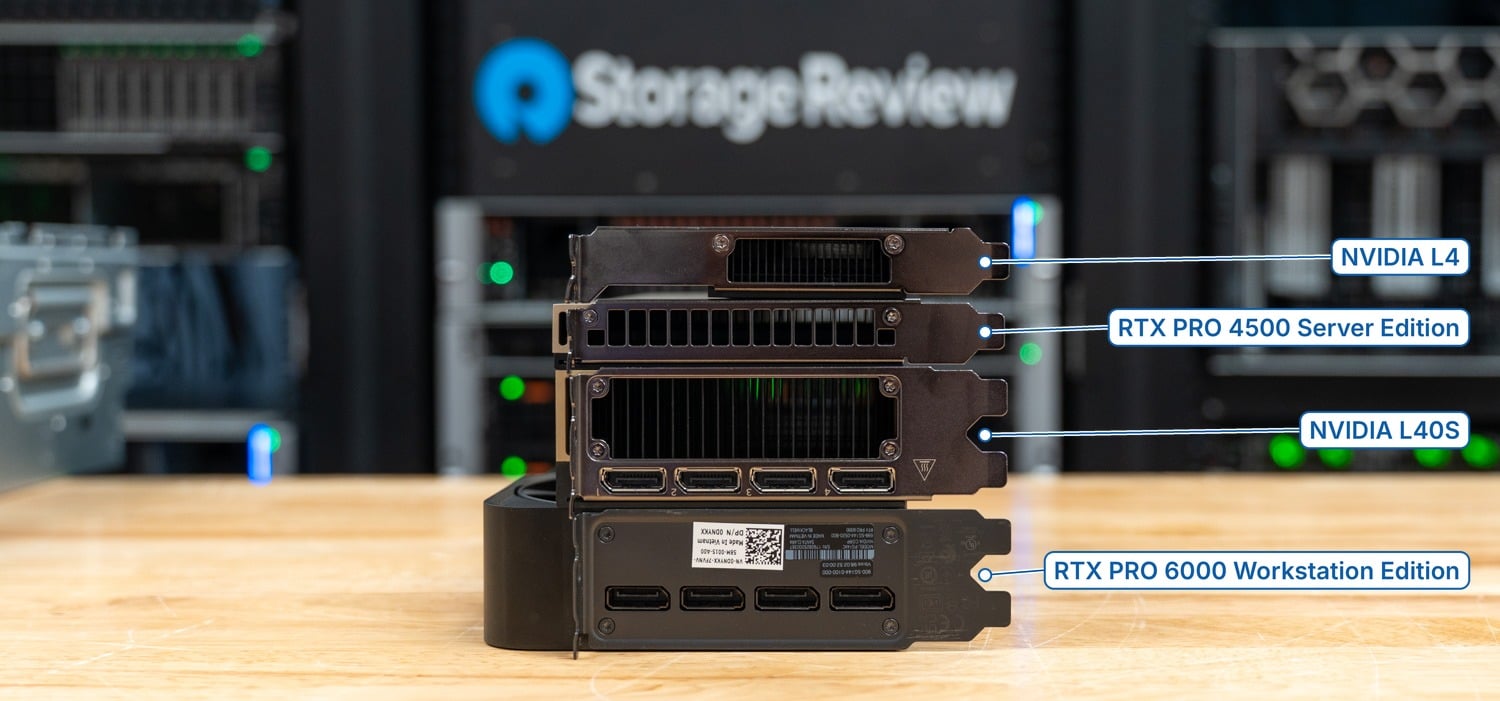
このカードにはディスプレイ出力がないため、vGPU仮想ワークステーションやレンダリングなどのグラフィックス作業はネットワーク経由で行われ、ブラケットには通気口があります。3つの第9世代NVENCエンジンと第3世代NVDECエンジンは、L4の世代に比べて4:2:2 H.264およびHEVCエンコードとデコードを追加し、NVIDIAはNVDECエンジンあたりのH.264デコードスループットがL4の2倍であると述べています。下のブラケットの写真を見ると、その違いがわかります。L4と4500には通気口しかなく、L40SとRTX PRO 6000 Workstation Editionにはそれぞれ4つのDisplayPort出力があります。
RTX PRO 4500 Blackwell Server Editionが適している場所
NVIDIAの説明によると、このカードの「中核的な価値は、165Wのパッシブ設計で、AI、演算処理、グラフィックス、ビデオアクセラレーションを組み合わせたシングルスロット設計」であり、「ラック密度、電力、冷却が主な導入制約となる」サーバー向けに設計されているとのことです。NVIDIAがRTX PROサーバーポートフォリオの主流データセンターおよびエッジセグメントと呼ぶ領域に位置づけられ、RTX PRO 6000 Blackwell Server Editionの下位に位置し、上位には何もない、Blackwellサーバーラインのエントリーポイントとなっています。
L4 プロセッサとの比較では、NVIDIA は Nemotron Nano モデルを使用した小規模モデル推論で最大 10 倍 (4500 の NVFP4 と L4 の FP8 の比較)、Cosmos Reason 2 を使用したビデオ要約で最大 4 倍、4K での SPECviewperf 15 で 1.9 倍、ストリーミング密度で 1.8 倍の性能向上を挙げています。CPU との比較では、Milvus の cuVS CAGRA を使用したベクトルデータベース処理で最大 50 倍、ビジョン AI で最大 100 倍の性能向上を挙げており、いずれも 8 枚のカードを搭載した 4500 サーバーとデュアルソケットの EPYC 9654 システムで測定されています。
Dellのサーバーチームによると、32GBの4500を3枚購入すると96GBの6000を1枚購入するのとほぼ同じ価格になるため、4500は主流のラックに搭載されるだろうとのこと。その場合、通常は容量の大きいカードの方が有利になる。このカードは、GPUやL4キャッシュを搭載しないサーバー向けであり、1枚以上の6000を搭載するように設計されたサーバーには最適とは言えない。
テストのセットアップ
4500、L40S、L4を、2つのIntel Xeon 6787Pプロセッサ(それぞれ86コア)と32個のDIMMにまたがる2TBのDDR5-6400を搭載したDell PowerEdge R770にインストールし、NVIDIAドライバ595.71.05を実行しました。テスト実行には、CUDA 13.4.1上のvLLM 0.27.1を搭載したNGC vLLM 26.08-py3コンテナを使用したため、ソフトウェアスタックはカード間で同一です。各カードはデフォルトの電力制限で個別にテストされ、R770は各カードに定格通りの電力を供給します。Dellは、このシャーシでのL4を72W、4500を165W、L40Sを350Wとしています。
RTX PRO 6000 Blackwellは、Dell Pro Max Tower T2に搭載されているワークステーション用グラフィックカードで、同じ筐体とドライバを使用しています。NVIDIAはワークステーション版とサーバー版の消費電力をどちらも600Wとしており、テスト結果も同じなので、サーバー用カードの代わりとして使用しています。ちなみに、これらのカードの拡張性について詳しく知りたい場合は、XE7740に搭載したRTX PRO 6000サーバーカードのレビュー記事もご用意しています。
6000 を 2 回実行しました。1 回はデフォルトの 600W で、もう 1 回は nvidia-smi を介して検証済みの 450W の制限を適用しました。これは、450W が GPU スロットの 6000 に R770 から供給できる最大電力であり、一般的な 2U サーバー用に 4500 と 6000 のどちらを選ぶかを検討している購入者が比較すべき数値だからです。6000 のホスト プラットフォームは異なりますが、これらの GPU 負荷の高いサービスでは、CPU と PCIe のトポロジーが結果に与える影響は、電力制限の影響よりもはるかに小さくなります。
我々は、vLLM のオンライン サービング ベンチマークを、同時実行レベル 1、2、4、8、16、32 で、2 つのリクエスト シェイプで使用しました。1 つは、チャットや短いエージェント ターンを近似する 512 個の入力トークンと 512 個の出力トークン、もう 1 つは、プリフィルが支配的で KV キャッシュが満たされる RAG およびドキュメント ワークを近似する 8,192 個の入力トークンと 1,024 個の出力です。可能な限りグループ内で最小のカードに適合するようにモデルが選択されているため、L4 の 24GB が最低サイズとなります。Ministral 3 3B Reasoning と Ministral 3 8B Reasoning は BF16、Ministral 3 14B Instruct は FP8、Qwen3.8-27B は NVFP4 で、32GB 以上のカードに適合しますが L4 には適合しません。
各並行処理レベルにおける出力トークンのスループットを報告し、状況が変わる場合には、事前入力トークンを含む総スループットも記載します。
ここに記載されていないもの:48GB以上のカードのみが搭載可能な大型モデル、MIGパーティショニング、vGPU、ビデオトランスコード、電力計測、2枚のカードで構成される4500構成、およびこのクラスより上位のデータセンター向けカード。
最大達成可能 Matmul FLOPS (MAMF)
MAMF は、持続的な高密度 GEMM テストで、各精度でカードが達成する最高の行列乗算スループットを報告するため、サービング スタックがなくなった後に FP4 ハードウェアが機能するかどうかを確認する最も簡単な方法です。4500 は、BF16 で 135.9 TFLOPS、FP8 で 280.1、NVFP4 で 568.6 を達成し、精度を一段階下げるごとにスループットがほぼ 2 倍になりました。NVIDIA の高密度ピーク 202、406、811 TFLOPS と比較すると、これは各精度でピークの 67% ~ 70% であり、NVIDIA 自身の cuBLAS のカードの数値 133、275、534 と一致しています。
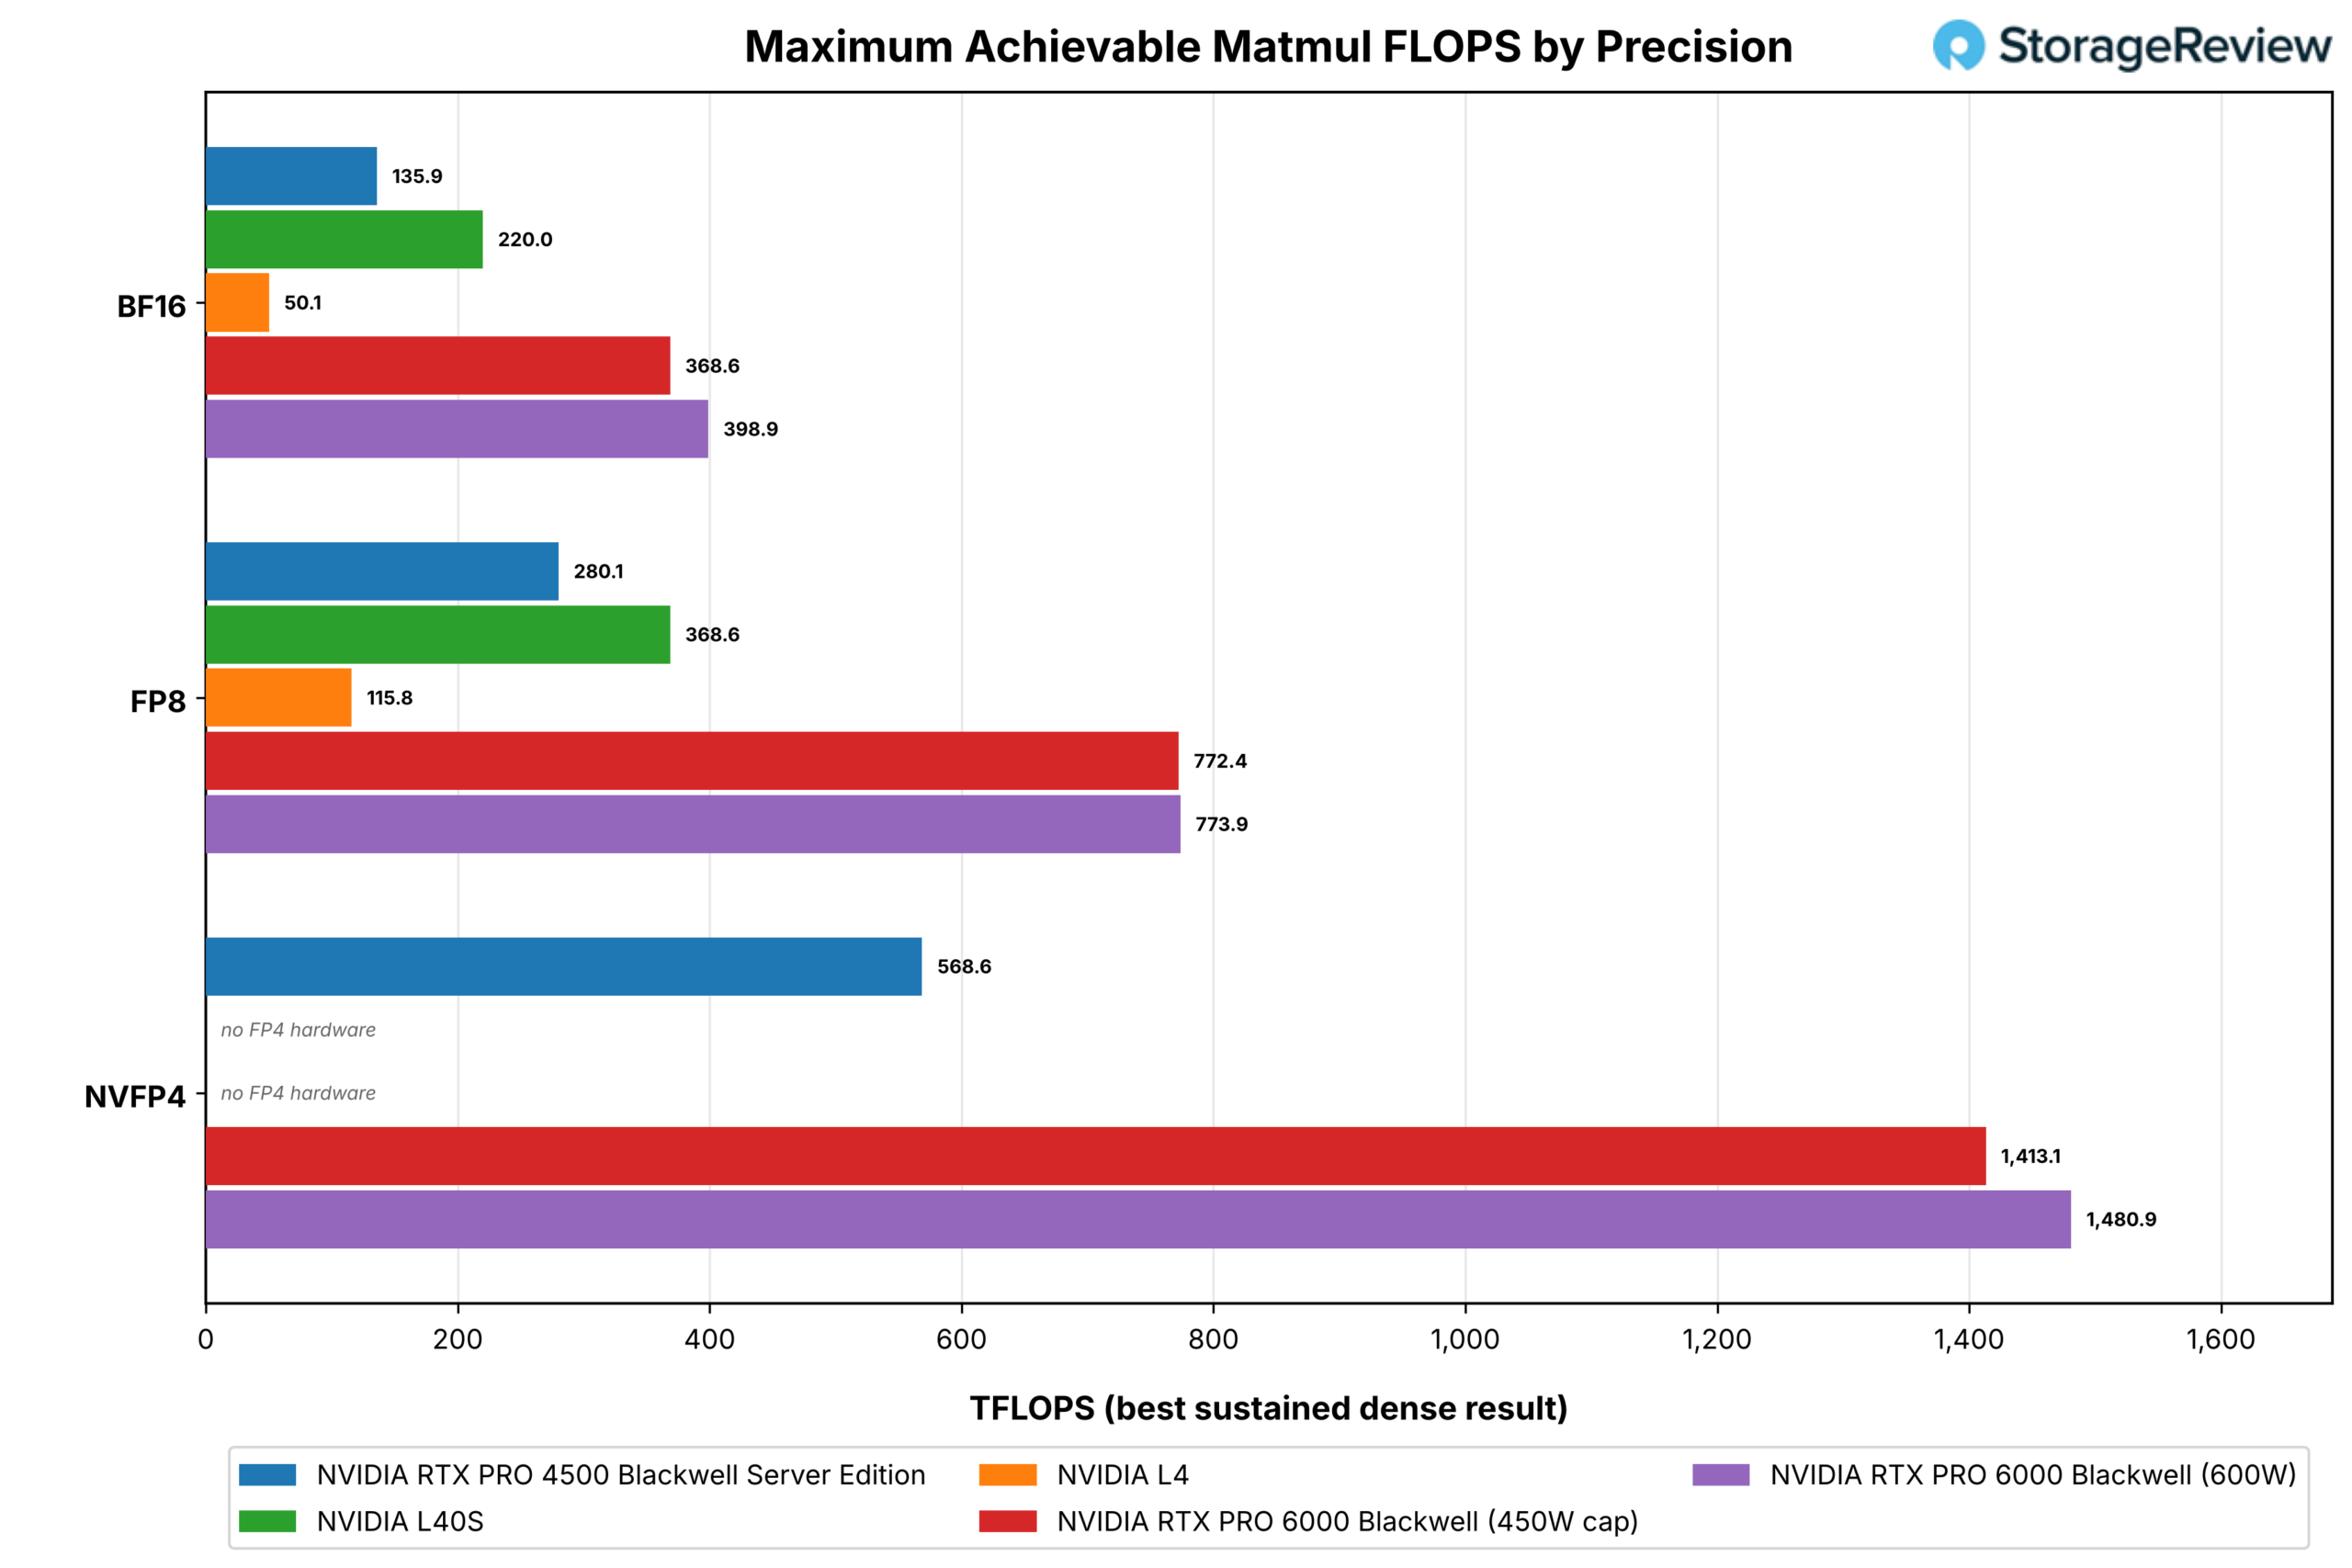
RTX PRO 6000 も同様にスケーリングし、600W で 398.9、773.9、1,480.9 TFLOPS に達し、3 つの精度全体で 4500 の 2.6 倍から 2.9 倍となり、ダイ サイズと電力予算の予測と一致しました。450W の上限では、368.6、772.4、1,413.1 に達しました。FP8 は変化せず、BF16 は 8 パーセント低下し、NVFP4 は 5 パーセント低下しました。これは、6000 の FP8 テンソル パスがこのテストで 450W 未満にあり、他の 2 つの精度は上限にわずかに近づくだけであることを示しています。L40S は BF16 と FP8 で 220.0 と 368.6 TFLOPS に達し、L4 は 50.1 と 115.8 に達しました。どちらのAdaカードにもFP4テンソルハードウェアは搭載されていません。
有用な比較対象は、4500のNVFP4の結果を他のすべてのFP8と比較することです。568.6 TFLOPSは、L40SのFP8の上限の1.5倍であり、上限が設定されている6000の74%に相当します。これは165Wのカードから得られたものです。これがFP4の優位性であり、GEMMレベルで実現されています。続くvLLMサービングの結果は、このビルドではまだサービングスタックに到達していないことを示しており、MAMFの結果は、NVFP4カーネルが追いつくにつれてサービング数がさらに増加していくことを示唆しています。
vLLMオンラインサービス:概要(512/512)
4500 の強みは、簡潔なコンテキストにあります。3 つの FP8 および BF16 モデルにおいて、同時実行数 32 での出力スループットは、Ministral 3 14B で 1,107 トークン/秒、L40S で 995 トークン/秒、Ministral 3 8B で 1,017 トークン/秒、Ministral 3 3B で 2,006 トークン/秒、L40S で 1,988 トークン/秒でした。これらのカードはすべて、165W の Blackwell カードが 350W の Ada カードと同等かそれ以上の性能を発揮しており、同時実行数 1 から 32 まで曲線がほぼ重なっているため、これはピークのみの結果ではありません。L4 は同じモデルで 364、279、704 を記録しており、4500 は前機種の 2.8 倍から 3.6 倍の性能となっています。

RTX PRO 6000 は、Blackwell の予算の残りが何をもたらすかを示しています。450W に制限すると、同じ 3 つのモデルで 2,161、2,042、4,069 トークン/秒に達し、4500 の 1.95 倍から 2.03 倍になります。フル 600W では、2,283、2,139、4,155 に達し、2.06 倍から 2.1 倍になります。2 つの 6000 曲線は、すべてのモデルで同時実行数 16 まで重なり、32 でのみ 2 ~ 5 パーセントの差になるため、短いコンテキストでは最後の 150W はほとんど追加されません。4500 と比較すると、これは 3 倍のメモリと R770 では 2.7 倍のスロット電力を持つカードの 2 倍のスループットです。

リクエストごとに 512 個のプリフィル トークンも含めた総スループットは、同じ順序になります。14B モデルの 4500 は 2,215 トークン/秒、L40S は 1,990 トークン/秒、L4 は 727 トークン/秒で、6000 は上限で 4,323 トークン/秒、600W では 4,566 トークン/秒です。L4 との差は 8B モデルで 3.6 倍と最も大きく、3B モデルで 2.8 倍と最も小さく、L40S との差は 4500 が 12 パーセント以上優位になることはありません。

vLLMオンライン配信:長文コンテキスト(8K/1K)
入力トークンが 8,192 になると状況が変わり、その理由は曲線の形状に表れています。Ministral 3 14B FP8 では、4500 は同時実行数 8 まで L40S に追従し、その後約 180 トークン/秒で横ばいになりますが、L40S は同時実行数 16 で 230 まで継続し、そこで維持されます。8B モデルも同様で、4500 は 32 で 185 トークン/秒、L40S は 277 トークン/秒で、4500 は 8 で、L40S は 16 で横ばいになります。3B モデルでは、両方のカードが 16 で横ばいになり、384 対 475 です。

理由は KV キャッシュ容量です。同時実行される 8K リクエストごとに、カード上にコンテキストが常駐している必要があり、重みがロードされると、32GB のフレームバッファは 48GB のものよりも少ない重みを保持します。vLLM が KV スペースを使い果たすと、有用な同時実行数の追加が停止し、スループットが横ばいになります。この理由だけで、4500 はこれらのモデルで同時実行数 32 において L40S に 17 ~ 33 パーセント劣ります。短いコンテキストの結果が示すように、計算側がボトルネックではありません。24GB で 300GB/s の L4 は、すべてのモデルで同時実行数 4 から 34 ~ 130 トークン/秒で横ばいです。

6000 の 96GB は、このテストでは不足することはなく、どのモデルでも曲線は 32 まで上昇し続けます。450W の上限では、552、589、973 トークン/秒に達し、4500 の 2.5 倍から 3.2 倍になりました。600W では、608、639、1,033 に達し、2.7 倍から 3.5 倍になりました。電力制限が現れる唯一の箇所はここです。長いコンテキストのプリフィルにより、6000 の計算バウンド時間が長くなるため、制限されたカードは、同時実行数 16 と 32 で 4 ~ 9 パーセント低下し、短いコンテキストでは 2 ~ 5 パーセント低下します。いずれにしても、4500 との比率は 2 倍から約 3 倍に広がり、その理由は電力よりもメモリです。

ワークロードがドキュメント Q&A、長いコンテキストでの RAG、または大きなツール出力を持つエージェントである場合、メモリが主な仕様となり、4500 の 32GB は同時実行の制約となります。チャット、分類、または短いエージェントのターンであれば、そうではありません。8K/1K での総スループットはプリフィルが支配的で、同じ順序が繰り返されます。14B モデルの 4500 では 1,713 トークン/秒、L40S では 2,070、L4 では 381、6000 では 4,971 が上限、600W では 5,474 です。
NVFP4:ソフトウェアが限界を決める場所
NVFP4 の Qwen3.8-27B は、Blackwell が採用している FP4 Tensor ハードウェアを使用するグループ内の唯一のモデルであり、その結果、レビューの中で最も平坦な曲線が得られました。ショートコンテキスト テストの同時実行数 32 では、4500 は 320 出力トークン/秒を生成しました。L40S、480、および RTX PRO 6000 は、上限で 621、600W で 616 に達しました。同時実行数 1 では、すべてのカードが 27B モデルで 17 ~ 22 トークン/秒の範囲に収まりました。これには 1.6TB/s の GDDR7 を搭載した 6000 も含まれます。同じカードは、14B FP8 モデルでシングル ストリームで 99 トークン/秒を出力します。

L40SにはFP4テンソルハードウェアがないため、vLLMは重みを逆量子化してより高精度で計算するNVFP4チェックポイントを実行します。これはメモリ帯域幅が制限されるパスであり、4500を1.5倍上回ります。4500と同じFP4ハードウェアを持ち、帯域幅が2倍の6000は、他のすべてのカードで2つのカードを分けるのと同じ約2倍の4500の性能に達し、450Wと600Wの実行はすべての同時実行で1パーセント以内の差であるため、カーネルも電力制限を受けません。
4つのシリーズすべてに共通するパターンとして、メモリ帯域幅に関係なくシングルストリームのスループットが変化しないこと、およびGPUの種類に関係なく同時実行数32の上限が480から621であることから、このvLLMビルドにおけるNVFP4カーネルパスがすべてのカードの制限要因となっていることが示唆されます。

8K/1K では、4500 は同時実行数 32 で 153 トークン/秒に達しましたが、L40S は 190、6000 は上限ありと上限なしの場合でそれぞれ 402 と 425 でした。これらは FP8 および BF16 モデルで示されたのと同じ KV キャッシュ制限の形状であり、6000 の 96GB が、他のモデルが横ばいになる中で、6000 が上昇し続ける理由となっています。
NVIDIAはこのカードで、Llama 3.1 8B (2K/256) で1,221トークン/秒、TensorRT-LLM を使用した Nemotron 3 Nano 30B A3B で905トークン/秒のFP4を実現しており、ハードウェアはNVIDIAのスタックで十分な性能を発揮しています。しかし、今日のデータから分かるのは、このカードのNVFP4は、テストしたすべてのGPUに共通するvLLMソフトウェアの問題であり、FP4スループットを期待する購入者は、実際に使用する前にサービングスタックをテストする必要があるということです。
定格ワットあたりのスループット
今回のテストでは電力測定を行わなかったため、今回得られる効率の計算は各カードのテスト済み電力制限に対するものです。Ministral 3 14B FP8、同時実行数32の場合、4500は定格ワットあたり6.7トークン/秒の出力を実現し、L40Sは2.8、L4は5.1、RTX PRO 6000は450Wの上限で4.8、6000は600Wで3.8となっています。3Bモデルでは、この比率は維持され、4500は12.2、L40Sは5.7、L4は9.8、上限の6000は9.0、6000は600Wで6.9となっています。
4500は、この指標で言えば、このグループの中で最も効率的なカードであり、上限が設定された6000だけがそれに近い性能を発揮します。6000の消費電力を450Wまで下げると、スループットが2~5%低下し、電力予算の25%が回復するため、効率が4分の1向上します。L4は、72Wという非常に小さな分母のおかげで、この指標では競争力を維持していますが、同じスループットを達成するには3倍のスロットとサーバーが必要となり、これは4500が解決しようとしたトレードオフです。
8K/1K では、順位が変わります。14B モデルでは、4500 が定格ワットあたり 1.2 トークン/秒、上限付き 6000 が 1.2、600W 6000 が 1.0、L40S が 0.7 となります。4500 の KV キャッシュがなくなると、スループットは増加しなくなりますが、電力定格は増加しないため、長いコンテキストでは 450W の 6000 が効率で同等になり、スロットあたり 2.9 倍の作業を実現します。
結論
RTX PRO 4500 Blackwell Server Editionは、NVIDIAが謳っている通りの性能を発揮します。Blackwellを、これまでL4が上限だったスロット、電力予算、シャーシクラスに搭載します。主流のサーバーでよく使われるモデル、つまり小規模から中規模の命令処理や、チャット程度のコンテキストでの推論モデルにおいて、L40Sの半分以下の電力でL40Sと同等のスループットを実現し、L4の3倍の性能を発揮します。
もちろん、限界はあります。まずメモリについてですが、32GBは本カードが対象とするモデルには十分な容量ですが、L40Sの48GB、特に6000の96GBが優位に立つロングコンテキストでの同時実行数には限界があります。また、同じサーバーで許容される電力制限下でも、6000は同じリクエスト形状で4500の約3倍の性能を発揮します。
Blackwellの主力機能であるNVFP4は、このvLLMビルドではFP4ハードウェアを搭載していないカードと同等の性能を発揮します。MAMFスイープでは、GEMMレベルでFP4ハードウェアがカードのFP8レートの2倍の性能を発揮していることが示されていますが、FP4の優位性はご自身の環境で検証する必要があります。ただし、ソフトウェアによるさらなる性能向上は明らかです。
2Uサーバー、またはFHFLカードを搭載した1Uシャーシを使用しているユーザーで、電源や冷却システムに手を加えることなく推論、ビジョンAI、トランスコーディング、仮想ワークステーションの容量を追加する必要がある場合は、RTX PRO 4500が最適な選択肢となるでしょう。さらに、L4sをまだ使用していて24GBでは容量不足になっているユーザーも、4500に魅力を感じるはずです。ワークロードが長時間にわたる場合やマルチテナント環境で、カードあたり48GB以上のメモリを必要とする組織には、RTX PRO 6000の方が適しています。
NVIDIAはこれらのカードに明確な2つの用途を定めたことで成功を収めており、4500はわずか165Wの消費電力でL4と6000の間のエッジAIのギャップを埋めている。
ランキング: RTX PRO 4500 Blackwell Server Editionは、当社の「最高のエンタープライズGPU」ランキングにおいて、シングルスロットGPU部門でトップの座を獲得しています。このランキングには、今回のレビューで取り上げたL40SとRTX PRO 6000のデータも掲載されています。



 Amazon