

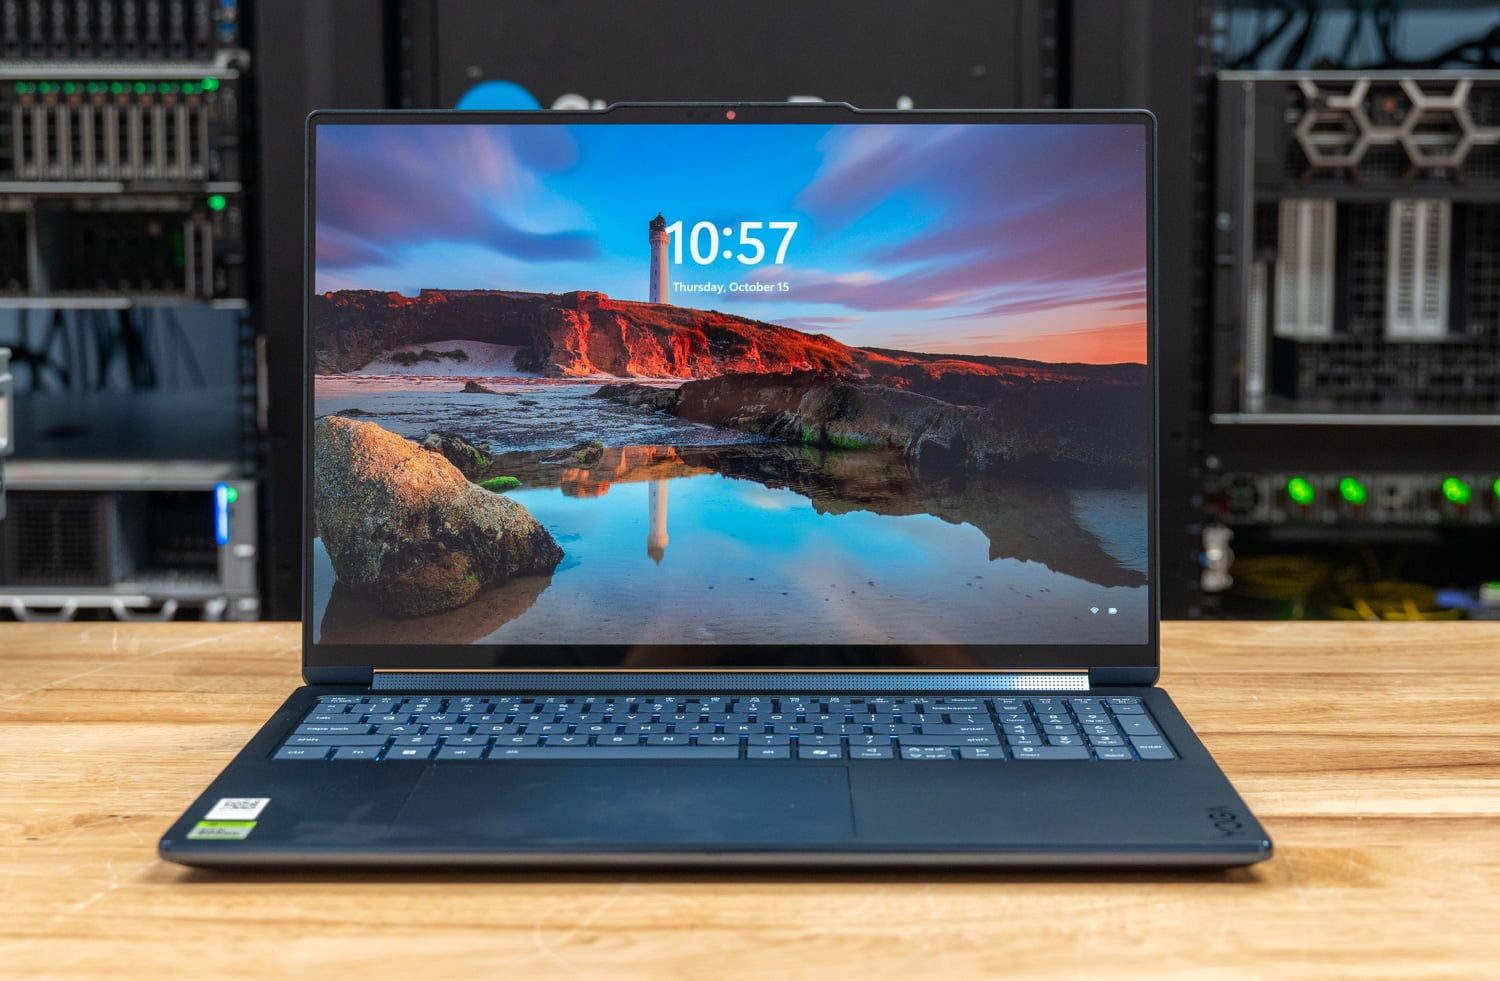
Lenovo Yoga 9n 2-in-1 16は、NVIDIA RTX Spark N1Xを搭載したコンバーチブルノートPCです。16インチのOLEDタッチスクリーンはヒンジで折りたたむことができ、タブレットモードとテントモードに切り替え可能です。ペン対応の触覚タッチパッドと厚さ0.69インチのアルミニウム製シャーシを採用しています。今回レビューしたモデルは、6,144コアのBlackwell GPU、64GBのLPDDR5Xメモリ、1TBのGen4 SSDを搭載したフルスペックのN1Xで、Best Buyでは3,749.99ドルで販売されています。18コア、32GBメモリ、1TBメモリのモデルは3,099.99ドルです。
Yogaの性能を比較する上で、3つの比較対象システムが役立ちます。HP OmniBook Ultra 16(128GB)は、16インチのクラムシェル型筐体に同じ20コアのN1Xプロセッサを搭載しており、これまでテストしたRTX Spark搭載ノートPCの中で最速です。そのため、Yogaの冷却性能向上に伴うトレードオフを測る基準となります。Lenovo Pro 9n 15は、18コア搭載モデルでYogaの兄弟機にあたります。Razer Blade 16は、Surface Laptop UltraのレビューでRTX 5090を搭載し、x64アーキテクチャの分野でトップの成績を収めたため、今回比較対象として登場します。レビューでは、筐体とデザイン、ローカルAI、CPU、メモリ、ゲーム性能、熱性能、ストレージについて解説します。バッテリー性能については、新しいテストハーネスが完成次第、後日発表します。
Yogaの性能を決定づけるのは温度です。OmniBookが98℃に達する全コア負荷時でも、YogaのCPUは71~86℃でピークに達し、30分間の連続ループでは72℃で安定動作しました。Lenovoは、通気口を拡大し、サーマルバンプを高くした再設計された熱制御システムと、通気口の後ろに空気の流れを確保するためのコンバーチブルヒンジが、この性能向上に貢献しているとしています。ただし、その代償として全コアクロックが低くなり、シングルスレッドではOmniBookと同等の性能を発揮するものの、マルチスレッドテストではYogaが4~10%劣る結果となっています。
主要なポイント(要点)
- 32GBのGPUメモリにより、当社のティアSモデルはフルスピードで動作します。 コーディングエージェントは、1秒あたり58.0トークンの速度でgpt-oss:20bを生成しました。これは128GBのOmniBookと同じ速度で、MLPerfもその5%以内の速度で動作しました。ティアMのQwen3.6-35B-A3Bは約40GBのGPUメモリを必要とするため、Yogaは対象外です。
- 私たちがテストした中で最もクールなRTX Spark搭載ノートPC: Cinebenchのピーク時で72℃、連続ループ全体でも72℃であり、OmniBookの98℃(最初のパスの100%で安定状態)と比較して低い値となっている。
- 25度でCPUスループットが数パーセント低下する: Cinebench 2026のマルチコアスコアは6,292で、OmniBookより10%低く、Razer Blade 16より22%高く、シングルコアスコアは557.0でHPと同等です。
- クリエイターのために作られたコンバーチブル: 最大輝度1,100ニトの2.8K OLEDディスプレイ、付属のYoga Pen Gen 2に対応した触覚フィードバック付きタッチパッド、回転式サウンドバーに搭載されたツイーター、そして重量4.28ポンドの筐体に99.9Whのバッテリーを搭載。
- QLCストレージは弱点である。 Gen4 QLC SSDはシーケンシャル読み取り速度が6,874MB/sでしたが、4Kランダム書き込みのIOPSはわずか68.9Kで、グループ内で最低値でした。また、コールドモデルのロード時間を約2秒遅らせました。
ビルドとデザイン
Yoga 9n 2-in-1は、Lenovo独自のコンバーチブルレイアウトを採用しており、ヒンジによってディスプレイをタブレット、テント、スタンドの各モードに折りたたむことができます。シャーシは上下ともアルミニウム製で、コズミックブルー仕上げ。最も薄い部分のサイズは14.17 x 9.57 x 0.69インチ、重量は4.28ポンドからとなっています。Lenovoによると、このデザインはMIL-STD-810H規格の試験に合格しており、底面カバーには50%リサイクルアルミニウムが使用されているとのことです。

Yogaは手に持った感触が、丸みを帯びたエッジとポート配置がPro 9nと共通しており、蓋はマグネットでしっかりと閉じられます。キーボードはテンキー付きのフルサイズレイアウトで、しっかりとした打鍵感があり、ガラス製の感圧パッドは両手で同時に操作できるほど十分な大きさです。YogaはPro 9nよりもやや幅が広く、ヒンジによってディスプレイを完全に折り畳んでタブレットとして使用できるため、Pro 9nのクラムシェルデザインよりもヒートシンクの通気口とヒンジの間に広いスペースが確保されています。
Yogaが他のRTX Spark搭載ノートPCと一線を画すのは、その冷却性能です。Lenovoは、通気口を拡大し、底面に盛り上がったサーマルバンプを設けることで、熱システムを再設計しました。また、コンバーチブルヒンジを採用することで、シャーシ背面の空気の流れを良くしています。その結果、StockfishテストではCPU温度が71℃に抑えられ、OmniBookの98℃を大きく下回りました。サーマルセクションでは、このCPUの低クロック動作について詳しく解説しています。

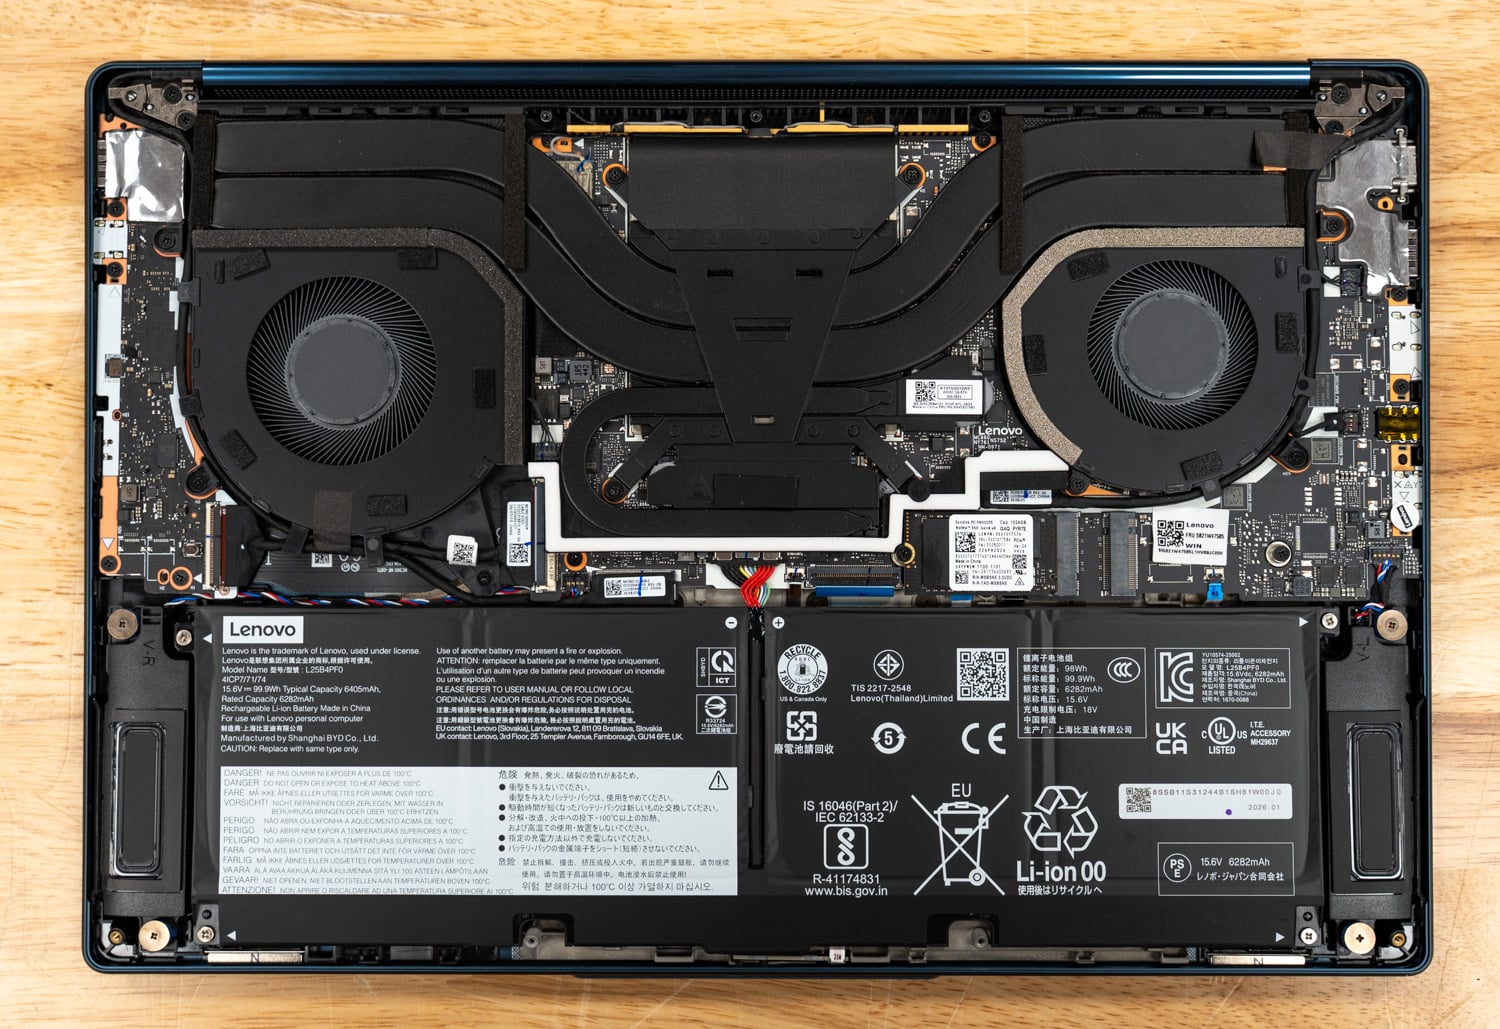
底面カバーの後半部分の大部分は、穴の開いた吸気グリルで覆われており、排気口はヒンジの下、後端に沿って配置されている。カバーを取り外すと、後端の角に2つのファンがあり、その間の基板中央には、ヒートパイプを備えた幅広のヒートシンクアセンブリが配置されている。
一見すると、Pro 9n と同じクーラーとファンアセンブリのように見えますが、Yoga 9n はダクトのないファンを採用しています。Pro 9n には、両方のファンの吸気口を部分的に塞ぐ小さな半月型のカバーが付いています。M.2 2242 SSD はボード中央のヒートシンクの下に配置され、その横に Lenovo が提供する 2 番目の M.2 スロットがあります。99.9Wh のバッテリーはシャーシの前半分を占め、両側の前面近くのスリットから音を出すウーファーエンクロージャーに挟まれています。
これまでのところ、Lenovoが他のNVIDIAモバイルプラットフォームと一線を画す設計上の決定事項の一つは、2242 M.2ベイを2基搭載している点です。他のプラットフォームは2280ベイを1基しか搭載していません。これによりYogaは2つ目のドライブオプションを持つことになりますが、2242 SSDは容量が小さく、一般的に2280 SSDよりも性能が劣るため、ストレージの性能面でその差が顕著に表れます。
16インチのPureSight Pro OLEDタッチスクリーンは、2880 x 1800の解像度で、30~120Hzの可変リフレッシュレートに対応しています。Lenovoは、HDRでのピーク輝度を1,100nit、sRGBとP3の色域を100%カバーし、Delta Eは1未満、Dolby Visionに対応し、VESA DisplayHDR True Black 1000認証を取得していると評価しています。オーディオシステムは、回転式サウンドバーヒンジに4つの2Wウーファーと2つの2Wツイーターを搭載しており、どのモードでもツイーターがユーザーの方を向くようになっています。

キーボードはキーストローク1.5mm、バックライト、コパイロットキーを搭載しています。その下には触覚フィードバック機能付きのフォースパッドがあり、Yoga Pen Gen 2の描画面としても機能します。Yoga Pen Gen 2はAES 3.0に対応し、8,192段階の筆圧感知と傾き検知が可能で、USB-Cで充電でき、蓋の背面にマグネットで固定できるケースに収納できます。9.2MPの赤外線カメラは電子シャッターを備え、3つのマイクが音声認識を担当します。
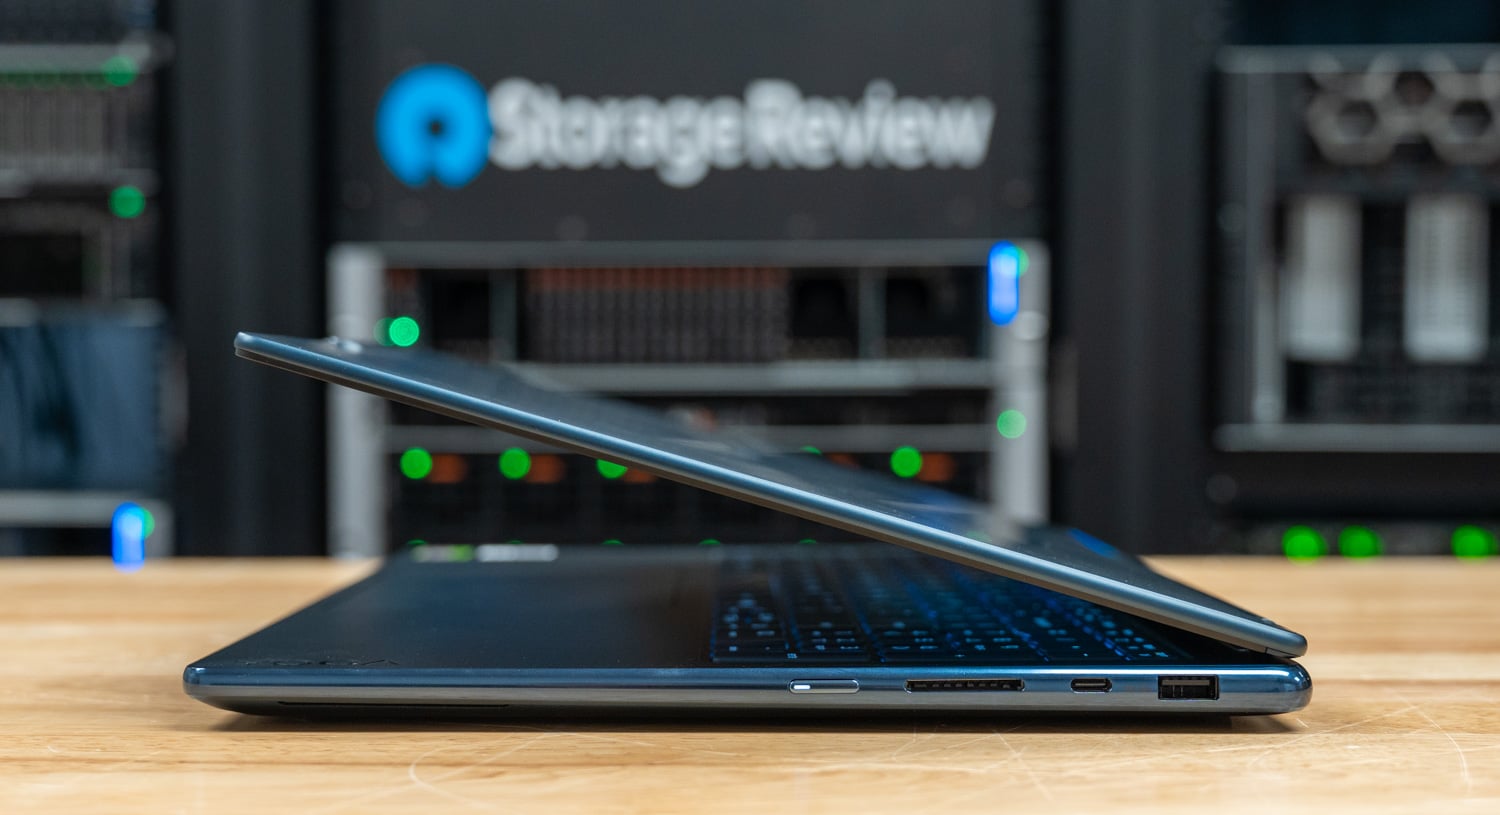
左側面にはHDMI 2.1、10GbpsのUSB-Aポート、Power DeliveryとDisplayPort 2.1に対応した40GbpsのUSB4ポート、ヘッドホンジャックが配置されています。右側面には電源ボタン、UHS-I SDカードリーダー、2つ目のUSB4ポート、2つ目のUSB-Aポートがあり、2つのUSB-Aポートのうち1つは常時オンになっています。ワイヤレス接続はWi-Fi 7とBluetooth 5.4に対応しており、99.9WhのバッテリーはRapid Charge Expressに対応しています。Lenovoによると、Rapid Charge Expressを使えば15分の充電で3時間使用できるとのことです。

RTX Spark N1Xプラットフォーム
RTX Sparkは、N1XスーパーチップをベースにしたWindows PCファミリーで、DGX Sparkに搭載されているGB10のノートPC版にあたります。Surface Laptop Ultraのレビューでは、このプラットフォームを取り上げています。Yogaには、20コアのGrace CPU(高速コア10個と高効率コア10個、SMT非対応)と6,144コアのBlackwell RTX GPUを組み合わせた、最上位のシリコンが搭載されています。
NVIDIAはノートPC向けN1Xプロセッサ搭載モデルに45~80Wの電力範囲を設定しており、その範囲内でOEMメーカーがノートPCをどのように冷却するかが、シリコン自体の性能と同様に結果に影響を与えます。LenovoはYogaを70W、HPはOmniBookを最大70W、LenovoはPro 9nを最大80Wとしていますが、同じ負荷条件下では3機種ともクロック周波数と温度が異なります。
N1XのLPDDR5XはCPUとGPUで共有されており、WindowsがGPUにどれだけのメモリを割り当てるかは、BIOSではなくNVIDIAアプリの設定で決定されるため、デスクトップから分割比率を変更できます。
弊社の64GB版Yogaは、GPUメモリ32GB、CPUメモリ32GBの構成でした。これは、弊社のティアSローカルAIモデルには適していますが、約40GBを必要とするティアMには適していません。また、すべてのRTX Sparkシステムと同様に、購入時のサイズ決定においてはメモリ容量が重要な要素となります。
固定分割はNVIDIAの制限ではなく、Windowsの制限です。WindowsはDGX SparkのLinuxスタックのようにCPUとGPU間でメモリを統合する機能をまだサポートしていないため、割り当てを事前に設定する必要があります。NVIDIAとMicrosoftは現在、この機能のサポートに取り組んでいるとのことです。
Windows 11 26H1はArm64上で動作します。x64アプリケーションはPrismエミュレーションを経由し、当社のスイートはすべてのオープンソースワークロードのネイティブArm64ビルドを使用するため、CPUの行ではシリコンを比較しています。
Lenovo Yoga 9n 2-in-1 16 仕様
| 製品仕様 | Lenovo Yoga 9n 2-in-1 16 (83N7000UUS) |
|---|---|
| プラットフォームの概要 | |
| プロセッサ | NVIDIA RTX Spark N1X、20コアCPU、6,144コアBlackwell RTX GPU(テスト時) NVIDIA RTX Spark N1X、18コアCPU、5,120コアBlackwell RTX GPU |
| メモリ | 64GB LPDDR5X-9400、256ビット(テスト済み)をはんだ付け。最大64GBまで拡張可能。 32GB GPU / 32GBシステム(テスト時) |
| Storage | 1TB PCIe Gen4 QLC M.2 2242 SSD サンディスク PC SN5100S 1TB(テスト済み) |
| オペレーティングシステム | Windows 11 (Arm64);テスト環境はWindows 11 Home |
| ディスプレイとI/O | |
| ディスプレイ | 16インチ 2.8K (2880 x 1800) PureSight Pro OLEDタッチスクリーン、30-120Hz VRR、16:10 最大輝度1,100ニト(HDR)、sRGBおよびP3カバー率100%、Delta E <1、Dolby Vision対応 VESA DisplayHDR True Black 1000、ガラス |
| ポート | USB4 40Gbpsポート×2(USB PD 3.0、DisplayPort 2.1対応) USB-Aポート×2(10Gbps、うち1つは常時接続) HDMI 2.1ポート×1(最大8K/60Hz対応) SDカードリーダー(UHS-I)×1 ヘッドホン/マイクコンボジャック×1 |
| 無線 | Wi-Fi 7 (802.11be 2×2)、Bluetooth 5.4 |
| カメラ | 9.2メガピクセル+赤外線(電子シャッター付き) |
| オーディオ | スピーカー6基:回転式サウンドバーに2Wウーファー4基、2Wツイーター2基を搭載。Dolby Atmos対応。 3x マイク |
| 入力 | バックライト付きキーボード、キーストローク1.5mm、コパイロットキー搭載 ペン対応の触覚フィードバックパッド Yoga Pen Gen 2(AES 3.0、8,192段階の筆圧レベル、同梱) |
| パワーと身体 | |
| 電池 | 99.9Wh、急速充電エクスプレス |
| 熱設計 | 大型通気口とサーマルバンプを装備。TDP 70W(Lenovo定格) |
| 寸法 | 14.17 x 9.57 x 0.69インチ(360 x 243.1 x 17.5mm) |
| 重量 | 4.28ポンド(1.94kg)から |
| 色と素材 | コズミックブルー、アルミニウム製トップ&ボトム;MIL-STD-810H試験済み |
| 価格 | |
| 価格(ベストバイ) | 3,099.99ドル(18コア、32GB、1TB)、3,749.99ドル(20コア、64GB、1TB、テスト機) |
テストのセットアップと方法論
今回レビューしたYoga 9n 2-in-1システムは、6,144コアのBlackwell GPUを搭載したRTX Spark N1X、GPUとシステムに32/32で分割された64GBのLPDDR5X-9400メモリ、そしてWindows 11 Home 26H1(Arm64)上で動作する1TBのSandisk SN5100S Gen4 SSDを搭載しています。ベンチマークはLenovoのパフォーマンスモードで実行しました。
今回の比較対象システムはすべて、OEMのドライバとユーティリティを含む工場出荷時のWindowsイメージを使用し、スクリプト化されたWindowsクライアントベンチマークスイートであるsr-client 1.2をフル実行およびピークプロファイルで実行しました。このスイートは、すべてのシステムで同じラボ設定を適用します。具体的には、Windowsの電源モードを「最高のパフォーマンス」に設定し、電源に接続した状態で、ディスプレイの輝度を50%に設定し、すべてのスリープタイマーとディスプレイオフタイマーを無効にし、WindowsファイアウォールとUACプロンプトを無効にしています。各結果は複数回のテストの中央値であり、ばらつきが2%を超えるテストは、スイートが再実行してから結果を受け入れます。
| システム | CPU | メモリ | GPUとAIのテストに使用されるGPU | SSD | OSとパフォーマンスモード |
|---|---|---|---|---|---|
| Lenovo Yoga 9n 2-in-1 16 | NVIDIA RTX Spark N1X、20コア/20スレッド | 64GB LPDDR5X-9400(GPU用32GB、システム用32GBに分割) | 6,144コアのBlackwell RTX(統合型、使用可能メモリ32GB) | サンディスク PC SN5100S 1TB、Gen4 x4 | Windows 11 Home 26H1 (Arm64)、Lenovoパフォーマンスモード |
| HP OmniBook Ultra 16 (128GB) | NVIDIA RTX Spark N1X、20コア/20スレッド | 128GB LPDDR5X-9400(GPU用64GB、システム用64GBに分割) | 6,144コアのBlackwell RTX(統合型、使用可能メモリ62.5GB) | サンディスク PC SN8050S 2TB、Gen5 x4 | Windows 11 Pro 26H1 (Arm64)、HPパフォーマンス |
| Lenovo Pro 9n 15 | NVIDIA RTX Spark N1X、18コア/18スレッド | 32GB LPDDR5X-9400(GPU用12GB、システム用20GBに分割) | 5,120コアのBlackwell RTX(統合型、使用可能メモリ12GB) | サムスン MZAL81T0HFLB 1TB、Gen4 x4 | Windows 11 Pro 26H1 (Arm64)、Lenovoパフォーマンスモード |
| Razerのブレード16 | AMD Ryzen AI 9 HX 370、12コア/24スレッド | 32GB LPDDR5X-8000 | NVIDIA GeForce RTX 5090 ノートパソコン用GPU、24GB | Samsung MZVL22T0 2TB、Gen4 x4 | Windows 11 Home 25H2 (x64)、Razer Synapse Performance |
以下の表には、2つのラベルが繰り返し登場します。「実行されず」とは、ハードウェアが要件を満たしていないため、テストスイートがテストを開始しなかったことを意味します。これは多くの場合、モデルが利用可能なGPUメモリ容量を超えているためです。Yogaの32GBとBlade 16の24GBはティアMを下回り、Pro 9nの12GBは両方のティアを下回ります。同じラベルは、12GBのPro 9nがメモリのためにスキップするOpenBLASのサイズを示しています。
N/Aは、そのハードウェアにはテストが適用されないことを意味します。例えば、SMT非対応のチップ上のSMTシングルコアや、ネイティブビルドを実行するx64システム上のエミュレーション行などが該当します。RTX SparkシステムがPrism経由でx64ソフトウェアを実行した場合、データにはその旨が明記されます。
ローカルAIパフォーマンス
ローカルAIの性能は、GPUがモデルをどれだけ速く実行できるか、そしてモデルが適切かどうかによって決まります。Yogaの32GBのGPU使用可能メモリは、ティアSモデルであるgpt-oss:20bを128GBのOmniBookと同じ生成速度で実行しますが、ティアMには及びません。ティアMでは、OmniBookの62.5GBが効果を発揮します。
MLPerfクライアントv2.0
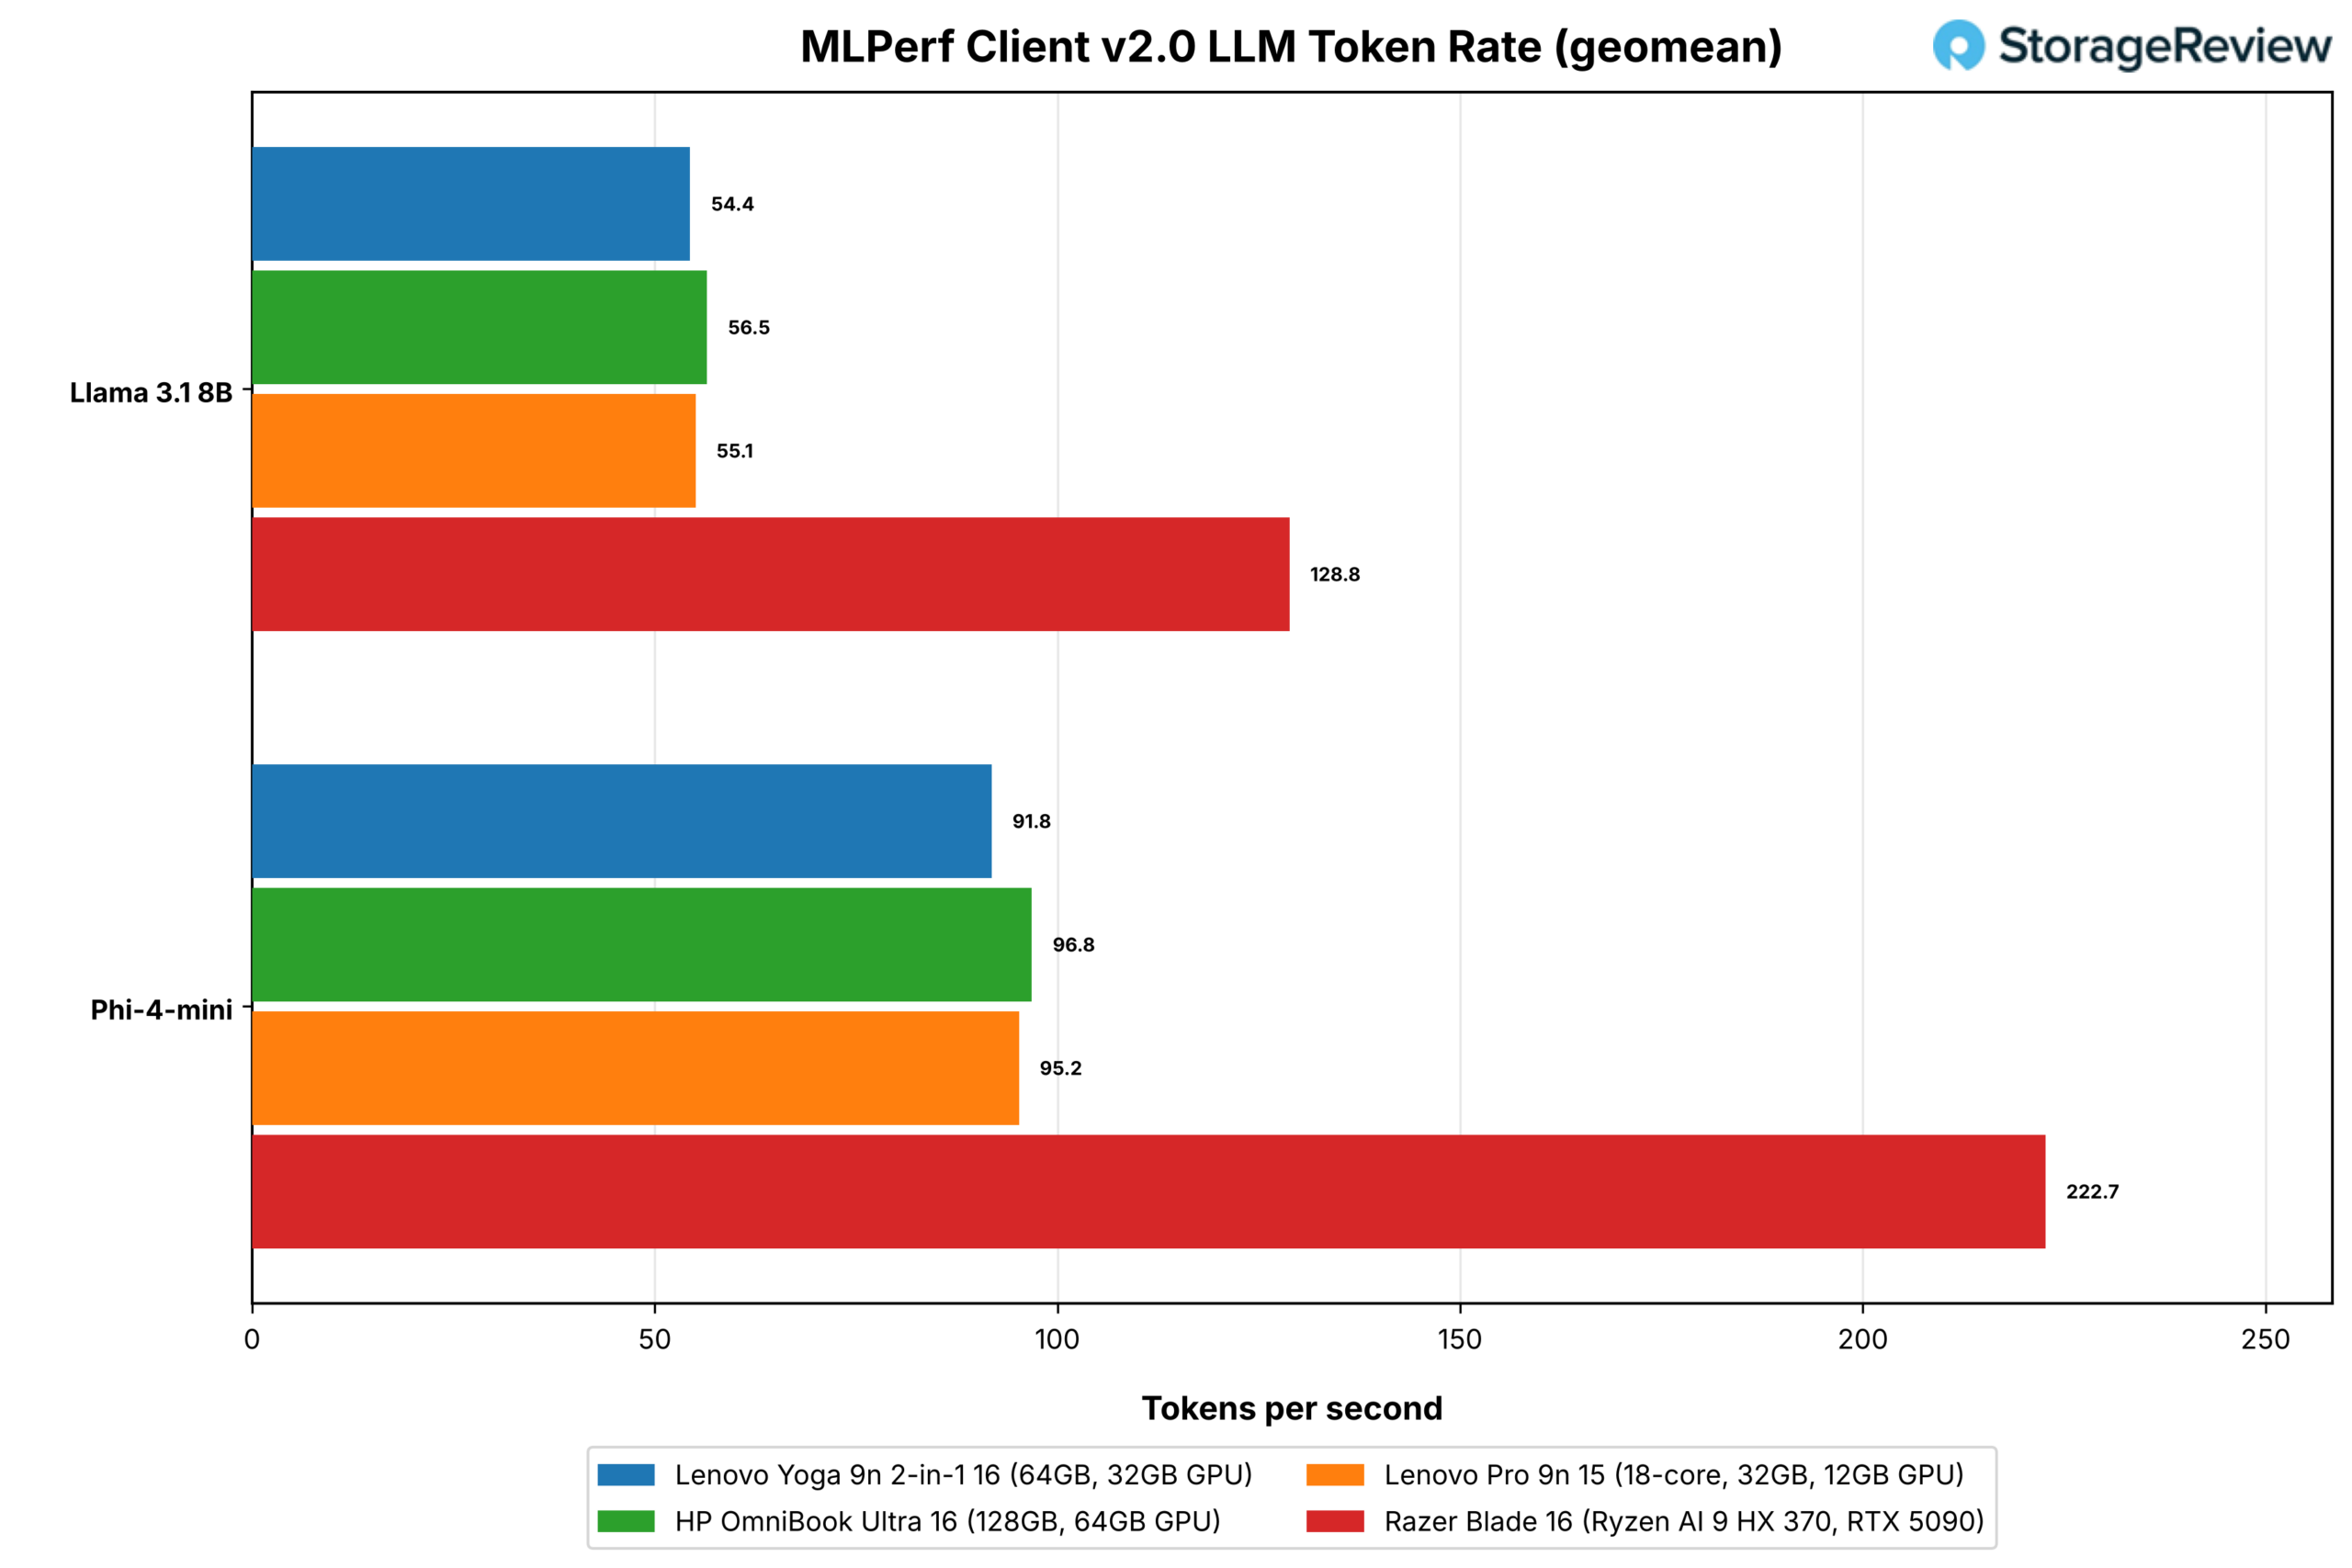
MLPerf Client は、Llama 3.1 8B と Phi-4-mini を 5 つのプロンプト カテゴリで実行し、最初のトークンまでの時間と、その後のトークンレートを幾何平均として報告します。ここに掲載されているすべてのシステムは CUDA を使用した llama.cpp を使用しているため、エンジンは同じであり、各行はハードウェアを比較しています。エージェント シナリオでは、Llama 3.1 8B をソフトウェア エンジニアリング エージェントおよびデータ アナリスト エージェントとして実行し、複数ターンにわたってツールを呼び出します。
| MLPerfクライアントv2.0 | ヨガ9n 2-in-1 16 | OmniBook Ultra 16 (128GB) | プロ9n15 | Razerのブレード16 |
|---|---|---|---|---|
| Llama 3.1 8B、最初のトークン取得までの時間、幾何平均(秒、値が小さいほど良い) | 0.353 | 0.274 | 0.303 | 0.149 |
| Llama 3.1 8B、トークンレート、幾何平均(トークン/秒) | 54.4 | 56.5 | 55.1 | 128.8 |
| Phi-4-mini、最初のトークンまでの時間、幾何平均(s、値が小さいほど良い) | 0.158 | 0.130 | 0.135 | 0.074 |
| Phi-4-mini、トークンレート、幾何平均(トークン/秒) | 91.8 | 96.8 | 95.2 | 222.7 |
| データアナリストエージェント、エンドツーエンド(s、数値が低いほど良い) | 59.7 | 53.0 | 56.2 | 27.8 |
| データアナリストエージェント、トークンレート(tok/秒) | 45.3 | 48.5 | 46.9 | 108.3 |
| SWEエージェント、エンドツーエンド(s、数値が小さいほど良い) | 51.6 | 45.3 | 48.0 | 24.6 |
| SWEエージェント、トークンレート(tok/秒) | 43.0 | 46.6 | 44.5 | 102.5 |
YogaはLlama 3.1 8Bで毎秒54.4トークン、Phi-4-miniで毎秒91.8トークンを生成し、OmniBookより4%と5%遅れをとった。メモリ帯域幅よりも演算能力に依存する最初のトークンでは、その差はさらに広がる。YogaはLlama 3.1で0.353秒かかったのに対し、HPは0.274秒で、18コアのPro 9nにも及ばなかった。このパターンは、Lenovoの冷却チューニングがGPUとCPUの両方に及んでいることを示唆している。YogaはMLPerfも3つのN1Xシステムの中で最も低いCPUクロックで実行した。
エージェントシナリオでは、Yogaはデータアナリストの処理に59.7秒、ソフトウェアエンジニアリングエージェントの処理に51.6秒を要し、OmniBookよりも13~14%長かった。一方、Blade 16はYogaの半分以下の時間で両方の処理を完了した。
モデルのロード
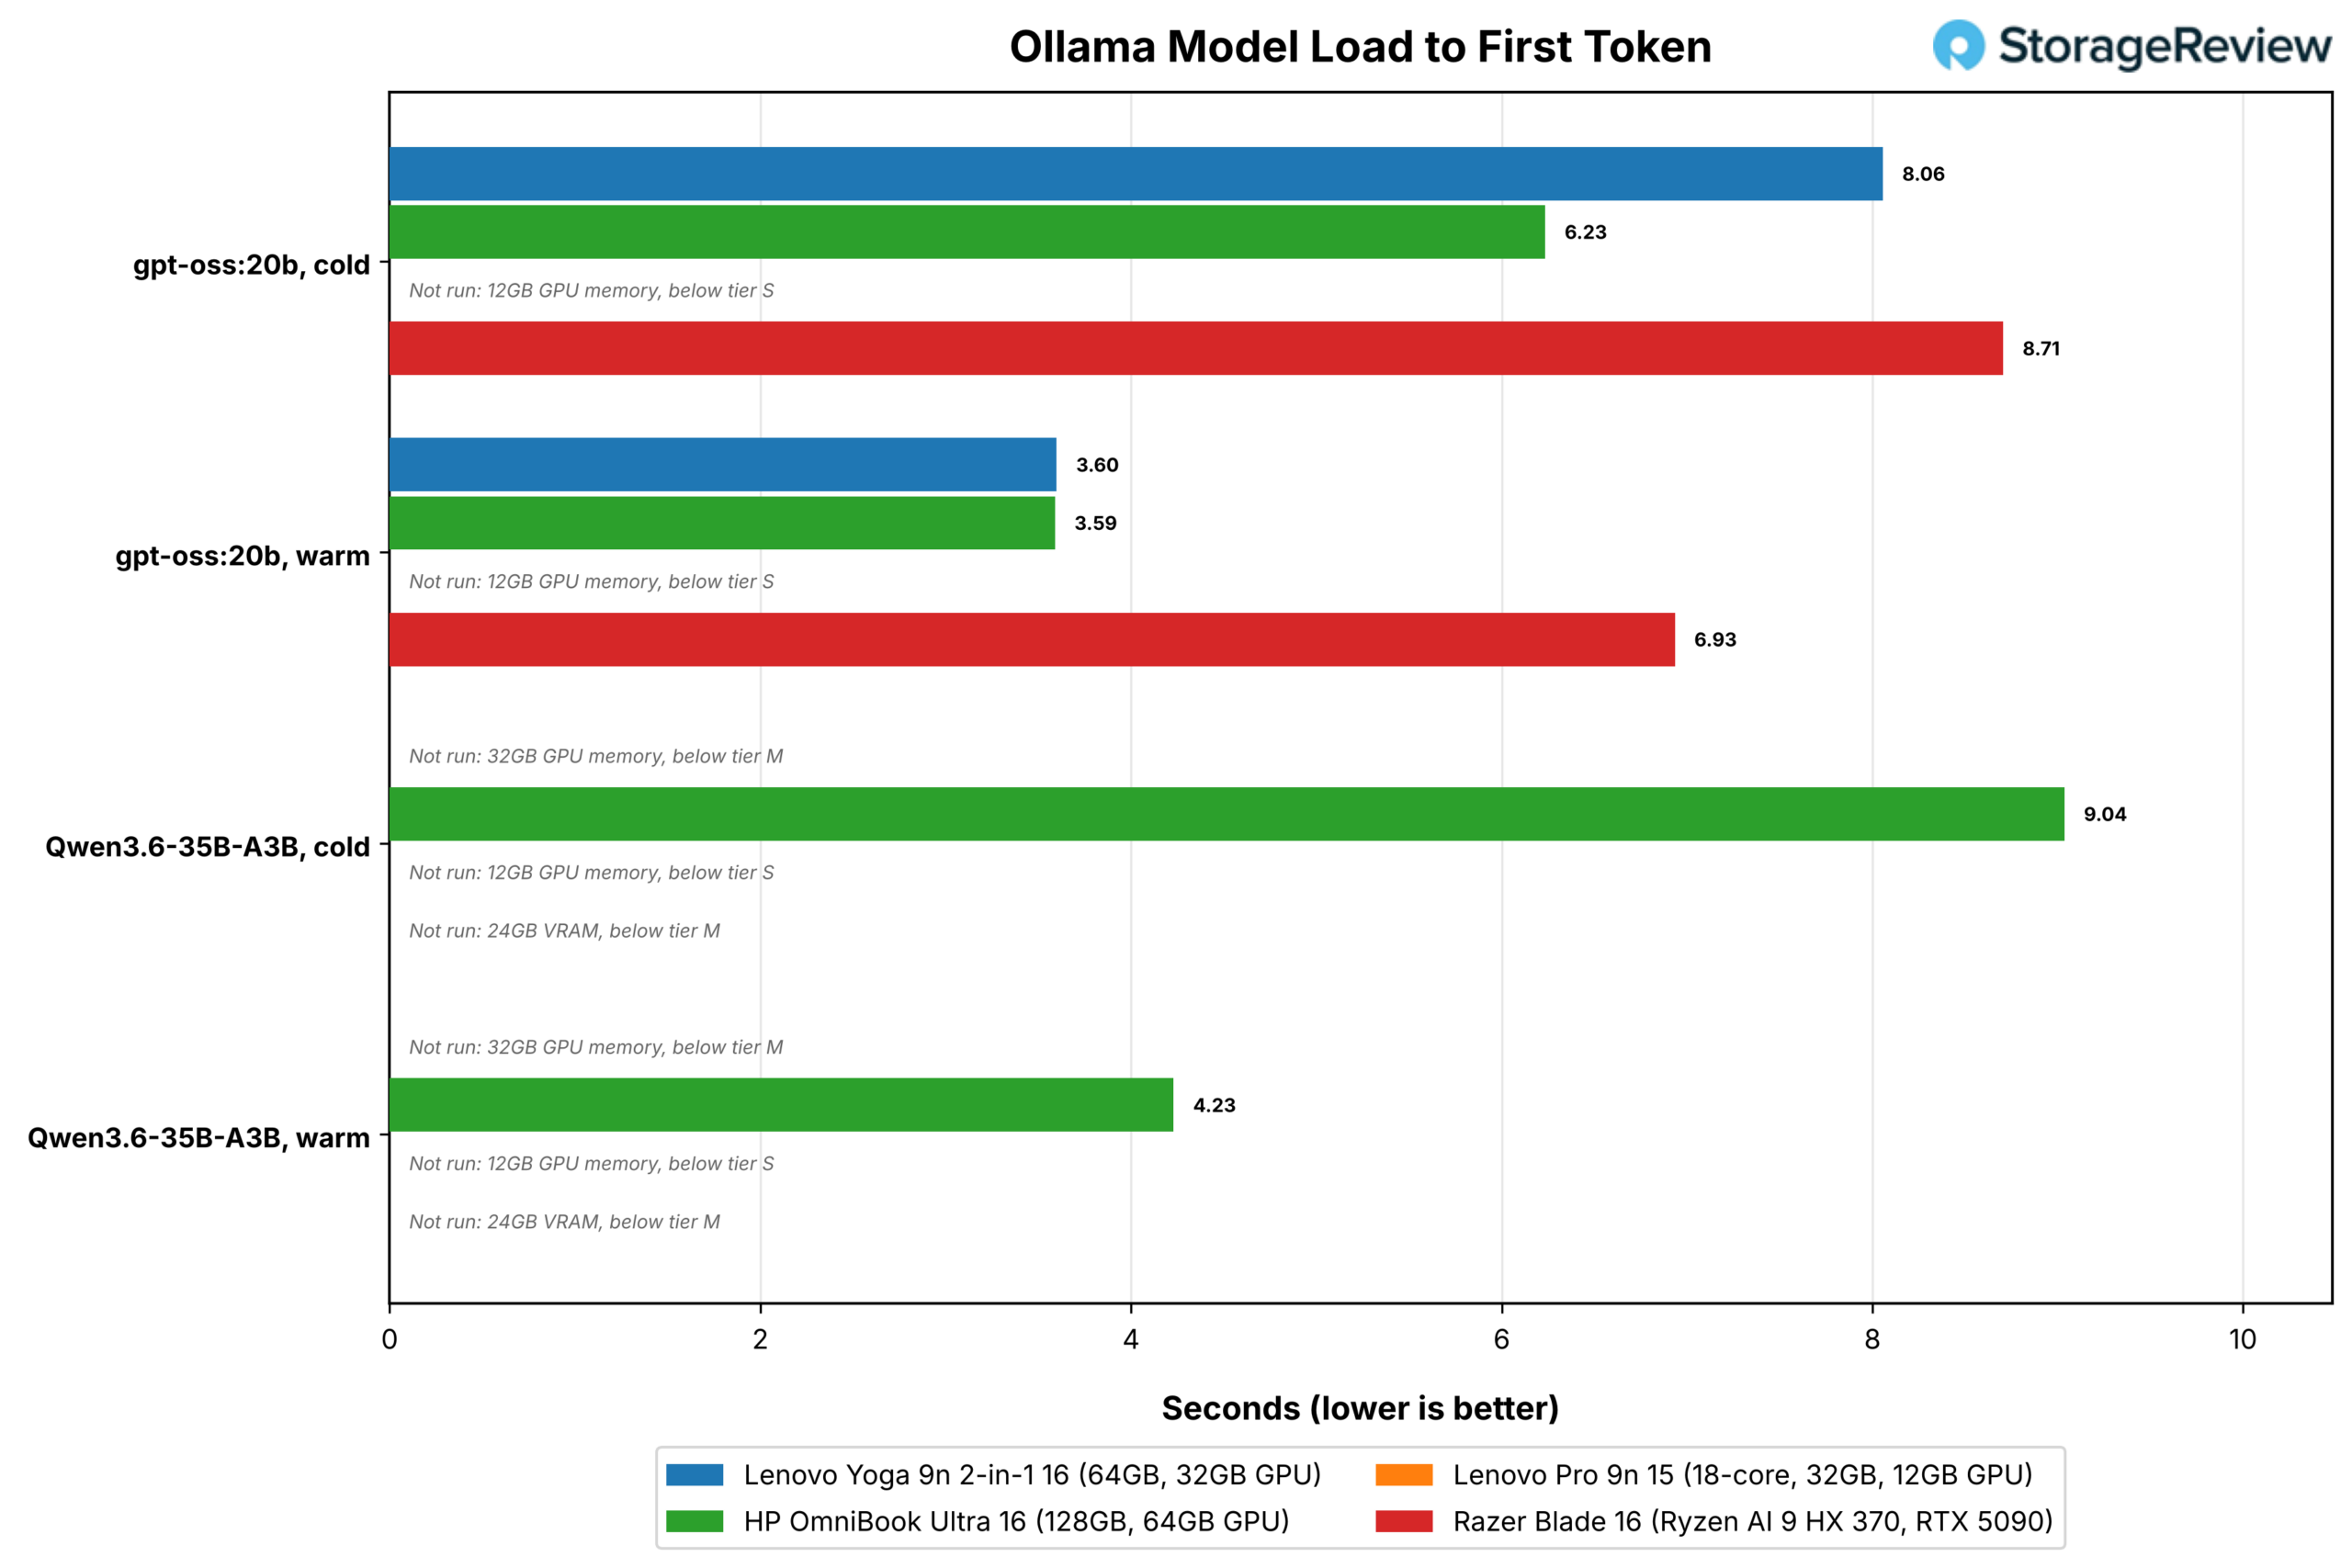
このテストでは、Ollama のローカル モデルが SSD から最初のトークンを生成するまでの時間を、コールド (ファイル キャッシュがフラッシュされた状態) とウォーム (ファイルが既にメモリにロードされている状態) で計測し、コールド ロード中に SSD がどれだけ速く読み込まれたかを報告します。ティア S では、GPU で使用可能なメモリが 16GB 以上のシステムで gpt-oss:20b (12.8GB) を使用します。ティア M では、約 40GB 以上のシステムで Qwen3.6-35B-A3B (21.1GB) を追加します。
| モデルの読み込み(メモリマッピング有効) | ヨガ9n 2-in-1 16 | OmniBook Ultra 16 (128GB) | プロ9n15 | Razerのブレード16 |
|---|---|---|---|---|
| gpt-oss:20b、最初のトークンへのコールドロード(s、数値が小さいほど良い) | 8.06 | 6.23 | 実行されません(GPUメモリ12GB) | 8.71 |
| gpt-oss:20b、最初のトークンをウォームロードします(s、数値が小さいほど良い) | 3.60 | 3.59 | 実行されません(GPUメモリ12GB) | 6.93 |
| gpt-oss:20b、コールドロード時の読み取りスループット(MB/秒) | 2,480 | 3,044 | 実行されません(GPUメモリ12GB) | 3,874 |
| Qwen3.6-35B-A3B、最初のトークンへのコールドロード(s、数値が小さいほど良い) | 動作しません(32GB GPUメモリ、ティアM未満) | 9.04 | 実行されません(GPUメモリ12GB) | 動作しません(24GB VRAM、ティアM未満) |
| Qwen3.6-35B-A3B、最初のトークンへのウォームロード(s、数値が小さいほど良い) | 動作しません(32GB GPUメモリ、ティアM未満) | 4.23 | 実行されません(GPUメモリ12GB) | 動作しません(24GB VRAM、ティアM未満) |
Yogaは、ウォーム状態では、gpt-oss:20bを最初のトークンまで3.60秒で取得し、OmniBookの3.59秒と同等のタイムを記録しました。コールド状態では、8.06秒かかり、6.23秒と差が開きました。これは、YogaのQLCドライブがロード中にモデルを2,480MB/sで読み取ったのに対し、OmniBookのGen5ドライブは3,044MB/sで読み取ったためです。Blade 16は、コールド状態でもウォーム状態でも8.71秒と6.93秒と最も遅く、これはウェイトが読み取られた後、PCIeを介してVRAMに移動する必要があるためです。
コーディングエージェント
Codex CLI は、Ollama が提供するローカル モデルを、固定リポジトリ内の固定コーディング タスクに通します。リポジトリの 11 個のテストがすべて合格すると、実行は成功となります。3 回の実行における平均実行時間、成功した回数、および生成率を報告します。エージェントとユーザーの同時実行テストでは、エージェントと Speedometer を同時に実行し、それぞれ単独で実行した場合と比較してどれだけ速度が低下するかを報告します。

| Codex CLI コーディングエージェント | ヨガ9n 2-in-1 16 | OmniBook Ultra 16 (128GB) | プロ9n15 | Razerのブレード16 |
|---|---|---|---|---|
| ティアS、gpt-oss:20b 64K: ウォールタイム(秒、数値が低いほど良い) | 132.5 | 115.3 | 実行されません(GPUメモリ12GB) | 64.4 |
| ティアS:成功(3件中) | 2 | 3 | 実行されません(GPUメモリ12GB) | 2 |
| ティアS:生成速度(tok/秒) | 58.0 | 58.0 | 実行されません(GPUメモリ12GB) | 137.9 |
| ティアM、gpt-oss:20b 128K: ウォールタイム(秒、数値が低いほど良い) | 動作しません(32GB GPUメモリ、ティアM未満) | 152.1 | 実行されません(GPUメモリ12GB) | 動作しません(24GB VRAM、ティアM未満) |
| ティアM、gpt-oss:20b 128K: 成功数(3件中) | 動作しません(32GB GPUメモリ、ティアM未満) | 3 | 実行されません(GPUメモリ12GB) | 動作しません(24GB VRAM、ティアM未満) |
| ティアM、Qwen3.6-35B-A3B 64K:ウォールタイム(秒、数値が低いほど良い) | 動作しません(32GB GPUメモリ、ティアM未満) | 72.0 | 実行されません(GPUメモリ12GB) | 動作しません(24GB VRAM、ティアM未満) |
| ティアM、Qwen3.6-35B-A3B 64K:成功(3回中) | 動作しません(32GB GPUメモリ、ティアM未満) | 3 | 実行されません(GPUメモリ12GB) | 動作しません(24GB VRAM、ティアM未満) |
| ティアM、Qwen3.6-35B-A3B 64K:生成速度(tok/秒) | 動作しません(32GB GPUメモリ、ティアM未満) | 89.5 | 実行されません(GPUメモリ12GB) | 動作しません(24GB VRAM、ティアM未満) |
| エージェント(スコア)の横にあるスピードメーター | 14.1 | 21.2 | 実行されません(GPUメモリ12GB) | 36.3 |
| エージェント横のスピードメーターの減速(x、数値が低いほど良い) | 2.44 | 1.73 | 実行されません(GPUメモリ12GB) | 1.06 |
| スピードメーター横のエージェント減速度(x、数値が低いほど良い) | 1.03 | 1.04 | 実行されません(GPUメモリ12GB) | 1.05 |
ティアSタスクでは、YogaはOmniBookと同じ毎秒58.0トークンを生成し、完了までに132.5秒かかり、HPの115.3秒より遅かった。3回の実行のうち2回は合格し、Blade 16と同じ結果だった。gpt-oss:20bはこのタスクを、テストした複数のシステムで3回に1回程度失敗するため、成功回数はハードウェアよりもモデルの特性を反映していると言える。Blade 16は毎秒137.9トークンで64.4秒で完了した。
同時実行性テストはYogaにとって最も厳しいものだった。エージェントが実行されると、YogaのSpeedometerスコアは36.1から14.1に低下し、2.44倍の速度低下となった。これは、専用GPU上で動作しCPUを使わないOmniBookの1.73倍、Blade 16の1.06倍と比較して顕著な差である。エージェント自体の速度低下はわずか3%だったため、Yogaは電力予算と共有メモリを巡って競合する場合、ブラウザよりもバックグラウンドジョブを優先する。
検索拡張生成
RAGテストでは、20,963個のSQuAD v1.1パッセージをnomic-embed-textで埋め込み、2,000問それぞれについて上位5つのパッセージを取得し、そのうち400問にPhi-4-miniで回答します。回答は、参照解答との完全一致率とF1スコアで評価されます。モデルはどのシステムでも動作するため、これは速度比較です。

| RAG | ヨガ9n 2-in-1 16 | OmniBook Ultra 16 (128GB) | プロ9n15 | Razerのブレード16 |
|---|---|---|---|---|
| 摂取壁時間:20,963回(秒、数値が低いほど良い) | 188.8 | 187.0 | 191.8 | 131.0 |
| 検索クエリ時間、p50(ミリ秒、数値が低いほど良い) | 22.6 | 23.3 | 24.2 | 20.9 |
| 回答、最初のトークンまでのPhi-4-mini時間、p50(秒、数値が小さいほど良い) | 0.181 | 0.155 | 0.171 | 0.109 |
| 回答、即時処理(tok/s) | 5,837 | 7,142 | 6,268 | 11,560 |
| 回答、生成速度(tok/秒) | 91.1 | 104.4 | 96.6 | 209.2 |
| 質問への回答、p50(数値が低いほど良い) | 0.262 | 0.227 | 0.252 | 0.159 |
| 回答 F1 (%) | 73.97 | 73.97 | 74.27 | 74.47 |
Yogaは、データ取り込み(188.8秒対187.0秒)とデータ取得ではOmniBookと同等でしたが、回答処理では劣っていました。Phi-4-miniは、プロンプトを毎秒5,837トークン処理したのに対し、OmniBookは7,142トークン処理し、生成速度は91.1対104.4でした。一般的な質問に対する回答時間は、クエリから回答まで0.262秒で、HPの0.227秒、Blade 16の0.159秒とほぼ同じでした。YogaとOmniBookの精度は同等でした。
CPUパフォーマンス
YogaのCPUの結果は、1つの法則に従います。シングルスレッドではOmniBookと同等ですが、すべてのコアでは劣ります。シングルスレッドの行はHPの約2%以内の差に収まり、Yogaは、ここに挙げたRTX Sparkシステムの中で最高の7-Zipシングルスレッド、PyPerformance go、regex_compileの結果を記録しました。マルチスレッドの行は2~28%遅れており、そのほとんどは4~10%の範囲ですが、StockfishとOpenBLASでは最も大きな差があります。Razer Blade 16と比較すると、Yogaはレンダリング、圧縮、コンパイルで依然として勝っています。
Cinebench 2026と持続負荷
Cinebench 2026は、CPU上でMaxonのRedshiftエンジンを使用してシーンをレンダリングし、シングルコア、SMTシングルコア(1つの物理コアで2つのスレッドを実行)、およびマルチコアのスループットを測定します。その後、マルチコア実行を約30分間繰り返す持続ループを実行し、定常状態を最初の実行結果と比較します。

| Cinebench 2026(ポイント、数値が高いほど性能が良い) | ヨガ9n 2-in-1 16 | OmniBook Ultra 16 (128GB) | プロ9n15 | Razerのブレード16 |
|---|---|---|---|---|
| シングルコア | 557.0 | 558.6 | 518.2 | 480.0 |
| SMTシングルコア | 無し | 無し | 無し | 661.3 |
| マルチコア | 6,292 | 7,004 | 6,394 | 5,179 |
| 持続ループ、1回目の通過 | 6,248 | 6,954 | 6,346 | 5,162 |
| 持続ループ、定常状態 | 6,256 | 6,942 | 6,416 | 5,206 |
| 定常状態/初回通過 | 1.001 | 0.998 | 1.011 | 1.009 |
Yogaのマルチコアスコアは6,292で、OmniBookの7,004より10%低く、18コアのPro 9nより2%低く、Blade 16より22%高く、シングルコアスコアはHPと同じ557.0でした。持続ループはここで最も平坦で、6,256の定常状態は最初のパスの100.1%で、CPUは72℃、3,015MHzでずっと維持されました。
7-Zip、Blender、HandBrake、およびLLVM
7-Zipの内蔵ベンチマークは、各スレッドおよび1つのコアにおけるLZMA圧縮および解凍のスループットを報告します。Blender 4.5は、CPU上でCyclesを使用してMonster、Junkshop、およびClassroomシーンをレンダリングします。HandBrakeは、x265とSVT-AV1を使用して4K60クリップの60秒をソフトウェアでエンコードし、LLVMテストはClangとNinjaを使用してLLVM 21.1.4ツリー全体をコンパイルします。

| 7-Zip、シングルスレッド(GIPS、数値が高いほど良い) | ヨガ9n 2-in-1 16 | OmniBook Ultra 16 (128GB) | プロ9n15 | Razerのブレード16 |
|---|---|---|---|---|
| トータル | 9.12 | 9.09 | 8.93 | 9.24 |
| 圧縮する | 7.35 | 7.31 | 7.26 | 7.28 |
| 圧縮解除する | 10.88 | 10.87 | 10.59 | 11.20 |


7-Zipでは、Yogaは全スレッドで145.3 GIPSを記録し、OmniBookより4%低く、Blade 16より15%高い結果となった。また、5スレッドでの合計9.12 GIPSは、RTX Spark搭載システムの中で最高だった。Blenderでは、MonsterとClassroomでHPに5%劣り、LLVMビルドは206.6秒に対し217.2秒と、Blade 16より34%短い時間で完了した。
HandBrakeのx265エンコードは38.6fpsで、OmniBookより6%遅い結果となった。SVT-AV1はRTX Spark搭載システムでは約15fpsだったのに対し、Blade 16では77.3fpsを記録しており、SVT-AV1のArm64コードパスがボトルネックとなっていることが示唆される。
Stockfish、Primesieve、Python、そしてブラウザ
Stockfishは、チェスの検索速度を1秒あたり数百万ノード単位で報告します。primesieveは、すべてのスレッドで10^12以下の素数を、1つのスレッドで10^11以下の素数をカウントします。PyPerformanceは、1つの高速コアに固定された3つのCPythonベンチマークを実行し、Speedometer 3.1はMicrosoft EdgeでのWebアプリケーションの応答性を測定します。最後の2行は、Prismエミュレーションで7-Zipのx64ビルドを実行します。
| ホイール試乗 | ヨガ9n 2-in-1 16 | OmniBook Ultra 16 (128GB) | プロ9n15 | Razerのブレード16 |
|---|---|---|---|---|
| Stockfishベンチ、全スレッド(Mnps、数値が高いほど良い) | 13.42 | 16.28 | 15.20 | 17.96 |
| Stockfishベンチ、スレッド1つ(Mnps、数値が高いほど良い) | 1.72 | 1.73 | 1.70 | 2.04 |
| primesieve 1e12、全スレッド(s、数値が小さいほど良い) | 10.77 | 9.57 | 10.56 | 10.60 |
| プライムシーブ 1e11、スレッド1つ(s、数値が低いほど良い) | 12.01 | 12.03 | 12.34 | 6.67 |
| PyPerformance 実行時間 (ミリ秒、数値が低いほど良い) | 110.6 | 111.2 | 114.1 | 75.2 |
| PyPerformance nbody (ミリ秒、数値が低いほど良い) | 80.5 | 80.4 | 82.5 | 60.8 |
| PyPerformance regex_compile (ミリ秒、数値が小さいほど良い) | 84.3 | 84.6 | 86.7 | 69.7 |
| スピードメーター 3.1、エッジ(スコア、数値が高いほど良い) | 36.1 | 36.7 | 33.9 | 38.4 |
| x64 7-Zip エミュレーション、全スレッド (GIPS) | 124.3 | 127.0 | 117.6 | 該当なし(ネイティブx64) |
| エミュレーション環境下のx64 7-Zip、シングルスレッド(GIPS) | 8.25 | 8.26 | 7.94 | 該当なし(ネイティブx64) |
Stockfishはクロックの差を最も明確に示しています。すべてのスレッドで、Yogaは13.42 Mnpsの検索速度を記録し、OmniBookと18コアのPro 9nの15.20 Mnpsに18%劣っていましたが、1つのスレッドでは約1.7 Mnpsで両者と同等でした。StockfishはYogaを3,057MHz、71℃で動作させましたが、HPは3,269MHz、98℃で動作しました。つまり、Yogaはクロック速度を約6%犠牲にし、温度を約27℃低く抑えていることになります。
シングルスレッドの行では、RTX Spark システムの中で Yoga が優位で、PyPerformance の実行時間は 110.6 ms と最速、Speedometer スコアは 36.1 でしたが、Python、primesieve、Stockfish、および browser の行では Blade 16 がリードし、シングルスレッドの primesieve を 12.01 秒に対して 6.67 秒で完了しました。7-Zip の x64 ビルドは、エミュレーションで 124.3 GIPS で実行され、ネイティブ結果の 86 パーセントでした。
GROMACS、OpenBLAS、およびメモリ
GROMACSは、16コアでbenchMEM分子動力学シミュレーションを実行し、最適な構成における1日あたりのシミュレーション時間をナノ秒単位で報告します。OpenBLASテストでは、3つの問題サイズでHPLスタイルの倍精度LU分解とDGEMM行列乗算を、全コアおよび最上位コアクラスのみで実行します。これは、スイートの中で最も負荷の高い浮動小数点演算です。STREAMは持続的なメモリ帯域幅を測定し、レイテンシの行は、単一アクセス時のメモリレイテンシとコア間レイテンシを測定します。
| テスト(数値が高いほど良い) | ヨガ9n 2-in-1 16 | OmniBook Ultra 16 (128GB) | プロ9n15 | Razerのブレード16 |
|---|---|---|---|---|
| GROMACS benchMEM、最適なレイアウト(ns/日) | 17.15 | 17.47 | 16.88 | 26.41 |
| OpenBLAS LU N=10000、すべてのコア (GFLOPS) | 281.3 | 324.0 | 303.4 | 400.9 |
| OpenBLAS LU N=20000、すべてのコア (GFLOPS) | 298.6 | 329.6 | 318.1 | 454.4 |
| OpenBLAS LU N=40000、すべてのコア (GFLOPS) | 282.5 | 348.8 | 実行不可(11.9GB必要) | 498.5 |
| OpenBLAS LU N=20000、最高コアクラス(GFLOPS) | 273.2 | 380.5 | 403.8 | 240.4 |
| OpenBLAS DGEMM M=8000、全コア(GFLOPS) | 312.7 | 398.5 | 357.6 | 455.4 |
| OpenBLAS DGEMM M=8000、最高コアクラス(GFLOPS) | 346.7 | 488.7 | 448.3 | 252.4 |
GROMACSではRTX Sparkシステムとの差はわずかで、Yogaは17.15 ns/日でしたが、OpenBLASではレビューの中で最も大きな差が見られました。Yogaの全コアLUソルブはN=20000で298.6 GFLOPSに達し、OmniBookより9%低く、DGEMMは22%遅れていました。OmniBookが優位に立つ最上位コアクラスのみで実行した場合、Yogaはさらに差が開き、380.5 GFLOPSに対して273.2 GFLOPSでした。Yogaは、64GB構成で実行可能なメモリを備えたN=40000を含むすべてのサイズを、85℃を超える温度で完了しました。

| ホイール試乗 | ヨガ9n 2-in-1 16 | OmniBook Ultra 16 (128GB) | プロ9n15 | Razerのブレード16 |
|---|---|---|---|---|
| ストリームコピー(MB/秒、数値が高いほど良い) | 118,738 | 130,790 | 127,682 | 43,731 |
| ストリームトライアド(MB/s、数値が高いほど良い) | 112,067 | 122,260 | 120,272 | 48,298 |
| メモリレイテンシ、1GiBバッファ、4KiBページ(ナノ秒、数値が小さいほど良い) | 141.8 | 143.1 | 143.4 | 129.6 |
| コア間レイテンシ、全ペアの平均値(ns、数値が小さいほど良好) | 162.8 | 156.8 | 160.6 | 57.0 |
STREAM TriadはYogaで112,067MB/sに達し、OmniBookより8%低く、Blade 16の2.3倍となったため、Yogaの低いクロック周波数はメモリサブシステムにも影響を与えていることがわかる。メモリレイテンシは141.8 nsで、ここで紹介したRTX Sparkシステムの中で最も低く、コア間レイテンシは162.8 nsで、プラットフォームの標準値とほぼ一致している。
ゲームおよびGPUエンコーディング
SuperTuxKart 1.5 は、内蔵ベンチマークを 1080p フルスクリーン、最高プリセット、垂直同期オフで実行します。1 回はゲームのネイティブ Arm64 ビルドで、もう 1 回はエミュレーションによる x64 ビルドで実行します。FFmpeg は、同じ 4K60 クリップを NVENC HEVC 8Mbps でエンコードし、利用可能な場合は Media Foundation HEVC エンコーダーも使用します。

| テスト(数値が高いほど良い) | ヨガ9n 2-in-1 16 | OmniBook Ultra 16 (128GB) | プロ9n15 | Razerのブレード16 |
|---|---|---|---|---|
| SuperTuxKart 1080p Ultra、ネイティブ、平均(fps) | 216.4 | 225.9 | 218.4 | 200.0 |
| SuperTuxKart 1080p Ultra、ネイティブ、安定(fps) | 131 | 143 | 140 | 115 |
| SuperTuxKart 1080p Ultra、x64 エミュレーション下、平均 (fps) | 186.8 | 266.5 | 248.6 | 該当なし(ネイティブx64) |
| SuperTuxKart 1080p Ultra、x64 エミュレーション下、安定した (fps) | 93 | 141 | 94 | 該当なし(ネイティブx64) |
| FFmpeg NVENC HEVC、4K60fps、8Mbps(フレームレート) | 139 | 138 | 139 | 132 |
| FFmpeg Media Foundation HEVC (fps) | 65 | 66 | 55 | 無し |
Yoga はネイティブ ビルドで平均 216.4 fps を記録し、OmniBook より 4% 低く、Pro 9n より 1% 以内の差で、Blade 16 の 200.0 を上回りました。これは、1080p では、ここに挙げたすべてのシステムで CPU がフレーム レートを決定するためです。 1 つの結果が際立っています。Yoga の x64 ビルドはエミュレーションで平均 186.8 fps を記録し、ネイティブ ビルドより遅くなりましたが、OmniBook と Pro 9n はエミュレーション ビルドを高速に実行したため、このテストを再実行して確認します。ハードウェア エンコードは、Yoga の NVENC HEVC で 139 fps を記録し、全体的に同等でした。
サーマル
Yogaは、これまでテストしたどのRTX Sparkノートブックよりも低温で動作しました。CPUテスト全体を通して、最高温度はStockfishでの71℃からHandBrakeでの86℃まででしたが、OmniBookでは同じテストすべてで98℃でした。また、30分間の連続ループでの平均温度は70℃で、HPの98℃よりも低くなっています。RTX SparkシステムはWindowsのサーマルゾーンを通してのみCPU温度を報告しますが、YogaのゾーンはHPが報告するセンサーと同じではない可能性があります。しかし、クロック周波数と電力特性から、この差の大部分は妥当であることがわかります。
| CPU温度、最大値/平均値(℃) | ヨガ9n 2-in-1 16 | OmniBook Ultra 16 (128GB) | プロ9n15 | Razerのブレード16 |
|---|---|---|---|---|
| Cinebench 2026 | 72 / 65 | 98 / 83 | 92 / 70 | 96 / 78 |
| 7-Zip | 76 / 62 | 98 / 78 | 83 / 63 | 99 / 84 |
| 干し魚 | 71 / 69 | 98 / 97 | 88 / 83 | 92 / 90 |
| ブレンダー | 80 / 75 | 98 / 96 | 91 / 80 | 95 / 87 |
| ハンドブレーキ | 86 / 71 | 98 / 86 | 93 / 74 | 92 / 86 |
| LLVMビルド | 81 / 75 | 98 / 92 | 87 / 79 | 98 / 93 |
| GROMACS | 84 / 81 | 98 / 96 | 89 / 85 | 97 / 94 |
| OpenBLAS | 85 / 74 | 98 / 95 | 92 / 83 | 91 / 87 |
| STREAM | 64 / 59 | 98 / 96 | 78 / 66 | 75 / 71 |
| スーパータックスカート | 68 / 62 | 95 / 82 | 74 / 68 | 89 / 82 |
| MLPerfクライアント | 72 / 60 | 93 / 84 | 76 / 66 | 97 / 76 |
| コーディングエージェント | 71 / 67 | 90 / 79 | 実行しない | 91 / 84 |
| RAG | 84 / 75 | 94 / 90 | 76 / 71 | 88 / 83 |
| 持続ループ | 72 / 70 | 98 / 98 | 92 / 87 | 94 / 90 |
冷却性能の向上に伴い、全コアのクロック周波数は低下しています。持続ループテストでは、Yogaは3,015MHzで動作しましたが、OmniBookは3,239MHz、Pro 9nは3,288MHzでした。このクロック周波数の差が、Yogaのマルチスレッド性能の劣勢の主な原因となっています。LenovoはYogaの消費電力を70Wとしていますが、これはHPがOmniBookに与えている数値と同じです。そのため、この差は消費電力の削減というよりも、温度と騒音に関するチューニング上の選択によるものと考えられます。
Yogaはスロットリングを行いません。これまでテストしたすべてのRTX Sparkシステムと同様に、負荷がかかっている間はクロック周波数を一定に保ち、同じテストでOmniBookが到達した98℃よりも12~27℃低い温度で動作します。
| 平均CPUクロック周波数(MHz) | ヨガ9n 2-in-1 16 | OmniBook Ultra 16 (128GB) | プロ9n15 | Razerのブレード16 |
|---|---|---|---|---|
| Cinebench 2026 | 2,799 | 2,962 | 2,951 | 4,158 |
| 7-Zip | 2,722 | 2,838 | 2,849 | 4,014 |
| 干し魚 | 3,057 | 3,269 | 3,292 | 3,645 |
| ブレンダー | 3,111 | 3,123 | 3,216 | 3,729 |
| ハンドブレーキ | 2,687 | 2,756 | 2,834 | 3,814 |
| LLVMビルド | 3,083 | 3,151 | 3,197 | 3,697 |
| GROMACS | 3,226 | 3,308 | 3,367 | 3,874 |
| OpenBLAS | 2,890 | 3,024 | 3,192 | 4,274 |
| STREAM | 3,077 | 3,258 | 3,101 | 3,684 |
| スーパータックスカート | 2,002 | 1,957 | 2,017 | 4,349 |
| MLPerfクライアント | 1,935 | 2,114 | 2,027 | 3,593 |
| コーディングエージェント | 1,945 | 2,078 | 実行しない | 3,789 |
| RAG | 2,707 | 2,749 | 2,760 | 3,764 |
| 持続ループ | 3,015 | 3,239 | 3,288 | 3,726 |
タブレットのように手に持ったり、膝の上に置いたりすることが多いノートパソコンにとって、このトレードオフは理にかなっています。30分間のレンダリング中に72℃で動作する16インチのコンバーチブルは、98℃に固定されるマシンとは全く異なるマシンであり、レンダリングとコンパイルのコストは数パーセントしか変わりません。YogaのSSDは、ストレージテスト中に最高67℃を記録しました。
貯蔵性能
ストレージテストでは、fioの4つのコーナーをブートドライブに対して5GBと25GBのフットプリントで実行し、ファイルシステムとrawデバイスの両方でテストを行い、ここでは25GBの結果を報告します。rawデバイスの行はNTFSとBitLockerをバイパスするため、両者の差はドライブの能力のうちWindowsのI/Oパスを通過する部分がどれだけ残っているかを示しています。BitLocker保護はYogaとPro 9nでは無効、OmniBookでは有効になっています。


| fio、25GBのフットプリント、QD32 | ヨガ9n 2-in-1 16 | OmniBook Ultra 16 (128GB) | プロ9n15 | Razerのブレード16 |
|---|---|---|---|---|
| シーケンシャル読み取り 128K、ファイルシステム (MB/秒) | 6,874 | 13,833 | 7,024 | 7,125 |
| シーケンシャル読み取り 128K、生デバイス (MB/秒) | 6,975 | 12,479 | 7,165 | 7,134 |
| シーケンシャル書き込み速度 128K (MB/秒) | 5,905 | 11,719 | 5,699 | 5,250 |
| ランダム読み取り 4K、ファイルシステム、ピーク (IOPS) | 394,468 | 437,833 | 338,936 | 694,597 |
| ランダム読み取り4K、デバイス生データ、ピーク値(IOPS) | 765,766 | 1,888,501 | 973,106 | 993,050 |
| ランダム書き込み4K、ピーク値(IOPS) | 68,923 | 228,354 | 192,000 | 648,446 |
| 生データ/ファイルシステムランダム読み取り | 1.94x | 4.31x | 2.87x | 1.43x |
| ランダム読み取り4K、4ジョブ、p99レイテンシ(米国、数値が低いほど良い) | 522 | 643 | 578 | 444 |
| ランダム書き込み4K、4ジョブ、p99レイテンシ(米国、数値が低いほど良い) | 12,255 | 586 | 758 | 371 |
| 駆動温度、最大(℃) | 67 | 52 | 78 | 60 |
LenovoはこのYogaの構成にPCIe Gen4 QLC M.2 2242ドライブを搭載しており、私たちのユニットには1TBのSandisk SN5100Sが搭載されています。シーケンシャル読み取り速度は6,874MB/s、書き込み速度は5,905MB/sで、Pro 9nとBlade 16のGen4ドライブと同等、OmniBookのGen5ドライブの約半分です。BitLocker保護をオフにすると、ファイルシステムのランダム読み取りは394.5K IOPSとなり、デバイスの生の765.8Kの52%を保持し、OmniBookよりもはるかに少ない損失となりました。
ランダム書き込みはドライブの弱点であり、SN5100S は 25GB フットプリントで 4K ランダム書き込みの IOPS が最大 68.9K で、Pro 9n の 192.0K の約 3 分の 1、Blade 16 の 10 分の 1 であり、4 つのジョブでの p99 書き込みレイテンシは 12.3 ms で、他のシステムでは 1 ms 未満でした。5GB フットプリントでは、同じテストがパスごとに大きく変動し、部分的とマークされているため、再実行します。QLC ドライブは日常的な使用やモデルの読み込みには十分ですが、この構成では最初に交換するコンポーネントです。
結論
Lenovo Yoga 9n 2-in-1 16は、テストしたRTX Spark搭載ノートPCの中で最も発熱が少なく、唯一のコンバーチブル型ノートPCです。Lenovo独自の熱設計により、通気口の拡大、サーマルバンプの隆起、空気の流れを確保したヒンジなどにより、N1Xは全コア負荷時でも71~86℃に抑えられ、HP OmniBook Ultra 16が98℃に達したのに対し、Yogaは30分間クロック周波数を低下させることなく維持しました。2.8K OLEDディスプレイ、ペン対応のForce Pad、回転式サウンドバー、99.9Whバッテリーを搭載したこのノートPCは、新しいRTX Sparkグループの中で最も完成度の高いクリエイティブノートPCと言えるでしょう。

その快適さの代償は、最大ポテンシャルよりもわずか数パーセント低いパフォーマンスです。Yogaの全コアクロックはOmniBookよりも最大で約220MHz低く、マルチスレッドの結果はほとんどのテストで4〜10パーセント遅れており、StockfishとOpenBLASではさらに大きな差があります。シングルスレッドではHPと同等で、GPU作業では約4〜18パーセント遅れています。32GBのGPU分割により、ティアSモデルはフルスピードで動作しますが、ティアMモデルはそうではなく、QLC SSDはグループ内で最も弱いランダム書き込みを記録しました。
他のすべてのSparkと同様に、プラットフォーム上の注意点がここにも当てはまります。具体的には、Windows on ArmのI/Oパス、x64ビルドに遅れをとるSVT-AV1などのArm64ポート、そしてコーディングエージェントの実行中にブラウザの動作を2.44倍遅くする共有メモリバスなどが挙げられます。これらのユニットの出荷開始に伴い、ソフトウェアエコシステムが急速に発展していくことを期待しています。
ペン、タブレットモード、OLEDディスプレイに加え、ローカルAIと20コアCPUを求めるクリエイターにとって、Yoga 9n 2-in-1はRTX Sparkプラットフォームのパフォーマンスをほとんど損なうことなく、はるかに低温で動作します。全コア処理能力の最後の10%を重視する購入者や、ティアMモデルを検討している場合は、128GB版を選ぶべきでしょう。

リーダーボード: Lenovo Yoga 9n 2-in-1 16は、ローカルAIに最適なノートパソコンのリーダーボードにおいて、最も発熱の少ないRTX Spark搭載ノートパソコンの座を獲得しています。



 Amazon