

Microsoft Surface Laptop Ultra for Businessは、NVIDIA製シリコンを搭載した初のSurfaceノートパソコンであり、当社がレビューする初のRTX Sparkシステムです。今回レビューしたユニットには、20コアのGrace Arm CPU、6,144コアのBlackwell RTX GPU、128GBのLPDDR5X統合メモリというフルチップが搭載されており、ユーザーは最大96GBをGPUに割り当てることができます。Microsoftの一般消費者向けストアでは、18コア、24GB、512GB SSDモデルの2,599.99ドルから、20コア、128GB、1TBモデルの5,899.99ドルまでの構成が掲載されています。今回のレビュー時点では、ビジネス構成の価格は確認できませんでした。
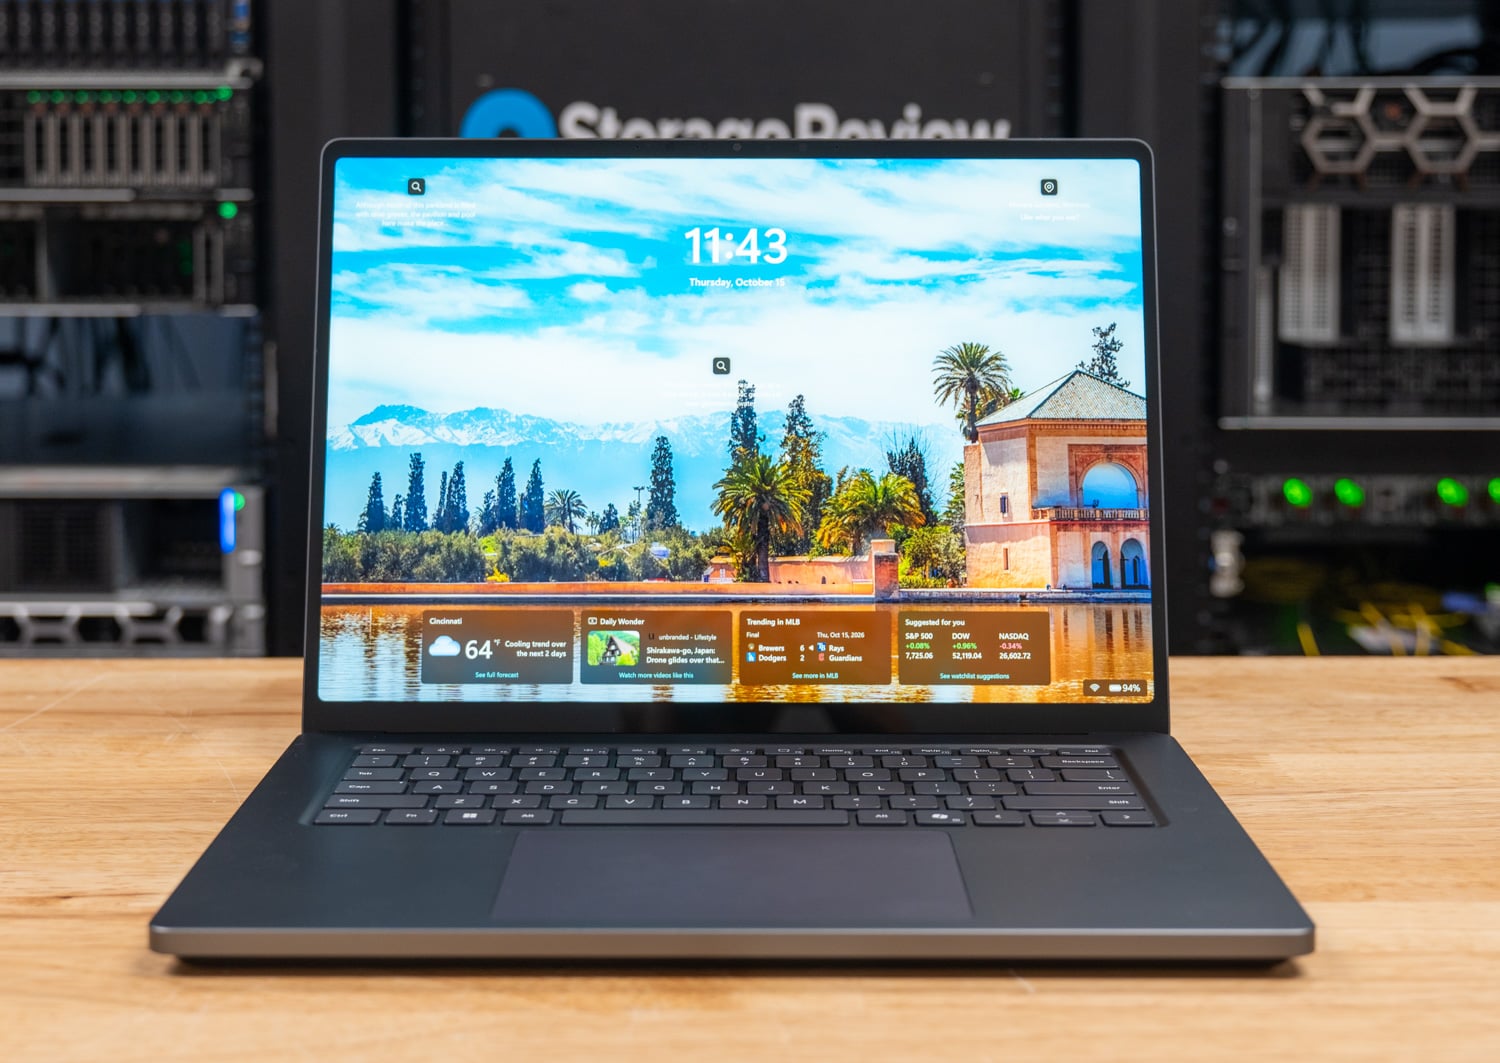
本レビューでは、N1Xのベンチマーク性能(ローカルAI、CPU、メモリ、ゲーム、熱性能、ストレージ)を、Intel Panther LakeおよびArrow Lake H、AMD Strix Point、NVIDIAのRTX 5090およびRTX PRO 2000ノートPC用GPUを搭載した現行のx64ノートPC4機種と比較検証します。デザイン、ディスプレイ、キーボード、バッテリー駆動時間、その他のハードウェアに関する印象は、ラボでの筐体テストが完了次第、後日改めてお伝えしますので、ここではプラットフォームと性能数値についてのみご紹介します。
20コアのN1Xは、グループ内のほぼすべてのマルチスレッドCPUテストで30%以上の差をつけて勝利し、NVIDIA GPUに64GBのメモリを割り当てることが可能で、これはこれまでのNVIDIAノートPC用GPUの中で最大容量であり、35Bパラメータのモデルを実用的な速度で実行できる。とはいえ、全コアによる倍精度演算を長時間実行したところ、一晩でこのノートPCの電力が3回も低下した。以前のレビュー機も同様の不具合を起こし、交換が必要になったため、熱管理のセクションは通常よりも重要だ。
主要なポイント(要点)
- 64GBのGPUメモリ(最大96GBまで拡張可能)により、実行できる内容が変わります。 gpt-oss:20bとQwen3.6-35B-A3Bはどちらも毎秒58~89トークンの速度でロードおよび生成します。Blade 16のRTX 5090は、24GBのメモリを搭載し、より大型のモデルを除くすべてのアプリケーションで2.3倍高速です。
- グループ内で最速のマルチコアCPU: Cinebench 2026マルチコアで6,963を記録し、Razer Blade 16より34%、Dell Pro Precision 5 16Sより47%高いスコアを獲得。LLVMのコンパイル時間は、次に速いシステムの327秒に対し、206秒だった。
- 122GB/秒のメモリ帯域幅を実現するが、レイテンシが増加する。 STREAM Triadは122,114MB/sの速度を達成し、Precision 5 16Sよりも48%高速でしたが、メモリレイテンシは251ナノ秒、コア間レイテンシは172ナノ秒と、グループ内で最悪であり、シングルスレッド処理で顕著に現れます。
- 1つの作業負荷で電力が遮断される: 10月14日、N=20000での全コアOpenBLAS LUソルバー処理中に、チップが他のテストで31分間98℃を維持した後、95℃で3回電源が切れた。これで2台のSurface Laptop Ultraが同様の故障を起こしたことになる。ログの証拠は、熱ではなく、電源供給またはファームウェアの保護機能に問題があることを示唆している。
- Windows on Arm はランダム I/O を制限します: Gen5 SK hynix ドライブは、生のデバイスからシーケンシャル読み取りで 14.1GB/s、IOPS 1.67M を実現していますが、NTFS と BitLocker を介した 4K ランダム I/O では 300K IOPS 付近で停止し、x64 システムの半分以下となっています。
RTX Spark N1Xプラットフォーム
RTX Sparkは、NVIDIAがN1Xスーパーチップをベースに開発したWindows PCファミリーの名称で、DGX Sparkに搭載されているGB10のノートPC版およびコンパクトデスクトップ版にあたります。 6月のComputexでこのファミリーを取り上げ、先週の予約販売で発売の詳細をお伝えしましたので、このセクションでは結果を理解する上で重要な点について解説します。

NVIDIAはノートPC向けN1Xを2種類提供しています。上位モデルは20コアのGrace CPUと6,144コアのBlackwell RTX GPU、最大128GBのLPDDR5Xを搭載し、下位モデルは18コアのCPUと5,120コアのGPUを搭載し、最大64GBのメモリを搭載しています。どちらもCPUとGPUを合わせたTDPは45~80Wで、デスクトップ版N1XとGB10の140Wと比べて低くなっています。今回テストしたSurfaceには20コアのCPUが搭載されており、Windowsでは10個の高速コアと10個の効率コアとして表示され、SMTは利用できません。
このプラットフォームを今回のレビュー対象である他のx64ノートパソコンと一線を画すのはメモリです。128GBのLPDDR5-9400メモリプールがNVLink-C2Cを介してチップの2つの部分に供給され、256ビットインターフェースでは9,400MT/sの速度が約300GB/sの理論帯域幅に相当します。Windowsはこれを、固定の専用割り当てと共有プールを持つ独立したカードのように認識します。
弊社のテスト機では、分割設定を64/64にしました。計測結果では、GPUで使用可能なメモリ容量は62.5GBで、これは弊社のローカルAIモデルティアの両方に該当します。LPDDR5Xの容量はNVIDIAアプリでユーザーが調整できますが、当然ながらシステム購入時に選択した合計容量に制限されます。そのため、同じ大容量モデルをメモリに搭載できない場合、32GBまたは48GBのSurfaceではAIベンチマークで同じ結果が得られません。
GPUは、第5世代Tensorコアと第4世代RTコア、第9世代NVENCと第6世代NVDECをそれぞれ1つずつ搭載したBlackwellで、NVIDIAの通常の「最大1ペタフロップ」のFP4演算能力を備えています。Microsoftの注釈では、これはスパース性を考慮した理論上のFP4 TOPSと説明されています。このレビューにおけるNVIDIA側のテストはすべて、出荷時のドライババージョン32.0.16.1742を使用して、ネイティブArm64ビルドのllama.cppとOllamaを介してCUDA上で実行されました。
Windowsはプラットフォームのもう一方の重要な要素です。SurfaceはArm64上でWindows 11 Pro 26H1を実行するため、x64アプリケーションはPrismエミュレーションを介して実行されます。また、CPUの結果が変換レイヤーではなくシリコンレベルで比較されるように、クライアントスイート全体をネイティブArm64バイナリで構築しました。ネイティブArm64ポートが未成熟な場合、またはx64ビルドしか選択肢がない場合は、結果にその旨を示します。これは、これらのケースによって以下の行のいくつかが決定されるためです。
Microsoft Surface Laptop Ultra for Businessの仕様

| 製品仕様 | Microsoft Surface Laptop Ultra for Business |
|---|---|
| プラットフォームの概要 | |
| プロセッサ | NVIDIA RTX Spark N1X、20コアGrace CPUと6,144コアBlackwell RTX GPU(テスト時) NVIDIA RTX Spark N1X、18コアGrace CPU、5,120コアBlackwell RTX GPU |
| NPU | NVIDIA NPU |
| メモリ | 24GB、32GB、48GB、64GB、または128GBのLPDDR5X統合メモリ 128GB LPDDR5-9400、ファームウェア分割64/64GB(テスト時) |
| Storage | 着脱式SSD:512GB(PCIe Gen4)、1TBまたは2TB(PCIe Gen5) 1TB SK hynix HFS001TFM9X189N、Gen5 x4(テスト済み) |
| オペレーティングシステム | Windows 11 Pro (Arm64)、24GB構成ではWindows 11 Homeがインストールされている。 |
| ディスプレイとI/O | |
| ディスプレイ | 15インチPixelSense Ultraタッチスクリーン、解像度3270 x 2180、最大120Hz、DCI-P3 100%、Dolby Vision IQ SDR(標準値)1,000ニト、HDR(ピーク値)2,000ニト(マイクロソフト社発表値) |
| ポート | USB-C / USB4ポート×2 マグネット接続対応USB-C / USB4ポート×1 1x HDMI 2.1b 1X USB-A 3.1 SDカードリーダー 3.5mmヘッドフォンジャック |
| 無線 | Wi-Fi 7 (MediaTek MT7925)、Bluetooth |
| カメラ | 1080pフルHD |
| パワーと身体 | |
| バッテリー駆動時間(マイクロソフトの主張) | 最大15時間のローカルビデオ再生 最大12時間のウェブ利用 (試作機、20コア、64GBメモリ、1TBストレージ、輝度150ニト) |
| 充電 | USB-Cポート搭載。115W以上のSurfaceまたはUSB-C PD対応電源で高速充電が可能。 |
| 重量 | 4.41ポンド(2.0 kg)を |
| 色 | プラチナ、ナイトフォール |
| セキュリティと価格 | |
| セキュリティ | セキュアコアPC、Windows Hello、デバイス暗号化(当方の端末ではBitLocker XTS-AES-128を使用) |
| 価格(マイクロソフト消費者向けストア) | 価格帯:2,599.99ドル(18コア、24GBメモリ、512GBストレージ)~5,899.99ドル(20コア、128GBメモリ、1TBストレージ、テスト機) |


テストのセットアップと方法論
今回レビューしたユニットは、6,144コアのBlackwell GPUを搭載したRTX Spark N1X、システムとGPUに64/64で分割された128GBのLPDDR5-9400メモリ、そして1TBのSK hynix Gen5 SSDを搭載し、Windows 11 Pro 26H1(Arm64)上で動作しています。ベンチマークテストは、最高のパフォーマンス電源モードで電源接続した状態で実施しました。バッテリー駆動時間のテスト結果は、後日、その他のハードウェアに関する感想とともに掲載予定です。

今回の比較対象となったすべてのシステムは、スクリプト化されたWindowsクライアントベンチマークスイートであるsr-client 1.2を、フル実行とピークプロファイルの両方で実行しました。各システムは、OEMのドライバとユーティリティがインストール済みの工場出荷時のWindowsイメージ上で、ベンダーの最高パフォーマンスモードに設定され、電源に接続された状態でテストされました。このスイートでは、Windowsの電源モードを「最高パフォーマンス」、ディスプレイの輝度を50%、スリープタイマーとディスプレイオフタイマーをすべて無効にし、WindowsファイアウォールとUACプロンプトを無効にした、同じラボ設定が適用されます。実行は最初から最後まで無人で行われ、各結果は複数回の実行の中央値です。また、スイートは、ばらつきが2%を超えるテストを再実行してから結果を受け入れます。
このスイートは、すべてのオープンソースワークロードに対してネイティブのArm64およびx64バイナリで記述されているため、Surfaceはシリコン上で競合できる性能を発揮します。
| システム | CPU | メモリ | GPUとAIのテストに使用されるGPU | SSD | OSとパフォーマンスモード |
|---|---|---|---|---|---|
| Microsoft Surface Laptop Ultra | NVIDIA RTX Spark N1X、20コア/20スレッド | 128GB LPDDR5-9400(64/64分割) | 6,144コアのBlackwell RTX(統合型、使用可能メモリ62.5GB) | SK hynix HFS001TFM9X 1TB、Gen5 x4 | Windows 11 Pro 26H1 (Arm64)、最高のパフォーマンス |
| Dell Pro Precision 5 16S | Intel Core Ultra X9 388H、16コア/16スレッド | 64GB LPDDR5-8533 | Intel Arc Pro B390(統合型) | SK hynix PCB01 1TB、Gen5 x4 | Windows 11 Pro 25H2 (x64)、Dell Optimizer Ultra Performance |
| Dell Pro 7 14 | AMD Ryzen AI 9 HX PRO 470、12コア/24スレッド | 64GB LPDDR5-8000 | AMD Radeon 890M(統合型、32GB VGM) | Samsung BM9C1a 1TB、第4世代 x4 | Windows 11 Pro 25H2 (x64)、Dellサーマルプロファイルパフォーマンス |
| Razerのブレード16 | AMD Ryzen AI 9 HX 370、12コア/24スレッド | 32GB LPDDR5-8000 | NVIDIA GeForce RTX 5090 ノートパソコン用GPU、24GB | Samsung MZVL22T0 2TB、Gen4 x4 | Windows 11 Home 25H2 (x64)、Razer Synapse Performance |
| Dell Pro Max 14 プレミアム | Intel Core Ultra 9 285H、16コア/16スレッド | 64GB LPDDR5-8400 | NVIDIA RTX PRO 2000 Blackwell ノートパソコン用GPU、8GB | SKハイニックス PC811 2TB | Windows 11 Pro 25H2 (x64)、Dell Optimizer Ultra Performance |
表には3つのラベルが繰り返し登場しますが、最初の2つの違いはAIセクションを読む上で重要です。DNFは、そのシステムでテストが開始されたものの完了しなかった、または失敗後にスキップされたことを意味し、このレビューではSurfaceのOpenBLAS実行とDell Pro 7 14のエージェント型MLPerfシナリオに該当します。
「実行されません」とは、ハードウェアが要件を満たしていないため、テストスイートがテストを開始しなかったことを意味します。これは多くの場合、モデルがシステムで提供できるGPUメモリ容量を超えているためです。Dell Pro Max 14 Premiumは使用可能なGPUメモリが7.7GBであるため、すべてのモデルロードおよびエージェントテストから除外され、Blade 16は24GBであるため、ティアMモデルを下回っています。「N/A」は、SMT非対応のチップ上のSMTシングルコアなど、テストが適用されないことを意味します。
ローカルAIパフォーマンス
これらのノートPCにおけるローカルAIの性能は、GPUがモデルをどれだけ高速に実行できるか、そしてそもそもモデルがGPUに収まるかどうかという2つの点に集約されます。Blade 16のRTX 5090は、24GBのメモリに収まるすべてのモデルにおいて、Surfaceの約2.3倍の速度でトークンを生成するため、最初の点では他の追随を許しません。一方、Surfaceは64GBの統合メモリをGPUに割り当てているため、実用的な速度でティアMモデルを実行できる唯一のシステムであり、2つ目の点ではSurfaceが優れています。
Pro Max 14に搭載されている8GBのRTX PRO 2000は、小型モデルではSurfaceに匹敵する性能を発揮するが、大型モデルでは容量不足となる。また、2つの統合型GPU x64システムでも、動作は遅いものの、あらゆる処理を実行できる。
MLPerfクライアントv2.0
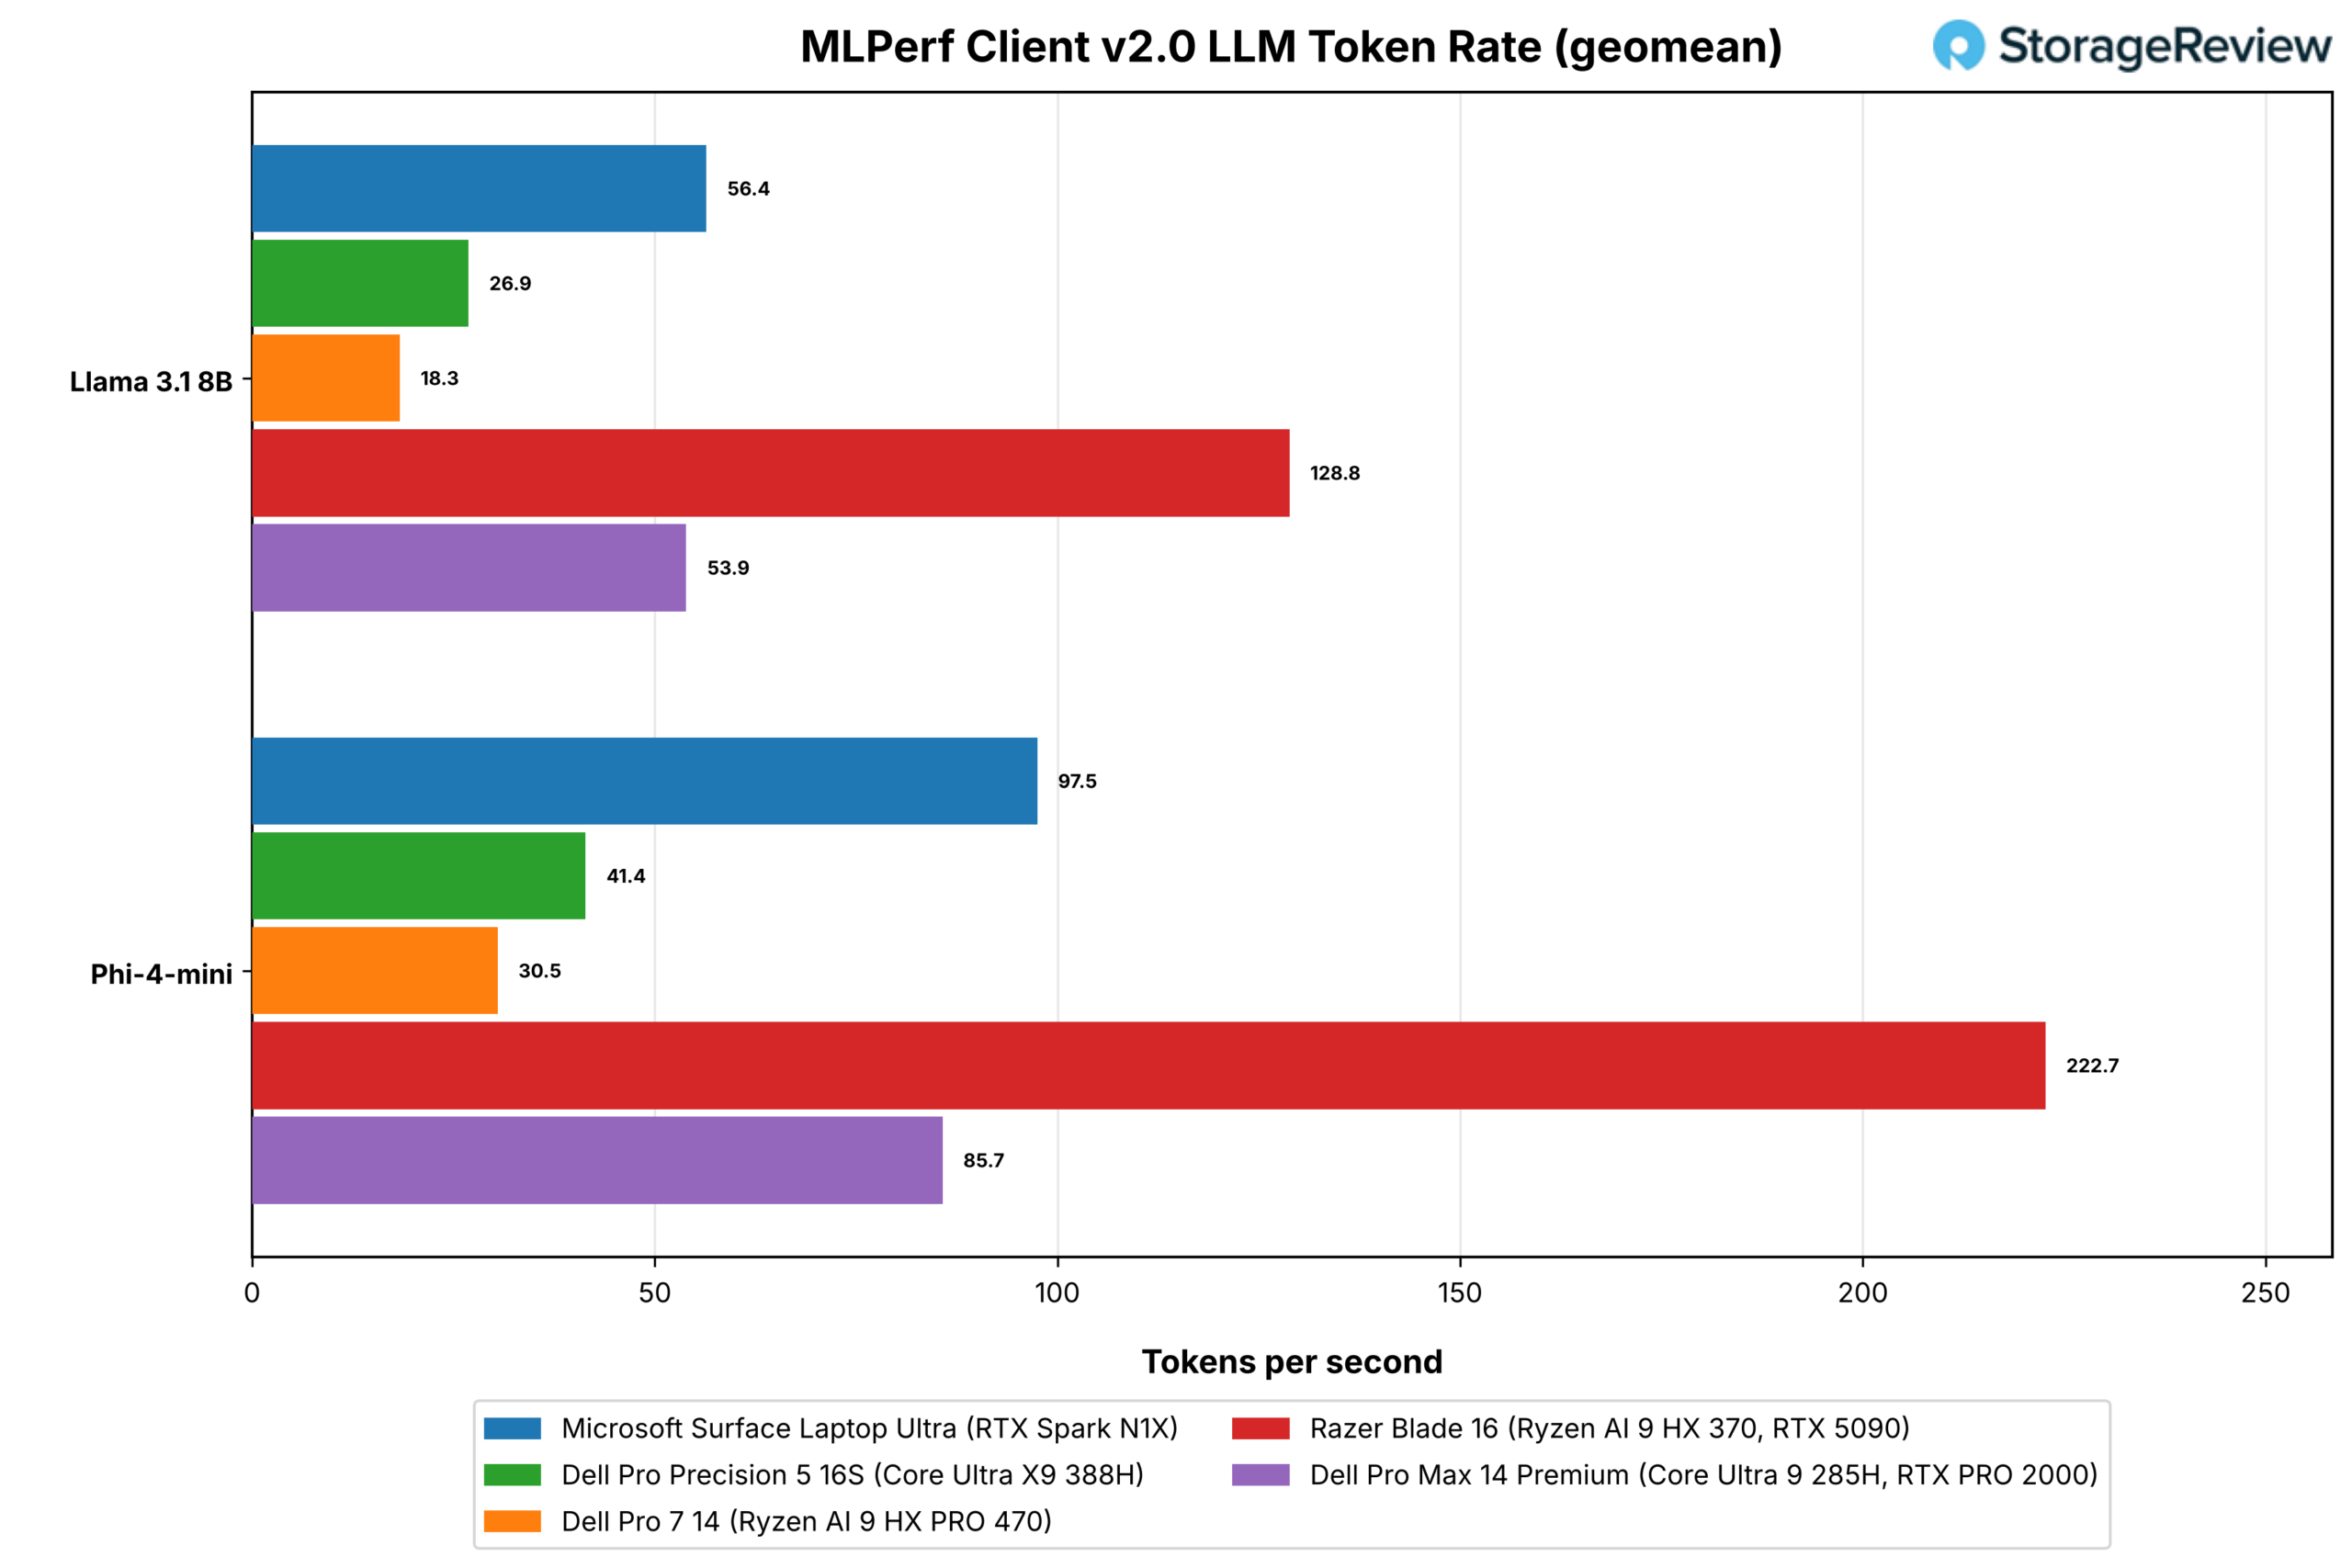
MLPerf Client は、Llama 3.1 8B と Phi-4-mini を 5 つのプロンプト カテゴリ (コンテンツ生成、クリエイティブ ライティング、要約、構造化テキスト、コード分析) で実行し、最初のトークンまでの時間と最初のトークン以降のトークン レートをそれらの幾何平均として報告します。各システムはベンダーの GPU パスを使用します。Precision 5 16S では Intel OpenVINO、Pro 7 14 では AMD の Windows ML と DirectML、3 つの NVIDIA システムでは llama.cpp と CUDA を使用するため、エンジンが異なり、行は出荷時のプラットフォームを比較しています。
| MLPerfクライアントv2.0 | Surface Laptop Ultra | Dell Pro Precision 5 16S | Dell Pro 7 14 | Razerのブレード16 | Dell Pro Max 14 プレミアム |
|---|---|---|---|---|---|
| Llama 3.1 8B、最初のトークン取得までの時間、幾何平均(秒、値が小さいほど良い) | 0.284 | 0.214 | 3.140 | 0.149 | 0.439 |
| Phi-4-mini、最初のトークンまでの時間、幾何平均(s、値が小さいほど良い) | 0.127 | 0.181 | 1.954 | 0.074 | 0.212 |
| データアナリストエージェント、エンドツーエンド(s、数値が低いほど良い) | 52.6 | 84.7 | リタイア | 27.8 | 61.8 |
| データアナリストエージェント、トークンレート(tok/秒) | 48.9 | 25.6 | リタイア | 108.3 | 45.4 |
| SWEエージェント、エンドツーエンド(s、数値が小さいほど良い) | 46.0 | 65.6 | リタイア | 24.6 | 52.6 |
| SWEエージェント、トークンレート(tok/秒) | 46.4 | 25.0 | リタイア | 102.5 | 42.8 |
Blade 16 は、Llama 3.1 8B で 128.8 tok/s、Phi-4-mini で 222.7 tok/s を生成し、Surface の 56.4 と 97.5 の 2.3 倍となりました。Pro Max 14 の RTX PRO 2000 は、5090 の帯域幅のほんの一部しか持っていませんが、それでも Llama 3.1 では Surface の 5 パーセント以内、Phi-4-mini では 12 パーセント未満に収まりました。これは、このサイズのモデルでは N1X の統合 GPU が小型のディスクリート カードのように動作することを示唆しています。
統合型x64 GPUの中で、Precision 5 16SのArc Pro B390はLlama 3.1で最初のトークンを素早く生成したが、Surfaceのトークン生成速度の半分だった。また、Pro 7 14のDirectMLパスは最も遅く、最初のトークン生成に3.1秒かかった。
MLPerfのエージェントシナリオでは、Llama 3.1 8Bをソフトウェアエンジニアリングエージェントとデータアナリストエージェントとして実行し、それぞれが複数のターンにわたってツールを呼び出します。Blade 16は両方のシナリオを28秒未満で完了し、Surfaceの半分の時間、Precision 5 16Sの3分の1以下の時間でした。Pro 7 14はどちらのシナリオも完了しませんでした。DirectMLはGPU用に32GBのメモリを確保していたにもかかわらず、エージェントプロンプトでメモリ不足に陥り、実行に失敗したため、DNFとマークされました。
モデルのロード
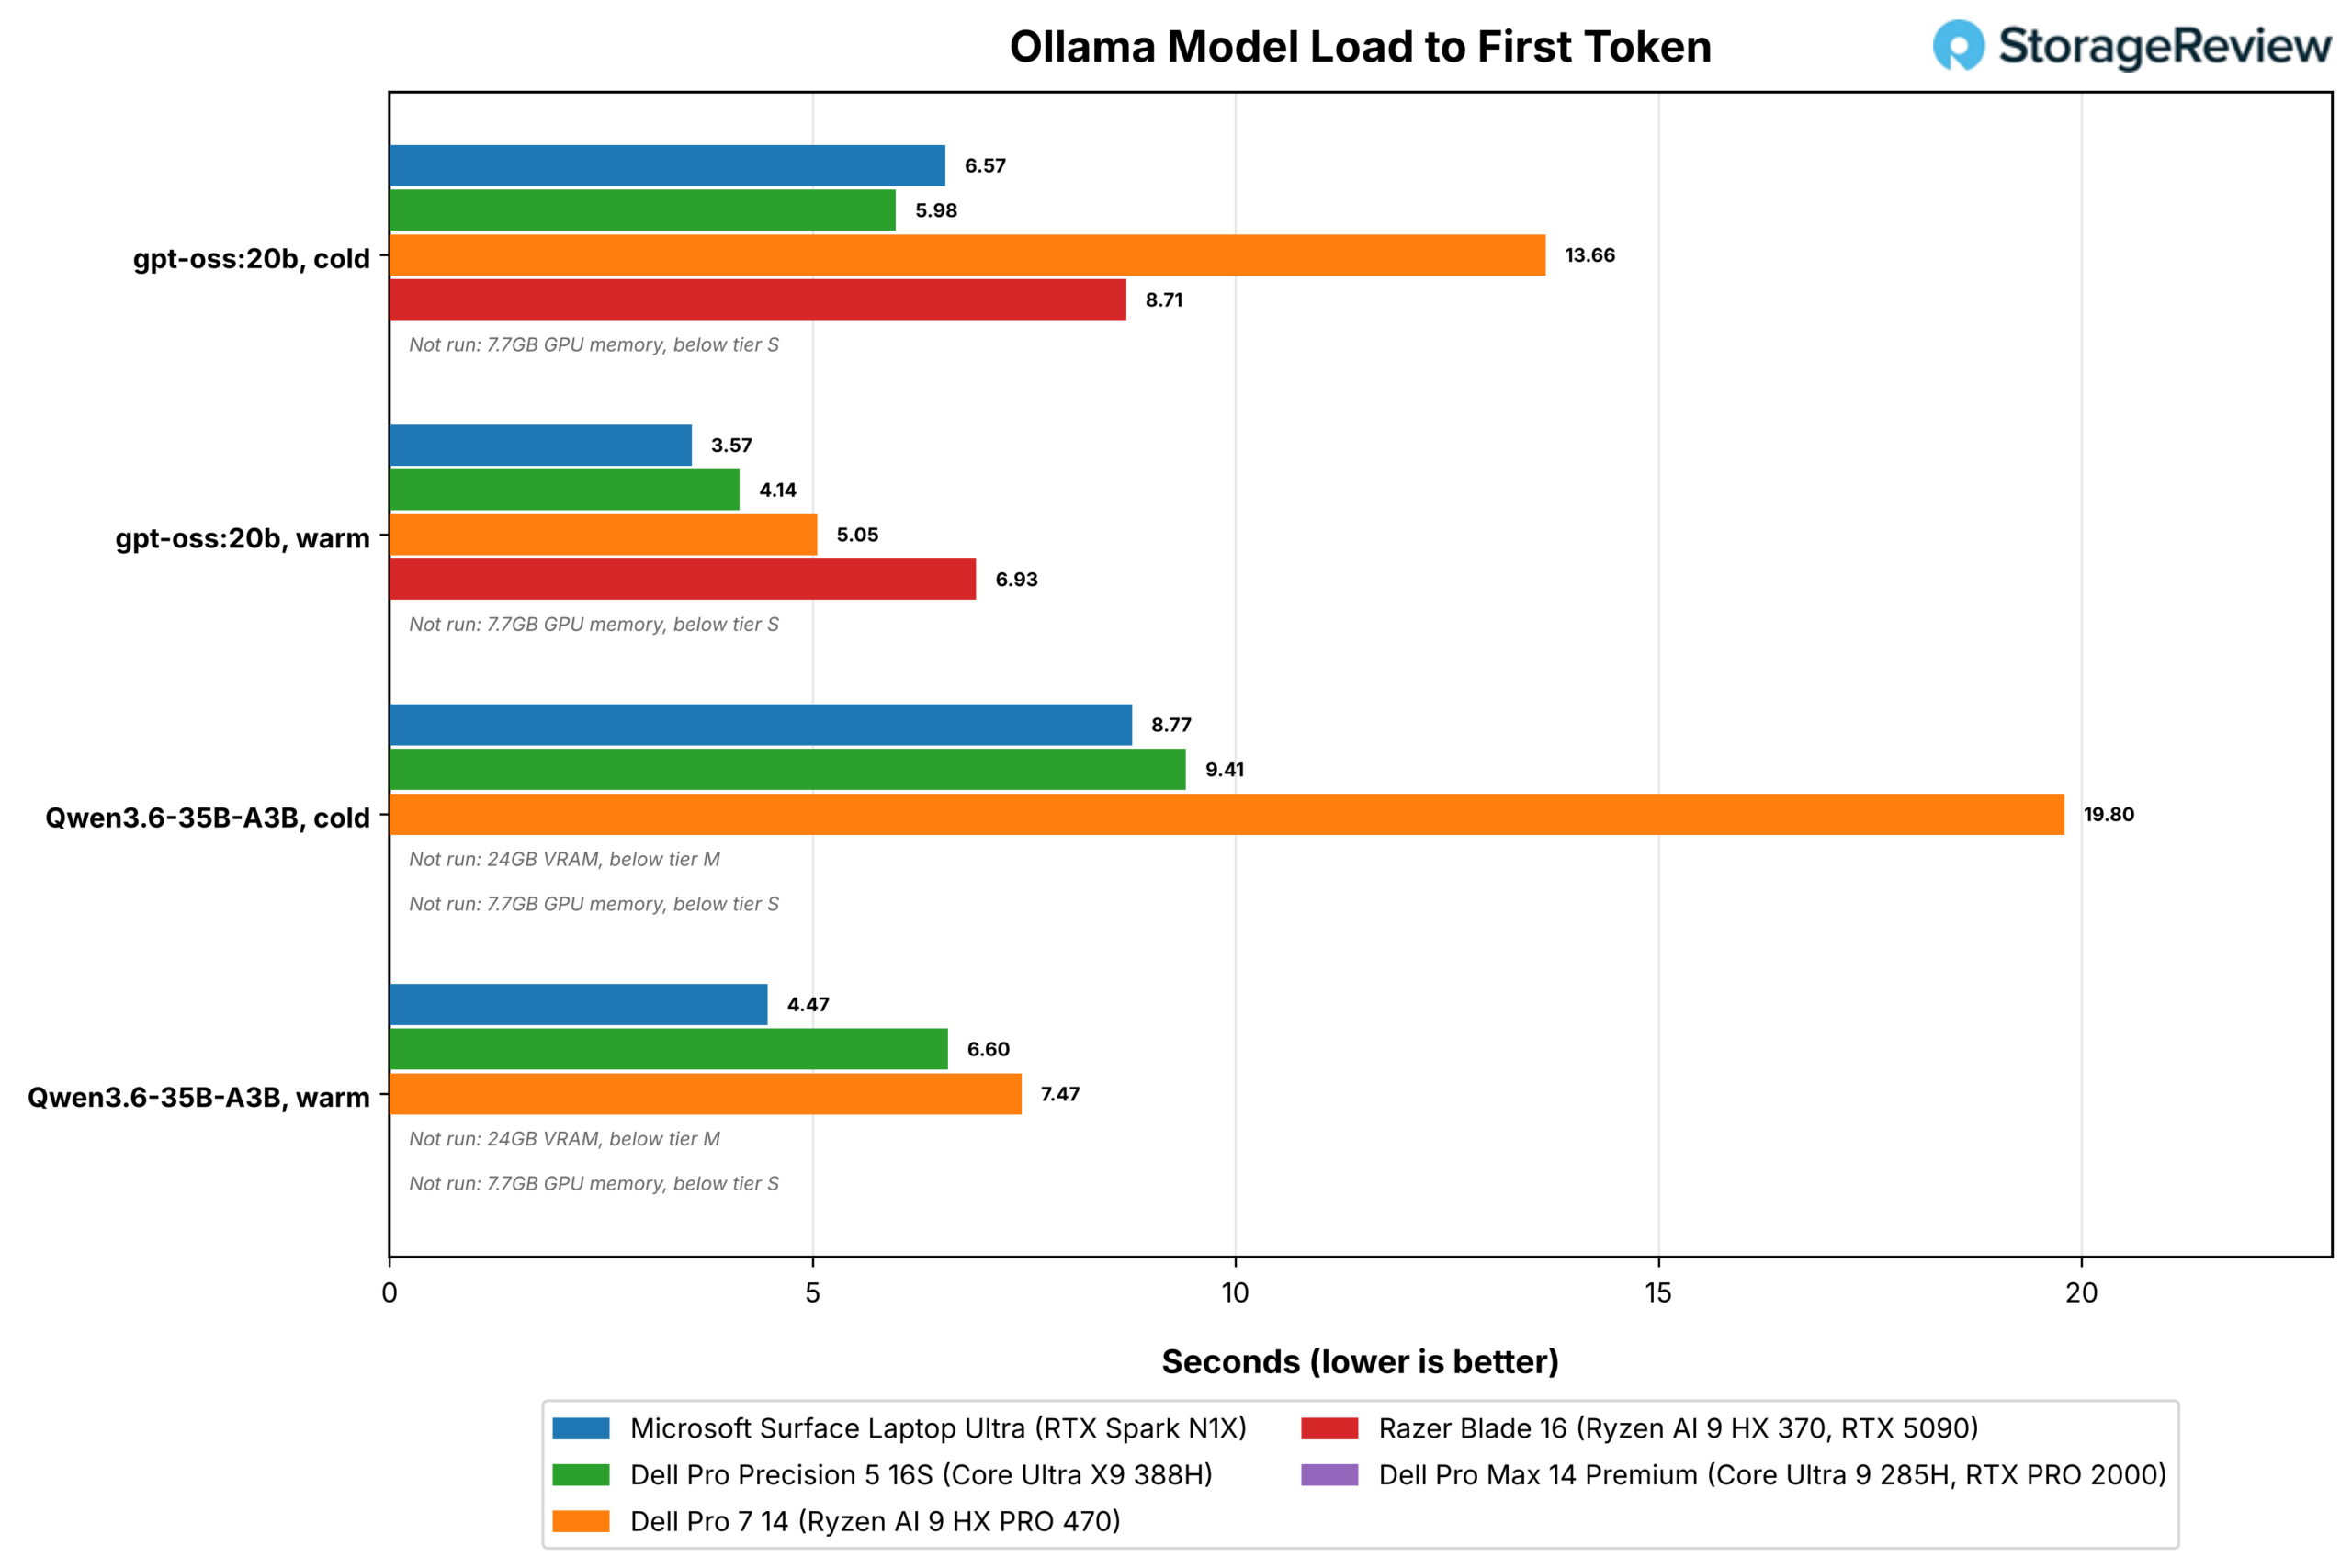
このテストでは、SSD から Ollama で最初に生成されたトークンまでのローカル モデルの実行時間を、コールド (ファイル キャッシュがフラッシュされた状態) とウォーム (ファイルが既にメモリにある状態) で計測し、その間に SSD がどれだけ速く読み込まれたかを報告します。ティア S では、GPU で使用可能なメモリが 16GB 以上のシステムで gpt-oss:20b (12.8GB) を使用します。ティア M では、約 40GB 以上のシステムで Qwen3.6-35B-A3B (21.1GB) を追加します。スワップ テストでは、Qwen3.6 をロードし、gpt-oss に切り替え、Qwen3.6 に戻るまでの時間を計測します。
| モデルの読み込み(メモリマッピング有効) | Surface Laptop Ultra | Dell Pro Precision 5 16S | Dell Pro 7 14 | Razerのブレード16 | Dell Pro Max 14 プレミアム |
|---|---|---|---|---|---|
| gpt-oss:20b、コールドロード時の読み取りスループット(MB/秒) | 3,080 | 3,251 | 1,246 | 3,874 | 実行されません(GPUメモリ7.7GB) |
| Qwen3.6-35B-A3B、モデル交換後に再読み込み(s、数値が低いほど良い) | 5.01 | 13.38 | 22.38 | 動作しません(24GB VRAM、ティアM未満) | 実行されません(GPUメモリ7.7GB) |
コールドロードはストレージテストであり、2 つの Gen5 システムがこれをリードしました。Precision 5 16S は gpt-oss:20b を最初のトークンまで 5.98 秒で取得し、Surface は 6.57 秒でした。Surface はすべてのウォームおよびティア M 行で勝利し、スワップ後の Qwen3.6 への復帰が 5.0 秒であるのに対し、Precision では 13.4 秒かかりました。これは、両方のモデルを 64GB の GPU メモリに常駐させておくことの利点です。Blade 16 はモデル ファイルを 3.9GB/s で最速で読み込みましたが、重みが PCIe を介して VRAM に移動する必要があるため、最初のトークンに到達するのが遅くなりました。統合メモリ システムでは、読み込まれた時点で重みが所定の位置に配置されます。
Blade 16とPro Max 14が欠落している行は、メモリの問題です。Blade 16は24GBのVRAMを搭載しているためティアMの要件を満たしておらず、Pro Max 14は使用可能なGPUメモリが7.7GBしかないためどのティアにも該当しないため、テストスイートではこれらの機種でテストが開始されませんでした。ストレージのセクションで書き込みの問題を取り上げているPro 7 14のSSDは、ここでは読み込み速度がわずか1.2GB/sで、コールドスタートで13.7秒かかりました。
コーディングエージェント
Codex CLI は、固定リポジトリ内の固定コーディングタスクを通じて、Ollama が提供するローカルモデルを実行します。リポジトリの 11 個のテストがすべて合格すると、実行は成功します。ここでは、3 回の実行の平均実行時間、成功した回数、および生成レートを報告します。エージェントとユーザーの同時実行テストでは、エージェントと Speedometer を同時に実行し、それぞれが単独で実行した場合と比較してどれだけ遅くなるかを報告します。これは、ユーザーが作業している間にエージェントが動作している場合に重要な問題です。

| Codex CLI コーディングエージェント | Surface Laptop Ultra | Dell Pro Precision 5 16S | Dell Pro 7 14 | Razerのブレード16 | Dell Pro Max 14 プレミアム |
|---|---|---|---|---|---|
| ティアS、gpt-oss:20b 64K: ウォールタイム(秒、数値が低いほど良い) | 191.8 | 584.2 | 376.0 | 64.4 | 実行されません(GPUメモリ7.7GB) |
| ティアS:成功(3件中) | 3 | 3 | 2 | 2 | 実行しない |
| ティアM、gpt-oss:20b 128K: ウォールタイム(秒、数値が低いほど良い) | 87.5 | 276.1 | 585.4 | 実行不可(ティアM未満) | 実行しない |
| ティアM、gpt-oss:20b 128K: 成功数(3件中) | 2 | 2 | 3 | 実行しない | 実行しない |
| ティアM、Qwen3.6-35B-A3B 64K:ウォールタイム(秒、数値が低いほど良い) | 88.6 | 351.7 | 678.2 | 実行不可(ティアM未満) | 実行しない |
| ティアM、Qwen3.6-35B-A3B 64K:成功(3回中) | 3 | 3 | 3 | 実行しない | 実行しない |
| エージェント(スコア)の横にあるスピードメーター | 18.1 | 26.6 | 19.2 | 36.3 | 実行しない |
| エージェント横のスピードメーターの減速(x、数値が低いほど良い) | 1.92 | 1.61 | 1.92 | 1.06 | 実行しない |
| スピードメーター横のエージェント減速度(x、数値が低いほど良い) | 1.10 | 1.00 | 1.11 | 1.05 | 実行しない |
Blade 16 は、ティア S タスクを 64 秒で 137.9 トーク/秒で完了し、Surface の 3 倍、Precision 5 16S の 9 倍の速さでしたが、Surface と Precision の 3 回の実行に対して、Blade は 2 回しか成功しませんでした。ティア M では、Surface は両方のタスクを 90 秒未満で完了し、Precision 5 16S の 3 ~ 4 倍、タスクごとに 10 ~ 11 分かかる Pro 7 14 の 7 ~ 8 倍の速さでした。実時間は、モデルが行うツール呼び出しの数にも依存するため、生成レートの方がハードウェアの数値としてより正確です。
並列処理テストは、ディスクリートGPUの真価が発揮される場面です。エージェントが実行されている場合、Blade 16のブラウザスコアは6%低下しました。これは、モデルがRTX 5090上で動作し、CPUには負荷がかからないためです。Surfaceでは、エージェントが統合GPUとメモリバスを他のすべてのコンポーネントと共有しているため、Speedometerは34.7から18.1へとほぼ半減し、Pro 7 14も同様に低下しました。エージェント自体は、どのシステムでもブラウザをほとんど認識しませんでした。
検索拡張生成
RAGテストでは、20,963個のSQuAD v1.1パッセージをnomic-embed-textで埋め込み、2,000問それぞれについて上位5つのパッセージを取得し、Phi-4-miniで解答します。そして、参照解答との完全一致率とF1スコアを算出します。同じ小型モデルがすべてのシステムで実行されるため、これは純粋な速度比較となります。

| RAG | Surface Laptop Ultra | Dell Pro Precision 5 16S | Dell Pro 7 14 | Razerのブレード16 | Dell Pro Max 14 プレミアム |
|---|---|---|---|---|---|
| 摂取壁時間:20,963回(秒、数値が低いほど良い) | 189.8 | 271.7 | 425.9 | 131.0 | 153.9 |
| 検索クエリ時間、p50(ミリ秒、数値が低いほど良い) | 23.4 | 22.2 | 31.3 | 20.9 | 21.6 |
| 回答、最初のトークンまでのPhi-4-mini時間、p50(秒、数値が小さいほど良い) | 0.161 | 0.855 | 1.527 | 0.109 | 0.260 |
| 回答、即時処理(tok/s) | 6,955 | 2,151 | 863 | 11,560 | 4,031 |
| 質問への回答、p50(数値が低いほど良い) | 0.235 | 0.997 | 1.688 | 0.159 | 0.341 |
| 回答 F1 (%) | 73.97 | 74.24 | 74.36 | 74.47 | 74.40 |
Blade 16 は 131 秒でコーパスを取り込み、典型的な質問に 0.16 秒で回答しました。これは Precision 5 16S の 6 倍の速さです。Pro Max 14 は 154 秒で取り込みで 2 位となり、Surface の 190 秒を上回りました。これは、埋め込みモデルと Phi-4-mini には 8GB で十分だからです。精度は、温度 0 で同じモデルを使用した場合と同様に、すべてのシステムで F1 の 0.5 ポイント以内で同一でした。したがって、RAG でこれらのノートブックを区別するのは、待ち時間だけです。
CPUパフォーマンス
CPUの性能は2つのプラットフォームによって大きく左右されます。Surfaceの20コアN1Xは、マルチスレッドテストでほぼすべてのテストで30%以上の差をつけて勝利する一方、Dell Pro Precision 5 16Sに搭載されているCore Ultra X9 388Hは、シングルスレッドで最速のx64 CPUであり、Python、ブラウザ、OpenBLASの処理でトップの性能を発揮します。この2つのプラットフォームの中で、Razer Blade 16のRyzen AI 9 HX 370はStockfishとGROMACSでトップに立ち、レンダリングとビルドのテストのほとんどで2位を獲得しています。また、Dell Pro 7 14とDell Pro Max 14 Premiumは、全コア処理で後塵を拝しています。
Cinebench 2026と持続負荷
Cinebench 2026は、CPU上でMaxonのRedshiftエンジンを使用してシーンをレンダリングし、シングルコア、SMTシングルコア(1つの物理コアで2つのスレッドを実行)、およびマルチコアのスループットを測定します。その後、マルチコア実行を約30分間繰り返す持続ループを実行し、定常状態のスコアを最初の実行結果と比較します。これにより、ノートPCが熱を吸収した後にどれだけ性能が向上するかが分かります。

Surface はマルチコアで 6,963 を記録し、Blade 16 を 34%、Precision 5 16S を 47% 上回り、シングルコアでは 558.5 対 534.8 で Precision をわずかに上回りました。シングルスレッドでは、2 つの AMD チップが劣り、Blade 16 は 480.0、Pro 7 14 は 464.4 で、Surface より 16% および 20% 低い結果となりました。SMT シングルコアはこれら 2 つにのみ適用され、2 番目のスレッドは Pro 7 14 で 33%、Blade 16 で 38% 向上します。
ループテストを継続的に実行した結果は、単純なスコアよりも各機種の性能差を明確に示しました。Surfaceは10回のテストを終えて7,016点を獲得し、開始時のスコアを1%上回りました。CPUはテスト中ずっと98℃、3.28GHzで安定していました。Blade 16も同様に安定したスコアを維持しました。Pro 7 14とPro Max 14は約2%スコアが低下し、Precision 5 16Sは約10分後に6.2%低下し、その後もそのスコアを維持しました。
| Cinebench 2026(ポイント、数値が高いほど性能が良い) | Surface Laptop Ultra | Dell Pro Precision 5 16S | Dell Pro 7 14 | Razerのブレード16 | Dell Pro Max 14 プレミアム |
|---|---|---|---|---|---|
| シングルコア | 558.5 | 534.8 | 464.4 | 480.0 | 482.6 |
| SMTシングルコア | 無し | 無し | 617.1 | 661.3 | 無し |
| マルチコア | 6,963 | 4,739 | 4,028 | 5,179 | 4,160 |
| 持続ループ、1回目の通過 | 6,938 | 4,765 | 4,040 | 5,162 | 4,314 |
| 持続ループ、定常状態 | 7,016 | 4,468 | 3,976 | 5,206 | 4,228 |
| 定常状態/初回通過 | 1.011 | 0.938 | 0.984 | 1.009 | 0.980 |
7-Zip
7-Zipに内蔵されているベンチマーク機能は、LZMA圧縮および解凍のスループットをギガ命令/秒単位で報告します。この数値は、各スレッドで1回、単一コアに固定した場合で1回表示されます。

Surfaceは全スレッドテストで151.0 GIPSを記録し、Blade 16を20%上回り、圧縮率156.9 GIPSで次点システムを35%も引き離し、トップに立った。Precision 5 16Sはシングルスレッドテストで9.8 GIPSを記録し、トップとなった。
Surfaceのシングルスレッド性能7.16 GIPSという数値には注意が必要です。このユニットでは、数分間負荷がかかったコアは、初期速度より約20%低い低速状態に移行し、負荷が終了するまでその状態が続きます。7-Zipのシングルスレッド処理は、47~67℃の温度で十分に長時間実行されるため、熱が原因ではありません。この状態は、スイートの順序で続くPyPerformanceとStockfishのシングルスレッド処理にも引き継がれます。
| 7-Zip、シングルスレッド(GIPS、数値が高いほど良い) | Surface Laptop Ultra | Dell Pro Precision 5 16S | Dell Pro 7 14 | Razerのブレード16 | Dell Pro Max 14 プレミアム |
|---|---|---|---|---|---|
| トータル | 7.16 | 9.80 | 9.01 | 9.24 | 8.84 |
| 圧縮する | 4.62 | 8.71 | 6.72 | 7.28 | 7.02 |
| 圧縮解除する | 9.70 | 10.88 | 11.31 | 11.20 | 10.73 |
ブレンダー
Blender 4.5は、CPU上でCyclesを使用して3つの標準ベンチマークシーン(モンスター、ジャンクショップ、教室)をレンダリングし、1分あたりのサンプル数を報告します。

3つのシーンすべてにおいて、Surface、Blade 16、Precision 5 16Sの順で順位は変わりませんでした。SurfaceはMonsterシーンでBlade 16を47%上回り、サンプリングレートは207.6サンプル/分でしたが、最も負荷の高いClassroomシーンでは93.2サンプル/分となり、18%の差に縮まりました。Pro 7 14とPro Max 14は、最後の2つの順位を入れ替えました。
ハンドブレーキ
HandBrakeは、4K60 Big Buck Bunnyクリップの60秒間をソフトウェアでx265(HEVC、中程度のプリセット、品質22)とSVT-AV1(プリセット8、品質30)でエンコードし、フレーム/秒を報告します。

2 つのエンコーダーは Surface について正反対のことを物語っています。 x265 の結果は 41.7 fps でグループを 25 パーセント上回りましたが、ネイティブ Arm64 SVT-AV1 ビルドは 15.4 fps で、x64 システムが生成したものの約 5 分の 1 でした。 x265 をリードしたコアはシリコン上で 5 倍遅くなることはないので、その差は SVT-AV1 の Arm64 コード パスにあり、これは結果を決定づけるソフトウェア スイートの中で最も明確な例です。 x64 システムの中では、Precision 5 16S が 80.8 fps で SVT-AV1 をリードし、Pro Max 14 と Blade 16 は 5 パーセント以内でした。
LLVMビルド
このテストでは、デフォルトのジョブ数でClangとNinjaを使用してLLVM 21.1.4ツリー全体をコンパイルします。これはスイートの中で最も長い全コアワークロードであり、CPUだけでなくメモリとストレージにも負荷がかかります。

Surface は LLVM のコンパイルを 206.4 秒で完了し、Blade 16 の 327.0 秒よりも 37% 高速でした。Precision 5 16S の 340.1 秒という数値は、Smart App Control をオフにして再テストした結果です。これは、最初の試行時に Smart App Control 機能がツールをブロックしたためです。Pro 7 14 は 410.5 秒と最も遅い結果となりました。
Stockfish、Primesieve、Python、そしてブラウザ
Stockfishの組み込みベンチマークは、チェスの検索速度を1秒あたりのノード数(百万単位)で報告します。primesieveは、すべてのスレッドで10^12以下の素数を、1つのスレッドで10^11以下の素数をカウントし、その時間を秒単位で計測します。PyPerformanceは、1つのコアに固定して3つのCPythonベンチマーク(go、nbody、regex_compile)を実行し、反復あたりの平均時間を報告します。また、Speedometer 3.1は、Microsoft EdgeでのWebアプリケーションの応答性を測定します。
| ホイール試乗 | Surface Laptop Ultra | Dell Pro Precision 5 16S | Dell Pro 7 14 | Razerのブレード16 | Dell Pro Max 14 プレミアム |
|---|---|---|---|---|---|
| Stockfishベンチ、全スレッド(Mnps、数値が高いほど良い) | 15.51 | 14.81 | 14.71 | 17.96 | 12.01 |
| Stockfishベンチ、スレッド1つ(Mnps、数値が高いほど良い) | 1.33 | 1.86 | 1.94 | 2.04 | 1.70 |
| primesieve 1e12、全スレッド(s、数値が小さいほど良い) | 9.82 | 11.31 | 14.80 | 10.60 | 14.30 |
| プライムシーブ 1e11、スレッド1つ(s、数値が低いほど良い) | 12.03 | 9.56 | 6.66 | 6.67 | 9.82 |
| PyPerformance 実行時間 (ミリ秒、数値が低いほど良い) | 123.9 | 69.2 | 75.9 | 75.2 | 74.1 |
| PyPerformance nbody (ミリ秒、数値が低いほど良い) | 89.8 | 53.2 | 62.3 | 60.8 | 61.3 |
| PyPerformance regex_compile (ミリ秒、数値が小さいほど良い) | 94.1 | 65.1 | 71.1 | 69.7 | 69.8 |
| スピードメーター 3.1、エッジ(スコア、数値が高いほど良い) | 34.7 | 42.7 | 36.8 | 38.4 | 42.0 |
Stockfishは、Surfaceが勝利できなかった数少ない全コアテストの1つです。Blade 16は両方のテストでトップとなり、全スレッドで16%の差をつけて終了しました。Surfaceの1スレッドの数値には、7-Zipの低速コアという注意書きが付随しています。primesieveでは逆の結果となり、Surfaceは全スレッドで9.82秒と最速で、2つのAMD CPUは1スレッドでIntelシステムより約30%高速でした。
Precision 5 16S は Python とブラウザーの行を制し、Pro Max 14 は Speedometer で 2% 以内の差でした。Surface は 4 つすべてで最下位でした。PyPerformance の実行は、同じ固定コアで 7-Zip に続いて行われ、遅い状態を引き継ぎます。また、Speedometer は Edge の Arm64 ビルドを他の x64 ビルドと比較して実行するため、これらの行は Surface のファームウェアとソフトウェアをコアと同じくらい測定します。このプラットフォームでのシングルスレッドの結果は、遅いコア状態が適用されない場合でも、x64 フィールドより 15 ~ 30 パーセント遅れており、以下のメモリ レイテンシの数値がその理由の一部を説明しています。
GROMACSとOpenBLAS
GROMACSは、4つのランクとスレッド構成で全コア上でbenchMEM分子動力学シミュレーションを実行し、1日あたりのシミュレーション時間をナノ秒単位で報告します。最も優れた構成が注目されます。OpenBLASテストでは、3つの問題サイズでHPLスタイルの倍精度LU分解とDGEMM行列乗算を、それぞれ全コア上と最上位コアクラスのみで実行します。これは、スイートの中で最も持続的な浮動小数点負荷が高いテストです。
| ホイール試乗 | Surface Laptop Ultra | Dell Pro Precision 5 16S | Dell Pro 7 14 | Razerのブレード16 | Dell Pro Max 14 プレミアム |
|---|---|---|---|---|---|
| GROMACS benchMEM、最適なレイアウト(ns/日、数値が大きいほど良い) | 17.29 | 24.87 | 21.58 | 26.41 | 22.74 |
| GROMACS、ランクごとに1スレッド(ナノ秒/日) | 17.21 | 25.01 | 21.58 | 26.59 | 0.84 |
| GROMACS、ランクあたり2スレッド(ナノ秒/日) | 16.80 | 24.02 | 21.22 | 24.83 | 22.88 |
| OpenBLAS DGEMM M=8000、全コア(GFLOPS、数値が高いほど性能が良い) | リタイア | 527.4 | 358.6 | 455.4 | 367.5 |
| OpenBLAS DGEMM M=8000、最高コアクラス(GFLOPS) | リタイア | 262.1 | 228.0 | 252.4 | 266.0 |
| OpenBLAS LU N=10000、すべてのコア (GFLOPS) | リタイア | 435.3 | 384.3 | 400.9 | 194.2 |
| OpenBLAS LU N=20000、すべてのコア (GFLOPS) | リタイア | 503.8 | 375.6 | 454.4 | 327.5 |
| OpenBLAS LU N=40000、すべてのコア (GFLOPS) | リタイア | 459.6 | 397.6 | 498.5 | 394.1 |
| OpenBLAS LU N=40000、最高コアクラス(GFLOPS) | リタイア | 255.2 | 221.9 | 250.9 | 271.6 |
Blade 16 は、26.4 ns/day で GROMACS のすべてのレイアウトでトップとなり、Precision 5 16S は 6% 差で後塵を拝しました。他の場所では優位に立つ Surface は、GROMACS の Arm64 ビルドには x64 システムで使用される AVX2 カーネルがないため、17.3 ns/day と最も遅い結果となりました。Pro Max 14 の 1 スレッド/ランク レイアウトでの 0.84 ns/day は、ほぼすべての時間をランク間通信に費やした異常値です。比較対象としては、Pro Max 14 のベスト レイアウトである 22.7 ns/day の数値が適切です。
Surface には OpenBLAS の結果がありません。全コア N=20000 LU ソルブでは、システムの電力が 3 回カットされ、2 つのノートブック サンプルにまたがったため、最後の実行ではそのステップをスキップして、他の 29 が完了するようにしました。この問題については、熱のセクションで説明しています。x64 システムの中では、Precision 5 16S が全コア DGEMM で 527 GFLOPS を記録し、2 つのより小さな LU ソルブでもトップでした。Blade 16 が最大のソルブを記録し、Pro Max 14 は最上位のコア クラスだけで最速でしたが、効率コアを追加することで、N=10000 の結果は 194 GFLOPS にまで低下しました。
メモリ帯域幅とレイテンシ
STREAMは持続的なメモリ帯域幅を測定します。メモリレイテンシは4KiBページ上の1GBバッファを使用し、コア間レイテンシは各コアペア間の往復時間を測定します。

| レイテンシ(ナノ秒、数値が低いほど良い) | Surface Laptop Ultra | Dell Pro Precision 5 16S | Dell Pro 7 14 | Razerのブレード16 | Dell Pro Max 14 プレミアム |
|---|---|---|---|---|---|
| メモリレイテンシ、4KiBページ | 251.1 | 115.5 | 146.7 | 129.6 | 170.7 |
| コアからコアまで、平均 | 171.6 | 88.2 | 49.7 | 57.0 | 58.3 |
| コア間、最大 | 362.6 | 129.4 | 74.6 | 95.9 | 153.1 |
Surface の LPDDR5-9400 は STREAM Triad で 122,114MB/s、Copy で 130,516MB/s を実現し、Precision 5 16S より 48% 高く、2 つの AMD システムより約 2.6 倍の帯域幅を実現しました。この帯域幅が、N1X がレンダリングとコンパイルのテストで勝利する大きな理由です。その代償はレイテンシです。メモリへのレイテンシは 251 ns、コア間のレイテンシは平均 172 ns で、どちらもグループ内で大きく最悪です。これが、シングルスレッドでレイテンシに敏感な結果につながっています。Precision 5 16S はメモリのレイテンシが 116 ns と最も低く、Pro 7 14 はコア間のメッシュが 50 ns と最も密でした。
ゲームおよびGPUエンコーディング
SuperTuxKart はこのスイートのリリースに含まれる唯一のゲームで、1080p では十分軽いため、結果は GPU だけでなく CPU とドライバーについてもよく表しています。内蔵ベンチマークは、Ultra 設定で 1920×1080 のフルスクリーンで、vsync をオフにして実行され、ディスクリート GPU がある場合はそれに固定され、平均フレーム レートに加えて、ゲーム独自の典型的な、ほぼ安定した、安定した数値が報告されます。これらは、フレーム タイム分布の徐々に低いポイントを表します。Surface では、Prism エミュレーションで x64 ビルドを実行しました。

Surfaceはネイティブで平均235.9fps、エミュレーションでx64ビルドを実行した場合は264.6fpsを記録し、Blade 16の200fpsを上回りました。これらのフレームレートでは、RTX 5090は限界には全く達していません。Blade 16はCPUとOpenGLドライバーによって制限されており、ディスプレイがRadeon 890Mに接続されているハイブリッドモードで動作するため、フレームごとにコピーが追加されます。
より顕著な結果はDell製PCで、Precision 5 16Sの統合型Arc Pro B390は平均166.8 fps、Pro Max 14のディスクリートRTX PRO 2000は150.8 fpsで、Pro Max 14はグループ内で最も低い安定値53 fpsでした。より負荷の高いタイトルであれば、5090は他のすべてのPCよりも優れているでしょう。
FFmpegは、同じ4K60クリップを、各ベンダーのハードウェアエンコーダー(Intel QSV、AMD AMF、またはNVIDIA NVENC)を使用して8Mb/sのHEVCにエンコードし、さらにWindows Media Foundationを介して個別にエンコードします。
| ハードウェアHEVCエンコード(フレームレート、数値が高いほど良い) | Surface Laptop Ultra | Dell Pro Precision 5 16S | Dell Pro 7 14 | Razerのブレード16 | Dell Pro Max 14 プレミアム |
|---|---|---|---|---|---|
| GPUベンダーエンコーダー、HEVC 8Mb/s | 135 (NVENC) | 128 (QSV) | 137 (AMF) | 132 (NVENC) | 該当なし(FFmpegのビルドに必要なドライバーよりも古い) |
| メディアファウンデーションエンコーダー、HEVC 8Mb/s | 55 | 該当なし(HEVC MFエンコーダーが見つかりませんでした) | 110 | 該当なし(ハイブリッドグラフィックス) | 該当なし(ハイブリッドグラフィックス) |
固定機能エンコーダは、このビットレートではほぼ互換性があり、QSV、AMF、NVENC 全体で 128 ~ 137 fps であり、Surface の単一の第 9 世代 NVENC は 135 fps です。Pro Max 14 では、他の 2 つの NVIDIA システムの 617.42 よりも古いドライバー 597.16 で NVENC が開かなかったため、結果がありません。Media Foundation は Pro 7 14 と Surface でのみ数値を生成しました。Precision 5 16S では HEVC エンコーダが見つからず、独自のアダプタを選択するためディスクリート GPU に紐づけることができない 2 つのハイブリッドグラフィックスシステムはスキップしました。
熱とOpenBLASの電源オフ
Surface は、最も長いワークロード中、平均 92 ~ 97 ℃ で、30 分間の連続ループを開始時より 1 パーセント速く完了しました。Blade 16 は、同じ結果で最高 98 ~ 99 ℃ に達しました。唯一、ステップダウンするシステムである Precision 5 16S は、タイマーによってステップダウンします。Surface の OpenBLAS DNF は、周囲の温度にもかかわらず、スムーズな熱による速度低下ではなく、スイートの中で最も重い浮動小数点負荷の下で、システムは完全に電源を失いました。

私たちが監視できるもの
sr-clientはLibreHardwareMonitorとWindowsパフォーマンスカウンターを介して数秒ごとにセンサーデータをサンプリングし、各テストの期間を要約しますが、現在のプラットフォーム間でカバレッジにばらつきがあります。2つのIntelシステムはLibreHardwareMonitorにCPU温度を全く報告しないため、テストスイートはテスト間の一定間隔で一時停止してしまいます。
ワークロード別のCPU温度とクロック周波数
| ワークロード(CPU最大/平均、℃) | Surface Laptop Ultra | Dell Pro Precision 5 16S | Dell Pro 7 14 | Razerのブレード16 | Dell Pro Max 14 プレミアム |
|---|---|---|---|---|---|
| Cinebench 2026 | 98 / 88 | センサーなし | 83 / 74 | 96 / 78 | センサーなし |
| 7-Zip | 98 / 65 | センサーなし | 75 / 70 | 99 / 84 | センサーなし |
| 干し魚 | 98 / 96 | センサーなし | 69 / 68 | 92 / 90 | センサーなし |
| ブレンダー | 98 / 93 | センサーなし | 76 / 70 | 95 / 87 | センサーなし |
| ハンドブレーキ | 98 / 84 | センサーなし | 82 / 72 | 92 / 86 | センサーなし |
| LLVMビルド | 98 / 92 | センサーなし | 74 / 68 | 98 / 93 | センサーなし |
| GROMACS | 98 / 96 | センサーなし | 71 / 70 | 97 / 94 | センサーなし |
| OpenBLAS | リタイア | センサーなし | 83 / 78 | 91 / 87 | センサーなし |
| STREAM | 98 / 92 | センサーなし | 69 / 66 | 75 / 71 | センサーなし |
| スーパータックスカート | 90 / 80 | センサーなし | 69 / 64 | 89 / 83 | センサーなし |
| MLPerfクライアント | 93 / 77 | センサーなし | 71 / 67 | 97 / 76 | センサーなし |
| コーディングエージェント | 86 / 78 | センサーなし | 78 / 68 | 91 / 84 | センサーなし |
Surface は、すべての負荷の高い全コアテストで 97 ~ 98 ℃ に達し、Stockfish、GROMACS、Blender の平均は 93 ℃ を超えており、これらのテストのほとんどで限界に近い状態が続いていることが示唆されます。メモリ テストである STREAM でも 98 ℃ に達しました。Blade 16 もほぼ同じくらい高温になり、7-Zip と LLVM ビルドで 98 ~ 99 ℃ に達しましたが、ほとんどのテストで平均は 5 ~ 10 ℃ 低くなりました。Pro 7 14 は最も低温で、テスト全体を通して最高 89 ℃ でした。これは、クロック周波数の低さと全コア スコアの低さの両方に合致しています。
| ワークロード(平均CPUクロック周波数、MHz) | Surface Laptop Ultra | Dell Pro Precision 5 16S | Dell Pro 7 14 | Razerのブレード16 | Dell Pro Max 14 プレミアム |
|---|---|---|---|---|---|
| Cinebench 2026 | 2,952 | 3,792 | 3,879 | 4,158 | 3,734 |
| 7-Zip | 2,405 | 3,936 | 3,767 | 4,014 | 3,710 |
| ブレンダー | 3,174 | 3,665 | 3,086 | 3,729 | 3,469 |
| LLVMビルド | 3,160 | 3,631 | 3,043 | 3,697 | 3,379 |
| GROMACS | 3,325 | 3,525 | 3,023 | 3,874 | 3,458 |
| STREAM | 3,255 | 4,014 | 3,590 | 3,684 | 4,057 |
| MLPerfクライアント | 2,165 | 2,632 | 3,036 | 3,593 | 3,861 |
| 持続ループ、定常状態 | 3,276 | 3,294 | 2,914 | 3,742 | 3,393 |
クロックはアーキテクチャによって意味が異なるため、チップのクロックが軽作業から重作業へとどのように変化するかについては、この列を下に読み進めてください。Surfaceは全コア作業で3.2~3.3GHzに落ち着き、98℃で維持できる速度で、そのクロックでの20コアは、より高いクロックでの12または16のx64コアを上回ります。Blade 16はほぼすべてのテストで最高のクロックを保持し、最も高温のテストでも3.6GHz以上を維持しました。そのため、持続的な全コア負荷の下で2.8~3.1GHzに低下したPro 7 14と同じシリコンファミリーでStockfishとGROMACSをリードしています。
持続ループは、各ファームウェアの戦略を最も明確に示しています。Surfaceは10回の試行すべてで98℃を維持し、最初の試行より1%高い温度で終了しました。Blade 16も同様に94℃で終了しました。どちらのシャーシもこの時点で熱的余裕は残っていませんが、ファームウェアがクロックを限界値で安定させているため、どちらも余裕は必要ありません。
Precision 5 16Sは唯一、性能が低下するシステムであり、その低下の仕方は毎回同じです。10~14分後にはスコアが約6%低下し、そのまま維持されます。2回目のフル実行でも、この低下は小数点以下3桁まで繰り返されました(0.938対0.939)。2回の実行で同じ分に低下が見られるということは、冷却システムの性能低下ではなく、Dellのファームウェアにおける長時間電力制限が原因であると考えられます。
Surface以外にも、RTX Spark搭載ノートPCで高温になる機種があります。ラボにある他のN1X搭載ノートPCも、全コア負荷時で90度台半ばから後半に達しますが、今のところ不具合は発生していません。証明はできませんが、NVIDIAがN1X搭載ノートPCの電力と熱に関する目標値をギリギリに設定しているため、各OEMの冷却システムとファームウェアがその限界値を維持する必要があり、Surfaceはこの点において他機種と異なっている、というのが我々の仮説です。冷却設計がこれらのプラットフォームの差別化要因となるため、レビューを進める上で熱管理は注目すべき点です。

過熱とOpenBLASの電源オフ
当社のSurface Laptop Ultraは、全コアOpenBLAS LUソルバーが20スレッドでN=20000の問題に切り替わる際に、3回電源が落ちました。他の29個のテストを完了させるために、最後の実行ではOpenBLASをスキップしたため、CPUセクションにDNFと表示されています。このような不具合が発生したのは今回で2台目です。最初のレビュー用ユニットは同じワークロードでハングアップし、排気端でOLEDディスプレイの欠陥と、コマンドで再現可能なCPU障害が発生し、交換されました。
| イベント | 何が走っていたのか | 喪失前の最後の読書 | その後 |
|---|---|---|---|
| 約20:06 | フル実行、26-openblas:N=10000のLUセット両方が完了(319.7および368.1 GFLOPS)、その後20スレッドでN=20000を実行 | CPU温度:95.7℃、3.2GHz(ステップ開始時:53℃) | 21:11に電源が入るまでオフの状態です。 |
| 約21:30 | 再現手順、パス1:N=10000の解決が12回成功、20スレッドでN=20000が開始 21:30:13 | 最高温度95.2℃、3.1GHz | 21:31に自動的に再起動しました |
| 約21:35 | 再現手順、パス1:同じシーケンス、N=20000、20スレッドで開始、21:35:10 | 最高温度95.5℃、3.2GHz | 22時半に戻る |
当初は、98℃で動作していたノートPCが過熱したのではないかと思いましたが、それが本当の問題ではないようです。Surfaceは、持続ループで31分間、Cinebenchで12分間98℃を維持した後、95.2℃から95.7℃に低下しました。Windowsはシャットダウンではなく、強制的な電源カットが発生しました。再起動のたびに、バグチェックコード0のKernel-Power 41がログに記録され、電源ボタンの押下はありませんでした。クラッシュダンプも、致命的なハードウェアエラーの記録も、熱によるシャットダウンイベントもありませんでした。これは、熱によるシャットダウンで通常発生するものです。
タイミングは秒単位で再現可能です。両方の再現装置とも、最初のパスで電源が切れました。これは、負荷開始から42~46秒後、N=20000の計算開始から14~16秒後のことです。電源が切れる前のすべての計算はHPL残差チェックに合格していたため、ハードウェアは切断直前まで正しく計算していました。
プラットフォームカウンターも両方のケースで同じ値でピークに達しました。PSYSサーマルゾーンは温度ではありませんが、アイドル時の約1,000から1,200まで負荷がかかると着実に上昇し、2回の再現損失時にはそれぞれ4,419と4,406を示しました。最初のSurfaceは2,808というはるかに低いPSYS値でダウンしたため、これはプラットフォームのファームウェア所有者にとっての手がかりであり、しきい値ではありません。
この障害は決定論的ではありません。最初の再起動後、ステップのフル実行の再試行では、N=40000までの8つの構成すべてを通過し、20スレッドでN=20000とN=40000のソルバーに対してそれぞれ336と370 GFLOPSの性能を発揮しました。つまり、このユニットでは4回の試行のうち3回で電源が切れたことになります。両方のユニットは交流電源に接続されていましたが、このユニットは前後ともバッテリー残量が100%でした。
Surface Laptop Ultra 2台が、異なるメモリ構成(1台目は96/32、2台目は64/64)で全く同じ不具合を起こしたことから、単一の不良ユニットではなく、このモデルの電源供給、冷却設計、または全コアFP64負荷時のファームウェア保護に問題があると考えられます。この不具合については既に報告済みであり、修正プログラムが提供され次第、本レビューを更新いたします。
電源オフの再現
我々の再現手順では、20スレッドでN=10000のLU解を6回、10スレッドでさらに6回、そして20スレッドでN=20000を実行しました。OpenBLASには、同じ処理を行うLINPACKベンチマーク(benchmark/linpack.c)が同梱されています。このベンチマークは、ランダムなN×N行列を作成し、dgetrfで因数分解し、dgetrsで解いて、サイズごとのMFlopsを報告するため、我々のスイートを使わなくても誰でもこの手順を再現できます。
Windows on Arm では、スレッド数から始まる 2 つの点が重要です。公式の Windows on Arm OpenBLAS リリースはスレッド数を 12 に制限しているため、20 コアすべてをロードできません。ライブラリは、より高い制限値で 0.3.34 ソースからビルドする必要があります。また、ベンチマークの Windows タイマーは MinGW スタイルのツールチェーンでのみコンパイルされるため、MSYS2 の CLANGARM64 シェルでビルドしてください。展開された OpenBLAS 0.3.34 ソースから:
pacman -S --needed mingw-w64-clang-aarch64-clang mingw-w64-clang-aarch64-cmake mingw-w64-clang-aarch64-ninja cmake -S . -B build -G Ninja -DCMAKE_BUILD_TYPE=Release -DTARGET=NEOVERSEN1 -DNUM_THREADS=256 -DNOFORTRAN=1 -DC_LAPACK=1 -DBUILD_BENCHMARKS=ON -DBUILD_TESTING=OFF cmake --build build --target benchmark_linpack_DOUBLE
次に、Windowsを「最高のパフォーマンス」に設定して電源を接続すると、このシーケンスは各電源喪失の直前の実行を繰り返します。私たちのSurfaceでは、最後のN=20000の計算中に電源が遮断されました。
cd build OPENBLAS_LOOPS=6 OPENBLAS_NUM_THREADS=20 ./benchmark_linpack_DOUBLE.exe 10000 10000 1 OPENBLAS_LOOPS=6 OPENBLAS_NUM_THREADS=10 ./benchmark_linpack_DOUBLE.exe 10000 10000 1 OPENBLAS_NUM_THREADS=20 ./benchmark_linpack_DOUBLE.exe 20000 20000 1
2 つの OPENBLAS_LOOPS=6 実行は、12 回の N=10000 ソルブでシステムをウォームアップし、再現手順と一致します。最後のコマンドは、20 コアすべてで N=20000 ソルブを開始しますが、Surface は 14 ~ 16 秒後に電源が切れました。
貯蔵性能
ストレージの結果は、5つのSSDを3つのグループに分類しました。SurfaceのGen5 SK hynixドライブは、シーケンシャルレコードで読み取り14.1GB/s、書き込み11.5GB/sを記録しました。Precision 5 16S、Pro Max 14、およびBlade 16は、ファイルシステムを介した4KランダムI/Oで650K~780K IOPSを実現しました。Pro 7 14のSamsung BM9C1aは、通常のGen4ドライブのように読み取りましたが、書き込み速度は約120MB/sで、これはドライブがQLCであることに起因する結果です。
fio フォーコーナーズ
クライアントストレージテストでは、システムが出荷された状態とまったく同じように、ブートボリューム上のファイルに対して NTFS と BitLocker を介して fio を実行するため、結果には OS と暗号化のコストがすべて含まれます。128K のシーケンシャル読み取りと書き込み (QD32)、および 4K のランダム読み取りと書き込み (QD32) を 4、8、16 ジョブで測定し、3 つの中で最も良い結果を報告します。各コーナーは 5GB のフットプリントで実行され、さらに 25GB で再度実行して、ワーキング セットがドライブの最速キャッシュを超えても結果が維持されるかどうかを確認します。比較対象は 25GB の行です。


| fio、5GBのフットプリント | Surface Laptop Ultra | Dell Pro Precision 5 16S | Dell Pro 7 14 | Razerのブレード16 | Dell Pro Max 14 プレミアム |
|---|---|---|---|---|---|
| シーケンシャル読み取り速度 128K QD32 (MB/秒) | 14,175 | 10,275 | 3,747 | 7,099 | 7,025 |
| シーケンシャル書き込み速度 128K QD32 (MB/秒) | 11,475 | 8,909 | 123 | 5,248 | 6,645 |
| ランダム読み取り 4K QD32、ピーク値 (IOPS) | 307,738 | 778,080 | 363,988 | 700,883 | 756,704 |
| ランダム書き込み 4K QD32、ピーク値 (IOPS) | 284,680 | 676,963 | 25,465 | 651,651 | 697,110 |
2台のGen5ドライブが連続行を支配しています。Surfaceは25GBのフットプリントで読み取り14,134MB/s、書き込み11,461MB/sを達成し、Precision 5 16Sは9,216MB/sと9,009MB/sで続き、3台のGen4システムは読み取り7.0~7.1GB/sに集中しました。ランダムI/Oではグループの順位が変わり、Precision 5 16S、Pro Max 14、Blade 16はすべて双方向で648K~780K IOPSに収まりましたが、Surfaceはドライブが高速であるにもかかわらず、読み取りと書き込みで300K IOPS付近で停滞し、x64システムの半分以下となりました。
生のデバイス行を見ると、上限がどこから来ているのかがわかります。物理ディスクに対して 4K ランダム読み取りを直接繰り返し実行し、NTFS と BitLocker をバイパスすると、Surface の SSD は 1,670,736 IOPS を達成し、ファイルシステムの結果の 5.6 倍になりました。したがって、300K の上限はドライブではなく、Windows on Arm ストレージ パスによって設定されています。最も可能性の高いコストは、メモリ整合性が有効になっている BitLocker のソフトウェア XTS-AES-128 であり、4 つのジョブ セット中に CPU を 57% に維持しました。
x64システムではIOPSの低下は少ないものの、それでも性能を十分に発揮できていない。Pro Max 14は1.94倍、Precision 5 16Sは1.57倍、Blade 16は1.43倍の低下が見られた。Pro 7 14だけは差が見られなかった。
ストレージの遅延とモデル負荷の上限
fioの25GBフットプリントにおける完了レイテンシ(マイクロ秒単位)と、AIモデル負荷テストが上限として使用するドライブの上限値:モデルファイルのDiskSpdによる1MBシーケンシャル読み取り。
| ホイール試乗 | Surface Laptop Ultra | Dell Pro Precision 5 16S | Dell Pro 7 14 | Razerのブレード16 | Dell Pro Max 14 プレミアム |
|---|---|---|---|---|---|
| シーケンシャルリード 128K、p99 (µs、数値が低いほど良い) | 391 | 971 | 2,179 | 1,384 | 873 |
| シーケンシャル書き込み 128K、p99 (µs、数値が低いほど良い) | 766 | 3,490 | 120,062 | 889 | 1,036 |
| ランダム読み取り4K、16ジョブ、平均値(µs、数値が低いほど良い) | 1,839 | 368 | 1,410 | 472 | 635 |
| ランダム書き込み 4K、16ジョブ、平均値(µs、数値が低いほど良い) | 1,984 | 444 | 23,703 | 470 | 636 |
| 生データランダム読み取り 4K QD32、ピーク時、25GB (IOPS) | 1,670,736 | 1,224,270 | 361,344 | 993,050 | 1,472,021 |
| モデル別ロードドライブ上限、ディスク速度 1M シーケンシャル読み取り (MB/秒) | 10,588 | 11,402 | 1,689 | 6,246 | 実行されませんでした(モデルロードテストが条件を満たさなかったため)。 |
Surface は最もタイトなシーケンシャル テールを持ち、Precision 5 16S は両方向で平均 4K レイテンシが最も低かった。Surface の 16 ジョブのランダム セットには、x64 システムでは見られなかったテールも存在した。平均が 1.8 ms と 2.3 ms であるのに対し、p99.99 レイテンシは読み取りで 4.8 秒、書き込みで 5.6 秒であり、約 10,000 回に 1 回が Windows on Arm パスで秒を待機していることになる。Surface の 4K p99 値は、その平均値を下回っており、正しくない可能性があるため、表から除外した。また、印刷する前に、fio が Arm64 でパーセンタイルをどのように報告するかを確認したい。
結論
Surface Laptop Ultra for Businessに搭載されているRTX Spark N1Xは、これまでノートPCで見た中で最も強力なマルチスレッドCPUであり、122GB/sのメモリ帯域幅と64GBのGPU割り当て(最大96GBまで調整可能)を組み合わせることで、NVIDIA GPUに搭載されるメモリ容量は、これまでのどのノートPCよりも多くなっています。Cinebench、7-Zip、Blender、x265、LLVMビルドで圧倒的なパフォーマンスを発揮し、シーケンシャルストレージの記録を読み取り14.1GB/s、書き込み11.5GB/sに更新しました。また、35BパラメータのティアMモデルを実用的な速度で実行できた唯一のシステムであり、コーディングエージェントのティアMタスクを90秒未満で完了しました。一方、x64統合システムでは5分から11分かかりました。

注意点は、現在出荷されているプラットフォーム特有のものです。Windows on Armのストレージパスでは、ランダムI/Oがドライブの性能の5分の1に制限され、メモリレイテンシはx64システムの2倍になります。シングルスレッド性能はx64に劣り、一部のArm64ポート(SVT-AV1、GROMACS)はx64ビルドに比べて著しく劣ります。また、統合GPUはシステム全体とメモリバスを共有しているため、エージェントが動作している間はデスクトップの動作が半分になります。
24GBのメモリを搭載できるモデルの場合、Razer Blade 16のRTX 5090はトークン生成速度が2.3倍速く、処理中も応答性を維持します。一方、Surfaceの最適な用途は、より小型のプラットフォームには収まらないモデルです。
これらの注意点とは別に、Surface Laptop Ultra の 2 台が、温度とは関係なく、同じ全コア倍精度負荷で自動的に電源が切れるという問題が発生しました。ログには、熱によるトリップではなく、強制的な電源カットとして記録されています。ほとんどの購入者は、20 スレッドで HPL スタイルのソルバーを実行することはないでしょうし、このノートパソコンは他のすべての持続テストで 98 ℃ を維持し、ポイントを失うことはありませんでした。しかし、ワークステーション クラスのノートパソコンは、最も重い正当なワークロードに耐えられるはずであり、Microsoft または NVIDIA がトリップの原因を説明するまでは、このマシンに関する疑問は残ります。
20Bから35Bのモデルをローカルで実行したり、大規模なツリーをコンパイルしたり、ノートパソコンのCPUでレンダリングしたりしたい開発者やアナリストにとって、このSurfaceに搭載されているN1Xは、今回の比較対象であるx64ノートパソコンではできないことを実現し、128GB構成ではその期待を非常に高いレベルで満たしています。
シングルスレッド処理、ブラウザベースの作業、または24GBのメモリを搭載した専用GPU搭載モデルを使用するユーザーにとって、x64アーキテクチャの製品がより良い選択肢となる可能性が高く、Precision 5 16SとBlade 16はその選択肢を二分する存在です。ラボでのシャーシテストが完了次第、ハードウェアの印象とバッテリー駆動時間について、またベンダーからの電源オフに関する回答が得られ次第、改めてお伝えします。
リーダーボード: Surface Laptop Ultra for Businessは、当社の「ローカルAIに最適なノートパソコン」リーダーボードのRTX Sparkセクションでテスト済みとして掲載されており、新しいクライアントスイートでテストした他のN1Xシステムと並んで掲載されています。また、「ビジネス向けノートパソコン」リーダーボードの「テスト済み」にも掲載されています。


 Amazon