

NVIDIAとMicrosoftは本日、RTX Spark搭載WindowsノートPCの予約注文を開始し、10月16日に発売予定。コンパクトデスクトップは11月に発売予定。NVIDIAは第4四半期にWindows向けDGX Stationのプレビュー版をリリースする予定。これらの発表は、サンフランシスコで開催されたMicrosoftのWindows AIおよびSurfaceイベントで行われた。このイベントでは、ジェンセン・フアン氏がサティア・ナデラ氏と共に登壇し、Microsoftはエージェント封じ込めレイヤーであるMicrosoft Execution ContainersがWindows 11で一般提供開始となったことを発表した。
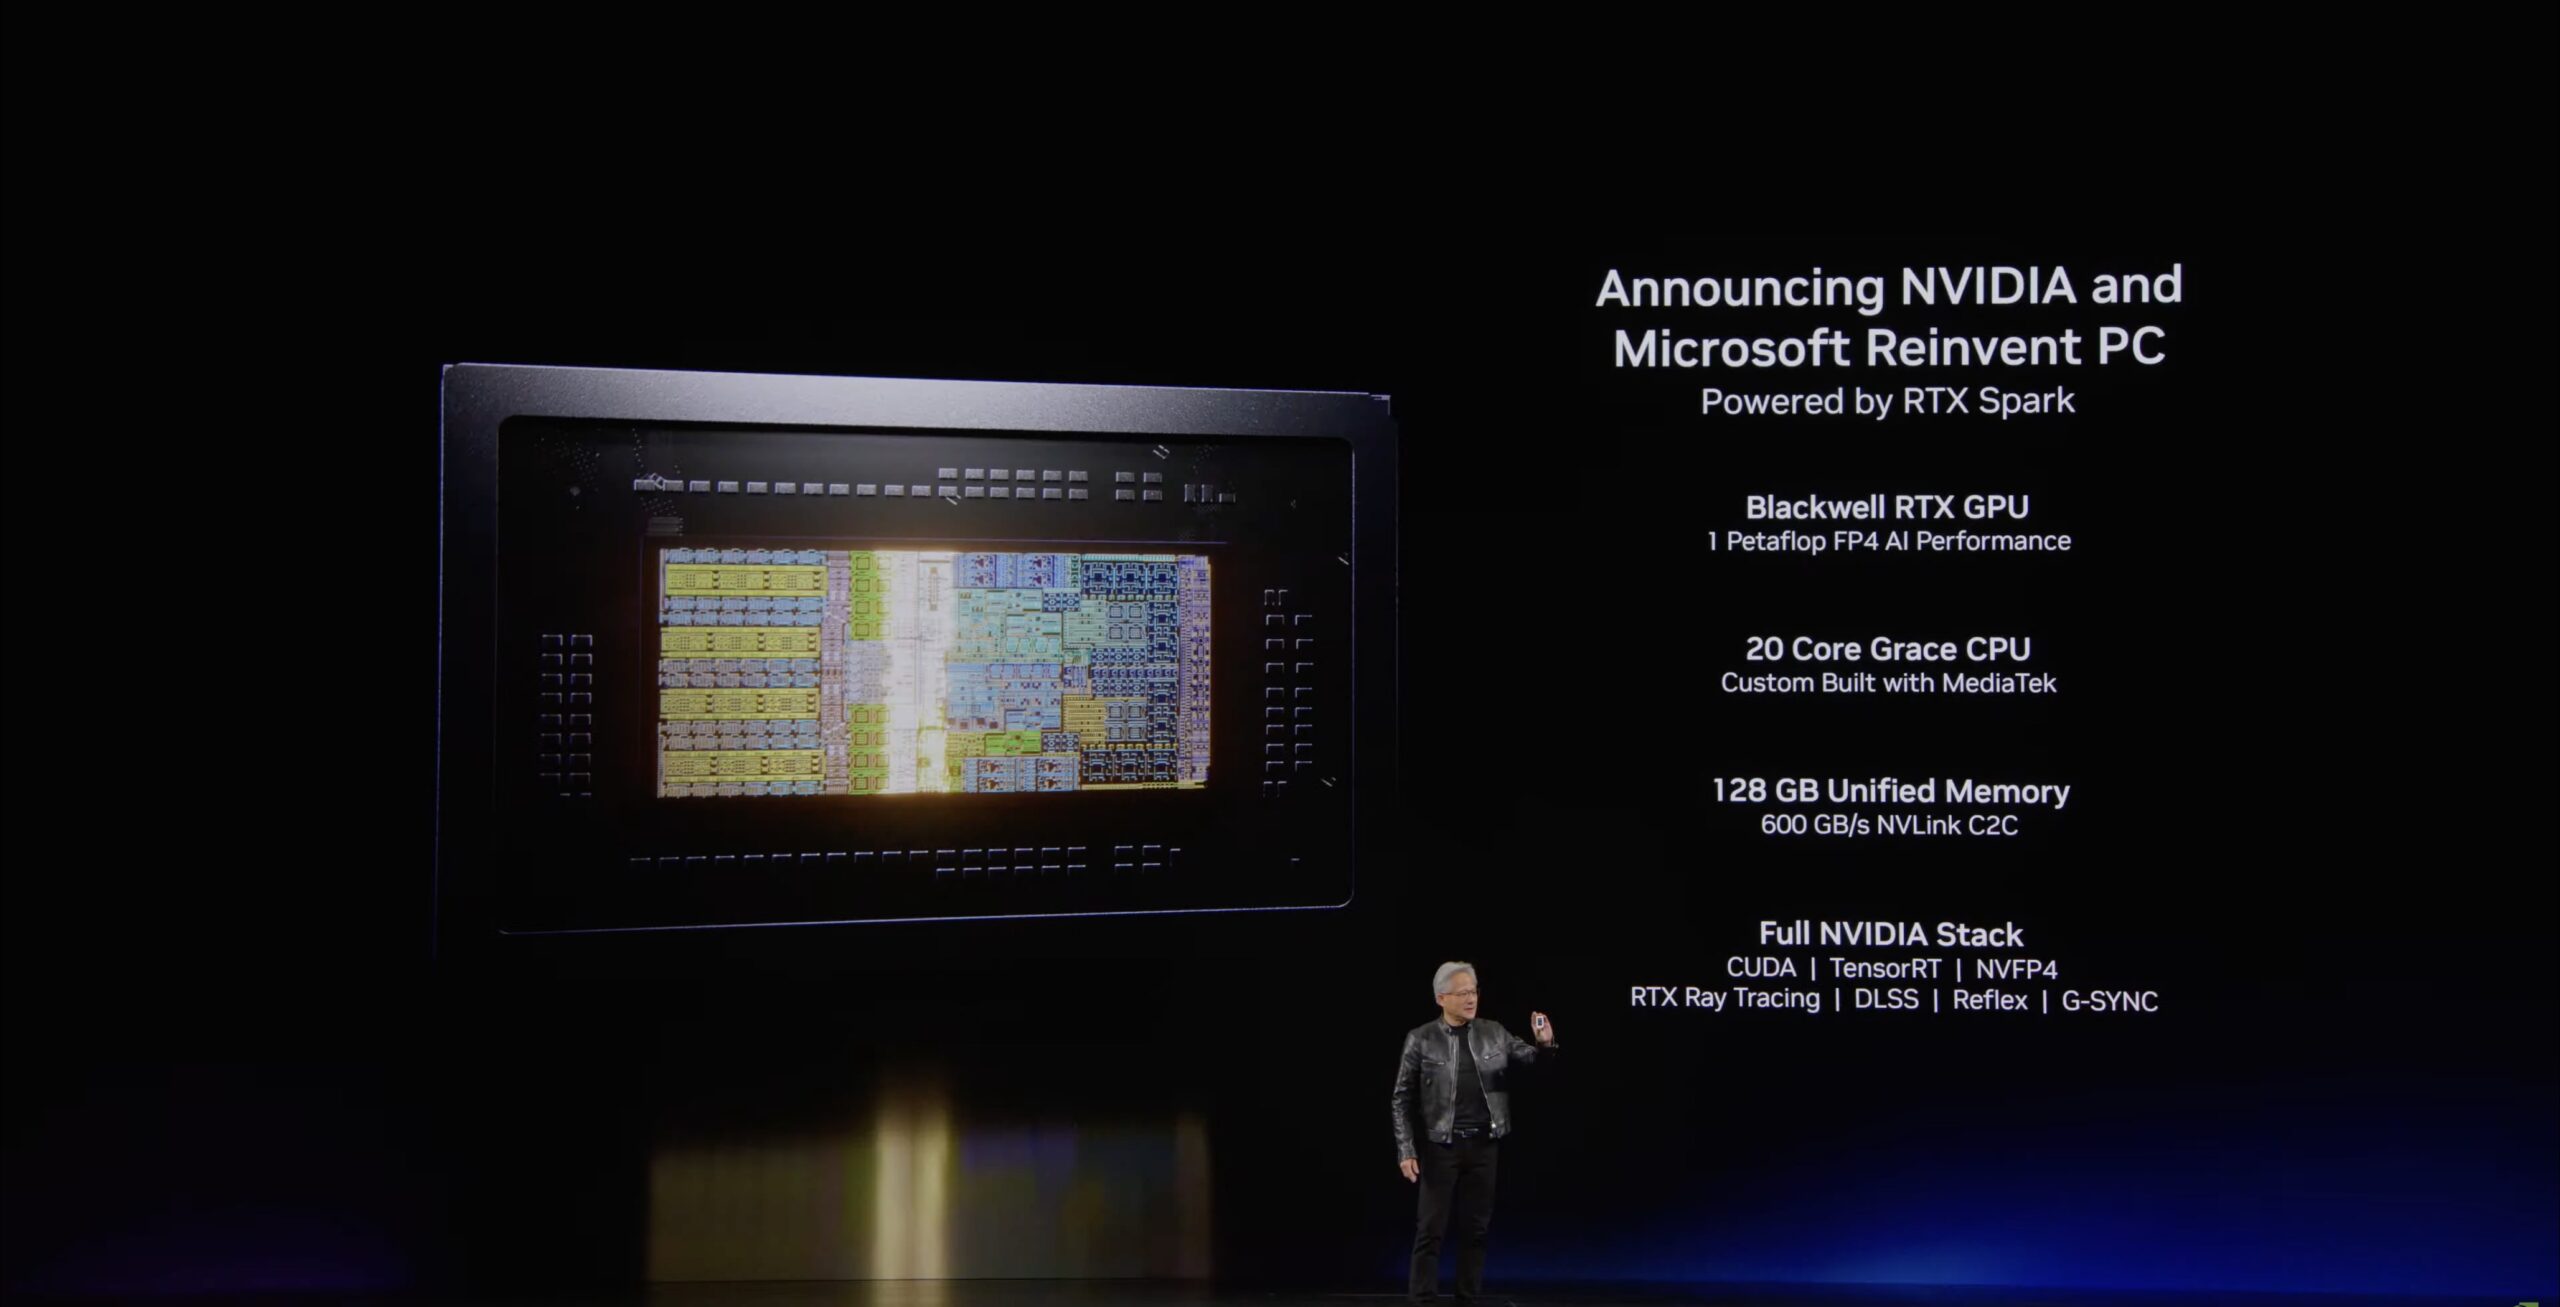
先日、Dell XPS 16 Creator Editionに関する記事でこれらのシステムのうち最初のものを紹介し、 6月のComputexでプラットフォーム自体についても取り上げました。今回の記事では、両社がイベントに合わせて公開した、これまで知られていなかった情報、すなわちN1Xスーパーチップの消費電力、Windowsが統合メモリプールをどのように分割するか、ノートパソコン上で1370億パラメータのコーディングモデルを実行した際の測定スループット、サンドボックスエージェントが実行される仕組み、そしてWindows DGX Stationの完全な仕様表について解説します。
RTX Spark N1X:2つのチップ、3つの電力範囲
NVIDIAのRTX Spark仕様表では、ノートPCとデスクトップPCが分けられており、その区分けはヘッドラインの数値よりも多くの情報を提供している。ノートPCには2種類のN1Xバリアントが用意されている。1つは6,144コアのBlackwell RTX GPU、20コアのGrace CPU、最大128GBの統合LPDDR5Xメモリを搭載したもの、もう1つは5,120コアのGPU、18コアCPU、最大64GBのメモリを搭載したもので、どちらもTDPは45~80Wとなっている。デスクトップPCには6,144コア、20コア、最大128GBのメモリを搭載したもののみが用意されており、NVIDIAはこれを140Wとしている。
その140Wという数値は、NVIDIAがDGX SparkのGB10用に公表しているTDPと同じで、CPUとGPUを合わせた値であり、NVIDIAが6月に述べた、2つのチップは異なるプラットフォーム向けに調整された同じシステムであるという説明と一致します。また、ノートPC版N1Xはデスクトップ版の定格電力の32%から57%で動作し、ファミリーのすべてのシステムは「最大1ペタフロップス」のFP4性能で販売されていることを意味します。MicrosoftのSurfaceの脚注では、この数値はスパース性を使用した理論上のFP4性能であると説明されています。
| 製品仕様 | RTX Spark N1X(ノートパソコン) | RTX Spark N1X(ノートパソコン) | RTX Spark N1X(デスクトップ) | GB10(DGX Spark) |
|---|---|---|---|---|
| GPU | 6,144コアのBlackwell RTX | 5,120コアのBlackwell RTX | 6,144コアのBlackwell RTX | Blackwell、第5世代Tensorコア、第4世代RTコア |
| CPU | 20コアのグレース | 18コアのグレース | 20コアのグレース | 20個のArmコア(Cortex-X925が10個、Cortex-A725が10個) |
| TDP | 45〜80 W | 45〜80 W | 140W | 140W(240W電源アダプター) |
| ユニファイドメモリ | 最大128GB LPDDR5X | 最大64GB LPDDR5X | 最大128GB LPDDR5X | 64GBまたは128GB LPDDR5X、273GB/s |
| メディアエンジン | 第9世代NVENC×1、第6世代NVDEC×1 | 第9世代NVENC×1、第6世代NVDEC×1 | 第9世代NVENC×1、第6世代NVDEC×1 | NVENC 1基、NVDEC 1基 |
| ディスプレイとI/O | PCIe Gen5、HDMI 2.1b、DisplayPort 2.1b | PCIe Gen5、HDMI 2.1b、DisplayPort 2.1b | PCIe Gen5、HDMI 2.1b、DisplayPort 2.1b | HDMI 2.1a、ConnectX-7 200Gb/s、10GbE |
| オペレーティングシステム | Windows 11 | Windows 11 | Windows 11 | NVIDIA DGX OS |
NVIDIAはN1Xの高密度FP4値を公表していません。GB300では両方の値を公表していますが、高密度値は疎な値の75%です。OEMの熱設計によって、DGX Sparkユニットでは見られなかったような違いがこれらのノートPCに生じると予想されます。ベンダーによる調整前のノートPCのTDP範囲内で35Wの差があることは、その最初の確かな証拠です。
Microsoftはデスクトップ向け製品で独自の工夫を凝らしている。Surface RTX Spark Dev Boxのページには、1,000個の通気口を備えたアルミニウム製シャーシ内部の熱設計電力(TDP)が100Wと記載されている。これはNVIDIAがデスクトップ向けN1XのTDPとして公表している値より40W低い。両社は異なる指標(一方はチップの定格、もう一方はシャーシの設計上のポイント)を測定している可能性があるが、11月にコンパクトデスクトップを比較検討する購入者は、各ベンダーに自社製品の持続的な消費電力について問い合わせるべきだろう。
メモリ速度は、GB10 とのもう 1 つのプラットフォームの違いです。Dell の XPS 仕様書には LPDDR5X が 9,400 MT/s と記載されており、GB10 のような 256 ビット インターフェイスでは 300.8GB/s となり、6 月に NVIDIA が公表した 300GB/s と一致し、DGX Spark の 273GB/s を約 10% 上回ります。CPU と GPU は 600GB/s の NVLink-C2C で接続されます。表の残りの部分は 3 つの部分すべてに共通です。第 5 世代 Tensor コア、第 4 世代 RT コア、DLSS 5、Frame Warp 付き Reflex 2、および DSC 付きで最大 4K 480Hz または 8K 120Hz の HDMI 2.1b。
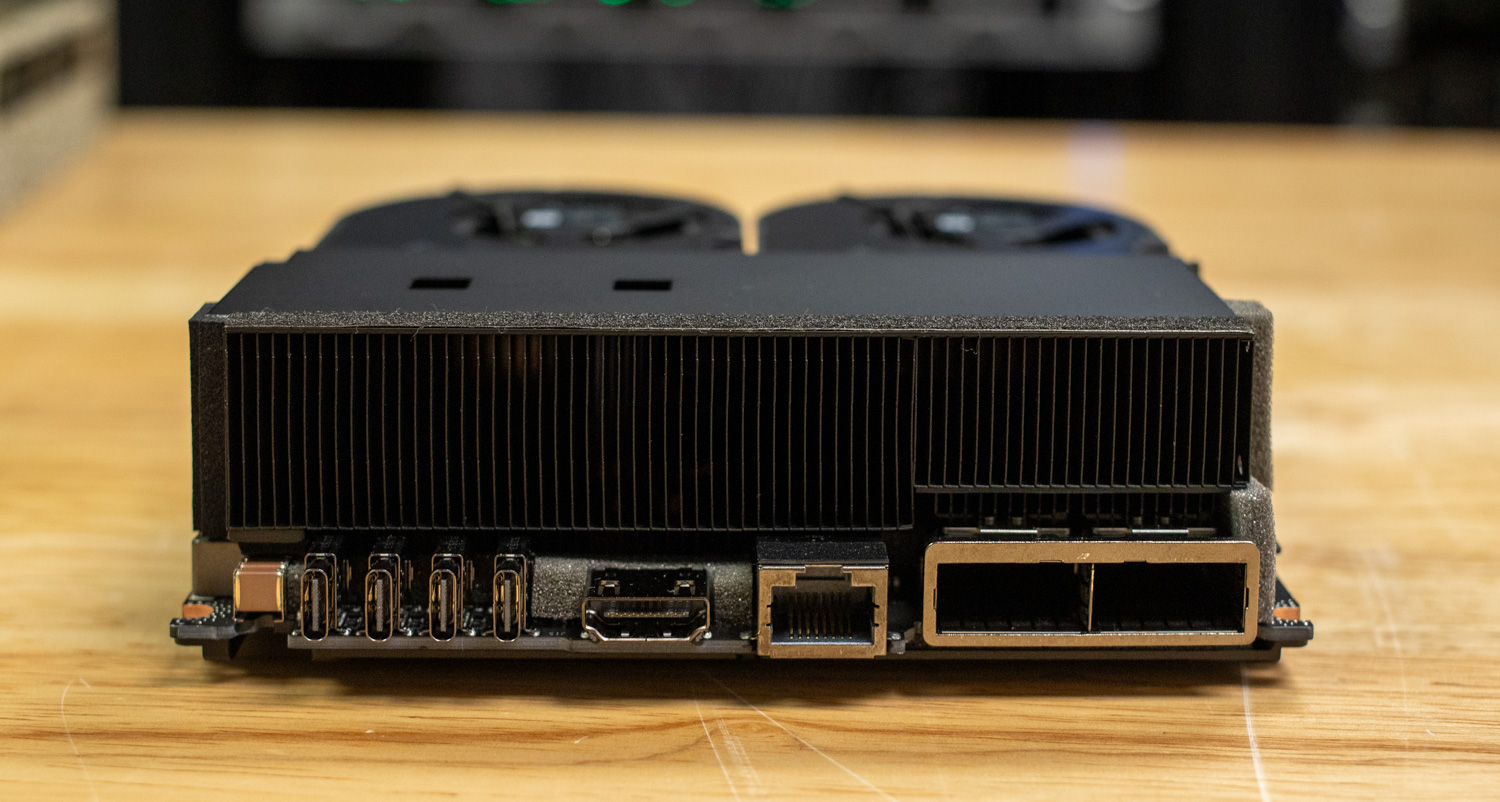
NVIDIAのマーケットプレイスには、予約注文可能なノートパソコンの構成が17種類掲載されており、そのラインナップには見出しの下にどれだけの製品が存在するかが示されています。私たちが目を通した15種類のうち、7種類は5,120コアのチップを使用しており、メモリは24GB、32GB、48GB、128GBの4種類、ストレージはPCIe Gen4とGen5ドライブが混在しています。
Windowsが128GBの統合メモリをどのように分割するか
メモリはCPUとGPU間で動的に共有され、GPUがアドレス指定できる最大メモリ容量は構成によって異なります。MicrosoftとGitHubのエンジニアリング記事に掲載されているタスクマネージャーのスクリーンショットには、6,144コアのN1Xを搭載したSurface Laptop Ultraでの表示例が示されています。Windowsは、専用GPUメモリ74.9GB、共有GPUメモリ35.5GB、合計GPUメモリ110GB、システムメモリ51.5GBを報告しています。
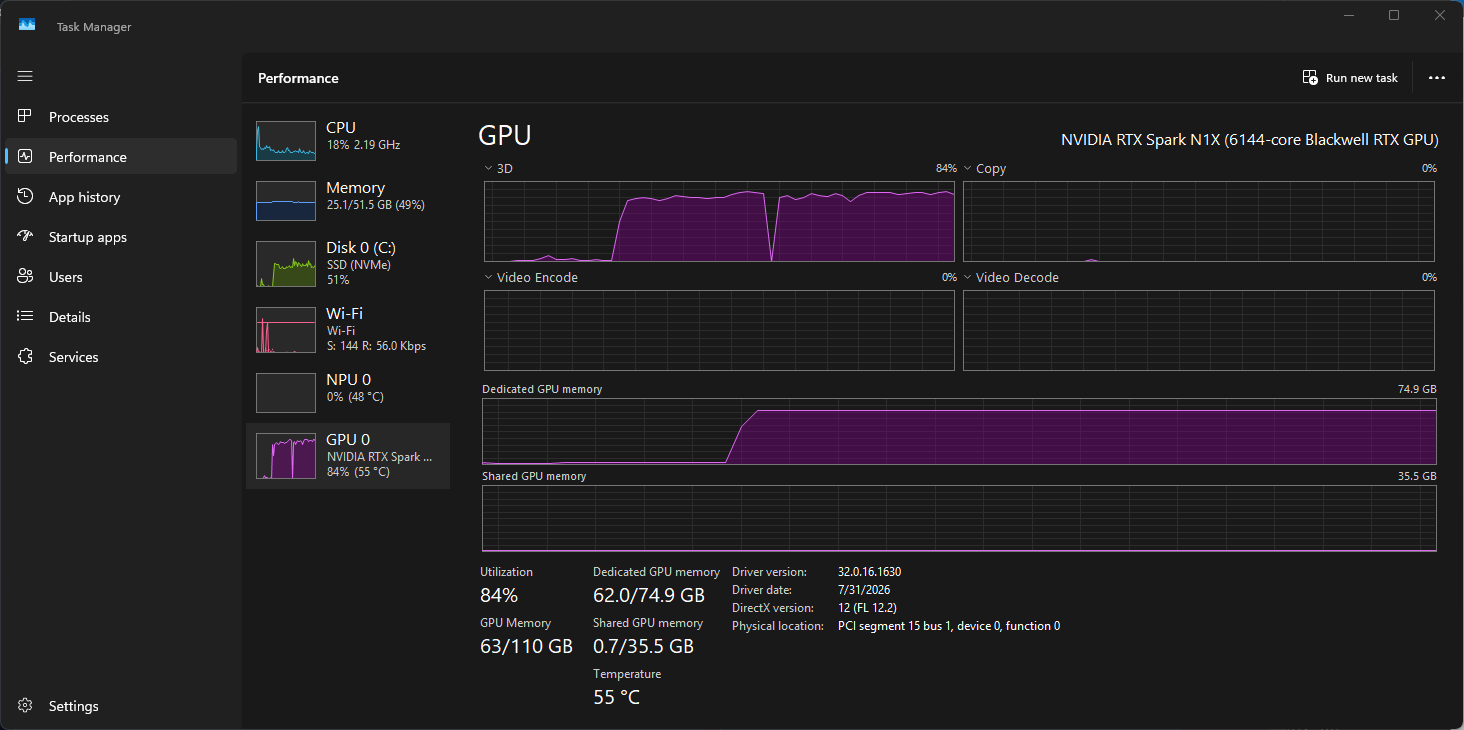
専用メモリとシステムメモリの合計は 126.4GB なので、Windows は統合プールをディスクリート カードと同じように表示しています。つまり、固定の専用割り当てがあり、GPU は上限までシステム メモリから借りることができます。このユニットでは、GPU の上限は 110GB、つまりインストールされている 128GB の 86% であり、重み、キー値キャッシュ、およびランタイム オーバーヘッドはすべてこの上限内に収まる必要があります。同じスクリーンショットには、7 月 31 日付けのドライバー 32.0.16.1630 と、GPU とは別のデバイスとしてリストされている NPU が表示されています。
この投稿では、モデルの重みはメモリ予算の一部に過ぎないことが明記されています。オペレーティングシステム、アプリケーション、推論ランタイム、そしてエージェントのコンテキストが拡大するにつれてアテンション状態を保持するKVキャッシュはすべて同じメモリプールからメモリを消費します。予約注文リストの大部分を占める24GBおよび32GB構成の場合、4ビットで27Bクラスのモデルを実装する余地はありますが、それ以上の容量はほとんどありません。発表資料に記載されている大規模モデルに関する記述はすべて128GB SKUを前提としています。
適合するもの:パラメータ数と重量あたりのビット数
同じチップについて提示されているパラメータの上限値は、若干ずれがあるようだ。NVIDIAの製品ページには、120万トークンのコンテキストで最大1億パラメータをモデル化できると記載されており、同社のブログでは、125億パラメータの例としてQwen 3.8 Flash Nextが挙げられている。Microsoftは、120億を超えるモデルがあると述べ、RTX Sparkに搭載されるモデルとして、137億パラメータのMAI Code 1.1 Flashと284億パラメータのDeepSeek V4 Flashを挙げている。Dellは200億パラメータとしている。この差は、各重みに割り当てられるビット数の違いによるものだ。
| モデル | 技術パラメータ | 精度 | フットプリント | ソース |
|---|---|---|---|---|
| MAIコード1.1フラッシュ | 総額137億人、アクティブユーザー数6.8億人(専門家を含む) | 混合精度、重みあたり約3.3ビット | 53GBの重み、256Kコンテキストでピーク時75.5GB | マイクロソフト、GitHub |
| NVIDIA Nemotron(近日発売予定) | 70億ドル以上 | 2ビット | 20GB強 | Microsoft |
| DeepSeek V4 フラッシュ | 284B | 記載されていない | 記載されていない | Microsoft |
| Qwen 3.8 フラッシュ ネクスト | 125B | 記載されていない | 記載されていない | NVIDIA |
| クウェン3.5 27B | 27B | 翻訳元 | 記載されていない | マイクロソフトのベンチマークに関する注釈 |
Microsoft の MAI Code 1.1 Flash の数値が最も完全です。BF16 のクラウド モデルは 274GB、デバイス上のビルドは 53GB で、Microsoft はこれを 80% 削減と呼んでおり、混合精度量子化で重みあたり約 3.3 ビットです。Nemotron の数値も同様で、70 億の重みに 2 ビットを使用すると、オーバーヘッドを除いて 17.5GB になります。DeepSeek V4 Flash は 284 億のパラメータがあり、コンテキストをロードする前に、110GB の GPU 上限内に収まるには重みあたり約 3.1 ~ 3.3 ビット以下が必要です。
3ビットの主張が注目に値するのは、その品質データによるものです。Microsoftは、SWE-Benchで量子化されたデバイス内モデルが70.8%であると報告しており、これはBF16クラウド版の72.6%と比較して検証されています。また、Terminal-Bench 2.1では66.29%で、62.9%と比較しています。2番目の結果では量子化モデルが先行していますが、89タスクのセットでは3タスクの差であり、ノイズと見なされます。比較対象であるUnslothのGPT-OSS-120B GGUFは、同じ2つのテストで32.0%と23.6%のスコアでした。
スループットは、CUDA バックエンドと Microsoft が DFlash2 スライディング ウィンドウ投機的デコードと呼ぶ機能を備えた llama.cpp の Windows Arm64 ビルドを Surface Laptop Ultra 上で実行し、合成コード生成ワークロードでテストした結果です。Microsoft のチャートにはデータ ラベルがないため、推定値は次のとおりです。2K プロンプトで毎秒約 63 トークン、8K で 61、32K で 57、64K で 52、120K で 55、256K で 39。256K コンテキストでのピーク メモリは 75.5GB で、タスク マネージャーのキャプチャで専用 GPU の値とほぼ一致します。

エージェントの作業において、プロンプト処理は重要な指標です。Microsoft は、64K コンテキストで毎秒 923.5 トークン、128K コンテキストで毎秒 769.8 トークンを提供しています。64K のコールドプロンプトの処理には約 71 秒、128K のコールドプロンプトでは最初の出力トークンが表示されるまでに約 170 秒かかります。ブログ記事では、モデルをロードしたままにしておいても応答時間が一定になるとは限らないこと、Copilot は作業のルーティング時にキャッシュの状態を考慮するため、レビュー用ハードウェアで最初に測定するのはプリフィルである、という関連事項が指摘されています。
MacBookの比較とその注釈
Microsoft の比較では、RTX Spark PC を M5 Pro と 64GB を搭載した 16 インチ MacBook Pro と比較しています。最初のトークンまでの時間は最大 2.1 倍速く、画像生成は 4.3 倍速く、ビデオ生成は 6.2 倍速くなっています。最初のトークンは、Microsoft が llama.cpp で Qwen3.5 27B (Q4_K_M) と固定の 8,192 トークンのプロンプトを使用して行ったテストです。残りの 2 つは NVIDIA が ComfyUI で行ったテストで、FLUX.2 Klein 4B (4 ステップ、1024 x 1024) と LTX 2.3 22B (121 フレーム、8 ステップ、1280 x 720) を使用しています。
脚注にはいくつかの但し書きがあり、まずハードウェアについてです。すべてのテストは9月に64GBのRTX Spark試作機で実行され、比較対象はAppleのM5 Proで、M5 Maxは含まれていません。ComfyUIのテストはどちらもNVFP4精度のモデルを使用しており、脚注にはMacのソフトウェア構成は記載されていません。言語モデルの結果は、プロンプトの長さ1つでのプリフィル測定であり、どちらの企業も1秒あたりのトークンデコード数の比較は公表していません。これは、ほとんどのローカルLLMユーザーが引用する数値です。
ゲームに関しては、NVIDIAは、タイトルや設定は明かさずに、RTX SparkがDLSS 5、Reflex、G-SYNCを使用して1440pで100フレーム/秒以上でAAAタイトルを実行できると述べています。Microsoftの貢献は、DirectXレイトレーシング、可変レートシェーディング、DirectStorage、およびAdvanced Shader Deliveryを備えたGears of War: E-Dayで、Microsoftによると、これにより最初の起動時のシェーダーコンパイルが数分から数秒に短縮され、さらにCall of Dutyが2027年にRTX Sparkに対応するという約束もしています。Prismとアンチチートの詳細については、Dellの報道をご覧ください。
Microsoft Execution Containers: エージェントサンドボックスの仕組み
MXCは、Windows 11搭載PCであればどれでも適用でき、macOSとLinux用のバックエンドを備えたオープンソースライブラリおよび多言語SDKとして提供されるため、今回の発表の中で最も影響力の大きい部分です。開発者は、ワークロードが必要とするものをJSONポリシーで宣言します。具体的には、変更可能なファイル、読み取り専用のファイル、インバウンドおよびアウトバウンドのネットワークアクセス、デスクトップへのアクセス権限などです。MXCはこのポリシーを分離バックエンドにマッピングし、実行時に適用します。ポリシーはワークロードの外部に存在するため、生成されたコードが自身にそれ以上のアクセス権限を付与することはできません。
| MXCバックエンド | プラットフォーム | メカニズム | 使用目的 |
|---|---|---|---|
| プロセスコンテナ | Windows 11、macOS、Linux | WindowsではAppContainer、macOSではSeatbelt、LinuxではBubblewrapが使われています。 | モデル生成コードとツール実行のための低遅延隔離 |
| セッションコンテナ | Windows 11のみ | 独自のデスクトップ、クリップボード、UI、入力を備えた、独立したWindowsアカウントとセッション | デスクトップが必要な長時間実行されるエージェントと自動化 |
| WSLコンテナ(WSLc) | Windows 11のみ | WSLを介したLinux実行環境 | Linuxファーストのエージェントツールチェーン |
| MicroVM | Windows 11およびLinux(実験的) | ハードウェアによって強制される仮想化境界 | リスクの高いワークロードと信頼できないコード |
ポリシー作成サイクルは、3つの動作モードでカバーされます。Enforcementモードではポリシー外の操作はすべてブロックされ、Learningモードではブロックされた操作がJSONアクティビティレポートに記録されます。Permissiveモードでは操作が許可され、拒否されるはずだった操作が記録されるため、チームはエージェントを実際の作業に通して実行し、その証拠に基づいて最小権限ポリシーを構築できます。アクティビティレポートは、Windows上のプロセスコンテナでのみ利用可能です。組織は管理ツールを使用して開発者のポリシーに独自の制約を追加でき、MicrosoftはMXCプロセスコンテナのIntune管理が間もなく提供されると述べています。
一般的に利用可能な機能について明確にしておくことが重要です。10月7日に出荷されたのは、封じ込め機能です。エージェントのID管理機能(Microsoft Entraがエージェントのアクションをサインインしているユーザーのアクションと区別する機能)は近日中に提供開始予定であり、Agent 365の制御機能をローカルエージェントに拡張する機能も同様です。これらの機能が提供されるまでは、MXCコンテナによってエージェントがアクセスできる範囲が制限されますが、セキュリティツールは依然としてユーザーのIDの下でのエージェントのアクティビティを認識し、Microsoftが説明するフリートレベルのガバナンスはまだ実装されていません。Microsoftの脚注には、大規模なガバナンスには追加のサービスが必要になる可能性があると付け加えられています。
GitHub の統合に関する説明は、その境界がどこにあるのかを示しています。Copilot は Windows 上でプロセス コンテナのベース層を使用し、シェル コマンドは、デフォルトでローカルの Model Context Protocol サーバーと言語サーバーとともにその中で実行されます。Copilot の組み込みファイル ツールはエージェント ハーネスで実行され、リクエストはポリシーに対してチェックされますが、オペレーティングシステムによって隔離されません。また、リモート MCP サーバーはローカル サンドボックスの外部に完全に存在します。ローカル推論は、シェル コマンドがどのモデルから要求されたかに関わらず同じアクセス権限を継承するため、これらの点を一切変更しません。
現在MXCをサポートするエージェントには、GitHub Copilot、OpenAI Codex、OpenClaw、Replit、LM Studio、Unsloth AIなどがあり、今後サポート予定のエージェントには、Claude Code、Perplexity、Manus、Hermes Agentなどが含まれています。NVIDIAはOpenShellをMXCに統合しており、Microsoftによると、これによりエージェントのファイルおよび推論サービスへのアクセスに関するポリシー制御、高度なネットワーク制御、資格情報管理、企業向けのOCSF監査機能が追加されるとのことです。
黄氏は発表の重みをコンテナ層に置き、「WindowsとDirectXがアプリケーションの構築方法に革命をもたらしたように、MXCはエージェントの構築と展開方法に革命をもたらすだろう」と述べた。我々の見解はより限定的だ。ポリシーモデルは健全であり、クロスプラットフォームSDKによって導入コストは低下するが、これまでに詳細に説明された統合は最も軽量なバックエンドを使用しており、エージェントが得られる分離性は、開発者が選択したバックエンドの強度に依存する。
ハイブリッドルーティング:HydraFusion、Windows ML、およびllama.cpp
ローカルモデルは、GitHub Copilot を通じて開発者に提供されます。GitHub が今年初めに各タスクを適切なクラウドモデルにルーティングするためにリリースした HydraFusion は、デバイス上のモデルにも拡張され、10 月下旬には Copilot アプリ、Copilot CLI、Visual Studio Code で実験的なプレビューが提供されます。開発者は配置を「自動」のままにするか、Windows ML プロバイダー経由の MAI Code 1.1 Flash または OpenAI 互換のローカルエンドポイントの背後にある任意のモデルを明示的に選択できます。
Microsoft は、上記の MAI Code の数値が生成されたランタイムである Windows ML に llama.cpp のサポートも追加しました。これにより、オープンモデルのエコシステムがプラットフォームへのサポートされたパスを取得できます。当社の「ベスト ローカル LLM ツール」ページでは、このプラットフォーム上に構築されたランタイムとフロントエンドを追跡しています。ただし、Microsoft 自身によるこの主張の規模は控えめです。同社の Dev Box ページでは、インテリジェント ルーティングにより Copilot ワークロードの最大 20% をローカル モデルにオフロードできると述べており、ローカル推論はトークン予算を拡張する方法として位置づけられ、クラウドが依然としてほとんどの作業を実行します。
システム、価格、および日程
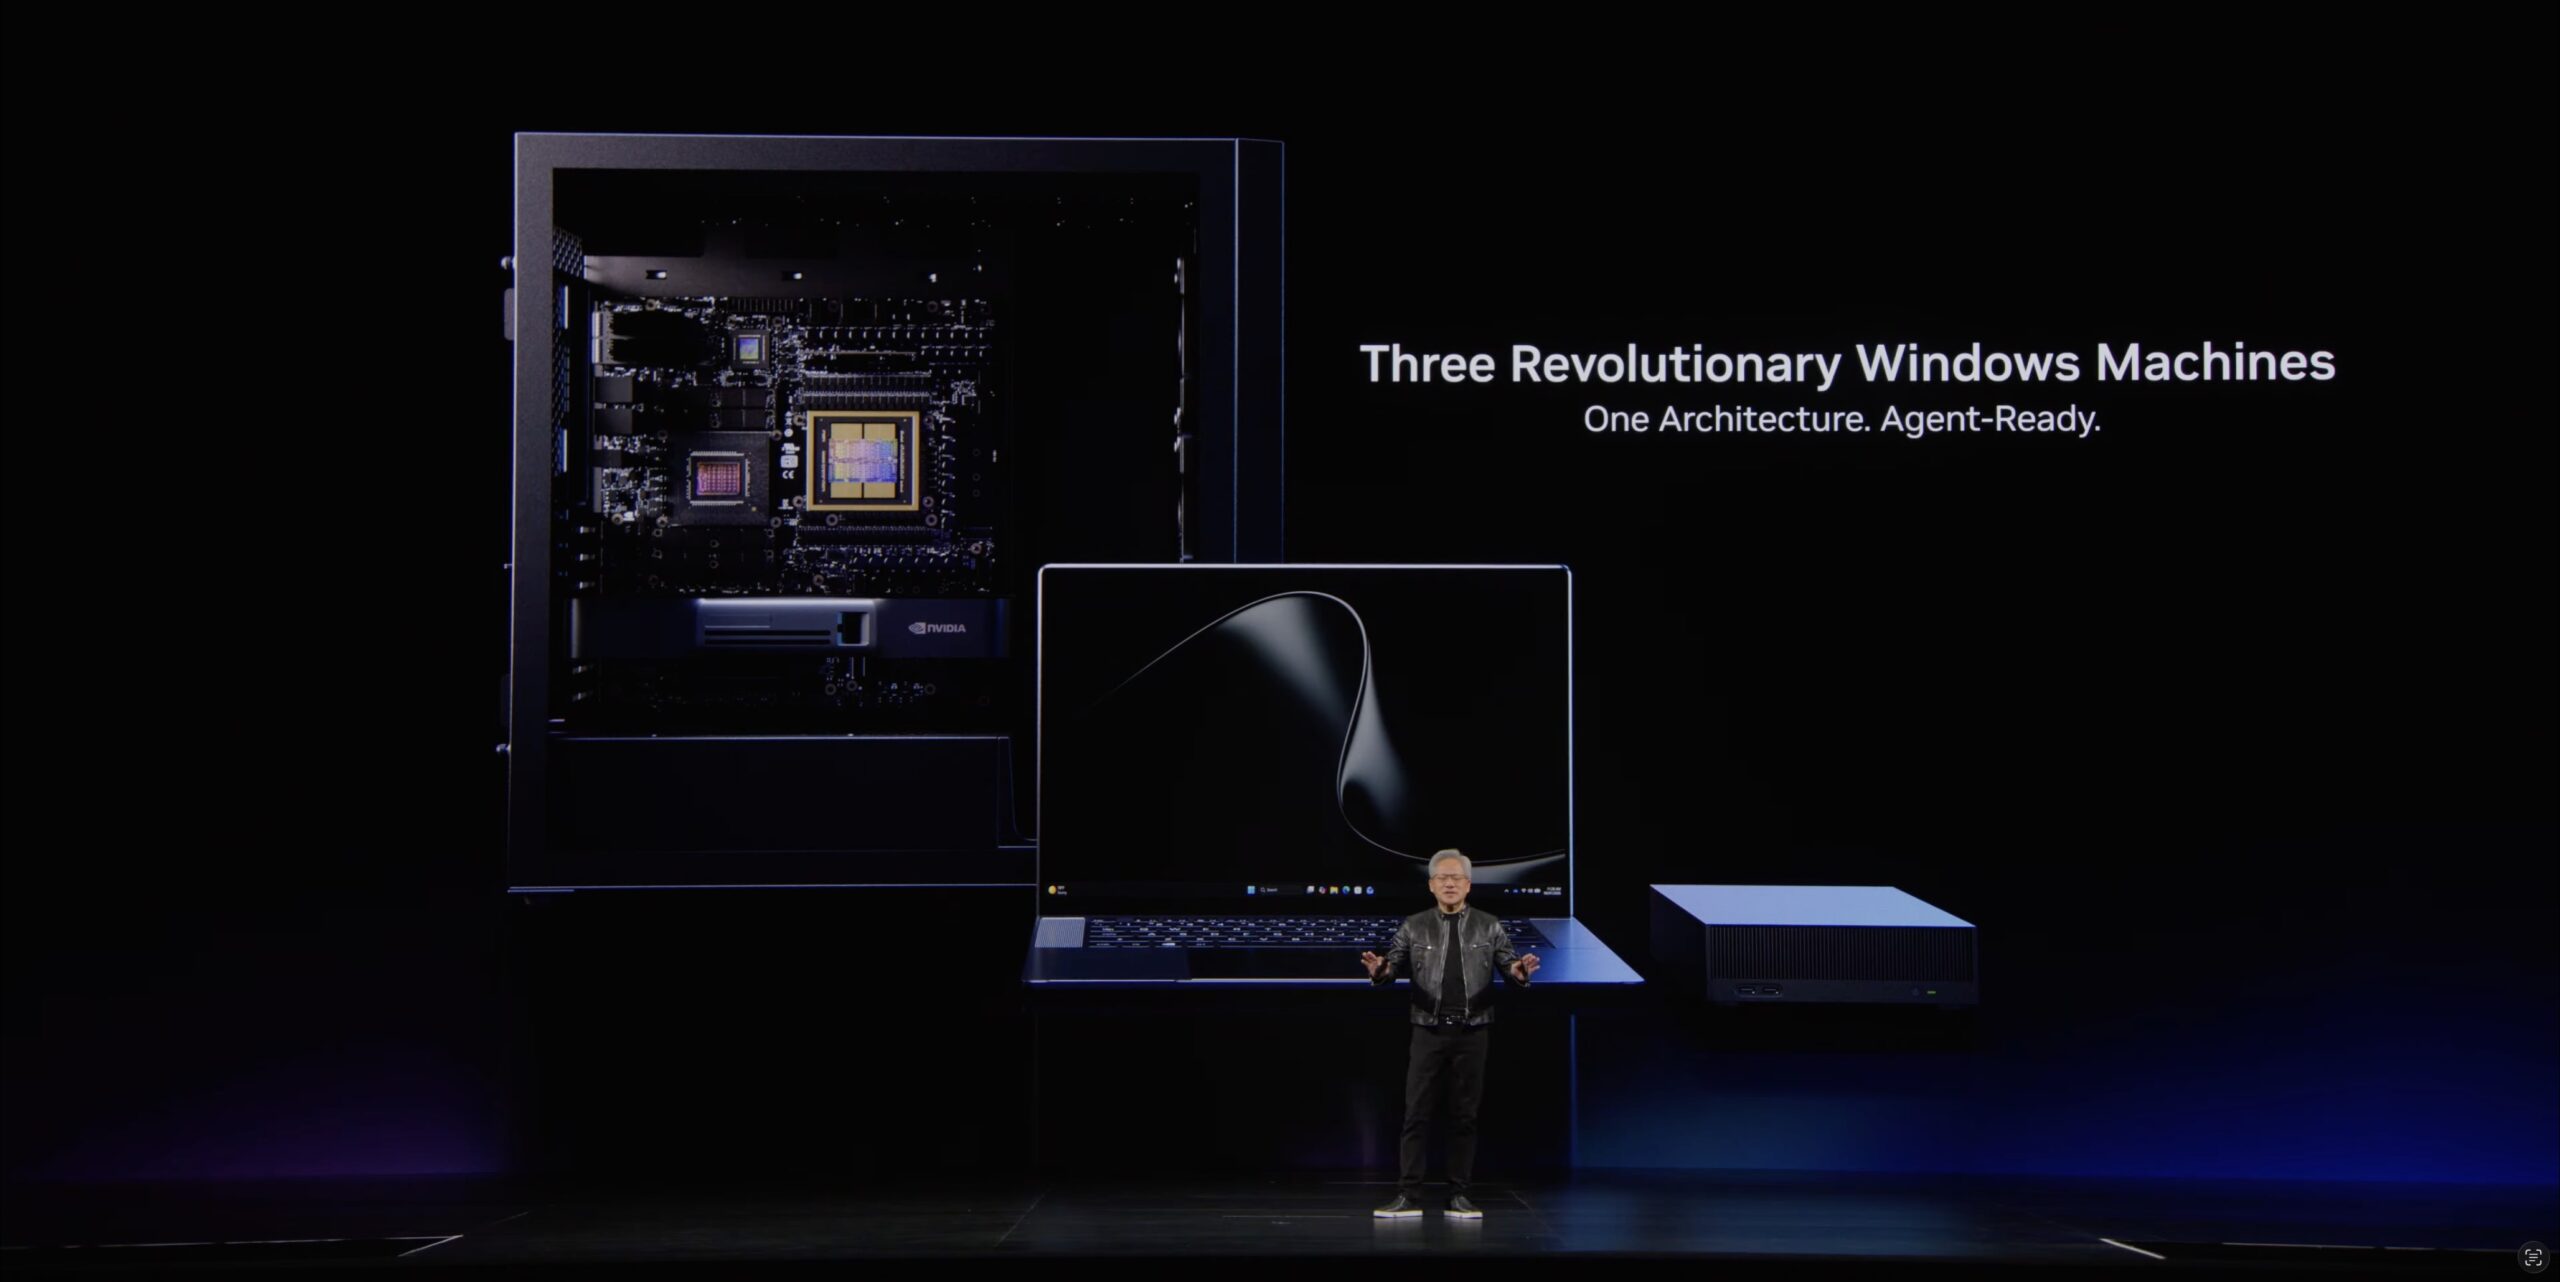
6社のOEMが10月16日発売予定のノートパソコンの予約販売を開始している。ASUS ProArt P16とP14、Dell XPS 16 Creator Edition、HP OmniBook Ultra 16、Lenovo Yoga 9n 2-in-1、MSI Prestige N16 Flip AI+、そしてMicrosoftのSurface Laptop Ultraだ。NVIDIAのマーケットプレイスにはHP OmniBook X 14も掲載されている。MSIのマシンは16インチUHD+タンデムOLEDと99.9Whのバッテリーを搭載している。NVIDIAはさらに、RTX Sparkシステムを出荷するベンダーとしてAcerとGigabyteの名前を挙げている。
Surface Laptop Ultra は、これまで見た中で最も安い RTX Spark 搭載モデルで、厚さ 18 mm、重さ 4.5 ポンドの筐体を採用し、価格は 2,599 ドルからとなっています。Microsoft は、現在の Surface Laptop の 2.5 倍の熱容量、10% のウィンドウで測定したピーク HDR 輝度 2,000 nit の 3270 x 2180 の 15 インチ 120Hz タッチスクリーン、ユーザーが取り外し可能なストレージ、ビデオとデータを伝送できるマグネット式の USB-C 充電ポートを搭載していると主張しています。一部の構成では 140W の電源が付属します。NVIDIA のマーケットプレイスで最も低い構成では、5,120 コアのチップと 24GB メモリ、512GB Gen4 SSD が組み合わされています。
Surface RTX Spark Dev Boxは、価格が発表された初のコンパクトデスクトップで、128GBモデルは5,999ドル。米国ではMicrosoft.comでのみ販売され、11月に出荷予定。Visual Studio Code、Git、GitHub Copilot、WSL、Python、Nodeがプリインストールされている。これは、メモリが2倍の64GB DGX Spark(4,999ドル)より1,000ドル高い。Microsoftは、USB-Cポート2つ、USB-Aポート、HDMIポート、イーサネットポート、ヘッドホンジャックを挙げているが、DGX Sparkのクラスタリングを可能にするConnectX-7ポートについては言及していない。これは、6月に提起したデスクトップネットワークに関する疑問への回答の1つである。
DGX Station for Windows:第4四半期、全仕様表付き
NVIDIA の DGX Station for Windows のページには「第 4 四半期に登場」と表示され、Microsoft は、システムが今年後半に登場すると述べ、最初に Dell Pro Precision with GB300 と HP ZGX Fury AI Station を挙げています。NVIDIA のパートナー リストには、ASUS、Gigabyte、MSI、Supermicro が追加されています。ハードウェアは、MSI XpertStation WS300、ASUS ExpertCenter Pro ET900N G3、および2 つのタワー クラスターで Ubuntu 上でテストした GB300 Grace Blackwell Ultra Desktop Superchip です。
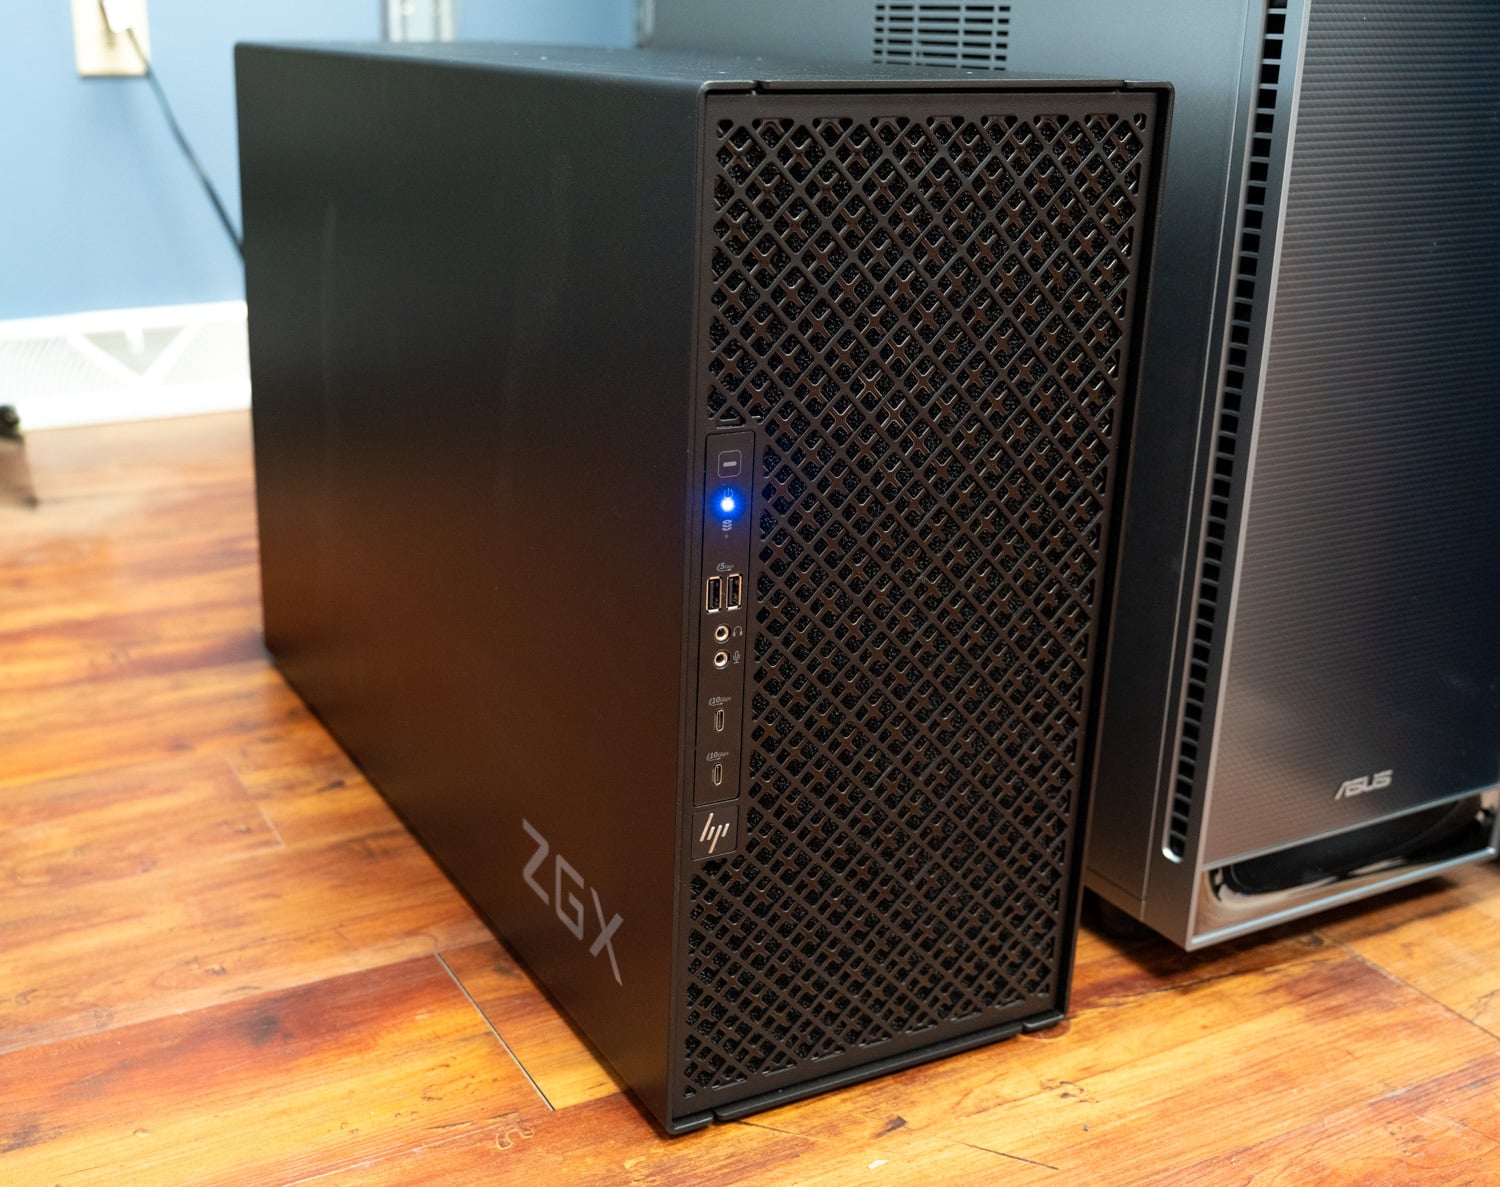
| 製品仕様 | Windows版NVIDIA DGX Station |
|---|---|
| GPU | NVIDIA Blackwell Ultra 1基、252GB HBM3e(7.1TB/s) |
| CPU | Graceプロセッサ1基、Neoverse V2コア72基、LPDDR5Xメモリ496GB(396GB/s) |
| コヒーレントメモリ | 最大748GB、NVLink-C2Cで900GB/s |
| FP4テンソルコア | スパース性ありで20 PFLOPS、スパース性なしで15 PFLOPS |
| FP8およびFP6テンソルコア | 10PFLOPS |
| FP16およびBF16テンソルコア | 5PFLOPS |
| TF32 テンソル コア | 2.5PFLOPS |
| FP32 / FP64 | 80 TFLOPS / 1.3 TFLOPS |
| Networking | ConnectX-8 SuperNIC、最大800Gb/s:ポートあたり400Gb/sのQSFP112×2 10GbE RJ-45ポート×1、1GbE RJ-45ポート×1(BMC) |
| Storage | M.2 PCIe Gen5スロット×4 |
| PCIeスロット | PCIe Gen5 x16 x 1、PCIe Gen5 x16 x 2(電気的にはx8) |
| 対応RTX PRO GPU | RTX PRO 6000 ワークステーションエディション、RTX PRO 6000 Blackwell Max-Q ワークステーションエディション、RTX PRO 4000 Blackwell SFF エディション、RTX PRO 2000 Blackwell(サポート状況はシステムによって異なる場合があります) |
| デコーダ | NVDEC 7、NVJPEG 7 |
| システム電源 | 1,600W、20A回路が必要 |
| オペレーティングシステム | Microsoft Windows、WSL経由のLinuxツールチェーン |
マイクロソフトは、Windows DGX Stationの用途を2つ挙げている。1つは、エンジニアリングや研究作業用の個人用AIスーパーコンピュータで、Llama 4 Maverick、Kimi K2.6、DeepSeek V4 Proといったモデルを実行できる。脚注によると、このハードウェアは最大1兆個のパラメータを持つモデルをサポートする。もう1つは、Windowsトークンファクトリーと呼ばれるもので、クラウドトークンの消費量を削減するために、チームで同時に32個以上のエージェントをサポートする共有システムだ。マイクロソフトによれば、IT部門はこれらのシステムを、Windows環境全体で使用しているツールと同じツールで管理できるという。
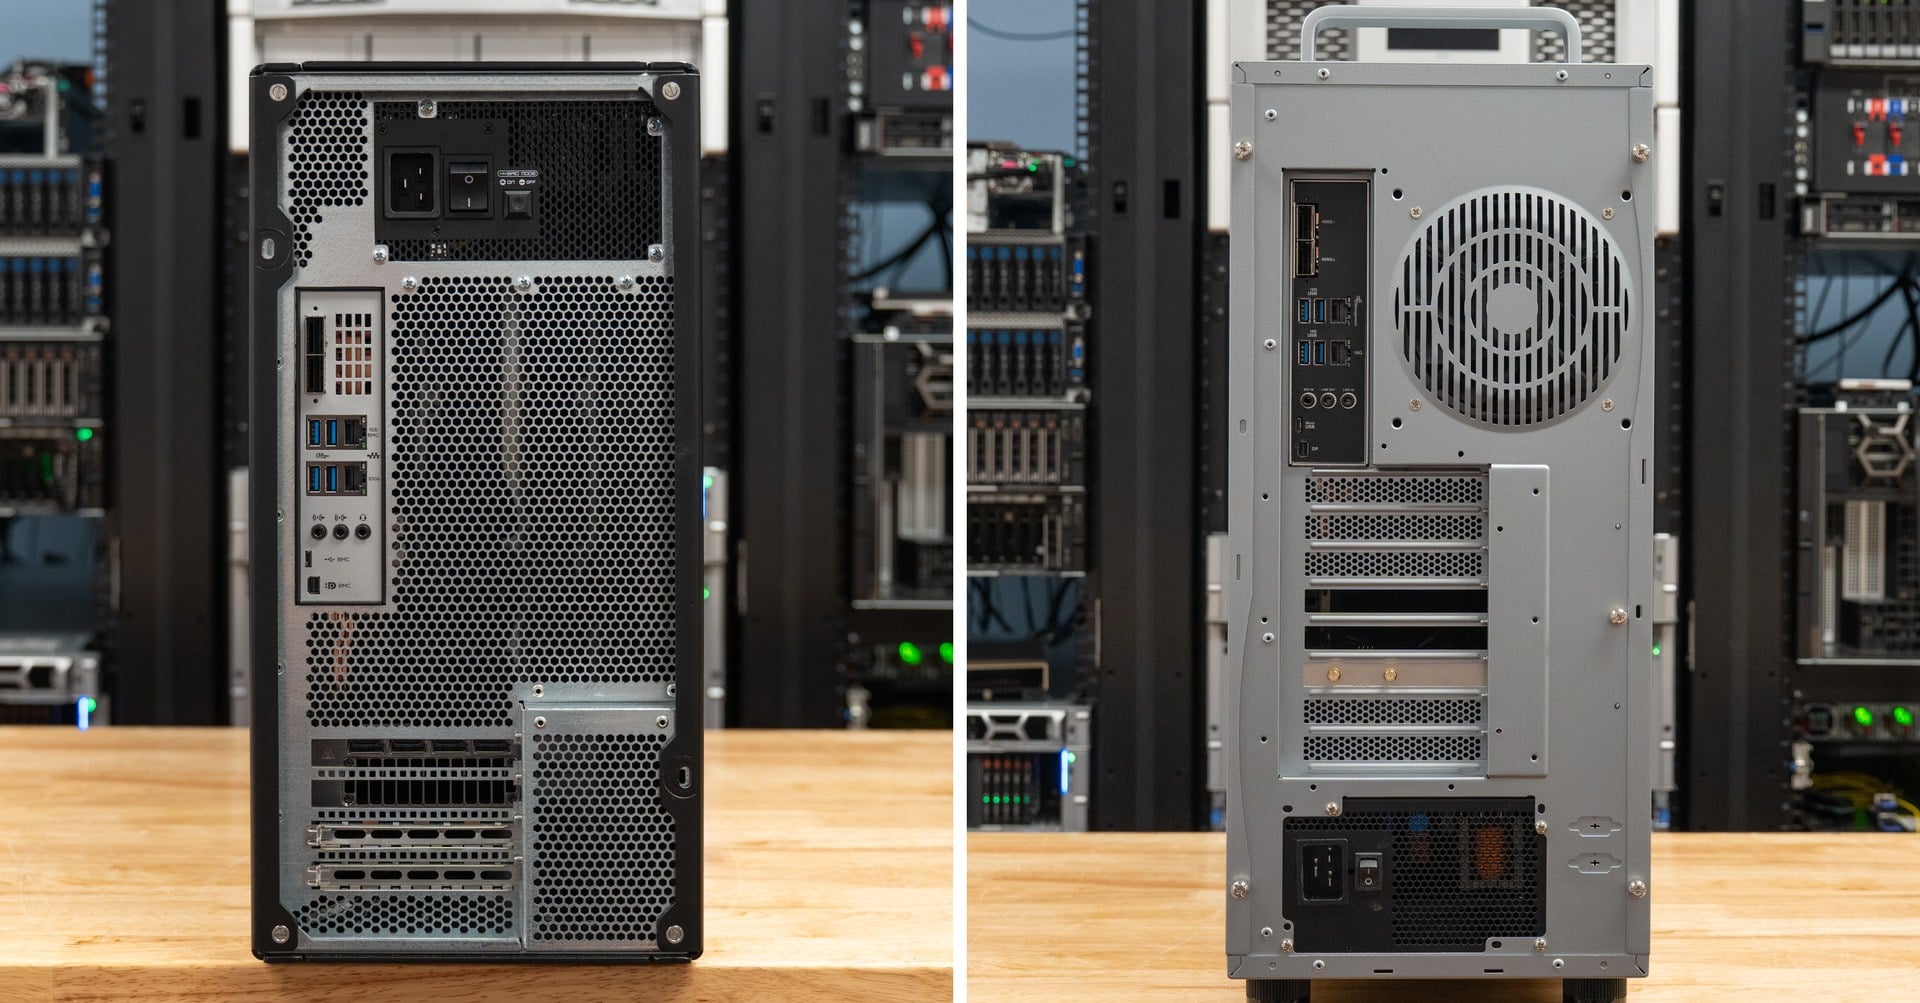
オプションのRTX PROカードは、LinuxよりもWindowsにおいてより重要になります。Computexで指摘したように、GB300に搭載されているBlackwell Ultra GPUにはRTコアがないため、Windowsの設計・エンジニアリングアプリケーションにおけるレイトレーシングによる可視化はアドインカード上で実行され、スーパーチップはAI処理を担当します。NVIDIAは、RTX PRO 2000から6000までの4種類のRTX PRO Blackwellカードをサポート対象として挙げており、サポート状況はシステムによって異なる場合があるとしています。
6月に提起した未解決の疑問は、依然として解決されていません。GB300に関する当社の調査はすべてUbuntu上でvLLMとNVIDIAコンテナスタックを使用して行われましたが、どちらの企業も、このハードウェア上でWindows上でネイティブに動作するサービングスタックとWSL上で動作するサービングスタック、あるいは72コアのGraceホストと2つの400Gb/sポートでWSLを使用した場合のスループットコストについて明らかにしていません。これらは、Windows搭載機がラボに届き次第、最初にテストする事項です。
まとめると
発表資料には、Computex で未解決のまま残されたいくつかの疑問に対する回答が記載されている。ノート PC では 45 ~ 80 W、デスクトップでは 140 W でチップが動作する。128GB オプションは 2 つのチップのうち大きい方に関連付けられている。Windows は、インストールされている合計よりも低い GPU アドレス指定可能なメモリに制限している。また、Microsoft 初のコンパクト デスクトップには高速ネットワークは記載されていない。Microsoft の Windows およびデバイス担当エグゼクティブ バイスプレジデントである Pavan Davuluri 氏の「このノート PC では、従来のマシンには収まらないモデルを実行できる」という発言は 128GB 構成に当てはまり、Microsoft の 137B コーディング モデルを毎秒約 60 トークンで実行することは、そのデモンストレーションである。
まだ明らかになっていないのは、特定のシャーシに依存するすべての要素です。長時間のエージェントセッションにおける持続的な電力、AppleのM5 MaxやAMDのStrix Haloシステムに対するデコードスループット、推論時のバッテリー駆動時間、そして128GBノートPCのほとんどの価格などです。また、先月ファームウェアでWindowsブート証明書を取得したGB10ベースのDGX SparkにWindowsがいつ搭載されるかも不明です。レビューユニットは、ローカルAI向けベストノートPCおよびローカルAI向けベストデスクトップPCのランキングと同じテストスイートでテストされます。



 Amazon