

SupermicroのJumpStartプログラムは、AIインフラストラクチャの購入前評価ツールキットの中で最も有用なツールの1つとして定着しています。共有環境でのスクリプト化されたデモではなく、JumpStartは、資格のあるユーザーにSSH、IPMI、VNCを介して実際のプロダクションサーバーへの無料かつ時間制限付きのベアメタルアクセスを提供し、実際のハードウェアでワークロードを実行できるようにします。昨年11月、NVIDIA HGX B200を搭載したX14システムを使用してこのプログラムを詳細に調査し、1週間の集中アクセスで何がわかるのか、何がわからないのかを明確に把握しました。今回は、Supermicroはアクセラレータのストーリーがまったく異なるH14 8Uシステムへのアクセスを提供しました。
今回テストしたのは、デュアル AMD EPYC 9575F プロセッサと 8 基の AMD Instinct MI350X GPU を搭載した 8U 空冷プラットフォームであるAS-8126GS-TNMRシステムです。MI350X は、TSMC の 3nm ノードで第 4 世代 CDNA アーキテクチャに基づいて構築され、GPU あたり 288GB の HBM3e を搭載した、AMD の現在のフラッグシップ データ センター アクセラレータです。AMD Infinity Fabric を介して相互接続された 8 基の GPU により、このサーバーは単一ノードで合計 2.3 TB の GPU メモリを提供し、総帯域幅は 1,024 GB/s です。システム全体では、3+3 冗長構成で 6 台の 5,250W Titanium レベル電源を使用し、Supermicro はスケールアウト展開のために GPU ごとに専用の 400 Gbps ネットワークを用意しています。
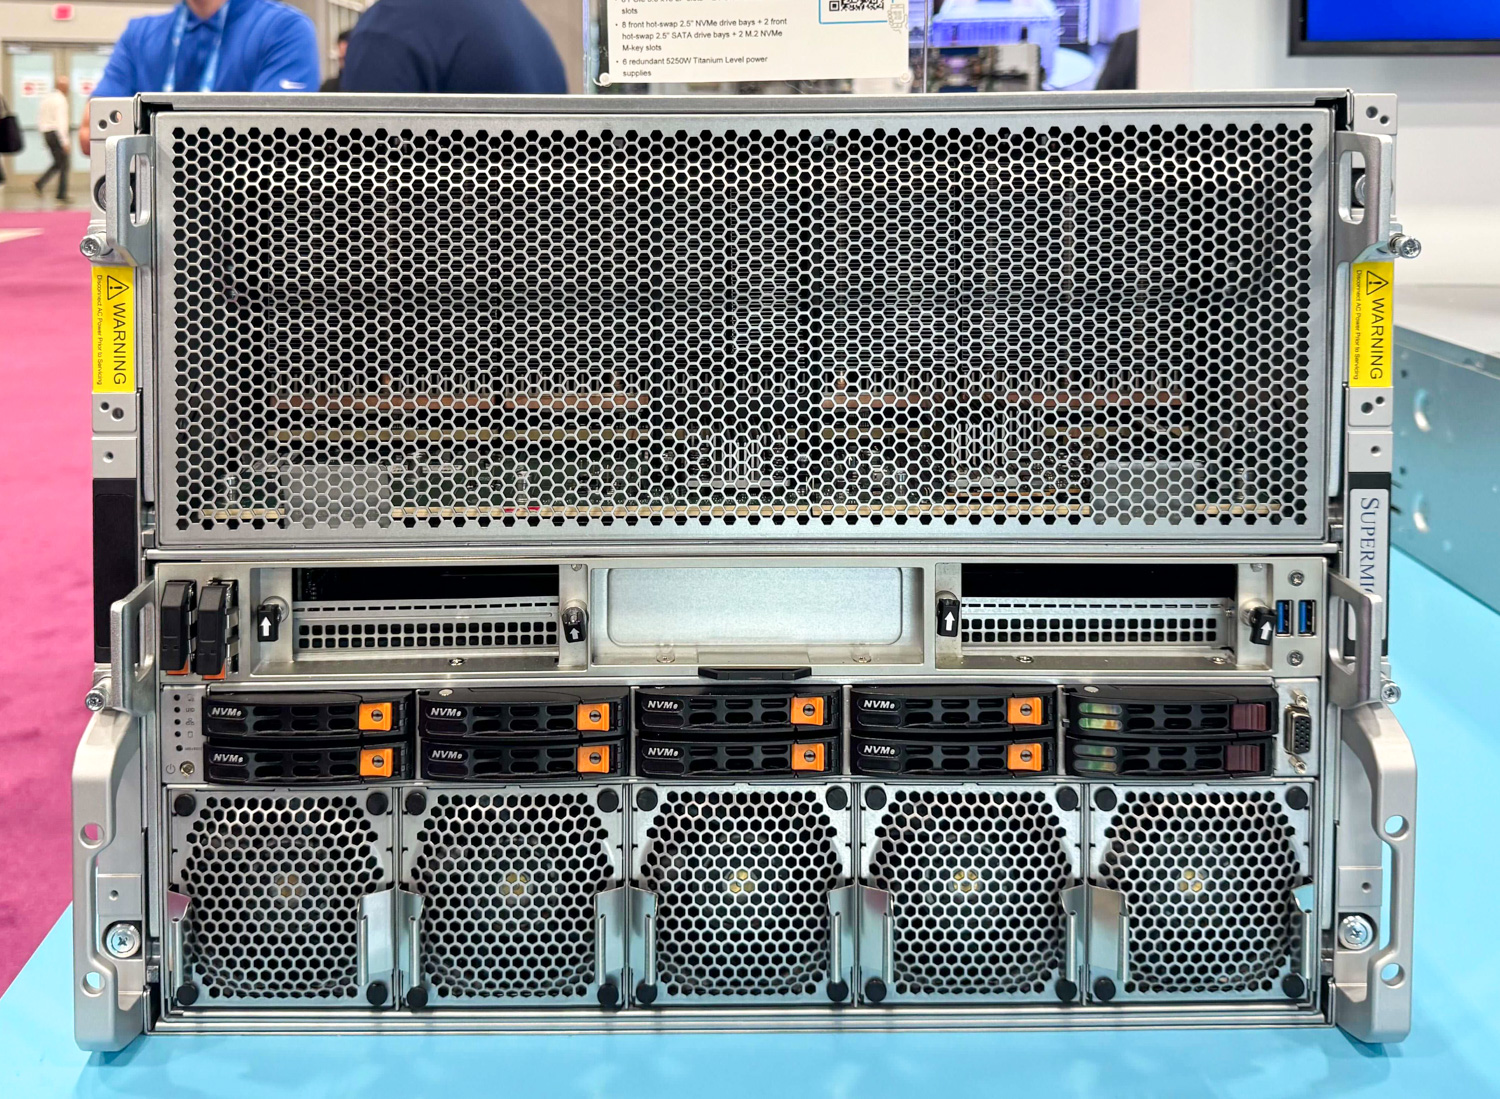
AMD のデータセンター GPU 市場における地位は過去 2 年間で大きく変化しており、MI350X 世代は、これまでの Instinct 製品よりも NVIDIA にとってより深刻な競争上の脅威となっています。2025 年 9 月にリリースされ、現在はバージョン 7.2 となっている ROCm 7 では、MI350X のネイティブ サポートに加え、推論パフォーマンスが大幅に向上し、CUDA との互換性ギャップを解消する HIP API の更新、PyTorch、JAX、TensorFlow、ONNX Runtime、vLLM、SGLang などのフレームワーク サポートが拡大されました。
vLLMプロジェクトは2025年12月下旬に専用のAMD ROCm CIパイプラインを追加し、AMDハードウェアを下流ポートではなく、その推論スタックにおける第一級プラットフォームとした。エコシステムの採用も無視できない。AMDとMetaは2026年2月に複数年、複数世代にわたる6ギガワットGPUの導入契約を発表し、Metaが既に本番環境で展開しているMI300およびMI350シリーズのハードウェアを基盤としている。世界最大級のAIインフラ事業者の1社によるこのレベルのコミットメントは、単なるマーケティング上の付け足しではない。
現在AIアクセラレータのインフラストラクチャを評価している組織にとって、NVIDIAハードウェアのリードタイムは依然として懸念事項です。問題は、AMDが代替案としてではなく、信頼できる選択肢となり得るかどうかです。ROCm 7.2.0と最新のvLLMを用いた1週間のテストに基づくと、その答えは18か月前とは大きく異なっています。
今回のテストでは、人気のあるモデルをいくつか取り上げました。単一ノードに搭載された2.3TBのHBM3eにより、Moonshot社のKimi K2.5やMiniMax M2.5といった大規模パラメータモデルに対して、単一サーバーでの推論が可能になりました。
AMD Instinct MI350X:アーキテクチャと世代間の改良点
MI350Xは、AMDのInstinctシリーズにおいて、これまでで最も野心的なアーキテクチャ上の世代交代を象徴する製品です。その背後にある設計上の決定を理解することは、その後のパフォーマンス結果を解釈する上で重要な背景となります。
CDNA 4 アーキテクチャとプロセスノードの移行
MI300シリーズからMI350シリーズへの根本的な変化は、アクセラレータ・コンピューティング・チップレット(XCD)にTSMCのN3Pプロセスノードを採用したことにあり、これは前世代で使用されていた5nmプロセスから移行したものです。トランジスタ総数は約185億個に達し、MI300世代と比較して約21%増加しましたが、消費電力の増加は伴っていません。
MI350Xは、AMDの実績あるマルチチップレット構成を採用しています。GPUパッケージの中核となるのは、主要な演算エンジンとして8つのアクセラレータ演算チップレット(XCD)です。各XCDには4つのシェーダーエンジンが搭載され、それぞれに8つのアクティブなCDNA 4演算ユニットが備わっているため、XCDあたり32個の演算ユニット、アクセラレータ全体では合計256個の演算ユニットが利用できます。
CDNA 4パッケージ設計では、I/Oダイ層も4タイルから2タイルに統合されました。この再編成により、AMDはInfinity Fabricバス幅を2倍にすることができ、2セクション間の帯域幅を向上させると同時に、バス周波数と動作電圧を下げて消費電力を削減することができました。
再設計された演算ユニットと拡張された高精度サポート
CDNA 4演算ユニットの行列演算機能により、大幅な性能向上を実現しています。MI350 CUは、MI300と比較して、16ビット(BF16、FP16)および8ビット(FP8、INT8)演算において、CUあたりのスループットが2倍に向上しています。
CDNA 4は、処理能力の向上に加え、MI300シリーズにはなかった低精度データタイプ、具体的にはFP6とFP4のハードウェアサポートを導入し、前世代から引き継がれた既存のFP8サポートも引き続き提供します。
MI350Xは、これらの標準フォーマットに加えて、OCPマイクロスケーリングのバリアントであるMXFP4、MXFP6、およびMXFP8のネイティブハードウェアサポートを追加しています。マイクロスケーリングフォーマットは、低精度演算のスループットの利点を提供しながら、標準的な量子化で通常可能なよりも高精度ベースラインに近い出力品質を維持するように設計されています。これはAMD固有の開発ではありません。NVIDIAのNVFP4フォーマットは同じマイクロスケーリングの原理に基づいて動作し、最先端モデルの展開で広く採用されており、OpenAIのGPT-OSSファミリーは、これらのフォーマットに基づいて構築された最も有名な例の1つです。MI350XのネイティブMXFP4サポートにより、ソフトウェアエミュレーションや精度促進に頼ることなく、これらのモデルや同様の量子化モデルファミリーに対応できます。
MI350Xは、MXFP4およびMXFP6で9.2 PFLOPsの性能を発揮し、OCP-FP8の4.6 PFLOPs、FP16の2.3 PFLOPs、ピーク時のエンジンクロック2,200 MHzと比較して大幅に向上しています。マイクロスケーリング量子化が可能な推論最適化環境では、FP8ワークロードと比較して演算能力が実質的に2倍になります。また、CDNA 4演算ユニットには新しいベクトルALUが追加され、2ビット演算をサポートし、BF16の結果をFP32に累積できるため、主要な行列演算パス外の低精度ベクトルワークロードに対して柔軟性が向上しています。
メモリサブシステム:HBM3e、インフィニティキャッシュ、および帯域幅効率
MI350シリーズは、大幅にアップグレードされたメモリサブシステムを備え、8つのHBM3eメモリスタックにより、GPUあたり合計288GBの容量を実現しています。各36GBスタックは、12個の24Gbitデバイスで構成され、ピンあたり8GbpsのHBM3eのフルピン速度で動作します。アーキテクチャは、HBMとInfinity Fabric/L2キャッシュの間に配置されたメモリサイドキャッシュであるAMDのInfinity Cacheを維持しています。これは、それぞれ2MBのキャッシュを備えた128チャネルで構成され、GPUあたり合計256MBとなります。AMDは、IOD内のオンダイネットワークバスを拡張し、低電圧で動作させることで、MI300シリーズと比較してワットあたりのメモリ帯域幅を約1.3倍向上させています。
MI300Xの192GBから288GBへのメモリ容量の増加は、GPUあたりのメモリ容量におけるAMDの優位性をさらに高め、大規模モデルの推論に直接的な影響を与えます。各MI350X GPUは、5000億を超えるパラメータを持つモデルを独立してホストできます。8つのGPUで構成されるサーバー全体では、合計2.3TBのHBM3eにより、数兆パラメータ規模の展開を複雑にするマルチノード分散の要件が不要になります。これは、本レビューで紹介するKimi K2.5とMiniMax M2.5の結果からも明らかです。
柔軟なパーティショニングとデプロイメントアーキテクチャ
MI350シリーズは、ソケットごとに柔軟なGPUパーティショニングをサポートし、メモリを2つの独立したクラスタに分割します。この柔軟性はXCDにも適用され、クアッドXCDクラスタをデュアルブロックまたはシングルブロックに分割できるため、CPX+NPS2で70Bモデルのインスタンスを8つなど、さまざまな構成に対応できます。共有インフラストラクチャ全体で異種推論ワークロードを実行する組織にとって、このパーティショニング機能は、モデル階層ごとに専用ハードウェアを用意する必要性を下げ、混在する展開環境全体での利用効率を向上させます。
MI350シリーズは、MI300シリーズシステムで使用されているUBB(ユニバーサルベースボード)インフラストラクチャとの互換性を維持しています。既存のサーバーシャーシ、電源供給、冷却インフラストラクチャは変更なしでそのまま使用できるため、MI300シリーズを既に導入している組織にとって、アップグレード時の負担が軽減されます。
MI355X:水冷式モデル
MI350シリーズは、同一のシリコンをベースとし、異なる熱動作範囲に合わせて最適化された2つのバリエーションで提供されます。今回テストしたMI350Xは空冷式モデルで、MI355Xは液冷式モデルです。液冷式モデルは、直接液冷設備が利用可能な高密度環境向けに設計されています。
両モデルとも同じ基本ハードウェアをベースにしていますが、MI355Xはより高い動作電力範囲により、より高いクロック周波数を維持できるため、MI350Xと比較して、実際のエンドツーエンドのワークロードで約20%のパフォーマンス向上を実現しています。MI355XのTBP上限は1,400Wで、MI350Xの1,000Wを上回ります。クロック速度は、空冷モデルの2.2GHzに対し、MI355Xは2.4GHzまで向上しています。
世代的な観点から見ると、MI355XプラットフォームはMI300Xと比較して理論上のピーク性能が最大4倍向上し、実際の推論性能はエージェントおよびチャットボットワークロードで約4.2倍、コンテンツ生成シナリオで約3倍向上します。MI350Xの導入を検討している組織にとって、2つのバリアント間の20%の性能差は明確な上限となります。DLCインフラストラクチャを持つ施設は、大規模な空冷構成を導入する前に、MI355Xを評価して、熱投資が特定のワークロードプロファイルに対して十分なスループット向上をもたらすかどうかを判断する必要があります。
Supermicro JumpStartプログラム経由でAMD Instinct MI350Xにアクセスする
JumpStartの利用を開始するには、Supermicroのポータルに登録する必要があります。登録後、資格のあるユーザーは利用可能なシステムを閲覧し、予約期間をスケジュールできます。承認されると、ポータルからSSH認証情報、IPMIアクセス、および予約期間中のWebベースのリモートコンソールが提供されます。システムにはUbuntuがプリインストールされており、すぐに使用できます。プロビジョニングの遅延やサポートとのやり取りは一切不要です。今回の予約期間は2026年3月23日から3月27日までで、HGX B200での以前のJumpStart利用と同様に、プラットフォームを丸1週間利用できました。
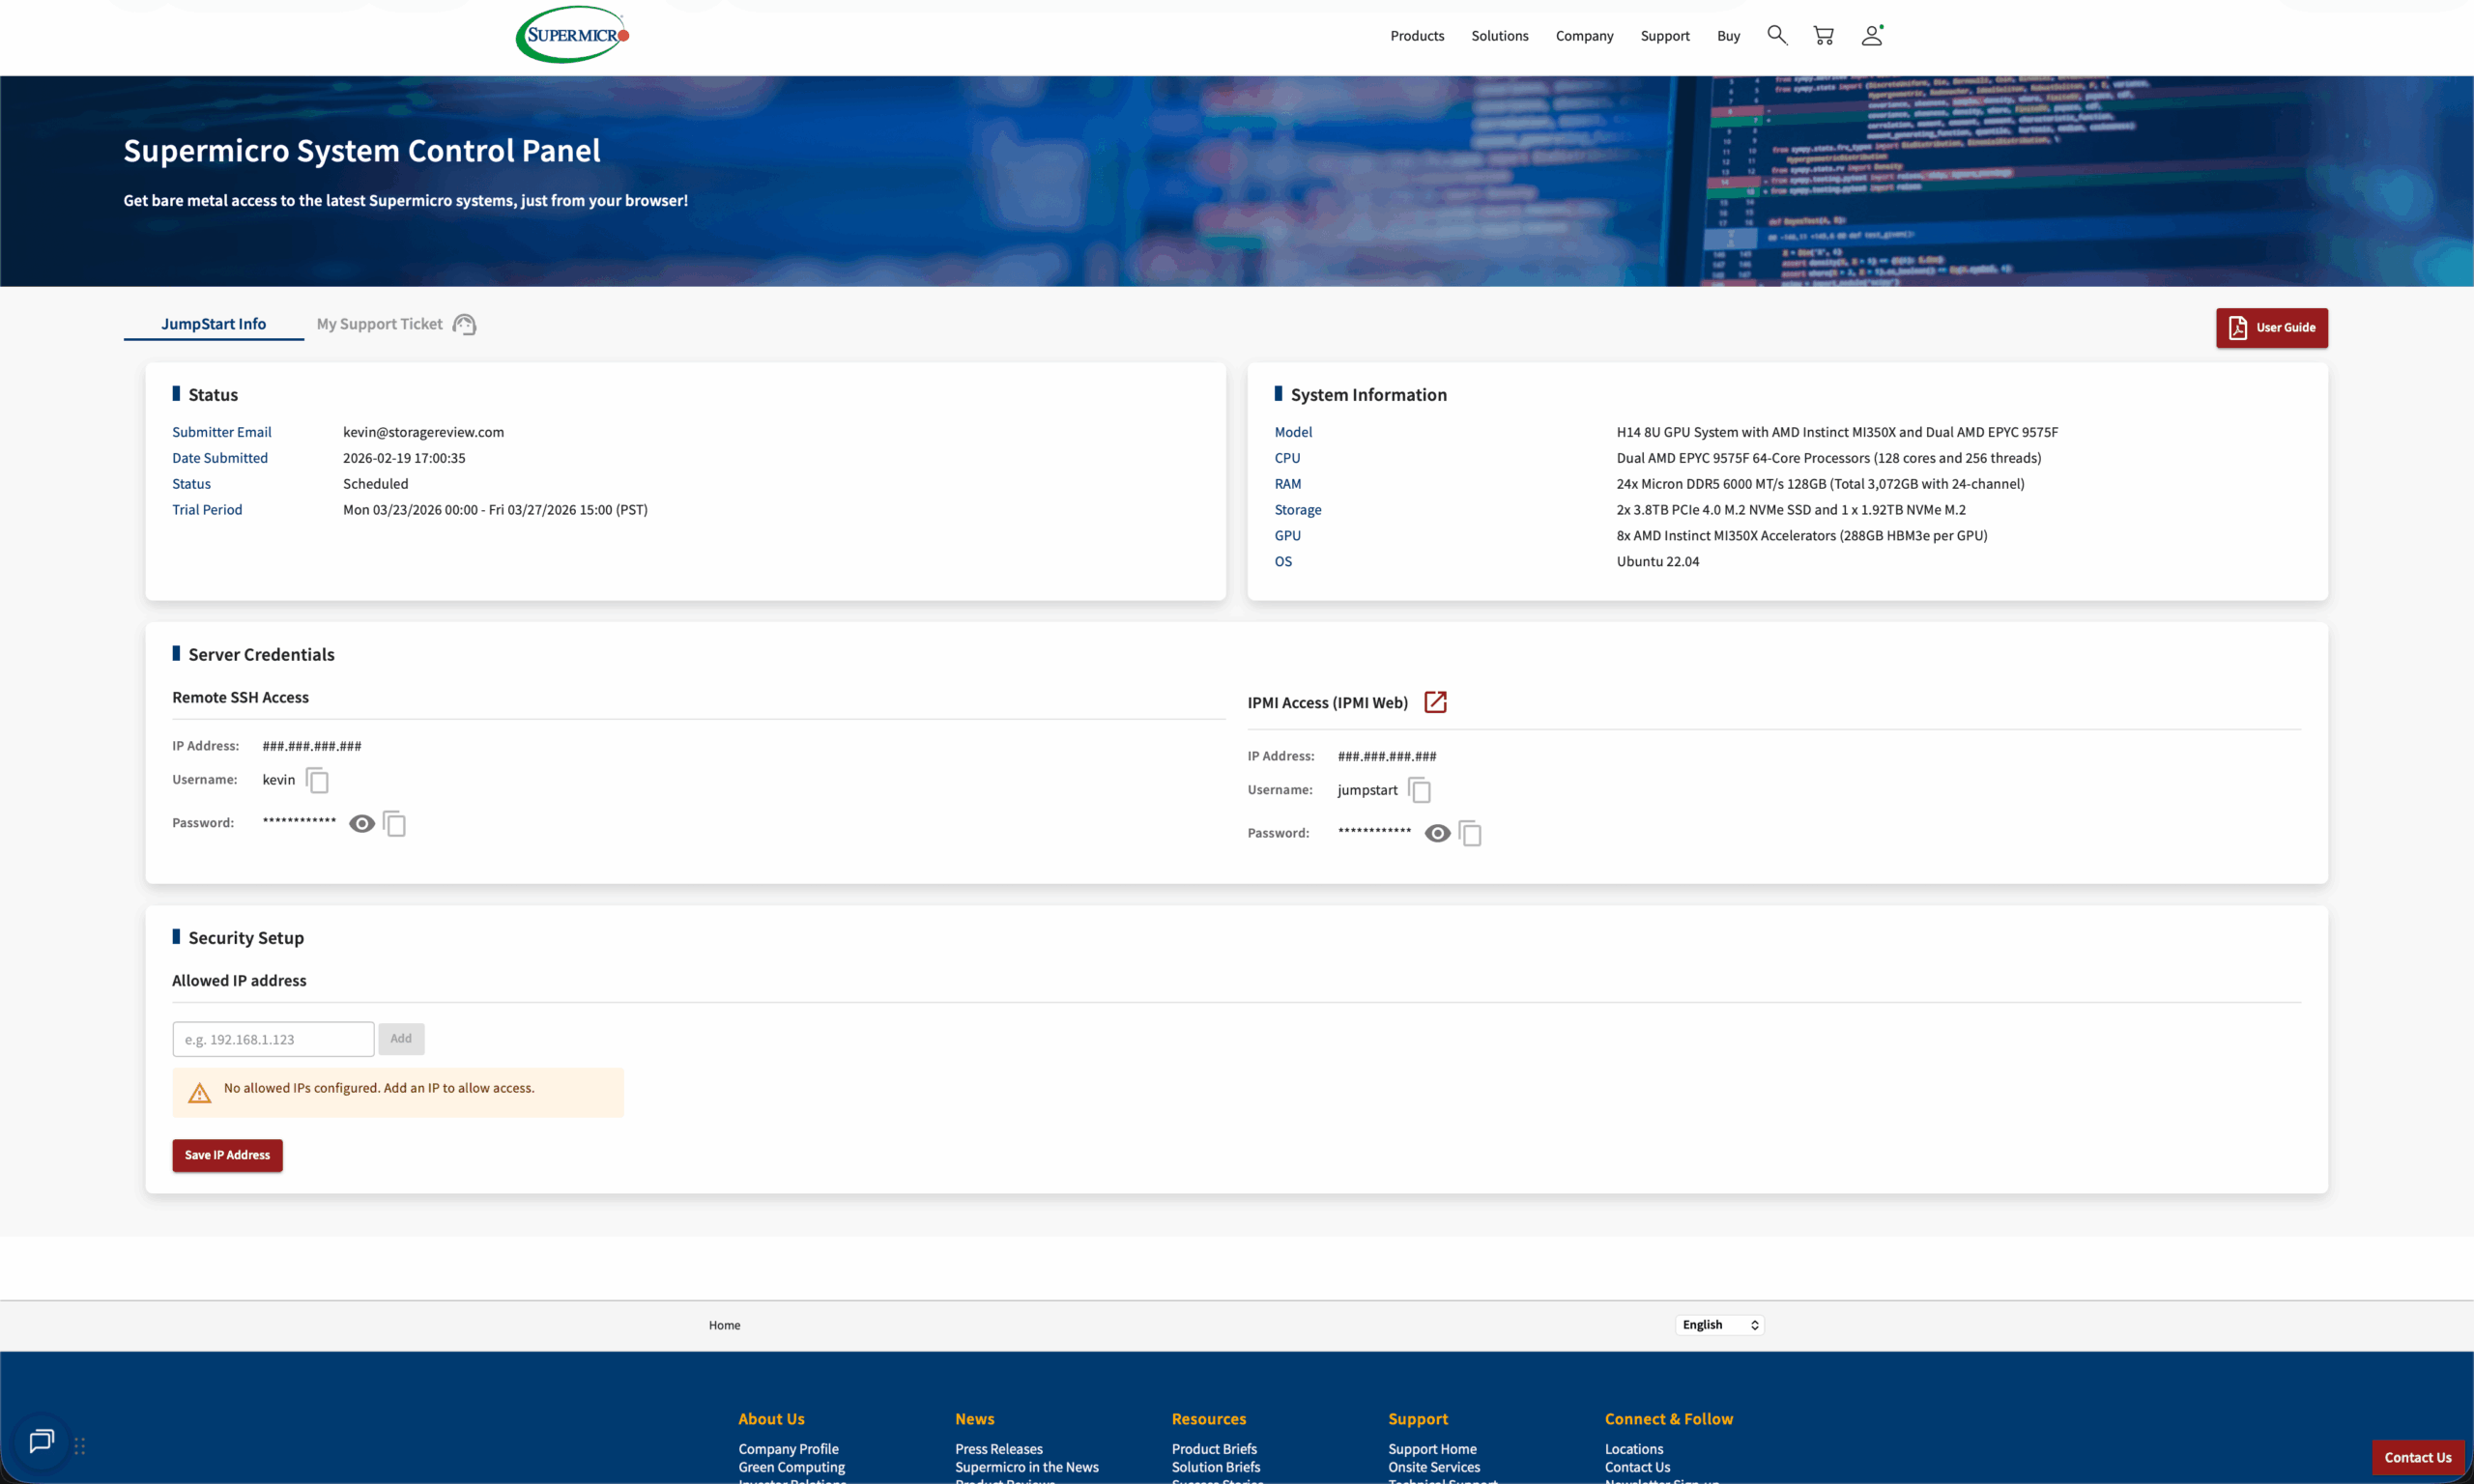
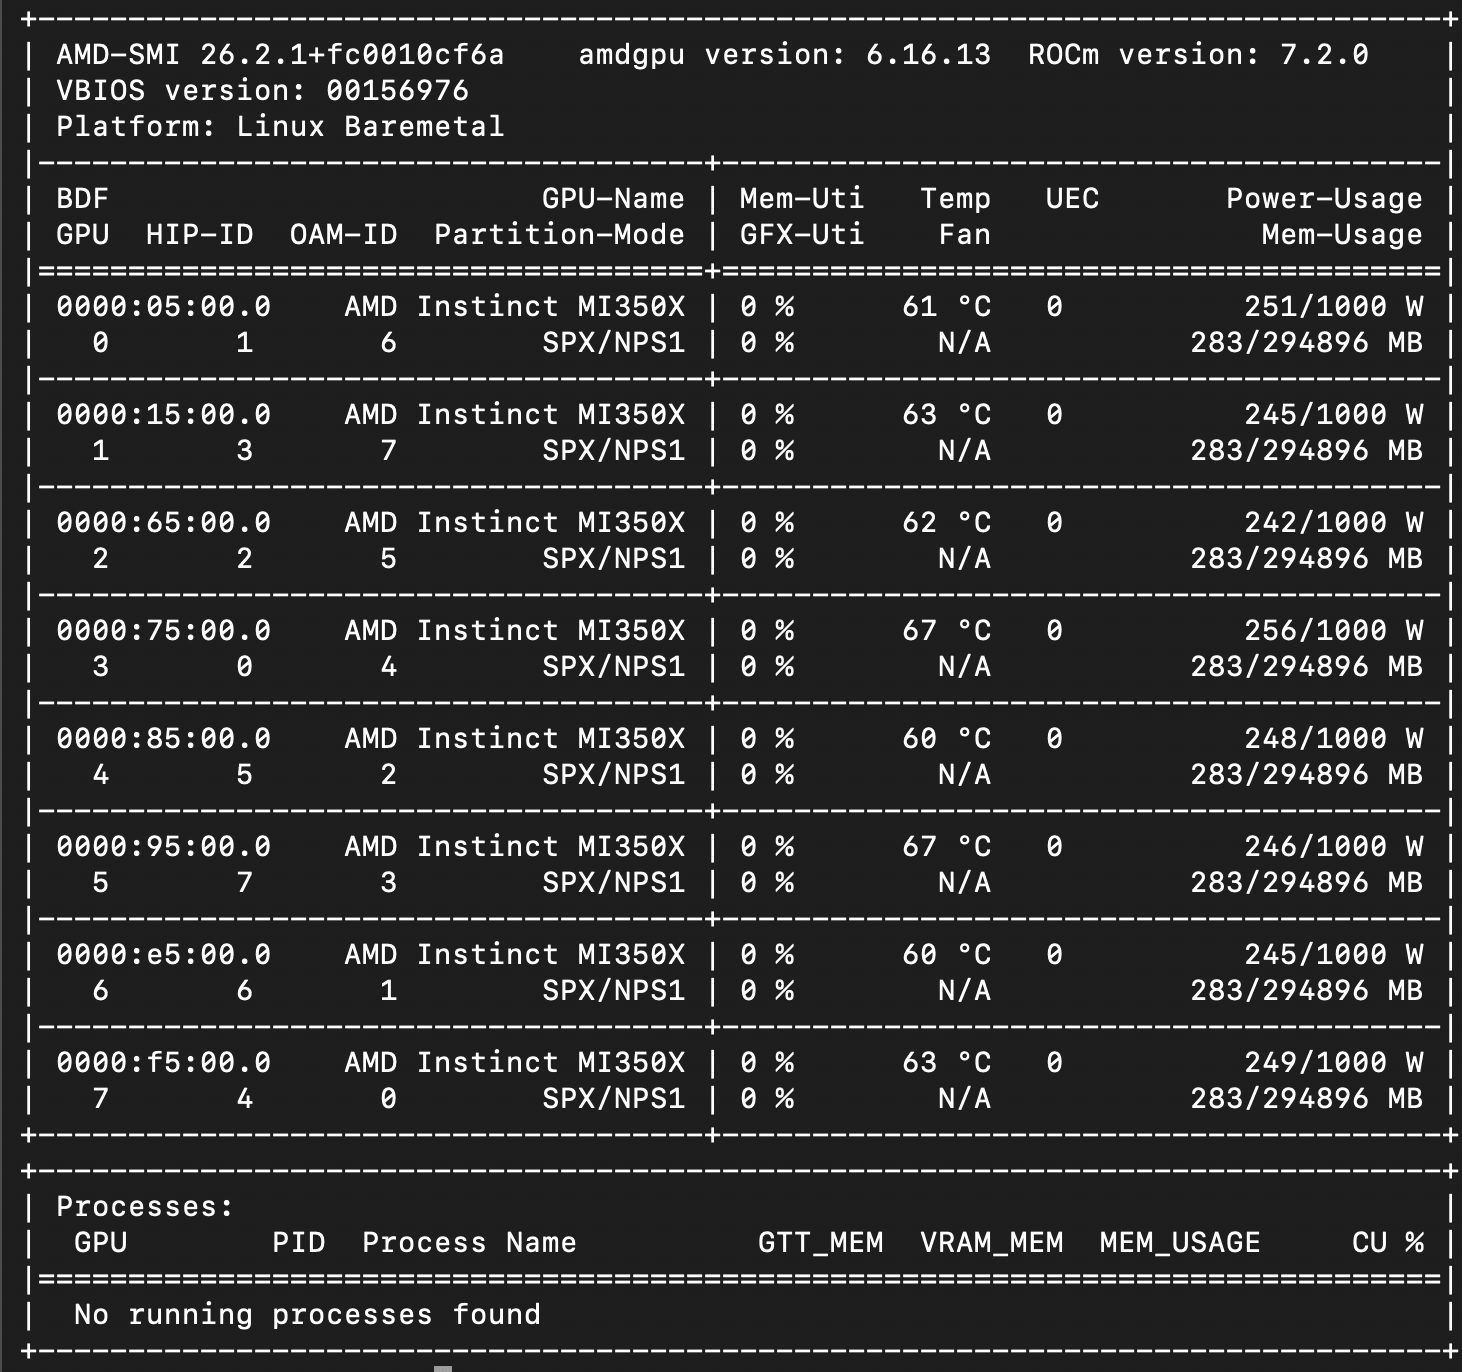
以下のスクリーンショットは、H14システムに対するジャンプスタートのターミナル出力を示しており、AMD-SMIツールによって8つのAMD Instinct MI350X GPUとその実行中のソフトウェアバージョンが表示されています。
AMD Instinct MI350X パフォーマンス テスト結果
システム構成
- シャーシ: スーパーマイクロH14
- CPU: デュアルAMD EPYC 9575F
- メモリ: 3TB DDR5
- GPU: 8個のAMD Instinct MI350X
- ストレージ: 3.8TB PCIe 4.0 M.2 NVMe SSD x 2 および 1.92TB NVMe M.2 SSD x 1
結果の概要
| モデル | 精度 | 等しい(256/256) | プレフィルド - ヘビー (8k/1k) | デコード負荷が高い(1k/8k) |
|---|---|---|---|---|
| GPT-OSS 20B | NVFP4 | 62,247 | 123,714 | 32,468 |
| GPT-OSS 120B | NVFP4 | 33,538 | 84,018 | 20,602 |
| ラマ3.1 8B 指示 | BF16 | 51,467 | 77,658 * | 19,326 |
| ミストラル スモール 3.1 24V | FP8 | 40,742 | 56,093 | 14,557 |
| ミストラル スモール 3.1 24V | BF16 | 30,530 | 53,740 | 13,559 |
| Qwen3 コーダー 30B A3B | BF16 | 34,980 | 51,550 | 11,782 |
| Qwen3 コーダー 30B A3B | FP8 | 25,928 | 47,179 | 11,014 |
| ミニマックスM2.5 | ブロックスケールFP8 | 14,391 | 23,689 | 6,068 |
| キミK2.5 | INT4 QAT + BF16 | 6,527 | 11,256 | 2,513 |
| すべての値はtok/s単位です。ピークスループットはBS=256で発生しました。*Llama 3.1 8B プリフィルヘビーはBS=128でピーク(77,658 tok/s)に達し、BS=256では76,893 tok/sでした。 | ||||
クロード・コード・サービング – ミニマックスM2.5
従来の生のLLM推論ベンチマークを超えて、このハードウェアがエージェント型コーディングワークフローにおいてどの程度優れたパフォーマンスを発揮するかを評価したいと考えました。具体的には、ローカルでホストされたモデルを使用して複数のClaude Codeセッションを同時に処理する場合です。このユースケースは、開発チームの生産性に直接関係します。つまり、単一ノードから提供されるAIコーディングアシスタントを、何人のエンジニアが同時に使用しても、エクスペリエンスが低下する前にどれだけの人数が利用できるかということです。
これをテストするために、中程度の難易度のコーディング問題(LRUキャッシュの実装、CLI todoアプリケーションの構築、マークダウンコンバータの作成、REST APIの構築などのタスク)のデータセットを生成し、各Claude Codeセッションを独自のDockerコンテナでローカルのvLLMサーバーに対して実行するベンチマークハーネスを構築しました。セッションと推論エンドポイントの間には透過プロキシが配置され、各Claude Codeインスタンスのリクエストごとのメトリクスをキャプチャします。使用したモデルはMiniMax M2.5で、8つのMI350X GPU上でvLLMを介して提供されます。M2.5は公開リーダーボードでトップランクのコーディングモデルではありませんが、多くのユーザーがローカルで実行できる高性能モデルであり、私たちの開発者仲間の多くも使用しています。
基準値として、本番環境のAPIアクセスで最も人気のあるルーティングサービスの1つであるOpenRouter.aiを介したAnthropic社のClaude Opus 4.6の平均出力スループットを使用します。この基準値は、APIリクエスト1件あたり約37トークン/秒です。
私たちは2つの重要な指標を測定しました。1つはClaude Codeセッションごとの1秒あたりの平均出力トークン数(各開発者が経験する数値)、もう1つはすべてのセッションにおける1秒あたりの合計出力トークン数(サーバーが生成する総作業量)です。
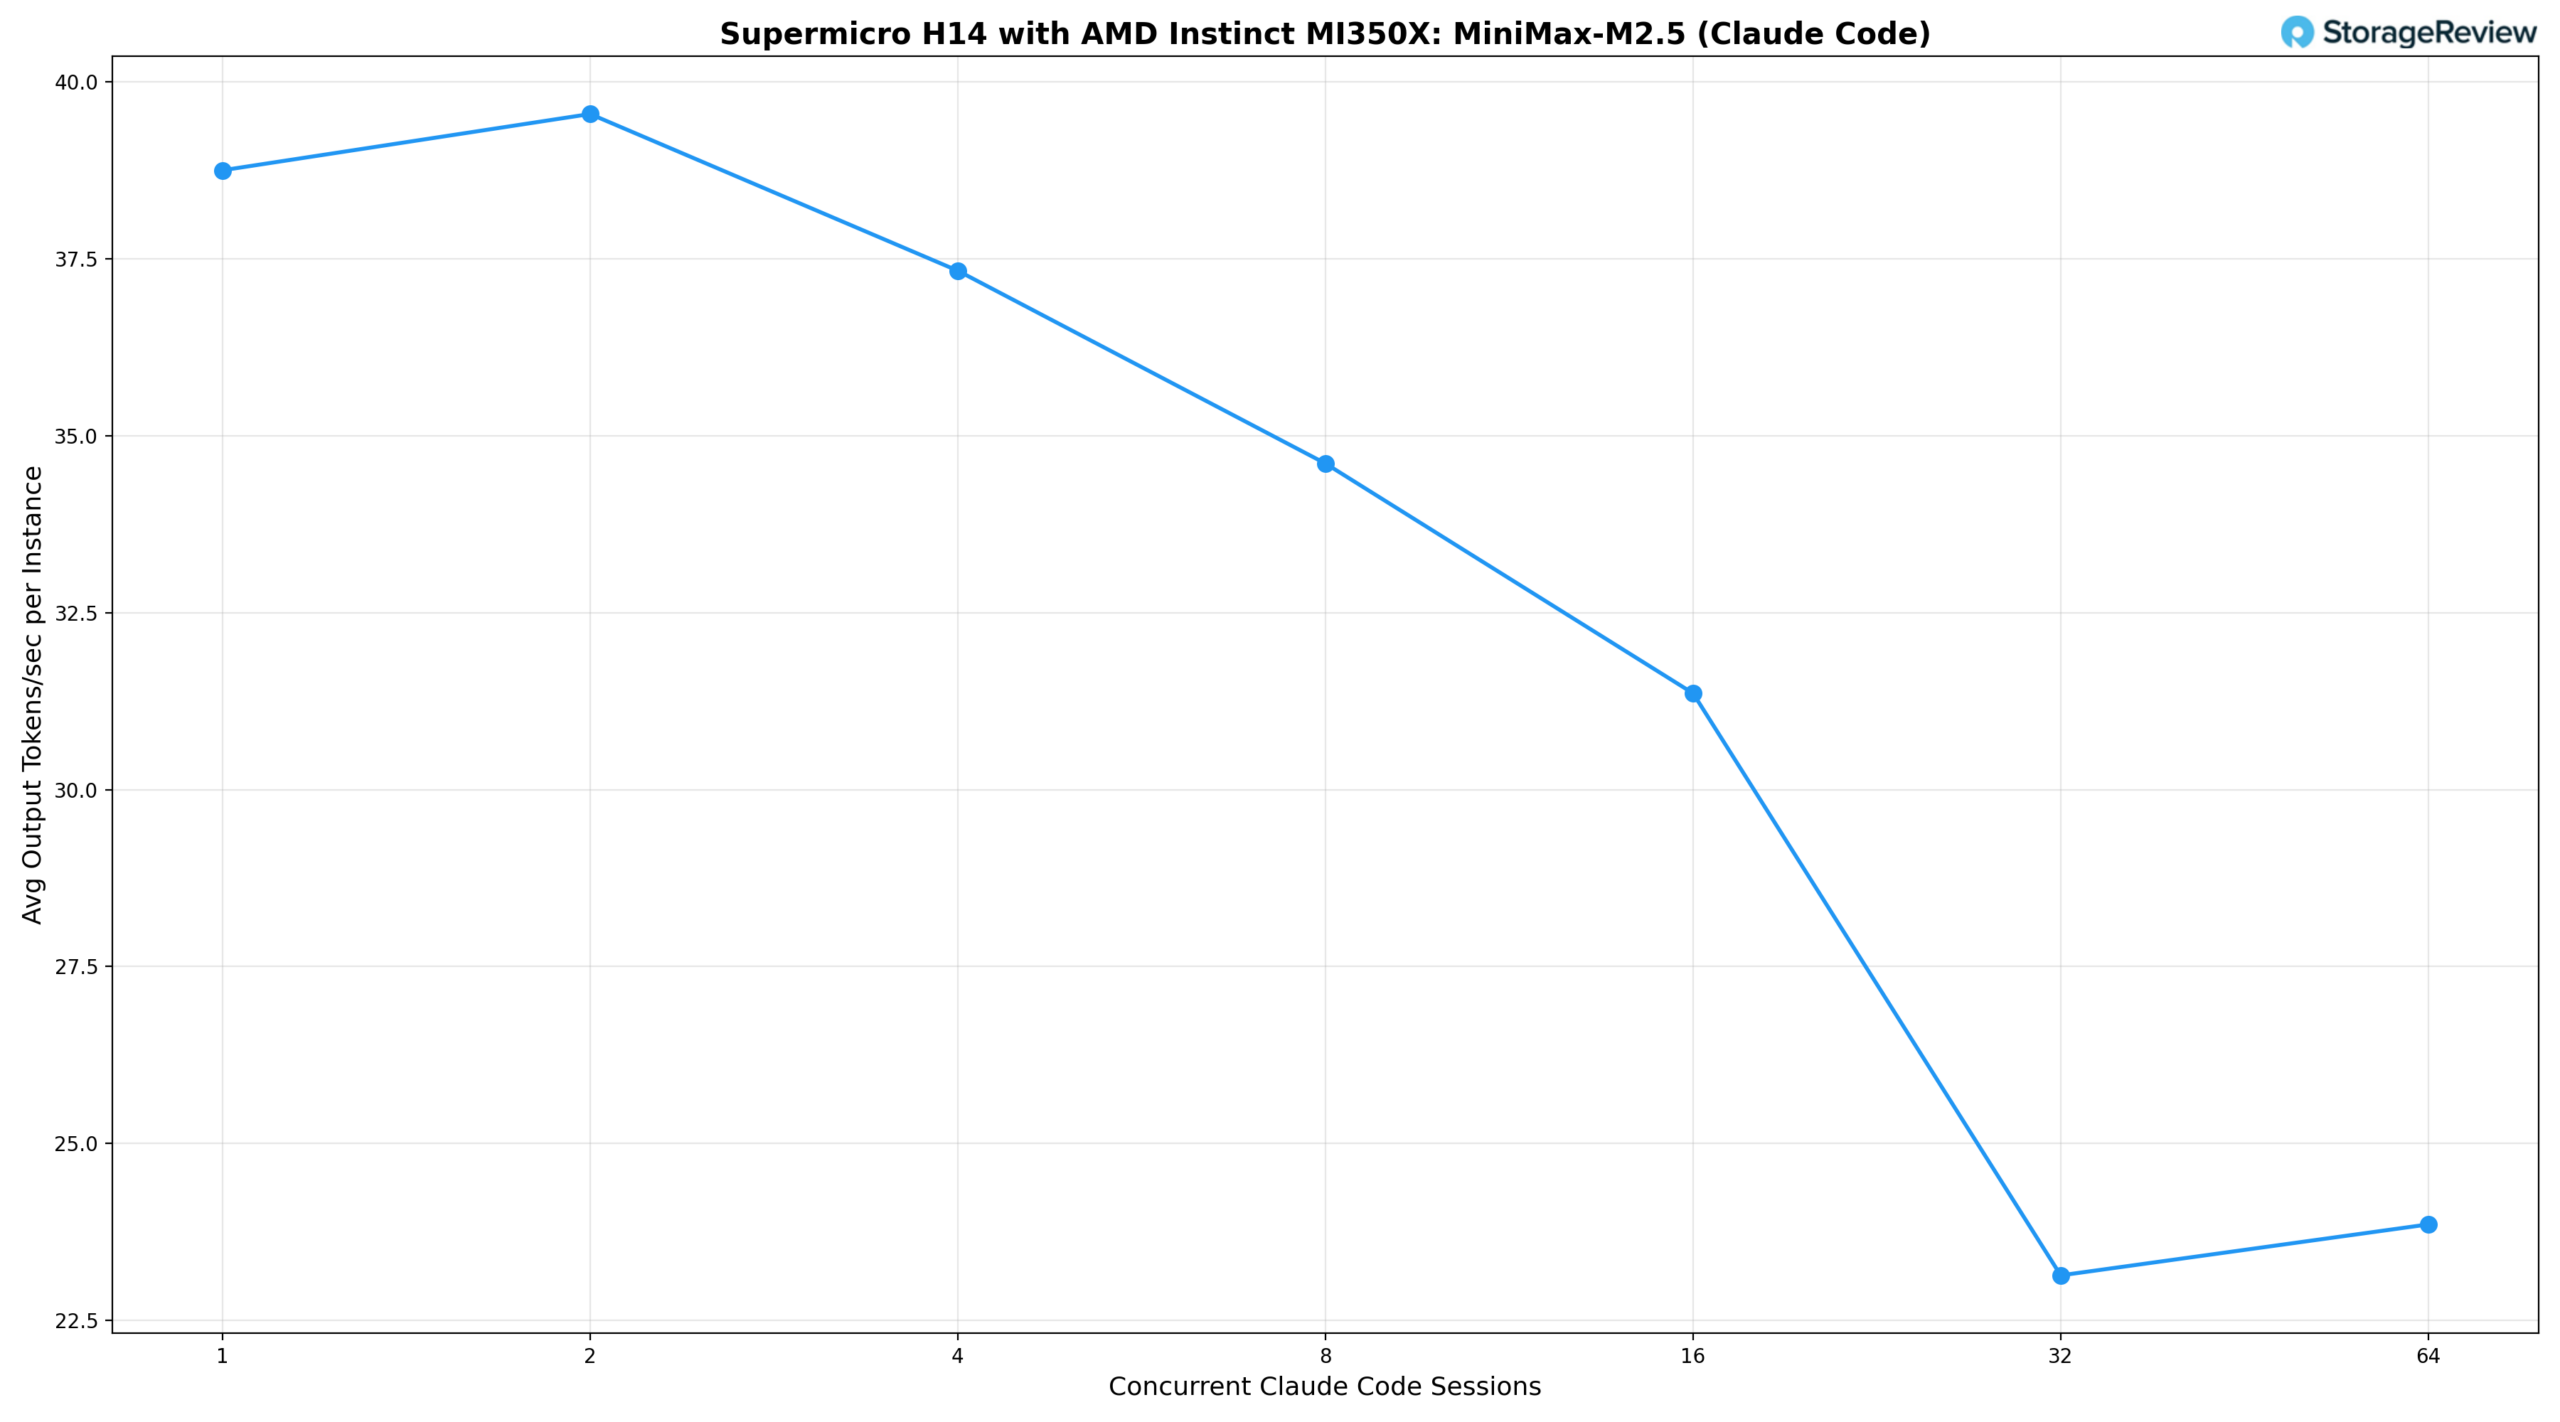
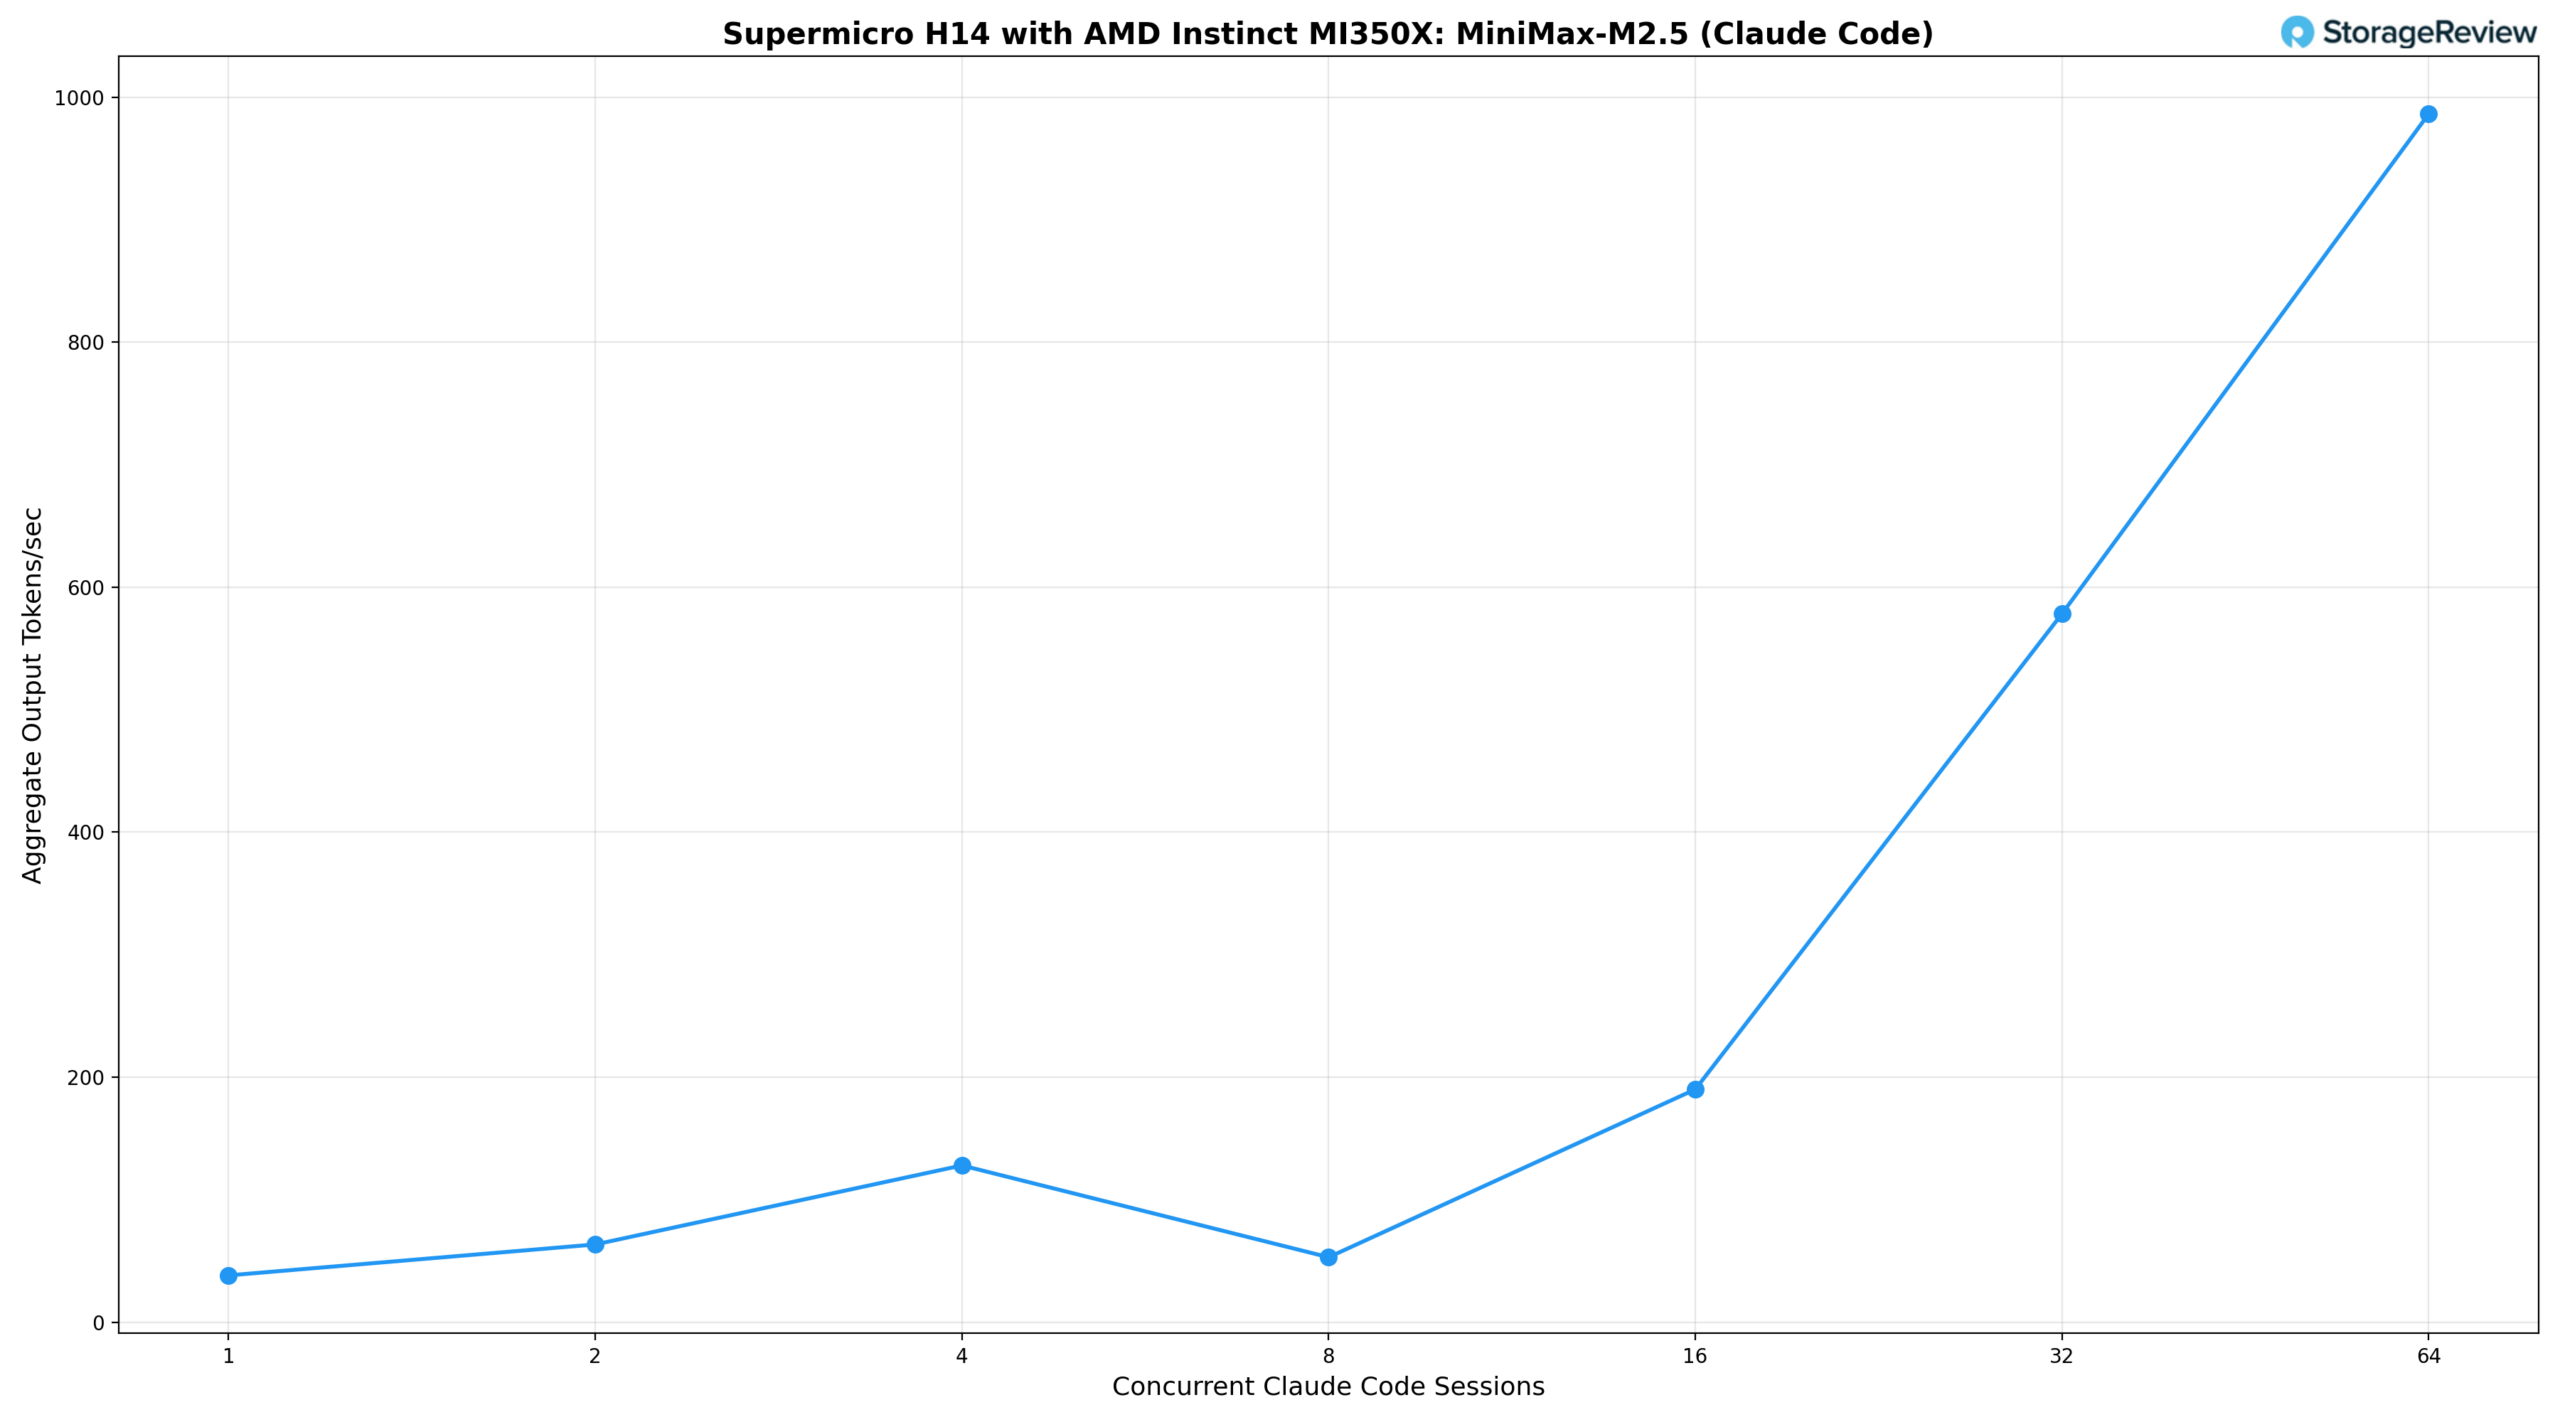
結果を見ると、同時セッションが1つの場合、ユーザーあたり38.8 tok/s、合計で38 tok/sとなり、OpenRouterクラウドのベースラインをわずかに上回ります。セッションが2つになると、vLLMのバッチ処理がオーバーヘッドを償却し始めるため、システムはユーザーあたり39.5 tok/sにわずかに上昇し、合計スループットは63 tok/sに上昇します。同時セッションが4つになると、ユーザーあたり37.3 tok/sとなり、クラウドのベースラインに一致しながら4人の開発者に同時にサービスを提供し、合計スループットは128 tok/sに達します。セッションが8つを超えると、インスタンスあたりのスループットは低下し始めます。セッションが8つの場合、ユーザーあたり34.6 tok/s、セッションが16の場合、合計190 tok/sで31.4 tok/sとなり、セッションが32と64の場合、ユーザーあたり約23 tok/sに落ち着きますが、合計スループットはそれぞれ578 tok/sと986 tok/sに上昇します。これは、バッチ処理によるスループットとインタラクティブ性のトレードオフの典型例です。システム全体では、より多くのリクエストをバッチ処理することでスループットを大幅に向上させることができますが、各ユーザーの応答時間は遅くなります。同時接続ユーザー数が64人であっても、各開発者はクラウドのベースラインよりは明らかに遅いものの、実用的なインタラクティブ体験を得ることができます。
数十もの商用APIサブスクリプションの同時利用コストと自社ホスティングインフラストラクチャのコストを比較検討している組織にとって、トレードオフは明確です。単一のMI350Xノードで16~32人のエンジニアからなる開発チームに対応でき、ユーザーごとの応答速度をクラウドのベースラインの60~85%に維持しながら、600~1,000トークン/秒の総出力を実現できます。さらに、データローカリティ、トークンごとのAPI料金なし、モデル選択の完全な制御といったメリットも得られます。
vLLMオンラインサービング – LLM推論パフォーマンス
vLLMは、LLM(論理論理モデル)向けの高スループット推論およびサービスエンジンとして最も人気のあるものの1つです。vLLMオンラインサービスベンチマークは、同時リクエスト下におけるこの推論エンジンの実際のサービスパフォーマンスを評価します。実行中のvLLMサーバーにリクエストを送信することで、本番環境のワークロードをシミュレートします。リクエストレート、入出力長、同時クライアント数などのパラメータは設定可能です。このベンチマークでは、スループット(1秒あたりのトークン数)、最初のトークン取得までの時間、出力トークンあたりの時間(TPOT)などの主要な指標を測定し、さまざまな負荷条件下でのvLLMのパフォーマンスをユーザーが理解するのに役立ちます。
さまざまなアーキテクチャ、パラメータスケール、量子化戦略にわたる包括的なモデルスイート全体で推論パフォーマンスをテストし、さまざまな同時実行プロファイルでのスループットを評価しました。
GPT-OSS 120Bおよび20B
GPT-OSSモデルファミリーは、Supermicro H14上で120B構成と20B構成の両方でテストされました。
GPT-OSS 120B
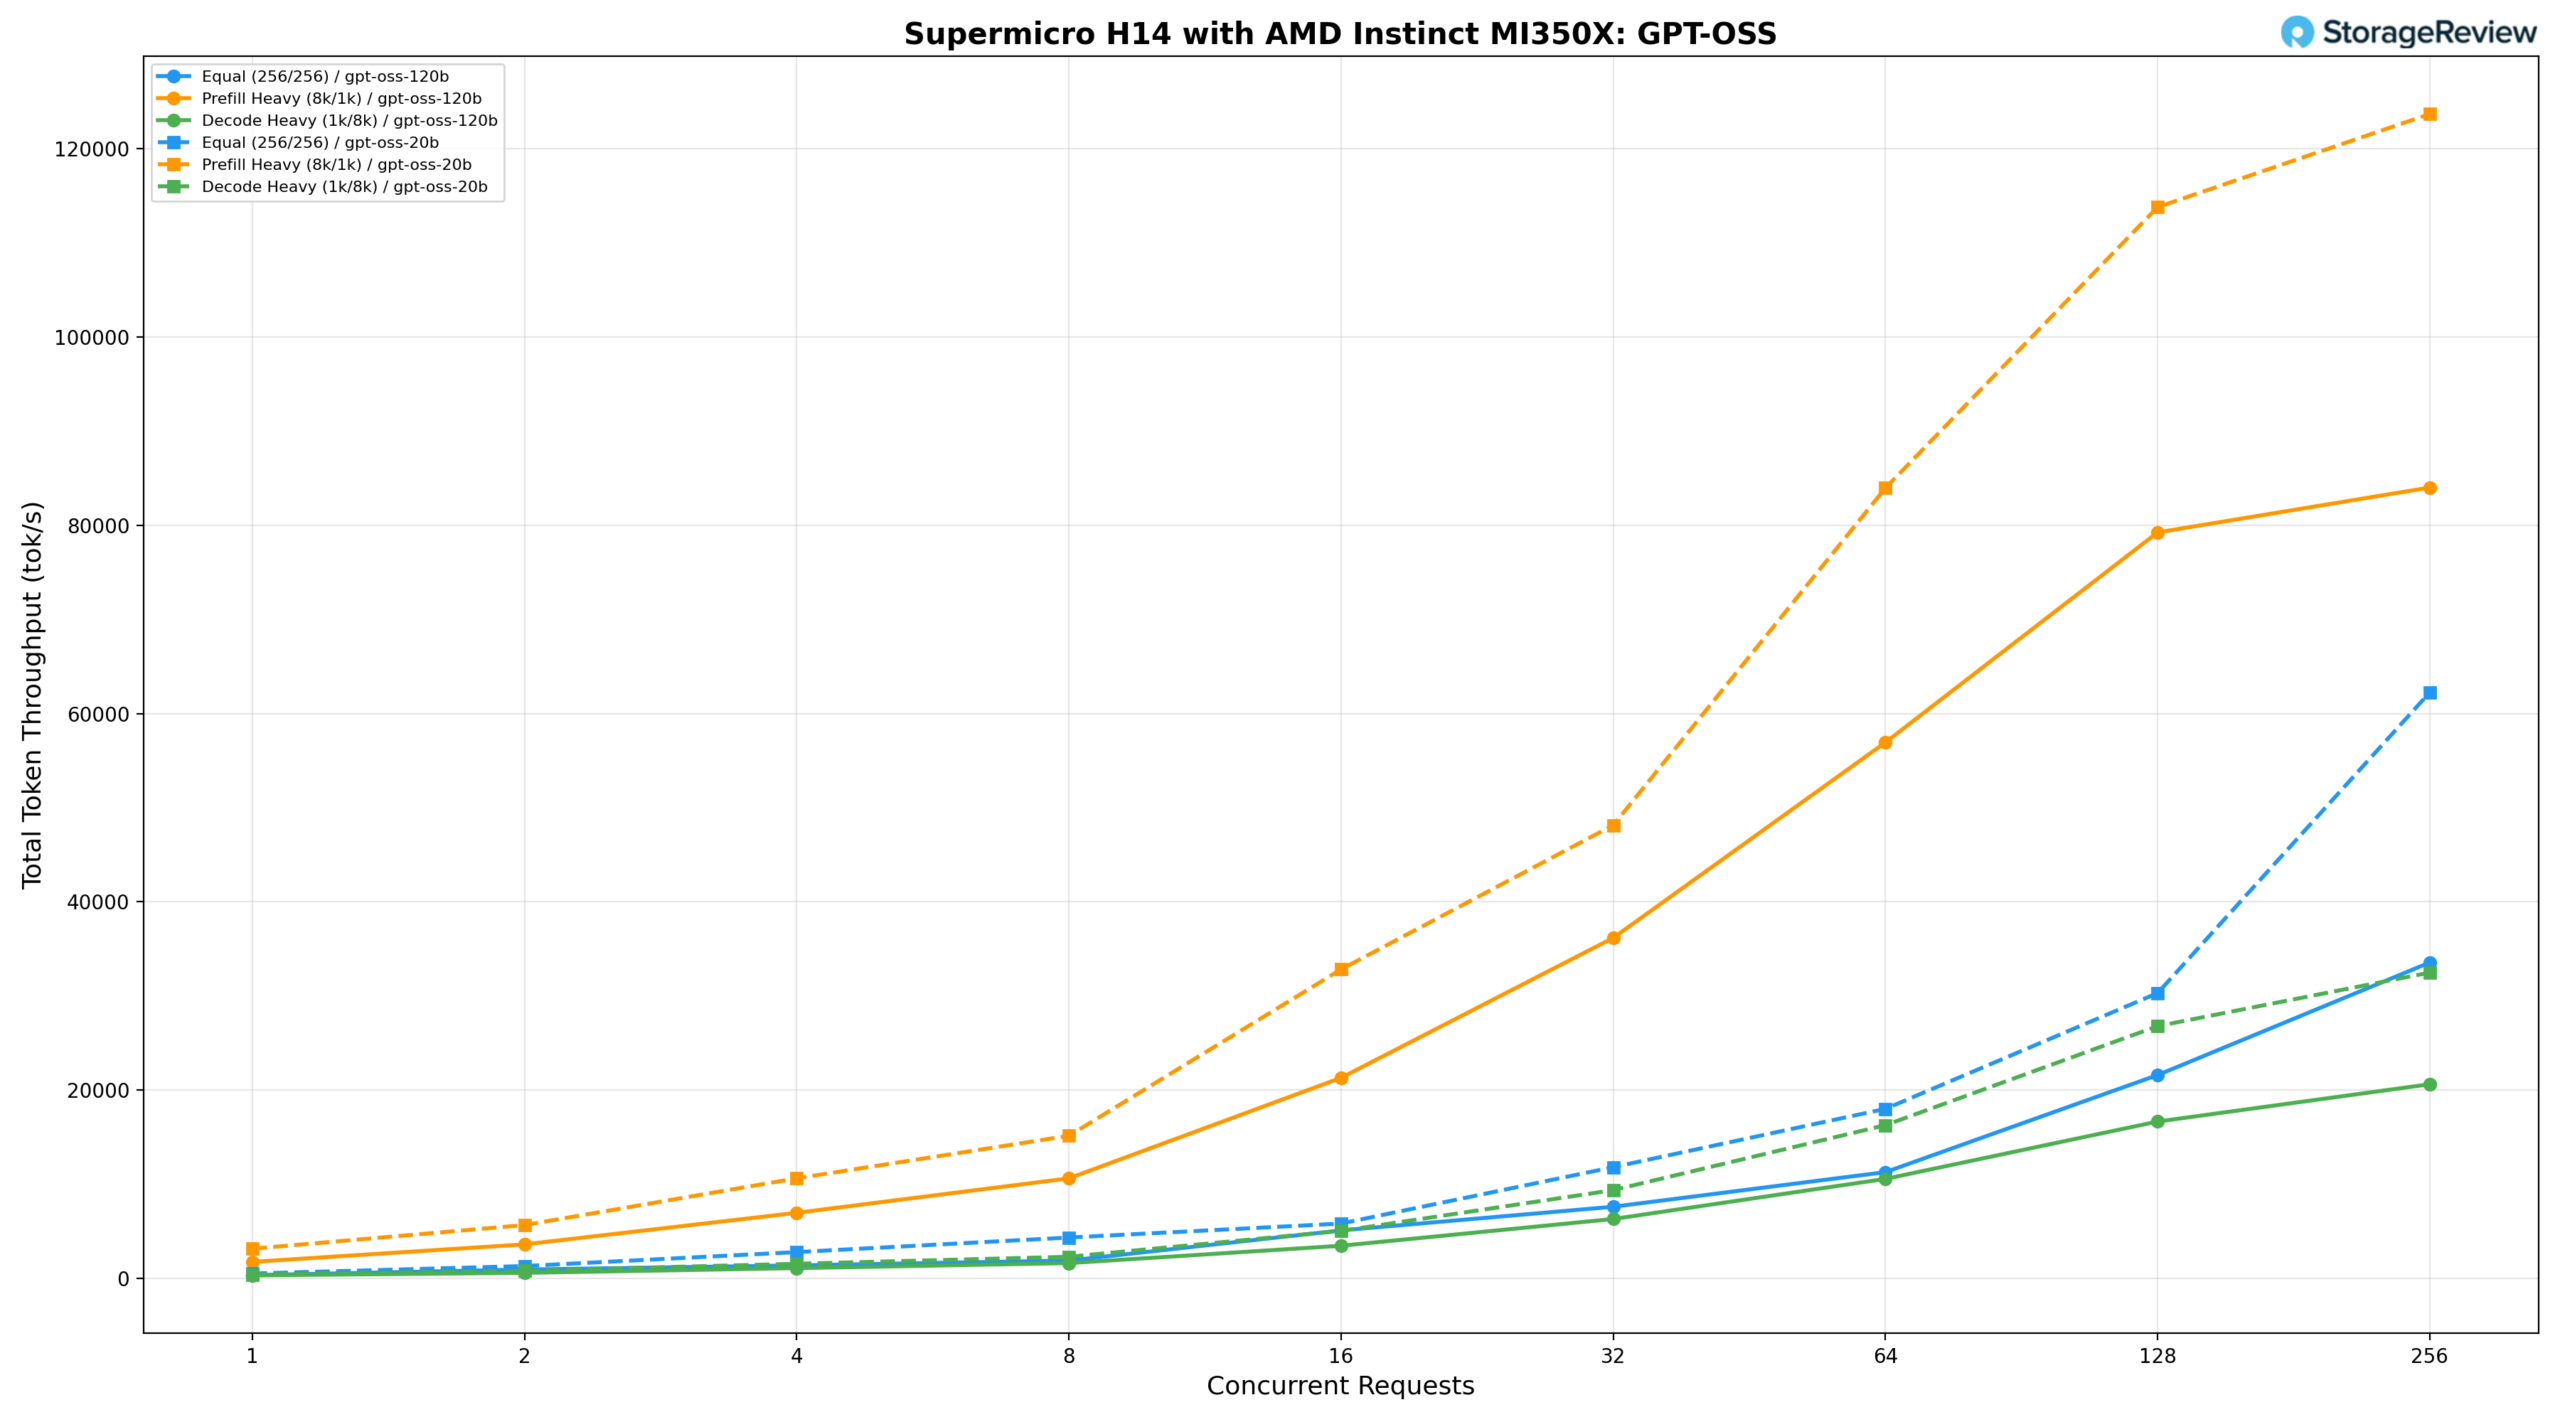
120B モデルは、同等のワークロード (256/256) で 313.42 tok/s を実現し、BS=64 で 11,261.72 tok/s に達し、BS=256 で 33,538.23 tok/s のピークに達します。プリフィル負荷が高い (8k/1k) 場合、1,724.84 tok/s から始まり、BS=32 で 36,156.80 tok/s、BS=128 で 79,247.76 tok/s まで上昇し、BS=256 で 84,018.79 tok/s のピークに達します。デコード負荷の高い処理(1k/8k)では、BS=1 での 288.90 tok/s から BS=256 での 20,602.52 tok/s まで増加しますが、低い同時実行レベルではレイテンシは適切に制御されています。
GPT-OSS 20B
20B モデルは、同等のワークロードで BS=1 で 485.17 tok/s を実現し、BS=64 で 17,986.36 tok/s に達し、BS=256 で 62,247.52 tok/s のピークに達します。プリフィル負荷が高い場合、3,120.72 tok/s から始まり、BS=32 で 48,132.52 tok/s、BS=64 で 83,968.71 tok/s まで上昇し、BS=256 で 123,714.50 tok/s のピークに達します。これは、両方のモデルサイズで記録された最高の絶対プリフィル処理量です。デコード処理負荷は、BS=1 時の 378.20 tok/s から BS=256 時の 32,468.67 tok/s に増加し、ピーク時の同時接続数で 120B の約 1.6 倍のデコードスループットを実現すると同時に、レイテンシ特性をより厳密に維持します。
Qwen3 Coder 30B A3B命令およびFP8命令
Supermicro H14 上の Qwen3-Coder-30B-A3B-Instruct は、標準精度 (BF16) と FP8 精度の両方でテストされました。
Qwen3-Coder-30B-A3B-Instruct (BF16)
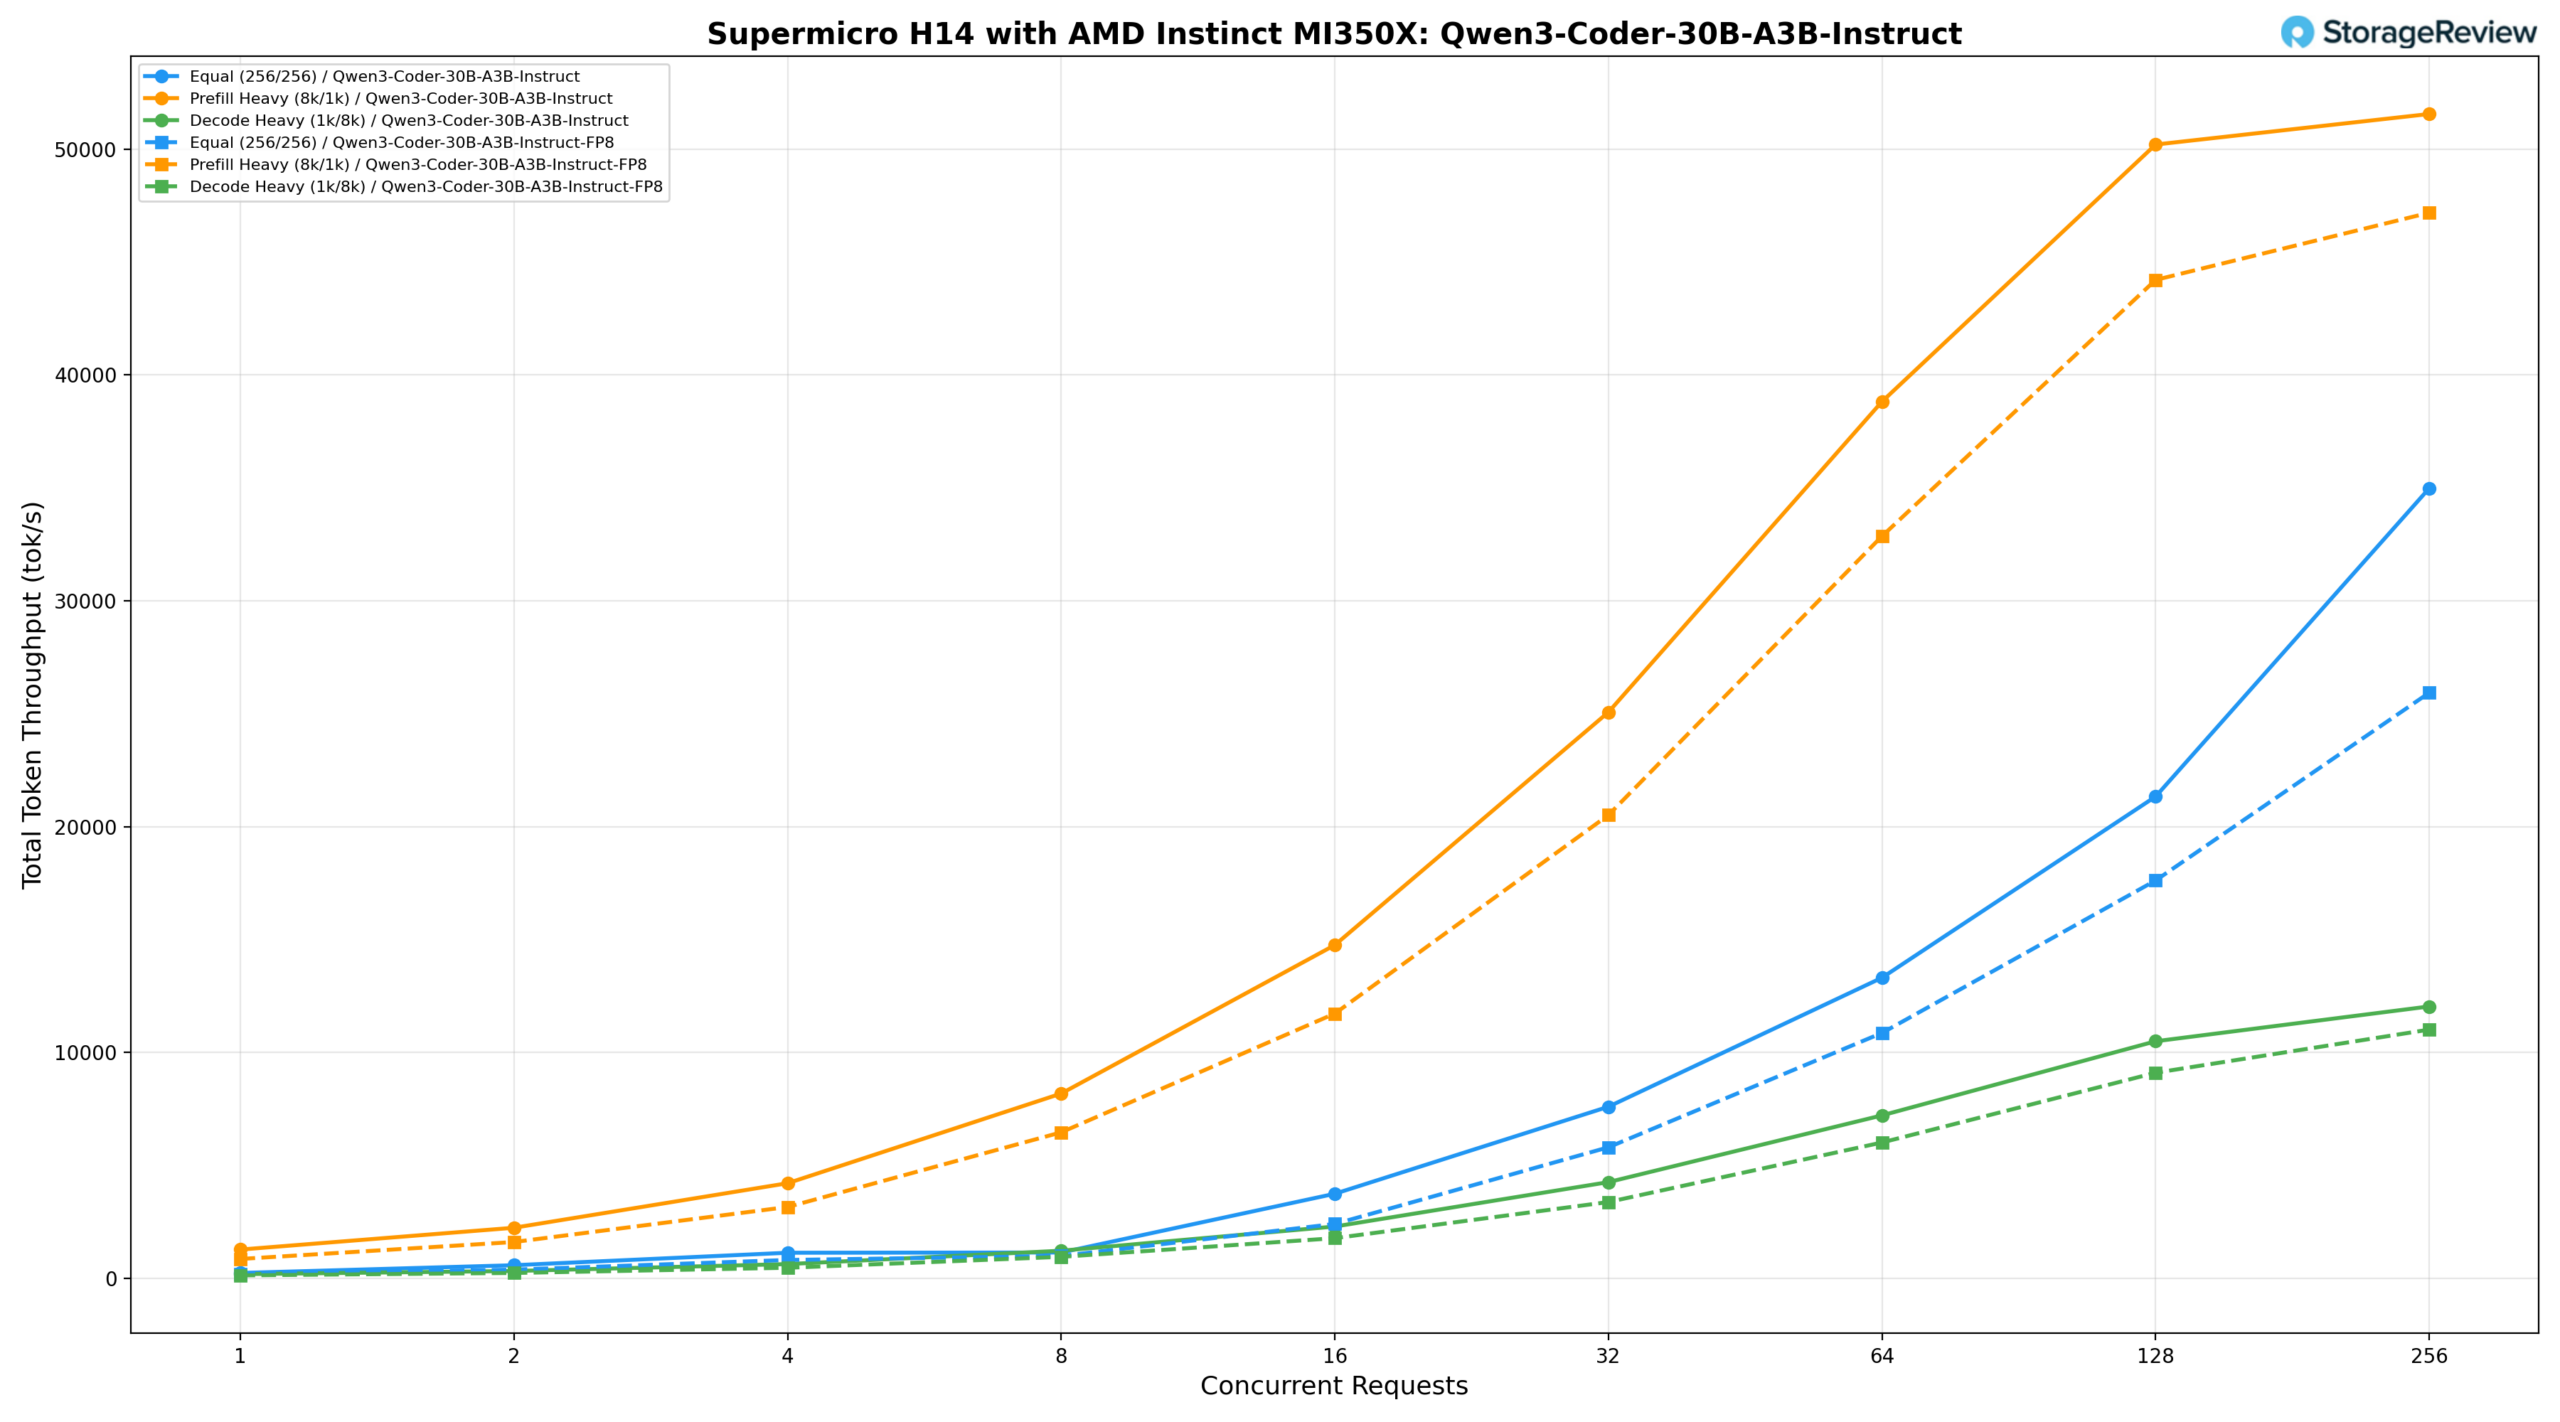
BF16では、均等なワークロード(256/256)はBS=1で240.53 tok/s、BS=64で13,312.70 tok/s、BS=128で21,333.79 tok/sに達し、BS=256でピークスループット34,980.97 tok/sとなります。プリフィルヘビー(8k/1k)は1,276.76 tok/sから始まり、BS=32で25,069.32 tok/s、BS=128で50,198.94 tok/sまで上昇し、BS=256でピークの51,550.66 tok/sに達します。デコード負荷の高い処理(1k/8k)は、BS=1 での約 188 tok/s から BS=256 での 11,782 tok/s まで着実に増加し、3 つのシナリオの中で最もタイトなレイテンシー プロファイルを維持します。
Qwen3-Coder-30B-A3B-Instruct (FP8)
FP8 バリアントは、同等のワークロードで BS=1 で 188.92 tok/s を実現し、BS=64 で 10,866.27 tok/s、BS=128 で 17,617.60 tok/s に達し、BS=256 で 25,928.77 tok/s のピークに達します。これは、全範囲で BF16 の結果よりわずかに劣ります。プリフィル負荷が高い場合は 860.07 tok/s から始まり、BS=32 で 20,513.77 tok/s、BS=128 で 44,205.46 tok/s まで上昇し、BS=256 で 47,179.15 tok/s のピークに達します。デコード負荷が高い場合、BS=1 での 133.79 tok/s から BS=256 での 11,014.95 tok/s まで一貫して増加し、全体を通して BF16 に近い値を維持します。
ミストラル・スモール3.1 24B 指示書2503
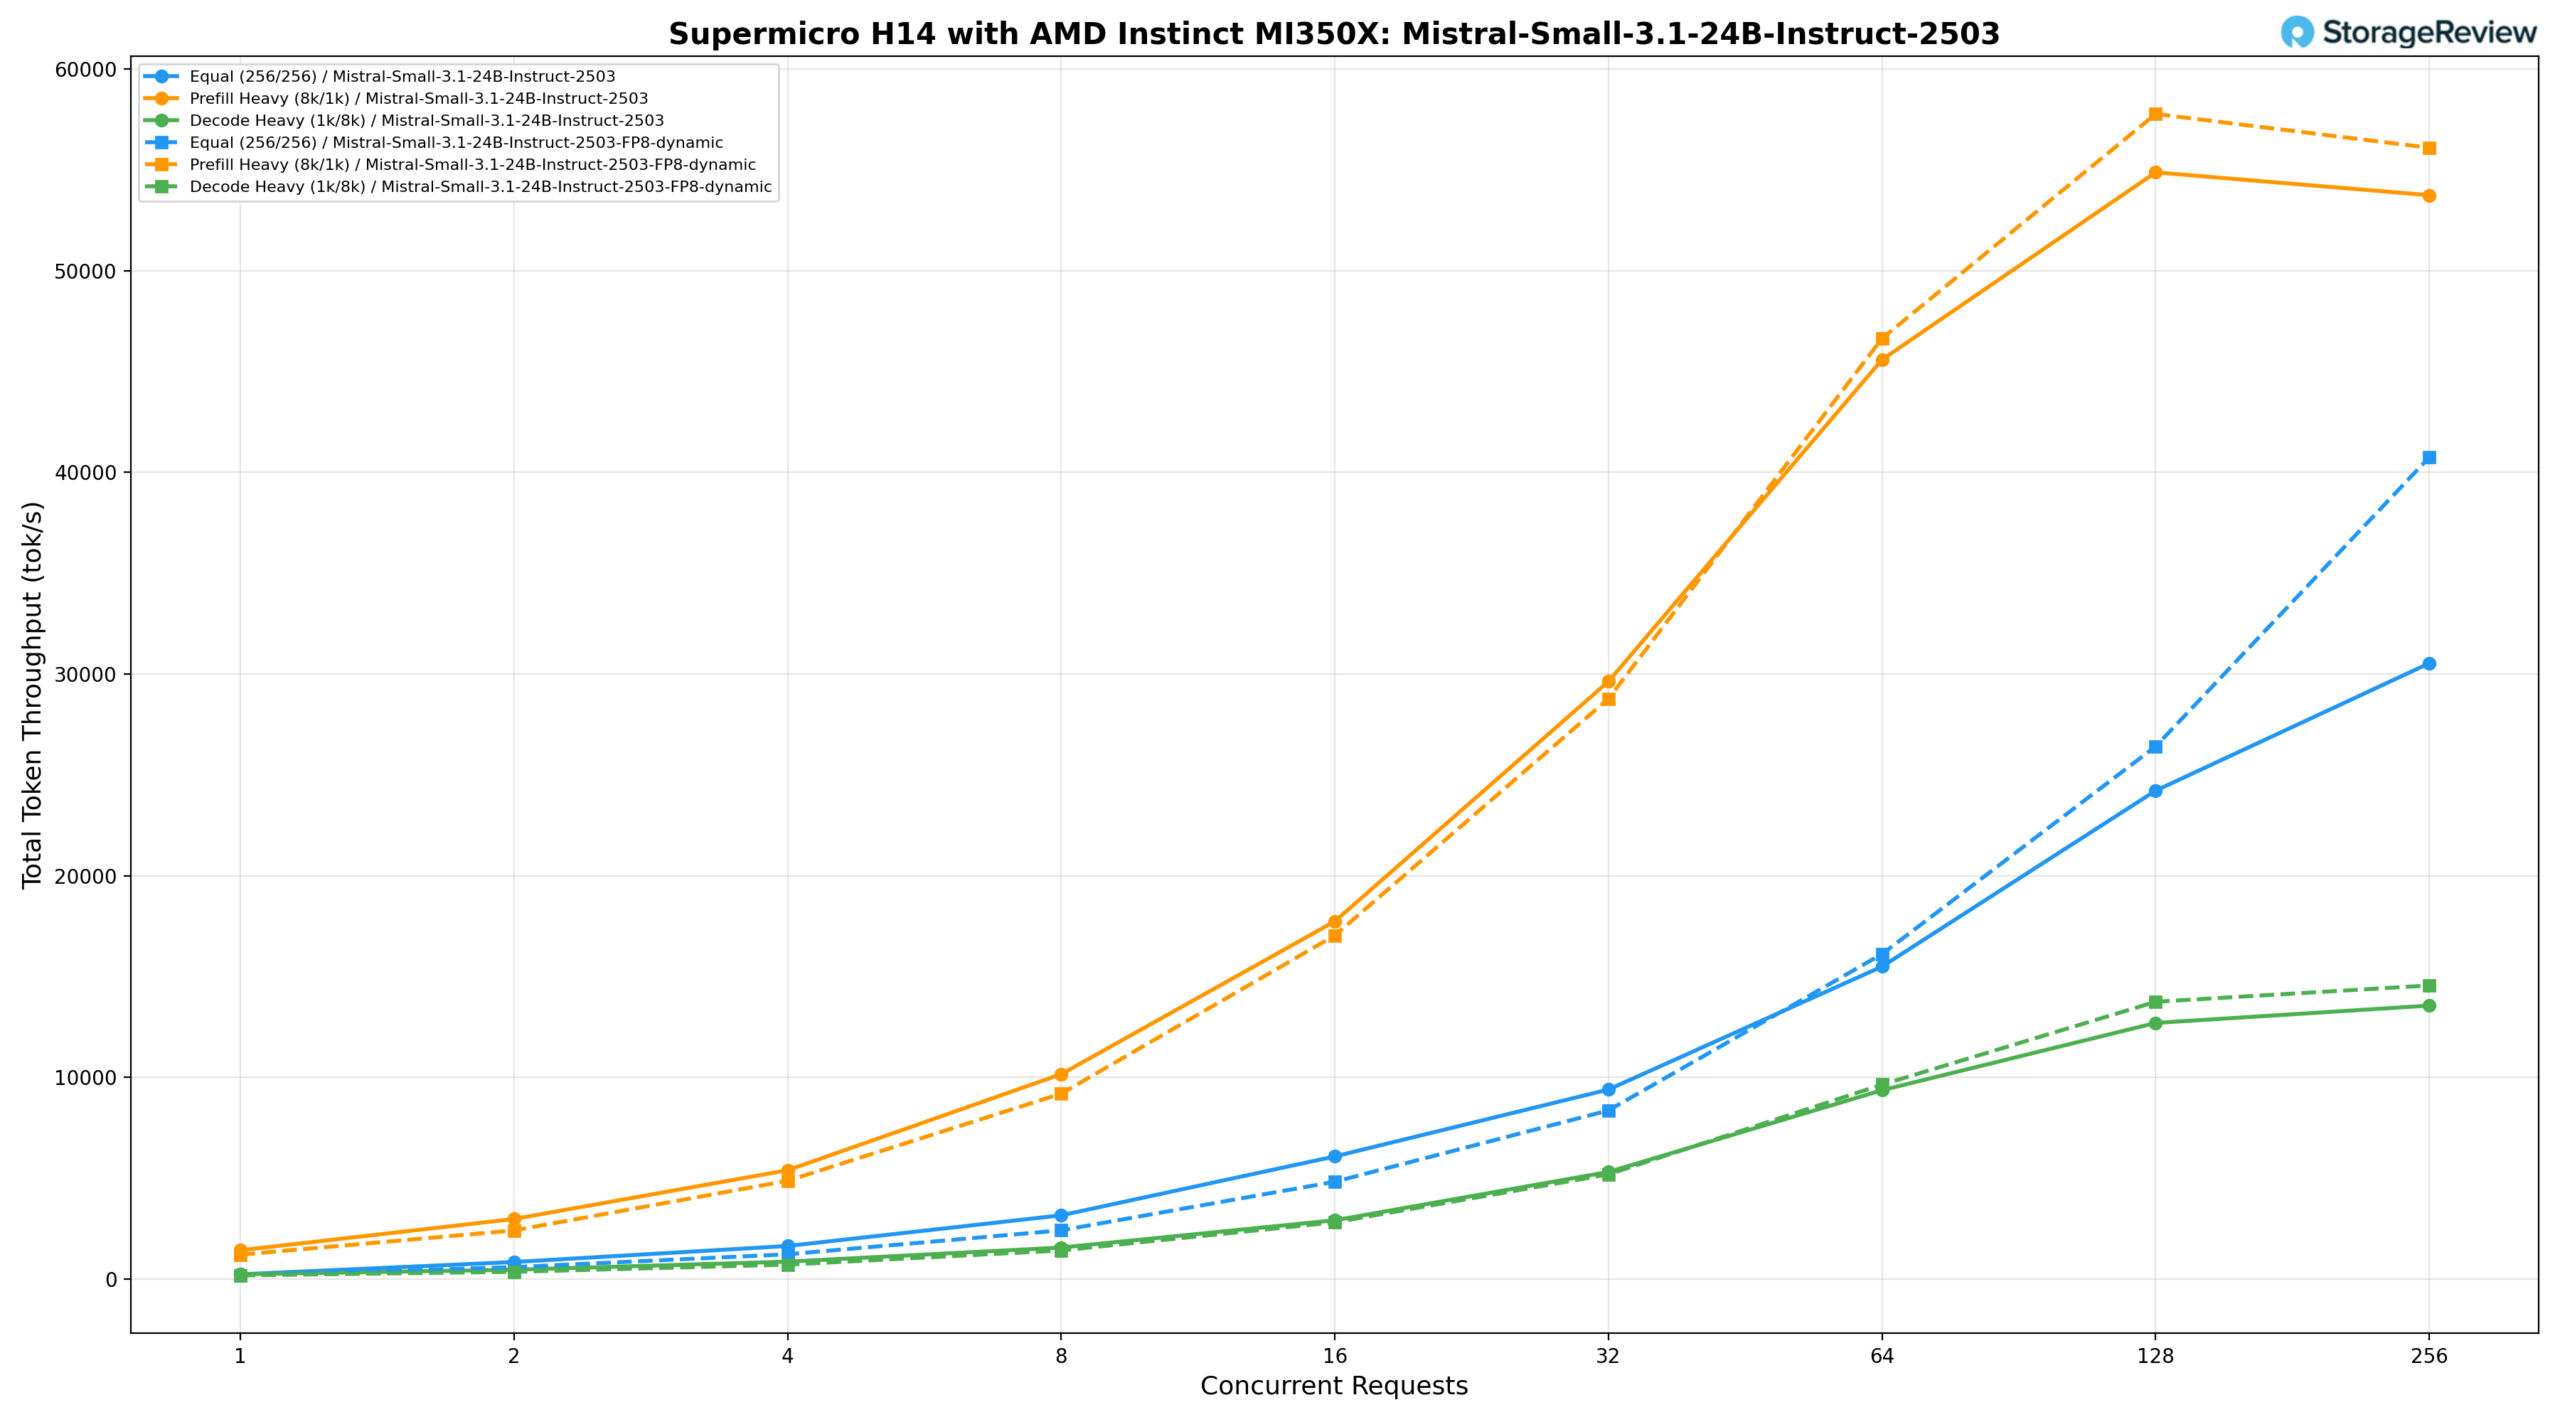
H14上で動作するMistral-Small-3.1-24B-Instruct-2503は、標準精度とFP8動的精度の両方でテストされ、3つのワークロードプロファイルすべてにおいて一貫したスケーリング性能を示しました。
ミストラル・スモール3.1-24B-インストラクト2503 (BF16)
BF16の精度では、均等なワークロード(256/256)はBS=1で236.15 tok/s、BS=64で15,494.56 tok/s、BS=128で24,216.52 tok/sに達し、BS=256で30,530.54 tok/sでピークに達します。プリフィルが重い(8k/1k)場合は、1,429.41 tok/sから始まり、BS=32で29,631.68 tok/s、BS=128で54,871.74 tok/sまで上昇し、BS=256で53,740.04 tok/sでピークに達します。デコード負荷が高い (1k/8k) は、BS=1 での 242.66 tok/s から BS=256 での 13,559.19 tok/s まで増加し、全範囲にわたって着実にスケーリングします。
Mistral-Small-3.1-24B-Instruct-2503 (FP8-dynamic)
FP8-dynamic バリアントは、同等のワークロードで BS=1 で 184.25 tok/s を実現し、BS=64 で 16,113.95 tok/s、BS=128 で 26,409.01 tok/s に達し、BS=256 で 40,742.04 tok/s のピークに達します。Prefill-heavy は 1,210.06 tok/s から始まり、BS=32 で 28,773.52 tok/s、BS=128 で 57,765.02 tok/s まで上昇し、BS=256 で 56,093.09 tok/s のピークに達し、BS=64 以降は標準精度の結果を上回ります。デコード負荷が高い場合、BS=1 での 183.94 tok/s から BS=256 での 14,557.94 tok/s まで増加し、中間域ではほぼ横ばいですが、BS=128 と BS=256 でわずかにリードします。
ラマ3.1 8B 指示
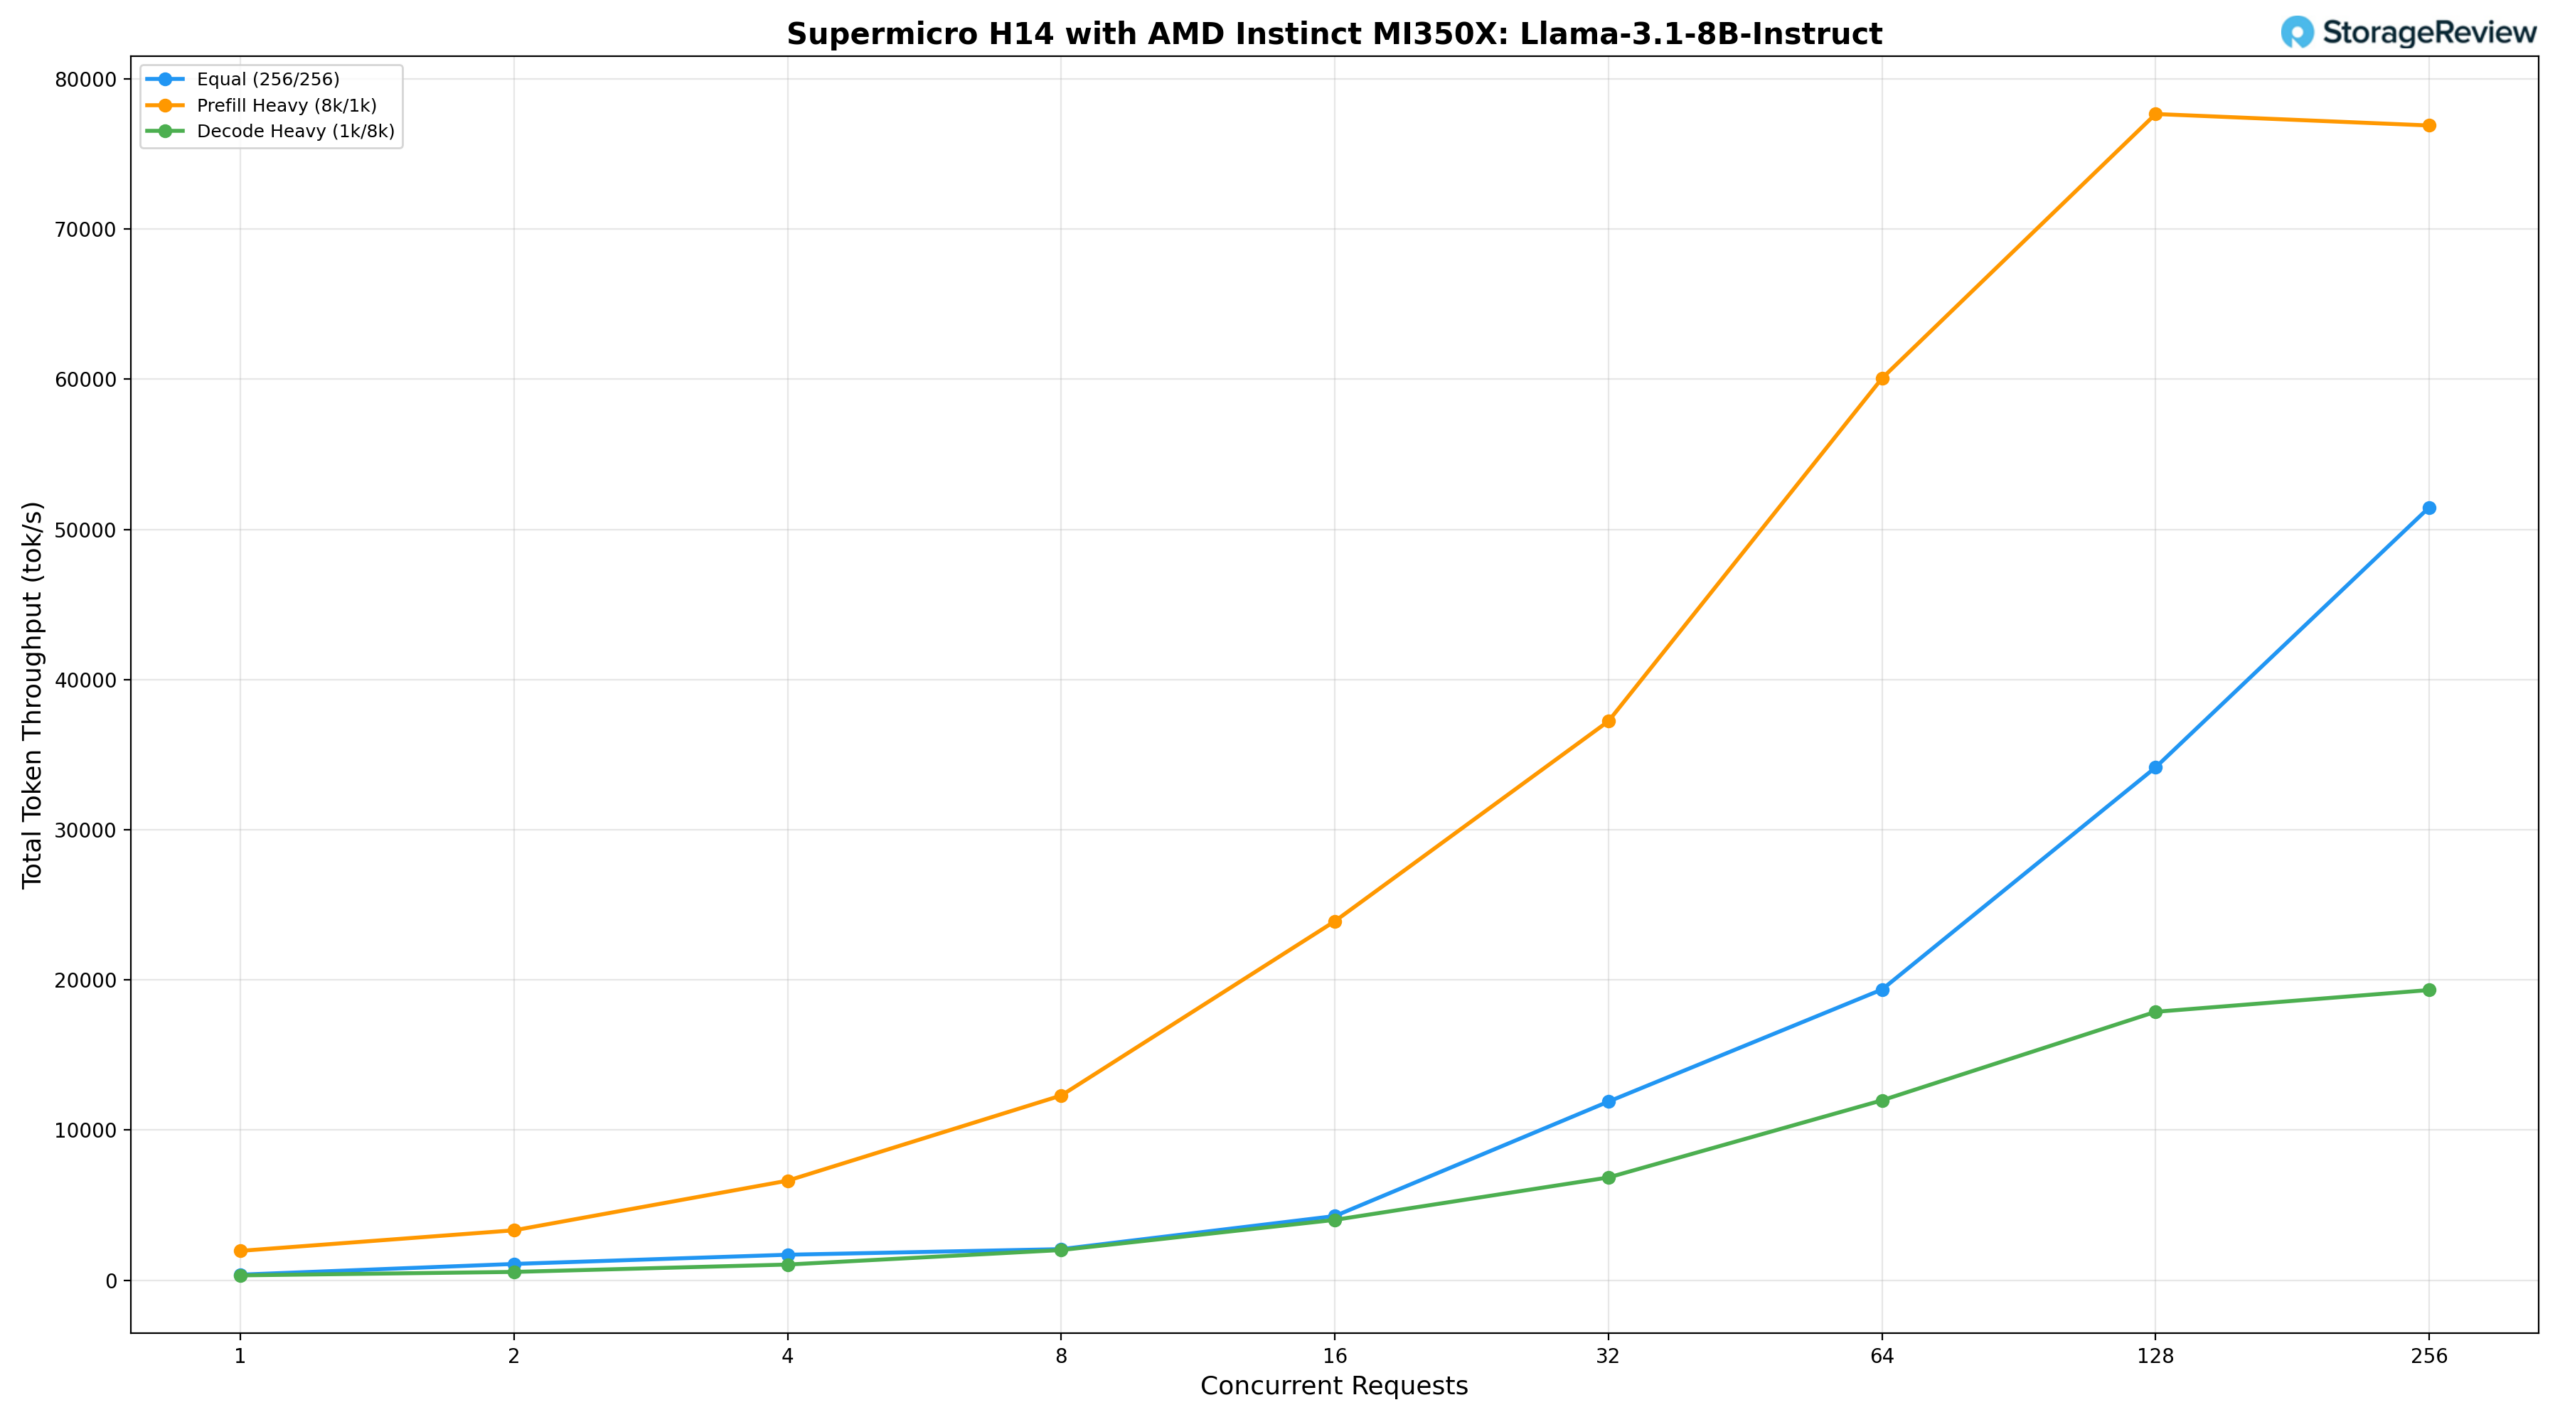
Llama-3.1-8B-Instructの場合、均等ワークロード(256/256)では、BS=1で373.26 tok/s、BS=64で19,363.33 tok/s、BS=128で34,155.70 tok/sに達し、BS=256で51,467.30 tok/sのピークに達しました。プリフィルヘビー(8k/1k)では、1,959.04 tok/sから始まり、BS=32で37,227.63 tok/s、BS=64で60,062.40 tok/sまで上昇し、BS=128で77,658.50 tok/sのピークに達した後、BS=256で76,893.77 tok/sまでわずかに低下しました。デコード負荷の高い(1k/8k)場合、開始時の速度は326.48 tok/sで、BS=128では17,877.52 tok/s、BS=256では19,326.35 tok/sに達し、テストした他のどの大規模モデルよりも同時実行範囲のさらに奥深くまでトークンあたりのレイテンシを低く維持します。
ミニマックスM2.5
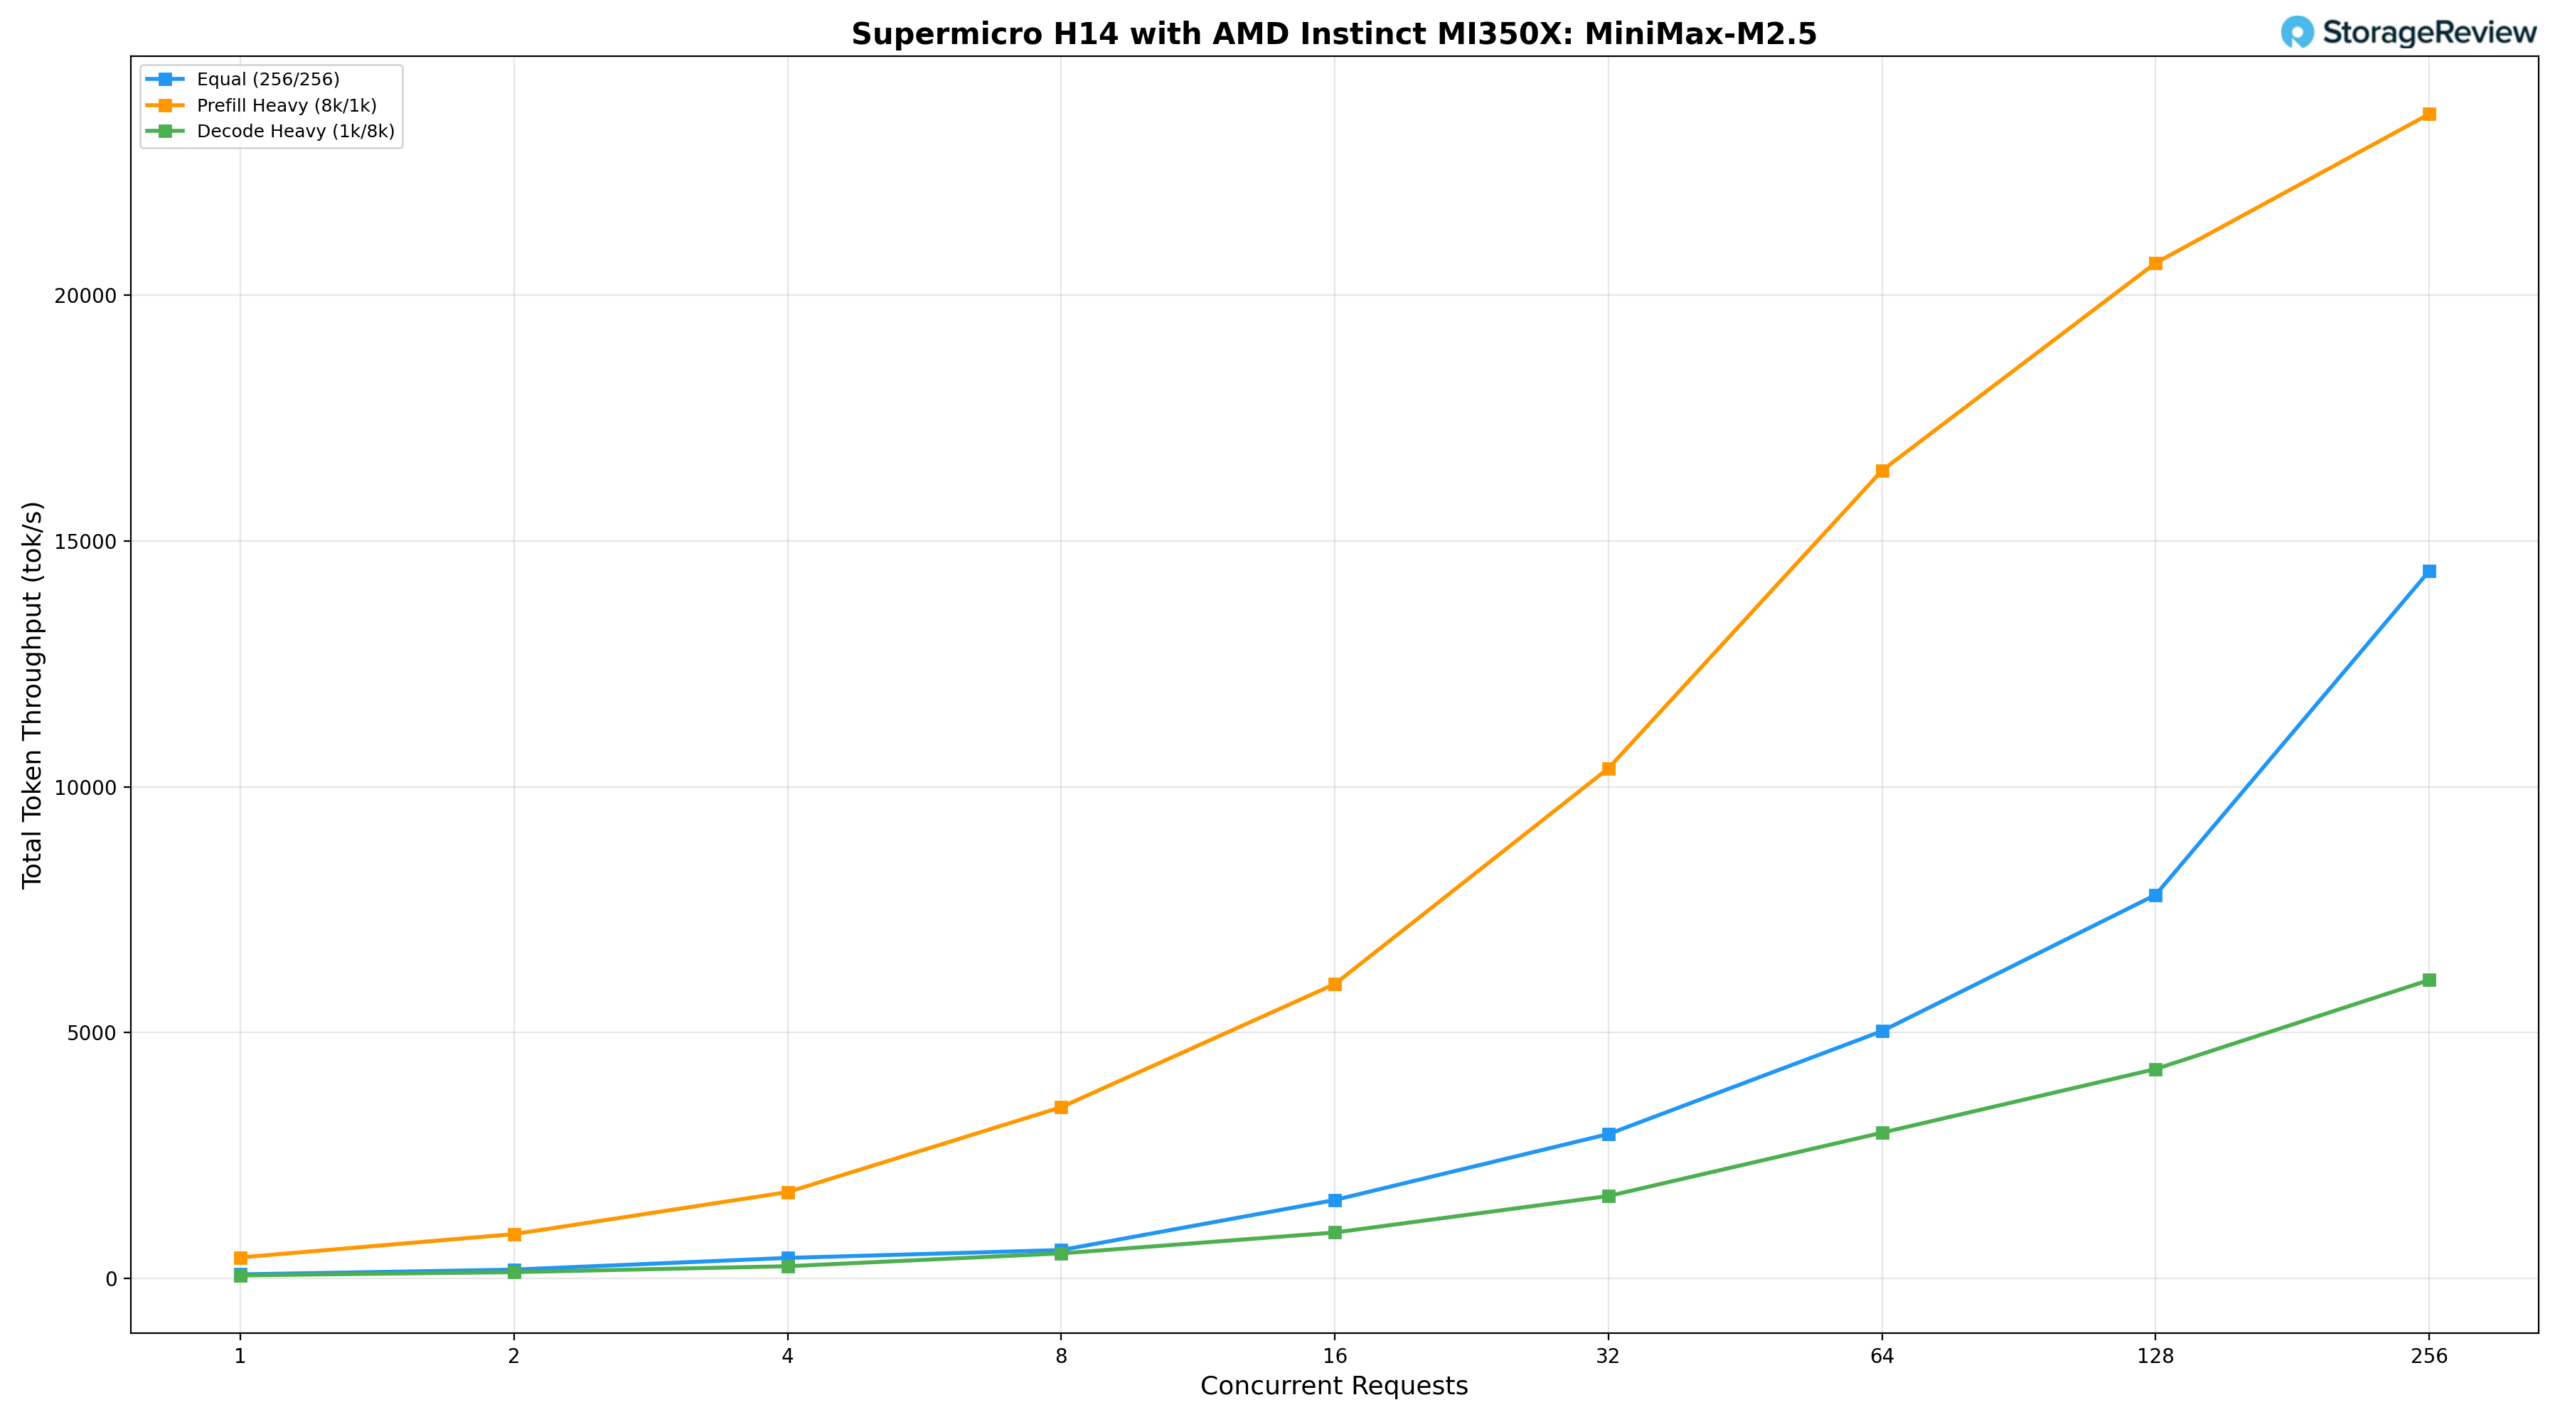
H14 に搭載されている MiniMax-M2.5 は、スループット プロファイルの点で Kimi K2.5 と中型モデルの中間に位置し、エキスパートの混合アーキテクチャを反映した特性を備え、モデル ラインナップを完成させます。均等なワークロード (256/256) では、BS=1 で 79.31 tok/s、BS=64 で 5,029.76 tok/s、BS=128 で 7,801.10 tok/s、BS=256 で 14,391.98 tok/s を実現します。プリフィル負荷が高い (8k/1k) シナリオは、3 つのシナリオの中で最も高いスケーリング性能を示し、424.41 tok/s から始まり、BS=32 で 10,376.75 tok/s、BS=128 で 20,658.57 tok/s まで上昇し、BS=256 で 23,689.18 tok/s のピークに達します。デコード負荷が高い (1k/8k) シナリオは、BS=128 で 4,257.68 tok/s、BS=256 で 6,068.70 tok/s まで着実にスケーリングし、同時実行範囲全体にわたって最も一貫したレイテンシの増加を示します。
キミK2.5
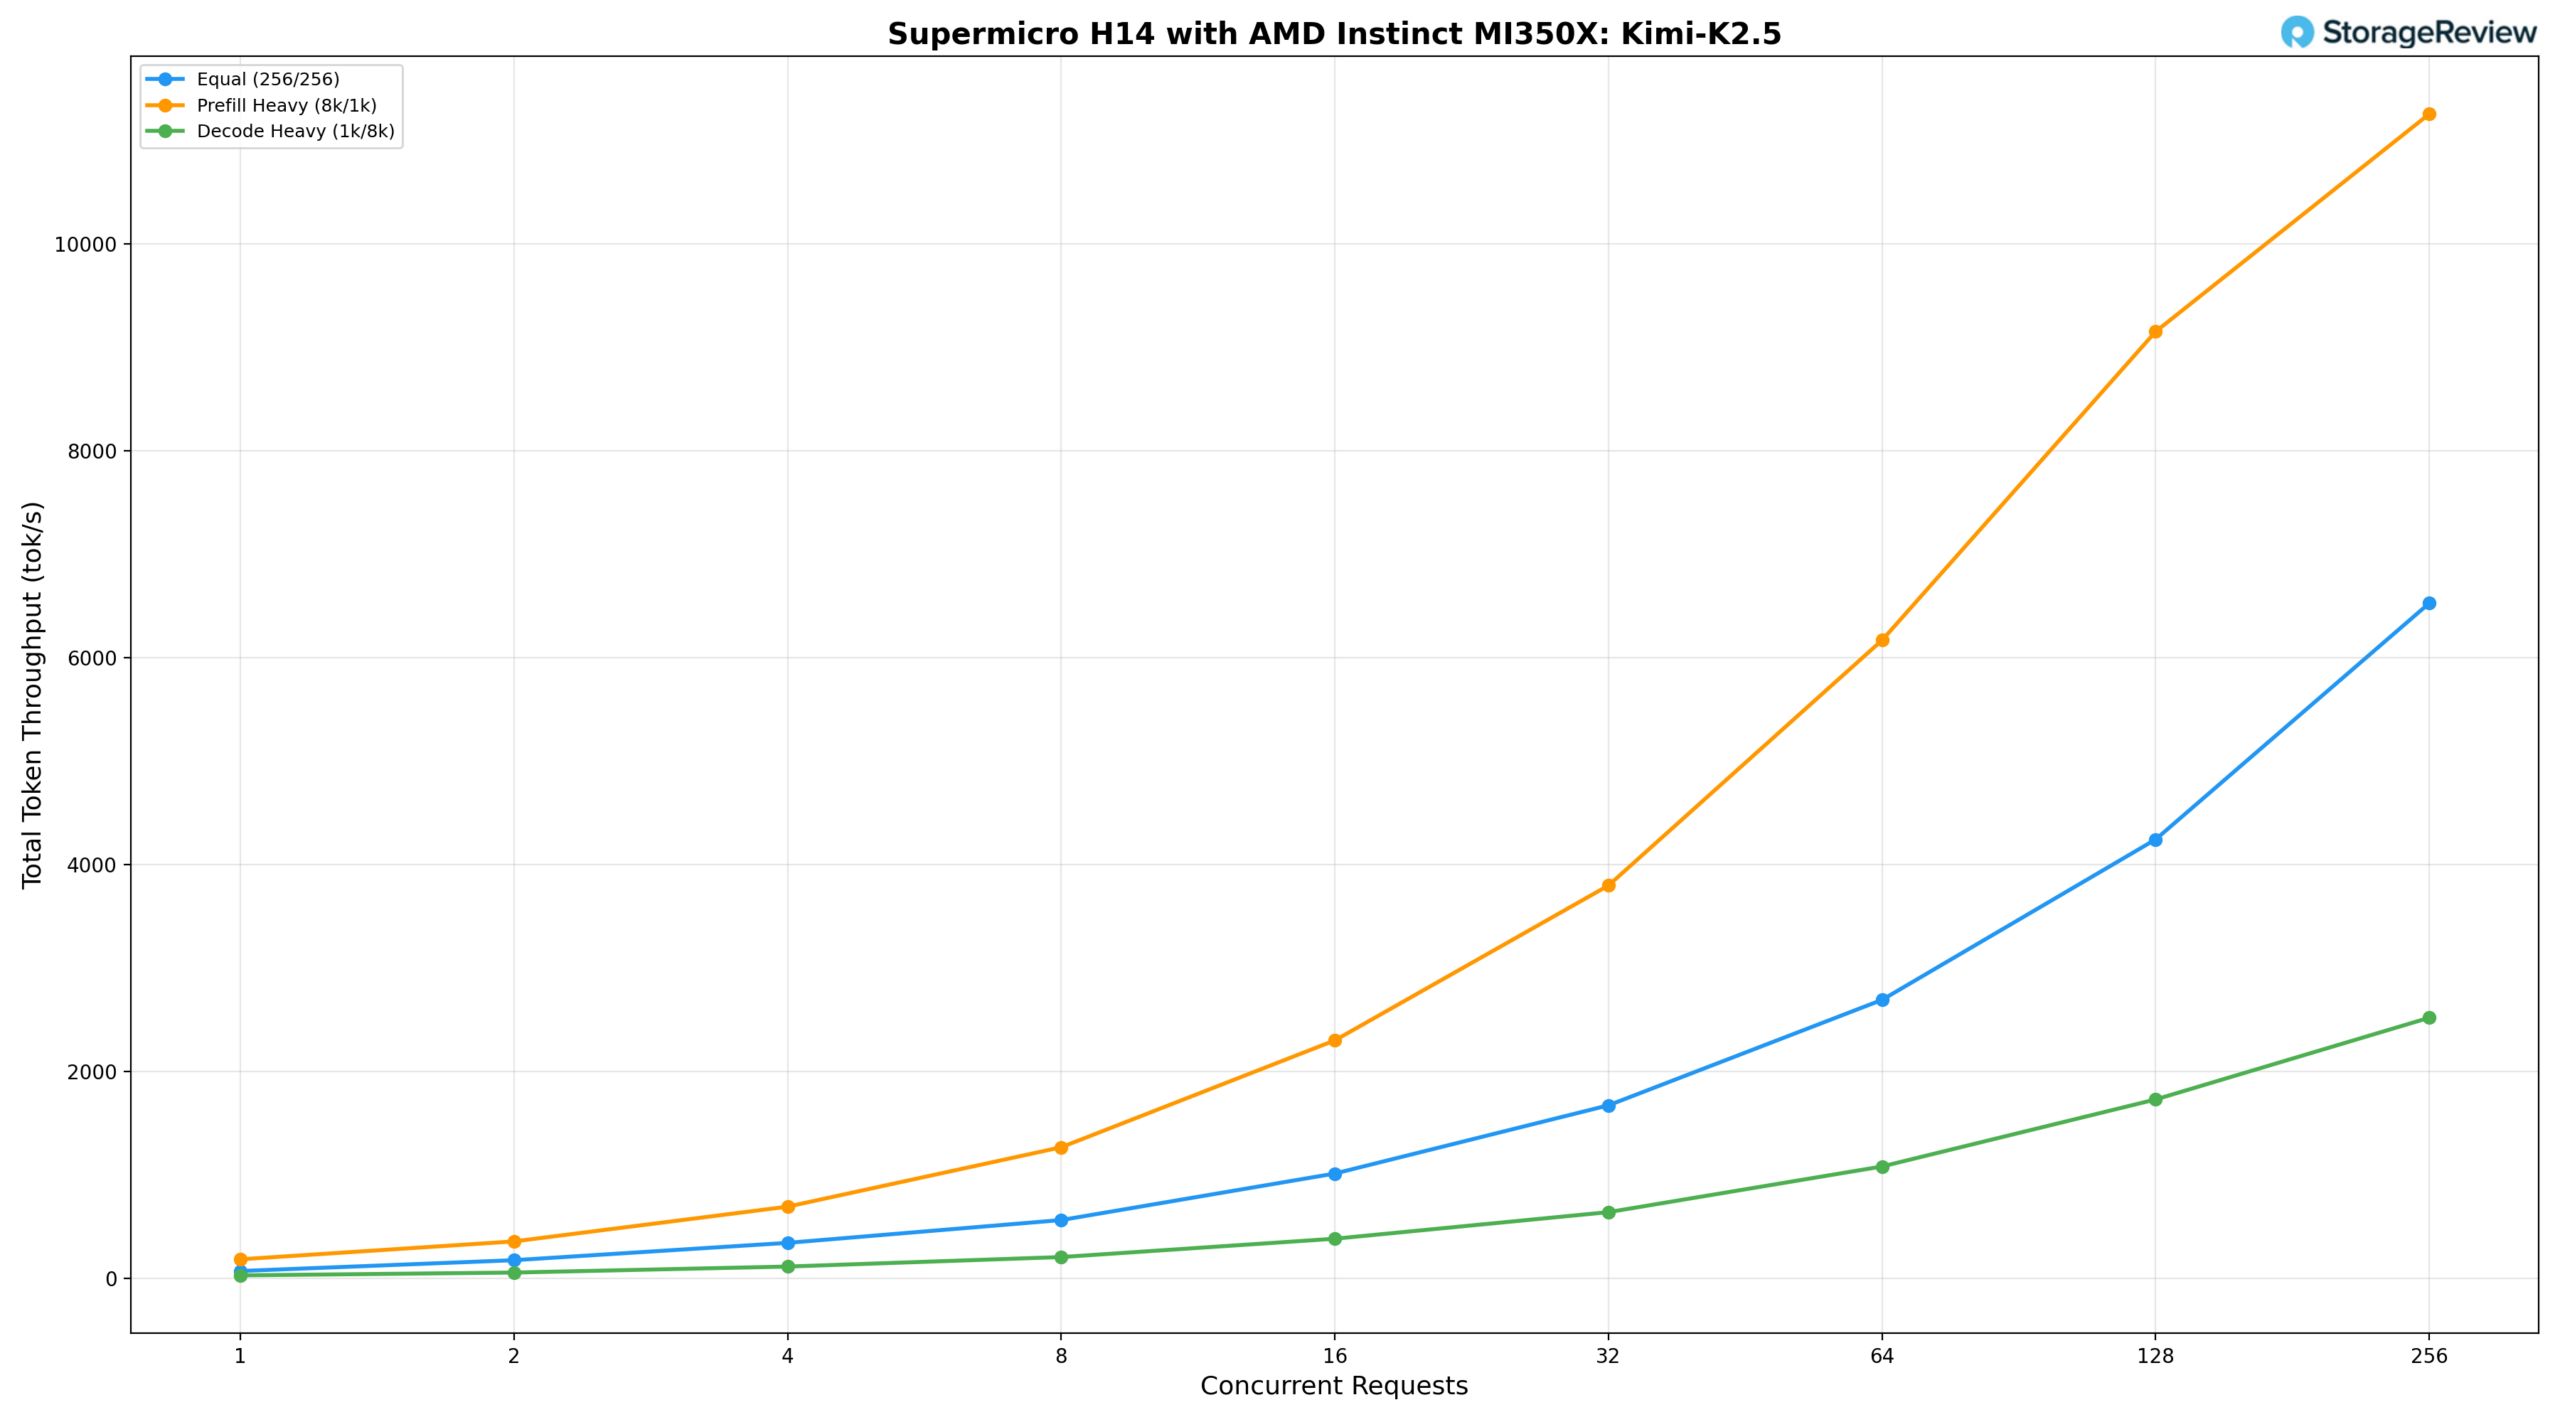
H14に搭載されているKimi K2.5(1兆パラメータモデル)は、今回のレビューでテストしたモデルの中で最大かつ最も高度なモデルであり、その処理能力はモデルの大きさを反映している。
均等なワークロード (256/256) では、BS=1 で 72.06 tok/s となり、BS=64 で 2,693.07 tok/s、BS=128 で 4,244.27 tok/s に達し、BS=256 でピーク 6,527.62 tok/s となります。プリフィルが多い (8k/1k) では、より積極的にスケーリングし、185.29 tok/s から始まり、BS=32 で 3,798.85 tok/s、BS=128 で 9,153.12 tok/s に達し、BS=256 でピーク スループット 11,256.69 tok/s となります。BS=128 から BS=256 へのステップ増加には大きなレイテンシ コストが伴い、このモデル サイズではフル バッチ深度でシステムがメモリと計算の限界に近づいていることを示しています。デコード負荷の高い(1k/8k)場合、BS=1での29.88 tok/sからBS=256での2,513.85 tok/sまで増加し、3つのシナリオの中で最もタイトなスケーリング曲線を実現するとともに、全範囲にわたって一貫したスループットの向上を示しています。
結論
AMD Instinct MI350Xは、ここでテストしたワークロードプロファイル全体で非常に優れた推論性能を発揮し、Supermicro AS-8126GS-TNMRは、その性能を最大限に活用できる優れたプラットフォームを提供します。アクセラレータあたり288GBのHBM3eと、Infinity Fabricを介して相互接続された8つのGPUにより、単一ノードで利用可能な合計2.3TBのGPUメモリは、マルチノード分散やモデル分割の回避策を必要とせずに、Kimi K2.5やMiniMax M2.5のような1兆パラメータモデルを処理するのに十分です。この機能により、大規模推論の展開アーキテクチャが大幅に簡素化されます。
小型モデルでも優れた結果が得られました。Llama 3.1 8Bは、プリフィル負荷の高いワークロードで77,000 tok/sを超える処理能力を発揮し、Mistral Small 3.1 24BやQwen3 Coder 30Bといったミッドレンジアーキテクチャは、並列処理範囲全体にわたって高いスループットと適切に制御されたレイテンシを維持しました。これらの結果は、バッチ深度が高くなっても処理能力が急激に低下するのではなく、負荷に応じて予測可能なスケーリングを実現するハードウェアプラットフォームであることを示しています。
ROCm 7.2 は、特に vLLM 0.18 と組み合わせた場合に、AMD 推論ソフトウェアスタックを大幅に改善します。この組み合わせにより、以前の ROCm 世代よりも明らかに安定性が高く、パフォーマンスも向上したサービス体験が実現します。また、より幅広いフレームワークをサポートし、以前の Instinct デプロイメントの特徴であった不具合も軽減されています。AMD ハードウェアを中心としたエコシステムの勢いも注目に値します。アップストリームの vLLM は、専用の AMD ROCm CI パイプラインを維持するようになり、Meta が 6 ギガワット規模で複数世代にわたるデプロイメントに取り組んでいることは、本番環境での検証が、管理されたベンチマーク環境をはるかに超えて行われていることを示しています。
Claude Codeによるサービス評価では、生のスループット数値に実用的な視点が加わります。単一のMI350Xノードは、最大16の同時コーディングセッションでクラウドベースラインに近い応答速度を維持し、最大64人の同時ユーザーと対話しながら、毎秒約1,000トークンの出力を生成しました。商用APIサブスクリプションのコストと自社ホスト型インフラストラクチャのコストを比較検討している組織にとって、この密度では経済性が明確になり、データの局所性、トークンごとのコストの排除、モデル選択の制限なしといった利点も得られます。
SupermicroのJumpStartプログラムは、インフラストラクチャ評価プロセスにおいてその地位を確固たるものにしています。プロビジョニングの手間を一切かけずに、本番環境のハードウェアに直接アクセスできるため、テスト期間全体を通して実際のワークロードを実環境下で実行することができました。アクセラレータの調達評価を行うチームにとって、このような実践的なアクセスは、仕様書の比較やベンダーによるデモよりもはるかに有益な情報源となります。



 Amazon