

Advancing AI 2026은 AMD의 역대 최대 규모 신제품 발표 행사였으며, 그 규모가 워낙 커서 저희는 보도를 두 부분으로 나누었습니다. 첫 번째 기사에서는 Instinct MI455X와 72개 GPU로 구성된 Helios 랙을 다뤘고, 이번 기사에서는 그 두 가지와 함께 다루기에는 너무 벅찼던 6세대 EPYC 서버 CPU(코드명 Venice)와 Verano 호스트 프로세서를 소개합니다. 특히 CPU는 별도의 기사로 다룰 가치가 있습니다. Venice는 소켓당 최대 256코어 512스레드를 제공하고, 1.6TB/s의 메모리 대역폭을 자랑하며, 서버 CPU 최초로 PCIe Gen 6를 탑재했고, 2017년에 출시된 1세대 EPYC보다 18배 높은 처리량을 제공합니다.
베니스(Venice)는 단순한 칩이 아닙니다. AMD가 모든 세션에서 강조했듯이, 베니스는 포트폴리오입니다. 하나의 CPU 프로필로 모든 것을 해결할 수는 없다는 것이죠. 동일한 Zen 6 세대는 고밀도 프로세서, 엔터프라이즈 프로세서, 스택형 캐시를 탑재한 HPC 프로세서, 그리고 저전력 LPDDR 호스트 등 다양한 제품군으로 나뉩니다. 따라서 속도와 성능에 앞서, 먼저 전체 라인업을 살펴보겠습니다.
베니스와 베라노 라인업
AMD는 최신 데이터 센터를 세 가지 서버 클래스로 분류하며, 자사의 포트폴리오는 이 모든 클래스를 지원하도록 설계되었습니다. 범용 CPU 서버는 웹 게이트웨이, 캐시, 애플리케이션 계층, 데이터베이스 및 스토리지를 실행하며, 이 모든 구성 요소는 해당 CPU에 의존합니다. GPU 서버는 가속기에 지속적으로 데이터를 공급하는 호스트 CPU가 필요하며, 이 작업에서는 단일 스레드 속도와 I/O 대역폭이 코어 수보다 중요합니다. 세 번째 클래스는 AI 서비스를 중심으로 발전해 온 오케스트레이션 및 도구 실행 코드를 위한 고밀도 CPU 서버입니다. 이러한 코드는 분기가 많고 지연이 발생하기 쉬우므로 무엇보다 스레드 처리가 중요합니다.
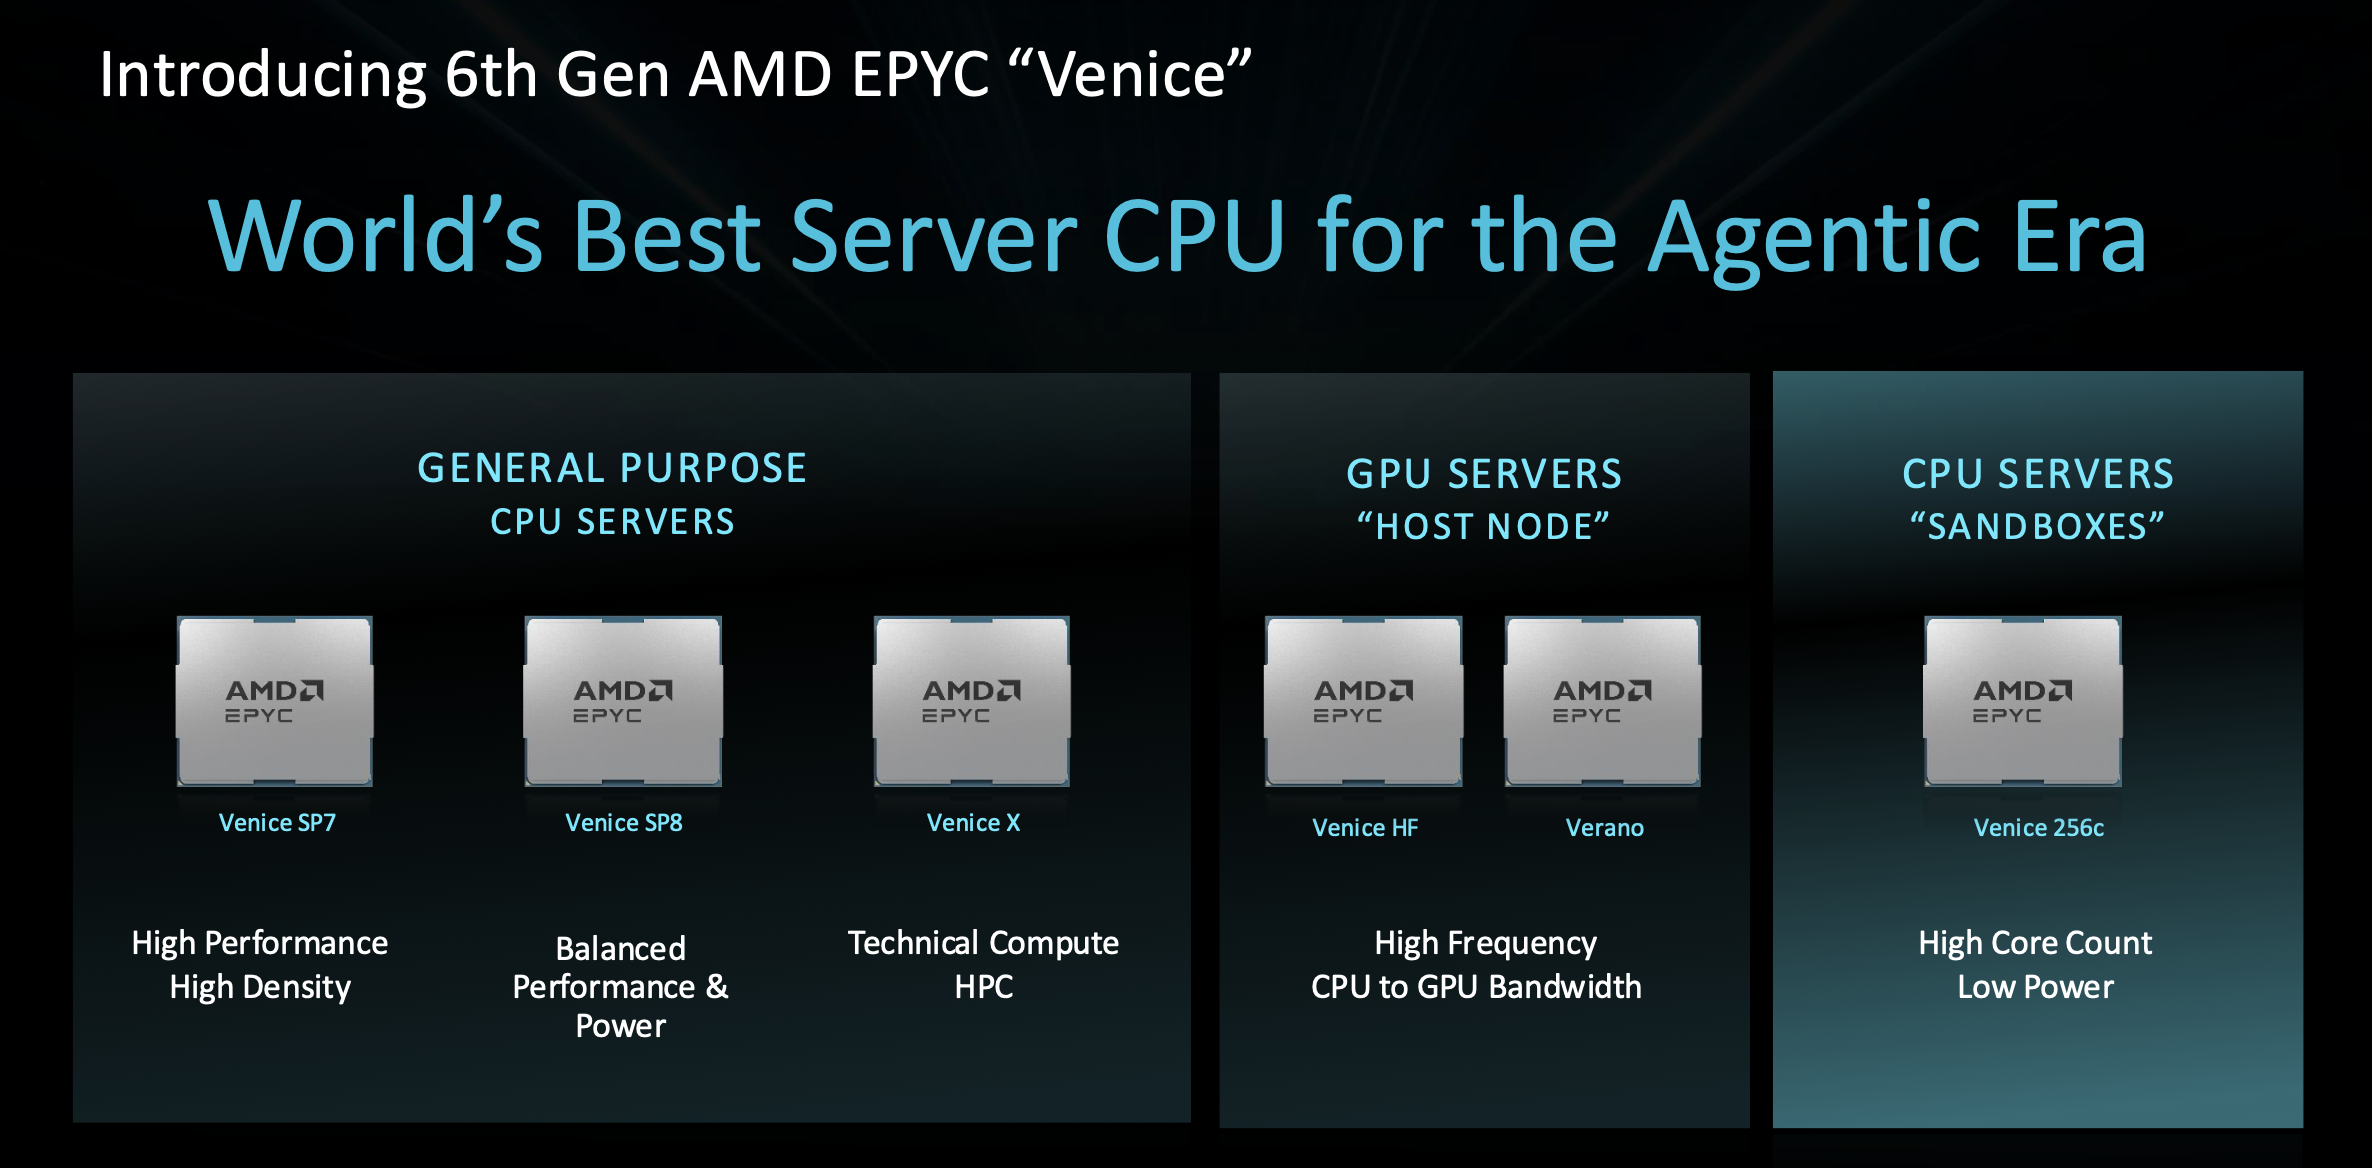
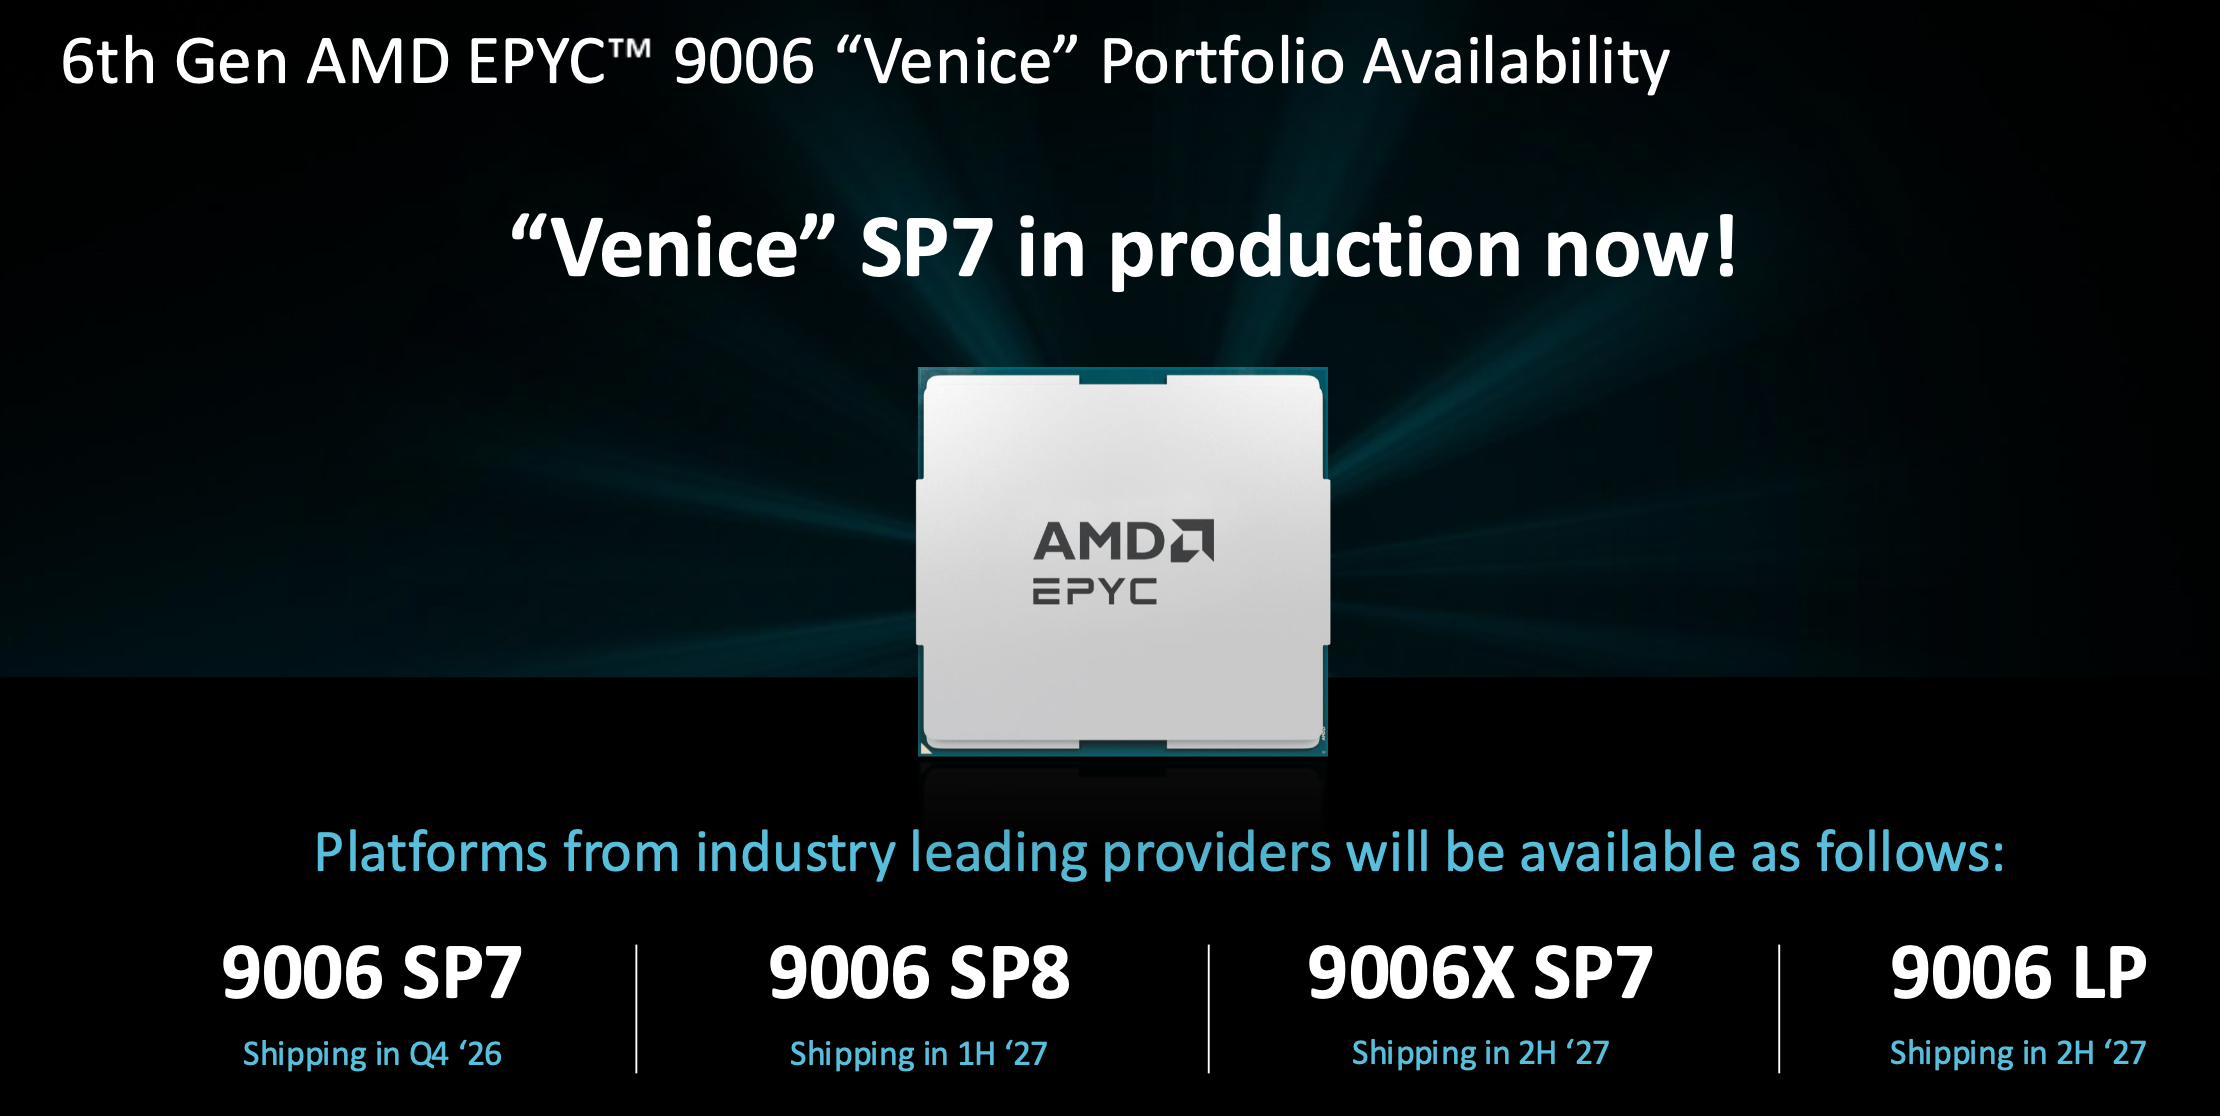
AMD의 제품 라인업은 총 네 가지로 구성되며, 각 플랫폼은 단계적으로 출시될 예정입니다. Venice SP7은 2026년 4분기, Venice SP8은 2027년 상반기, 그리고 Venice-X와 Verano는 하반기에 출시됩니다. AMD는 동일한 실리콘을 여섯 가지 방식으로 분할하여 세 가지 등급으로 분류합니다. 범용 프로세서는 Venice SP7, SP8, Venice-X로 구성됩니다. 호스트 프로세서는 고주파수 Venice와 Verano, 그리고 LPDDR 메모리를 조합하여 사용합니다. 고밀도 컴퓨팅 프로세서는 Venice 256c로, 저전력에 높은 코어 수를 제공하며, 전력 예산이 허용하는 한 최대한 많은 스레드를 랙에 탑재할 수 있도록 설계되었습니다. Verano는 범용 프로세서로도 활용될 수 있는데, AMD는 시스템 전력 소비 대비 성능이 중요한 모든 분야에서 Verano를 사용할 수 있을 것이라고 밝혔습니다.
각주 덕분에 SKU를 미리 살펴볼 수 있습니다. 256코어 EPYC 9996이 스택의 최상위 모델이고, 9956은 동일한 코어 수를 400W로 제공하며, 96코어 9686F는 고주파 호스트 칩입니다. Helios는 모든 컴퓨팅 트레이에 자체 버전의 호스트 실리콘인 EPYC 9G76을 탑재하고 있습니다.
타협 없는 등급
사양표를 살펴보기 전에, 빅 소켓이 어디에 위치하는지 간단히 설명드리겠습니다. 베니스 SP7은 AMD의 최고급, 타협 없는 성능을 추구하는 데이터센터, 하이퍼스케일러, HPC 컴퓨팅 환경을 위해 마련되었습니다. 이러한 환경에서는 랙당 처리량이 가장 중요한 요소이며, 비용을 아끼지 않고 투자해야 합니다. 서버 제조사들은 이미 베니스 SP7을 중심으로 제품군을 재편하고 있습니다. 델은 오랫동안 사용해 온 파워엣지(PowerEdge) 명명 체계를 변경하여 베니스 SP7을 위한 공간을 확보했으며, 이제 이 등급의 컴퓨팅 제품은 파워엣지 R9825와 랙 스케일 M9825를 필두로 하는 새로운 9000 시리즈에 포함됩니다. 이 두 제품은 3U 섀시에 베니스 칩 두 개를 탑재한 플래그십 모델입니다.
주요 사양
온 가족이 하나의 기반 위에 집을 짓고 살며, 토리노 이후로 거의 모든 부분이 새롭게 단장되었습니다.
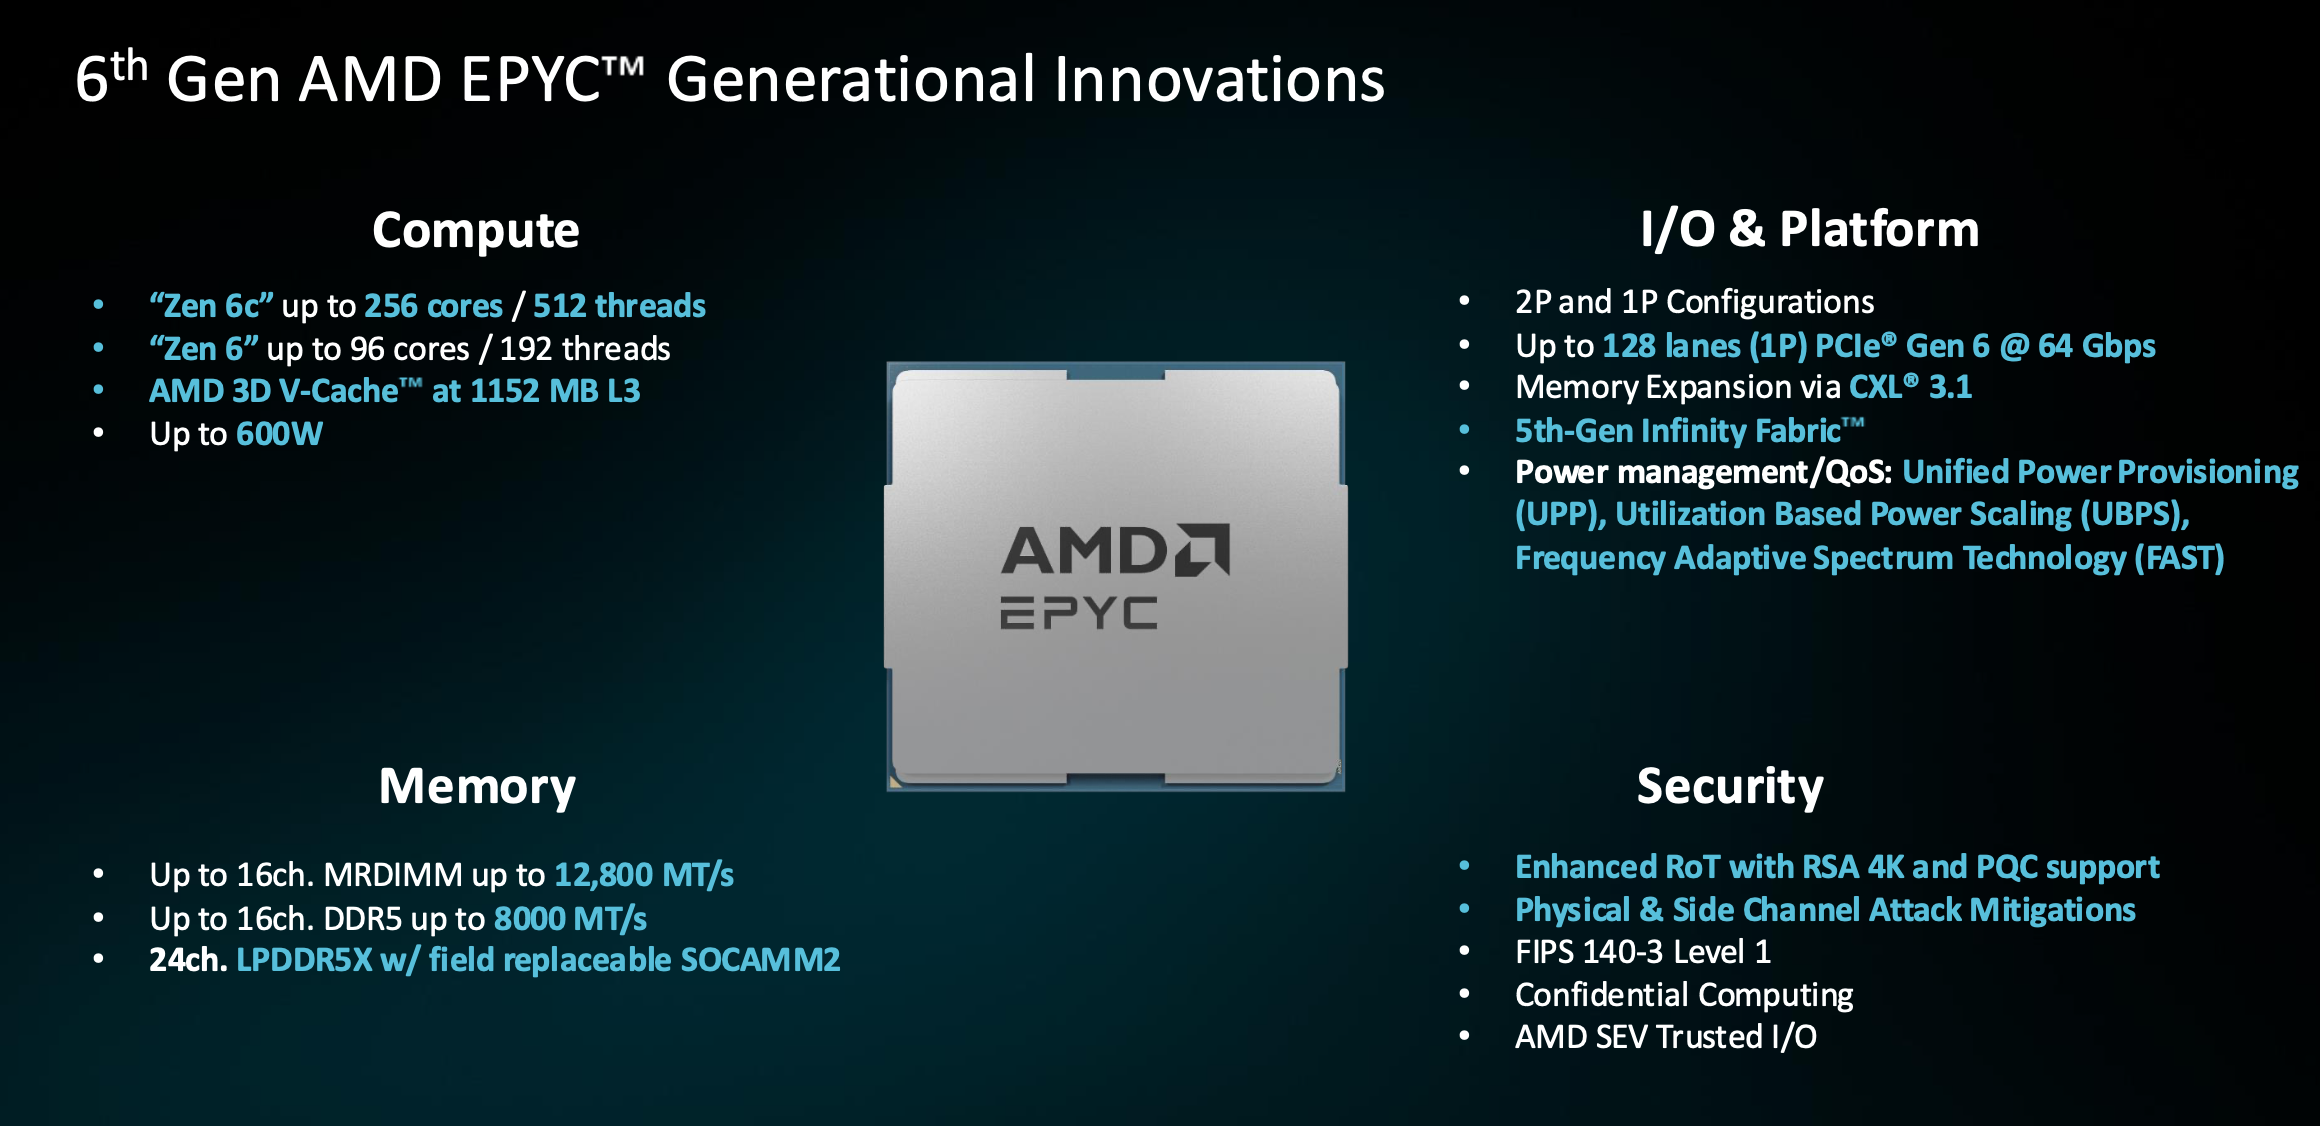
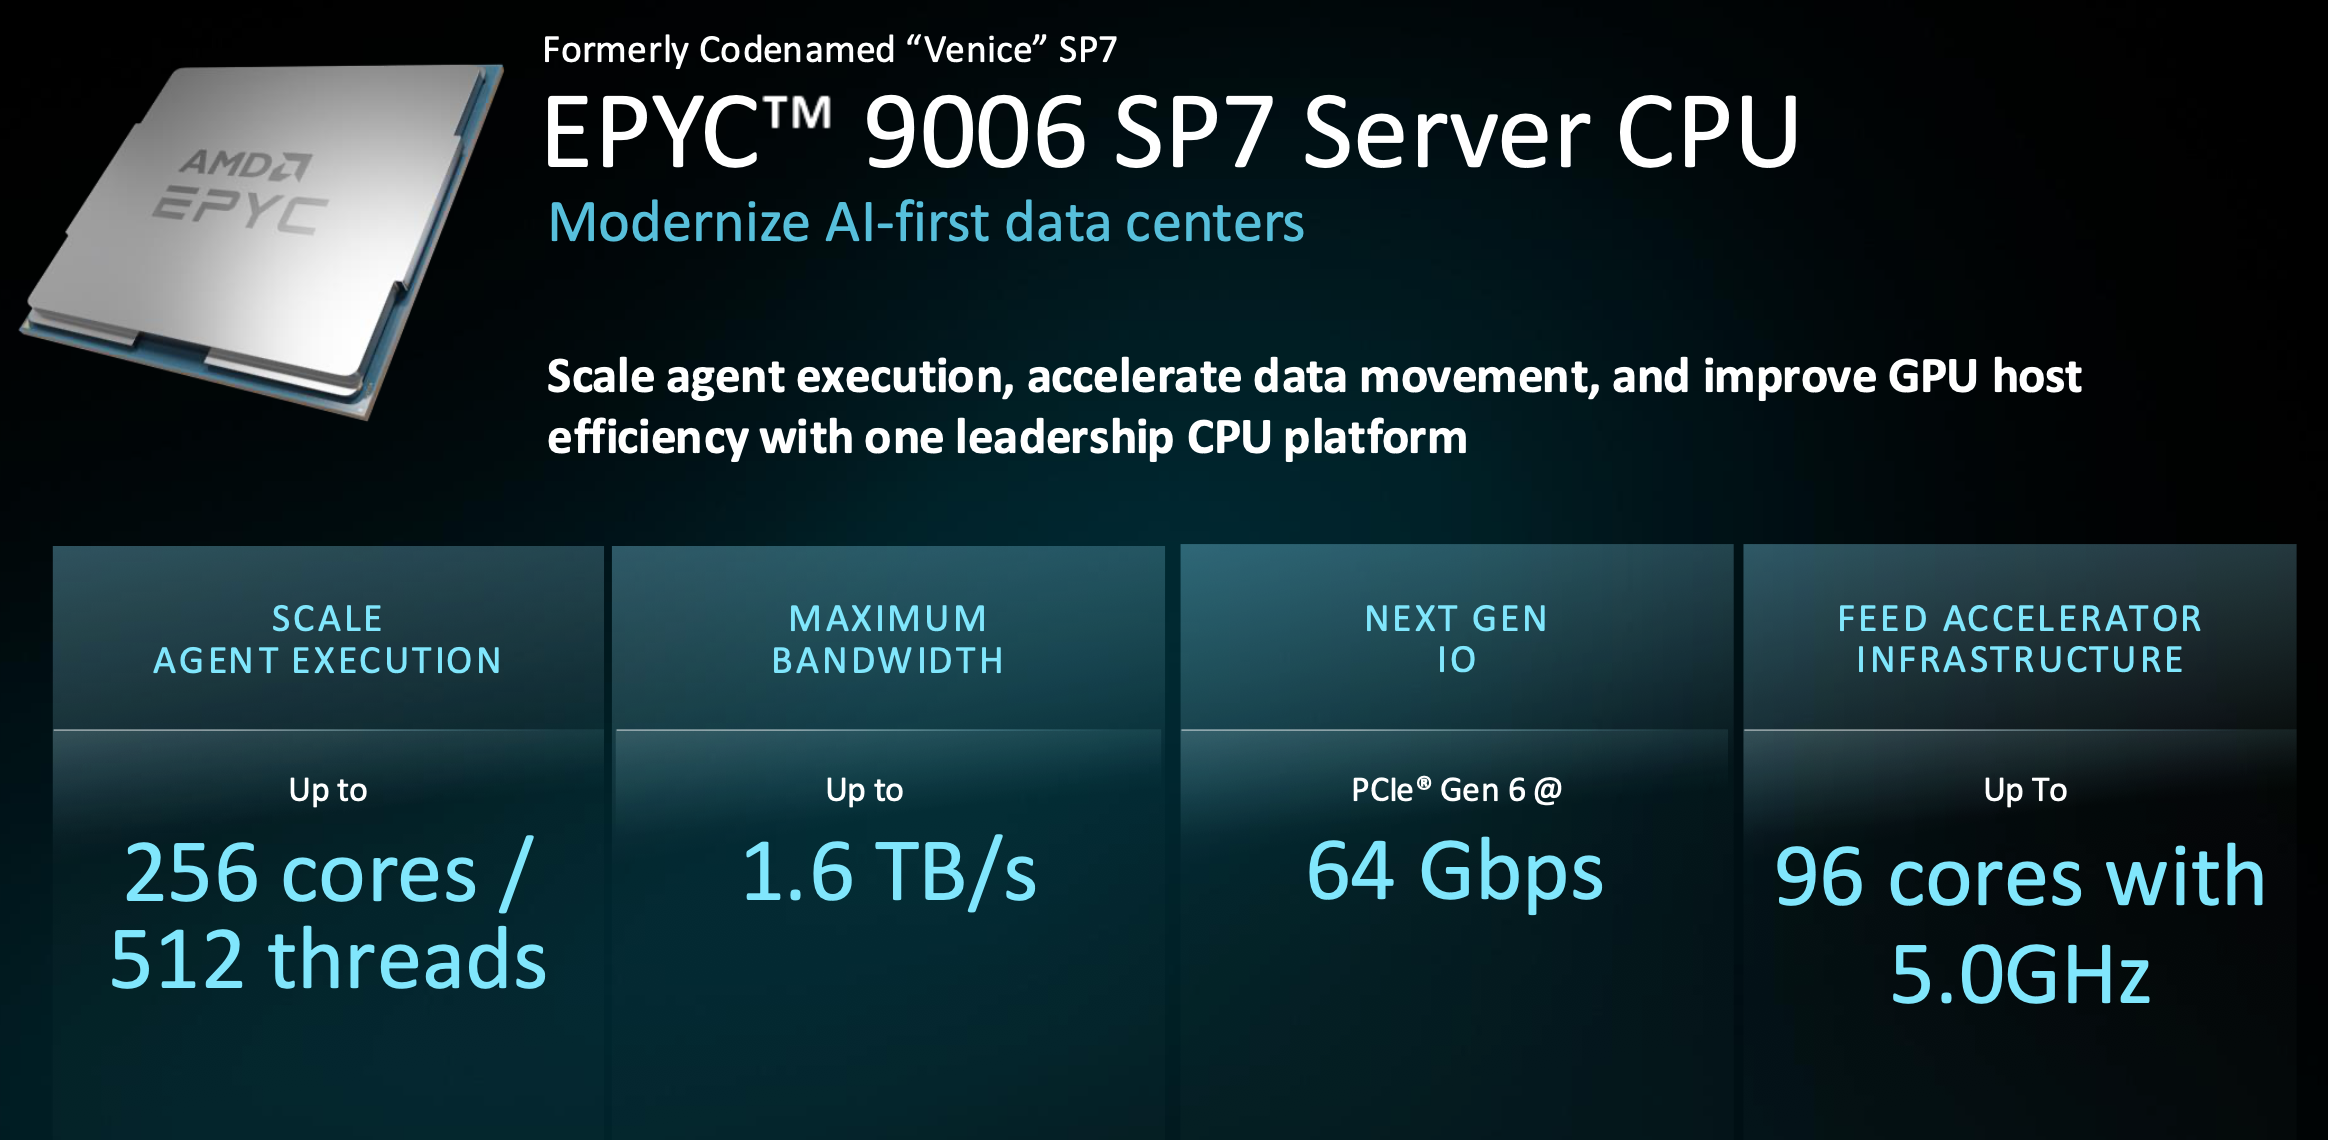
먼저 코어부터 살펴보겠습니다. Zen 6는 두 가지 버전으로 출시됩니다. 컴팩트한 Zen 6c는 최대 600W의 전력 소모로 256개의 코어와 512개의 스레드를 소켓에 탑재했고, 표준 버전은 96개의 코어와 5GHz의 클럭 속도를 제공합니다. AMD는 동일한 코어 수를 가진 경쟁 제품보다 코어당 성능이 최대 20% 향상되었다고 주장하며, 코어 밀도가 높아졌다고 해서 캐시 용량이 줄어들지는 않습니다. 256코어 다이조차도 코어당 약 4MB의 L3 캐시를 유지하며, 플래그십 모델은 무려 1GB의 L3 캐시를 제공합니다. AVX-512는 토크나이저와 30억~80억 개의 파라미터를 사용하는 모델링 작업을 처리하는데, 이러한 작업은 점점 더 CPU 자체에서 실행됩니다.
이러한 코어에 데이터를 공급하려면 훨씬 더 큰 메모리 시스템이 필요합니다. 8,000MT/s의 DDR5 16채널 또는 12,800MT/s의 MRDIMM을 사용하면 소켓당 1.6TB/s의 대역폭을 확보할 수 있는데, Turin은 12채널에서 614GB/s를 제공했습니다. I/O 성능도 마찬가지로 크게 향상되었습니다. Venice는 PCIe Gen 6를 지원하는 최초의 서버 CPU로, 64GT/s의 대역폭을 가진 128레인을 제공하여 현재 가속기에 연결되는 다른 어떤 CPU보다 레인당 대역폭이 두 배나 높습니다. 이는 나중에 자세히 살펴볼 호스트 노드 기술 주장의 기반이 됩니다. CXL 3.1은 이러한 레인을 활용하여 메모리를 확장하며, 일부 듀얼 소켓 AI 호스트 플랫폼은 소켓 간 xGMI 대역폭을 희생하여 I/O 대역폭을 늘려 160개의 가용 레인을 확보합니다. 두 가지 조용한 추가 기능은 코어에 부담을 주지 않고 데이터를 이동합니다. SDXI는 메모리 복사와 30~50개 코어에 해당하는 암호화 작업을 오프로드하고, 스마트 데이터 캐시 주입은 네트워크 패킷을 DRAM을 거치지 않고 캐시에 직접 저장합니다.
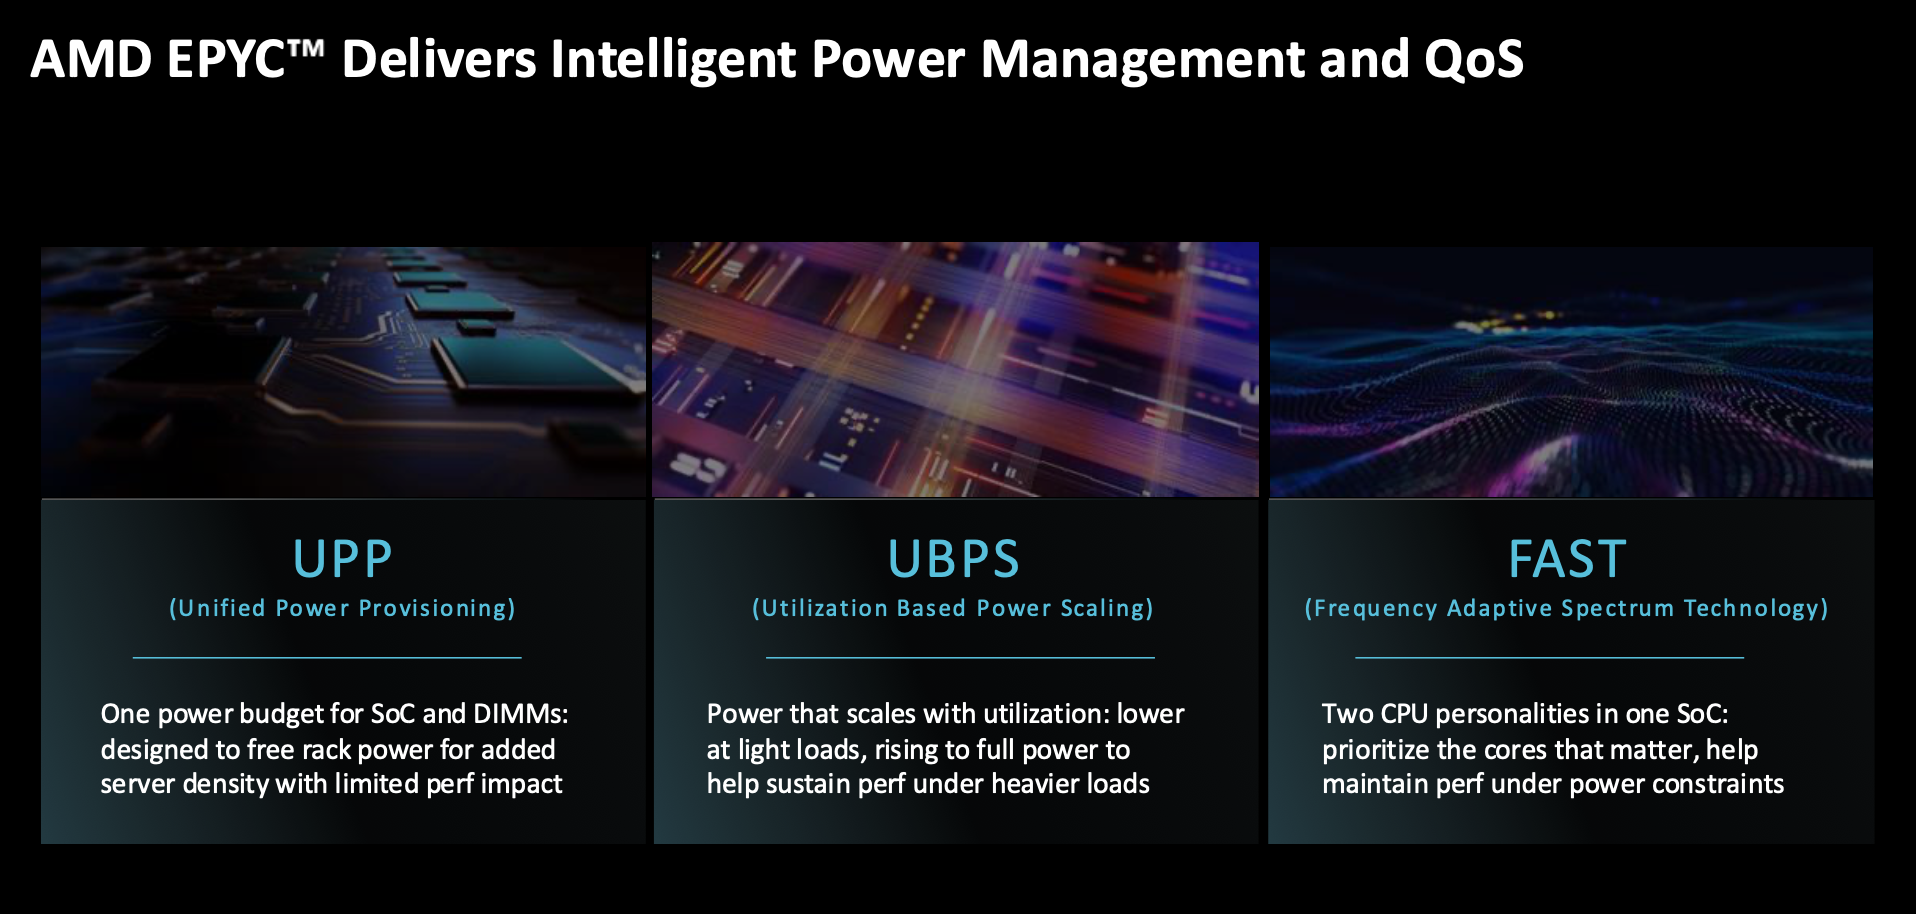
전력 관리에는 세 가지 새로운 조절 기능이 추가되었으며, 이는 AMD가 향후 수행할 모든 랙 비교가 전력 예산 내에서 이루어지기 때문에 중요합니다. UPP는 SoC와 DIMM의 전력 예산을 하나로 통합하여 메모리 집약적인 워크로드는 DIMM으로 전력을 이동시키고 연산 집약적인 워크로드는 전력을 다시 끌어들여 고정된 예산 내에서 성능을 향상시키거나 랙의 전력을 더 많은 노드에 할당할 수 있도록 합니다. UBPS는 낮은 사용률에서 전력을 제한하여 일반적인 저부하 성능 향상을 포기하는 대신 안정적이고 예측 가능한 부하 곡선을 유지합니다. 성능 향상을 선호하는 운영자는 이 기능을 끌 수 있습니다. FAST는 하나의 SoC를 두 가지 특성으로 분할하여 우선순위 코어는 고주파수로 유지하고 백그라운드 코어는 저속으로 실행되도록 함으로써 지연 시간에 민감한 작업이 배치 작업과 소켓을 공유하더라도 성능 저하를 방지합니다.
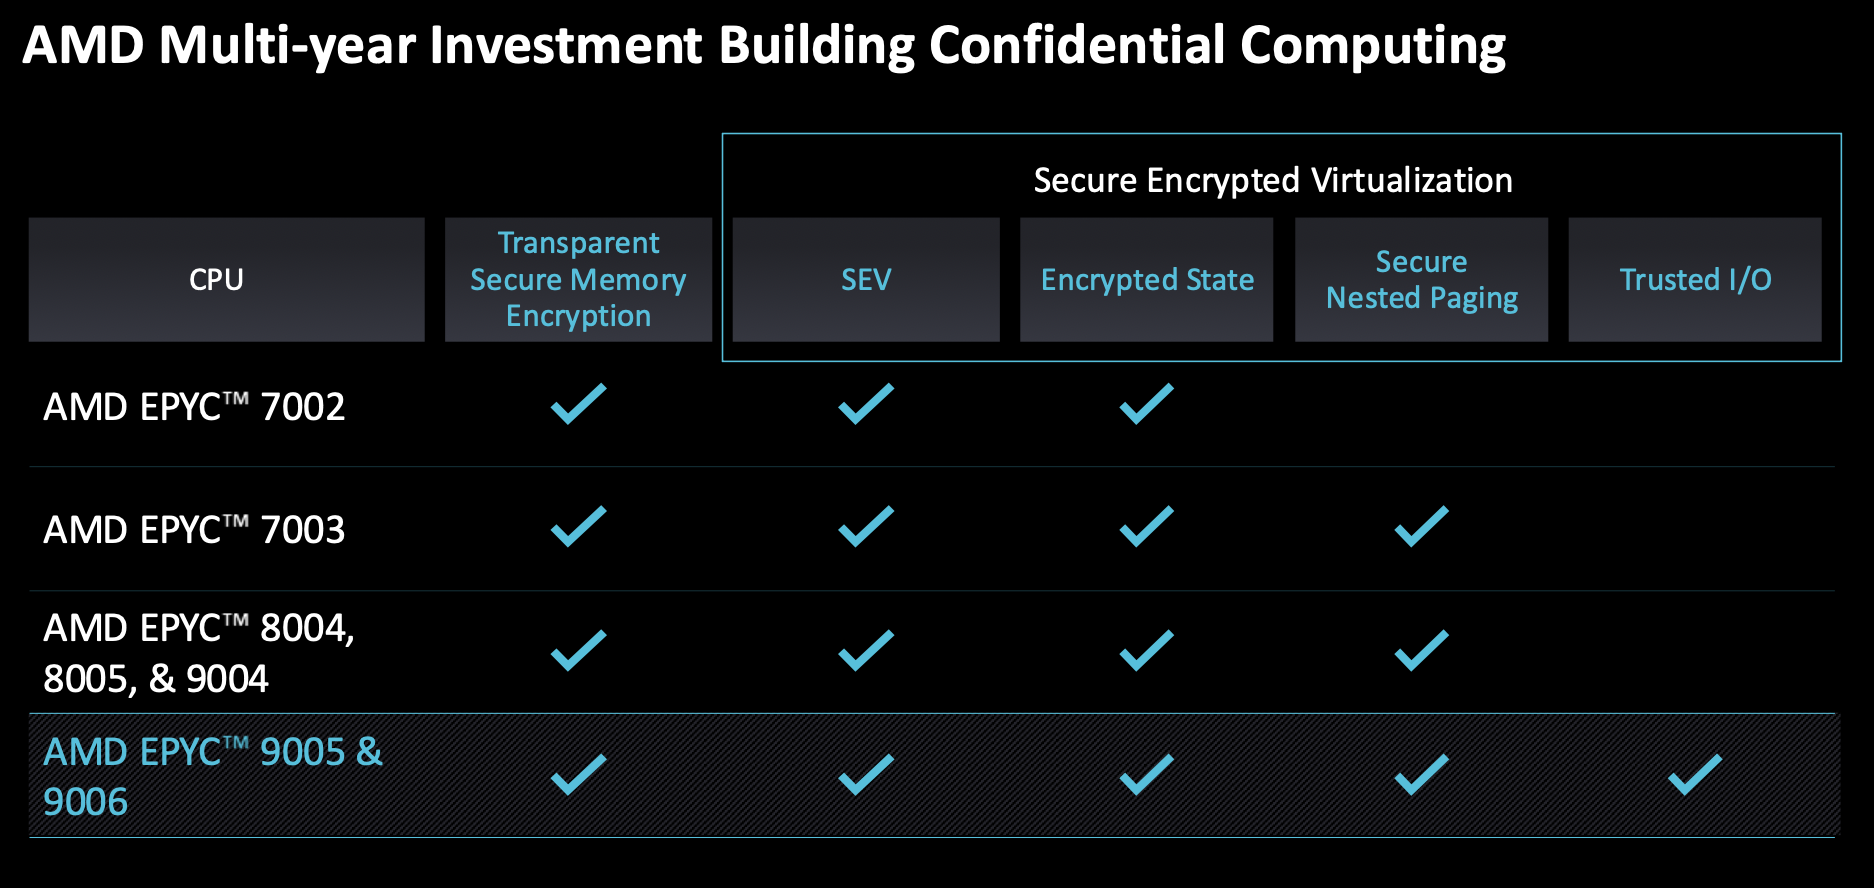
보안 측면에서 Venice는 EPYC 7002의 SEV부터 암호화된 상태, 안전한 중첩 페이징, Turin에서 선보인 Trusted I/O에 이르기까지 기밀 컴퓨팅 계보를 이어갑니다. 이번 세대의 새로운 기능으로는 RSA-4K 및 양자 후 알고리즘을 사용한 향상된 신뢰 루트, 물리적 및 사이드 채널 공격 완화, FIPS 140-3 레벨 1 인증, 그리고 검증 가능한 제조 이력을 제공하는 Device Provenance가 있으며, Venice는 AMD 제품 중 최초로 이러한 기능을 탑재할 예정입니다.
포트폴리오 내부
네 부분은 공통된 이름에서 짐작할 수 있는 것보다 훨씬 더 많은 차이점을 가지고 있습니다.
| 스펙 | 9006 SP7 | 9006 SP8 | 9006X SP7 | 9006 LP “베라노” |
|---|---|---|---|---|
| 코어 | 최대 256개(512개 스레드) | 8 ~ 128 | 최대 96까지 | 최대 72까지 |
| 피크 주파수 | 5.0GHz, 96코어(HF) | HF 옵션 제공 | 약 5.15GHz | 최대 5.0GHz |
| 메모리 | 16채널, 최대 1.6TB/s | 채널당 DIMM 2개씩 장착된 8채널 | 12,800 MT/s 속도의 16채널 MRDIMM | 24채널 LPDDR5X, SOCAMM2 |
| L3 캐시 | 1024MB 최대 | 코어 수에 따라 다릅니다. | 1152MB (3D V-캐시) | 코어 수에 따라 다릅니다. |
| I / O | PCIe 6세대, 128레인 1P | 128개의 PCIe 레인, 1P 및 2P | PCIe 6세대 | 향상된 xGMI는 112 GT/s입니다. |
| 을 목표로 | 초고밀도, AI 호스트 | 엔터프라이즈, 엣지 컴퓨팅, NEBS 친화적 | HPC, AI 전처리 | 랙 스케일 AI 호스트 |
EPYC 9006 SP7
SP7은 현재 생산 중인 플래그십 소켓이며, 파트너 플랫폼은 4분기에 출시될 예정입니다. 이 고성능 CPU는 AMD가 가장 빠르게 생산량을 늘리고 있다고 밝힌 Turin HF 시리즈의 후속 제품이며, 가장 큰 비중을 차지하는 것은 Helios입니다. Helios에서는 모든 컴퓨팅 트레이의 호스트 CPU가 1TB DDR5 메모리를 통해 Infinity Fabric으로 랙의 일관성 있는 메모리 도메인에 연결됩니다. 소켓이 표준화되어 있기 때문에 256코어 플래그십 모델을 포함한 모든 SP7 SKU가 호환되며, 이 내용은 관련 기사에서 다뤘습니다.
EPYC 9006 SP8
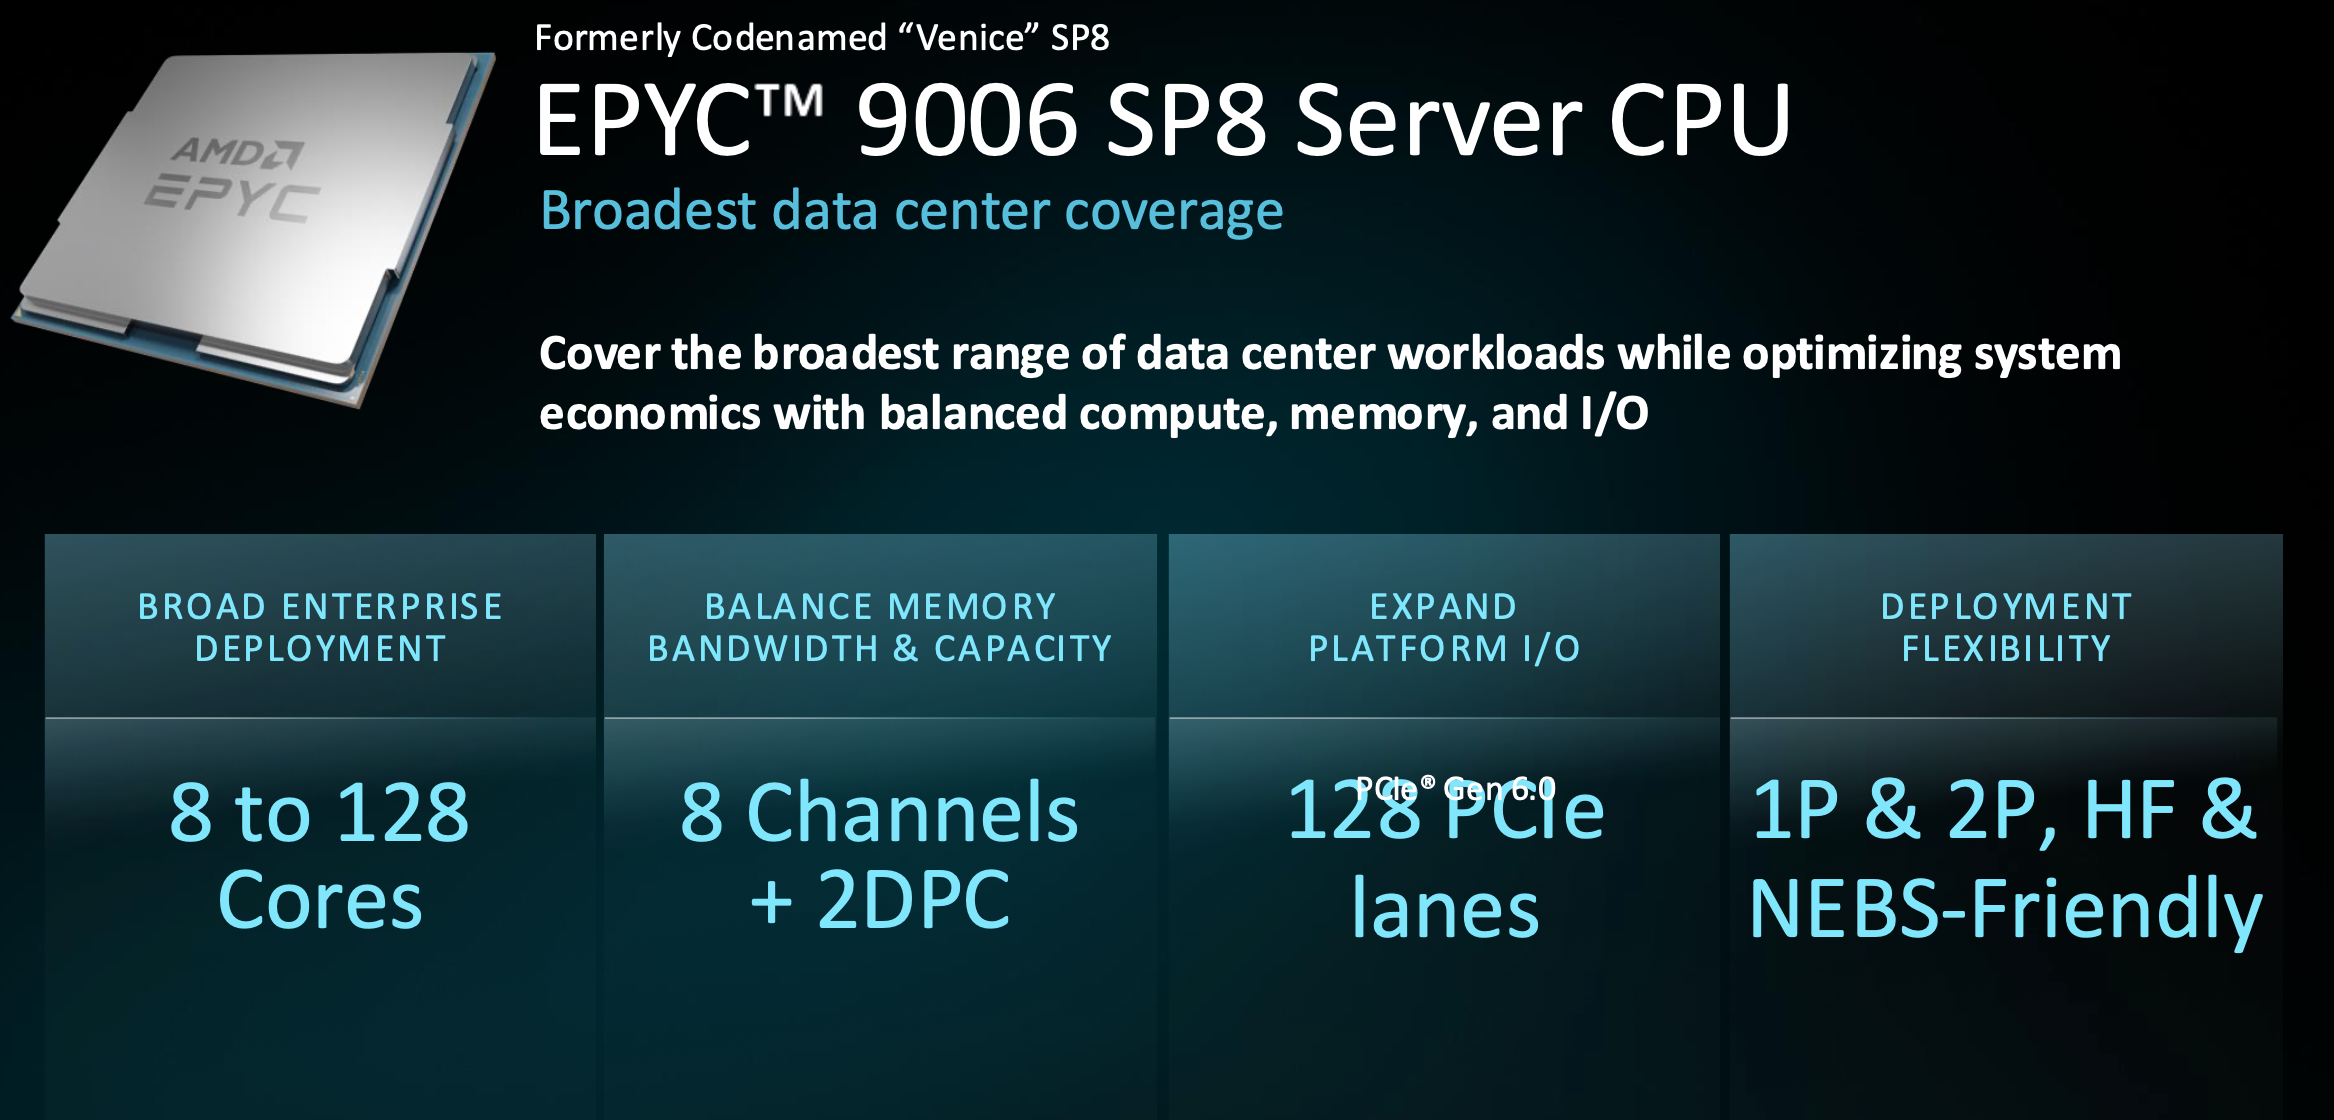
SP8은 거대한 소켓 대신 시스템 경제성을 우선시합니다. 8개에서 128개 코어를 지원하며, 채널당 2개의 DIMM을 장착할 수 있는 8개의 메모리 채널을 제공하고, 128개의 PCIe 레인을 유지합니다. 또한, 통신 및 엣지 컴퓨팅 환경에 적합한 고주파수 및 NEBS(Non-End System) 친화적인 옵션을 제공하는 1P 및 2P 구성으로 제공됩니다. AMD는 기업 환경에 최적화된 성능을 강조하며, 기업 거래에서 중요한 요소는 랙당 가격이 아닌 시스템 가격 대비 성능이라는 점을 내세웁니다.
EPYC 9006X “베니스-X”
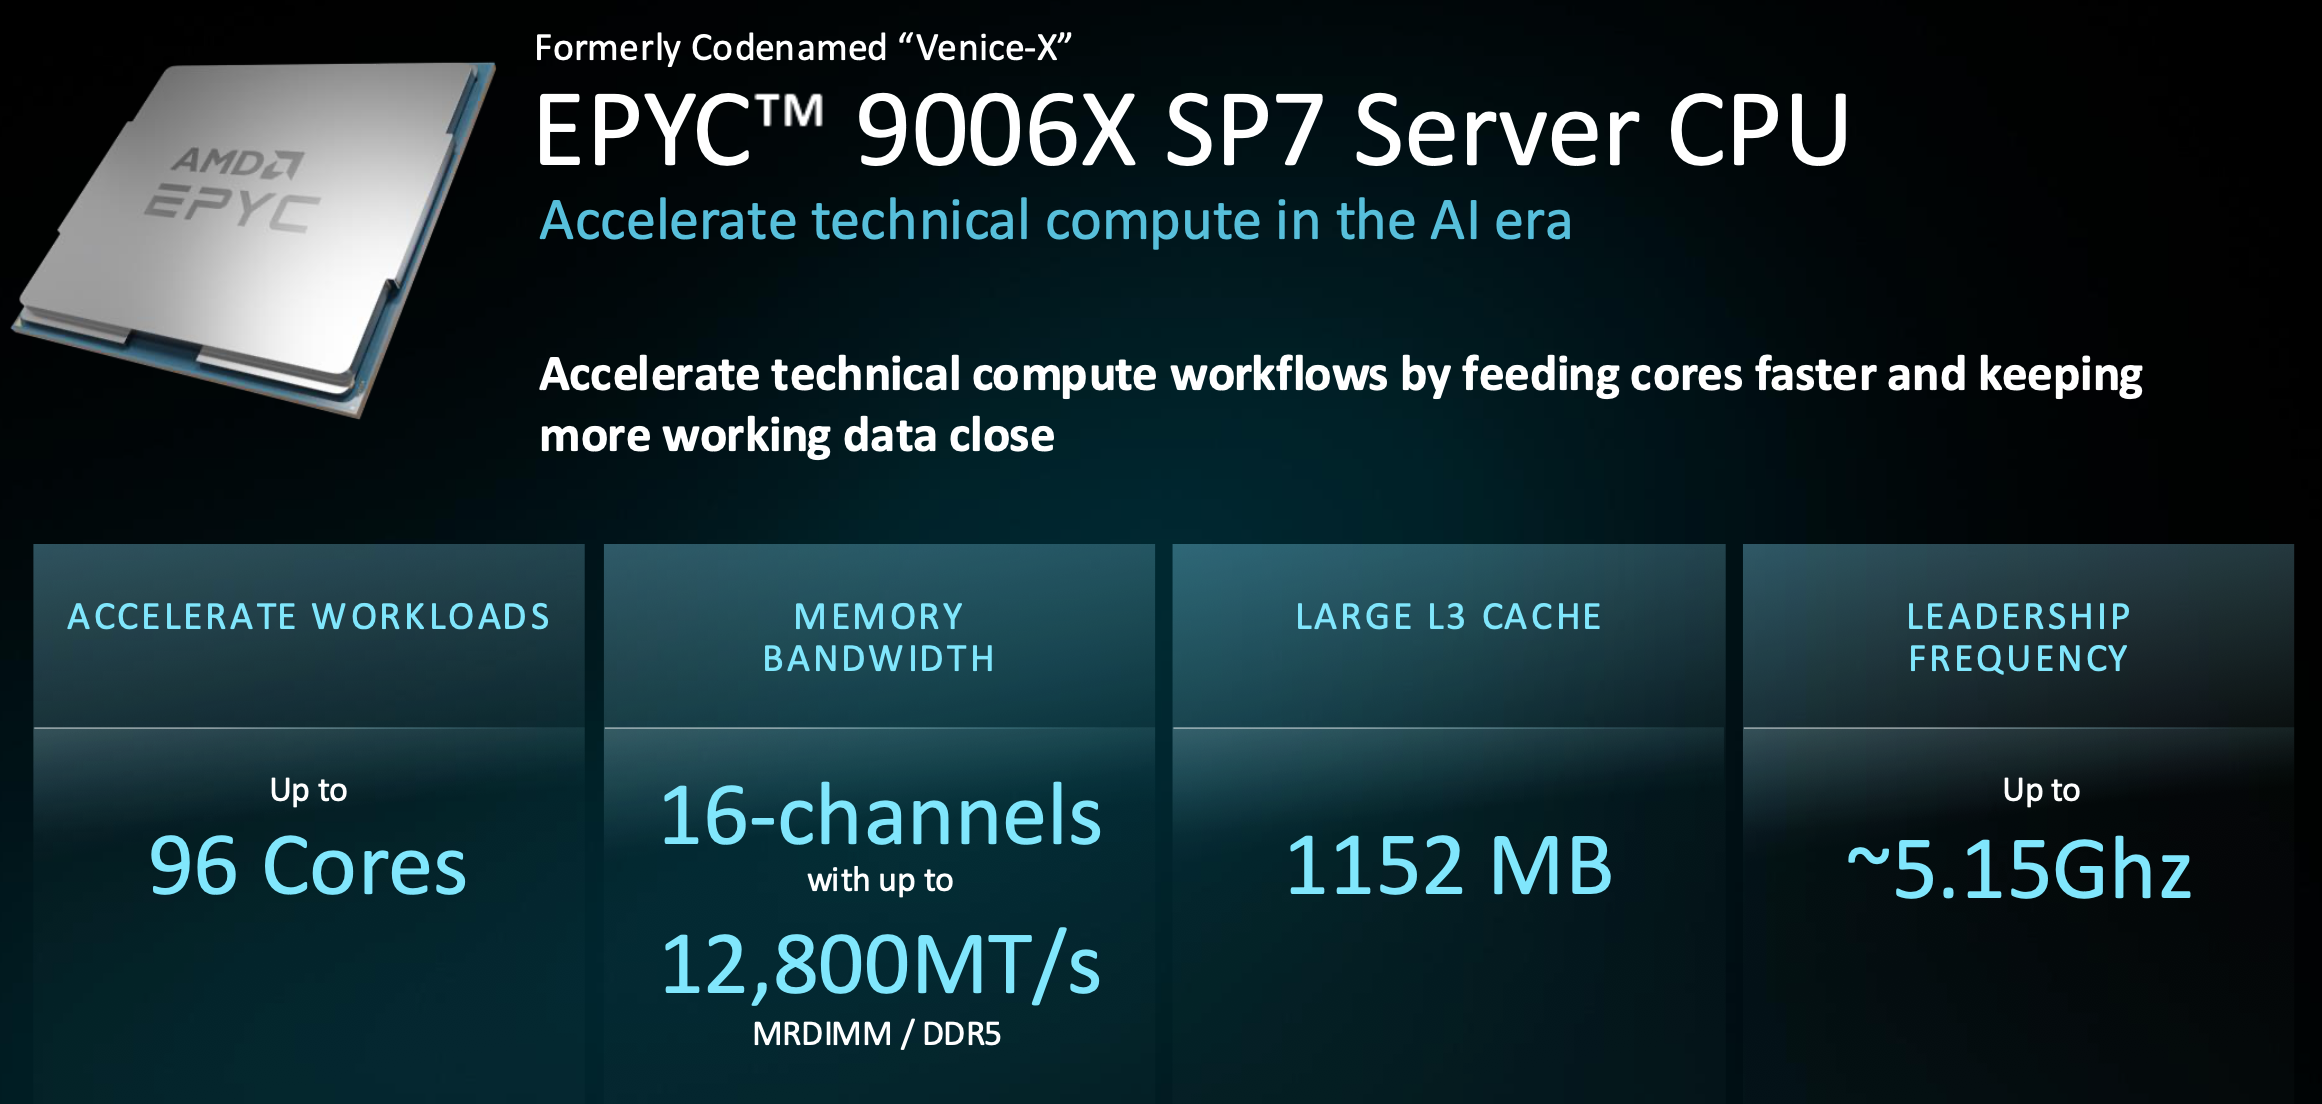
Venice-X는 96코어 고주파 구성에 3D V-캐시를 추가하여 L3 캐시를 1152MB로 확장했는데, 이는 표준 SP7 부품 대비 코어당 캐시 용량의 약 3배에 해당합니다. 클럭 속도는 약 5.15GHz에 달하며, 16채널, 12,800 MT/s의 메모리 시스템은 그대로 유지됩니다. 이 프로세서의 목표는 시뮬레이션 및 모델링, 대규모 분석, 인메모리 데이터베이스, 그리고 학습 파이프라인에 데이터를 제공하는 AI 전처리 등, 추가 코어 수보다 캐시에 저장된 작업 세트가 더 중요한 워크로드에 적합합니다.
EPYC 9006 LP “베라노”
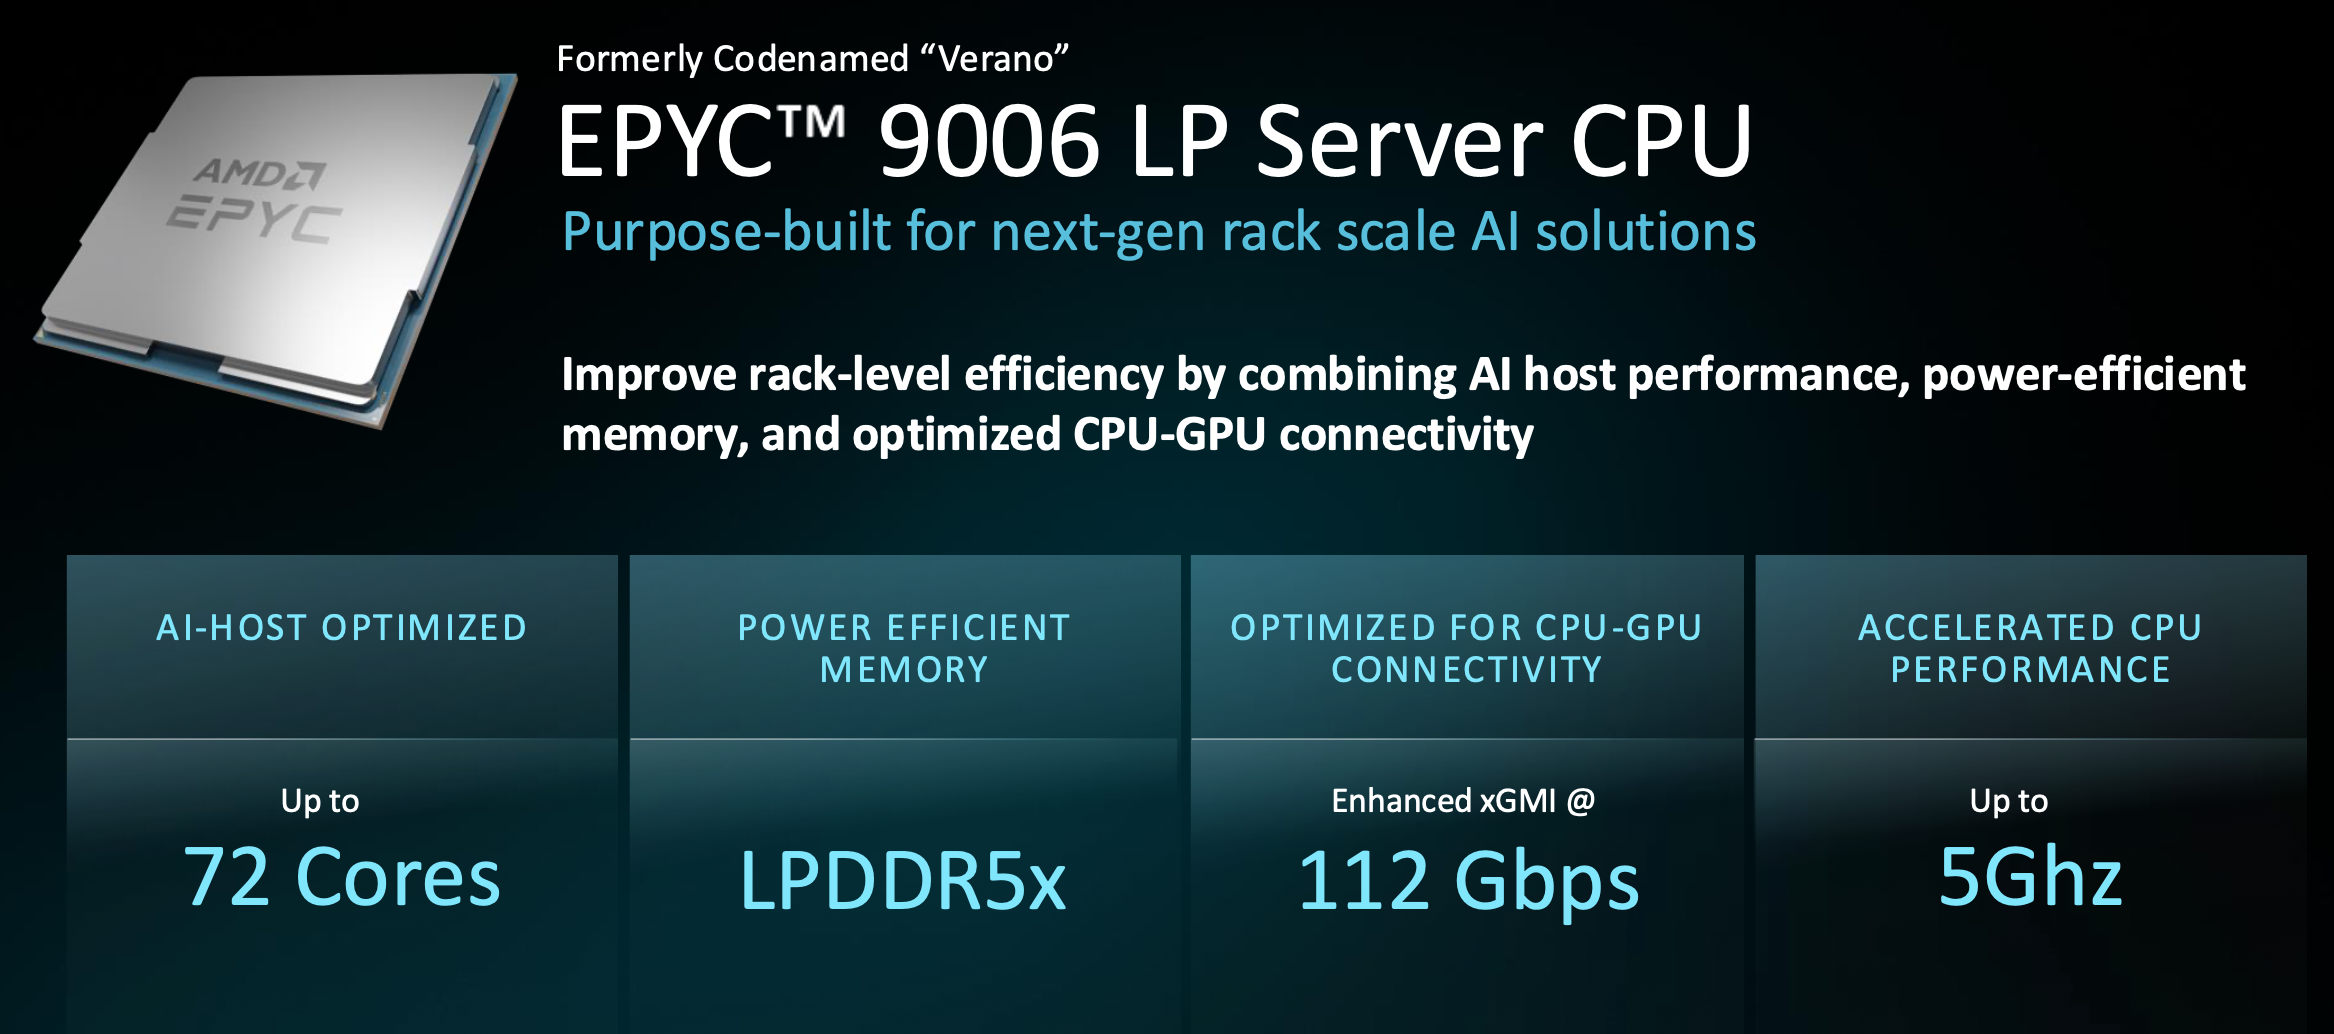
베라노는 제품군 중 가장 특화된 모델로, AI 호스트 노드로서의 기능을 최우선으로 합니다. 최대 72개의 코어(5GHz), 24채널의 LPDDR5X 메모리, 그리고 CPU-GPU 트래픽 전송을 위한 향상된 112 GT/s xGMI 링크를 갖추고 있습니다. LPDDR 메모리는 SOCAMM2 모듈에 탑재되어 있어 현장에서 교체가 가능하며, 납땜된 메모리 고장으로 전체 보드를 폐기해야 하는 상황에서 매우 중요한 장점입니다. 또한 베라노는 NVIDIA의 베라에 대한 AMD의 직접적인 대응 모델이며, AMD가 이 경쟁 구도를 분명히 드러냈기 때문에 이 부분은 나중에 다시 자세히 살펴보겠습니다.
베니스는 어떤 곳일까요?
AMD는 토리노에서 먼저 자사가 이미 확보한 선두 자리를, 베니스에서 얼마나 격차를 벌리고 있는지를 보여주며 두 차례에 걸쳐 자신들의 주장을 입증했습니다.
오늘 토리노가 앞서고 있습니다.
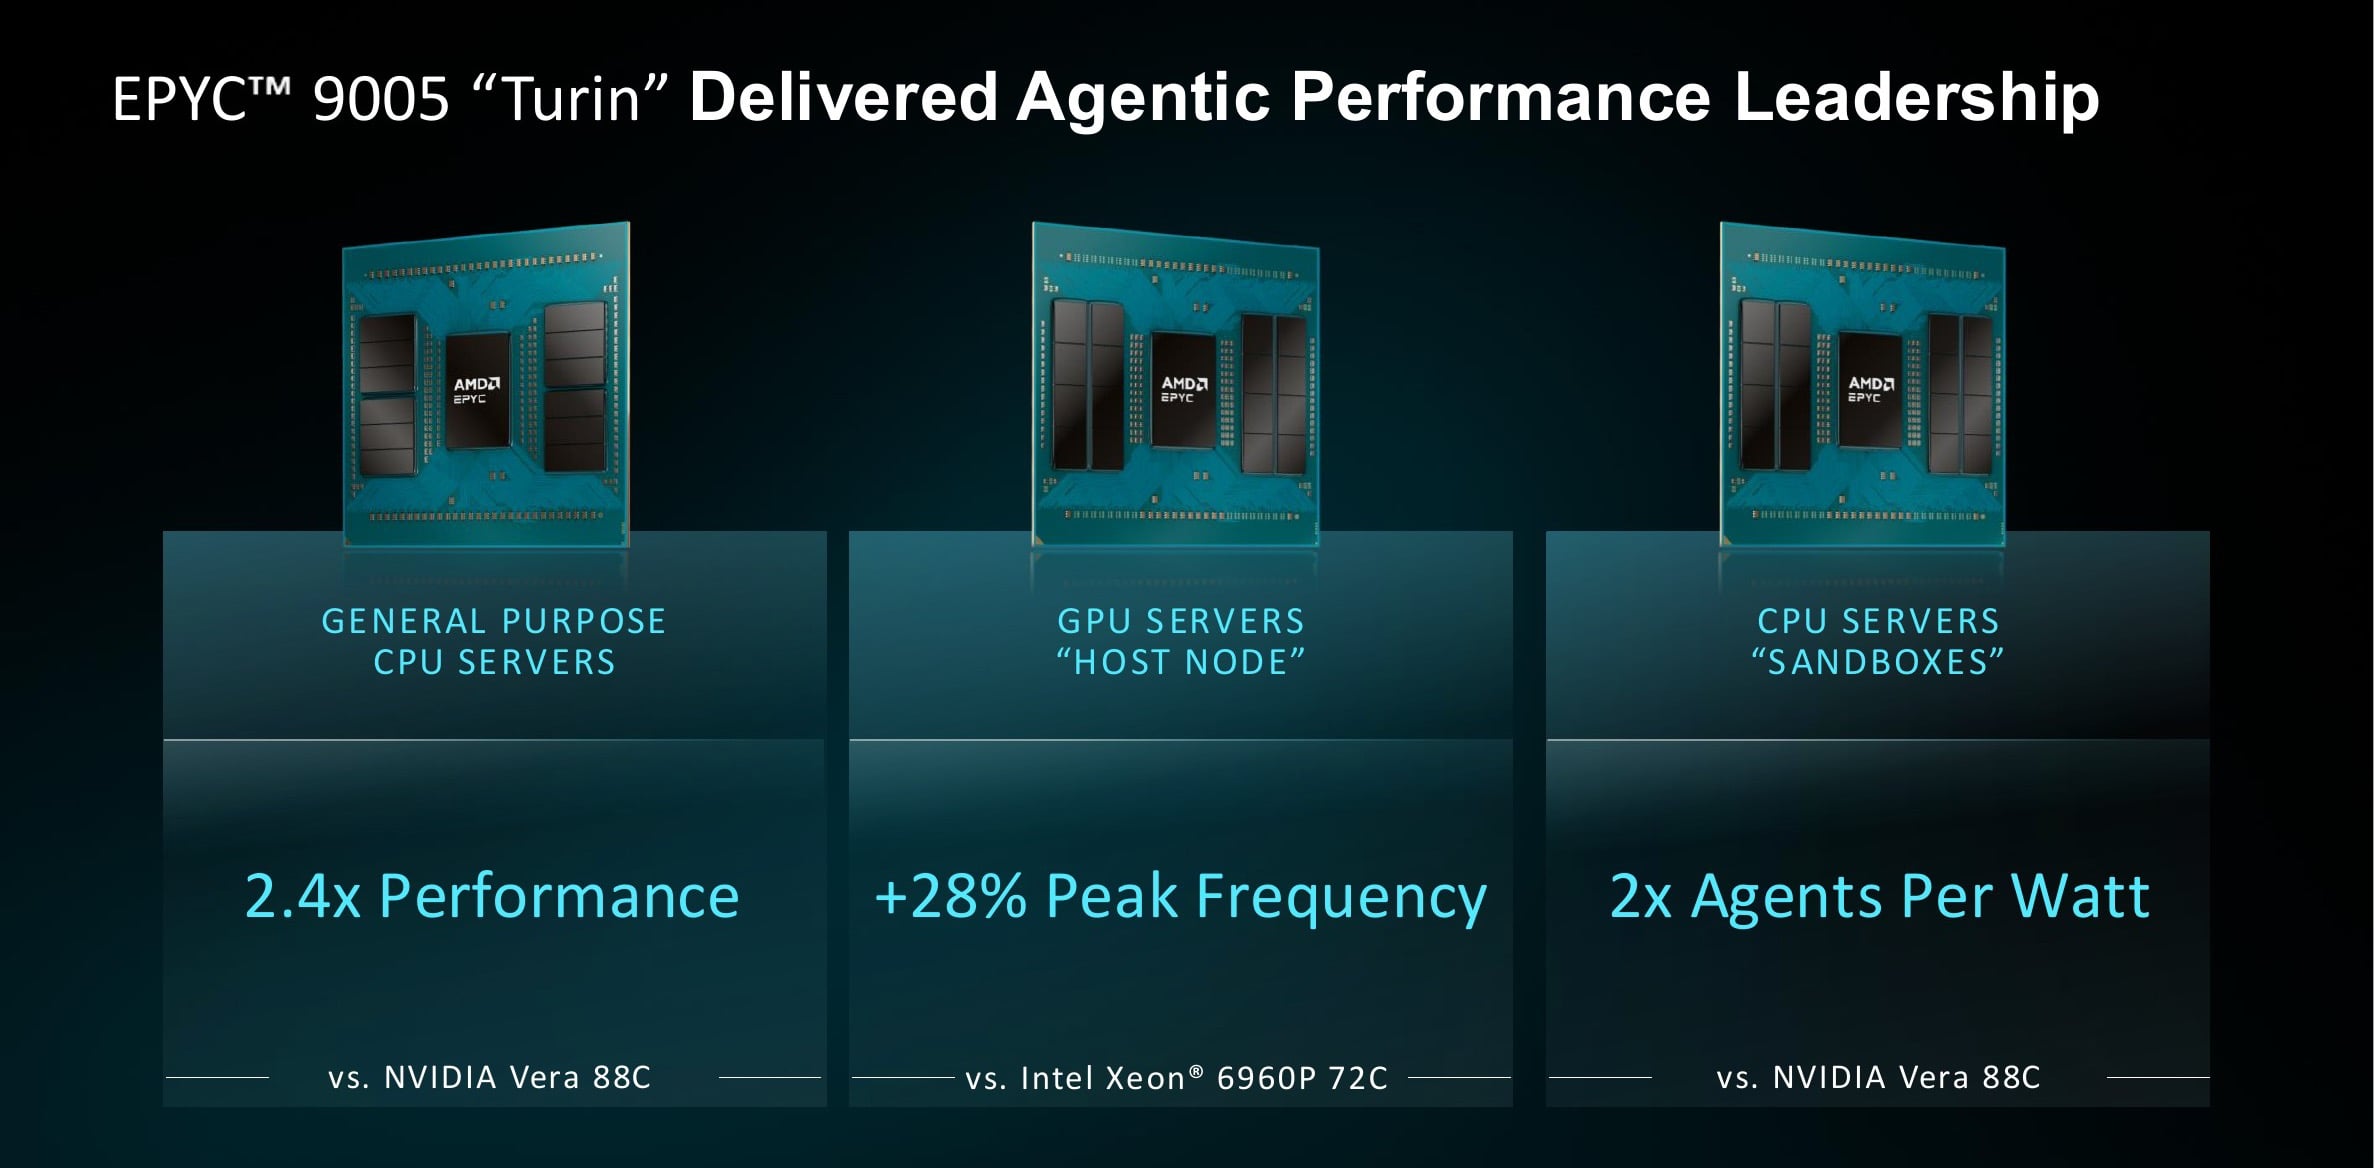
AMD는 비교 대상을 주로 NVIDIA의 Vera(Vera Rubin 플랫폼에 탑재된 Arm CPU)로 삼았으며, 이미 출시된 최신 세대 제품부터 비교를 시작했습니다. AMD의 랙 레벨 모델링에 따르면, Turin 랙은 Vera보다 범용 처리량이 2.4배 높고, 와트당 에이전트 수는 두 배 더 많습니다. 이 모델은 두 랙 모두 100kW의 전력 예산으로 고정하고, 384코어의 2P EPYC 9965와 176코어의 2P Vera 보드를 비교 대상으로 삼아, SPECrate 2017 추정치, 서버 측 Java, NGINX, Redis, Memcached, 그리고 TPC-C 파생 프로그램 등 6가지 워크로드에 대한 평균값을 계산했습니다.
이 글의 나머지 부분에도 두 가지 주의 사항이 적용됩니다. Vera는 아직 출시되지 않았으므로 모든 Vera 수치는 NVIDIA가 공개 자료에서 설명한 88코어, 450W 제품에 대한 AMD의 추정치입니다. 또한 에이전트 기반 워크로드에 대한 표준 벤치마크가 없기 때문에 AMD는 와트당 에이전트 수를 계산할 때 하드웨어 스레드를 에이전트의 대용으로 사용합니다.
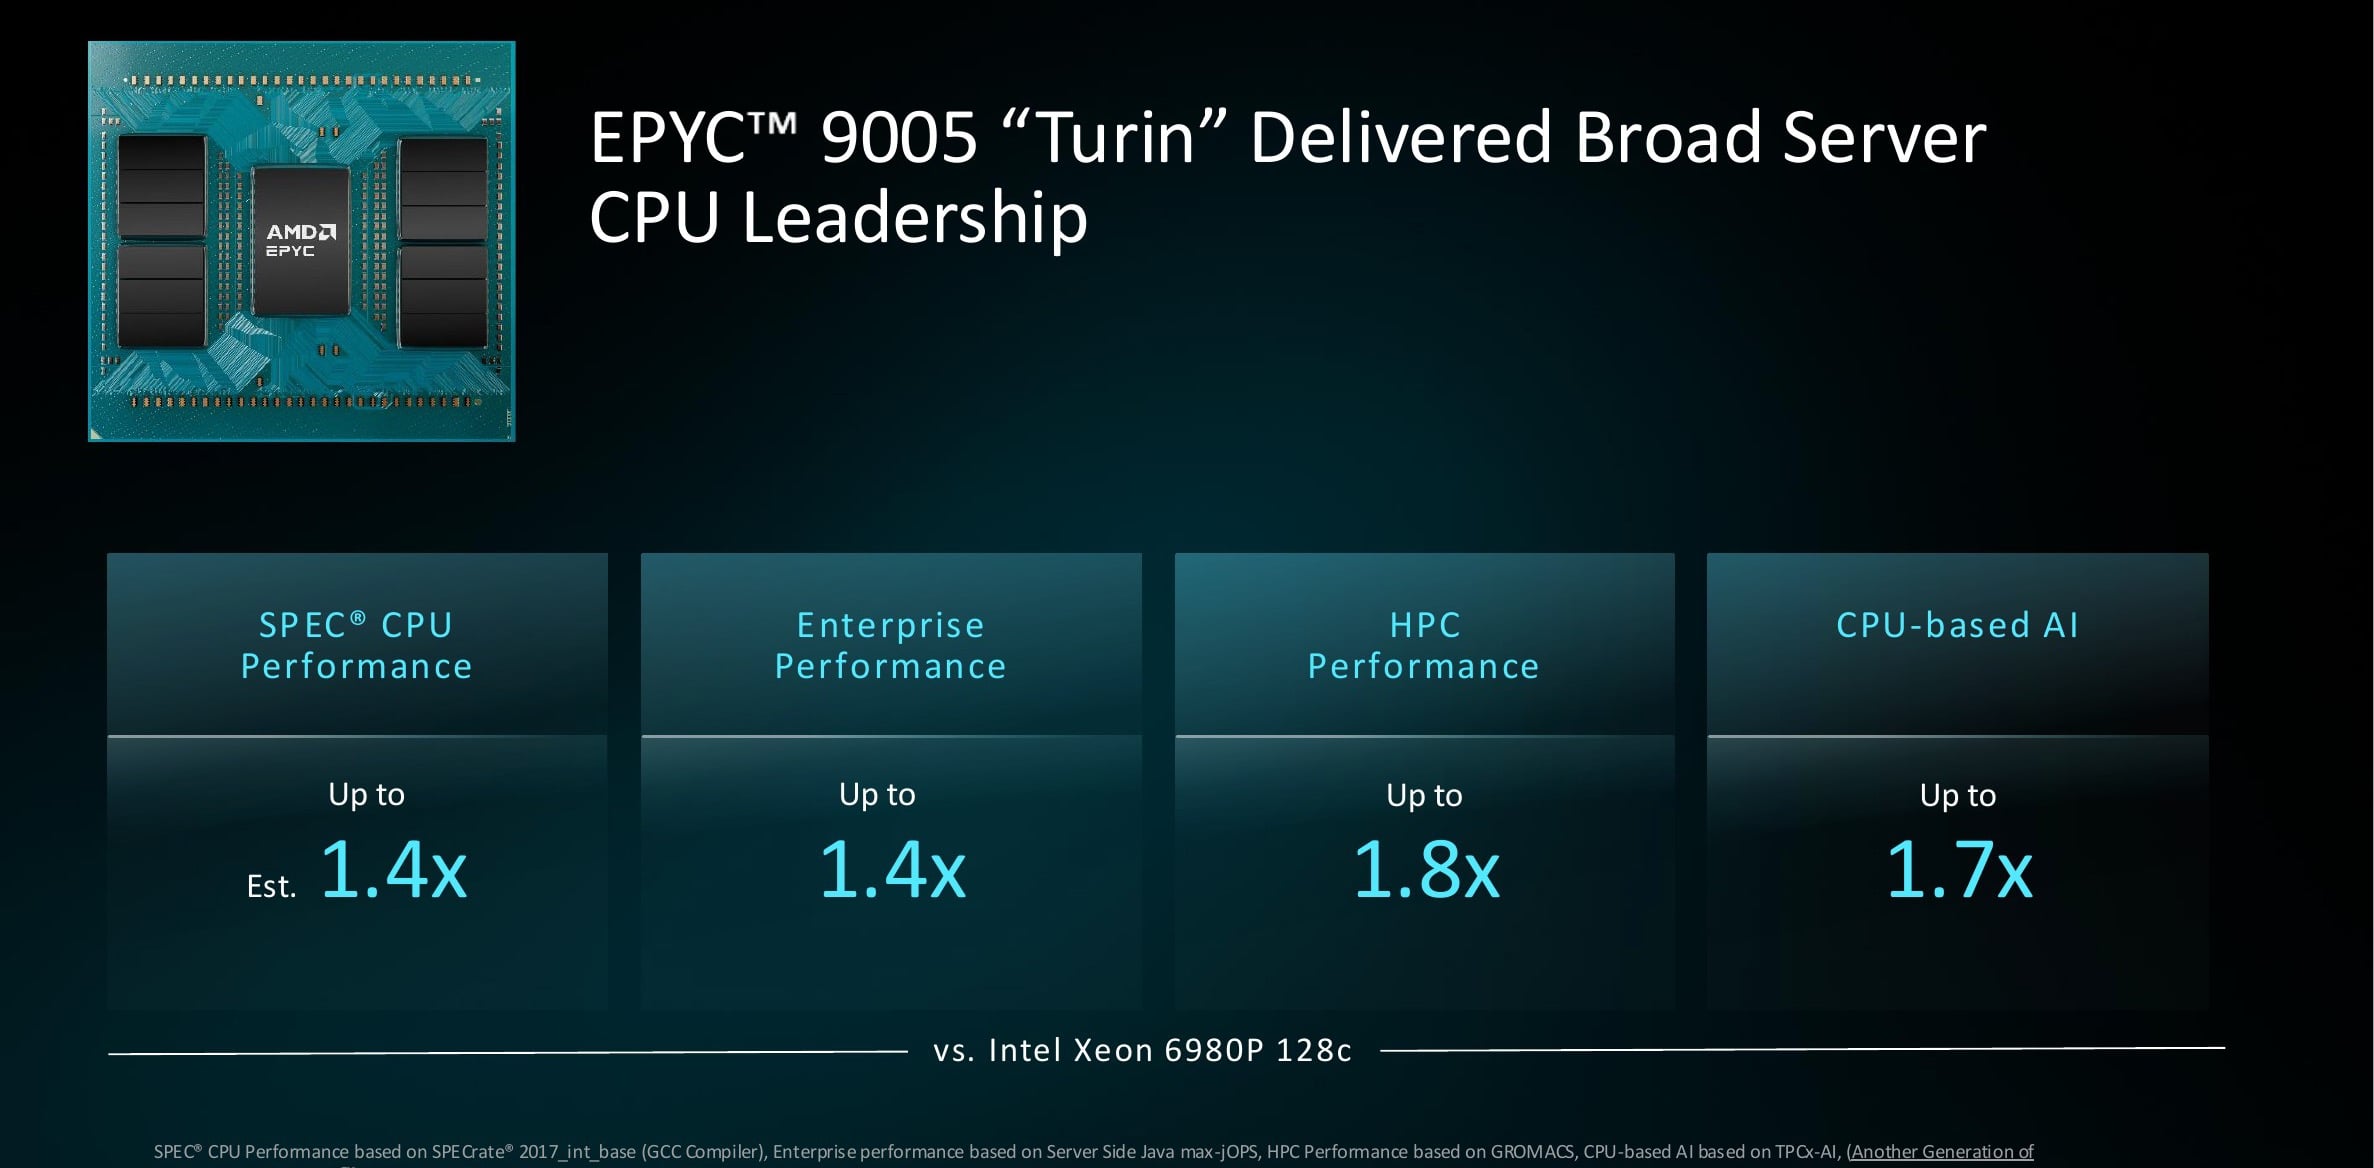
인텔과의 비교는 양측 모두 AMD가 직접 벤치마킹할 수 있는 부품을 출시했기 때문에 더욱 확실한 근거를 가지고 있습니다. Turin의 호스트 CPU는 5.0GHz에 도달하는 반면, 동급의 Xeon은 최대 3.9GHz로, 단일 스레드가 GPU에 데이터를 공급할 때 중요한 28%의 주파수 우위를 보입니다. 소켓 단위로 128코어 Xeon 6980P와 비교했을 때, AMD는 Turin이 SPEC CPU에서 최대 1.4배, 엔터프라이즈 Java에서 1.4배, HPC에서 1.8배, CPU 기반 AI에서 1.7배의 성능을 보인다고 측정했습니다.
베니스는 모든 틈을 넓힌다
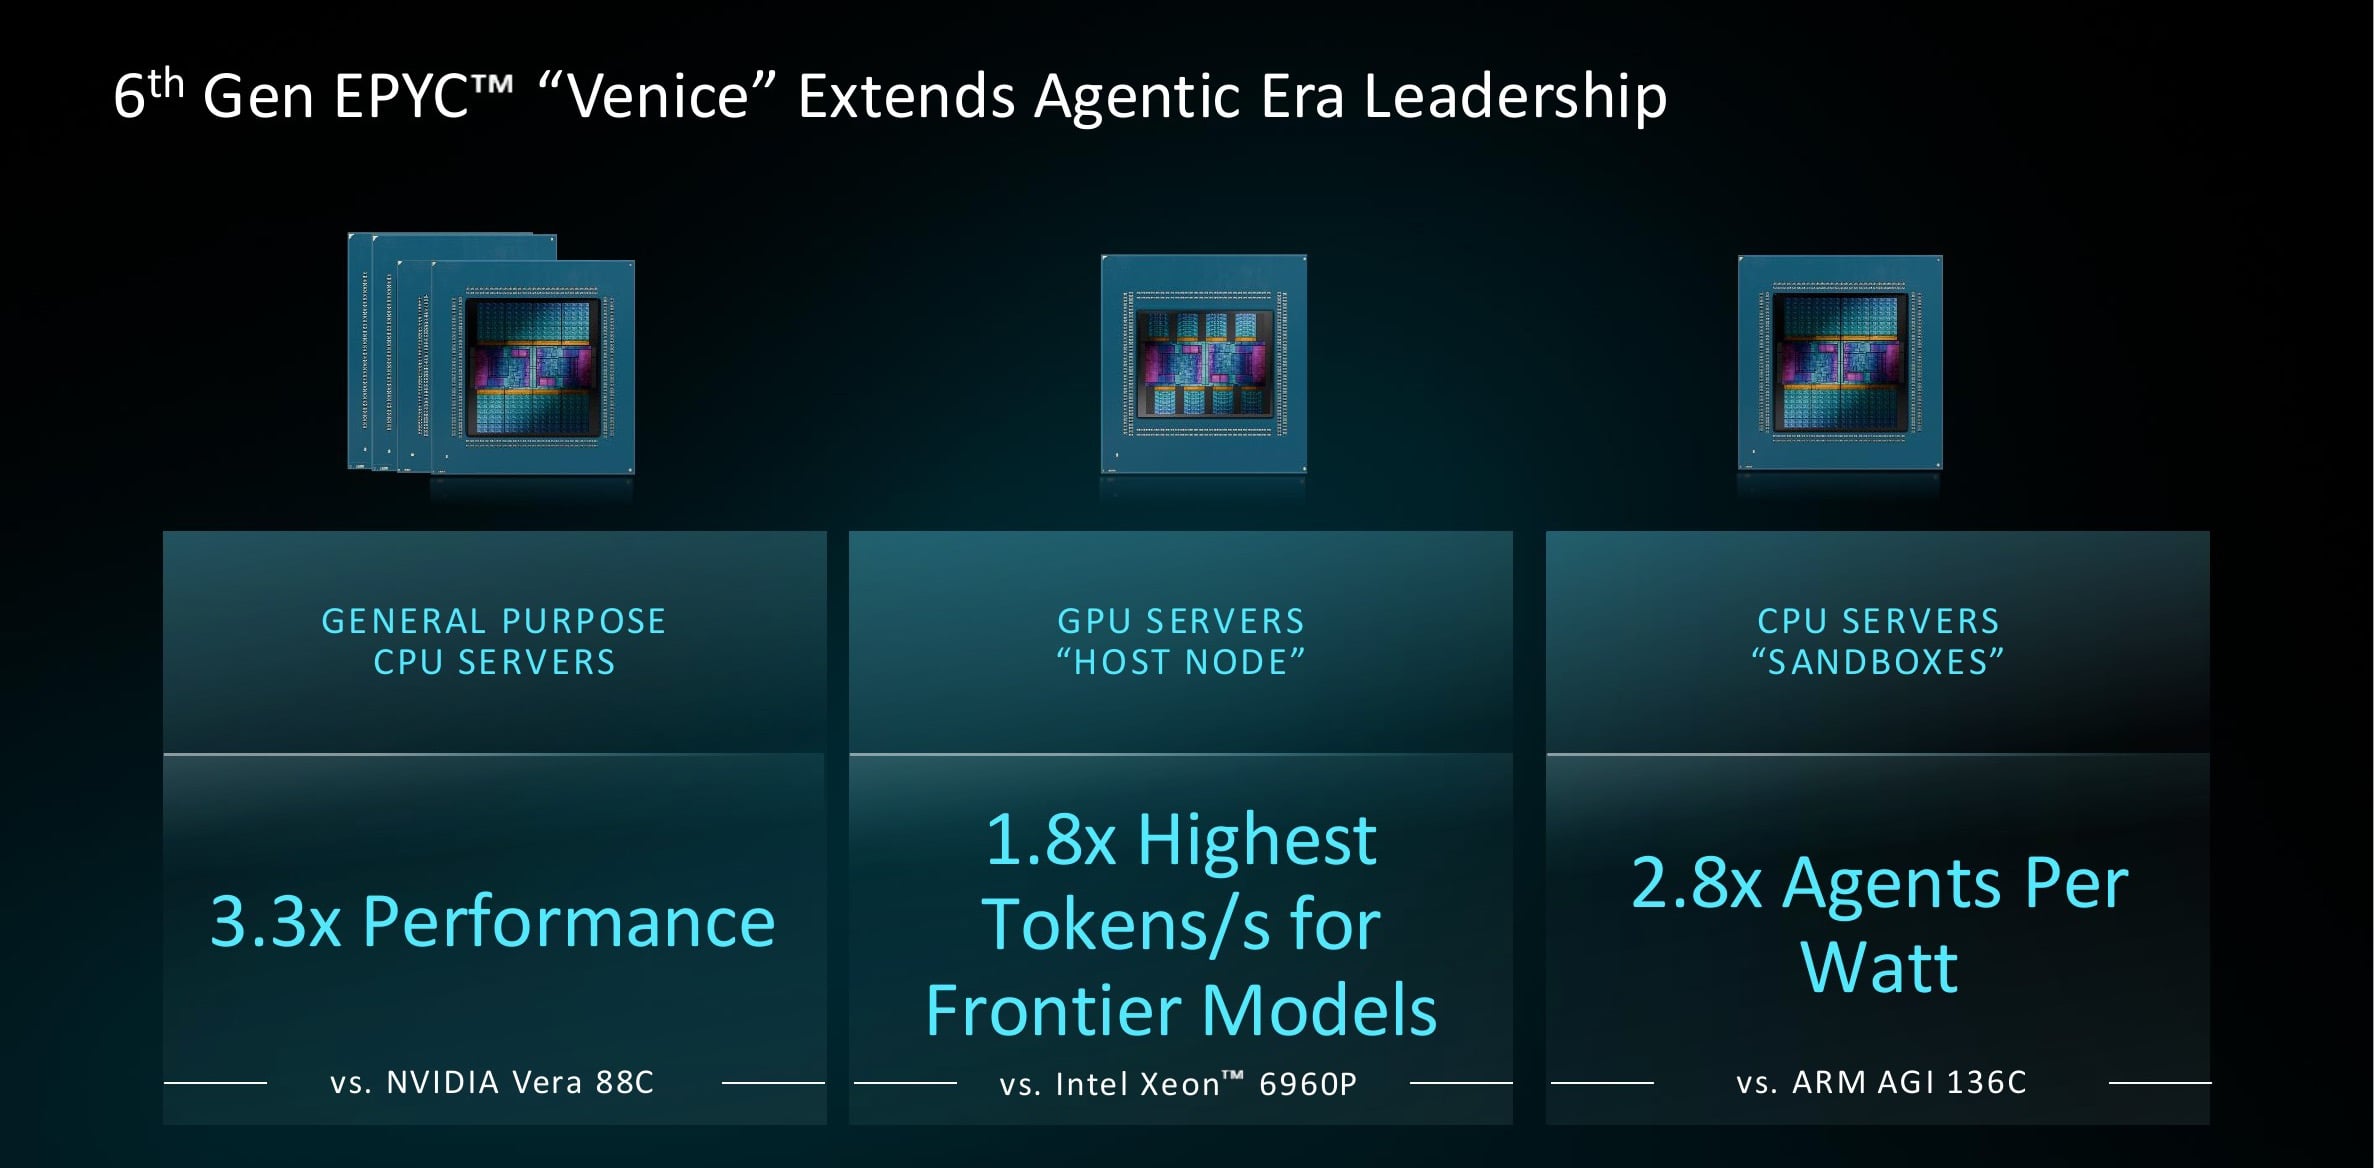
베니스는 이러한 모든 우위를 더욱 강화합니다. 동일한 100kW 랙 모델에서 베라의 176개 코어에 비해 베니스는 512개의 코어를 탑재하여 AMD는 범용 성능이 베라보다 3.3배 빠르다고 주장합니다. 베니스는 136코어 Arm AGI보다 와트당 에이전트 처리량이 2.8배 높고, GPU를 탑재한 경우 최첨단 모델에서 초당 토큰 처리량이 1.8배 높습니다. 이 1.8배라는 수치는 헤드라인에서 암시하는 것보다 더 제한적인 시나리오를 나타내며, 아래 호스트 노드 섹션에서 다시 살펴보겠습니다.
베라와의 정면 대결
SPECrate 2026에서 AMD는 2P Venice 9996의 성능을 Vera의 925 대비 2070으로 추정하여 처리량에서 2.2배 우위를 보였으며, 코어당 성능은 Vera보다 약 1.2배 앞섰습니다. 두 결과 모두 NVIDIA가 Vera 성능 발표에 사용한 것과 동일한 툴체인인 GCC 15.2로 컴파일되었습니다.
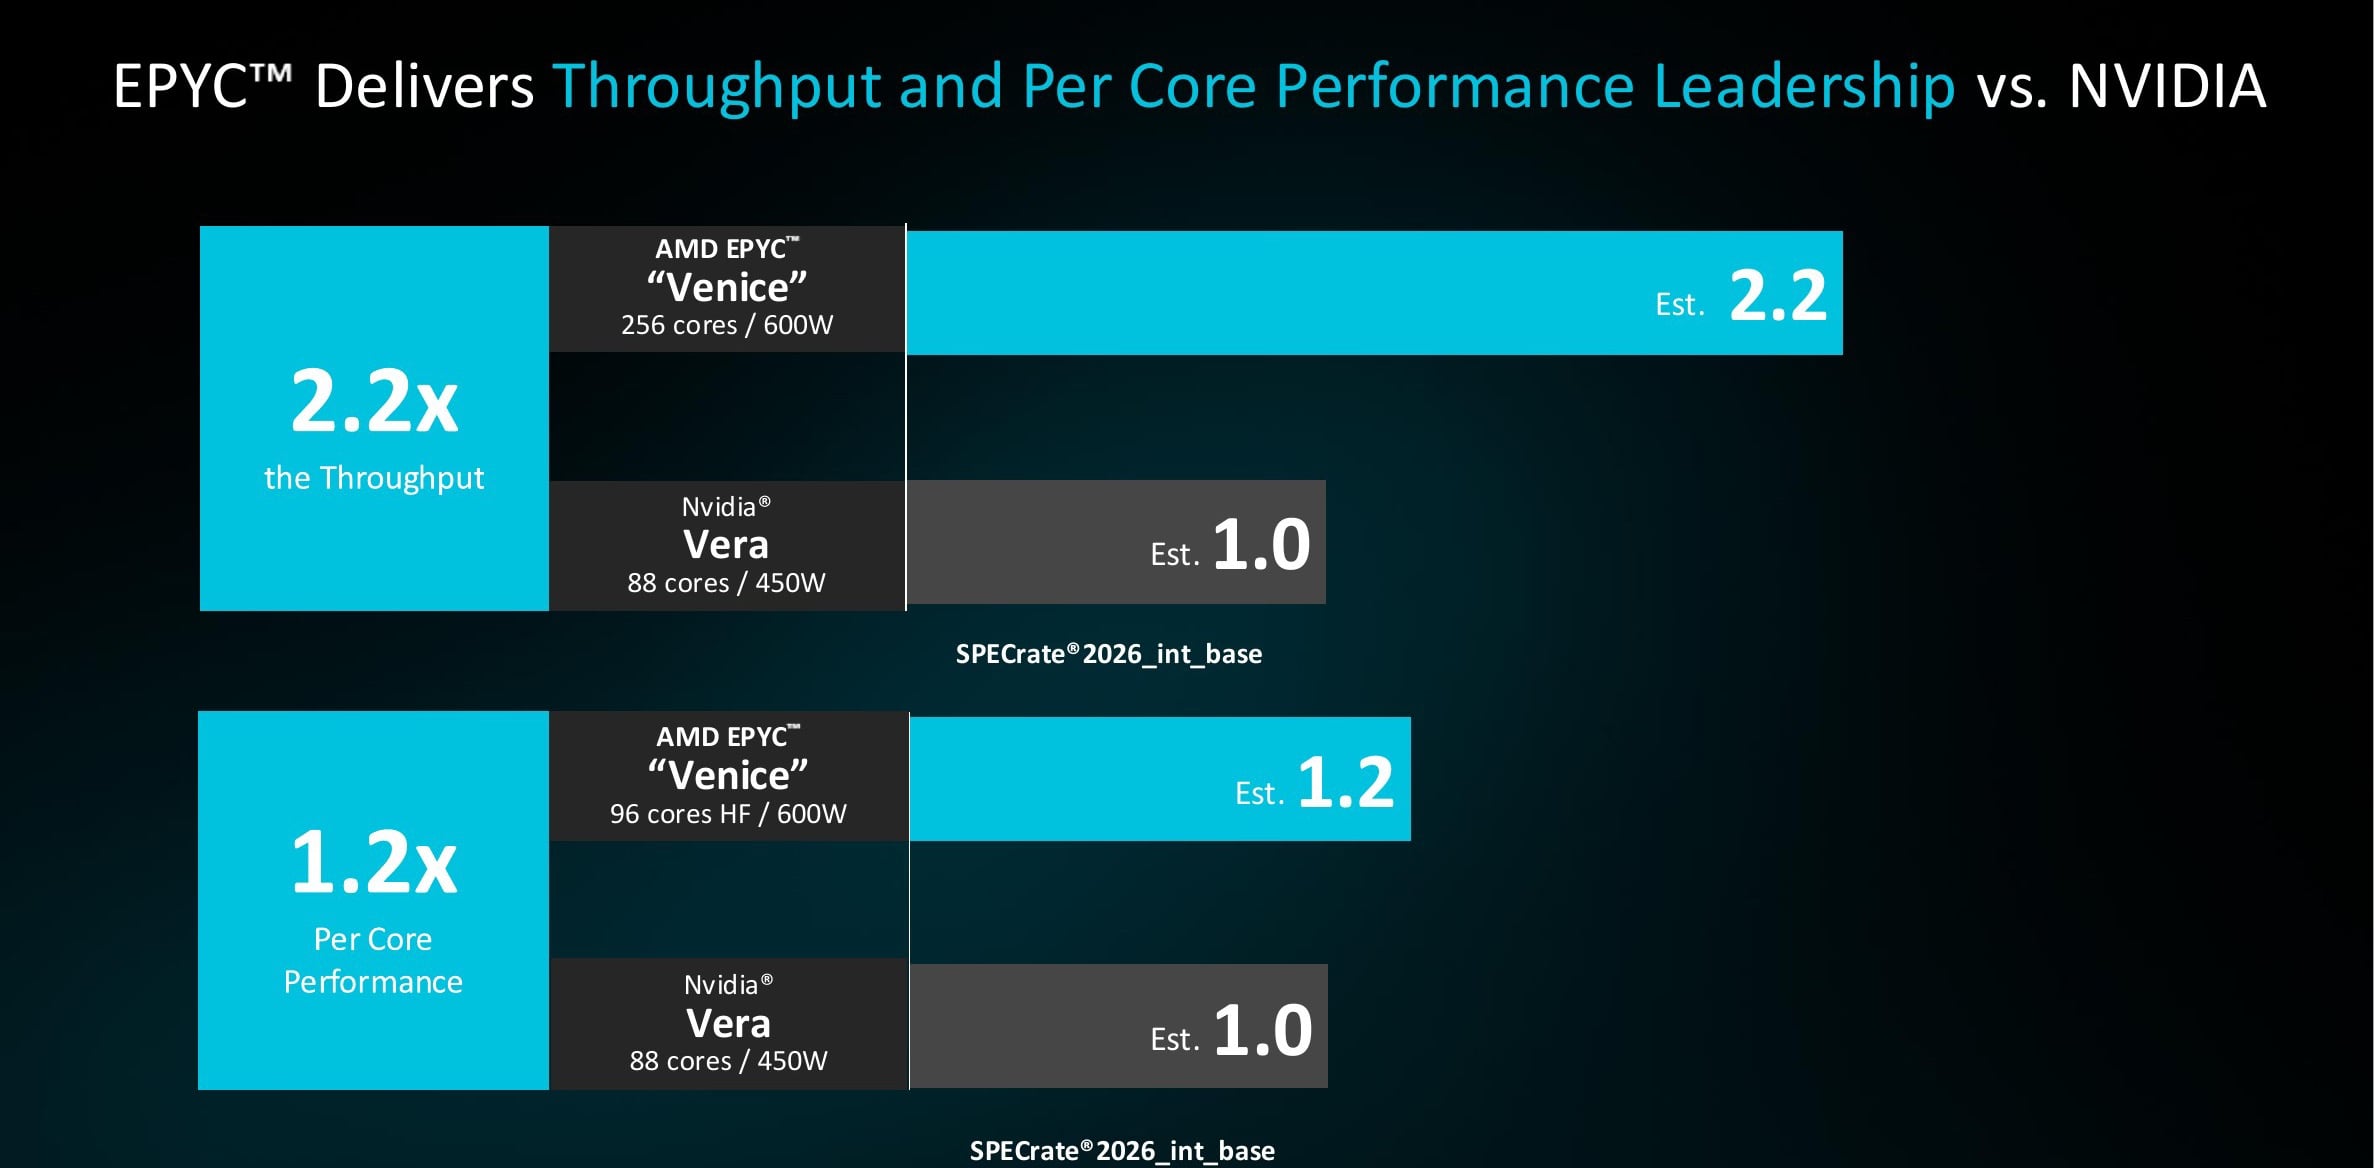
출시 주간 동안 코어당 성능 향상 폭은 실제로 증가했습니다. AMD의 CPU 엔지니어링을 총괄하는 라비 쿠푸스와미는 언론과의 인터뷰에서 AMD가 당초 코어당 10%의 성능 우위를 주장했었다고 밝혔습니다. NVIDIA가 주 초에 Vera의 자체 측정 결과를 발표한 후, NVIDIA 팀은 동일한 컴파일러와 설정을 사용하여 비교를 다시 수행했고, 아직 튜닝이 완료되지 않은 상태에서도 20%의 우위를 측정했습니다. 그는 2.2배의 처리량 차이가 AMD의 내부 예상치와 일치한다고 말했습니다. 별도의 각주에서는 AMD 자체 AOCC 컴파일러를 사용하여 SPECrate 2017에서 코어당 비교를 다시 계산한 결과 1.7배가 나왔으며, 따라서 20%가 두 계산 중 더 보수적인 수치임을 알 수 있습니다.
인텔과 Arm
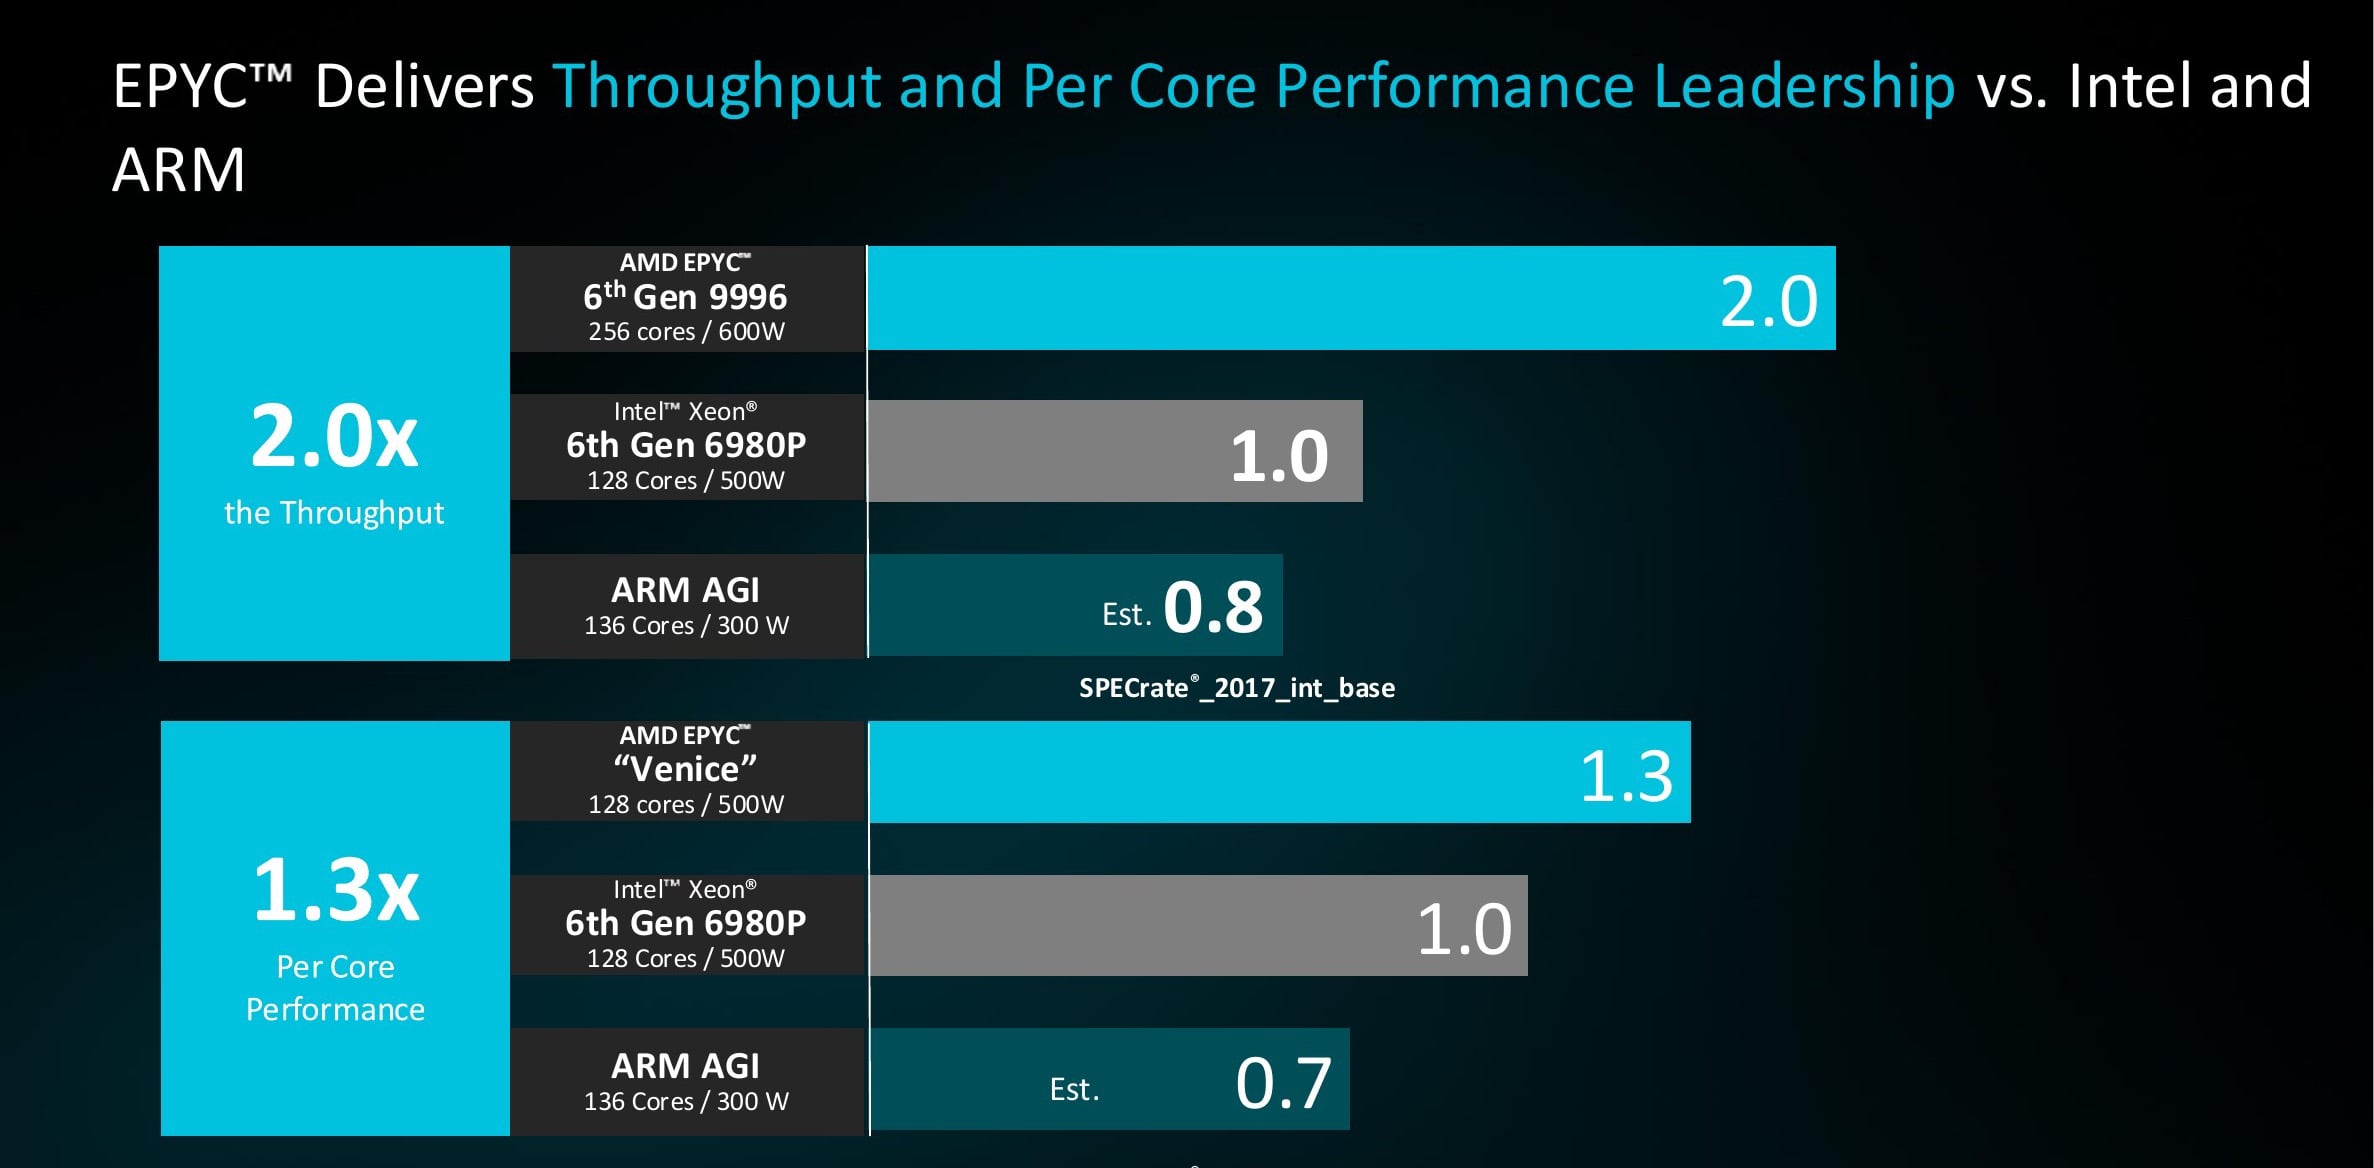
AMD는 SPECrate 2017에서 더 광범위한 순위를 보여주었습니다. Venice 9996이 4900점(256코어, 600W, 1kU 기준 14,904달러)으로 1위를 차지했고, Turin 9965가 3240점, Intel의 Xeon 6980P가 2510점(128코어, 500W, 13,955달러), Arm AGI가 1944점(136코어, 300W), Vera가 1459점을 기록했습니다. 9996, AGI, Vera의 수치는 AMD의 추정치이며, Turin과 Intel의 점수는 공식 발표된 결과입니다. Intel 제품과 비교했을 때, AMD는 비슷한 가격대에서 약 두 배의 처리량, 즉 두 배의 가성비를 제공합니다. 코어당 성능으로 따지면, 128코어, 500W의 Venice 구성은 6980P보다 1.3배, Arm AGI는 0.7배 높은 성능을 보였습니다. 위의 Vera 비교와 달리, 여기서는 각 벤더의 점수가 해당 벤더가 사용하는 최적의 툴체인(AMD의 경우 AOCC, Intel의 경우 OneAPI, Arm의 경우 GCC 13)을 사용하여 산출되었습니다.
클라우드 네이티브 및 HPC
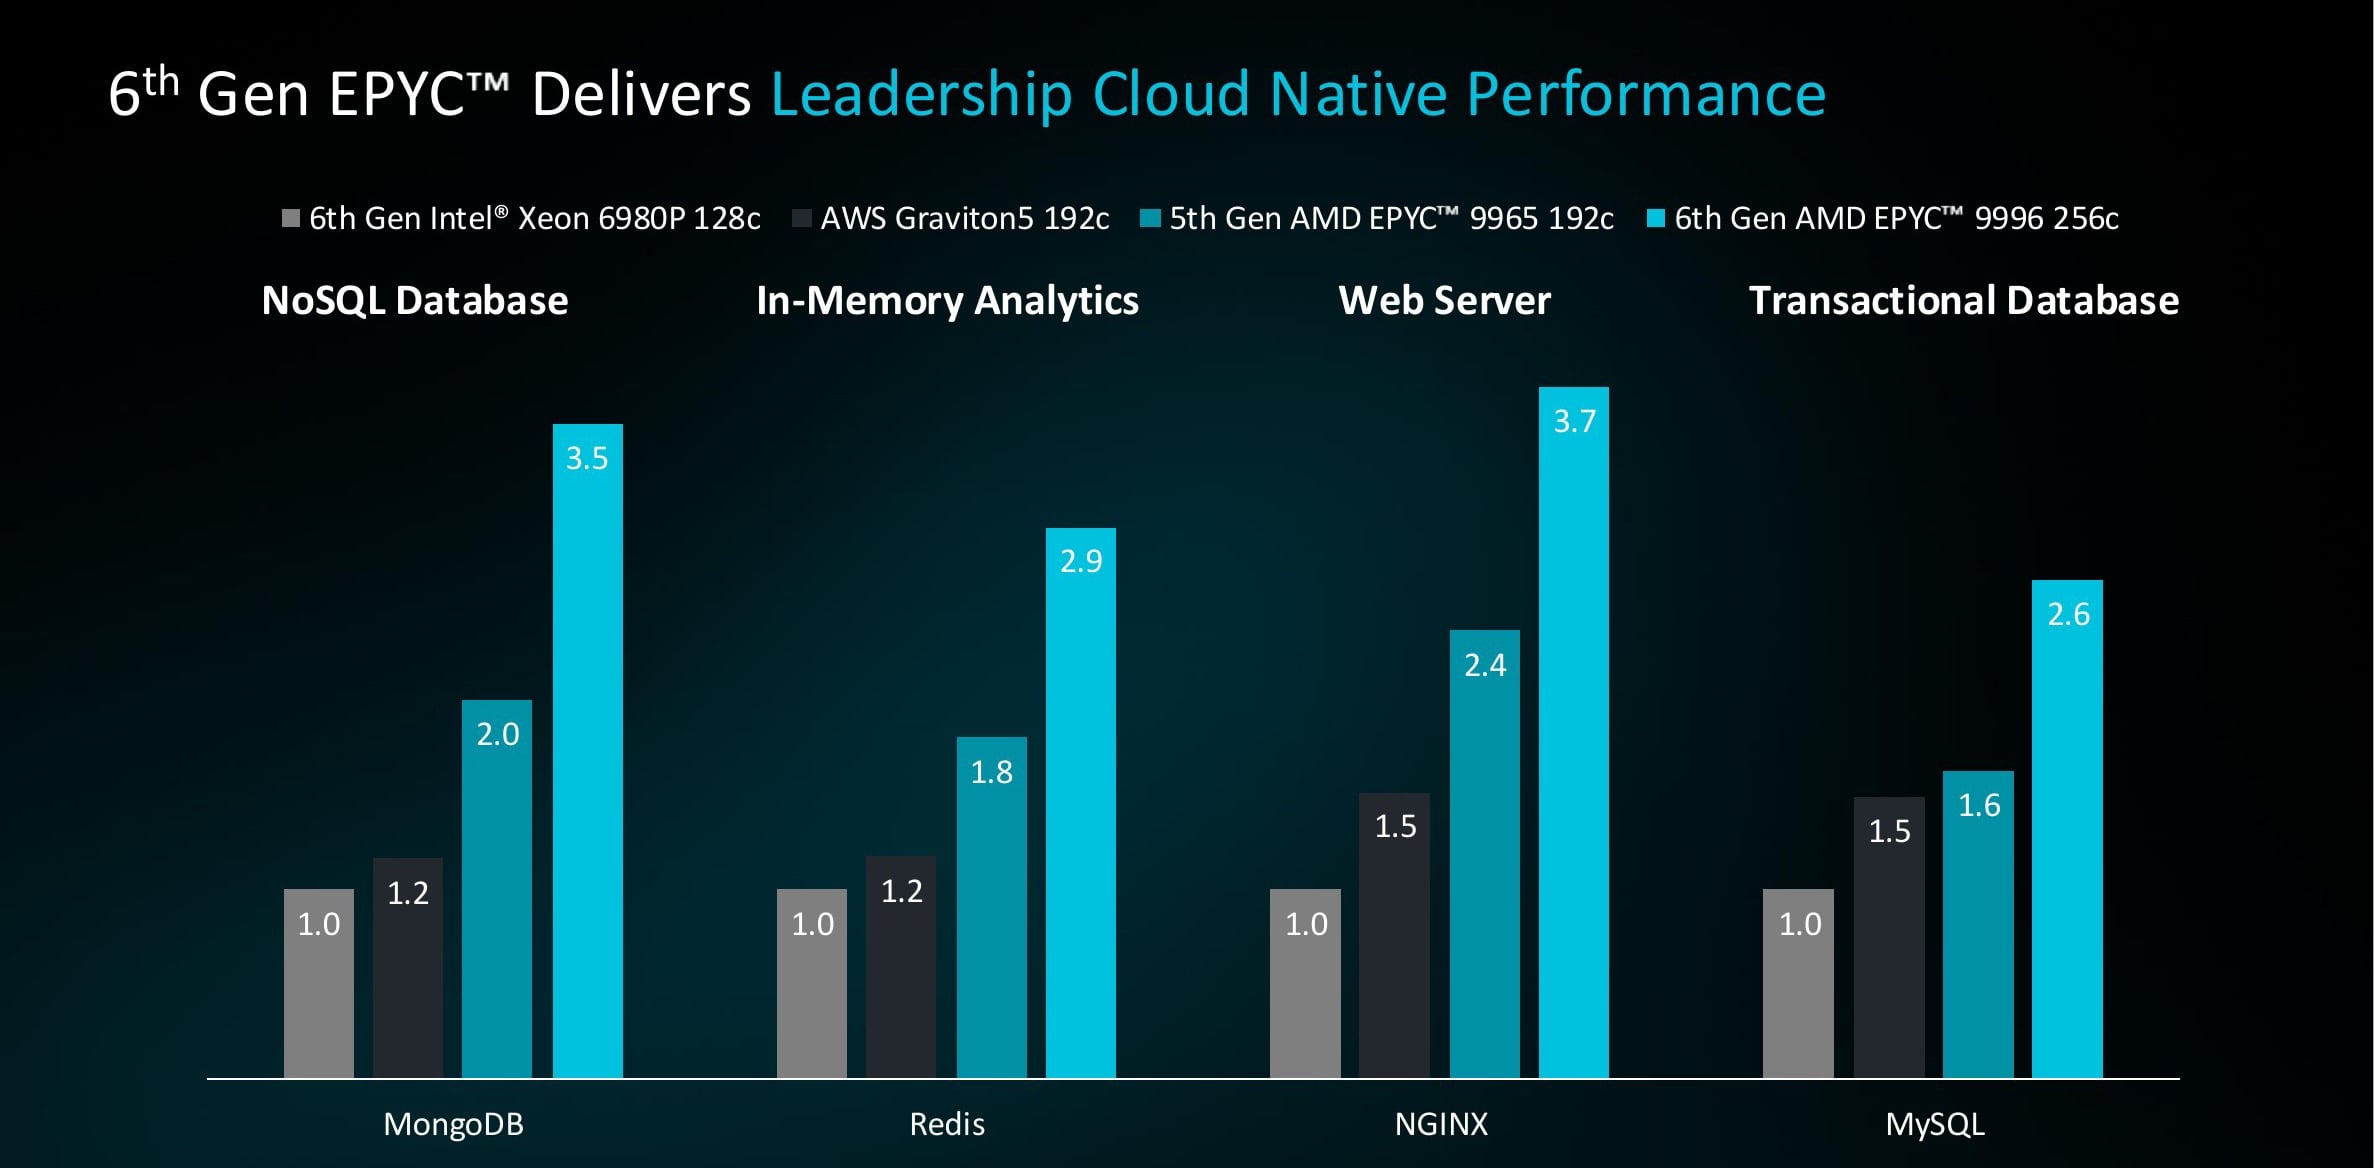
AMD는 또한 워크로드별로 비교 결과를 세분화했으며, 모든 결과는 인텔 6980P를 1.0으로 기준으로 삼았습니다. 클라우드 네이티브 환경에서 256코어 Venice 9996은 MongoDB에서 3.5배, Redis에서 2.9배, NGINX에서 3.7배, MySQL에서 2.6배의 성능을 보였습니다. Turin은 동일한 테스트에서 1.6배에서 2.4배 사이의 성능을, Graviton5는 1.2배에서 1.5배 사이의 성능을 기록했습니다.
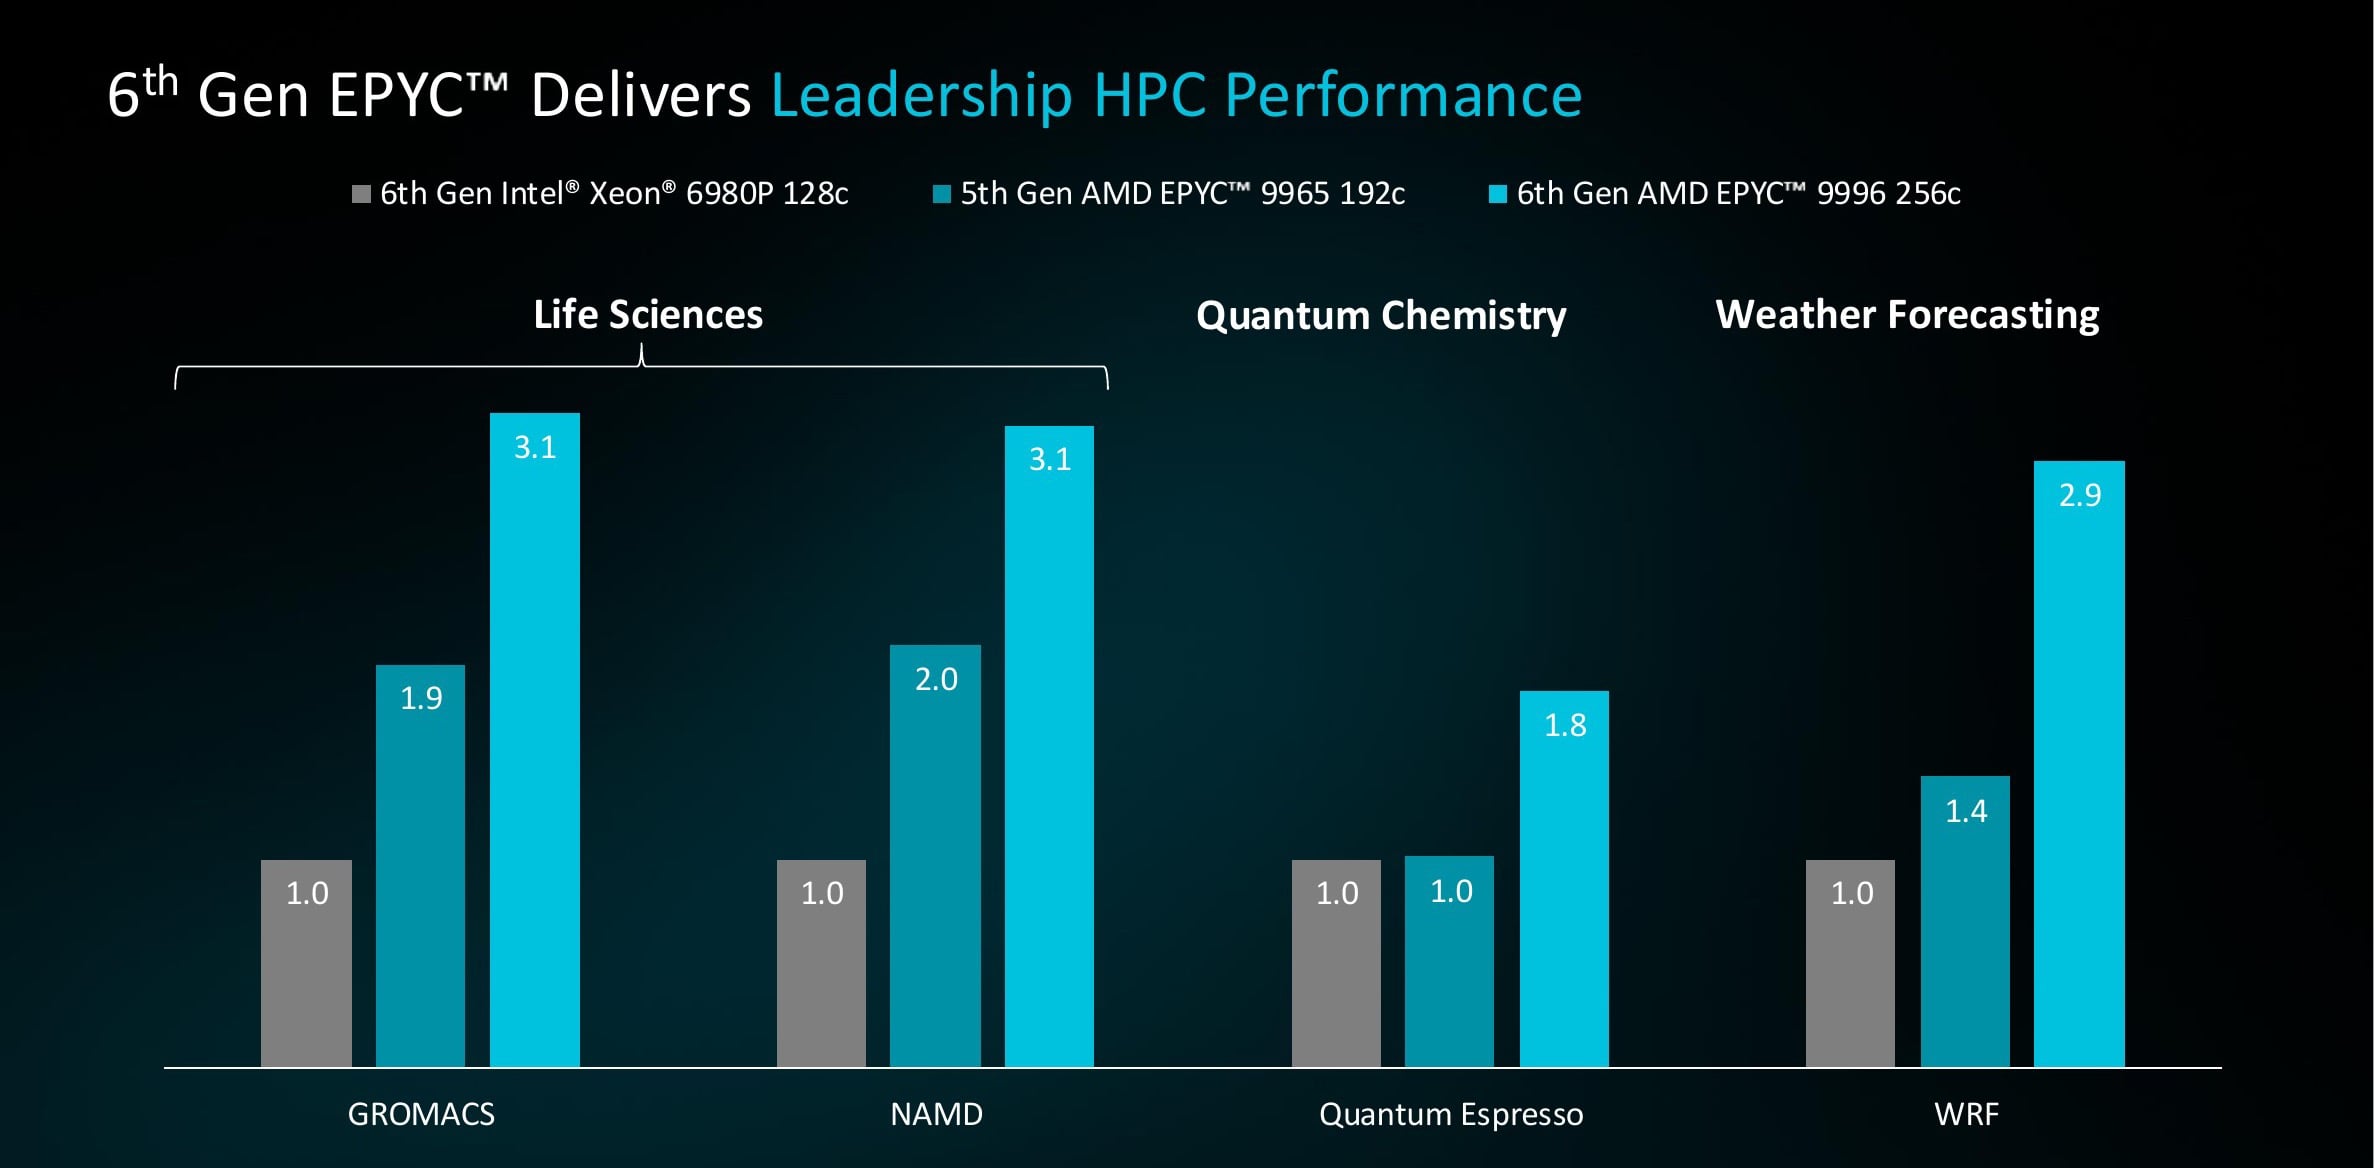
HPC 환경에서 Venice는 GROMACS와 NAMD에서 3.1배, WRF에서 2.9배, Quantum Espresso에서 1.8배의 성능을 보였습니다. 메모리 구성에 따라 이러한 수치는 크게 달라집니다. 표준 8,000 MT/s RDIMM을 사용했을 때 Venice는 GROMACS에서 Xeon 기준 성능 대비 2.81배의 성능을 보였지만, 12,800 MT/s MRDIMM을 사용하면 3.13배로, WRF에서는 동일한 업그레이드로 2.25배에서 2.90배로 성능이 향상되었습니다. AMD는 워크로드와 메모리에 따라 HPC 성능 우위를 1.8배에서 3.5배까지 제시하고 있습니다. Intel 기준 성능은 8,800 MT/s MRDIMM을 사용했으므로, 성능 차이는 업그레이드된 AMD 메모리를 느린 Intel 구성과 조합해서 발생하는 것이 아닙니다.
호스트 노드와 1.8배 보상 주장
이로써 우리는 초당 1.8배 토큰 처리량 증가라는 주장에 다시 주목하게 됩니다. 이를 뒷받침하는 하드웨어 개선 사항은 다음과 같습니다. 5GHz 호스트 프로세서의 코어 수는 기존 64개에서 96개로 늘어났고, 호스트 메모리 대역폭은 614GB/s에서 1.6TB/s로 증가했으며, PCIe Gen 6는 CPU와 GPU 간 연결 대역폭을 두 배로 늘렸습니다.
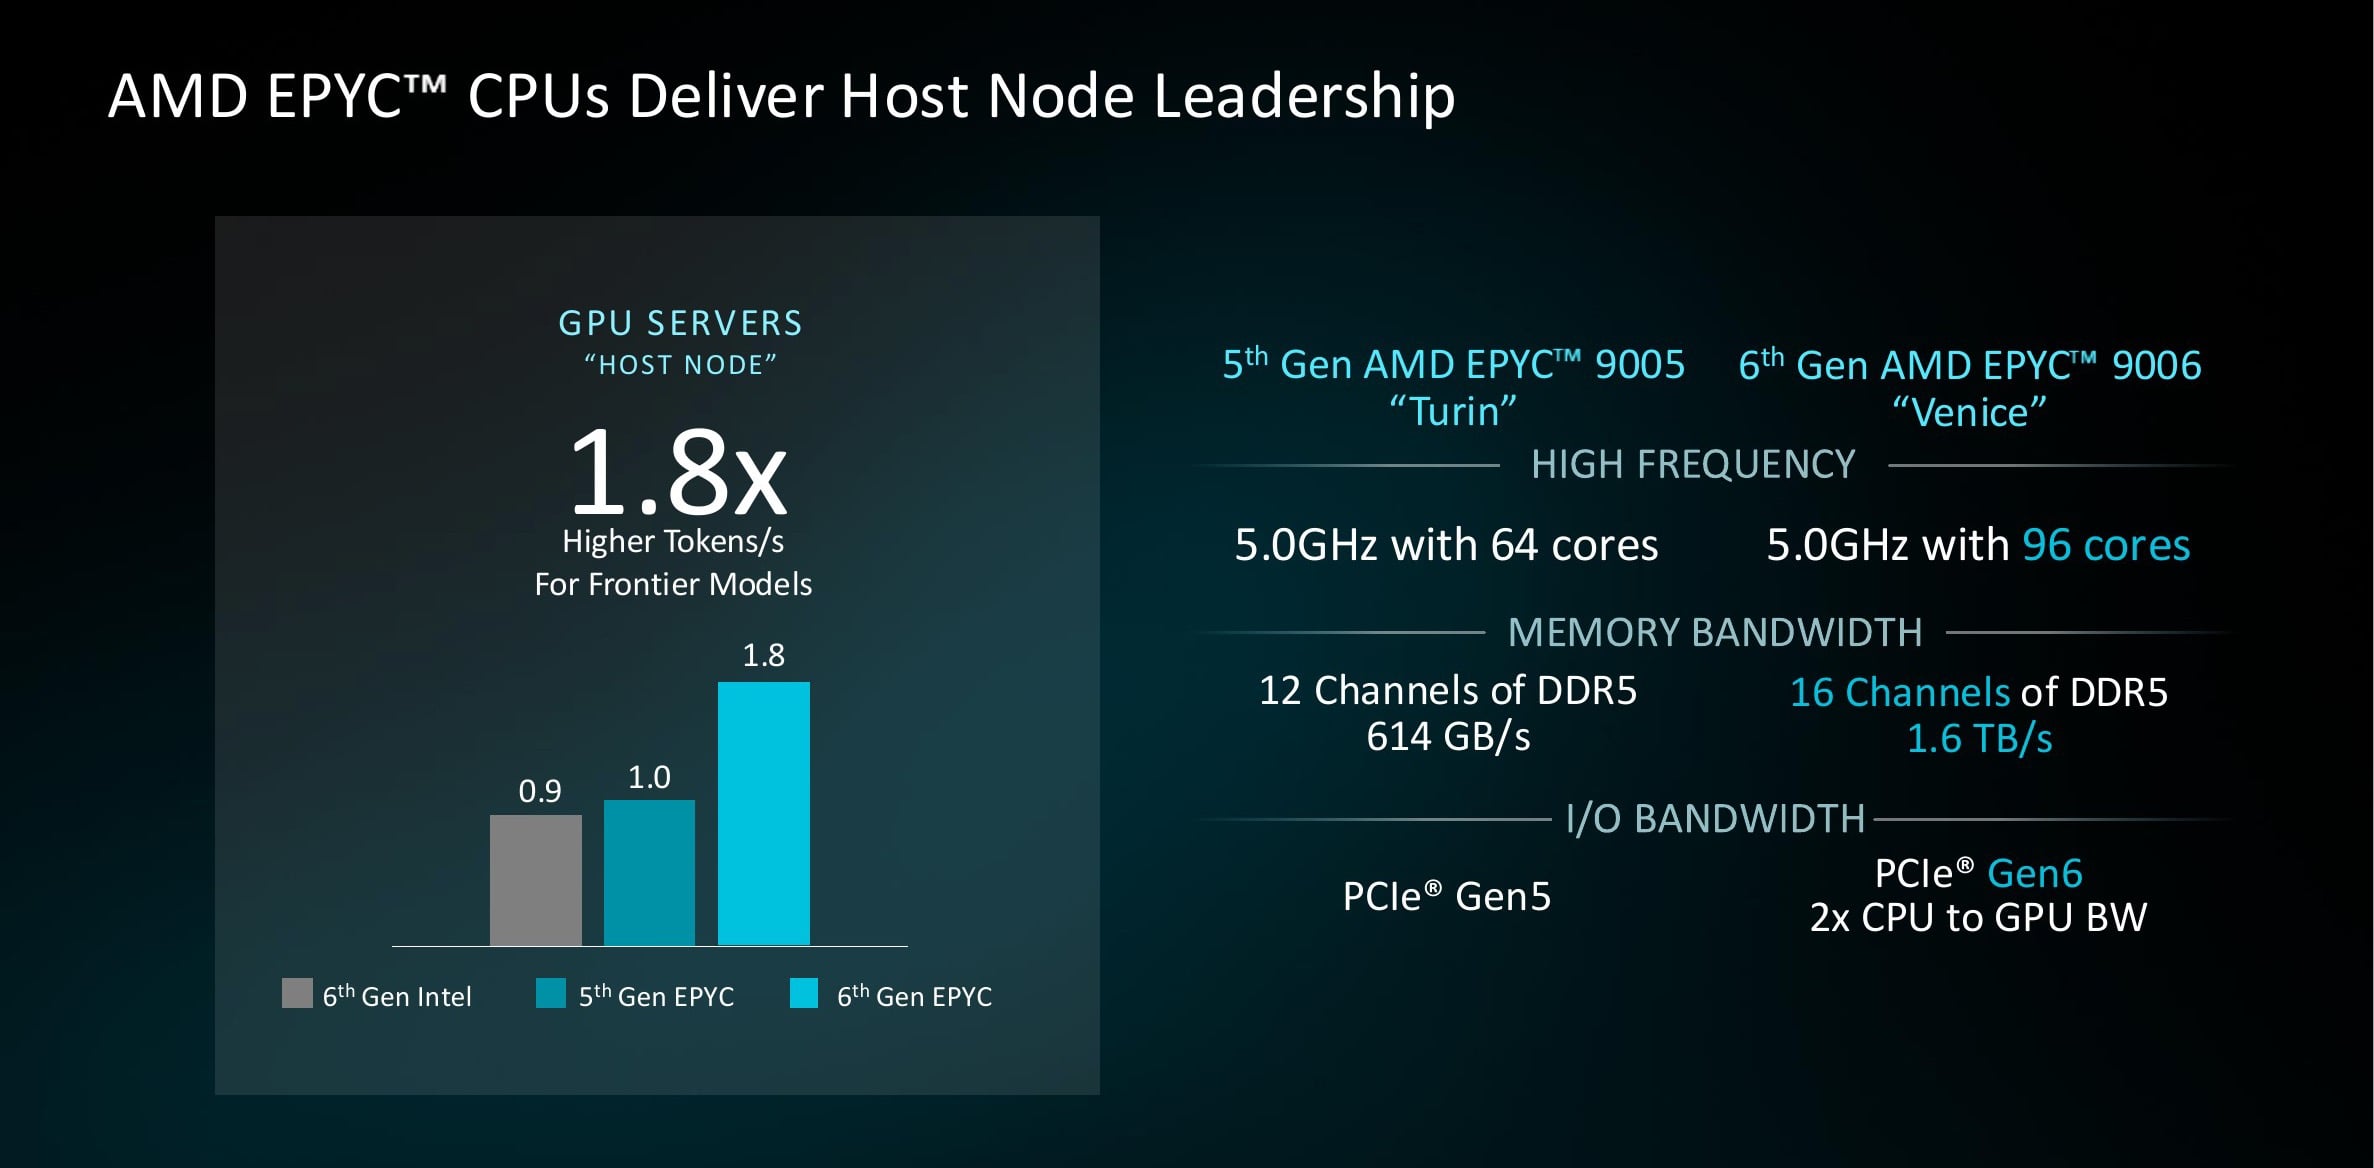
우선 기준점을 확인해야 합니다. AMD는 이 차트를 인텔이 아닌 토리노(Turin)를 1.0으로 설정하고 6세대 제온(Xeon)을 0.9로 설정했습니다. 따라서 동일한 주장을 제온 6960P와 비교했을 때 거의 2배에 가까운 성능 향상이 나타나는 것입니다. 예상되는 성능 향상은 거의 전적으로 I/O 대역폭에서 비롯됩니다. AMD는 Qwen3-30B의 BF16 가중치를 호스트 메모리에서 GPU로 스트리밍하는 CPU 오프로드 테스트를 실행했는데, PCIe Gen 5 x16 수신 경로는 이론적 최대치의 89%~95%로 작동하는 반면 호스트 DRAM 읽기 속도는 이론적 최대치의 10% 미만에 머물렀습니다. 디코딩 속도는 전송 속도에 의해 제한되었으므로 PCIe Gen 6으로 링크를 두 배로 늘리면 이 테스트에서 1.8배~1.9배의 성능 향상이 나타납니다. 현재 베니스는 가속기에 PCIe Gen 6을 제공하는 유일한 서버 CPU이므로 이러한 이점은 실질적이며 현재로서는 독점적입니다. 하지만 그 범위는 좁습니다. 1.8배라는 수치는 대역폭 제한이 있는 오프로드 패턴 하나를 설명하는 것이며, 베니스 호스트에서 모든 모델이 1.8배 더 빠르게 작동한다는 것을 의미하는 것은 아닙니다. 현재 출시된 하드웨어에서, 토리노 호스트는 동일한 8배속 B200 시스템에서 vLLM 및 NIM 워크로드 전반에 걸쳐 첫 토큰 처리 시간에서 Xeon 6960P보다 기하 평균 13% 빠른 성능을 보이며, 최상의 경우 36%까지 향상됩니다.
랙 밀도
마지막 주장은 밀도에 관한 것입니다. 베네치아 실타래 한 묶음에는 49,152개의 코어가 들어있고, 토리노 실타래는 36,864개, 베라 실타래는 22,528개이며, 각 부분에는 코어 수의 두 배에 달하는 실이 들어있습니다. 이 카드 덱에 있는 모든 주장 중에서, 각주를 적용하면 이 주장이 가장 크게 바뀝니다.
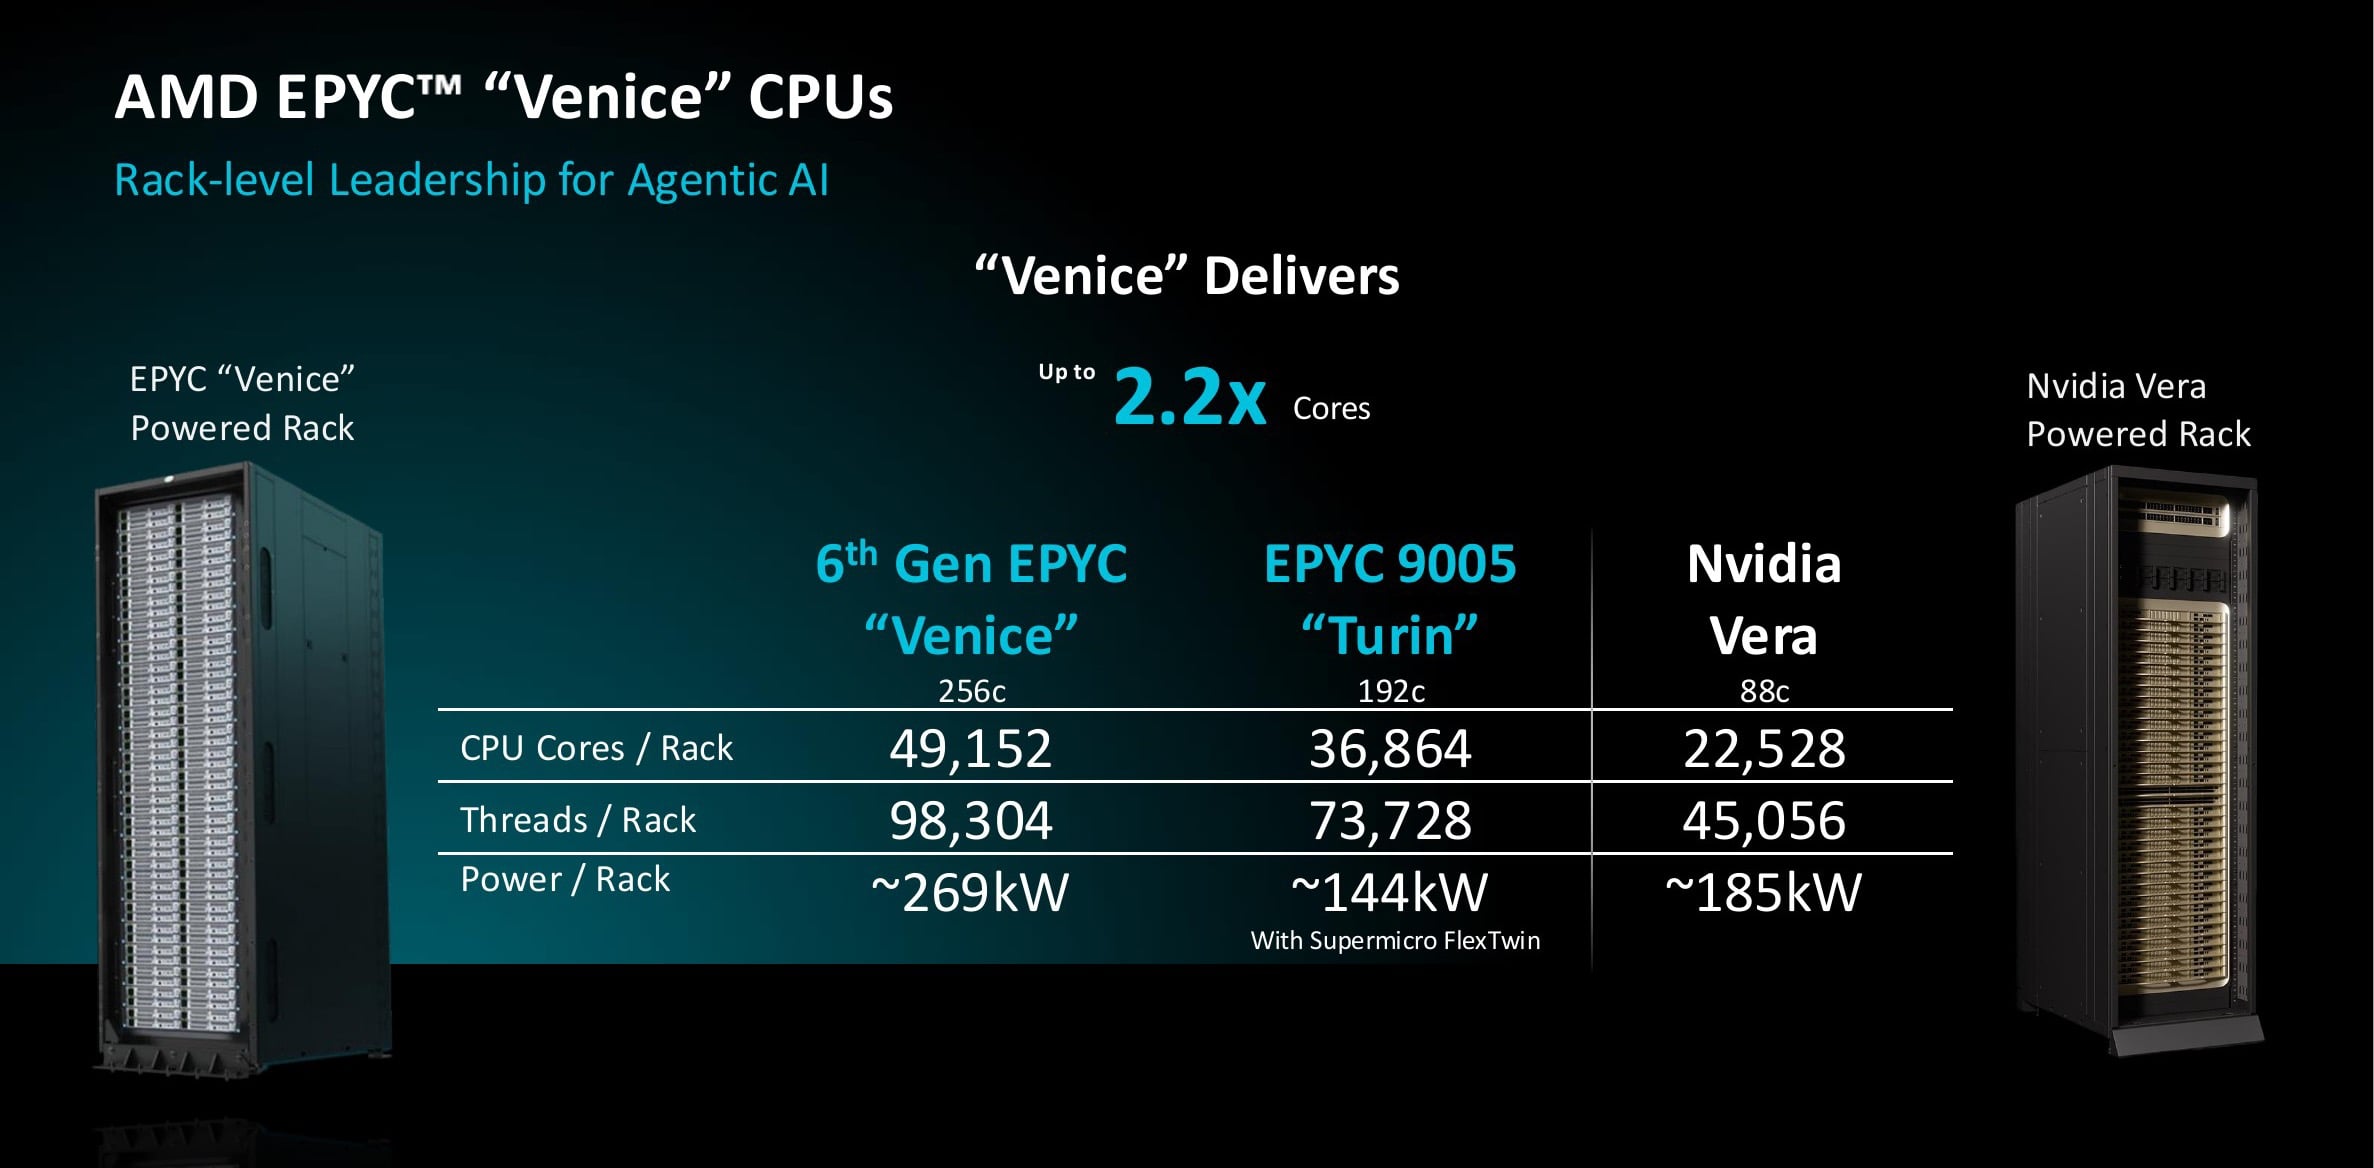
헤드라인은 Vera의 2.2배 코어 수이지만, Venice 랙은 Vera의 185kW보다 높은 269kW의 전력을 소모하면서 이를 달성하므로 두 랙을 동일한 전력으로 비교한 것은 아닙니다. AMD의 각주에는 정규화된 버전이 제공됩니다. 두 랙 모두 100kW의 전력 제한을 적용했을 때, 9996은 Vera의 2.08배, Turin의 1.86배, Intel 6980P의 1.24배의 코어 수를 제공합니다. 플래그십 모델 대신 400W EPYC 9956을 사용하면 AMD는 전력 소모를 26% 줄이면서 Vera의 1.91배 코어 수를 제공할 것으로 예상하며, 이는 랙 와트당 2.57배의 코어 수로 이어집니다. 어떤 전력 예산을 고정하느냐에 따라 우위는 1.9배에서 2.2배 사이가 되며, 이 기사의 모든 Vera 수치와 마찬가지로 NVIDIA 랙은 실제 측정된 하드웨어가 아닌 공개된 사양을 기반으로 모델링되었습니다. 밀도 우위는 정규화 후에도 유지됩니다. 단순히 2.2X라는 제목보다 크기가 작을 뿐입니다.
큰 깡패
개별적인 주장들은 차치하고라도, 서버 CPU 시장 최상위 부문에서 AMD는 현재 직접적인 경쟁자가 없습니다. 인텔의 최고 성능 제품조차 AMD가 이미 교체 중인 Turin 세대에 미치지 못합니다. AMD가 제시한 모든 차트에서 Arm 기반 경쟁 제품들은 Turin보다 성능이 떨어집니다. Vera는 아직 출시되지 않았고, AMD는 Vera의 처리량이 1년 반 전에 출시된 Turin 9965의 절반에도 못 미친다고 추정하고 있으며, Venice는 Turin의 처리량을 두 배 정도 뛰어넘는다고 합니다. 이러한 입지 덕분에 AMD는 Mercury Research에 따르면 서버 CPU 시장 점유율 46%를 차지하고 있습니다. 시장 상황 또한 마찬가지입니다. 현재 최상위 EPYC 제품에 대한 수요가 공급을 초과하고 있으며, 이로 인해 납기가 길어지고 있습니다.
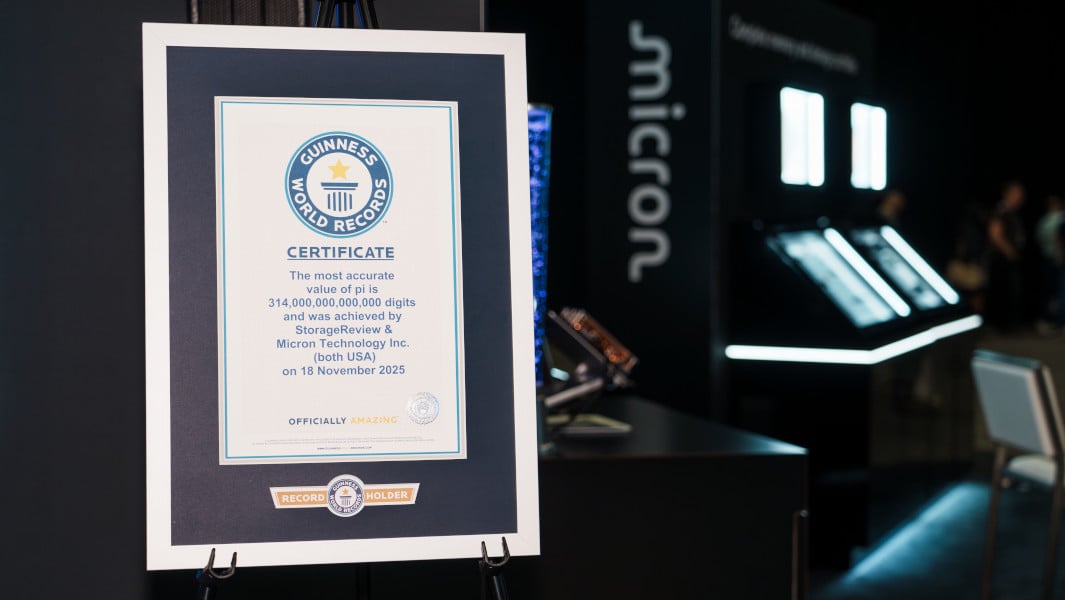
여기에 저희의 데이터를 추가해 보겠습니다. 314조 자리 파이(π) 계산 세계 기록은 192코어 EPYC 9965 CPU 두 개와 1.5TB DDR5 메모리가 장착된 Dell PowerEdge R7725 서버에서 실행되었습니다. 이는 AMD Turin 랙의 모델이 되는 384코어 2P 구성과 동일합니다. 계산은 110일 동안 모든 코어에 부하를 걸어 가동했으며, 단 한 순간의 다운타임도 없이 완료되었습니다. 만약 어느 한 순간이라도 메모리 오류나 시스템 충돌이 발생했다면 기록 달성은 불가능했을 것입니다. 평균 전력 소모량은 약 1,600W였으며, 전체 실행에 소요된 전력은 4,305kWh로, 1조 자리당 13.7kWh에 해당합니다. 이는 이전 300조 자리 기록 달성에 소요된 약 225일 동안의 추정 전력 소모량 33,600kWh보다 훨씬 적은 양입니다.
맺음말
베니스(Venice)는 AMD가 지금까지 선보인 서버 CPU 출시 행사 중 가장 강력한 행사였으며, 그 핵심은 바로 폭넓은 제품군에 있었습니다. Zen 6 한 세대는 256코어 고밀도 프로세서부터 엔터프라이즈 소켓, 1152MB 스택형 캐시 HPC 칩, 그리고 LPDDR 호스트 노드까지 아우르므로, 고객은 동일한 아키텍처와 소프트웨어 기반으로 데이터 센터의 모든 계층을 구축할 수 있습니다. 이번 출시의 핵심 수치는 세부 사항을 살펴보면 더욱 확실해집니다. 비슷한 가격대에서 인텔 제품보다 약 두 배 높은 처리량, 동일한 컴파일러를 사용했을 때 Vera 대비 코어당 20% 향상된 성능, 그리고 전력 소비량에 따라 NVIDIA 호스트 CPU보다 1.9배에서 2.2배 높은 랙 밀도를 제공합니다.
상업적인 측면에서는 예측이 필요 없습니다. SP7은 현재 생산 중이며 파트너 플랫폼은 4분기에 출시될 예정입니다. SP8은 2027년 상반기에 출시될 예정이며, 그 뒤를 이어 Venice-X와 Verano가 출시될 것입니다. 이 제품들을 판매하는 회사는 이미 서버 CPU 매출의 46%를 차지하고 있으며, 현재 제품에 대한 수요가 공급을 훨씬 초과하고 있어 구매자들은 이탈하기보다는 기다리는 추세입니다. Venice 출시가 1년 늦어지더라도 Turin이 이미 출하량과 미출하량을 불문하고 차트상의 다른 모든 제품을 능가하고 있기 때문에 이 기사의 비교 결과는 여전히 AMD의 선두 위치를 보여줄 것입니다. AMD는 현재로서는 가장 가까운 경쟁자가 바로 자사의 이전 세대 제품일 정도로 압도적인 선두를 달리고 있습니다.


 아마존