

AMD는 기업용 데이터센터를 재구축하지 않고도 온프레미스 AI 추론을 구현하고자 하는 기업을 위한 PCIe 가속기인 Instinct MI350P를 발표했습니다. 이 카드는 표준 공랭식 서버에 적합하도록 설계된 듀얼 슬롯, 풀 사이즈, 풀 길이 디자인입니다. 또한 AMD가 현세대 Instinct 칩을 일반 서버에 장착할 수 있는 폼팩터로 출시한 것은 거의 4년 만에 처음입니다.
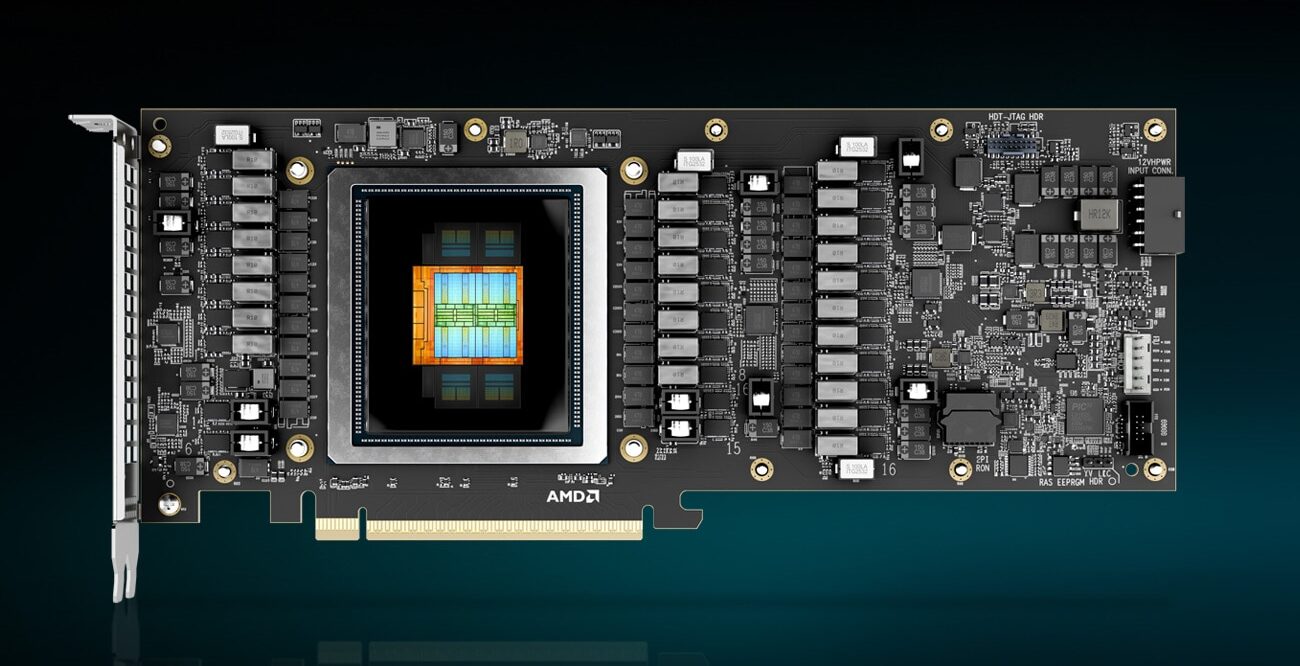
PCIe Instinct 제품군은 2022년 초 MI210 출시 이후 사실상 잠잠했습니다. 이후 모든 세대(MI300X, MI325X, 그리고 OAM MI350X)는 유니버설 베이스보드에 OAM 소켓 모듈 형태로 탑재되어, 단일 트레이에 1,000W급 가속기 8개를 장착할 수 있도록 전력 공급 및 공기 흐름을 고려한 전용 섀시가 필요했습니다. 이는 랙 단위로 GPU를 구매하는 하이퍼스케일러에게는 적합하지만, 온프레미스 추론 환경을 원하지만 맞춤형 AI 랙 구축에 투자할 여력이 없거나 투자하지 않으려는 기업에는 적합하지 않습니다. MI350P는 이러한 공백을 메워주며, 현재 NVIDIA는 동일한 등급의 플래그십 서버용 PCIe 카드를 보유하고 있지 않기 때문에 AMD가 당분간 이 시장을 독점하고 있습니다.
하드웨어: MI350P vs. MI350X OAM
MI350P는 MI350X를 선별한 제품이 아닙니다. AMD는 더 작은 칩을 설계했습니다. MI350X는 각각 4개의 가속기 복합 다이(XCD)를 포함하는 2개의 I/O 다이를 탑재하여 총 8개의 XCD와 256개의 컴퓨팅 유닛을 갖추고 있습니다. MI350P는 4개의 XCD와 128개의 컴퓨팅 유닛을 갖춘 단일 I/O 다이를 사용하는데, 이는 MI350X의 절반 크기이지만 동일한 2.2GHz의 최대 클럭 속도로 작동합니다. 메모리 구성도 마찬가지입니다. HBM3E 스택은 8개가 아닌 4개이며, 버스는 8,192비트 버스 대신 4,096비트 버스를 사용합니다. 또한, 메모리 용량은 8TB/s의 288GB 대신 4TB/s의 144GB입니다.
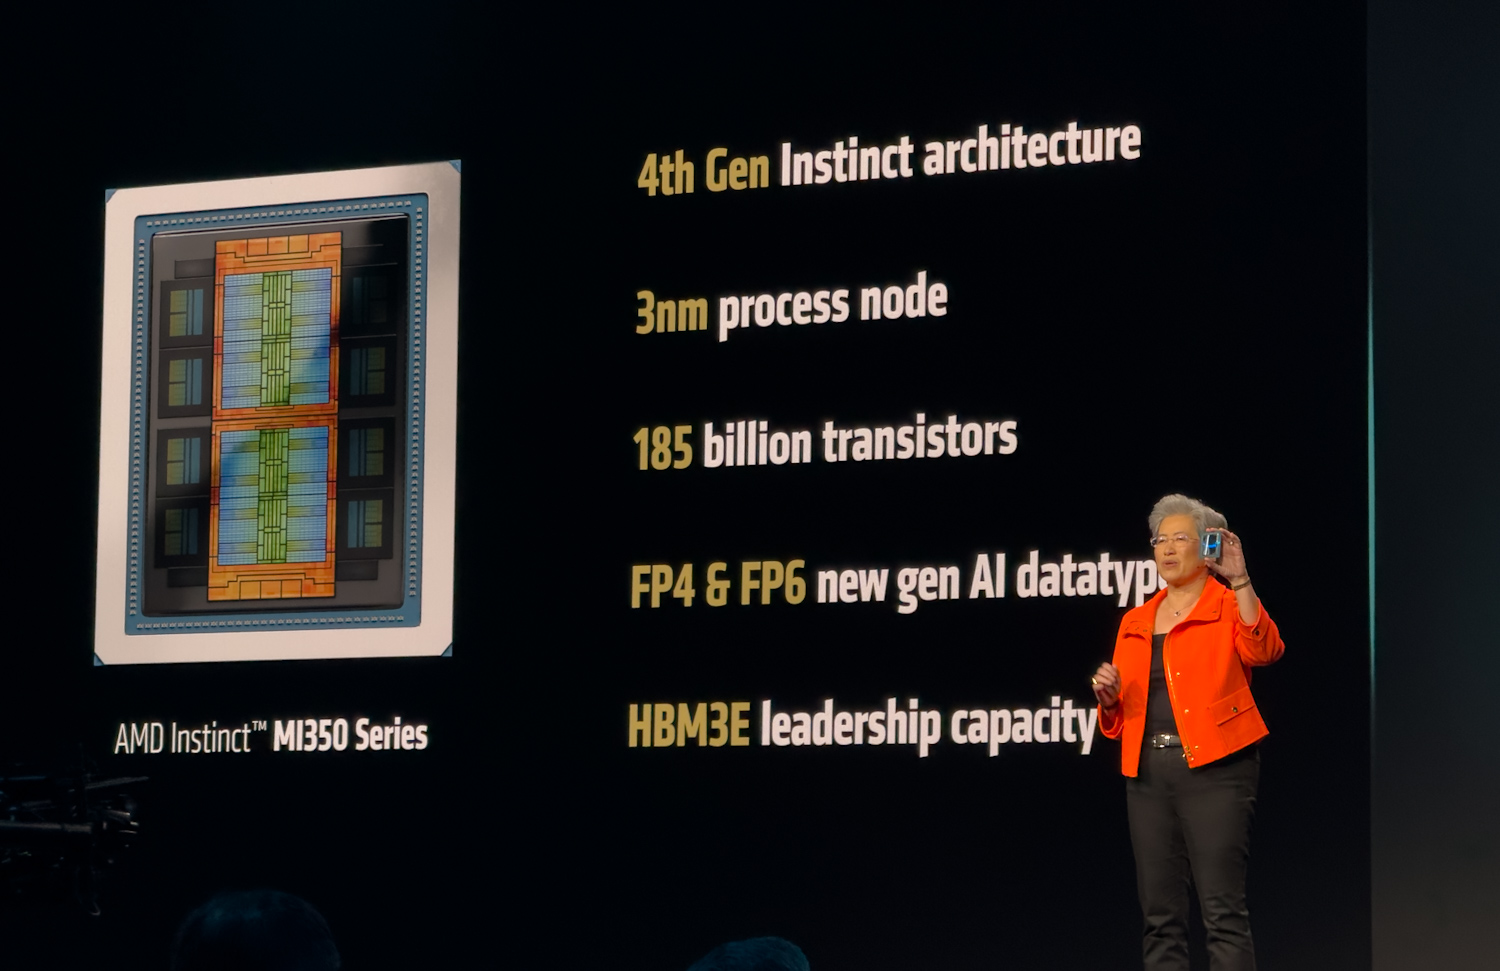
최대 연산 성능 또한 절반으로 줄어듭니다. MI350P는 MXFP4에서 최대 4,600 TFLOPS를 기록하는 반면 MI350X는 9.2 PFLOPS에 그치고, FP8에서는 2,300 TFLOPS를 기록하며 MI350X의 4.6 PFLOPS보다 성능이 떨어집니다. BF16, FP16 및 나머지 정밀도 스택에서도 성능 차이는 크지 않습니다. AMD가 최대 성능뿐 아니라 실제 성능도 함께 공개한 것은 고무적인 일입니다. 실제 성능은 MXFP4에서 2,299 TFLOPS, FP8에서 1,529 TFLOPS, BF16에서 713 TFLOPS입니다. 이 수치는 600W 전력 소모 범위 내에서 그래픽 카드가 실제로 수행할 수 있는 성능을 반영하며, 전력 및 메모리 대역폭 제한으로 인해 이론적인 최대 성능이 저하되는 것을 방지합니다.
저희는 Supermicro의 Jumpstart 프로그램을 통해 MI350X 플랫폼을 살펴보았고, 추론 워크로드 전반에 걸친 성능에 진심으로 감명받았습니다. MI350P를 입수하여 테스트하고, 설계된 기존 서버 섀시에서 PCIe 변형 제품이 어떤 성능을 보여줄지 매우 기대하고 있습니다.
| AMD 인스팅트 MI350P PCIe 카드 | ||
|---|---|---|
| 스펙 | 납품된 FLOPS | 최대 (TFLOPS) |
| 성능 | ||
| BF16 | 713 | 1150 |
| FP16 | 672 | 1150 |
| FP8 | 1529 | 2300 |
| MXFP8 | 1327 | 2300 |
| MXFP6 | 1804 | 4600 |
| MXFP4 | 2299 | 4600 |
| 메모리 및 파티셔닝 | ||
| 메모리 용량 | 144GB HBM3E | 144GB HBM3E |
| 메모리 대역폭 | 3.6 TB / 초 | 4.0 TB / 초 |
| GPU 인스턴스 | 최대 4개 (각 36GB) | 최대 4개 (각 36GB) |
| 플랫폼 | ||
| 비디오 및 JPEG 디코딩 | ||
| GPU 스케일업 인터커넥트 | 지원되지 않음 | 지원되지 않음 |
| 제품 FF | FHFL 듀얼 슬롯 공랭식 | FHFL 듀얼 슬롯 공랭식 |
| 최대 총 보드 전력(TBP) | 600W (450W까지 구성 가능) |
600W (450W까지 구성 가능) |
| PCIe 호스트 | x16 PCIe Gen 5, 128GB/s | x16 PCIe Gen 5, 128GB/s |
전력 소모량이 완전히 절반으로 줄지는 않습니다. MI350P는 TBP(Temporal Power Power)가 600W로, MI350X의 1,000W의 약 60% 수준입니다. 600W는 PCIe CEM 규격에서 정한 최대 전력 소모량이므로, 이 그래픽 카드는 슬롯에서 허용하는 최대 온도로 작동합니다. 최대 전력이나 냉각 용량을 제공하지 못하는 케이스를 위해 450W 모드도 제공되지만, 성능은 다소 저하됩니다. 600W 정격 전력은 MI350P를 NVIDIA의 H200 NVL 및 RTX Pro 6000 서버와 같은 가격대에 위치시키며, 이 제품군에서 경쟁 제품으로 주목받을 것입니다.
NVIDIA의 H200에 적용된 NVL4 방식과 달리, AMD는 MI350P에서 GPU의 인피니티 패브릭 링크를 외부에 노출하지 않습니다. 모든 집합적 통신은 PCIe Gen5 x16(128GB/s) 링크를 통해 이루어집니다.
8개의 GPU를 공랭식으로 냉각하는 이야기
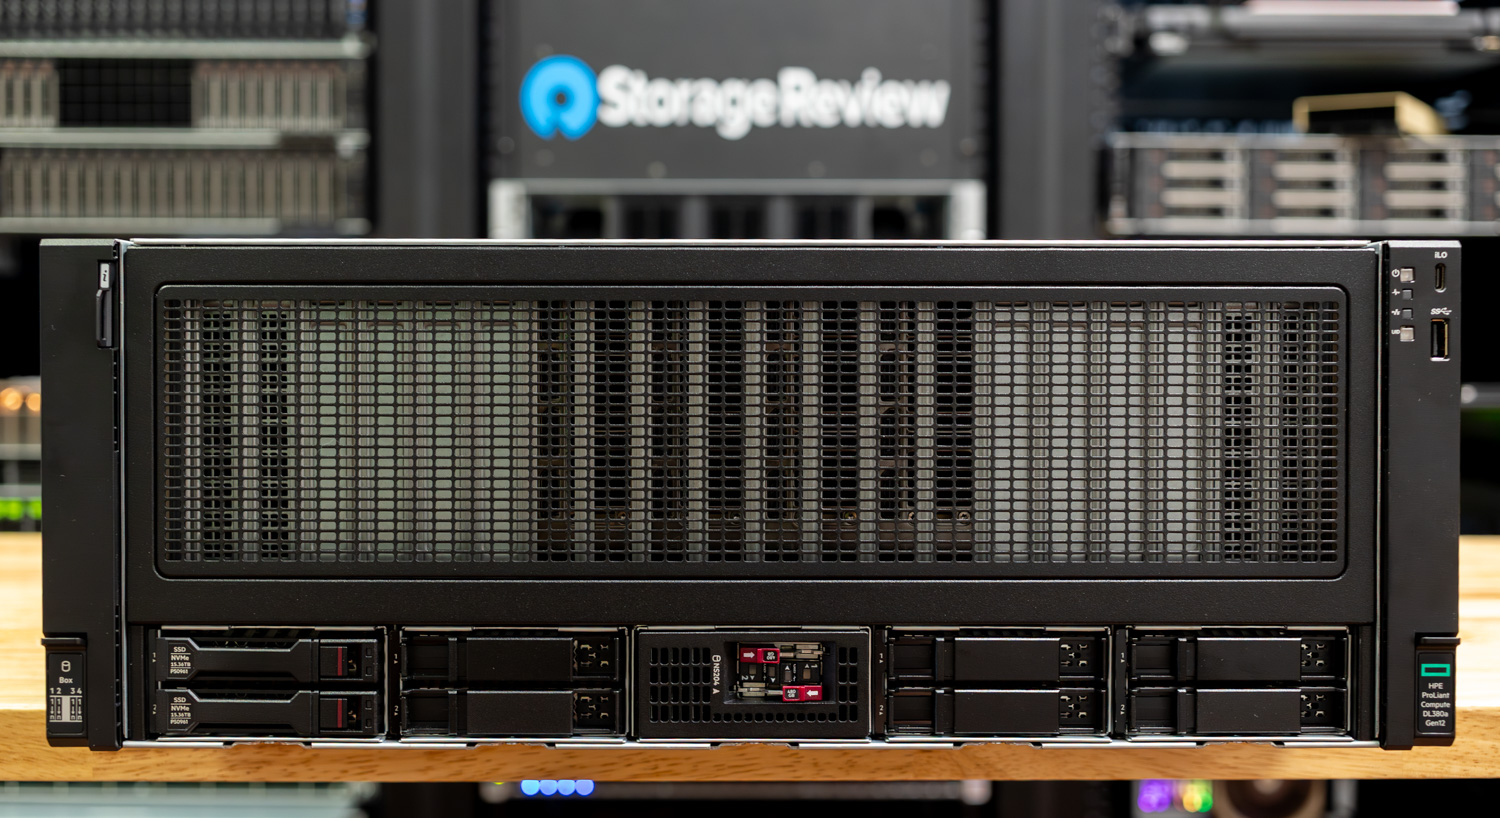
MI350P는 표준 듀얼 슬롯, 풀 하이트, 풀 랭스 PCIe 카드이므로 기업에서 이미 구축 및 운영 중인 서버, 특히 주요 OEM에서 출시 중인 8개 GPU를 탑재한 공랭식 플랫폼에 적합합니다. 이전에 리뷰했던 Dell PowerEdge XE7740과 HPE ProLiant DL380a Gen12가 대표적인 대상입니다. 이 두 서버는 600W급 카드에 최적화된 전력 공급 및 공기 흐름 설계를 갖춘 공랭식 섀시에 8개의 듀얼 슬롯 FHFL 가속기를 탑재하도록 특별히 설계되었습니다. 별도의 랙이나 수랭식 냉각 시스템, OAM 베이스보드가 필요하지 않습니다.
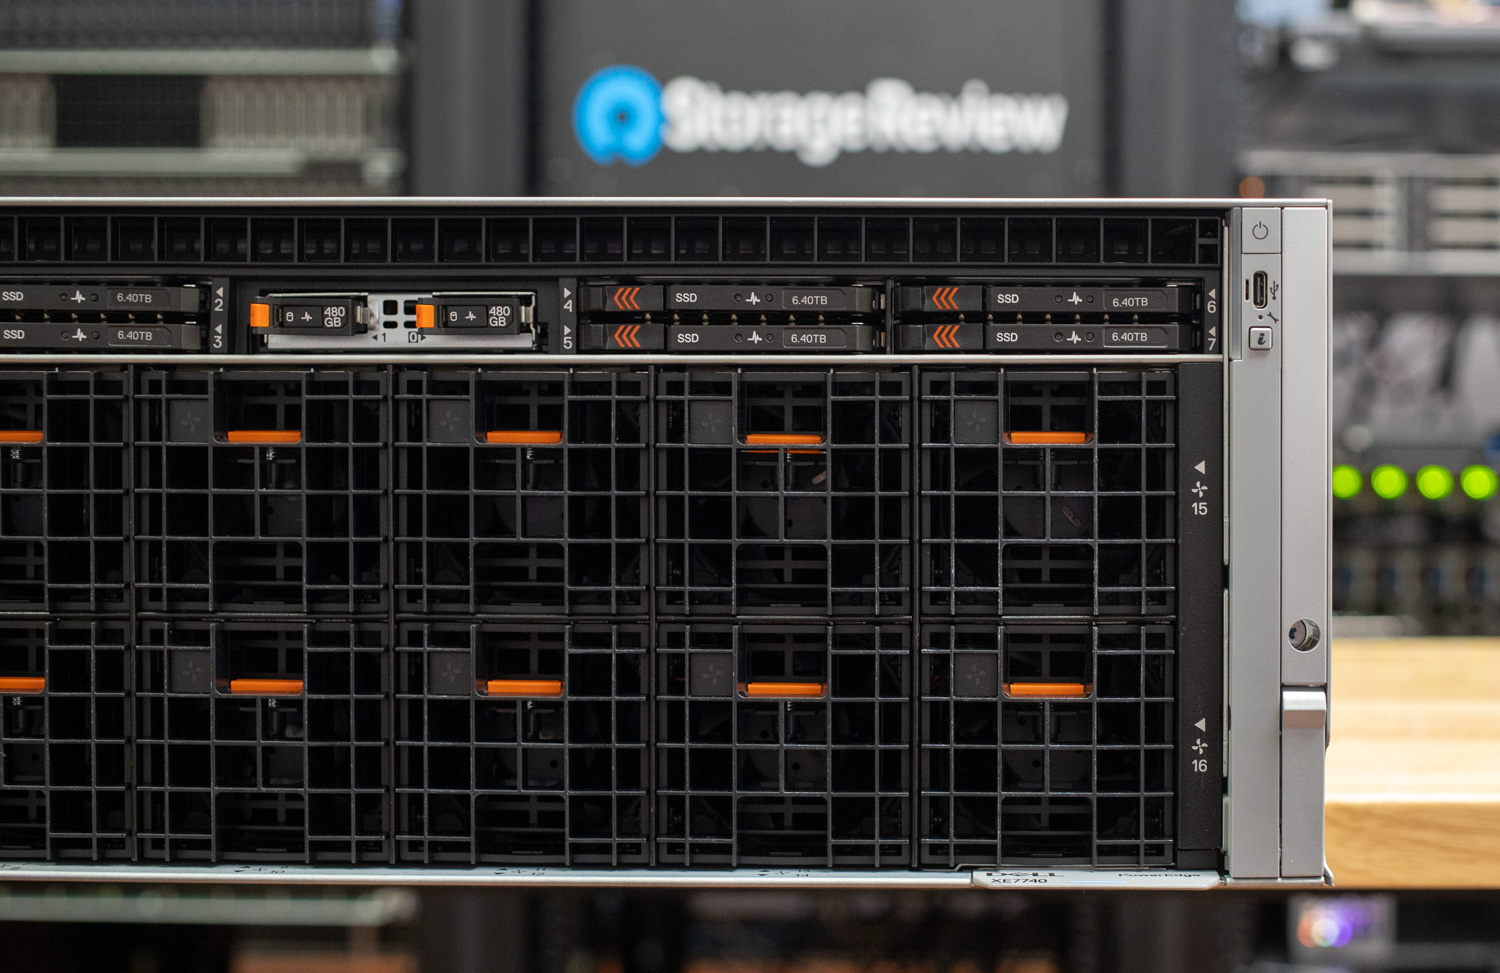
이러한 시스템 중 하나에 8개의 MI350P 카드를 구성하면 1,152GB의 HBM3E 메모리와 32TB/s의 총 메모리 대역폭을 단일 공랭식 박스에 담을 수 있습니다. 대규모 개방형 가중치 모델에 대한 추론의 경우, 단일 섀시에서 MXFP4 메모리에 1조 개의 파라미터를 가진 모델을 호스팅하기에 충분합니다. 하지만 앞서 언급했듯이, 확장 패브릭이 없다는 단점이 있습니다. OAM MI350X에서는 GPU가 유니버설 베이스보드를 통해 인피니티 패브릭으로 통신합니다. MI350P에서는 모든 GPU 간 통신이 호스트에 도달하는 데 사용되는 것과 동일한 경로인 PCIe Gen5 x16을 통해 128GB/s로 이루어집니다. 추론 워크로드, 특히 노드 내 텐서 병렬 샤딩 및 노드 간 파이프라인 또는 데이터 병렬 처리가 필요한 경우에는 이러한 방식이 적합합니다. 하지만 모든 리듀스 대역폭이 스텝 타임을 지배하는 긴밀하게 연결된 학습의 경우에는 OAM 플랫폼이 여전히 최적의 선택입니다.
정밀 포맷
MI350P에서 지원하는 포맷은 새로운 것이 아니지만, 정밀도는 여전히 중요한 부분입니다. MI350X도 동일한 포맷을 지원합니다. 그럼에도 불구하고 정밀도가 중요한 이유는 OCP 블록 스케일링 데이터 타입(MXFP8, MXFP6, MXFP4)이 최첨단 모델 연구소에서 모델 학습 및 배포에 사용하는 표준 포맷으로 자리 잡았기 때문입니다. 이러한 포맷을 사용하면 연구소는 품질 저하 없이 낮은 정밀도로 모델을 학습할 수 있으며, 추론 성능 향상 효과를 즉시 확인할 수 있습니다.
정밀도가 낮을수록 속도가 빠릅니다. MXFP4는 FP8보다 두 배 이상 빠르고, BF16보다 최대 네 배 빠릅니다. 이러한 속도 향상은 실제 워크로드에서 확연히 드러납니다. OpenAI의 gpt-oss 릴리스를 통해 처리량 향상이 명확해졌으며, Kimi K2.6과 같은 최첨단 모델은 사후 양자화가 아닌 처음부터 INT4로 양자화 인식 학습을 통해 구현되고 있습니다. 또 다른 중요한 요소는 메모리입니다. INT4와 MXFP4 가중치는 BF16의 4분의 1에 불과한 메모리 공간을 차지합니다. 이는 수조 개의 파라미터를 가진 모델도 8개의 GPU가 장착된 단일 서버에 저장할 수 있음을 의미합니다. 대규모 개방형 가중치 모델을 온프레미스에 호스팅하려는 기업의 경우, 단일 랙과 모든 네트워킹 및 오케스트레이션이 필요한 멀티 노드 클러스터 간의 차이가 상당합니다.
히프 라인
온프레미스 AI를 검토하는 대부분의 기업은 컴퓨팅 여유 공간이 부족해지기 전에 전력, 냉각, 랙 밀도 또는 예산 문제에 부딪힙니다. 기존 서버 환경에 통합할 수 있는 PCIe Instinct는 이러한 제약 조건의 가장 큰 부분을 우회할 수 있습니다. 현재 NVIDIA는 Instinct와 경쟁할 만한 플래그십 서버용 PCIe 카드를 보유하고 있지 않기 때문에 AMD는 당분간 이 시장에서 독보적인 위치를 차지할 수 있을 것입니다.
자세한 내용은 AMD Instinct 페이지에서 확인할 수 있습니다.


 아마존