

클라우데라는 퍼블릭 클라우드, 자체 운영 환경, 온프레미스 프라이빗 인프라 전반에 걸쳐 프로덕션급 워크로드를 구축, 배포 및 확장할 수 있도록 설계된 하이브리드 데이터 및 AI 플랫폼인 클라우데라 애니웨어 클라우드(Cloudera Anywhere Cloud)를 출시했습니다 . 이 플랫폼은 독립형으로 배포하거나 기존 엔터프라이즈 데이터 레이크에 직접 통합할 수 있습니다. 또한 로컬 스토리지 계층에서 데이터를 마이그레이션할 필요 없이 자동화된 관리, 모듈식 서비스 프로비저닝, 통합된 데이터 거버넌스를 제공하는 중앙 집중식 제어 플레인을 제공합니다.
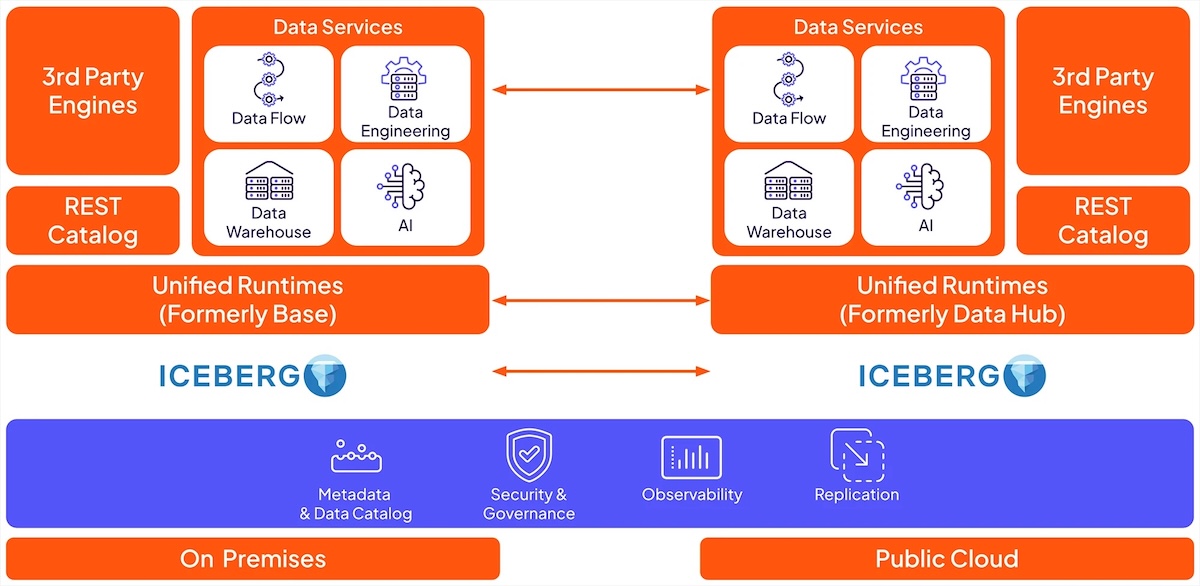
아키텍처 개요 및 워크로드 이동성
클라우데라 애니웨어 클라우드는 컴퓨팅 서비스와 기본 스토리지 인프라를 분리하는 모듈식의 분산형 아키텍처를 활용합니다. 이러한 설계 덕분에 기술 팀은 Apache Spark, Apache Kafka, Trino를 비롯한 독립적인 분석 엔진과 자체 서비스 마켓플레이스 블루프린트를 통해 맞춤형 오픈 소스 또는 타사 엔진을 배포할 수 있습니다. 이 시스템은 표준 API, Apache Iceberg 오픈 테이블 형식 , Polaris 카탈로그를 사용하여 이기종 인프라 전반에 걸쳐 이러한 분산 컴퓨팅 엔진을 연결함으로써 독점 데이터 형식과 맞춤형 통합에 따른 추가 비용을 제거합니다.
인프라 성능 병목 현상과 복잡한 데이터 상주 규정은 기업의 AI 파이프라인이 파일럿 단계에서 프로덕션 단계로 전환될 때 종종 지연을 초래합니다. 클라우데라는 최근 연구 결과를 인용하며 IT 리더의 73%가 인프라 성능 제약으로 인해 운영 계획이 지연되었다고 응답했다고 밝혔습니다. 클라우데라 애니웨어 클라우드는 워크로드를 로컬에 배치하여 이러한 운영 지연 문제를 해결합니다. 애플리케이션은 비즈니스, 규제 또는 하드웨어 요구 사항에 따라 지정된 위치에서 실행되므로, 서로 다른 환경 간에 대규모 데이터 세트를 복제하거나 전송할 필요가 없습니다.
거버넌스, 에이전트 기반 자동화 및 제어
이 플랫폼은 분산 스토리지 및 컴퓨팅 노드 전반에 걸쳐 네이티브 제로 트러스트 보안 제어 기능을 통합합니다. 이 프레임워크는 주권 클라우드, 프라이빗 클라우드, 퍼블릭 클라우드 계층 전반에 걸쳐 데이터 계보, 접근 경계 및 지속적인 규정 준수를 유지합니다. 배포 시 기존 엔터프라이즈 거버넌스 정책을 자동으로 상속하여 데이터 주권 및 지적 재산권을 보호합니다.
일상적인 운영을 간소화하기 위해 클라우데라는 제어 인터페이스에 에이전트 기반 코파일럿을 통합했습니다. 이 코파일럿은 자연어 명령을 실행 가능한 운영 작업으로 변환합니다. 예를 들어 컴퓨팅 엔진을 시작하거나, 인프라 리소스를 구성하거나, 연결된 환경 전반에 걸쳐 엔드투엔드 데이터 파이프라인을 오케스트레이션할 수 있습니다.
클라우데라의 최고 제품 책임자(CPO)인 레오 브루닉은 “엔터프라이즈 AI는 퍼블릭 클라우드 전용 모델을 넘어서는 성장을 이루었습니다.”라고 말했습니다. “기업은 혁신과 통제권 사이에서 선택할 필요가 없습니다. 클라우데라 애니웨어 클라우드는 클라우드의 속도와 유연성을 기업 데이터에 직접 제공합니다. 이를 통해 기업은 데이터와 지적 재산에 대한 완전한 소유권을 유지하면서 AI 이니셔티브를 가속화하고, 인프라, 토큰 및 비즈니스 모델 비용을 최적화할 수 있습니다.”
이번 출시로 클라우데라는 VAST Data와의 공동 AI 팩토리 스택을 포함한 최근 인프라 사업 확장에 박차를 가하고 있습니다 . 클라우데라는 이번 주 싱가포르에서 열리는 EVOLVE 행사에서 클라우데라 애니웨어 클라우드를 선보일 예정입니다.
NVIDIA cuDF를 통한 GPU 가속 Spark
클라우데라는 플랫폼 출시와 함께 NVIDIA의 cuDF CUDA-X 라이브러리를 기반으로 구축된 클라우데라 데이터 엔지니어링의 Apache Spark 4.1용 네이티브 GPU 가속 기능을 발표했습니다 . cuDF 플러그인은 PySpark 또는 SQL 코드를 변경할 필요 없이 기존 Spark 파이프라인을 가속화하며, 클라우데라는 이를 통해 클라우드 컴퓨팅 비용을 절감하면서 AI에 사용할 데이터를 더 빠르게 준비할 수 있다고 설명합니다. 이 기능은 Anywhere Cloud의 일부로 클라우데라 데이터 엔지니어링에 포함되어 제공됩니다.


 아마존