

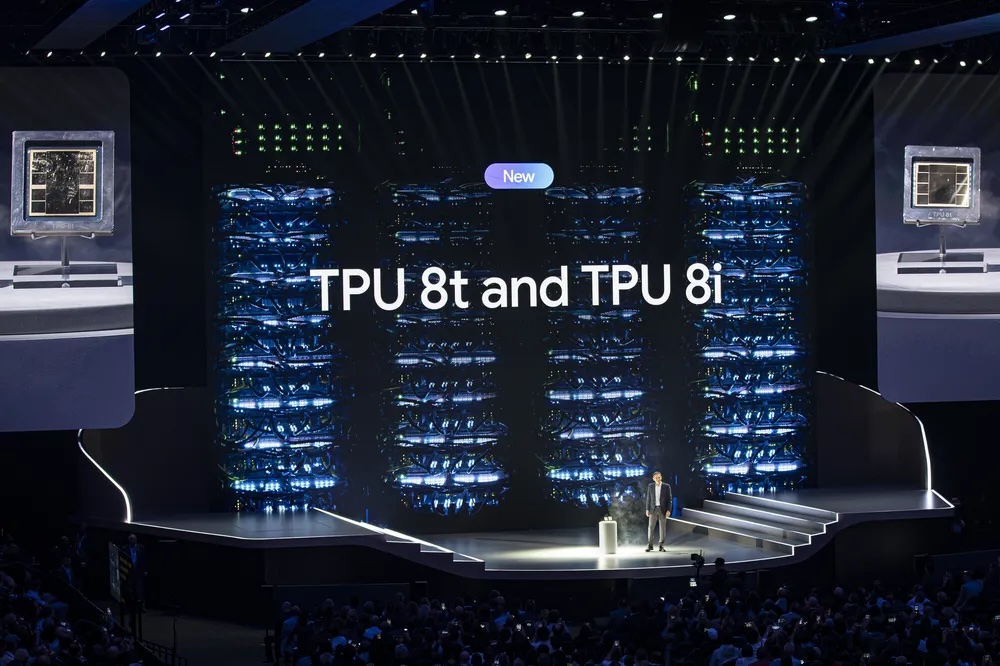
구글은 Google Cloud Next에서 차세대 AI 가속기인 TPU 8t "Sunfish" (학습용)와 TPU 8i "Zebrafish" (추론용), 그리고 새로운 Virgo 데이터 센터 패브릭을 발표했습니다. 구글 블로그 게시글을 보면 이 칩들은 "에이전트 시대"에 최적화되어 있음을 알 수 있습니다. 수십만 개의 칩을 사용하여 최첨단 혼합형 전문가 모델을 학습시키고, 낮은 지연 시간과 경쟁력 있는 토큰당 가격으로 동일한 모델을 제공하는 데 중점을 두고 있습니다. 8t와 8i는 호스트 플랫폼과 패브릭은 공유하지만 메모리 용량, 온칩 SRAM, 인터커넥트 토폴로지, 온칩 특화 기능에서 차이가 있는 아키텍처를 가진 두 개의 칩입니다. 8t는 대규모 밀집 행렬 곱셈(matmul)에 최적화되어 있으며, 8i는 실리콘 기반 KV 캐시와 토큰당 집합 지연 시간을 최소화하는 데 중점을 두고 설계되었습니다.
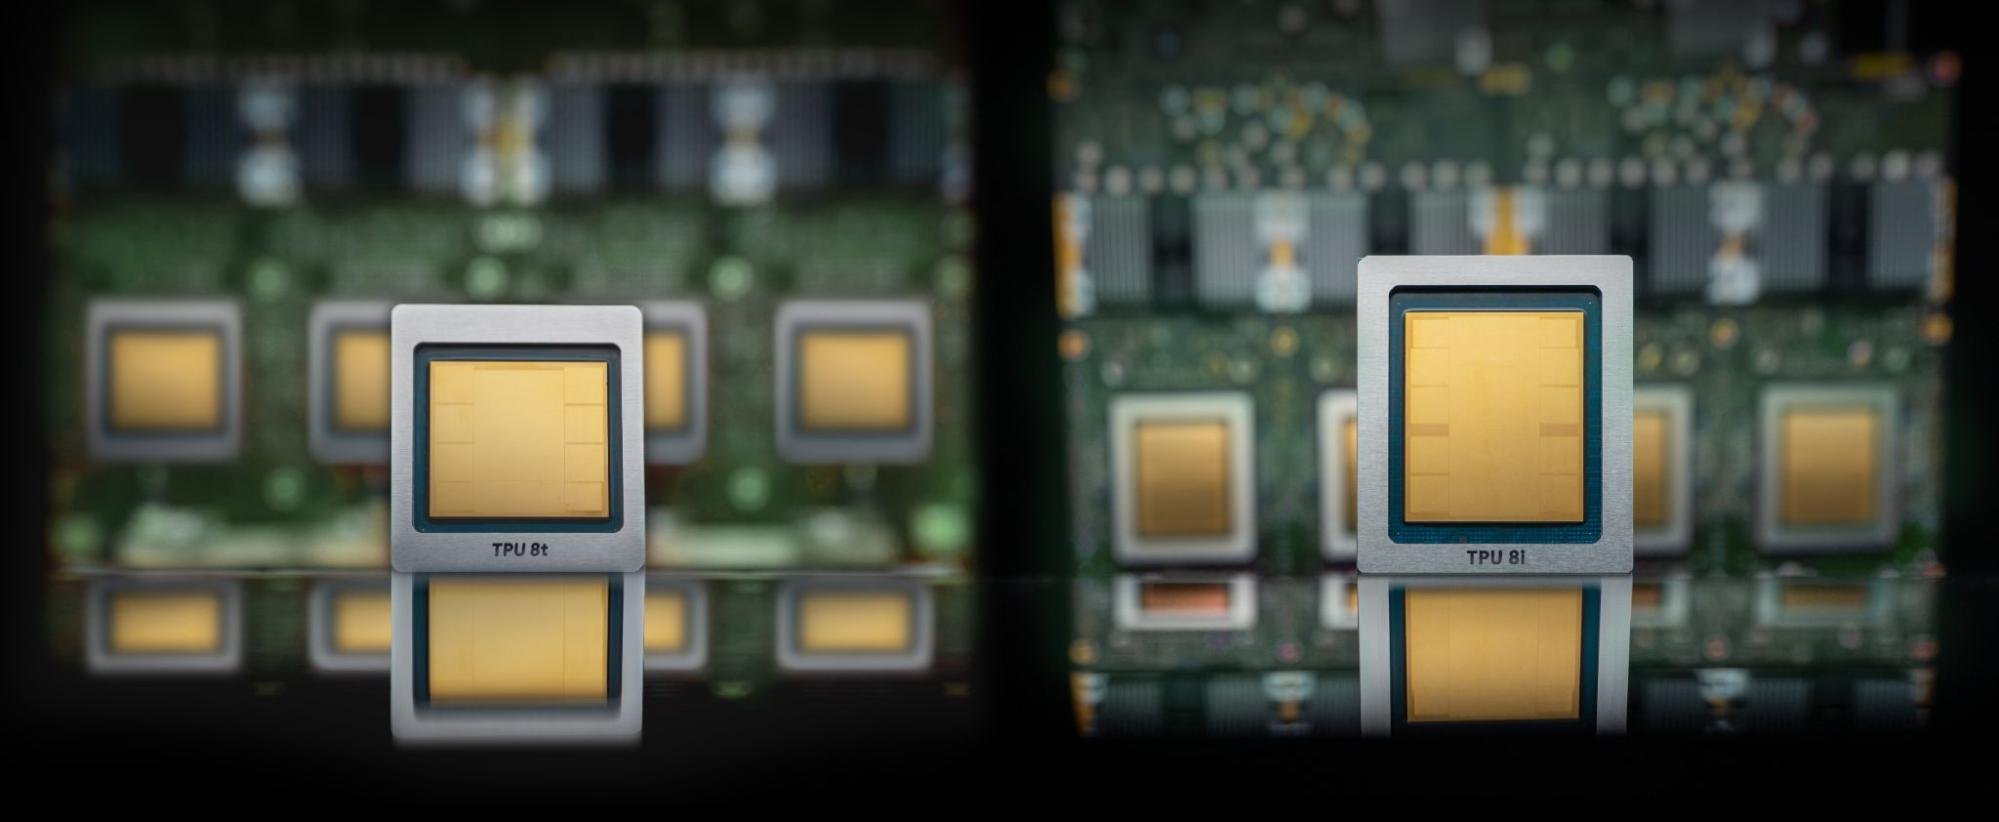
단일 8t 슈퍼포드는 최대 9,600개의 칩으로 확장 가능하고, 2PB의 HBM을 탑재하며, FP4 연산에서 121EFLOPS의 성능을 제공합니다. 이는 Ironwood 슈퍼포드의 포드당 연산 성능보다 거의 3배 높은 수치입니다. 8i는 1,152개의 칩으로 구성된 확장 도메인 내에서 288GB의 HBM과 384MB의 온칩 SRAM(Ironwood의 3배)을 결합하여 LLM 추론에서 Ironwood보다 80% 향상된 가격 대비 성능을 제공한다고 주장합니다. Virgo는 두 칩 제품군을 하나의 데이터 센터 패브릭으로 통합하여 134,000개 이상의 8t 칩을 47Pb/s의 논블로킹 바이섹션 대역폭으로 연결하며, 가속기당 대역폭은 이전 세대보다 최대 4배 높고, 무부하 지연 시간은 40% 감소했습니다.
TPU란 실제로 무엇인가
8개의 실리콘에 대해 자세히 알아보기 전에 TPU가 무엇이며 GPU와 어떻게 다른지 배경 설명을 드리겠습니다. 8개의 설계 결정은 이러한 맥락을 이해해야만 의미가 있기 때문입니다.
텐서 처리 장치(TPU)는 구글이 2015년부터 지속적으로 개선해 온 맞춤형 ASIC입니다. 모든 세대는 동일한 핵심 아이디어를 기반으로 설계되었습니다. GPU처럼 수천 개의 작은 코어를 동적으로 스케줄링하는 대신, TPU는 온칩 소프트웨어 관리 SRAM 스크래치패드에서 데이터를 공급받고 사전 컴파일된 컴파일러에 의해 구동되는 소수의 매우 큰 MXU(행렬 곱셈 장치)를 중심으로 작동합니다. 각 칩에는 하나의 대형 시스톨릭 어레이 MXU를 중심으로 구성된 몇 개의 TensorCore와 추천 임베딩에서 중요한 불규칙적인 수집-분산 조회 작업을 처리하는 소수의 SparseCore가 포함되어 있습니다. 데이터는 HBM에서 스크래치패드를 거쳐 MXU를 통과한 후 다시 스크래치패드로 돌아가 출력되며, 벡터 처리 장치(VPU)가 활성화, 정규화 및 축소 연산을 처리합니다. 하드웨어 워프 스케줄러, GPU에서 볼 수 있는 L1 또는 L2 캐시 계층 구조, 동적 디스패치는 없습니다.
이 설계의 장점은 밀집 선형 대수에서 효율성이 높다는 것입니다. 컴파일러가 모든 텐서의 위치와 콜렉티브 연산의 실행 시점을 미리 결정하기 때문에 캐시 미스로 인한 지터나 워프 스케줄러 비용이 발생하지 않습니다. 이는 수만 개의 칩이 콜렉티브 연산을 통해 동기화되어야 하는 상황에서 매우 중요한 요소입니다. 잘 조정된 학습 워크로드의 경우 TPU에서 실제 모델의 FLOP 활용률은 기존 GPU보다 높은 경향이 있습니다. 단점은 동적 형태, 불규칙적인 희소 패턴, 토큰 분포가 고르지 않은 MoE 라우팅 또는 그래프 신경망과 같이 대규모 밀집 행렬 곱셈에 깔끔하게 매핑되지 않는 모든 것을 효율적으로 표현하기 어렵다는 것입니다. 또한 TPU는 기존 GPU에 비해 칩당 HBM 탑재량이 적었고 지원하는 프레임워크도 훨씬 제한적이었습니다. XLA와 JAX는 기본 지원 프레임워크이지만, PyTorch는 최근까지 변환 계층이 필요했습니다. 게다가 컴파일러, 런타임, 네트워킹 라이브러리 및 멀티팟 소프트웨어 스택은 Google 내부에서 소스 코드가 공개되지 않은 채로 남아 있습니다.
희소성은 GPU와 TPU 사이의 철학적 차이를 가장 명확하게 보여주는 예이며, 그 이유는 마케팅보다는 구조적인 차이에 있습니다. NVIDIA는 Ampere 시절부터 Tensor Core에서 2:4 구조적 희소성을 지원해 왔으며, 이론적으로 희소 워크로드의 성능은 밀집 워크로드의 두 배입니다. Tensor Core는 기본적으로 디스패치 장치입니다. MMA 명령어마다 명시적인 피연산자 로드를 수행하므로, 압축된 2-out-of-4 블록과 인덱스 메타데이터를 허용하는 희소 MMA 변형을 추가하는 것은 기존 명령어 세트를 간단하게 확장하는 것입니다. 하드웨어는 매 사이클마다 0이 아닌 값과 해당 인덱스만 곱셈 배열로 가져오고, 0은 암묵적으로 건너뜁니다.
시스톨릭 어레이는 정반대로 작동합니다. 모든 PE(처리 요소)는 매 사이클마다 연산을 수행하며, 피연산자는 레지스터 간 직접 경로를 통해 한 PE에서 다음 PE로 동기화되어 어레이를 통해 전달됩니다. 이러한 결정론적 데이터 흐름 덕분에 SIMT 방식보다 전력 효율성이 뛰어납니다. 즉, SRAM을 반복적으로 읽지 않고, 명령어 디스패치 오버헤드가 없으며, 피연산자를 최대한 재사용할 수 있습니다. 하지만 이는 하드웨어가 파이프라인을 중단하지 않고는 매 사이클마다 값이 0인 요소를 건너뛸 수 없다는 것을 의미하기도 합니다.

출처 : Google
TPU는 타일 수준에서 희소성을 여전히 활용할 수 있습니다. 예를 들어, MXU 크기의 타일 전체가 모두 0으로 채워져 있으면 컴파일러는 해당 타일에 대한 작업을 스케줄링하지 않습니다. 그러나 Google이 구조적 희소성에 대한 하드웨어 가속을 추가하지 않은 것은 의도적인 선택입니다. 시스톨릭 어레이에 M:N 구조적 희소성을 추가하는 것은 여러 가지 기술을 사용하여 구현할 수 있으며, 각 기술마다 장단점이 다릅니다. 한 가지 기술은 SRAM과 어레이의 입력 포트 사이에 압축 장치를 배치하는 것입니다. 하지만 시스톨릭 어레이는 파이프라인이지 디스패처가 아닙니다. 시스톨릭 어레이의 효율성은 모든 처리 요소가 매 사이클마다 바쁘게 작동하면서 피연산자가 결정론적인 주기로 도착하는 데서 비롯됩니다. 피연산자를 건너뛰도록 허용하면 두 가지 비용 중 하나가 발생합니다. 첫째, 0으로 채워진 부분에서 파이프라인이 멈추게 되어 애초에 이러한 아키텍처를 설계하게 된 동기인 효율성 이점을 잃게 됩니다. 둘째, 어레이에 들어가기 전에 압축된 입력에서 전체 폭 스트림을 재구성하기 위해 전용 압축 해제 하드웨어를 추가해야 하는데, 이는 다이 면적을 차지하고 지연 시간을 증가시킵니다.
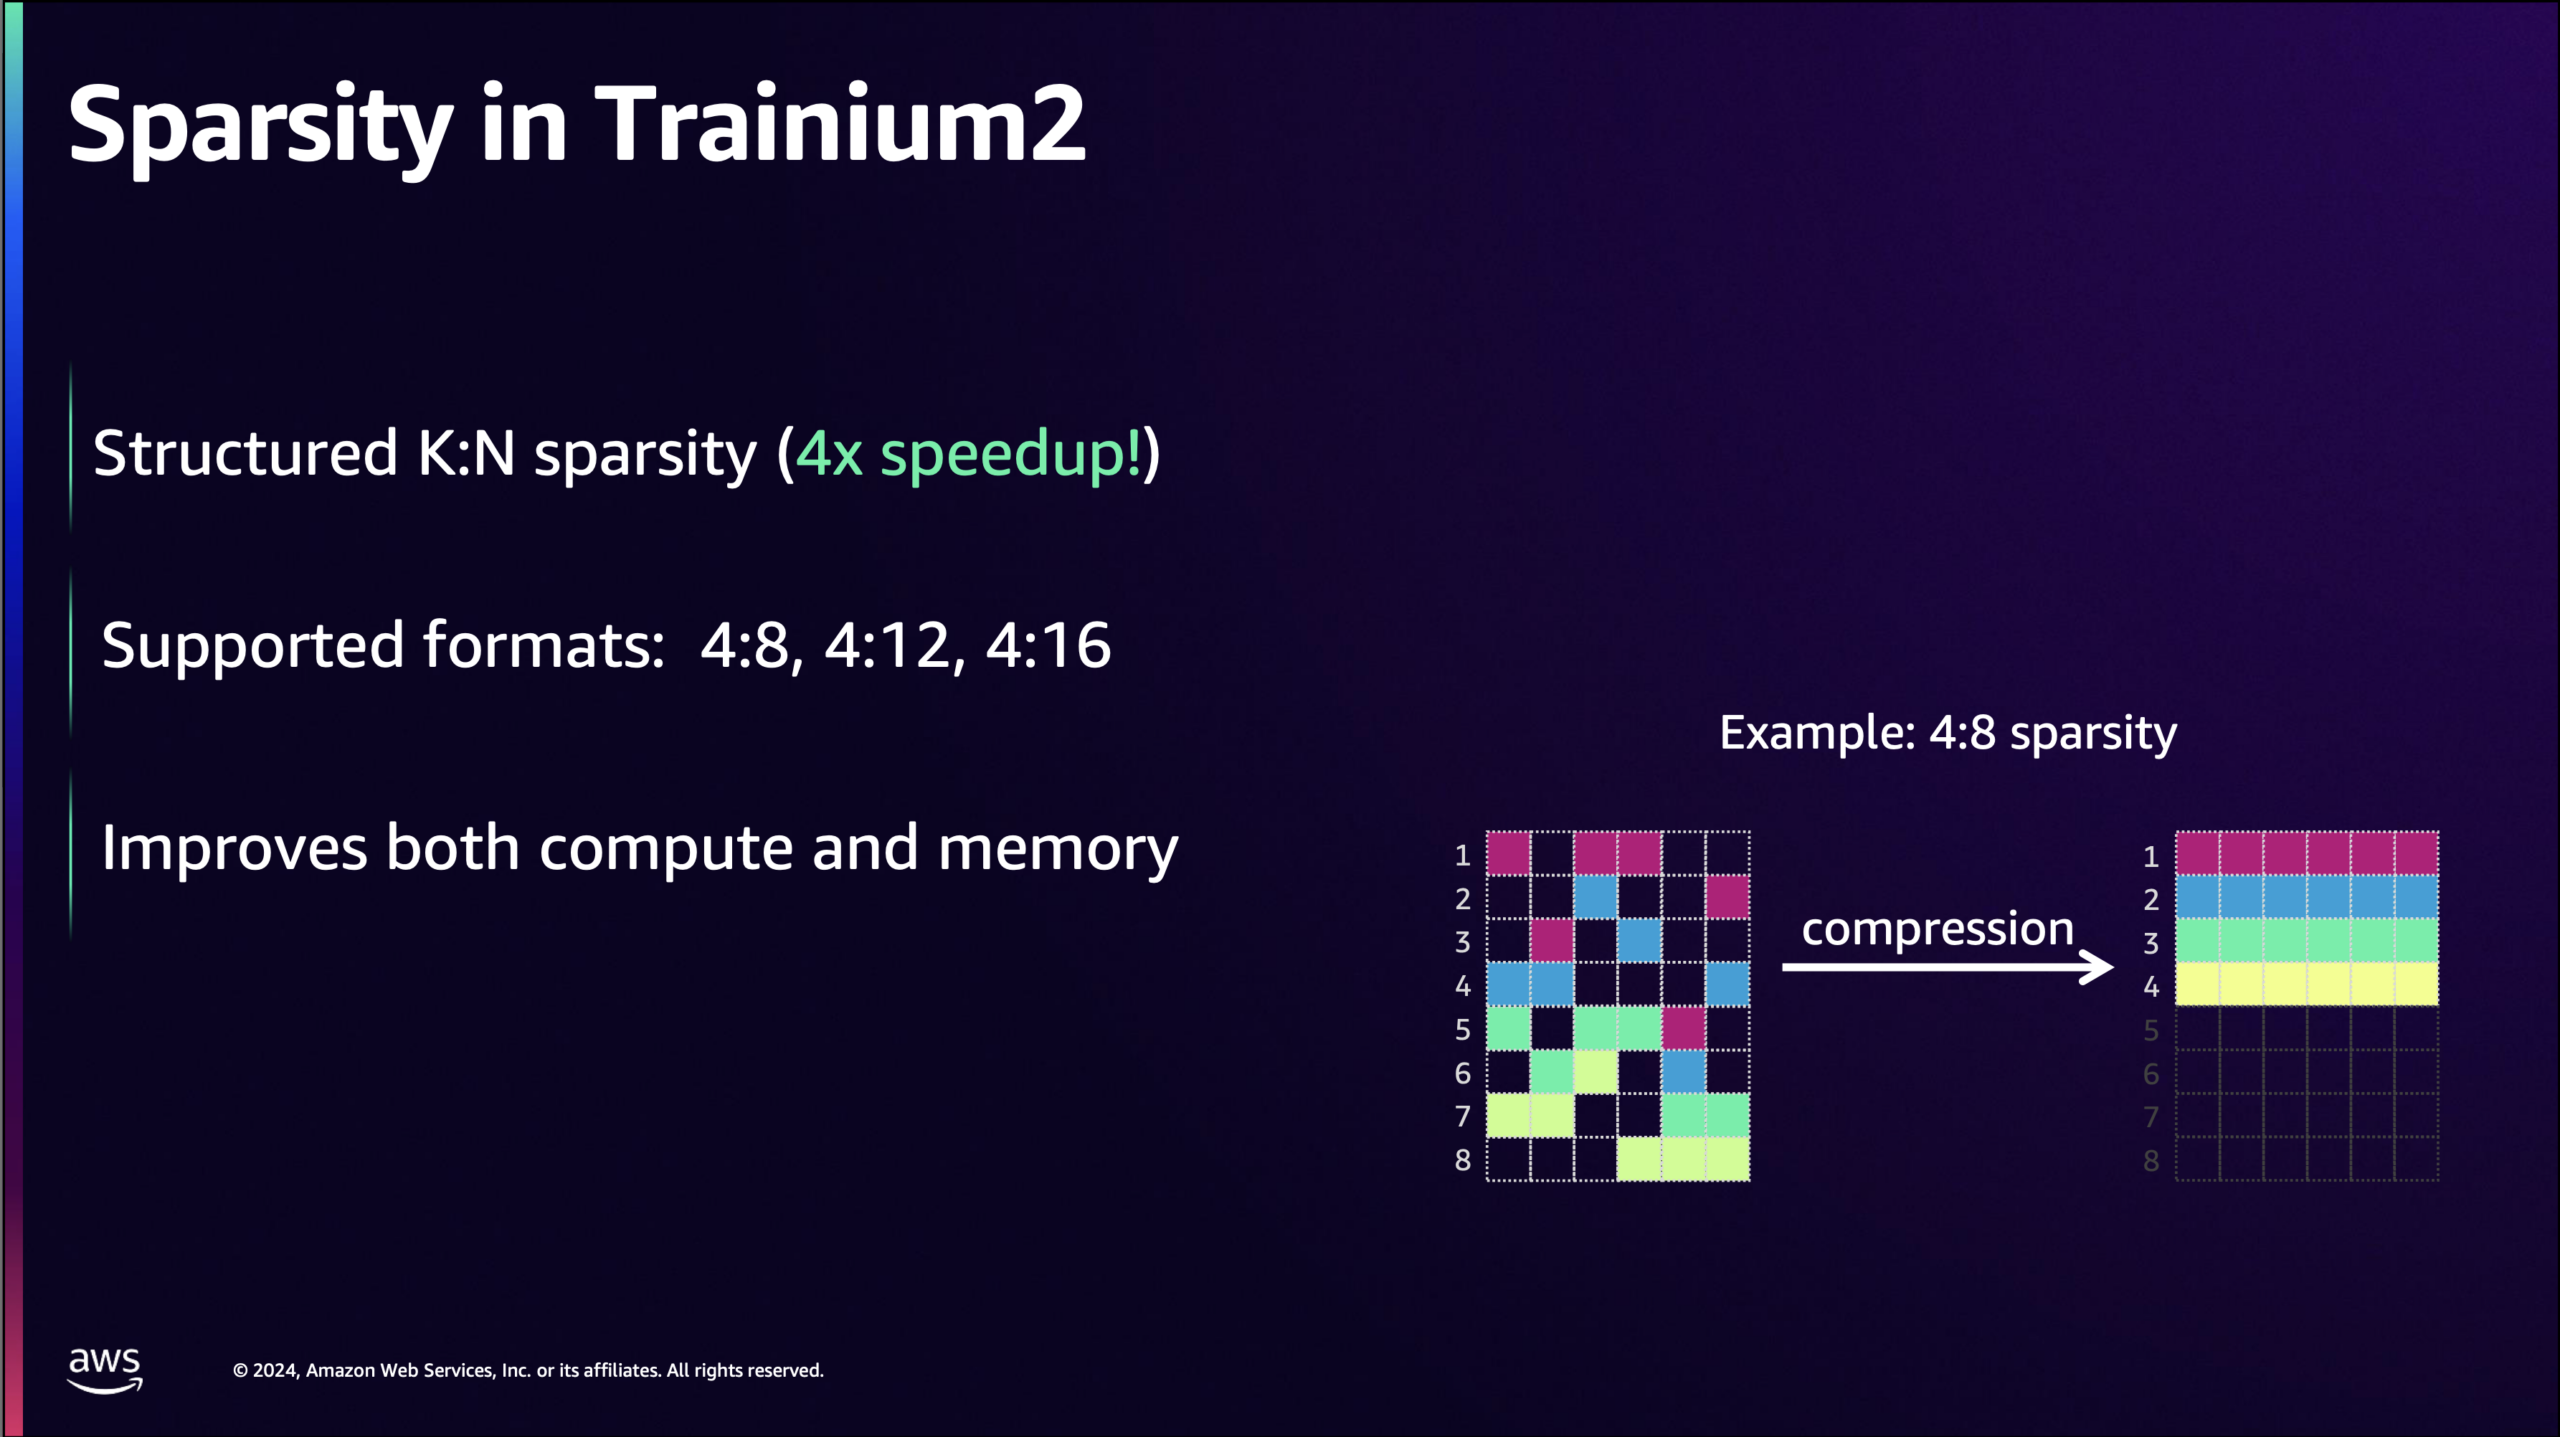
출처: AWS
일부 가속기는 시스톨릭 어레이와 하드웨어 희소성 지원을 결합합니다. AWS는 Trainium2 및 Trainium3에 내장된 엔진인 NeuronCore-v3를 기반으로 이러한 기능을 구현했습니다. 이 구현은 하드웨어 희소 시스톨릭 어레이의 예를 보여줍니다. NeuronCore-v3 텐서 엔진은 고정 가중치 행렬과 스트리밍 활성화 행렬을 사용하는 128×128 시스톨릭 어레이이며, 축소 차원은 어레이의 분할 차원에 맞춰 정렬됩니다. 희소 모드에서 입력 데이터 경로는 밀집 BF16 및 FP16에서 사이클당 2×128개 요소에서 5×128개 요소로 확장되며, 고정 측은 원래의 밀집 가중치 대신 압축된 가중치 행렬 표현을 사용합니다. 컴파일 시 가중치 텐서는 M:N 형식으로 처리됩니다. 축소 차원을 따라 연속된 N개 요소 중 M개만 유지되며, 0이 아닌 위치는 압축된 비트마스크로 인코딩됩니다. 압축 버퍼에는 M개의 값만 저장되며, 크기는 N/M만큼 줄어듭니다. matmul 명령어가 실행될 때 하드웨어는 압축된 가중치를 읽고 비트마스크를 사용하여 고정 타일에서 해당 활성화 값을 올바른 처리 요소로 라우팅합니다. 0을 곱해야 하는 PE는 해당 슬롯에 대한 작업을 받지 않습니다. 비트마스크 조회 및 라우팅이 어레이 자체가 아니라 어레이에 데이터를 공급하는 압축 해제기에서 이루어지기 때문에 파이프라인은 0에서 멈추지 않고 0이 아닌 값에 대해 최대 처리량으로 계속 작동합니다.
TPU는 밀집 행렬 곱셈만 하는 것이 아닙니다. 여러 세대에 걸쳐 TPU에는 TensorCore와 함께 SparseCore가 포함되어 왔습니다. SparseCore는 추천 모델의 특징인 불규칙적인 데이터 수집-분산 접근 패턴에 맞춰 설계된 도메인 특화 엔진입니다. YouTube 순위 모델이나 검색 광고 관련성 모델은 밀집 트랜스포머와는 다릅니다. 대부분의 파라미터는 수백 기가바이트에서 페타바이트 규모에 이르는 임베딩 테이블에 저장되며, 연산 시간의 대부분은 이러한 테이블에서 간단한 조회를 수행하고, 검색된 값을 가볍게 변환하고, 결과를 결합하는 데 소요됩니다. 이러한 접근 패턴은 MXU에서는 최악의 경우이며, GPU의 캐시 계층 구조에서도 크게 나아지지 않습니다. SparseCore는 바로 이러한 환경에 최적화되어 있습니다. HBM에 저장된 임베딩 테이블에 대한 고처리량 데이터 수집-분산 연산을 수행하며, 임베딩 파이프라인의 나머지 부분이 의존하는 중복 제거 및 결합 연산을 하드웨어에서 지원합니다. 동일한 하드웨어는 MoE 전문가 라우팅에도 도움이 됩니다. 상위 k개 선택을 통해 전문가 인덱스가 생성되면 나머지 라우팅 프로세스(전문가별 토큰 순열, 칩 간 전송, 전문가 출력 수집 및 가중치 감소 수행)는 임베딩 파이프라인과 동일한 수집/분산/감소 패턴을 따르며, SparseCore의 정렬 지원 기능이 상위 k개 단계 자체를 처리합니다.
이러한 배경을 바탕으로, 다음과 같은 공지사항을 알려드립니다.
TPU 8t “선피쉬”
첫 번째 발표인 TPU 8t(코드명 Sunfish)는 학습용 칩입니다. Ironwood에서 한 단계 발전한 이 칩은 대부분의 측면에서 예상되는 발전 방향을 따르고 있습니다. 즉, 메모리 용량과 대역폭이 증가했으며, 더욱 세분화된 데이터 유형에 대한 네이티브 지원이 강화되었습니다. 각 칩에는 6개의 12-Hi HBM3e 스택(총 216GB, 6.5TB/s 대역폭)에서 데이터를 공급받는 단일 TensorCore가 탑재되어 있으며, 이는 Ironwood의 8개 스택에 걸쳐 192GB에서 증가한 수치입니다. 온칩 Vmem SRAM은 128MB로 유지됩니다.
MXU의 네이티브 FP4 처리가 연산 성능 향상의 대부분을 차지합니다. 동일한 물리적 배열에서 8비트 대신 4비트로 행렬 곱셈을 실행하면 사이클당 처리량이 두 배로 증가하는데, 이것이 바로 Google이 Ironwood의 FP8 연산 성능 4.6 PFLOPS에서 8t의 FP4 연산 성능 12.6 PFLOPS로 향상시킨 비결입니다. 혼합 정밀도 학습에서도 최적화 단계에서는 가중치의 FP32 마스터 복사본을 유지합니다. FP4는 연산 시간의 대부분을 소모하는 작업 텐서의 크기를 줄여줍니다.
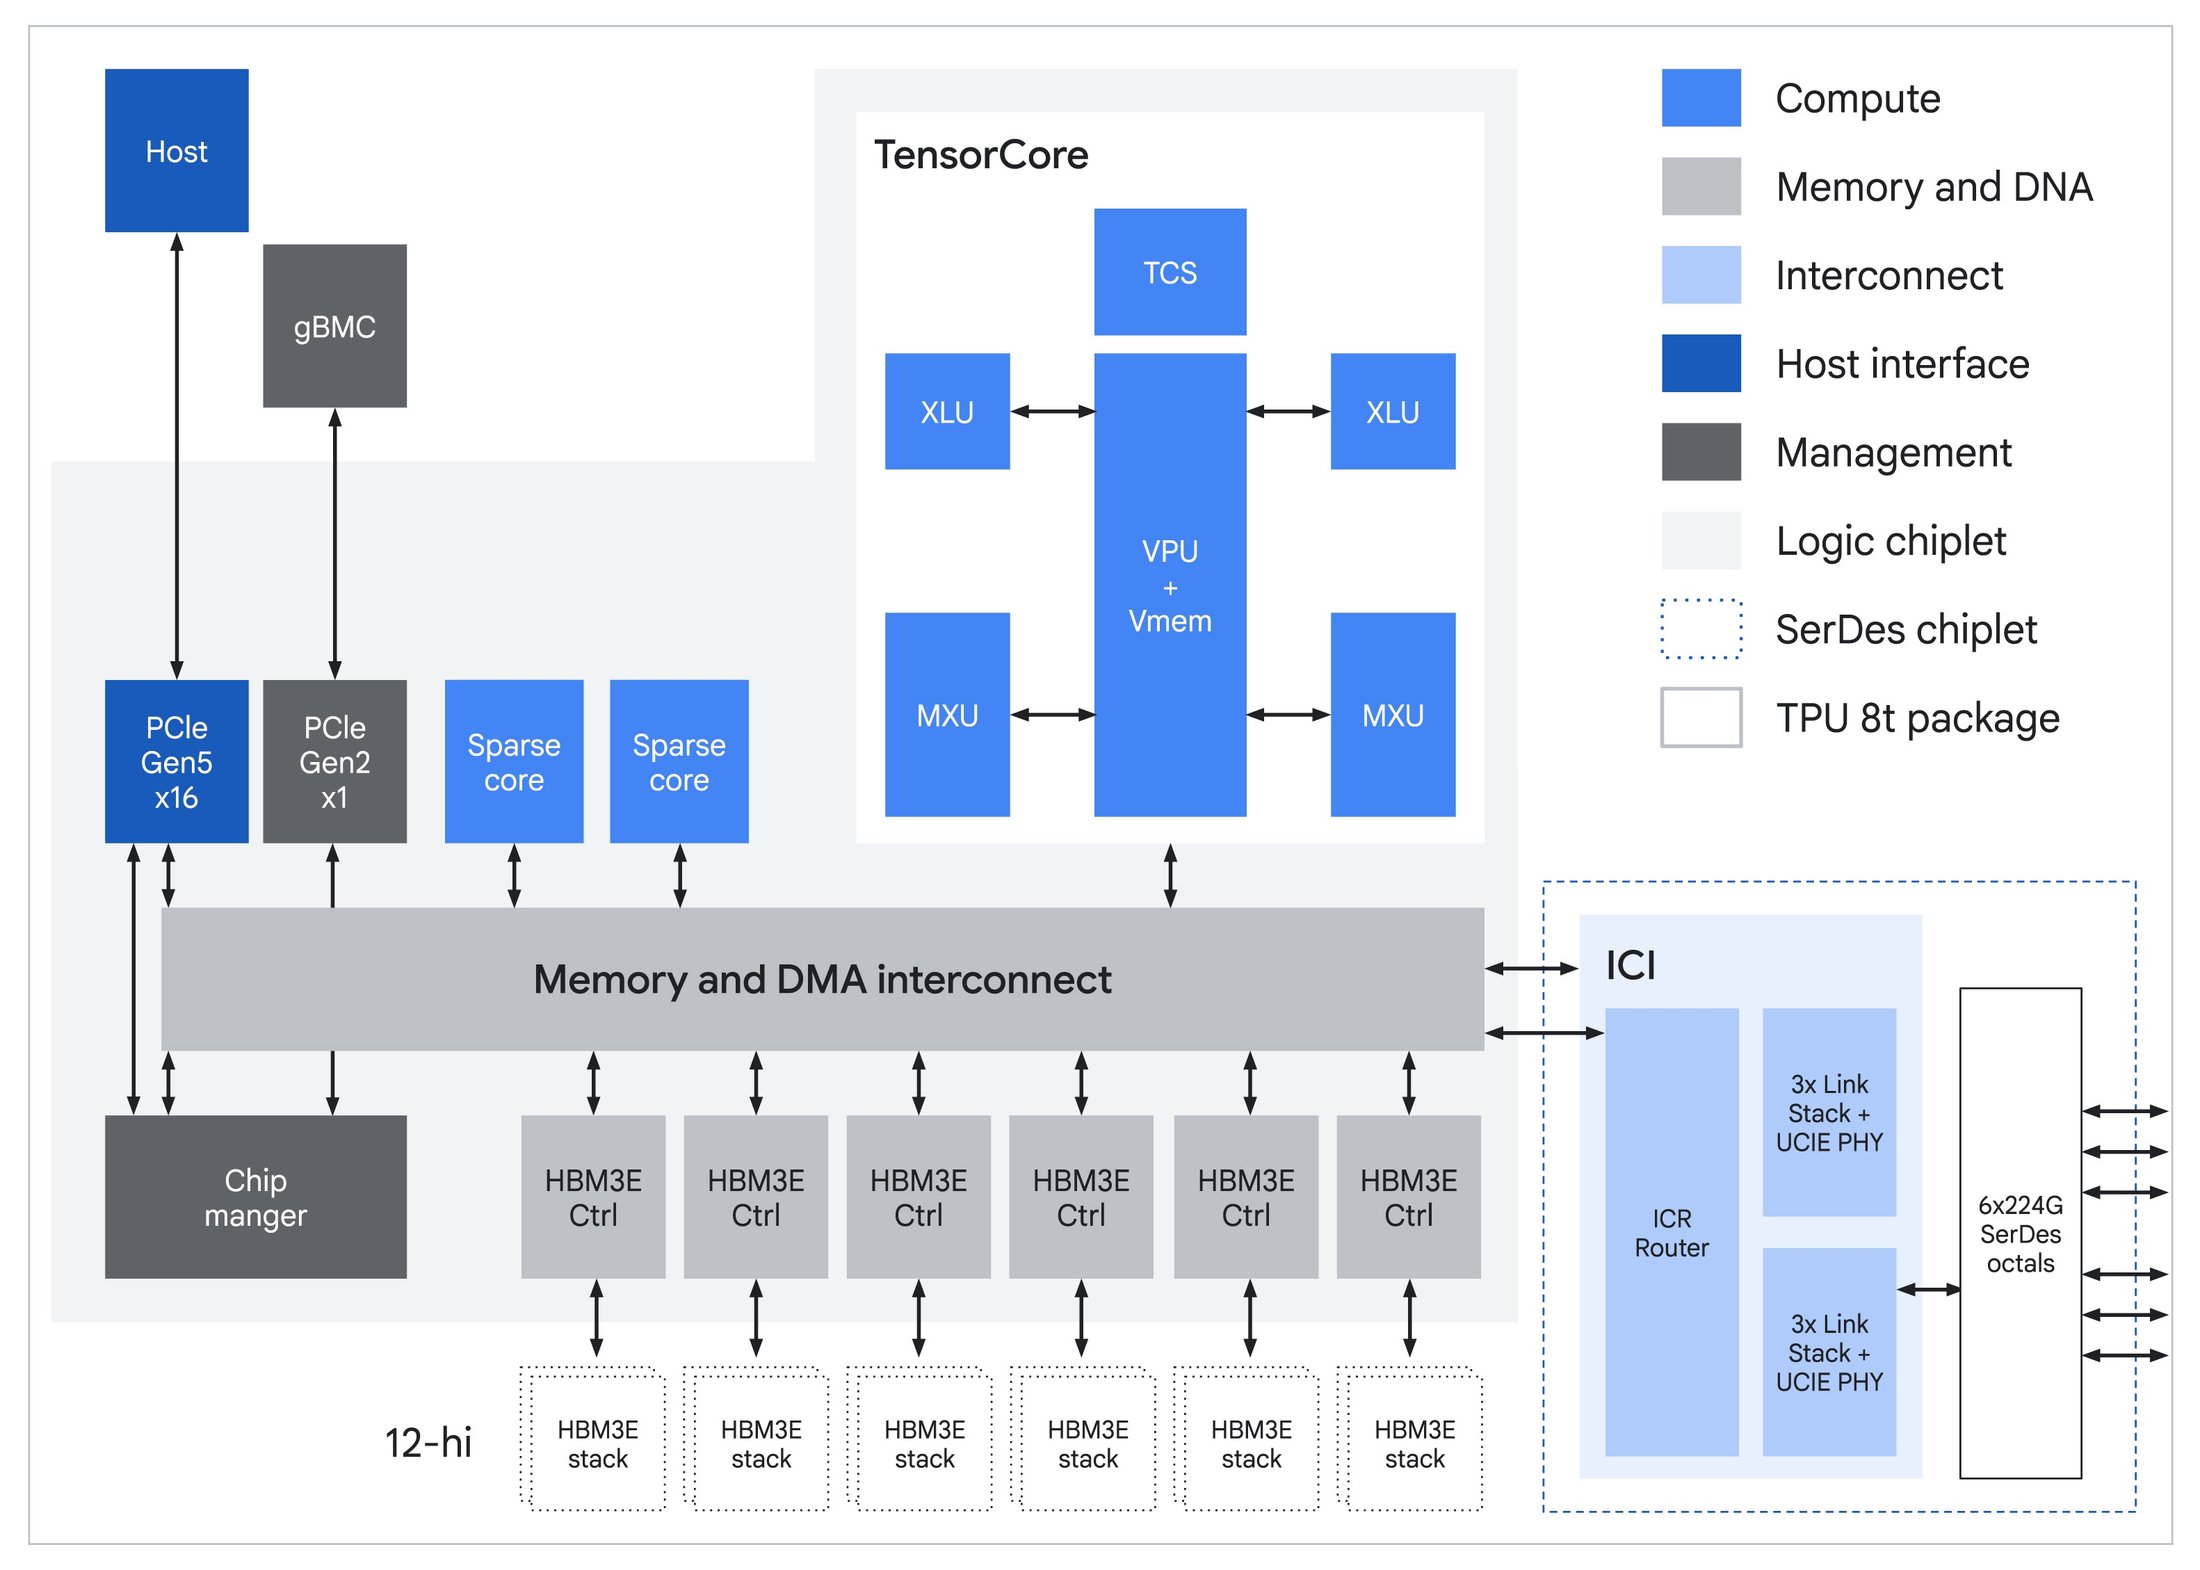
출처 : Google
상호 연결(ICI)에 대한 설명은 간단합니다. ICI 대역폭은 칩당 19.2Tb/s로 두 배 증가하고, 9,600개의 칩으로 구성된 슈퍼포드는 2PB의 HBM과 121EFLOPS의 성능을 제공하며, 3D 토러스 토폴로지는 그대로 유지됩니다. 토러스 구조는 학습에 적합한데, 그 이유는 최첨단 작업들이 링 구조에 최적화된 집합 연산으로 이루어지기 때문입니다. 데이터 및 텐서 병렬 처리를 위한 전체 리듀스(all-reduce), FSDP를 위한 전체 개더(all-gather) 및 리듀스 스캐터(reduce-scatter), 그리고 파이프라인 병렬 포인트 투 포인트 전송 등이 그 예입니다. 이러한 연산들은 모두 토러스 축에 깔끔하게 매핑됩니다.
구글은 v4 이후 모든 TPU에 탑재되어 온 SparseCore를 그대로 유지합니다. SparseCore는 원래 DLRM 스타일 추천 모델을 위해 설계되었으며, 이러한 모델에서는 대부분의 연산 시간이 대규모 임베딩 테이블에 대한 불규칙적인 데이터 수집 및 분산 작업에 소요됩니다. 동일한 하드웨어는 MoE(혼합 전문가) 라우팅도 처리합니다. JAX는 불규칙적인 전체 대 전체(ragged all-to-all) 통신과 이에 상응하는 불규칙적인 소수점 통신(ragged_dot)을 일급 연산으로 제공하며, 각 칩은 각 피어에게 서로 다른 크기의 데이터 덩어리를 전송할 수 있습니다. 이는 상위 k개 라우팅이 데이터에 따라 달라지고 각 전문가에게 전달되는 토큰 수가 매 단계마다 변하기 때문에 MoE 디스패치의 실제 형태와 일치합니다. 컴파일러는 불규칙적인 통신과 불규칙적인 전문가 연산을 단일 스케줄링된 작업으로 통합하고, SparseCore는 주변의 정렬 및 순열 작업을 처리합니다. 혼합 전문가(MoE)가 이제 최첨단 모델에서 지배적인 아키텍처가 되면서, 이 하드웨어는 원래 설계 목적이었던 광고 및 순위 지정 작업뿐만 아니라 모든 최신 학습 작업에서 그 가치를 입증하고 있습니다.
이것들은 진화적인 단계입니다. 더 큰 변화는 TPUDirect 도입과 Axion 기반 호스트로의 전환인데, 이 두 가지 모두 최첨단 규모에서만 드러나는 병목 현상을 해결합니다.
TPUDirect RDMA 및 TPUDirect 스토리지
이전 세대의 TPU는 네트워크 및 스토리지 I/O에 호스트를 매개로 하는 경로를 사용했습니다. 패킷이 먼저 호스트 DRAM에 도착한 후, 별도의 DMA를 통해 TPU HBM으로 복사되었습니다. 즉, 호스트 CPU가 개입하는 두 번의 메모리 트랜잭션이 발생했습니다. TPUDirect RDMA는 이러한 바운스 버퍼를 제거합니다. NIC는 PCIe 피어 투 피어 방식을 통해 TPU HBM을 직접 읽고 쓰므로 데이터 경로에서 호스트가 배제됩니다. NVIDIA는 GPUDirect RDMA를 통해 이와 동등한 기능을 수년 동안 제공해 왔으며, 호스트 매개 경로 대비 약 10배의 성능 향상을 주장해 왔습니다. 이제 Google도 TPU 측에서 이와 동일한 기능을 구현하고 있습니다.
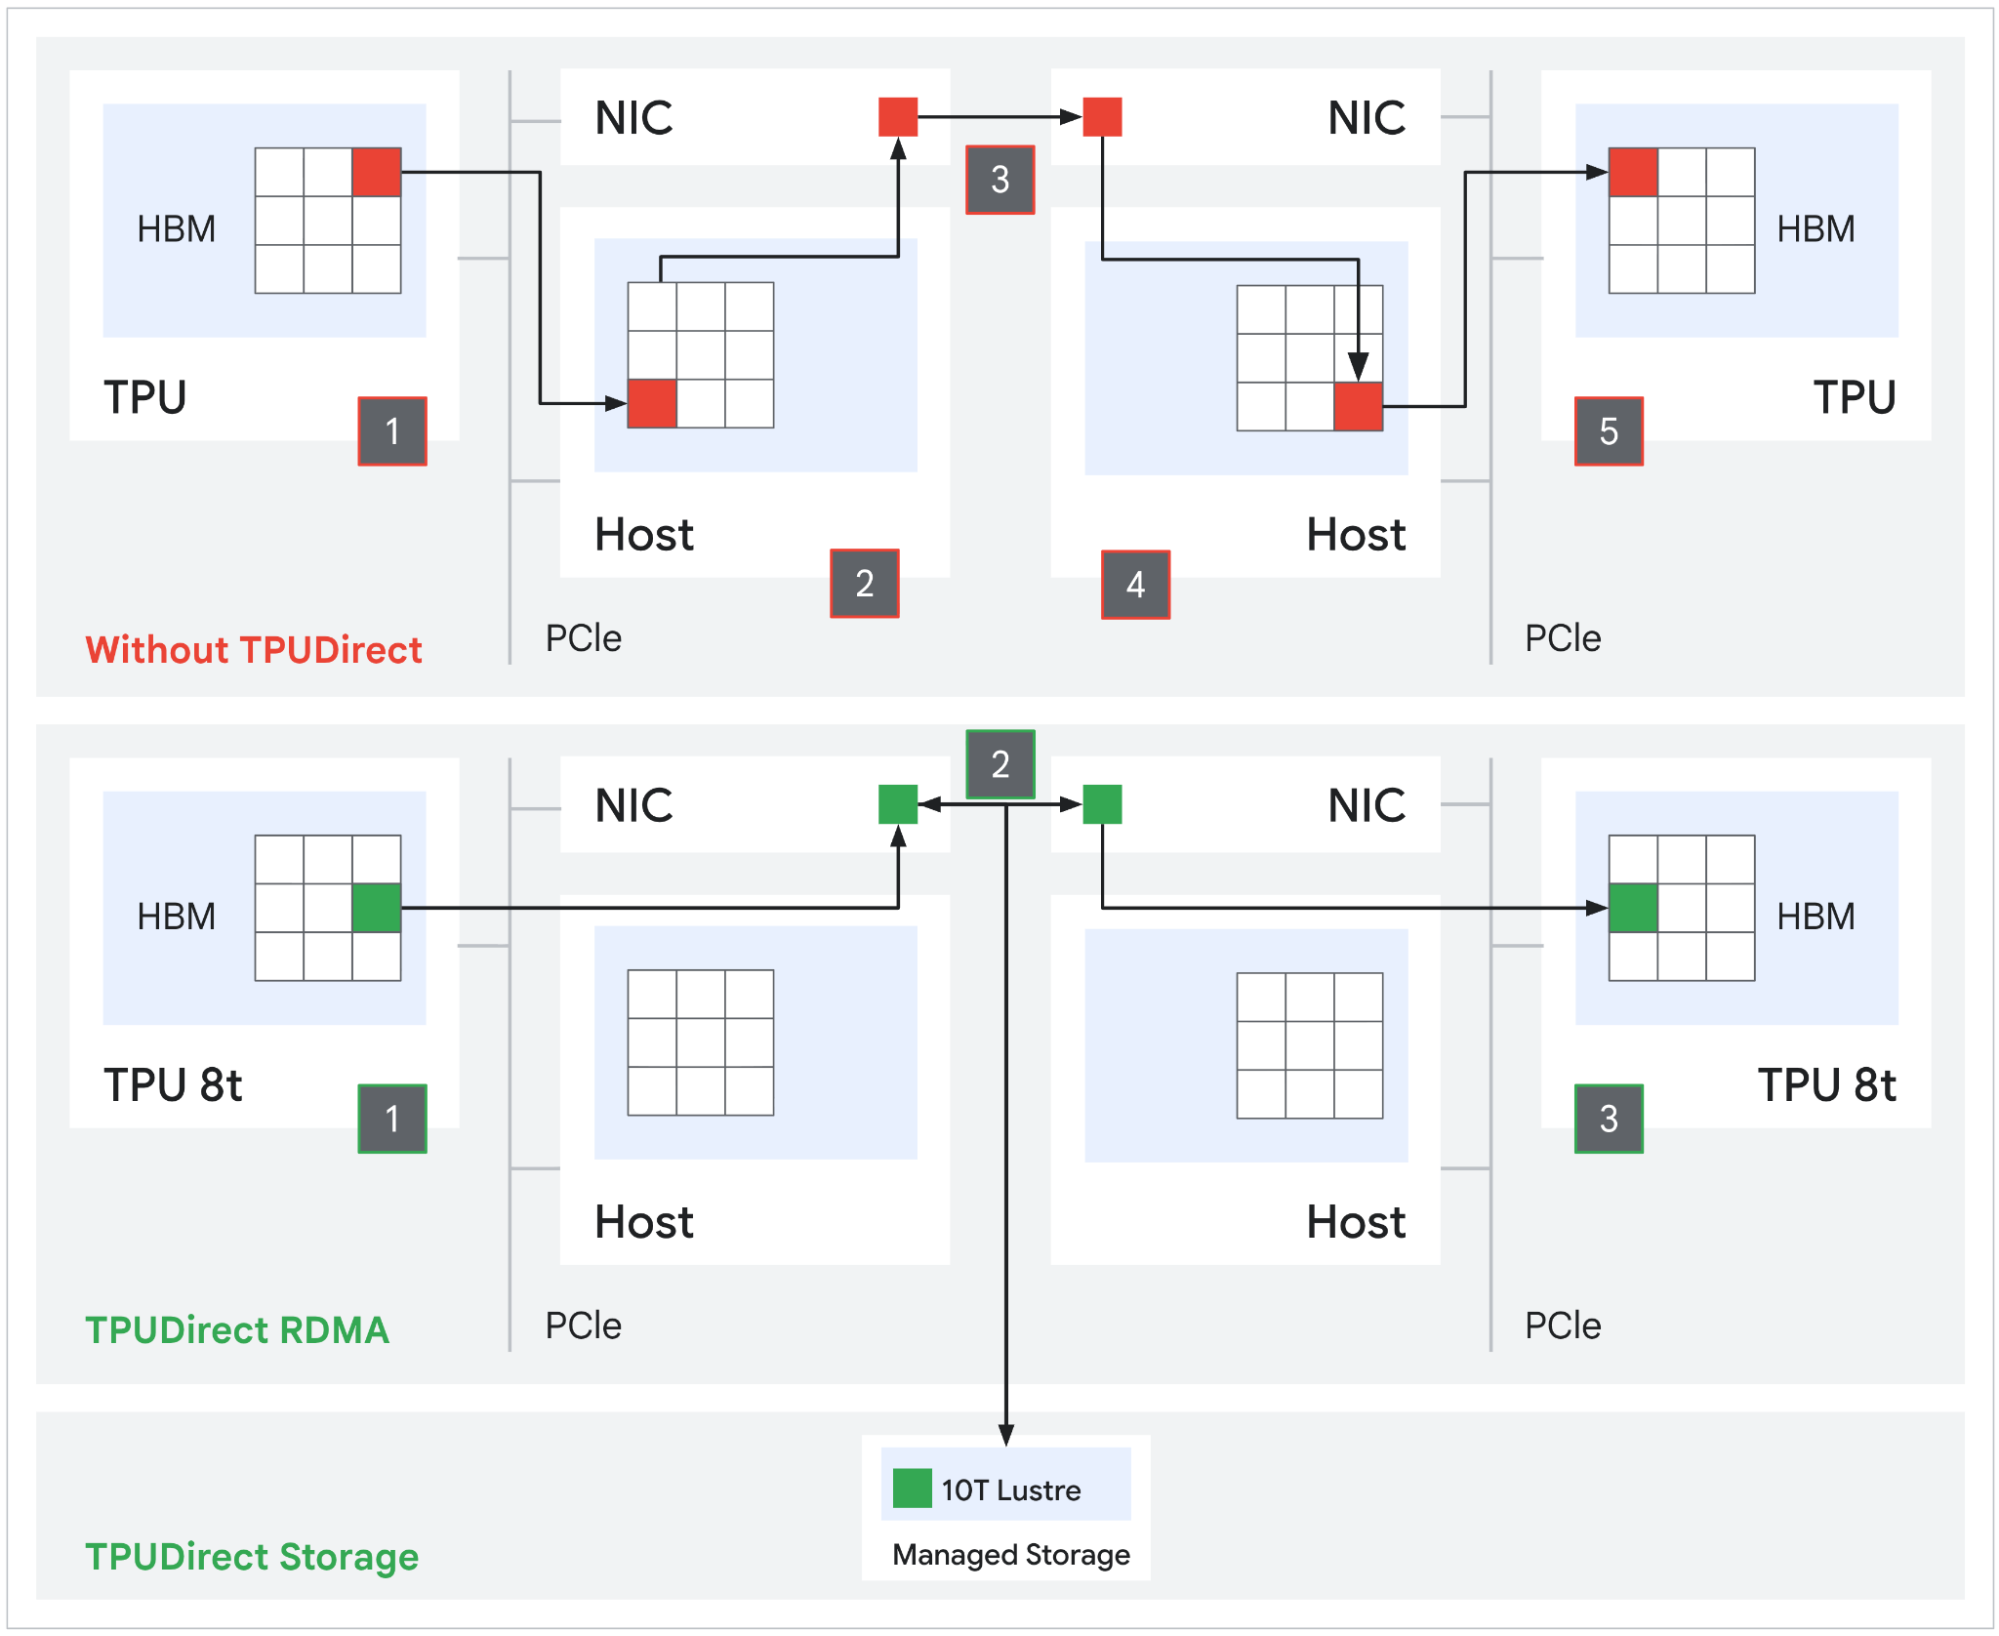
출처 : Google
TPUDirect Storage는 동일한 원리를 영구 저장소에도 적용합니다. 텐서는 TPU HBM과 관리형 Lustre 간에 초당 10TB의 속도로 직접 이동하며, Google은 이를 통해 Ironwood의 동일 경로보다 10배 빠른 저장소 접근 속도를 제공한다고 주장합니다. 체크포인트 크기가 수백 테라바이트에 달할 수 있는 최첨단 규모에서는, 몇 주에 걸쳐 진행되는 학습 과정에서 체크포인트와 데이터셋을 회선 속도로 스트리밍할 것인지, 아니면 MXU 파이프라인이 호스트 I/O를 기다리며 멈춰버릴 것인지가 중요한 차이를 만듭니다.
암 액시온 호스트
이전의 모든 TPU 세대는 타사 x86 호스트에서 실행되었습니다. 8t는 시스템 헤더로 Google 자체의 Axion 프로세서(Arm Neoverse V2 기반 CPU)를 사용하는 최초의 TPU입니다. TPU 포드에서 호스트 CPU의 역할은 매우 중요하며, 규모가 커질수록 더욱 어려워집니다. 호스트 CPU는 입력 파이프라인을 구동하고, 수 페타바이트 규모의 데이터 세트를 디코딩 및 셔플링하고, JAX/XLA 제어 평면을 관리하고, 체크포인트 직렬화를 처리하고, 수천 개의 칩에 걸쳐 SPMD 디스패치를 조정합니다. 호스트가 멈추면 MXU는 유휴 상태가 됩니다.
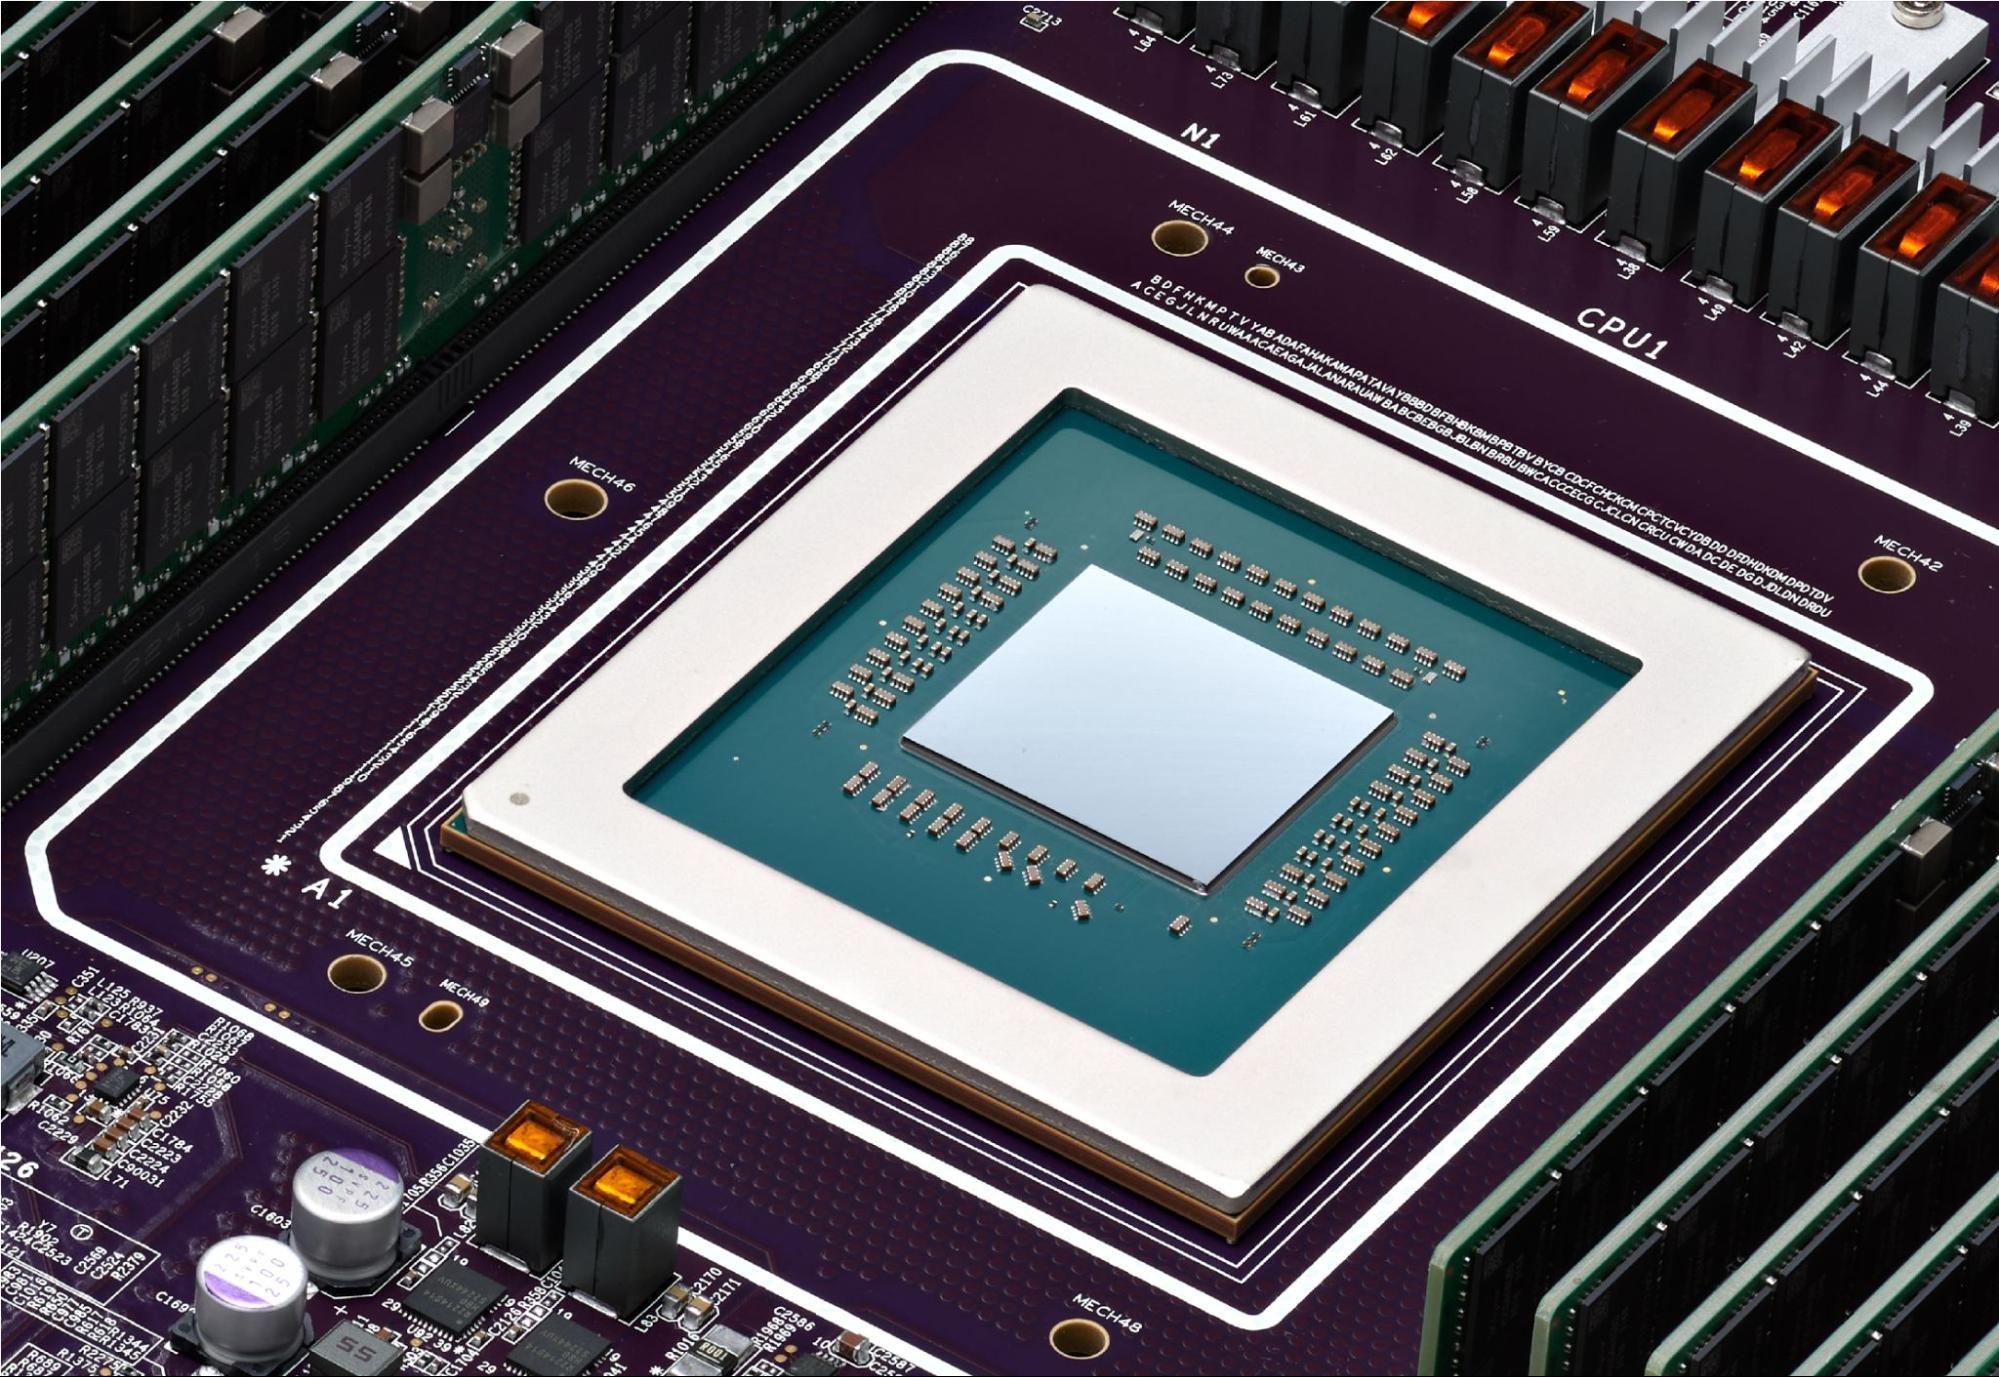
구글은 8t 플랫폼에서 Axion 기반 NUMA 격리 기술을 통해 호스트 측 지터가 동기화된 집단 학습 단계로 유입되는 것을 방지한다고 명시적으로 언급했습니다. 포드당 9,600개의 칩이 탑재된 환경에서는 호스트별 작은 문제라도 누적되어 처리량 손실로 이어질 수 있습니다. TPUDirect는 호스트를 대량 전송에서 제외함으로써 데이터 경로 측면의 문제를 해결합니다. Axion은 각 TPU에 충분한 전용 CPU 대역폭을 제공하여 전처리가 병목 현상이 되지 않도록 제어 경로 측면을 담당합니다. 또한 구글은 8세대 플랫폼에서 서버당 물리적 Axion 호스트 비율을 높여 칩 수에 따라 증가하는 오케스트레이션 오버헤드에 대해 Ironwood의 호스트 구성보다 더 큰 여유 공간을 확보했습니다.
TPU 8i "제브라피쉬"
추론 칩은 8t와 마찬가지로 Axion 호스트 플랫폼, 네이티브 FP4, HBM3e 메모리 세대를 공유하지만, 내부 실리콘은 다른 병목 현상을 해결하도록 설계되었습니다. 학습은 연산량에 좌우되는 반면, 추론 디코딩은 메모리 대역폭에 좌우됩니다. 8i의 아키텍처적 차이점은 대부분 이러한 차이에서 비롯됩니다.
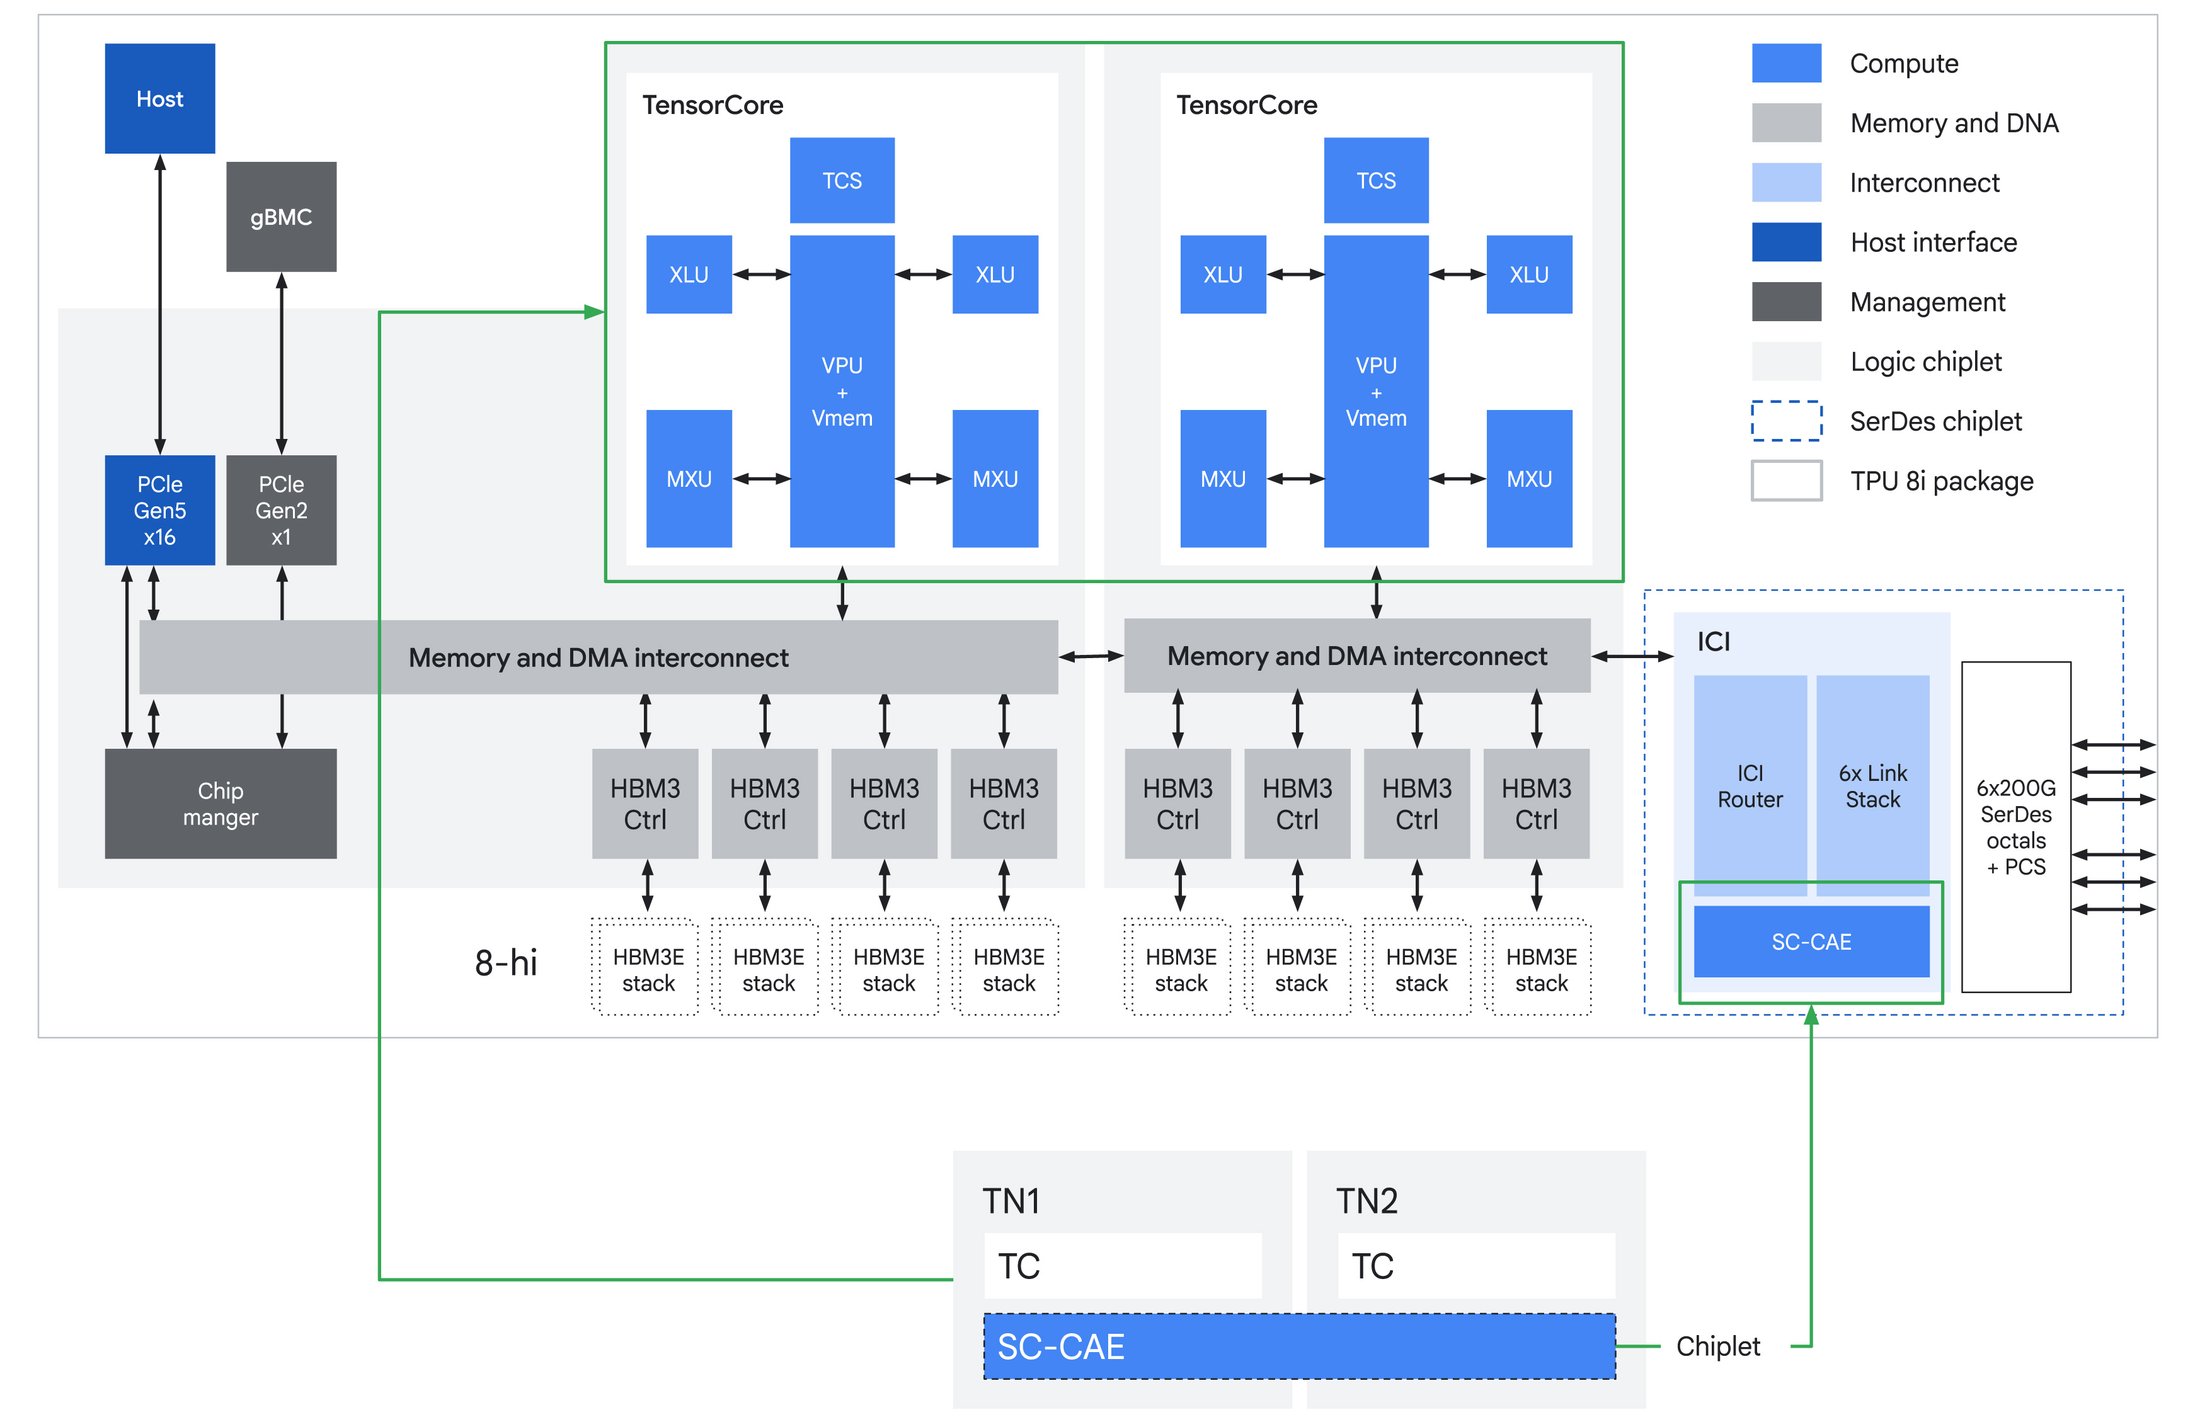
가장 큰 변화는 온칩 SRAM입니다. 8i는 384MB의 Vmem을 탑재했는데, 이는 Ironwood의 세 배에 달하는 용량입니다. 이 용량 증가는 KV 캐시와 관련이 있습니다. 롱 컨텍스트 디코딩 과정에서 생성되는 각 토큰은 이전 토큰들의 누적된 키-값 상태를 읽어야 합니다. 대부분의 가속기에서는 이 읽기 작업을 HBM에서 수행하기 때문에 디코딩 처리량은 연산 능력보다는 메모리 대역폭에 의해 제한됩니다. 8i는 의미 있는 KV 캐시 용량을 온칩에 모두 탑재할 수 있도록 설계되었습니다. 온칩 SRAM의 대역폭은 HBM보다 약 10배 정도 높기 때문에, HBM 대신 SRAM에서 KV 읽기를 수행하면 토큰당 지연 시간이 단축되고 동일한 전력 소모에서 초당 처리 토큰 수가 증가합니다.
출처 : Google
또 다른 주요 차이점은 TensorCore 구성입니다. 8t가 12.6 PFLOPS의 단일 TensorCore를 사용하는 반면, 8i는 연산을 두 개의 TensorCore로 분산하여 총 10.1 PFLOPS의 성능을 발휘합니다. 최고 처리량이 낮아진 것이 성능 저하처럼 보일 수 있지만, 칩 수준에서 추론이 실제로 어떻게 작동하는지를 고려하면 그렇지 않습니다. 학습 워크로드는 배치 처리가 주를 이룹니다. 대규모 연산은 고정 오버헤드를 분산시키고, 하나의 대형 MXU는 거의 최대 활용률을 유지할 수 있습니다. 추론 디코딩은 이와 반대입니다. 배치 크기는 작고, 토큰별 연산 시간은 짧으며, 칩은 순수 연산보다는 집합 연산, 샘플링 및 라우팅에 상당한 시간을 소비합니다. 하나의 대형 엔진은 이러한 불규칙적인 공백 시간 동안 작동이 중단됩니다. 두 개의 TensorCore로 분산함으로써 8i는 연산 단계를 더욱 효율적으로 중첩할 수 있으며, 각 TensorCore는 자체적으로 직접 연결된 4개의 HBM 스택(총 288GB, 패키지 전체 8.6 TB/s)에서 데이터를 공급받습니다. 그 결과, 실제로 인터랙티브 서빙에서 실행되는 배치 크기에서 지속적인 활용률이 높아집니다.
규모 확장 도메인 수준에서 Boardfly 포드에 있는 1,024개의 활성 칩은 총 약 295TB의 HBM, 384GB의 온칩 SRAM, 그리고 10.3 EFLOPS의 FP4 연산 능력을 제공합니다. 추론에 가장 중요한 것은 SRAM 용량입니다. 도메인 전체에 걸쳐 384GB의 온칩 캐시는 HBM을 건드리지 않고도 상당한 KV 상태를 저장하기에 충분하며, 이것이 바로 낮은 지연 시간으로 장기 컨텍스트 서비스를 가능하게 하는 핵심 요소입니다.
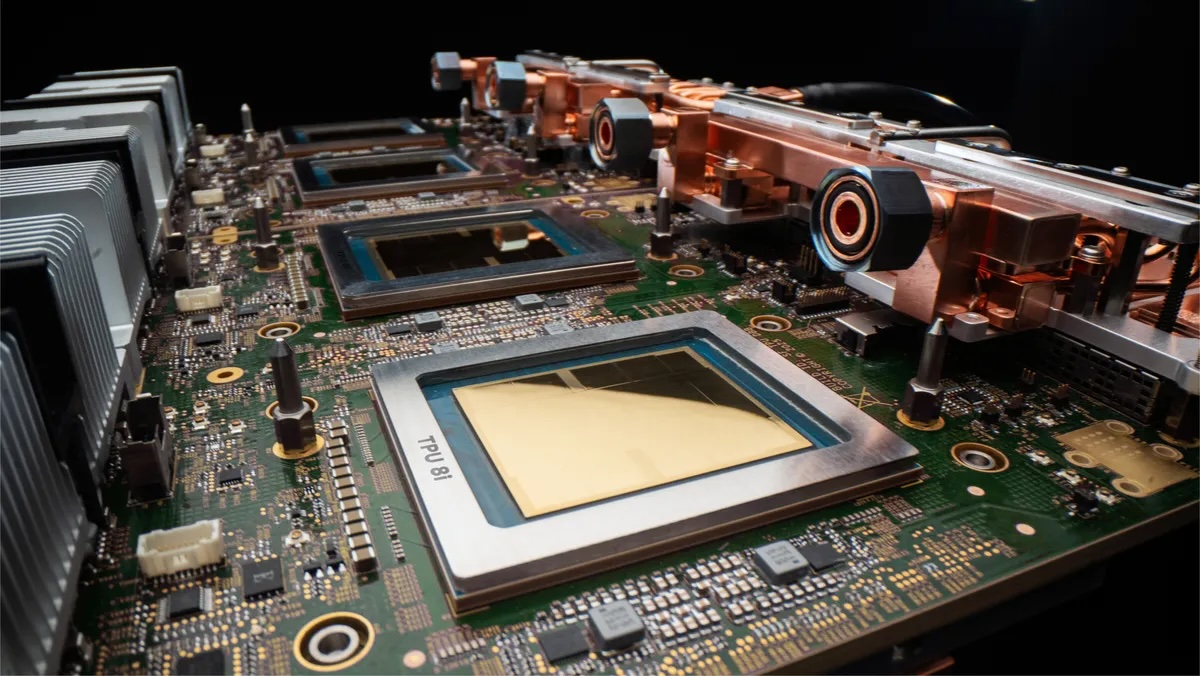
호스트 측도 동일한 논리를 따릅니다. Google은 Ironwood에 비해 8i에서 서버당 물리적 Axion 호스트 수를 늘렸다고 밝혔습니다. 추론 서버는 토큰화, 샘플링 로직, 라우팅, 배치 처리 및 에이전트 런타임 오케스트레이션에 토큰당 상당한 시간을 소비합니다. 이러한 오버헤드는 모델 크기보다는 동시 접속자 수에 따라 증가하며, 에이전트 기반 워크로드가 생성하는 요청 속도에서는 호스트가 병목 현상이 될 수 있습니다. 가속기당 호스트 CPU 수를 늘리는 것이 가장 간단한 해결책입니다.
집단 가속 엔진
또 다른 주요 칩 내 변경 사항은 Ironwood에 탑재되었던 4개의 SparseCore를 대체하는 Collectives Acceleration Engine입니다. SparseCore는 전용 수집-분산 하드웨어를 사용하여 MoE 라우팅 및 임베딩 조회를 처리하므로, 추론 칩에서 이를 제거한 것은 8i가 다른 병목 현상을 최적화했음을 의미합니다.
CAE가 해결하는 병목 현상은 집합적 지연 시간입니다. 디코딩된 모든 토큰은 참여 칩들의 동기화를 필요로 합니다. 즉, 어텐션 출력은 모두 리듀스되어야 하고, 전문가 라우팅 메타데이터는 브로드캐스트되어야 하며, 샘플링된 토큰은 다음 단계로 전파되어야 합니다. GPU에서는 이러한 조정이 NCCL을 통해 소프트웨어적으로 이루어지며, NCCL은 집합 연산을 일련의 커널 실행 및 네트워크 작업으로 스케줄링합니다. 8i에서는 CAE가 TensorCore와 함께 자체 칩렛 다이에 탑재된 전용 실리콘으로, 이러한 동기화 기본 요소를 하드웨어에서 처리합니다.
구글은 아이언우드 대비 온칩 집단 지연 시간이 최대 5배 낮다고 주장합니다. 학습 규모의 배치 크기에서는 이러한 개선 효과가 계산 시간에 묻혀버리지만, 집단 지연 시간은 전체 단계에서 차지하는 비중이 작습니다. 그러나 작은 배치 크기와 짧은 토큰별 처리 시간 간격을 사용하는 대화형 추론 환경에서는 집단 지연 시간이 토큰별 처리 시간에 큰 영향을 미치므로, 5배 감소 효과는 초당 토큰 처리량과 토큰당 가격에 반영됩니다.
8i는 또한 3D 토러스 토폴로지에서 Google이 Boardfly라고 부르는, Dragonfly에서 영감을 받은 계층적 토폴로지로 전환합니다. Boardfly는 링 집합 대역폭을 희생하는 대신 모든 노드 간 지연 시간을 줄이는 방식입니다. Boardfly에 대해서는 아래에서 자세히 살펴보겠습니다.
보드플라이 토폴로지
8i는 학습과 추론의 통신 패턴이 다르기 때문에 8t와는 다른 토폴로지를 사용합니다.
3D 토러스는 링 콜렉티브에 이상적입니다. 각 칩은 6개의 이웃 칩을 가지며, 데이터는 링을 따라 순환하고, 어떤 칩도 임의의 트래픽을 라우팅하지 않습니다. 학습은 이러한 링 친화적인 패턴을 중심으로 이루어지기 때문에 8t는 토러스 구조를 유지합니다. 링 올리듀스(ring all-reduce)는 단일 토러스 축에 완벽하게 매핑됩니다. 최첨단 작업은 일반적으로 데이터 병렬 처리를 한 축에, 텐서 병렬 처리를 다른 축에, 파이프라인 병렬 처리를 세 번째 축에 배치합니다. 토폴로지와 워크로드가 완벽하게 일치하는 것입니다.
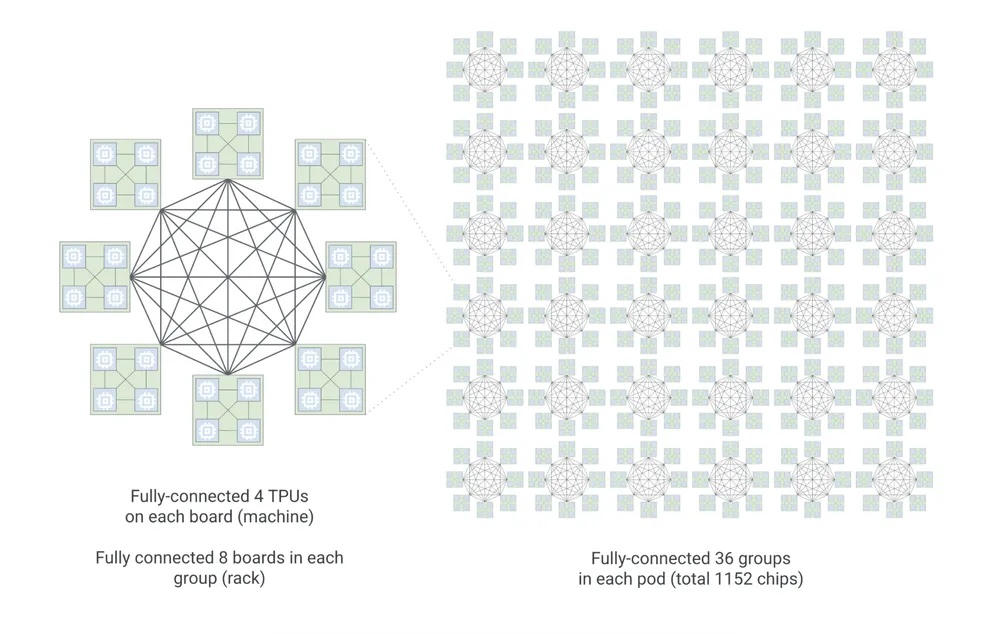
대규모 MoE 모델을 위한 추론은 일반적인 통신 프로필과는 다릅니다. 전문가들은 여러 칩에 분산되어 있으며, 디코딩된 모든 토큰은 전체 칩 간 통신을 유발합니다. 즉, 토큰은 패브릭 전체에 흩어져 있는 할당된 전문가에게 도달해야 하고, 전문가의 출력은 다시 반환되어야 합니다. 이는 링 구조가 아닙니다. 임의의 지점 간 트래픽이며, 1,024개의 칩으로 구성된 3D 토러스에서 두 칩 사이의 최악의 경로는 16홉입니다. Google은 이 계산을 다음과 같이 설명합니다. "3D 토러스에서 노드는 각 차원이 링처럼 감싸는 격자 형태로 배열됩니다. 8 x 8 x 16(1024개 칩) 구성에서 가장 멀리 있는 칩에 도달하려면 패킷은 각 링의 절반 거리를 이동해야 합니다."
3D 토러스 = 8/2(X) + 8/2(Y) + 16/2(Z) = 16 홉
토러스는 밀집 학습에서 흔히 볼 수 있는 인접 칩 간 통신에는 매우 효율적이지만, 모든 칩 간 통신 패턴에서는 지연 시간을 발생시킵니다. 추론 모델과 MoE(Modified Earth) 시대에는 토큰을 라우팅하기 위해 어떤 칩이든 다른 칩과 통신해야 할 수 있으므로 이러한 홉 수는 중요한 요소가 됩니다.
지연 시간에 민감한 대화형 서비스의 경우, 이러한 추가 홉으로 인해 토큰당 지연 시간이 SLO(서비스 수준 목표)를 초과하게 됩니다.
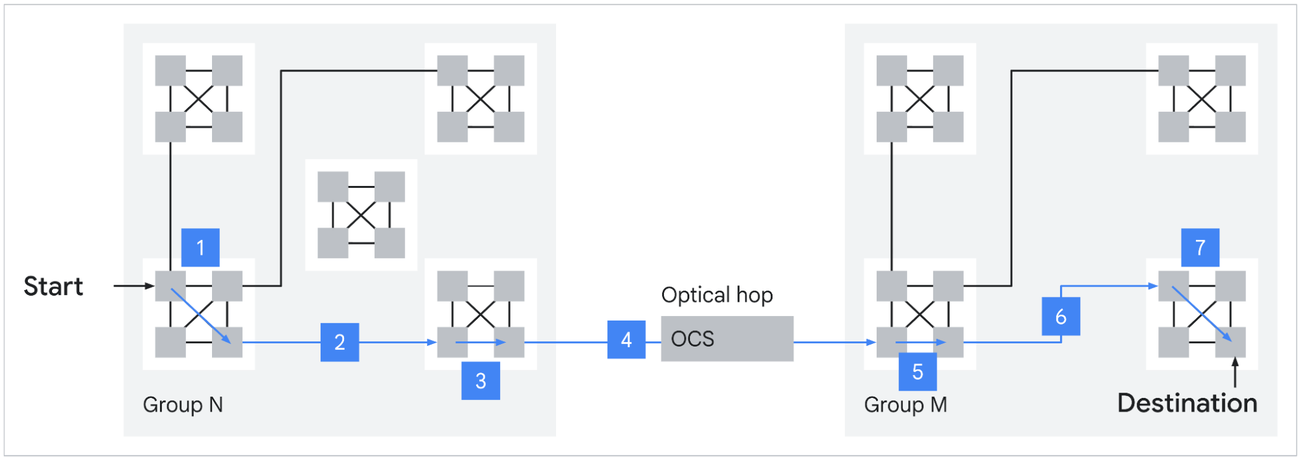
출처 : Google
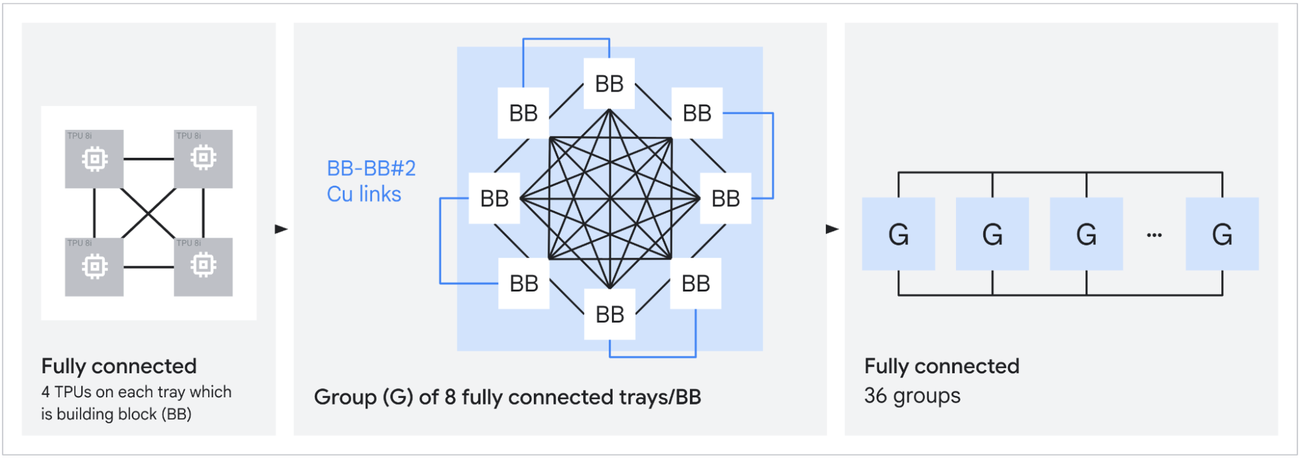
Boardfly는 Dragonfly에서 영감을 받아 설계된 계층 구조로, 직경을 최소화합니다. 이 구조는 3단계로 구성됩니다. 기본 구성 요소는 16개의 외부 연결을 가진 4개의 칩으로 이루어진 링입니다. 이러한 구성 요소 8개가 모여 그룹을 형성하고, 각 그룹은 구리 케이블로 완전히 연결되어 그룹당 11개의 링크를 갖습니다. 36개의 그룹이 광 회로 스위치를 통해 연결되어 포드를 구성합니다. 결과적으로 최대 7개의 홉으로 구성된 1,152개의 칩(활성 칩 1,024개) 규모의 확장 도메인이 구현되며, 이는 토러스 구조 대비 56% 감소된 수치입니다. Google은 이를 통해 MoE 전체 네트워크 연결과 같이 통신 집약적인 워크로드에서 지연 시간을 최대 50%까지 개선할 수 있다고 주장합니다.
더 큰 규모의 확장 영역은 전문가 복제에도 중요한 역할을 합니다. ICI 패브릭당 칩 수가 많아지면 대규모 MoE의 각 전문가를 더 많이 복제할 수 있으므로 라우팅 불균형을 완화하고 토큰 분배가 편향될 때 디코딩 지연 시간을 일정하게 유지할 수 있습니다. Top-k 라우팅은 데이터에 따라 달라지므로 특정 단계에서 일부 전문가는 다른 전문가보다 더 많은 토큰을 처리하게 됩니다. 복제는 이러한 변동성을 흡수합니다. 이러한 트래픽 증가를 처리하기 위해 ICI 대역폭을 칩당 19.2Tb/s로 두 배로 늘렸습니다.
버고 네트워크
9,600개의 칩으로 구성된 슈퍼포드는 규모가 크지만, 최첨단 기술 학습 실행에는 점점 더 많은 용량이 필요합니다. Virgo는 데이터 센터 내의 슈퍼포드를 연결하는 스케일아웃 패브릭으로, 작업 규모가 단일 스케일업 도메인을 초과할 경우 포드 간의 동서 RDMA 트래픽을 처리합니다.
단일 Virgo 패브릭은 47Pb/s의 논블로킹 양방향 대역폭으로 134,000개 이상의 8t 칩을 연결하며, 이는 이전 세대 대비 가속기당 대역폭이 최대 4배 증가하고 무부하 지연 시간이 40% 감소한 것입니다. 이 아키텍처는 다중 평면 설계와 독립적인 제어 도메인을 갖춘 고차수 스위치 기반의 평면형 2계층 논블로킹 토폴로지입니다.
기존 Clos 패브릭은 포트 수와 비용을 관리 가능한 수준으로 유지하기 위해 상위 계층에서 과도하게 트래픽을 할당합니다. 이는 일반적인 클라우드 환경에서 흔히 발생하는 북-남 트래픽(클라이언트가 로드 밸런서에 연결되고, 로드 밸런서가 애플리케이션 서버에 연결되고, 애플리케이션 서버가 스토리지에 연결되는 패턴)에는 효과적입니다. 하지만 AI 학습 워크로드는 거의 전적으로 패브릭을 가로지르는 동-서 트래픽(칩 간 연결)이며, 이러한 트래픽은 주로 이분법적 방식으로 처리됩니다. 어떤 계층에서든 과도한 트래픽 할당이 발생하면 학습 단계 시간이 곧바로 단축됩니다. Virgo의 평면형 2계층 설계와 고라딕스 스위치는 ASIC당 충분한 포트를 갖춘 스위치를 구축하여 패브릭의 상당 부분을 두 홉 내에 종료할 수 있도록 함으로써 스파인 계층의 병목 현상을 해결합니다.
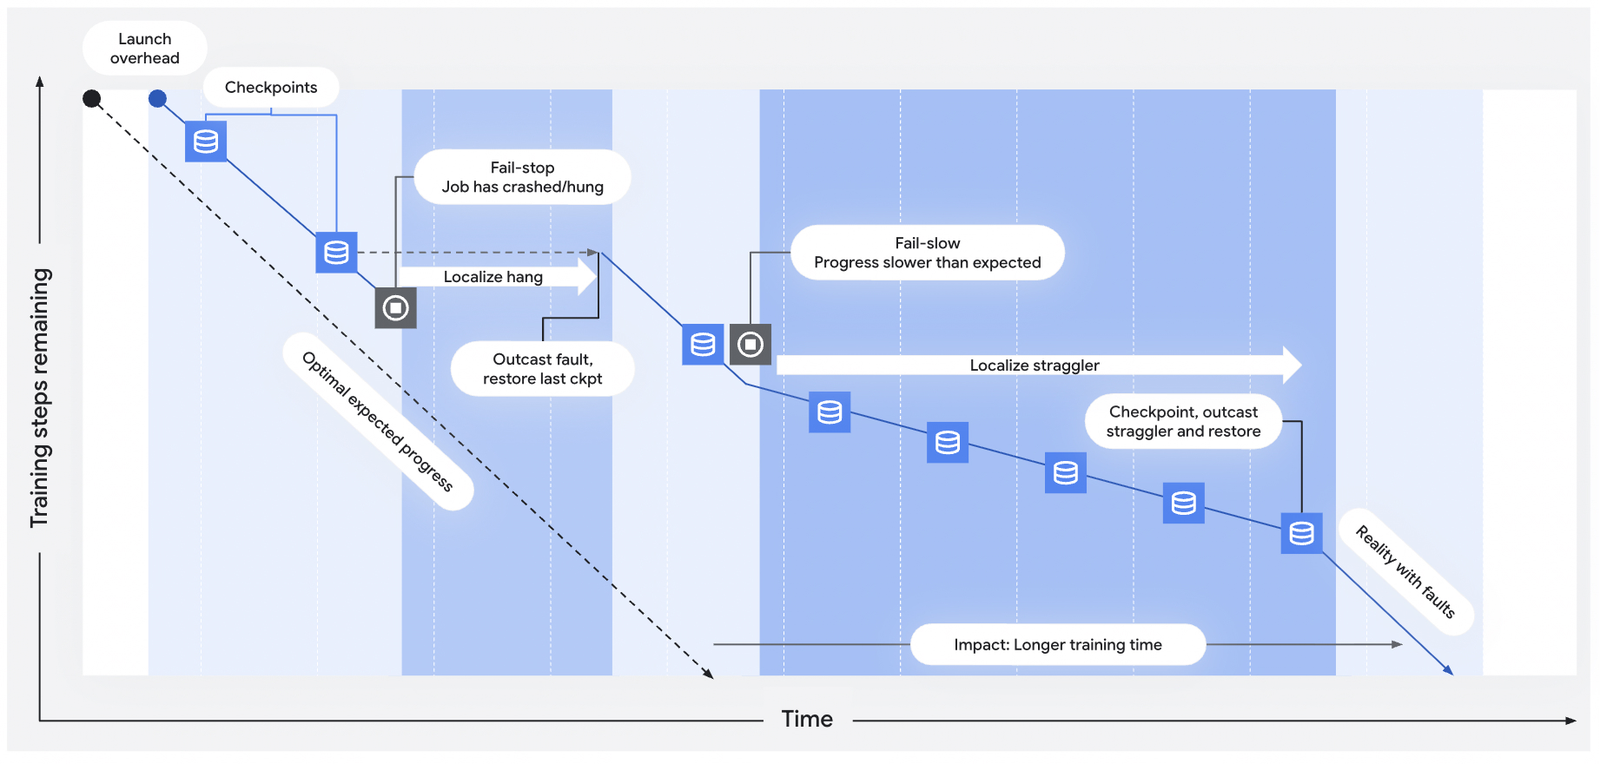
이러한 규모에서는 신뢰성 엔지니어링이 매우 중요하며, 구글의 MEMS 기반 광 회로 스위치(OCS)에 크게 의존합니다. OCS를 통해 구글은 배선을 다시 할 필요 없이 작업 간 물리적 토폴로지를 재구성할 수 있으며, 더 중요한 것은 작업 도중 오류가 발생한 칩이나 링크를 우회하여 라우팅할 수 있다는 점입니다. 오류가 감지되면 OCS는 영향을 받는 패브릭 부분을 밀리초 단위로 재매핑하여 수동 개입의 필요성을 없애줍니다. 1밀리초 미만의 텔레메트리 데이터는 자동화된 지연 및 멈춤 감지 기능을 제공합니다. 빠른 감지와 OCS 기반 재라우팅의 조합은 10만 개 이상의 칩 규모에서 평균 인터럽트 간격(MTBI)과 평균 복구 시간(MTR)을 최적화합니다. 이러한 규모에서는 수 주에 걸친 실행 동안 오류가 발생할 확률이 거의 100%에 달합니다. 구글이 8t 포드에 대해 제시한 97%의 처리량 목표는 바로 이 인프라에 기반합니다. 동일한 OCS 기술은 TPU 스택 전체에 걸쳐 사용됩니다. ICI 계층에서 큐브들을 슈퍼포드로 연결하고, 8i 스케일업 계층에서 Boardfly 그룹을 연결하며, Virgo 계층에서 포드 간 트래픽을 처리합니다.
134,000개의 칩을 사용하면 총 연산 능력은 FP4 기준으로 약 1,690 EFLOPS, 또는 약 1.7 ZFLOPS에 달합니다. 구글은 이 아키텍처가 단일 논리적 학습 클러스터에서 최대 백만 개의 칩까지 거의 선형적으로 확장 가능하다고 밝혔지만, 현재 배포 환경에서는 아직 그 한계에 도달하지 않았습니다.
주피터 및 멀티 데이터 센터 규모
Virgo는 데이터 센터 내에서 동서 방향 가속기 트래픽을 처리하지만, 최상위 계층은 아닙니다. Jupiter는 현재 5세대에 접어든 Google의 기존 남북 방향 패브릭으로, 프런트엔드 트래픽과 분산 스토리지 및 컴퓨팅 리소스에 대한 액세스를 처리합니다. Jupiter는 Cloud Next에서 발표된 것이 아니라, 8세대가 구축되는 기반이 되는 기존 인프라입니다.
최신 Jupiter 버전은 Apollo MEMS OCS 스위치를 사용하여 데이터 센터 건물당 약 108W의 전력을 소비하며, 이는 동등한 전기 패킷 스위치의 약 3,000W에 비해 훨씬 효율적입니다. 이를 통해 99.999%의 가용성과 13Pb/s의 양방향 대역폭을 제공합니다. 이 네트워크는 Google의 데이터 센터를 외부 세계 및 데이터 센터 간에 연결하는 핵심 인프라입니다.
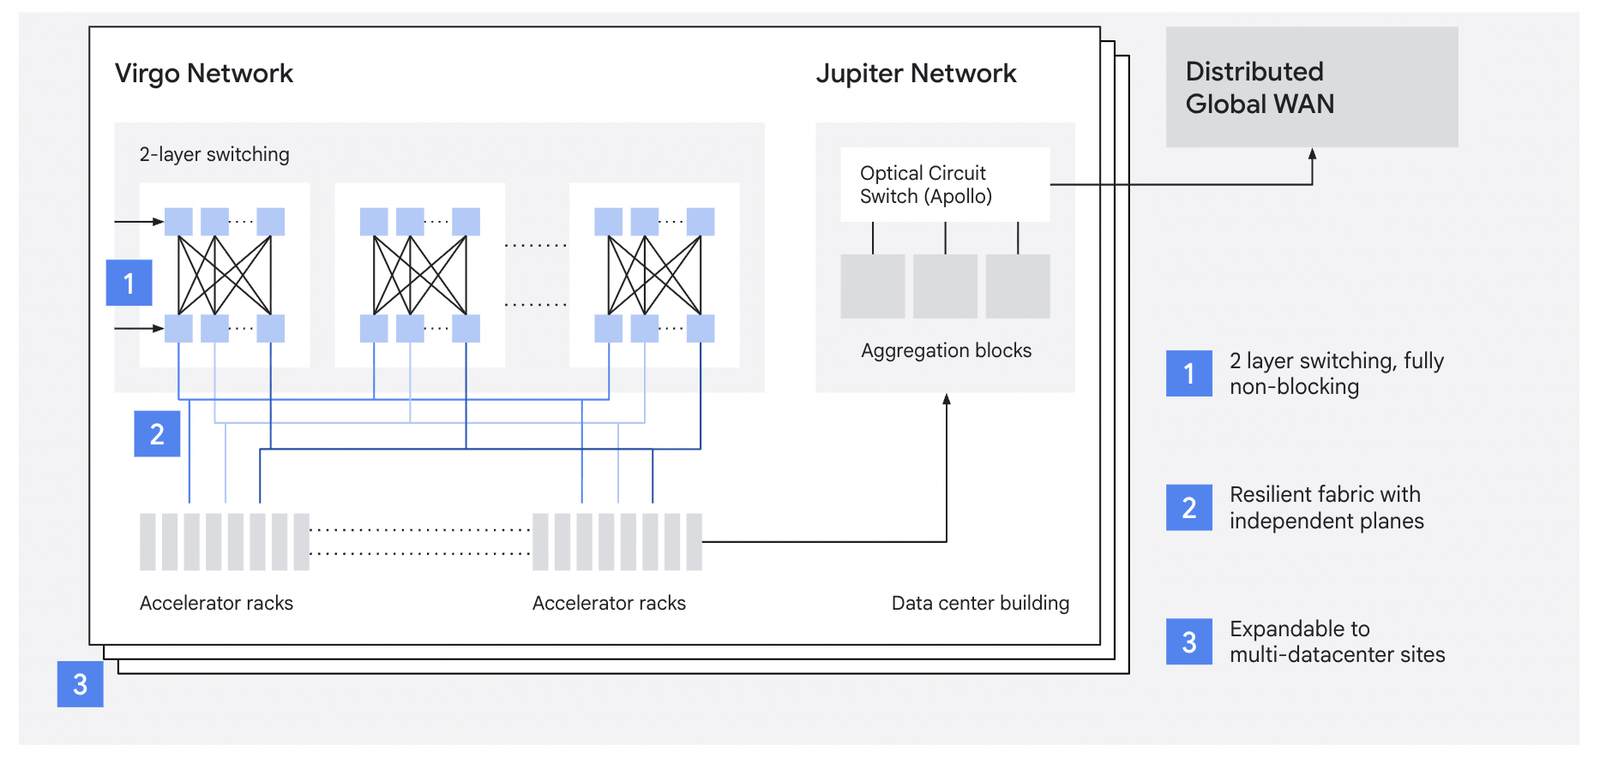
단일 데이터 센터의 처리 능력과 공간을 초과하는 학습 실행의 경우, Jupiter는 여러 사이트에 걸쳐 확장을 가능하게 합니다. 이러한 구성은 계층적으로 이루어지는데, Pod 내부에는 ICI가, 사이트 내 Pod 간에는 Virgo가, 사이트 간에는 Jupiter가 사용됩니다. Google의 Pathways 소프트웨어 스택은 이러한 다중 데이터 센터 도메인에 걸쳐 워크로드를 단일 논리 클러스터처럼 처리할 수 있습니다.
약 1.7 ZFLOPS의 성능을 가진 단일 Virgo 패브릭은 현재까지 발표된 AI 학습 클러스터 중 가장 큰 규모입니다. Jupiter로 연결된 여러 Virgo 패브릭은 백만 개 이상의 TPU 칩을 처리할 수 있으며, 이는 현재 배포 규모에서는 아직 달성하지 못했지만 Google이 목표로 하는 규모입니다.
생산물량 및 활용률
순수 FLOP 수치 자체보다 그중에서 실제로 유용한 작업을 수행하는 비율이 더 중요합니다. 구글은 8톤 규모의 슈퍼포드에 대해 97%의 처리량 목표를 제시했는데, 이는 실제 처리 시간의 97%가 복구, 지연 또는 조정 오버헤드가 아닌 생산적인 연산에 사용된다는 의미입니다. 이 수치는 앞서 설명한 OCS 기반 내결함성과 1밀리초 미만의 텔레메트리 속도에 따라 달라집니다.
모델 FLOP 활용률(MFU)은 또 다른 변수입니다. MFU는 칩이 실제 워크로드에서 이론적 최대 FLOP 중 실제로 유지하는 비율을 측정합니다. SemiAnalysis는 TPU MFU가 40%일 때 유효 학습 FLOP당 비용이 GB300 NVL72 대비 약 62% 감소하고, 손익분기점은 TPU MFU 약 15%라고 추정합니다. Anthropic이 공개한 TPU 경제성 분석에 따르면 실제 운영 비용은 손익분기점을 훨씬 웃도는 수준입니다. 높은 처리량(칩을 지속적으로 가동)과 경쟁력 있는 MFU(칩이 작동 중일 때 활용도를 높임)의 조합이 TPU의 총소유비용(TCO)을 대규모 환경에서 효율적으로 만드는 요인입니다.
8이 앉는 곳
TPU 8을 NVIDIA의 현재 및 향후 플랫폼과 비교할 때는 단위에 특히 주의해야 합니다. NVIDIA는 NVLink 대역폭을 양방향 총합으로 표기하는데, 1.8TB/s의 NVLink 5를 지원하는 B200은 양방향으로 900GB/s의 대역폭을 제공합니다. NVIDIA가 발표하는 FLOPs 수치는 일반적으로 2:4 스파스 구성이며, 밀집 구성은 그 절반입니다. 반면 Google의 TPU 수치는 밀집 구성이며 양방향입니다. 따라서 비교 자료를 읽을 때는 대역폭이 단방향인지 양방향인지, FLOPs가 밀집 구성인지 스파스 구성인지 반드시 확인해야 합니다.
칩 단위 FP4 처리량 기준으로 8t 환경에서 12.6 PFLOPS의 밀집 연산 성능을 보이는 것은 GB200의 10 PFLOPS 희소 연산(밀집 연산 시 5 PFLOPS)과 GB300의 20 PFLOPS 희소 연산(밀집 연산 시 15 PFLOPS) 사이에 위치합니다. 칩 단위 성능 비교는 근접하지만, 규모 확장 측면에서는 큰 차이가 있습니다. GB300 NVL72 랙은 하나의 NVLink 도메인에 72개의 GPU를 탑재합니다. 반면 8t 슈퍼포드는 단일 3D 토러스에 9,600개의 칩으로 구성됩니다. 이는 단일 집합 도메인에 133배 더 많은 칩이 탑재된다는 것을 의미하며, 바로 이 차이가 최첨단 기술 학습을 위한 플랫폼 간의 격차를 결정짓는 요인입니다.
NVIDIA는 가만히 있지 않습니다. Vera Rubin은 2026년 하반기에 출시될 예정이며, 패키지당 50 PFLOPS의 NVFP4 추론 성능(SemiAnalysis는 이 수치가 적응형 압축을 가정한 것인지 의문을 제기했지만), 22 TB/s의 대역폭을 가진 288 GB의 HBM4, 그리고 3.6 TB/s의 양방향 대역폭을 가진 NVLink 6를 제공합니다. 2027년 하반기에 출시될 Rubin Ultra는 4개의 레티클 다이를 결합하여 패키지당 최대 100 PFLOPS의 FP4 추론 성능과 1 TB의 HBM4e를 제공합니다. Kyber NVL576은 단일 랙에 576개의 Rubin Ultra GPU를 바인딩하여 15 EFLOPS의 FP4 추론 성능을 제공합니다. 이는 Google의 규모 확장 우위를 좁히기 시작하지만, 576개의 GPU는 여전히 8톤 규모의 슈퍼포드에 비해 규모가 훨씬 작습니다.
8이 가져오는 이점은 다음과 같습니다. 도메인 크기 확장(9,600개 칩 대 72개 GPU 또는 Kyber 이후 576개), 단일 패브릭 규모(47Pb/s에서 134,000개 이상의 칩), 정적 XLA 스케줄링을 통한 결정론적 지연 시간, TPU 모델에 적합한 워크로드에 대한 총소유비용(TCO).
8개의 트레일이 존재하는 이유: 칩당 HBM 용량(216GB 대 Rubin의 288GB HBM4), 희소성(NVIDIA는 2:4 하드웨어 경로를 가지고 있지만 Google은 그렇지 않음), 그리고 생태계의 폭(CUDA, cuDNN, TensorRT-LLM 및 PyTorch 우선 서빙 스택이 NVIDIA에 먼저 출시됨; TPU에서 네이티브 PyTorch는 아직 미리 보기 단계임).
두 플랫폼 모두 수요가 있습니다. Meta는 2027년부터 자사 데이터 센터에 Google TPU를 도입하기 위한 수십억 달러 규모의 계약을 논의 중인 것으로 알려졌으며, 2026년부터 클라우드 TPU 임대 서비스도 제공될 가능성이 있습니다. 동시에 Google Cloud는 NVIDIA Vera Rubin NVL72 기반의 A5X 인스턴스를 발표했는데, 이는 단일 사이트 내에서 최대 80,000만 개의 Rubin GPU, 여러 사이트에 걸쳐 배포할 경우 최대 960,000만 개의 GPU까지 확장 가능합니다. Google은 이 두 가지 모두를 대규모로 구축하고 있습니다.
마무리
8세대 TPU는 단일 칩이 아닌 두 개의 칩으로 구성되어 있으며, 범용 AI 워크로드보다는 현재 대규모 학습 및 에이전트 추론에 최적화된 설계를 특징으로 합니다. 8t는 슈퍼포드당 최대 9,600개의 칩, Virgo 패브릭당 최대 134,000개 이상의 칩까지 확장이 가능합니다. 8i는 SparseCores 대신 집합 가속 실리콘을, 3D 토러스 대신 Boardfly를 적용하여 대규모 MoE(Mixed-of-Experts) 서비스에 필요한 지연 시간 목표를 충족합니다. NVIDIA의 로드맵(Vera Rubin, Rubin Ultra, Kyber 포함)은 2026년에서 2027년 사이에 이러한 격차를 줄여나갈 것이지만, 현재로서는 확장성 측면에서의 우위가 여전히 유효합니다. 수십만 개의 칩에서 전문가 혼합 모델을 실행하는 최첨단 연구소의 경우, 8세대 TPU는 Grace Blackwell의 유력한 대안이며, Meta의 논의는 시장이 이러한 점을 반영하기 시작했음을 시사합니다.


 아마존