

Meta는 멀티모달 인텔리전스 기능을 강화하는 모델 모음인 최신 AI 혁신인 Llama 4를 출시했습니다. Llama 4는 뛰어난 효율성과 성능을 제공하는 Mixture-of-Experts(MoE) 아키텍처를 기반으로 합니다.
MoE 모델 및 희소성 이해
전문가 혼합(MoE) 모델은 전체 모델이 모든 입력을 처리하는 기존의 밀집 모델과 크게 다릅니다. MoE 모델에서는 "전문가"라고 하는 전체 매개변수의 하위 집합만 각 입력에 대해 활성화됩니다. 이 선택적 활성화는 입력의 특성에 따라 달라지므로 모델이 리소스를 동적으로 할당하고 효율성을 높일 수 있습니다.
희소성은 MoE 모델에서 필수적인 개념으로, 특정 입력에 대한 비활성 매개변수의 비율을 나타냅니다. MoE 모델은 성능을 유지하거나 향상시키면서 희소성을 활용하여 계산 비용을 크게 줄일 수 있습니다.
Llama 4 가족을 만나보세요: Scout, Maverick, Behemoth
Llama 4 제품군은 Llama 4 Scout, Llama 4 Maverick, Llama 4 Behemoth의 세 가지 모델로 구성되어 있습니다. 각 모델은 다양한 사용 사례와 요구 사항에 맞게 설계되었습니다.
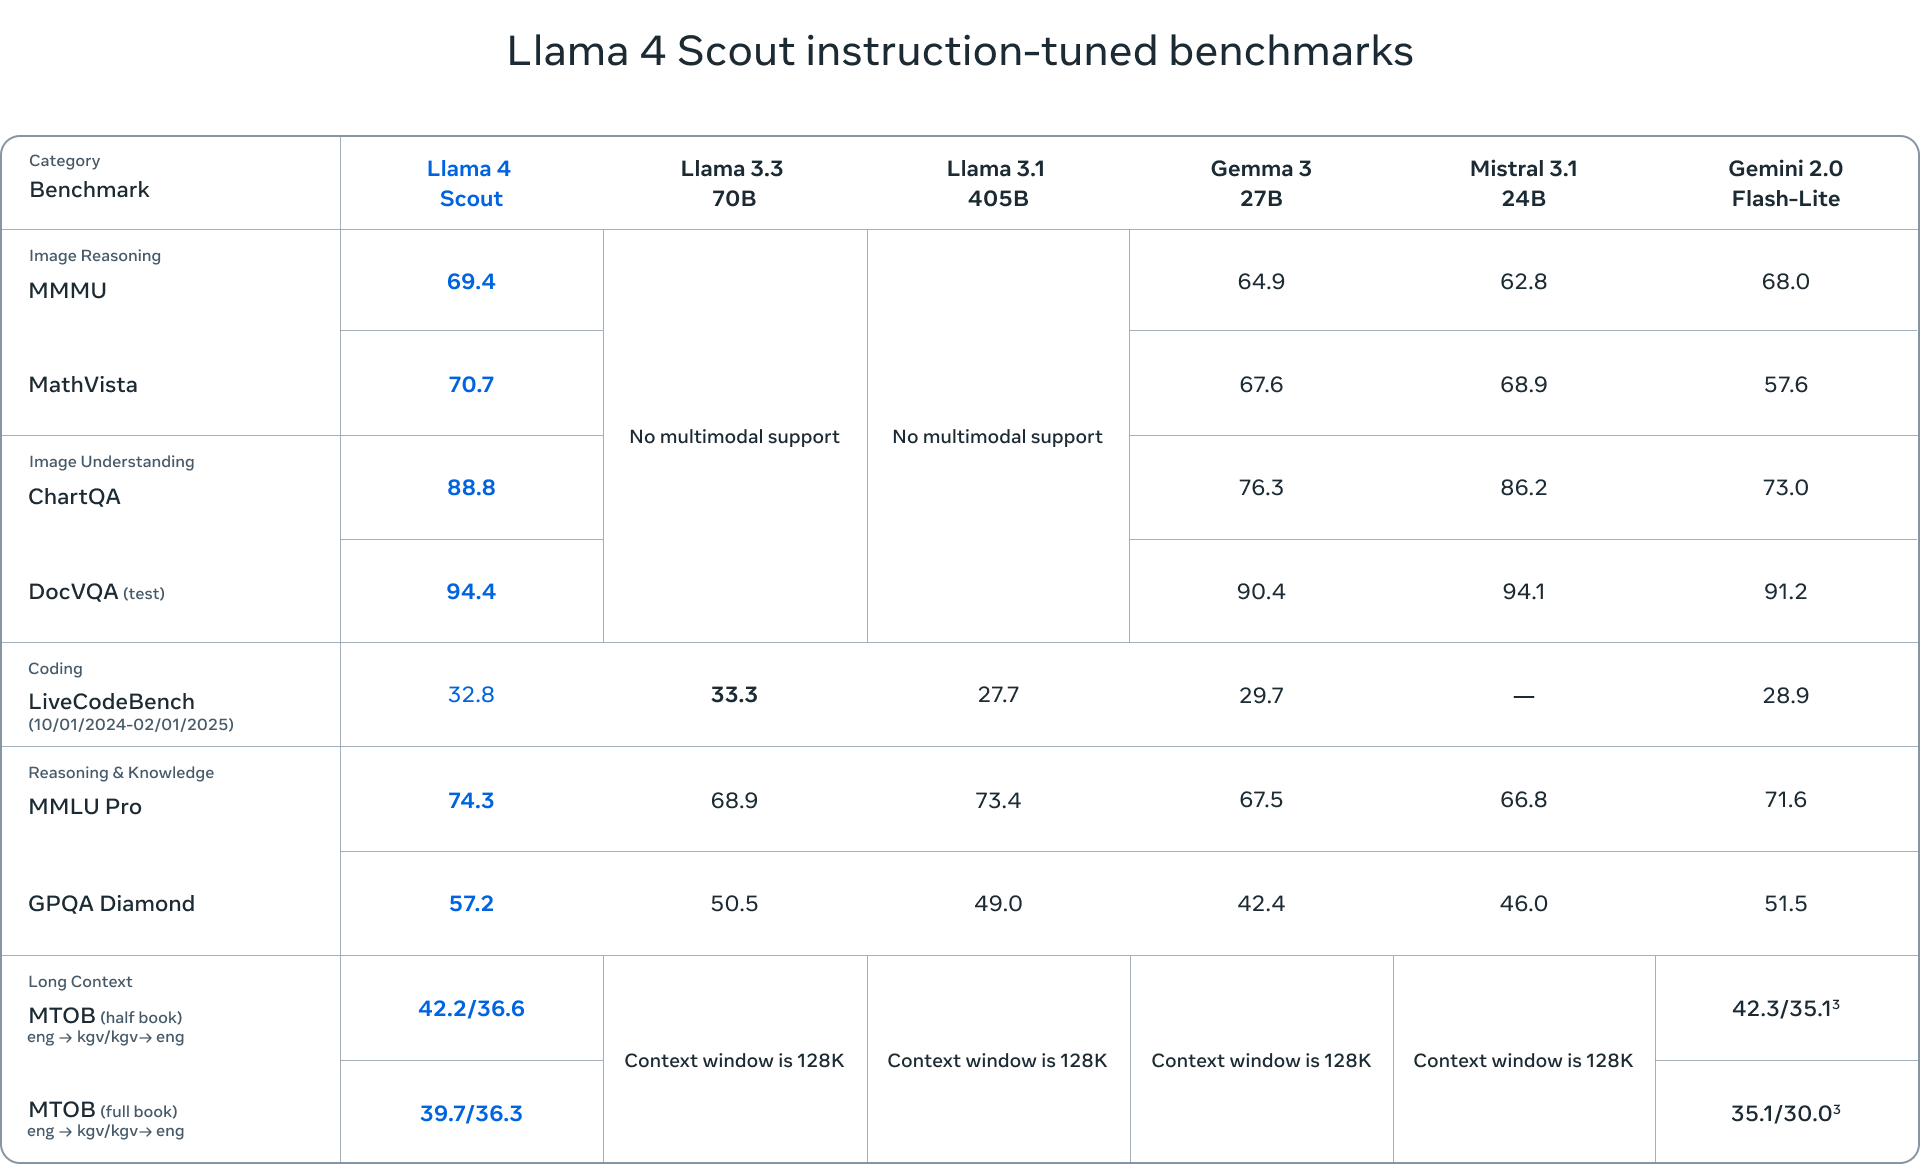
- Llama 4 Scout는 17명의 전문가에 걸쳐 109억 개의 활성 매개변수와 16억 개의 총 매개변수를 갖춘 컴팩트한 모델입니다. 효율성을 위해 최적화되었으며 단일 NVIDIA H100 GPU(FP4 Quantized)에서 실행할 수 있습니다. Scout는 인상적인 10만 개의 토큰 컨텍스트 창을 자랑하여 긴 컨텍스트 이해가 필요한 애플리케이션에 이상적입니다.
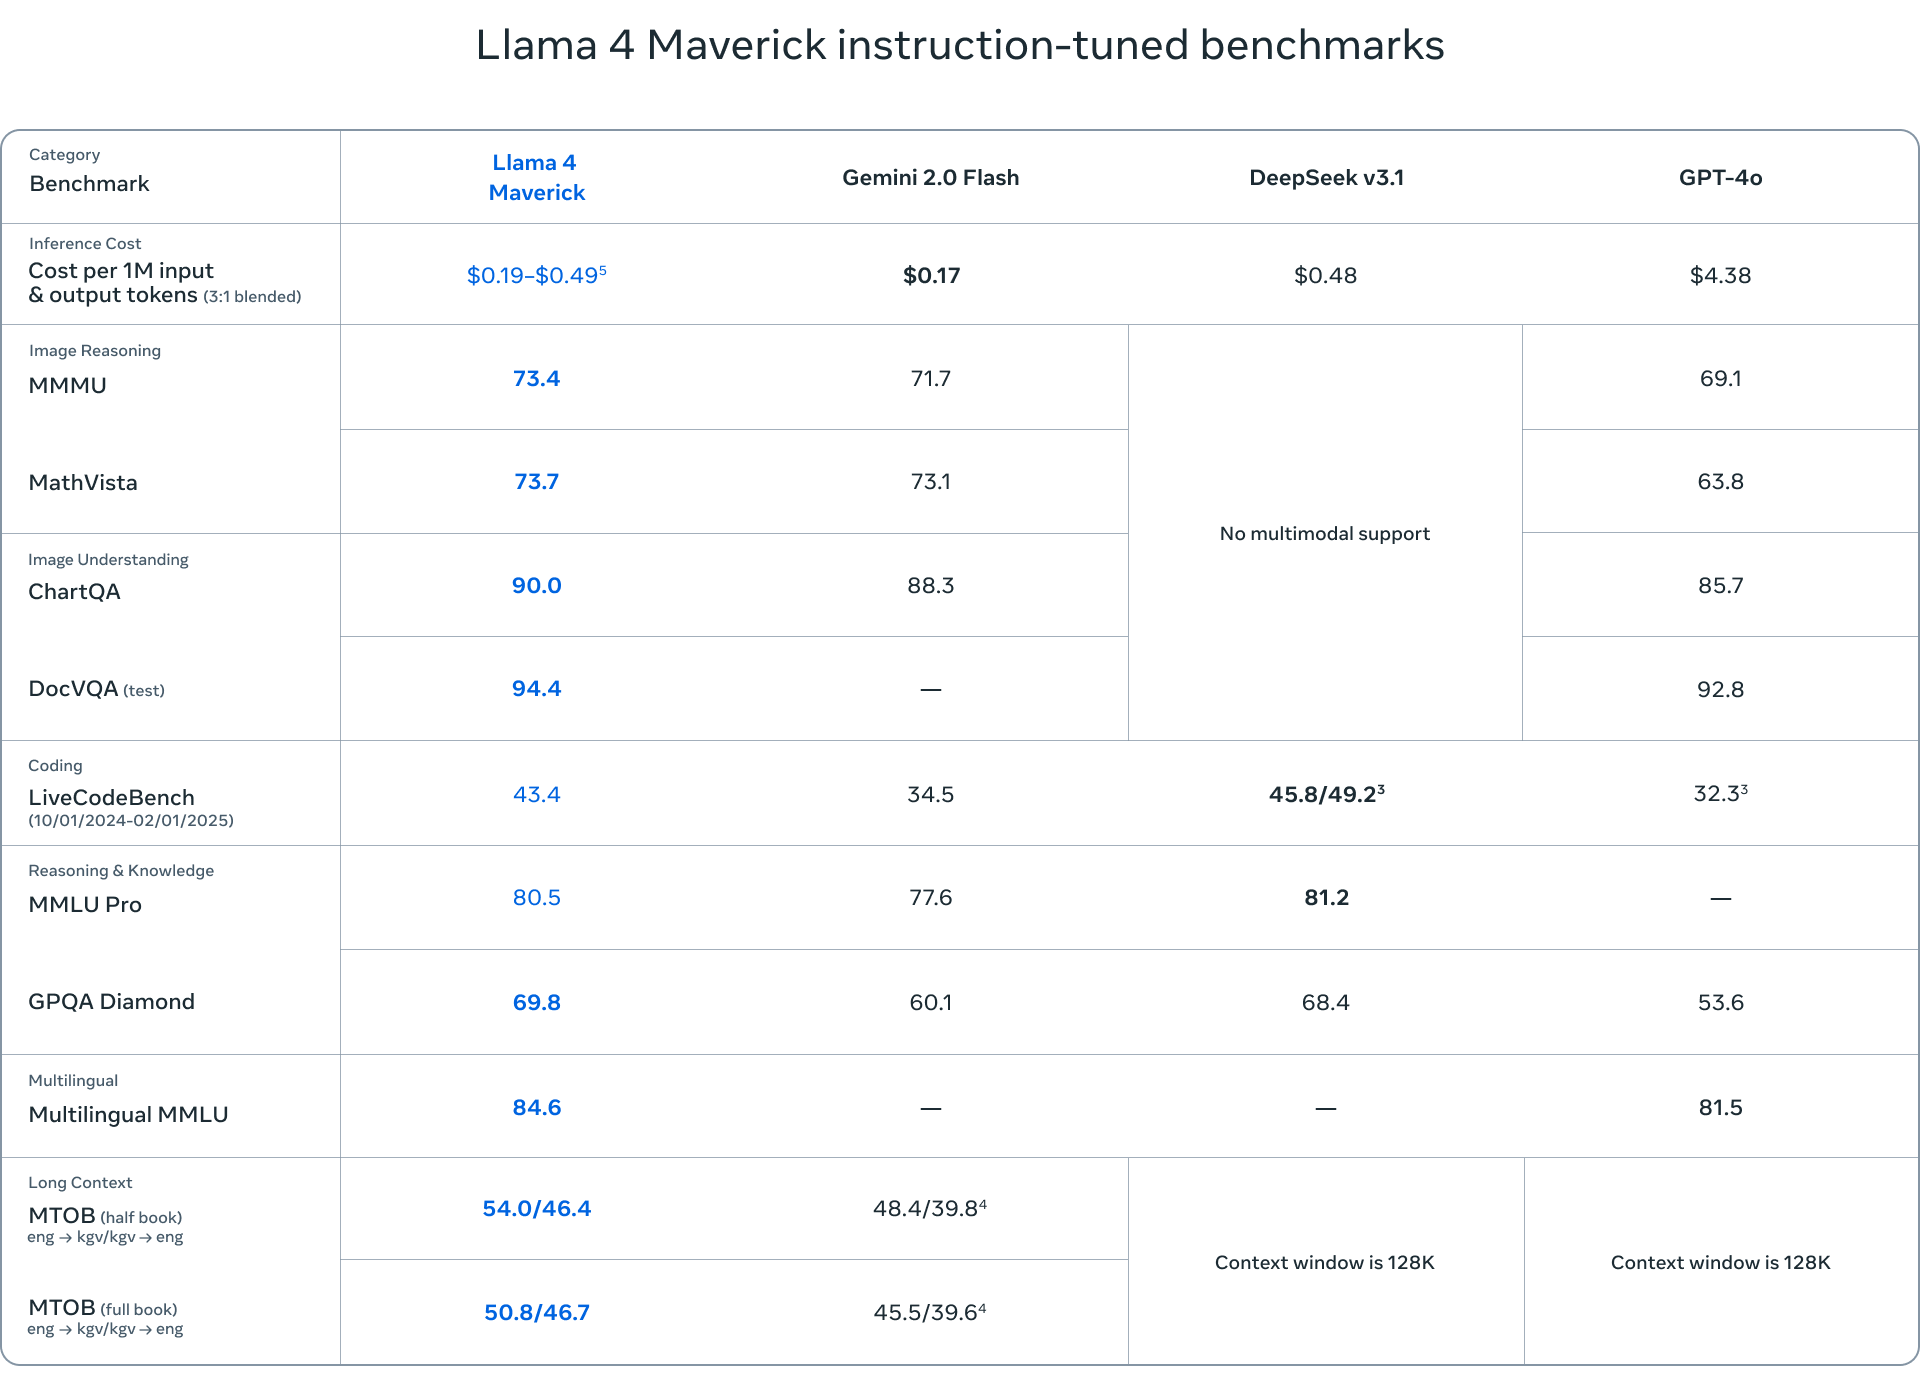
- Llama 4 Maverick은 동일한 17억 개의 활성 매개변수를 사용하지만 128명의 전문가를 보유하고 있어 총 400억 개의 매개변수를 가진 더욱 강력한 모델입니다. Maverick은 다중 모드 이해, 다국어 작업 및 코딩에서 뛰어나며 GPT-4o 및 Gemini 2.0 Flash와 같은 경쟁자보다 성능이 뛰어납니다.
- Llama 4 Behemoth는 288억 개의 활성 매개변수와 2명의 전문가에 걸쳐 약 16조 개의 총 매개변수를 갖춘 이 제품군에서 가장 큰 모델입니다. Behemoth는 아직 훈련 중이지만 이미 다양한 벤치마크에서 최첨단 성능을 입증했으며 GPT-4.5 및 Claude Sonnet 3.7과 같은 모델을 능가했습니다.
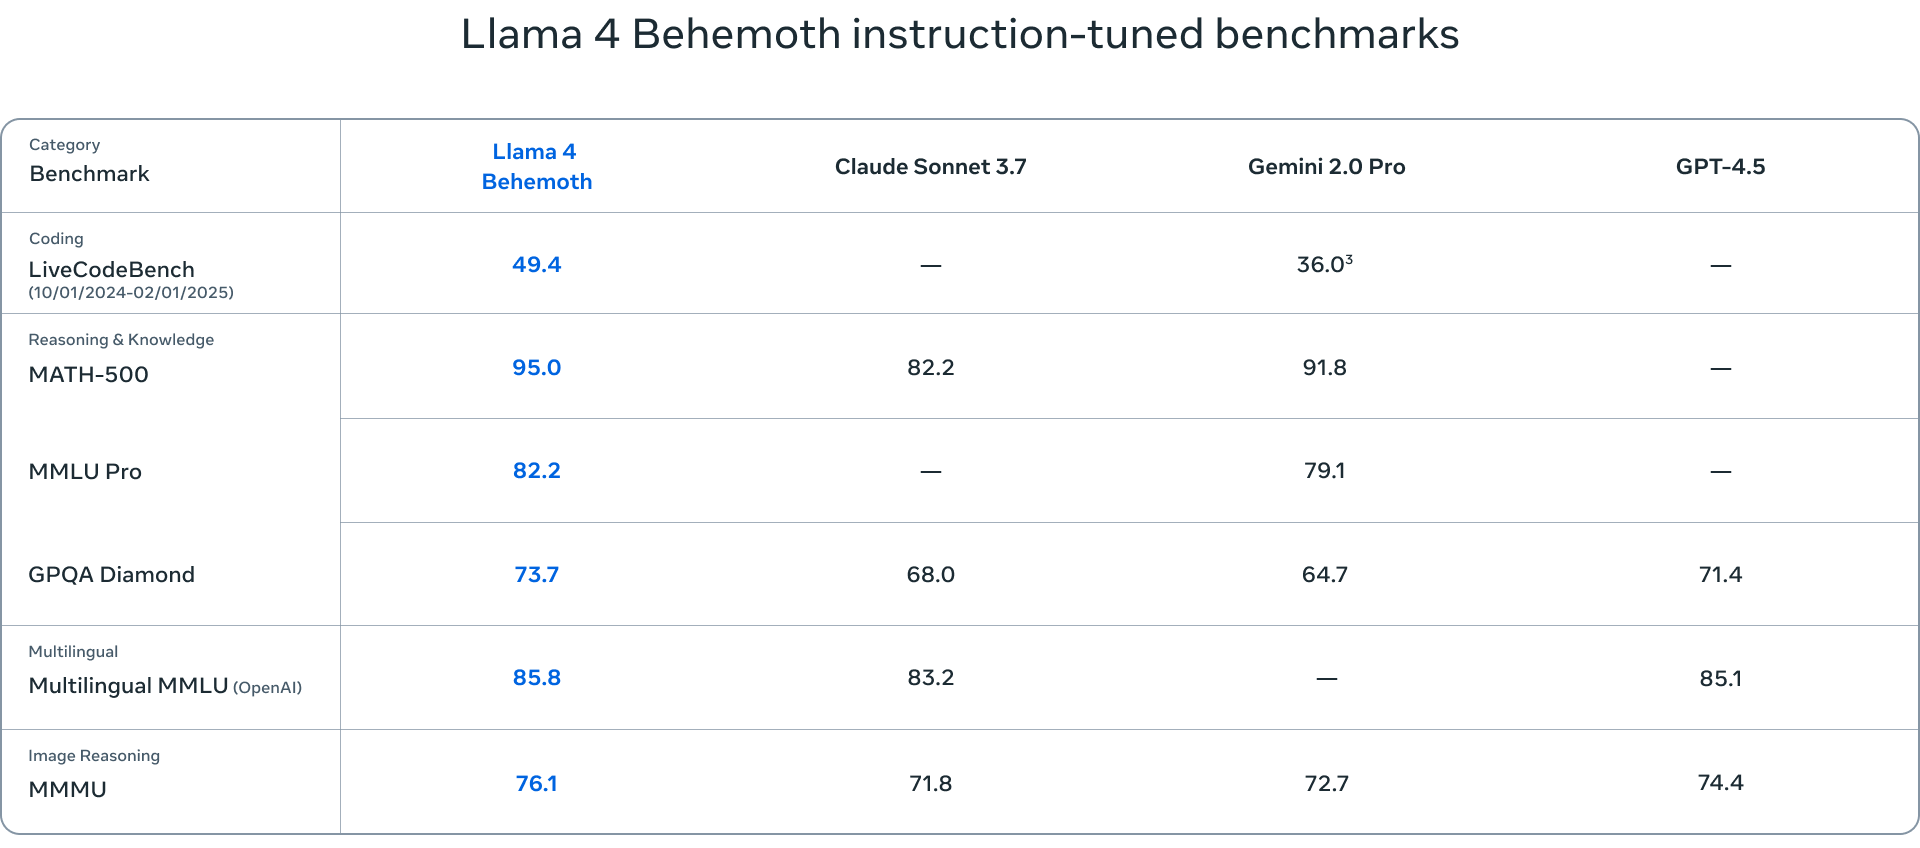
Llama 4 모델을 평가하는 데 사용된 벤치마크는 언어 이해(MMLU – Massive Multitask Language Understanding, GPQA – Google-Proof Question Answering), 수학적 문제 해결(MATH – Mathematical Problem-Solving, MathVista – 시각적 맥락에서 수학적 문제 해결을 위한 벤치마크), 멀티모달 이해(MMMU – Massive Multimodal Multitask Understanding)를 포함한 다양한 작업을 포괄합니다. 이러한 표준 벤치마크는 모델의 역량에 대한 포괄적인 평가를 제공하고 뛰어난 영역이나 추가 개선이 필요한 영역을 식별하는 데 도움이 됩니다.
Llama 4에서 교사 모델의 역할
교사 모델은 더 작은 모델을 안내하고 증류를 통해 지식과 역량을 이 모델에 전달하는 대규모 사전 훈련된 모델입니다. Llama 4의 경우 Behemoth는 교사 모델 역할을 하며 Scout와 Maverick 모두에 지식을 증류합니다. 증류 프로세스에는 더 작은 모델이 교사 모델의 동작을 모방하도록 훈련하여 강점과 약점에서 학습할 수 있도록 하는 것이 포함됩니다. 이 접근 방식을 통해 더 작은 모델은 더 효율적이고 확장 가능한 동시에 인상적인 성능을 달성할 수 있습니다.
시사점 및 향후 방향
Llama 4의 출시는 AI 분야에서 중요한 이정표로, 연구, 개발 및 응용 분야에 광범위한 영향을 미칩니다. 역사적으로 Llama 모델은 다운스트림 연구의 촉매제였으며, 다양한 연구와 혁신에 영감을 주었습니다. Llama 4 출시는 이러한 추세를 이어갈 것으로 예상되며, 연구자들은 복잡한 작업과 과제를 해결하기 위해 모델을 구축하고 미세 조정할 수 있습니다.
많은 모델이 Llama 모델을 기반으로 미세 조정되고 구축되어 Llama 아키텍처의 다양성과 잠재력을 입증했습니다. Llama 4 릴리스는 연구자와 개발자가 모델을 활용하여 새롭고 혁신적인 애플리케이션을 만들면서 이러한 추세를 가속화할 가능성이 높습니다. 이는 Llama 4가 강력한 모델 릴리스이며 광범위한 연구 및 개발 활동을 가능하게 하기 때문에 중요합니다.
Llama 4 모델은 이전 모델과 마찬가지로 사고하지 않는다는 점에 주목할 가치가 있습니다. 따라서 향후 Llama 4 시리즈 출시는 추론을 위해 사후 훈련을 거쳐 성능을 더욱 향상시킬 수 있습니다.


 아마존