

MLCommons는 오늘 MLPerf Storage v3.0 결과를 발표했습니다. 이번 라운드에서는 벤치마크 내용뿐 아니라 선두 기업에도 변화가 생겼습니다. 처음으로, 유일하게 검증된 AI 스토리지 벤치마크인 MLPerf Storage v3.0은 학습 처리량, 체크포인트, 그리고 두 가지 새로운 추론 워크로드(벡터 데이터베이스 테스트 및 KV 캐시 테스트)를 포함한 전체 파이프라인을 포괄합니다. 19개 기관이 143개의 결과를 제출했으며, 그중 11개 기관은 이번에 처음으로 데이터를 제출했습니다. 여기에는 Microsoft Azure, NVIDIA, Everpure를 비롯하여 대부분의 독자들에게는 생소할 수 있는 여러 AI 스토리지 스타트업들이 포함됩니다. 또한, v2.0에서 선두를 이끌었던 DDN, Huawei, Hammerspace, Lightbits는 이번 라운드에 참여하지 않았습니다.
먼저 비교 관련 유의사항을 말씀드리겠습니다. v3.0에서는 시뮬레이션 가속기가 H100에서 B200으로 변경되어 가속기별 대역폭 제한이 높아졌으므로 v3.0의 수치는 v2.0 결과와 직접 비교할 수 없습니다. 이 데이터는 MLCommons에서 검증한 벤더 제출 자료이며, StorageReview는 자체적으로 테스트를 수행하거나 검증하지 않았습니다.
검문소 설치가 주요 사건입니다
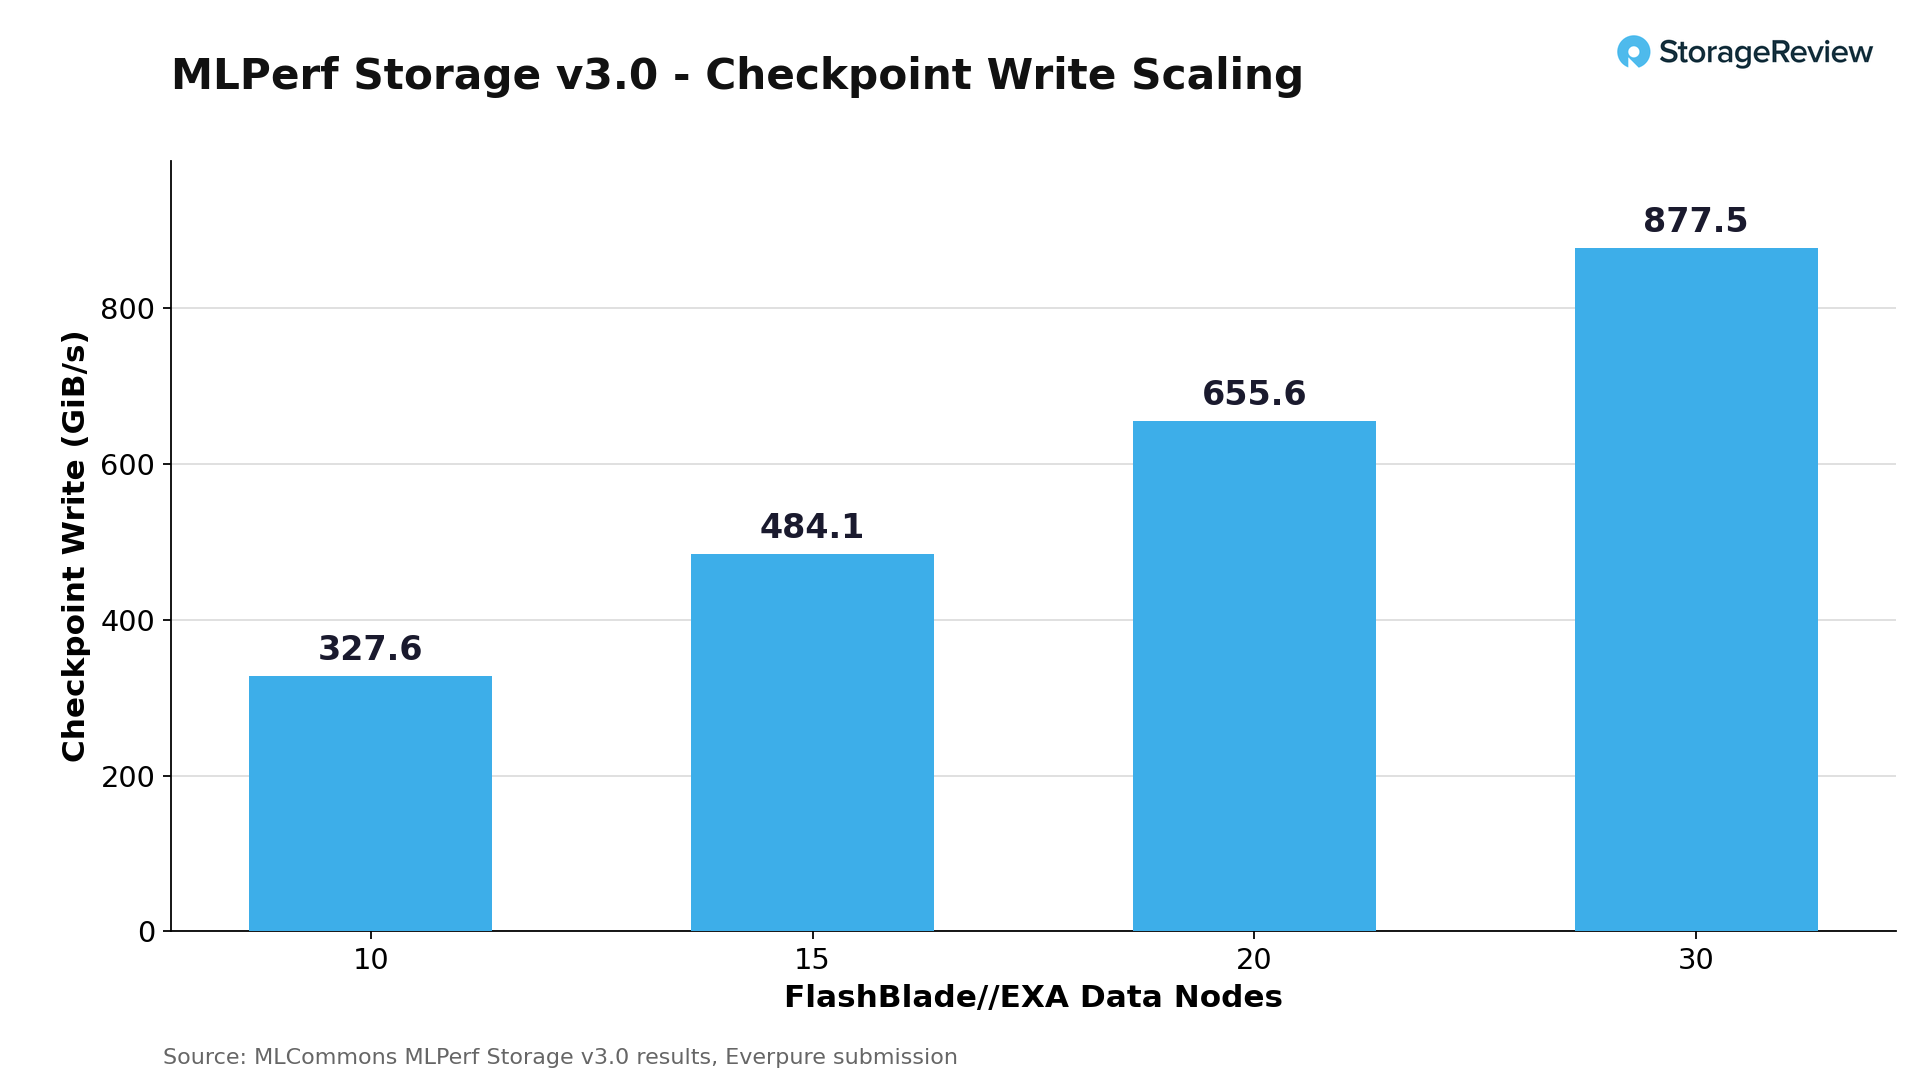
MLCommons는 체크포인트 작업을 주요 워크로드로 추가했습니다. 이는 체크포인트 작업이 검증된 병목 현상으로 작용하기 때문입니다. 최첨단 규모의 학습 작업은 정기적으로 엄청난 양의 상태 데이터를 기록하는데, 체크포인트를 플러시하는 데 소요되는 매 순간이 가속기 유휴 시간으로 이어집니다. 이번 라운드에서 가장 높은 수치는 바로 이 부분에서 나왔습니다. Everpure(이전 Pure Storage)는 MLPerf Storage에 처음 참가하여 FlashBlade//EXA 테스트 결과를 제출했는데, 데이터 노드 수에 따라 거의 선형적으로 확장되는 성능을 보여주었습니다. 데이터 노드 10개에서 체크포인트 쓰기 속도는 327.6GiB/s, 15개에서 484.1GiB/s, 20개에서 655.6GiB/s, 그리고 30개에서 쓰기 속도 877.5GiB/s, 읽기 속도 833.0GiB/s를 기록했습니다. Everpure는 지난 1년 동안 //EXA의 처리량에 대해 높은 수치를 주장해 왔는데, 이번 검증된 결과는 이러한 주장을 뒷받침하는 첫 번째 사례입니다.
두 번째로 높은 체크포인트 기록은 업계에 있어 더 큰 의미를 지닌다고 할 수 있습니다. 벤치마크에 제출된 최초의 하이퍼스케일 클라우드 스토리지 서비스인 Azure Managed Lustre는 128개 클라이언트가 있는 4,096TiB 배포 환경에서 642.2GiB/s의 체크포인트 쓰기 속도를 기록했습니다. 불과 두 라운드 전만 해도 관리형 클라우드 파일 서비스가 인공지능 전용 스토리지 어레이와 어깨를 나란히 하는 성능을 보여줄 것이라고는 상상하기 어려웠을 것입니다.
| 체크포인트(상위 제출물) | 시스템 | 흑백 쓰기(GiB/s) |
|---|---|---|
| 에버 퓨어 | FlashBlade//EXA, 데이터 노드 30개 | 877.5 |
| 하늘빛 | 관리형 Lustre, 4,096TiB, 128개 클라이언트 | 642.2 |
| 얀롱테크 | F9000X, 클라이언트 8개 | 313.7 |
| 쑤저우 쯔산 롱린 | 여러 구성 | 313.7 |
| 튜링데이터 | F9200, 클라이언트 8개 | 307.1 |
| 유빅스 | UbiPower18000, 스토리지 노드 3개 | 293.8 |
교육: 당신이 아마도 모를 이름들
3D U-Net 학습 리더보드는 신규 참가자들의 차지입니다. YanRongTech의 F9000X는 99개의 시뮬레이션된 B200 가속기에 데이터를 공급하며 543.9GiB/s의 읽기 대역폭을 유지하여 이번 라운드에서 가장 높은 학습 처리량을 기록했습니다. 싱가포르의 AI 인프라 기업인 TuringData는 이번 대회 첫 참가에서 3개의 스토리지 노드만으로 96개의 시뮬레이션된 B200에 데이터를 공급하며 541.5GiB/s를 기록하여 4GiB/s 차이로 뒤처졌습니다. 동일한 3노드 F9200 클러스터는 Checkpoint-70B 테스트에서도 539.9GiB/s의 읽기 속도와 307.1GiB/s의 쓰기 속도를 보였습니다. UBIX의 UbiPower18000은 16개의 15.36TB NVMe 드라이브와 쿼드 NDR400 네트워킹을 갖춘 3개의 스토리지 노드로 구성되어 454.1GiB/s의 성능을 달성했습니다. HPE는 K3000 모델로 345.8GiB/s의 성능을 보여주며 교육 결과를 제출한 유일한 기존 엔터프라이즈 어레이 공급업체였습니다.
| 3D U-Net 교육 (최고 제출작) | 읽기/쓰기(GiB/s) | 모의 B200 가속기 |
|---|---|---|
| 얀롱테크 F9000X | 543.9 | 99 |
| 튜링데이터 F9200 | 541.5 | 96 |
| UBIX UbiPower18000 | 454.1 | 80 |
| 쑤저우 쯔산 롱린 | 433.4 | 80 |
| 팜GPU | 406.7 | 75 |
| Azure 관리형 광택 | 379.1 | 70 |
추론 기능이 벤치마크에 합류했습니다
두 가지 새로운 워크로드는 스토리지 수요가 실제로 증가하는 부분을 보여줍니다. KV 캐시 테스트는 스토리지 시스템이 장기 컨텍스트 LLM 서빙을 위해 어텐션 상태를 얼마나 빠르게 인/아웃할 수 있는지를 측정하는데, 이는 Dell 및 Solidigm KV 캐시 오프로드 작업 에서 심층적으로 분석한 패턴 입니다. Everpure는 51개 호스트로 구성된 FlashBlade//EXA 시스템에서 1,623.4 GiB/s의 KV 캐시 읽기 속도로 이번 라운드에서 가장 높은 수치를 기록했으며, UBIX(443.7 GiB/s)와 FarmGPU(443.6 GiB/s)가 표준 규모 제출에서 선두를 차지했습니다. 벡터 데이터베이스 측면에서는 TTA의 Seahorse 시스템이 초당 57,620개의 쿼리를 처리하며 쿼리 처리량 차트에서 1위를 기록했습니다.
또 다른 구조적 변화는 프로토콜입니다. v3.0에서는 S3 객체 스토리지 지원이 추가되었으며, 제출된 데이터의 약 6분의 1이 이를 사용했습니다. NVIDIA는 OCI, AWS, GCP의 베어메탈 구성에 걸쳐 20개의 AIStore 데이터를 제출하여 이 중 대부분을 차지했으며, 체크포인트 쓰기 속도는 최대 133.3GiB/s에 달했습니다. 절대적인 수치는 병렬 파일 시스템에는 미치지 못하지만, 벤치마크 내에서 객체 스토리지를 사용하여 학습 및 체크포인트 워크로드를 실행하는 것은 POSIX 파일 시스템이 한때 독점했던 영역을 벗어나는 중요한 의미를 지닙니다.
MLCommons는 이번 라운드에서 전력 소비량과 랙 공간 효율성을 주요 지표로 추적하기 시작했습니다.
에버퓨어 플래시블레이드//EXA
Everpure FlashBlade//EXA 시스템은 405B 및 1.25T 파라미터 모델 체크포인트 범주와 키-값(KV) 캐시 검색 벤치마크에서 모두 선두를 차지하며, 데이터 집약적인 인공지능 학습 및 추론 워크로드 동안 높은 처리량을 유지하는 플랫폼의 능력을 입증했습니다.
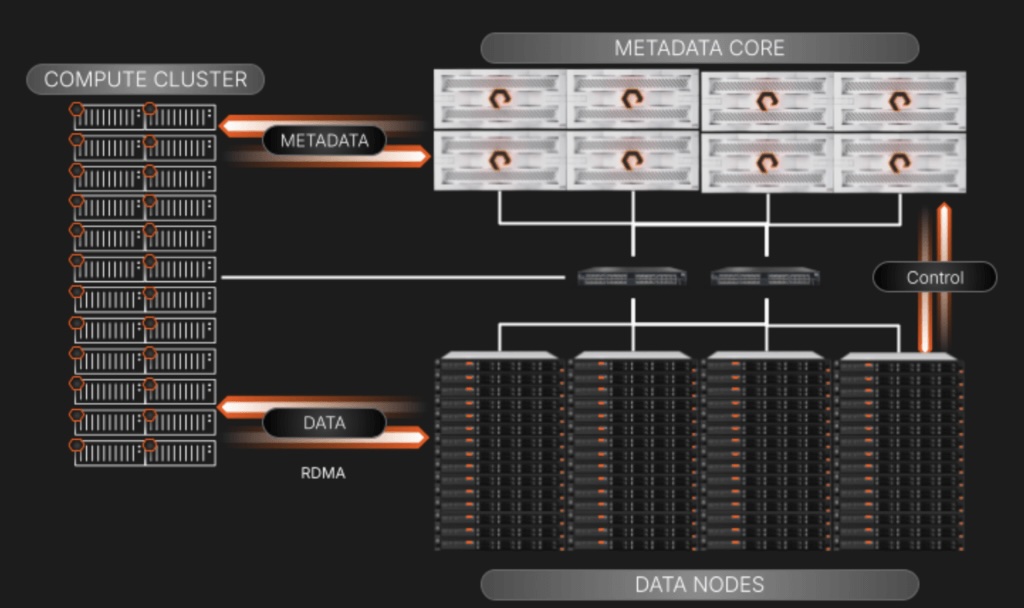
Everpure가 제출한 구성은 30개의 FlashBlade//EXA 블레이드(메타데이터 처리를 위한 120개의 DirectFlash 모듈)와 30개의 Linux/NVMe 데이터 노드를 조합하여 단일 파일 시스템에서 약 866TB의 가용 용량을 제공했습니다. 메타데이터는 pNFS/TCP를 통해, 대용량 데이터는 RDMA 기반 NFSv3를 통해 분산 저장했습니다. 1,024개의 클라이언트 가속기를 사용한 1.25T 파라미터 체크포인트 시뮬레이션에서 30개 노드 구성은 17.74초 동안 877.52GiB/s의 쓰기 대역폭을 유지했으며, 28.99초 동안 588.28GiB/s의 읽기 대역폭을 유지했습니다. KV 캐시 추론 테스트에서 스토리지 전용 Llama 3.1 8B 실행 시 85,736 토큰/초, 스토리지와 시스템 메모리를 결합한 8B 실행 시 67,642 토큰/초, 스토리지 전용 70B 실행 시 33,403 토큰/초의 결과가 보고되었습니다.
예약 불참이 의미하는 바는 무엇일까요?
벤치마크 라운드는 두 가지를 보여줍니다. 제출 업체가 무엇을 할 수 있는지, 그리고 불참 업체가 어떤 결과를 보여주지 않았는지입니다. 최대 규모의 네오클라우드 및 AI 팩토리 구축 사례를 보유한 VAST Data, WEKA, DDN은 모두 v3.0에 참여하지 않았으며, v2.0에 참여했던 Huawei, Hammerspace, Lightbits도 마찬가지였습니다. 업체들이 라운드를 건너뛰는 이유는 엔지니어링 주기, 출시 시점, 벤치마크 관련 정책 등 여러 가지가 있을 수 있습니다. 라운드 불참 자체가 시스템 속도가 느리다는 것을 의미하는 것은 아닙니다. 하지만 이는 검증된 기록과 실제 구축 사례가 서로 다른 업체 목록을 가리킨다는 것을 의미하며, 구매자는 두 가지 모두를 고려해야 합니다. 저희 ' 최고의 스토리지 어레이' 페이지는 이러한 구분을 정확하게 보여주며, 검증된 내용과 실제 구축 사례를 구분하여 표시하고 있으며, v3.0의 전체 결과를 반영하여 업데이트되었습니다.
v3.0 결과는 오늘 MLCommons 스토리지 벤치마크 페이지 에 공개되었습니다.



 아마존