

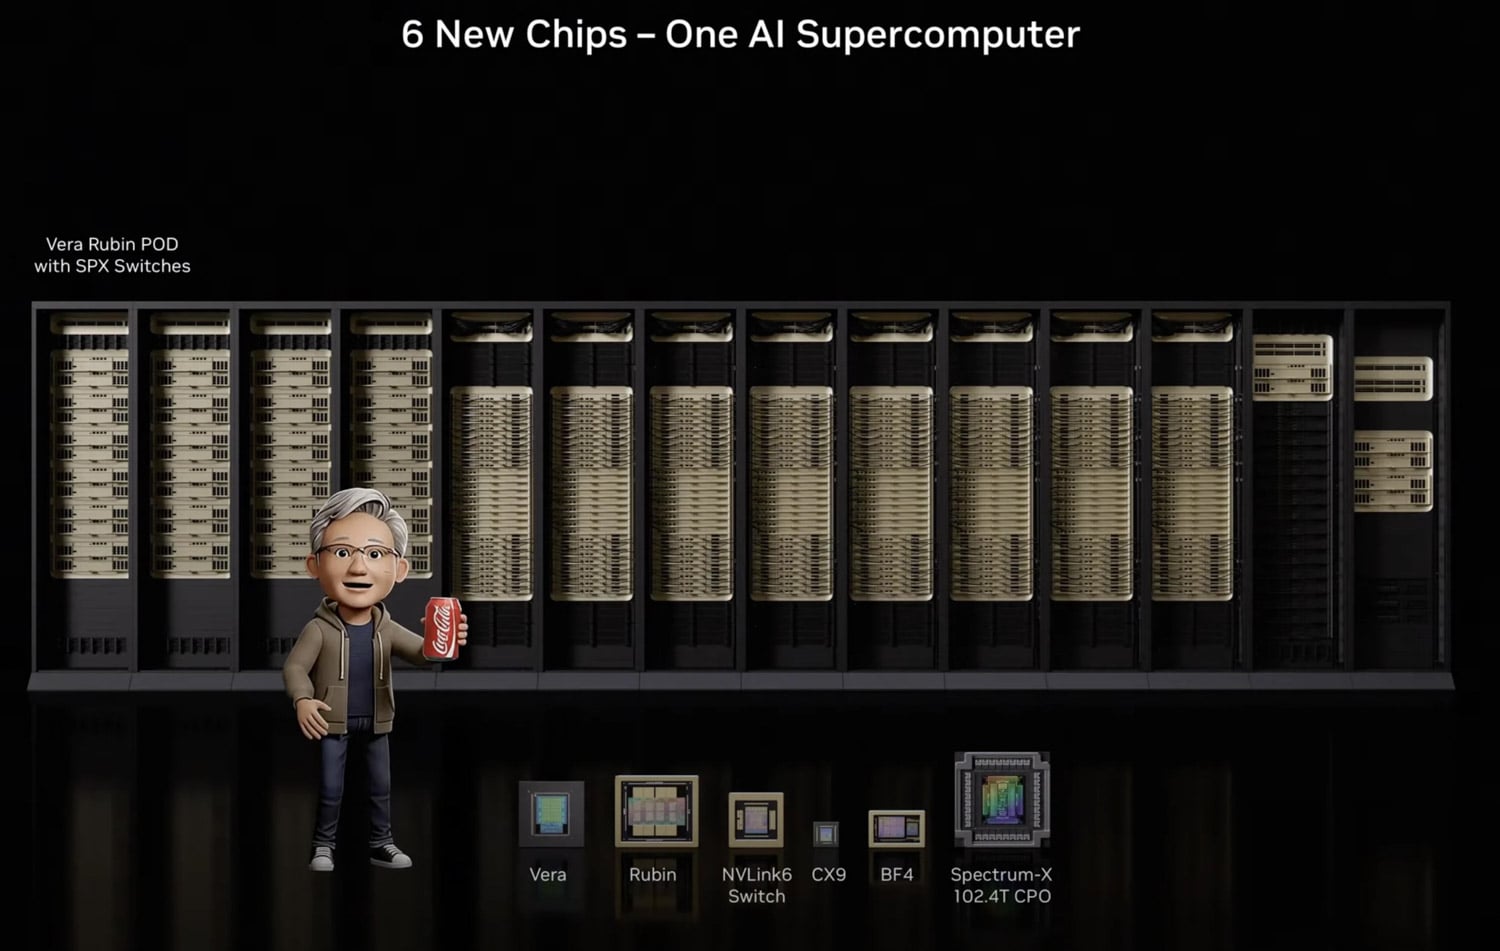
NVIDIA는 CES 2026에서 Vera Rubin NVL72 랙 스케일 시스템을 중심으로 하는 Rubin 플랫폼을 공개했습니다. 이는 NVIDIA의 3세대 랙 스케일 아키텍처로, 공동 설계된 6개의 칩을 하나의 통합 시스템으로 결합한 것입니다. 이 플랫폼은 2026년 하반기에 파트너사를 통해 출시될 예정이며, 6개의 칩 모두 이미 생산을 완료하고 현재 실제 워크로드를 이용한 검증을 진행 중입니다.
Vera Rubin NVL72: 6개의 칩, 하나의 통합 시스템
Vera Rubin NVL72는 NVIDIA가 "극한 공동 설계"라고 부르는 방식을 사용하는데, 이는 6개의 서로 다른 칩을 함께 개발하여 통합 시스템으로 작동하도록 하는 것입니다.
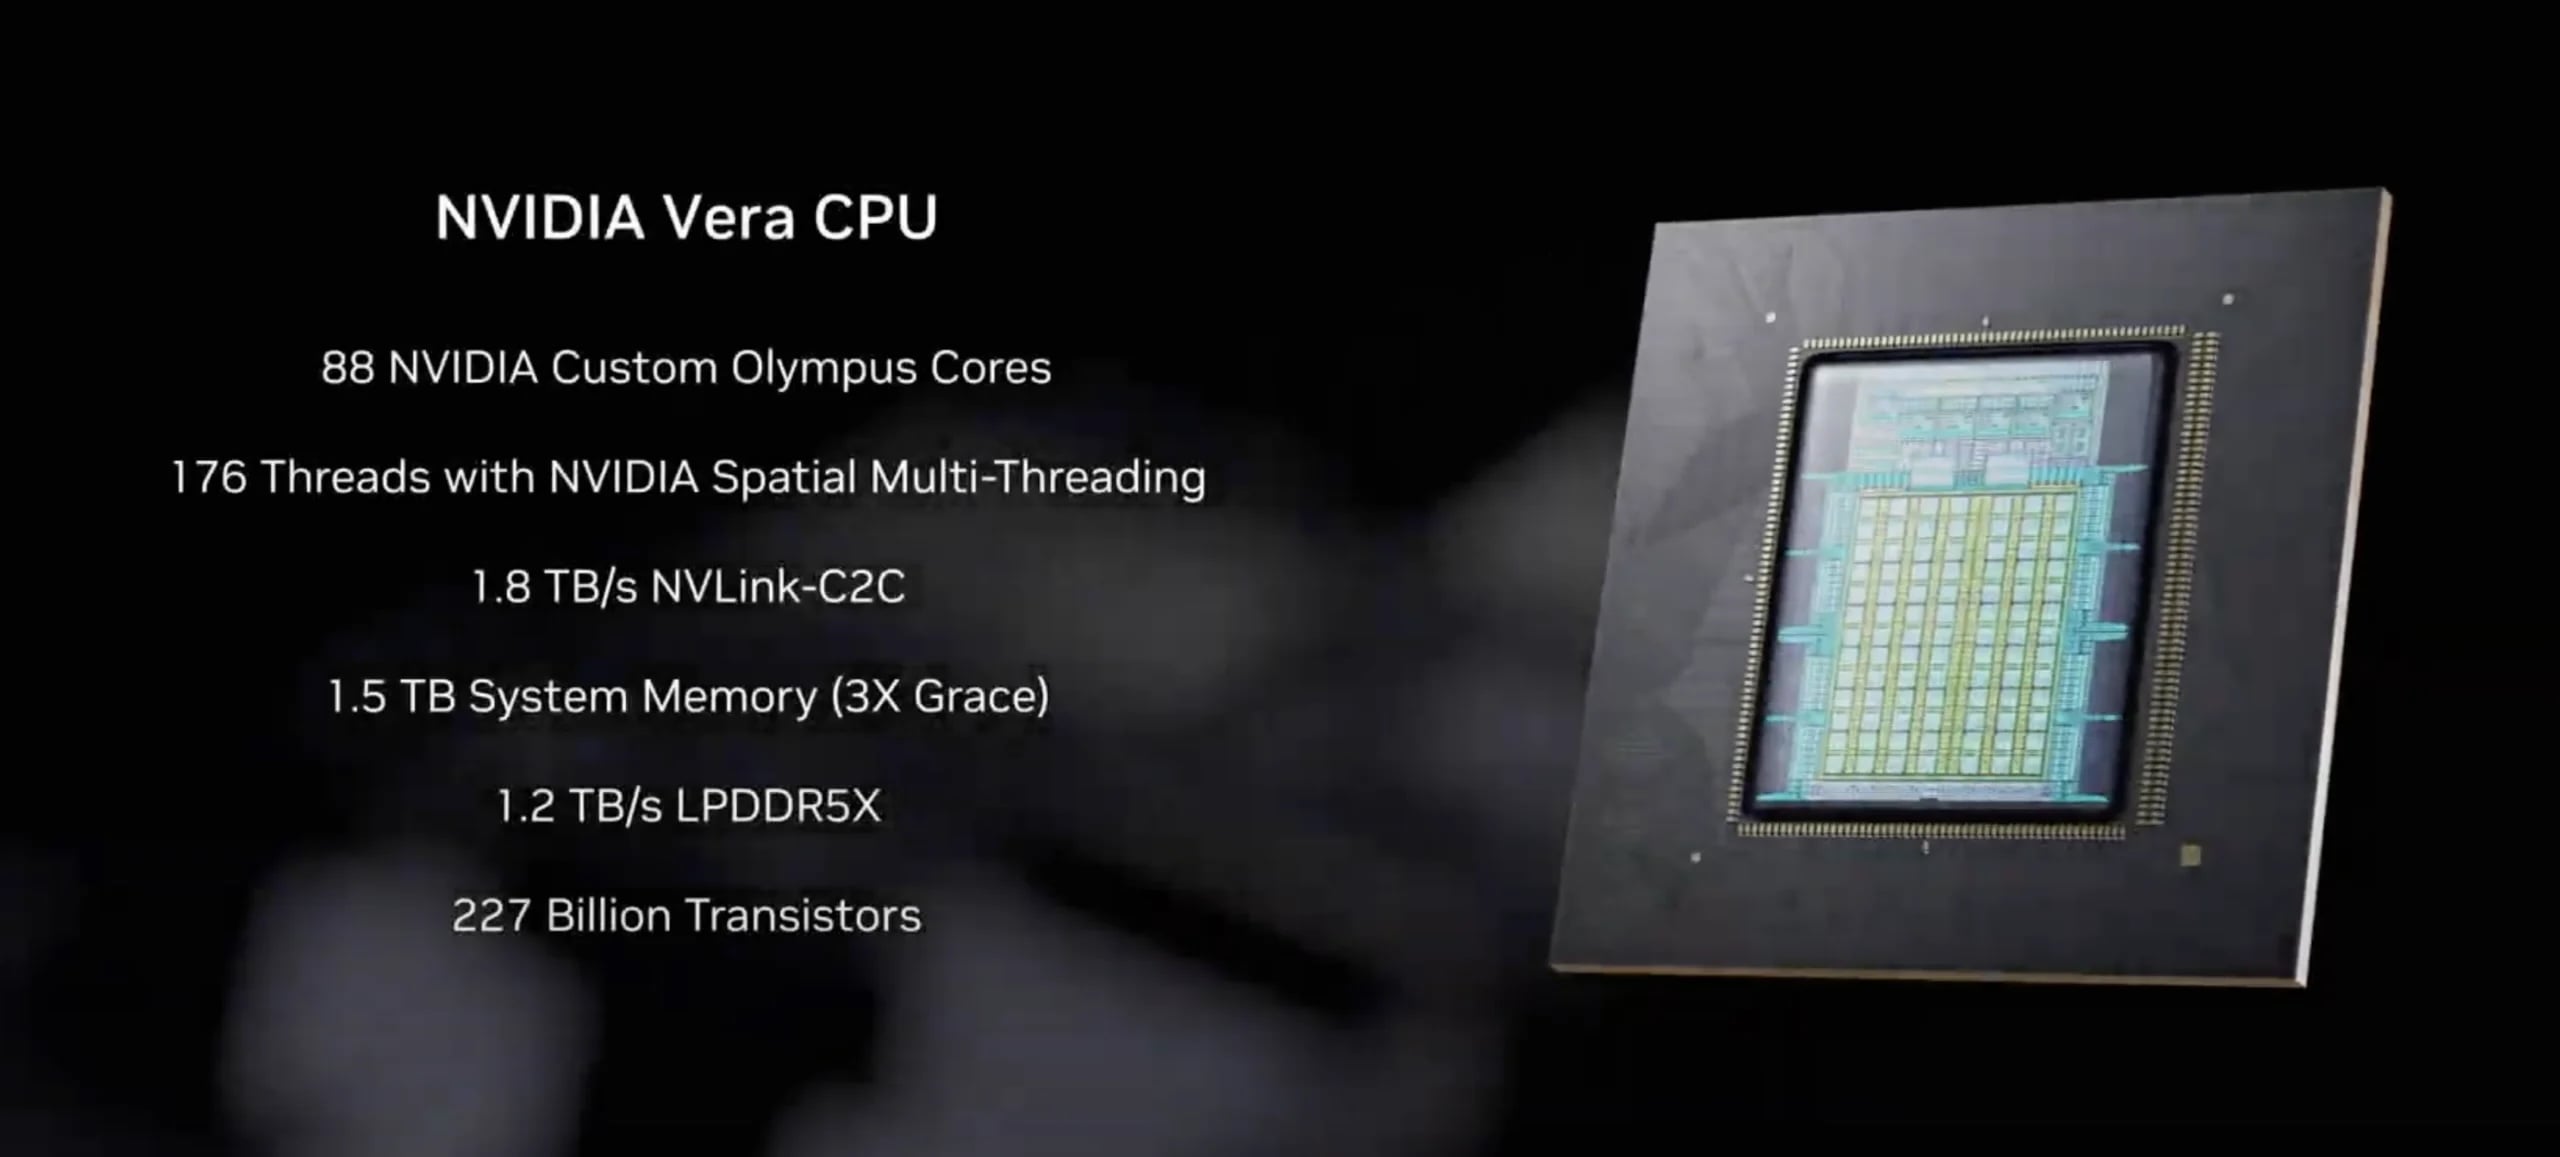
Vera CPU: AI 팩토리를 위해 설계된 ARM 실리콘
NVIDIA가 AI 워크로드용 맞춤형 ARM 실리콘에 대한 투자를 지속하는 가운데, 첫 번째로 공개된 칩은 NVIDIA Vera CPU였습니다. Armv9.2와 완벽하게 호환되는 88개의 맞춤형 Olympus ARM 코어를 기반으로 구축된 Vera는 최신 AI 팩토리의 데이터 처리 및 에이전트 처리 요구 사항에 맞춰 특별히 설계되었습니다. NVLink-C2C 연결을 통해 Rubin GPU에 1.8TB/s의 대역폭을 제공하며, 이는 이전 세대 대비 C2C 대역폭을 두 배로 늘리고 PCIe Gen 6보다 7배 빠른 속도를 제공합니다. Vera CPU는 이전 세대 Grace CPU에 비해 데이터 처리, 압축 및 코드 컴파일 성능이 두 배 향상되었습니다.
세대 비교: 블랙웰 울트라 vs. 베라 루빈 NVL72
| 스펙 | GB300 NVL72 (블랙웰 울트라) | VR NVL72 (베라 루빈) |
|---|---|---|
| GPU 개수 | 72개의 블랙웰 울트라 GPU | 72개의 루빈 GPU |
| CPU 수 | 36개의 그레이스 CPU | 36개의 Vera CPU |
| CPU 코어 | CPU당 72개의 ARM 코어 | CPU당 88개의 올림푸스 ARM 코어 |
| FP4 추론 성능 | 1.44 엑사플롭스 | 3.6 엑사플롭스 |
| GPU당 NVFP4 (추론) | 20PFLOPS | 50PFLOPS |
| GPU당 NVFP4 (학습) | 10PFLOPS | 35PFLOPS |
| GPU 메모리 유형 | HBM3e | HBM4 |
| GPU 메모리 대역폭 | ~8TB/초 | ~22TB/초 |
| NVLink 생성 | NV링크 5 | NV링크 6 |
| NVLink 대역폭(GPU당) | 1.8 TB / 초 | 3.6 TB / 초 |
| 랙 규모 NVLink 대역폭 | 130 TB / 초 | 260 TB / 초 |
| 스케일아웃 NIC | ConnectX-8 (800Gb/s) | ConnectX-9 (1.6TB/s) |
| CPU-GPU 상호 연결 | NVLink-C2C (900GB/s) | NVLink-C2C (1.8 TB/s) |
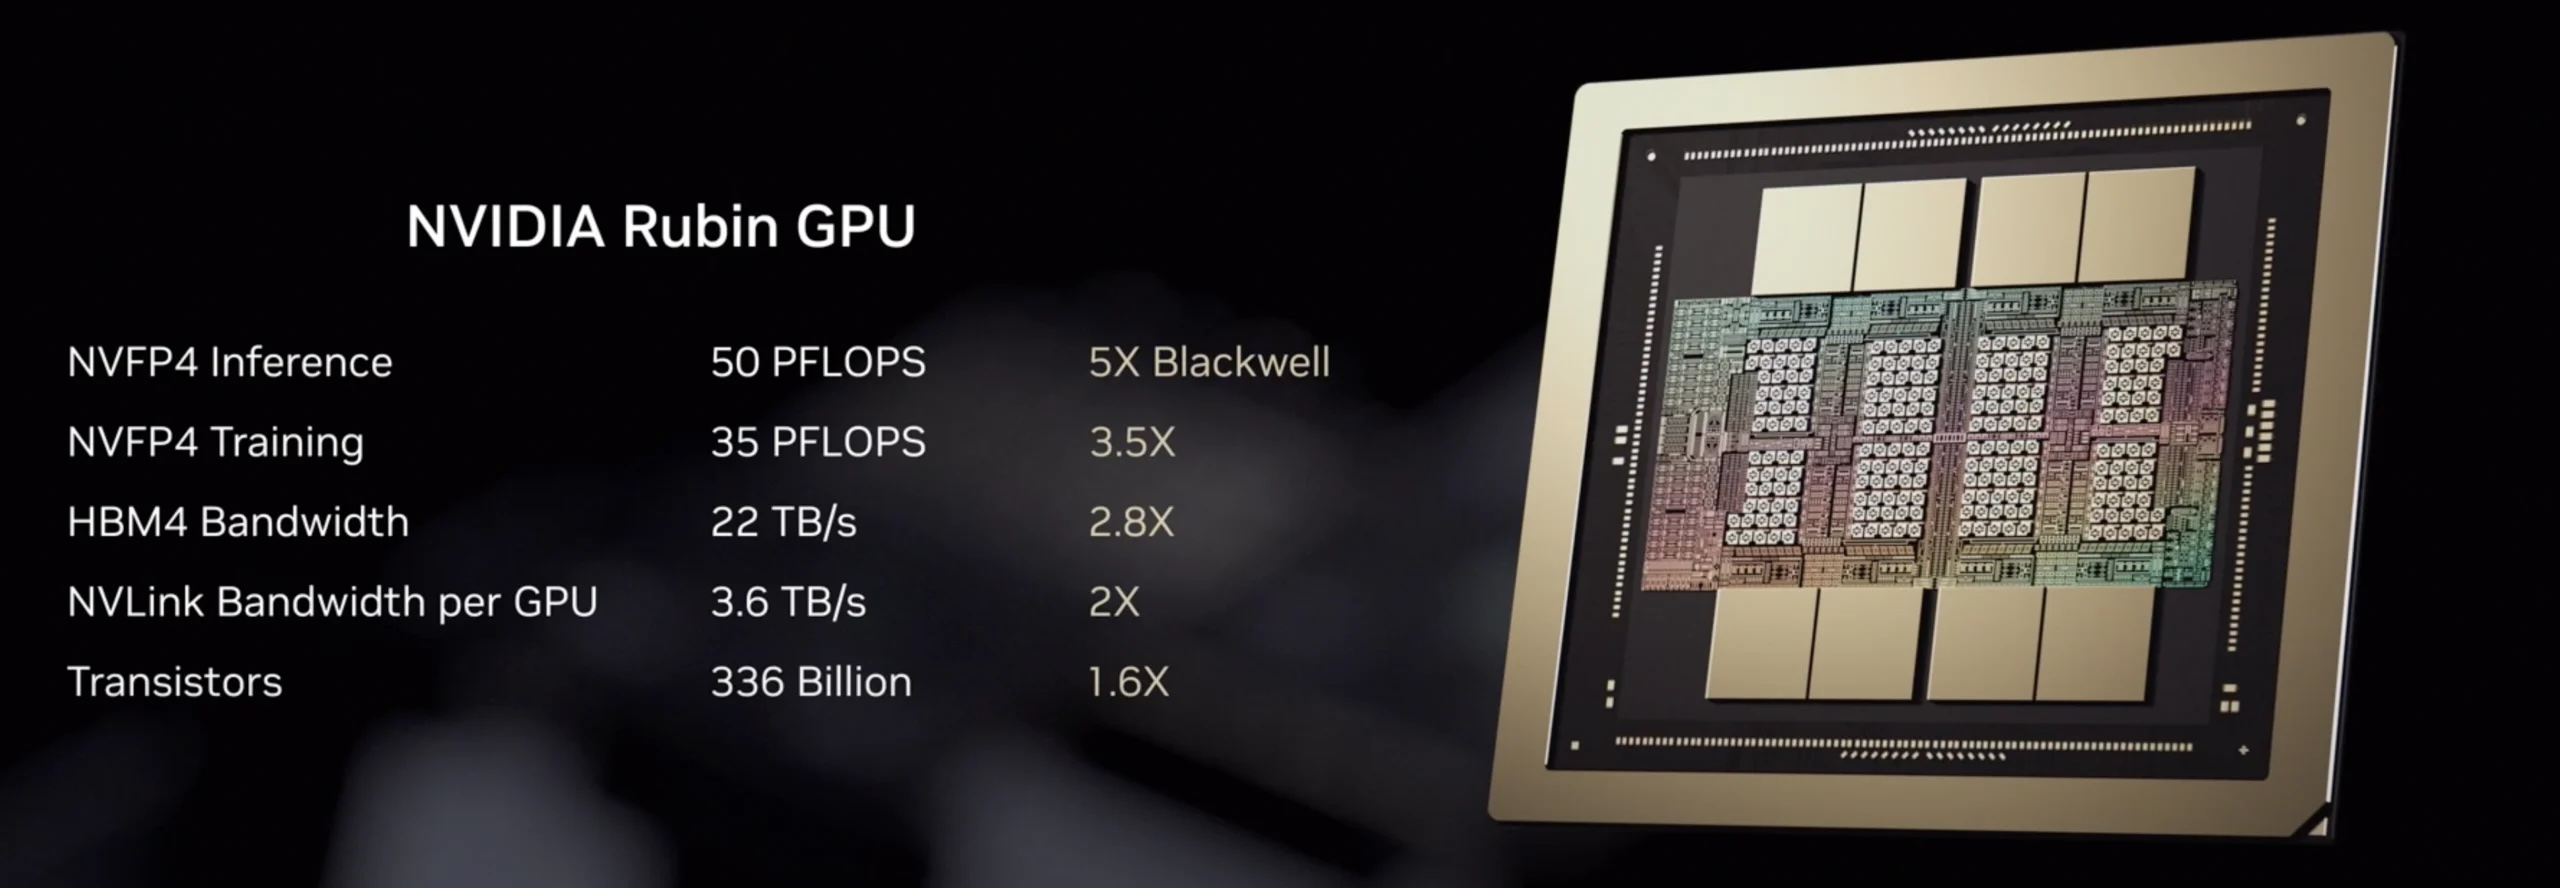
Rubin GPU: Transformer Engines, NVFP4 및 HBM4
다음으로 소개할 제품은 이번 행사의 주인공인 NVIDIA Rubin GPU였습니다. Rubin GPU는 하드웨어 가속 적응형 압축 기능을 갖춘 3세대 Transformer 엔진을 탑재하고 있습니다. 이 기술은 트랜스포머 레이어 전반에 걸쳐 정밀도를 동적으로 조정하여 정밀도를 낮춰도 되는 영역에서는 처리량을 높이고, 중요한 영역에서는 정확도를 유지합니다. 이 NVFP4 구현은 추론에서 50페타플롭스(Blackwell의 5배), 학습에서 35페타플롭스(Blackwell의 3.5배)의 연산 성능을 제공합니다. Rubin GPU는 최대 22TB/s의 대역폭을 가진 HBM4 메모리를 최초로 통합한 제품으로, 대규모 MoE 모델이 직면했던 메모리 대역폭 문제를 해결하는 데 크게 기여할 것입니다.
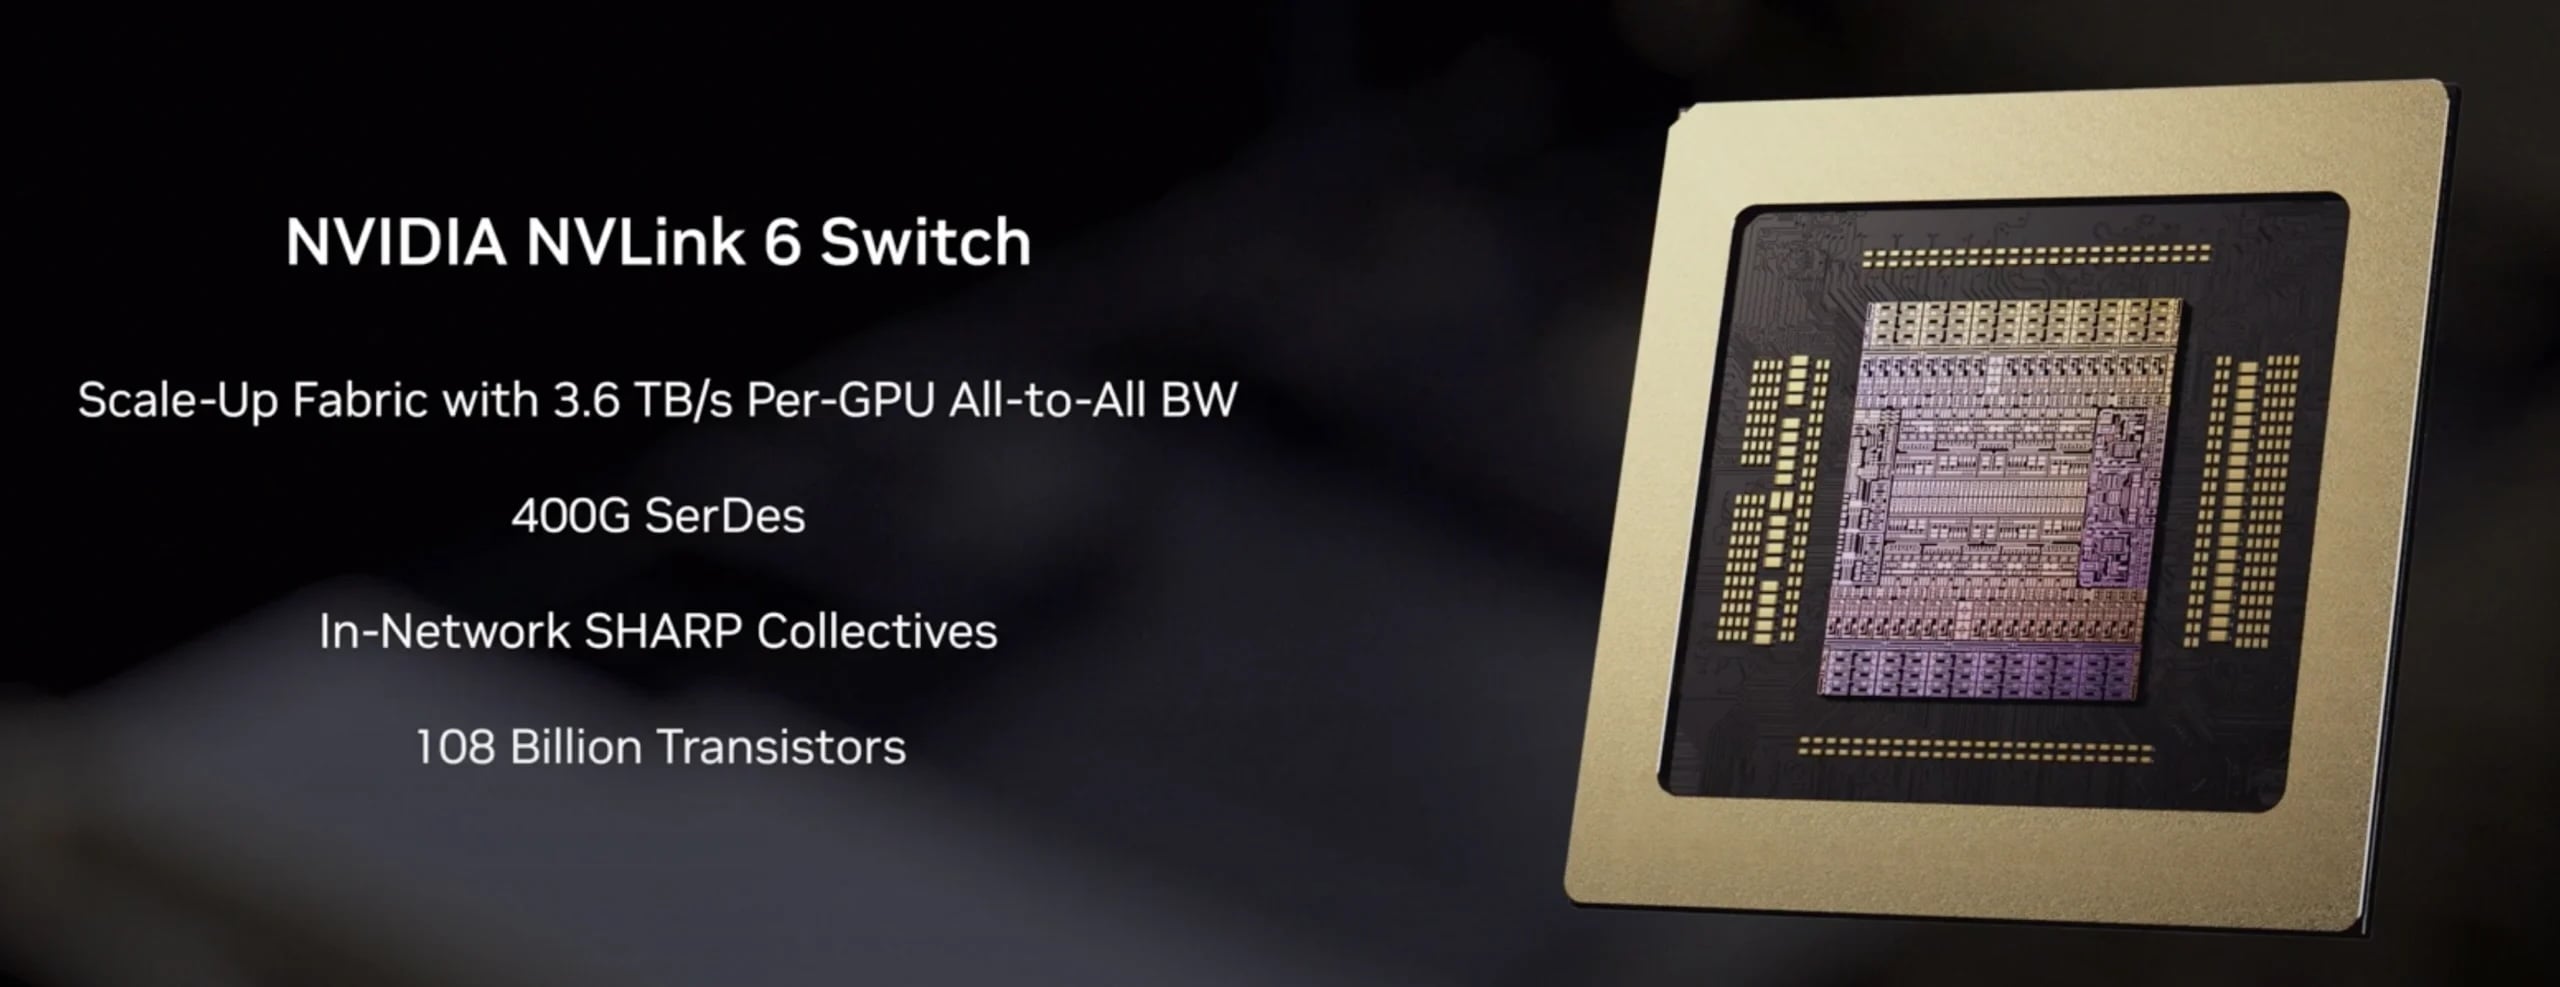
NVLink 6: 랙 규모의 모든 장치 간 통신
NVIDIA NVLink 6 스위치는 GPU당 대역폭을 3.6TB/s로 두 배로 늘려주며, 전체 랙은 260TB/s의 확장형 네트워킹을 제공합니다. 이는 전 세계 인터넷의 단면 대역폭보다 두 배 이상 높은 수치입니다. 이러한 확장형 패브릭을 통해 모든 GPU는 다른 모든 GPU와 동시에 통신할 수 있으며(MoE 전문가 병렬 처리에 필수적), 모든 전문가가 클러스터 전체에서 결과를 공유해야 합니다. 내장된 네트워크 내 컴퓨팅 기능은 집단 연산을 가속화하고 혼잡을 줄여주며, GPU 사이클을 소모하는 작업을 오프로드합니다.
ConnectX-9 SuperNIC: 스케일아웃 네트워킹의 새로운 기준 제시
NVIDIA ConnectX-9 SuperNIC은 확장형 네트워킹을 지원하며, 랙을 넘어선 통신을 위해 GPU당 1.6TB/s의 RDMA 대역폭을 제공합니다. Vera CPU와 공동 설계된 ConnectX-9는 데이터 경로 효율성을 극대화하고, 완전 소프트웨어 정의 방식의 프로그래밍 가능한 가속 데이터 경로를 도입하여 AI 연구소에서 특정 모델 아키텍처에 최적화된 맞춤형 데이터 이동 알고리즘을 구현할 수 있도록 지원합니다.
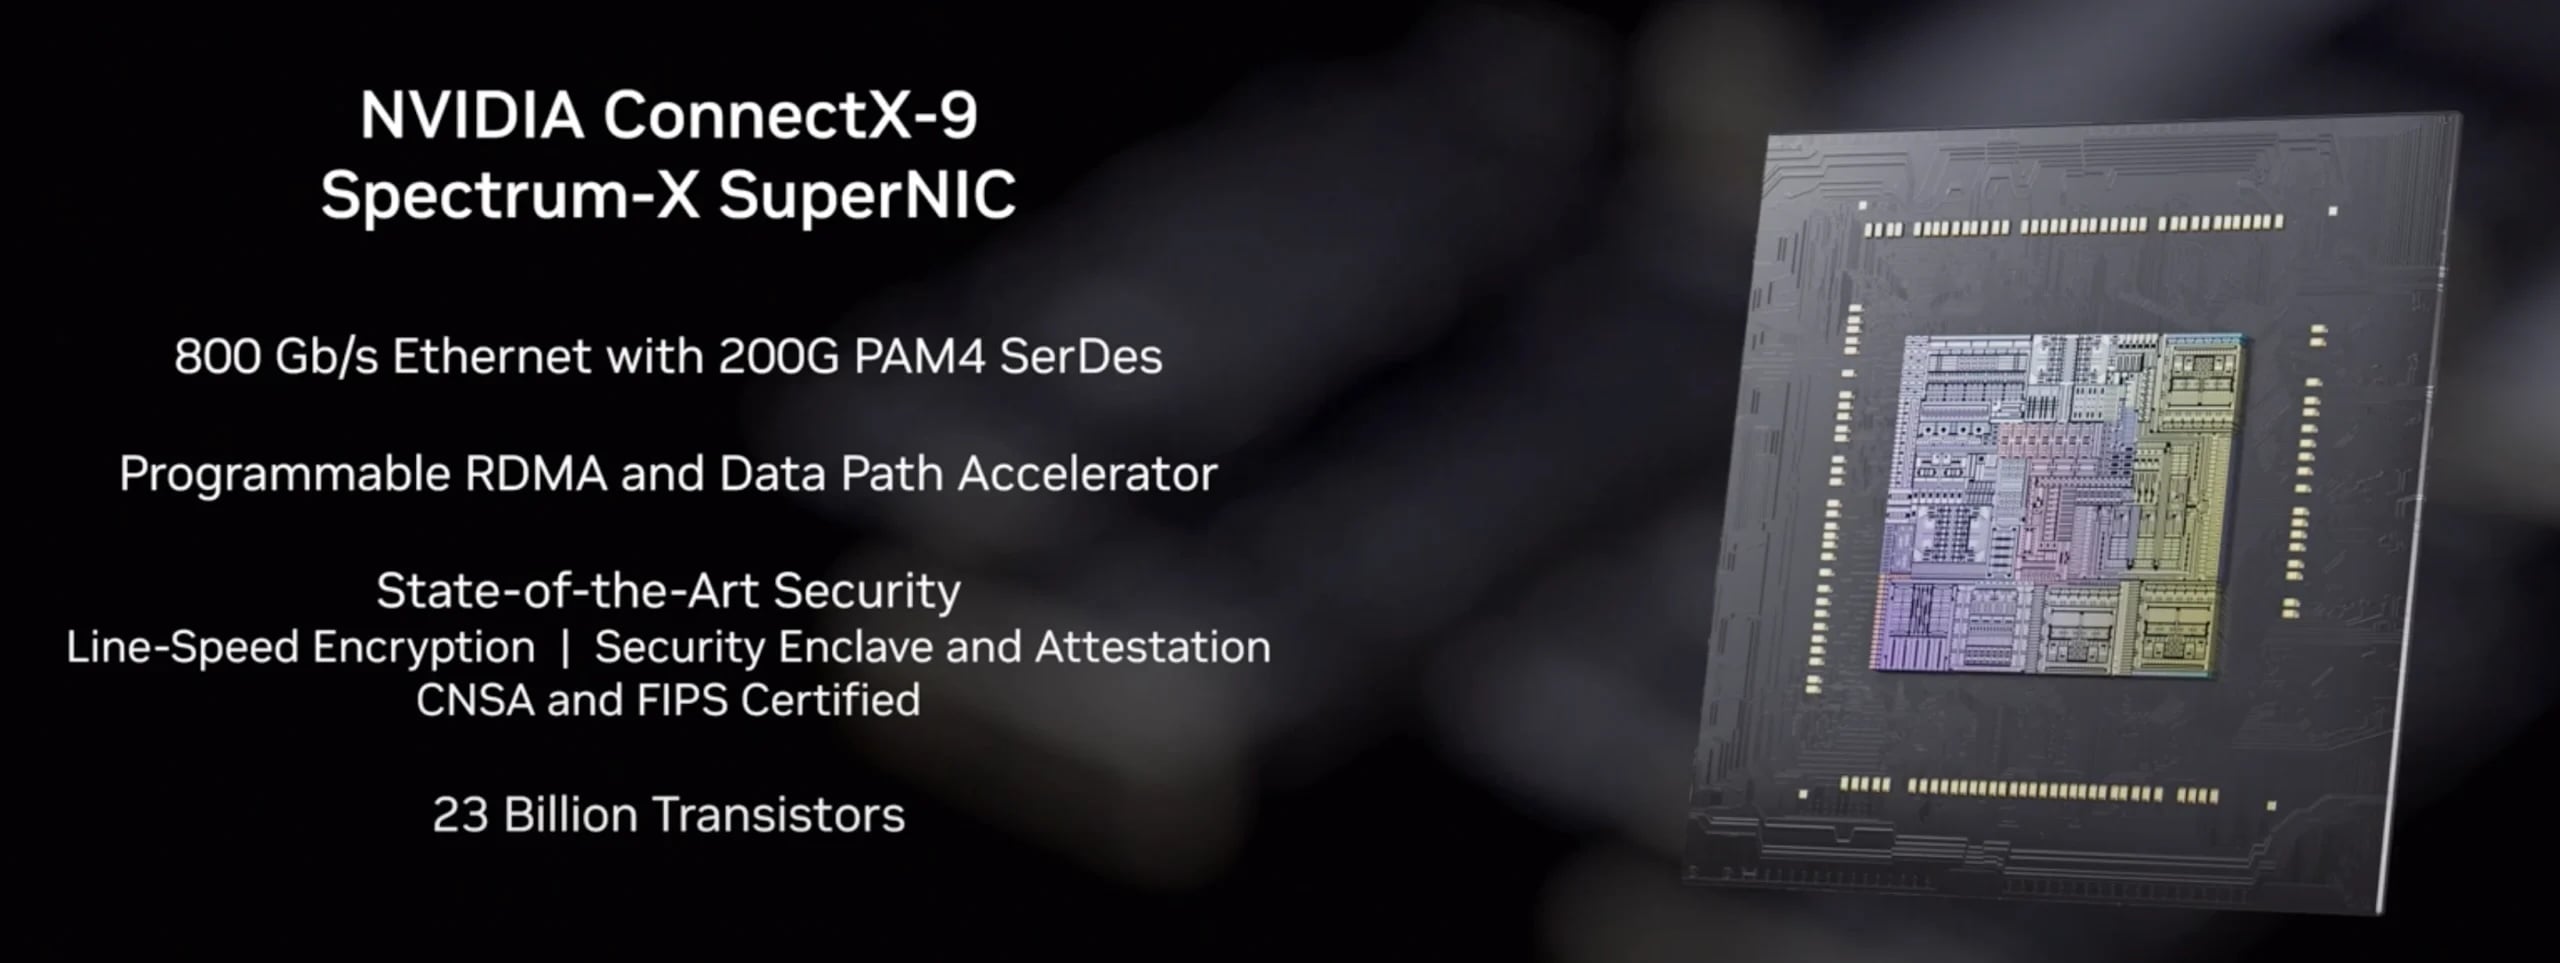
BlueField-4 DPU 및 ASTRA 보안 아키텍처
BlueField-4는 NVIDIA의 4세대 데이터 처리 장치(DPU)로, AI 워크로드를 위한 스토리지 및 네트워킹에 대한 근본적인 재구상을 제시합니다. 새로운 DPU는 BlueField-3의 16개 ARM Cortex-A78 코어와 비교하여 64개의 NVIDIA급 CPU 코어를 탑재하여 컴퓨팅 성능을 6배 향상시켰습니다. 또한 BlueField-3의 ConnectX-7 대신 ConnectX-9 SuperNIC이 통합되어 네트워크 대역폭을 800Gb/s로 두 배로 늘렸습니다. GPU의 데이터 스토리지 접근 속도도 이전 세대보다 2배 빨라졌습니다. 이러한 사양 개선 외에도 BlueField-4의 중요성은 NVIDIA가 대규모 에이전트형 AI에 필수적이라고 강조하는 새로운 AI 네이티브 스토리지 인프라를 구현한다는 데 있습니다.
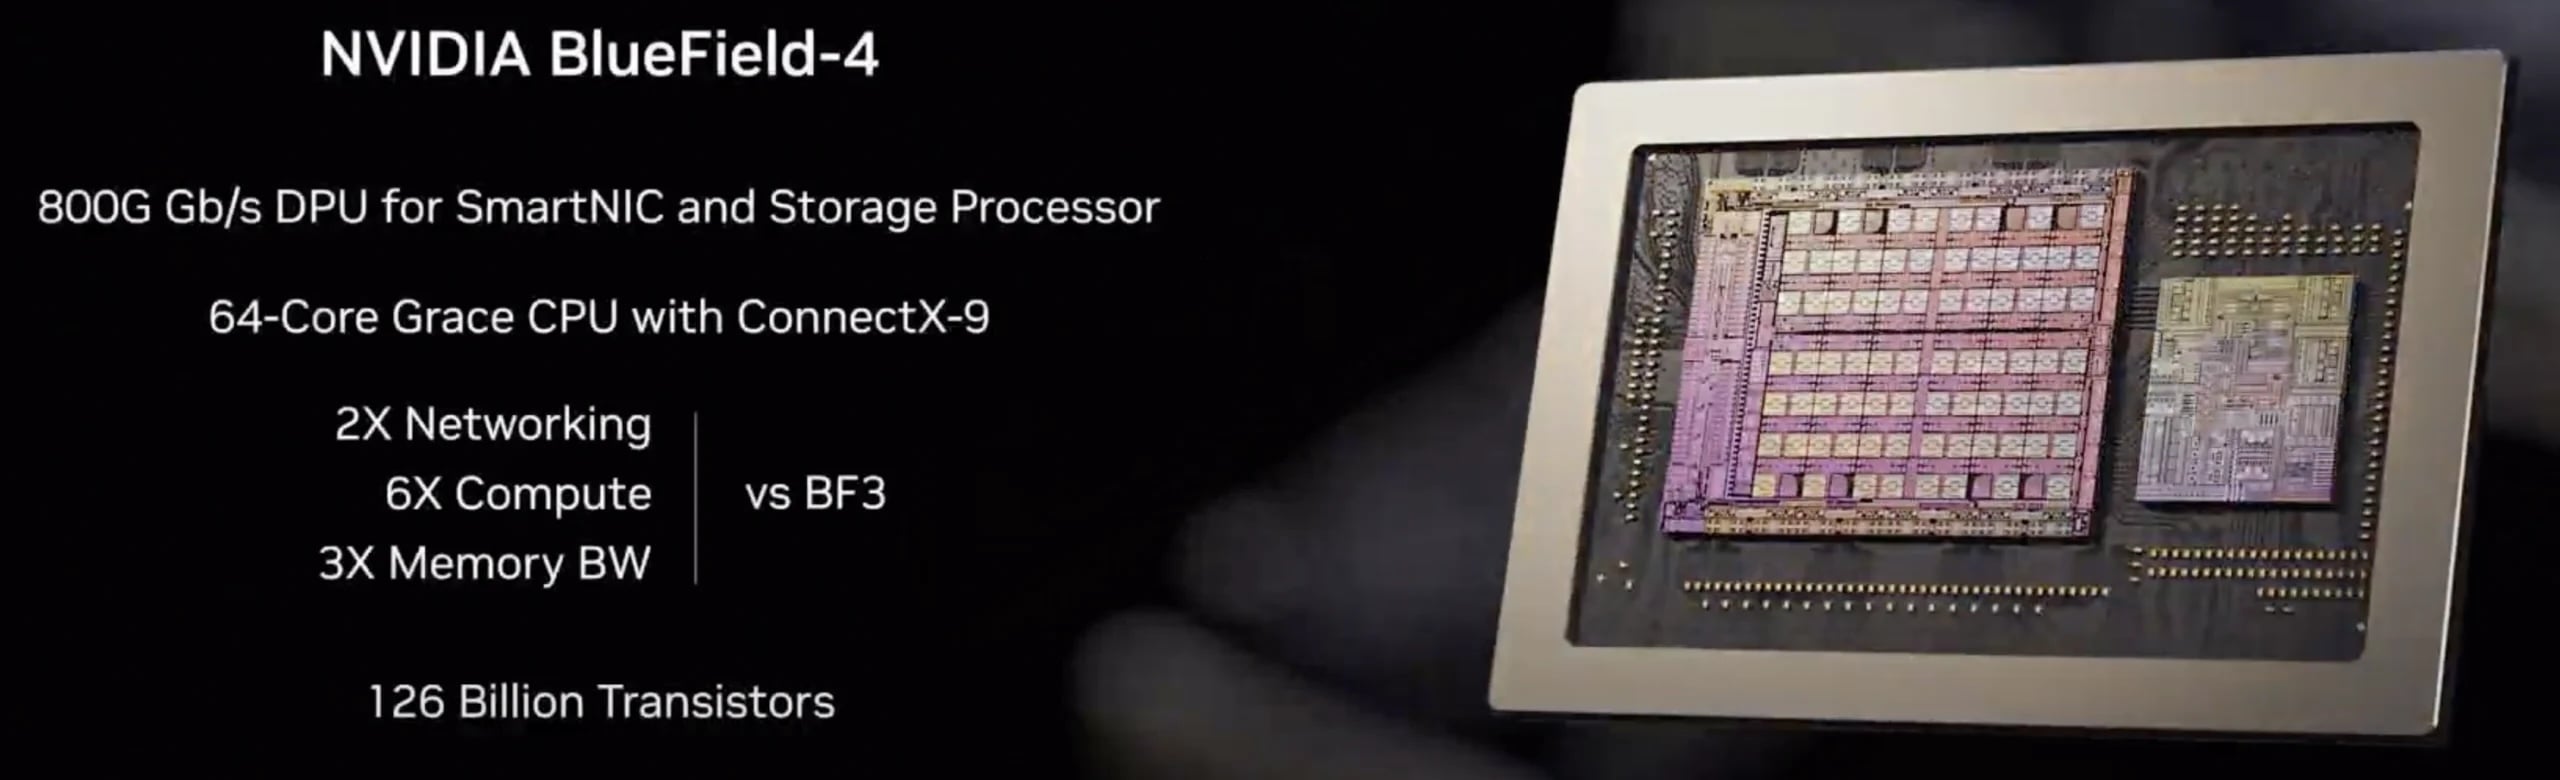
BlueField-4는 네트워킹, 스토리지 및 보안 처리를 오프로드하여 Rubin GPU와 Vera CPU가 모델 실행에 집중할 수 있도록 합니다. 이 제품은 NVIDIA Enterprise AI Factory에서 검증된 설계에 완벽하게 통합되었으며 Red Hat, Palo Alto Networks, Fortinet 등의 에코시스템 지원을 받습니다.
BlueField-4는 ASTRA(Advanced Secure Trusted Resource Architecture)를 도입했습니다. 이 시스템 수준의 신뢰 아키텍처는 성능 저하 없이 대규모 AI 환경을 안전하게 프로비저닝, 격리 및 운영하기 위한 단일 제어 지점을 제공합니다.
랙 전체에 걸친 기밀 컴퓨팅
Vera Rubin NVL72는 시스템 전체에 걸쳐 NVIDIA 기밀 컴퓨팅을 제공하는 최초의 랙 스케일 플랫폼입니다. 3세대 기밀 컴퓨팅은 CPU, GPU 및 전체 NVLink 도메인에서 데이터 보안을 유지하며, 모든 버스는 전송 중에 암호화됩니다. 이는 공유 인프라에서 자체 모델을 실행하는 기업 및 AI 연구소에서 점점 더 중요해지는 문제, 즉 타사 시스템에 배포된 경우에도 모델, 학습 데이터 및 추론 워크로드가 안전하게 보호되도록 보장하는 문제를 해결합니다.
NVIDIA Spectrum-6 이더넷 스위치는 NVIDIA의 스케일아웃 네트워크를 지원합니다. 200G SerDes 기술과 CPO(Co-Packaged Optics)를 기반으로 구축되어 102TB/s의 스위칭 용량을 제공하며 VR NVL72 랙 전체에서 동서 트래픽을 처리합니다. CPO로의 전환은 매우 중요한 의미를 지닙니다. NVIDIA는 광학 모듈을 스위치 실리콘에 직접 통합함으로써 기존의 플러그형 광학 모듈 대비 10배 높은 신뢰성, 5배 긴 가동 시간, 5배 향상된 전력 효율을 달성했다고 주장합니다.

교육부 모델의 비용 및 효율성 개선
NVIDIA는 VR NVL72가 Blackwell과 동일한 지연 시간에서 대규모 전문가 혼합 모델 추론에 필요한 토큰 비용을 7분의 1로 줄인다고 밝혔습니다. 또한 동일한 대규모 MoE 모델을 동일한 시간 내에 학습하는 데 필요한 GPU 개수는 4분의 1에 불과합니다. 이 플랫폼은 와트당 추론 연산 성능을 8배 향상시킵니다.
이러한 개선 사항은 특정 토큰에 대해 전문가의 일부만 활성화하는 MoE 모델의 요구 사항을 충족합니다. Kimi K2 Thinking과 같은 모델은 384명의 전문가를 활용하지만 한 번에 8명만 활성화하므로 대규모 GPU 통신이 필요합니다. VR NVL72의 260TB/s 확장형 네트워킹은 이러한 통신 패턴을 처리합니다.
대규모 확장을 위해 설계된 케이블 없는 랙
VR NVL72는 내부 케이블 대신 PCB와 커넥터만을 사용하는 모듈식, 무케이블, 무팬, 무호스 트레이 설계를 도입했습니다. 컴퓨팅 트레이는 랙에 삽입될 때 블라인드 메이트 커넥터를 통해 연결되므로 수동 케이블 정리가 필요 없습니다. 외부 연결은 액체 냉각 블록에 연결되는 두 개의 액체 유입 및 유출 호스뿐입니다.

이전 시스템(예: GB300 NVL72)은 컴퓨팅 트레이 하나를 조립하는 데 약 100분이 소요되었습니다. 각 케이블 연결부는 잠재적인 고장 지점이었으며, 수십만 개의 GPU가 사용되는 규모에서는 이는 매우 중요한 문제가 되었습니다. 케이블 배선은 냉각 경로를 제한하고 공간을 차지했으며, 팬은 기계적 복잡성과 소음을 증가시켰습니다.
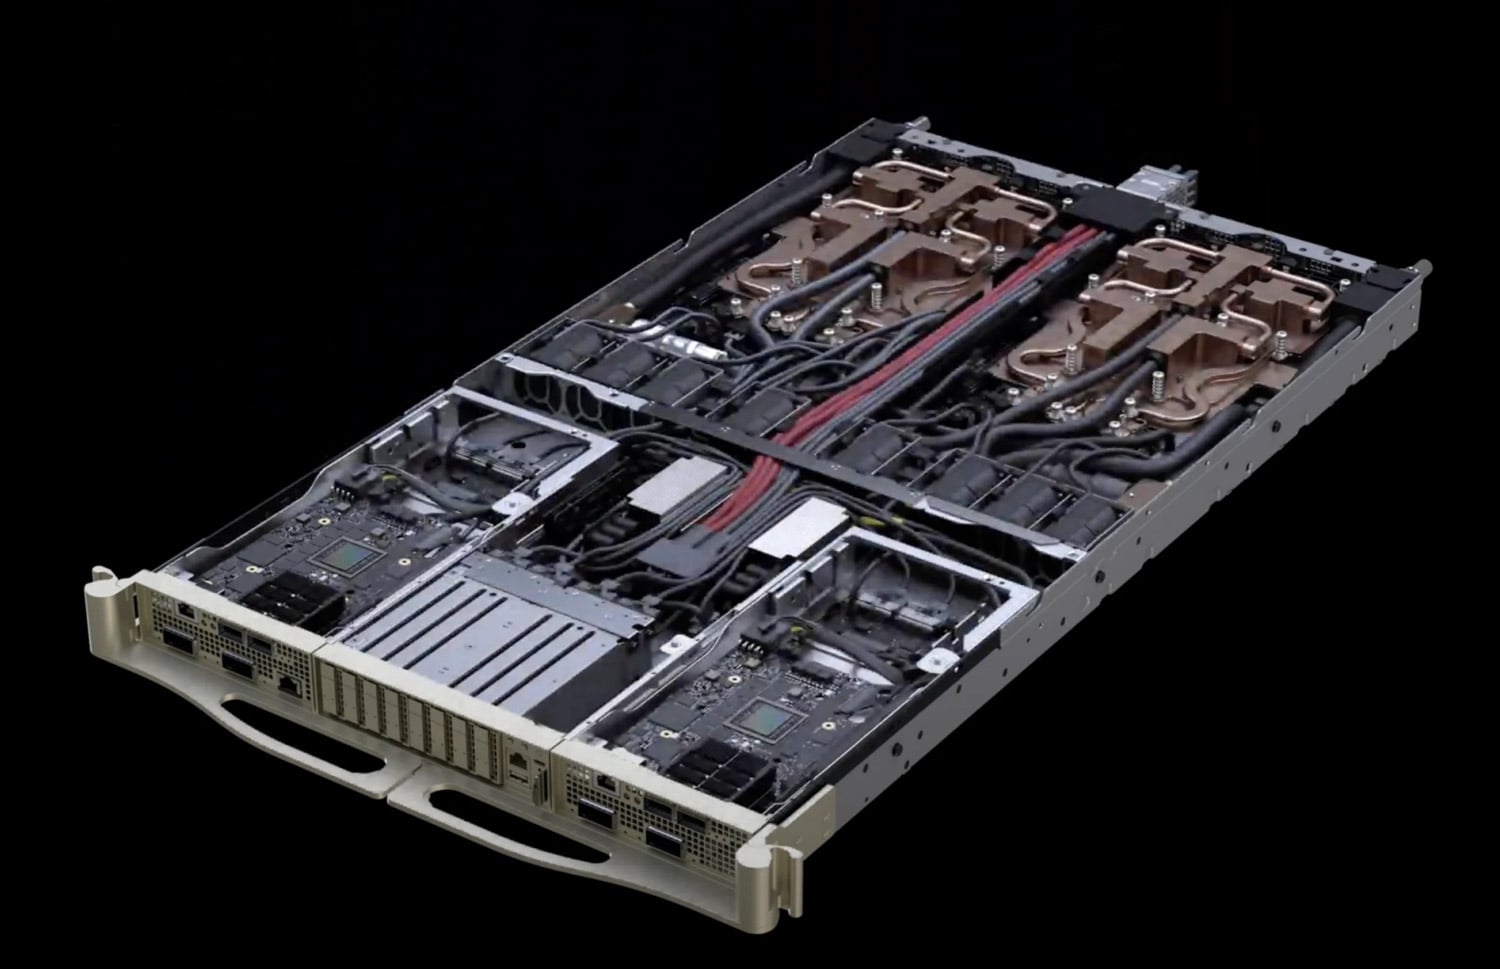
새로운 설계는 조립 및 서비스 시간을 18배 단축합니다. 또한 이 플랫폼은 GPU, CPU 및 NVLink를 아우르는 2세대 RAS(신뢰성, 가용성, 서비스 용이성) 엔진을 탑재하여 실시간 상태 점검, 내결함성 및 사전 예방적 유지 관리를 제공합니다. NVLink 스위치 트레이는 이제 가동 중지 시간 없이 유지 보수를 지원하므로 스위치 트레이를 제거하거나 부분적으로 채우는 동안에도 랙을 계속 운영할 수 있습니다. 수십만 개의 GPU가 있는 규모에서 이러한 서비스 용이성 개선은 클러스터 가동 시간과 처리량 향상으로 직결됩니다.
이 아키텍처는 향후 더욱 고밀도 구성을 가능하게 합니다. 이는 또한 이전에 AI 인프라 서밋에서 소개했던 베라 루빈의 CPX 랙 디자인을 구현하는 데 핵심적인 요소이며 , 이미 고밀도 설계에 컨텍스트 프로세싱 GPU를 동일한 컴퓨팅 슬레드에 추가합니다.
추론 컨텍스트 메모리 저장 플랫폼
NVIDIA는 CES 2026에서 KV 캐시를 위해 특별히 설계된 새로운 AI 네이티브 스토리지 인프라인 추론 컨텍스트 메모리 스토리지 플랫폼(Inference Context Memory Storage Platform)을 발표했습니다. 이 플랫폼은 BlueField-4 및 Spectrum-X 이더넷 네트워킹을 기반으로 하며, 추론 컨텍스트에 사용되는 기존 네트워크 스토리지보다 초당 최대 5배 높은 토큰 처리 속도, 총소유비용(TCO) 대비 최대 5배 높은 성능, 최대 5배 높은 전력 효율성, 그리고 최초 토큰 획득 시간(Time-to-First Token, TTT) 20배 단축을 제공합니다. BlueField-4의 하드웨어 가속 KV 캐시 배치는 메타데이터 오버헤드를 제거하고 데이터 이동을 최소화하며, Spectrum-X 이더넷은 RDMA 기반 액세스를 위한 고대역폭, 저지연 패브릭을 제공합니다.
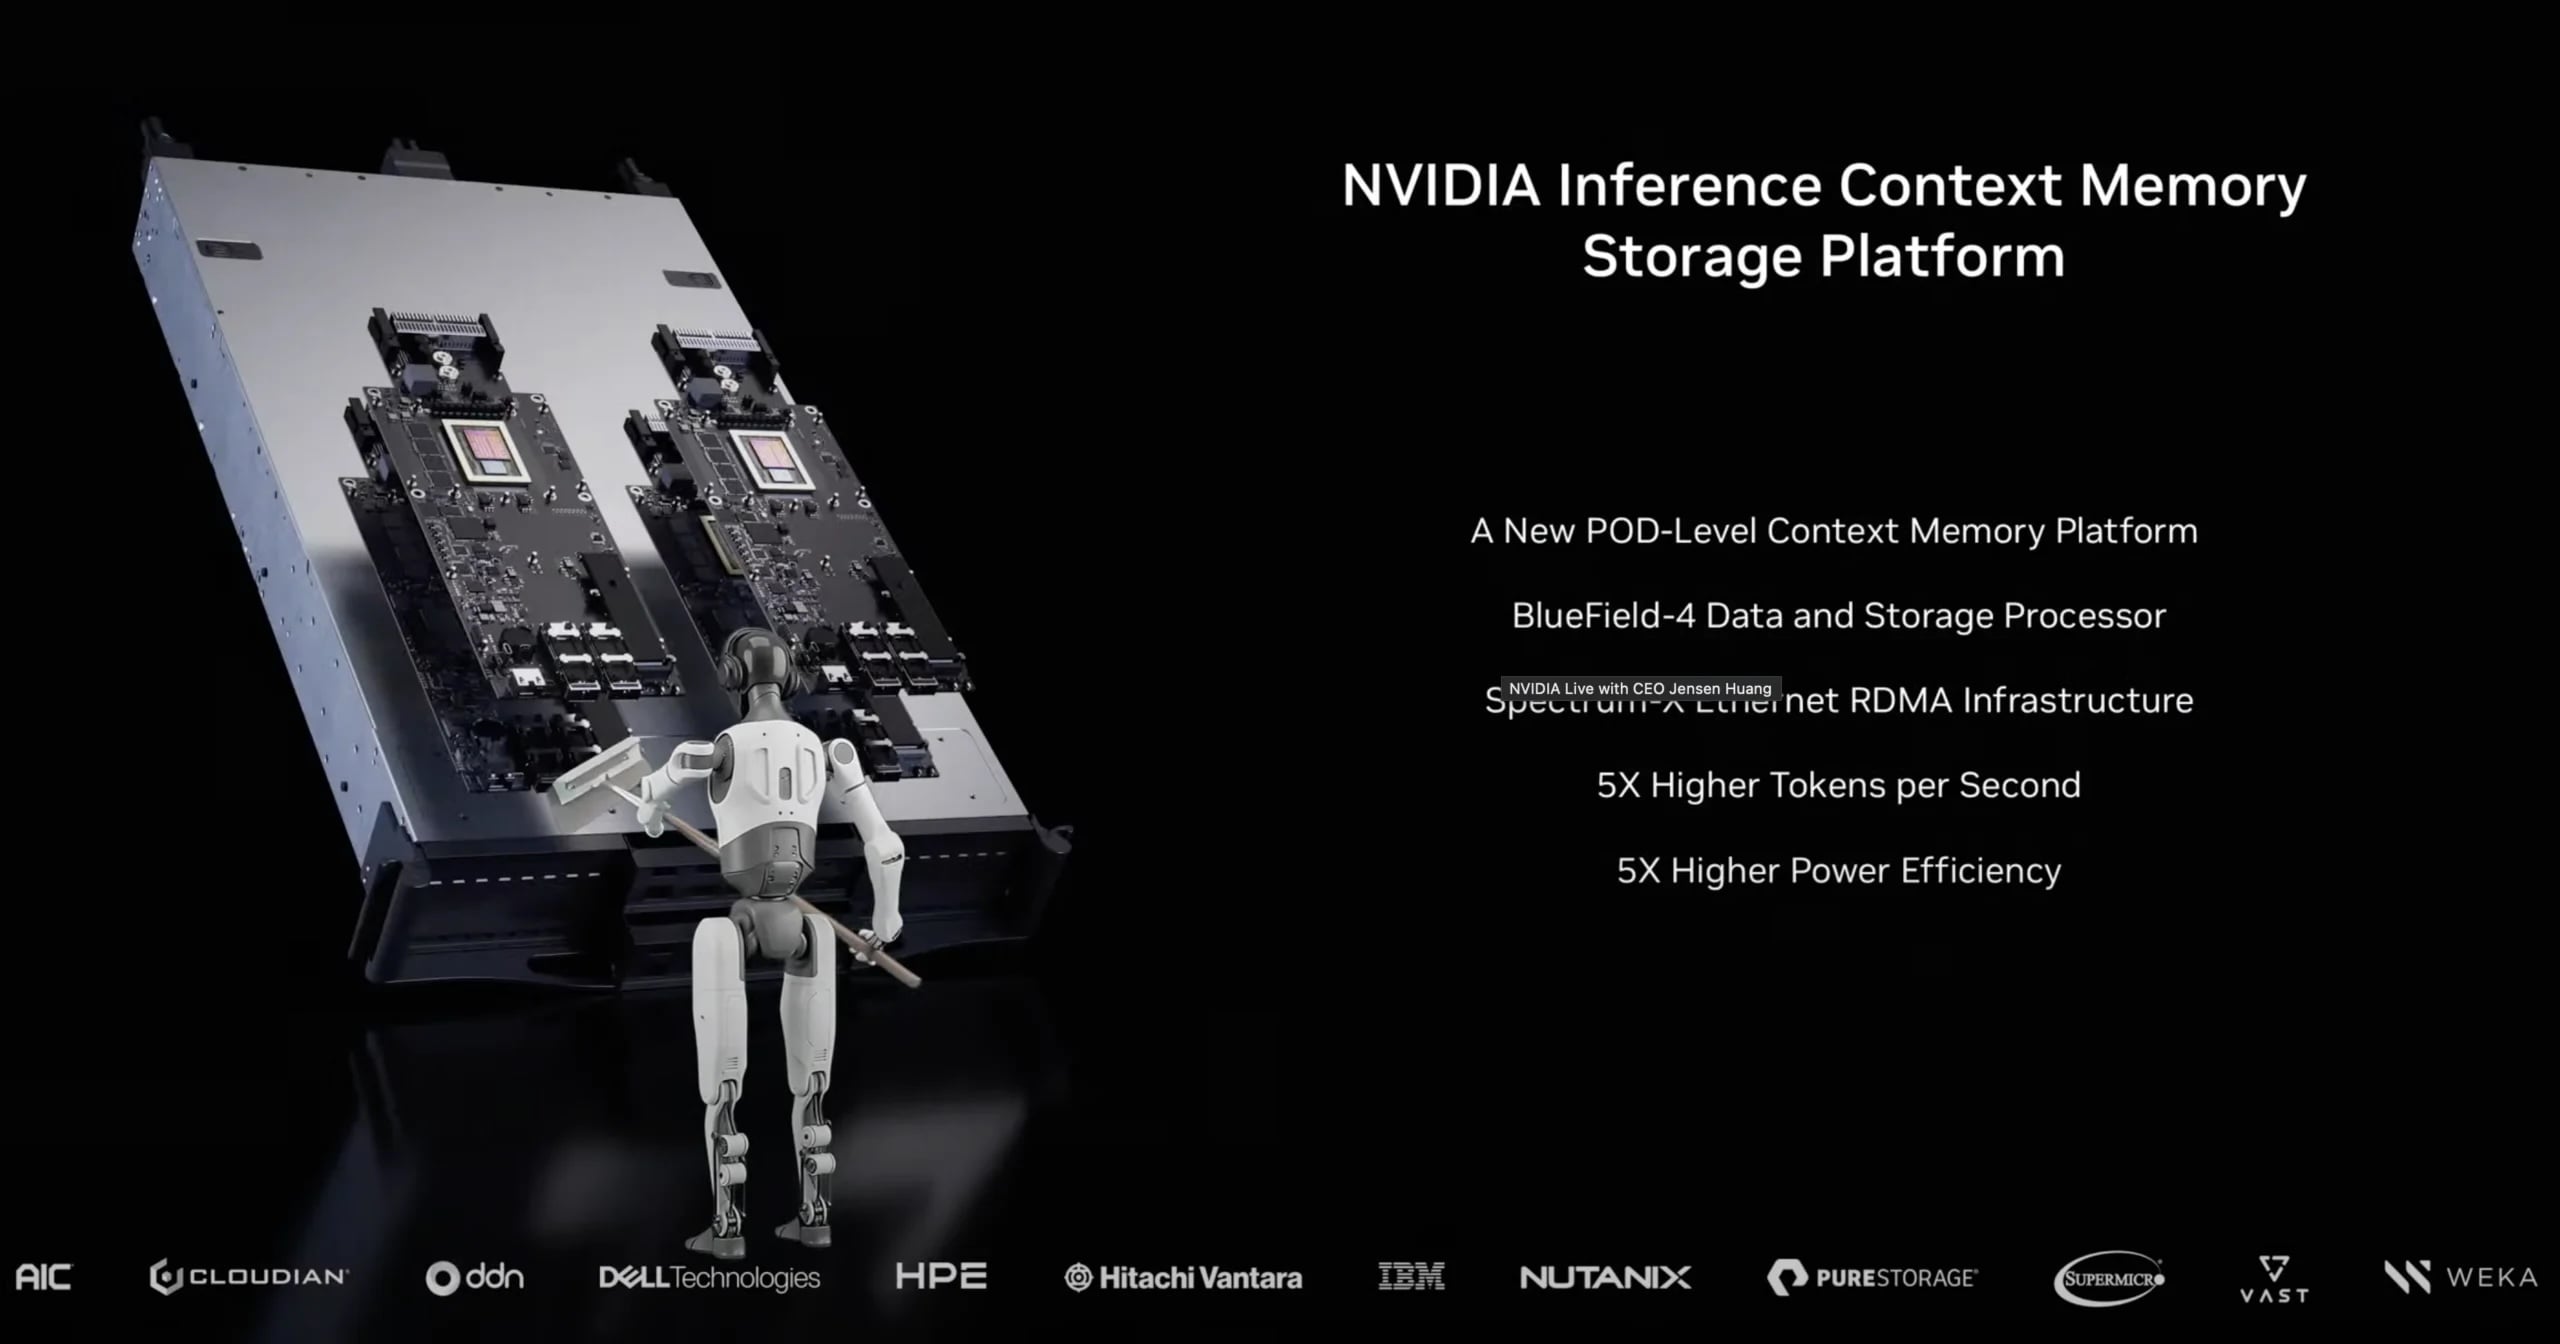
이 플랫폼은 LLM 추론에서 점점 심각해지는 병목 현상인 키-값(KV) 캐시 관리 문제를 해결합니다. 트랜스포머 모델은 생성된 각 토큰이 이전의 모든 토큰을 고려해야 하는 어텐션 메커니즘을 사용합니다. 캐싱이 없으면 모든 토큰에 대해 키-값 벡터를 다시 계산해야 하므로 시간 복잡도가 O(n²)이 됩니다. KV 캐싱은 이러한 사전 계산된 행렬을 메모리에 저장하여 재사용함으로써 시간 복잡도를 O(n)으로 줄입니다. 하지만 문제는 KV 캐시 크기가 시퀀스 길이와 배치 크기에 비례하여 선형적으로 증가한다는 것입니다. 단일 장문 컨텍스트 대화는 수 기가바이트의 메모리를 소비할 수 있습니다. 멀티테넌트 환경에서는 수백만 개의 토큰에 이르는 컨텍스트 윈도우에 걸쳐 수천 개의 동시 요청을 처리해야 하므로 GPU HBM이 한계에 도달합니다. 운영자는 배치 크기를 줄이거나, 컨텍스트 윈도우를 단축하거나, 더 많은 GPU를 구매해야 합니다.
기존 네트워크 스토리지는 수많은 동시 세션에 분산된 수 테라바이트 규모의 임시 데이터에 대한 저지연 랜덤 액세스가 필요한 KV 캐시 액세스 패턴에 맞게 설계되지 않았습니다. 추론 컨텍스트 메모리 스토리지 플랫폼(Inference Context Memory Storage Platform)은 GPU HBM과 기존 스토리지 사이에 위치하여 이러한 워크로드에 최적화된 전용 스토리지 계층을 제공합니다. 이를 통해 AI 팩토리는 GPU 컴퓨팅 성능과 관계없이 컨텍스트 용량을 확장할 수 있습니다. 이전에 Pliops의 KV 캐시 가속기를 사용하여 NVIDIA Dynamo에서 KV 캐시 오프로딩이 어떻게 작동하는지 다룬 바 있습니다. NVIDIA는 NVIDIA 추론 컨텍스트 메모리 스토리지 플랫폼을 통해 이를 확장하고 오픈 소스 Dynamo 프로젝트와 통합합니다. 이 플랫폼은 분산된 사전 채우기/디코딩 단계, 스마트 라우팅, 계층형 스토리지 오프로딩을 통합하는 소프트웨어 프레임워크를 제공합니다.
VAST Data, NetApp, DDN, Dell Technologies, HPE, Hitachi Vantara, IBM, Nutanix, Pure Storage, WEKA를 포함한 스토리지 파트너사들은 BlueField-4 기반 플랫폼을 구축하고 있으며, 이 플랫폼들은 2026년 하반기에 출시될 예정입니다.
Alpamayo: 자율주행 차량을 위한 추론 기반 물리적 AI
NVIDIA는 안전하고 추론 기반의 자율주행차(AV) 개발을 가속화하도록 설계된 개방형 AI 모델, 시뮬레이션 도구 및 데이터 세트인 Alpamayo 제품군을 발표했습니다. Alpamayo 제품군은 인간과 유사한 사고 과정을 자율주행차의 의사 결정에 적용하는 사고 연쇄형 추론 기반 비전-언어-행동 모델을 도입했습니다. NVIDIA Halo 안전 시스템이 이러한 시스템의 기반이 됩니다.
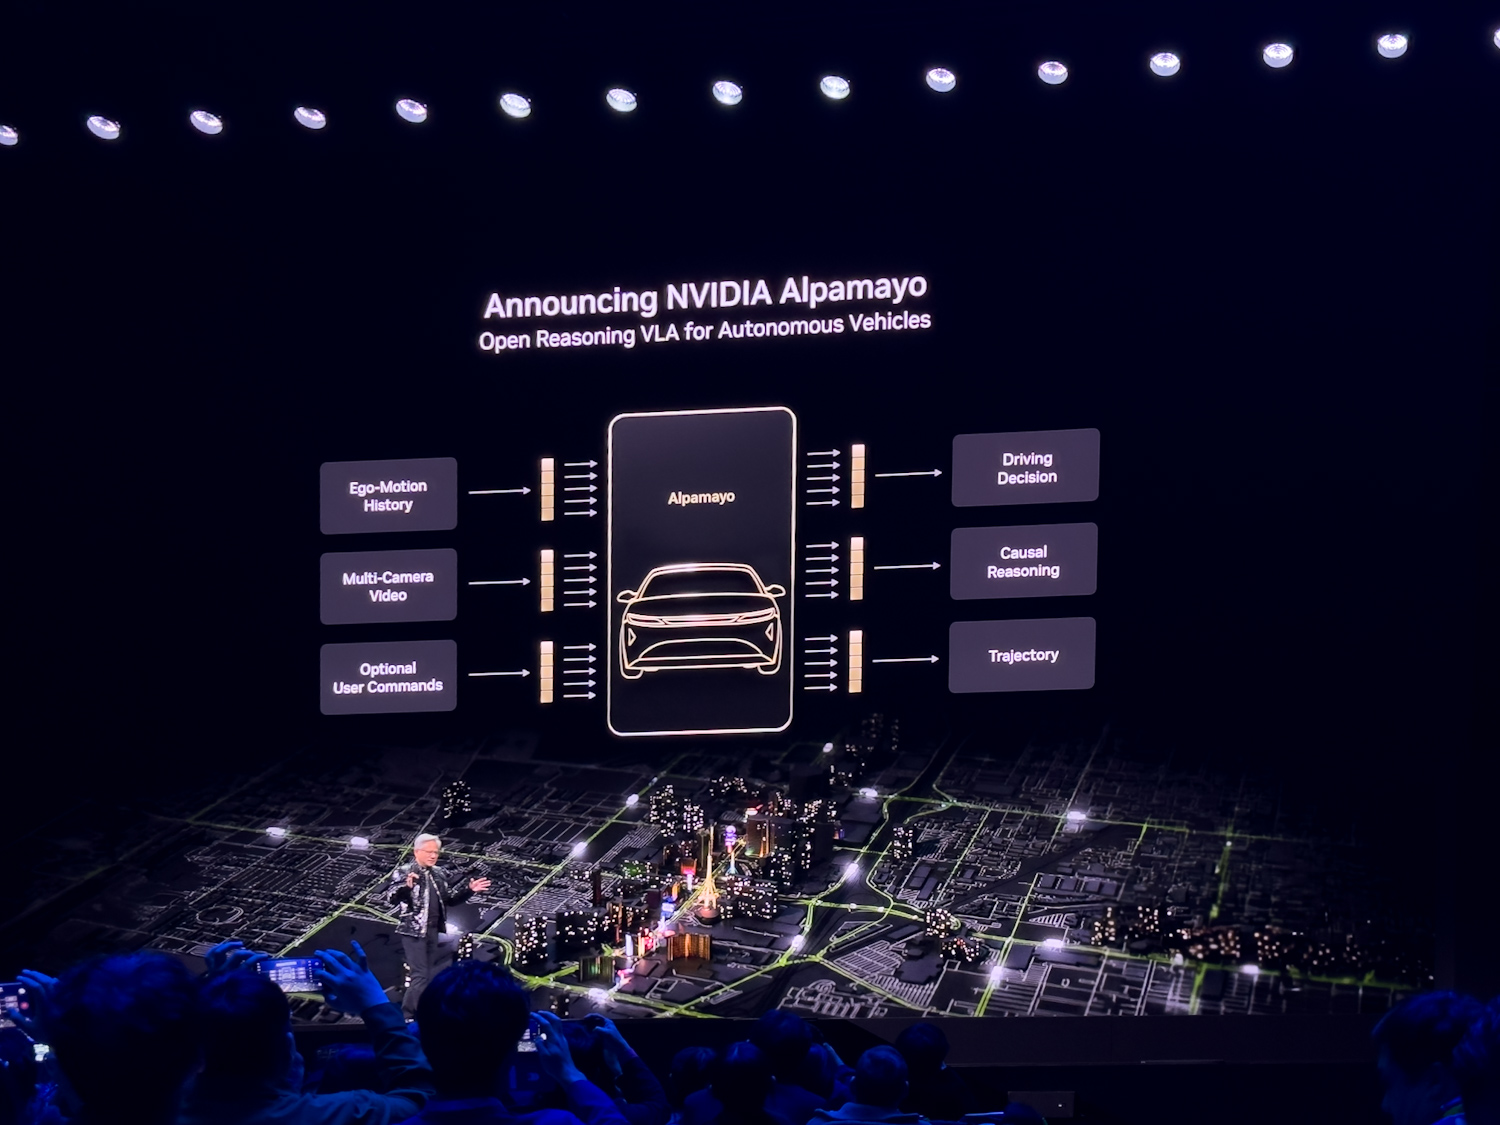
기존 자율주행 아키텍처는 상황 인지와 계획을 분리하여 새로운 상황이나 예측 불가능한 상황이 발생할 때 확장성이 제한될 수 있습니다. 드물고 복잡한 시나리오가 끊임없이 발생하는 이른바 "롱테일(long tail)" 현상은 자율주행 시스템이 안전하게 대처하기 가장 어려운 과제 중 하나입니다. 알파마요(Alpamayo)는 모델이 인과관계를 추론하고, 새로운 시나리오를 단계별로 분석하여 주행 능력과 설명력을 향상시킴으로써 이러한 문제를 해결합니다.
알파마요 모델은 차량에서 직접 실행되는 대신, 개발자가 미세 조정하고 정제하여 완전한 자율주행 시스템 스택의 핵심으로 활용할 수 있는 대규모 교육 모델 역할을 합니다. 개발자는 알파마요를 차량 개발을 위한 더 작은 런타임 모델로 변환하거나, 추론 기반 평가 도구 및 자동 라벨링 시스템과 같은 자율주행 개발 도구의 기반으로 사용할 수 있습니다.
알파마요 모델, 시뮬레이션 및 공개 데이터 세트
Alpamayo 1은 업계 최초의 추론 연쇄형 VLA(비디오 추론 분석) 모델로, AV 연구 커뮤니티를 위해 설계되었으며 Hugging Face에서 이용할 수 있습니다. 10억 개의 파라미터를 가진 아키텍처를 기반으로, Alpamayo 1은 비디오 입력을 사용하여 추론 과정과 함께 궤적을 생성하고 각 결정의 논리를 보여줍니다. Alpamayo 1은 오픈 소스 모델 가중치와 추론 스크립트를 제공합니다. 향후 출시될 모델들은 더 많은 파라미터, 더욱 상세한 추론 기능, 향상된 입력 및 출력 유연성, 그리고 상업적 활용 옵션을 제공할 예정입니다.
AlpaSim은 GitHub에서 이용 가능한, 고정밀 자율주행차 개발을 위한 완전 오픈소스 엔드투엔드 시뮬레이션 프레임워크입니다. 현실적인 센서 모델링, 구성 가능한 교통 역학, 확장 가능한 폐쇄 루프 테스트 환경을 제공하여 신속한 검증 및 정책 개선을 가능하게 합니다.
Physical AI 오픈 데이터셋은 광범위한 지역과 환경에서 수집된 1,700시간 이상의 운전 데이터를 포함하고 있으며, 추론 아키텍처 발전에 필수적인 희귀하고 복잡한 실제 상황을 다룹니다. 이 데이터셋은 Hugging Face에서 이용할 수 있습니다.
개발자는 자체 항공기 데이터를 기반으로 Alpamayo 모델을 세밀하게 조정하고, NVIDIA DRIVE AGX Thor 가속 컴퓨팅으로 구축된 NVIDIA DRIVE Hyperion 아키텍처에 통합하고, 상용 배포 전에 시뮬레이션에서 성능을 검증할 수 있습니다.
NVIDIA DRIVE, 이중화된 AV 스택 및 메르세데스-벤츠 CLA
NVIDIA는 수천 명의 팀원들과 함께 8년 동안 자율주행차 개발에 매진해 왔습니다. 이 회사는 칩(듀얼 오린, 차세대 듀얼 토르), 인프라(옴니버스 및 코스모스), 모델(알파마요), 애플리케이션 레이어 등 전체 스택을 구축했습니다. 메르세데스-벤츠는 5년 전 NVIDIA와 협력하여 이 스택을 도입했습니다.
NVIDIA가 개발한 최초의 풀스택 자율주행 차량인 메르세데스-벤츠 CLA는 2026년 1분기에 미국, 2분기에 유럽, 그리고 3/4분기에 아시아에서 출시될 예정입니다. 유로 NCAP는 CLA에 2025년 평가에 제출된 모든 차량 중 최고 수준의 능동 안전 등급을 부여했습니다. 시스템의 모든 코드와 칩은 안전 인증을 획득했습니다.

이 시스템은 두 개의 완전한 자율주행(AV) 스택을 병렬로 실행합니다. 알파마요 스택은 사고 연쇄 추론 방식을 사용하여 복잡한 주행 시나리오를 처리합니다. 그 아래에 있는 두 번째 기존 자율주행 스택은 완벽한 추적성을 갖추고 있으며 개발에 6~7년이 걸렸습니다. 정책 및 안전 평가자는 신뢰도 수준에 따라 어떤 스택을 사용할지 결정합니다. 알파마요 스택이 확신이 부족한 시나리오에 직면하면 기존 스택으로 전환됩니다. 이러한 소프트웨어의 다양성과 중복성은 안전에 중요한 시스템에서 하드웨어 중복성을 활용하는 방식과 유사합니다.
NVIDIA는 Alpamayo의 새로운 버전을 통해 시스템을 지속적으로 업데이트할 예정입니다. JLR, Lucid, Uber, Berkeley DeepDrive를 포함한 모빌리티 파트너들은 추론 기반 레벨 4 자율주행 개발에 Alpamayo를 사용하고 있습니다.
새로운 물리적 AI 모델 및 로봇 발표
NVIDIA는 CES 2026에서 인프라 및 시스템 발표와 더불어 로봇 개발을 가속화하기 위한 새로운 오픈 모델, 프레임워크 및 엣지 플랫폼을 공개하며 물리 AI 전략을 강화했습니다. 회사는 로봇 학습을 위한 코스모스(Cosmos) 월드 모델과 GR00T 추론 모델의 업데이트 버전을 소개했으며, 대규모 로봇 평가를 위한 새로운 오픈 소스 툴(Isaac Lab-Arena 포함)도 선보였습니다. OSMO는 이기종 컴퓨팅 환경 전반에 걸쳐 학습 워크플로우를 간소화하도록 설계된 엣지-클라우드 오케스트레이션 프레임워크입니다.

NVIDIA는 보스턴 다이내믹스, 캐터필러, LG전자, 뉴라 로보틱스 등 파트너사들이 NVIDIA 기술 기반의 차세대 자율 로봇을 선보이며 자사 로봇 스택이 업계 전반에 걸쳐 널리 채택되고 있음을 강조했습니다. 또한 NVIDIA는 허깅 페이스(Hugging Face)와의 협력을 강화하여 NVIDIA Isaac 및 GR00T 모델을 오픈소스 LeRobot 프레임워크에 통합함으로써 전 세계 로봇 개발자 커뮤니티의 접근성을 더욱 확대할 것이라고 발표했습니다.
엣지 컴퓨팅 분야에서 NVIDIA는 블랙웰 기반 젯슨 T4000 모듈의 출시를 확정 발표하며, 자율 기계 및 산업용 로봇 분야에서 AI 컴퓨팅 성능과 에너지 효율성을 크게 향상시킨다고 밝혔습니다. 이러한 발표는 NVIDIA가 데이터 센터를 넘어 시뮬레이션, 모델링, 엣지 컴퓨팅, 그리고 로봇 및 자율 시스템 전반에 걸친 실제 배포에 이르기까지 풀 스택 AI 플랫폼을 확장하려는 노력을 더욱 강화하는 것입니다.


 아마존