

엔비디아는 블랙웰 GPU 아키텍처를 위해 개발된 새로운 기법인 헬릭스 병렬화(Helix Parallelism)를 선보였습니다. 이 기법은 매우 방대한 데이터셋을 처리하는 실시간 AI 성능을 향상시키기 위한 것입니다. 이 기법은 LLM(Local Learning Machine)이 수백만 개의 토큰 컨텍스트를 처리해야 하는 증가하는 요구에 부응합니다. 엔비디아는 이 접근법이 기존 방식보다 최대 32배 빠른 처리 속도를 제공하여 더욱 복잡하고 반응성이 뛰어난 AI 애플리케이션을 구현할 수 있음을 입증했습니다.
백만 토큰 챌린지: AI에 새로운 접근 방식이 필요한 이유
AI의 경계는 단순한 질의를 넘어 복잡하고 장기적인 추론으로 확장되었습니다. 고급 애플리케이션은 효과를 발휘하기 위해 매우 광범위한 맥락을 필요로 합니다. 수개월 분의 대화를 기억하는 AI 비서, 기가바이트 단위의 판례를 한 번에 분석하는 법률 도구, 전체 저장소를 이해하는 코딩 파트너 등. 이러한 작업에는 수백만 개의 토큰 처리가 필요합니다.
그러나 이 수준까지 확장하면 두 가지 근본적인 병목 현상이 발생합니다.
- KV 캐시 병목 현상: 자기회귀 토큰 생성 시, 모델은 이차 스케일링 인자를 피하기 위해 이전에 생성된 토큰에 대한 어텐션(attention)을 계산합니다. 이를 위해 이전에 생성된 토큰을 캐시하는데, 이 프로세스를 KV 캐시라고 합니다. 수백만 개의 토큰 컨텍스트가 있는 경우, 이 캐시는 엄청나게 커져 GPU 메모리 대역폭을 포화시키고 응답 시간을 크게 지연시킵니다.
- FFN 가중치 병목 현상: 모델이 생성하는 모든 새 토큰에 대해 메모리에서 방대한 피드포워드 네트워크(FFN) 가중치를 로드해야 합니다. 지연 시간이 짧은 대화형 애플리케이션에서는 이러한 지속적인 로드 프로세스가 지연의 주요 원인이 됩니다.
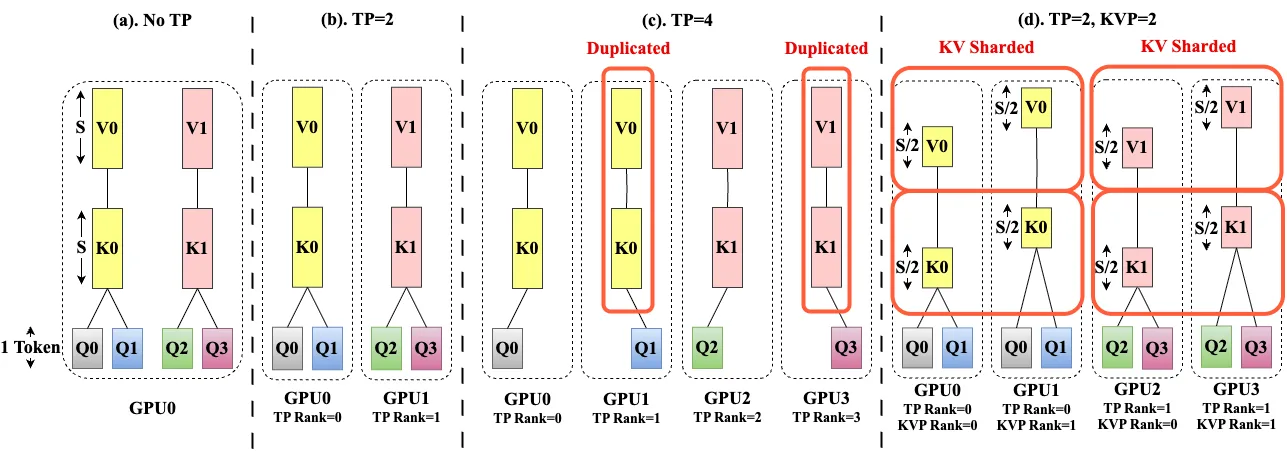
현재 우리는 모델의 텐서와 그에 따른 메모리 및 연산 작업을 여러 GPU로 분할하는 텐서 병렬화(Tensor Parallelism)와 같은 방법에 의존하고 있습니다. 일부 작업에서는 효과적이지만, 새로운 어텐션 메커니즘이 등장하면서 그 이점이 감소합니다. GQA(Grouped Query Attention)나 MLA(Multi-Latent Attention)와 같은 어텐션 메커니즘에서는 메모리 사용량을 줄이기 위해 여러 쿼리 헤드가 더 작은 KV 헤드 세트를 공유합니다. 그러나 텐서 병렬화 크기가 KV 헤드 수를 초과하면 모든 단계에서 GPU 간 통신으로 인해 상당한 지연 시간이 발생하여 KV 헤드 복제가 필요하게 됩니다. 이러한 복제는 텐서 병렬화의 일부 이점을 무효화합니다.
나선 평행성
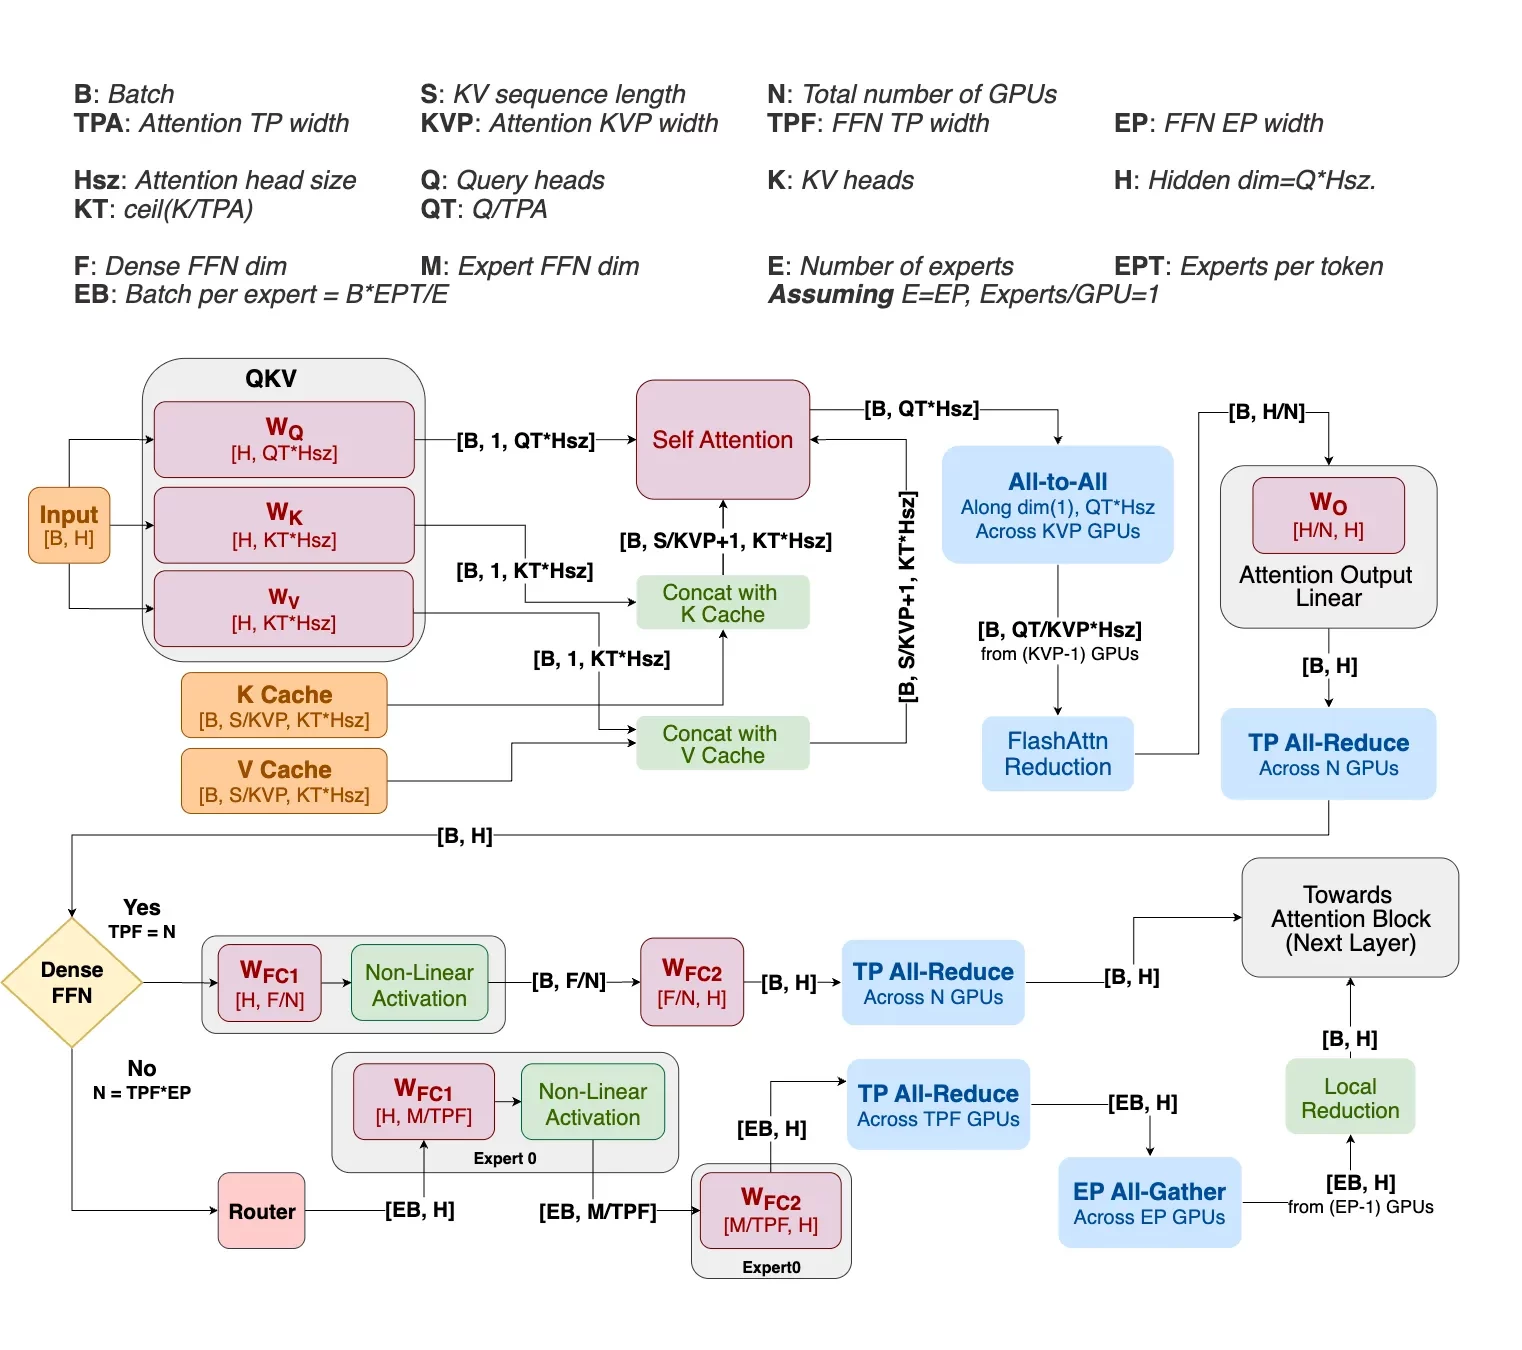
이 퍼즐을 해결하기 위해 NVIDIA의 Helix Parallelism은 두 병목 현상을 별도의 문제로 취급하여 매끄럽고 시간적인 파이프라인을 통해 해결하는 하이브리드 전략을 도입합니다. Helix는 전체 프로세스에 단일 병렬 처리 방식을 사용하는 대신, 동일한 GPU 풀을 동적으로 재구성하여 각 계산 단계에 최적의 전략을 사용합니다.
모델의 각 계층에 대해 두 가지 주요 단계로 프로세스를 나눌 수 있습니다.
1단계: 주의 단계(KV 캐시 처리)
Helix는 두 가지 병렬 처리 방식을 결합하여 KV 캐시 병목 현상을 직접 해결합니다. 첫째, KV 병렬 처리를 적용하여 KV 캐시 자체를 시퀀스 차원을 따라 여러 GPU에 분산합니다. 즉, 각 GPU는 전체 컨텍스트의 일부만 저장하므로 메모리 부담이 줄어듭니다.
동시에, 텐서 병렬 처리를 사용하여 어텐션 헤드를 분할하여 분할 횟수가 KV 헤드 수를 초과하지 않도록 합니다. 이러한 조합은 기존 텐서 병렬 처리의 문제점인 캐시 중복을 방지합니다. 결과적으로, 어느 GPU에도 과부하가 걸리지 않고 방대한 컨텍스트에서 어텐션을 효율적으로 계산할 수 있는 2D GPU 그리드가 생성됩니다. 이러한 GPU 간의 통신은 컨텍스트 길이에 관계없이 비용이 발생하는 단일의 효율적인 전체 대 전체 교환을 통해 처리되므로 확장성이 매우 뛰어납니다.
2단계: FFN 단계(FFN 가중치 처리)
어텐션 단계 마지막에 이루어지는 전체 대 전체 통신은 출력 데이터를 여러 GPU에 분할합니다. 즉, FFN 계산을 즉시 시작할 수 있도록 데이터가 완벽하게 정리되어 있음을 의미합니다.
동일한 GPU 풀이 대규모 텐서 병렬 처리 그룹으로 재프로비저닝됩니다. 데이터가 미리 분할되어 있으므로 각 GPU는 방대한 FFN 가중치의 샤드를 사용하여 로컬 행렬 곱셈을 수행할 수 있습니다. 이 초기 계산은 GPU 간 통신 없이 병렬로 진행되어 속도를 극대화합니다. 이 로컬 계산 단계 이후에만 GPU는 효율적인 올리듀스 통신에 참여하여 부분 결과를 최종 출력으로 결합합니다.
퍼즐의 마지막 조각은 Helix가 KV 캐시가 커짐에 따라 이를 어떻게 관리하는가입니다. 모델이 새로운 토큰을 생성하면 캐시에 추가해야 합니다. 순진한 접근 방식으로는 모든 새 토큰을 단일 GPU에 기록하여 메모리 핫스팟을 만들 수 있습니다. Helix는 영리한 라운드 로빈 업데이트 시스템을 통해 이를 방지합니다. 예를 들어, 새 토큰의 첫 번째 블록은 GPU 0으로, 다음 블록은 GPU 1로 이동하는 식으로 진행됩니다. 이러한 단계적 접근 방식은 KV Parallelism 그룹의 모든 GPU에서 메모리 사용량이 균일하게 증가하도록 하여 컨텍스트 크기에 관계없이 균형 잡힌 성능과 일관된 처리량을 유지합니다.
블랙웰의 새로운 성능 프런티어
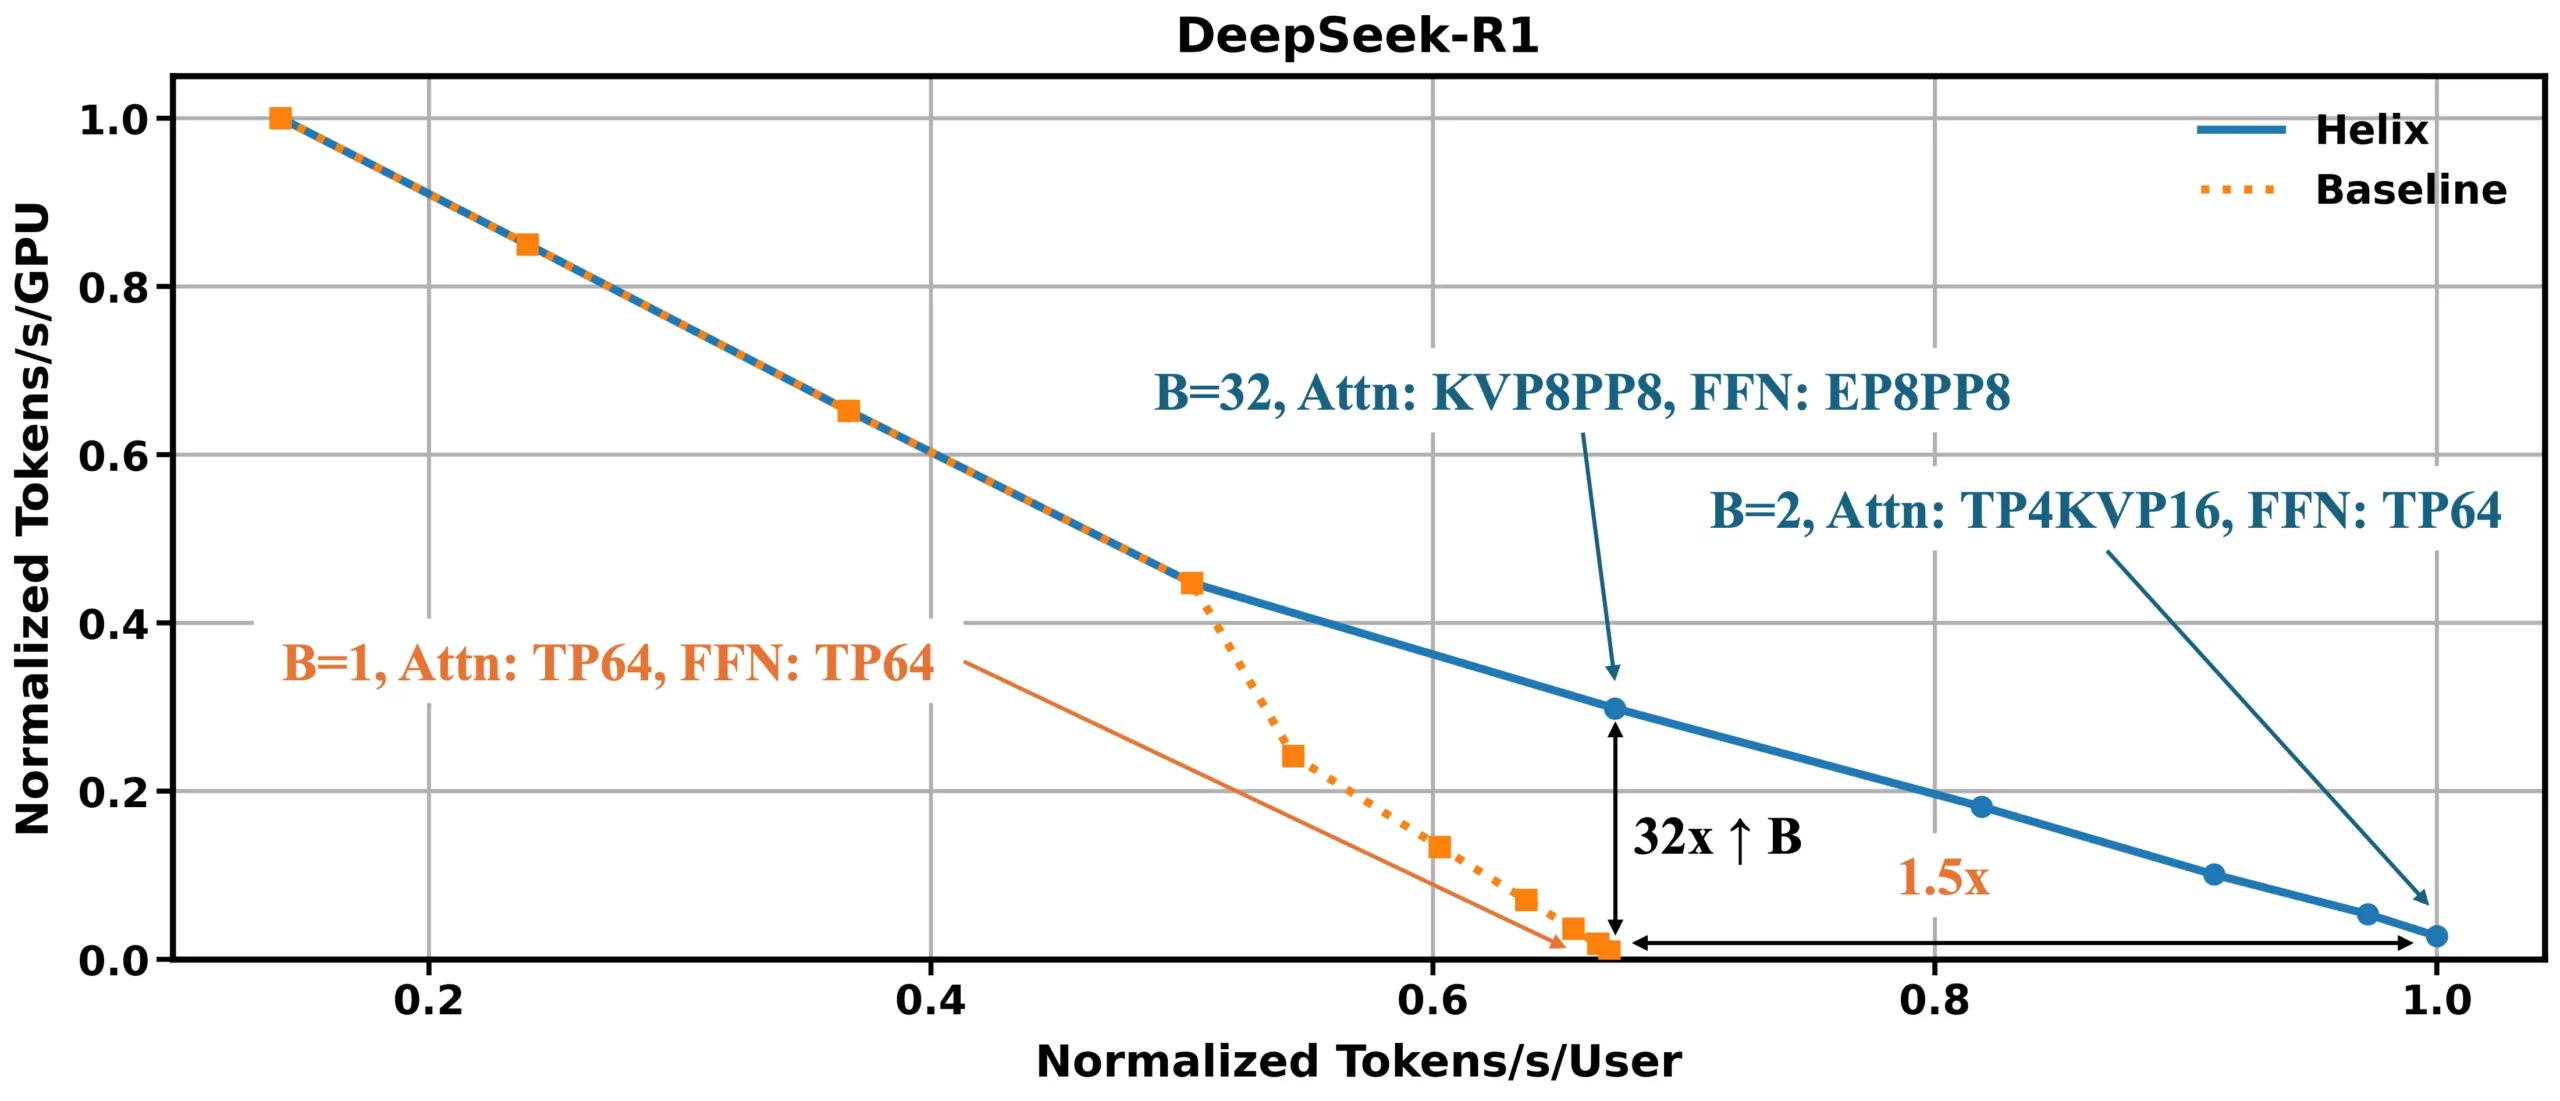
Helix는 롱 컨텍스트 LLM 디코딩에 대한 새로운 성능 기준을 제시합니다. 이 결과는 DeepSeek R72 1B 매개변수 모델(FP671)을 사용하여 Blackwell NVL4에서 가상 32만 토큰 컨텍스트를 기반으로 파티셔닝 전략과 배치 크기를 체계적으로 변경하여 처리량-지연 시간 간 최적의 절충점을 찾는 철저한 시뮬레이션을 기반으로 합니다. 많은 사용자에게 동시에 서비스를 제공하는 것과 같이 대규모 확장성이 필요한 애플리케이션의 경우, Helix는 주어진 지연 시간 예산 내에서 동시 사용자 수를 최대 1.5배까지 향상시킬 수 있습니다. 단일 사용자 응답성이 중요한 저동시성 환경에서는 이 기술을 통해 달성 가능한 최소 토큰 간 지연 시간을 줄여 사용자 상호 작용성을 최대 XNUMX배까지 향상시킬 수 있습니다. 이러한 이점은 사용 가능한 모든 장치에서 KV 캐시와 FFN 가중치를 모두 샤딩하여 DRAM 부하를 크게 줄이고 컴퓨팅 효율성을 향상시킴으로써 가능합니다.
방법론 및 시뮬레이션 결과에 대한 더 자세한 기술적 분석은 다음 링크에서 전체 보고서를 참조하십시오.


 아마존