

WhiteFiber는 지리적으로 분산된 데이터 센터에서 작동하도록 설계된 분산형 GPU 슈퍼클러스터 아키텍처인 Project Redwood의 초기 연구 개발 결과를 공개했습니다. 지난주 발표된 이 테스트는 83km의 다크 파이버를 통해 111.2Tbps의 처리량을 달성했으며, 왕복 지연 시간은 0.9ms로 보장되었습니다.
화이트파이버는 지연 시간이 해당 거리에서 광섬유를 통해 빛이 이동할 때 발생하는 물리적 전파 한계의 8% 이내라고 밝혔습니다. 이 회사는 테스트에 사용 가능한 광섬유 스펙트럼의 일부만 사용했는데, 이는 기존에 발표된 유사한 전체 스펙트럼 현장 시험 결과보다 약 두 배의 용량을 달성한 것이라고 설명했습니다. 또한 2026년 3분기 상용 출시를 목표로 전체 스펙트럼을 활용한 테스트를 진행할 계획입니다.
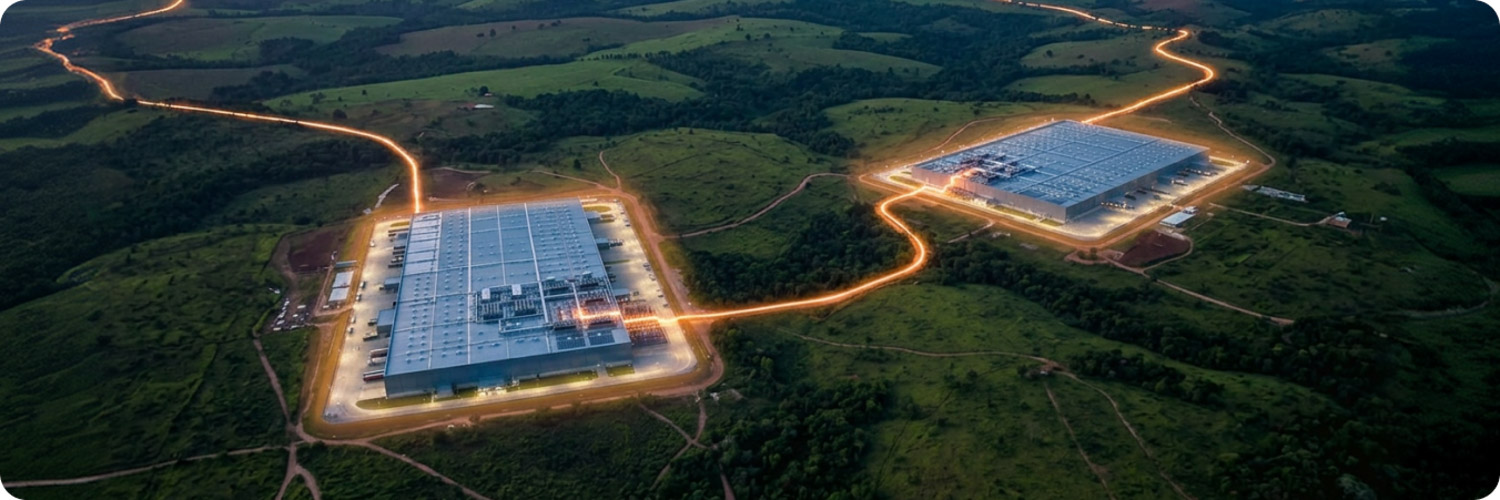
이 프로젝트는 DriveNets 및 WEKA와 협력하여 완료되었습니다. DriveNets는 시설 간 이더넷 기반 AI 패브릭을 제공하고, WEKA NeuralMesh는 클러스터 전체에 걸쳐 스토리지 및 메모리 인프라를 제공합니다. WhiteFiber는 이 구현과 관련된 특허를 출원했습니다.
여러 사이트를 하나의 GPU 클러스터로 처리
이 아키텍처는 기존의 DCI 링크로 연결된 두 개의 독립적인 클러스터가 아니라, 두 개의 데이터 센터가 하나의 논리적 GPU 슈퍼클러스터처럼 작동하도록 설계되었습니다. 이러한 차이점은 GPU 간 동기화, 공동 작업, 공유 데이터 인프라에 대한 접근성이 클러스터의 활용 가능한 규모를 결정하는 AI 학습 및 추론 워크로드에 중요합니다.
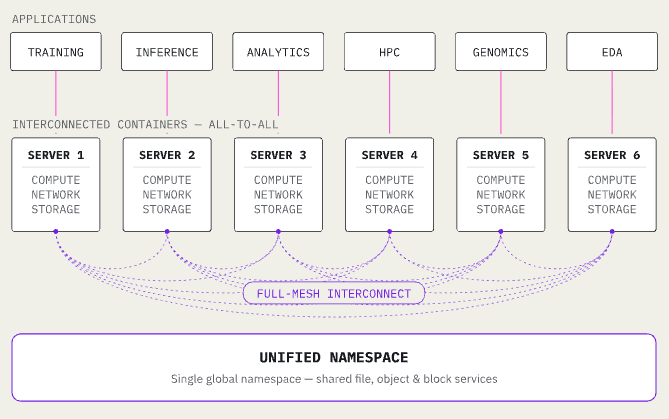
WhiteFiber는 단일 사이트의 가용 전력, 냉각, 공간, 복원력 설계 또는 데이터 주권 요구 사항을 초과하는 워크로드에 적합한 플랫폼을 제공합니다. 또한 엣지 컴퓨팅, 통신 및 주권 AI 배포 분야에서도 활용 가능성을 보고 있습니다.
DriveNets는 이번 발표에서 하드웨어에 대해 자세히 설명했습니다. 해당 패브릭은 52마일(약 83km) 떨어진 두 개의 WhiteFiber NVIDIA H200 GPU 클러스터를 연결하며, DriveNets는 이번 구축을 업계 최초의 상용 장거리 확장형 AI 슈퍼클러스터로, 실험실 환경이 아닌 실제 운영 환경에서 검증되었다고 밝혔습니다. 검증의 일환으로, 두 회사는 단일 사이트 내의 랙 간 성능과 두 사이트에 걸쳐 있는 랙 간 성능을 비교했으며, 방법론에 대한 자세한 내용은 DriveNets의 백서에 나와 있습니다.
드라이브넷 패브릭 디자인
사이트 간 환경은 이중화된 다크 파이버와 DriveNets AI 패브릭을 사용하여 GPU 및 스토리지 트래픽을 전송합니다. DriveNets는 이 아키텍처를 기존의 장거리 이더넷 확장이 아닌 예측 가능한 분산 AI 통신을 위해 구축된 스케줄링된 이더넷 패브릭으로 설명합니다.
이 설계는 DriveNets의 9300F, 5300R, 5301R 스위치에서 실행되는 Fabric Scheduled Ethernet 기술을 사용하여 여러 사이트에 걸쳐 AI 패브릭을 확장합니다. 이 접근 방식은 셀 기반 로드 밸런싱, 종단 간 가상 출력 큐잉(VOT), 그리고 사이트 간 링크에서 혼잡을 유발하기 전에 동기화된 AI 트래픽 급증을 흡수하는 딥 버퍼 인터커넥트를 결합합니다. DriveNets는 그 결과 전체 클러스터가 한 곳에 있는 것처럼 예측 가능하고 손실 없는 사이트 간 연결을 통해 GPU 활용률을 높게 유지할 수 있다고 설명합니다.
이러한 메커니즘들은 통합된 컴퓨팅 및 스토리지 패브릭을 지원하는 동시에 원거리 집단 통신에서 예측 가능한 동작을 유지하는 것을 목표로 합니다. 다중 테넌트 격리는 명시된 설계 목표의 일부입니다.
그 결과, 광섬유 경로를 단순히 사이트 간 전송 연결이 아닌 AI 패브릭의 일부로 취급하는 아키텍처가 탄생했습니다. 목표는 클러스터 전체에서 실행되는 워크로드에 있어 물리적 데이터 센터 경계의 운영상 중요성을 줄이는 것입니다.
NVIDIA Spectrum-XGS와는 다른 접근 방식
WhiteFiber의 테스트 플랫폼은 NVIDIA Spectrum-XGS 이더넷과는 별개입니다. 하지만 이 연구는 AI 인프라의 "확장성"을 향한 업계 전반의 움직임과 맥락을 같이합니다.
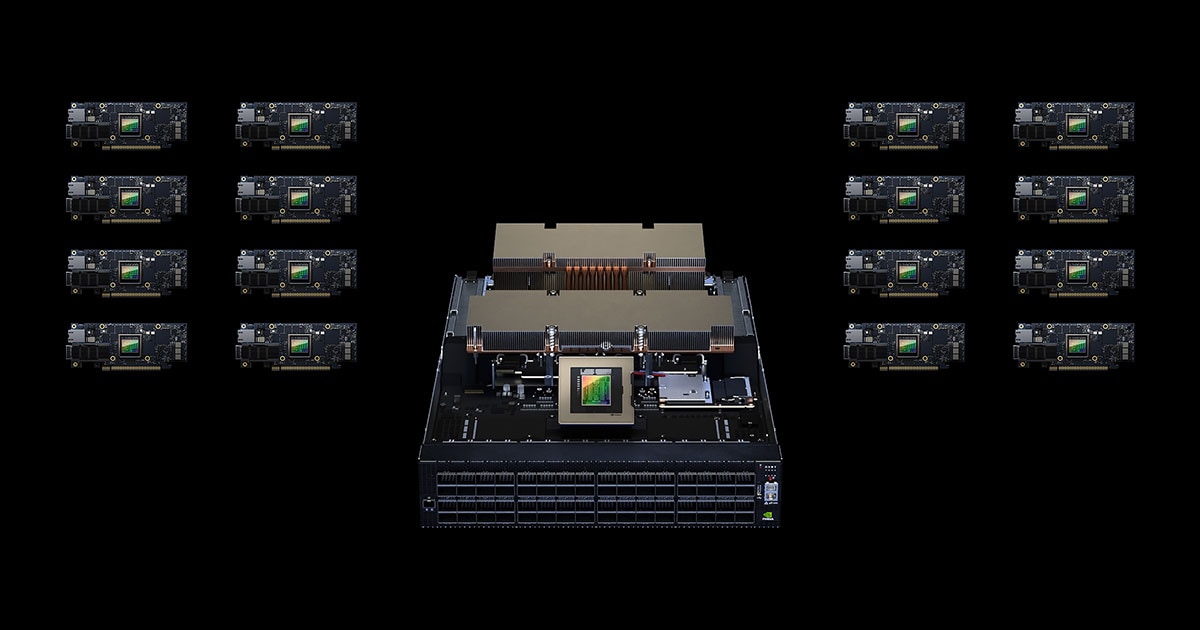
Hot Chips 2025에서 NVIDIA CEO 젠슨 황은 대규모 AI 팩토리를 구축하기 위해 도시, 국가, 대륙에 걸쳐 데이터 센터를 연결해야 한다고 강조했습니다. NVIDIA의 Spectrum-XGS 방식은 거리 인식 혼잡 제어, 정밀 지연 시간 관리, 원격 측정 기능을 활용하여 분산 GPU 통신의 예측 가능성을 향상시킵니다. CoreWeave는 NVIDIA가 언급한 초기 도입 기업 중 하나입니다.
WhiteFiber는 NVIDIA가 Spectrum-XGS 구축과 관련하여 공개한 것보다 더 구체적인 초기 현장 테스트 결과를 제공했습니다. 83km 테스트에서 WhiteFiber는 111.2Tbps의 속도와 0.9ms의 왕복 지연 시간을 기록했지만, 두 시스템은 서로 다른 아키텍처를 사용하므로 결과를 직접 비교할 수는 없습니다.
분산형 교육이 단일 시설을 넘어 확장되고 있습니다.
화이트파이버의 이번 발표는 다른 클라우드 및 인프라 제공업체들이 다중 사이트 AI 학습 및 추론 아키텍처를 검토하고 있는 가운데 나온 것입니다.
오라클 클라우드 인프라스트럭처와 엔비디아는 NeMo 프레임워크와 Megatron-Core를 사용하여 약 1,000km 떨어진 데이터 센터 간 LLM(Long Level Model) 학습을 실행하는 연구 결과를 발표했습니다. 엔비디아는 계층적 all-reduce 방식과 데이터 센터 간 분할 통신을 통해 96% 이상의 학습 확장성을 달성했다고 보고했습니다. 이 연구는 주로 소프트웨어 및 시스템 시연에 초점을 맞춘 것으로, 메트로 스케일 전송 벤치마크는 아닙니다.
구글은 또한 TPU 멀티슬라이스를 개발하여 여러 TPU 슬라이스가 자사 데이터센터 네트워크와 광 인터커넥트를 통해 더 큰 분산 학습 환경으로 작동할 수 있도록 했습니다. 구글은 제미니 학습에 여러 데이터센터가 사용되었으며, 이 플랫폼은 대규모 워크로드 분할 및 복원력을 관리하도록 설계되었다고 밝혔습니다.
WhiteFiber는 특히 고대역폭, 저지연 메트로 연결에 초점을 맞춰 GPU 클라우드 인프라에 유사한 사이트 간 설계 방식을 도입하는 것을 목표로 하고 있습니다. 회사는 2026년 3분기 상용 배포를 앞두고 아키텍처 및 가용성에 대한 자세한 정보를 추가로 제공할 예정입니다.


 아마존