

PERC975 시리즈 RAID 컨트롤러의 Dell H13i는 Dell이 975년 넘게 하드웨어 RAID 분야에서 이룬 가장 큰 도약입니다. Dell은 PERC 제품군에 대한 정기적인 업데이트를 출시해 왔지만, 이러한 업데이트는 대부분 점진적인 것이었으며, PCIe 세대가 발전함에 따라 컨트롤러 튜닝과 대역폭 향상에 중점을 두었습니다. 그러나 기본 아키텍처는 수년간 엔터프라이즈 RAID를 정의해 온 SATA 및 SAS 레거시에 묶여 있었습니다. PERC H51i는 이러한 악순환의 고리를 단번에 끊습니다. Broadcom의 SAS975xx 칩셋 제품군을 기반으로 제작된 이 컨트롤러는 플래시 우선 및 NVMe 네이티브 설계로의 확실한 전환을 의미합니다. NVMe 드라이브를 독점적으로 지원하고 기존 HDD 및 SATA 기술에 대한 지원을 없앰으로써 HXNUMXi는 데이터 집약적이고 AI 우선적인 최신 워크로드의 고성능, 저지연성 요구에 최적화된 미래 지향적인 스토리지 인프라 접근 방식을 통합했습니다.
주요 요점
- 플래시 우선 NVMe RAID: PERC13 H975i는 SAS/SATA에서 완전히 벗어나 NVMe 기반, AI 지원 아키텍처를 위한 Broadcom SAS51xx를 기반으로 구축되었습니다.
- 큰 세대적 도약: 컨트롤러당 최대 5개의 NVMe 드라이브(16개로 16개)를 탑재한 PCIe Gen32 x52.5은 테스트에서 컨트롤러당 12.5GB/s 및 12M IOPS를 제공했으며, PERC88에 비해 읽기 대역폭이 +318%, 쓰기 대역폭이 +31%, 4K 읽기 IOPS가 +466%, 4K 쓰기 IOPS가 +XNUMX% 향상되었습니다.
- AI 서버 적합성: 전면 통합 설계로 GPU를 위한 후면 PCIe 슬롯이 확보되고, MCIO 실행 시간이 단축되며, 가속기당 전용 스토리지 파이프를 사용할 수 있어 CPU 오버헤드 없이 안정적이고 결정론적인 처리량이 가능합니다.
- 스트레스 하에서의 회복력: 슈퍼커패시터로 보호되는 캐시와 빠른 재구축으로 재구축 중에도 높은 성능을 유지하면서(최대 10GB/s 읽기, 53.7GB/s 쓰기, 68M/17.3M 5.33K IOPS) 시간을 TiB당 4분으로 단축합니다.
- 엔드투엔드 보안: 하드웨어 신뢰 루트, SPDM 장치 ID, 드라이브, 전송 중인 데이터, 컨트롤러 캐시를 포괄하는 전체 스펙트럼 암호화.
PERC H975i는 탁월한 성능과 혁신적인 아키텍처를 제공합니다. PCIe Gen 5 x16 호스트 인터페이스를 활용하고 최대 16개의 NVMe 드라이브(컨트롤러 32개로 시스템당 975개의 NVMe 드라이브)를 지원하는 H52.5i는 테스트에서 최대 12.5GB/s의 놀라운 처리량과 컨트롤러당 2만 IOPS를 달성했습니다. 이는 최대 12만 IOPS와 6.9GB/s의 처리량을 기록한 PERC27에 비해 모든 주요 항목에서 거의 두 배의 성능 향상을 의미합니다. PERC13은 단순한 성능 향상 외에도, 기존 배터리 백업 시스템을 대체하는 슈퍼커패시터 기반 캐시 보호 메커니즘을 도입하여 운영 안정성을 저해하지 않으면서 데이터 무결성을 보장합니다. 이전 모델의 보안 기능을 기반으로 H975i는 이제 풀 스펙트럼 암호화 기능을 확장하여 캐시 내 데이터를 암호화하고 전송 중 및 저장 중 모두에서 포괄적인 보호 기능을 제공합니다.
PERC H975i는 AI 워크로드의 전례 없는 컴퓨팅 요구를 충족하도록 설계된 특수 목적 스토리지 가속기로 등장했습니다. 고밀도와 고성능을 모두 제공하며, CPU 오버헤드 없이 지연 시간이 짧은 스토리지를 제공합니다. 실제로 x5 인터페이스를 포화시킬 수 있는 PCIe Gen16 RAID 카드를 Gen5 GPU와 함께 사용하면 각 가속기에 전용 스토리지 파이프라인이 제공됩니다. 이를 통해 PCIe/NUMA 토폴로지가 간소화되어 노이즈가 많은 이웃(noisy-neighbor) 효과를 방지하고 리빌드 또는 백그라운드 작업을 해당 GPU의 I/O 도메인에 격리할 수 있습니다.
이를 듀얼 RAID 카드와 두 개의 GPU로 확장하면 공유 레인이나 캐시에서 경합을 피하면서 선형 성능을 유지할 수 있습니다. 결과적으로 데이터 소모가 많은 학습 및 추론(대규모 배치, 빠른 셔플, 빠른 체크포인트 읽기)에 대한 입력 대역폭이 더욱 안정적이며, 부하 발생 시 및 리빌드 시 지연 시간 분포가 더욱 좁아집니다. 이 아키텍처는 단순히 최대 성능을 높이는 데 그치지 않고 처리량을 더욱 결정적으로 만들어주는데, 이는 멀티 GPU AI 서버가 높은 활용도를 유지하는 데 필요한 바로 그 기능입니다.
Dell PERC12 H965i 및 PERC13 H975i 사양
| 제품 특장점 | PERC12 H965i 전면 | PERC13 H975i 전면 |
|---|---|---|
| RAID 레벨 | 0, 1, 5, 6, 10, 50, 60 | 0, 1, 5, 6, 10, 50, 60 |
| 비RAID(JBOD) | 가능 | 가능 |
| 호스트 버스 유형 | PCIe 4세대 x16 | PCIe 5세대 x16 |
| 사이드밴드 관리 | I2C, PCIe VDM | I2C, PCIe VDM |
| 포트당 인클로저 | 적용 할 수 없음 | 적용 할 수 없음 |
| 프로세서/칩셋 | Broadcom RAID-on-Chip, SAS4116W | Broadcom RAID-on-Chip, SAS5132W |
| 에너지 팩 / 전원 백업 | 배터리 | 수퍼 커패시터 |
| 로컬 키 관리 보안 | 가능 | 가능 |
| 보안 엔터프라이즈 키 관리자 | 가능 | 가능 |
| 컨트롤러 대기열 깊이 | 8,192 | 8,192 |
| 비휘발성 캐시 | 가능 | 가능 |
| 캐시 메모리 | 8GB DDR4 3200MT/s | 통합 RAID 캐시 |
| 캐시 함수 | 쓰기 저장, 미리 읽기, 쓰기 동시, 항상 쓰기 저장, 미리 읽기 없음 | 쓰기 저장, 쓰기 동시, 항상 쓰기 저장, 미리 읽기 없음 |
| 최대 복합 가상 디스크 | 64 | 16 |
| 최대 단순 가상 디스크 | 240 | 64 |
| 최대 디스크 그룹 | 64 | 32 |
| 디스크 그룹당 최대 VD | 16 | 8 |
| 최대 핫 스페어 장치 | 64 | 8 |
| 지원되는 핫스왑 장치 | 가능 | 가능 |
| 자동 구성(기본 및 한 번 실행) | 가능 | 가능 |
| 하드웨어 XOR 엔진 | 가능 | 가능 |
| 온라인 용량 확장 | 가능 | 가능 |
| 전용 및 글로벌 핫 스페어 | 가능 | 가능 |
| 지원되는 드라이브 유형 | NVMe Gen3 및 Gen4 | NVMe Gen3, Gen4 및 Gen5 |
| VD 스트립 요소 크기 | 64KB | 64KB |
| NVMe PCIe 지원 | Gen4 | Gen5 |
| 구성 최대 NVMe 드라이브 | 컨트롤러당 8개 드라이브 | 컨트롤러당 16개 드라이브 |
| 지원되는 섹터 크기 | 512B, 512e, 4Kn | 512B, 512e, 4Kn |
| 스토리지 부팅 지원 | UEFI 전용 | UEFI 전용 |
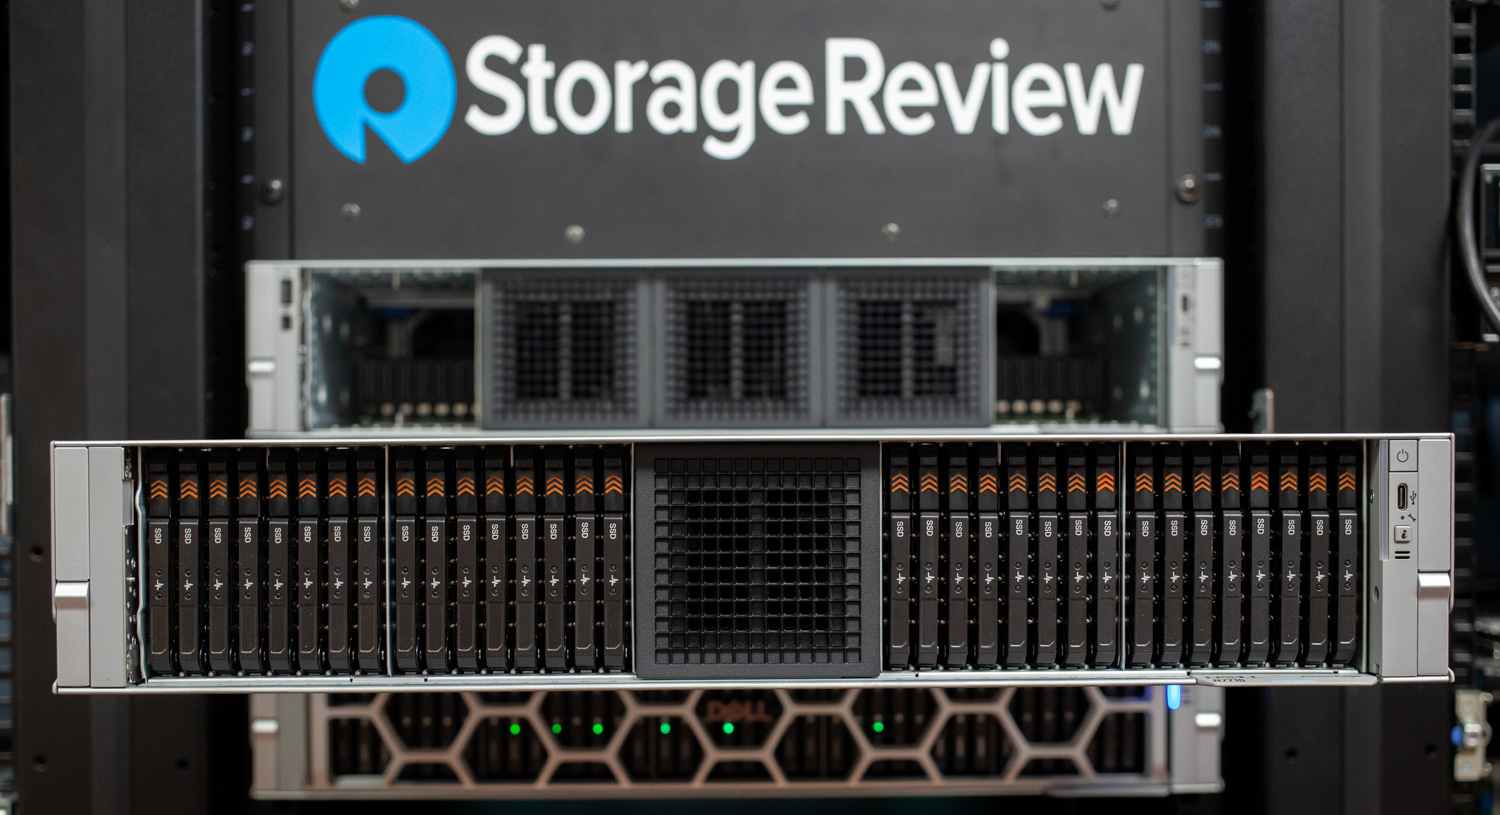
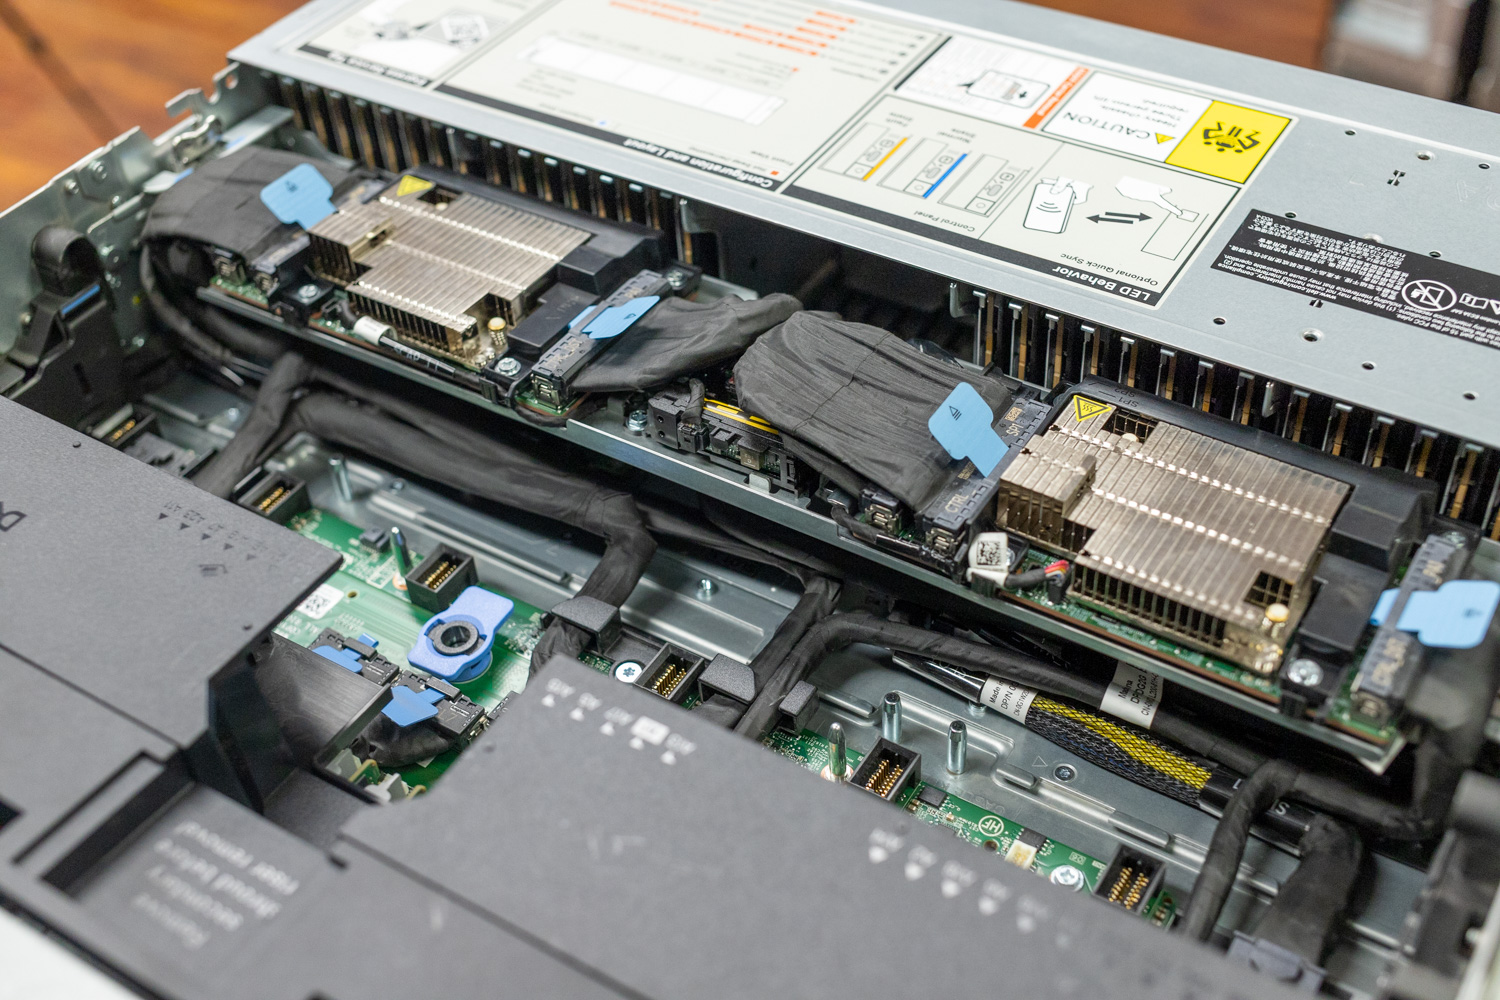
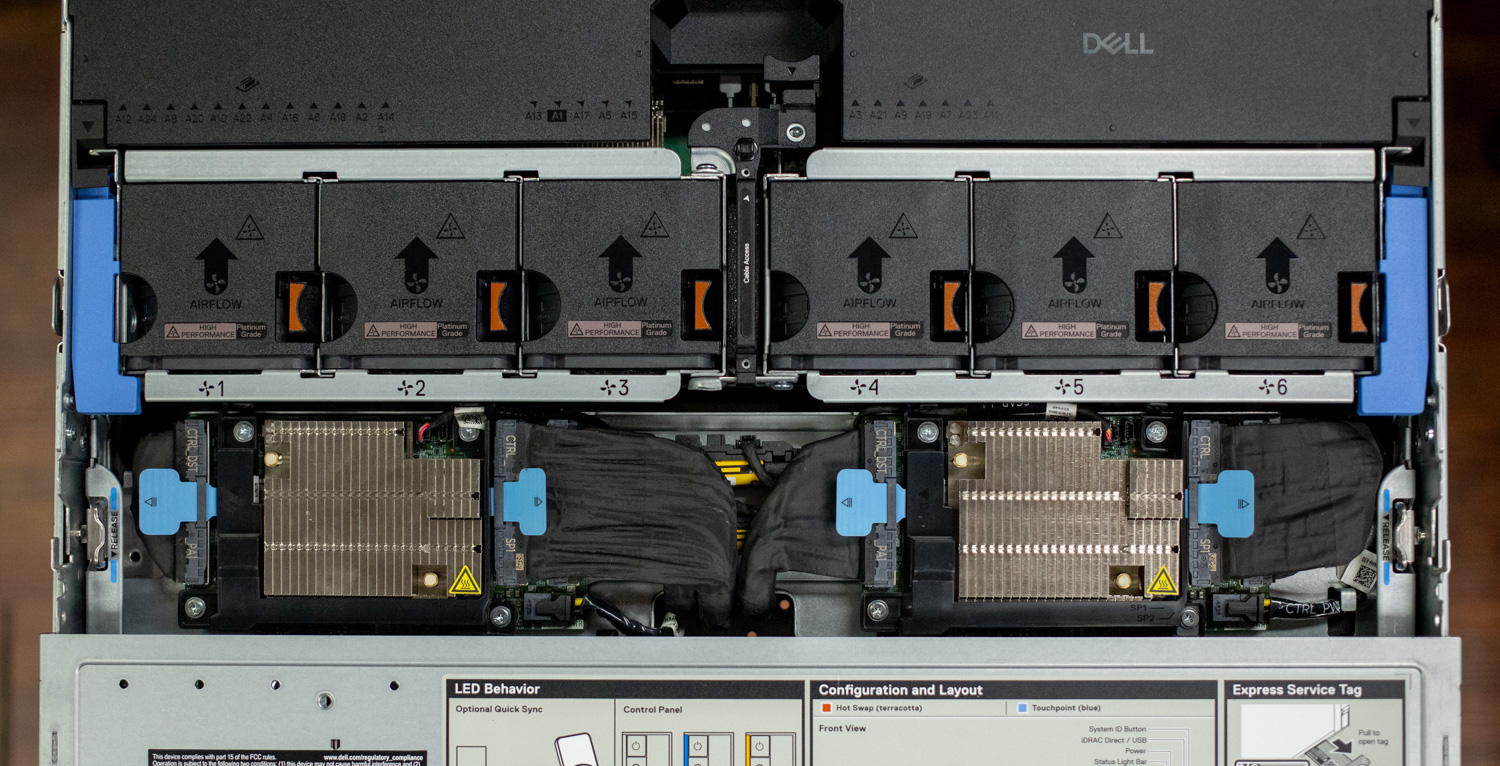
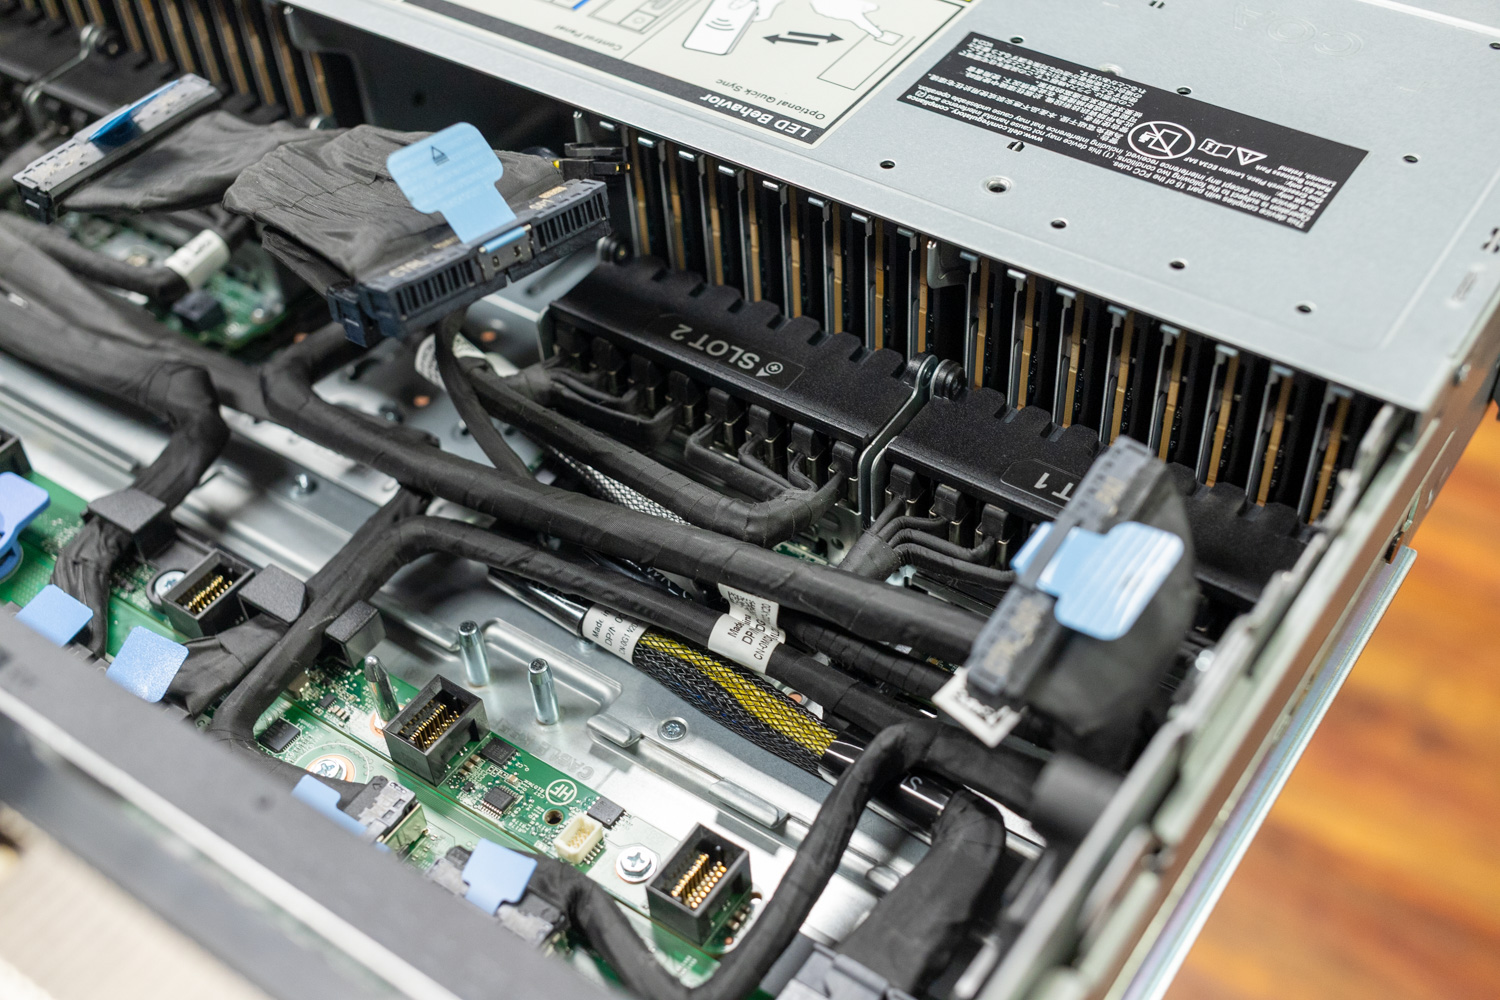
Dell PowerEdge 서버의 PERC13 H975i 전면 컨트롤러는 시스템 아키텍처에 완벽하게 통합되도록 설계되었습니다. 후면 PCIe 슬롯을 차지하는 기존 추가 카드와 달리, H975i는 전면 드라이브 백플레인에 직접 연결되고 전용 PCIe 5.0 인터페이스를 통해 마더보드의 전면 MCIO 커넥터와 연결됩니다. 이러한 통합 설계는 고성능 GPU 및 추가 PCIe 확장을 위해 후면 PCIe 슬롯을 그대로 유지하면서도 케이블 길이를 크게 줄였습니다. 이는 신호 무결성 유지에 도움이 되어 시스템의 안정성과 서비스 용이성을 높여줍니다. 결과적으로 고밀도 컴퓨팅 집약적 배포를 위한 더욱 깔끔한 내부 레이아웃과 향상된 공기 흐름을 제공합니다.
H975i는 실리콘 레벨의 하드웨어 검증부터 SED 드라이브에 저장된 데이터의 풀 스펙트럼 데이터 암호화까지 아우르는 포괄적인 보안 아키텍처를 구현합니다. 하드웨어 신뢰 루트(Root of Trust)는 내부 부팅 ROM부터 각 펌웨어 구성 요소까지 변경 불가능한 암호화 검증 체인을 구축하여 인증된 Dell 인증 펌웨어만 컨트롤러에서 실행되도록 보장합니다. 이 하드웨어 기반 보안은 SPDM(Security Protocol and Data Model) 구현을 통해 확장되며, 각 컨트롤러에는 고유한 장치 ID 인증서가 포함되어 iDRAC이 실시간 인증 검증을 수행할 수 있도록 합니다. 이 컨트롤러는 암호화 보호 기능을 기존의 저장 데이터 시나리오를 넘어 캐시 메모리까지 확장합니다. 또한, 무단 펌웨어가 접근할 수 없는 보안 메모리 영역에 암호화 키를 보관합니다. 따라서 드라이브에 저장되어 있든 캐시에서 처리 중이든 중요한 데이터는 안전하게 보호됩니다.
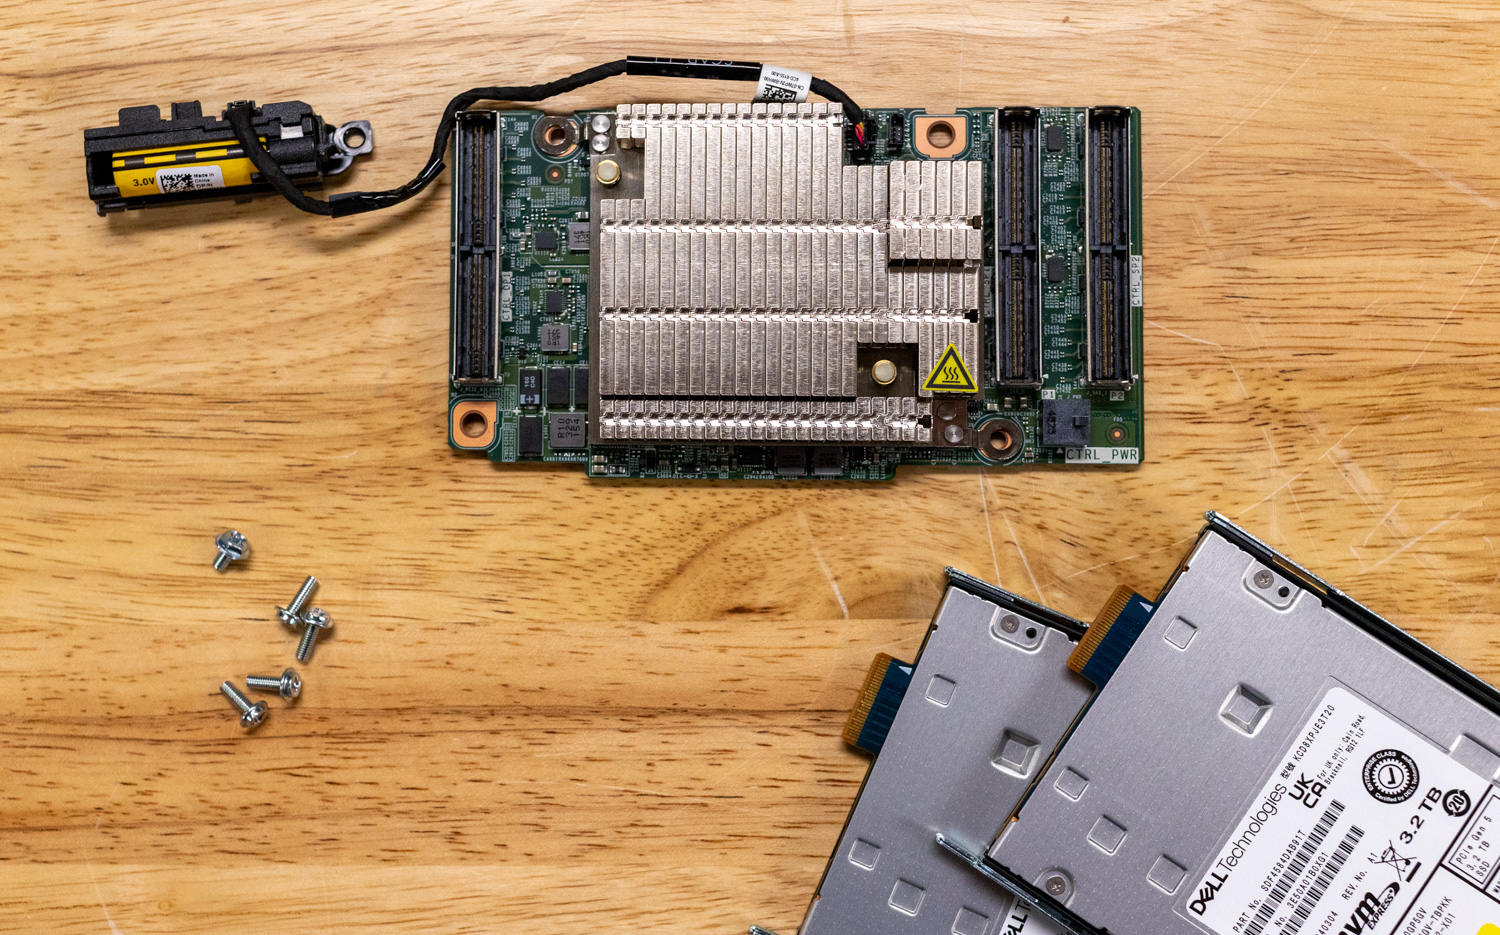
H975i의 전력 보호 기능은 슈퍼커패시터를 통합함으로써 기존 배터리 백업 시스템에서 크게 발전한 부분입니다. 슈퍼커패시터는 예상치 못한 정전 발생 시 즉각적인 전력 공급을 제공하여 암호화되고 완전한 캐시 플러시를 비휘발성 스토리지에 저장하고, 데이터는 무기한 보호됩니다. 또한, 학습 사이클에 4~8시간이 필요한 배터리 기반 시스템과 달리, H975i의 슈퍼커패시터는 교정 중 성능 저하 없이 5~10분 이내에 투명 학습 사이클을 완료합니다. 이러한 설계는 배터리 솔루션에 내재된 유지 관리 부담과 성능 저하 문제를 해소하는 동시에 미션 크리티컬 데이터 보호에 탁월한 안정성을 제공합니다.
통합 모니터링 및 관리
Dell의 PERC13 RAID 컨트롤러는 Dell의 많은 RAID 솔루션과 마찬가지로 BIOS의 시스템 설정을 통한 플랫폼 부팅, iDRAC 웹 GUI, PERC12 유틸리티, 심지어 Dell OpenManage UI와 CLI를 포함하여 다양한 방법으로 관리하고 모니터링할 수 있습니다.
iDRAC 컨트롤러 관리
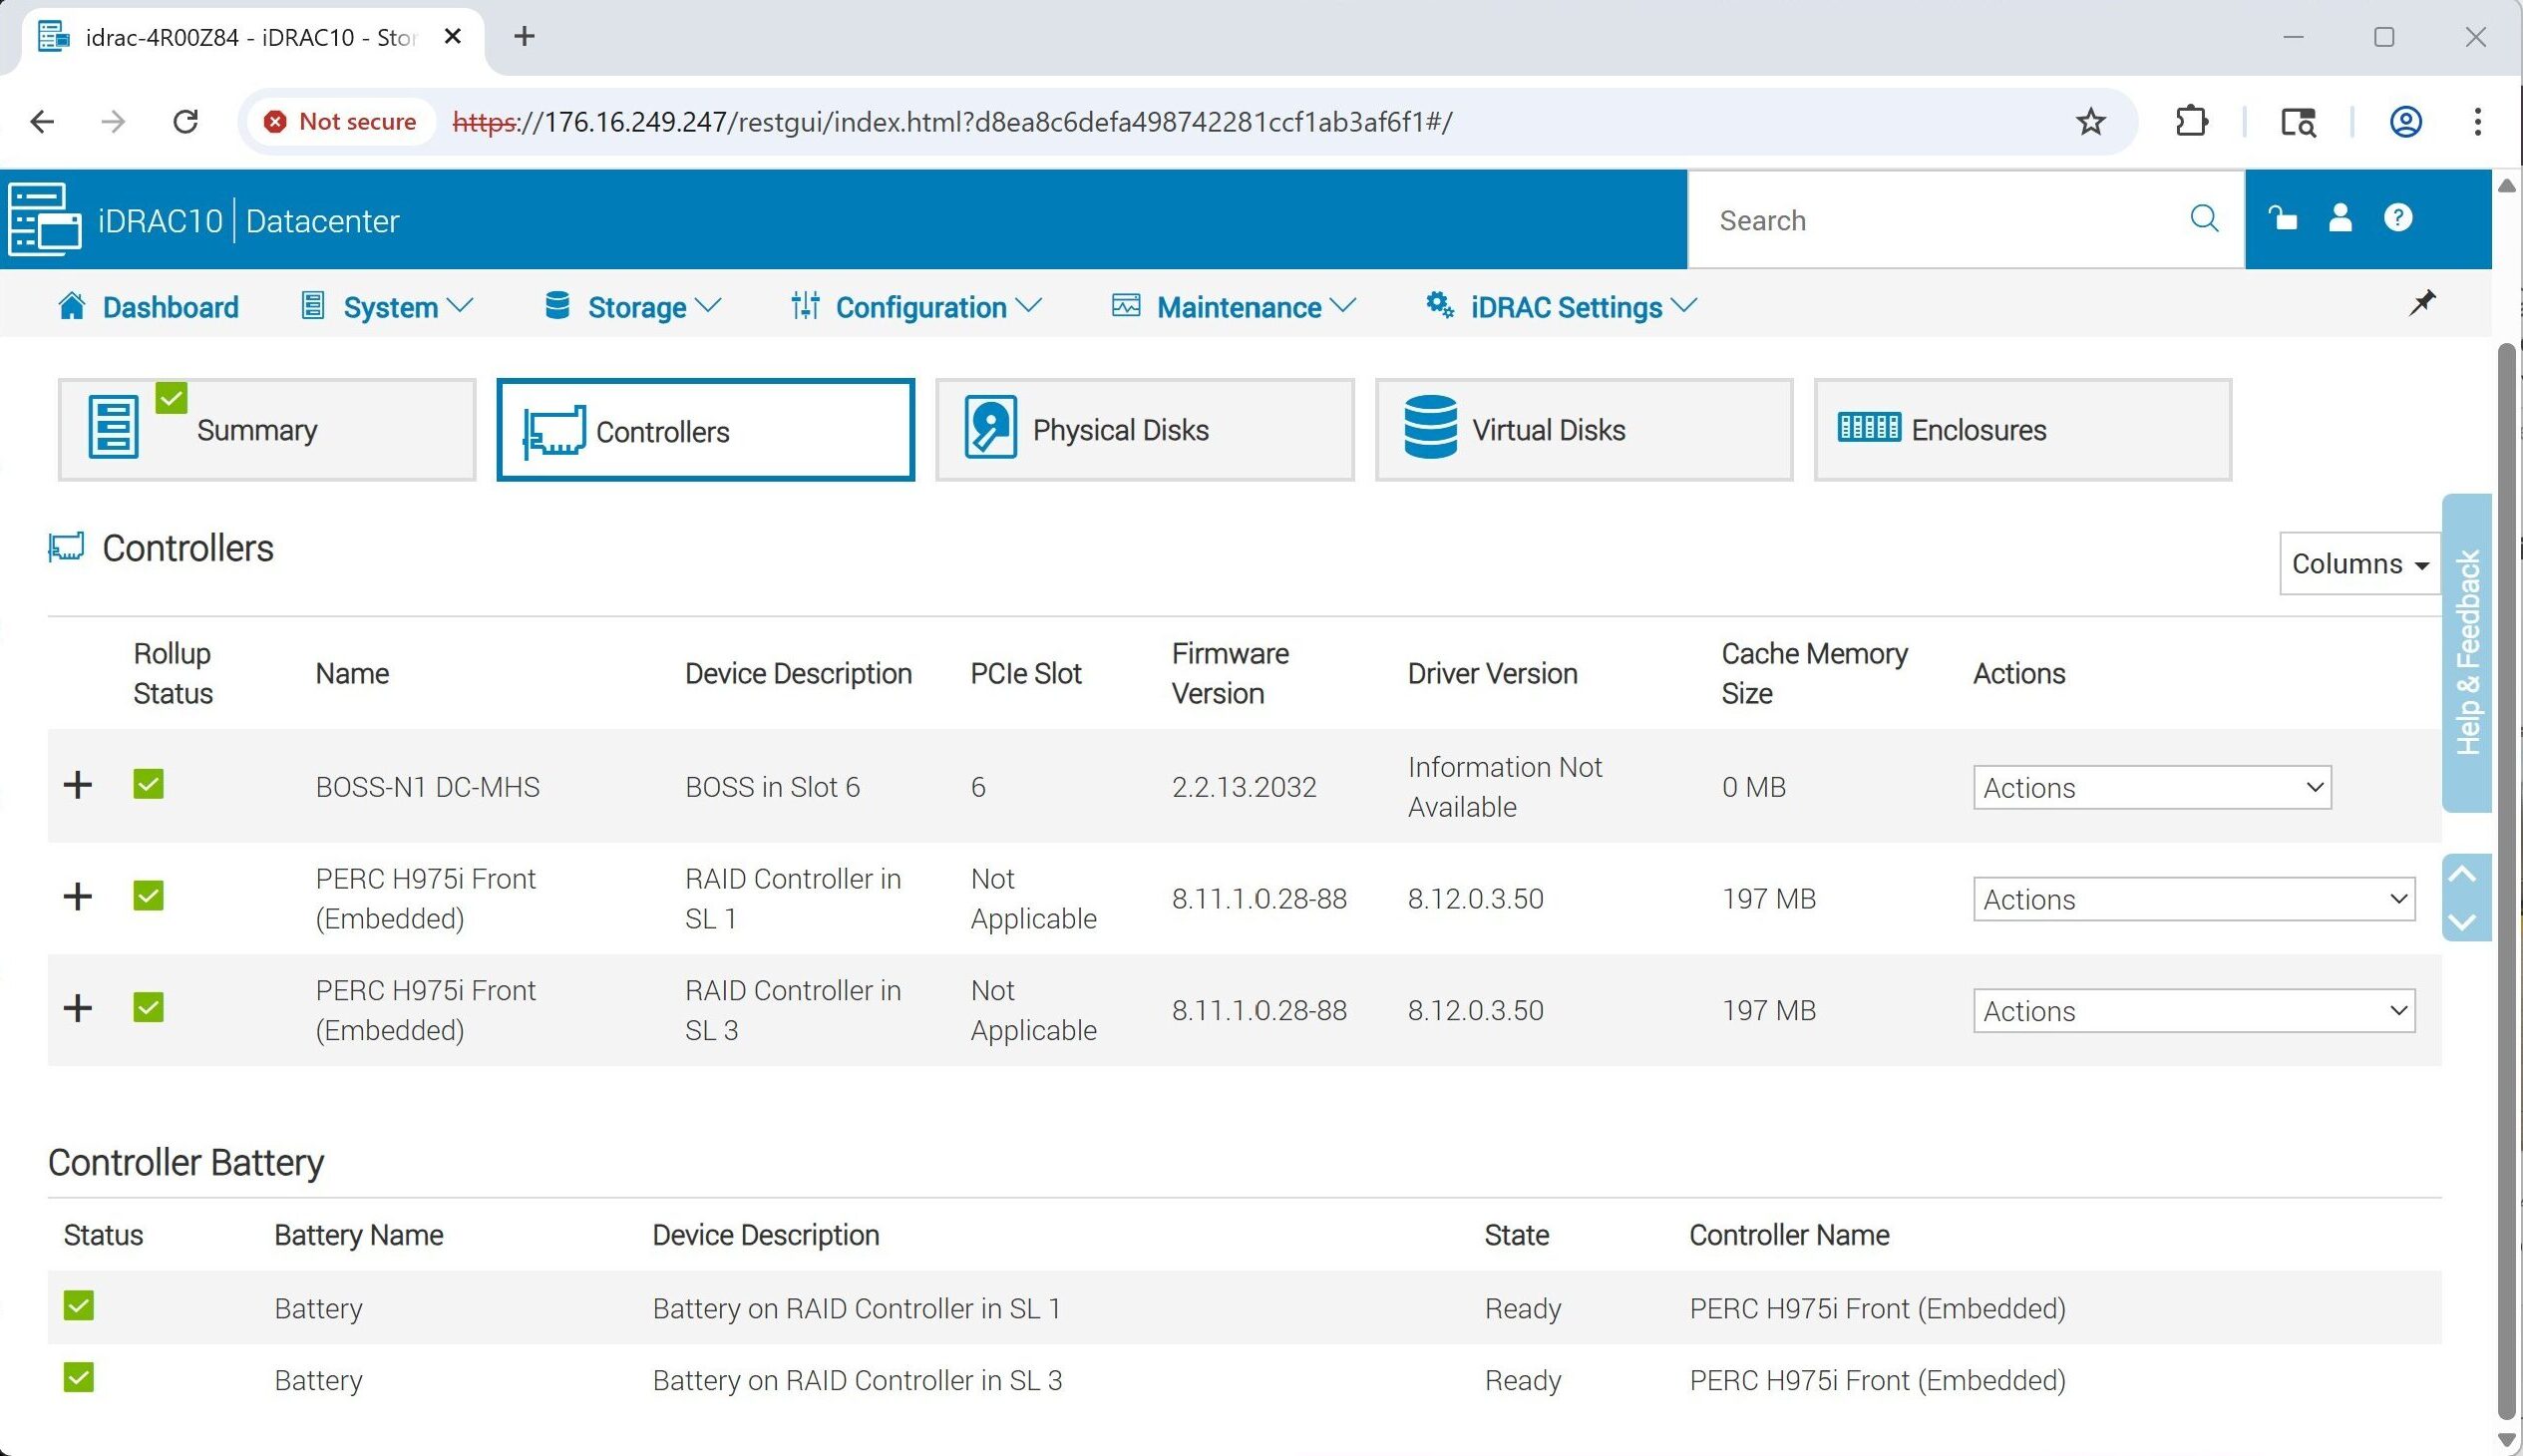
iDRAC 관리 인터페이스를 볼 때 컨트롤러 탭은 서버의 스토리지 하드웨어 개요를 제공합니다. BOSS 카드와 함께 듀얼 PERC H975i 컨트롤러가 표시되며, 펌웨어 버전, 캐시 메모리, 배터리 상태 정보가 함께 제공됩니다. 이 요약 정보를 통해 BIOS에 액세스하거나 CLI 도구를 사용하지 않고도 컨트롤러의 준비 상태와 구성을 빠르게 확인할 수 있습니다.
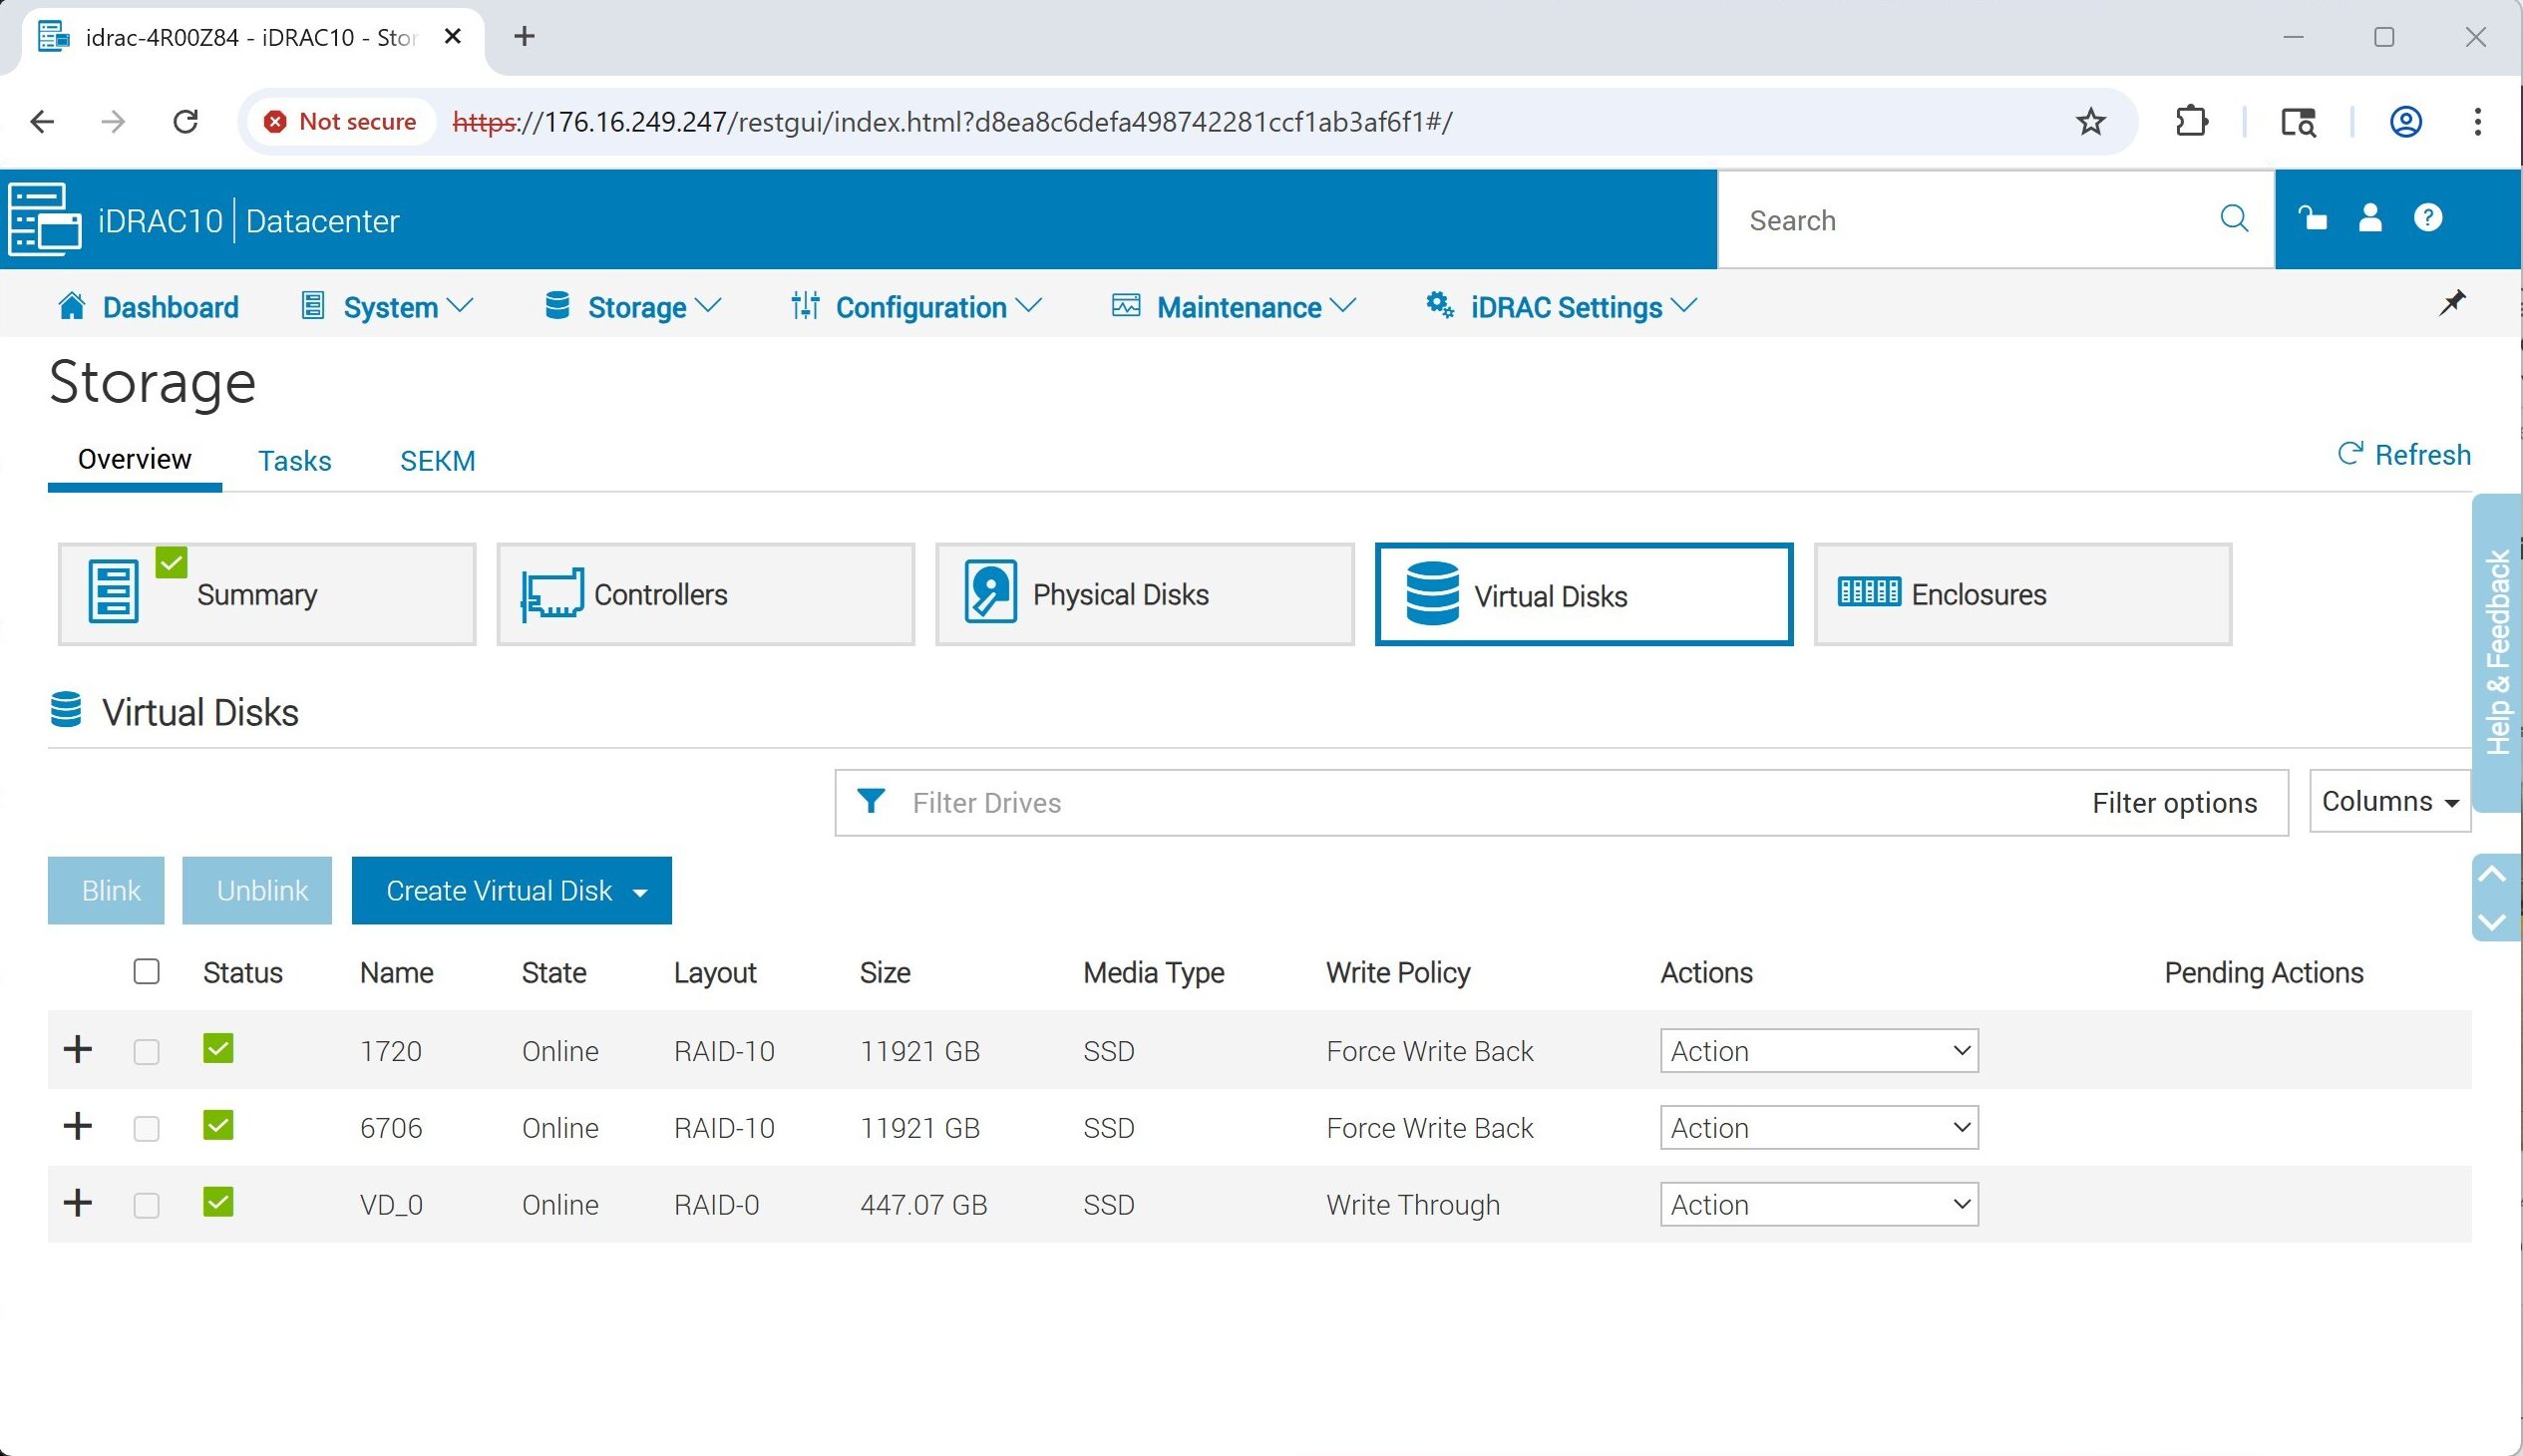
iDRAC의 가상 디스크 탭에는 생성된 스토리지 어레이와 RAID 레벨, 크기, 캐싱 정책이 표시됩니다. 이 시스템에는 SSD를 기반으로 구축된 두 개의 RAID-10 그룹이 나열되어 있습니다. 이 보기에서 관리자는 볼륨이 온라인 상태인지 확인하고, 새 가상 디스크를 생성하고, 작업 메뉴를 사용하여 기존 구성을 조정하거나 삭제할 수 있습니다.
RAID 컨트롤러 구성 유틸리티
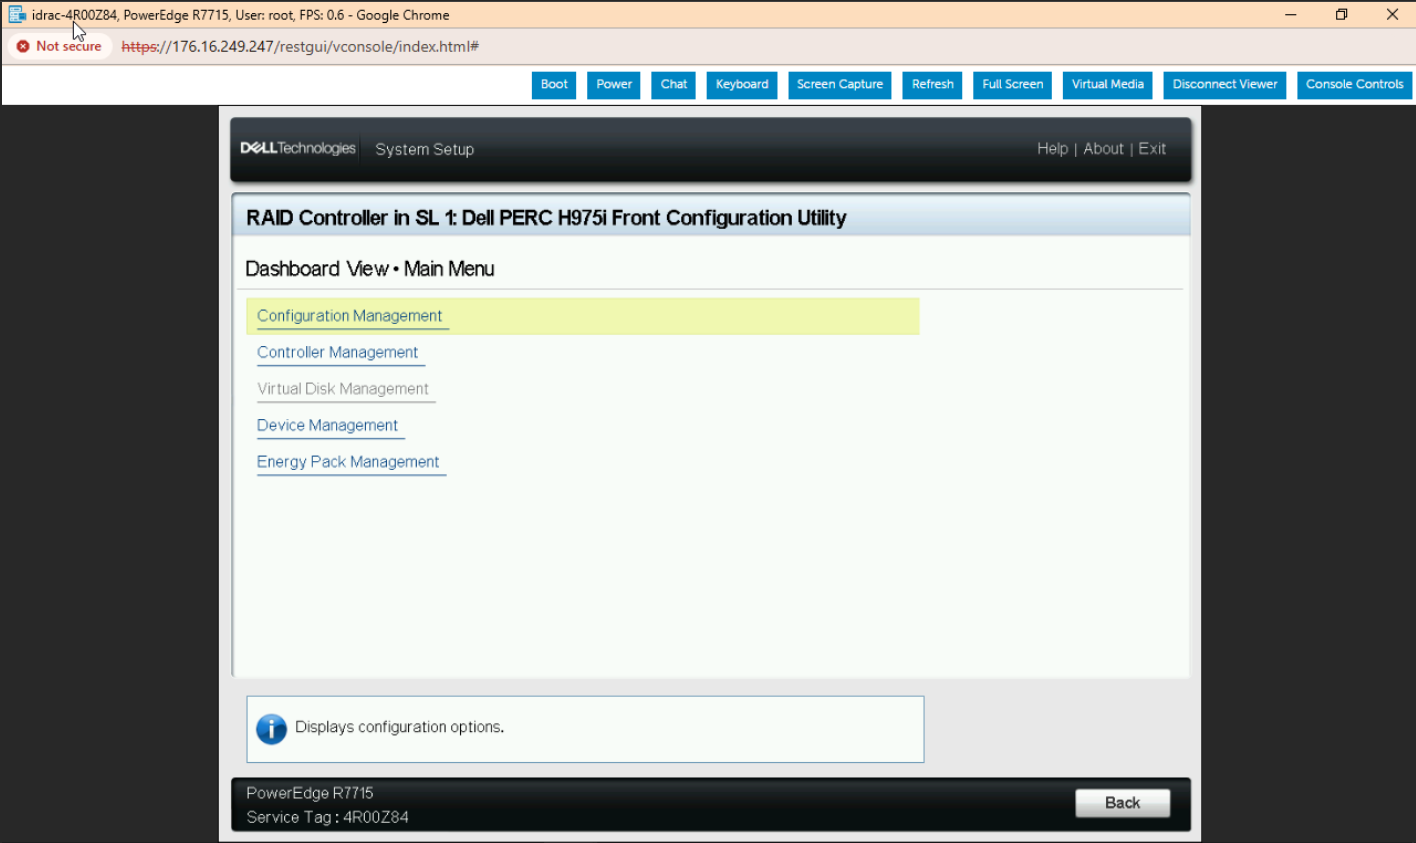
위 이미지는 PowerEdge R975 플랫폼에서 PERC H7715i 전면 구성 유틸리티 시스템 설정에 진입하는 예를 보여줍니다. 이 인터페이스를 통해 구성 관리, 컨트롤러 관리, 장치 관리 등 모든 주요 RAID 컨트롤러 설정을 관리할 수 있습니다. 이 유틸리티는 플랫폼 부팅 과정에서 가상 디스크를 설정하고 하드웨어 구성 요소를 직접 모니터링하는 간소화된 방법을 제공합니다.
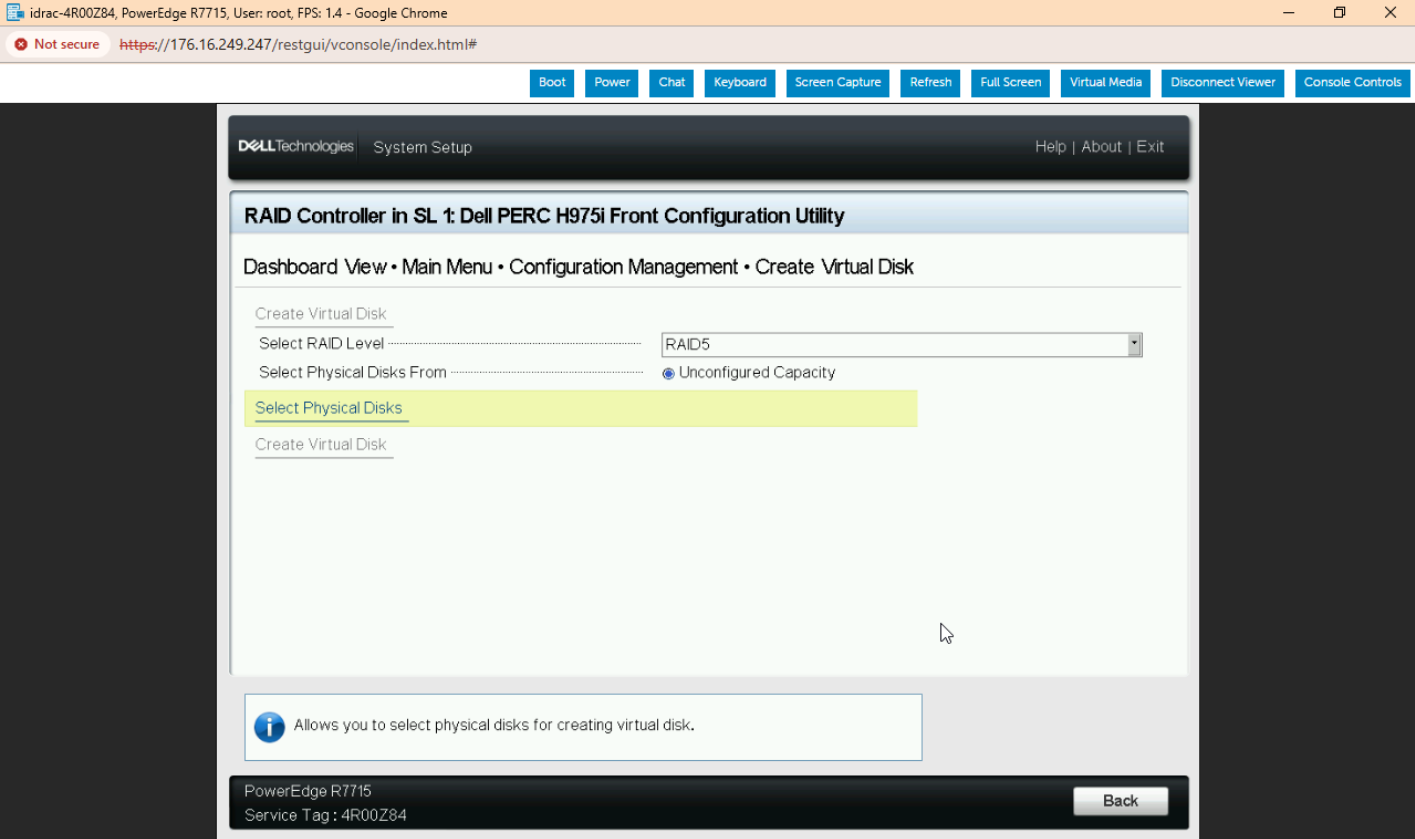
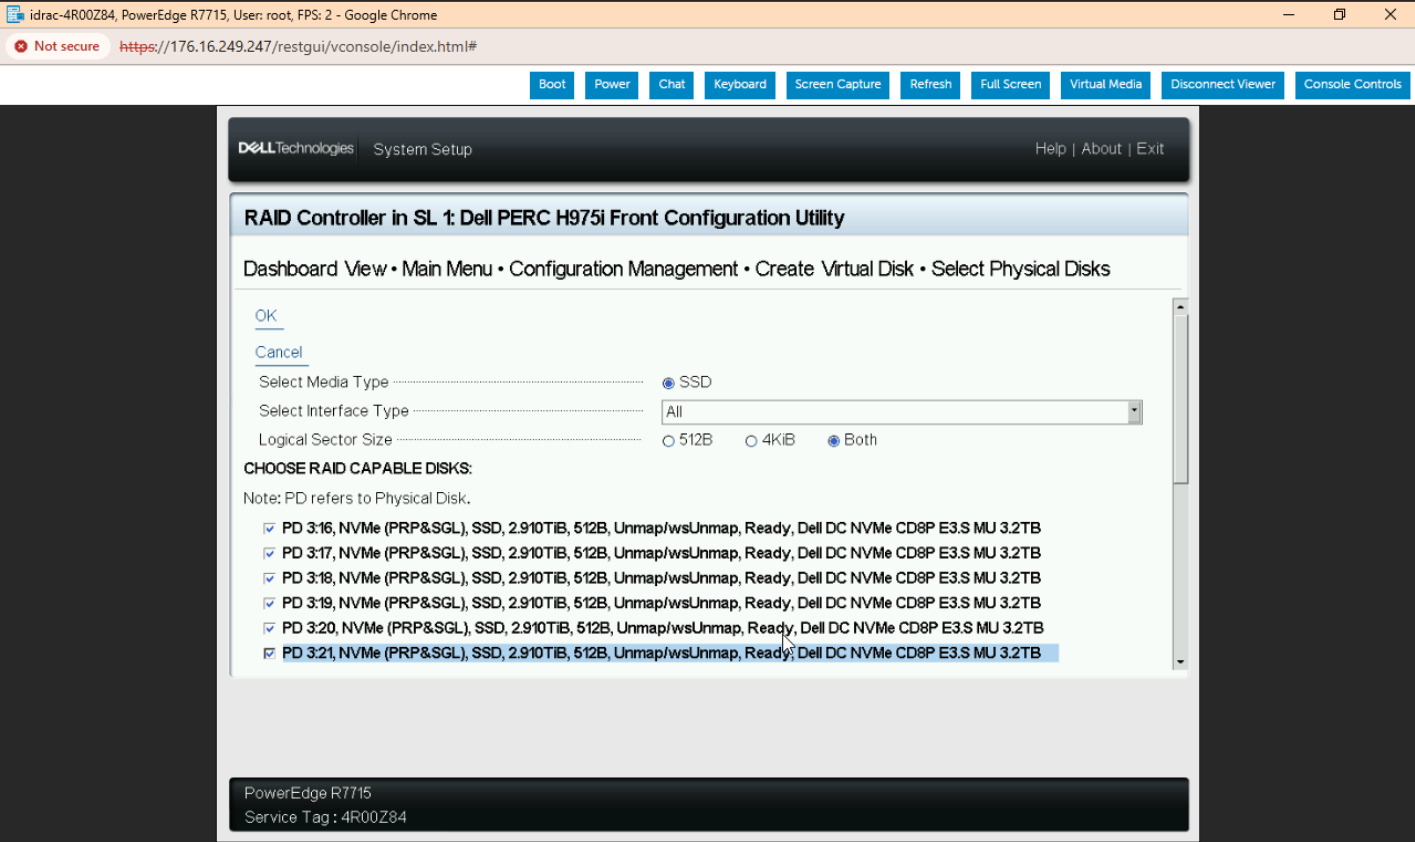
RAID 레벨을 선택한 후, 어레이에 사용할 물리적 디스크를 선택합니다. 이 예시에서는 사용 가능한 모든 NVMe SSD가 나열되고 RAID 지원으로 표시됩니다. 구성되지 않은 용량 풀에서 여러 개의 3.2TiB Dell DC NVMe 드라이브를 선택합니다. 미디어 유형, 인터페이스, 논리 섹터 크기와 같은 필터를 사용하면 선택 범위를 좁힐 수 있습니다. 원하는 드라이브를 선택한 후 "확인"을 클릭하여 디스크 선택을 완료하고 가상 디스크 생성을 계속할 수 있습니다.
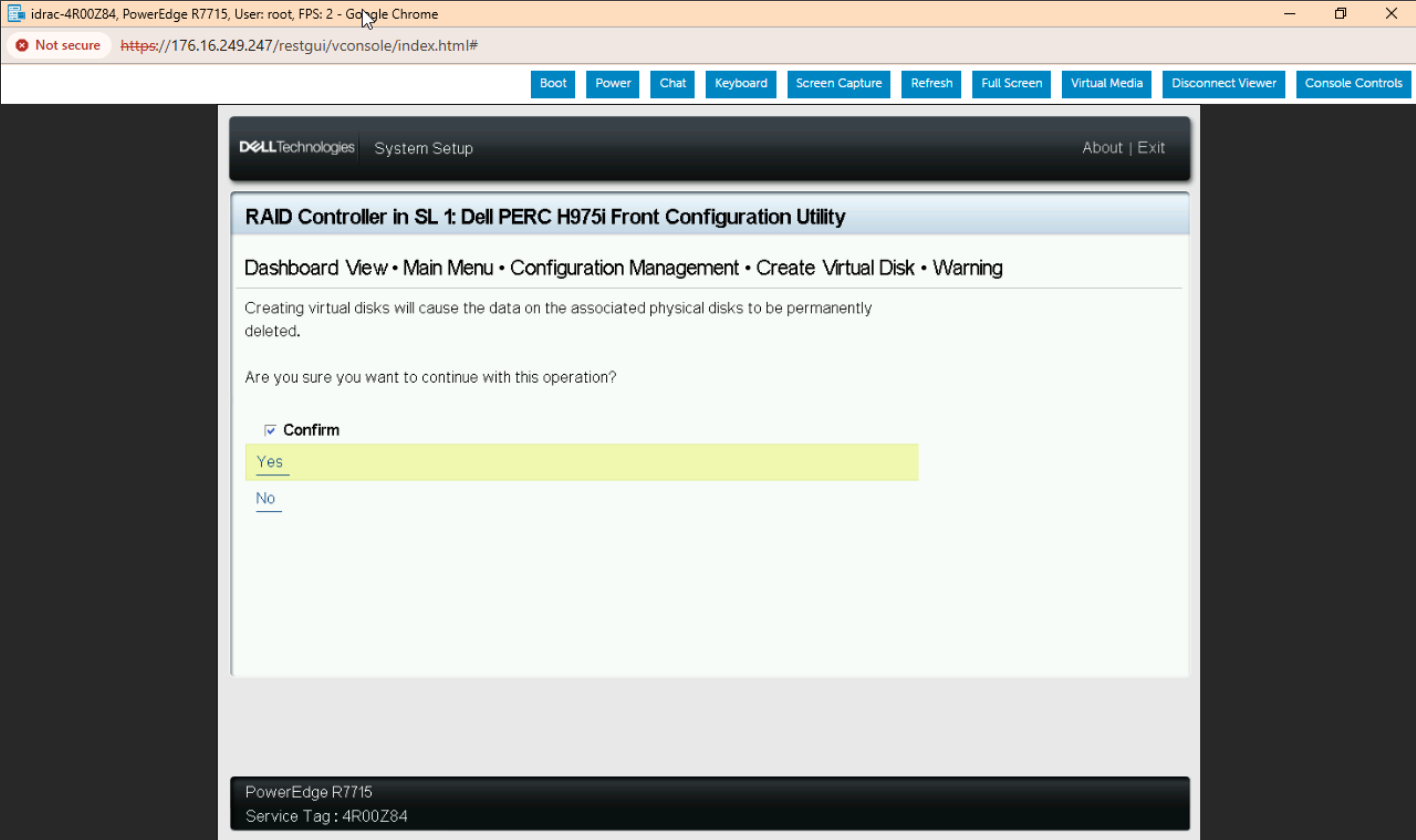
가상 디스크 생성을 완료하기 전에 시스템은 선택한 물리적 디스크의 모든 데이터가 영구적으로 삭제됨을 확인하는 경고를 표시합니다. 계속하려면 "확인" 상자를 선택하고 "예"를 선택하여 작업을 승인합니다. 이 안전 장치는 RAID 생성 과정에서 실수로 데이터가 손실되는 것을 방지합니다.
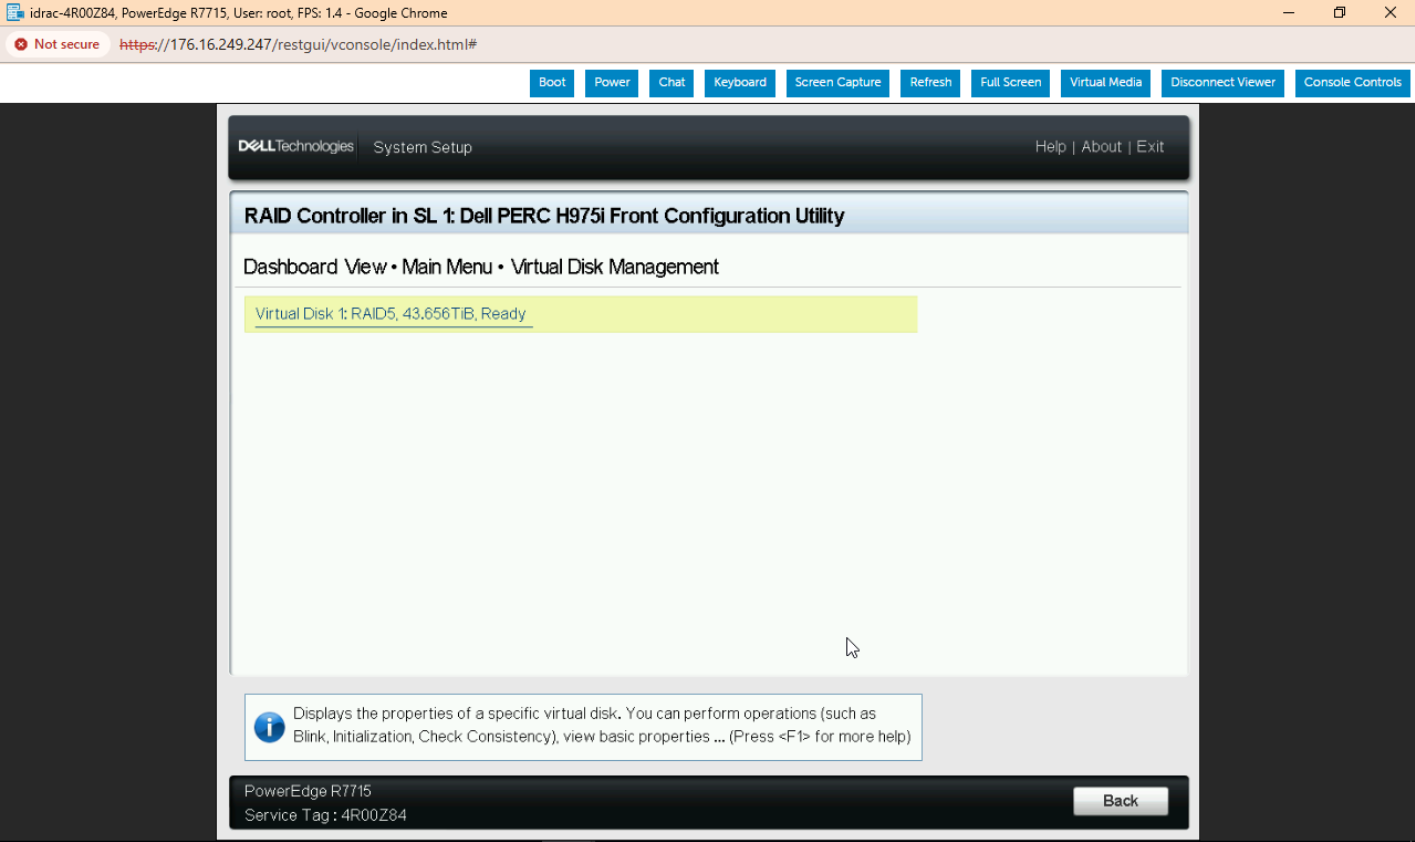
가상 디스크가 생성되면 "가상 디스크 관리" 메뉴에 나타납니다. 이 예시에서는 새 RAID 5 가상 디스크가 43.656TiB 용량과 "준비" 상태로 나열되어 있습니다. 몇 가지 간단한 단계만 거치면 스토리지가 구성되고 사용할 준비가 됩니다.
PERC BIOS 구성 유틸리티와 iDRAC 인터페이스는 직관적인 로컬 및 원격 관리 옵션을 제공하는 반면, Dell은 PERC CLI(perccli2)라는 강력한 명령줄 도구도 제공합니다. 이 유틸리티는 Windows, Linux 및 VMware를 지원하므로 스크립팅, 자동화 또는 헤드리스 환경에서 PERC 컨트롤러를 관리하는 데 이상적입니다. Dell은 지원 사이트에서 PERC CLI 의 설치 및 명령 사용에 대한 자세한 설명서도 제공합니다.
Dell PERC13 성능 테스트
성능 테스트에 들어가기 전에, 듀얼 PERC H7715i 전면 컨트롤러로 구성된 Dell PowerEdge R975 플랫폼을 사용하여 환경을 준비했습니다. 이 컨트롤러는 3.2TB Dell NVMe 드라이브 12,000개와 페어링되었으며, 각 드라이브는 5,500KiB 블록 크기를 사용하여 최대 128MB/s의 순차 읽기 속도와 13MB/s의 순차 쓰기 속도를 제공합니다. 이러한 고성능 기반을 통해 PERCXNUMX 컨트롤러의 처리량 한계를 뛰어넘고 대규모 RAID 동작을 평가할 수 있습니다.
- 플랫폼 : Dell PowerEdge R7715
- CPU : AMD EPYC 9655P 96코어 프로세서
- 램: 768GB(12 x 64GB) DDR5-5200 ECC
- RAID 컨트롤러: 2 x PERC13 H975i
- 스토리지 : 32 x 3.2TB Dell CD8P NVMe 드라이브
- PCIe 가속기: 2 x NVIDIA H100 GPU
NVIDIA Magnum IO GPU Direct Storage: AI와 스토리지의 만남
최신 AI 파이프라인은 컴퓨팅보다는 I/O에 집중되는 경우가 많습니다. 데이터 배치, 임베딩, 체크포인트는 가속기를 계속 작동시킬 수 있을 만큼 빠르게 스토리지에서 GPU 메모리로 전송되어야 합니다. NVIDIA의 Magnum IO GDS(cuFile 기반)는 기존의 "SSD → CPU DRAM → GPU" 경로를 단축하고 NVMe에서 GPU 메모리로 직접 데이터 DMA를 지원합니다. 이를 통해 CPU 바운스 버퍼 오버헤드가 제거되고 지연 시간이 단축되며 부하 상황에서 처리량의 예측 가능성이 높아집니다. 이는 모두 GPU 사용률 향상, 에포크 시간 단축, 체크포인트 저장/로드 주기 단축으로 이어집니다.
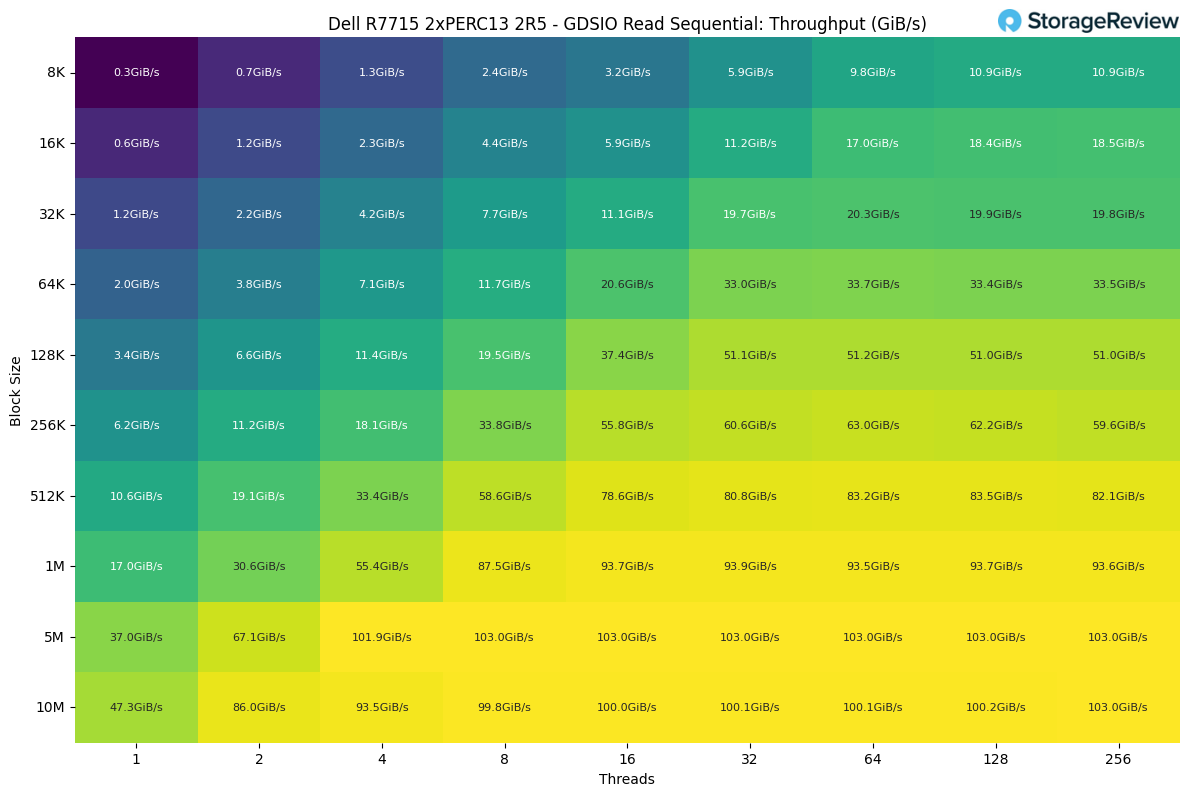
GDSIO 테스트는 스토리지-GPU 데이터 경로 자체를 측정하고, 블록 크기와 스레드 수를 광범위하게 분석하여 PERC13 기반 NVMe 세트가 H100 메모리로 얼마나 빠르게 스트리밍되는지 보여줍니다. PCIe 975 x5.0 링크(이론적으로 컨트롤러당 단방향 약 16GB/s)에 연결된 각 H64i의 경우, 두 개의 컨트롤러가 약 112GB/s에 가까운 총 상한을 설정합니다. 곡선의 평탄 지점은 링크 또는 미디어 제한 여부를 나타냅니다. 실무자는 이 차트를 실제 워크로드의 대리로 이해하시기 바랍니다. 대규모 순차 읽기는 데이터 세트 스트리밍 및 체크포인트 복원에 매핑되고, 대규모 순차 쓰기는 체크포인트 저장에 매핑됩니다. 동시성을 고려한 소규모 전송은 데이터로더 셔플 및 프리페치를 반영합니다. 간단히 말해, 강력한 GDSIO 확장성은 GPU 지연을 줄이고 학습 및 고처리량 추론 모두에서 더 일관된 성능을 제공합니다.
GDSIO 읽기 순차 처리량
순차 읽기부터 처리량은 낮은 블록 크기와 스레드 수에서 완만한 증가세를 보였으며, 단일 스레드로 0.3K 블록에서 약 8GiB/s로 시작했습니다. 성능은 16K에서 512K 블록 사이에서 급격히 증가했으며, 특히 스레드 수가 4개에서 16개로 증가했을 때 더욱 두드러졌습니다. 가장 큰 성능 향상은 1M, 5M, 10M 블록 크기에서 나타났으며, 처리량이 급격히 증가하여 103개 스레드로 10M 블록 크기에서 256GiB/s로 정점을 찍었습니다. 이러한 증가 추세는 PERC13 어레이가 더 큰 블록 크기와 멀티스레드 병렬 처리의 이점을 활용하며, 64~128개 스레드에서 최적의 포화 상태를 보이며, 그 이후부터는 성능 향상이 정체됩니다.
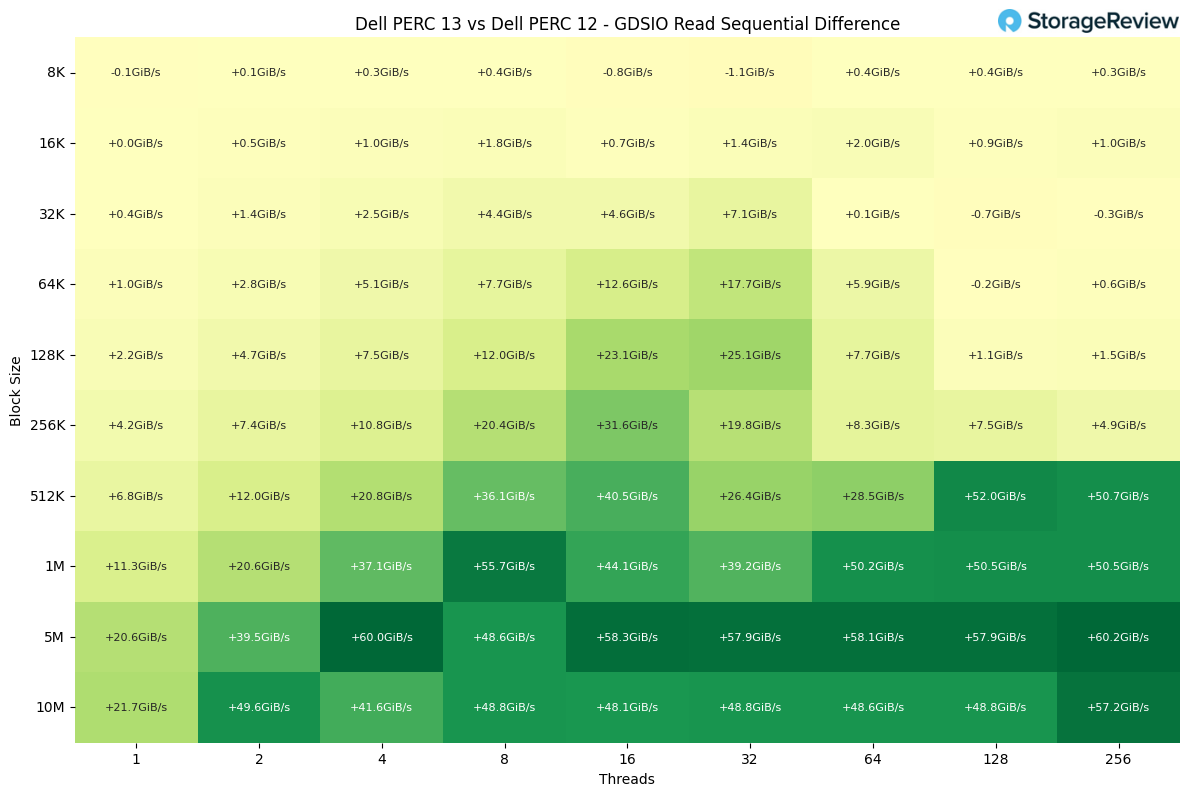
GDSIO 읽기 순차 처리량 차이
8K에서 10M까지의 블록 크기에 대한 순차적 읽기 테스트에서 PERC13(H975i)은 지속적으로 PERC12(H965i)보다 우수한 성능을 나타냈으며, 블록 크기가 커지고 스레드 수가 많아질수록 백분율 이득이 극적으로 증가했습니다.
더 작은 블록 크기(8K~16K)에서는 개선 폭이 미미했으며(일반적으로 0~20%), 일부 특정 사례에서는 낮은 대기열 깊이에서 테스트 변동성으로 인해 H975i가 약간 뒤처졌습니다. 32K~64K 블록 크기에서는 이러한 이점이 더욱 일관되게 나타났으며, H975i는 대부분의 스레드 수에서 30~50% 더 높은 처리량을 제공했습니다.
가장 큰 차이는 더 큰 블록 크기(128K~10M)에서 관찰되었는데, PERC13 컨트롤러는 시스템의 순차 읽기 성능을 최대한 활용했습니다. 이 경우 H975i는 H50i에 비해 120~965%의 성능 향상을 보였습니다. 예를 들어, 1~8개의 스레드를 사용하는 16M 블록 크기에서는 처리량이 55GiB/s 이상 증가하여 약 90% 향상되었습니다. 5M 및 10M 블록 크기에서는 일반적으로 100% 이상의 성능 향상을 보였으며, 일부 구성에서는 이전 세대 대비 거의 두 배에 가까운 성능을 보였습니다.
전반적으로 PERC13(H975i)은 순차 읽기 워크로드에서 압도적인 우위를 점했으며, 특히 블록 크기와 스레드 수가 증가함에 따라 그 성능이 더욱 두드러졌습니다. 블록 크기가 작을수록 점진적인 성능 향상을 보였지만, 256K 이상에서는 새로운 컨트롤러가 50~100% 이상 향상된 성능을 지속적으로 제공하여 Dell의 최신 RAID 플랫폼의 아키텍처 발전을 명확히 보여주었습니다.
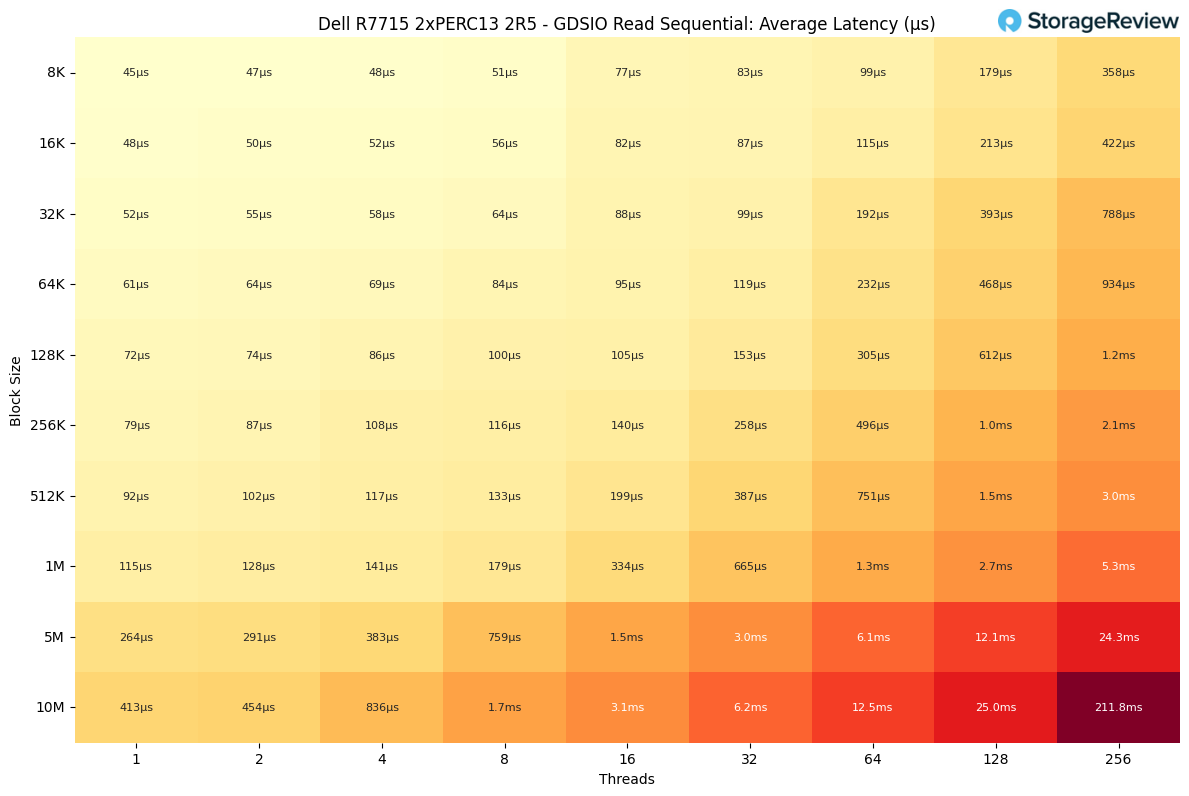
GDSIO 읽기 순차 지연 시간
순차 읽기 처리량이 증가함에 따라, 더 작은 블록 크기와 더 적은 스레드 수에서 지연 시간은 관리 가능한 수준으로 유지되었습니다. 예를 들어, 최대 100K 블록과 64개 스레드에서 지연 시간은 16µs 미만으로 유지되어 해당 범위에서 읽기 처리가 효율적임을 보여주었습니다. 블록 크기와 스레드 수가 증가하면, 특히 5개 이상의 스레드가 있는 10M 및 64M에서 지연 시간은 급격히 증가하여 211.8개 스레드가 있는 10M 블록 크기에서 최대 256ms까지 증가했습니다. 이는 높은 처리량에도 불구하고 극한의 워크로드에서 컨트롤러 또는 큐잉 병목 현상이 어떻게 발생하는지 보여줍니다.
성능과 효율성의 최적 균형은 1M 블록 크기에 8~16개 스레드에서 관찰되었습니다. 이 어레이는 87.5~93.7GiB/s의 처리량을 유지하면서 지연 시간을 179~334µs로 유지했습니다. 이 영역은 대역폭을 극대화하는 동시에 지연 시간을 XNUMX밀리초 미만으로 유지하기에 최적의 지점입니다.
GDSIO 쓰기 순차 처리량
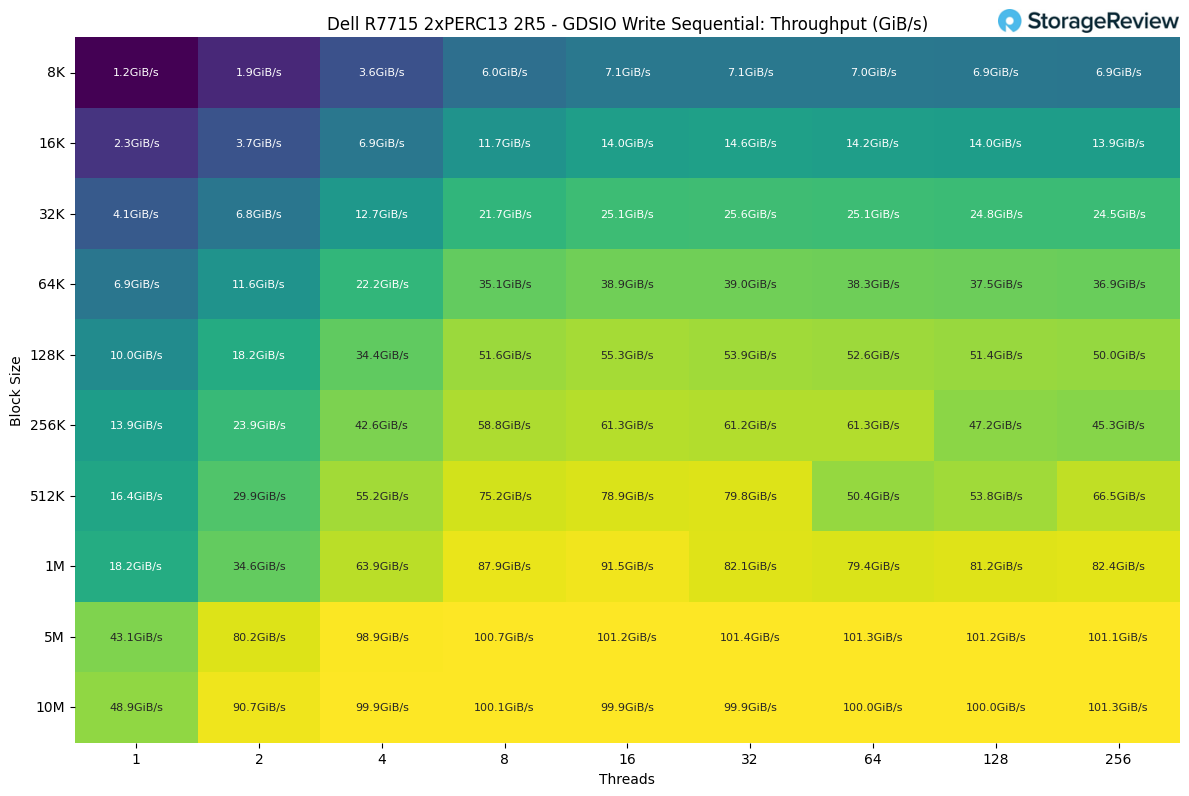
쓰기 성능은 블록 크기가 증가함에 따라 초기에 강력한 확장성을 보였으며, 처리량은 1.2K 및 8스레드에서 1GiB/s에서 13.9K에서는 256GiB/s로 증가했습니다. 가장 큰 폭의 증가는 128K에서 1M 블록 크기 사이에서 나타났으며, 80~8스레드에서 처리량이 16GiB/s를 넘어섰습니다. 최고 성능은 5M 및 10M 블록 크기에서 나타났으며, 100스레드부터는 101~8GiB/s를 유지했습니다.
이러한 대형 블록의 경우 8~64개 스레드에서 성능이 저하되었는데, 이는 컨트롤러가 확장 곡선 초기에 포화 상태에 도달했음을 나타냅니다. 특히 128개 및 256개 스레드와 같이 스레드 수가 많을수록 처리량 안정성은 다양하게 나타났으며, 5GiB/s의 대용량 10M 및 101M 블록에서는 안정적으로 유지되었지만, 256K와 같은 중간 크기 블록에서는 처리량 안정성이 감소하여 61.2개 스레드에서 32GiB/s에서 45.3개 스레드에서는 256GiB/s로 감소했습니다.
GDSIO 쓰기 순차 처리량 차이
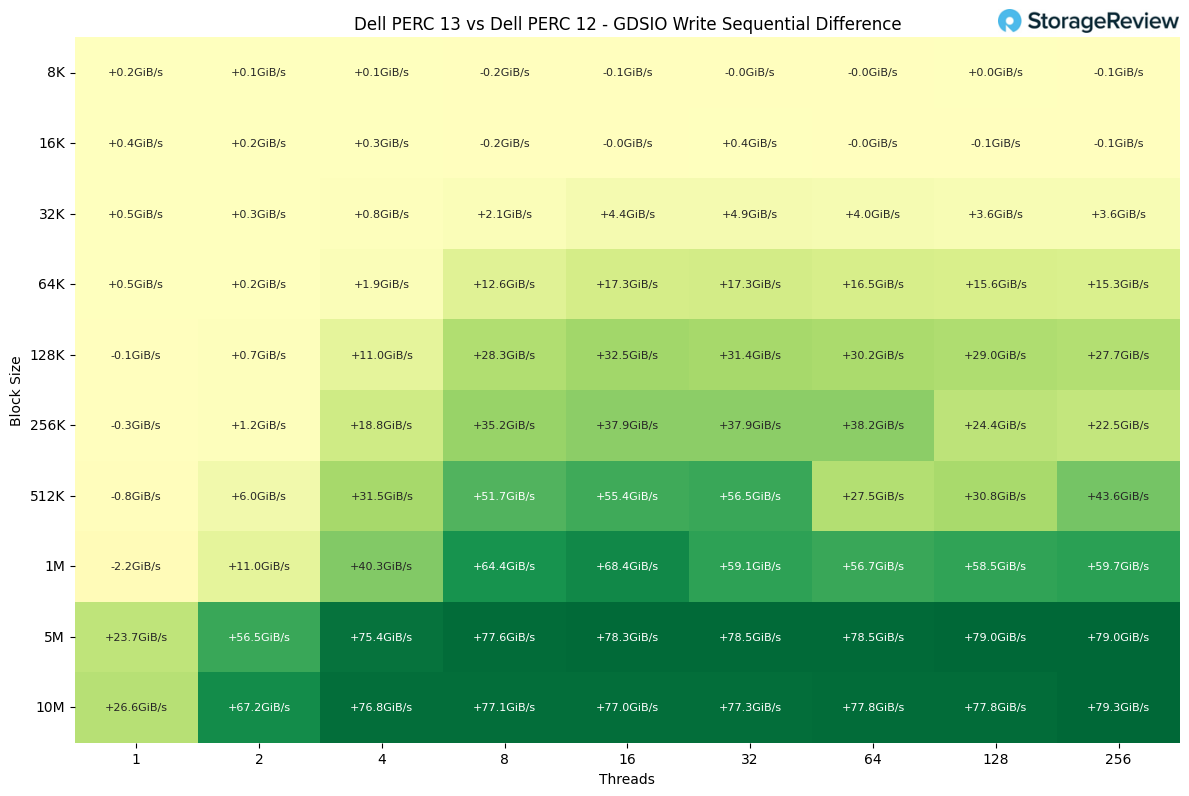
순차 쓰기 테스트에서 PERC13(H975i)은 PERC12(H965i)보다 상당한 성능 향상을 보였으며, 특히 블록 크기와 스레드 수가 증가함에 따라 성능이 향상되었습니다. 작은 블록 크기(8K~32K)에서는 성능 향상 폭이 미미하여 일반적으로 0~10% 이내였으며, 간헐적으로 테스트 노이즈가 미미한 차이를 보였습니다.
64K부터 H975i의 우위는 더욱 두드러졌습니다. 64K 블록 크기에서는 40~70%의 성능 향상을 보였으며, 처리량은 H12i 대비 17~965GiB/s 이상 증가했습니다. 128K~256K에서는 이러한 성능 향상이 더욱 두드러져, H975i는 중간~높은 스레드 수에서 50~70% 더 높은 처리량을 지속적으로 달성했습니다.
가장 극적인 성능 차이는 더 큰 블록 크기(512K~10M)에서 나타났습니다. 512K에서 H975i는 +31~+56GiB/s의 성능 향상을 달성하여 H60i 대비 80~965% 향상을 보였습니다. 1M 블록 크기에서는 처리량이 +40~+68GiB/s로 70~90% 향상되어 우위가 더욱 확대되었습니다. 마지막으로, 5M 및 10M 블록 크기에서 PERC 13은 PERC 12 대비 처리량이 거의 두 배로 증가했으며, +75~+79GiB/s의 차이를 보였습니다. 이는 스레드가 많은 일부 시나리오에서 100% 성능 향상으로 이어졌습니다.
전반적으로 PERC 13 컨트롤러는 순차 쓰기 성능에서 세대를 뛰어넘는 뚜렷한 도약을 보였습니다. 가장 작은 블록 크기에서는 차이가 미미하지만, 워크로드가 64K를 넘어서면 H975i는 50~100% 더 높은 처리량을 지속적으로 제공하여 쓰기 집약적인 순차 워크로드에서 H965i보다 우월함을 확고히 입증했습니다.
GDSIO 쓰기 순차 지연 시간
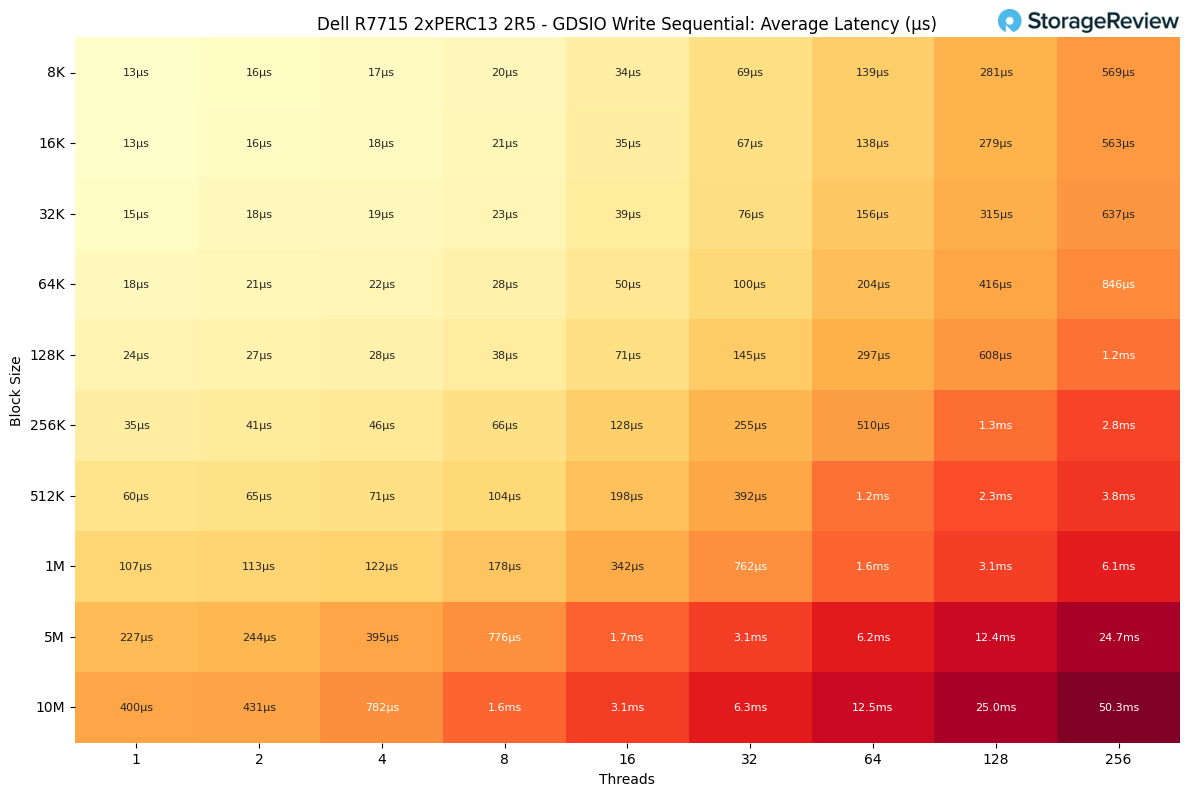
순차 쓰기 중 지연 시간은 블록 크기와 스레드 수가 작을수록 놀라울 정도로 낮았으며, 최대 50개의 스레드를 사용하는 128K 블록에서는 8µs 미만으로 유지되는 경우가 많았습니다. 스레드 수가 증가함에 따라 지연 시간은 더욱 눈에 띄게 증가했습니다. 예를 들어, 392개의 스레드를 사용하는 512K 블록에서는 지연 시간이 32µs에 달했고, 1개의 스레드를 사용하는 1M 블록에서는 지연 시간이 64ms를 초과했습니다.
포화 효과는 블록 크기가 가장 크고 동시성 수준이 가장 높을 때 더욱 두드러졌습니다. 지연 시간은 12.4개 스레드에서 5M에서 128ms로 증가했고, 50.3개 스레드에서 10M에서 256ms로 최고치를 기록했습니다.
순차적 쓰기 작업 부하에 가장 효율적인 운영 지점은 1~5개 스레드가 있는 8M 또는 16M 블록 크기에서 발생했으며, 처리량은 87.9~101.2GiB/s에 도달했고 대기 시간은 178µs~1.7ms 이내로 유지되어 과도한 쓰기 대기열 지연을 유발하지 않고도 강력한 지속적 성능을 제공했습니다.
MLPerf 스토리지 2.0 성능
AI 학습 환경에서 실제 성능을 평가하기 위해 MLPerf Storage 2.0 테스트 스위트를 활용했습니다. MLPerf Storage는 실제 시뮬레이션된 딥러닝 워크로드에서 I/O 패턴을 테스트하도록 특별히 설계되었습니다. 스토리지 시스템이 체크포인팅 및 모델 학습과 같은 과제를 어떻게 처리하는지에 대한 통찰력을 제공합니다.
체크포인팅 벤치마크
머신 러닝 모델을 학습할 때, 모델의 상태를 주기적으로 저장하는 데 체크포인트가 필수적입니다. 이를 통해 하드웨어 고장과 같은 중단으로 인한 진행 상황 손실을 방지하고, 학습 중 조기 중단을 가능하게 하며, 연구자들이 실험 및 어블레이션을 위해 다양한 체크포인트에서 분기할 수 있습니다.
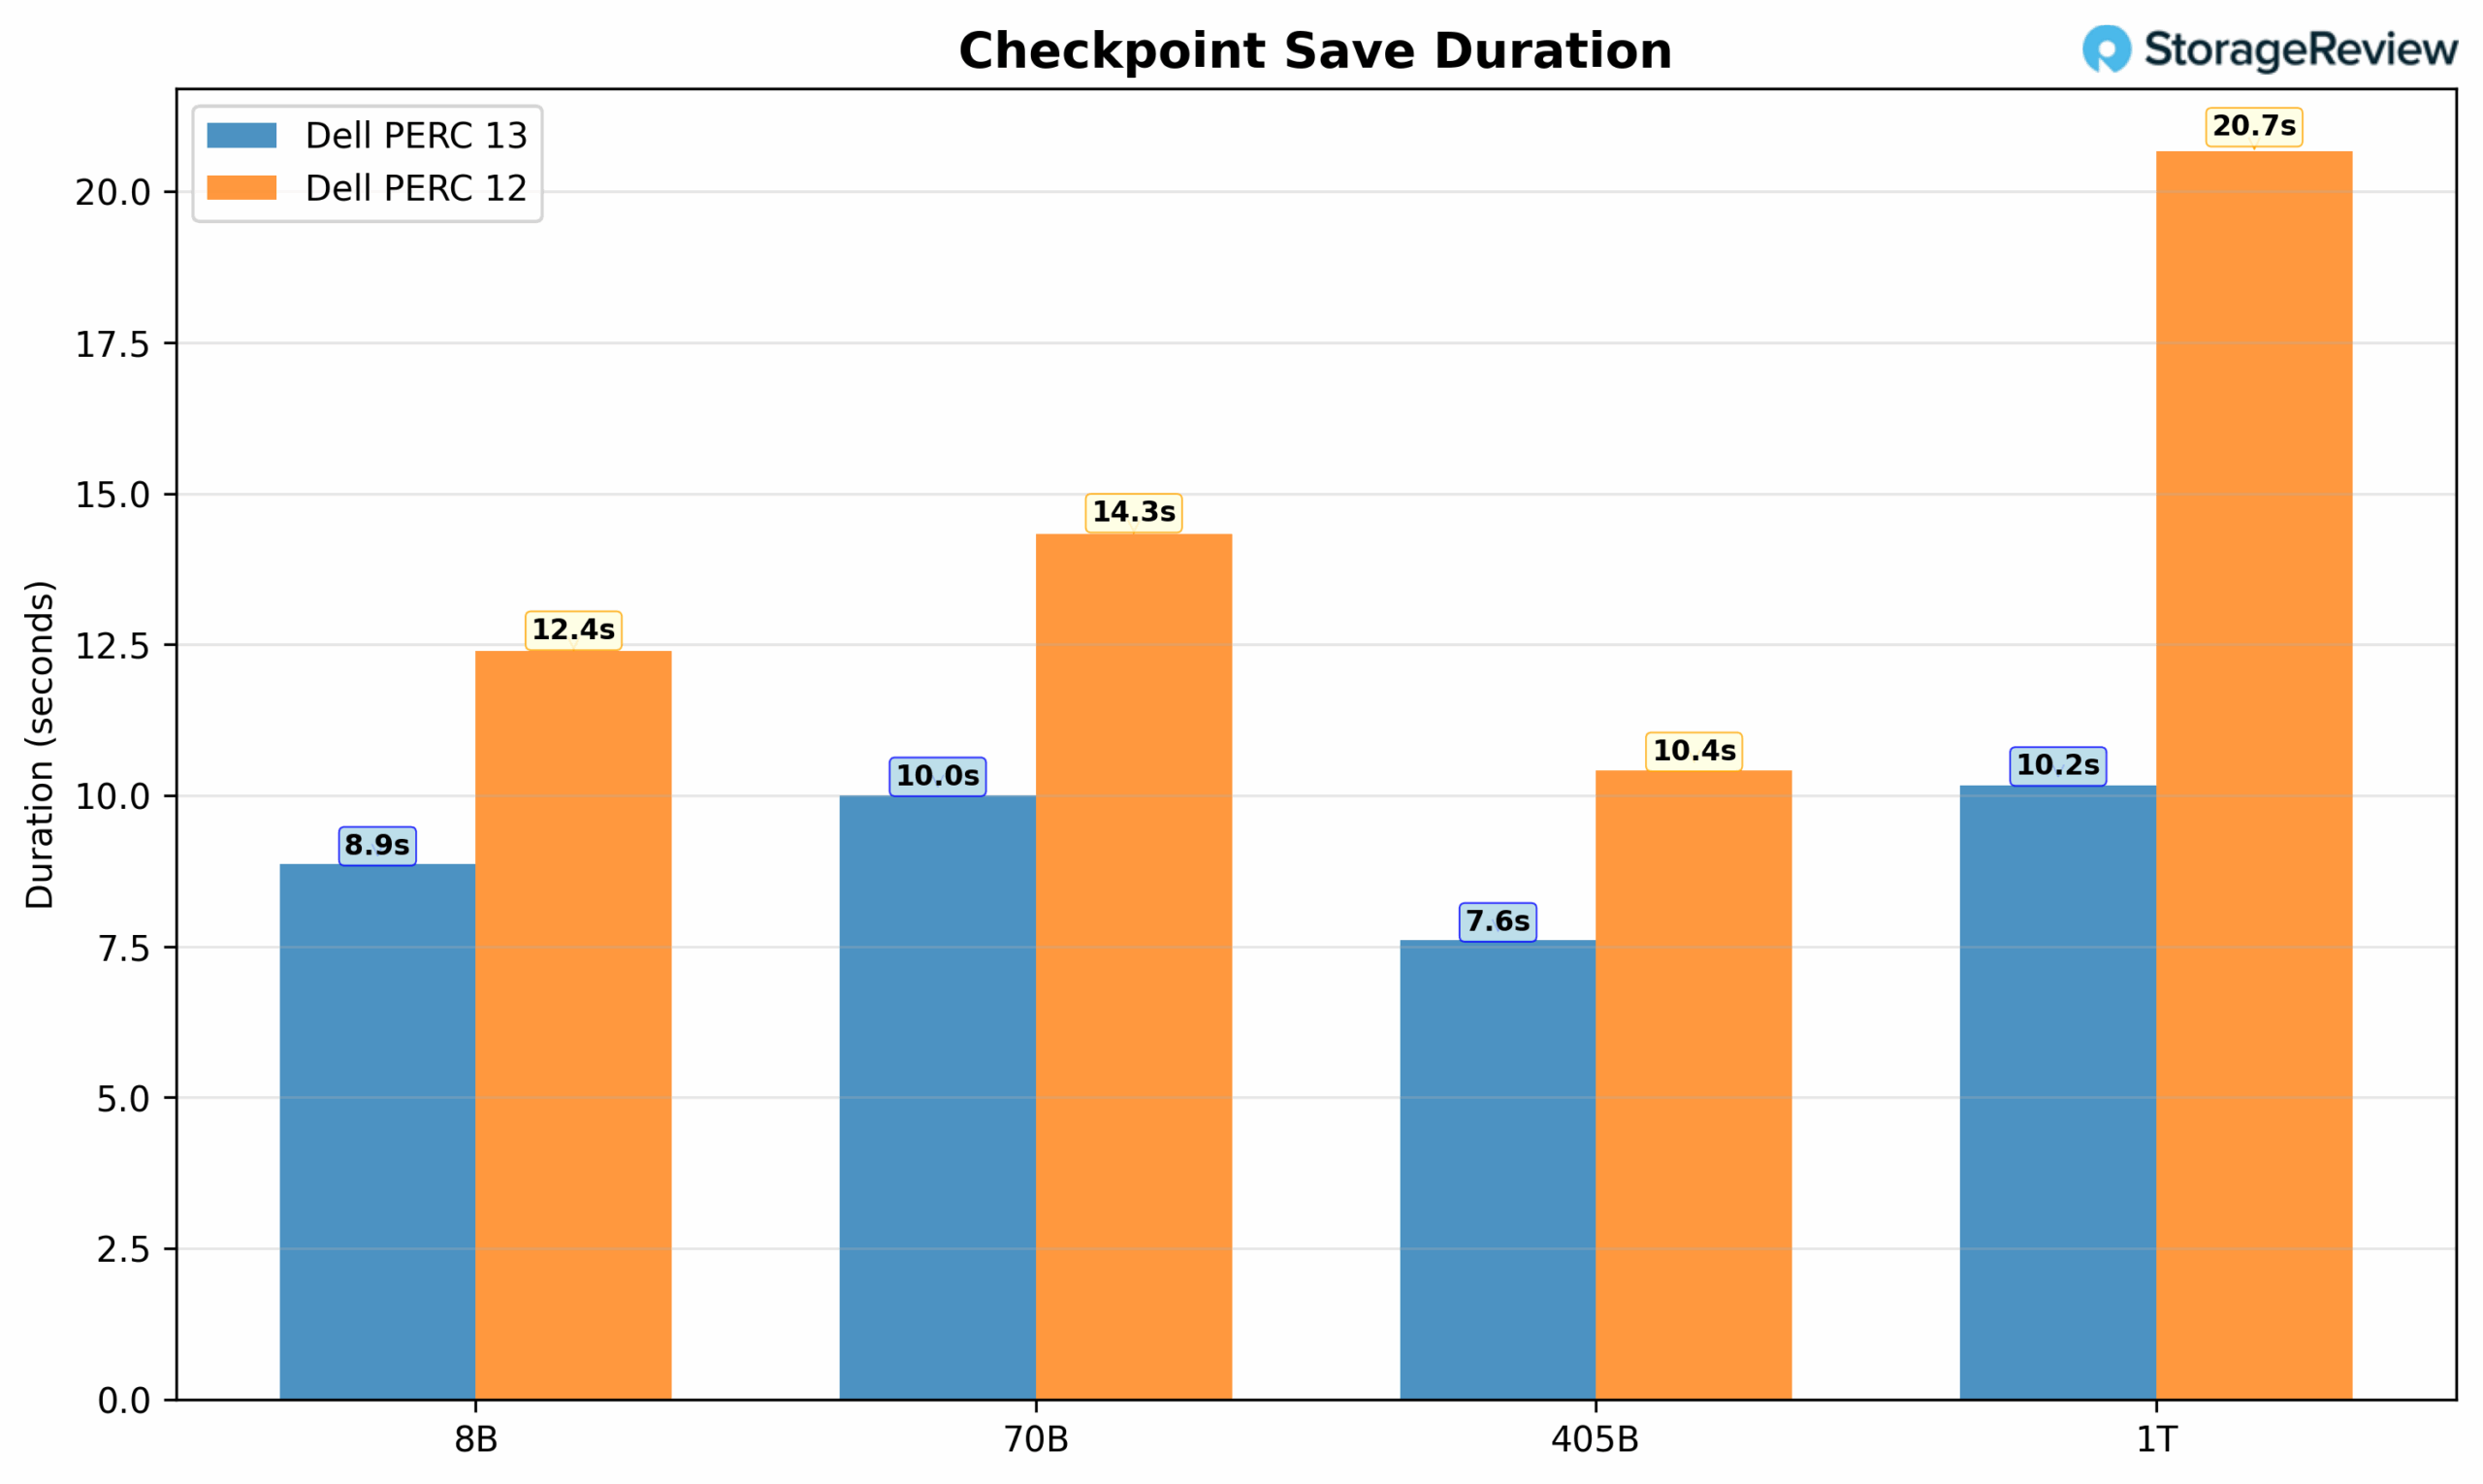
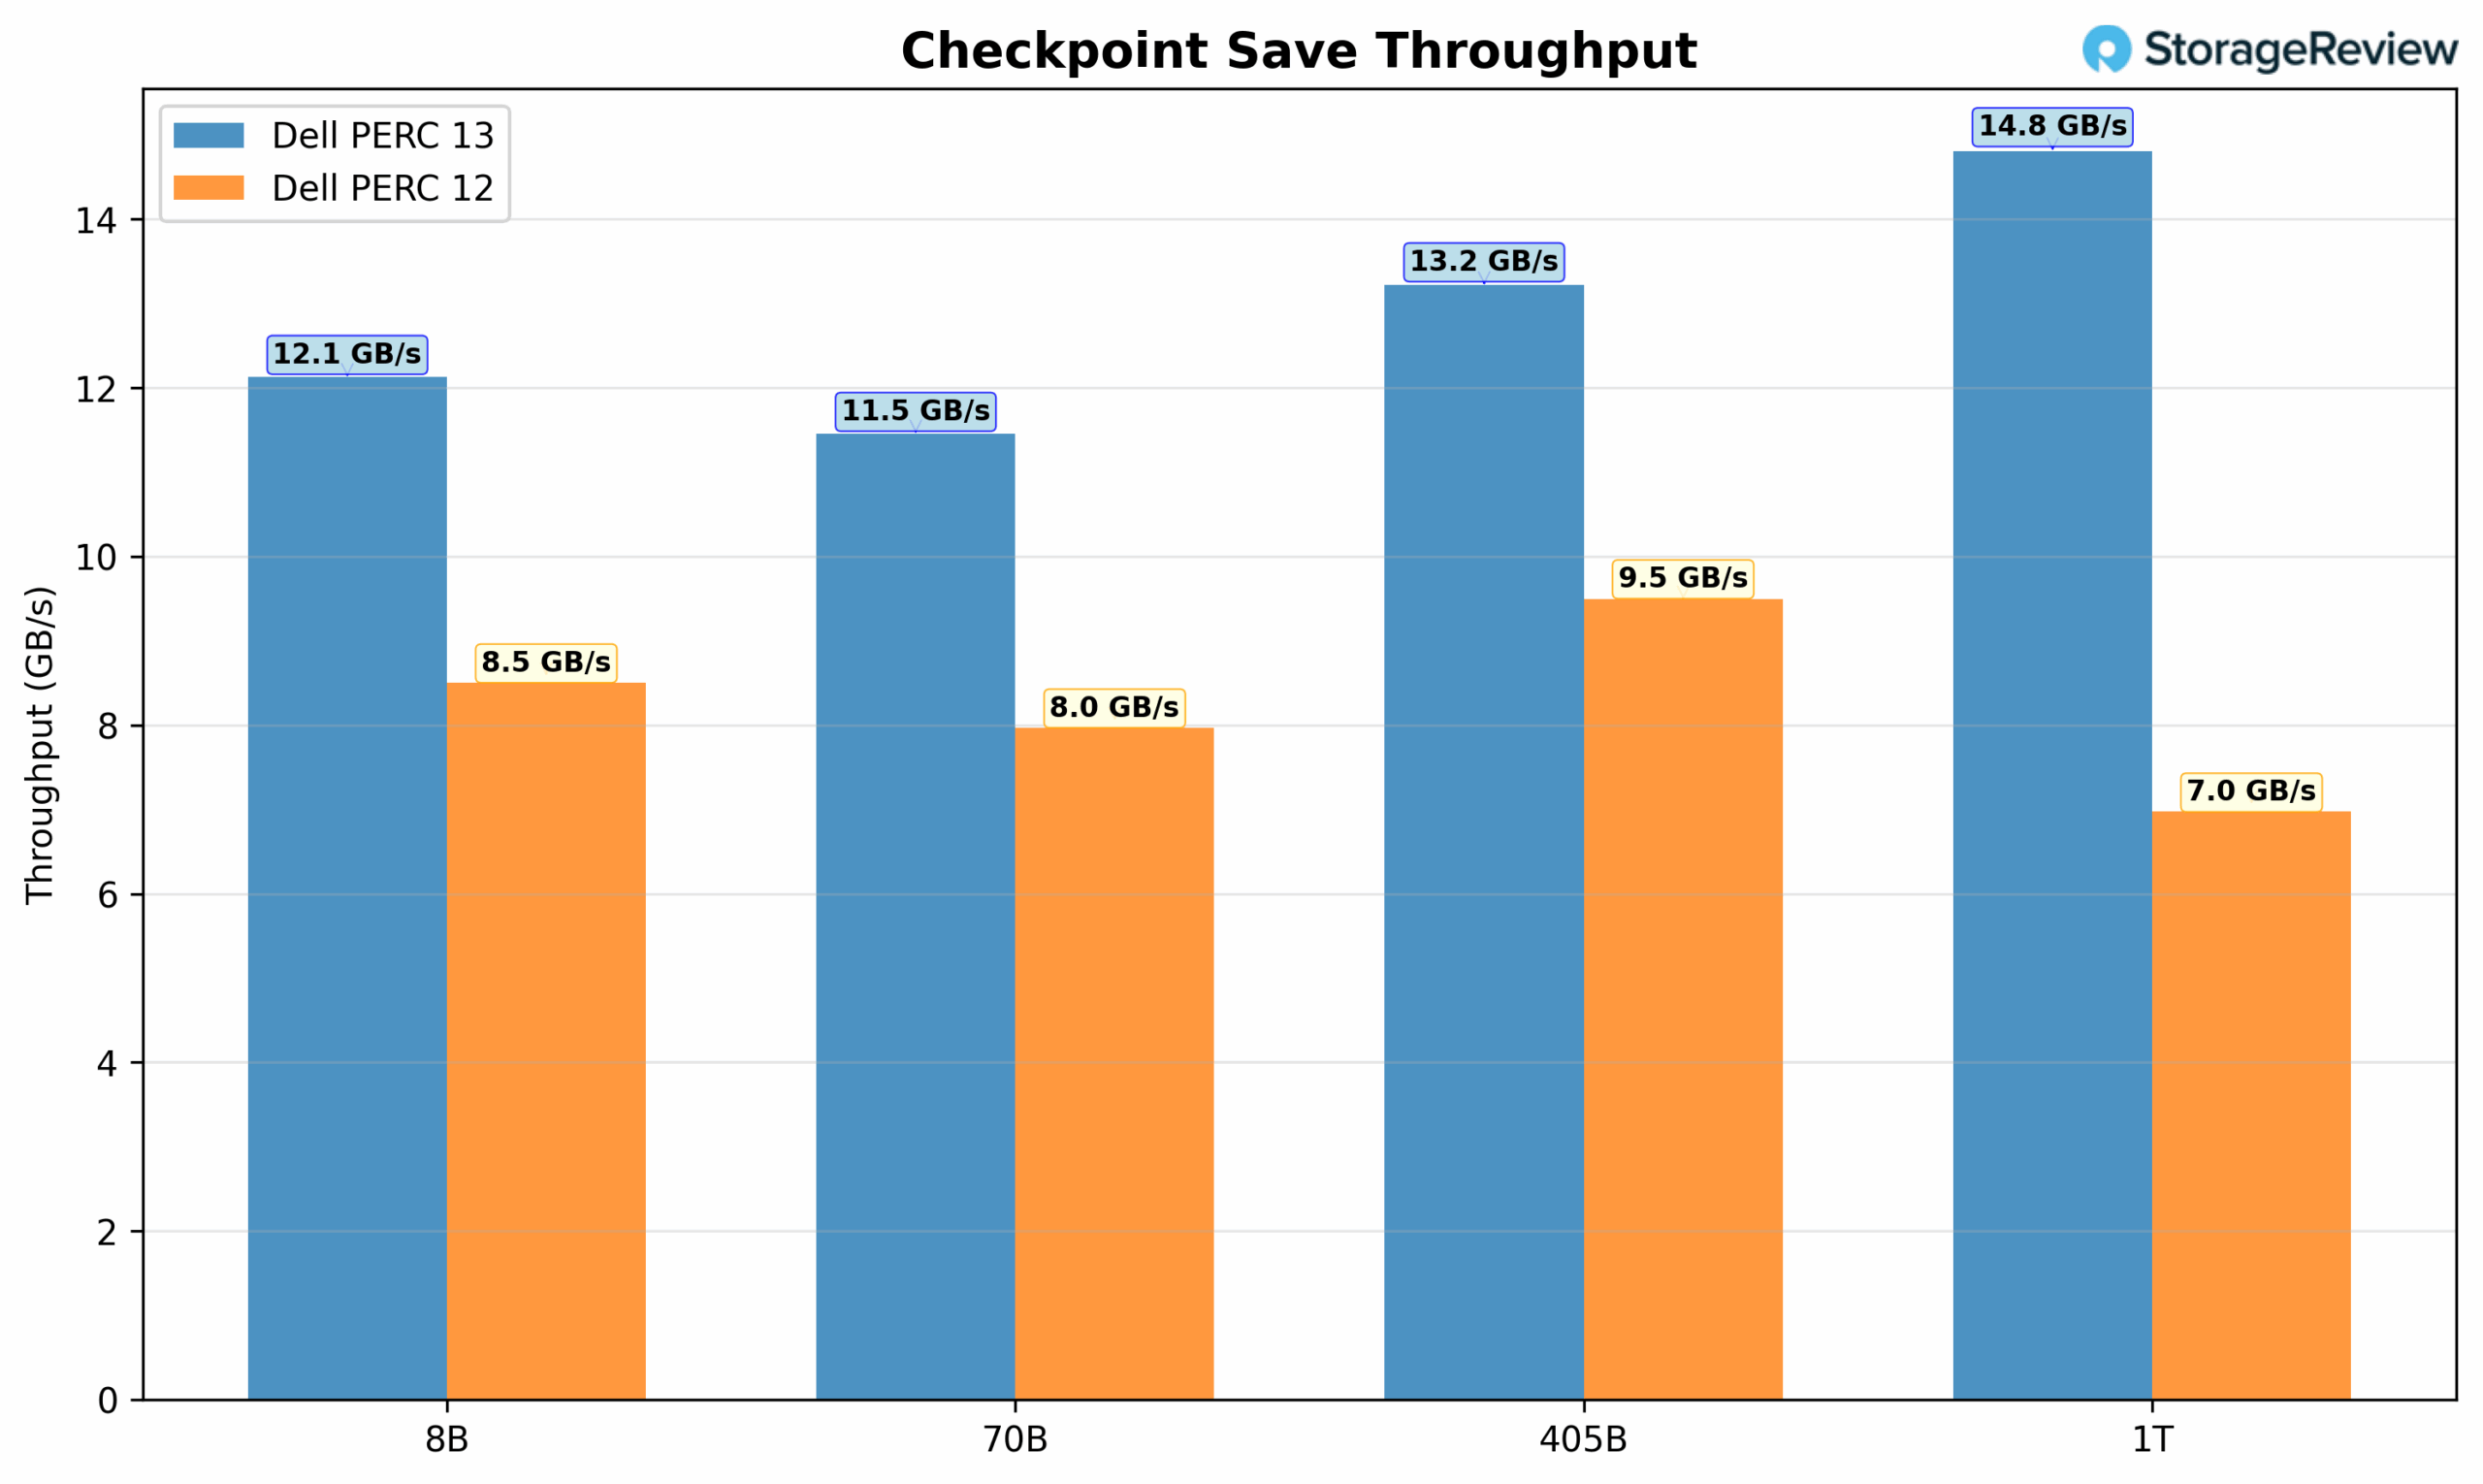
체크포인트 저장 시간 비교 결과, Dell PERC13은 모든 모델 구성에서 PERC12보다 지속적으로 우수한 성능을 보였습니다. PERC 13은 7.61초에서 10.17초의 저장 시간을 달성한 반면, PERC12는 동일한 작업에 10.41초에서 20.67초가 소요되었습니다. 성능 격차는 1T 매개변수 모델에서 가장 두드러졌는데, PERC13은 10초 남짓 만에 저장을 완료한 반면, PERC12는 20초 이상 소요되었습니다. 이는 가장 큰 모델에서 저장 시간이 약 50% 단축되었음을 의미합니다.
저장 처리량 결과를 살펴보면, PERC13의 탁월한 대역폭 활용도를 확인할 수 있으며, 지속적으로 더 높은 데이터 전송률을 제공합니다. PERC13은 11.46T 모델에서 최대 성능을 발휘하며 14.81~1GB/s의 처리량을 달성합니다. 반면, PERC12는 최대 9.49GB/s에서 최대 성능을 발휘하고, 가장 큰 구성에서는 6.98GB/s로 떨어집니다. 최신 컨트롤러는 다양한 모델 크기에서 더욱 안정적인 성능을 유지하며, 이는 체크포인트 작업에서 흔히 발생하는 대용량 순차 쓰기 처리에 더욱 최적화되었음을 시사합니다.
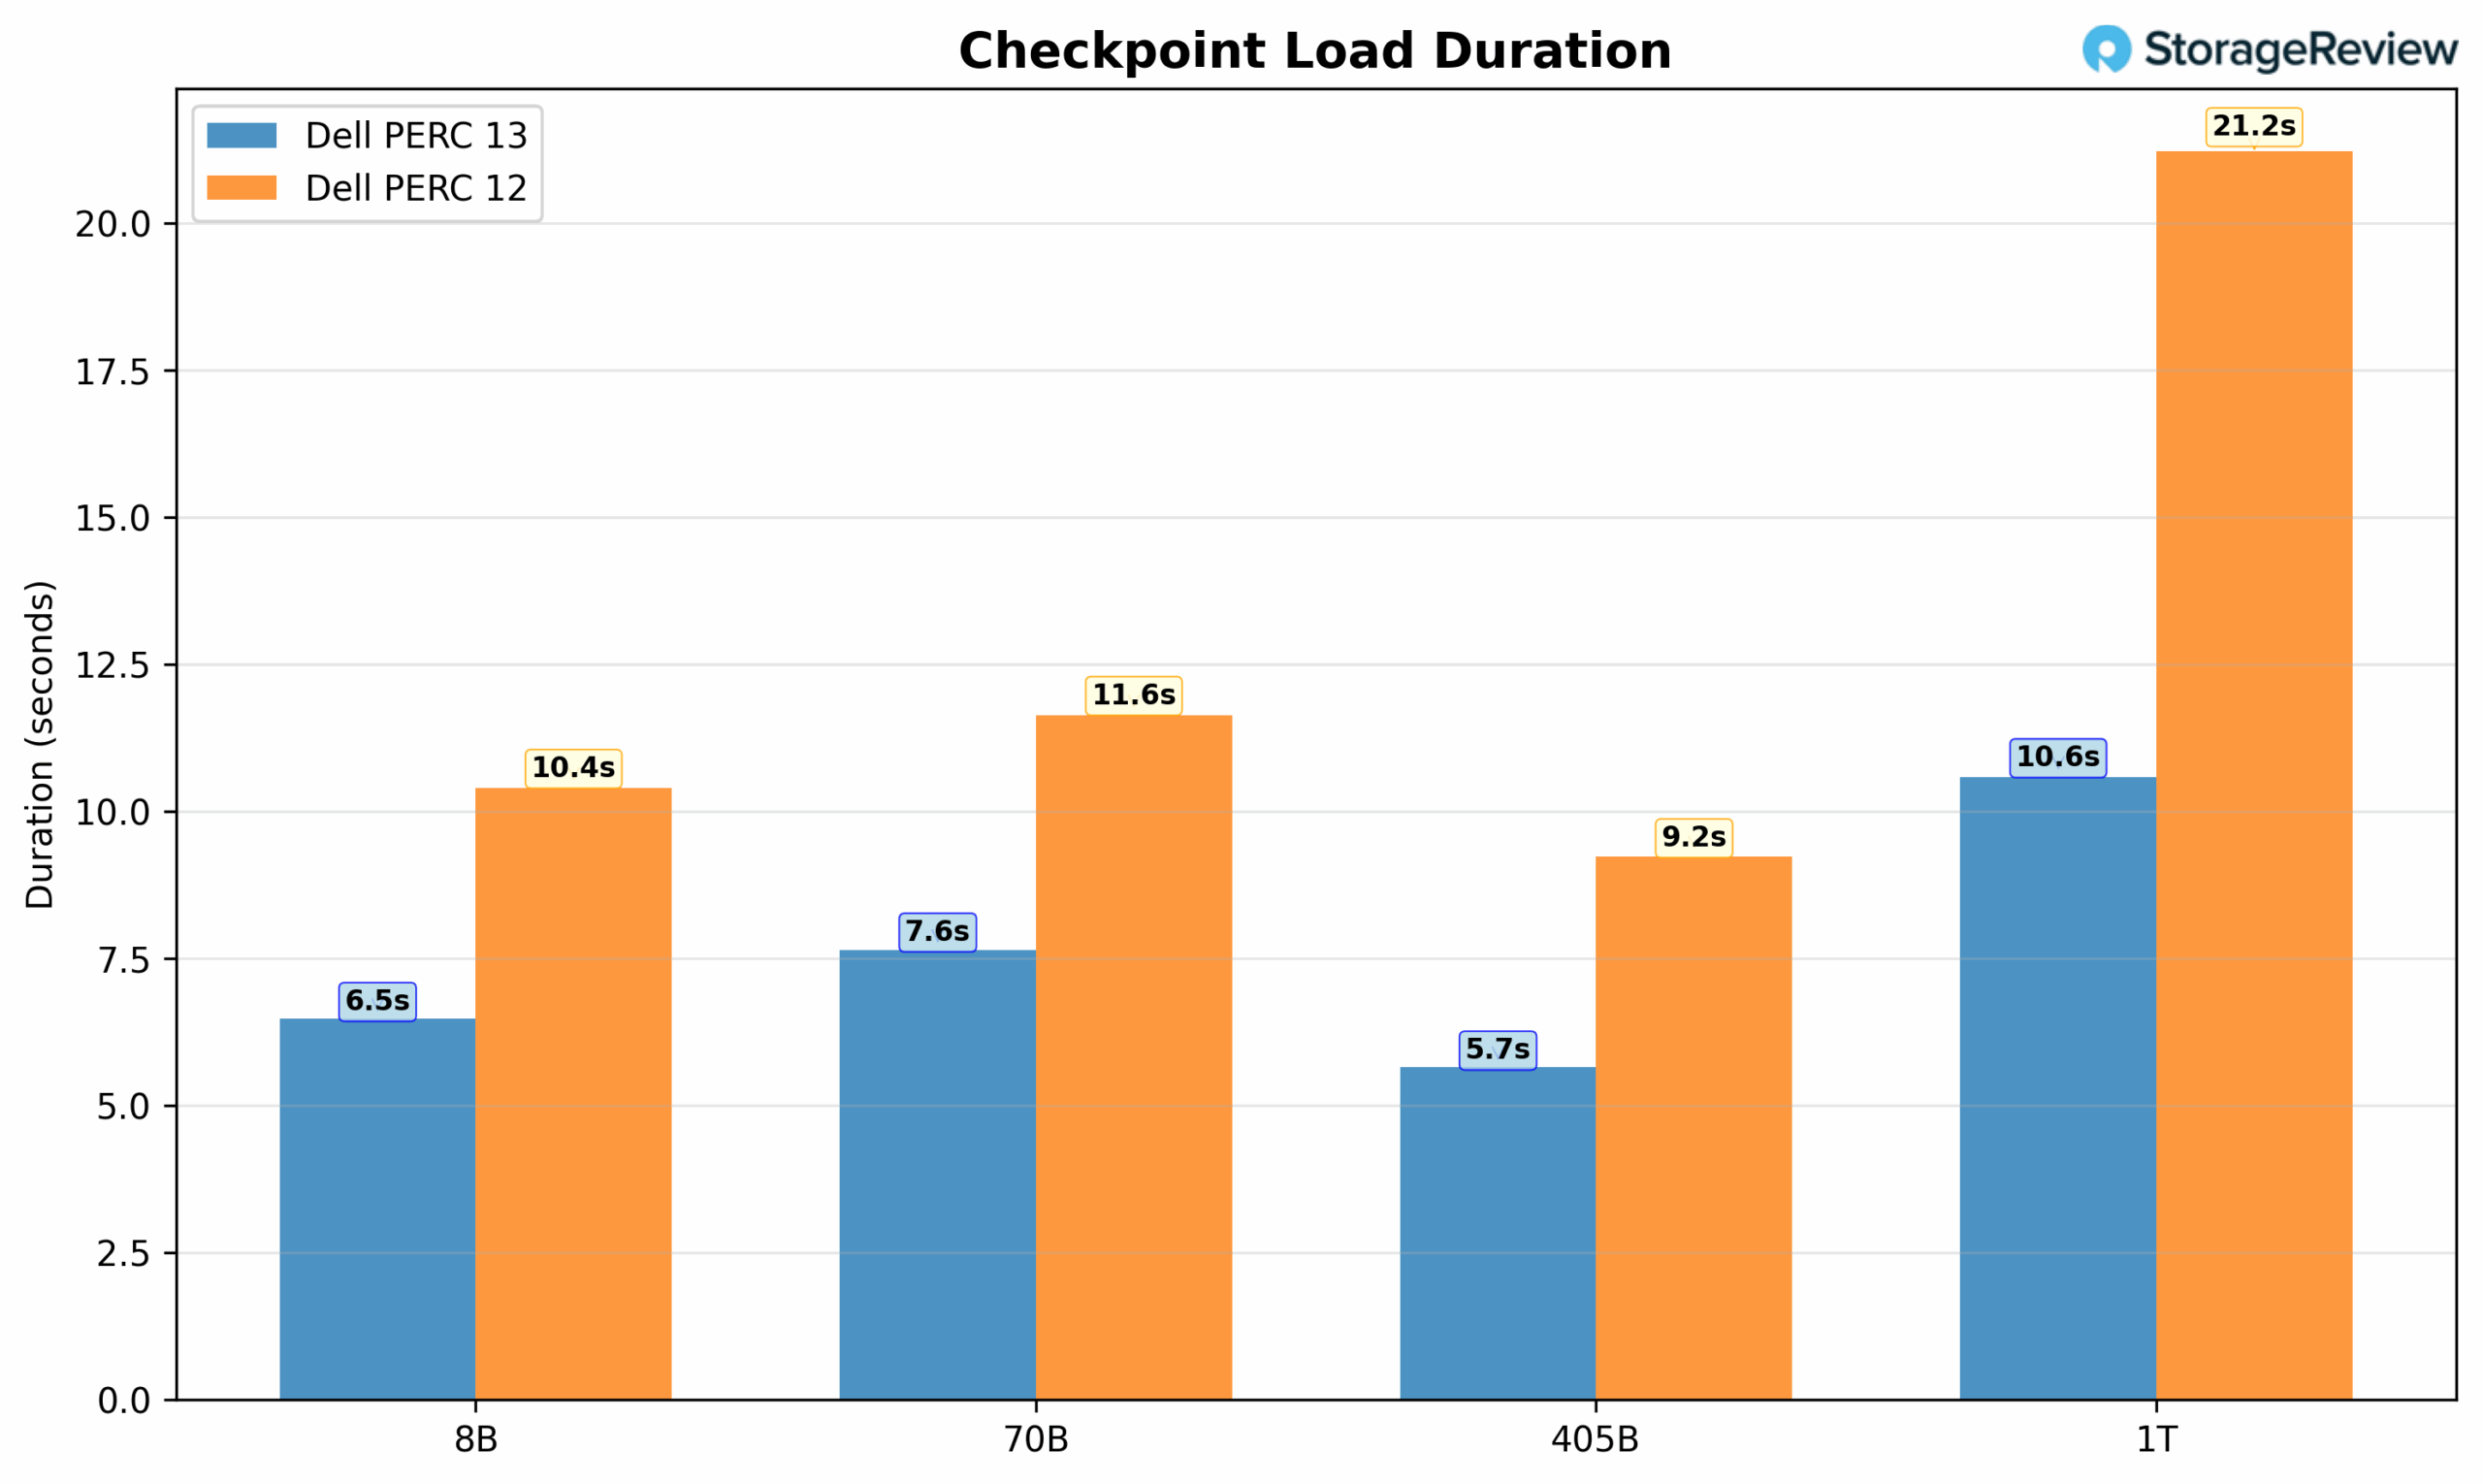
부하 지속 시간 비교는 PERC13의 유사한 이점을 보여주지만, 성능 차이는 모델 크기에 따라 다릅니다. 소형 모델(8B, 70B)의 경우, PERC 13은 PERC35보다 체크포인트를 약 40~12% 더 빠르게 로드했습니다. 그러나 1T 모델에서 가장 큰 개선을 보였는데, PERC13은 10.58초 만에 로드된 반면, PERC12는 21.22초로 거의 50% 단축되었습니다. 이처럼 빠른 복구 시간은 중단 후 체크포인트에서 훈련을 재개할 때 다운타임을 최소화하는 데 매우 중요합니다.
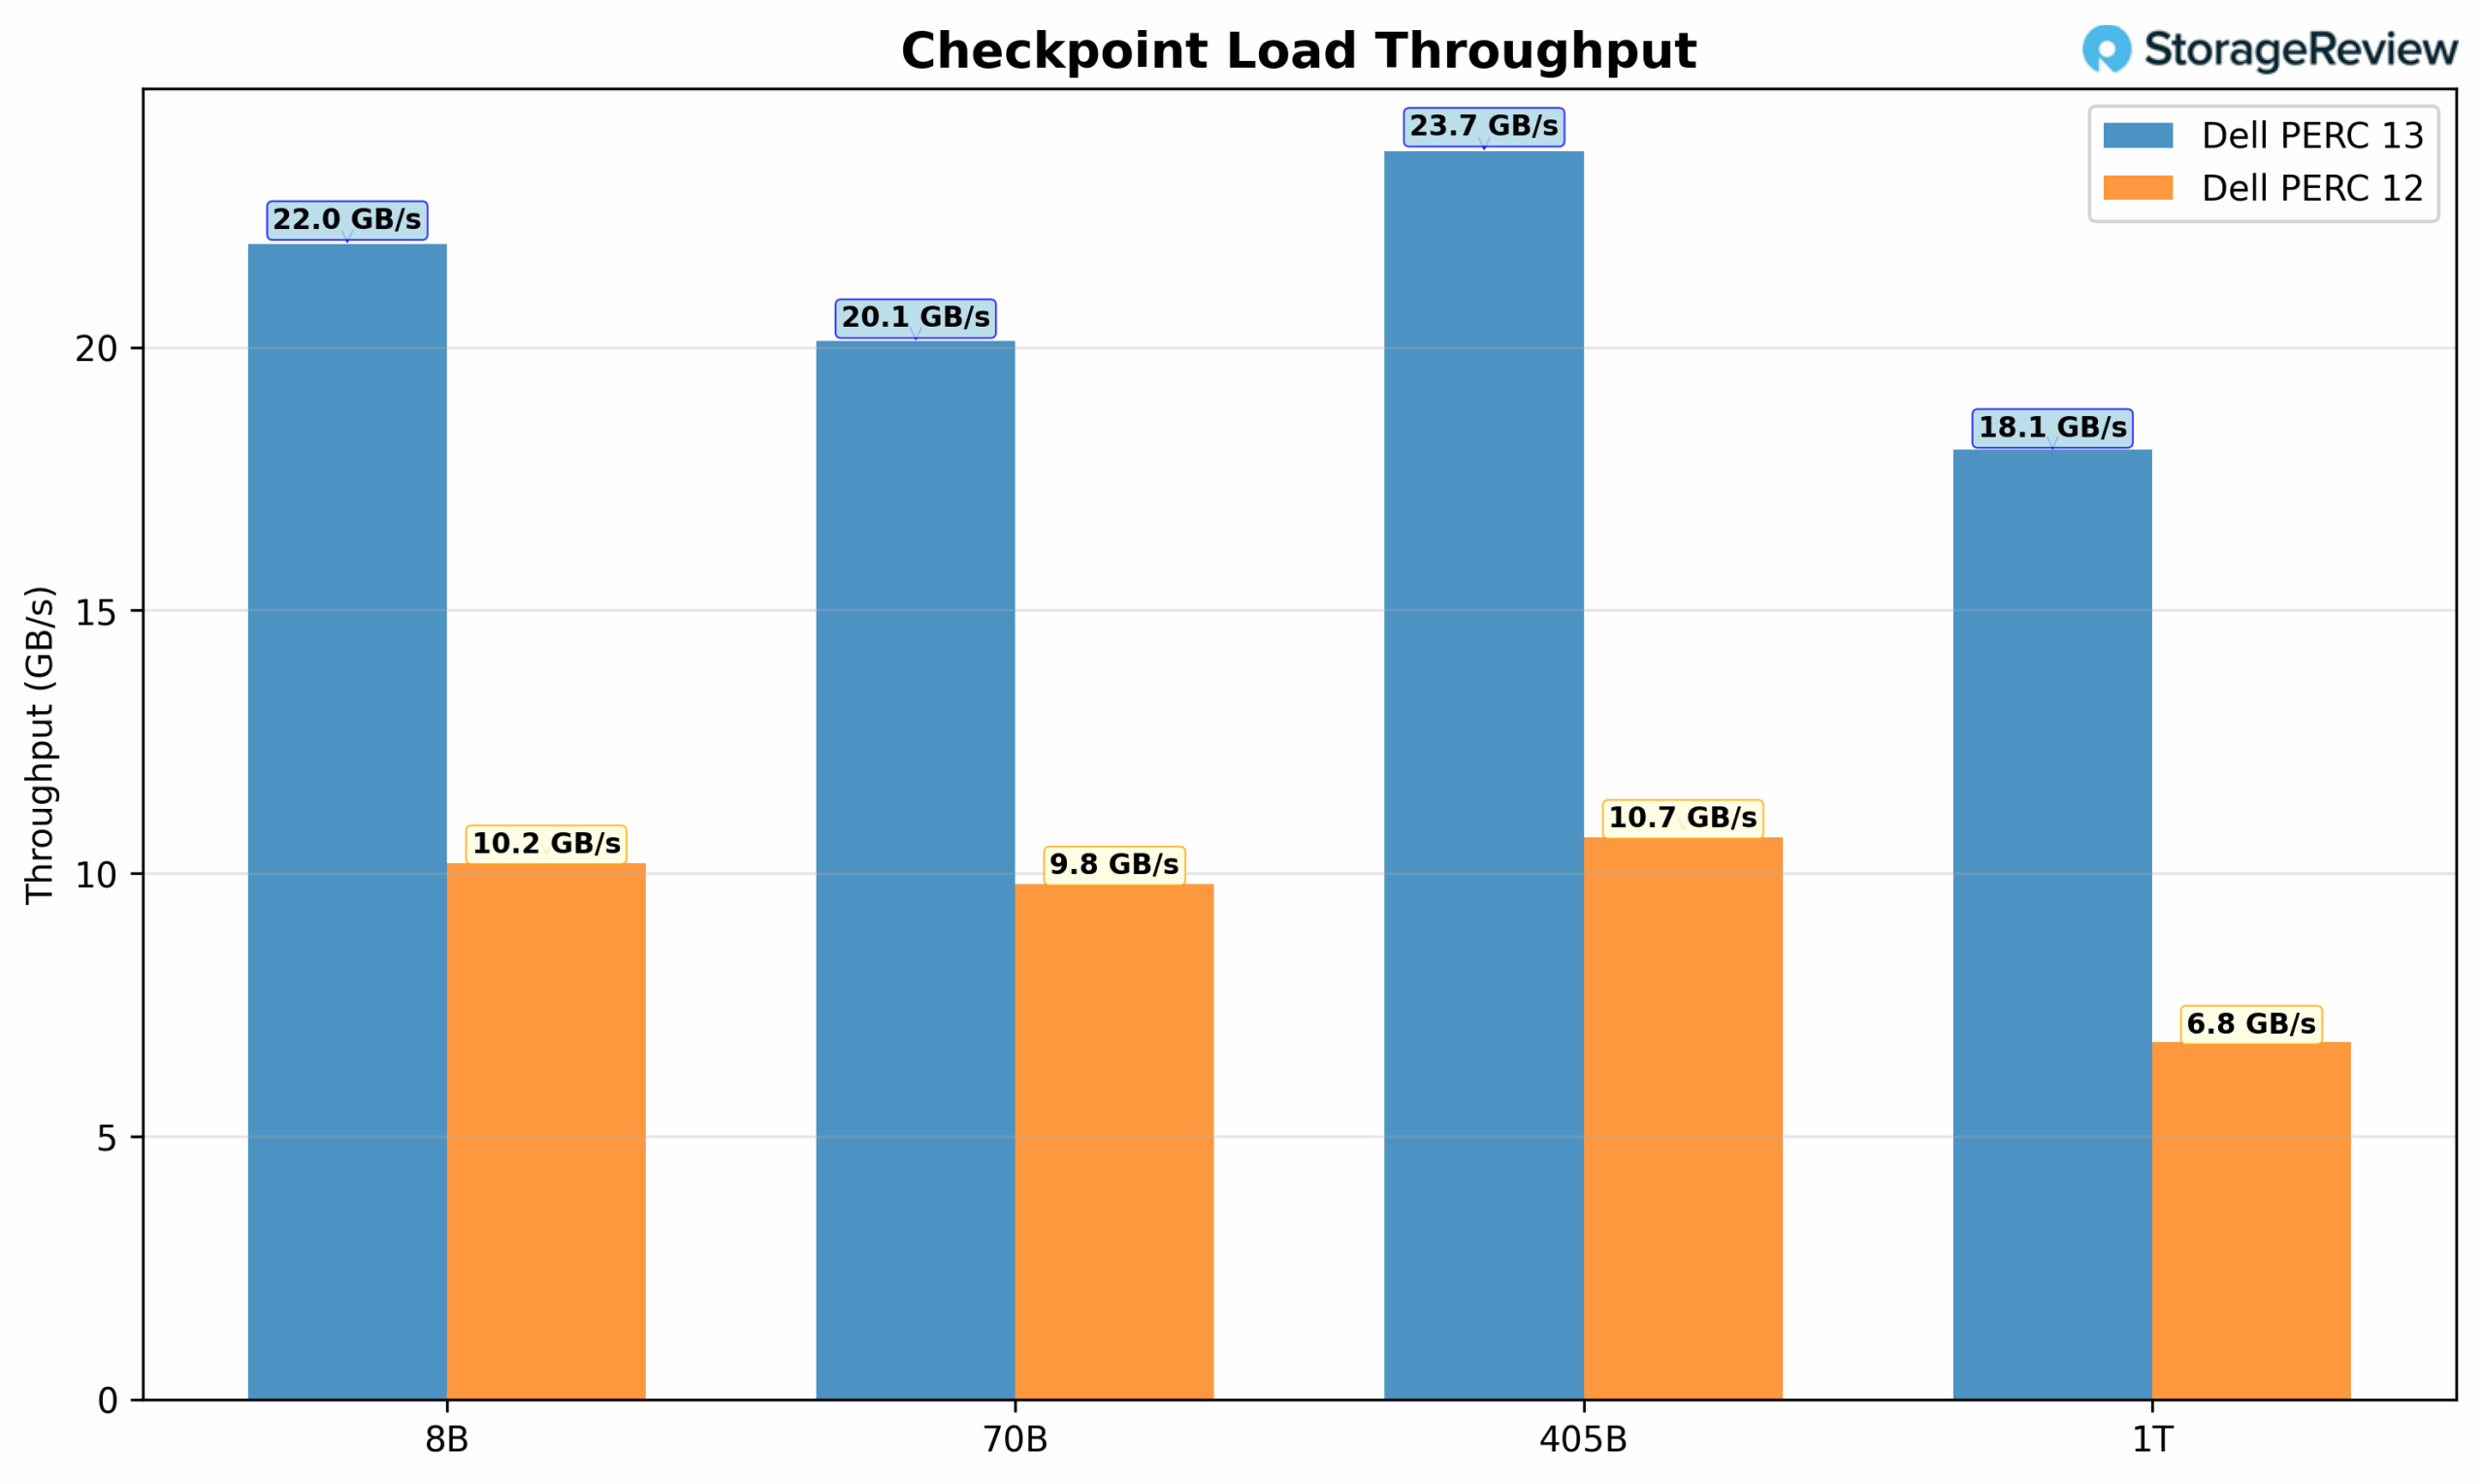
마지막으로, 부하 처리량 지표를 살펴보면 PERC13은 모든 구성에서 18GB/s 이상의 처리량을 일관되게 유지하며 23.73B 모델에서 최대 405GB/s에 도달하여 확실한 성능 우위를 보였습니다. 반면, PERC12는 6.8GB/s에서 10.68GB/s로 낮은 성능을 보였습니다.
FIO 성능 벤치마크
이번 리뷰에서는 개선 사항을 강조하기 위해 새로운 테스트 방식을 도입했지만, 지난번 델 PERC12 컨트롤러 관련 기사에서 사용했던 데이터 중 일부를 다시 가져와 최대 대역폭과 최대 처리량의 차이를 보여드리겠습니다.
PERC13이 개선되었다고 말하는 것은 과장된 표현입니다. 각 컨트롤러에 단일 RAID5 볼륨을 사용했을 때 읽기 대역폭은 88%, 쓰기 대역폭은 318%, 31K 랜덤 읽기 성능은 4%, 그리고 466K 랜덤 쓰기 성능은 무려 4% 향상되었습니다. 이는 PERC 13 컨트롤러의 최고 성능은 아닙니다. 가상 디스크가 많을수록 더 빠른 속도가 가능합니다. 그러나 이 결과는 총 용량을 최대화했을 때의 단일 네임스페이스 성능을 반영합니다.
| 작업량 | 듀얼 PERC 12(2 x RAID5) | 듀얼 PERC 13(2 x RAID5) | 성능 향상 |
|---|---|---|---|
| 128K 순차 읽기 | 56,107(MB/초) | 105,227(MB/초) | 88% |
| 128K 순차 쓰기 | 24,351(MB/초) | 101,723(MB/초) | 318% |
| 4KB 랜덤 읽기 | 13,205,656(IOP) | 17,342,057(IOP) | 31% |
| 4KB 랜덤 쓰기 | 1,725,198(IOP) | 9,758,677(IOP) | 466% |
우리는 패리티 보호와 함께 우수한 용량 조합을 제공하는 RAID 975를 활용하여 Dell PERC H965i 및 PERC H5i 컨트롤러의 성능에 집중했습니다.Dell PERC H975i에서 여러 가상 디스크(VD) 구성을 조사했습니다.RAID 8(5R8)에 5개의 VD, RAID 4(5R4)에 5개의 VD, RAID 2(5R2)에 5개의 VD입니다.또한 Dell PERC H965i에서 두 가지 구성, RAID 4(5R4)에 5개의 VD와 RAID 2(5R2)에 5개의 VD를 테스트했습니다.구성은 각 컨트롤러가 관리할 수 있는 SSD 수에 따라 선택되었습니다.최신 PERC 13 컨트롤러는 최대 16개의 SSD를 관리할 수 있으며, 각각 4개의 SSD로 구성된 최대 5개의 RAID 4 그룹으로 쉽게 나눌 수 있습니다.이전 PERC12는 8개의 SSD만 관리할 수 있었기 때문에 최대 2개의 RAID5 SSD 그룹을 테스트하는 것으로 제한되었습니다. 이 구성은 8R5 시스템의 경우 각 PERC RAID 컨트롤러에 4개의 5드라이브 RAID XNUMX가 있다는 것을 의미합니다.
각 구성은 동일한 벤치마킹 프로세스를 거쳤으며, 순차적인 워크로드를 사용하여 두 번의 전체 장치 쓰기로 구성된 사전 조정 단계로 시작했습니다. 정상 상태에 도달한 후 다양한 액세스 패턴에 걸쳐 성능을 측정했습니다. 새로운 워크로드 테스트 전에는 결과의 일관성을 보장하기 위해 해당 전송 크기를 사용하여 사전 조정 주기를 다시 실행했습니다.
128K 순차 쓰기 대역폭
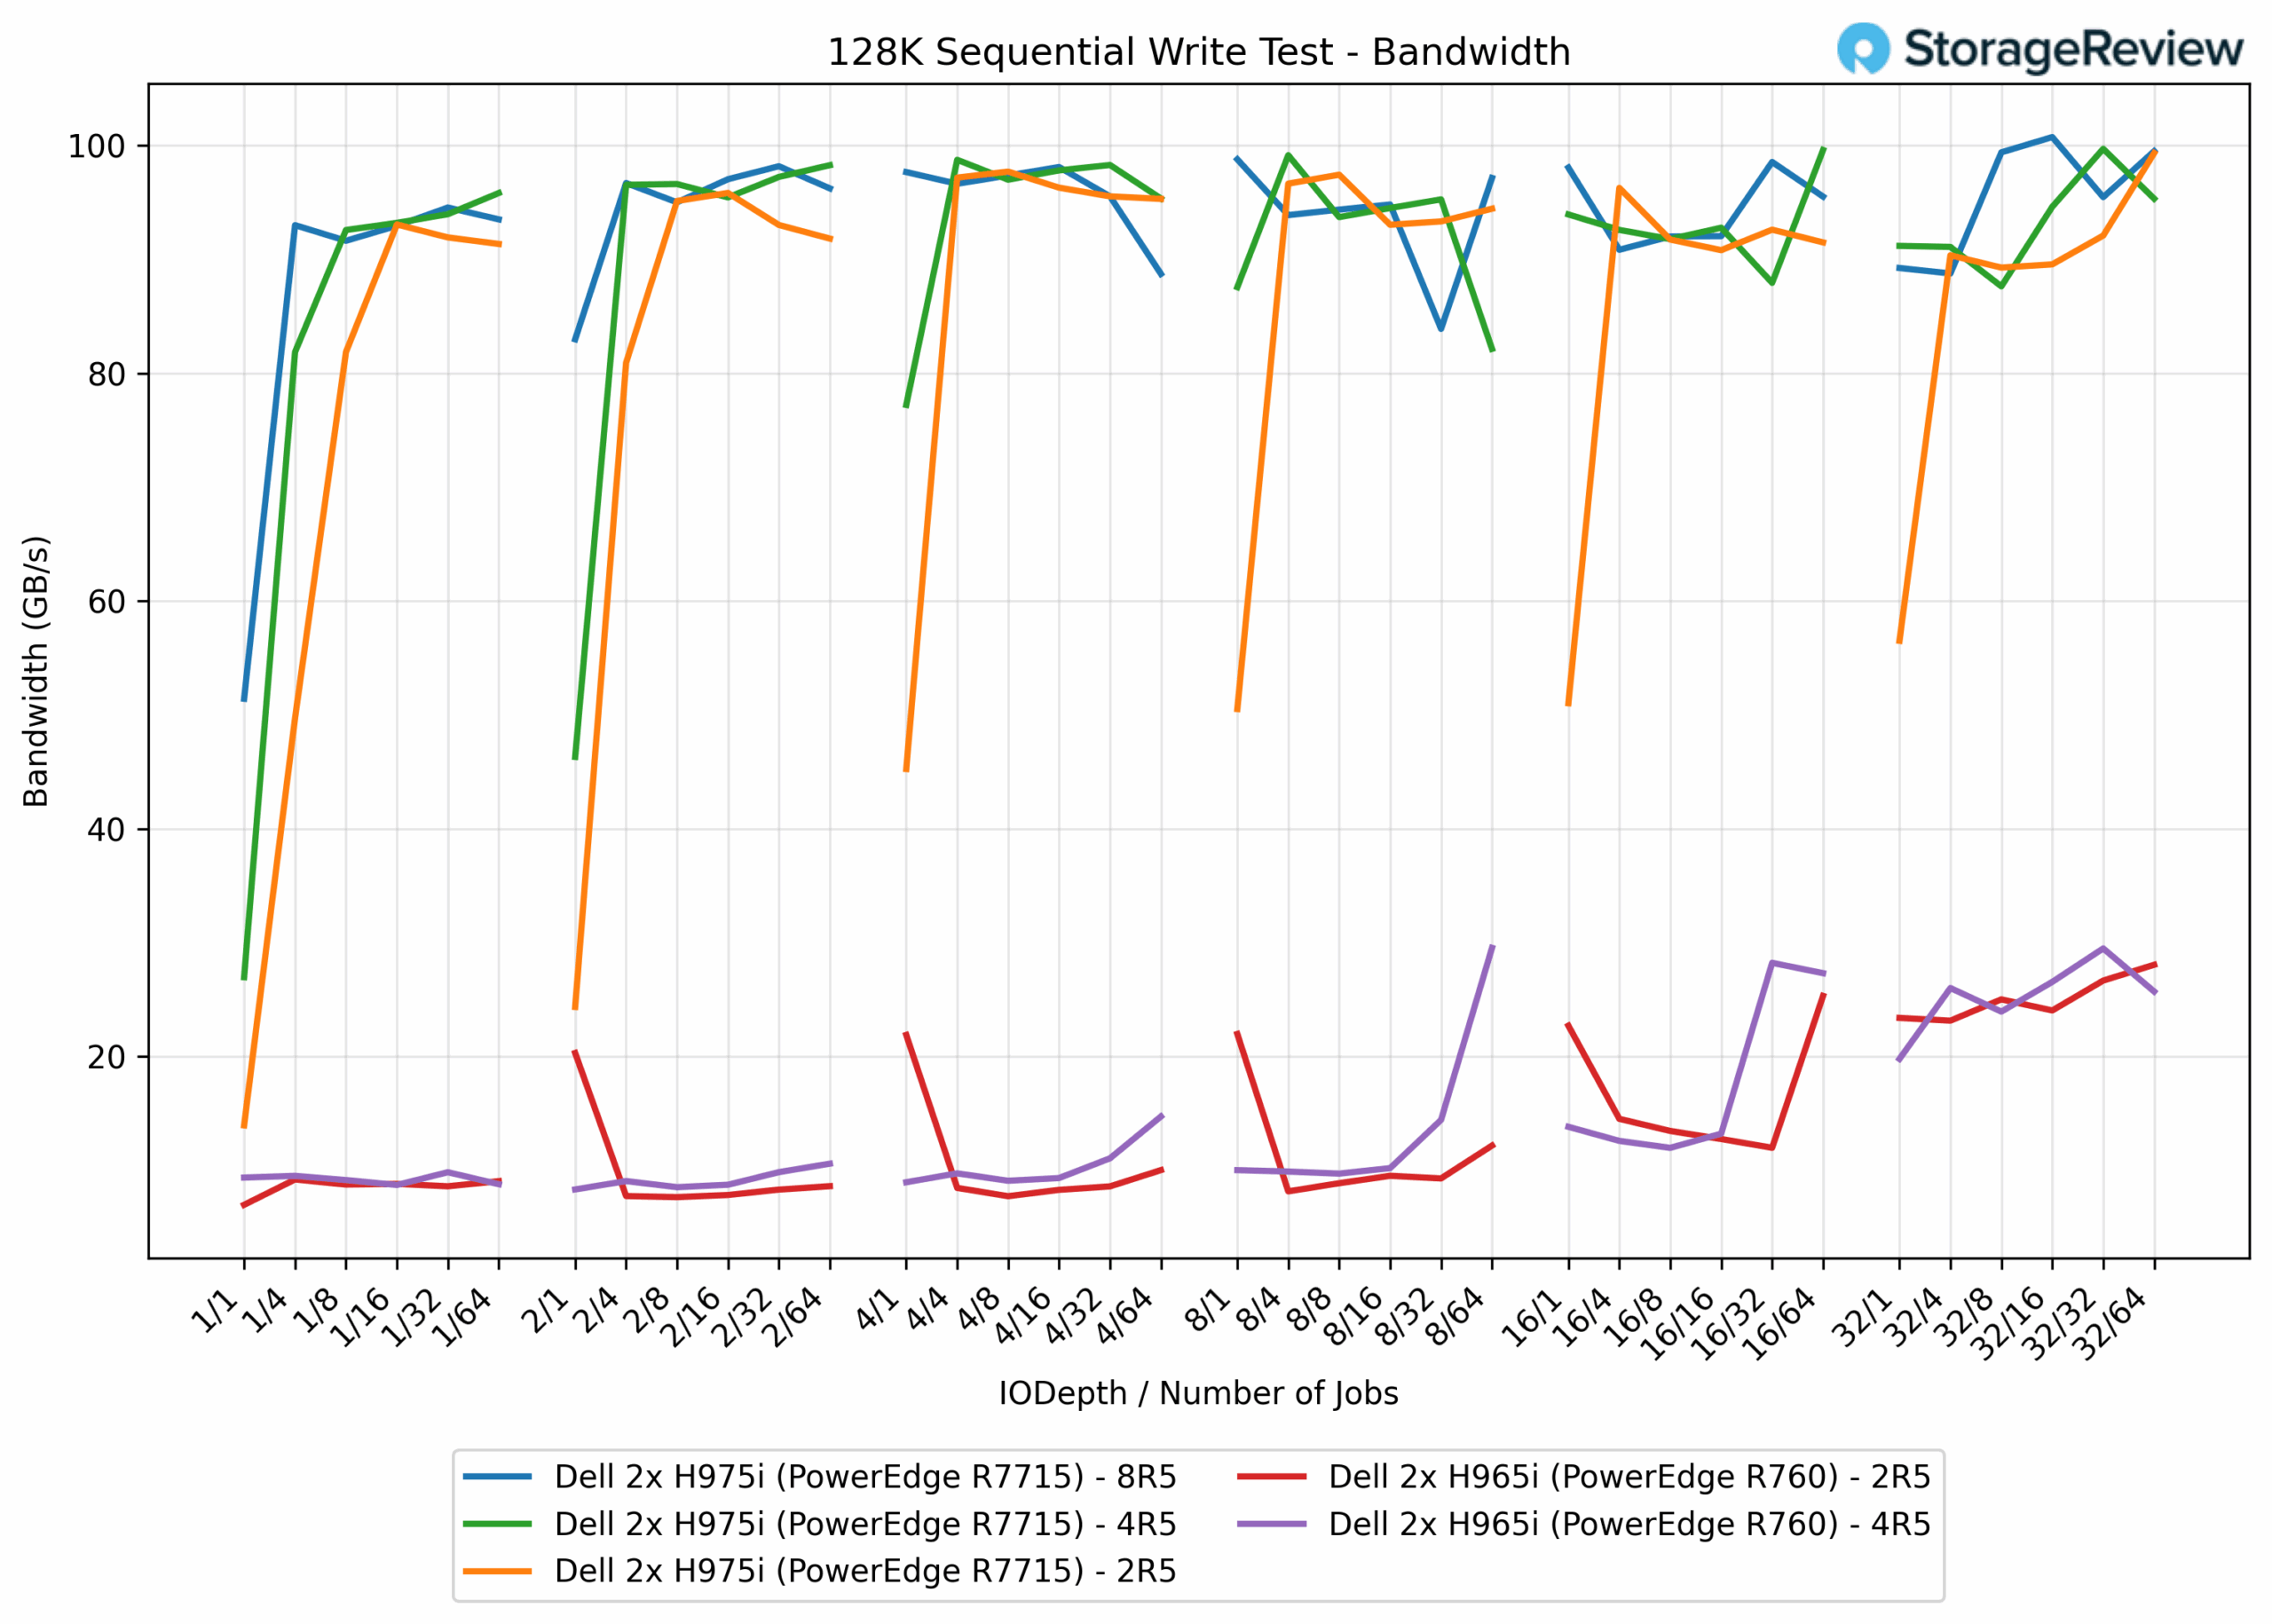
128K 순차 쓰기 테스트에서 컨트롤러 세대 간에 극적인 성능 차이가 나타났습니다.PERC H965i 어레이는 적당한 처리량을 제공했으며, 2R5 구성은 28.1GB/s, 4R5 구성은 29.5GB/s에 도달하여 추가 RAID 디스크로 인한 확장이 최소화되었습니다.극도로 대조적으로 PERC H975i 컨트롤러는 모든 구성에서 탁월한 성능을 제공했습니다.2R5 어레이는 99.3GB/s(253%), 4R5 구성은 99.7GB/s(238%), 8R5 구성은 최대 101.3GB/s(H243i 965R4 대비 5%)에 도달했습니다.전반적으로 H975i는 디스크 수와 관계없이 100GB/s 근처에 밀집되어 128K 순차 쓰기에 대한 컨트롤러의 대역폭 한계에 도달했음을 나타냅니다.
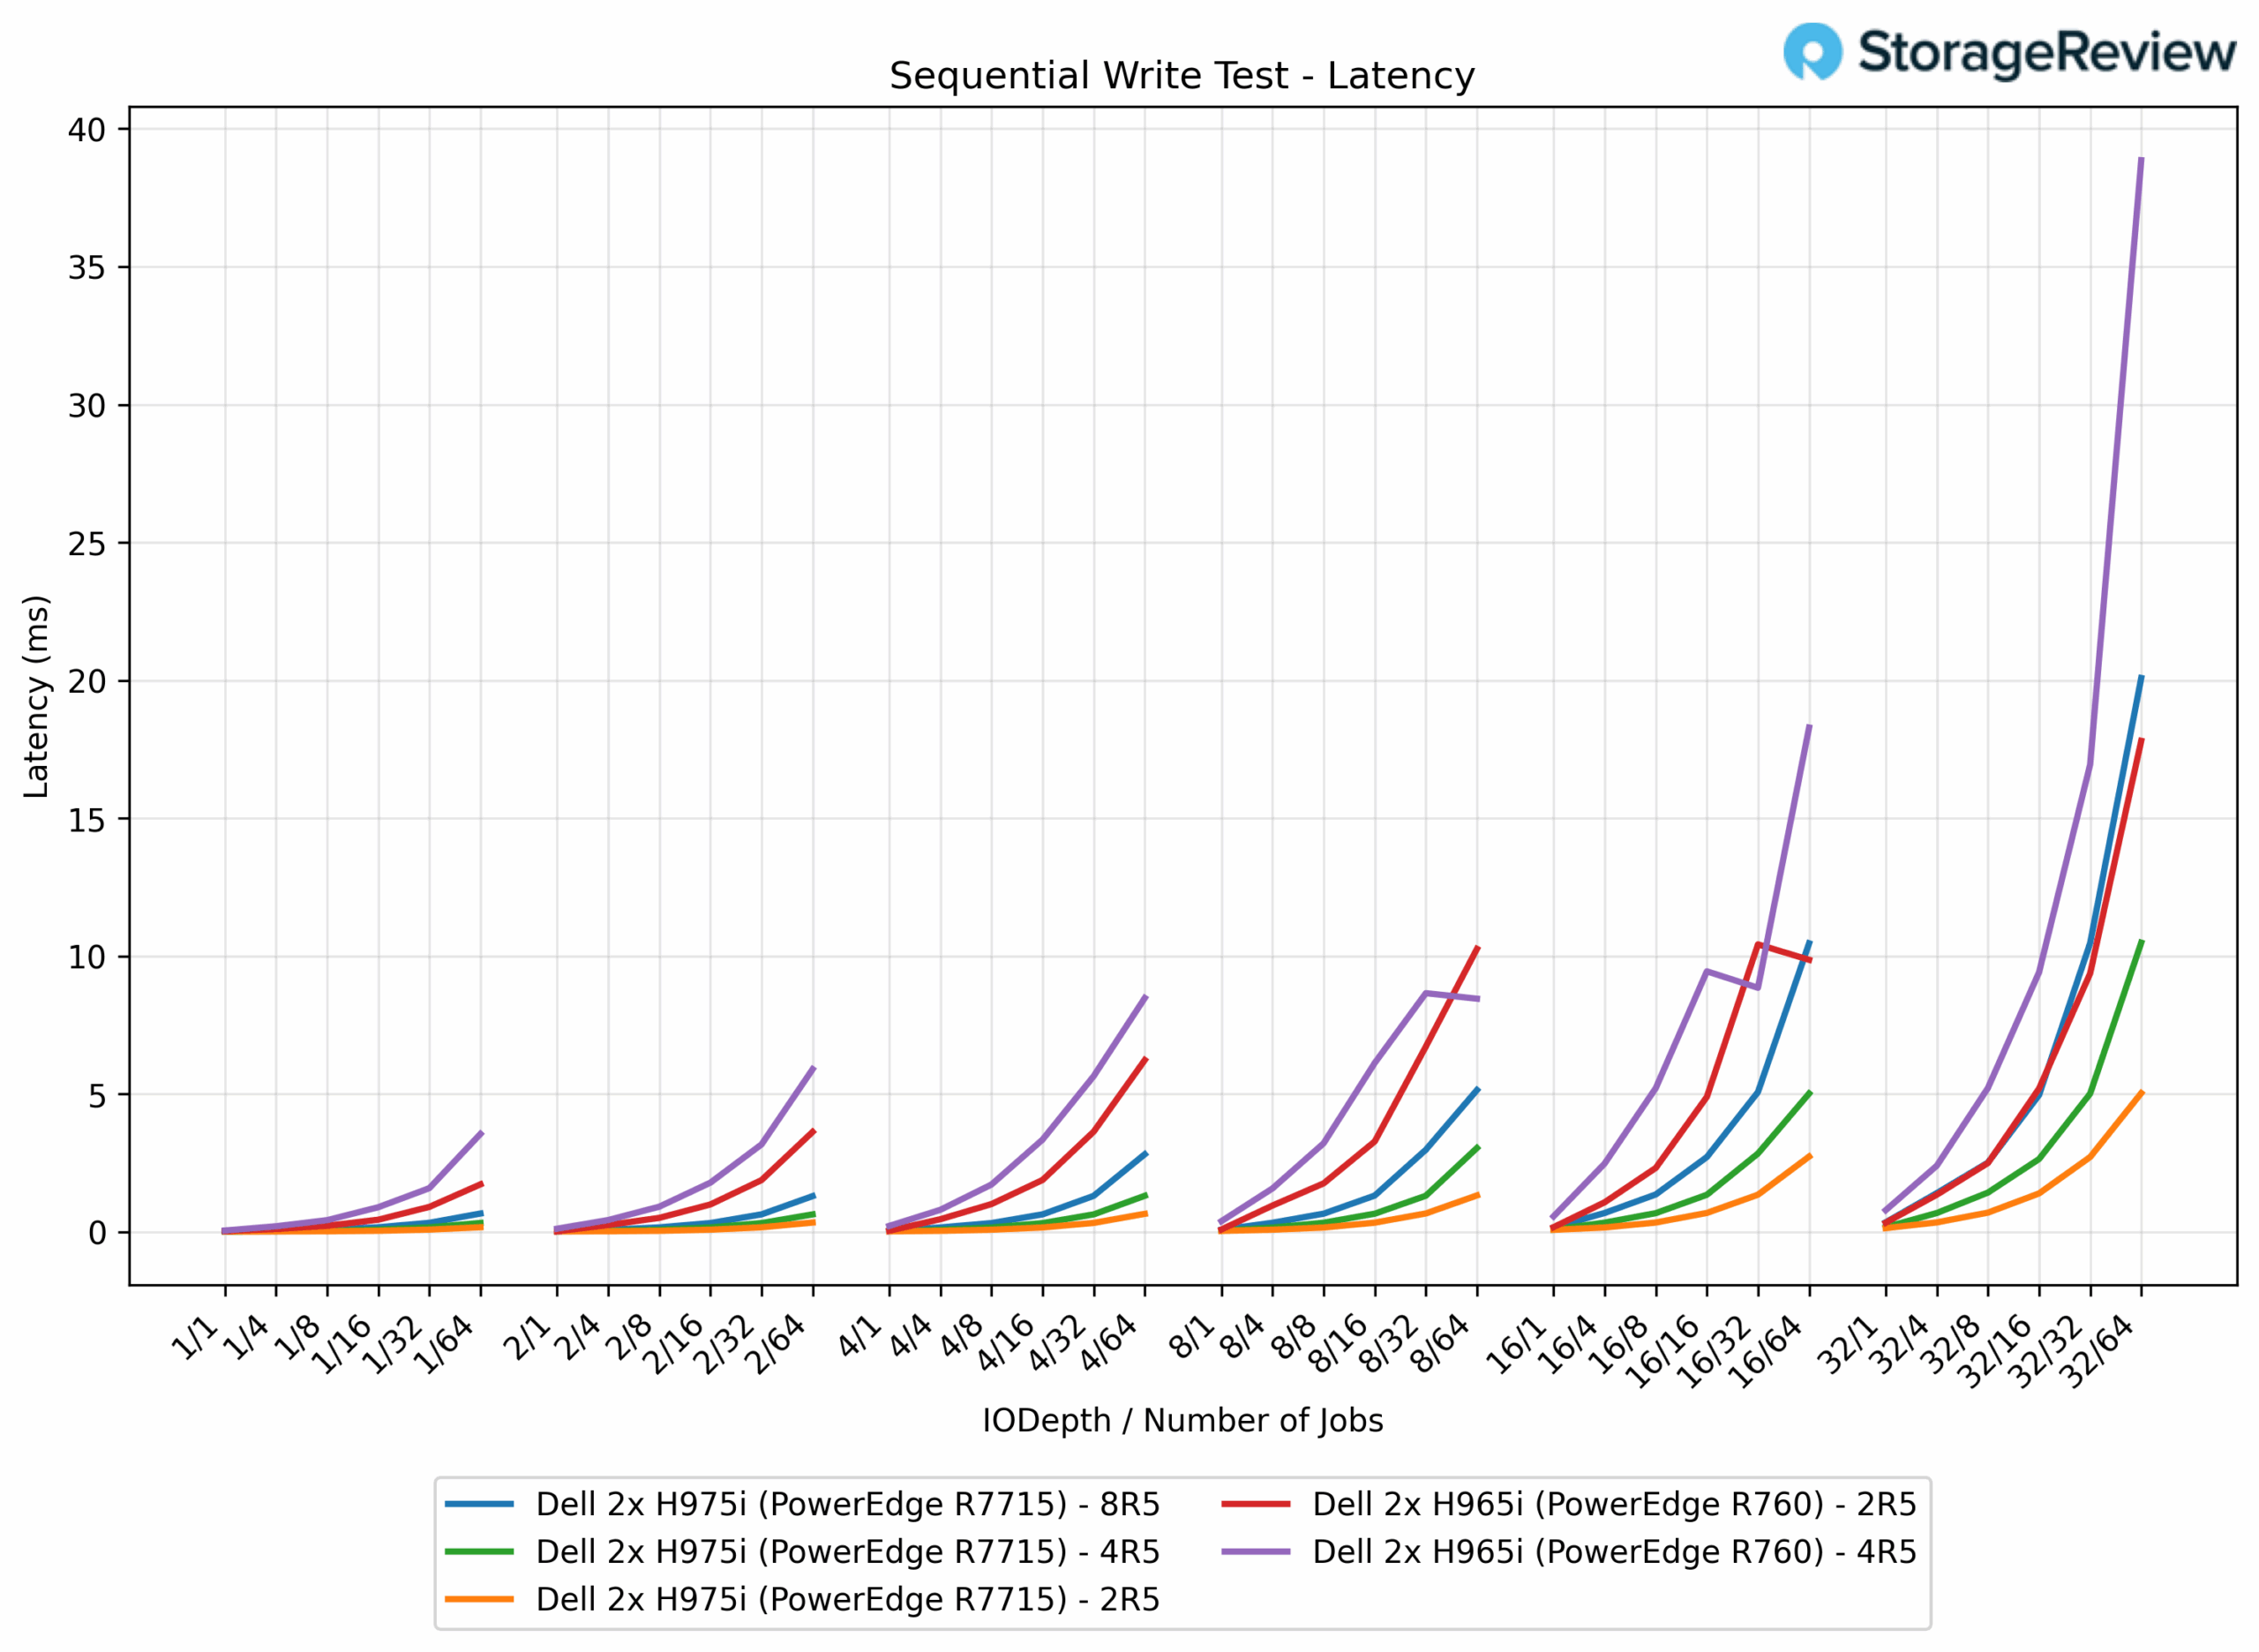
128K 순차 쓰기 대기 시간
128K 순차 쓰기 지연 시간 테스트에서 컨트롤러 세대 간에 명확한 차이가 나타났습니다. PERC H965i 어레이는 더 높은 지연 시간을 보였으며, 2R5 구성은 0.0238ms에서 최대 17.8ms, 4R5 구성은 38.9ms로 RAID 디스크 추가 시 이점이 거의 없었습니다. 반면, PERC H975i 컨트롤러는 모든 구성에서 현저히 낮은 지연 시간을 기록했습니다. 2R5 어레이는 0.0173ms에서 5.0ms(최대 지연 시간 대비 72% 감소), 4R5 구성은 0.0179ms에서 10.5ms(최대 지연 시간 대비 73% 감소), 8R5 구성은 0.0188ms에서 20.1ms(H48i 965R4 대비 5% 감소)였습니다.
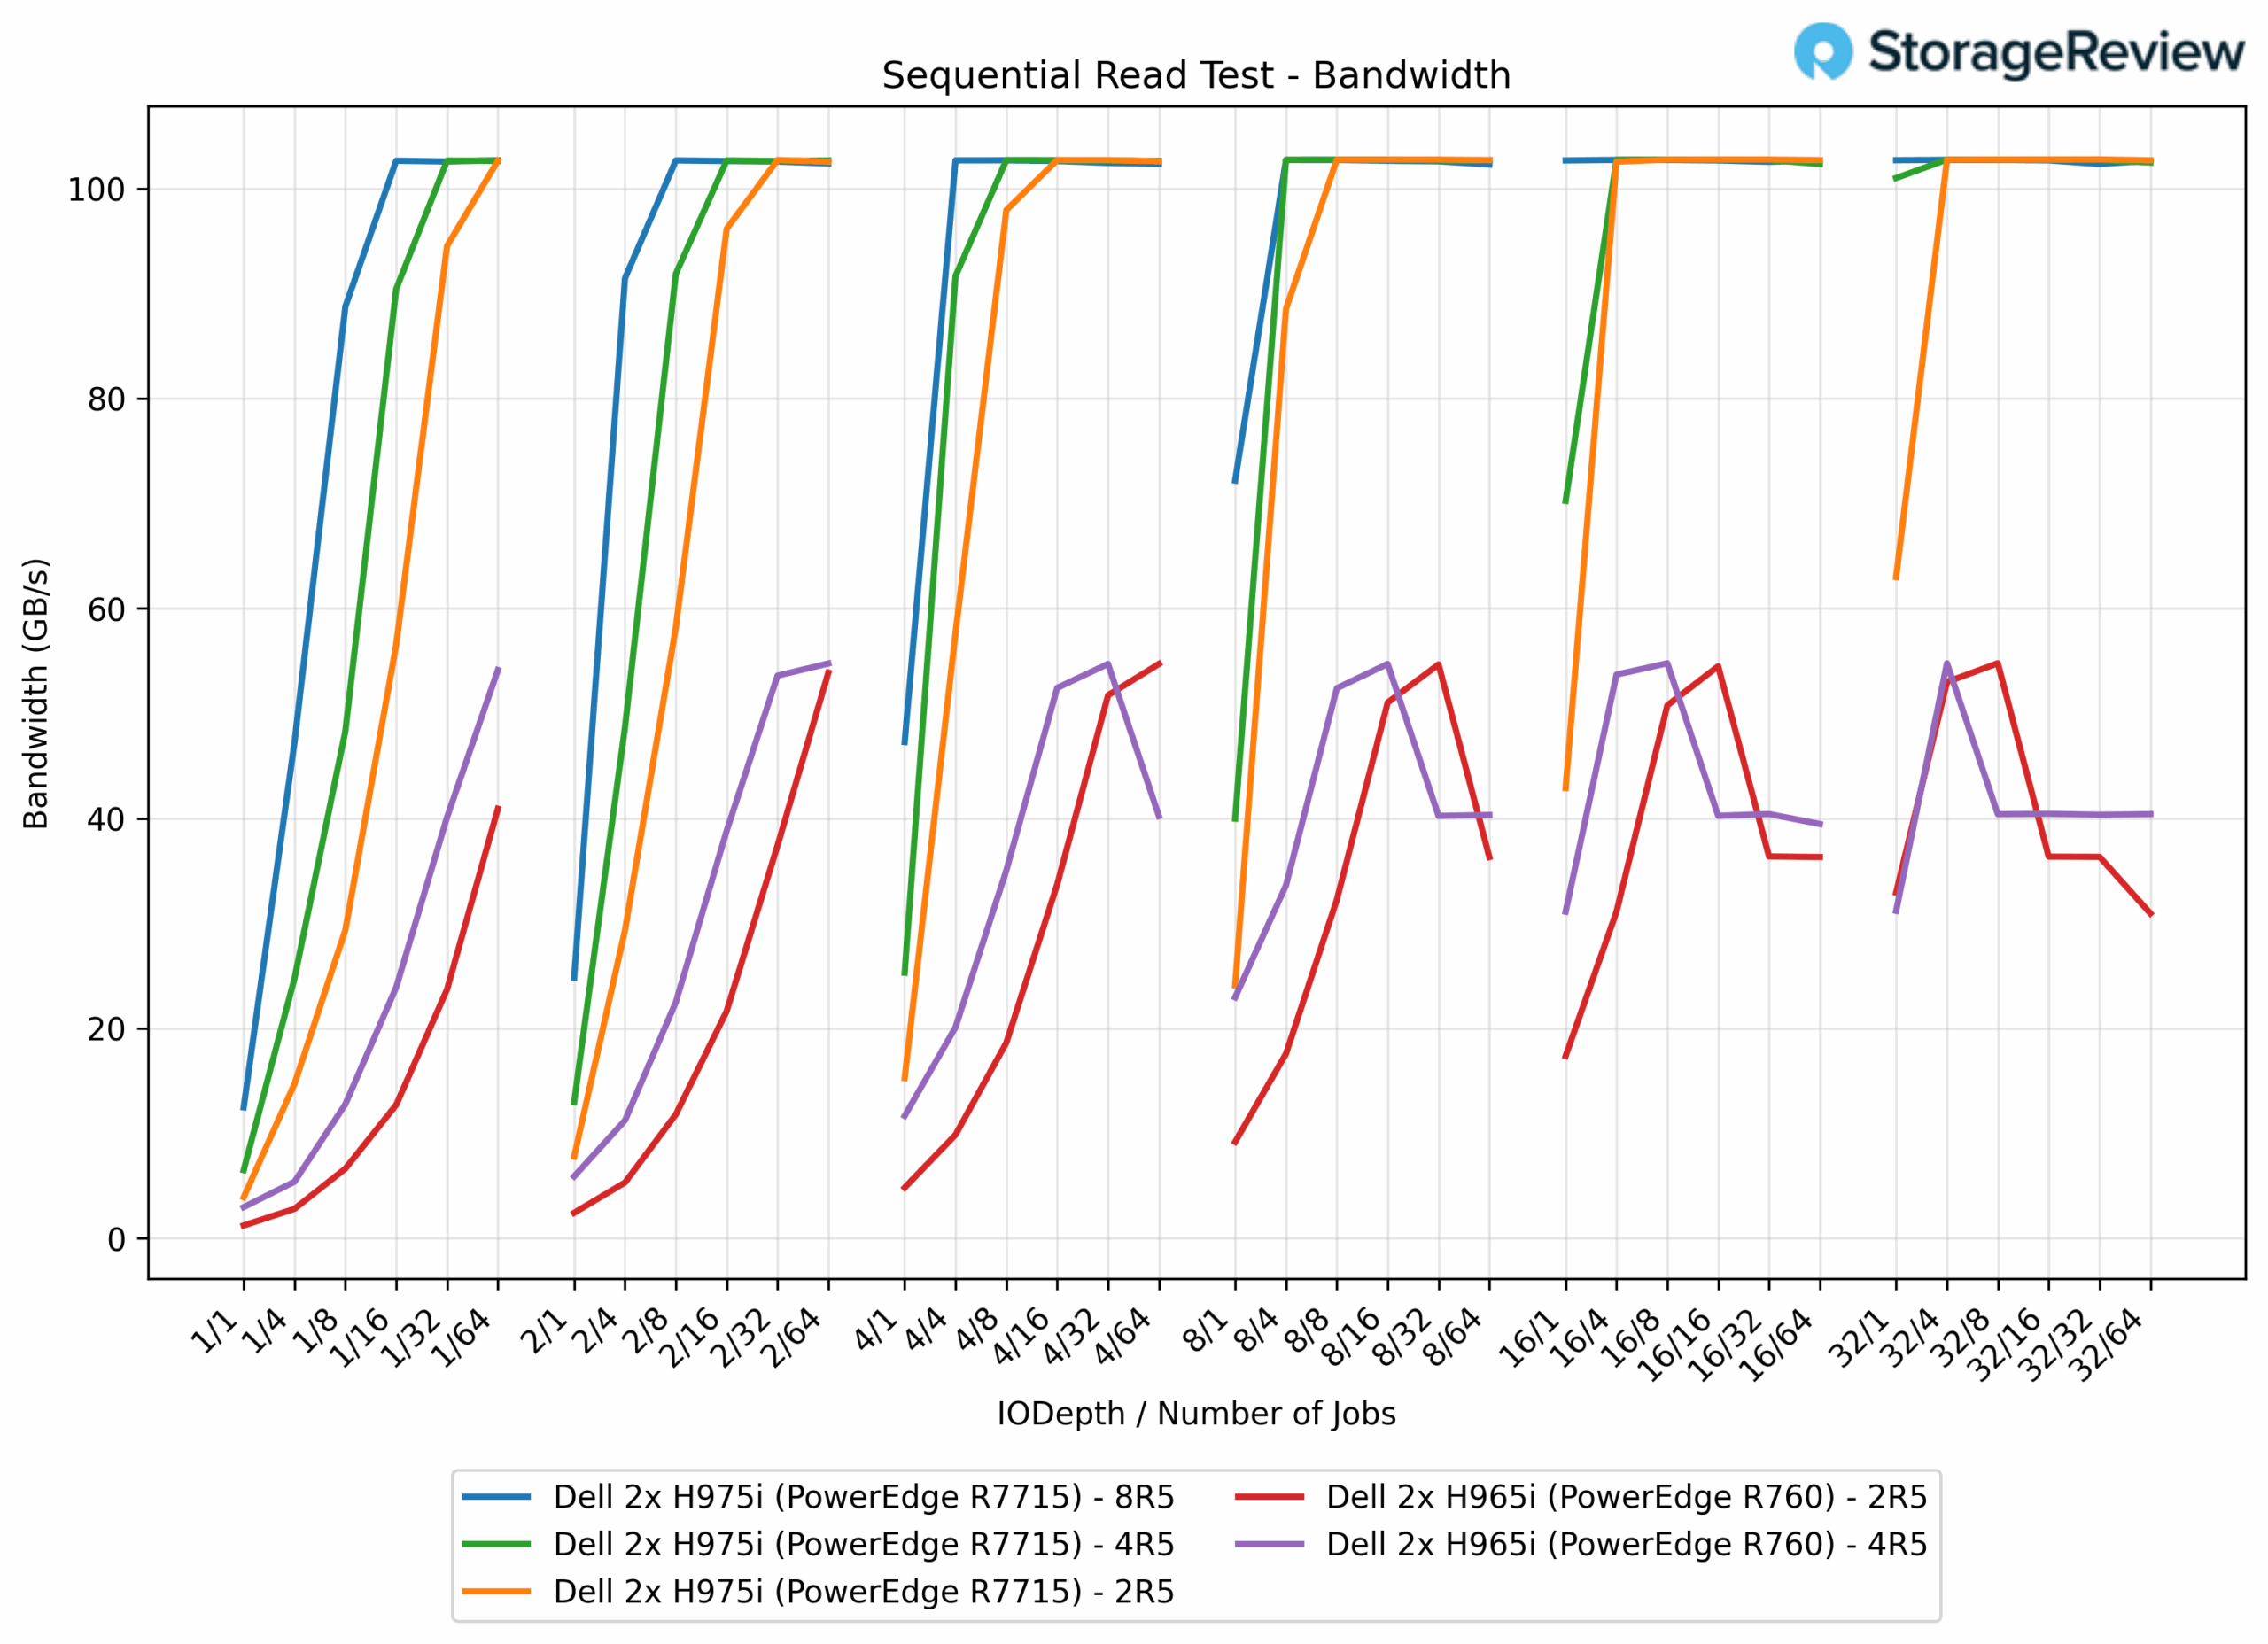
128K 순차 읽기 대역폭
Dell 시스템에서 128K 순차 읽기 테스트에서 PERC H965i 컨트롤러는 두 구성 모두에서 일관된 성능을 보였습니다. 2R5 어레이는 최대 54.8GB/s의 대역폭을 달성했으며, 4R5 구성도 54.8GB/s에 도달했습니다. 반면, PERC H975i 컨트롤러는 세 구성 모두 약 102.7~102.8GB/s의 최대 대역폭에 도달하여 상당히 우수한 성능을 보였습니다. H975i 2R5 어레이는 102.8GB/s(87% 향상), 4R5 구성은 102.7GB/s(87% 향상), 8R5 구성은 102.7GB/s(87% 향상)를 달성했습니다. 특히, H965i 컨트롤러는 2R5와 4R5 구성 사이에서 의미 있는 성능 확장을 보이지 않은 반면, H975i 컨트롤러는 모든 RAID 5 구성에서 일관되게 높은 성능을 유지했으며, 어레이의 드라이브 수에 관계없이 대역폭 한계에 도달한 것으로 나타났습니다.
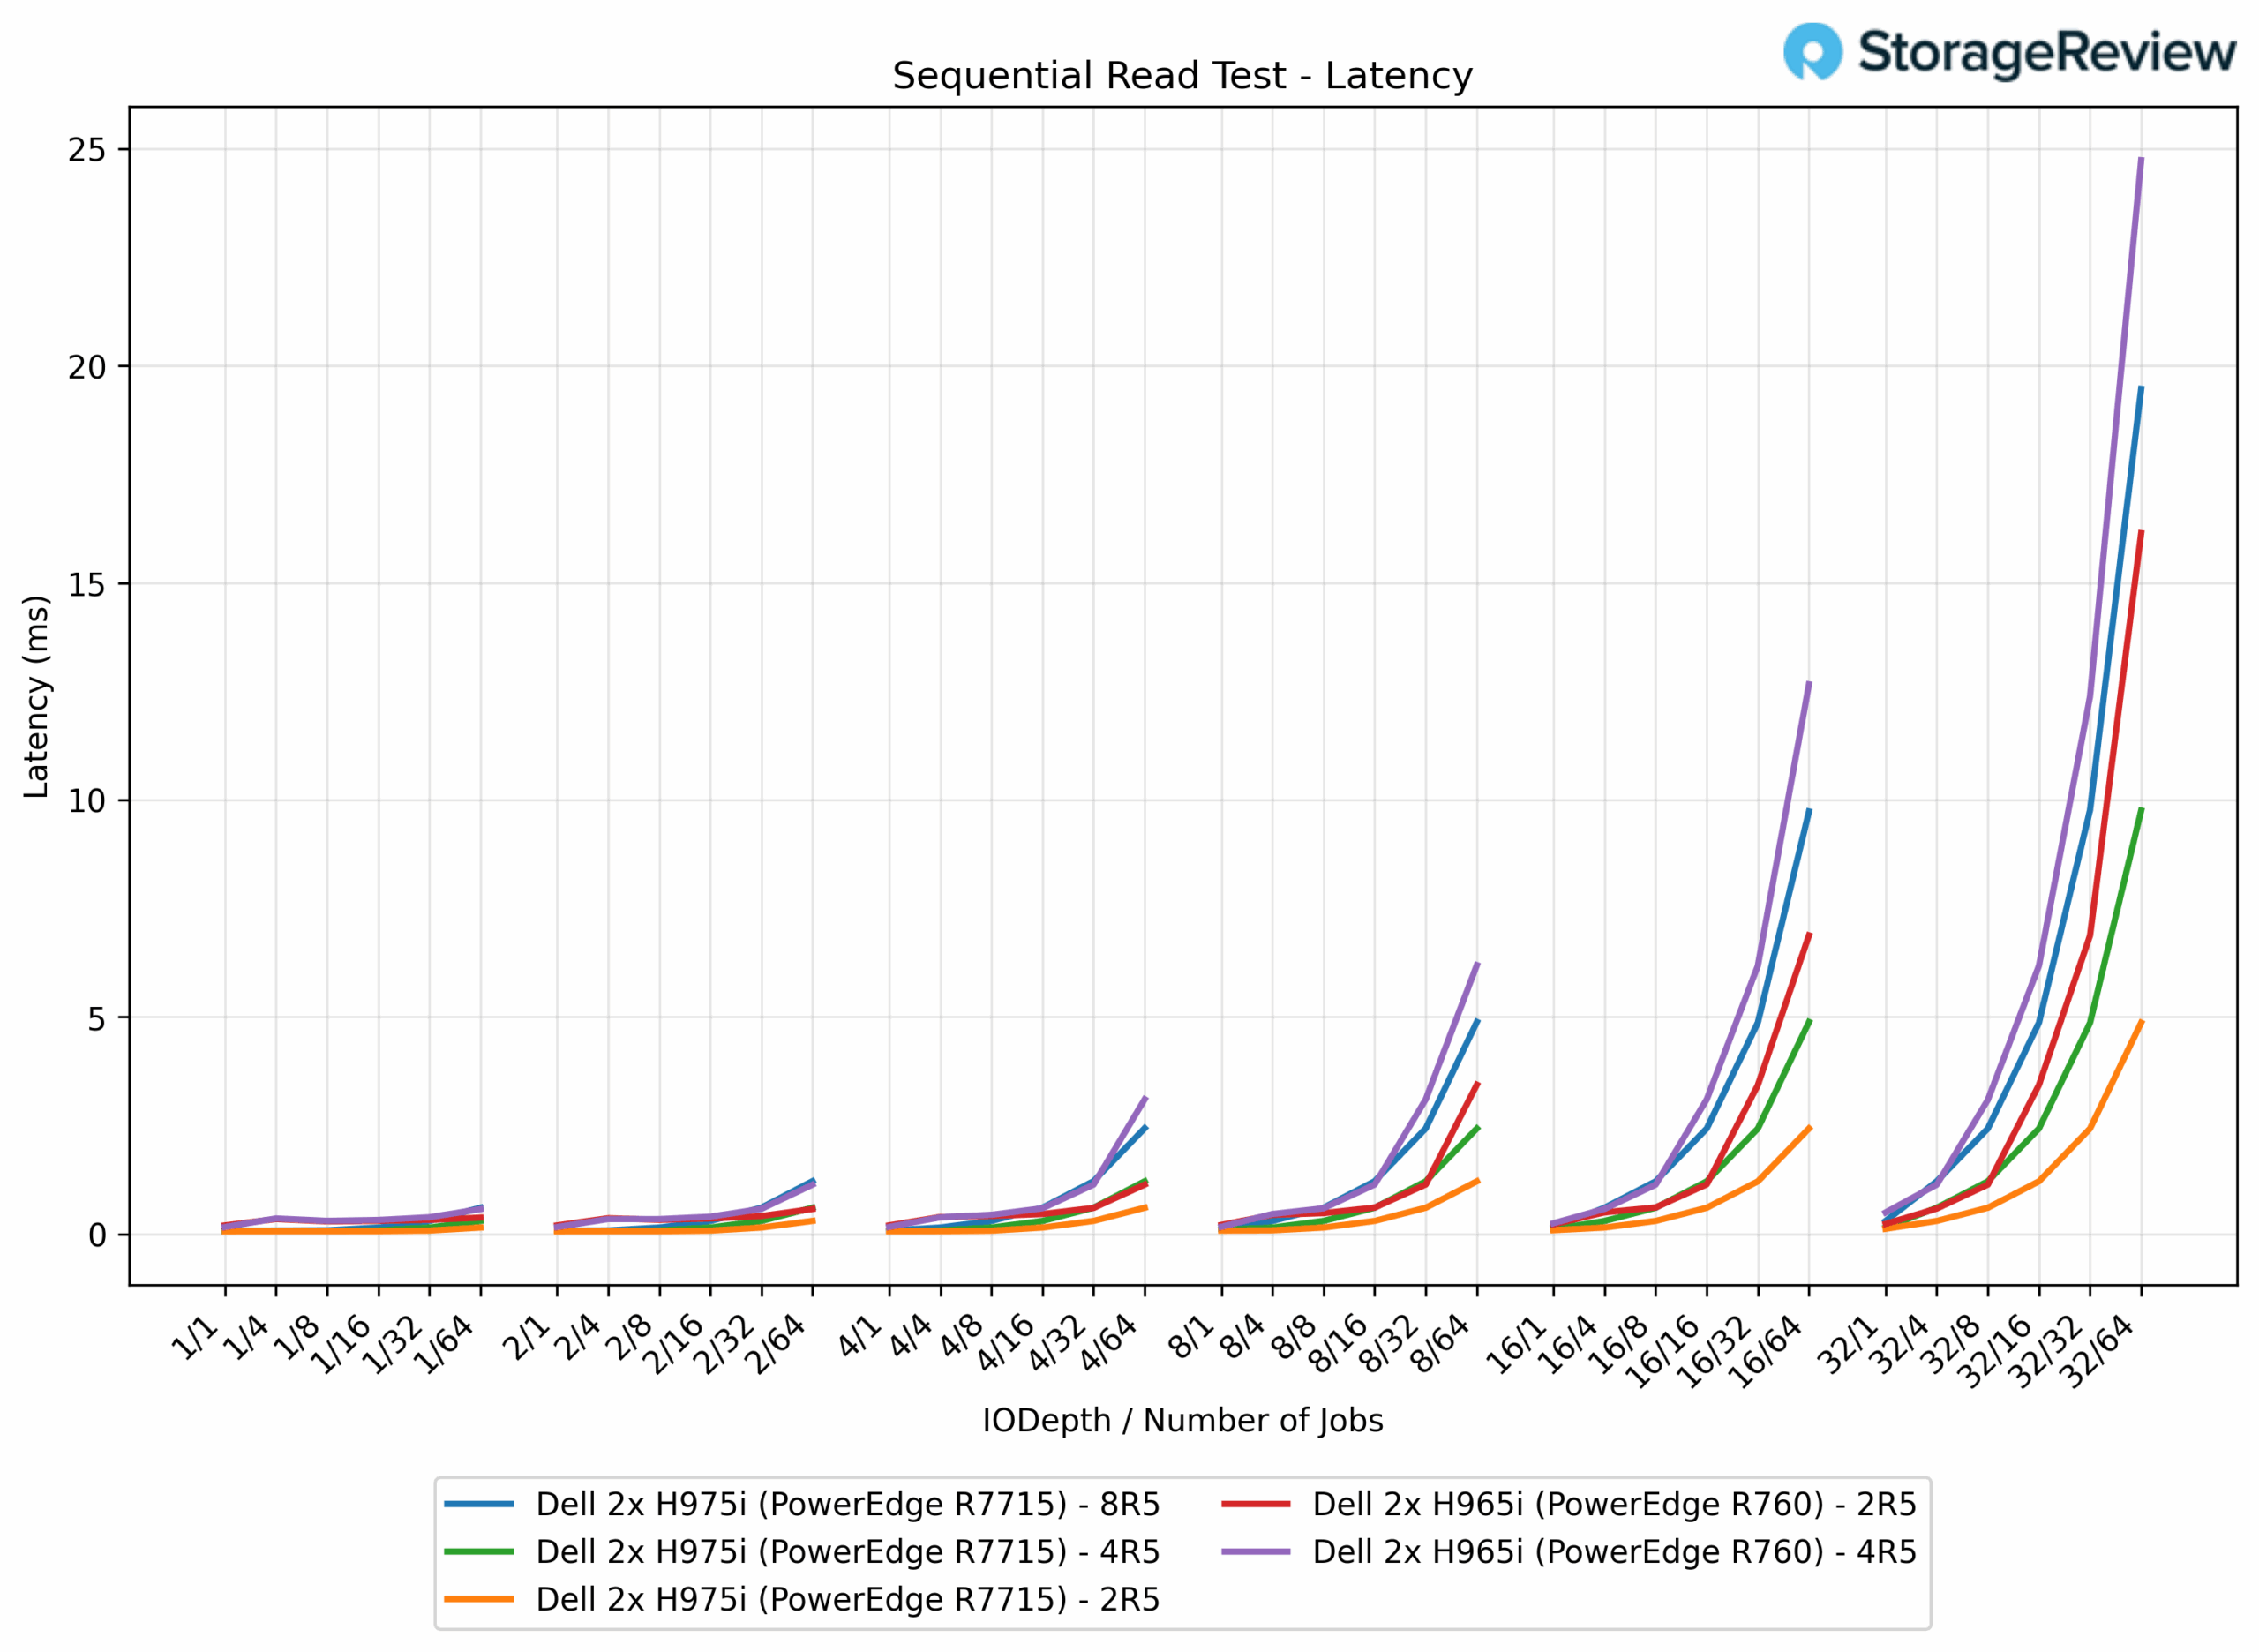
128K 순차 읽기 대기 시간
128K 순차 읽기 지연 시간 테스트에서 PERC H965i는 0.2006R16.1 구성에서 2ms~5ms, 0.1644R24.7 구성에서 4ms~5ms의 지연 시간을 기록했으며, 드라이브 확장에 따라 변동성이 증가하는 것을 보여주었습니다. 이에 비해 PERC H975i는 훨씬 더 효율적이었으며, 2R5 구성은 0.062ms~4.9ms(최대 지연 시간 80% 감소), 4R5 구성은 0.075ms~9.8ms(최대 지연 시간 60% 감소), 8R5 구성은 최대 지연 시간 19.5ms(H21i 965R4 대비 5% 감소)를 기록했습니다.
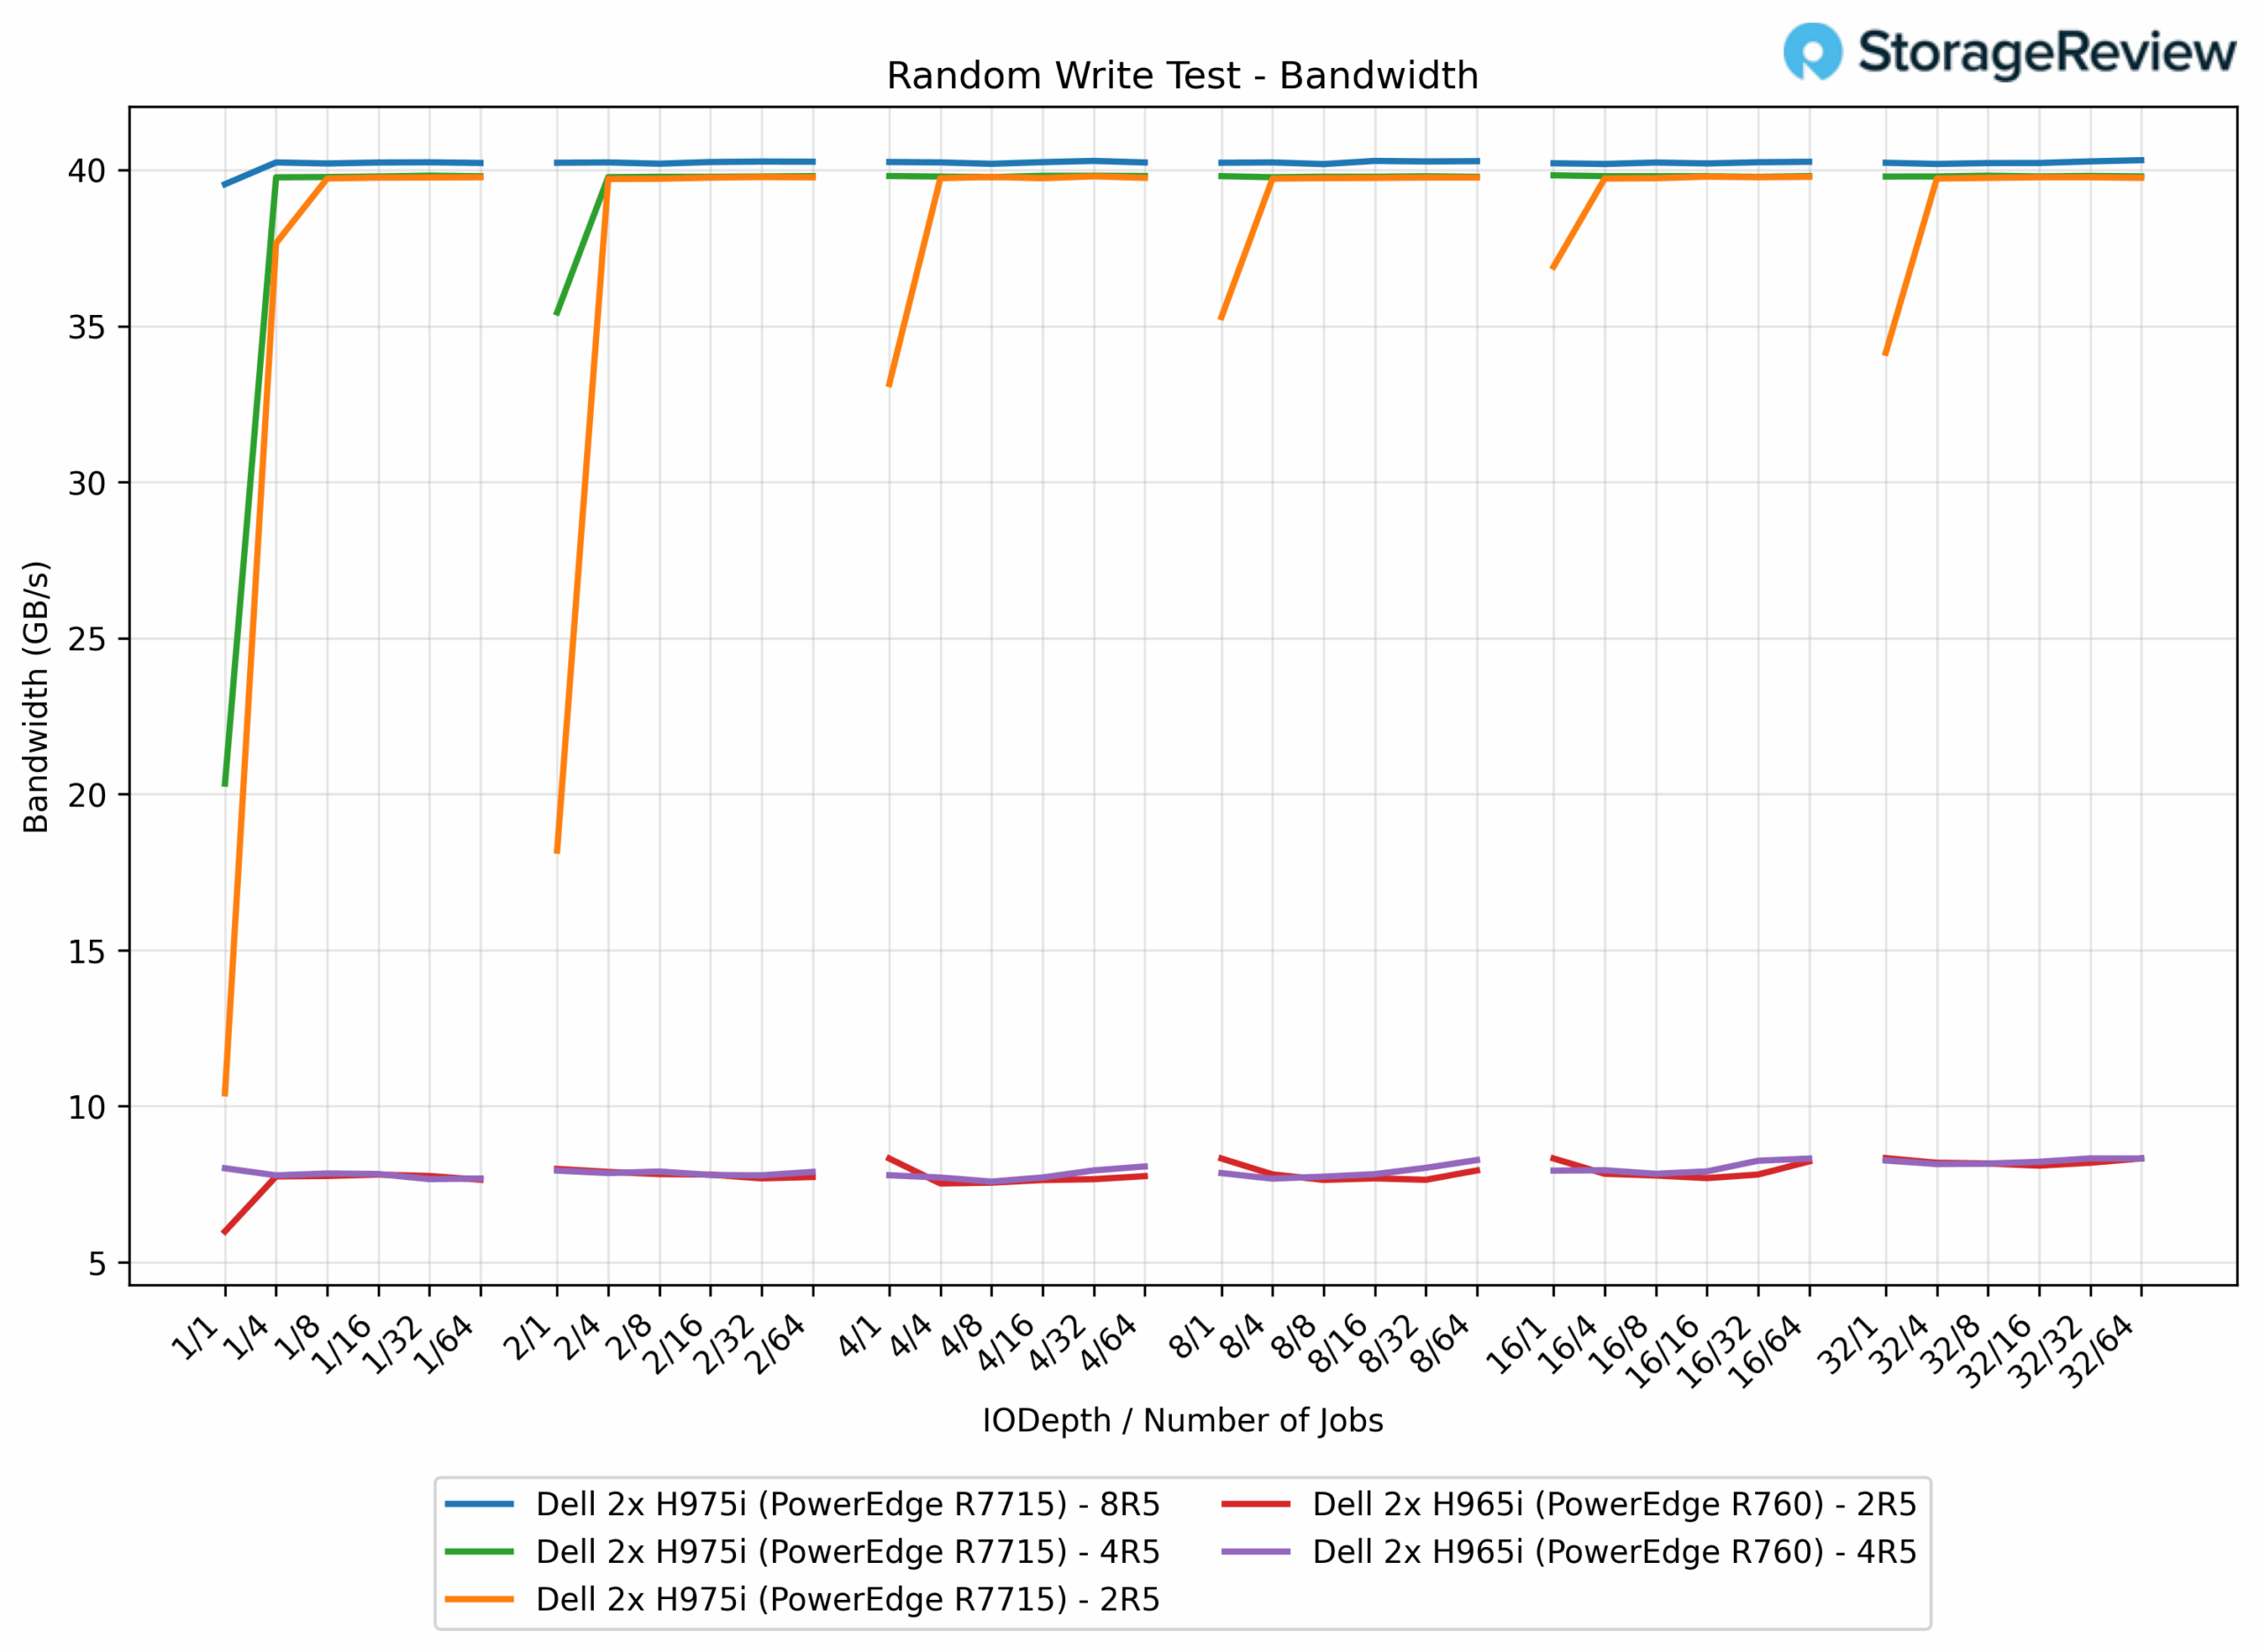
64k 임의 쓰기 대역폭
64K 랜덤 쓰기 테스트에서 기존 PERC H965i 컨트롤러는 일관적이지만 제한적인 성능을 보였으며, 2R5 및 4R5 구성 모두 디스크 수에 관계없이 거의 동일한 8.3GB/s의 처리량을 달성했습니다. 이와는 대조적으로 PERC H975i 컨트롤러는 탁월한 성능 향상을 보였습니다. 2R5 구성은 39.8GB/s(379% 향상)에 도달했고, 4R5 구성은 동일한 39.8GB/s의 최대 대역폭(379% 향상)을 유지했습니다. H8i의 5R975 어레이는 40.3GB/s(386% 향상)로 약간 앞서 나갔습니다.
64k 임의 쓰기 대기 시간
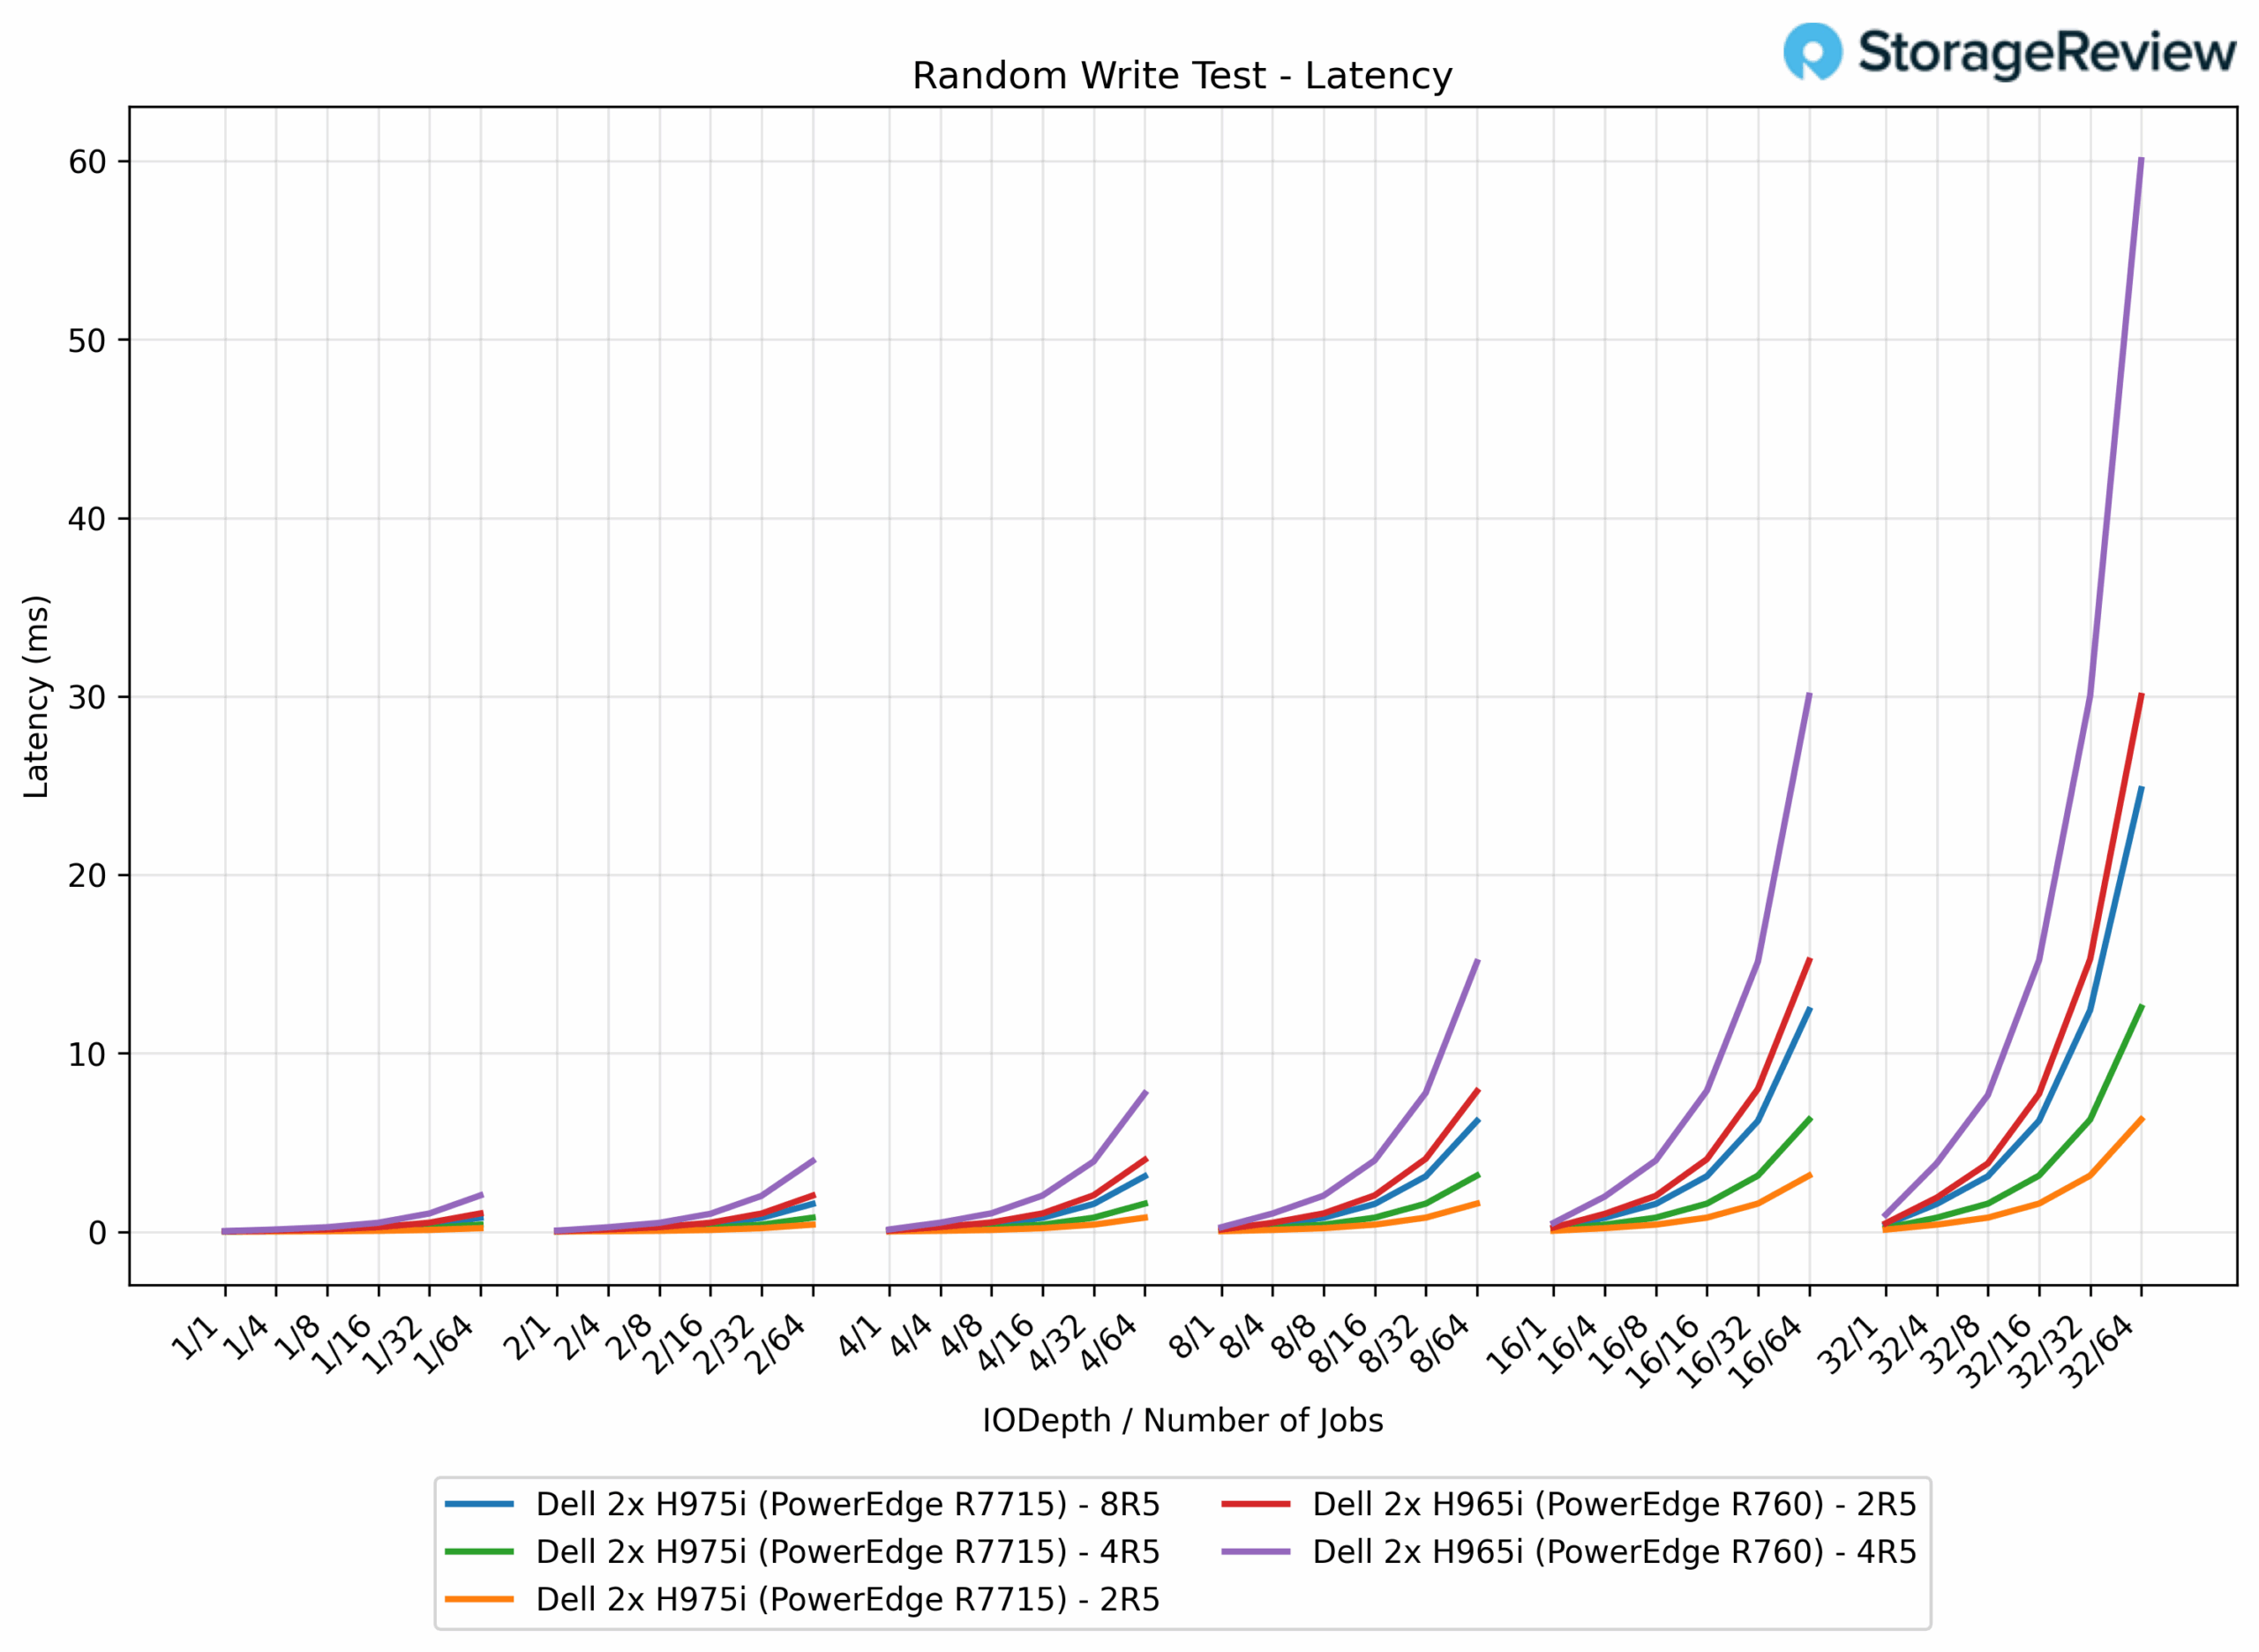
64K 랜덤 쓰기 지연 시간 테스트에서 H965i는 더 높은 부하에서 어려움을 겪었는데, 2R5는 0.020ms에서 최대 30.0ms, 4R5는 최대 60.0ms까지 나타났습니다. 이와는 대조적으로 H975i 컨트롤러는 훨씬 더 나은 성능을 보였습니다. 2R5는 0.0115ms에서 6.3ms(최대 지연 시간 79% 감소), 4R5는 12.6ms(최대 지연 시간 79% 감소), 8R5는 24.8ms(H59i 965R4 대비 5% 감소)의 최대 지연 시간을 기록했습니다.
64k 랜덤 읽기 대역폭
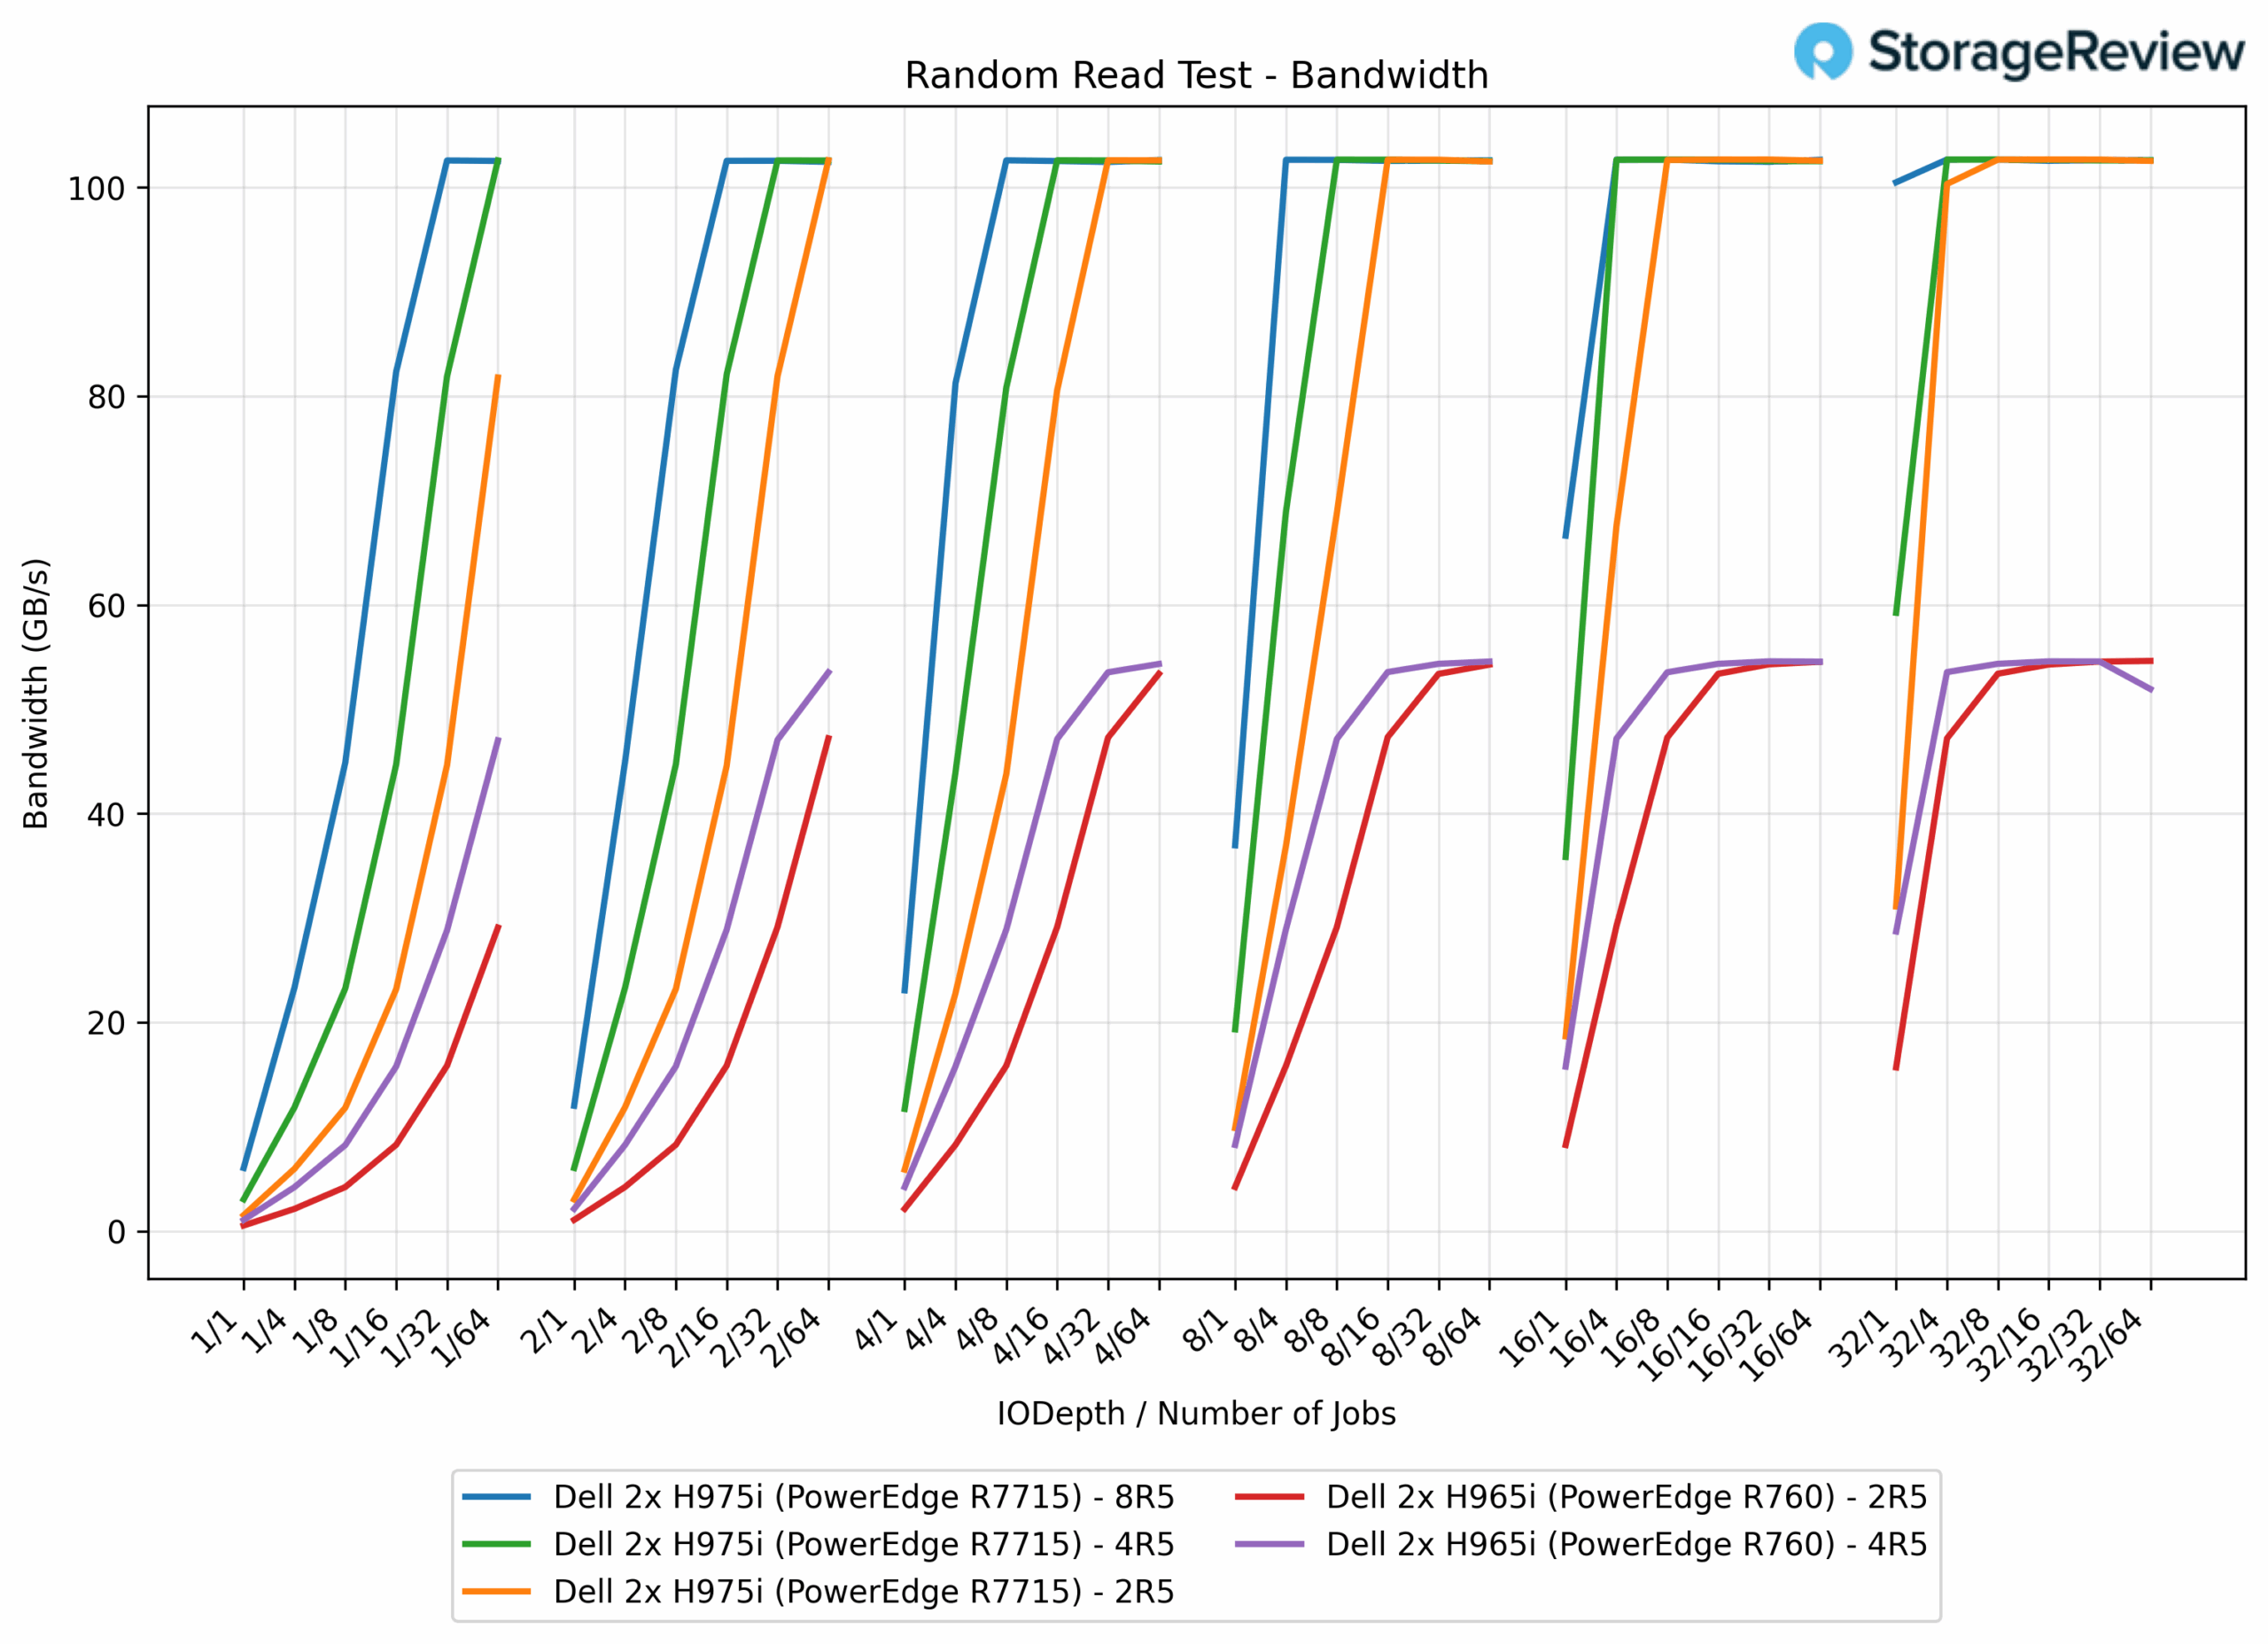
64K 랜덤 읽기 테스트에서 965R2 및 5R4 어레이를 모두 갖춘 PERC H5i는 거의 동일한 54.6GB/s 처리량을 달성했습니다. 이와는 대조적으로, PERC H975i 컨트롤러는 세 가지 구성 모두 약 102.7GB/s에 도달하여 H88i보다 965% 향상된 성능을 보였습니다. 특히, H975i 구성은 다양한 RAID 어레이 크기에서 놀라운 일관성을 보였으며, RAID-102.7 어레이에서 드라이브 수 102.7개, 2개 또는 4개에 관계없이 최대 대역폭 범위가 8GB/s에서 5GB/s에 불과했습니다. 이는 64K 랜덤 읽기 작업 부하에서 컨트롤러를 완전히 포화시킬 수 있으며 최신 H975i 플랫폼에서 드라이브 제한이 발생하지 않음을 시사합니다.
64k 랜덤 읽기 대기 시간
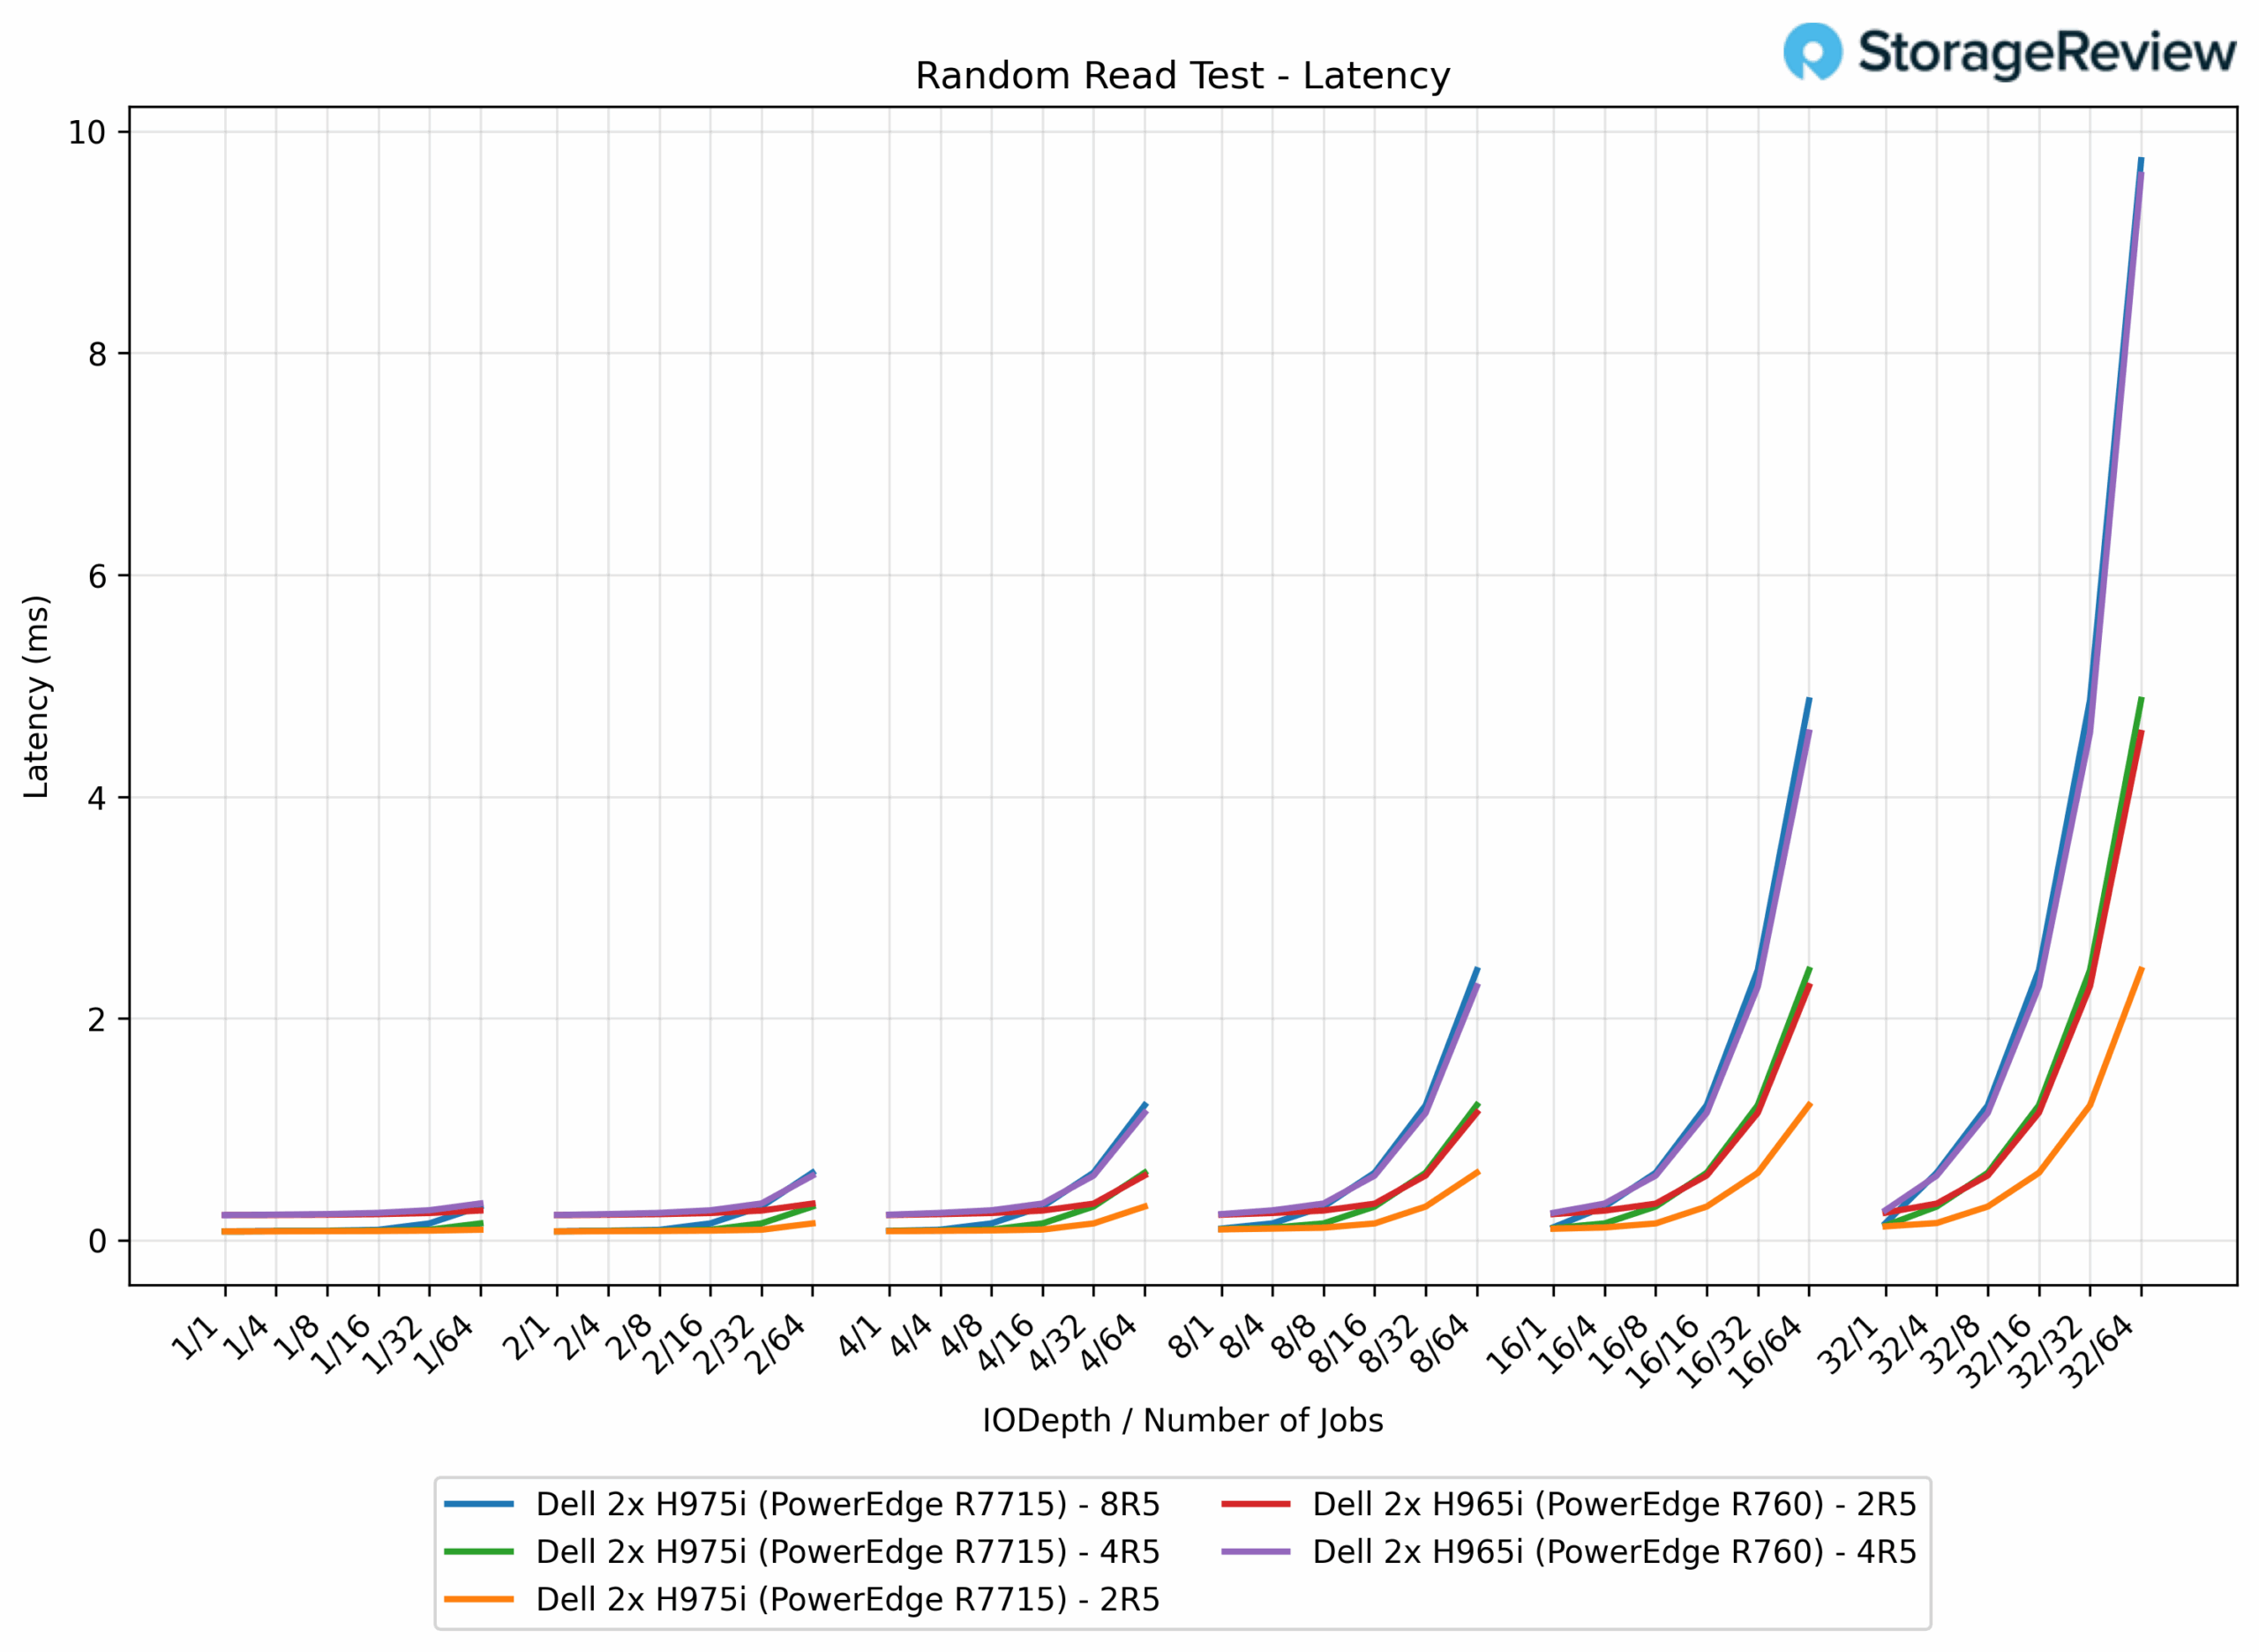
64K 랜덤 읽기의 경우, H965i 2R5 어레이는 0.226ms에서 4.6ms까지, 4R5 구성은 9.6ms까지 지연 시간을 보였습니다. H975i로 전환하자 지연 시간이 상당히 단축되었는데, 2R5는 0.080ms에서 2.4ms(최대 지연 시간 48% 감소), 4R5는 0.080ms에서 4.9ms(최대 지연 시간 49% 감소), 8R5는 0.080ms에서 9.7ms(H965i 4R5와 동일)로 측정되었습니다. 전반적으로 H975i는 RAID 그룹 전반에 걸쳐 더욱 엄격한 제어와 더 낮은 지연 시간 상한을 보였습니다.
16k 순차 쓰기 IOPS
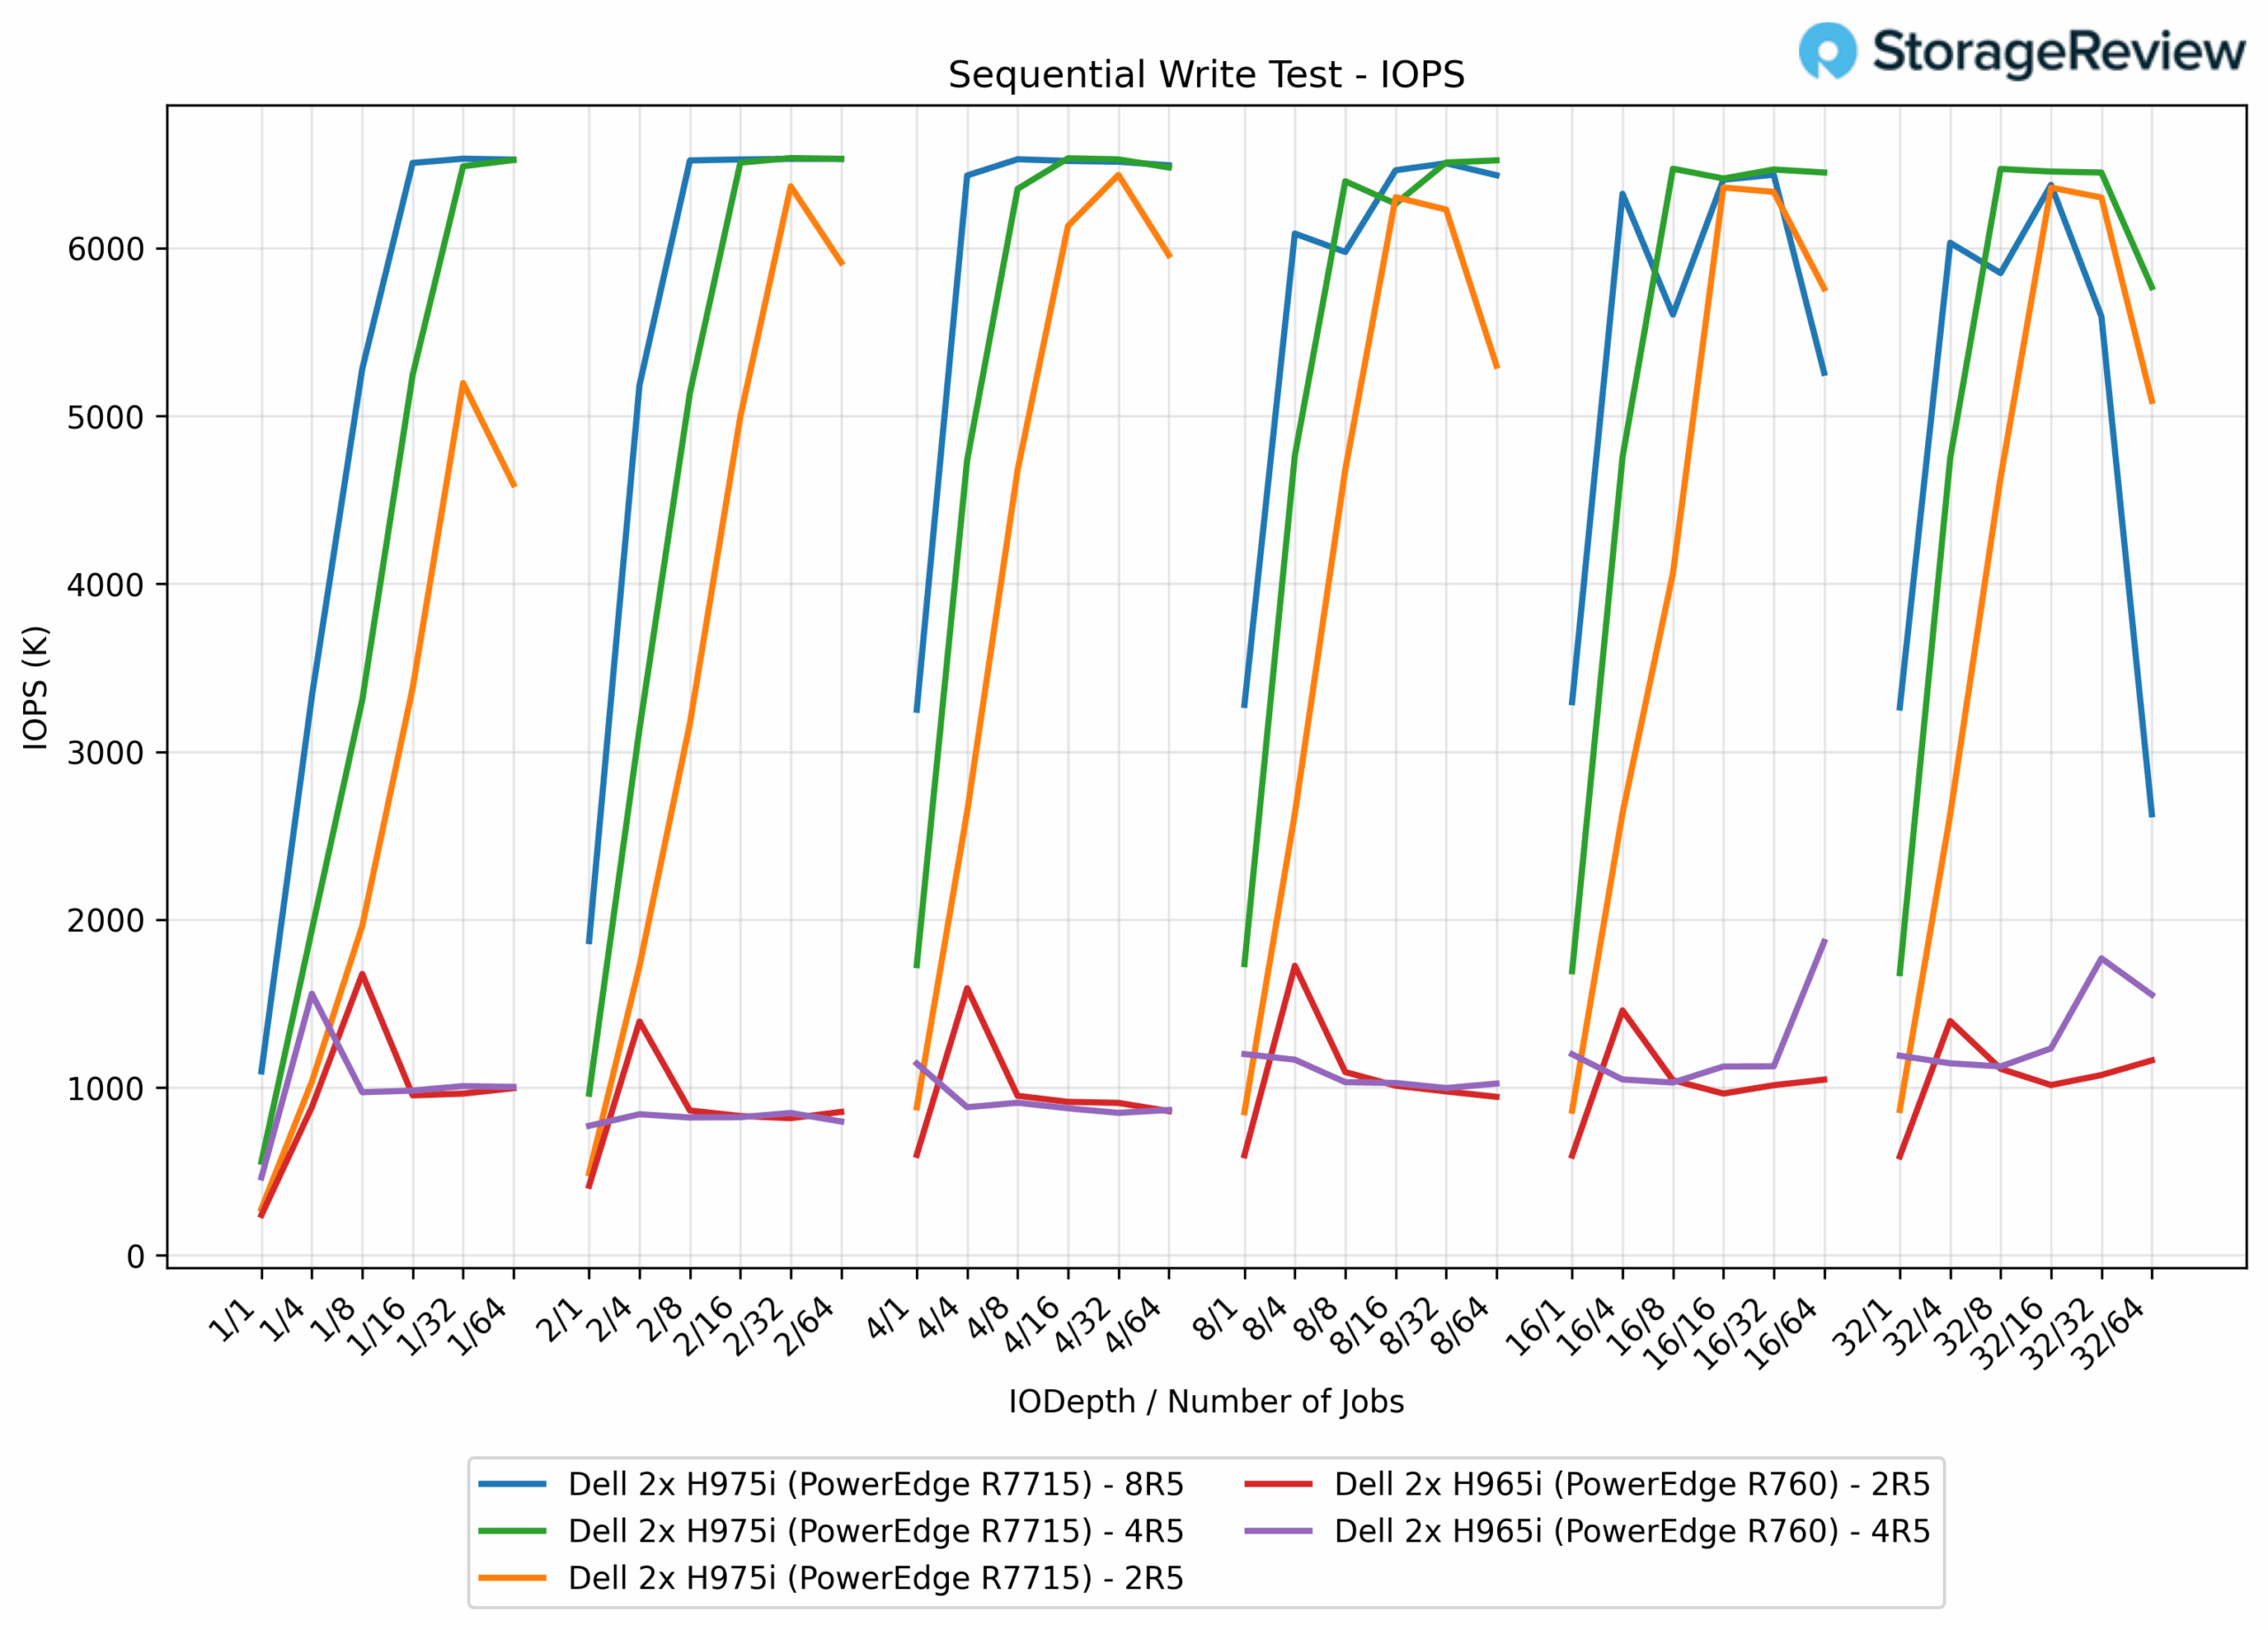
16K 순차 쓰기 테스트에서 PERC H965i 컨트롤러는 적당한 성능을 보였으며, 2R5 구성은 1.73만 IOPS, 4R5 구성은 1.87만 IOPS를 달성했습니다. 반면 PERC H975i는 2R5 구성에서 6.44만 IOPS(H272i 대비 965% 향상)로 극적인 성능 향상을 보였습니다. H975i의 4R5 어레이는 최대 6.54만 IOPS(H250i 대비 8% 향상)를 기록했고, 5R6.53 구성은 249만 IOPS(H965i 4R5 대비 6.5% 향상)를 달성했습니다. 이는 컨트롤러가 16K 블록 크기에서 약 XNUMX만 IOPS로 포화 상태임을 다시 한번 보여줍니다.
16k 순차 쓰기 대기 시간
16K 순차 쓰기에서 H965i 어레이는 0.0080R3.5에서 2~5ms, 0.0083R5.3에서 4~5ms의 성능을 보였습니다. H975i는 2R5가 0.0070ms~0.80ms(77% 감소), 4R5가 최대 1.42ms(73% 감소), 8R5가 최대 6.2ms(H17i 965R4 대비 5% 감소)로 우수한 효율을 보였습니다. 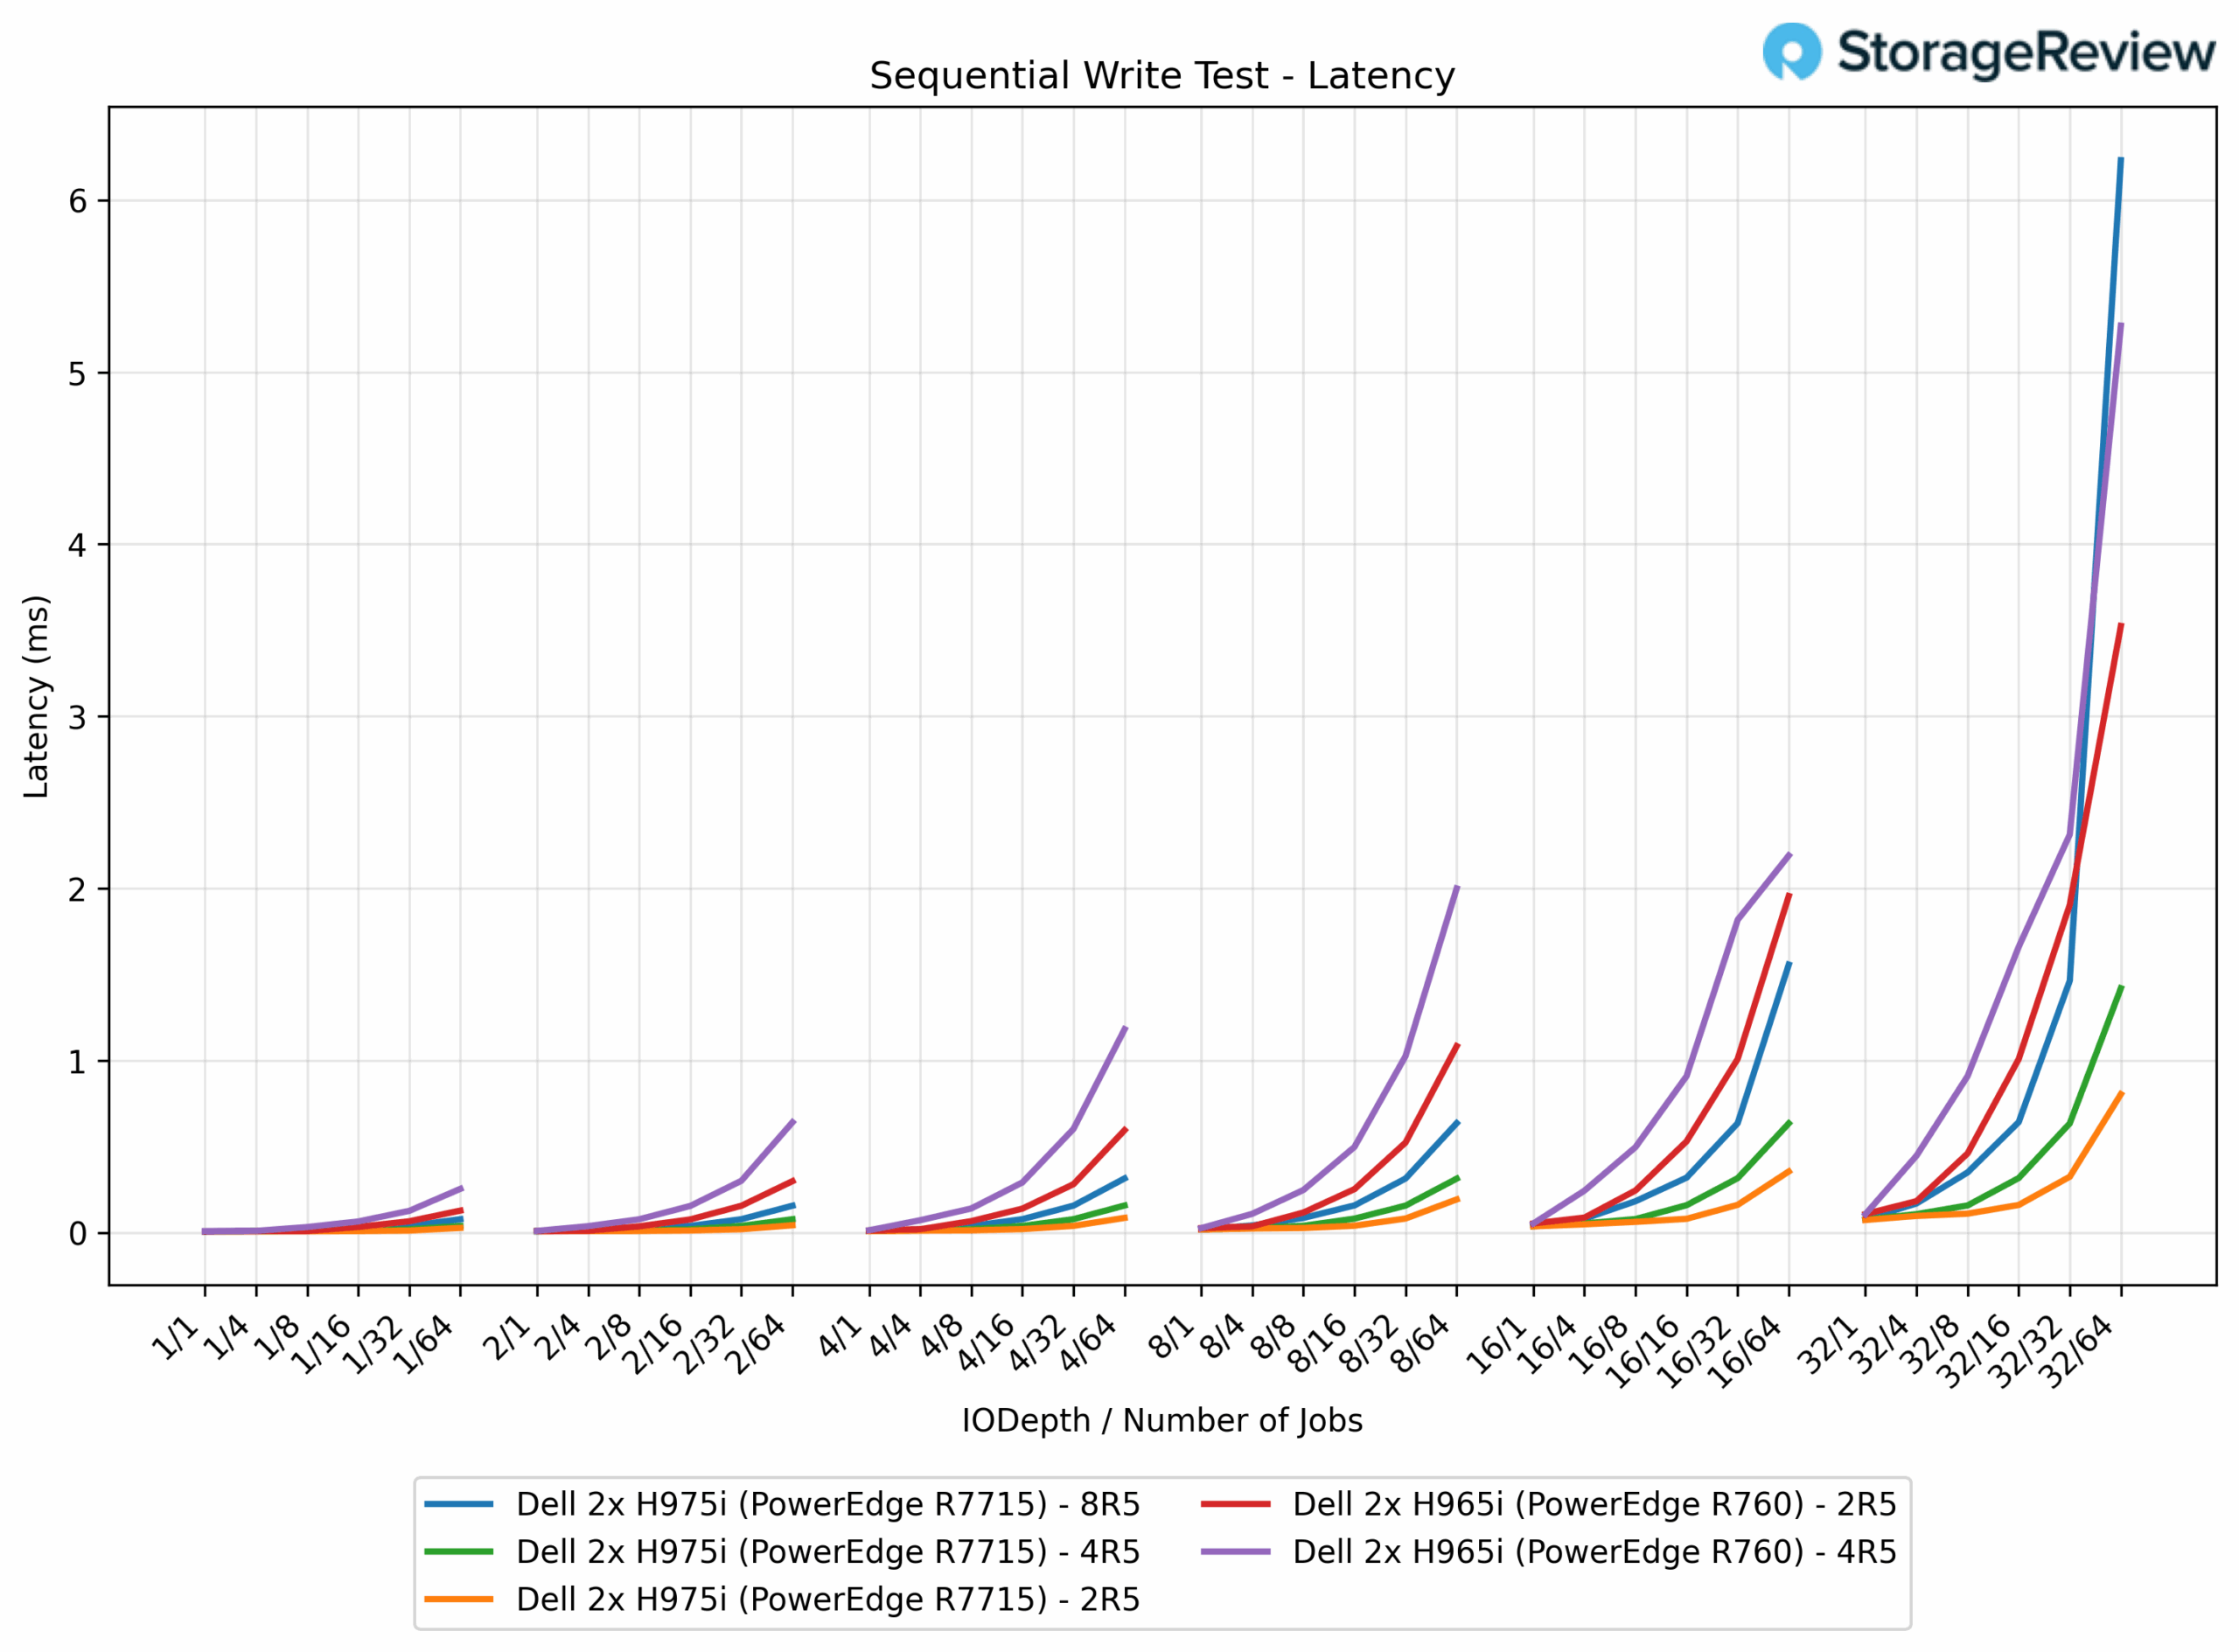
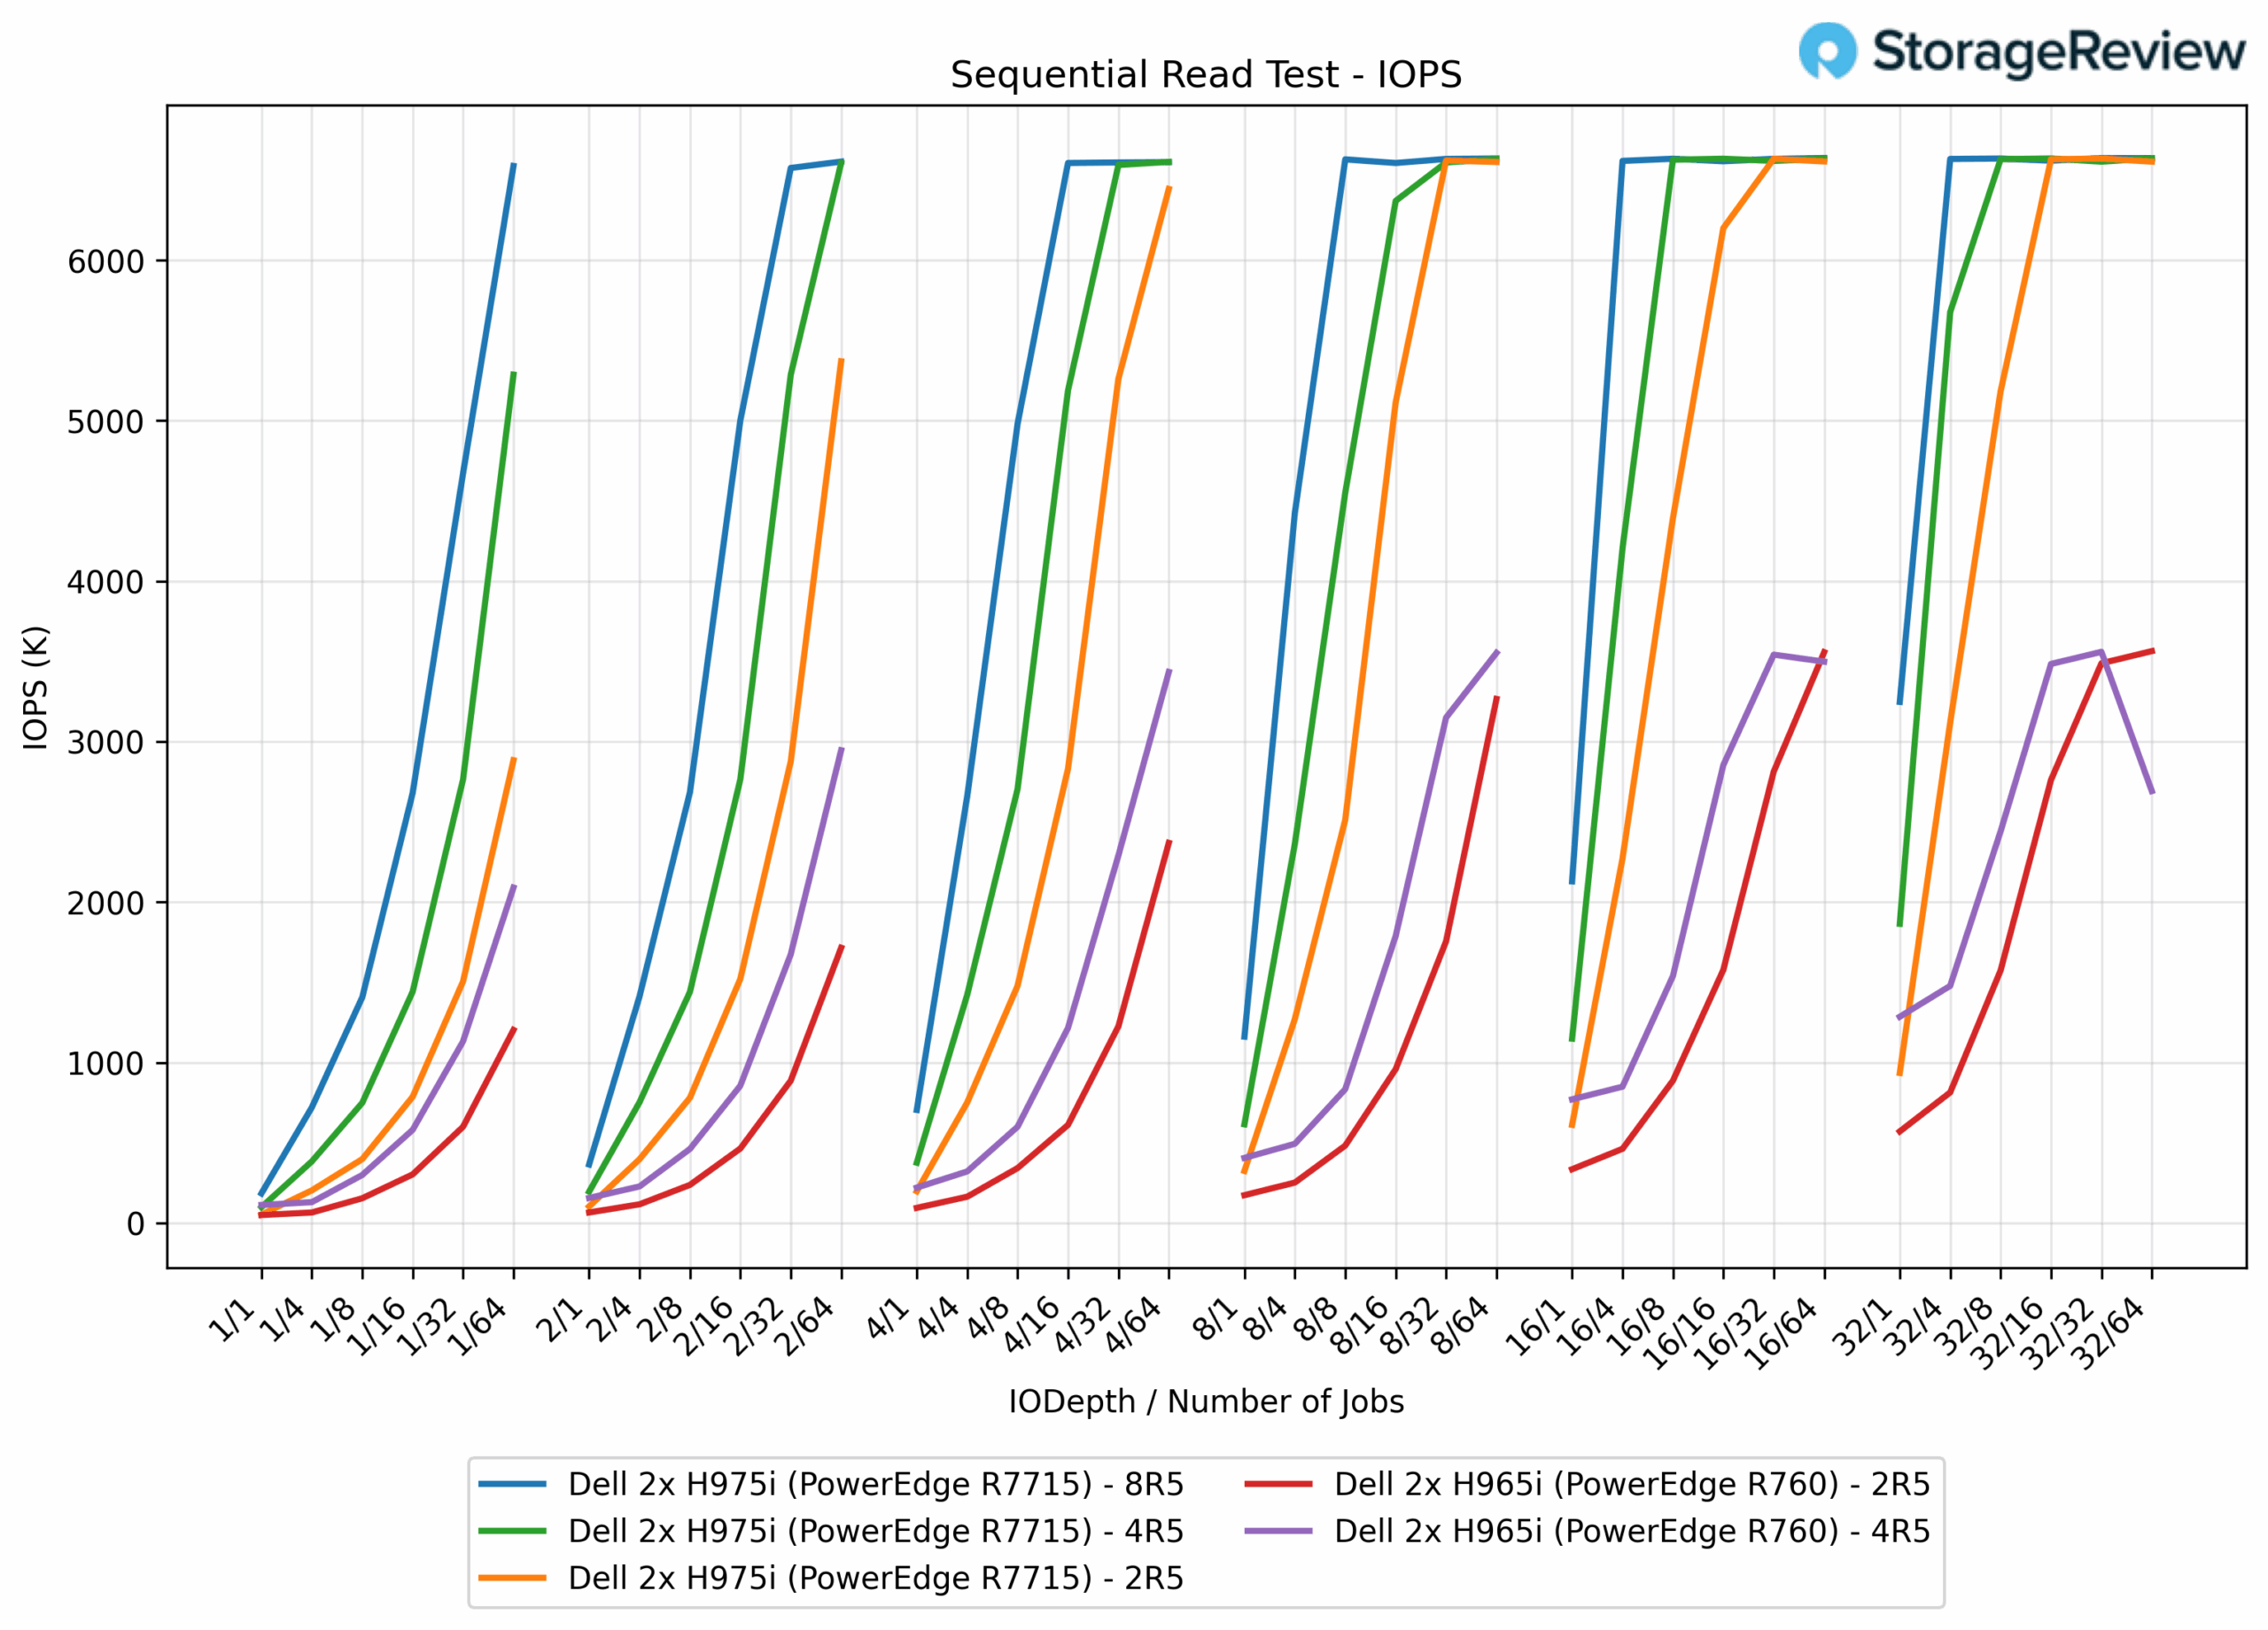
16k 순차 읽기 IOPS
16K 순차 읽기 테스트에서 PERC H965i 컨트롤러는 일관된 결과를 보였으며, 2R5 구성은 3.56만 IOPS, 4R5 구성은 3.56만 IOPS를 달성했습니다. 반면, PERC H975i 컨트롤러는 모든 구성이 6.64만 IOPS를 중심으로 밀집되어 H86i 대비 965% 향상된 성능을 보였습니다.
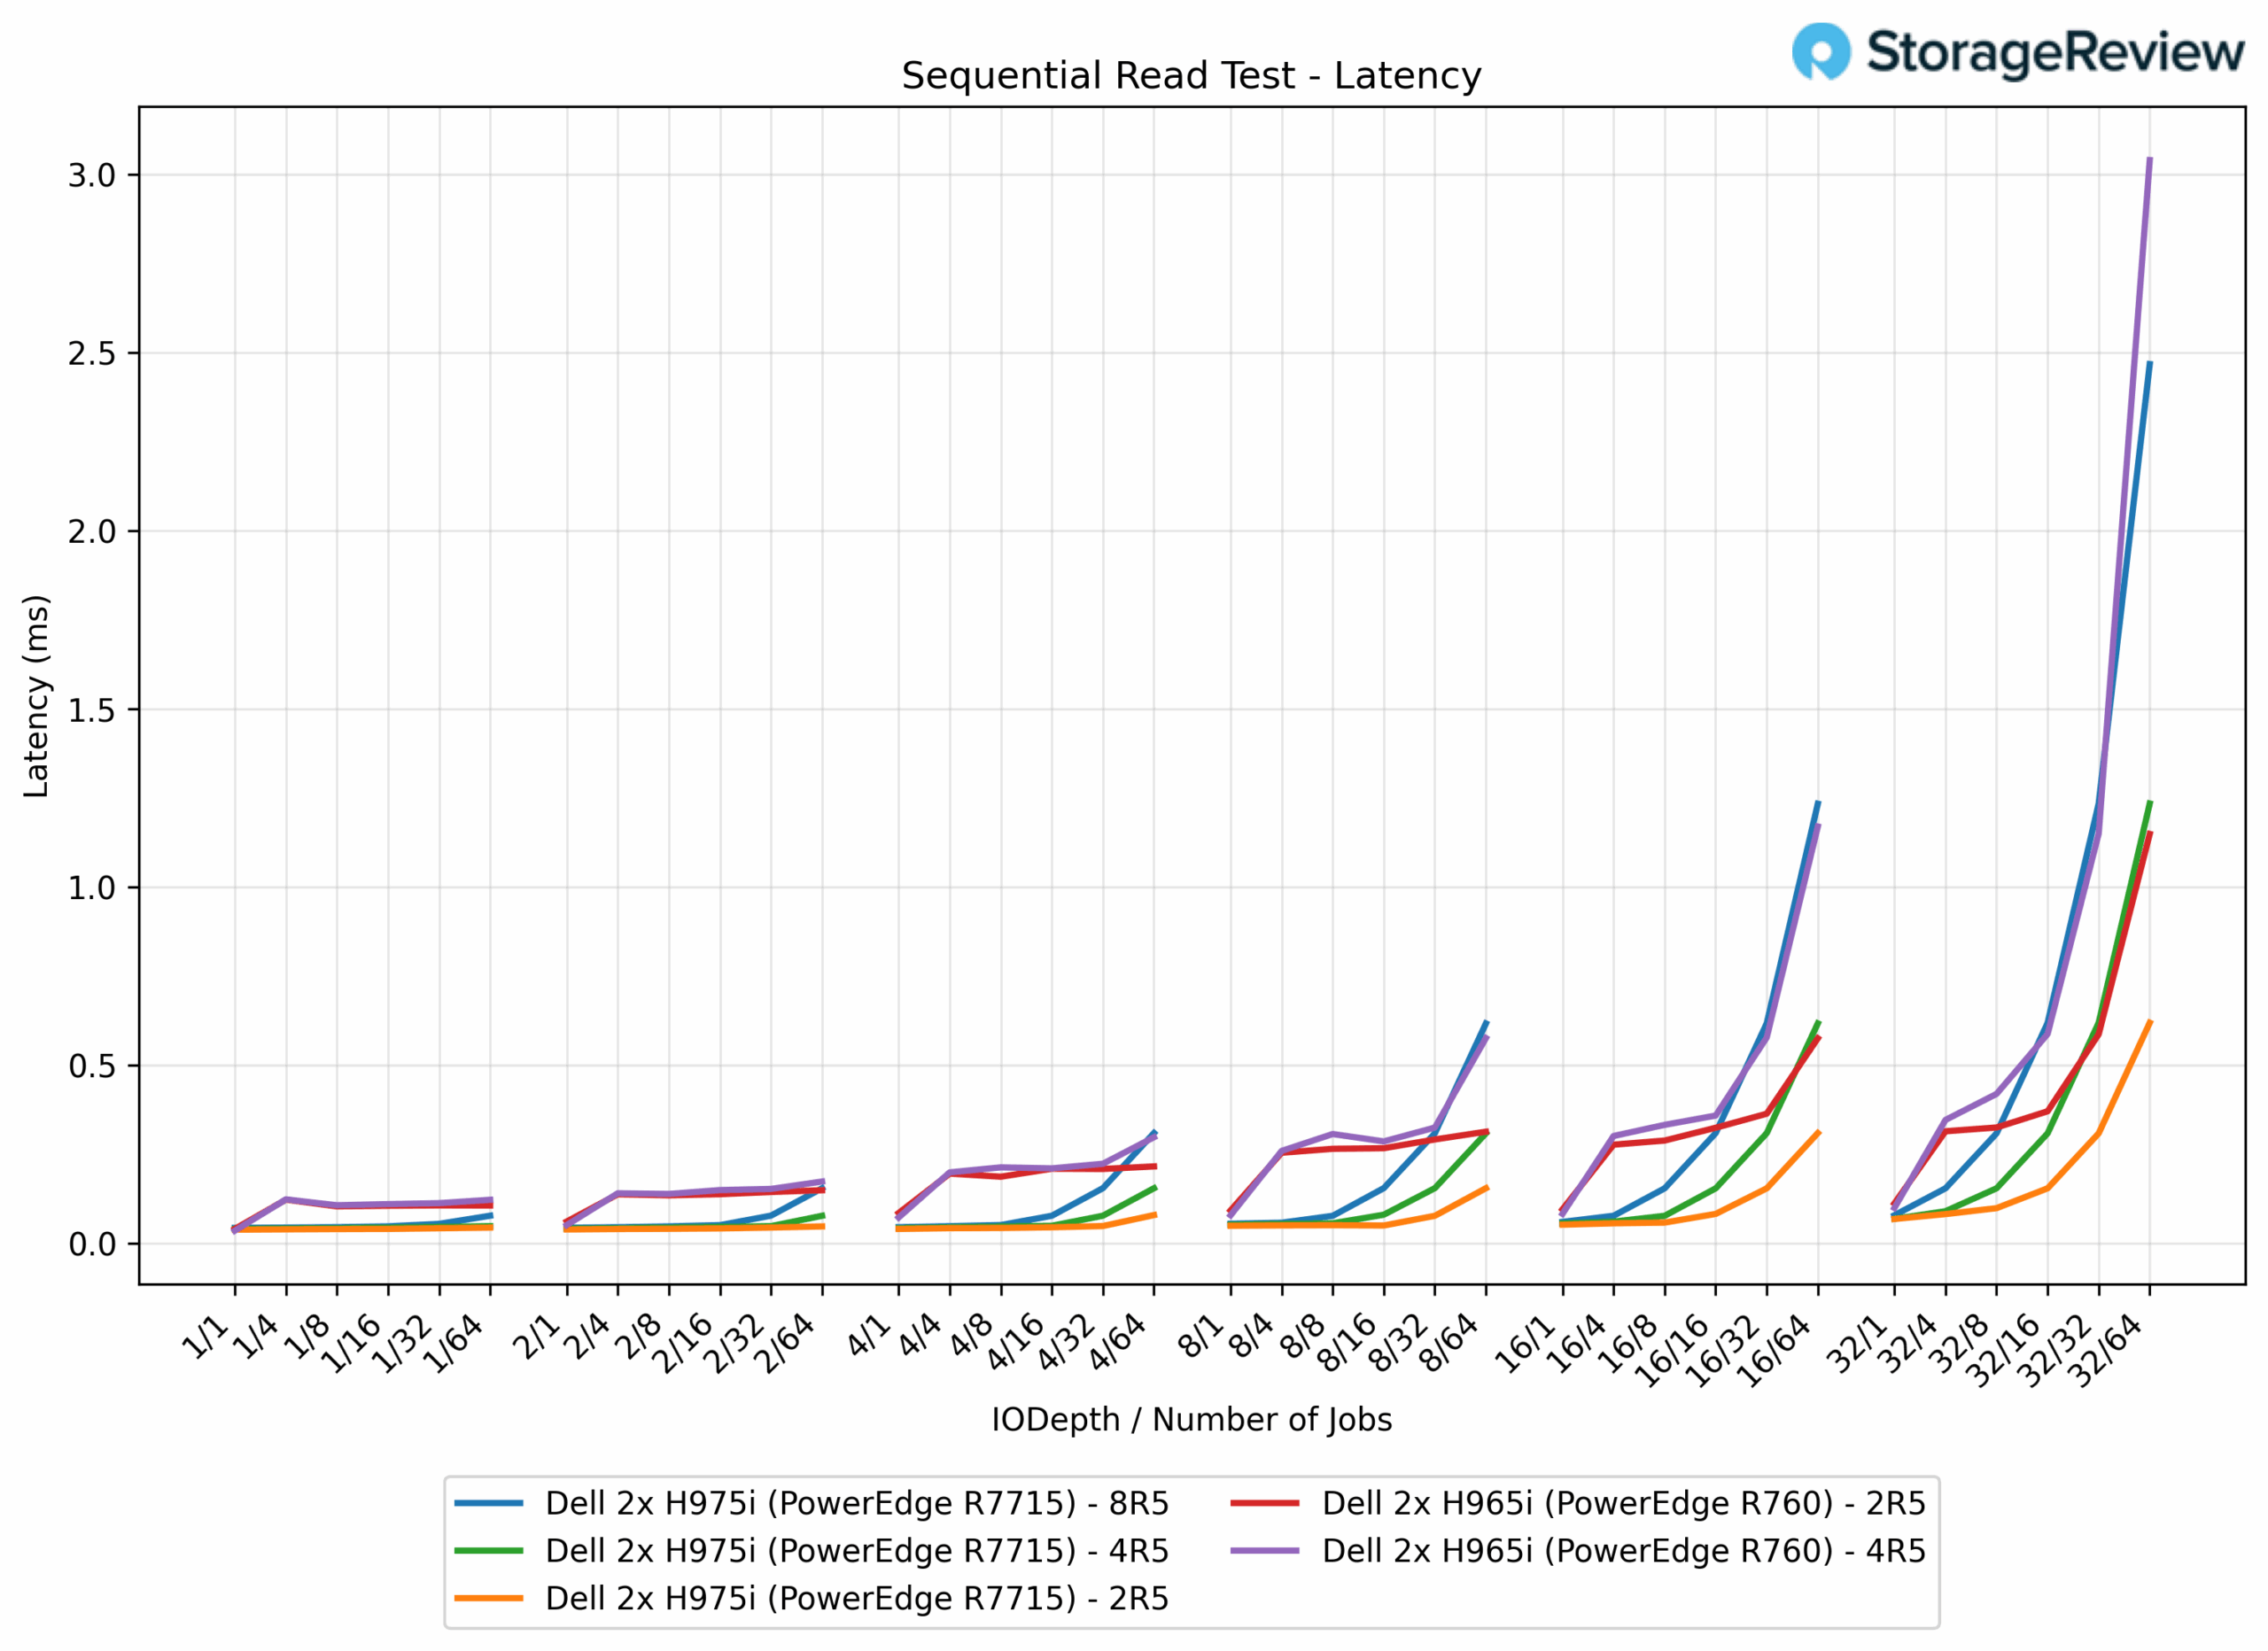
16k 순차 읽기 대기 시간
16K 순차 읽기에서 H965i 2R5 어레이의 지연 시간은 0.040ms에서 1.15ms 사이였고, 4R5는 최대 3.0ms까지 증가했습니다. H975i에서는 지연 시간이 개선되었습니다. 2R5는 0.038~0.62ms(46% 감소), 4R5는 1.23ms(59% 감소), 8R5는 2.47ms(H19i 965R4 대비 5% 감소)로 나타났습니다.
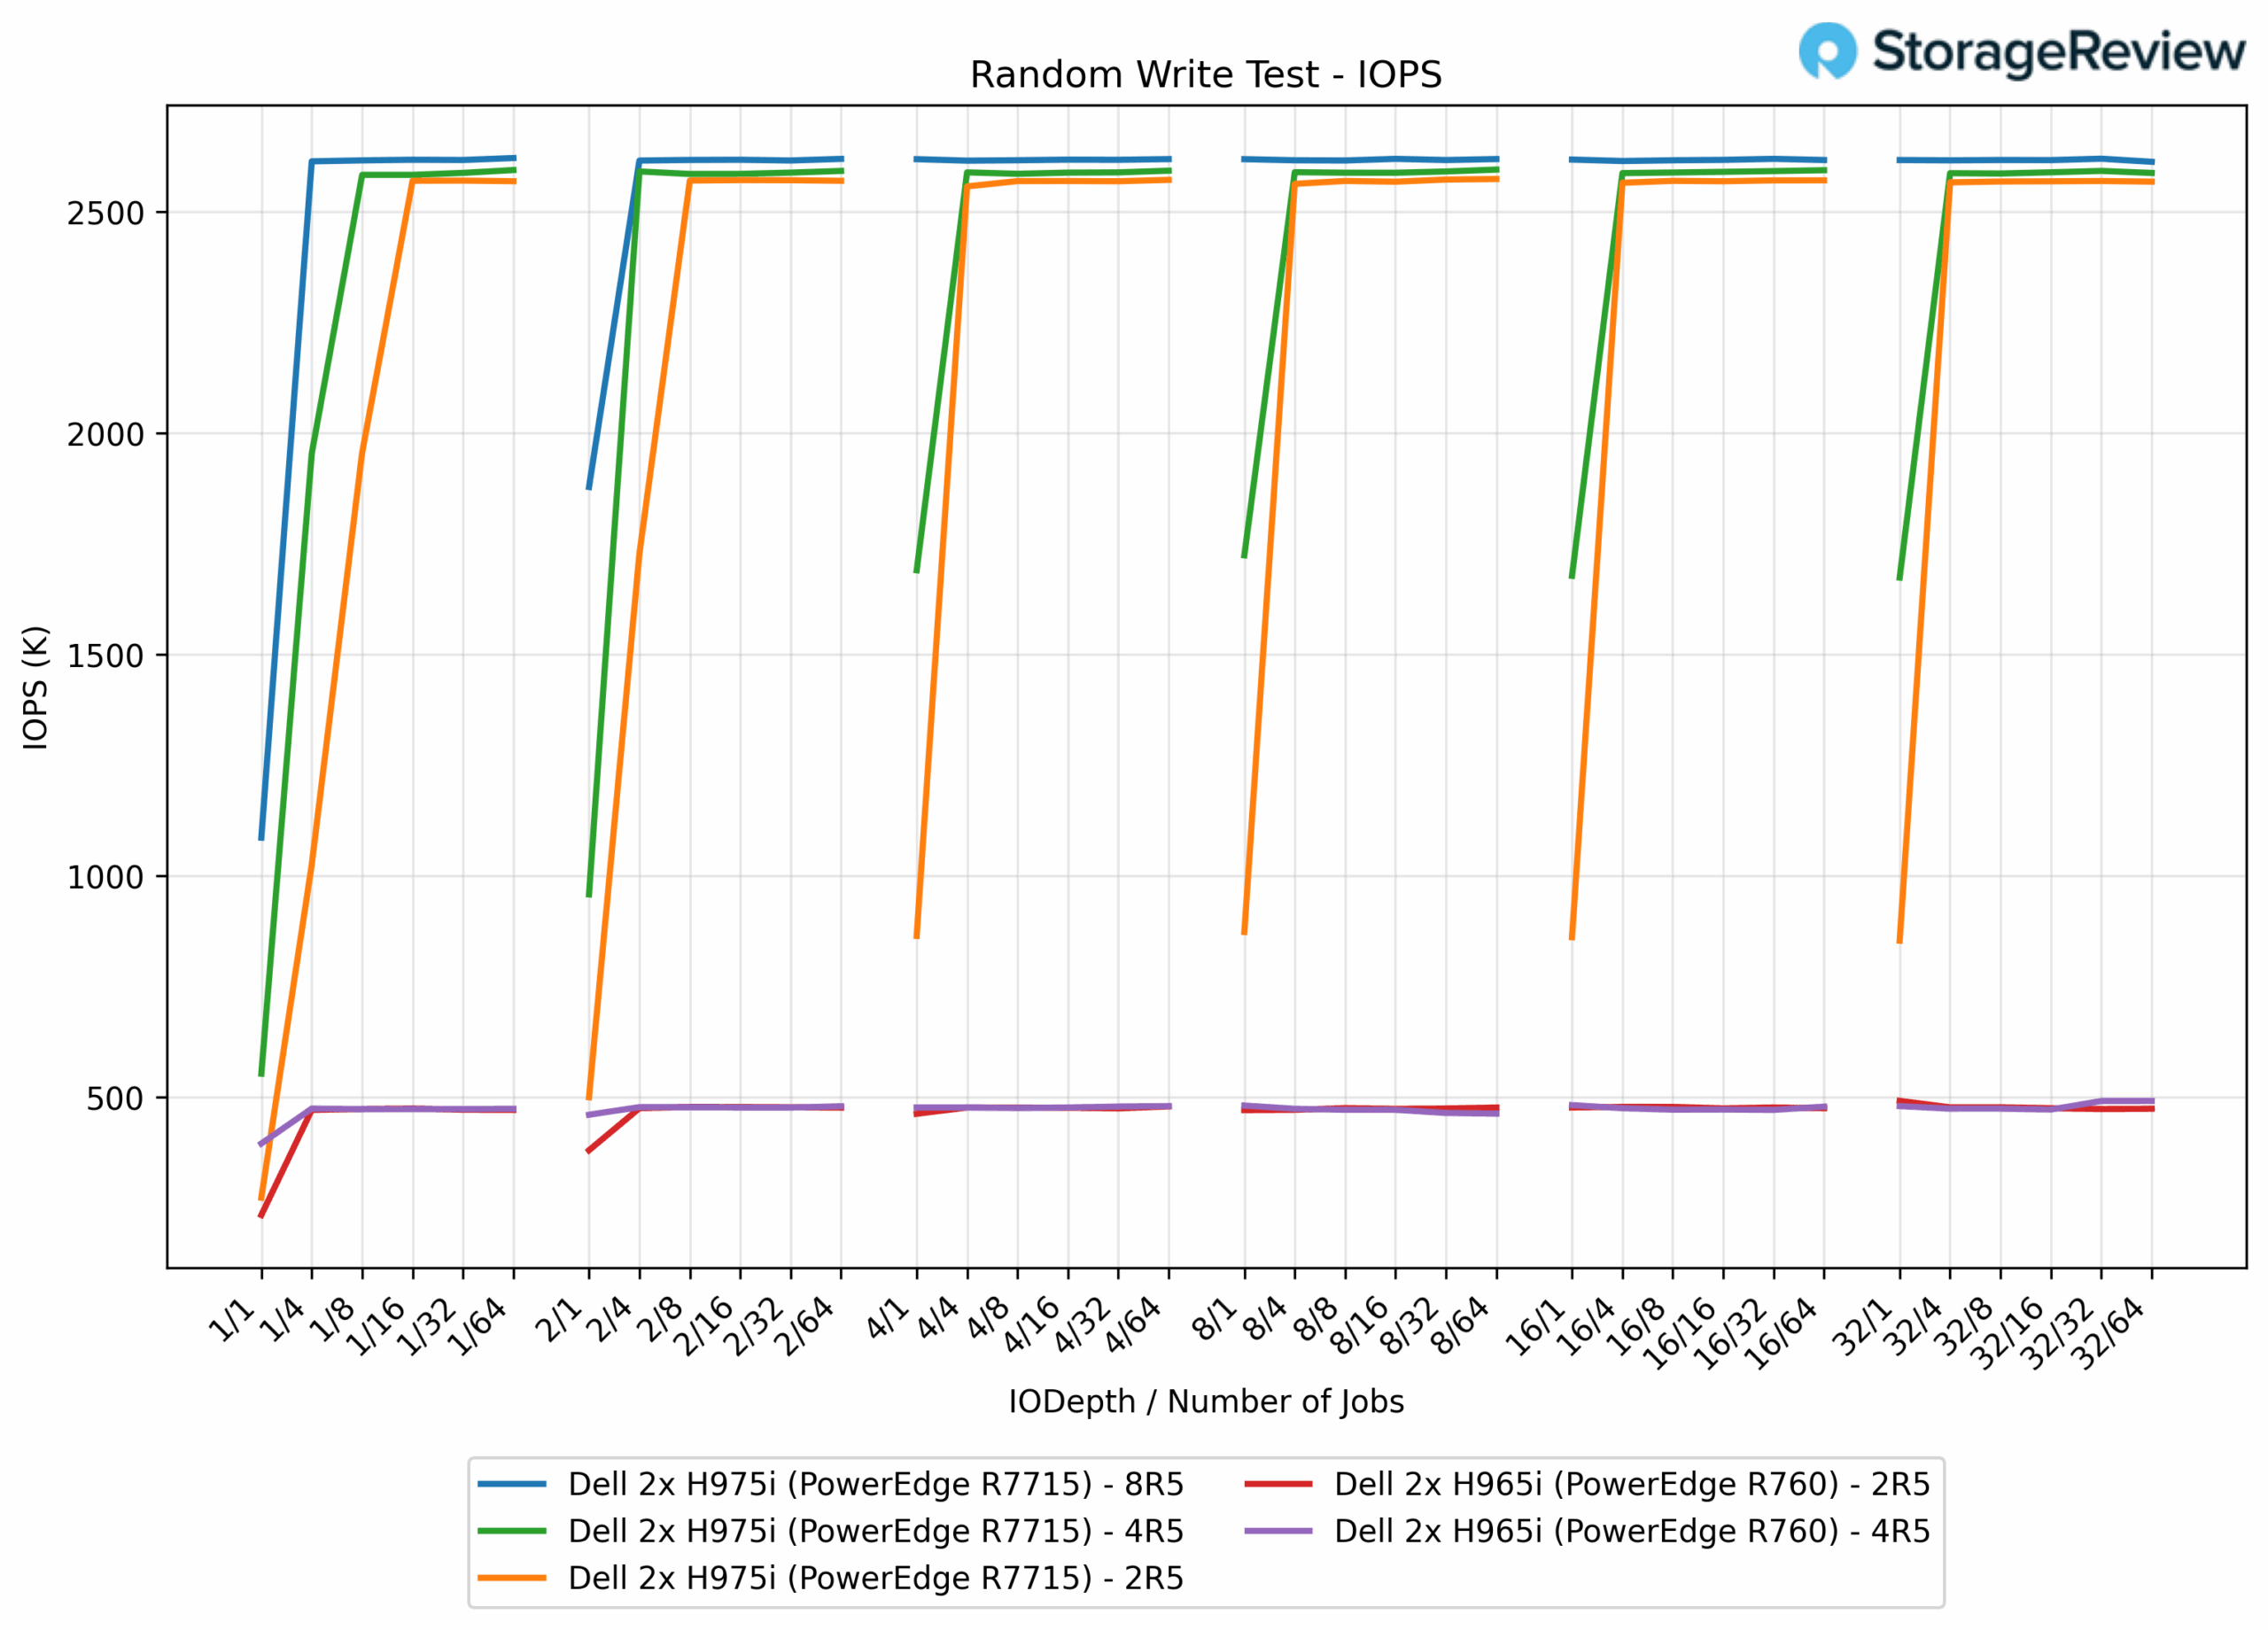
16k 임의 쓰기 IOPS
16K 블록 크기에서 랜덤 I/O를 수행한 결과, 테스트 초반에 포화점에 도달하는 것을 확인했습니다. 두 PERC H965i 구성(2R5 및 4R5) 모두 약 492,000 IOPS로 거의 동일한 성능을 보였습니다. 975R2 어레이를 탑재한 PERC H5i 컨트롤러는 2.57만 IOPS(422% 향상)를 달성했습니다. H975i 4R5 및 8R5 구성은 약 2.60만 IOPS(428% 향상)로 약간 더 높았습니다.
16k 임의 쓰기 대기 시간
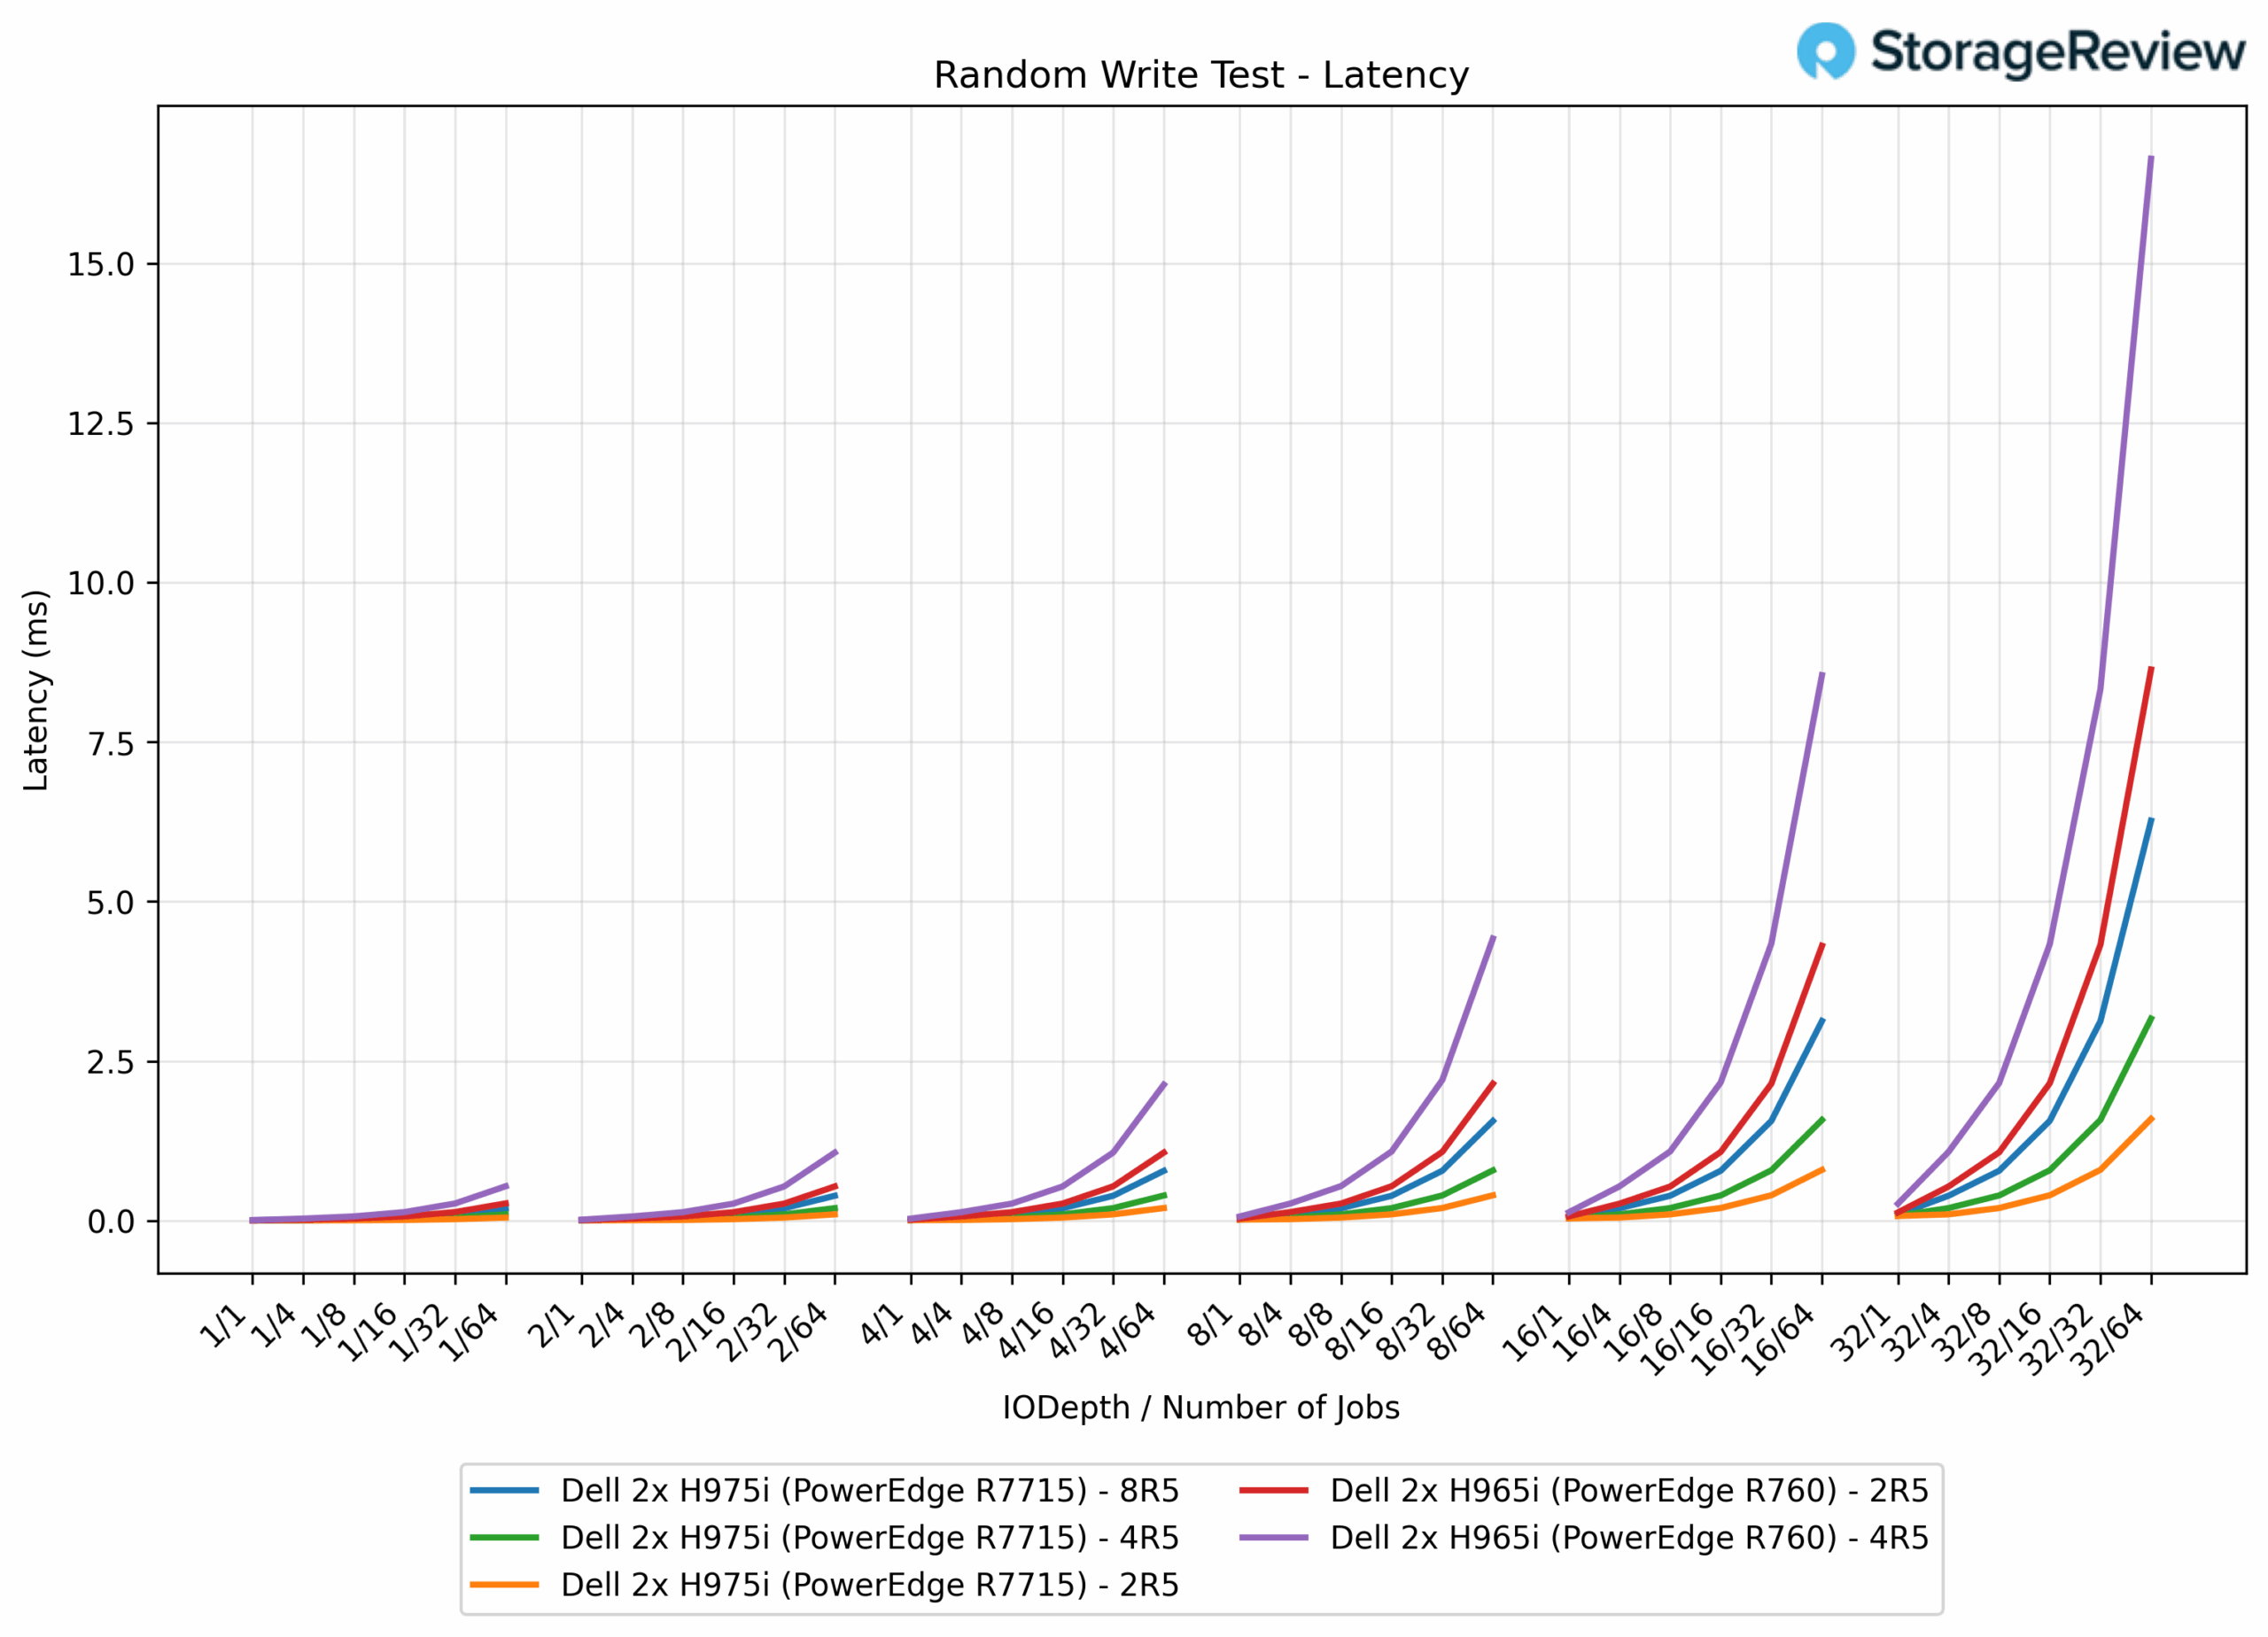
16K 랜덤 쓰기에서 H965i는 더 높은 지연 시간을 겪었는데, 2R5는 0.0082~8.6ms, 4R5는 16.6ms에 달했습니다. H975i는 2R5가 0.0070~1.59ms(82% 감소), 4R5는 최대 3.17ms(81% 감소), 8R5는 최대 6.27ms(H62i 965R4 대비 5% 감소)로 크게 개선되었습니다.
16k 임의 읽기 IOPS
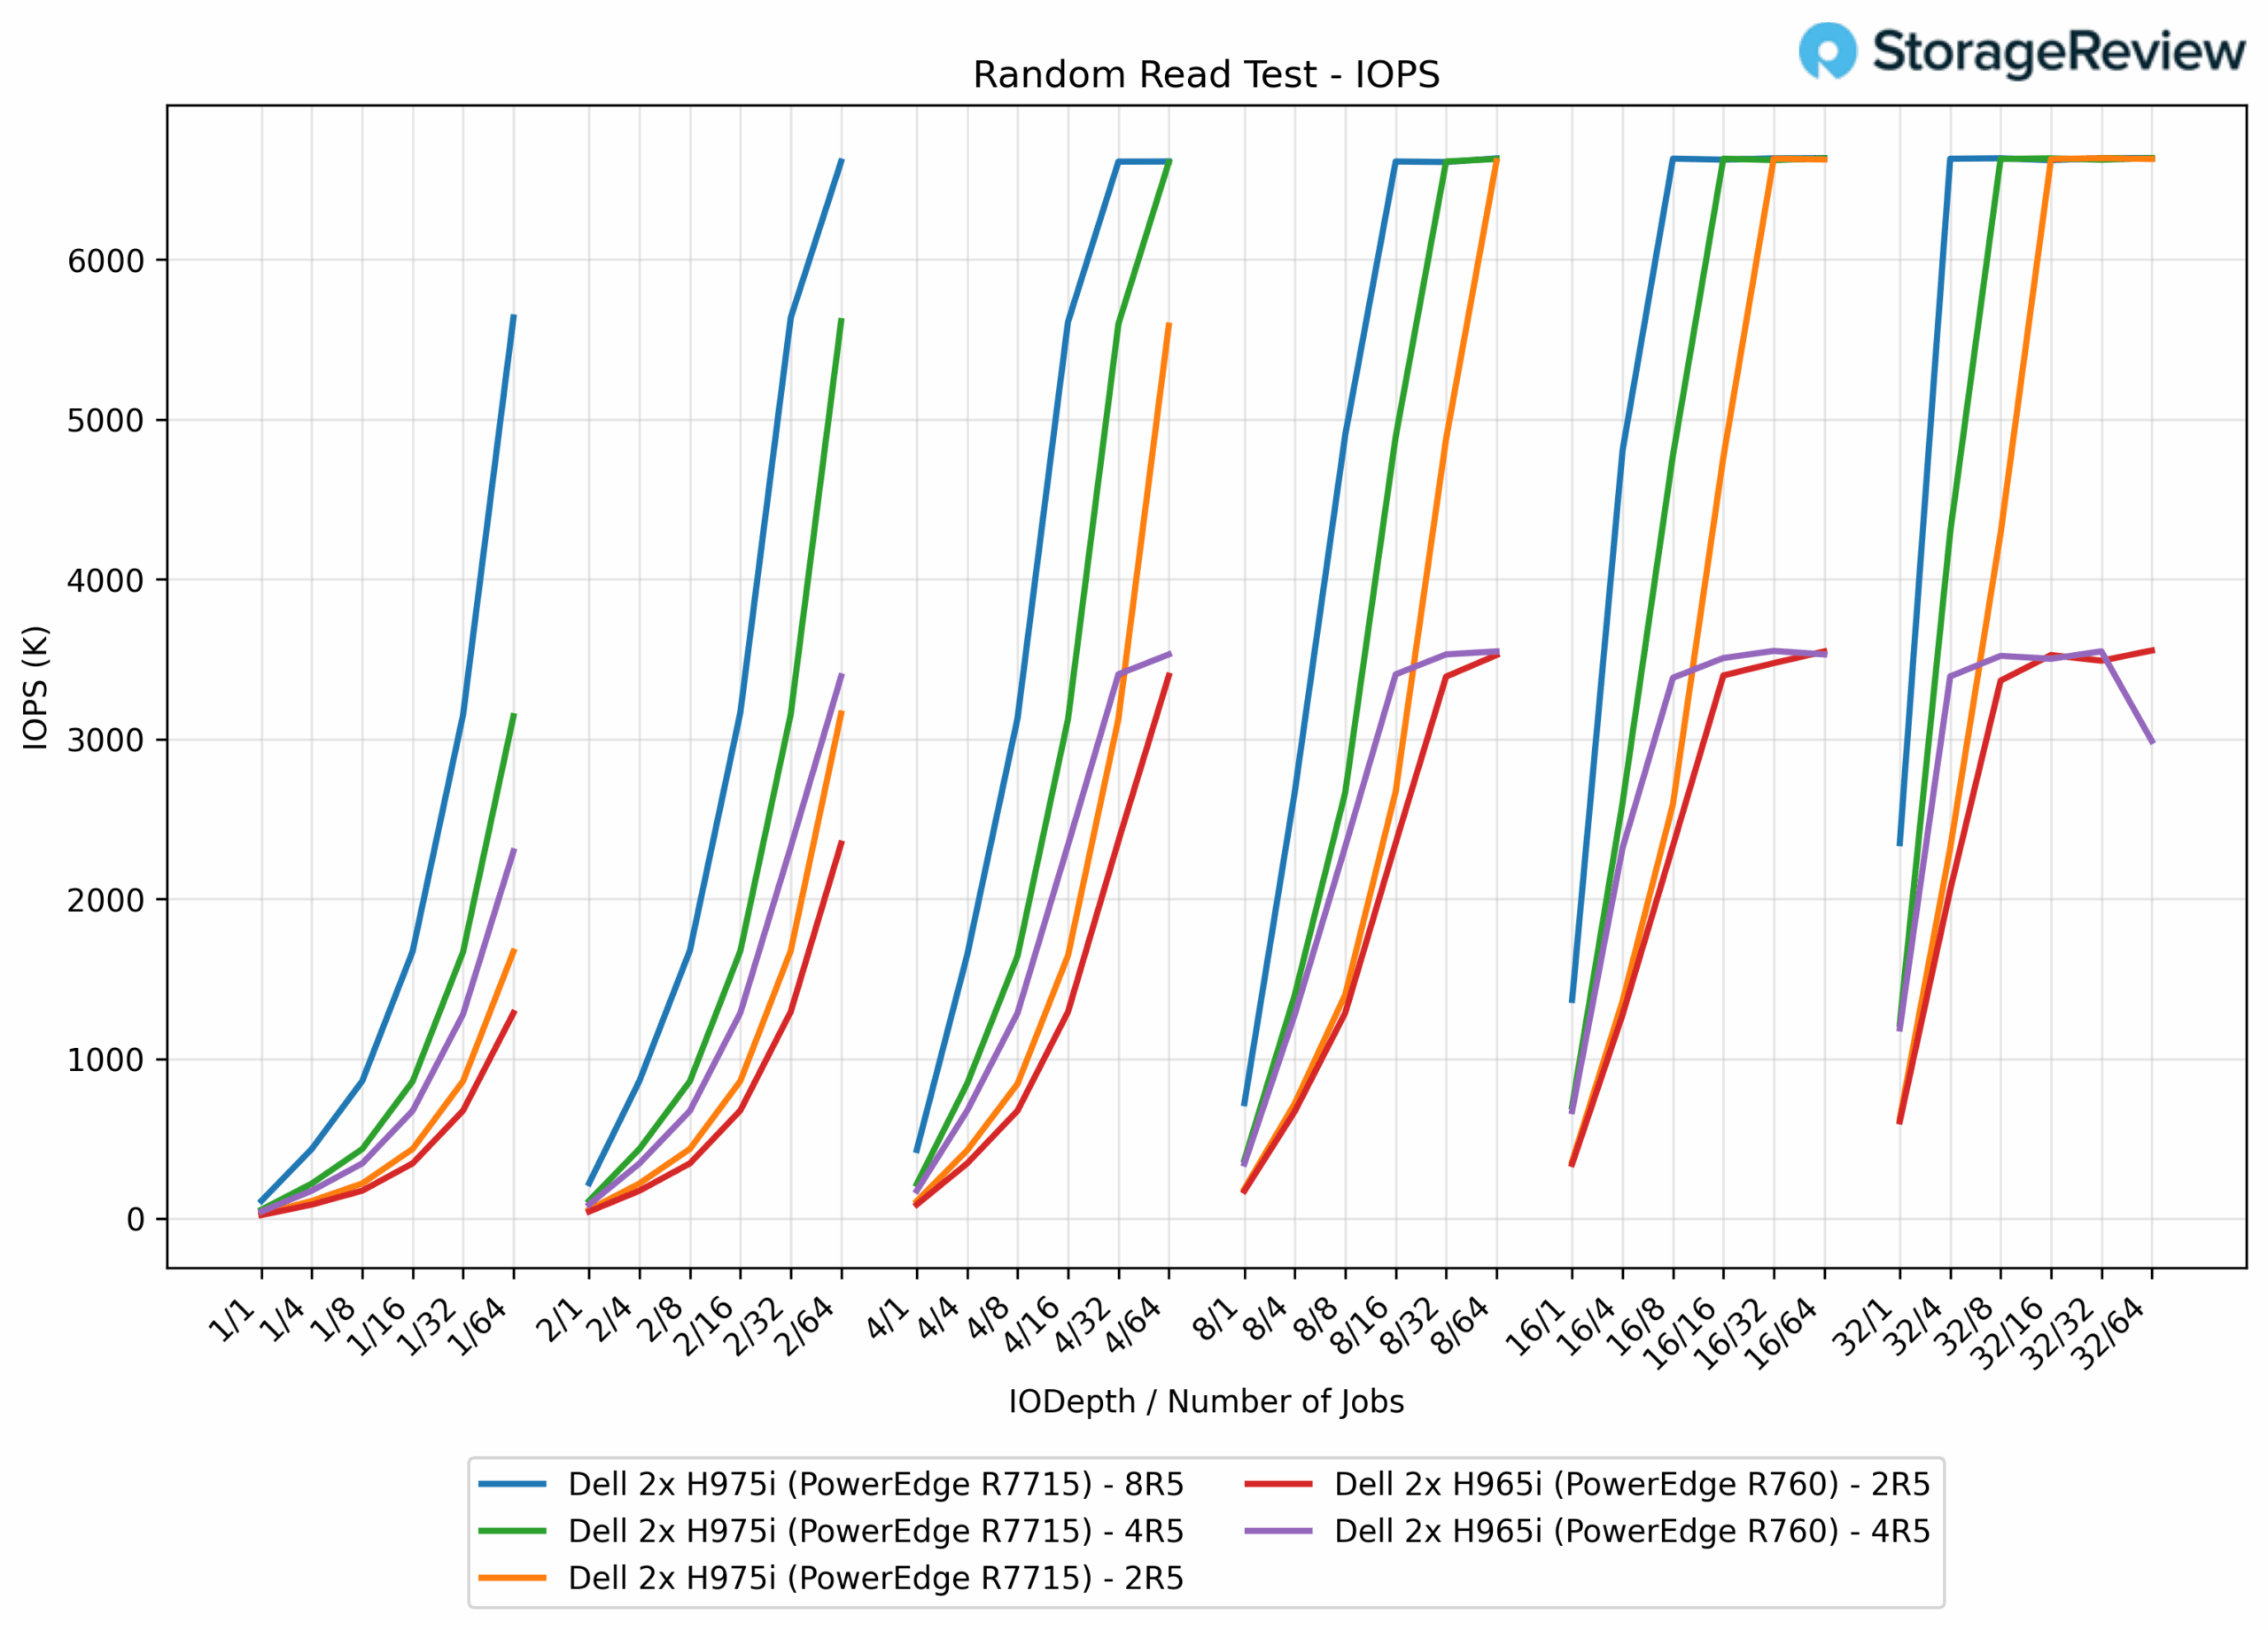
16K 랜덤 읽기에서 PERC H965i 구성은 일관된 성능을 제공했으며, 2R5 어레이는 3.55만 IOPS, 4R5 어레이는 3.55만 IOPS를 달성했습니다. PERC H975i 2R5, 4R5, 8R5 구성은 약 6.64만 IOPS로 거의 동일한 최대 성능을 달성했으며, 이는 H87i 세대 대비 965% 향상된 수치입니다.
16k 랜덤 읽기 대기 시간
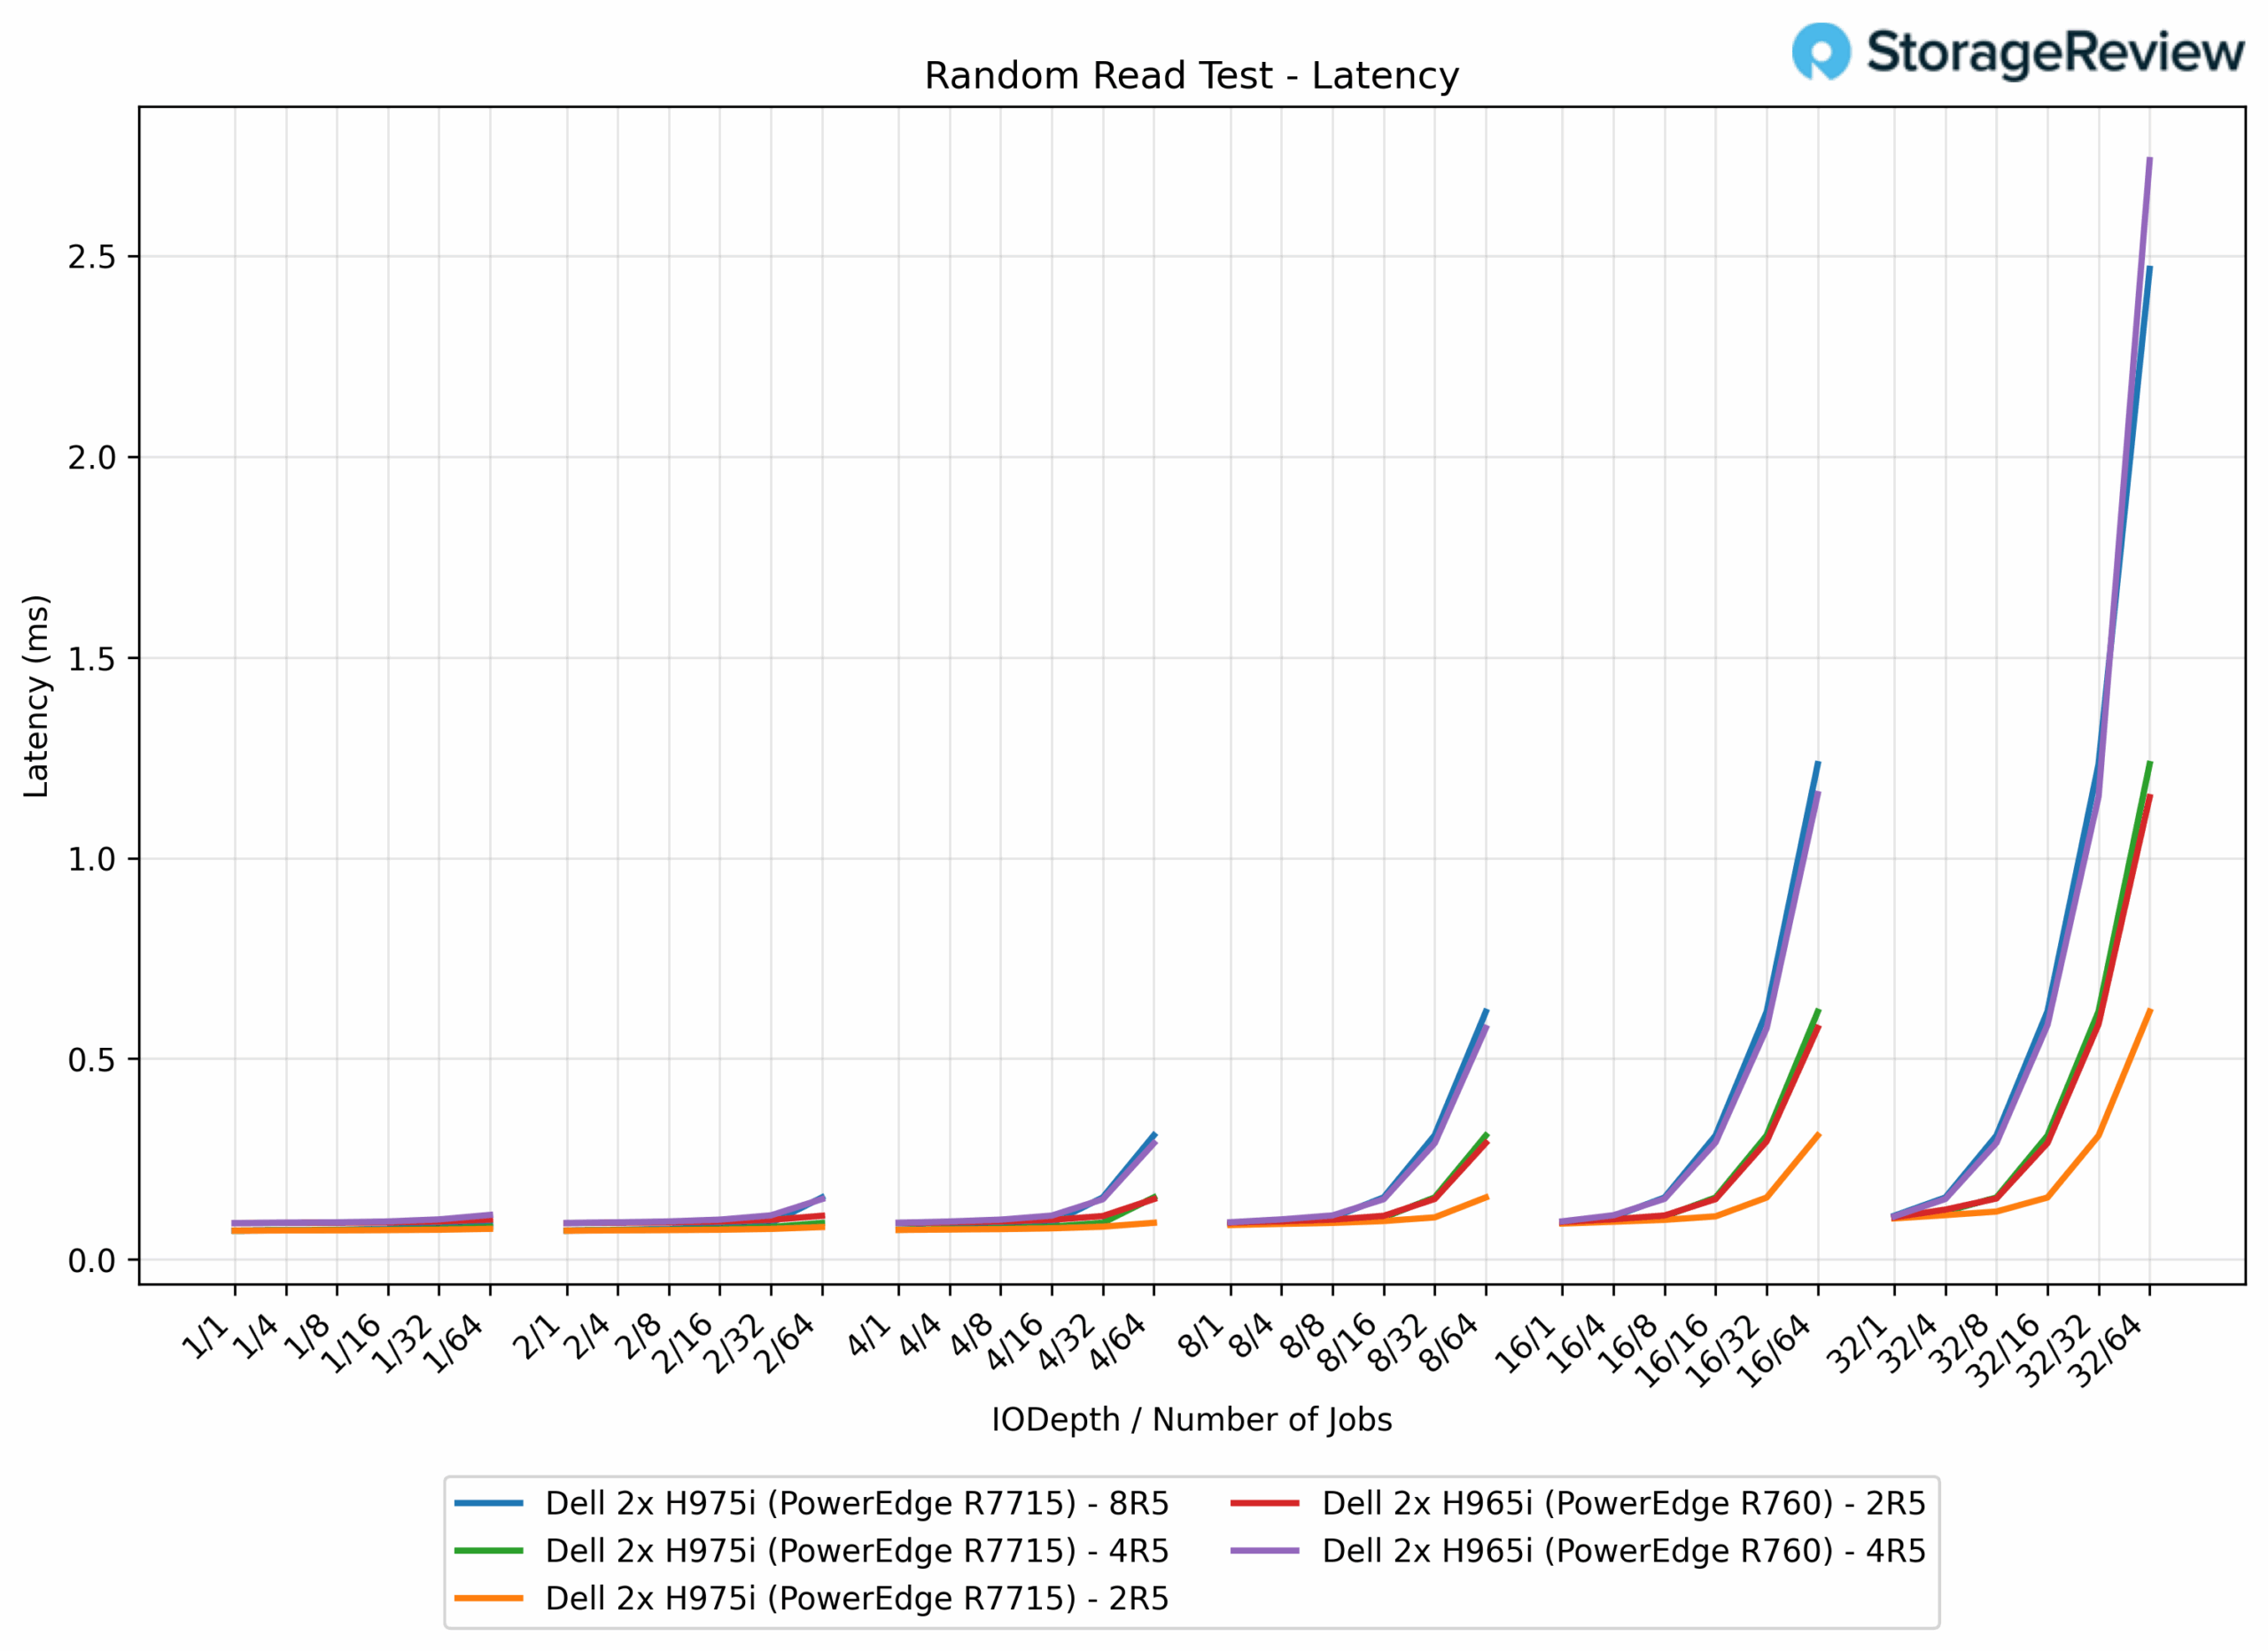
16K 랜덤 읽기에서 H965i 어레이는 0.0906R1.15에서 2~5ms, 2.74R4에서 최대 5ms의 지연 시간을 기록했습니다. H975i는 2R5에서 0.072~0.62ms(46% 감소), 4R5에서 최대 1.23ms(55% 감소), 8R5에서 최대 2.47ms(H10i 965R4 대비 5% 감소)로 지연 시간을 다시 한 번 단축했습니다.
4K 무작위 쓰기 IOPS
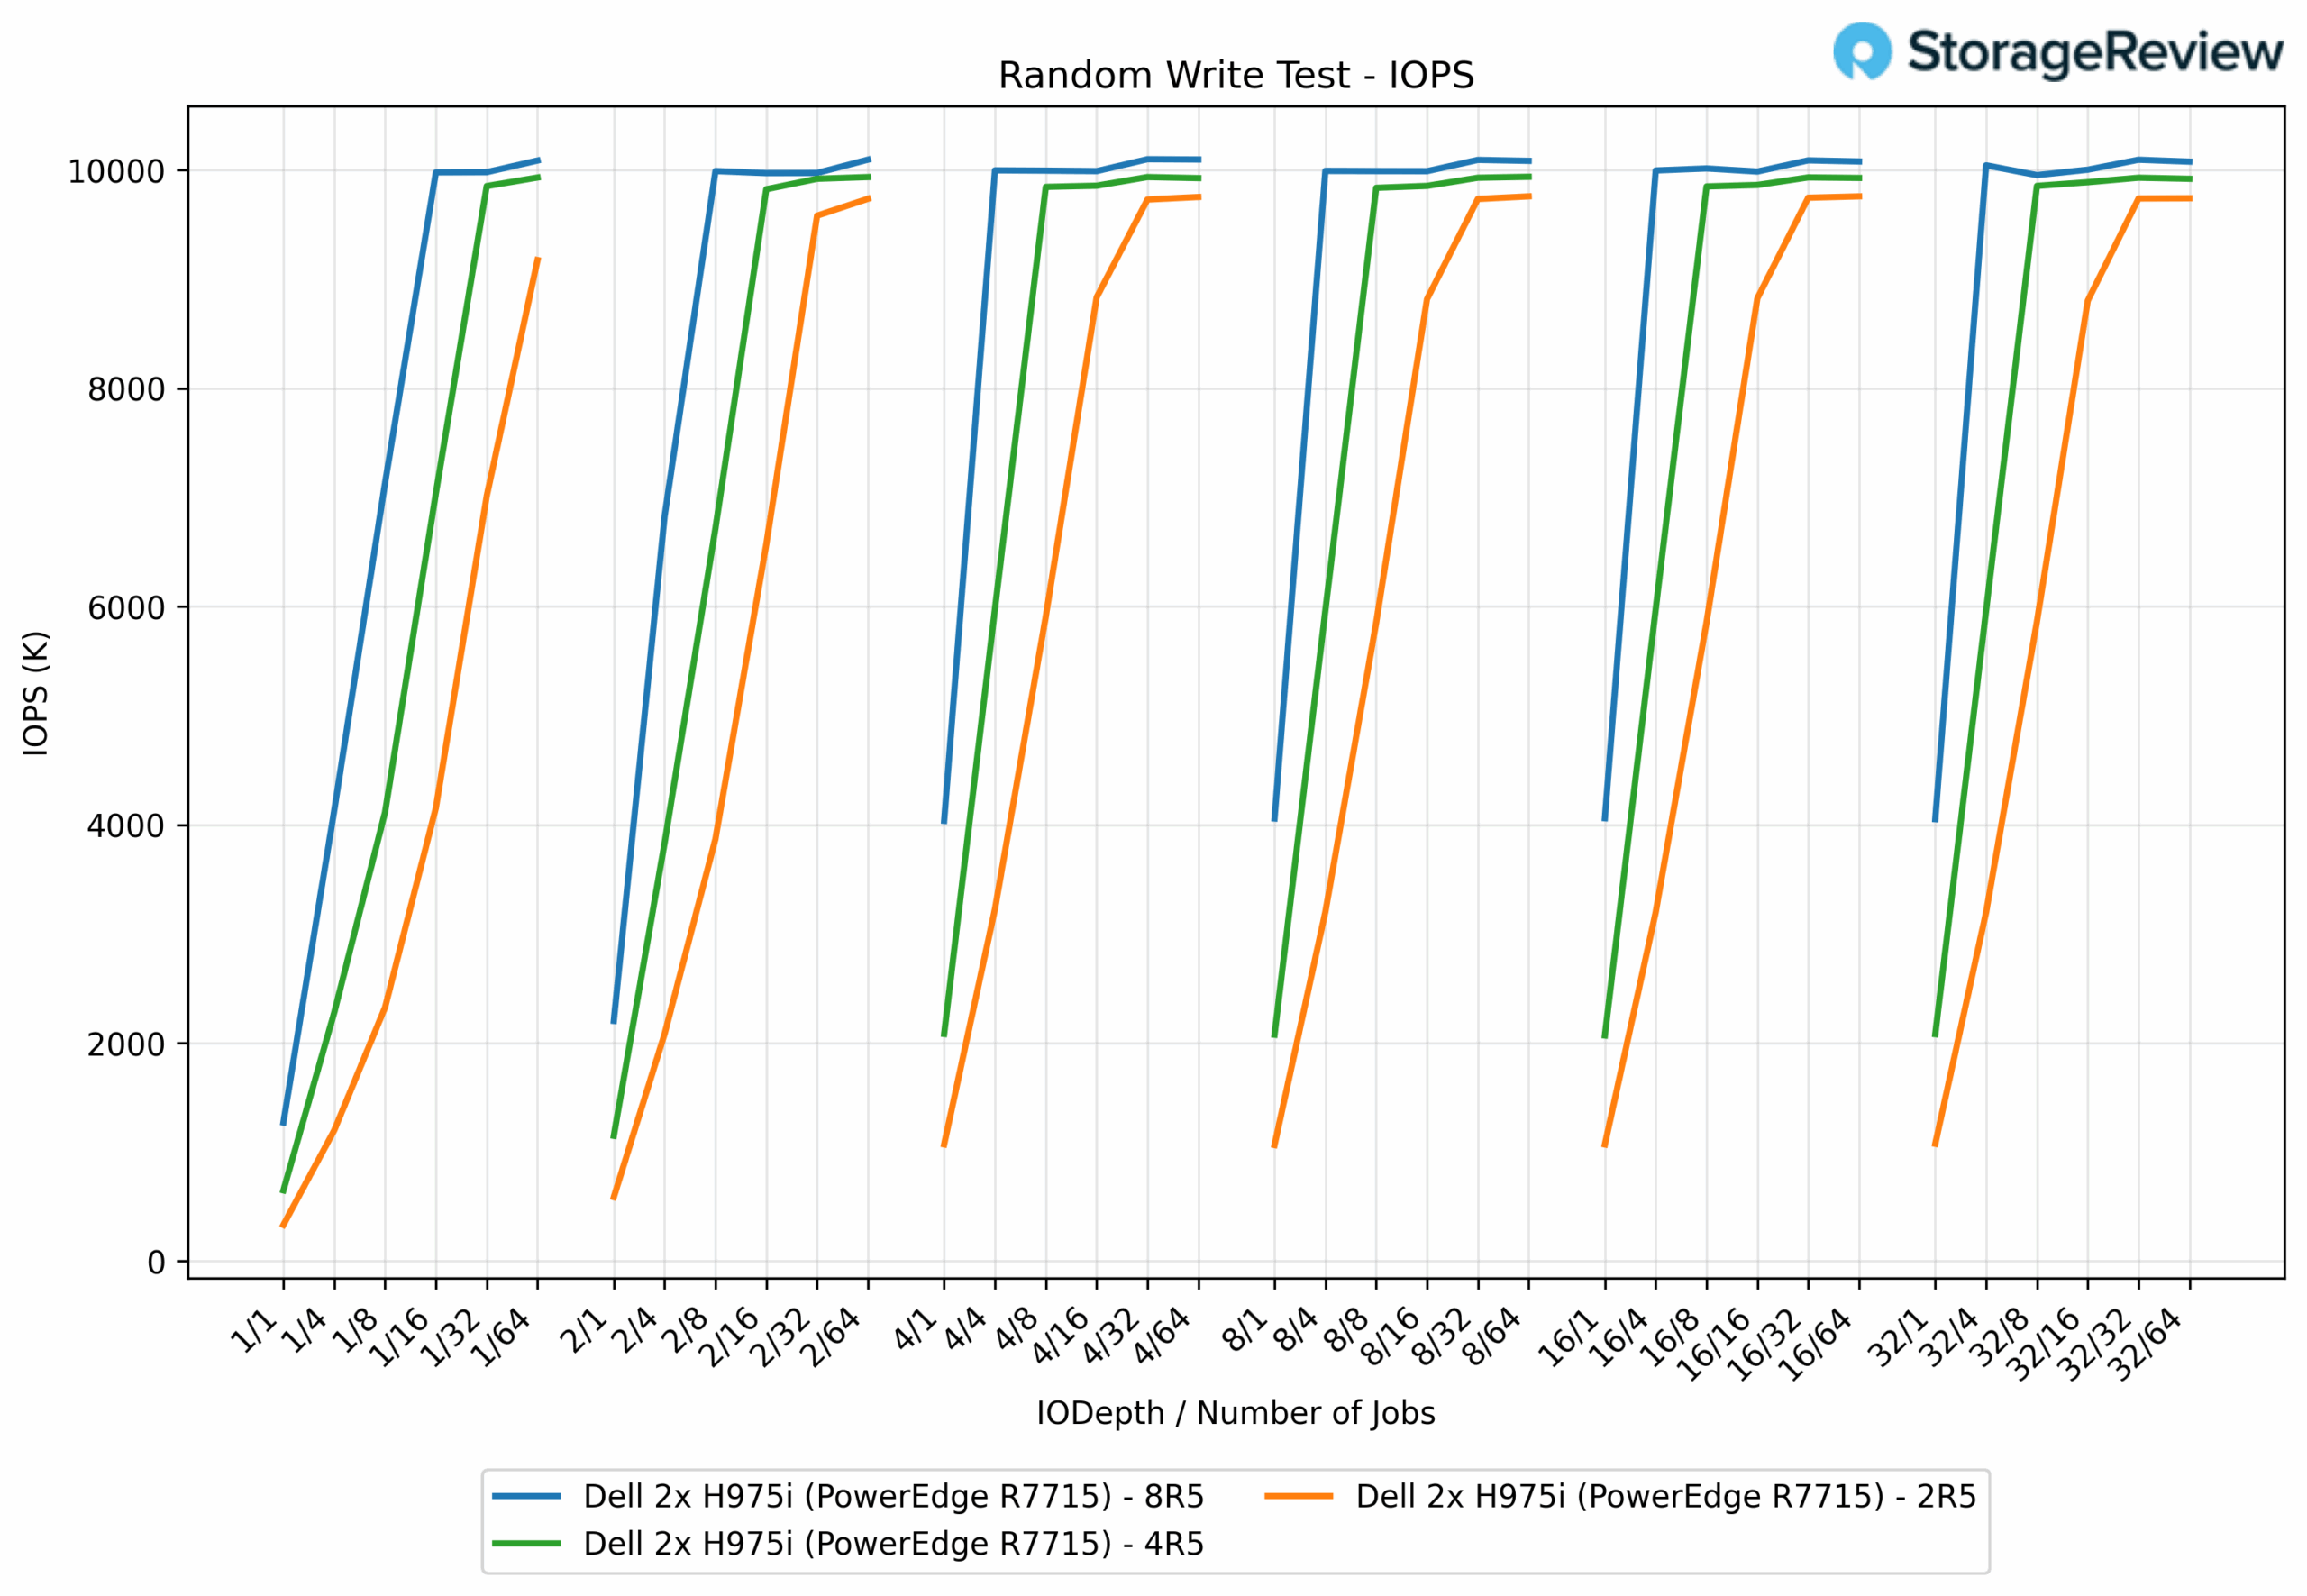
4K 랜덤 쓰기 테스트에서 975R2 구성의 PERC H5i 컨트롤러는 최대 9.76만 IOPS를 달성했고, 4R5 구성은 9.94만 IOPS로 약간 더 높은 성능을 보였습니다. 8R5 구성은 10.10만 IOPS로 가장 높은 성능을 보였습니다.
4K 임의 쓰기 지연 시간
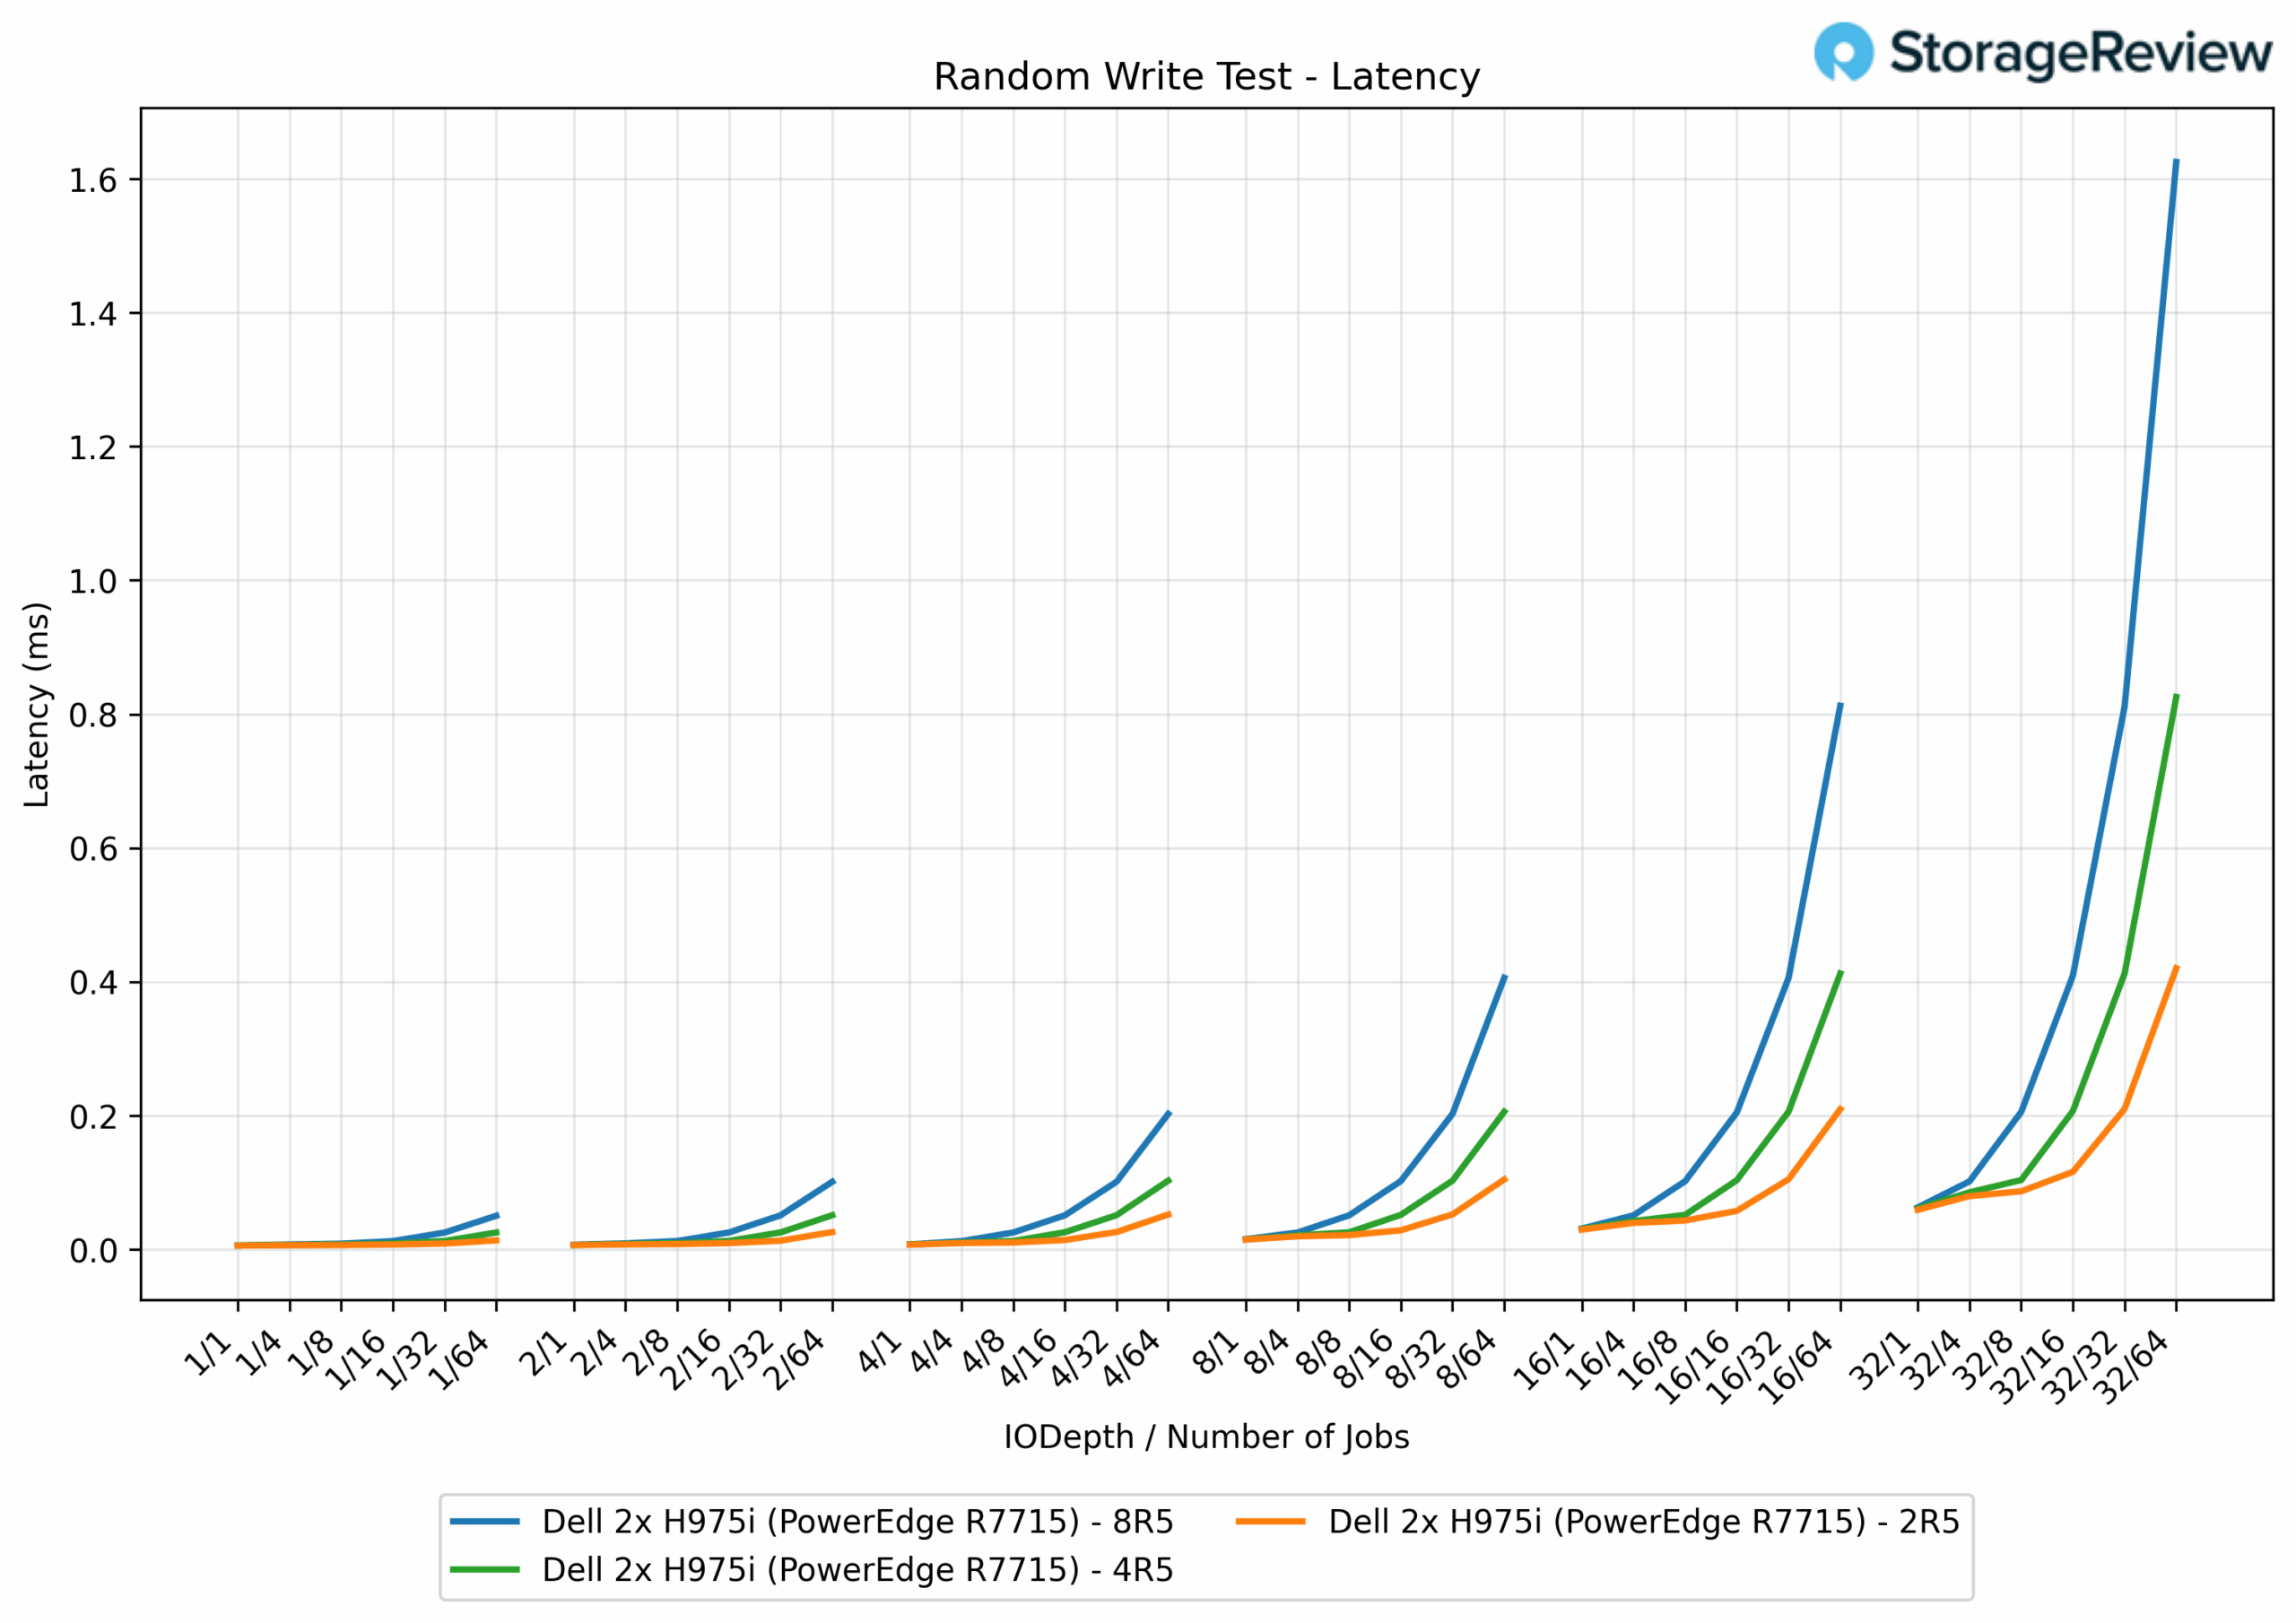
4K 테스트에서는 H975i의 최대 성능만을 평가했습니다. 모든 어레이에서 지연 시간은 매우 우수했습니다. 2R5는 0.0058ms에서 0.47ms, 4R5는 0.88ms, 8R5는 1.63ms였습니다. 이러한 결과는 가장 작은 블록 크기에서 H975i가 2ms 미만의 매우 낮은 지연 시간을 지속적으로 유지했음을 보여줍니다.
4K 무작위 읽기 IOPS
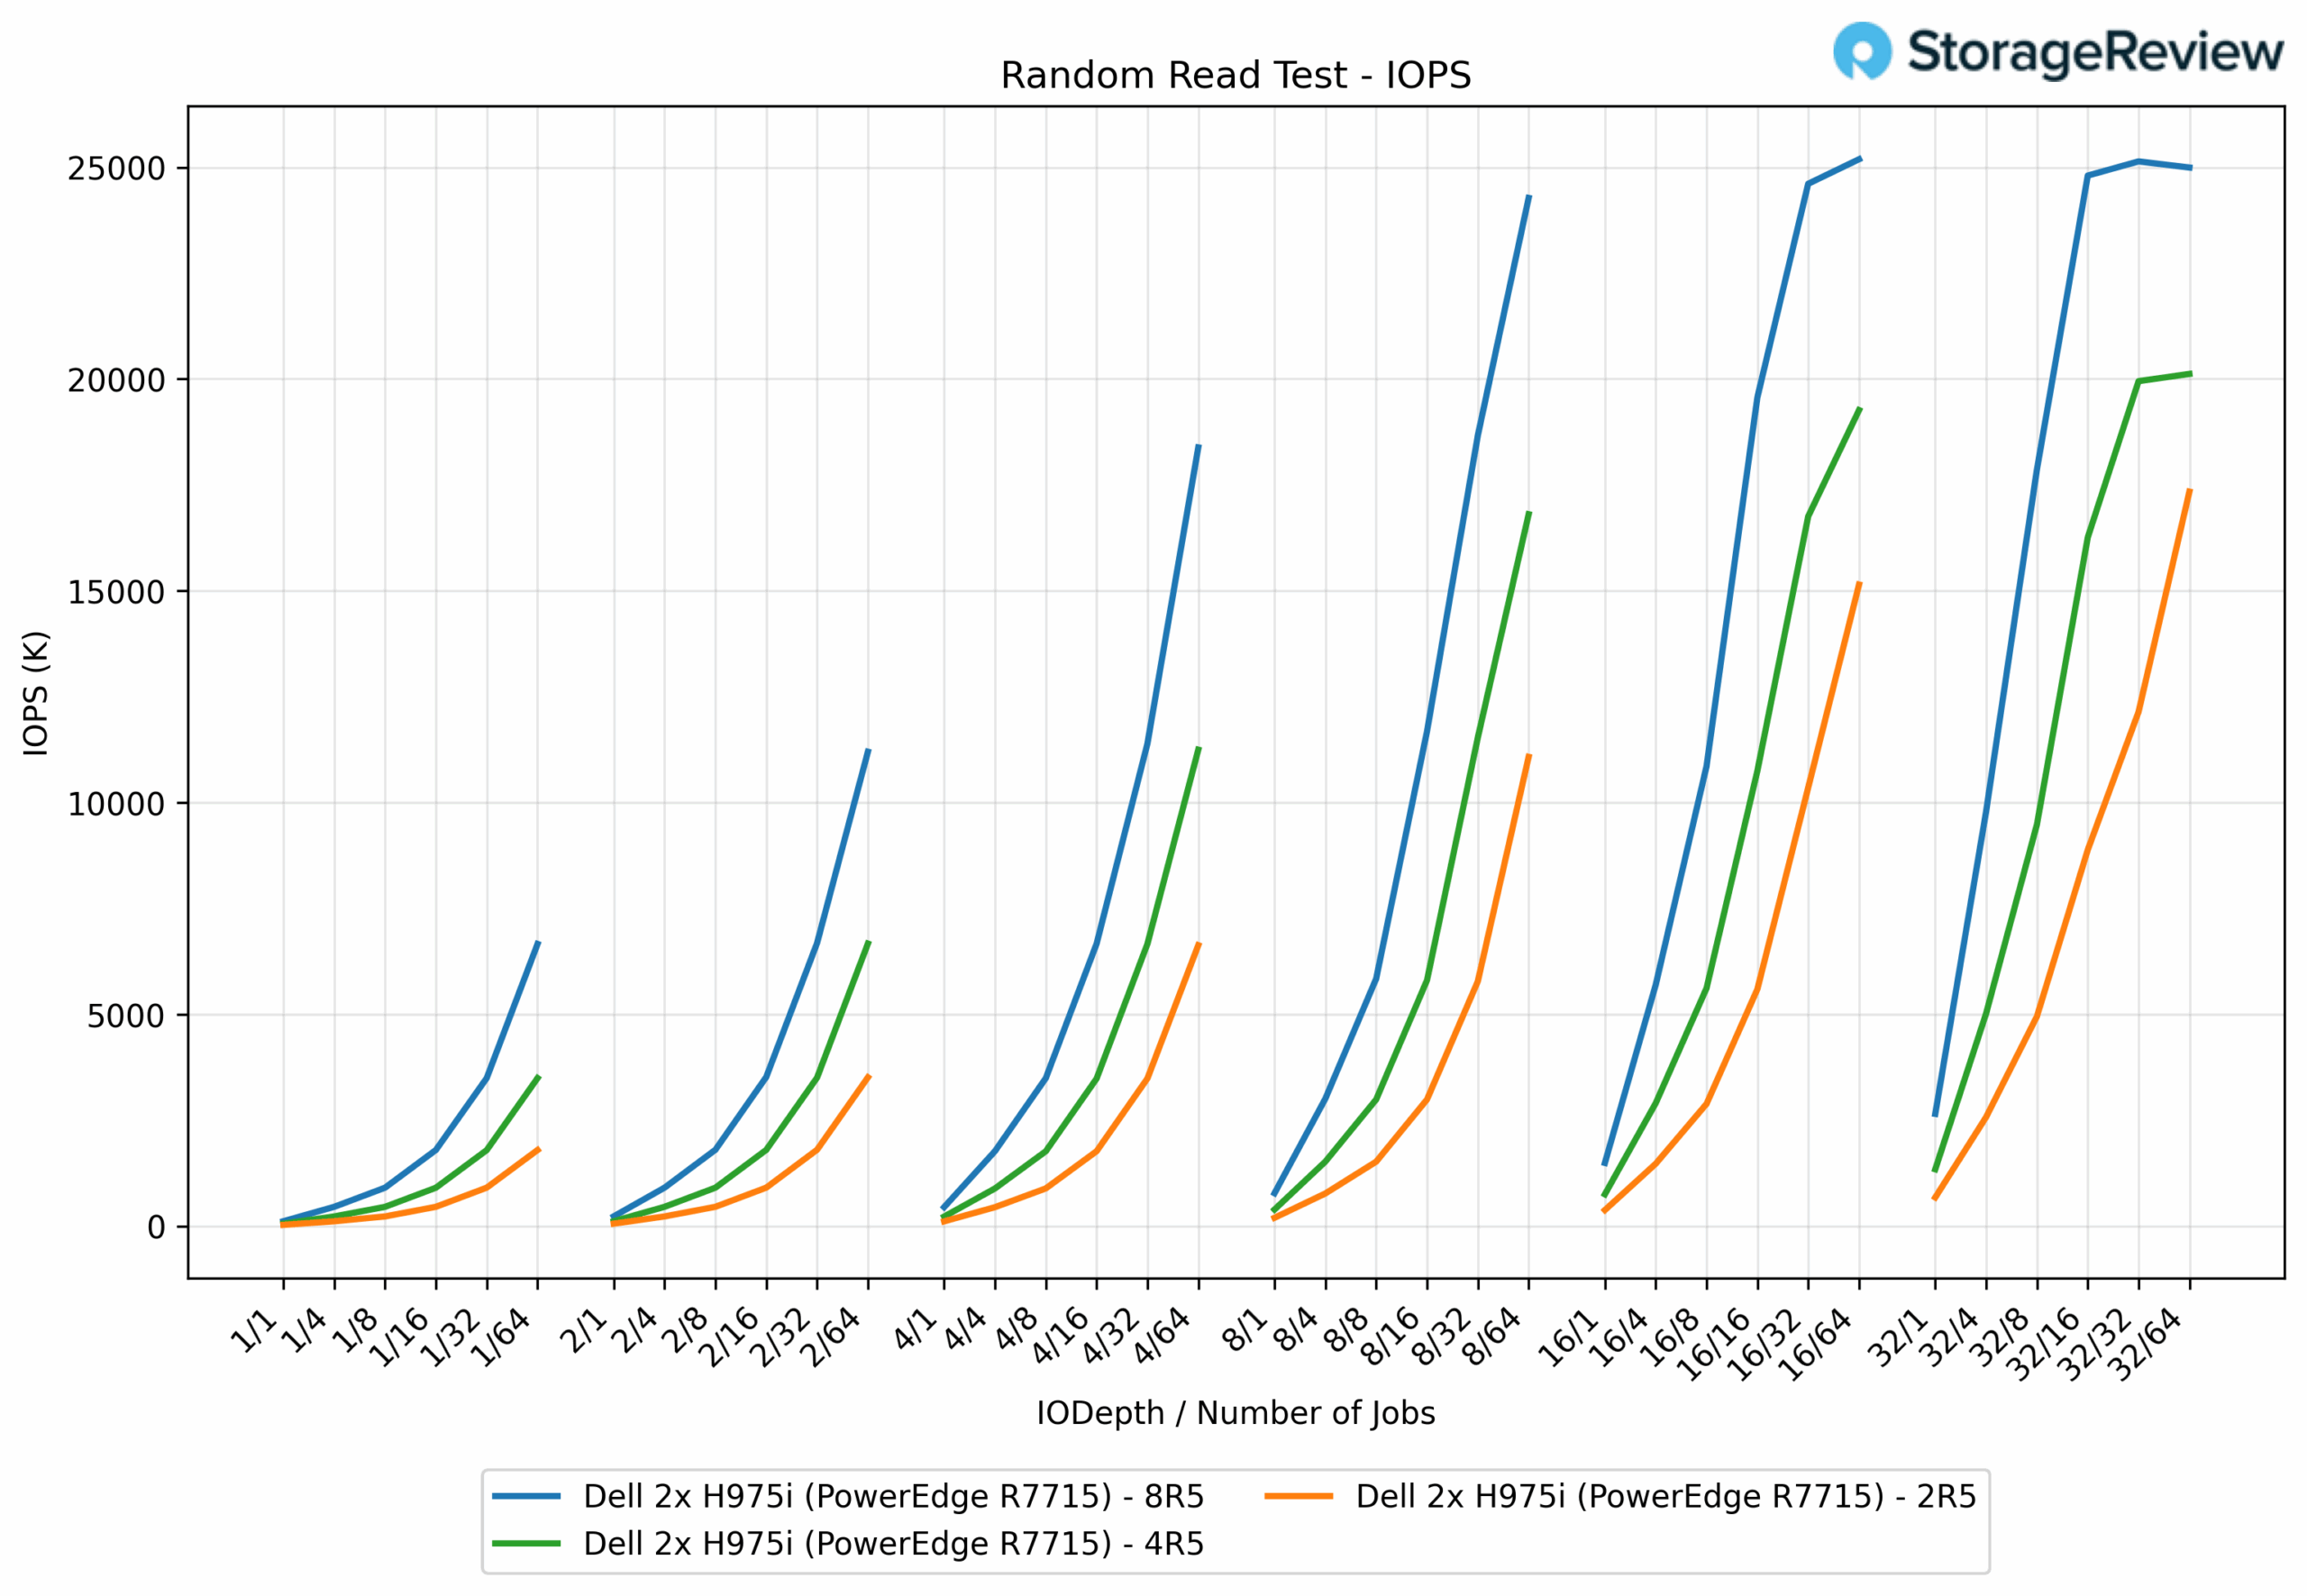
가장 흥미로운 차트 중 하나를 마지막으로 남겨두겠습니다. 4K 랜덤 읽기 테스트에서 975R2 구성의 H5i는 무려 17.3만 IOPS를 기록했습니다. H975i 4R5 구성은 20.1만 IOPS를 달성했고, 8R5 구성은 25.2만 IOPS로 가장 높은 처리량을 기록했습니다.
4K 랜덤 읽기 대기 시간
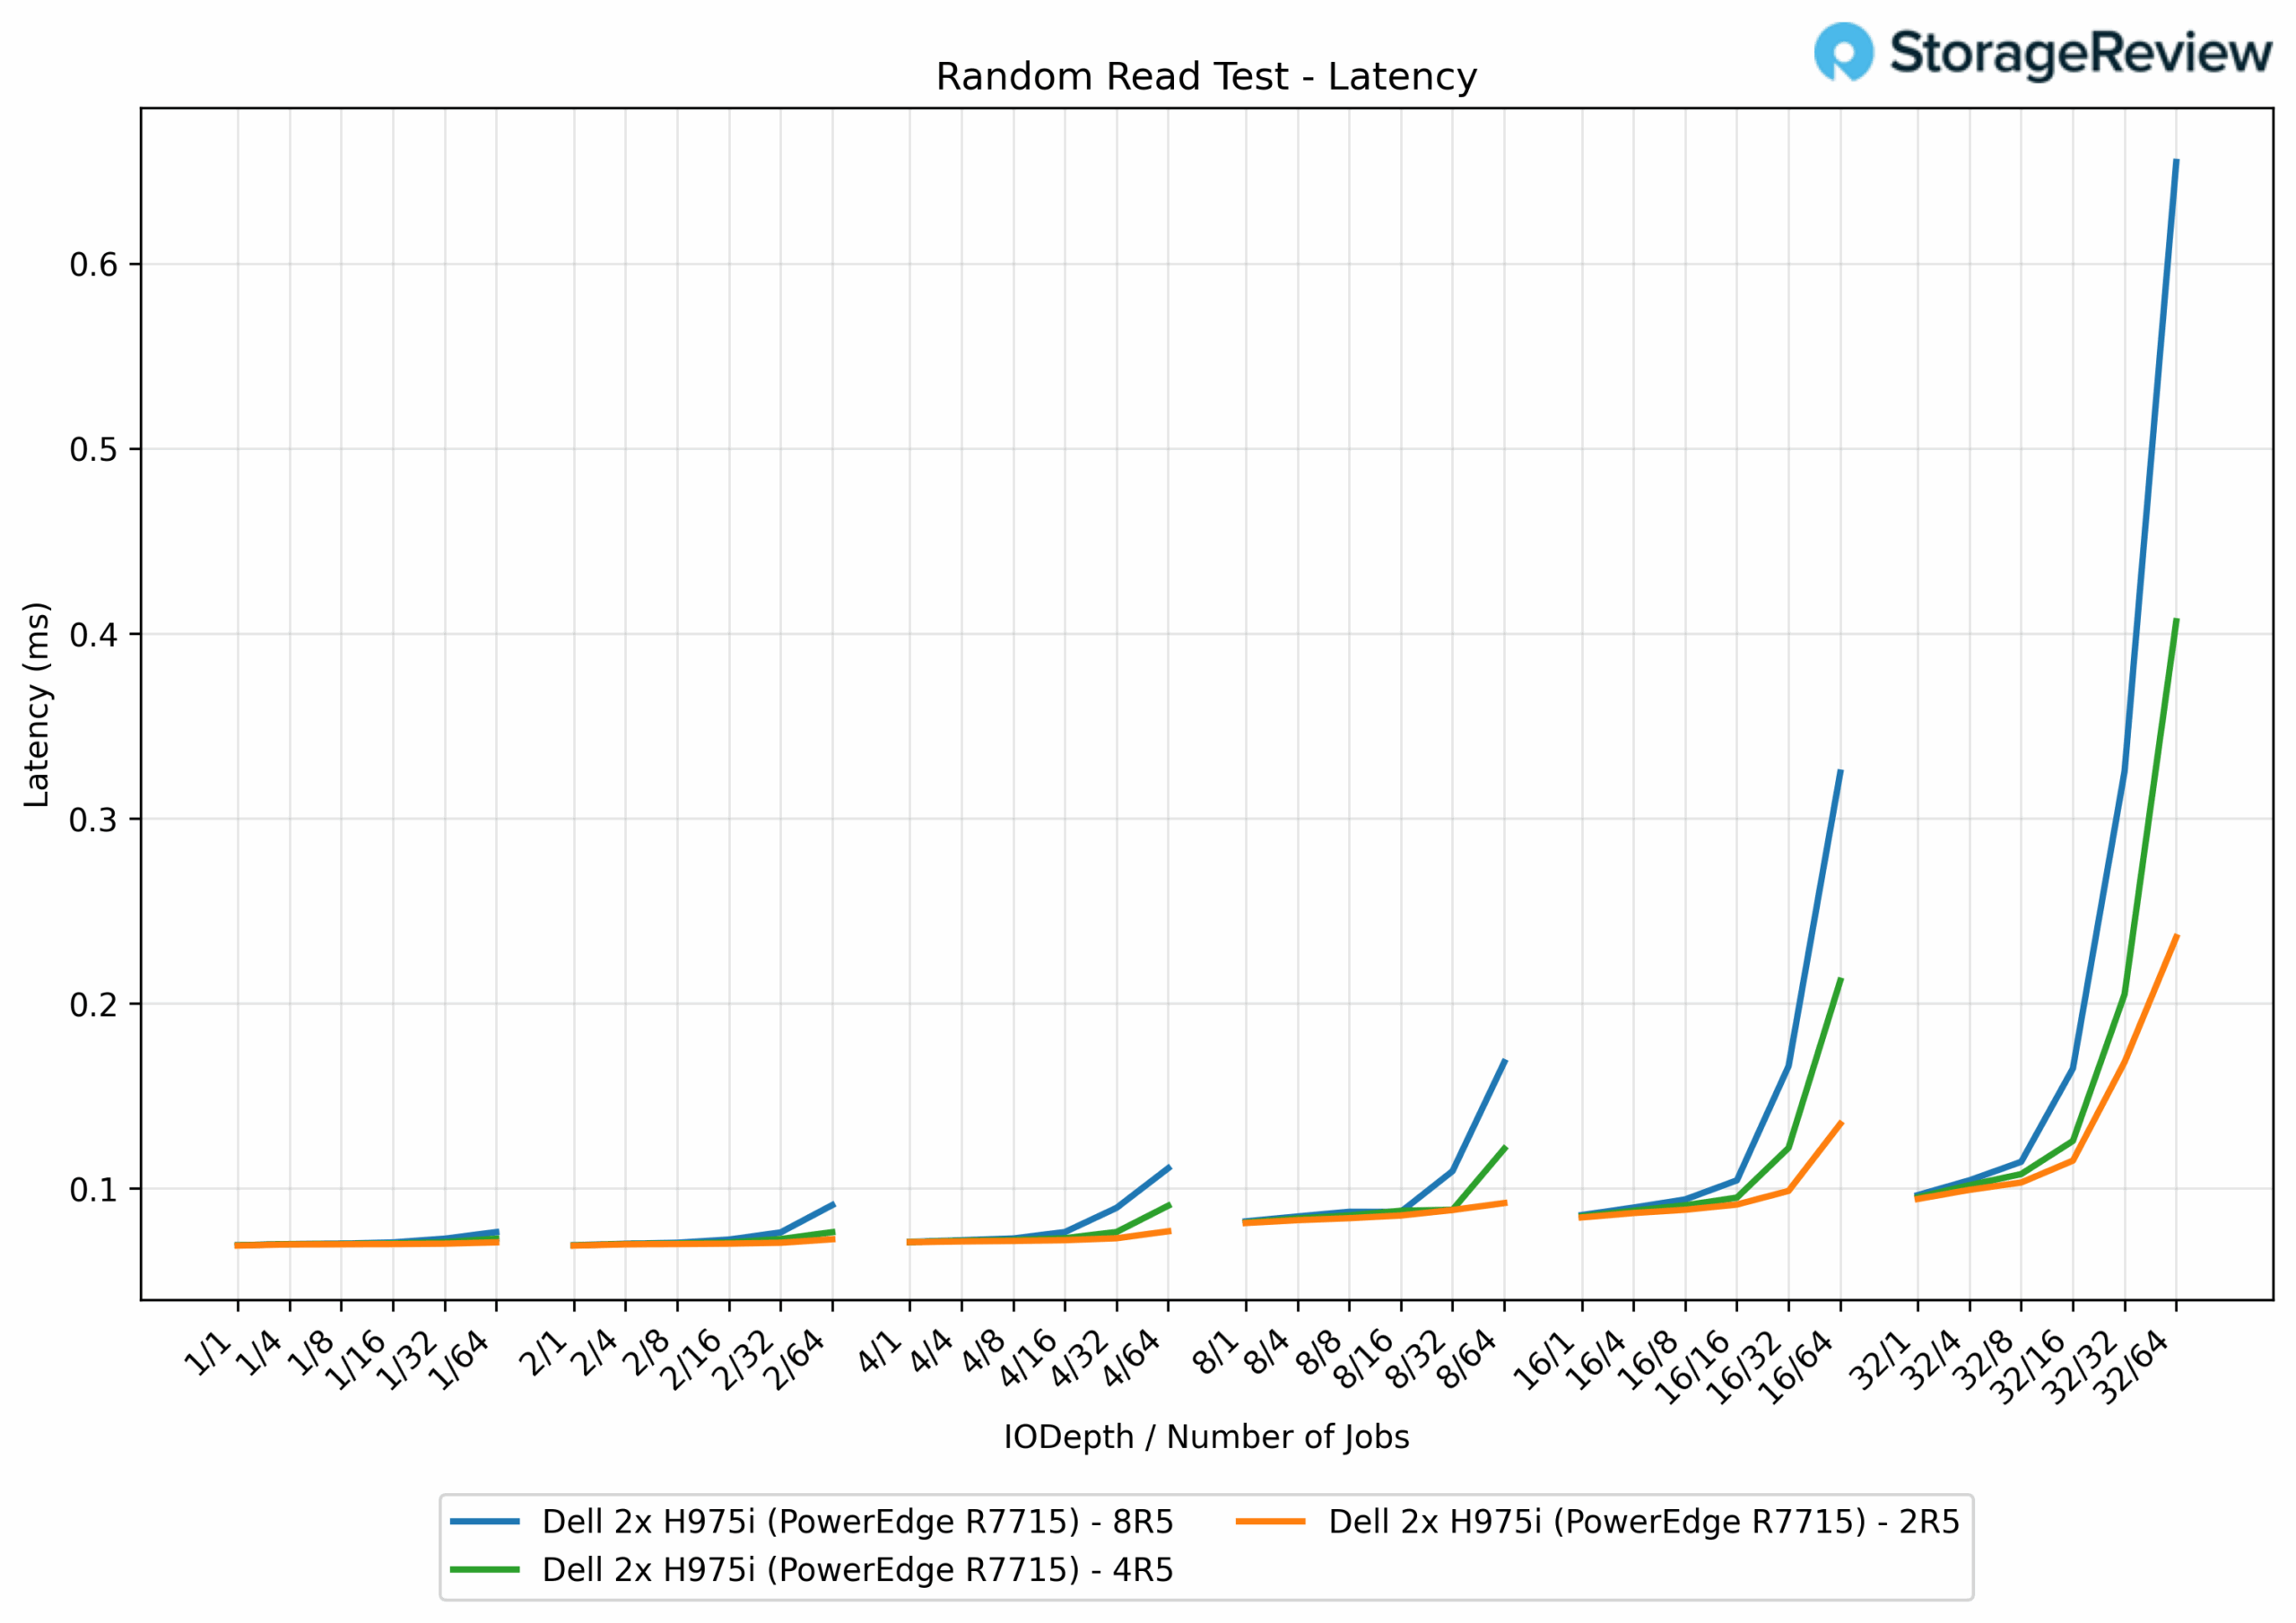
4K 랜덤 읽기에서 모든 어레이에서 지연 시간은 0.069ms에서 시작했으며, 2R5는 0.29ms, 4R5는 0.53ms, 8R5는 0.65ms로 최고치를 기록했습니다. 모든 RAID 그룹에서 낮은 지연 시간 상한선은 H975i가 소규모 랜덤 읽기를 놀라울 정도로 효율적으로 처리할 수 있음을 보여줍니다.
재구축 시 성능 저하 없음
PERC12에 비해 Dell PERC13 컨트롤러는 어레이 재구축 중 모든 워크로드에서 훨씬 더 높은 처리량을 제공합니다. 순차 읽기 속도는 53.7GB/s에서 25GB/s로 두 배 이상 향상되었으며(114.7% 증가), 순차 쓰기 속도는 68GB/s에서 14.6GB/s로 363.7% 증가했습니다. 소규모 블록 성능은 이러한 격차를 더욱 벌립니다. 4K 랜덤 읽기는 17.33만 IOPS에서 4.68만 IOPS로 270.4% 증가했고, 4K 랜덤 쓰기는 5.33만 IOPS에서 0.48만 IOPS로 1013.1% 증가했습니다. 간단히 말해, PERC13은 재구축으로 인한 영향을 최소화하고 가장 집중적인 유지 관리 기간 동안에도 호스트 헤드룸을 유지합니다.
| 작업량 | 듀얼 PERC 12(2 × RAID5) – 재구축 | 듀얼 PERC 13(2 × RAID5) – 재구축 | % 개선 |
|---|---|---|---|
| 순차 읽기 대역폭 | 25(GB/초) | 53.7(GB/초) | 114.7% |
| 순차 쓰기 대역폭 | 14.7(GB/초) | 68(GB/초) | 363.7% |
| 4KB 랜덤 읽기 | 4,676,748(IOPS) | 17,326,888(IOP) | 270.4% |
| 4KB 랜덤 쓰기 | 479,144(IOP) | 5,333,783(IOP) | 1013.1% |
작업 부하를 늦추지 않고 빠르게 재구축
Dell은 또한 복원력과 재구축 성능 면에서도 엄청난 향상을 이루었다고 주장하며, PERC80에서 테라바이트당 12분 이상 걸리던 어레이 재구축 시간이 PERC10에서는 테라바이트당 13분으로 단축되었다고 밝혔습니다. 이러한 속도는 위험 발생 가능성을 낮추고 컨트롤러의 하드웨어 XOR 엔진, 캐시 가속, 데이터 경로 최적화의 완성도를 보여줍니다.
RAID5 재구축 테스트에서 PERC13은 컨트롤러가 재구축 우선순위를 지정할 수 있도록 설정했을 때 PERC12보다 일관되게 짧은 재구축 시간을 보였지만, 쓰기 부하가 매우 높을 경우 이러한 이점이 상쇄될 수 있다는 점에 유의해야 했습니다. 우선순위 재구축을 활성화하면 컨트롤러는 재구축 작업에 리소스를 우선적으로 할당합니다. 이를 통해 PERC13 컨트롤러는 순차적 읽기 부하 상황에서 재구축 시간을 크게 단축할 수 있었습니다. 호스트 부하가 가장 낮을 때(125MB/s) 재구축 시간은 11.53분/TiB에서 5.32분/TiB로 감소했습니다. 가장 높은 부하에서도 재구축 시간은 16.96분/TiB에서 7.73분/TiB로 단축되었으며, 훨씬 높은 호스트 읽기 속도(22.4GB/s 대비 60GB/s)를 유지했습니다.
순차 쓰기 부하 조건에서 PERC13은 경부하 리빌드 속도를 7.51에서 4.98 Min/TiB로 향상시켰지만, 가장 높은 쓰기 부하 조건에서는 리빌드 시간이 15.29 Min/TiB로 증가하여 R760의 13.09 Min/TiB보다 더 길어졌습니다. 이는 두 가지 측면에서 살펴볼 수 있습니다. PERC13의 리빌드 속도는 더 느렸지만, PERC13보다 거의 운영 환경 수준의 쓰기 워크로드 속도(12GB/s vs 62.5GB/s)를 유지했습니다. 다시 말해, 우선순위 리빌드는 특히 읽기 작업이 많은 작업에서 더 빠른 리빌드 윈도우라는 약속을 지킵니다. 단, 시스템이 동시에 매우 많은 쓰기 작업을 수행하는 경우는 예외입니다. PERC12의 높은 호스트 처리량 덕분에 리빌드 시간이 더 길어질 수 있습니다.
| 시나리오 | 듀얼 PERC 12(2 × RAID5) | 듀얼 PERC 13(2 × RAID5) | ||
|---|---|---|---|---|
| 최소/TiB | 총 대역폭 | 최소/TiB | 총 대역폭 | |
| 순차적 읽기 – 가벼운 활동 | 11.53 | 0.125 GB / 초 | 5.32 | 0.125 GB / 초 |
| 순차적 읽기 - 활동이 많음 | 16.96 | 22.4 GB / 초 | 7.73 | 60 GB / 초 |
| 순차적 쓰기 – 가벼운 활동 | 7.51 | 0.125 GB / 초 | 4.98 | 0.125 GB / 초 |
| 순차적 쓰기 - 활동이 많음 | 13.09 | 12 GB / 초 | 15.29 | 62.5 GB / 초 |
우선순위 호스트로 전환하면 재구축 속도는 희생하더라도 애플리케이션 I/O를 의도적으로 보호할 수 있으며, 읽기 성능은 비슷하지만 쓰기 성능은 더욱 미세하게 향상됩니다. 읽기 워크로드에서 PERC13 컨트롤러는 이전 PERC12보다 훨씬 빠르게 재구축을 완료하여 경부하 시간은 11.23에서 6.70 Min/TiB로, 중부하 시간은 38.44에서 19.75 Min/TiB로 단축되었습니다. 동시에 더 많은 호스트 트래픽(중부하 지점에서 46.2GB/s 대비 24.1GB/s)을 처리합니다. 쓰기 워크로드의 경우, 우선순위 호스트는 프로덕션 성능을 최우선으로 유지합니다. PERC13은 최소 부하(7.80 Min/TiB 대비 5.67 Min/TiB)에서 더 빠르지만, 최대 쓰기 부하에서는 재구축 속도가 32.81 Min/TiB로 확장되는 반면, PERC12는 25.40 Min/TiB입니다. 재구축 시간은 약간 늘어나지만 PERC13은 호스트에 훨씬 더 높은 호스트 쓰기 대역폭(62.4GB/s 대 12.5GB/s)을 제공합니다.
| 시나리오 | 듀얼 PERC 12(2 × RAID5) | 듀얼 PERC 13(2 × RAID5) | ||
|---|---|---|---|---|
| 최소/TiB | 총 대역폭 | 최소/TiB | 총 대역폭 | |
| 순차적 읽기 – 가벼운 활동 | 11.23 | 0.125 GB / 초 | 6.70 | 0.125 GB / 초 |
| 순차적 읽기 - 활동이 많음 | 38.44 | 24.1 GB / 초 | 19.75 | 46 GB / 초 |
| 순차적 쓰기 – 가벼운 활동 | 7.80 | 0.125 GB / 초 | 5.67 | 0.125 GB / 초 |
| 순차적 쓰기 - 활동이 많음 | 25.40 | 12.5 GB / 초 | 32.81 | 62.4 GB / 초 |
배포 관점에서 보면 선택은 간단합니다. 취약성 발생 시간을 최소화해야 하고 I/O 우선순위를 낮춰도 되는 경우, PERC13의 Rebuild Priority 기능은 특히 읽기 작업이 많은 시나리오에서 재구축 시간을 단축합니다. 애플리케이션 응답성 유지가 불가피한 경우, Priority Host가 바로 그 역할을 합니다. PERC13은 읽기 재구축에 탁월한 성능을 발휘하지만, 쓰기 작업이 많은 경우에는 재구축 시간이 절대적으로 중요한 경우 스케줄링이나 적절한 스로틀링이 필요할 수 있습니다.
맺음말
Dell PERC H975i는 하드웨어 RAID를 NVMe 중심 엔터프라이즈 데이터 센터를 위한 매력적인 솔루션으로 자리매김합니다. JBOD 및 소프트웨어 RAID 구현이 스케일아웃 환경에서 인기를 얻고 있지만, 이러한 접근 방식은 운영상의 복잡성, CPU 오버헤드, 드라이브 장애 발생 시 복구 시간 연장 등의 문제를 야기합니다. H975i는 전용 패리티 엔진, 가속화된 리빌드 작업, 그리고 Dell 인프라 스택 내 통합 관리 기능을 통해 특수 목적의 하드웨어 가속 기능을 제공합니다.
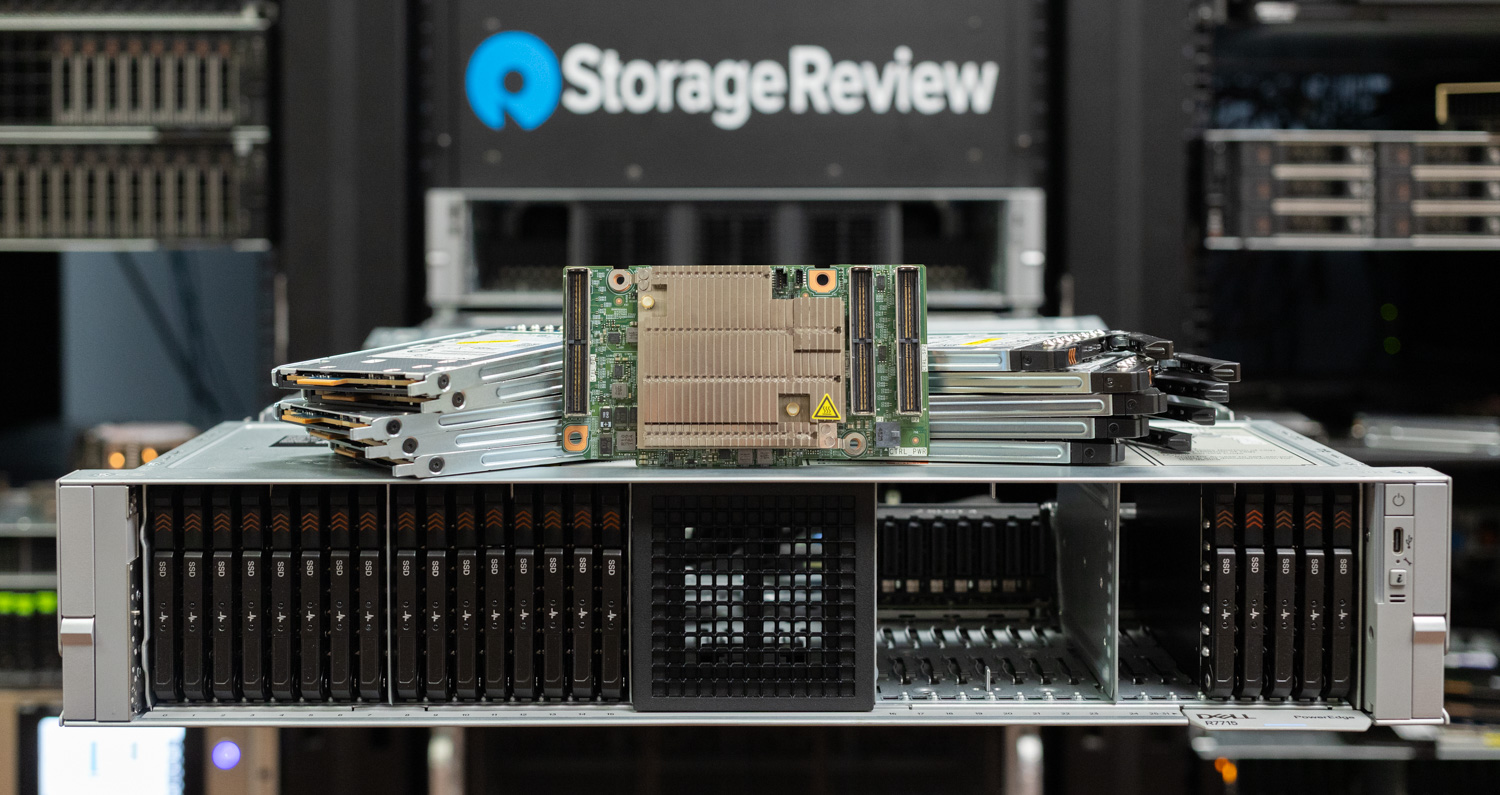
일관된 처리량 특성, 최소 대기 시간 변화, 최대 가동 시간 안정성을 요구하는 AI 및 머신 러닝 워크로드의 경우, 하드웨어 관리형 RAID 아키텍처는 중요한 호스트 처리 리소스를 소모하지 않고도 계산 성능과 운영 복원력을 모두 제공합니다.
성능 테스트를 통해 아키텍처 개선 사항을 검증한 결과, H975i는 PERC88 세대 대비 318% 더 높은 순차 읽기 대역폭과 12% 더 높은 순차 쓰기 대역폭을 제공합니다. 최대 103GB/s 처리량과 25.2만 IOPS의 측정 결과는 데이터 집약적인 워크로드를 위한 컨트롤러의 성능을 보여줍니다. 또한, 복구 작업 중 테라바이트당 80분 이상 걸리던 재구축 시간이 테라바이트당 10분으로 단축되었으며, 운영 환경에 가까운 성능 수준을 유지했습니다.
H975i의 PCIe Gen5 x16 인터페이스와 전면 통합 설계는 스토리지 경합 없이 고밀도 GPU 구축을 지원하여 다중 가속기 구성에서 예측 가능한 성능 확장을 가능하게 합니다. 많은 PowerEdge 서버가 H965i와 H975i RAID 컨트롤러를 모두 제공하므로, 새로운 워크로드를 활용하는 조직은 최신 제품을 선택해야 합니다. 대규모 AI 인프라를 구축하는 경우, H975i는 컴퓨팅 리소스 활용도를 극대화하는 데 필요한 고대역폭, 저지연 스토리지 기반을 제공합니다.


 아마존