

인텔의 프로젝트 배틀매트릭스는 접근 가능한 AI 인프라를 위한 매력적인 솔루션으로, 다중 GPU 설계를 통해 워크스테이션 섀시에 상당한 GPU 메모리 용량을 제공합니다. 코드명 배틀메이지 아크 프로 B60 프로페셔널 GPU를 기반으로 구축된 이 플랫폼은 클라우드 구독 비용이나 데이터 개인정보 보호 문제 없이 대규모 언어 모델을 로컬에 배포하려는 조직을 대상으로 합니다. 단일 시스템 내 8개의 GPU에 최대 192GB의 VRAM을 제공하는 배틀매트릭스는 AI 추론 워크로드를 위한 다른 프로페셔널 GPU 생태계보다 비교적 비용 효율적인 대안으로 자리매김했습니다.
Instagram에서이 게시물보기
배틀매트릭스를 기존 워크스테이션 구성과 차별화하는 것은 인텔의 듀얼 GPU 카드 설계입니다. 이 설계는 PCIe 분기 지원이 필요한 단일 PCB에 두 개의 B60 GPU를 탑재합니다. 이러한 밀도 최적화 방식을 통해 서버 마더보드가 필요한 구성도 가능하며, Arc Pro B60은 GPU당 24GB의 GDDR6 메모리를 탑재하여 메모리 집약적인 트랜스포머 모델에 특히 적합합니다. 초기 테스트 결과 유망한 잠재력을 보여주지만, 소프트웨어 최적화는 여전히 하드웨어 성능에 미치지 못합니다.
공시
테스트는 Intel LLM Scaler의 개발 브랜치를 포함한 초기 소프트웨어 및 드라이버 개정 버전을 사용하여 수행되었습니다. 또한, 테스트 플랫폼은 Intel의 Xeon 플랫폼이 아닌 AMD EPYC 프로세서를 사용합니다. Intel은 Battlematrix를 Xeon 6 프로세서를 탑재한 Intel 솔루션으로 분류하고 있으며, Intel CPU를 탑재한 프로덕션 시스템은 본 결과보다 더 높은 성능을 보일 수 있습니다. 소프트웨어 성숙도와 플랫폼 최적화는 2026년에 걸쳐 개선될 것으로 예상되므로, 이 결과는 예비적인 결과라고 판단하시기 바랍니다.
사양 및 아키텍처
| 스펙 | 세부 |
|---|---|
| 제품 수집 | Intel® Arc™ Pro B 시리즈 그래픽 |
| 코드 네임 | 전투 마법사 |
| GPU 아키텍처 | Xe2(TSMC N5) |
| Xe-색상 | 20 |
| 렌더 슬라이스 | 5 |
| 광선 추적 장치 | 20 |
| XMX 엔진 | 160 |
| Xe 벡터 엔진 | 160 |
| 그래픽 시계 | 2400 MHz |
| 그래픽 클럭(LP 모드) | 2000 MHz |
| GPU FP32 성능 | 12.28 TFLOPS |
| GPU 피크 TOPS(INT8) | 197 |
| 총 보드 전력(TBP) | 200 승 |
| 메모리 | 24 GB GDDR6 |
| 메모리 인터페이스 | 192-bit |
| 메모리 대역폭 | 456 GB / 초 |
| 메모리 속도 | 19Gbps |
| PCIe 인터페이스 | PCIe 5.0 x8 |
| 지원되는 디스플레이 | 4 |
| 그래픽 출력 | HDMI 2.1 | DP2.1(UHBR 13.5) | DP2.1(UHBR 10) |
| 최대 해상도(HDMI) | 7680 x 4320 @ 120Hz |
| 최대 해상도(DP) | 7680 x 4320 @ 60Hz |
| HDMI 가변 재생 빈도 | 가능 |
| VESA 적응 형 동기화 | 가능 |
| H.264 / H.265 / AV1 인코딩/디코딩 | 가능 |
| 레이 트레이싱 지원 | 가능 |
| oneAPI 지원 | 가능 |
| OpenVINO 지원 | 가능 |
| Intel IPEX 지원 | 가능 |
| Intel XeSS 지원 | 가능 |
The 인텔 아크 프로 B60 게임 중심 기업과 실리콘 기반을 공유합니다. 인텔 아크 B580두 제품 모두 TSMC 5nm 공정으로 제조된 동일한 다이를 사용합니다. 272mm² 크기의 이 칩은 19.6억 개의 트랜지스터를 포함하고 있으며, 20개의 Xe2 코어를 통합하여 GPU당 12.28 TFLOPS의 FP32 연산 성능과 197 TOPS의 INT8 AI 성능을 제공한다고 광고됩니다. 핵심적인 차이점은 메모리 구성에 있습니다. B580은 12GB GDDR6 메모리를 탑재하는 반면, B60은 용량이 두 배인 24GB입니다.
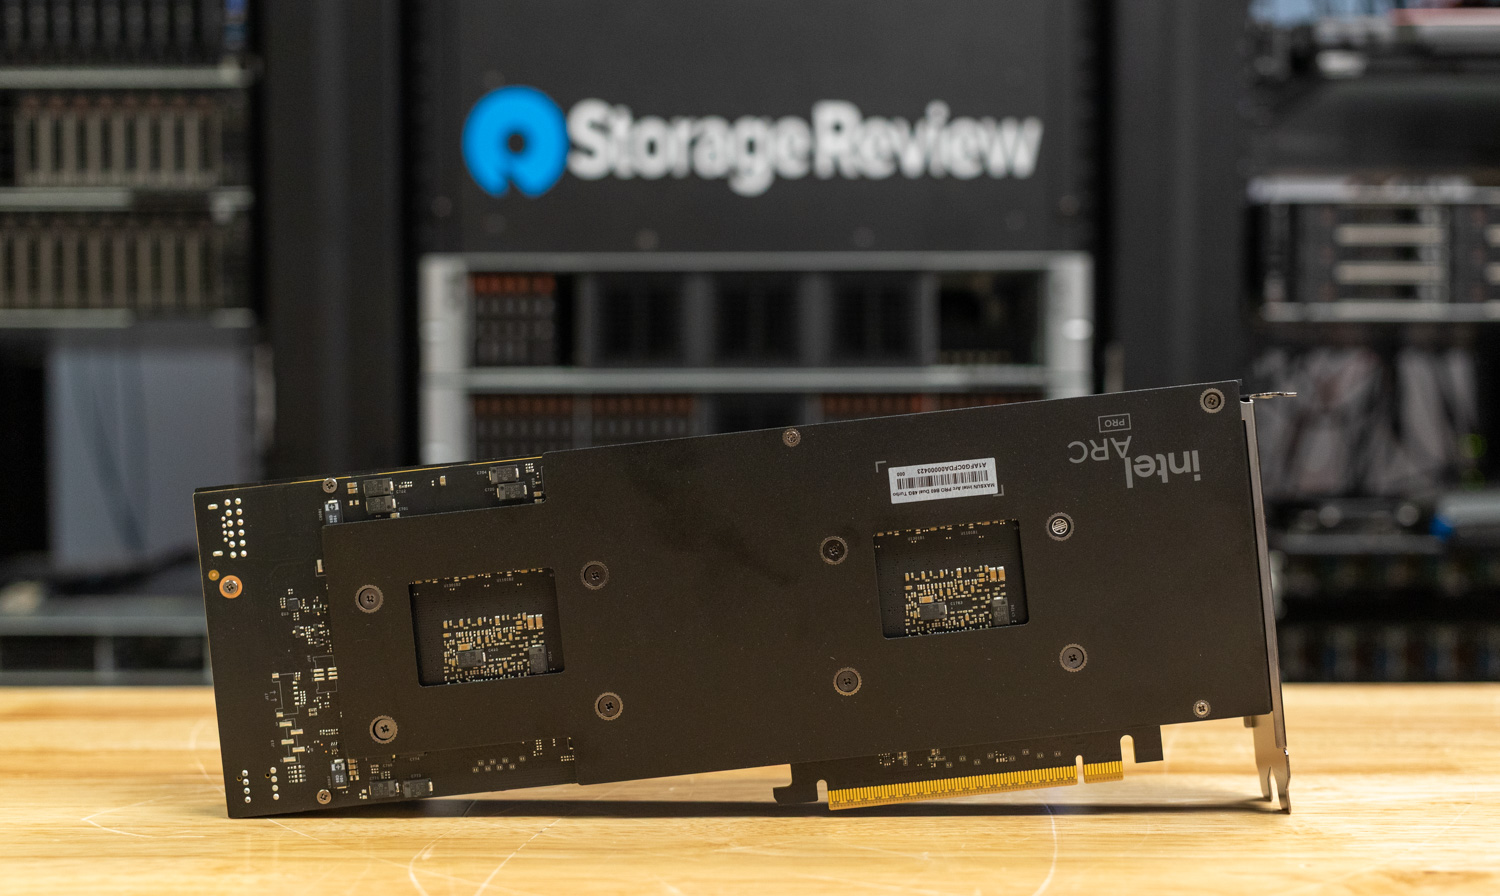
각 B60 GPU는 192비트 메모리 인터페이스에서 2,400MHz로 작동하여 GPU당 456GB/s의 대역폭을 제공합니다. 이 아키텍처는 GPU당 160개의 XMX(Xe Matrix Extensions) AI 엔진을 탑재하여 AI 추론에서 행렬 연산을 가속화하도록 특별히 설계되었습니다.
듀얼 GPU 설계 및 PCIe 분기
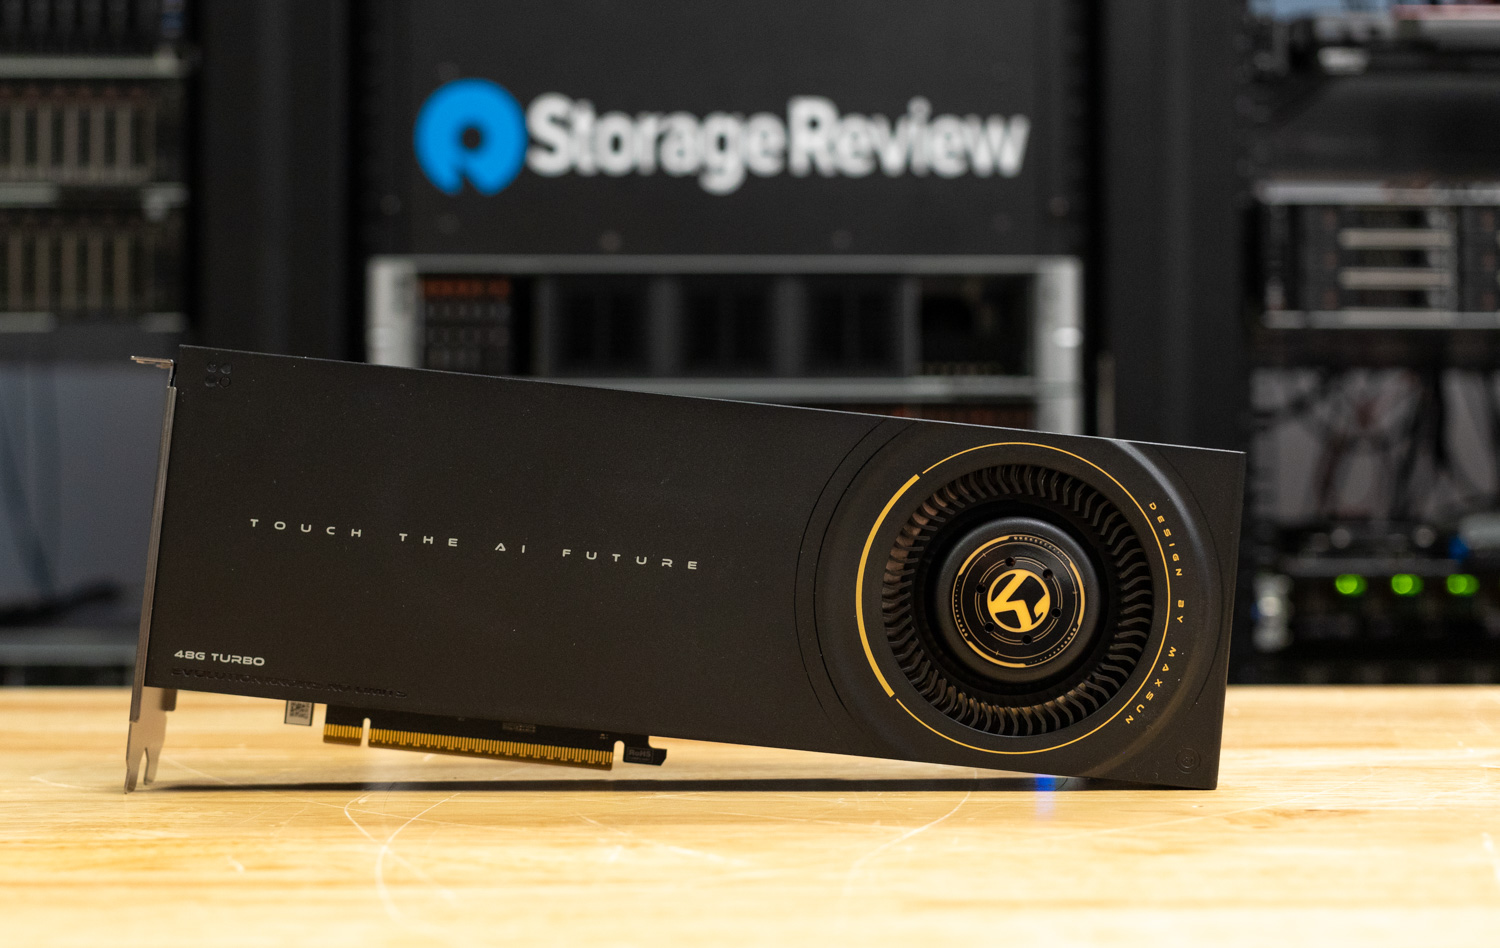
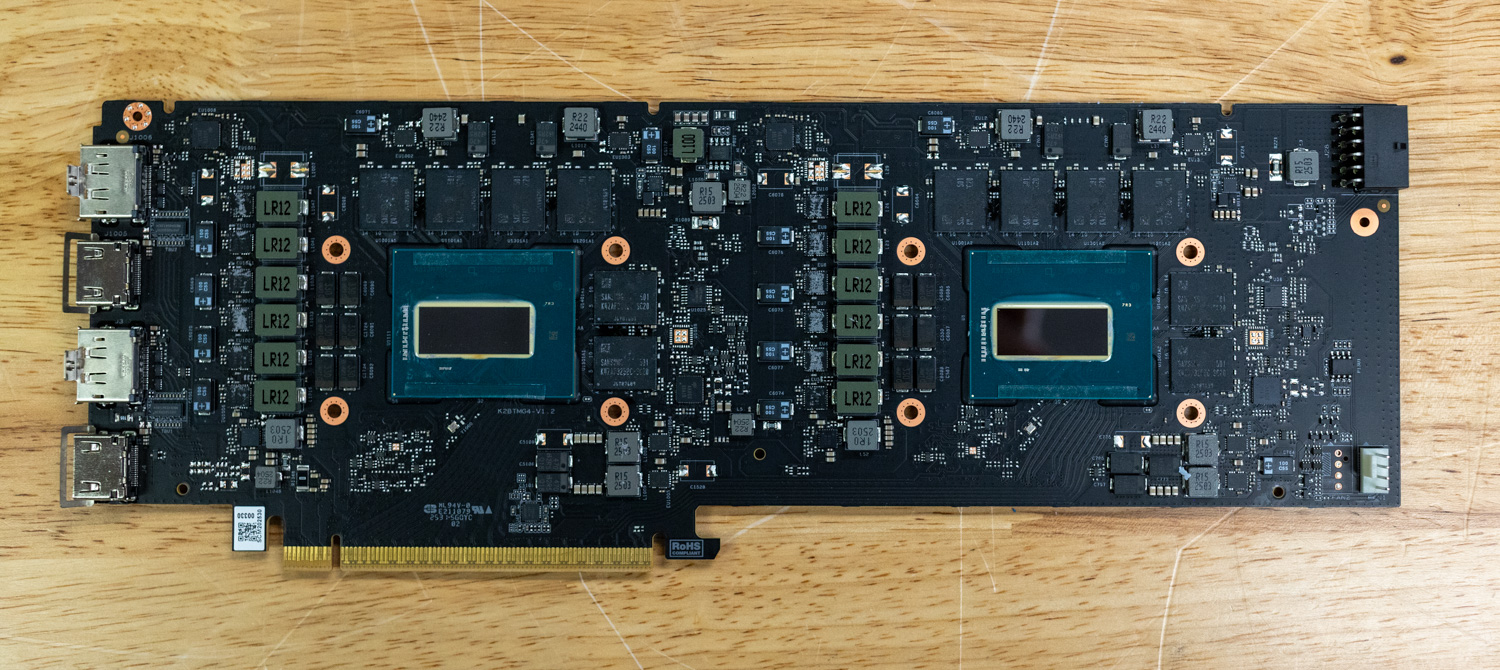
Maxsun Arc Pro B60 Dual 48G Turbo는 인텔의 고밀도 전략을 잘 보여주는 제품입니다. 두 개의 GPU가 하나의 듀얼 슬롯 카드에 탑재되어 있으며, PCIe 5.0 x8 인터페이스를 통해 독립적으로 연결됩니다. 기존의 듀얼 GPU 설계처럼 칩들을 연결하여 하나의 GPU처럼 작동시키는 방식과는 달리, B60의 각 GPU는 시스템에 독립적인 장치로 인식되므로 마더보드에서 PCIe x8/x8 분기 기능을 지원해야 합니다. 하나의 x16 슬롯이 전기적으로 두 개의 x8 연결로 분할되어 각 GPU에 전용 대역폭이 할당됩니다.
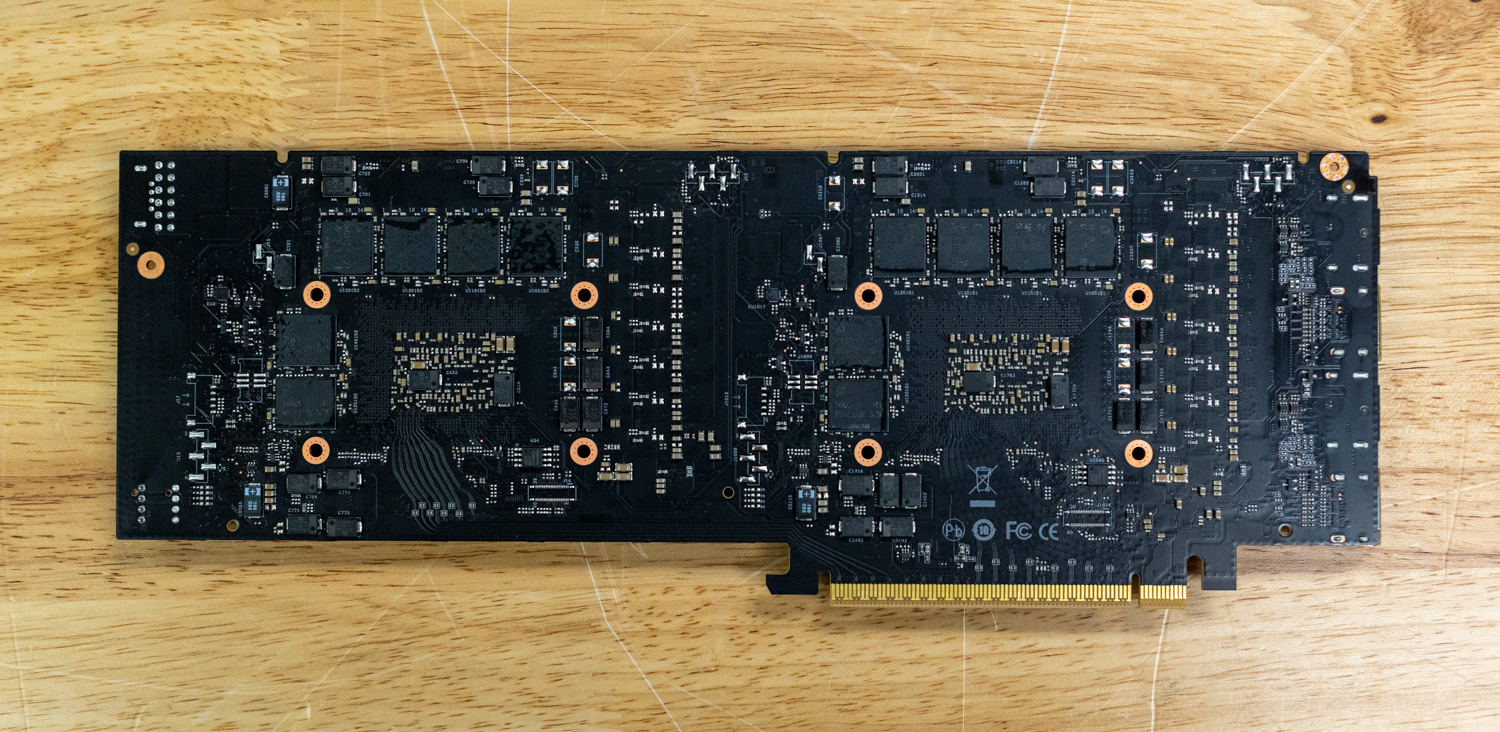
PCIe 5.0 x8은 GPU당 128GB/s의 양방향 대역폭을 제공하며, 이는 PCIe 4.0 x16과 동일합니다. 듀얼 카드 구성은 길이가 300mm이고, 블로어 스타일 쿨링 방식으로 두 개의 슬롯을 차지하며, 600W 정격의 12V-2×6 커넥터 하나를 통해 총 400W 의 보드 전력을 소모합니다.
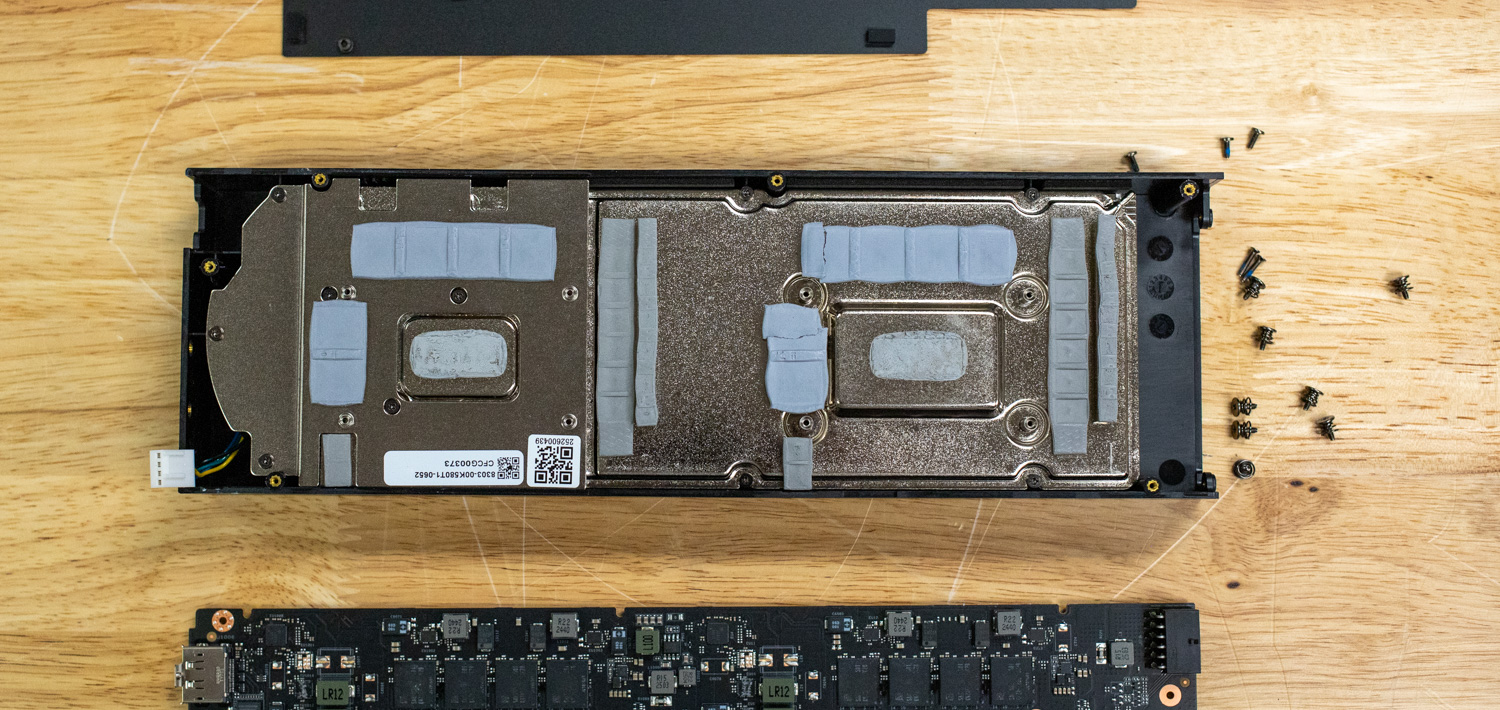
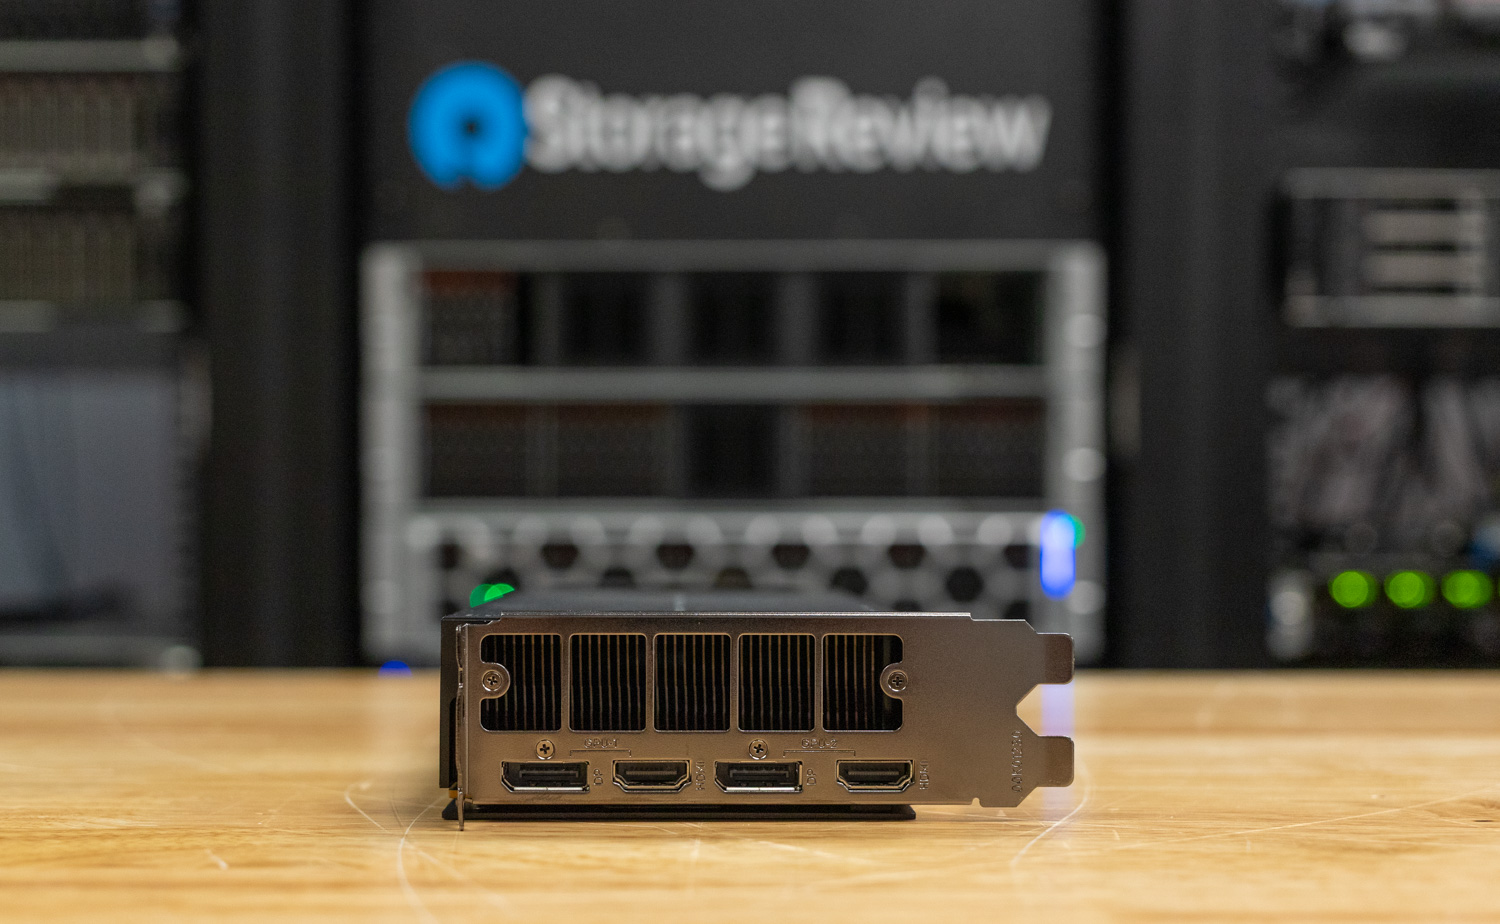
각 듀얼 카드는 4개의 디스플레이 출력을 제공합니다. GPU당 2개의 DisplayPort 2.1 UHBR20 포트와 2개의 HDMI 2.1a 포트가 각각 하나씩 있으며, 이를 통해 가상화된 데스크톱 환경이나 다중 사용자 시스템에 맞는 개별 비디오 출력 구성을 구현할 수 있습니다. 중요한 점은 각 GPU에서 두 개의 디스플레이 출력 중 한 개만 동시에 사용할 수 있다는 것입니다.
Instagram에서이 게시물보기
8개의 GPU Battlematrix 구성
인텔의 레퍼런스 배틀매트릭스 사양은 워크스테이션 섀시에 최대 8개의 Arc Pro B60 GPU를 지원하며 , 이는 4개의 듀얼 GPU 카드를 사용하여 구현됩니다. 이 구성은 다음과 같은 성능을 제공합니다.
- 총 192GB 시스템 VRAM (8 × 24GB)
- 1,280개의 XMX AI 엔진
- 1,576 INT8 탑 집계 컴퓨팅
- 3.6TB/초 결합된 메모리 대역폭
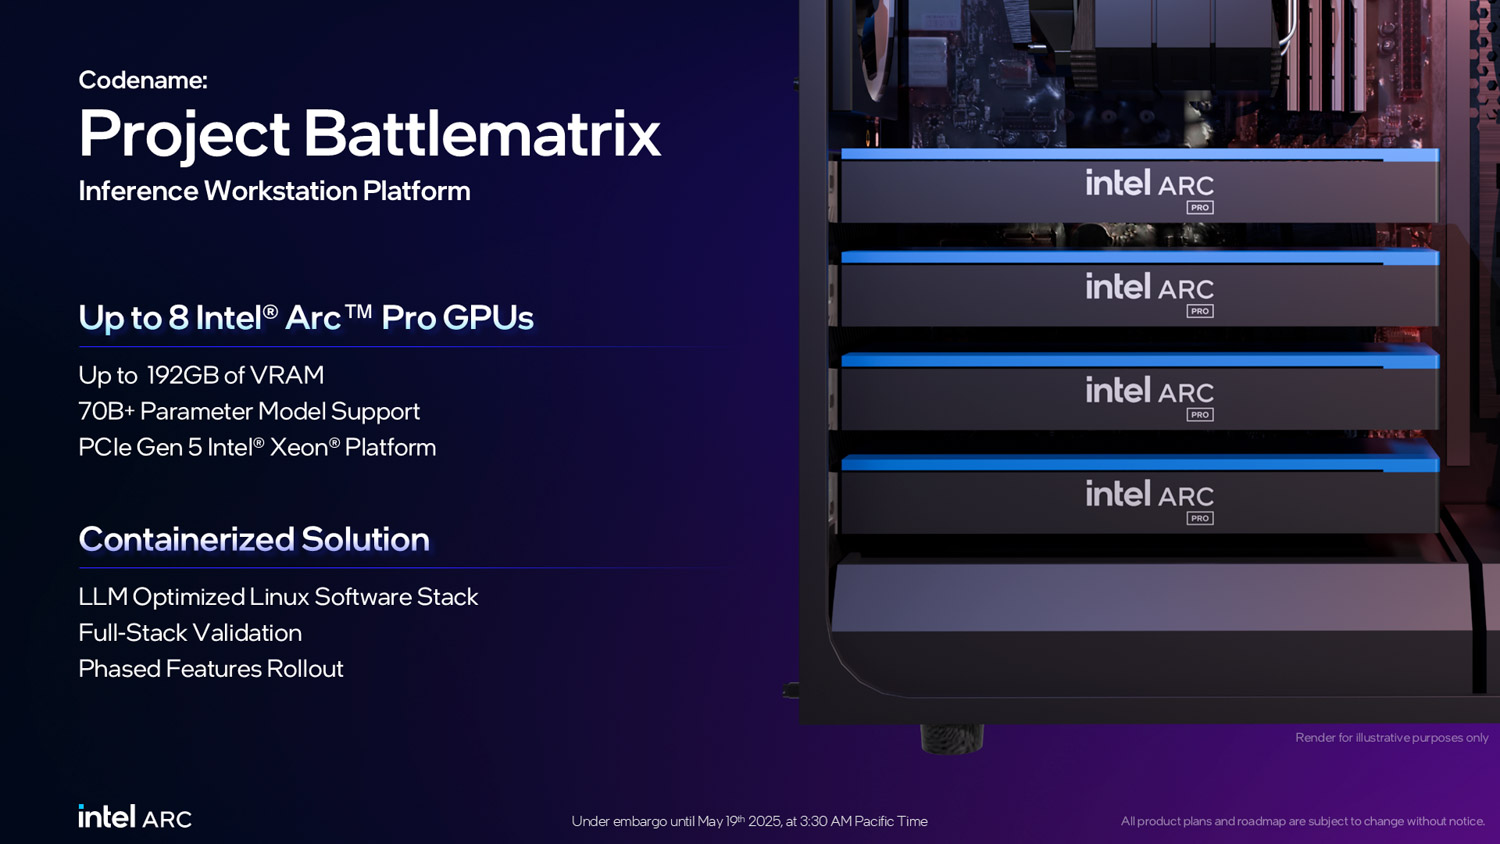
이 플랫폼에는 분기를 지원하는 PCIe 5.0 x16 슬롯 4개가 있는 마더보드가 필요하며, Battlematrix 사양에는 Xeon 6 프로세서도 포함됩니다. 그러나 Battlematrix 구성에 대한 다른 정보는 현재 제공되지 않습니다.
사용 사례 및 가치 제안
대상 고객
인텔의 프로젝트 배틀매트릭스는 온프레미스 인프라가 필요한 AI 개발팀, 민감한 코드베이스를 사용하는 AI 지원 워크플로를 구현하는 소프트웨어 엔지니어링 조직, 그리고 클라우드 기반 추론 서비스에 대한 비용 효율적인 대안을 모색하는 조직, 이 세 가지 시장 부문을 목표로 합니다. 이 플랫폼의 핵심 가치는 다년 클라우드 구독 대비 데이터 주권과 총소유비용(TCO) 절감이라는 이점을 중심으로 합니다.
개인 AI 및 에이전트 개발
Battlematrix 플랫폼의 주요 강점은 광범위한 컨텍스트 창과 상당한 매개변수 수가 필요한 대규모 언어 모델의 개발 워크플로를 지원하는 데 있습니다.
에이전트 시스템을 구축하는 개발팀은 특히 가용 메모리 헤드룸의 이점을 누립니다. RAG 에이전트 구현은 일반적으로 기본 언어 모델, 벡터 검색을 위한 임베딩 모델, 그리고 순위 재지정 모델 등 여러 구성 요소를 GPU 메모리에 동시에 유지합니다. 또한, 에이전트 워크플로는 다단계 추론, 도구 사용 및 자체 수정을 수행하여 반복 작업을 통해 상당한 컨텍스트 윈도우를 생성합니다. 대규모 코드베이스를 분석하는 코딩 에이전트는 운영 수명 주기 동안 100만 개 이상의 토큰을 축적할 수 있습니다.
미래의 VDI 및 가상화된 게임
인텔의 로드맵에는 Arc Pro B60 GPU에서 SR-IOV(단일 루트 I/O 가상화) 지원을 활성화하여 하드웨어를 다중 사용자 그래픽 플랫폼으로 전환하는 것이 포함됩니다. SR-IOV를 사용하면 물리적 GPU를 여러 개의 가상 GPU로 분할할 수 있으며, 각 GPU는 직접 하드웨어 액세스와 격리된 메모리 공간을 통해 별도의 가상 머신에 할당될 수 있습니다.
이 기능을 사용하면 라이선스 없이도 단일 8개 GPU Battlematrix 시스템으로 CAD 애플리케이션, 비디오 편집 또는 일반 게임용 전용 GPU 가속 기능을 통해 수십 명의 동시 사용자를 지원하는 VDI(Virtual Desktop Infrastructure) 시나리오를 구현할 수 있습니다. 기존 VDI 솔루션은 하드웨어 비용 외에도 높은 라이선스 비용이 필요하며, 이로 인해 더 비싼 전문가용 또는 데이터센터용 GPU가 필요한 경우가 많습니다. 인텔은 라이선스 없이 가상화를 구현함으로써 이러한 운영 비용을 절감합니다.
가격 및 가치 제안
인텔은 Arc Pro B60의 가격을 GPU당 약 600달러로 발표했습니다. 초기 테스트 및 개발 시에는 단일 또는 듀얼 카드 구성(600달러~1,200달러)을 통해 손쉽게 시작할 수 있습니다. 48GB VRAM을 탑재한 듀얼 GPU 카드 하나면 양자화된 모델에 충분한 용량을 제공하고, 널리 사용되는 오픈소스 LLM 애플리케이션의 상당 부분을 처리할 수 있습니다.
테스트한 Maxsun Dual Arc Pro B60 Dual 48G Turbo 구성은 인텔의 최초 발표와 동일하게 Maxsun에서 직접 판매하는 1,200달러입니다. 하지만 최근 메모리 가격 변동이 영향을 미칠 수 있습니다.
진입 가격대에서 탁월한 가치
단일 및 듀얼 카드 구성은 소규모 팀, 개인 개발자, 그리고 홈랩 사용자에게 매력적인 경제성을 제공합니다. 24GB GPU 메모리는 600달러, 48GB는 1,200달러로, 일반적으로 최소 두 배 이상 비싼 전문가용 GPU보다 훨씬 저렴합니다.
이러한 가치 제안은 기업 예산을 투자하지 않고도 AI 통합을 모색하는 조직에 특히 적합합니다.
vLLM 온라인 서비스 벤치마크 성능
vLLM은 LLM을 위한 가장 널리 사용되는 고처리량 추론 및 서빙 엔진입니다. vLLM 온라인 서빙 벤치마크는 동시 요청 환경에서 실제 서빙 성능을 측정하는 성능 평가 도구입니다. 요청률, 입출력 길이, 동시 클라이언트 수와 같은 구성 가능한 매개변수를 사용하여 실행 중인 vLLM 서버에 요청을 전송하여 프로덕션 워크로드를 시뮬레이션합니다. 이 벤치마크는 처리량(초당 토큰), 첫 번째 토큰까지의 시간(TTFT), 출력 토큰당 시간(TPOT) 등의 주요 지표를 측정하여 사용자가 다양한 부하 조건에서 vLLM의 성능을 이해하는 데 도움을 줍니다.
테스트 플랫폼:
- 서버 : 슈퍼마이크로 AS-4125GS-TNRT
- 프로세서 : AMD EPYC 9374F
- 메모리: 512GB 삼성 4800 MT/s DDR5
- GPU: 4배 Maxsun MS-Intel ARC Pro B60 듀얼 48G 터보
양자화 지원 및 제한 사항
이러한 GPU는 최적의 성능을 위해 INT4 양자화를 타겟으로 하는 저정밀도 추론에서 탁월한 성능을 발휘해야 합니다. 그러나 테스트 중이던 Intel LLM 스케일러의 초기 개발 버전으로 인해 MXFP4 마이크로스케일링 형식으로 처음 학습된 GPT OSS 모델만 정상적으로 작동했습니다. 표준 INT4, FP8, AWQ를 포함한 다른 양자화 형식은 완전히 시작되지 못했습니다. 이러한 제한으로 인해 이러한 GPU를 철저하게 테스트하는 데 상당한 제약이 있었지만, 소프트웨어 스택이 발전함에 따라 양자화에 대한 지원이 더욱 확대될 것으로 예상합니다.
대부분의 모델을 두 가지 구성, 즉 8개의 GPU를 사용하는 Battlematrix 전체 구성과 모델을 메모리에 저장하는 데 필요한 최소 GPU 수로 테스트했습니다. 이 비교를 통해 흥미로운 확장 특성, 특히 낮은 배치 크기에서의 통신 오버헤드를 확인할 수 있었습니다.
마이크로스케일링 데이터 유형
마이크로스케일링은 큰 매개변수 그룹에 걸쳐 균일한 양자화를 적용하는 대신, 작은 가중치 블록에 세밀한 스케일링 계수를 적용하는 고급 양자화 방식을 나타냅니다. MXFP4 형식은 블록 부동 소수점 표현을 사용하여 이 기술을 구현합니다. 각 마이크로스케일 블록은 공통 지수를 스케일링 계수로 공유하여 4비트 정밀도를 달성하는 동시에 수치 정밀도를 유지합니다. MXFP4 데이터 유형의 주요 이점은 BF16과 같은 고정밀 형식에서 양자화하는 것과 달리 INT4로 모델을 양자화해도 응답 품질이 크게 저하되지 않는다는 것입니다. GPT OSS 모델은 기본적으로 MXFP4를 지원하지 않으므로 B60에서 INT4 양자화로 실행됩니다.
오픈AI GPT-OSS 20B
20B 매개변수 모델은 통신 오버헤드 현상을 명확하게 보여줍니다. 배치 크기가 1일 때 단일 GPU는 사용자당 49.22 tok/s의 처리량을 제공하는 반면, 8개의 GPU에 분산될 때는 22.83 tok/s에 불과합니다. 단일 GPU 구성은 2배 이상 성능이 뛰어납니다. 그러나 8개 GPU 구성은 더 높은 동시성에서 탁월한 성능을 보이며, 배치 크기가 16일 때 총 처리량 511.99 tok/s를 달성합니다.
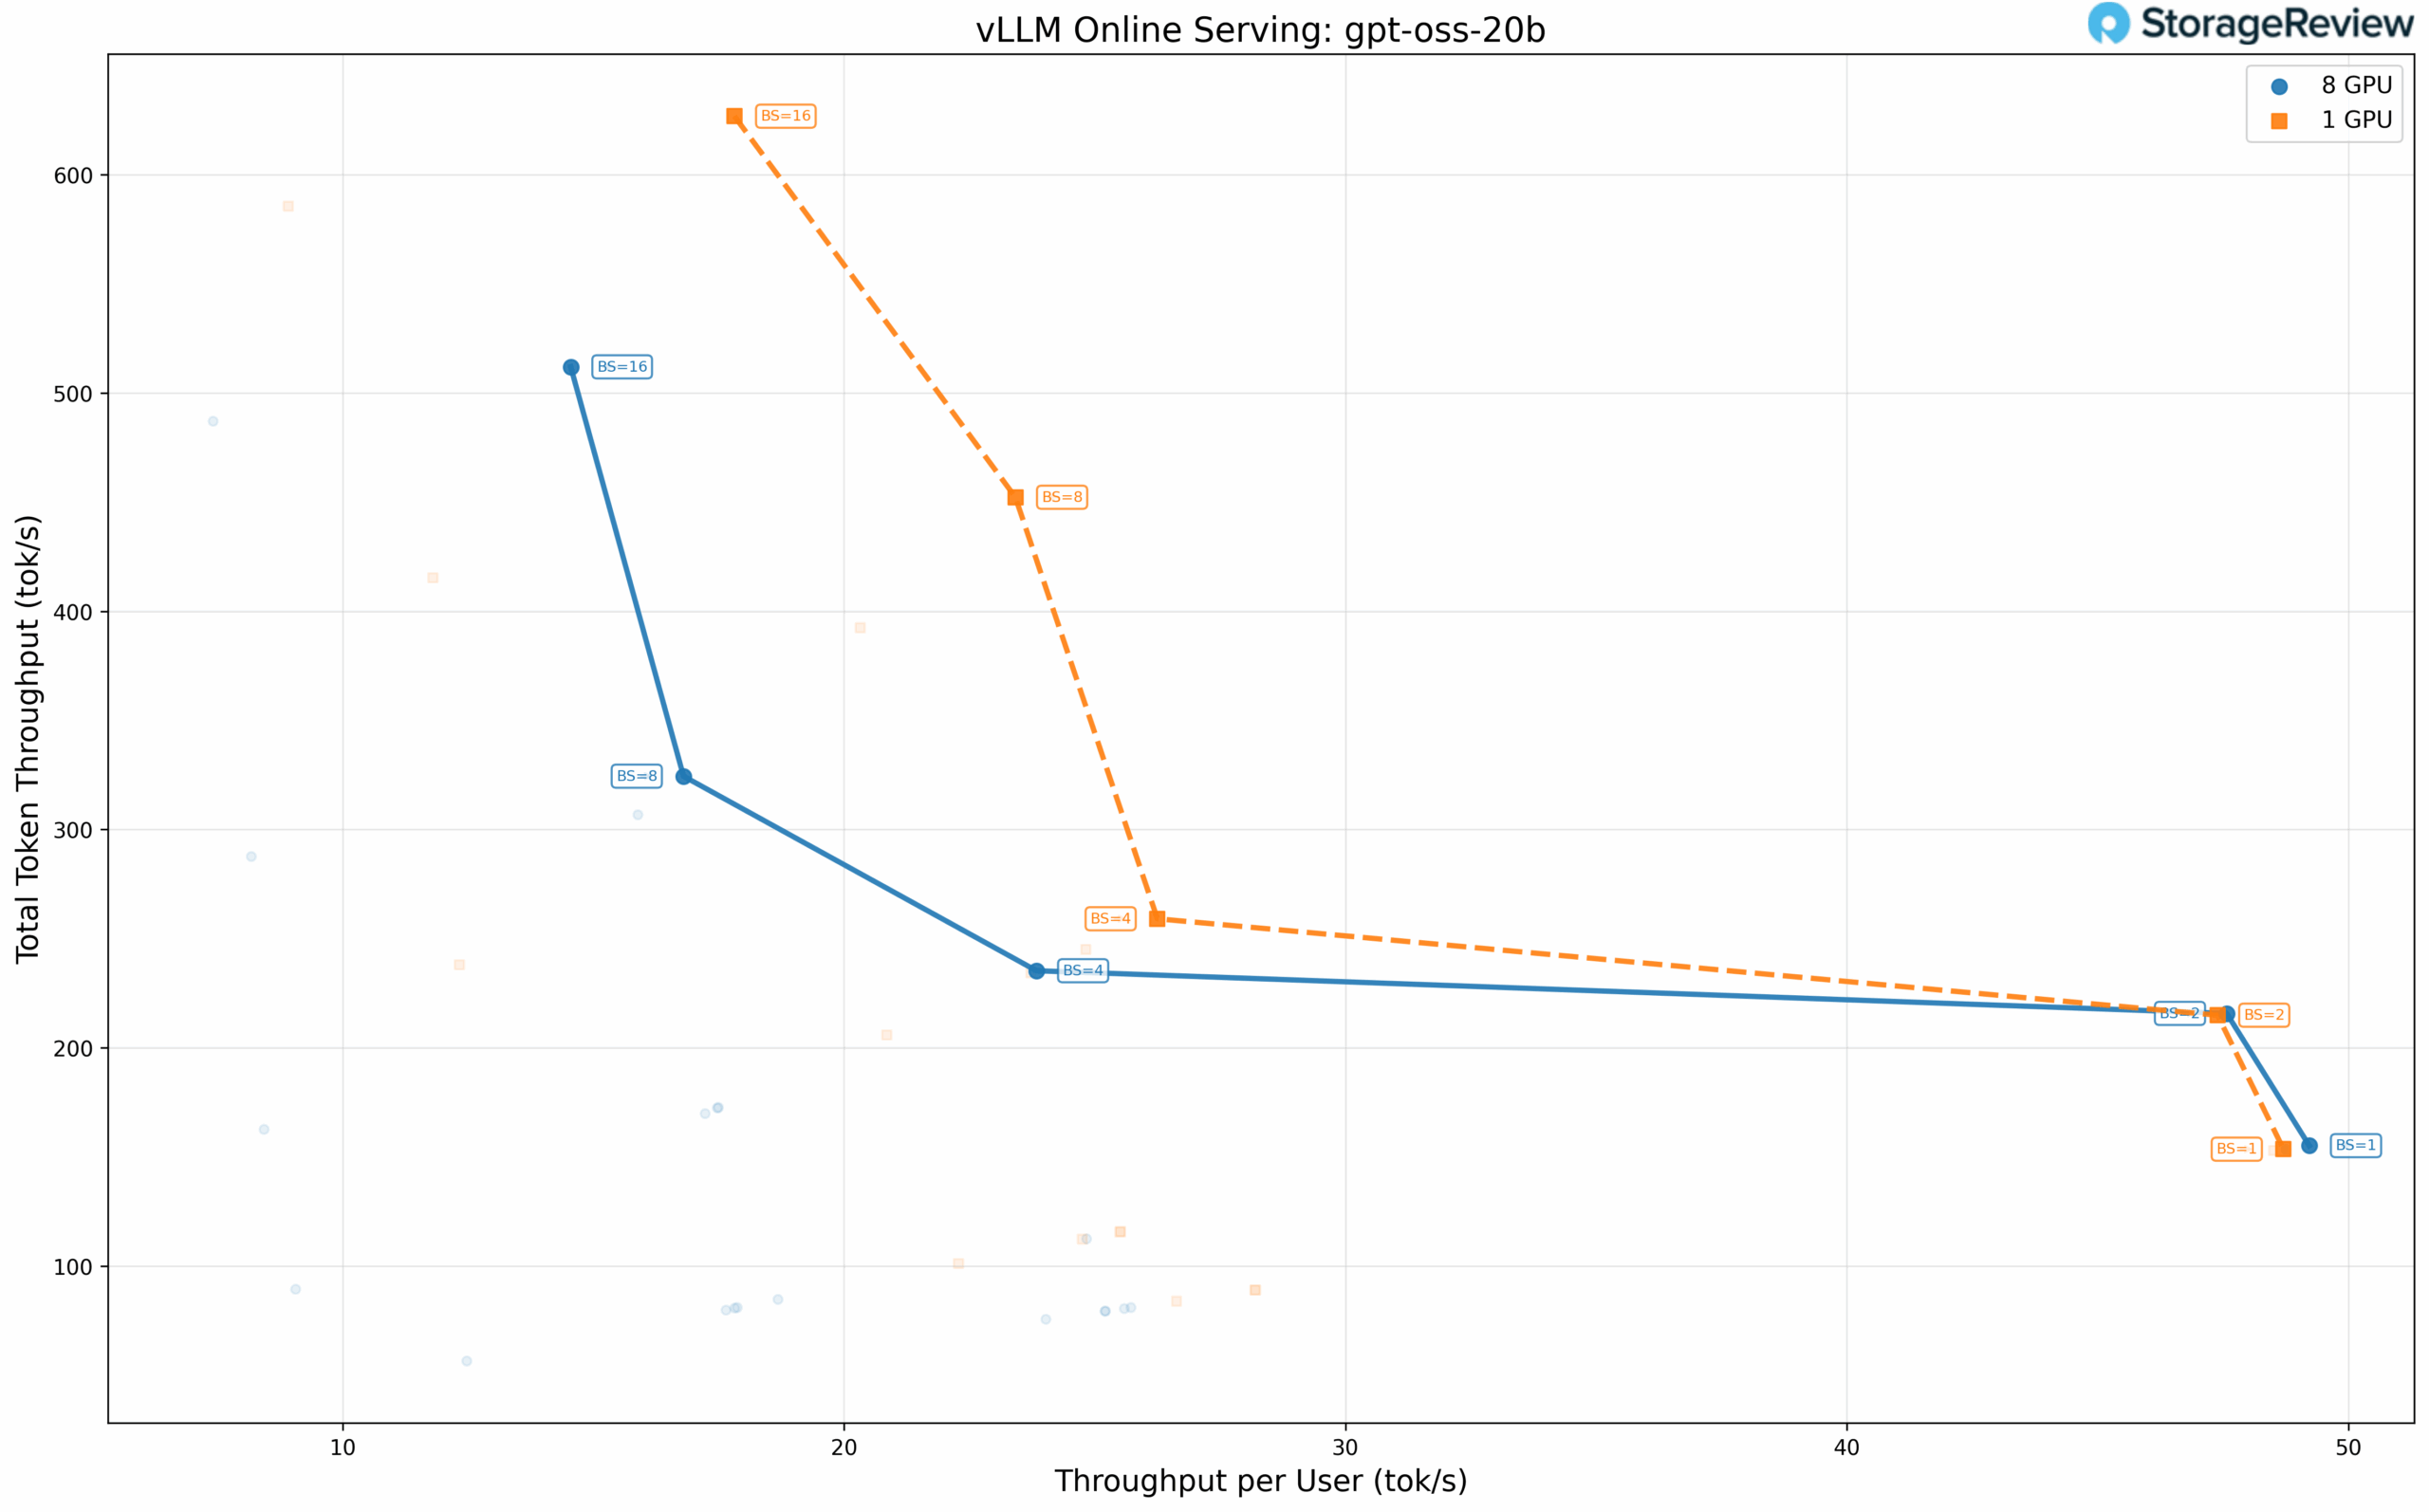 최소 GPU 구성은 실제로 배치 크기 16에서 더 높은 총 처리량을 달성합니다. TP=4일 때 626.84 tok/s, TP=8일 때 511.99 tok/s입니다. 이러한 반직관적인 결과는 더 적은 수의 GPU에 충분히 적합한 모델과 컨텍스트 길이의 경우, 하드웨어를 추가하면 그에 비례하는 성능 향상 없이 통신 오버헤드가 발생한다는 것을 보여줍니다.
오픈AI GPT-OSS 120B
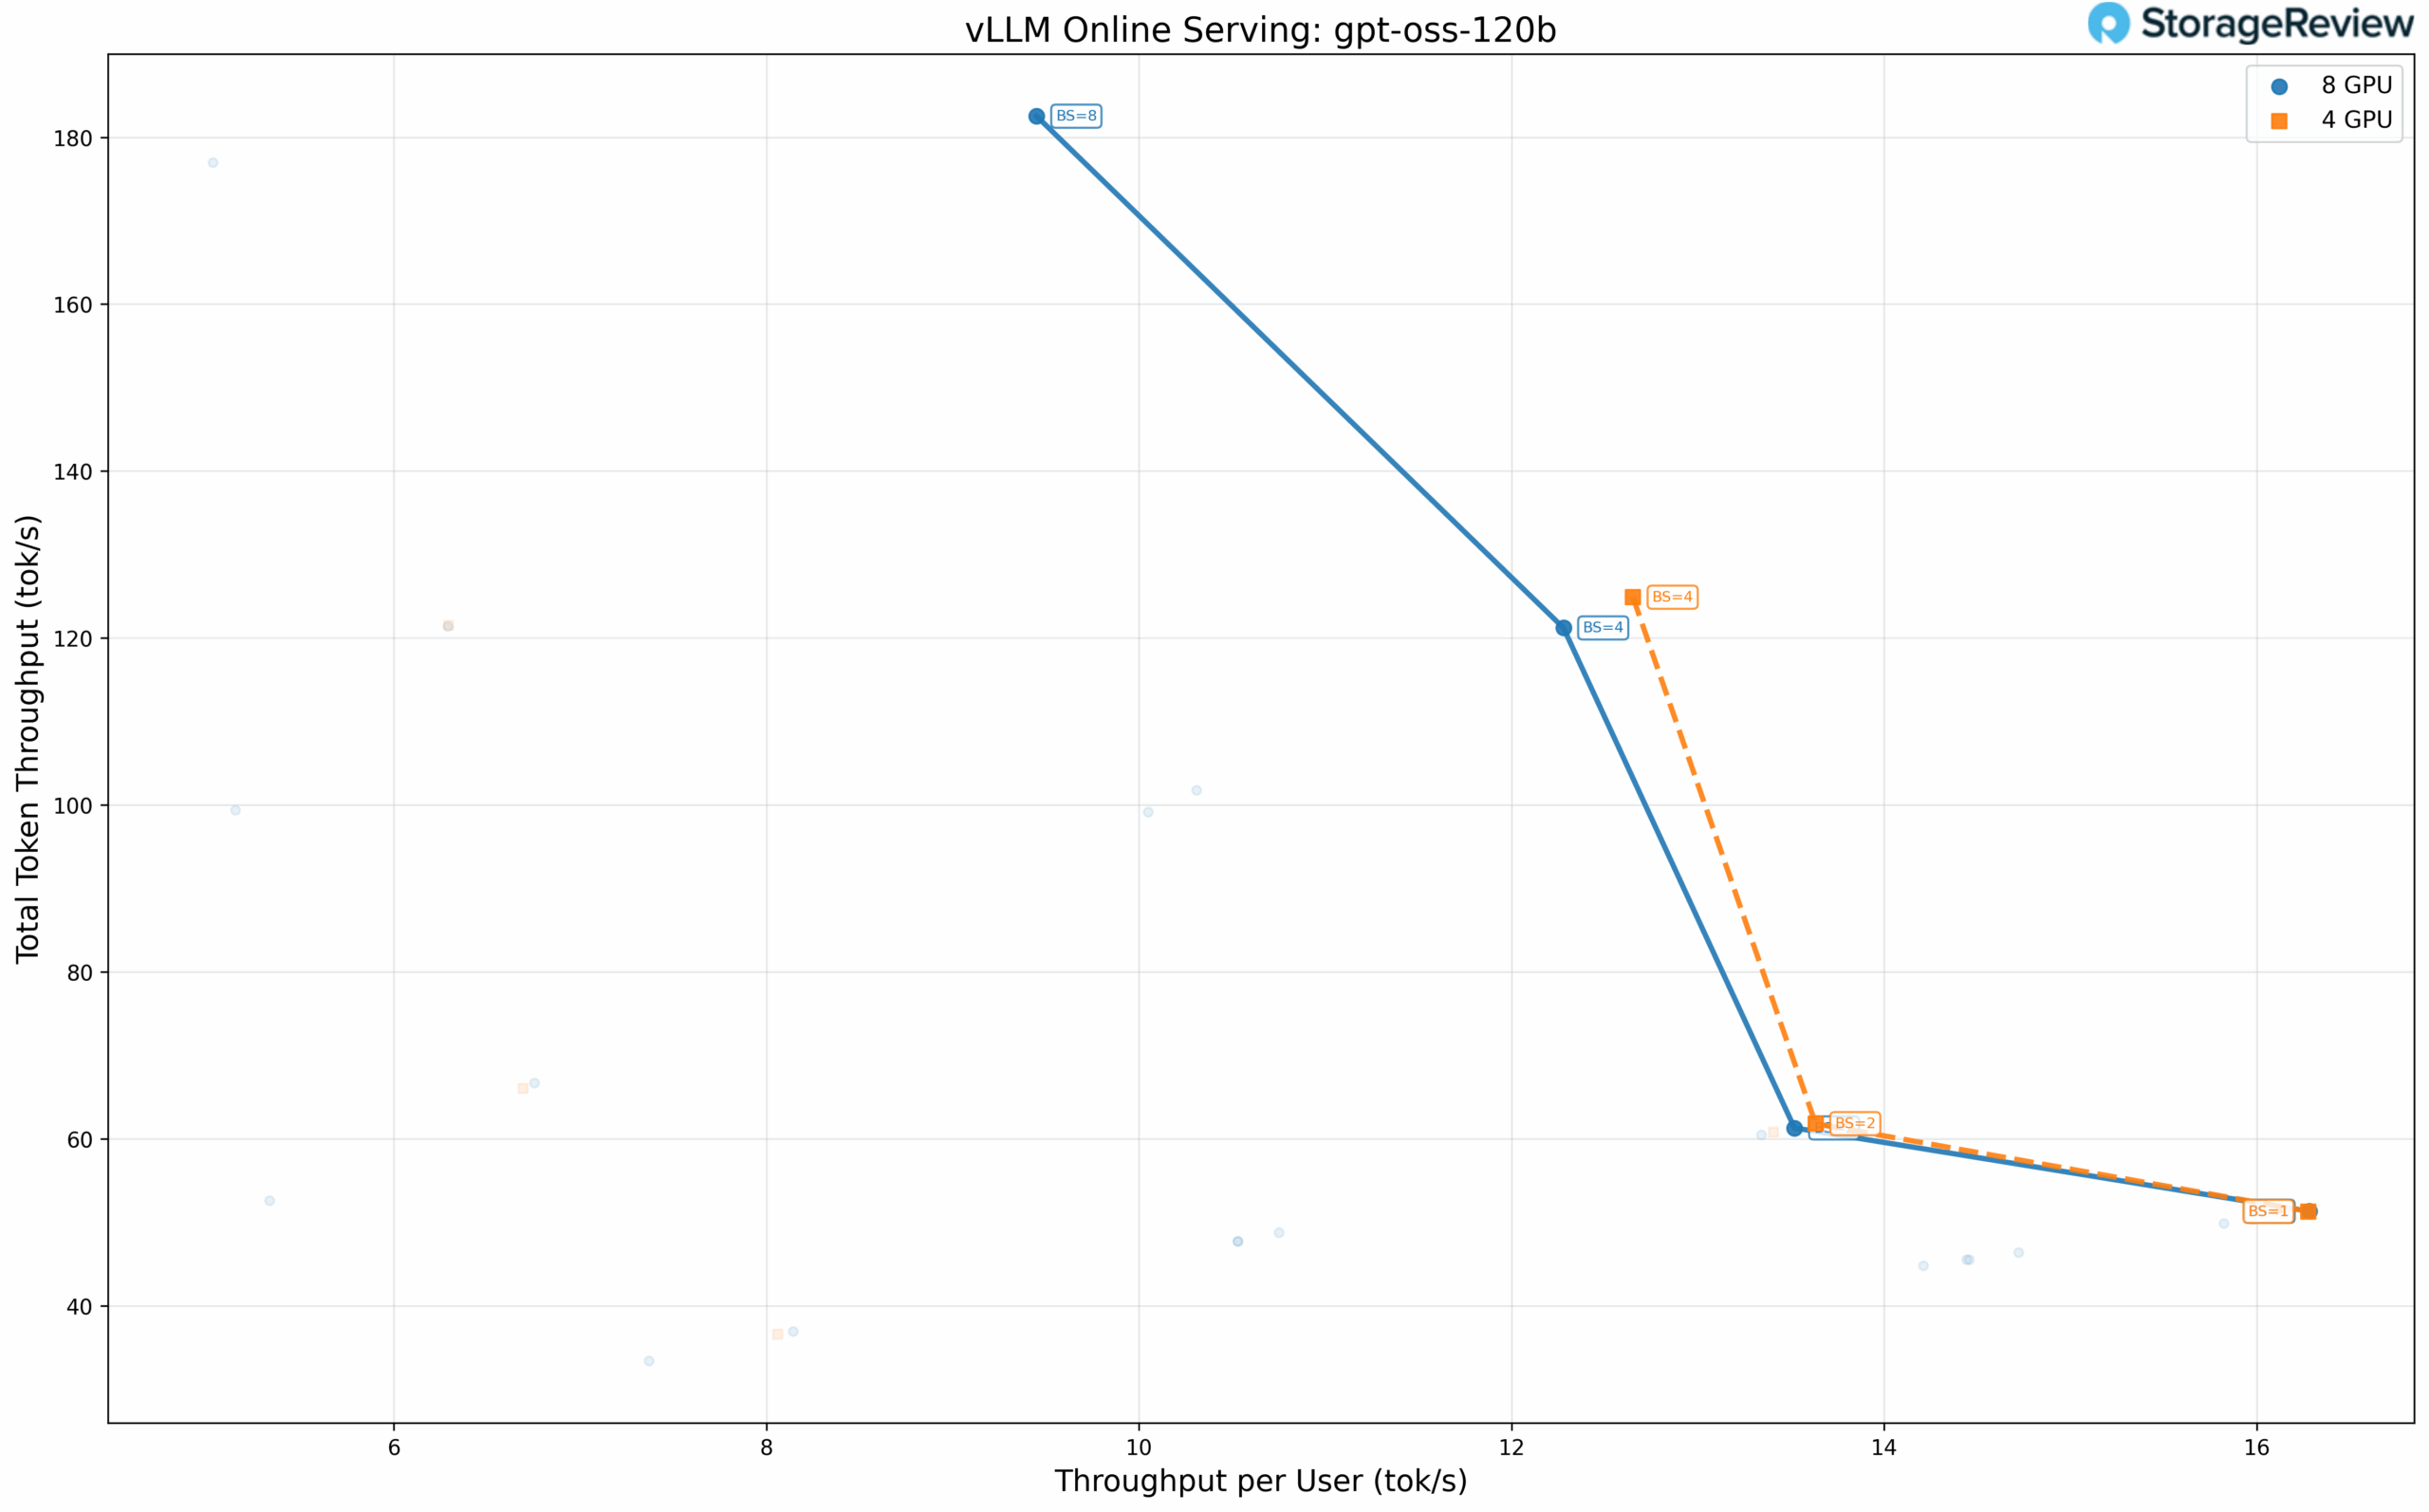
더 큰 120B 모델은 최소 4개의 GPU를 필요로 하므로 단일 GPU 비교가 필요 없습니다. 4개와 8개 GPU 구성 간의 성능은 더욱 밀접하게 수렴하며, 배치 크기 1에서 사용자당 처리량은 거의 동일합니다(두 경우 모두 16.28 tok/s). 8개 GPU 구성은 데이터 병렬 처리를 통해 더 높은 배치 크기에서 약간의 이득을 제공합니다.
전문가 혼합: Qwen3 Coder 30B-A3B
희소 MoE 아키텍처는 추론 과정에서 하위 집합만 활성화하면서 많은 매개변수 수를 유지합니다. Qwen3 Coder 30B-A3B는 전체 30B 매개변수 풀에서 토큰당 약 3B 매개변수를 활성화하므로 로컬 코딩 어시스턴트 배포에 널리 사용됩니다.
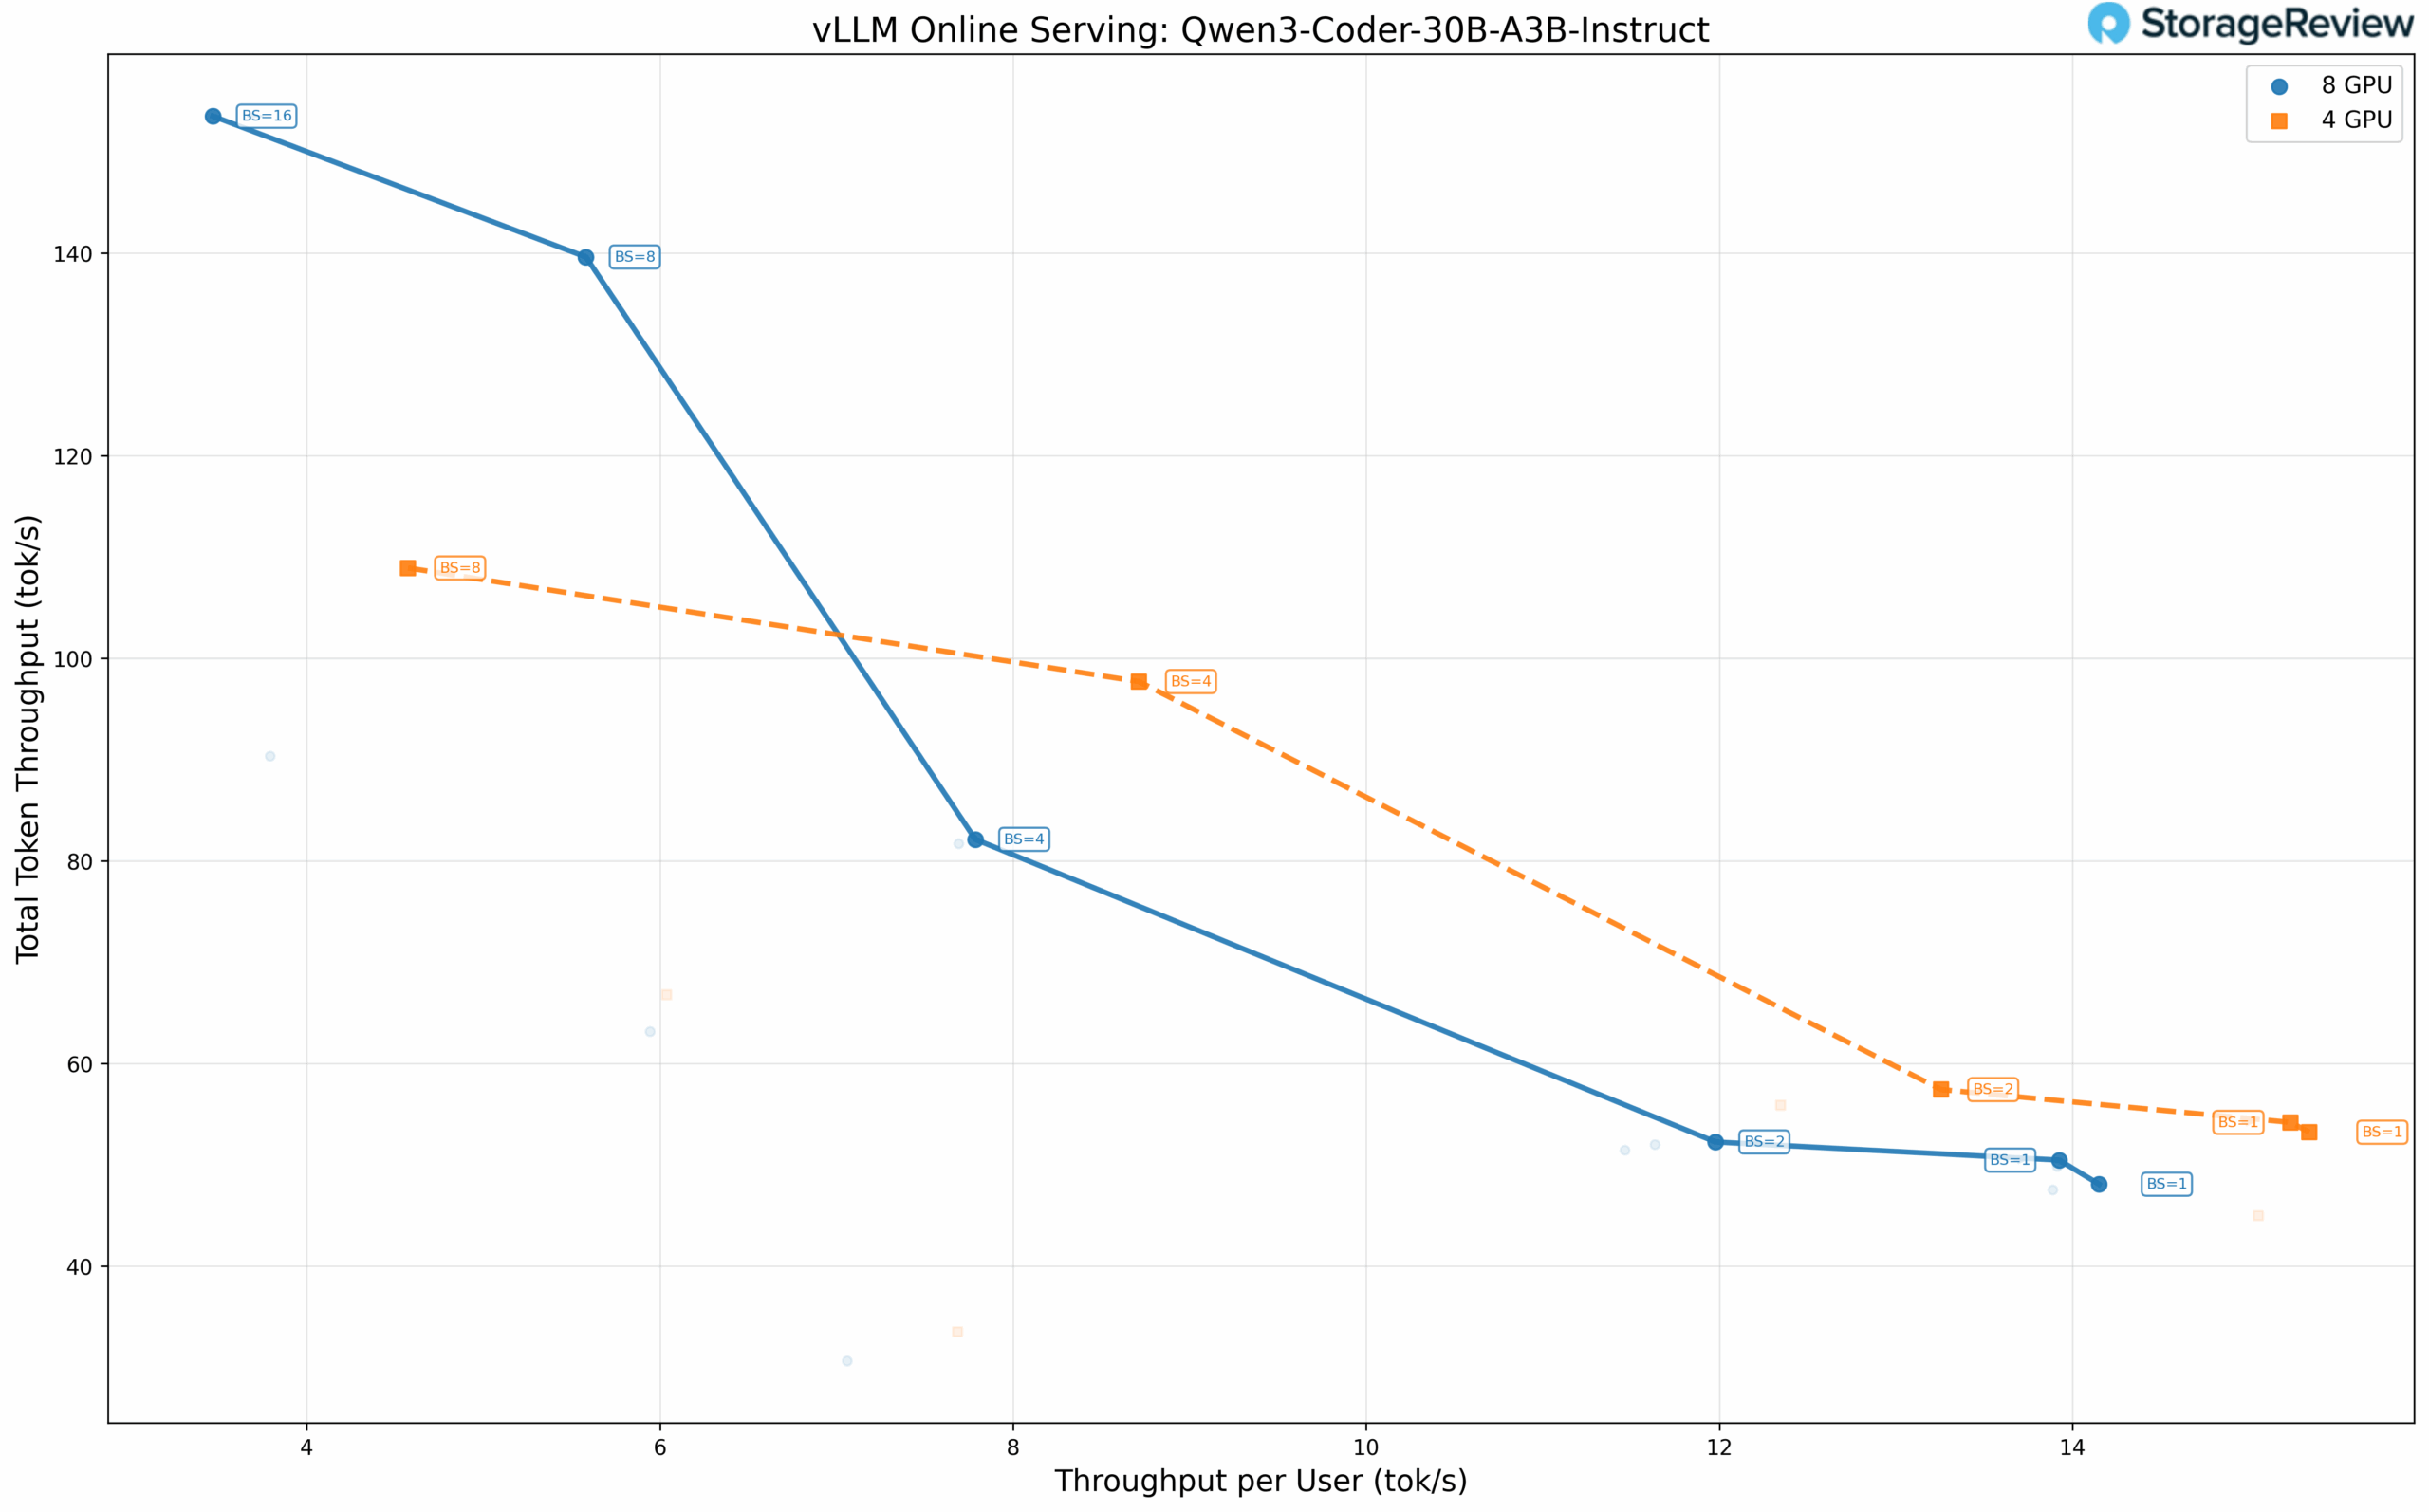
BF16 정밀도에서 테스트한 결과, 4개의 GPU 구성은 낮은 배치 크기에서 다시 한번 이점을 보여줍니다. 배치 크기 1에서 사용자당 처리량은 TP=4일 때 15.34 tok/s에 도달하는 반면, TP=8일 때는 14.15 tok/s에 도달합니다.
조밀한 모델
밀집 모델은 기존 LLM 아키텍처를 따르며, 추론 과정에서 모든 매개변수와 활성화 값이 사용되므로 희소 모델보다 계산량이 더 많습니다. 테스트 기간 동안 INT4 양자화가 제대로 작동하지 않아 이러한 모델은 BF16 정밀도로 실행되었습니다.
라마 3.1 8B 지시
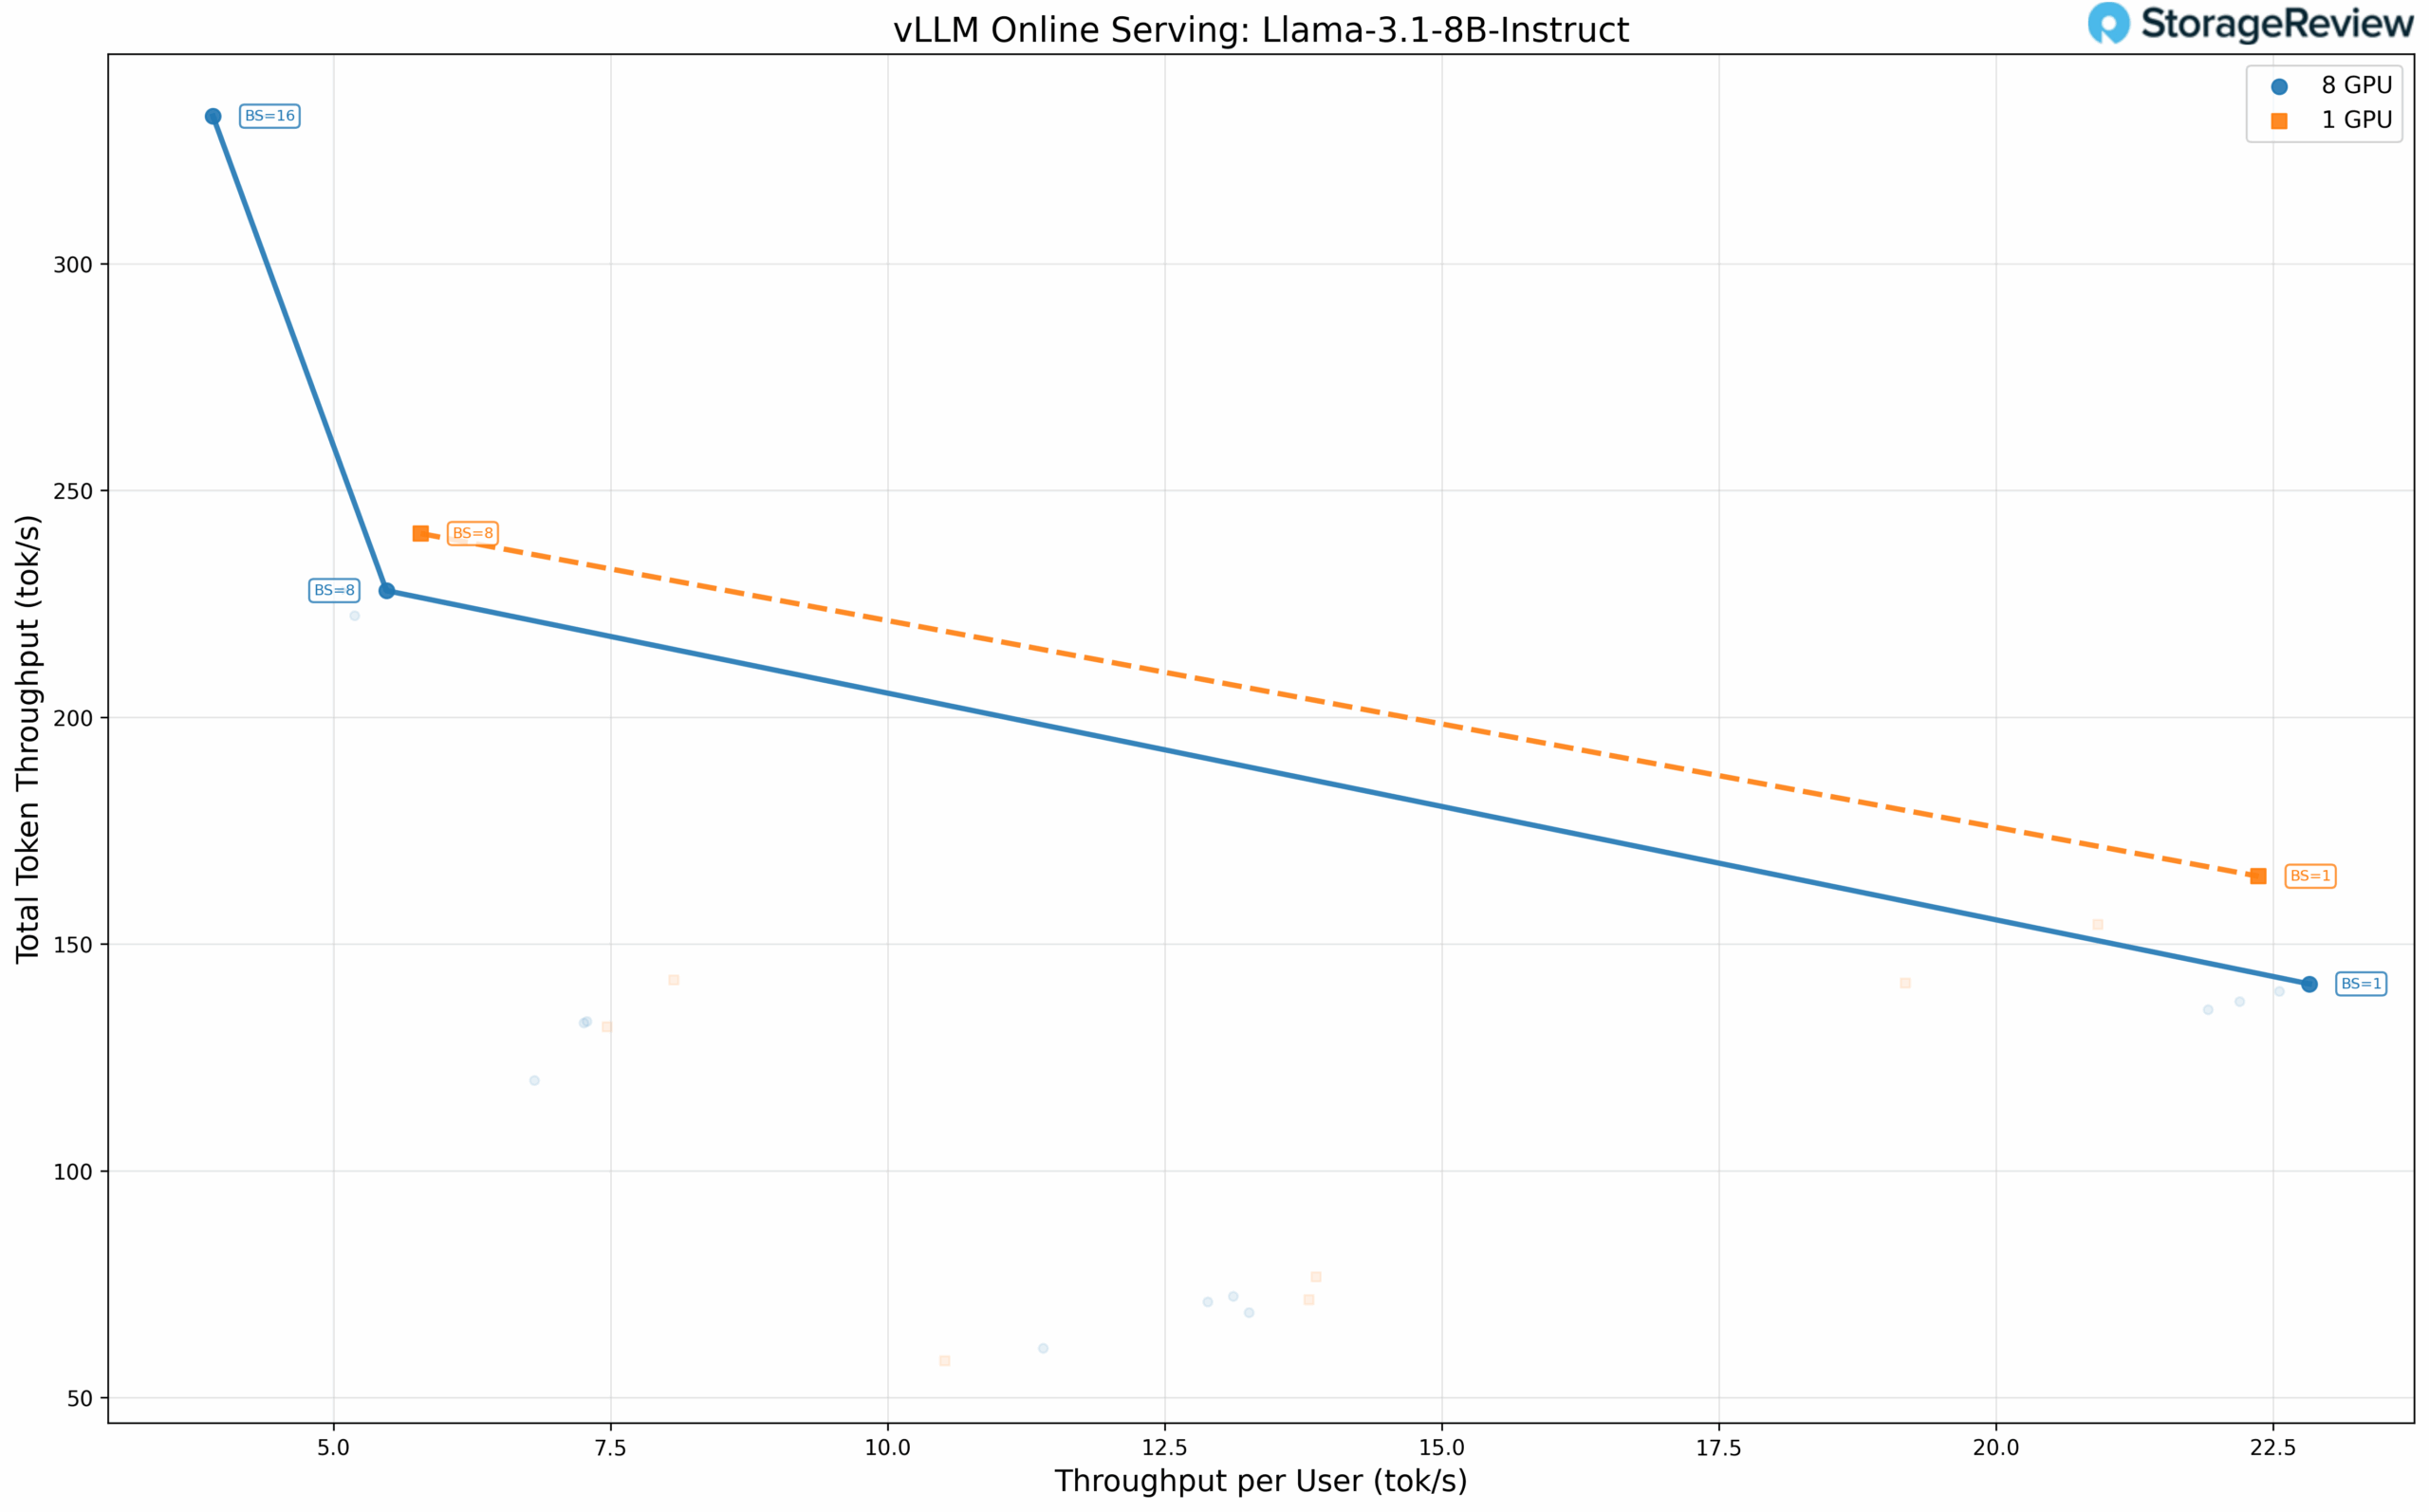
컴팩트한 8B 모델은 단일 GPU에 적합하도록 설계되었지만, 스케일링 동작을 특성화하기 위해 여러 구성에서 테스트되었습니다. 결과는 패턴을 확인합니다. 4개의 GPU는 배치 크기 8에서 총 240.48 tok/s의 처리량을 제공하는 반면, 8개의 GPU는 동일한 배치 크기에서 227.90 tok/s의 처리량을 제공합니다. 배치 크기 1에서 사용자당 처리량은 거의 동일하게 유지됩니다(22.37 tok/s 대 22.83 tok/s).
미스트랄 스몰 3.1 24B 지시
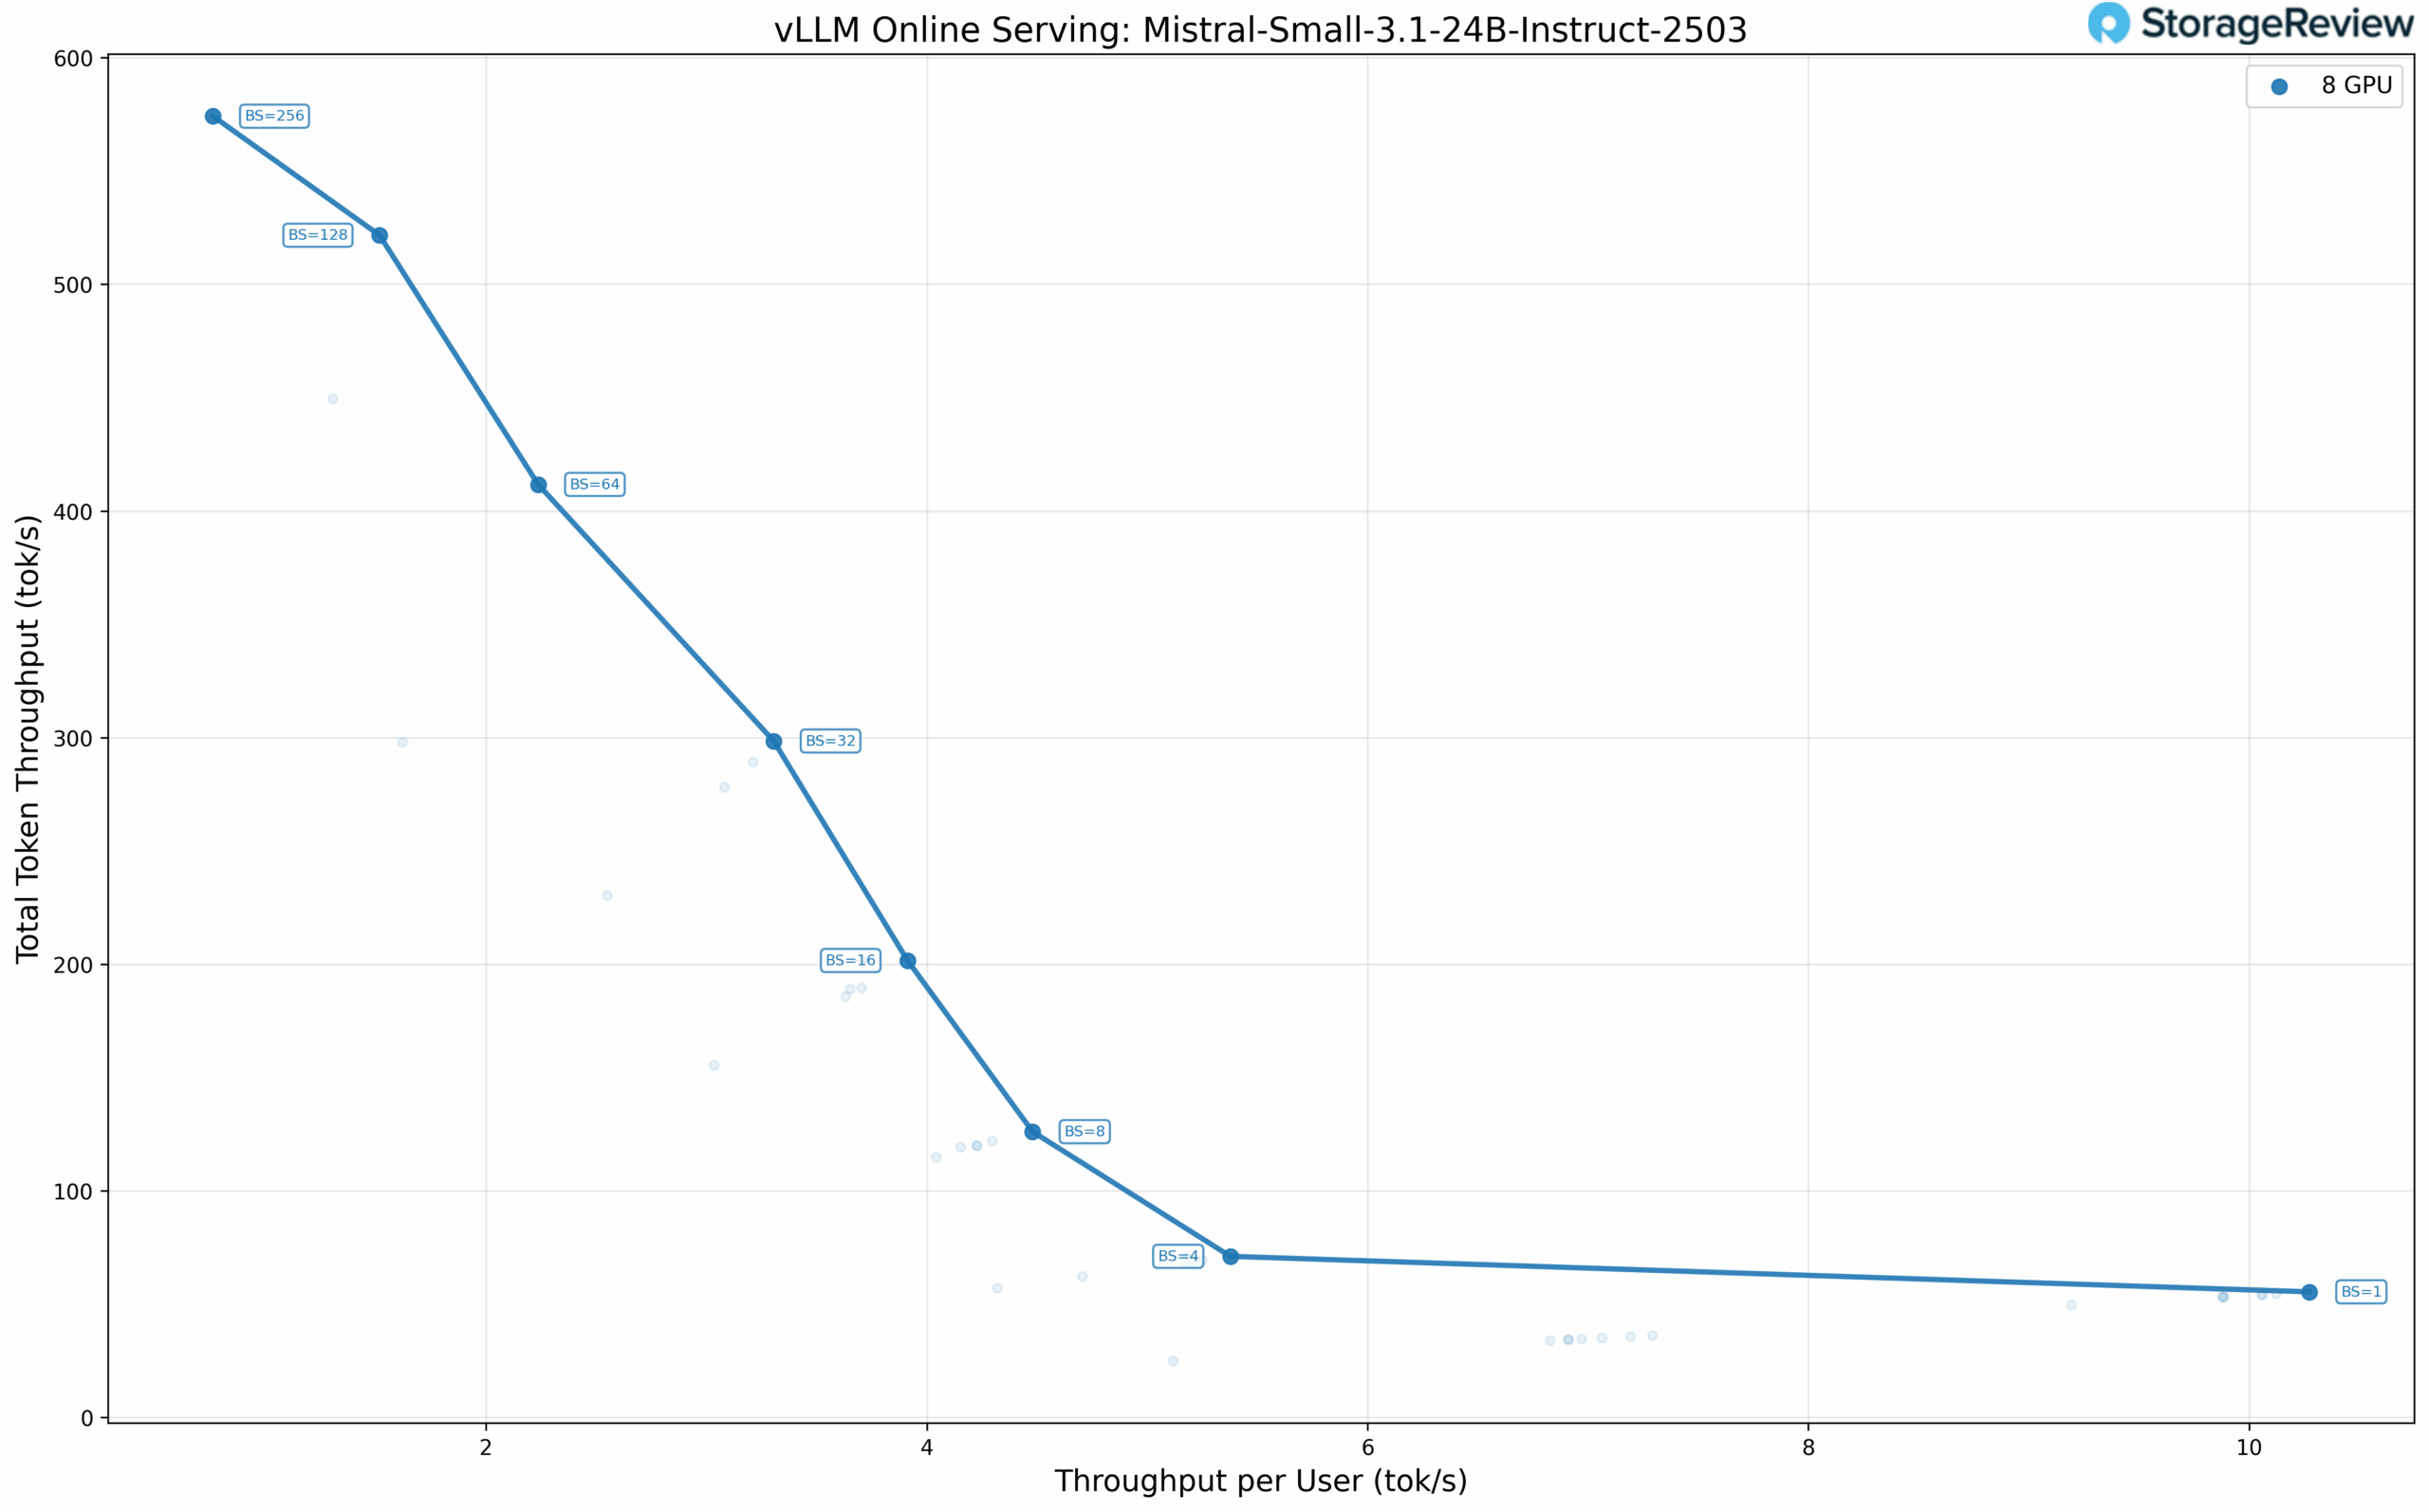
24B 매개변수 Mistral 모델은 더 높은 워크로드를 나타냅니다. BF16 정밀도에서 이 모델은 더 높은 배치 크기에서 강력한 처리량 확장을 달성하여, 8개의 GPU 모두에서 배치 크기 256에서 574.16 tok/s에 도달합니다.
조사 결과
테스트된 모든 모델에서 일관된 패턴이 나타납니다. 256개의 입력/출력 토큰 구성에서 배치 크기가 작을 경우, 모델에 필요한 최소한의 GPU만 사용하는 것이 8개의 GPU 전체에 분산하는 것보다 사용자당 성능이 더 우수합니다 . PCIe 5.0 속도에서도 PCIe를 통한 GPU 간 통신 오버헤드는 단일 사용자 또는 낮은 동시 접속 시나리오에서 병렬화 이점을 상쇄하는 지연 시간을 발생시킵니다.
이 결과는 배포 계획에 실질적인 영향을 미칩니다. 단일 사용자 코딩 어시스턴트 또는 저동시성 에이전트 워크플로를 사용하는 조직은 더 작은 GPU 구성으로도 만족스러운 성능을 얻을 수 있습니다. 전체 8개 GPU Battlematrix 구성은 일괄 추론 워크로드, 합성 데이터 생성 또는 요청당 지연 시간보다 총 처리량이 더 중요한 고동시성 서비스 시나리오에 가장 적합하며, 특히 더 많은 메모리를 필요로 하는 더 큰 모델을 사용할 때 더욱 그렇습니다.
Arc Pro B60s 사용 경험
제한된 테스트에서 테스트 결과는 놀라울 정도로 간단했습니다. 카드 설치 및 실행은 간단했고, 배틀메이지(Battlemage)를 지원하는 vLLM의 개발 브랜치인 LLM-Scaler 설정도 마찬가지로 간단했습니다. 하지만 소프트웨어는 아직 개발 초기 단계였습니다. 테스트를 시작했을 때 GPU 통계를 가져올 수 없었고, 텐서 병렬 처리 외에 전문가 병렬 처리나 파이프라인 병렬 처리와 같은 여러 시스템 간 확장을 위한 다른 병렬 처리 전략도 제대로 활용하지 못했습니다. 하지만 소프트웨어 스택의 출시 전 상태를 고려했을 때 이러한 한계는 예상했습니다.
저희가 처음 유튜브에 올린 짧은 영상 이후 냉각 성능에 대한 논의가 활발하게 이루어졌습니다 . 많은 분들이 개방형 테스트 환경에서 그래픽 카드가 과열될 수 있다는 우려를 표해주셨습니다. 열 모니터링 장비가 없었기 때문에, 적절한 공기 흐름을 확보하기 위해 결국 그래픽 카드를 서버 케이스로 옮겨 테스트했습니다. 인텔의 홍보 이미지에서처럼 최종 배틀매트릭스 구성은 워크스테이션 케이스에 그래픽 카드를 촘촘하게 쌓아서 사용하는 것이므로, 정식 리뷰에서는 워크스테이션 환경에서의 냉각 성능 테스트도 진행할 예정입니다.
폼 팩터 측면에서 이 카드들은 표준 워크스테이션 GPU보다 약간 길어 케이스 호환성에 문제가 발생할 수 있습니다. 하지만 대부분의 서버 케이스는 카드 앞쪽 가장자리에 지지 브래킷을 위한 추가 공간을 제공하기 때문에 서버 섀시에는 문제없이 장착됩니다.
향후 테스트 계획
B60의 정식 출시 및 일반 공급 이후 Intel Battlematrix를 다시 검토하고 더욱 광범위한 검토를 진행할 계획입니다. 다양한 모델과 배포 구성에 대한 추가 vLLM 테스트를 통해 LLM 추론 성능을 평가할 것입니다. 이 미리보기에는 표시되지 않았지만, 현재 소프트웨어 상태에서 이러한 GPU는 디코딩 작업보다 프리필(prefill)에서 더 나은 성능을 보이는 것으로 확인되었습니다. 전체 검토에서는 프리필 및 디코드 중심 추론 워크로드를 심층적으로 분석하여 이러한 동작을 특성화할 것입니다.
홈랩 커뮤니티에서는 가장 인기 있는 홈랩 워크로드 중 하나인 미디어 서버에 이러한 GPU를 사용하는 데 관심을 보였습니다. 저희는 Discord 커뮤니티 회원들과 함께 Plex 및 Jellyfin을 사용하여 이러한 GPU를 테스트할 계획입니다 . SolidWorks 및 Autodesk와 같은 전문 워크로드에 대한 CAD 성능 테스트도 고려 중입니다. 또한 Discord 회원을 위한 다중 사용자 VDI 서버를 구축하기 위해 Proxmox와 SR-IOV를 활용하여 동시 데스크톱 밀도 및 클라우드 게임 성능을 평가할 계획입니다.
맺음말
인텔의 Arc Pro B60 Battlematrix는 워크스테이션 가격대에서 대용량 GPU 메모리를 사용할 수 있는 매력적인 플랫폼입니다. 듀얼 GPU 카드 설계는 밀도 제약을 해결하고, GPU당 24GB 할당은 LLM 추론 워크로드에 적합하며, 가격 구조는 기존 전문가용 GPU 생태계에 대한 매력적인 대안을 제시합니다. 최첨단 성능보다 데이터 주권과 비용 효율성을 우선시하는 조직이라면 이 플랫폼을 고려해 볼 만합니다.
소프트웨어 성숙도는 여전히 주요 제약 조건입니다. 인텔이 LLM 스케일러를 통한 프레임워크 최적화와 지속적인 드라이버 개선에 투자한 것은 Arc GPU 제품군을 상당한 가치로 유지하려는 의지를 보여줍니다.
NVIDIA DGX Spark 가 제공하는 놀라운 성능에 비해 8개의 GPU로 구성된 배틀매트릭스 구성이 얼마나 인기를 끌지는 미지수입니다 . 진정한 관건은 600~1,200달러라는 저렴한 가격으로 진입 장벽을 대폭 낮춘 싱글 및 듀얼 카드 구성일 것입니다.
드라이버 업데이트가 나오고 소프트웨어 프레임워크가 성숙해짐에 따라 테스트를 지속적으로 확대해 나갈 예정입니다. 직접 테스트해 보고 싶으시다면, 저희 디스코드 서버에 가입하세요 . B60 접근 권한이 제한된 커뮤니티 서버가 있습니다.


 아마존