

NVIDIA DGX Spark는 접근 가능한 AI 인프라의 전환점을 보여줍니다. 2017년, 트랜스포머 아키텍처를 소개한 획기적인 논문 "Attention is All You Need"는 8개의 GPU로 구성된 P100 서버 구성을 기반으로 수십 킬로와트시의 전력을 소모하고 상당한 데이터센터 공간을 점유했습니다. 오늘날 DGX Spark는 240와트의 소형 데스크톱 폼팩터에서 탁월한 연산 성능을 제공합니다. 전력 효율과 폼팩터 압축의 획기적인 발전 덕분에 이전에는 데이터센터에서만 가능했던 AI 기능을 개별 연구원, 소규모 팀, 그리고 분산 개발 조직에서도 활용할 수 있게 되었습니다.
Spark를 기존 데스크톱 AI 솔루션과 차별화하는 요소는 전체 개발 라이프사이클에 대한 포괄적인 접근 방식입니다. Spark는 실험, 미세 조정, 배포 간의 절충을 강요하는 대신 모든 단계에서 진정한 역량을 제공합니다. 128GB 통합 메모리 아키텍처는 기존 워크스테이션에서 클라우드 리소스가 필요했던 모델의 전체 매개변수 미세 조정을 지원하는 동시에, 합성 데이터 생성을 포함한 일괄 추론 워크로드에 적합한 초당 수백 개의 토큰 처리량을 제공합니다. 200Gb 패브릭 기능을 갖춘 ConnectX-7 네트워킹이 포함되어 있어 기업은 더 큰 규모의 모델 탐색을 위해 여러 Spark 시스템을 클러스터링할 수 있습니다. 하지만 앞으로 살펴보겠지만, 단일 시스템만으로도 놀라운 성능을 발휘합니다.
주요 요점
데스크톱에서 즐기는 데이터센터급 성능 : 1.13리터 크기에 240W 전력을 소비하는 GB10 Grace Blackwell은 3,999달러에 판매되며, 최대 1페타플롭의 FP4 스파스 연산 성능을 제공합니다.
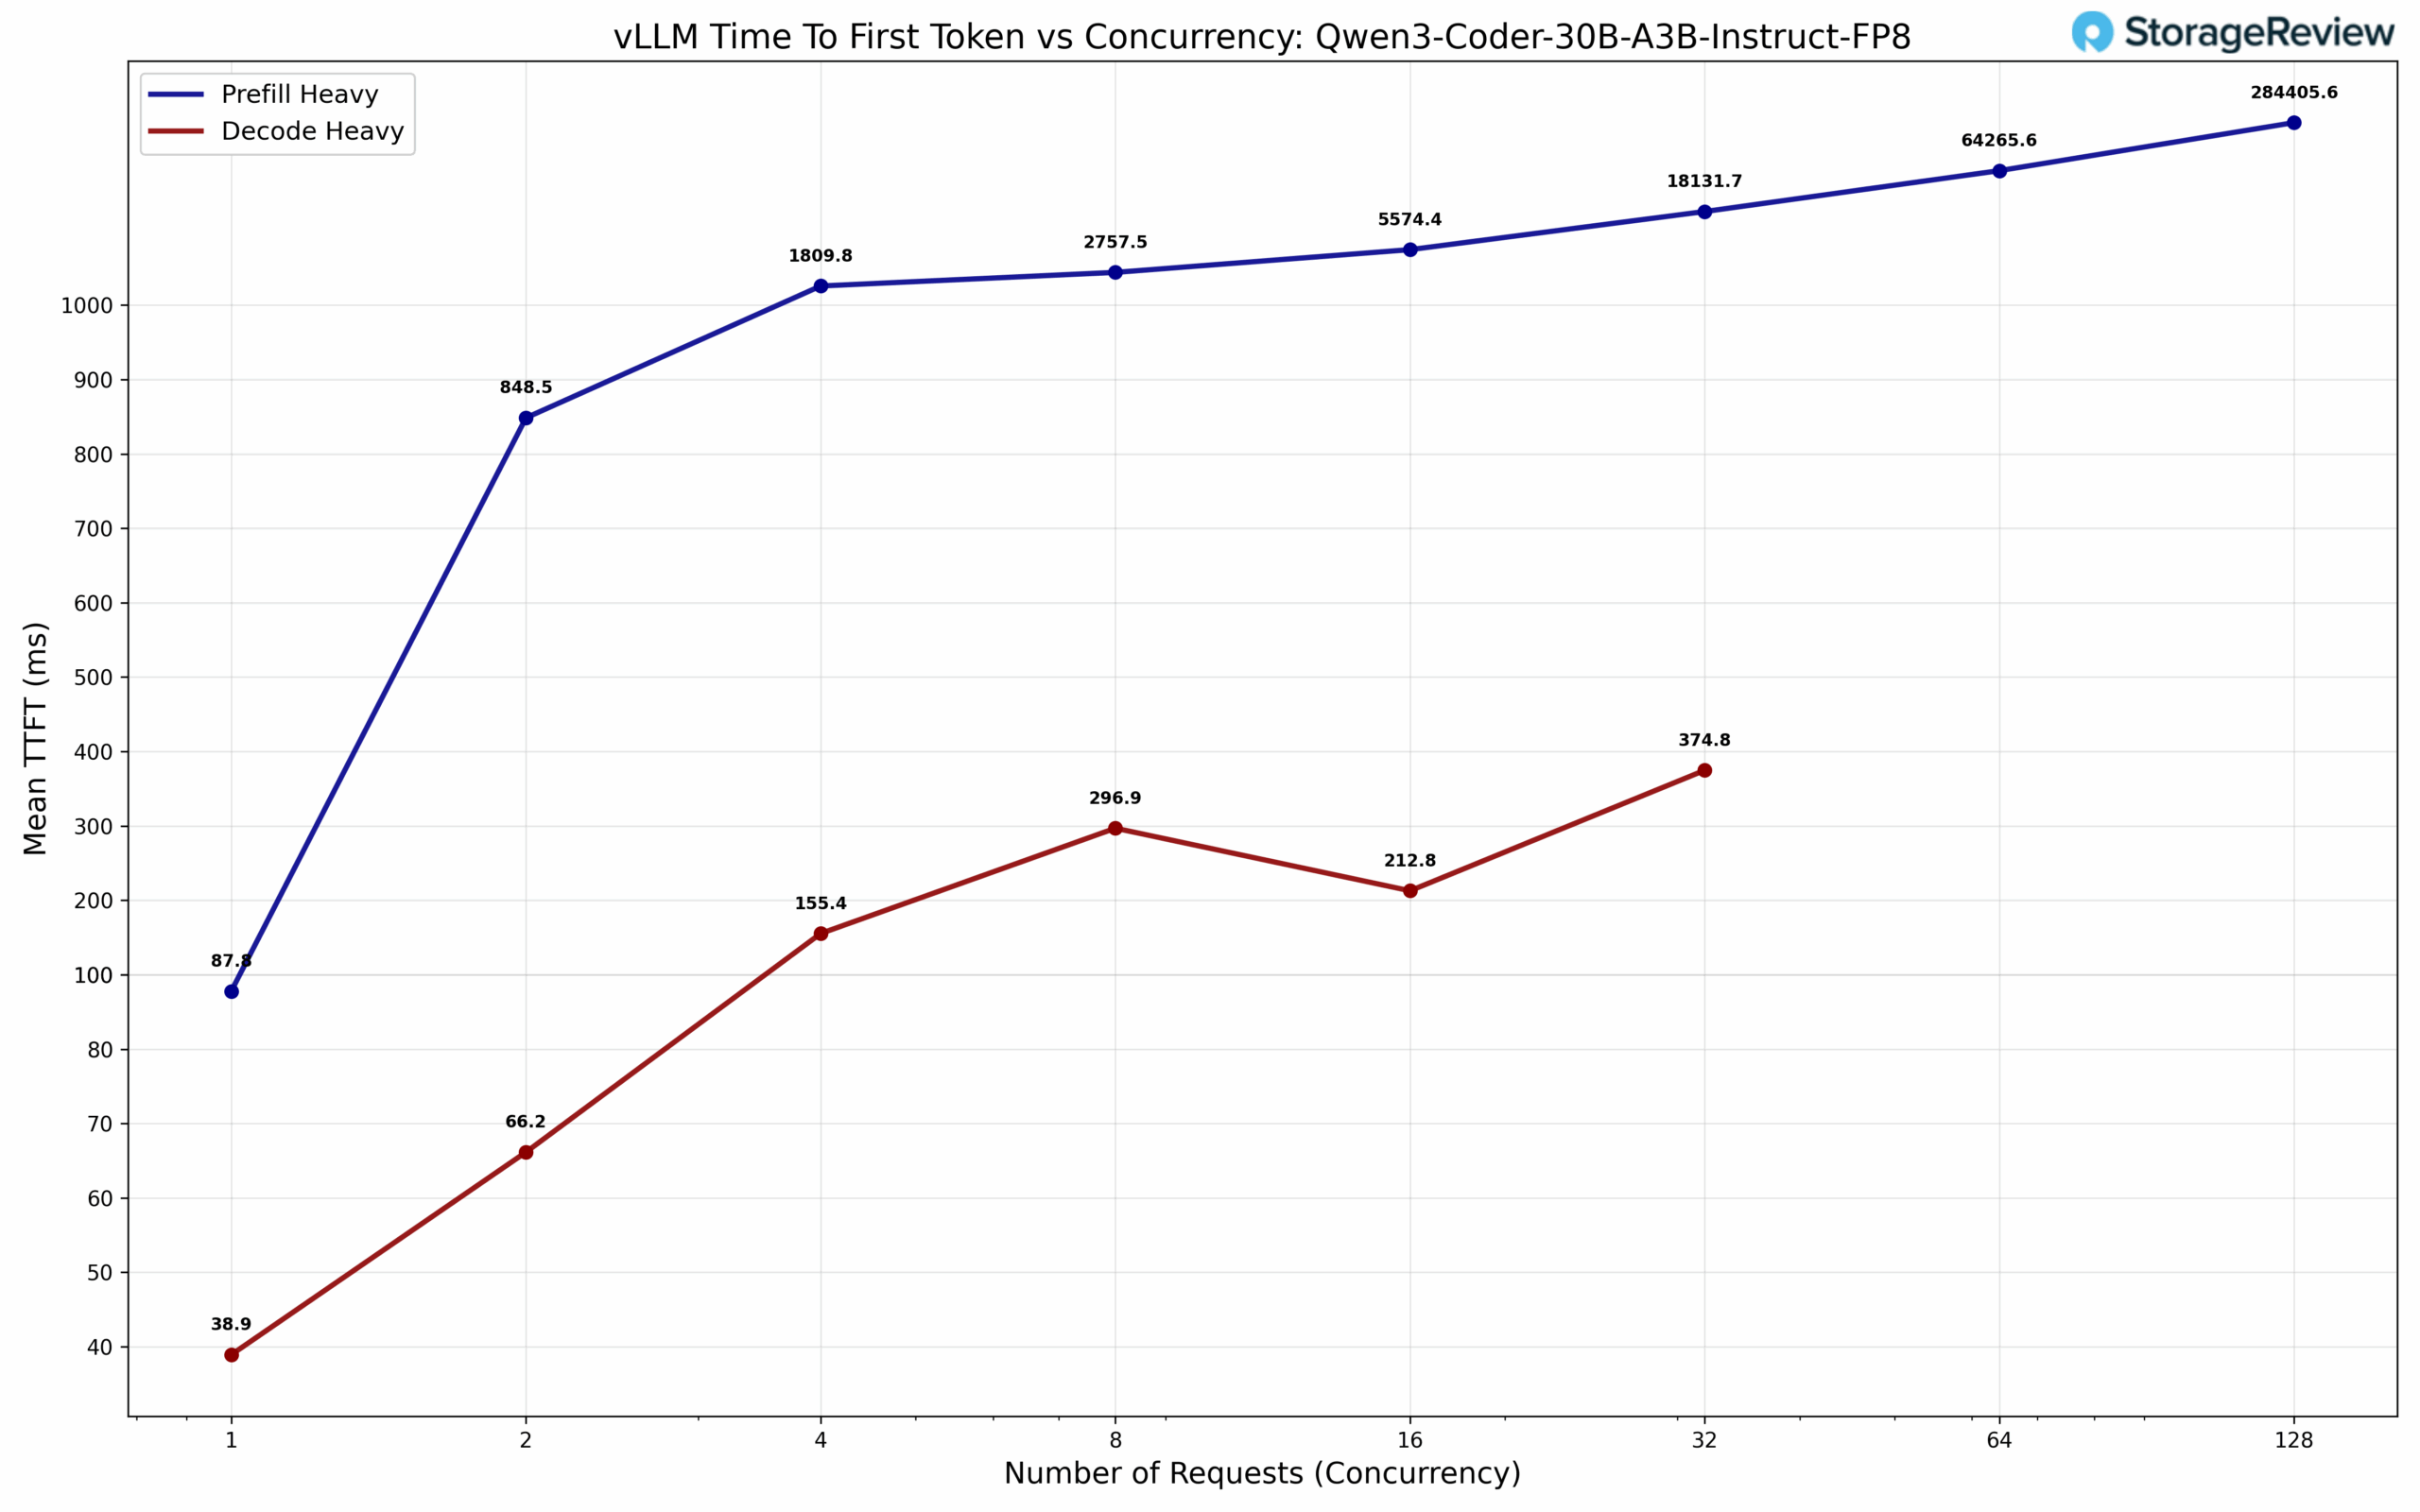
워크플로우를 혁신하는 메모리 : 128GB 통합 메모리를 통해 8B 모델의 모든 파라미터를 로컬에서 미세 조정하고 고처리량 추론을 수행할 수 있습니다. 테스트 결과, Llama 3.1 8B FP4 모델은 128개의 동시 실행에서 약 924 tok/s의 처리량을, Qwen3 Coder 30B-A3B FP8 모델은 64개의 배치에서 약 483 tok/s의 처리량을 기록했습니다.
확장성과 고속 스토리지 연결 준비 완료 : 통합 ConnectX-7은 클러스터링 또는 NVMe-oF를 위한 200G 패브릭을 제공합니다. 내장된 2242 Gen5 NVMe는 편리하지만 I/O 부하가 큰 경우에는 한계가 있으므로, 지속적인 처리량을 위해서는 RDMA를 통한 외부 NVMe-oF 연결이 더 나은 선택입니다.
출시 당일부터 사용 가능한 소프트웨어 완성도 : DGX OS, CUDA, cuDNN, TensorRT, AI Workbench, 컨테이너 및 워크플로우 플레이북이 포함되어 있어 팀에서 실제 워크로드를 즉시 실행할 수 있습니다.
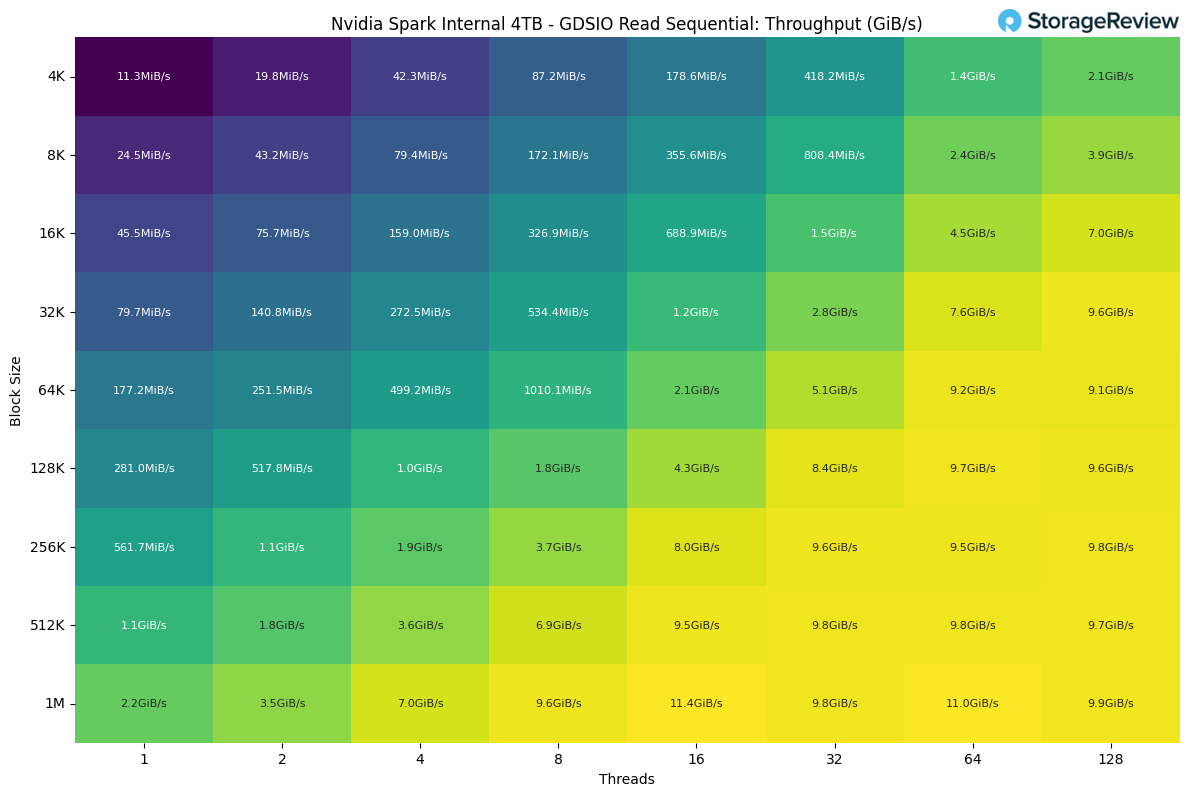
실제 성능 검증 완료: MAMF는 BF16에서 약 99.8 TFLOPs, FP8에서 약 207.7 TFLOPs를 기록했습니다. GDSIO 읽기 속도는 내부적으로 최대 약 11.4 GiB/s에 달했으며, 200G 패브릭에서는 더 높은 성능을 기대할 수 있습니다.
DGX Spark란 무엇이고, 누가 고려해야 할까요?
NVIDIA DGX Spark는 단순한 GPU 구성 요소가 아닌, 근본적으로 완전한 AI 개발 플랫폼입니다. 핵심에는 5세대 텐서 코어를 탑재한 Blackwell 아키텍처 GPU와 20코어 Arm CPU(Cortex-X925 10개 + Cortex-A725 10개)를 NVLink-C2C를 통해 연결하는 GB10 Grace Blackwell Superchip이 있습니다. NVIDIA에 따르면, 이러한 일관된 상호 연결 아키텍처는 PCIe Gen 5보다 최대 5배 더 높은 대역폭을 제공하여 개별 처리 영역이 아닌 통합된 컴퓨팅 패브릭을 구축합니다.
사용자가 쉽게 시작할 수 있도록 NVIDIA는 CUDA, cuDNN, TensorRT, NVIDIA Container Runtime, AI Workbench를 포함한 완전한 AI 소프트웨어 스택이 사전 구성된 Ubuntu Desktop 기반 DGX OS를 제공합니다. 이를 통해 맞춤형 워크스테이션 빌드에서 흔히 발생하는 드라이버 문제와 환경 구성 오버헤드를 해소할 수 있습니다. 이 시스템은 유연한 배포 패러다임을 제공합니다. 주변 장치를 연결하여 전체 Ubuntu 데스크톱 환경을 갖춘 소형 워크스테이션으로 사용하거나, JupyterLab, VS Code, Cursor IDE, SSH 터미널과 원활하게 통합되는 NVIDIA Sync를 통해 액세스 가능한 헤드리스 네트워크 어플라이언스로 배포할 수 있습니다.
이는 AI 실무자, 언어 모델을 미세 조정하는 연구자, RAPIDS 워크플로를 가속화하는 데이터 과학자, 에이전트 시스템을 구현하는 개발자, 또는 소규모로 애블러티브 모델을 사용하는 아키텍처를 실험하는 팀을 위해 특별히 구축된 인프라입니다. Spark는 데이터 센터의 복잡성 없이 강력한 AI 연산 역량을 필요로 하는 전문가를 대상으로 합니다.
NVIDIA DGX Spark 기술 사양
| 스펙 | 세부 정보 |
|---|---|
| 아키텍처 | |
| GPU | NVIDIA Blackwell 아키텍처 |
| CPU | 20코어 Arm(Cortex-X925 10개 + Cortex-A725 10개) |
| 텐서 코어 | 5th 생성 |
| RT 코어 | 4th 생성 |
| NVENC / NVDEC | 1×/1× |
| 메모리 | |
| 시스템 메모리 | 128GB LPDDR5X(통합 시스템 메모리) |
| 메모리 인터페이스 | 256-bit |
| 메모리 대역폭 | 273 GB / 초 |
| 성능 | |
| FP4 | 최대 1페타플롭(Sparsity 포함) |
| 스토리지 | |
| 스토리지 | 1TB 또는 4TB NVMe M.2(자체 암호화) |
| 입/출력 라인 | |
| USB | 4× Type-C USB 3.2 Gen 2×2(20Gbps) |
| Ethernet | 1× 10GbE RJ-45 |
| NIC | ConnectX-7 Smart NIC – 2x 200G QSFP(최대 200G 대역폭 허용) |
| Wireless | Wi-Fi 7, Bluetooth 5.3 |
| 오디오 출력 | HDMI 다중채널 오디오 출력 |
| 디스플레이 커넥터 | 1× HDMI 2.1a |
| Mechanical | |
| 크기 | 150 × 150 × 50.5mm(5.9 × 5.9 × 1.98인치) |
| 중량(평량) | 1.2의 kg |
| 전력 소비 | 240 승 |
NVIDIA DGX Spark 디자인 및 빌드
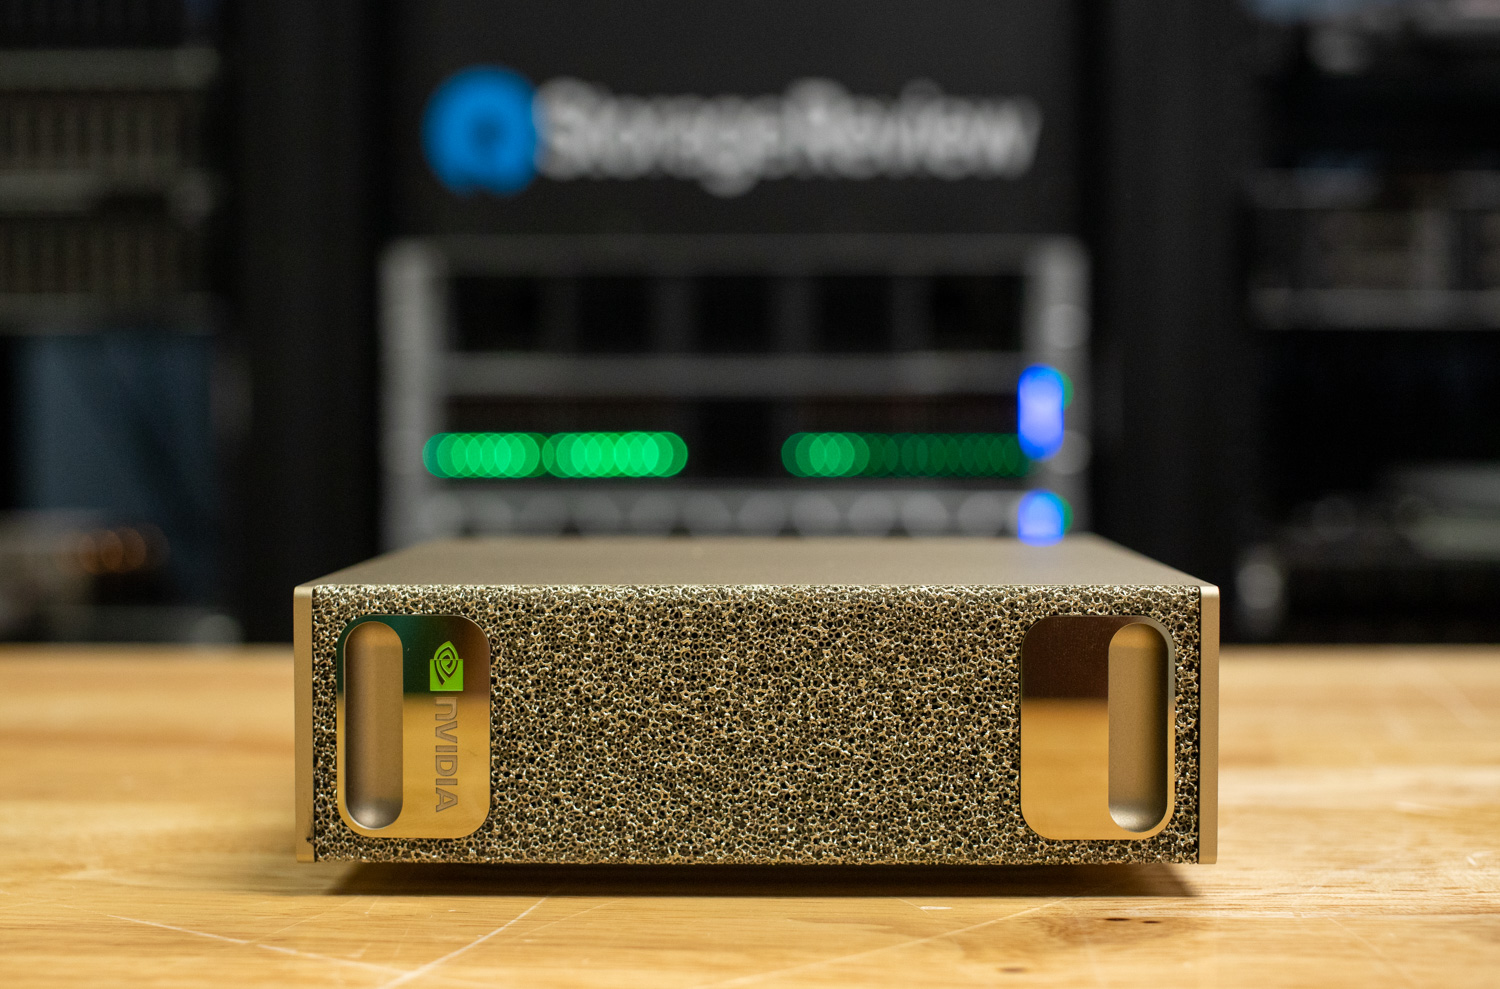
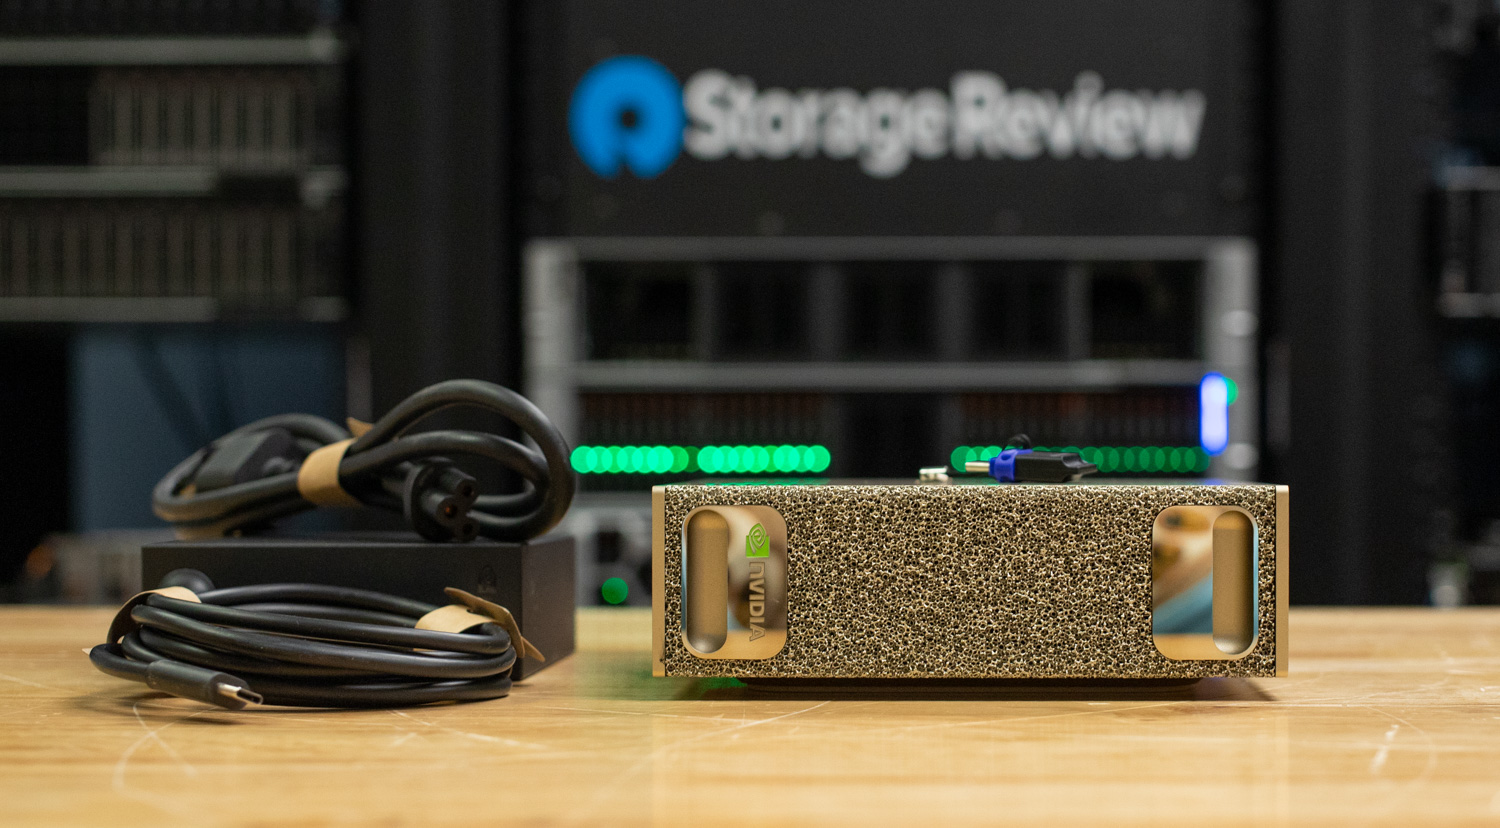
NVIDIA DGX Spark는 NVIDIA의 독보적인 산업 디자인 언어를 계승하여, 대형 DGX 시스템의 디자인과 느낌을 그대로 반영한 컴팩트한 섀시를 선보입니다. 전면 패널은 소형 핸드홀드 컷아웃을 특징으로 하며, 오리지널 풀사이즈 DGX 유닛의 핸들을 연상시킵니다. 또한, 금박을 입힌 메탈릭 마감은 세련되고 고급스러운 질감을 선사하며, NVIDIA의 상징적인 녹색 로고 배지가 더욱 돋보입니다.
DGX Spark의 크기는 5.9 x 5.9 x 1.98인치(150 x 150 x 50.5mm)이고 무게는 2.6파운드(1.2kg)로, 총 내부 용량은 1.13리터입니다. 이는 1리터 소형 폼팩터 PC에 속합니다. 작은 크기에도 불구하고, 수동형 열 분산기 역할도 하는 100% 금속 합금 케이스 덕분에 견고하고 견고한 느낌을 제공하며, 형태와 기능 모두에 중점을 두고 있습니다.
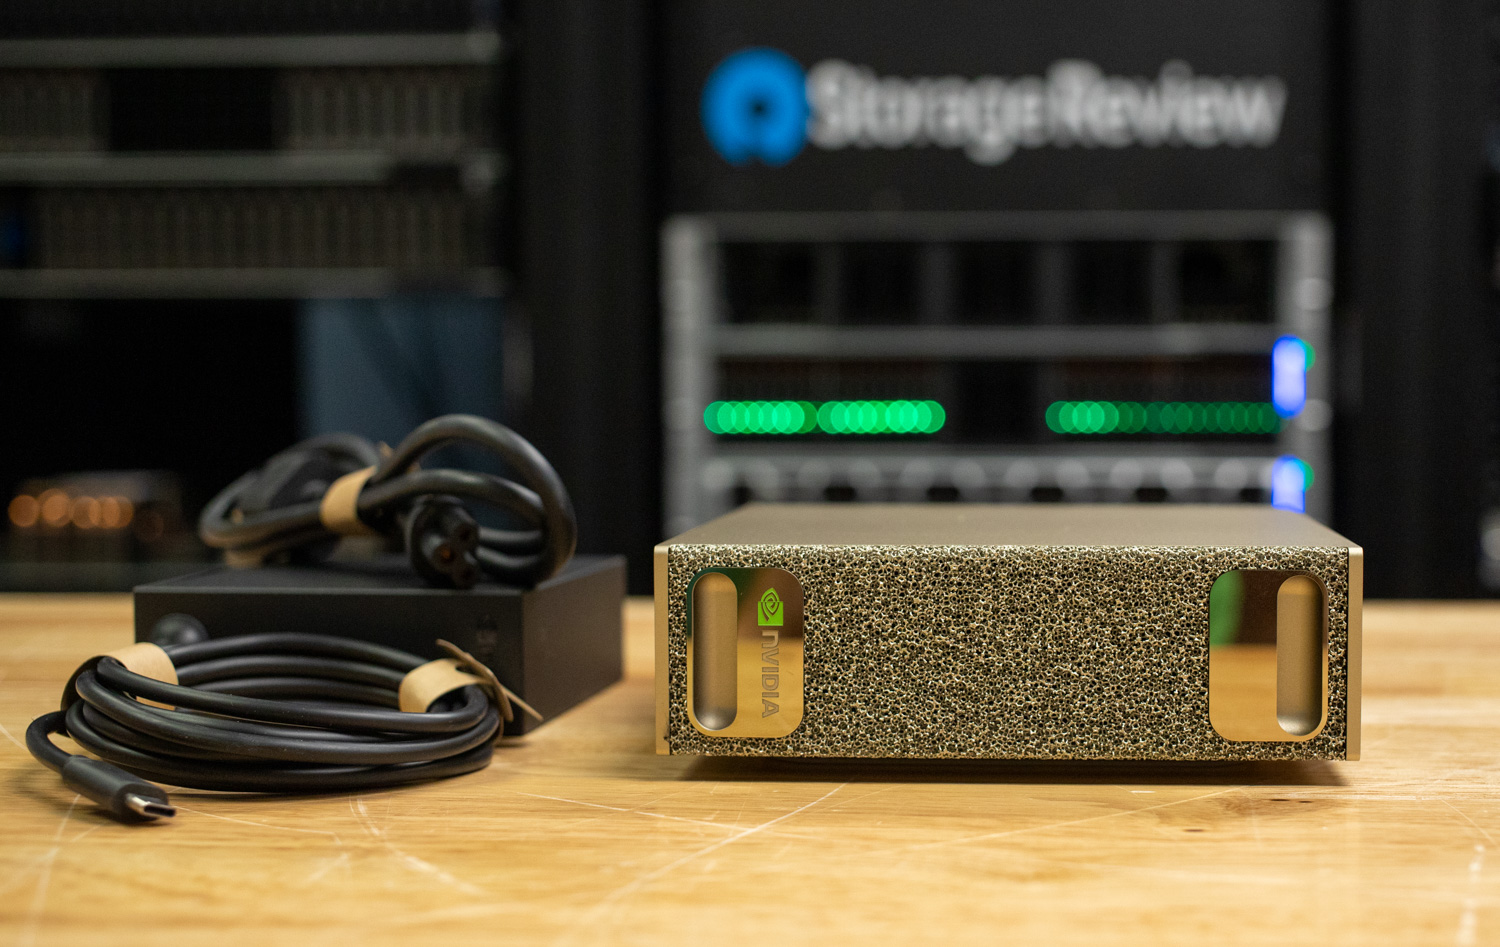
전원은 이미지에서 본체 옆에 보이는 240W USB-C 외장 전원 어댑터를 통해 공급됩니다. 이 어댑터는 컴팩트하고 견고하게 제작되었으며, AC 입력에는 표준 C5(클로버리프) 커넥터를 사용하고 DGX Spark의 깔끔하고 효율적인 디자인과 조화를 이룹니다.
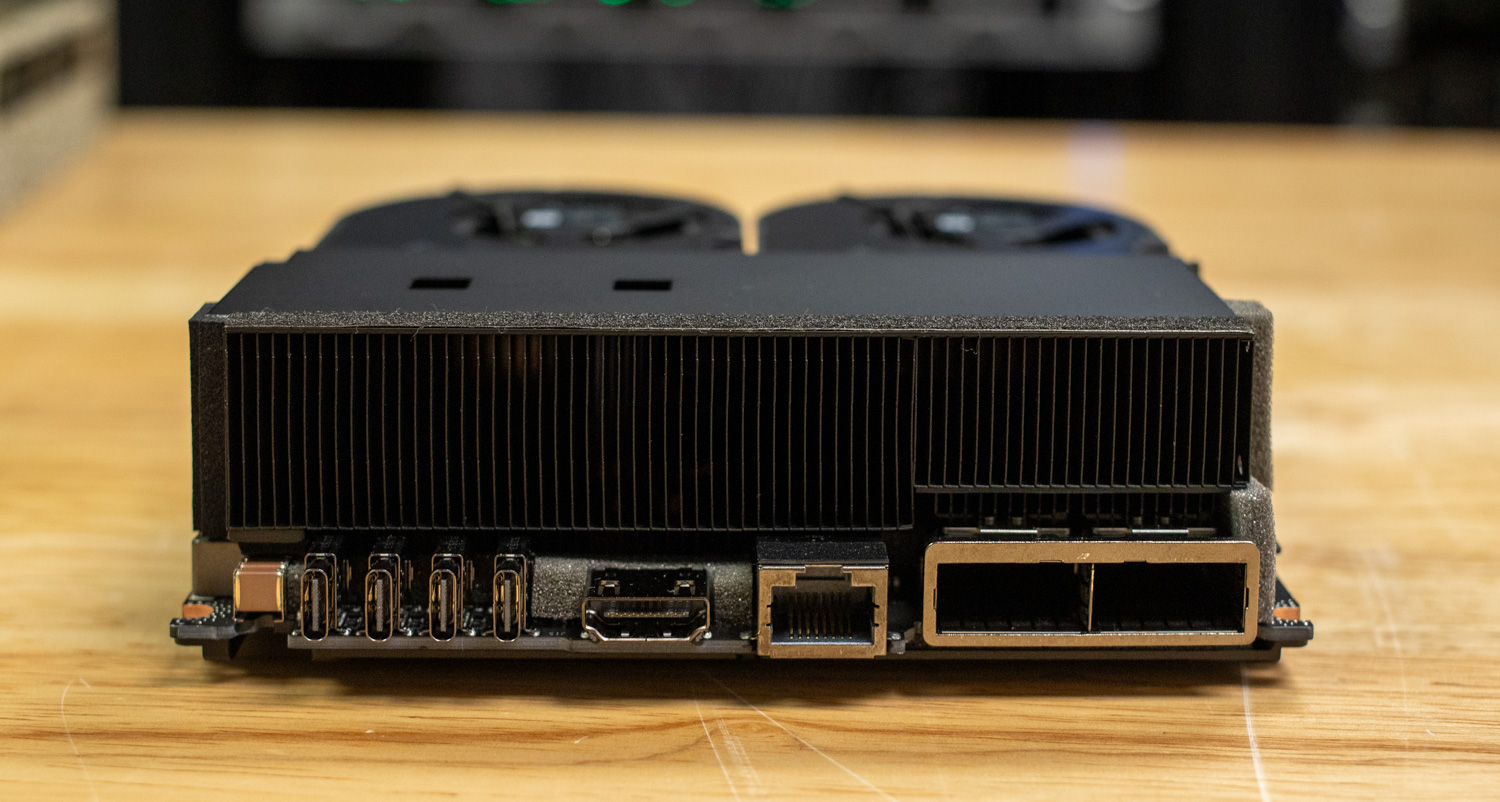
DGX Spark의 후면을 살펴보면, 전면과 동일한 금색 반점 텍스처 마감을 그대로 이어받아 섀시 전체에 걸쳐 통일감 있는 디자인을 유지합니다. 왼쪽부터 전원 버튼은 USB-C 포트 4개 옆에 위치하며, 그중 하나는 전원 공급을 담당합니다. 그 뒤로는 HDMI 2.1a 출력 포트 1개, 10GbE RJ-45 포트 1개가 있으며, 이 제품의 가장 큰 특징은 통합 NVIDIA ConnectX-7 SmartNIC으로 구동되는 듀얼 200GbE QSFP56 인터페이스입니다.
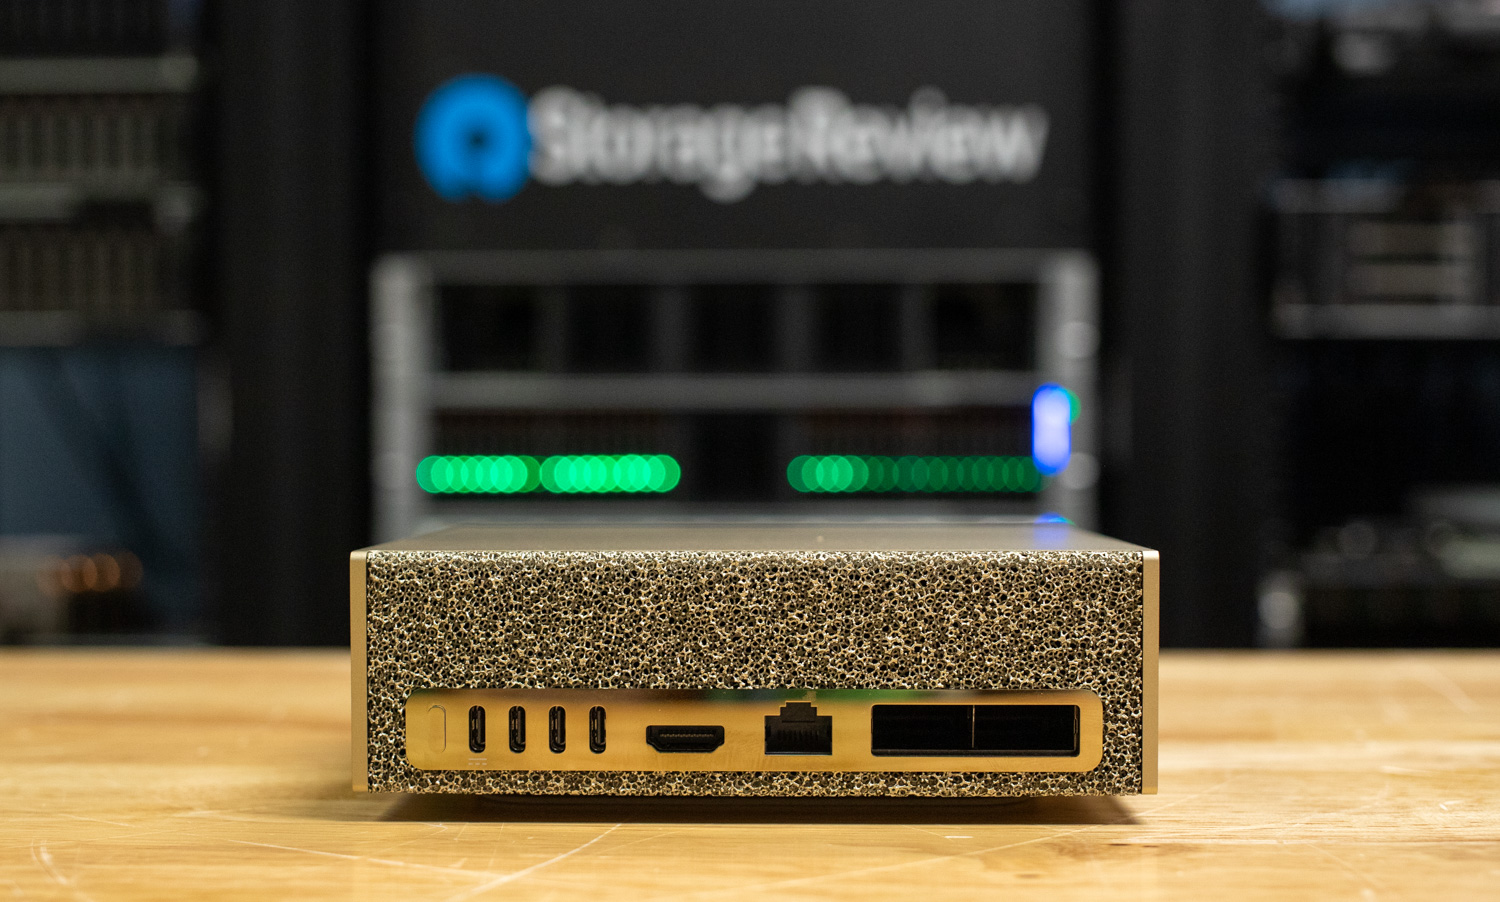
언뜻 보기에 Spark는 400G의 연결을 지원한다고 생각하실 수 있지만, 아쉽게도 PCIe 제한으로 인해 Spark는 200G의 연결만 제공합니다. 더 자세히 알아보기 위해 Spark의 토폴로지를 자세히 살펴보았습니다.
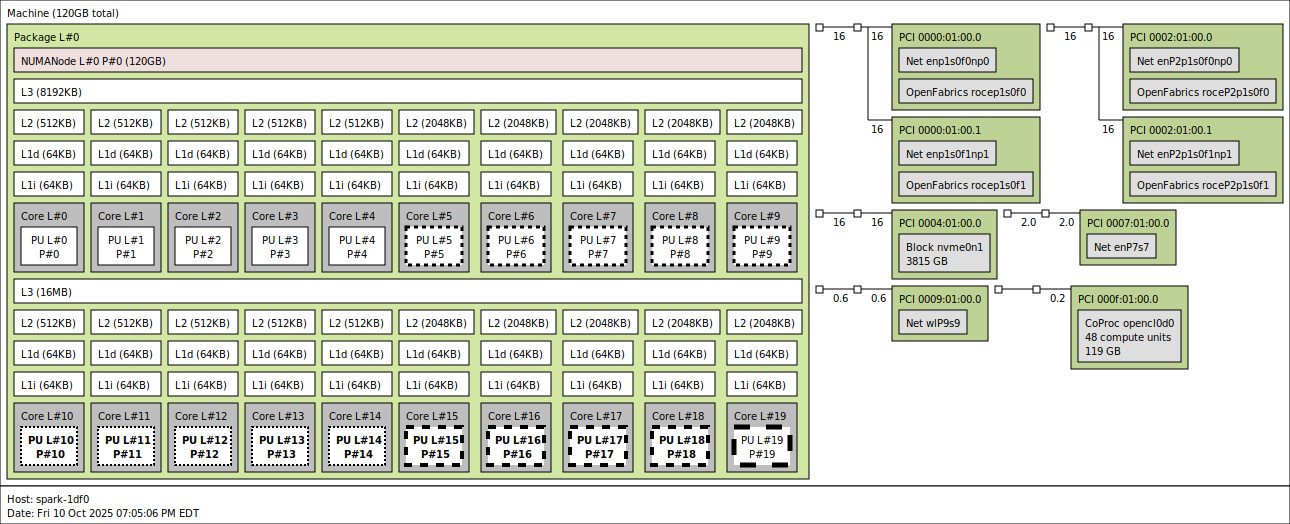
lstopo를 사용하여 CX7 NIC의 두 상호 연결을 관찰했습니다. 전기적으로 CX7은 두 개의 Gen5 x4 링크를 통해 연결됩니다. OS 내에서 이러한 연결은 각각 최대 200G의 대역폭을 지원하는 네 개의 인터페이스로 나타납니다. 테스트 시간이 제한되어 NVMe-oF 테스트 외에는 이 플랫폼의 모든 네트워킹 문제를 발견할 수 없었습니다. 자세한 내용은 이 글의 뒷부분에서 설명합니다. 하지만 이 플랫폼을 더 자세히 살펴보고, 여러 개의 스파크를 클러스터링하여 미니 클러스터를 만드는 것과 같은 기능을 더 자세히 다루는 글을 추후에 게시할 계획입니다.
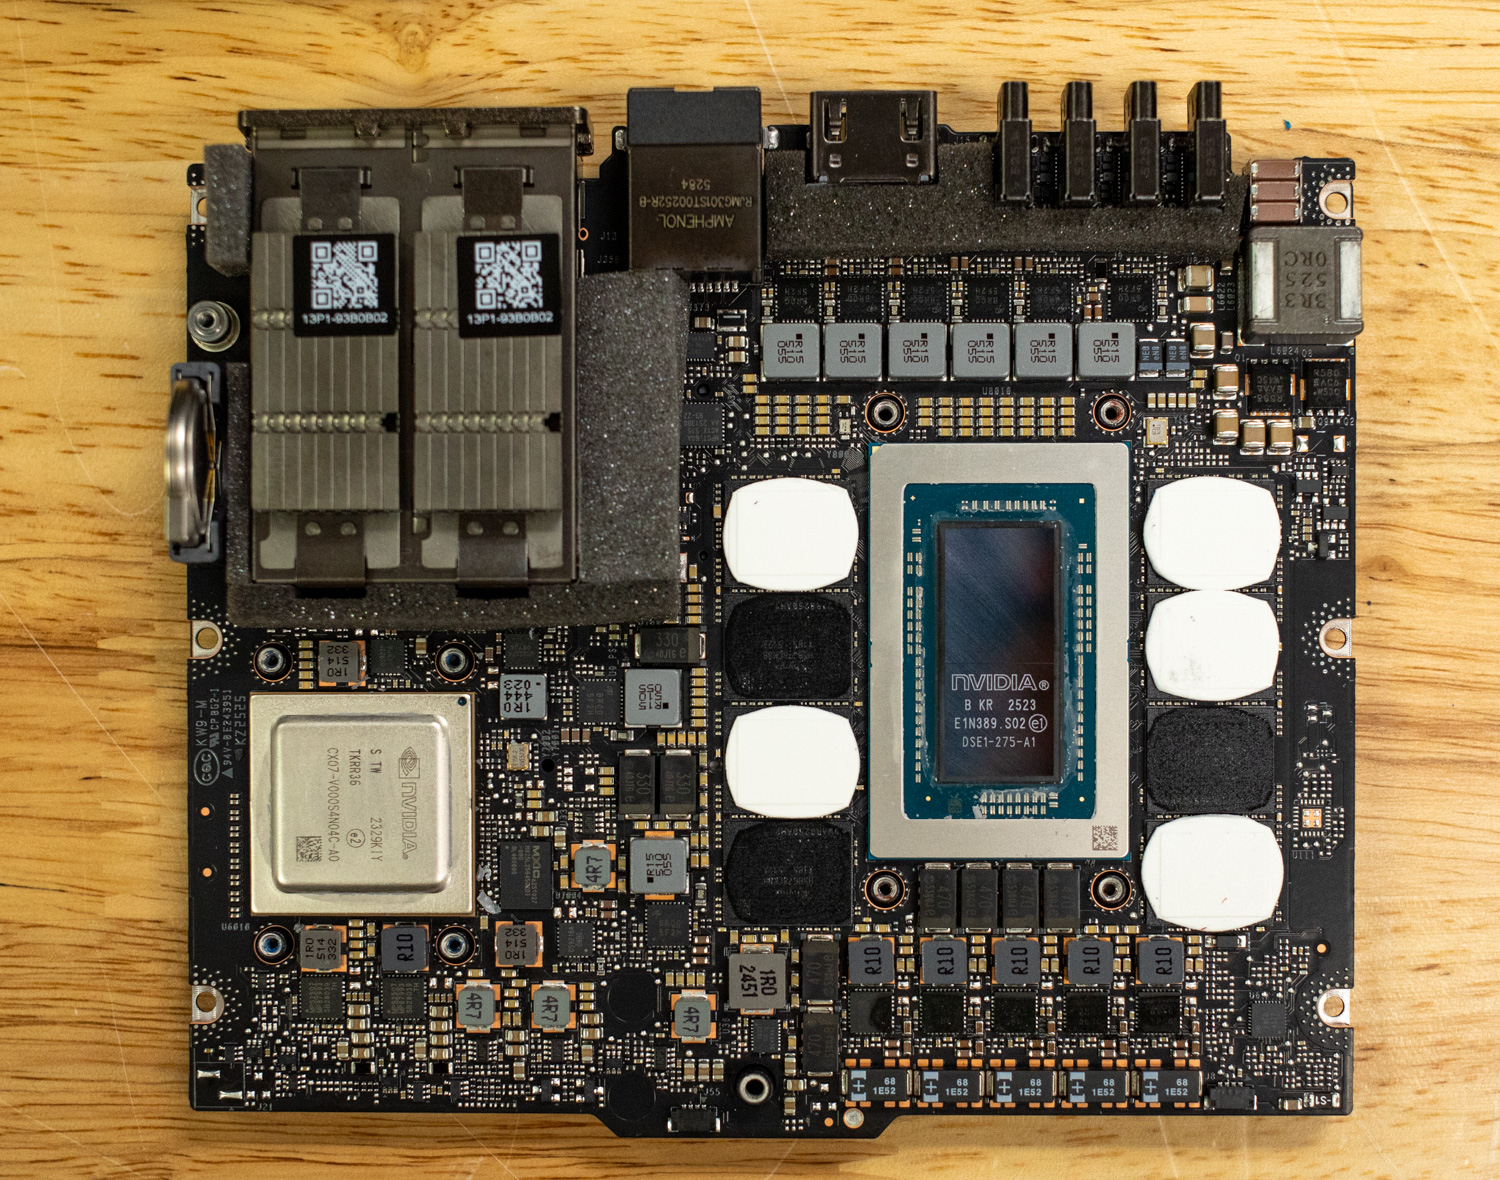
다른 연결 장치를 살펴보면, 다음은 Gen5 x4에 연결된 작은 2242 폼 팩터 M.2 SSD이고, 그 다음은 PCIe Gen4 x1 링크에 연결된 Realtek RJ45 10GbE 컨트롤러, PCIe Gen3 x1 링크에 연결된 MediaTek Wi-Fi 컨트롤러입니다.
CPU를 자세히 살펴보면, Spark는 Intel의 최신 프로세서와 유사한 이기종 빅리틀 아키텍처를 갖춘 20코어 Arm 프로세서를 탑재하고 있습니다. 이 아키텍처는 Cortex-A725 효율 코어 10개와 Cortex-X925 성능 코어 10개로 구성되어 있으며, 두 개의 L3 캐시 클러스터에 분산되어 있습니다. 첫 번째 클러스터(8MB L3)에는 CPU 0~4번(Cortex-A725, 최대 2808MHz)과 CPU 5~9번(Cortex-X925, 최대 3900MHz)이, 두 번째 클러스터(16MB L3)에는 CPU 10~14번(Cortex-A725, 최대 2860MHz)과 CPU 15~19번(Cortex-X925, 최대 3978~4004MHz)이 포함되어 있습니다. 각 코어는 64KB L1 데이터 캐시와 64KB L1 명령어 캐시를 가지고 있지만, L2 캐시는 코어 유형에 따라 상당한 차이를 보입니다. 효율형 Cortex-A725 코어는 512KB L2 캐시를 가지고 있는 반면, 성능형 Cortex-X925 코어는 훨씬 더 큰 2MB L2 캐시(4배 더 큼)를 가지고 있습니다. 가장 빠른 코어는 CPU 15~19로, 더 큰 16MB L3 캐시와 더 높은 주파수의 이점을 누리며, CPU 19는 4004MHz로 최고 성능을 발휘합니다. 이러한 다양한 전력/주파수 수준은 위에 표시된 토폴로지에서 코어의 점선으로 표시됩니다.
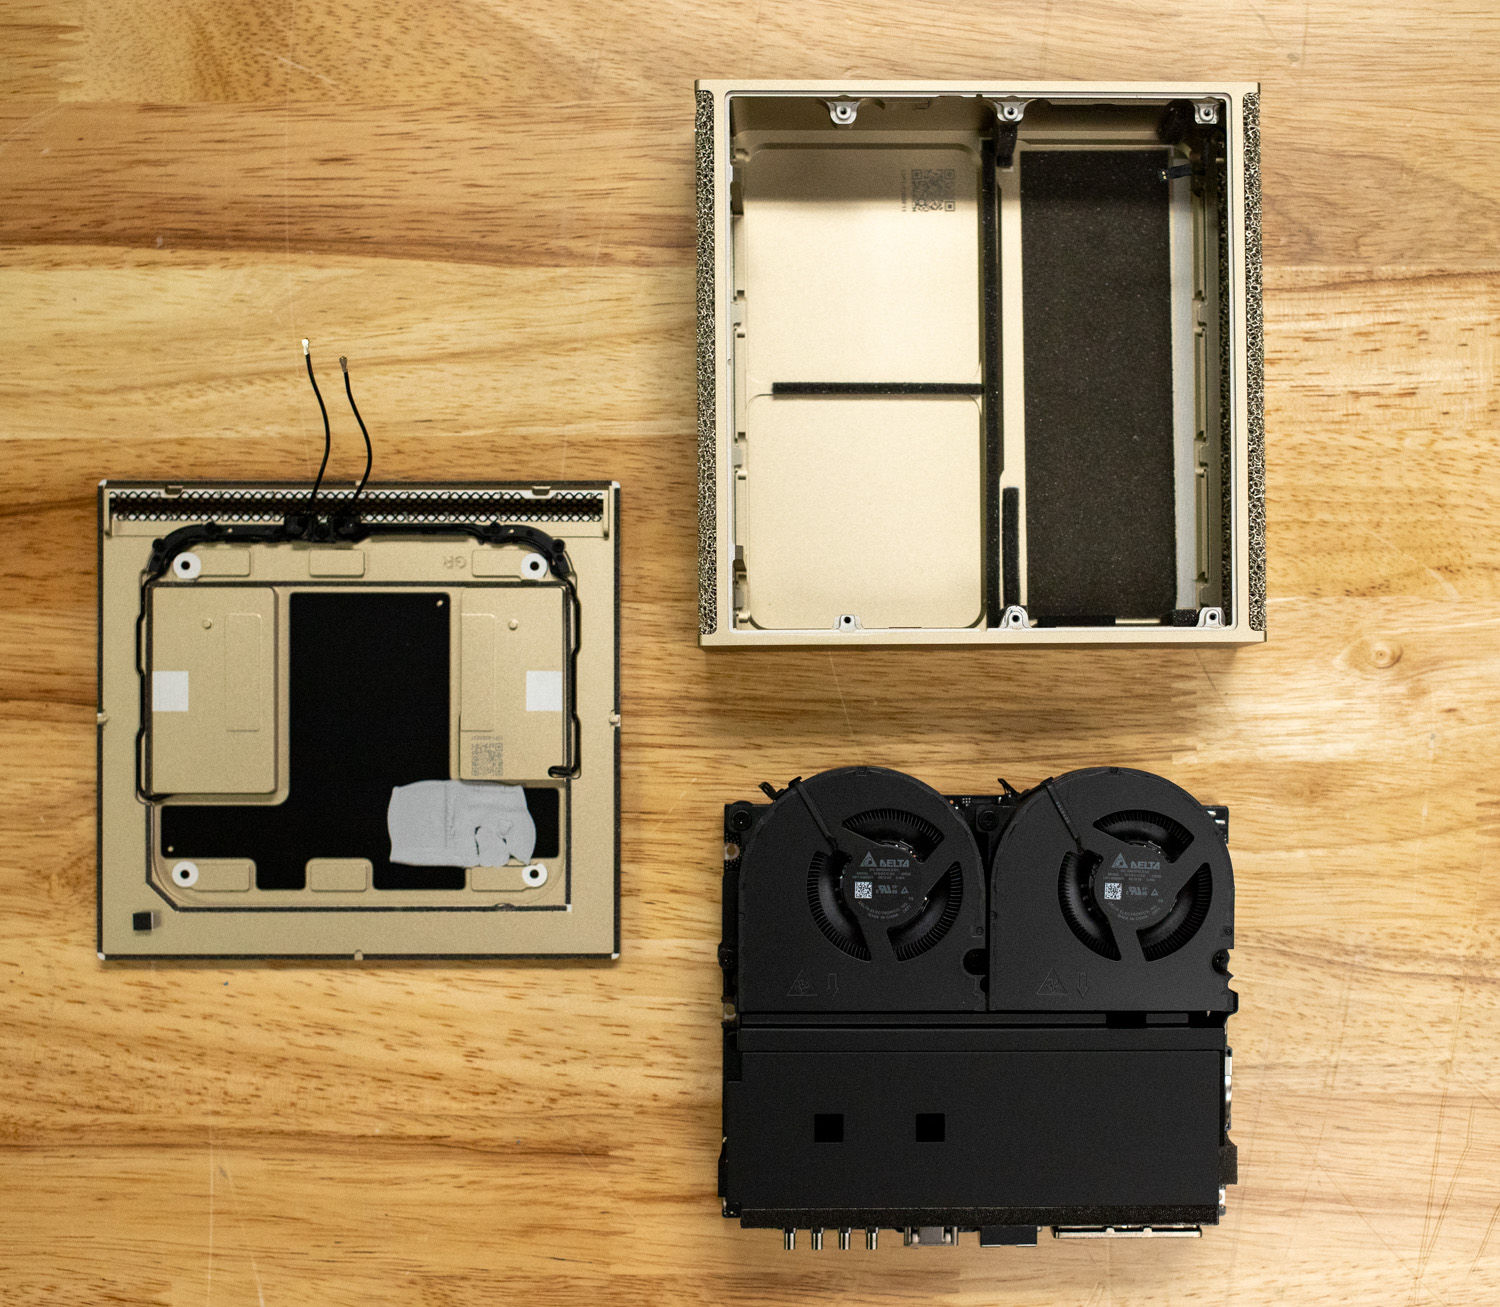
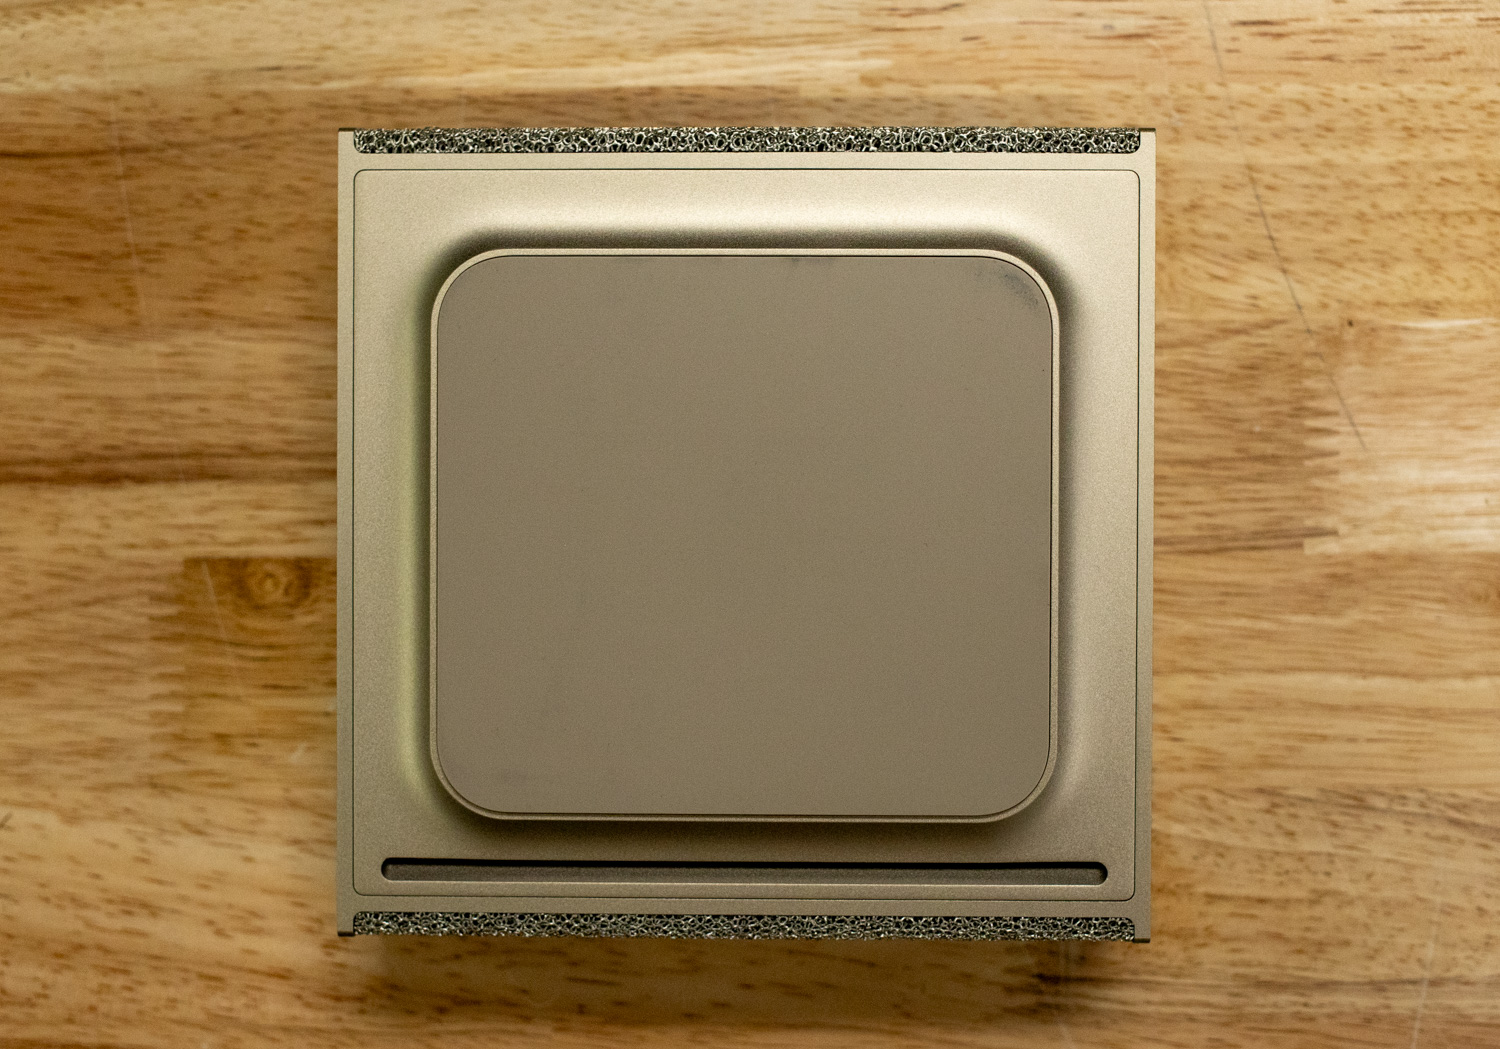
줌아웃을 하고 DGX Spark를 뒤집어 봤습니다. 눈에 보이는 플라스틱 부품은 본체 하단에 자석으로 고정되는 베이스 커버뿐입니다. 이 디자인은 외부를 깔끔하게 유지하면서도 내부 부품에 빠르게 접근할 수 있도록 해줍니다. 자석 베이스를 제거하면 네 개의 나사가 드러나 주요 내부 공간에 접근할 수 있습니다.
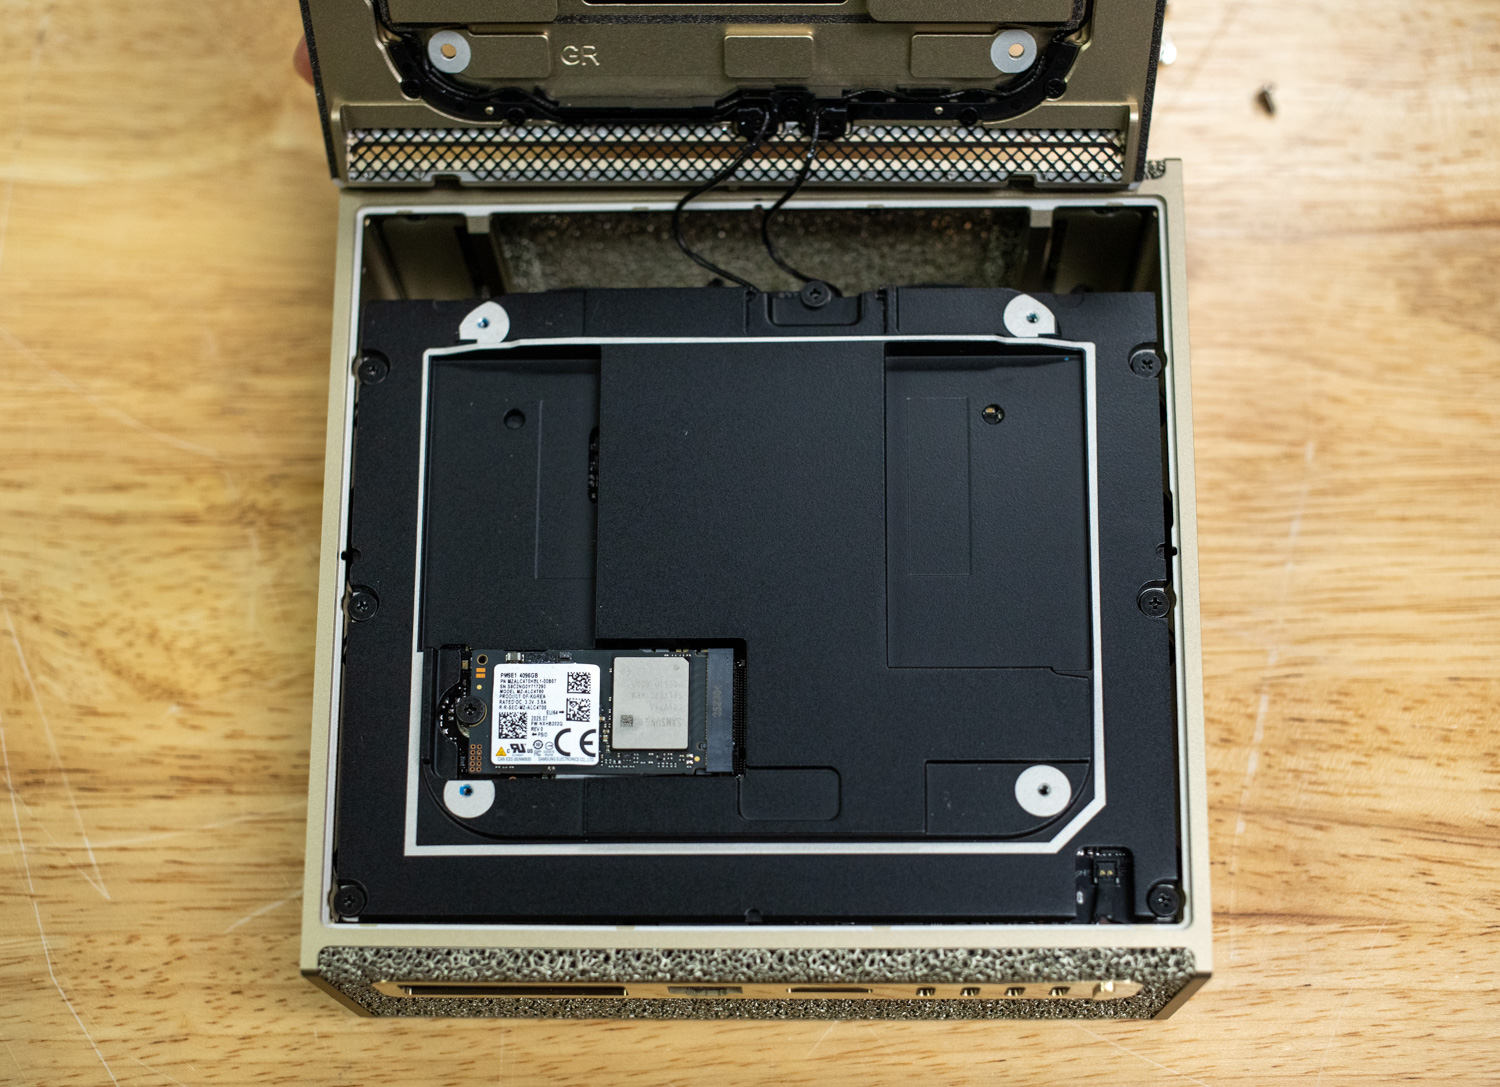
내부에서는 안테나 배선이 장치 상단으로 연결되어 있어 Wi-Fi 7과 Bluetooth 5.3 연결이 포함되어 있음을 확인할 수 있습니다. 이는 유연한 네트워크 옵션을 제공하며, 특히 유선 연결이 어려운 모바일 또는 실험실 환경에서 유용합니다.
또한 이 장치의 스토리지 솔루션인 PCIe Gen5 2242 M.2 SSD도 눈에 띕니다. 이는 이러한 고성능 하드웨어에서는 흔하지 않은 폼팩터입니다. 여기에 표시된 구성에는 4TB 삼성 NVMe 드라이브가 포함되어 있습니다.
DGX Spark를 자세히 살펴보면 시스템의 핵심인 NVIDIA Grace Blackwell의 GB10 슈퍼칩이 드러납니다. GB10 슈퍼칩 옆에는 8개의 LPDDR5X 통합 시스템 메모리가 납땜되어 있으며, 273GB/s의 대역폭을 제공하여 CPU와 GPU 작업 모두에서 빠른 데이터 액세스를 보장합니다.
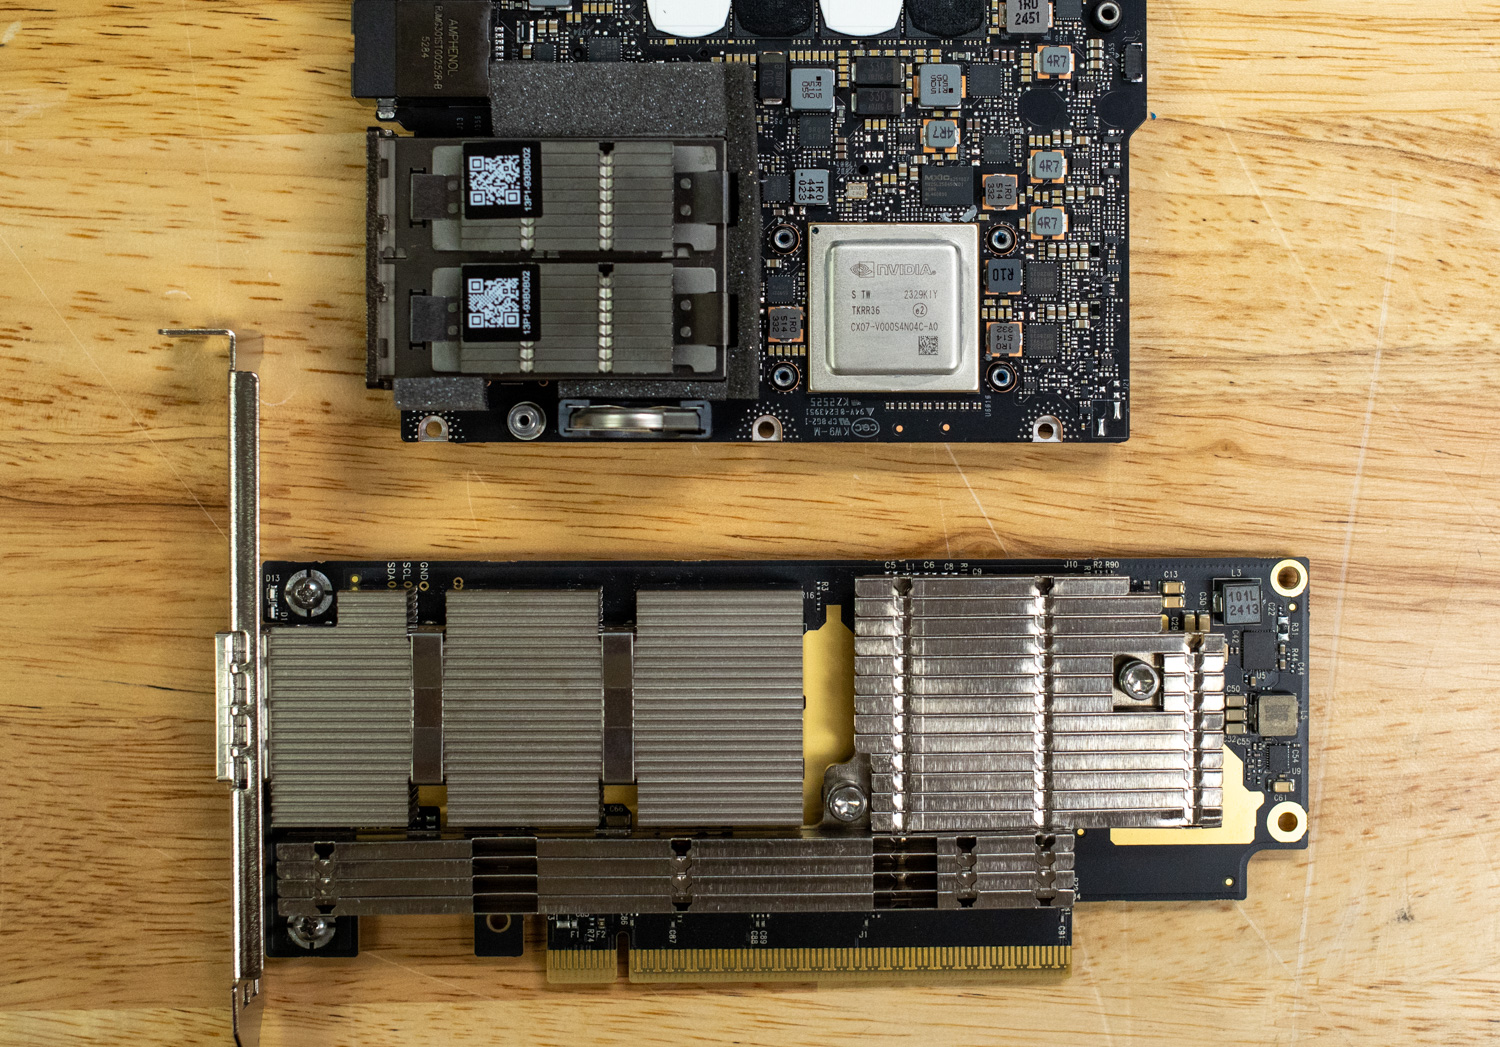
칩 바로 옆에는 CX7 NIC가 있는데, 앞서 언급했듯이 200G의 연결을 제공합니다. 이를 통해 사용자는 Spark를 고속 스토리지에 연결하거나 여러 Spark 인스턴스를 함께 클러스터링할 수 있습니다. NVIDIA는 더 큰 규모의 AI 모델을 지원하기 위해 직접 연결할 수 있는 두 대의 Spark 클러스터를 검증하여 판매하고 있습니다.
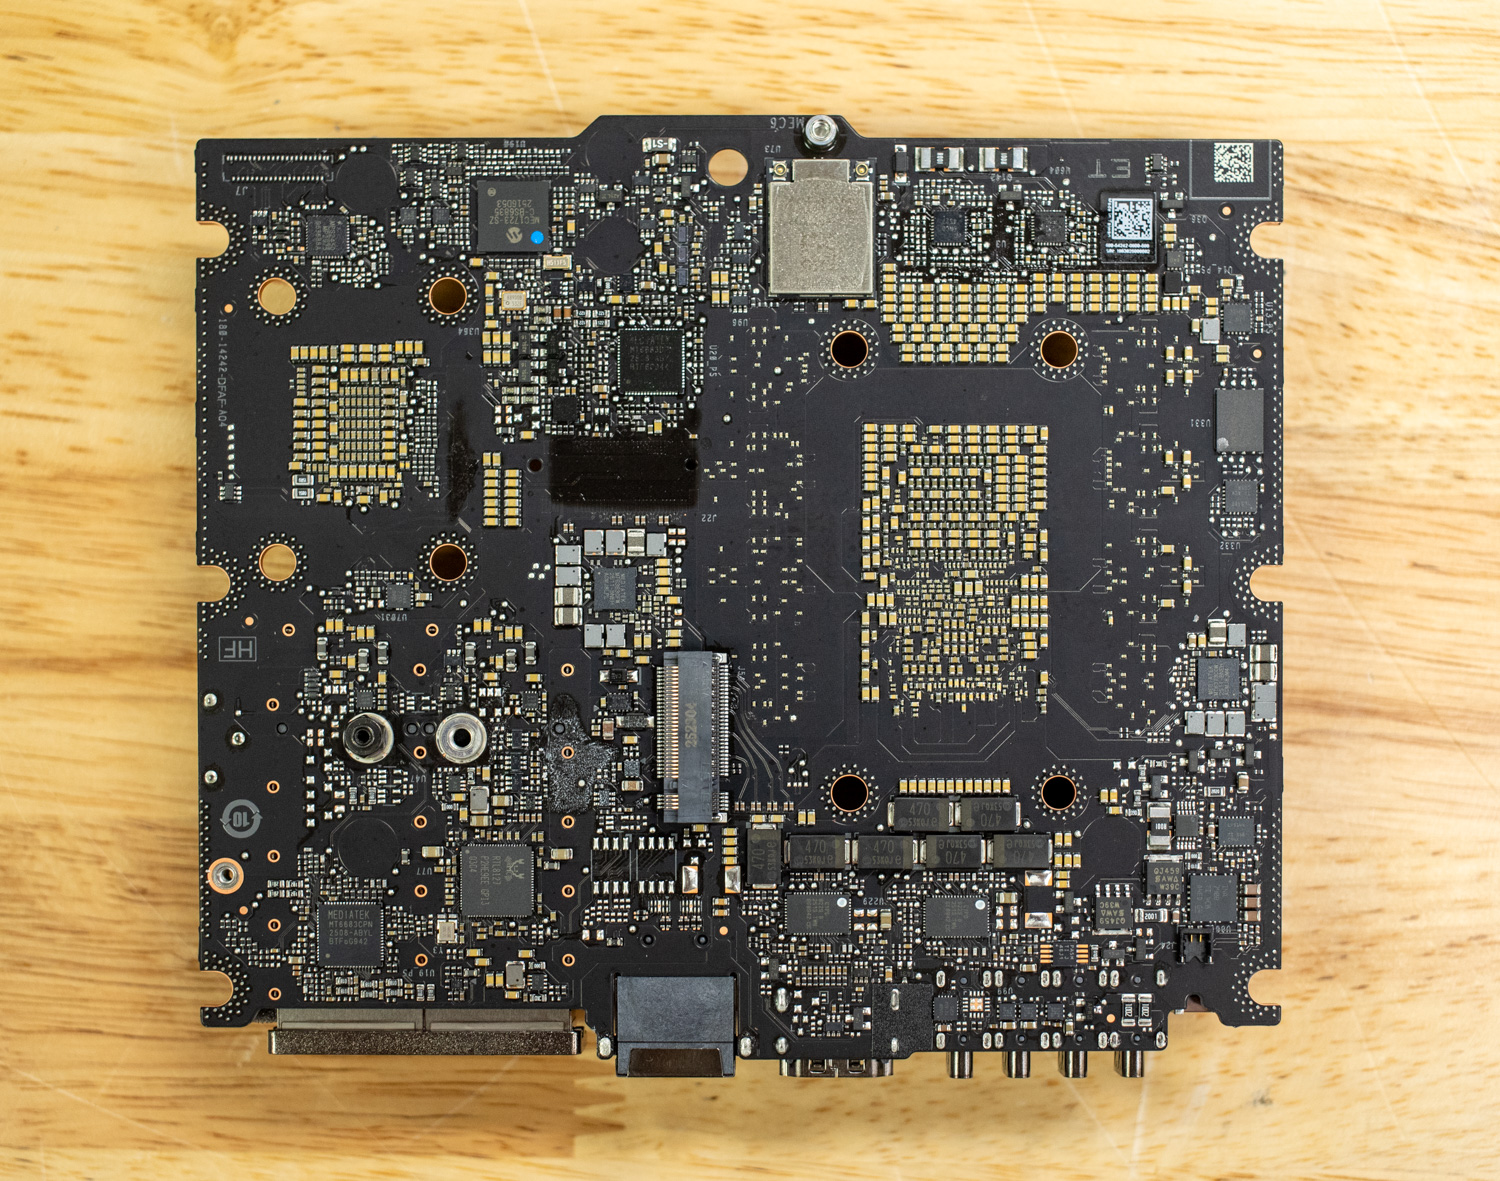
마지막으로 보드를 뒤집으면 PCIe Gen5 x4 2242 M.2 SSD와 PCIe Gen3x1 MediaTek Wi-Fi 어댑터를 포함한 모든 PCIe 연결 기능이 드러납니다.
Spark가 필수불가결한 이유: 최신 AI 개발 어플라이언스
DGX Spark는 여러 가지 전문적인 맥락에서 특히 매력적인 것으로 입증되었으며, 각 맥락에서는 통합 메모리, 컴팩트한 폼 팩터, 포괄적인 소프트웨어 통합의 고유한 조합이 이점을 제공합니다.
데이터 과학 가속화: 판다스에서 프로덕션까지
데이터 과학자에게 NVIDIA DGX Spark는 워크플로 속도와 경험을 크게 향상시킵니다. 200Gbps 대역폭을 제공하는 ConnectX-7 네트워킹은 CUDA X 가속 라이브러리와 결합되어 데이터 전처리를 혁신합니다. AI와 데이터 과학은 '양질의 데이터 입력, 양질 데이터 출력'을 기반으로 구축됩니다. 전통적으로 기존 머신러닝 프로젝트에서 가장 시간이 많이 소요되는 단계는 데이터 정리와 특성 추출입니다. 기존 워크플로는 일반적으로 판다스와 같은 도구에 데이터 세트를 로드하고 CPU 코어에서 변환을 수행하는 방식으로 진행되므로 속도가 느립니다. 수동 탐색 및 특성 엔지니어링 또한 심각한 장애 요소가 될 수 있습니다. Spark는 RAPIDS를 통해 엔드투엔드 GPU 가속을 지원합니다.
일반적인 엔터프라이즈 데이터 과학 시나리오에는 40~80GB 범위의 데이터셋에 대한 피처 엔지니어링(여러 테이블 결합, 시간적 윈도우에 걸친 집계 계산, 범주형 인코딩 처리, 분포 정규화)이 포함됩니다. CPU 인프라에서 이러한 전처리 작업은 몇 시간이 소요될 수 있습니다. RAPIDS cuDF를 사용하면 전체 데이터셋을 Spark의 128GB 통합 메모리에 로드하여 10배 이상의 가속으로 몇 분 만에 작업을 완료할 수 있습니다. 이후 모델 학습은 cuML을 사용한 기존 머신러닝이든 PyTorch를 사용한 딥러닝이든 동일한 이점을 제공하며, 데이터 과학자들이 가설을 반복하기보다는 인프라를 기다리는 기존의 병목 현상을 제거합니다.
합성 데이터 생성: 로봇 공학 및 시뮬레이션
4세대 RT 코어의 탑재로 Spark는 새로운 워크플로우, 즉 월드 모델 학습을 위한 합성 데이터 생성에 있어 독보적인 위치를 확보하게 되었습니다. 견고한 조작 정책을 학습하려면 전통적으로 수만 건의 실제 시뮬레이션이 필요했는데, 이는 비용과 시간이 매우 많이 소요되는 작업이었습니다. Isaac Sim이나 Omniverse와 같은 플랫폼의 사실적인 시뮬레이션은 대안을 제시했지만, 물리적으로 정확한 조명, 반사 및 재질을 적용한 레이 트레이싱 이미지 렌더링에는 NVIDIA의 L40S 나 RTX 6000 Ada와 같은 고가의 워크스테이션 GPU가 필수적이었습니다.
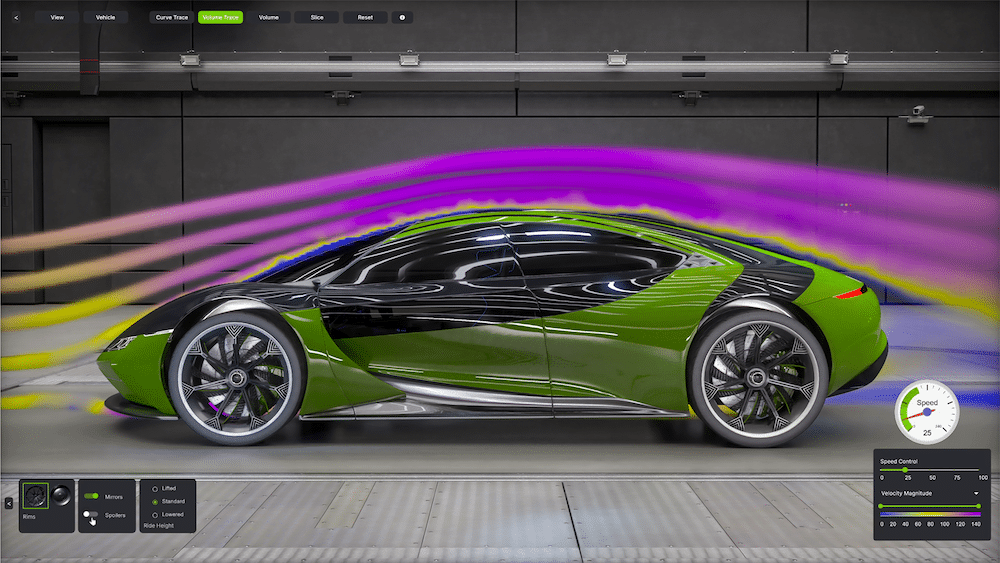
출처: NVIDIA
Spark는 이러한 워크플로우를 통합합니다. RT 코어는 OpenUSD 워크로드가 합성 데이터 생성을 처리할 수 있도록 지원하고, Tensor 코어는 청사진/워크플로우에서 AI 추론에 사용됩니다. 이전에는 조직에서 렌더링을 위해 여러 대의 머신과 추론에 최적화된 별도의 서버를 구축해야 했습니다. 이제 단일 240W 어플라이언스로 이러한 작업을 수행할 수 있습니다. 자율 조작을 연구하는 로봇 스타트업, 대학 연구실 또는 자동차 제조업체의 경우 이러한 통합을 통해 개발 일정과 자본 지출을 크게 줄일 수 있습니다.
저희는 이전 NVIDIA L40S 관련 기사 에서 전용 L40S 렌더링 시스템과 H100 추론 프로세서를 조합하여 유사한 합성 데이터 생성 파이프라인을 구축한 바 있습니다 . GB10은 이러한 기능들을 하나의 개발 어플라이언스로 통합함으로써 이 워크플로우를 한 단계 발전시켰습니다. 향후 분석에서는 로봇 조작 시나리오를 대표하는 렌더링 및 기타 워크로드를 대상으로 Spark RT Core의 성능을 이러한 개별 구성과 비교하는 추가 테스트를 진행할 예정입니다.
바이브 코딩 혁명
테슬라의 전 AI 디렉터이자 OpenAI의 창립 멤버였던 안드레이 카르파티는 AI의 지원을 받아 신속하게 소프트웨어를 개발하는 새로운 접근 방식을 설명하기 위해 "바이브 코딩"이라는 용어를 만들었습니다. 바이브 코딩은 코드를 한 줄씩 꼼꼼하게 작성하는 대신, LLM(학습자)을 대화형 페어 프로그래머로 활용하여 자연어로 기능을 설명하고, 구현 스캐폴딩을 생성하고, 대화형 개선을 통해 반복하고, 기능을 신속하게 프로토타입화합니다. 이 워크플로는 코딩을 의도적인 구성에서 맥락, API, 아키텍처 패턴을 이해하는 AI와의 안내 대화로 전환하여 개별 개발자가 전례 없는 속도로 놀랍도록 정교한 시스템을 구축할 수 있도록 합니다.
OpenRouter의 사용량 순위 에서 볼 수 있듯이 , AI 기반 코딩 도입 규모는 꾸준히 코딩 중심 모델이 추론량에서 압도적인 우위를 차지하고 있습니다. 코딩의 주요 사용자층인 기술 전문가들은 일반적으로 파워 유저로서 여러 컨텍스트에서 여러 코딩 에이전트를 병렬로 실행합니다. 또한 오픈 소스 모델이 주요 벤치마크 에서 독점 모델과 점점 더 동등한 성능을 보임에 따라 , 개발자들은 속도 제한을 없애고, 중요한 개발 기간 동안 가용성을 보장하며, 독점 프로젝트의 코드 기밀성을 유지하기 위해 로컬 추론 배포를 모색하고 있습니다.
r/LocalLLaMA 커뮤니티는 멀티 GPU 워크스테이션부터 로컬 모델을 구동하는 덕트 테이프로 연결된 서버, 소비자 하드웨어 전반에 걸친 분산 추론, 그리고 지속적인 고처리량 생성을 가능하게 하는 정교한 냉각 솔루션에 이르기까지, 정말 인상적인 맞춤형 빌드를 선보입니다. 그러나 이러한 구성에는 상당한 장벽이 존재합니다. 수만 달러를 초과하는 자본 지출, 상당한 전력 소비, 표준 사무실 환경이 아닌 전용 공간을 필요로 하는 열 관리 문제, 그리고 구성, 최적화 및 문제 해결을 위한 상당한 기술 전문 지식 등이 있습니다.
Spark는 이러한 가치 제안을 근본적으로 변화시킵니다. 128GB 통합 메모리를 탑재한 Spark는 3,999달러에 불과한 가격으로, 240W에 불과한 조용하고 컴팩트하며 전력 효율적인 어플라이언스에서 뛰어난 모델 추론 성능을 제공합니다. 로컬 코딩 어시스턴트 인프라를 구축하려는 사용자는 더 이상 킬로와트시(kW)의 전력을 소모하고 상당한 열을 발생시키는 정교한 홈랩을 필요로 하지 않습니다. 사전 구성된 DGX OS를 기반으로 하는 검증된 어플라이언스 방식은 이전에는 Linux 및 CUDA 전문 지식을 갖춘 사용자만 로컬 LLM 배포를 할 수 있었던 구성 복잡성을 해소합니다.
Spark는 인프라 마찰을 제거하는 것 외에도 코드 개인 정보 보호 및 모델 사용자 정의와 관련된 중요한 문제를 해결합니다. 클라우드 기반 코딩 어시스턴트는 소스 코드를 원격 서버로 전송해야 하는데, 이는 독점 알고리즘, 보안이 중요한 인프라 또는 규제 데이터를 처리하는 조직에서는 불가능한 일입니다. Spark의 로컬 추론 기능은 코드가 개발 환경을 벗어나지 않도록 보장합니다. 또한, 128GB 메모리 용량은 코딩 모델의 전체 매개변수 미세 조정을 지원하여 숙련된 개발자가 내부 코드베이스에서 모델을 특화할 수 있도록 합니다. 이 기능은 공개 학습 데이터에서 충분히 표현되지 않는 도메인별 언어, 사용자 정의 프레임워크 또는 아키텍처 패턴을 사용하는 조직에 특히 유용합니다.
DGX Spark에서 NVIDIA NeMo를 사용한 미세 조정
DGX Spark의 128GB 통합 메모리는 기존에는 값비싼 멀티 GPU 클라우드 설정이 필요했던 8B 모델의 전체 매개변수 미세 조정을 지원합니다. 표준 Adam 최적화를 적용한 Qwen3 8B의 전체 미세 조정에는 약 132GB(모델 가중치 16GB, 옵티마이저 상태 96GB, 그래디언트 16GB, 활성화 값 포함)가 필요하며, 이는 듀얼 H100 80GB 구성을 능가합니다. 메모리 효율적인 8비트 Adam을 사용하면 배치 크기에 따라 필요 메모리가 약 70GB로 줄어들어 Spark의 메모리 풀에 여유롭게 들어갑니다. 이는 전체 미세 조정이 복잡한 추론 작업에서 LoRA보다 4~6% 더 높은 정확도를 제공하기 때문에 중요합니다. 클라우드 기반 2× H100 80GB 설정은 분산 학습 복잡성을 고려하여 시간당 약 5달러가 소요되는 반면, Spark는 3,999달러의 일회성 투자로 단일 시스템 학습을 제공합니다.
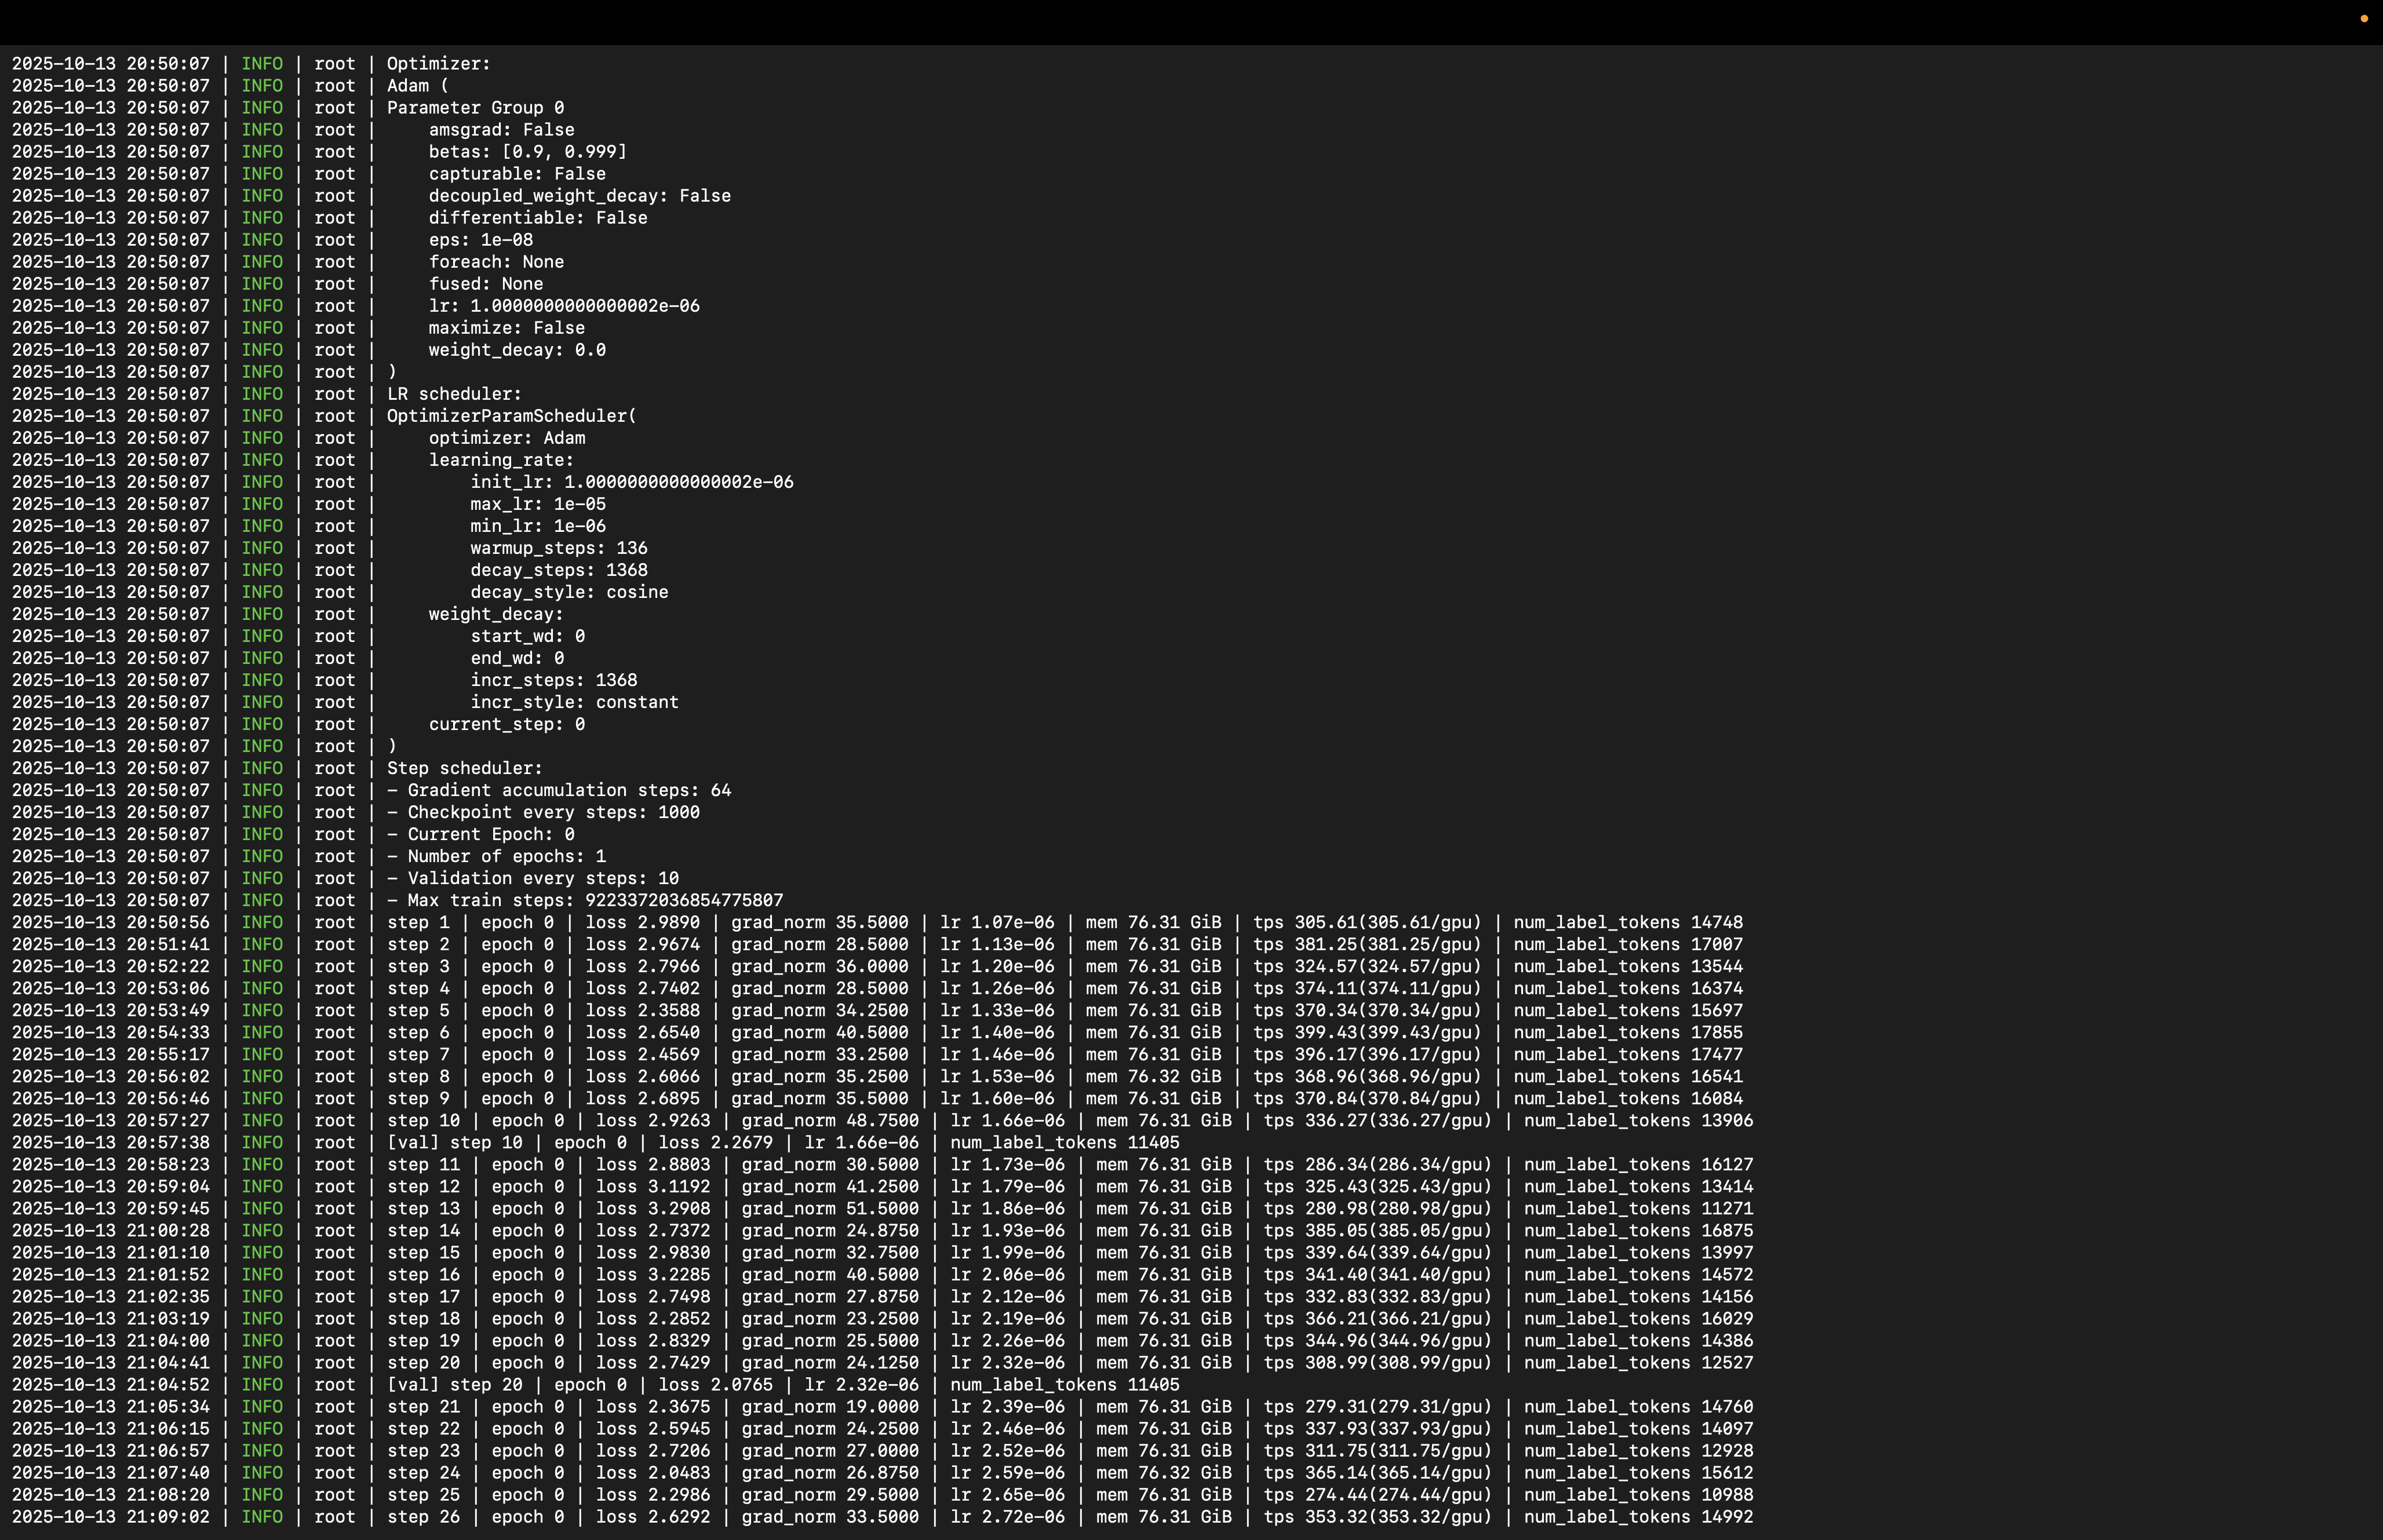
NVIDIA NeMo Automodel은 체크포인트 변환 없이 모든 Hugging Face 모델에 대해 Day-0 지원을 제공하여 엔터프라이즈 학습 프레임워크의 번거로움을 해소합니다. HuggingFace Hub에서 Qwen3 8B를 직접 로드하고 데이터 세트 소스, 옵티마이저 설정 및 LoRA 대상을 지정하는 YAML 파일을 통해 미세 조정을 구성합니다. NeMo는 세이프텐서(safetensor) 호환성을 통해 분산 체크포인팅을 자동화하고, 융합 CUDA 커널을 구현하여 2~5배의 속도 향상을 제공하며, 그래디언트 누적을 처리합니다.
편안한 UI로 이미지 생성
ComfyUI는 Stable Diffusion 및 관련 디퓨전 모델을 고도로 사용자 정의 가능한 창의적인 파이프라인으로 변환하는 노드 기반 그래픽 인터페이스를 제공합니다. 단순화된 매개변수 슬라이더 뒤에 복잡성을 추상화하는 기존 웹 기반 인터페이스와 달리, ComfyUI는 사용자가 모델 로딩, 프롬프트 인코딩, 잠재 확산 샘플링, VAE 디코딩 또는 업스케일링 변환과 같은 특정 작업을 나타내는 개별 기능 노드를 연결하여 워크플로를 구성하는 시각적 그래프 아키텍처를 사용합니다. 이러한 모듈식 설계는 전체 생성 파이프라인에 대한 세부적인 제어를 가능하게 하여 모든 계산 단계를 투명하고 조정 가능하게 만듭니다. 또한 사용자는 여러 모델을 연결하고, 사용자 정의 샘플링 일정을 구현하고, 단순화된 인터페이스에서는 불가능한 ControlNet 가이드와 같은 고급 기술을 통합할 수 있습니다.
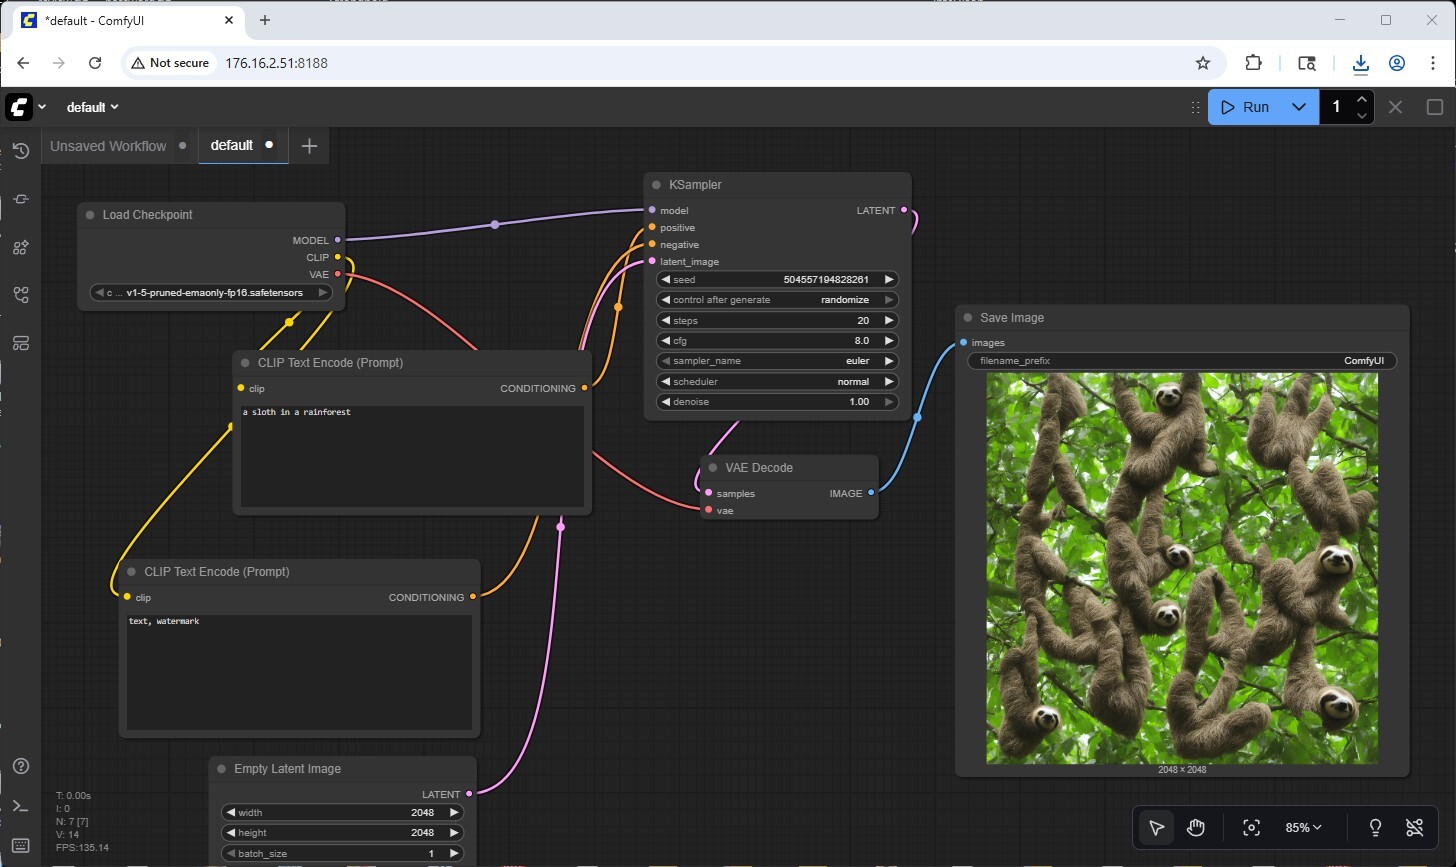
DGX Spark에서 ComfyUI는 Blackwell GPU의 텐서 코어를 활용하여 가속 확산 샘플링을 수행하며, 샘플링 복잡도에 따라 일반적으로 15~30초 안에 생성을 완료합니다. 128GB 통합 메모리 아키텍처는 특히 여러 체크포인트 모델, LoRA 어댑터, VAE 디코더를 메모리에 동시에 유지하여 VRAM 제한 시스템에서 발생하는 재로드 오버헤드를 제거하는 데 큰 이점을 제공합니다. 사용자는 API 속도 제한, 생성당 클라우드 비용, 그리고 독점적인 크리에이티브 워크플로와 관련된 개인정보 보호 문제 없이 사실상 무제한의 AI 아트워크를 로컬에서 생성할 수 있습니다. 워크플로 지속성 모델은 운영적 가치를 더합니다. 전체 파이프라인은 JSON 파일로 직렬화되어 버전 관리, 팀 간 공유 또는 생성된 이미지에 메타데이터로 직접 내장할 수 있습니다. 이를 통해 합성 데이터세트 파이프라인을 구축하거나 생성된 자산 전반에 걸쳐 일관된 예술적 스타일을 유지하는 조직에 필수적인 재현성을 확보할 수 있습니다.
NVIDIA DGX Spark 성능 테스트
vLLM 온라인 제공 – LLM 추론 테스트
vLLM은 LLM을 위한 가장 널리 사용되는 고처리량 추론 및 서빙 엔진입니다. vLLM 온라인 서빙 벤치마크는 동시 요청 처리 시 이 추론 엔진의 실제 서빙 성능을 측정하도록 설계된 성능 평가 도구입니다. 요청 속도, 입출력 길이, 동시 클라이언트 수와 같은 구성 가능한 매개변수를 사용하여 실행 중인 vLLM 서버에 요청을 전송하여 프로덕션 워크로드를 시뮬레이션합니다. 이 벤치마크는 초당 토큰 수, 첫 번째 토큰까지의 시간, 출력 토큰당 시간 등 주요 지표를 측정하여 사용자가 다양한 부하 조건에서 vLLM의 성능을 이해하는 데 도움을 줍니다.
우리는 오늘날 프로덕션 배포에서 가장 인기 있는 아키텍처와 모델 유형을 대표하는 포괄적인 모델 제품군에서 추론 성능을 테스트했습니다.
전문가 모델의 혼합
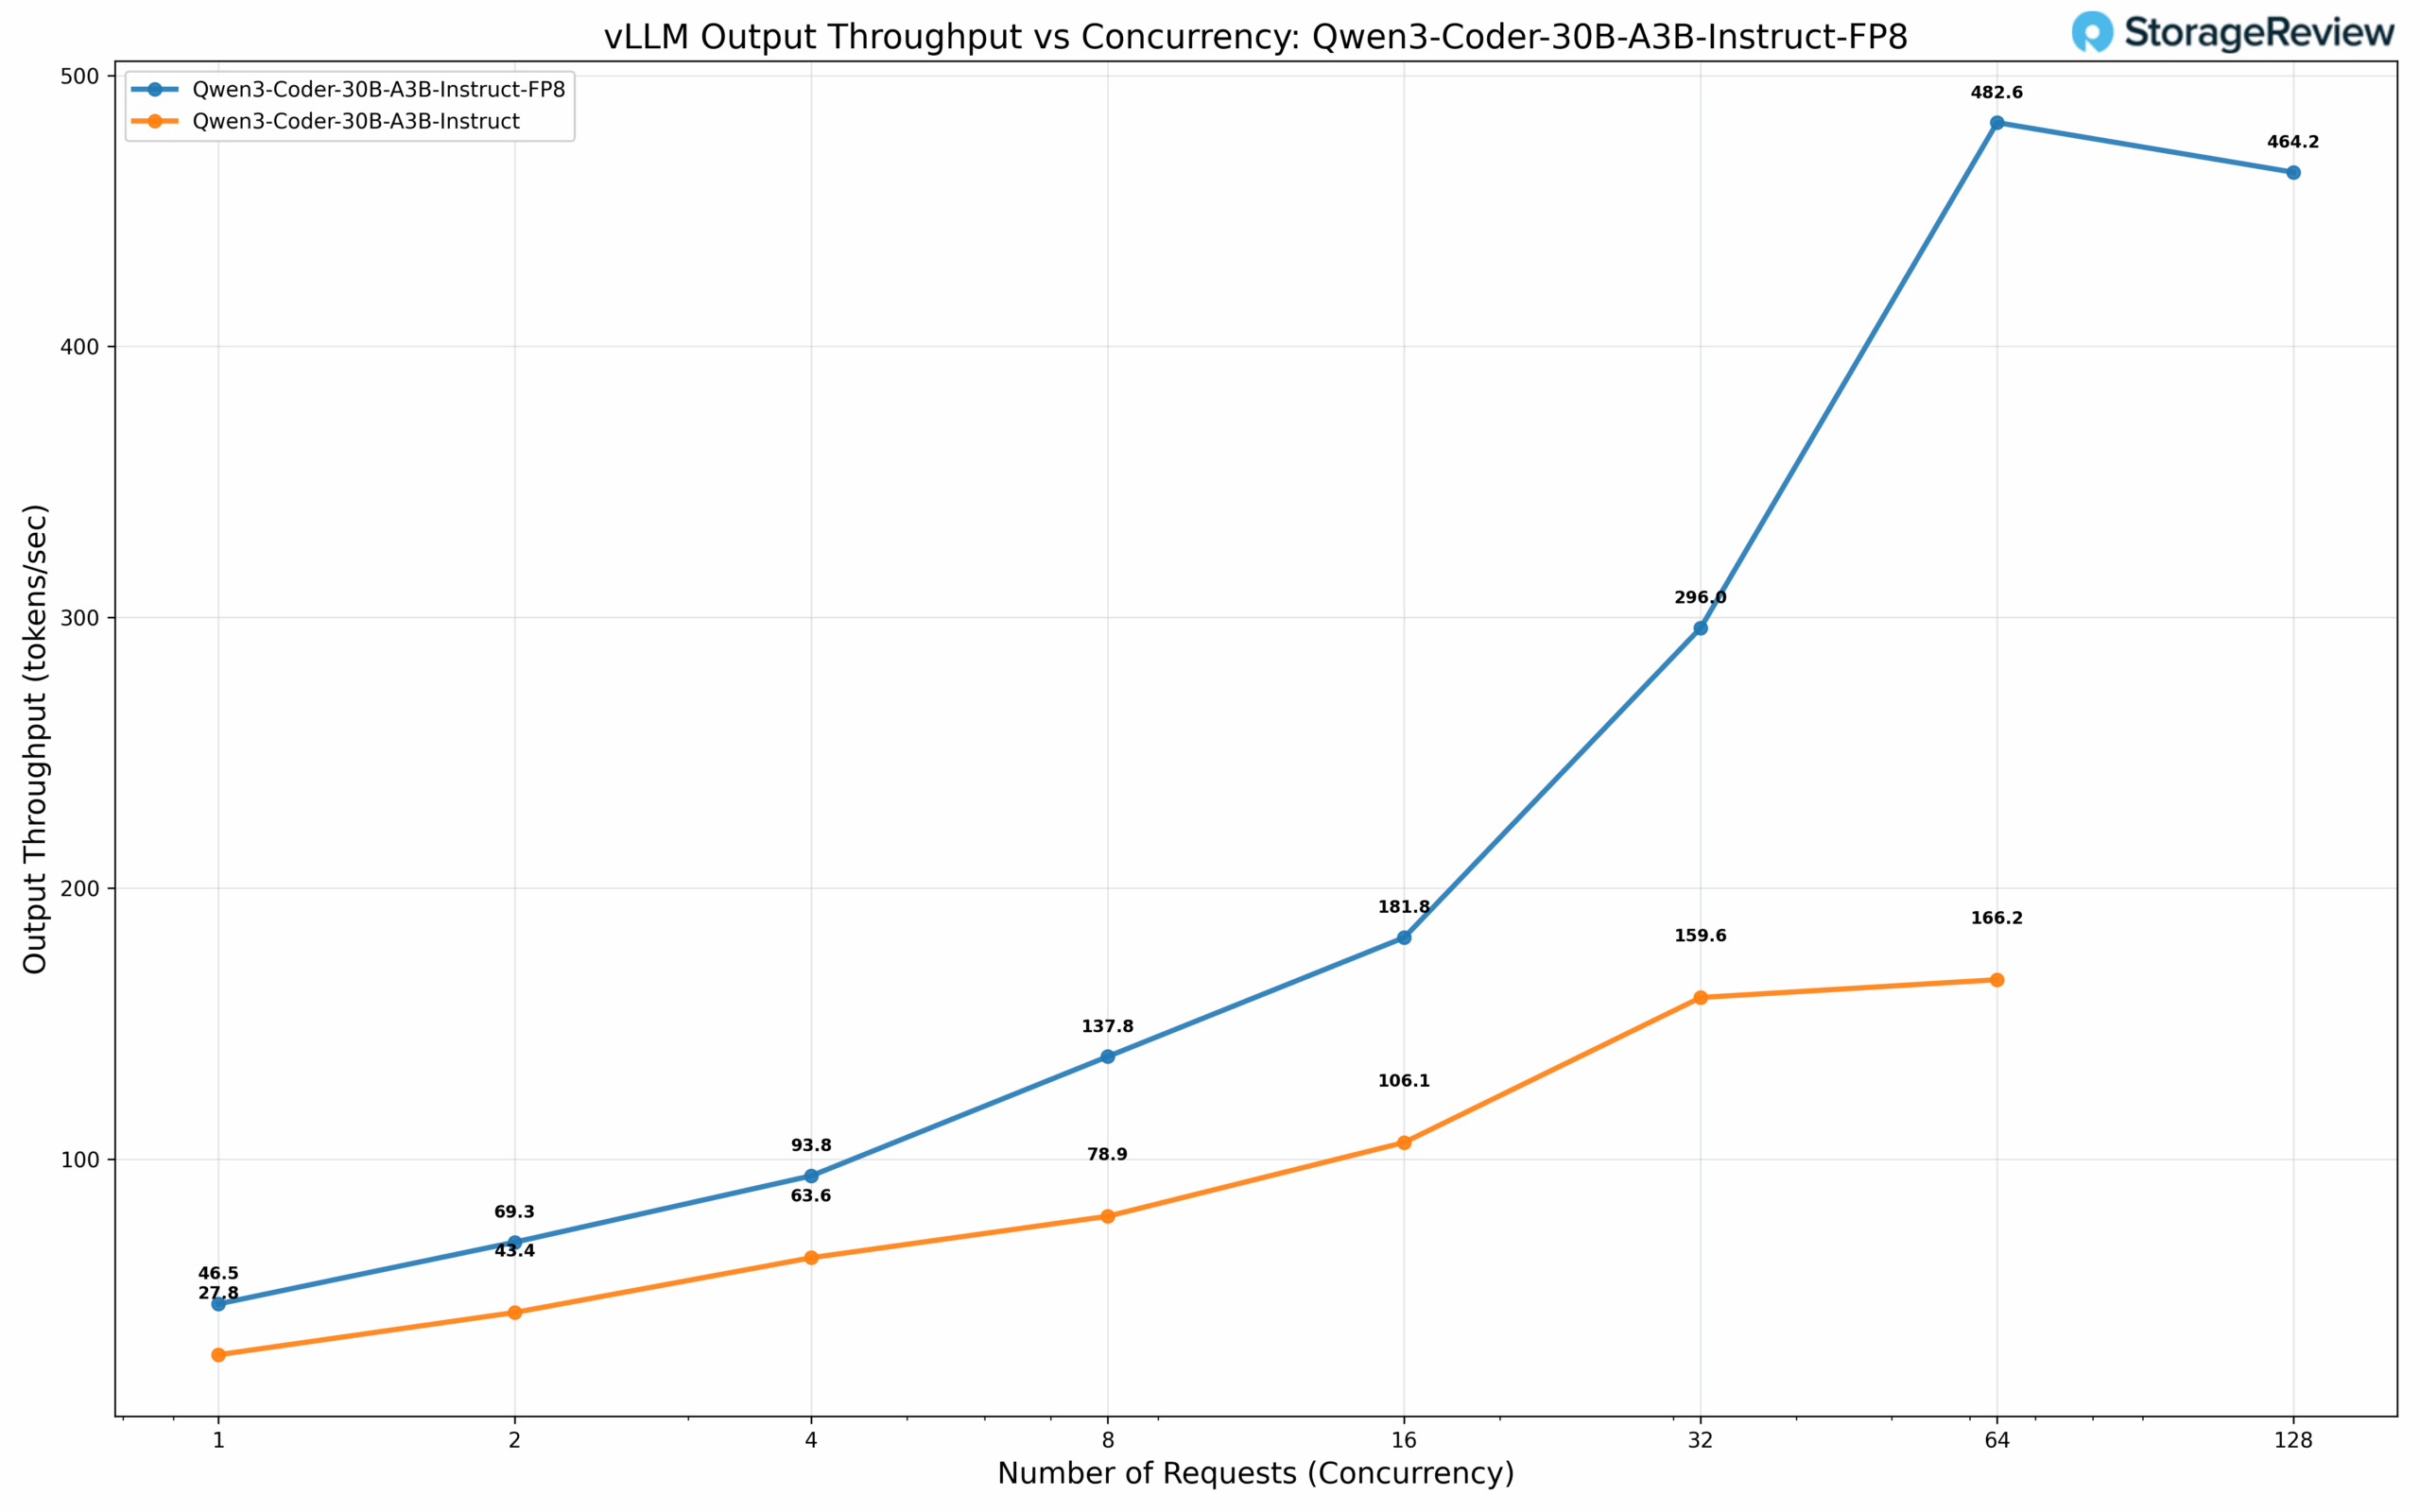
로컬 추론 배포에 가장 널리 사용되는 코딩 모델 중 하나인 Qwen3 Coder 30B-A3B를 평가했습니다. 이 희소 아키텍처는 BF16 정밀도에서 30B 매개변수의 전체 모델 크기를 유지하면서 생성된 토큰당 3B 매개변수만 활성화합니다. 기본 모델과 Qwen의 FP8 양자화 변형 모델을 모두 벤치마킹했습니다. FP8 양자화 모델은 상당한 성능 향상을 보였습니다. 동시성 1에서 46.5 tok/s를 달성하고, 배치 크기 64에서는 482.6 tok/s까지 놀라운 확장성을 보였습니다. 기본 BF16 모델은 동시성 1에서 27.8 tok/s를 제공하고, 배치 크기 64에서는 166.2 tok/s에 도달하여 거의 3배의 성능 차이를 보였습니다.
조밀한 모델
밀집 모델은 추론 과정에서 모든 매개변수와 활성화가 사용되는 기존 LLM 아키텍처를 나타내며, 이는 희소 모델에 비해 더 많은 계산 집약적인 처리를 초래합니다. 모델 규모와 양자화 전략에 따른 성능 특성을 종합적으로 평가하기 위해 다섯 가지 밀집 모델 구성을 벤치마킹했습니다.
테스트 세트에는 Mistral AI의 Mistral Small 3.1 24B(BF16 정밀도)와 RedHat AI의 Mistral Small 3.1 24B FP8 동적 양자화 버전이 포함되었습니다. 동적 양자화는 선택적 가중치 양자화 기법을 사용하여 성능-정확도 간의 상충 관계를 최적화하여 모델 성능 저하를 최소화하는 동시에 정밀도를 전략적으로 낮춥니다. 이러한 대규모 고밀도 모델에 대해 기본 BF16 구성과 NVIDIA의 FP8 및 FP4 양자화 버전, 이렇게 세 가지 정밀도 형식에 대한 Meta Llama 3.1 8B 평가를 수행했습니다. 이 모델 선택 전략을 통해 모델 규모에 따른 직접적인 성능 비교가 가능해졌으며, 점진적 양자화가 추론 처리량에 미치는 영향도 분리할 수 있었습니다.
성능 분석: 대규모 밀집 모델
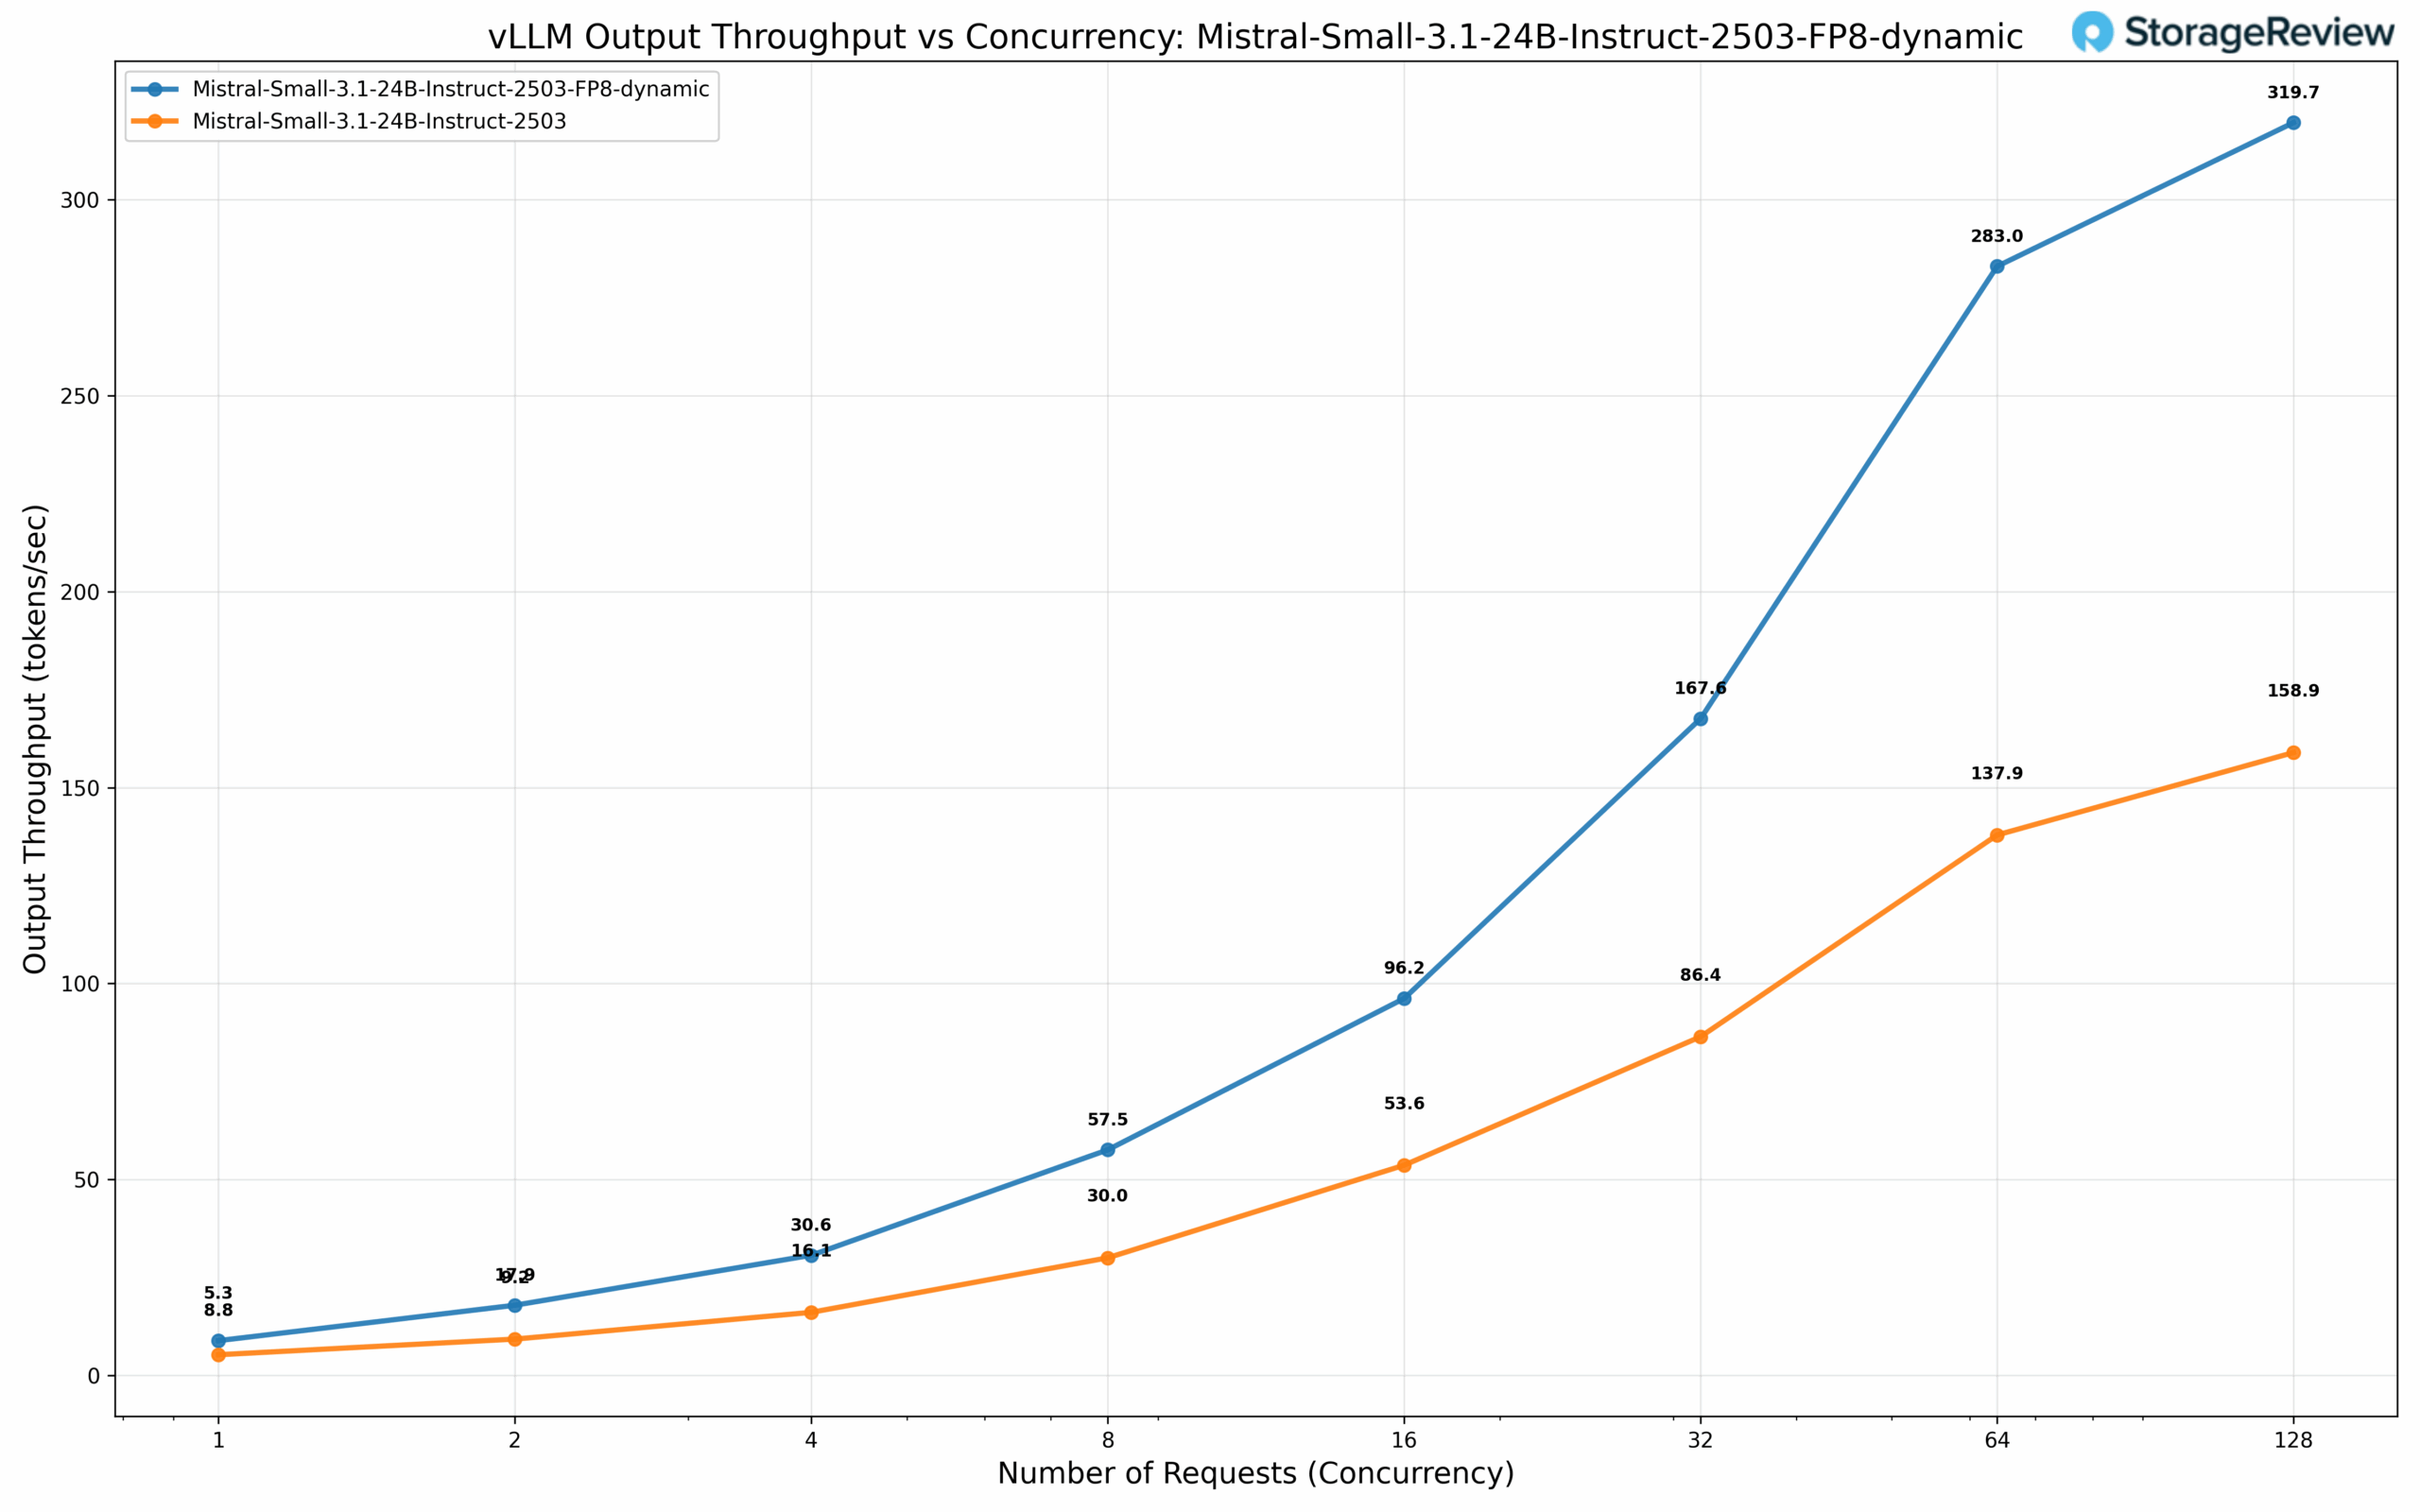
BF16 정밀도의 Mistral Small 3.1 24B는 동시성 1에서 5.3 tok/s의 기준 처리량을 보이며, 128개의 동시 요청에서 158.9 tok/s의 상당한 처리량으로 확장됩니다. FP8 동적 양자화 버전은 낮은 동시성에서 8.8 tok/s의 소폭 증가를 보이지만, 확장 시 2배의 성능 향상을 달성하여 128개의 동시성에서 319.7 tok/s를 달성합니다. 이는 고처리량 서비스 시나리오에서 동적 양자화의 효과를 보여줍니다.
성능 분석: 컴팩트 밀집 모델
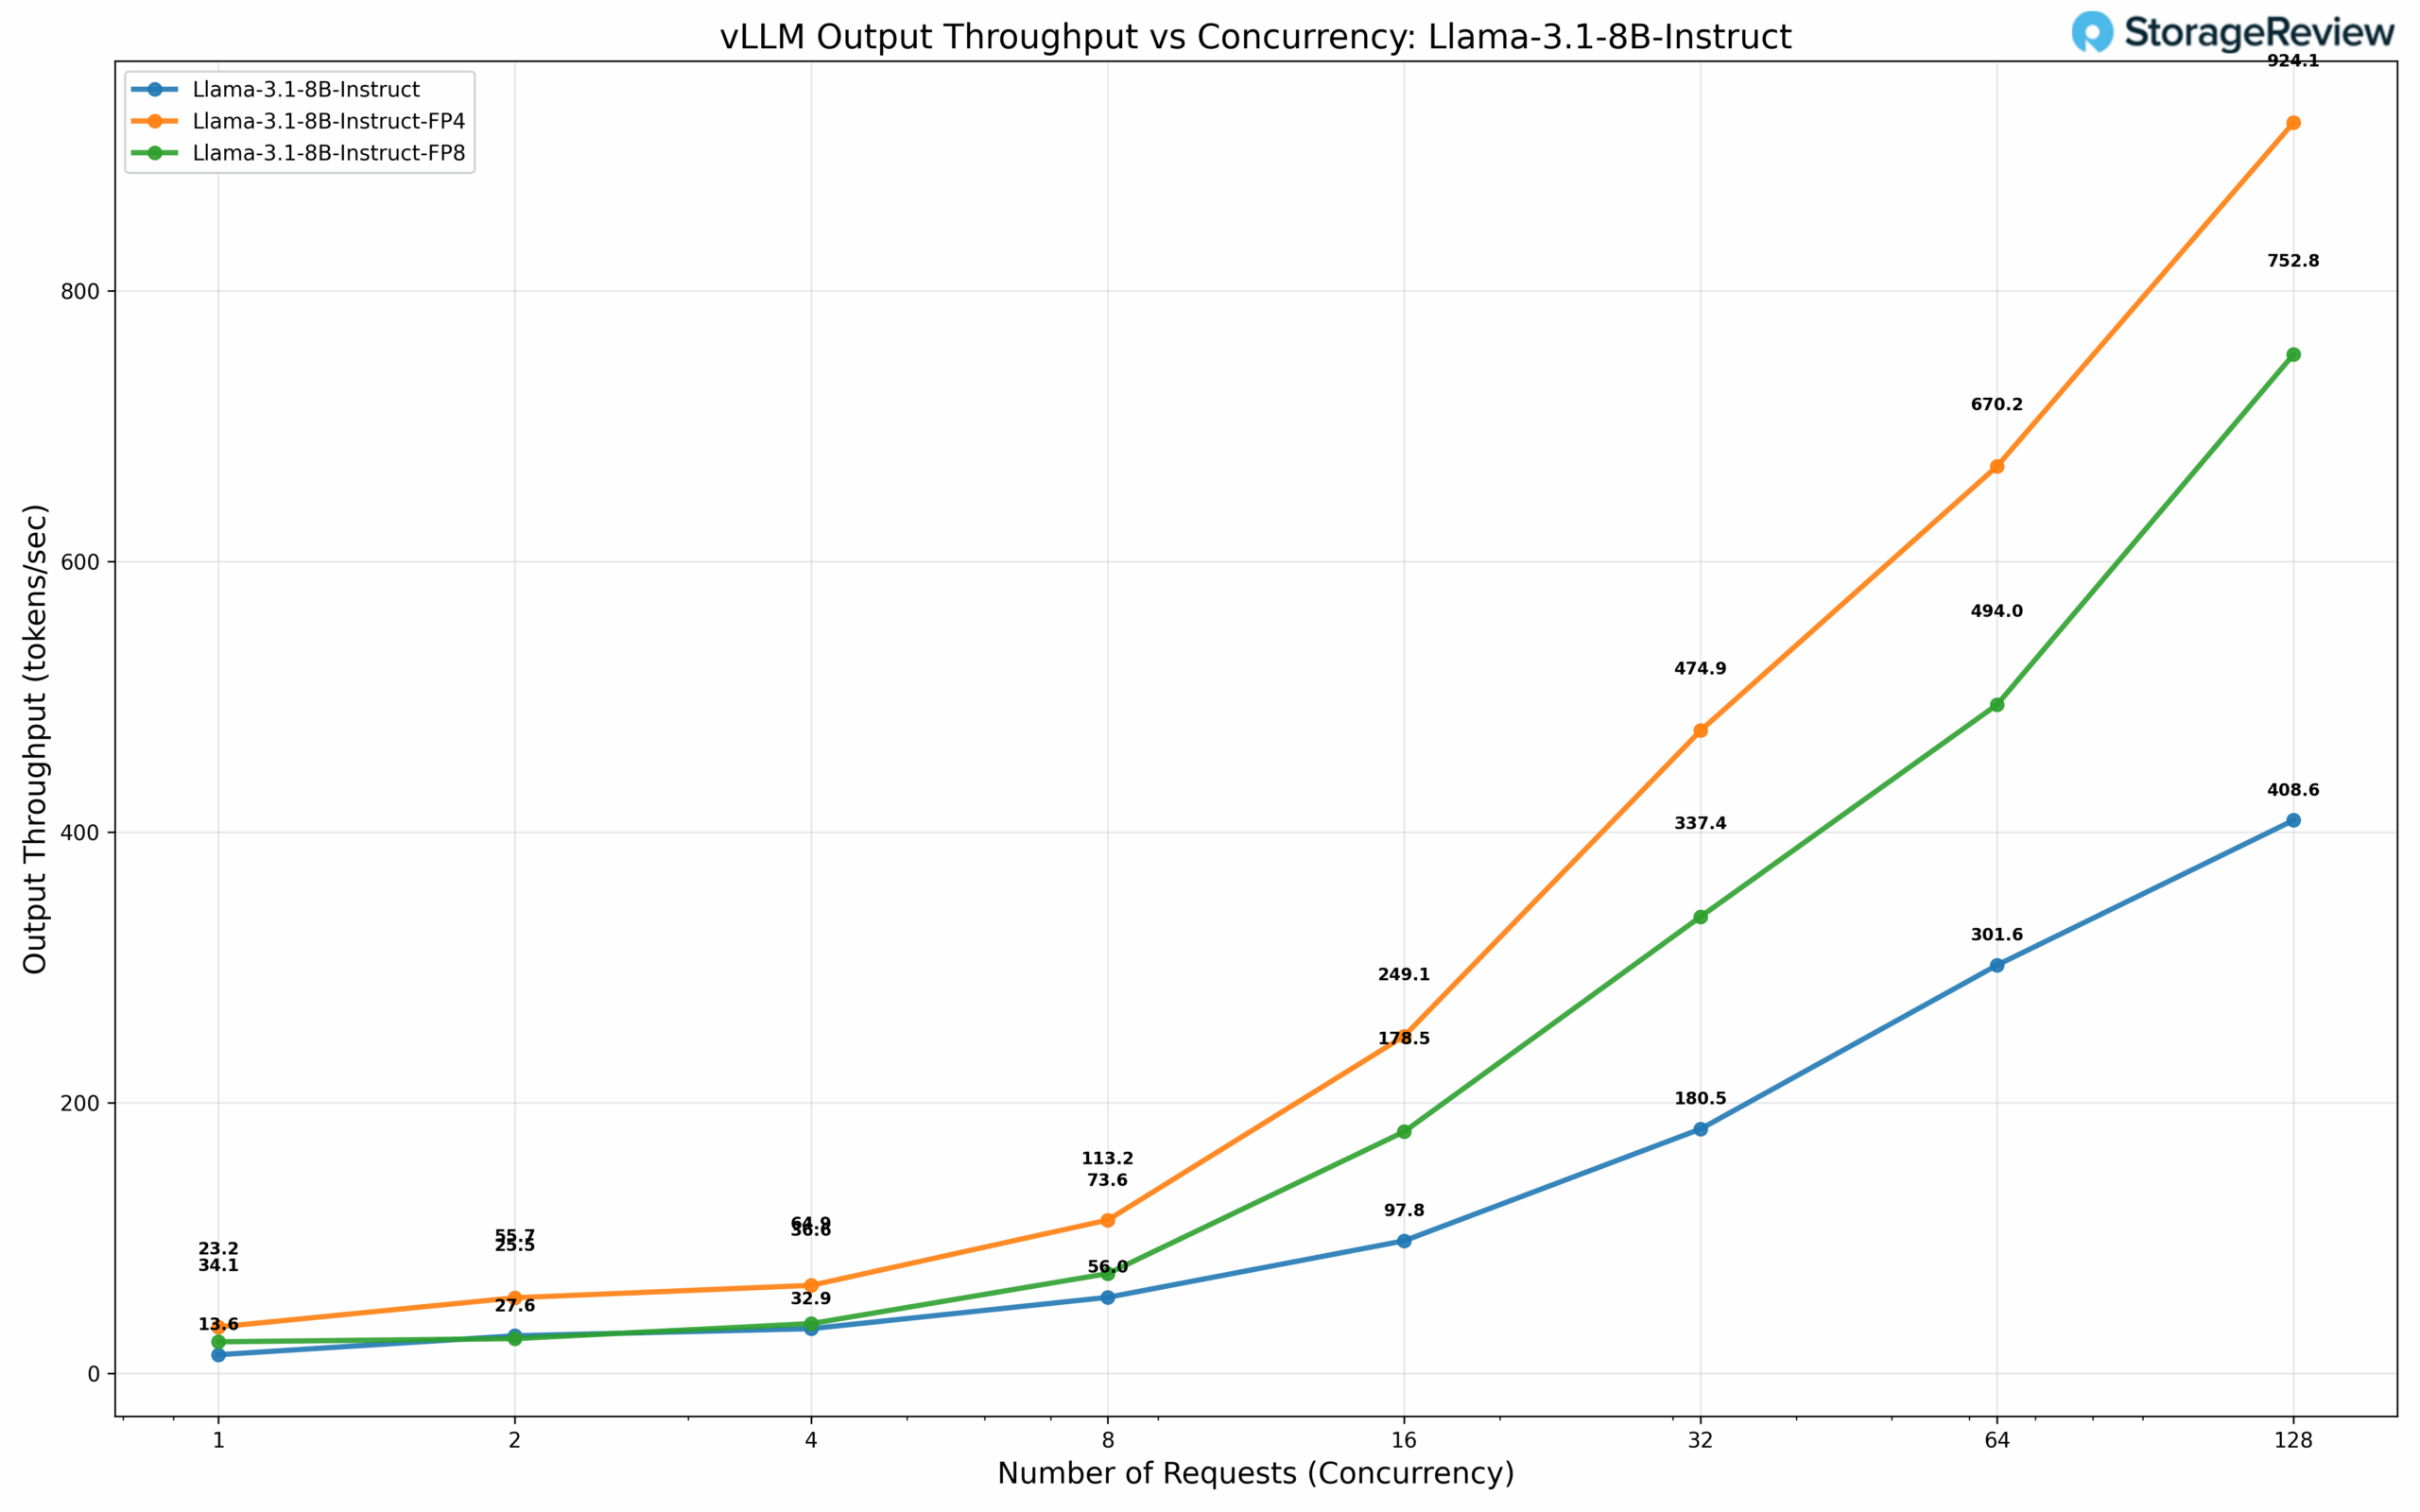
Llama 3.1 8B 아키텍처는 양자화 전략에 따라 현저히 다른 성능 특성을 보입니다. BF16 정밀도에서 이 모델은 동시성 1에서 13.6 tok/s를 제공하며, 128개의 동시 요청에서 408.6 tok/s로 확장됩니다. FP8 양자화로 전환하면 동시성 레벨 1과 128에서 각각 23.2 tok/s와 752.8 tok/s를 제공하여 대규모 처리량이 84% 향상됩니다. FP4 구성은 성능을 더욱 향상시켜 동일한 동시성 레벨에서 34.1 tok/s와 924.1 tok/s를 달성합니다. 이는 적극적인 양자화 전략이 많은 프로덕션 워크로드에서 허용 가능한 모델 품질을 유지하면서 기준 정밀도보다 2.3배의 성능 향상을 제공할 수 있음을 보여줍니다.
마이크로스케일링 데이터 유형
마이크로스케일링은 대규모 매개변수 그룹에 걸쳐 균일한 양자화를 적용하는 대신, 작은 가중치 블록에 세밀한 스케일링 계수를 적용하는 고급 양자화 방식을 나타냅니다. NVIDIA의 NVFP4 포맷은 8~32개 값으로 구성된 각 마이크로스케일 블록이 공통 지수를 스케일링 계수로 공유하는 블록형 부동 소수점 표현을 통해 이 기술을 구현합니다. 이러한 세밀한 접근 방식은 수치적 정밀도를 유지하면서도 4비트 표현을 구현하여 변압기 아키텍처에 필수적인 동적 범위를 유지합니다. 이 포맷은 NVIDIA의 텐서 코어 아키텍처와 통합되어 행렬 연산 중 즉각적인 압축 해제를 통해 효율적인 혼합 정밀도 계산을 가능하게 합니다.
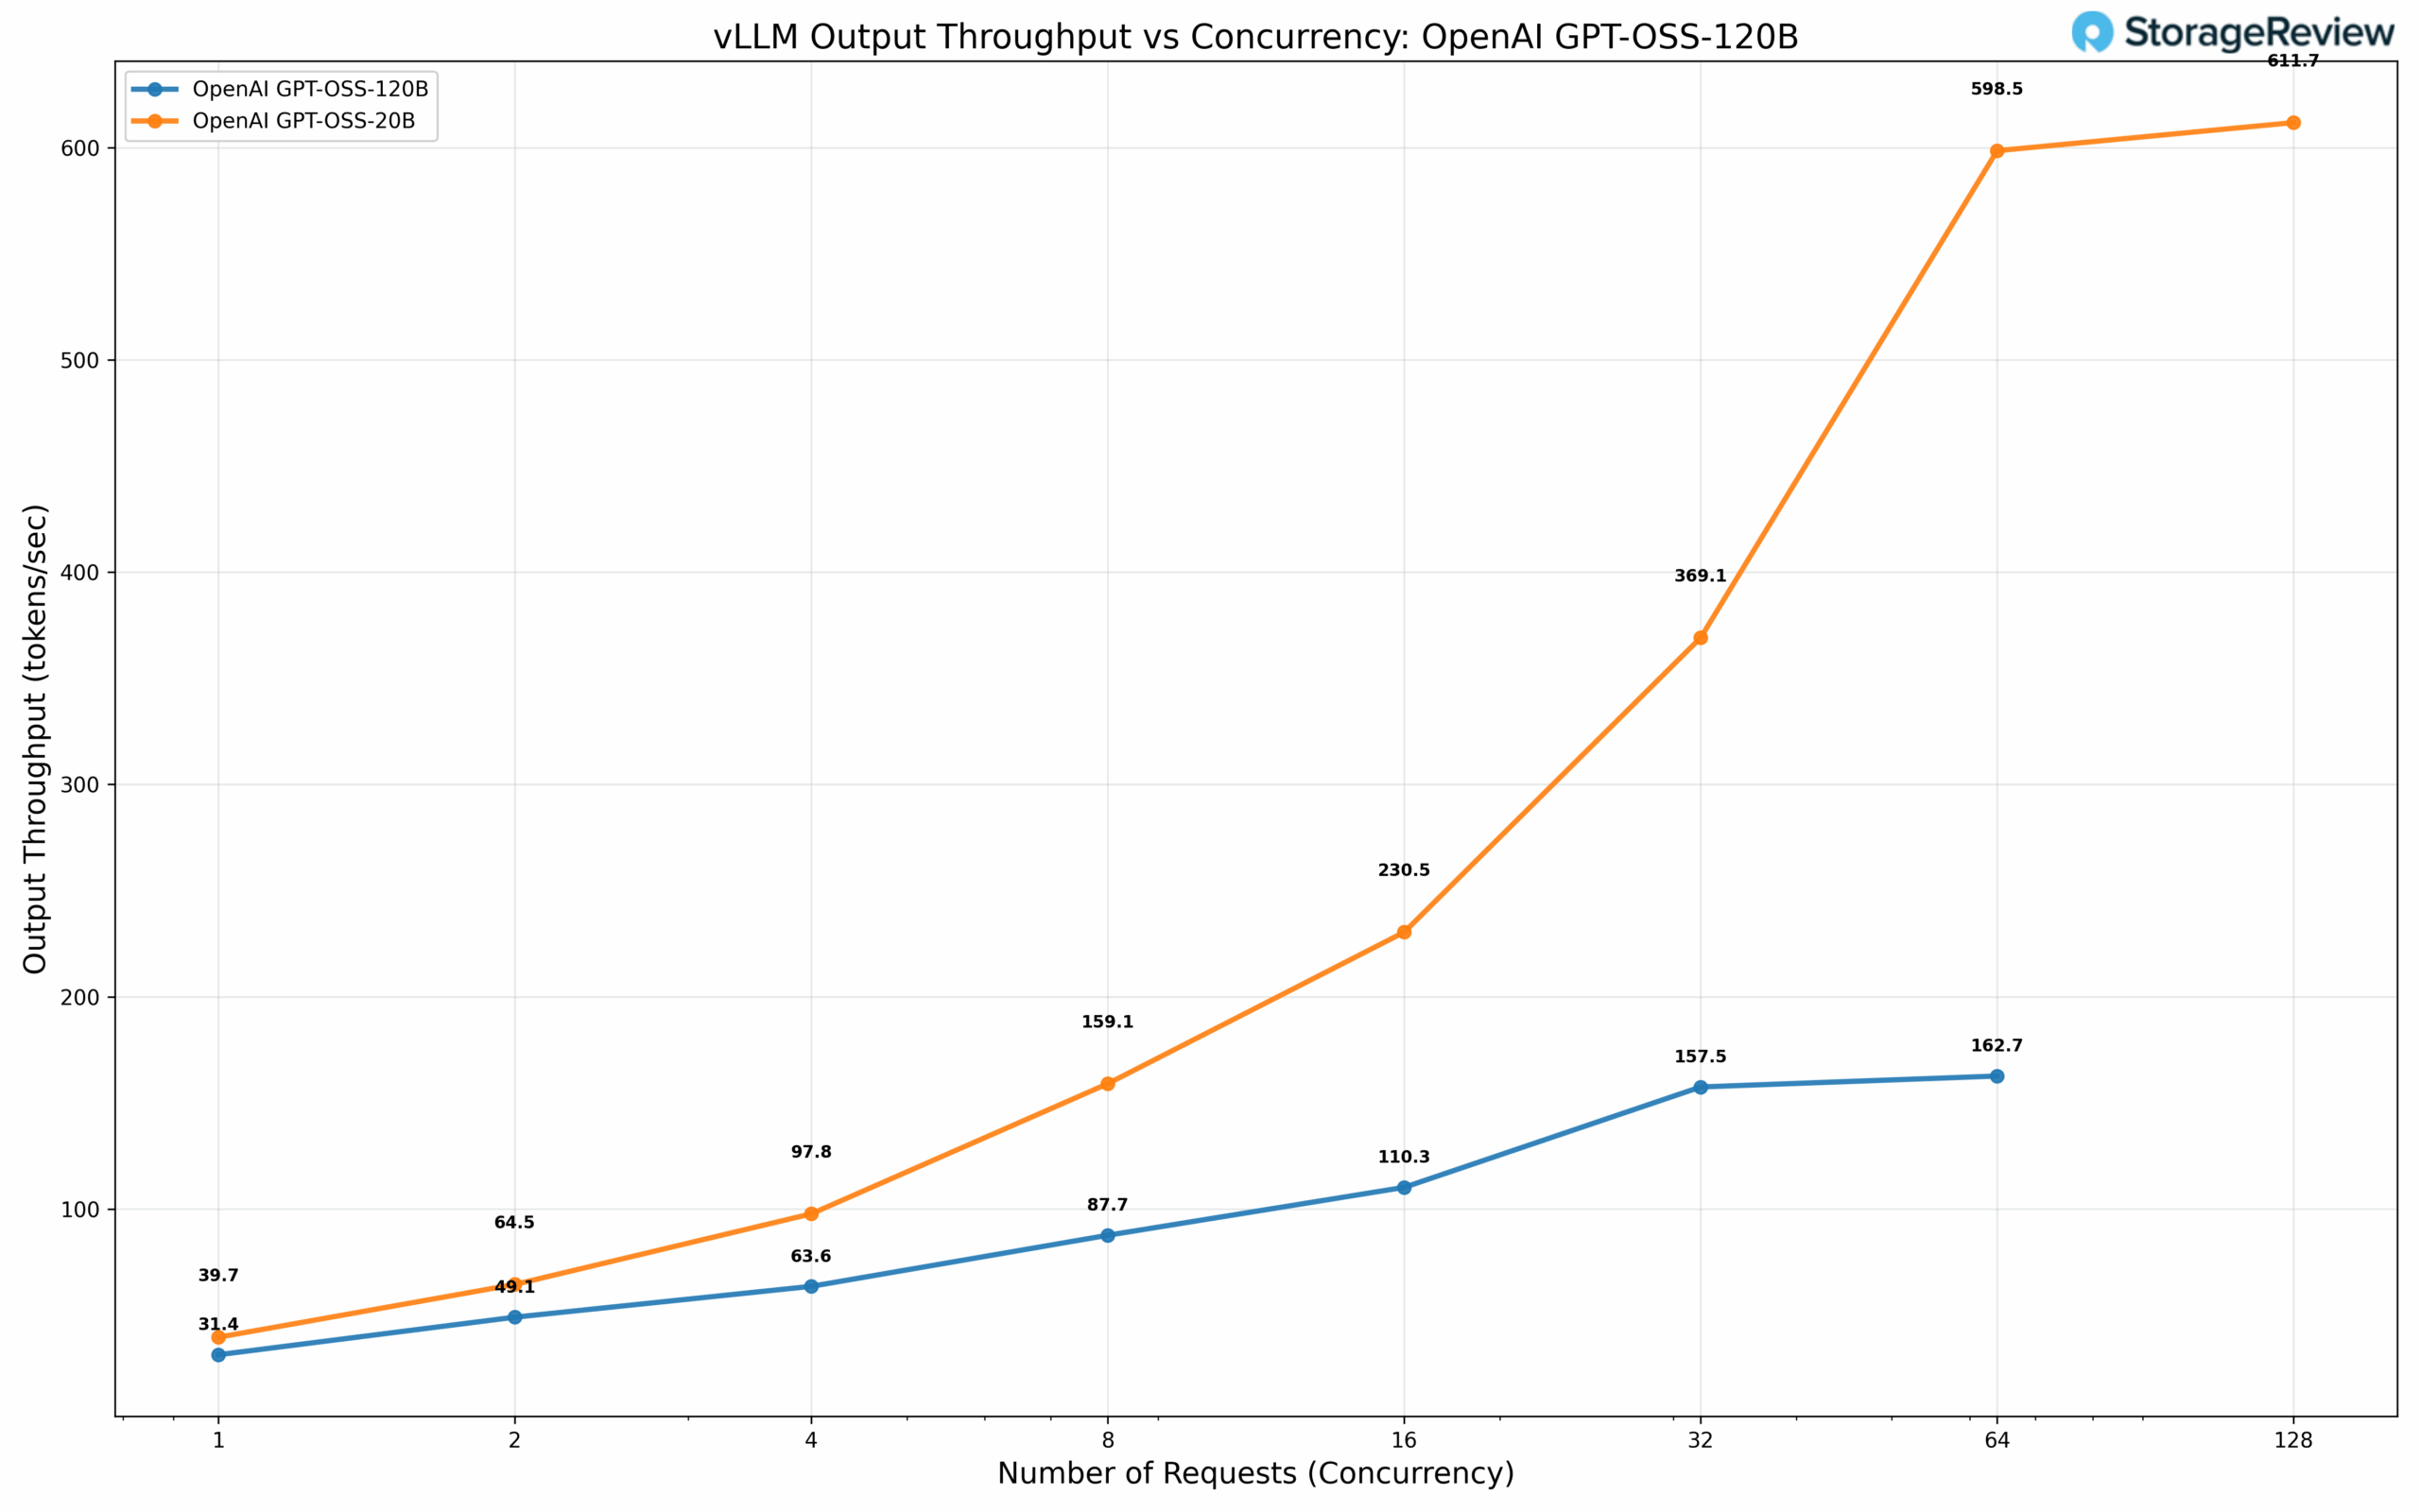
NVFP4 양자화를 사용하여 OpenAI의 GPT OSS 모델을 20B 및 120B 매개변수 스케일에서 평가했습니다. 20B 매개변수 모델은 동시성 1에서 39.7 tok/s를 달성하고, 128개의 동시 요청에서 611.7 tok/s로 확장되었습니다. 120B 매개변수 모델은 동시성 1에서 31.4 tok/s, 64개의 동시 요청에서 162.7 tok/s를 달성했습니다.
참고: 출력 처리량은 요청별 처리량이 아닌 요청 전체의 처리량입니다.
시간 제한으로 인해 TensorRT 테스트를 완료하지 못했습니다. Spark에서 더 많은 추론 프레임워크에서의 성능을 살펴보는 후속 기사를 기대해주세요.
사전 채우기 및 무거운 추론 디코딩
LLM 추론은 근본적으로 두 개의 서로 다른 계산 단계로 분해될 수 있으며, 각 단계는 현저하게 다른 성능 특성과 리소스 사용 패턴을 보입니다. 사전 채우기 단계는 전체 입력 프롬프트를 단일 병렬 연산으로 처리하여 모든 입력 토큰에 대해 동시에 어텐션 메커니즘을 계산합니다. 이는 텐서 코어와 연산 유닛을 완전히 포화시키는 연산 집약적인 연산입니다. 반대로, 디코딩 단계는 출력 토큰을 자기회귀적으로 생성하여 순차적인 연산을 통해 한 번에 하나의 토큰씩 생성합니다. 이러한 순차적인 연산은 연산 집약도가 낮지만, 모델이 가중치와 증가하는 키-값 캐시에 반복적으로 접근해야 하므로 메모리 대역폭을 상당히 많이 요구합니다. 이로 인해 근본적으로 다른 병목 현상이 발생합니다. 사전 채우기 연산은 일반적으로 연산에 의존하는 반면, 디코딩 연산은 메모리 대역폭을 많이 사용하게 되어 메모리 하위 시스템 제약에 특히 취약합니다.
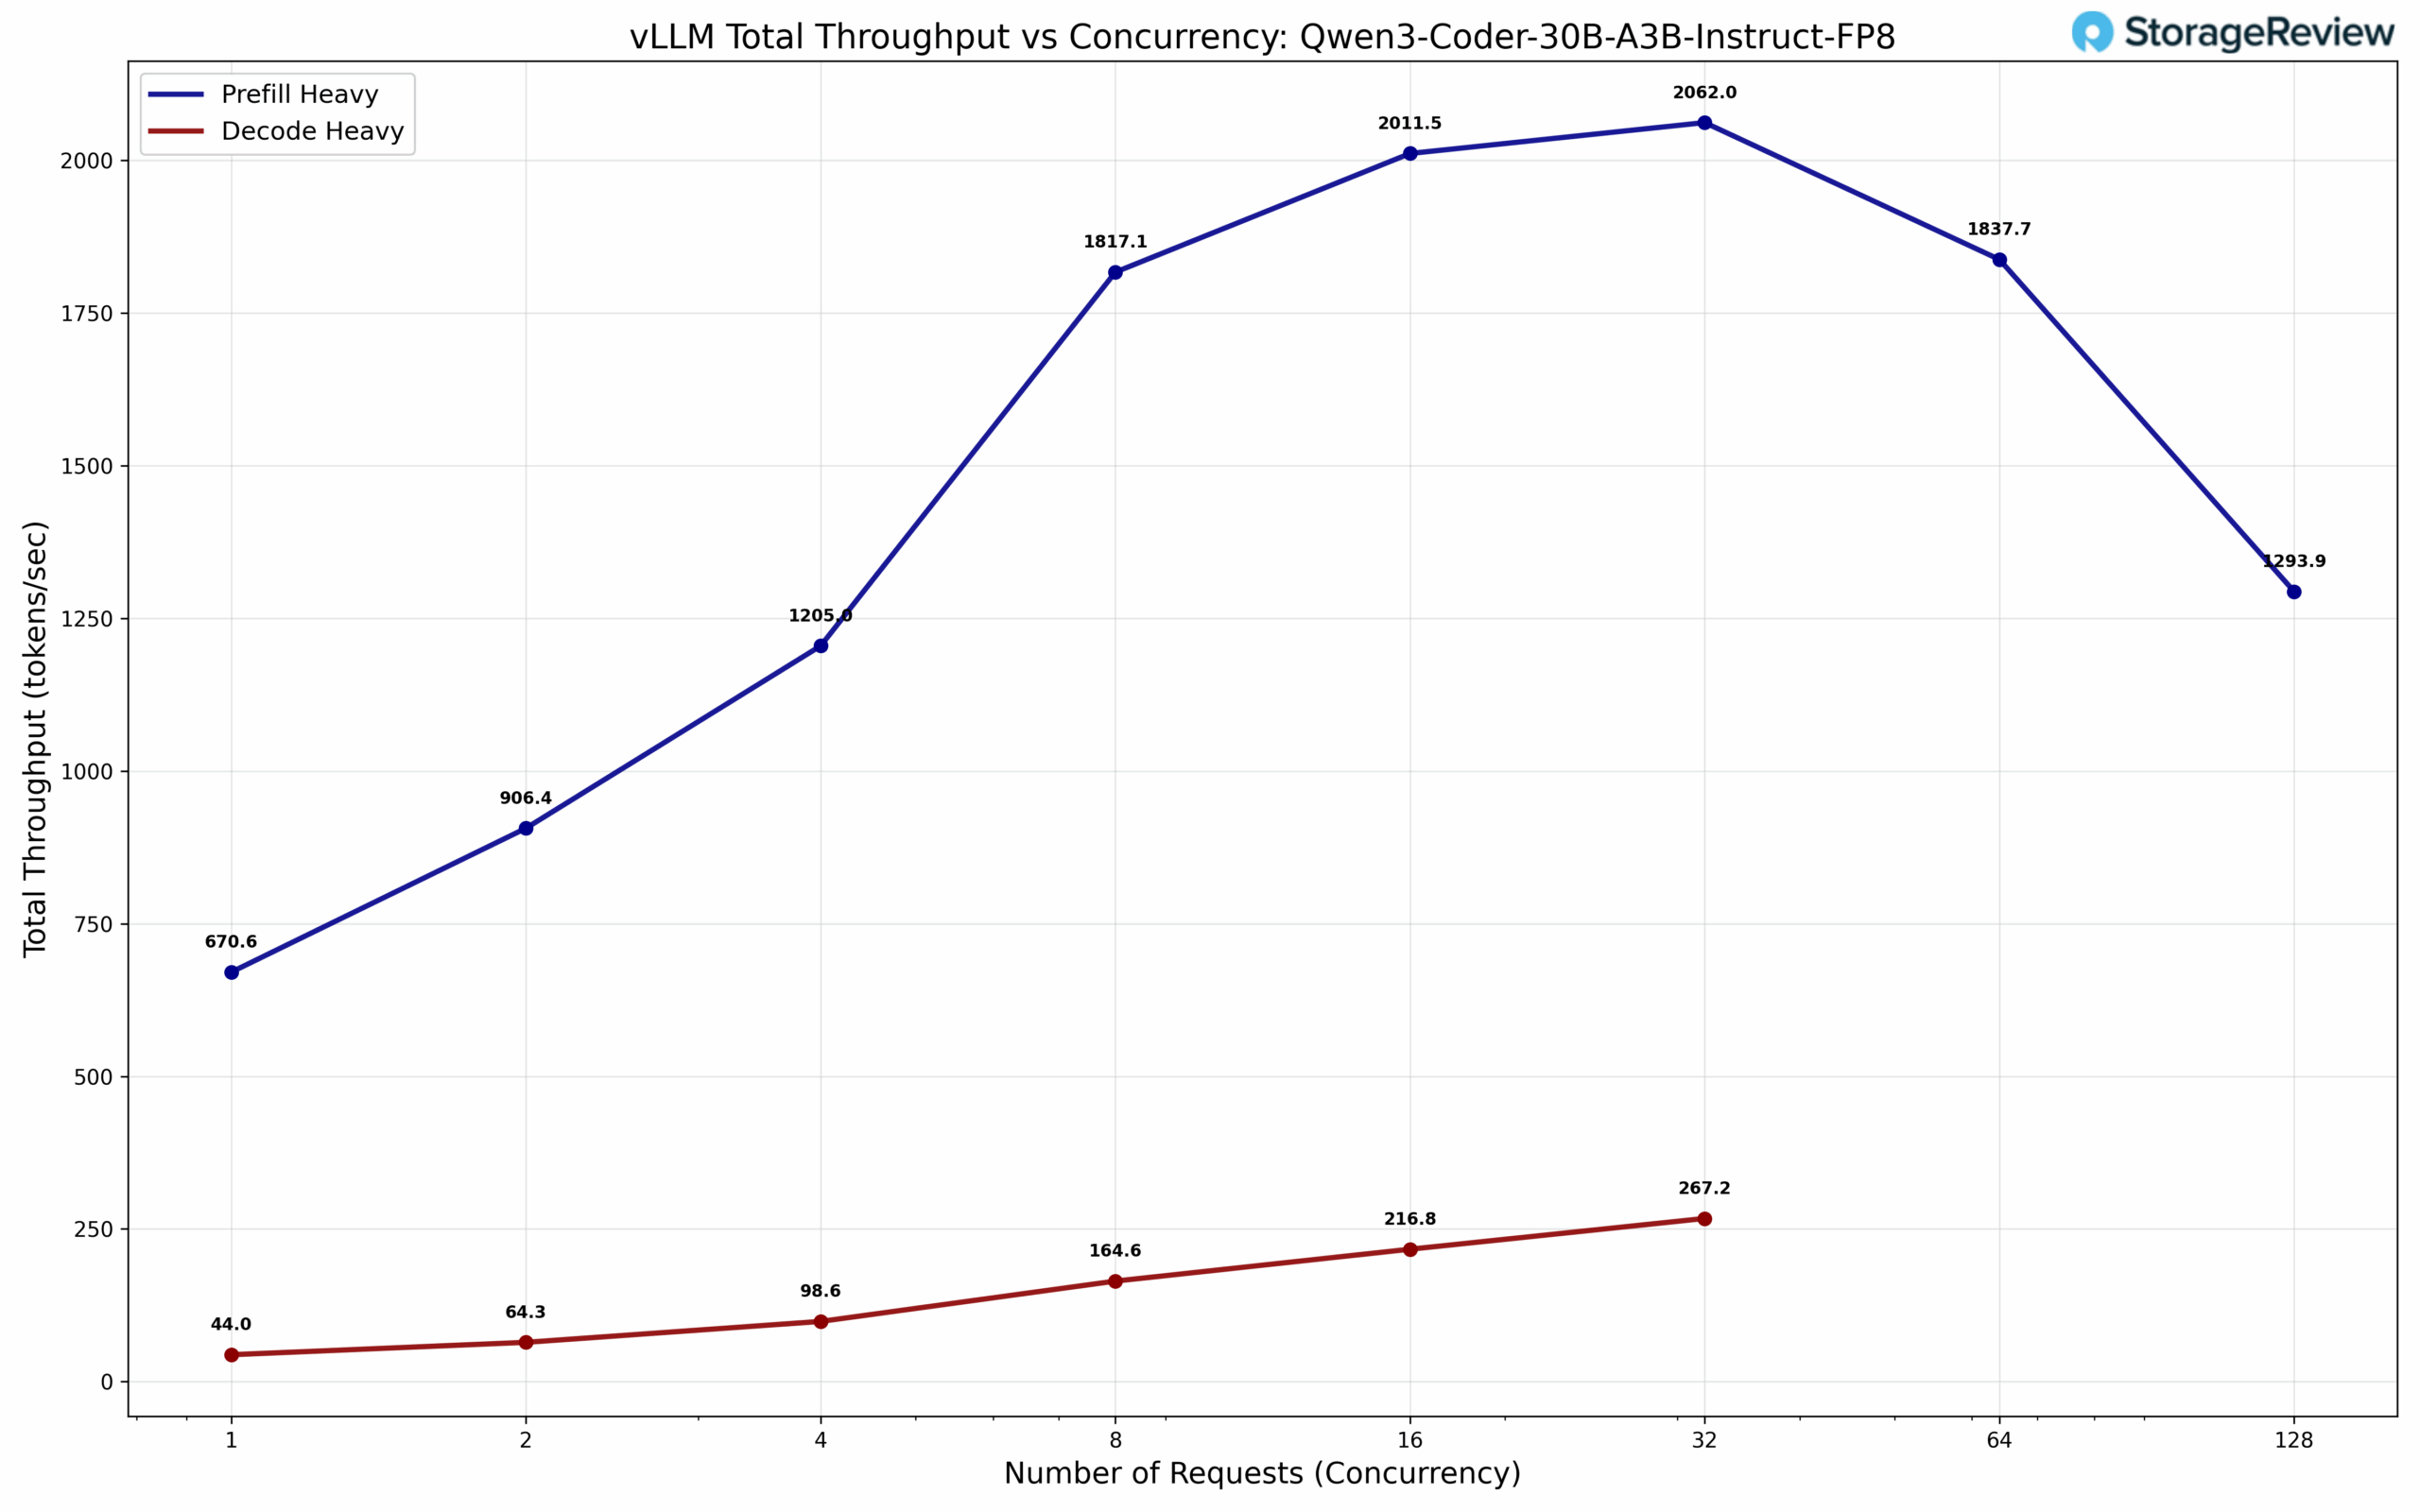
두 가지 서로 다른 워크로드 프로필에 대해 포괄적인 테스트를 수행했습니다. 512개의 입력 토큰과 8,192개의 출력 토큰을 사용하는 디코딩 중심 추론과 8,192개의 입력 토큰과 512개의 출력 토큰을 사용하는 사전 채우기 중심 추론입니다. 성능 특성 분석은 예상되는 아키텍처 상충 관계를 보여줍니다. Spark는 컴퓨팅 리소스가 주요 병목 지점으로 남아 있는 사전 채우기 중심 워크로드에서는 경쟁력 있는 처리량을 보여주지만, 디코딩 중심 시나리오에서는 성능이 저하됩니다. 이러한 성능 차이는 메모리 대역폭 제약과 정확히 일치합니다. 디코딩 작업의 순차적 특성과 집약적인 메모리 액세스 패턴은 Spark 아키텍처에 내재된 대역폭 제한을 직접적으로 드러냅니다. 이러한 결과는 다음 섹션에서 MAMF 측정 결과를 해석하는 데 중요한 맥락을 제공합니다. 두 벤치마크 스위트 모두 실제 추론 배포에서 메모리 대역폭을 근본적인 성능 제한 요소로 일관되게 식별하기 때문입니다.
최대 달성 가능 Matmul FLOPS(MAMF)
MAMF(Maximum Achievable Matmul FLOPS)는 머신러닝 가속기에서 행렬 곱셈 연산 중 실제로 달성할 수 있는 최대 초당 부동 소수점 연산 처리량을 측정하기 위해 설계된 실용적인 성능 지표입니다. 이는 하드웨어 사양에 흔히 명시되는 이론적인 최대 FLOPS보다 더 정확한 벤치마크를 제공합니다. 본 연구에서는 Stas Beckman이 개발한 mamf-finder 벤치마크를 사용합니다.
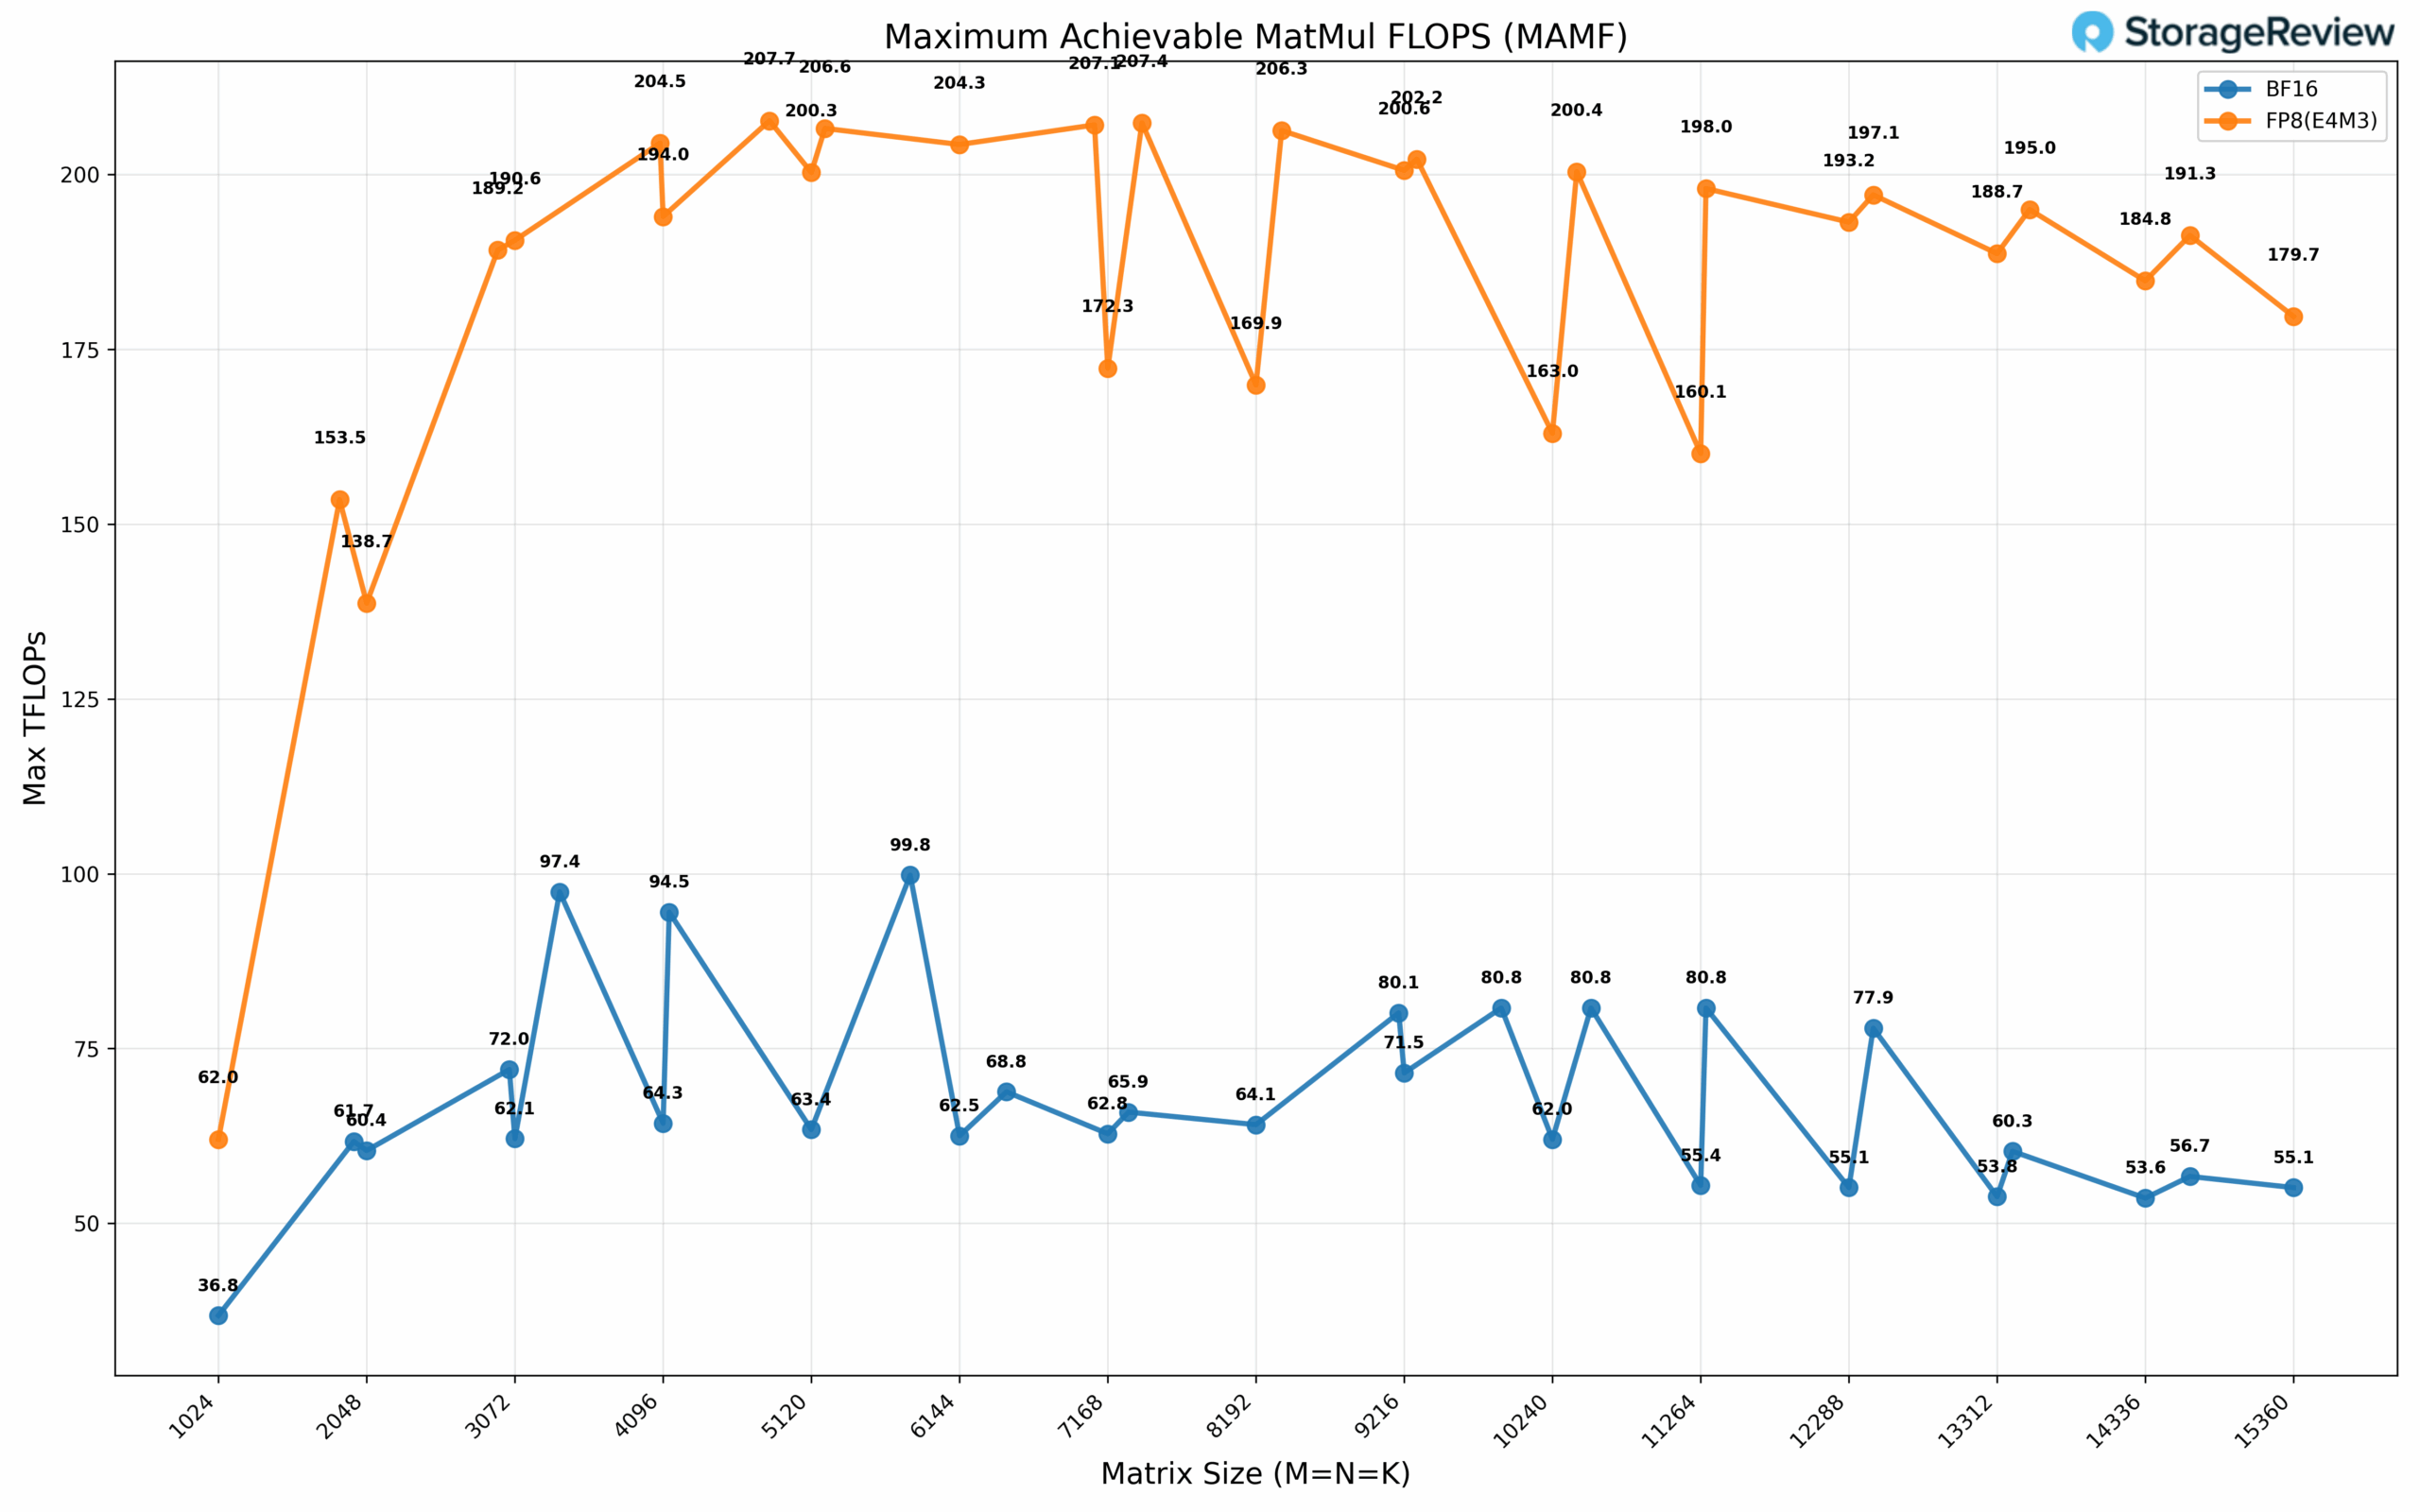
BF16 정밀도에서 MAMF는 99.8 TFLOPs이며, FP8(E4M3)은 207.7 TFLOPs의 MAMF를 보입니다. 시간 제약으로 인해 FP4 MAMF에 대한 포괄적인 특성 분석을 수행하지 못했습니다. 그러나 관찰된 정밀도 기반 스케일링 패턴을 외삽하면, FP8 대비 2배의 추가적인 성능 향상을 예상하며, 고밀도 FP4 연산에서 약 400 TFLOPs의 성능을 얻을 수 있습니다. 2:1 구조화 희소성 최적화를 고려할 때, 이는 이론적 FP4 성능의 약 80%에 해당하며, 희소한 계산 워크로드에서 약 800 TFLOPs의 성능을 달성합니다. 이 리뷰에서는 다루지 않을 여러 가지 이유로 이러한 MAMF 측정값이 이론적으로 발표된 사양에 미치지 못할 수 있다는 점에 유의해야 합니다.
GPU 직접 스토리지
Spark에서 수행한 테스트 중 하나는 MagnumIO GPU Direct Storage(GDS) 테스트였습니다. GDS는 NVIDIA에서 개발한 기능으로, GPU가 NVMe 드라이브나 기타 고속 저장 장치에 저장된 데이터에 액세스할 때 CPU를 거치지 않고 바로 접근할 수 있도록 합니다. GDS는 CPU와 시스템 메모리를 거치지 않고 GPU와 저장 장치 간의 직접 통신을 가능하게 하여 지연 시간을 크게 줄이고 데이터 처리량을 향상시킵니다.
GPU 직접 스토리지 작동 방식
전통적으로 GPU가 NVMe 드라이브에 저장된 데이터를 처리할 때 데이터는 GPU에 도달하기 전에 먼저 CPU와 시스템 메모리를 거쳐야 합니다. 이 프로세스는 CPU가 중개자가 되어 지연 시간을 늘리고 귀중한 시스템 리소스를 소모하기 때문에 병목 현상이 발생합니다. GPU Direct Storage는 GPU가 PCIe 버스를 통해 스토리지 장치에서 직접 데이터에 액세스할 수 있도록 하여 이러한 비효율성을 제거합니다. 이 직접 경로는 데이터 이동과 관련된 오버헤드를 줄여 더 빠르고 효율적인 데이터 전송을 가능하게 합니다.
AI 워크로드, 특히 딥 러닝과 관련된 워크로드는 매우 데이터 집약적입니다. 대규모 신경망을 훈련하려면 테라바이트 규모의 데이터를 처리해야 하며, 데이터 전송이 지연되면 GPU 활용도가 낮아지고 훈련 시간이 길어질 수 있습니다. GPU Direct Storage는 데이터가 가능한 한 빨리 GPU에 전달되도록 하여 유휴 시간을 최소화하고 계산 효율성을 극대화함으로써 이러한 과제를 해결합니다.
또한 GDS는 비디오 처리, 자연어 처리 또는 실시간 추론과 같이 대용량 데이터 세트를 스트리밍하는 작업 부하에 특히 유용합니다. GDS는 CPU에 대한 의존도를 줄임으로써 데이터 이동을 가속화하고 다른 작업을 위한 CPU 리소스를 확보하여 전반적인 시스템 성능을 더욱 향상시킵니다.
GDSIO – 내부 4TB M.2
NVIDIA DGX Spark는 흥미로운 스토리지 선택지를 제공합니다. 소형 케이스 내부 크기를 고려했을 때, NVIDIA는 비교적 덜 일반적인 Gen5 2242 M.2 SSD를 선택했습니다. 이 유형의 SSD에 익숙하지 않은 분들을 위해 설명드리자면, 데스크톱에서 흔히 사용되는 80mm보다 짧은 42mm 버전입니다. 드라이브 선택 폭이 좁으며, 이 크기에서 최대 용량은 4TB입니다. 하지만 가장 큰 문제는 성능입니다. 2242 및 2230 모델과 같은 소형 SSD는 드라이브 속도보다 크기를 우선시합니다. 이러한 SSD는 휴대용 게임 콘솔, 태블릿, 그리고 일부 노트북에서 흔히 사용됩니다.
2230 및 2242 SSD PCB에는 공간이 많지 않아 컨트롤러, DRAM, NAND 패키지를 위한 공간이 부족합니다. 테스트 과정에서 이러한 단점 중 일부를 발견했습니다. 1TB 또는 128GB 용량에 GDSIO 워크로드를 적용했을 때 SSD가 잠기고 Spark를 다시 이미징해야 했습니다. 테스트 용량을 64GB로 줄이고 스레드 수를 늘리면 이 문제가 해결되었습니다. 이러한 문제는 일반적으로 일반적인 고성능 80mm SSD에서는 발생하지 않습니다.
내부 드라이브의 순차 읽기 성능을 살펴보면, 16개 스레드를 사용하는 1M 블록 크기에서 가장 높은 처리량이 11.4GiB/s를 달성하는 것을 확인할 수 있습니다.
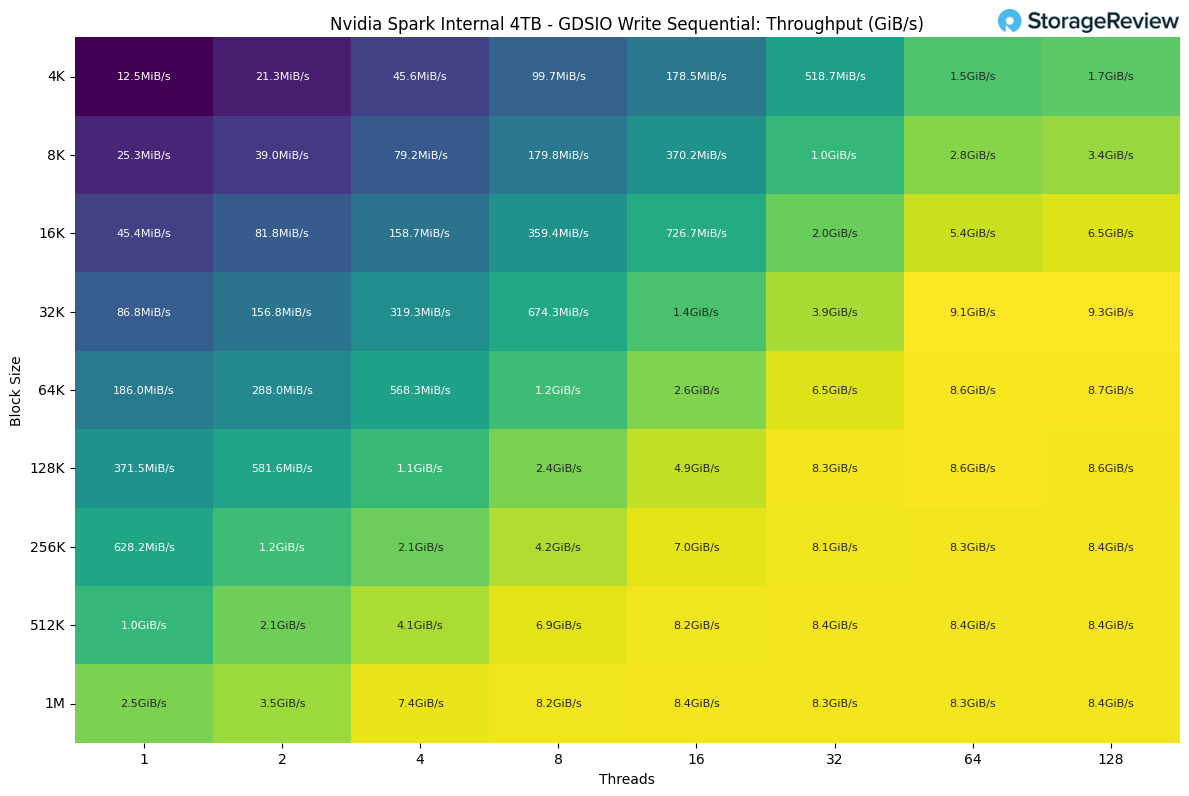
순차 쓰기 성능을 살펴보면, 이 드라이브는 128개 스레드를 사용하는 32k 블록 크기에서 가장 높은 처리량을 달성합니다. 더 큰 블록 크기에서는 성능이 정체되어 평균 8.3GiB/s 정도를 보입니다.
더욱 집중적인 개발 작업을 위해 NVIDIA DGX Spark를 구매하려는 구매자, 특히 소규모 클러스터를 만들려는 기업의 경우, 온보드 200Gb NVIDIA ConnectX-7 NIC를 활용하는 방법을 적극 권장합니다.
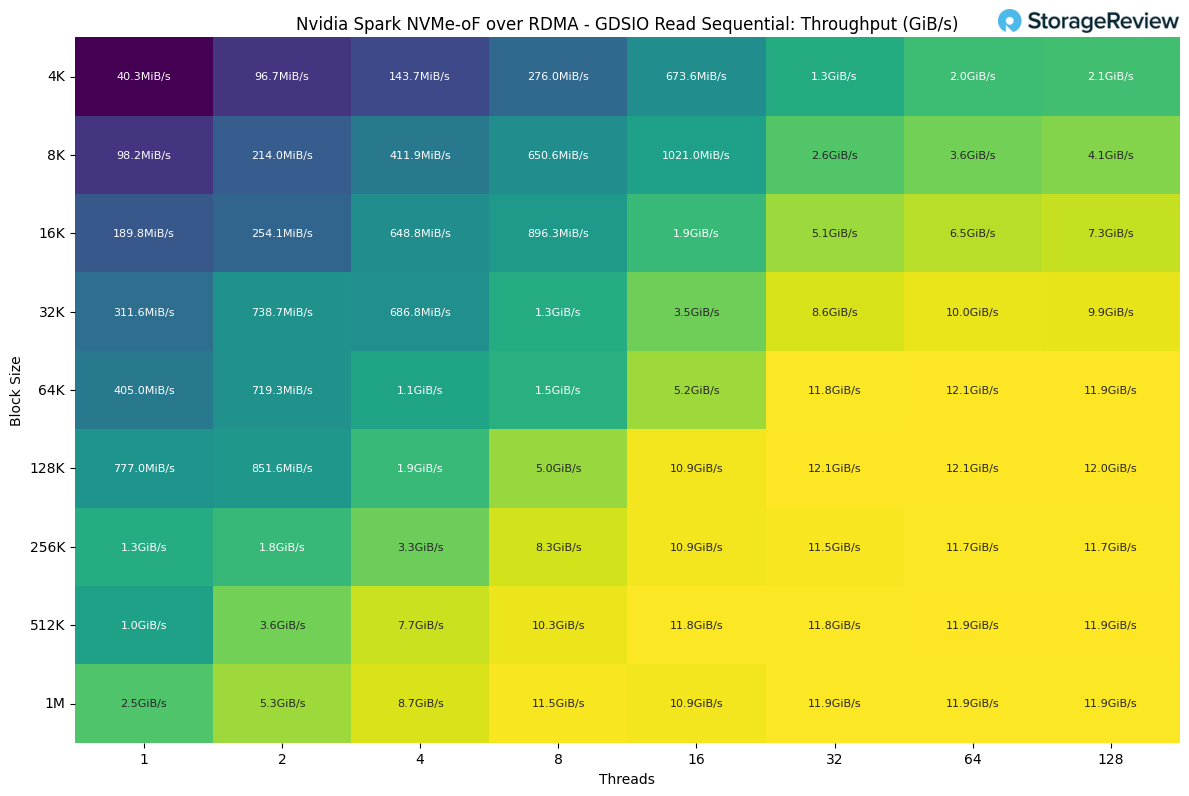
GDSIO – RDMA를 통한 NVMe-oF
NVIDIA DGX Spark를 사용한 NVMe-oF RDMA 테스트를 위해 PEAK:AIO 소프트웨어를 활용하여 Dell PowerEdge R770에 NVMe-oF 타겟을 생성하고, Micron 9550 3.84TB SSD 6개를 RDMA로 연결했습니다. 앞서 언급했듯이 Spark의 CX7 NIC는 고유한 특성을 가지고 있으며, 시간 제약으로 인해 Spark는 100G 연결로만 테스트할 수 있었습니다. Spark와 PEAK:AIO 모두 훨씬 더 높은 성능을 달성할 수 있습니다. 향후 Spark를 사용하여 추가 스토리지 및 네트워크 테스트를 진행할 예정입니다.
내부 드라이브의 순차 읽기 성능을 살펴보면, 32개 스레드로 128k 블록 크기에서 가장 높은 처리량이 나타나 12.1GiB/s를 달성했습니다.
순차 쓰기 성능을 살펴보면, 이 드라이브는 16개 스레드를 사용하는 128k 블록 크기에서 가장 높은 처리량을 달성합니다. 더 큰 블록 크기에서는 성능이 정체되어 평균 11.3GiB/s 정도를 보입니다.
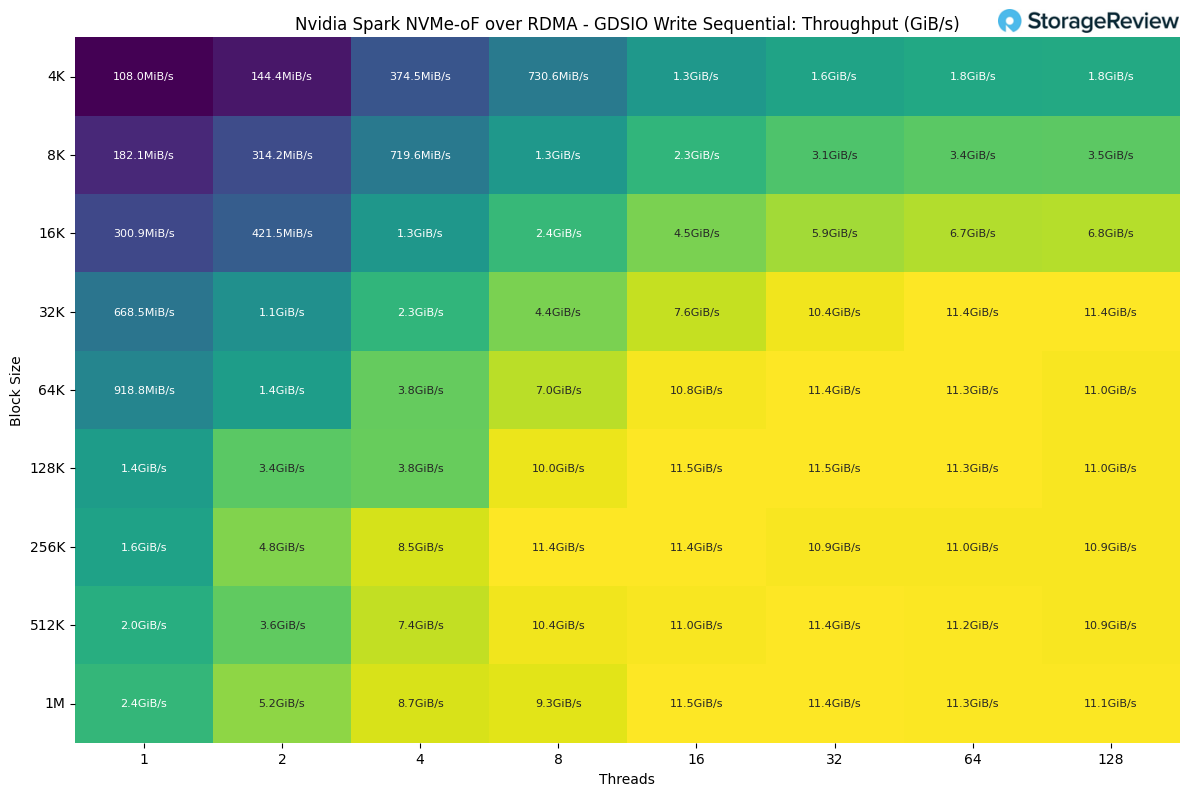
이 결과에는 미묘한 차이가 있습니다. 앞서 언급한 시간 및 네트워킹 관련 이유로 인해 이론적인 최대값의 절반만 확인되었습니다. 또한, 128k 블록 크기에서의 최고 처리량은 사용된 엔터프라이즈 드라이브나 PEAK:AIO의 IO 처리 방식 등 여러 요인의 영향을 받습니다. 실제 결과는 다를 수 있으며, 향후 Spark 테스트를 통해 더 많은 결과를 도출할 계획입니다.
Day-One 소프트웨어 생태계
NVIDIA를 비롯한 여러 공급업체는 소프트웨어 준비성에 상당한 투자를 해왔는데, 이는 얼리어답터들이 불완전한 문서와 누락된 툴을 탐색하던 일반적인 하드웨어 출시와는 확연히 다른 모습입니다. Spark는 일반적인 워크플로우를 포괄하는 포괄적인 플레이북을 제공합니다. 확산 모델을 위한 ComfyUI, 최적화된 추론을 위한 TRT-LLM, 로컬 모델 서빙을 위한 Open WebUI를 탑재한 Ollama, 미세 조정을 위한 Unsloth, 그리고 LangGraph를 활용한 다중 에이전트 아키텍처가 여기에 포함됩니다.
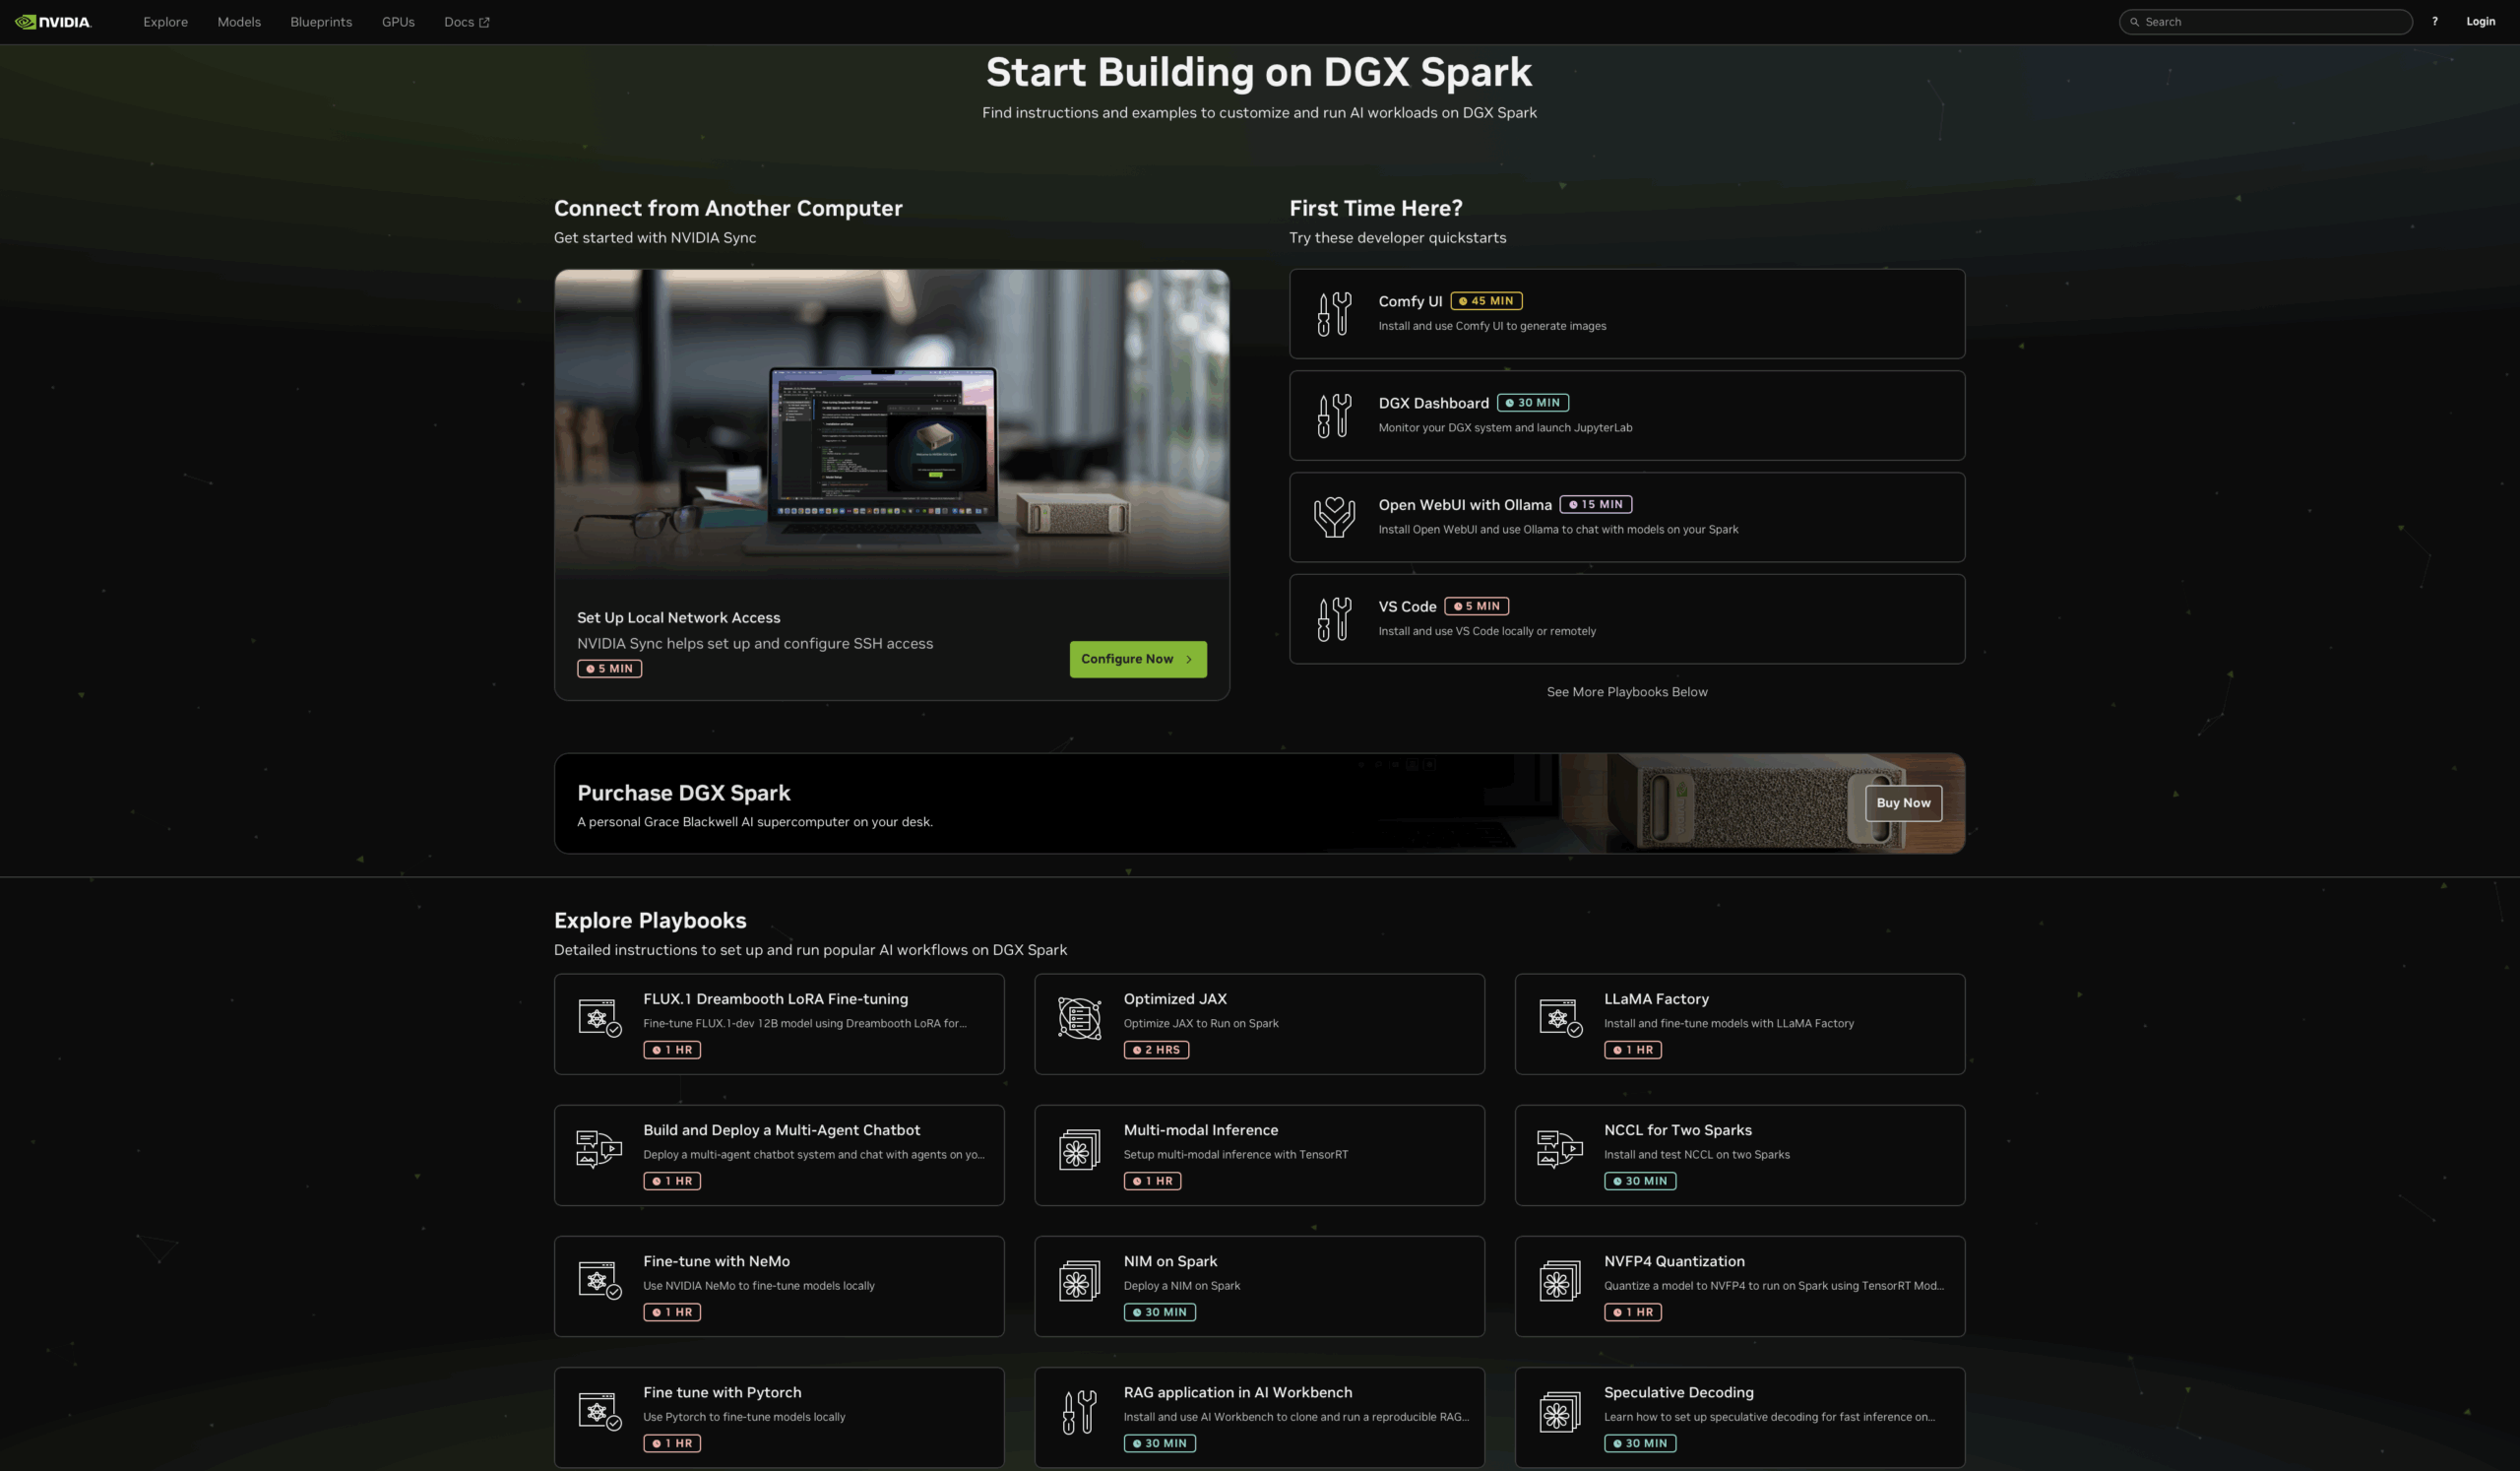
이러한 소프트웨어 성숙도는 평가 경험을 혁신적으로 변화시킵니다. 개발자는 환경 설정에 며칠씩 소요하는 대신, 대표적인 워크로드를 실행하여 Spark가 요구 사항을 충족하는지 즉시 평가할 수 있습니다. 플레이북은 지침뿐만 아니라 컨테이너화된 환경, 샘플 데이터 세트, 예상 성능 지표까지 제공합니다.
가용성 및 OEM 시스템
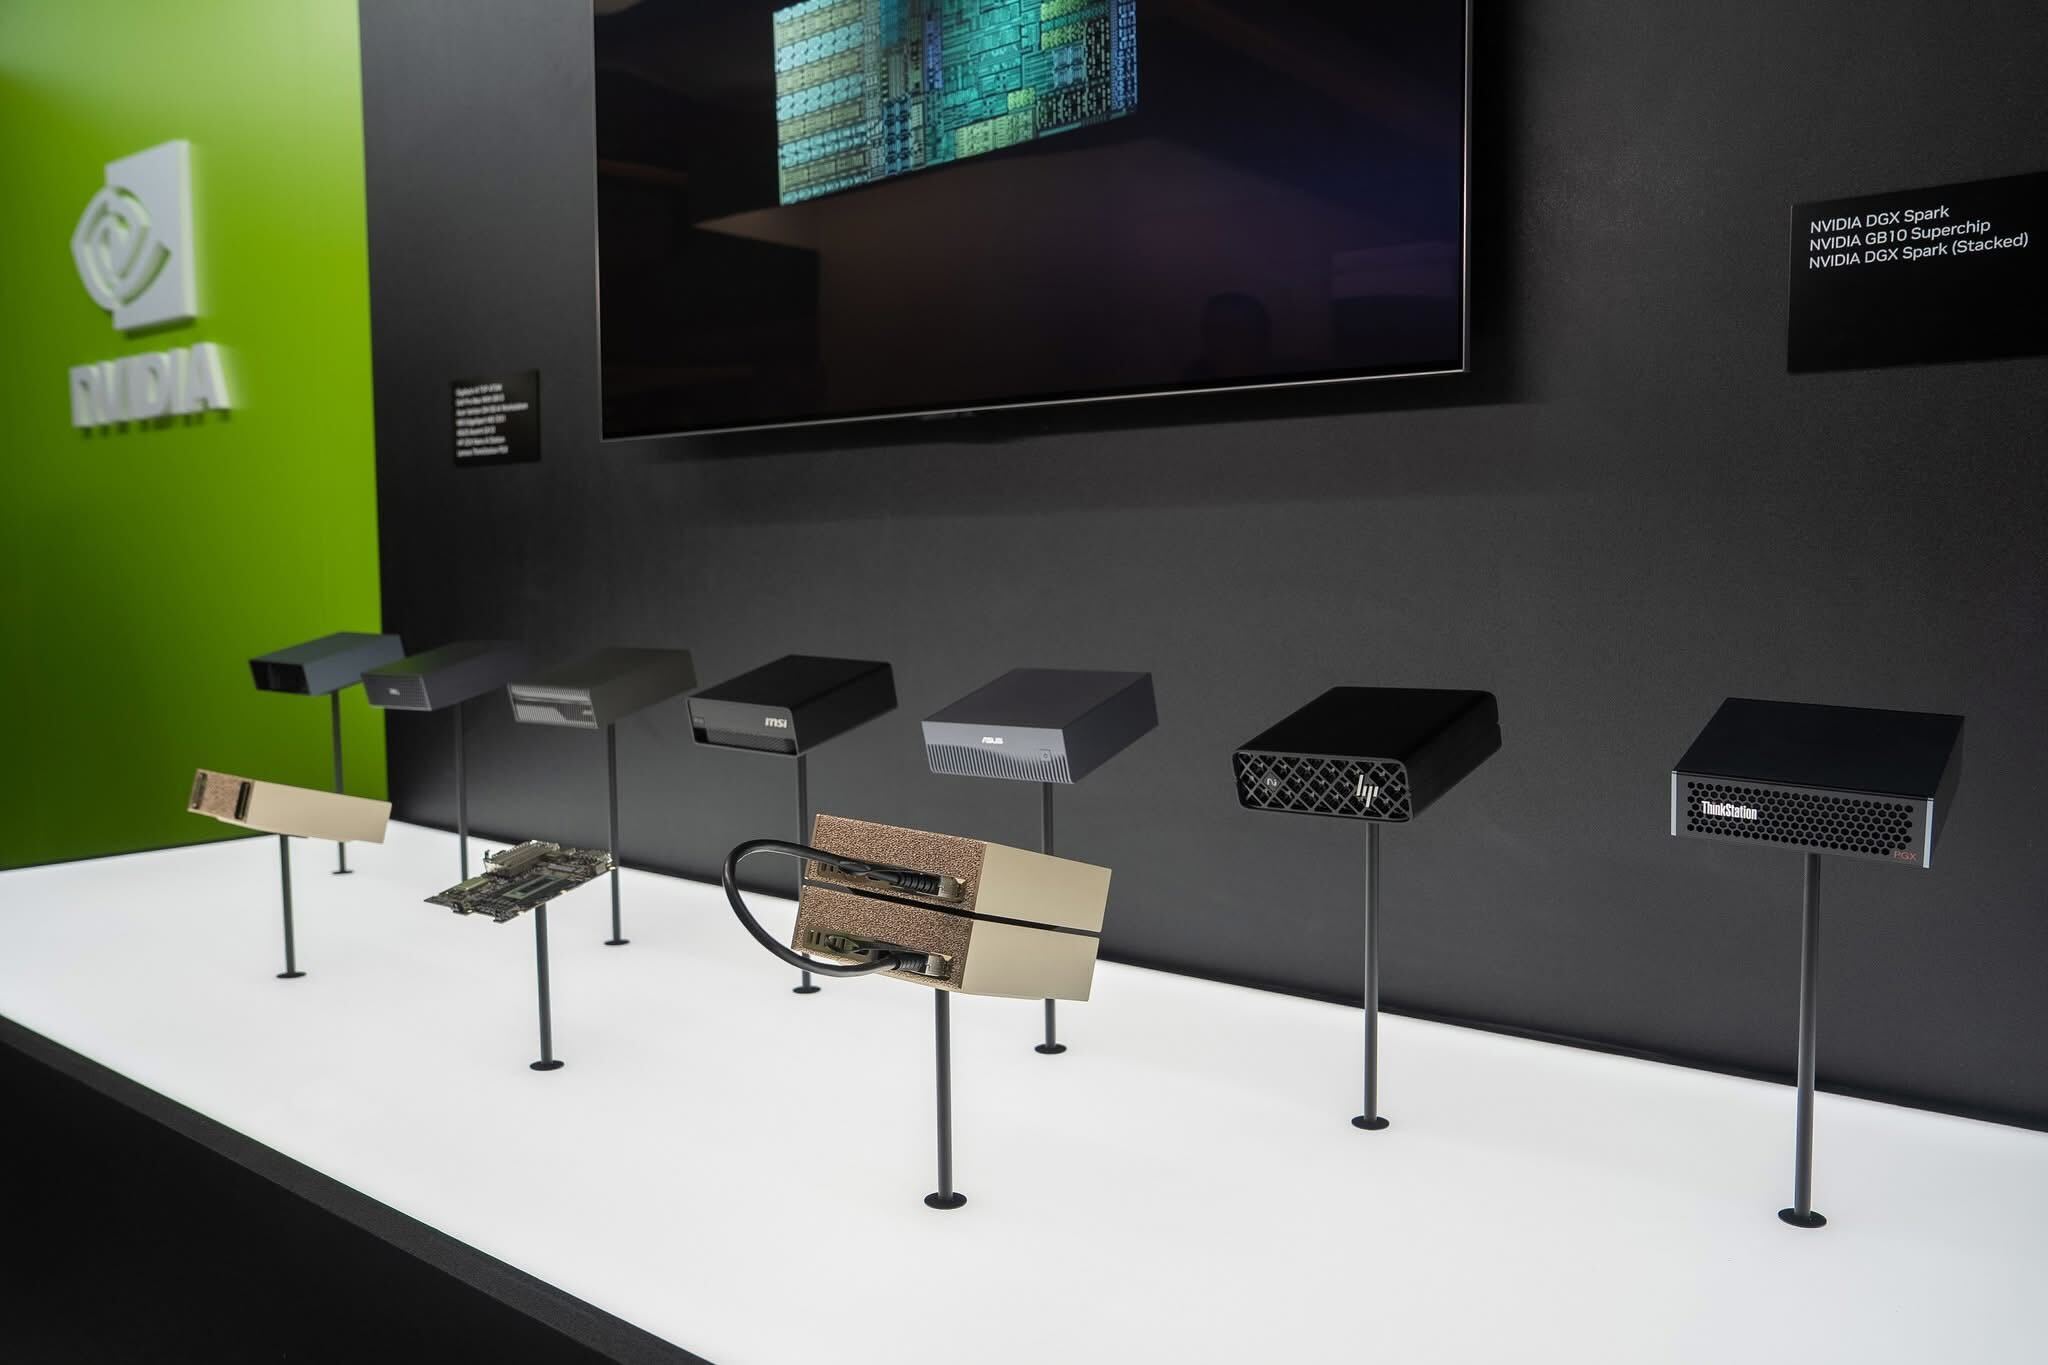
NVIDIA Founders Edition은 4TB 구성 기준으로 3,999달러에 주문 가능하며, 일반 판매는 10월 15일부터 시작됩니다. NVIDIA 자체 제품 외에도 주요 OEM 업체에서 여러 GB10 데스크톱이 출시될 예정입니다. 모든 OEM의 핵심 하드웨어는 거의 유사하지만, 차별화를 위한 약간의 여유가 있을 수 있습니다. 하지만 가격 차이는 대부분 스토리지 선택에 따라 발생할 것으로 예상됩니다. Dell Pro Max GB10, Lenovo ThinkStation PGX, Acer Veriton GN100, ASUS Ascent GX10 등 이미 많은 제품이 출시되었습니다.
출처: 엔비디아
맺음말
엔비디아 DGX 스파크는 첨단 AI 컴퓨팅 인프라의 접근성 패러다임에 있어 근본적인 전환점을 제시합니다. 128GB 통합 메모리, 1페타플롭의 스파스 FP4 성능, 4세대 RT 코어, 그리고 ConnectX-7 네트워킹을 탑재한 GB10 그레이스 블랙웰 슈퍼칩의 성능을 240W, 1.13리터 용량의 3,999달러짜리 기기에 통합함으로써, 엔비디아는 과거 데이터센터급 AI 역량을 개별 연구원과 소규모 개발팀이 누리지 못했던 장벽을 효과적으로 허물었습니다.
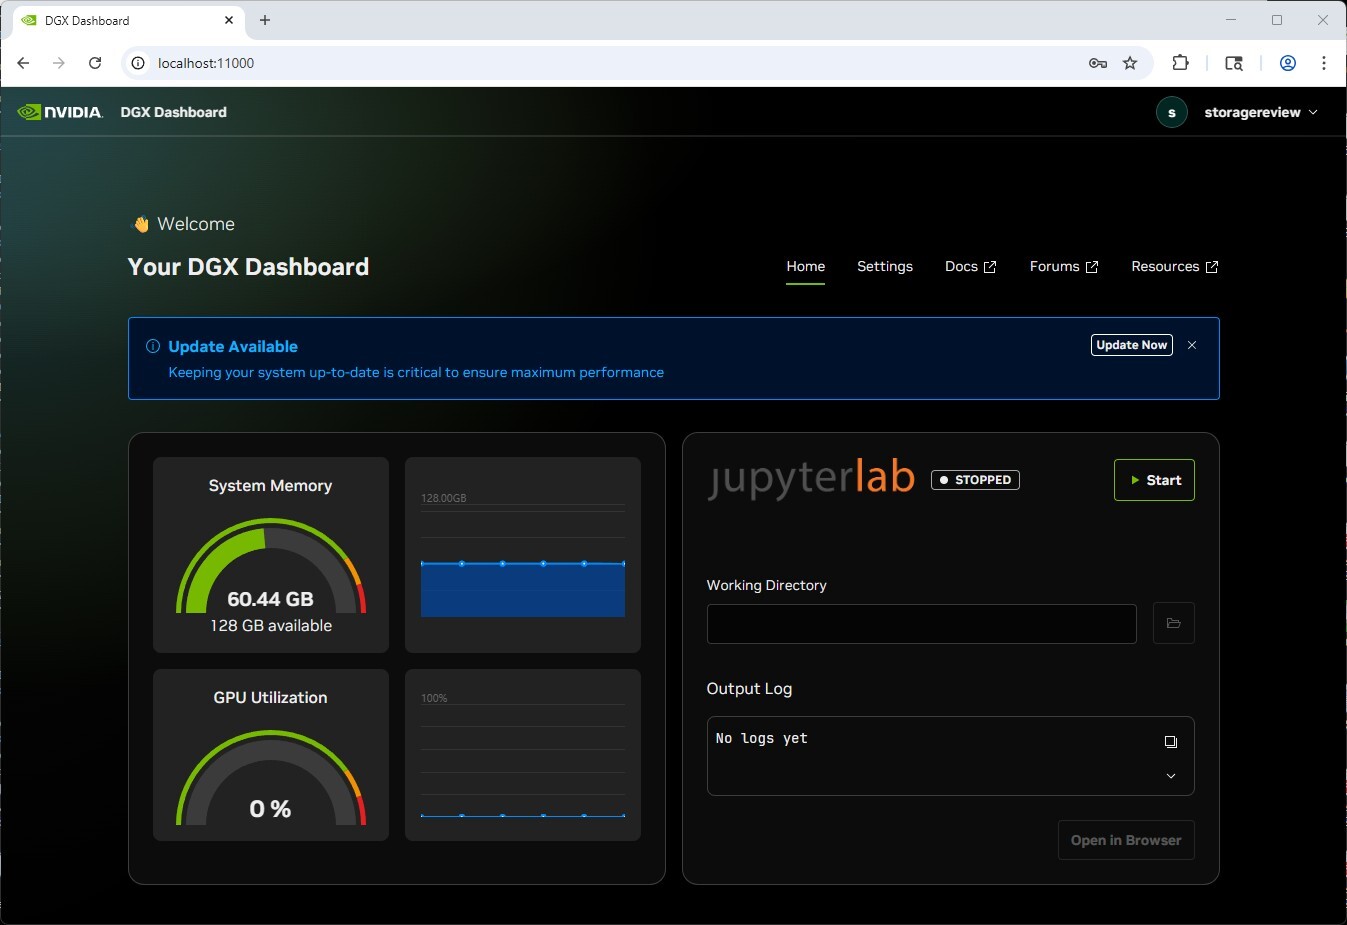
검증된 어플라이언스 방식은 AI 인프라 구축 시 지속적으로 발생하는 문제, 즉 맞춤형 구성 유지 관리에 따른 운영 오버헤드를 해결합니다. Spark 유닛을 구축하는 조직은 DGX OS, CUDA 툴킷, 프레임워크 컨테이너, 하드웨어 펌웨어를 포함한 전체 스택에 대한 NVIDIA의 포괄적인 테스트 및 검증을 통해 맞춤형 워크스테이션 구축을 어렵게 만드는 구성 부채를 제거할 수 있습니다. DGX 대시보드의 통합 업데이트 관리, 시스템 모니터링, JupyterLab 프로비저닝은 운영 부담을 더욱 줄이는 동시에 NVIDIA Sync의 자동 SSH 키 배포 및 터널 관리 기능은 원격 액세스를 원활하게 지원합니다. 규모 확장이 필요한 조직의 경우, 이는 눈에 띄게 빠른 온보딩으로 이어집니다. 신규 연구원은 표준화된 하드웨어를 받고, 검증된 2노드 클러스터링 구성을 통해 기존 인프라에 연결하여 드라이버 충돌이나 네트워크 패브릭 구성 문제를 해결하는 데 며칠이 걸리는 대신 몇 시간 내에 생산적인 작업을 시작할 수 있습니다.
DGX Spark는 이미 작고 조용한 어플라이언스로 진정한 AI 성능을 제공하고 있으며, 초기 결과는 데이터센터 부담 없이 강력한 성능을 원하는 팀에게 DGX Spark가 왜 중요한지 보여줍니다. 이야기는 이제 막 시작일 뿐입니다. 200G 패브릭, NVMe-oF 타겟, 그리고 다중 노드 클러스터링으로 테스트를 확장하여 확장 효율성, 더 큰 모델 풋프린트, 그리고 공유 스토리지 아키텍처를 탐구할 계획입니다. 소프트웨어 및 파트너 생태계가 성숙해짐에 따라, Spark 구축 환경은 강력한 단일 노드 구성에서 이 플랫폼을 더욱 강화하는 긴밀하게 통합되고 처리량이 높은 미니 클러스터로 진화할 것으로 예상합니다.
순위표: NVIDIA DGX Spark는 당사의 로컬 AI용 최고 데스크톱 시스템 순위표에서 종합 최고 데스크톱 AI 시스템 자리를 차지했습니다.
리더보드: 이러한 유형의 시스템에 대한 크기 조정 지침은 에이전트 AI용 RAM, GPU 및 스토리지 가이드에서 확인할 수 있습니다.


 아마존