

L40S는 데이터 센터 GPU 생태계의 중요한 간극을 메웁니다. 엔비디아 H100과 같은 컴퓨팅 중심 AI 학습 GPU는 순수 성능을 우선시하지만 그래픽 가속은 전혀 고려하지 않는 반면, 기존의 전문 시각화 카드는 최신 추론 워크로드와 새로운 AI 기반 그래픽 애플리케이션에서 요구하는 AI 연산 능력이 부족합니다. 이러한 포지셔닝은 합성 데이터 생성, 멀티모달 AI 개발, 그리고 컴퓨팅 성능과 그래픽 성능이 모두 필수적인 Omniverse 애플리케이션에 특히 유용합니다.
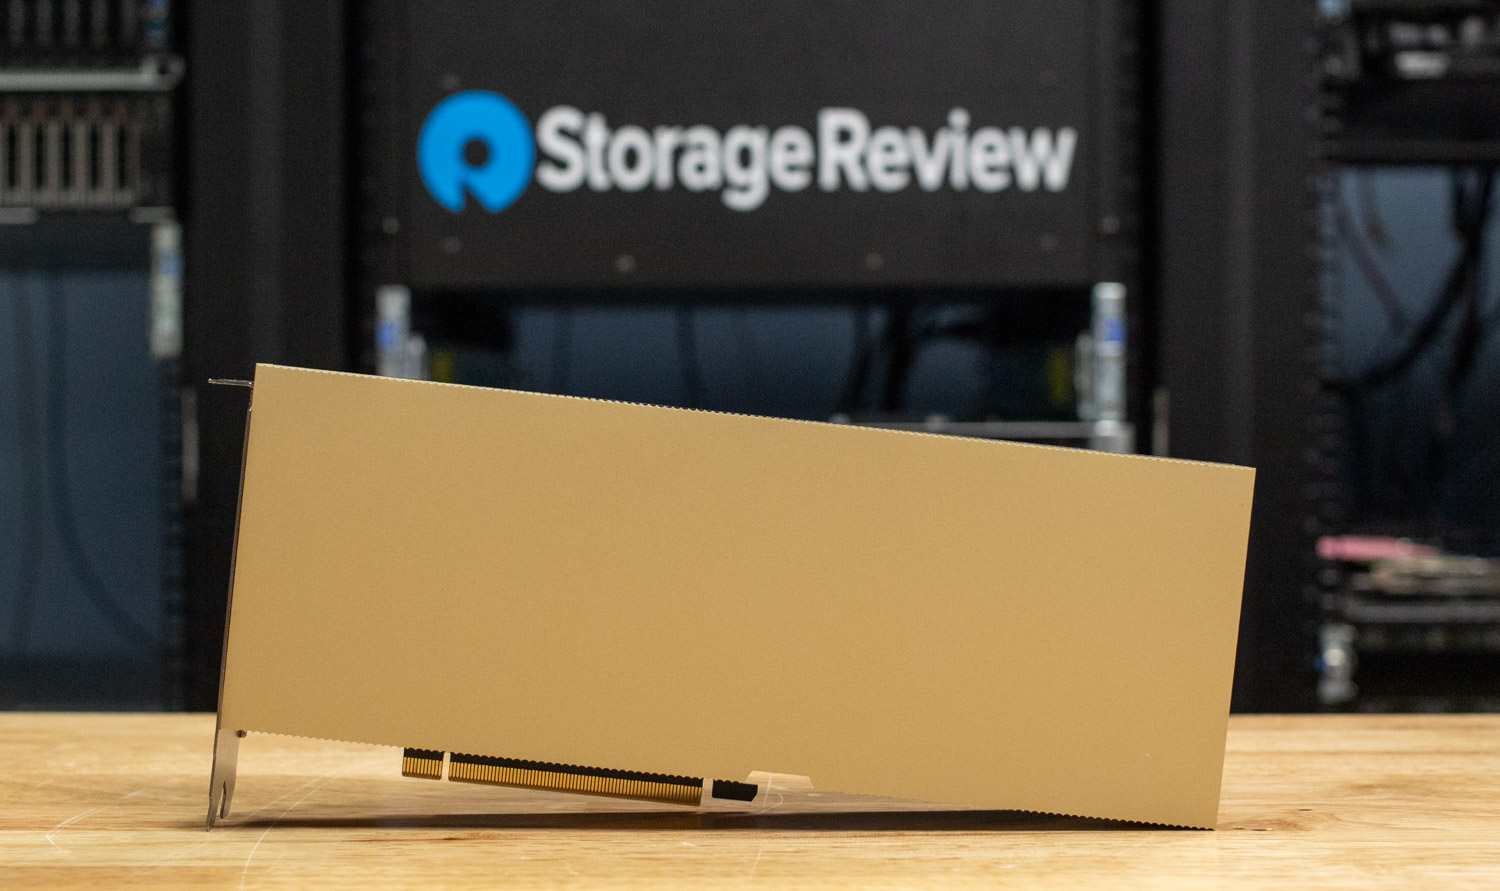
NVIDIA L40S 사양
| 스펙 | L40 | L40S | H100 80G PCIe |
| GPU 아키텍처 | 에이다 러브 레이스 | 에이다 러브 레이스 | 홉 따는 사람 |
| GPU 다이 | AD102 | AD102 | GH100 |
| 쿠다 코어 | 18,176 | 18,176 | 14,592 |
| 텐서 코어 | 568(4세대) | 568(4세대) | 456 |
| RT 코어 | 142(3세대) | 142(3세대) | - |
| GPU 메모리 | 48GB GDDR6(ECC 포함) | 48GB GDDR6(ECC 포함) | 80GB HBM2e |
| 메모리 대역폭 | 864 GB / 초 | 864 GB / 초 | 2 TB / 초 |
| 메모리 인터페이스 | 384-bit | 384-bit | 5120-bit |
| 최대 소비 전력 | 300W | 350W | 350W |
| 폼 팩터 | 높이 4.4인치 x 길이 10.5인치: 듀얼 슬롯 | 높이 4.4인치 x 길이 10.5인치: 듀얼 슬롯 | 높이 4.4인치 x 길이 10.5인치: 듀얼 슬롯 |
| 열 솔루션 | 수동 | 수동 | 수동 |
| 디스플레이 커넥터 | 4x 디스플레이 포트 1.4a | 4x 디스플레이 포트 1.4a | - |
| PCIe 인터페이스 | 4세대 x16 | 4세대 x16 | 5세대 x16 |
| 전원 커넥터 | 16 핀 | 16 핀 | 16 핀 |
| vGPU 지원 | 가능 | 가능 | 아니 |
| 멀티 인스턴스 GPU(MiG) | 아니 | 아니 | 가능 |
| NVLink 지원 | 아니 | 아니 | 아니 |
성능 사양
| 메트릭 | L40 퍼포먼스 | L40S 성능 | H100 성능 |
| FP32 성능 | 90.5 TFLOPS | 91.6 TFLOPS | 51.2 TFLOPS |
| TF32 텐서 코어 | 362.1 TFLOPS | 366 TFLOPS | 756 TFLOPS |
| FP16 텐서 코어 | 724 TFLOPS | 733 TFLOPS | 1513 TFLOPS |
| FP8 텐서 코어 | 1,448 TFLOPS | 1,466 TFLOPS | 3026 TFLOPS |
| 피크 INT8 텐서 TOPS | 1,448 TFLOPS | 1,466 TFLOPS | 3026 상단 |
| RT 코어 성능 | 209 TFLOPS | 212 TFLOPS | - |
(성능 수치는 희소성을 갖습니다)
NVIDIA L40S 대 H100
사양을 자세히 살펴보면 NVIDIA L40S와 H100의 고유한 디자인 철학을 알 수 있습니다. L40S는 Ada Lovelace 아키텍처를 기반으로 제작되었으며, NVIDIA의 고급 워크스테이션 그래픽 카드에 사용되는 것과 동일한 AD102 다이를 사용합니다. 이러한 전통 덕분에 18,176개의 CUDA 코어를 탑재하여 기존 그래픽 렌더링 및 과학 컴퓨팅의 초석인 뛰어난 단정밀도 FP32 성능을 제공합니다. 이와 대조적으로 H100의 Hopper 아키텍처와 GH100 다이는 무엇보다도 AI 및 HPC 워크로드에 최적화되어 있습니다.
가장 두드러지는 차별점은 코어 구성입니다. L40S는 142세대 RT 코어 568개와 100세대 텐서 코어 40개를 탑재하고 있습니다. RT 코어는 H100에는 전혀 없는 레이 트레이싱 가속을 위한 특수 하드웨어로, L8S는 이를 통해 사실적인 렌더링을 구현할 수 있는 독보적인 역량을 갖추게 되었습니다. HXNUMX은 텐서 코어 수가 적지만, 더욱 빠르고 진보된 성능을 제공하며 FPXNUMX과 같은 새로운 AI 데이터 형식에 최적화되어 있어 원시 AI 성능 측면에서 압도적인 우위를 점하고 있습니다.
이러한 상충 관계는 메모리 서브시스템에서도 분명하게 드러납니다. H100은 80GB의 고가 HBM2e 메모리를 사용하여 2TB/s의 놀라운 대역폭을 제공합니다. 이는 대규모 AI 모델 학습 및 추론 과정에서 SM에 전력을 공급하는 데 필수적입니다. L40S는 보다 일반적인 48GB GDDR6 메모리를 사용하여 864GB/s의 대역폭을 제공합니다. H100의 절반에도 미치지 못하지만, 여전히 상당한 용량으로, 대용량 3D 장면, 고해상도 텍스처, 그리고 추론을 위한 대용량 AI 모델을 로딩하기에 매우 적합합니다.
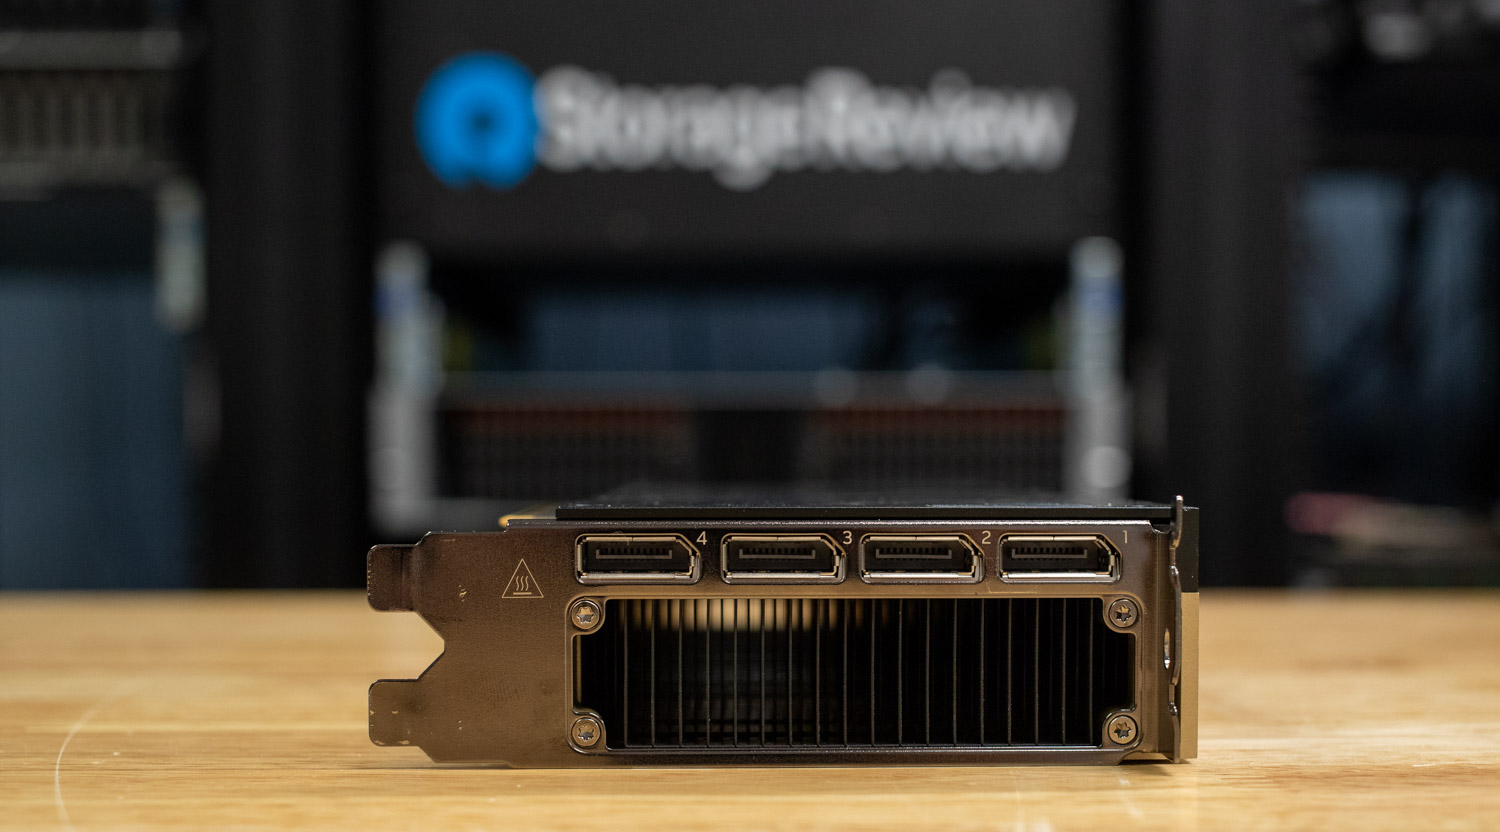
마지막으로, 기능 세트는 각 제품의 역할을 간략하게 설명합니다. L40S는 1.4개의 DisplayPort 100a 출력과 강력한 vGPU 지원을 제공하여 가상화된 워크스테이션, 렌더 팜, 클라우드 게임 배포에 이상적입니다. 디스플레이 출력이나 vGPU 기능이 없는 H350은 대신 다중 인스턴스 GPU(MiG) 기술을 제공합니다. 이 기술을 통해 여러 개의 작고 분리된 GPU 인스턴스로 분할하여 여러 컴퓨팅 집약적인 워크로드를 동시에 처리할 수 있습니다. L40S와 PCIe H100은 공유 듀얼 슬롯, 수동 열 관리 설계, 그리고 XNUMXW의 전력 소모량을 통해 다양한 업계 표준 서버에 유연하게 배포할 수 있습니다.
L40S를 NVIDIA의 플래그십 모델인 H100과 비교하면 두 모델의 역할 차이가 명확해집니다. H100은 동세대 GPU 중 AI 학습 성능 면에서 단연 최고 수준이지만, 이 비교는 그 일부만을 보여줄 뿐입니다. L40 역시 NVIDIA 라인업에 속하며, L300S의 40W 전력 소모량보다 낮은 350W TDP를 제공하여 더 낮은 전력 소모량으로 유사한 성능을 제공한다는 점은 주목할 만합니다.
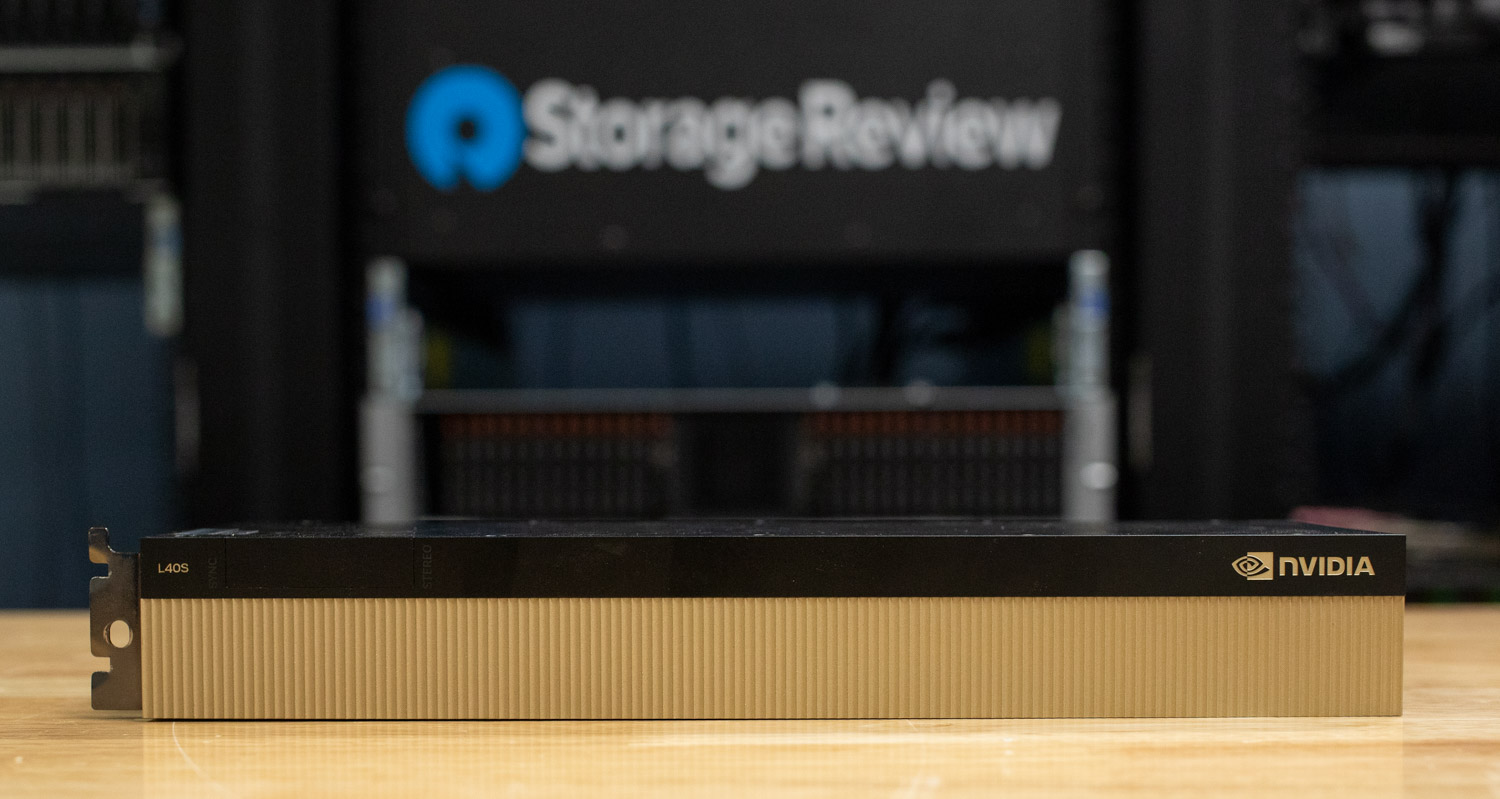
여기서 살펴보는 H100은 HBM80e 메모리를 탑재한 오리지널 2GB PCIe 버전입니다. NVIDIA는 이후 H100 NVL과 같은 변형 모델로 이 제품군을 확장했습니다. H80 NVL은 오리지널 94GB PCIe 모델을 대체하는 제품으로, 400GB 메모리와 더 높은 100W TDP를 제공하며 듀얼 GPU 구성을 위한 NVLink 지원 기능을 추가합니다. H8 제품군은 200-GPU SXM 구성과 동일한 GPU 다이를 사용하지만 PCIe 및 SXM 폼팩터 모두에서 향상된 성능을 제공하는 최신 HXNUMX으로 확장됩니다.
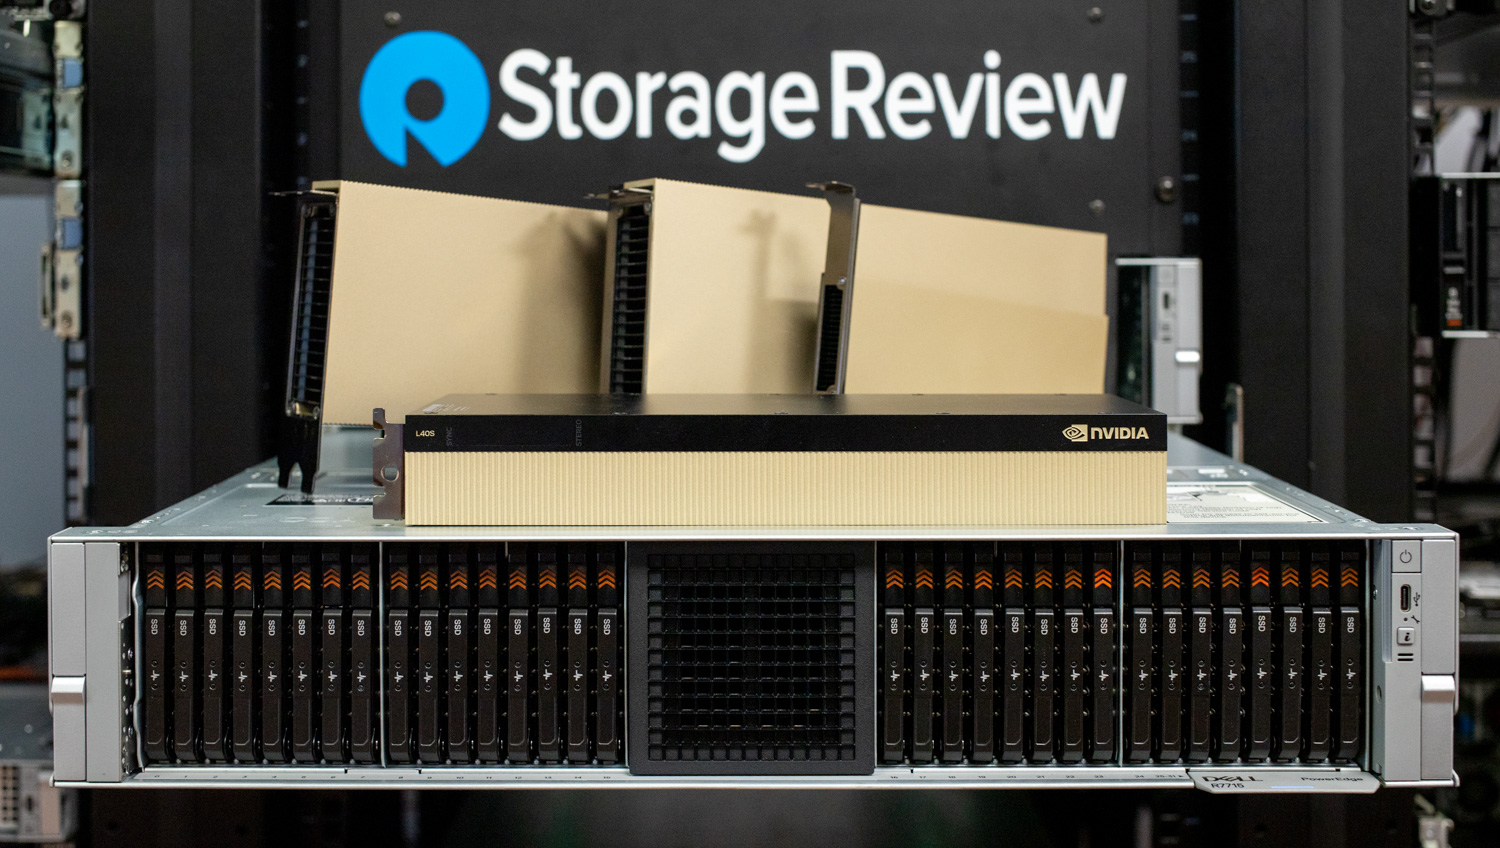
L40S와 H100의 차이점은 데이터센터 GPU 설계의 전략적 차이를 보여줍니다. H100은 AI 및 고성능 컴퓨팅 워크로드에 최적화된 순수 컴퓨팅 중심 카드입니다. 최대 연산 처리량을 주요 목표로 하는 대규모 AI 학습을 목표로 합니다. 방대한 HBM2e 메모리 대역폭부터 특화된 텐서 코어에 이르기까지 모든 설계 측면은 가장 까다로운 신경망 학습 시나리오를 위해 설계되었습니다.
반면, L40S는 다재다능하게 설계된 범용 GPU로, 그래픽 집약적인 워크로드 및 NVIDIA vGPU 배포와 함께 AI 추론을 지원합니다. AI 추론을 위한 유능하고 비용 효율적인 솔루션이지만, 진정한 강점은 H100으로는 구현할 수 없는 다양한 그래픽 집약적 애플리케이션을 지원한다는 것입니다.
그래픽 집약적 작업 부하 및 전문 애플리케이션
L40S는 연산 능력과 고급 렌더링 기능이 모두 필요한 다양한 그래픽 집약적 영역에서 탁월한 성능을 발휘합니다. 3D 렌더링 및 애니메이션 분야에서 스튜디오는 복잡한 장면 렌더링에 L40S를 활용하는데, RT 코어는 컴퓨팅 전용 GPU에서는 불가능한 레이 트레이싱 계산을 가속화합니다. 영화 및 TV 제작사에서는 이러한 기능을 실시간 사전 시각화에 활용하여 감독과 촬영 감독이 촬영 중에 CGI 장면의 사실적인 렌더링을 확인할 수 있도록 하여 후반 작업 시간과 비용을 획기적으로 절감합니다.
건축 및 엔지니어링 회사는 L40S를 실시간 건축 시각화 및 제품 설계에 활용하여, 고객은 실제 시공에 앞서 사실적인 건물 렌더링을 살펴보거나 상세한 제품 프로토타입을 검토할 수 있습니다. 이 카드의 전문적인 그래픽 성능은 엔지니어가 복잡한 시뮬레이션을 위한 연산 능력과 부드럽고 충실한 뷰포트 성능을 위한 그래픽 가속을 모두 필요로 하는 CAD 워크스테이션에도 이상적입니다.
미디어 및 엔터테인먼트 분야에서 L40S는 최종 품질의 애니메이션 프레임을 처리하는 렌더 팜을 지원합니다. 동시에 vGPU 기능을 통해 아티스트는 원격으로 강력한 그래픽 워크스테이션에 접속할 수 있는 클라우드 기반 크리에이티브 워크플로를 구현할 수 있습니다. 비디오 편집 및 후반 작업 시설에서는 그래픽 가속과 상당한 컴퓨팅 리소스가 필요한 실시간 효과 처리, 컬러 그레이딩, 합성 워크플로에 L40S를 사용합니다.
가상 데스크톱 인프라(VDI) 시장은 또 다른 주요 응용 분야입니다. L40S의 vGPU 기술은 여러 사용자가 그래픽 가속 가상 데스크톱을 위해 GPU 리소스를 공유할 수 있도록 지원합니다. 이를 통해 각 사용자에게 개별 GPU를 할당하지 않고도 기업 환경에서 전문적인 그래픽 기능을 활용할 수 있습니다.
물리학 기반 AI 훈련으로의 진화
더 중요한 것은 L40S가 H100에는 전혀 없는 기능을 제공한다는 것입니다. 핵심적인 차별화 요소는 L40S의 142개 100세대 RT 코어로, 실시간 레이 트레이싱과 사실적인 렌더링을 지원합니다. H40에는 RT 코어가 없어 그래픽 가속을 수행할 수 없지만, LXNUMXS의 RT 코어는 AI 연산과 고급 그래픽이 모두 필요한 애플리케이션에 탁월한 선택입니다.
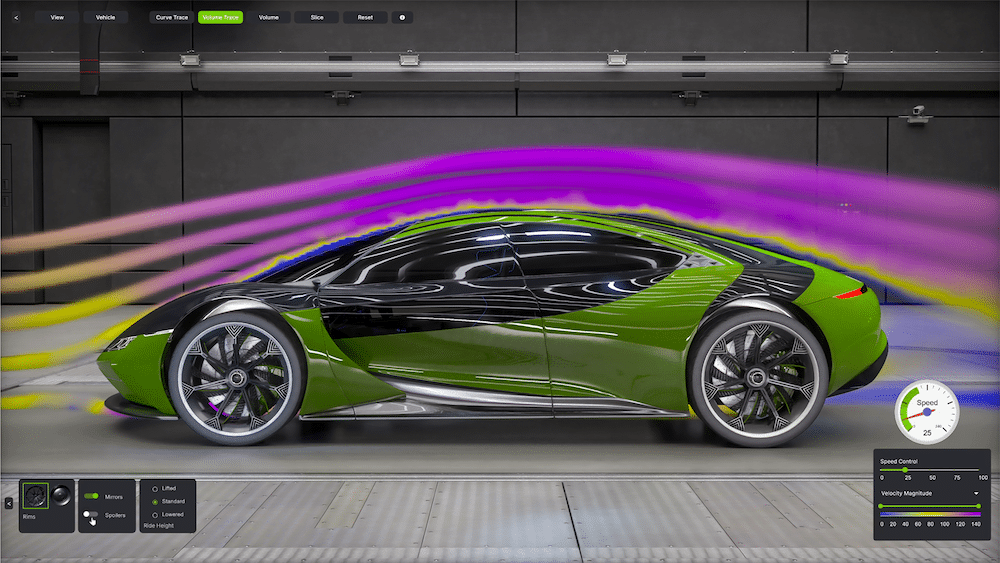
출처: 엔비디아
AI 기반 3D 모델링, 디지털 트윈 시뮬레이션, 그리고 Universal Scene Description(OpenUSD) 워크플로의 인기가 높아짐에 따라 이러한 구분은 점점 더 중요해지고 있습니다. 인공지능의 다음 단계는 단순히 대규모 언어 모델을 훈련하는 것이 아니라, 물리 법칙, 공간 관계, 그리고 현실 세계의 상호작용을 이해하는 세계 모델을 개발하는 것입니다. 이러한 진화는 훈련 데이터 생성 방식에 근본적인 변화를 요구합니다.
기존 AI 모델을 학습하는 데는 NVIDIA의 플래그십 컴퓨팅 GPU가 크게 의존하는 반면, 차세대 물리적 기반 세계 모델을 학습하는 데는 다른 접근 방식이 필요합니다. 이러한 고급 AI 시스템은 시각적 정보뿐만 아니라 물리적 속성, 조명 동작, 재료 상호작용, 공간 관계까지 포착하는 방대한 양의 학습 데이터가 필요합니다. L40S와 같은 GPU는 대규모 학습 데이터 생성에 필수적인 요소로 자리 잡았으며, RT 코어는 더욱 정교한 AI 모델을 학습하는 데 필요한 물리적으로 정확한 합성 환경을 구축할 수 있도록 지원합니다.
전용 RT 코어가 구동하는 고급 그래픽 렌더링 기능은 바로 L40S를 NVIDIA의 Omniverse 플랫폼과 물리 기반 AI 개발의 광범위한 생태계에 이상적인 엔진으로 만드는 요소입니다.
옴니버스
Omniverse 는 개발자가 OpenUSD(Universal Scene Description) 기반의 애플리케이션과 워크플로우를 구축할 수 있도록 지원하는 API, SDK 및 서비스 개발 플랫폼입니다. 물리적으로 정확한 실시간 3D 가상 세계를 생성하고 연결하도록 설계되었으며, NVIDIA의 RTX 기술을 산업 및 로봇 시뮬레이션 워크플로우에 직접 통합하여 사실적인 레이 트레이싱 렌더링을 구현합니다. 강력한 RT 코어를 탑재한 L40S는 이러한 까다로운 RTX 렌더링 워크로드를 구동하는 데 필요한 하드웨어 가속을 제공하여 개발자가 빛, 재질 및 물리 효과를 놀라운 사실감으로 시뮬레이션할 수 있도록 지원합니다.
Omniverse는 단순한 시각화 도구를 넘어 차세대 물리 AI 개발을 위한 플랫폼입니다. 이러한 현실감 넘치는 가상 세계, 즉 "디지털 트윈"을 구축함으로써 개발자는 복잡한 산업 시설을 시뮬레이션하고, 로봇 전체를 테스트하고, 자율주행차를 실제 환경에 적용하기 전에 안전한 가상 환경에서 검증할 수 있습니다. 중요한 것은 이러한 고충실도 시뮬레이션이 방대한 물리 기반 합성 데이터를 생성하는 기반이 된다는 것입니다. 이는 컴퓨팅 중심 GPU에서 실행되는 강력한 AI 모델을 학습시키는 데 중요한 리소스가 됩니다.
로봇공학을 위한 합성 조작 동작 생성
NVIDIA Isaac GR00T 합성 조작 동작 생성 청사진은 로봇 훈련을 위한 프레임워크를 제공하며, L40S의 RT 코어 기능이 최소한의 사람 시연만으로 대규모 데이터 세트를 생성하는 데 어떻게 도움이 되는지 보여줍니다. 이 워크플로는 로봇 개발의 주요 과제 중 하나인 로봇 조작 작업에 필요한 충분하고 고품질의 훈련 데이터를 수집하는 데 드는 시간과 비용 문제를 해결합니다.
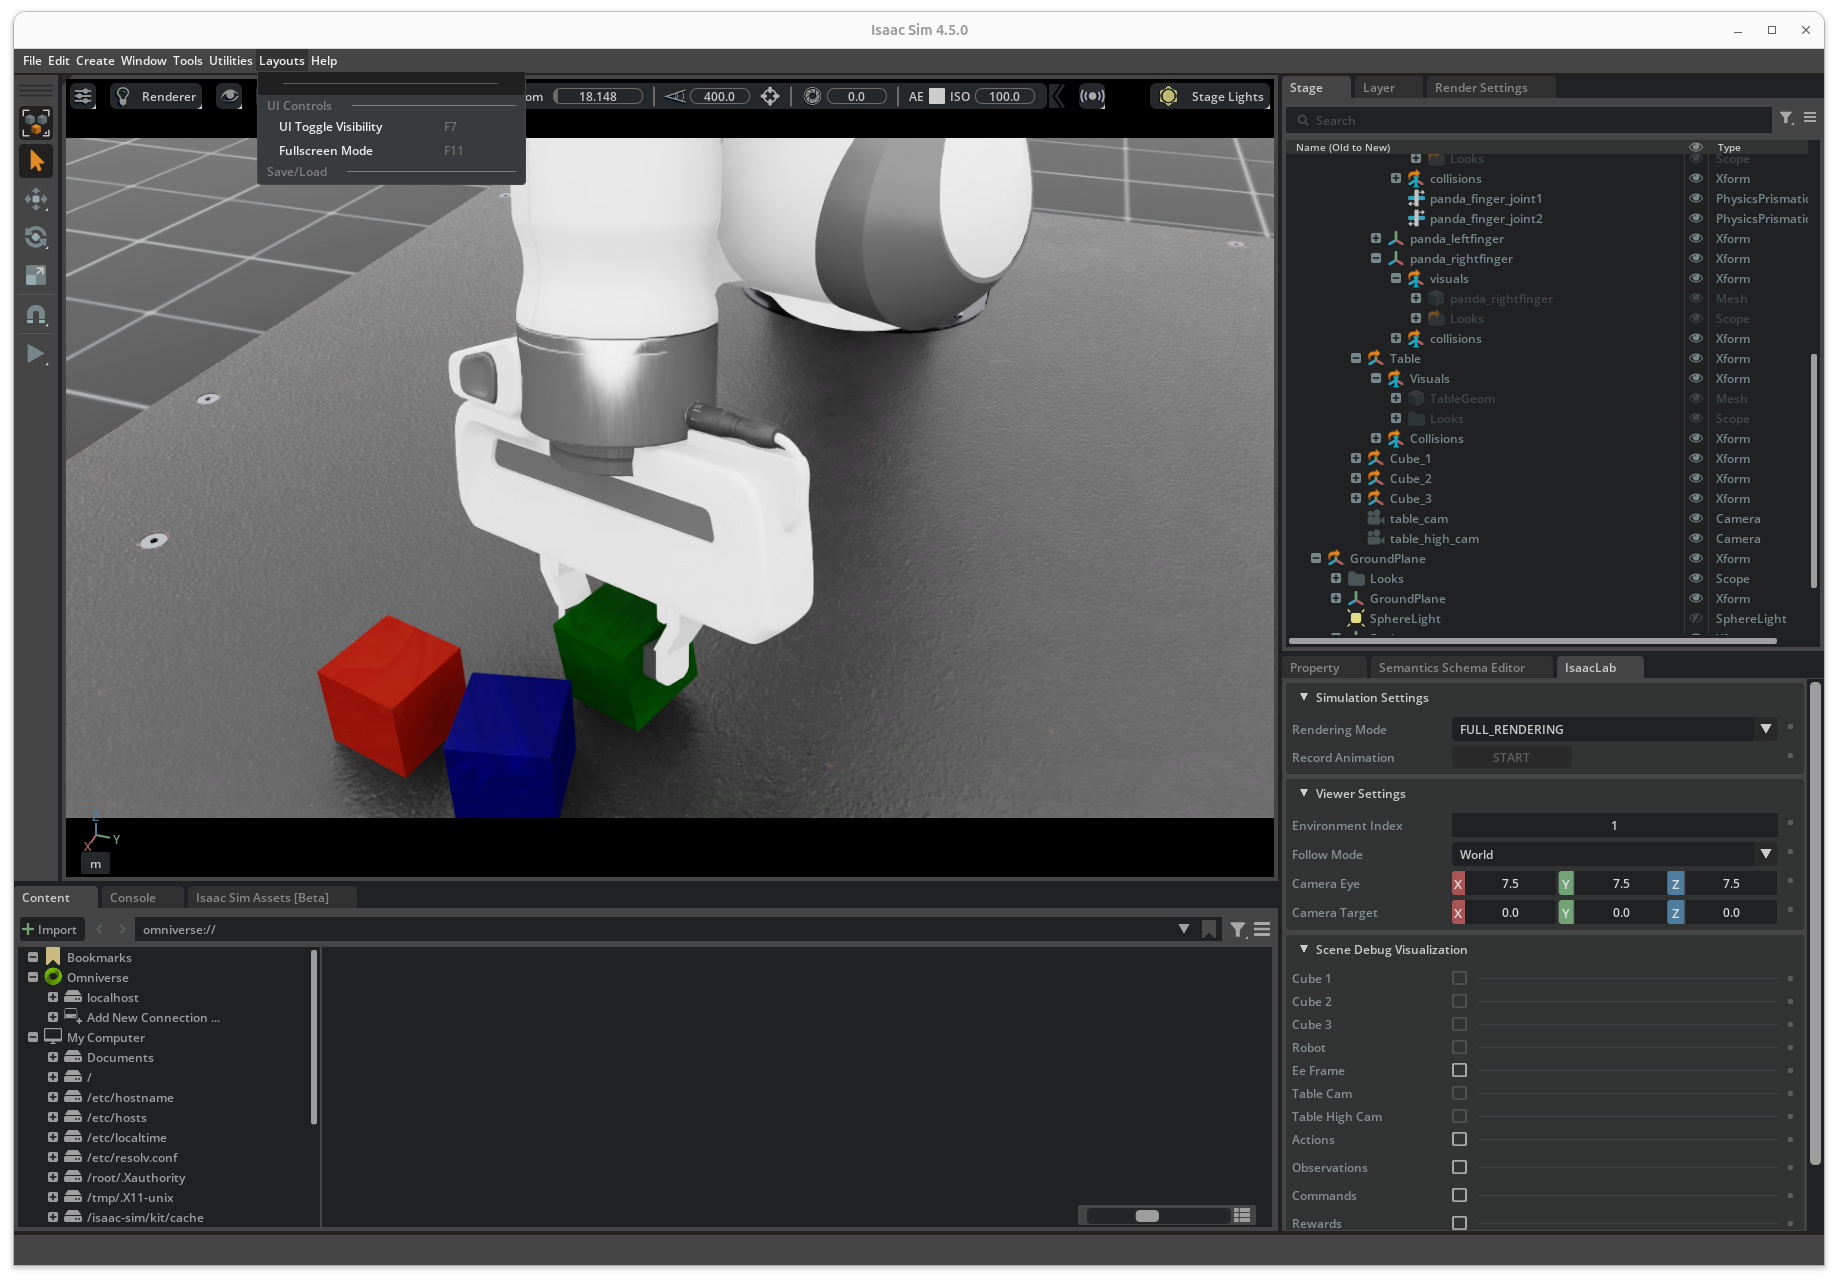
기존의 로봇 훈련은 로봇이 전문가의 시연을 관찰하고 모방함으로써 새로운 기술을 습득하는 지도 학습이나 모방 학습에 크게 의존합니다. 그러나 완벽한 시연을 만드는 것은 어렵고, 현실 세계에서 광범위하고 고품질의 데이터 세트를 수집하는 것은 지루하고 시간 소모적이며 비용도 많이 듭니다. 적절하게 훈련된 인간 작업자가 고품질 시연 하나를 녹화하는 데 일반적으로 약 1분이 소요되는데, 이는 상당한 인력 투입과 오류 가능성으로 인해 확장이 어렵습니다.
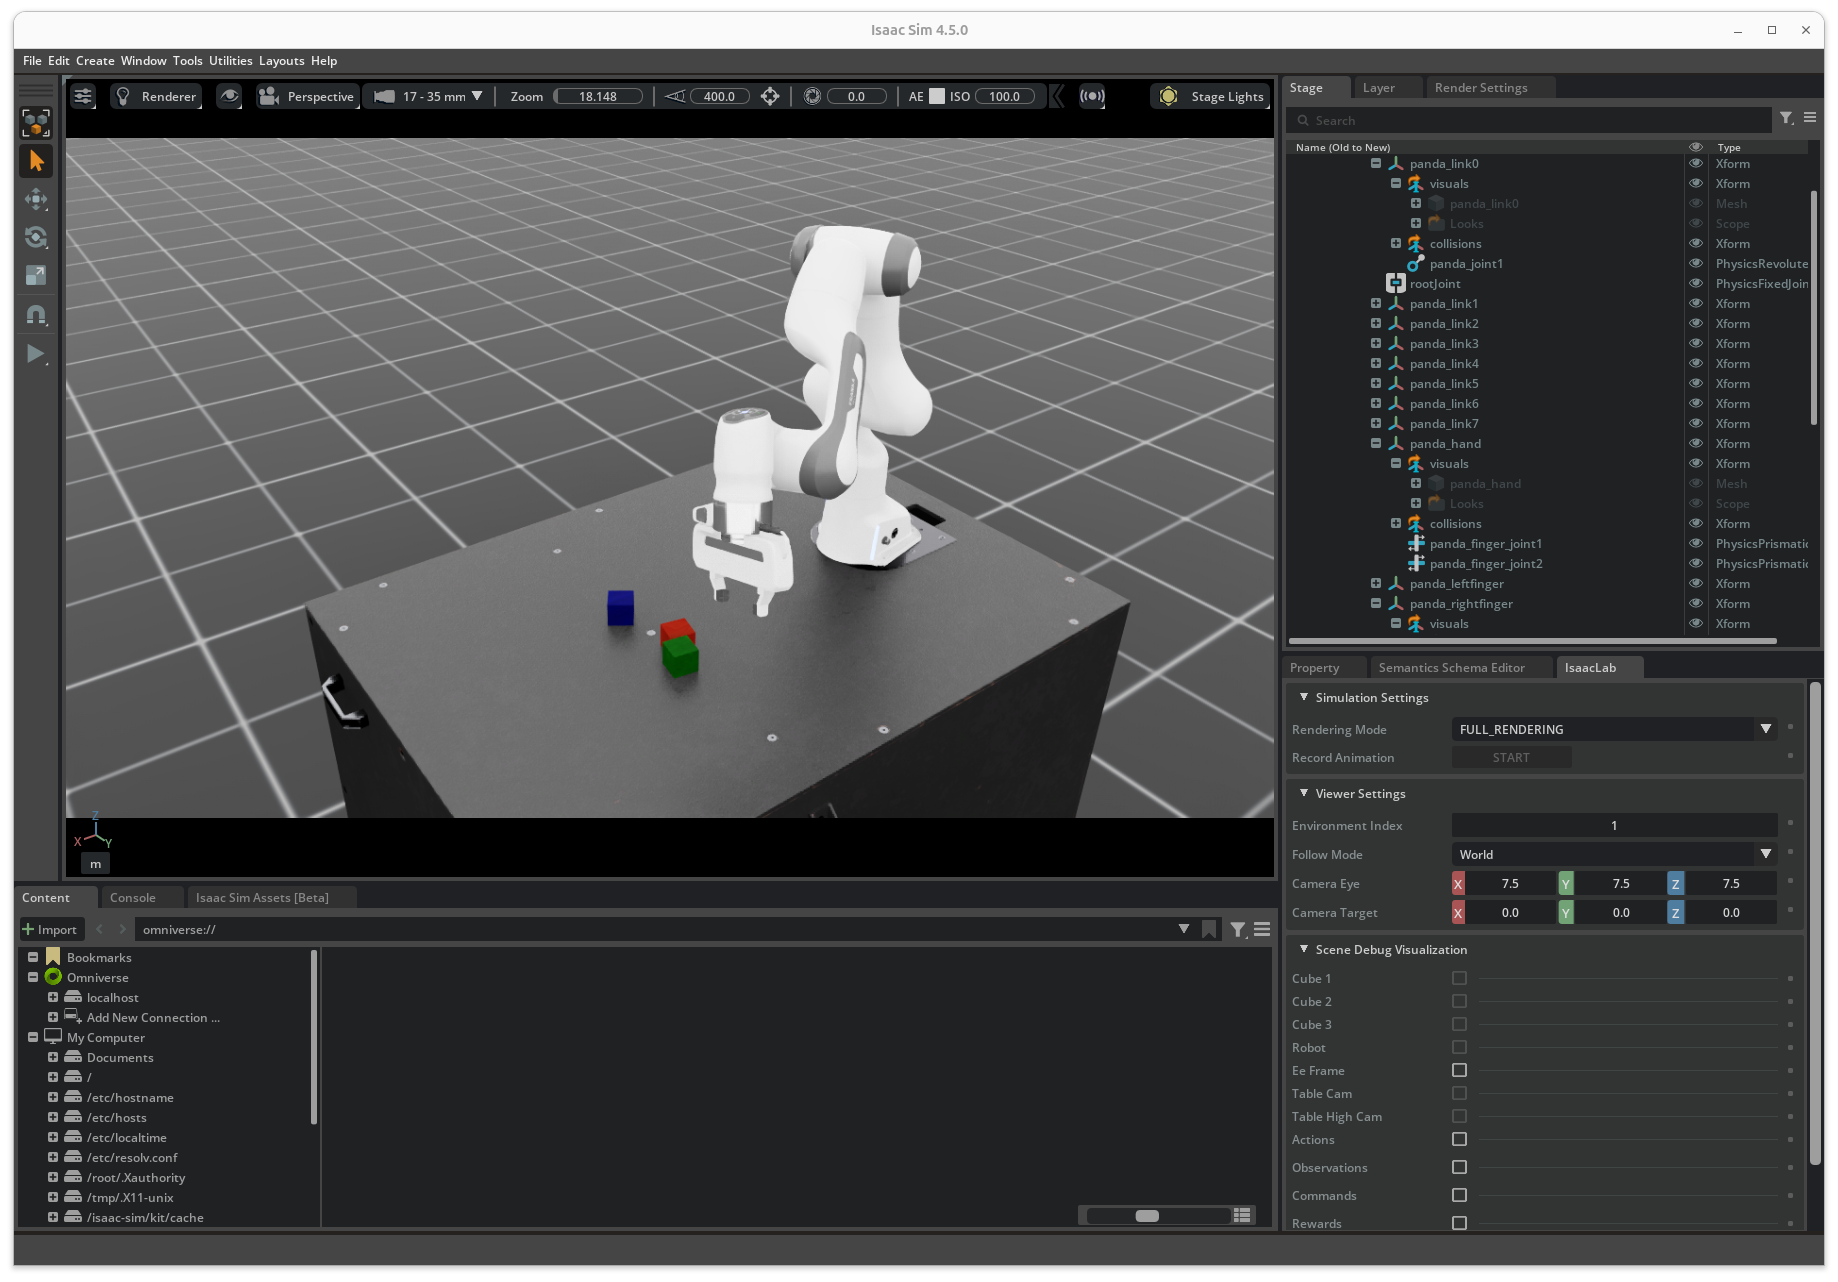
Isaac GR00T 청사진은 물리적으로 정확한 시뮬레이션에서 생성된 합성 데이터를 활용하여 데이터 수집 프로세스를 가속화함으로써 이러한 과제를 해결합니다. 기업은 단 몇 시간의 인적 시연만으로도 기하급수적으로 더 많은 데이터를 수집할 수 있습니다.
Isaac GR00T 설계도 는 포괄적인 합성 데이터 생성 파이프라인을 구축하기 위해 함께 작동하는 세 가지 핵심 구성 요소로 이루어져 있습니다.
- GR00T-텔레옵 숙련된 작업자가 Apple Vision Pro와 같은 공간 컴퓨팅 장치를 사용하여 가상 로봇을 제어할 수 있도록 지원합니다. 이 시스템을 통해 작업자는 사실적인 가상 환경에서 복잡한 조작 작업을 시연하고, 동작 궤적뿐만 아니라 환경적 맥락과 물체의 상호작용까지 포착할 수 있습니다. Apple Vision Pro는 손 추적 데이터를 Isaac Lab으로 스트리밍하고, Isaac Lab은 동시에 로봇 환경의 몰입형 뷰를 장치로 스트리밍하여 로봇을 직관적이고 인터랙티브하게 제어할 수 있도록 합니다.
- GR00T-미믹 녹화된 데모를 고급 시뮬레이션 기술을 사용하여 더 큰 합성 데이터 세트로 곱합니다. 이 구성 요소는 녹화된 데모를 입력으로 사용하여 Isaac Lab에서 추가적인 합성 동작 궤적을 생성하여 단일 팔 및 양손 휴머노이드 로봇 조작을 모두 지원합니다. 이 프로세스는 데모의 주요 지점에 주석을 달고 보간을 사용하여 합성 궤적이 매끄럽고 상황에 맞게 생성되도록 보장합니다.
- GR00T-Gen NVIDIA Omniverse와 Cosmos 플랫폼을 활용하여 3D 업스케일링 및 도메인 무작위화를 통해 합성 데이터 세트를 확장합니다. 이 구성 요소는 장면의 배경, 조명 및 기타 변수를 무작위화하여 다양성을 더합니다. 또한 NVIDIA Cosmos Transfer를 통해 생성된 이미지를 증강하여 시뮬레이션과 실제 이미지의 차이를 줄이는 데 도움이 되는 사실적인 이미지를 구현합니다.
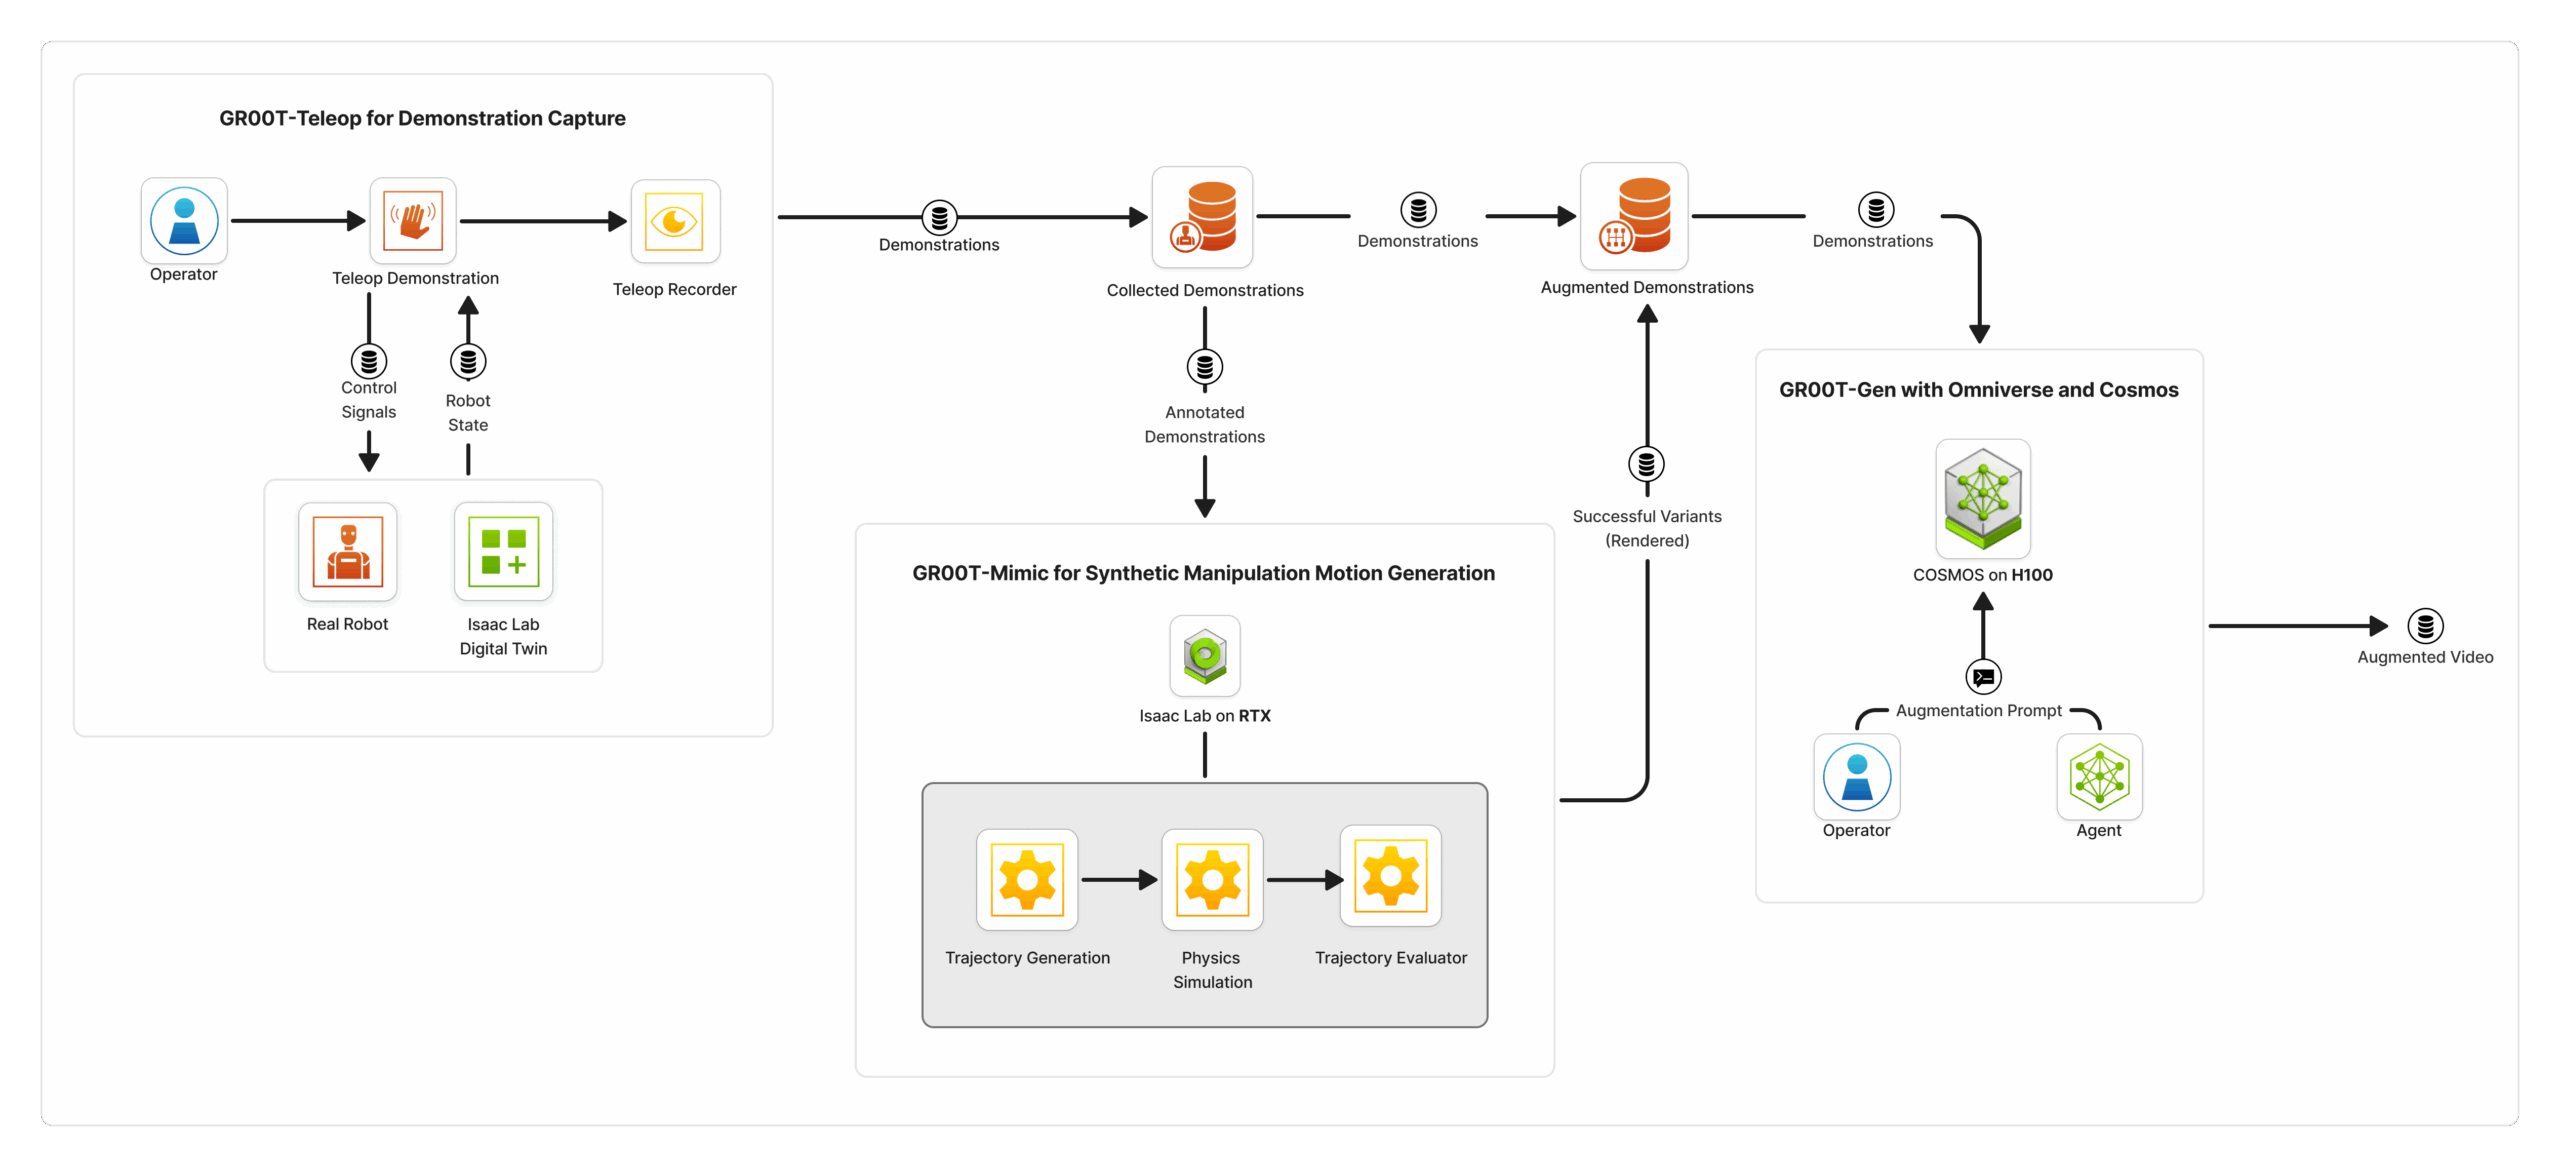
이 파이프라인은 현대 데이터 센터 GPU의 전문적이고 상호 보완적인 역할을 완벽하게 보여줍니다. 전용 RT 코어를 탑재한 L40S는 월드 빌더 역할을 합니다. 사실적이고 다채로운 가상 환경을 구축하는 데 필요한 물리 기반 렌더링, 실시간 레이 트레이싱, 도메인 무작위화를 처리하는 데이터 생성 초기 단계에 필수적입니다.
이렇게 구축된 고화질 가상 세계는 차세대 기술의 기반이 됩니다. NVIDIA Cosmos 와 같은 생성형 AI 모델은 H100과 같은 연산 중심 GPU에서 실행되어 최종 학습 데이터를 생성합니다. H100은 L40S가 구현한 현실적인 환경을 활용하여 수백만 개의 역동적이고 물리적으로 인지된 시나리오를 생성합니다.
AI 추론 성능 벤치마크
L40S와 같은 카드가 널리 사용되는 또 다른 사용 사례는 비용 효율적인 추론입니다. L40S의 실제 AI 추론 성능을 H100과 비교하여 평가하기 위해, 최대 토큰 길이가 14K인 BF16에서 Nvidia의 Open Reasoning Nemotron 32B 매개변수 모델을 실행하는 vLLM을 사용하여 LLM 성능을 벤치마킹했습니다.
vLLM 벤치마크 결과
H100은 L4.2S보다 약 40배 높은 처리량을 제공하며 탁월한 성능 리더십을 보여줍니다. 이러한 장점은 H100의 두 배 향상된 텐서 코어 성능과 두 배 이상 향상된 메모리 대역폭(2TB/s vs 864GB/s)에서 비롯됩니다.
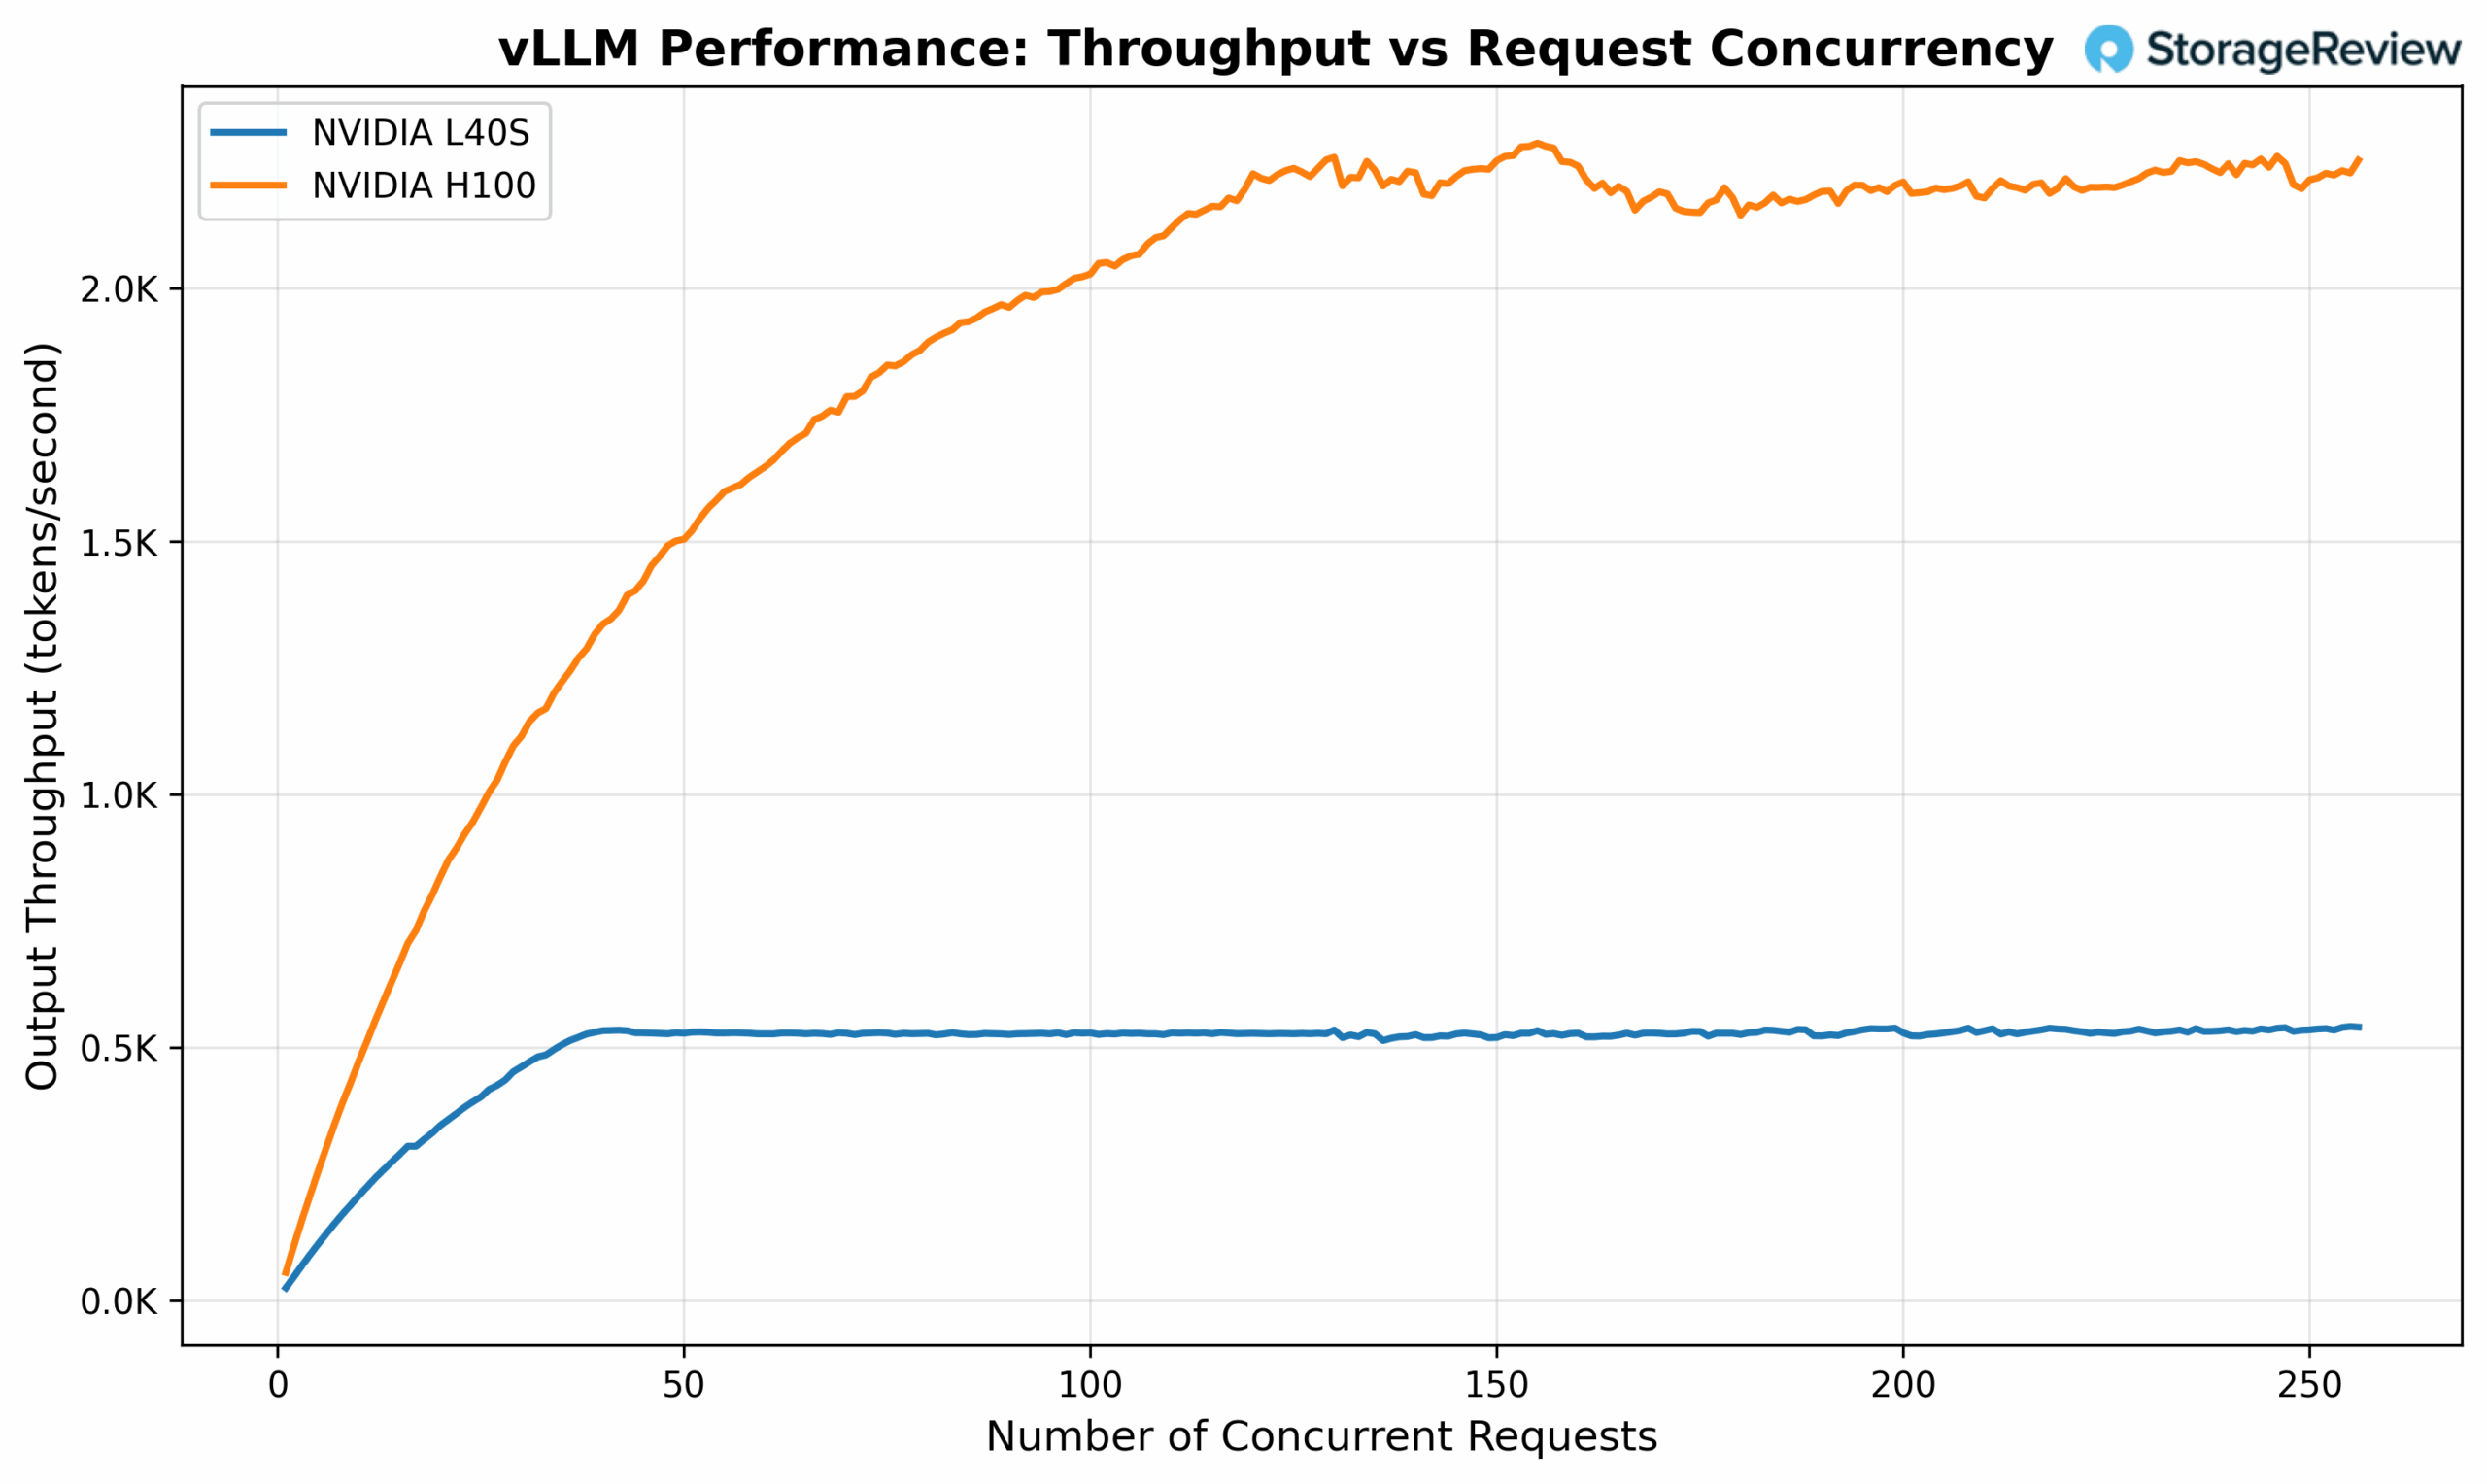
하지만 가격 대비 성능은 다릅니다. L40S는 일반적으로 H100 가격의 40분의 XNUMX도 안 되어 다양한 추론 워크로드에 비용 효율성이 뛰어납니다. 절대적인 최고 성능이 중요하지 않은 추론 서비스를 운영하는 조직에서는 LXNUMXS가 더 나은 총소유비용(TCO)을 제공한다는 것을 알게 되는 경우가 많습니다.
선형 성능이 있는 섹션을 두 번 클릭하면 L40S가 매우 수용 가능한 수준의 성능을 제공하며, ~16ms TPOT(출력 토큰당 시간) SLO로 52개의 동시 요청을 처리할 수 있음을 알 수 있습니다.
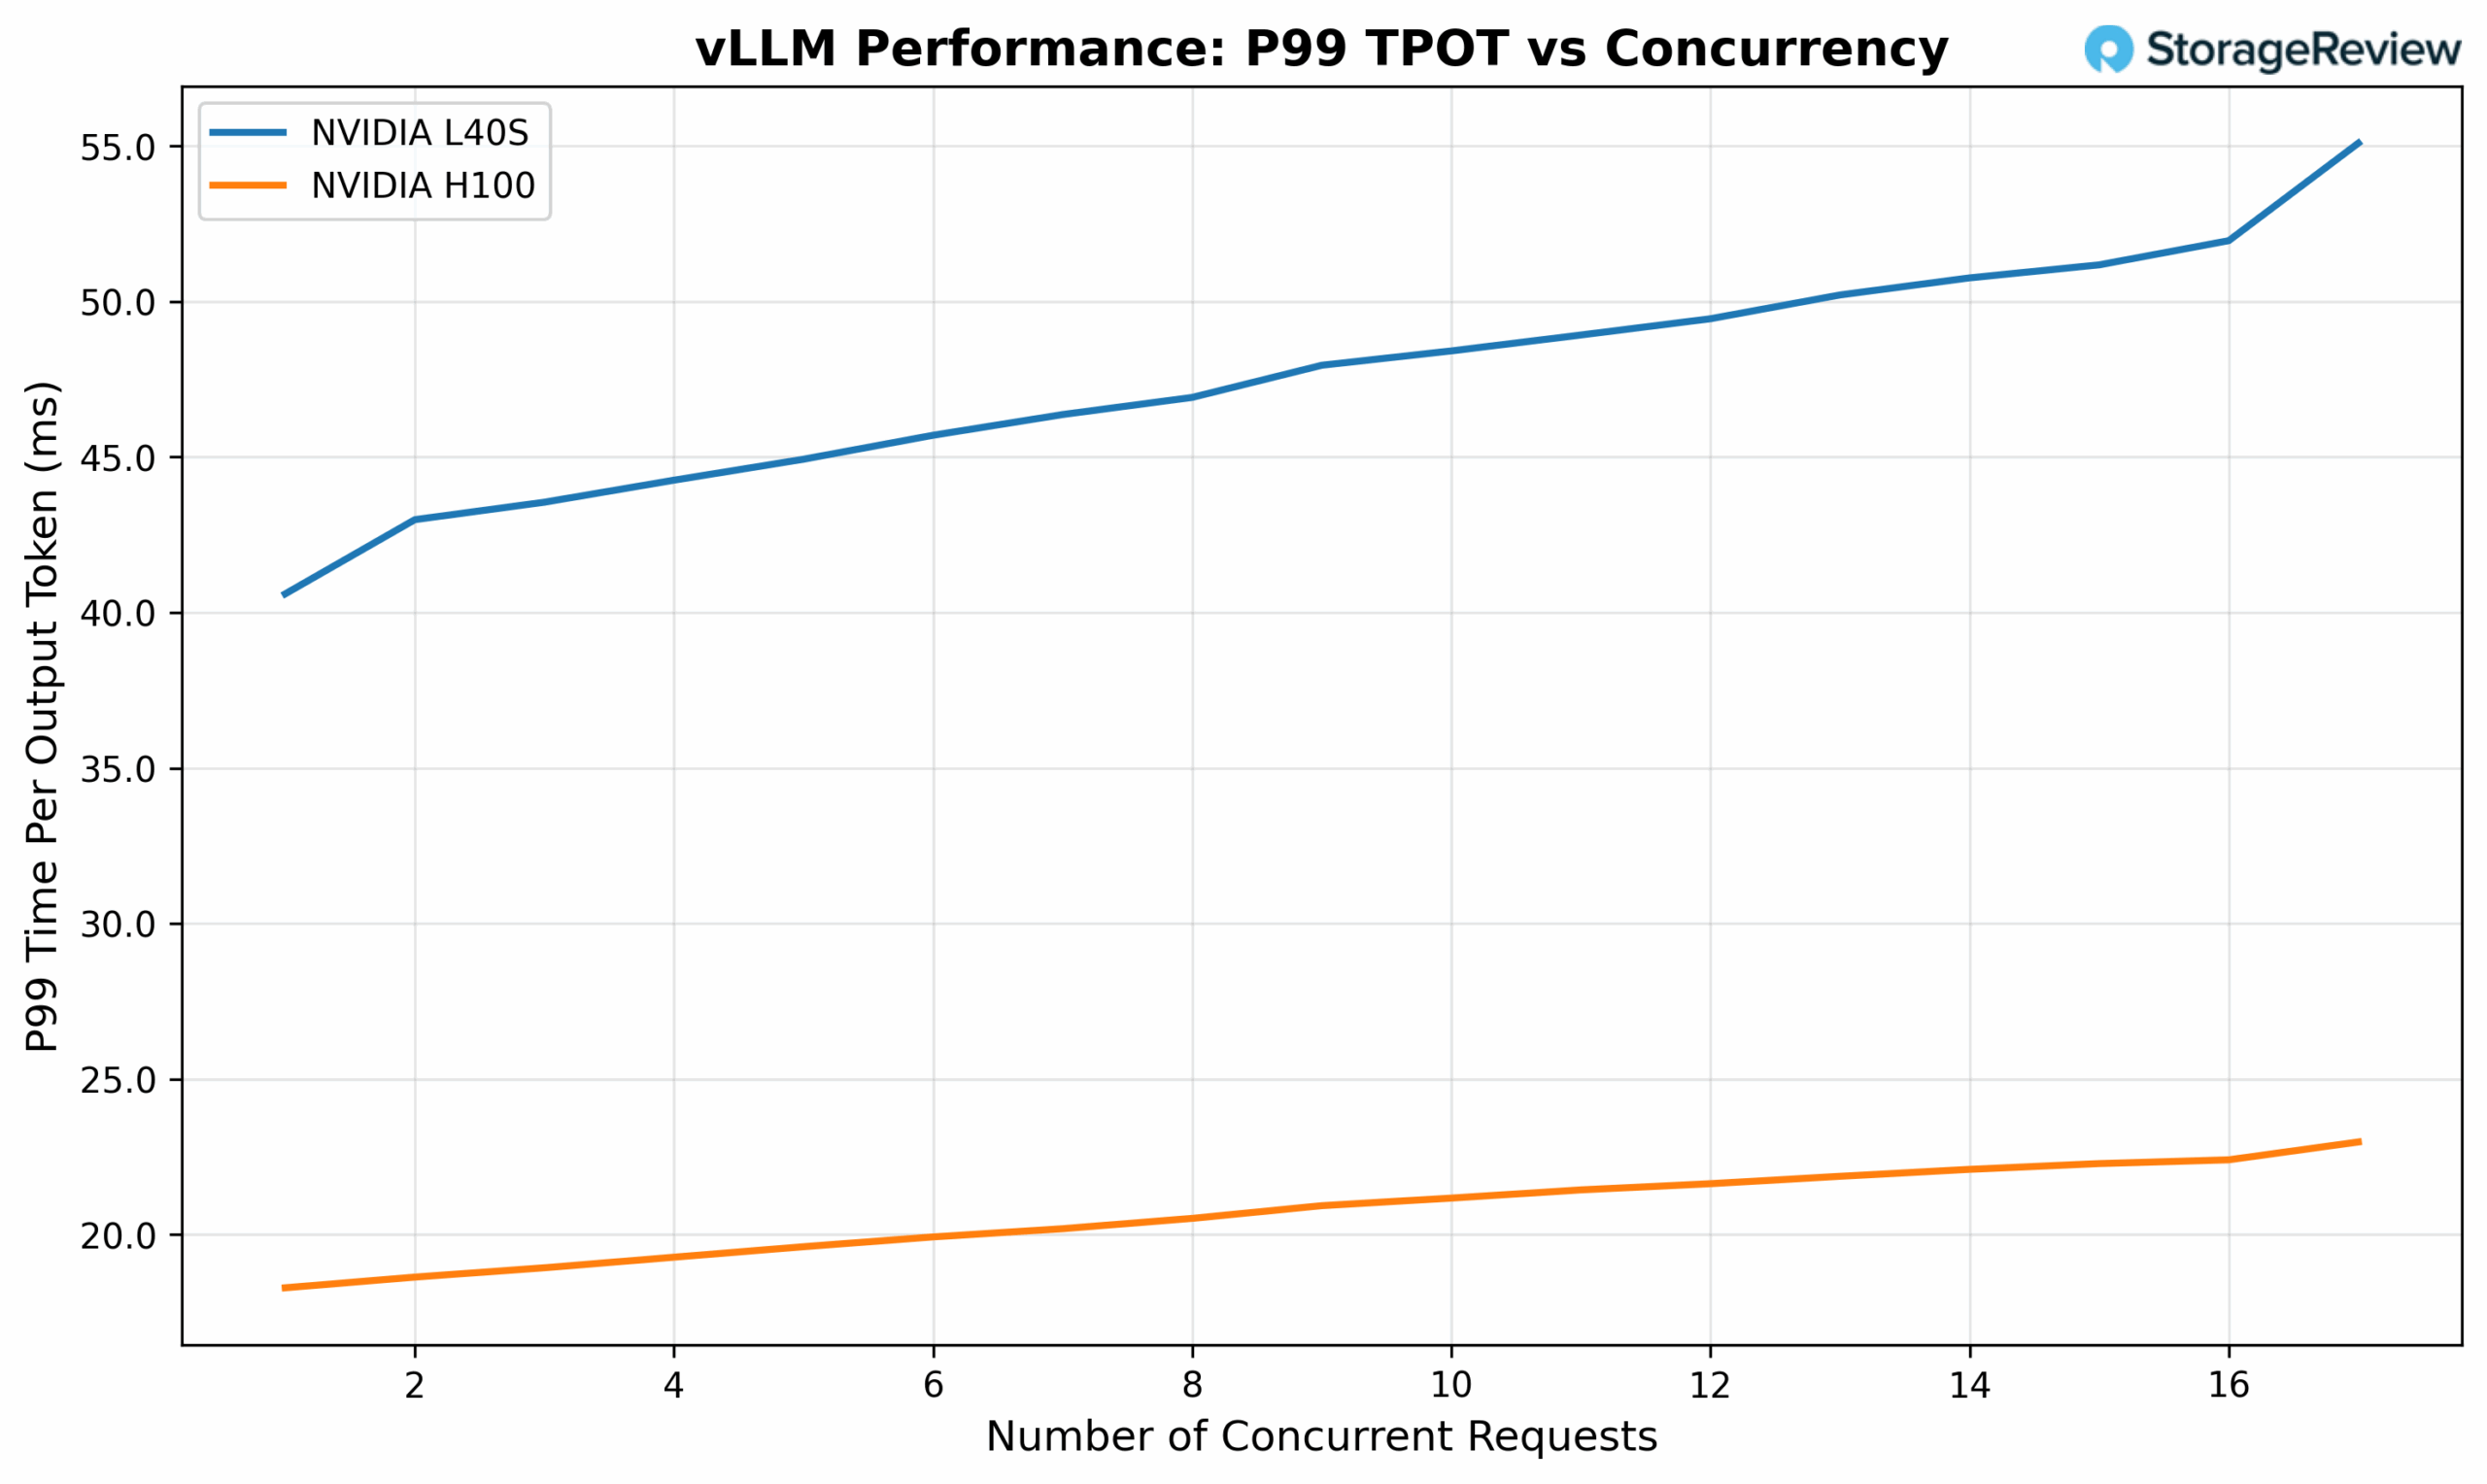
중요한 점은 AI 추론, 특히 텍스트 생성의 디코딩 단계는 기본적으로 메모리 대역폭을 많이 사용하는 작업이라는 점입니다. 추론 과정에서 모델은 GPU 메모리에 저장된 가중치에 반복적으로 접근하여 새로운 토큰을 생성해야 하므로, 메모리 처리량이 심각한 성능 병목 현상을 초래합니다. 이러한 특성은 뛰어난 메모리 대역폭과 향상된 텐서 코어 성능을 갖춘 H100이 자연스럽게 더 높은 추론 처리량을 달성하는 이유를 설명합니다.
하지만 AI 추론과 그래픽 가속이 모두 필요한 배포 시나리오(예: AI 강화 효과가 적용된 실시간 렌더링, AI 기반 기능이 적용된 대화형 애플리케이션)의 경우 L40S가 유일하게 실행 가능한 옵션이 됩니다.
맺음말
NVIDIA L40S와 최신 Blackwell RTX Pro 6000 후속 모델은 AI 컴퓨팅과 고급 그래픽 기능이 점점 더 융합되는 현대 데이터 센터의 변화하는 요구에 대응하는 전략적으로 설계된 GPU로 자리매김했습니다. H100 및 B200 GPU가 순수 AI 학습 및 추론 워크로드 분야에서 여전히 명실상부한 선두주자이지만, L40S는 컴퓨팅 중심 AI 카드와 기존 전문 시각화 솔루션 간의 간극을 메우는 범용 GPU로서 독보적이고 가치 있는 틈새 시장을 개척합니다.
L40S의 독보적인 가치 제안은 AI 추론 기능과 그래픽 가속 기능을 모두 요구하는 시나리오에서 가장 두드러집니다. 142개의 100세대 RT 코어는 HXNUMX과 같은 컴퓨팅 전용 GPU로는 불가능한 애플리케이션을 지원합니다. 전문가용 워크플로우의 실시간 레이 트레이싱부터 차세대 AI 학습을 위한 사실적인 합성 데이터 생성까지, LXNUMXS는 이러한 두 가지 기능을 통해 디지털 트윈 개발, 물리 기반 AI 학습, 그리고 성장하는 Omniverse 생태계와 같은 새로운 애플리케이션에 필수적인 솔루션입니다.
경제적인 측면에서 L40S는 H100의 최고 AI 성능을 필요로 하지 않는 조직에 매력적인 가치를 제공합니다. H100 가격의 약 40분의 40에 불과한 LXNUMXS는 뛰어난 추론 성능을 제공하는 동시에 데이터 센터 구축에 엄청난 다재다능함을 더하는 그래픽 기능을 제공합니다. 많은 조직에서 이러한 비용 효율성과 다재다능함의 조합은 LXNUMXS를 AI 및 그래픽 솔루션에 각각 투자하는 것보다 더 실용적인 선택으로 만듭니다.


 아마존