

AI 인프라가 발전함에 따라 데이터 파이프라인은 더욱 빠르고 광범위하며 복잡해지고 있습니다. 대규모 모델 학습부터 대규모 실시간 추론까지, 스토리지 서브시스템은 GPU가 필요한 데이터를 지속적으로 수신할 수 있도록 보장하는 데 필수적입니다. AI 클러스터에서 스토리지의 중요성이 점점 커짐에 따라, 기업들은 특히 데이터 손실이나 다운타임이 용납될 수 없는 환경에서 높은 처리량, 예측 가능한 성능, 그리고 복원력을 제공하는 방법을 재고하고 있습니다.
AI 모델의 크기가 기하급수적으로 증가함에 따라 이러한 과제는 더욱 심각해지고 있습니다. 최신의 대규모 언어 모델과 기반 모델은 학습 진행 상황을 유지하기 위해 빈번한 체크포인트 작업이 필요합니다. 모델 크기가 수십억 개에서 수조 개로 늘어남에 따라 이러한 체크포인트에 필요한 저장 공간도 그에 비례하여 증가합니다. 따라서 매우 빠른 쓰기 및 읽기 성능을 유지하면서도 방대한 체크포인트 파일을 처리할 수 있는 대규모 통합 스토리지 네임스페이스가 절실히 필요합니다. 기존 스토리지 아키텍처는 이러한 까다로운 워크로드에 필요한 용량과 속도를 모두 제공하는 데 어려움을 겪고 있습니다.
모델 가중치를 CPU 메모리에 저장하여 GPU가 학습을 계속할 수 있도록 하는 비동기 체크포인팅과 같은 기존 체크포인트 관리 방식은 모델이 커짐에 따라 상당한 제약에 직면합니다. 이러한 체크포인트를 시스템 메모리에 임시로 저장하는 것은 점점 더 낭비적이고 비용이 많이 들며, 막대한 양의 RAM을 필요로 하게 되어 시스템 비용과 전력 소비가 증가합니다. 더 중요한 것은, 모델 크기가 계속 커짐에 따라 메모리에 임시로 저장해야 하는 데이터의 양이 엄청나게 늘어나 이러한 접근 방식은 완전히 비현실적일 수 있다는 것입니다.
Graid Technology는 이러한 과제를 해결하기 위해 특별히 고안된 새로운 접근 방식을 도입했습니다. SupremeRAID SR1010 과 같은 이전 솔루션에서 확립된 소프트웨어 정의 모델을 기반으로 구축된 Graid의 새로운 SupremeRAID AE(AI 에디션) 는 최소한의 인프라 변경만으로 AI 워크로드에 엔터프라이즈급 RAID 기능을 제공합니다. 전용 하드웨어 RAID 카드나 맞춤형 어플라이언스 대신, AE는 소프트웨어 라이선스 형태로 제공되며 기존 NVIDIA GPU의 일부만 사용합니다. 즉, 기업은 1) 추가 PCIe 슬롯을 사용하거나, 2) 인프라를 변경하거나, 3) 학습 및 추론 워크로드에서 GPU 성능에 큰 영향을 미치지 않고도 엔터프라이즈급 스토리지 성능과 안정성을 확보할 수 있습니다.
주요 요점
- 대규모 고성능: SupremeRAID AE는 최대 183.60GB/s의 읽기 처리량과 최대 54.23GB/s의 쓰기 처리량을 달성하여 까다로운 AI 요구 사항을 충족합니다.
- 최소 GPU 오버헤드: GPU 집약적 추론 중 최소한의 오버헤드(~4%)를 발생시켜 전반적으로 강력한 시스템 성능을 유지합니다.
- 대규모 통합 스토리지 네임스페이스: 어레이당 최대 32개의 NVMe SSD를 지원하여 단일 통합 네임스페이스에서 약 1PB의 스토리지를 제공합니다.
- 고급 통합 기능: NVIDIA GPUDirect 스토리지 및 주요 AI 중심 파일 시스템(BeeGFS, Lustre, Ceph)과 완벽하게 통합됩니다.
- 단순화된 인프라: 전용 RAID 하드웨어를 제거하여 복잡성, 비용, 운영 오버헤드를 크게 줄입니다.
고급 AI 워크로드를 위한 최적화된 스토리지 및 복원력
SupremeRAID AE는 단일 어레이에서 최대 32개의 NVMe SSD를 지원하여 통합 네임스페이스로 통합합니다. 이러한 구조 덕분에 AI 워크로드는 복원력을 유지하면서도 대용량 데이터 세트에 효율적으로 액세스할 수 있으며, 이는 특히 장기간 학습 작업을 실행하는 환경에서 매우 중요합니다. 드라이브 장애 발생 시에도 어레이는 사용 가능한 상태로 유지되며 체크포인트 진행 상황은 그대로 유지됩니다. 이러한 보호 기능은 데이터 손실이나 시간이 많이 소요되는 재시작 위험을 최소화하여 대규모 모델이나 대용량 추론 파이프라인을 관리하는 팀에게 매우 유용합니다.
SupremeRAID AE의 지능형 리소스 관리 기능은 AI 워크로드에 대한 추가적인 최적화 기회를 제공합니다. 테스트 결과 동시 작업 시 오버헤드가 최소화되었지만, 스마트 스케줄링을 통해 그 영향을 더욱 줄일 수 있습니다. 체크포인트 작업은 일반적으로 동일한 노드에서 활성 학습과 동시에 실행되지 않습니다. 체크포인트 단계에서는 학습이 일시적으로 중단되는 경우가 많습니다. 이러한 시간 간격 동안 SupremeRAID AE는 사용되지 않는 GPU 리소스를 추가로 활용하여 체크포인트 완료 속도를 높일 수 있습니다.
SupremeRAID AE는 NVIDIA GPUDirect 스토리지도 지원합니다. 이를 통해 스토리지와 GPU 메모리 간의 직접 경로가 가능해져 지연 시간이 단축되고 I/O 효율성이 향상됩니다. BeeGFS, Lustre, Ceph와 같은 AI 중심 파일 시스템과 통합되며, 자동화를 위한 오케스트레이션 지원 API와 함께 지능형 데이터 오프로드 기능을 제공합니다. SupremeRAID AE는 RAID의 이점을 최신 AI 워크플로에 적용할 수 있는 간편하면서도 강력한 방법을 제공합니다.
SupremeRAID AE는 학습 워크로드 외에도 최신 AI 추론 시나리오의 중요한 요구 사항을 해결합니다. 조직이 추론 작업을 확장함에 따라 지속적인 KV 캐시 관리, 프리필-디코드 최적화, 계층형 메모리 아키텍처와 같은 고급 전략에 대한 의존도가 점점 높아지고 있습니다. 이러한 기술은 VRAM 용량을 초과할 경우 KV 캐시를 스토리지로 오프로드해야 하는 경우가 많습니다. NVIDIA Dynamo, Red Hat의 LLM-D, vLLM 프로덕션 스택과 같은 솔루션은 모두 빠르고 대용량의 스토리지를 기반으로 하는 계층형 KV 캐싱 통합을 통합합니다. 이러한 시나리오에서 저지연 추론을 유지하기 위해서는 대규모 고성능 스토리지 풀을 확보하는 것이 필수적이며, SupremeRAID AE는 대용량과 탁월한 속도를 모두 제공하여 이러한 고급 추론 아키텍처를 위한 이상적인 기반을 제공합니다.
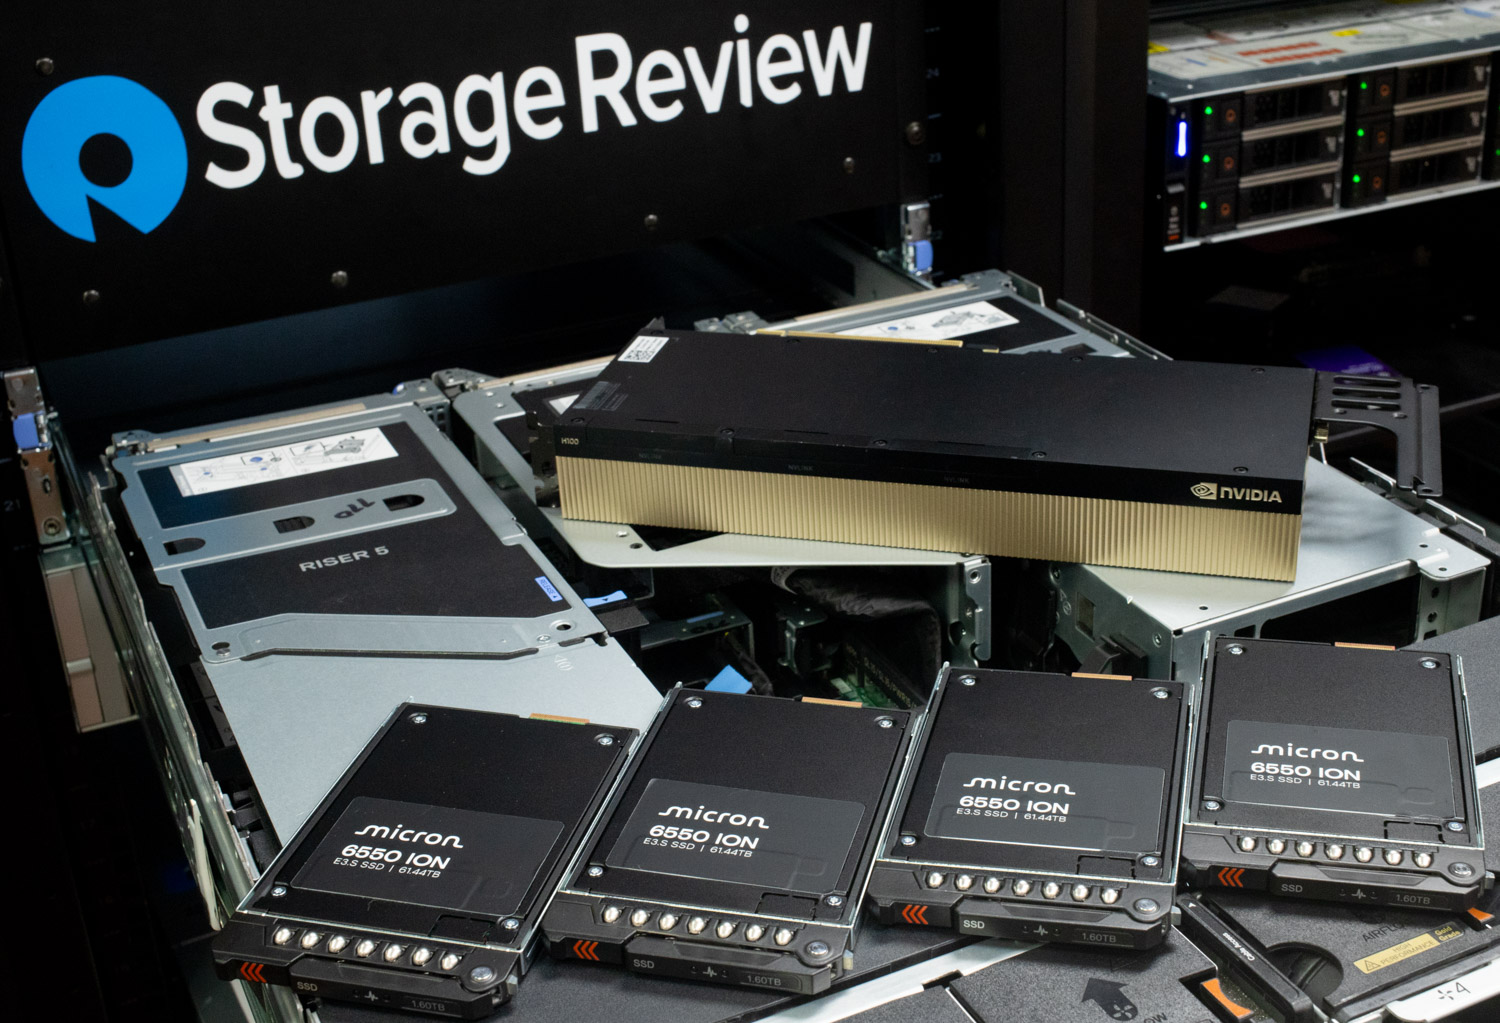
이 분석에서는 듀얼 NVIDIA H770 GPU와 100개의 Micron 16 6550TB Gen61.44 NVMe SSD를 탑재한 Dell PowerEdge R5 플랫폼에서 실행되는 SupremeRAID AE를 평가합니다. GDSIO 및 FIO 도구를 사용하여 RAID 5 환경에서의 성능을 분석하고, 라이브 LLM 추론 워크로드에서 Graid AE가 GPU 동작에 미치는 영향을 살펴봅니다. 이 솔루션이 성능, 용량, 복원력, 그리고 단순성이 모두 함께 확장되어야 하는 엔터프라이즈급 AI 환경에 어떻게 통합되는지 이해하는 것이 목표입니다.
숫자 속의 이야기: SupremeRAID AE 성능 심층 분석
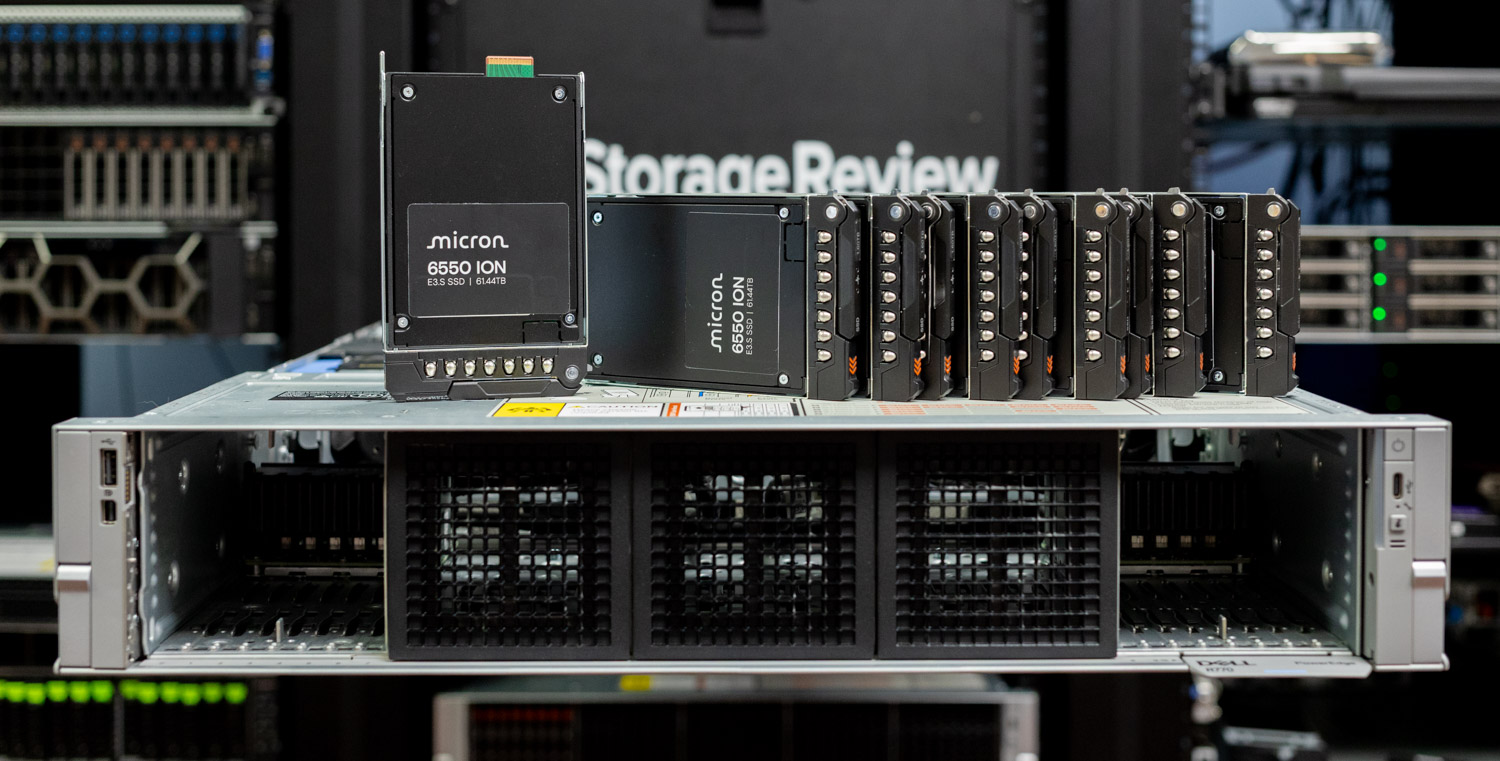
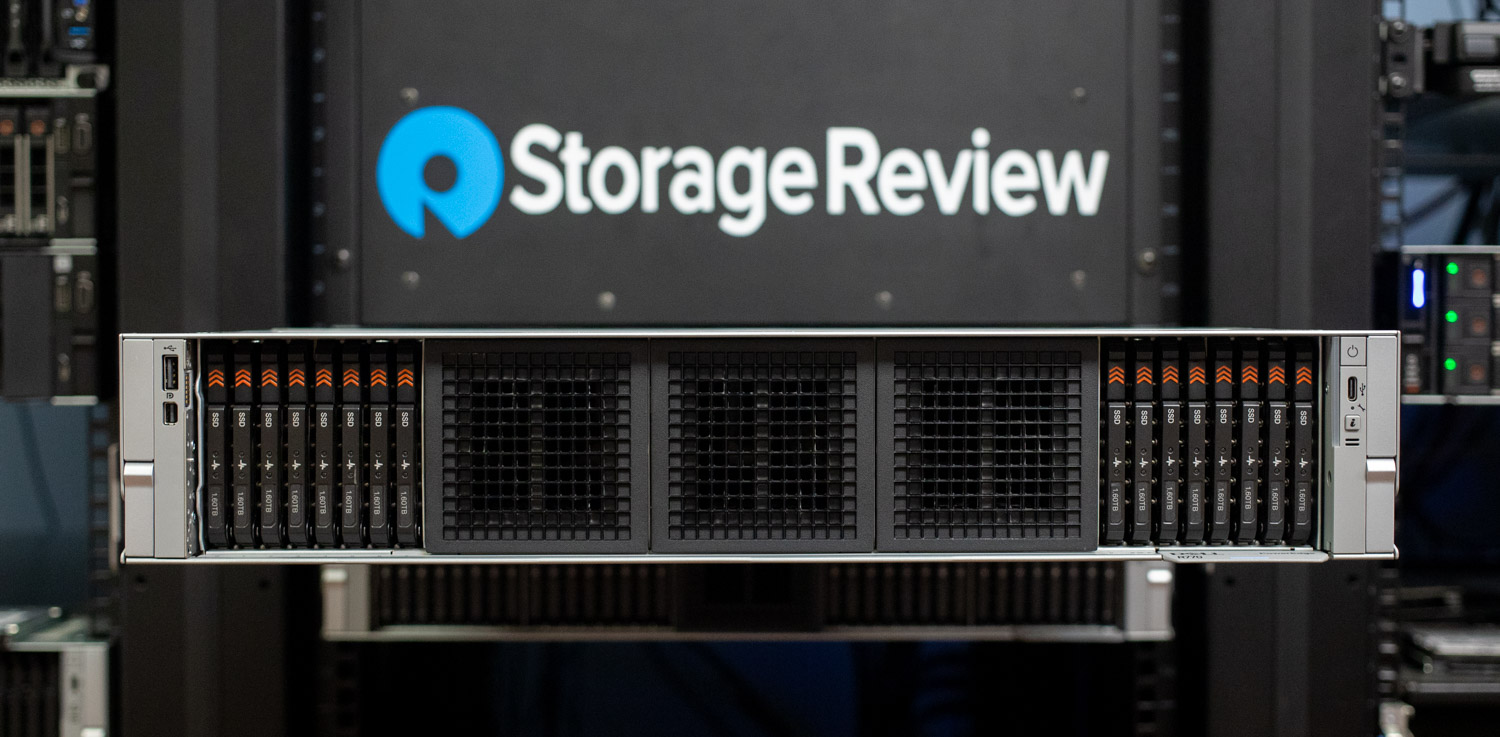
Graid SupremeRAID AE의 성능을 테스트하기 위해 듀얼 NVIDIA H770 GPU와 전면에 100개의 E16.S 베이를 갖춘 Dell PowerEdge R3을 구성했습니다. Intel의 최신 Xeon 6 플랫폼을 기반으로 하는 이 시스템은 두 개의 Intel Xeon 6787P 프로세서로 구성되었으며, 각 프로세서는 86개의 코어를 제공하여 AI, HPC 및 데이터 집약적인 환경에서 고도로 병렬화된 워크로드를 처리합니다.
R770은 16개의 E3.S 베이로 구성되었으며, 스토리지는 광범위한 워크로드에서 일관된 성능을 제공하도록 설계된 Micron 6550 ION 61.44TB Gen5 NVMe TLC SSD로 완전히 채워졌습니다. Micron SSD는 탁월한 성능과 대용량의 이상적인 균형을 제공하여 AI 워크로드가 높은 처리량을 유지하는 동시에 AI 인프라를 대폭 간소화할 수 있도록 지원합니다. 단 16개의 드라이브에 페타바이트급 스토리지를 탑재하여 기업은 단일 서버 내에서 방대한 데이터 세트와 대규모 모델 체크포인트를 효율적으로 관리하고 복잡성과 인프라 오버헤드를 크게 줄일 수 있습니다.
테스트 시스템 사양
- 플랫폼 : 델 파워에지 R770
- CPU : 2x Intel Xeon 6787P(각각 86코어)
- 메모리 : 32x Micron 64GB 듀얼 랭크 DDR5 6400MT/s 총 메모리: 2TB
- 네트워킹 : DELL BRCM 4P 25G SFP 57504S OCP NIC
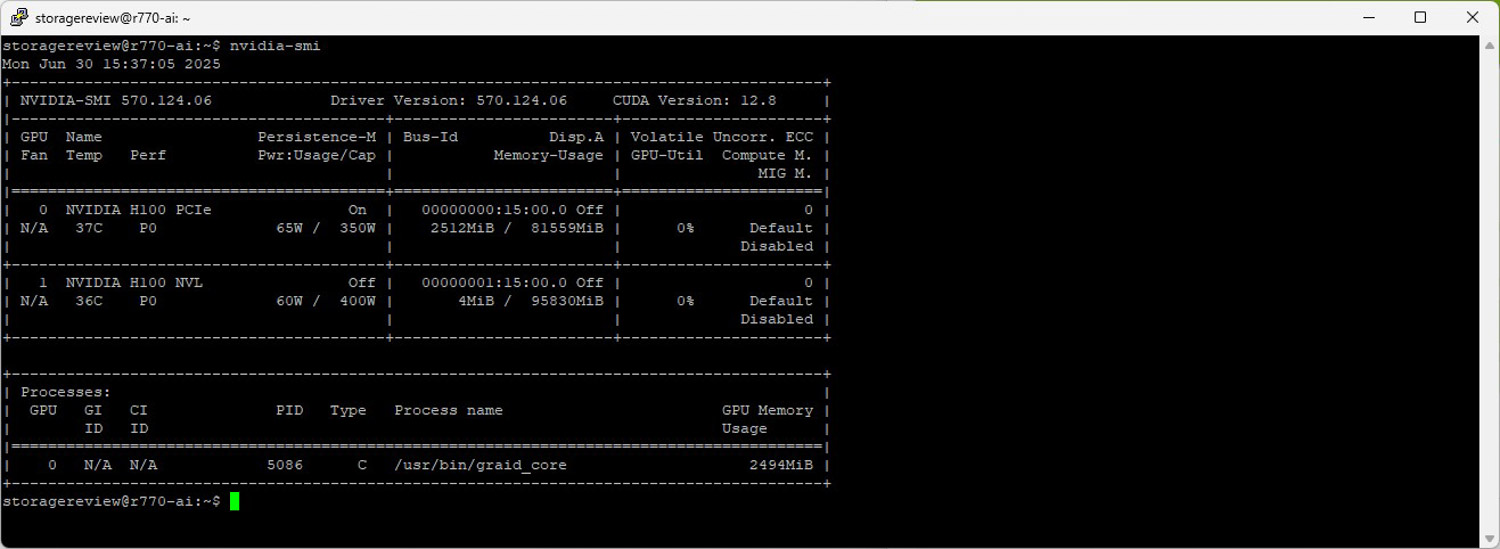
- GPU 1: 엔비디아 H100(VRAM 80GB)
- GPU 2: NVIDIA H100NVL(VRAM 96GB)
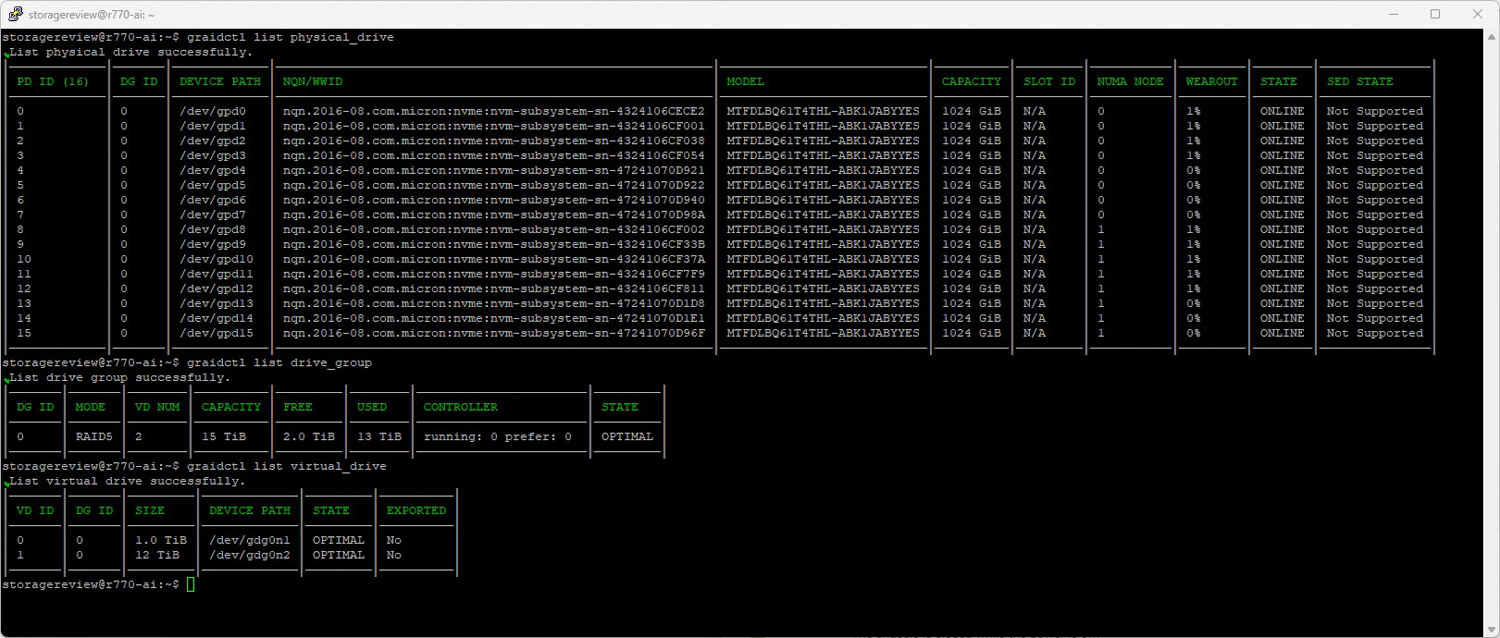
- 스토리지 : 16 X 61TB 마이크론 ION 6550 SSD(915TB RAID 5 풀)
이 성능 테스트의 일환으로 Micron SSD는 SupremeRAID AE를 사용하여 단일 RAID 5 풀로 구성되었습니다. 이 레이아웃은 SupremeRAID AE가 대용량 스토리지를 요구하는 AI 기반 환경에서 성능과 내결함성의 균형을 얼마나 잘 유지하는지 평가하기 위해 선택되었습니다. RAID 5는 모든 드라이브에 패리티를 분산하여 단일 드라이브 장애로부터 데이터를 보호하는 동시에 사용 가능한 스토리지 용량을 유지합니다.
성능 테스트를 본격적으로 시작하기 전에, Graid를 사용하여 스토리지 성능을 측정할 때 GDSIO와 FIO의 차이점을 파악하는 것이 중요합니다. 이전 Graid 성능 평가에서 중요한 점은 최대 대역폭을 제한하는 병목 현상(예: 하드웨어 RAID 카드)이 없다는 것입니다. 하드웨어 RAID 카드는 연결된 스토리지 장치를 관리하며, PCIe 슬롯은 이 과정에서 병목 현상이 발생할 수 있습니다. Graid는 RAID 작업에 GPU를 사용하지만 모든 데이터가 GPU를 통과할 필요는 없습니다. 따라서 GPU는 대역폭을 제한하지 않습니다.
FIO 스토리지 벤치마크는 CPU를 활용하여 스토리지에 액세스하는 방식으로 스토리지 성능을 측정하며, 스토리지 솔루션에 의해서만 제한됩니다. 반면 GDSIO는 GPU Direct Storage의 성능을 측정하는데, 이 경우 GPU가 성능 제한 요인이 될 수 있습니다. 예를 들어 NVIDIA H100은 PCIe Gen5 x16 인터페이스를 갖추고 있으며 약 63GB/s의 입출력 대역폭을 지원합니다. 이 맥락에서 GPU 성능 병목 현상을 논의할 때, 문제는 Graid 병목 현상이 아니라 GPU Direct Storage를 통해 GPU가 지원할 수 있는 대역폭과 관련이 있습니다.
NVIDIA GPU 직접 스토리지
이 테스트벤치에서 수행한 테스트 중 하나는 Magnum IO GPU Direct Storage(GDS) 테스트였습니다. GDS는 NVIDIA에서 개발한 기능으로, GPU가 NVMe 드라이브나 다른 고속 스토리지 장치에 저장된 데이터에 액세스할 때 CPU를 우회할 수 있도록 해줍니다. GDS는 CPU와 시스템 메모리를 통해 데이터를 라우팅하는 대신 GPU와 스토리지 장치 간의 직접 통신을 가능하게 하여 대기 시간을 크게 줄이고 데이터 처리량을 개선합니다.
GPU 직접 스토리지 작동 방식
전통적으로 GPU가 NVMe 드라이브에 저장된 데이터를 처리할 때 데이터는 GPU에 도달하기 전에 먼저 CPU와 시스템 메모리를 거쳐야 합니다. 이 프로세스는 CPU가 중개자가 되어 지연 시간을 늘리고 귀중한 시스템 리소스를 소모하기 때문에 병목 현상이 발생합니다. GPU Direct Storage는 GPU가 PCIe 버스를 통해 스토리지 장치에서 직접 데이터에 액세스할 수 있도록 하여 이러한 비효율성을 제거합니다. 이 직접 경로는 데이터 이동과 관련된 오버헤드를 줄여 더 빠르고 효율적인 데이터 전송을 가능하게 합니다.
AI 워크로드, 특히 딥 러닝과 관련된 워크로드는 매우 데이터 집약적입니다. 대규모 신경망을 훈련하려면 테라바이트 규모의 데이터를 처리해야 하며, 데이터 전송이 지연되면 GPU 활용도가 낮아지고 훈련 시간이 길어질 수 있습니다. GPU Direct Storage는 데이터가 가능한 한 빨리 GPU에 전달되도록 하여 유휴 시간을 최소화하고 계산 효율성을 극대화함으로써 이러한 과제를 해결합니다.
또한 GDS는 비디오 처리, 자연어 처리 또는 실시간 추론과 같이 대용량 데이터 세트를 스트리밍하는 작업 부하에 특히 유용합니다. GDS는 CPU에 대한 의존도를 줄임으로써 데이터 이동을 가속화하고 다른 작업을 위한 CPU 리소스를 확보하여 전반적인 시스템 성능을 더욱 향상시킵니다.
GDSIO 16 드라이브 임의 읽기 처리량
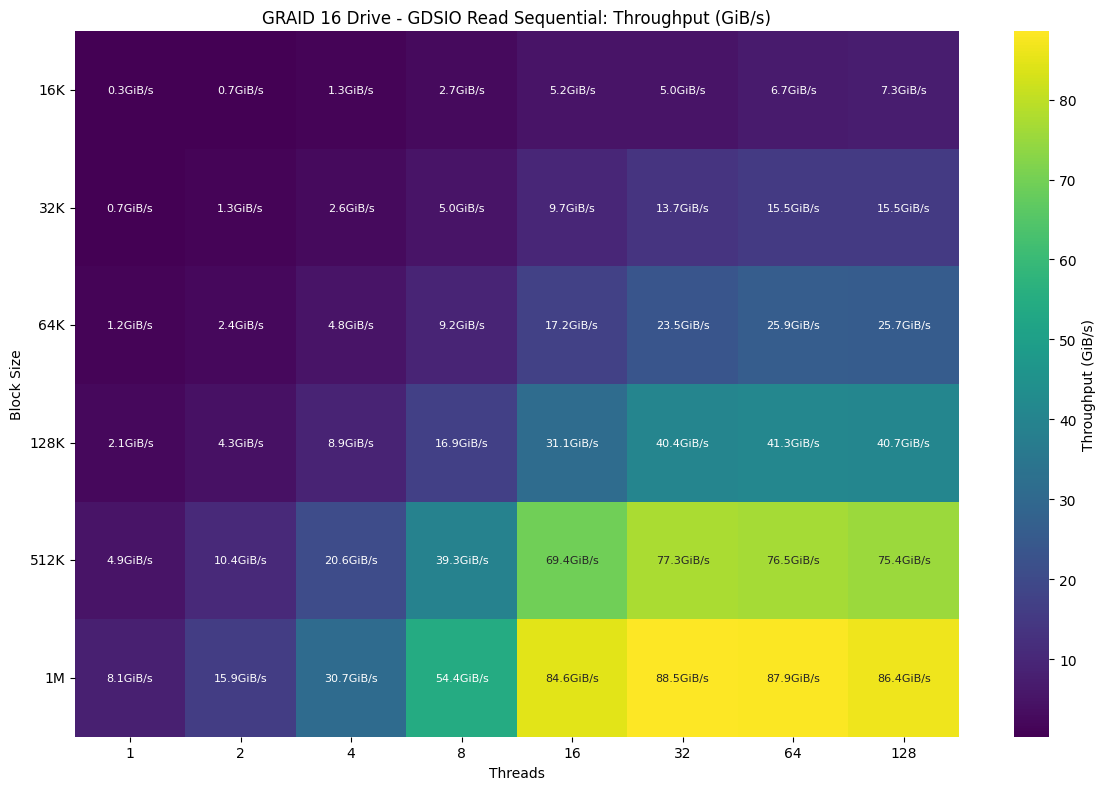
성능 수치를 자세히 살펴보기 전에, GDSIO 수치를 기준으로 읽기 및 쓰기 성능을 제한하는 요소는 GPU라는 점을 알아두는 것이 중요합니다. 이 테스트는 GPU에서 푸시하거나 풀링할 수 있는 최대 스토리지 성능을 측정하도록 설계되었습니다. 결국 PCIe 슬롯에서 병목 현상이 발생하는데, PCIe Gen5 x16의 경우 병목 현상은 약 63GB/s입니다.
GDSIO 임의 읽기 처리량 측면에서, 어레이는 더 큰 블록 크기와 더 높은 스레드 수에서 가장 강력한 결과를 보였지만, 낮은 스레드에서는 효율적인 확장에 어려움을 겪었습니다. 16K/128 스레드에서 상황은 더욱 눈에 띄게 개선되어 7.3GiB/s에 도달했지만, 진정한 처리량 가속은 32K 이상에서야 나타나기 시작했으며, 어레이는 15.5 스레드에서 64GiB/s에 도달했습니다. 64K에서는 상당한 성능 향상이 관찰되어 25.9GiB/s로 상승했고, 128K에서는 성능이 급등하여 41.3 스레드에서 64GiB/s에 도달했으며, 40 스레드까지 128GiB/s 이상을 유지했습니다. 최대 처리량은 1 스레드에서 32M 블록 크기에서 달성되었으며, 어레이는 88.5GiB/s에 도달했고 가장 높은 스레드 수에서도 이 수준을 유지했습니다.
GDSIO 16 드라이브 임의 읽기 지연 시간
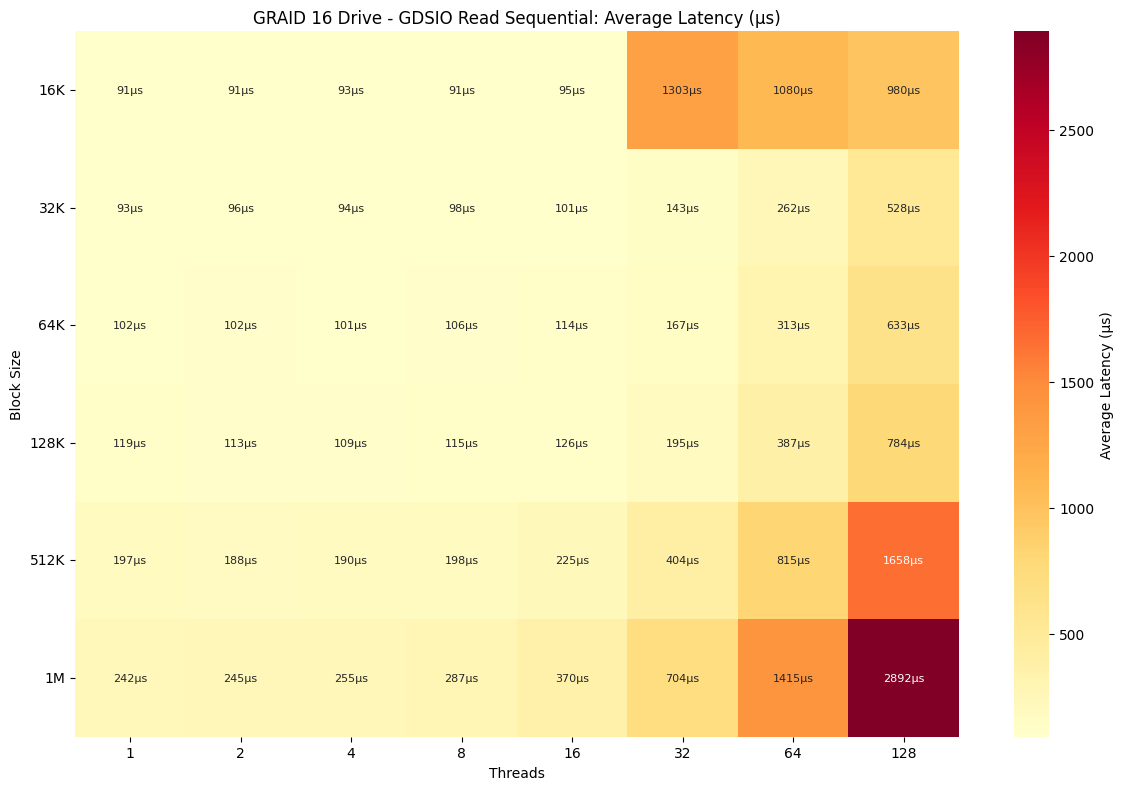
처리량 결과에 따라 배열의 임의 읽기 지연 시간 프로필은 앞서 관찰된 확장 동작을 반영했습니다. 지연 시간은 모든 블록 크기와 스레드 수에서 최대 16개 스레드까지 매우 낮게 유지되었으며, 최대 0.1K까지 모든 경우 값이 128ms 미만으로 유지되었습니다. 128K와 같은 더 큰 블록도 0.13ms에서 0.20ms 사이로 유지되었습니다. 그러나 16개 스레드를 넘어서면 지연 시간이 눈에 띄게 증가했습니다. 16k/32개 스레드에서 지연 시간은 계속 증가하여 결국 980개 스레드에서 128ms에 도달했습니다. 마찬가지로 처리량이 가장 높은 1M 읽기는 스레드 하나에서 0.242ms에서 2.892개 스레드에서 128ms로 증가했습니다. 이러한 추세는 모든 크기에서 일관되게 나타났으며, 중간 정도의 동시성에서는 지연 시간이 일정하게 유지되었지만 스레드 수가 32개를 넘어 증가함에 따라, 특히 블록 크기가 커짐에 따라 급격히 증가했습니다.
GDSIO 16 드라이브 임의 쓰기 처리량
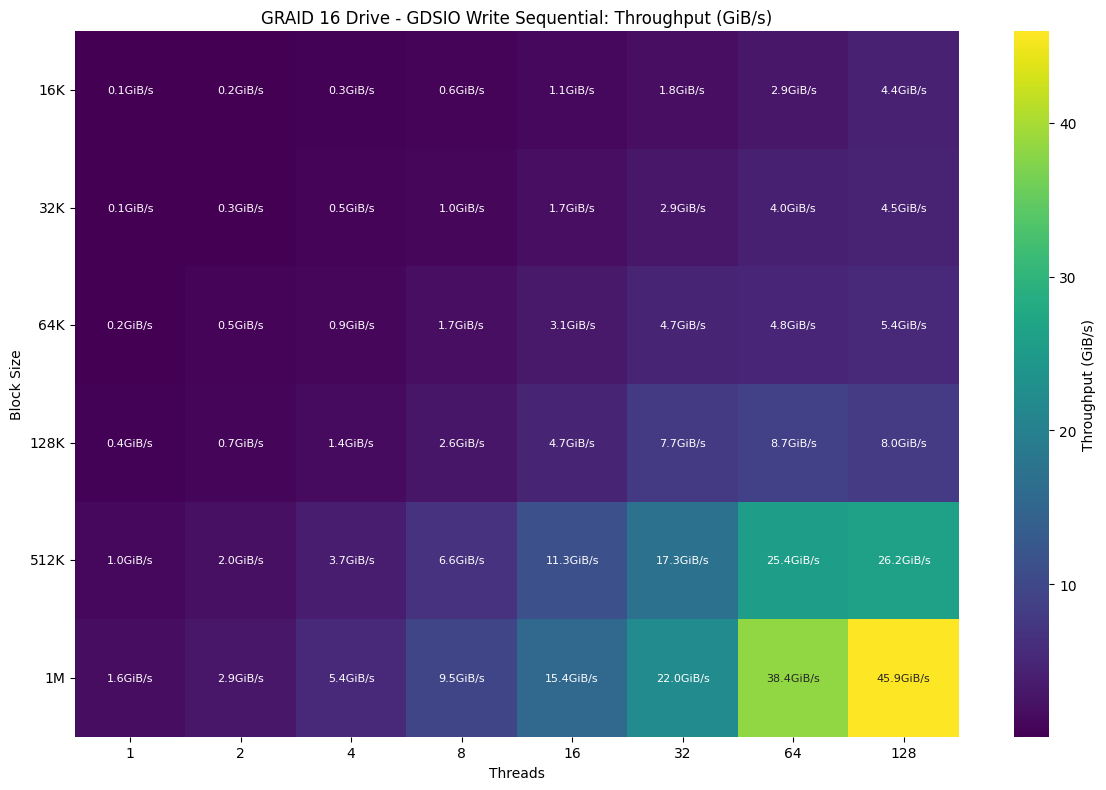
GDSIO 쓰기 처리량으로 넘어가면, 어레이는 읽기 처리량에 비해 전반적으로 점진적으로 확장되면서도 더 큰 블록 크기에서 다시 한번 강력한 성능을 보였습니다. 성능은 32K부터 눈에 띄게 향상되기 시작하여 처리량이 5.9GiB/s를 넘어섰고, 특히 64개 스레드 이상에서는 512K 및 1M 블록이 높은 스레드 수에서도 지속적인 성능 향상을 보였습니다. 64개 스레드 이상에서는 512K 쓰기가 25.4GiB/s에 도달했고, 1M 블록은 38.4GiB/s로 최고치를 기록했습니다. 128개 스레드에서는 1M 쓰기가 계속해서 확장되어 최대 45.9GiB/s까지 도달했습니다. 512K 및 128K 블록 크기도 높은 동시성 환경에서 일관되게 유지되어 각각 26.2GiB/s와 8.0GiB/s로 평준화되었습니다.
GDSIO 16 드라이브 임의 쓰기 대기 시간
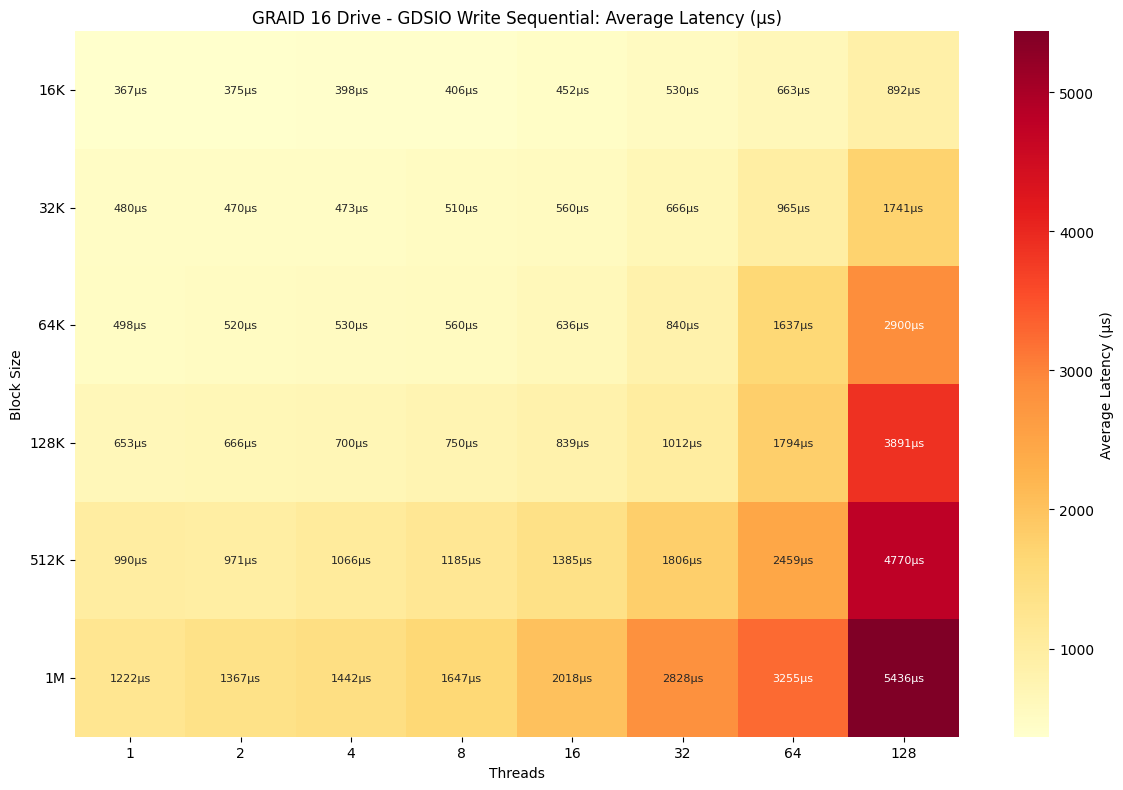
강력한 쓰기 처리량 확장 이후, 어레이에서 임의 쓰기의 지연 시간 프로필은 블록 크기와 스레드 수가 증가함에 따라 꾸준히 증가했습니다. 스레드 수가 적을 때도 쓰기 지연 시간은 읽기 지연 시간보다 현저히 길어지기 시작하여 0.367ms에서 시작하여 블록 크기가 커질수록 1.222M에서 최대 1ms까지 증가했습니다. 동시성이 증가함에 따라 지연 시간은 스레드 16개까지 점진적으로 증가한 후 더욱 빠르게 가속화되었습니다. 스레드 64개에서 쓰기는 0.663ms에 도달했고, 1M 쓰기는 3.255ms까지 증가했습니다. 스레드 128개와 256개에서는 지연 시간이 크게 증가했으며, 특히 블록 크기가 클 때 더욱 그러했습니다. 예를 들어, 512K 쓰기는 4.770개 스레드에서 128ms에 도달했고, 512K와 1M 쓰기는 5ms를 넘어 5.436M에서 1ms로 정점을 찍었습니다.
FIO 성능 벤치마크
다음으로, 단일 RAID5 풀에서 FIO 성능을 측정해 보겠습니다. GDSIO는 궁극적으로 시스템에 설치된 GPU의 성능과 PCIe 대역폭에 따라 달라지지만, FIO는 SSD 성능과 RAID 솔루션 자체의 성능에 따라 더 높아질 수 있습니다.
전체 어레이는 일관된 테스트 프로세스를 거칩니다. 순차 쓰기 워크로드를 사용하여 두 번의 전체 볼륨 채우기로 구성된 사전 조정 단계부터 시작하여, 순차 및 무작위 워크로드가 순차적으로 진행됩니다. 이를 통해 성능 측정이 시작되기 전에 드라이브가 정상 상태에 도달하는지 확인합니다.
새로운 작업 유형마다 해당 전송 크기를 사용하여 사전 조정을 다시 시작하여 결과의 정확성과 일관성을 유지했습니다.
이 섹션에서는 Graid 16 SSD RAID 5 어레이에 적용된 다음의 무작위 쓰기/읽기 FIO 벤치마크를 강조합니다.
- 1M 랜덤 쓰기/읽기
- 64K 랜덤 쓰기/읽기
- 16K 랜덤 쓰기/읽기
- 4K 랜덤 쓰기/읽기
1M 랜덤 읽기/쓰기 대역폭
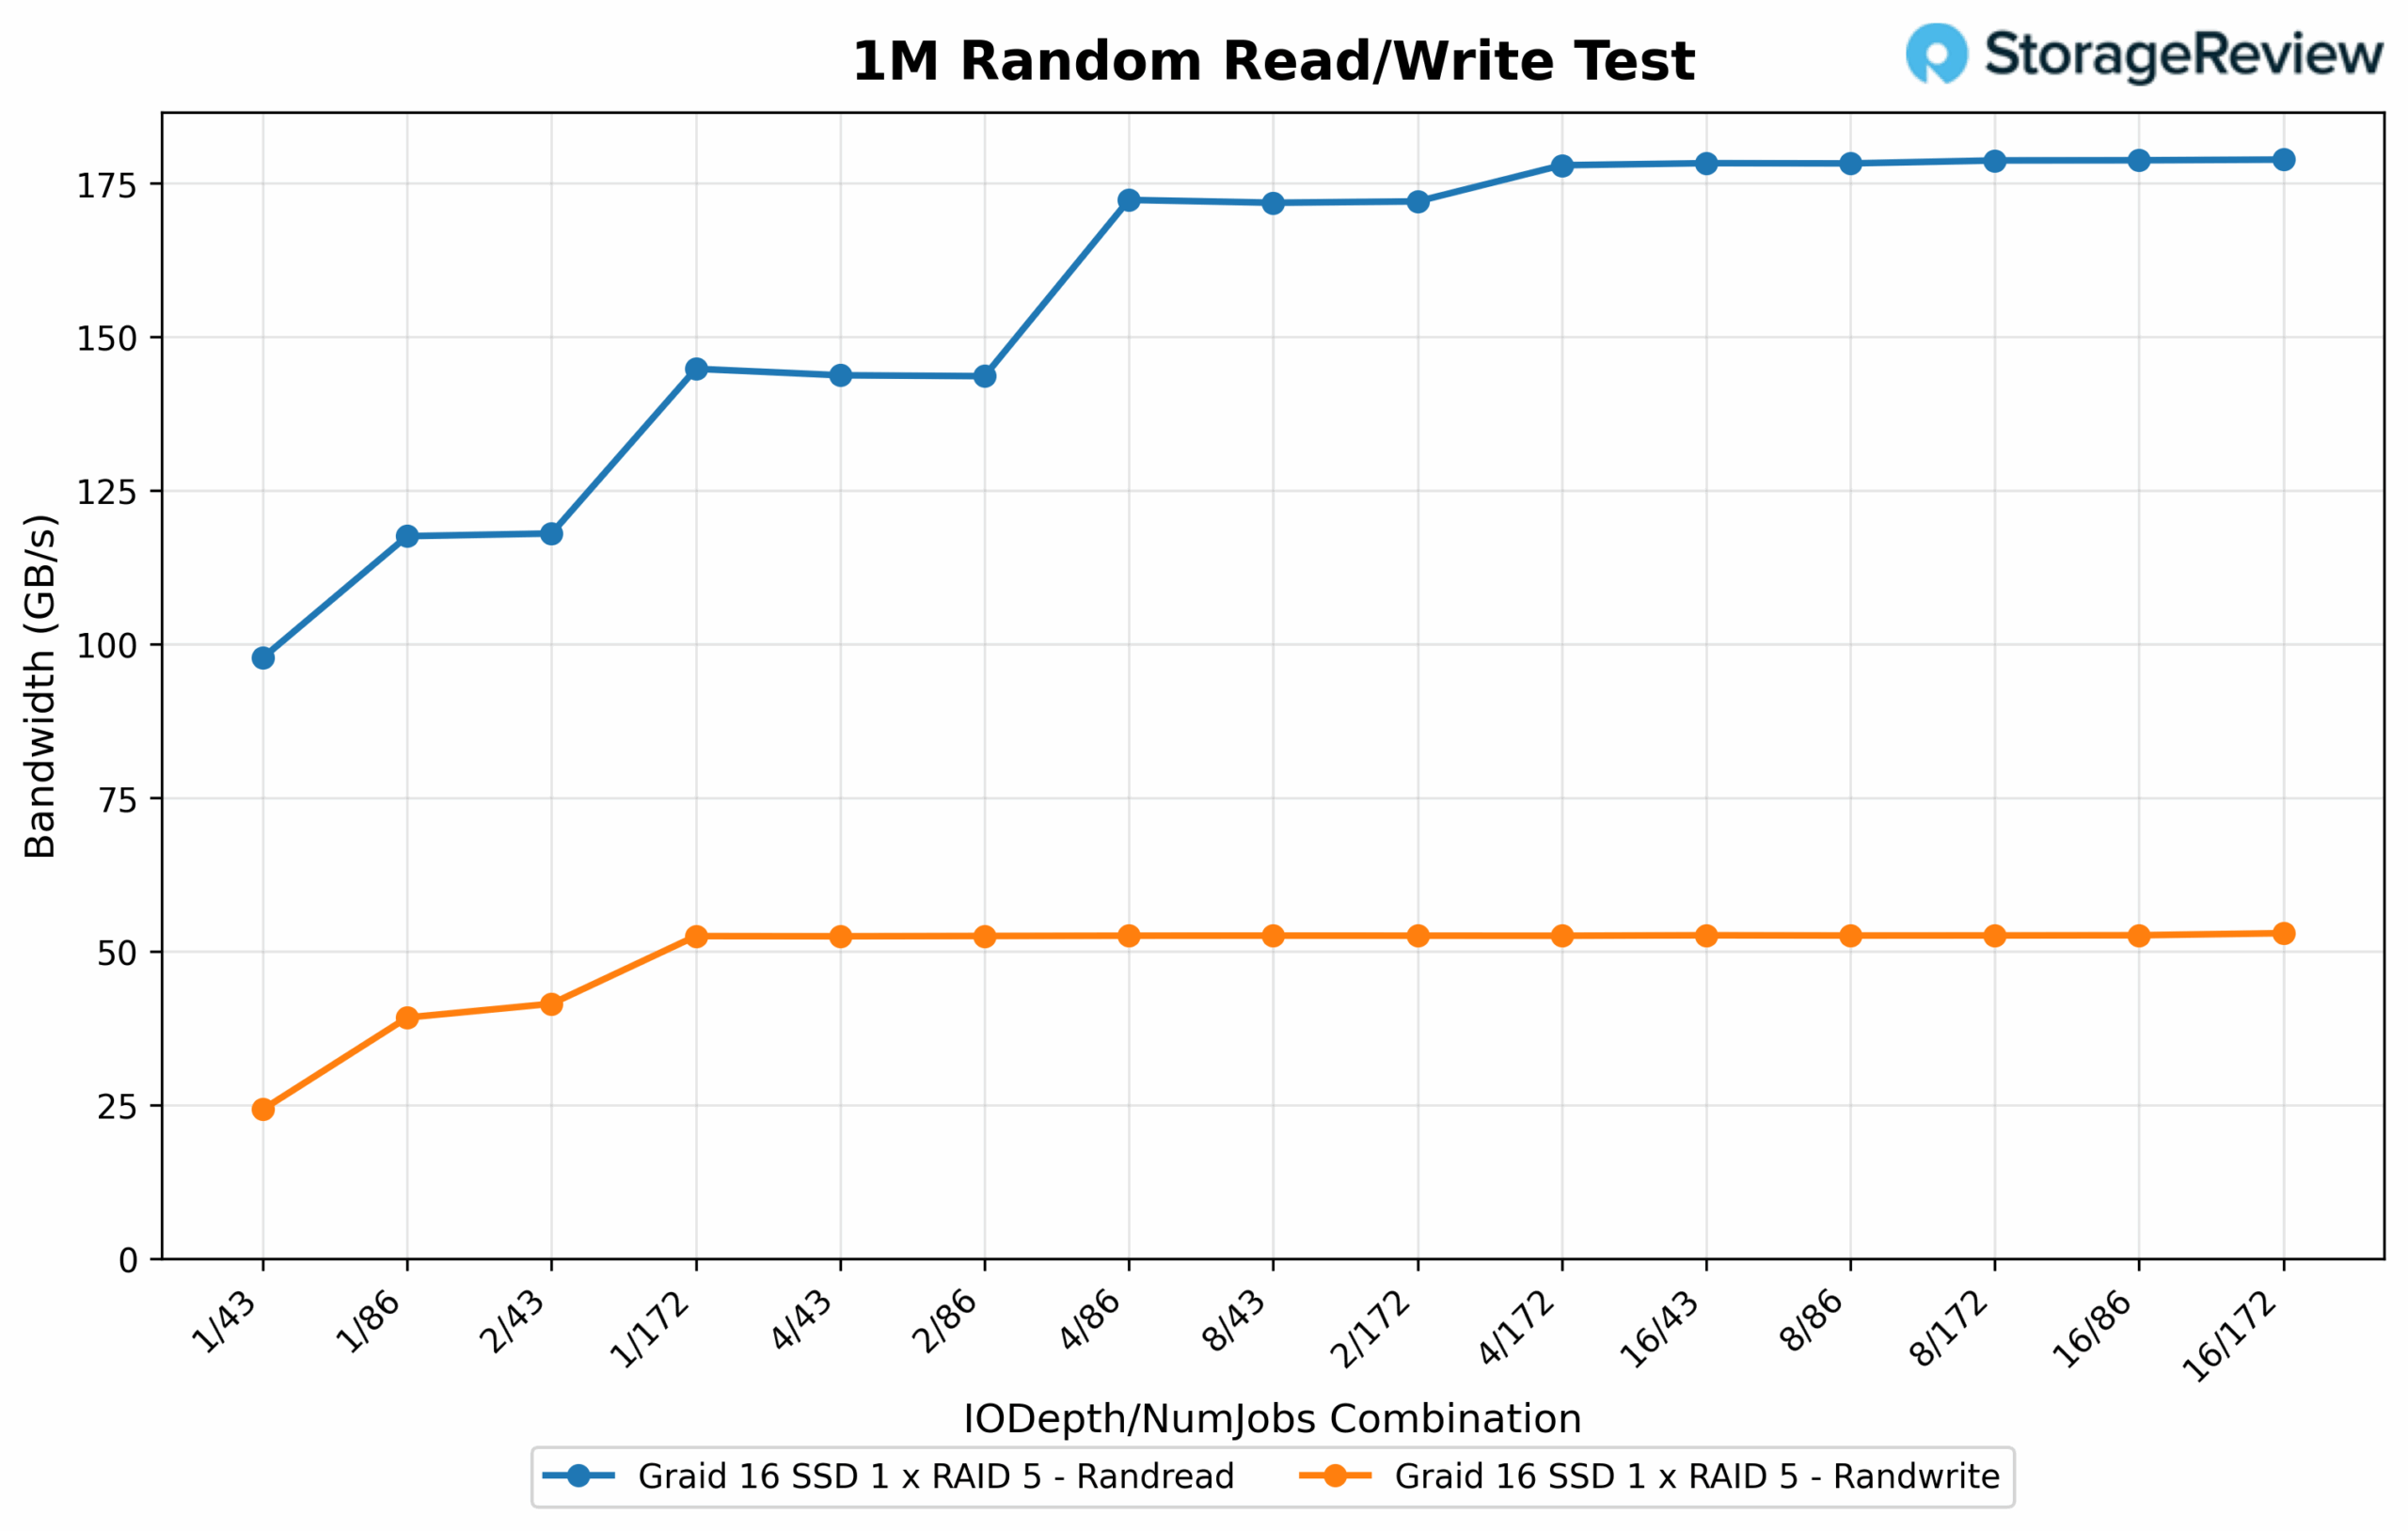
무작위 1M 작업으로 전환했을 때, 읽기 대역폭은 183.60개의 작업으로 16개의 IO depth를 사용했을 때 최대 172GB/s에 도달하여 성능 곡선을 선도했습니다. 이는 테스트된 구성 중 가장 공격적인 구성이었습니다. 8/172와 4/172에서도 유사한 높은 처리량 결과가 기록되었으며, 두 구성 모두 182GB/s를 초과했습니다. 이는 작업 수와 depth 증가에 따라 어레이의 확장성을 잘 보여줍니다. 4/86 및 16/43과 같은 중간 범위 구성에서도 147GB/s 이상을 유지하며 다양한 동시성 수준에서 일관된 읽기 성능을 보여주었습니다. 쓰기로 전환했을 때, 무작위 1M 대역폭은 54.233/8에서 최대 172GB/s에 도달했으며, 53.77/2에서도 거의 동일한 86GB/s를 기록하여 병렬 워크로드에서 효율적인 쓰기 확장을 검증했습니다. 1/43 및 2/43과 같은 하위 스레드 조합에서는 성능이 원활하게 감소하여 각각 24.88GB/s 및 42.48GB/s를 생성했으며, 적당한 동시성 수준에서도 여전히 강한 포화 곡선을 반영했습니다.
1M 랜덤 읽기/쓰기 대기 시간
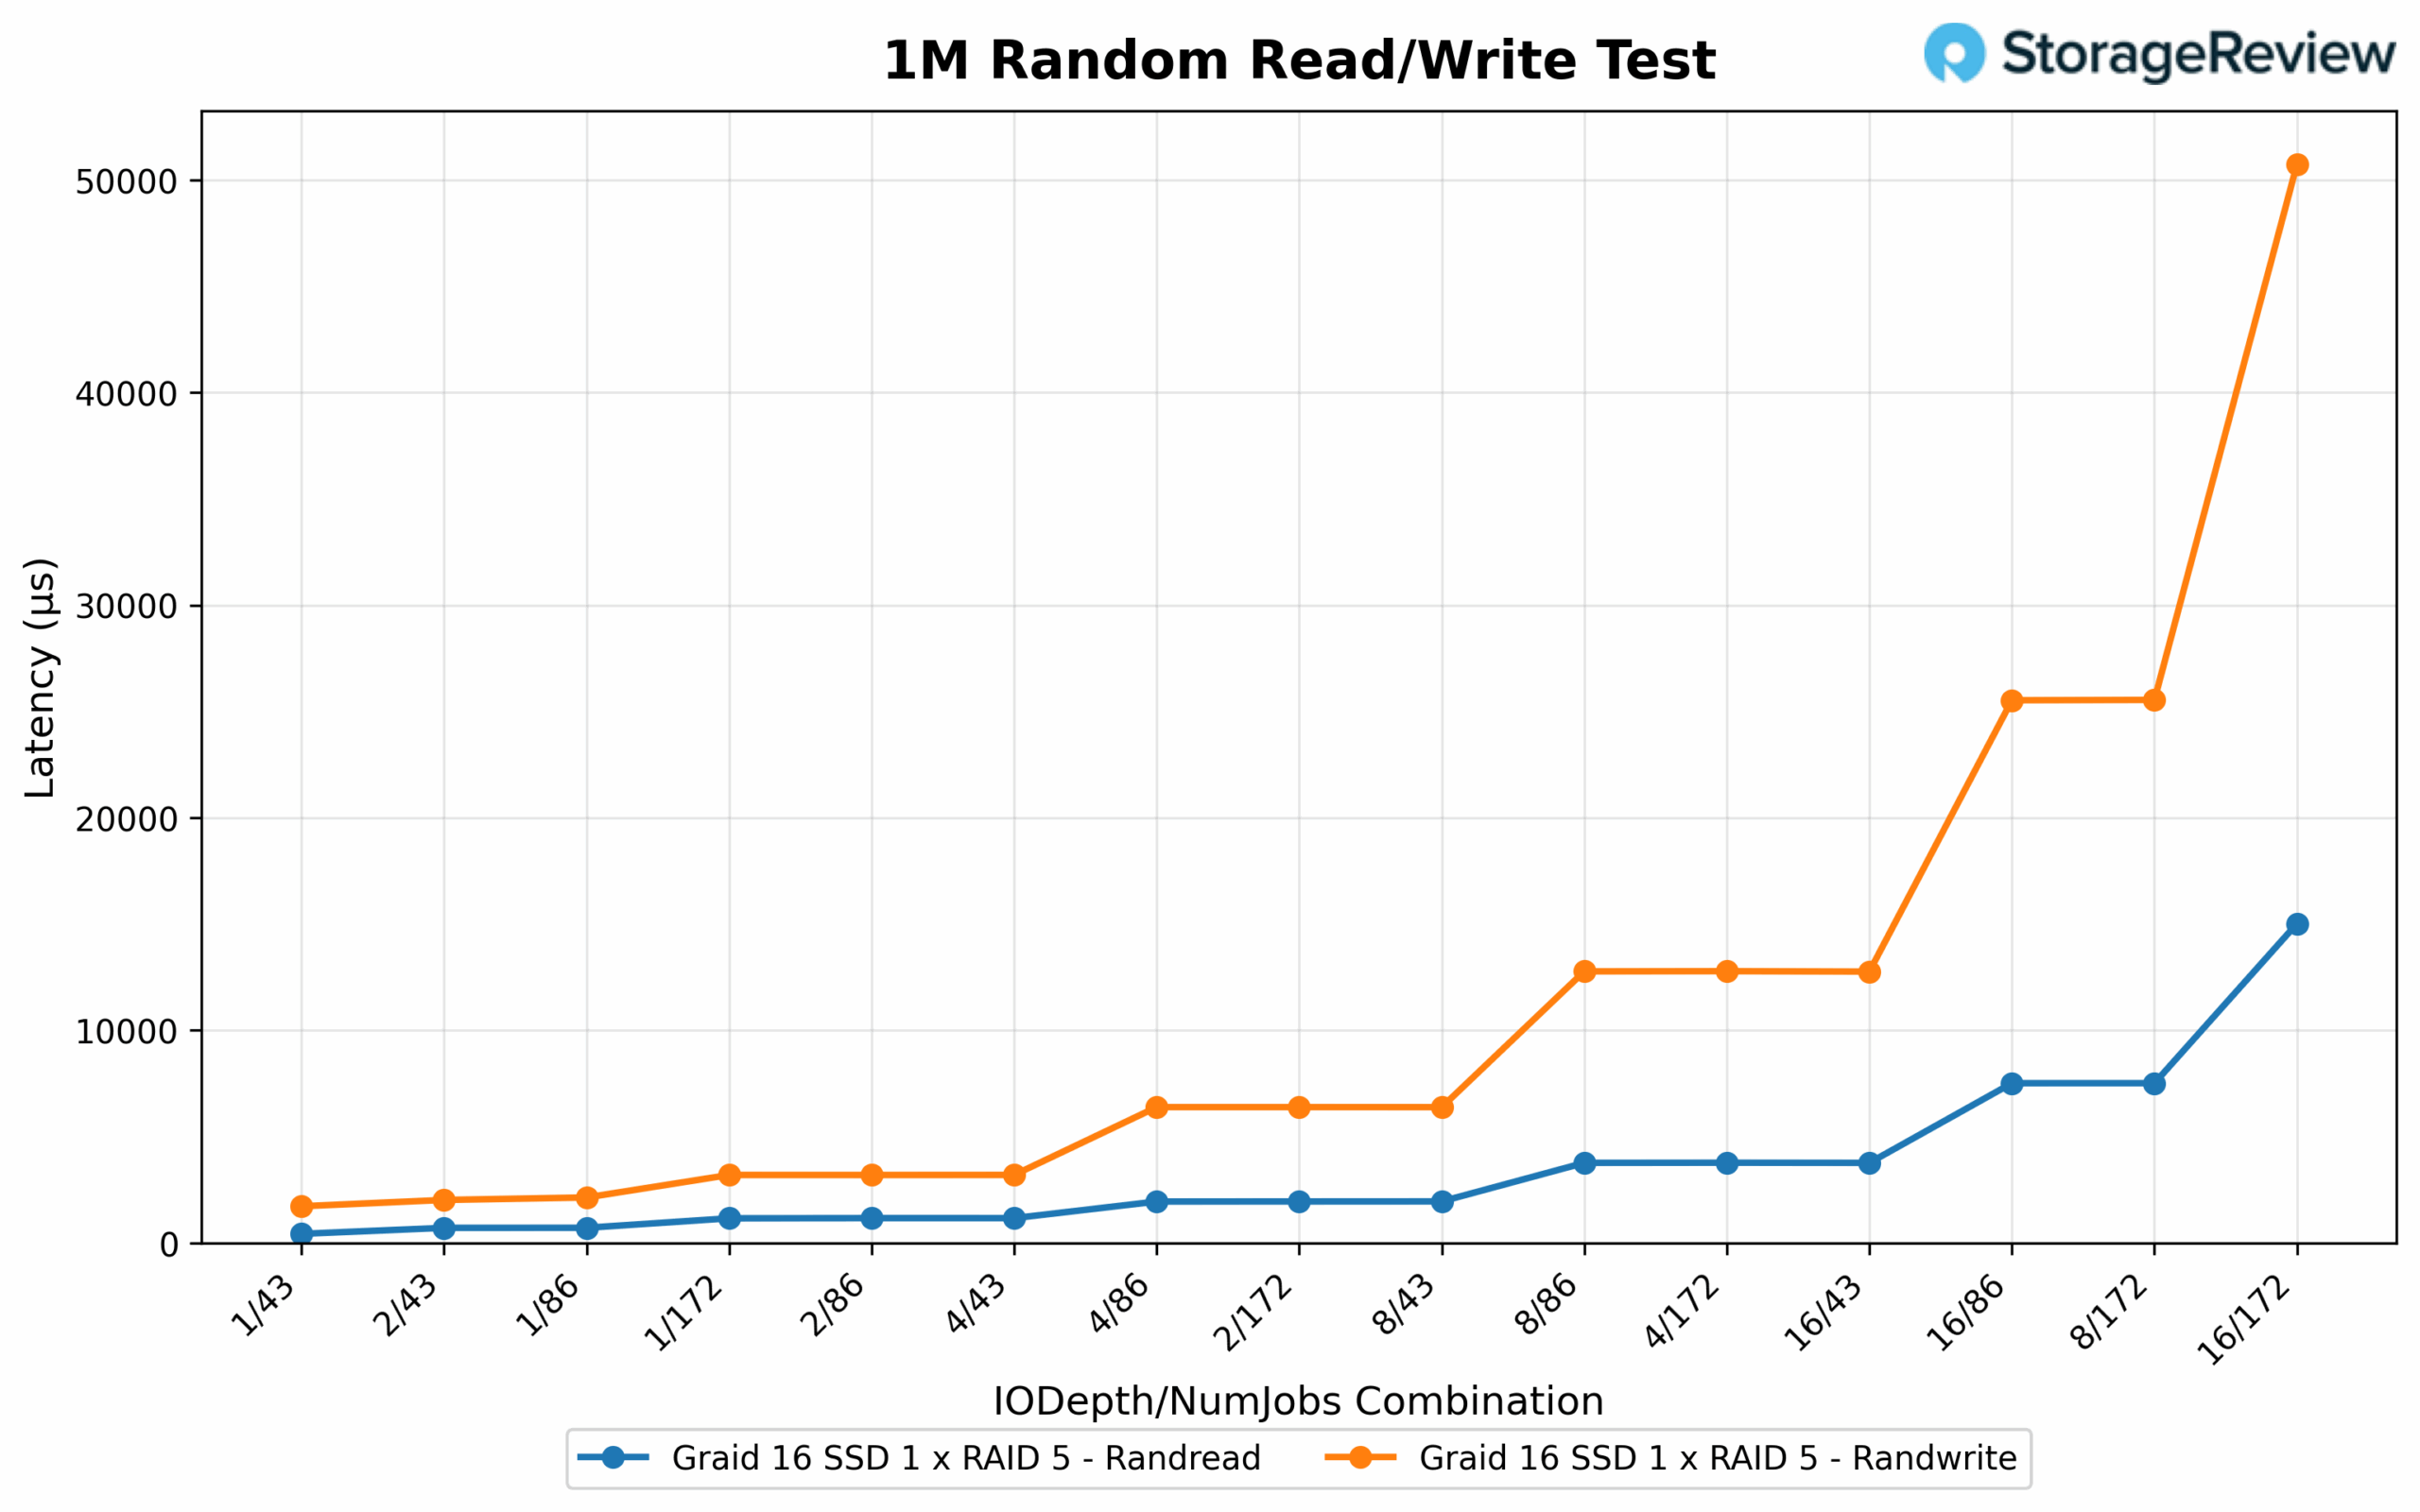
테스트 범위 전체에서 읽기 지연 시간은 제어된 상태를 유지했습니다. 관찰된 최저 지연 시간은 0.714/2과 86/4에서 모두 86ms였으며, 8/172와 4/172와 같은 고수준 로드는 2ms 미만을 유지했습니다. 가장 높은 읽기 처리량을 생성하는 구성인 16/172는 7.516ms로 가장 높은 지연 시간을 기록했습니다. 큐가 깊어질수록 응답 시간이 길어지는 명백한 상충 관계였습니다. 쓰기 측면에서도 지연 시간은 유사한 패턴을 보였습니다. 가장 낮은 쓰기 지연 시간은 1.727/1에서 43ms로 측정되었습니다. 2/86에서는 3.197ms로 처리량과 지연 시간의 균형이 잘 맞았습니다. 8/43과 같은 고수준 동시성 옵션은 6.389ms를 기록했고, 16/172 구성은 최대 쓰기 성능을 제공하면서도 50.741ms로 가장 높은 지연 시간을 기록했습니다. 이는 극한 깊이에서 처리량과 응답성 간의 익숙한 반비례 관계를 강조합니다.
64K 랜덤 읽기/쓰기 대역폭
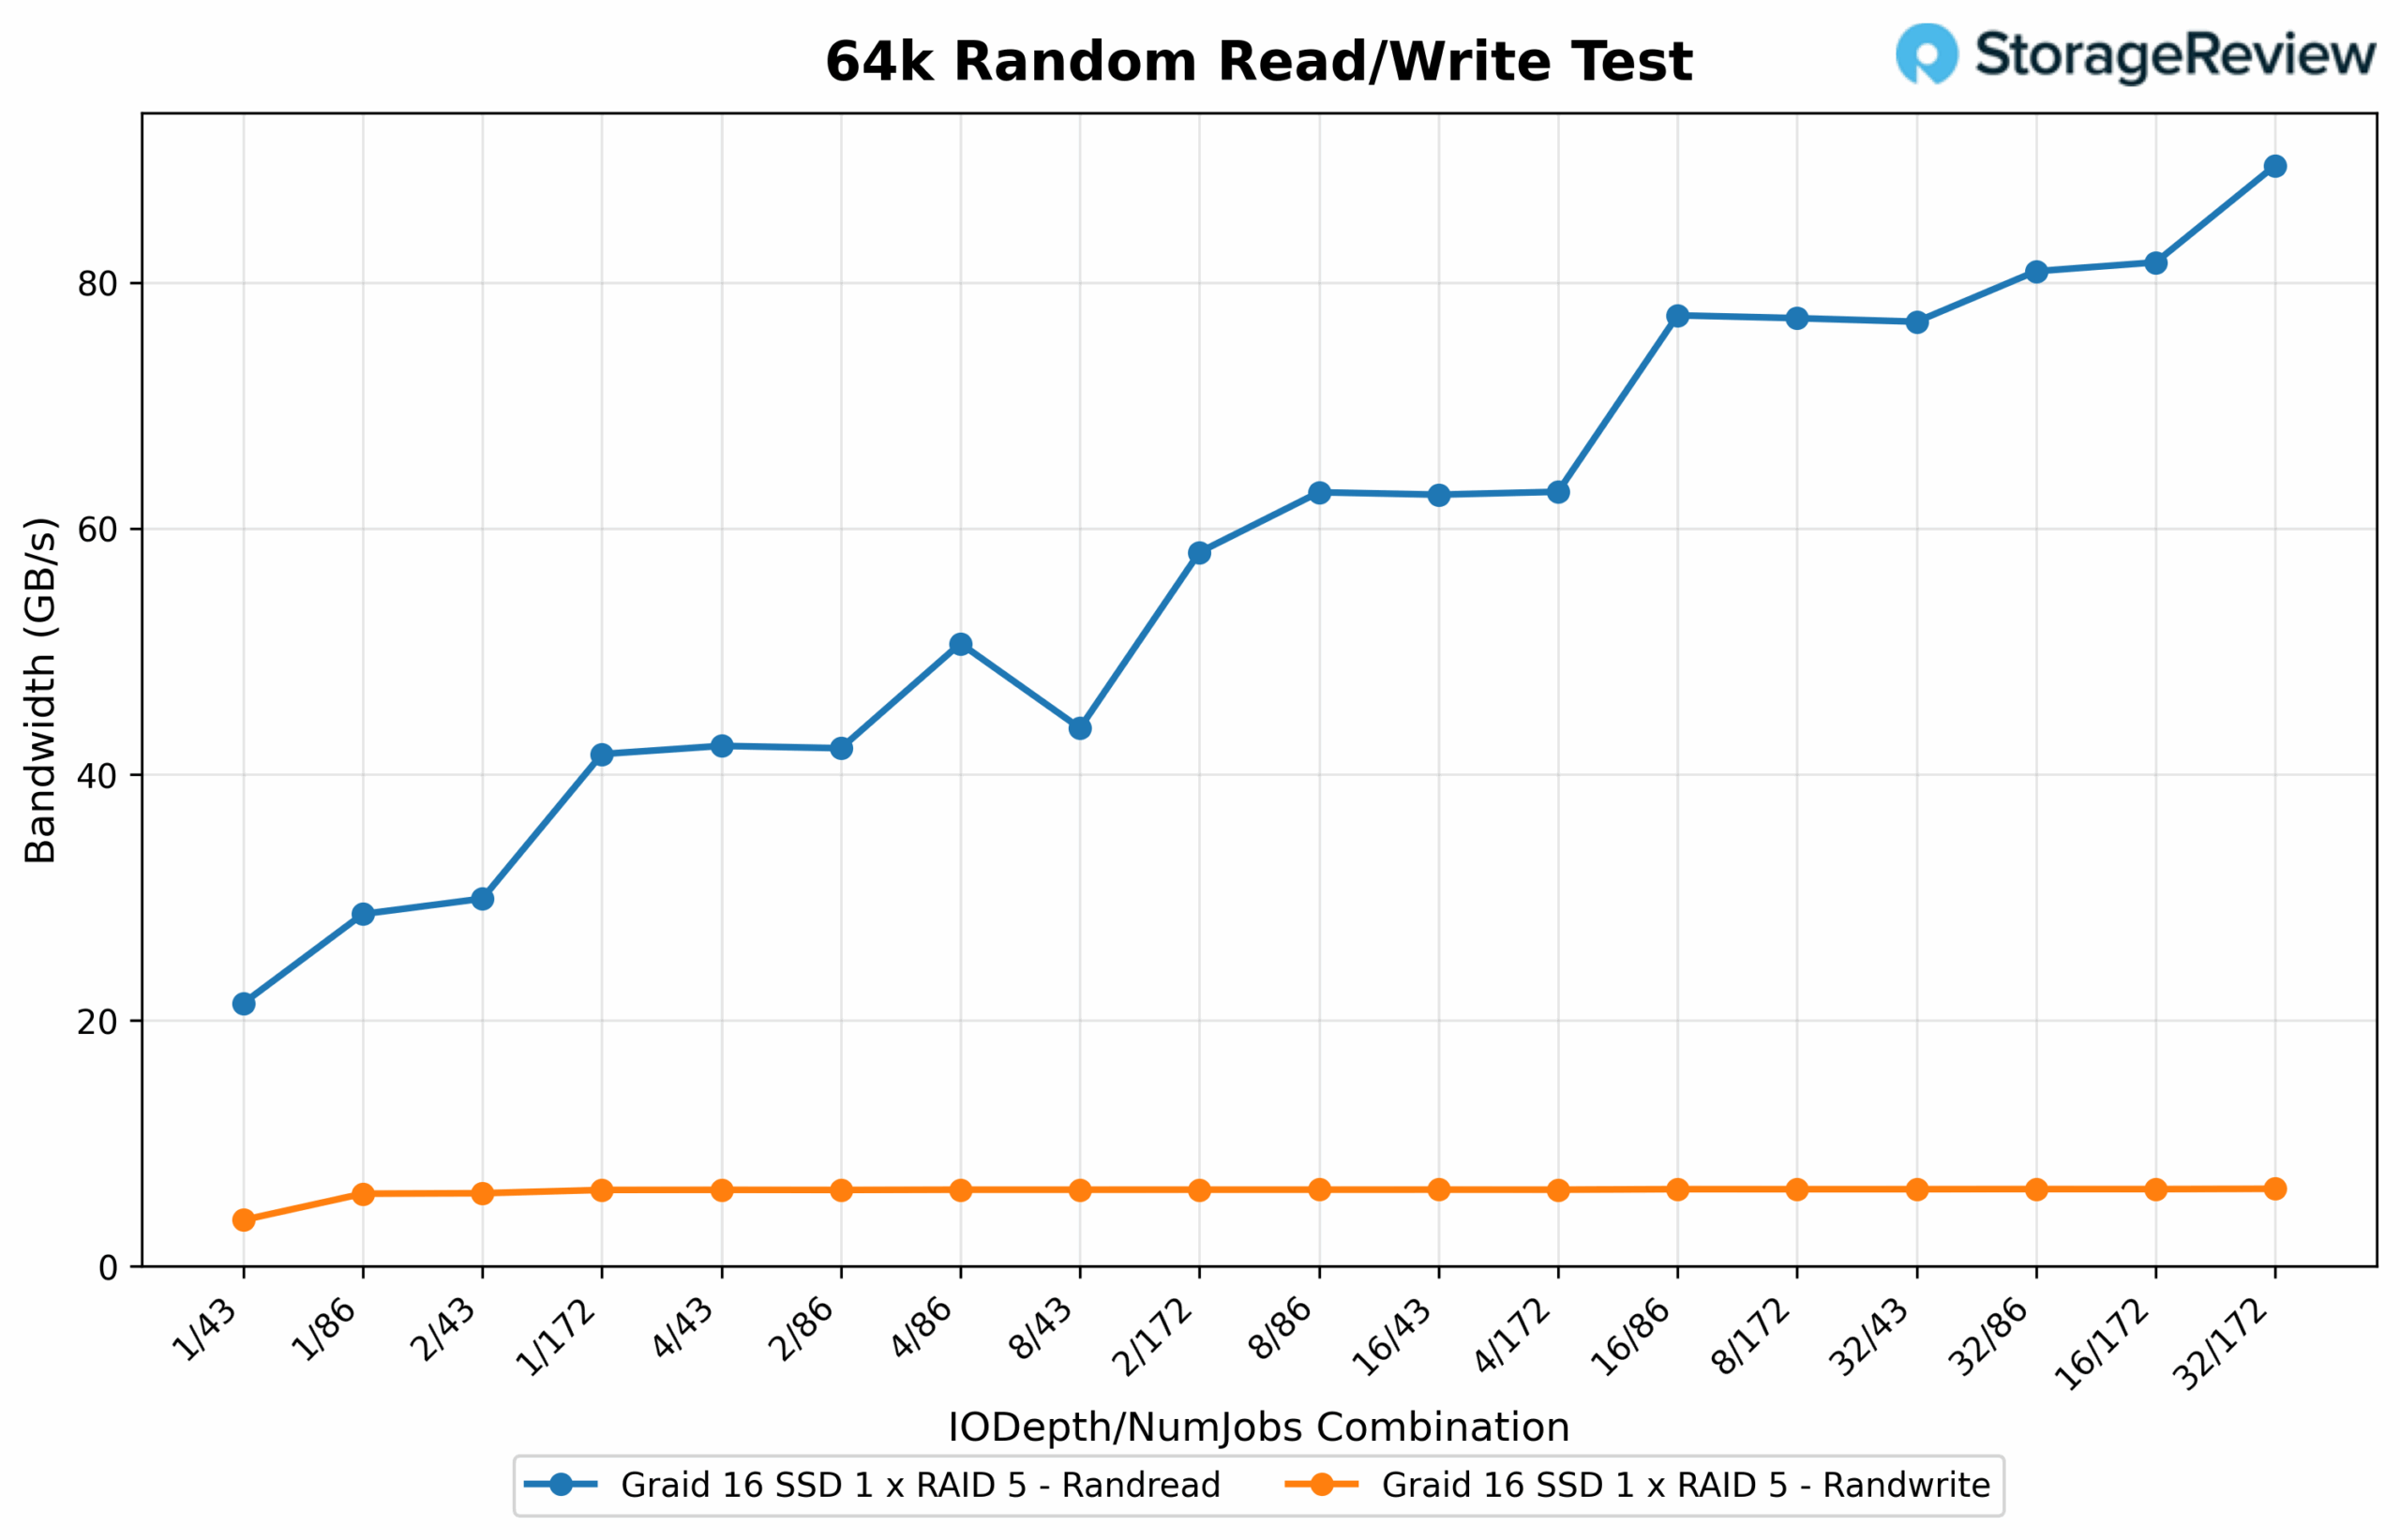
무작위 64K 작업으로 전환하면서 대기열 깊이와 작업 수가 증가함에 따라 읽기 대역폭이 크게 향상되어 91.65 IO 깊이에서 32개 작업으로 최대 172GB/s에 도달했습니다. 16/172 구성에서 83.59GB/s, 32/86 구성에서 82.85GB/s를 포함한 여러 다른 구성도 뒤따랐으며, 이는 워크로드 확장에 따른 일관된 성능 향상을 보여줍니다. 8/172 및 16/86과 같은 중간 범위 설정은 78GB/s에서 79GB/s 사이에서 강력한 성능을 유지했습니다. 반면, 1/43 및 1/172와 같은 낮은 동시성 조합은 21.89GB/s에서 42.63GB/s까지 처리량 수준이 감소하여 어레이가 최대 성능을 위해 병렬 처리에 의존함을 보여줍니다. 쓰기 측면에서 64K 무작위 대역폭은 6.44/32 구성에서 최대 86GB/s에 도달했습니다. 32/172 및 16/86을 포함한 다른 최고 성능 구성도 각각 6.41GB/s와 6.36GB/s를 기록하며 유사한 수준을 보였습니다. 대부분의 테스트 지점은 6.3GB/s와 6.4GB/s 사이에 집중되어 다양한 대기열 크기에 걸쳐 안정적인 일관성을 보였습니다. 1/43과 같은 가벼운 구성은 3.83GB/s로 가장 낮은 쓰기 성능을 보였으며, 이는 더 높은 워크로드에서 점진적인 성능 향상 추세를 여전히 뒷받침합니다.
64K 랜덤 읽기/쓰기 대기 시간
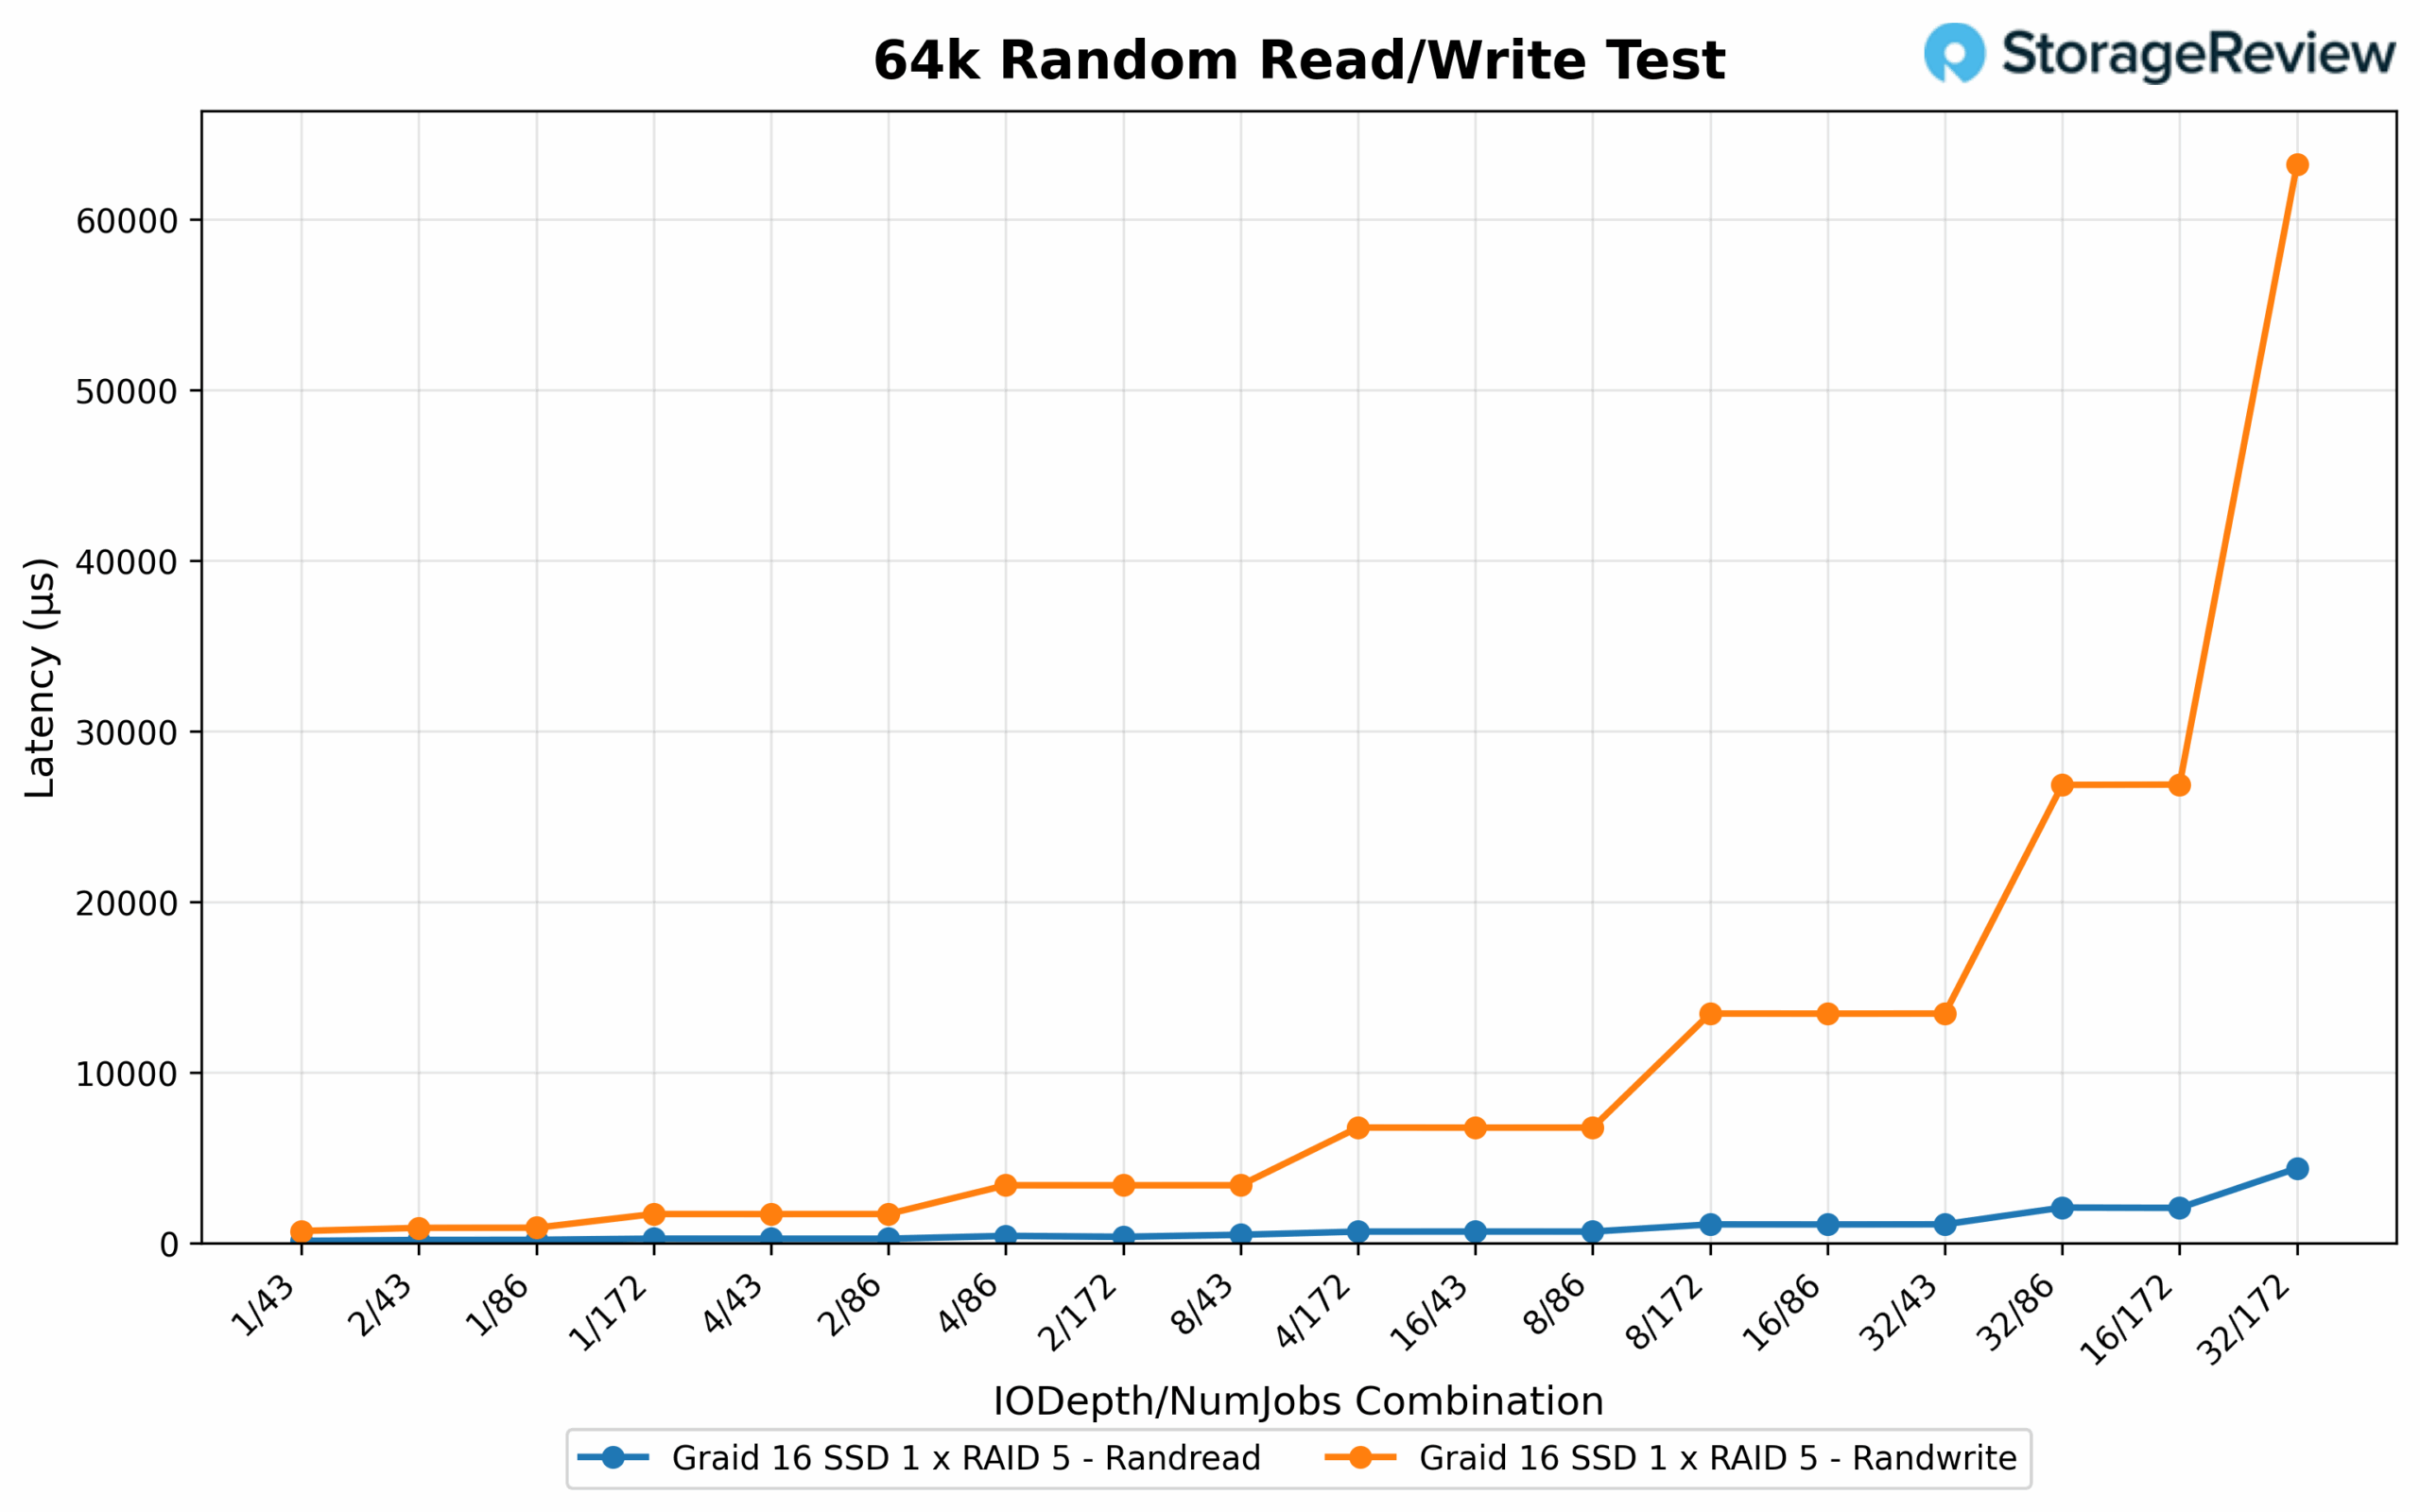
무작위 64K 읽기 지연 시간은 대부분의 테스트 사례에서 일관되게 낮은 수준을 유지했습니다. 가장 낮은 지연 시간은 0.123/1에서 43ms였고, 그 뒤를 이어 0.175/1에서 86ms였습니다. 처리량이 증가함에 따라 지연 시간은 제어된 범위 내에서 유지되었습니다. 4/172는 0.666ms, 16/172는 2.057ms였습니다. 더 높은 부하 조건에서도 응답성은 효율적인 상태를 유지했으며, 32/86은 최고 대역폭 결과 중 하나를 기록했음에도 불구하고 2.076ms를 기록했습니다. 쓰기 측면에서 지연 시간은 깊이와 작업 수에 따라 더 급격하게 증가했습니다. 가장 낮은 지연 시간은 2/43에서 0.887ms였으며, 4/43과 2/86은 각각 1.694ms와 1.697ms로 그 뒤를 바짝 쫓았습니다. 더 무거운 구성에서는 응답 시간에서 분명한 상충 현상이 나타났습니다. 8/172는 13.445ms를 기록했고, 16/172는 26.862ms로 늘어났으며, 32/172는 63.201ms에서 정점을 찍었습니다. 이는 작업 부하가 증가함에 따라 대기열 오버헤드가 증가했음을 보여줍니다.
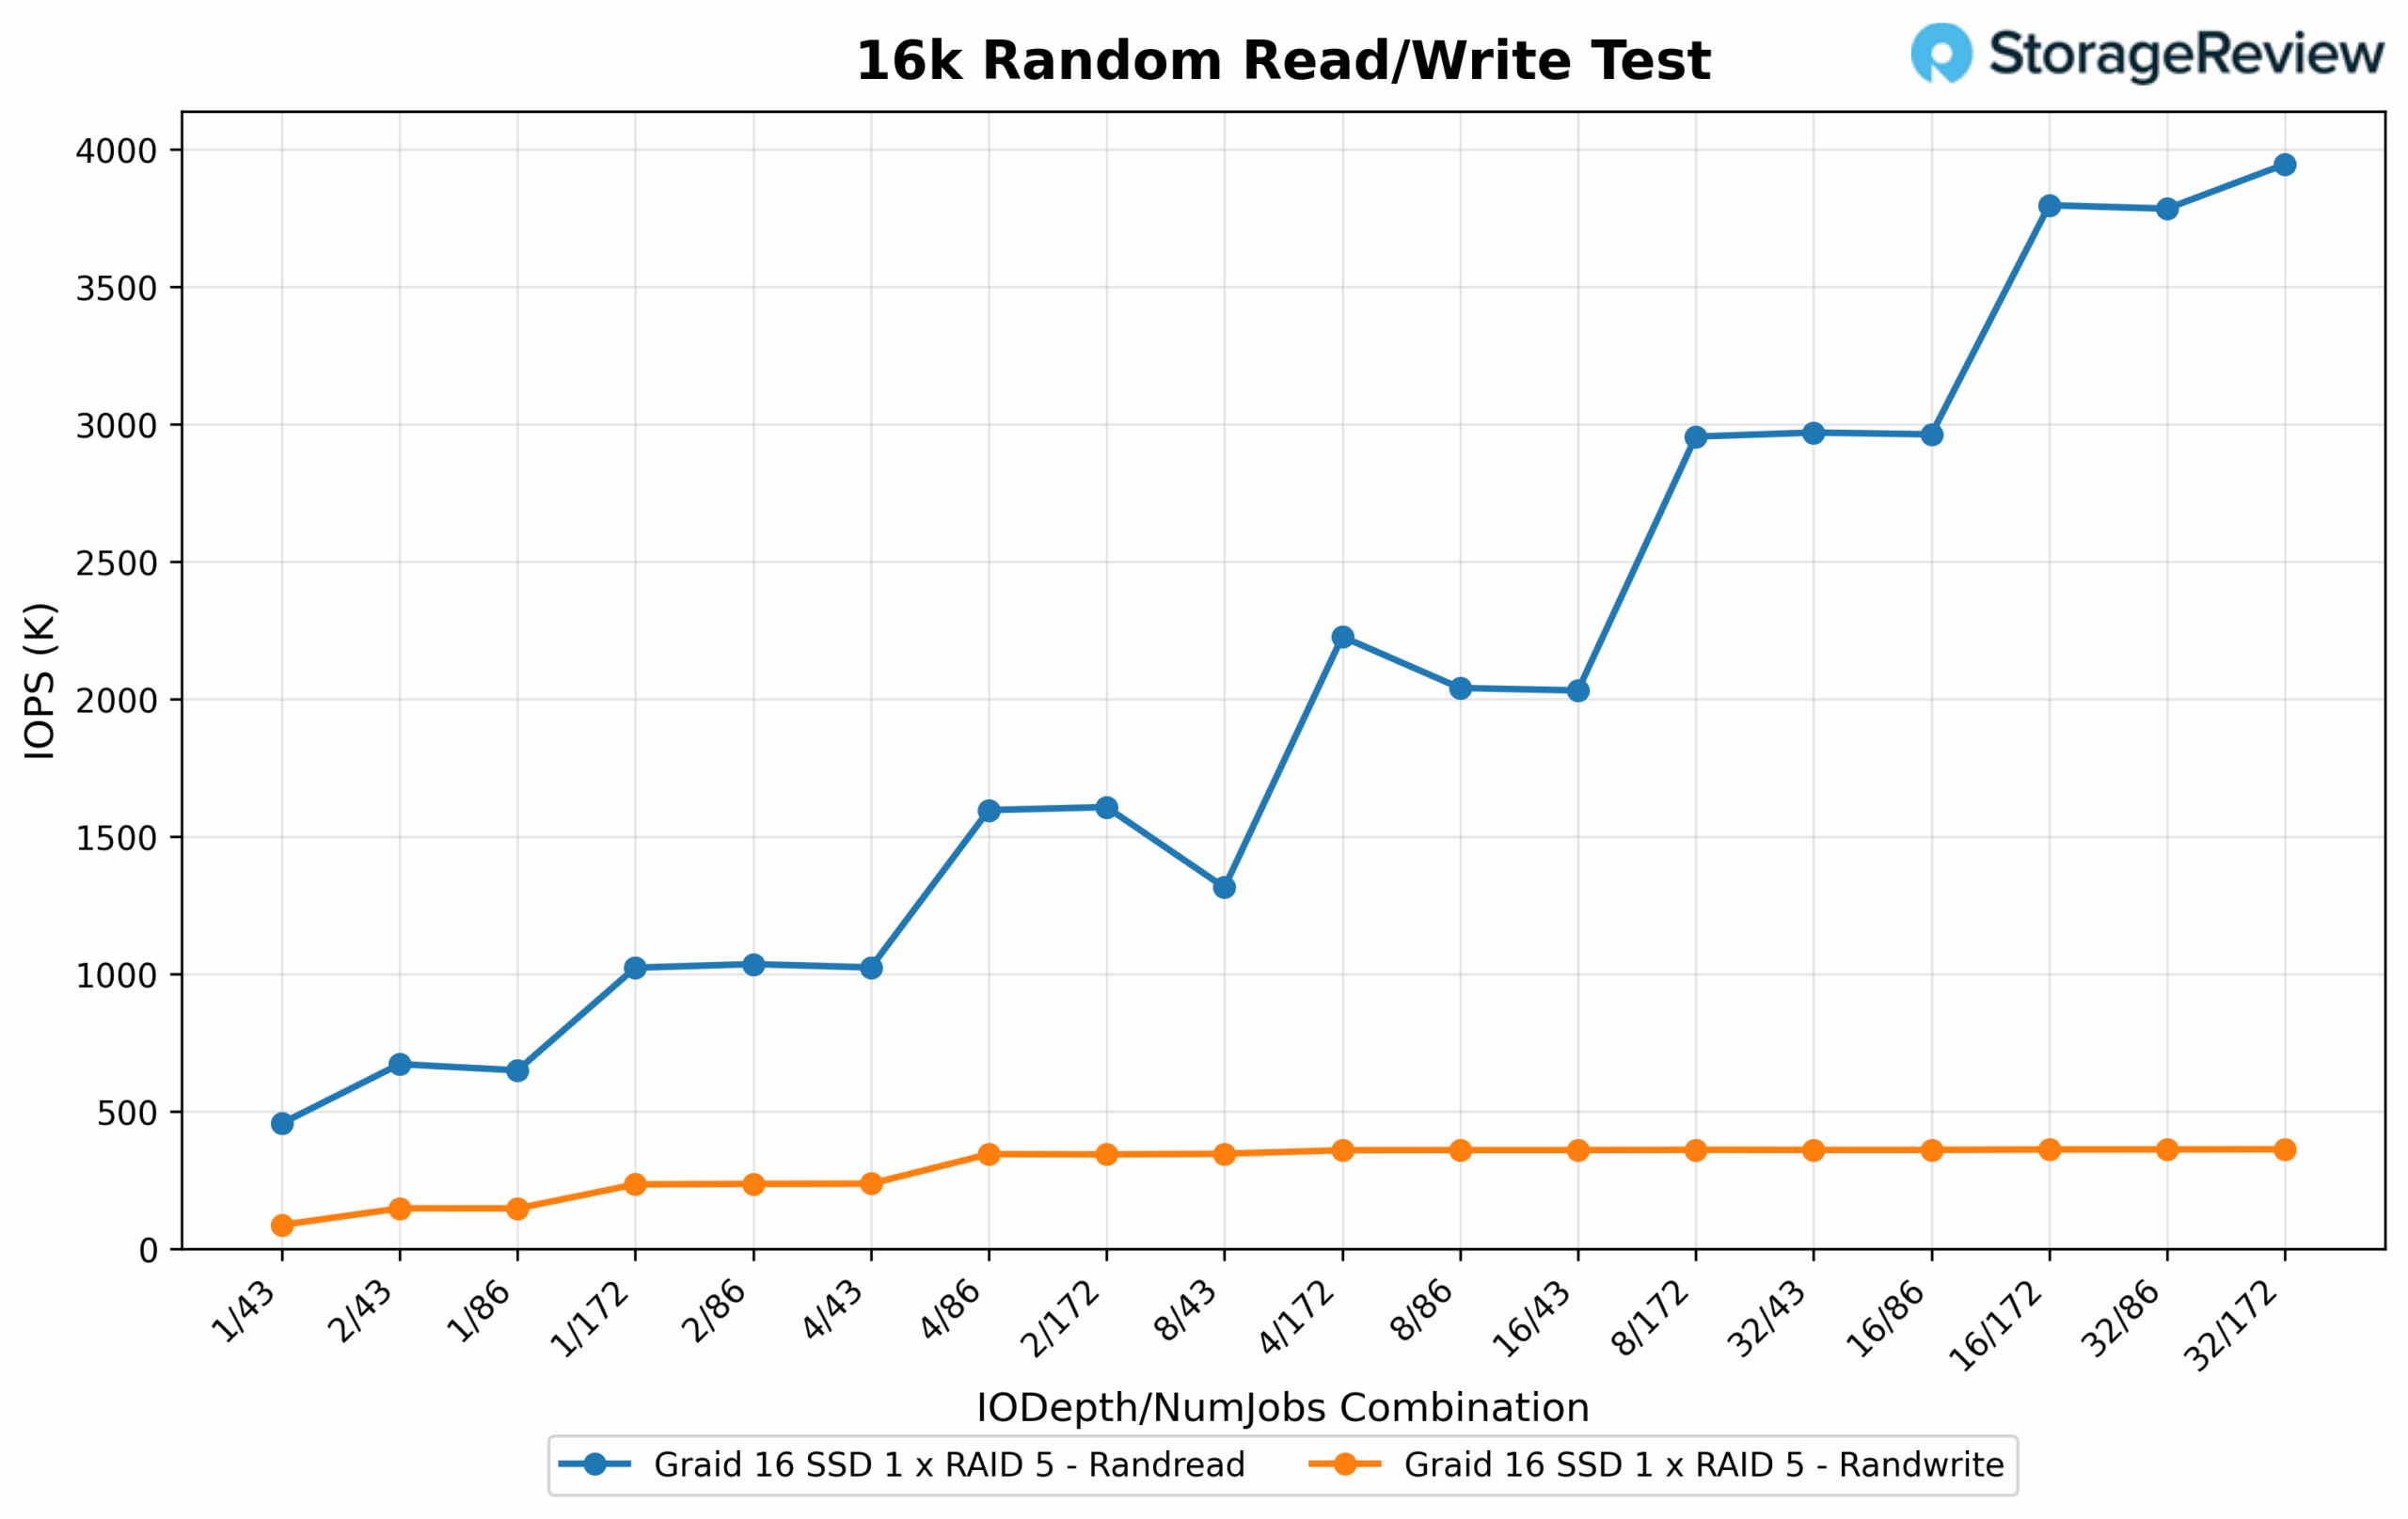
16K 랜덤 읽기/쓰기 IOPS
최대 IOPS에서도 무작위 16K 읽기 지연 시간은 낮은 수준을 유지했습니다. 가장 우수한 응답 속도는 가벼운 구성에서 나타났으며, 1/43은 0.087ms, 1/86은 0.114ms를 기록했습니다. 4/86과 8/86과 같이 더 높은 동시성 조합은 각각 0.236ms와 0.420ms를 기록했습니다. 최고 성능 구성에서도 적절한 지연 시간을 유지했으며, 16/172는 1.143ms, 32/172는 2.372ms를 기록했습니다. 이는 응답 시간에 대한 관리 가능한 영향으로 효율적인 확장을 보여줍니다. 무작위 16K 쓰기의 경우, 가장 낮은 지연 시간은 2/43으로 0.848ms였으며, 그 다음으로 1.253/4은 43ms, 1.415/1은 43ms였습니다. 깊이와 작업 수가 증가함에 따라 대기 시간은 점차 증가했습니다. 8/172는 5.574ms에 달했고, 16/172와 32/172는 각각 10.455ms와 22.958ms로 상승했습니다. 이는 대기열 포화가 증가함에 따라 예상되는 상충 관계가 있음을 보여줍니다.
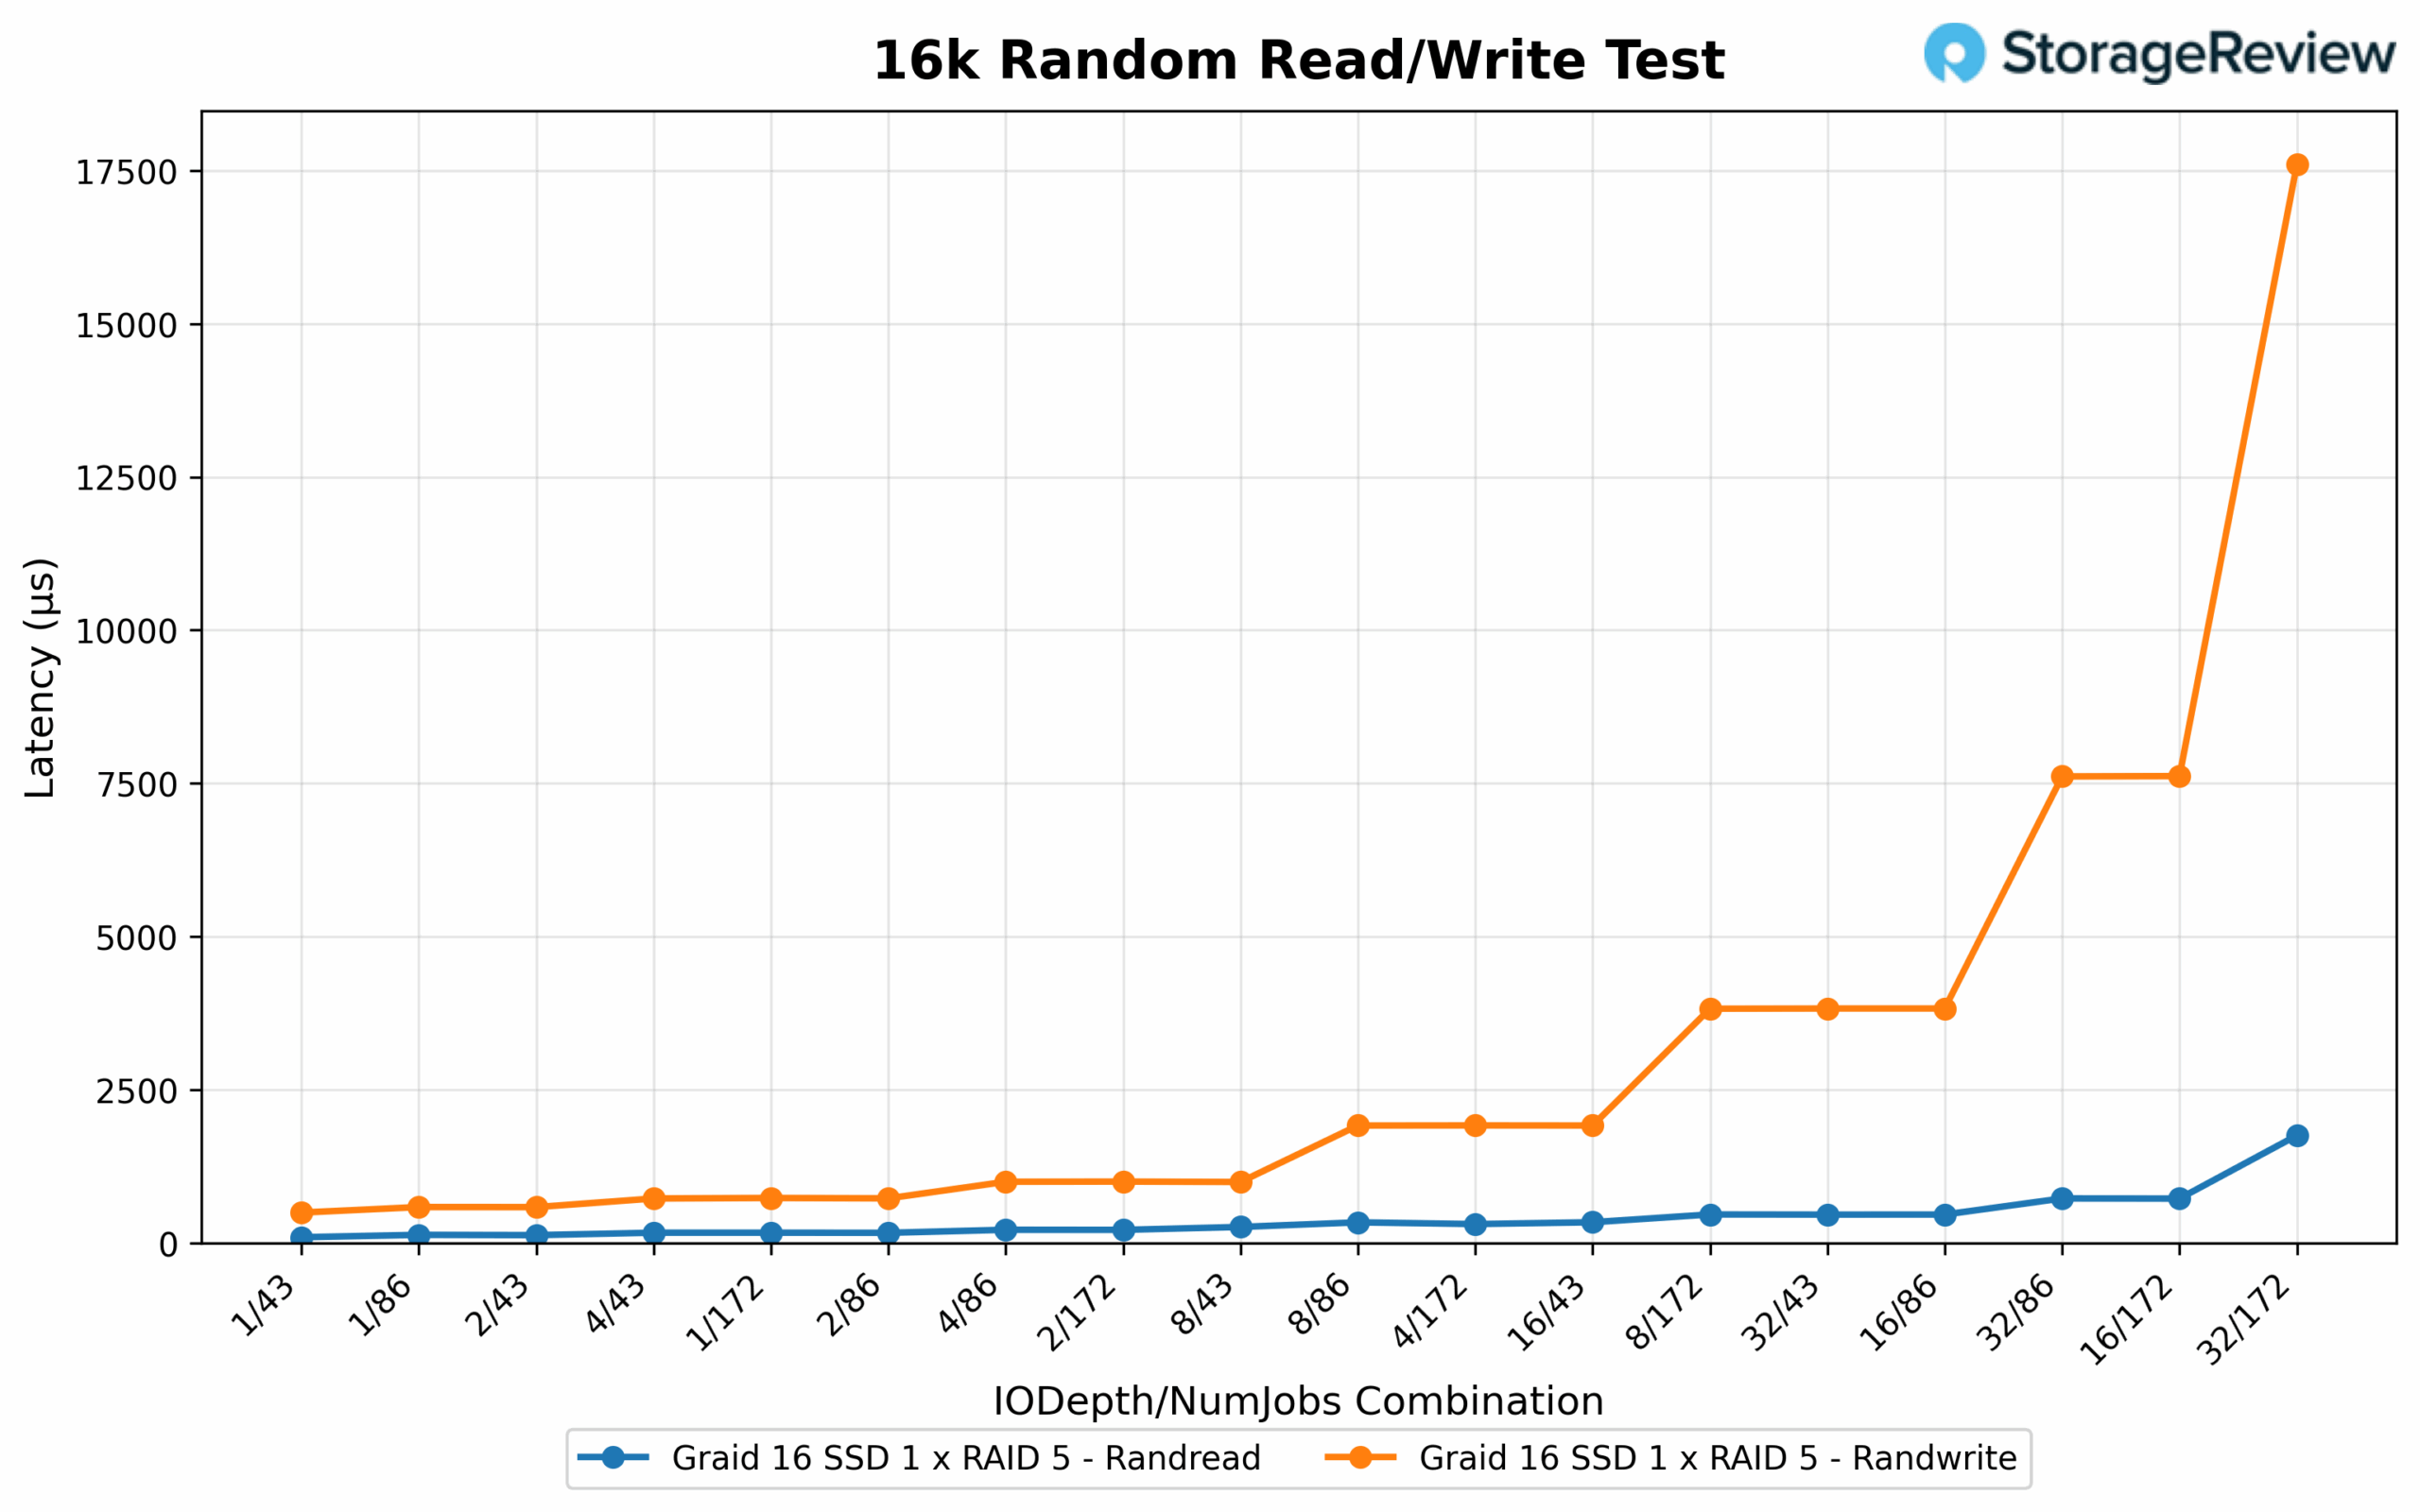
16K 랜덤 읽기/쓰기 대기 시간
무작위 16K 읽기 지연 시간은 전반적으로 일관되게 낮은 수준을 유지했습니다. 응답 속도가 가장 빠른 구성은 1ms의 43/0.123 구성이었고, 그 뒤를 1ms의 86/0.175 구성이 바짝 뒤따랐습니다. 최대 부하 상황에서도 32/172 및 16/172 구성은 지연 시간을 2.1ms 미만으로 유지하여 어레이가 높은 IOPS를 처리하면서도 빠른 응답 시간을 유지했음을 보여주었습니다. 반면, 무작위 16K 쓰기 지연 시간은 변동 폭이 더 컸습니다. 가장 낮은 지연 시간은 0.496/1 구성에서 43ms였으며, 2/86 및 4/43 구성과 같은 효율적인 구성은 1ms 미만을 유지했습니다. 동시성과 깊이가 증가함에 따라 지연 시간도 증가했습니다. 16/172 구성은 7.017ms, 32/172 구성은 17.246ms를 기록하여 최대 처리량과 최대 포화 상태에서의 응답성 간의 상충 관계를 더욱 확고히 했습니다.
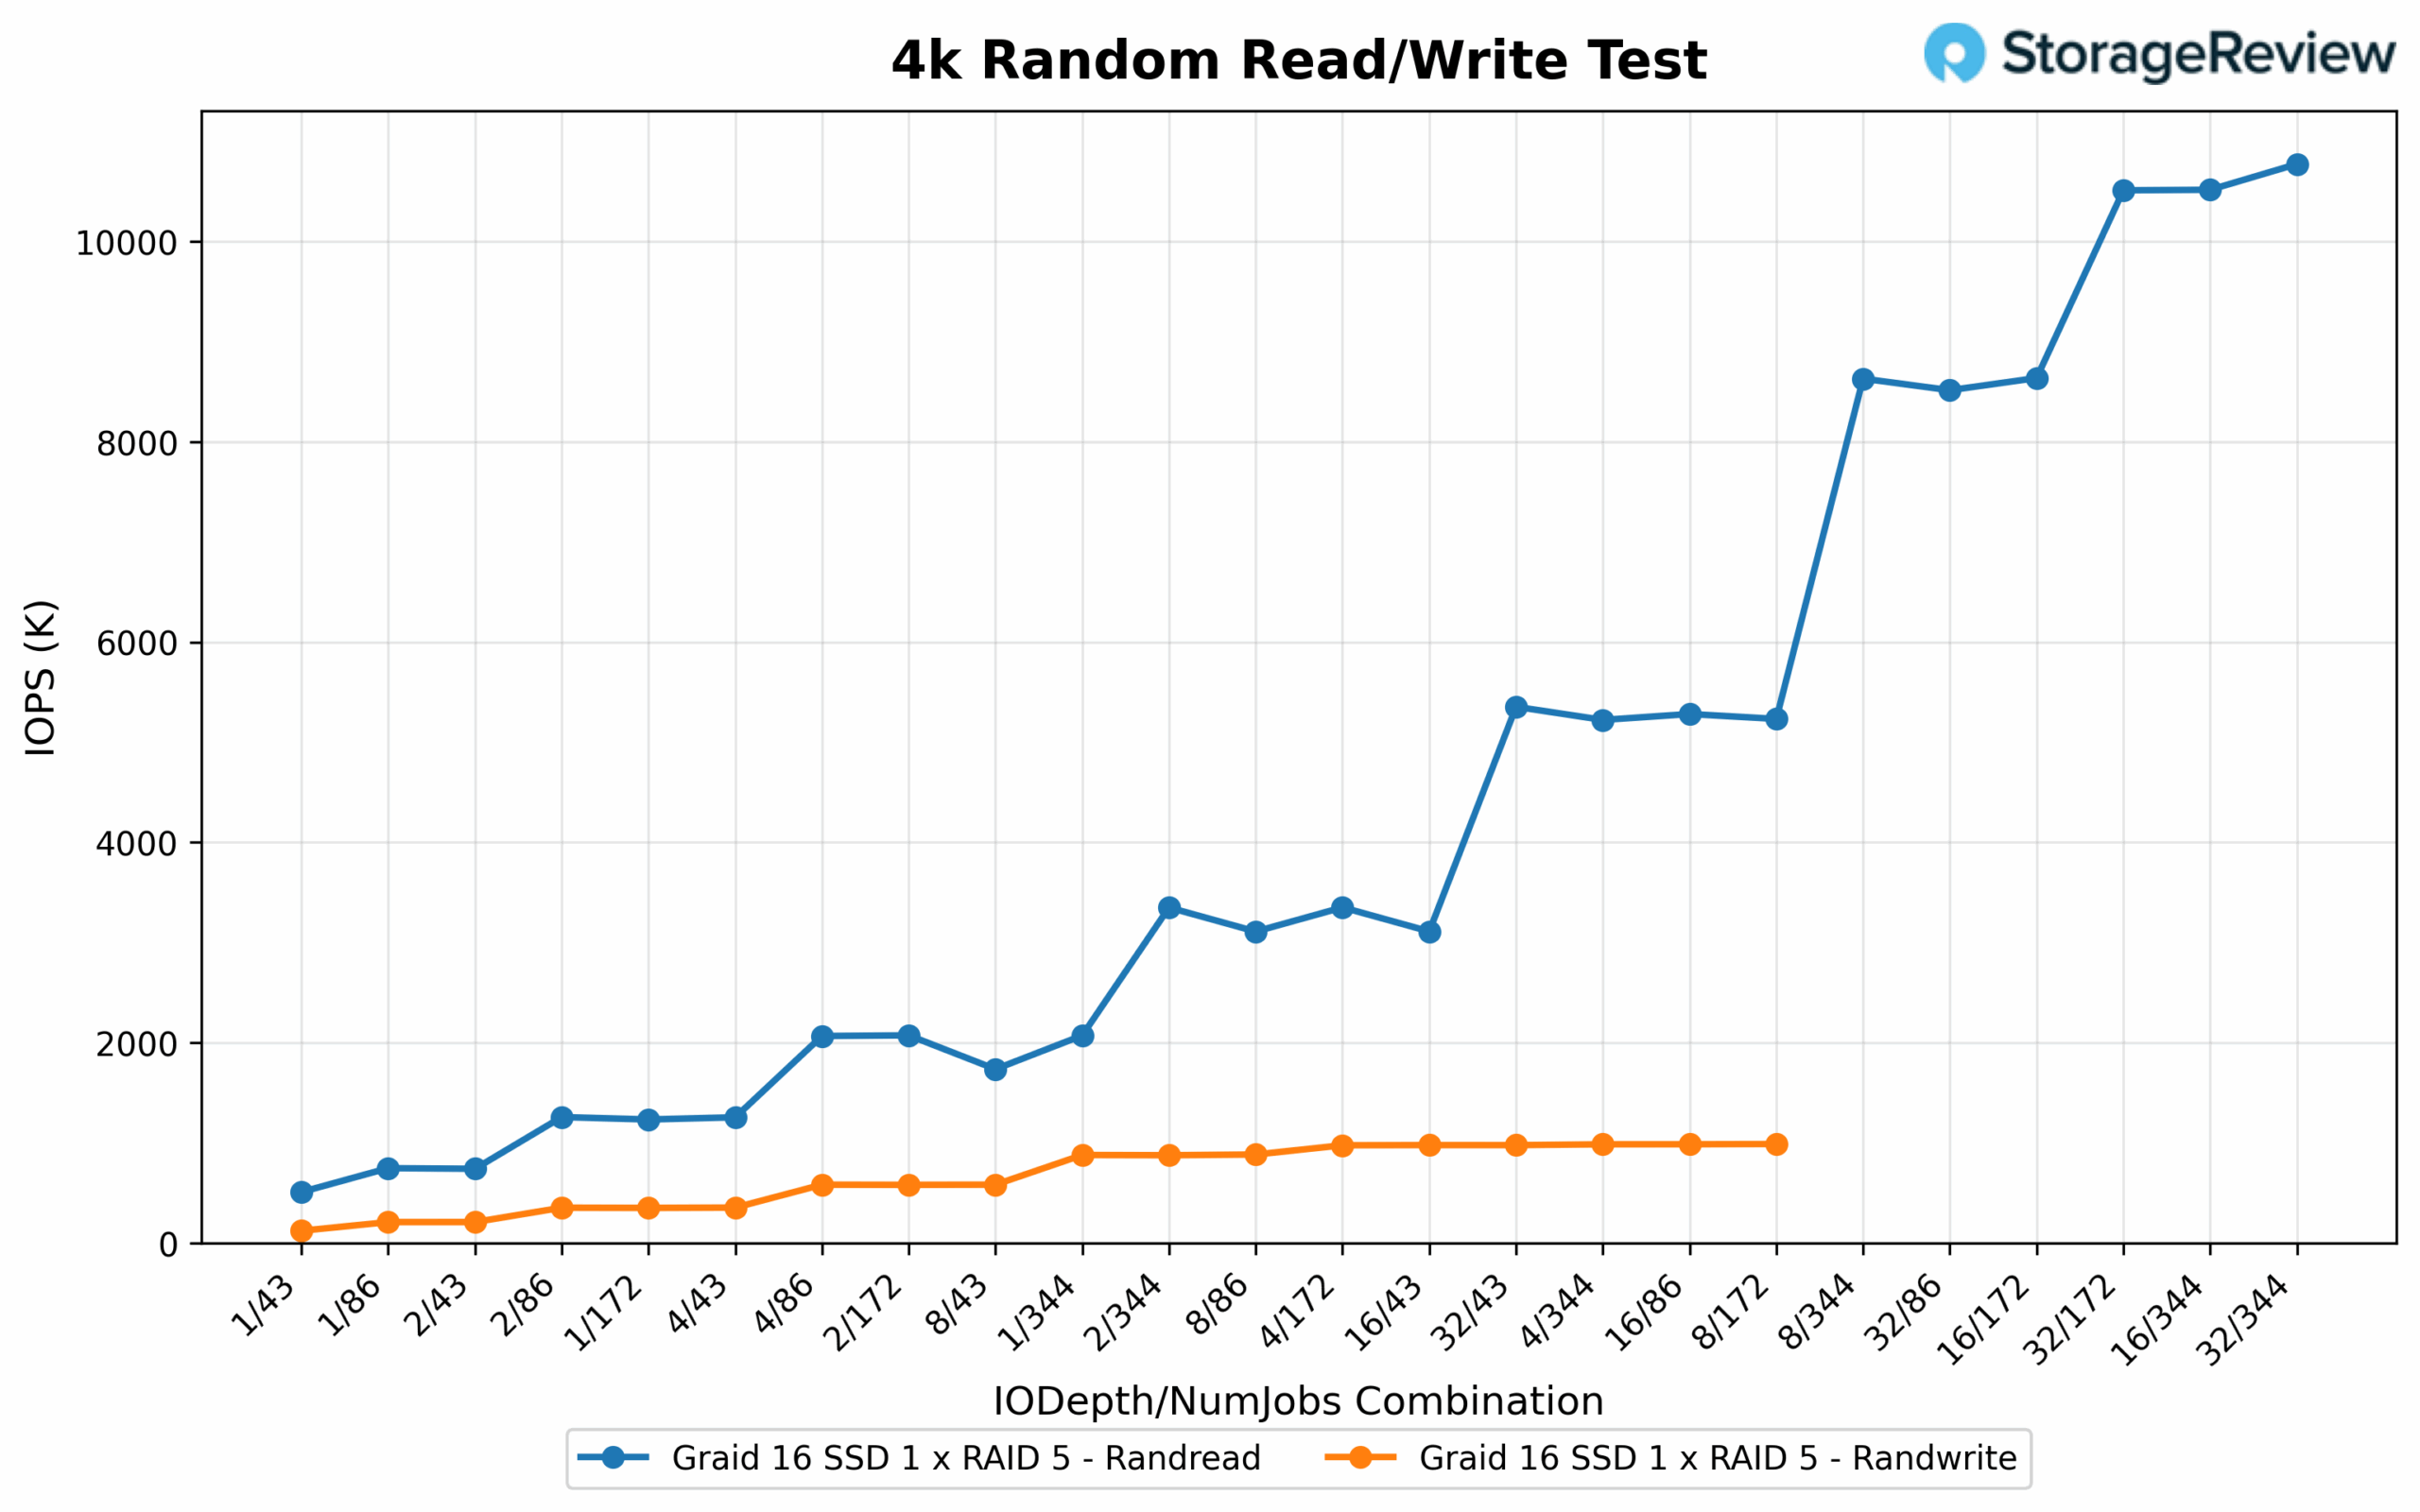
4K 랜덤 읽기/쓰기 IOPS
더 높은 동시성 부하 상황에서, 무작위 4K 읽기 IOPS는 10.77 IOPS, 32개 작업에서 344만 IOPS라는 인상적인 최고치에 도달했습니다. 16/344 IOPS(10.52만), 4/344 IOPS(10.51만), 8/344 IOPS(10.42만) 등 다른 구성도 그 뒤를 따랐으며, 모두 공격적인 큐 및 작업 깊이 조합을 통해 탁월한 확장성을 보여주었습니다. 8/172 및 16/172와 같은 축소된 깊이 옵션도 5.23만 IOPS에서 5.35만 IOPS 사이의 강력한 처리량을 유지하여, 어레이가 까다로운 병렬 워크로드를 처리할 수 있는 역량을 더욱 강조했습니다. 쓰기 측면에서는 4/987.9 IOPS에서 32K IOPS가 172K로 최고치를 기록했습니다. 유사한 고효율 구성으로는 32K에서 86/985.1, 16K에서 172/985.6, 8K에서 172/976.9가 포함되었습니다. 8/86부터 16/86까지의 추가 조합은 875K에서 977K 범위에서 성능을 유지하여 동시 쓰기 작업으로 완전히 포화되었을 때 어레이의 일관성과 안정성을 강화했습니다.
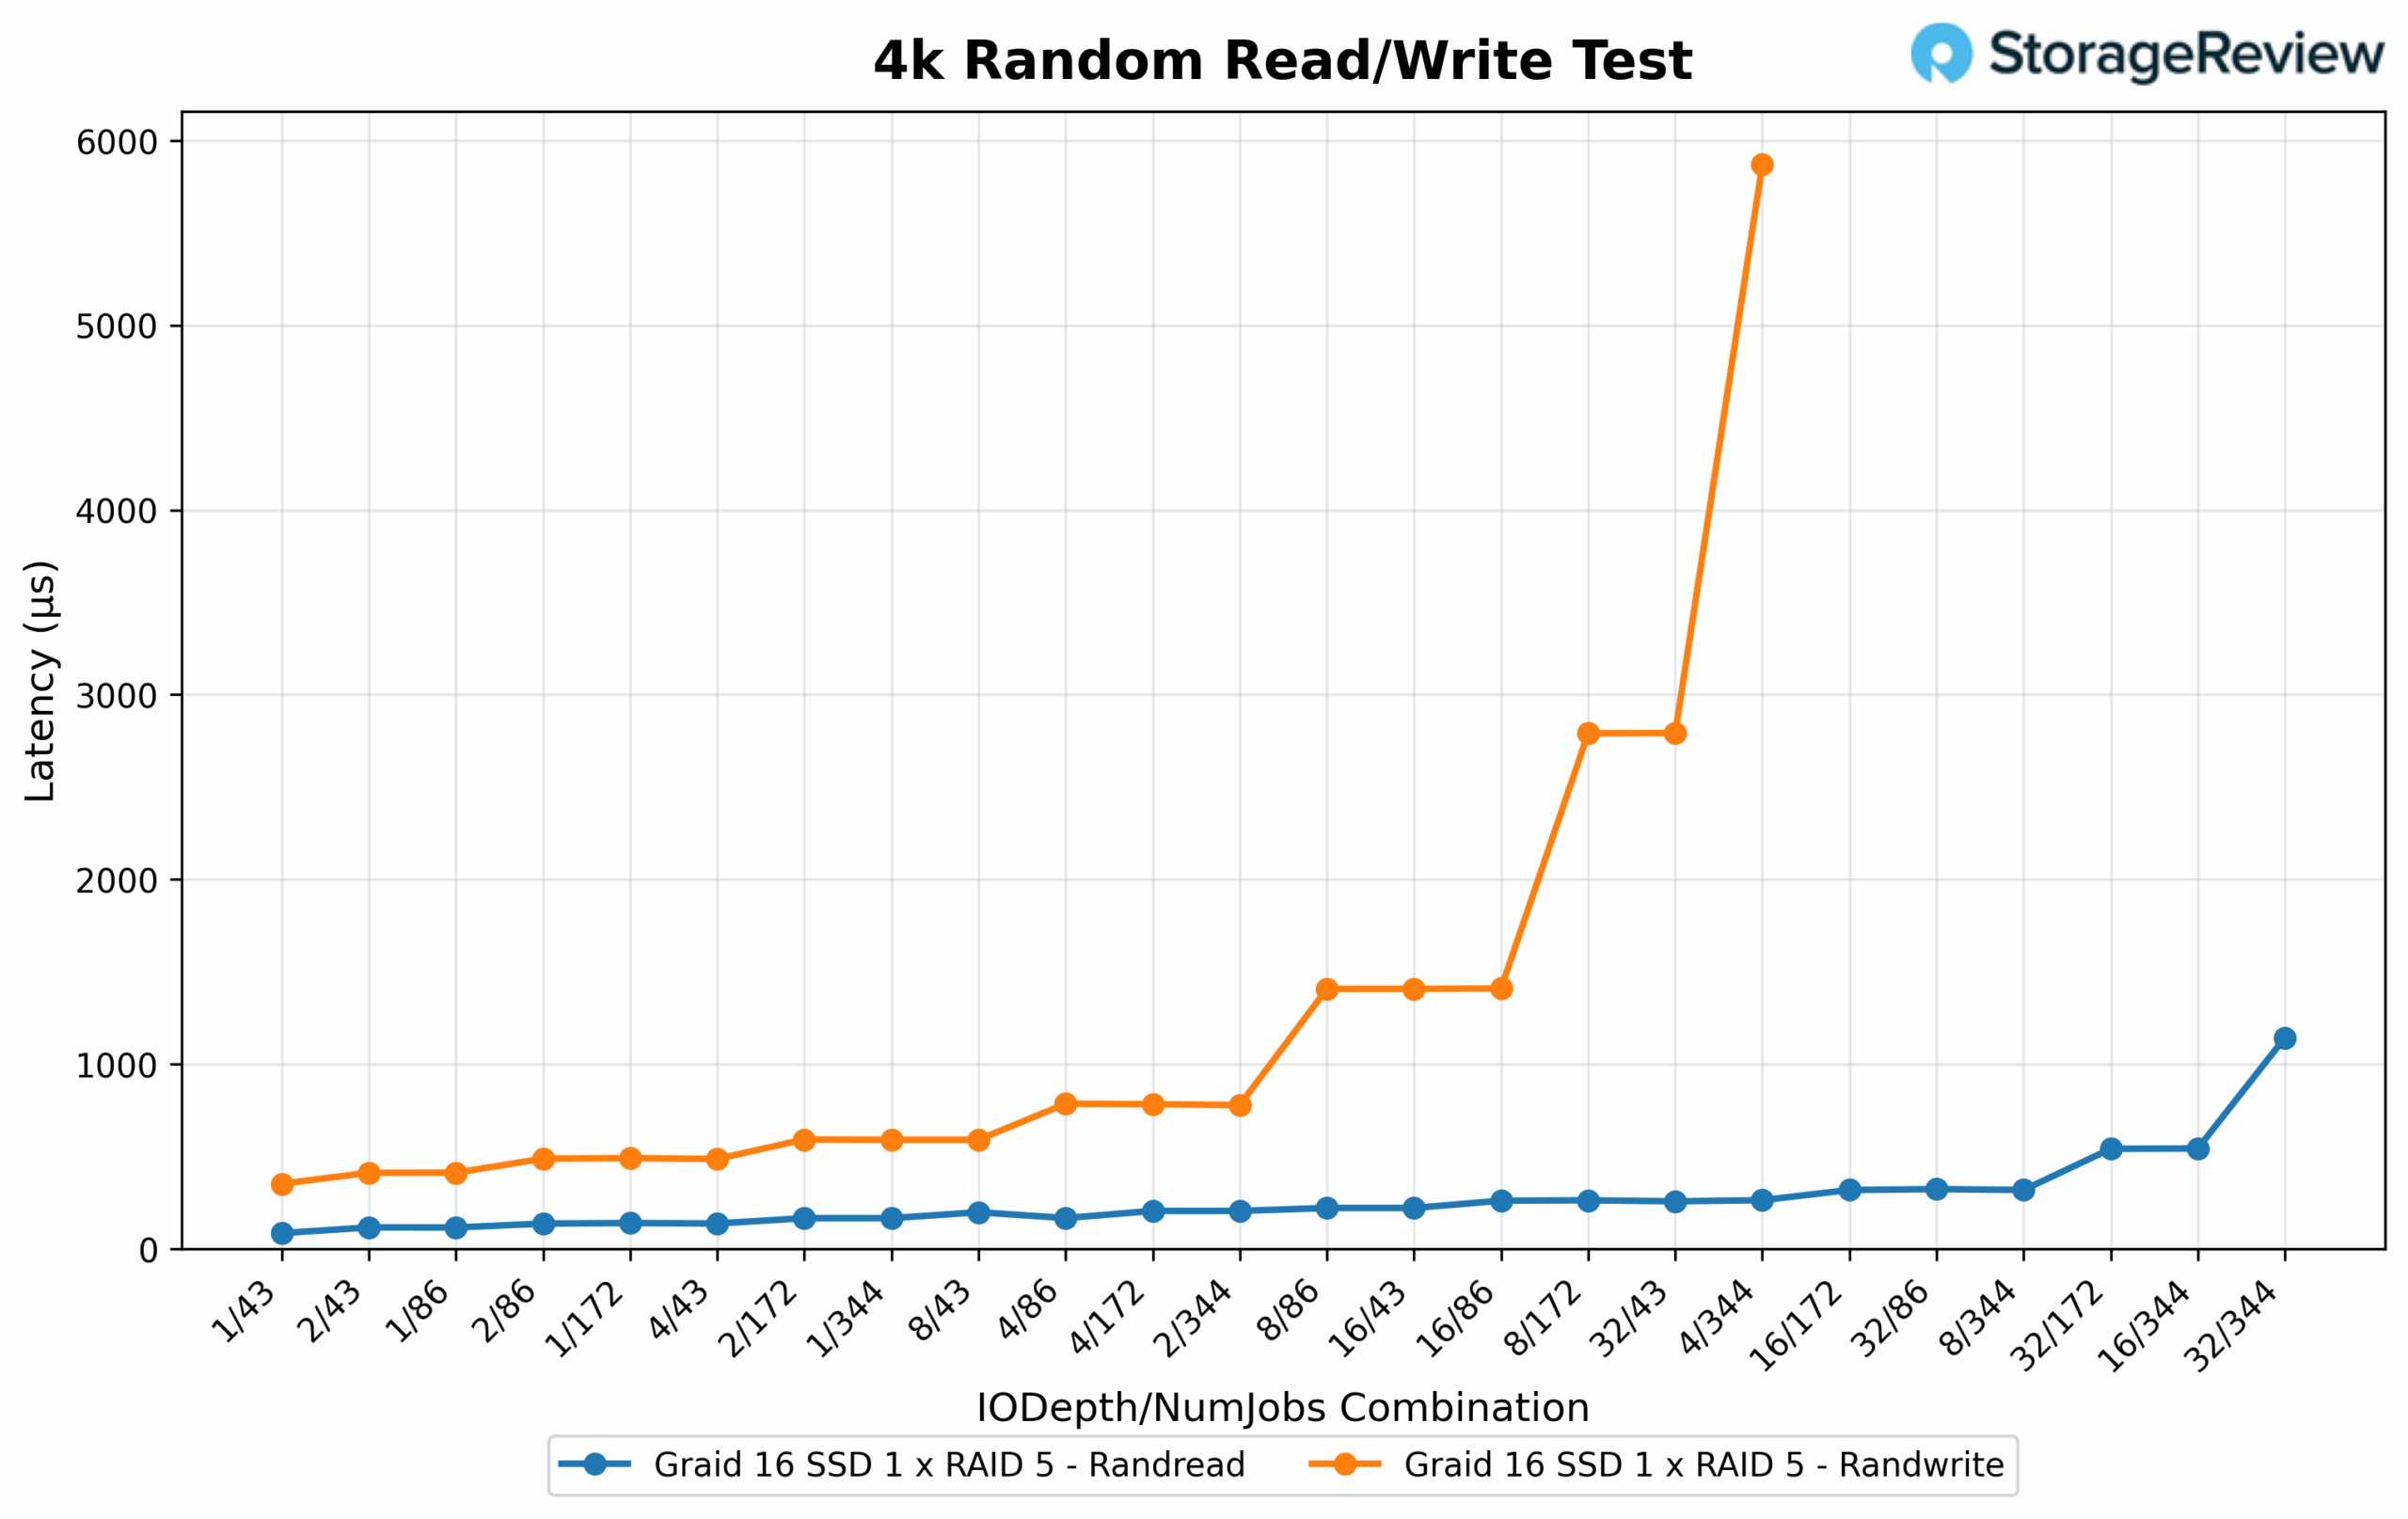
4K 랜덤 읽기/쓰기 대기 시간
무작위 4K 읽기 지연 시간은 전반적으로 매우 낮게 유지되었습니다. 가장 빠른 응답 시간은 0.084/1에서 86ms였으며, 1/43, 2/43, 4/43을 포함한 여러 구성은 모두 0.12ms 미만으로 떨어졌습니다. 최대 IOPS에서도 지연 시간은 잘 제어되었으며, 최고 성능의 32/344 구성은 1.142ms로 유지되었습니다. 이는 어레이가 최대 처리량에 도달했음에도 불구하고 뛰어난 응답성을 보여줍니다. 쓰기 측면에서도 무작위 4K 지연 시간 또한 잘 관리되었습니다. 기록된 최저값은 0.352/1에서 43ms였으며, 1/86, 2/43, 4/43과 같은 다른 고효율 구성은 모두 0.6ms 미만으로 유지되었습니다. 32/172 및 32/86과 같은 고처리량 구성에서는 지연 시간이 2.79ms에서 5.87ms 사이로 약간 증가했지만, 지속적인 쓰기 포화 수준을 고려하면 허용 가능한 범위 내에 머물렀습니다.
Graid SupremeRAID AE GPU 오버헤드 측정
Graid의 SupremeRAID AE 스토리지 성능 지표를 살펴볼 때, GPU 리소스를 공유하는 SupremeRAID가 동일한 GPU를 사용하는 워크로드에 어떤 영향을 미칠 수 있는지 고려하는 것이 중요합니다. 이전 SupremeRAID 구축에서는 시스템의 GPU가 Graid 전용이었습니다. 이 솔루션을 사용하면 Graid가 활용하고 리소스를 공유할 수 있는 GPU가 이미 포함된 플랫폼에 구축할 수 있습니다. 오버헤드 영향을 측정하기 위해 vLLM을 사용하여 LLM 추론 시나리오를 구축했습니다. Graid가 유휴 상태일 때와 Graid가 RAID 172 풀에서 5GB를 읽을 때 워크로드의 기준 성능을 측정했습니다. 이는 추론 워크로드를 시뮬레이션하여 워크로드가 실행되는 동안 다음 워크로드를 미리 할당합니다. vLLM이 GPU 사용률을 100%까지 끌어올리면 모든 Graid 작업이 토큰 속도와 지연 시간에 영향을 미칩니다.
AI 워크로드의 경우, 3.3K KV 캐시 크기를 가진 Llama 70 16B 모델을 사용하여 vLLM으로 추론을 실행했습니다. 이 과정에서 두 카드의 VRAM(16G 카드는 78G, 80G 카드는 86G)을 거의 완전히 사용했습니다. 그런 다음 최대 출력 길이가 94개 토큰인 vLLM 벤치마킹 스크립트를 실행했습니다. 각 테스트는 최대 동시 요청 수가 256개인 256개 쿼리를 실행했으며, 연속 배칭을 사용하여 현실적인 요청 패턴을 시뮬레이션했습니다. 수집된 지표는 Tok/s, 첫 번째 토큰까지의 시간(TTFT), 출력 토큰당 시간(TPOT), 토큰 간 지연 시간(ITL)입니다. 추론 테스트 중에 실행된 FIO 워크로드는 각각 32GB를 읽는 172개의 16K 랜덤 읽기 작업으로 구성되었습니다.
처리량은 전반적으로 소폭 감소했습니다. 요청 처리량은 초당 1.86건에서 1.78건으로 4.3% 감소했습니다. 출력 토큰 처리량은 초당 225.44건에서 215.94건으로 4.2% 감소했습니다. 총 토큰 처리량은 초당 2029.77건에서 1944.30건으로 4.2% 감소했습니다. 이는 전송 과정에서 성능에 약간의 영향을 미치는 오버헤드가 발생했음을 시사합니다.
지연 시간 지표는 엇갈린 결과를 보였습니다. 평균 TTFT는 3.6ms에서 6,704ms로 6,945% 증가한 반면, 중간 TTFT는 1.5% 증가했습니다. 흥미롭게도 P99 TTFT는 2.8ms에서 14,199ms로 13,803% 감소하여 개선되었으며, 이는 해당 지표에서 최종 성능이 향상되었음을 나타냅니다. TPOT의 경우, 평균은 5.3% 증가한 반면, 중간값은 0.65% 증가하여 비교적 일정했습니다. 그러나 P99 TPOT는 24.6ms에서 127.69ms로 159.15% 급등하여 최악의 토큰 생성 시간이 상당한 영향을 받았음을 보여줍니다. 토큰 간 지연 시간(ITL)도 유사한 추세를 보였으며, 평균은 5.1% 증가하고, 중간값은 거의 변화가 없었으며, P99는 2.2% 증가했습니다.
vLLM 워크로드와 함께 실행되는 Graid의 SupremeRAID AE는 처리량이 작지만 지속적으로 감소(약 4%)하는 동시에 평균 지연 시간이 약간 증가하고 토큰 생성 시 P99 성능이 눈에 띄게 저하되었습니다. 이러한 영향에도 불구하고 시스템은 완전히 안정적이고 응답성이 우수했으며, Llama 3.3 70B와 같은 대규모 모델을 사용하는 높은 동시성 추론이 Graid SupremeRAID AE와 함께 사용하더라도 안정적으로 수행될 수 있음을 보여주었습니다.
| 메트릭(낮은 지속 시간 / 높은 토크/초가 더 좋음) | 기준 | 172GB FIO 읽기 작업 |
| 성공적인 요청 | 256 | 256 |
| 벤치마크 기간(초) | 137.68 | 143.73 |
| 총 입력 토큰 | 248,414 | 248,414 |
| 총 생성된 토큰 | 31,037 | 31,037 |
| 요청 처리량(req/s) | 1.86 | 1.78 |
| 출력 토큰 처리량(tok/s) | 225.44 | 215.94 |
| 총 토큰 처리량(tok/s) | 2029.77 | 1944.30 |
| 첫 번째 토큰까지의 시간(TTFT)(지연 시간이 짧을수록 좋음) | ||
| 평균 TTFT(ms) | 6,704.43 | 6,945.72 |
| 중앙값 TTFT(ms) | 6,469.88 | 6,569.80 |
| P99 TTFT(ms) | 14,199.21 | 13,803.62 |
| 출력 토큰당 시간(TPOT, 첫 번째 토큰 제외)(지연 시간이 짧을수록 좋음) | ||
| 평균 TPOT(ms) | 81.44 | 85.72 |
| 중앙 TPOT(ms) | 80.38 | 80.90 |
| P99 TPOT(ms) | 127.69 | 159.15 |
| 토큰 간 지연 시간(ITL)(지연 시간이 짧을수록 좋음) | ||
| 평균 ITL(ms) | 79.94 | 83.99 |
| 중간 ITL(ms) | 49.75 | 49.78 |
| P99 ITL(ms) | 539.07 | 550.73 |
생각을 폐쇄
Graid SupremeRAID AE는 AI 인프라를 구축하거나 확장하는 조직에 실용적이고 효과적인 솔루션을 제공합니다. SupremeRAID AE는 기존 하드웨어 RAID를 GPU 기반 소프트웨어 정의 방식으로 대체하여 배포를 간소화하는 동시에 최신 AI 워크플로우를 지연시키는 일반적인 병목 현상을 제거합니다.
테스트 결과, 최대 32개의 NVMe SSD를 하나의 복원력 있는 네임스페이스로 통합하여 단일 서버에서 거의 1PB에 달하는 용량과 탁월한 성능을 제공하는 것이 확인되었습니다. 최대 183GB/s의 읽기 및 54GB/s의 쓰기 처리량과 라이브 추론 중 최소한의 GPU 오버헤드를 결합한 결과는 대규모 모델 체크포인팅과 저지연 추론이라는 두 가지 요구 사항을 대규모로 충족할 수 있음을 입증합니다.
SupremeRAID AE는 전용 RAID 하드웨어의 비용과 복잡성을 제거하고 NVIDIA GPUDirect 스토리지 및 AI 중심 파일 시스템과 같은 기술과 완벽하게 통합되어 미래 지향적인 스토리지 기반을 구축합니다. 추론 효율화 및 운영 위험 감소에 중점을 둔 조직을 위해 SupremeRAID AE는 프로덕션 AI 환경에 필요한 성능, 단순성 및 복원력을 제공합니다.


 아마존