

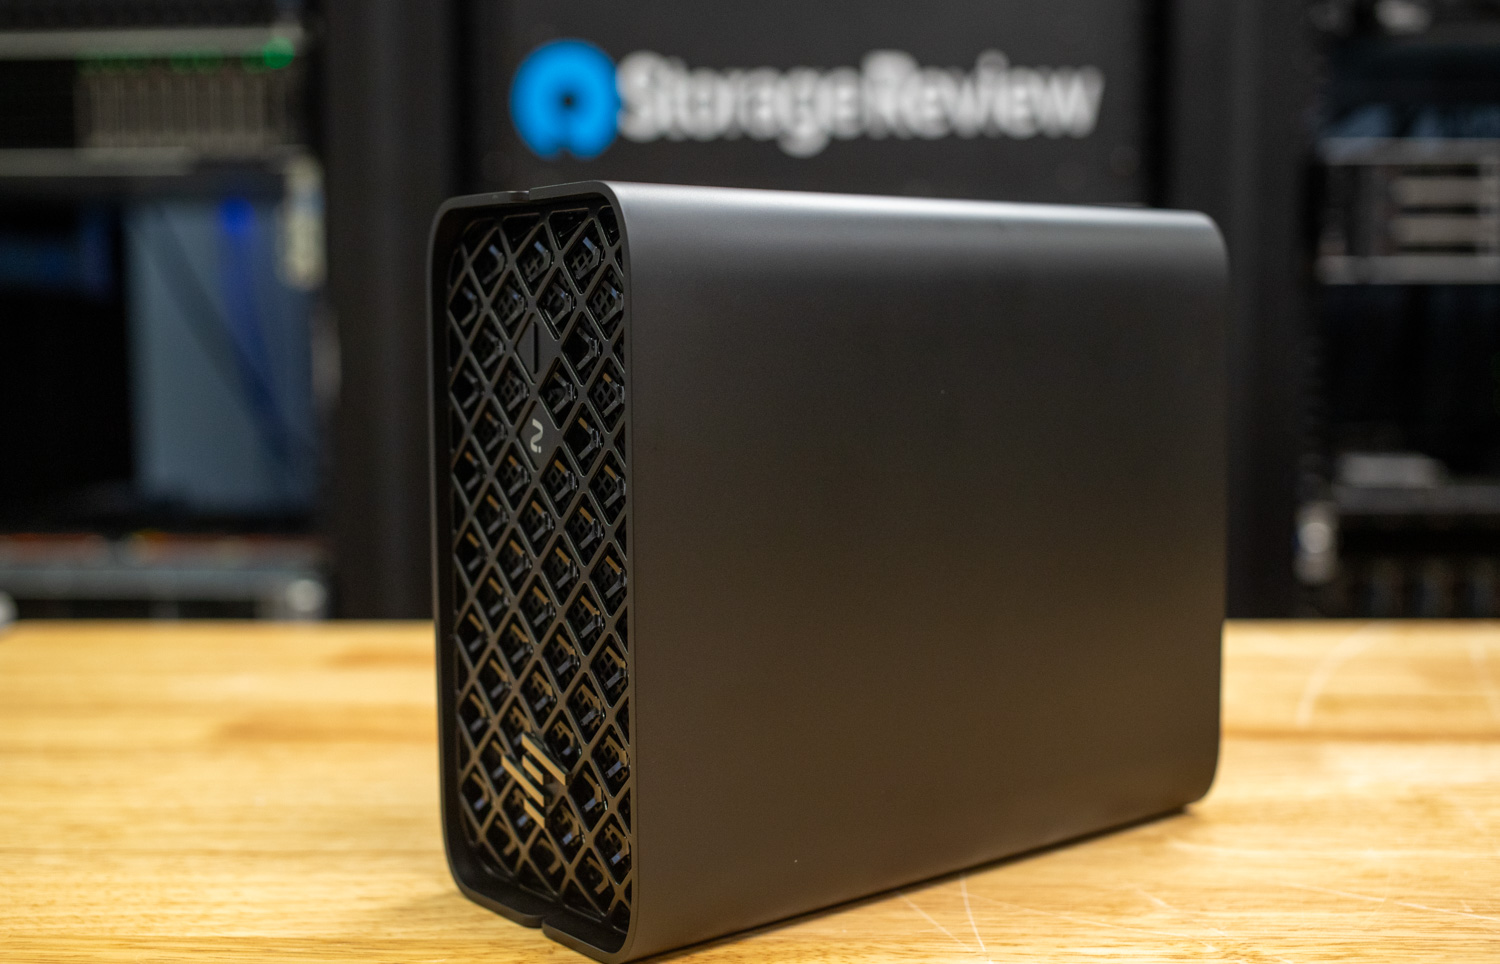
HP Z2 Mini G1a 워크스테이션은 고도로 맞춤화된 컴팩트 컴퓨팅 분야에서 과감한 진전을 보여줍니다. 3D 모델링, AI 개발, 디지털 콘텐츠 제작 등의 분야 전문가를 위해 설계된 이 강력한 워크스테이션은 뛰어난 휴대성과 정밀성을 모두 갖추고 있습니다. 이 워크스테이션의 핵심에는 멀티태스킹, 렌더링 및 로컬 LLM 작업에 가속화된 성능을 제공하는 AMD Ryzen AI Max PRO 시리즈 프로세서가 탑재되어 있습니다.
시스템의 핵심에는 395년 초 출시될 최첨단 프로세서인 AMD Ryzen AI MAX+ Pro 2025가 있습니다. CPU 클럭 속도는 최대 5.1GHz까지 향상되고 16개의 코어를 탑재하여 강력한 컴퓨팅 성능을 제공합니다. 또한 AMD Radeon 8060S 내장 그래픽과 결합되어 있습니다. 또한, 많은 AI 제품과 마찬가지로, 내장된 신경망 처리 장치는 까다로운 AI 워크로드에 50 TOPS(초당 8060억 개의 연산)의 추가 성능을 제공합니다. Radeon 96S 내장 그래픽은 최대 XNUMXGB의 VRAM을 할당할 수 있어 GPU 집약적인 워크로드에서도 경쟁력을 발휘합니다. 이를 통해 로컬 LLM 추론 워크로드는 물론 렌더링 및 콘텐츠 제작 분야에서 독보적인 우위를 점할 수 있습니다.
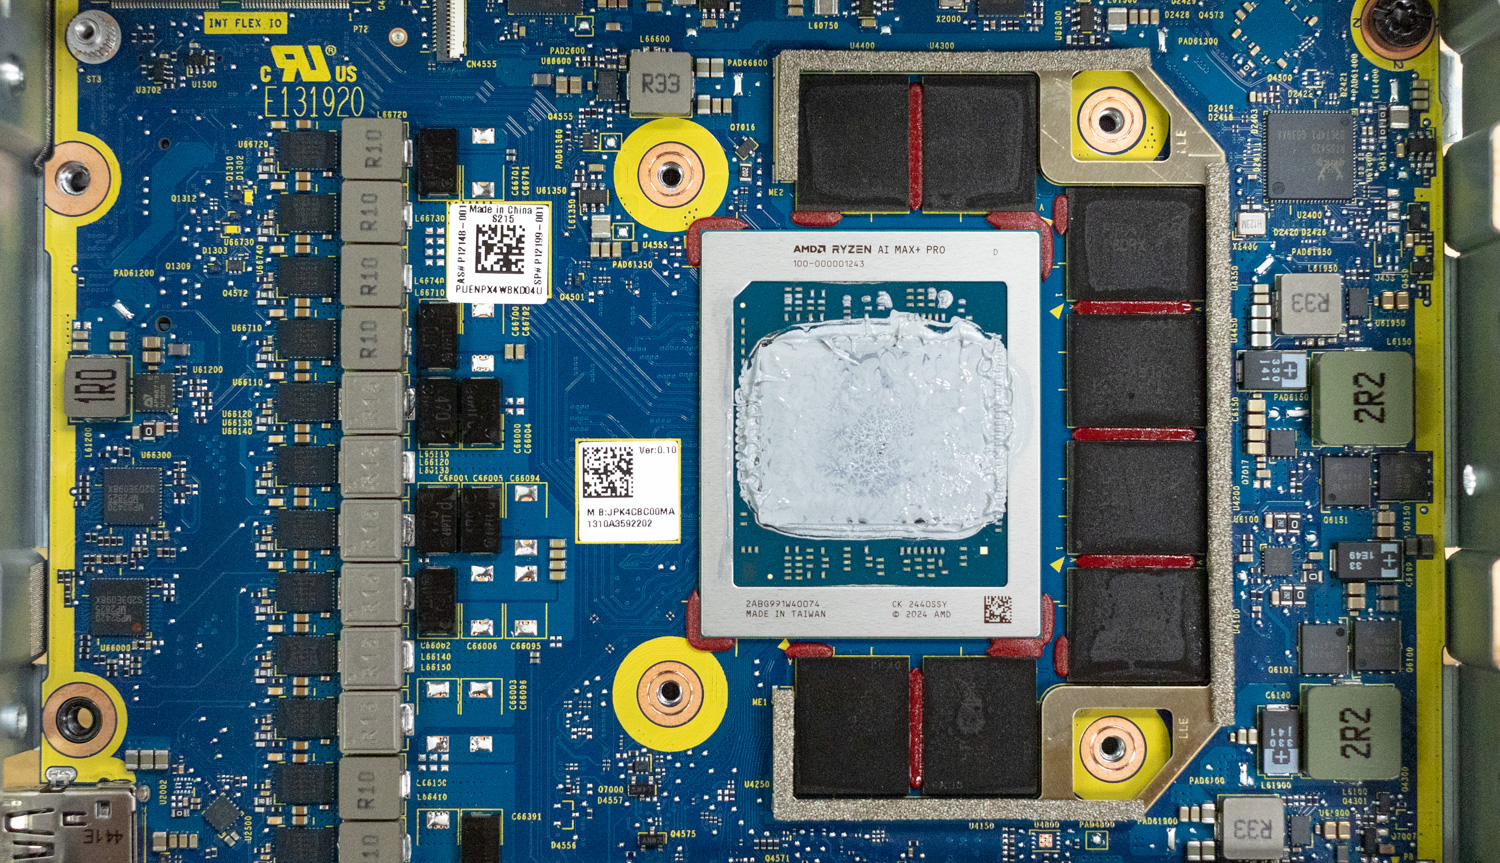
사용자가 HP Z2 Mini G1a를 구성할 때 이 시스템은 다른 시스템과 다르게 확장됩니다. CPU와 GPU가 함께 확장됩니다. 예를 들어, 기본 구성에는 Radeon 380S 그래픽과 8040GB 공유 메모리를 갖춘 AMD Ryzen AI Max Pro 32이 포함됩니다. 128GB로 메모리를 확장하는 등 메모리 용량을 늘리면 CPU와 GPU도 변경됩니다. 이 변경으로 Radeon 395S 그래픽과 8060GB 공유 메모리를 갖춘 Ryzen AI Max+ Pro 128로 변경됩니다.
이번 리뷰에서 다룬 시스템은 라이젠 AI Max+ Pro 395 칩셋을 탑재한 Z2 Mini G1a입니다. 16코어 CPU와 Radeon 8060S 그래픽 카드가 128GB DDR5 메모리를 공유합니다. 리뷰에 사용된 시스템은 1TB SSD 두 개가 장착되어 있으며, 정가는 4,781달러이지만 실제 판매 가격은 훨씬 저렴합니다. 올해 초 리뷰했던 HP ZBook Ultra G1a 의 경우 가격이 상당한 우려 사항이었지만, 다행히 가격과 성능이 크게 개선되었습니다. 현재 B&H에서는 최고 사양의 Z2 Mini G1a(2TB SSD 탑재)를 3,342.65달러에 판매하고 있습니다.
HP ZCentral 원격 부스트
HP가 전문가용 워크스테이션 제품군에서 제공하는 흥미로운 기능 중 하나는 HP ZCentral Remote Boost입니다. HP ZCentral Remote Boost는 HP의 원격 연결 소프트웨어(이전 명칭: HP Remote Graphics Software 또는 RGS)입니다. 가상 머신(VM)이 아닌 실제 워크스테이션에서 사용하도록 설계되었습니다. Remote Boost는 엔드포인트 장치를 사무실이나 집에 있는 Z 워크스테이션에 연결하여 사용자가 엔드포인트 장치를 통해 시스템에 접속하여 그래픽 작업이 많은 작업을 수행할 수 있도록 합니다.
그러면 여러 사용자가 하나의 워크스테이션을 데이터 센터, 데이터 클로젯, 심지어 업무용 책상 등 어디에 있든 활용할 수 있습니다. 수신자가 네트워크를 통해 송신자 시스템에 접속할 수 있다면, VPN이 있는 WAN 환경에서도 컴퓨팅 리소스를 완전히 원격으로 사용할 수 있습니다.
전반적으로 HP Remote Boost는 매우 만족스러운 사용자 경험을 제공했습니다. 이 유용한 기술에 대한 자세한 내용은 백서 " 작동 방식: HP ZCentral Remote Boost"를 참조하시기 바랍니다. 이 기술은 현재 그 어느 때보다 더욱 중요해졌습니다.
HP Z2 Mini G1a 사양
| 카테고리 | 기술 사양 |
|---|---|
| 사용 가능한 운영 체제 |
|
| 프로세서 제품군 | AMD Ryzen AI Max PRO 프로세서 |
| 사용 가능한 프로세서 |
|
| 신경 처리 장치 | AMD 라이젠 AI(50 TOPS) |
| 제품 색상 | 흑 옥색 |
| 폼 팩터 | 미니 |
| 최대 메모리 | 128GB LPDDR5X-8533 MT/s ECC, 최대 8000 MT/s 전송 속도 |
| 내부 저장 |
|
| 사용 가능한 그래픽 |
|
| 오디오 | 통합 모노 스피커, Realtek ALC3205-VA2-CG, 2.0W 내장 모노 스피커 |
| 확장 슬롯 | 2개의 M.2 2280 PCIe 4×4; 1개의 WLAN용 M.2 2230 |
| 포트 및 커넥터 |
|
| 키보드 옵션 | HP USB 비즈니스 슬림 스마트카드 CCID 키보드; HP 125 블랙 유선 키보드; HP 320K 유선 키보드 |
| 마우스 옵션 | HP 유선 데스크탑 128 레이저 마우스; HP 유선 320M 마우스; HP 125 유선 마우스 |
| 통신 | LAN: Realtek RTL8125BPH-CG 2.5GbE; WLAN: MediaTek Wi-Fi 7 MT7925(2×2) 및 Bluetooth 5.4 |
| 소프트웨어 | HP UEFI BIOS 인증 2.7B; HP PC 하드웨어 진단 Windows; HP Image Assistant; HP Manageability Integration Kit 10; Performance Advisor 3.0 |
| 보안 관리 | HP Secure Erase; HP Sure Click; HP BIOSphere Gen6; Sure Recover Gen4; HP Sure Admin; Hood Sensor 옵션 키트; HP Client Security Manager Gen6; HP Sure Start Gen7; HP Sure Sense Gen2; HP Sure Run Gen5; Microsoft Pluton; HP Wolf Pro Security Edition |
| 관리 기능 | 고성능 모드, 저소음 모드, 랙 모드, 성능 모드 |
| 출력 | 300W 내부 전원 어댑터, 최대 92% 효율, 활성 PFC |
| 크기 | 3.4 x 6.6 x 7.9인치; 8.55 x 16.8 x 20cm(표준 데스크탑 방향) |
| 중량(평량) | 최소 5.07파운드(2.3kg)부터 시작; 패키지 최소 9파운드(4.1kg)부터 시작 |
| 에코라벨 | IT ECO 선언, SEPA, 대만 그린 마크, 일본 PC 그린 라벨, FEMP, Climate+가 포함된 EPEAT Gold, 한국 MEPS |
| 에너지 인증 | ENERGY STAR 인증 |
| 지속 가능한 영향 | 대량 포장 가능; ITE 유래 폐쇄 루프 플라스틱 10%; 제품 탄소 발자국; 소비자 후 재활용 플라스틱 최소 65% 포함; 산업 후 재활용 강철 최소 20% 포함; QR 코드 지원 제품 포털(2025년 XNUMX월); 새로운 에너지 소비 대시보드 |
| 디스플레이 지원 | 최대 4개의 디스플레이를 동시에 지원합니다. 각 Mini DisplayPort는 하나의 디스플레이를 구동할 수 있으며, 각 Thunderbolt 포트는 두 개의 디스플레이를 구동할 수 있습니다. |
설계 및 구축
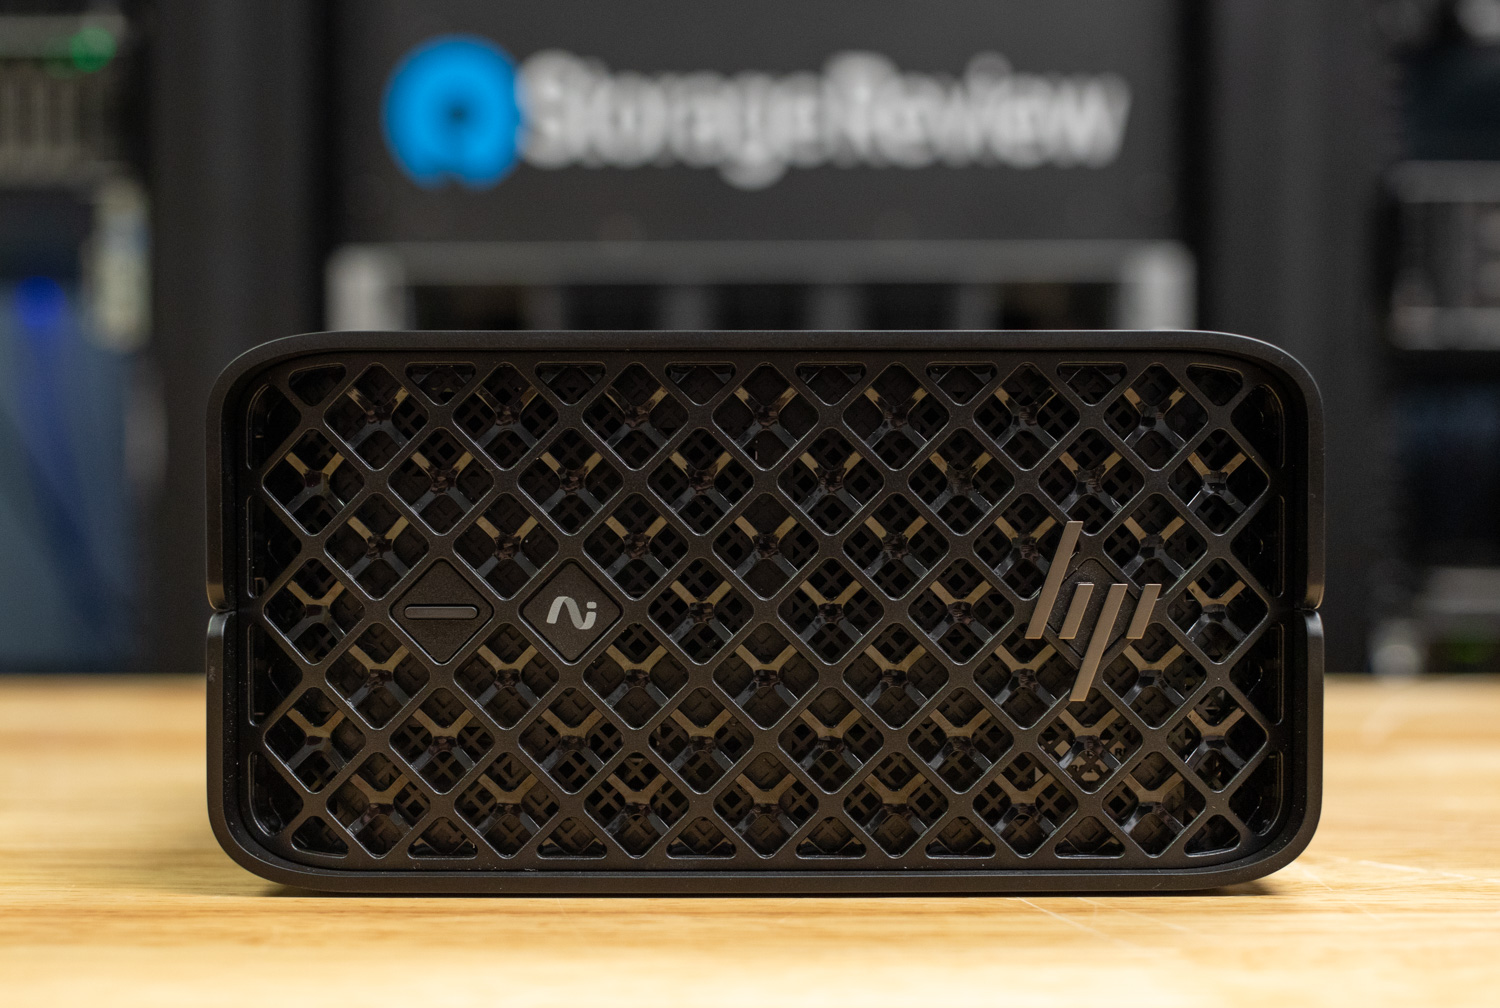
HP Z2 Mini G1a의 전면은 간결한 레이아웃으로 세련된 디자인을 자랑합니다. 전면 베젤에는 멋진 격자 프레임이 적용되었으며, 한쪽에는 HP 로고가, 다른 쪽에는 전원 버튼이 있습니다. 이 격자는 기능적으로 설계되어 공기가 케이스 내부를 자유롭게 순환할 수 있도록 도와줍니다.
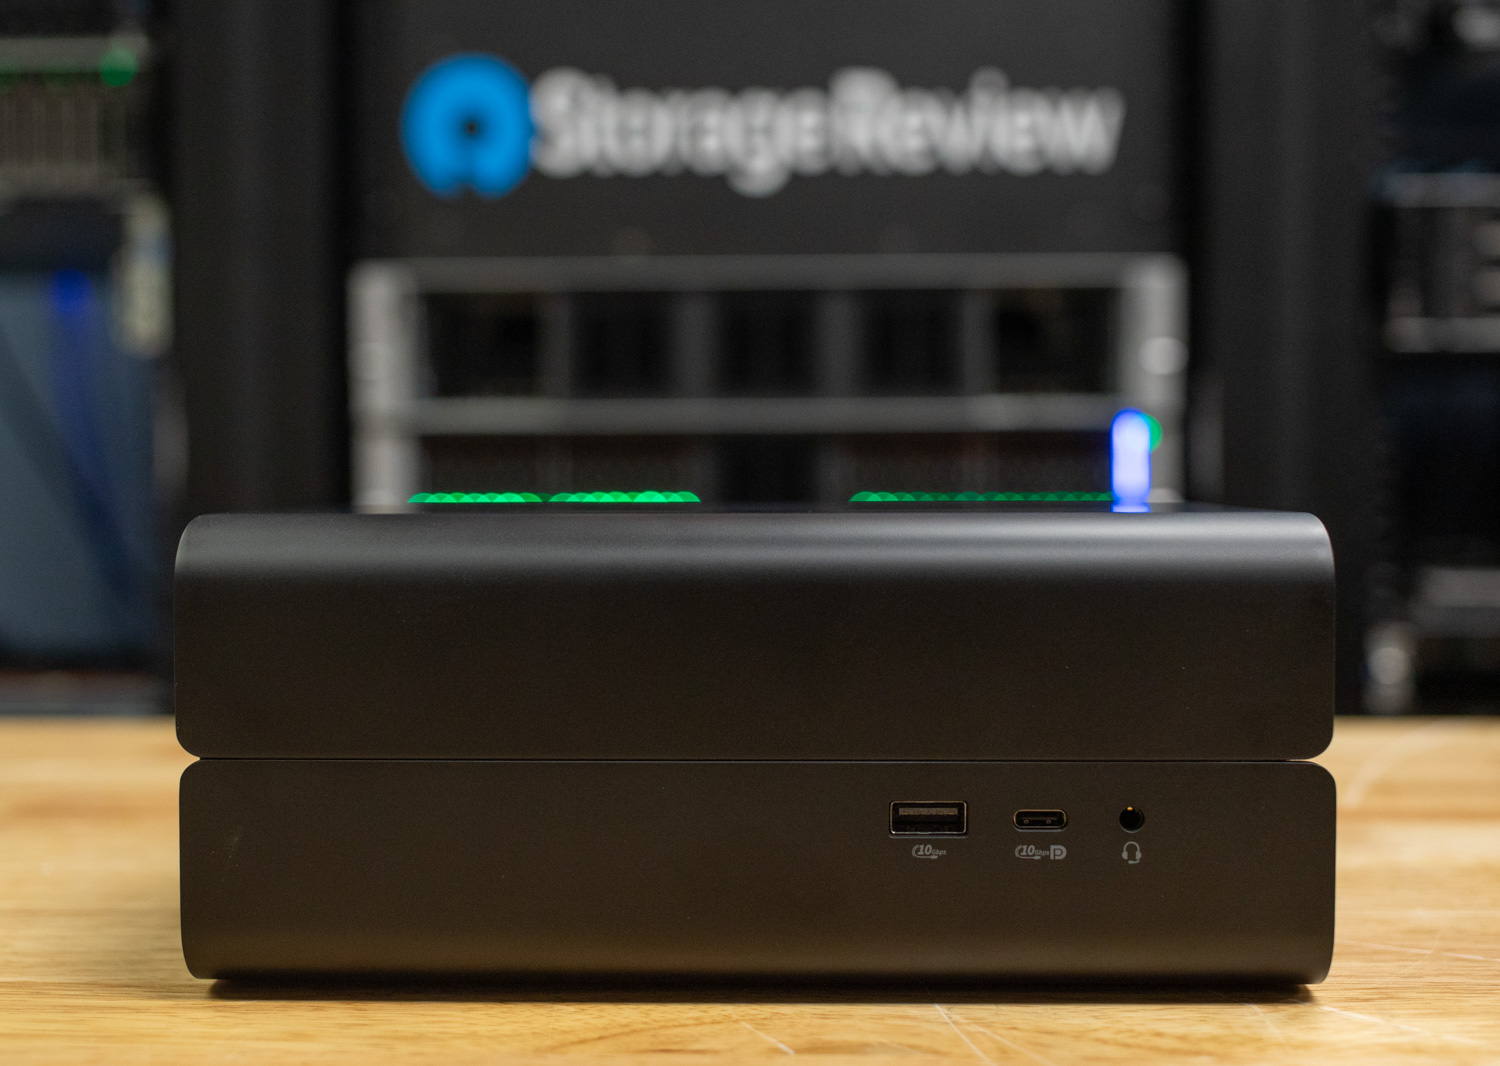
Z2 Mini G1a의 한쪽 면에는 10W 출력의 15Gbps USB-C 포트, 10GBps 연결 기능을 갖춘 USB-A 포트, 헤드폰/마이크 잭 등 여러 개의 포트가 있습니다.
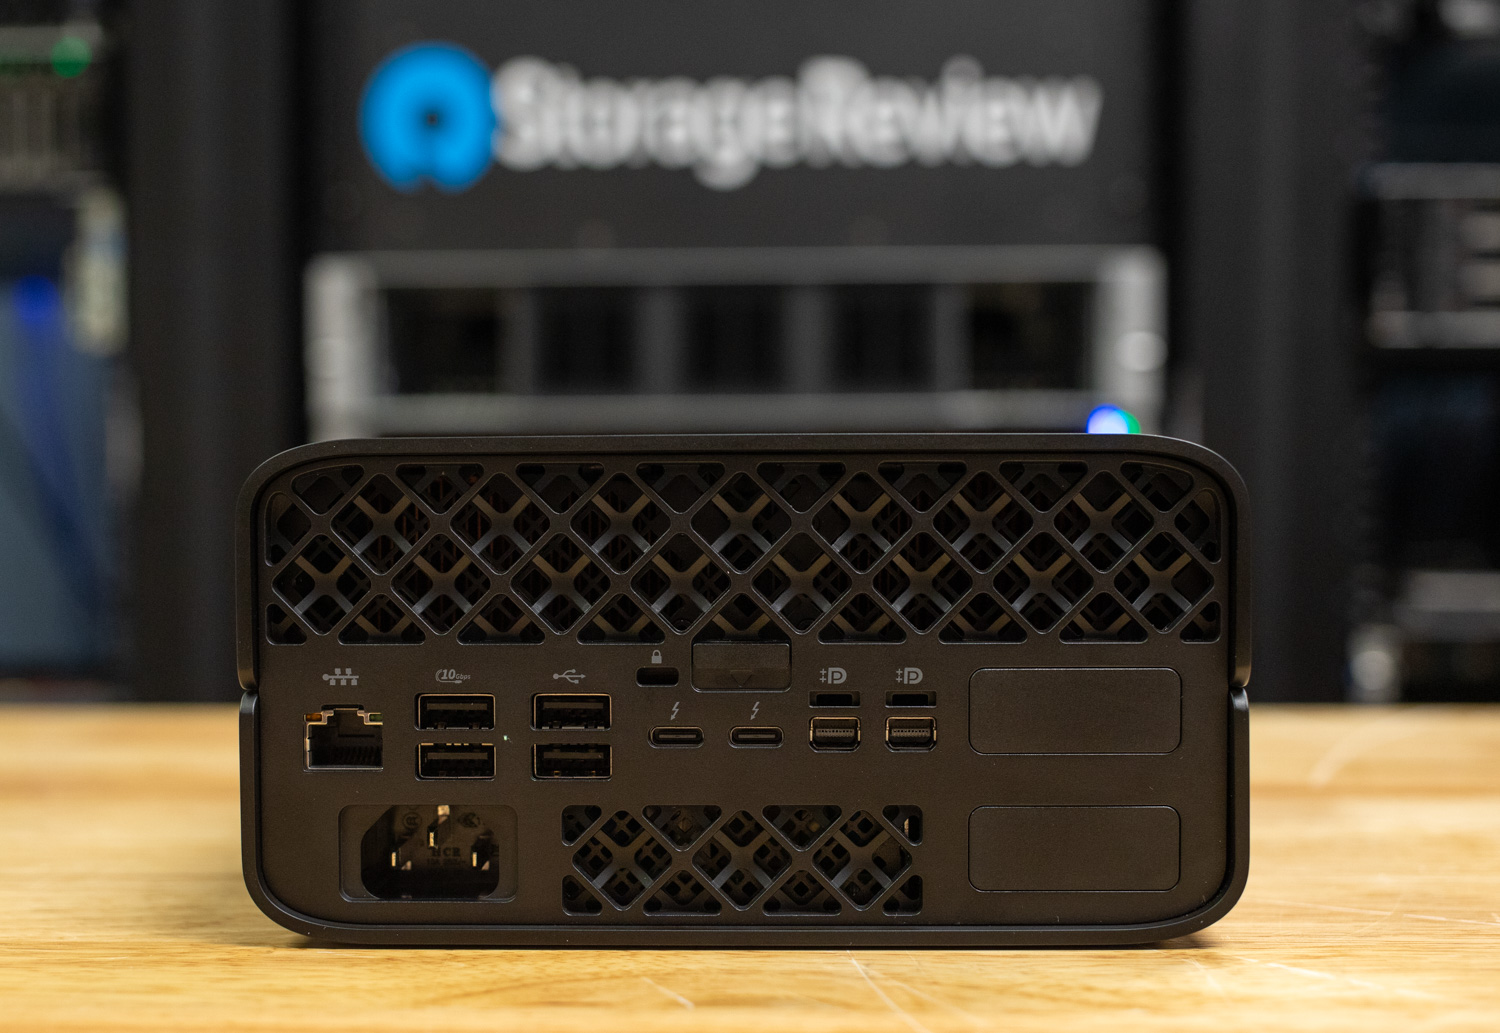
이 시스템 뒷면에는 다양한 포트가 있습니다. Mini DP 2.1 2.0개, USB 3.0 10개, USB 4 40Gb/s 2.5개, Thunderbolt 5 USB-C 1Gb/s 1개, XNUMXGbE 포트, 그리고 전원 공급 장치 연결부와 케이블 잠금 장치가 포함되어 있습니다. 전원 공급 장치가 완전히 통합되어 있어 별도의 전원 어댑터가 필요 없습니다. HP는 사용자가 원하는 대로 변경할 수 있는 두 개의 Flex IO 슬롯을 제공하여 더욱 다양한 사용자 정의 기능을 지원합니다. 상단 슬롯은 듀얼 포트 USB-A XNUMXGb/s 콤보 또는 직렬 포트가 있는 XNUMXGbE NIC 중에서 선택할 수 있습니다. 하단 슬롯은 직렬 포트를 통해 다른 XNUMXGbE NIC, 추가 외부 전원 버튼, 그리고 대역 외(OOB) 관리를 위한 HP 원격 시스템 컨트롤러로 구성할 수 있습니다.
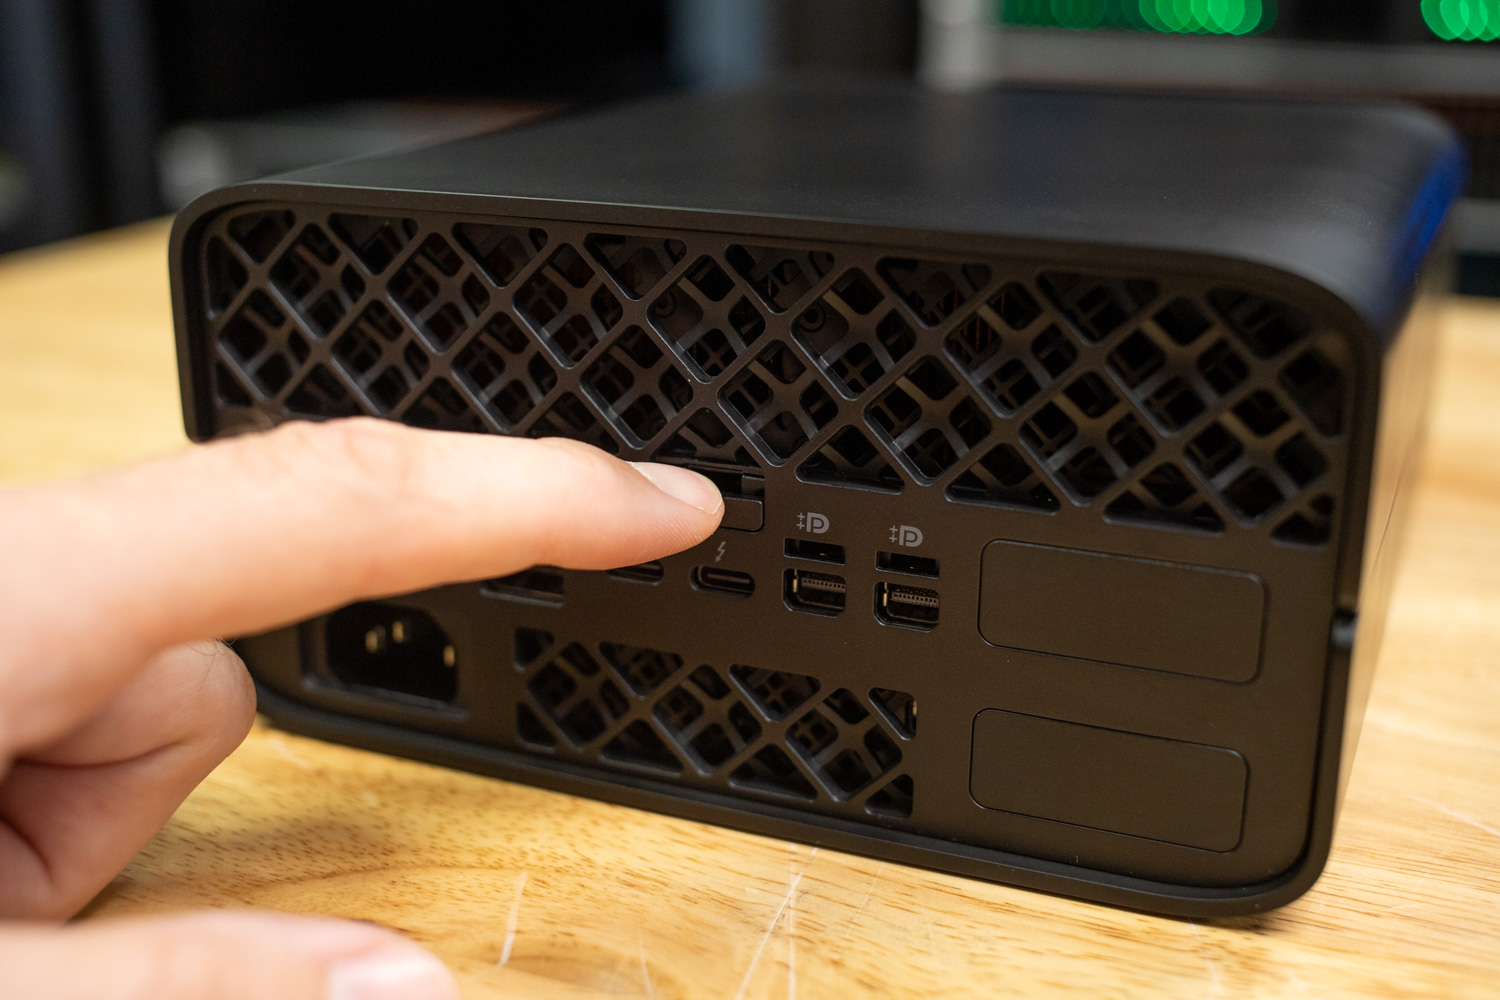
HP Z2 Mini G1a를 자세히 살펴보려면 뒷면의 손가락 걸쇠를 사용하여 상단 덮개를 편리하게 밀어서 빼냅니다.
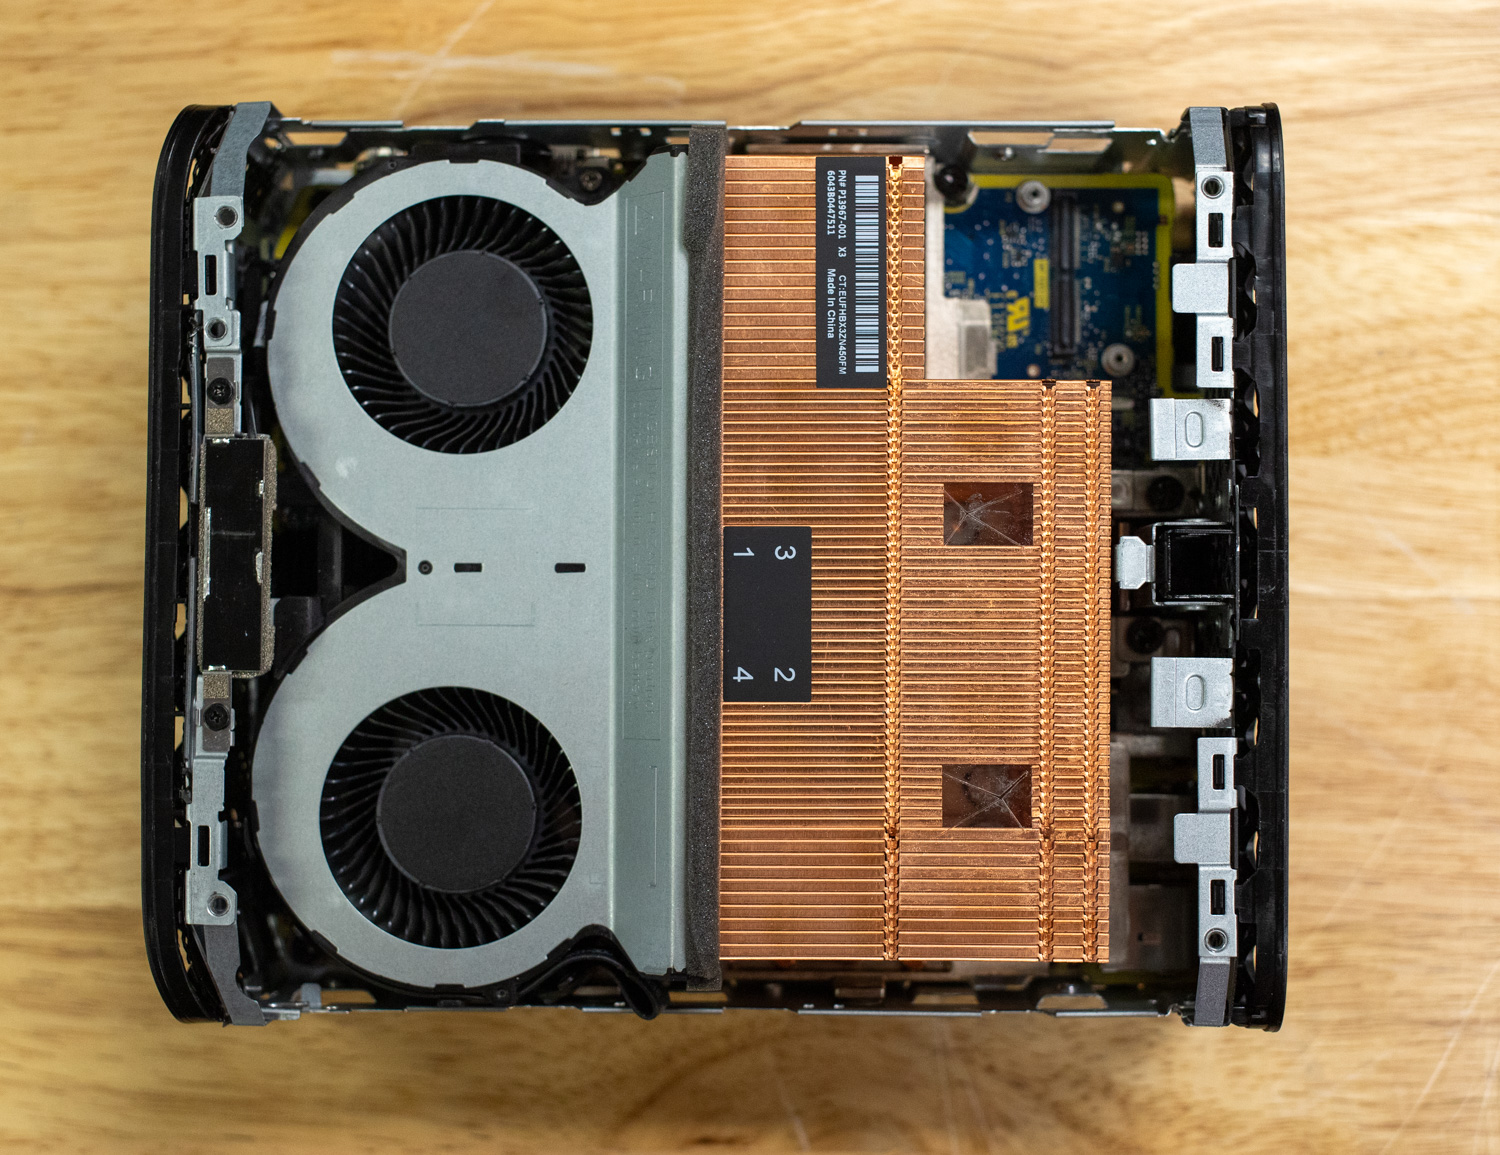
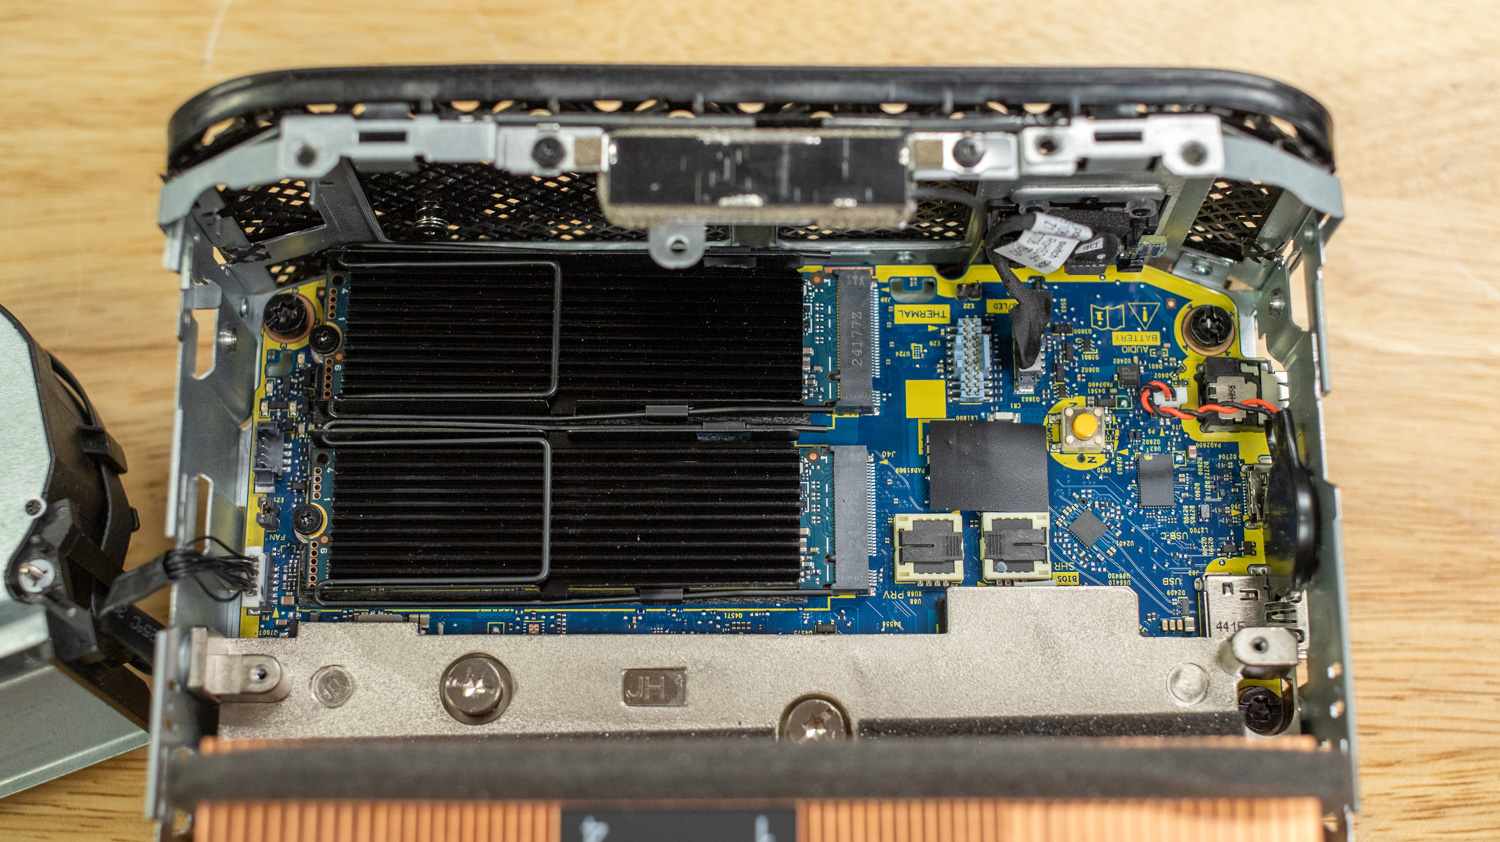
대형 팬과 방열판 조합이 마더보드 대부분을 덮고 있어 AMD Ryzen CPU/GPU를 냉각합니다. 시스템 RAM은 납땜되어 있어 수리가 불가능하지만, Z2 Mini G1a는 두 개의 PCIe Gen4 M.2 슬롯을 제공합니다. 팬 어셈블리와 방열판을 연결하는 작은 나사 두 개를 제거하고 팬 어셈블리를 들어 올리면 슬롯에 접근할 수 있습니다.
집중적으로 사용하는 동안 일부 팬 소음이 눈에 띄기는 했지만, 대형 작업 공간에서 들을 수 있는 소음만큼 두드러지거나 공격적이지는 않았습니다.
HP Z2 Mini G1a 성능 테스트
이번 리뷰에서는 HP Z2 Mini G1a를 이전에 리뷰했던 HP ZBook Ultra G1a 14인치 노트북 과 비교해 보겠습니다 . 워크스테이션과 노트북은 동일한 부품을 사용하므로, 데스크톱 폼팩터에 더 강력한 성능과 향상된 냉각 기능을 더한 제품이 얼마나 뛰어난지 확인할 수 있습니다.
UL Procyon: AI 컴퓨터 비전
Procyon AI 컴퓨터 비전 벤치마크는 AI 추론 엔진의 성능에 대한 상세한 통찰력을 제공합니다. 여러 공급업체의 엔진을 통합하여 기기의 성능을 정확하게 반영하는 성능 점수를 제공합니다. 이 벤치마크는 CPU, GPU, NPU 등 다양한 하드웨어 유형에서 최첨단 신경망 모델의 AI 가속 성능을 비교하여 평가합니다. 이를 통해 사용자는 다양한 워크로드 규모와 조건에서 상대적인 효율성을 평가할 수 있습니다.
실제 AI 워크로드를 반영하기 위해 이 벤치마크는 최신 컴퓨터 비전 작업과의 관련성을 고려하여 선정된 3개의 다양한 신경망 모델을 사용합니다. MobileNet V4는 이미지에서 피사체를 식별하도록 설계된 컴팩트하고 모바일 중심적인 모델이며, Inception VXNUMX는 더 깊고 복잡한 아키텍처를 사용하여 동일한 작업을 수행합니다.
YOLO V3(You Only Look Once)는 실시간으로 객체 확률을 추정하여 객체 감지에 특화되어 있습니다. MobileNet V3를 기반으로 구축된 DeepLab V2는 의미론적 이미지 분할 및 픽셀 클러스터링에 중점을 둡니다. 연산량이 가장 높은 테스트인 Real-ESRGAN은 이미지를 250x250에서 1,000x1,000 해상도로 업스케일링합니다. 마지막으로, ResNet 50은 심층 신경망의 더욱 효과적인 학습을 가능하게 하는 강력한 분류 모델입니다.
HP Z2 Mini G1a는 CPU 테스트에서 HP ZBook Ultra G1a 14인치보다 약간 더 빠른 성능을 보였습니다. 워크스테이션은 전체 227점, 노트북은 전체 186점을 기록했습니다. 각 항목에 비례하여 워크스테이션의 시간이 눈에 띄게 더 빨랐습니다. REAL-ESRGAN 테스트에서 가장 좋은 결과를 보였으며, 워크스테이션은 1,892.10ms, 모바일 플랫폼은 2,138.97ms를 기록했습니다. 전반적으로 속도 차이가 확연히 드러나며, 워크스테이션이 점수에서 우위를 점했지만, 두 플랫폼 모두 훌륭한 점수를 기록했습니다.
GPU 테스트에서 노트북은 583점으로 워크스테이션의 528점보다 높은 점수를 기록했습니다. Radeon 8060S 내장 그래픽은 두 시스템 모두에서 높은 성능을 보여주었습니다. 그러나 노트북의 결과는 대부분의 항목에서 약간 더 빨랐습니다. 유일한 예외는 MobileNet V3로, 워크스테이션은 0.42ms, 노트북은 0.46ms를 기록했습니다. 그러나 나머지 결과에서는 정반대였습니다. 예를 들어 가장 큰 워크로드인 REAL-ESRGAN을 살펴보면, 워크스테이션은 211.76ms로 노트북(11ms)보다 약 200.40ms 느렸습니다.
HP Z2 Mini G1a와 HP ZBook Ultra G1a 14인치 모두 NPU 테스트에서 좋은 성능을 보였습니다. 워크스테이션의 총점 1,761점과 노트북의 총점 1,773점을 보면 ZBook 모바일 플랫폼이 NPU 테스트에서 더 우수한 것으로 보입니다. 그러나 DeepLab V3와 REAL-ESRGAN을 제외한 거의 모든 항목에서 차이는 XNUMX분의 XNUMX밀리초에 불과합니다. 두 시스템 모두 AI 추론에서 뛰어난 성능을 보여주며, 이는 성능이 유사함을 시사합니다.
| UL Procyon: AI 컴퓨터 비전 추론(낮을수록 좋음) | HP Z2 Mini G1a(Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14인치(Ryzen AI Max+ PRO 395 | Radeon 8060S) |
| CPU 시간 | ||
| AI 컴퓨터 비전 전체 점수(높을수록 좋음) | 227 | 186 |
| 모바일넷 V3 | 0.75 MS | 1.09 MS |
| 레스넷 50 | 5.99 MS | 6.84 MS |
| 인셉션 V4 | 17.12 MS | 19.80 MS |
| 딥랩 V3 | 21.20 MS | 28.27 MS |
| 욜로 V3 | 36.58 MS | 41.64 MS |
| 리얼에스간 | 1,892.10 MS | 2,138.97 MS |
| GPU 시간 | ||
| AI 컴퓨터 비전 전체 점수(높을수록 좋음) | 528 | 583 |
| 모바일넷 V3 | 0.42 MS | 0.46 MS |
| 레스넷 50 | 3.85 MS | 3.27 MS |
| 인셉션 V4 | 15.15 MS | 11.62 MS |
| 딥랩 V3 | 10.98 MS | 10.72 MS |
| 욜로 V3 | 12.64 MS | 10.57 MS |
| 리얼에스간 | 211.76 MS | 200.40 MS |
| NPU 타임즈 | ||
| AI 컴퓨터 비전 전체 점수(높을수록 좋음) | 1,761 | 1,773 |
| 모바일넷 V3 | 0.27 MS | 0.27 MS |
| 레스넷 50 | 0.83 MS | 0.82 MS |
| 인셉션 V4 | 1.72 MS | 1.71 MS |
| 딥랩 V3 | 4.31 MS | 4.22 MS |
| 욜로 V3 | 3.17 MS | 3.15 MS |
| 리얼에스간 | 100.05 MS | 100.83 MS |
UL Procyon: AI 텍스트 생성
Procyon AI 텍스트 생성 벤치마크는 간결하고 일관된 평가 방법을 제공하여 AI LLM 성능 테스트를 간소화합니다. 이 벤치마크를 통해 여러 LLM 모델에 대한 반복 테스트가 가능하며, 대규모 모델과 다양한 변수로 인한 복잡성을 최소화할 수 있습니다. AI 하드웨어 분야의 선두 기업들과 협력하여 개발된 이 벤치마크는 로컬 AI 가속기 활용을 최적화하여 더욱 안정적이고 효율적인 성능 평가를 제공합니다. 아래 측정 결과는 TensorRT를 사용하여 테스트되었습니다.
AI 텍스트 생성 테스트를 완료한 후, 결과는 일관된 패턴을 보였으며, HP Z2 Mini G1a가 HP ZBook Ultra G1a보다 약간 앞섰지만 차이는 미미했습니다. 예를 들어 Phi 벤치마크에서 Z2 Mini는 965점을 기록한 반면 ZBook은 922점을 기록했습니다. 첫 번째 토큰 생성 시간은 Z1.898 Mini가 2초, ZBook이 1.956초로 거의 동일했습니다. 초당 출력 토큰 수(TOT)도 각각 68.967과 64.986으로 비슷한 수준이었습니다. 이러한 수치는 Z2 Mini가 작업 처리 속도가 약간 더 빠르지만, 추론 과정에서는 두 시스템 모두 비슷한 수준의 응답성을 제공한다는 것을 시사합니다.
이러한 추세는 Mistral과 Llama3 테스트에서도 이어졌습니다. Z2 Mini는 각각 850점과 766점을, ZBook은 각각 829점과 756점을 기록했습니다. 출력 속도와 토큰 지연 시간도 비슷한 수준으로 나타났습니다. 이러한 일관된 결과는 두 시스템 모두, 특히 실제 환경에서 중간 크기 모델을 실행할 때 유사한 성능 수준을 제공한다는 것을 보여줍니다.
Llama2 테스트는 전반적으로 가장 유사한 결과를 보였습니다. Z2 Mini는 첫 번째 토큰까지 걸리는 시간(TTP) 936초로 3.813점을 기록했고, ZBook은 929초로 3.860점을 기록했습니다. 두 결과 간의 작은 차이는 최신 AI 워크로드 처리에 있어 두 시스템이 얼마나 유사한지를 보여줍니다.
전반적으로 Z2 Mini는 각 테스트에서 꾸준히 약간 앞서 나가지만, 데이터에 따르면 두 시스템 모두 TensorRT를 사용하여 LLM을 실행할 때 거의 동등한 성능을 보입니다. 이러한 차이는 합성 벤치마크에서는 분명하게 나타날 수 있지만, 대부분의 사용 시나리오에서 유의미한 성능 격차로 이어질 가능성은 낮습니다.
| UL Procyon: AI 텍스트 생성 | HP Z2 Mini G1a(Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14인치(Ryzen AI Max+ PRO 395 | Radeon 8060S) |
| 파이 전체 점수 | 965 | 922 |
| 첫 번째 토큰까지의 Phi 출력 시간 | 1.898 초 | 1.956 초 |
| 초당 Phi 출력 토큰 | 68.967 토큰/초 | 64.986 토큰/초 |
| 파이 전체 기간 | 52.666 초 | 55.501 초 |
| 미스트랄 종합 점수 | 850 | 829 |
| 미스트랄 출력 시간 첫 번째 토큰까지 | 2.734 초 | 2.783 초 |
| 초당 미스트랄 출력 토큰 | 43.358 토큰/초 | 41.992 토큰/초 |
| 미스트랄 전체 기간 | 81.716 초 | 84.065 초 |
| Llama3 전체 점수 | 766 | 756 |
| Llama3 첫 번째 토큰까지의 출력 시간 | 2.545 초 | 2.578 초 |
| Llama3 초당 출력 토큰 | 36.752 토큰/초 | 36.243 토큰/초 |
| 라마3 전체 지속 시간 | 91.987 초 | 93.200 초 |
| Llama2 전체 점수 | 936 | 929 |
| Llama2 첫 번째 토큰까지의 출력 시간 | 3.813 초 | 3.860 초 |
| Llama2 초당 출력 토큰 | 24.685 토큰/초 | 24.619 토큰/초 |
| 라마2 전체 지속 시간 | 136.077 초 | 136.720 초 |
UL 프로키온: AI 이미지 생성
Procyon AI 이미지 생성 벤치마크는 저전력 NPU부터 고성능 GPU에 이르기까지 다양한 하드웨어에서 AI 추론 성능을 일관되고 정확하게 측정하는 방법을 제공합니다. 이 벤치마크는 고성능 GPU용 Stable Diffusion XL(FP16), 중성능 GPU용 Stable Diffusion 1.5(FP16), 저전력 장치용 Stable Diffusion 1.5(INT8)의 세 가지 테스트로 구성됩니다. 각 시스템에 최적화된 추론 엔진을 사용하여 공정하고 비교 가능한 결과를 보장합니다.
실제 사용을 시뮬레이션하기 위해, 이 벤치마크는 표준화된 텍스트 프롬프트 세트에서 이미지를 생성하여 모든 기기에서 일관된 텍스트-이미지 AI 워크로드를 생성합니다. 각 테스트는 전체 점수, 총 생성 시간, 이미지 생성 속도 등 주요 성능 지표를 제공하여 모델과 하드웨어 구성 간의 간단하고 효과적인 비교를 가능하게 합니다.
HP Z2 Mini G1a와 HP ZBook Ultra G1a 모두 Procyon AI 이미지 생성 벤치마크에 포함된 세 가지 이미지 생성 테스트 중 두 가지를 실행할 수 있었습니다. 구체적으로, 두 시스템 모두 FP1.5 정밀도를 사용하는 Stable Diffusion 16 테스트와 더 까다로운 Stable Diffusion XL FP16 테스트를 완료했습니다. Stable Diffusion 8의 INT1.5 버전은 두 구성 모두에서 지원되지 않았습니다.
Stable Diffusion 1.5 FP16 테스트에서 Z2 Mini는 전체 점수 725점, 총 생성 시간 137.815초, 이미지당 생성 속도 8.613초로 워크로드를 완료했습니다. ZBook은 전체 점수 648점, 총 생성 시간 154.203초, 이미지당 생성 속도 9.638초로 비슷한 결과를 보였습니다. 이러한 수치는 두 시스템 모두 Ryzen AI Max+ PRO 2 프로세서와 Radeon 395S GPU를 공유함에도 불구하고 Z8060 Mini가 처리 효율 면에서 여전히 우위를 점하고 있음을 시사합니다.
Stable Diffusion XL FP16 테스트에서도 유사한 패턴이 나타났습니다. Z2 Mini는 전체 점수 570점을 기록하고 1,052.468초 만에 벤치마크를 완료했으며, 이미지당 65.779초의 속도로 이미지를 생성했습니다. 반면 ZBook은 451점과 총 1,329.592초의 속도로 이미지를 생성했으며, 이미지당 83.100초의 속도로 이미지를 생성했습니다. 두 시스템 모두 이러한 대형 모델을 처리할 수 있지만, Z2 Mini가 지속적으로 더 빠르게 작업을 완료하며, 동일한 하드웨어 제약 조건에서 성능이 약간 더 최적화되었음을 보여줍니다.
| UL Procyon: AI 이미지 생성 | HP Z2 Mini G1a(Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14인치(Ryzen AI Max+ PRO 395 | Radeon 8060S) |
| 안정적 확산 1.5(FP16) – 전체 점수 | 725 | 648 |
| 안정적 확산 1.5(FP16) – 전체 시간 | 137.815 초 | 154.203 초 |
| 안정적 확산 1.5(FP16) – 이미지 생성 속도 | 8.613초/이미지 | 9.638초/이미지 |
| 안정적 확산 1.5(INT8) – 전체 점수 | N/A | N/A |
| 안정적 확산 1.5(INT8) – 전체 시간 | N/A | N/A |
| 안정적 확산 1.5(INT8) – 이미지 생성 속도 | N/A | N/A |
| Stable Diffusion XL(FP16) – 전체 점수 | 570 | 451 |
| 안정적 확산 XL(FP16) – 전체 시간 | 1,052.468 초 | 1,329.592 초 |
| 안정된 확산 XL(FP16) – 이미지 생성 속도 | 65.779초/이미지 | 83.100초/이미지 |
SPEC워크스테이션 4
SPECworkstation 4.0 벤치마크는 워크스테이션 성능의 모든 핵심 요소를 평가하는 종합적인 도구입니다. CPU, 그래픽, 가속기 및 디스크 성능을 실제 사용 환경에서 측정하여 전문가들이 하드웨어 투자에 대한 정보에 입각한 결정을 내릴 수 있도록 지원합니다. 이 벤치마크에는 데이터 과학 작업 및 ONNX 런타임 기반 추론 테스트를 포함한 AI 및 ML 워크로드에 특화된 테스트 세트가 포함되어 있으며, 이는 워크스테이션 환경에서 AI/ML의 중요성이 점점 커지고 있음을 반영합니다. 7개 산업 분야와 4개 하드웨어 하위 시스템을 포괄하여 오늘날 워크스테이션 성능에 대한 상세하고 관련성 높은 측정값을 제공합니다.
결과에 따르면 Z2 Mini는 대부분의 범주에서 전반적으로 더 높은 점수를 받았으며, 이는 지속적인 작업 부하에서 약간의 성능 우위를 나타냄을 보여줍니다. 에너지 테스트에서 Z2 Mini는 2.50점을 받았고, ZBook은 2.20점을 받았습니다. 금융 서비스 부문은 워크스테이션 2.35점, 노트북 1.60점으로 격차가 더 컸습니다. 생명 과학 부문도 비슷한 추세를 보였으며, Z2 Mini는 2.60점, ZBook은 2.20점을 받았습니다. 미디어 및 엔터테인먼트 부문은 각각 2.22점과 1.90점을 받았고, 제품 디자인은 워크스테이션 2.00점, 노트북 1.74점을 받았습니다.
ZBook이 앞서 나간 유일한 사례는 생산성 및 개발 부문으로, ZBook은 1.03점을 기록한 반면 Z2 Mini는 1.00점을 기록했습니다. 이러한 차이는 크지 않지만, 두 시스템 모두 동일한 프로세서와 GPU를 사용함에도 불구하고 Z2 Mini가 워크스테이션급 애플리케이션에서 약간 더 일관된 처리량을 제공할 수 있음을 시사합니다.
| SPECworkstation 4.0.0(높을수록 좋음) |
HP Z2 Mini G1a(Ryzen AI Max+ PRO 395 | Radeon 8060S) |
HP ZBook Ultra G1a 14인치(Ryzen AI Max+ PRO 395 | Radeon 8060S) |
| 에너지 | 2.50 | 2.20 |
| 금융 서비스 | 2.35 | 1.60 |
| 생명과학 | 2.60 | 2.20 |
| 미디어 및 엔터테인먼트 | 2.22 | 1.90 |
| 제품 디자인 | 2.00 | 1.74 |
| 생산성 및 개발 | 1.00 | 1.03 |
럭스마크
Luxmark는 오픈소스 레이 트레이싱 렌더러인 LuxRender를 활용하여 고도로 세부적인 3D 장면 처리 시 시스템의 성능을 평가하는 GPU 벤치마크입니다. 이 벤치마크는 서버 및 워크스테이션의 그래픽 렌더링 성능, 특히 정확한 조명 시뮬레이션이 필수적인 시각 효과 및 건축 시각화 애플리케이션의 성능을 평가하는 데 적합합니다.
HP Z2 Mini G1a와 HP ZBook Ultra G1a 모두 이 테스트에서 좋은 성적을 거두었으며, 이는 Ryzen AI Max+ PRO 395와 Radeon 8060S의 강력한 성능을 보여줍니다. Hallbench 테스트에서 Z2 Mini는 8,477점을 기록하여 ZBook의 7,833점을 약간 앞섰습니다. 마찬가지로, Food 테스트에서도 워크스테이션은 3,943점, 노트북은 3,915점을 기록했습니다. 이러한 결과는 편차가 미미하여 두 시스템 모두 가벼운 3D 렌더링 작업에서 중간 정도의 성능을 보이는 작업에 적합함을 시사합니다.
특히 두 기기 모두 유연한 메모리 할당 기능을 제공하여 CPU와 GPU 작업 간에 RAM을 동적으로 공유할 수 있습니다. 이러한 기능은 일반적으로 고사양 그래픽 성능과 관련되지 않는 소형 폼팩터에서도 렌더링 작업을 효율적으로 처리할 수 있도록 지원합니다.
| Luxmark(높을수록 좋음) | HP Z2 Mini G1a(Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14인치(Ryzen AI Max+ PRO 395 | Radeon 8060S) |
| 홀벤치 | 8,477 | 7,833 |
| 음식 | 3,943 | 3,915 |
7-Zip 압축
7-Zip 압축 벤치마크는 압축 및 압축 해제 작업 중 CPU 성능을 평가하여 GIPS(초당 기가 명령어) 및 CPU 사용률로 등급을 측정합니다. 더 높은 GIPS와 효율적인 CPU 사용률은 우수한 성능을 나타냅니다.
결과 등급을 살펴보면, HP Z2 Mini G1a와 HP ZBook Ultra G1a 모두 강력하고 유사한 성능을 제공합니다. 압축 시 Z2 Mini는 139.298 GIPS의 최종 등급을 기록했는데, 이는 ZBook의 139.617 GIPS보다 약간 낮습니다. 그러나 압축 해제 시 Z2 Mini는 163.969 GIPS로 ZBook의 174.046 GIPS보다 높은 등급을 기록했습니다.
두 워크로드를 모두 고려했을 때, Z151.634 Mini의 총 GIPS는 2GIPS, ZBook의 총 GIPS는 156.832GIPS였습니다. 이러한 결과는 두 시스템 모두 압축률이 높은 워크플로우를 처리하는 데 매우 뛰어나지만, 특히 압축 해제 단계에서 ZBook이 전체 처리량 면에서 약간 더 우수함을 나타냅니다.
| 7-Zip 압축 벤치마크(높을수록 좋음) | HP Z2 Mini G1a(Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14인치(Ryzen AI Max+ PRO 395 | Radeon 8060S) | |||
| 압축 | |||||
| 현재 CPU 사용량 | 2,734% | 2,868% | |||
| 현재 등급/사용 | 5.136 깁스 | 4.883 깁스 | |||
| 현재 평가 | 140.405 깁스 | 140.061 깁스 | |||
| 결과 CPU 사용량 | 2,718% | 2,855% | |||
| 결과 등급/사용 | 5.126 깁스 | 4.890 깁스 | |||
| 결과 등급 | 139.298 깁스 | 139.617 깁스 | |||
| 압축 해제 | |||||
| 현재 CPU 사용량 | 2,343% | 2,904% | |||
| 현재 등급/사용 | 6.805 깁스 | 6.029 깁스 | |||
| 현재 평가 | 159.451 깁스 | 175.104 깁스 | |||
| 결과 CPU 사용량 | 2,414% | 2,887% | |||
| 결과 등급/사용 | 6.793 깁스 | 6.028 깁스 | |||
| 결과 등급 | 163.969 깁스 | 174.046 깁스 | |||
| 총 평점 | |||||
| 총 CPU 사용량 | 2,566% | 2,871% | |||
| 총 등급/사용량 | 5.959 깁스 | 5.459 깁스 | |||
| 총 평점 | 151.634 깁스 | 156.832 깁스 | |||
Blackmagic RAW 속도 테스트
Blackmagic RAW Speed Test는 Blackmagic RAW 코덱을 사용하여 비디오 재생 및 편집을 처리하는 시스템의 성능을 측정하는 성능 벤치마킹 도구입니다. 시스템이 고해상도 비디오 파일을 얼마나 잘 디코딩하고 재생할 수 있는지 평가하며, CPU 및 GPU 기반 처리에 대한 프레임 속도를 제공합니다.
8K CPU 테스트에서 HP Z2 Mini G1a는 초당 124프레임을 기록하여 초당 1프레임을 기록한 HP ZBook Ultra G102a를 앞지르는 성능을 보였습니다. 이는 CPU 기반 디코딩 작업에서 이 워크스테이션이 약간 우위를 점함을 시사합니다. 그러나 OpenCL을 사용한 GPU 가속 결과는 정반대 경향을 보입니다. ZBook은 초당 78프레임으로, Z74 Mini의 2프레임보다 약간 더 높은 프레임 속도를 기록했습니다.
| Blackmagic RAW 속도 테스트 | HP Z2 Mini G1a(Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14인치(Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|
| 8K CPU | 124의 FPS | 102의 FPS |
| 8K 오픈클 | 74의 FPS | 78의 FPS |
Blackmagic Disk Speed Test
Blackmagic Disk Speed Test는 읽기 및 쓰기 속도를 측정하여 저장 장치 성능을 평가하고, 비디오 편집 및 대용량 파일 전송과 같이 데이터 집약적인 작업을 처리하는 시스템의 능력에 대한 통찰력을 제공합니다.
HP Z2 Mini G1a는 두 개의 PCIe Gen4 슬롯을 제공하며, 두 슬롯 모두 접근 및 업그레이드가 매우 간편합니다. SSD 성능은 특정 구성에 어떤 부품이 사용되는지에 따라 약간씩 달라질 수 있습니다.
| 디스크 속도 테스트(높을수록 좋음) | HP Z2 Mini G1a(Ryzen AI Max+ PRO 395 | Radeon 8060S) |
HP ZBook Ultra G1a 14인치(Ryzen AI Max+ PRO 395 | Radeon 8060S) |
| 읽기 | 4,549.3 MB / s의 | 4,547.3 MB / s의 |
| 쓰다 | 5,344 MB / s의 | 4,264.8 MB / s의 |
블렌더 벤치마크
블렌더는 오픈소스 3D 모델링 애플리케이션입니다. 이 벤치마크는 블렌더 벤치마크 유틸리티를 사용하여 실행되었습니다. 점수는 분당 샘플 수로 측정되며, 값이 높을수록 성능이 우수함을 나타냅니다.
HP Z2 Mini G1a는 테스트된 세 가지 장면 모두에서 HP ZBook Ultra G1a보다 지속적으로 우수한 성능을 보였습니다. 몬스터 프로젝트에서 Z2 Mini는 분당 224.3개의 샘플을 처리한 반면, ZBook은 189.29개를 기록했습니다. 정크샵 장면에서는 각각 분당 149.5개와 129.42개의 샘플을 처리했습니다. 마지막으로 교실 장면에서 Z2 Mini는 분당 116.3개의 샘플을 처리한 반면, ZBook은 분당 94.14개의 샘플을 처리했습니다.
| 블렌더 벤치마크 CPU(분당 샘플 수, 높을수록 좋음) | HP Z2 Mini G1a(Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14인치(Ryzen AI Max+ PRO 395 | Radeon 8060S) |
| 몬스터 | 224.3 샘플/m | 189.29 샘플/m |
| 정크샵 | 149.5 샘플/m | 129.42 샘플/m |
| 교실 | 116.3 샘플/m | 94.14 샘플/m |
Blender의 OptiX 엔진을 사용하여 GPU 기반 렌더링으로 전환했을 때, 두 시스템 간의 성능 분포가 더욱 균형 있게 나타났습니다. 몬스터 장면에서 HP ZBook Ultra G1a는 분당 661.50개의 샘플을 렌더링하여 Z2 Mini의 분당 616.1개의 샘플을 약간 앞섰습니다. 이는 두 기기 모두 동일한 Radeon 8060S 그래픽을 사용했음에도 불구하고, 이 특정 장면에서 ZBook이 GPU 측면에서 약간 우위를 점했음을 시사합니다.
그러나 정크샵과 클래스룸 테스트에서는 Z2 Mini가 근소한 차이로 우위를 점했습니다. Z350.6 Mini는 분당 342.7과 341.92 샘플링을 기록한 반면, ZBook은 같은 장면에서 분당 333.26와 XNUMX 샘플링을 기록했습니다. 이러한 차이는 비교적 미미하며 예상된 변동 범위 내에 있습니다. 이는 두 시스템 모두 OptiX에서 거의 동일한 GPU 렌더링 성능을 제공함을 시사합니다.
| Blender 벤치마크 GPU(분당 샘플 수, 높을수록 좋음) | HP Z2 Mini G1a(Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14인치(Ryzen AI Max+ PRO 395 | Radeon 8060S) |
| 몬스터 | 745.55 샘플/m | 661.50 샘플/m |
| 정크샵 | 366.54 샘플/m | 341.92 샘플/m |
| 교실 | 359.01 샘플/m | 333.26 샘플/m |
y-크런처
y-cruncher는 파이(π)를 비롯한 수학적 상수를 수조 자릿수까지 계산할 수 있는 멀티스레드 및 확장 가능한 프로그램입니다. 2009년 출시 이후 오버클러커와 하드웨어 마니아들에게 인기 있는 벤치마킹 및 스트레스 테스트 애플리케이션으로 자리매김했습니다.
HP Z2 Mini G1a 측정 결과는 HP ZBook Ultra G1a 14인치와 일치합니다. 이 워크스테이션은 모든 연산 단위에서 미묘한 우위를 보였으며, 1억 자릿수 테스트에서 12.965초가 걸렸습니다. 2.5억 자릿수 테스트와 5억 자릿수 테스트에서는 그 차이가 몇 초 더 벌어졌습니다. 34.533억 자릿수 테스트에서는 2.5초, 75.021억 자릿수 테스트에서는 5초가 걸렸는데, 이는 매우 정확한 결과입니다. 워크스테이션이 10억 자릿수 테스트에서는 160.252초로 앞서 나갔는데, 이는 ZBook보다 11초 빠른 기록으로, 주로 노트북의 전력 제한으로 인한 것입니다.
| Y-Cruncher(총 계산 시간) | HP Z2 Mini G1a(Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14인치(Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|
| 1 억 | 12.965 초 | 12.93 초 |
| 2.5 억 | 34.533 초 | 34.91 초 |
| 5 억 | 75.021 초 | 78.19 초 |
| 10 억 | 160.252 초 | 171.72 초 |
Geekbench 6
Geekbench 6는 전반적인 시스템 성능을 측정하는 크로스 플랫폼 벤치마크입니다.
HP Z2 Mini G1a의 결과는 놀랍지 않습니다. CPU 점수는 싱글 코어 2,862점, 멀티 코어 12,210점으로 노트북과 거의 동일합니다. 앞서 언급한 것과 유사한 이유로 GPU OpenCL 점수는 91,591점으로 상승세를 보였습니다. 제공된 점수는 CPU 사용량이 많은 작업은 이 시스템에서 문제가 되지 않을 것임을 시사합니다. GPU의 경우, Radeon 8060S 내장 그래픽은 2019년경 출시된 신형 그래픽 카드와 비슷한 수준으로, 미니 워크스테이션에 적합합니다.
| Geekbench 6 (높을수록 좋음) | HP Z2 Mini G1a(Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14인치(Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|
| CPU 단일 코어 | 2,862 | 2,825 |
| CPU 멀티 코어 | 17,210 | 17,562 |
| GPU 오픈CL | 91,591 | 85,337 |
Cinebench R23
Cinebench R23은 3D 렌더링 워크로드에서 CPU 성능을 평가하는 데 널리 알려진 벤치마크입니다. Cinema 4D 엔진을 사용하여 프로세서가 단일 스레드 및 멀티 스레드 작업을 얼마나 잘 처리하는지 측정하여 전반적인 응답성과 병렬 처리 성능에 대한 통찰력을 제공합니다.
멀티코어 테스트에서 HP Z2 Mini G1a는 37,156점을 기록하여 1점을 기록한 HP ZBook Ultra G29,112a보다 상당히 앞섰습니다. 이는 Z2 Mini가 섀시의 열 조건이 더 양호하여 더 무거운 멀티스레드 렌더링 워크로드를 더 잘 견딜 수 있음을 시사합니다.
단일 코어 성능 측면에서 두 시스템은 거의 동일한 결과를 보였습니다. Z2 Mini는 2,020점을 기록했고, ZBook은 1,984점으로 그 뒤를 바짝 쫓았습니다. 이 수치는 두 기기 모두 뷰포트 상호작용이나 기본 모델링 작업과 같이 스레드가 적은 작업에서 유사한 성능을 제공한다는 것을 나타냅니다.
| Cinebench R23(높을수록 좋음) | HP Z2 Mini G1a(Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14인치(Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|
| 멀티 코어 | 37,156 | 29,112 |
| 싱글 코어 | 2,020 | 1,984 |
Cinebench 2024
Cinebench 2024는 R23의 기반을 바탕으로 CPU 성능에 지속적으로 중점을 두는 동시에 GPU 기반 렌더링 테스트를 도입했습니다. 이 세그먼트에서는 CPU 점수만 분석하여 각 시스템이 최신 3D 렌더링 작업을 얼마나 잘 처리하는지에 대한 최신 정보를 제공합니다.
멀티코어 테스트에서 HP Z2 Mini G1a는 1,906점을 기록하여 HP ZBook Ultra G1a의 1,579점을 능가했습니다. 이는 R23에서 나타난 패턴과 유사합니다. Z2 Mini는 더 효율적인 멀티스레드 처리량을 보였으며, 부하 상황에서도 지속적인 성능이 향상되었을 가능성이 높습니다.
단일 코어 결과는 거의 동일했습니다. Z2 Mini는 112점을 기록한 반면, ZBook은 111점으로 단 XNUMX점 뒤처졌습니다. 이는 가벼운 편집이나 실시간 애플리케이션 상호작용과 같이 개별 스레드에 의존하는 작업에서 유사한 성능을 보인다는 것을 시사합니다.
| Cinebench 2024(높을수록 좋음) | HP Z2 Mini G1a(Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14인치(Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|
| 멀티 코어 | 1,906 | 1,579 |
| 싱글 코어 | 112 | 111 |
Ollama Gemma3 LLM 성과
실제 워크로드에서 HP Z2 Mini G1a가 대용량 언어 모델(LLM) 추론을 어떻게 처리하는지 평가하기 위해, 본 리뷰의 성능 섹션을 분석하도록 설계된 프롬프트를 갖춘 Ollama를 사용했습니다. 테스트된 모델은 1.5억 개에서 최대 70억 개의 매개변수를 포함하며, 해당되는 경우 Gemma3 변형을 사용했습니다. 이 워크로드는 GPU와 CPU 리소스 모두에 부담을 주며, 특히 메모리 용량, 추론 처리량 및 컴퓨팅 안정성에 영향을 미치는 긴 프롬프트 시퀀스의 경우 더욱 그렇습니다.
Ollama 1.5B 및 7B와 같은 소형 모델은 각각 4.76초와 36.65초 만에 완료되어 빠르게 실행되었습니다. 두 모델 모두 신속한 평가가 효율적이었으며, 토큰 처리 속도는 716.99B 모델의 경우 초당 1.5개, 799.29B 모델의 경우 초당 7개였습니다. 그러나 모델 크기가 커질수록 출력 평가 속도는 감소합니다. 1.5B 모델에서는 출력 토큰이 초당 112.18개 생성되었지만, 7B 모델은 초당 36.86개 완료되었습니다.
예상대로 모델 크기가 커질수록 성능은 저하됩니다. 14B 모델은 완료하는 데 약 65초가 걸렸고, 생성 속도는 초당 18.90개의 토큰으로 느려졌습니다. 32B 모델은 훨씬 더 큰 속도 저하를 보였으며, 총 94.29초가 걸렸고 초당 9.38개의 토큰을 생성했습니다. 가장 연산량이 많은 테스트인 70B 모델은 164.73초가 걸렸고, 초당 4.24개의 토큰만 생성했습니다.
KV 캐싱 최적화 덕분에 초기 프롬프트 평가는 모든 규모에서 효율적으로 유지되지만, 모델 크기와 메모리 요구량이 증가함에 따라 총 생성 시간과 토큰 출력 속도는 예측 가능하게 저하됩니다. HP Z2 Mini G1a는 최대 70B 티어까지 확장 가능하지만, 길거나 복잡한 프롬프트의 경우 14B를 초과하면 응답 속도가 눈에 띄게 저하될 수 있습니다.
| 올라마 1.5B | 총 기간(초) | 로드 지속 시간(ms) | 프롬프트 평가 횟수(토큰) | 프롬프트 평가 기간(ms) | 신속한 평가율 | 평가 횟수(토큰) | 평가 기간(초) | 평가율 |
|---|---|---|---|---|---|---|---|---|
| HP Z2 미니 g1a | 4.76들 | 17.21 MS | 22 | 30.68 MS | 716.99tk/초 | 528 | 4.71들 | 112.18tk/초 |
| 올라마 7B | ||||||||
| HP Z2 미니 g1a | 36.65들 | 18.21 MS | 22 | 27.52 MS | 799.29tk/초 | 1349 | 36.06들 | 36.86tk/초 |
| 올라마 14B | ||||||||
| HP Z2 미니 g1a | 64.97들 | 18.66 MS | 22 | 28.41 MS | 774.37tk/초 | 1227 | 64.92들 | 18.90tk/초 |
| 올라마 32B | ||||||||
| HP Z2 미니 g1a | 94.29들 | 73.83 MS | 22 | 69.27 MS | 317.61tk/초 | 883 | 94.14들 | 9.38tk/초 |
| 올라마 70B | ||||||||
| HP Z2 미니 g1a | 164.73들 | 21.97 MS | 22 | 38.90 MS | 565.52tk/초 | 699 | 164.67들 | 4.24tk/초 |
OpenAI의 새로운 GPT-OSS 120B 모델 지원
며칠 전, OpenAI는 오랜만에 첫 오픈소스 LLM 릴리스인 GPT-OSS 120B와 20B 모델을 출시했습니다. GPT-OSS 120B는 MXFP4 양자화로 네이티브 학습된 최초의 모델 중 하나로서 획기적인 성과를 보여줍니다. OpenAI에 따르면, 이 모델은 MXFP4 형식으로 MoE 가중치 양자화를 통해 사후 학습을 거쳐 매개변수당 가중치를 4.25비트로 줄였습니다. MoE 가중치가 전체 매개변수 수의 90% 이상을 차지하기 때문에, 이러한 적극적인 양자화 덕분에 120B 모델은 단일 80GB H100 GPU 또는 저희의 경우 395GB 공유 메모리를 갖춘 Ryzen AI Max+ PRO 96에 적합하게 되었습니다. 이러한 업계 동향과의 일치는 특히 정확도가 낮은 Mixture of Experts 모델이 점점 더 보편화됨에 따라 컴퓨팅 성능이 낮은 기기도 추론에서 뛰어난 성능을 제공할 수 있게 됨에 따라 매우 중요합니다.
이 네이티브 MXFP4 트레이닝은 또한 중요한 이점을 제공합니다. AI Max+ PRO 4에 배포하기 위해 Int395로 추가 양자화할 때, BF16에서 Int4로 양자화할 때 일반적으로 발생하는 상당한 손실에 비해 품질 저하가 최소화됩니다. 결과적으로 GPT-OSS 120B는 AI Max+ PRO 395에서 실행할 수 있는 최고 성능 모델 중 하나로, 거의 완벽한 품질을 제공합니다.
Z2 Mini G1a는 이러한 낮은 정밀도의 아키텍처 추세를 활용하여 기존에는 6000배나 비싼 엔터프라이즈급 하드웨어(예: 96GB VRAM이 탑재된 NVIDIA RTX XNUMX Pro)가 필요했던 것을 대규모 LLM 실험을 위한 접근 가능한 워크스테이션 솔루션으로 전환합니다.
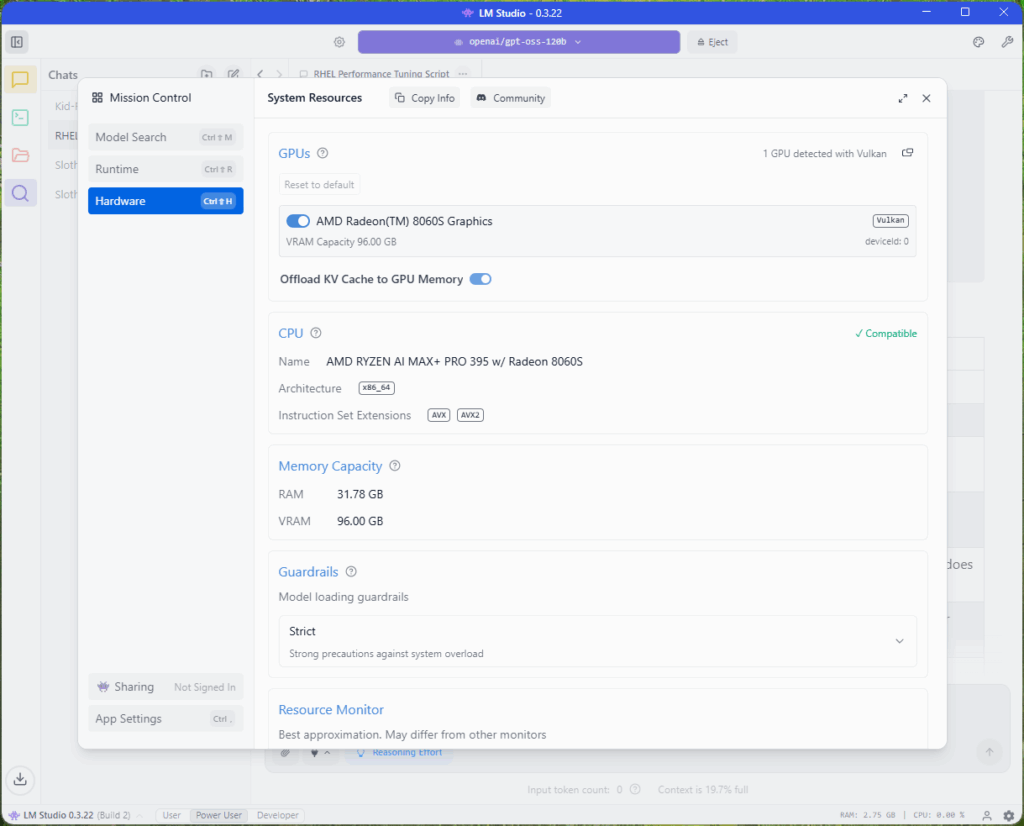
LM Studio에서 볼 수 있듯이, 시스템은 8060GB VRAM을 탑재한 Radeon 96S GPU를 감지하고 모델 실행 호환성을 확인합니다. 또한, 이 구성은 KV 캐시를 GPU 메모리로 오프로드하여 긴 프롬프트나 장시간 대화에 대한 추론 효율성을 더욱 향상시킵니다. OpenAI의 엄격한 모델 가드레일을 활성화하면 LLM 워크로드가 많은 경우에도 시스템이 과부하로부터 안전하게 보호됩니다.
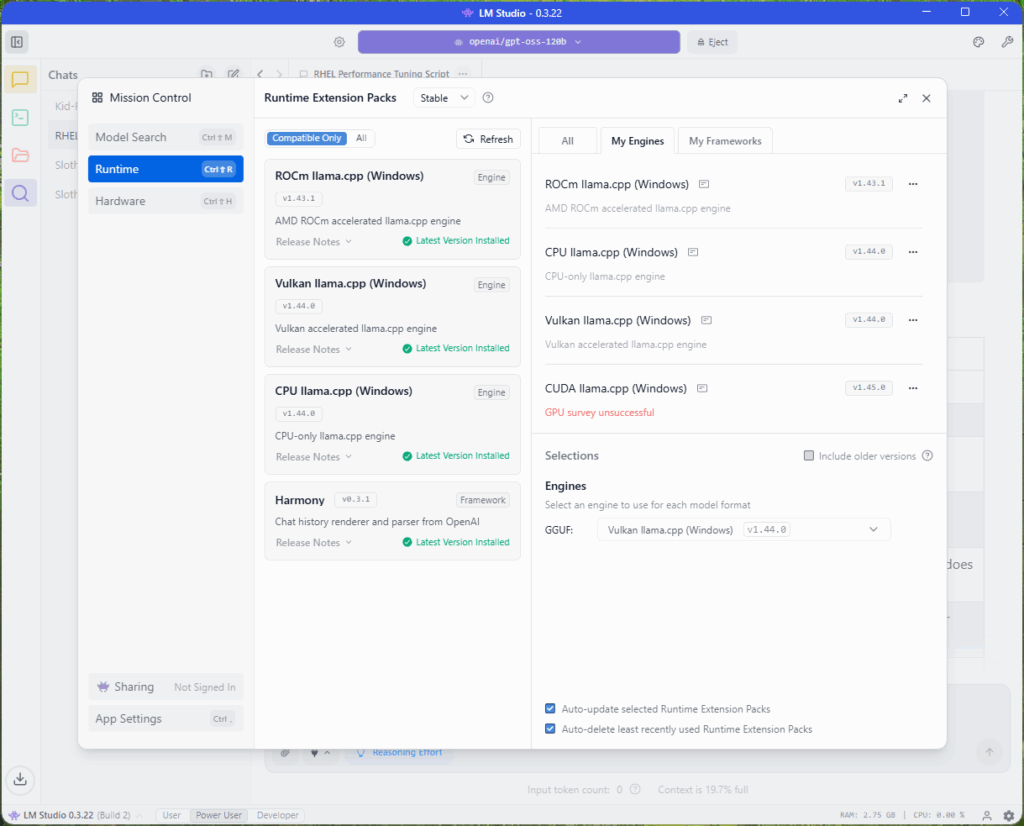
설치된 런타임 확장 팩에는 ROCm llama.cpp(Windows), Vulkan llama.cpp(Windows), CPU llama.cpp(Windows) 및 Harmony 프레임워크가 포함되어 있습니다. CUDA도 나열되어 있지만 NVIDIA GPU가 필요하고 시스템에 AMD Radeon 8060S가 장착되어 있어 사용할 수 없습니다.
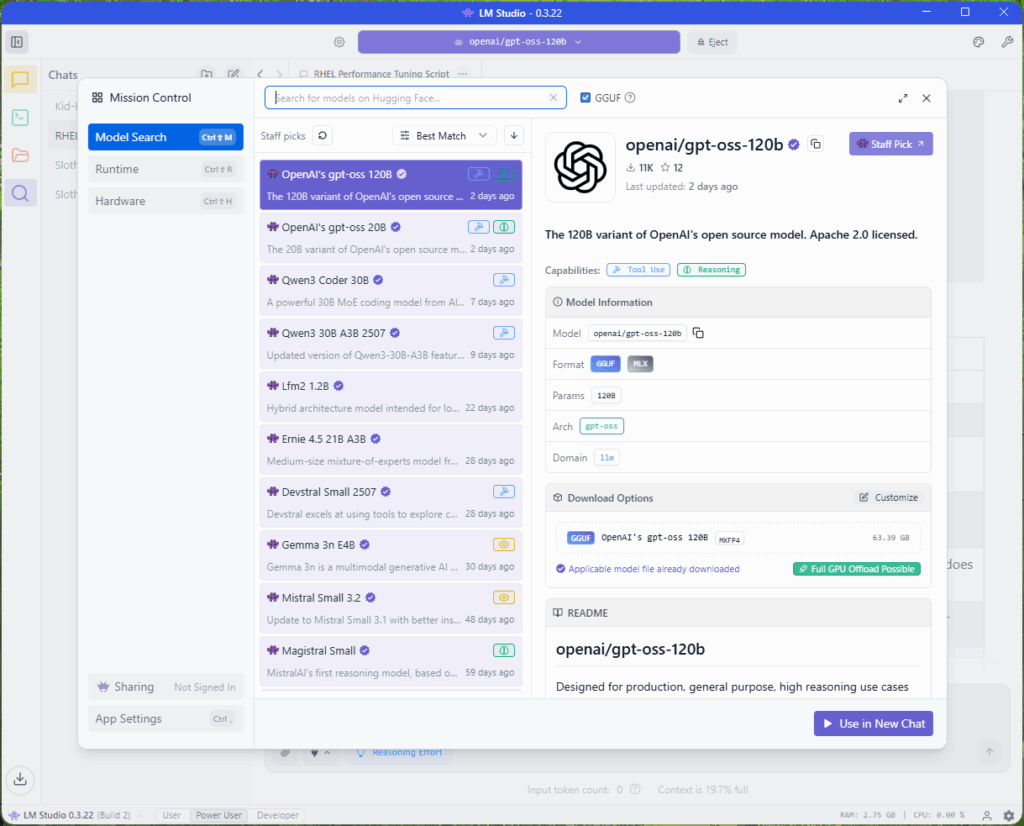
이번 실행을 위해 아래 이미지는 앞서 언급한 OpenAI GPT OSS 120B 모델과 그 형식, 아키텍처, 크기를 보여줍니다. GGUF 형식을 사용하며 총 크기는 63.39GB이고, 전체 GPU 오프로드를 위해 구성되었습니다.
사용 측면에서 HP Z2 Mini G1a는 120B 매개변수 모델을 사용하여 초당 40토큰에 가까운 속도를 유지하며 놀라운 성능을 보였습니다. LLM과 여러 차례 심도 있는 논의를 진행했습니다. VRAM 제약으로 인해 많은 시스템이 제한적으로 사용하는 소규모 모델을 사용하는 것보다 응답 품질이 훨씬 우수했습니다.
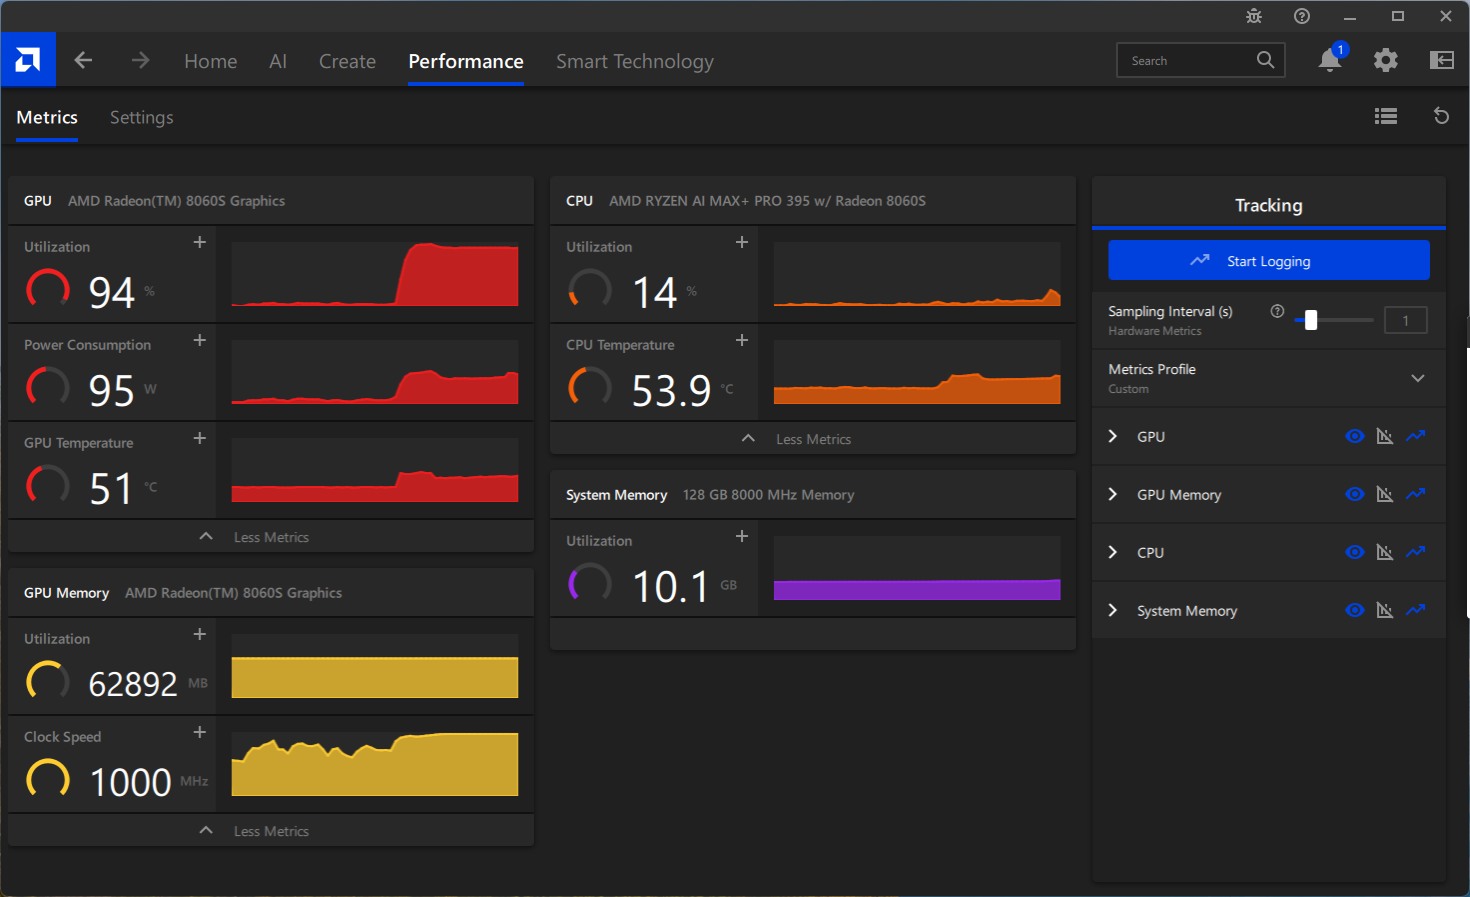
LLM을 실행한 상태에서 시스템 통계를 살펴보면 GPU가 100W에 약간 못 미치는 전력을 소모하고, GPU와 CPU 전체의 온도는 51~54°C로 안정적으로 유지되었습니다.
맺음말
HP Z2 Mini G1a는 올해 테스트한 시스템 중 가장 놀라운 제품 중 하나입니다. 겉보기에는 내장 그래픽이 탑재된 소형 데스크톱처럼 보입니다. 하지만 실제로 이 소형 워크스테이션은 특히 AI 워크로드에서 기대 이상의 성능을 꾸준히 제공합니다. 시중 가격은 약 3,300달러로, 고급 외장 GPU를 탑재한 시스템을 포함하여 훨씬 더 크고 비싼 시스템과 경쟁합니다.
이번 시스템을 통해 올해 초 리뷰했던 HP ZBook Ultra G1a 14인치 노트북을 다시 살펴볼 기회가 생겼습니다 . 당시 우리는 높은 가격과 부족한 성능, 특히 AI 관련 작업에서의 부진함에 실망했었습니다. 비슷한 AMD 하드웨어를 사용했음에도 불구하고, 이 노트북은 추론 처리에서 버벅거렸고, AI 성능이 광고 문구에 미치지 못한다고 지적했습니다. 당시 우리는 그다지 감명받지 못했습니다.
몇 달간의 소프트웨어 업데이트와 대규모 업데이트만으로도 얼마나 큰 변화를 가져올 수 있는지! AMD의 드라이버 및 런타임 지원에 대한 지속적인 노력 덕분에 Ryzen AI Max+ Pro 395는 이제 우리가 기대했던 성능을 발휘합니다. 128GB의 공유 메모리와 최대 96GB의 VRAM을 갖춘 Z2 Mini G1a는 OpenAI의 GPT-OSS 120B와 같은 대용량 로컬 모델을 놀라울 정도로 쉽게 실행할 수 있습니다. 이전에는 RTX 10,000 또는 이와 유사한 GPU가 장착된 6000만 달러짜리 워크스테이션이 필요했습니다. 이제는 훨씬 저렴한 가격으로 컴팩트한 케이스에 담을 수 있습니다.
HP는 단순한 부품 선택 이상의 가치를 제공합니다. Z2 Mini G1a는 강력한 방열 성능, 뛰어난 포트 유연성, 그리고 Flex IO 및 HP ZCentral Remote Boost와 같은 옵션 기능을 탑재하여 전문적인 환경에서 의미 있는 가치를 더하는 세심한 설계를 자랑합니다.
이 시스템은 소형 폼팩터 워크스테이션이 제공할 수 있는 기대치를 완전히 바꿔놓습니다. 인상적인 로컬 AI 성능, 지능형 디자인, 그리고 믿기 어려울 만큼 매력적인 가격이 결합되었습니다. 이러한 이유로 HP Z2 Mini G1a는 Editor's Choice 상을 수상했습니다. 그만큼 훌륭합니다.
순위표: HP Z2 Mini G1a는 외장 GPU가 없는 제품 중 로컬 AI용 최고의 데스크톱 순위에서 1위를 차지했습니다.
순위표: HP Z2 Mini G1a는 최고의 데스크톱 워크스테이션 순위표에서 최고의 미니 워크스테이션 자리를 차지하고 있습니다.
리더보드: 이러한 유형의 시스템에 대한 크기 조정 지침은 에이전트 AI용 RAM, GPU 및 스토리지 가이드에서 확인할 수 있습니다.


 아마존