

O evento Advancing AI 2026 foi o maior lançamento da AMD até o momento, tão grande que dividimos nossa cobertura em duas partes. Nosso primeiro artigo abordou o Instinct MI455X e o rack Helios com 72 GPUs; este artigo complementar cobre o que não coube confortavelmente ao lado deles: os processadores EPYC de 6ª geração para servidores, codinome Venice, e o processador host Verano. O processador merece um destaque especial. O Venice oferece até 256 núcleos e 512 threads por soquete, 1.6 TB/s de largura de banda de memória, a primeira interface PCIe Gen 6 em um processador para servidores e 18 vezes o desempenho do EPYC de primeira geração de 2017.
Venice também não é apenas um chip. É um portfólio, um ponto que a AMD repetiu em todas as apresentações: um perfil de CPU não serve para tudo. A mesma geração Zen 6 se desdobra em uma versão para alta densidade de processadores, uma versão para empresas, uma versão HPC com cache empilhado e uma versão de baixo consumo com LPDDR. Então, antes de falarmos sobre velocidades e especificações, vamos dar uma olhada na linha de produtos.
A programação de Veneza e Verano
A AMD divide os data centers modernos em três classes de servidores, e seu portfólio foi projetado para atender a todas elas. Servidores de CPU de uso geral executam os gateways da web, caches, camadas de aplicativos, bancos de dados e armazenamento dos quais tudo depende. Servidores de GPU precisam de uma CPU host que alimente os aceleradores, uma tarefa em que a velocidade de execução em um único núcleo e a largura de banda de E/S são mais importantes do que a quantidade de núcleos. A terceira classe é a de servidores de CPU de alta densidade para o código de orquestração e execução de ferramentas que surgiu em torno dos serviços de IA; esse código é repleto de ramificações e propenso a travamentos, e, acima de tudo, exige threads.
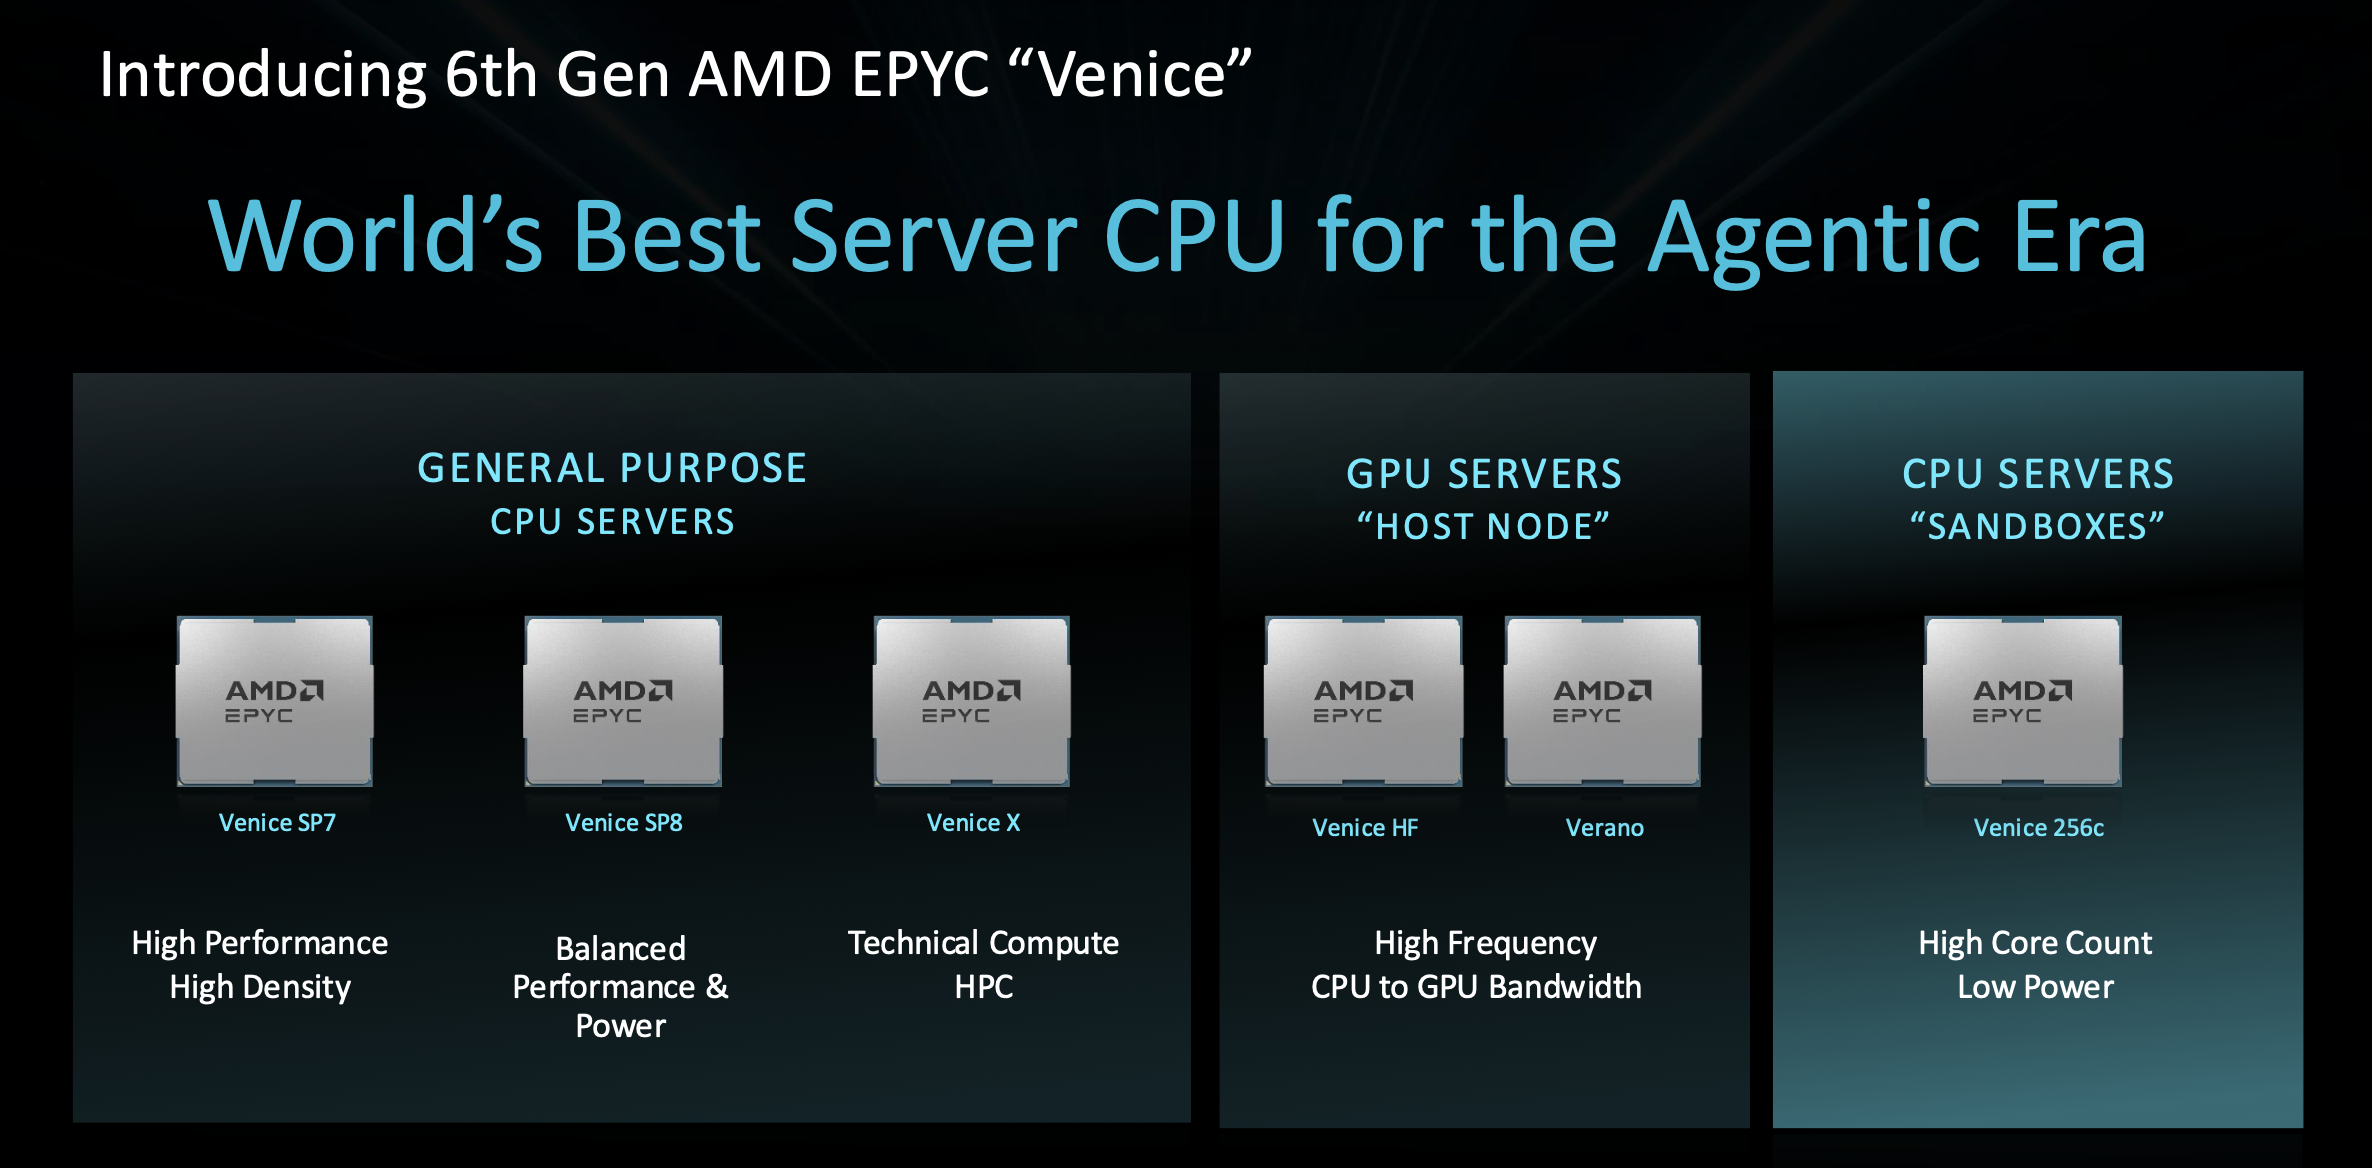
A linha de produtos consiste em quatro plataformas, que chegam em ondas: Venice SP7 no quarto trimestre de 2026, Venice SP8 no primeiro semestre de 2027 e Venice-X e Verano no segundo semestre. A AMD divide o mesmo silício em seis partes, e a versão mais refinada é alocada diretamente em três níveis. A linha de uso geral recebe Venice SP7, SP8 e Venice-X. A linha para servidores host combina um processador Venice de alta frequência com o Verano e sua memória LPDDR. A linha de computação de alta densidade recebe o que a descrição chama de Venice 256c: alta contagem de núcleos com baixo consumo de energia, projetado para acomodar o máximo de threads possível em um rack, dentro dos limites de energia disponíveis. O Verano também tem uma função secundária: a AMD afirma que clientes selecionados o utilizarão como um processador de uso geral, onde o desempenho por watt do sistema for o fator limitante.
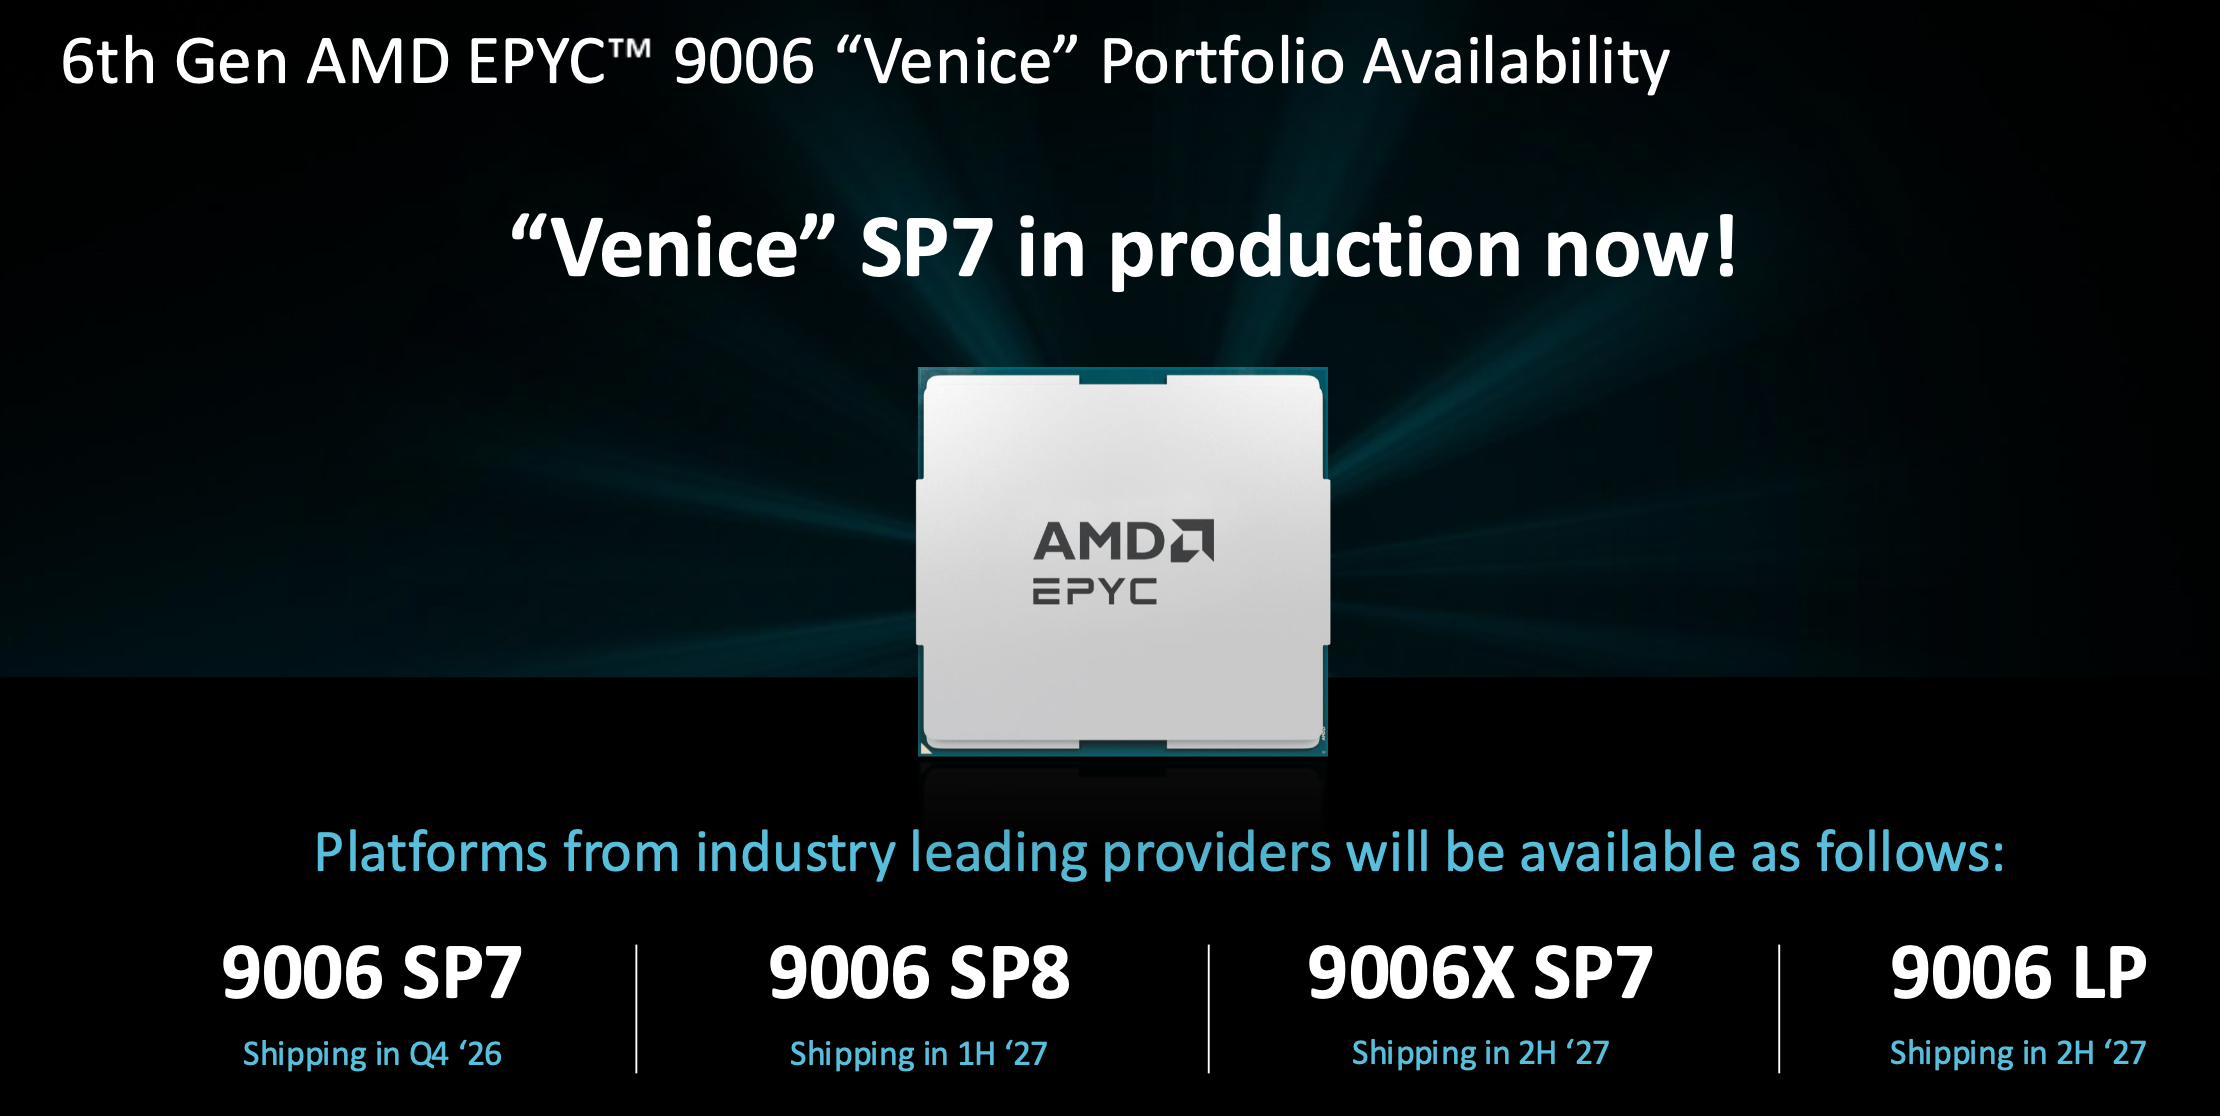
Graças às notas de rodapé, temos um vislumbre das especificações dos processadores. O EPYC 9996 de 256 núcleos lidera a linha, o 9956 possui os mesmos núcleos com 400 W de potência, e o 9686F de 96 núcleos é o processador host de alta frequência. A Helios tem sua própria versão desse silício host, o EPYC 9G76, em cada unidade de computação.
O nível sem concessões
Antes das especificações técnicas, uma palavra sobre a posição do socket Venice SP7. O Venice SP2 é reservado para a linha de servidores de alto desempenho da AMD, sem concessões: data centers, hiperescaladores e computação de alto desempenho (HPC), onde a taxa de transferência por rack é o fator decisivo, sem economia de custos. Os fabricantes de servidores já estão reestruturando seus produtos em torno dele. A Dell dividiu seu esquema de nomenclatura PowerEdge, já consolidado, para abrir espaço, e essa classe de computação agora faz parte da nova série 9000, liderada pelo PowerEdge R9825 e pelo Rack Scale M9825, os modelos topo de linha com dois chips Venice em um chassi 3U.
Especificações principais
Toda a família constrói sobre uma única plataforma, e quase todos os seus cantos são novos desde Turim.
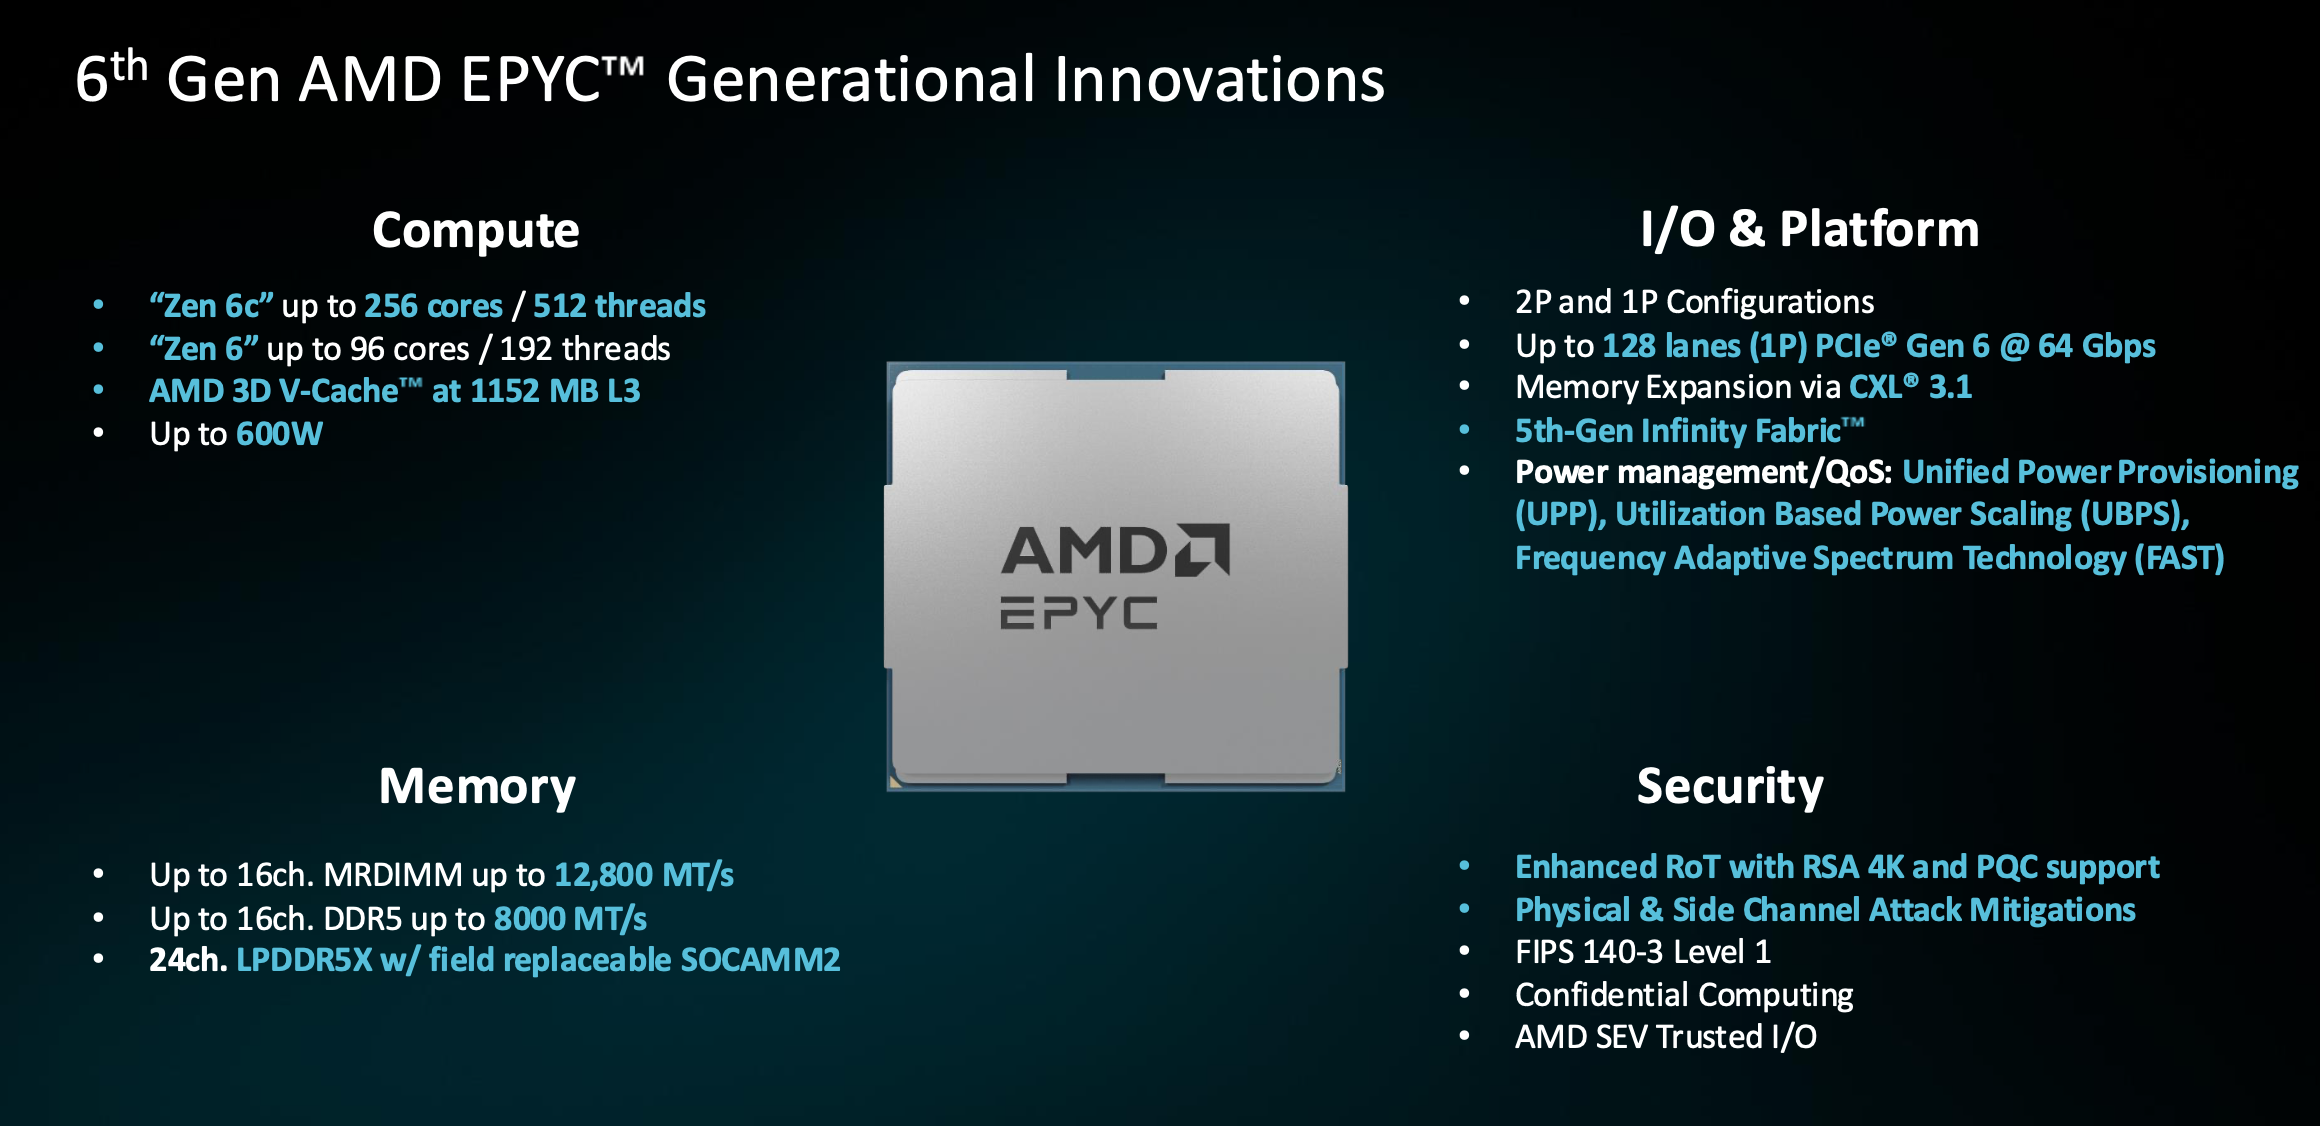
Comecemos pelos núcleos. O Zen 6 vem em duas versões: o compacto Zen 6c, com 256 núcleos e 512 threads em um soquete, suporta até 600W, enquanto a versão padrão tem 96 núcleos, mas atinge 5GHz de clock. A AMD afirma um desempenho por núcleo até 20% superior ao de processadores concorrentes com a mesma quantidade de núcleos, e a densidade não reduz o cache: mesmo o die de 256 núcleos mantém cerca de 4MB de cache L3 por núcleo, chegando a um gigabyte no modelo topo de linha. O AVX-512 lida com os tokenizadores e os modelos de 3 a 8 bilhões de parâmetros que são cada vez mais executados na própria CPU.
Alimentar esses núcleos exige um sistema de memória muito maior: 16 canais de DDR5 a 8,000 MT/s ou MRDIMM a 12,800 MT/s, o que permite 1.6 TB/s por soquete, enquanto o Turin atingia 614 GB/s com 12 canais. A E/S também evoluiu significativamente. O Venice é o primeiro processador de servidor com PCIe Gen 6, com 128 pistas a 64 GT/s, o dobro da largura de banda por pista de qualquer outro dispositivo conectado a aceleradores atualmente, e a base da afirmação sobre o nó host que analisaremos mais adiante. O CXL 3.1 utiliza essas pistas para expansão de memória, e algumas plataformas host de IA com dois soquetes priorizam a E/S em detrimento da largura de banda xGMI entre soquetes, alcançando 160 pistas utilizáveis. Duas adições mais silenciosas movimentam dados sem sobrecarregar os núcleos: o SDXI descarrega as cópias de memória e o equivalente a 30 a 50 núcleos em criptografia, e a Injeção Inteligente de Cache de Dados (Smart Data Cache Injection) coloca os pacotes de rede diretamente no cache em vez de roteá-los pela DRAM.
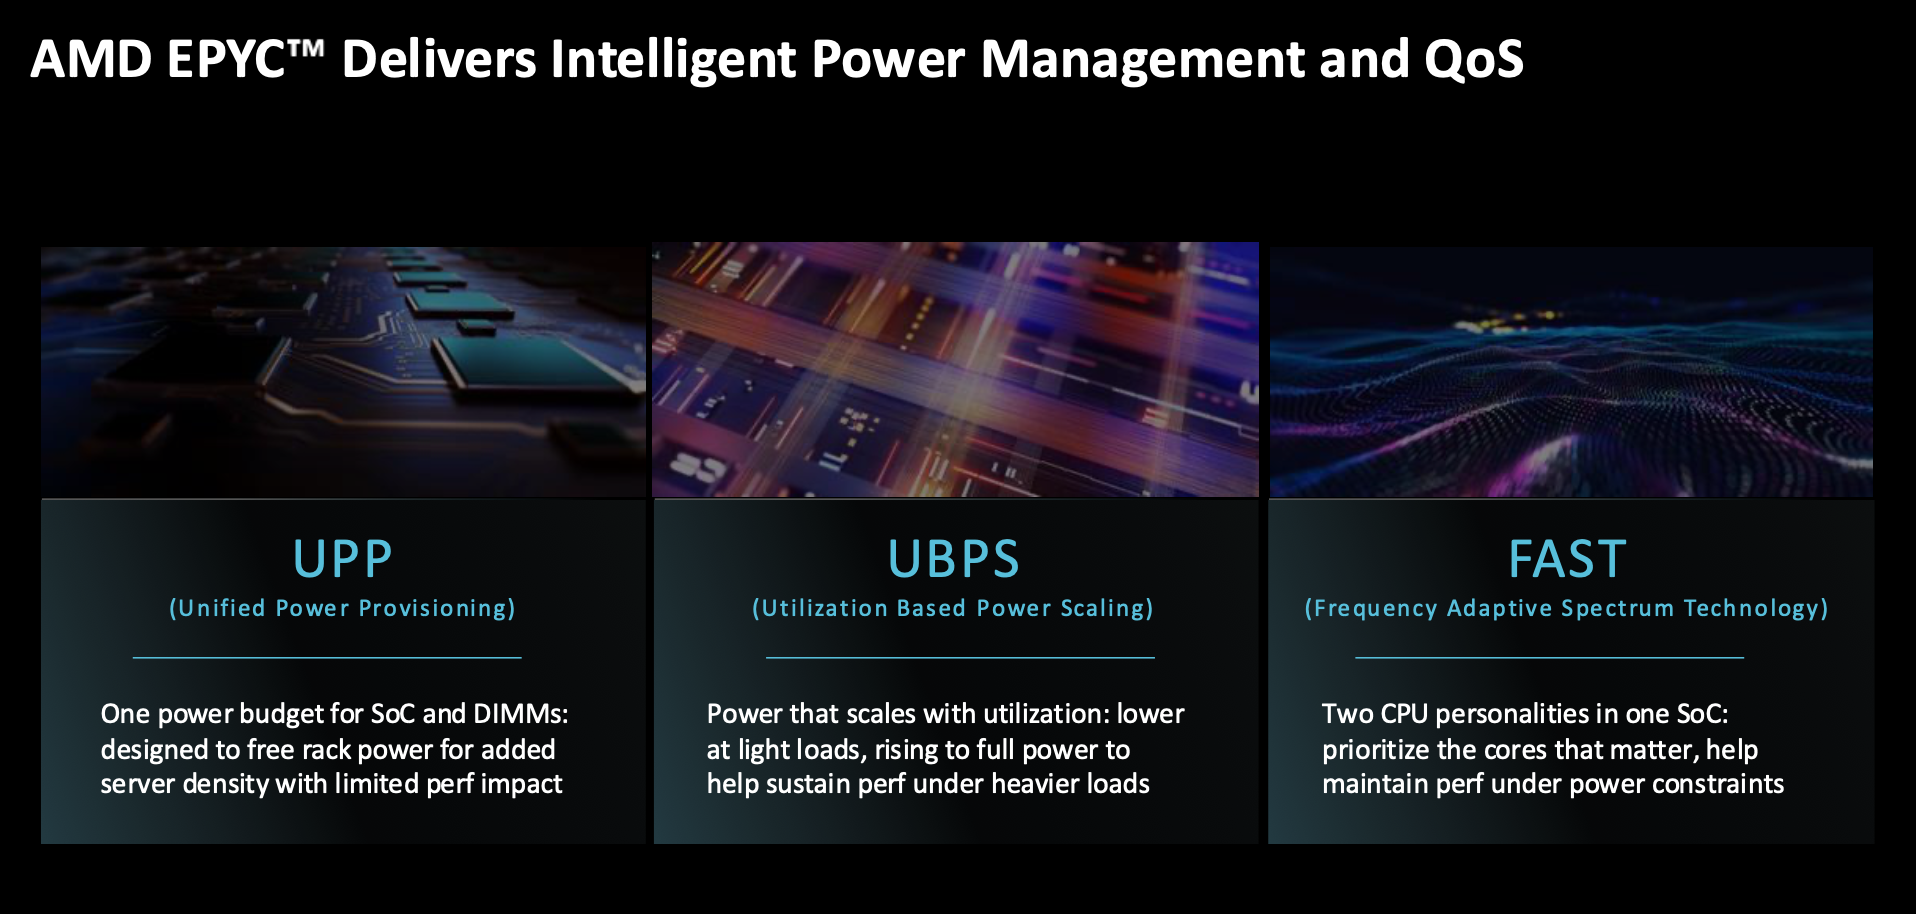
O gerenciamento de energia recebe três novos parâmetros, e eles são importantes porque todas as comparações de racks que a AMD fizer posteriormente serão feitas dentro de um orçamento de energia. O UPP combina os orçamentos do SoC e dos DIMMs em um só, de modo que uma carga de trabalho com uso intensivo de memória transfere energia para os DIMMs e uma carga com uso intensivo de computação os reduz, o que aumenta o desempenho dentro de um orçamento fixo ou libera energia do rack para mais nós. O UBPS limita o consumo de energia em baixa utilização, trocando o aumento de desempenho usual em cargas leves por uma linha de carga plana e previsível; os operadores que preferirem o aumento podem desativá-lo. O FAST divide um SoC em duas personalidades, mantendo os núcleos prioritários em alta frequência enquanto os núcleos em segundo plano operam em frequências mais baixas, para que o trabalho crítico em termos de latência que compartilha um soquete com trabalhos em lote não seja prejudicado.
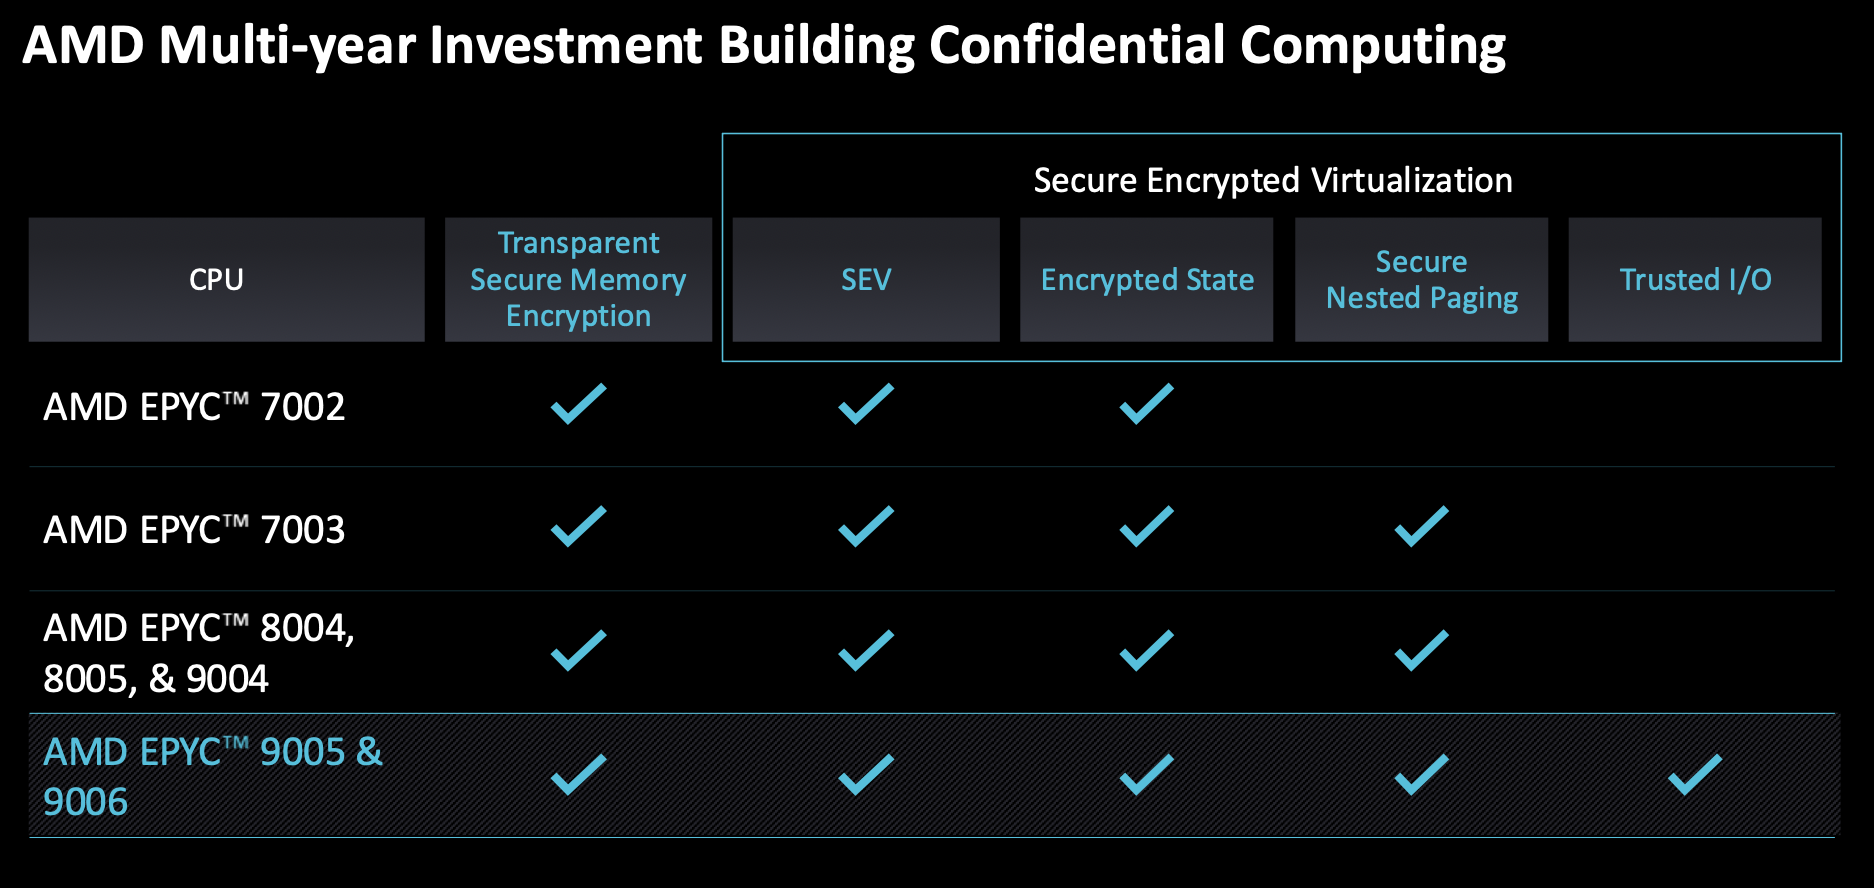
Em termos de segurança, o Venice dá continuidade a uma linhagem de computação confidencial que vai do SEV no EPYC 7002, passando por estado criptografado, paginação aninhada segura e o Trusted I/O, introduzido com o Turin. Novidades desta geração: uma raiz de confiança aprimorada com RSA-4K e algoritmos pós-quânticos, mitigação de ataques físicos e de canal lateral, certificação FIPS 140-3 Nível 1 e Device Provenance, um histórico de fabricação atestável que o Venice estará entre os primeiros produtos da AMD a possuir.
Dentro do Portfólio
As quatro partes diferem mais do que o nome comum sugere.
| Especificação | 9006 SP7 | 9006 SP8 | 9006X SP7 | 9006 LP “Verano” |
|---|---|---|---|---|
| Núcleos | Até 256 (512 fios) | 8 a 128 | Até 96 | Até 72 |
| Frequência de pico | 5.0 GHz com 96 núcleos (HF) | Opções de HF oferecidas | ~ 5.15GHz | Até 5.0GHz |
| Memória | 16 canais, até 1.6 TB/s | 8 canais com 2 DIMMs por canal | MRDIMM de 16 canais a 12,800 MT/s | 24 canais LPDDR5X, SOCAMM2 |
| cache de L3 | Até 1024 MB | Dependente da contagem de núcleos | 1152 MB (V-Cache 3D) | Dependente da contagem de núcleos |
| I / O | PCIe Gen 6, 96 pistas | 128 pistas PCIe, 1P e 2P | PCIe Geração 6 | xGMI aprimorado a 112 GT/s |
| Destinado a | Densidade em hiperescala, host de IA | Empresarial, edge computing, compatível com NEBS | HPC, pré-processamento de IA | Host de IA em escala de rack |
EPYC 9006 SP7
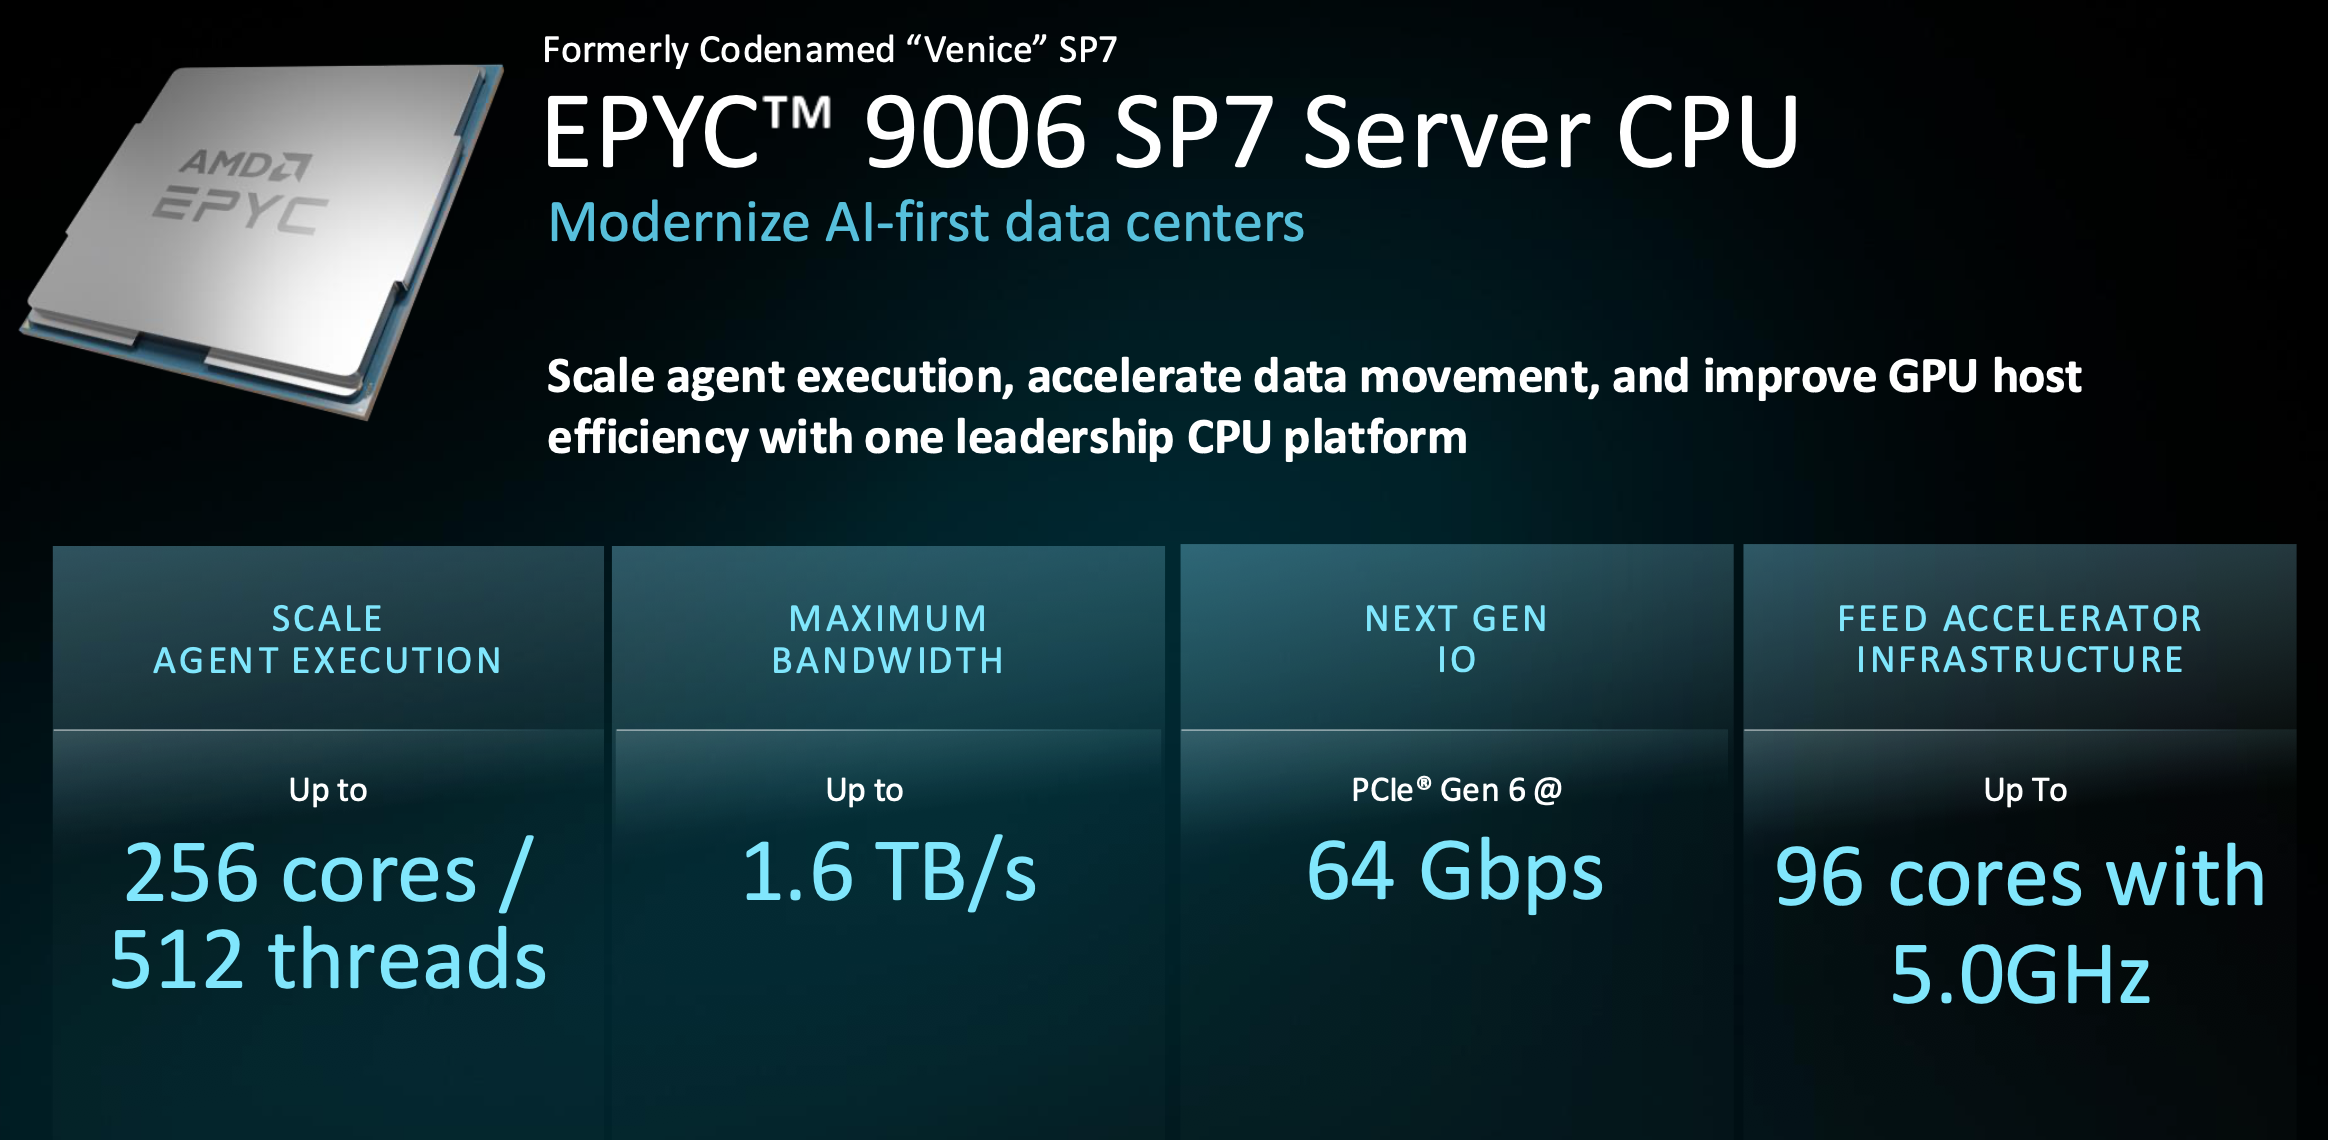
O SP7 é o socket principal e o que está em produção atualmente; as plataformas de parceiros chegarão no quarto trimestre. Seus processadores de alta frequência sucedem os componentes Turin HF, que, segundo a AMD, estavam entre seus SKUs de lançamento mais rápido, e sua maior implementação é no Helios, onde a CPU host em cada bandeja de computação se integra ao domínio de memória coerente do rack por meio do Infinity Fabric, com 1 TB de DDR5. Como o socket é padrão, qualquer SKU SP7, até mesmo o modelo principal de 256 núcleos, é compatível, um ponto que abordamos no artigo complementar.
EPYC 9006 SP8
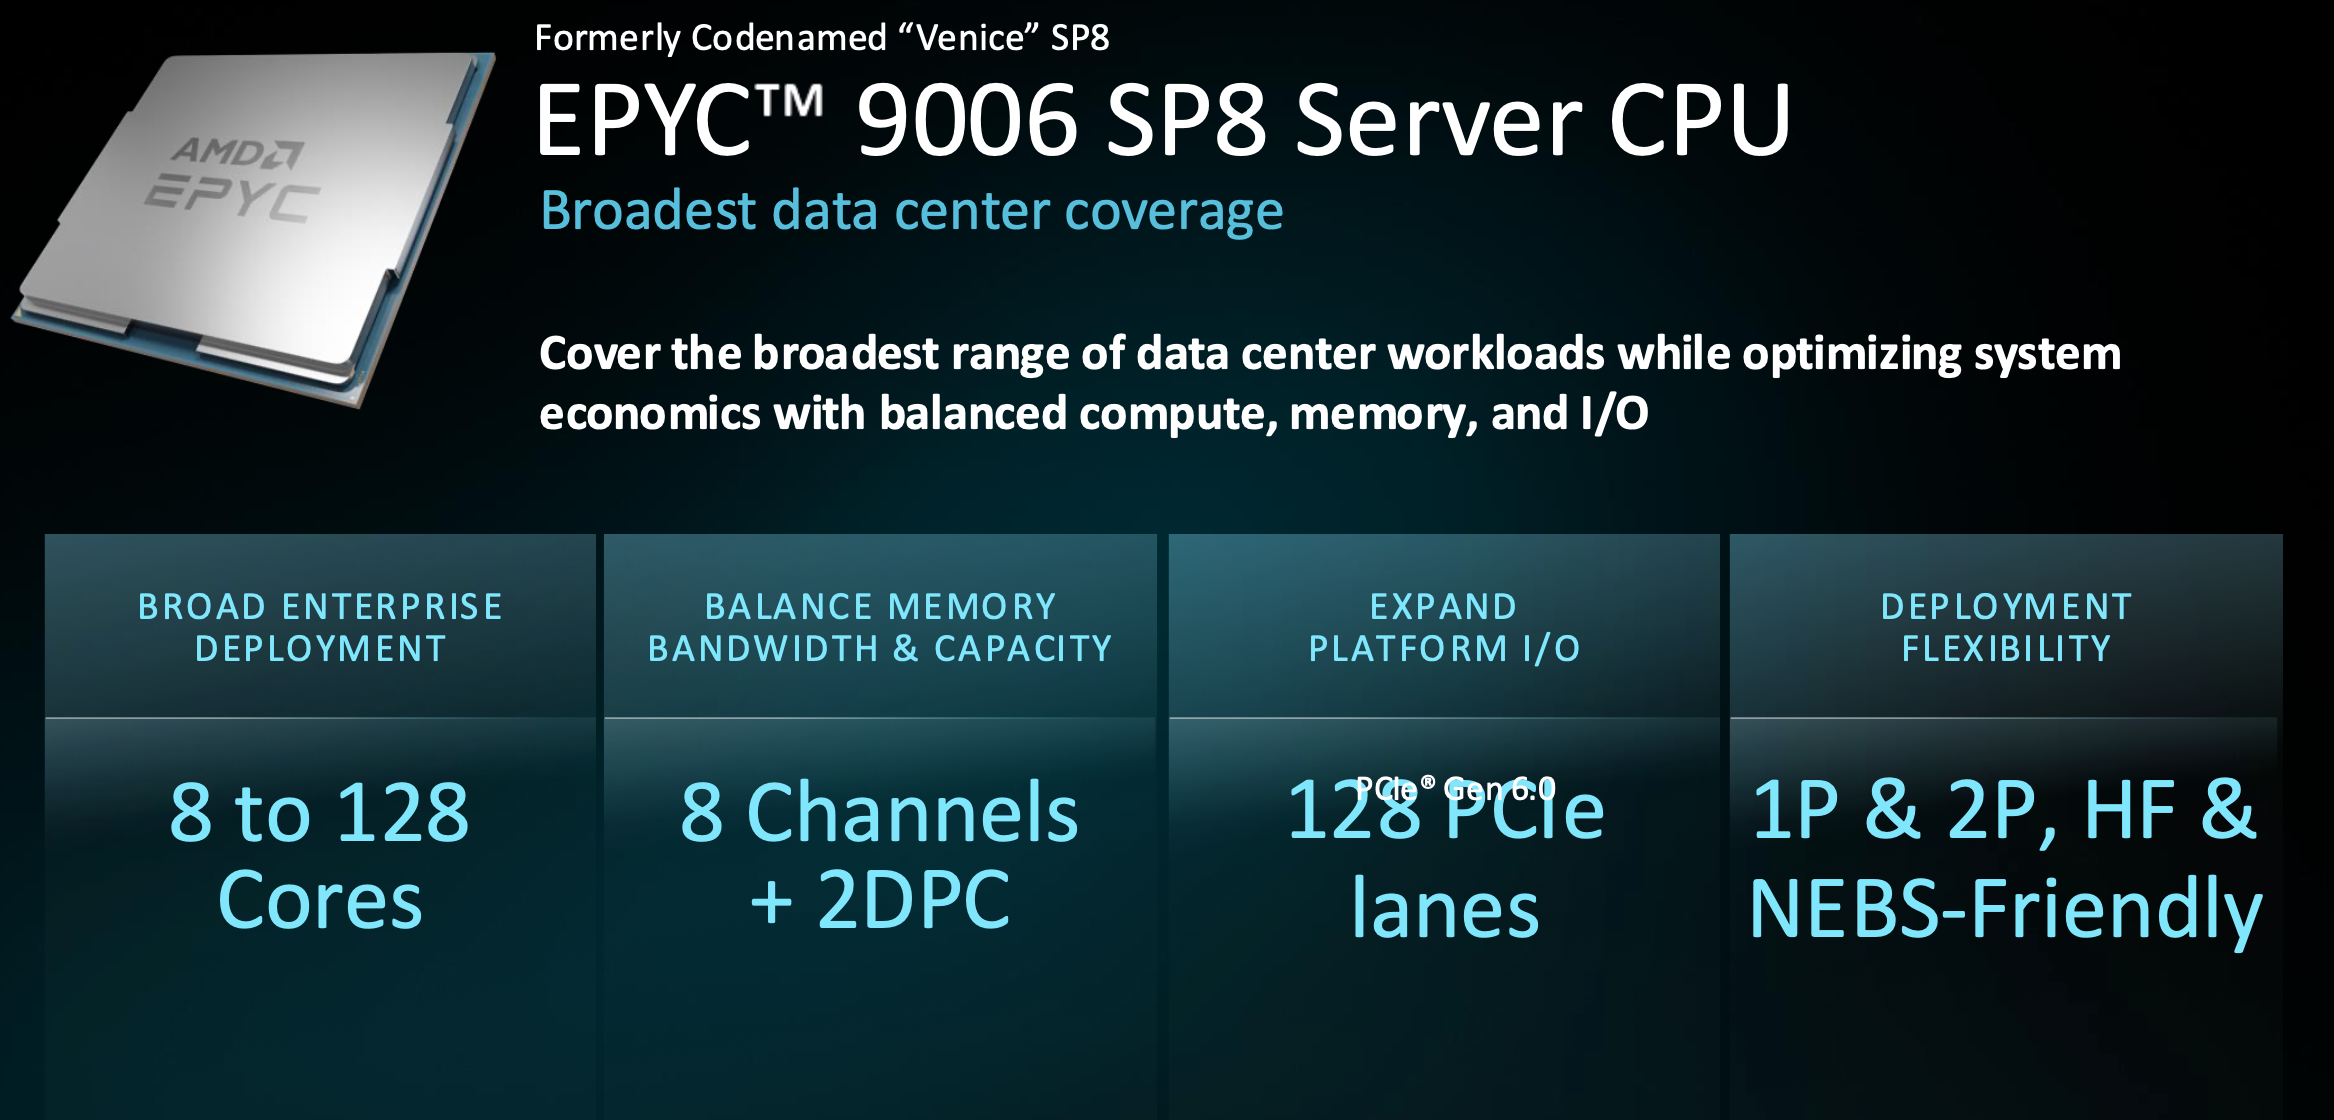
O SP8 troca o soquete gigante por economia de sistema. Ele abrange de 8 a 128 núcleos, opera com 8 canais de memória com 2 DIMMs por canal, mantém 128 pistas PCIe e está disponível em versões 1P e 2P com opções de alta frequência e compatíveis com NEBS para implantações em telecomunicações e edge computing. A proposta da AMD é desempenho sob medida para empresas, onde a métrica que fecha negócios é o desempenho por dólar investido no sistema, e não por rack.
EPYC 9006X “Venice-X”
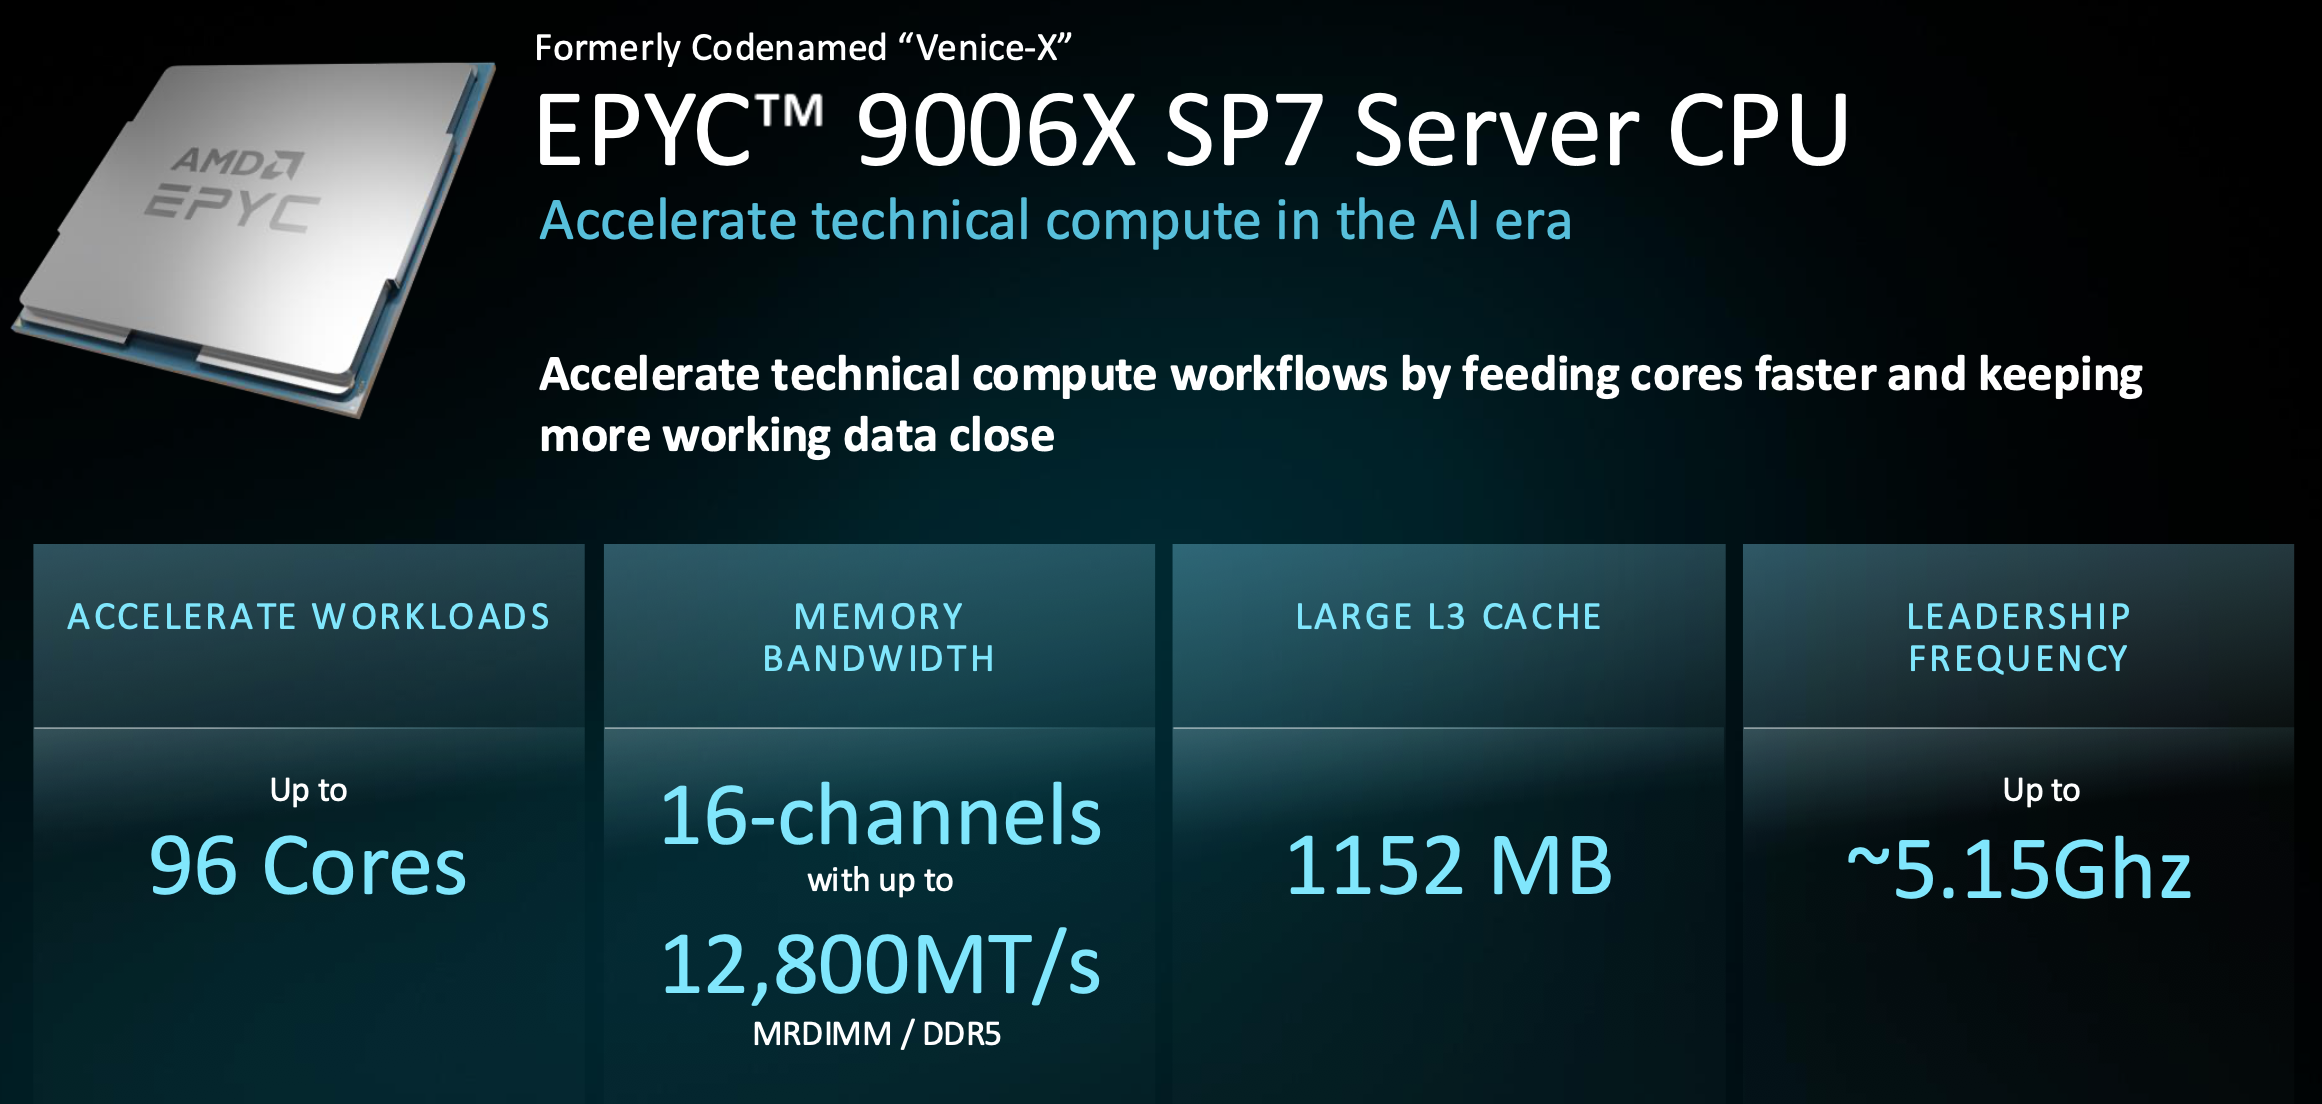
A arquitetura Venice-X incorpora o V-Cache 3D na configuração de alta frequência de 96 núcleos e eleva o cache L3 para 1152 MB, aproximadamente o triplo da quantidade de cache por núcleo em comparação com os processadores SP7 padrão. As frequências atingem cerca de 5.15 GHz, e o sistema de memória completo de 16 canais e 12,800 MT/s é mantido. Os alvos de aplicação são simulação e modelagem, análises em larga escala, bancos de dados em memória e pré-processamento de IA para pipelines de treinamento — cargas de trabalho onde um conjunto de dados em cache é mais importante do que núcleos adicionais.
EPYC 9006 LP “Verano”
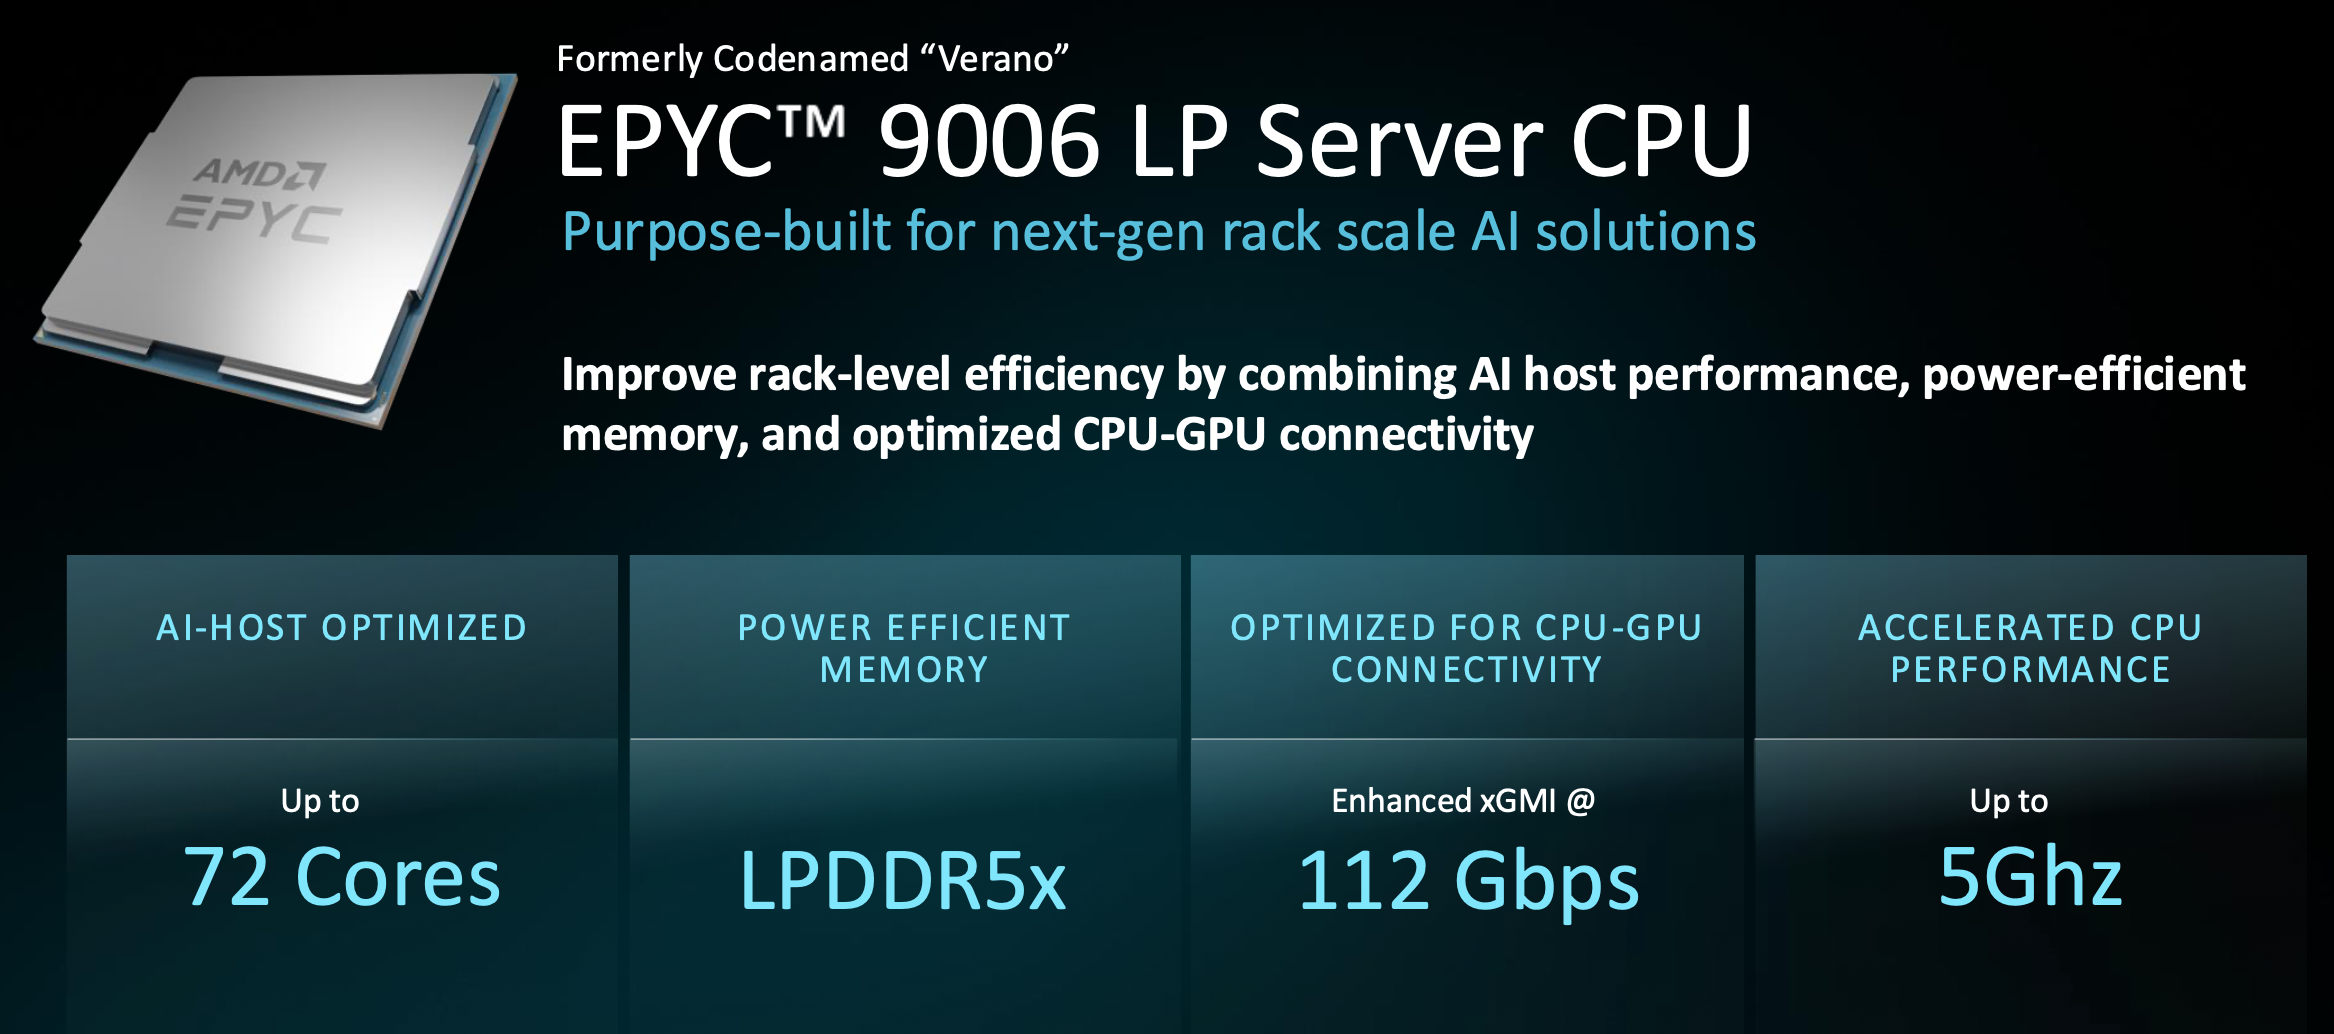
O Verano é o componente mais focado da família: um nó host de IA em primeiro lugar, com até 72 núcleos a 5 GHz, 24 canais de LPDDR5X e um link xGMI aprimorado de 112 GT/s para tráfego de CPU para GPU. A memória LPDDR está em módulos SOCAMM2 que podem ser substituídos em campo, o que é importante em uma frota onde uma falha na memória soldada inviabilizaria toda a placa. É também a resposta direta da AMD ao Vera da NVIDIA, uma comparação que abordaremos mais adiante, pois a AMD certamente abordou esse tema.
Como Veneza se compara
A AMD apresentou suas propostas em duas etapas, começando por Turim para mostrar a vantagem que já detém e, em seguida, por Veneza para demonstrar o quanto está se distanciando.
A vantagem de Turim hoje
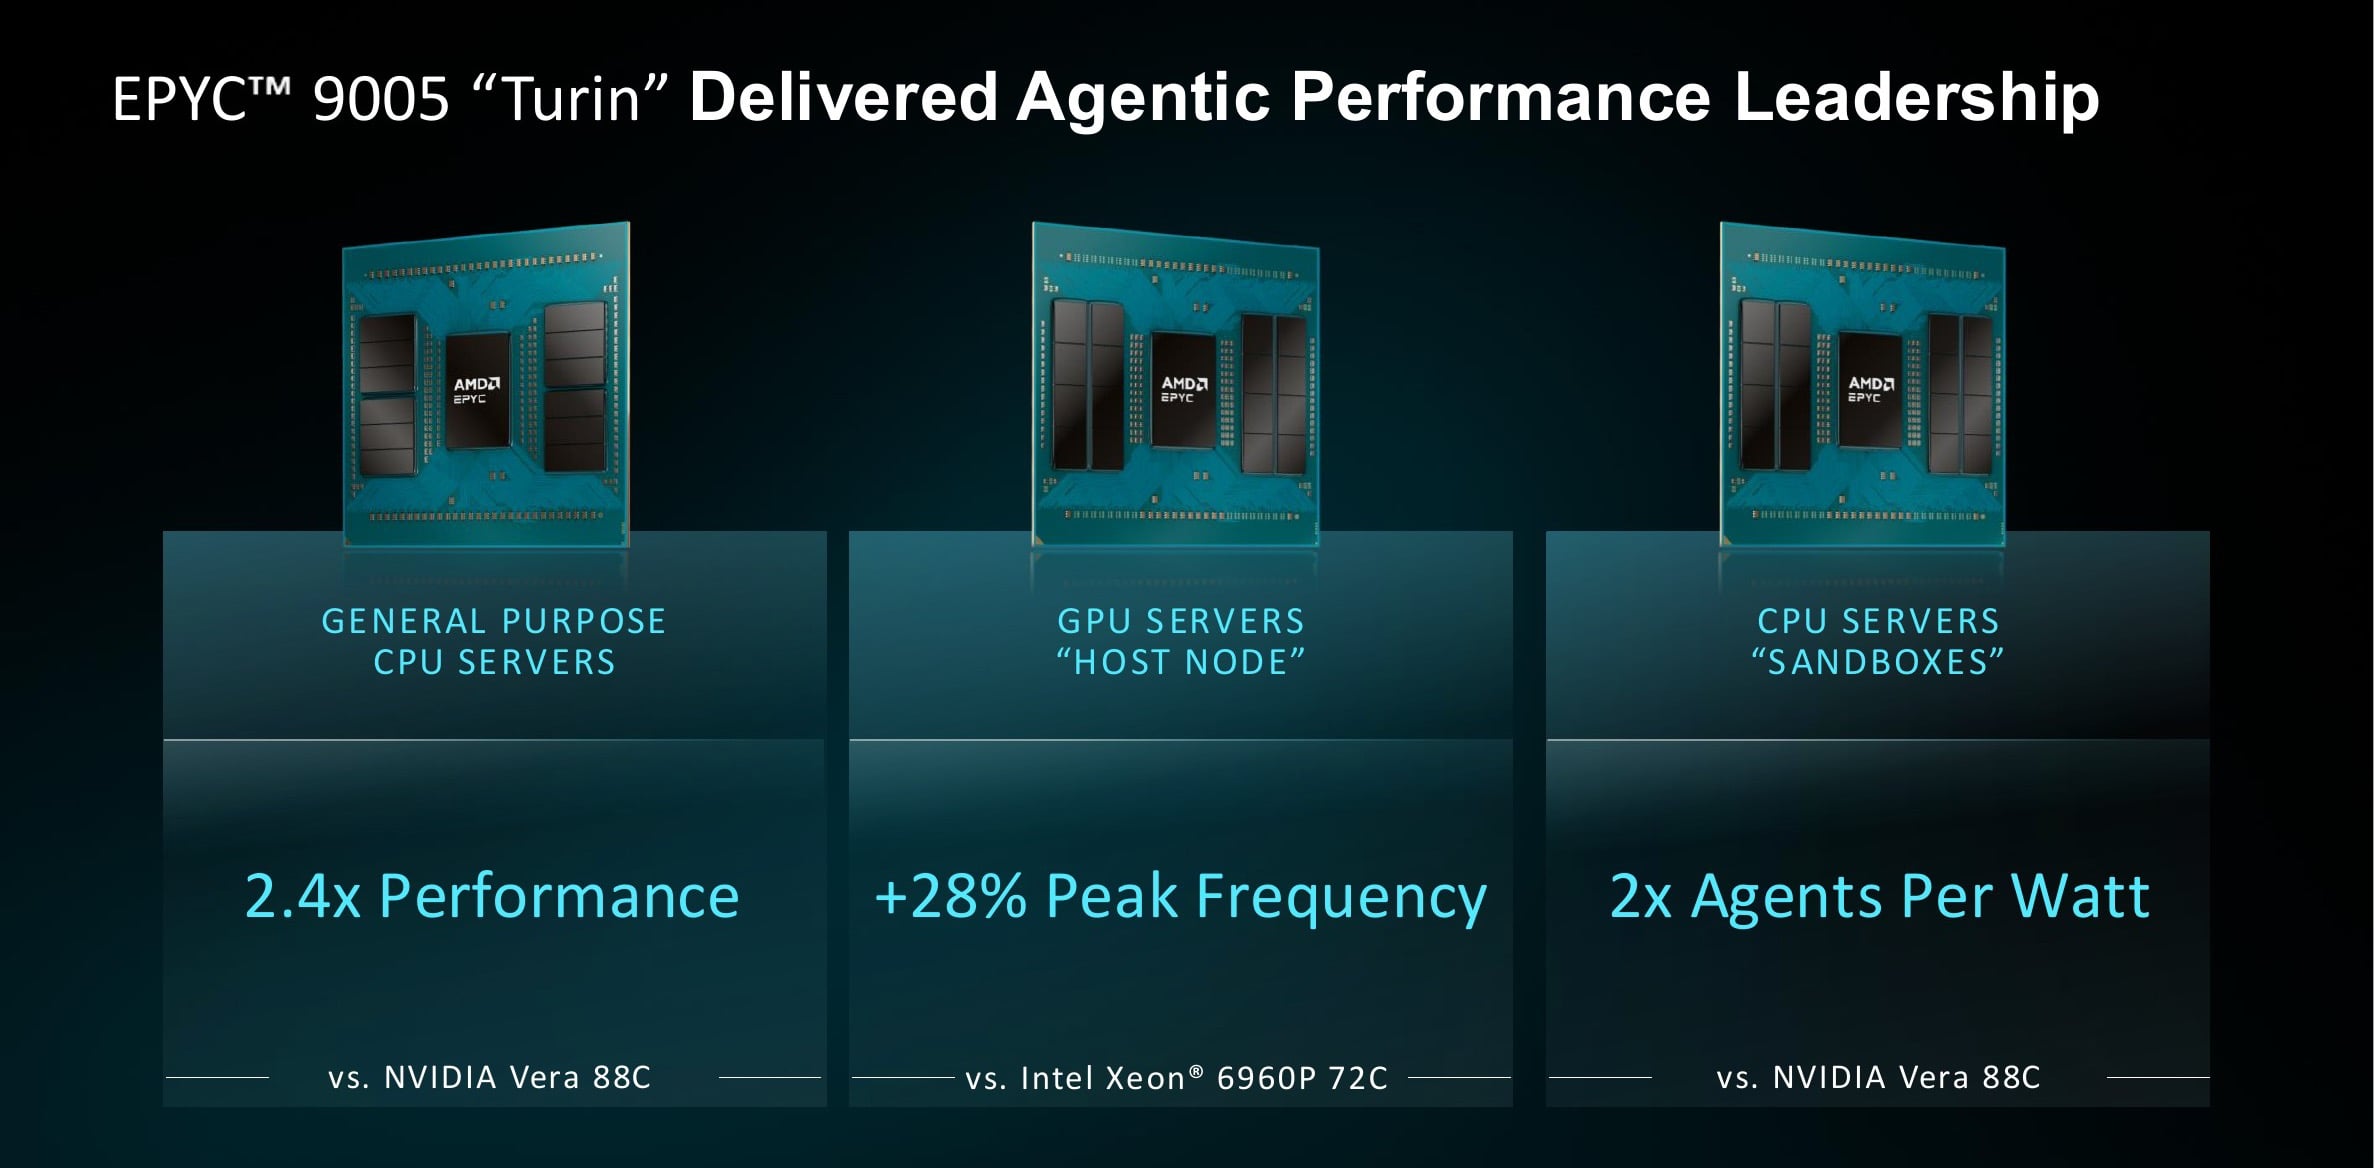
A AMD direcionou a maior parte de suas comparações para o Vera da NVIDIA, a CPU Arm na plataforma Vera Rubin, e começou com a geração que já está disponível no mercado. De acordo com a modelagem em nível de rack da AMD, um rack de Turin oferece 2.4 vezes o desempenho de uso geral do Vera e o dobro de agentes por watt. O modelo fixa ambos os racks em um orçamento de energia de 100 kW, compara um EPYC 9965 de 2 processadores com 384 núcleos a uma placa Vera de 2 processadores com 176 núcleos e calcula a média dos resultados em seis cargas de trabalho: SPECrate 2017 estimado, Java do lado do servidor, NGINX, Redis, Memcached e um derivado de TPC-C.
Duas ressalvas se aplicam aqui e ao restante deste artigo. O Vera ainda não foi lançado, portanto, todos os números referentes ao Vera são estimativas da AMD para o processador de 88 núcleos e 450 W descrito pela NVIDIA em seus materiais públicos. Além disso, como não existe um benchmark padrão para cargas de trabalho com agentes, a AMD considera os threads de hardware como uma aproximação para agentes em seus cálculos de agentes por watt.
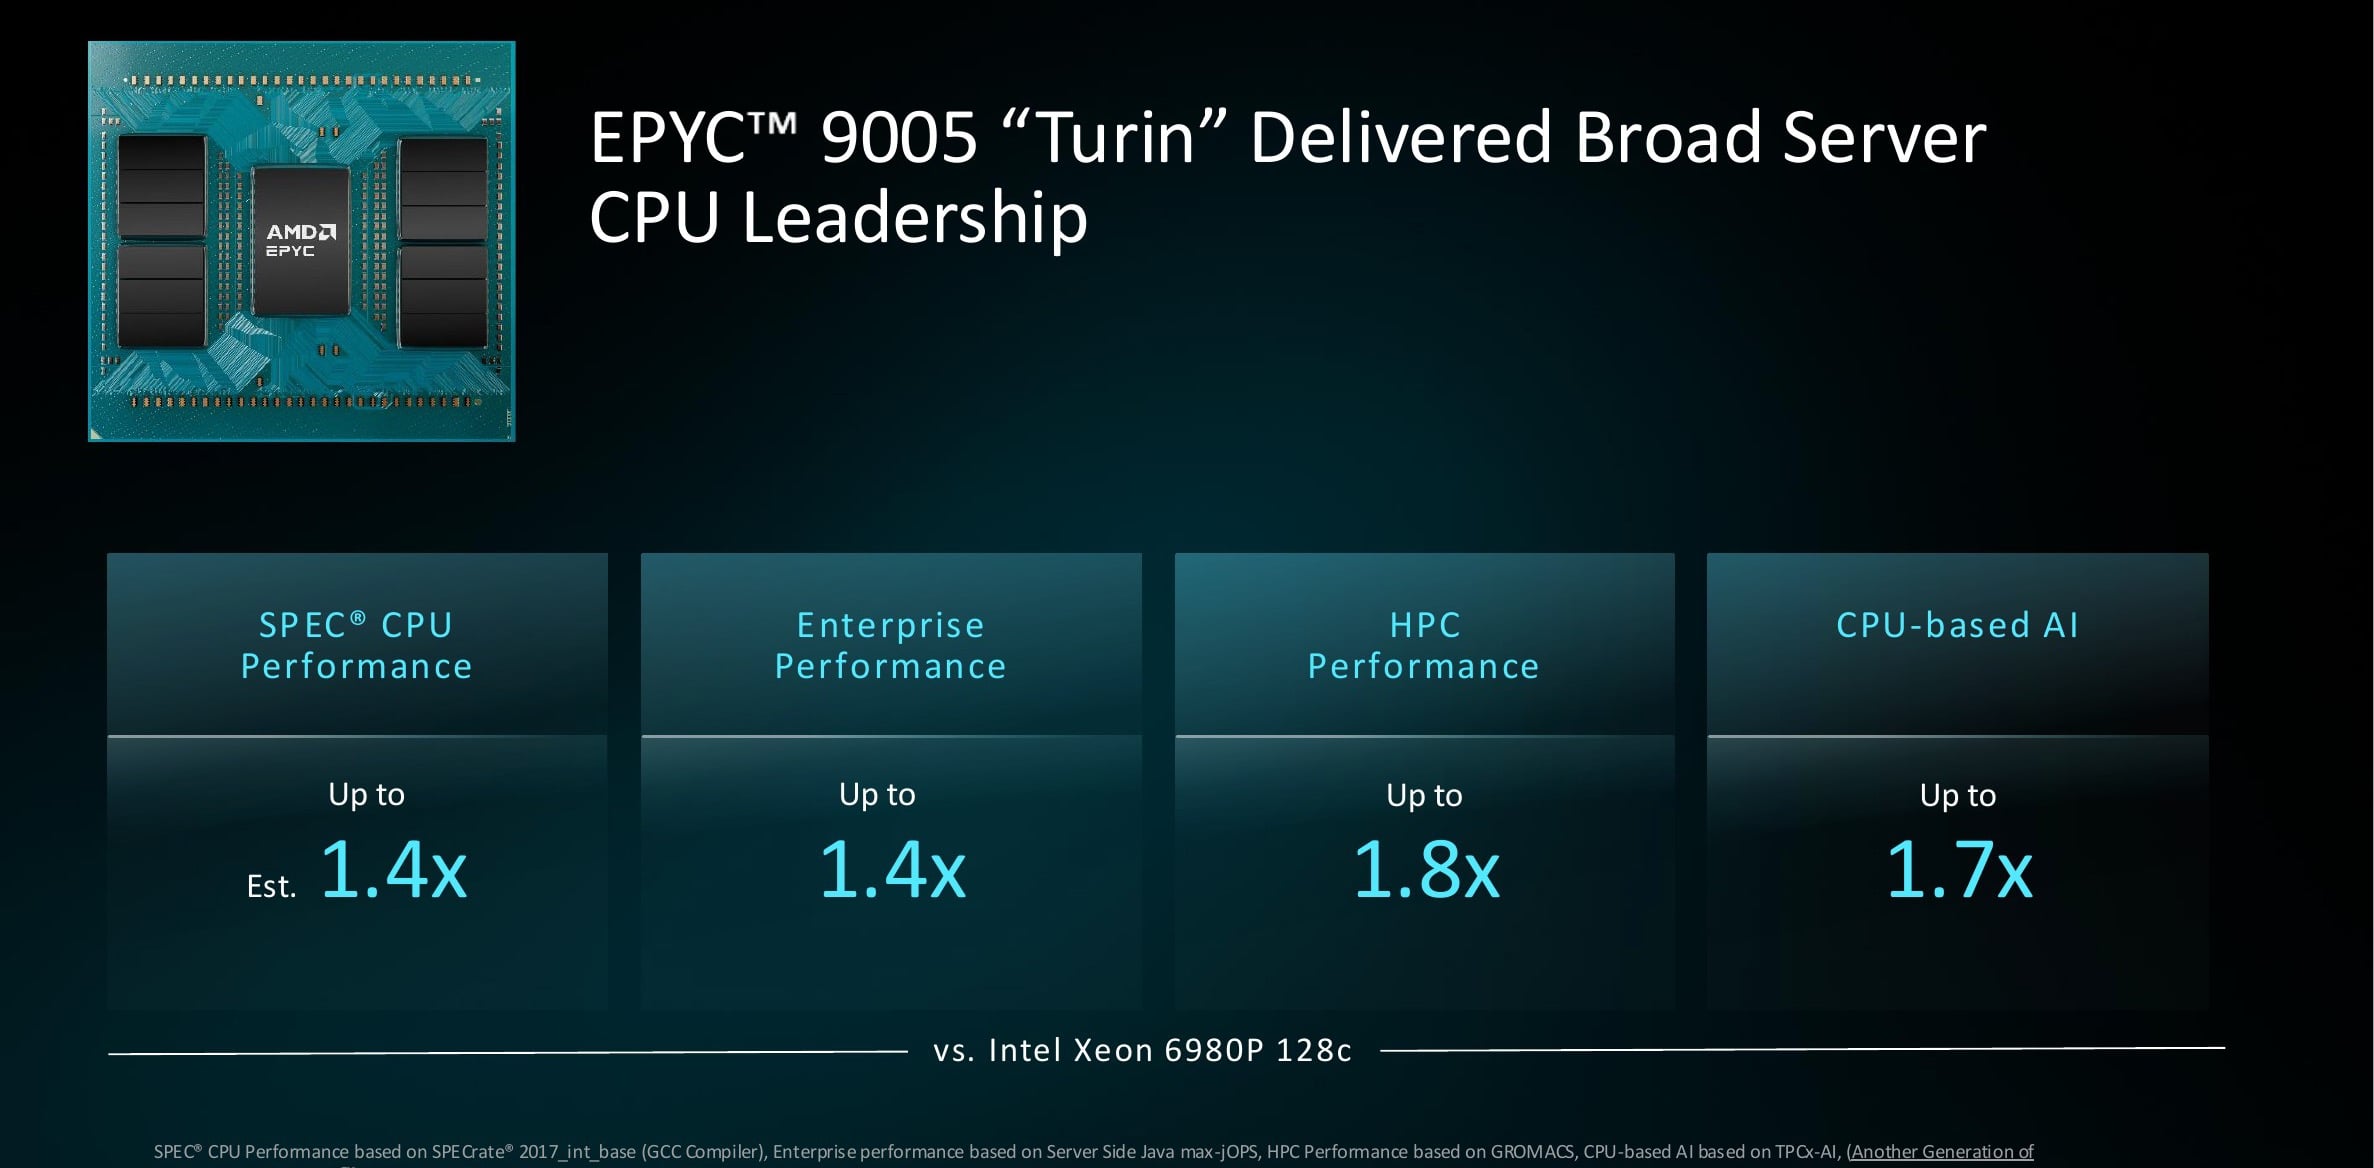
A comparação com a Intel se baseia em fundamentos mais sólidos, já que ambas as empresas utilizam componentes que a AMD pôde testar diretamente. Os processadores do Turin atingem 5.0 GHz, enquanto o Xeon equivalente chega a 3.9 GHz, uma vantagem de frequência de 28% que faz diferença quando threads individuais alimentam as GPUs. Comparando soquete por soquete com o Xeon 6980P de 128 núcleos, a AMD mede o desempenho do Turin em até 1.4 vezes superior no SPEC CPU, 1.4 vezes superior em Java empresarial, 1.8 vezes superior em HPC e 1.7 vezes superior em IA baseada em CPU.
Veneza amplia cada lacuna
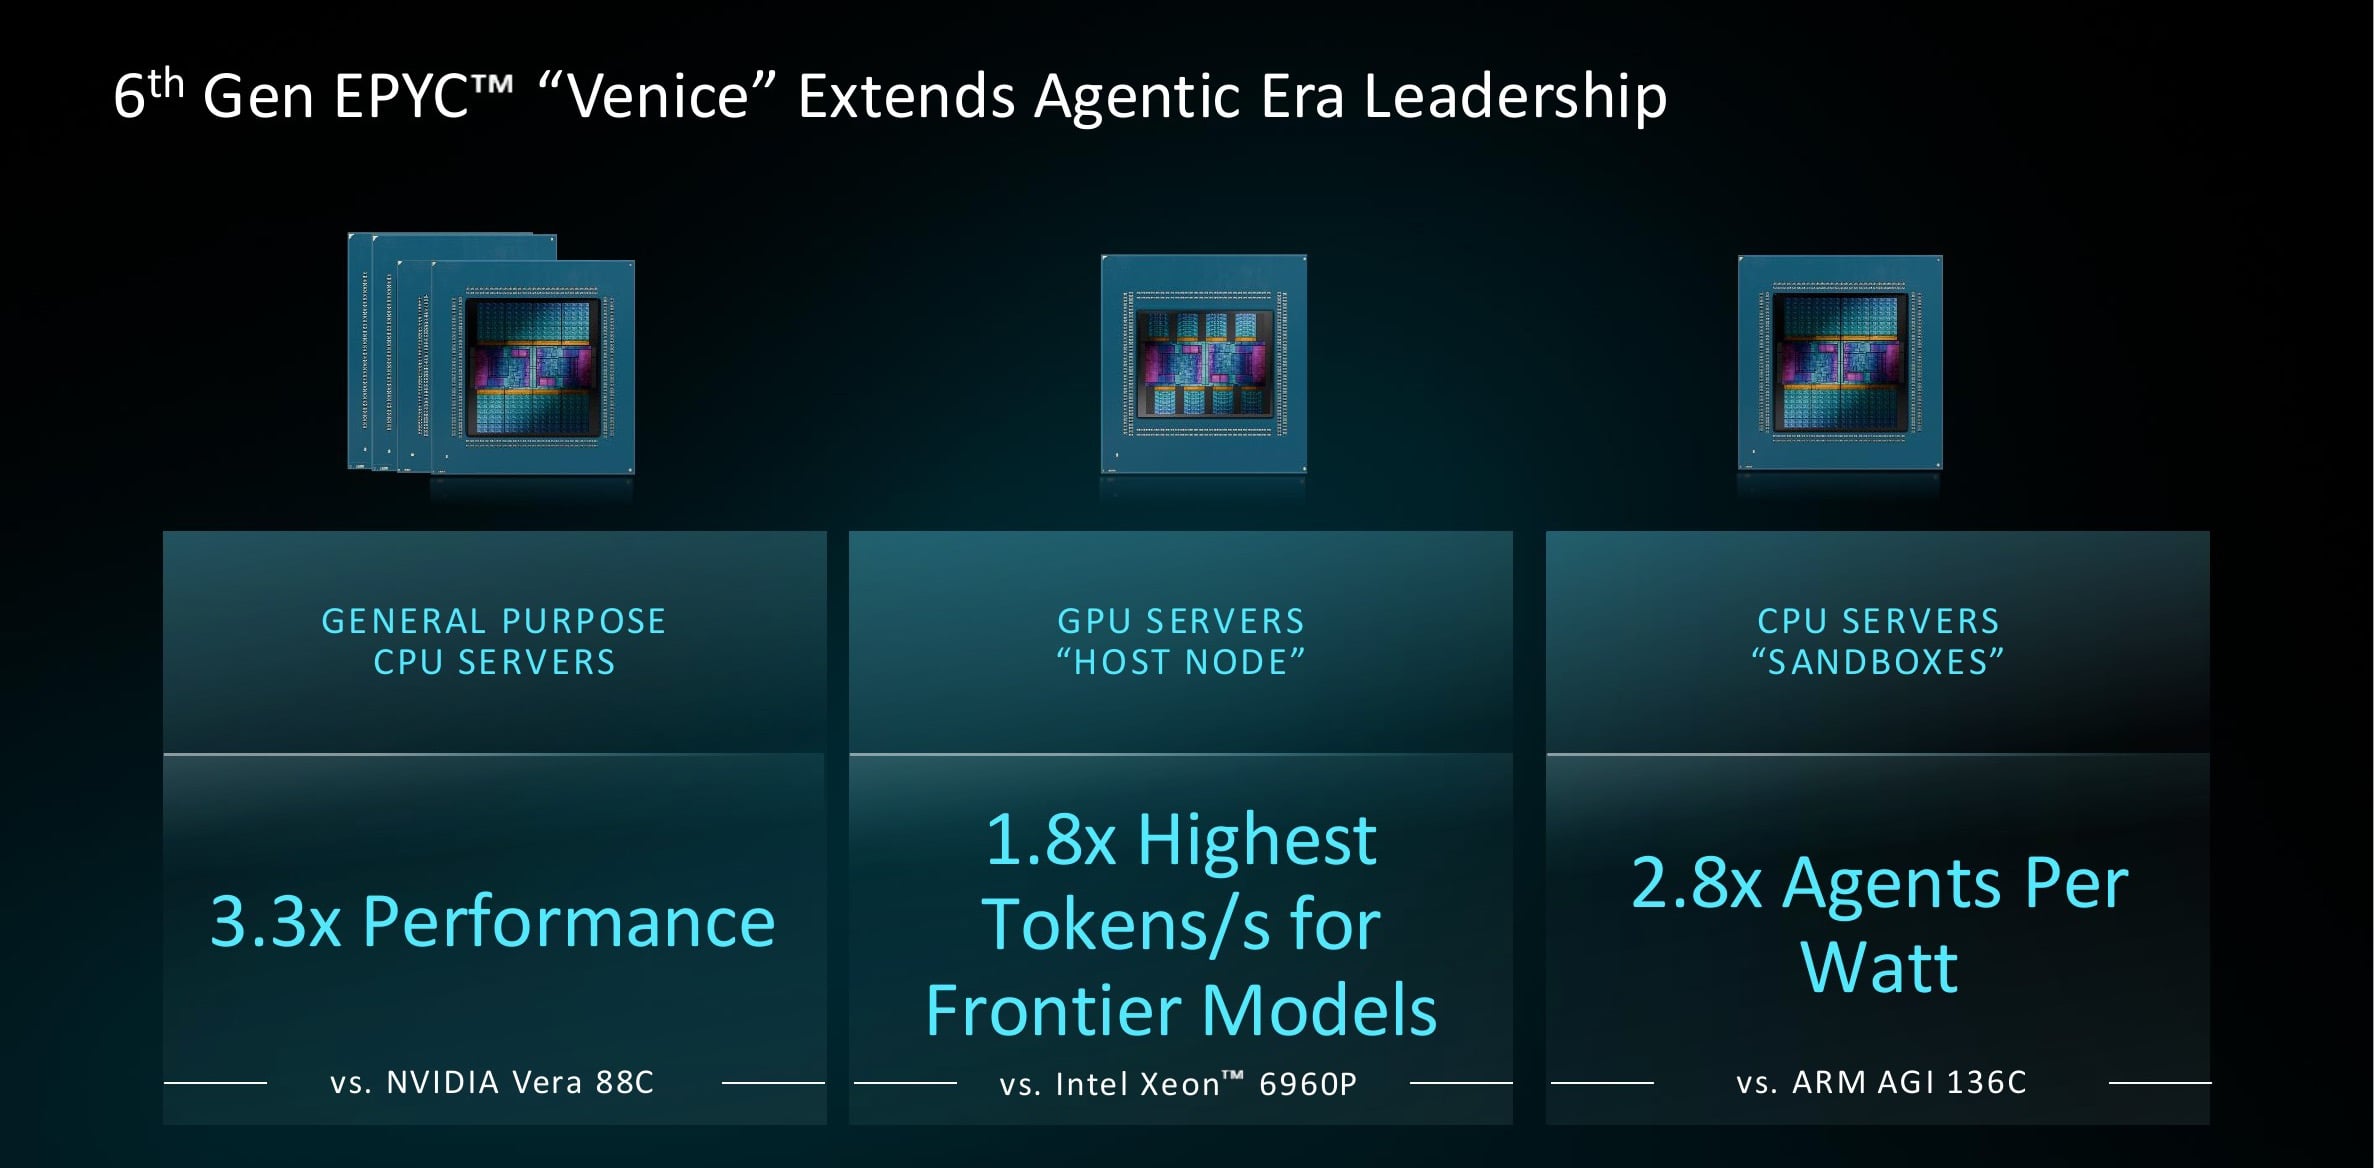
Venice amplia cada uma dessas vantagens. No mesmo modelo de rack de 100 kW, agora com 512 núcleos Venice contra os 176 do Vera, a AMD afirma um desempenho 3.3 vezes superior ao do Vera em aplicações de uso geral. O Venice atinge 2.8 vezes mais agentes por watt do que o AGI Arm de 136 núcleos e 1.8 vezes mais tokens por segundo em modelos de ponta quando o Venice hospeda GPUs. Esse valor de 1.8 vezes mede um cenário mais específico do que o título sugere, e voltaremos a ele na seção sobre nós host abaixo.
Confronto direto com Vera
No SPECrate 2026, a AMD estima que o Venice 9996 de 2 processadores terá desempenho semelhante ao da RTX 2070, contra 925 do Vera, uma vantagem de desempenho de 2.2 vezes. Isso coloca o processador de 96 núcleos e alta frequência com um desempenho cerca de 1.2 vezes superior ao do Vera por núcleo. Ambos os resultados foram compilados com o GCC 15.2, a mesma cadeia de ferramentas usada pela NVIDIA para divulgar os números do Vera.
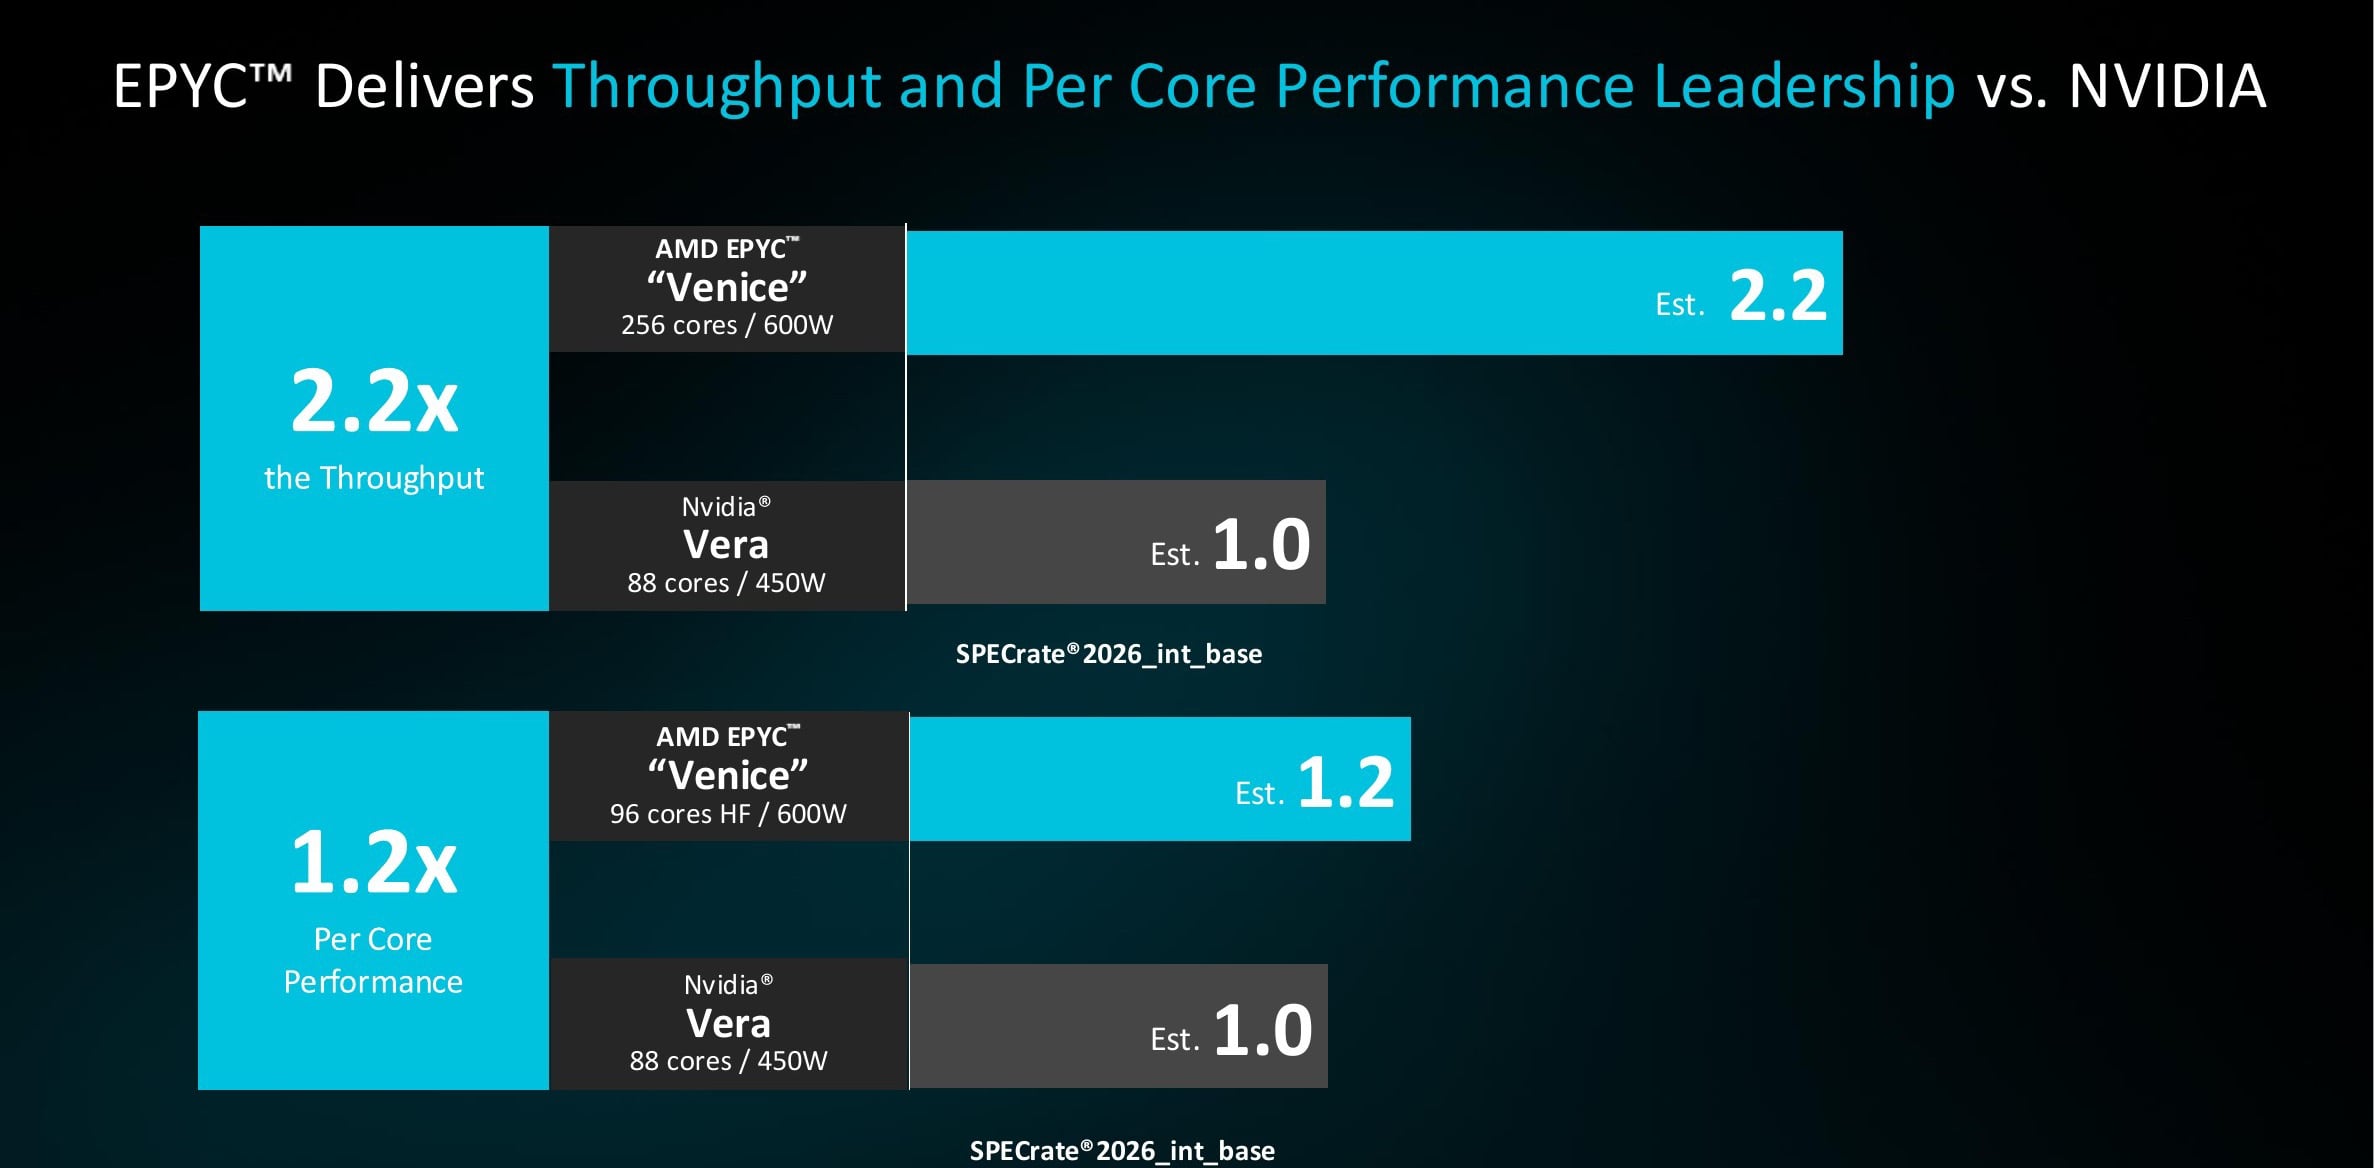
A alegação de desempenho por núcleo aumentou durante a semana de lançamento. Ravi Kuppuswamy, responsável pela engenharia de CPUs da AMD, declarou à imprensa que a AMD havia inicialmente alegado uma vantagem de 10% por núcleo. Após a NVIDIA publicar seus próprios números do Vera no início da semana, sua equipe refez a comparação usando o mesmo compilador e configurações, e constatou uma vantagem de 20%, com ajustes ainda incompletos. A diferença de desempenho de 2.2 vezes, segundo ele, sempre correspondeu às projeções internas da AMD. Uma nota de rodapé separada recalcula a comparação por núcleo no SPECrate 2017 usando o próprio compilador AOCC da AMD, chegando a 1.7 vezes, o que torna 20% o cálculo mais conservador.
Intel e Braço
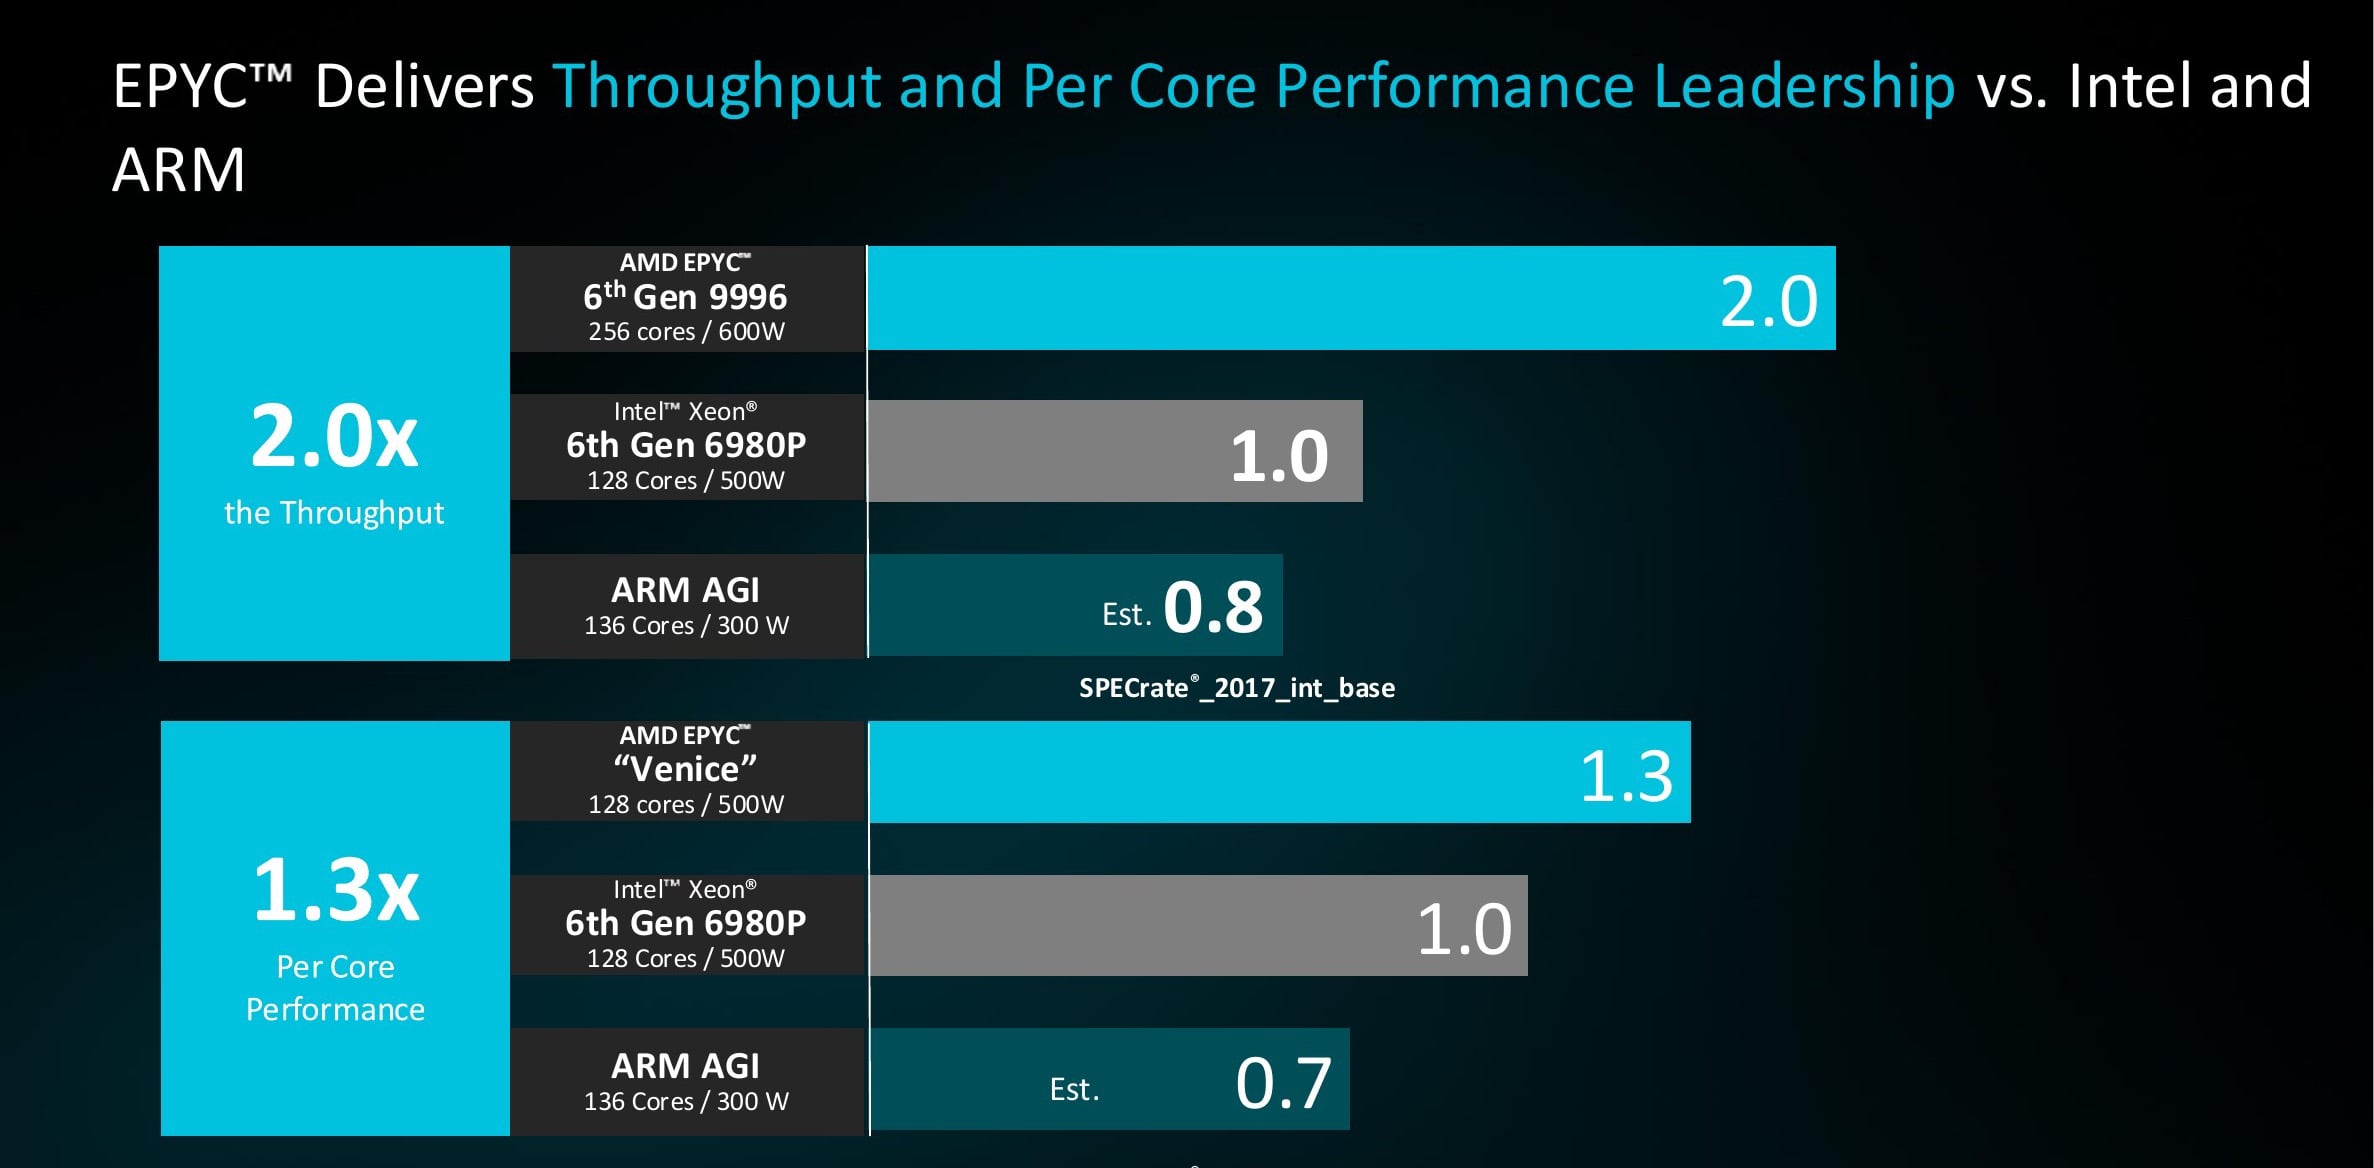
A AMD também apresentou um ranking mais abrangente do SPECrate 2017. O Venice 9996 lidera com 4900 pontos (256 núcleos, 600W, US$ 14,904 para 1 unidades), seguido pelo Turin 9965 com 3240, o Xeon 6980P da Intel com 2510 (128 núcleos, 500W, US$ 13,955), o Arm AGI com 1944 (136 núcleos, 300W) e o Vera com 1459. Os valores do 9996, AGI e Vera são estimativas da AMD; as pontuações do Turin e da Intel são resultados publicados. Em comparação com a Intel, isso representa aproximadamente o dobro do desempenho por um preço de tabela comparável, ou seja, o dobro do desempenho por dólar. Por núcleo, uma configuração do Venice com 128 núcleos e 500W alcança 1.3 vezes o desempenho do 6980P, enquanto o Arm AGI fica em 0.7 vezes. Diferentemente da comparação com a Vera acima, a pontuação de cada fornecedor aqui foi produzida com seu próprio conjunto de ferramentas otimizado: AOCC para AMD, OneAPI para Intel e GCC 13 para Arm.
Nativo da nuvem e HPC
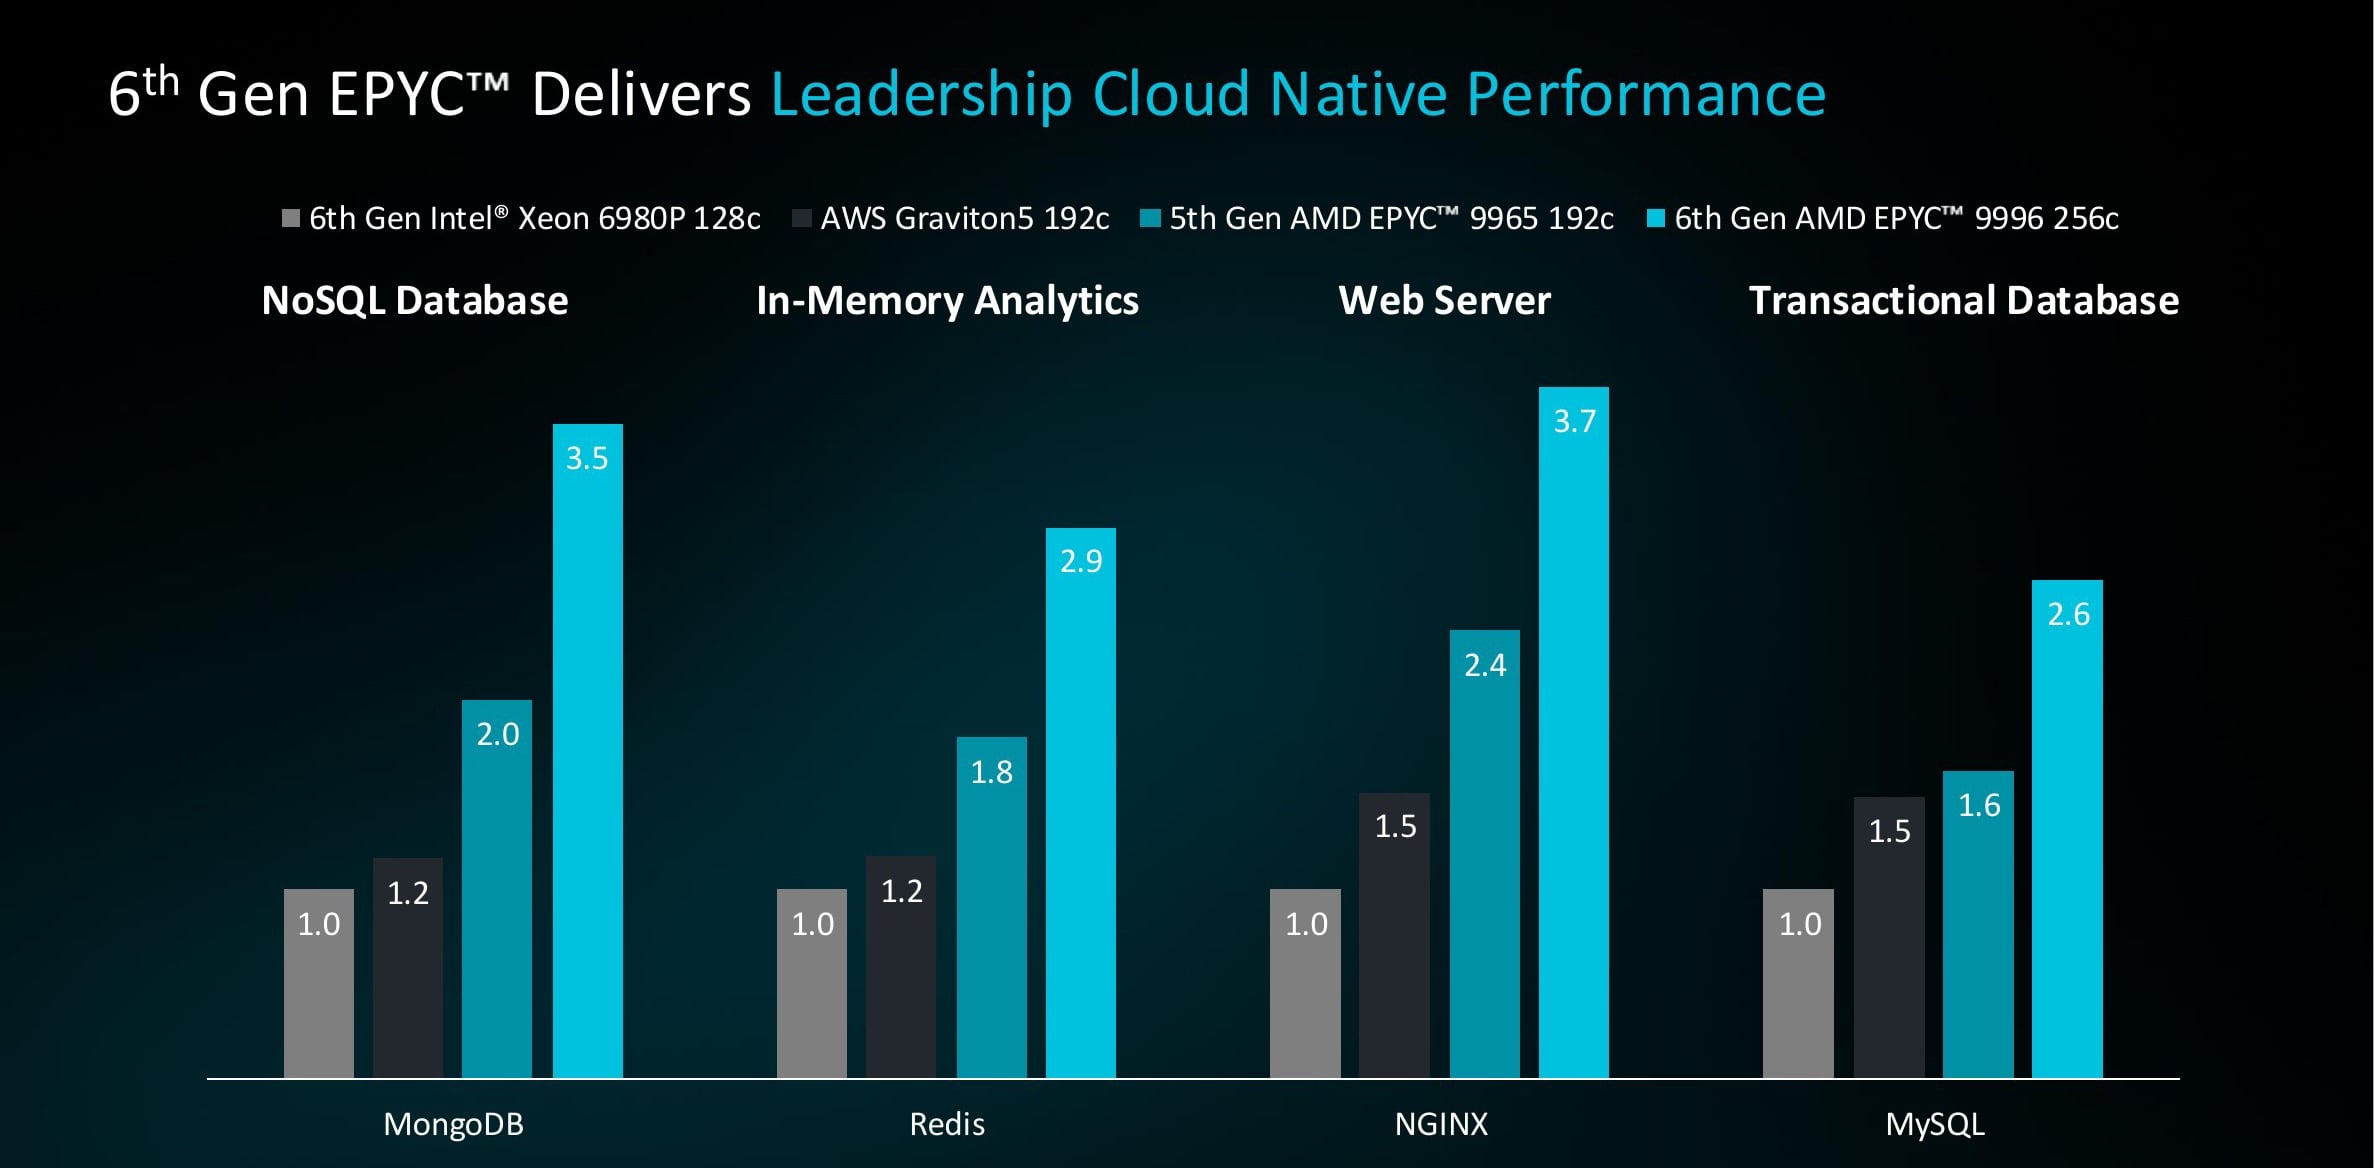
A AMD também dividiu a comparação por carga de trabalho, com cada resultado indexado ao 6980P da Intel em 1.0. No lado de aplicações nativas em nuvem, o Venice 9996 de 256 núcleos apresenta desempenho 3.5 vezes superior no MongoDB, 2.9 vezes superior no Redis, 3.7 vezes superior no NGINX e 2.6 vezes superior no MySQL. O Turin fica entre 1.6 vezes e 2.4 vezes superior nos mesmos testes, e o Graviton5 entre 1.2 vezes e 1.5 vezes superior.
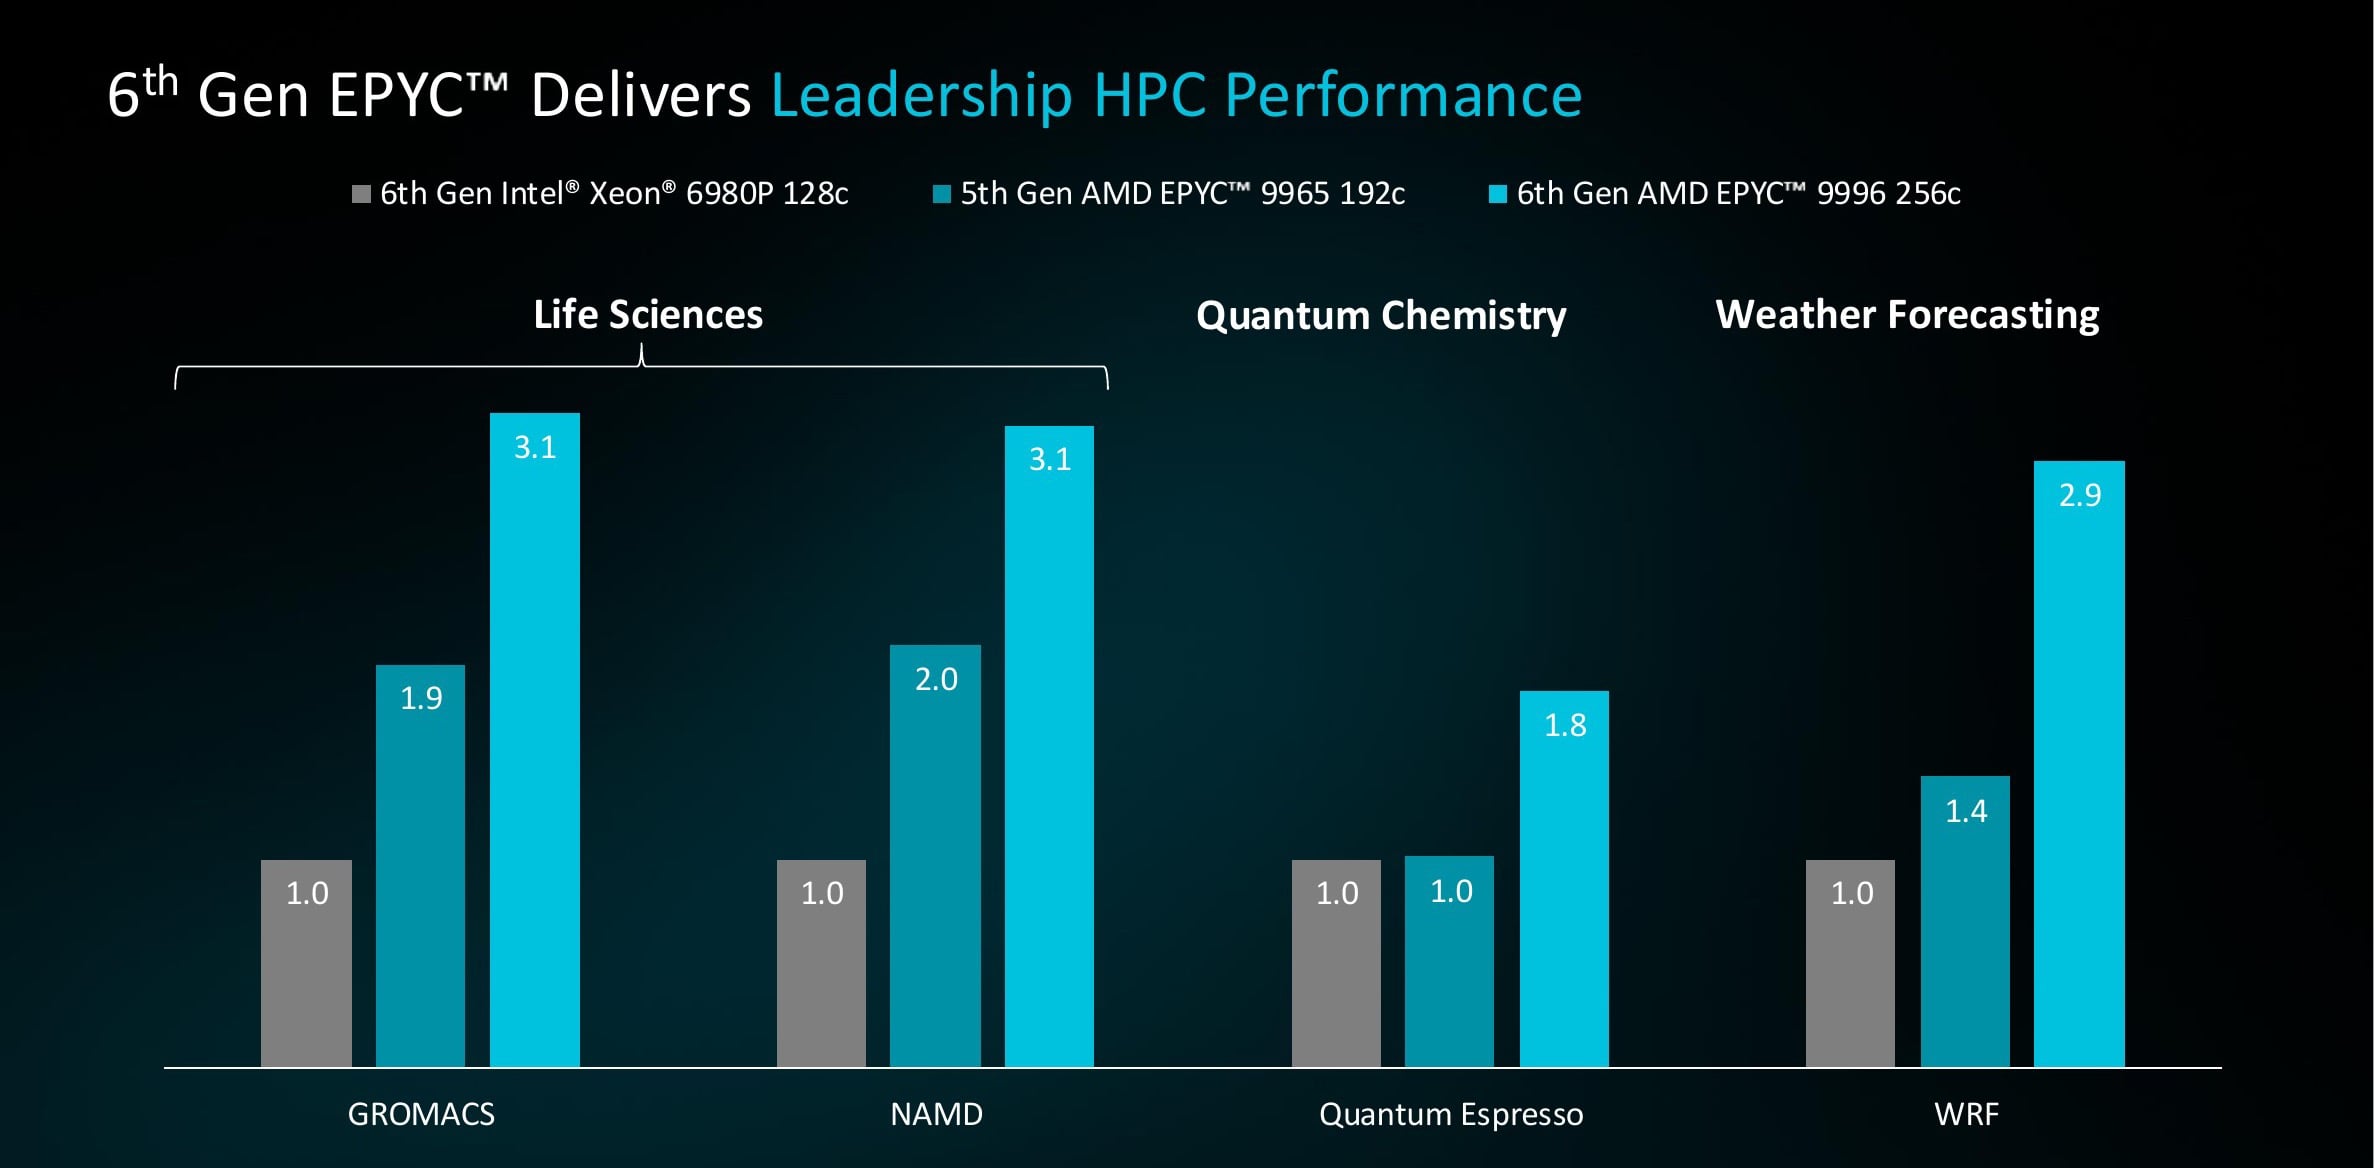
Em computação de alto desempenho (HPC), o Venice alcança 3.1 vezes mais pontos no GROMACS e NAMD, 2.9 vezes no WRF e 1.8 vezes no Quantum Espresso. A configuração da memória altera esses números substancialmente. Com RDIMMs padrão de 8,000 MT/s, o Venice alcança 2.81 vezes o desempenho da linha de base Xeon no GROMACS; MRDIMMs de 12,800 MT/s elevam esse valor para 3.13 vezes, e a mesma atualização aumenta o desempenho no WRF de 2.25 vezes para 2.90 vezes. A AMD resume sua vantagem em HPC como algo entre 1.8 e 3.5 vezes, dependendo da carga de trabalho e da memória. A linha de base Intel utilizava MRDIMMs de 8,800 MT/s, portanto, a diferença não se deve à combinação de memória AMD atualizada com uma configuração Intel lenta.
O nó host e a reivindicação de 1.8×
Isso nos leva de volta à afirmação de 1.8x tokens por segundo. As melhorias de hardware por trás disso são fáceis de listar: a parte principal de 5 GHz agora possui 96 núcleos em vez de 64, a largura de banda da memória principal aumenta de 614 GB/s para 1.6 TB/s e o PCIe Gen 6 dobra a largura de banda do link CPU-GPU.
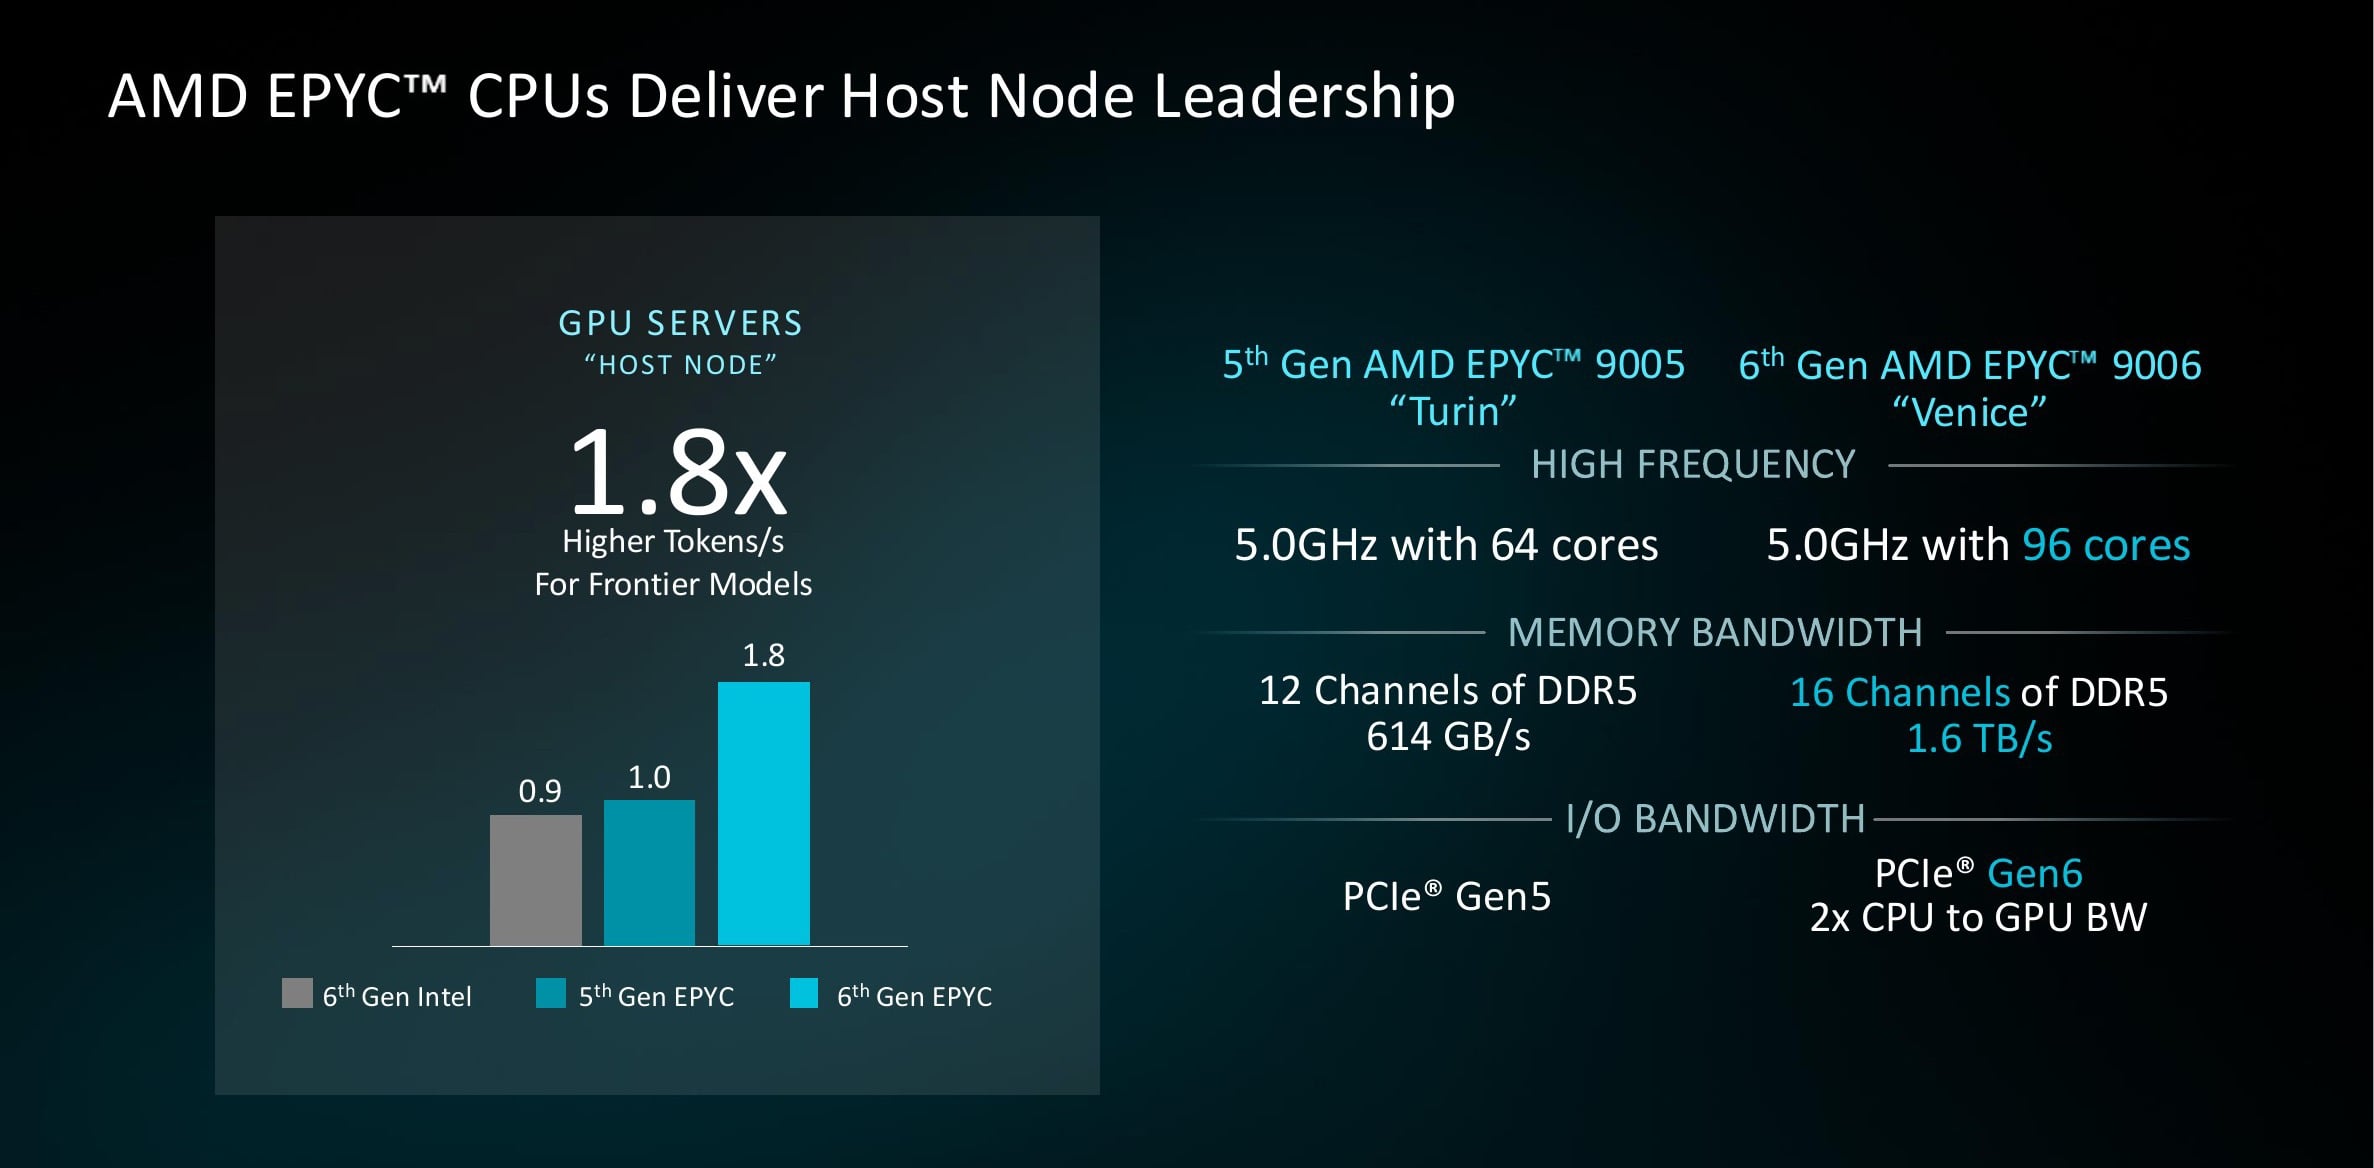
O primeiro passo é verificar a linha de base. A AMD indexou este gráfico em relação ao Turin em 1.0, em vez de usar o Intel, e posicionou o Xeon de 6ª geração em 0.9. É por isso que a mesma afirmação se aproxima de 2x quando comparada ao Xeon 6960P. O ganho projetado vem quase inteiramente da largura de banda de E/S. A AMD realizou um teste de descarregamento de CPU que transmitiu os pesos BF16 do Qwen3-30B da memória do host para a GPU e constatou que o caminho de recebimento PCIe Gen 5 x16 operava entre 89% e 95% de seu limite teórico, enquanto as leituras da DRAM do host permaneceram abaixo de 10% de seu limite teórico. A velocidade de decodificação foi limitada pela transferência, portanto, dobrar o link com PCIe Gen 6 resulta em uma melhoria de 1.8x a 1.9x neste teste. O Venice é atualmente a única CPU de servidor que oferece PCIe Gen 6 para aceleradores, então a vantagem é real e, por enquanto, exclusiva. Seu escopo é limitado, no entanto: o 1.8X descreve um padrão de descarregamento limitado pela largura de banda e não deve ser interpretado como uma promessa de que as GPUs atenderão a todos os modelos 1.8 vezes mais rápido em hosts Venice. No hardware disponível atualmente, um host Turin supera um Xeon 6960P em uma média geométrica de 13% no tempo até o primeiro token em cargas de trabalho vLLM e NIM no mesmo sistema B200 8X, com uma melhoria de 36% no melhor cenário.
Densidade de rack
A última afirmação diz respeito à densidade: 49,152 núcleos de Veneza em um rack, contra 36,864 para Turim e 22,528 para Vera, sendo que cada parte contém o dobro de fios em relação aos núcleos. De todas as afirmações do baralho, esta é a que mais se altera após a aplicação das notas de rodapé.
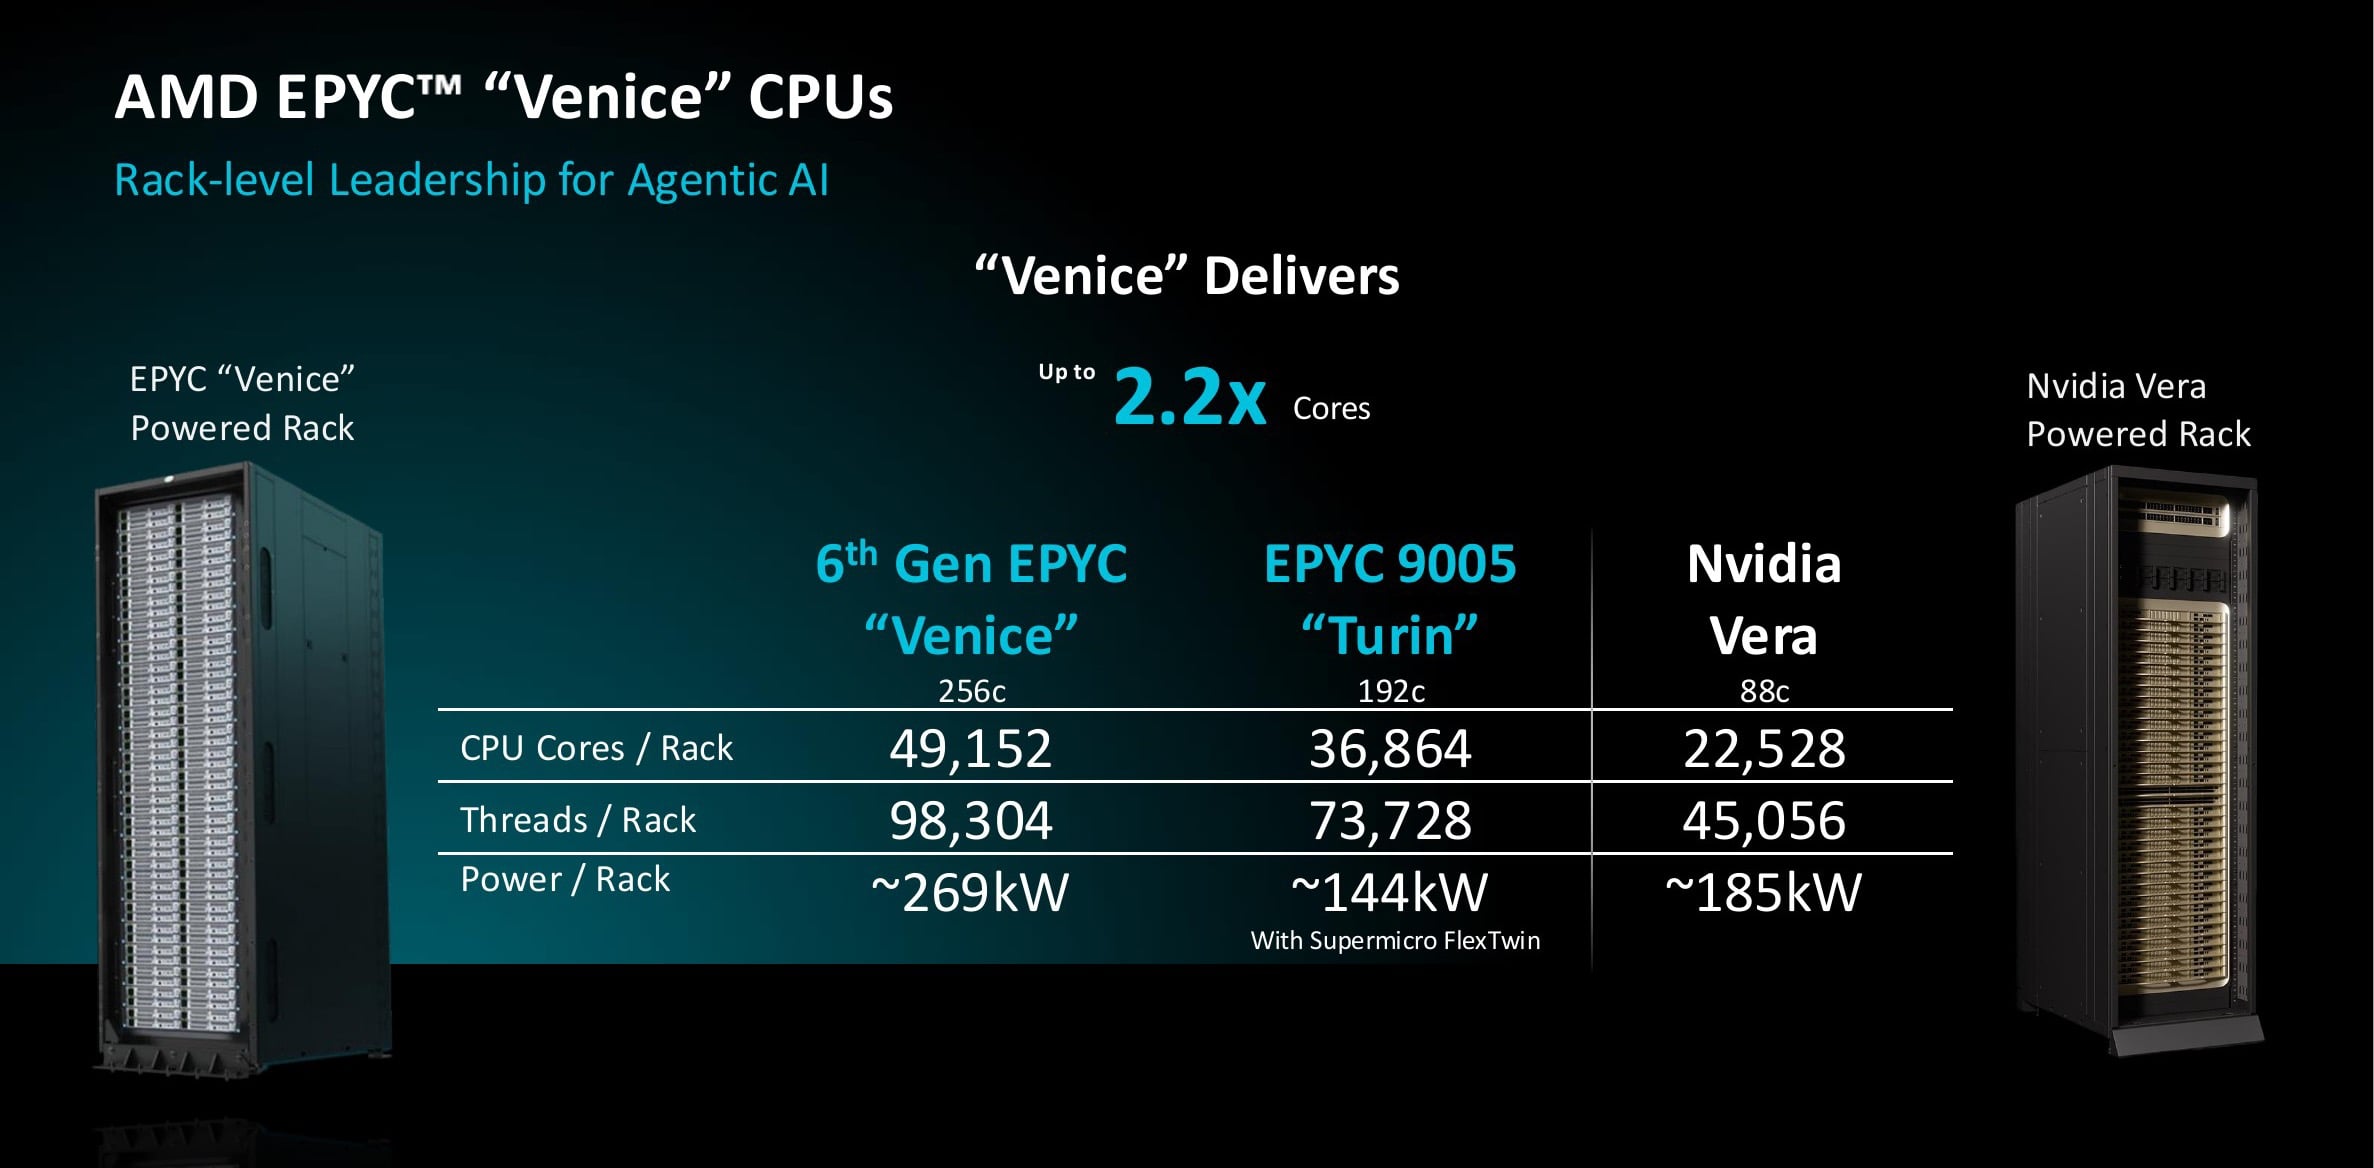
O destaque é o número de núcleos do Vera, 2.2 vezes maior, mas o rack Venice atinge esse resultado consumindo 269 kW, em comparação com os 185 kW do Vera. Portanto, os dois racks não são comparados com potência equivalente. As notas de rodapé da AMD fornecem versões normalizadas. Com ambos os racks limitados a 100 kW, o 9996 oferece 2.08 vezes mais núcleos que o Vera, 1.86 vezes mais que o Turin e 1.24 vezes mais que o 6980P da Intel. Substituindo o EPYC 9956 de 400 W pelo modelo topo de linha, a AMD estima 1.91 vezes mais núcleos que o Vera com 26% menos energia, resultando em 2.57 vezes mais núcleos por watt de rack. Dependendo do limite de energia mantido fixo, a vantagem fica entre 1.9 e 2.2 vezes. E, como em todos os números do Vera neste artigo, o rack da NVIDIA é modelado a partir de especificações publicadas, e não de hardware medido. A vantagem de densidade se mantém mesmo após a normalização. É simplesmente menor que o título 2.2X.
O valentão
Deixando de lado as afirmações individuais: no segmento de ponta do mercado de CPUs para servidores, a AMD atualmente não tem um concorrente direto. O melhor processador da Intel fica atrás do Turin, a geração que a AMD já está substituindo. Os concorrentes da Arm estão abaixo do Turin em todos os gráficos apresentados pela AMD. O Vera ainda não foi lançado, e a estimativa da AMD coloca seu desempenho em menos da metade do Turin 9965, que está no mercado há um ano e meio, com o Venice praticamente dobrando o desempenho do Turin. Essa posição levou a AMD a alcançar 46% da receita de CPUs para servidores, segundo a Mercury Research. As evidências do mercado apontam na mesma direção. A demanda por processadores EPYC de ponta atualmente supera a oferta, e os prazos de entrega se estenderam como consequência.
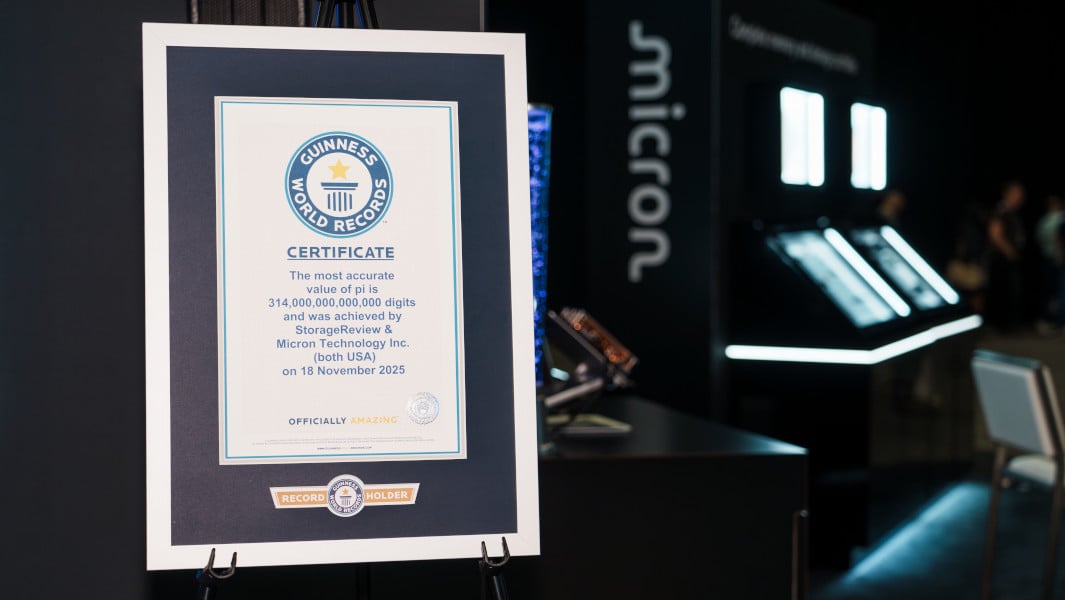
Podemos adicionar nosso próprio dado aqui. Nosso recorde mundial de 314 trilhões de dígitos de Pi foi executado em um Dell PowerEdge R7725 com dois processadores EPYC 9965 de 192 núcleos e 1.5 TB de DDR5, a mesma configuração de 384 núcleos e 2 processadores que a AMD usa em seus racks Turin. O cálculo manteve todos os núcleos em carga por 110 dias e terminou sem um segundo de inatividade; um único erro de memória ou travamento em qualquer ponto teria comprometido a tentativa. O consumo de energia teve uma média de cerca de 1,600 W, e a execução completa consumiu 4,305 kWh, ou 13.7 kWh por trilhão de dígitos, contra uma estimativa de 33,600 kWh em aproximadamente 225 dias para o recorde anterior de 300 trilhões de dígitos.
Conclusão
Venice é o lançamento de CPU para servidores mais robusto já realizado pela AMD, e seu foco principal é a abrangência. Uma única geração Zen 6 abrange desde um componente com densidade de 256 núcleos até um soquete empresarial, um chip HPC com cache empilhado de 1152 MB e um nó host LPDDR, permitindo que o cliente construa todas as camadas de um data center com a mesma arquitetura e base de software. Os números que sustentam o lançamento se confirmam ao analisarmos as especificações: desempenho aproximadamente duas vezes maior que o da Intel a um preço comparável, vantagem de 20% por núcleo em relação ao Vera com um compilador equivalente e densidade de rack entre 1.9x e 2.2x maior que a CPU host da NVIDIA, dependendo do consumo de energia.
A parte comercial da história dispensa previsões. O SP7 já está em produção, com as plataformas de parceiros previstas para o quarto trimestre; o SP8 chega no primeiro semestre de 2027, seguido pelo Venice-X e pelo Verano. A empresa que os vende já detém 46% da receita de CPUs para servidores, e a demanda por seus componentes atuais supera em muito a oferta, então os compradores preferem esperar na fila a mudar de fornecedor. O lançamento do Venice pode atrasar um ano, e as comparações neste artigo ainda seriam interpretadas como liderança, porque o Turin já supera todos os outros no gráfico, sejam eles já comercializados ou não. A AMD está tão à frente que seu concorrente mais próximo, por enquanto, é sua própria geração anterior.


 Amazon