

A série AMD Instinct MI300 apresenta uma nova abordagem à arquitetura de aceleradores para IA, combinando tecnologias avançadas para impulsionar o progresso em computação de alto desempenho e inteligência artificial. Com seu design sofisticado, a série MI300 promete remodelar os limites do poder e da eficiência computacional.
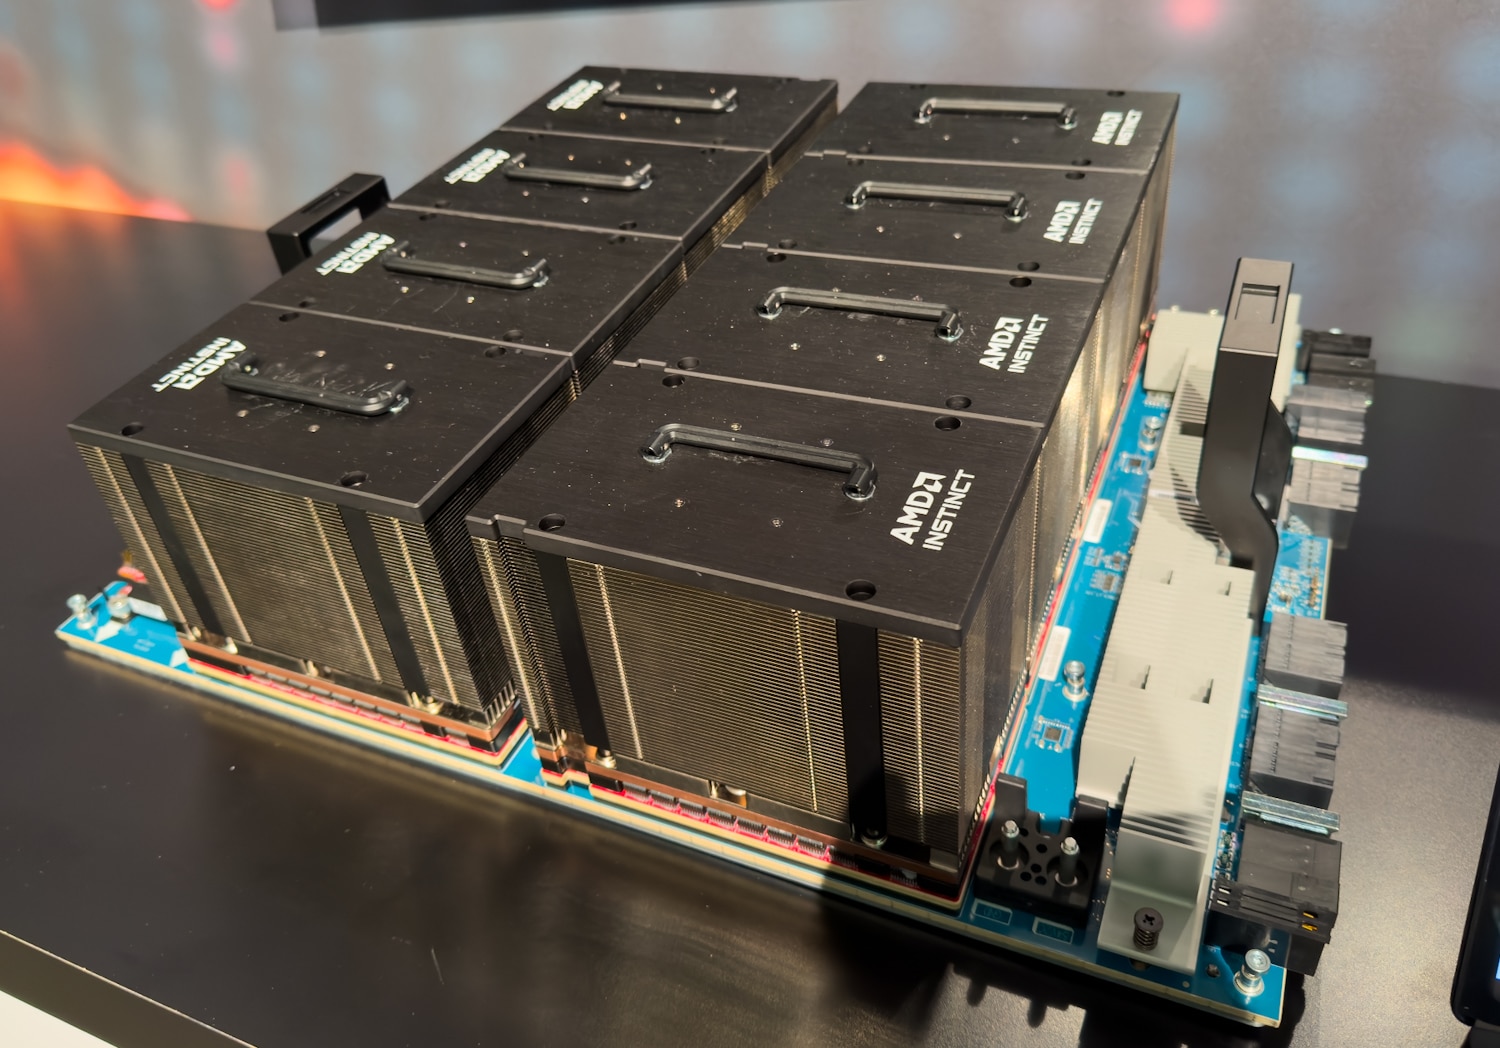
Visão geral da família MI300
Há muito terreno a percorrer aqui, e a nuance entre os dois é sutil, mas importante.
| Especificação | MI300x | MI300a |
|---|---|---|
| Núcleos de CPU | 12 chips como um único dispositivo • Quatro IOD e oito XCD • Infinity Fabric AP e embalagem 3D |
13 chips como um único APU • CPU 8c 16t x86 x 3 CCDs (24 núcleos no total) • Quatro IOD, três CCD e seis XCD • Infinity Fabric AP e embalagem 3D |
| Cache (L3) | Cache L32 de 3 MB compartilhado por oito núcleos | Somente L1 e L2 |
| Capacidade HBM3 | 196GB | 128GB |
| Cache Infinity | • 256 MB com BW de pico de 17 TB/s • Amplificação de largura de banda XCD • Redução de potência HBM • Coerência de cache multi-XCD e CCD • Pré-buscador para latência de memória da CPU |
• 256 MB com BW de pico de 17 TB/s • Amplificação de largura de banda XCD • Redução de potência HBM • Coerência de cache multi-XCD |
| Arquitetura unificada | N/D | HBM unificado e cache infinito • Compartilhamento de dados CCD e XCD • Redução da movimentação de dados • Programação simplificada |
Zen 4 CPU Complex Die (CCD) e melhorias
No coração da APU MI300A está o CPU Complex Die (CCD) 'Zen 4', com oito núcleos AMD 'Zen 4' x86 multithreaded, cada um com 1 MB de cache L2 e 32 MB de cache L3 compartilhado. Esta arquitetura robusta suporta multithreading simultâneo (SMT) e incorpora atualizações ISA essenciais, incluindo BFLOAT16, VNNI e AVX-512, com um caminho de dados de 256b. O sistema de memória é igualmente impressionante, com endereçamento virtual/físico de 48b/48b, garantindo suporte de memória expansivo.
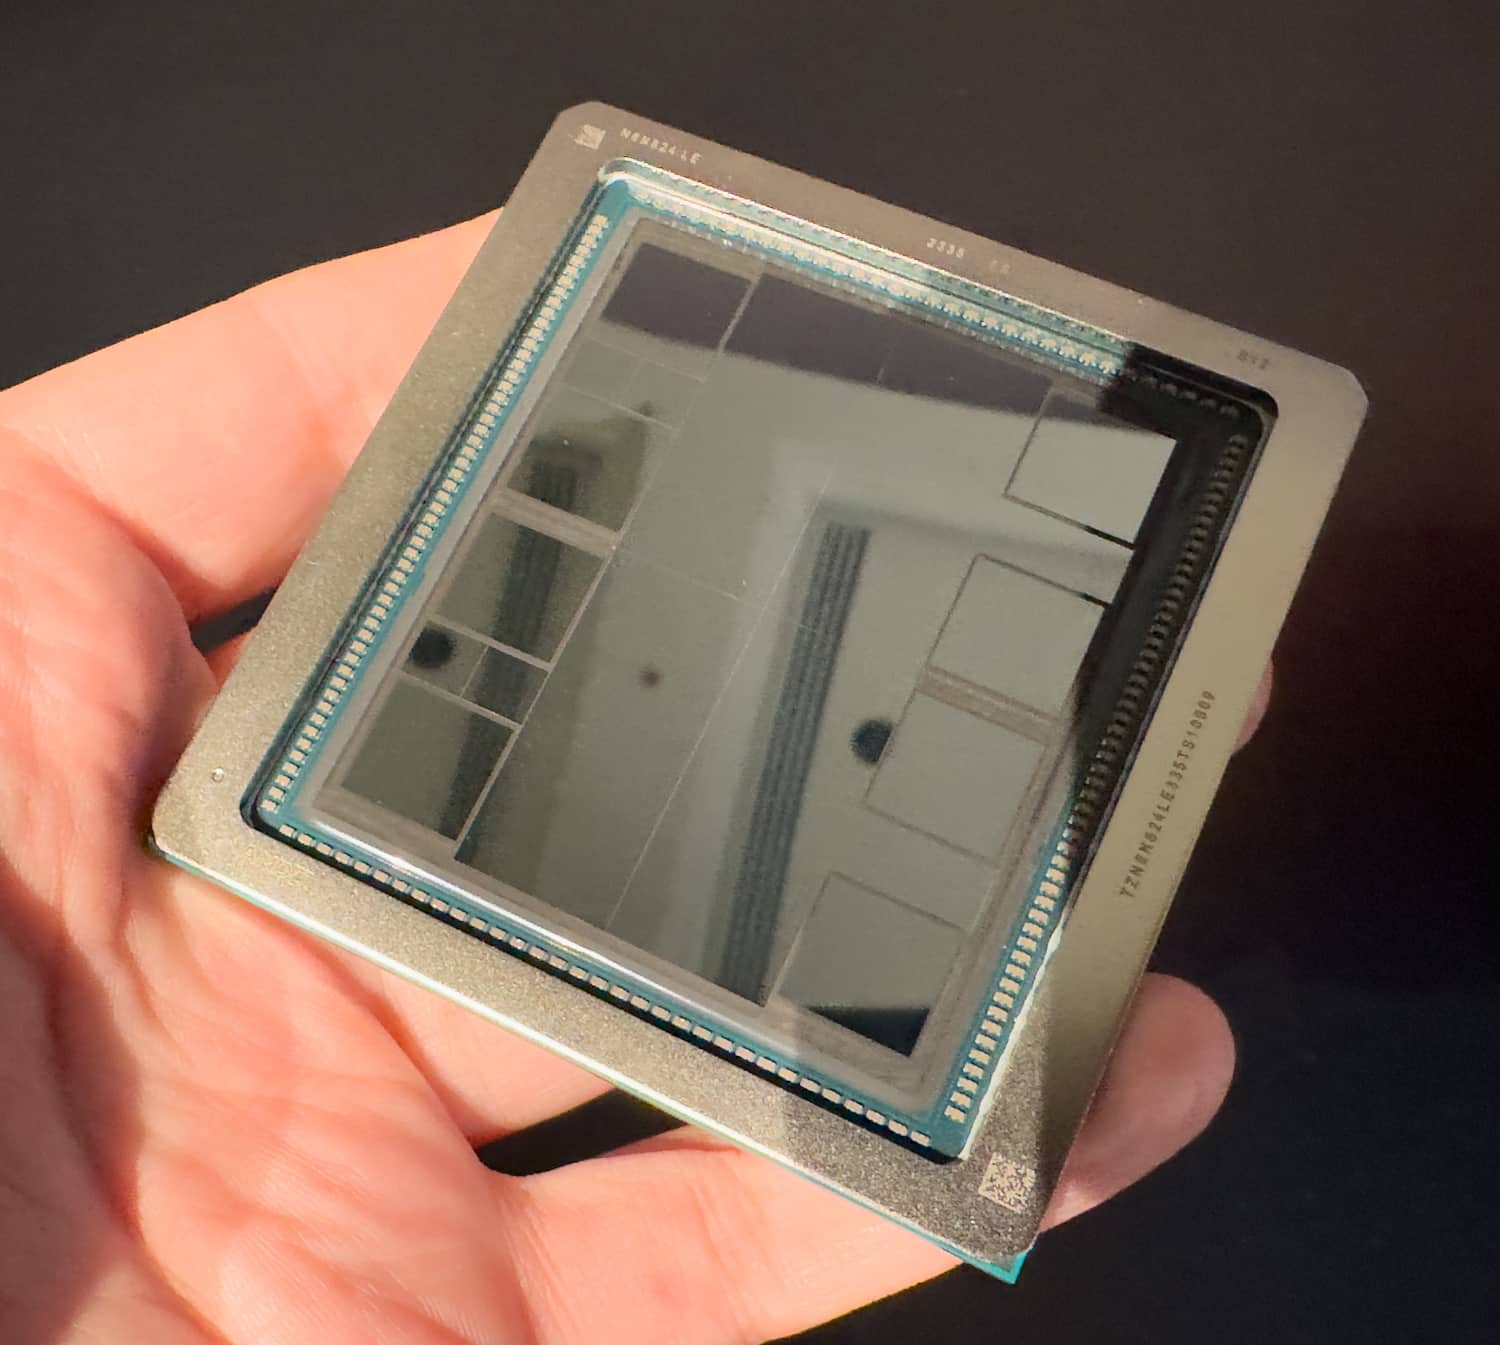
Unidade de computação e sistema de memória CDNA 3
A unidade de computação CDNA 3 da série MI300 apresenta melhorias notáveis. Cada Accelerator Complex Die (XCD) abriga 38 unidades de computação CDNA 3, apoiadas por um cache L4 compartilhado de 2 MB e cache L1 otimizado para bytes/FLOP. Estas unidades suportam uma variedade de formatos numéricos como TF32 e FP8 e estão em conformidade com os padrões OCP FP8. O sistema de memória foi projetado para maximizar a eficiência do compartilhamento de dados e reduzir a latência, graças ao inovador Infinity Cache e Infinity Fabric Interface da AMD.
Embalagem híbrida 3.5D: um salto na integração
Um destaque importante da família MI300 é seu pacote híbrido 3.5D, aumentando significativamente a computação e o HBM (memória de alta largura de banda) dentro de um pacote. Este método de empacotamento oferece interconexões de chips densas e com baixo consumo de energia, melhorando a eficiência geral do sistema. A série MI300 emprega uma abordagem de construção modular, permitindo configurações flexíveis e escalabilidade.
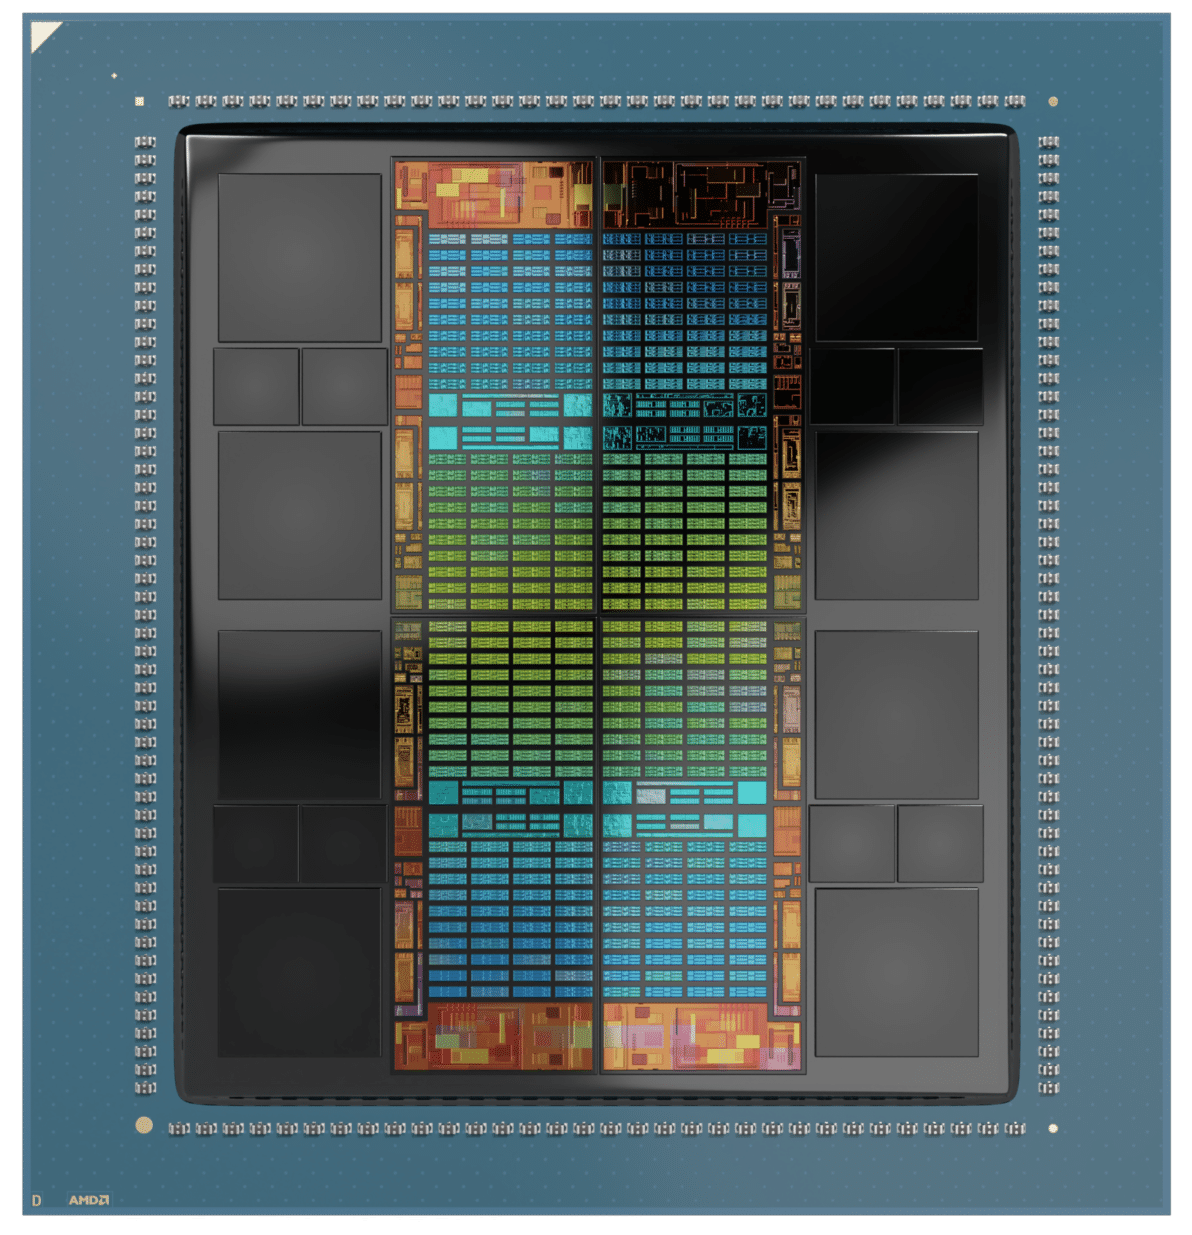
Gerenciamento avançado de energia e design térmico
O sistema de gerenciamento de energia da família MI300 é adaptado para lidar com cargas de trabalho computacionais intensivas, com foco no design na eficiência de energia e na extração de calor. A arquitetura térmica exclusiva suporta TDPs (Thermal Design Power) superiores a 550 W, garantindo desempenho confiável mesmo sob condições exigentes. O sistema de fornecimento de energia foi engenhosamente projetado para acomodar diferentes matrizes e orientações empilhadas, garantindo alinhamento preciso e eficiência.
Desempenho do AMD MI300
A AMD lançou um produto interessante no mercado com sua plataforma Instinct MI300X e está posicionando-o como um forte concorrente do difícil de encontrar H100 HGX da Nvidia. A plataforma MI300X vem com 1.5 TB de memória HBM3, o que ofusca significativamente a capacidade de memória de 640 GB do H100 HGX, algo que todo desenvolvedor ficará feliz em ter. No lado do poder computacional bruto, a AMD assume a liderança com cerca de 10.4 petaFLOPS de desempenho FP16/BF16, aproximadamente 1.3 vezes o do H100 HGX, prometendo maior eficiência para cálculos complexos.
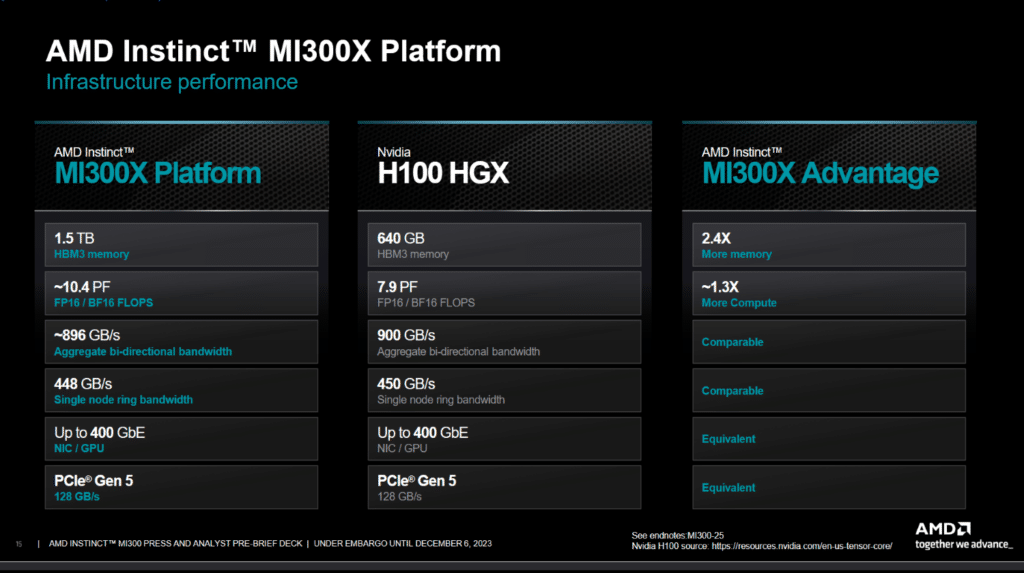
Em relação às outras especificações principais, as duas plataformas estão próximas da paridade, combinando avanços em largura de banda bidirecional agregada e recursos de interface de rede, cada uma fornecendo até 400 GbE e mantendo a paridade com interfaces PCIe Gen 5 a 128 GB/s. O duelo entre AMD e NVIDIA exibe uma inovação rápida e sem precedentes no setor de HPC/AI, à medida que os fabricantes continuam lançando novas tecnologias para atender às crescentes demandas por mais memória e computação mais rápida.
Pensamentos de Encerramento
A série AMD Instinct MI300, com sua avançada arquitetura modular e de chips, poderosos núcleos de CPU e GPU e embalagens e gerenciamento de energia inovadores, tem muito a oferecer em computação de alto desempenho e inteligência artificial. Seu design reflete uma integração bem pensada de potência, desempenho e eficiência, estabelecendo novos padrões para futuras tecnologias computacionais.
À medida que o mundo da computação antecipa ansiosamente a implantação completa da série MI300, será interessante ver se a AMD consegue acompanhar o fornecimento e os avanços tecnológicos, ao mesmo tempo que impulsiona continuamente a inovação nos domínios de HPC e IA. A AMD está oferecendo uma solução atraente e comparável à série MI300.


 Amazon