

A AMD divulgou os resultados do MLPerf Inference v6.0, posicionando a GPU Instinct MI355X como uma plataforma de inferência escalável para implantações em nós únicos, múltiplos nós e ambientes heterogêneos. A submissão vai além de ganhos incrementais, adicionando novas cargas de trabalho, demonstrando throughput em escala de cluster superior a 1 milhão de tokens por segundo e validando a reprodutibilidade em um ecossistema de parceiros em expansão.
A arquitetura CDNA 4 visa a inferência de alta capacidade.
A GPU Instinct MI355X é baseada na arquitetura CDNA 4 da AMD , construída em um processo FinFET de 3 nm | 6 nm da TSMC (utiliza um design de chiplet de processo duplo: os chips de computação (XCDs) usam o nó de 3 nm da TSMC, enquanto os chips de E/S usam 6 nm), integrando 185 bilhões de transistores e suportando os formatos de dados FP4 e FP6. Vale ressaltar que isso se aplica a todo o pacote multichiplet, e não a um chip monolítico. Cada GPU inclui até 288 GB de memória HBM3E, permitindo o suporte a modelos com até 520 bilhões de parâmetros em um único dispositivo. A AMD considera essa combinação de densidade de computação e capacidade de memória crucial para a inferência de modelos grandes sem particionamento excessivo do modelo.
A plataforma está disponível em configurações UBB8 com opções de resfriamento a ar e resfriamento líquido direto, atendendo aos requisitos de implantação de data centers.
A capacidade de processamento de múltiplos nós ultrapassa 1 milhão de tokens por segundo.
Um resultado fundamental desta rodada foi a AMD ultrapassar a marca de 1 milhão de tokens por segundo em escala de cluster. Utilizando GPUs Instinct MI355X, a AMD alcançou esse patamar no Llama 2 70B, tanto em cenários de servidor quanto offline, e no GPT-OSS-120B em cenário offline.
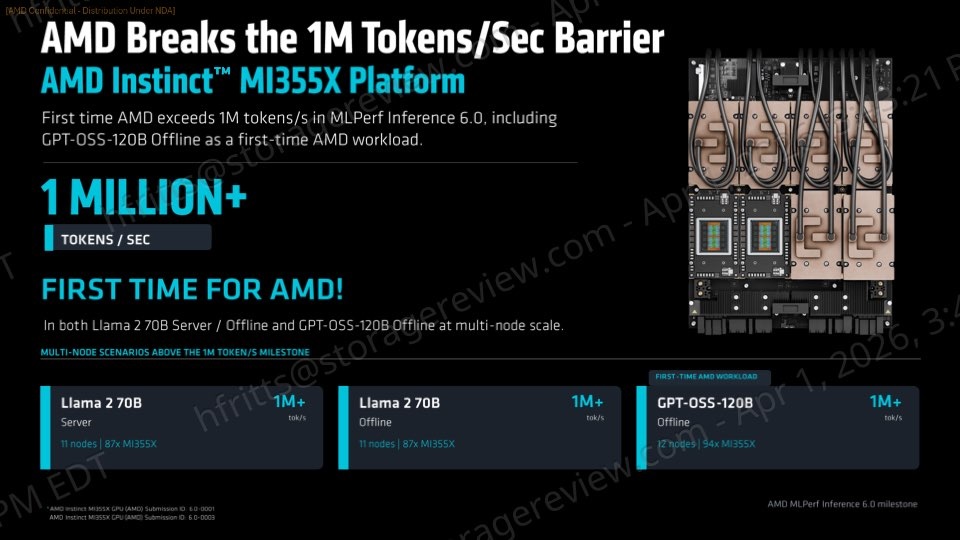
Esses resultados refletem uma mudança na avaliação do desempenho de inferência, priorizando o nível do cluster em vez de cada acelerador individualmente. A taxa de transferência agregada e o tempo de resposta são cada vez mais utilizados para determinar a prontidão para produção de implantações de IA em larga escala.
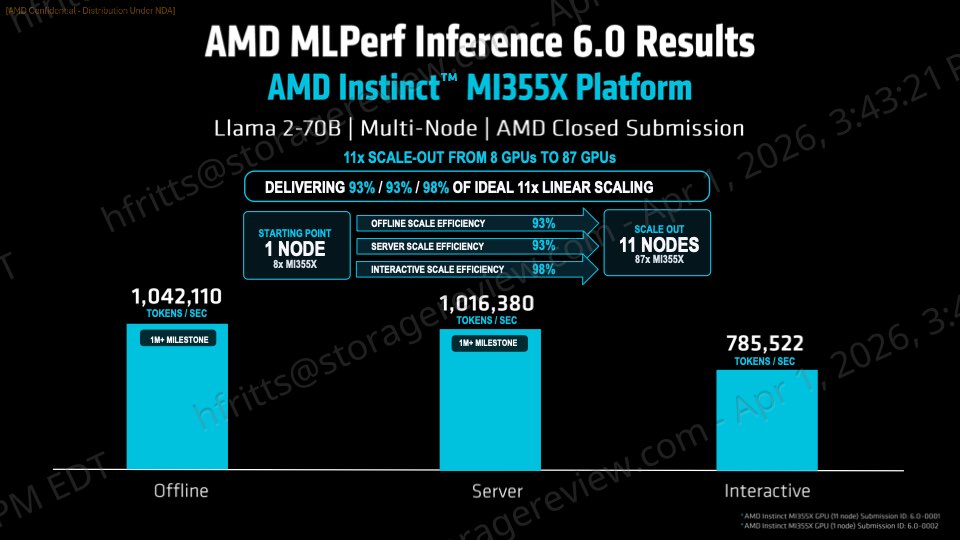
A AMD também demonstrou escalabilidade eficiente. No Llama 2 70B, uma configuração de 11 nós e 87 GPUs atingiu mais de 1 milhão de tokens por segundo em cenários offline, de servidor e interativos, com eficiência de escalabilidade variando de 93% a 98%. No GPT-OSS-120B, um cluster de 12 nós e 94 GPUs alcançou desempenho semelhante com mais de 90% de eficiência de escalabilidade. Esses resultados indicam que os ganhos de desempenho se traduzem efetivamente à medida que as implantações se expandem para além de um único sistema.
Ganhos geracionais e desempenho competitivo de nó único
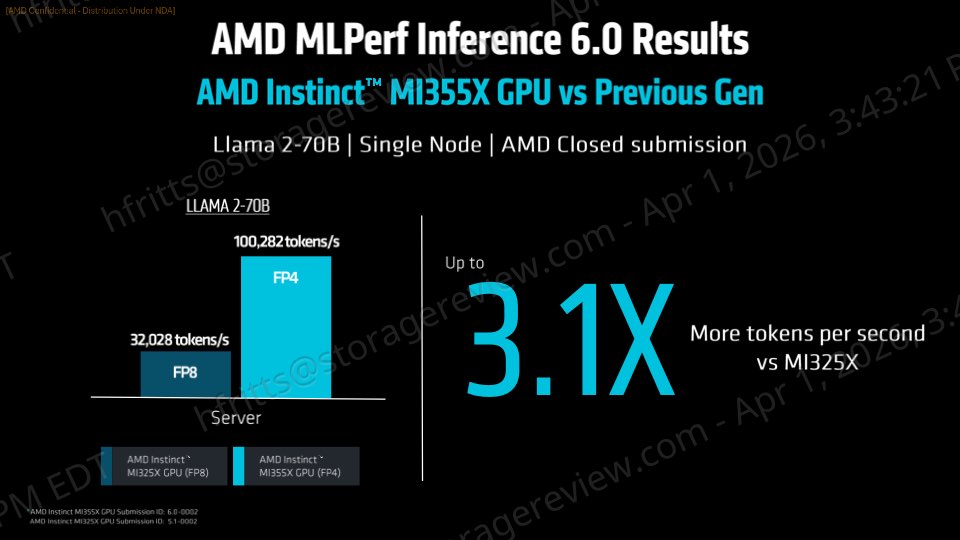
A AMD reportou um aumento de desempenho de 3.1x no Llama 2 70B Server em comparação com a geração anterior do Instinct MI325X, atingindo 100,282 tokens por segundo. A melhoria reflete tanto mudanças arquitetônicas quanto otimizações de software ROCm. As pontuações offline melhoraram 4.4x e as pontuações do Server melhoraram 4.8x em comparação com as rodadas anteriores. Esses ganhos são atribuídos principalmente à quantização FP4.
Em comparações de nó único, o MI355X demonstrou posicionamento competitivo em relação às plataformas NVIDIA. No Llama 2 70B, a AMD igualou a NVIDIA B200 em taxa de transferência offline, alcançou quase a mesma taxa de transferência em desempenho de servidor e superou o desempenho interativo. Contra a B300 da Nvidia, a GPU da AMD oferece 92% em modo offline, 93% em modo servidor e a supera com 104% em modo interativo.
A ativação do modelo pela primeira vez amplia a cobertura.
O MLPerf Inference v6.0 inclui diversas novas cargas de trabalho, e a AMD aproveitou esta rodada para demonstrar a rápida ativação do modelo. O GPT-OSS-120B, um modelo de mistura de especialistas, foi introduzido pela primeira vez e alcançou resultados competitivos em comparação com os sistemas da NVIDIA, tanto em cenários offline quanto em servidores.
A AMD também apresentou resultados para geração de texto para vídeo em WAN-2.2, marcando sua entrada na inferência de vídeo multimodal e generativa. Embora a submissão oficial tenha se concentrado na latência de fluxo único, os resultados foram competitivos com os de plataformas existentes. O ajuste posterior à submissão melhorou ainda mais o desempenho, indicando espaço para otimização à medida que o software amadurece.
Essas adições destacam o foco da AMD em expandir além dos benchmarks LLM tradicionais para oferecer suporte a cargas de trabalho de IA emergentes.
O software ROCm permite escalonamento e inferência heterogênea.
A AMD atribui grande parte do desempenho e da escalabilidade à sua pilha de software ROCm. Os aprimoramentos incluem execução FP4 otimizada, comunicação GPU-para-GPU melhorada para inferência distribuída e suporte para distribuição dinâmica de carga de trabalho em ambientes heterogêneos.
A submissão inicial heterogênea para o MLPerf foi desenvolvida usando três modelos de GPU AMD Instinct: MI300X, MI325X e MI355X. Submetida pela Dell e MangoBoost, a configuração alcançou 141,521 tokens por segundo no Llama 2 70B Server e 151,843 tokens por segundo no Llama 2 70B Offline.
Vale ressaltar que a plataforma AMD Instinct MI355X estava localizada no laboratório da Dell nos Estados Unidos, enquanto as plataformas Instinct MI300X e MI325X estavam na Coreia. Isso demonstra a capacidade de coordenar sistemas em diferentes localizações geográficas.
Crescimento e Reprodutibilidade do Ecossistema
O ecossistema de parceiros da AMD expandiu-se nesta rodada do MLPerf, com nove empresas submetendo resultados em várias gerações de GPUs Instinct. Entre os fornecedores participantes estavam Cisco, Dell, Giga Computing, HPE, MangoBoost, MiTAC, Oracle, Supermicro e Red Hat.
Os resultados enviados pelos parceiros corresponderam de perto aos resultados internos da AMD, geralmente dentro de uma margem de 4% e, em alguns casos, dentro de 1%. Essa consistência indica que o desempenho é reproduzível em plataformas OEM e de nuvem, reduzindo o risco de implementação e aumentando a confiança nos resultados em situações reais.


 Amazon