

A conteinerização dos fluxos de trabalho de desenvolvimento, teste e produção está revolucionando a gestão de TI em todos os níveis, tanto para aplicações e serviços voltados para o cliente quanto para aplicações e serviços internos. As organizações ganham eficiência no desenvolvimento e reduzem o tempo de implantação ao utilizarem arquiteturas baseadas em microsserviços construídas em contêineres e frameworks de orquestração de contêineres como o Kubernetes.
A transição da TI clássica para abordagens baseadas em contêineres geralmente se origina de esforços iniciais de equipes ou departamentos de DevOps que criam um ambiente protótipo para que outras equipes o repliquem. Embora essas equipes façam isso para ganhar eficiência e flexibilidade, o resultado frequentemente são silos de clusters de DevOps e, consequentemente, baixo desempenho (recursos insuficientes) ou baixa utilização (recursos subutilizados fora dos horários de pico de demanda). Normalmente, ambos os problemas ocorrem: enquanto uma equipe está com recursos sobrecarregados, outras podem ter muitos ciclos ociosos disponíveis. Pior ainda, as equipes frequentemente superdimensionam seus recursos, o que gera custos altíssimos. Os padrões da indústria para utilização de clusters geralmente giram em torno de 20%.
A consolidação de clusters (ou contas de nuvem, nesse caso) de muitos para menos, de preferência em apenas um, e o compartilhamento dos recursos entre equipes e casos de uso é a receita para aumentar o desempenho e a produção, reduzindo custos. A consolidação e o compartilhamento realmente permitem que você faça mais com menos – se você puder compartilhar de forma eficaz, automática e justa.
As estruturas de orquestração de contêineres atuais, como Kubernetes , Docker Swarm ou Mesos, não permitem que você faça isso de forma nativa. Kubernetes e Swarm oferecem esquemas simplistas de distribuição de carga de trabalho, como 'spread' (round-robin), 'pack' ou 'random', e exigem que você segmente os recursos do cluster manualmente por meio de conceitos como namespaces ou rótulos. No Mesos, diferentes tipos de cargas de trabalho (por exemplo, Spark, Hadoop ou serviços do Marathon) trazem seus próprios agendadores, que podem ou não oferecer políticas de compartilhamento de recursos (com sua própria lógica e configuração), mas as cargas de trabalho competirão entre si pelo acesso aos recursos e não há um sistema de políticas abrangente que entenda quais são as cargas de trabalho mais importantes para um negócio e como atender às suas necessidades sem sobrecarregar os recursos.
Para casos de uso de compartilhamento de recursos não triviais, cada um desses sistemas exigirá muita intervenção manual e ainda exigirá superprovisionamento ou sofrerá impactos de desempenho causados por conflitos de recursos.
O que é realmente necessário para poder compartilhar um pool de recursos entre organizações e tipos arbitrários de cargas de trabalho (em contêineres, mas também não em contêineres) é um sistema de política avançado que entenda as características da carga de trabalho e as prioridades de negócios para que possa automatizar a tomada de decisões sobre alocação de recursos e realocar recursos sob demanda quando as condições de fronteira ou demandas mudarem.
O Navops Command é um exemplo único desse tipo de capacidade. Ele amplia o Kubernetes e adiciona políticas sofisticadas, dinâmicas e orientadas à demanda, que automatizam a tomada de decisões sobre a priorização de cargas de trabalho e o consumo de recursos a qualquer momento. Comparado a outras estruturas de orquestração de contêineres, o Kubernetes oferece o conjunto mais completo de recursos robustos para gerenciar cargas de trabalho de forma confiável (como controladores automatizados para réplicas, jobs, deployments, admissão de cargas de trabalho etc.). Com o Navops Command integrado ao Kubernetes, você pode executar builds de software, testes automatizados e deployments de produção de diversos aplicativos e ambientes de serviço no mesmo cluster ou pool de nuvem. As tarefas de DevOps e os serviços de produção podem vir de várias equipes e ter diferentes níveis de importância, que podem variar ao longo do dia. O Navops Command garante que nenhuma das cargas de trabalho relacionadas interfira na execução das outras, enquanto ambas são executadas conforme o necessário.
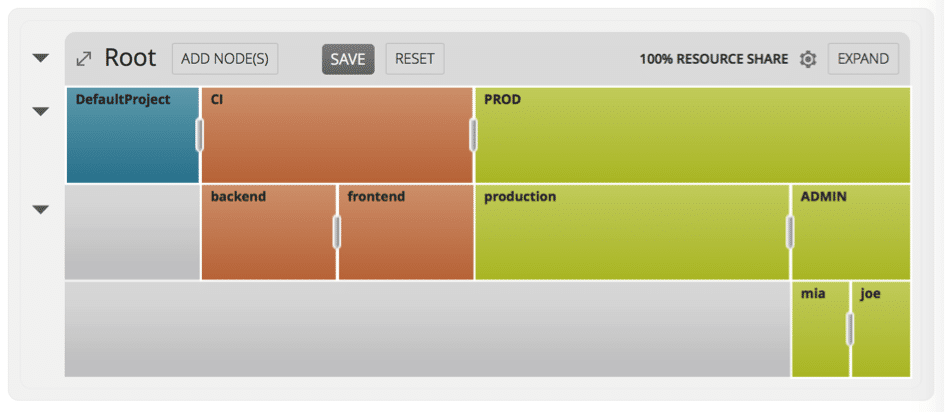
Figura 1: Política do Comando Navops 'Compartilhamentos Proporcionais' automatizando o compartilhamento de recursos entre grupos, projetos e indivíduos
Com o Navops Command é possível atingir taxas de utilização do cluster de 80% ou mais. Ele oferece seus benefícios mesmo dentro de uma única equipe quando você executa várias tarefas, como criação, teste e operações, e oferece ainda mais benefícios quando você compartilha entre as equipes.
O Navops Command demonstra o que é necessário para executar com eficiência aplicações baseadas em microsserviços, bem como outras cargas de trabalho conteinerizadas, em um ambiente compartilhado (local ou na nuvem). Atualmente, está disponível para qualquer tipo de distribuição Kubernetes e pode ser avaliado facilmente, conforme descrito aqui.
Sobre o autor
Fritz Ferstl é atualmente CTO e Desenvolvimento de Negócios EMEA na Univa Corporation.
Fritz Ferstl traz 20 anos de experiência em grid e computação em nuvem para a Univa e, como Diretor de Tecnologia, ajudará a definir a visão técnica enquanto lidera alianças estratégicas. Fritz, há muito considerado o pai do software Grid Engine e seus precursores Codine e GRD, administrou o negócio de software Grid Engine dentro da Sun Microsystems e da Oracle nos últimos 10 anos, levando-o de uma tecnologia iniciante para a solução de gerenciamento de carga de trabalho mais amplamente implantada em alguns dos ambientes de data center mais desafiadores do planeta. Sob a liderança de Fritz, o software Grid Engine era de código aberto e desenvolveu uma comunidade vibrante.


 Amazon