

A Intel apresentou seus planos para computação de alto desempenho na SC26, com o Diamond Rapids, sua arquitetura de servidor Xeon de próxima geração, como peça central. A Intel afirma que a plataforma terá escalabilidade para até 256 núcleos de alto desempenho, com até 1.6 TB/s de largura de banda de memória e até 1.28 GB de cache de último nível. O esboço foi feito por Jeff McVeigh, vice-presidente e gerente geral de Programas Estratégicos de Data Center, e também abrange a série D de GPUs da Intel, software de HPC, fotônica de silício e desenvolvimento quântico. A Intel não divulgou uma data de lançamento para o Diamond Rapids.
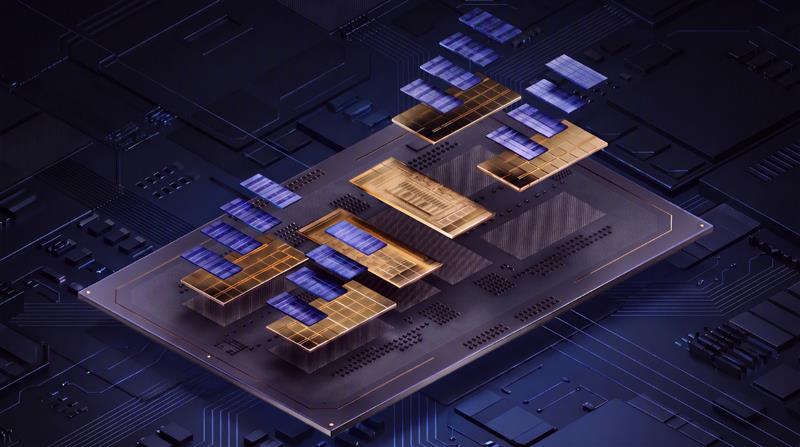
Arquitetura de CPU Diamond Rapids
A Intel descreve o Diamond Rapids , detalhado no Hot Chips como um design 18A-P, como uma combinação de maior densidade de computação com mais largura de banda de memória, caches maiores e aceleração de CPU expandida. As Extensões de Desempenho Avançado (APX) da Intel visam o desempenho por thread, e o que a Intel chama de tecido de memória unificado proporciona a taxa de transferência de 1.6 TB/s. A Intel não informou quantos canais de memória ou qual a velocidade da memória por trás desse número, nem se ele se aplica a todos os soquetes.
A arquitetura também suporta Intel AVX 10.2 e Intel Advanced Matrix Extensions (Intel AMX) aprimorado. A Intel afirma que a próxima geração do Xeon é a única CPU de servidor x86 com computação matricial integrada para cargas de trabalho de HPC e IA. Para referência em relação à quantidade de núcleos, os processadores AMD EPYC Venice de ponta que analisamos possuem 256 núcleos Zen 6 por soquete.
McVeigh estruturou o roteiro em torno de sistemas mistos, nos quais as CPUs orquestram fluxos de trabalho e executam bibliotecas de comunicação paralelas, enquanto os aceleradores assumem o trabalho de IA, escrevendo que o futuro da HPC é "aberto, heterogêneo e equilibrado".
GPUs Intel série D e software HPC
A série D de GPUs da Intel combina aceleração de IA com computação de dupla precisão (FP64) em uma placa PCIe refrigerada a ar, com suporte a tipos de dados que vão de FP4 e MXFP4 até FP64. A GPU D270, da Intel, possui 160 GB de LPDDR5X com largura de banda de memória de 1.5 TB/s, e configurações desenvolvidas por parceiros podem chegar a 480 GB. O argumento da Intel para centros de pesquisa centra-se na capacidade de memória, já que manter conjuntos de dados de trabalho maiores na placa reduz o particionamento e as transferências entre o host e o acelerador que tornam os fluxos de trabalho científicos mais lentos. A Intel também promove a placa para agentes de IA sempre ativos que geram código e iniciam tarefas de computação.
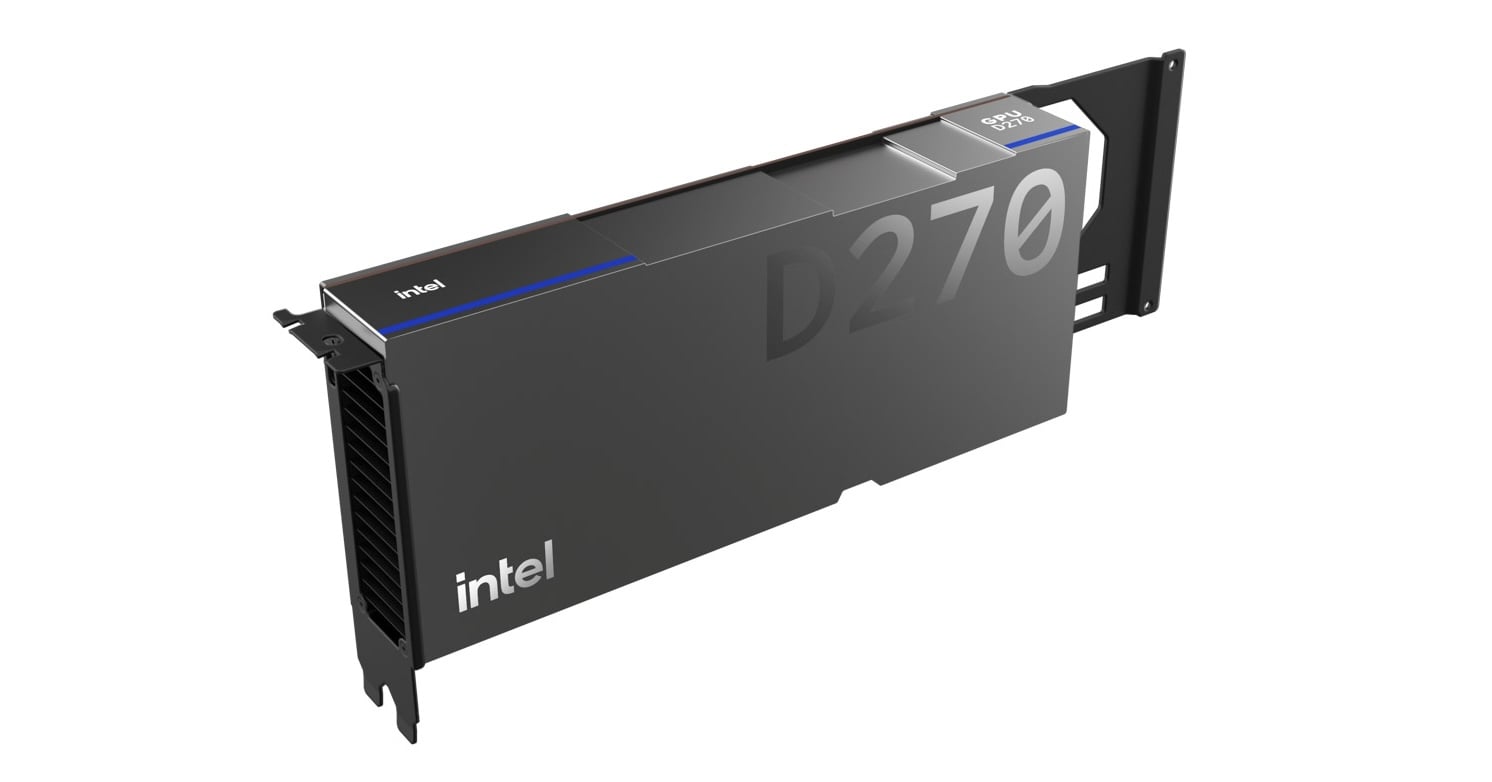
A Intel está realizando duas demonstrações ao vivo da GPU D270, a placa da série D anteriormente conhecida pelo codinome Crescent Island, em seu estande na SC26. A primeira é um miniaplicativo de imageamento sísmico da Veridien, que foi portado de HIP e CUDA para SYCL em menos de um mês, e a Intel afirma que 90% de seus kernels funcionaram bem sem nenhuma otimização específica da Intel. A segunda divide um pipeline de inferência entre placas D270 que lidam com o pré-preenchimento e unidades SambaNova SN50 que lidam com a decodificação, com processadores Xeon 6 e Xeon 6+ orquestrando o processo.
A Intel também publicou comparações com a RTX PRO 6000 Blackwell Server Edition da NVIDIA. Em cargas de trabalho financeiras FP64, a empresa alega um desempenho até 5.9 vezes superior no modelo Monte Carlo europeu, 5.6 vezes superior no modelo Black-Scholes europeu, 4.6 vezes superior no modelo de precificação binomial e 1.92 vezes superior no modelo Black-Scholes americano, com a D270 consumindo 350 W e a placa NVIDIA, 600 W. Para inferência, a Intel alega uma latência até 29% menor no Drex v2.0 e um aumento de 1.12 vezes na taxa de transferência de tokens de saída no Qwen3-30B-A3B em FP8.
Estes são resultados de fornecedores em silício de pré-produção, e não os executamos nem os auditamos. A configuração de teste financeiro da Intel lista oito placas NVIDIA contra uma única D270 e não informa se os resultados são normalizados por placa, e as execuções de inferência da NVIDIA usaram uma máquina virtual da AWS.
Em relação ao software, a Intel afirma que continuará investindo em Intel MPI, Fortran, otimizações de compiladores e oneAPI para que as bases de código paralelas existentes continuem funcionando bem em sistemas mistos de CPU e GPU. A empresa também está trabalhando na integração com frameworks de IA, runtimes de inferência e ambientes de implantação. O objetivo declarado é que modelos e ferramentas padrão funcionem em novos hardwares, como a série D, desde o primeiro dia de sua implementação.
Conectividade Óptica e Desenvolvimento Quântico
A Intel também destacou seu trabalho em fotônica de silício, que usa luz para transmitir dados por distâncias maiores com o que a empresa descreve como uma fração da energia gasta em conexões de cobre. A Intel não apresentou números ou um cronograma de produtos para comprovar essa afirmação.
Em relação à computação quântica, a Intel reiterou os argumentos a favor de sua proposta de aquisição da Classiq , que combinaria a plataforma automatizada de síntese de algoritmos quânticos da Classiq com a tecnologia de qubits de spin em silício e a fabricação de chips da Intel. A Intel afirmou que espera concluir o negócio no primeiro semestre de 2027, sujeito à aprovação dos órgãos reguladores.


 Amazon