

No OCP Global Summit de 2025, a Intel enfatizou a inferência de IA ao revelar dois avanços importantes: uma nova GPU para data center chamada "Crescent Island" e um design de referência em escala de rack para o Gaudi 3. Ambos os desenvolvimentos se alinham com a crescente transição do treinamento de modelos para a inferência generalizada em tempo real, onde fatores como latência, largura de banda de memória, eficiência e simplicidade operacional são agora cruciais.
Do treinamento estático à inferência generalizada em tempo real
O CTO da Intel, Sachin Katti, resumiu a transição observando que, à medida que a IA agêntica se torna mais difundida, a inferência se torna contínua, rica em contexto e cada vez mais intensiva em termos de sistema. Para gerenciar os crescentes volumes de tokens, as combinações complexas de modalidades e os rigorosos requisitos de SLA, torna-se necessária uma infraestrutura heterogênea que combine silício otimizado com uma pilha de software aberta e centrada no desenvolvedor. Nesse ambiente, as GPUs de data center com arquitetura Xe da Intel oferecem a capacidade e a confiabilidade necessárias à medida que os comprimentos de sequência e as taxas de token aumentam, enquanto o Gaudi 3 oferece suporte a um ecossistema de inferência aberto e escalável com custo total de propriedade (TCO) previsível.
A principal conclusão não é simplesmente "chips mais rápidos". O sucesso da inferência depende da integração de sistemas: memória com reconhecimento de topologia, interconexões flexíveis, energia e resfriamento adequados aos perfis de utilização e orquestração que trata modelos, tokens e fluxos como cidadãos de primeira classe. As empresas não querem ficar presas precisamente no momento em que precisam iterar entre modelos, estruturas e pilhas de serviço.
Abrangendo PC, Edge e Data Center
A Intel afirma estar em uma posição única para oferecer abrangência de ponta a ponta, com PCs de IA, edge industrial e racks de data center baseados em CPUs Xeon 6, aceleradores Gaudi 3 e GPUs Intel. Os temas comuns incluem:
- A flexibilidade do PCIe na diversidade permite a reutilização de áreas existentes quando adequado e permite o dimensionamento para racks centrados em malha, se necessário.
- Os projetos em escala de rack garantem desempenho previsível por watt e incluem opções de resfriamento líquido quando requisitos térmicos e de alta densidade exigem isso.
- Uma plataforma de software abrangente e integrada que visa garantir o desenvolvimento perfeito em vários tipos de silício e níveis de implantação.
A parceria com a OCP reforça a preferência da empresa por designs abertos e referenciáveis, que são mais fáceis de adquirir, validar e dimensionar nas operações.
Crescent Island: Uma GPU de Data Center Ajustada para Economia de Inferência
Crescent Island é a próxima GPU para data center da Intel, projetada para servidores corporativos refrigerados a ar que exigem alta taxa de transferência de tokens sem a necessidade de soluções avançadas de energia ou resfriamento. Seu foco é prático: priorizar a eficiência de custos e o desempenho energético, ao mesmo tempo em que oferece a capacidade de memória e a largura de banda essenciais para tarefas de inferência modernas.
Os destaques incluem:
- Microarquitetura Xe3P focada em desempenho por watt. Isso se alinha bem com a inferência de estado estacionário, onde a utilização é sustentada e a sensibilidade ao custo é alta.
- Memória LPDDR5X de 160 GB no cartão. Para servidores LLM/RAG, sumarização de contexto longo e pipelines multimodais, a capacidade de memória e a largura de banda geralmente limitam o QPS e a latência de cauda mais do que o TOPS bruto.
- Amplo suporte a tipos de dados, projetado com provedores de "tokens como serviço" em mente. A flexibilidade de precisão/quantização mista é essencial para reduzir a taxa de transferência e, ao mesmo tempo, preservar a precisão dos endpoints de produção.
- Preparação de software por meio da pilha aberta e unificada da Intel. A otimização antecipada nas GPUs Arc Pro Série B visa otimizar os fluxos de trabalho dos desenvolvedores e minimizar o atrito de portabilidade.
- Cronograma: A amostragem de clientes para Crescent Island é esperada para o segundo semestre de 2026. Para compradores que planejam ciclos de atualização de 2026–2027, isso oferece uma janela prática para pilotar a pilha de software e os padrões de atendimento de modelos agora.
Crescent Island é sobre economia de inferência em escala. É refrigerado a ar, voltado para capacidade e focado em desempenho/W. Suponha que suas cargas de trabalho sejam dominadas por serviços com uso intensivo de tokens e SLOs de latência estrita. Nesse caso, os 160 GB integrados e os tipos de dados eficientes devem se traduzir em mais sessões simultâneas por watt e menos surpresas no cluster à medida que os comprimentos das sequências aumentam.
Gaudi 3: Rack-Scale referenciável para modelos grandes e inferência em tempo real
O Gaudi 3 abrange desde implementações PCIe até configurações completas em escala de rack, oferecendo um caminho para escalabilidade sem a necessidade de uma mudança arquitetônica radical. O novo design de referência em escala de rack é voltado para empresas que padronizam a inferência de modelos complexos e sistemas de tempo real com baixa latência.
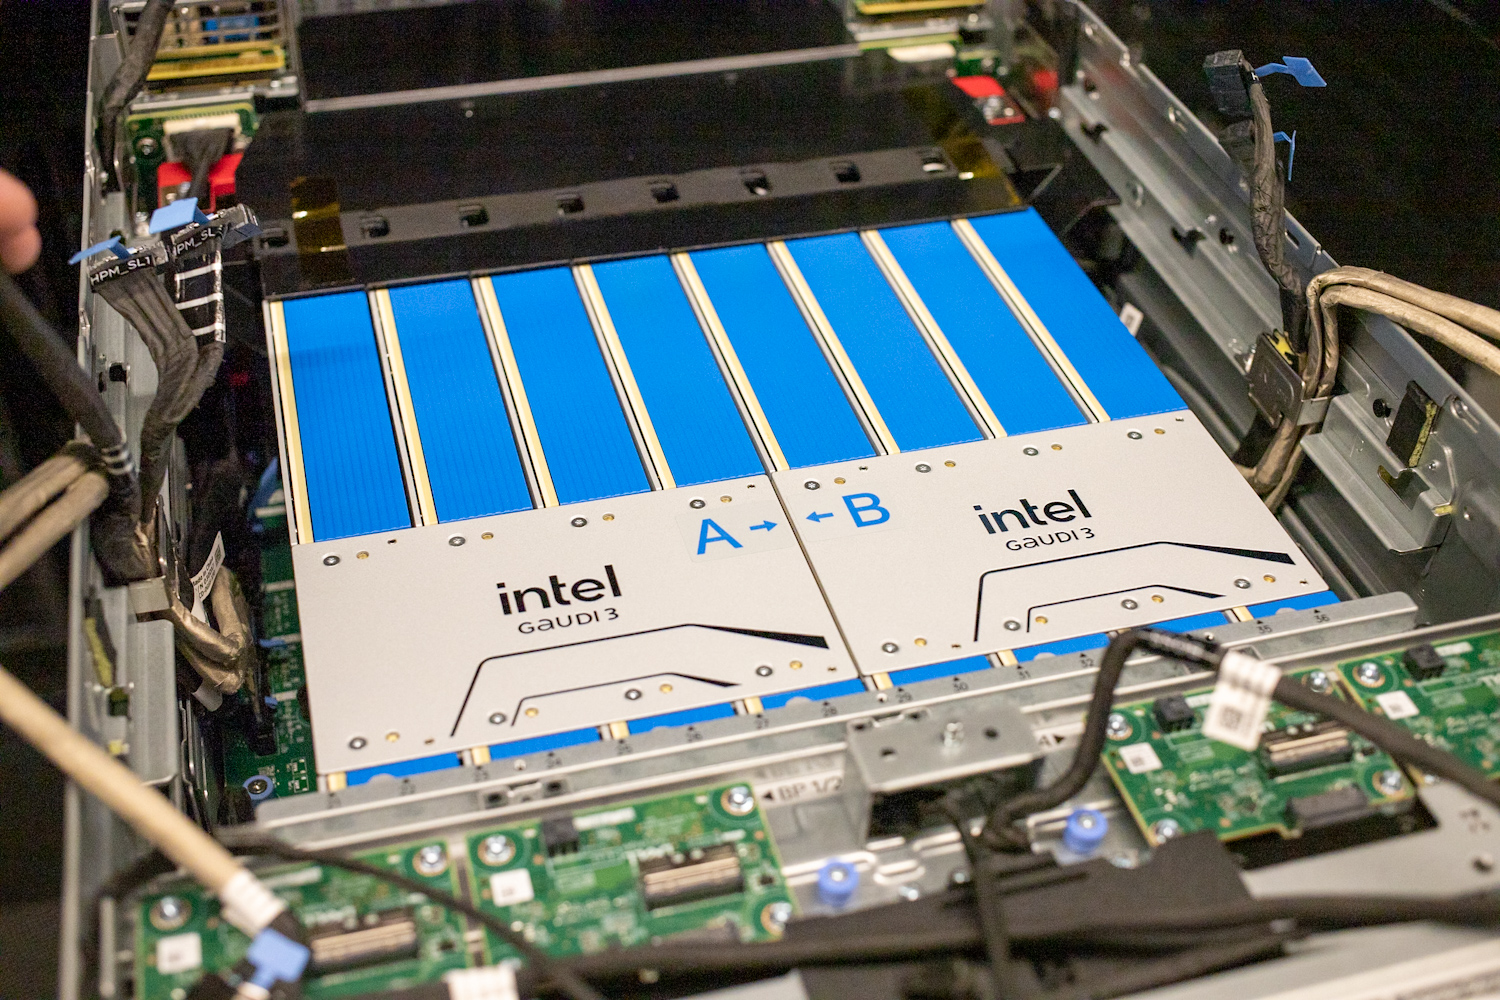
Elementos chave:
- A sequência PCIe-para-rack começa com placas PCIe nos servidores atuais e se estende aos racks, conforme determinado pelos tamanhos dos modelos, simultaneidade e perfis de SLA. Essa abordagem, uma estratégia corporativa comum, ajuda a minimizar os riscos do projeto.
- Suporta até 64 aceleradores por rack com 8.2 TB de memória de alta largura de banda. O principal recurso, o domínio de memória (HBD), permite mais parâmetros e contextos de memória mais longos, resultando em menos quedas de desempenho e latência de cauda mais consistente.
- As opções de resfriamento líquido são essenciais em densidades de aceleradores onde o resfriamento a ar por si só limita a inferência sustentada.
- A orquestração envolve uma pilha de software aberta, como Kubernetes, servidores de modelo padrão e estruturas populares, o que simplifica a integração com arquiteturas MLOps e service-mesh existentes.
Na inferência de produção, fatores como topologia de memória e gerenciamento térmico consistente superam o desempenho teórico máximo. O rack Gaudi 3, que possui 8.2 TB de HBM em 64 aceleradores, atende a necessidades práticas como carregar múltiplas variantes grandes, gerenciar prompts longos e lidar com picos de processamento sem causar sobrecarga. O resfriamento líquido não é apenas opcional nessas densidades; é essencial para manter o QPS e a latência sob estresse térmico.
Timeline
- Software: A pilha de software unificada e aberta da Intel está sendo preparada nas GPUs Arc Pro Série B para dar aos desenvolvedores uma janela inicial para otimização e integração de CI/CD.
- Ilha Crescente: Amostragem de clientes projetada para o 2º semestre de 26. Planeje avaliações sobre prontidão de software, perfis de serviço baseados em memória e restrições de data center refrigerado a ar.
- Gaudi 3 prateleiras: Os projetos de referência especificam até 64 aceleradores/rack, 8.2 TB de HBM e resfriamento líquido, alinhando instalações e envelopes de energia/resfriamento antecipadamente com suas equipes de DC/colo.


 Amazon