

A Meta descreveu o rápido desenvolvimento do seu programa Meta Training and Inference Accelerator (MTIA). A empresa apresentou quatro gerações de chips criadas em aproximadamente dois anos. Esses chips resolvem um problema crucial de infraestrutura que a Meta considera essencial para a IA em todo o mundo: a rápida adaptação a arquiteturas de modelos em constante evolução, a baixo custo e sem depender de longos ciclos de desenvolvimento de silício. O MTIA faz parte de uma estratégia mais ampla para silício, e a Meta reafirmou sua colaboração com a Broadcom para o desenvolvimento desses chips.
Segundo a Meta, centenas de milhares de dispositivos MTIA já foram implantados em produção e diversos modelos internos foram integrados. O trabalho de validação inclui testes com grandes modelos de linguagem, como o Llama. A empresa já havia publicado detalhes técnicos sobre as duas primeiras gerações do MTIA, MTIA 100 e MTIA 200, em artigos de pesquisa da ISCA. Agora, a plataforma está sendo expandida com os MTIA 300, 400, 450 e 500. Esses novos componentes ampliam a cobertura da inferência de classificação e recomendação (R&R) para o treinamento de R&R e, cada vez mais, para cargas de trabalho gerais de IA GenAI, especialmente inferência, com implantações em andamento ou planejadas para 2026 e 2027.
Iteração como princípio de design
Um tema fundamental é a cadência. A Meta argumenta que a evolução do modelo é mais rápida do que o desenvolvimento tradicional de chips, que pode levar até dois anos desde o projeto até a produção. A Meta constrói os chips MTIA na arquitetura RISC-V de código aberto, com a Taiwan Semiconductor Manufacturing Corporation (TSMC) responsável pela fabricação. A resposta é uma abordagem de design iterativa e modular. Cada geração se baseia em chiplets reutilizáveis e é otimizada com base nos insights mais recentes sobre operadoras e serviços. A empresa também enfatizou a importância da reutilização além do próprio chip. Os modelos MTIA 400, 450 e 500 compartilham o mesmo chassi, rack e infraestrutura de rede. Isso permite atualizações rápidas, reduzindo o tempo entre a prontidão do silício e a implantação no data center.
MTIA 300: Redes e Coletividades Integradas ao Silício
A arquitetura MTIA 300 constitui a base do novo roteiro. Inicialmente, foi otimizada para o treinamento de R&R (Repetição e Regressão), a principal carga de trabalho do Meta antes do surgimento da GenAI. A arquitetura inclui chiplets de rede integrados, mecanismos de mensagens dedicados para comunicação coletiva eficiente e computação próxima à memória para reduzir a carga nas operações coletivas. Embora focada em R&R, esses componentes de comunicação também suportam o treinamento de GenAI e a eficiência de inferência em versões posteriores.
Em nível de bloco, a Meta descreveu o MTIA 300 como um projeto multi-chiplet com um chiplet de computação, dois chiplets de rede e múltiplas pilhas HBM. O bloco de computação é organizado como uma grade de elementos de processamento (PEs), com PEs extras para aumentar o rendimento. Cada PE inclui dois núcleos vetoriais RISC-V, um mecanismo de produto escalar para operações matriciais, uma unidade de função especializada para ativações e operações elemento a elemento, um mecanismo de redução para acumulação e comunicação entre PEs e um mecanismo DMA para transferência local de dados.
MTIA 400: Uma virada rumo à IA de geração com alegações de produtividade competitiva
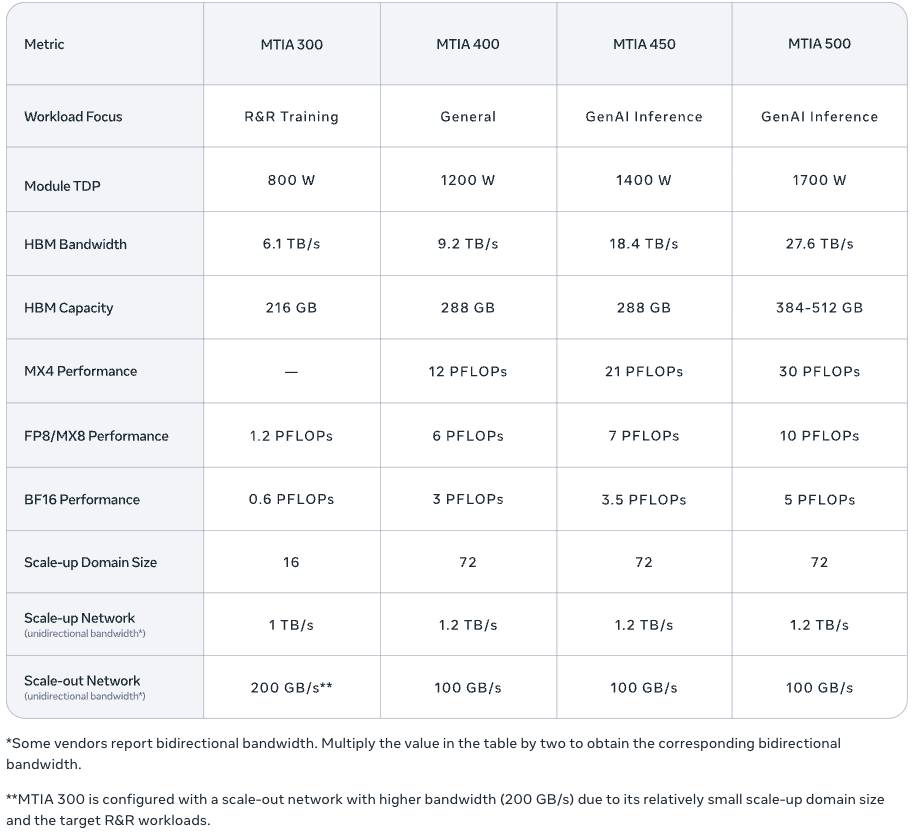
O MTIA 400 aprimora o MTIA 300 para melhor suportar GenAI, mantendo as capacidades de R&R. A Meta descreve o MTIA 400 como uma grande atualização, relatando 400% mais FLOPS FP8 e 51% mais largura de banda HBM do que o MTIA 300. Arquiteturalmente, o MTIA 400 combina dois chiplets de computação para aumentar a densidade de processamento e adiciona suporte para formatos de baixa precisão MX8 e MX4 aprimorados, que a Meta considera essenciais para inferência GenAI eficiente.

O projeto do sistema continua sendo um foco fundamental. A Meta descreveu uma implementação em escala de rack na qual 72 dispositivos MTIA 400 se conectam por meio de um backplane comutado, formando um único domínio escalável. Para implementações flexíveis, a Meta mencionou racks com resfriamento líquido assistido por ar (AALC) para acelerar a configuração em data centers existentes. Também observou que a plataforma é compatível com soluções de resfriamento líquido.
MTIA 450: A otimização da inferência GenAI começa com a largura de banda da memória.
O MTIA 450 é uma versão aprimorada do MTIA 400, com foco em inferência e impulsionado pela crescente demanda por inferência GenAI. A Meta identificou a largura de banda da HBM como o principal fator limitante do desempenho de inferência e a dobrou do MTIA 400 para o MTIA 450. A empresa também relatou um aumento de 75% nos FLOPS do MX4 para melhorar os cálculos de mistura de especialistas, juntamente com aceleração por hardware para reduzir gargalos comuns em operações de atenção e feedforward, particularmente no comportamento de Softmax e FlashAttention.
A Meta destacou seu trabalho com tipos de dados como um fator importante. O MTIA 450 vai além do FP8 e do MX8, atingindo a taxa de transferência do MX4 com seis vezes a velocidade do FP16/BF16. O chip suporta cálculos mistos de baixa precisão sem a necessidade de conversões de software. Ele apresenta inovações personalizadas para tipos de dados, projetadas para preservar a qualidade do modelo e, ao mesmo tempo, aumentar o FLOPS com impacto mínimo na área. O lançamento em massa do MTIA 450 está previsto para o início de 2027.
MTIA 500: Mais largura de banda, mais capacidade, maior decomposição de chiplets.
O MTIA 500 mantém o foco em inferência com melhorias adicionais em memória e computação. A Meta afirmou que o MTIA 500 aumenta a largura de banda da HBM em 50% em relação ao MTIA 450, eleva a capacidade da HBM em até 80% e aumenta o desempenho de FLOPS do MX4 em 43%. O design do chiplet avança com uma configuração 2x2 de chiplets de computação menores, circundados por múltiplas pilhas HBM e dois chiplets de rede. Ele também inclui um chiplet System-on-Chip (SoC) para conectividade PCIe com a CPU do host e NICs de expansão horizontal. A Meta mencionou aceleração de hardware adicional e alterações nos tipos de dados para solucionar gargalos de inferência.
O MTIA 500 está programado para implantação em massa em 2027.
Fácil adoção
A Meta está alinhando o MTIA com o objetivo de facilitar a adoção, enfatizando ferramentas padrão do setor em vez de uma estrutura especializada. A empresa descreveu o MTIA como nativo do PyTorch, funcionando perfeitamente com os processos de compilação do PyTorch 2.x e suportando execução imediata e em modo gráfico. No modo gráfico, os desenvolvedores podem usar `torch.compile` e `torch.export` para otimizar grafos sem precisar reescrever modelos específicos do MTIA, permitindo a implantação paralela em GPUs e no próprio MTIA.
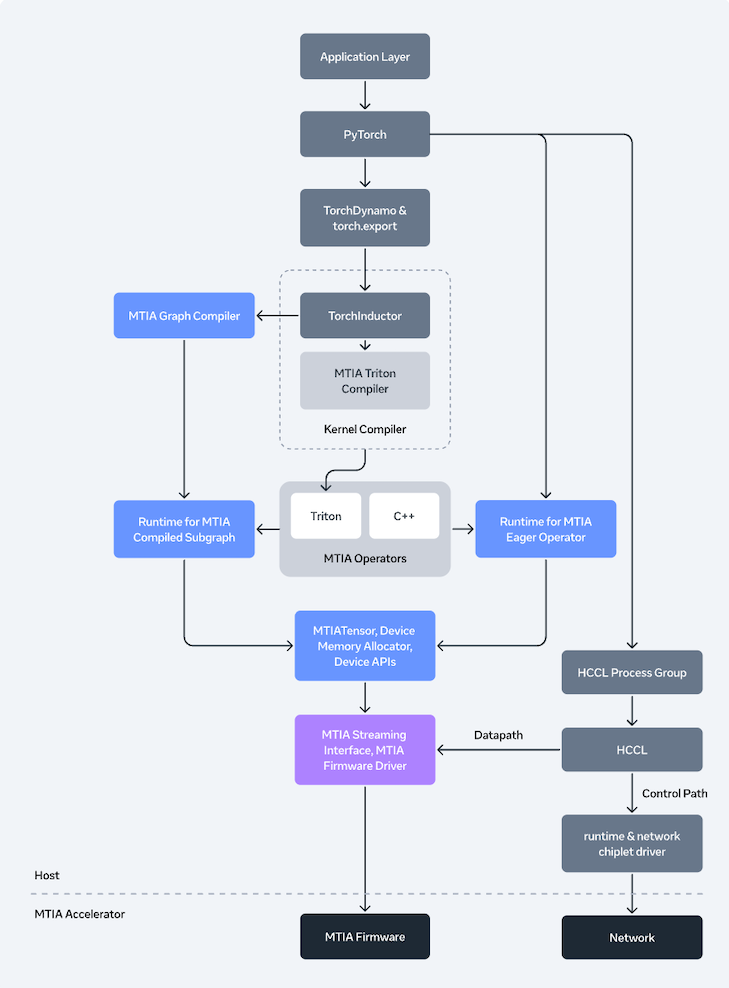
Nos bastidores, a Meta detalhou uma pilha de compiladores MTIA construída sobre o Torch FX IR e o TorchInductor. As camadas inferiores utilizam Triton, MLIR e LLVM, juntamente com otimizações específicas do MTIA, incluindo melhorias na fusão de kernels e extensões para partes críticas de desempenho. O ajuste automático é um recurso fundamental para selecionar entre diferentes estratégias de compilação.
Para execução distribuída, a Meta introduziu sua Biblioteca de Comunicações Coletivas Hoot (HCCL). Essa biblioteca é semelhante às pilhas coletivas de GPU, mas otimizada para os chiplets de rede e mecanismos de mensagens integrados do MTIA. Ela utiliza computação próxima à memória para acelerar as operações de redução. A Meta também oferece suporte à fusão de computação coletiva para diminuir a latência e possui uma pilha de transporte projetada para gerenciar o caminho dos dados e reduzir a sobrecarga do host.
Em tempo de execução, a Meta demonstrou um ambiente de execução de dispositivo que gerencia memória, agendamento e coordenação entre os modos eager e gráfico. Ela também introduziu um driver de espaço do usuário baseado em Rust, abandonando o tradicional driver Linux embutido no kernel. O firmware é escrito em Rust puro, priorizando baixa latência e segurança.
Para o serviço GenAI, a Meta descreveu sua integração com o vLLM usando um sistema de plugins. Isso substitui operadores-chave como FlashAttention e LayerNorm fundido por kernels específicos do MTIA. Também habilita o modo gráfico por meio de um backend torch.compile personalizado. Além disso, a Meta mencionou ferramentas para gerenciar grandes implantações do MTIA, incluindo monitoramento, criação de perfis, depuração e observabilidade em hosts e dispositivos.
Qual é o próximo
O roteiro MTIA atualizado da Meta enfatiza a economia da inferência GenAI, destacando a largura de banda HBM e os formatos de baixa precisão como fatores-chave. Se a Meta cumprir seus cronogramas de implementação, os MTIA 450 e 500 servirão como os primeiros testes em larga escala para determinar se uma estratégia de acelerador com foco em inferência, baseada em iterações rápidas de chiplets e software padronizado, pode manter as vantagens sobre as plataformas de GPU convencionais para fornecer serviços GenAI.


 Amazon