

O Open Compute Project (OCP) anunciou as adições do servidor de borda Wiwynn ES200 e da placa de base da GPU NVIDIA HGX-H100 à sua plataforma.
O servidor de borda de profundidade curta da Wiwynn foi projetado para atender à crescente demanda por poder de computação em sites de borda, especificamente para aplicativos como inferência instantânea de IA, análise de dados no local e processamento de vídeo multicanal.
Espera-se que a especificação física da placa de base GPU HGX-H100 da NVIDIA ajude a melhorar a capacidade do subprojeto OAI da OCP de aproveitar o HGX e desenvolver especificações de sistema e plataforma escalonáveis, econômicas e de alta eficiência para computação de alto desempenho em aplicativos de IA e HPC.
Servidor de borda Wiwynn ES200
O Wiwynn ES200 é um servidor de borda de soquete duplo 2U alimentado por um processador Intel Xeon Scalable de 3ª geração. Com o balanceamento NUMA, ele pode fornecer o poder de computação de cada processador instalado para atender diferentes cargas de trabalho separadamente, sem criar gargalos de comunicação entre as CPUs.
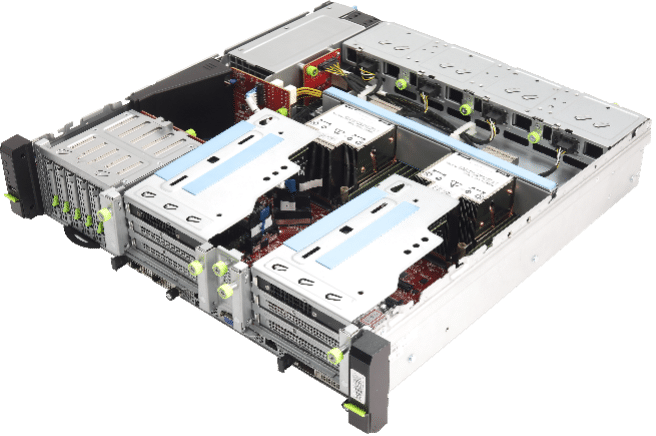
Ele também possui slots PCIe Gen4 x16 adicionais, que podem ser equipados com duas placas de expansão de largura dupla. Isso adiciona muita flexibilidade ao sistema, tornando-o ideal para casos de uso como aceleração de inferência de IA, transcodificação de vídeo e análise de dados, bem como casos de uso que necessitam de conectividade de rede adicional. Ele conta com módulos de armazenamento flexíveis, incluindo SSDs EDSFF (E1.S) ou U.2 e duas placas de rede OCP 3.0, permitindo que o ES200 ofereça processamento de dados local impressionante e conexão de rede de alta largura de banda.
O ES200 também é compatível com NEBS-3 e apresenta um formato compacto de profundidade curta. Além disso, o Wiwynn indica que pode funcionar sem problemas em condições operacionais difíceis e caber em vários locais de borda.
Especificações do nó do servidor Wiwynn ES200 Edge
| Especificação do nó | |
| Subcontratante | Processadores escaláveis Intel Xeon de 3ª geração, TDP 250 W/270 W |
| Soquetes do processador | 2 |
| Chipset | Série Intel C621A |
| Total | TPM v2.0 (opção) |
| Barramento de Sistema | Interconexão Intel UltraPath; 11.2 GT/s |
| Memória | 16 slots DIMM; DDR4 até 3200 MT/s e até 64 GB por DIMM; 12 slots DIMM com até 2 DCPMMs (Intel Barlow Pass) |
| Armazenamento | ‧ Um slot de módulo SSD 2280/22110 M.2 integrado ‧ Seis U.2 (15/7 mm) ou Oito EDSFF E1.S (5.9/9.5 mm) |
| Slots de expansão | Até seis slots PCIe Gen4: ‧ Duas PCIe x16 FHFL de largura dupla + uma PCIe x8 FHHL ‧ Um slot PCIe x16 FHHL + Dois slots PCIe x8 FHHL ‧ Seis slots PCIe x8 FHHL são opcionais por demanda Dois OCP 3.0 NIC x16 integrados |
| LAN de gerenciamento | ‧ Uma porta BMC dedicada GbE |
| Portas I / O | ‧ Botão liga/desliga com LED ‧ Botão UID com LED ‧ Botão RST ‧ Três portas USB ‧ Porta de gerenciamento BMC (lado frontal) ‧ Porta VGA (D-sub) |
| Especificação do chassi | |
| Dimensões | Rack 2U; 86(A) x 440 (L) x 450 (P) (mm) |
| PSU | Hot-pluggable, redundante (1+1) 1600 W CRPS |
| Fan | Quatro rotores duplos 8038, redundantes (7+1) |
| Peso | 14.47kg |
| Meio Ambiente | ‧ Faixa de temperatura operacional ambiente: -5 a +55 graus Celsius
‧ Umidade relativa operacional e de armazenamento: 10% a 90% (sem condensação) ‧ Faixa de temperatura de armazenamento: -40 a +70 graus Celsius |
NVIDIA Rodapé HGX-H100
A NVIDIA HGX-H100 é uma placa-mãe que suporta oito dos módulos de GPU Hopper mais recentes . A especificação física da placa-mãe HGX define aspectos como as dimensões físicas, interfaces de host, gerenciamento e interfaces de depuração. O pacote de contribuição da NVIDIA também inclui a especificação física da placa-mãe, a lista de pinos de entrada/saída e um mapa de pinos, além de desenhos 2D e 3D.
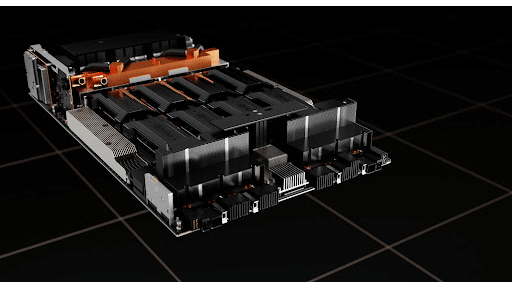
A lista a seguir da OCP indica como a contribuição da NVIDIA HGX se baseia em seus “quatro princípios”: eficiência, escalabilidade, abertura e impacto:
- Eficiência – Este é o fator de forma da placa base HGX de 3ª geração, e cada geração forneceu aproximadamente 3x-5x maior taxa de transferência de treinamento de IA enquanto consome energia ativa semelhante. Como resultado, a placa de base HGX é agora o padrão de fato, com a maioria dos hyperscalers globais projetando em torno desse fator de forma para treinamento e inferência de IA.
- Escalabilidade – Globalmente, centenas de milhares de sistemas HGX estão em produção. Os sistemas e gabinetes para este fator de forma serão estáveis e construídos em escala. A especificação HGX incluirá dimensões físicas, interfaces de gerenciamento para monitoramento/depuração etc. para serviços em escala.
- Abertura – Os sistemas baseados em HGX são a plataforma de treinamento de IA mais comum globalmente. Muitos OEMs/ODMs construíram sistemas de IA baseados em HGX. Com a contribuição desta especificação física HGX, o grupo OAI convergirá UBB2.0 com a especificação HGX tanto quanto possível. Os OEMs/ODMs podem aproveitar o mesmo design de sistema com diferentes aceleradores em placas de base do tipo UBB/HGX, como a mesma dimensão de placa de base, interfaces de host, interfaces de gerenciamento, fornecimento de energia, etc.
- Impacto – As plataformas NVIDIA HGX se tornaram o padrão global de fato para plataformas de treinamento de IA. A abertura desse fator de forma da placa base HGX permite que outros fornecedores de aceleradores de IA aproveitem o ecossistema HGX de sistemas e gabinetes. Isso deve acelerar outros fornecedores de IA para aproveitar a infraestrutura existente e adotar suas soluções mais cedo. Isso acelera ainda mais a inovação nos campos de IA/HPC.


 Amazon