

A NVIDIA anunciou duas iniciativas significativas voltadas para computação de alto desempenho e IA: a aquisição da SchedMD, empresa por trás do gerenciador de cargas de trabalho Slurm, e o lançamento da família Nemotron 3 de modelos, dados e ferramentas abertos para IA multiagente. Juntos, esses esforços reforçam a posição da NVIDIA em HPC, IA generativa e infraestrutura de IA empresarial, mantendo uma forte ênfase em software aberto e independente de fornecedores.
Slurm e SchedMD: fortalecendo o agendamento de HPC aberto e independente de fornecedores.
A SchedMD é a principal desenvolvedora do Slurm, um dos gerenciadores de carga de trabalho de código aberto mais amplamente utilizados em clusters de HPC e IA. O Slurm é usado para enfileirar, agendar e alocar recursos computacionais em clusters de grande escala que executam cargas de trabalho paralelas altamente acopladas. À medida que o tamanho dos clusters e a complexidade dos modelos aumentam, o agendamento eficiente torna-se crucial para manter a utilização e a taxa de transferência.
A presença do Slurm em HPC é substancial. Ele é usado em mais da metade dos 10 e 100 principais sistemas da lista TOP500, impulsionado por sua escalabilidade, alto desempenho e suporte para gerenciamento de políticas complexas. Para cargas de trabalho de IA, o Slurm se tornou um componente essencial da infraestrutura usada por desenvolvedores de modelos fundamentais e construtores de IA para orquestrar o treinamento e a inferência de modelos em larga escala em sistemas acelerados por GPU.
Após a aquisição, a NVIDIA planeja continuar desenvolvendo e distribuindo o Slurm como um software de código aberto e independente de fornecedores. A empresa afirma que o Slurm permanecerá acessível à comunidade de HPC e IA em geral e continuará a oferecer suporte a ambientes heterogêneos em uma ampla gama de plataformas de hardware e software. A NVIDIA colabora com a SchedMD há mais de uma década, e esta aquisição formal visa acelerar esse roteiro, em vez de representar uma mudança estratégica.
A liderança da SchedMD considera o acordo uma validação do papel central do Slurm em HPC e IA. A empresa observou que a expertise da NVIDIA em computação acelerada deve ajudar o Slurm a atender às futuras necessidades de IA e supercomputação, preservando seu modelo de código aberto e o engajamento com a comunidade.
Impacto no cliente e suporte à plataforma
Para os clientes atuais do SchedMD, a NVIDIA pretende manter a continuidade do suporte, treinamento e desenvolvimento do Slurm. As implementações atuais do Slurm abrangem provedores de nuvem, fabricantes, empresas de IA e organizações de pesquisa em setores como direção autônoma, saúde e ciências da vida, energia, serviços financeiros, governo e manufatura em geral.
A NVIDIA também espera acelerar o acesso do SchedMD a novos sistemas e arquiteturas. Para clientes que padronizam a plataforma de computação acelerada da NVIDIA, isso deve se traduzir em suporte mais rápido para novas gerações de GPUs e configurações de sistema. Ao mesmo tempo, a NVIDIA reitera que o Slurm continuará a oferecer suporte a uma ampla gama de ambientes heterogêneos, permitindo que clusters de diferentes fornecedores adotem novos recursos do Slurm sem ficarem presos a uma única pilha de hardware.
O esforço conjunto entre a NVIDIA e a SchedMD é enquadrado como parte de uma iniciativa mais ampla para fortalecer o ecossistema de software de código aberto em HPC e IA, permitindo a inovação em diversos setores e escalas de implementação.
Nemotron 3: Modelos MoE abertos para IA multiagente e agética
Ao mesmo tempo, a NVIDIA apresentou a família Nemotron 3 , um ecossistema aberto de modelos, conjuntos de dados e bibliotecas para a criação de sistemas de IA com agentes transparentes e eficientes. À medida que as organizações migram de chatbots de modelo único para arquiteturas multiagentes mais complexas, elas enfrentam desafios como a sobrecarga de comunicação entre os agentes, a deriva de contexto em fluxos de trabalho longos e o aumento dos custos de inferência. Há também uma crescente demanda por transparência para permitir a compreensão e a confiança em sistemas de IA incorporados em processos de negócios críticos.
O Nemotron 3 visa atender a esses requisitos com uma arquitetura híbrida de mistura latente de especialistas (MoE) projetada para cargas de trabalho multiagentes em grande escala. Os modelos têm como objetivo suportar comportamento colaborativo de agentes, habilidades especializadas e roteamento eficiente de tarefas, mantendo perfis de desempenho e custo previsíveis.
Jensen Huang, fundador e CEO da NVIDIA, enfatizou que a inovação aberta é essencial para o avanço da IA. Ele destacou que o Nemotron transforma IA de ponta em uma plataforma acessível, aumentando a transparência e a eficiência para apoiar o desenvolvimento de sistemas agentes em larga escala.
Iniciativas nacionais e regionais de IA na Europa, Coreia do Sul e outras regiões já consideram o Nemotron como base para o desenvolvimento de IA aberta e controlada localmente. Os primeiros a adotá-lo, incluindo Accenture, Cadence, CrowdStrike, Cursor, Deloitte, Palantir, Perplexity e outros, estão incorporando modelos do Nemotron em fluxos de trabalho que abrangem manufatura, segurança cibernética, engenharia de software, mídia e comunicações.
Linha de modelos: Nano, Super e Ultra
O Nemotron 3 consiste em três níveis principais de modelos MoE, cada um direcionado a diferentes classes de cargas de trabalho:
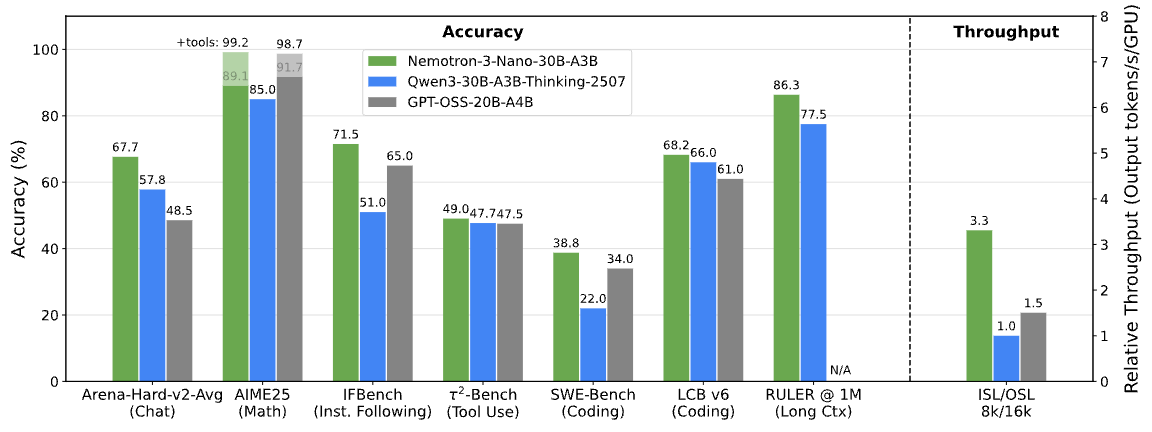
- Nano é um modelo pequeno, com aproximadamente 30 bilhões de parâmetros, que ativa até 3 bilhões de parâmetros por token pela inferência eficiente. É adequado para tarefas like depuração, sumarização, IA dutose recuperação de informações, onde baixa latência e custo estão localizadas crucial. Está O design híbrido MoE oferece até 4 vezes mais capacidade de processamento de tokens do que o Nemotron 2 Nano e reduz os custos de raciocínio em até 60%, diminuindo os custos gerais de inferência.Com uma janela de contexto de 1 milhão de tokens, o Nemotron 3 Nano a manters mais estado em todo longo fluxos de trabalho, melhorando a precisão e conectando contextos distantes. Avaliações independentes o classificam como tal. entre os modelos mais abertos e eficientes em sua classe, com top precisão entre perscrutars.
- Super é um modelo de raciocínio de alta precisão com aproximadamente 100 bilhões de parâmetros e até 10 bilhões de parâmetros ativos por token. Ele foi projetado para aplicações multiagentes, nas quais diversos agentes colaboram para atingir objetivos complexos com requisitos de baixa latência. Super é adequado para cenários onde a profundidade de raciocínio, o uso de ferramentas e a coordenação entre agentes precisam ser escaláveis sem incorrer no perfil de custo dos maiores modelos.
- O Ultra é o modelo de ponta e funciona como um grande mecanismo de raciocínio, com aproximadamente 500 bilhões de parâmetros e até 50 bilhões de parâmetros ativos por token. Ele é destinado aos fluxos de trabalho de IA mais exigentes, incluindo pesquisa aprofundada, planejamento estratégico e sistemas complexos de apoio à decisão que requerem raciocínio de alta qualidade em contextos muito extensos.
Os modelos Nemotron 3 Super e Ultra são treinados usando o formato NVFP4 de 4 bits da NVIDIA na arquitetura Blackwell. Esse formato de treinamento reduz significativamente o consumo de memória e melhora o desempenho do treinamento, mantendo uma precisão comparável à de formatos de maior precisão. Para empresas e provedores de serviços, isso pode permitir o treinamento de modelos maiores na infraestrutura existente ou reduzir a quantidade de hardware necessária para uma determinada escala.
Com essa família de modelos em camadas, os desenvolvedores podem adequar o tamanho e os recursos do modelo a cargas de trabalho e metas de custo específicas, escalando de dezenas a centenas de agentes, mantendo um raciocínio de longo prazo mais rápido e preciso em fluxos de trabalho complexos e com várias etapas.
Roteamento, Token Economics e Estratégias de Modelo Híbrido
À medida que os sistemas multiagentes amadurecem, muitas organizações estão adotando estratégias de modelos híbridos. Modelos proprietários de ponta são usados para as tarefas de raciocínio mais complexas, enquanto modelos abertos, eficientes e personalizáveis, lidam com cargas de trabalho rotineiras ou especializadas em domínios específicos. O Nemotron 3 foi projetado especificamente para esse tipo de arquitetura baseada em roteamento.
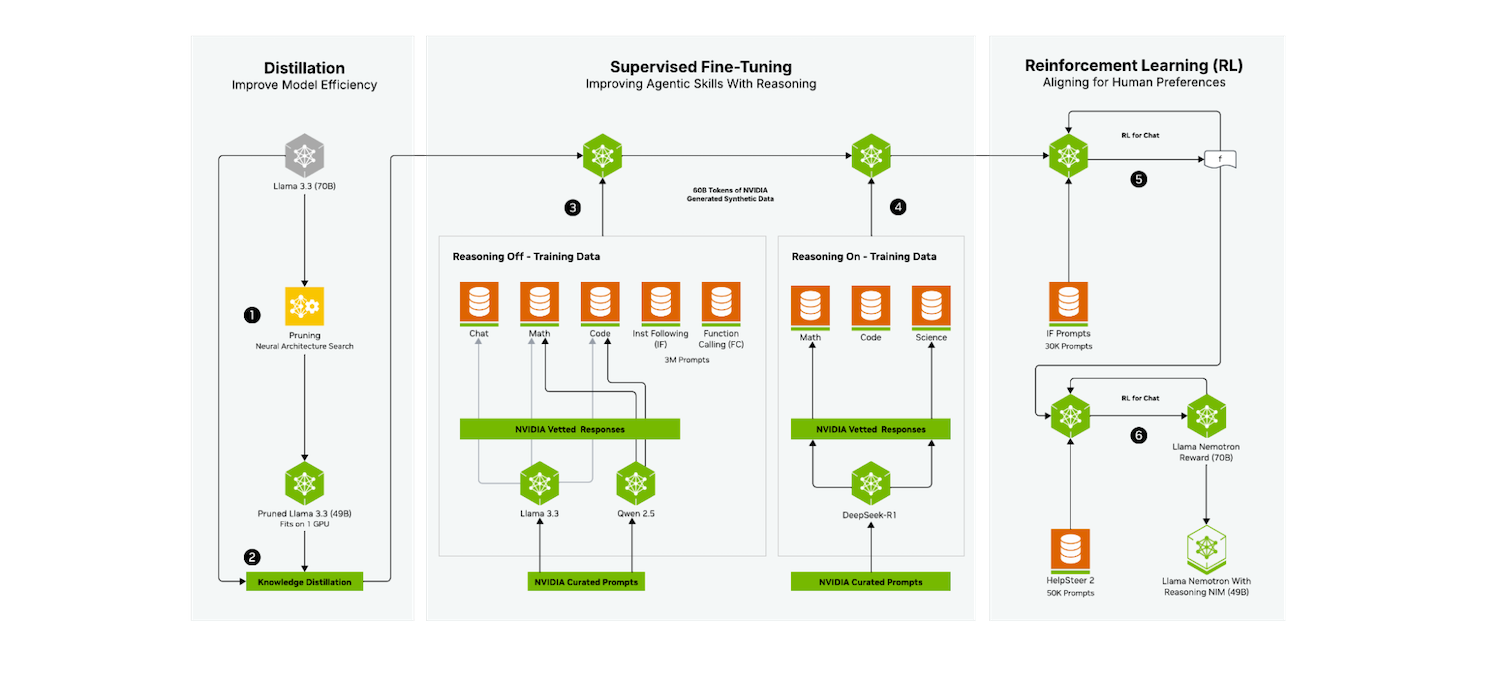
Em uma configuração típica, um roteador de agentes analisa as tarefas em tempo real. Ele as distribui para um modelo Nemotron otimizado, como o Nemotron 3 Ultra, ou para um modelo proprietário quando este oferece valor exclusivo. Essa abordagem ajuda a otimizar a economia de tokens, reservando a capacidade de ponta, mais cara, para os casos mais exigentes e aproveitando o Nemotron para cargas de trabalho de alta taxa de transferência e alta eficiência.
Parceiros que desenvolvem assistentes de IA e plataformas de agentes relatam que essa estratégia de roteamento permite oferecer maior capacidade de resposta e melhor controle de custos, mantendo a flexibilidade para integrar diferentes fornecedores de modelos e estratégias de treinamento ao longo do tempo.
Dados Abertos, Bibliotecas e Ferramentas de Segurança
Além dos próprios modelos, a NVIDIA está lançando um conjunto substancial de recursos abertos para dar suporte ao desenvolvimento de agentes personalizados:
Conjuntos de dados de treinamento e RL
A NVIDIA está disponibilizando 3 trilhões de tokens de conjuntos de dados Nemotron para pré-aprendizado, pós-aprendizado e aprendizado por reforço. Esses conjuntos de dados incluem uma ampla gama de exemplos envolvendo raciocínio, codificação e fluxos de trabalho de várias etapas que podem ser usados para treinar ou ajustar agentes específicos de domínio. O conjunto de dados Nemotron Agentic Safety oferece dados de telemetria do mundo real que as equipes podem usar para avaliar e aprimorar a segurança de sistemas autônomos complexos.
Academia NeMo e NeMo RL
Para simplificar o aprendizado por reforço e o pós-treinamento, a NVIDIA lançou o NeMo Gym e o NeMo RL como bibliotecas de código aberto. Elas fornecem ambientes de treinamento e fundamentos de pós-treinamento alinhados com os modelos Nemotron, que também podem ser estendidos ou adaptados para outras arquiteturas. O NeMo Evaluator está incluído para avaliar a segurança e o desempenho do modelo em uma variedade de benchmarks e casos de uso.
Todas essas ferramentas e conjuntos de dados estão disponíveis no GitHub e no Hugging Face, permitindo que as equipes os integrem em pipelines de MLOps e fluxos de trabalho de treinamento existentes. Empresas do ecossistema, como Prime Intellect e Unsloth, já estão integrando ambientes de treinamento do NeMo Gym em suas plataformas para simplificar o aprendizado por reforço para usuários corporativos.
Os modelos do Nemotron 3 também são compatíveis com estruturas populares de inferência e implantação, incluindo LM Studio, llama.cpp, SGLang e vLLM, o que facilita a realização de experimentação local e a implantação em diversos ambientes.
Disponibilidade
O Nemotron 3 Nano já está disponível através de diversos canais de distribuição, conforme descrito abaixo.
Plataformas de modelos e provedores de inferência: O modelo Nemotron 3 Nano está disponível no Hugging Face e por meio de provedores de inferência, incluindo Baseten, DeepInfra, Fireworks, FriendliAI, OpenRouter e Together AI. Esses serviços oferecem às equipes um caminho rápido para avaliar o modelo e integrá-lo a aplicativos existentes.
Plataformas empresariais: Os modelos Nemotron estão sendo integrados a plataformas empresariais de IA e dados, incluindo Couchbase, DataRobot, H2O.ai, JFrog, Lambda e UiPath. Isso permite que os clientes incorporem recursos baseados em Nemotron diretamente em suas infraestruturas de dados, orquestração e automação.
Nuvem pública e microsserviços NIM: Para usuários de nuvem pública, o Nemotron 3 Nano estará disponível na AWS por meio do Amazon Bedrock para inferência sem servidor e também estará disponível no Google Cloud, CoreWeave, Crusoe, Microsoft Foundry, Nebius, Nscale e Yotta.
O Nemotron 3 Nano também é oferecido como um microsserviço NVIDIA NIM para implantação segura e escalável em infraestrutura acelerada pela NVIDIA, proporcionando às empresas maior controle sobre privacidade, localização de dados e desempenho.
Espera-se que os modelos Nemotron 3 Super e Ultra estejam disponíveis no primeiro semestre de 2026, dando às organizações tempo para padronizar o uso do modelo Nano para os primeiros casos de uso de agentes e planejar futuras migrações para modelos maiores à medida que as necessidades aumentarem.


 Amazon