

A NVIDIA anunciou o Minerva na GTC Berlin, uma plataforma AIOps que coleta telemetria de GPUs, redes, armazenamento, agendadores e das cargas de trabalho de IA em execução, aplicando aprendizado de máquina para encontrar componentes com desempenho abaixo do esperado antes que eles prejudiquem o desempenho de um processo de treinamento. Dell Technologies, Lenovo e Supermicro oferecerão a plataforma em seus portfólios de operações de IA para fábricas, a IREN já a utiliza e IBM, Jio, Lambda, Quake AI, Tesla, Aolani e Bitdeer AI planejam implementá-la. A NVIDIA ainda não divulgou preços nem a data de lançamento.
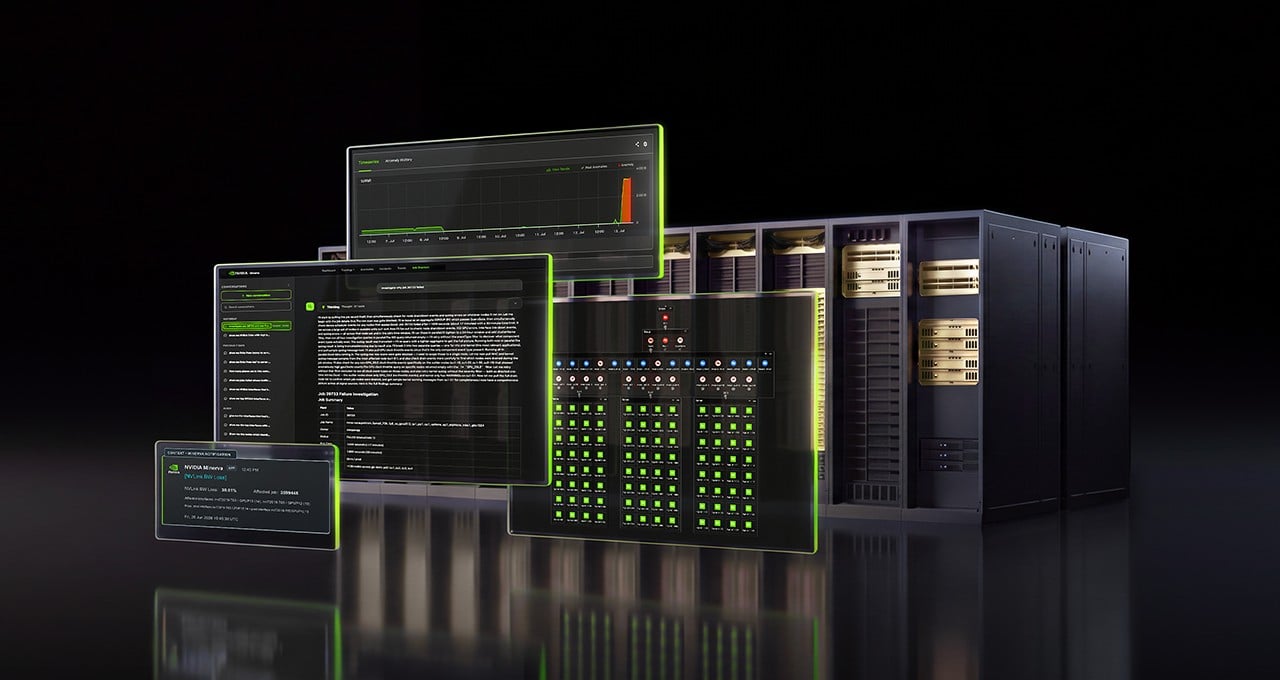
O problema que a Minerva visa solucionar é conhecido por todos os operadores de clusters de grande porte: milhares de GPUs em uma rede de alta velocidade se comportam como uma única máquina, de modo que uma única peça com desempenho abaixo do esperado compromete todo o processo. Os exemplos da NVIDIA incluem uma GPU operando em temperatura mais alta que as demais e um SSD NVMe com desempenho comprometido sob carga, o tipo de sinal de dados que hoje reside em ferramentas de rede, ferramentas de computação e no painel de controle de uma equipe de aprendizado de máquina, cada uma com uma visão separada do mesmo cluster.
O que Minerva assiste
Minerva constrói um grafo de conhecimento dinâmico que mapeia GPUs, SuperNICs, switches, cabos e os trabalhos agendados para eles, analisando então o que a NVIDIA descreve como bilhões de pontos de dados por hora com aprendizado de máquina supervisionado e não supervisionado. Os modelos aprendem o comportamento normal da fábrica, sinalizam anomalias nunca antes vistas, preveem falhas em desenvolvimento e correlacionam eventos relacionados usando a topologia, de modo que um trabalho de treinamento lento possa ser rastreado até o componente responsável em fábricas de grande porte da NVIDIA, com centenas de milhares de GPUs.
Os resultados são organizados como incidentes, com eventos relacionados agrupados em um único item e uma provável causa raiz associada. Segundo a NVIDIA, isso substitui uma enxurrada de alertas por um único item acionável. Um assistente integrado responde a perguntas em linguagem natural com base na telemetria em tempo real e recomenda uma correção. A plataforma se conecta a ferramentas externas de gerenciamento de dados. Os operadores escolhem se a correção será aplicada manualmente ou se a Minerva a encaminhará para a automação por meio de APIs de infraestrutura e sistemas externos.
A NVIDIA define o retorno como rendimento da fábrica de IA, que mede em horas de GPU, produtividade, tempo de atividade do cluster e produção de tokens. Os resultados alegados são intervalos mais longos entre interrupções, reparos mais rápidos e menos alertas para triagem, com a equipe de operações passando de uma manutenção reativa para uma proativa. Essas são alegações do fornecedor sem números anexados; a NVIDIA não publicou o tempo médio de reparo ou os números de tempo de atividade do Minerva.
Sua posição na pilha
A NVIDIA já comercializa software operacional para seus projetos de referência. O Mission Control , lançado em março de 2025, gerencia o provisionamento de clusters por meio do Base Command Manager, o gerenciamento de cargas de trabalho por meio do Run:ai, a telemetria e a recuperação autônoma de tarefas para sistemas DGX SuperPOD. Na mesma semana do Minerva, a NVIDIA colocou três componentes de código aberto do DSX OS em versão prévia para desenvolvedores, voltados para o gerenciamento do ciclo de vida de fábricas de IA: o Config Manager para configuração de rede, o Rack Management Service para gerenciamento de energia, inventário, firmware e switches em nível de rack e o Cluster Readiness Engine para validação de clusters de GPUs com cargas de trabalho distribuídas.
A dimensão do problema que o Minerva visa resolver ficou evidente no artigo da Meta sobre o Prometheus na semana passada. A Meta executa cada domínio NVL72 como uma partição de 64 GPUs, com as outras oito GPUs reservadas nos racks, mantém cerca de 2% dos racks em reserva e coloca em quarentena todos os sistemas reparados até que sejam validados. Um ano de trabalho de investigação da causa raiz com engenheiros da NVIDIA no local reduziu as interrupções em 99% e aumentou o tempo médio entre interrupções para mais de 54,000 horas de GPU, com uma meta de 100,000.
Trata-se de um hiperescalador que executa um pipeline de telemetria desenvolvido especificamente para esse fim e uma equipe conjunta de triagem com a NVIDIA. O Minerva parece ser uma versão integrada dessa metodologia, algo mais próximo de uma solução pronta para uso para empresas ou neoclouds que desejam visibilidade de nível hiperescalador sobre a integridade de GPUs, infraestrutura e armazenamento, além do fluxo de trabalho de backup e reinicialização associado, fornecido pelos mesmos OEMs que vendem os racks.
A NVIDIA não divulgou a relação entre o Minerva e o Mission Control ou o DSX OS, se será distribuído como software, appliance ou serviço hospedado, nem qual será a aparência da embalagem OEM da Dell, Lenovo e Supermicro. A página de documentação do produto direciona os clientes para a equipe de contas da NVIDIA para obter o guia do usuário. O cliente de referência é a IREN, que, segundo a NVIDIA, já utiliza o Minerva para otimizar suas fábricas de IA.
“O NVIDIA Minerva oferece à nossa equipe de operações uma visão unificada da rede, das GPUs e dos trabalhos em execução nelas”, disse Denis Skrinnikoff, diretor de tecnologia da IREN, que atribuiu à ferramenta o mérito de ter permitido que a equipe dedicasse mais tempo à manutenção proativa.
Para o lado do armazenamento, a afirmação interessante é que o comportamento do disco sob carga é uma entrada juntamente com a telemetria da GPU e da malha, já que um dispositivo NVMe que está ficando mais lento raramente aparece na utilização da GPU até que um ponto de verificação ou estágio de carregamento de dados seja interrompido. A profundidade dessa telemetria de armazenamento e quais OEMs e plataformas de arrays a alimentam são detalhes que serão interessantes de se explorar à medida que essa solução chegar ao mercado.



 Amazon