

As infraestruturas de IA são notoriamente exigentes em termos de recursos, e as empresas enfrentam constantemente o desafio de otimizar a utilização de GPUs. A Dell Technologies, por meio de sua plataforma AI Factory, está enfrentando esse desafio integrando a solução de orquestração Run:ai , recentemente adquirida pela NVIDIA . Em uma publicação recente no blog da Dell , a empresa destacou como o Run:ai maximiza a utilização de recursos e acelera os resultados de IA, transformando a maneira como as empresas implantam e gerenciam recursos de GPU em escala.
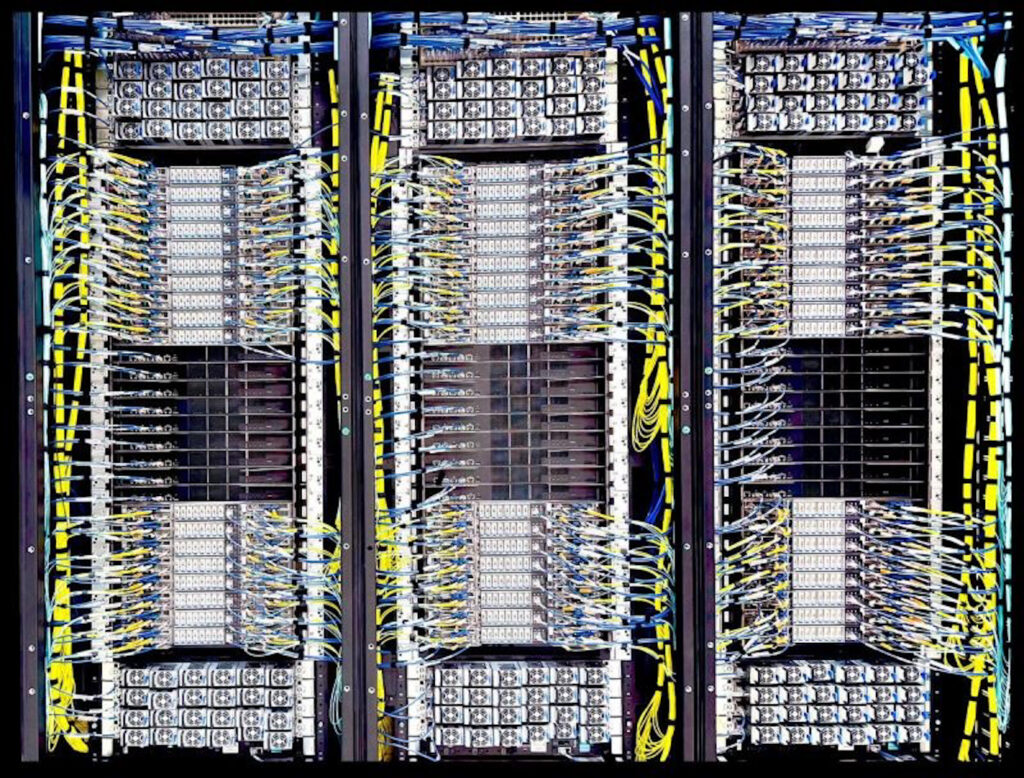
Cluster Dell NVL72
O que exatamente é Run:ai?
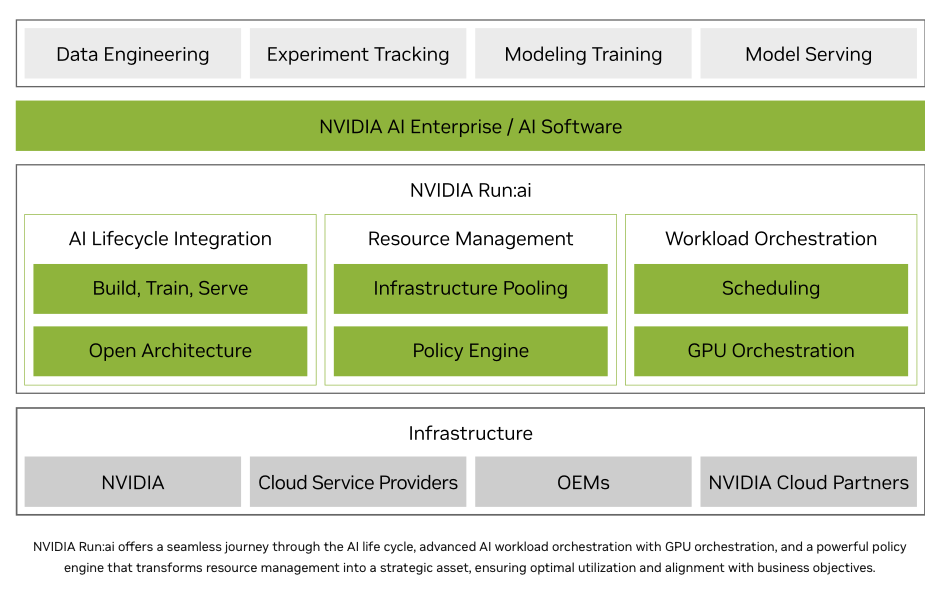
Run:ai é uma plataforma de orquestração construída no Kubernetes, projetada especificamente para cargas de trabalho centradas em GPU. Fundada em 2018, a Run:ai ganhou força ao abordar um desafio generalizado do setor: o uso ineficiente de GPUs. Tradicionalmente, as GPUs atribuídas a cargas de trabalho de IA frequentemente ficam ociosas ou subutilizadas. A Run:ai resolve esse problema agrupando dinamicamente e agendando de forma inteligente os recursos de GPU, permitindo alocação fracionada de GPU, implantações eficientes de múltiplas GPUs e gerenciamento integrado em ambientes híbridos, em nuvem e locais.
Reconhecendo o potencial do Run:ai para remodelar drasticamente a infraestrutura de IA, a NVIDIA concluiu a aquisição da empresa em dezembro de 2024 por aproximadamente US$ 700 milhões. Curiosamente, a NVIDIA se comprometeu a eventualmente disponibilizar o código-fonte do Run:ai, sinalizando sua intenção de fomentar uma ampla adoção do ecossistema além de suas plataformas de hardware. Espera-se que essa medida acelere ainda mais a inovação e a eficiência em toda a indústria.
Para quem busca uma perspectiva técnica mais aprofundada sobre gerenciamento de recursos, a documentação da NVIDIA detalha como o Run:ai é essencial para orquestrar cargas de trabalho em sistemas GB200 NVL72. O documento destaca uma lacuna crítica: o Kubernetes não reconhece nativamente a arquitetura MNNVL da NVIDIA, o que torna o gerenciamento e o agendamento de cargas de trabalho nesses domínios de alto desempenho mais complexos. O Run:ai abstrai essa complexidade detectando automaticamente os domínios NVLink e simplificando o envio de cargas de trabalho distribuídas. Isso garante que os pods sejam alocados corretamente em nós com interconexões NVLink, eliminando a necessidade de conhecimento profundo de hardware ou configuração manual para cada tarefa. Esses recursos demonstram como a plataforma otimiza as operações em ambientes de treinamento densos, permitindo que as organizações aproveitem ao máximo o poder de configurações de hardware avançadas, como o GB200 NVL72.
Por que isso é importante para a empresa
Para organizações que executam cargas de trabalho com uso intensivo de GPU, especialmente aquelas que envolvem IA generativa e grandes modelos de linguagem, a subutilização da GPU representa um risco substancial: desperdício de investimento. O Run:ai resolve diretamente essas ineficiências, com a NVIDIA relatando que as organizações que utilizam a plataforma podem observar melhorias na utilização da GPU em até cinco vezes.
Esse nível de otimização não apenas aumenta o ROI, como também remodela fundamentalmente a eficiência operacional. Equipes antes limitadas por recursos limitados e processos complexos de agendamento agora têm as ferramentas para implantar mais modelos simultaneamente, escalar rapidamente e experimentar de forma mais agressiva, tudo isso sem investimentos adicionais em hardware. Embora essas metodologias sejam comuns em grandes implantações de HPC, o nível de eficiência necessário para maximizar a utilização da GPU é menos comum nas empresas.
Amplo ímpeto da indústria
Vários grandes provedores de infraestrutura estão adotando a plataforma, sinalizando um impulso crescente no cenário de TI empresarial.
A Dell continua a expandir sua estrutura AI Factory, com tecnologias NVIDIA em seu núcleo, incluindo o Run:ai. O uso do Run:ai pela Dell ilustra como as empresas podem migrar da alocação de recursos manual e isolada para um agendamento mais dinâmico e automatizado, que impulsiona maior eficiência em ambientes multi-inquilinos.
A HPE oferece o Run:ai como parte do seu GreenLake Marketplace, integrando-o à plataforma Ezmeral para permitir o agendamento avançado de GPUs, alocação fracionada e orquestração de infraestrutura híbrida. Isso permite que os clientes implementem e gerenciem cargas de trabalho de IA com maior precisão e escalabilidade.
A Cisco integra o Run:ai com seus servidores UCS Série X e a plataforma de operações em nuvem Intersight. Sua solução destaca o gerenciamento de cotas, o compartilhamento fracionado de GPUs e o monitoramento em tempo real para dar suporte a implantações de IA em larga escala em infraestruturas locais.
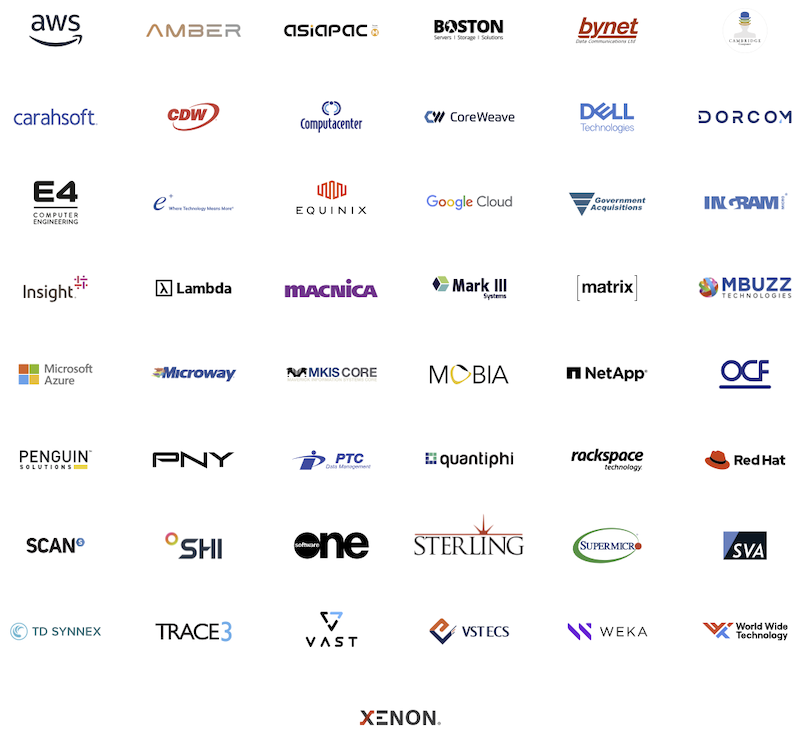
Destacamos apenas alguns dos parceiros da Run:ai. A NVIDIA possui uma extensa lista de logotipos, como visto acima. Em geral, os principais OEMs e provedores de plataformas de nuvem estão se alinhando à Run:ai em sua busca por fornecer soluções de infraestrutura de IA mais inovadoras e eficientes.



 Amazon