

A NVIDIA introduziu o Paralelismo Helix, um novo método desenvolvido para sua arquitetura de GPU Blackwell com o objetivo de aprimorar o desempenho de IA em tempo real com conjuntos de dados muito grandes. A técnica atende à crescente necessidade de LLMs processarem contextos com milhões de tokens. A NVIDIA demonstra que essa abordagem pode aumentar a velocidade de processamento em até 32 vezes em relação aos métodos convencionais, permitindo aplicações de IA mais complexas e responsivas.
O Desafio do Milhão de Tokens: Por que a IA Precisava de uma Nova Abordagem
A fronteira da IA ultrapassou consultas simples e avançou para o raciocínio complexo e de longo prazo. Aplicações avançadas exigem um contexto extremamente amplo para serem eficazes. Um assistente de IA que memoriza meses de conversas, uma ferramenta jurídica que analisa gigabytes de jurisprudência de uma só vez ou um parceiro de programação que compreende um repositório inteiro. Essas tarefas exigem o processamento de milhões de tokens.
No entanto, escalar até esse nível expõe dois gargalos fundamentais.
- O Gargalo do Cache KV: Durante a geração autorregressiva de tokens, os modelos calculam a atenção aos tokens gerados anteriormente para evitar um fator de escala quadrático. Para isso, os tokens gerados anteriormente são armazenados em cache, um processo conhecido como cache KV. Em contextos com milhões de tokens, esse cache se torna enorme, saturando a largura de banda da memória da GPU e reduzindo drasticamente os tempos de resposta.
- O Gargalo de Peso da FFN: Para cada novo token gerado por um modelo, ele precisa carregar pesos massivos da Rede Feed-Forward (FFN) da memória. Em aplicações interativas de baixa latência, esse processo de carregamento constante se torna uma fonte primária de atraso.
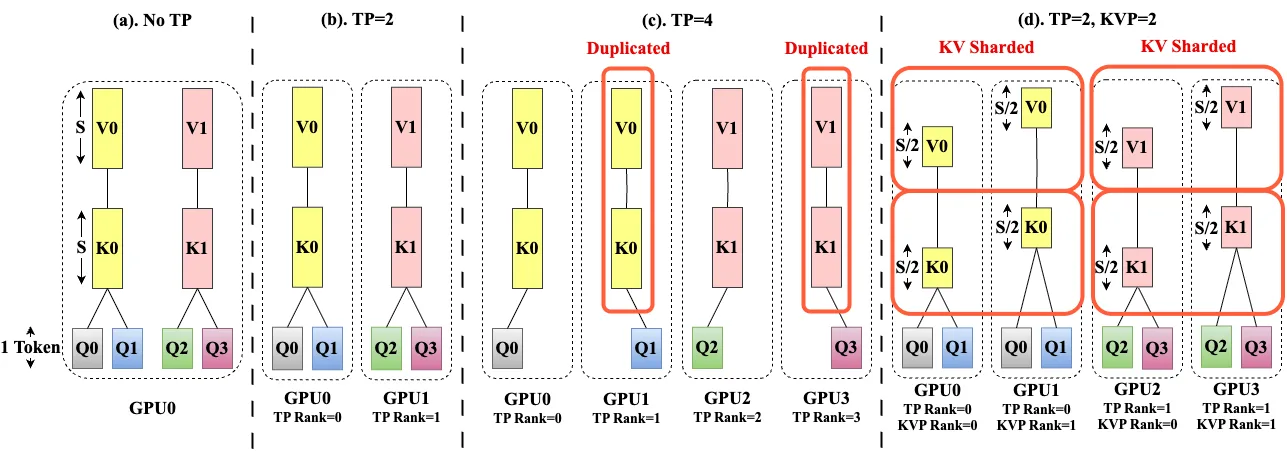
Atualmente, utilizamos métodos como o Paralelismo Tensor, que divide os tensores de um modelo e, portanto, a memória necessária e o trabalho computacional entre múltiplas GPUs. Embora eficaz para algumas tarefas, seus benefícios diminuem com mecanismos de atenção mais recentes. Em mecanismos de atenção como GQA (Atenção de Consulta Agrupada) ou MLA (Atenção Multi-Latent), para reduzir o uso de memória, múltiplas cabeças de consulta compartilham um conjunto menor de cabeças KV. No entanto, quando o tamanho do Paralelismo Tensor excede o número de cabeças KV, é necessária a duplicação das cabeças KV devido à latência significativa introduzida pela comunicação entre GPUs em cada etapa. Essa duplicação anula alguns benefícios do Paralelismo Tensor.
Paralelismo de hélice
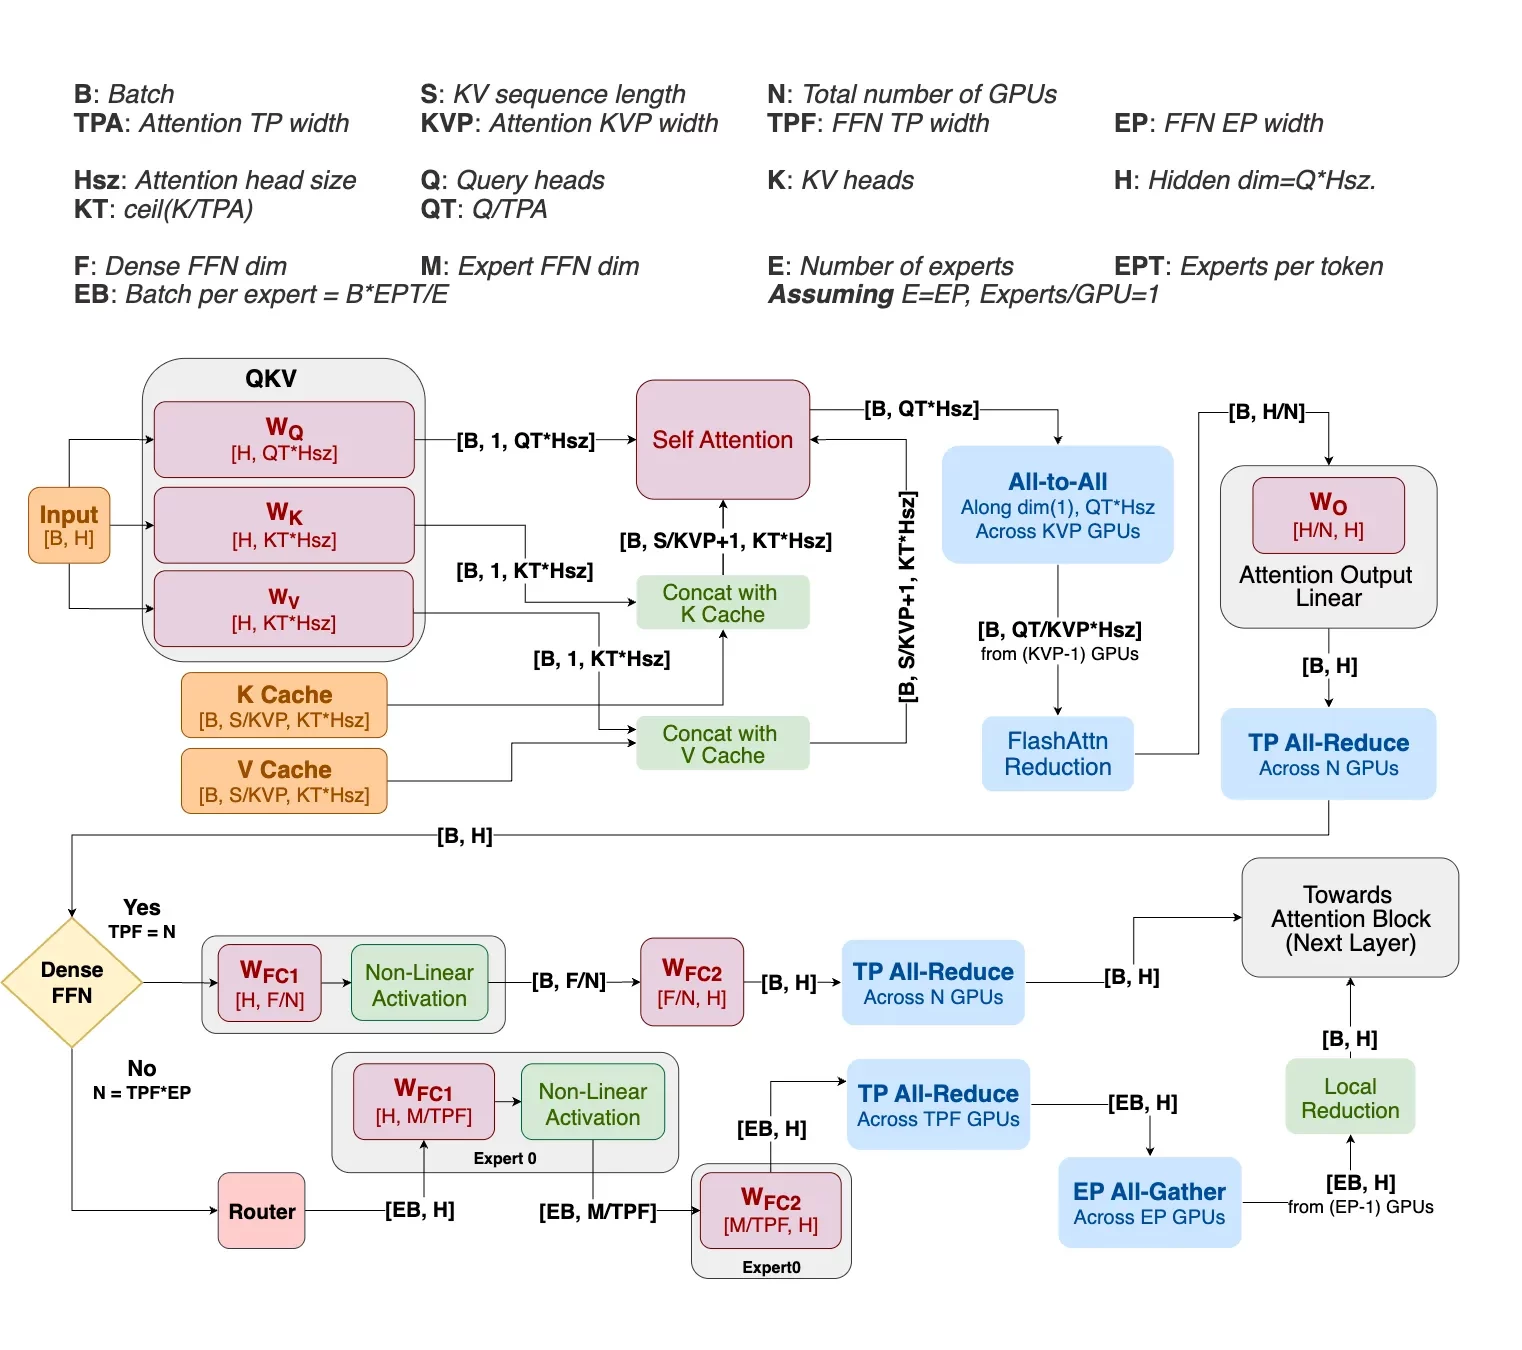
Para resolver esse quebra-cabeça, o Helix Parallelism da NVIDIA introduz uma estratégia híbrida que trata os dois gargalos como problemas separados a serem resolvidos em um pipeline temporal contínuo. Em vez de usar um único método de paralelismo para todo o processo, o Helix reconfigura dinamicamente o mesmo conjunto de GPUs para usar a estratégia ideal para cada etapa da computação.
O processo pode ser dividido em duas fases principais para cada camada do modelo.
Fase 1: A Fase de Atenção (Lidando com o Cache KV)
O Helix aborda diretamente o gargalo do cache KV combinando duas formas de paralelismo. Primeiro, ele aplica o Paralelismo KV, que fragmenta o próprio cache KV entre várias GPUs ao longo da dimensão da sequência. Isso significa que cada GPU armazena apenas uma parte do contexto total, reduzindo a sobrecarga de memória.
Simultaneamente, ele utiliza o Paralelismo Tensor para dividir as cabeças de atenção, garantindo que o número de divisões não exceda o número de cabeças KV. Essa combinação evita a duplicação de cache que afeta o Paralelismo Tensor tradicional. O resultado é uma grade 2D de GPUs que pode computar a atenção com eficiência em um contexto massivo sem que nenhuma GPU fique sobrecarregada. A comunicação entre essas GPUs é gerenciada por uma única e eficiente troca de todos para todos, cujo custo é independente do comprimento do contexto, tornando-a altamente escalável.
Fase 2: A Fase FFN (Enfrentando os Pesos FFN)
A comunicação de todos para todos ao final da fase de atenção também particiona os dados de saída entre as GPUs. Isso significa que os dados já estão perfeitamente organizados para que a computação FFN comece imediatamente.
O mesmo conjunto de GPUs é reprovisionado em um grande grupo de Paralelismo Tensor. Como os dados são pré-particionados, cada GPU pode realizar uma multiplicação de matriz local usando seu fragmento dos pesos FFN massivos. Essa computação inicial ocorre em paralelo, sem comunicação entre GPUs, maximizando a velocidade. Somente após essa etapa de computação local as GPUs participam de uma comunicação eficiente de redução total para combinar seus resultados parciais na saída final.
Uma peça final do quebra-cabeça é como o Helix gerencia o cache KV à medida que ele cresce. À medida que o modelo gera novos tokens, eles devem ser anexados ao cache. Uma abordagem ingênua poderia criar um hotspot de memória gravando todos os novos tokens em uma única GPU. O Helix evita isso com um sistema inteligente de atualização round-robin. Por exemplo, o primeiro bloco de novos tokens pode ir para a GPU 0, o bloco seguinte para a GPU 1 e assim por diante. Essa abordagem escalonada garante que o uso de memória cresça uniformemente em todas as GPUs no grupo de Paralelismo KV, mantendo um desempenho equilibrado e uma taxa de transferência consistente, independentemente do tamanho do contexto.
Uma nova fronteira de desempenho em Blackwell
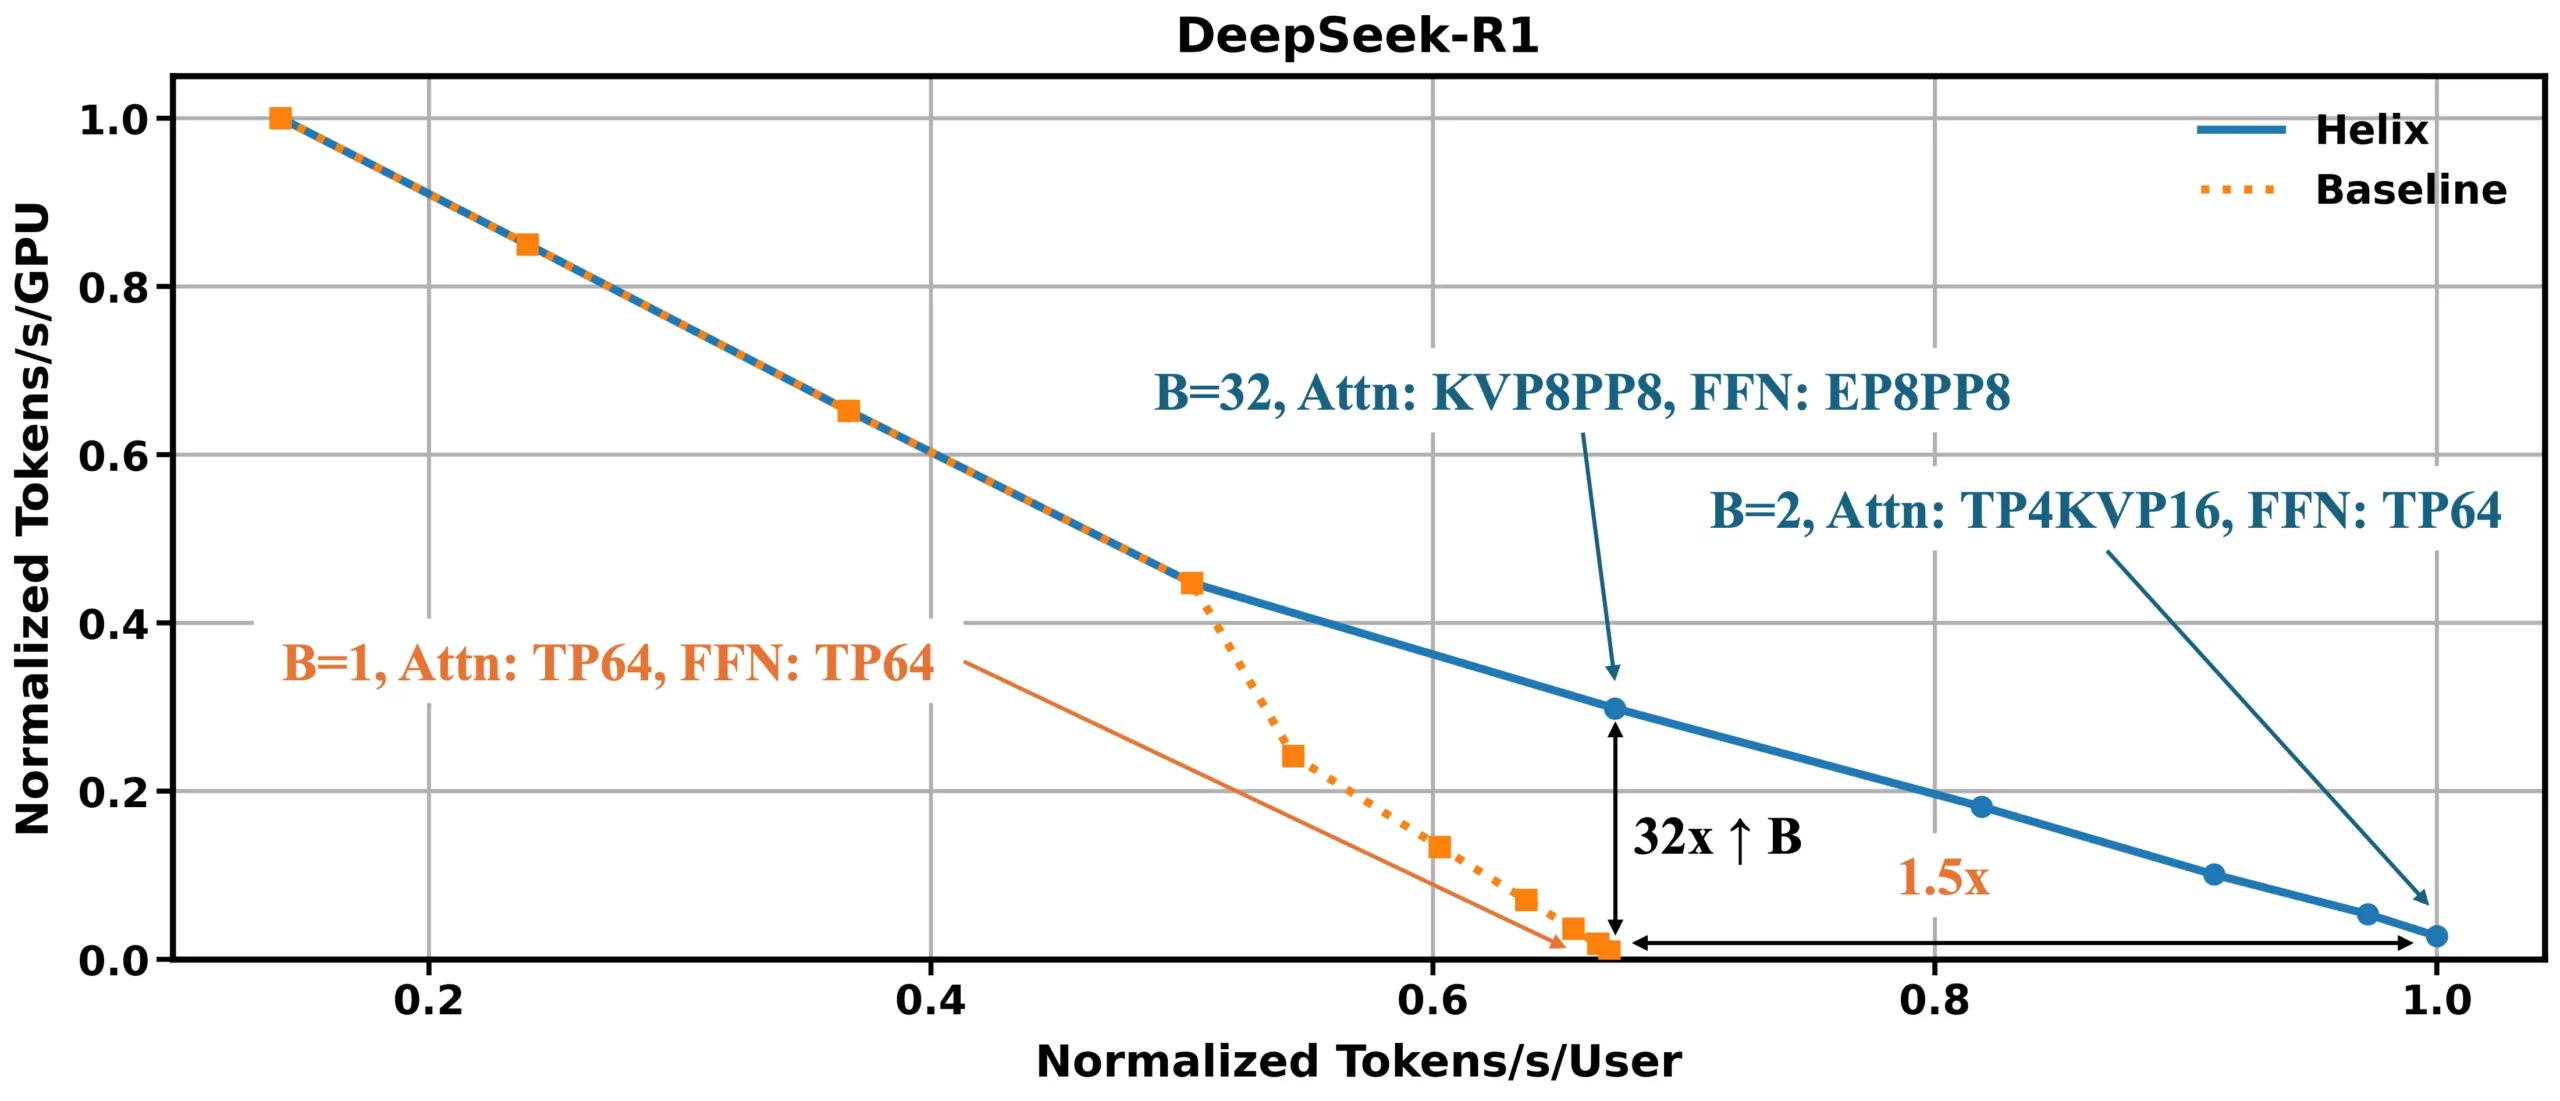
O Helix estabelece um novo padrão de desempenho para decodificação LLM de longo contexto. Os resultados são baseados em uma simulação exaustiva no Blackwell NVL72 usando o modelo de parâmetros DeepSeek R1 671B (FP4) com um contexto hipotético de um milhão de tokens, variando sistematicamente as estratégias de particionamento e os tamanhos de lote para encontrar as melhores compensações entre taxa de transferência e latência. Para aplicações que exigem escalabilidade massiva, como atender a vários usuários simultaneamente, o Helix pode aumentar o número de usuários simultâneos em até 32x para um determinado orçamento de latência. Para configurações de baixa simultaneidade, onde a capacidade de resposta de um único usuário é crítica, a técnica pode melhorar a interatividade do usuário em até 1.5x, reduzindo a latência mínima de token para token atingível. Esses ganhos são possíveis pela fragmentação dos pesos do cache KV e do FFN em todos os dispositivos disponíveis, o que reduz drasticamente a pressão da DRAM e melhora a eficiência computacional.
Para uma análise técnica mais aprofundada da metodologia e dos resultados da simulação, acesse o relatório completo através deste link.


 Amazon