

A Pliops anunciou uma parceria estratégica com o vLLM Production Stack , uma implementação de referência de código aberto para clusters, projetada para otimizar grandes cargas de trabalho de inferência de modelos de linguagem (LLM). Essa parceria é fundamental, visto que a comunidade de IA se prepara para se reunir na conferência GTC 2025. Ao combinar o backend de armazenamento chave-valor (KV) avançado da Pliops com a arquitetura robusta do vLLM Production Stack, a colaboração estabelece um novo padrão de referência para desempenho, eficiência e escalabilidade em IA.
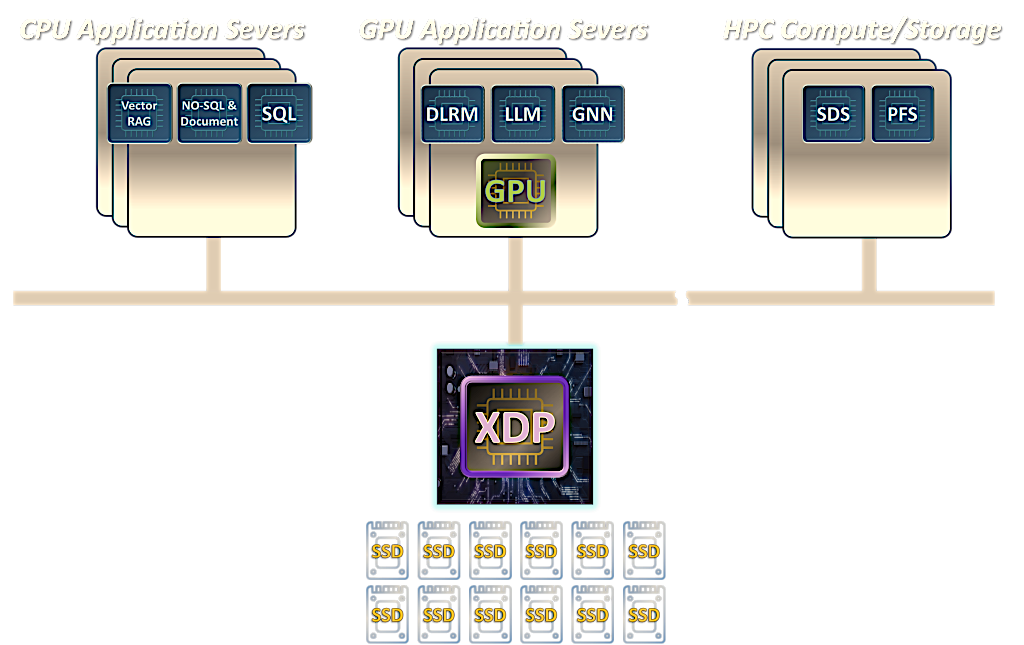
Junchen Jiang, chefe do LMCache Lab na Universidade de Chicago, destacou o potencial da colaboração, ressaltando sua capacidade de aprimorar a eficiência e o desempenho da inferência LLM. A solução conjunta traz recursos avançados de Busca e Recuperação de Vetor ao introduzir uma nova camada de memória em escala de petabyte abaixo da High Bandwidth Memory (HBM). Os caches KV computados são retidos e recuperados de forma eficiente usando armazenamento inteligente desagregado, acelerando a inferência vLLM.
Para uma introdução ao Pliops, confira nosso artigo detalhado.
Sobre aquele KVCache
A maioria dos grandes modelos de linguagem usa arquiteturas de transformadores, que dependem de mecanismos de atenção envolvendo matrizes de Consulta, Chave e Valor. Ao gerar tokens sequencialmente, os transformadores repetidamente computam a atenção, exigindo o recálculo de matrizes de Chave e Valor (KV) anteriores, levando a um aumento no custo computacional. O cache de KV aborda isso armazenando matrizes de KV computadas anteriormente, permitindo a reutilização em previsões de tokens subsequentes, melhorando significativamente a eficiência de geração e o rendimento.
No entanto, isso introduz novos desafios. Os caches KV podem se tornar muito grandes, particularmente durante gerações longas ou inferência em lote com tamanhos de lote típicos de 32, eventualmente excedendo a memória disponível. Para lidar com essa limitação, um backend de armazenamento de cache KV se torna essencial.
Pliops XDP LightningAI
A implantação do XDP LightningAI da Pliops em data centers representa uma mudança de paradigma em relação à relação custo-benefício, proporcionando economias substanciais em comparação às arquiteturas tradicionais. Ao adicionar servidores XDP LightningAI dedicados junto com a infraestrutura existente, as organizações podem obter economias notáveis, incluindo uma otimização de 67% no espaço de rack, uma redução de 66% no consumo de energia, uma economia anual de OpEx de 58% e uma redução de 69% nos custos de investimento inicial.
A Pliops continua a avançar com seu Extreme Data Processor (XDP), o XDP-PRO ASIC, complementado por uma pilha de software de IA abrangente e nós distribuídos. Utilizando uma interface de E/S de valor-chave iniciada por GPU, esta solução permite escalabilidade e desempenho sem precedentes. O XDP LightningAI da Pliops oferece melhorias substanciais de desempenho de ponta a ponta, alcançando ganhos de até 8X para inferência vLLM, acelerando significativamente as cargas de trabalho de IA generativa (GenAI). Com a integração de tendências de ponta do setor, como DeepSeek, a Pliops garante adaptabilidade robusta para futuros desenvolvimentos de IA.
A Pliops apresentou esses avanços no AI DevWorld, destacando como o XDP LightningAI revoluciona o desempenho do LLM ao reduzir significativamente o poder computacional e o custo. Esta demonstração ilustrou o comprometimento da Pliops em permitir inovação de IA sustentável em escala empresarial.
Colaboração contínua
A Pliops posiciona as organizações para maximizar o potencial de insights baseados em IA e manter uma vantagem competitiva em um cenário de tecnologia em rápida evolução, fornecendo acesso instantâneo a dados acionáveis e garantindo um caminho de integração perfeito.
O roteiro futuro para a colaboração inclui a integração essencial da pilha KV-IO da Pliops na pilha de produção, progredindo em direção a recursos avançados, como cache de prompt em conversas multi-turn, descarregamento de cache KV escalável e estratégias de roteamento simplificadas.


 Amazon