

A NVIDIA se apresenta na conferência Hot Chips de Stanford com uma mensagem clara: o data center é o computador, e seu limite de desempenho é determinado mais pela malha de interconexão do que pelos FLOPS brutos. Ao longo de cinco sessões, a NVIDIA mostrará como o Spectrum-XGS Ethernet, o NVLink de quinta geração com NVLink Fusion, os switches fotônicos alimentados por CPO e o novo supercomputador de desktop DGX Spark funcionam em conjunto. Essa integração visa transformar dezenas de milhares de GPUs em uma única fábrica de IA geradora de receita.
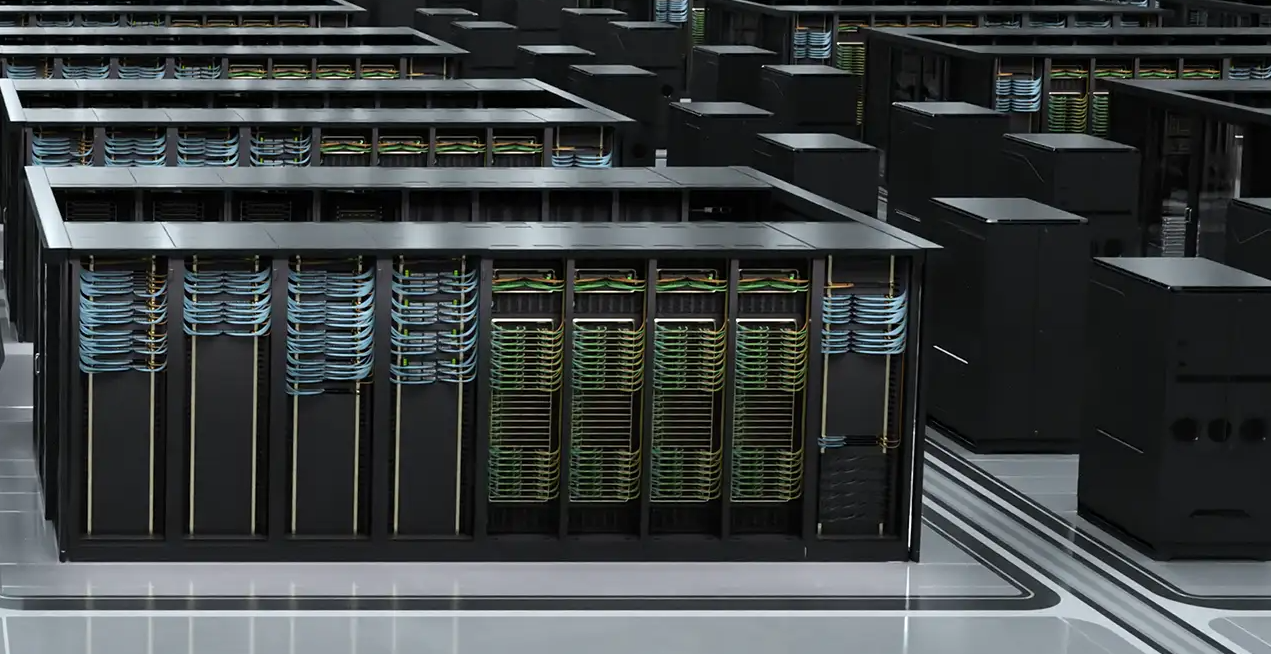
Um tecido de três camadas para fábricas de IA
Os LLMs modernos são aplicações distribuídas implicitamente. Eles transmitem trilhões de parâmetros entre GPUs, sincronizam atualizações de gradiente em cadências de microssegundos e devem retornar o primeiro token ao usuário em menos de um batimento cardíaco. Essa carga de trabalho impulsiona uma hierarquia de interconexões:
- Aumente a escala dentro de um rack para que as GPUs funcionem como núcleos em um único processador grande.
- Escale entre racks para que o cluster opere como um sistema unificado.
- Escale em data centers inteiros para obter redundância geográfica, compartilhamento de capacidade e conformidade com regulamentações.
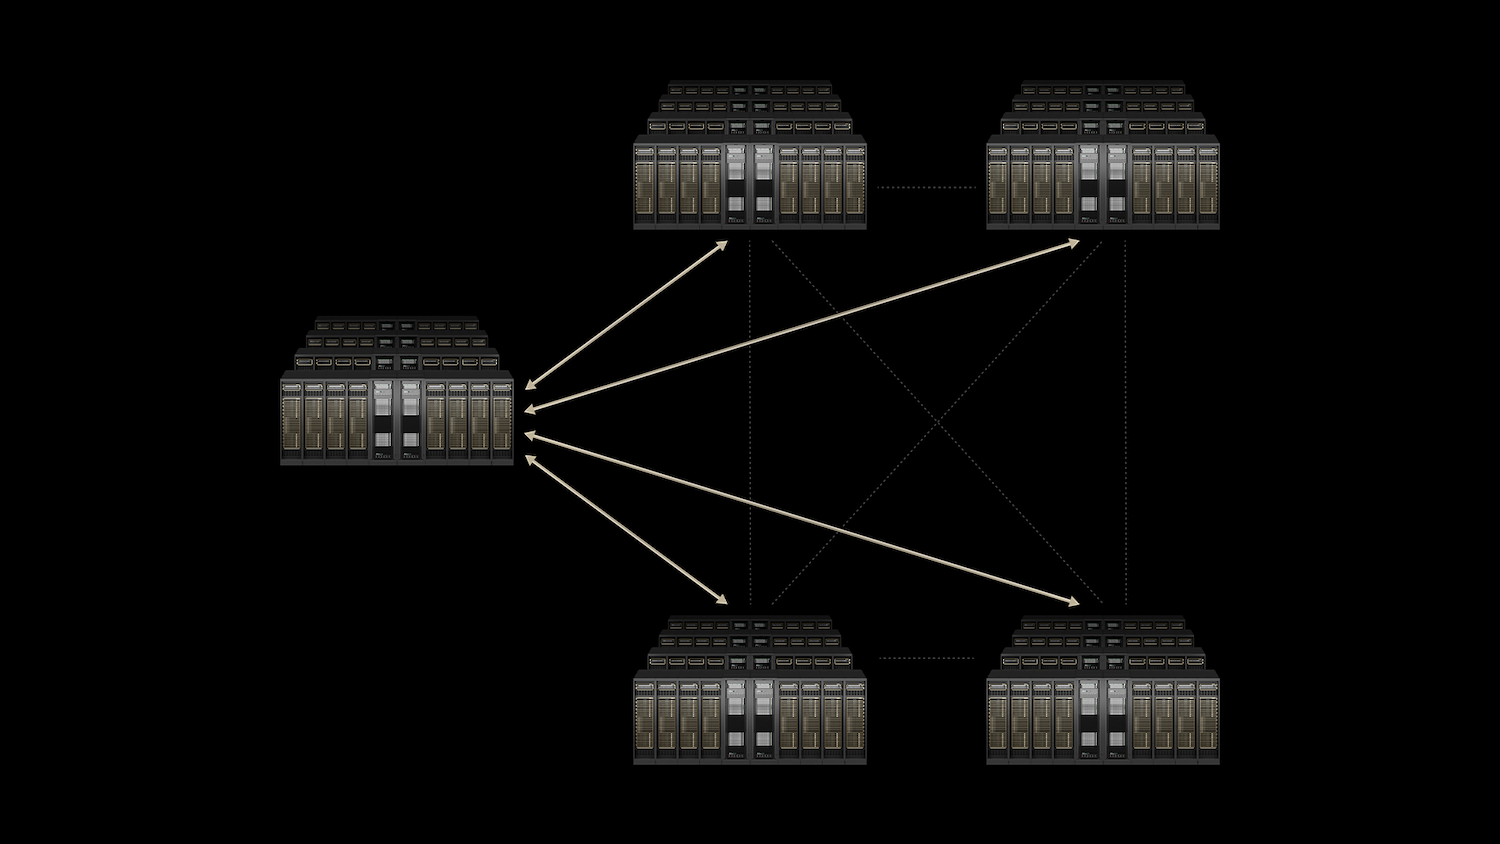
A resposta da NVIDIA é uma pilha verticalmente integrada. NVLink e NVLink Switch dominam o domínio de escalonamento vertical; Quantum InfiniBand e Spectrum-X dominam o escalonamento horizontal; o novo Spectrum-XGS Ethernet estende a rede sem perdas e ajustada por IA entre data centers. A Óptica Co-Empacotada (CPO) reduz os limites de potência e densidade que clusters com milhões de GPUs atingiriam de outra forma.
Ethernet Spectrum-XGS
A tecnologia Ethernet tradicional foi projetada principalmente para lidar com tráfego de melhor esforço, o que significa que funcionava bem para comunicações simples de servidor único. No entanto, à medida que avançamos para um mundo cada vez mais dependente da IA, nos deparamos com novos desafios.
Com o surgimento de coletivos de IA e sistemas de inferência multilocatários, os requisitos de desempenho de rede evoluíram significativamente. Essas aplicações modernas exigem um nível de confiabilidade e velocidade que a Ethernet tradicional simplesmente não consegue oferecer.
Especificamente, eles exigem jitter zero, o que significa que não há variabilidade na latência, o que é crucial para o processamento em tempo real. Além disso, a latência determinística garante que as respostas sejam previsíveis e consistentes, o que é vital para aplicações que dependem de feedback imediato. Por fim, a taxa de transferência próxima à taxa de linha é essencial para lidar com o alto volume de dados processados durante cargas de microrajadas, onde o tráfego de dados pode atingir picos inesperados.
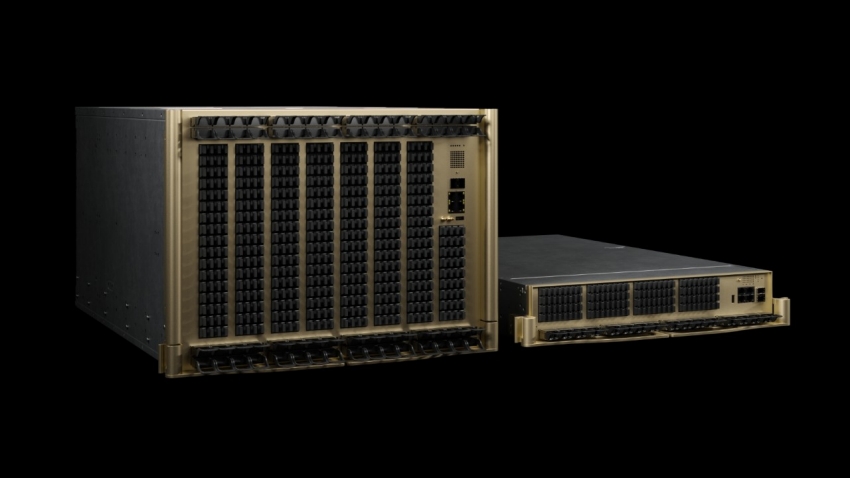
O Spectrum-X é uma solução que opera perfeitamente dentro de um data center, enquanto o Spectrum-XGS leva essa inovação a um novo patamar, expandindo suas capacidades para múltiplos data centers. Ele integra switches avançados baseados em ASIC Spectrum-6 ou -4 com SuperNICs ultrarrápidas de 800 Gb/s, especificamente as variantes BlueField-3 ou ConnectX-8. Essas tecnologias trabalham em conjunto para gerenciar congestionamentos e reordenar pacotes de forma eficiente, garantindo um fluxo de dados contínuo.
O que diferencia este sistema é sua telemetria inteligente, que coleta dados de cada porta e os alimenta na lógica de controle de congestionamento no switch, permitindo a remodelação do tráfego em tempo real. Em clusters de produção, isso resulta em um desempenho notável, mantendo a taxa de transferência acima de 95% da capacidade teórica em uma impressionante escala de GPU de 32k. Em contraste, a Ethernet 800G tradicional tem dificuldades, atingindo apenas cerca de 60% de taxa de transferência em colisões coletivas.
Além disso, o Spectrum-XGS garante a conformidade com os padrões, tornando o SONiC e o Cumulus Linux componentes integrais de seu ecossistema. Isso significa que as operadoras de nuvem e corporativas podem manter suas pilhas de automação existentes, beneficiando-se do determinismo superior tipicamente associado ao InfiniBand. As melhorias levam a uma maior utilização da GPU e à redução da latência, o que se traduz em mais tokens por watt e objetivos de nível de serviço mais rigorosos. Além disso, permite que as operadoras integrem novos inquilinos à mesma frota sem sofrer quedas de desempenho, tornando-se um divisor de águas no setor.
NVLink e NVLink Fusion: O Rack como uma GPU Gigante
A quinta geração do NVLink oferece impressionantes 1.8 TB/s de largura de banda ponto a ponto e impressionantes 130 TB/s de largura de banda agregada em um rack NVL72. Essa conectividade aprimorada permite que cada GPU se comunique diretamente com todas as outras GPUs em apenas um salto, transformando efetivamente todo o rack em um domínio de memória coerente. Graças à Biblioteca de Comunicações Coletivas da NVIDIA (NCCL), que foi aprimorada ao longo de dez anos, os desenvolvedores de aplicações podem atingir taxas próximas à de rede sem esforço, sem a necessidade de escrever código de comunicação personalizado para diferentes topologias.
Além disso, o recente anúncio do NVLink Fusion abre possibilidades empolgantes para hiperescaladores. Essa inovação permite que CPUs ou XPUs personalizadas integrem perfeitamente NVLink SERDES ou chiplets via UCIe para aceleradores, ou NVLink-C2C para CPUs, permitindo que esses componentes sejam colocados diretamente na malha NVLink. Uma vantagem significativa do Fusion é sua especificação de rack modular MGX, que conta com uma cadeia de suprimentos totalmente qualificada. Isso significa que os mesmos fornecedores que atualmente fornecem racks NVL72 também podem fornecer racks Fusion, reduzindo significativamente o tempo de lançamento no mercado para empresas que buscam implementar essa tecnologia.
Em termos de economia de inferência, a influência do NVLink é evidente na fronteira de Pareto tradicional entre taxa de transferência por watt e latência. Ao migrar de uma malha PCIe para um nó de switch NVLink, tanto a taxa de transferência quanto a latência melhoram, e avanços adicionais podem ser alcançados com a atualização para o rack NVLink. Isso se traduz no processamento de mais consultas de usuários por quilowatt-hora, além de reduzir o investimento de capital amortizado por token gerado, tornando o NVLink uma ferramenta poderosa para aumentar a eficiência operacional.
O NVLink de quinta geração oferece 1.8 TB/s de largura de banda ponto a ponto e 130 TB/s de largura de banda agregada dentro de um rack NVL72. Com o NVLink Switch, cada GPU se conecta em um único salto, tornando todo o rack um domínio de memória coerente. As operações coletivas são executadas por meio do NCCL, uma biblioteca que está em seu décimo ano de produção, ajustada para todas as topologias imagináveis e com reconhecimento automático de topologia. Assim, os desenvolvedores de aplicativos não precisam de código de comunicação personalizado para atingir taxas próximas às da rede elétrica.
Óptica Co-Empacotada (CPO): Quebrando a barreira de energia a 800 Gb/s e além
Switches modulares plugáveis tradicionais são o padrão de rede há algum tempo. No entanto, as ineficiências inerentes a esses sistemas estão se tornando cada vez mais aparentes. Quando os dados saem do ASIC, eles percorrem longas trilhas de PCB e passam por vários conectores antes de chegar a um módulo óptico com DSP. Essa jornada resulta em perdas significativas, frequentemente de até 22 dB no domínio elétrico, e consome impressionantes 30 W por porta apenas para recuperar o sinal. À medida que avançamos em direção a taxas de dados mais altas, como 200 G PAM4 hoje e um ambicioso 1.6 T em um futuro próximo, as limitações dessa arquitetura se tornam claras, levando a orçamentos de energia explosivos e restrições na densidade da placa frontal.
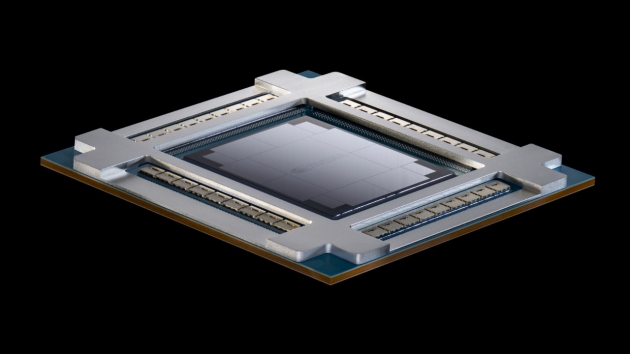
Conheça as soluções inovadoras da NVIDIA: Quantum-X Photonics para InfiniBand e Spectrum-X Photonics para Ethernet. Ao integrar os mecanismos ópticos diretamente no pacote do switch, eles reduzem drasticamente o comprimento do caminho elétrico. Isso não apenas minimiza as perdas para cerca de 4 dB, como também reduz o consumo de energia da porta para aproximadamente 9 W — uma melhoria impressionante.
Na próxima semana, veremos o lançamento de dois gabinetes de refrigeração líquida de última geração: o modelo de 128 portas, com impressionantes 102.4 Tb/s de throughput, e o modelo de 512 portas, que eleva esse limite ainda mais para 409.6 Tb/s. Este último modelo possui um shuffle de fibra integrado, garantindo que cada porta se conecte perfeitamente ao feixe de fibra correto, sem a necessidade de patches manuais complexos. Os dados de campo iniciais são promissores, indicando uma eficiência energética 3.5 vezes maior e um tempo médio entre falhas cerca de 10 vezes maior em comparação com os pluggables tradicionais. Além disso, a janela de inicialização por cluster é 1.3 vez mais rápida, agilizando a implantação.
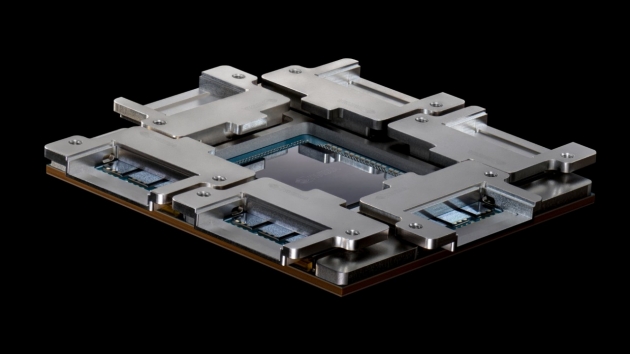
Embora essas soluções avançadas só estejam disponíveis em 2026, os projetos já estão em andamento. Isso é crucial para operadoras que planejam instalações com capacidade para gigawatts ou governos que consideram laboratórios nacionais com milhões de GPUs. A tecnologia CPO (Coherent Photonics Optics) da NVIDIA define claramente um caminho para se manter dentro dos limites de potência e evitar o temido pesadelo da manutenção óptica, abrindo caminho para um futuro mais eficiente e potente em redes de alto desempenho.
DGX Spark e o Sistema: Do Protótipo de Desktop à Produção em Escala de Rack
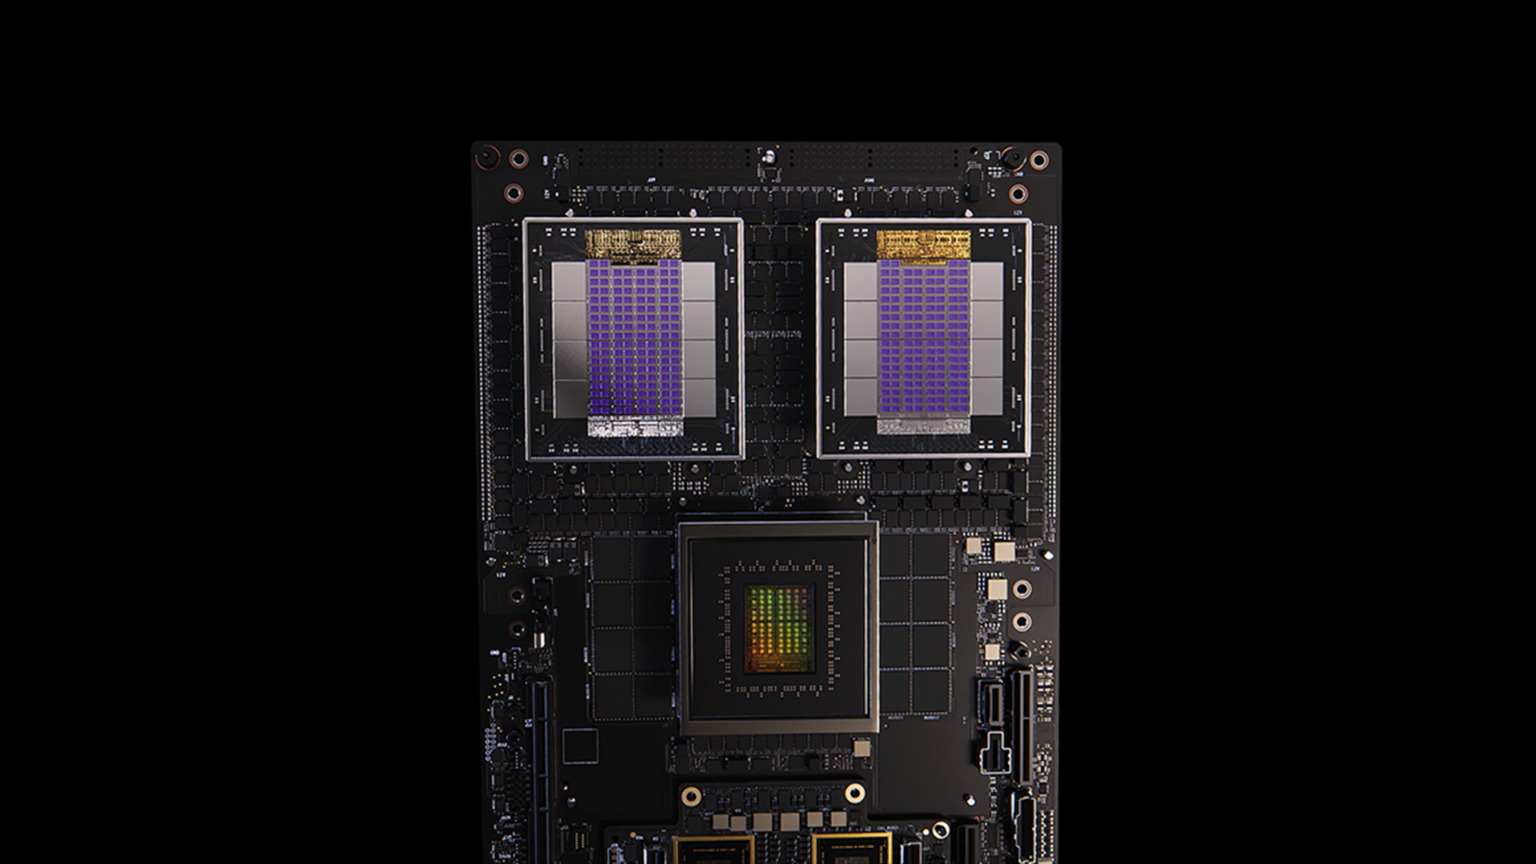
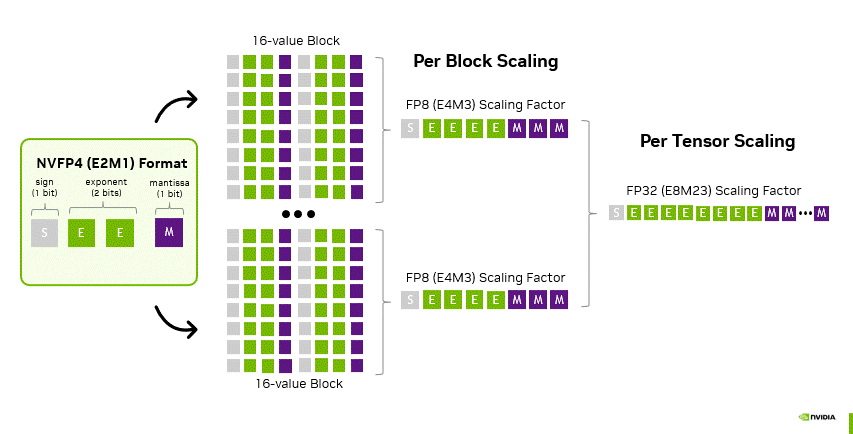
Nem todas as cargas de trabalho começam em hiperescala. O DGX Spark , com tecnologia do novo Superchip GB10, compacta núcleos Tensor Blackwell, inferência NVFP4 (ponto flutuante de 4 bits) e todas as bibliotecas CUDA-X em um chassi de mesa. Os desenvolvedores treinam, ajustam e compõem o RAG localmente e, em seguida, migram contêineres idênticos para racks GB200 ou GB300 NVL72 quando as cargas de trabalho amadurecem.
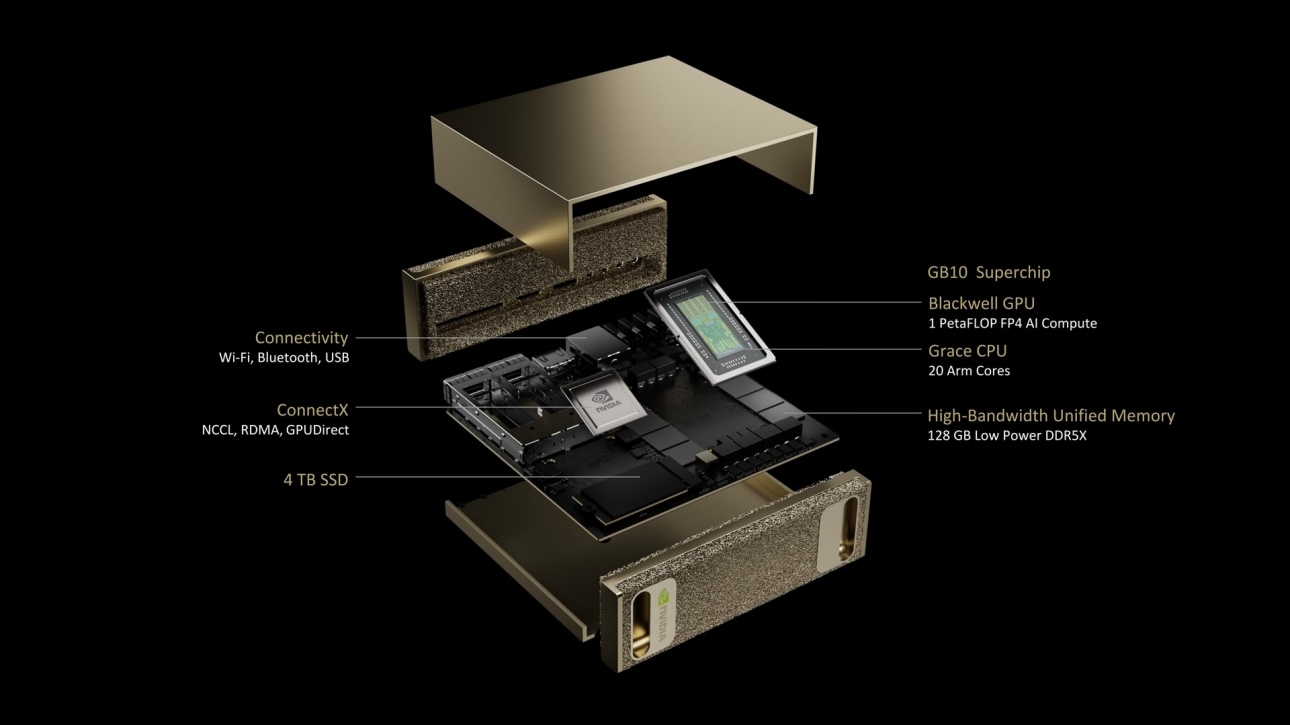
Esse continuum permite que as empresas testem IA agêntica, percepção robótica ou tarefas generativas multimodais sem bloqueios em slots de cluster. Para o campo, o Spark é um cavalo de Troia: coloque um no laboratório de um cliente, deixe seus pesquisadores verem em primeira mão as acelerações de inferência de 4 bits, e as expansões seguem.
O multiplicador de software: TensorRT-LLM, Dynamo e microsserviços NIM
As interconexões de hardware definem limites; o software determina a proximidade das cargas de trabalho reais. A NVIDIA demonstrará o TensorRT-LLM executando o modelo GPT-OSS de 120 bilhões de parâmetros em NVFP4, atingindo quatro vezes a interatividade do TorchServe padrão em contextos longos. Em racks GB200, o DeepSeek-R1 a 671 B apresenta uma taxa de transferência 2.5 vezes maior por GPU com o escalonador de pipeline desagregado do Dynamo, sem aumentar o custo por consulta. Tudo isso chega como microsserviços NIM — endpoints em contêineres que se conectam a clusters do Kubernetes ou a pilhas bare-metal locais.
O código aberto sustenta a pilha. O RAPIDS acelera o ETL de ponta a ponta em GPUs; os modelos CUTLASS permitem kernels personalizados de alto desempenho; o NeMo e o BioNeMo estendem o PyTorch para treinamento de LLM e dobramento de proteínas de ponta, mantendo 100% OSS. A mensagem para os compradores cautelosos com o aprisionamento: a NVIDIA é "aberta onde importa, otimizada onde importa".
Implicações competitivas e comerciais
A NVIDIA conquistou uma posição única no cenário tecnológico por meio de sua abordagem verticalmente integrada, especialmente em contraste com fornecedores de switches de silício e startups aceleradoras desagregadas. Essa estratégia permite que a NVIDIA ofereça não apenas componentes individuais, mas soluções abrangentes que abrangem uma arquitetura de referência. Essa arquitetura é apoiada por uma cadeia de suprimentos comprovada, um roteiro de dois anos claramente definido e uma superfície de API de alto nível conhecida como NIM, que simplifica a complexidade da conexão para desenvolvedores.
Para hiperescaladores, as ofertas da NVIDIA são atraentes devido à sua ênfase em Acordos de Nível de Serviço (SLAs) determinísticos e risco operacional mínimo. Ao implementar racks NVLink, essas organizações podem obter recursos de inferência premium, essenciais para aplicações que exigem processamento rápido de dados. Além disso, a tecnologia Spectrum-X facilita a expansão da capacidade, permitindo que hiperescaladores expandam sua infraestrutura perfeitamente. A introdução do Spectrum-XGS permite a federação de regiões, aumentando assim a eficiência da alocação de recursos em data centers distribuídos geograficamente. Essa integração suporta a operação de planos de controle Ethernet padrão, garantindo compatibilidade e facilidade de gerenciamento dentro da infraestrutura existente.
Para as empresas, o apelo da tecnologia da NVIDIA reside em sua capacidade de maximizar a receita por rack. O sistema Spectrum-X, por exemplo, aumenta significativamente a eficácia dos ciclos de GPU — em até 35%. Isso significa que as empresas podem obter maior produtividade, seja na forma de tokens, imagens ou ações automatizadas, sem aumentar os gastos de capital. Consequentemente, as empresas podem extrair mais valor de seus investimentos existentes, alinhando-se às necessidades contemporâneas de eficiência e custo-benefício em um mercado competitivo.
Concluindo!
A narrativa em torno dos Hot Chips representa uma mudança notável no panorama da tecnologia da computação, particularmente em relação à inteligência artificial (IA). Ela enfatiza que a rede agora é considerada um acelerador fundamental na computação, comparável em importância a avanços como núcleos tensores.
Tecnologias como o NVLink são essenciais, pois transformam um rack de servidores em um chip lógico coeso, aprimorando o desempenho e a eficiência. O Spectrum-X desempenha um papel crucial na facilitação de coletivos de submilissegundos em redes extensas, enquanto o Spectrum-XGS estende essa estrutura de alto desempenho em escala global. Além disso, o CPO foi projetado para garantir que os requisitos de potência e densidade sejam preparados para o futuro, atendendo às crescentes demandas de aplicações de IA. O DGX Spark, por outro lado, é fundamental para fomentar a adoção dessas tecnologias, incentivando as empresas a adotar soluções inovadoras.
Coletivamente, esses avanços têm o potencial de mudar a dinâmica econômica dos processos de inferência e treinamento. Isso é particularmente relevante porque as empresas estão atualmente em uma encruzilhada, ponderando suas opções entre construir nova infraestrutura, alugar soluções existentes ou adiar investimentos em recursos de IA em larga escala. A posição da NVIDIA é inequívoca: as organizações devem investir na construção de sua própria infraestrutura, mas com ênfase em uma estrutura de rede meticulosamente projetada — da espinha dorsal de cobre ao switch fotônico — para suportar a era vindoura dominada por fábricas impulsionadas por IA.


 Amazon