

A WhiteFiber divulgou os resultados iniciais de P&D do Projeto Redwood, uma arquitetura de supercluster de GPUs distribuída, projetada para operar em data centers geograficamente separados. Anunciado na semana passada, o teste alcançou uma taxa de transferência de 111.2 Tbps em 83 km de fibra escura, com uma latência de ida e volta garantida de 0.9 ms.
A WhiteFiber afirmou que a latência está dentro de 8% do limite físico de propagação da luz que viaja pela fibra nessa distância. A empresa utilizou apenas parte do espectro de fibra disponível no teste, um resultado que, segundo ela, já é aproximadamente o dobro da capacidade de testes de campo comparáveis de espectro completo já publicados, e planeja ativar o espectro completo antes do lançamento comercial previsto para o terceiro trimestre de 2026.
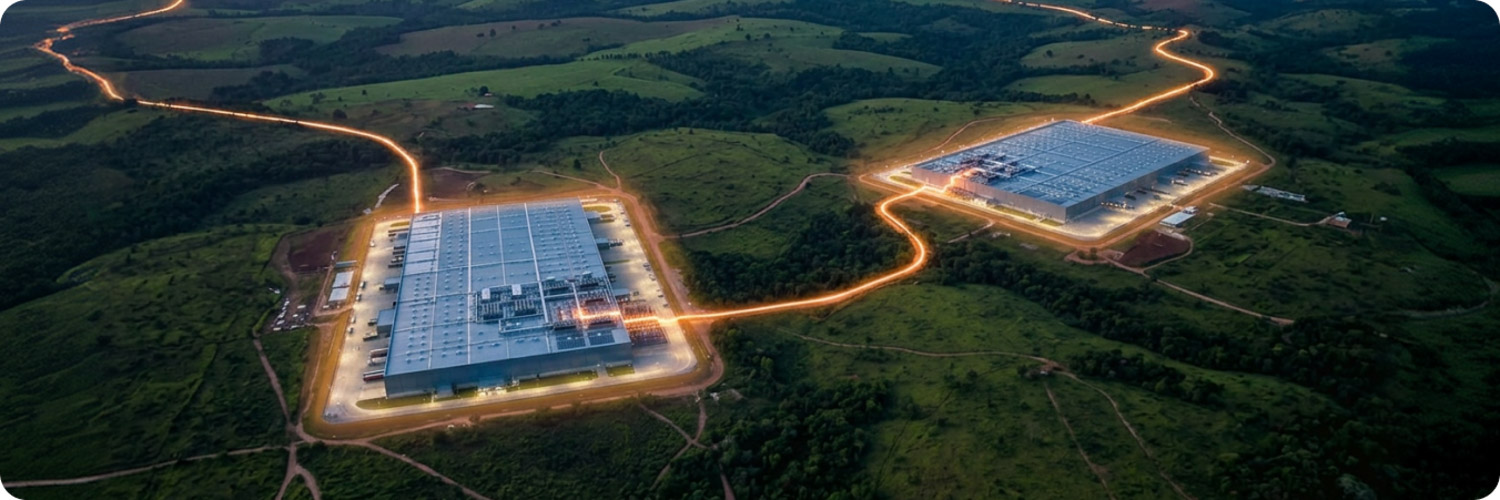
O trabalho foi concluído com a colaboração da DriveNets e da WEKA. A DriveNets fornece a estrutura de IA baseada em Ethernet entre as instalações, enquanto a WEKA NeuralMesh fornece a infraestrutura de armazenamento e memória que abrange o cluster. A WhiteFiber já submeteu pedidos de patente relacionados à implementação.
Tratando vários sites como um único cluster de GPUs
A arquitetura foi concebida para que dois data centers funcionem como um único supercluster lógico de GPUs, em vez de dois clusters operados independentemente e conectados por um link DCI convencional. Essa distinção é importante para cargas de trabalho de treinamento e inferência de IA, onde a sincronização entre GPUs, as operações coletivas e o acesso à infraestrutura de dados compartilhada podem determinar a escalabilidade utilizável do cluster.
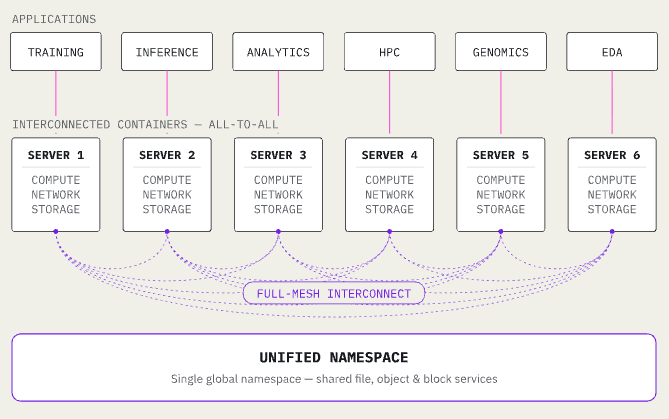
A WhiteFiber posiciona a plataforma para cargas de trabalho que ultrapassam a capacidade de energia, refrigeração, espaço, projeto de resiliência ou requisitos de soberania de dados disponíveis em um único local. A empresa também vislumbra aplicações em computação de borda, telecomunicações e implantações de IA soberana.
O anúncio complementar da DriveNets identifica o hardware: a estrutura conecta dois clusters de GPUs NVIDIA H200 da WhiteFiber, localizados a 52 quilômetros de distância um do outro. A DriveNets descreve a implementação como o primeiro supercluster de IA comercial e escalável a longa distância do setor, validado em escala de produção, e não em laboratório. Como parte da validação, as empresas compararam o desempenho rack a rack em um único local com o desempenho rack a rack abrangendo os dois locais. Os detalhes da metodologia estão no white paper da DriveNets.
Design de tecido DriveNets
O ambiente entre sites utiliza fibra escura redundante e a tecnologia DriveNets AI Fabric para transportar o tráfego de GPUs e armazenamento. A DriveNets caracteriza a arquitetura como uma estrutura Ethernet agendada, projetada para comunicações de IA distribuídas e previsíveis, em vez de uma extensão Ethernet de longa distância tradicional.
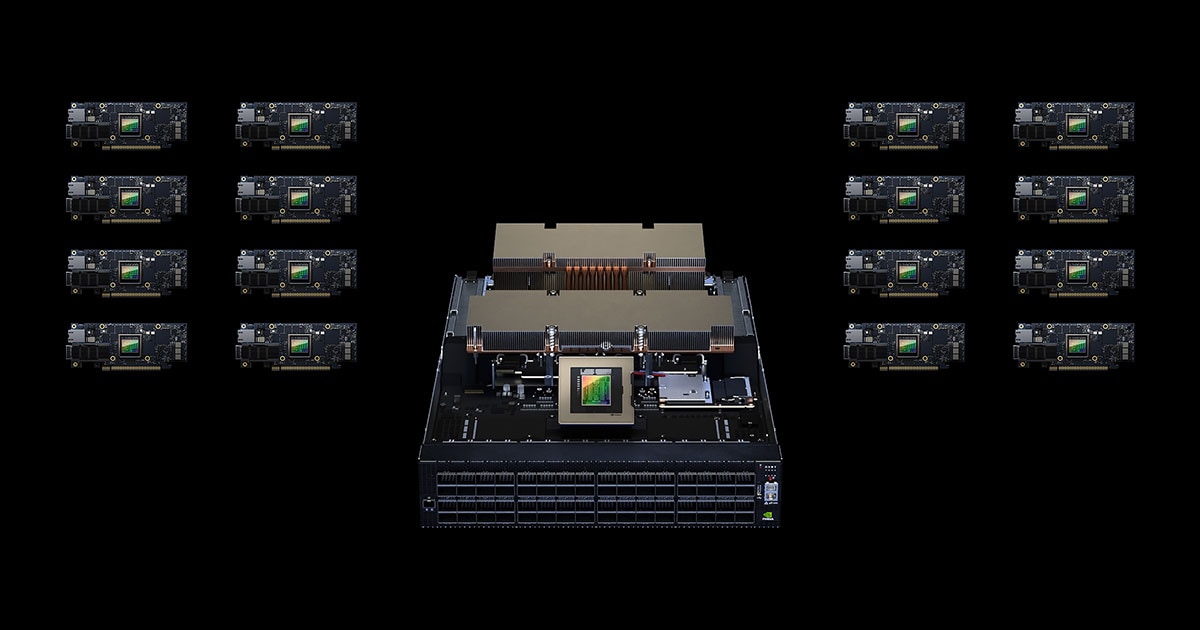
O projeto estende a infraestrutura de IA entre os sites usando a tecnologia Fabric Scheduled Ethernet da DriveNets, executada em seus switches 9300F, 5300R e 5301R. A abordagem combina balanceamento de carga baseado em células, enfileiramento de saída virtual de ponta a ponta e interconexões com buffer profundo que absorvem picos de tráfego de IA sincronizados antes que causem congestionamento nos links entre os sites. A DriveNets afirma que o resultado é uma conectividade previsível e sem perdas entre os sites, que mantém a utilização da GPU alta, como se todo o cluster estivesse sob o mesmo teto.
Em conjunto, esses mecanismos visam preservar o comportamento previsível das comunicações coletivas à distância, ao mesmo tempo que suportam uma infraestrutura unificada de computação e armazenamento. O isolamento multi-inquilino faz parte do objetivo declarado do projeto.
O resultado é uma arquitetura que trata a rota de fibra como parte de uma estrutura de IA, e não simplesmente como uma conexão de transporte entre sites. O objetivo é reduzir a importância operacional do limite físico do data center para as cargas de trabalho executadas em todo o cluster.
Uma abordagem distinta da NVIDIA Spectrum-XGS
A plataforma de testes da WhiteFiber é distinta da NVIDIA Spectrum-XGS Ethernet. No entanto, o trabalho está alinhado com o esforço mais amplo da indústria em direção a uma infraestrutura de IA "escalável".
Na Hot Chips 2025, o CEO da NVIDIA, Jensen Huang, descreveu a necessidade de interligar data centers em diferentes cidades, países e continentes para formar fábricas de IA em larga escala. A abordagem Spectrum-XGS da NVIDIA utiliza controle de congestionamento com reconhecimento de distância, gerenciamento preciso de latência e telemetria para melhorar a previsibilidade da comunicação distribuída entre GPUs. A CoreWeave está entre as empresas pioneiras na adoção dessa tecnologia, segundo a NVIDIA.
A WhiteFiber forneceu métricas iniciais de testes de campo mais específicas do que a NVIDIA divulgou publicamente para implantações do Spectrum-XGS. Seu teste de 83 km apresentou 111.2 Tbps e latência de ida e volta de 0.9 ms, embora os sistemas usem arquiteturas diferentes e seus resultados não sejam diretamente comparáveis.
O treinamento distribuído vai além de uma única instalação.
O anúncio da WhiteFiber surge num momento em que outros fornecedores de nuvem e infraestrutura investigam arquiteturas de treinamento e inferência de IA em vários locais.
A Oracle Cloud Infrastructure e a NVIDIA publicaram um trabalho utilizando o framework NeMo e o Megatron-Core para executar treinamento LLM em data centers separados por aproximadamente 1,000 km. A NVIDIA relatou uma escalabilidade de treinamento superior a 96% por meio de redução hierárquica total e comunicações inter-data centers fragmentadas. Esse trabalho é principalmente uma demonstração de software e sistemas, e não um benchmark de transporte em escala metropolitana.
O Google também desenvolveu o TPU Multislice, permitindo que várias fatias de TPU operem como um ambiente de treinamento distribuído maior em sua rede de data centers e interconexões ópticas. O Google afirmou que o treinamento do Gemini utilizou vários data centers, com a plataforma projetada para gerenciar o particionamento de carga de trabalho e a resiliência em escala.
A WhiteFiber pretende implementar um design semelhante de infraestrutura entre locais para computação em nuvem com GPUs, com foco específico em conectividade metropolitana de alta largura de banda e baixa latência. A empresa planeja fornecer mais detalhes sobre a arquitetura e a disponibilidade à medida que avança para a implantação comercial no terceiro trimestre de 2026.


 Amazon