

Pode-se argumentar que os processadores AMD chegaram primeiro: os mini PCs e laptops Strix Halo já vinham com 128 GB de memória unificada muito antes da NVIDIA entrar em cena. Mas a categoria de desktops com IA local foi efetivamente criada pela NVIDIA quando colocou um superchip Grace Blackwell em um gabinete de um litro e o chamou de DGX Spark . A proposta era simples: uma máquina de nível desenvolvedor com memória unificada suficiente para suportar modelos robustos, instalada em uma mesa em vez de ser distribuída na nuvem. O AMD Ryzen AI Halo é a resposta da AMD a essa máquina. A AMD o anunciou juntamente com a série Ryzen AI Max PRO 400 em maio de 2026; as pré-vendas começaram em junho, exclusivamente pela Micro Center , com disponibilidade nas lojas a partir de 10 de julho. O Ryzen AI Halo chega com dimensões semelhantes, 128 GB de memória unificada, preço de US$ 3,999 e uma pequena lista de decisões que o tornam uma proposta significativamente diferente do Spark.
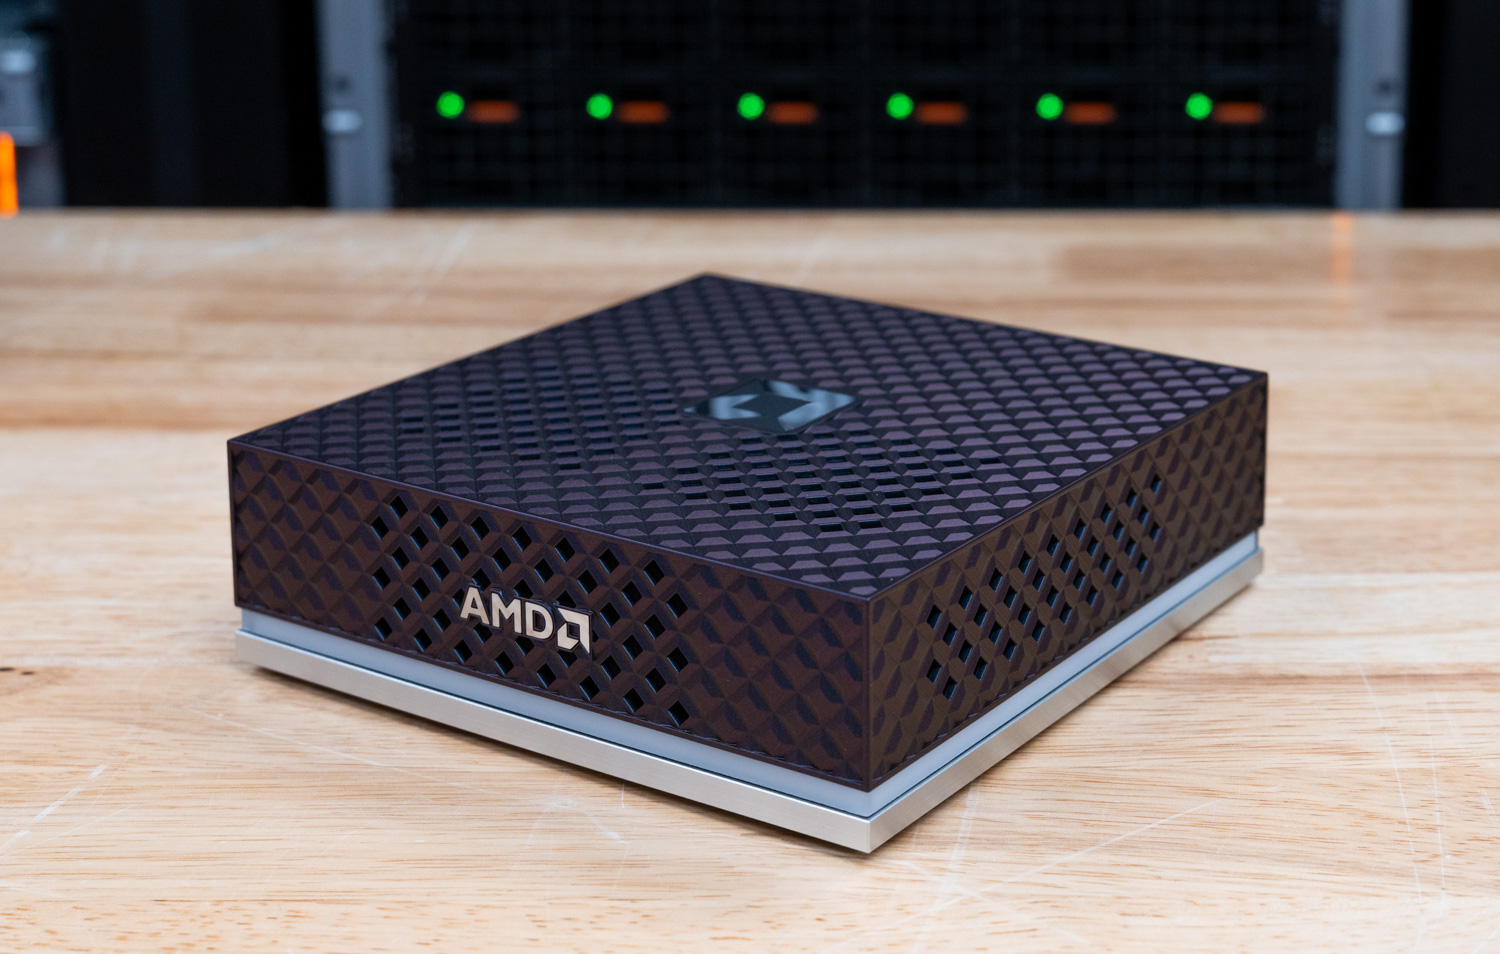
A AMD apresenta o Halo como sua primeira plataforma de desenvolvimento de IA, oferecendo aos desenvolvedores um caminho rápido e descomplicado para criar e executar IA localmente. Por dentro, encontramos o Ryzen AI Max+ 395, um processador "Zen 5" de 16 núcleos e 32 threads com gráficos integrados Radeon 8060S (40 unidades de computação RDNA 3.5) e uma NPU XDNA 2 com classificação de 50 TOPS, tudo isso em uma plataforma que a AMD anuncia com até 126 TOPS de desempenho combinado em IA. Os 128 GB de memória LPDDR5x operam a 8000 MT/s, oferecendo 256 GB/s de largura de banda, e toda a plataforma é alimentada por uma única entrada USB-C com potência de 120 W. A AMD afirma que o pool de memória é suficiente para armazenar modelos com até 200 bilhões de parâmetros na memória do dispositivo. Trata-se de uma mini-estação de trabalho x86 completa, o que representa a principal diferença.
A diferença está no Windows. O Spark roda o sistema operacional DGX da NVIDIA, baseado em Linux, e nada mais; o Halo inicializa o Windows 11 ou a imagem de desenvolvedor Linux da AMD no mesmo hardware. O suporte nativo ao Windows foi o pedido mais comum que ouvimos de pessoas interessadas no Spark, e isso redefine o público-alvo do dispositivo. O próprio posicionamento da AMD reforça essa ideia: Windows e Linux versus o Spark, que é exclusivo para Linux ( pelo menos até o momento ).
Três outras decisões diferenciam o Halo do Spark, e cada uma delas aborda uma reclamação frequente sobre o modelo anterior. O Halo utiliza um SSD M.2 2280 padrão, em vez do menos comum 2242 presente no Spark, o que amplia consideravelmente o leque de opções de terceiros, incluindo capacidades de 8 TB, para quem desejar substituir o SSD. Ele vem com a Memória Gráfica Variável (VGM) pré-configurada para sua alocação máxima em ambos os sistemas operacionais, permitindo que modelos com grande capacidade de processamento sejam carregados sem ajustes manuais. Além disso, o chassi é revestido por um anel iluminado, uma pequena correção em relação às unidades Spark escuras e sem iluminação que alguns compradores receberam, dependendo do fabricante. O custo da abordagem da AMD se reflete na parte traseira da caixa, onde não há interconexão de alta velocidade, apenas 10GbE, o que limita as possibilidades de clusterização com múltiplos nós. Essas são as concessões a serem feitas, e elas definem as cargas de trabalho para as quais esta máquina foi projetada antes mesmo de qualquer teste de benchmark.
Em relação ao preço, as nuances fazem a diferença. O Halo tem preço sugerido de US$ 3,999 com um SSD de 2 TB, o que o coloca exatamente na faixa de preço de um sistema básico da classe Spark. A comparação depende de qual Spark você está considerando. O próprio DGX Spark da NVIDIA, com o SSD maior, agora custa perto de US$ 4,700, uma mudança relacionada à escassez de memórias LPDDR5X e NAND. Os sistemas básicos Grace Blackwell da ASUS e de outros fabricantes ainda são vendidos por cerca de US$ 4,000 e estão disponíveis na Amazon hoje (link de afiliado). Comparado com a média da categoria, o Halo está em pé de igualdade, e sua justificativa reside nas decisões acima, e não em oferecer um preço mais baixo que a concorrência.
Executamos o Halo no conjunto de ferramentas de IA local da StorageReview, tanto no Windows quanto no Linux, e os resultados são apresentados juntamente com a análise de design e software ao longo desta avaliação.
Principais lições
- A alternativa x86 com dois sistemas operacionais: O Ryzen AI Halo é o único dispositivo na categoria do Spark que inicializa o Windows 11 ou o Linux em uma plataforma x86 completa, por US$ 3,999 com um SSD de 2 TB, contra os US$ 4,699 do DGX Spark Founders Edition.
- Memória para armazenar modelos grandes: 128 GB de memória unificada LPDDR5x-8000 a 256 GB/s suportam modelos com até 200 bilhões de parâmetros localmente, com memória gráfica variável pré-configurada para que modelos grandes sejam carregados sem configuração manual.
- O Ryzen AI Max+ 395 mais potente que já testamos: O Halo superou o HP Z2 Mini G1a e o ZBook Ultra G1a em praticamente todas as tarefas do Windows, incluindo 37,316 no Cinebench R23 multi-core, 184.2 GIPS no 7-Zip e as melhores pontuações em geração de texto (Phi 1,192) e geração de imagem (SD 1.5 FP16 937) no Procyon AI.
- Vitórias da CPU, derrotas da inferência contra o Spark: No Linux, o Halo superou o DGX Spark em tarefas de CPU, comprimindo 11% mais rápido e descomprimindo 38% mais rápido no 7-Zip, além de concluir a compilação do LLVM 14% mais cedo. No entanto, apresentou desempenho de 2 a 4 vezes inferior na maioria dos cenários de serviço vLLM com maior concorrência, chegando a 8.8 vezes em tarefas com uso intensivo de pré-preenchimento em arquivos GPT OSS de 120 bits.
- Armazenamento adequado, rede modesta: Um compartimento M.2 2280 padrão permite atualizações de terceiros para até 8 TB, embora a plataforma negocie o chipset Micron 4600 Gen5 incluído para Gen4 por projeto, e a única porta 10GbE sem estrutura de alta velocidade impossibilite o clustering de vários nós que o ConnectX-7 de 200G do Spark permite.
Especificações
| Especificação | Sistema AMD Ryzen AI Halo |
|---|---|
| Subcontratante | |
| CPU | Processador AMD Ryzen™ AI Max+ 395 16 núcleos / 32 threads (arquitetura Zen 5) |
| GPU | Placa gráfica integrada AMD Radeon™ 8060S 40 Unidades de Computação (Arquitetura RDNA™ 3.5) |
| NPU | AMD XDNA™ 2 NPU |
| Memória | |
| Tipo de memória | LPDDR5x |
| Capacidade de memória | 128GB |
| Velocidade da memória | 8000MT / s |
| Largura de banda de memória | 256GB / s |
| Armazenamento | |
| Armazenamento | SSD M.2 NVMe de 2 TB (SED) |
| Rede e conectividade | |
| Ethernet | 1 × 10GbE |
| Wi-Fi | Wi-Fi 7 |
| Bluetooth | 5.4 Bluetooth |
| I / O | |
| USB | 3 × USB-C, 1 × USB-C (Entrada de alimentação) |
| Saída de exibição | 1 × HDMI 2.1b |
| System | |
| TDP | 120W |
| Sistema Operacional | Linux ou Windows 11 |
| Dimensões | 150 × 150 × 45.4 mm (5.9 × 5.9 × 1.79 pol.) |
| Peso | Menos de 1.2 kg (2.65 lbs) |
Configuração e design do AMD Ryzen AI Halo
O sistema AMD Ryzen AI Halo utiliza um formato compacto, semelhante ao do NVIDIA Spark, medindo apenas 150 × 150 × 45.4 mm e pesando menos de 1.2 kg. O chassi de alumínio apresenta um padrão geométrico de ventilação agressivo na parte superior e frontal, conferindo ao sistema uma aparência distinta e maximizando o fluxo de ar para o sistema de resfriamento. Apesar de seu tamanho reduzido, a plataforma foi projetada como uma estação de trabalho de IA completa, capaz de lidar com aplicativos de estação de trabalho, inferência LLM local e cargas de trabalho de desenvolvimento de IA.
Frente
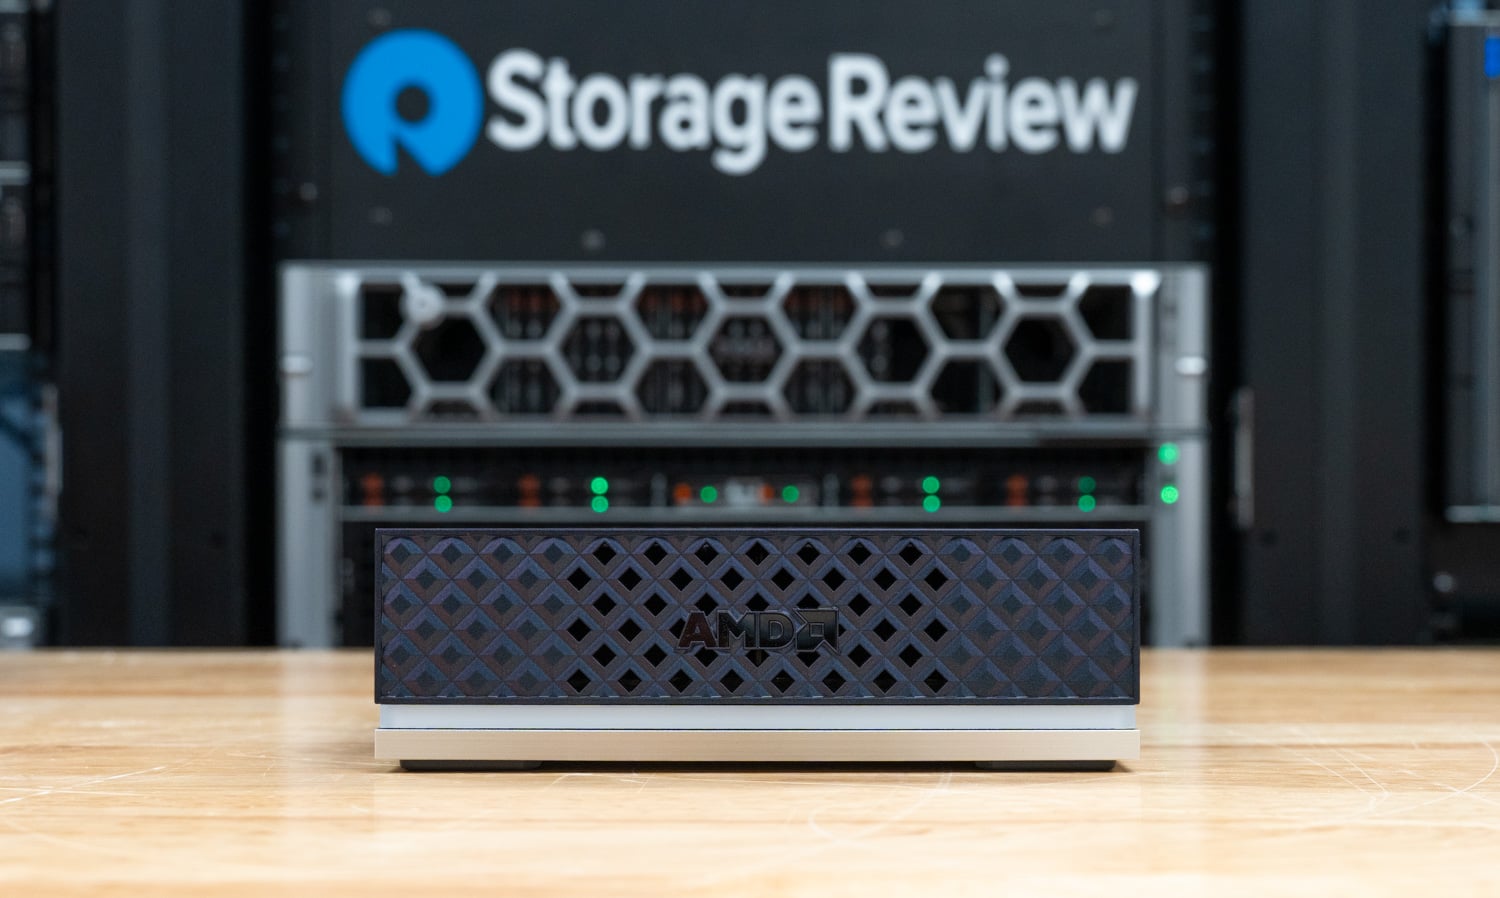
A parte frontal do sistema foi projetada para ser limpa, consistindo quase inteiramente em uma grande grade de ventilação em malha que se estende por toda a largura do chassi. Em vez de colocar portas na parte frontal, a AMD dedica essa área ao fluxo de ar, permitindo que o ar frio entre no sistema através da grande entrada com padrão, mantendo a parte frontal livre de obstruções. Um detalhe prateado na parte inferior do chassi proporciona um sutil contraste visual com a estrutura predominantemente preta fosca.
I / O traseiro
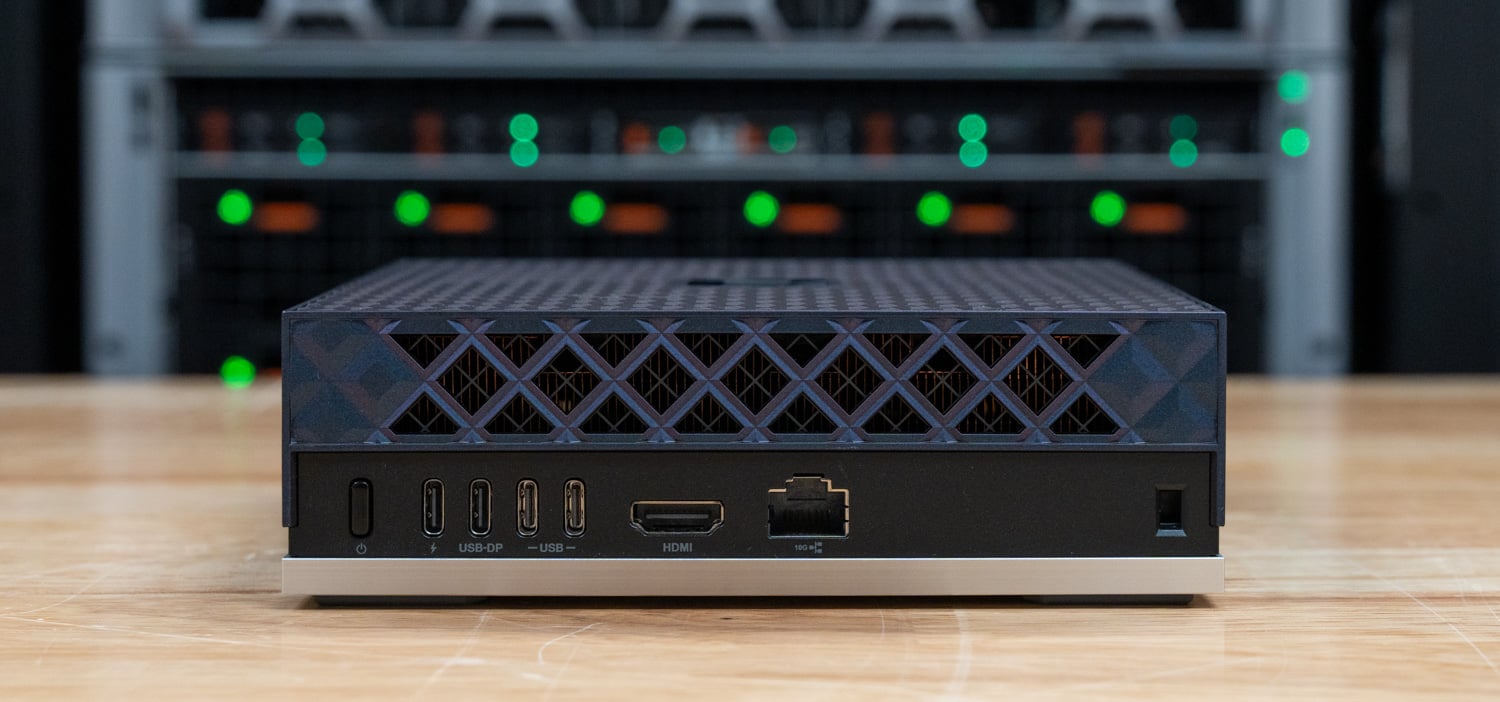
Todas as conexões externas estão localizadas na parte traseira do sistema. Da esquerda para a direita, o painel traseiro inclui o seguinte:
- Entrada de alimentação USB-C
- Porta USB-C com modo alternativo DisplayPort
- Duas portas USB-C adicionais
- Saída HDMI 2.1b
- Ethernet RJ45 de 10 GbE
- Slot para trava de segurança Kensington
O sistema oferece três portas de dados USB-C, além de um conector de alimentação USB-C dedicado, permitindo a conexão simultânea de vários periféricos e monitores de alta velocidade. A porta HDMI 2.1b proporciona saída de vídeo nativa, enquanto a interface Ethernet 10GbE integrada torna a plataforma ideal para conectividade NAS de alta velocidade, transferência de conjuntos de dados de IA e ambientes de desenvolvimento local.
Design Interno
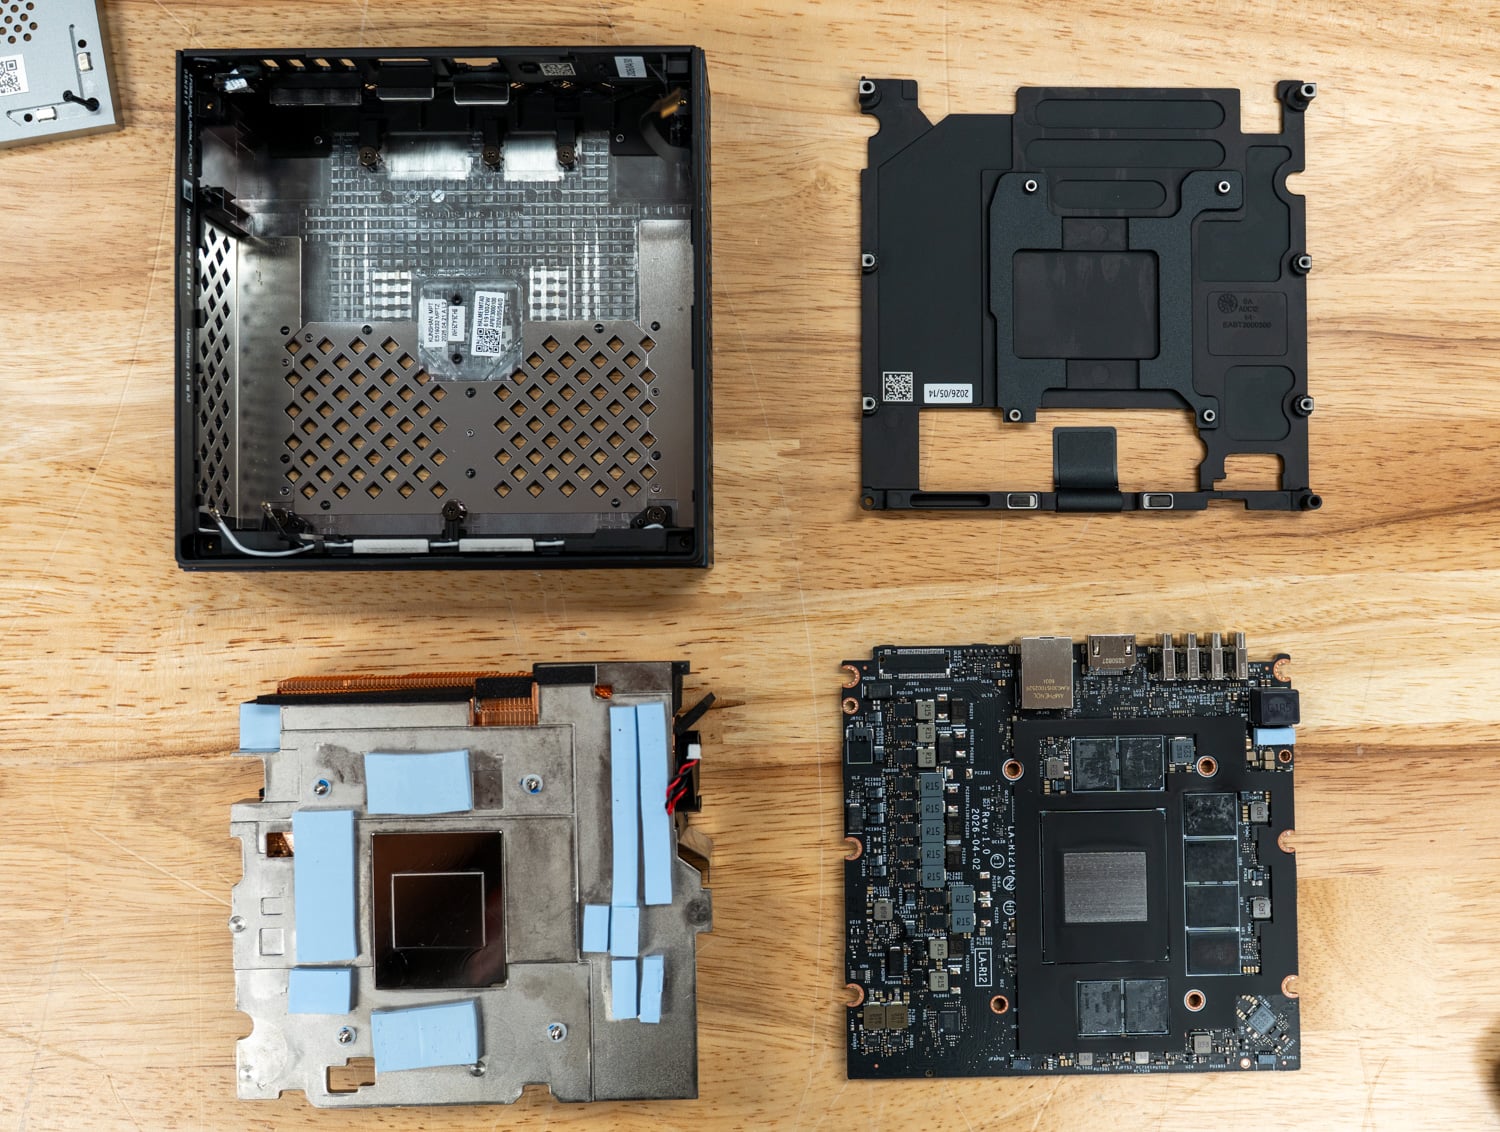
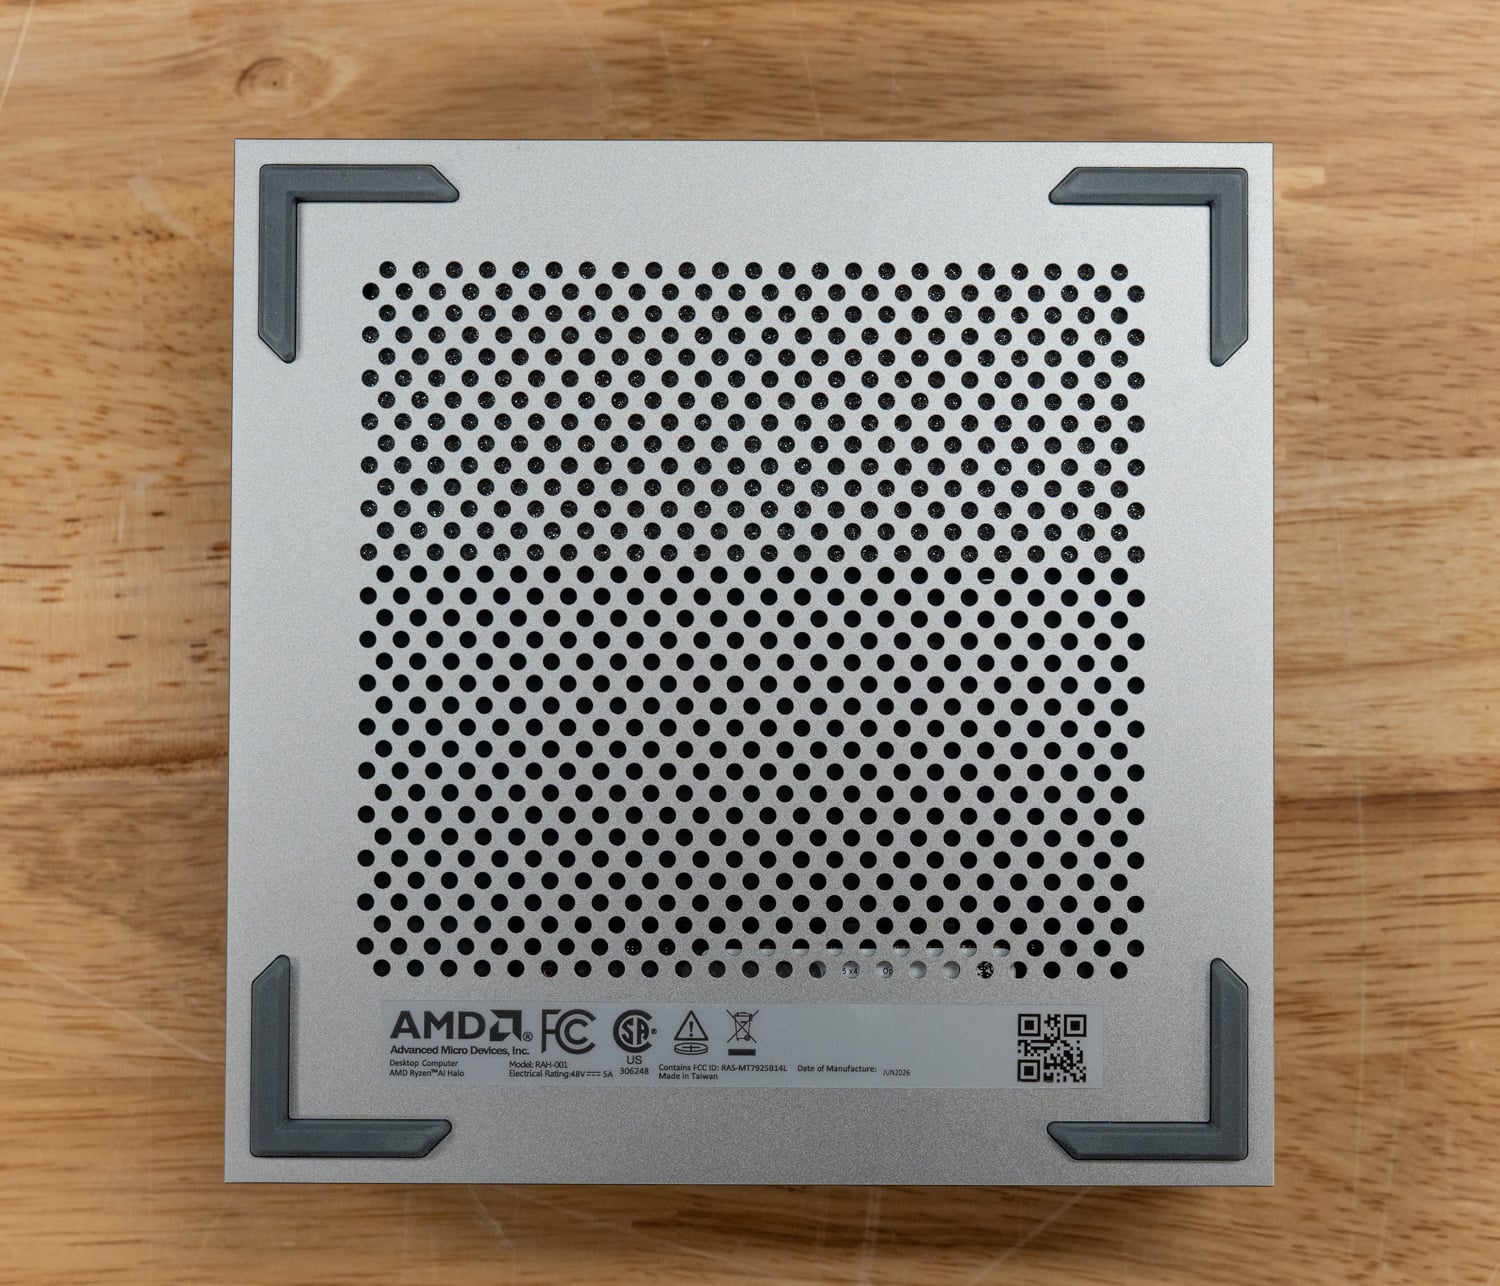
A parte inferior do Ryzen AI Halo possui uma grande abertura perfurada que puxa o ar para resfriar os componentes montados na parte inferior da placa, e quatro pés de borracha nos cantos mantêm a unidade estável em uma mesa ou prateleira.
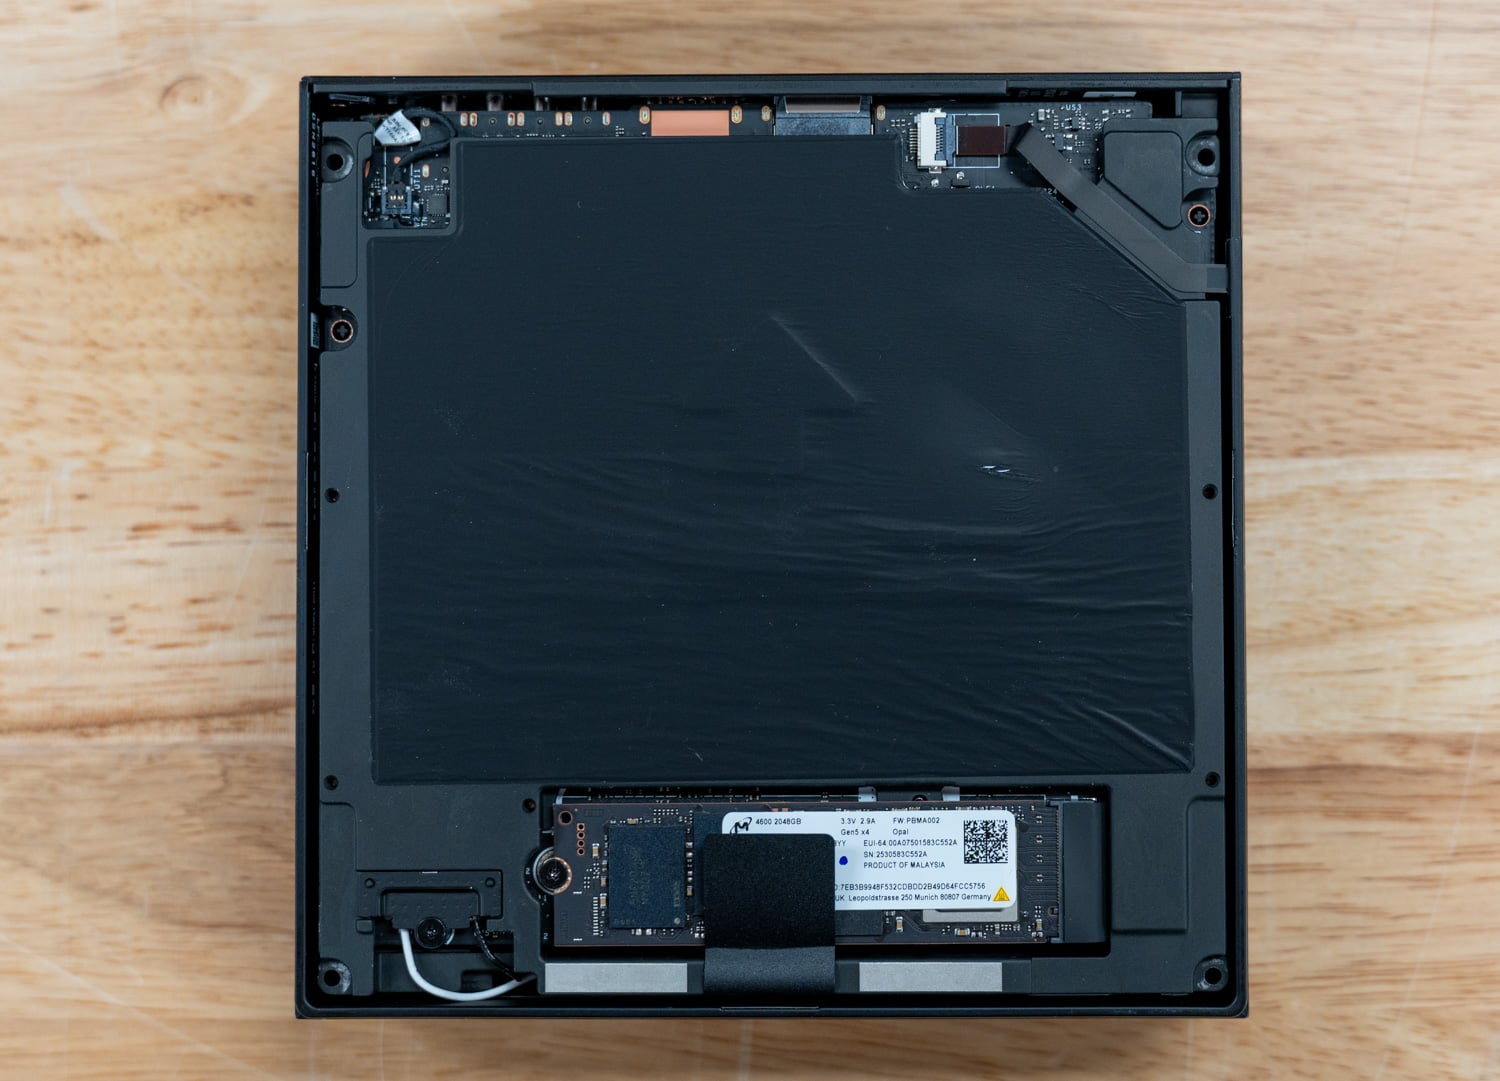
A remoção dos quatro parafusos que prendem o painel inferior revela o compartimento para SSD M.2 e alguns componentes da placa-mãe, incluindo o conector da placa Wi-Fi. Na unidade que analisamos, esse compartimento contém um SSD Micron 4600 Gen5 x4 de 2 TB, enquanto uma película adesiva preta protege o restante da placa da parte inferior exposta.
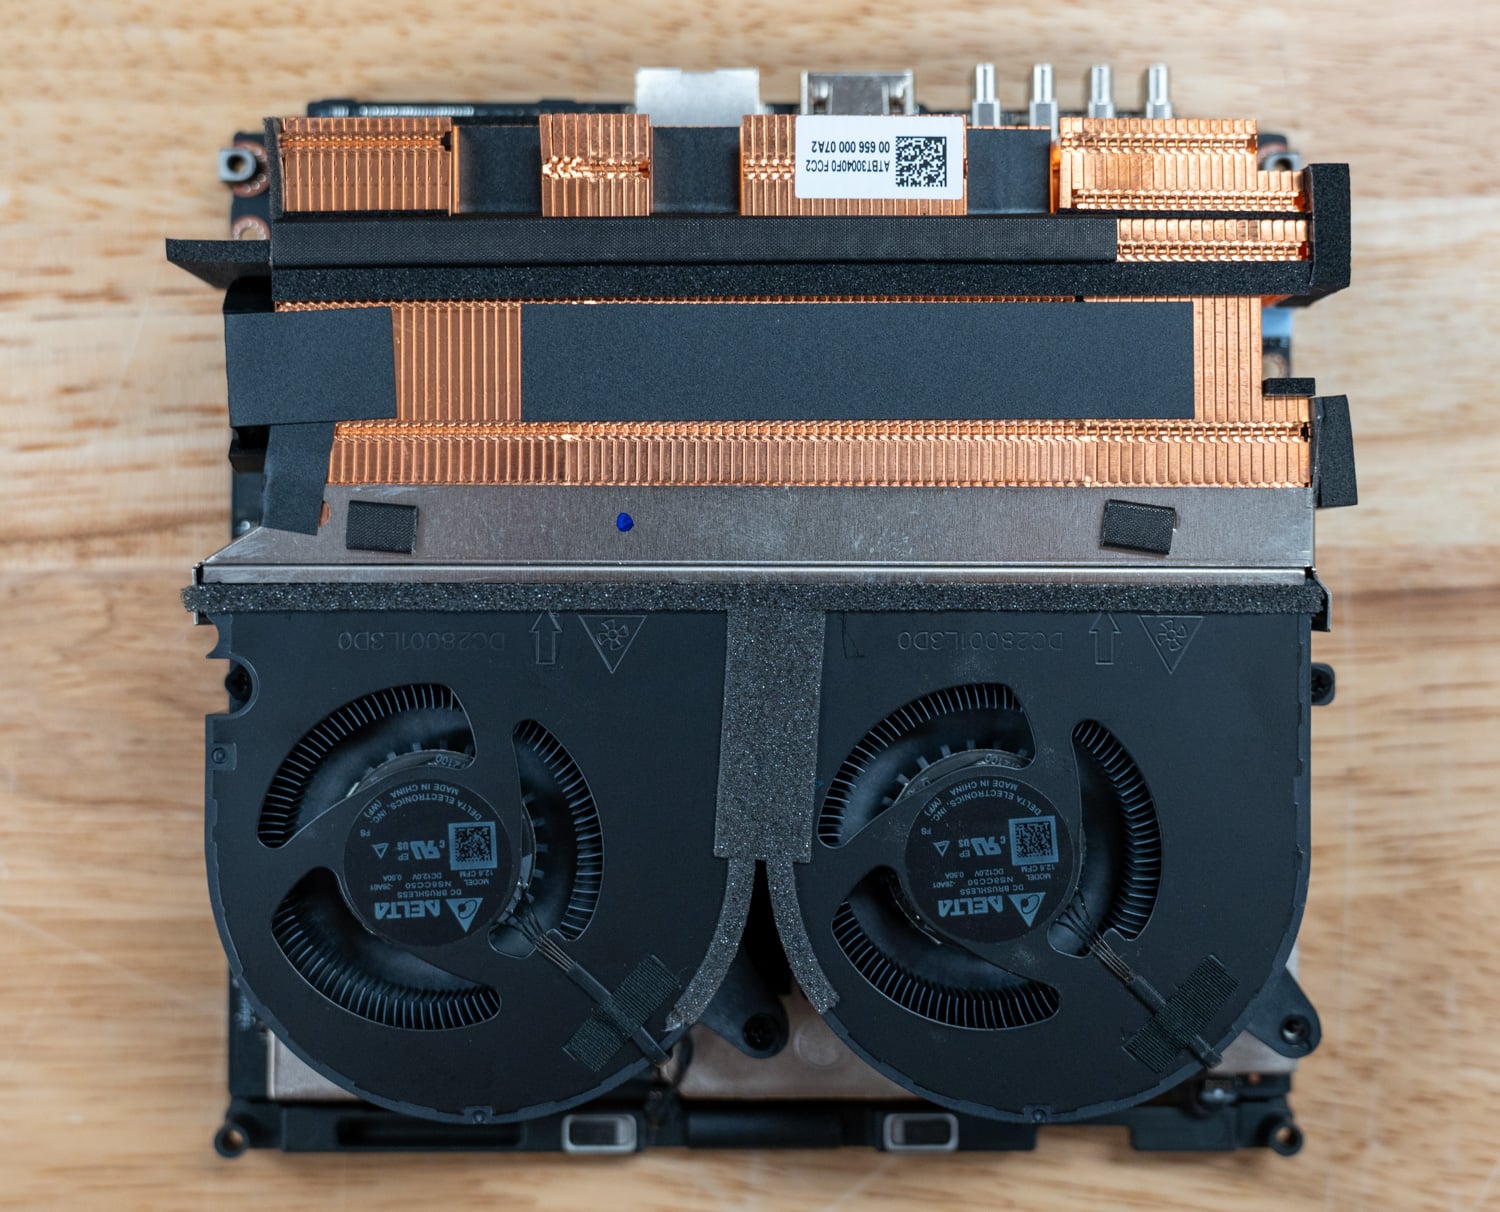
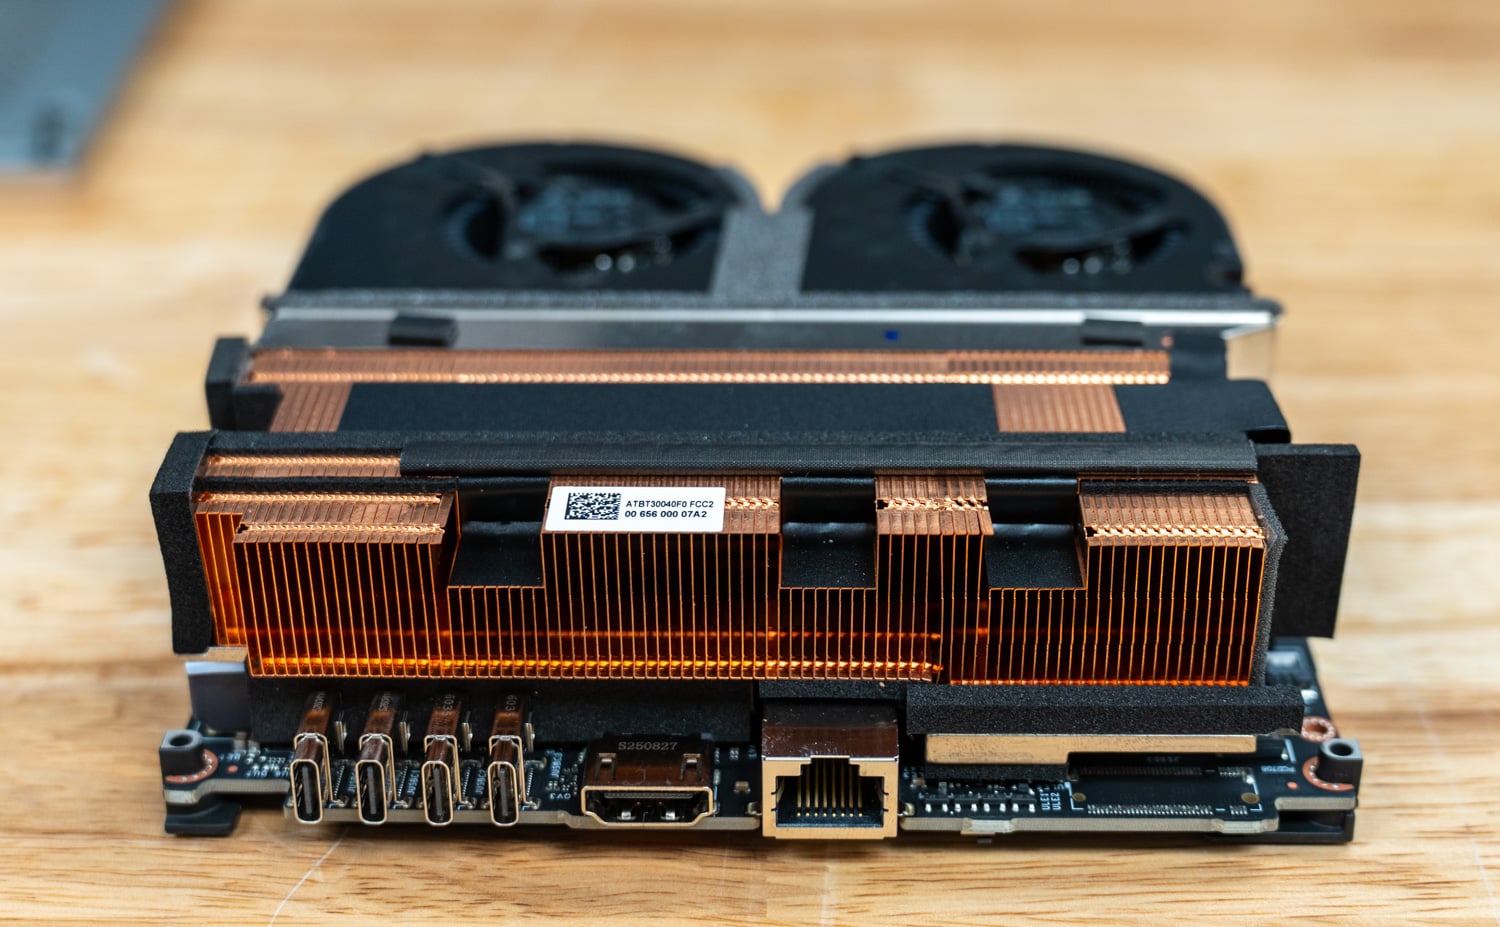
Para o resfriamento, a AMD adotou uma abordagem semelhante à do DGX Spark da NVIDIA, usando duas ventoinhas que puxam o ar através de um dissipador de calor com aletas e o expelem pela parte traseira do gabinete.
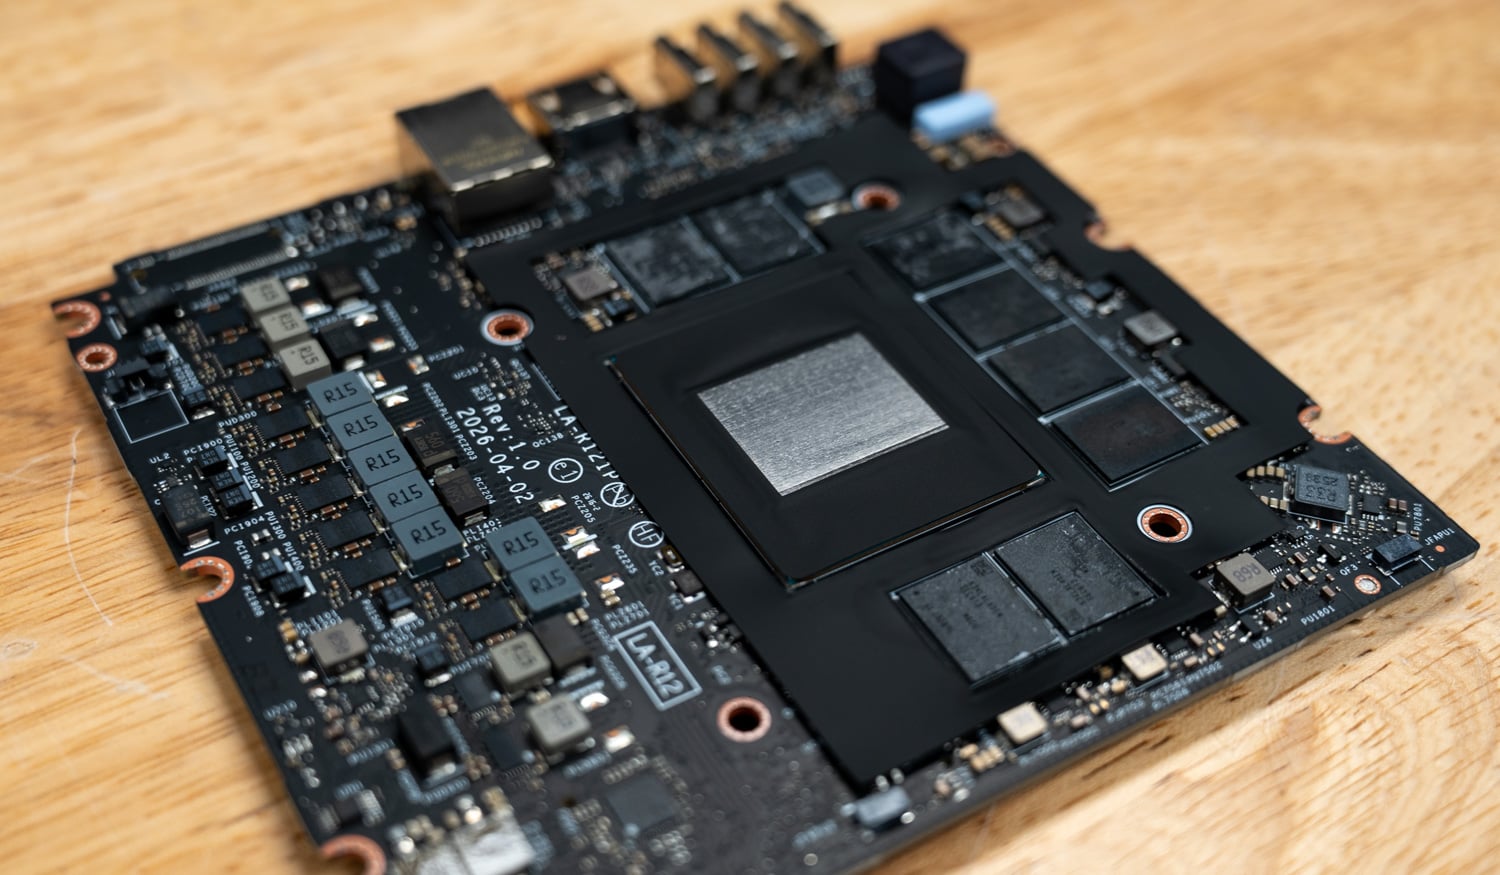
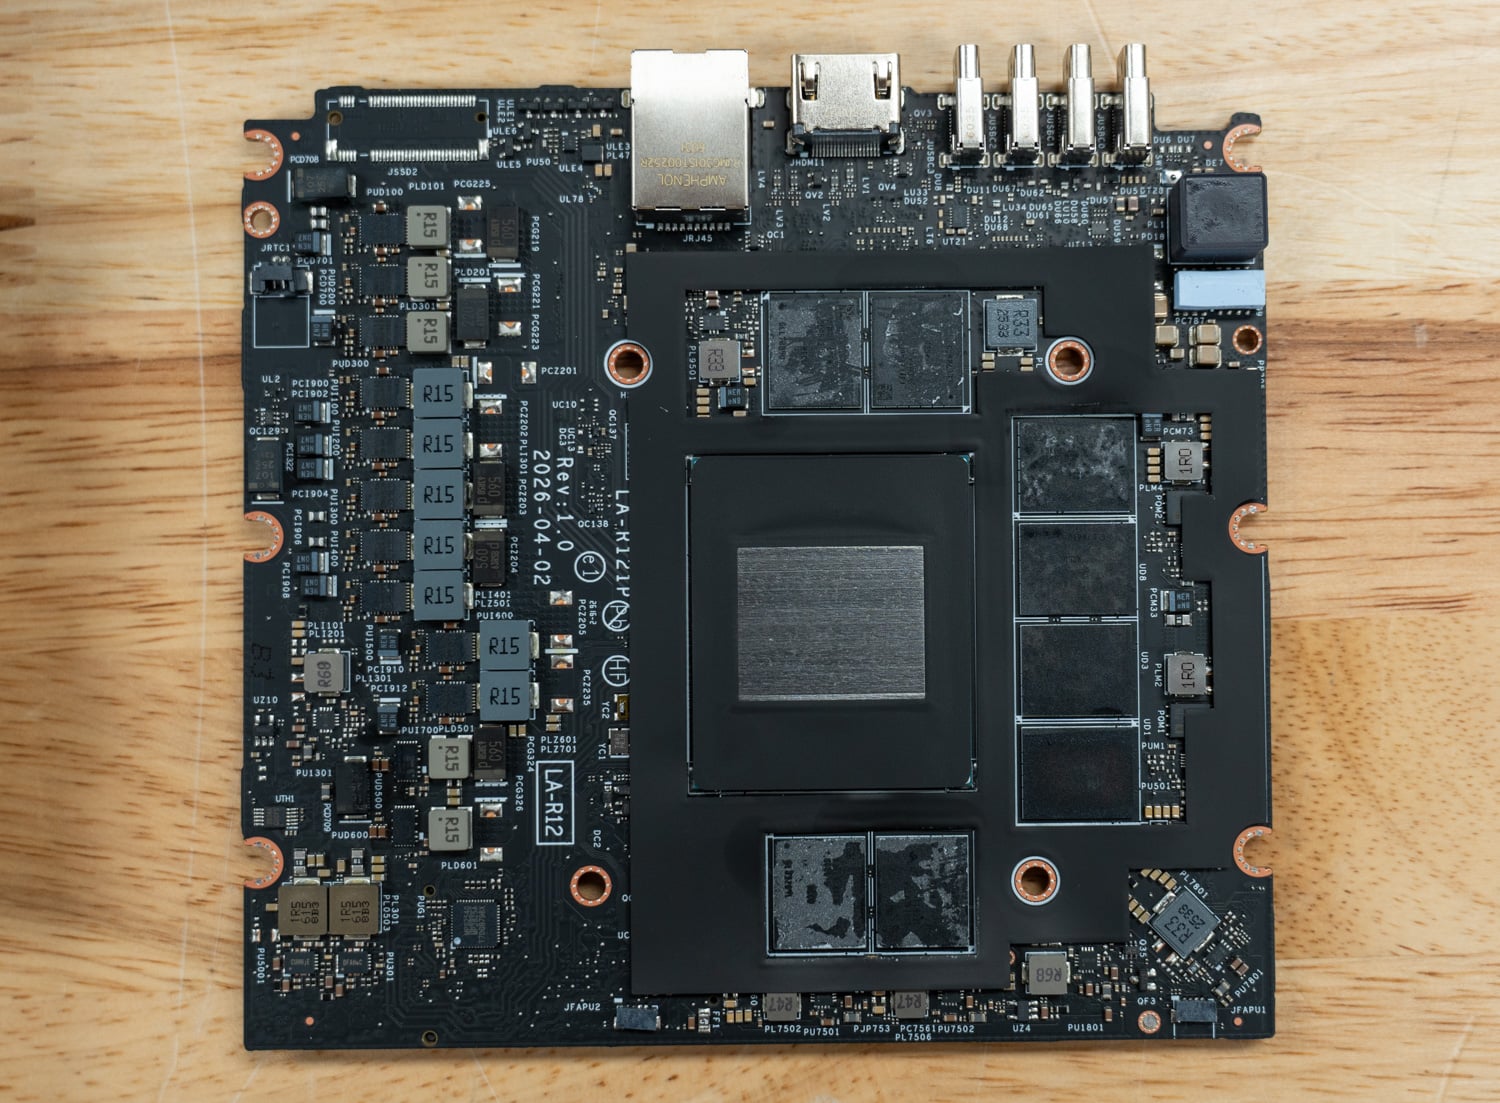
Com o conjunto de refrigeração removido, a placa-mãe fica visível, revelando o chip da APU no centro, ladeado pelos módulos de memória em ambos os lados e o circuito VRM percorrendo a borda esquerda. O quadrado prateado visível no chip não é metal líquido nem uma pasta térmica; é o resíduo de uma almofada térmica ou revestimento sólido que a AMD aplicou como interface entre o chip e o dissipador de calor, o que explica sua aparência uniforme e seca, em vez do aspecto úmido e borrado que a pasta ou o metal líquido normalmente deixam.
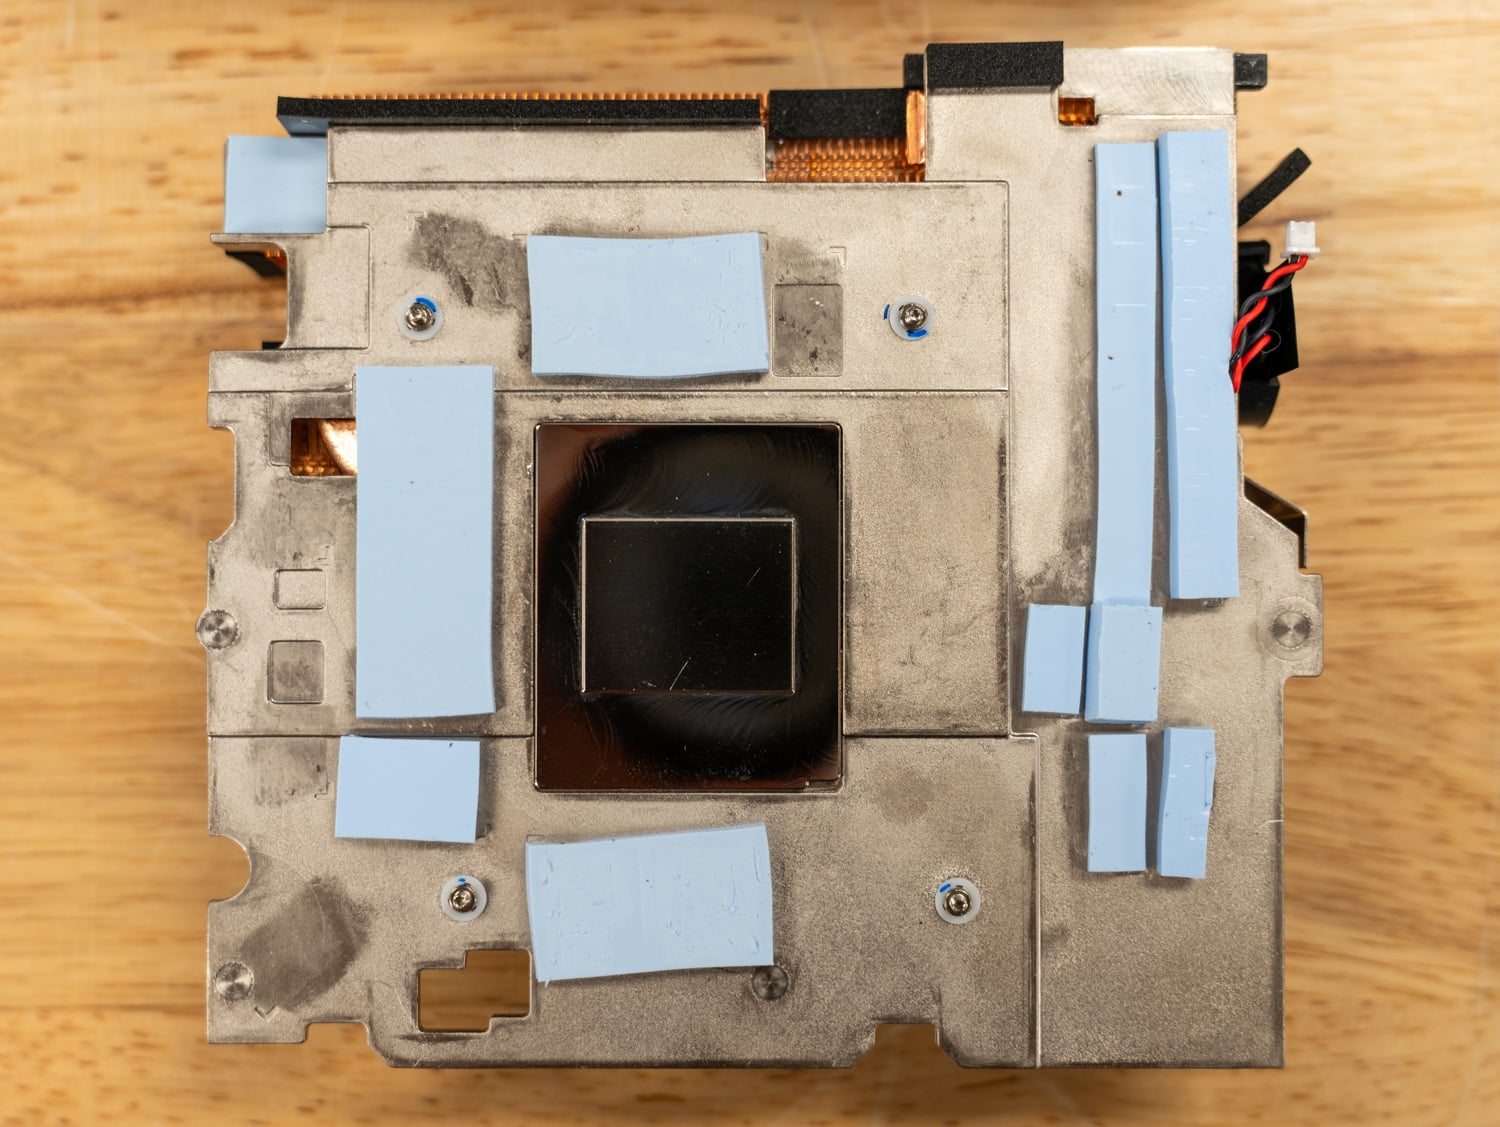
Ao virar o dissipador de calor, revela-se a parte inferior da placa fria, onde uma seção polida como um espelho faz contato direto com o chip. Ao mesmo tempo, as zonas de memória e de alimentação circundantes são cobertas com almofadas térmicas pré-aplicadas de espessura variável.
Testes de desempenho do AMD Ryzen AI Halo
Avaliamos a plataforma AMD Ryzen AI Halo no Windows e no Linux para analisar seu desempenho em aplicações de estação de trabalho e cargas de trabalho focadas em IA. Para os testes no Windows, o sistema AMD Ryzen AI Halo foi comparado com dois sistemas disponíveis comercialmente equipados com o Ryzen AI Max+ PRO 395: o HP Z2 Mini G1a, uma estação de trabalho desktop compacta, e o HP ZBook Ultra G1a de 14 polegadas, uma estação de trabalho móvel. Como os três sistemas compartilham a mesma arquitetura de processador e a placa gráfica integrada Radeon 8060S, essas comparações destacam o desempenho da plataforma Halo em diferentes condições térmicas e configurações de sistema.
Para os testes em Linux, focamos em cargas de trabalho de desenvolvimento de IA e armazenamento, comparando o sistema Ryzen AI Halo com o NVIDIA DGX Spark. Esses testes priorizaram o desempenho de benchmarks de armazenamento FIO e inferência vLLM, comparando a plataforma de desenvolvimento baseada no Ryzen AI Halo da AMD com o sistema de desenvolvimento de IA da NVIDIA, desenvolvido especificamente para inferência de modelos de linguagem locais de grande porte.
Unidades testadas
UL Procyon: Visão Computacional de IA
O Procyon AI Computer Vision Benchmark fornece informações detalhadas sobre o desempenho de mecanismos de inferência de IA em nível profissional. Ao incorporar mecanismos de diversos fornecedores, ele oferece pontuações de desempenho que refletem com precisão as capacidades de um dispositivo. O benchmark avalia modelos de redes neurais de última geração, comparando seu desempenho de aceleração de IA em diferentes tipos de hardware — incluindo CPU, GPU e NPU — permitindo que os usuários avaliem a eficiência relativa em uma variedade de cargas de trabalho e condições.
Para refletir as cargas de trabalho de IA do mundo real, o benchmark utiliza seis modelos de redes neurais diversos, cada um selecionado por sua relevância para tarefas modernas de visão computacional. O MobileNet V3 é um modelo compacto, focado em dispositivos móveis, projetado para identificação de objetos em imagens, enquanto o Inception V4 executa a mesma tarefa com uma arquitetura mais profunda e complexa.
YOLO V3 (You Only Look Once) é especializado em detecção de objetos em tempo real, estimando probabilidades de objetos. DeepLab V3, baseado no MobileNet V2, concentra-se na segmentação semântica de imagens e no agrupamento de pixels. Real-ESRGAN, o teste mais exigente em termos computacionais, aumenta a resolução de imagens de 250×250 para 1,000×1,000. Por fim, ResNet 50 é um modelo de classificação robusto que permite um treinamento mais eficaz de redes neurais profundas.
A plataforma Ryzen AI Halo apresentou um desempenho consistentemente forte em inferência de IA em cargas de trabalho de CPU e GPU. Nos testes de CPU, obteve uma pontuação geral de 216, ficando ligeiramente atrás do HP Z2 Mini (227) e superando com folga o HP ZBook Ultra (186). A inferência de GPU foi ainda mais impressionante, com o sistema Halo conquistando a maior pontuação geral, 553, à frente do ZBook Ultra (528) e do Z2 Mini (528). Também registrou a inferência MobileNet V3 mais rápida, com 0.38 ms, e concluiu a exigente carga de trabalho REAL-ESRGAN em 185.08 ms, em comparação com 211.76 ms no Z2 Mini e 200.40 ms no ZBook Ultra.
| UL Procyon: Inferência de visão computacional de IA (quanto menor, melhor) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) | HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Tempos de CPU | |||
| Pontuação geral da visão computacional de IA (quanto maior, melhor) | 216 | 227 | 186 |
| MobileNet V3 | 0.73 ms | 0.75 ms | 1.09 ms |
| ResNet 50 | 6.02 ms | 5.99 ms | 6.84 ms |
| Inception V4 | 17.18 ms | 17.12 ms | 19.80 ms |
| DeepLab V3 | 29.21 ms | 21.20 ms | 28.27 ms |
| YOLO V3 | 35.60 ms | 36.58 ms | 41.64 ms |
| REAL-ESRGAN | 1,931.13 ms | 1,892.10 ms | 2,138.97 ms |
| Tempos de GPU | |||
| Pontuação geral da visão computacional de IA (quanto maior, melhor) | 553 | 528 | 583 |
| MobileNet V3 | 0.38 ms | 0.42 ms | 0.46 ms |
| ResNet 50 | 4.04 ms | 3.85 ms | 3.27 ms |
| Inception V4 | 13.26 ms | 15.15 ms | 11.62 ms |
| DeepLab V3 | 12.72 ms | 10.98 ms | 10.72 ms |
| YOLO V3 | 11.17 ms | 12.64 ms | 10.57 ms |
| REAL-ESRGAN | 185.08 ms | 211.76 ms | 200.40 ms |
UL Procyon: Geração de texto de IA
O Procyon AI Text Generation Benchmark simplifica os testes de desempenho de modelos de aprendizado de máquina de IA (LLM) ao fornecer um método de avaliação conciso e consistente. Ele permite testes repetidos em vários modelos de LLM, minimizando a complexidade de modelos grandes e fatores variáveis. Desenvolvido com líderes em hardware de IA, ele otimiza o uso de aceleradores de IA locais para avaliações de desempenho mais confiáveis e eficientes. Os resultados abaixo foram medidos usando o TensorRT.
A plataforma de referência Ryzen AI Halo liderou todos os modelos de linguagem testados no Procyon AI Text Generation. Ela alcançou a maior pontuação geral no Phi, com 1,192, em comparação com 965 para o HP Z2 Mini e 922 para o HP ZBook Ultra. O Mistral seguiu uma tendência semelhante, com uma pontuação de 998, à frente de 850 e 829, enquanto o Llama3 ficou em 847, superando os sistemas concorrentes com 766 e 756, respectivamente. A plataforma Halo também reduziu o tempo para o primeiro token em todos os modelos, produzindo o primeiro token Phi em apenas 0.996 segundos, quase metade da latência dos sistemas HP. Embora a taxa de transferência de geração de tokens ocasionalmente tenha favorecido o Z2 Mini, a latência de inicialização significativamente menor da plataforma Halo resultou nas melhores pontuações gerais do benchmark.
| UL Procyon: Geração de texto de IA | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Pontuação geral Phi | 1,192 | 965 | 922 |
| Tempo de saída Phi para o primeiro token | 0.996 segundos | 1.898 segundos | 1.956 segundos |
| Tokens de saída Phi por segundo | 55.271 fichas/s | 68.967 fichas/s | 64.986 fichas/s |
| Phi Duração Geral | 56.237 segundos | 52.666 segundos | 55.501 segundos |
| Mistral Pontuação Geral | 998 | 850 | 829 |
| Tempo de saída do Mistral para o primeiro token | 1.603 segundos | 2.734 segundos | 2.783 segundos |
| Tokens de saída Mistral por segundo | 35.027 fichas/s | 43.358 fichas/s | 41.992 fichas/s |
| Mistral Duração total | 88.582 segundos | 81.716 segundos | 84.065 segundos |
| Pontuação geral do Llama3 | 847 | 766 | 756 |
| Tempo de saída do Llama3 para o primeiro token | 1.963 segundos | 2.545 segundos | 2.578 segundos |
| Tokens de saída Llama3 por segundo | 34.630 fichas/s | 36.752 fichas/s | 36.243 fichas/s |
| Llama3 Duração total | 92.026 segundos | 91.987 segundos | 93.200 segundos |
| Pontuação geral do Llama2 | N/D | 936 | 929 |
| Tempo de saída do Llama2 para o primeiro token | N/A segundos | 3.813 segundos | 3.860 segundos |
| Tokens de saída Llama2 por segundo | N/A tokens/s | 24.685 fichas/s | 24.619 fichas/s |
| Llama2 Duração total | N/A segundos | 136.077 segundos | 136.720 segundos |
UL Procyon: Geração de imagem AI
O benchmark Procyon AI Image Generation oferece uma maneira consistente e precisa de medir o desempenho de inferência de IA em hardware que varia de NPUs de baixo consumo a GPUs de ponta. Ele inclui três testes: Stable Diffusion XL (FP16) para GPUs de ponta, Stable Diffusion 1.5 (FP16) para GPUs de potência moderada e Stable Diffusion 1.5 (INT8) para dispositivos de baixo consumo. O benchmark utiliza o mecanismo de inferência ideal para cada sistema, garantindo resultados justos e comparáveis.
A geração de imagens provou ser uma das cargas de trabalho mais fortes do Ryzen AI Halo. No teste Stable Diffusion 1.5 FP16, a plataforma Halo alcançou uma pontuação geral de 937, em comparação com 725 para o Z2 Mini e 648 para o ZBook Ultra, reduzindo o tempo de geração para 106.7 segundos, contra 137.8 e 154.2 segundos, respectivamente. O Stable Diffusion XL apresentou uma vantagem igualmente expressiva, com o sistema Halo concluindo em 878.5 segundos, aproximadamente 174 segundos mais rápido que o Z2 Mini e mais de 450 segundos mais rápido que o ZBook Ultra. A plataforma também completou o benchmark Stable Diffusion 1.5 INT8 com uma pontuação geral de 9,158, uma carga de trabalho indisponível em qualquer um dos sistemas de comparação da HP.
| UL Procyon: Geração de Imagens por IA | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Difusão Estável 1.5 (FP16) – Pontuação Geral | 937 | 725 | 648 |
| Difusão Estável 1.5 (FP16) – Tempo Geral | 106.7 segundos | 137.815 segundos | 154.203 segundos |
| Difusão Estável 1.5 (FP16) – Velocidade de Geração de Imagem | 6.670 s/image | 8.613 s/image | 9.638 s/image |
| Difusão Estável 1.5 (INT8) – Pontuação Geral | 9,158 | N/D | N/D |
| Difusão Estável 1.5 (INT8) – Tempo Geral | 27.298 segundos | N/D | N/D |
| Difusão Estável 1.5 (INT8) – Velocidade de Geração de Imagem | 3.412 s/image | N/D | N/D |
| Difusão Estável XL (FP16) – Pontuação Geral | 682 | 570 | 451 |
| Difusão Estável XL (FP16) – Tempo Geral | 878.493 segundos | 1,052.468 segundos | 1,329.592 segundos |
| Stable Diffusion XL (FP16) – Velocidade de geração de imagem | 54.906 s/image | 65.779 s/image | 83.100 s/image |
Estação de trabalho SPEC 4
O benchmark SPECworkstation 4.0 é uma ferramenta abrangente para avaliar todos os aspectos-chave do desempenho de estações de trabalho. Ele fornece uma medida realista do desempenho da CPU, da placa gráfica, do acelerador e do disco, oferecendo aos profissionais os dados necessários para tomar decisões informadas sobre seus investimentos em hardware. O benchmark inclui um conjunto dedicado de testes focados em cargas de trabalho de IA e ML, como tarefas de ciência de dados e testes de inferência baseados no ONNX Runtime, refletindo a crescente importância da IA/ML em ambientes de estações de trabalho. Ele abrange sete setores verticais e quatro subsistemas de hardware, fornecendo uma medida detalhada e relevante do desempenho das estações de trabalho atuais.
O SPECworkstation 4 destacou as capacidades equilibradas da plataforma Ryzen AI Halo para estações de trabalho. Ela obteve as pontuações mais altas em Serviços Financeiros (2.92), Mídia e Entretenimento (2.97), Design de Produto (2.22) e Produtividade e Desenvolvimento (1.27), superando tanto o HP Z2 Mini quanto o HP ZBook Ultra nessas categorias. O Z2 Mini apresentou uma ligeira vantagem em Energia (2.50 vs. 2.35) e Ciências da Vida (2.60 vs. 2.33). No geral, a plataforma de referência Halo demonstrou um desempenho sólido em todas as cargas de trabalho profissionais do benchmark e manteve-se competitiva em todas as categorias testadas.
| SPECworkstation 4.0.0 (quanto maior, melhor) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S)
|
HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Energia | 2.35 | 2.50 | 2.20 |
| Serviços Financeiros | 2.92 | 2.35 | 1.60 |
| Ciências da Vida | 2.33 | 2.60 | 2.20 |
| Mídia e Entretenimento | 2.97 | 2.22 | 1.90 |
| Produto Design | 2.22 | 2.00 | 1.74 |
| Produtividade e Desenvolvimento | 1.27 | 1.00 | 1.03 |
Luxmark
O Luxmark é um benchmark de GPU que utiliza o LuxRender, um renderizador de traçado de raios de código aberto, para avaliar o desempenho de um sistema com cenas 3D altamente detalhadas. Este benchmark é útil para avaliar as capacidades de renderização gráfica de servidores e estações de trabalho, especialmente para aplicações de efeitos visuais e visualização arquitetônica, onde a simulação precisa de luz é crucial.
Os resultados do Luxmark mostraram uma diferença mínima entre as três plataformas Ryzen AI Max+ 395. O sistema de referência Halo obteve a maior pontuação no teste Food, com 4,158 pontos, superando o Z2 Mini (3,943) e o ZBook Ultra (3,915). No teste Hallbench, alcançou 8,014 pontos, ficando ligeiramente atrás do Z2 Mini (8,477), mas à frente do ZBook Ultra (7,833). No geral, os resultados sugerem que os sistemas baseados na Radeon 8060S oferecem desempenho de ray tracing muito semelhante, independentemente do formato.
| Luxmark (mais alto é melhor) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Banco de corredor | 8,014 | 8,477 | 7,833 |
| Alimentícia | 4,158 | 3,943 | 3,915 |
Compressão 7-Zip
O benchmark de compressão 7-Zip avalia o desempenho da CPU durante a compressão e descompressão, medindo o desempenho em GIPS (Gigainstruções por Segundo) e o uso da CPU. Valores mais altos de GIPS e uso eficiente da CPU indicam desempenho superior.
A plataforma Ryzen AI Halo liderou todas as principais categorias no benchmark 7-Zip. Ela alcançou uma taxa de compressão de 176.7 GIPS, em comparação com 139.3 GIPS no HP Z2 Mini e 139.6 GIPS no ZBook Ultra. O desempenho de descompressão também se manteve forte, com 191.6 GIPS, superando os 164.0 GIPS do Z2 Mini e os 174.0 GIPS do ZBook Ultra. Combinando os resultados, a plataforma Halo alcançou a maior taxa geral de 184.2 GIPS, superando os sistemas concorrentes em cerca de 20% e demonstrando excelente taxa de transferência de inteiros para cargas de trabalho de criação e extração de arquivos.
| Referência de compressão 7-Zip (quanto maior, melhor) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) | |||
|---|---|---|---|---|---|---|
| Compressão | ||||||
| Uso atual da CPU | 2,741% | 2,734% | 2,868% | |||
| Classificação/uso atual | 6.370 GIP | 5.136 GIP | 4.883 GIP | |||
| Classificação da corrente | 174.589 GIP | 140.405 GIP | 140.061 GIP | |||
| Uso de CPU resultante | 2,751% | 2,718% | 2,855% | |||
| Classificação/uso resultante | 6.424 GIP | 5.126 GIP | 4.890 GIP | |||
| Avaliação resultante | 176.742 GIP | 139.298 GIP | 139.617 GIP | |||
| Descomprimindo | ||||||
| Uso atual da CPU | 2,568% | 2,343% | 2,904% | |||
| Classificação/uso atual | 7.670 GIP | 6.805 GIP | 6.029 GIP | |||
| Classificação da corrente | 196.986 GIP | 159.451 GIP | 175.104 GIP | |||
| Uso de CPU resultante | 2,469% | 2,414% | 2,887% | |||
| Classificação/uso resultante | 7.766 GIP | 6.793 GIP | 6.028 GIP | |||
| Avaliação resultante | 191.645 GIP | 163.969 GIP | 174.046 GIP | |||
| Avaliação Total | ||||||
| Uso total da CPU | 2,610% | 2,566% | 2,871% | |||
| Avaliação/uso total | 7.095 GIP | 5.959 GIP | 5.459 GIP | |||
| Avaliação Total | 184.194 GIP | 151.634 GIP | 156.832 GIP | |||
Referência do liquidificador
O Blender é um aplicativo de modelagem 3D de código aberto. Este teste de desempenho foi executado com o utilitário Blender Benchmark. A pontuação é medida em amostras por minuto, com valores mais altos indicando melhor desempenho.
A renderização por CPU foi outra área em que o Ryzen AI Halo se destacou. Na cena Monster, alcançou 244.7 amostras por minuto, superando o HP Z2 Mini (224.3) e o HP ZBook Ultra (189.3). A cena Junkshop ficou em segundo lugar, com 159.4 amostras por minuto, em comparação com 149.5 e 129.4, enquanto a cena Classroom atingiu 131.6 amostras por minuto, superando o Z2 Mini (116.3) em cerca de 13% e o ZBook Ultra (94.1) em quase 40%. Esses resultados demonstram que o Ryzen AI Max+ 395 oferece excelente desempenho em renderização multithread, apesar de seu tamanho compacto para uma estação de trabalho.
| CPU de referência do Blender (amostras por minuto, quanto maior, melhor) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Monstro | 244.7 amostras/m | 224.3 amostras/m | 189.29 amostras/m |
| sucata | 159.4 amostras/m | 149.5 amostras/m | 129.42 amostras/m |
| Sala de aula | 131.6 amostras/m | 116.3 amostras/m | 94.14 amostras/m |
Os resultados de renderização por GPU foram muito mais próximos entre os sistemas. A plataforma de referência Halo renderizou a cena Monster a 704.2 amostras por minuto, ficando atrás do Z2 Mini (745.6), mas à frente do ZBook Ultra (661.5). O cenário Junkshop apresentou um empate técnico entre a plataforma Halo (366.6) e o Z2 Mini (366.5). Ao mesmo tempo, o sistema Halo obteve a maior pontuação no cenário Classroom, com 361.5 amostras por minuto, superando por pouco o Z2 Mini (359.0) e o ZBook Ultra (333.3). Os resultados indicam que a Radeon 8060S oferece um desempenho de renderização por GPU notavelmente consistente em todas as implementações.
| GPU Blender Benchmark (amostras por minuto, quanto maior, melhor) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Monstro | 704.2 amostras/m | 745.55 amostras/m | 661.50 amostras/m |
| sucata | 366.6 amostras/m | 366.54 amostras/m | 341.92 amostras/m |
| Sala de aula | 361.51 amostras/m | 359.01 amostras/m | 333.26 amostras/m |
triturador de y
O y-cruncher é um programa multithread e escalável capaz de calcular o Pi e outras constantes matemáticas com trilhões de dígitos. Desde o seu lançamento em 2009, tornou-se uma ferramenta popular para testes de desempenho e estresse entre overclockers e entusiastas de hardware.
Os resultados do y-cruncher foram divididos de acordo com o tamanho da computação. Nas execuções de 1 bilhão e 2.5 bilhões de dígitos, os três sistemas terminaram com uma diferença de apenas alguns décimos de segundo, com os sistemas HP ligeiramente à frente. À medida que a carga de trabalho aumentava, o Halo se destacava, concluindo a computação de 5 bilhões de dígitos em 71.948 segundos, em comparação com 75.021 segundos para o Z2 Mini e 78.19 segundos para o ZBook Ultra. Com 10 bilhões de dígitos, o Halo terminou em 151.409 segundos, aproximadamente 6% à frente do Z2 Mini e 12% à frente do ZBook Ultra, sugerindo que o chassi do desktop suporta melhor cargas multithread pesadas à medida que os tempos de execução aumentam.
| Y-Cruncher (tempo total de cálculo) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| 1 bilhões | 13.193 segundos | 12.965 segundos | 12.93 segundos |
| 2.5 bilhões | 34.578 segundos | 34.533 segundos | 34.91 segundos |
| 5 bilhões | 71.948 segundos | 75.021 segundos | 78.19 segundos |
| 10 bilhões | 151.409 segundos | 160.252 segundos | 171.72 segundos |
Geekbench 6
O Geekbench 6 é um benchmark multiplataforma que mede o desempenho geral do sistema.
O Geekbench 6 reforçou o perfil de desempenho equilibrado da plataforma Halo. Ela alcançou a maior pontuação em single-core, com 2,986, à frente do HP Z2 Mini (2,862) e do ZBook Ultra (2,825). O desempenho em multi-core também liderou a comparação, com 18,068. A Radeon 8060S registrou a maior pontuação em OpenCL para GPU, com 92,883, superando por pouco o Z2 Mini (91,591) e superando com folga o ZBook Ultra (85,337). As lideranças consistentes nos testes de CPU e GPU ilustram o desempenho completo da plataforma Ryzen AI Max+ 395.
| Geekbench 6 (quanto mais alto, melhor) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| CPU de núcleo único | 2,986 | 2,862 | 2,825 |
| CPU multinúcleo | 18,068 | 17,210 | 17,562 |
| GPU OpenCL | 92,883 | 91,591 | 85,337 |
Cinebench R23
O Cinebench R23 é um benchmark amplamente reconhecido para avaliar o desempenho da CPU em cargas de trabalho de renderização 3D. Utilizando o motor gráfico do Cinema 4D, ele mede a capacidade do processador de lidar com tarefas de um único núcleo e com múltiplos núcleos, oferecendo informações sobre a capacidade de resposta geral e os recursos de processamento paralelo.
O Cinebench R23 mostrou uma disputa acirrada entre as duas implementações de desktop com o Ryzen AI Max+ 395. A plataforma de referência Halo obteve uma pontuação multi-core de 37,316, superando os 37,156 do HP Z2 Mini, enquanto ambas ultrapassaram com folga os 29,112 do HP ZBook Ultra. O desempenho single-core seguiu o mesmo padrão, com a plataforma Halo marcando 2,047, em comparação com 2,020 do Z2 Mini e 1,984 do ZBook Ultra. Embora as margens sobre o Z2 Mini tenham sido pequenas, o sistema Halo consistentemente se manteve no topo do benchmark.
| Cinebench R23 (quanto maior, melhor) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Multi-Core | 37,316 | 37,156 | 29,112 |
| Único nucleo | 2,047 | 2,020 | 1,984 |
Cinebench 2024
O Cinebench 2024 baseia-se na versão R23, introduzindo testes de renderização baseados em GPU, mantendo o foco no desempenho da CPU. Nesta seção, analisamos apenas as pontuações da CPU, que oferecem uma visão atualizada de como cada sistema lida com tarefas modernas de renderização 3D.
O benchmark Cinebench 2024, mais recente, apresentou resultados semelhantes aos do R23. O Ryzen AI Halo registrou a maior pontuação em múltiplos núcleos, com 1,916 pontos, ficando ligeiramente à frente do HP Z2 Mini (1,906) e mantendo uma vantagem considerável sobre o HP ZBook Ultra (1,579). O desempenho em núcleo único também favoreceu a plataforma Halo, com 116 pontos, em comparação com 112 do Z2 Mini e 111 do ZBook Ultra. Embora as diferenças entre os sistemas desktop tenham permanecido pequenas, os resultados reforçam a capacidade do Ryzen AI Max+ 395 de oferecer desempenho de renderização de CPU de alto nível de forma consistente.
| Cinebench 2024 (quanto maior, melhor) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Multi-Core | 1,916 | 1,906 | 1,579 |
| Único nucleo | 116 | 112 | 111 |
Benchmarks da Phoronix
O Phoronix Test Suite é uma plataforma de benchmarking automatizada e de código aberto que suporta mais de 450 perfis de teste e mais de 100 conjuntos de testes através do OpenBenchmarking.org. Ele cuida de tudo, desde a instalação de dependências até a execução de testes e a coleta de resultados, tornando-o ideal para comparações de desempenho, validação de hardware e integração contínua. Analisaremos o desempenho nos testes Stream, 7-Zip e LLVM.
Ao analisar o conjunto de benchmarks do Phoronix, observamos uma divisão bastante equilibrada entre a plataforma AMD Ryzen AI Halo e a NVIDIA DGX Spark. O sistema Ryzen AI Halo liderou consistentemente as cargas de trabalho centradas na CPU, superando o DGX Spark em 11% na compressão 7-Zip, 38% na descompressão 7-Zip e concluindo o teste de compilação LLVM 14% mais rápido. O DGX Spark, por outro lado, demonstrou maior largura de banda de memória sustentada, liderando os testes STREAM Scale, Triad e Add em 17%, 13% e 15%, respectivamente. O Halo manteve uma vantagem de 18% no benchmark STREAM Copy, ilustrando que, embora ambos os sistemas sejam altamente capazes, a plataforma Ryzen AI Halo prioriza o desempenho computacional de propósito geral, enquanto o DGX Spark demonstra maior taxa de transferência em cargas de trabalho focadas em largura de banda de memória.
| Testar | AMD Ryzen AI Halo | NVIDIA DGX Spark | Vencedora |
|---|---|---|---|
| Compressão 7-Zip (MIPS) | 186,921 | 169,052 | Halo (+11%) |
| Descompressão 7-Zip (MIPS) | 146,109 | 106,084 | Halo (+38%) |
| Cópia de STREAM (MB/s) | 145,363 | 123,730 | Halo (+18%) |
| Escala STREAM (MB/s) | 110,611 | 128,970 | Faísca (+17%) |
| STREAM Triad (MB/s) | 107,105 | 121,433 | Faísca (+13%) |
| Adicionar STREAM (MB/s) | 107,022 | 122,815 | Faísca (+15%) |
| Compilação LLVM (Make, segundos) | 431.8 | 504.3 | Halo (14% mais rápido) |
Referência de desempenho da FIO
Para medir o desempenho de armazenamento com base em métricas comuns do setor, usamos o fio. Nosso teste tradicional de SSD pré-condiciona cada unidade com duas cargas completas como unidade secundária; aqui, testamos cada unidade no sistema, por meio do sistema de arquivos. Anteriormente, testamos os sistemas NVIDIA com GDSIO, mas a AMD não oferece um teste de armazenamento direto na GPU comparável, portanto, executar o fio em nível de sistema de arquivos em ambas as plataformas as coloca em igualdade de condições, o que é mais importante do que testar as unidades individualmente.
Tanto o NVIDIA DGX Spark (Founders Edition) quanto o AMD Ryzen AI Halo vêm com um SSD PCIe Gen5, então, em teoria, as duas plataformas têm limites idênticos para largura de banda bruta do SSD. Na prática, porém, o SSD do Halo opera em velocidades de link PCIe Gen4 neste sistema, o que limita a largura de banda disponível bem abaixo da capacidade do próprio SSD. Essa limitação de velocidade de link é importante ter em mente ao longo desta seção, pois representa uma parcela significativa da diferença de largura de banda entre as duas plataformas.
Nesta seção, nos concentramos nos seguintes benchmarks de FIO:
- 128K sequencial
- 64K aleatório
- 16K sequencial
- 16K aleatório
- 4K aleatório
Leitura sequencial de 128K
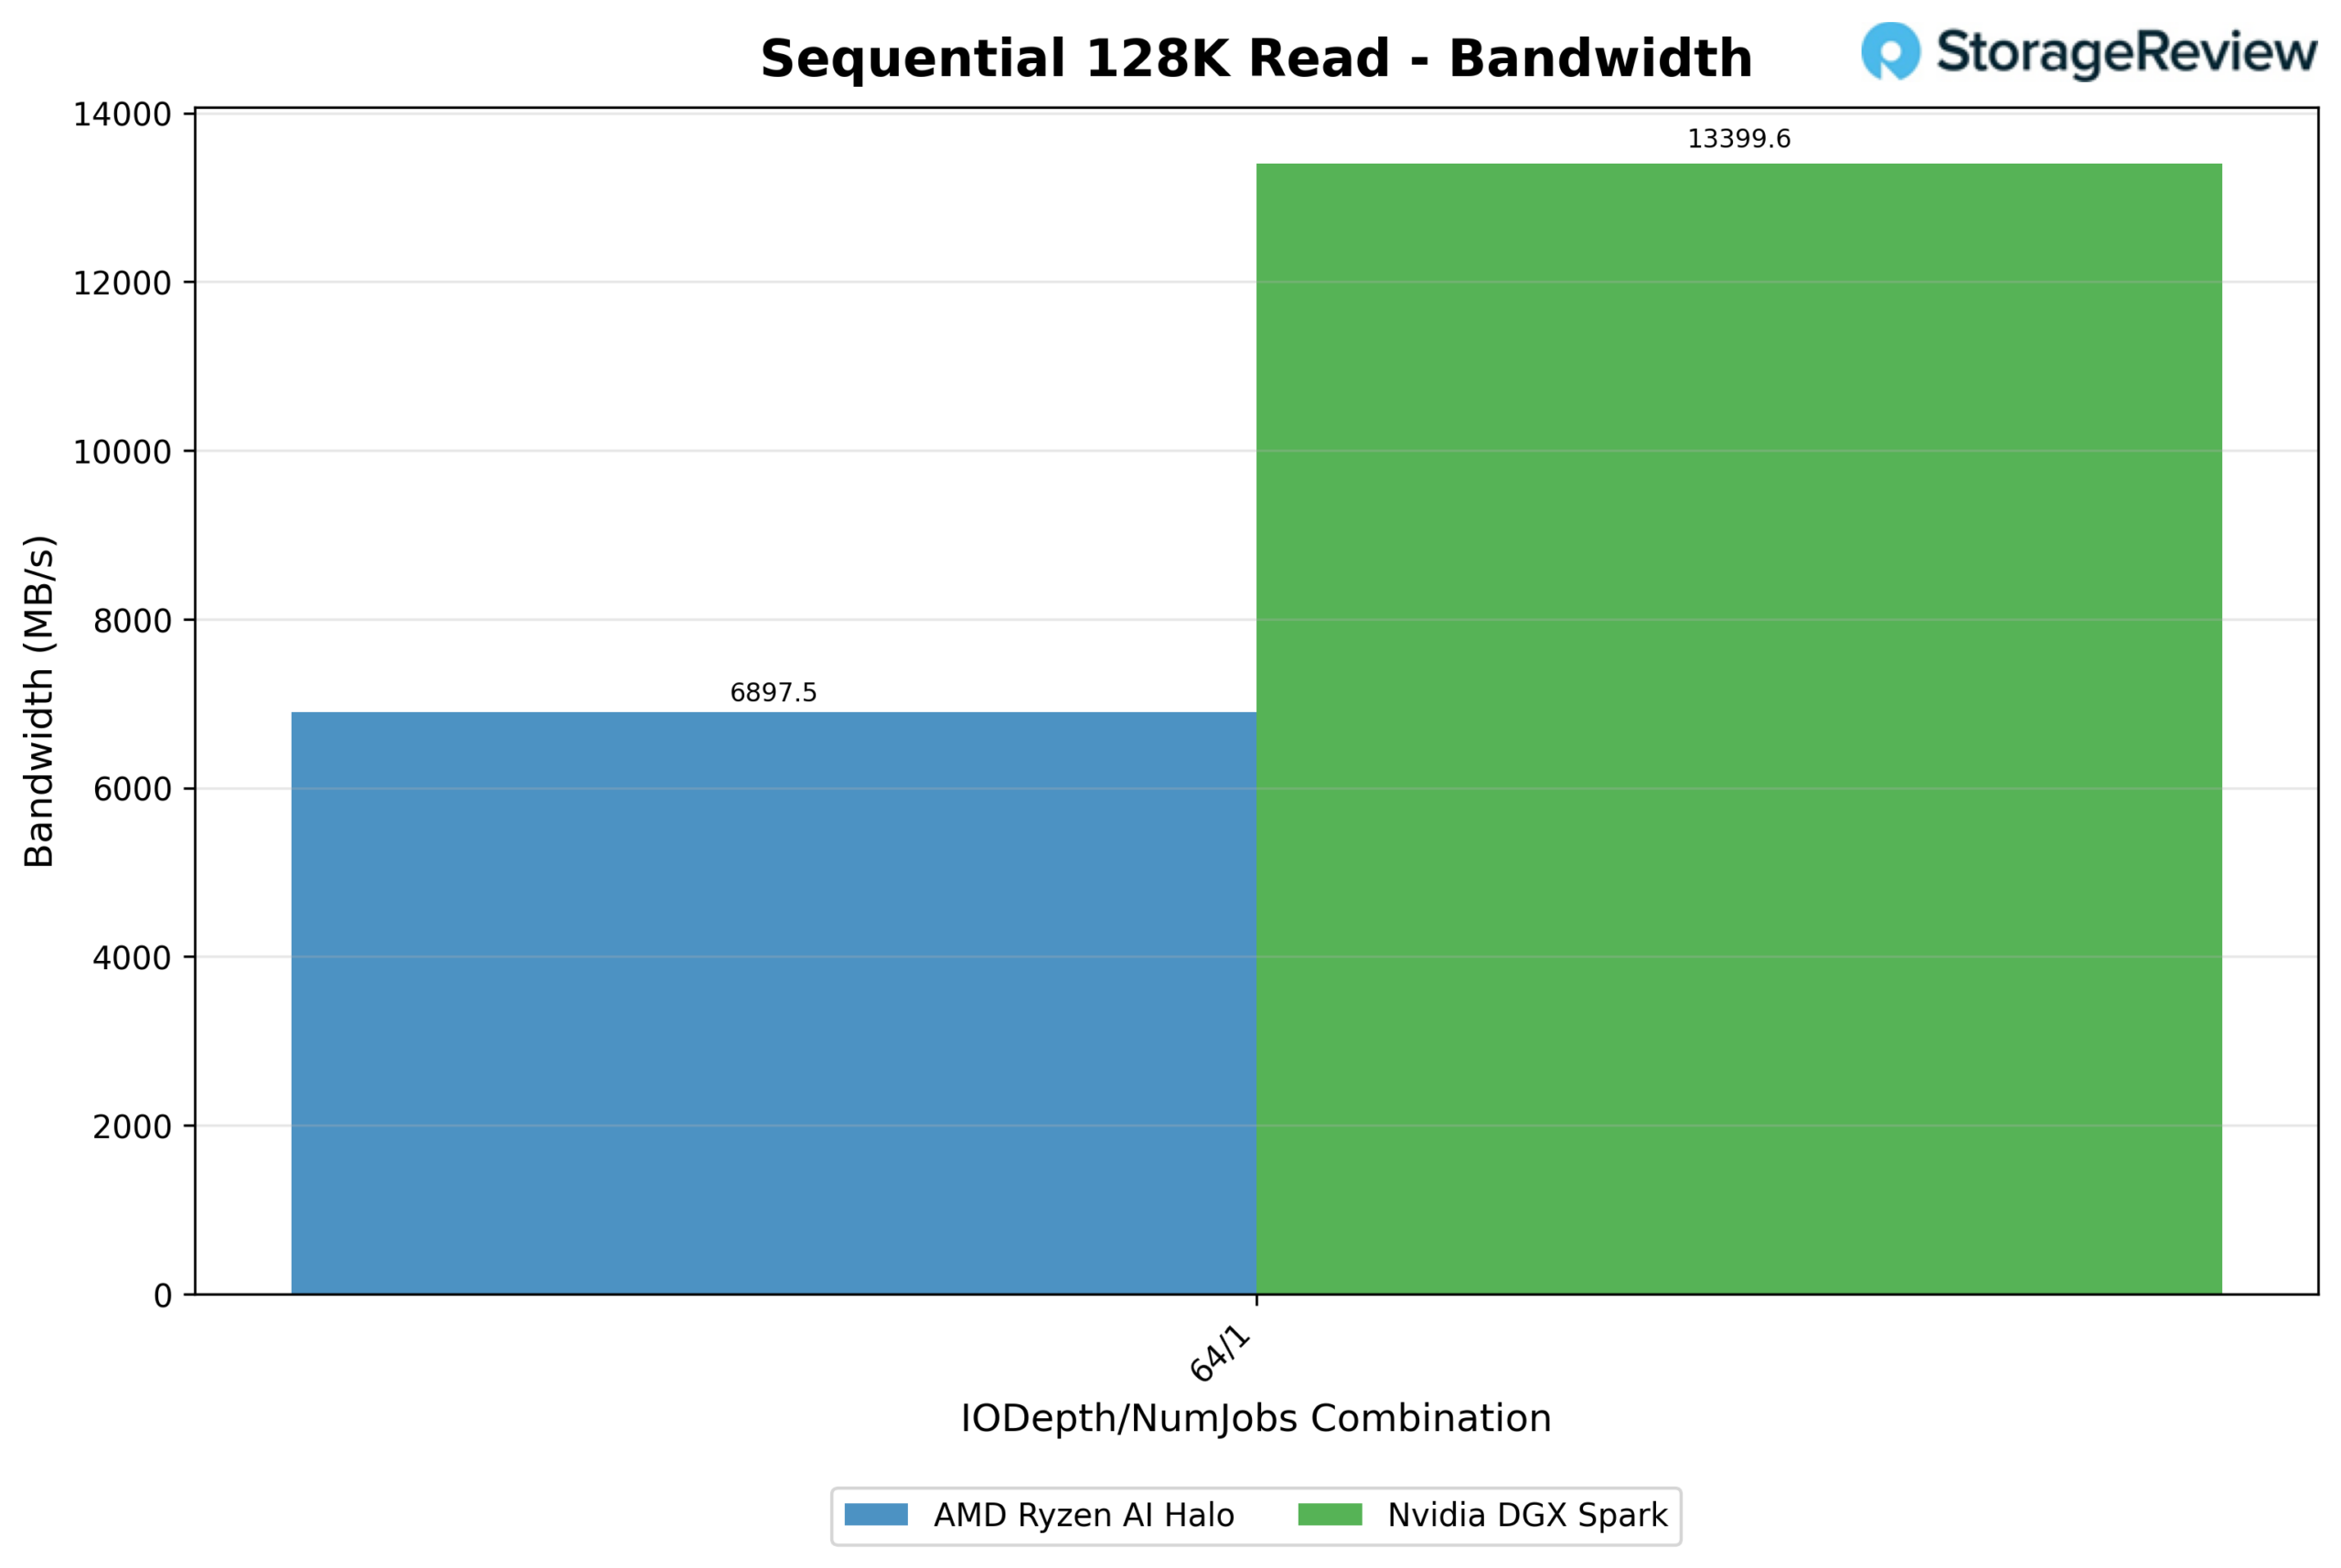
Em uma leitura sequencial de 128 KB com fila profunda e em um único núcleo (64/1), o NVIDIA DGX Spark atingiu 13,399.6 MB/s, quase o dobro dos 6,897.5 MB/s do AMD Ryzen AI Halo. A latência seguiu o mesmo padrão: a latência média do Spark nessa profundidade foi de 0.597 ms, enquanto o Halo ficou para trás com 1.159 ms, quase duas vezes mais lento por solicitação, apesar de mover metade dos dados. Essa é a diferença mais clara em toda a análise, sugerindo que a pilha de armazenamento do Spark foi projetada para uma taxa de transferência sequencial sustentada mais alta nesse tamanho de bloco.
Gravação sequencial de 128K
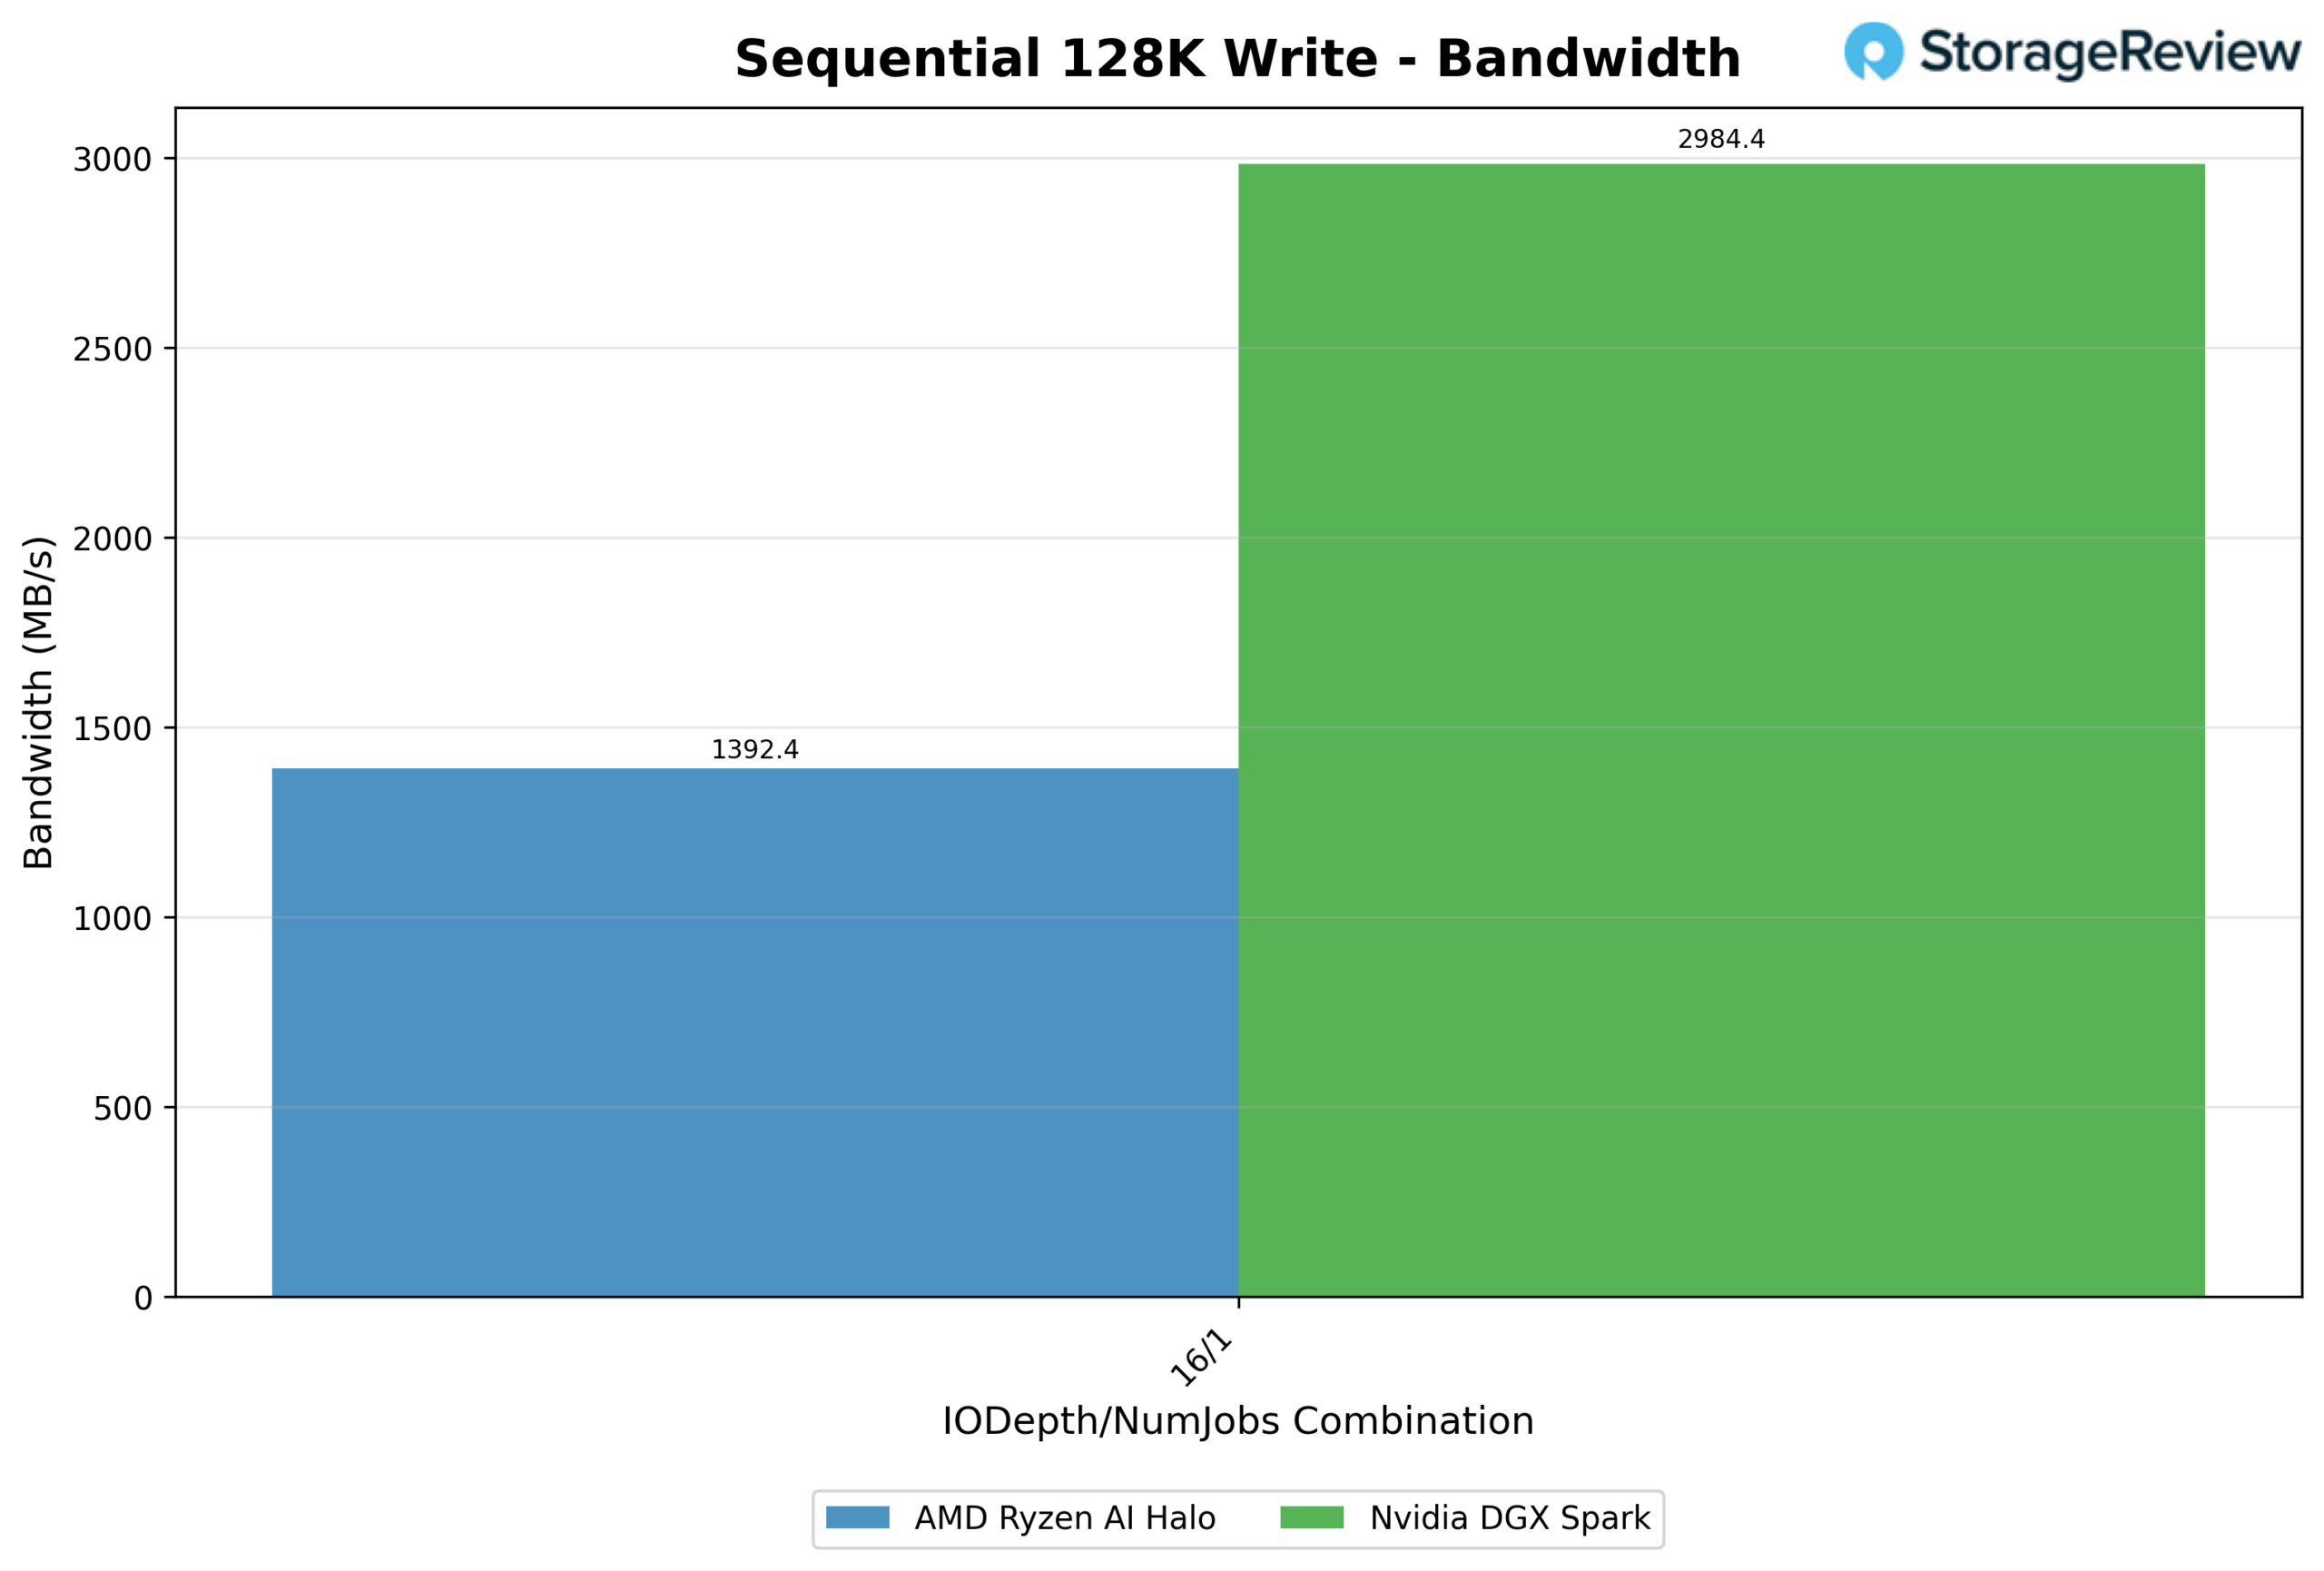
O lado da escrita conta uma história semelhante. Com IODepth 16/1, o Spark atingiu 2,984.4 MB/s, em comparação com os 1,392.4 MB/s do Halo, uma vantagem de 114% para a NVIDIA. A latência também favoreceu o Spark, com 0.67 ms contra 1.436 ms do Halo. Combinando com os resultados de leitura, o desempenho sequencial de 128K é, de longe, o melhor do Spark em relação ao Halo.
Leitura aleatória 64K
É aqui que a vantagem de latência do Halo em filas de baixa profundidade realmente se destaca. Com uma fila de 1/1, o Halo respondeu em apenas 0.051 ms, contra 0.275 ms do Spark, mais de 5 vezes mais rápido para uma única solicitação pendente. Essa diferença se mantém em filas de profundidade baixa a média, com o Halo registrando latência bem abaixo de 0.2 ms, enquanto o Spark oscila entre 0.2 e 0.45 ms durante a maior parte do teste.
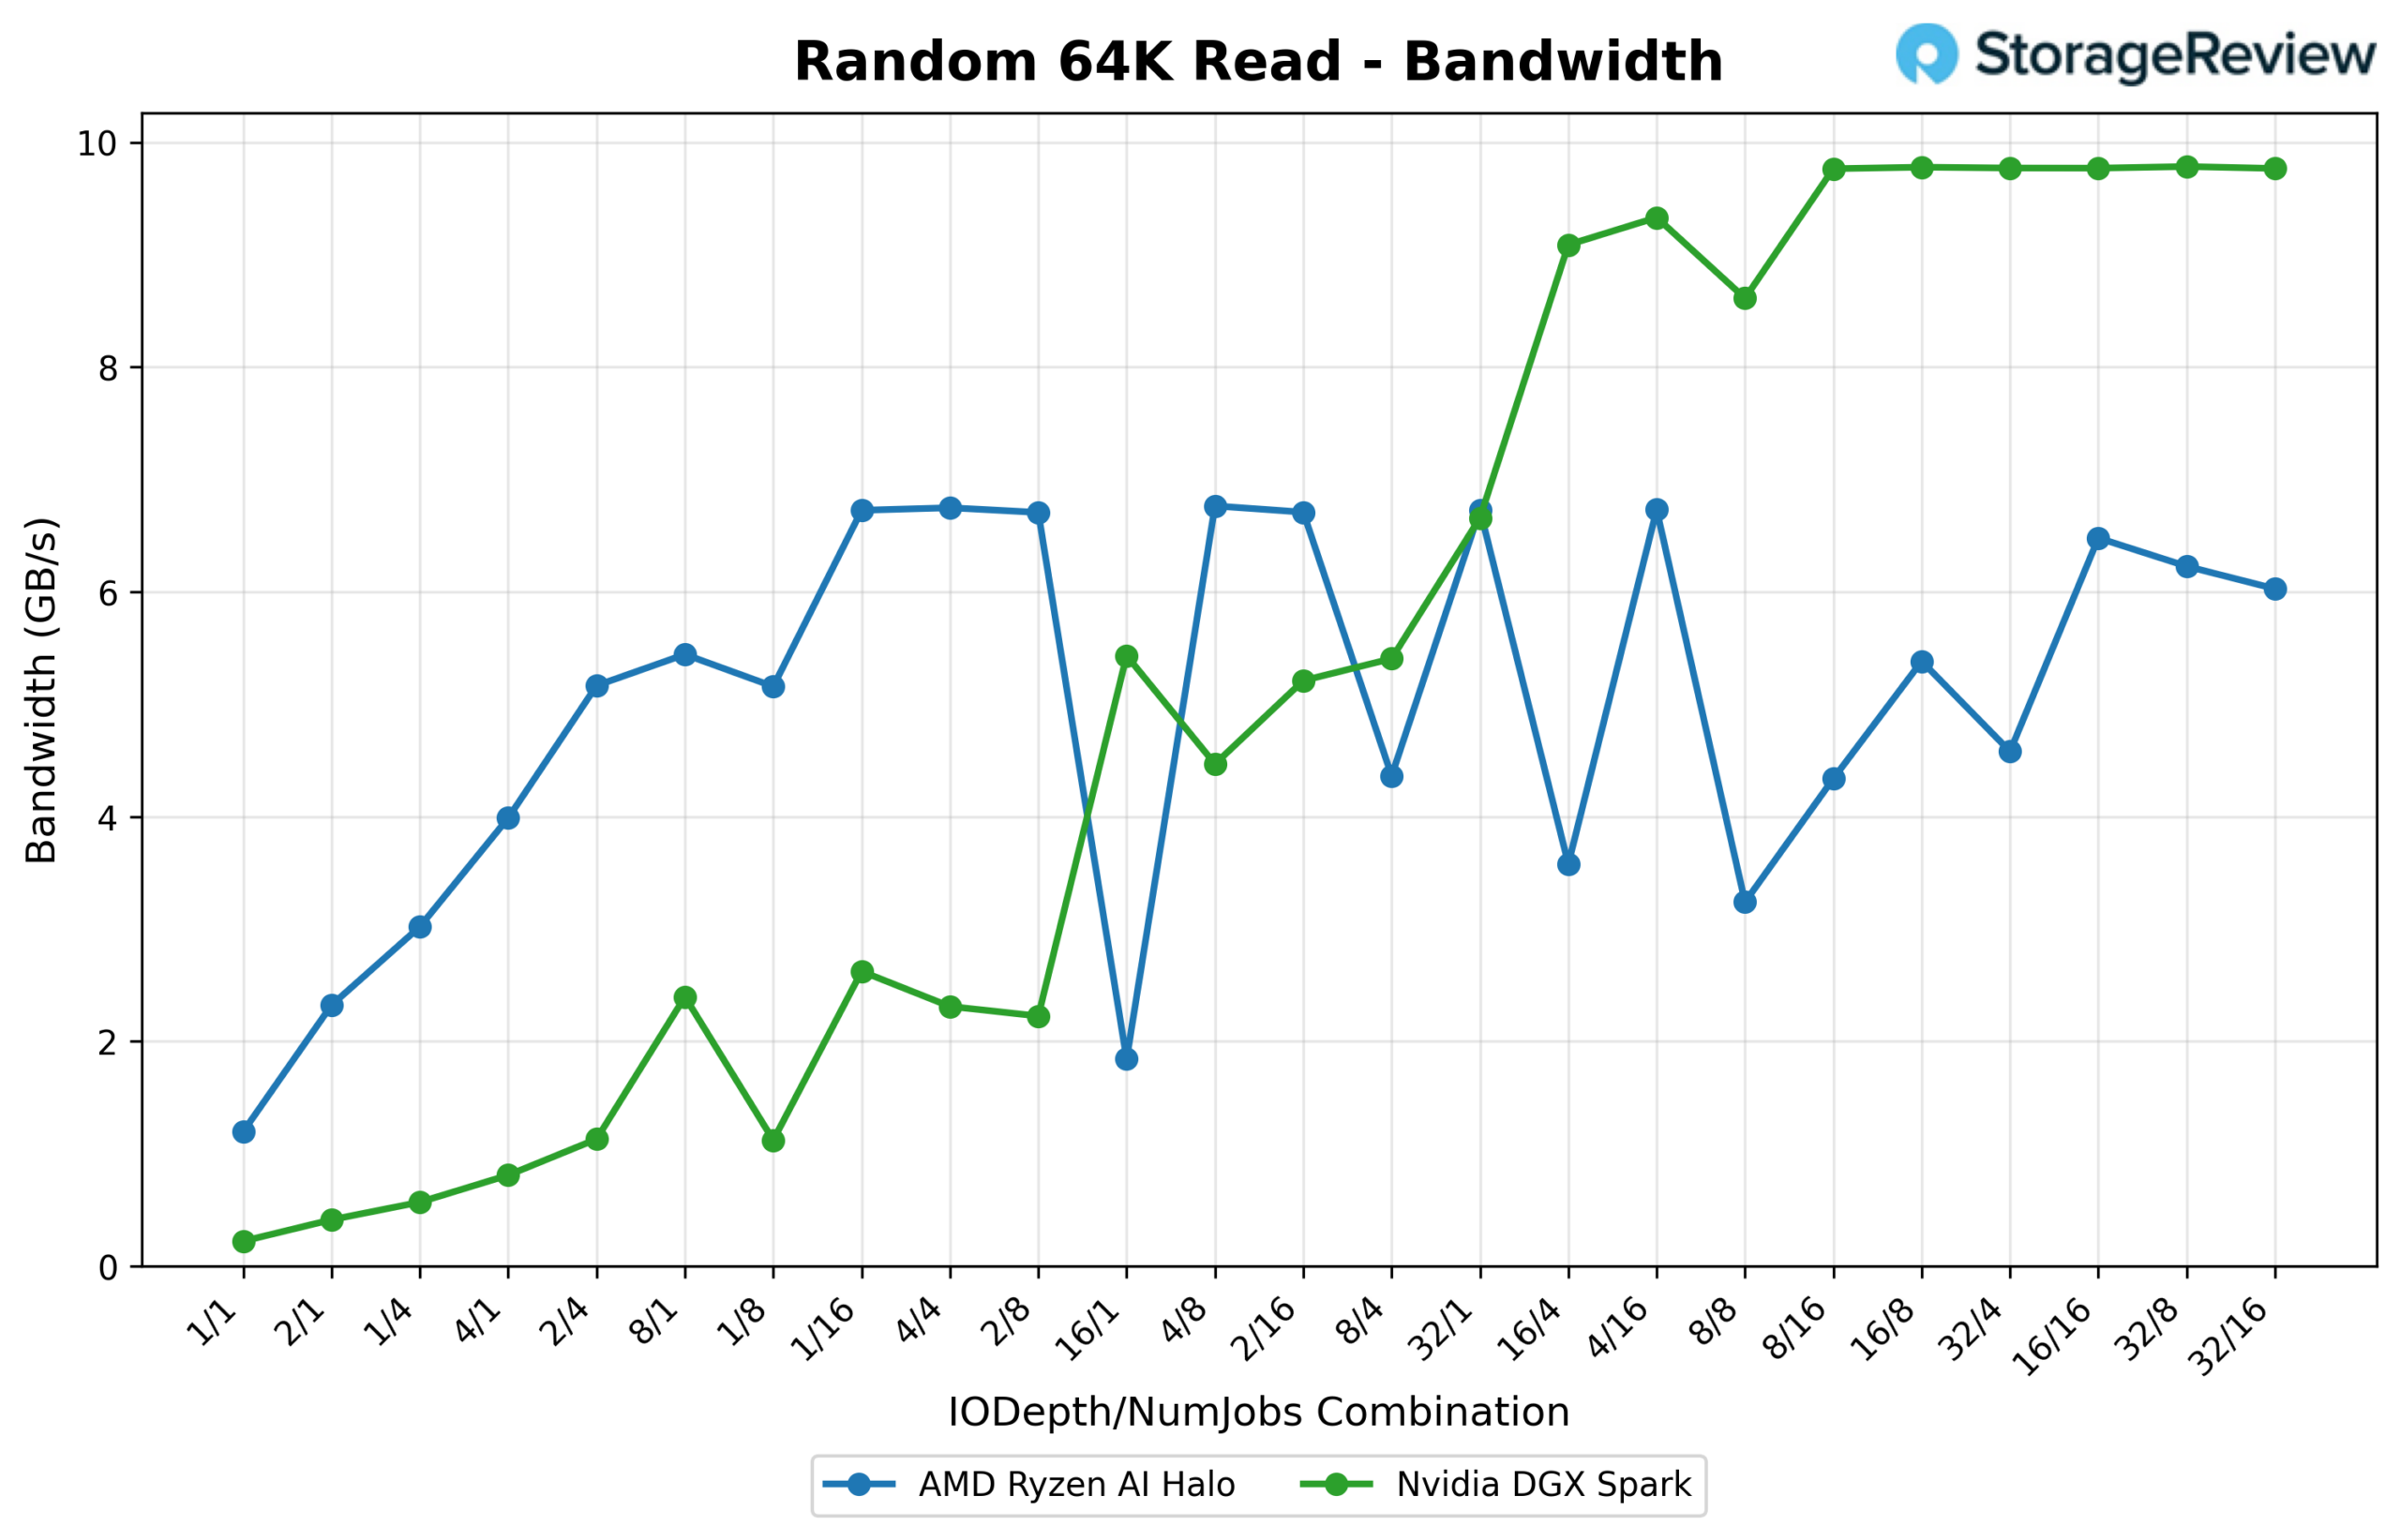
A situação muda completamente em grande escala. À medida que a profundidade da fila e a contagem de threads ultrapassam aproximadamente 16/4, a largura de banda do Spark se estabiliza em torno de 9.8 GB/s a partir de 8/16, atingindo um pico de 10,019.1 MB/s (160.3 mil IOPS) em 32/8. O Halo nunca atinge esse limite: ele satura na faixa de 6.0 a 6.9 GB/s, com um pico de 6,926.5 MB/s (110.8 mil IOPS) em 4/8. Sua curva de largura de banda é visivelmente mais errática, oscilando entre aproximadamente 2 e 6.8 GB/s, dependendo da combinação de profundidade/número de threads, em vez de subir suavemente.
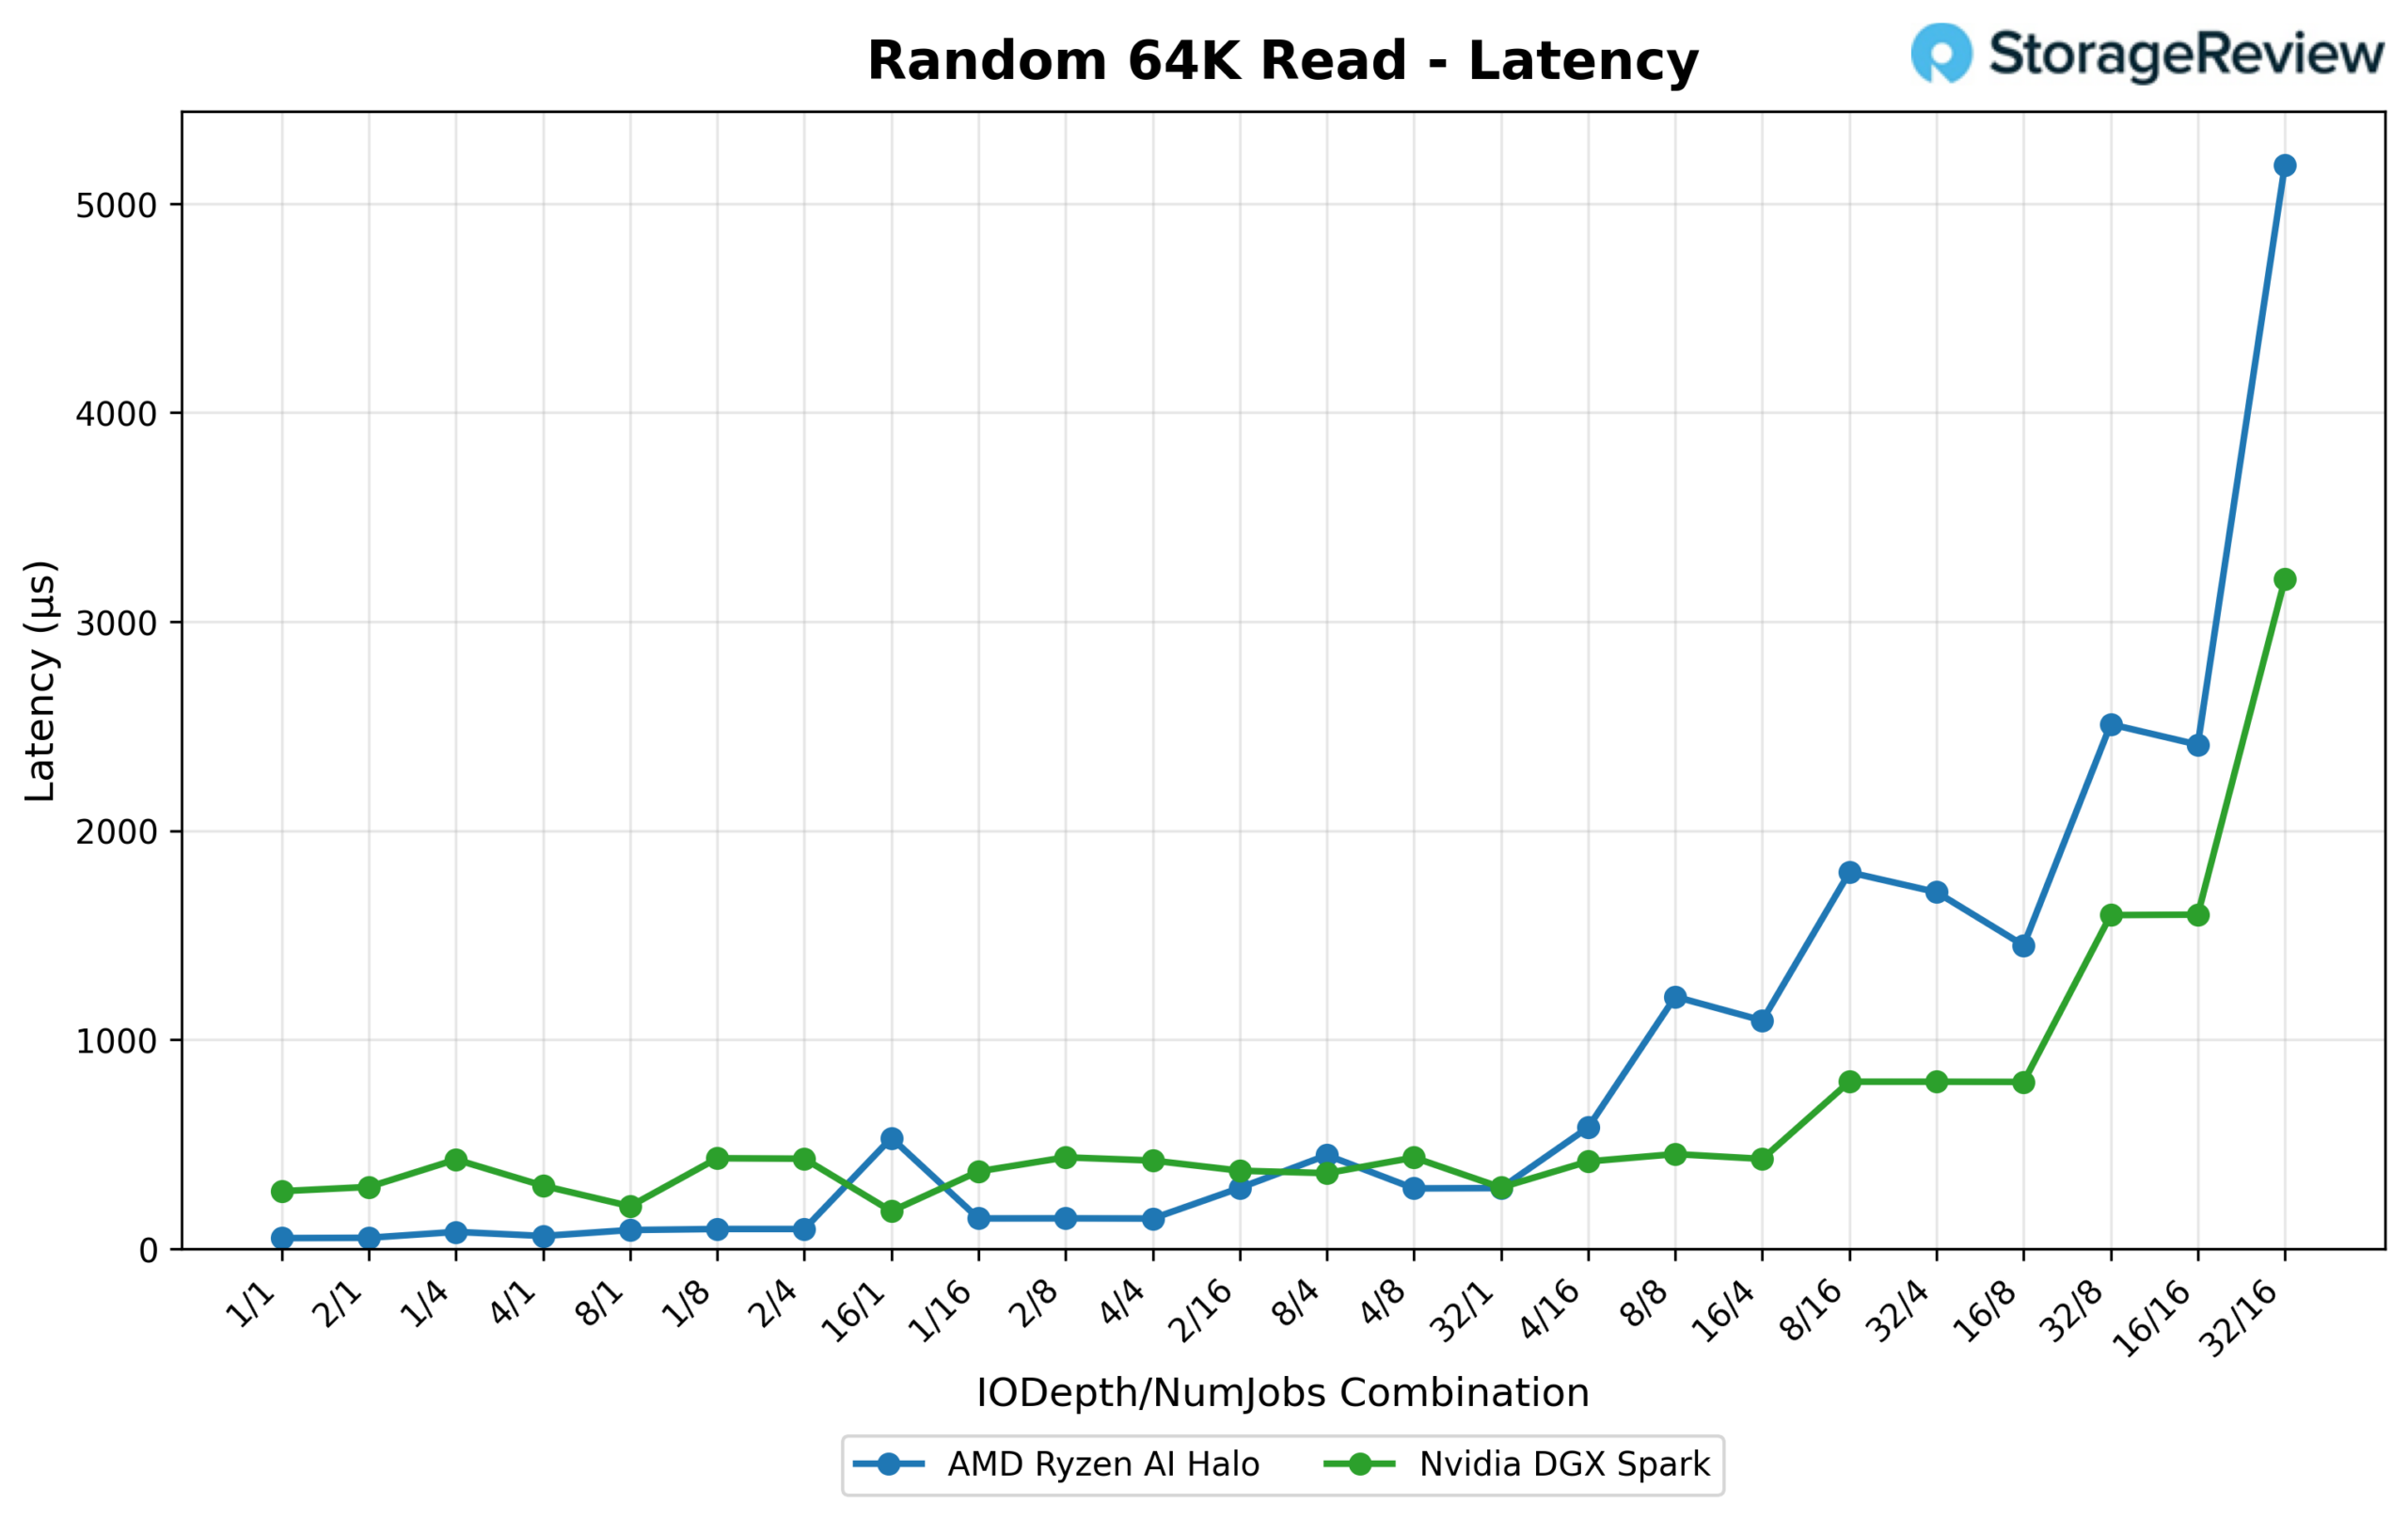
A latência em saturação total também favorece o Spark: com 32/16, a latência média do Halo sobe para 5.185 ms, em comparação com os 3.204 ms do Spark, o que significa que o Halo paga por sua baixa capacidade de resposta em filas com um comportamento pior na cauda da fila quando esta está totalmente carregada.
Gravação aleatória 64K
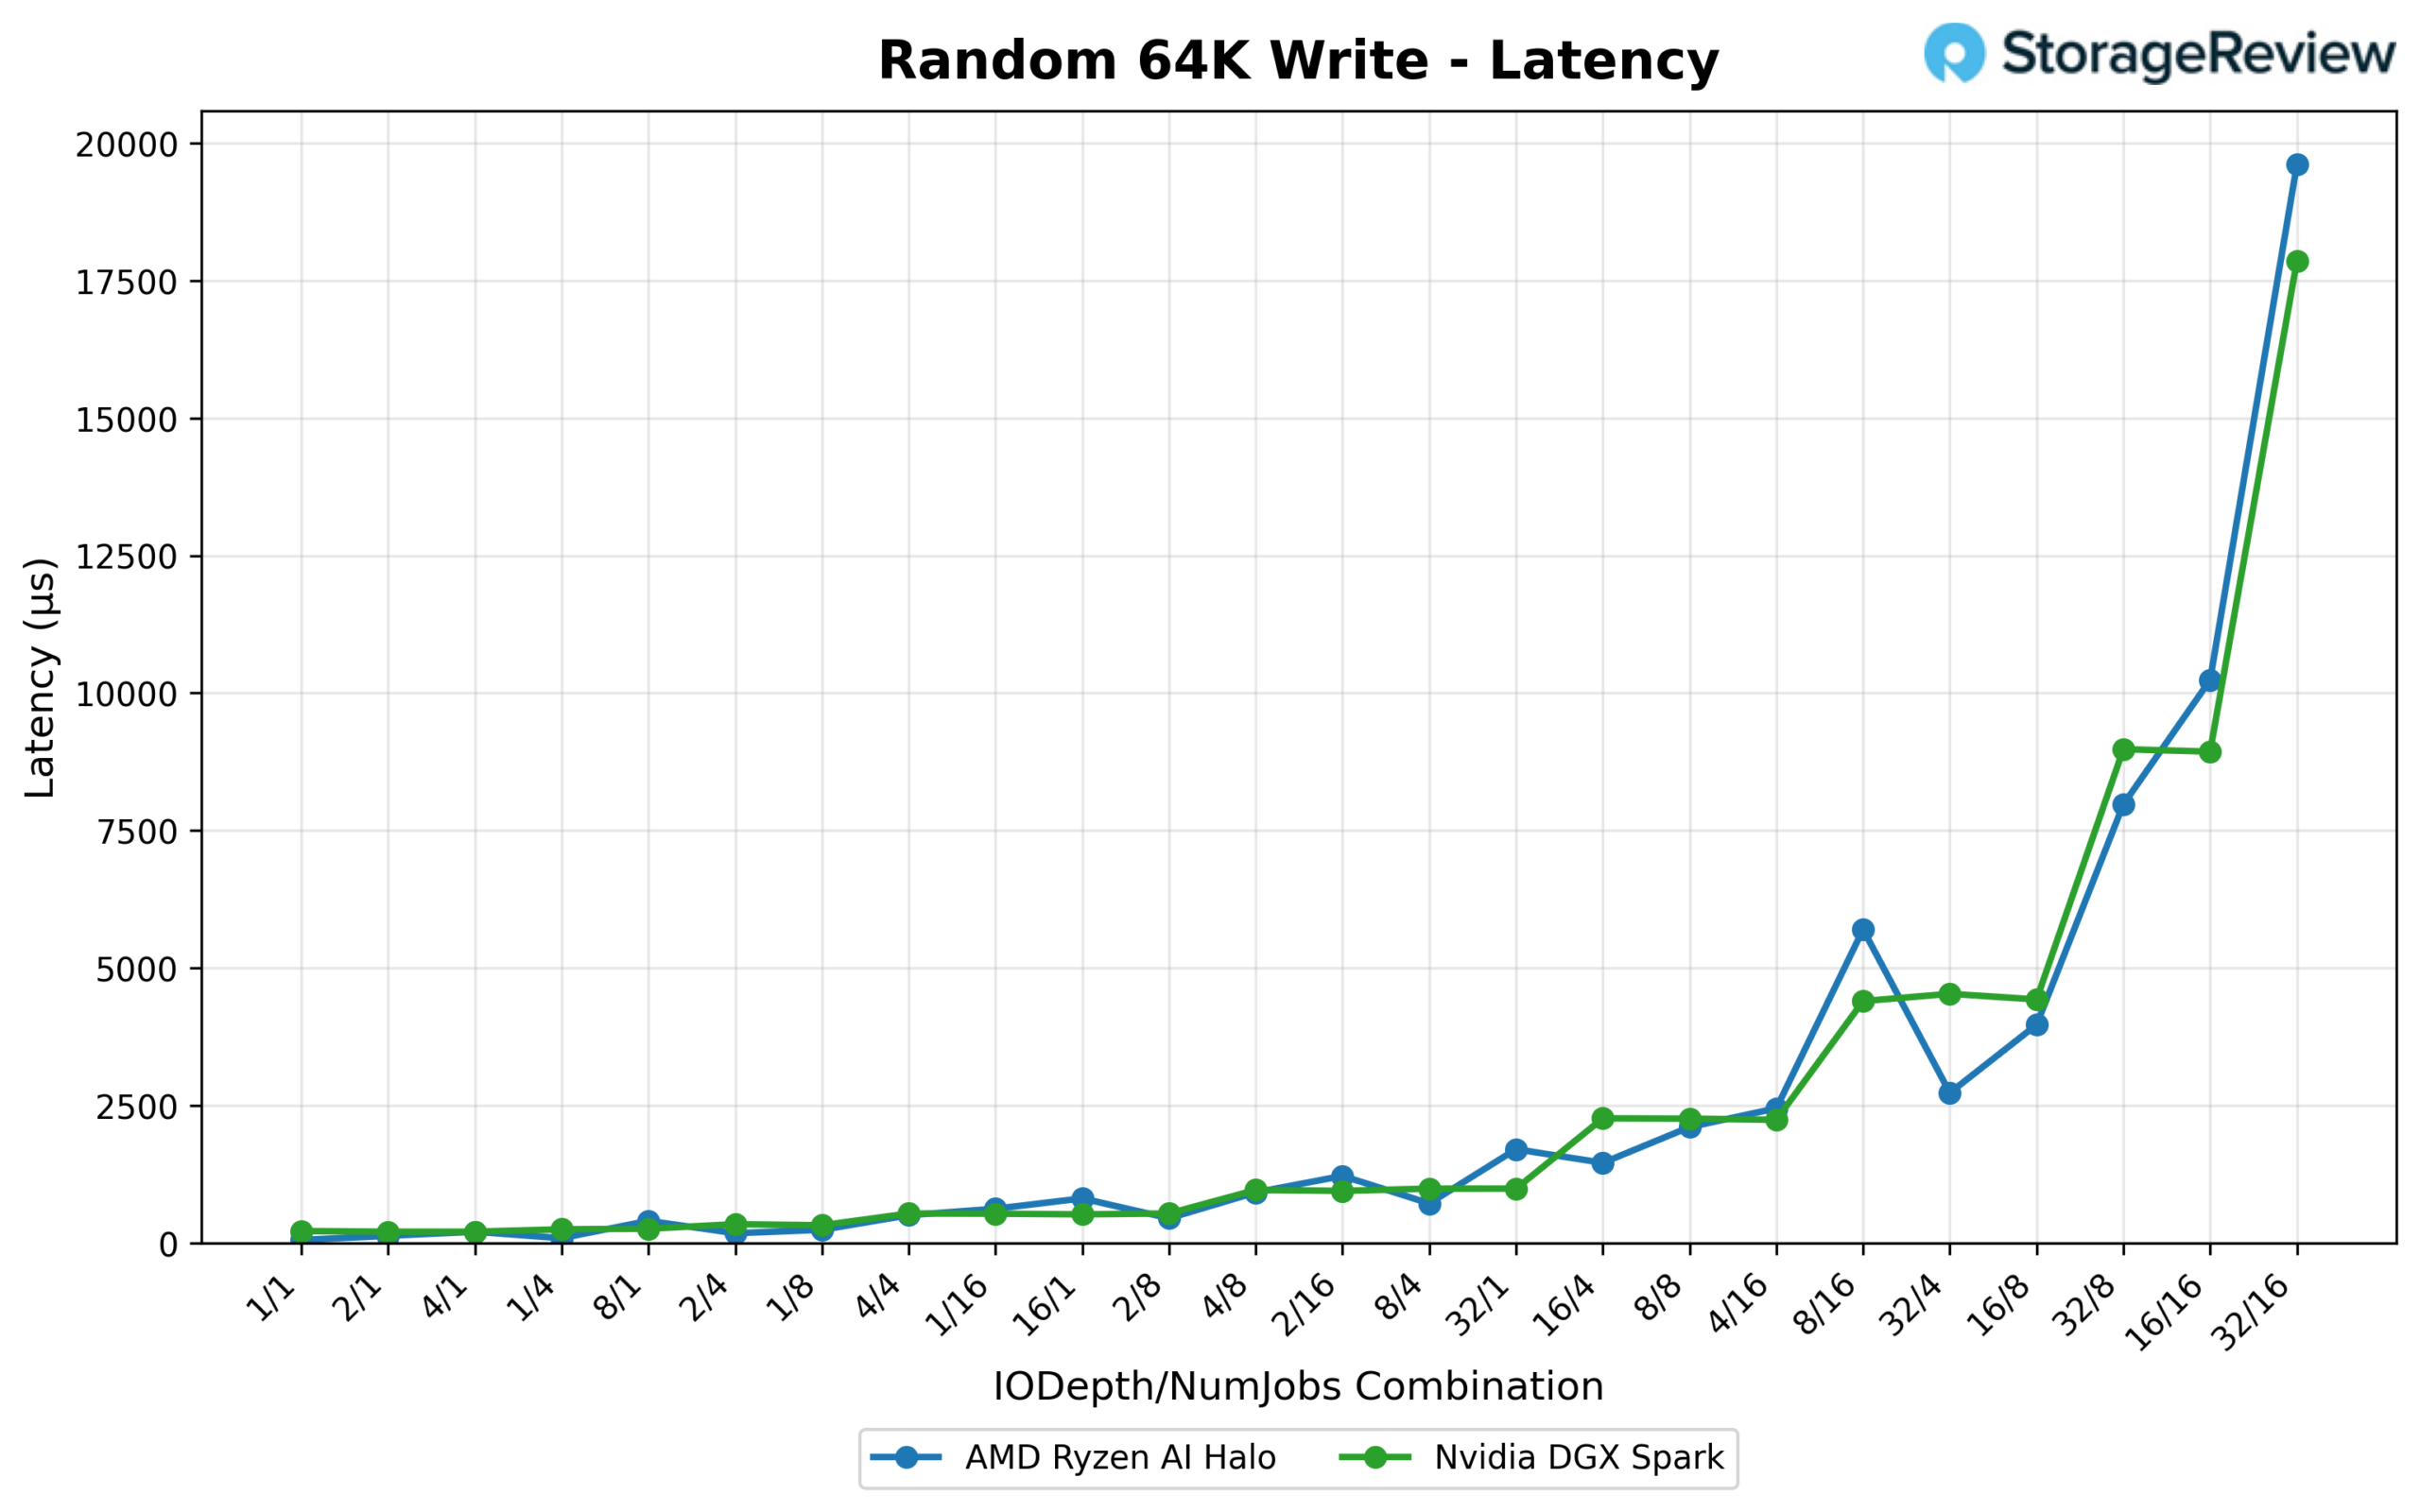
A largura de banda de escrita aleatória de 64 KB é mais próxima entre as duas plataformas do que a largura de banda de leitura, embora os formatos das curvas sejam muito diferentes. A largura de banda do Halo é mais instável: ela salta repetidamente acima de 2.5 GB/s (atingindo um pico de 2,929.1 MB/s / 46.9 mil IOPS em 32/4) antes de cair de volta para a faixa de 1.1 a 1.5 GB/s em combinações adjacentes. O Spark é comparativamente mais estável, mantendo-se em uma faixa de 1.7 a 2.0 GB/s durante a maior parte da varredura e atingindo um pico de 2,106.6 MB/s (33.7 mil IOPS) em 2/16.
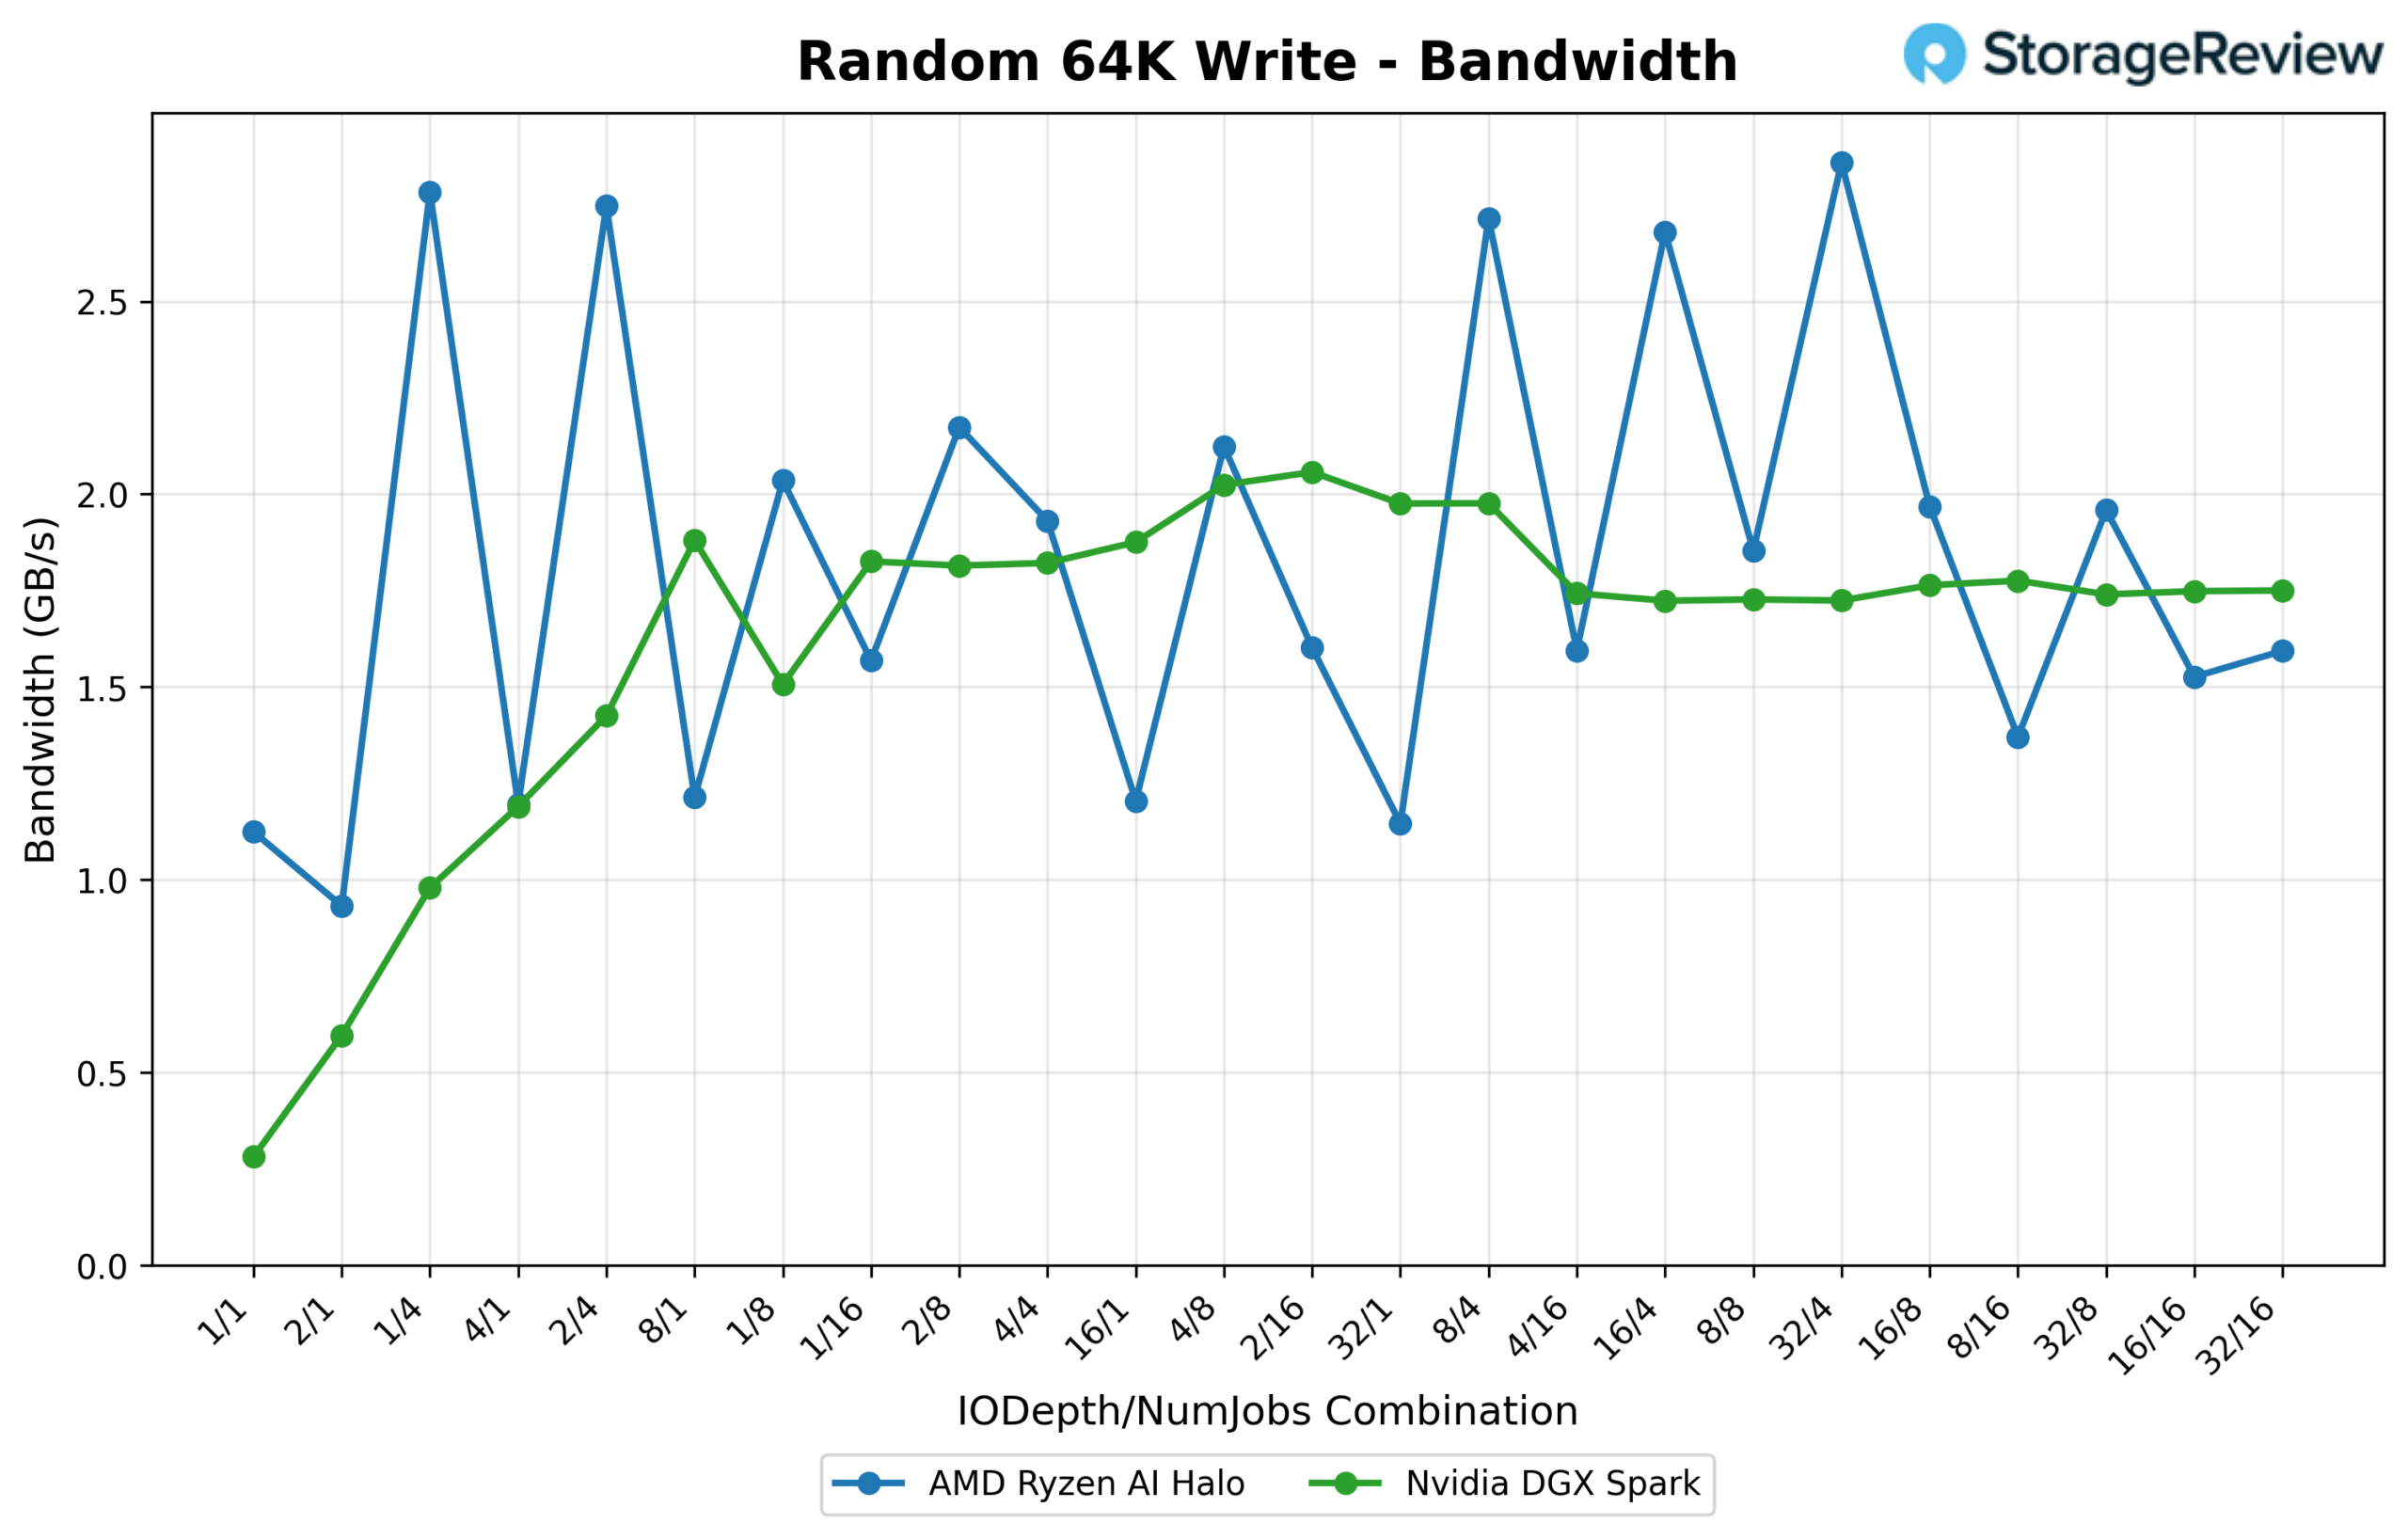
A latência reflete o padrão de leitura de 64K: o Halo é dramaticamente mais rápido com baixa profundidade de fila (0.054 ms em 1/1 contra 0.217 ms para o Spark), e ambos os drives apresentam forte degradação à medida que a profundidade da fila e a contagem de threads aumentam para dois dígitos. Com saturação total (32/16), a latência do Halo atinge 19.611 ms, em comparação com os 17.857 ms do Spark. Ambos os drives estão claramente sob forte estresse de amplificação de escrita neste ponto, com o Halo novamente apresentando desempenho ligeiramente pior no topo da curva.
Leitura sequencial de 16K
A largura de banda permanece alta durante a maior parte do teste, com ambos os drives apresentando variações entre aproximadamente 1 e 8 GB/s, dependendo da combinação de profundidade/threads. O Spark supera o pico mais alto, atingindo 8,069.3 MB/s (516.4 mil IOPS) em 32/1, enquanto o Halo alcança o máximo de 6,715.8 MB/s (429.8 mil IOPS) em 8/4.
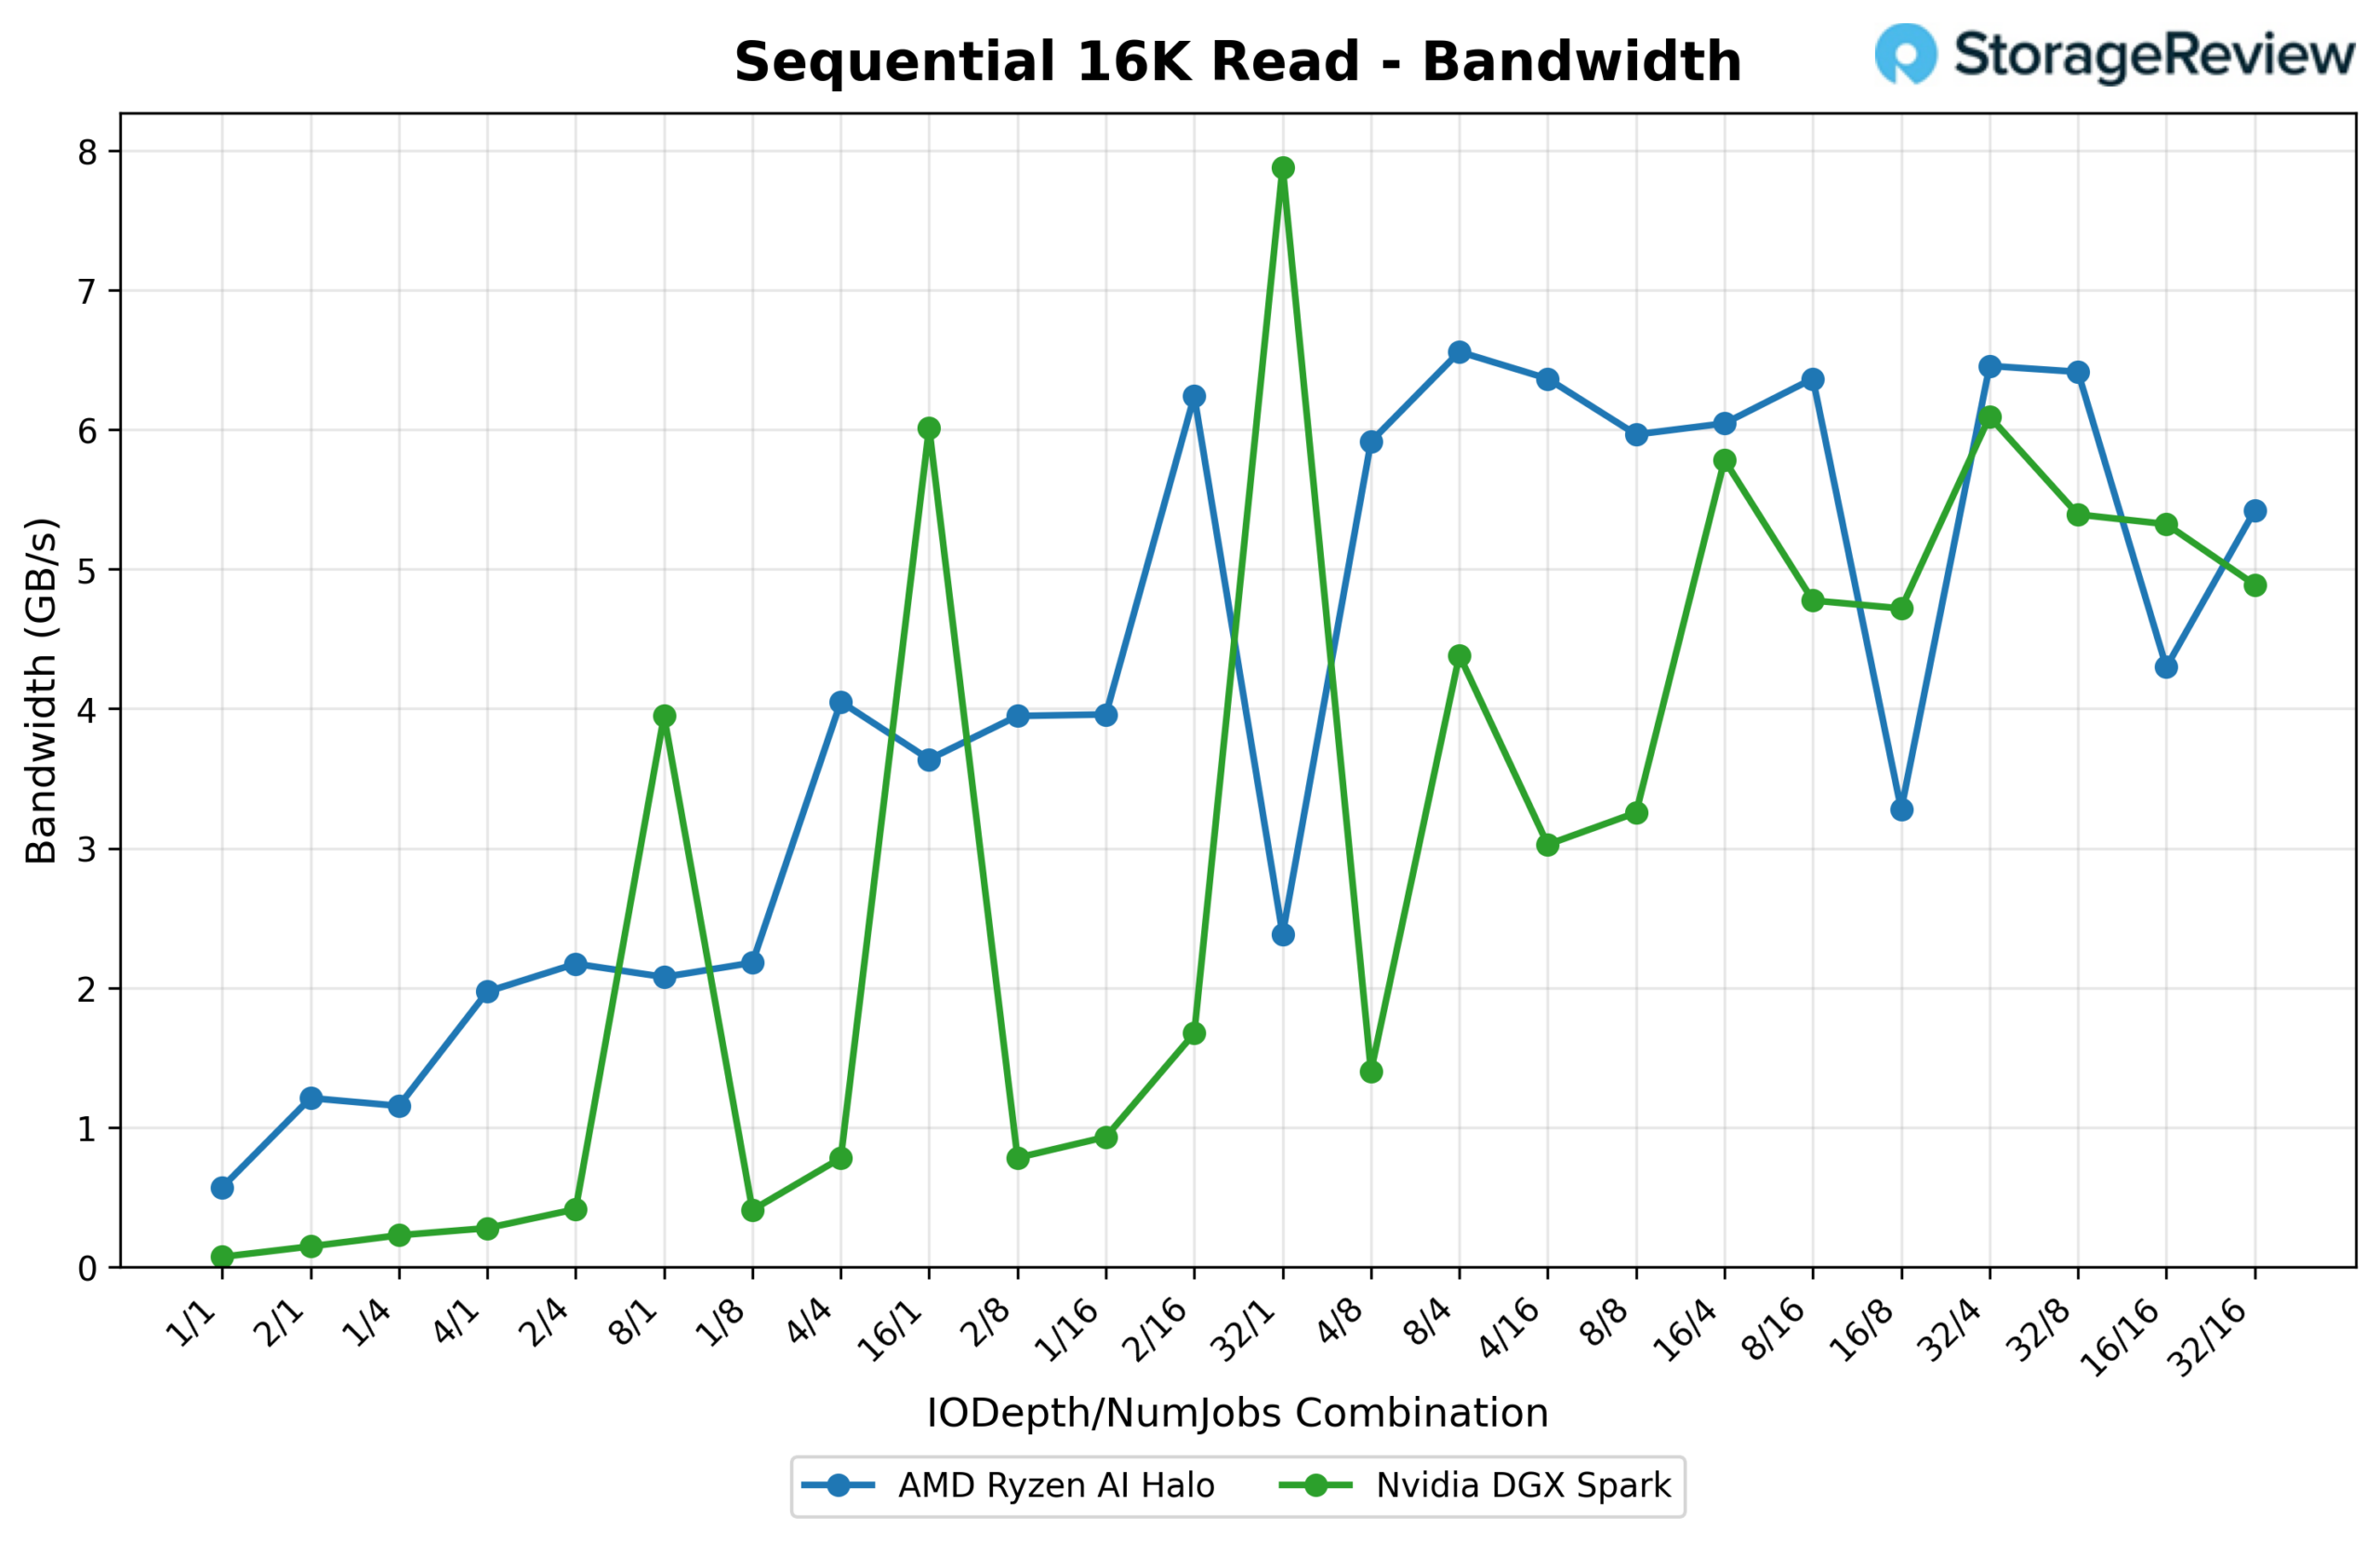
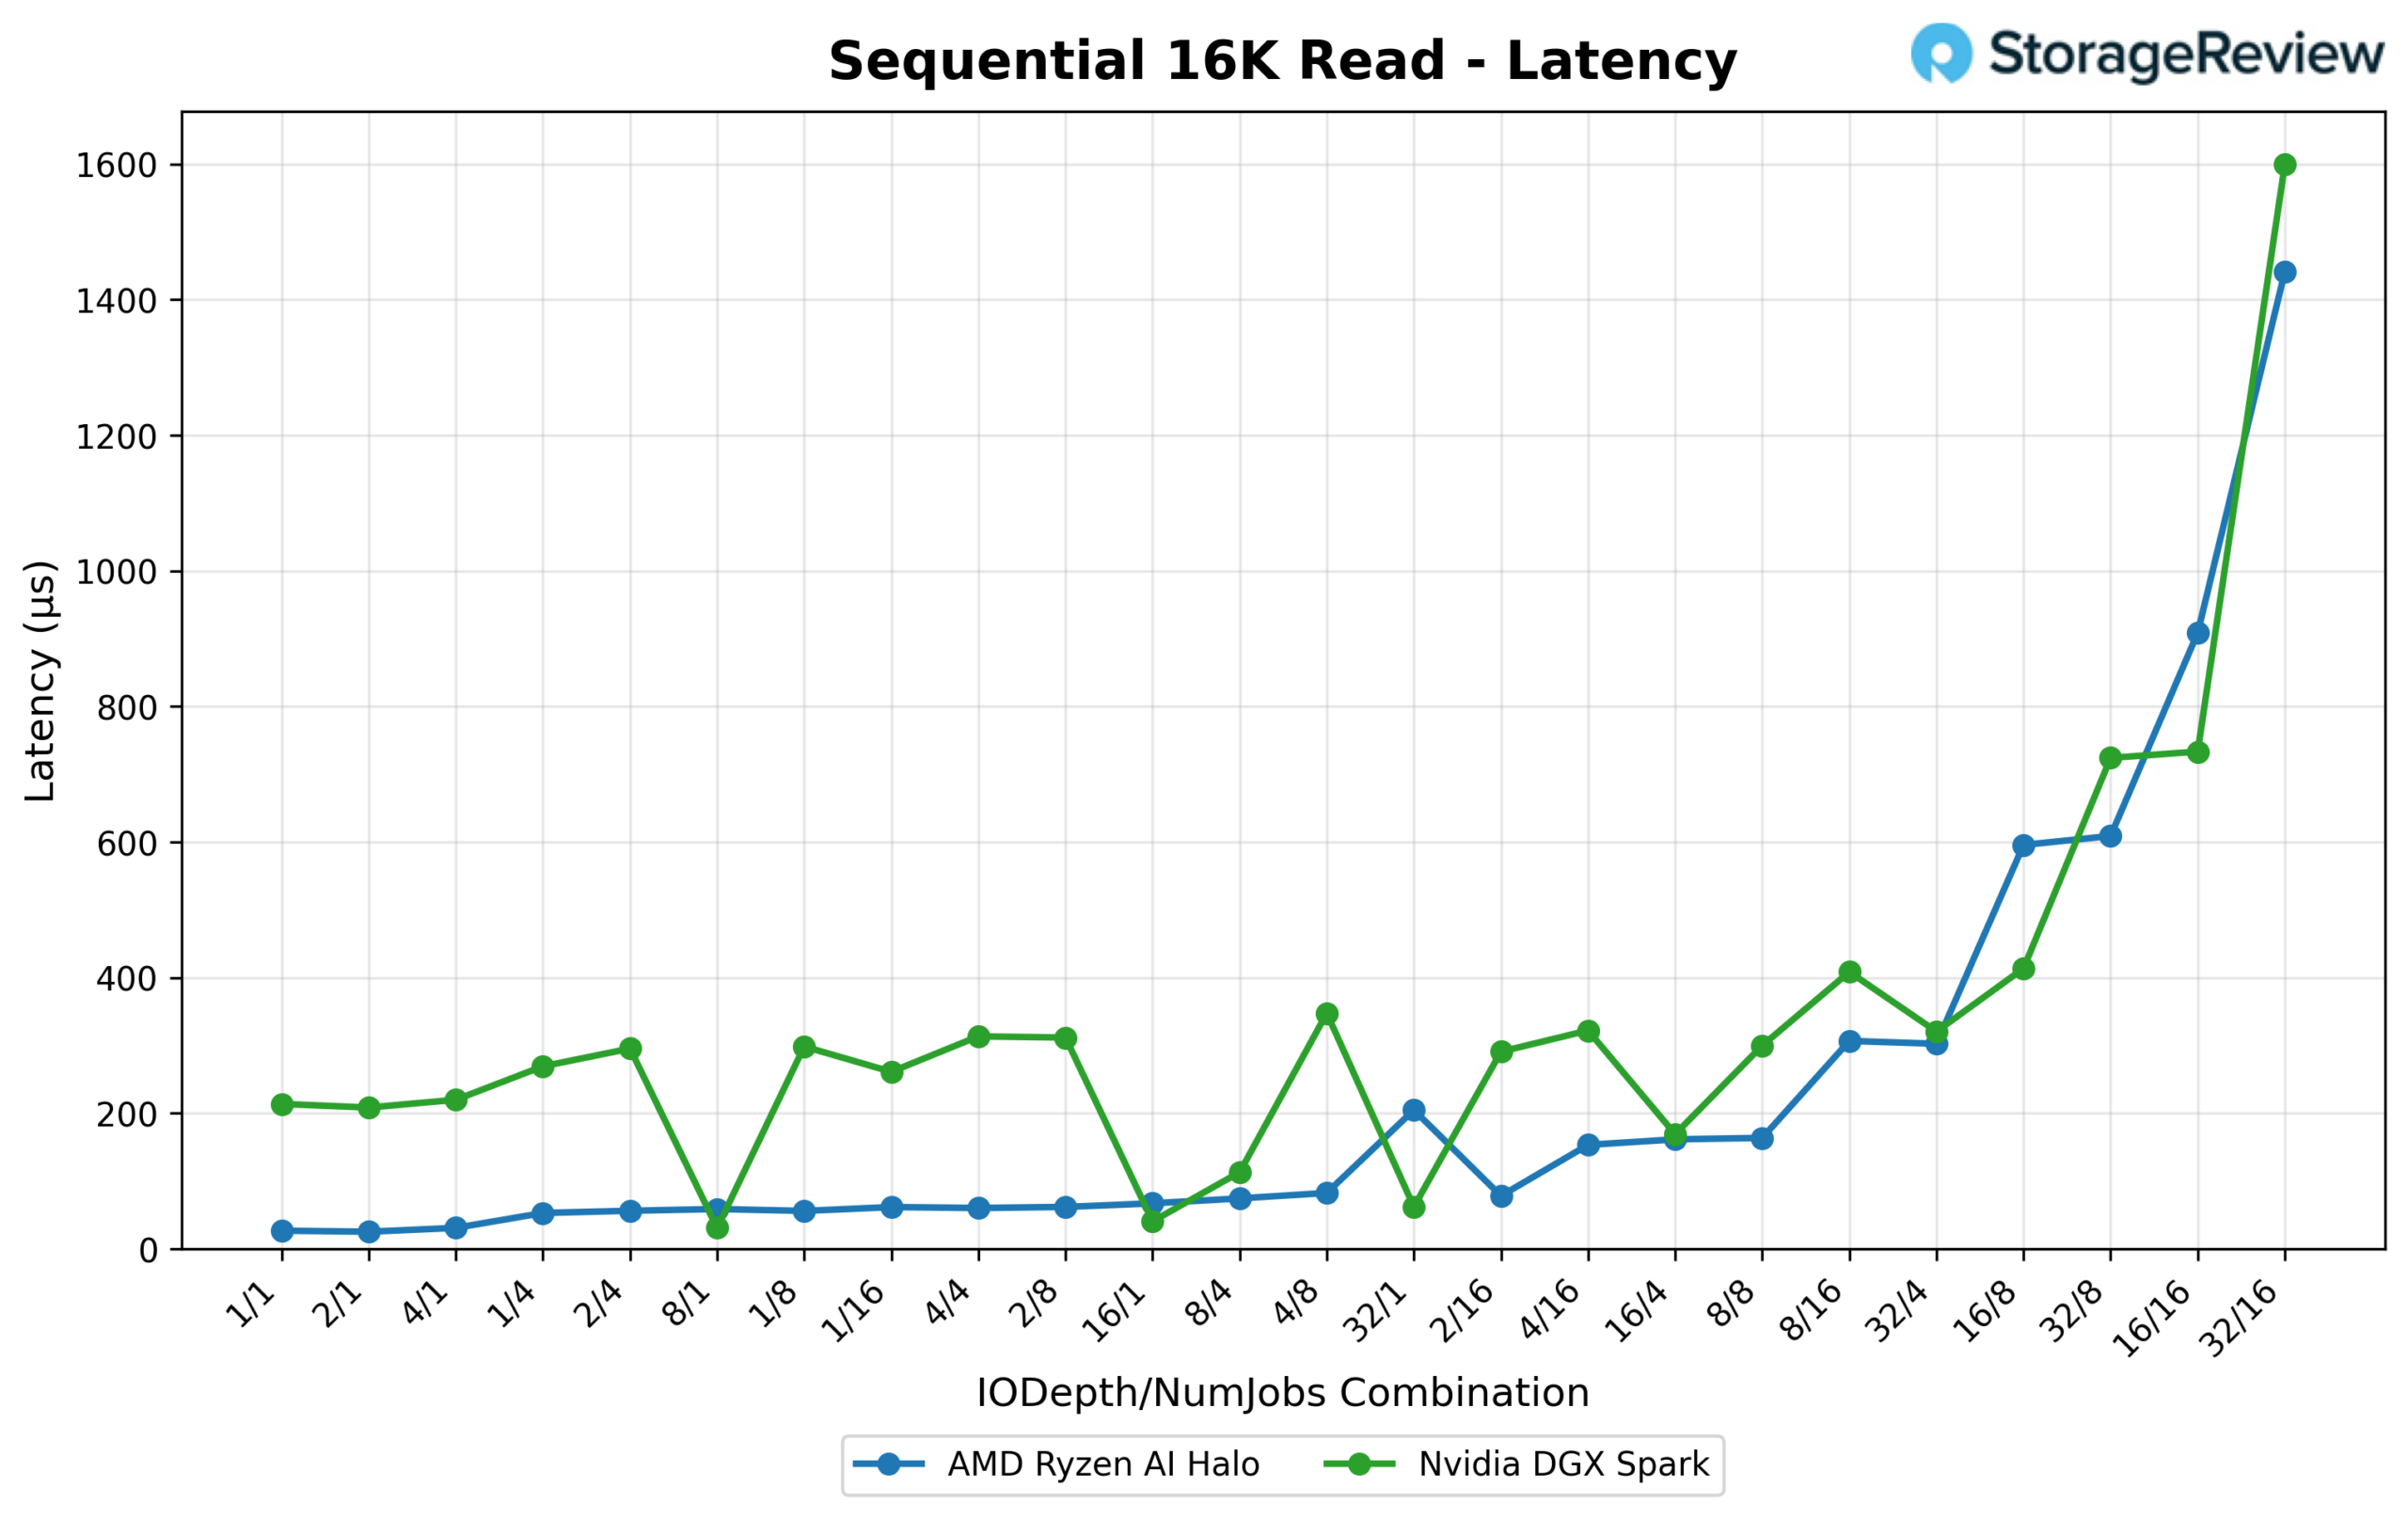
A latência favorece o Halo em todos os pontos, exceto no topo da fila. Na combinação 1/1, o Halo responde em 0.027 ms, contra 0.214 ms do Spark, e mantém uma latência menor durante a maior parte da varredura. Somente nas combinações mais complexas a diferença diminui. Na combinação 32/16, a latência média do Halo, de 1.441 ms, fica um pouco abaixo dos 1.599 ms do Spark, tornando este um dos poucos pontos em que a curva de latência do Halo não ultrapassa a do Spark na saturação.
Gravação sequencial de 16K
A largura de banda também é semelhante aqui: o Spark atinge um pico de 2,141.6 MB/s (137.1 mil IOPS) em 16/1, e o Halo não fica muito atrás, com 1,970.9 MB/s (126.1 mil IOPS) em 1/8.
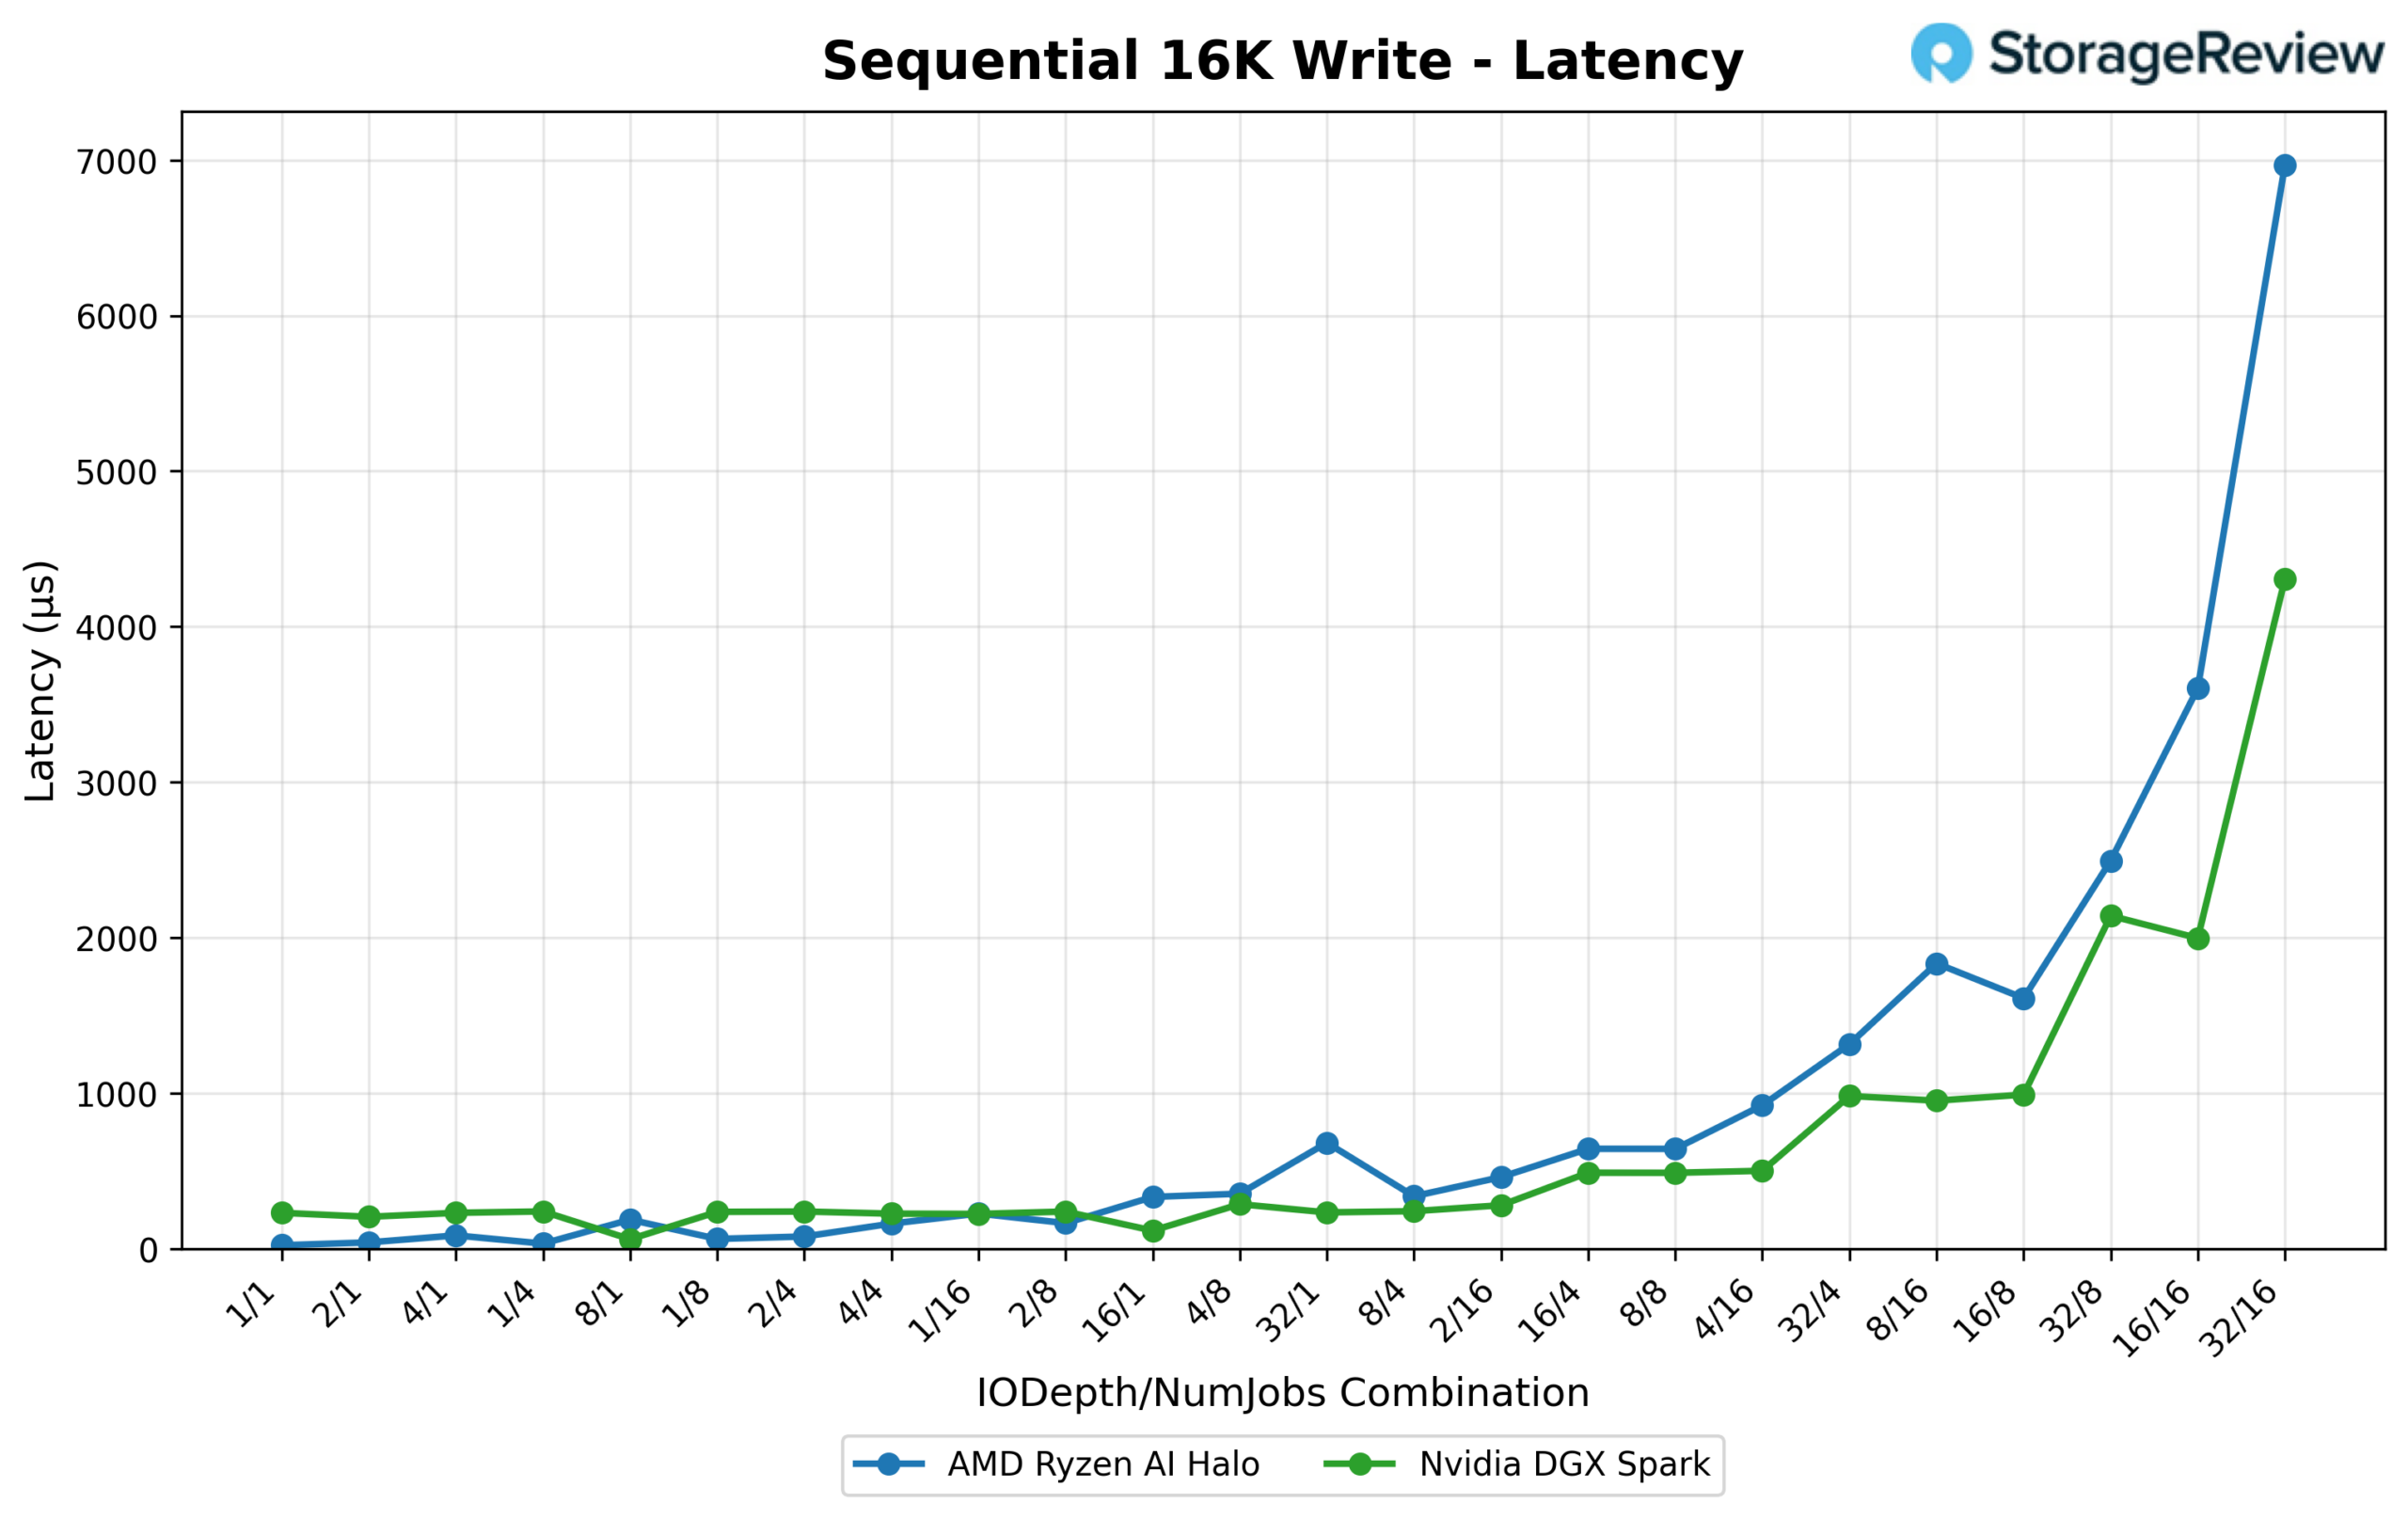
A latência é onde os dois divergem drasticamente. O Halo começa muito à frente com baixa profundidade de fila (0.022 ms em 1/1 contra 0.231 ms do Spark), mas sua curva de latência aumenta drasticamente à medida que a fila se enche. Em 32/16, a latência média do Halo sobe para 6.967 ms, bem acima dos 4.306 ms do Spark no mesmo ponto. A curva do Halo também é muito menos previsível ao longo do caminho, com picos acentuados em diversas combinações intermediárias, enquanto o Spark permanece comparativamente estável.
Leitura aleatória 16K
Este é um dos melhores desempenhos do Halo. Ele apresenta uma largura de banda máxima superior, de 6,609.4 MB/s (423.0 IOPS) em 32/16, em comparação com os 6,082.6 MB/s (389.3 IOPS) do Spark na mesma combinação.
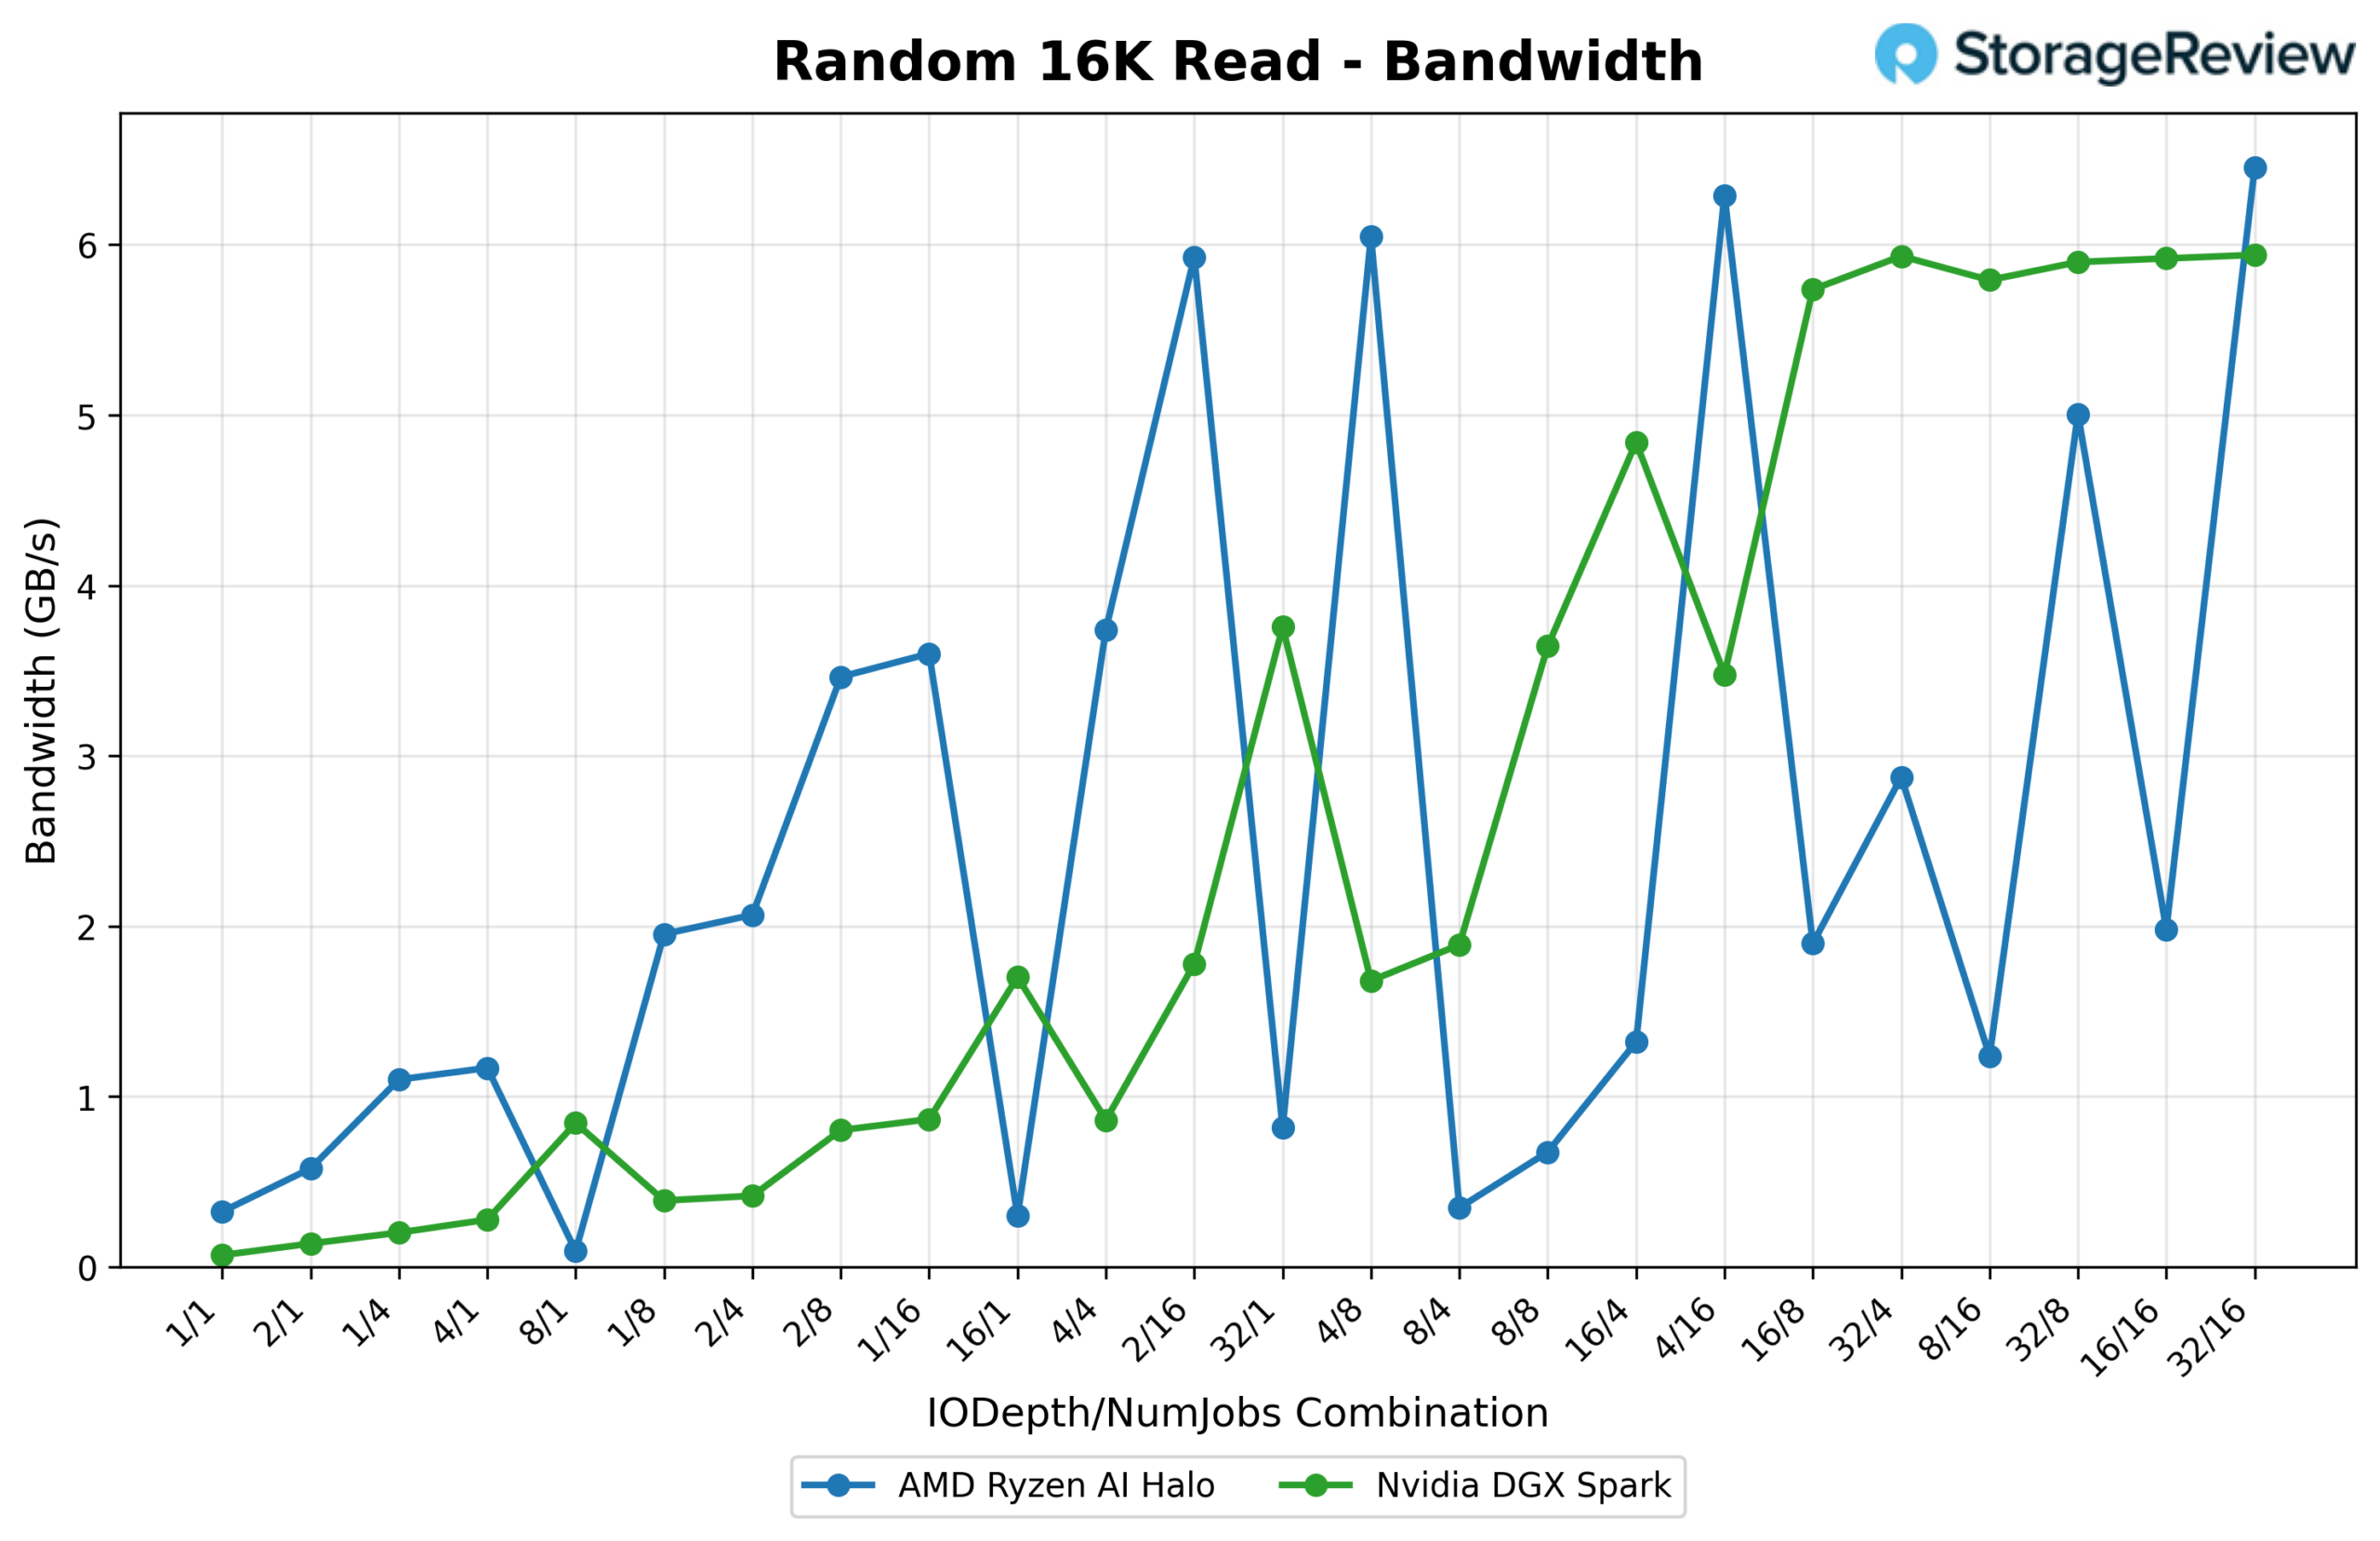
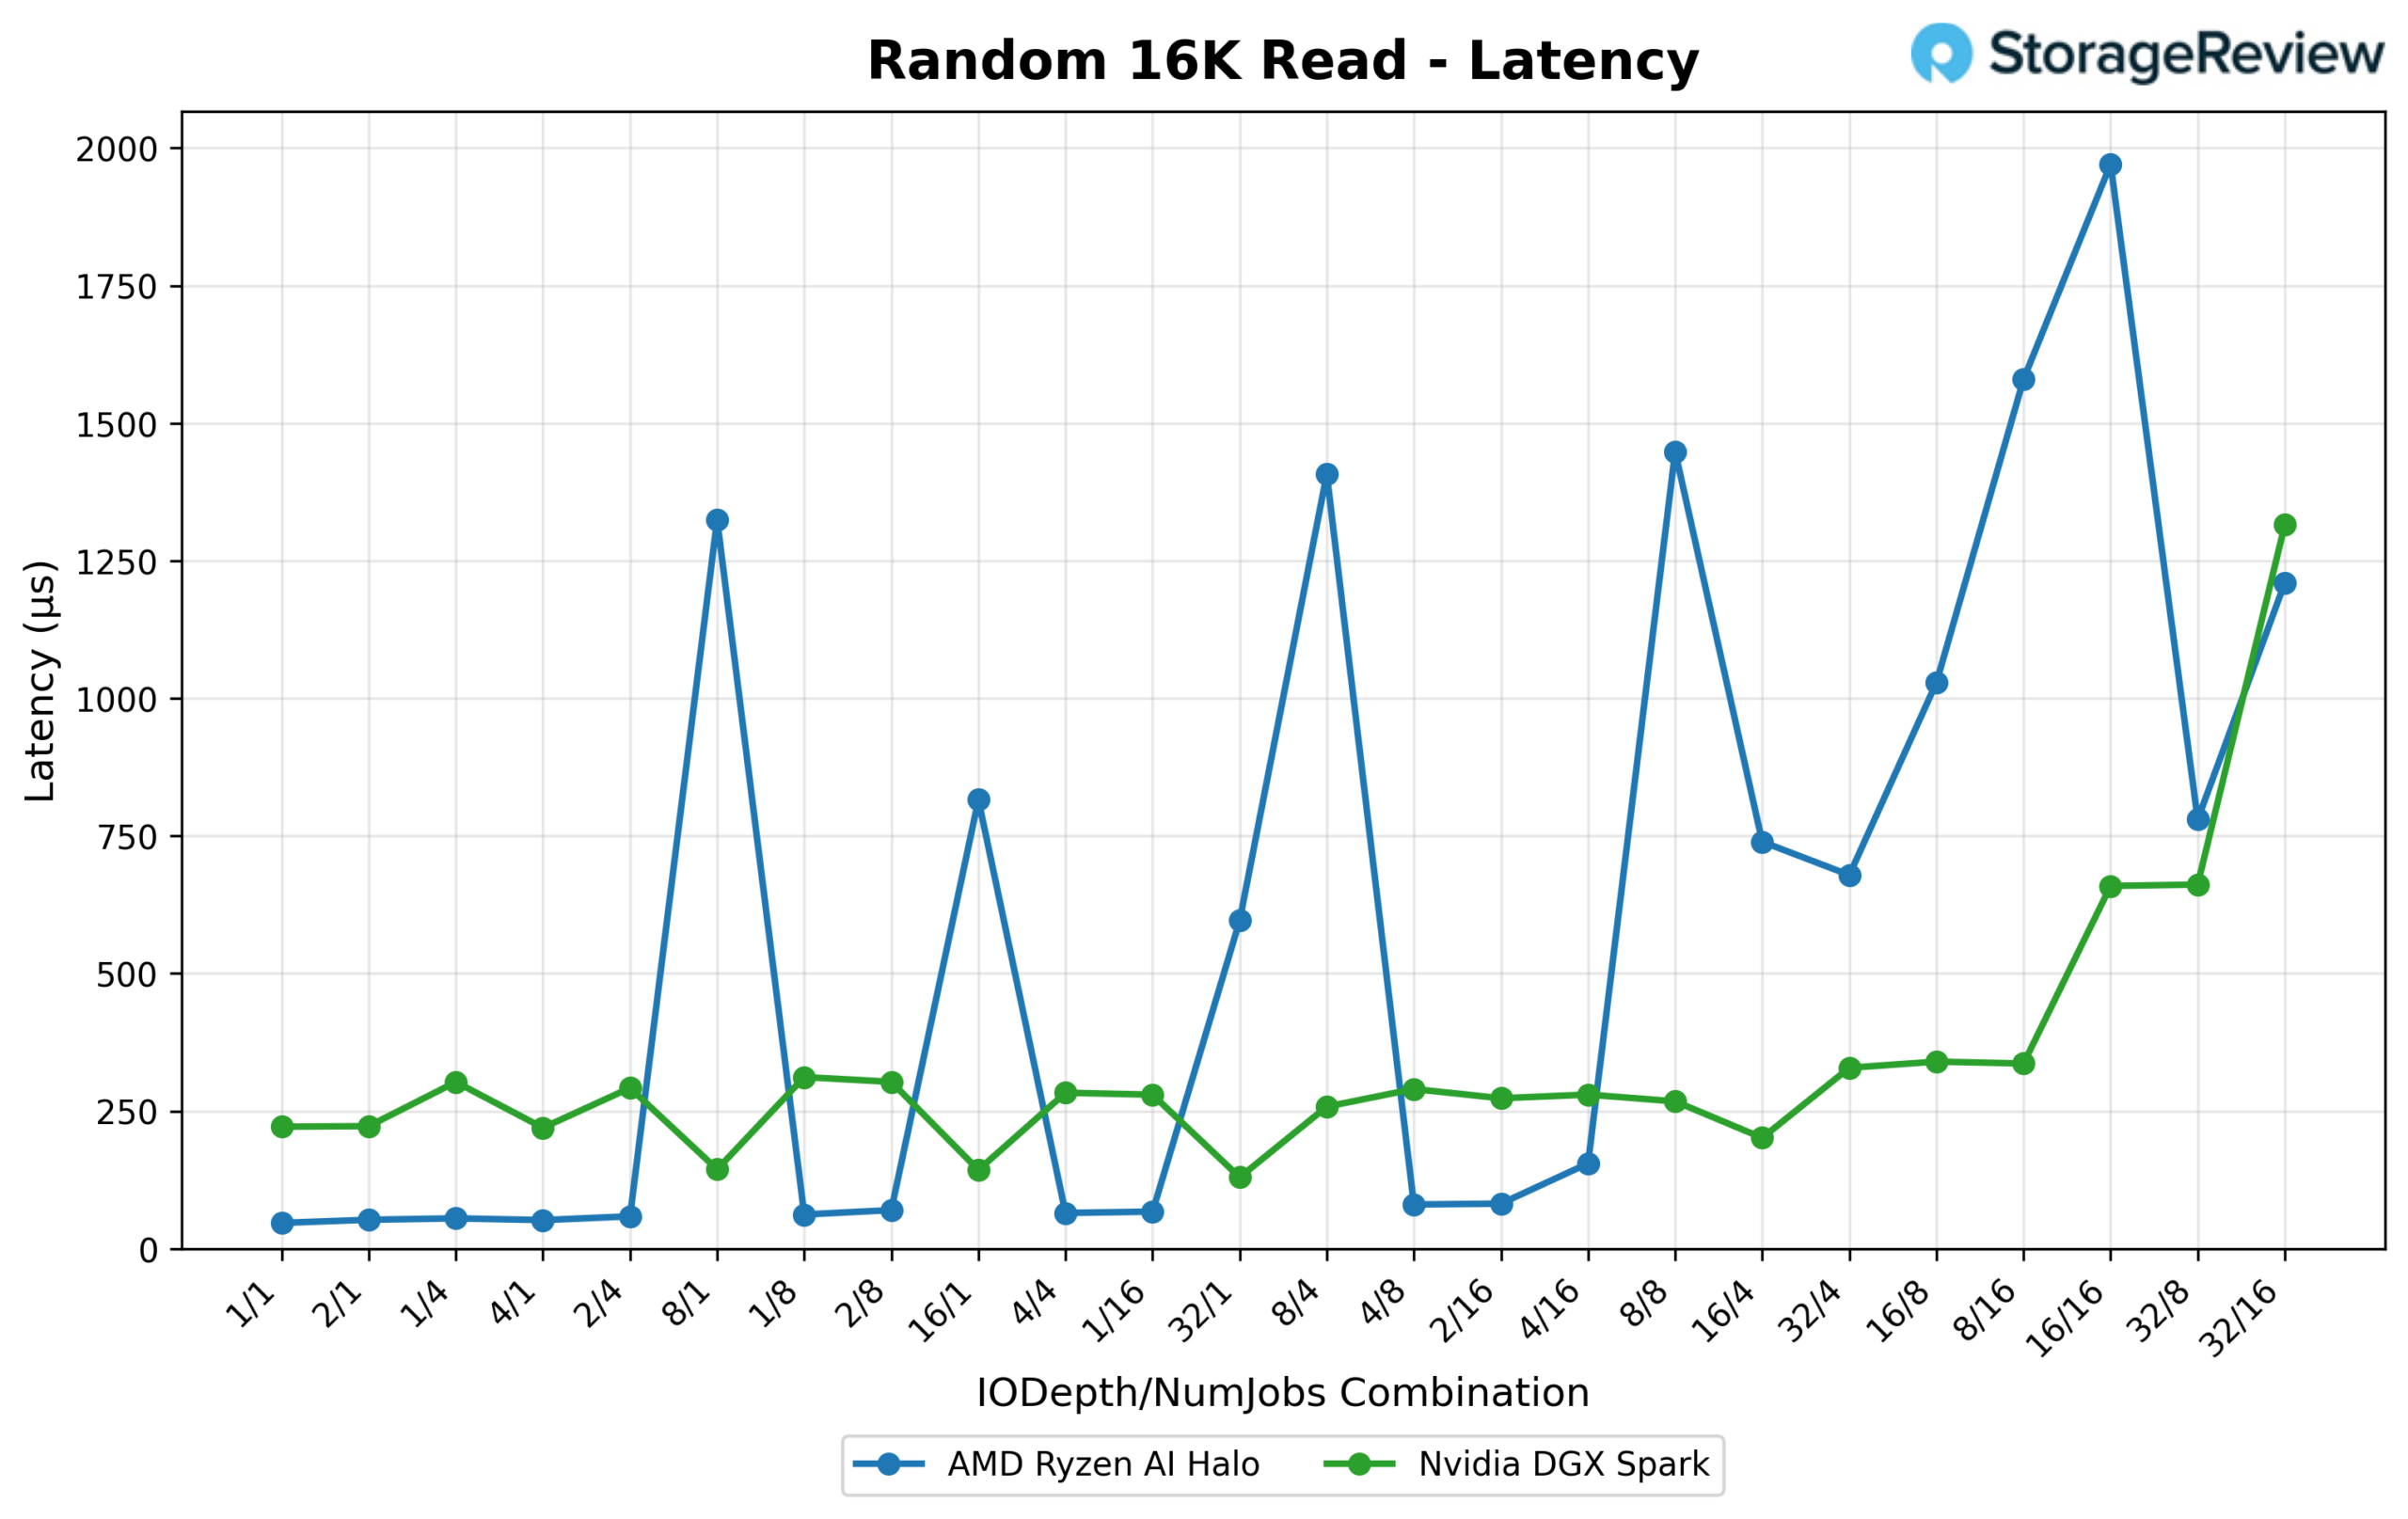
A latência começa novamente muito a favor do Halo (0.047 ms em 1/1 contra 0.222 ms para o Spark). Ainda assim, a curva de latência do Halo é muito mais volátil ao longo da varredura, com picos acentuados em 8/1, 16/1, 8/4 e 8/8 que ultrapassam em muito a curva comparativamente suave (embora com uma linha de base mais alta) do Spark. No topo da fila, a latência máxima do Halo de 1.971 ms (em 16/16) excede o pico do Spark de 1.315 ms (em 32/16), portanto, o Halo troca consistência por velocidade bruta em filas de baixa profundidade.
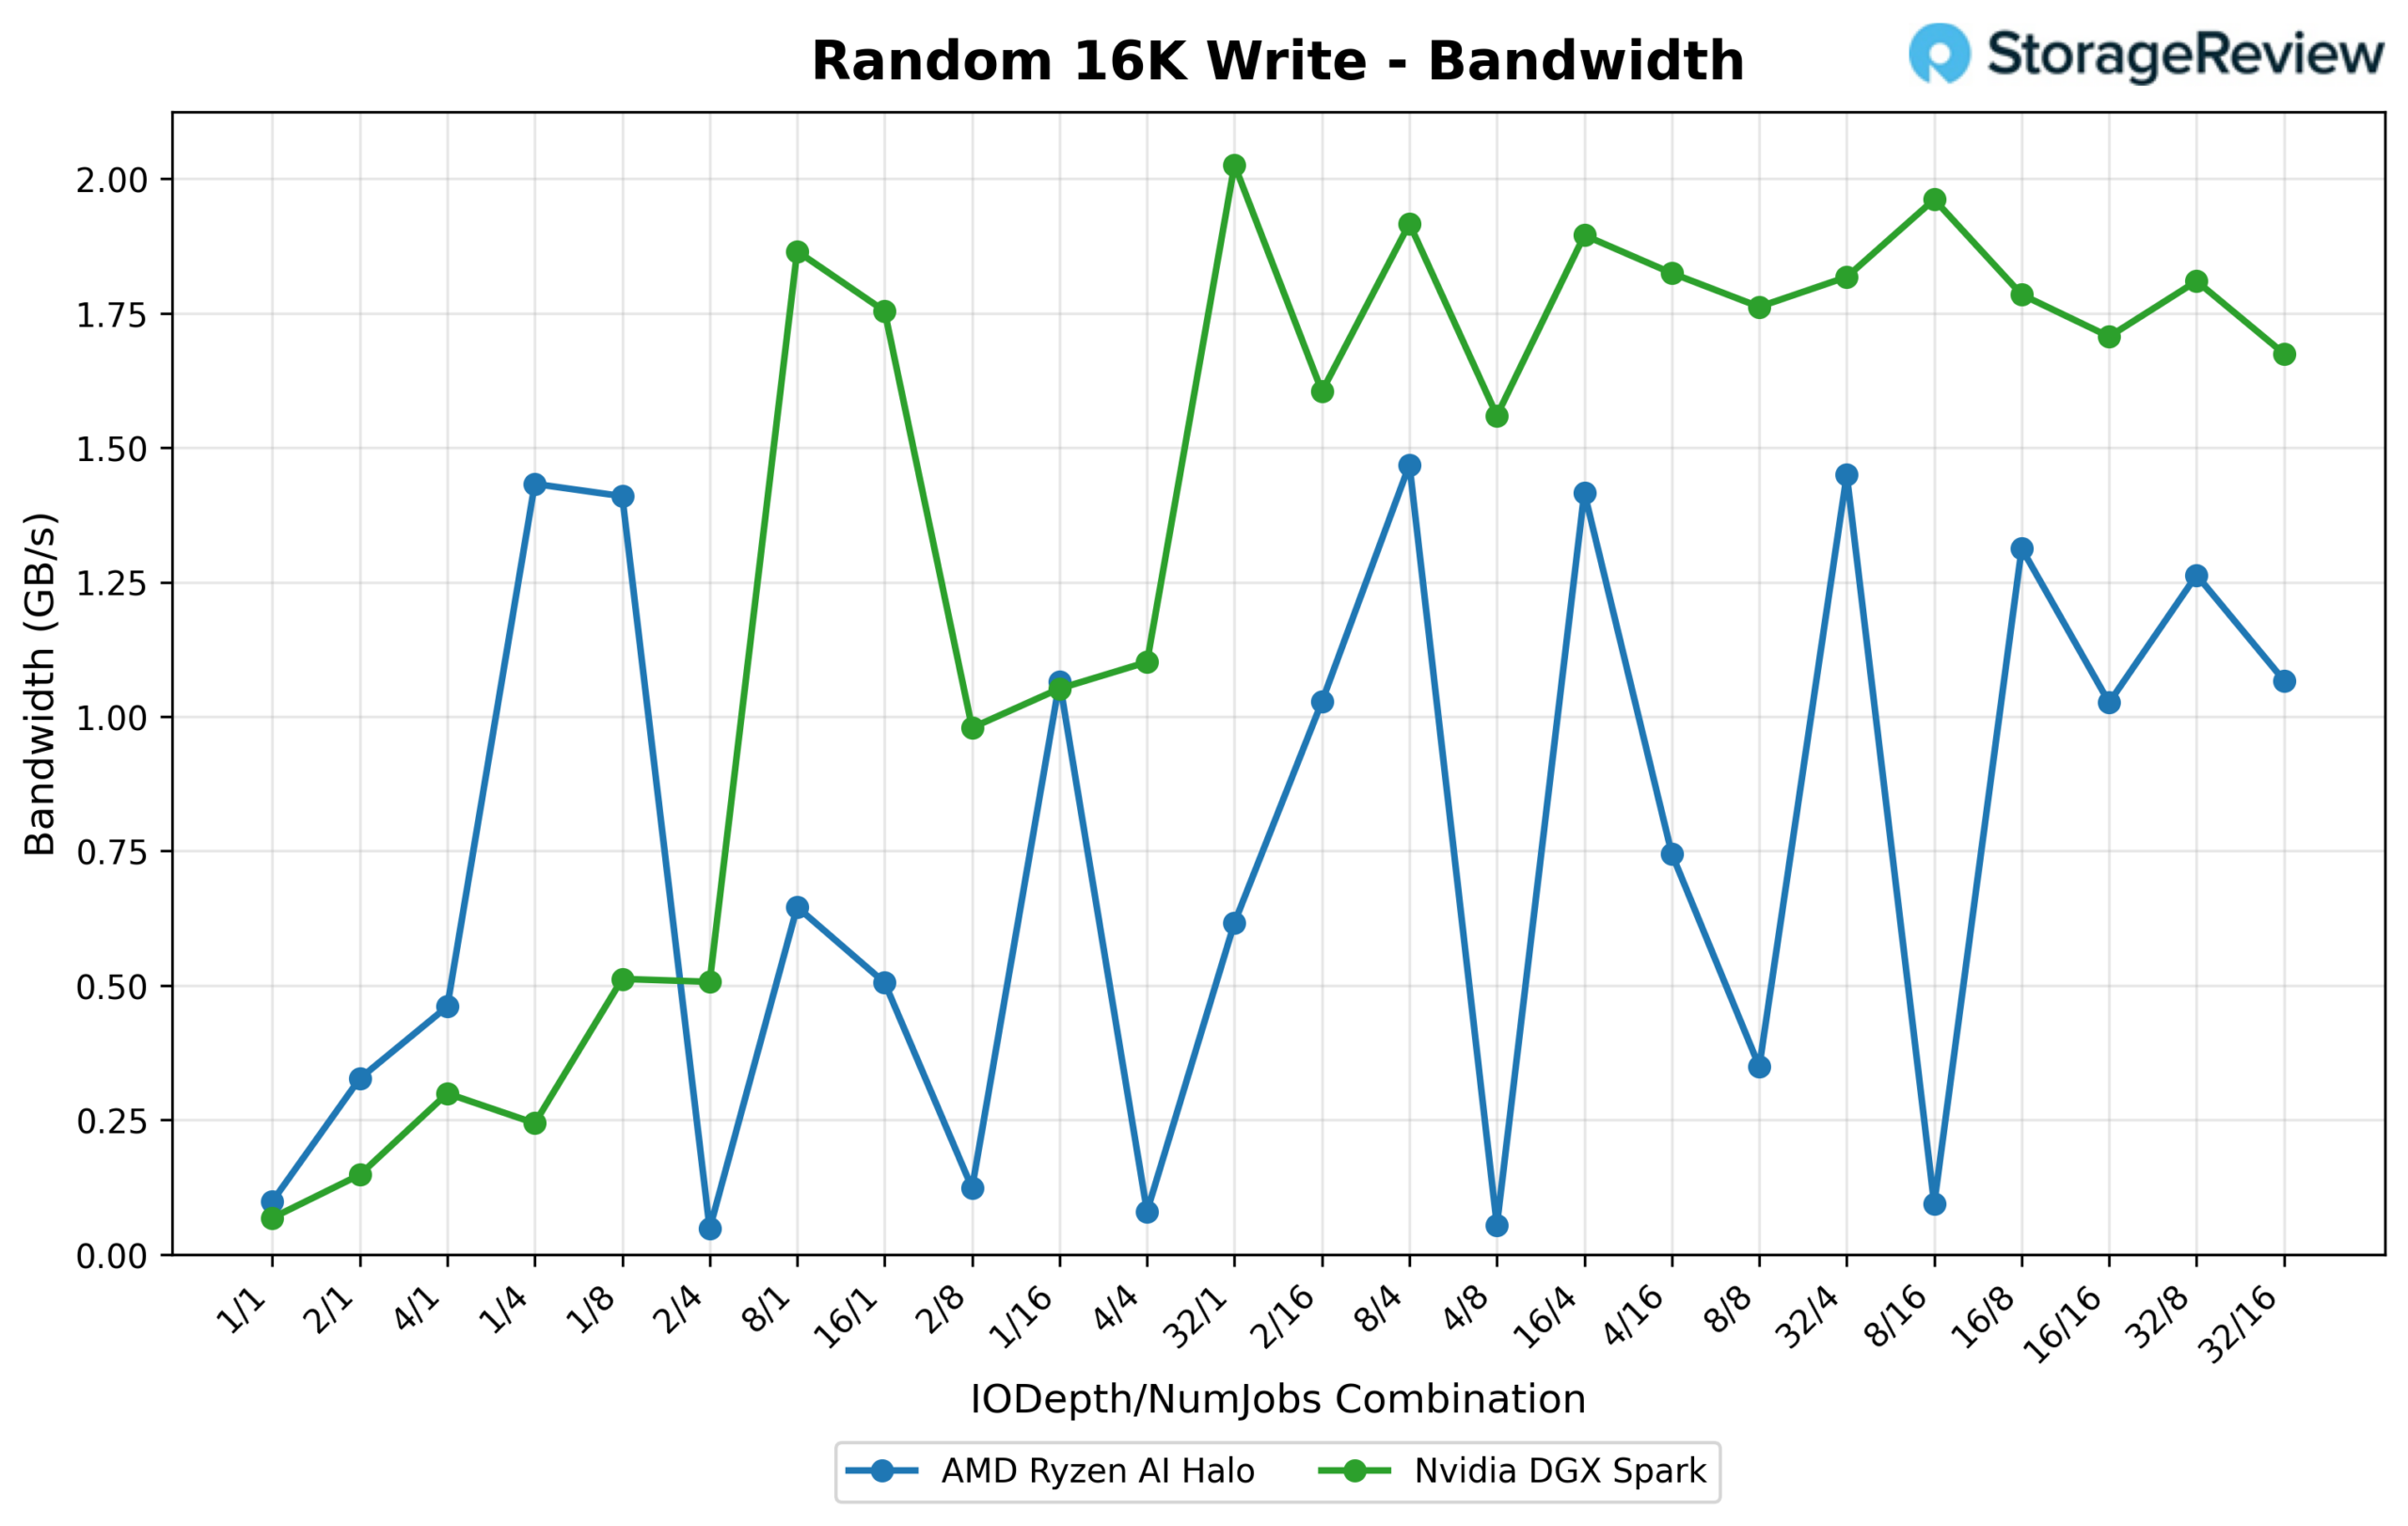
Gravação aleatória 16K
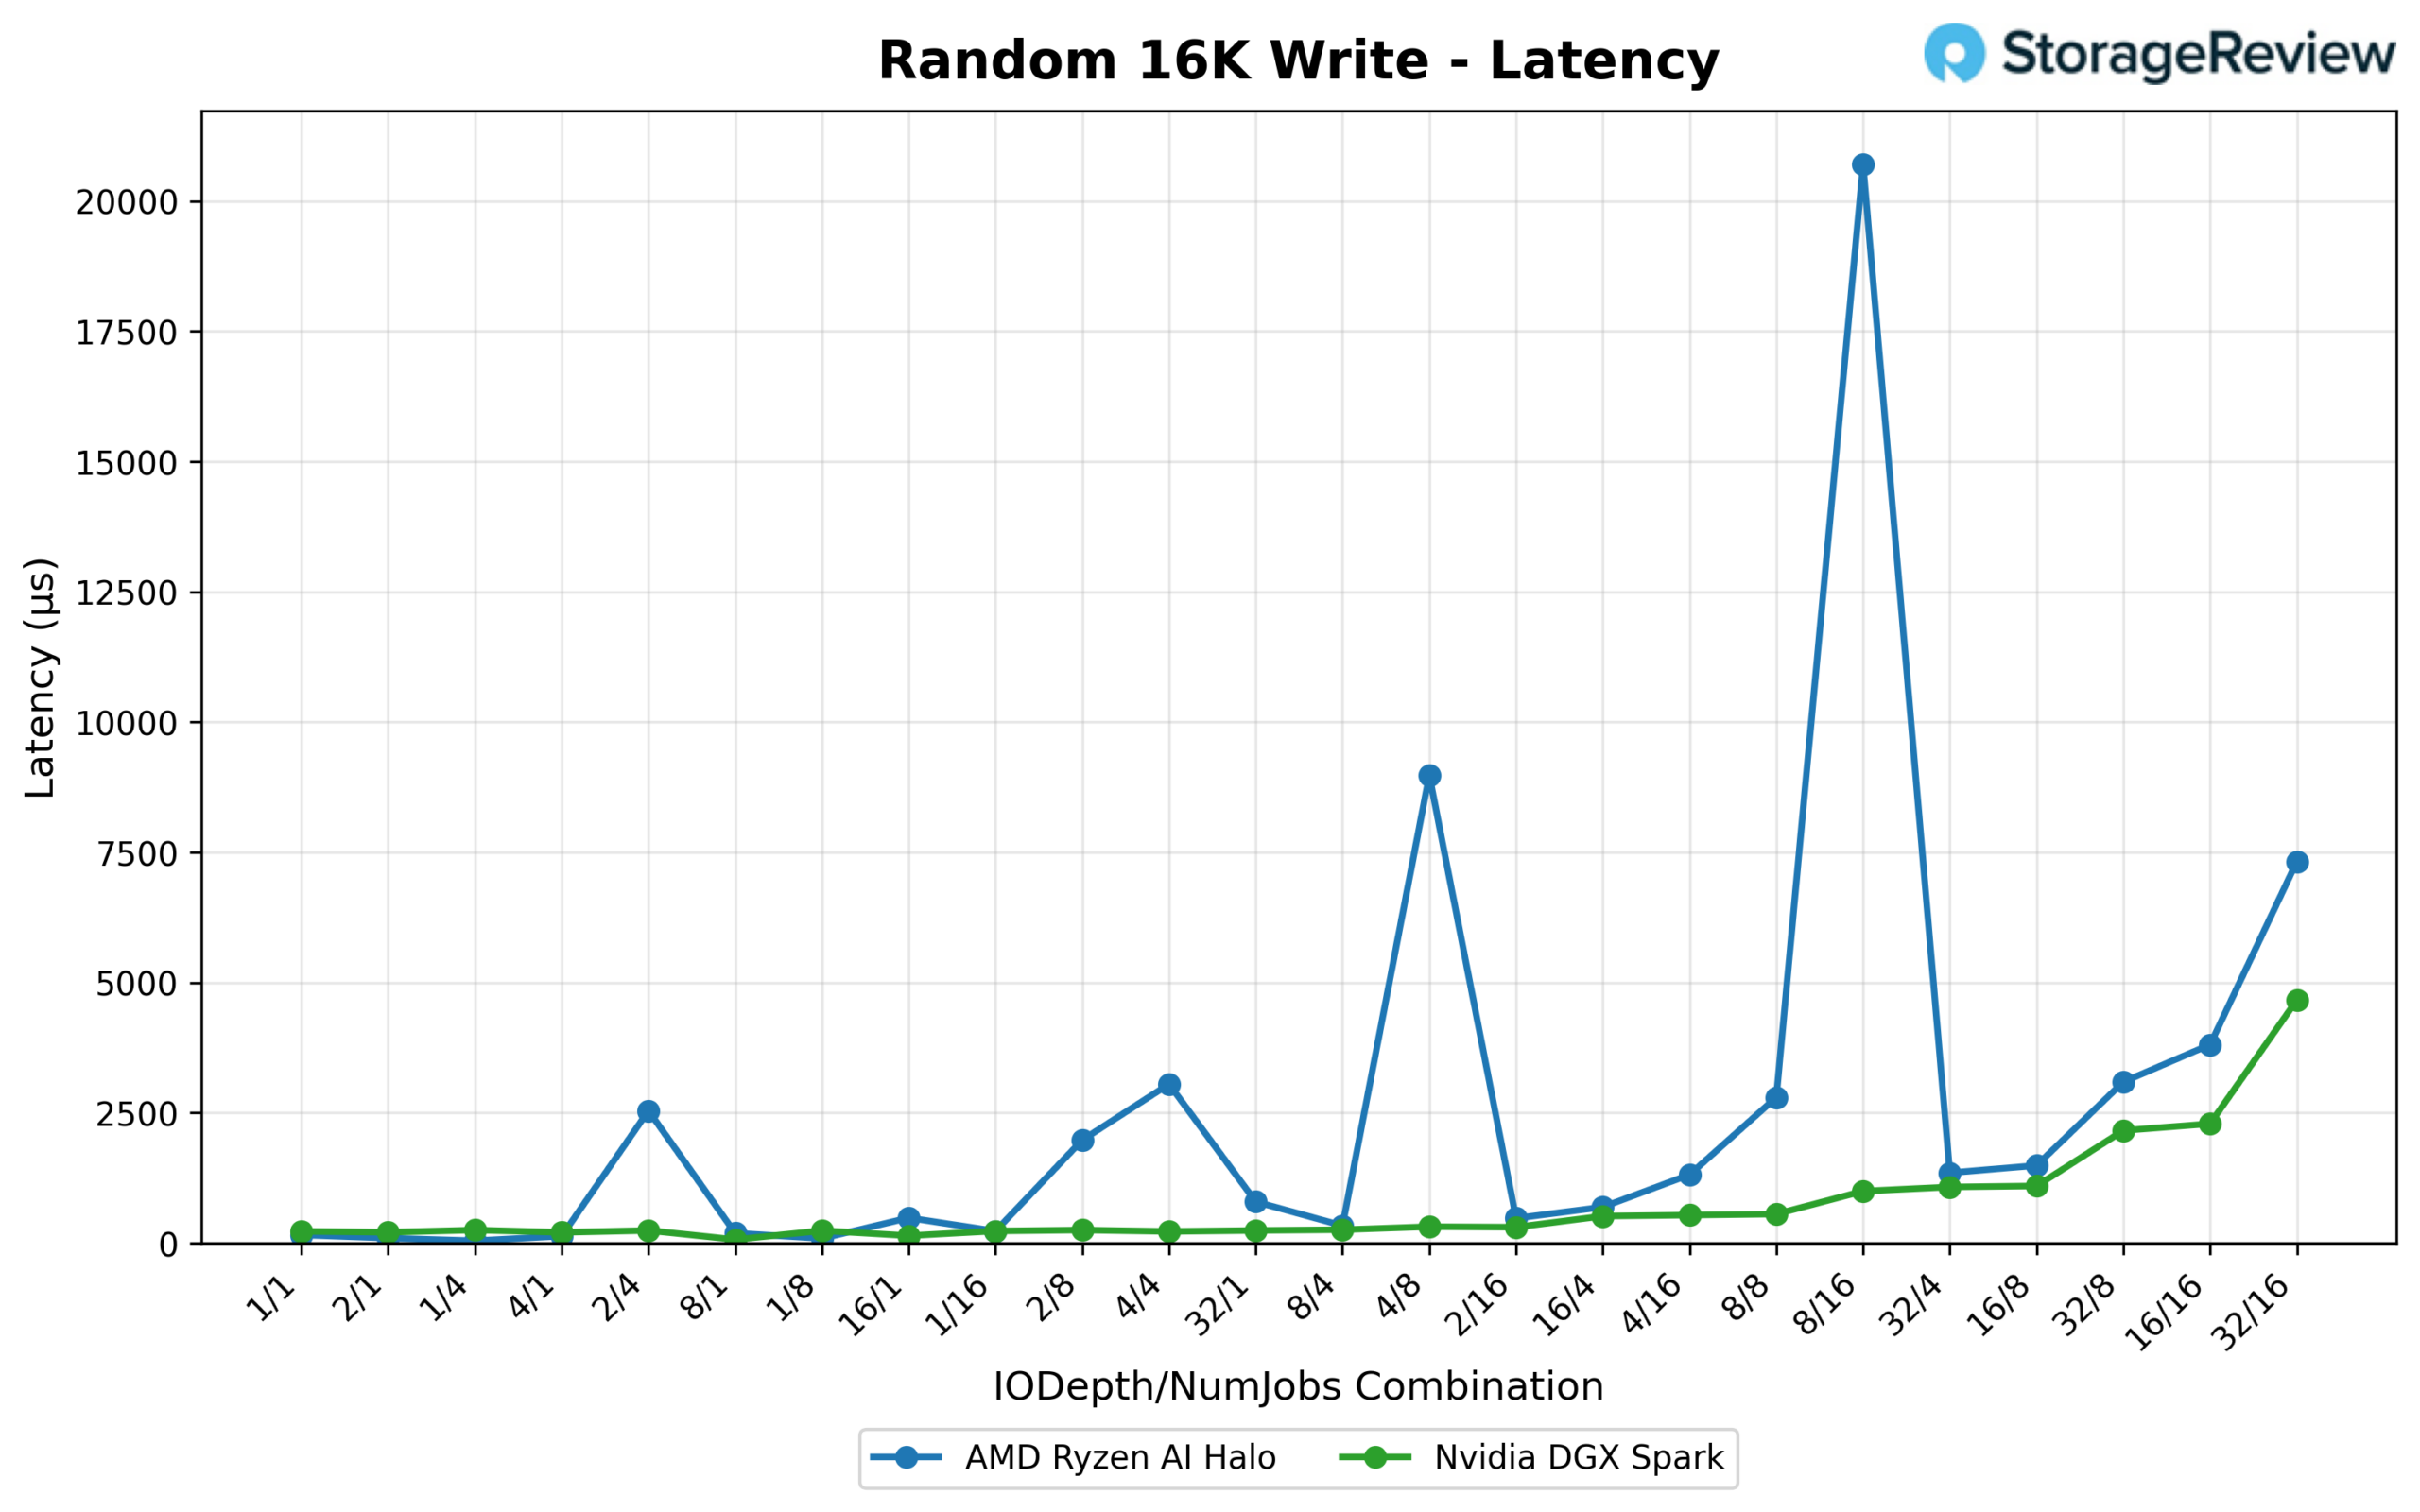
A largura de banda favorece o Spark neste caso, que atinge 2,074.1 MB/s (132.7 mil IOPS) em 32/1, em comparação com os 1,503.5 MB/s (96.2 mil IOPS) do Halo em 8/4. A curva de largura de banda do Spark também é consideravelmente mais consistente, mantendo-se na faixa de 1.6 a 2.0 GB/s durante a maior parte da varredura após a rampa inicial. Em comparação, o Halo oscila drasticamente entre aproximadamente 0.1 e 1.5 GB/s de uma combinação para outra.
A latência é o ponto forte deste teste: o Halo começa com uma latência menor em 1/1 (0.154 ms contra 0.224 ms), mas em 8/16 sua latência média dispara para um valor extremo de 20.698 ms, quase 4.5 vezes maior que o pior caso do Spark, de 4.664 ms, em qualquer ponto do teste. Tirando esse pico isolado, a latência do Halo é razoável, mas trata-se de um valor discrepante significativo que merece atenção para qualquer carga de trabalho que possa ser executada nessa combinação específica de profundidade/threads.
Leitura aleatória 4K
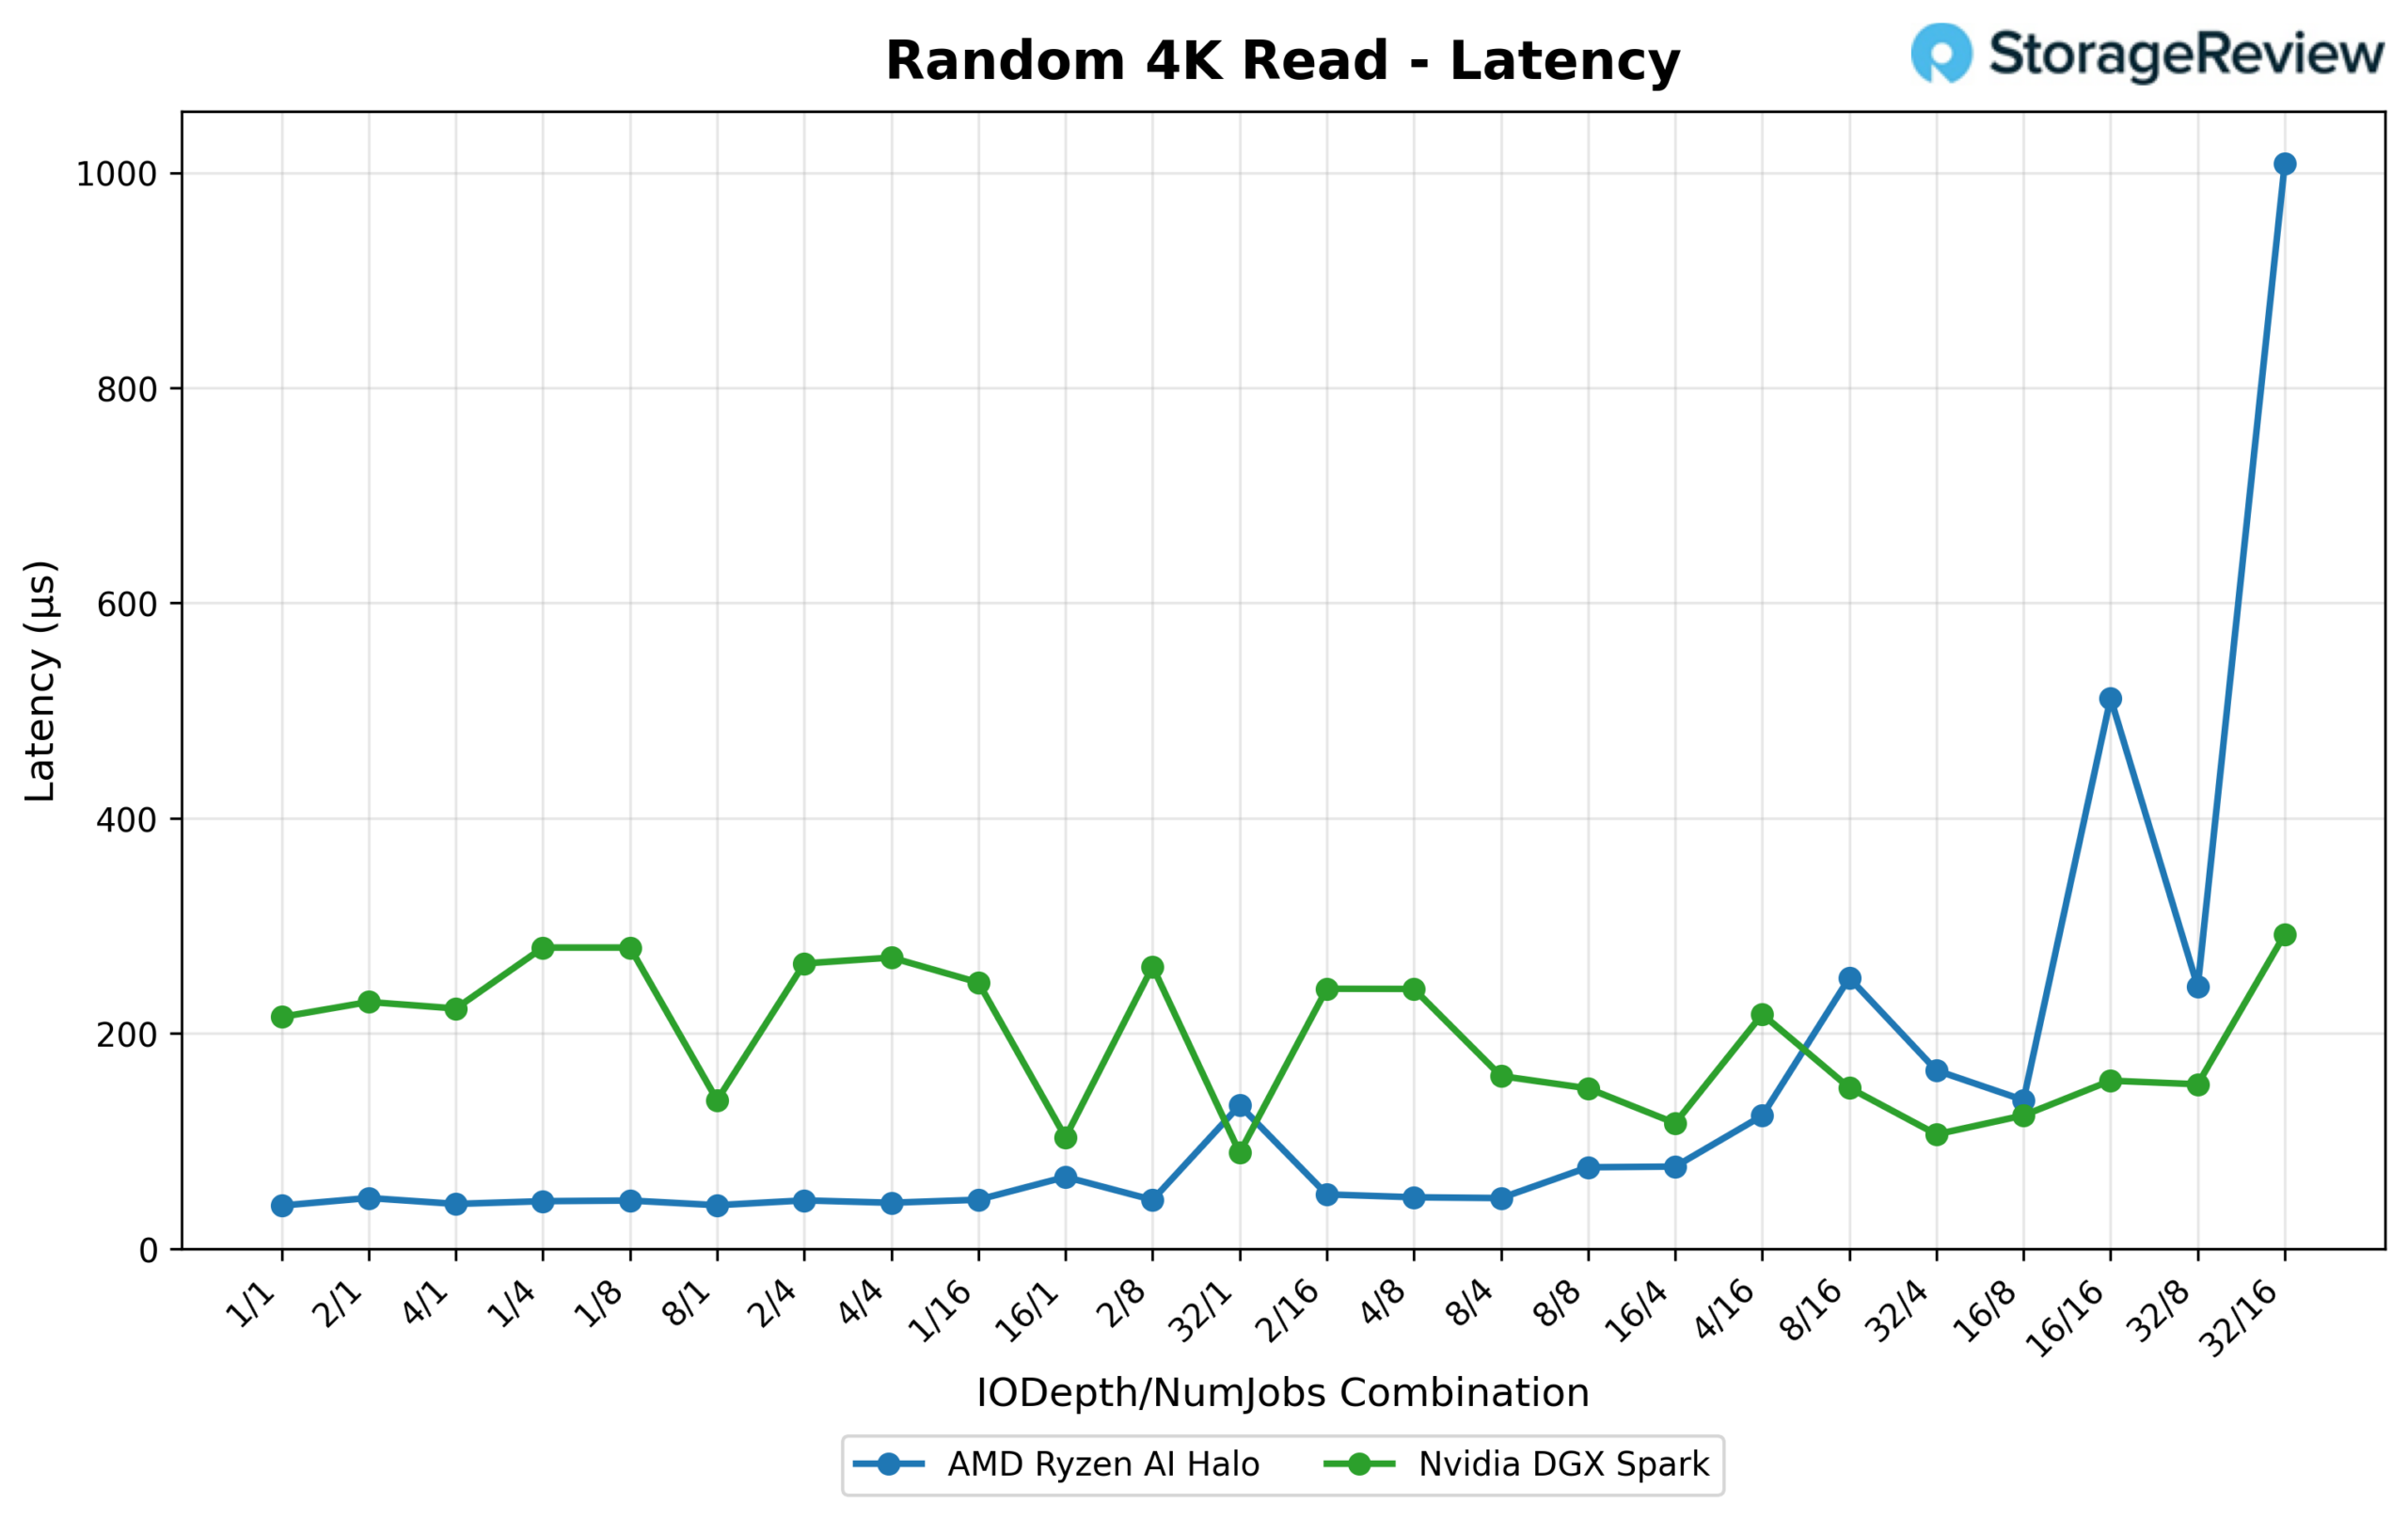
Em filas com baixa profundidade, o Halo responde dramaticamente mais rápido (0.04 ms a 1/1 contra 0.215 ms do Spark) e mantém uma vantagem de latência na maior parte da faixa baixa a média da varredura. Mas o Spark se destaca decisivamente em termos de taxa de transferência em grande escala: seu pico de IOPS atinge 1,750.7K (6,838.8 MB/s) a 32/16, bem acima do pico do Halo de 1,050.4K IOPS (4,103.2 MB/s) a 32/8.
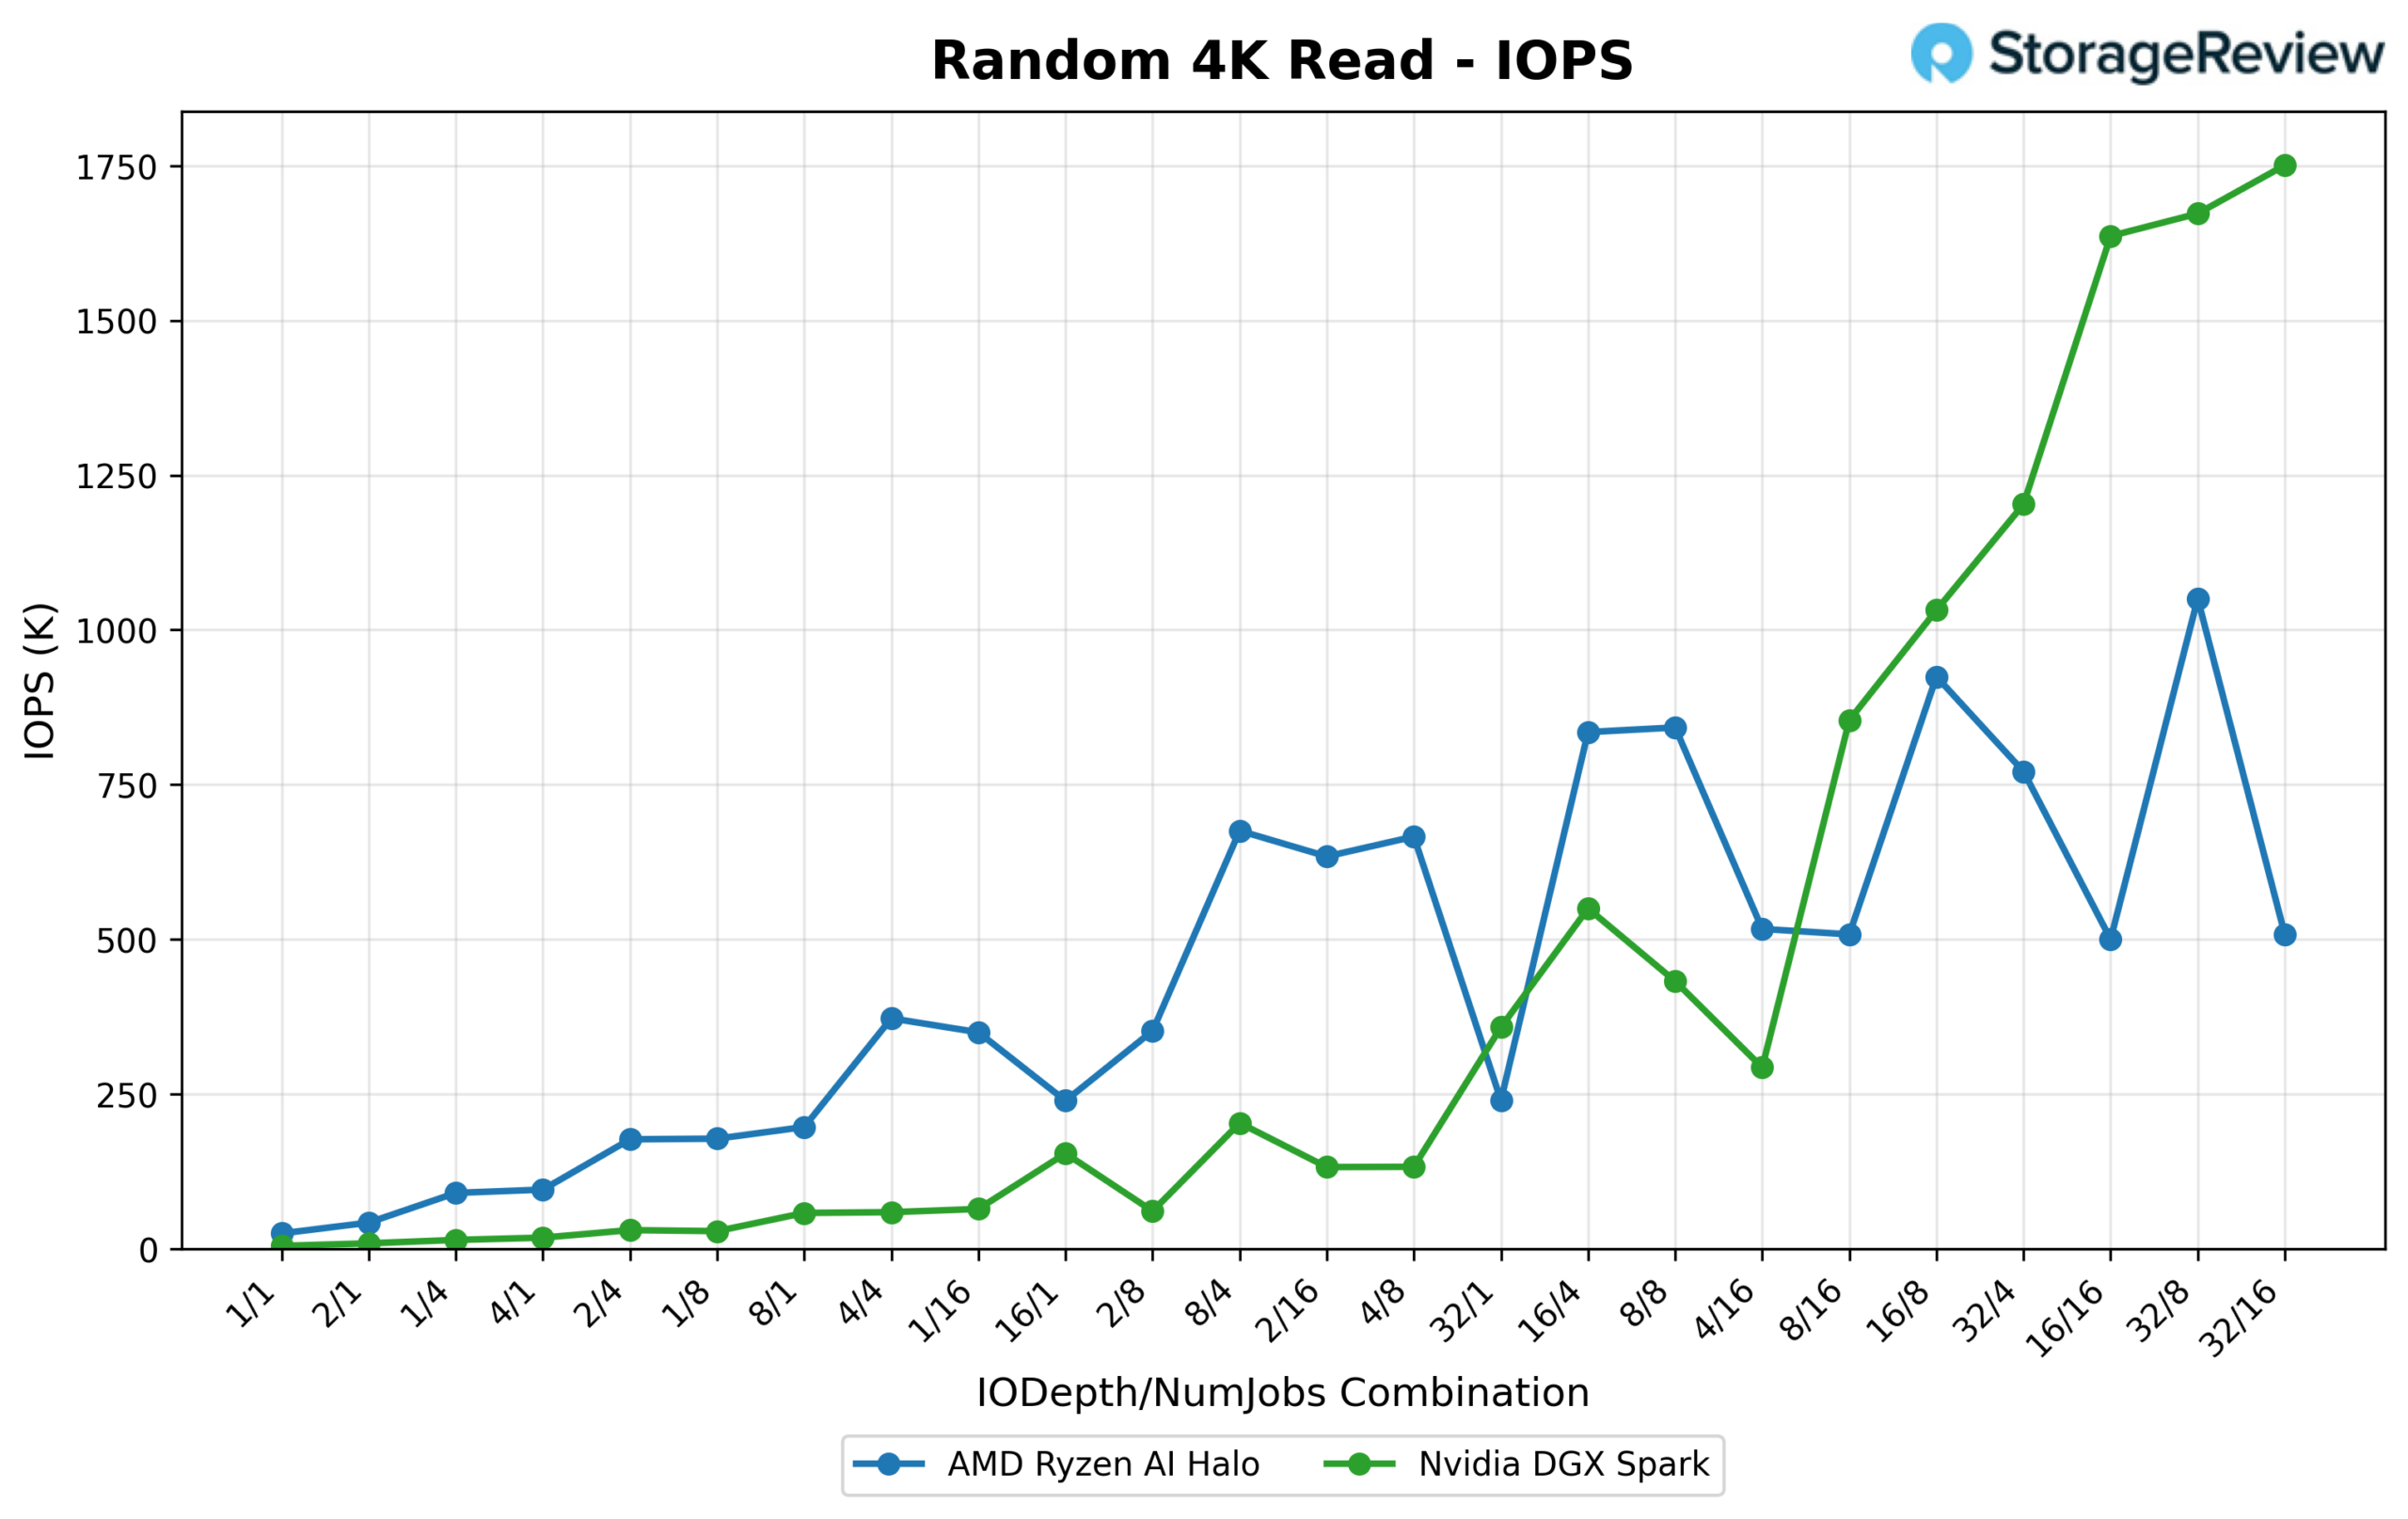
Curiosamente, o padrão de latência se inverte em filas com alta profundidade. A curva de latência do Spark permanece relativamente controlada mesmo com o aumento da profundidade e do número de threads, atingindo um pico de apenas 0.292 ms. O Halo, por outro lado, apresenta picos acentuados em 16/16 (0.513 ms) e novamente em 32/16 (1.009 ms), excedendo sua linha de base em estado estável em mais de 3 vezes, o que significa que sua excelente capacidade de resposta em filas com baixa profundidade não se mantém em condições de saturação total.
Gravação aleatória 4K
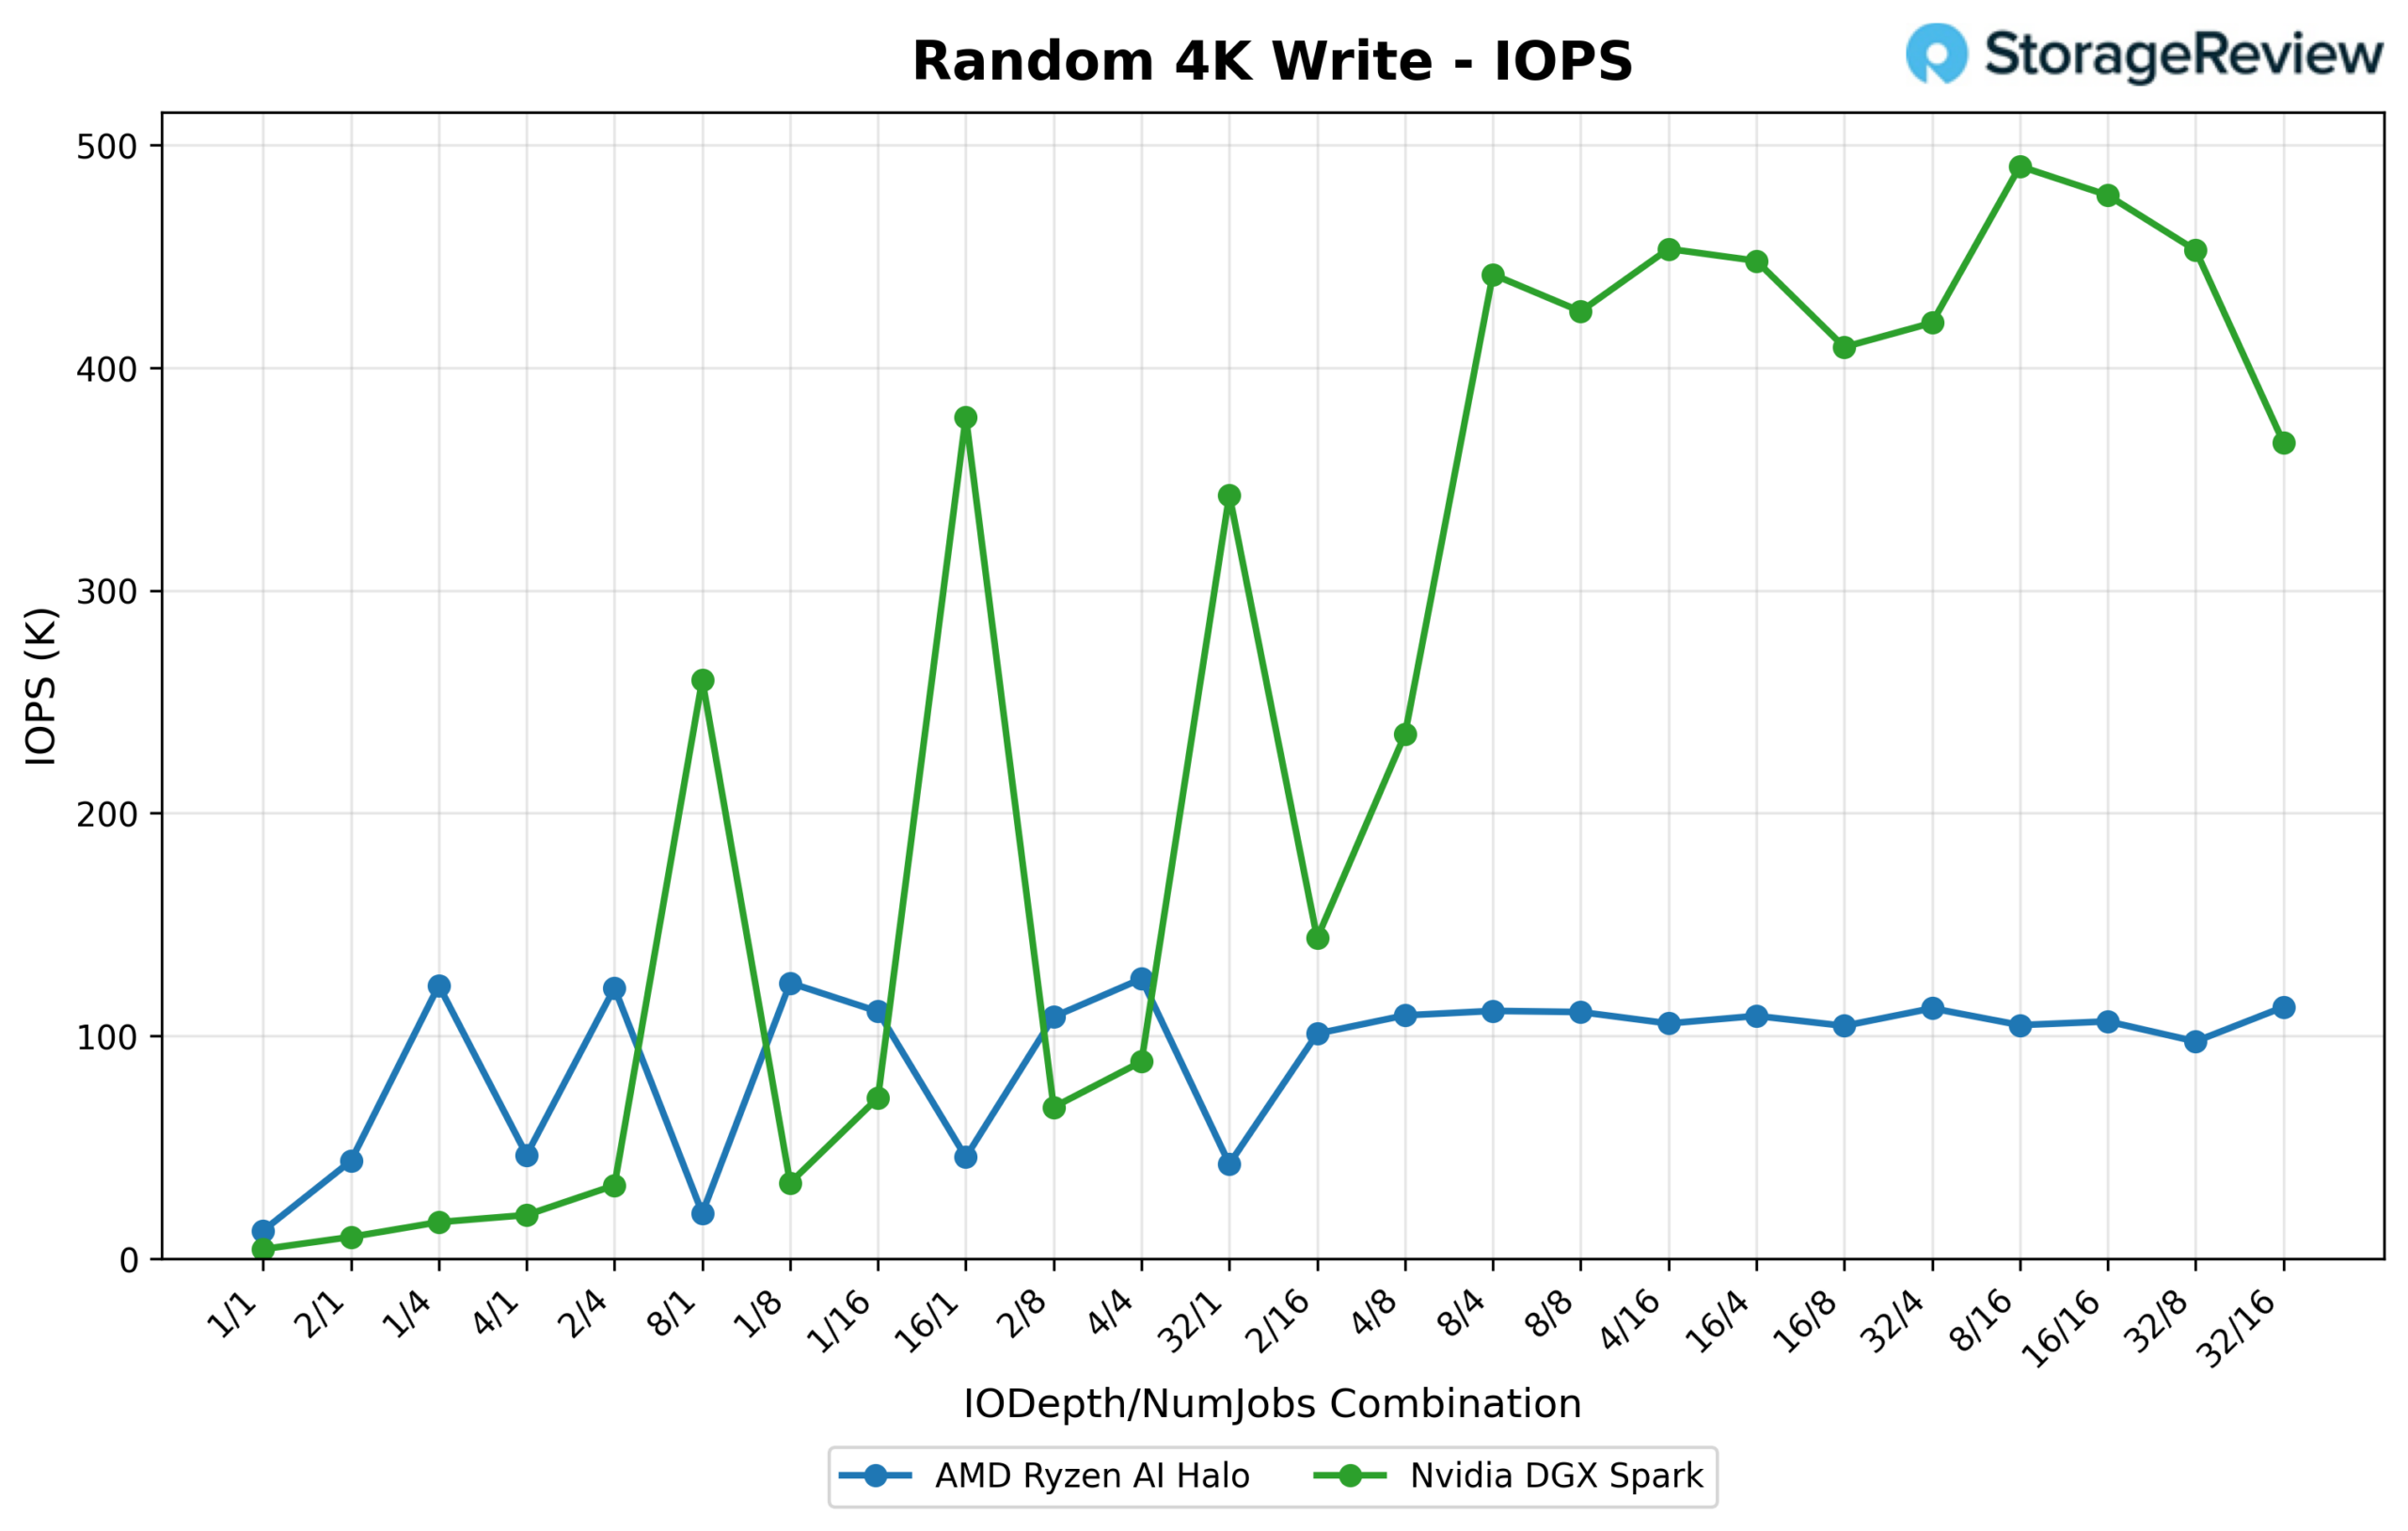
Esta é a maior diferença de IOPS observada no teste. O desempenho de gravação aleatória de 4K do Spark aumenta acentuadamente conforme a profundidade da fila e o número de threads aumentam, atingindo 490.4 mil IOPS (1,915.6 MB/s) em 8/16. O Halo, por sua vez, atinge um platô muito mais cedo e em um nível muito mais baixo, chegando a um máximo de 125.6 mil IOPS (490.7 MB/s) em 4/4 e nunca ultrapassando aproximadamente 110-115 mil IOPS durante o restante do teste. O Spark está operando com quase 4 vezes o desempenho máximo do Halo neste caso.
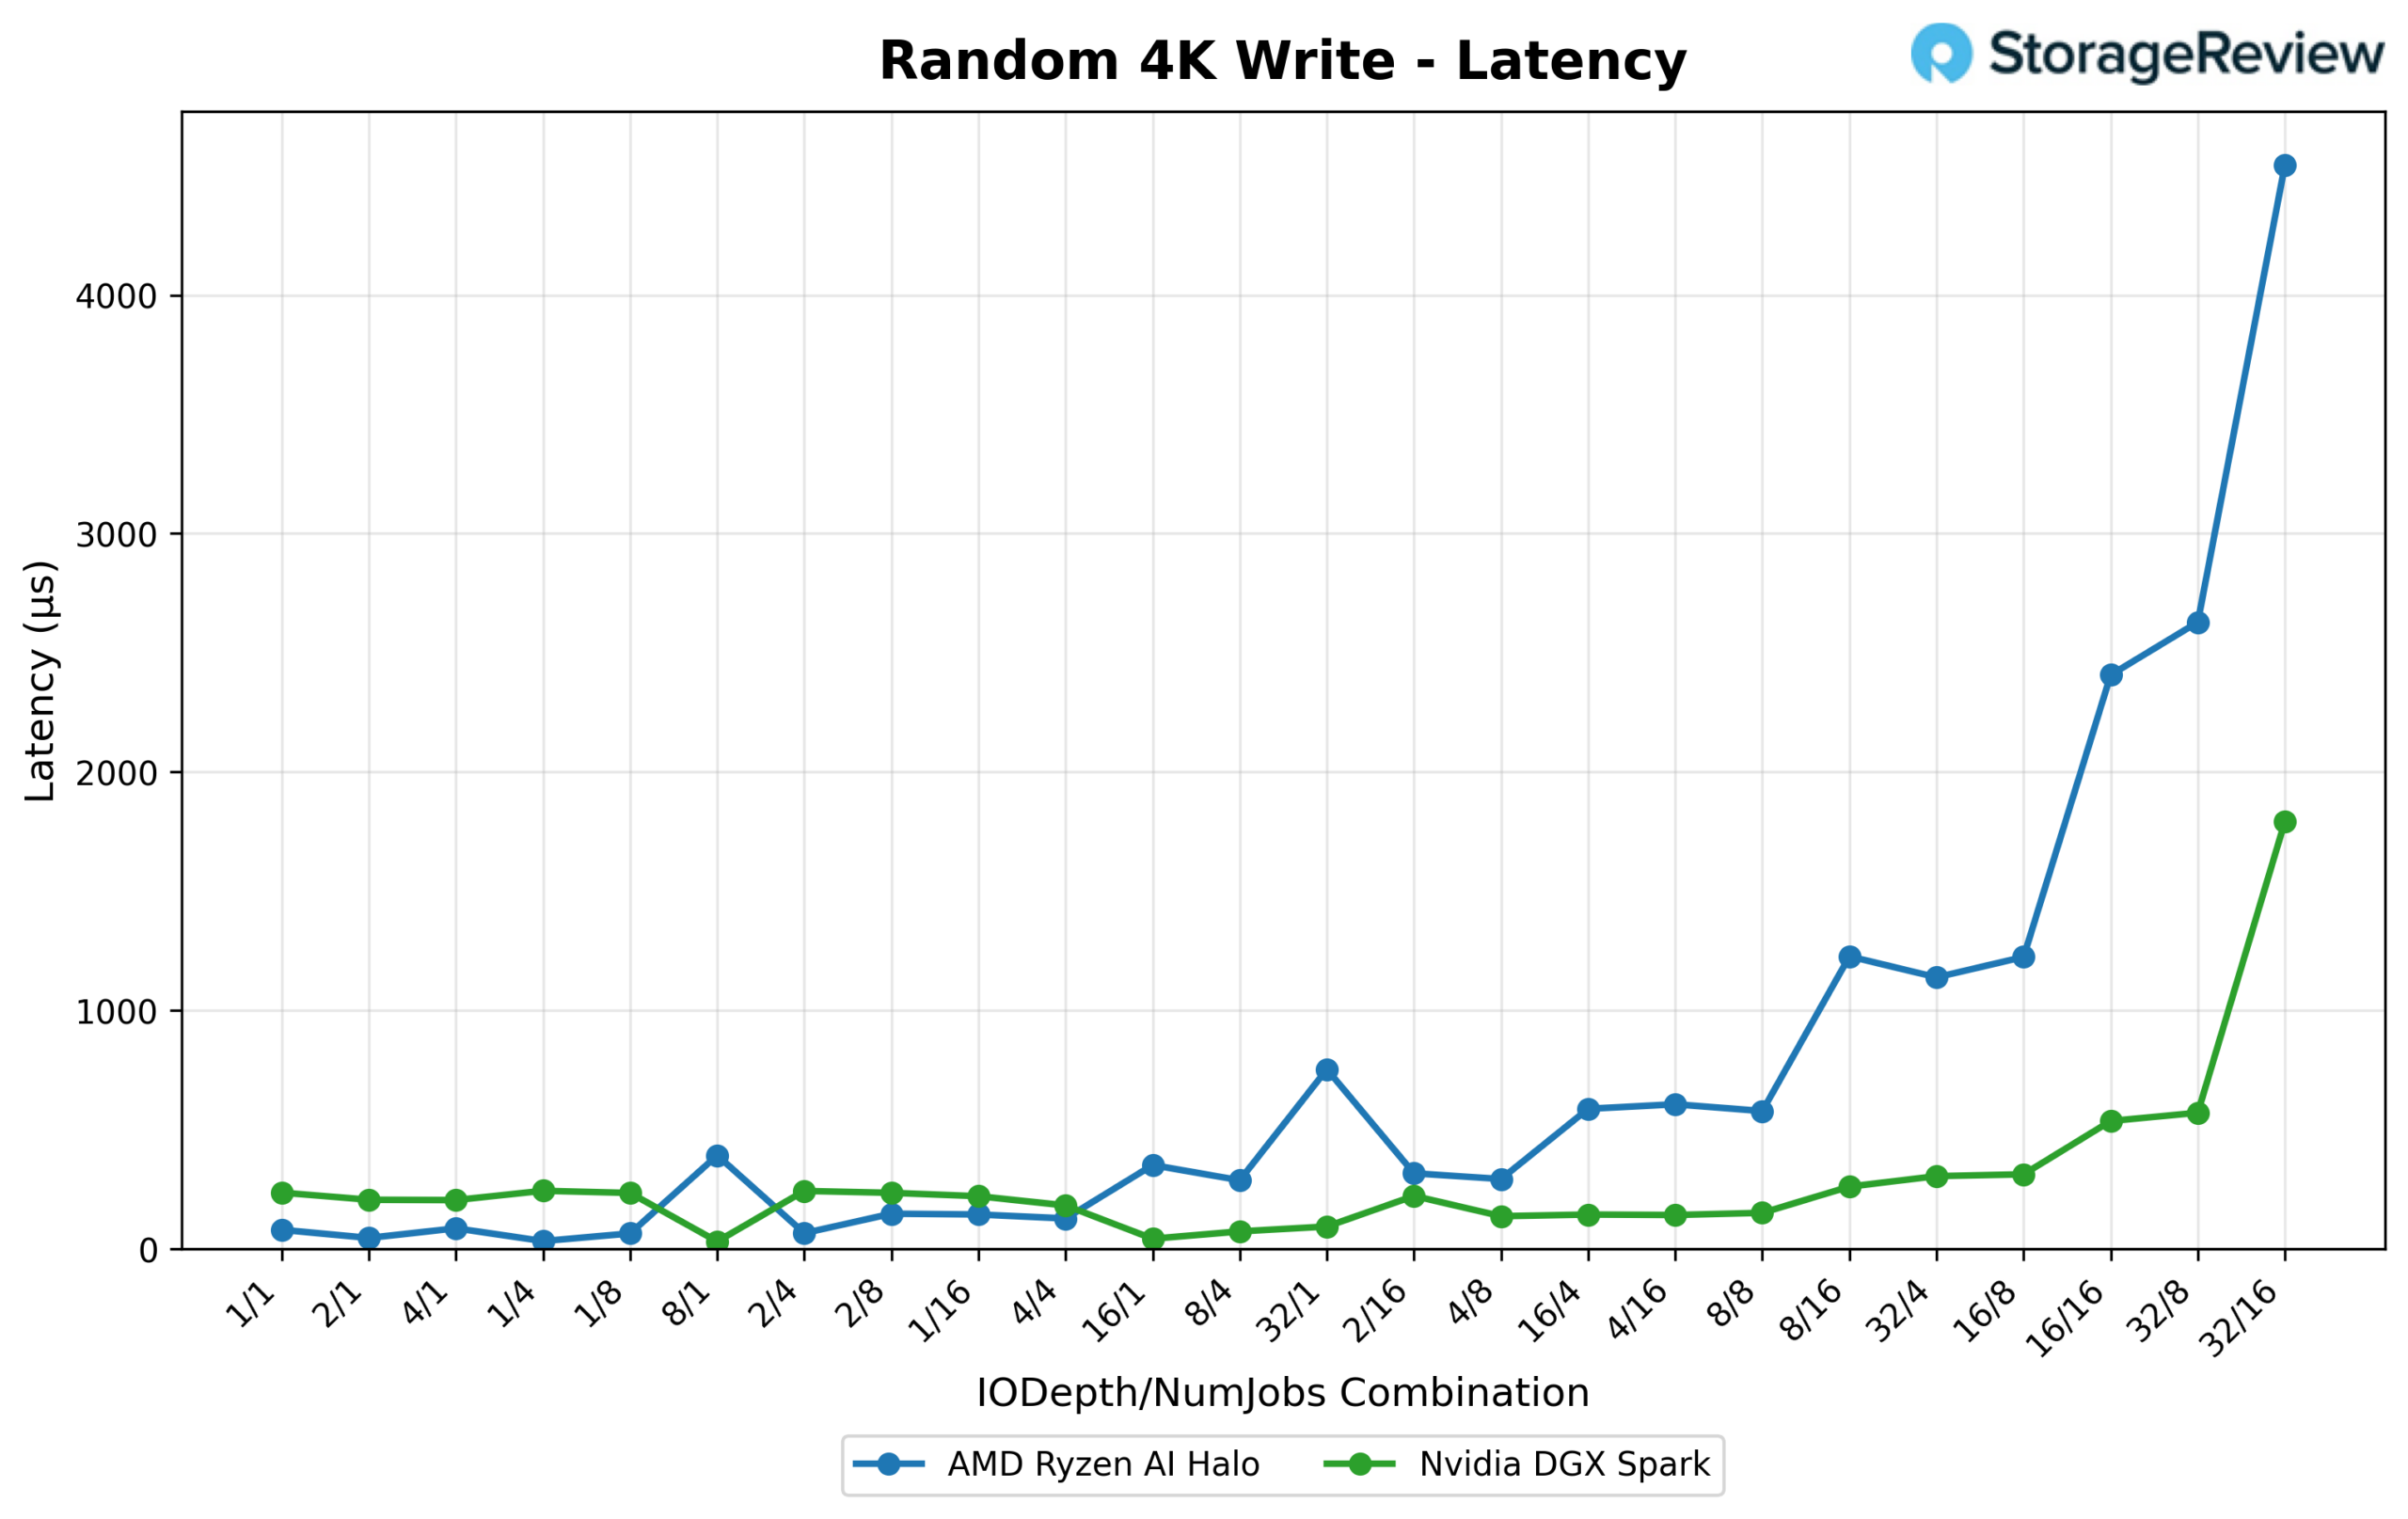
A latência começa novamente a favorecer o Halo em profundidades de fila baixas (0.079 ms contra 0.235 ms em 1/1). Em 32/16, a latência média do Halo subiu para 4.546 ms, enquanto a do Spark permanece comparativamente controlada em 1.792 ms. Combinado com a diferença de IOPS, este é o teste em que a vantagem do Spark é mais pronunciada e mais consistente em toda a varredura de profundidade/threads.
Serviço online vLLM – Desempenho de inferência LLM
O vLLM é um dos mecanismos de inferência e serviço de alto desempenho mais populares para LLMs. O benchmark de serviço online do vLLM avalia o desempenho real desse mecanismo de inferência sob solicitações simultâneas. Ele simula cargas de trabalho de produção enviando solicitações para um servidor vLLM em execução, com parâmetros configuráveis como taxa de solicitações, comprimentos de entrada e saída e número de clientes simultâneos. O benchmark mede métricas importantes, incluindo taxa de transferência (tokens por segundo), tempo até o primeiro token e tempo por token de saída (TPOT), ajudando os usuários a entender como o vLLM se comporta sob diferentes condições de carga.
Testamos o desempenho da inferência em um conjunto abrangente de modelos que abrangem várias arquiteturas, escalas de parâmetros e estratégias de quantização para avaliar a taxa de transferência em diferentes perfis de concorrência.
GPT OSS 120B
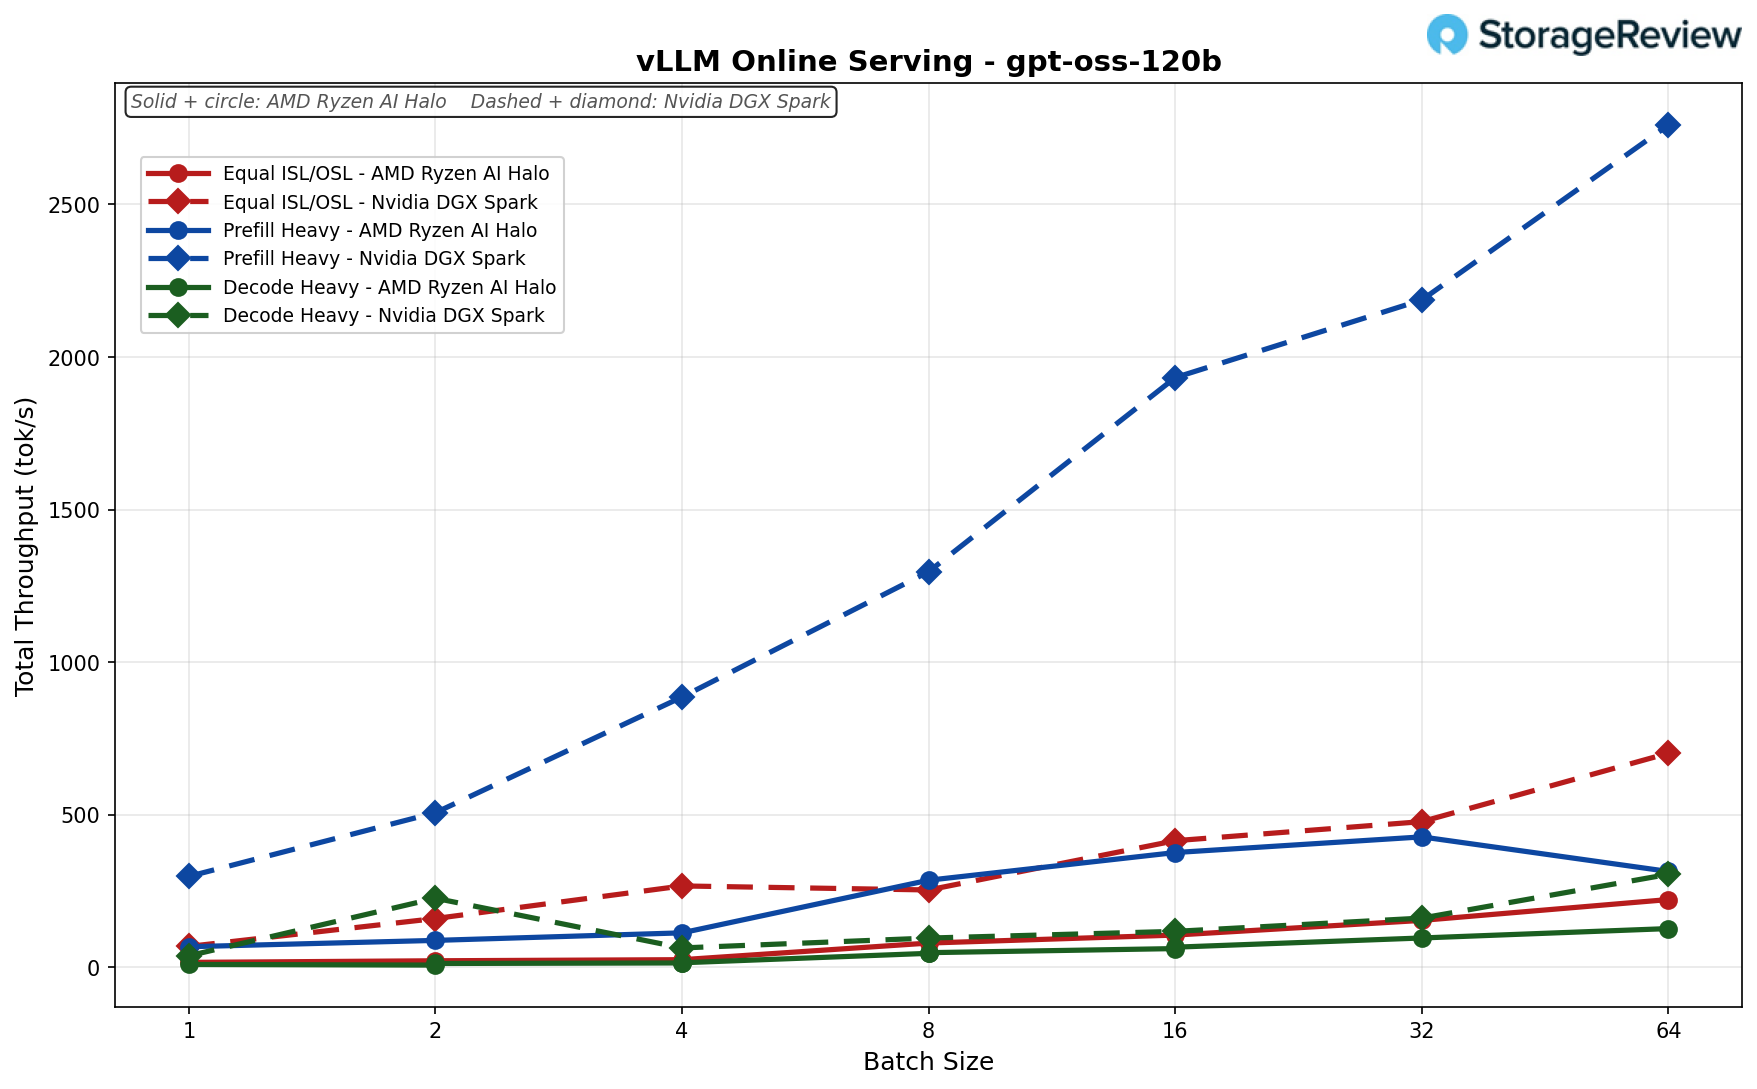
ISL/OSL iguais (256/256): O Halo atingiu 222 tok/s com tamanho de lote 64, enquanto o Spark alcançou 701 (cerca de 3.2 vezes menos).
Prefill Heavy (8k/1k): A capacidade de processamento do Halo atingiu o pico no lote 32 (427 tok/s), caindo para 314 no lote 64, enquanto a do Spark subiu para 2,760 (cerca de 8.8 vezes) — a maior diferença entre os lotes.
Decodificação Pesada (1k/8k): O Halo atingiu 127 tok/s, em comparação com os 305 do Spark com tamanho de lote 64 (cerca de 2.4 vezes).
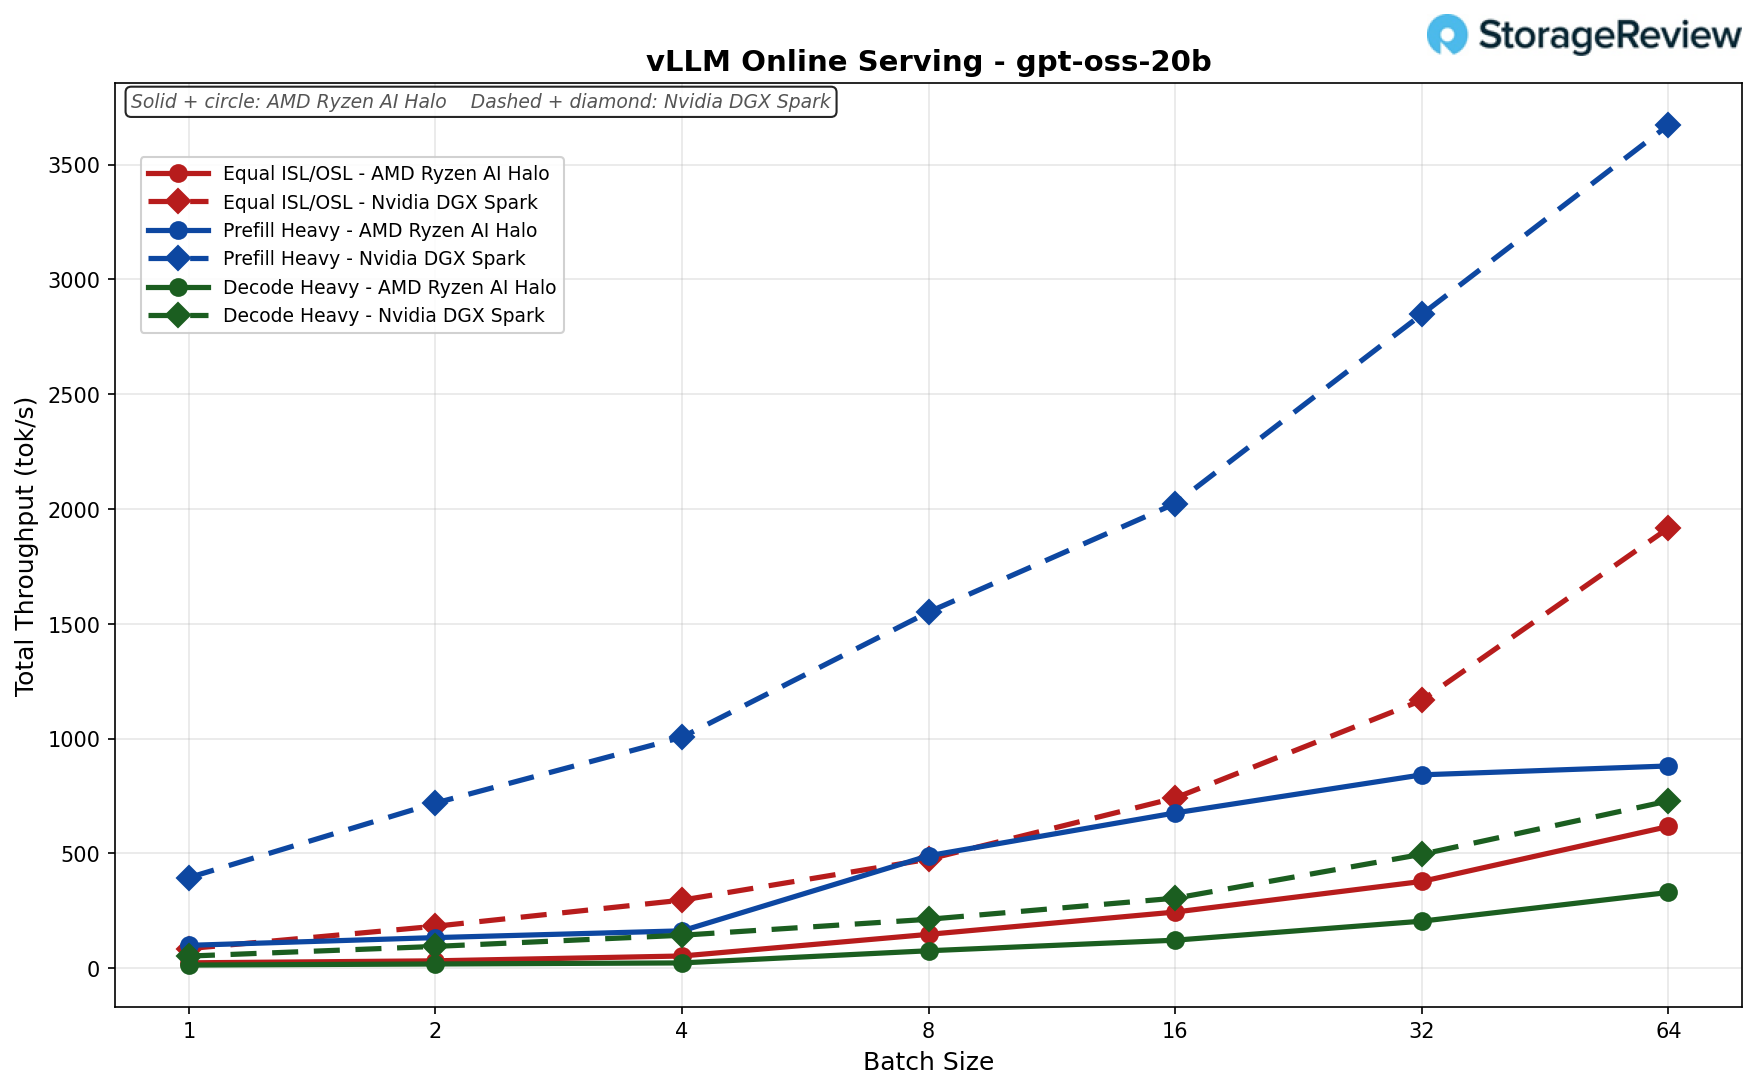
GPT OSS 20B
ISL/OSL iguais (256/256): Spark liderou em todos os lotes, escalando para 1,917 tok/s contra 617 tok/s no lote 64 (Spark cerca de 3.1 vezes à frente).
Prefill Heavy (8k/1k): A maior vantagem da Spark, subindo para 3,672 contra 881 tok/s no tamanho do lote 64 (Spark cerca de 4.2 vezes à frente).
Decodificação pesada (1k/8k): O Spark está à frente em todos os aspectos, atingindo 728 tok/s contra 330 tok/s no lote 64 (Spark cerca de 2.2 vezes à frente).
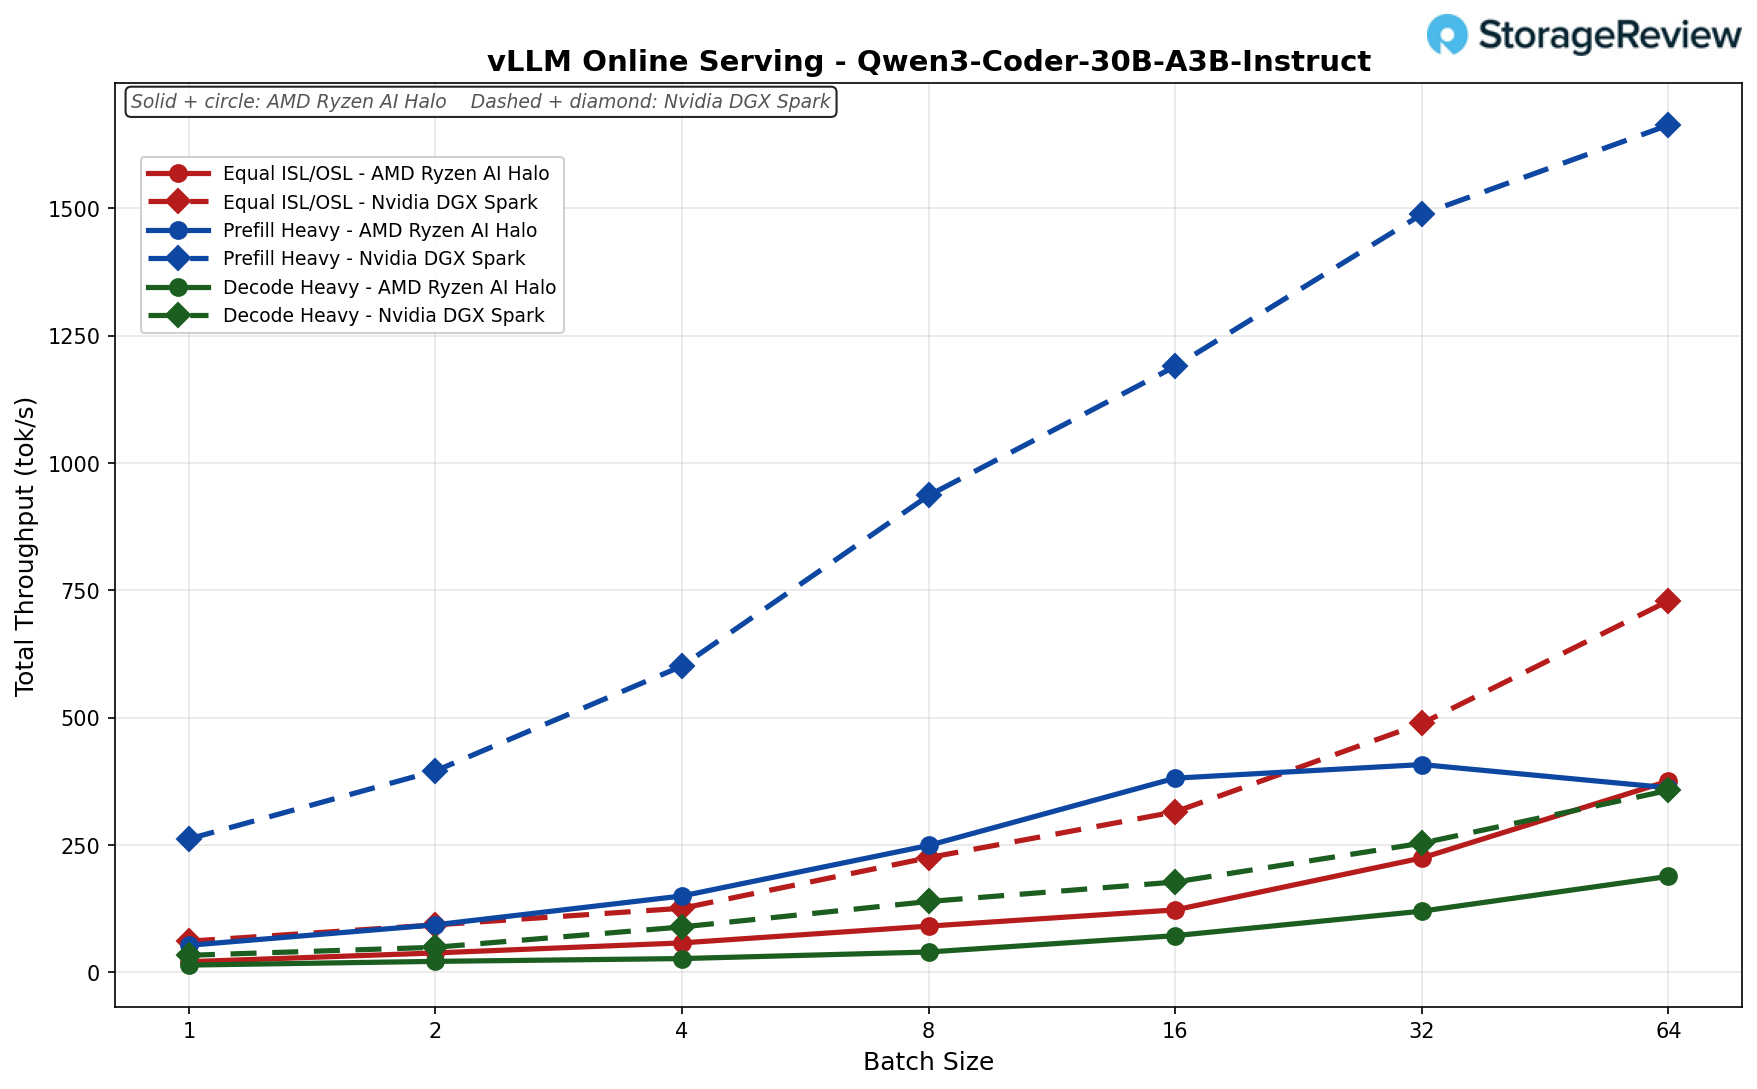
Qwen3 Coder 30B A3B Instruir
ISL/OSL igual (256/256): O Halo escalou para 376 tok/s com tamanho de lote 64, aproximadamente metade dos 729 do Spark (cerca de 1.9x) — um dos resultados de ISL/OSL igual mais próximos.
Prefill Heavy (8k/1k): O Halo atingiu o pico no lote 32 (408 tok/s), depois caiu para 362 no lote 64, ficando atrás do Spark, que atingiu 1,663 (cerca de 4.6 vezes).
Decodificação Pesada (1k/8k): O Halo atingiu 188 tok/s, em comparação com os 357 do Spark com tamanho de lote 64 (cerca de 1.9x).
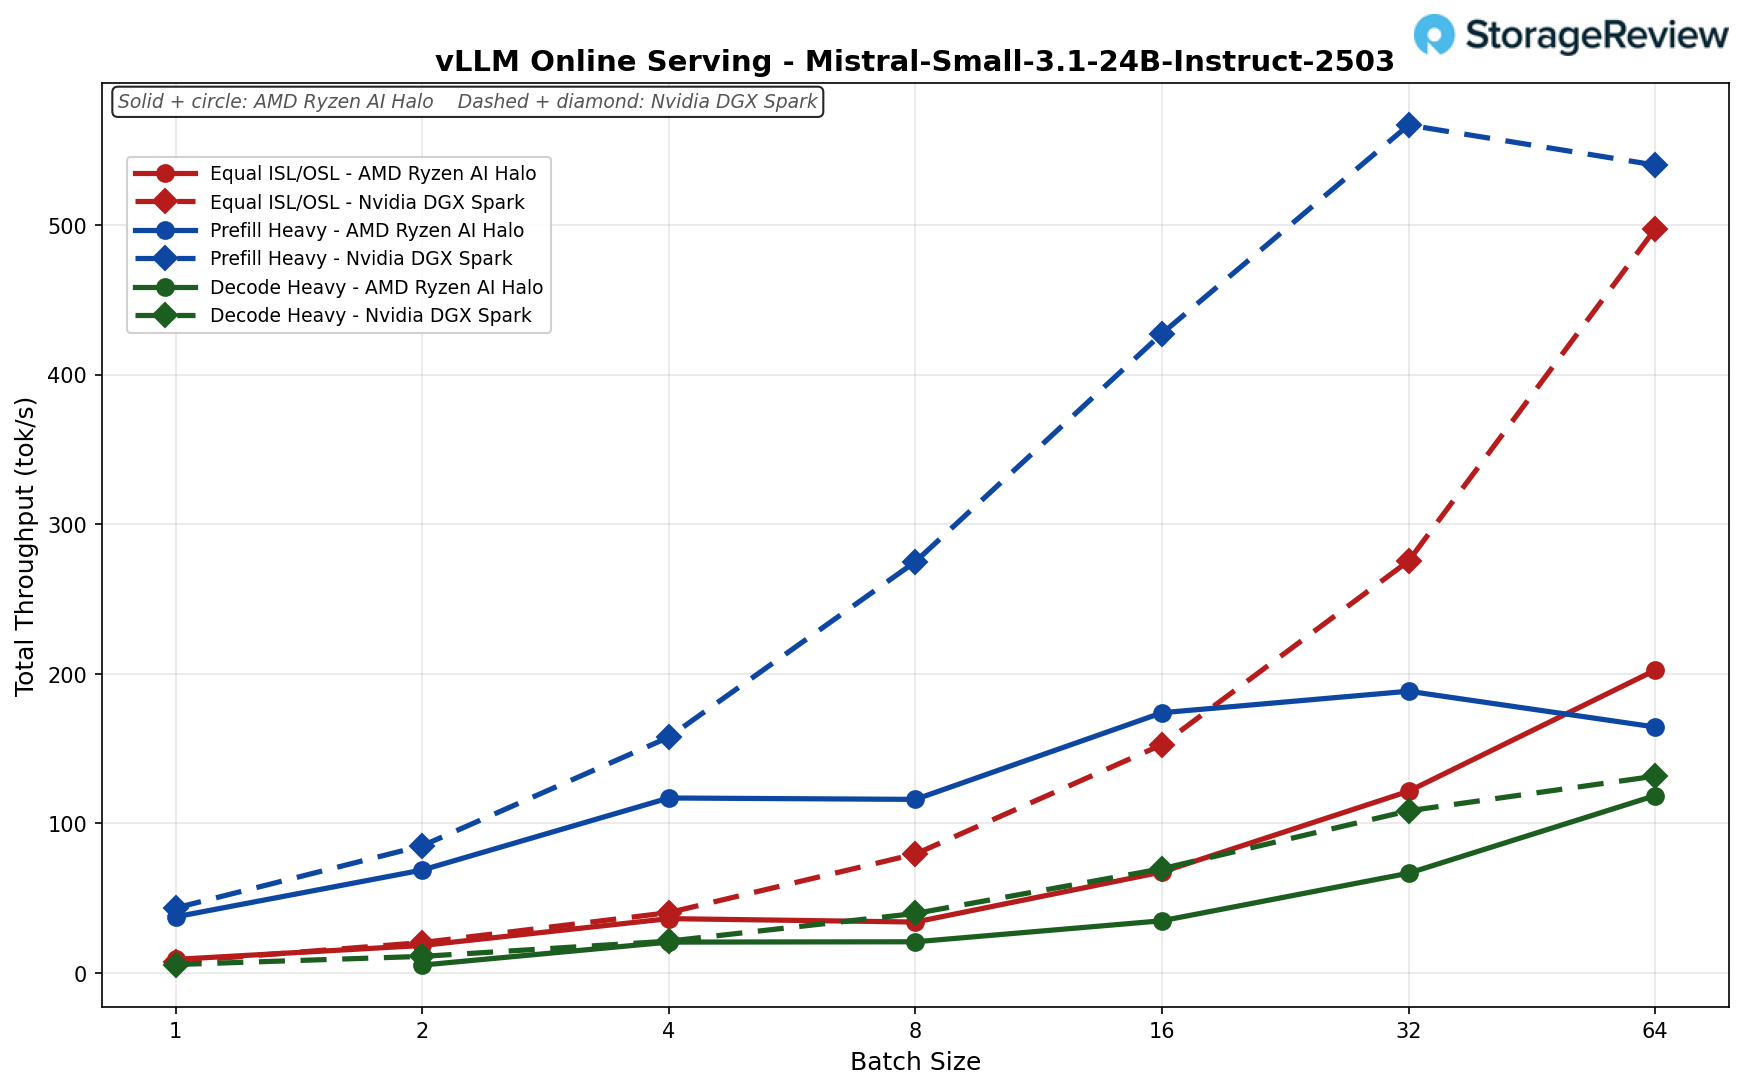
Mistral Pequeno 3.1 24B Instruções
ISL/OSL iguais (256/256): O Halo chegou a liderar no lote 1 (9 vs 8 tok/s), depois estabilizou em 202 tok/s no lote 64, enquanto o Spark ficou em 498 (cerca de 2.5 vezes atrás).
Prefill Heavy (8k/1k): O Halo atingiu o pico no lote 32 (188 tok/s) e caiu ligeiramente para 164 no lote 64, ficando atrás dos 540 do Spark (cerca de 3.3 vezes).
Decodificação Pesada (1k/8k): Praticamente empatados durante todo o teste, o Halo alcançou 119 tok/s contra os 132 do Spark no lote 64 (com uma diferença de cerca de 11%).
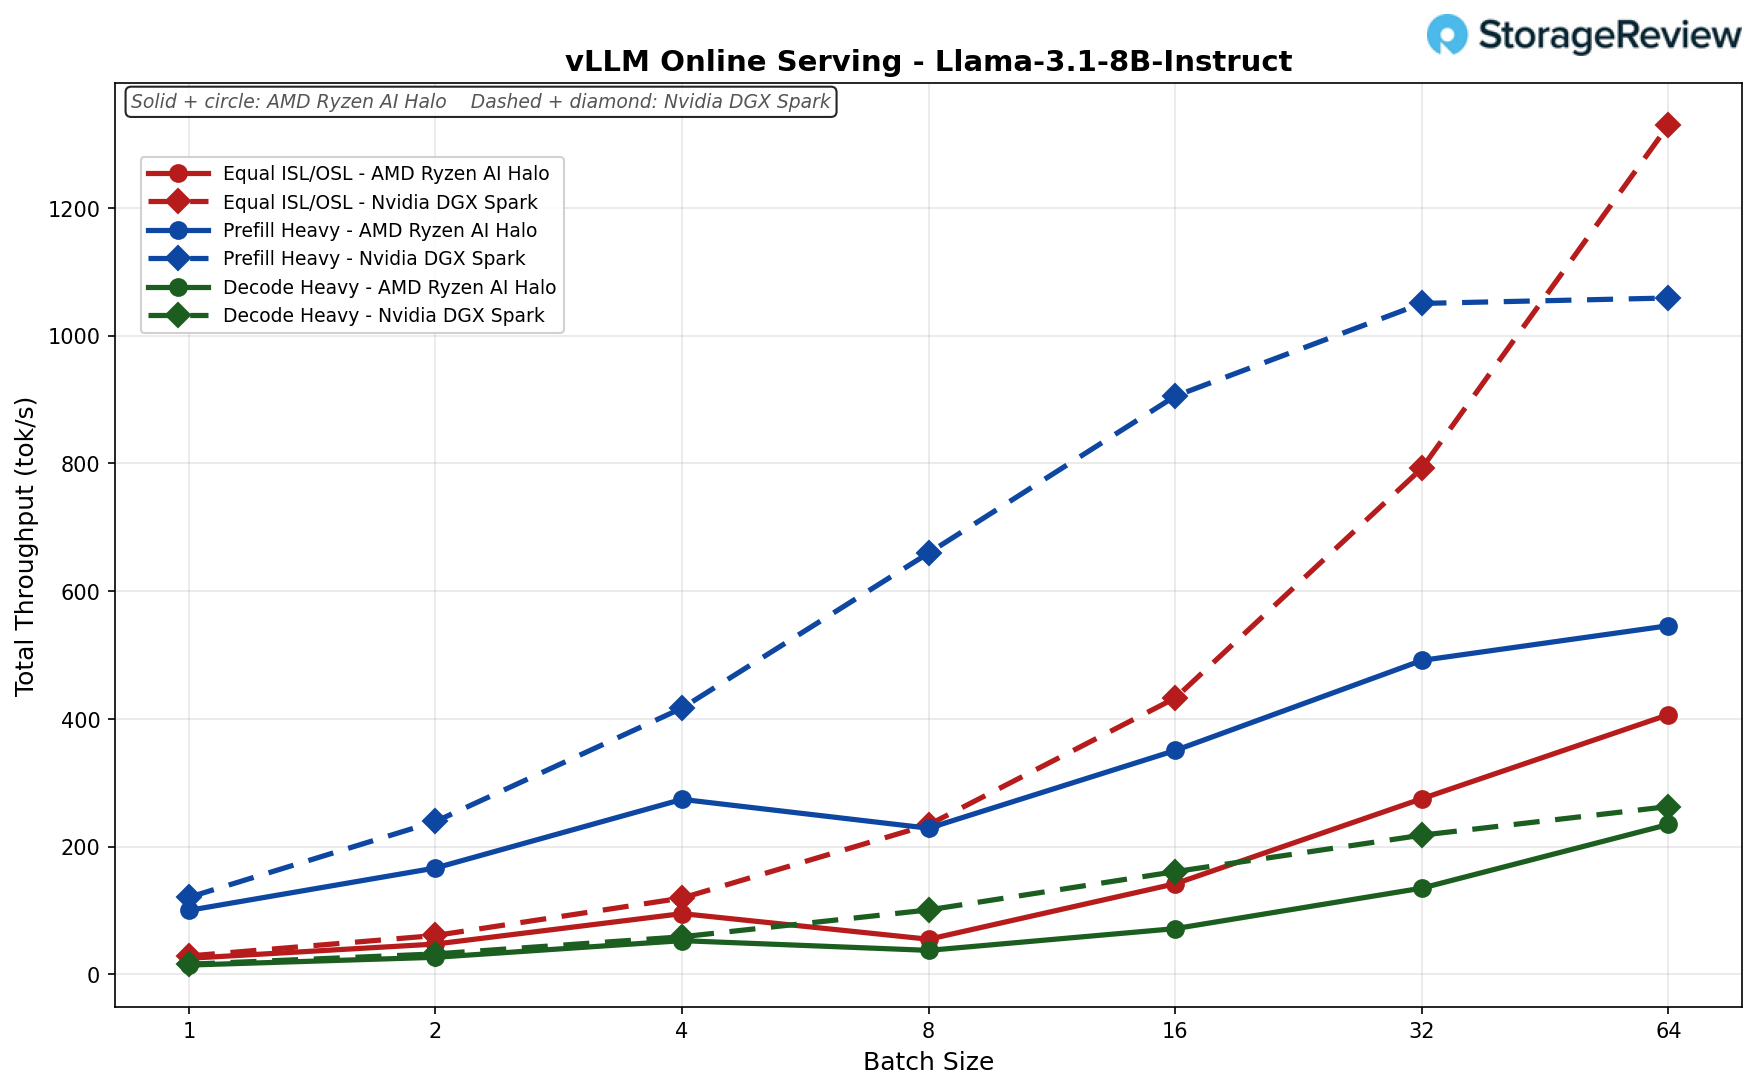
Lhama 3.1 8B Instruir
ISL/OSL iguais (256/256): O Halo escalou de forma limpa de 25 tok/s no lote 1 para 407 tok/s no lote 64, acompanhando de perto o Spark até o lote 4, após o qual o Spark ultrapassou para 1,330 (o Halo ficou cerca de 3.3 vezes atrás no pico).
Prefill Heavy (8k/1k): O Halo atingiu 546 tok/s com um tamanho de lote de 64, comportando aproximadamente metade dos 1,059 do Spark.
Decodificação Pesada (1k/8k): O cenário mais competitivo do Halo, atingindo 235 tok/s contra os 263 do Spark com um tamanho de lote de 64 (dentro de cerca de 12%).
Lhama 3.1 8B Instruções FP4
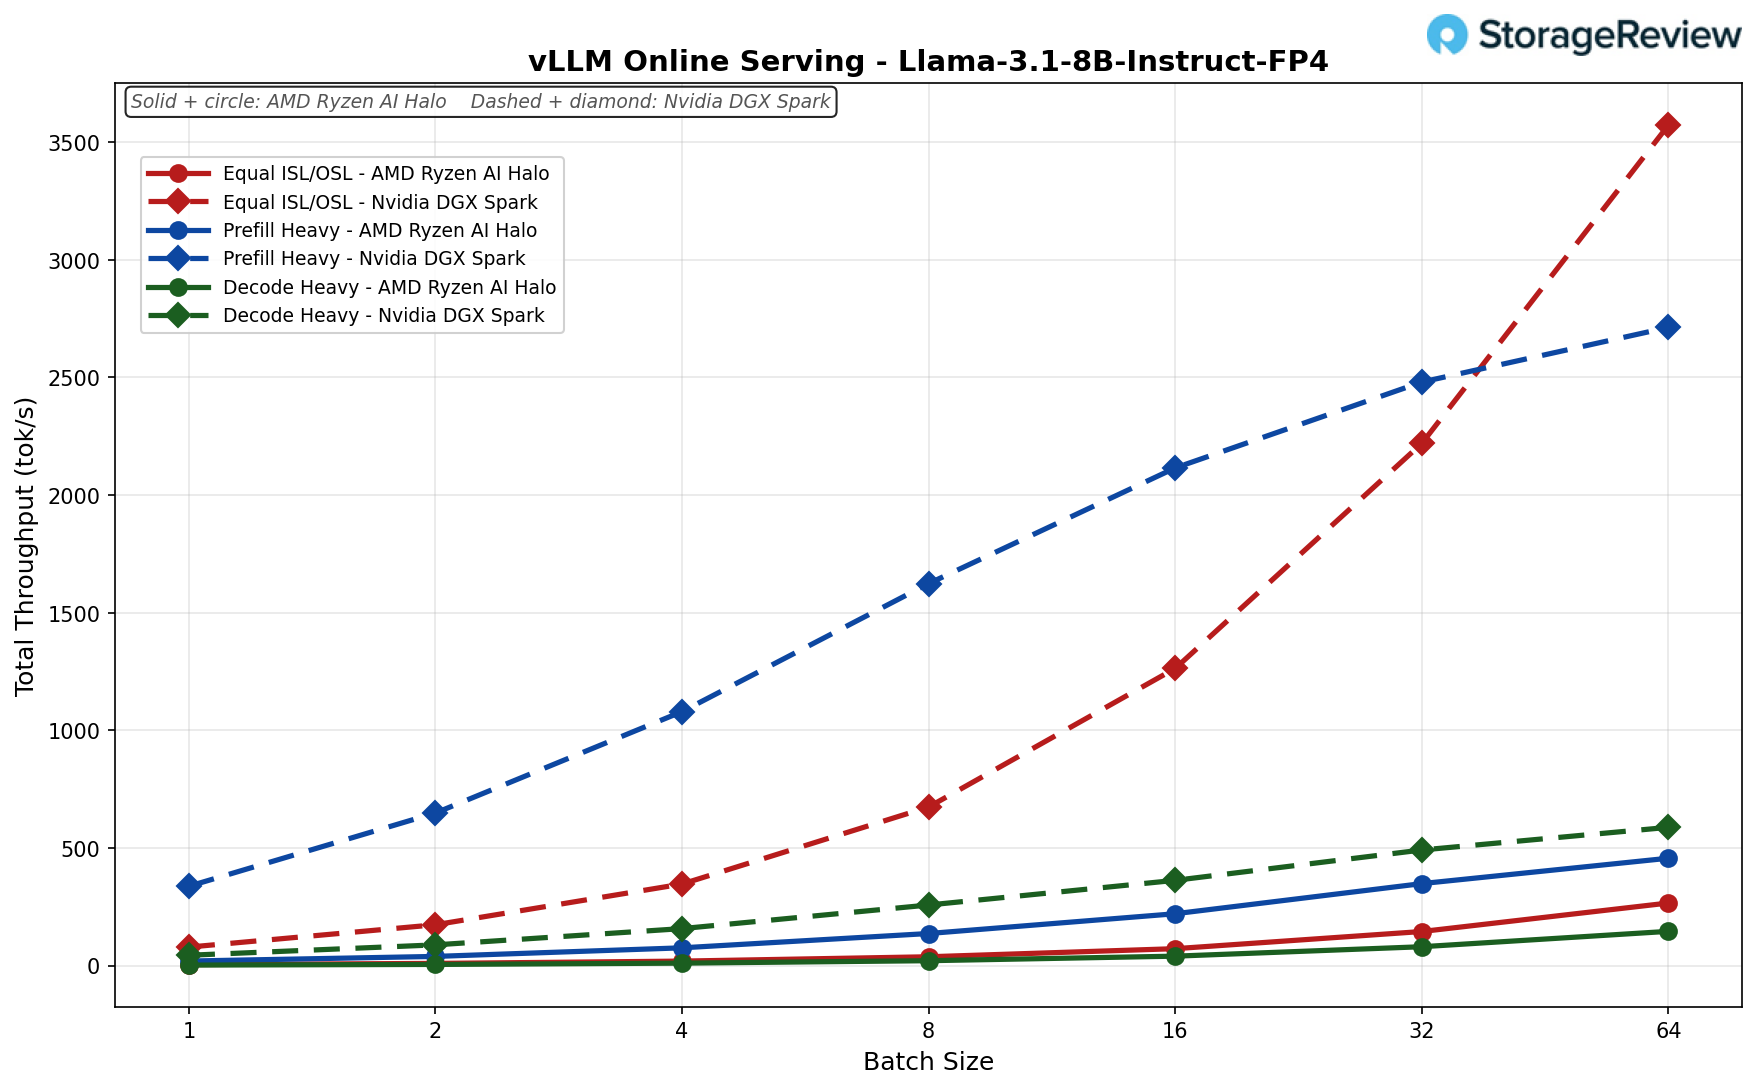
ISL/OSL iguais (256/256): O Halo atingiu um pico de 267 tok/s no tamanho de lote 64, muito atrás dos 3,573 do Spark — o FP4 mostra a maior diferença (cerca de 13.4x).
Pré-carregamento pesado (8k/1k): O Halo atingiu 457 tok/s com um tamanho de lote de 64, em comparação com os 2,713 do Spark (cerca de 5.9 vezes).
Decodificação Pesada (1k/8k): O Halo atingiu 146 tok/s, em comparação com os 588 tok/s do Spark com um tamanho de lote de 64 (cerca de 4 vezes).
Conclusão
O AMD Ryzen AI Halo entra em uma categoria que a NVIDIA efetivamente criou com o DGX Spark, e não tenta superar o Spark em seu próprio jogo. Em nossos testes com vLLM, o Spark apresentou uma vantagem de desempenho de 2 a 4 vezes na maioria dos cenários com maior concorrência, chegando a 8.8 vezes em tarefas com uso intensivo de pré-preenchimento em GPT OSS 120B e reduzindo para cerca de 10% apenas em dois testes com uso intensivo de decodificação. Além disso, seu subsistema de armazenamento venceu quase todos os testes fio em saturação. O que o Halo oferece, em vez disso, são os mesmos 128 GB de memória unificada e o limite de 200 bilhões de parâmetros em um formato similar, por US$ 3,999 contra os US$ 4,699 do Spark Founders Edition (embora alguns fabricantes o vendam por menos de US$ 4,000), em uma máquina x86 completa que inicializa Windows 11 ou Linux, em vez de apenas o sistema operacional DGX.
Deixando o Spark de lado, o Halo é a implementação mais potente de IA Max+ 395 que já testamos. Ele obteve as melhores pontuações contra o HP Z2 Mini G1a e o ZBook Ultra G1a em praticamente todos os testes de carga de trabalho do Windows: 37,316 no Cinebench R23 multi-core, 184.2 GIPS no 7-Zip contra 151.6 e 156.8 dos HPs, as maiores pontuações de geração de texto e imagem com IA Procyon e os tempos mais rápidos no y-cruncher com 5 e 10 bilhões de dígitos. No Linux, contra o Spark, ele venceu os testes Phoronix que exigem mais da CPU, comprimindo 11% mais rápido no 7-Zip e concluindo a compilação do LLVM 14% mais cedo. Trata-se, antes de tudo, de uma estação de trabalho compacta, com a função de desenvolvedor de IA integrada, em vez de substituí-la.
Desenvolvedores que precisam do máximo de tokens locais por segundo, ou que planejam agrupar nós em uma rede de alta velocidade, ainda devem optar pelo Spark; o 10GbE do Halo e seus limites de vLLM não chegam nem perto. Para desenvolvedores que criam soluções com ROCm, equipes que precisam do Windows integrado ou qualquer pessoa que queira um único dispositivo para cargas de trabalho profissionais e modelagem local, o Halo é a melhor opção, e o compartimento M.2 2280 padrão e a memória gráfica variável pré-configurada resolvem duas das reclamações mais comuns dos usuários do Spark. A AMD também afirmou que a plataforma receberá os processadores Ryzen AI Max PRO Série 400 com até 192 GB de memória unificada no terceiro trimestre, então os compradores que buscam modelos maiores têm um caminho claro a seguir sem precisar trocar de plataforma.
Página do produto – AMD Ryzen AI Halo
Classificação: O AMD Ryzen AI Halo ocupa o primeiro lugar na nossa classificação de Melhores Alternativas x86 para Desktops com IA Local.



 Amazon