

O mercado de infraestrutura de IA não está se movendo em uma única direção; ele está se dividindo em dois mundos distintos. De um lado, estão os clusters de treinamento de ponta, construídos para desenvolver modelos fundamentais em escala massiva, fortemente acoplados a arquiteturas proprietárias e a um conjunto restrito de aceleradores. Do outro, está a realidade em rápida expansão da inferência empresarial, onde as organizações implantam modelos para atender usuários, processar dados em tempo real e gerar valor comercial mensurável. O Dell PowerEdge XE7740 foi projetado especificamente para este segundo mundo.
Principais lições
- O PowerEdge XE7740 foi projetado para inferência empresarial. Com sistema térmico de zona dupla, topologia PCIe Gen5 estruturada e rede escalável alinhada a cargas de trabalho reais de produção.
- O equilíbrio do sistema é intencional. Combinando a densidade de 6 núcleos do Xeon, alta largura de banda de memória e PCIe Gen 5 E3.S NVMe para suportar o descarregamento e a orquestração do cache KV.
- A flexibilidade do silício é fundamental. Suportando uma ampla gama de aceleradores PCIe Gen5 sem a necessidade de reformulação da infraestrutura.
- A plataforma se adapta perfeitamente ao longo do tempo, Desde a implantação parcial de GPUs em um único chassi até a inferência distribuída em vários racks usando oito slots de rede dedicados Gen5 x16 na parte traseira.
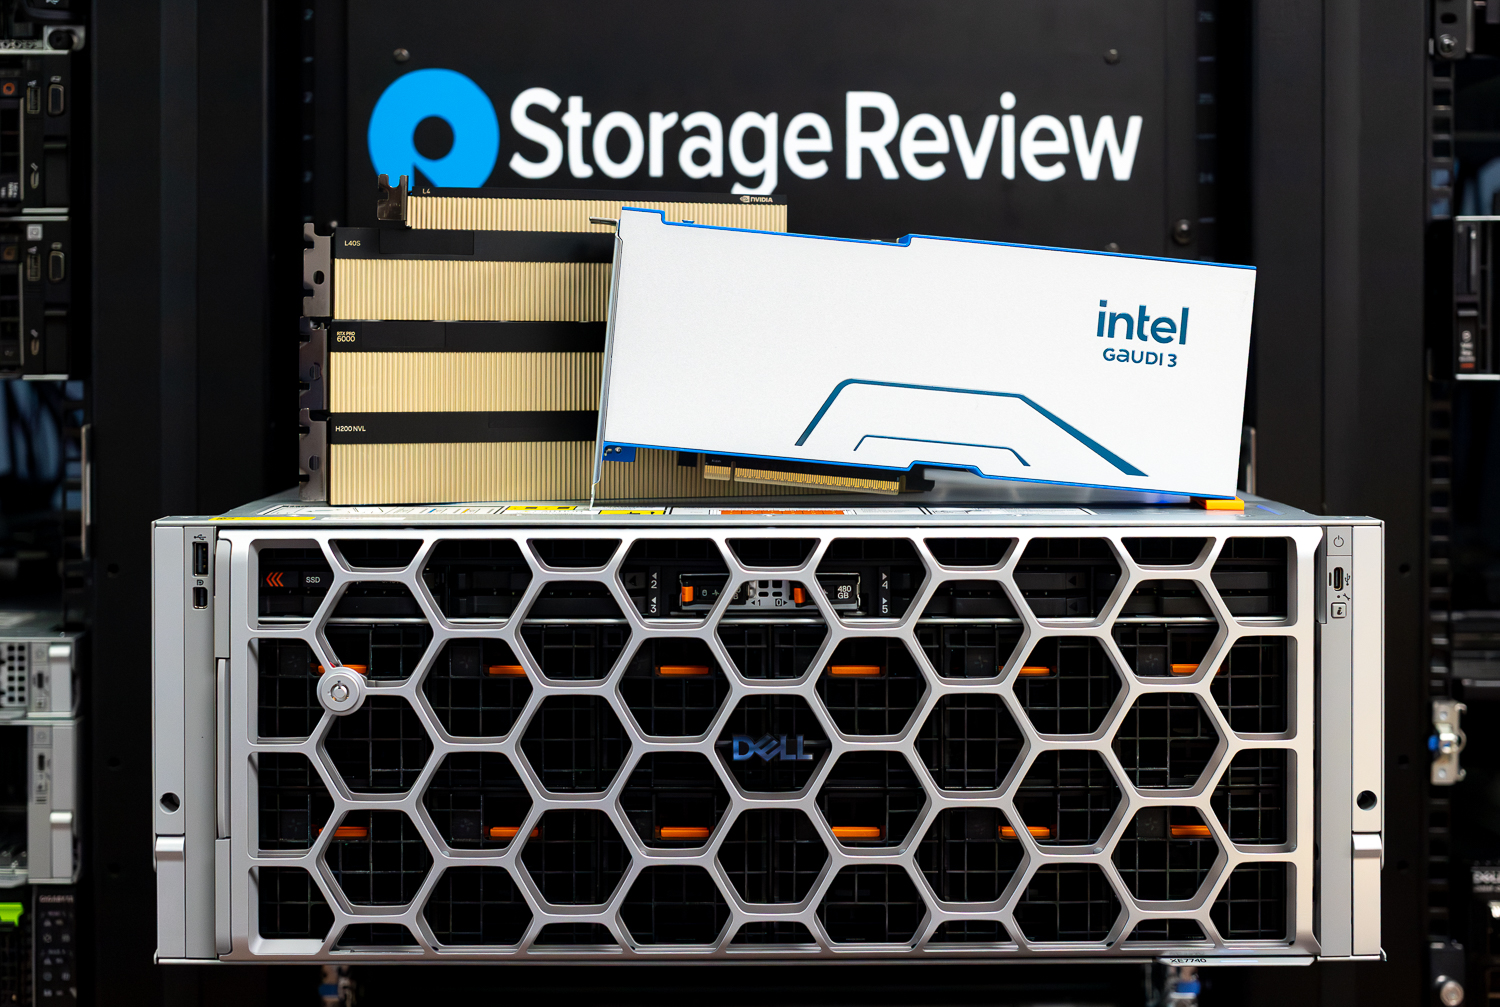
No cerne do XE7740 está o compromisso com a diversidade de silício. Em vez de ancorar a plataforma a um único roteiro de aceleradores, a Dell construiu um sistema que se adapta à disponibilidade, ao custo e à prontidão organizacional. O XE7740 suporta uma gama de aceleradores PCIe Gen5, incluindo as GPUs NVIDIA RTX PRO 6000, H100/200, L40S, L4 e A16 para organizações que valorizam a ampla compatibilidade com o ecossistema, e o Intel Gaudi 3 para equipes que buscam um caminho de inferência mais econômico e prontamente disponível. Os aceleradores Gaudi 3 já estão disponíveis, permitindo que as organizações passem do planejamento à implementação sem os atrasos de aquisição que frequentemente moldam a estratégia de aceleradores.
À medida que a inferência se torna a carga de trabalho dominante em IA, a disponibilidade e a estrutura de custos tornam-se cruciais. A maioria das empresas não está treinando modelos de ponta. Elas executam pipelines de inferência, atendem modelos de linguagem de médio porte, alimentam fluxos de trabalho de geração aprimorados por recuperação e implementam visão computacional em produção. Nesse contexto, o Gaudi 3 se posiciona como um dos aceleradores de inferência modernos mais acessíveis do mercado, oferecendo uma arquitetura contemporânea com memória de alta largura de banda e escalabilidade horizontal baseada em Ethernet, sem o custo elevado das GPUs de treinamento de ponta. Dentro do XE7740, o Gaudi 3 visa menos a substituição de GPUs existentes e mais a viabilização de implementações de inferência sustentáveis.
A plataforma que envolve os aceleradores é igualmente bem projetada. O XE7740 é baseado em processadores Intel Xeon 6 e, em sistemas focados em inferência, a CPU continua sendo um componente crítico. O alto número de núcleos e a maior largura de banda da memória fornecem a capacidade necessária para tarefas de agendamento, tokenização, pré-processamento e orquestração que atuam diretamente no caminho crítico da inferência. O armazenamento NVMe E3.S montado na parte frontal oferece suporte adicional ao armazenamento local de dados e ao descarregamento do cache KV, reduzindo a carga do acelerador e melhorando a eficiência geral do sistema. Esse design equilibrado reflete a compreensão de que o desempenho da inferência é moldado por todo o sistema, e não apenas pelos aceleradores.
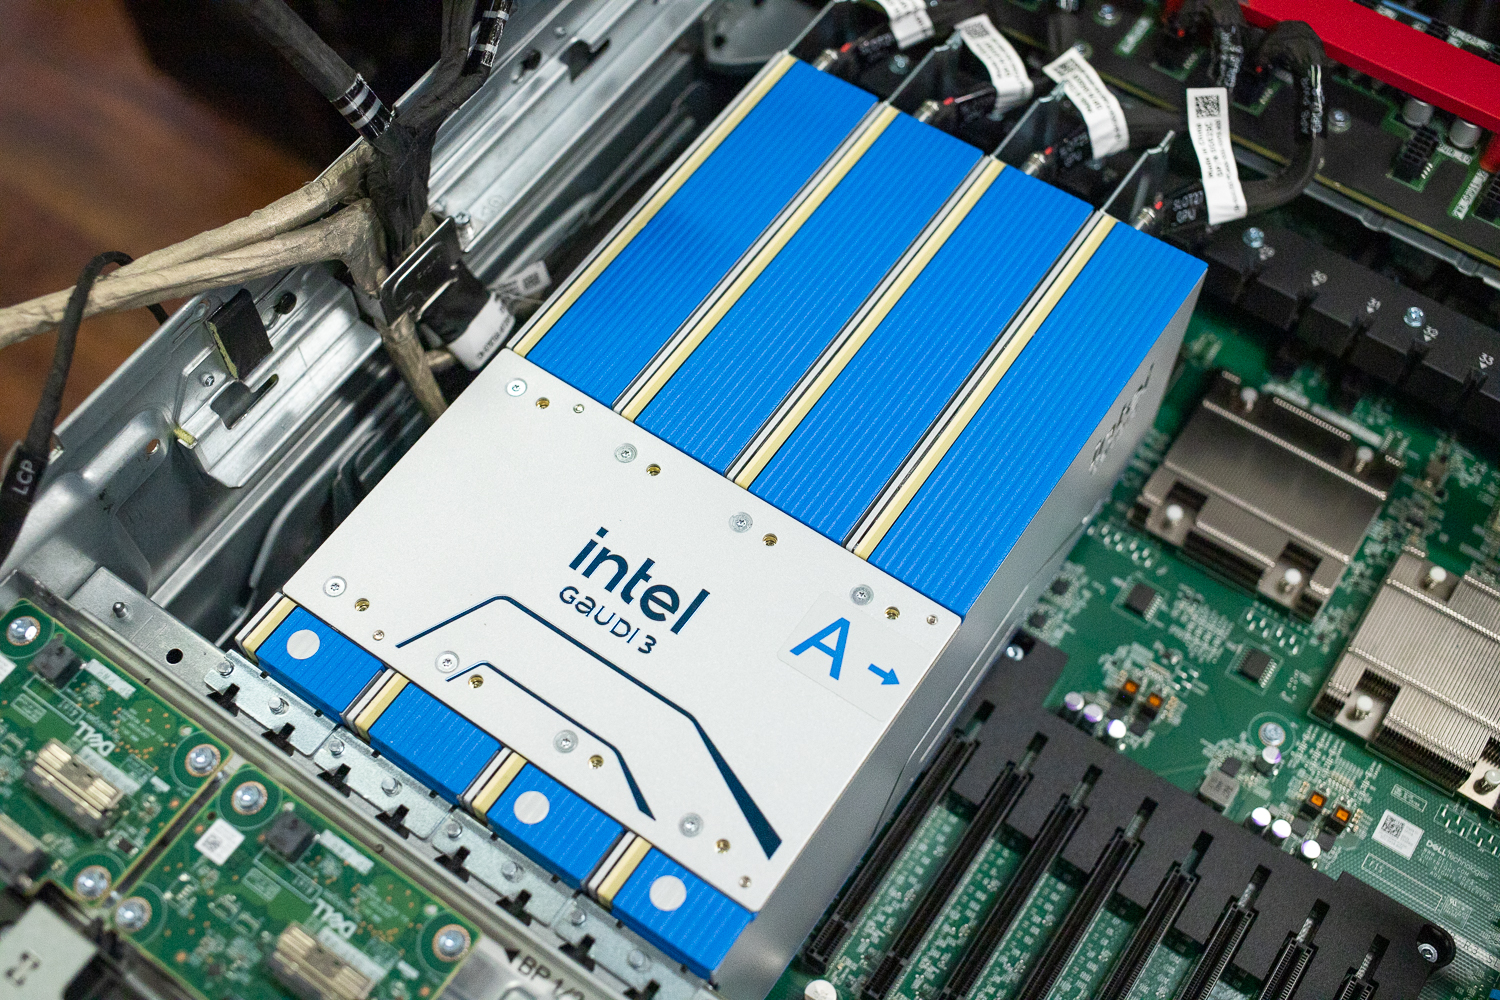
O XE7740 também foi projetado para escalar de forma eficiente ao longo do tempo. As organizações podem começar com uma configuração modesta, como dois ou quatro aceleradores, e obter valor imediato sem precisar preencher todo o chassi. À medida que os requisitos aumentam, a mesma plataforma pode ser escalada verticalmente ou migrar para inferência distribuída. Oito slots PCIe Gen5 x16 voltados para trás oferecem largura de banda dedicada para redes de alta velocidade, permitindo que o XE7740 sirva como um bloco de construção para clusters de inferência escaláveis. O suporte opcional a DPU amplia ainda mais essa flexibilidade, descarregando tarefas de rede e comunicação à medida que as implementações amadurecem.
Principais especificações do Dell PowerEdge XE7740
| Especificação | PowerEdge XE7740 |
|---|---|
| Características do PowerEdge XE7740 | |
| Subcontratante | Dois processadores Intel® Xeon® série 6, com até 86 núcleos por processador. |
| Caça-níqueis | |
| Aceleradores PCIe | 8x PCIe Gen 5 x16 DW-FHFL até 600 W, ou
16x PCIe Gen 5 x16 SW-FHFL até 75 W |
| Placas de rede PCIe |
|
| Fator de forma | |
| Fator de forma | Servidor de rack 4U |
| Memória | |
| Velocidade DIMM, capacidade máxima | Até 6400 MT/s, 4 TB máx. |
| Slots de módulo de memória | 32 slots DDR5 DIMM Suporta apenas memórias RDIMM DDR5 ECC registradas. |
| Armazenamento | |
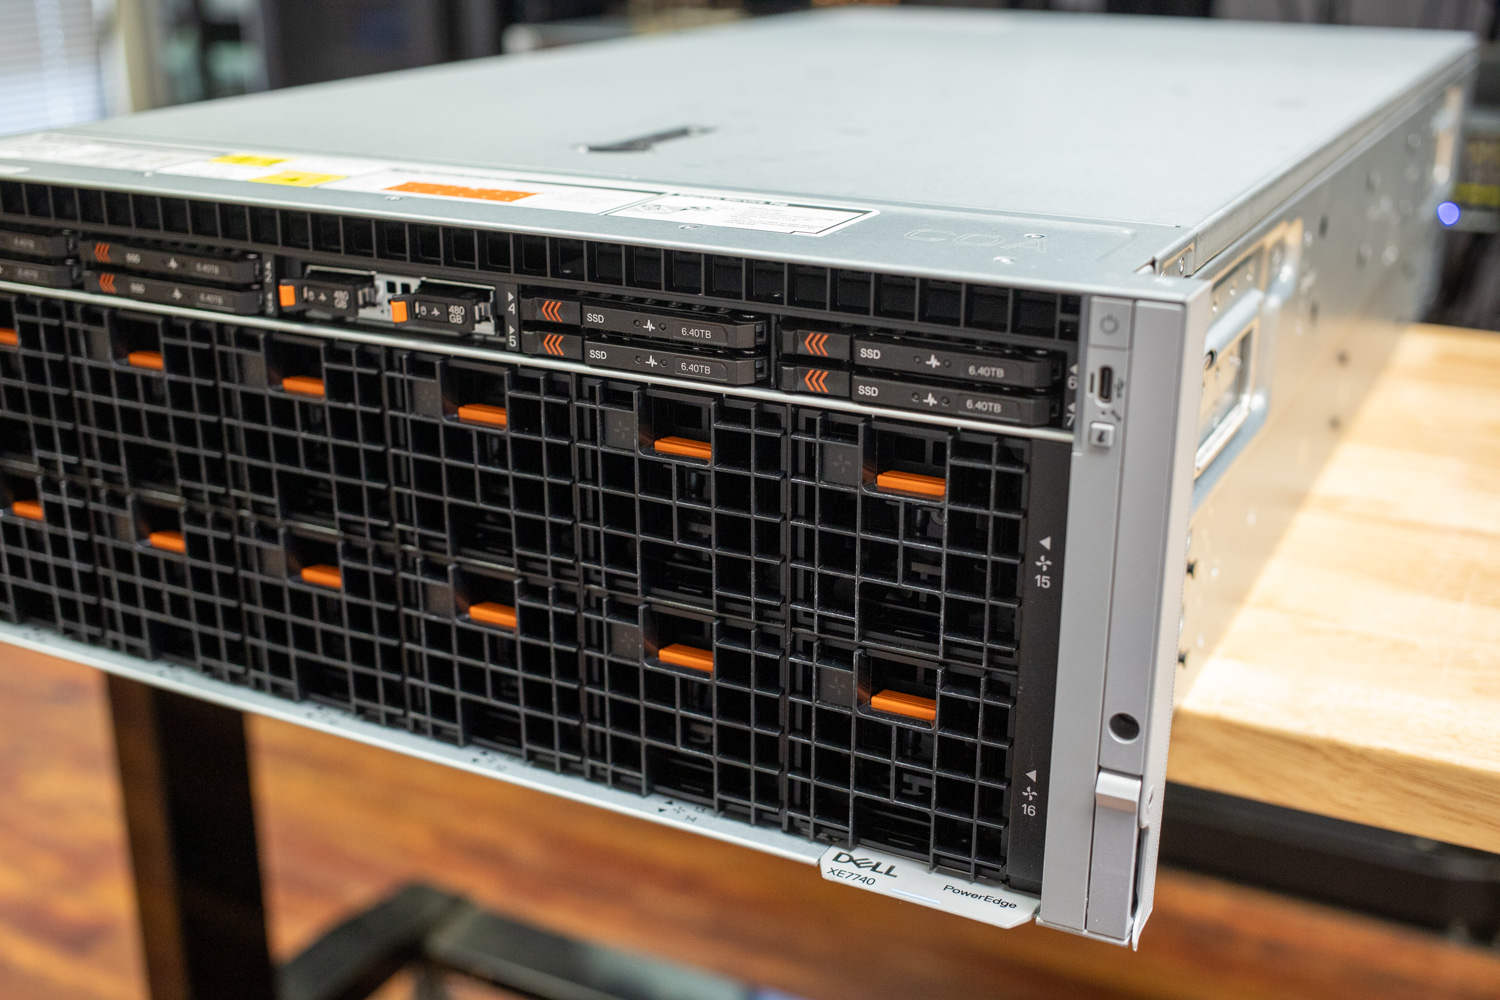
| Baías frontais | Até 8 x EDSFF E3.S Gen5 NVMe (SSD) máximo de 122.88 TB |
| Controladores de armazenamento | |
| Bota interna | Subsistema de armazenamento otimizado para inicialização (BOSS-N1 DC-MHS): HWRAID 1, 2 x M.2
SSDs NVMe |
| Fonte de energia | |
| Fonte de energia | Fonte de alimentação redundante de 3200 W em titânio, 200-240 V CA ou 240 V CC, com troca a quente.
Multicapacidade para fonte de alimentação de 3200 W:
Multicapacidade para fonte de alimentação de 2400 W:
ATENÇÃO: O sistema requer pelo menos uma fonte de alimentação na zona da CPU e uma fonte de alimentação na zona da GPU para manter o BMC e a alimentação em modo de espera. Se a zona da GPU não tiver nenhuma fonte de alimentação instalada, o sistema permanecerá em modo de espera. Para garantir redundância total, instale N+N fontes de alimentação em cada zona: 1+1 na zona da CPU e 3+3 na zona da GPU. Remover todas as fontes de alimentação da zona da CPU enquanto o sistema estiver ligado causará um desligamento imediato e poderá resultar em perda de dados. |
| Opções de resfriamento | |
| Opções de resfriamento | Resfriamento a ar |
| fãs | Até quatro conjuntos de ventoinhas de alto desempenho (HPR) com certificação Platinum (módulo de ventoinha dupla) instaladas na bandeja central.
Até doze ventoinhas de alto desempenho (HPR) com certificação Platinum instaladas na parte frontal do sistema. Todos são fãs de troca a quente |
| Portos | |
| Opções de rede | 1 E/S compatível com PCIe Gen 5 OCP 3.0 (suportada por 8 pistas PCIe) |
| Portas frontais | 1 x USB 2.0 Tipo A (opcional) 1 x Mini-DisplayPort (opcional) 1 x USB 2.0 Type-C de modo duplo (porta Host/iDRAC Direct) |
| Portas traseiras | 1 porta Ethernet dedicada para iDRAC/BMC 2 portas USB 3.1 Tipo A 1 x VGA |
| Portas internas | 1 x USB 3.1 tipo A |
Projeto e construção do XE7740
Arquitetura de Zona Dupla: Separação de CPU e GPU
Uma das escolhas de design mais marcantes do XE7740 é a sua separação física em duas zonas distintas de refrigeração e alimentação. A seção superior de 1U abriga a zona da CPU, que inclui os dois processadores Xeon 6, todos os 32 slots DIMM, o armazenamento e o módulo de gerenciamento DC-SCM. A zona da CPU utiliza quatro conjuntos de módulos de alto desempenho com duas ventoinhas (40×40×56mm) que fornecem um fluxo de ar de 47.4 CFM.
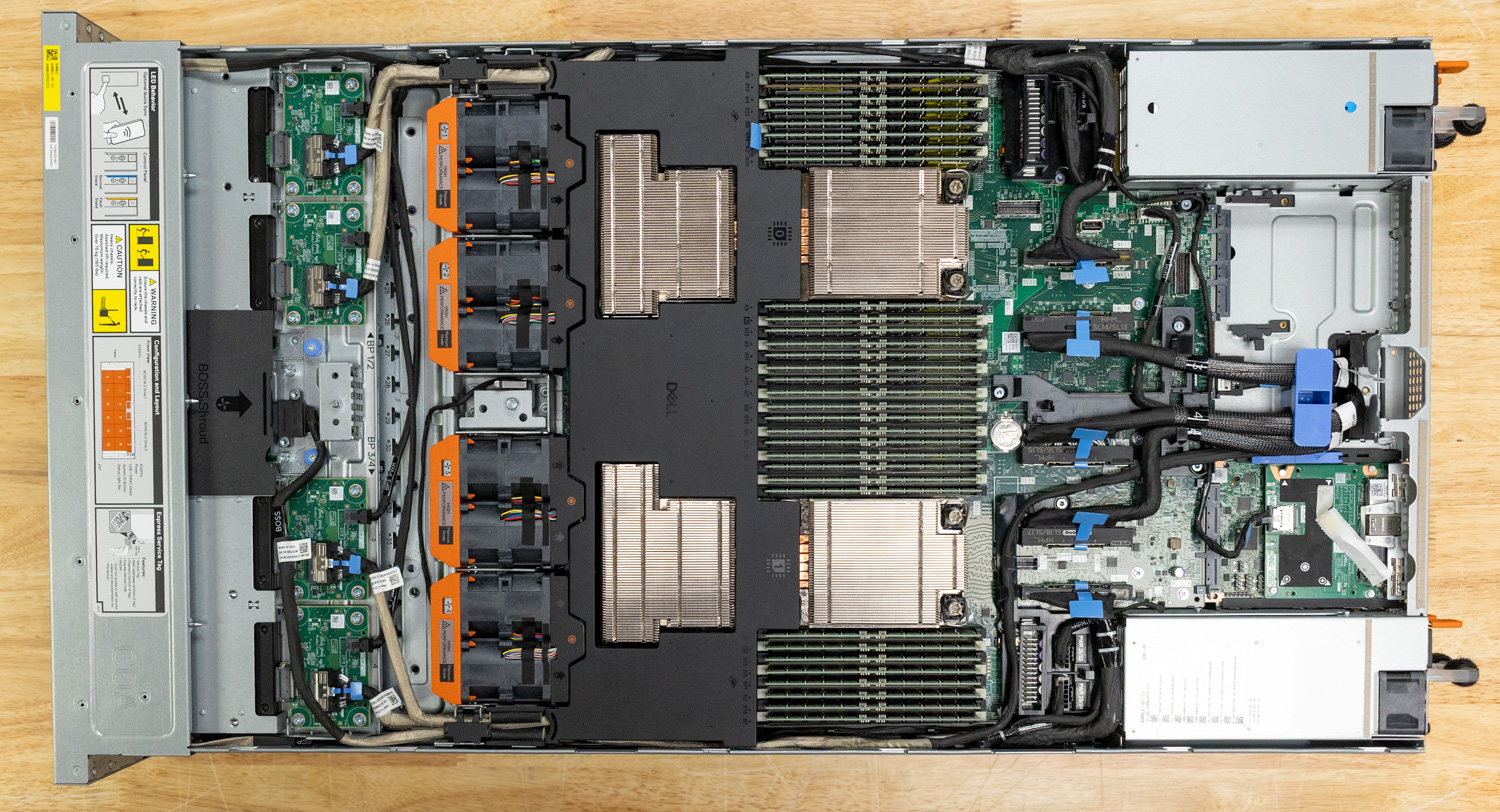
A seção inferior de 3U é a zona da GPU, contendo todos os slots de aceleradores com sua própria infraestrutura de resfriamento dedicada, juntamente com a placa base PCIe (PBB), slots de expansão PCIe traseiros e conectividade OCP NIC. A zona da GPU utiliza doze ventoinhas maiores de alto desempenho (60×60×56 mm) com capacidade de fluxo de ar significativamente maior, de até 122.2 CFM por ventoinha, em comparação com as ventoinhas da CPU. Todas as ventoinhas são hot-swappable. Essa abordagem de resfriamento de zona dupla significa que as demandas térmicas de aceleradores de alto TDP (até 600 W por placa) não comprometem o resfriamento da CPU e da memória, e vice-versa, em um rack padrão de 19 polegadas.
A Dell dedicou especial atenção à otimização do fluxo de ar no XE7740. Sistemas com alta densidade de aceleradores exigem, inerentemente, uma quantidade substancial de cabos internos, incluindo cabos de alimentação auxiliar da GPU, cabos de sinal PCIe entre a placa HPM e a PBB, e conexões da placa de ventoinhas. No XE7740, esses cabos são roteados ao longo das paredes laterais do chassi utilizando suportes e capas de cabos dedicados. Cada cabo é fabricado com o comprimento exato necessário; não há excesso de cabos dentro do sistema. Ao manter os cabos fora do canal central de fluxo de ar, o design preserva um caminho de fluxo de ar livre da frente para trás e minimiza a impedância nas zonas de resfriamento da CPU e da GPU.
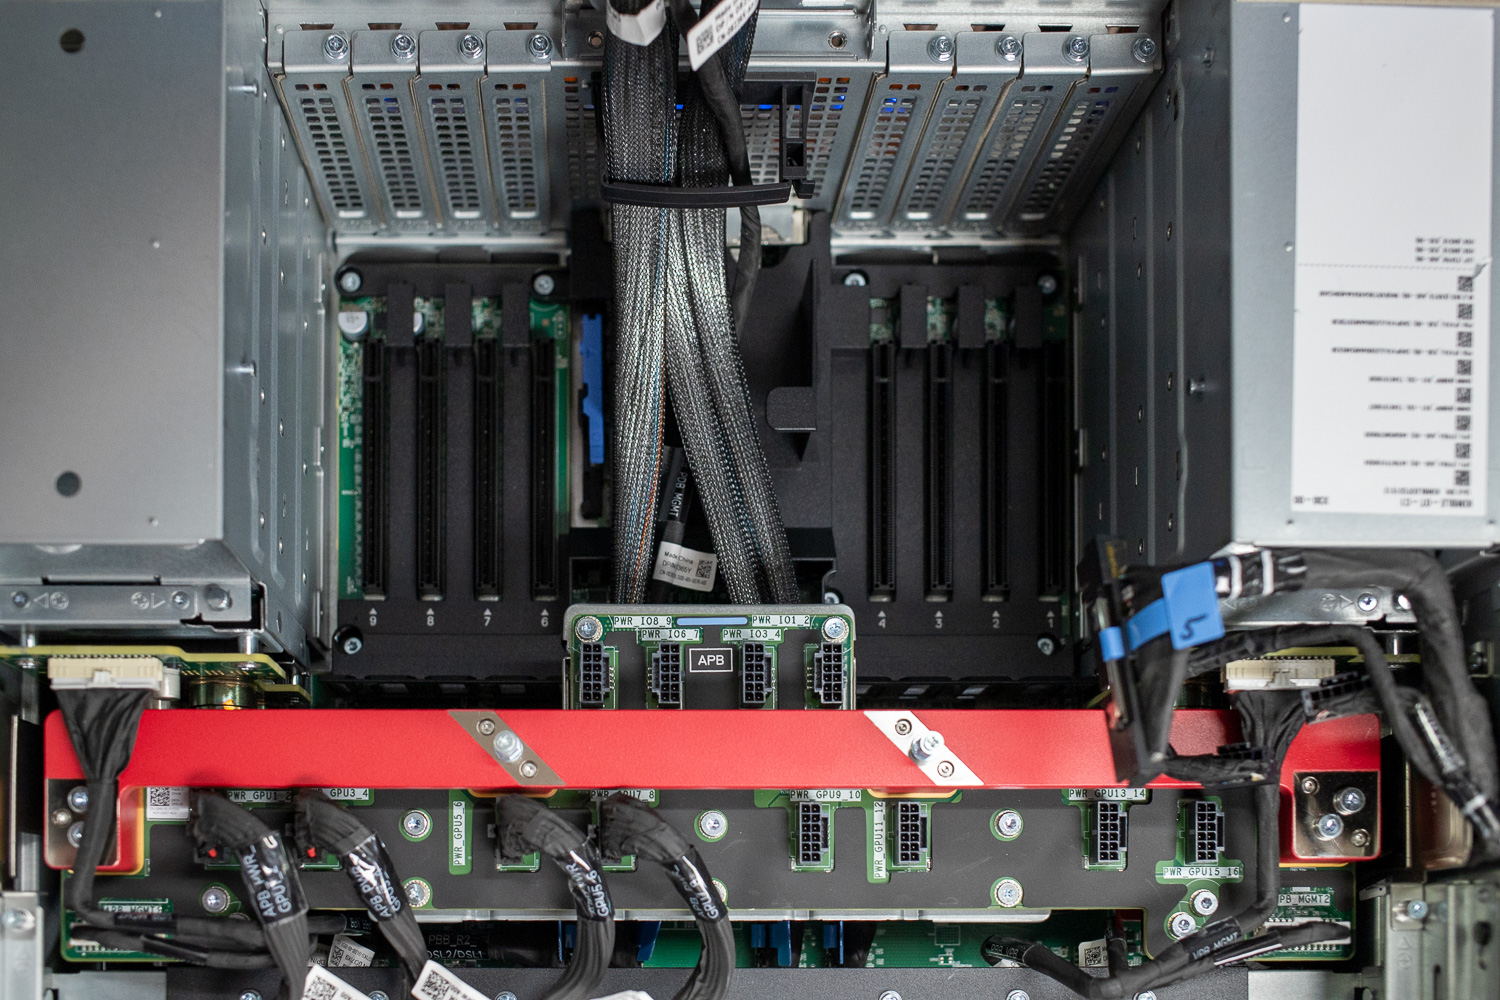
Em um chassi que abriga até oito aceleradores de 600 W, mesmo pequenas obstruções no fluxo de ar podem criar pontos quentes localizados e forçar as ventoinhas a funcionar em velocidades mais altas, aumentando o consumo de energia e o ruído. A abordagem de gerenciamento de cabos da Dell mantém o centro do chassi livre para um fluxo de ar direto e desobstruído sobre os componentes que mais precisam.
Topologia e fluxo de dados do switch PCIe
O subsistema PCIe do XE7740 é construído em torno de quatro switches PCIe Gen 5 na placa base PCIe (PBB), designados de SW1 a SW4. Esses switches formam a espinha dorsal da arquitetura de E/S do sistema, conectando aceleradores, rede e armazenamento aos dois processadores Xeon 6 em uma topologia cuidadosamente organizada.
Os 16 slots internos para GPUs são divididos em dois bancos de oito, com cada banco atendido por um par de switches PCIe, cada um conectado a montante de uma CPU. Dentro de cada banco, pares de slots de GPU adjacentes de largura dupla se intercalam entre os dois switches. No lado da CPU0, o SW1 atende os slots de GPU 21 e 25, bem como os slots PCIe traseiros 8 e 9, enquanto o SW2 atende os slots de GPU 23 e 27, bem como os slots PCIe traseiros 6 e 7. No lado da CPU1, o SW3 atende os slots de GPU 29 e 33, bem como os slots PCIe traseiros 3 e 4, enquanto o SW4 atende os slots de GPU 31 e 35, bem como os slots PCIe traseiros 1 e 2.

Cada domínio de CPU, portanto, possui quatro slots de acelerador de largura dupla, quatro slots de NIC/E/S voltados para trás e quatro dos oito compartimentos de armazenamento NVMe E3.S voltados para a frente. Essa topologia de switch tem implicações significativas para o fluxo de dados, particularmente para o tráfego baseado em RDMA. Como cada switch hospeda slots de acelerador e de NIC traseiros, um acelerador e um adaptador de rede no mesmo switch podem realizar transferências RDMA inteiramente dentro da estrutura do switch. Os dados nunca precisam atravessar o complexo raiz da CPU, eliminando o buffer de retorno da CPU que seria necessário quando um dispositivo PCIe em uma porta raiz se comunica com um dispositivo em outra. Isso reduz a latência, evita o consumo de largura de banda de memória da CPU e libera ciclos de CPU para outras tarefas.
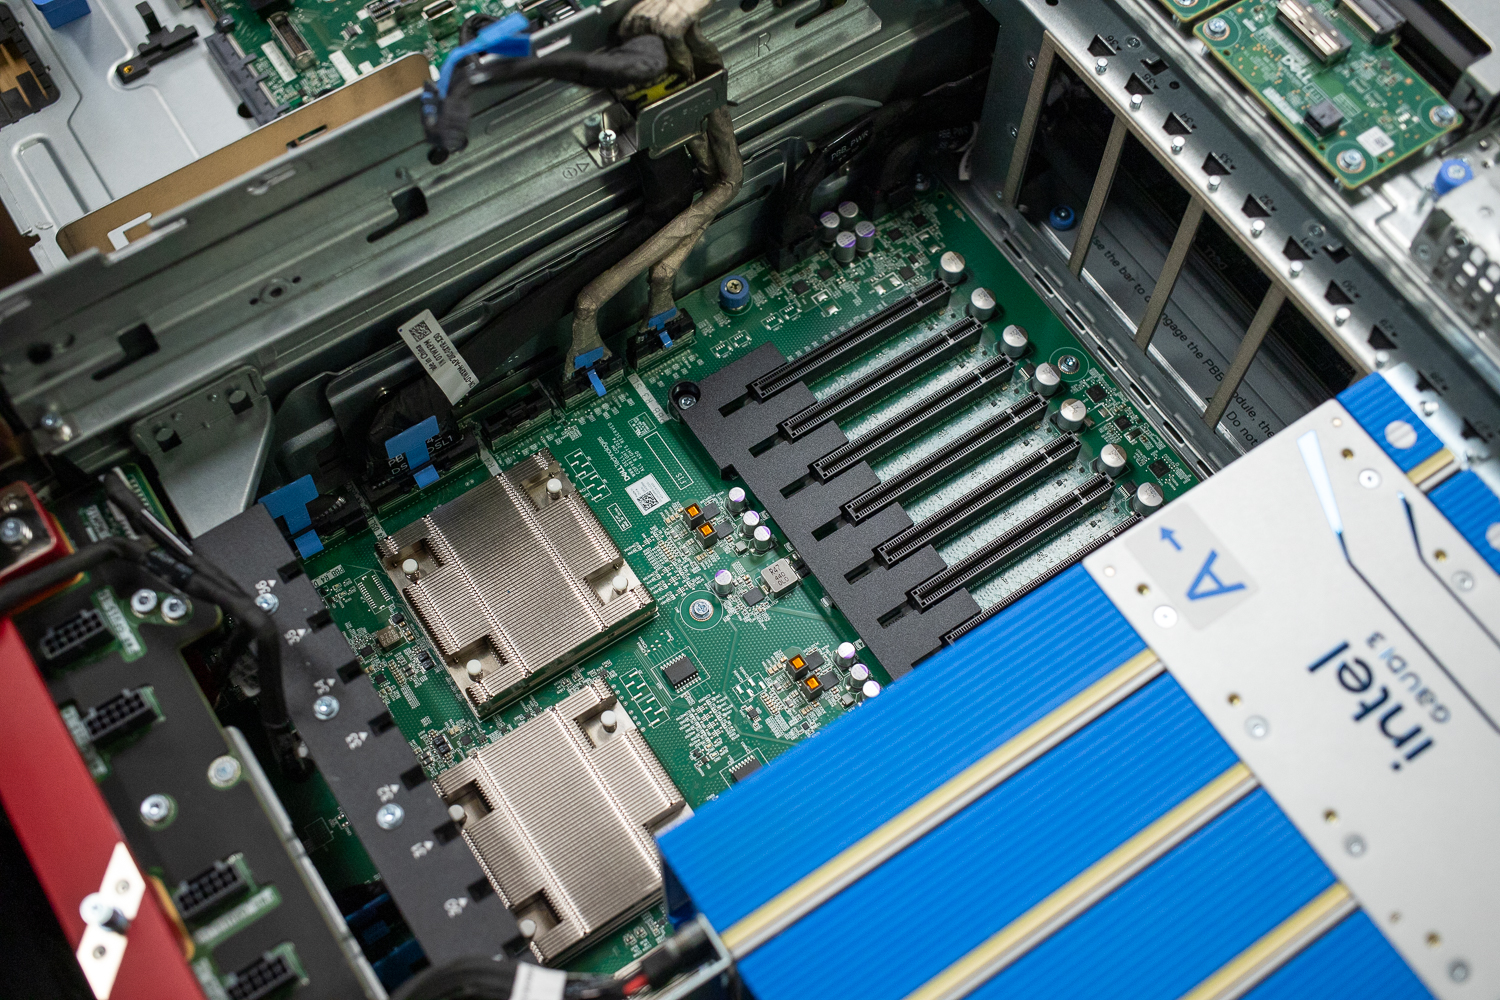
A comunicação dentro do domínio de uma única CPU entre seus dois switches é roteada pelo complexo raiz da CPU, mas permanece local ao socket. A comunicação entre CPUs, no entanto, precisa atravessar os links UPI entre os dois processadores Xeon 6. O 6787P oferece quatro links UPI 2.0 com 24 GT/s cada, proporcionando uma largura de banda considerável entre sockets. Contudo, o tráfego entre um acelerador no banco de switches da CPU0 e uma NIC no banco de switches da CPU1 terá inerentemente uma latência maior do que as transferências locais entre switches ou no mesmo socket.
Os switches em si não estão diretamente interconectados. Todo o tráfego entre switches passa pelo complexo raiz da CPU, portanto, entender a afinidade entre slots de GPU, slots de NIC, armazenamento e soquetes de CPU é importante. Para simplificar essa complexidade para as organizações, a Dell oferece configurações validadas e otimizadas para aceleradores populares.
Fonte de alimentação de zona dupla
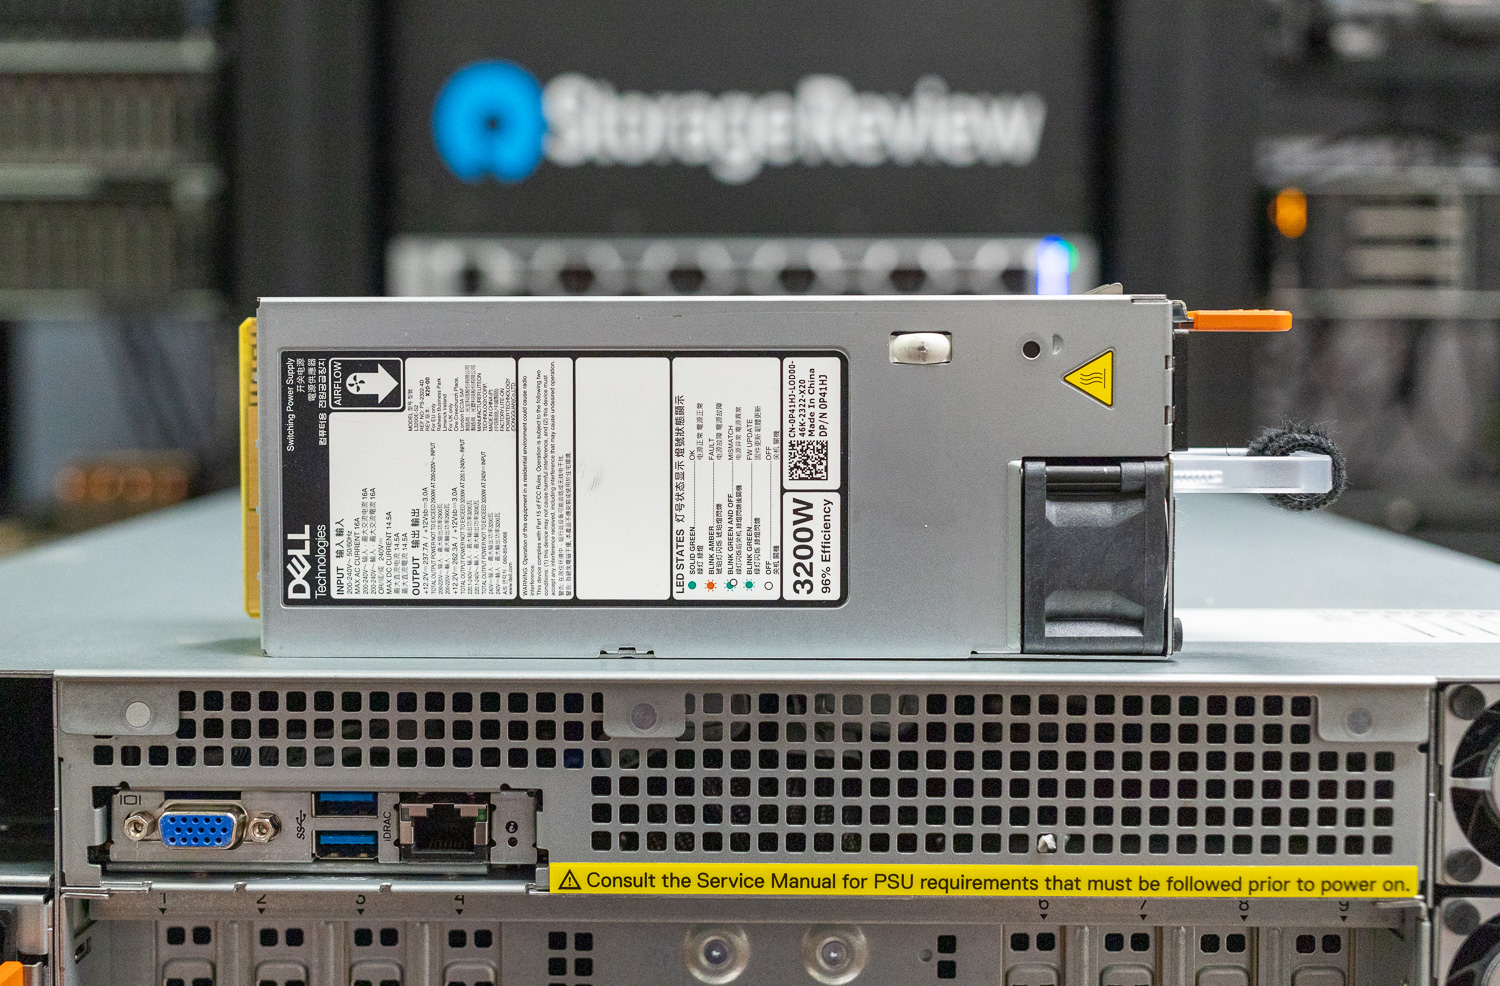
O fornecimento de energia do XE7740 reflete sua arquitetura térmica com um design de fonte de alimentação de zona dupla um tanto incomum. O sistema suporta até oito unidades de fonte de alimentação hot-swappable, divididas em duas zonas: a Zona 1 (zona da CPU) abriga as fontes de alimentação 1 e 2, enquanto a Zona 2 (zona da GPU) abriga as fontes de alimentação 3 a 8.
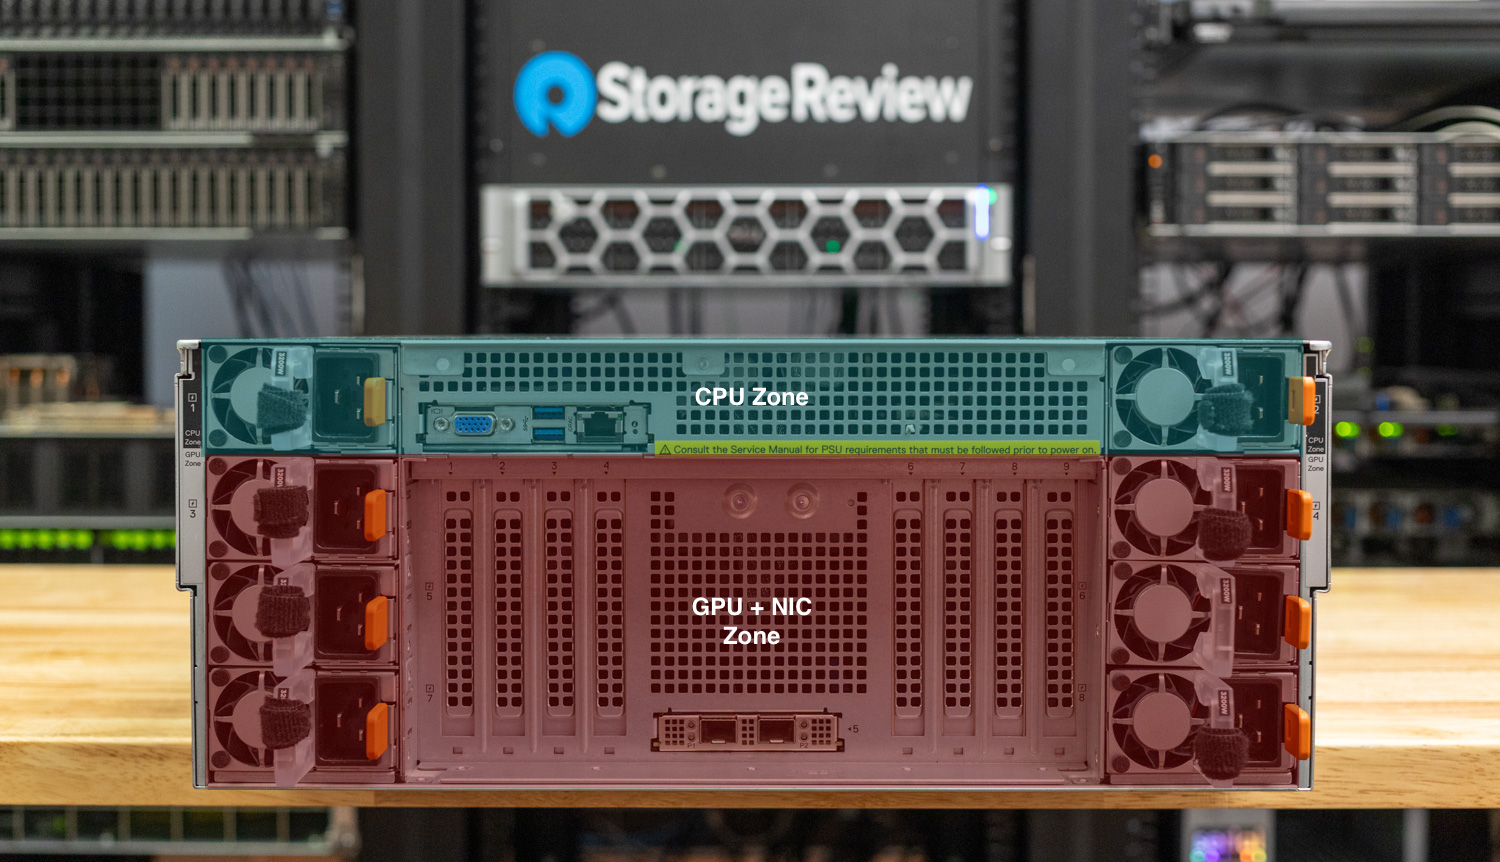
O sistema requer pelo menos uma fonte de alimentação em cada zona para manter o BMC e a alimentação em modo de espera. Se alguma das zonas perder energia CA enquanto o sistema estiver em funcionamento, o sistema será desligado imediatamente para evitar perda de dados. As zonas são interdependentes para operação, mesmo estando fisicamente e eletricamente separadas. Para redundância total, a Dell recomenda uma configuração 1+1 na zona da CPU e uma configuração 3+3 na zona da GPU, o que significa que todos os oito compartimentos de fontes de alimentação devem estar ocupados para uma implementação totalmente redundante.
Dell AIOps, Gerenciamento e Confiabilidade Empresarial
A plataforma PowerEdge da Dell conquistou uma reputação no setor pela sua confiabilidade e facilidade de manutenção. Os clientes corporativos destacam consistentemente os mesmos pontos: os sistemas PowerEdge são construídos para durar, a equipe de suporte da Dell resolve problemas rapidamente e as ferramentas de gerenciamento são maduras e bem integradas. O XE7740 dá continuidade a essa tradição, e a Dell fez avanços significativos tanto no gerenciamento de hardware quanto na segurança nesta geração.
iDRAC10
O XE7740 vem equipado com o iDRAC 10 de última geração da Dell, uma atualização substancial em relação ao já competente iDRAC 9, no qual os clientes da Dell confiam há anos. Implementado como um Módulo de Controle Seguro de Data Center (DC-SCM) em conformidade com o padrão OCP DC-MHS, o iDRAC 10 não é apenas uma atualização de firmware; ele representa um novo hardware. O controlador possui quatro núcleos de 1 GHz com arquitetura de 64 bits e 2 GB de memória DDR4 (o dobro da geração anterior), oferecendo desempenho e capacidade de resposta significativamente aprimorados para operações de gerenciamento.
Em termos de segurança, o iDRAC 10 introduz diversas melhorias notáveis. A plataforma apresenta suporte criptográfico mais robusto em todos os aspectos, incluindo autenticação SHA-384 e SHA-512 e criptografia AES-256 resistente à computação quântica, enquanto o setor se prepara para as ameaças criptográficas pós-quânticas. Um enclave de segurança integrado e dedicado dentro do silício do iDRAC 10 gerencia as funções de resiliência cibernética, incluindo atestação em nível de dispositivo e a Raiz de Confiança personalizada da Dell. Essa Raiz de Confiança baseada em hardware garante que todo o firmware (BIOS, iDRAC e firmware de componentes) seja verificado criptograficamente antes da execução, protegendo contra ataques à cadeia de suprimentos e adulteração de firmware.
A Verificação Segura de Componentes garante que os sistemas entregues pela fábrica da Dell cheguem com os componentes e configurações exatos especificados pelo cliente, mantendo a integridade desde a fabricação até a implantação. O firmware iDRAC 10 mais recente também oferece uma interface de usuário modular e renovada que aprimora a experiência administrativa diária.
OpenManage Enterprise
Para gerenciamento de frotas em grande escala, o Dell OpenManage Enterprise oferece monitoramento centralizado, atualizações de firmware e gerenciamento de configuração em todas as implementações PowerEdge. Uma adição recente notável para implementações focadas em IA é que o OME agora oferece visibilidade direta das estatísticas da GPU e do acelerador: consumo de energia, temperatura, utilização, contagem de erros e muito mais, sem a necessidade de ferramentas específicas de cada fornecedor. Para organizações que gerenciam dezenas ou centenas de nós XE7740 em um cluster de inferência, esse plano de gerenciamento unificado representa uma simplificação operacional significativa.
IntelXeon 6
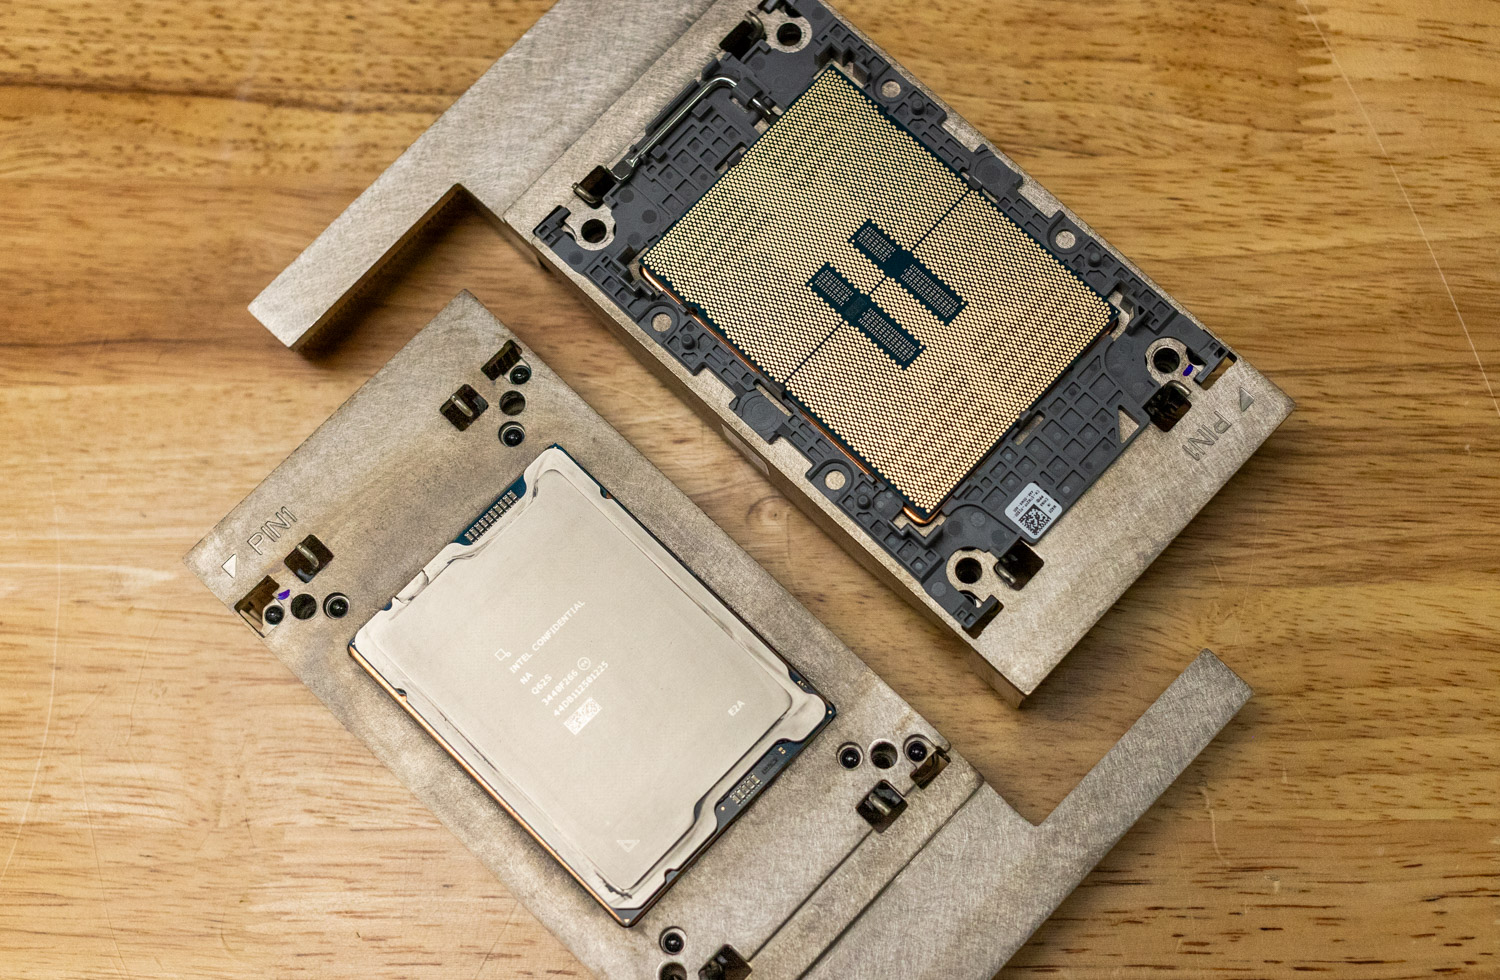
No coração do XE7740 estão dois processadores Intel Xeon 6 6787P, o carro-chefe da série Xeon 6700P. Construído com a arquitetura Granite Rapids usando a tecnologia Intel de 3 nm, o 6787P oferece 86 núcleos P (172 threads) por soquete com um TDP de 350 W, clock base de 2.0 GHz e clock turbo de 3.8 GHz.
O que torna o Granite Rapids particularmente relevante para infraestrutura de IA é a combinação de um alto número de núcleos e seu subsistema de memória. Cada processador 6787P oferece oito canais de memória DDR5 com velocidades de até 6400 MT/s. Com um chipset XE7740 de dois soquetes equipado com 32 módulos DIMM, o sistema pode ser configurado para até 4 TB de memória total.
A capacidade de memória e a largura de banda são cruciais para cargas de trabalho de IA, especialmente ao se utilizar o descarregamento do cache KV. À medida que modelos de linguagem grandes aumentam o comprimento do contexto, o cache KV escala proporcionalmente e pode consumir uma quantidade significativa da memória do acelerador. Descarregar partes do cache KV para a memória do sistema ou para um armazenamento rápido permite que a HBM (Memória de Alta Prioridade) do acelerador seja usada de forma mais eficiente para computação ativa, reduzindo o tempo até o primeiro token (TTFT) em chats com múltiplas interações.
Vale destacar também as unidades de tensores AMX do Xeon 6, que executam tarefas significativas no lado da CPU. Isso inclui pré-processamento, tokenização e inferência híbrida que envolvem operações matriciais. Isso se torna especialmente útil com frameworks de inferência como o SGLang, que utiliza a CPU para gerenciamento de cache de árvore radix para chave-valor e agendamento com sobrecarga zero.
Placas adicionais Intel Gaudi 3: Inferência competitiva em escala
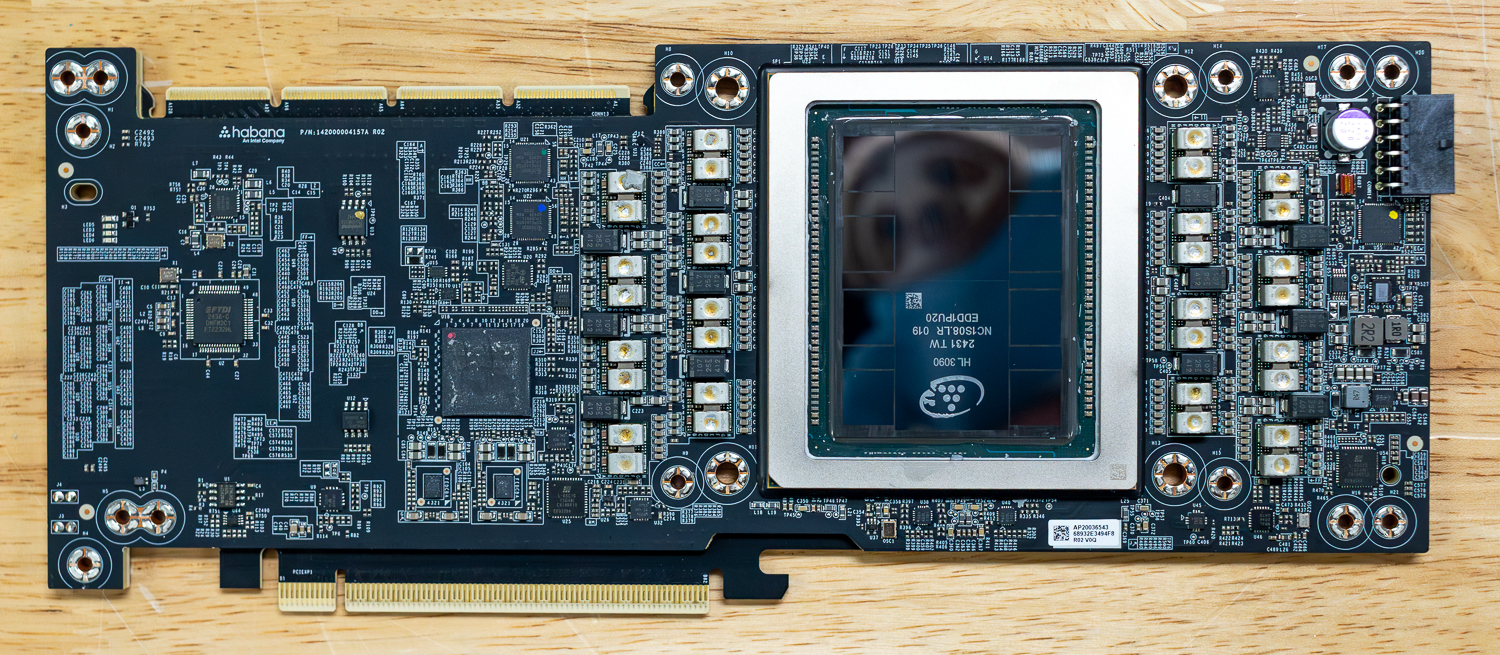
O Gaudi 3 da Intel é o acelerador de IA carro-chefe da empresa, lançado no quarto trimestre de 2024. A Intel está posicionando esses aceleradores de forma muito agressiva, em vez de competir diretamente com os aceleradores de treinamento de data center de ponta. O Gaudi 3 está sendo direcionado especificamente para o segmento de inferência.
A inferência de modelos baseada em Transformers em todos os LLMs populares atualmente é fundamentalmente limitada pela memória. Durante a fase de decodificação da geração autorregressiva, o modelo gera tokens um de cada vez, lendo os pesos do modelo e as entradas do cache chave-valor para cada token produzido. O gargalo não está na capacidade computacional, mas na largura de banda da memória, ou seja, na velocidade com que o acelerador consegue transmitir dados da HBM para os mecanismos de computação.
O Gaudi 3 possui 128 GB de HBM2e com largura de banda de memória de 3.7 TB/s. Arquiteturalmente, o Gaudi 3 é construído com o processo de 5 nm da TSMC e utiliza um design de chiplet de dois chips: dois chips de silício idênticos unidos por uma interconexão de alta largura de banda, apresentando-se como um único dispositivo unificado para o software. O poder computacional é organizado em quatro núcleos de aprendizado profundo (DCOREs), cada um contendo 2 MMEs, 16 TPCs e 24 MB de cache SRAM local. Os 96 MB de SRAM integrada fornecem 12.8 TB/s de largura de banda interna. O acelerador também integra 14 decodificadores de mídia dedicados (H.265, H.264, JPEG, VP9), permitindo o pré-processamento rápido de visão para cargas de trabalho multimodais.
Uma grande parte dos modelos de IA de código aberto de ponta lançados atualmente são treinados nativamente em FP8 ou são modelos híbridos que combinam pesos FP8 (E4M3) e BF16. O Gaudi 3 oferece aceleração FP8 nativa para esses modelos em seus 8 mecanismos de multiplicação de matrizes e 64 núcleos de processamento de tensores, fornecendo 1.8 PFlops de computação FP8.
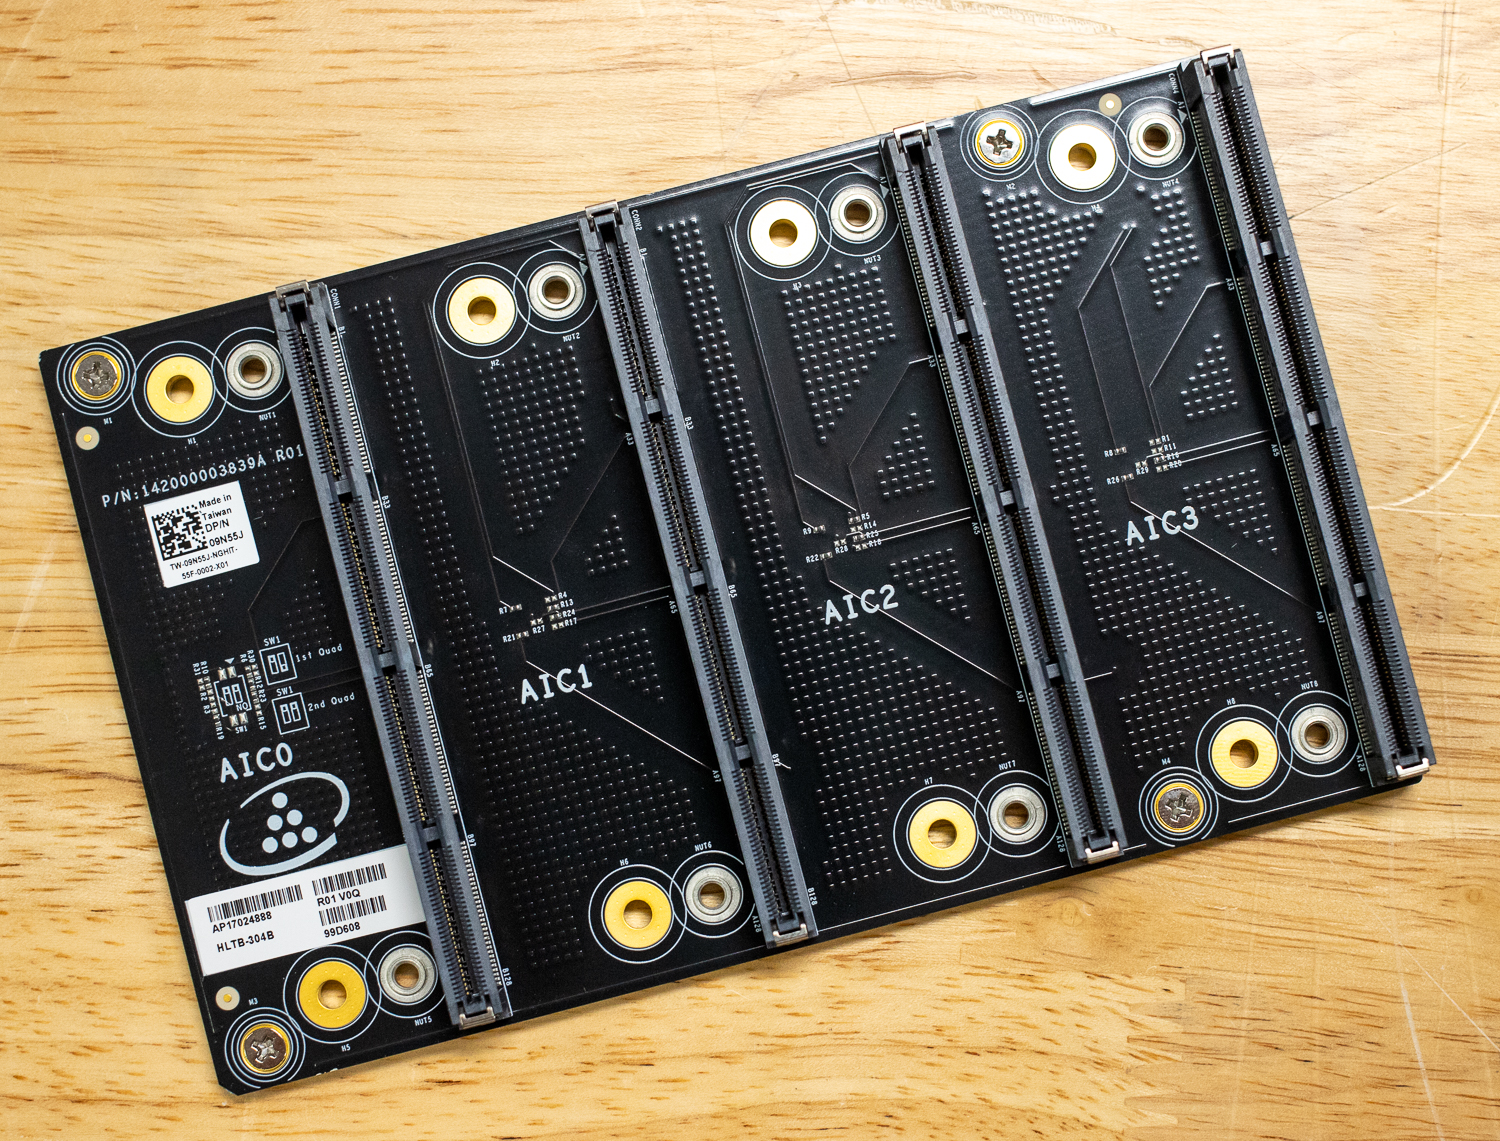
O Gaudi 3 também integra rede RDMA sobre Ethernet Convergida (RoCEv2) com 24 portas GbE de 200 MHz na versão OAM, integradas diretamente no silício. Embora a variante de placa de expansão PCIe usada no XE7740 não exponha todas essas portas da mesma forma, as variantes de placa de expansão suportam a interligação de 4 placas para uma comunicação mais rápida entre elas.
Desempenho e benchmarks
Detalhes da configuração do XE7740:
- 2 processadores Intel Xeon 6787P (86 núcleos, 2.00 GHz)
- 2 TB DDR5 (32 x 64 GB 5200 MT/s DDR5
- 4 x Intel Gaudi 3 PCIe AI Accelerator com 128 GB de HBM
- Servidor Ubuntu 24.04.5
Desempenho de serviço online vLLM
Para avaliar as capacidades de inferência do Dell XE7740 com aceleradores Intel Gaud 3, realizamos testes de desempenho do serviço online vLLM em uma variedade de modelos populares, abrangendo diferentes arquiteturas, contagens de parâmetros e formatos de precisão. Cada modelo foi testado em três perfis de carga de trabalho com contagens de solicitações simultâneas variando de 1 a 128.
A inferência LLM consiste em duas fases distintas. A fase de pré-preenchimento processa todos os tokens de entrada em paralelo antes que qualquer token de saída possa ser gerado, tornando-se uma operação computacionalmente limitada que escala linearmente com o número de tokens de entrada. A fase de decodificação, então, gera os tokens de saída um de cada vez (autorregressivamente), onde cada novo token requer a leitura dos pesos completos do modelo da memória, mas realiza relativamente pouco processamento por token — tornando-a limitada pela largura de banda da memória.
Essas duas fases sobrecarregam partes fundamentalmente diferentes do acelerador, por isso testamos três perfis de carga de trabalho que alteram o equilíbrio entre elas:
- A igualdade (1024 tokens de entrada/1024 tokens de saída) representa interações de bate-papo equilibradas.
- O Prefill Heavy (8192 entradas/1024 saídas) simula a geração aumentada por recuperação ou o resumo de contexto longo, em que o sistema deve processar grandes contextos de entrada.
- Decode Heavy (1024 entradas/8192 saídas) representa a geração de conteúdo de formato longo, onde a largura de banda de memória sustentada determina a taxa de transferência.
Nesta seção, focamos em duas métricas principais. A taxa de transferência total de tokens, medida em tokens por segundo, captura a capacidade geral de atendimento do sistema sob carga. O tempo até o primeiro token (TTFT) mede o atraso entre o envio de uma solicitação e o recebimento do primeiro token gerado. Como o modelo precisa concluir toda a fase de preenchimento prévio antes de emitir o primeiro token, o TTFT está diretamente ligado à capacidade computacional do acelerador. Isso torna o cenário com alta demanda de preenchimento prévio (combinado com o TTFT) um indicador particularmente útil para entender a capacidade computacional bruta dos aceleradores Gaudi 3, já que o sistema precisa processar todos os 8,192 tokens de entrada antes que o usuário veja qualquer resposta.
Por outro lado, o cenário com grande volume de decodificação testa a largura de banda da memória dos aceleradores, já que o sistema precisa manter uma alta taxa de transferência para milhares de tokens gerados. O TTFT (Tempo até o Primeiro Token) é crucial para aplicações interativas em que os usuários aguardam uma resposta antes que o streaming possa começar. Um sistema pode atingir uma excelente taxa de transferência sob processamento em lote intenso, mas ainda apresentar lentidão se o TTFT ficar muito alto; portanto, ambas as métricas são importantes para implantações em produção.
Uma observação sobre os resultados de precisão FP8: embora os aceleradores Intel Gaudi 3 incluam aceleração computacional FP8 nativa (e o FP8, em teoria, deva oferecer maior taxa de transferência do que o BF16), os números de desempenho FP8 em nossos benchmarks são inferiores aos de seus equivalentes BF16. Isso não é uma limitação de hardware, mas sim uma questão de maturidade do software na versão modificada do vLLM pela Intel. A versão que testamos (instalador vLLM 2.7.1 no Gaudi Docker 1.22.2) ainda não otimizou completamente seus caminhos de código FP8. A Intel possui uma nova versão do vLLM baseada em plugins, atualmente em versão beta, que pode solucionar muitos desses problemas de desempenho.
Lhama 3.1 8B Instruir
O Llama 3.1 8B Instruct é um modelo de transformador denso da Meta, o que significa que todos os parâmetros estão ativos para cada token gerado. Com 8 bilhões de parâmetros, está entre os modelos de código aberto mais populares. Modelos desse porte são comuns em tarefas cotidianas, como resumir documentos curtos, redigir e-mails e mensagens, responder a perguntas simples e alimentar interações básicas de chatbots, onde velocidade e custo-benefício são mais importantes do que raciocínio complexo.
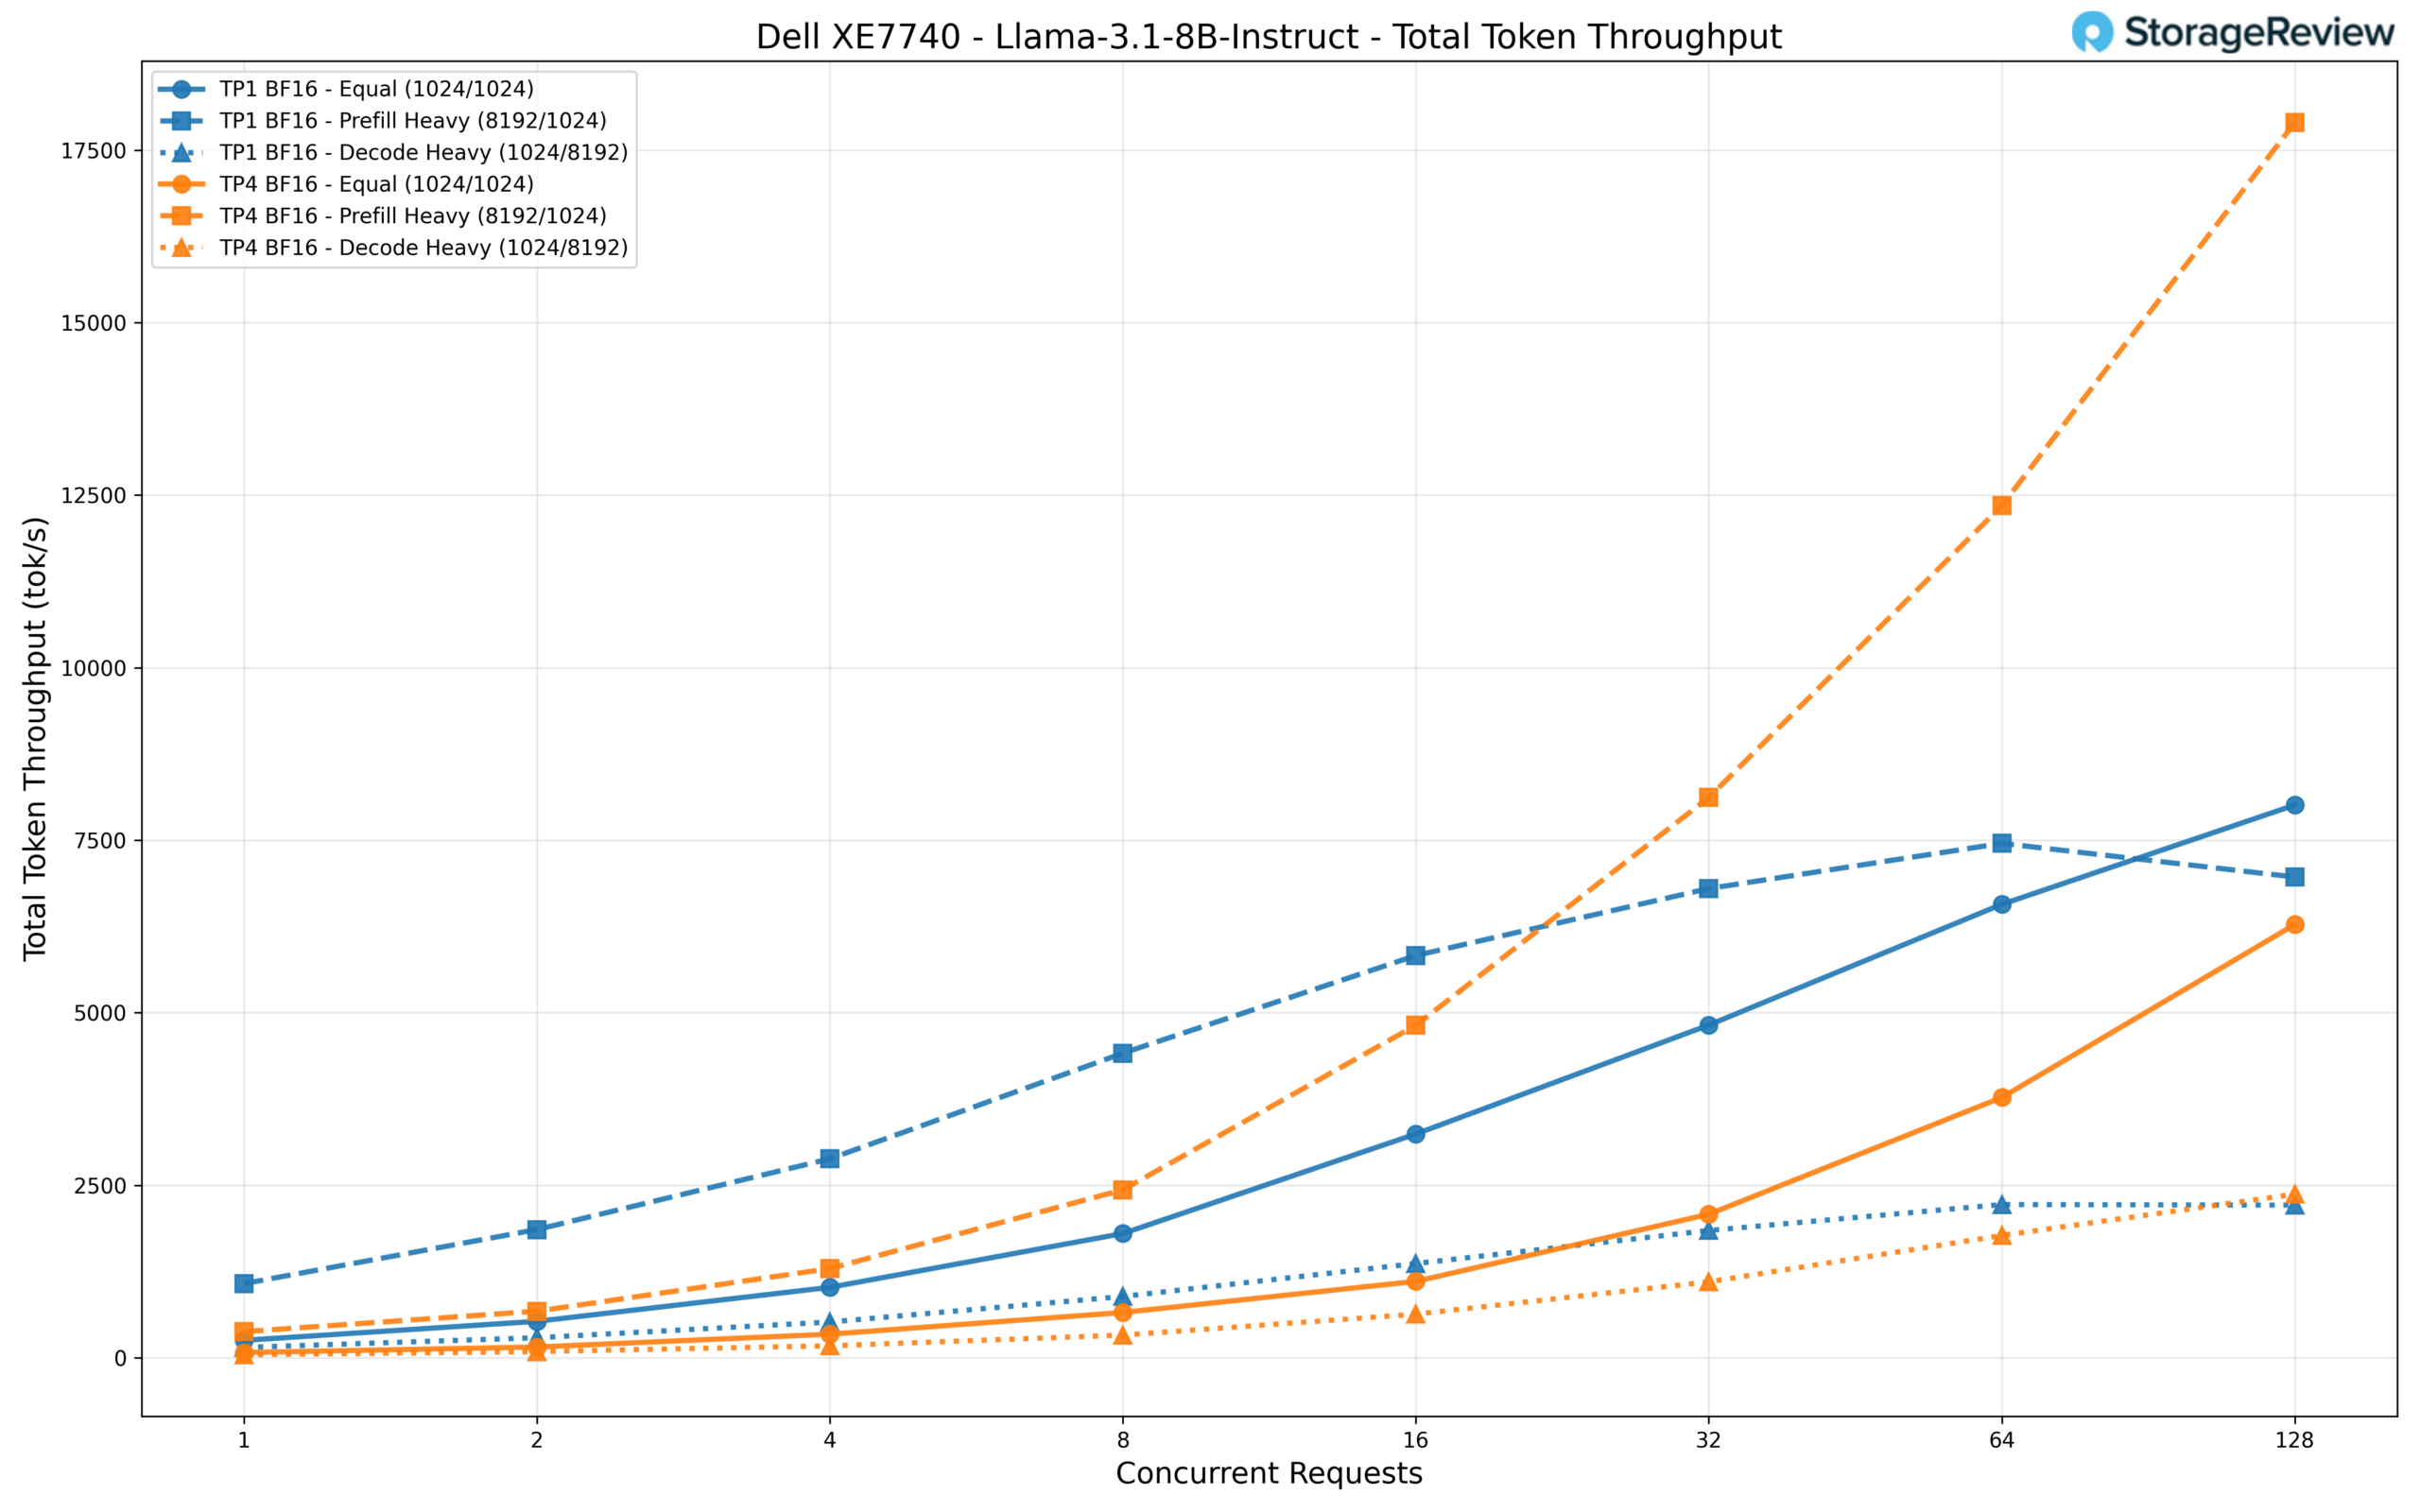
Testamos este modelo nas configurações TP1 (acelerador único) e TP4 (todos os quatro aceleradores Gaudi 3). Executando em TP1, o modelo atinge uma taxa de transferência total de aproximadamente 8,000 tok/s com 128 requisições simultâneas na mesma carga de trabalho, escalando de forma eficiente a partir de cerca de 250 tok/s com uma única requisição. O cenário com grande volume de pré-preenchimento (prefill) mostra um padrão interessante: enquanto TP1 atinge um pico de cerca de 7,000 tok/s, TP4 dispara para mais de 17,900 tok/s com 128 requisições simultâneas, aproveitando os aceleradores adicionais para processar o grande contexto de entrada de forma mais eficiente.
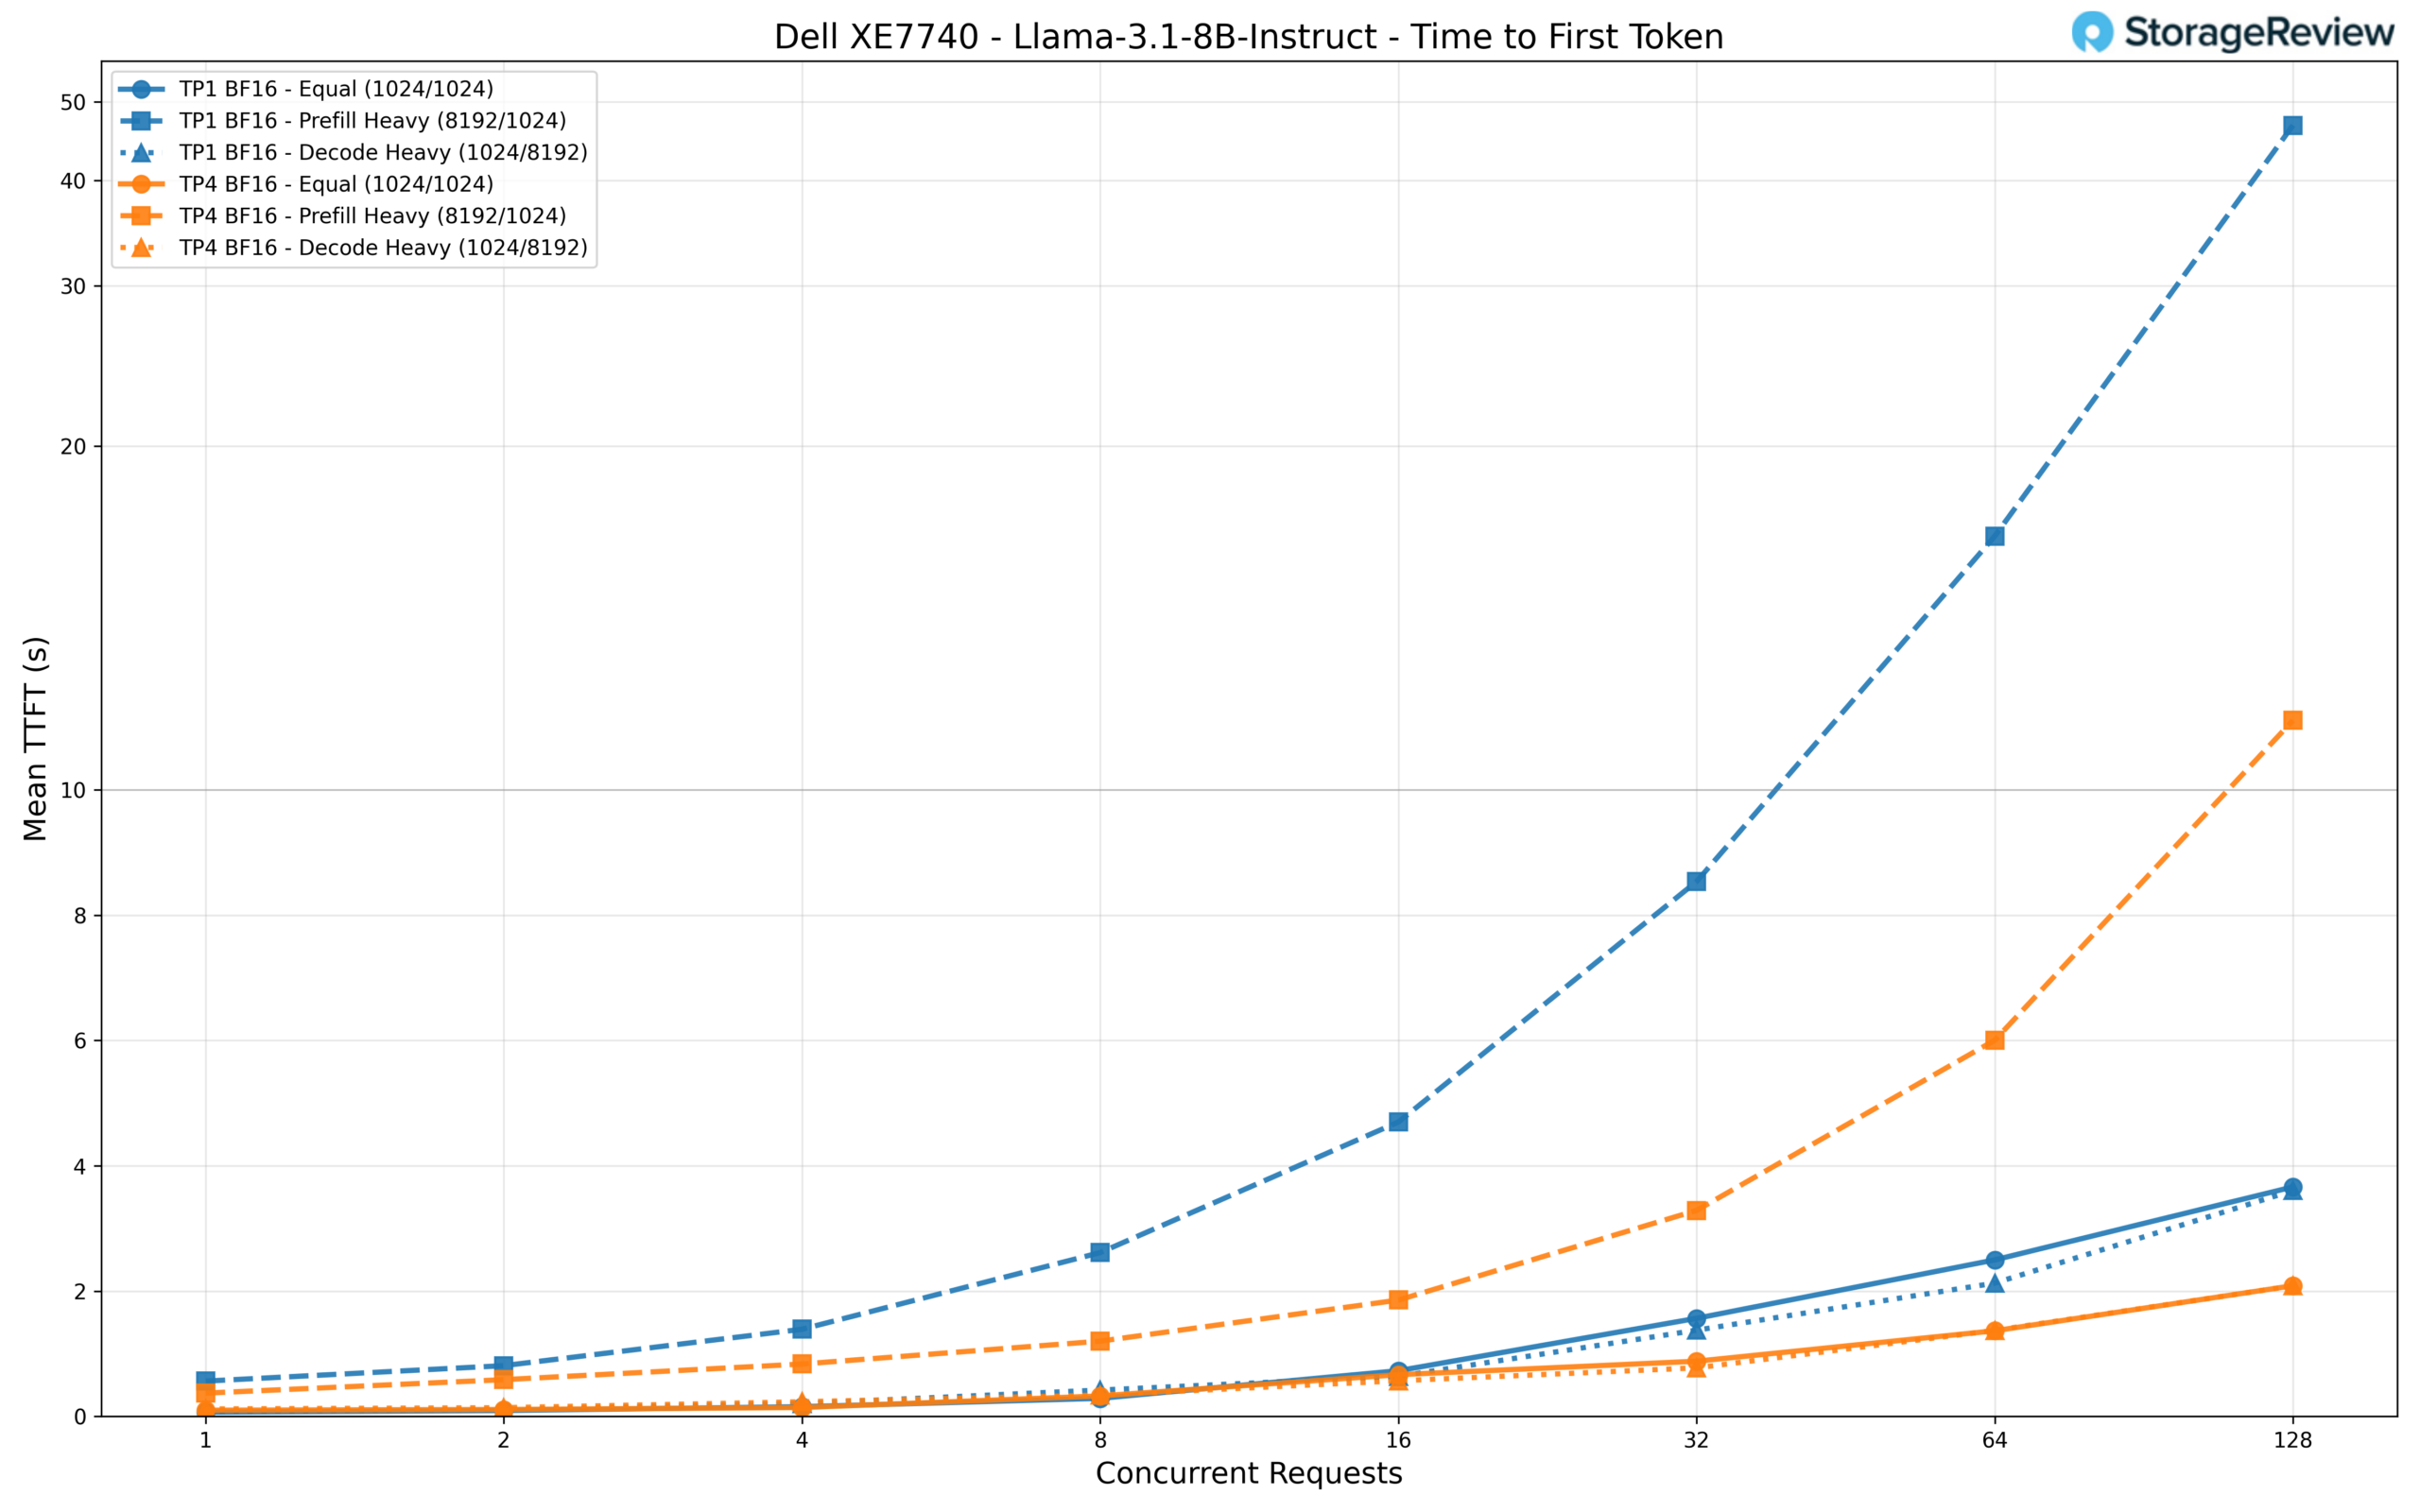
Para latência de usuário único, o TP1 na verdade oferece um TTFT menor com baixa concorrência (67 ms contra 98 ms para o TP4), refletindo a sobrecarga de coordenar quatro aceleradores para um modelo que cabe confortavelmente em um só. Conforme a carga aumenta, no entanto, o TP4 se destaca decisivamente. Com 128 requisições simultâneas, o TP4 mantém o TTFT em torno de 2 segundos para cargas de trabalho iguais e de decodificação, enquanto o TP1 sobe para 3.7 segundos e 6.6 segundos, respectivamente. O cenário com grande quantidade de pré-preenchimento é onde a diferença se torna mais dramática: o TP1 atinge quase 47 segundos de TTFT com 128 requisições, enquanto o TP4 o mantém em torno de 11 segundos.
Lhama 3.1 70B Instruir
O Llama 3.1 70B Instruct é o modelo denso maior da família Llama 3.1 da Meta. Com 70 bits de parâmetros, ele oferece capacidades substancialmente melhores de seguimento de instruções e multilíngue do que a variante de 8 bits. Modelos nessa escala são ideais para cargas de trabalho de agentes mais intensivas, como agentes de suporte ao cliente, assistentes de pesquisa com várias etapas, análise complexa de documentos e tarefas que exigem a manutenção de um contexto coerente ao longo de interações mais longas.
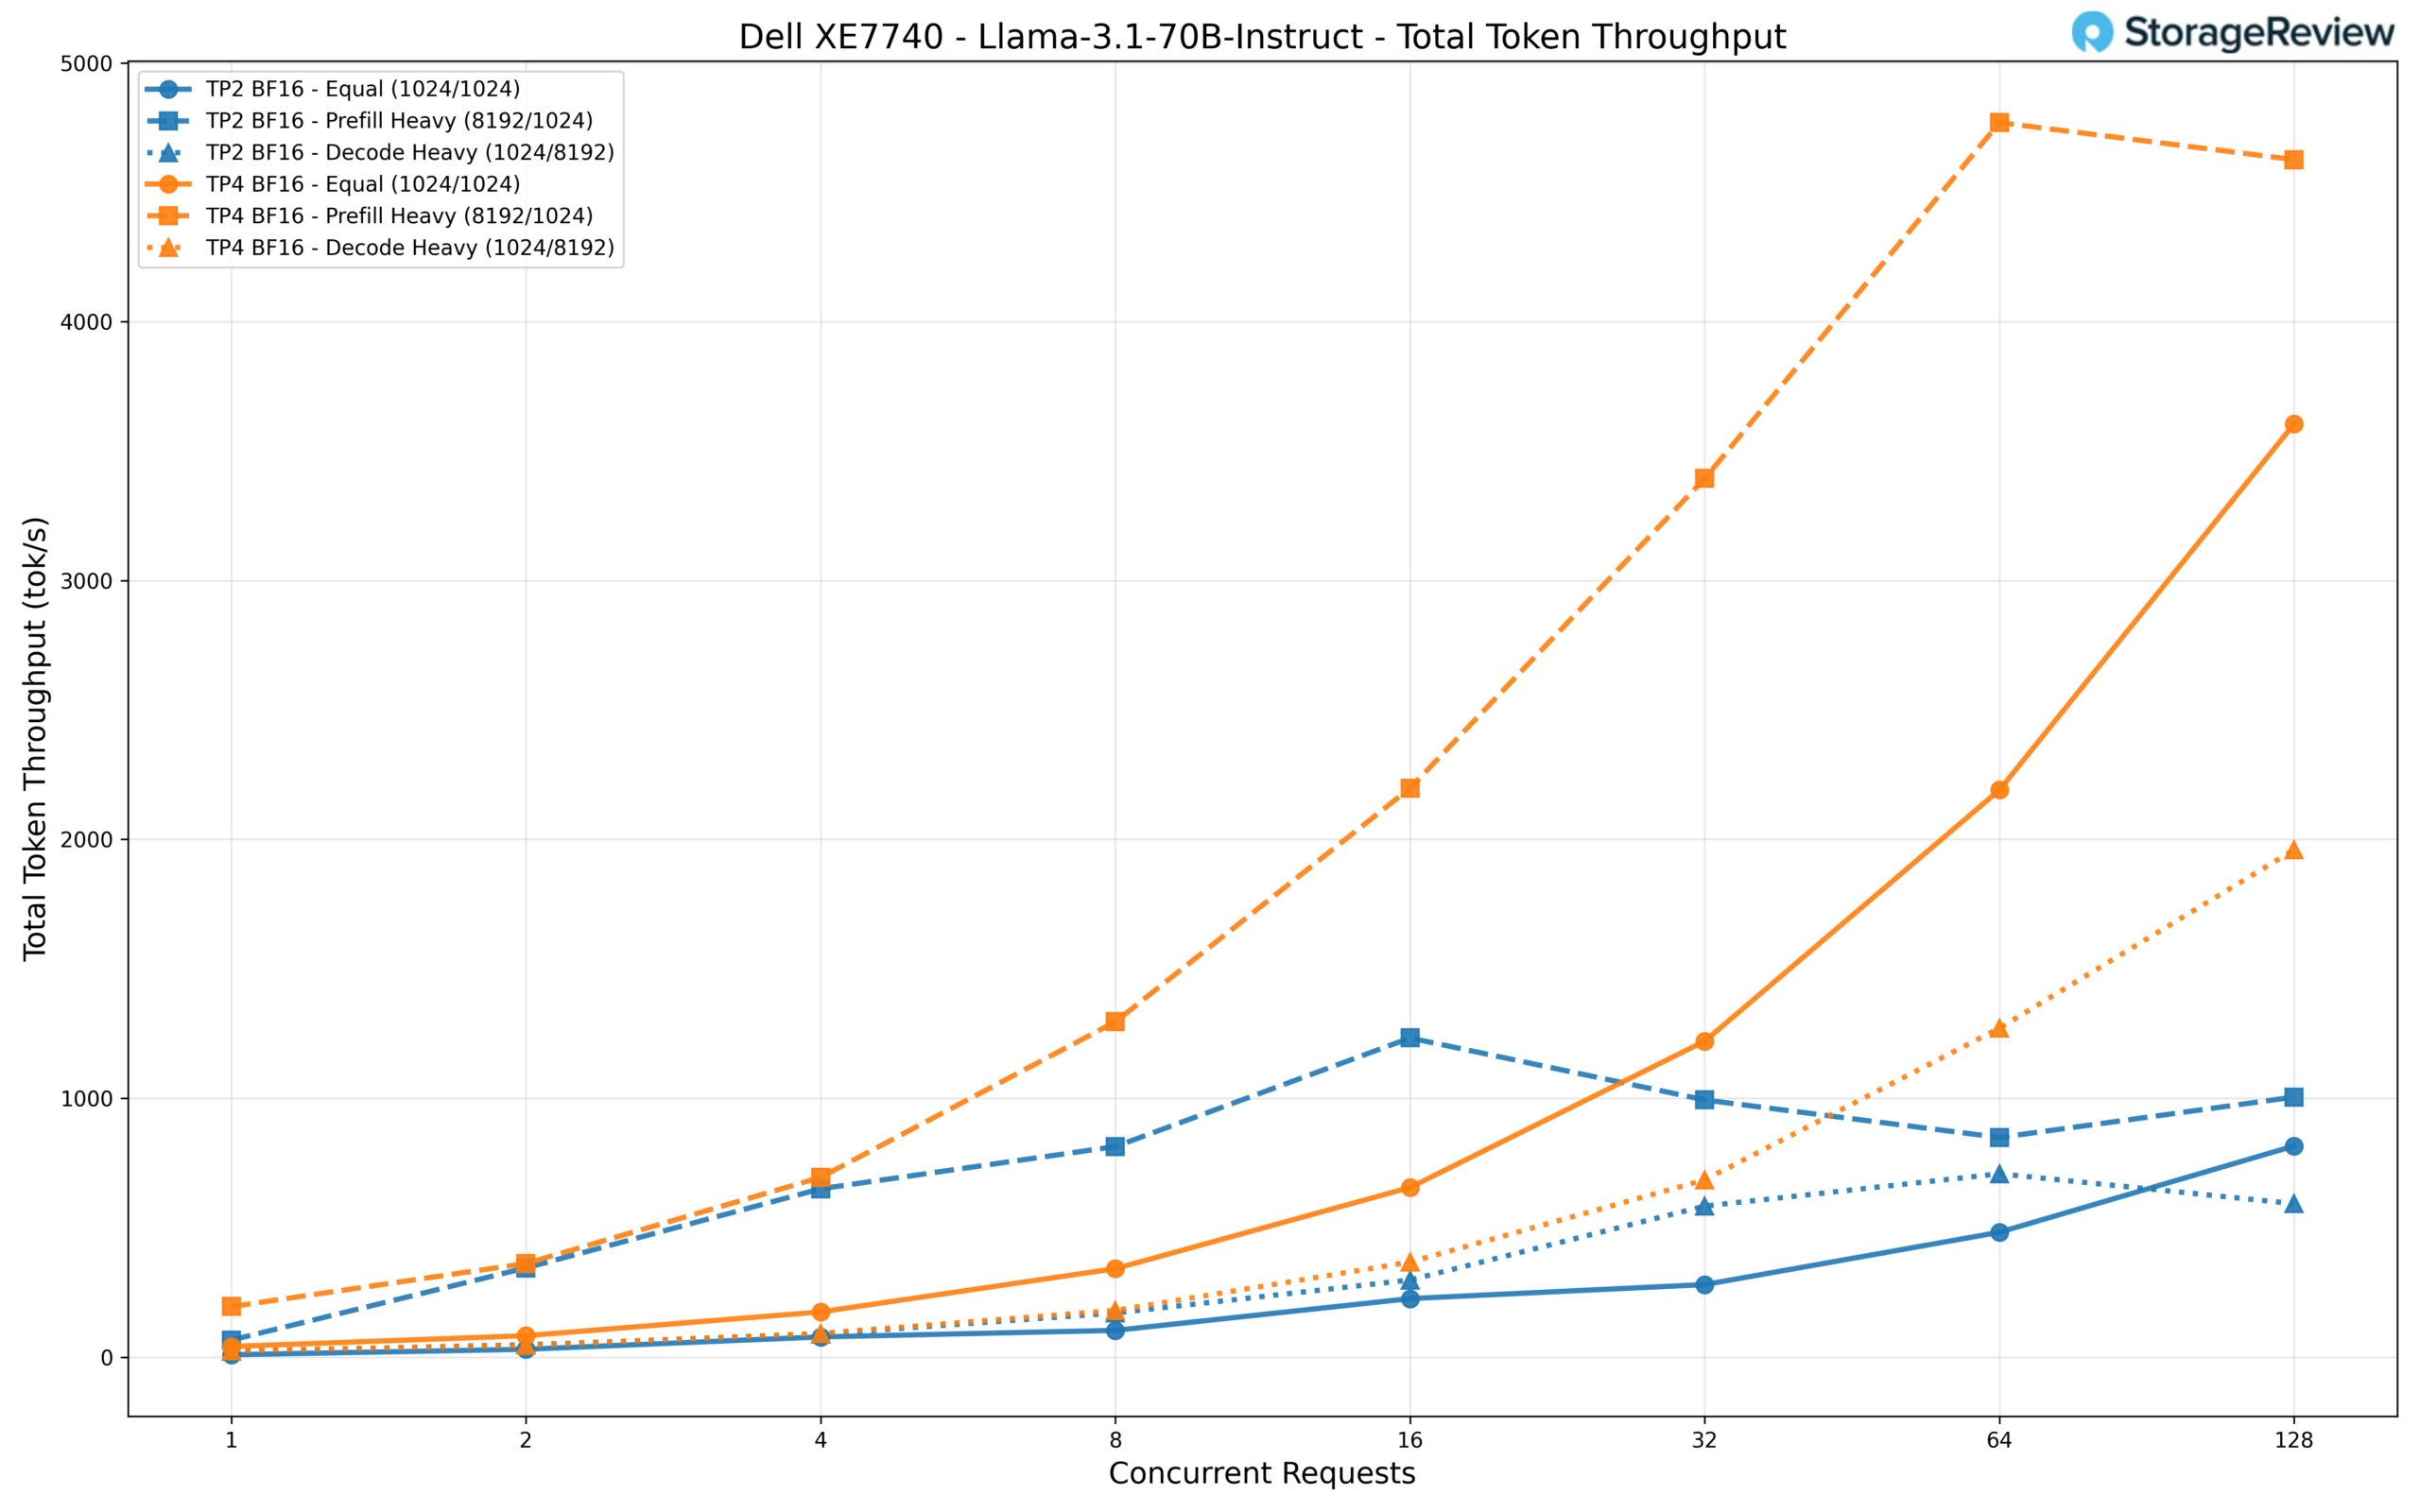
Testamos este modelo com as configurações TP2 e TP4. A diferença de desempenho entre as duas é substancial. Com 128 requisições simultâneas, o TP4 atinge aproximadamente 3,600 tok/s em uma carga de trabalho equivalente e alcança um pico próximo a 4,600 tok/s no cenário com grande volume de pré-preenchimento. Isso representa um aumento de aproximadamente 4.4 vezes e 4.6 vezes no desempenho do TP2, que atinge um máximo de cerca de 816 tok/s e 1,005 tok/s, respectivamente. Mesmo a carga de trabalho com grande volume de decodificação alcança cerca de 1,960 tok/s no TP4, em comparação com 593 tok/s no TP2.
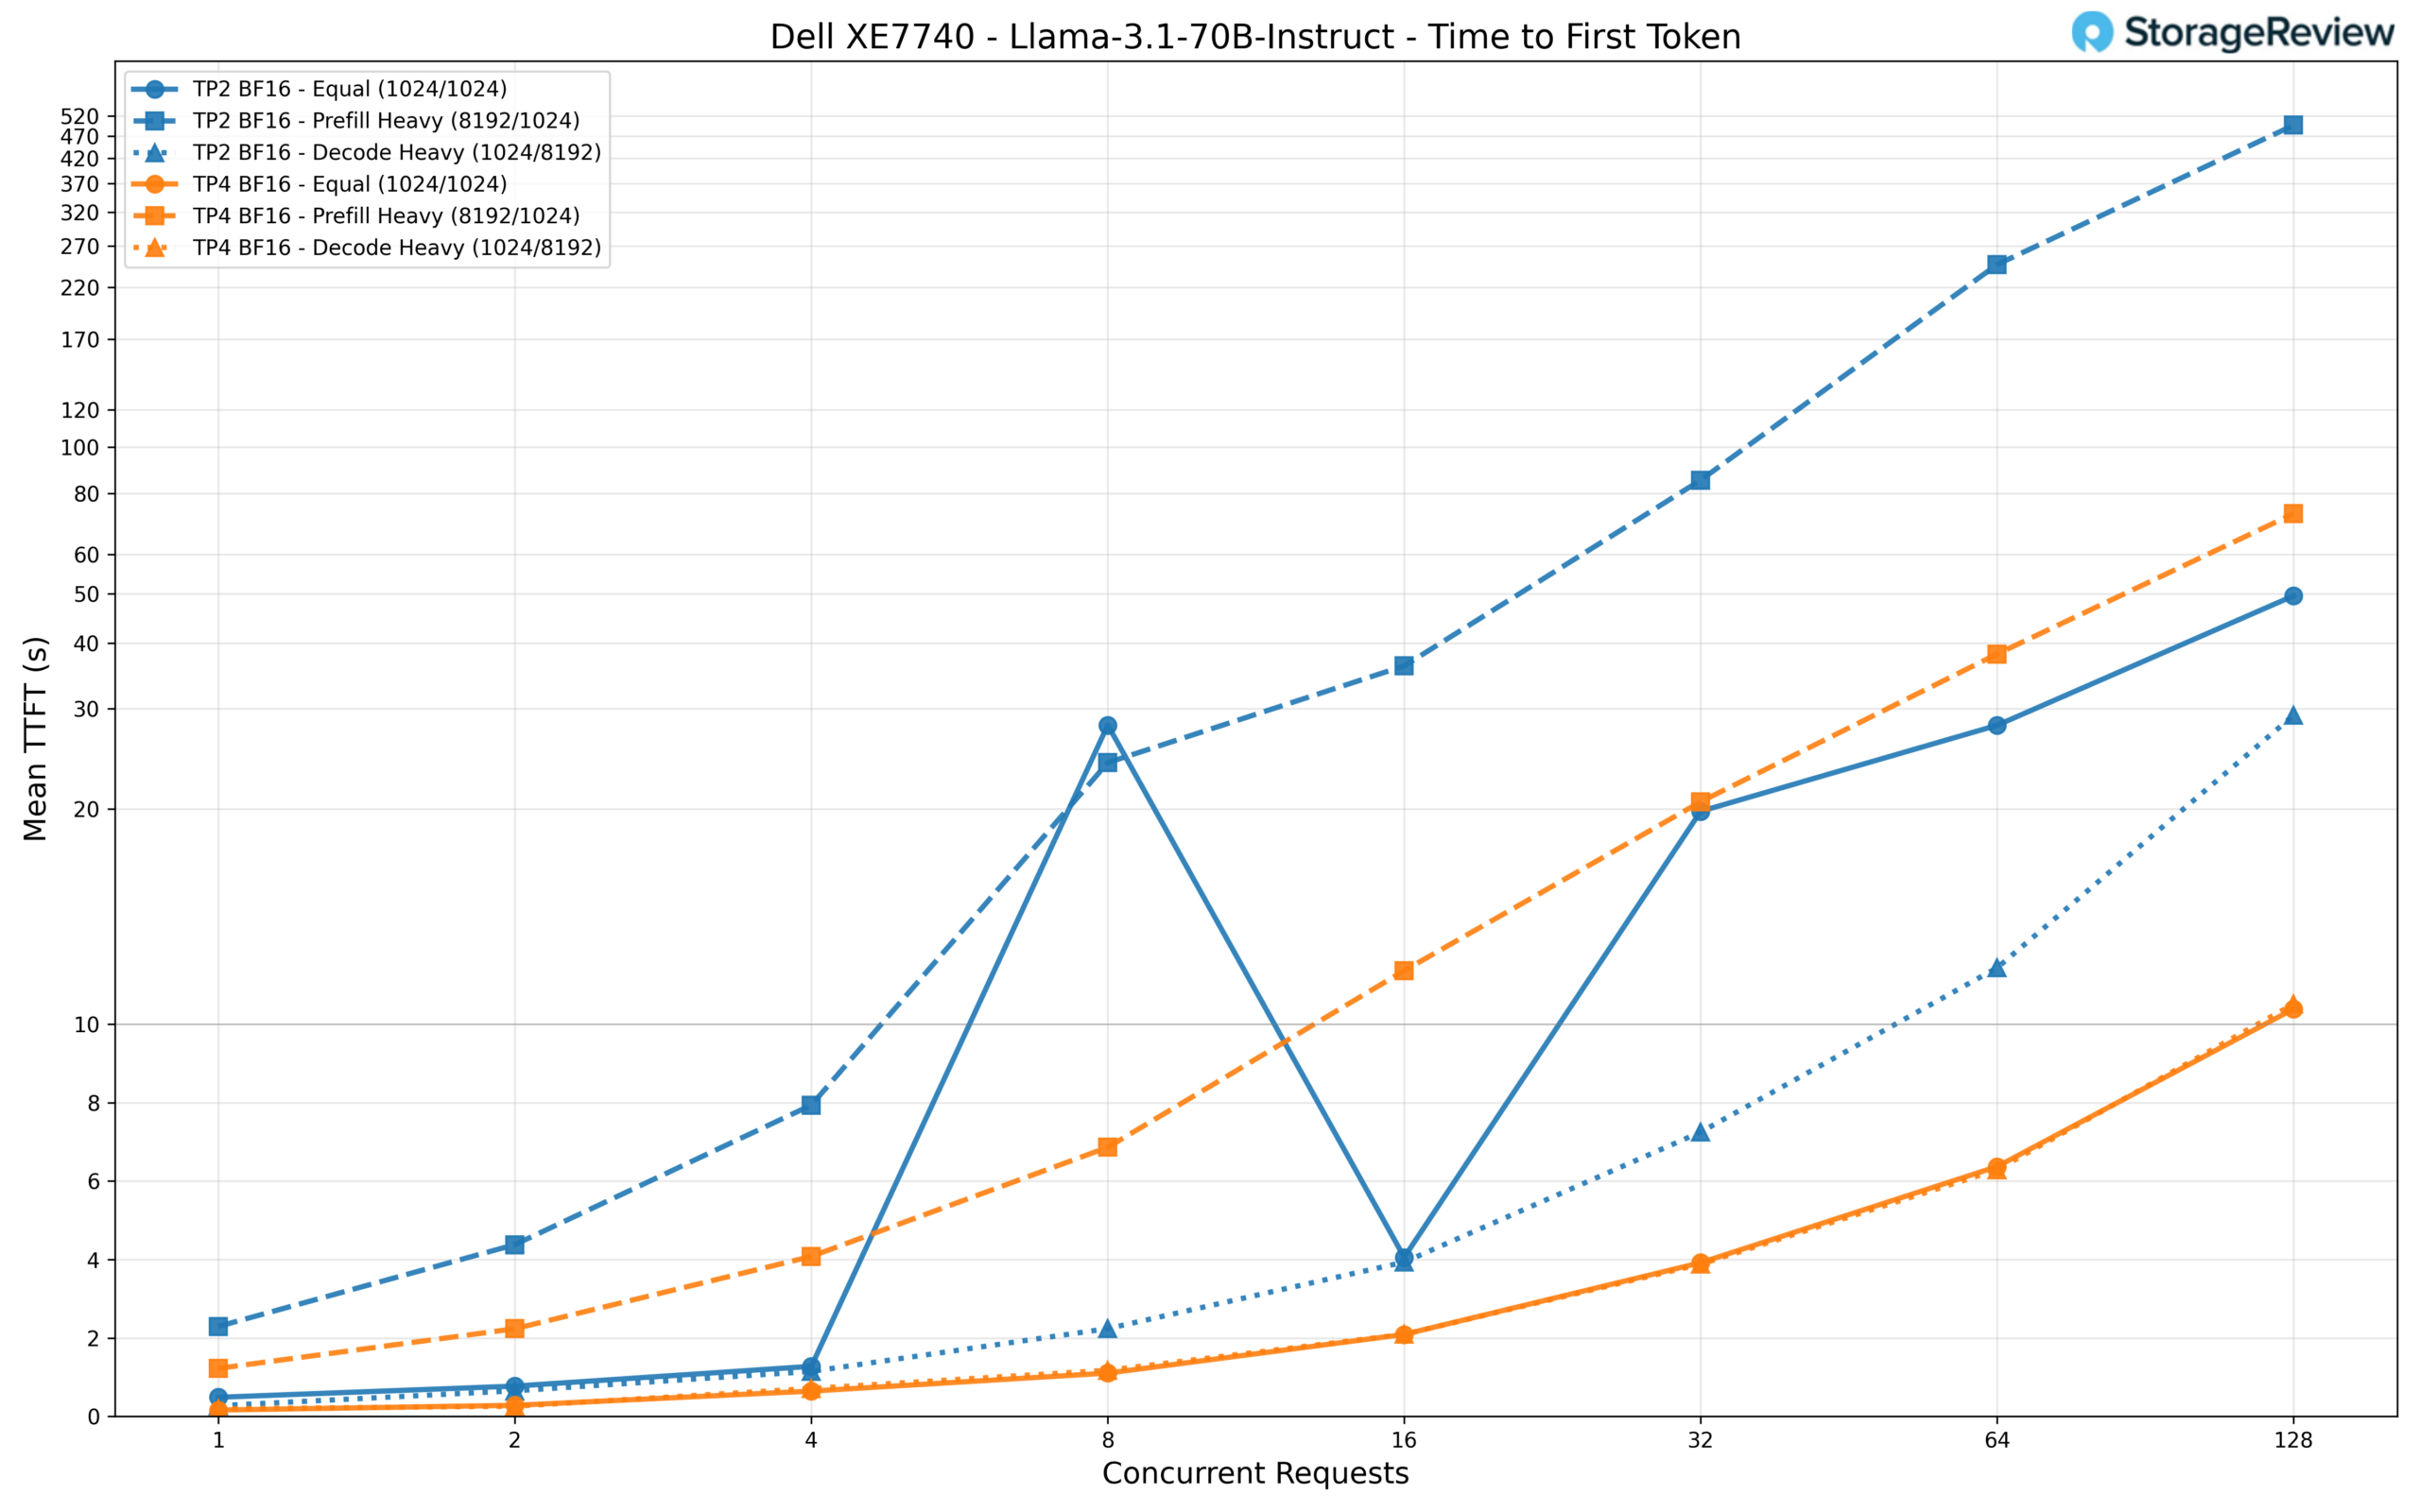
Para o TTFT (Tempo até o Primeiro Token), o TP2 apresenta dificuldades sob carga com o grande volume de pré-preenchimento, atingindo um tempo impressionante de 496 segundos com 128 requisições simultâneas, tornando-o praticamente inutilizável para aplicações interativas. O TP4 reduz esse tempo para cerca de 73 segundos. Para as cargas de trabalho de igualdade e decodificação, o TP4 mantém o TTFT em aproximadamente 10 segundos com 128 requisições, enquanto o TP2 atinge 50 e 29 segundos, respectivamente. Com baixa concorrência, o TP4 entrega respostas do primeiro token em cerca de 160 ms para a carga de trabalho de igualdade, em comparação com 486 ms no TP2.
Instruções do codificador Qwen3 30B-A3B
O Qwen3 Coder 30B-A3B é um dos modelos de codificação mais populares para implementações de inferência local e utiliza uma arquitetura de Mistura de Especialistas (MoE). Ao contrário dos modelos densos, onde cada parâmetro participa de cada passagem direta, os modelos MoE roteiam cada token através de um pequeno subconjunto de redes de especialistas. O Qwen3 Coder mantém um tamanho de modelo completo de 30 bilhões de parâmetros com precisão BF16, ativando apenas 3 bilhões de parâmetros por token gerado. Esse padrão de ativação esparsa significa que o modelo pode fornecer a qualidade de uma rede muito maior, exigindo apenas uma fração do poder computacional por token, tornando-o extremamente eficiente em hardware que suporte a sobrecarga de roteamento. Para usuários finais, este modelo é ideal para auxílio em tarefas de codificação do dia a dia, como gerar código repetitivo, completar funções, explicar código, escrever testes unitários e lidar com tarefas rotineiras de desenvolvimento que se beneficiam de um modelo especializado em código sem exigir raciocínio complexo.
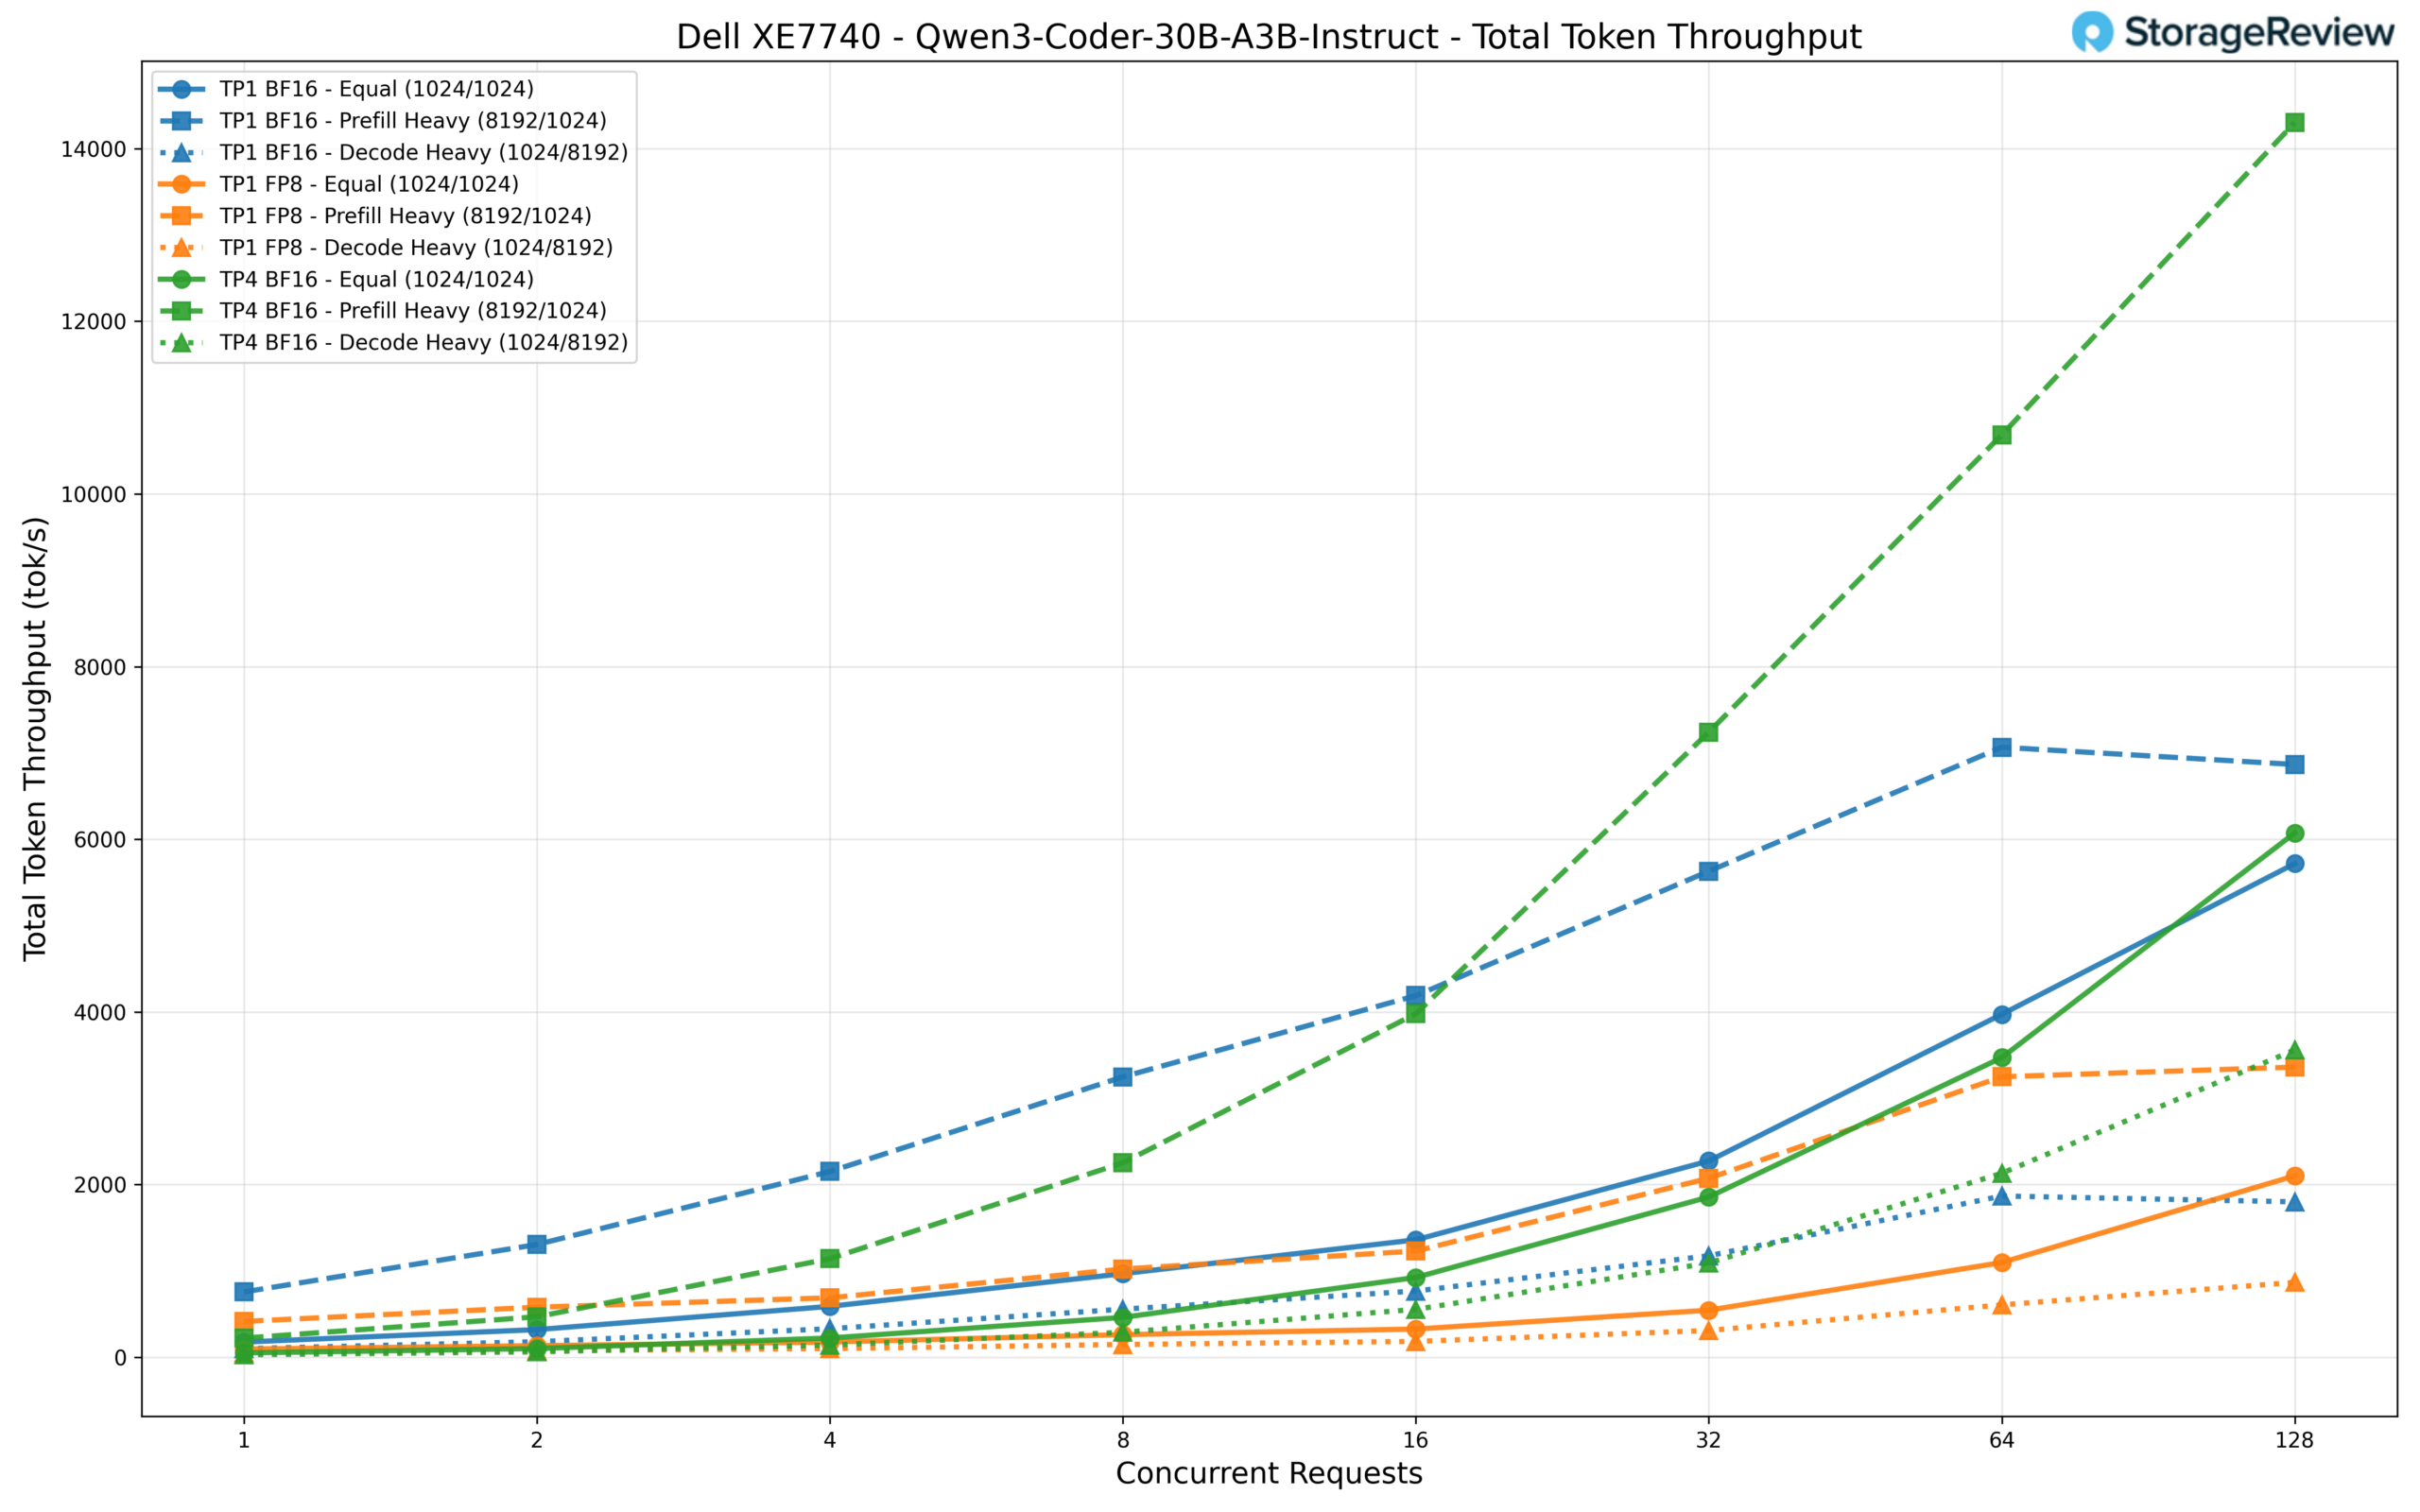
Testamos três configurações: TP1 BF16, TP1 FP8 e TP4 BF16. Com 128 requisições simultâneas, o TP4 BF16 lidera o grupo com aproximadamente 14,300 tok/s no cenário de pré-carregamento intenso, o maior valor de throughput que registramos em qualquer modelo em nosso conjunto de testes. O TP1 BF16 vem em seguida com cerca de 6,900 tok/s no mesmo cenário, enquanto o TP1 FP8 fica para trás com cerca de 3,360 tok/s. Na carga de trabalho equivalente, a diferença diminui um pouco, com o TP4 atingindo 6,073 tok/s, o TP1 BF16 com 5,718 tok/s e o TP1 FP8 com 2,101 tok/s. Como discutido na nota sobre o FP8 acima, os números mais baixos do FP8 aqui refletem o estado atual do fork vLLM da Intel, e não um gargalo de hardware.
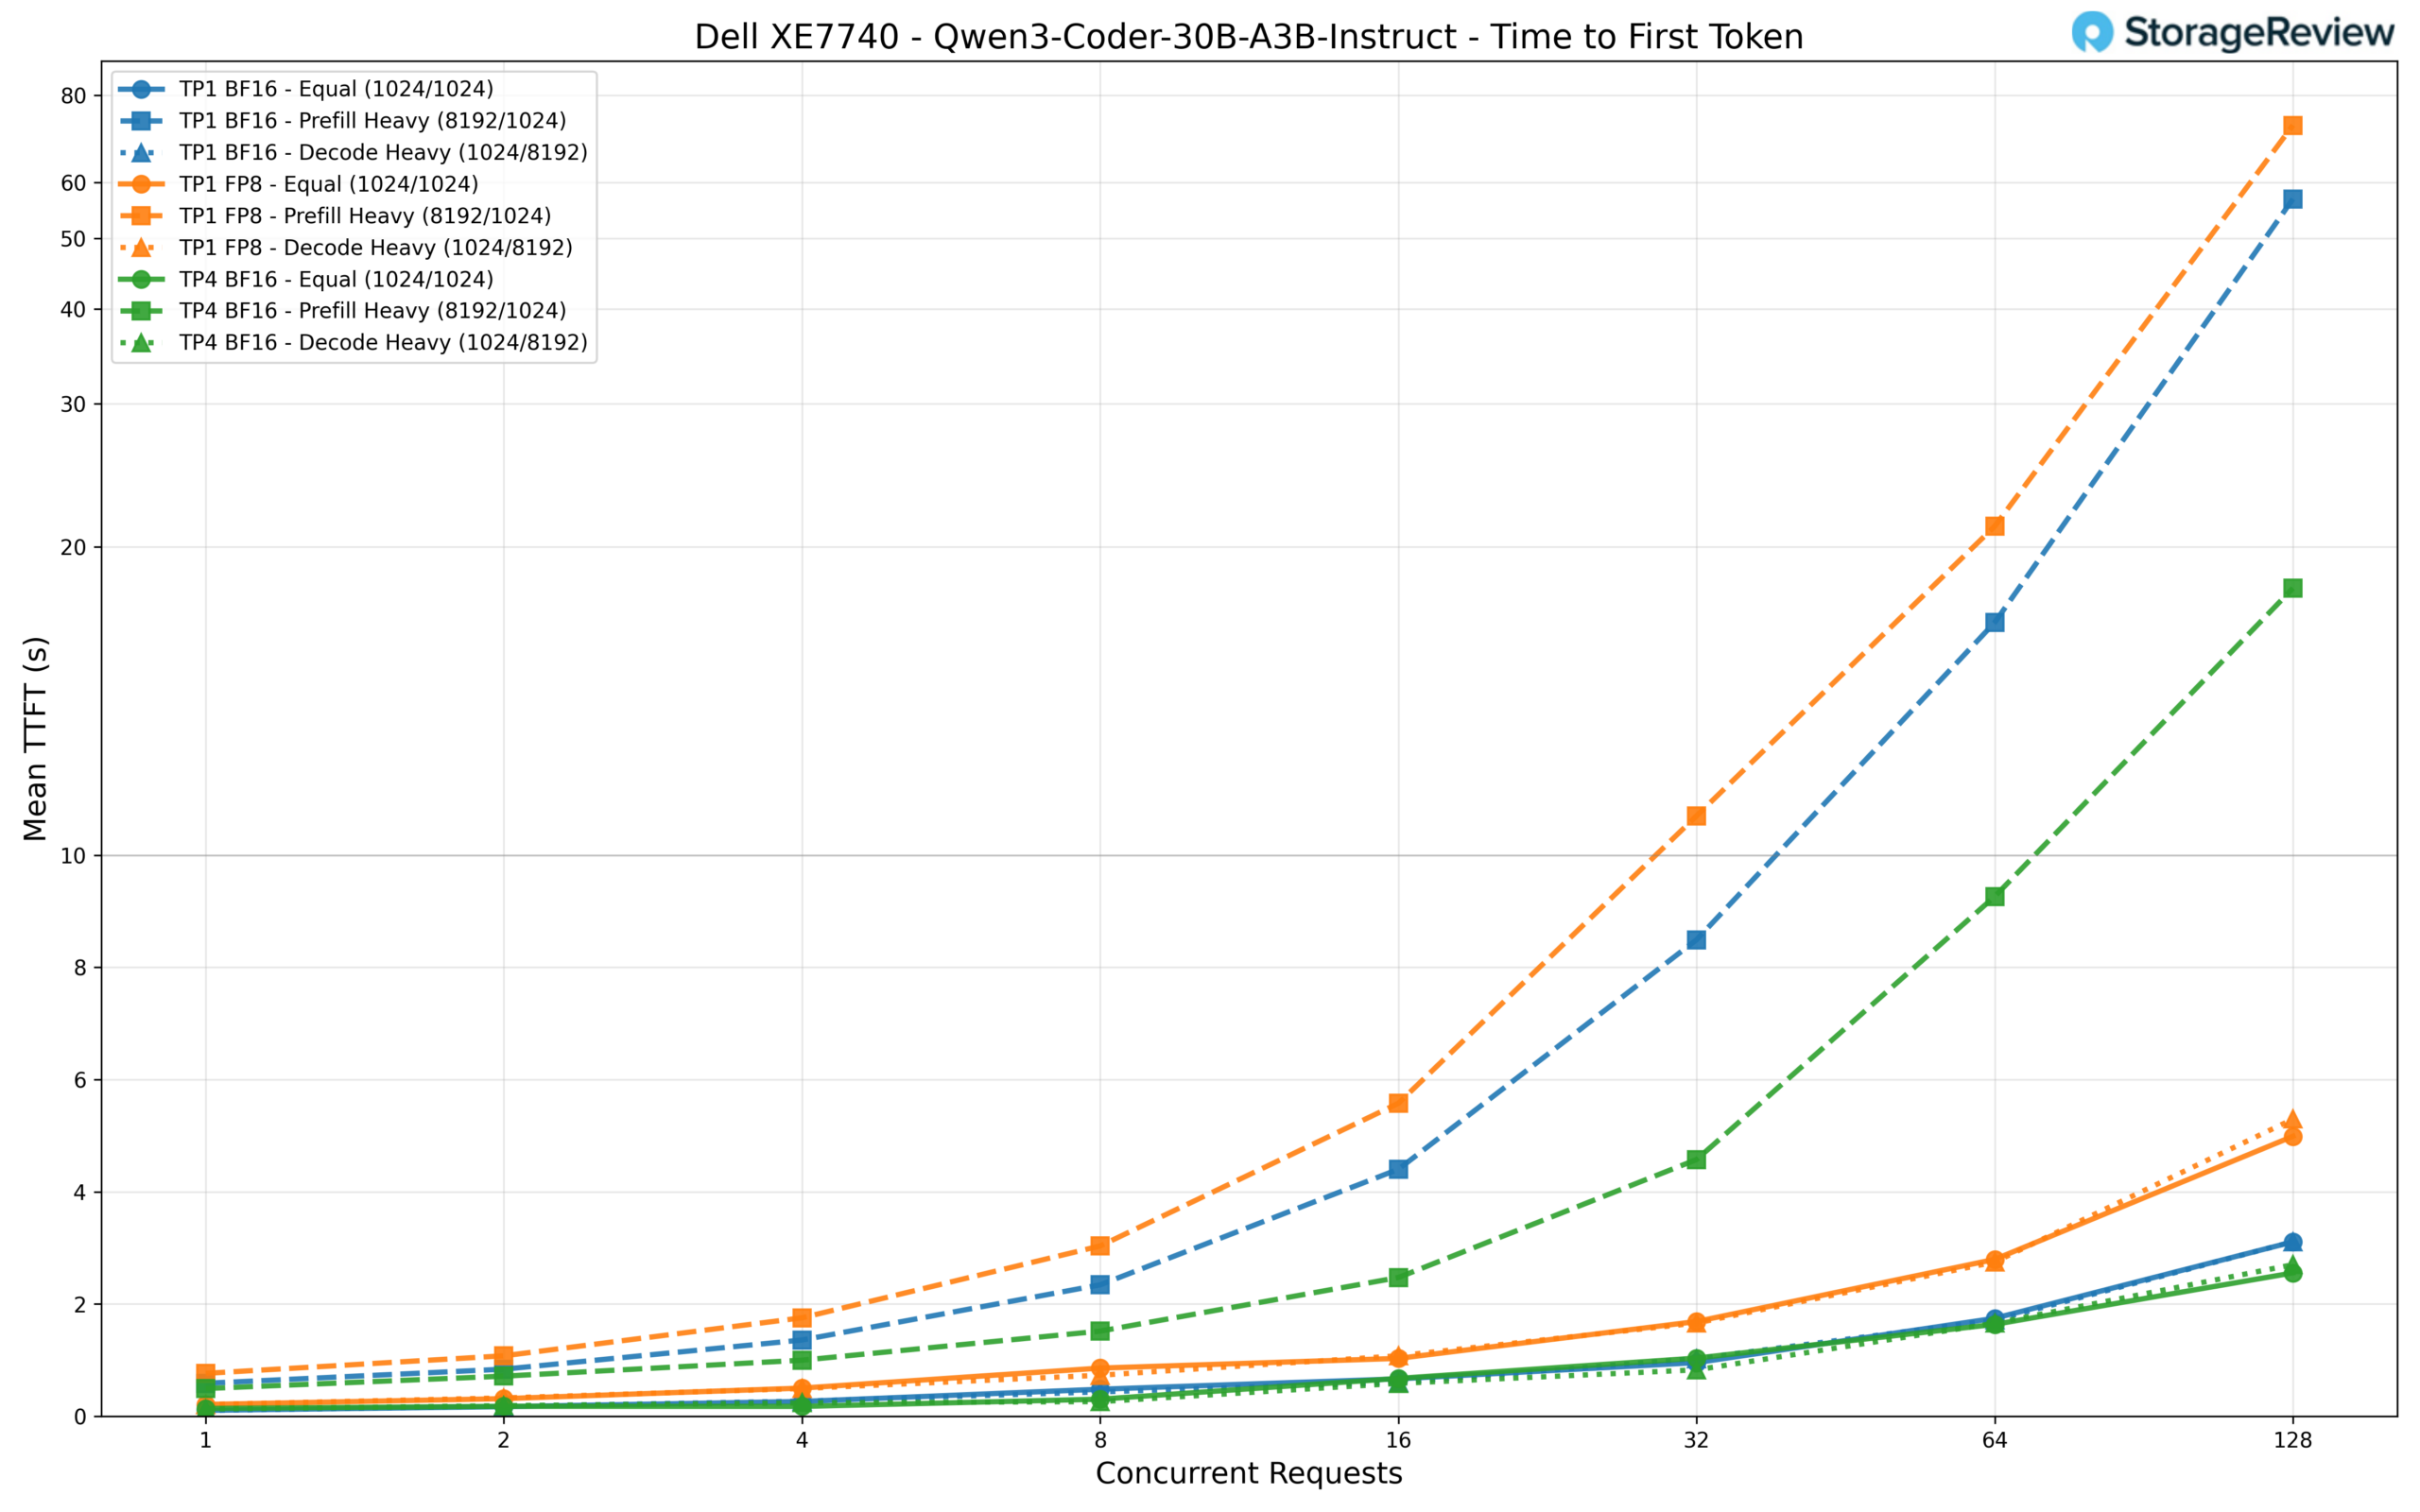
O TTFT permanece baixo graças ao padrão de ativação esparso. O TP4 BF16 oferece latência do primeiro token de cerca de 140 ms com carga de usuário único e se mantém em aproximadamente 2.6 segundos com 128 requisições simultâneas na mesma carga de trabalho. O TP1 BF16 é comparável em baixa concorrência (106 ms), mas sobe para 3.1 segundos sob carga máxima. O cenário com uso intensivo de pré-preenchimento diferencia claramente as configurações: o TP4 atinge cerca de 18 segundos com 128 requisições, o TP1 BF16 chega a 57 segundos e o TP1 FP8 se estende a 72 segundos.
Qwen3 235B-A22B Pensando
O maior modelo em nosso conjunto de benchmarks, Qwen3 235B-A22B Thinking, é um modelo de raciocínio MoE massivo com 235 bilhões de parâmetros totais e 22 bilhões de parâmetros ativos por token. Além de sua escala gigantesca, este modelo inclui recursos integrados de raciocínio em cadeia, permitindo que ele decomponha problemas complexos passo a passo antes de chegar a uma resposta, ao custo de mais tokens de decodificação. Isso o torna particularmente adequado para as tarefas mais desafiadoras: geração e depuração de código avançado, resolução de problemas matemáticos, raciocínio lógico em várias etapas e fluxos de trabalho complexos e com agentes, onde a precisão importa mais do que a velocidade bruta. Este modelo requer TP4 para ser executado e o testamos nas precisões BF16 e FP8.
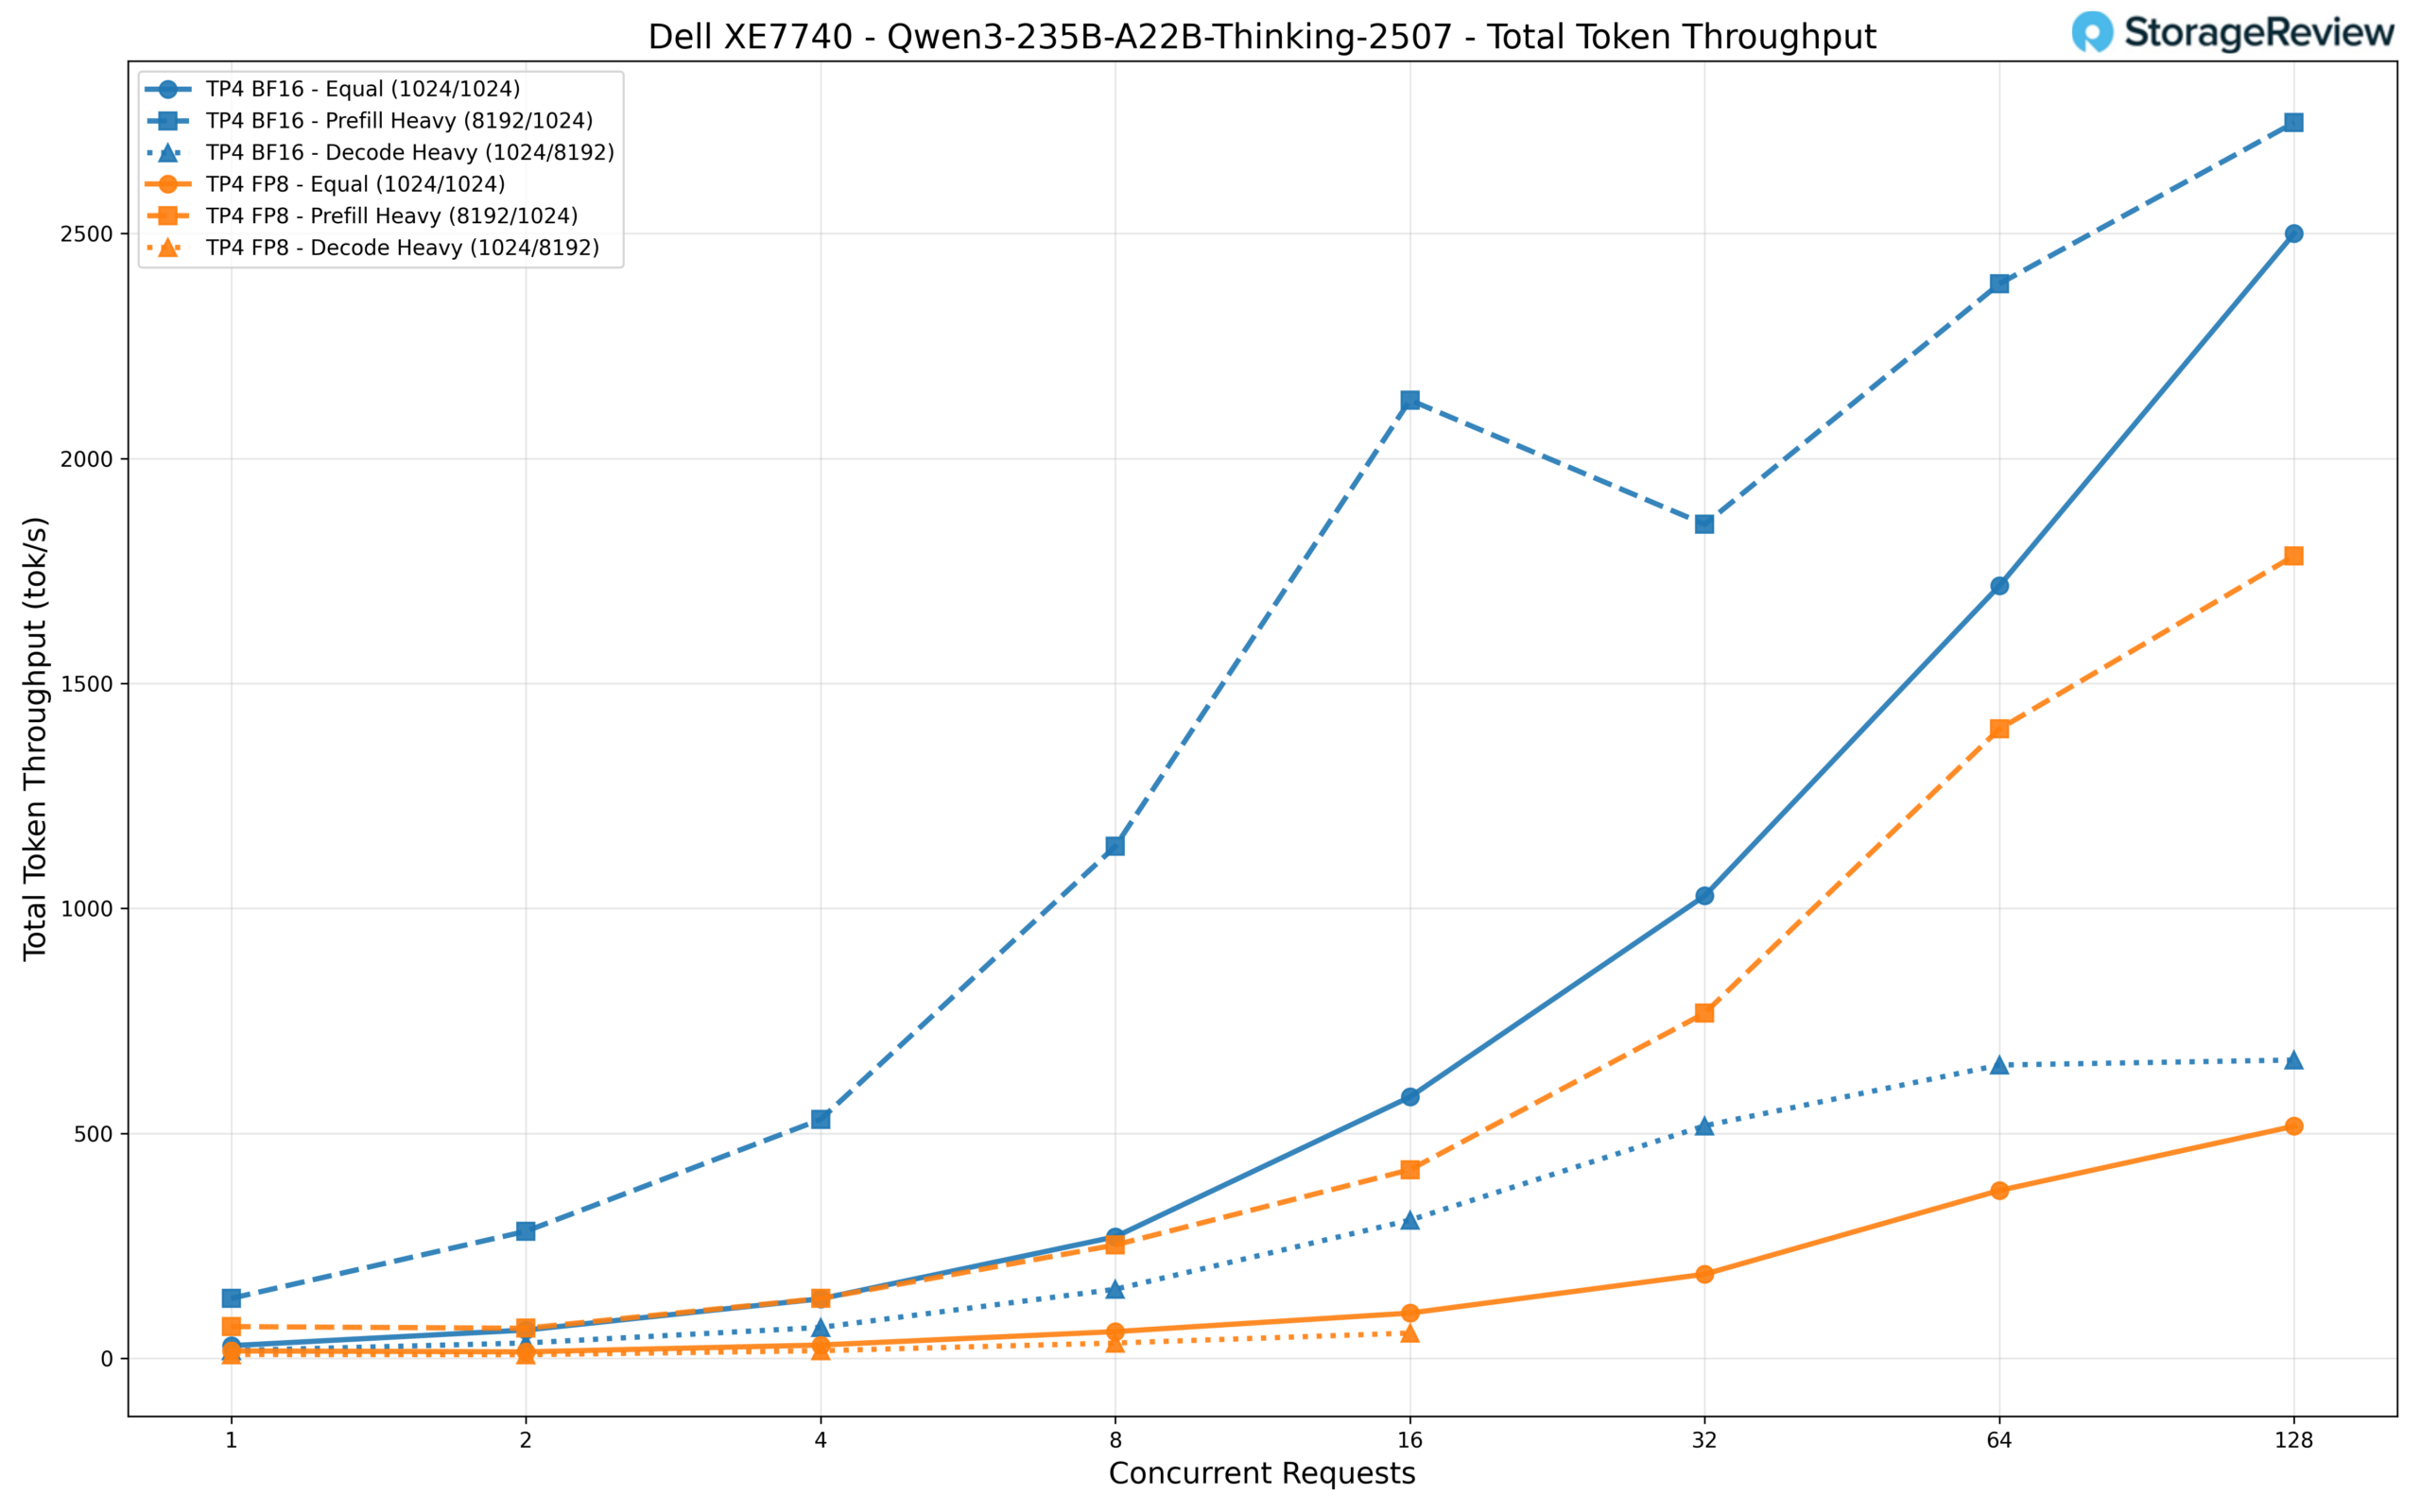
O BF16 supera claramente o FP8 em todos os aspectos. Com 128 requisições simultâneas, o BF16 atinge aproximadamente 2,750 tok/s na carga de trabalho com uso intensivo de pré-preenchimento e 2,500 tok/s na carga de trabalho equivalente, enquanto o FP8 atinge cerca de 1,784 tok/s e 516 tok/s, respectivamente. A variante FP8 também apresentou timeouts no cenário com uso intensivo de decodificação em níveis de concorrência mais altos (mais de 32 requisições).
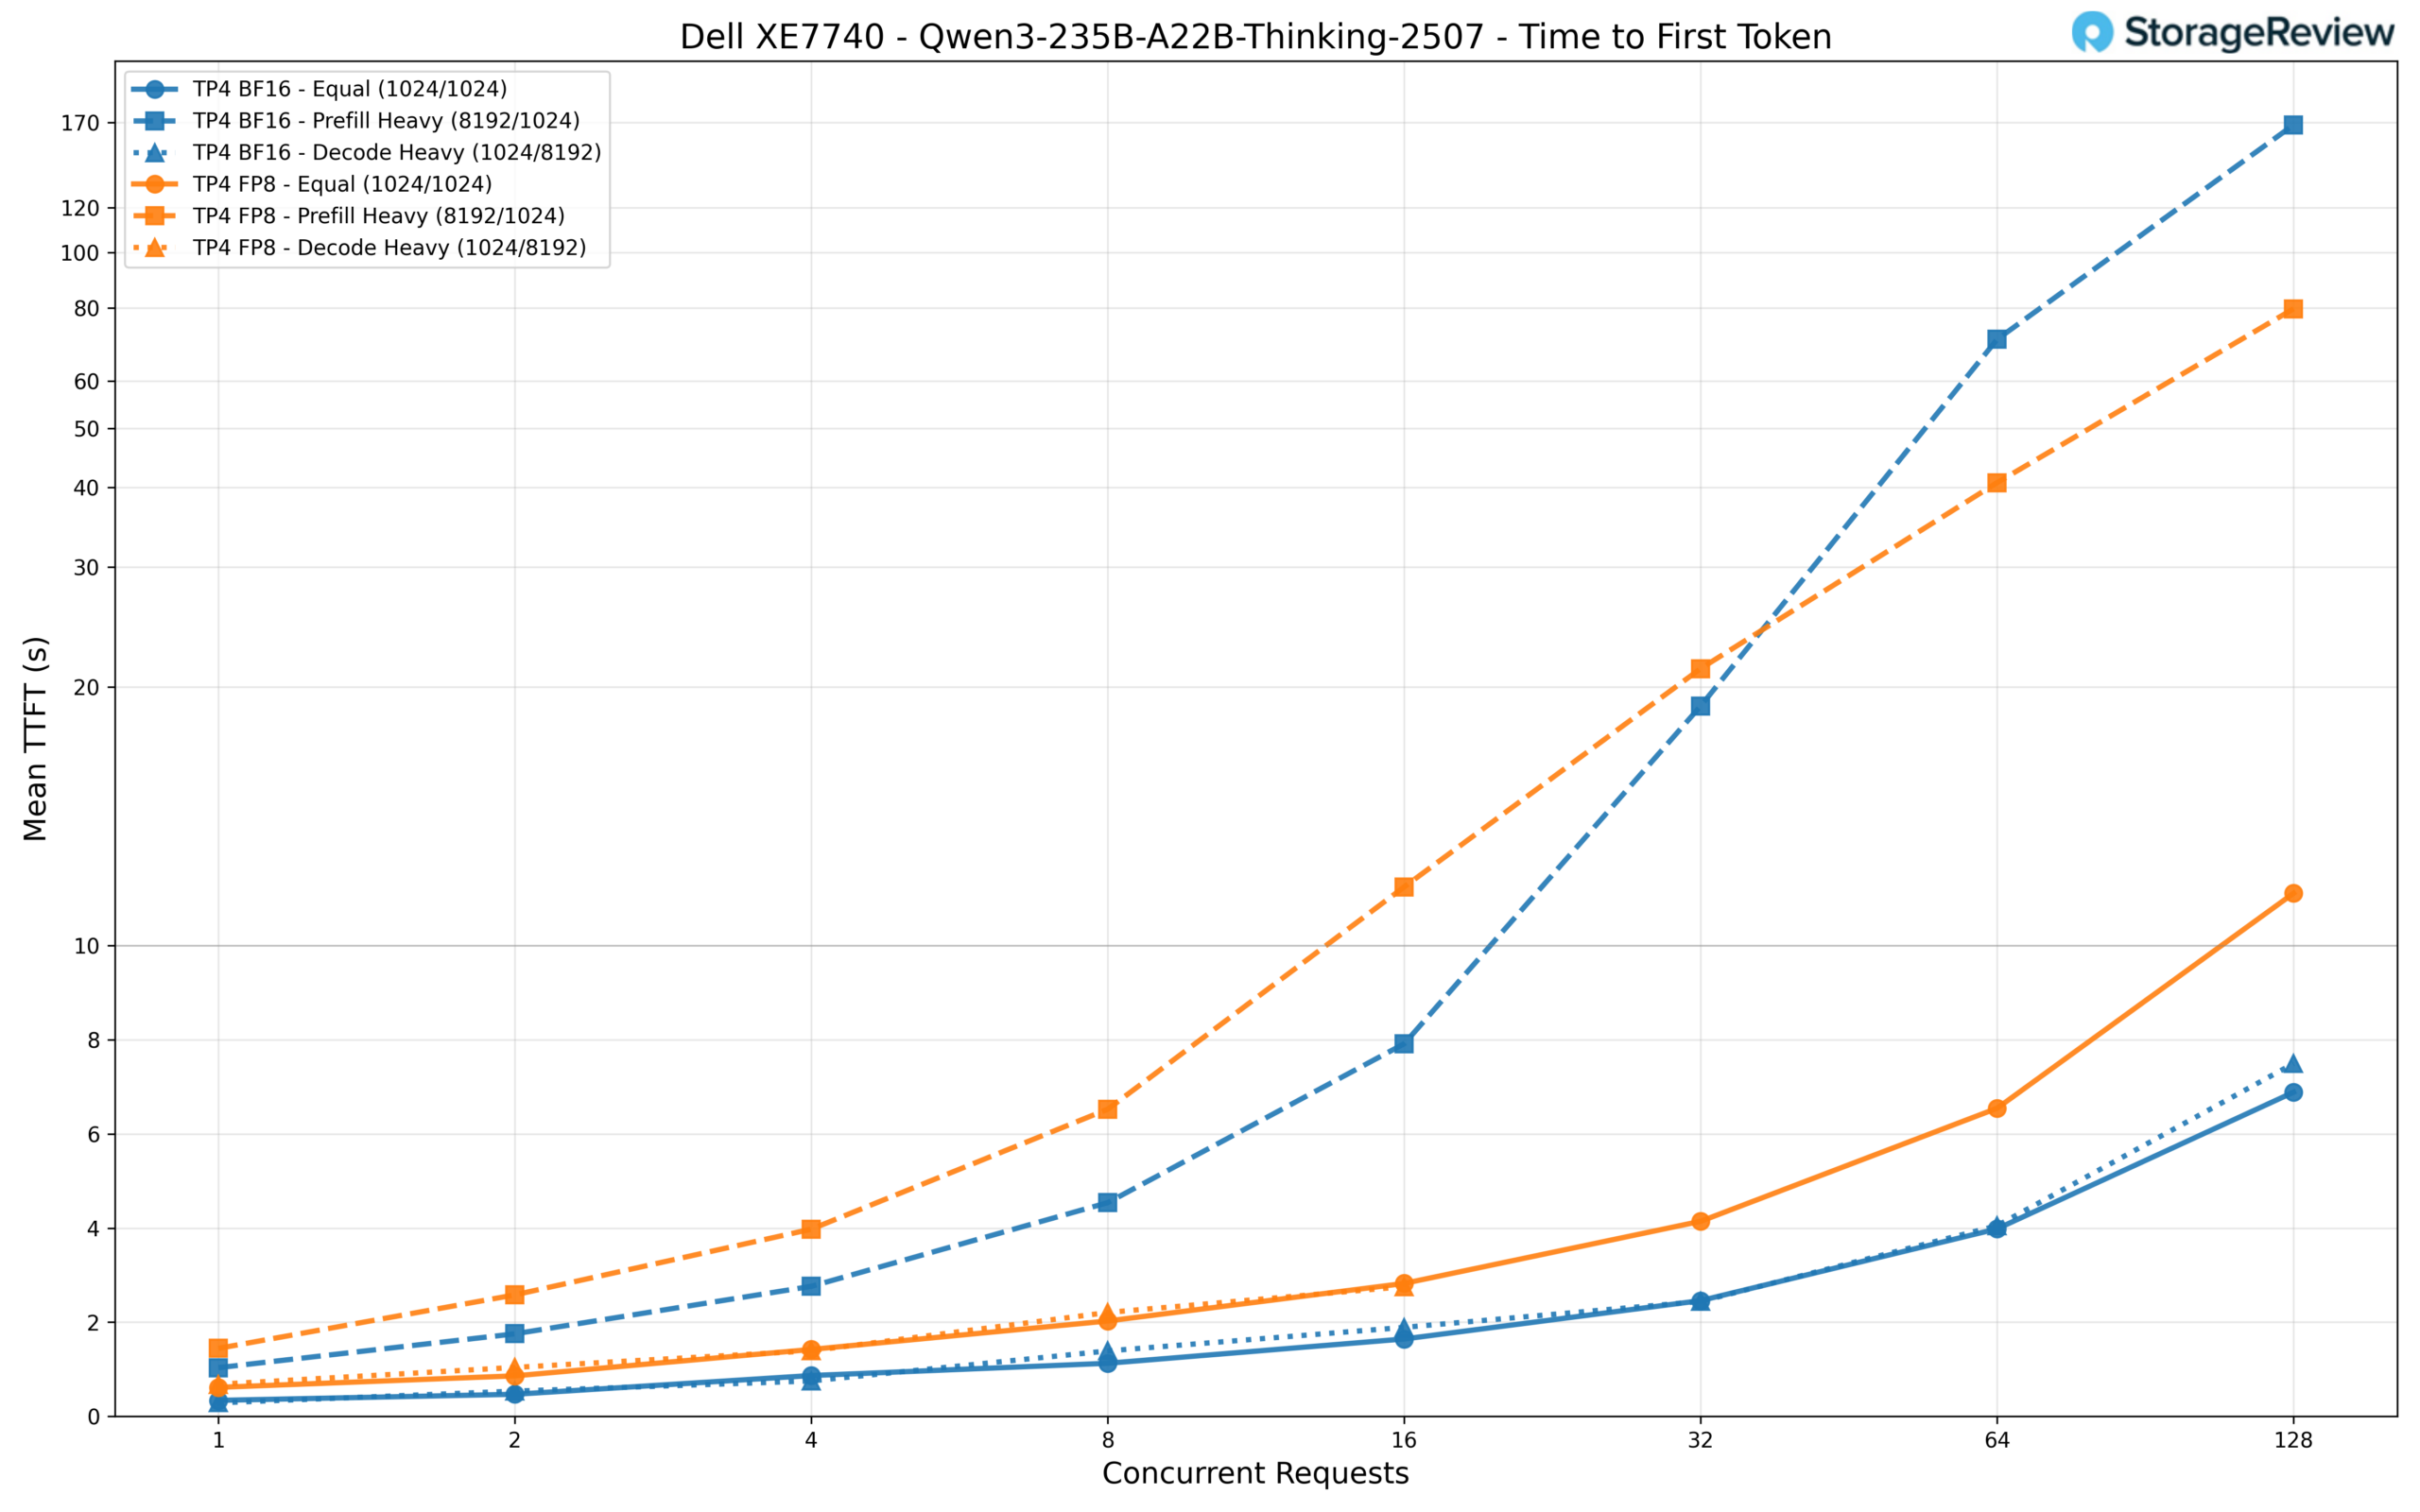
Para o TTFT, o BF16 inicia em torno de 340 ms para uma única requisição de igual duração e escala para aproximadamente 6.9 segundos com 128 requisições simultâneas. Isso é bastante responsivo para um modelo dessa escala. O FP8 é aproximadamente duas vezes mais lento em todos os casos, começando em 615 ms e atingindo cerca de 11.2 segundos com carga máxima. A carga de trabalho com grande quantidade de pré-preenchimento é o cenário mais exigente, com o BF16 chegando a 168 segundos e o FP8 a 80 segundos com 128 requisições.
Quem pode se beneficiar do Tech & Data Studio?
A demanda por inferência não está diminuindo. Seja para implantar modelos internamente e acelerar o trabalho das equipes de desenvolvimento, incorporar IA em produtos voltados para o cliente ou implementar pipelines de automação que funcionam 24 horas por dia, 7 dias por semana, os requisitos de computação continuam aumentando. E com essa demanda, surge um gargalo conhecido: a aquisição. Os prazos de entrega de aceleradores populares podem se estender por meses, paralisando projetos que já foram financiados e tiveram equipes contratadas.
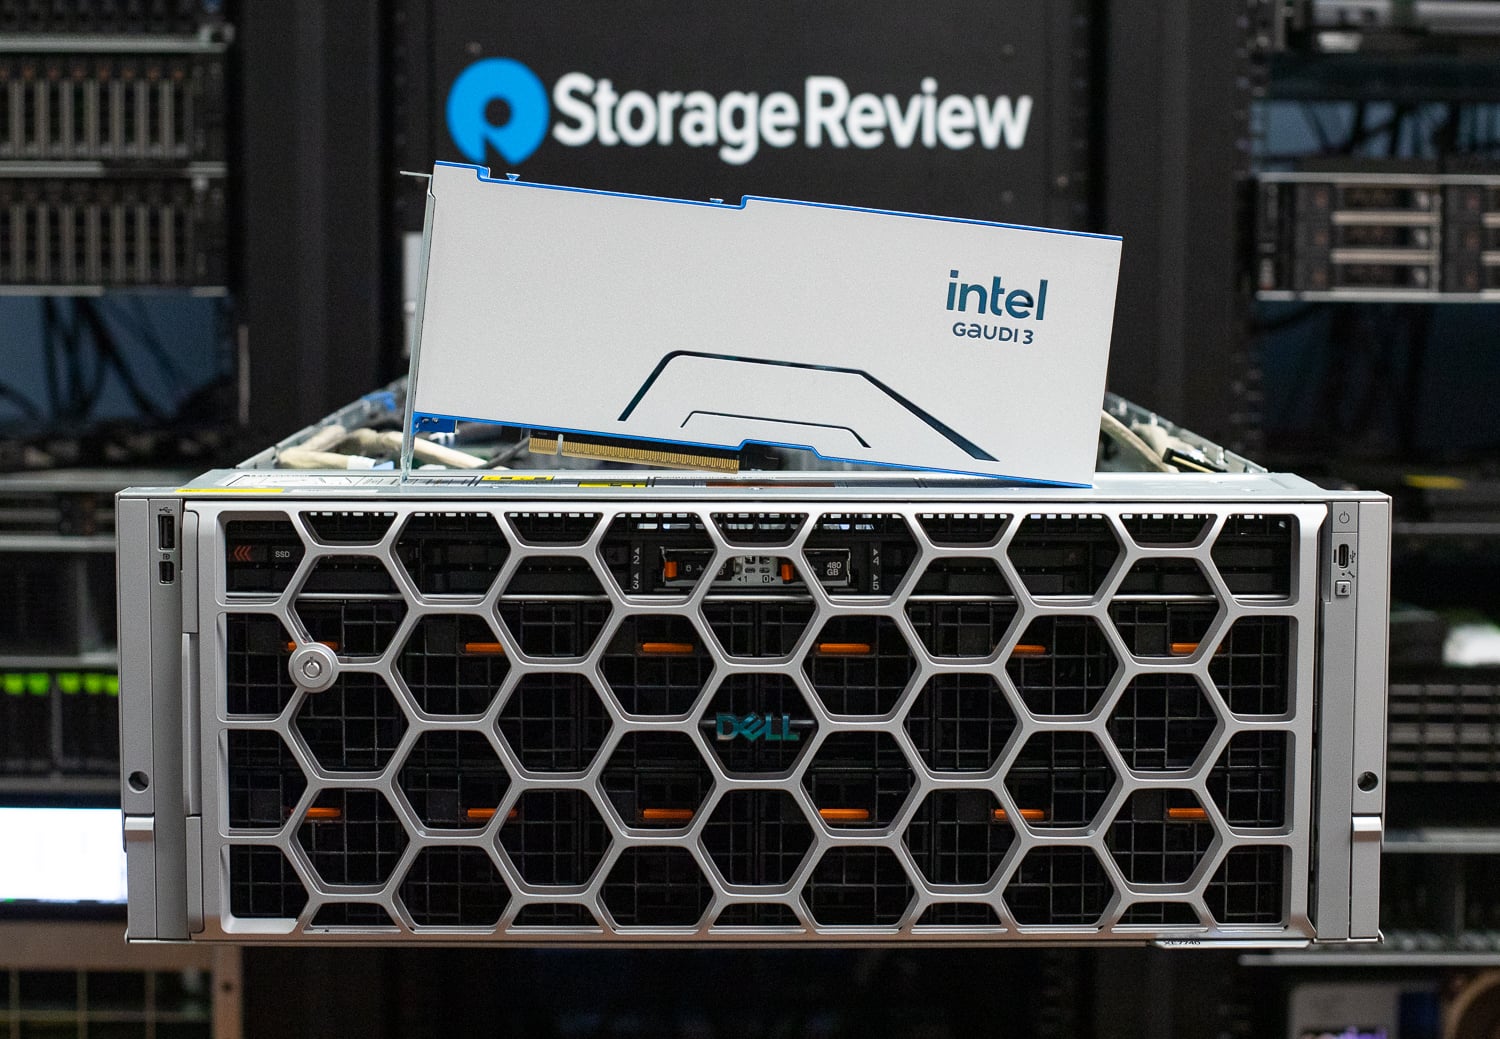
O XE7740, configurado com Intel Gaudi 3, resolve essa limitação diretamente. Os aceleradores Gaudi 3 já estão disponíveis e a Intel fornece modelos de implementação validados para que as equipes possam passar da desembalagem à execução de inferência em poucas horas. A Dell facilita ainda mais o processo com programas de teste e compra que permitem a instalação de sistemas XE7740 diretamente em seu ambiente, possibilitando a validação do desempenho em relação às suas cargas de trabalho, dados e infraestrutura reais antes de se comprometer com uma implementação completa. Essa combinação de disponibilidade imediata, rápido retorno sobre o investimento e avaliação de baixo risco torna a configuração Gaudi 3 particularmente atraente para organizações que precisam de capacidade de inferência hoje e não podem se dar ao luxo de esperar em filas de alocação.
Dito isso, o XE7740 não é uma plataforma de acelerador único. Com o compromisso da Dell com a diversidade de silício, a mesma plataforma pode ser adquirida com uma variedade de opções e todos os aceleradores populares do mercado, e a escolha certa depende inteiramente da carga de trabalho. Pipelines de processamento de vídeo, por exemplo, são uma opção natural para GPUs NVIDIA L4, e o XE7740 pode ser equipado com 16 GPUs L4, juntamente com 8 slots de NIC PCIe Gen5 x16, para um sistema de streaming e transcodificação sem concessões. Organizações que executam cargas de trabalho de IA mistas em diferentes departamentos podem padronizar o chassi XE7740 e simplesmente variar a configuração do acelerador para atender a cada implementação, simplificando o gerenciamento da frota e adaptando a capacidade computacional à tarefa.
Conclusão
O Dell PowerEdge XE7740 foi projetado para as realidades da inferência empresarial. Seu design térmico de zona dupla, topologia PCIe estruturada, arquitetura de memória de alta largura de banda e capacidade de rede escalável formam um sistema construído para cargas de trabalho de produção contínuas. Essas não são escolhas de design acidentais; elas refletem um modelo de infraestrutura onde a inferência é executada continuamente, escala de forma previsível e se integra perfeitamente às operações existentes do data center. Nesta avaliação, o Intel Gaudi 3 demonstra que o XE7740 oferece inferência hoje em arquiteturas densas e MoE, com comportamento de escalabilidade previsível e forte taxa de transferência limitada pela memória. As otimizações de software continuarão a melhorar, mas a base arquitetônica da plataforma já é sólida.
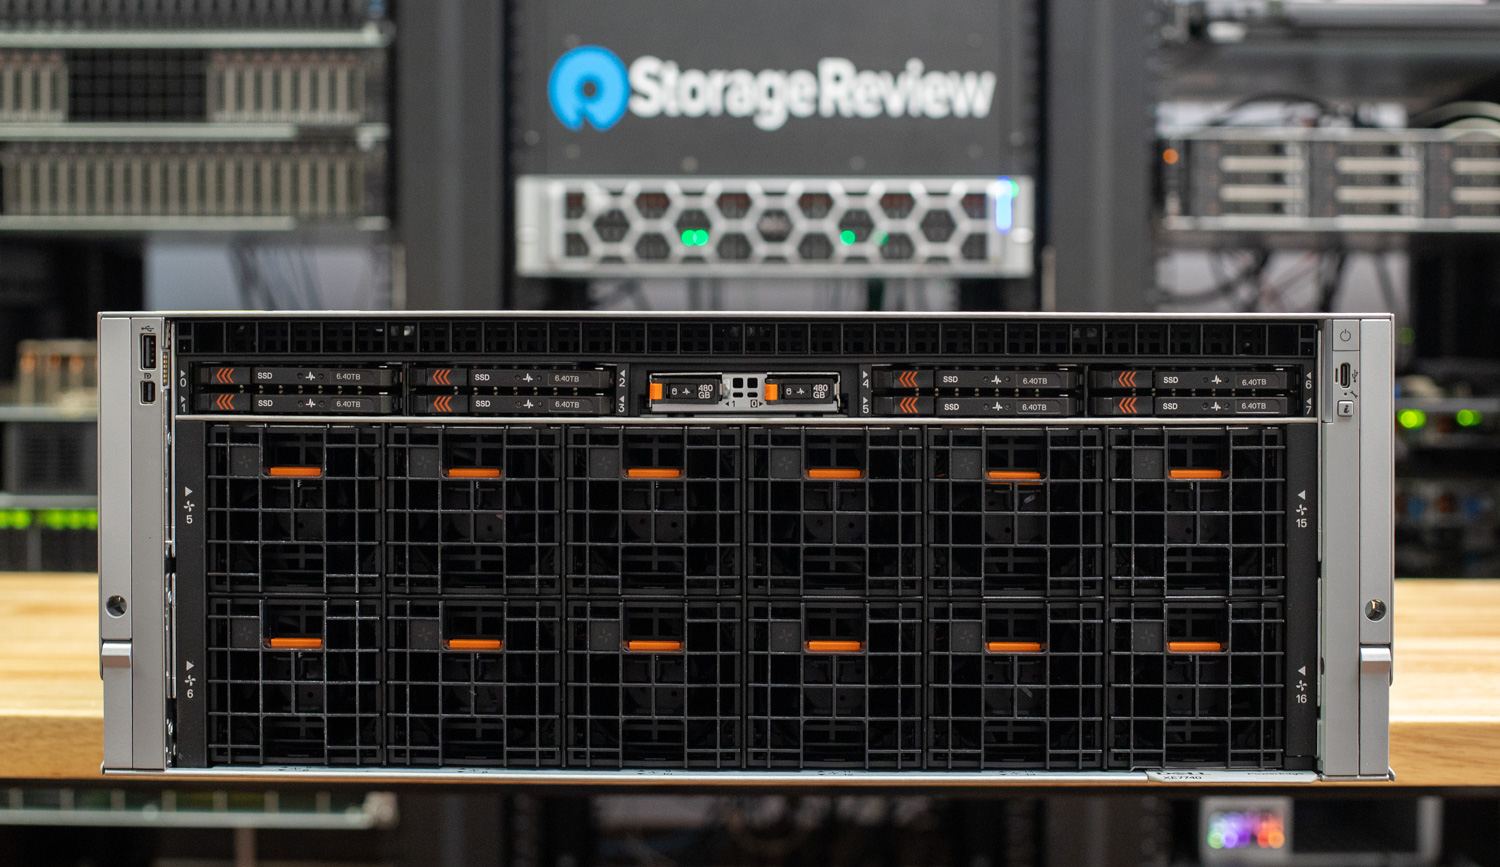
Mais importante ainda, o XE7740 estabelece um modelo robusto para a infraestrutura de IA empresarial. As organizações podem padronizar um chassi, uma pilha de gerenciamento e um modelo de implantação consistentes, enquanto evoluem a estratégia de aceleração ao longo do tempo. À medida que os modelos crescem, as cargas de trabalho se diversificam e a inferência se torna mais integrada às operações de negócios, a necessidade de uma infraestrutura estável e adaptável só aumentará. O PowerEdge XE7740 está posicionado para atender a essa trajetória. Ele oferece o equilíbrio arquitetônico, a maturidade operacional e a capacidade de expansão necessários para a IA empresarial, à medida que ela passa da rápida adoção para a integração de longo prazo.
Este relatório é patrocinado pela Dell Technologies. Todas as visões e opiniões expressas neste relatório são baseadas em nossa visão imparcial do(s) produto(s) em consideração.


 Amazon