

Existem duas histórias no Dell Pro Max 16 Plus, e elas seguem direções opostas. Uma delas é a de uma estação de trabalho móvel de ponta: processador Intel Core Ultra 9 285HX de 24 núcleos, até 256 GB de memória CAMM2, três slots M.2, placa gráfica NVIDIA RTX PRO Blackwell até a série 5000 com 24 GB de GDDR7, construção em conformidade com o padrão militar MIL-STD-810H e um chassi no qual a Dell claramente investiu em engenharia.
A outra opção é o modelo em análise, que troca a GPU por uma placa de inferência Qualcomm AIC100 PC, um módulo dual-SoC baseado no silício Cloud AI 100 de 2019 e um conjunto de softwares que transforma a maioria das cargas de trabalho de inferência modernas em uma experiência árdua. Este é um exemplo do que acontece quando um chassi topo de linha é combinado com o acelerador errado e por que os clientes precisam entender o conjunto de softwares por trás de uma solução de IA antes de fechar o negócio. Antes de chegarmos ao porquê, vamos analisar o laptop como um todo.
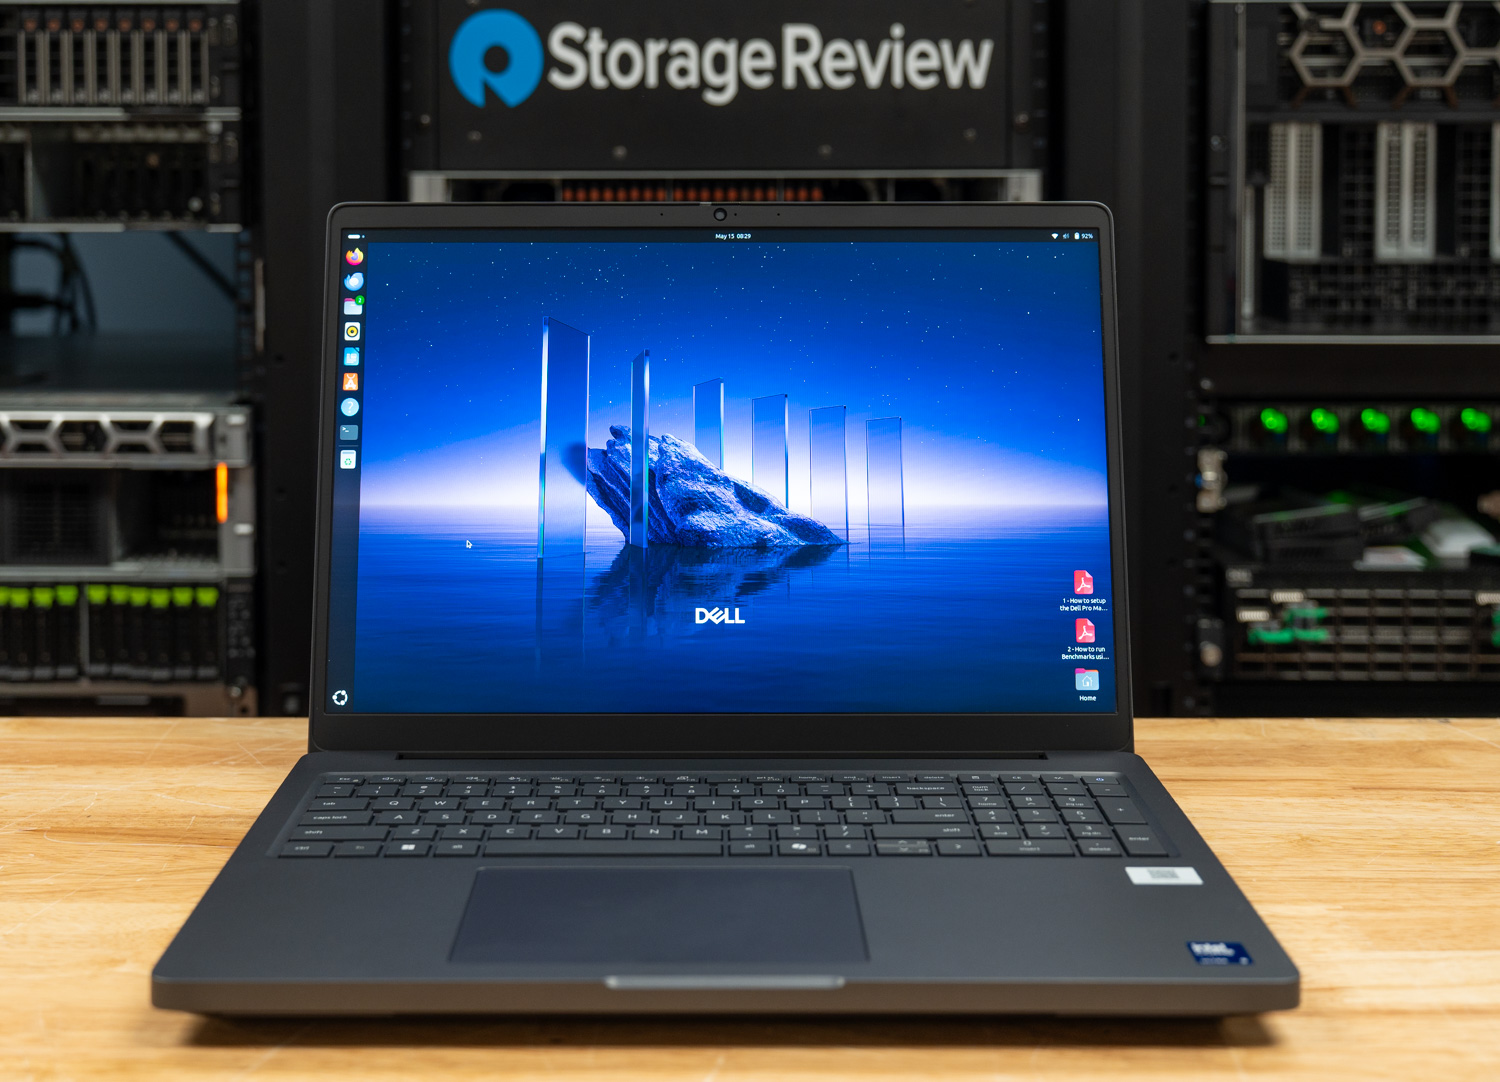
O Pro Max 16 Plus ocupa o topo da linha de workstations Pro Max da Dell, oferecendo mais potência bruta do que o Pro Max 16 de entrada e o Pro Max 16 Premium, mais fino. Seu núcleo é o processador Intel Core Ultra 9 285HX, um chip escalável de 55 watts e 24 núcleos com turbo boost de 5.5 GHz. Todas as configurações de CPU são compatíveis com Intel vPro Enterprise, reforçando as credenciais de nível empresarial do notebook. Os preços começam em US$ 2,779.
As opções gráficas variam desde os gráficos integrados da Intel até a RTX PRO 1000 da NVIDIA, baseada na arquitetura Blackwell, chegando até a RTX PRO 5000 , que analisamos anteriormente e que possui impressionantes 24 GB de memória GDDR7. As configurações de armazenamento e memória são igualmente generosas: até 12 TB em três slots M.2 Gen5 e até 128 GB de memória DDR5-6400 fornecida pelo módulo CAMM2 da Dell.
As opções de tela variam de um painel IPS básico de 1920 x 1200 até a vibrante tela sensível ao toque OLED de 3840 x 2400. Uma opção intermediária de 1920 x 1200 fica entre as duas, adicionando 500 nits de brilho, taxa de atualização variável de 120 Hz e cobertura completa do espaço de cores DCI-P3. Com mais de 100 certificações ISV, os profissionais criativos podem esperar que seus aplicativos funcionem sem problemas.
Os recursos de segurança são de nível empresarial, incluindo leitor de impressões digitais, suporte para Smart Card, NFC, câmera infravermelha de 8 MP para reconhecimento facial e o Dell Control Vault 3. Uma garantia padrão de três anos completa o pacote, reforçando o papel do notebook como uma ferramenta robusta para trabalho exigente.
Especificações do Dell Pro Max 16 Plus
| Especificação | Dell Pro Max 16 Plus |
|---|---|
| Plataforma | |
| Subcontratante | Intel Core Ultra 5 245HX Intel Core Ultra 7 265HX Intel Core Ultra 9 285HX |
| Sistema Operacional | Janelas 11 Pro UbuntuLinux 24.04 LTS |
| Memória | 16 GB a 128 GB CSoDIMM ou CAMM2, 1 slot |
| Gráficos e aceleração de IA | |
| Placa | Gráficos Intel Integrated NVIDIA RTX PRO 1000 8 GB NVIDIA RTX PRO 2000 8 GB NVIDIA RTX PRO 3000 12 GB NVIDIA RTX PRO 4000 16 GB NVIDIA RTX PRO 5000 24 GB Qualcomm AI Cloud 100 64GB (2x 32GB) |
| Armazenamento e exibição | |
| Armazenamento | Até 3x M.2 SSD, 4 TB cada RAID 0/1/5 disponível |
| Ecrã | 16 polegadas 16:10 1920×1200, 300 nits, 45% NTSC, 60Hz, sem toque 1920×1200, 500 nits, 100% DCI-P3, VRR de 120 Hz, sem toque 3840×2400, 500 nits, OLED, toque |
| Conectividade e Energia | |
| Câmara | 8 MP IR |
| Rede sem fio | Intel Wi-Fi 7 BE200, com ou sem Bluetooth 5.4 Banda larga móvel disponível |
| Bateria | 6Whr-célula 96 |
| Adaptador de energia | 165W ou 280W |
| Segurança e instalações físicas | |
| Recursos de Segurança | Webcam IR Leitor de impressão digital Leitor de cartão inteligente NFC Cofre de Controle 3 |
| Dimensões e Peso | 1.22 por 10.18 por 14.17 polegadas Peso inicial: 5.63 libras |
| Garantia | Padrão de três anos, reparo no local no próximo dia útil |
Construir e projetar
Assim como a unidade anterior que analisamos, o Pro Max 16 Plus é assumidamente robusto, possuindo certificação MIL-STD-810H para durabilidade em ambientes exigentes. A combinação de materiais da Dell prioriza a sustentabilidade, incorporando plástico reciclado pós-consumo, magnésio e cobalto reciclados e plásticos de base biológica. Ao manuseá-lo, percebe-se uma rigidez excepcional, sem qualquer flexibilidade perceptível. Em resumo, é construído como um tanque.
Este é um computador robusto. Com 1.22 cm de espessura (incluindo os pés) e peso inicial de 5.63 kg, não foi projetado para viagens frequentes, embora suas dimensões de 10.18 x 14.17 cm sejam razoavelmente compactas para uma tela de 16 polegadas com proporção 16:10. A webcam fica na parte superior da tampa, com uma tampa deslizante para privacidade; nossa unidade de teste veio com a versão infravermelha para reconhecimento facial.
Esteticamente, a linguagem de design da Dell é discreta ao extremo. O exterior em tons de cinza e preto e a marca sutil enfatizam que este é um produto que prioriza a função em detrimento da forma. A linha Pro Max Premium oferece mais estilo visual, mas sacrifica desempenho e capacidade de expansão.
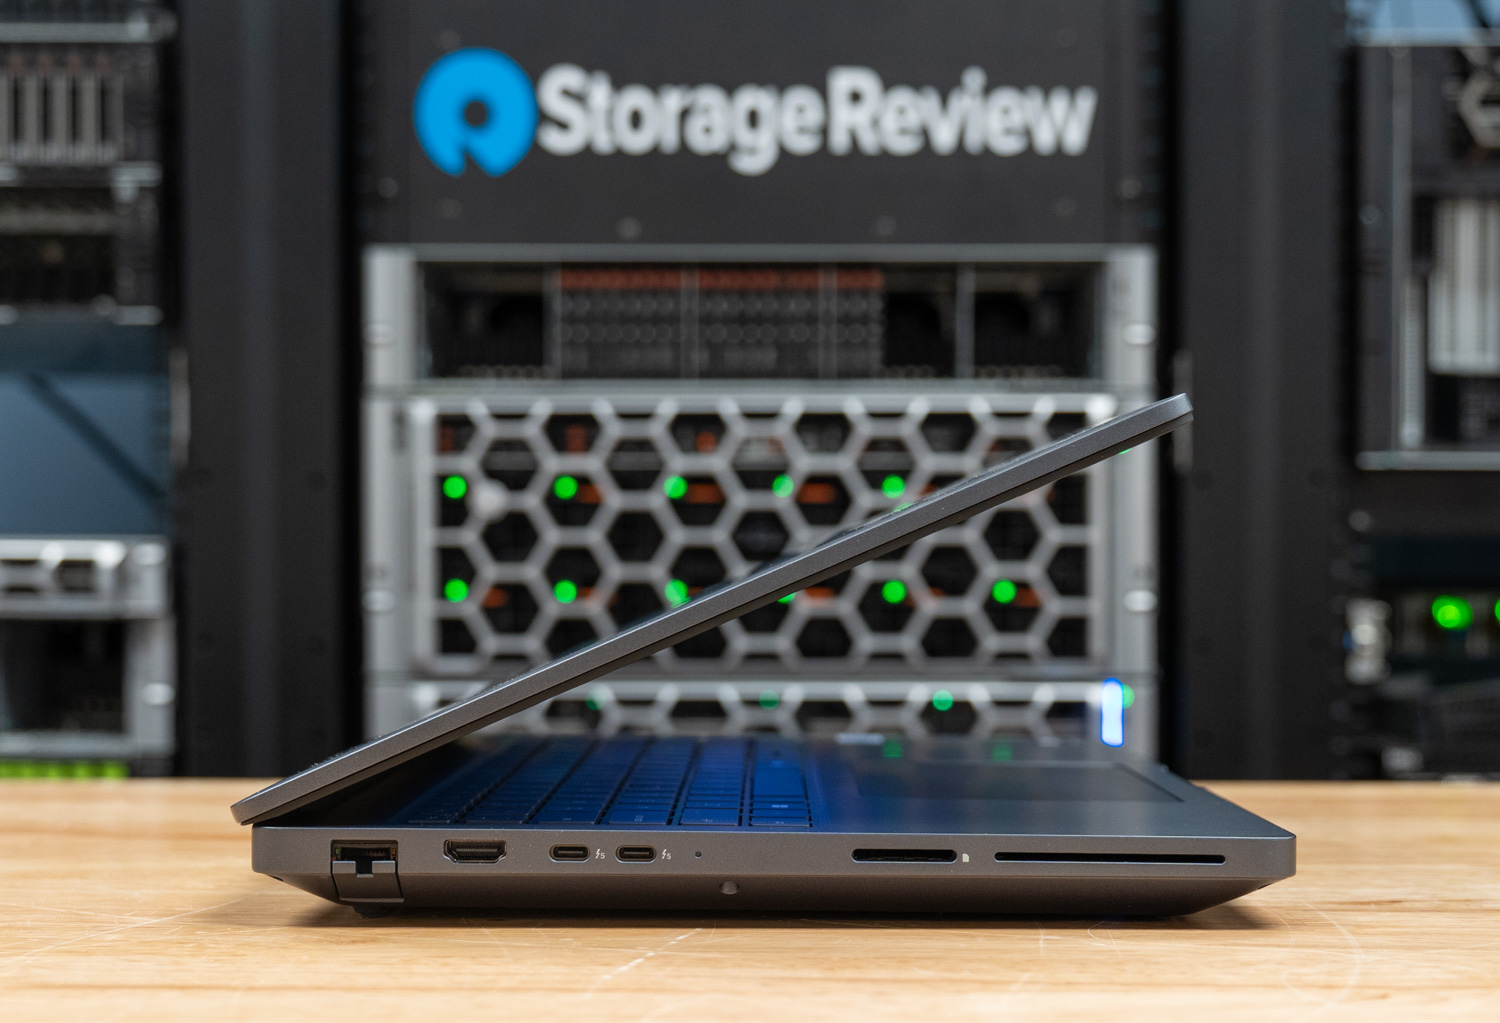
A seleção abrangente de portas começa na borda esquerda:
- Ethernet RJ45 de 2.5 Gbps
- Saída HDMI 2.1
- Duas portas Thunderbolt 5 (USB-C)
- Leitor de cartão SD
- Slot para SmartCard opcional
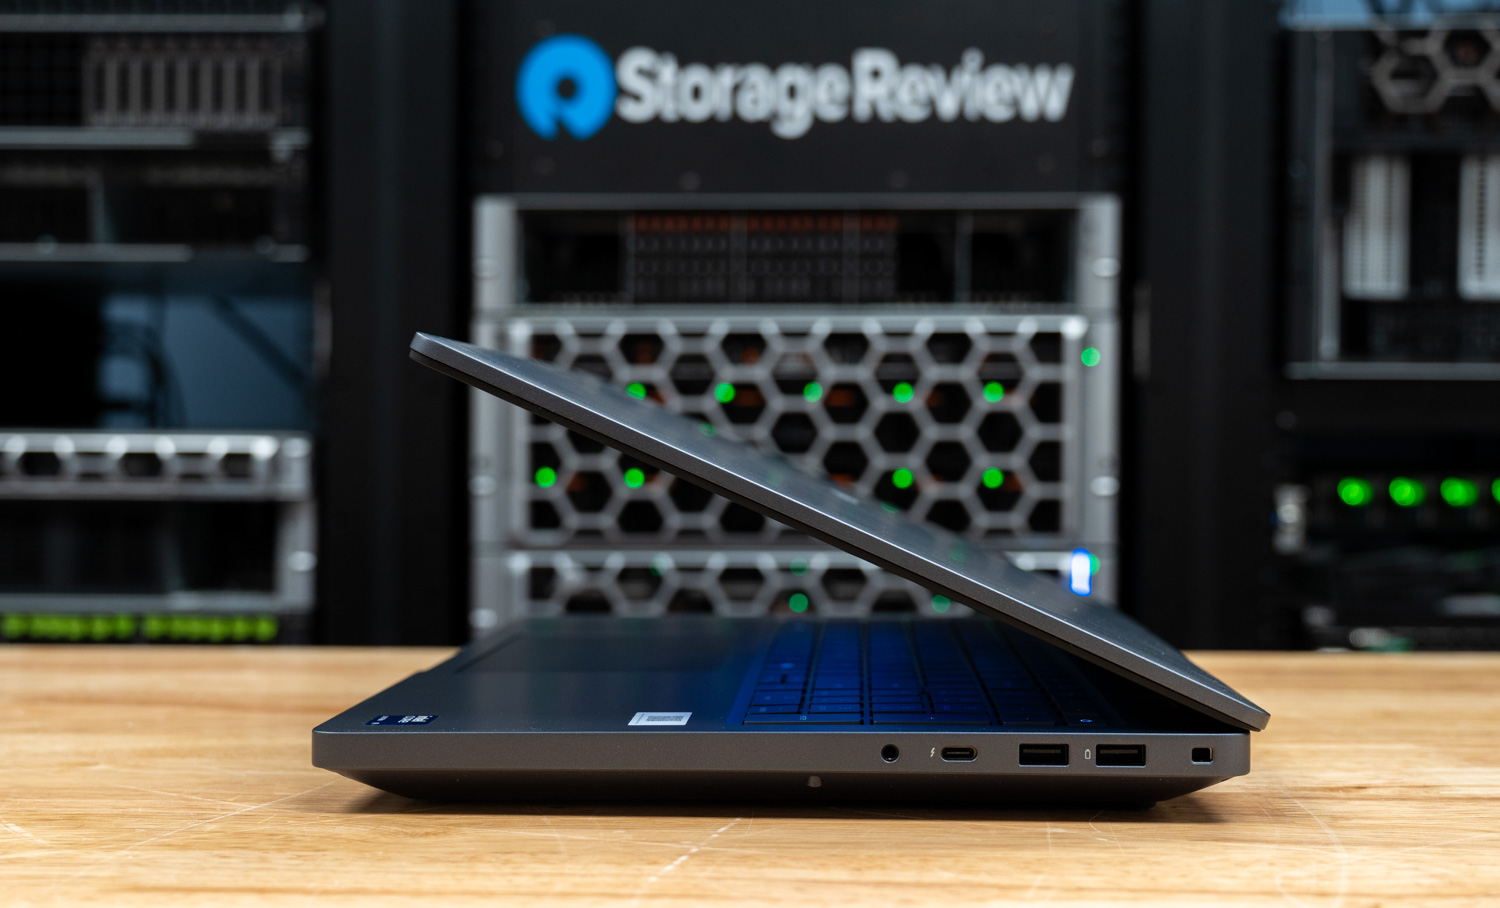
À direita:
- 3.5mm jack de áudio
- Thunderbolt 4 (USB-C)
- Duas portas USB 3.2 Gen1 Tipo A
- Slot de fecho
Não há portas na parte traseira. A conectividade sem fio é feita pelo módulo BE200 da Intel, compatível com Wi-Fi 7 e Bluetooth 5.4. O Bluetooth pode ser desativado em configurações personalizadas, e a banda larga móvel 5G também está disponível.
Tela e dispositivos de entrada
Nossa unidade de teste possui um monitor Dell de 16 polegadas com resolução de 1920×1200 e taxa de atualização de 120Hz (VRR), que oferece excelente qualidade de imagem para uso diário. As cores são vibrantes e, com cobertura de 100% do espaço de cores DCI-P3, é ideal para fluxos de trabalho que exigem precisão de cores, após a calibração. O brilho de 500 nits também contribui para que o monitor permaneça confortável mesmo em ambientes de escritório ou estúdio com muita luminosidade.
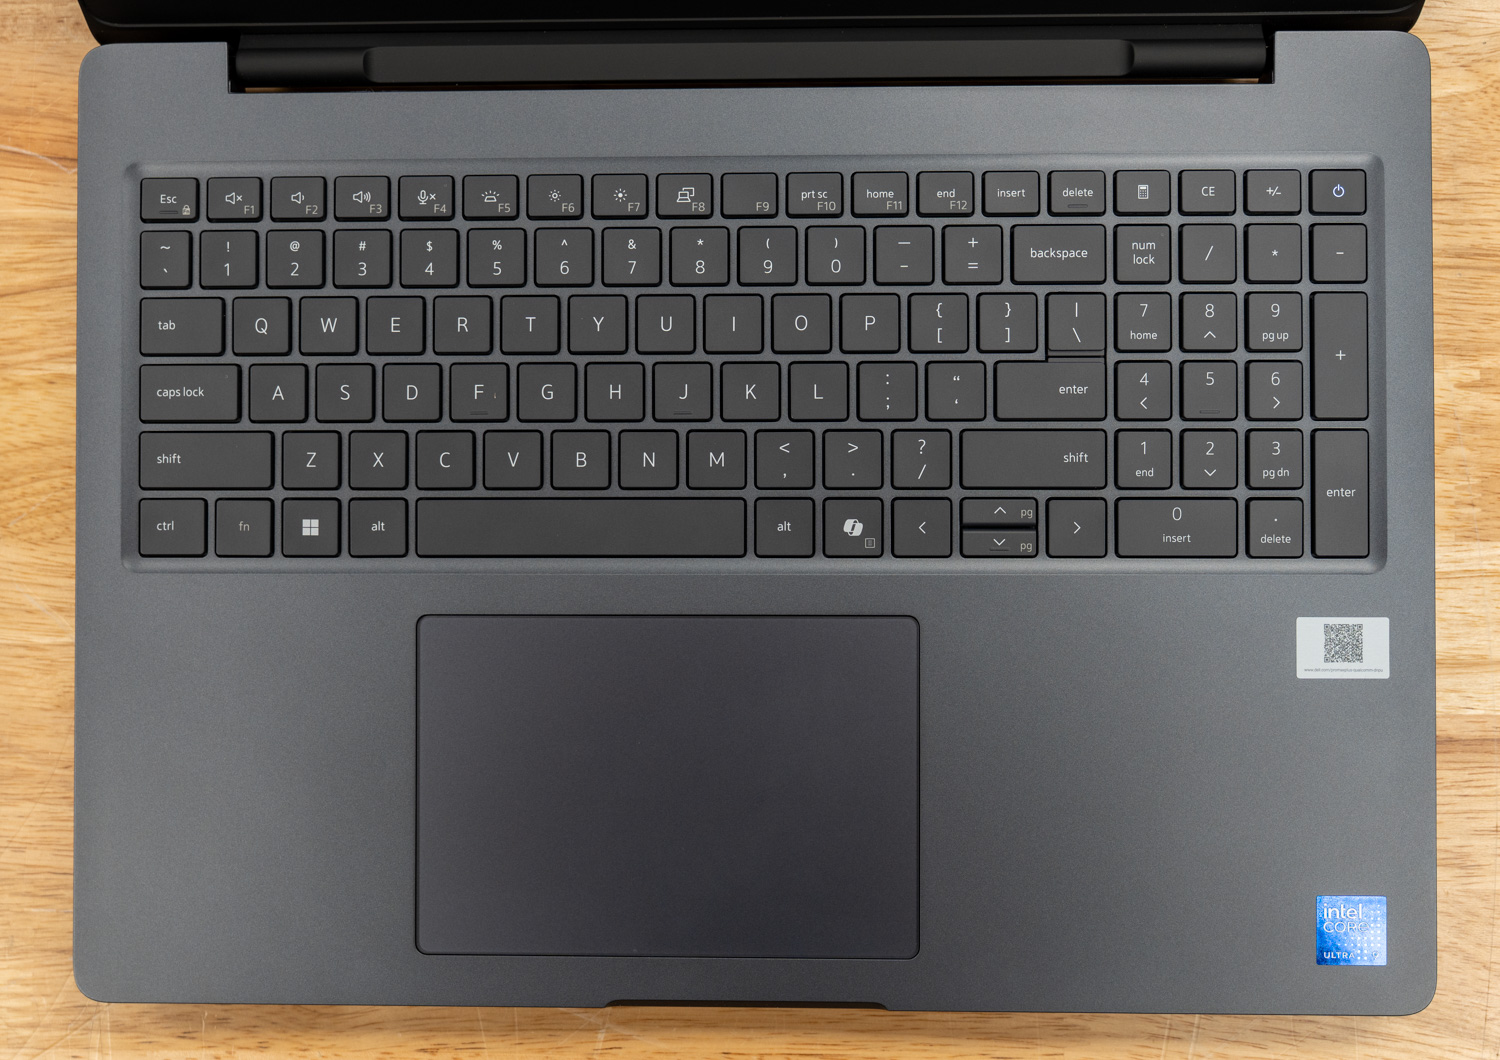
O teclado da Dell é ideal para longas sessões de digitação, com teclas de tamanho normal que oferecem uma sensação leve e responsiva, além de um feedback tátil preciso. A retroiluminação branca garante a visibilidade em ambientes com pouca luz. O layout é em grande parte convencional, mas o tamanho irregular das teclas de seta pode causar pressionamentos acidentais ocasionais, e a posição das teclas Home e End é uma desvantagem específica; elas compartilham espaço com F11 e F12, portanto, ativar o Fn-Lock (Fn + Esc) para priorizar a linha de funções força o pressionamento de Fn + F11 ou F12 para acessá-las. Teclas dedicadas para Page Up e Page Down seriam bem-vindas; em vez disso, elas são funções secundárias das setas para cima e para baixo, que já são as teclas mais incômodas do conjunto. O botão liga/desliga, localizado no canto superior direito, também funciona como sensor de impressões digitais.
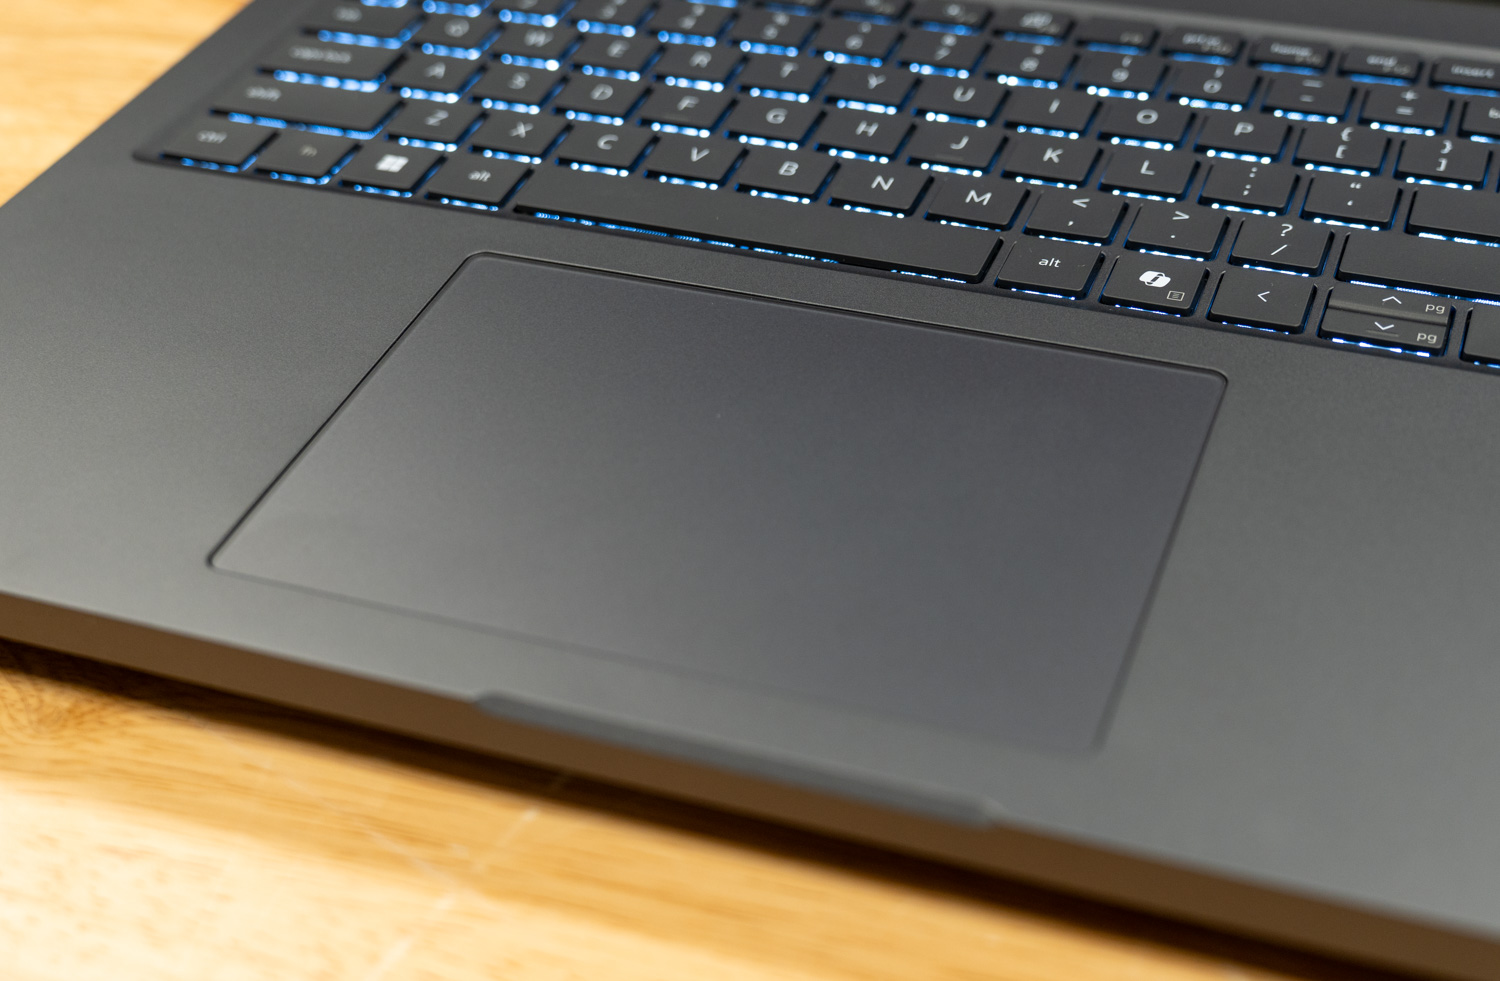
O touchpad de tamanho generoso complementa o formato de 16 polegadas. Sua superfície lisa e antirreflexo oferece rastreamento preciso, e a rejeição de palma funcionou perfeitamente durante todos os testes.
Capacidade de atualização
O Pro Max 16 Plus foi projetado pensando em expansão, oferecendo um potencial de atualização substancial. Ele possui três slots M.2 Gen5 para armazenamento, um slot CAMM2 para upgrades de memória e diversos componentes modulares, incluindo portas USB-C substituíveis.
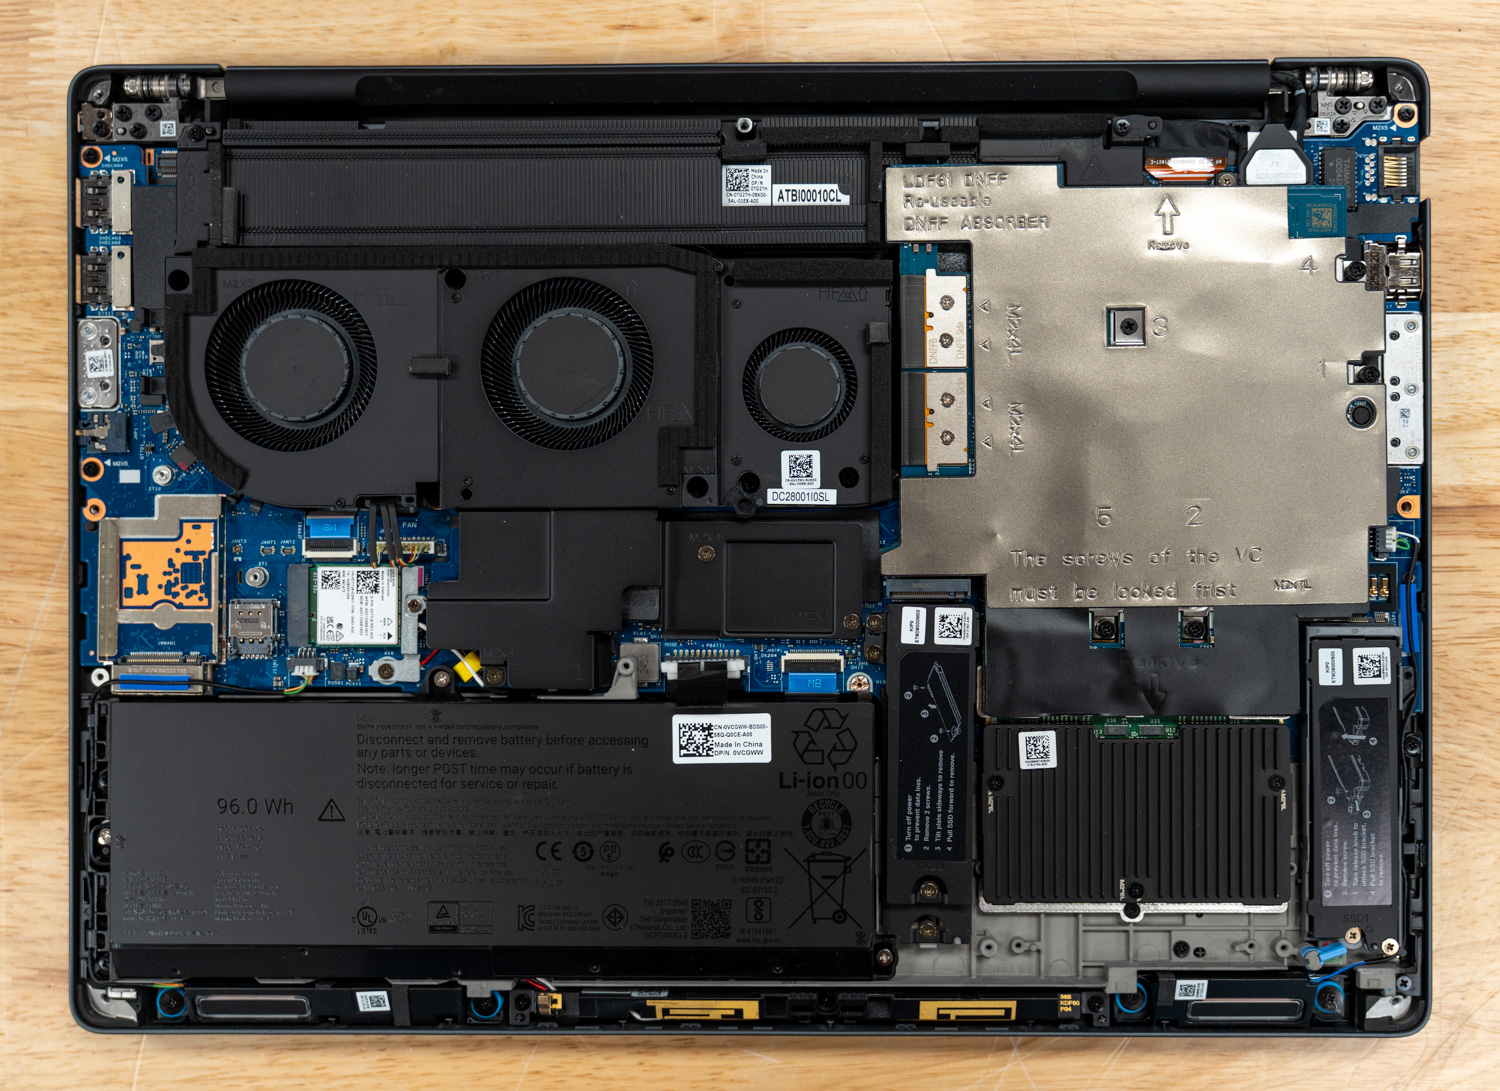
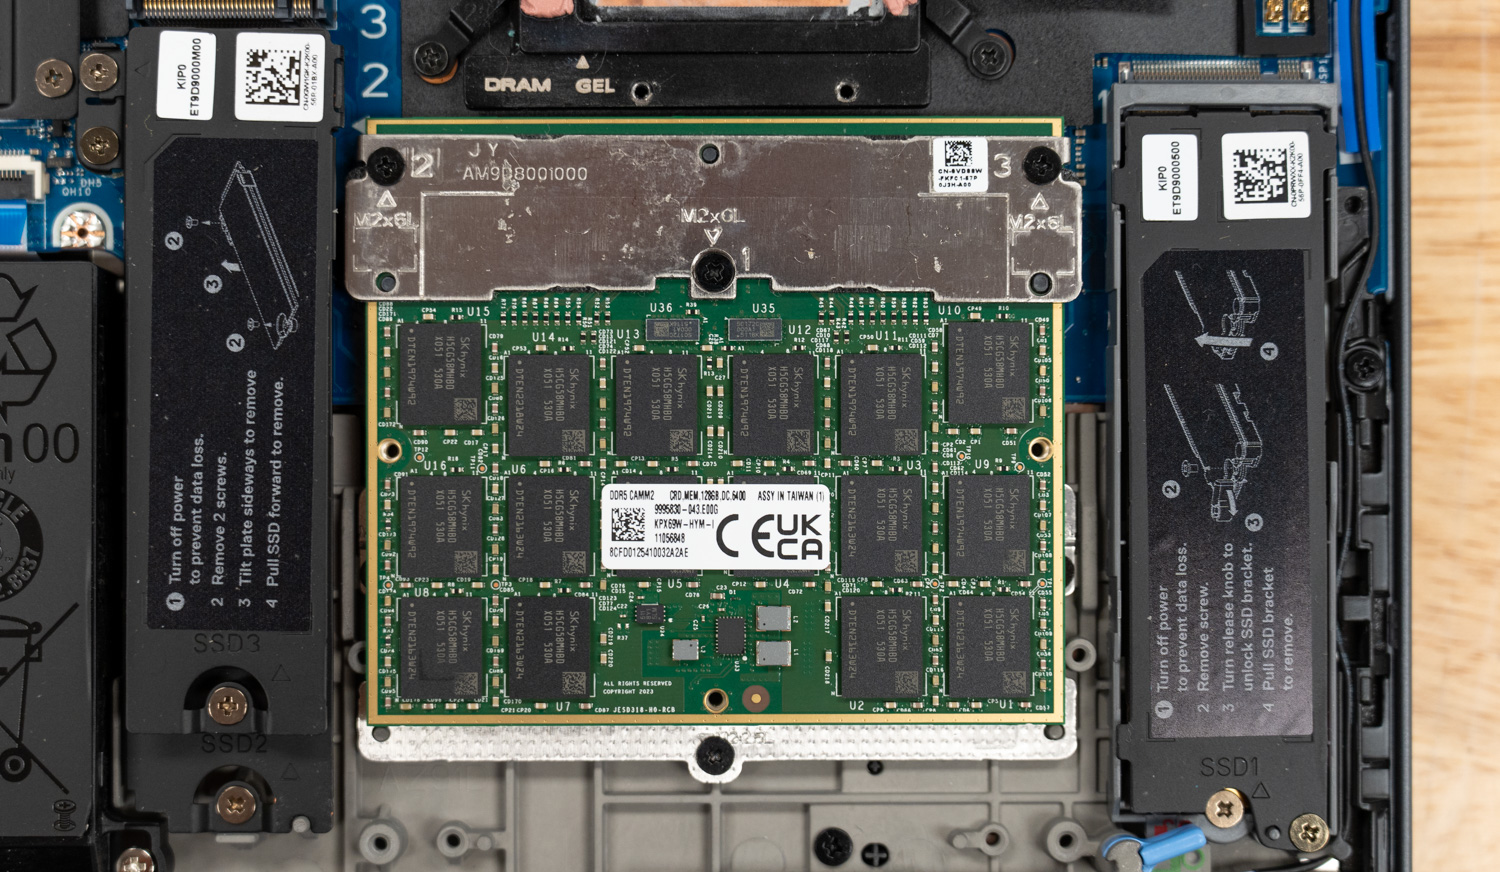
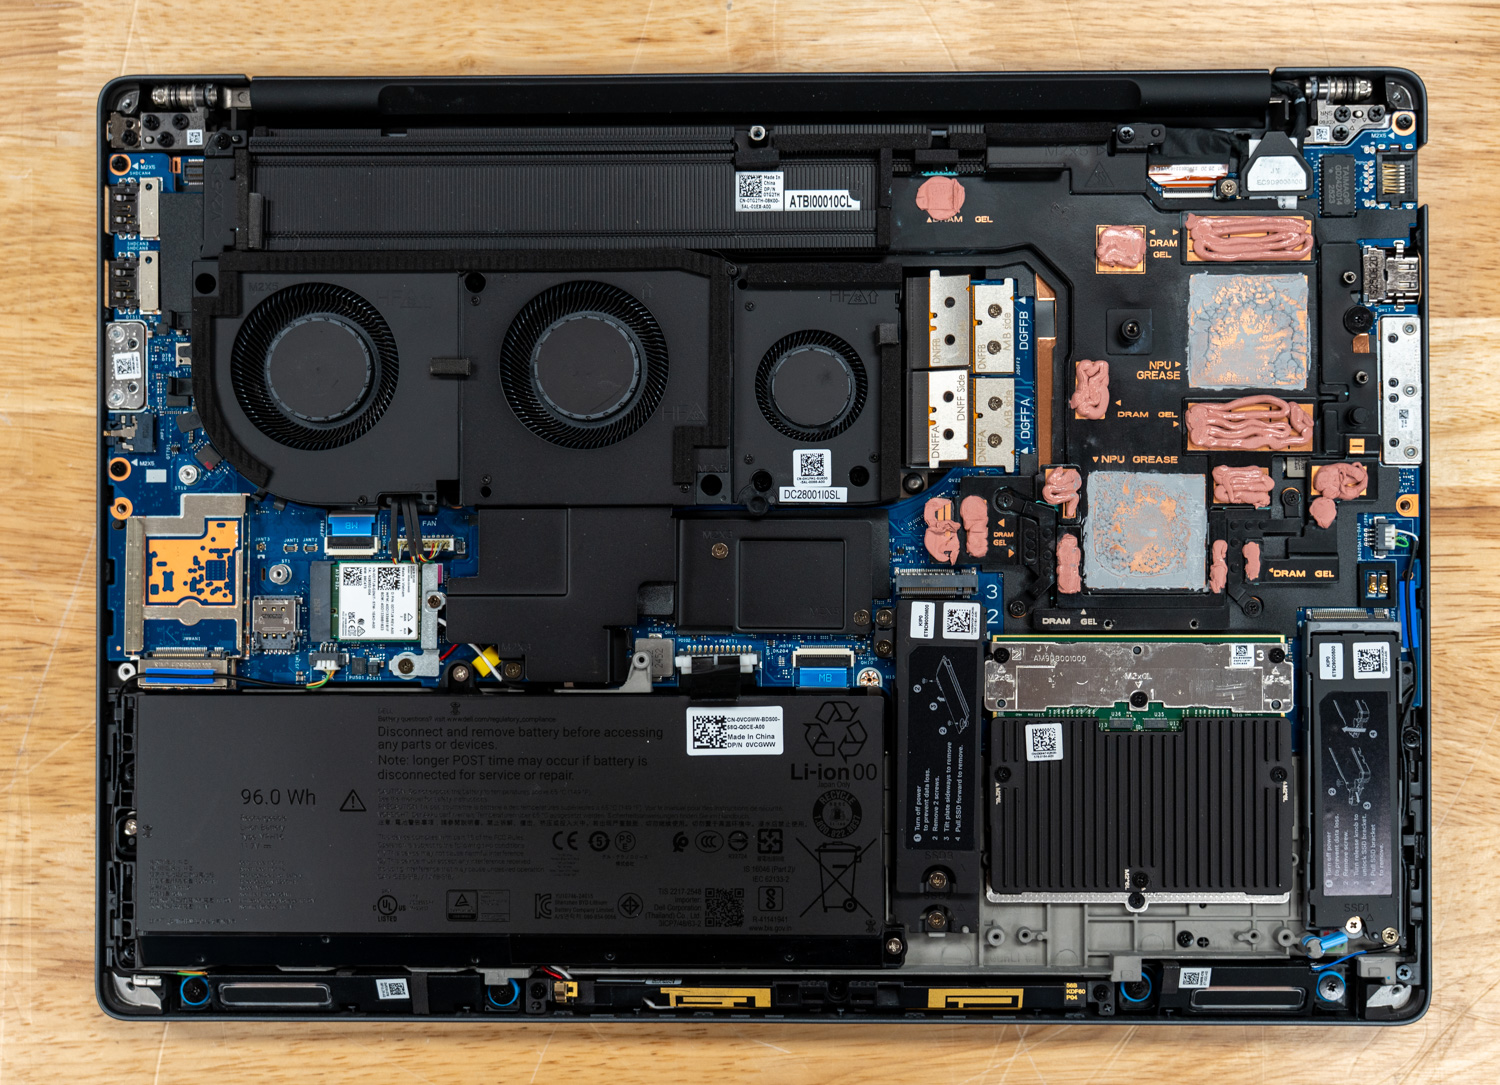
O acesso aos componentes internos é simples: remova os parafusos da borda e levante o painel inferior de trás para frente. Lá dentro, você encontrará um robusto sistema de refrigeração com três ventoinhas e uma bateria de 96 Wh de boa capacidade. O módulo de memória CAMM2 fica no canto inferior direito, posicionado sob um dissipador de calor dedicado e ladeado pelos slots M.2. É difícil perceber pela foto, mas o slot M.2 à esquerda é, na verdade, um slot duplo que acomoda dois drives no mesmo espaço. A placa de rede sem fio M.2, também substituível pelo usuário, fica logo acima da bateria.
A estrela do show: Qualcomm AIC100
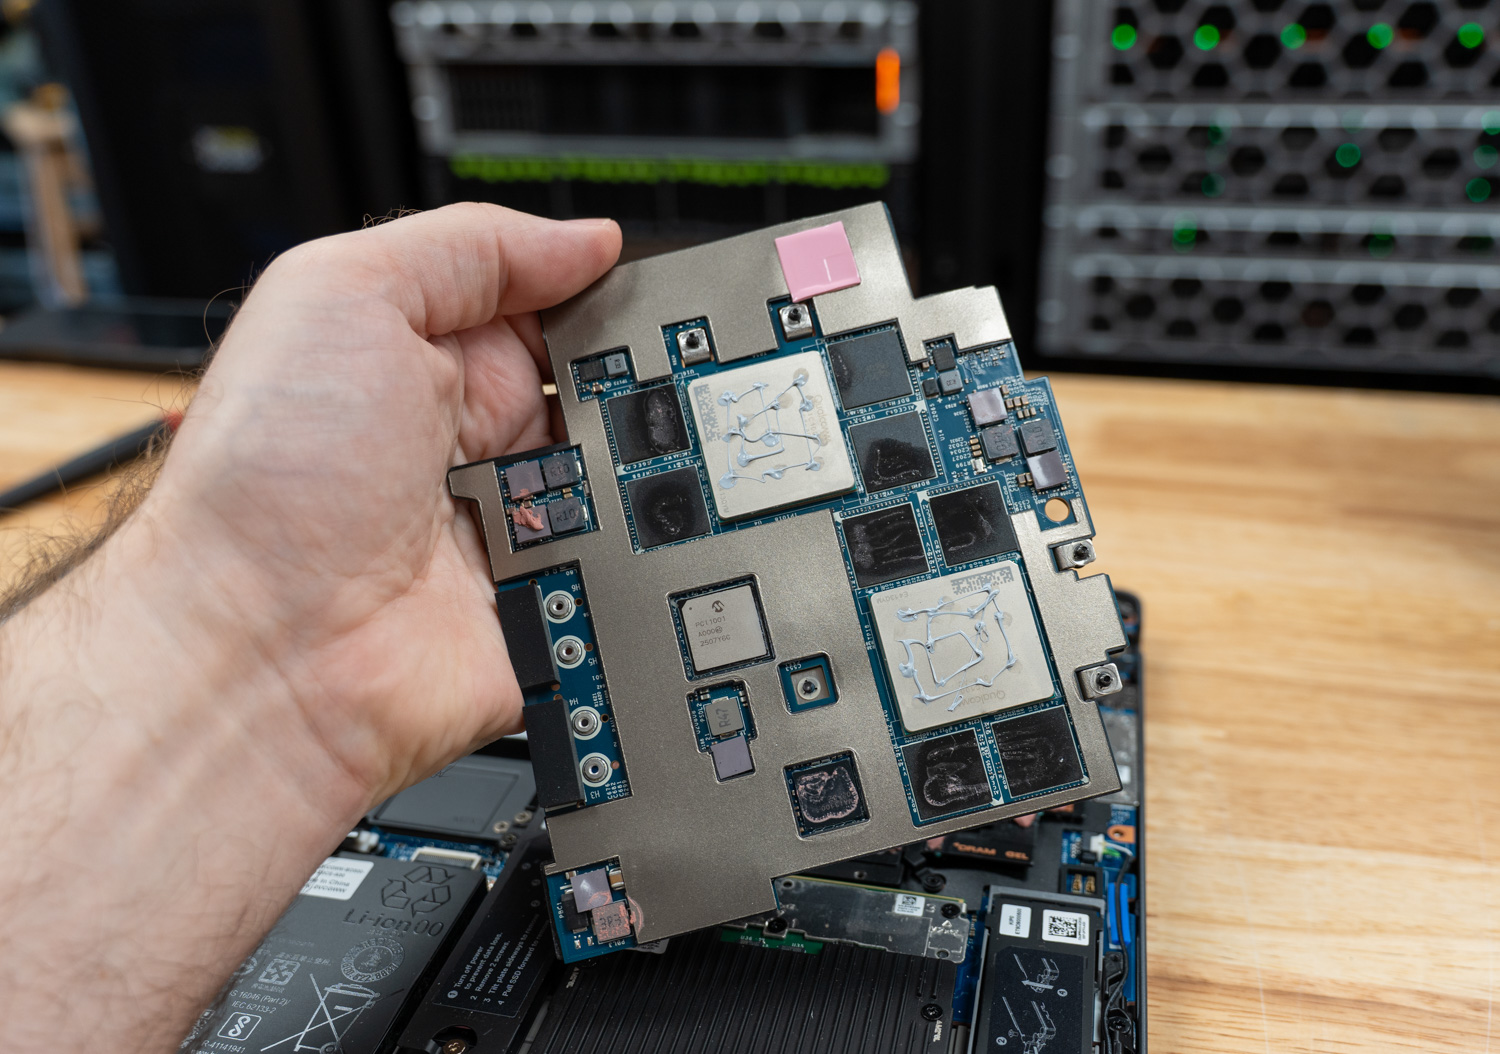
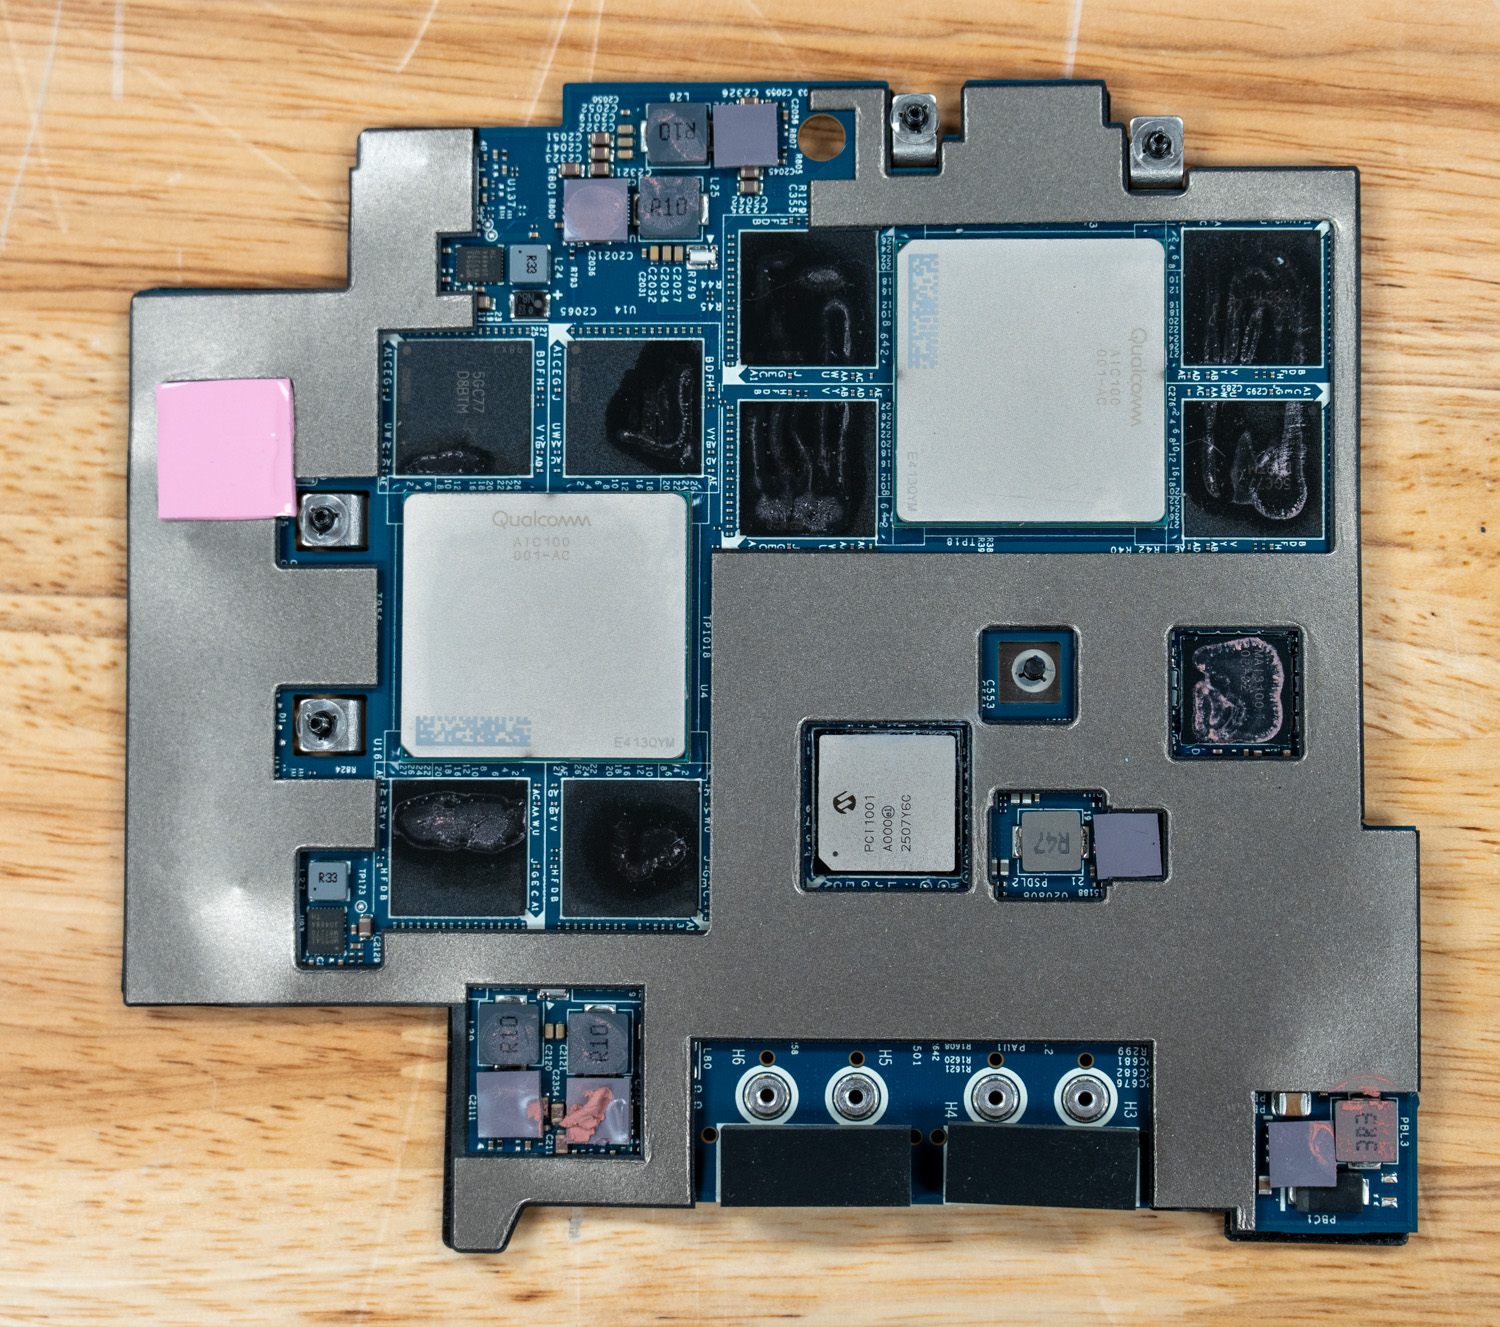
O modelo da Dell em análise vem com a NPU Qualcomm AI 100, um módulo único que abriga dois SoCs Qualcomm Cloud AI 100 lado a lado. Cada SoC contribui com 16 núcleos de IA, totalizando 32 núcleos no módulo, e cada um possui seus próprios 32 GB de LPDDR4x, apresentados ao host como duas NPUs individuais.
A Dell e a Qualcomm anunciam uma taxa de transferência de aproximadamente 450 TOPS para a interface INT8 e a capacidade de executar modelos na faixa de 100 bilhões de parâmetros. A Dell demonstrou publicamente o Llama 4 Scout (109 bilhões de parâmetros, MoE) rodando localmente em um laptop. Os dois SoCs se comunicam com o host por meio do driver acelerador QAIC do Linux, com os pacotes de firmware integrados ao repositório linux-firmware.
Até aqui, tudo razoável. Os números, isoladamente, são grandes. O problema está no silício que está por trás desses números.
A Qualcomm anunciou o Cloud AI 100 em abril de 2019, disponibilizou amostras no final de 2020 e iniciou sua comercialização no primeiro semestre de 2021. O chip é construído em um processo de 7 nm e utiliza quatro controladores LPDDR4X de 64 bits rodando a 2100 MHz (LPDDR4X-4200), oferecendo 136 GB/s de largura de banda de memória por SoC, de acordo com a documentação da arquitetura Cloud AI da Qualcomm.
Originalmente, foi projetado para o formato PCIe. Colocar dois desses chips em um módulo personalizado e inseri-lo em um laptop de 2025 não altera as vantagens e desvantagens inerentes. Trata-se de silício da era 2019 com tecnologia de memória da mesma era, atualizado e renomeado, mas arquiteturalmente da mesma família. Quando chegou ao Dell Pro Max 16 Plus, o restante da indústria já havia migrado para HBM2e, HBM3, HBM3e e LPDDR5X, e agora caminha para GDDR7 e HBM4 em aceleradores de IA de alto desempenho.
Mas a questão mais profunda importa mais do que a largura de banda da memória. Existem muitos projetos de chips brilhantes e equipes de engenharia na indústria que entendem o problema da inferência de IA em um nível muito profundo, e a própria arquitetura Cloud AI 100 pode muito bem ser competente. O problema é que os engenheiros de software que realmente fazem um produto sobreviver ou fracassar já investiram pesado em outro ecossistema: o CUDA. A menos que haja um forte incentivo para mudar, os desenvolvedores permanecem com a cadeia de ferramentas que já possui ótimo suporte, documentação e ajuda da comunidade. A NVIDIA conquistou a base de desenvolvedores cedo e construiu uma enorme comunidade ao seu redor. A AMD passou anos ficando para trás nesse aspecto, mas as revisões recentes do ROCm são realmente excelentes e a diferença está diminuindo. Soluções como o Mojo e o MAX da Modular permitem até mesmo que você direcione para NVIDIA ou AMD com o mesmo código e, às vezes, superam os runtimes nativos. Todos os outros aceleradores, no entanto, lutam com a adoção pública devido à falta de suporte de software.
A adoção pública é a expressão-chave. Grandes organizações como o Google podem investir bilhões em XLA e JAX para fazer as TPUs funcionarem perfeitamente . Startups privadas bem financiadas e laboratórios de IA podem escrever kernels personalizados para seus próprios conjuntos específicos de modelos, sem se preocuparem com o fato de que ninguém mais possa replicar a pilha que estão construindo para infinitos casos de uso público; elas estão construindo para os problemas que enfrentam. Para um consumidor público, ou mesmo para a maioria das empresas, uma aceleradora sem um ecossistema de desenvolvedores público próspero é praticamente inútil. Você perderá semanas tentando migrar seu modelo para ela e, no momento em que a Hugging Face lançar uma nova arquitetura, você se deparará com uma tarefa de recompilação (ou um erro de modelo não suportado), enquanto todos que usam CUDA e ROCm terão suporte desde o primeiro dia.
Para ser bem claro: o AIC100 neste laptop está completamente inviável. Ninguém deveria comprá-lo. Nenhuma organização deveria comprá-lo, a menos que tenha os recursos de engenharia e a intenção explícita de implementar inferência do zero para sua carga de trabalho específica, e esteja disposta a assumir a responsabilidade pela manutenção dessa infraestrutura.
A realidade do software e das ferramentas
Para entender por que essa recomendação é tão rigorosa, é preciso analisar o que a inferência de envio neste cartão realmente envolve.
Os componentes voltados para o usuário são divididos em dois SDKs e uma biblioteca wrapper. O SDK da Plataforma de IA em Nuvem da Qualcomm inclui o driver do kernel (o driver accel/qaic upstream no Linux mainline), o firmware do dispositivo, o runtime integrado e APIs de baixo nível. O SDK de Aplicativos se sobrepõe e fornece o compilador qaic-exec, a CLI de inferência qaic-runner, integração com o ONNX Runtime por meio de um provedor de execução QAIC, bindings para Python e uma versão modificada do vLLM. A biblioteca Qualcomm efficient-transformers, também chamada de QEfficient, é um wrapper do Hugging Face Transformers que reimplementa arquiteturas LLM populares com as formas estáticas, layouts de cache KV e transformações de grafo exigidas pelo AIC100. O Qualcomm AI Hub é um catálogo de modelos separado e um produto de compilação como serviço voltado mais para dispositivos da classe Snapdragon do que para o AIC100, embora compartilhe a mesma marca.
O processo de compilação é rígido. Você pega um modelo PyTorch, exporta-o usando `torch.export` ou ONNX e o envia para o `qaic-exec` com flags como `-convert-to-fp16`, `-mxfp6-matmul`, um tamanho de lote, um comprimento de contexto e uma contagem de SoCs de destino. O compilador realiza o agendamento antecipado e o posicionamento de memória, e então emite um QPC (Qualcomm Program Container), um binário selado que define o layout da memória, o formato do cache KV, o tamanho do lote, o comprimento da sequência de pré-preenchimento e o comprimento do contexto. Não há JIT (Just-in-Time). De acordo com a própria documentação do LLM da Qualcomm, o compilador AI 100 antecipado pré-aloca recursos do dispositivo com base no comprimento do prompt, comprimento da geração, cache KV e tamanho do lote, e o Cloud AI 100 suporta apenas formatos de entrada estáticos. Qualquer alteração nesses parâmetros de tempo de compilação aciona outra compilação completa, que pode levar muitos minutos para modelos pequenos e horas para modelos grandes.
A lista de arquiteturas suportadas é muito curta. A biblioteca QEfficient e o catálogo QPC pré-compilado hospedado no Zentree, que a Dell indica aos clientes, abrangem principalmente modelos mais antigos, e apenas alguns valem a pena usar em 2026.
Os checkpoints nativos mais recentes do FP8 exigem requantização. Se um modelo for distribuído nativamente em MXFP4, como os populares modelos GPT-OSS, você precisará realizar um processo de conversão e recompilação em vez de simplesmente inserir os pesos. Nada disso é impossível de contornar se você estiver disposto a fazer o trabalho, mas é um custo constante.
Há também o problema de concorrência, que é onde o laptop deixa a desejar, mesmo para desenvolvedores focados em desempenho imediato. As imagens de contêiner fornecidas pela Dell, que a empresa instrui os usuários a baixar e executar com o vLLM, são baseadas em QPCs pré-compiladas pela Zentree com formatos específicos, e os contêineres fornecidos só funcionam com concorrência 1. Independentemente do formato da sequência de entrada ou saída, você obtém uma taxa de transferência fixa para um determinado modelo. Várias solicitações paralelas não são executadas simultaneamente; elas são enfileiradas e processadas sequencialmente pelo vLLM. Você não pode criar lotes dinamicamente. Não é possível usar o processamento em lote contínuo da maneira que o vLLM ou o SGLang oferecem gratuitamente em GPUs Team Red ou Green. Para obter qualquer concorrência acima de 1, você precisa recompilar o QPC com um tamanho de lote maior.
Os exemplos da Dell apresentam este laptop para desenvolvedores, e o caso de uso de IA mais popular para desenvolvedores hoje é a programação intuitiva com ferramentas como Claude Code, OpenCode e similares. Uma única solicitação para essas ferramentas pode se ramificar em várias chamadas LLM paralelas; por padrão, essas NPUs enfileiram essas solicitações e as processam sequencialmente, em vez de em paralelo, de modo que algo que levaria segundos em um NVIDIA Spark levará minutos nesta configuração.
Desempenho
O sistema fornecido pela Dell para testes possui a seguinte configuração:
- Processador Intel Core Ultra 9 285HX
- Placa de Inferência Qualcomm AIC100 para PC
- 128 GB 6400 MT/s CAMM2 DDR5
- 4TB SSD
Antes de apresentar os números, uma nota metodológica. Como descrito acima, o AIC100 executa QPCs pré-compilados com tamanho de lote, comprimento de sequência e layout de cache KV fixos. A Dell envia este laptop com um conjunto selecionado de QPCs pré-compilados hospedados no Zentree e uma imagem de contêiner vLLM que os baixa na primeira inicialização. Esse conjunto de QPCs pré-configurados, servido pelo contêiner de referência da Dell com concorrência 1, é o que o usuário final recebe ao abrir a caixa do computador e seguir a documentação da Dell, e essa é a configuração que utilizamos para os testes de desempenho.
Temos as ferramentas para fazer diferente. Poderíamos extrair o qaic-exec, criar um ponto de verificação, executá-lo com o torch.export, requantizar, recompilar um QPC com um tamanho de lote maior e alimentá-lo novamente com o vLLM. Poderíamos escrever kernels personalizados para o driver acelerador QAIC, se quiséssemos. Optamos por não fazê-lo, já que a grande maioria dos compradores no mercado-alvo deste laptop — desenvolvedores, engenheiros interessados em IA e equipes piloto corporativas — não fará esse trabalho. Eles simplesmente extrairão o contêiner, executarão o programa e avaliarão o produto com base no resultado. E foi isso que medimos.
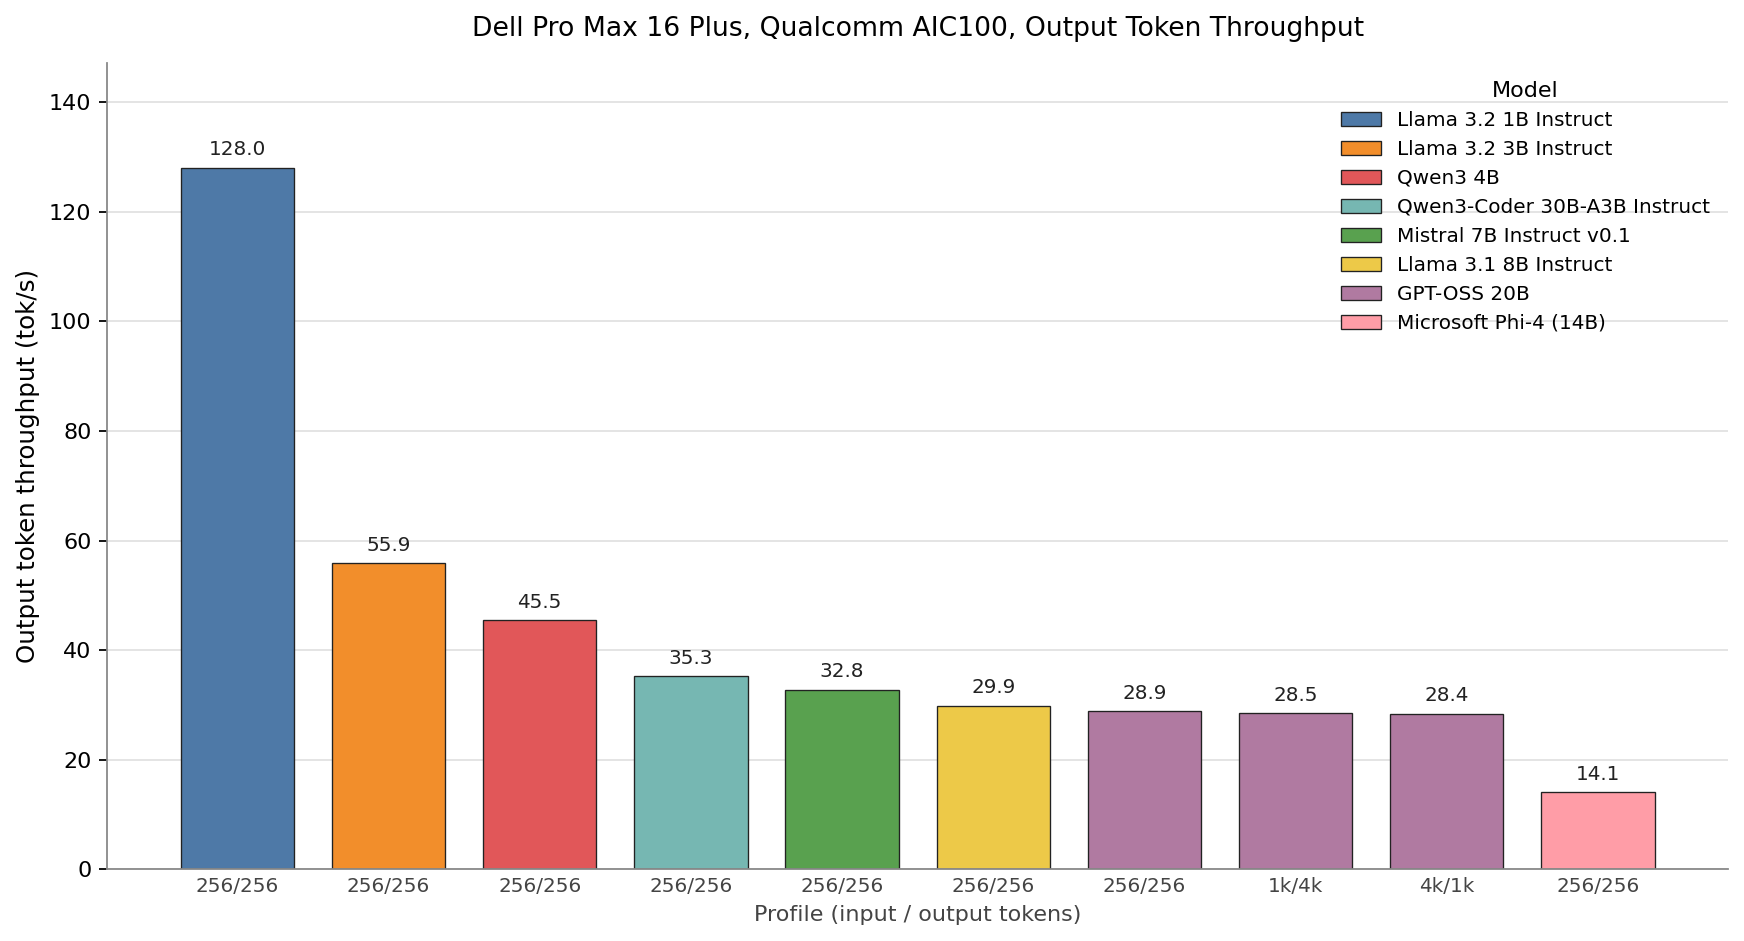
Cada barra representa um QPC compilado pela Qualcomm, executado com pesos MXFP6 e um cache KV MXINT8, a precisão usada em todos os artefatos enviados pela Dell. O Llama 3.2 1B é o único modelo no gráfico que ultrapassa 100 TPS, atingindo 128 TPS. O Llama 3.2 3B vem em seguida, com 56 TPS, o Qwen3 4B com 45 TPS, o Qwen3-Coder 30B-A3B com 35 TPS, o Mistral 7B com 33 TPS e o Llama 3.1 8B com 30 TPS. O GPT-OSS 20B apresenta taxas de 28.9, 28.5 e 28.4 TPS nos perfis 256/256, 1k/4k e 4k/1k, respectivamente, confirmando o que a documentação da Qualcomm promete sobre o compilador AOT: uma vez que um QPC é criado para uma determinada forma, a taxa de decodificação é fixa e o comprimento do prompt não altera o custo por token. O Phi-4 fecha a lista com 14 TPS.
Embora modelos maiores que os mencionados acima caibam nesta placa, não os testamos. Fazer isso, por exemplo, com o modelo Llama 4 Scout, demonstrado publicamente pela Dell, exigiria reduzir ainda mais a precisão para INT4 e, na prática, um modelo menor e menos quantizado terá um desempenho superior a um modelo maior e altamente quantizado em diversas cargas de trabalho.
O contêiner vLLM fornecido também executa cada QPC com batch_size=1, e confirmamos na prática que emitir duas solicitações simultâneas não dobra a taxa de transferência. A segunda solicitação simplesmente aguarda na fila de software até que a primeira termine. Não há processamento em lote contínuo, processamento em lote em andamento ou decodificação especulativa disponíveis na pilha fornecida. Para agentes de codificação como Claude Code ou OpenCode, que distribuem várias chamadas LLM paralelas a partir de uma única solicitação de usuário, esse limite de fluxo único transforma o que deveria ser um tempo de resposta de alguns segundos em uma espera de vários minutos. Aumentar a dimensão do lote exige a recompilação do QPC no host, o que nos leva de volta ao impasse que já havíamos recusado.
Vamos comparar isso com o NVIDIA Spark. Com um comprimento de sequência de entrada/saída de 256/256, o Spark consegue executar o modelo de 120 bits mais rápido do que o Qualcomm AIC 100 da Dell consegue executar o modelo de 20 bits. E esses nem são os melhores números que o Spark pode oferecer, já que esses resultados foram coletados usando o kernel Marlin nas versões de lançamento do software.
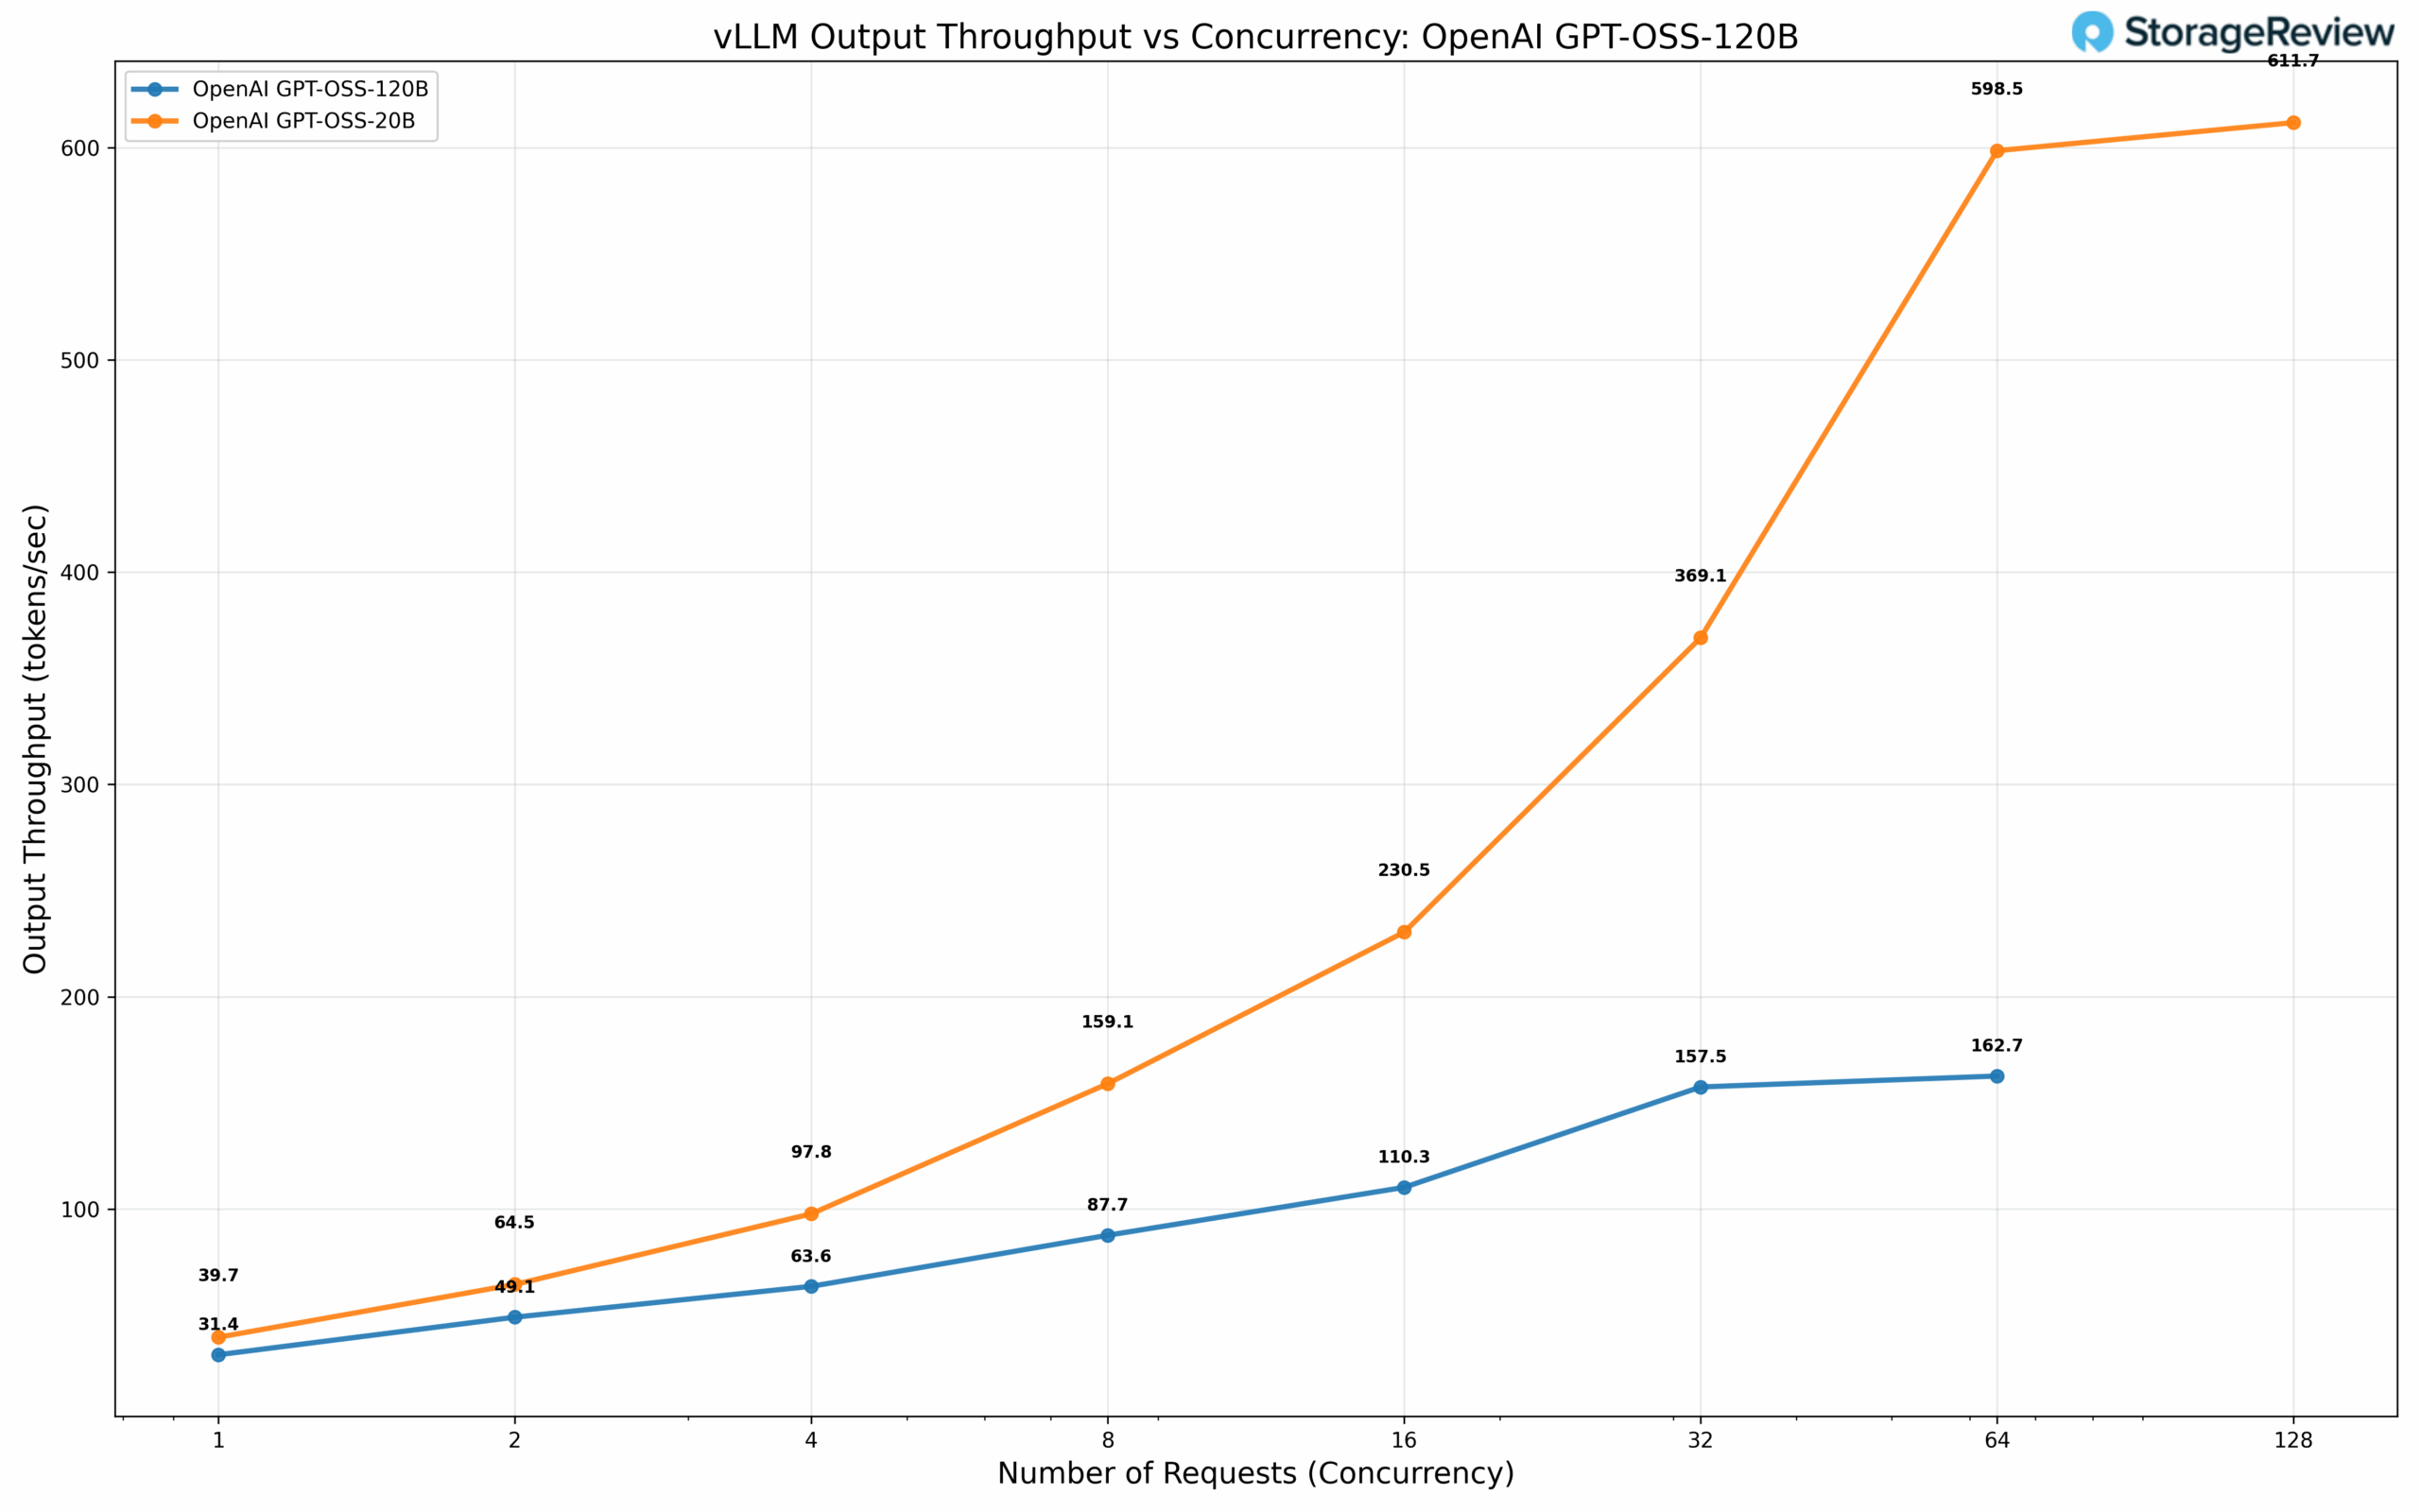
A conclusão é limitada. Para um único usuário, uma única conversa e um modelo pequeno o suficiente para que 136 GB/s de LPDDR4X por SoC não sejam a restrição limitante (Llama 3.2 1B e, possivelmente, Llama 3.2 3B), o AIC100 neste laptop é utilizável. Para qualquer coisa maior, na configuração que o cliente realmente recebe, a combinação de decodificação de fluxo único e um pipeline de compilação de formato estático que penaliza qualquer formato que a Qualcomm não tenha pré-compilado deixa este acelerador atrás da NPU e da GPU integradas no mesmo Intel Core Ultra HX com o qual está localizado, sem falar das placas de vídeo dedicadas da NVIDIA com as quais o mesmo chassi pode ser encomendado.
Se compararmos as especificações técnicas por um instante, o NVIDIA Spark oferece 273 GB/s , e testamos o máximo de operações de ponto flutuante (MAMF) alcançáveis em FP8 (E4M3) a 200 TFLOPS em um único chip. O QAIC, por sua vez, anuncia oferecer 272 GB/s em dois chips e 435 TFLOPS em INT8. Portanto, em teoria, o desempenho deveria ser semelhante, mas o da Qualcomm fica para trás devido ao software.
Para quem é este produto e você deveria comprá-lo?
Para quem busca realizar trabalhos sérios de IA hoje em dia, a resposta é não. Não compre essa configuração.
A loja da Dell nos EUA lista o modelo AIC100 do Pro Max 16 Plus por US$ 14,871.56 para a configuração topo de linha (Core Ultra 9 285HX, 128 GB de RAM, SSD de 4 TB), US$ 9,661.56 para uma configuração intermediária (Core Ultra 7 265HX, 64 GB de RAM, SSD de 1 TB) e US$ 8,831.56 para a configuração básica AIC100. Todos os modelos são enviados apenas com Ubuntu Linux; suporte para Windows estará disponível em breve. Na configuração testada, o preço do notebook fica na faixa de US$ 14,000 a US$ 15,000.
Para referência, o NVIDIA DGX Spark está atualmente à venda por US$ 4,699. Por esse valor, você leva um Superchip Grace Blackwell GB10 , 128 GB de memória LPDDR5X unificada, um SSD NVMe de 4 TB, uma GPU Blackwell e aproximadamente 1 petaflop de poder computacional de IA FP4, tudo isso com o suporte do pacote completo de software CUDA, TensorRT-LLM, NIM e todo o ecossistema NVIDIA. Um único DGX Spark supera o AIC100 deste laptop em praticamente todas as cargas de trabalho de IA realistas, e faz isso com softwares que qualquer engenheiro de IA contratado este ano já sabe usar. Pelo preço da nossa unidade de teste, você poderia comprar três DGX Sparks, equipar cada um com um monitor, periféricos e uma mesa, e ainda sobraria dinheiro. Se inteligência artificial compacta não é a sua praia, uma estação de trabalho Dell Pro Max Tower T2 com Intel 285K, 128 GB de RAM DDR5 e uma GPU NVIDIA RTX Pro 6000 também custa em torno de US$ 15,000, dependendo do tamanho do SSD que você escolher.
É difícil escapar da sensação de que a Dell colocou o equivalente a lixo eletrônico em um chassi que, de outra forma, seria excelente. O Pro Max 16 Plus com uma RTX PRO 5000 é uma estação de trabalho móvel fantástica. A mesma máquina, com uma AIC100, é um experimento científico confuso sob garantia da Dell.
Conclusão
Se você for um entusiasta de eletrônica lendo isso daqui a alguns anos e se deparar com um desses laptops em promoção por duzentos ou trezentos dólares, não hesite em comprá-lo. O sistema é reparável e atualizável, o teclado é bom e usar os módulos AIC100 para fazer algo interessante como um projeto de fim de semana é exatamente o tipo de diversão descomplicada que esse hardware merece.
Se você está tentando realizar trabalhos sérios de IA hoje em dia, configure seu Pro Max 16 Plus com qualquer outro acelerador. Uma GPU móvel NVIDIA RTX PRO, mesmo a RTX PRO 1000 de entrada, atenderá melhor às suas necessidades do que os módulos AIC100. A NPU integrada do Intel Core Ultra HX será mais adequada em muitos cenários práticos, pois pelo menos é compatível com o Windows ML, o OpenVINO e o conjunto de ferramentas de IA para PC já existente.
Uma sugestão que vale a pena oferecer à Dell: o Pro Max 16 Plus é um excelente chassi, e a linha Pro Max é uma das plataformas de workstation móvel mais robustas do mercado. O modelo AIC100, da forma como é enviado, não atende a esse padrão de forma alguma. Uma linha de produtos experimentais ou de pré-visualização para desenvolvedores, claramente identificada como tal, permitiria à Dell disponibilizar aceleradores inovadores para clientes que desejam experimentá-los, sem associar o nome Pro Max a uma tecnologia que ainda não está pronta. A marca Pro Max merece ser protegida, e existe uma maneira transparente de fazer isso, ao mesmo tempo que se encontra um destino para hardware experimental.


 Amazon