

No Google Cloud Next, o Google anunciou seus aceleradores de IA de próxima geração: o TPU 8t “Sunfish” para treinamento e o TPU 8i “Zebrafish” para inferência, juntamente com sua nova arquitetura de data center Virgo. Pelos posts do blog do Google, fica claro que esses chips são otimizados para a “era dos agentes”: treinar modelos de ponta com mistura de especialistas em escala de centenas de milhares de chips e, em seguida, disponibilizar esses mesmos modelos com baixa latência e metas agressivas de preço por token. O 8t e o 8i são dois chips arquiteturalmente distintos que compartilham uma plataforma host e uma arquitetura de data center, mas divergem em capacidade de memória, SRAM on-chip, topologia de interconexão e especialização on-die. O 8t foi projetado para multiplicação de matrizes densas (matmul) em escala, enquanto o 8i foi projetado em torno de cache KV on-silício e latência coletiva por token.
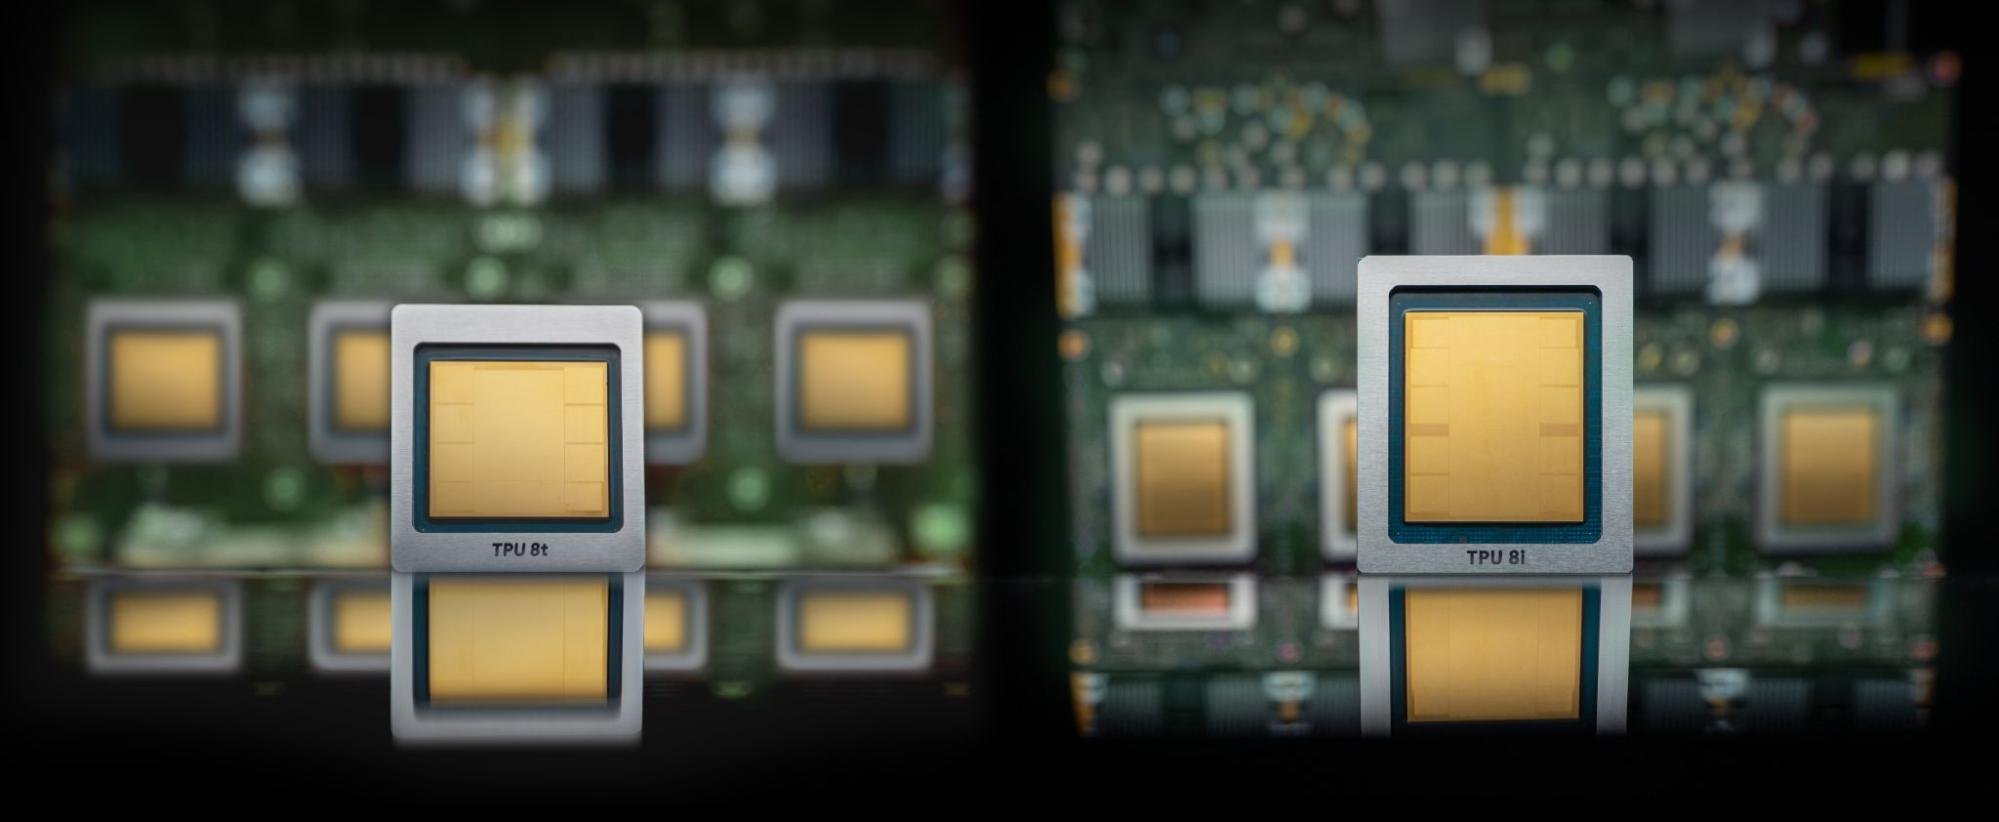
Um único superpod 8t escala para até 9,600 chips, comporta 2 PB de HBM e oferece 121 EFLOPS de computação FP4, quase 3 vezes mais poder computacional por pod do que um superpod Ironwood. O 8i combina 288 GB de HBM com 384 MB de SRAM on-chip (3 vezes mais que o Ironwood) em um domínio de escalabilidade de 1,152 chips e alega um desempenho por dólar 80% melhor do que o Ironwood para inferência LLM. O Virgo integra ambas as famílias de chips em uma única estrutura de data center que conecta mais de 134,000 chips 8t com 47 Pb/s de largura de banda de bisseção não bloqueante, com até 4 vezes mais largura de banda por acelerador e latência sem carga 40% menor do que a geração anterior.
O que é, de fato, um TPU?
Antes de abordarmos os 8 chips de silício, é importante explicar o que é uma TPU e como ela difere de uma GPU, pois as 8 decisões de design só fazem sentido nesse contexto.
Uma Unidade de Processamento de Tensores (TPU) é um ASIC personalizado que o Google vem aprimorando desde 2015. Cada geração foi construída em torno da mesma ideia central: em vez de agendar milhares de núcleos pequenos dinamicamente, como faz uma GPU, uma TPU se concentra em um pequeno número de MXUs (unidades de multiplicação de matrizes) muito grandes, alimentadas por um scratchpad SRAM gerenciado por software no chip e controladas por um compilador AOT (ahead-of-time). Cada chip carrega alguns TensorCores, cada um construído em torno de um grande MXU de matriz sistólica, além de um conjunto menor de SparseCores dedicados às buscas irregulares de coleta e dispersão que dominam os embeddings de recomendações. Os dados fluem da HBM (memória de base alta) através do scratchpad, pelo MXU, de volta ao scratchpad e saem novamente, com uma Unidade de Processamento Vetorial (VPU) lidando com ativações, normalizações e reduções em paralelo. Não há agendador de warp por hardware, nenhuma hierarquia de cache L1 ou L2 no sentido de GPU e nenhum despacho dinâmico.
A vantagem desse design é a eficiência em álgebra linear densa. Com um compilador que decide onde cada tensor reside e quando cada operação coletiva é acionada, não há jitter de falhas de cache nem sobrecarga do agendador de warps, o que é mais importante do que parece quando dezenas de milhares de chips precisam permanecer sincronizados durante uma operação coletiva. A utilização de FLOPs de modelos do mundo real em TPUs para cargas de trabalho de treinamento bem ajustadas tende a ser maior do que em GPUs tradicionais. A desvantagem é que qualquer coisa que não se mapeie perfeitamente para grandes multiplicações de matrizes densas, especificamente formas dinâmicas, padrões de esparsidade irregulares, roteamento MoE com distribuição desigual de tokens ou redes neurais gráficas, é mais difícil de expressar de forma eficiente. Historicamente, as TPUs também carregavam menos HBM por chip do que suas contrapartes em GPU e tinham suporte a frameworks muito mais restrito. XLA e JAX são de primeira classe; PyTorch, até recentemente, exigia uma camada de tradução; além disso, o compilador, o runtime, as bibliotecas de rede e a pilha de software multi-pod permanecem de código fechado dentro do Google.
A esparsidade é o exemplo mais claro da diferença filosófica entre GPUs e TPUs, e a razão é estrutural, não de marketing. A NVIDIA oferece suporte à esparsidade estruturada 2:4 em Tensor Cores desde a arquitetura Ampere e, em teoria, o desempenho para cargas de trabalho esparsas é o dobro do desempenho para cargas de trabalho densas. Um Tensor Core é fundamentalmente uma unidade de despacho: ele realiza carregamentos explícitos de operandos por instrução MMA, portanto, adicionar uma variante MMA esparsa que aceite um bloco comprimido 2-de-4 mais metadados de índice é uma extensão direta do conjunto de instruções existente. A cada ciclo, o hardware extrai apenas os valores diferentes de zero e seus índices para o array multiplicador, ignorando implicitamente os zeros.
Um arranjo sistólico funciona de maneira oposta. Cada PE (elemento de processamento) computa a cada ciclo, com operandos fluindo pelo arranjo em sincronia por meio de caminhos diretos de registrador para registrador, de um PE para o próximo. Esse fluxo de dados determinístico é exatamente de onde vem a vantagem de eficiência energética sobre o SIMT: sem leituras repetidas da SRAM, sem sobrecarga de despacho de instruções, reutilização máxima de operandos. Mas isso também significa que o hardware não pode pular um elemento com valor zero por ciclo sem interromper o pipeline.

Fonte: Google
As TPUs ainda podem explorar a esparsidade no nível do bloco; se um bloco inteiro do tamanho de uma MXU for composto apenas de zeros, o compilador não agenda trabalho para ele. No entanto, a escolha do Google de não adicionar aceleração de hardware para esparsidade estruturada é deliberada. Adicionar esparsidade estruturada M:N a um array sistólico pode ser alcançado usando várias técnicas, cada uma com diferentes vantagens e desvantagens. Uma dessas técnicas requer uma unidade de compressão localizada entre a SRAM e as portas de entrada do array. Mas um array sistólico é um pipeline, não um despachante. Sua garantia de eficiência vem dos operandos que chegam em uma cadência determinística, com cada elemento de processamento ocupado a cada ciclo. Permitir que operandos sejam ignorados impõe um dos dois custos. Paralisar o pipeline nos zeros, o que elimina a vantagem de eficiência que motivou a arquitetura em primeiro lugar. Ou adicionar hardware de descompressor dedicado para reconstruir um fluxo de largura total a partir da entrada comprimida antes que ela entre no array, o que consumiria área do chip e adicionaria latência.
Fonte: AWS
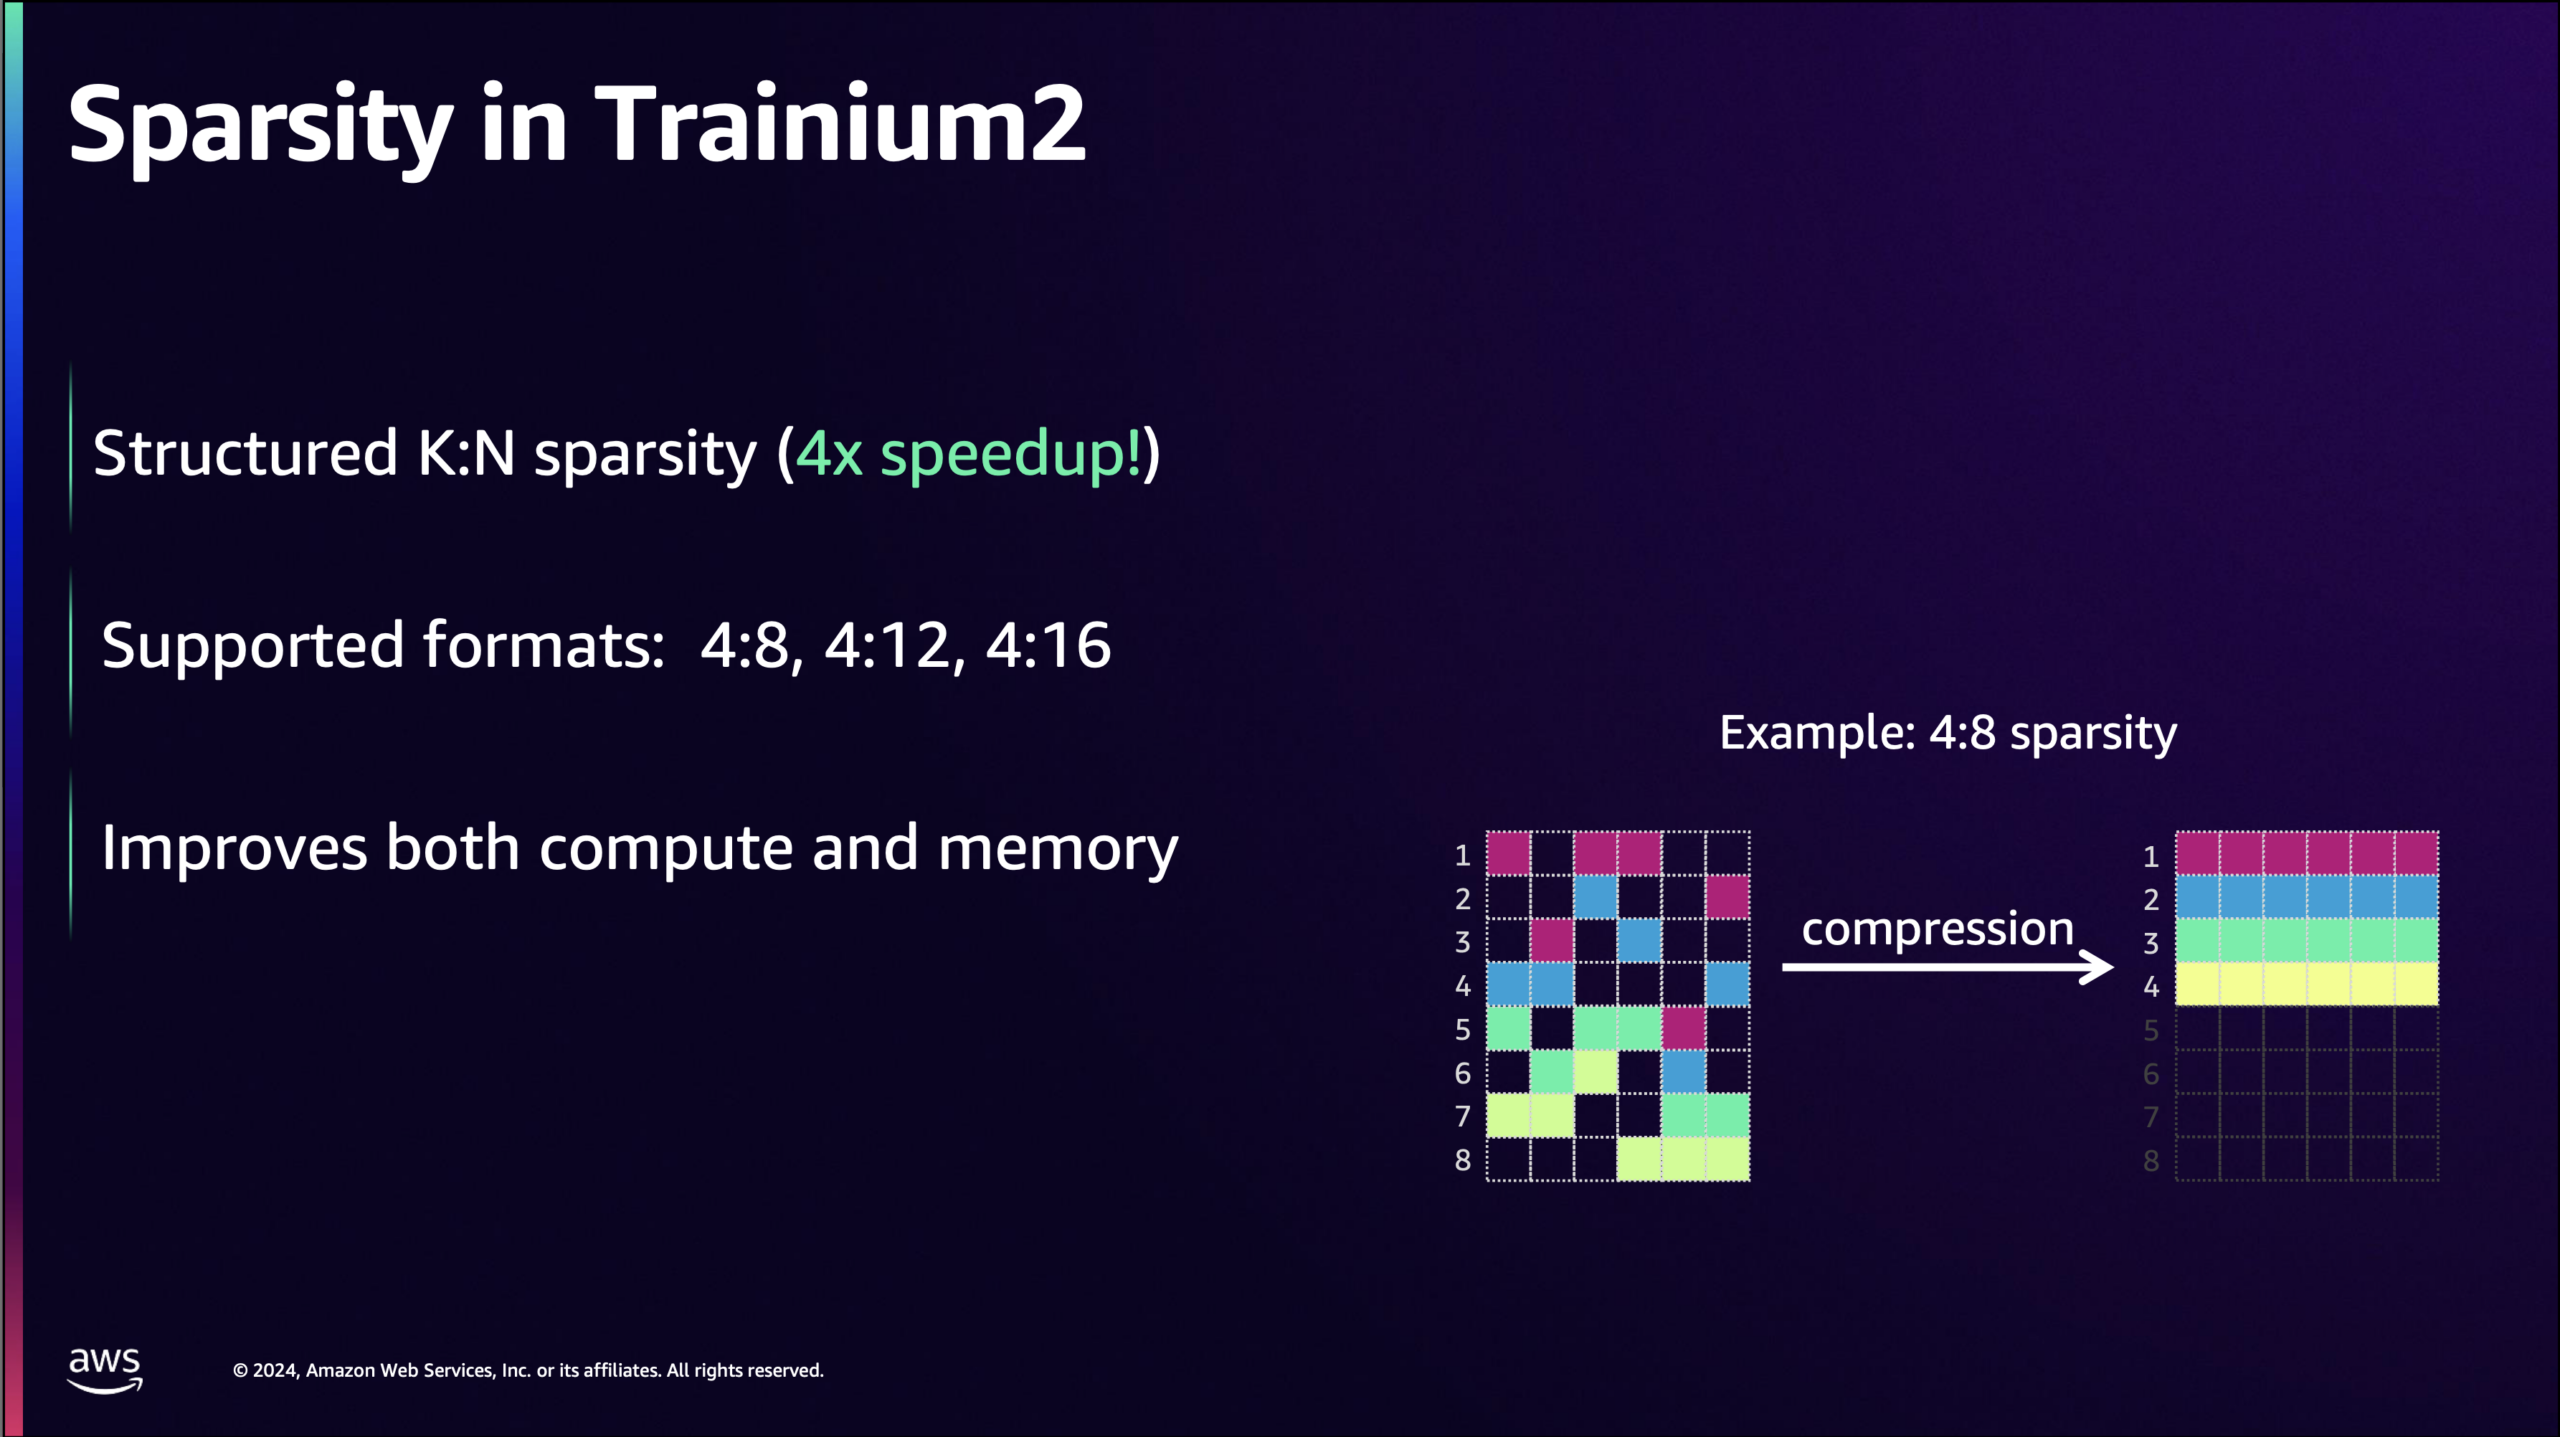
Alguns aceleradores combinam matrizes sistólicas com suporte de hardware para esparsidade. A AWS construiu uma a partir do NeuronCore-v3, o mecanismo presente no Trainium2 e no Trainium3. A implementação mostra como é uma matriz sistólica com suporte de hardware para esparsidade. O mecanismo de tensores NeuronCore-v3 é uma matriz sistólica de 128×128 que opera em uma matriz de pesos estacionária e uma matriz de ativação de fluxo contínuo, com a dimensão de contração alinhada à dimensão de partição da matriz. No modo esparso, o caminho de dados de entrada se expande de 2×128 elementos por ciclo em BF16 e FP16 densos para 5×128 elementos por ciclo, e o lado estacionário se alimenta de uma representação comprimida da matriz de pesos em vez dos pesos densos originais. Em tempo de compilação, o tensor de pesos é processado em um formato M:N. De cada N elementos contíguos ao longo da dimensão de contração, apenas M são retidos, com uma máscara de bits compacta codificando quais posições são diferentes de zero. O buffer comprimido armazena apenas os valores M, reduzindo-se por um fator de N/M. Quando a instrução `matmul` é executada, o hardware lê os pesos comprimidos e usa a máscara de bits para rotear as ativações correspondentes do bloco estacionário para os elementos de processamento corretos. Os elementos de processamento que seriam multiplicados por zero não recebem trabalho para esse slot. Como a busca e o roteamento da máscara de bits residem no descompressor que alimenta a matriz, e não na própria matriz, o pipeline mantém a taxa de transferência máxima em valores diferentes de zero, em vez de parar em zeros.
A multiplicação de matrizes densas não é a única função de uma TPU. Há várias gerações, as TPUs incluem um SparseCore juntamente com os TensorCores. O SparseCore é um mecanismo específico de domínio projetado para os padrões de acesso irregulares de coleta e dispersão que definem os modelos de recomendação. Um modelo de classificação do YouTube ou um modelo de relevância de anúncios de pesquisa não se assemelha a um Transformer denso. A maioria de seus parâmetros reside em tabelas de embeddings que podem variar de centenas de gigabytes à escala de petabytes, e a maior parte do seu tempo de computação é gasto realizando pequenas consultas nessas tabelas, transformando levemente os valores recuperados e combinando os resultados. Esse padrão de acesso representa o pior cenário para uma MXU e é apenas marginalmente melhor para a hierarquia de cache de uma GPU. Os SparseCores são otimizados precisamente para isso: operações de coleta e dispersão de alto desempenho em tabelas de embeddings residentes na HBM, com suporte de hardware para as operações de deduplicação e combinação das quais o restante do pipeline de embeddings depende. O mesmo hardware também auxilia no roteamento especializado do MoE porque, uma vez que a seleção top-k produz índices especializados, o restante do processo de roteamento (permutação de tokens por especialista, envio deles entre os chips, coleta das saídas dos especialistas e execução da redução ponderada) segue o mesmo padrão de coleta/dispersão/redução do pipeline de incorporação, com o suporte de classificação do SparseCore cobrindo a própria etapa top-k.
Com esse contexto, aqui estão os anúncios.
TPU 8t “Peixe-Sol”
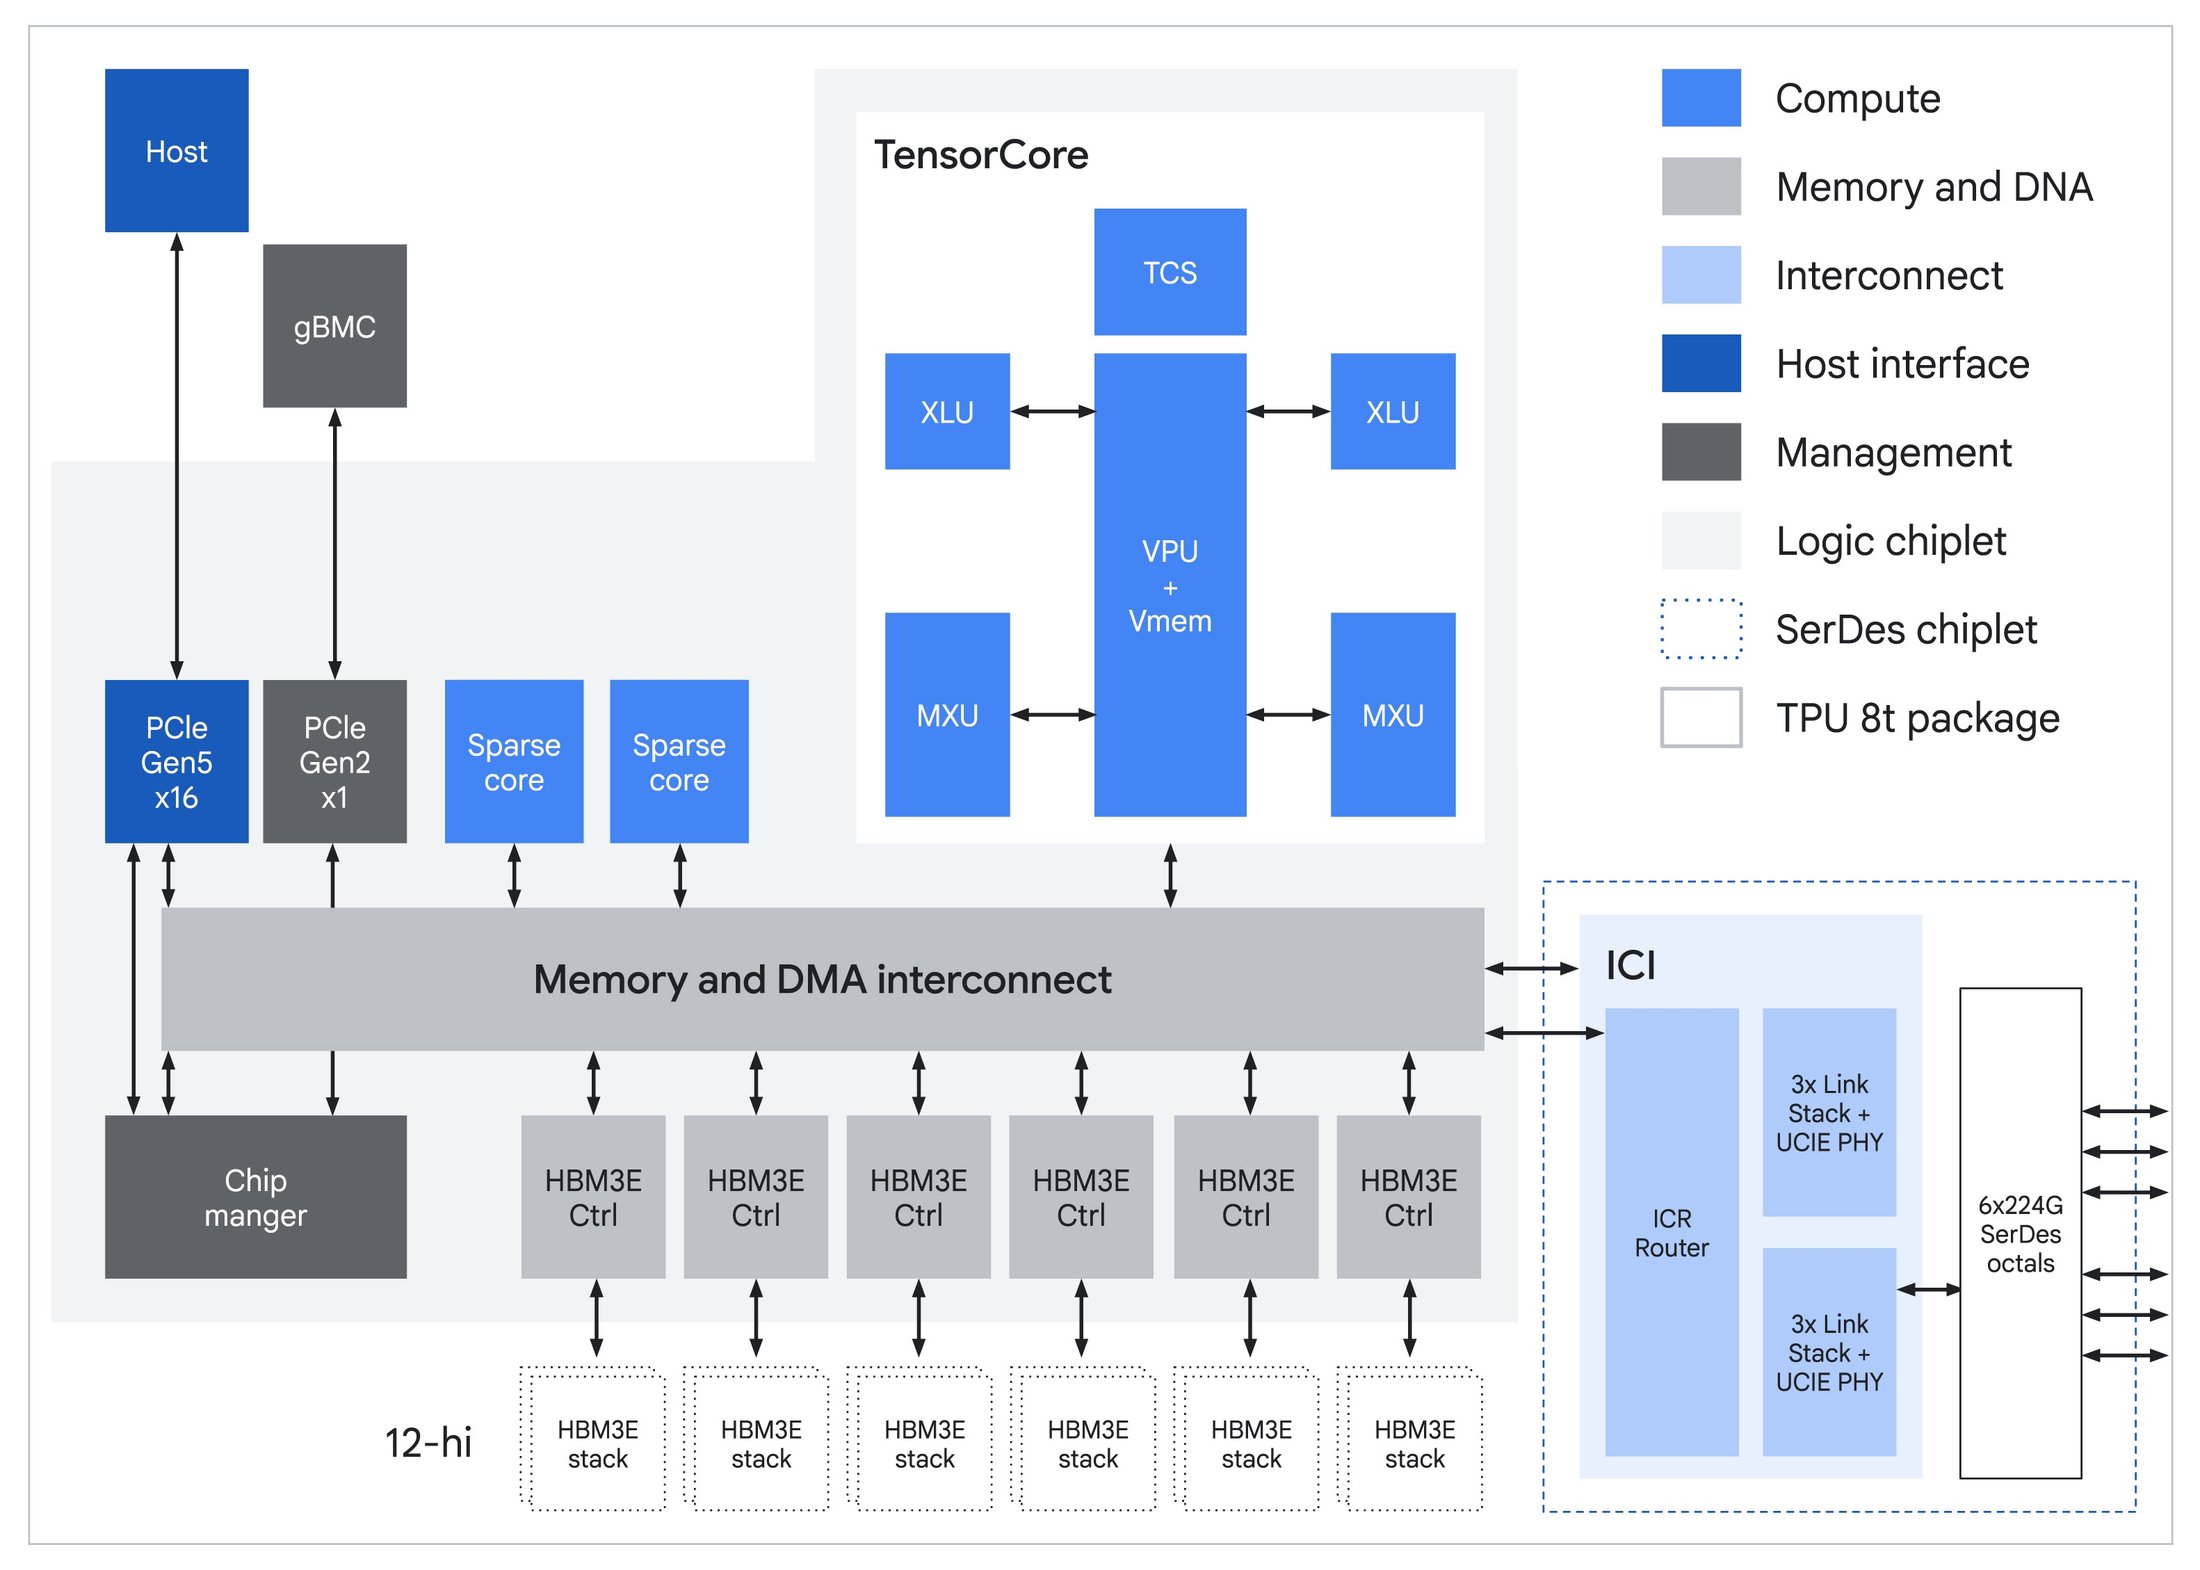
O primeiro anúncio, o TPU 8t com codinome Sunfish, é o chip de treinamento. A evolução geracional em relação ao Ironwood segue a trajetória esperada na maioria dos aspectos: mais memória, mais largura de banda e suporte nativo para tipos de dados mais restritos. Cada chip possui um único TensorCore alimentado por seis stacks HBM3e de 12 núcleos, totalizando 216 GB a 6.5 TB/s, um aumento em relação aos 192 GB do Ironwood distribuídos em oito stacks. A memória Vmem SRAM integrada permanece em 128 MB.
A maior parte do salto computacional vem do FP4 nativo na MXU. Executar multiplicações de matrizes em 4 bits em vez de 8 bits dobra a taxa de transferência por ciclo para a mesma matriz física, o que explica a transição do Google de 4.6 PFLOPS em FP8 do Ironwood para 12.6 PFLOPS em FP4 do 8t. O treinamento de precisão mista ainda mantém uma cópia mestre FP32 dos pesos para a etapa de otimização; o FP4 reduz os tensores de trabalho que consomem a maior parte do tempo de computação.
Fonte: Google
A história da interconexão é simples. A largura de banda da ICI dobra para 19.2 Tb/s por chip, o superpod de 9,600 chips agrega 2 PB de HBM e 121 EFLOPS, e a topologia de toroide 3D é mantida. O toroide faz sentido para o treinamento porque as tarefas de vanguarda são dominadas por coletivos compatíveis com anéis: all-reduces para paralelismo de dados e tensores, all-gathers e reduce-scatters para FSDP e envios ponto a ponto paralelos em pipeline. Todos esses se mapeiam perfeitamente aos eixos do toroide.
O Google também mantém os SparseCores que vêm presentes em todas as TPUs desde a versão 4. Seu propósito original era o desenvolvimento de modelos de recomendação no estilo DLRM, onde a maior parte do tempo de computação é dedicada à coleta e dispersão irregulares em tabelas de embeddings massivas. O mesmo hardware também lida com o roteamento MoE. O JAX expõe o roteamento ragged all-to-all e o ragged_dot correspondente como operações de primeira classe, nas quais cada chip pode enviar um bloco de tamanho diferente para cada nó. Isso corresponde ao formato real do despacho MoE, pois o roteamento top-k depende dos dados e o número de tokens que fluem para cada especialista varia a cada etapa. O compilador funde a comunicação irregular e a multiplicação de matrizes (matmul) irregular entre especialistas em uma única operação agendada, enquanto o SparseCore lida com a classificação e permutação subsequentes. Com a arquitetura de mistura de especialistas (MoE) agora dominante em modelos de ponta, esse hardware comprova seu valor em todas as tarefas de treinamento modernas, não apenas nas cargas de trabalho de anúncios e classificação para as quais foi originalmente projetado.
Esses são passos evolutivos. As mudanças mais significativas são o TPUDirect e a migração para hosts baseados em Axion, ambos resolvendo gargalos que só se tornam visíveis em escala de vanguarda.
TPUDirect RDMA e armazenamento TPUDirect
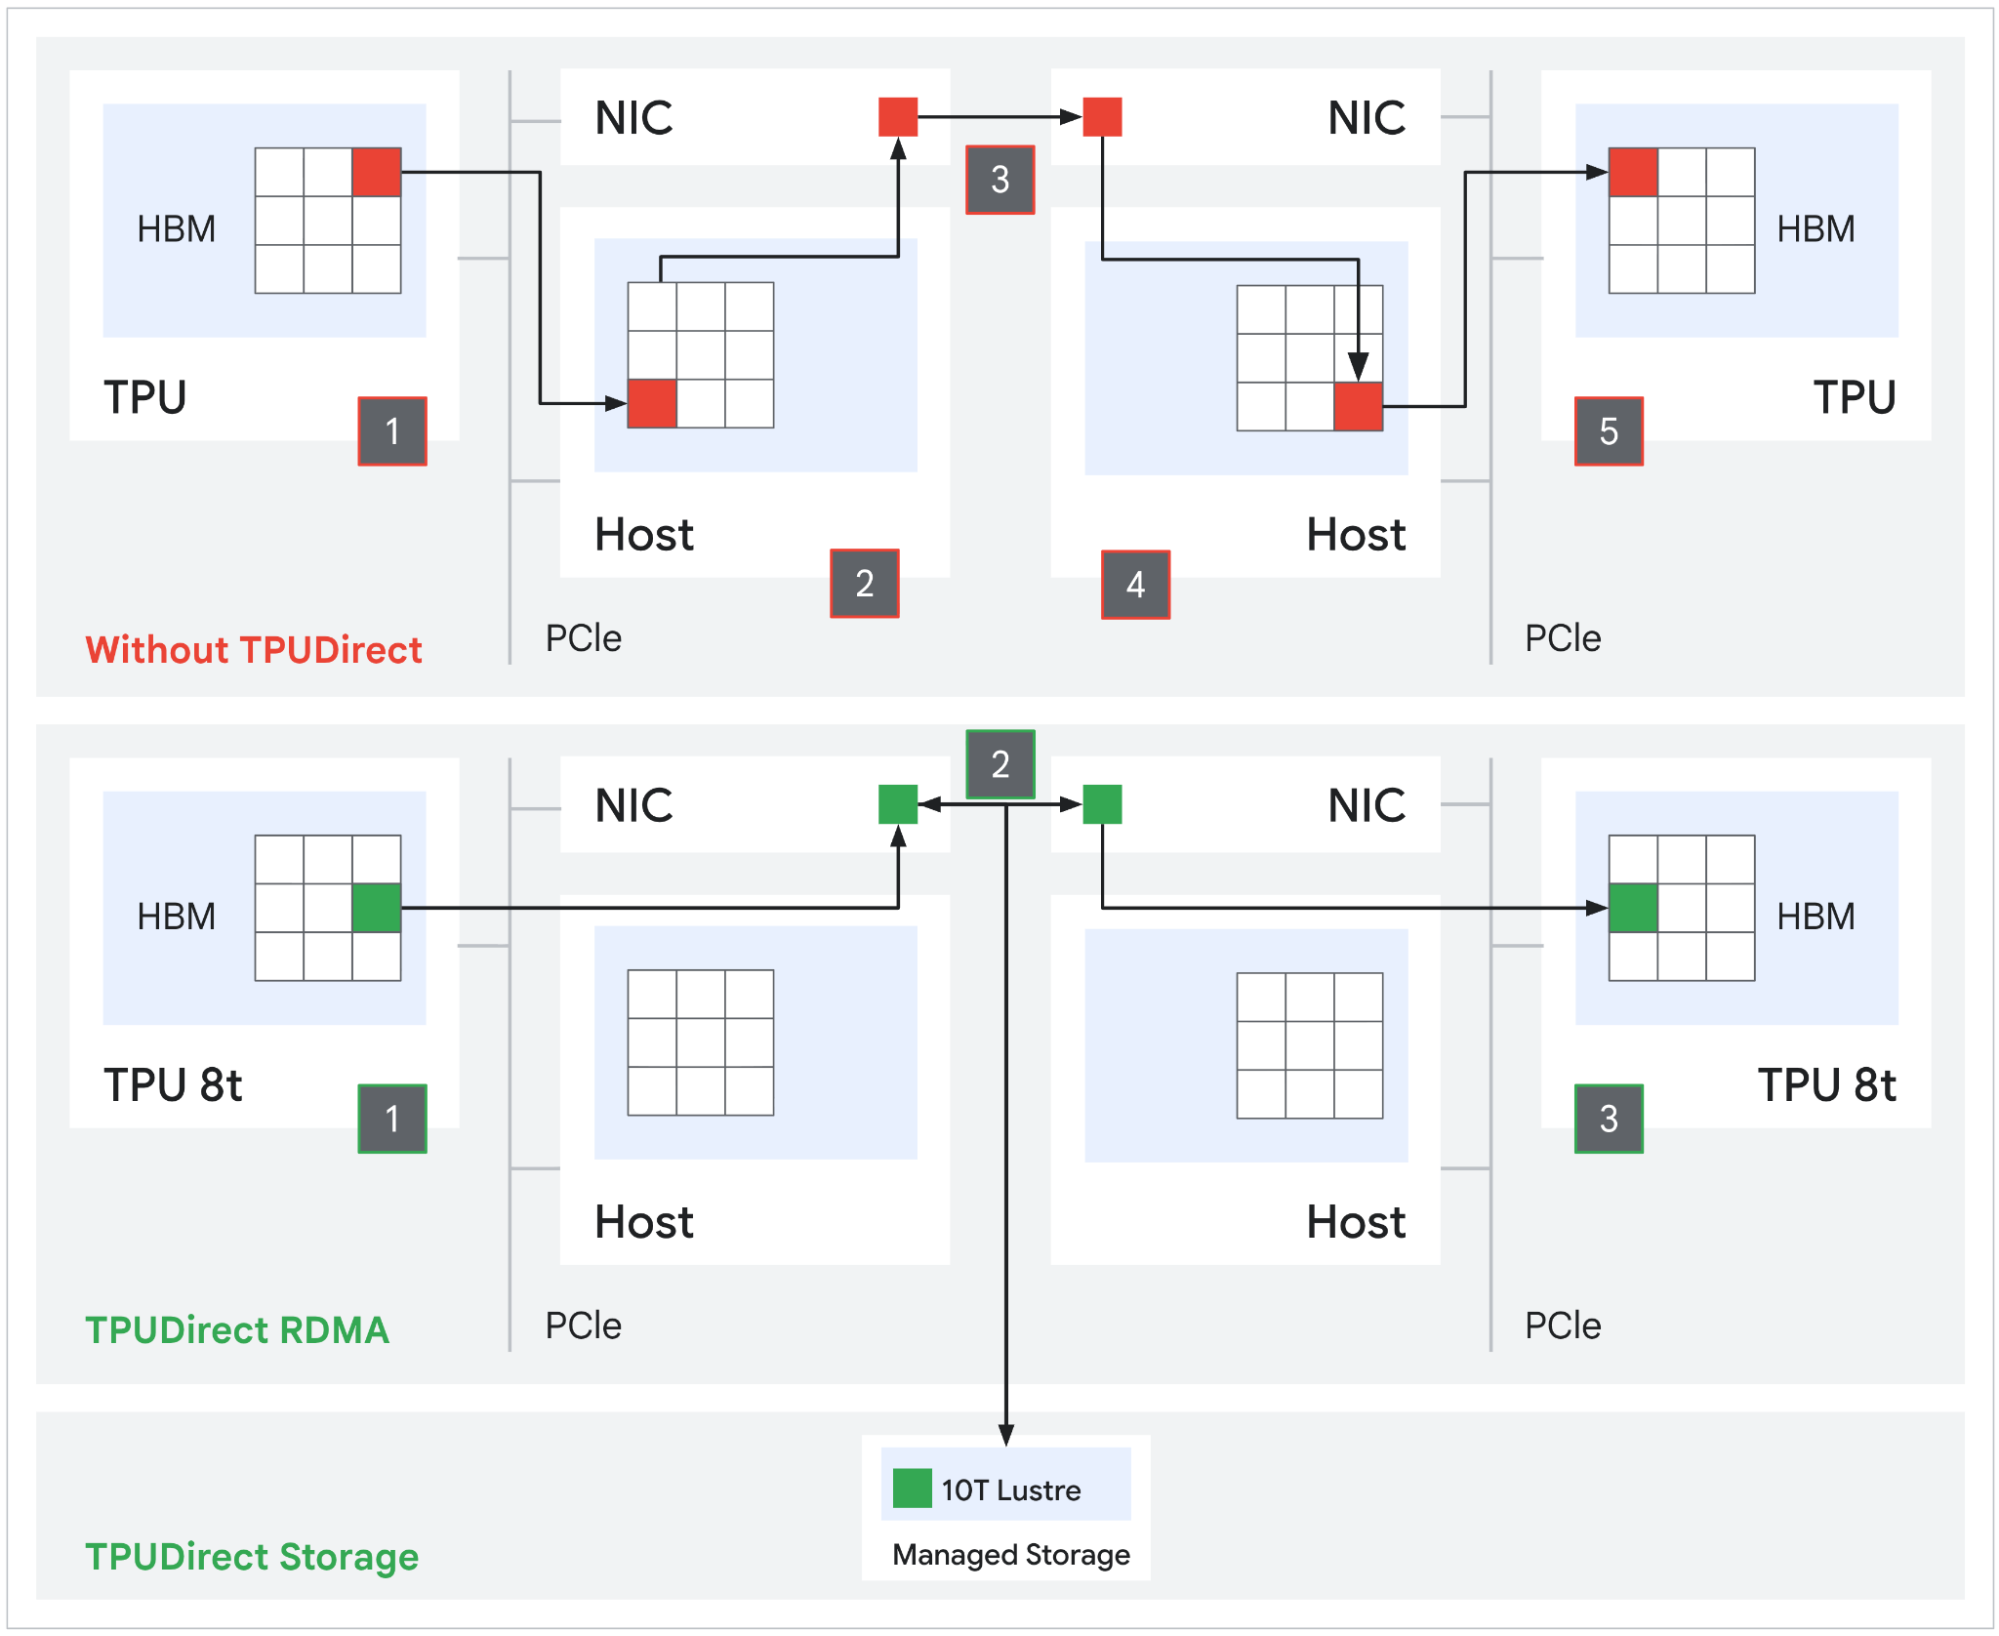
As gerações anteriores de TPU utilizavam um caminho mediado pelo host para E/S de rede e armazenamento: os pacotes chegavam primeiro à DRAM do host e, em seguida, um DMA separado os copiava para a HBM da TPU. Isso representava duas transações de memória com a CPU do host no processo. O TPUDirect RDMA elimina o buffer de transferência. A placa de rede lê e grava na HBM da TPU diretamente via PCIe ponto a ponto, removendo o host do caminho de dados. A NVIDIA oferece capacidade equivalente com o GPUDirect RDMA há anos e cita uma melhoria de aproximadamente 10 vezes em relação ao caminho mediado pelo host. O Google agora está igualando isso no lado da TPU.
Fonte: Google
O TPUDirect Storage estende o mesmo princípio ao armazenamento persistente. Os tensores são movidos diretamente entre o TPU HBM e o Managed Lustre a uma taxa agregada de 10 TB/s, o que, segundo o Google, oferece acesso ao armazenamento 10 vezes mais rápido do que o caminho equivalente no Ironwood. Em escalas extremas, onde os checkpoints podem chegar a centenas de terabytes, a diferença reside em se uma execução de treinamento de várias semanas transmite checkpoints e conjuntos de dados na velocidade da linha ou se o pipeline MXU fica paralisado aguardando operações de E/S do host.
Hosts Arm Axion
Todas as gerações anteriores de TPU rodavam em hosts x86 de terceiros. A 8t é a primeira a usar o processador Axion do próprio Google, uma CPU baseada em Arm Neoverse V2, como cabeçalho do sistema. O trabalho da CPU do host em um pod de TPU é real e se torna mais complexo em escalas extremas: ela controla o pipeline de entrada, decodifica e embaralha conjuntos de dados de vários petabytes, gerencia o plano de controle JAX/XLA, lida com a serialização de checkpoints e coordena o despacho de SPMD em milhares de chips. Se o host travar, a MXU fica ociosa.
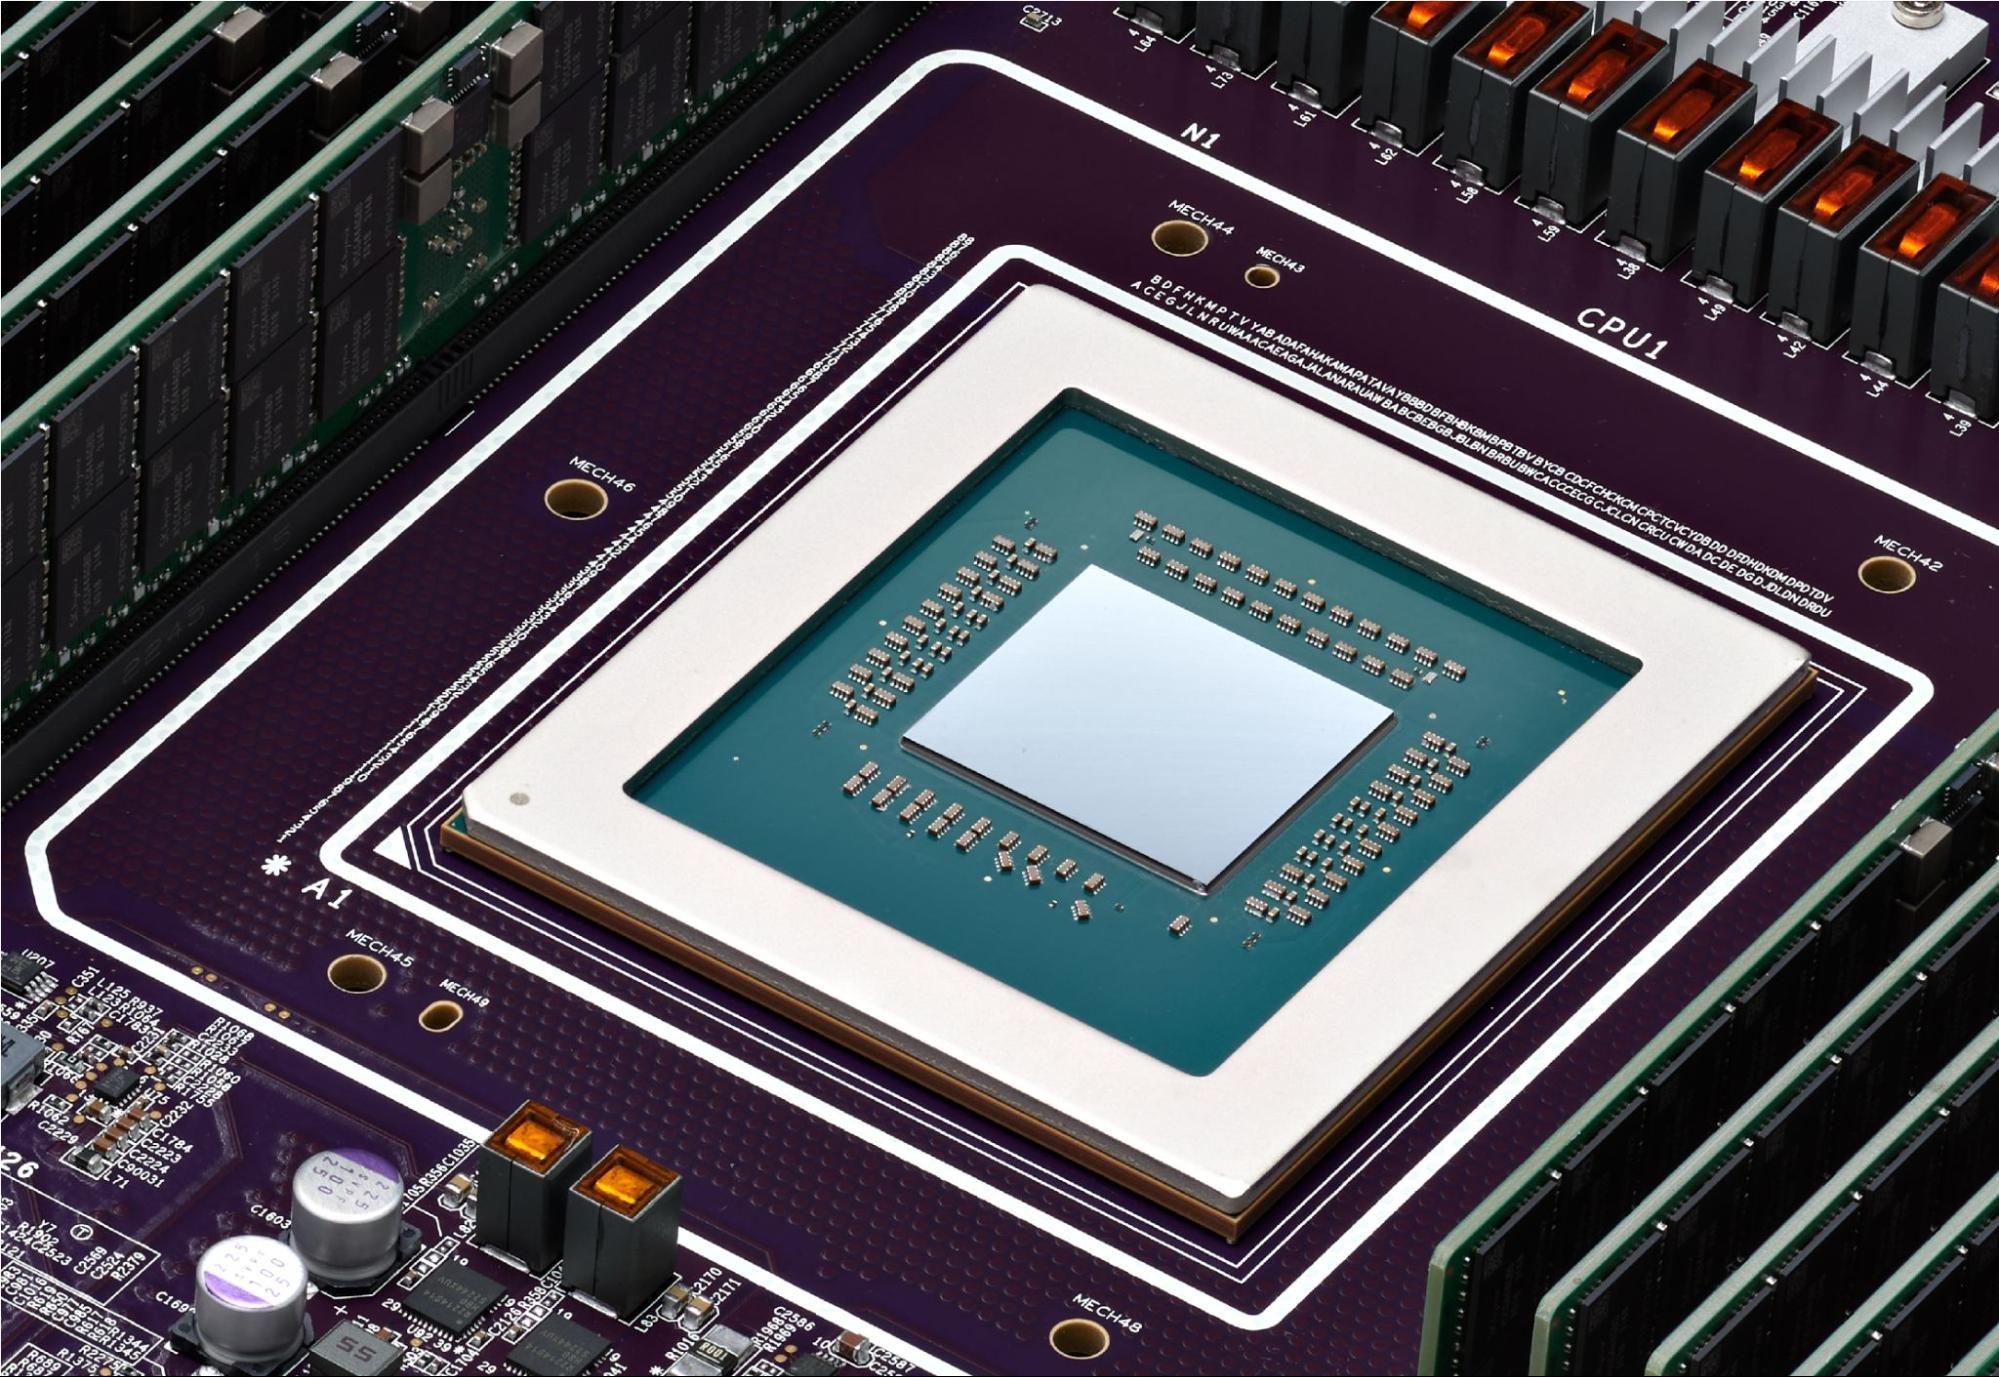
O Google destaca especificamente o isolamento NUMA com tecnologia Axion na plataforma 8t como o mecanismo que impede que a instabilidade do host interfira nas fases coletivas sincronizadas do treinamento. Com 9,600 chips por pod, mesmo pequenas oscilações por host se acumulam, resultando em perda mensurável de desempenho. O TPUDirect lida com o caminho de dados removendo o host das transferências em massa. O Axion lida com o caminho de controle, fornecendo a cada TPU largura de banda de CPU dedicada suficiente para que o pré-processamento nunca se torne o gargalo. O Google também aumentou a proporção de hosts Axion físicos por servidor na plataforma de oitava geração, dando à sobrecarga de orquestração, que escala com a quantidade de chips, mais espaço do que a configuração de host do Ironwood oferecia.
TPU 8i “Peixe-zebra”
O chip de inferência compartilha a plataforma host Axion do 8t, FP4 nativo e geração de memória HBM3e, mas o silício subjacente visa um gargalo diferente. O treinamento é limitado pela capacidade computacional; a decodificação da inferência é limitada pela largura de banda da memória. A maioria das diferenças arquitetônicas do 8i decorre disso.
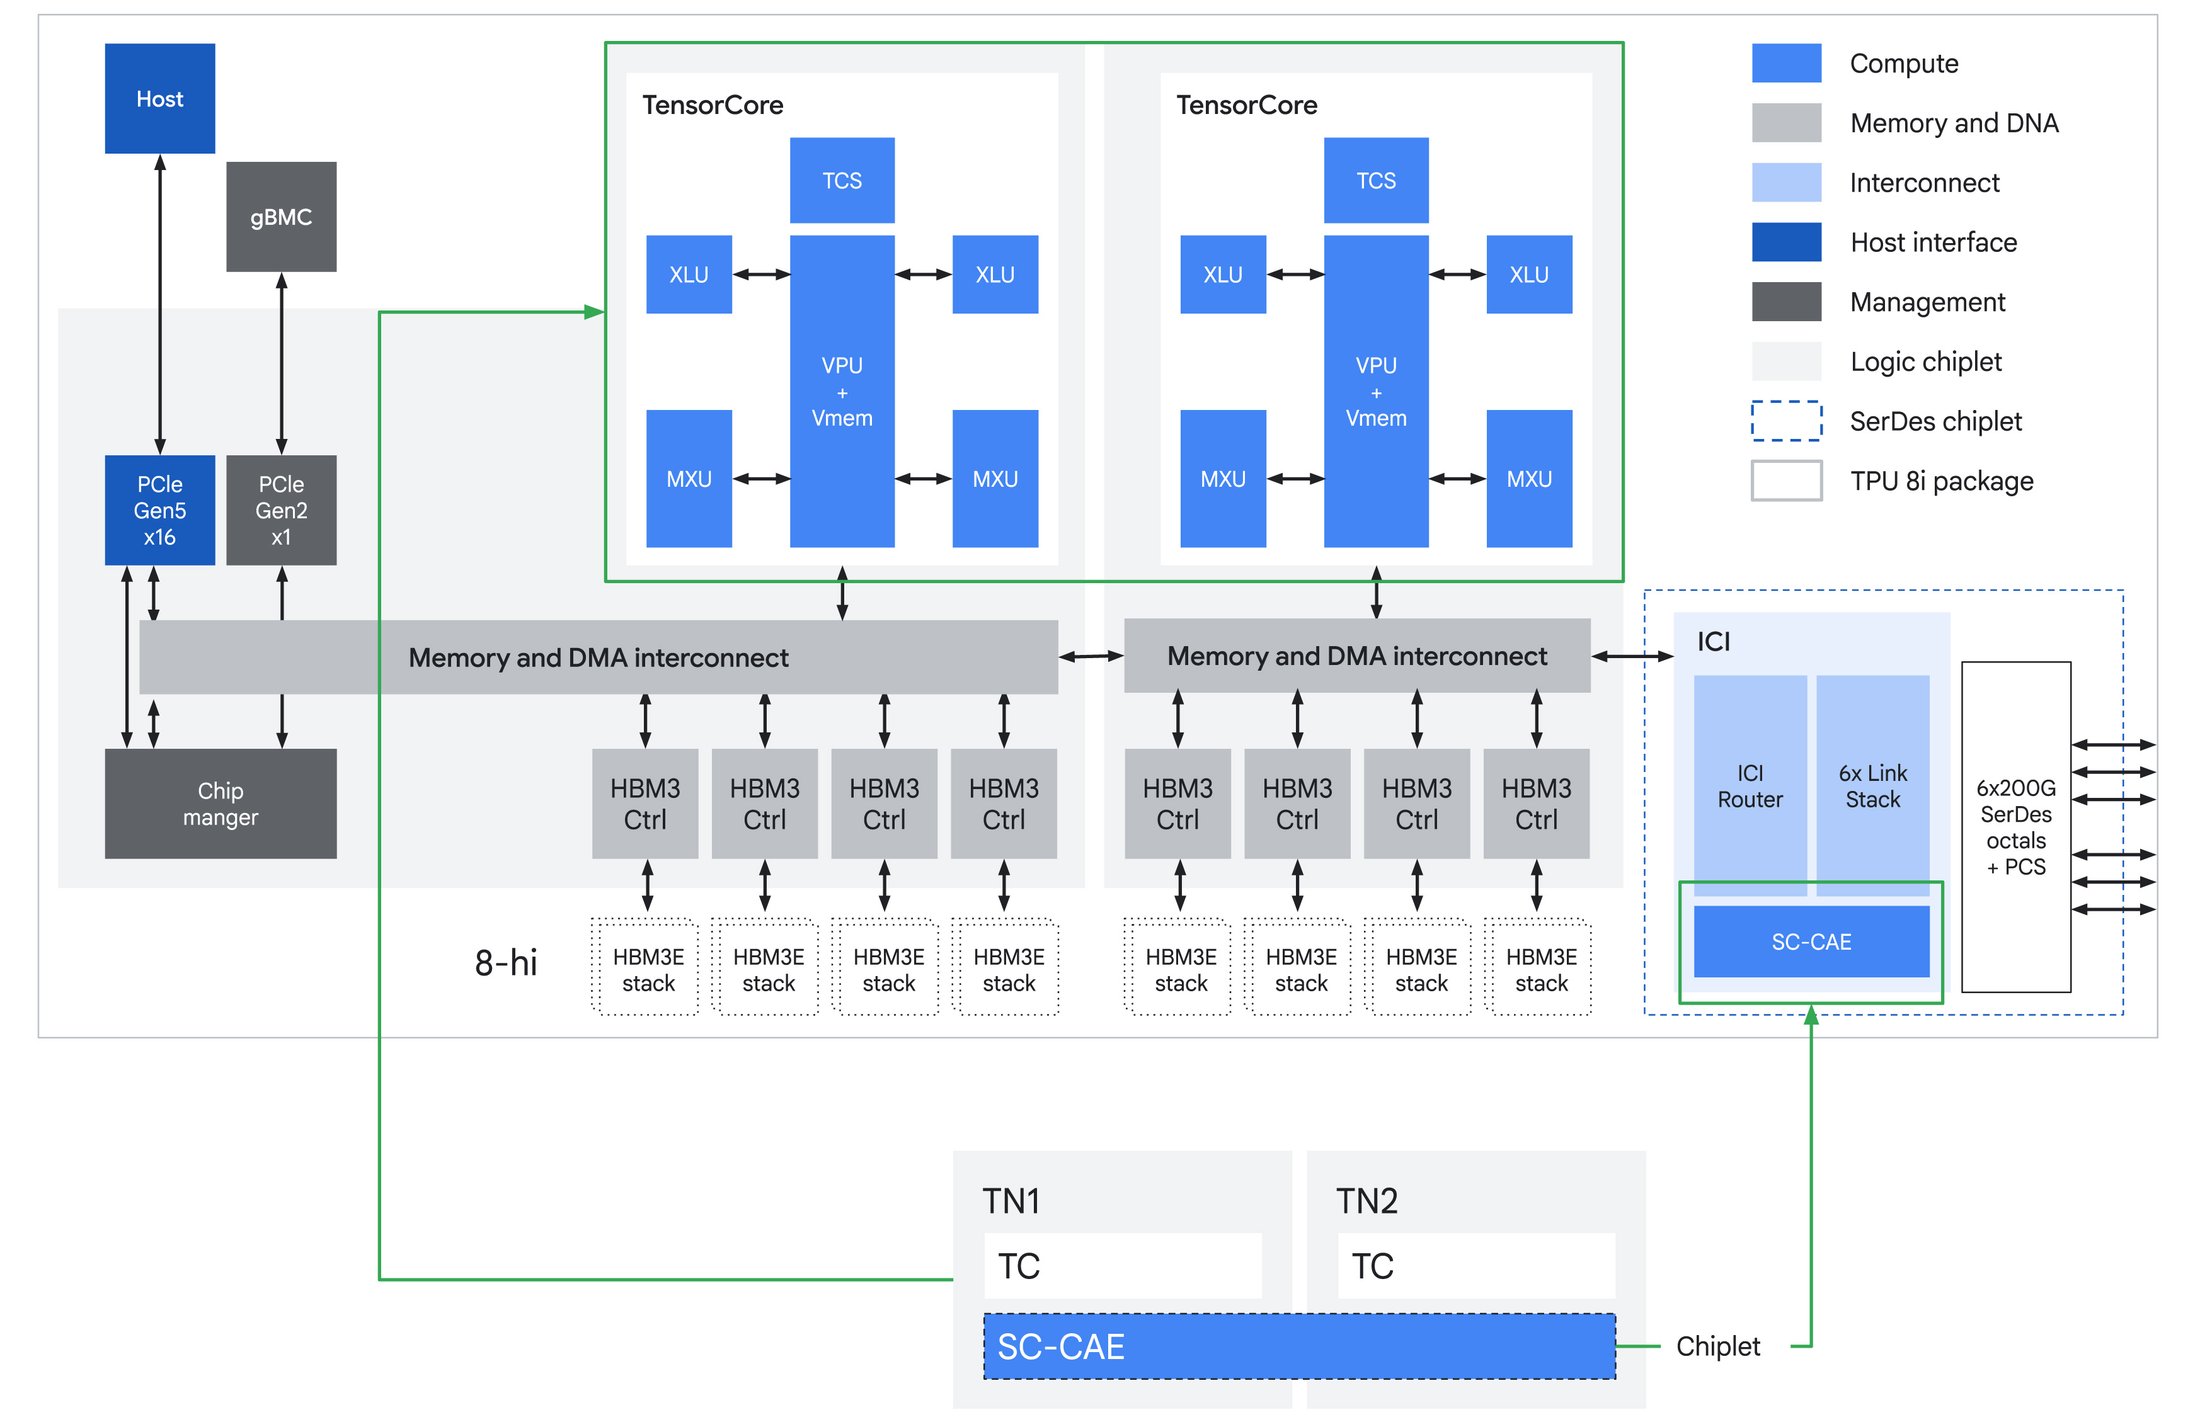
A maior mudança está na SRAM integrada. O 8i possui 384 MB de Vmem, três vezes mais do que o Ironwood. A razão pela qual isso é importante é o cache KV. Durante a decodificação de contexto longo, cada token gerado requer a leitura dos estados chave-valor acumulados dos tokens anteriores. Na maioria dos aceleradores, essa leitura é feita da HBM, o que significa que a taxa de transferência de decodificação é limitada pela largura de banda da memória, e não pela capacidade computacional. O 8i foi dimensionado para armazenar quantidades significativas de cache KV inteiramente no silício. A largura de banda da SRAM integrada é aproximadamente uma ordem de magnitude maior do que a da HBM, portanto, cada leitura de KV feita a partir da SRAM, em vez da HBM, significa menor latência por token e maior número de tokens por segundo com a mesma potência.
Fonte: Google
A configuração do TensorCore é a outra grande diferença. Enquanto o 8t usa um único TensorCore com 12.6 PFLOPS, o 8i divide o processamento entre dois TensorCores com um total combinado de 10.1 PFLOPS. Uma taxa de transferência máxima menor pode parecer uma desvantagem até considerarmos como a inferência realmente funciona no nível do chip. As cargas de trabalho de treinamento são dominadas por lotes: grandes multiplicações de matrizes amortizam a sobrecarga fixa, e uma única MXU grande pode sustentar uma utilização próxima ao pico. A decodificação de inferência é o oposto. Os tamanhos dos lotes são pequenos, as janelas de computação por token são curtas e o chip gasta uma fração significativa do seu tempo em operações coletivas, amostragem e roteamento, em vez de multiplicação de matrizes pura. Um único mecanismo grande trava durante essas lacunas irregulares. A divisão em dois TensorCores permite que o 8i sobreponha as fases de computação de forma mais eficaz, com cada TensorCore alimentado por suas próprias quatro pilhas HBM diretamente conectadas, totalizando 288 GB a 8.6 TB/s em todo o pacote. O resultado é uma utilização sustentada mais elevada nos tamanhos de lote que são efetivamente utilizados no serviço interativo.
Em um nível de escalabilidade, os 1,024 chips ativos em um pod do Boardfly totalizam aproximadamente 295 TB de HBM, 384 GB de SRAM on-chip e 10.3 EFLOPS de computação FP4. O valor da SRAM é o mais importante para a inferência: 384 GB de cache on-chip em todo o domínio são suficientes para armazenar um estado KV substancial sem acessar a HBM, o que torna viável o fornecimento de contexto longo com baixa latência.
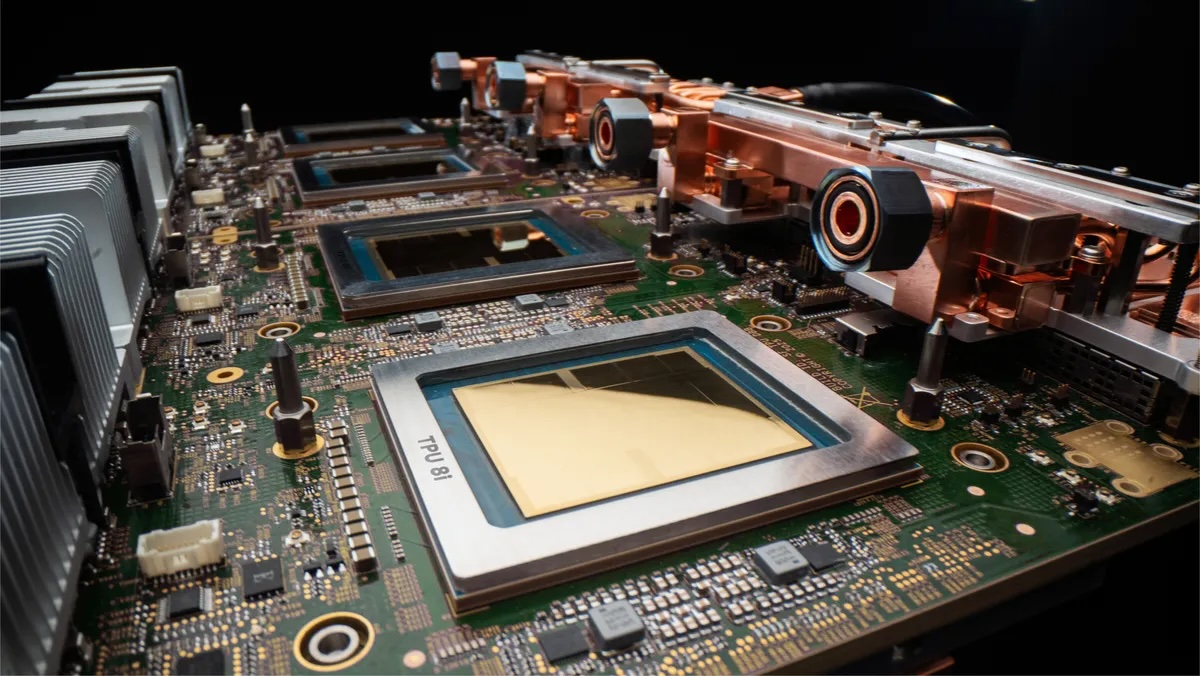
O lado do host segue a mesma lógica. O Google afirma ter aumentado o número de hosts Axion físicos por servidor no 8i em comparação com o Ironwood. Os servidores de inferência gastam uma fração considerável do tempo por token em tokenização, lógica de amostragem, roteamento, processamento em lote e orquestração do tempo de execução do agente. Essas sobrecargas escalam com a concorrência, e não com o tamanho do modelo, e, com as taxas de requisição geradas por cargas de trabalho com agentes, o host pode se tornar o gargalo. Mais CPUs por acelerador no host é a solução mais simples.
Motor de Aceleração Coletiva
A outra grande mudança no chip é o Collectives Acceleration Engine, que substitui os quatro SparseCores presentes no Ironwood. Os SparseCores lidam com o roteamento MoE e as buscas de incorporação com hardware dedicado de coleta e dispersão, removendo-os assim dos sinais do chip de inferência que o 8i otimiza para um gargalo diferente.
O gargalo que o CAE resolve é a latência coletiva. Cada token decodificado exige que os chips participantes se sincronizem: as saídas de atenção devem ser totalmente reduzidas, os metadados de roteamento especializado devem ser transmitidos e os tokens amostrados devem se propagar para a próxima etapa. Nas GPUs, essa coordenação ocorre em software por meio do NCCL, que agenda os coletivos como uma sequência de execuções do kernel e operações de rede. No 8i, o CAE é um chip dedicado localizado em seu próprio chiplet, ao lado dos TensorCores, que lida com essas primitivas de sincronização em hardware.
O Google afirma que a latência coletiva no chip é até 5 vezes menor em comparação com a Ironwood. Em tamanhos de lote de treinamento, essa melhoria seria absorvida pelo tempo de computação; a latência coletiva representa uma pequena fração do tempo total. Em lotes pequenos e janelas curtas por token, típicas da inferência interativa, a latência coletiva pode dominar o tempo por token, de modo que a redução de 5 vezes se reflete em tokens por segundo e no preço por token.
A 8i também migra da topologia de toroide 3D para o que o Google chama de Boardfly, uma topologia hierárquica inspirada na Dragonfly que troca largura de banda coletiva em anel por latência de comunicação total. Analisaremos o Boardfly em detalhes a seguir.
Topologia Boardfly
O protocolo 8i utiliza uma topologia diferente do protocolo 8t porque o treinamento e a inferência possuem padrões de comunicação distintos.
O toroide 3D é ideal para coletivos em anel: cada chip tem seis vizinhos, os dados giram ao redor do anel e nenhum chip roteia tráfego arbitrário. O treinamento é dominado por esses padrões compatíveis com anéis, e é por isso que o 8t mantém o toroide. Uma operação all-reduce em anel se adapta perfeitamente a um único eixo do toroide. Tarefas de vanguarda normalmente colocam o paralelismo de dados em um eixo, o paralelismo de tensores em outro e o paralelismo de pipeline no terceiro. A topologia e a carga de trabalho são compatíveis.
A inferência que serve um grande modelo MoE tem um perfil de comunicação diferente. Os especialistas estão distribuídos por vários chips, e cada token decodificado aciona uma comunicação total: os tokens devem alcançar seus especialistas designados, espalhados pela rede, e as respostas dos especialistas devem retornar. Isso não é um anel. É um tráfego ponto a ponto arbitrário e, em um toroide 3D de 1,024 chips, o caminho mais difícil entre quaisquer dois chips tem 16 saltos. O Google explica esse cálculo para nós: “Em um toroide 3D, os nós são organizados em uma grade onde cada dimensão se enrola como um anel. Para alcançar o chip mais distante possível em uma configuração de 8 x 8 x 16 (1024 chips), um pacote deve percorrer metade da distância de cada anel:
Toroide 3D = 8/2(X) + 8/2(Y) + 16/2(Z) = 16 saltos
Embora o toro seja altamente eficiente para a comunicação entre vizinhos, típica do treinamento denso, ele cria uma latência adicional para padrões de comunicação entre todos os chips. Na era dos modelos de raciocínio e da MoE (Moving of Efficiency), em que qualquer chip pode precisar se comunicar com qualquer outro chip para rotear um token, essa contagem de saltos é importante.
Para o serviço interativo sensível à latência, esses saltos extras fazem com que a latência por token ultrapasse o limite de desempenho (SLO).
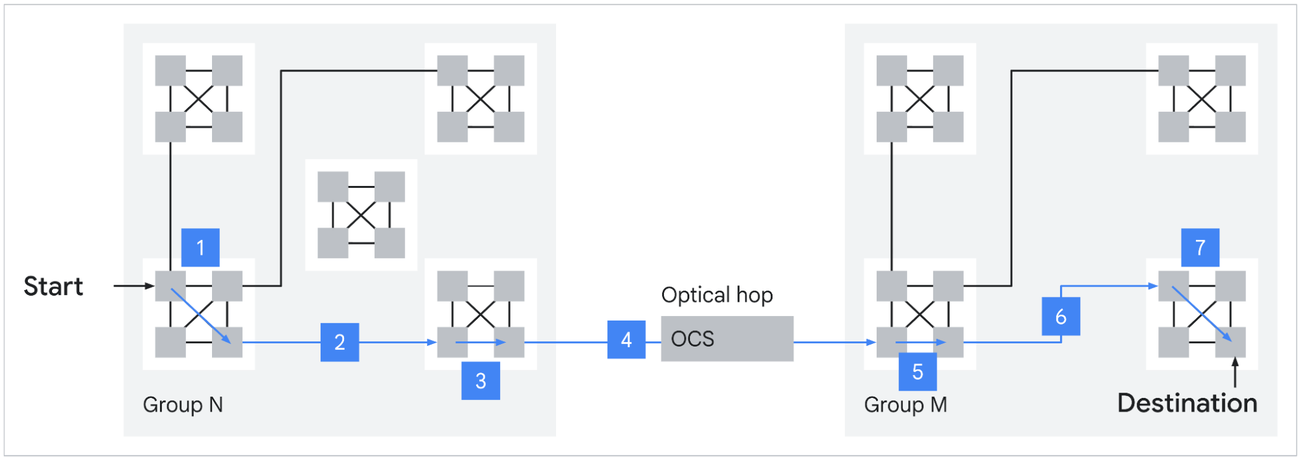
Fonte: Google
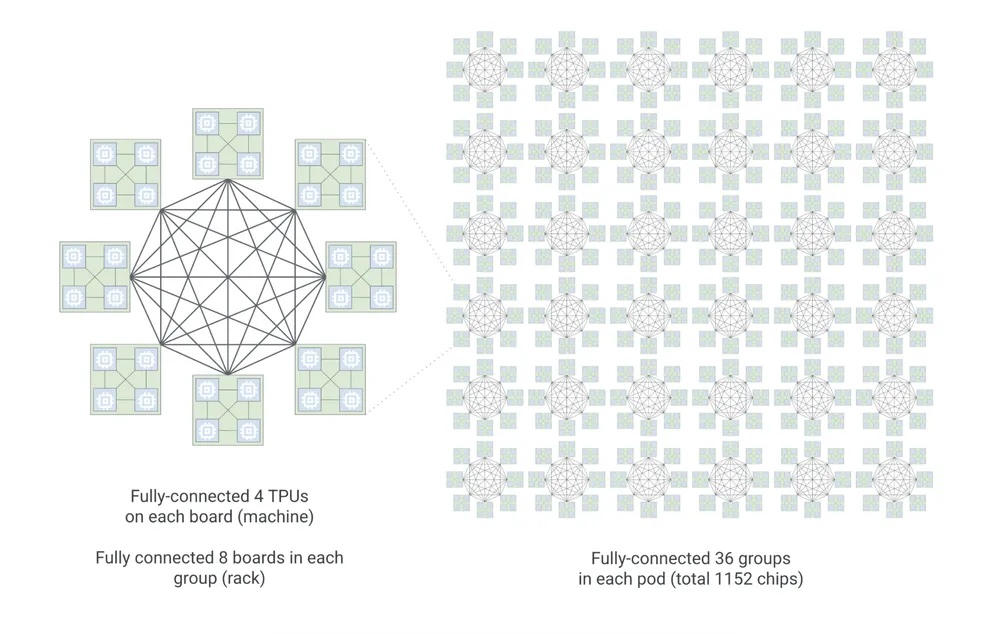
O Boardfly é uma hierarquia inspirada na libélula, projetada para comprimir esse diâmetro. A estrutura possui três níveis. O bloco de construção é um anel de quatro chips com 16 conexões externas. Oito desses blocos formam um grupo, totalmente conectado por meio de cabeamento de cobre com 11 links por grupo. Trinta e seis grupos se conectam por meio de switches de circuito óptico para formar um pod. O resultado é um domínio de escalabilidade de 1,152 chips (1,024 ativos) com um máximo de 7 saltos entre quaisquer dois chips, uma redução de 56% em relação ao toroide. O Google afirma que isso proporciona uma melhoria de até 50% na latência para cargas de trabalho com uso intensivo de comunicação, como o MoE all-to-all.
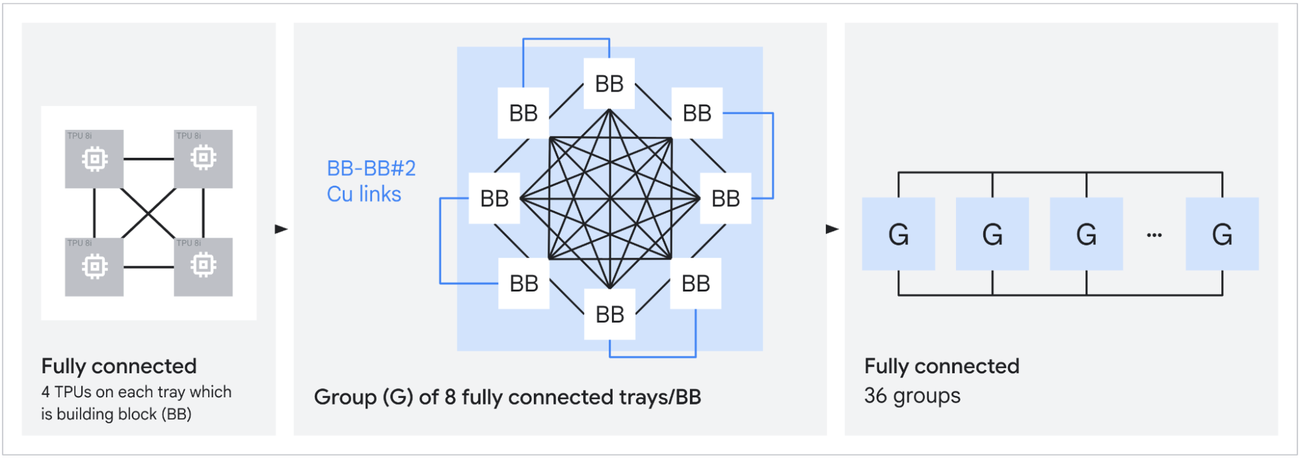
A escalabilidade ampliada também é importante para a replicação de especialistas. Mais chips por estrutura ICI significa que cada especialista em um grande MoE pode ser replicado mais vezes, o que suaviza o desequilíbrio de roteamento e mantém a latência de decodificação estável quando a distribuição de tokens é assimétrica. O roteamento top-k depende dos dados; alguns especialistas verão mais tokens do que outros em qualquer etapa. A replicação absorve essa variação. A largura de banda da ICI foi duplicada para 19.2 Tb/s por chip, em parte para lidar com o tráfego resultante.
Rede Virgem
Um superpod de 9,600 chips é grande, mas as execuções de treinamento de ponta exigem cada vez mais recursos. O Virgo é a estrutura de expansão horizontal que conecta os superpods dentro de um data center, gerenciando o tráfego RDMA leste-oeste entre os pods quando uma tarefa ultrapassa a capacidade de um único domínio de expansão vertical.
Uma única malha Virgo interliga mais de 134,000 chips 8t com uma largura de banda bisseccional não bloqueante de 47 Pb/s, até 4 vezes maior largura de banda por acelerador e 40% menor latência sem carga em comparação com a geração anterior. A arquitetura consiste em uma topologia plana de duas camadas não bloqueante, construída sobre switches de alta radix com um design multiplanar e domínios de controle independentes.
As arquiteturas Clos tradicionais sobrecarregam as camadas superiores para manter o número de portas e os custos sob controle. Isso funciona bem quando a maior parte do tráfego é norte-sul, que é o padrão em nuvens de uso geral: os clientes acessam os balanceadores de carga, os balanceadores de carga acessam os servidores de aplicação, e os servidores de aplicação acessam o armazenamento. As cargas de trabalho de treinamento de IA são quase inteiramente leste-oeste, de chip para chip em toda a arquitetura, e os coletivos são dominados por bisseção. Qualquer sobrecarga em qualquer camada impacta diretamente o tempo de execução do treinamento. O design plano de duas camadas do Virgo, com switches de alta radix, elimina o gargalo da camada de spine, construindo switches com portas suficientes por ASIC para terminar uma fração significativa da arquitetura em dois saltos.
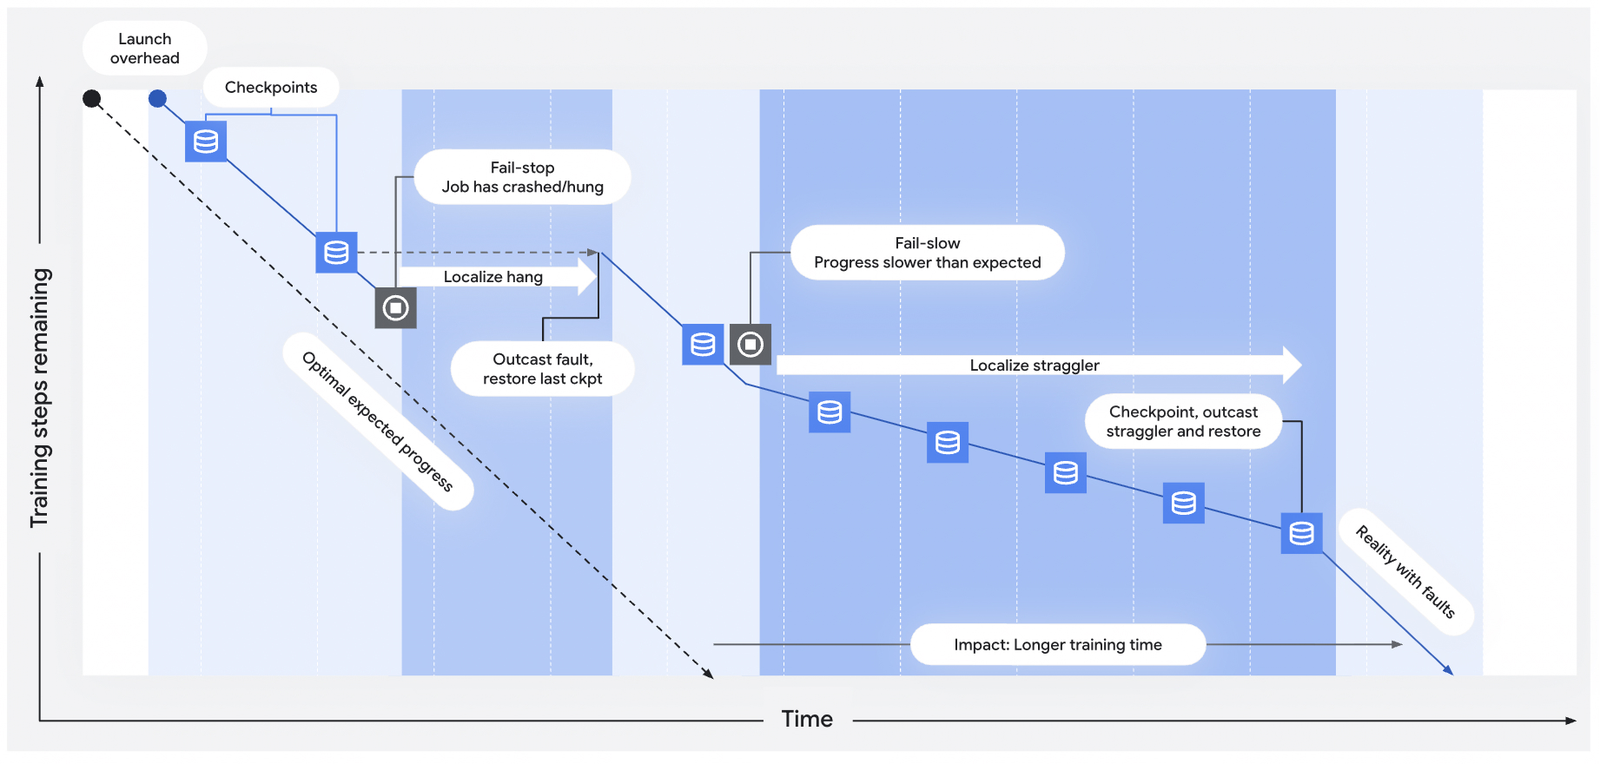
A engenharia de confiabilidade é crucial nessa escala e depende fortemente dos switches de circuito óptico (OCS) baseados em MEMS do Google. O OCS permite que o Google reconfigure a topologia física entre tarefas sem precisar refazer nenhuma fiação e, mais importante, redirecione o tráfego em torno de chips ou links com falha durante a execução. Quando uma falha é detectada, o OCS pode remapear a parte afetada da estrutura em milissegundos, eliminando a necessidade de intervenção manual. A telemetria em submilissegundos alimenta a detecção automatizada de falhas e travamentos. A combinação de detecção rápida e redirecionamento baseado em OCS otimiza o tempo médio entre interrupções (MTBI) e o tempo médio de recuperação (MTTR) em uma escala de mais de 100,000 chips, onde a certeza estatística de alguma falha durante uma execução de várias semanas se aproxima de 100%. A meta de 97% de taxa de transferência efetiva (goodput) que o Google cita para pods de 8 toneladas depende dessa infraestrutura. A mesma tecnologia OCS aparece em toda a pilha TPU: ela une cubos em superpods na camada ICI, conecta grupos Boardfly na camada de escalonamento 8i e lida com o tráfego entre pods na camada Virgo.
Com 134,000 chips, a capacidade computacional agregada atinge aproximadamente 1,690 EFLOPS de FP4, ou cerca de 1.7 ZFLOPS. O Google afirma que a arquitetura suporta escalonamento quase linear para até um milhão de chips em um único cluster lógico de treinamento, embora as implementações atuais ainda não tenham atingido esse limite.
Júpiter e a escala de múltiplos data centers
Virgo gerencia o tráfego de aceleração leste-oeste dentro de um data center, mas não é a camada superior da pilha. Jupiter é a infraestrutura norte-sul existente do Google, agora em sua quinta geração, que lida com o tráfego de front-end e o acesso a recursos distribuídos de armazenamento e computação. Jupiter não foi anunciado no Cloud Next; trata-se da infraestrutura existente sobre a qual a oitava geração se baseia.
A versão mais recente do Jupiter oferece 13 Pb/s de largura de banda bisseccional por edifício de data center com 99.999% de disponibilidade, usando switches Apollo MEMS OCS com consumo aproximado de 108 W por OCS, em comparação com cerca de 3,000 W para um switch de pacotes elétrico equivalente. Essa é a infraestrutura que conecta os data centers do Google ao mundo exterior e entre si.
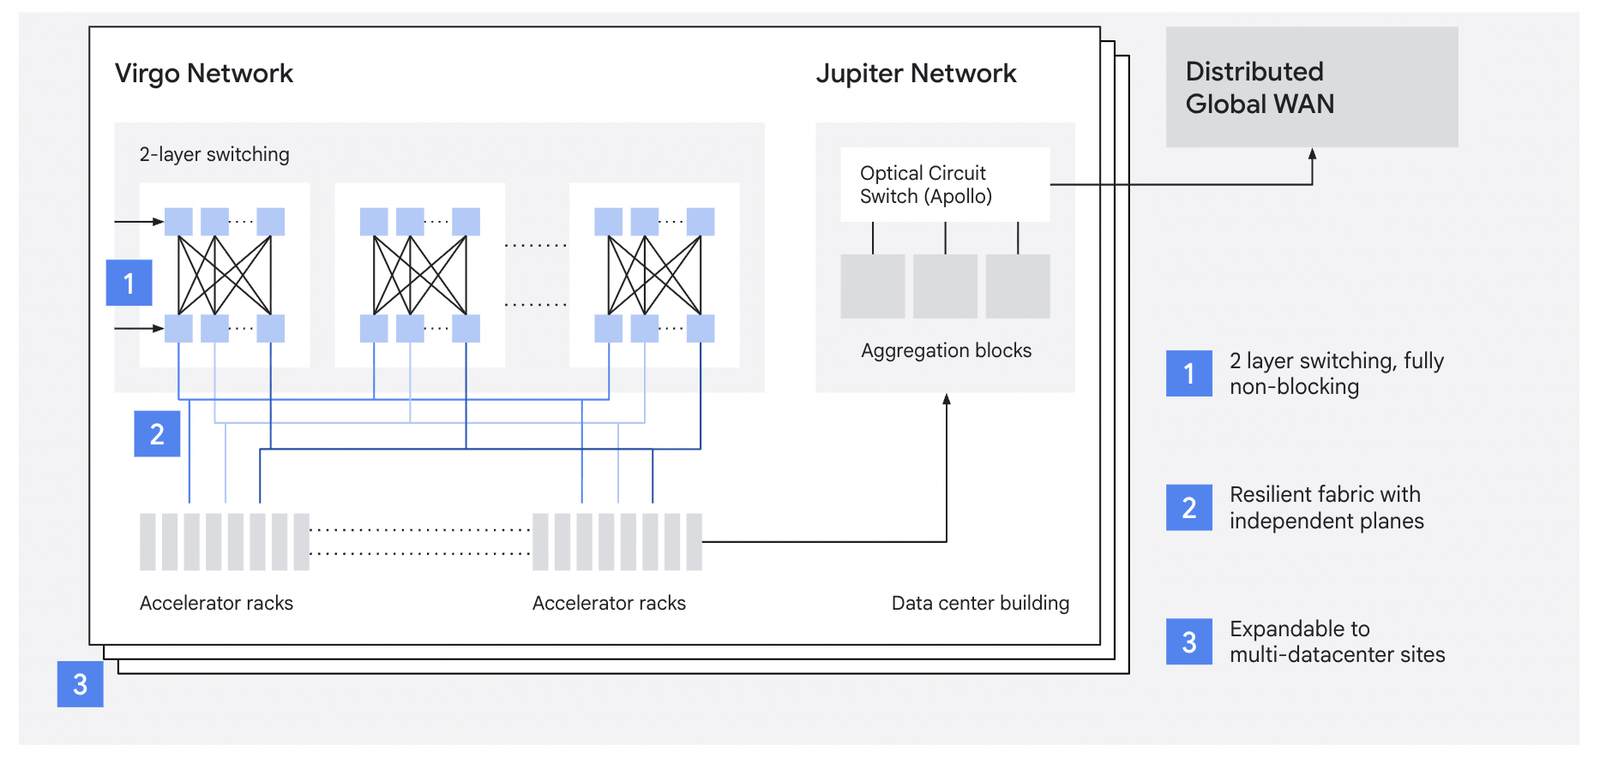
Para execuções de treinamento que excedem a capacidade de processamento e o espaço de um único data center, o Jupiter permite a escalabilidade em vários locais. A combinação é feita em camadas: ICI dentro de um pod, Virgo entre pods dentro de um local e Jupiter entre os locais. O conjunto de software Pathways do Google pode lidar com cargas de trabalho nesses domínios de vários data centers como um único cluster lógico.
Com cerca de 1.7 ZFLOPS, uma única estrutura Virgo é o maior cluster de treinamento de IA anunciado. Várias estruturas Virgo interligadas por Jupiter podem endereçar mais de um milhão de chips TPU, que é a escala que o Google almeja, mesmo que as implementações atuais ainda não a tenham alcançado.
Produtividade e Utilização
O número bruto de FLOPs importa menos do que a fração desses FLOPs que produzem trabalho útil. O Google cita uma meta de 97% de produtividade para superpods de 8 toneladas, o que significa que 97% do tempo real é gasto em computação produtiva, em vez de recuperação, paralisações ou sobrecarga de coordenação. Esse número depende da tolerância a falhas baseada em OCS e da telemetria em submilissegundos mencionada anteriormente.
A Utilização de FLOPs do Modelo (MFU) é a outra variável. A MFU mede qual fração do pico teórico de FLOPs o chip realmente suporta em uma carga de trabalho real. A SemiAnalysis estima que, com uma MFU de TPU de 40%, o custo por FLOP de treinamento efetivo cai aproximadamente 62% em comparação com o GB300 NVL72, com o ponto de equilíbrio em cerca de 15% de MFU de TPU. Os dados econômicos de TPU divulgados publicamente pela Anthropic sugerem que eles operam bem acima desse ponto de equilíbrio. A combinação de alta produtividade (mantendo os chips em execução) e MFU competitiva (mantendo os chips ocupados durante a execução) é o que torna o Custo Total de Propriedade (TCO) do TPU viável em escala.
Onde 8 se sentam
Comparar o TPU 8 com as plataformas atuais e futuras da NVIDIA exige atenção cuidadosa às unidades. A NVIDIA cita a largura de banda do NVLink como agregada bidirecional; um B200 com 1.8 TB/s NVLink 5 corresponde a 900 GB/s por direção. Os valores de FLOP divulgados pela NVIDIA geralmente se referem a uma proporção de 2:4 para redes esparsas; para redes densas, esse valor é a metade. Os números do TPU do Google se referem a redes densas e bidirecionais. Ao analisar qualquer comparação, verifique se a largura de banda é unidirecional ou bidirecional e se os valores de FLOP se referem a redes densas ou esparsas.
O desempenho por chip em FP4, com 8t e 12.6 PFLOPS em alta densidade, situa-se entre os 10 PFLOPS em baixa densidade do GB200 (5 PFLOPS em alta densidade) e os 20 PFLOPS em baixa densidade do GB300 (15 PFLOPS em alta densidade). A comparação por chip é próxima. A comparação de escalabilidade, porém, não. Um rack GB300 NVL72 comporta 72 GPUs em um domínio NVLink. Um superpod 8t consiste em 9,600 chips em um único toroide 3D. Isso representa 133 vezes mais chips em um único domínio coletivo, que é a diferença que separa as plataformas para treinamento de ponta.
A NVIDIA não está parada. A Vera Rubin será lançada no segundo semestre de 2026 com 50 PFLOPS de inferência NVFP4 por pacote (embora a SemiAnalysis tenha questionado se esse número pressupõe compressão adaptativa), 288 GB de HBM4 a 22 TB/s e NVLink 6 a 3.6 TB/s bidirecional. A Rubin Ultra, no segundo semestre de 2027, combina quatro chips de retículo para até 100 PFLOPS FP4 e 1 TB de HBM4e por pacote. O Kyber NVL576 reunirá 576 GPUs Rubin Ultra em um único rack com 15 EFLOPS de inferência FP4. Isso começa a reduzir a vantagem de escalabilidade do Google, embora 576 GPUs ainda sejam uma ordem de magnitude menor que um superpod de 8 toneladas.
Onde 8 se destacam: escalabilidade do tamanho do domínio (9,600 chips versus 72 GPUs, ou 576 pós-Kyber), escalabilidade de tecido único (mais de 134,000 chips a 47 Pb/s), latência determinística do agendamento XLA estático e TCO para cargas de trabalho que se encaixam no modelo TPU.
Em oito aspectos: capacidade HBM por chip (216 GB contra os 288 GB HBM4 de Rubin), esparsidade (a NVIDIA possui um caminho de hardware 2:4, o Google não) e amplitude do ecossistema (CUDA, cuDNN, TensorRT-LLM e a pilha de serviços PyTorch chegam primeiro à NVIDIA; o PyTorch nativo em TPU ainda está em versão prévia).
Ambas as plataformas têm demanda. A Meta está supostamente em negociações para um acordo multimilionário para implantar TPUs do Google em seus data centers a partir de 2027, com potencial para aluguel de Cloud TPU já em 2026. Ao mesmo tempo, o Google Cloud anunciou instâncias A5X baseadas em GPUs NVIDIA Vera Rubin NVL72, com escalabilidade para 80,000 GPUs Rubin em um único site e 960,000 GPUs em implantações com vários sites. O Google está implementando ambas em grande escala.
Embrulhar
A TPU de oitava geração consiste em dois chips em vez de um, projetada para o que o treinamento em larga escala e a inferência de agentes representam hoje, em vez de cargas de trabalho de IA de propósito geral. A 8t eleva a escalabilidade vertical para 9,600 chips por superpod e a escalabilidade horizontal para mais de 134,000 chips por Virgo fabric. A 8i troca os SparseCores por silício de aceleração coletiva e substitui o torus 3D pelo Boardfly para atender às metas de latência exigidas pelo serviço MoE em escala. O roadmap da NVIDIA, com Vera Rubin, Rubin Ultra e Kyber, reduzirá algumas dessas diferenças entre 2026 e 2027, mas a vantagem em escalabilidade vertical persiste por enquanto. Para laboratórios de ponta que executam modelos de mistura de especialistas em centenas de milhares de chips, a 8 é uma alternativa viável ao Grace Blackwell, e as discussões da Meta sugerem que o mercado está começando a precificar isso.


 Amazon