

A NVIDIA RTX PRO 4500 Blackwell Server Edition é a placa que a NVIDIA desenvolveu para os servidores que a maioria das empresas já possui. Trata-se de uma placa de slot único, com resfriamento passivo, 165 W de potência, 32 GB de GDDR7 e o conjunto completo de recursos Blackwell: núcleos Tensor de quinta geração com FP4, núcleos RT de quarta geração, três codificadores e três decodificadores, além de suporte a GPU Multi-Instance, que permite dividi-la em duas partições isoladas de 16 GB. Ela substitui a L4 como porta de entrada para a linha de servidores RTX PRO da NVIDIA e se encaixa em gabinetes PowerEdge, ProLiant ou ThinkSystem 2U sem preocupações com alimentação ou refrigeração.

A proposta da NVIDIA para a placa é o dimensionamento correto: a maioria das empresas não está construindo fábricas de IA; elas operam data centers antigos com refrigeração a ar e limites rígidos de energia por rack, e precisam de uma primeira etapa de computação acelerada que não exija uma nova classe de servidor. Ou então, trabalham na borda da rede, onde a RTX PRO 4500 se alinha melhor com as cargas de trabalho e as restrições de energia que normalmente determinam o que pode ser implementado.
A RTX PRO 6000 Blackwell ocupa o topo desse mercado com 96 GB e até 600 W. A 4500 mantém a mesma arquitetura e reduz praticamente tudo o resto pela metade, permitindo que clientes com modelos menores, muitas tarefas menores ou um orçamento para escalabilidade horizontal com foco no custo por watt obtenham a Blackwell sem pagar por capacidade extra que não usarão.
As cargas de trabalho para essa classe de GPU são bem conhecidas: inferência de modelos de linguagem de pequeno porte, IA de visão e análise de vídeo, busca vetorial e geração de incorporação, transcodificação e estações de trabalho virtuais sob vGPU 20. Ela oferece mais de 5 vezes o desempenho da L4 para inferência de modelos de pequeno e médio porte e até 10 vezes em modelos Nemotron. Seus parceiros de lançamento incluem a NTT DATA para vídeo na borda, a Pacific Biosciences para sequenciamento e a Nokia para estações base AI-RAN. A AWS construiu suas novas instâncias G7 com base nessa arquitetura como substituta da G6.
Já testamos a placa em comparação com o L4 dentro de um HPE ProLiant DL145 Gen11 em nossa análise da RTX PRO 4500 edge , onde ela apresentou um desempenho 2.7 vezes superior ao do L4. Esta análise busca esclarecer o quão próxima ela chega do desempenho do L40S de 350 W e dois slots, que tem sido a placa de inferência padrão para o mercado mainstream nos últimos dois anos, e quais são os benefícios adicionais de memória e potência que a RTX PRO 6000, superior a ela, oferece.
Para descobrir, colocamos o 4500 em um Dell PowerEdge R770 contra um L40S e um L4, adicionamos os dados da RTX PRO 6000 Blackwell do nosso Dell Pro Max Tower T2 tanto em sua configuração padrão de 600W quanto em uma configuração de 450W, correspondente ao que o R770 permite para um slot de GPU, e executamos o serviço online vLLM em quatro modelos com dois comprimentos de contexto.
Em resumo, em conversas e contextos de agentes típicos, o 4500 acompanha o L40S nos modelos FP8 e BF16 com menos da metade do consumo de energia; com entrada 8K, o buffer de quadros de 32 GB mostra suas limitações; e o NVFP4, a precisão que a NVIDIA destaca em sua apresentação da linha Blackwell, tem desempenho semelhante ao restante da linha nesta configuração vLLM.
Principais lições
- Potência de transferência do L40S a 165 W em um único slot: Com entrada e saída de 512 tokens, a 4500 igualou ou superou a L40S em todos os modelos FP8 e BF16 que testamos, 1,107 contra 995 tokens/s no Ministral 3 14B FP8 e 2,006 contra 1,988 no Ministral 3 3B, com uma placa classificada para 47% da potência da L40S e metade de seus slots.
- Aproximadamente 3 vezes o nível 4 que substitui: Taxa de transferência de saída de 2.8x a 3.6x superior à do L4 em contexto curto, com consumo de energia da placa 2.3x superior ao do L4.
- 32 GB tem um limite: Com uma taxa de entrada de 8K, o 4500 ficou 17 a 33% atrás do L40S, e suas curvas se estabilizaram em 8 de concorrência, enquanto o L40S continuou subindo até 16. Essa estabilização ocorre devido ao esgotamento do cache KV, e 32 GB definem esse limite.
- NVFP4 é uma questão de software, em todas as placas: Na arquitetura Qwen3.8-27B NVFP4, a 4500 produziu 320 tokens/s com concorrência 32, a L40S 480 sem nenhum hardware FP4 e a RTX PRO 6000 621. O caminho NVFP4 nesta versão vLLM não escala com a largura de banda da memória em nenhuma delas, enquanto a varredura MAMF mostra o hardware FP4 da 4500 atingindo 568.6 TFLOPS contra 280.1 no FP8.
- O que o cartão de crédito maior lhe proporciona: Com um limite de 450W, o máximo permitido por um slot de GPU Dell R770, a RTX PRO 6000 apresentou desempenho aproximadamente duas vezes superior ao da 4500 em contextos curtos e de 2.5 a 3.2 vezes superior em 8K. Sua potência máxima de 600W adicionou de 1 a 2% em contextos curtos e de 4 a 9% em contextos longos, portanto, a maior vantagem da 6000 sobre a 4500 reside na memória.
Especificações da NVIDIA RTX PRO 4500 Blackwell Server Edition
Existem duas placas com o nome RTX PRO 4500 Blackwell, e elas são semelhantes, mas não são o mesmo produto. A Workstation Edition, anunciada na GTC 2025, é uma placa de 200W, com dois slots, resfriamento ativo, quatro saídas DisplayPort e 896 GB/s de largura de banda de memória. A Server Edition, que estamos analisando aqui, chegou à GTC 2026 como uma placa passiva, sem monitor, de 165W e com 800 GB/s de largura de banda, e troca as saídas de vídeo e um pouco de overclock por recursos para data centers: MIG, computação confidencial, um terceiro NVENC e NVDEC, e suporte a vGPU 20. Internamente, ambas possuem a mesma GPU de 10,496 núcleos e 32 GB de GDDR7 com ECC.
Os dados da NVIDIA indicam que o chip possui 45.6 bilhões de transistores em 378 mm² de silício personalizado de 4 nm da TSMC, com 82 núcleos RT de quarta geração, o que resulta em 82 SMs e 328 Tensor Cores. Esses números se referem ao GB203, a mesma família de chips da RTX 5080, com pequenas alterações. Os valores de Tensor Core abaixo são os picos da NVIDIA com baixa densidade de bits; com baixa densidade, o valor é a metade, o que o próprio programa peakTOPS da NVIDIA confirma em 805 TFLOPS FP8 e 403 TFLOPS FP16, medidos nesta placa.
| Especificação | RTX PRO 4500 Blackwell SE | L4 | L40S | RTX PRO 6000 Blackwell SE |
|---|---|---|---|---|
| Visão geral da plataforma | ||||
| Plataforma | NVIDIA Blackwell | NVIDIA Ada Lovelace | NVIDIA Ada Lovelace | NVIDIA Blackwell |
| Cursos de CUDA | 10,496 | 7,424 | 18,176 | 24,064 |
| RT Núcleos | 82 (4ª geração) | 58 (3ª Geração) | 142 (3ª Geração) | 188 (4ª geração) |
| Memória GPU | 32 GB GDDR7 com ECC | 24GB GDDR6 | 48 GB GDDR6 com ECC | 96 GB GDDR7 com ECC |
| Interface de Memória | 256-bit | 192-bit | 384-bit | 512-bit |
| Largura de banda de memória | 800GB / s | 300GB / s | 864GB / s | 1,597GB / s |
| Desempenho (valores máximos da NVIDIA, taxas de tensores com esparsidade) | ||||
| FP32 | 51 TFLOPS | 30.3 TFLOPS | 91.6 TFLOPS | 120 TFLOPS |
| Tensor FP16 / BF16 | 406 TFLOPS | 242 TFLOPS | 733 TFLOPS | 1 PFLOPS |
| Tensor FP8 | 811 TFLOPS | 485 TFLOPS | 1,466 TFLOPS | 2 PFLOPS |
| Tensor FP4 | 1.6 PFLOPS | Não suportado | Não suportado | 4 PFLOPS |
| Desempenho do núcleo RT | 154 TFLOPS | Não listado | 209 TFLOPS | 355 TFLOPS |
| Potência e Fator de Forma | ||||
| Potência máxima da placa | 165W | 72W | 350W | Até 600W (configurável) |
| Fator de Forma | Slot único, FHFL 4.4 "x 10.5" |
Slot único, HHHL | Slot duplo, FHFL 4.4 "x 10.5" |
Slot duplo, FHFL (ar) Slot único, FHXL (líquido) |
| Térmico | Renda | Renda | Renda | Passivo (ar) ou líquido |
| Conector de força | 1 x PCIe CEM5 de 16 pinos | Slot alimentado | 1x 16-pin | 1 x PCIe CEM5 de 16 pinos |
| Interconexão | PCIe 5.0 x16 | PCIe 4.0 x16 | PCIe 4.0 x16 | PCIe 5.0 x16 |
| Peso | 1,055g | Não listado | Não listado | Não listado |
| Diferenciais | ||||
| GPU de várias instâncias | Até 2x 16GB | Não | Não | Até 4x 24GB |
| NVENC/NVDEC | 3x / 3x | 2x / 4x | 3x / 3x | 4x / 4x |
| Computação Confidencial | Suportado | Não | Não | Suportado |
| Suporte vGPU | Sim (vGPU 20) | Sim | Sim | Sim |
Design e Construção
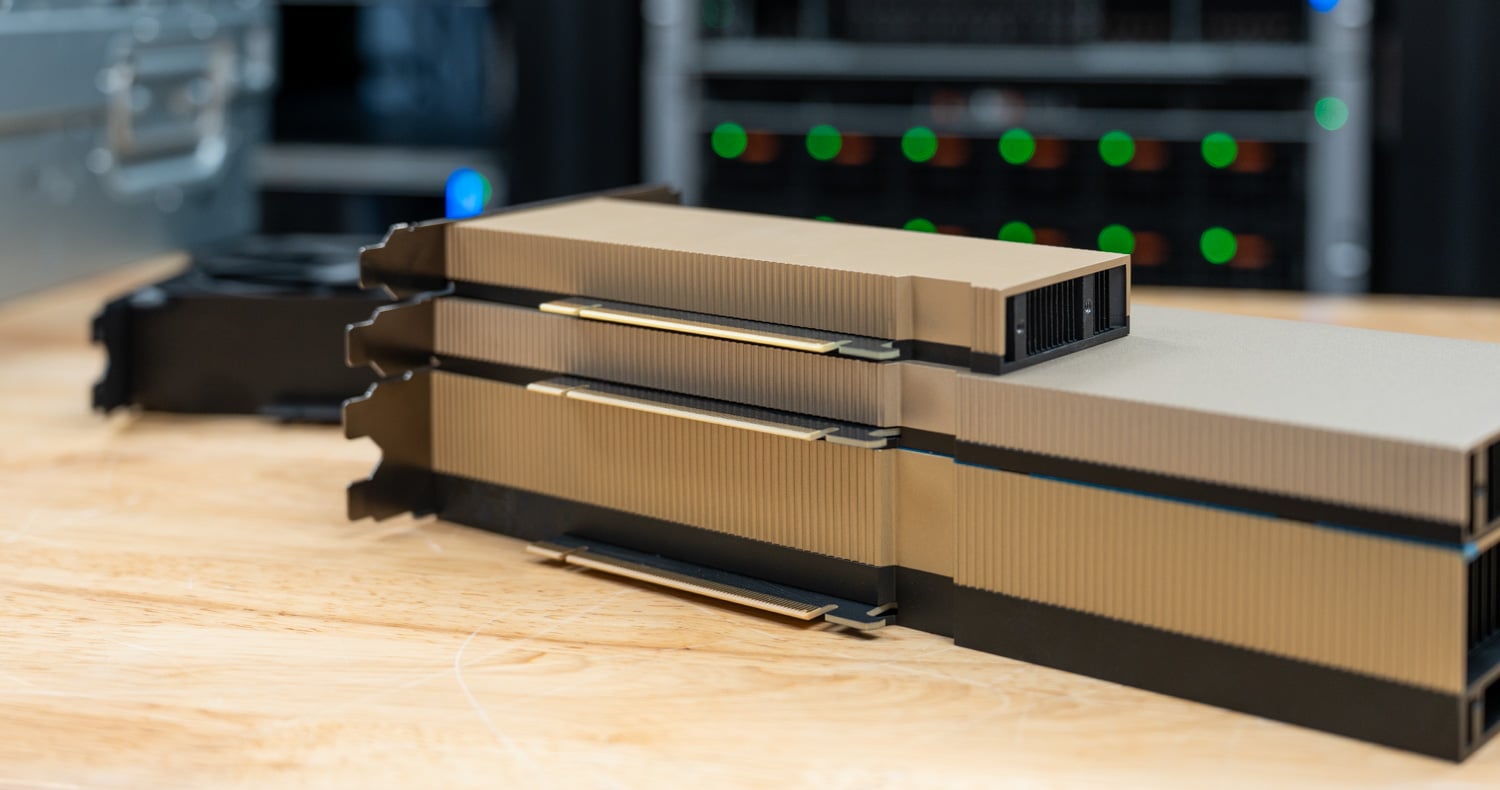
A 4500 Server Edition é uma placa de tamanho padrão (FHFL), com 4.4 polegadas de altura e 10.5 polegadas de comprimento, ocupando um slot inteiro. Essa é uma mudança importante em relação à L4, que era uma placa de tamanho reduzido (metade da altura e metade do comprimento). A L4 ainda serve como referência para seus benchmarks, mas o formato foi alterado para FHFL para acomodar a memória, a entrada de energia de 16 pinos e um dissipador de calor capaz de dissipar 165W apenas com a circulação de ar do gabinete.

Esse formato é a única diferença real em relação ao L4, que se encaixava em qualquer slot HHHL e obtinha seus 72 W do slot, sendo, portanto, utilizado em servidores 1U e gabinetes de pequeno porte. O 4500 tem altura e comprimento padrão e precisa do cabo de 16 pinos, e os servidores 1U convencionais com os quais trabalhamos, incluindo a atual linha PowerEdge 1U da Dell, têm como limite placas HHHL ou FHHL sem esse conector.
Na prática, trata-se de uma placa 2U, ou uma para os poucos chassis whitebox 1U construídos em torno de slots FHFL, portanto, uma loja que comprou placas L4 para chassis 1U ou edge não terá uma substituição direta.
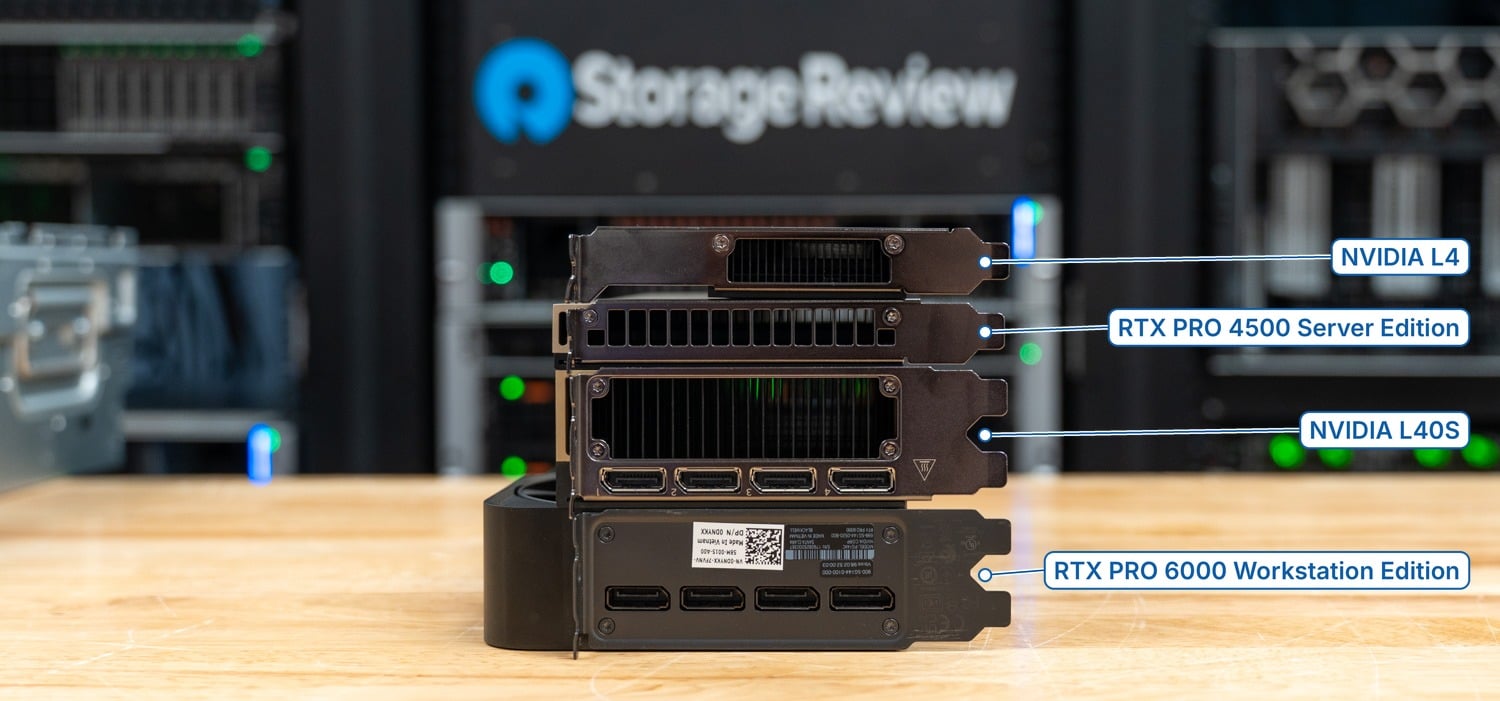
Empilhado de lado, com o L4 acima e o L40S abaixo, o 4500 precisa de um slot onde o L40S precisa de dois. É por isso que um servidor 2U que comporta quatro placas de tamanho duplo pode acomodar oito desses módulos, e também por que as instâncias G7 da AWS executam até oito deles por host.
A alimentação é fornecida através de um único conector PCIe CEM5 de 16 pinos, o mesmo conector usado na RTX PRO 6000, sem opção auxiliar de 8 pinos. O resfriamento é totalmente passivo, portanto a placa depende das ventoinhas do servidor e terá seu desempenho reduzido em gabinetes com pouca ventilação, o que é normal para essa categoria, e todas as outras GPUs têm o mesmo requisito.
A placa não possui saídas de vídeo, portanto, o processamento gráfico, seja em estações de trabalho virtuais com vGPU ou renderização, é feito pela rede, e o suporte é ventilado. Os três mecanismos NVENC de nona geração e os três mecanismos NVDEC de sexta geração adicionam codificação e decodificação 4:2:2 H.264 e HEVC em relação à geração do L4, e a NVIDIA anuncia o dobro da taxa de transferência de decodificação H.264 por mecanismo NVDEC em comparação com o L4. A imagem do suporte abaixo torna a diferença visível: o L4 e a 4500 possuem apenas aberturas de ventilação, enquanto o L40S e a RTX PRO 6000 Workstation Edition possuem quatro saídas DisplayPort cada.
Onde se encaixa a RTX PRO 4500 Blackwell Server Edition
A NVIDIA afirma que o principal valor da placa é a combinação de IA, computação, gráficos e aceleração de vídeo em um design passivo de slot único de 165 W, desenvolvido para servidores onde a densidade de rack, energia e refrigeração são as principais restrições de implantação. Ela se posiciona no que a NVIDIA chama de segmento principal de data center e edge do portfólio de servidores RTX PRO, abaixo da RTX PRO 6000 Blackwell Server Edition e acima de nenhum outro modelo; é o ponto de entrada da linha de servidores Blackwell.
Em comparação com o L4, a NVIDIA cita um desempenho até 10 vezes superior na inferência de modelos pequenos com seus modelos Nemotron Nano (NVFP4 no 4500 contra FP8 no L4), até 4 vezes superior na sumarização de vídeo com o Cosmos Reason 2, 1.9 vezes superior no SPECviewperf 15 em 4K e 1.8 vezes superior na densidade de streaming. Em comparação com CPUs, cita um desempenho até 50 vezes superior no trabalho com bancos de dados vetoriais com o cuVS CAGRA no Milvus e até 100 vezes superior em IA de visão, ambos medidos em servidores 4500 com oito placas de vídeo contra sistemas EPYC 9654 de dois soquetes.
A equipe de servidores da Dell nos informou que vê a placa de vídeo 4500 em racks convencionais, já que três placas 4500 de 32 GB custam quase o mesmo que uma placa 6000 de 96 GB, e nesse caso, a placa com maior capacidade geralmente leva vantagem. Esta placa é para um servidor que, de outra forma, não teria GPU ou um cache L4, e não é a opção ideal para um servidor projetado para receber uma ou mais placas 6000.
Test Setup
Instalamos as placas de vídeo 4500, L40S e L4 em nosso servidor Dell PowerEdge R770, configurado com dois processadores Intel Xeon 6787P (86 núcleos cada) e 2 TB de memória DDR5-6400 distribuída em 32 slots DIMM, executando o driver NVIDIA 595.71.05. Os testes utilizaram o container NGC vLLM 26.08-py3, que carrega o vLLM 0.27.1 no CUDA 13.4.1, portanto, a pilha de software é idêntica em todas as placas. Cada placa foi testada individualmente em seu limite de potência padrão, e o R770 fornece a cada placa sua potência nominal máxima: a Dell lista o consumo da L4 em 72 W, o da 4500 em 165 W e o da L40S em 350 W nesse chassi.
A RTX PRO 6000 Blackwell é a placa de vídeo para workstations presente no nosso Dell Pro Max Tower T2, com o mesmo gabinete e driver. A NVIDIA classifica as edições para workstations e servidores com o mesmo consumo de 600W, e o desempenho em nossos testes foi o mesmo, então ela representa a placa para servidores. Aliás, temos uma análise das placas RTX PRO 6000 Server em um gabinete XE7740, caso você queira saber mais sobre o potencial de escalabilidade dessas placas.
Executamos o teste com a placa de vídeo 6000 duas vezes: uma com sua potência padrão de 600 W e outra com um limite de 450 W verificado, aplicado através do nvidia-smi. Isso porque 450 W é o máximo que a R770 fornece para uma 6000 em um slot de GPU, e é o valor que um comprador que está escolhendo entre uma 4500 e uma 6000 para um servidor 2U típico deve usar como referência. A plataforma host difere para a 6000, mas, nessas cargas de processamento com uso intensivo de GPU, a CPU e a topologia PCIe influenciam o resultado em muito menos do que o limite de potência.
Utilizamos o benchmark de serviço online do vLLM em níveis de concorrência de 1, 2, 4, 8, 16 e 32 com dois formatos de requisição: 512 tokens de entrada e 512 tokens de saída, que simulam chats e breves interações entre agentes, e 8,192 tokens de entrada com 1,024 de saída, que simulam o processamento de RAG e documentos onde o preenchimento automático (prefill) predomina e o cache KV é preenchido. Os modelos foram escolhidos para se adequarem à menor placa do grupo, sempre que possível, portanto, os 24 GB da L4 definem o limite mínimo: Ministral 3 3B Reasoning e Ministral 3 8B Reasoning em BF16, Ministral 3 14B Instruct em FP8 e Qwen3.8-27B em NVFP4, que se adequa às placas de 32 GB e superiores, mas não à L4.
Apresentamos a taxa de transferência de tokens de saída em cada nível de concorrência e citamos a taxa de transferência total, incluindo tokens de preenchimento prévio, onde isso altera o cenário.
O que não está presente: modelos maiores que apenas os cartões de 48 GB ou mais suportam, particionamento MIG, vGPU, transcodificação de vídeo, consumo de energia medido, a configuração de dois cartões 4500 e os cartões para data center acima dessa classe.
Máximo FLOPS de Matmul Alcançáveis (MAMF)
O MAMF é um teste GEMM denso e sustentado que reporta a melhor taxa de transferência de multiplicação de matrizes (matmul) que uma placa atinge em cada precisão, tornando-se a maneira mais fácil de verificar se o hardware FP4 funciona quando a pilha de serviço é removida. A 4500 atingiu 135.9 TFLOPS em BF16, 280.1 em FP8 e 568.6 em NVFP4, com cada redução na precisão quase dobrando a taxa de transferência. Comparado aos picos densos da NVIDIA de 202, 406 e 811 TFLOPS, isso representa de 67% a 70% do pico em cada precisão, e está em consonância com os próprios números cuBLAS da NVIDIA para a placa, de 133, 275 e 534.
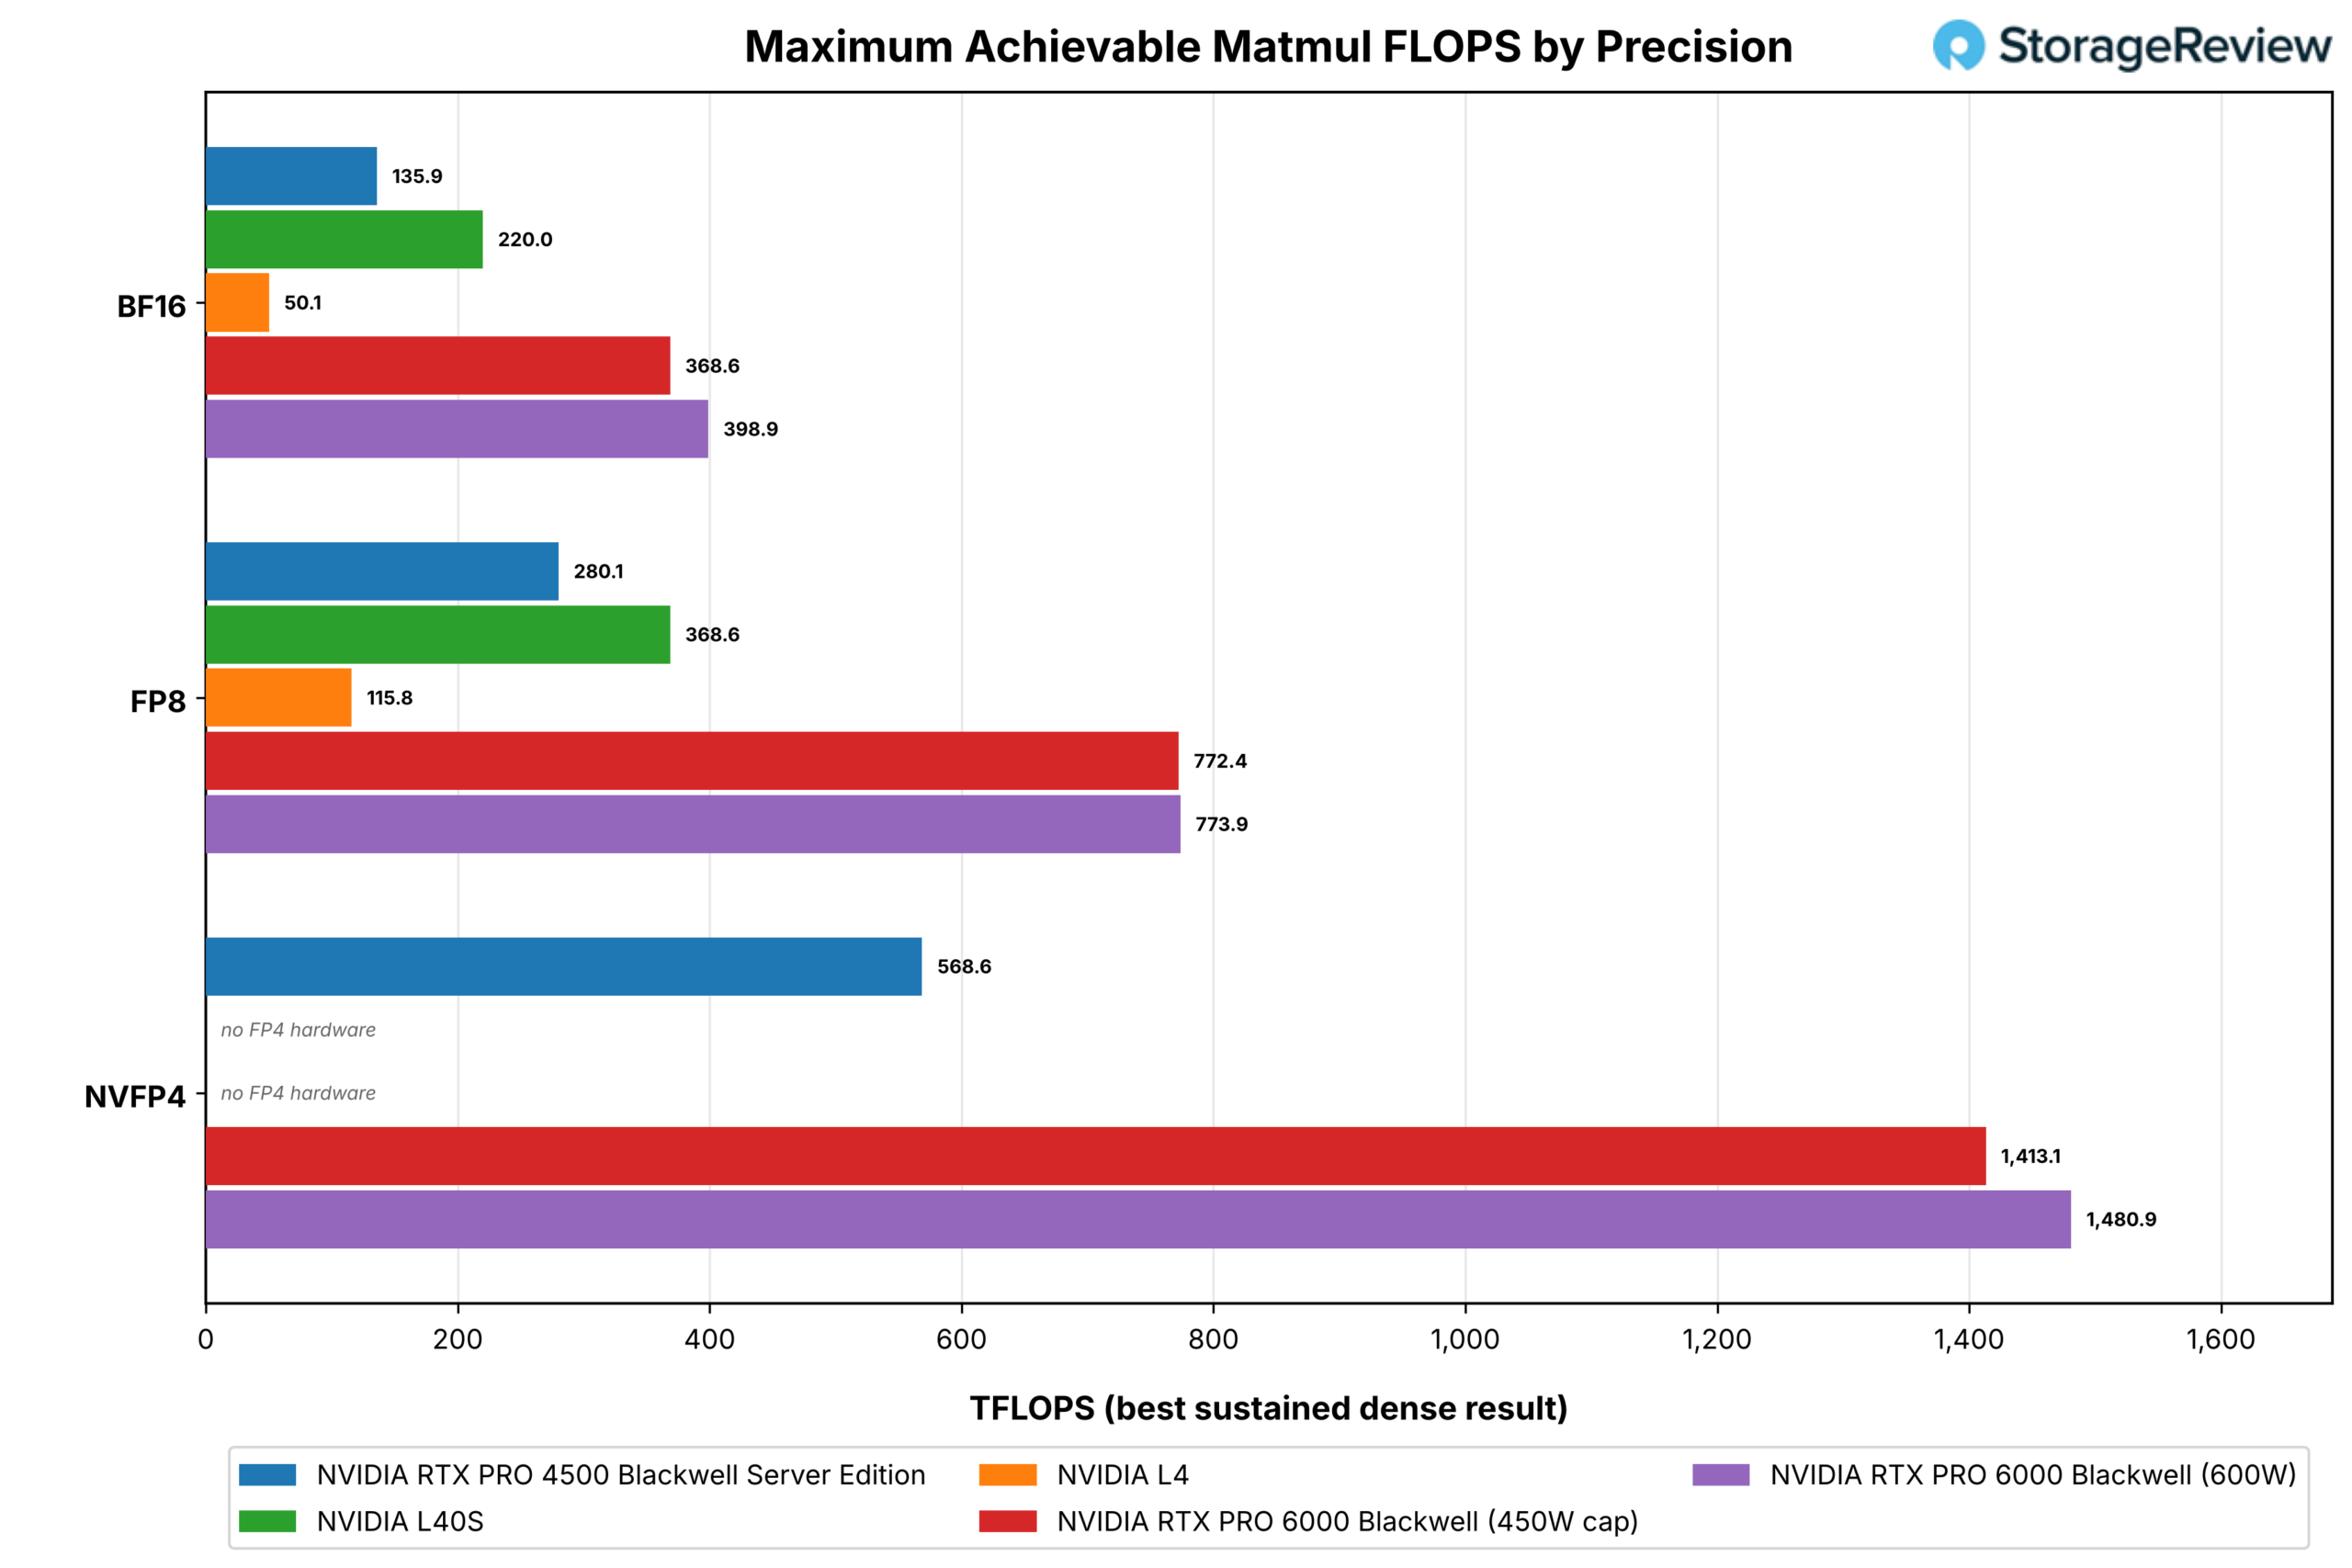
A RTX PRO 6000 apresentou desempenho similar, atingindo 398.9, 773.9 e 1,480.9 TFLOPS a 600W, de 2.6 a 2.9 vezes o desempenho da 4500 nas três precisões, o que corresponde ao previsto pelo tamanho do chip e pelo orçamento de energia. Com o limite de 450W, alcançou 368.6, 772.4 e 1,413.1: o desempenho em FP8 permaneceu estável, o em BF16 apresentou queda de 8% e o em NVFP4, de 5%. Isso indica que o caminho Tensor FP8 da 6000 consome menos de 450W neste teste, e as outras duas precisões apenas atingem o limite máximo. A L40S alcançou 220.0 e 368.6 TFLOPS em BF16 e FP8, respectivamente, e a L4 alcançou 50.1 e 115.8; nenhuma das placas Ada possui hardware Tensor FP4.
A comparação útil é o resultado NVFP4 do 4500 contra o FP8 de todos os outros: 568.6 TFLOPS é 1.5 vezes o limite FP8 do L40S e 74% do limite do 6000, com uma placa de 165W. Essa é a vantagem do FP4, e ela existe no nível do GEMM. Os resultados de serviço vLLM que seguem mostram que ele ainda não atingiu a pilha de serviço nesta versão, e o resultado do MAMF sugere que os números de serviço continuarão a crescer à medida que os kernels NVFP4 forem atualizados.
Serviço online vLLM: Contexto curto (512/512)
Em resumo, é no contexto que o 4500 se destaca: nos três modelos FP8 e BF16, sua taxa de transferência de saída com concorrência 32 foi de 1,107 tokens/s no Ministral 3 14B contra 995 do L40S, 1,017 contra 1,005 no Ministral 3 8B e 2,006 contra 1,988 no Ministral 3 3B. Cada um desses modelos utiliza uma placa Blackwell de 165W, igualando ou superando uma placa Ada de 350W, e as curvas de desempenho se sobrepõem em níveis de concorrência de 1 a 32, portanto, não se trata apenas de um resultado de pico. O L4 atingiu 364, 279 e 704 nos mesmos modelos, o que coloca o 4500 com desempenho de 2.8x a 3.6x superior ao de seu antecessor.

A RTX PRO 6000 demonstra o que o restante da linha Blackwell oferece em termos de custo-benefício. Com potência limitada a 450W, ela atingiu 2,161, 2,042 e 4,069 tokens/s nos mesmos três modelos, de 1.95x a 2.03x o desempenho da 4500; com potência máxima de 600W, alcançou 2,283, 2,139 e 4,155, o que representa um aumento de 2.06x a 2.1x. As duas curvas de desempenho da 6000 se sobrepõem até a concorrência 16 em todos os modelos e se separam por apenas 2 a 5% na concorrência 32, portanto, em um contexto mais amplo, os últimos 150W adicionam pouco. Em comparação com a 4500, isso representa o dobro da taxa de transferência de uma placa com o triplo da memória e, no caso da R770, 2.7x a potência do slot.

A taxa de transferência total, que inclui os 512 tokens de pré-carregamento por solicitação, segue a mesma ordem: 2,215 tokens/s para o modelo 4500 de 14 bits contra 1,990 para o L40S e 727 para o L4, com o modelo 6000 atingindo 4,323 tokens/s no limite e 4,566 no modelo de 600W. A diferença para o L4 é maior no modelo de 8 bits (3.6x) e menor no modelo de 3 bits (2.8x), enquanto a diferença para o L40S nunca ultrapassa 12% a favor do modelo 4500.

Serviço online vLLM: Contexto longo (8K/1K)
Com 8,192 tokens de entrada, o cenário muda, e o motivo fica evidente no formato das curvas. No Ministral 3 14B FP8, o 4500 acompanha o L40S até a concorrência 8, estabilizando-se em cerca de 180 tokens/s, enquanto o L40S continua até 230 na concorrência 16 e se mantém nesse patamar. O modelo 8B apresenta o mesmo comportamento: 185 tokens/s para o 4500 em 32 contra 277 para o L40S, com o 4500 atingindo um platô em 8 e o L40S em 16. No modelo 3B, ambas as placas atingem um platô em 16, 384 contra 475.

O motivo é a capacidade do cache KV: cada requisição simultânea de 8K precisa que seu contexto esteja residente na placa, e uma vez que os pesos são carregados, um buffer de quadros de 32 GB comporta menos deles do que um de 48 GB. Quando o vLLM fica sem espaço no cache KV, ele para de adicionar concorrência útil e a curva de throughput se estabiliza. O 4500 perde de 17% a 33% para o L40S com concorrência 32 nesses modelos apenas por esse motivo; o gargalo não está no processamento, como mostram os resultados com contextos curtos. O L4, com 24 GB e 300 GB/s, mantém um desempenho estável a partir da concorrência 4 em todos os modelos, com taxas de 34 a 130 tokens/s.

Os 96 GB da 6000 nunca ficam sem memória neste teste, e suas curvas continuam subindo até 32 em todos os modelos. Com o limite de 450 W, ela atingiu 552, 589 e 973 tokens/s, de 2.5 a 3.2 vezes o desempenho da 4500; com 600 W, atingiu 608, 639 e 1,033, ou de 2.7 a 3.5 vezes. Este é o único caso em que o limite de energia se faz presente: o pré-carregamento de contexto longo mantém a 6000 computacionalmente limitada por mais tempo, então a placa com limite de energia perde de 4 a 9% em concorrência 16 e 32, contra 2 a 5% em contexto curto. De qualquer forma, a proporção em relação à 4500 aumenta de 2x para aproximadamente 3x, e a memória é o principal motivo, mais do que a potência.

Se sua carga de trabalho envolve perguntas e respostas sobre documentos, RAG em contextos longos ou agentes que geram grandes quantidades de dados de ferramentas, a memória é a especificação predominante, e os 32 GB do modelo 4500 representam uma limitação de concorrência. Se for para bate-papo, classificação ou turnos curtos de agentes, não é. A taxa de transferência total em 8K/1K é dominada pelo preenchimento automático e repete a mesma ordem: 1,713 tokens/s para o modelo 4500 de 14 bits contra 2,070 para o L40S e 381 para o L4, com o modelo 6000 atingindo 4,971 no limite e 5,474 no 600W.
NVFP4: Onde o Software Define o Limite
A Qwen3.8-27B em NVFP4 é o único modelo do grupo que utiliza o hardware Tensor FP4, tecnologia com a qual a Blackwell está liderando, e o resultado é o conjunto de curvas mais planas da análise. Com concorrência 32 no teste de contexto curto, a 4500 produziu 320 tokens de saída/s; a L40S, a 480 e a RTX PRO 6000 atingiram 621, com limite de desempenho, e 616 com 600W. Com concorrência 1, todas as placas ficaram entre 17 e 22 tokens/s em um modelo 27B, incluindo a 6000 com 1.6 TB/s de GDDR7, onde a mesma placa entrega 99 tokens/s em fluxo único no modelo FP8 de 14 bits.

O L40S não possui hardware Tensor FP4, então o vLLM executa um checkpoint NVFP4 desquantizando os pesos e computando com maior precisão, um caminho limitado pela largura de banda da memória, e supera o 4500 em 1.5x. O 6000, que possui o mesmo hardware FP4 que o 4500 e o dobro da sua largura de banda, fica aproximadamente duas vezes melhor que o 4500 em todos os outros aspectos, e seus consumos de 450W e 600W ficam dentro de 1% um do outro em todas as operações simultâneas, então o kernel também não é limitado pelo consumo de energia.
O padrão observado em todas as quatro séries, com taxa de transferência de fluxo único que não varia com a largura de banda da memória e um limite de concorrência-32 de 480 a 621, independentemente da GPU subjacente, aponta para o caminho do kernel NVFP4 nesta versão vLLM como o limite em todas as placas.

Com taxas de transferência de 8K/1K, o modelo 4500 atingiu 153 tokens/s com concorrência de 32, em comparação com 190 para o L40S e 402 e 425 para o 6000, com e sem limite de cache KV. Esses são os mesmos valores de desempenho, limitados pelo cache KV, que os modelos FP8 e BF16 apresentaram, sendo os 96 GB do 6000 novamente o motivo pelo qual seu desempenho continua subindo enquanto os outros se estabilizam.
A NVIDIA alcançou 1,221 tokens/s no FP4 desta placa com Llama 3.1 8B a 2K/256 e 905 tokens/s no Nemotron 3 Nano 30B A3B sob TensorRT-LLM, portanto o hardware entrega resultados satisfatórios com a pilha da NVIDIA. O que os dados atuais indicam é que o desempenho do NVFP4 nesta placa é uma característica do software vLLM, comum a todas as GPUs que testamos, e compradores que contam com a alta taxa de transferência do FP4 devem testar sua pilha de servidores antes de apostar nisso.
Potência de transferência por watt nominal
Nesta rodada, não medimos o consumo de energia, portanto, os cálculos de eficiência disponíveis agora se referem ao limite de potência testado de cada placa. No Ministral 3 14B FP8 com 32 núcleos simultâneos, a 4500 entrega 6.7 tokens de saída/s por watt nominal, contra 2.8 para o L40S, 5.1 para o L4, 4.8 para a RTX PRO 6000 com seu limite de 450W e 3.8 para a 6000 com 600W. No modelo 3B, a proporção se mantém: 12.2 para a 4500, 5.7 para o L40S, 9.8 para o L4, 9.0 para a 6000 com limite de potência e 6.9 para a 6000 com 600W.
A placa 4500 é a mais eficiente do grupo nesse quesito em contextos de curto prazo, e a 6000, com seu consumo limitado, é a única que chega perto. Reduzir o consumo da 6000 para 450W custa de 2 a 5% da taxa de transferência e recupera 25% do seu orçamento de energia, o que explica o aumento de um quarto em sua eficiência. A placa de camada 4 (L4) se mantém competitiva nesse quesito porque 72W é um denominador muito pequeno, mas precisa de três vezes mais slots e servidores para atingir a mesma taxa de transferência, justamente a desvantagem que a 4500 foi projetada para eliminar.
Em contextos de 8K/1K, a ordem muda: o 4500 atinge 1.2 tokens/s por watt nominal no modelo 14B, o 6000 com limite de 1.2, e o 6000 de 600W com 1.0, com o L40S em 0.7. Assim que o 4500 fica sem cache KV, sua taxa de transferência para de crescer, enquanto sua potência nominal não, então, em contextos longos, o 6000 de 450W iguala sua eficiência e entrega 2.9 vezes mais trabalho por slot.
Conclusão
A RTX PRO 4500 Blackwell Server Edition faz exatamente o que a NVIDIA promete: coloca a tecnologia Blackwell em um slot, com um limite de consumo de energia e em uma classe de chassis que antes atingiam o máximo de um L4. Nos modelos que a maioria dos servidores convencionais utiliza, como instruções de pequeno e médio porte e modelos de raciocínio em contextos de chat, ela oferece o desempenho de um L40S em uma placa de slot único com menos da metade do consumo de energia de um L40S e três vezes mais desempenho do que um L4 conseguia oferecer.
Existem, obviamente, limites. Começando pela memória: 32 GB é capacidade suficiente para os modelos para os quais esta placa é destinada, mas limita a concorrência em contextos longos, onde os 48 GB do L40S e, principalmente, os 96 GB do 6000 se destacam, e onde o 6000 executa aproximadamente 3 vezes mais que o 4500 com o mesmo formato de requisição, mesmo com sua potência limitada ao que o mesmo servidor permitiria.
O NVFP4, o principal recurso de precisão da Blackwell, tem desempenho semelhante ao de placas sem hardware FP4 nesta configuração vLLM, embora o teste MAMF mostre que o hardware FP4 oferece o dobro da taxa FP8 da placa no nível GEMM. Portanto, a vantagem do FP4 precisa ser verificada em sua própria configuração, mas claramente há mais potencial de melhoria por meio de software.
Qualquer pessoa com servidores 2U ou chassis 1U que suportem placas FHFL e que precise adicionar capacidade de inferência, visão computacional, transcodificação ou estações de trabalho virtuais sem comprometer a alimentação ou o sistema de refrigeração encontrará na RTX PRO 4500 uma excelente opção. Além disso, quem ainda utiliza caches L4 e já ultrapassou a capacidade de 24 GB por placa certamente se interessará pela 4500. Para organizações cujas cargas de trabalho exigem 48 GB ou mais por placa, seja por meio de contextos longos ou ambientes multi-inquilino, a RTX PRO 6000 é a melhor escolha.
A NVIDIA fez um bom trabalho ao designar duas categorias distintas para essas placas, e a 4500 preenche a lacuna de IA de ponta entre a L4 e a 6000, consumindo apenas 165W.
Classificação: A RTX PRO 4500 Blackwell Server Edition ocupa o primeiro lugar como Melhor GPU de Slot Único em nossa classificação de Melhores GPUs Empresariais , onde também aparecem os dados da L40S e da RTX PRO 6000 desta análise.



 Amazon