

A NVIDIA RTX PRO 4500 Blackwell Server Edition é a placa que a NVIDIA desenvolveu principalmente para substituir o cache L4 em servidores que operam fora do data center: slot único, PCIe Gen5, resfriamento passivo, 165 W, com 32 GB de GDDR7 e o conjunto completo de recursos Blackwell, incluindo Tensor Cores FP4 e GPU Multi-Instance. A HPE nos enviou um ProLiant DL145 Gen11, o servidor edge de profundidade reduzida que utiliza em conjunto com esta GPU em sua solução edge Nemotron, e executamos o mesmo teste de varredura de serviço vLLM na RTX PRO 4500 e em um cache L4 no mesmo chassi. Esta análise da RTX PRO 4500 edge se concentra nessa comparação: o que um site que já utiliza um cache L4 em um servidor edge ganha ao substituir a placa pela 4500, em termos de tokens, latência e consumo de energia.

Em dois modelos pequenos de BF16 com concorrência prática, a RTX PRO 4500 oferece 2.7 vezes a taxa de transferência de saída do L4, mantém a latência do primeiro token abaixo de um segundo em cargas onde o L4 já entrou em uma fila e aumenta o consumo total do servidor DL145 de cerca de 196 W para cerca de 301 W para fazer isso. Por watt de GPU, o ganho é de 1.3 a 1.4 vezes. Por placa, é a diferença entre atender de 32 a 64 sessões de bate-papo simultâneas e atender 256. Por servidor, o DL145 requer até três L4s, e três com 32 sessões cada se aproximam da taxa de transferência de uma 4500, portanto, o desempenho da 4500 em nível de servidor depende da velocidade por usuário, da latência, de um único pool de memória de 32 GB e do FP4.
Este artigo analisa o desempenho de uma placa de vídeo em um servidor edge em comparação com sua antecessora, na plataforma Metrum AI® Bench, com os modelos que se encaixam perfeitamente nas configurações de 24 GB e 32 GB. A RTX PRO 4500 Server Edition também merece uma comparação mais ampla com o restante da linha de placas de inferência da NVIDIA, e estamos realizando esses testes para um artigo separado. Para este artigo, a comparação com o cache L4 é a mais relevante, e adicionamos um conjunto de dados da RTX PRO 6000 Blackwell apenas para mostrar o desempenho do NVFP4 em um modelo de 26 bits quando comparado a uma placa maior. A RTX PRO 6000 não é suportada no servidor edge da HPE.
Principais lições
- 2.7 vezes mais L4 no mesmo servidor: Em 18 combinações de entrada e saída no Qwen3.5-4B e no Gemma 4 E4B, a RTX PRO 4500 apresentou uma mediana de 2.7 vezes a quantidade de tokens de saída por segundo do L4 com 8 a 32 solicitações simultâneas, e de 3.0 a 3.2 vezes com 256 solicitações, com ambas as placas no mesmo HPE ProLiant DL145 Gen11.
- A latência é o maior obstáculo: O 4500 gera de 12 a 15 ms por token, contra 35 a 40 ms no L4, e com 256 requisições simultâneas, seu tempo médio para o primeiro token permaneceu entre 264 ms e 650 ms em solicitações de 256 tokens, enquanto no L4 subiu para 9 e 39 segundos.
- 105W a mais na tomada, 2.7 vezes mais fichas: O DL145 consumiu cerca de 196 W operando na linha L4 e cerca de 301 W na linha 4500, com 32 máquinas simultâneas. A produção de tokens por watt do sistema passou de 2.7 para 5.1 no Qwen3.5-4B e de 2.9 para 5.6 no Gemma 4 E4B.
- A velocidade por usuário se mantém em 256 sessões com prompts em formato de chat: Dividindo a produção pela concorrência, o 4500 ainda fornece a cada usuário de 11 a 22 tokens por segundo com 256 usuários simultâneos em respostas de 256 tokens ou mais para prompts curtos e médios, enquanto o L4 caiu para 3.7 a 8.7. O L4 fica abaixo de um limite de 10 tokens por segundo entre 32 e 256 sessões na maioria dos formatos e entre 8 e 16 no formato 1,024/32 com preenchimento automático; o 4500 permanece acima desse limite com 256 sessões, exceto em formatos de resposta curta e prompts de 1,024 tokens.
- 32 GB e FP4 abrem uma classe de modelos que o L4 não consegue executar nativamente: Em um Gemma 4 26B-A4B em NVFP4 com cache FP8 KV, a 4500 produziu 1,613 tokens de saída por segundo com 32 operações simultâneas a 165 W, cerca de metade do que uma RTX PRO 6000 Blackwell conseguiu em uma estação de trabalho, consumindo de 266 a 471 W com 8 a 32 operações simultâneas. Com 256 operações simultâneas, a diferença aumenta para cerca de 2.5 vezes.
Para que foi projetada a RTX PRO 4500 Server Edition?
A NVIDIA anunciou a RTX PRO 4500 Blackwell Server Edition na GTC 2026 como o modelo de entrada da sua família de servidores RTX PRO e sucessora da L4. Ela compartilha o nome com a placa de workstation RTX PRO 4500 Blackwell, e ambas compartilham o mesmo silício e 10,496 núcleos CUDA, mas são produtos diferentes. A Server Edition remove as saídas de vídeo e a ventoinha, limita o consumo de energia da placa a 165 W e adiciona o conjunto de recursos para data centers: MIG com até duas instâncias de 16 GB, computação confidencial, um terceiro NVENC e NVDEC, e suporte a vGPU. A NVIDIA classifica sua memória em 800 GB/s e seu pico de Tensor FP4 em 1.6 PFLOPS com sparsity, e descreve a placa como uma “GPU Blackwell com baixo consumo de energia para IA empresarial” voltada para “servidores de data center e edge convencionais”. Abordamos esse assunto em nossa cobertura da HPE GTC 2026.
A NVIDIA também alterou o formato: a L4 que analisamos em 2024 é uma placa de 72 W com metade da altura e do comprimento, equipada com 24 GB de GDDR6 a 300 GB/s, enquanto a RTX PRO 4500 Server Edition é uma placa de slot único com altura e comprimento totais, consumindo 165 W. Portanto, ela ainda ocupa um slot, mas requer um cabo riser de comprimento total e um cabo de alimentação de 16 pinos. O slot padrão do DL145 Gen11 tem altura e comprimento totais, e a HPE configurou nossa unidade com o cabo riser e o cabo de alimentação de comprimento total. Em teoria, a 4500 oferece 2.7 vezes a largura de banda de memória da L4, 33% mais memória e 1.7 vezes o pico de Tensor FP8 com 2.3 vezes mais consumo de energia, além de um caminho FP4 para o qual a L4 não possui hardware.
| Especificação | RTX PRO 4500 Blackwell Server Edition | NVIDIA L4 |
|---|---|---|
| Visão geral da plataforma | ||
| Plataforma | Blackwell | Ada Lovelace |
| Núcleos CUDA | 10,496 | 7,424 |
| Memória | 32 GB GDDR7 com ECC | 24GB GDDR6 |
| Largura de banda de memória | 800GB / s | 300GB / s |
| Desempenho (valores máximos da NVIDIA, com esparsidade) | ||
| FP32 | 51 TFLOPS | 30.3 TFLOPS |
| Tensor FP8 | 811 TFLOPS | 485 TFLOPS |
| Tensor FP4 | 1.6 PFLOPS | Não suportado |
| Potência e Fator de Forma | ||
| Poder do conselho | 165W | 72W |
| Fator de forma | Slot único, altura total, comprimento total, passivo | Slot único, meia altura, meia largura, passivo |
| Conector de força | 1 x PCIe CEM5 de 16 pinos | Slot alimentado |
| Interface | PCIe 5.0 x16 | PCIe 4.0 x16 |
| Diferenciais | ||
| MIG | Até 2 instâncias de 16 GB. | Não |
| NVENC/NVDEC | 3 / 3 | 2 / 4 |
| Computação confidencial | Capazes | Não |
Servidor Edge: HPE ProLiant DL145 Gen11
A HPE posiciona o DL145 Gen11 como o servidor ideal para locais sem sala de servidores. A descrição da solução para o DL145 e a placa de vídeo NVIDIA Nemotron apresenta um dispositivo quase silencioso, montável na parede, com classificação de temperatura de -5°C a 55°C, para gabinetes com pouca ventilação, locais empoeirados e ambientes com temperaturas extremas (quentes ou frias), com iLO e Compute Ops Management para integração em centenas de locais que possuem apenas energia e Ethernet. A HPE sugere os setores de varejo, saúde, finanças, manufatura e energia como os principais alvos, e as cargas de trabalho listadas são as que serão avaliadas nesta análise: modelos de linguagem simples, RAG e busca vetorial executadas localmente, garantindo que dados sensíveis à latência e regulamentados nunca saiam do local. Já analisamos o DL145 Gen11 quando foi lançado, portanto, não repetiremos a descrição da plataforma aqui.
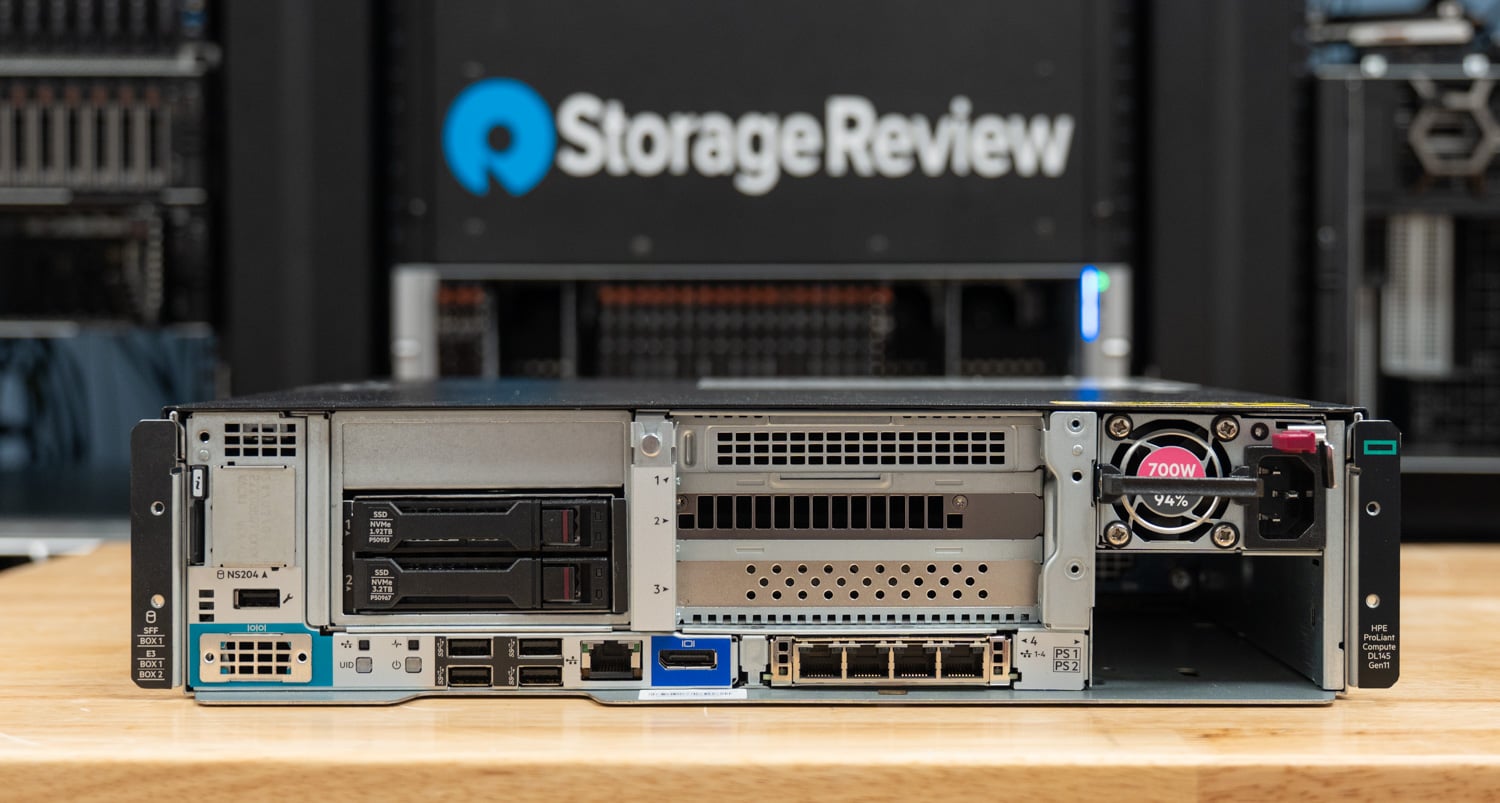
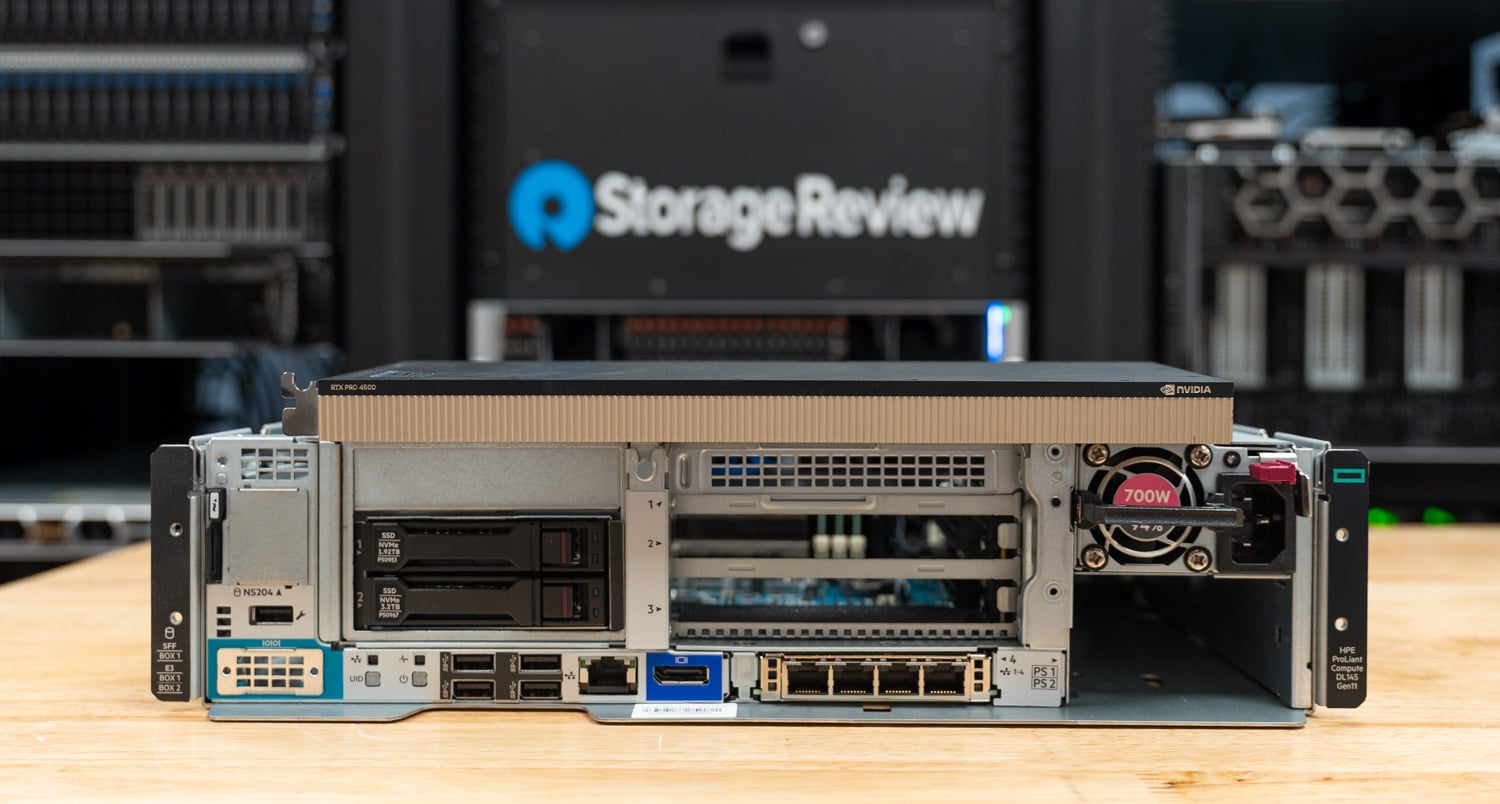
A unidade enviada pela HPE para este teste está configurada com um único processador AMD EPYC 8534P, um componente Siena de 64 núcleos e 128 threads, 96 GB de memória DDR5-4800 em seis módulos DIMM de 16 GB e a placa de vídeo RTX PRO 4500 Blackwell Server Edition instalada em um riser de comprimento total. O chassi possui um backplane U.3 de duas baias; nossa unidade foi enviada com cabeamento de backplane apenas SATA, então inicializamos o sistema a partir de um SSD NVMe Solidigm D7-P5620 de 6.4 TB em um slot PCIe, o que não teve influência nos resultados da GPU. A comparação com o L4 utilizou a mesma configuração de servidor. A 4500 é a placa que a HPE utiliza nesta plataforma para sua solução de edge computing Nemotron; o L4 é o que um proprietário de um DL145 dos últimos dois anos provavelmente tem instalado nesse slot atualmente.
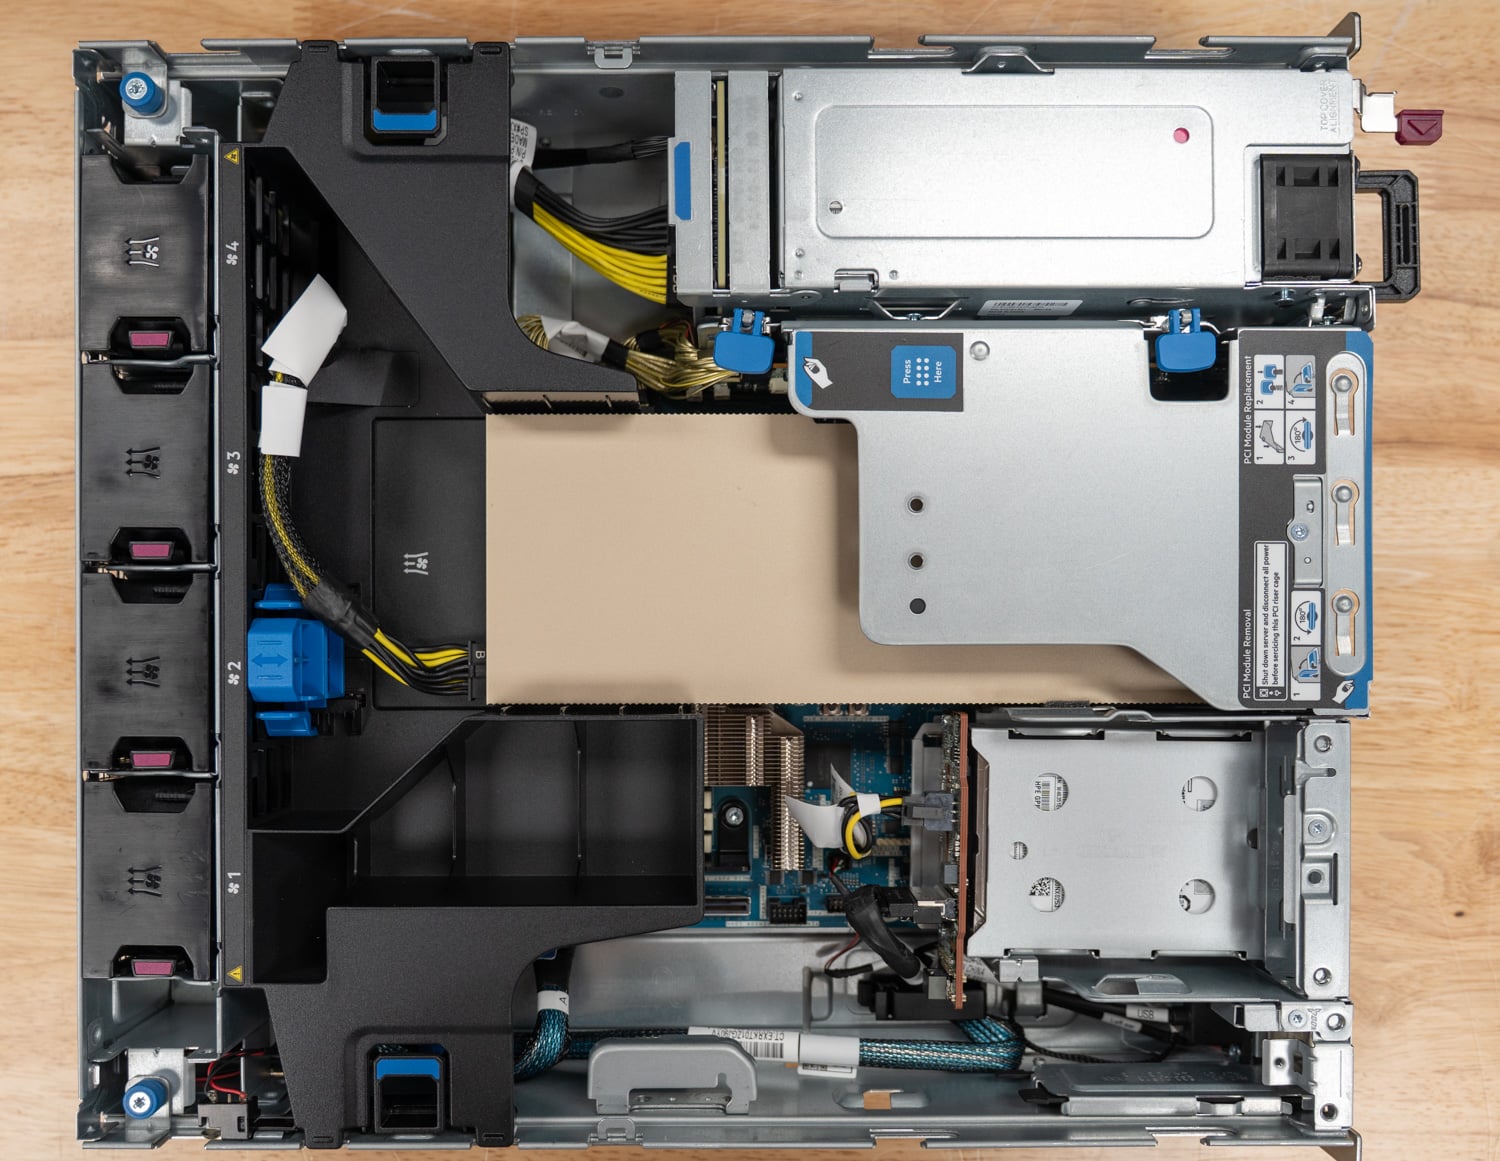
Mais dois dados da plataforma alimentam a análise abaixo: o DL145 reporta o consumo de energia total do servidor através do iLO, e a Bench Platform registrou esse valor juntamente com o consumo da própria placa de vídeo em cada execução, permitindo-nos falar em watts na tomada e watts na placa. Além disso, o sistema de refrigeração do servidor manteve ambas as placas passivas dentro de seus limites: a 4500 atingiu um pico de temperatura média da GPU de 84°C durante as execuções mais longas e a L4, 86°C, ambas sob carga de inferência sustentada em potência máxima em um chassi 2U de profundidade reduzida.
Como testamos
Todos os dados de inferência desta análise foram coletados com a plataforma Metrum AI Bench (versão 3.9.2, registrada nos arquivos de execução com seu nome anterior, Metrum Insights), utilizando o vLLM 0.24.0 como mecanismo de serviço. A plataforma Bench executa uma grade fixa de cenários em cada sistema, registra a taxa de transferência, os percentis de latência, a telemetria da GPU e o consumo de energia do host para cada cenário e exporta os resultados como um único conjunto de dados por tarefa. Já escrevemos sobre o trabalho da Metrum AI com a Oregon State University , e a Dell utilizou a mesma plataforma para seu relatório técnico sobre o R770AP; esta é a primeira vez que a utilizamos para realizar nossa própria comparação de GPUs de ponta a ponta. Os engenheiros da Metrum AI e nosso laboratório executaram as tarefas em conjunto, com a plataforma Bench realizando a coleta de dados e nossa equipe configurando o hardware, os modelos e as perguntas.
A Metrum AI também publica um complemento de código aberto, o Metrum AI Bench CLI , que os leitores podem usar para executar o mesmo tipo de testes em seus próprios sistemas. Metrum AI é uma marca registrada, e Metrum AI Bench CLI e Metrum AI Bench Platform são marcas comerciais da Metrum AI, Inc. O uso do Metrum AI Bench não implica endosso por parte da Metrum AI.
A grade consiste em nove formatos de prompt: todas as combinações de 32, 256 e 1,024 tokens de entrada com 32, 256 e 1,024 tokens de saída máximos, cada uma executada com 1, 8, 16, 32 e 256 requisições simultâneas, para 45 cenários por modelo por GPU. A execução do Gemma 4 no L4 também incluiu 64 e 128 requisições simultâneas, o que se mostrou útil para encontrar seu limite máximo. Cada cenário envia 15 requisições por fluxo, de 1 a 32 requisições simultâneas, e 1,280 requisições com 256. O job Gemma 4 E4B do 4500 foi executado três vezes; a variação entre os cenários nas repetições foi inferior a 2%, e relatamos a mediana. Os trabalhos L4 e 4500 BF16 e os dois trabalhos Gemma 4 26B, um em cada placa, totalizam 378 execuções de cenário, e entre eles houve uma solicitação com falha em uma repetição de um cenário 4500, que mencionamos apenas para fins de transparência.
Três modelos foram utilizados no teste: Qwen3.5-4B e Gemma 4 E4B, ambos executados em BF16 com cache KV BF16. Esses modelos foram executados tanto no L4 quanto no 4500 e representam o tamanho de modelo que uma implementação de edge computing em uma placa de 24 GB atende realisticamente hoje em dia. O modelo Gemma 4 26B-A4B, uma mistura de especialistas com 26 bits e cerca de 4 bits de parâmetros ativos, foi executado em NVFP4 com cache KV FP8 apenas no 4500, utilizando uma RTX PRO 6000 Blackwell Workstation Edition (600 W) em um Dell Pro Max Tower T2 como ponto de referência. O L4 não possui computação FP4 nativa e não há espaço para esse modelo em BF16, portanto, ele não foi incluído nessa parte do teste.
Três observações sobre a leitura dos gráficos: iniciamos os gráficos de throughput com 8 requisições simultâneas. Os cenários de requisição única são curtos o suficiente (15 requisições, alguns segundos cada) para que a primeira requisição de cada cenário Qwen de usuário único na placa 4500, que apresentou um atraso de 37 a 39 segundos no primeiro token, distorça o valor do throughput da execução. Portanto, para o caso de usuário único, relatamos a latência por token e o tempo de resposta, que não são afetados. O consumo de energia da GPU é uma média amostrada, então calculamos tokens por watt apenas em execuções longas o suficiente para a média se estabilizar, o que na prática significa 16 requisições simultâneas ou mais. E com 256 requisições simultâneas e prompts longos, ambas as placas ficam sem cache KV e o vLLM enfileira as requisições; esses pontos ainda representam números reais de throughput, mas os valores de tempo até o primeiro token nessa carga descrevem uma fila, e consideramos 32 requisições simultâneas como a faixa de operação para uso sensível à latência.
Qwen3.5-4B
A tabela abaixo apresenta uma comparação completa entre o Qwen3.5 e o 4B: a quantidade de tokens de saída por segundo em ambas as placas para cada formato de solicitação, de 8 a 256 solicitações simultâneas. O mesmo formato de curva se repete em todos os nove painéis, com o 4500 apresentando um desempenho inicial de cerca de 2.5 a 2.8 vezes maior que o L4 com 8 solicitações simultâneas, escalando um pouco mais rápido até 32 solicitações e atingindo de 2.4 a 3.2 vezes maior com 256 solicitações.
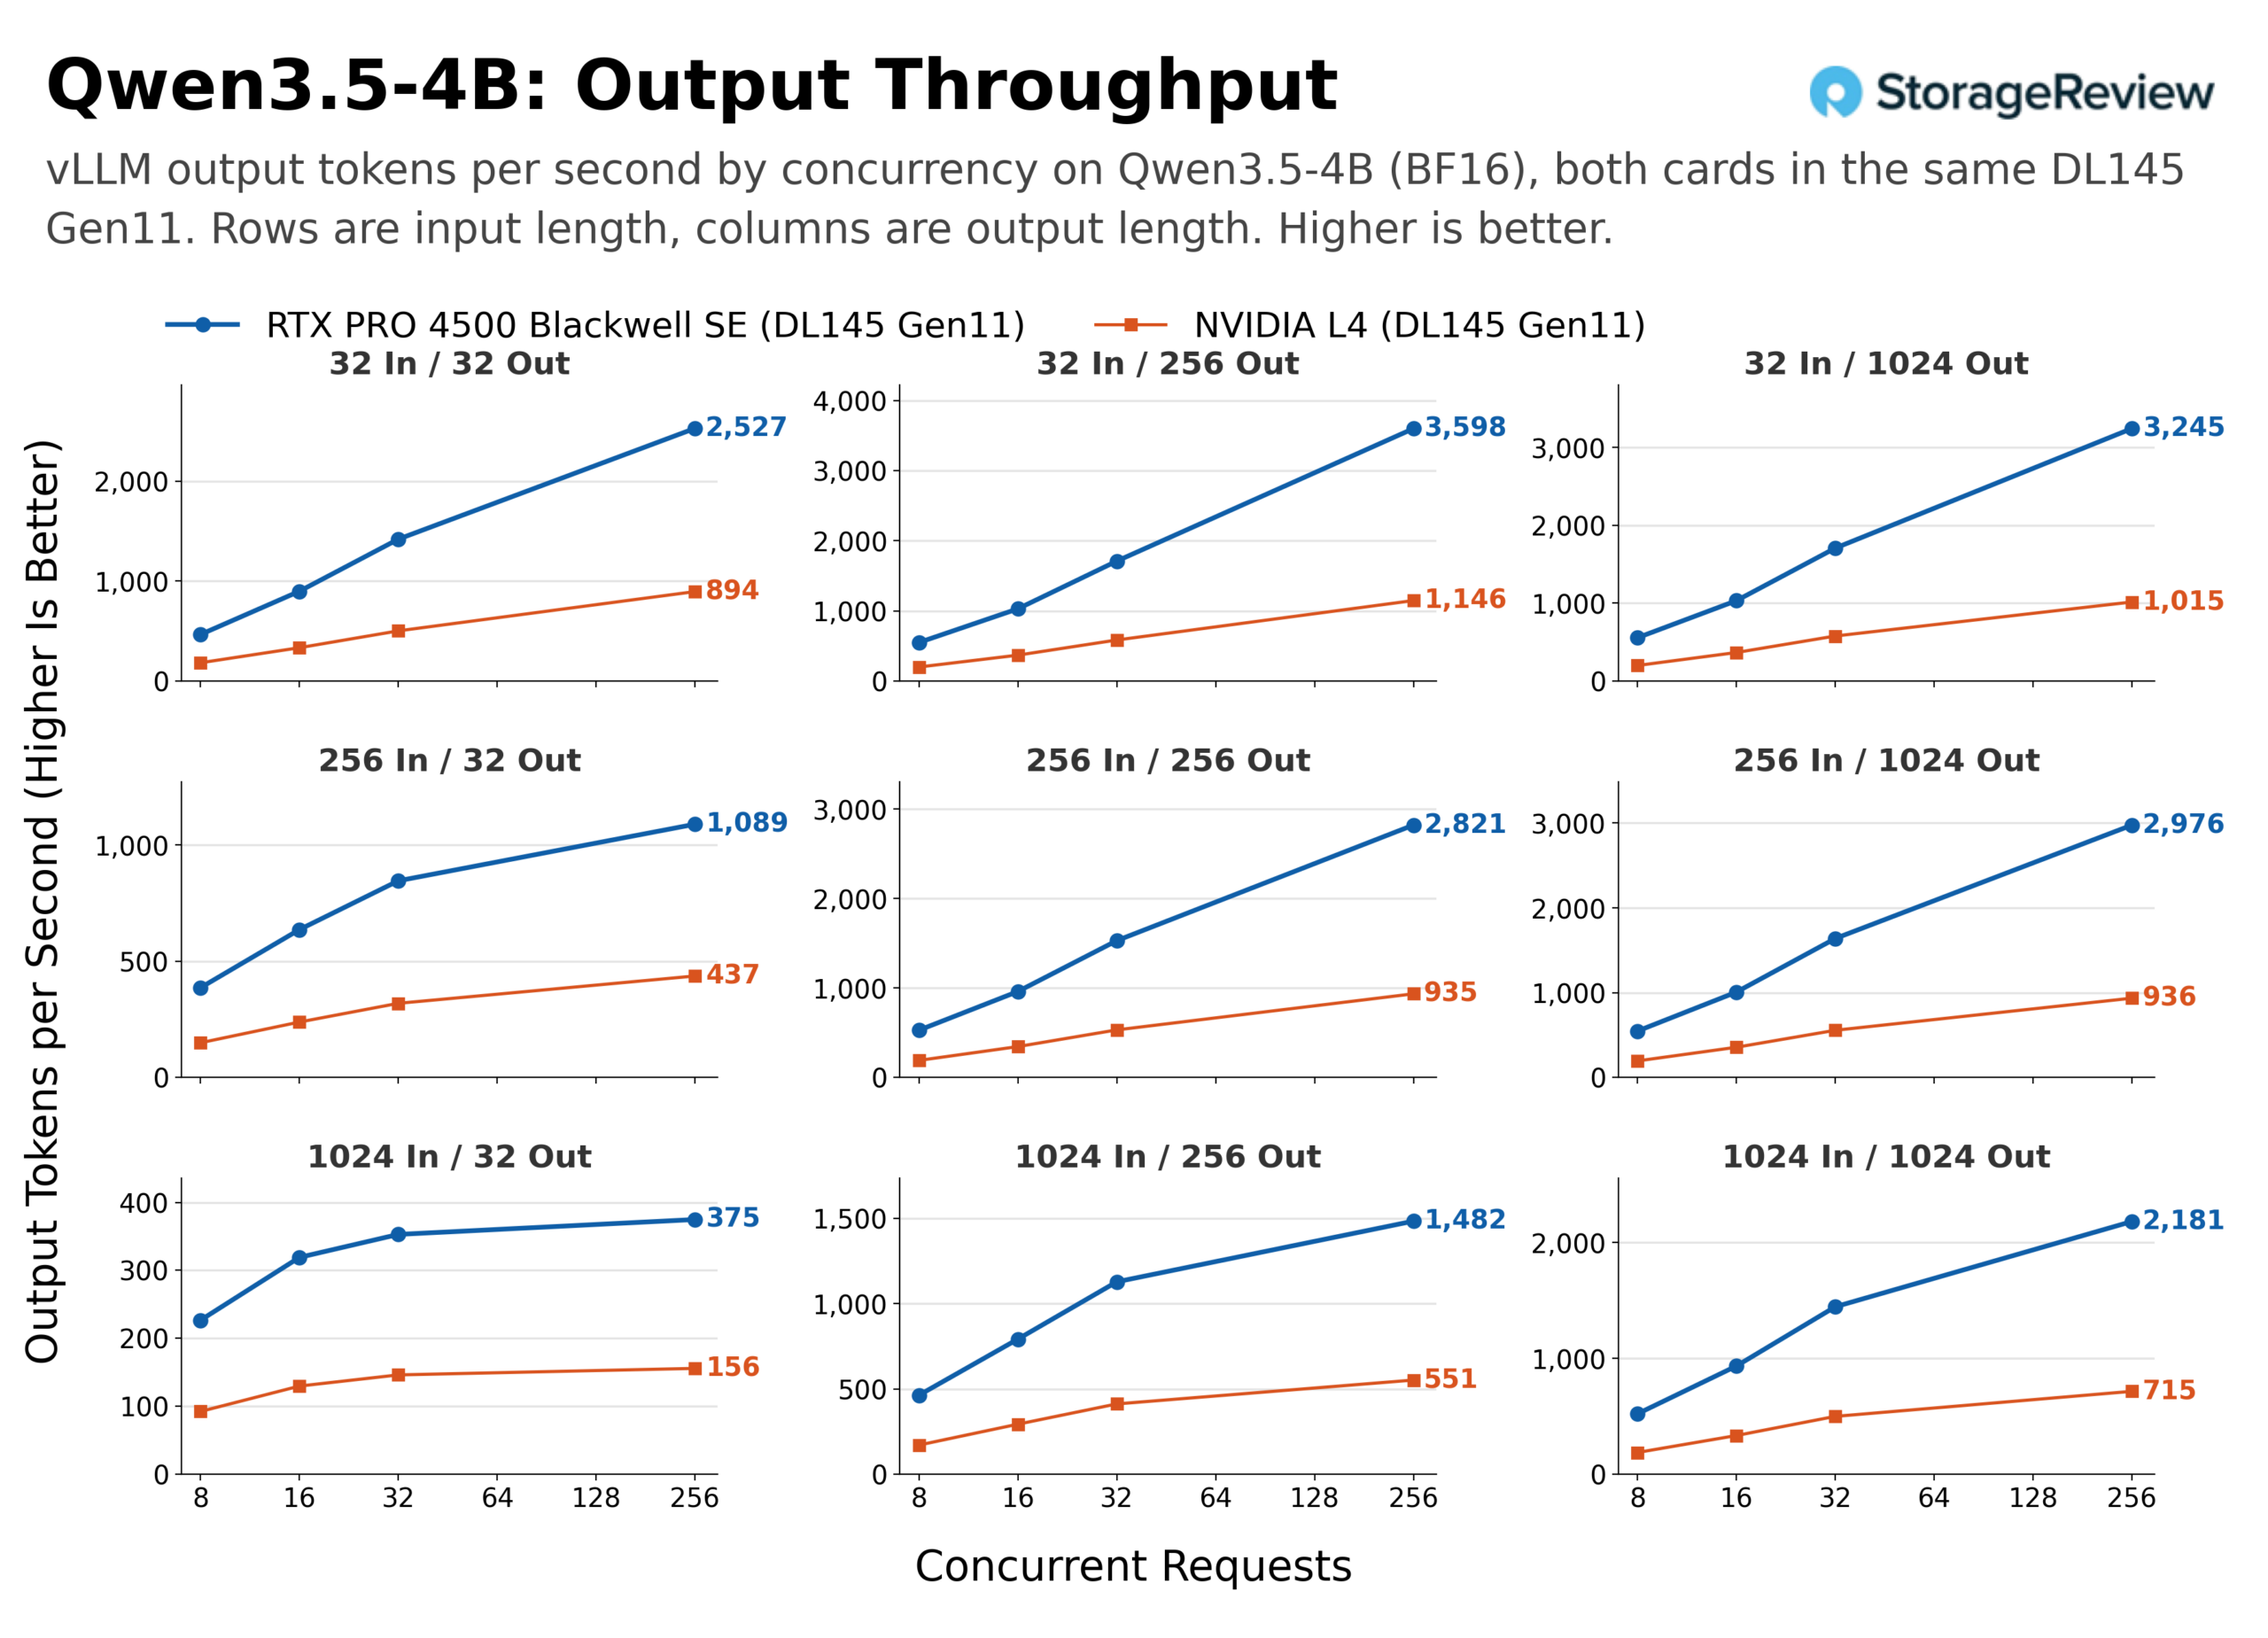
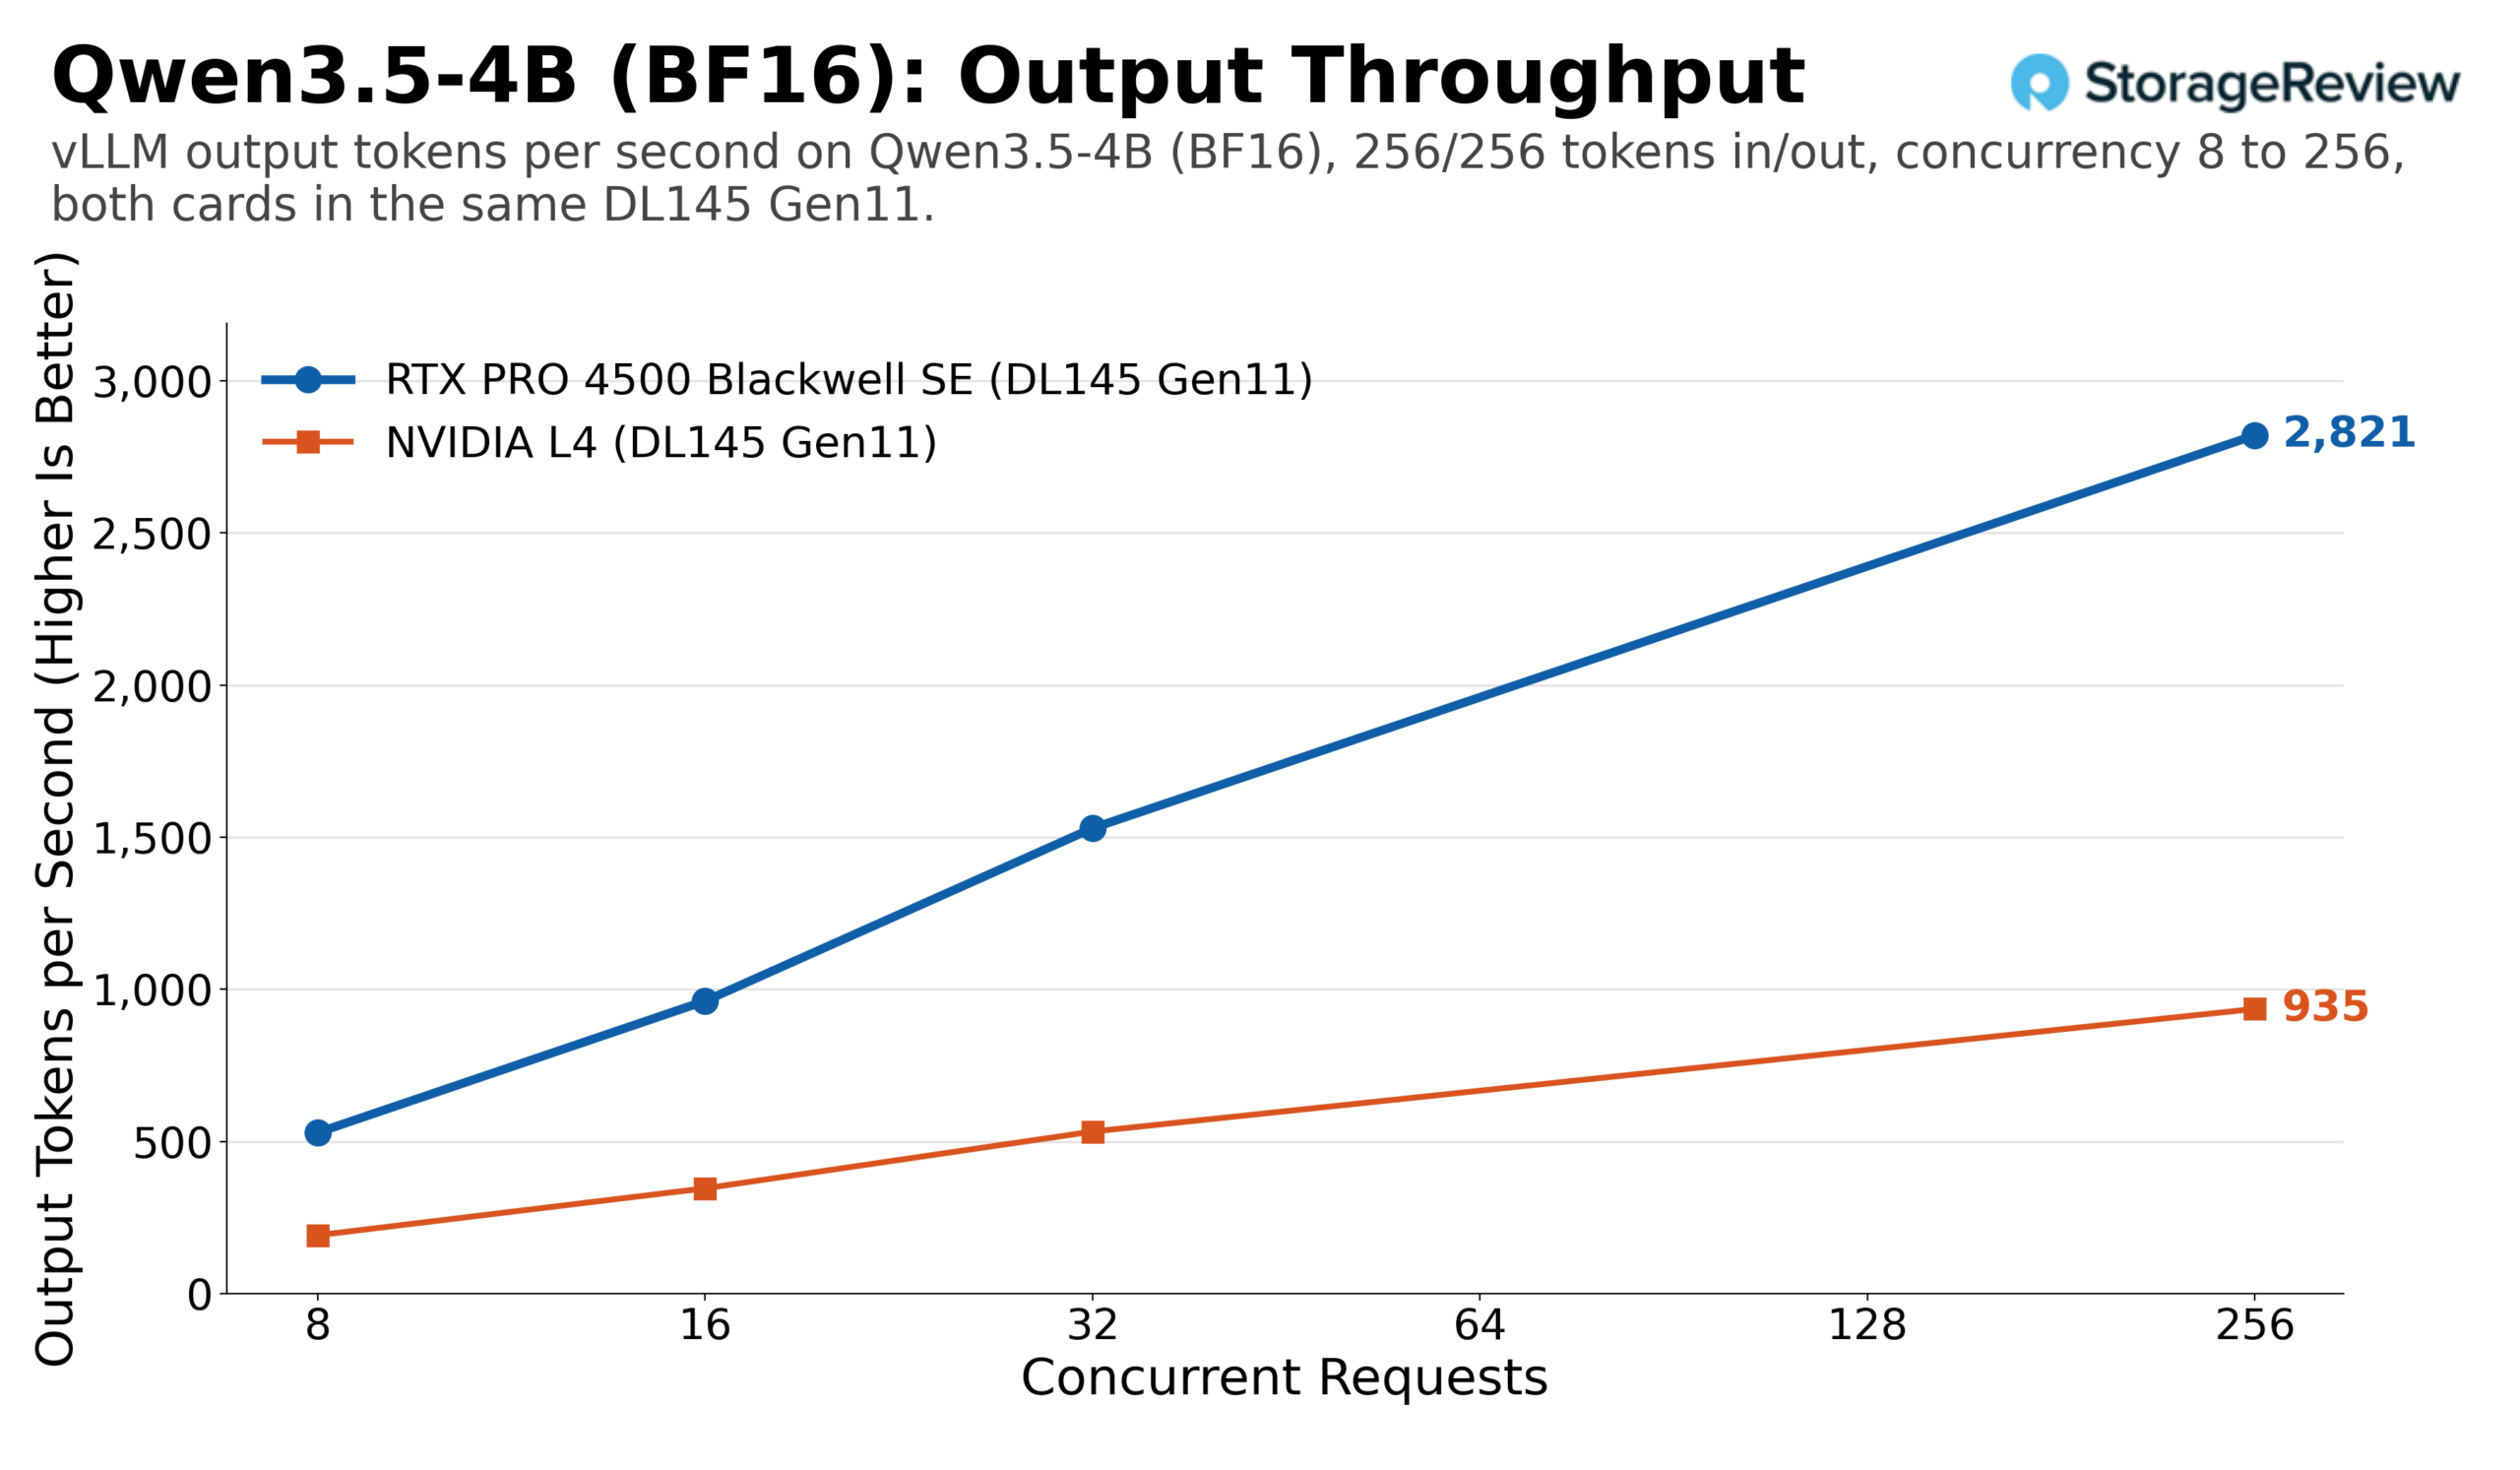
Tomando como referência o formato de 256 entradas e 256 saídas para um chat: com 8 conexões simultâneas, a placa L4 produziu 192 tokens de saída por segundo e a 4500, 529 (2.76x); com 32 conexões simultâneas, 532 contra 1,529 (2.87x); com 256 conexões simultâneas, 935 contra 2,821 (3.02x). O formato mais longo, com 1,024 tokens em cada sentido, segue esse padrão quase exatamente: 499 contra 1,445 com 32 conexões simultâneas e 715 contra 2,181 com 256. A menor diferença em toda a grade ocorre no caso de 1,024 entradas e 32 saídas, com grande volume de pré-preenchimento, onde a 4500 mantém um desempenho estável de 2.4x a partir de 8 conexões simultâneas, porque essa carga de trabalho consiste quase inteiramente em processamento de prompts e ambas as placas têm sua capacidade computacional limitada desde o início. Qwen3.5-4B sobe constantemente nesse formato em ambos os cartões. A única queda simultânea em 16 nas grades BF16 é a Gemma 4 E4B de 4500 pontos em 1,024/32, que apareceu em todas as três repetições; ainda não identificamos a causa.
Para um único usuário, a taxa de transferência subestima a diferença, pois o que uma pessoa vê é a velocidade com que as palavras aparecem. No formato 256/256, o processador 4500 gerou uma mediana de 12.4 ms por token, enquanto o L4 gerou 35.0 ms. Assim, uma resposta de 256 tokens levou cerca de 3.2 segundos no 4500 e 9.0 segundos no L4. Com 1,024 tokens em cada sentido, o tempo foi de 13.1 segundos contra 36.6 segundos. A latência do primeiro token para esse usuário isolado foi de 43 ms no 4500 e 81 ms no L4 para o prompt mais curto, e 99 ms contra 219 ms para o mais longo.
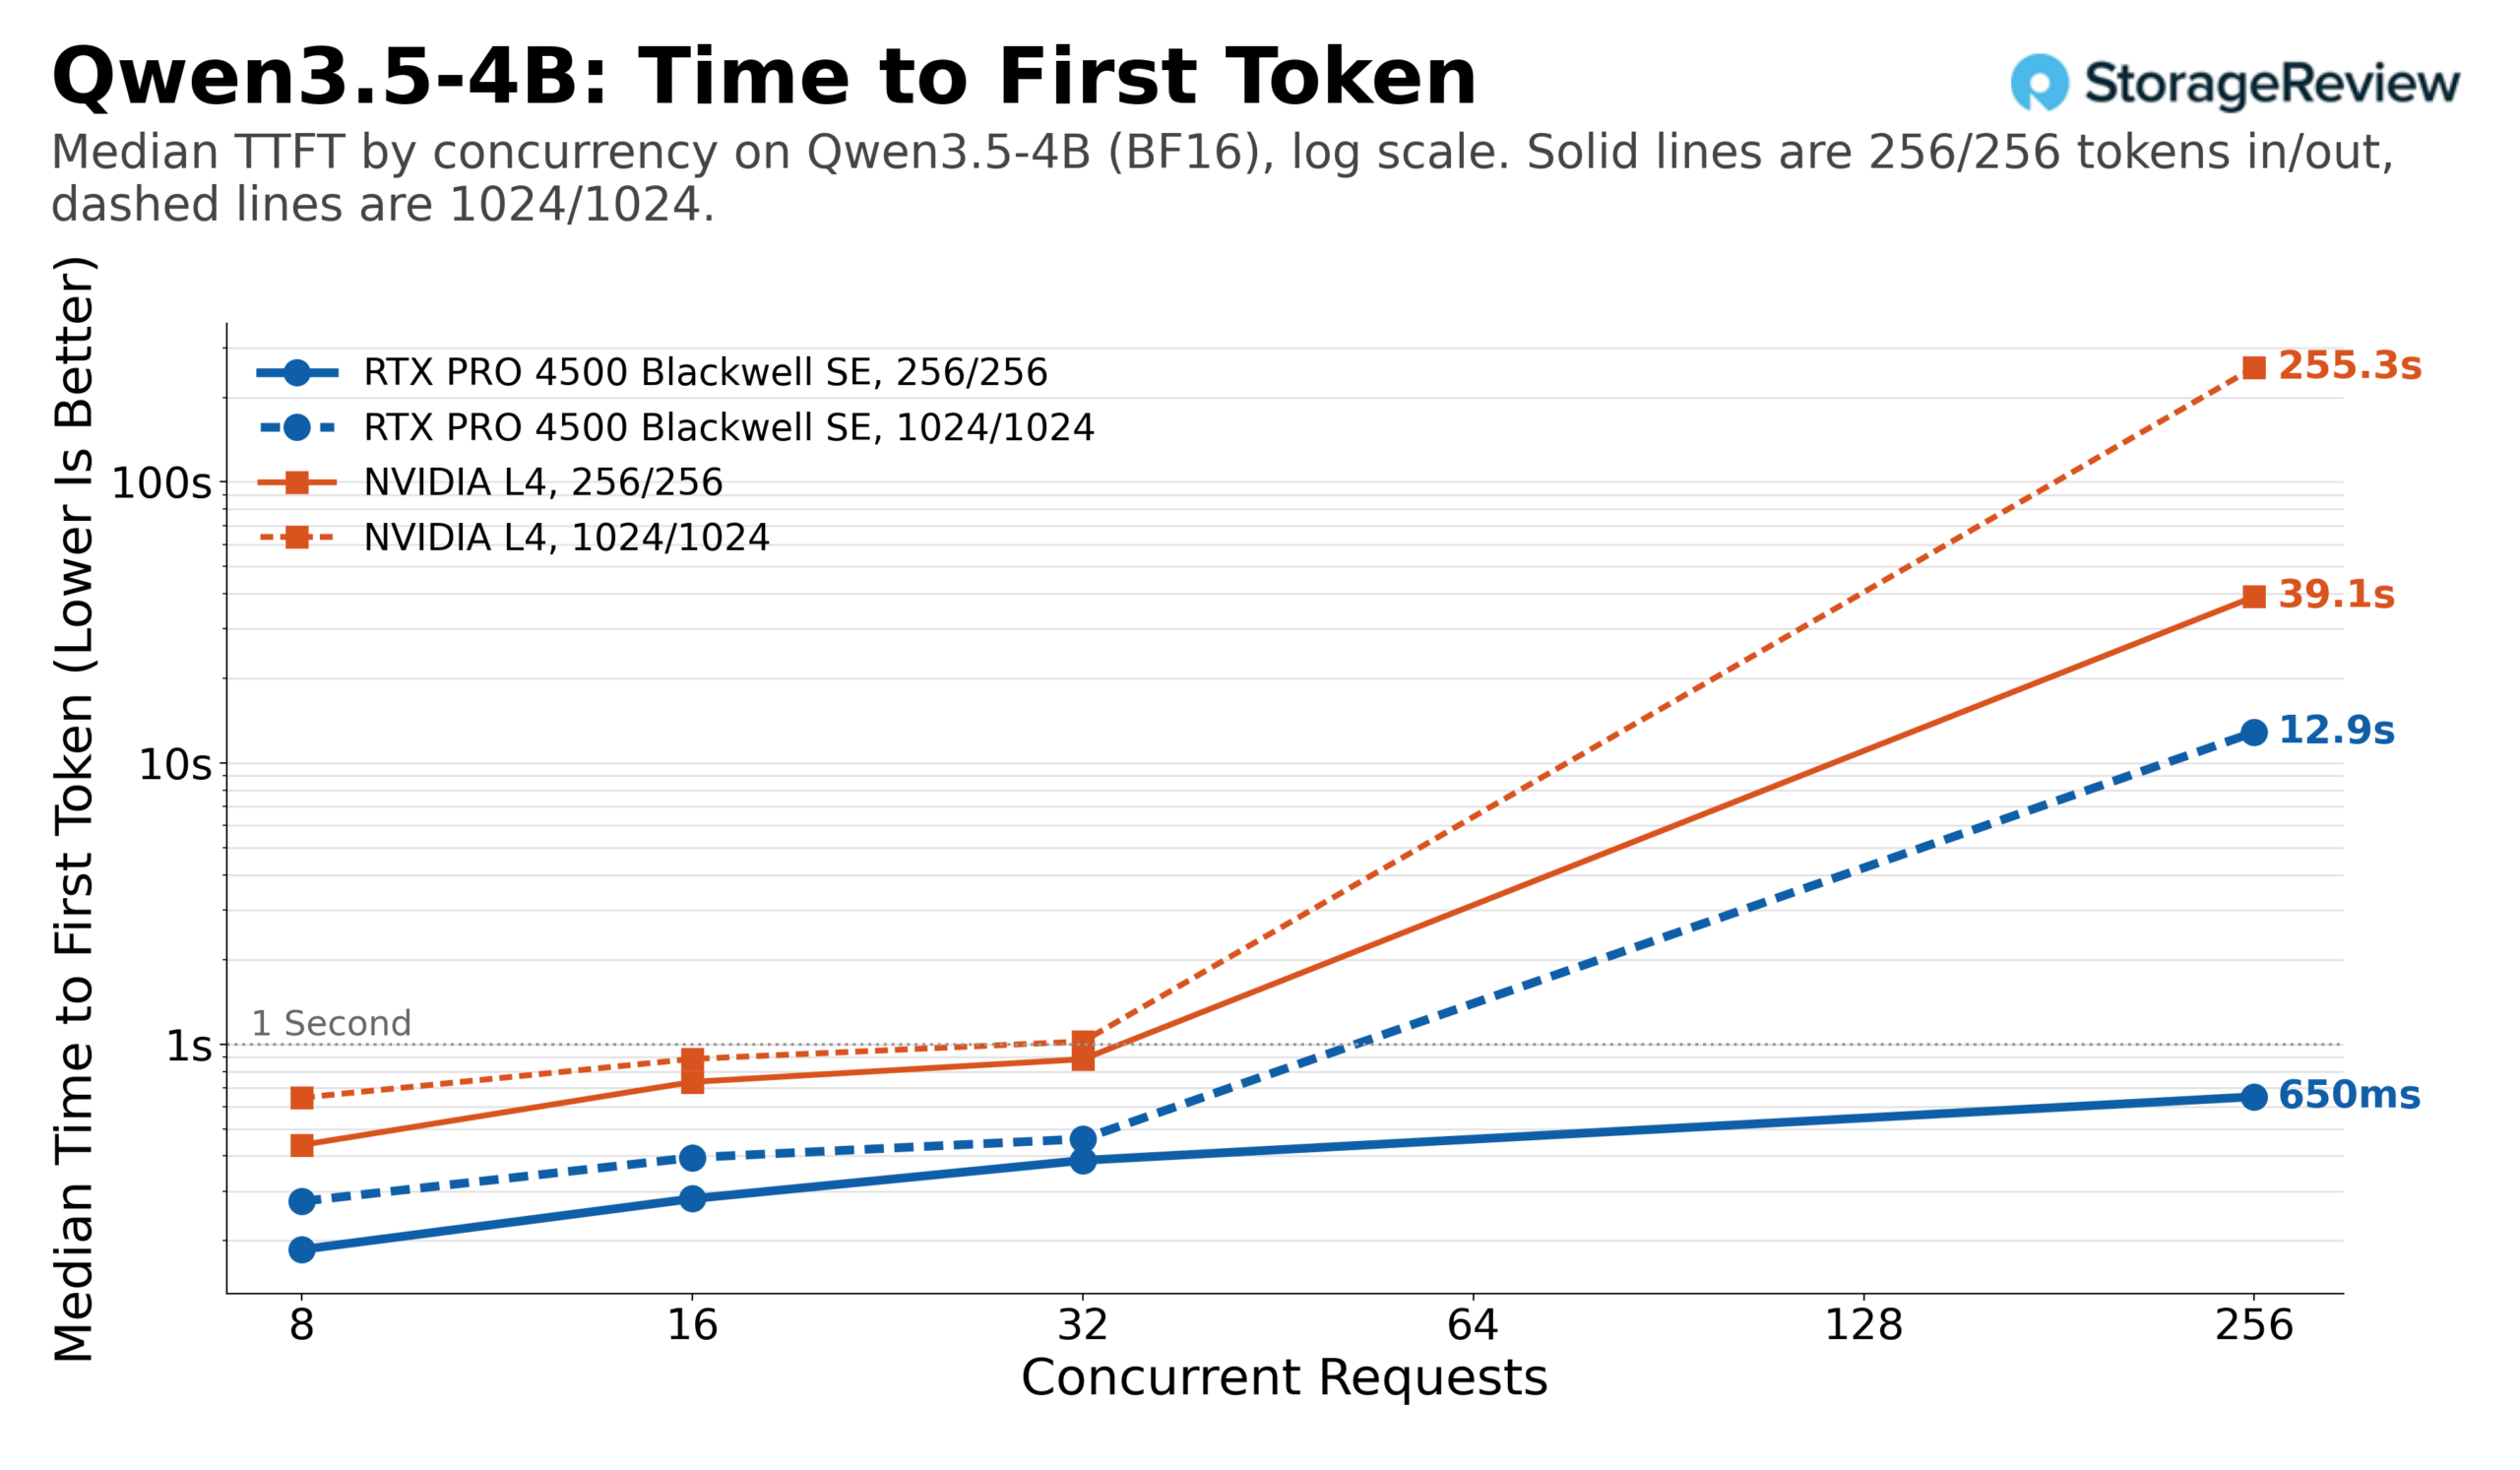
Sob carga, a diferença de latência aumenta: com 32 requisições simultâneas no formato 256/256, o tempo médio para o primeiro token no L4 foi de 884 ms, enquanto no 4500 foi de 386 ms. Com 256 requisições simultâneas, o L4 subiu para 39 segundos, enquanto o 4500 se manteve em 650 ms. No formato 1,024/1,024, o L4 já estava acima de um segundo com 32 requisições simultâneas (1,022 ms) e atingiu 255 segundos com 256, o que significa que uma requisição ficou na fila do vLLM por quatro minutos aguardando a liberação do cache KV. O 4500 ultrapassou a marca de um segundo nesse formato apenas com 256 requisições simultâneas, em 12.9 segundos. No gráfico abaixo, as linhas do L4 saem da área de plotagem entre 32 e 256; Os modelos 4500 mantêm o tempo abaixo de um segundo no percurso mais curto, do início ao fim.
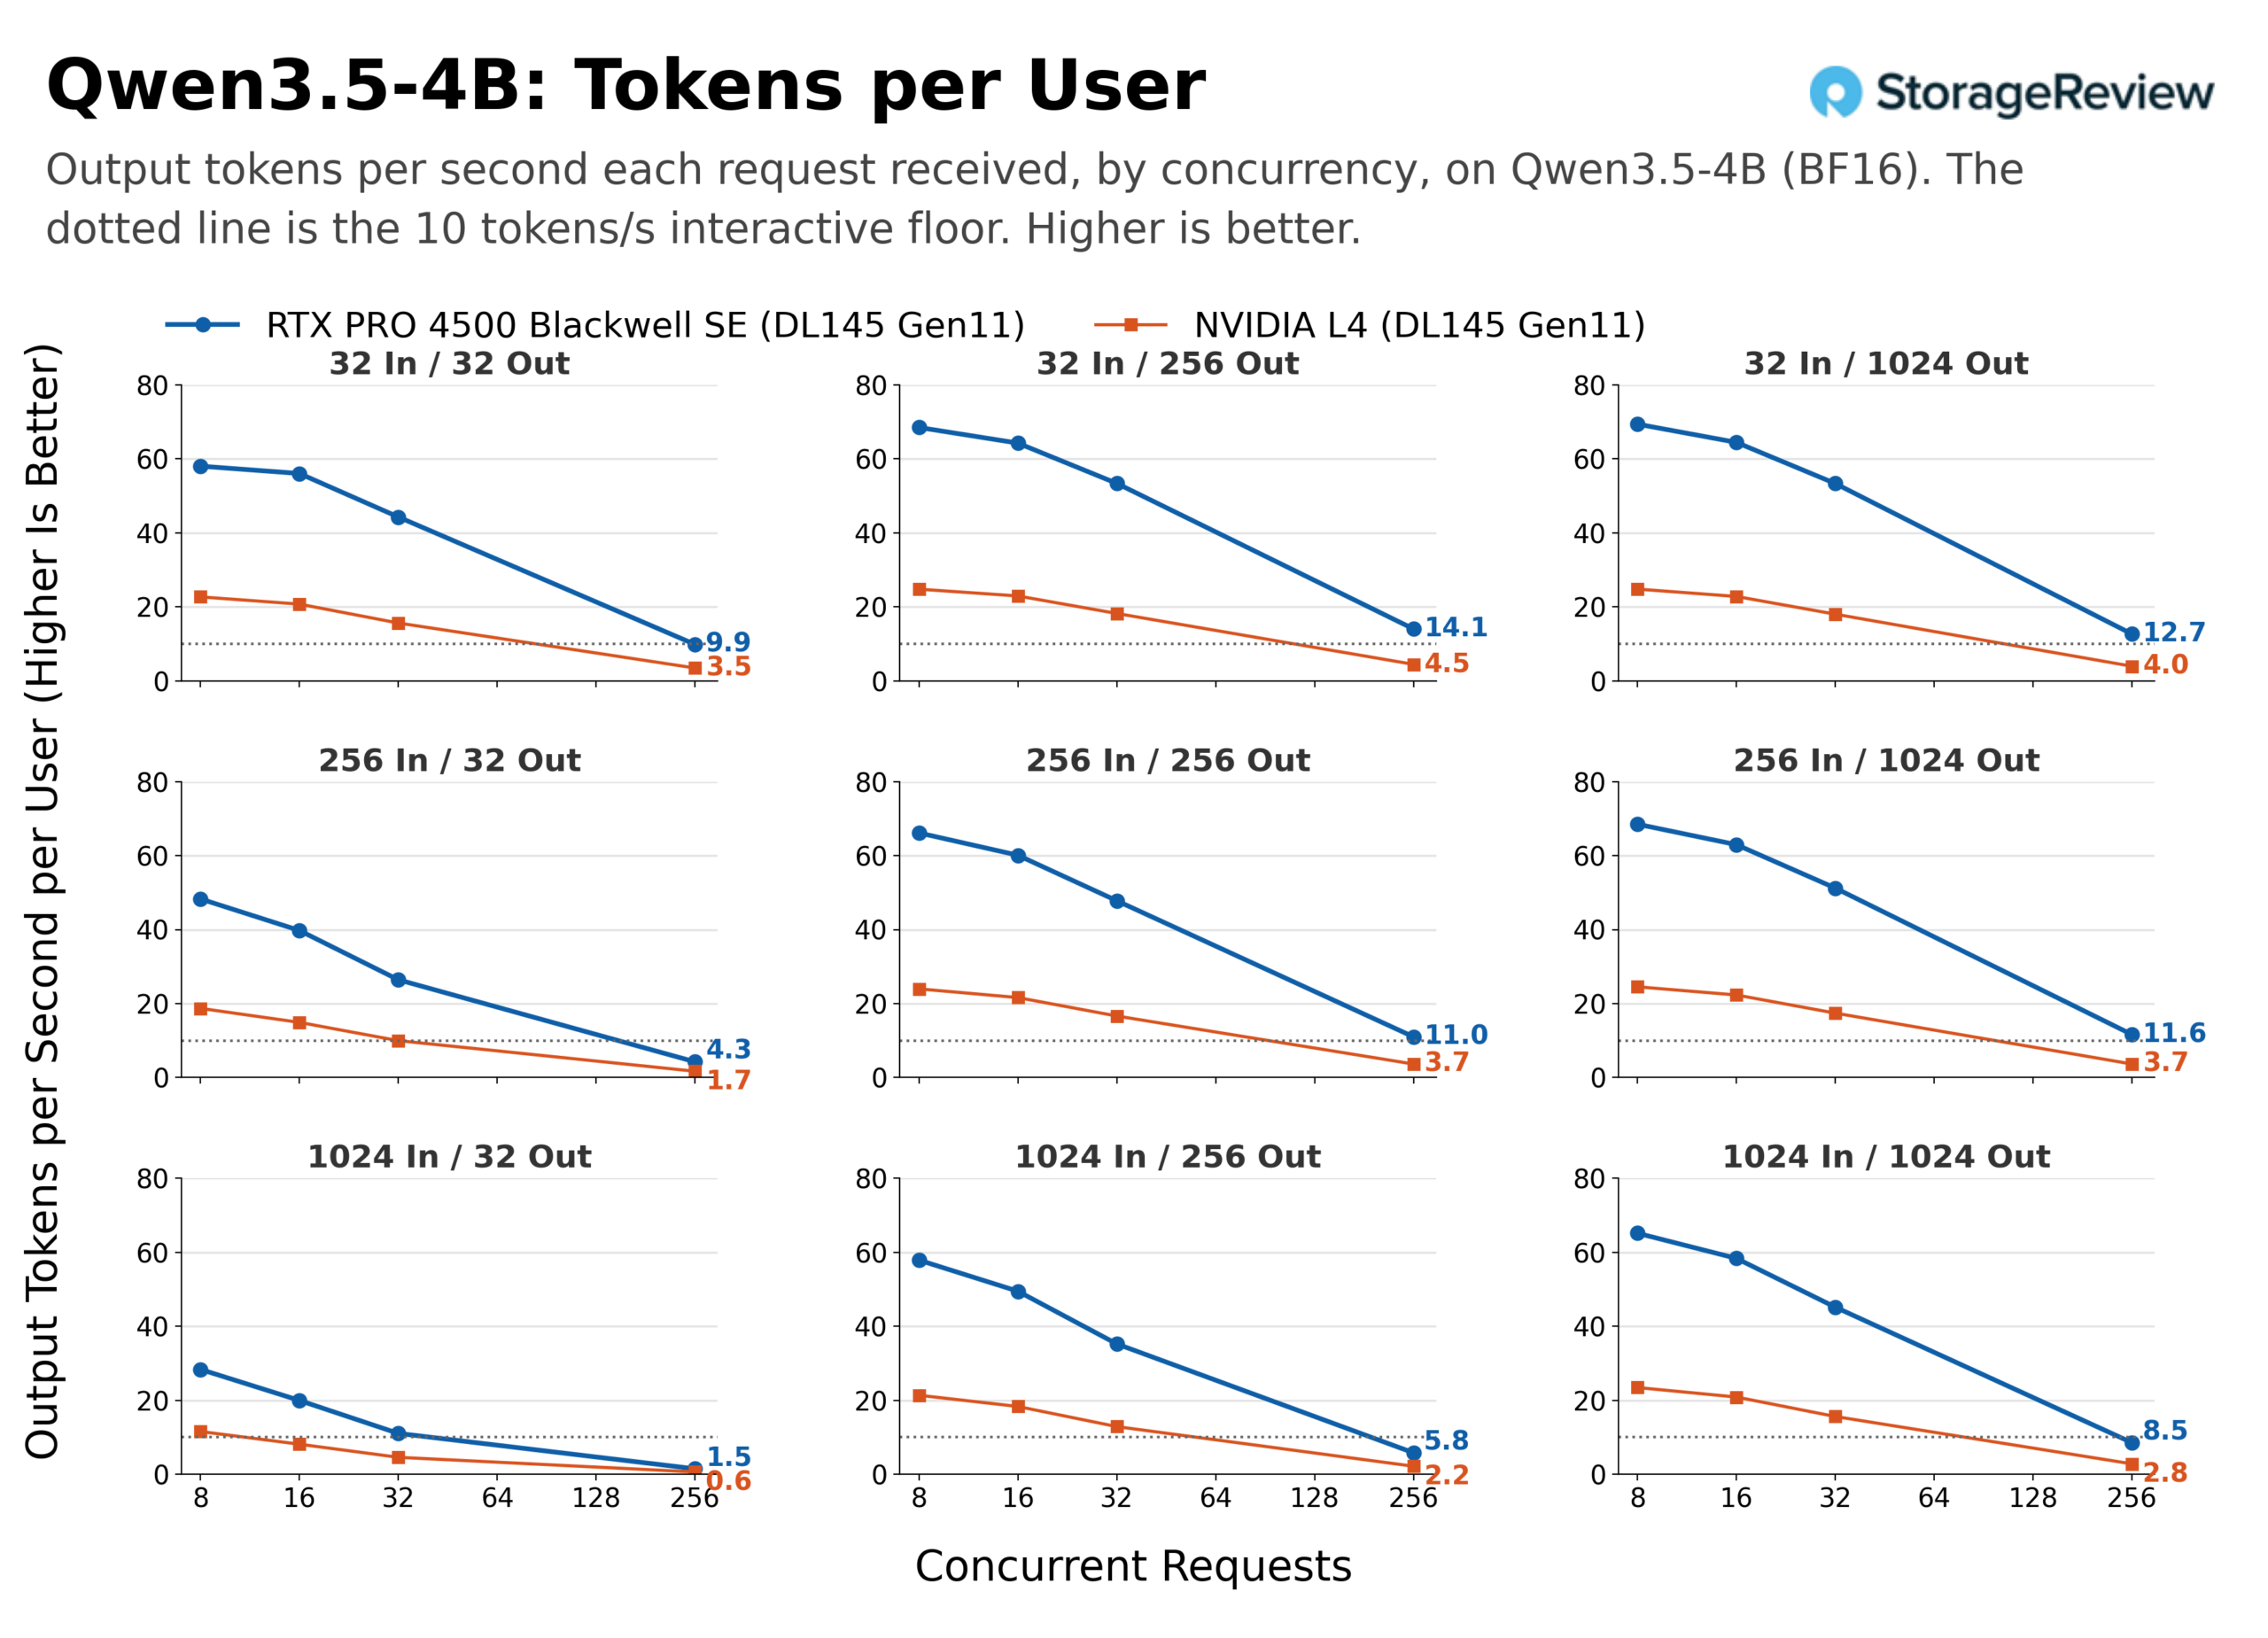
Outra forma de interpretar os mesmos dados é por usuário: tokens de saída por segundo divididos pelo número de requisições simultâneas, que representa a taxa que cada pessoa na fila vê, plotada na tabela abaixo para cada formato em relação a um limite mínimo de 10 tokens por segundo, que serve como um limiar comum para uso interativo. Com 32 requisições simultâneas, o 4500 entrega de 44 a 53 tokens por segundo por usuário em todos os formatos, exceto no de 1,024 entradas e 32 saídas, onde a taxa é de 11, enquanto o L4 fica entre 10 e 18 e já caiu para 4.6 nesse mesmo formato. Com 256 concorrentes, o L4500 permanece acima do limite inferior nas quatro combinações em formato de chat (14.1 em 32/256, 12.7 em 32/1,024, 11.0 em 256/256 e 11.6 em 256/1,024), atinge o limite inferior em 9.9 em 32/32 e fica abaixo dele nos prompts de 1,024 tokens e nos formatos de resposta curta, chegando a 1.5 em 1,024/32, onde quase todo o trabalho é de preenchimento prévio. O L4 fica abaixo do limite inferior em todos os formatos com 256 concorrentes, entre 0.6 e 4.5. Nada foi testado entre 32 e 256 concorrentes, então o ponto em que cada linha cruza o limite inferior pontilhado fica em algum lugar entre essas duas concorrências; O que o gráfico mostra é que a intersecção do L4 ocorre bem antes do 256 em todas as formas, e a do 4500 ocorre no 256 ou próximo a ele nas formas do chat.
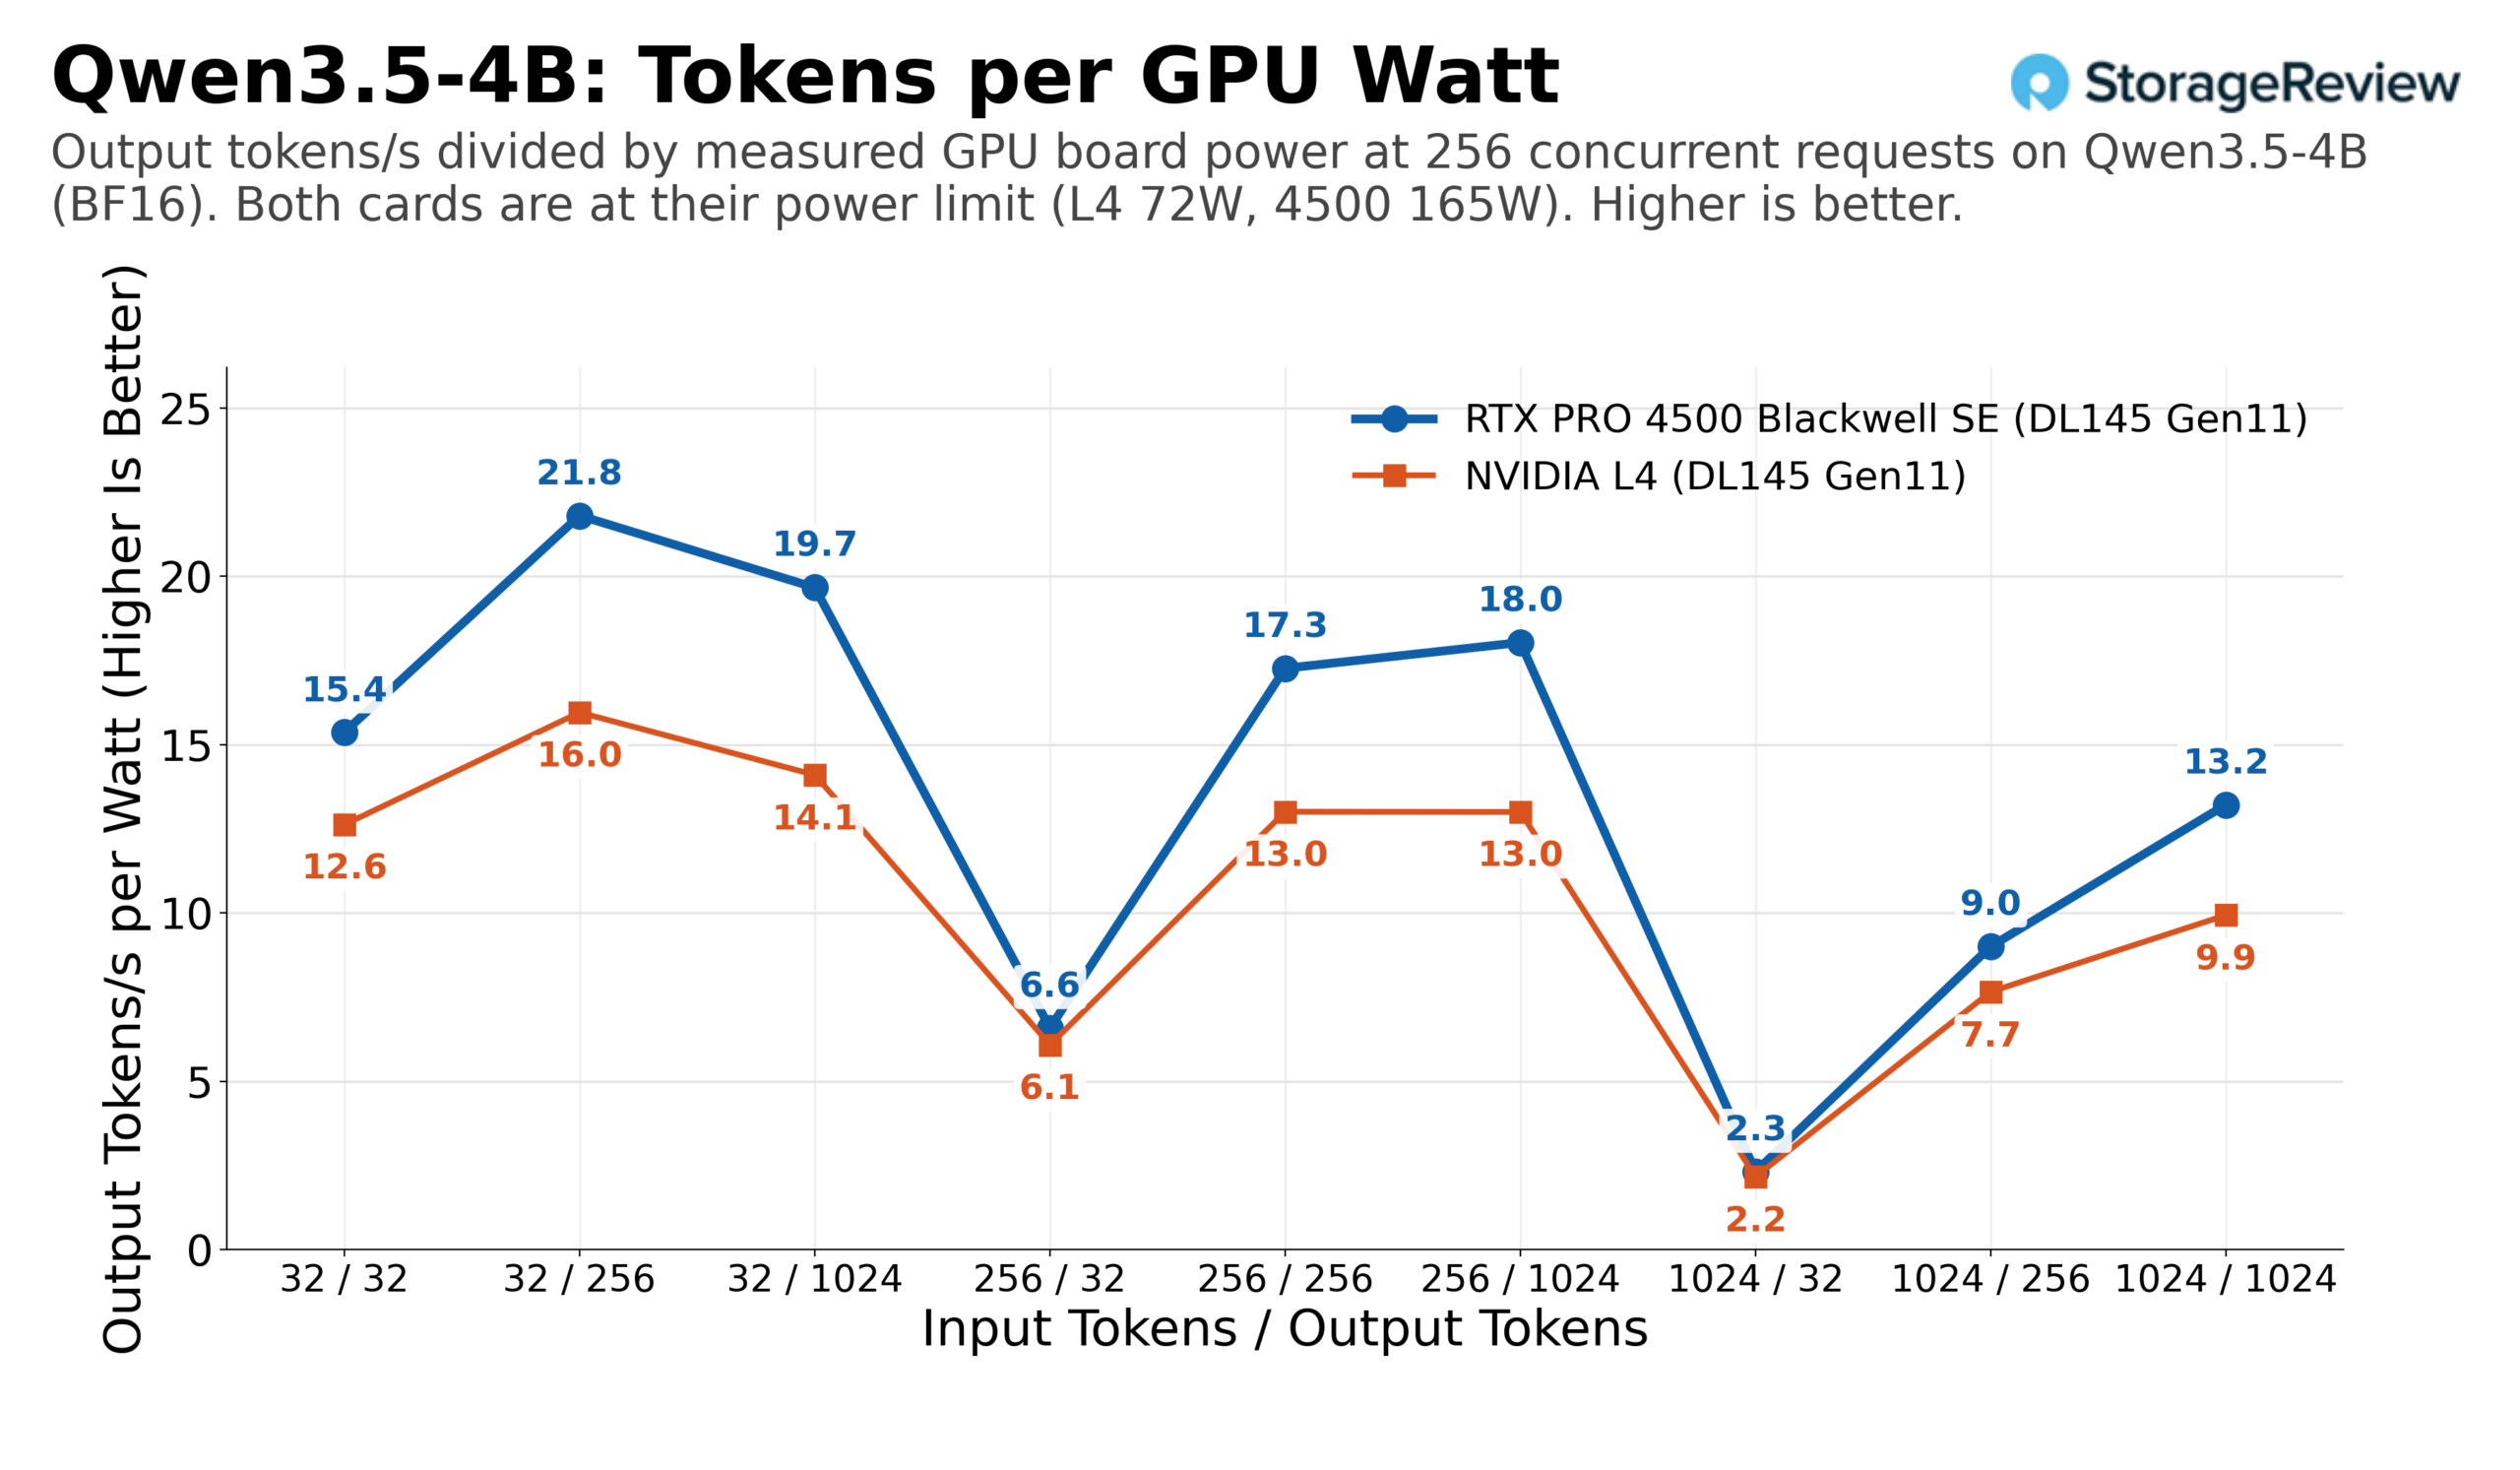
Ambas as placas operaram próximas ou no limite de consumo de energia da placa, 72W para a L4 e 165W para a 4500, na maioria dos formatos a partir de 16 operações simultâneas. Os formatos com menor número de tokens por watt apresentaram consumo menor, como 125W na 4500 para Qwen3.5-4B 32/32 com 32 operações simultâneas, portanto, a quantidade de tokens por watt da GPU acompanha de perto a taxa de transferência. Com 256 operações simultâneas, a 4500 produziu uma mediana de 1.33 vezes mais tokens por watt do que a L4 nos nove formatos testados, variando de 1.07 vezes no caso de 1,024/32 com limite de preenchimento a 1.39 vezes em 256/1,024. Multiplicando isso pela diferença de consumo de energia de 2.3 vezes, obtém-se uma vantagem de 3 vezes na taxa de transferência, com os 1.33 vezes provenientes da arquitetura Blackwell, que realiza mais operações por watt, e os 2.3 vezes da 4500, que consome mais watts.
Gemma 4 E4B
Gemma 4 E4B é o membro menor da família Gemma 4 do Google, onde o "E" representa os parâmetros efetivos de 4B. Seu comportamento é semelhante ao da Qwen3.5-4B em ambas as placas, com uma escalabilidade ligeiramente melhor no topo da grade. A taxa de transferência mediana com 8 a 32 conexões simultâneas é de 2.67x (variando de 2.31x a 3.07x), e com 256 conexões simultâneas é de 3.20x, com a configuração 1,024/1,024 atingindo 3.82x devido ao cache L4 estar muito próximo do seu limite de KV.
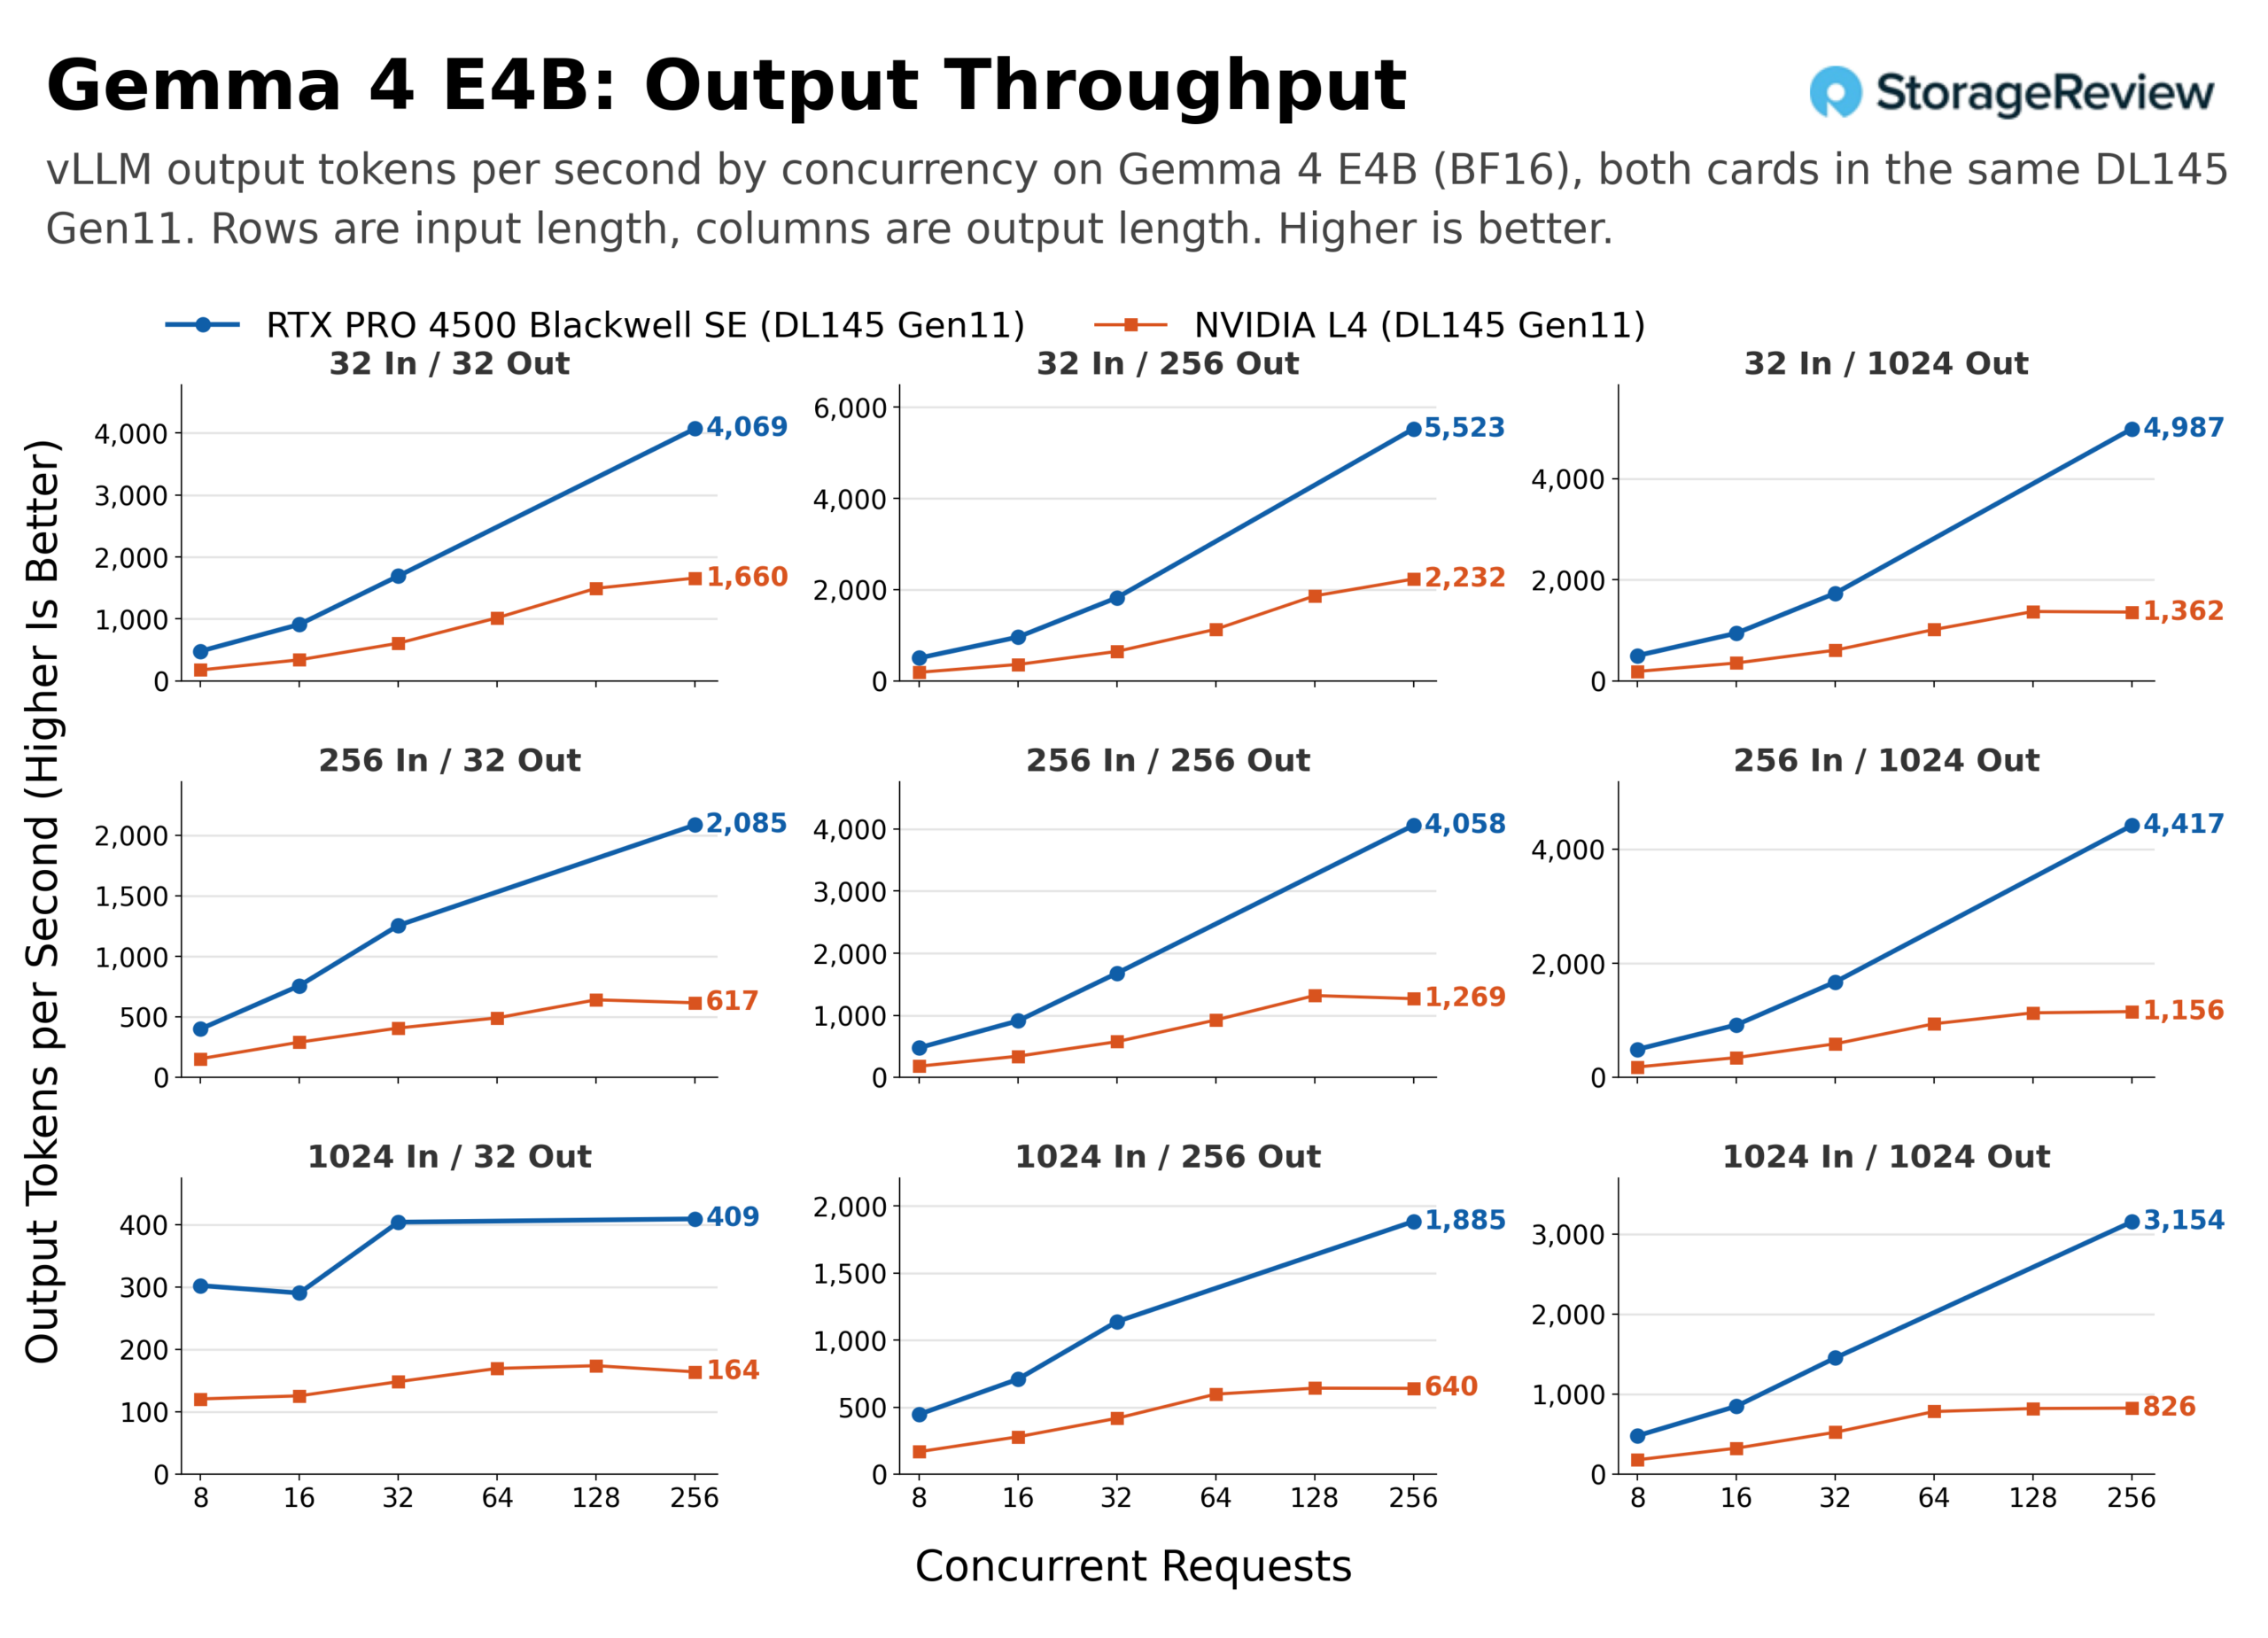
Na configuração 256/256, o L4 produziu 183 tokens de saída por segundo com 8 sessões simultâneas, 577 com 32 e 1,269 com 256; o 4500 produziu 479, 1,678 e 4,058. Na configuração 1,024/1,024, o L4 apresentou 180, 524 e 826, enquanto o 4500 apresentou 480, 1,454 e 3,154. O desempenho do 4500 com 256 sessões simultâneas na configuração longa é 3.8 vezes maior que o do L4, e a razão para isso é visível na curva do L4: ele adicionou apenas 302 tokens por segundo ao passar de 32 para 256 sessões simultâneas, porque não tinha memória disponível para adicionar novas sessões.
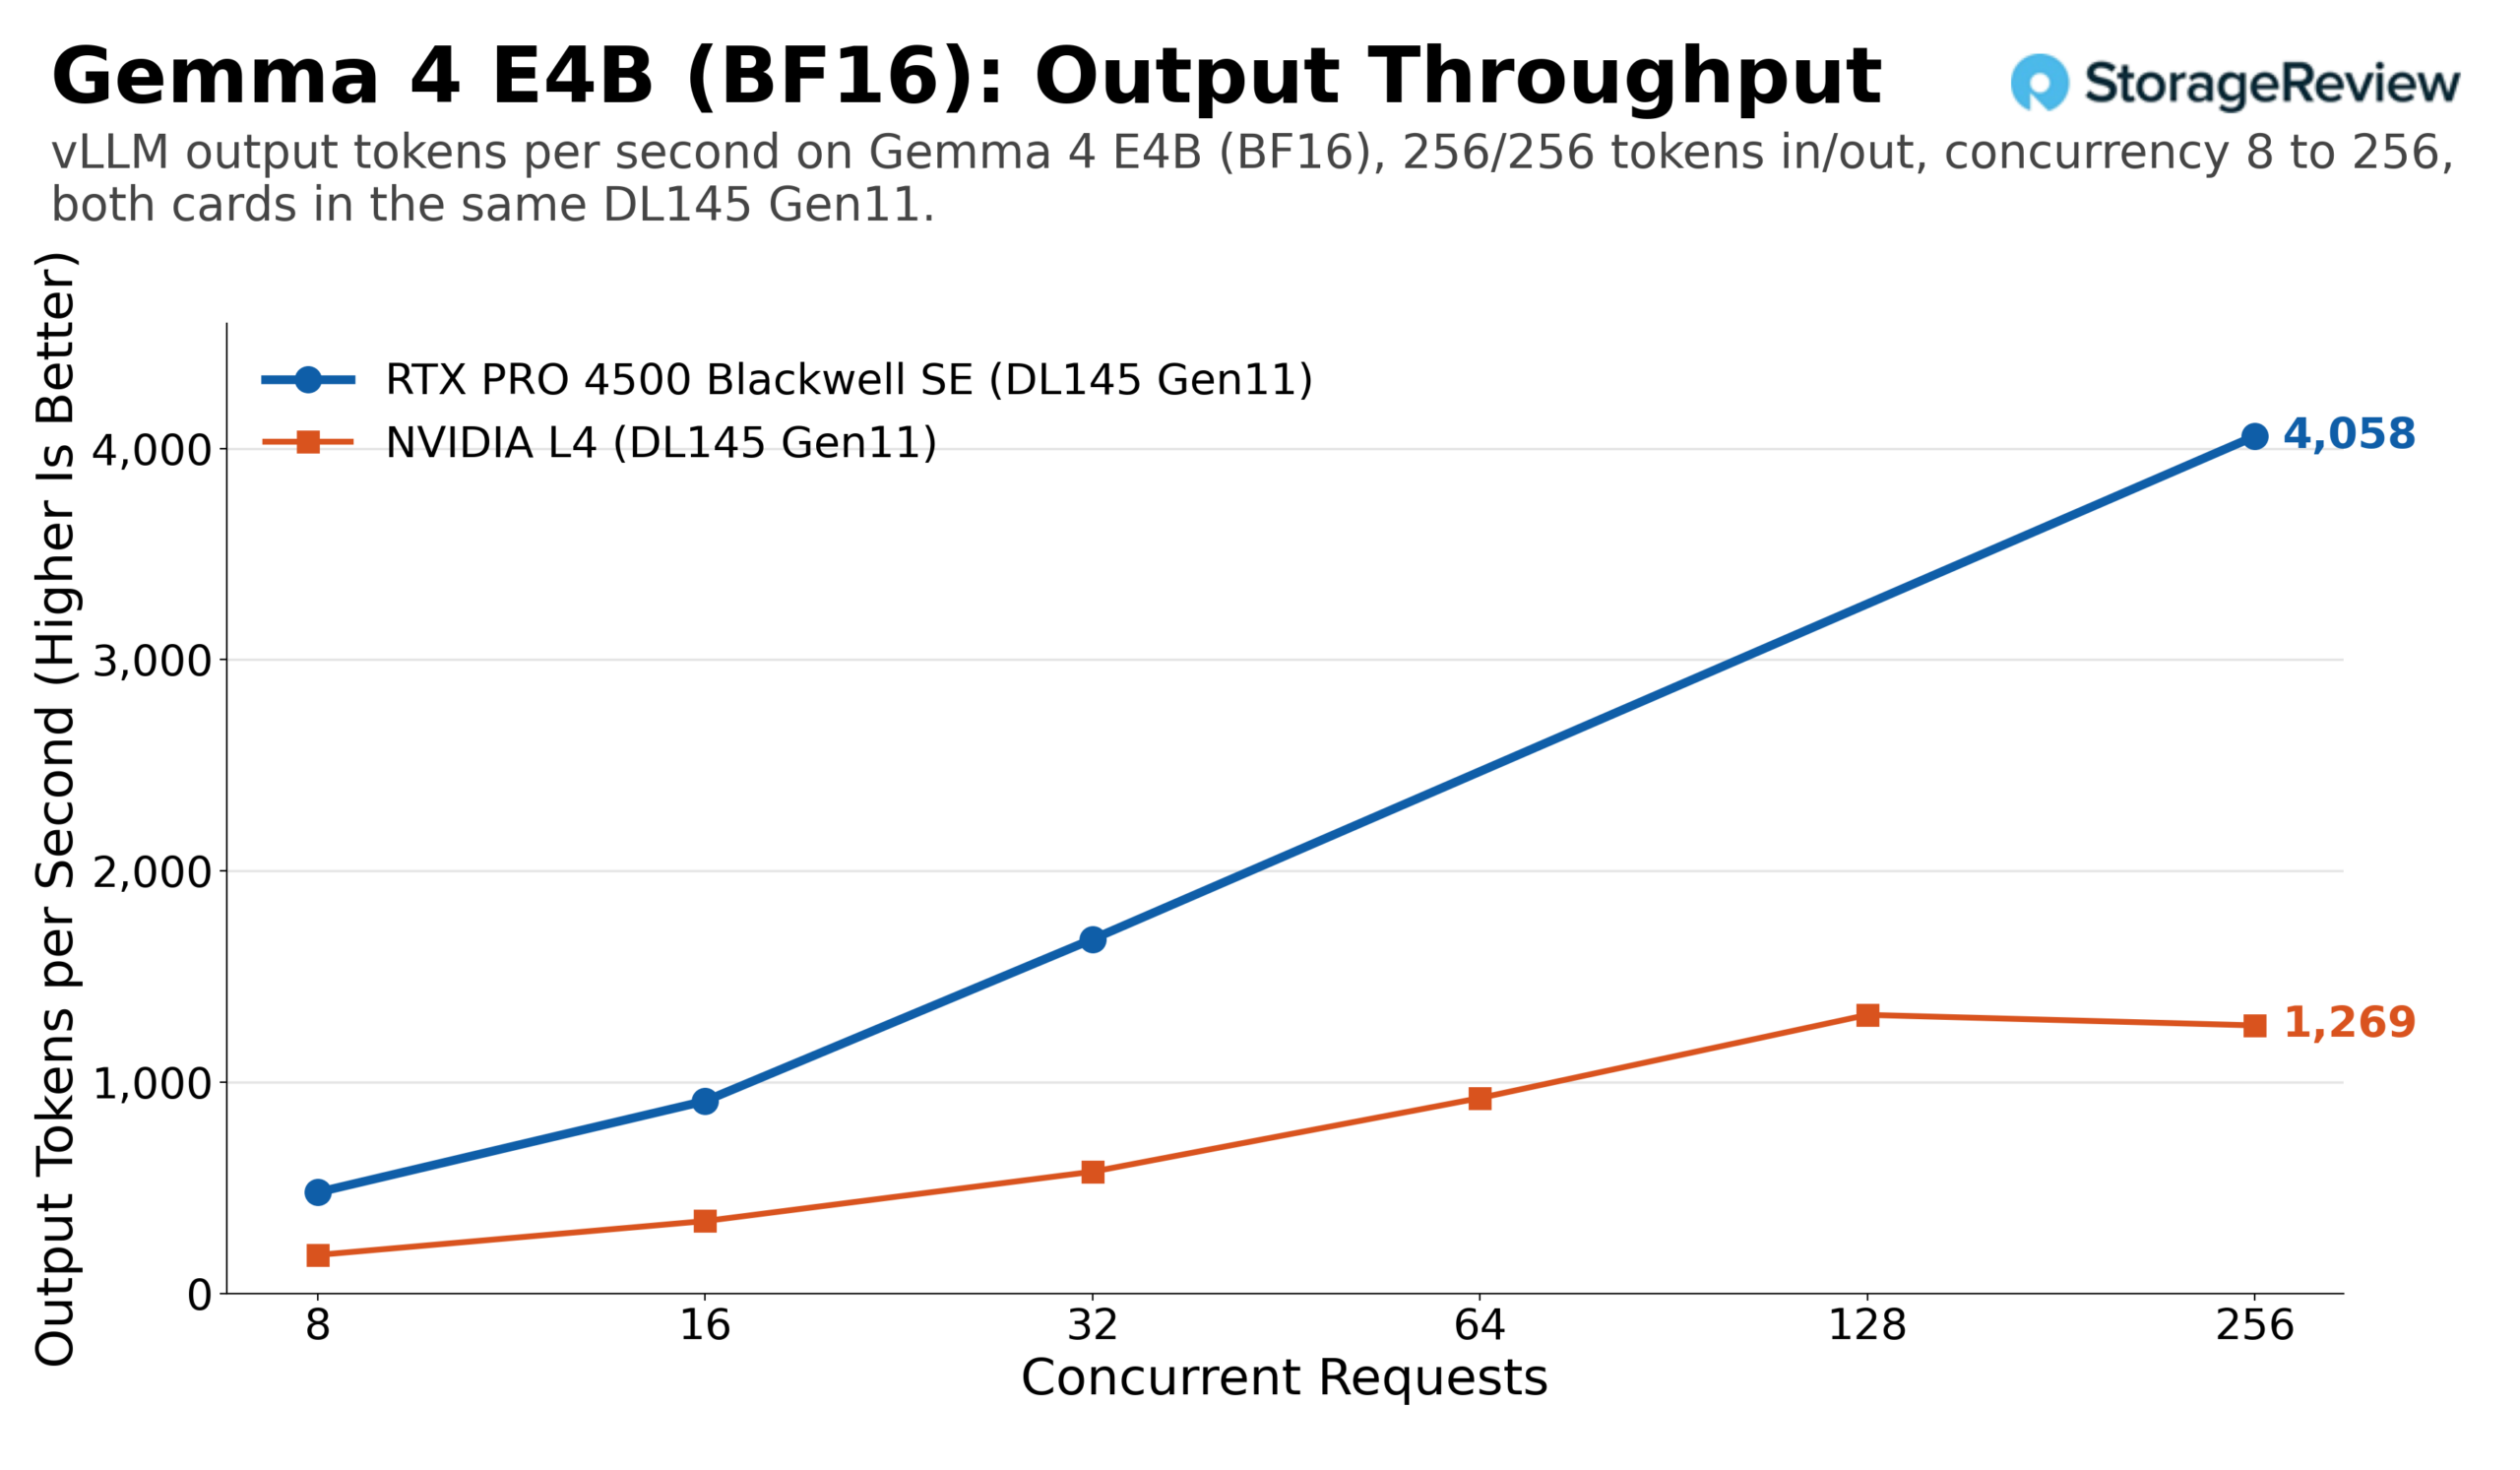
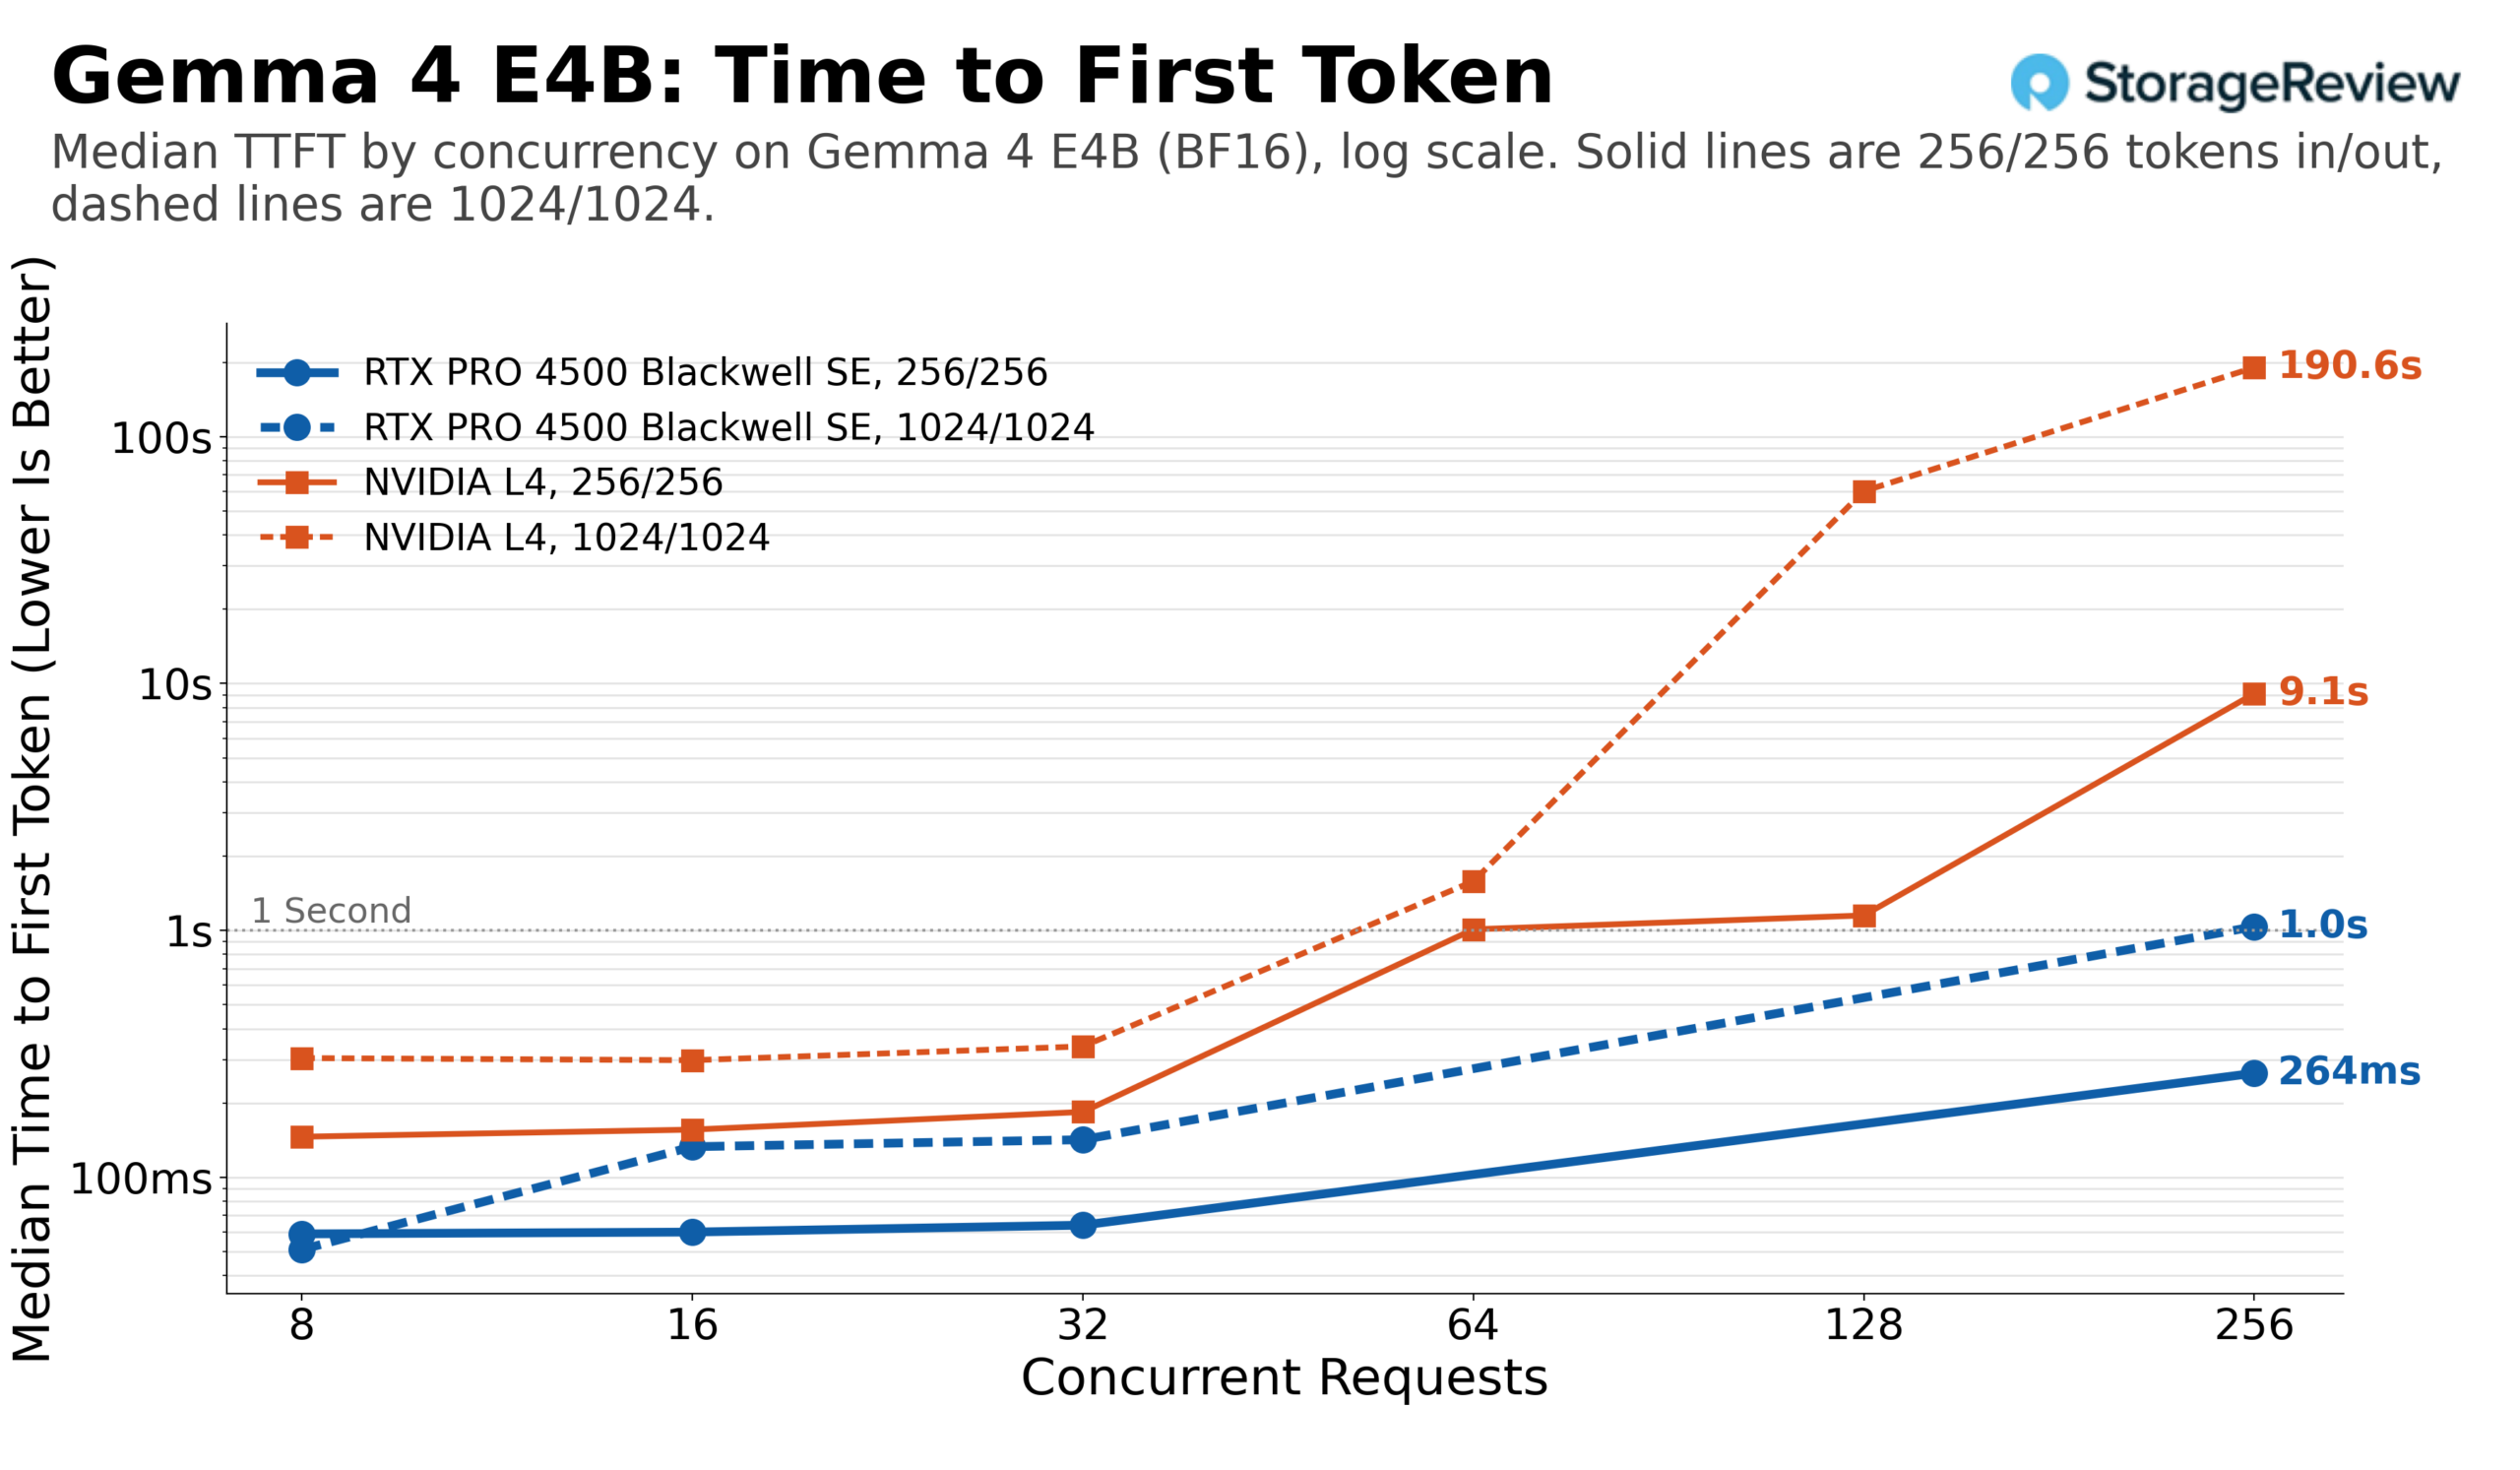
Como o trabalho Gemma 4 do L4 incluía 64 e 128 processos simultâneos, este modelo mostra exatamente onde o L4 apresenta limitações. Seu tempo mediano para o primeiro token no formato 256/256 foi de 184 ms com 32 processos simultâneos, pouco mais de um segundo com 64 e 9.1 segundos com 256. No formato 1,024/1,024, foi de 339 ms com 32 processos simultâneos, mais de um segundo com 64, 60 segundos com 128 e 191 segundos com 256. O 4500 manteve-se em 64 ms com 32 processos simultâneos e 264 ms com 256 no formato mais curto, e no formato mais longo foi de 142 ms com 32 e ultrapassou um segundo apenas com 256, atingindo 1,036 ms. Assim, para Gemma 4 E4B em prompts de chat, o L4 neste servidor é uma placa de 32 a 64 sessões, e o 4500 é uma placa de 256 sessões com latência de sobra.
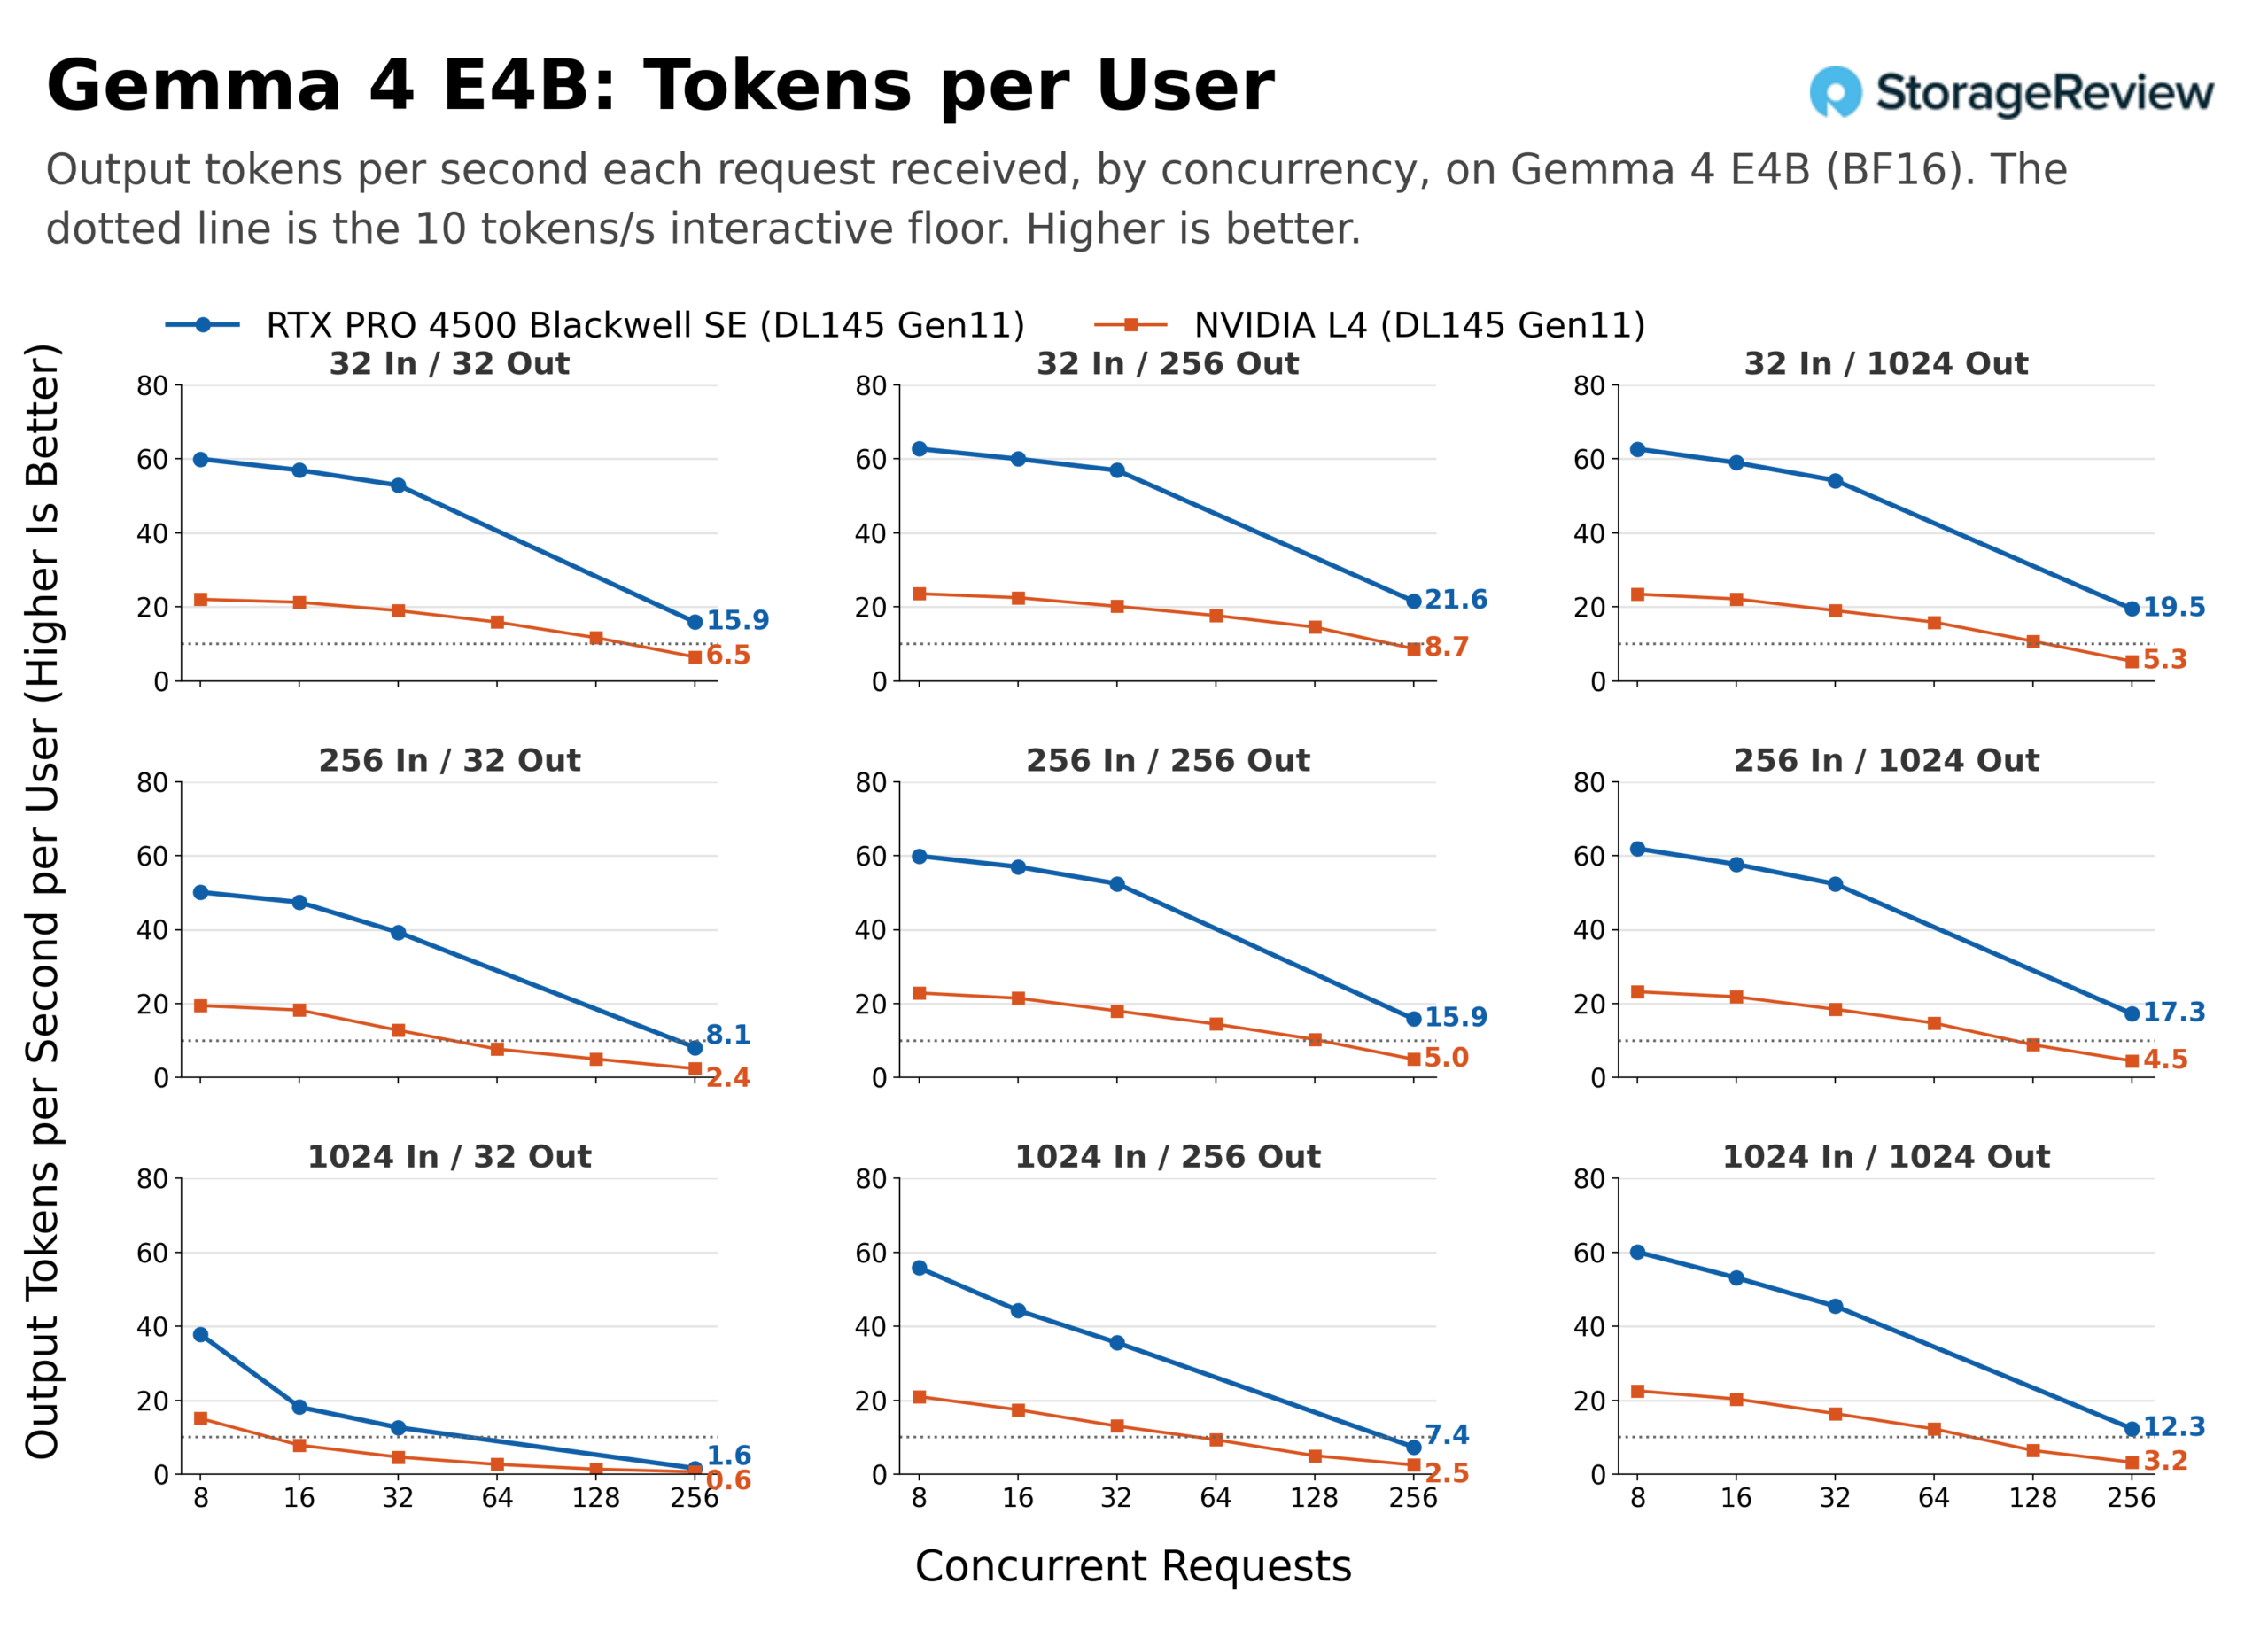
A visualização por usuário, com os pontos 64 e 128 do L4 preenchidos, mostra onde ele cruza o limite inferior. Em 256/256, o L4 entrega 18.0 tokens por segundo por usuário com 32 usuários simultâneos, 14.5 com 64, 10.3 com 128 e 5.0 com 256, portanto, ele cruza o limite inferior de 10 tokens por segundo entre 128 e 256 nesse formato. Em 256/1,024, ele está em 8.9 com 128, e nos formatos de resposta curta e de 1,024 entradas, ele está abaixo do limite inferior em 64 (7.7 em 256/32, 9.3 em 1,024/256). O modelo 4500 apresenta uma taxa de 52 a 57 entradas por usuário nos formatos de chat com 32 usuários simultâneos e permanece acima do limite mínimo de 256 em seis dos nove formatos (15.9 a 21.6 nos formatos de 32 e 256 entradas, exceto 256/32, e 12.3 em 1,024/1,024), ficando abaixo desse limite apenas nos três formatos de resposta curta e pergunta longa (8.1 em 256/32, 7.4 em 1,024/256 e 1.6 em 1,024/32).
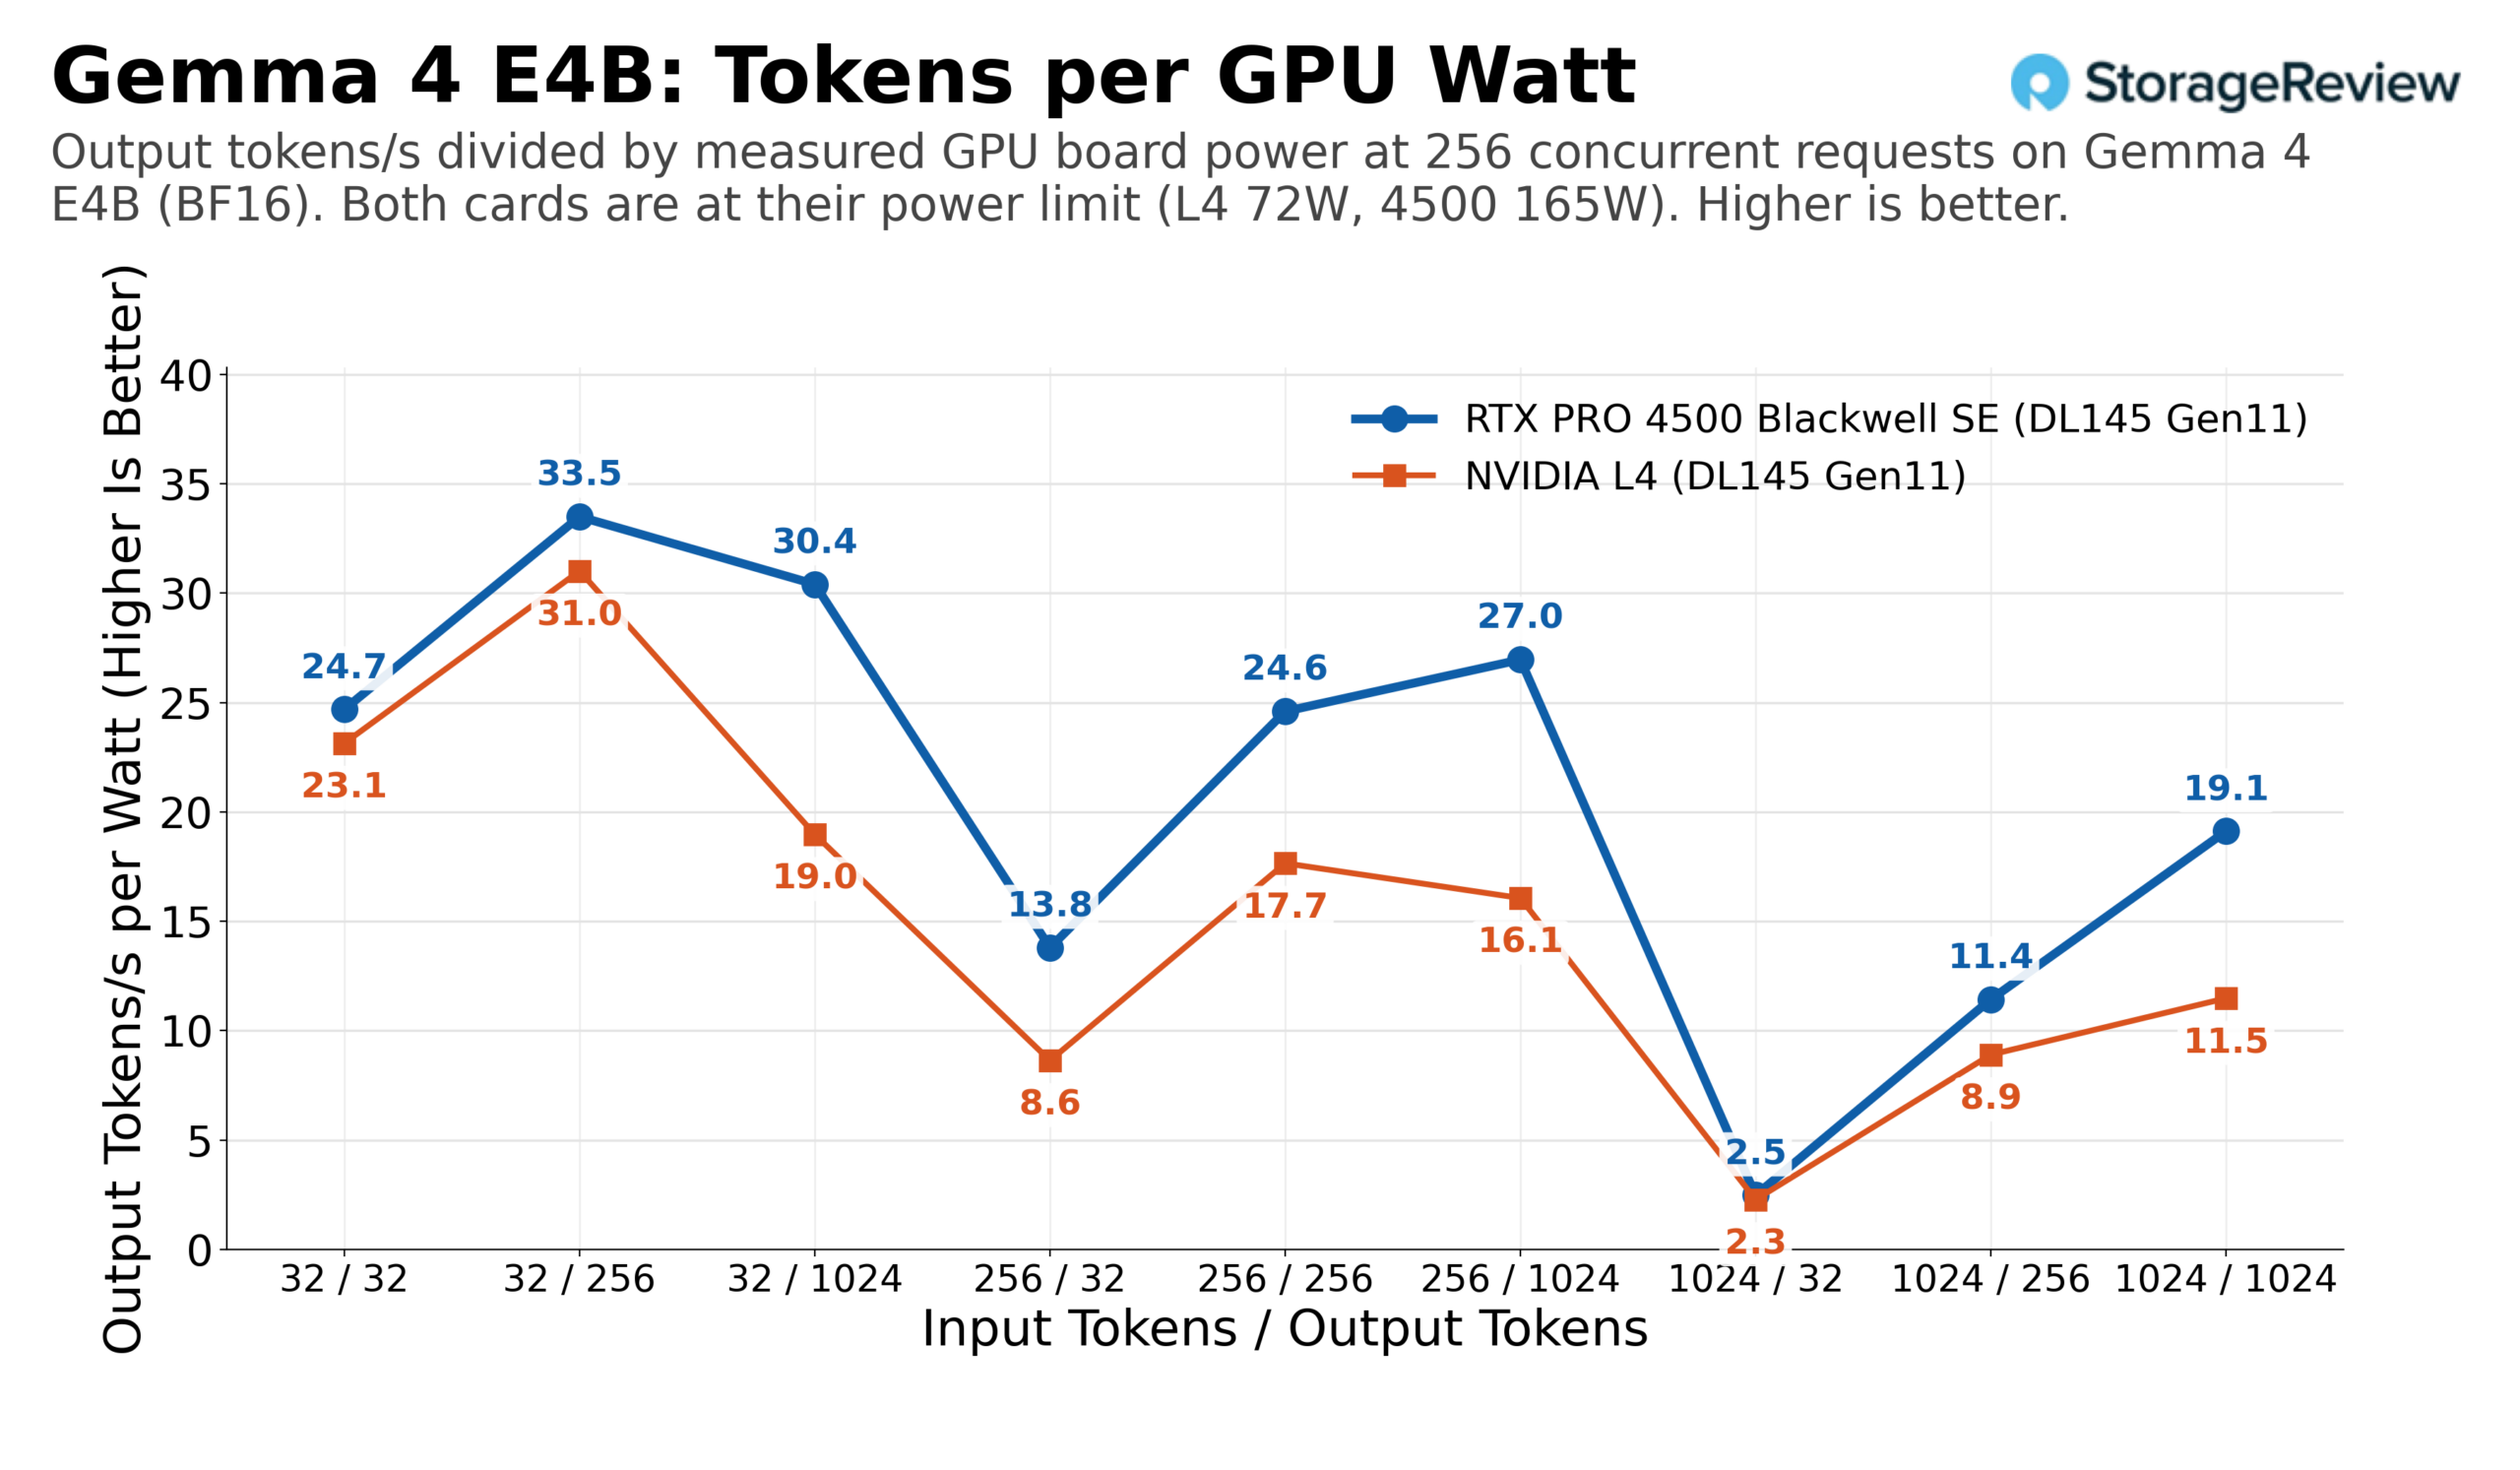
Por watt de GPU, o Gemma 4 E4B oferece ao 4500 uma mediana de 1.39x o L4 em 256 operações simultâneas, com a maior margem, 1.68x, em 256/1,024 e 1.6x ou melhor nas outras configurações de resposta longa onde o L4 sofre com a falta de cache KV, e a menor margem, 1.07x, em 32/32, onde a carga de trabalho é muito curta para que qualquer uma das placas consiga atingir o máximo desempenho. Em 256/256, são 24.6 tokens de saída por segundo por watt contra 17.7.
A latência por token para um único usuário corresponde à de Qwen: 14.1 ms por token no 4500 contra 39.1 ms no L4 em 256/256, e 14.6 ms contra 39.8 ms em 1,024/1,024, portanto, uma resposta com 1,024 tokens leva cerca de 15 segundos no 4500 e 41 segundos no L4.
Energia na parede
Os servidores de borda geralmente têm pouca energia disponível, então monitoramos o consumo total do servidor por meio do iLO do DL145 em cada execução. Sob carga leve, em execuções com um único usuário e a GPU consumindo de 43 a 65 W, o servidor ficou em torno de 160 W com qualquer uma das placas instaladas. Servindo 32 usuários simultâneos na configuração 256/256, o consumo médio foi de 196 W com a L4 e 301 W com a RTX PRO 4500, e essas médias se mantiveram em ambos os modelos BF16; o máximo que registramos foi de 209 W com a L4 e 308 W com a 4500. Portanto, o upgrade custa cerca de 105 W na tomada sob carga, o que é próximo da diferença de 93 W nas especificações de potência das placas, mais uma pequena perda de conversão e a sobrecarga adicional da ventoinha.
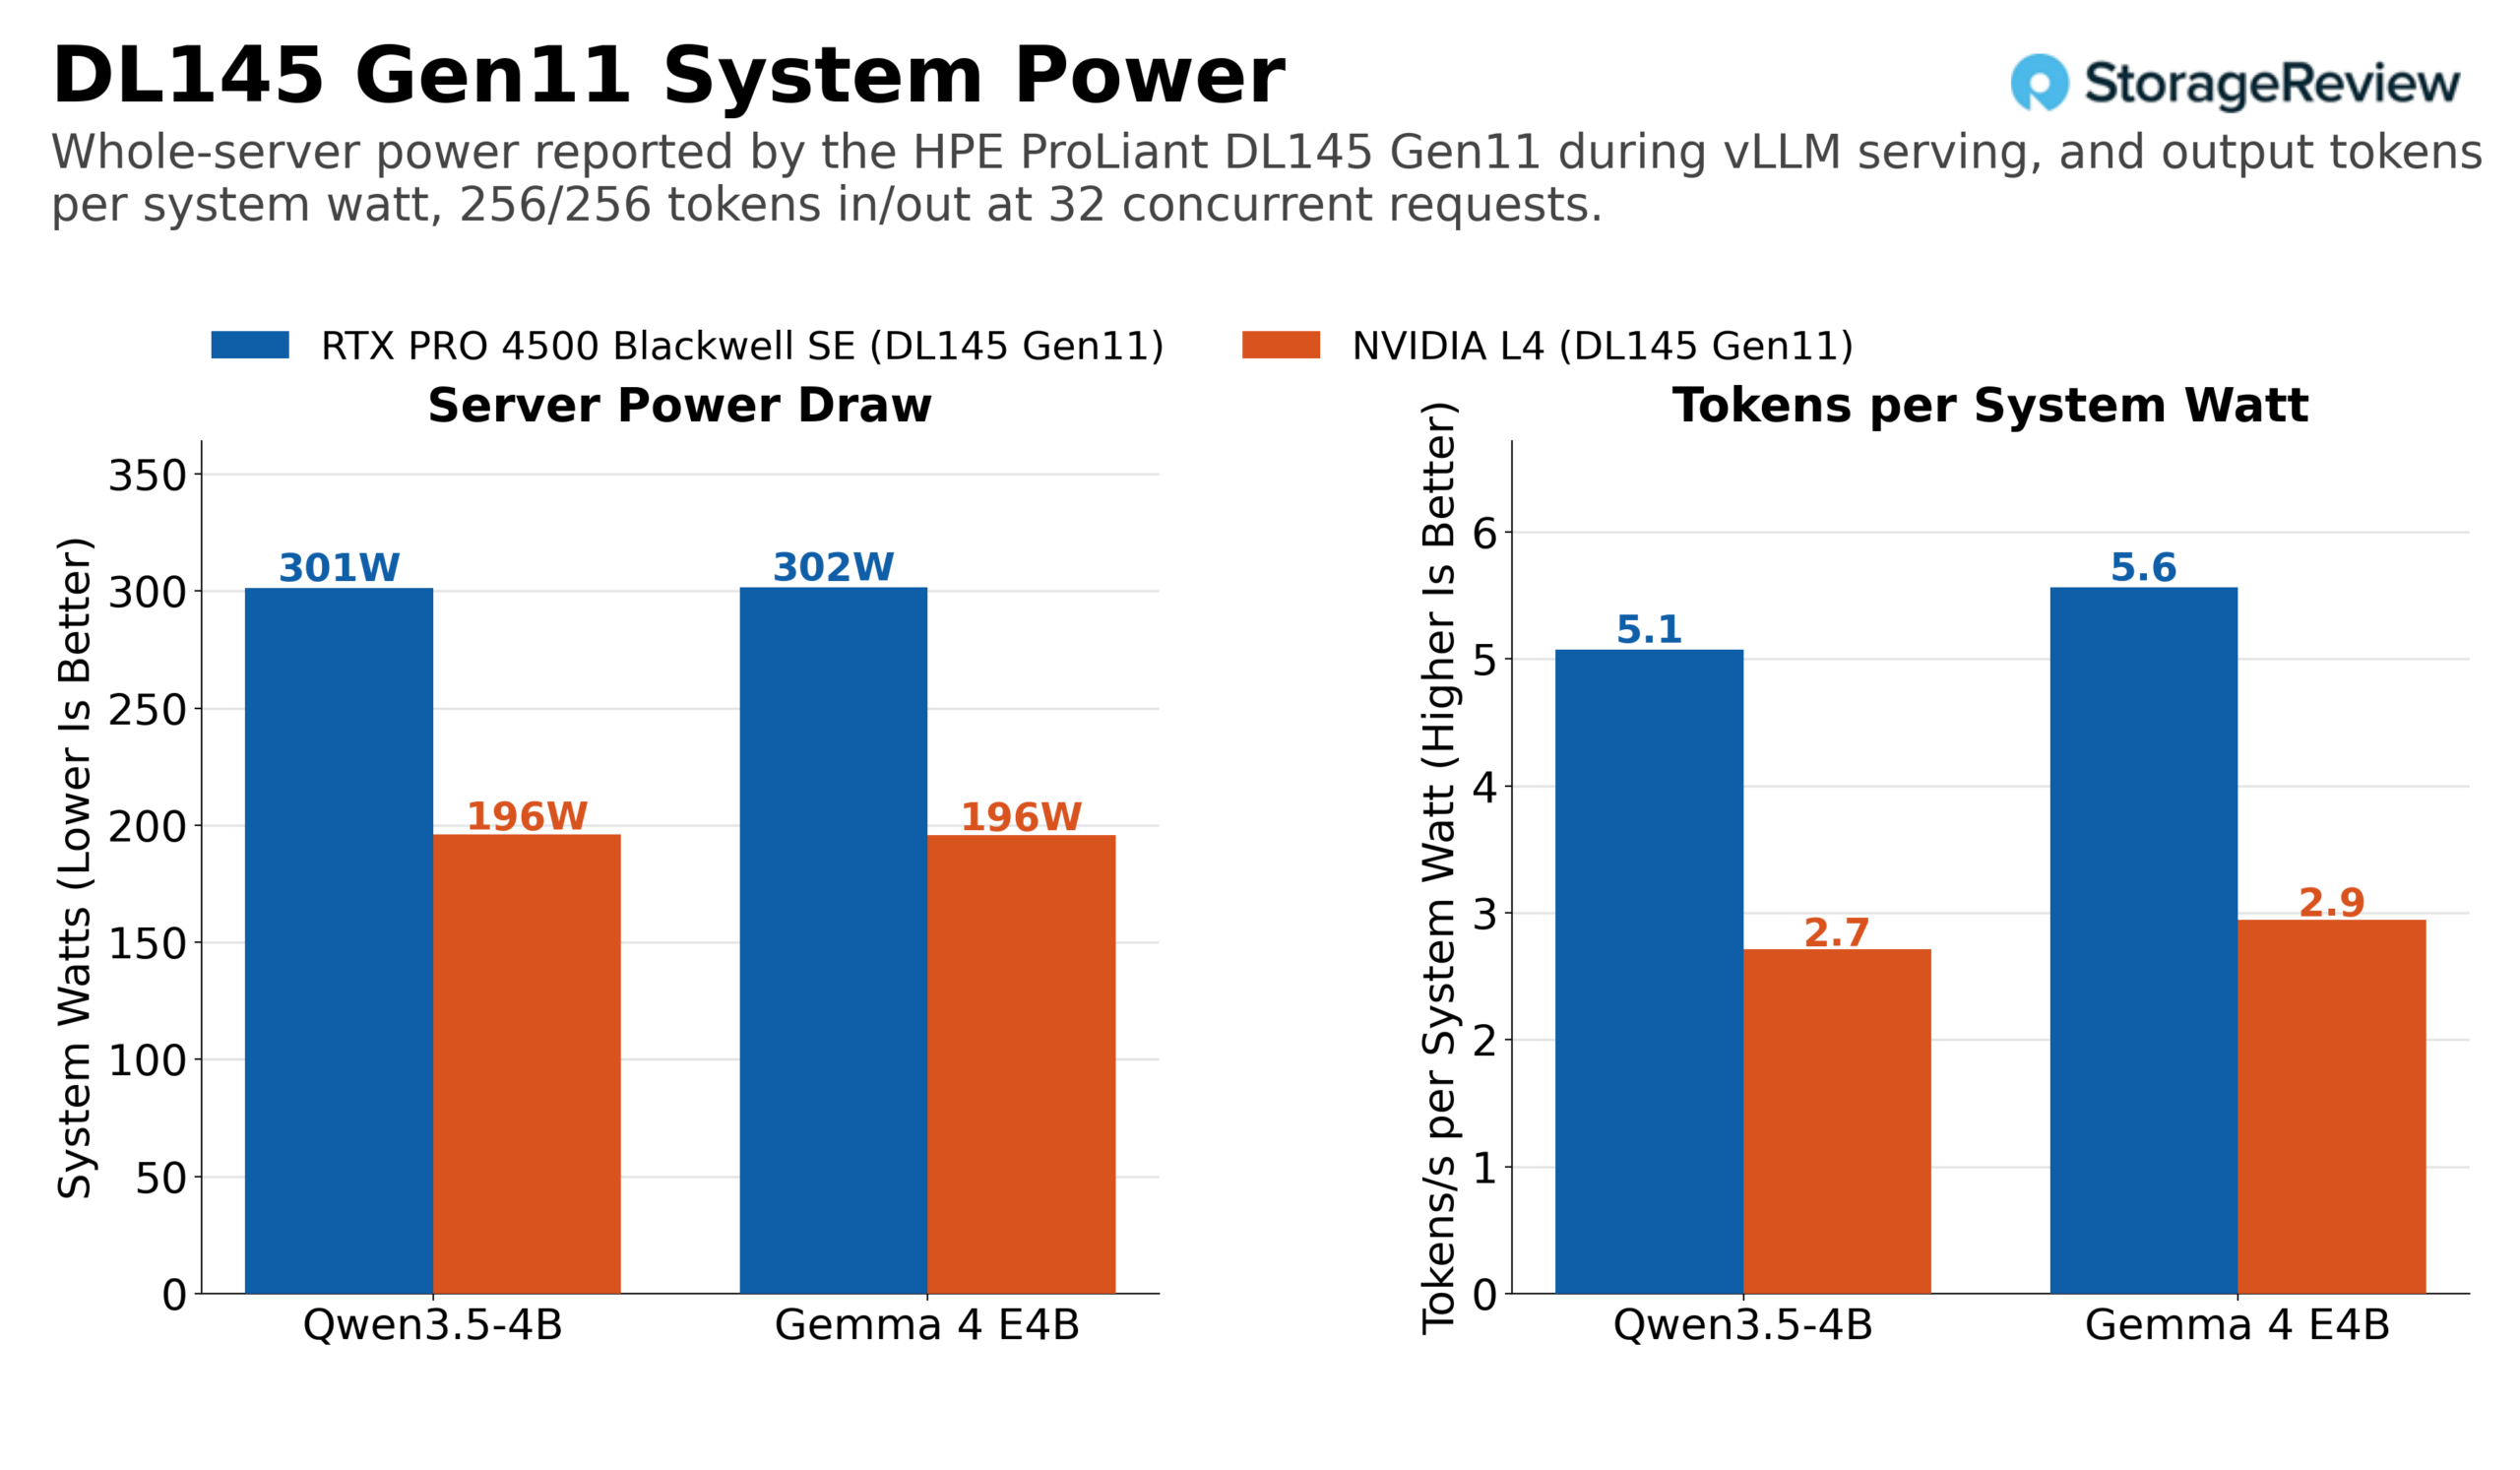
Com 32 conexões simultâneas em 256/256, o servidor produziu 2.7 tokens de saída por segundo por watt de sistema no Qwen3.5-4B com o L4 e 5.1 com o 4500; no Gemma 4 E4B, 2.9 e 5.6. O ganho de eficiência em nível de sistema é maior do que em nível de placa, porque grande parte do consumo do DL145 é um custo fixo: a CPU, a memória, os ventiladores e o armazenamento consomem praticamente o mesmo, independentemente de a GPU estar produzindo 532 tokens por segundo ou 1,529. Um site que paga pelo servidor já obtém 1.9 vezes mais tokens por watt na tomada com a troca de memória, contra 1.3 vezes com a placa. Para uma frota dimensionada com base em um orçamento de energia por site, esse é o número a ser considerado no planejamento.
O que 32 GB e NVFP4 adicionam
Tudo o que foi mencionado acima é trabalho que o L4 consegue fazer, só que mais lentamente. Outro argumento a favor do 4500 é uma classe de modelo que o L4 não consegue processar nativamente: Gemma 4 26B-A4B em NVFP4, um modelo de mistura de especialistas de 26 bits com cerca de 4 bits de parâmetros ativos por token, servido com um cache KV FP8. No BF16, os pesos desse modelo sozinhos excedem 24 GB; em NVFP4, eles cabem nos 32 GB do 4500 com espaço para um cache KV funcional, e os núcleos Tensor FP4 do Blackwell executam o formato nativamente. O vLLM consegue carregar pesos NVFP4 na arquitetura Ada do L4 por meio de um kernel somente de pesos, e os pesos de 4 bits, com cerca de 14 GB, caberiam em 24 GB, mas o L4 não possui computação FP4 nativa, então não o executamos lá. Para efeito de comparação, executamos a mesma tarefa em uma RTX PRO 6000 Blackwell Workstation Edition, uma placa de 96 GB e 600 W, em um Dell Pro Max Tower T2. Trata-se de um host diferente e de uma classe de placa diferente, e a incluímos apenas para que os números da 4500 tenham um ponto de referência.
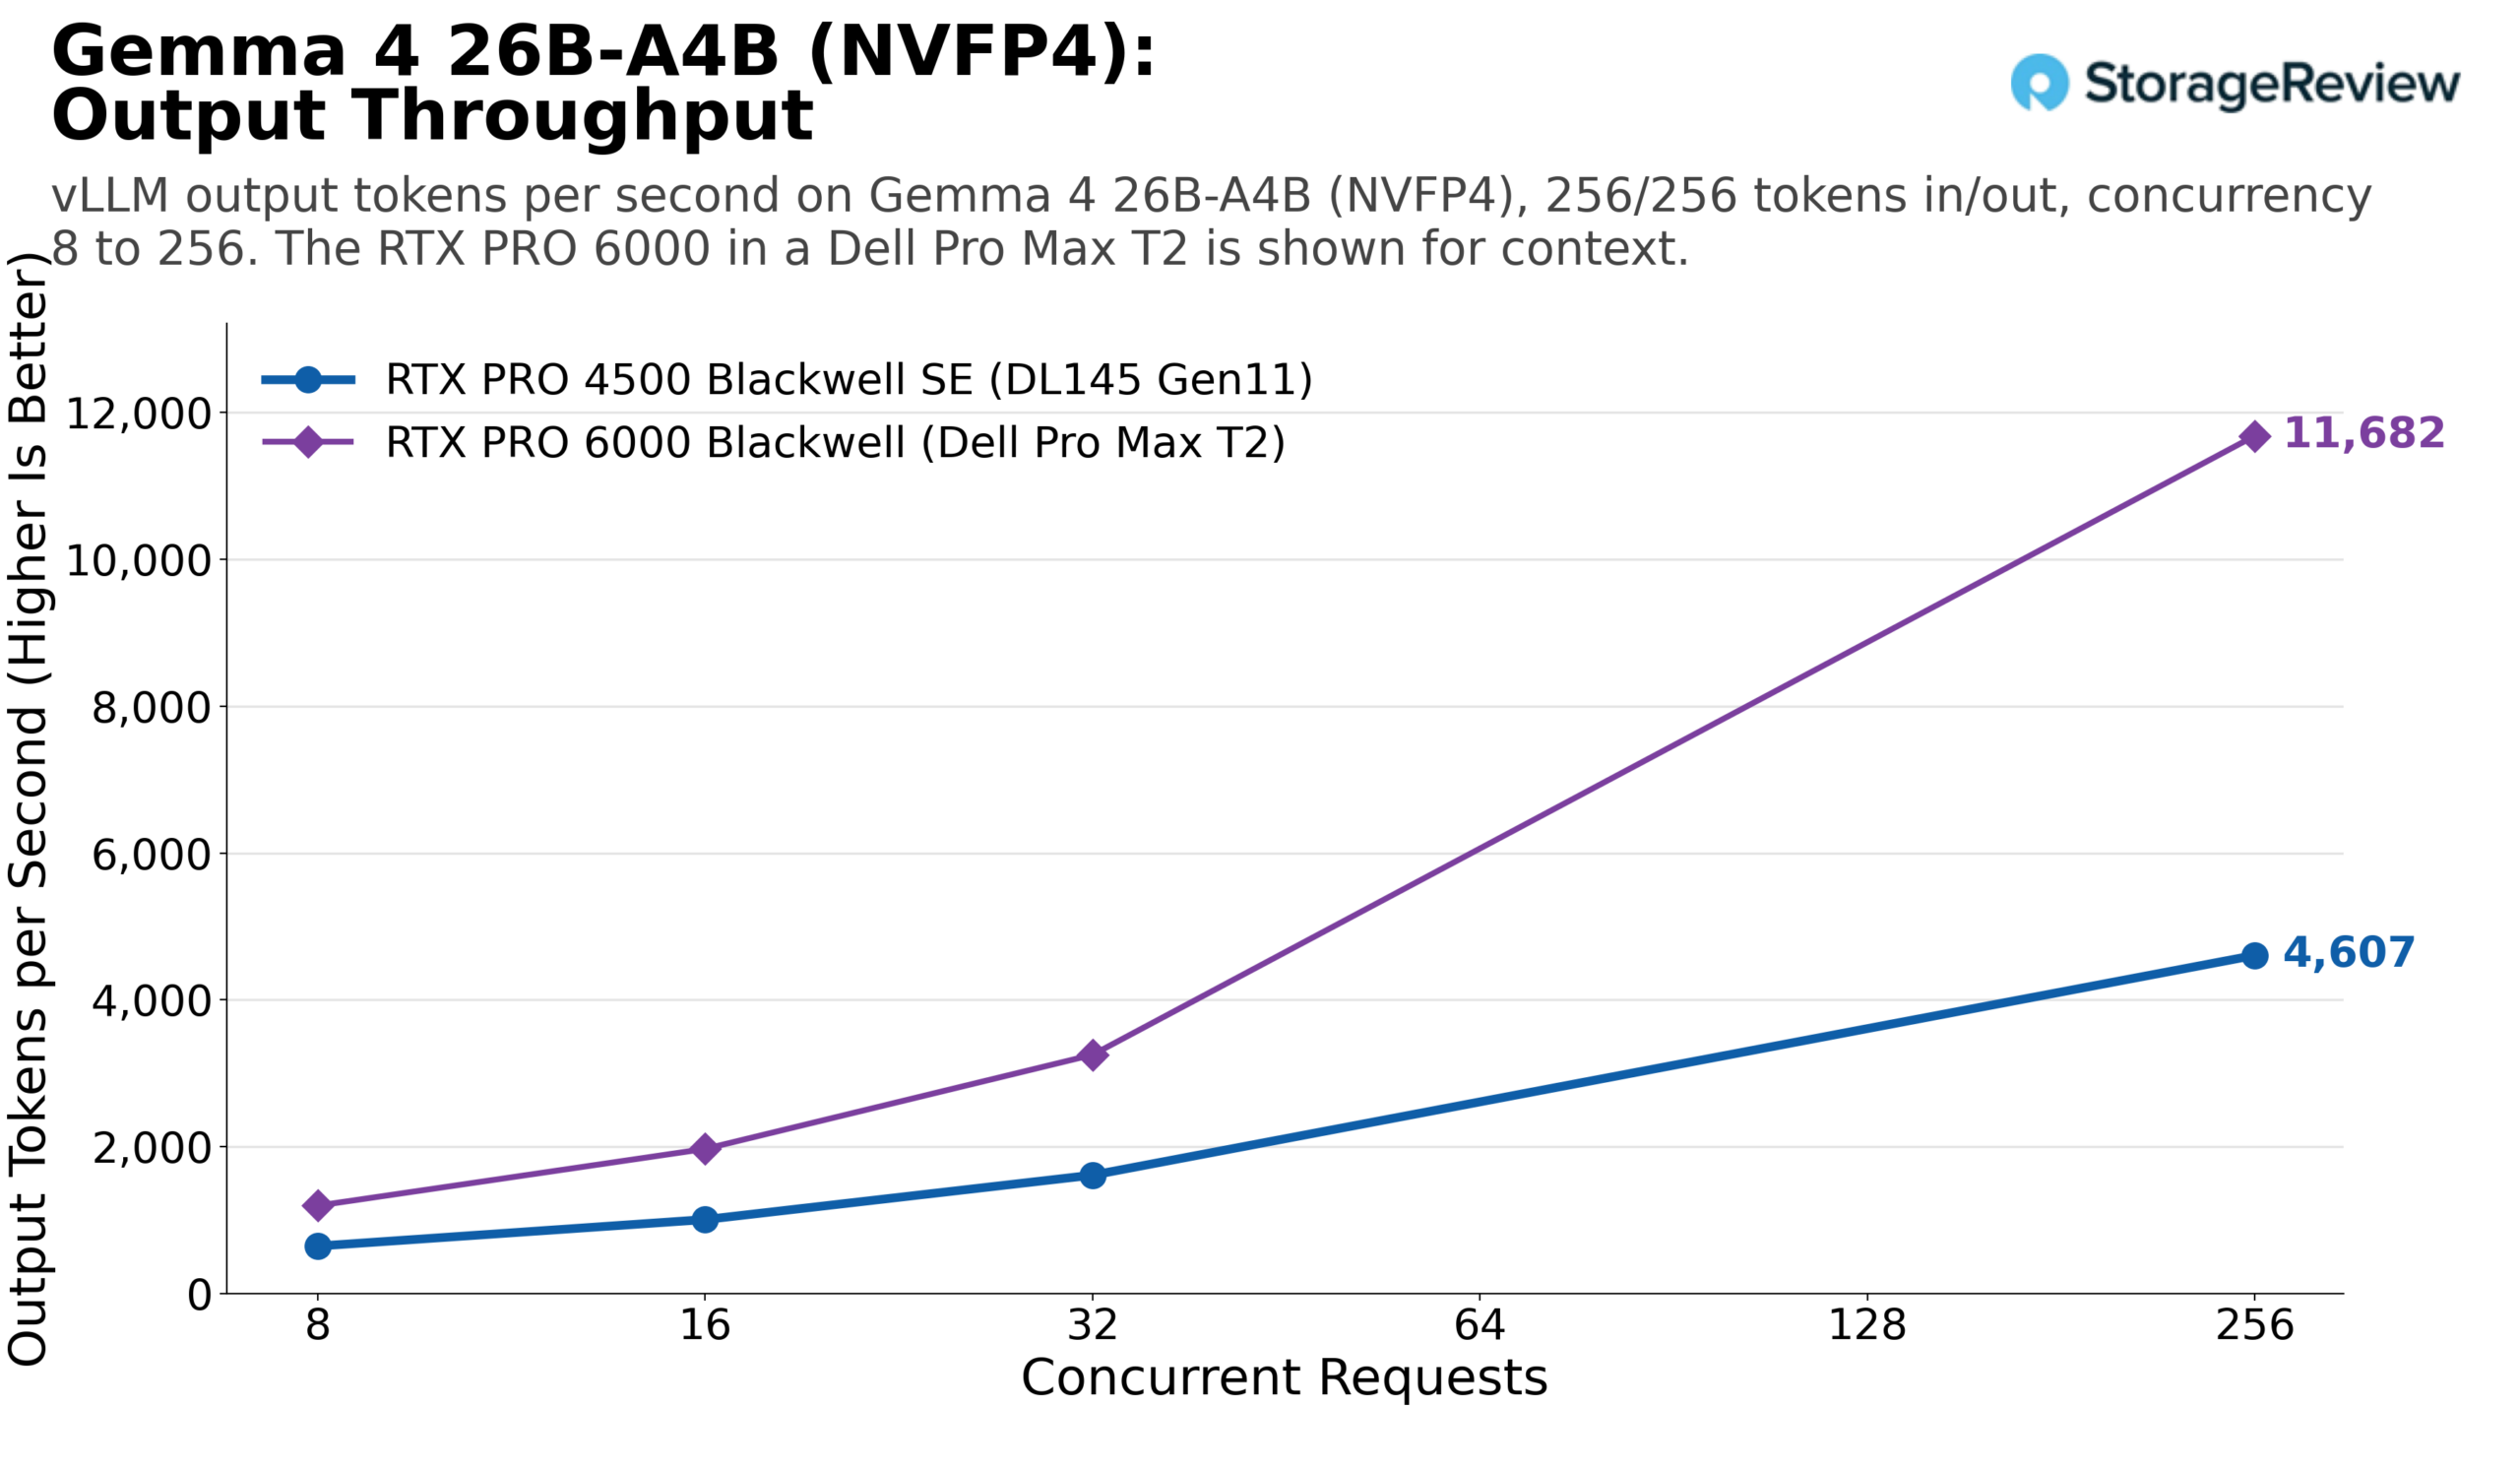
Em 256/256, a RTX 4500 produziu 647 tokens de saída por segundo com 8 operações simultâneas, 1,613 com 32 e 4,607 com 256; a RTX PRO 6000 produziu 1,198, 3,252 e 11,682, respectivamente. De 8 a 32 operações simultâneas, a RTX 4500 apresentou desempenho entre 48% e 55% da RTX 6000 em todos os formatos, exceto no caso de 1,024/32 com pré-preenchimento, onde o desempenho cai para 29% com 32 operações simultâneas, consumindo 165W, contra 266W a 471W medidos na RTX 6000 para os formatos analisados. Com 256 operações simultâneas, o desempenho cai para 23% a 42% à medida que seus 32GB de memória são preenchidos.
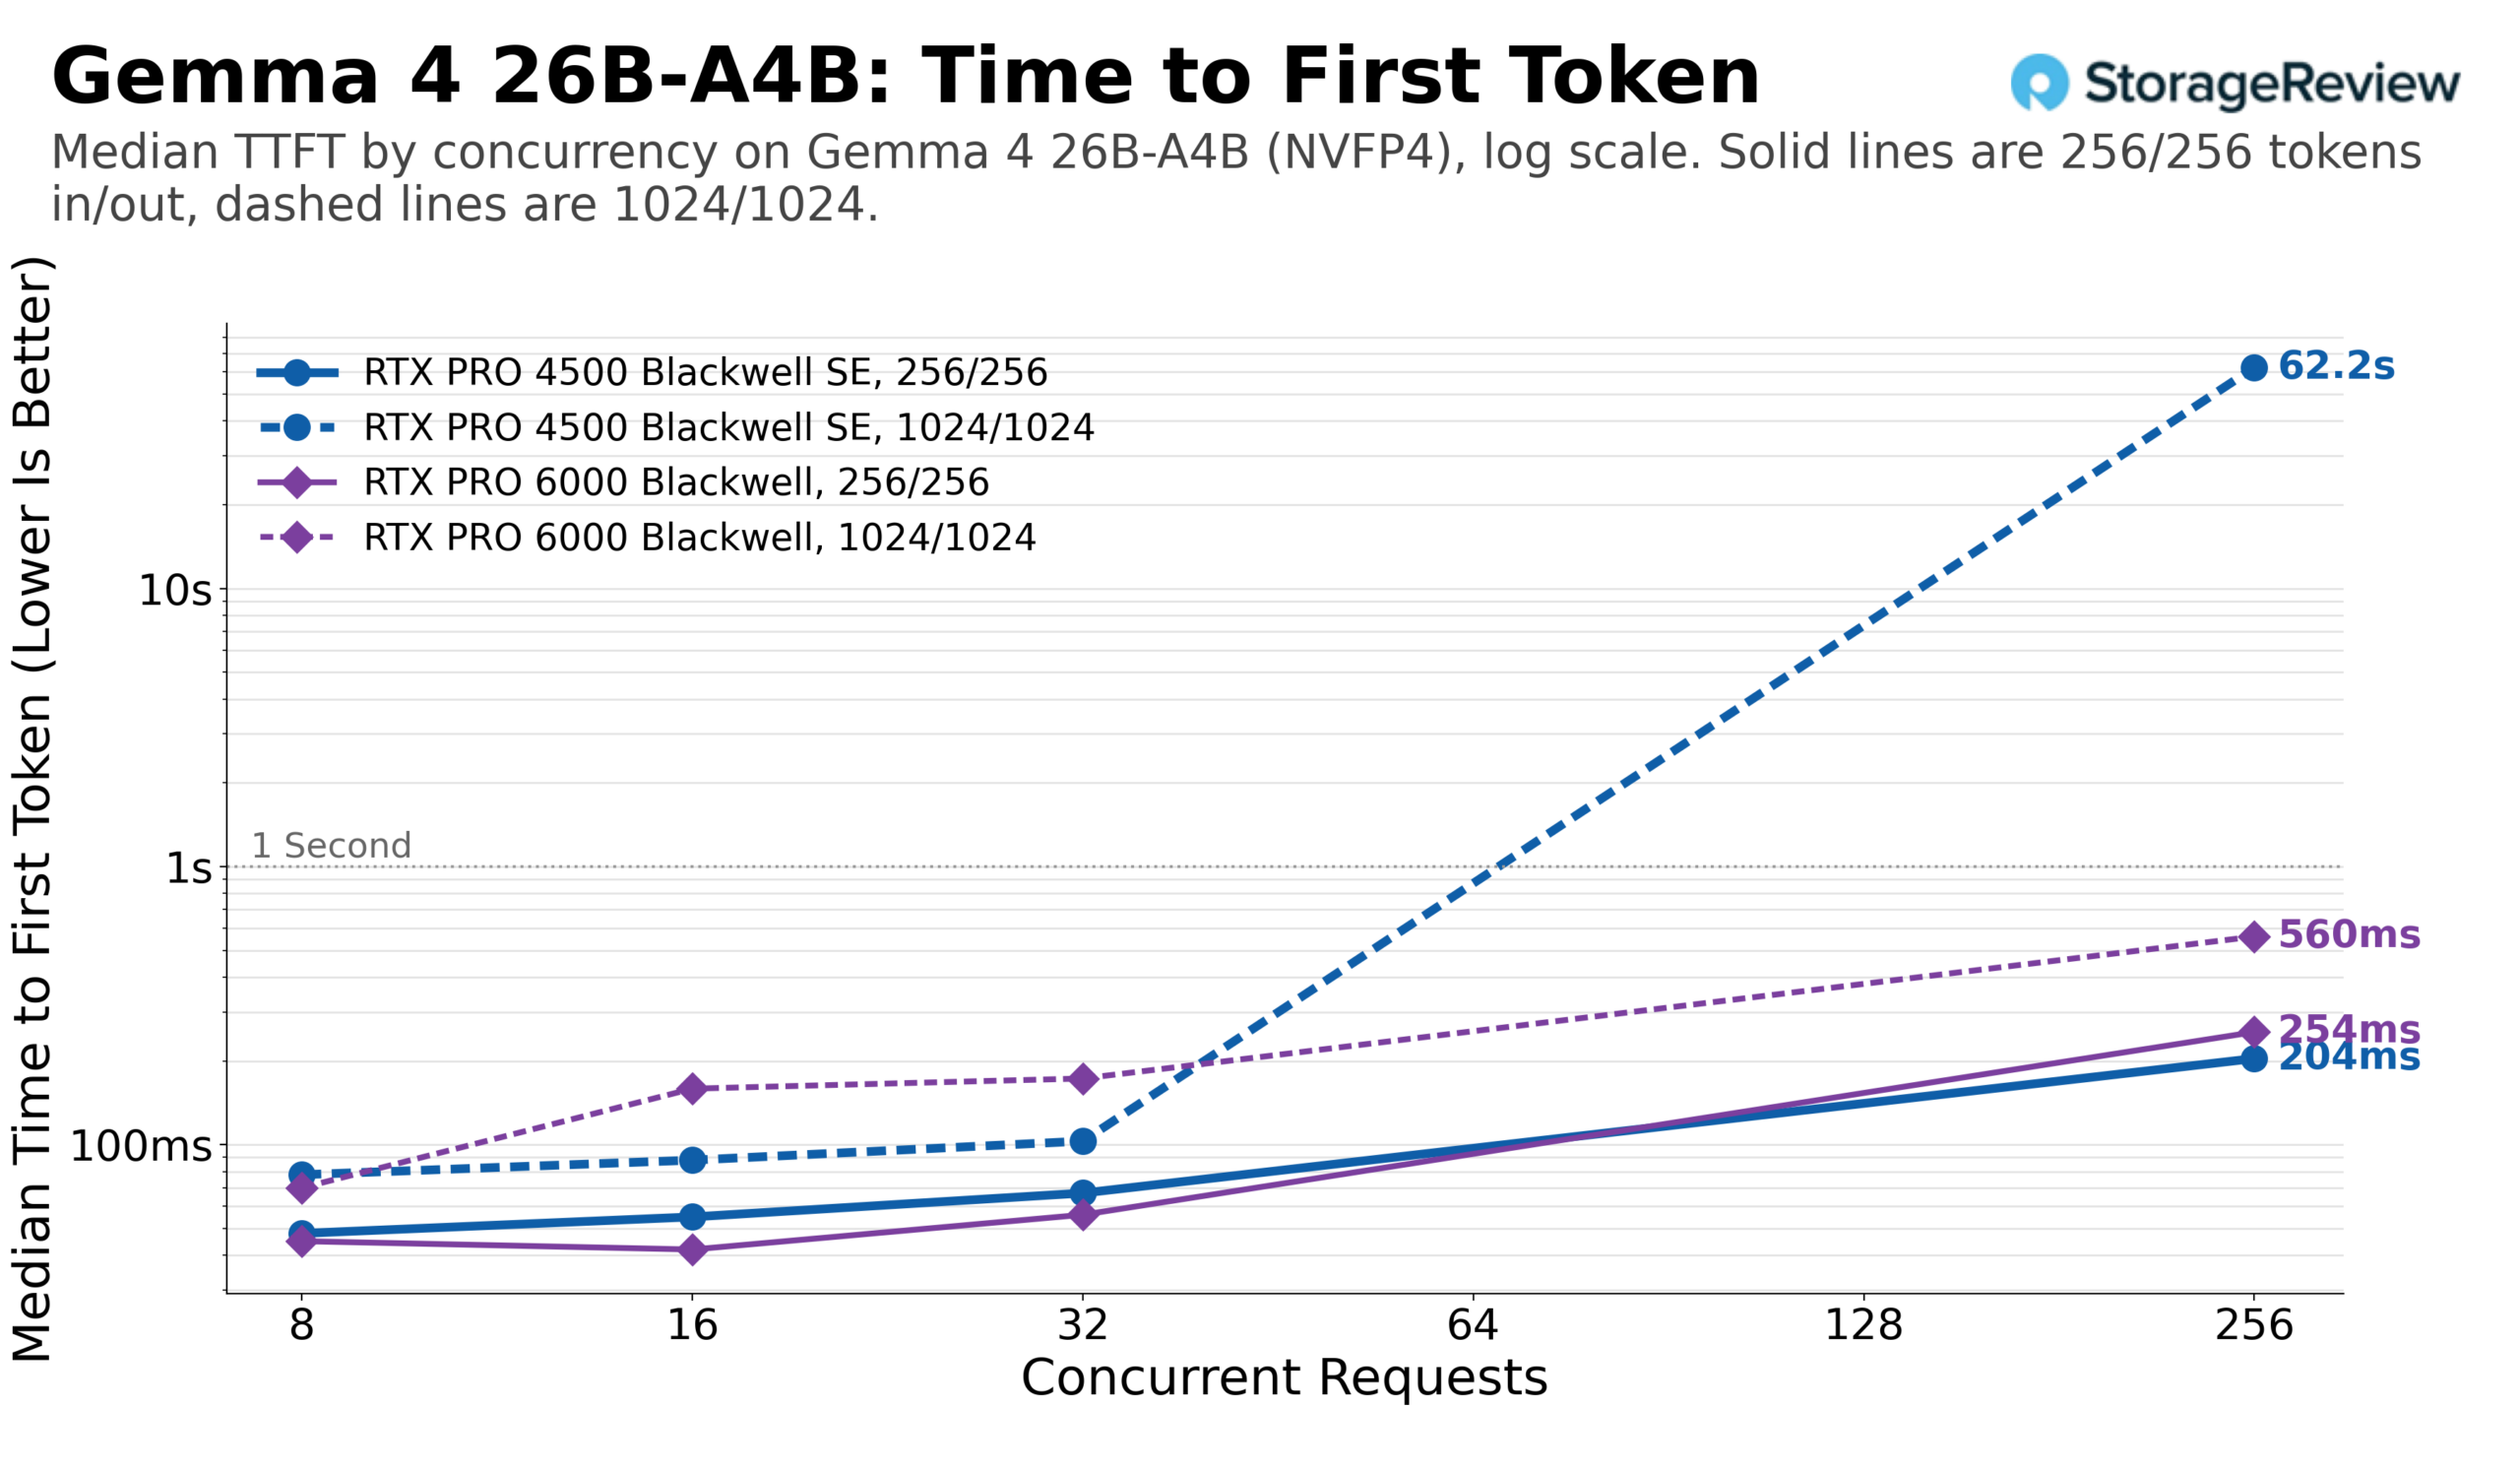
A latência do primeiro token conta a mesma história que os modelos BF16: com 32 sessões simultâneas, a mediana do 4500 foi de 67 ms em 256/256 e 103 ms em 1,024/1,024, dentro de algumas dezenas de milissegundos do 6000 em ambos os casos, e permaneceu em 204 ms com 256 sessões simultâneas no formato curto. Em 1,024/1,024 com 256 sessões simultâneas, o 4500 entrou em fila por 62 segundos, enquanto o 6000, com três vezes mais memória, manteve-se em 560 ms. Para um MoE de 26 bits, o 4500 é uma placa de 32 sessões em contexto longo e uma placa de 256 sessões em comprimento de chat, e executa o modelo em hardware FP4 que o L4 não possui.
A fonte DL145 consumiu um máximo de 306 W alimentando o modelo de 26 bits no modelo 4500, contra um pico de 308 W nos modelos de 4 bits, porque a placa consome 165 W em ambos os casos. Um modelo de 26 bits em um gabinete EdgeBox, com consumo de 300 W na tomada, representa a melhoria de capacidade aqui, e não consome mais energia do que os modelos menores.
Conclusão
A NVIDIA classifica a RTX PRO 4500 Blackwell Server Edition com desempenho mais de 5 vezes superior ao da L4, um número que se baseia em FP4 e NIM. Em uma comparação direta no BF16, utilizando o mesmo servidor DL145 Gen11, a 4500 apresentou uma taxa de transferência mediana 2.7 vezes maior que a da L4 em dois modelos pequenos com concorrência de trabalho e de 3.0 a 3.2 vezes maior em saturação, gerou tokens 2.8 vezes mais rápido para um único usuário e manteve a latência do primeiro token abaixo de um segundo em cargas onde a L4 estava em fila por dezenas de segundos. A L4 mantém cada usuário acima de 10 tokens de saída por segundo em até 32 a 256 sessões na maioria dos formatos, e apenas em 8 no formato 1,024/32 com preenchimento automático, enquanto a 4500 faz isso com 256 sessões em prompts de chat. O modelo 4500 também serviu à locomotiva Gemma 4 26B-A4B no sistema NVFP4, um modelo que o L4 não consegue executar nativamente.
O custo é de 105 W na tomada, variando de cerca de 196 W a cerca de 301 W para todo o servidor sob carga, e 2.3 vezes a potência da placa na GPU. Medido na GPU, o 4500 é de 1.3 a 1.4 vezes mais eficiente que o L4 por token de saída; medido na tomada, onde o restante do consumo do sistema ocorre independentemente, é cerca de 1.9 vezes mais eficiente. Sites desse porte, com um orçamento de energia por servidor, acharão o 4500 um uso melhor dos watts que já estão gastando, e sites desse porte, com um único 4500, atingirão a mesma taxa de transferência de três servidores L4 com 32 sessões cada, com geração 2.8 vezes mais rápida por usuário e um único pool de 32 GB.
A ressalva sobre o escopo mencionada no início da análise permanece válida, pois esta é uma comparação direta entre uma placa e sua antecessora em um servidor Edge de três modelos menores. Além disso, a posição da RTX PRO 4500 Server Edition entre o L40S, a RTX PRO 6000 Server Edition e o restante da linha atual de placas de vídeo para inferência é uma questão à parte, que abordaremos em um artigo mais abrangente. Respondendo à pergunta de um proprietário de um DL145 com uma placa L4, a resposta é que a 4500 é a atualização para a qual a plataforma foi projetada, desde que o chassi possua o riser de comprimento total e a alimentação de 16 pinos necessários. A escolha da HPE por esta placa para este servidor, para o Nemotron na borda, é perfeitamente adequada ao desempenho do hardware.
O próprio DL145 Gen11 aparece na seção de borda do nosso Melhores servidores placar, onde esse resultado agora ancora a história da inferência de borda.
Classificação: A RTX PRO 4500 Blackwell Server Edition detém o título de Melhor GPU de Slot Único em nossa classificação de Melhores GPUs Empresariais , e a L4 detém o título de Melhor Placa Alimentada por Slot para 1U e Edge.



 Amazon