

Durante a maior parte de sua trajetória em data centers, a NVIDIA tratou a CPU como pouco mais do que o chip que alimentava a GPU. O Grace, seu primeiro processador para servidores, se encaixava nesse padrão. Ele utilizava os núcleos Neoverse V2 da Arm, disponíveis no mercado, e era comercializado principalmente como a metade da CPU dos superchips Grace Hopper e Grace Blackwell. Esses superchips, no entanto, introduziram um componente duradouro da plataforma: o NVLink-C2C, uma conexão que permite que a CPU e a GPU acessem a memória uma da outra de forma coerente, com uma largura de banda muito maior do que a do PCIe.
Its successor, Vera, is far more ambitious. It is a clean-sheet design built around Olympus, NVIDIA’s custom Arm core. Olympus implements Armv9.2, and each Vera CPU features 88 cores and 176 threads. Alongside the new cores, the memory subsystem is the other highlight. Each CPU supports up to 1.5TB of LPDDR5X on SOCAMM modules, with an advertised peak bandwidth of 1.2TB/s per socket, which gives Vera the power efficiency of mobile-class DRAM while keeping the memory field-replaceable. Across the two sockets in our test server, that rating comes to 2.4TB/s, and we measured 2,073GB/s on STREAM Triad.
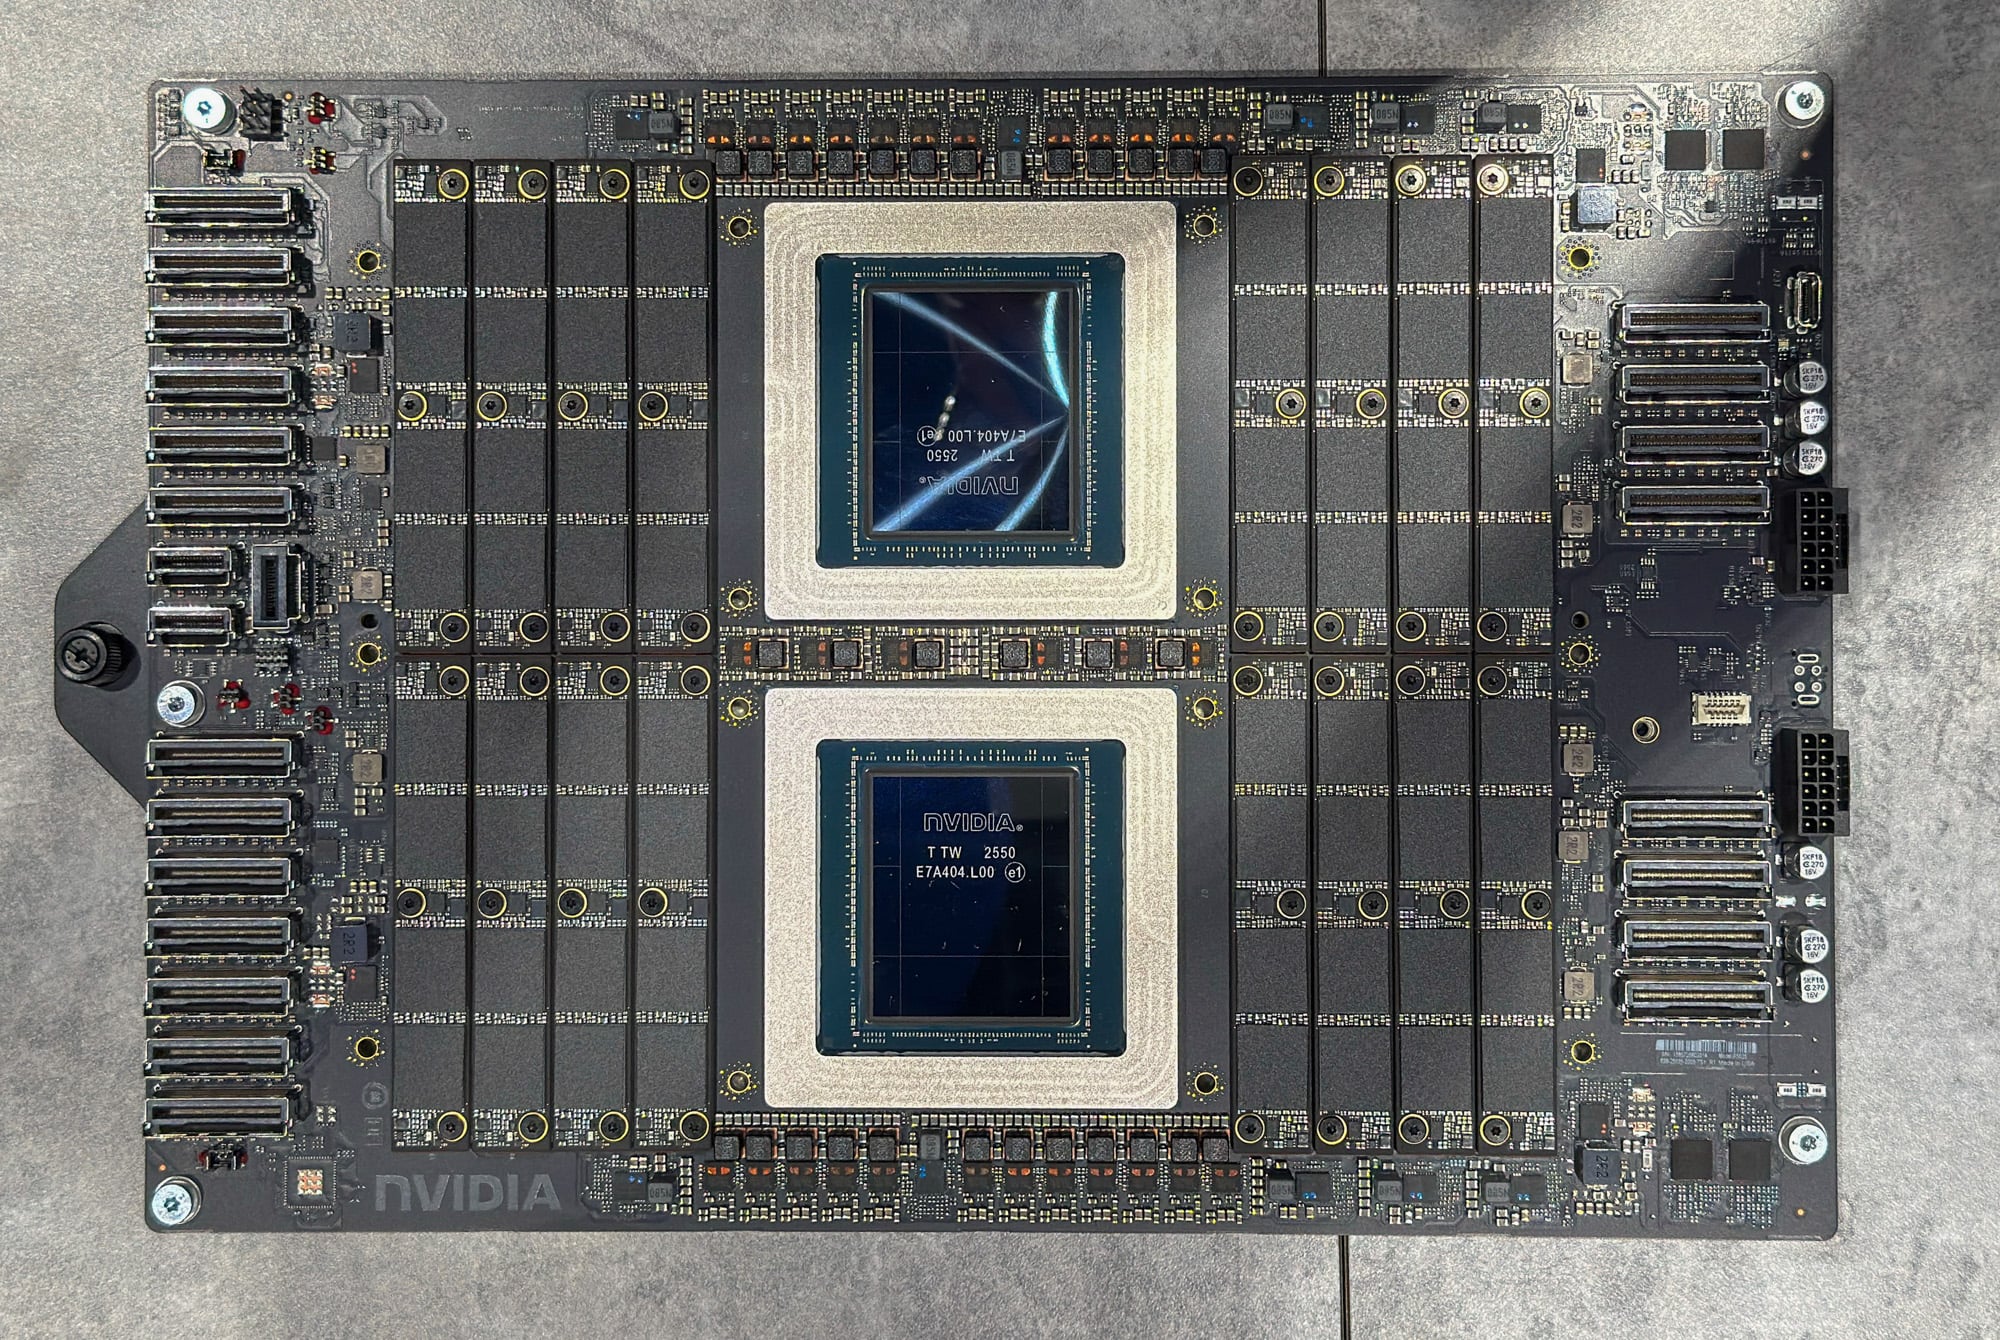
Essa ambição se estende aos locais de implantação do Vera. Ele ainda é fornecido como parte do superchip nos sistemas Vera Rubin, mas a NVIDIA também expandiu seu uso para a plataforma de armazenamento BlueField-4 STX e para servidores com CPUs independentes para ambientes de teste (sandboxes) com agentes. O Vera também está conquistando amplo apoio de OEMs, provedores de hiperescala e NCPs: Dell, HPE e Supermicro adicionaram servidores Vera às suas linhas de produtos, e provedores de hiperescala e NCPs estão prontos para torná-lo uma oferta convencional. Essa ampla disponibilidade é importante porque, como nossos resultados mostrarão, o Vera é um concorrente de peso para seus equivalentes x86 e oferece às organizações um terceiro fornecedor de CPU para ajudar a diversificar suas cadeias de suprimentos.
Principais lições
- A largura de banda da memória mais que dobra em todos os sistemas x86. Dois sockets Vera mantiveram taxas de transferência superiores a 2 TB/s no STREAM Triad, 2.3 vezes o melhor servidor DDR5 que testamos. Mesmo ao ler a memória do outro socket via NVLink-C2C, os núcleos do Vera obtiveram mais largura de banda do que qualquer socket x86 obtém da memória local, e a latência local com hugepages foi 13% menor do que no EPYC 9175F.
- Um chip bem equilibrado para o amplo segmento intermediário do mercado. Um núcleo Olympus de 3.4 GHz apresentou desempenho 12% superior no teste 7-Zip em comparação com o EPYC 9175F de 5.0 GHz e venceu dois dos três testes Python de thread única realizados contra ele. Em carga máxima, o Vera atingiu de 63% a 72% do desempenho do EPYC 9965 no teste 7-Zip com menos da metade dos núcleos, mantendo-se próximo ao desempenho por núcleo da AMD em uma única thread e ao desempenho geral do sistema.
- O trabalho com vetores e criptografia é o ponto fraco evidente. Seis pipelines SVE2 de 128 bits não conseguem igualar o AVX-512 de 512 bits no código escrito para ele. Em um sistema com 16 núcleos pareados, o Vera executou o benchmark GROMACS benchMEM com metade da taxa do EPYC 9175F e dois terços da do EPYC 9965, e um núcleo único criptografado com AES-256-GCM a cerca de um terço da velocidade do 9175F. Em todo o sistema, o EPYC 9965 de 384 núcleos apresentou um desempenho aproximadamente três vezes superior tanto no benchmark GROMACS benchPEP quanto no AES.
- Computação de alto desempenho (HPC) com recursos limitados por memória transforma largura de banda em velocidade. Na grande rede OpenFOAM, o Vera apresentou desempenho 1.44 vezes superior ao do EPYC 9965 de 384 núcleos e 1.20 vezes superior ao do Xeon 6978P de 240 núcleos. Na rede menor, onde os caches L3 x86 maiores representam uma parcela significativa do problema, o Vera ficou em segundo lugar, a menos de 12% do 9965.
- Bancos de dados e análises já são competitivos. No teste HammerDB TPROC-C em um único soquete, o Vera com 88 núcleos superou o EPYC 9965 com 192 núcleos em 26% no PostgreSQL e 8% no MariaDB, enquanto ficou 19% atrás no MySQL e 15% no VillageSQL; o Xeon 6787P ficou atrás do Vera em todos os cinco mecanismos. O Vera também completou o teste ClickBench em 23% menos tempo que o EPYC 9965 e atendeu 34% mais requisições em um conjunto de trabalho Valkey de 256 GB.
Especificações
| Especificação | CPU NVIDIA Vera |
|---|---|
| Computação e Potência | |
| Setores de | NVIDIA Olympus, Armv9.2 com SVE2 e FP8 |
| Núcleos e roscas por soquete | 88 núcleos, 176 threads (NVIDIA Spatial Multithreading) |
| Velocidade do relógio (medida) | 3.41GHz |
| TDP | Configurável de 250 W a 450 W |
| Resfriamento | Ar ou líquido |
| Esconderijo | |
| Instrução L1 | 64 KB por núcleo |
| Dados L1 | 96 KB por núcleo, 6 vias |
| L2 | 2 MB por núcleo, privado |
| Cache de nível de sistema (L3) | 164 MB por soquete, particionamento Arm MPAM |
| tecido | Tecido de Coerência Escalável de 2ª geração, bisseção de 3.4 TB/s |
| Memória | |
| Formato | LPDDR5X em 8 módulos SOCAMM2 por soquete |
| controladores | 8x 128 bits (1,024 bits agregados) |
| Agilidade (Speed) | Até 9,600MT / s |
| Largura de Banda | Até 1.2 TB/s por soquete (classificação do fornecedor) |
| Capacidade | 256 GB a 1.5 TB por slot |
| I / O | |
| PCIe | Gen6, 88 pistas por soquete (plataforma somente para CPU) bifurcação x16, x8, x4, x2 |
| CXL | 3.1, Expansão e agrupamento de memória do tipo 3 |
| NVLink-C2C | Criptografia bidirecional, coerente e autenticada de segunda geração, com velocidade de transferência de 1.8 TB/s. |
| Total | |
| Computação confidencial | Domínios Arm CCA, RME-DA e RME-CDA, TDISP, chaves por VM |
Por que a NVIDIA quer entrar no mercado de CPUs?
Para entender por que a Vera é importante para a NVIDIA, é preciso analisar como a empresa cresceu. A NVIDIA construiu sua posição no mercado de data centers em torno da GPU e, em seguida, expandiu para a infraestrutura necessária para manter essas GPUs em funcionamento. No lado do hardware, a aquisição da Mellanox em 2020 trouxe a tecnologia de rede que conecta servidores e transfere dados entre eles. No lado do software, CUDA, DOCA e o conjunto de softwares mais amplo ampliaram o alcance da NVIDIA na programação e operação desse hardware. Juntas, essas peças deram à empresa o controle sobre grande parte da plataforma de computação acelerada.
Mas a plataforma ainda precisava de uma CPU de uso geral. Algo tinha que executar o sistema operacional, preparar os dados, gerenciar os aplicativos e coordenar o trabalho enviado aos aceleradores. Durante grande parte da expansão da NVIDIA, a Intel e a AMD desempenharam esse papel. Isso deixou a NVIDIA em uma posição delicada: ela podia fornecer as GPUs, a rede e grande parte do software, mas ainda dependia do processador de outra empresa no centro do servidor.
Grace foi o primeiro grande passo para mudar esse cenário. Construído em torno dos núcleos Arm Neoverse V2, ele forneceu à NVIDIA uma CPU para data centers e uma maneira de conectar essa CPU mais diretamente às suas GPUs por meio do NVLink-C2C. Ainda assim, Grace deixou uma lacuna de desempenho a ser preenchida. Sua largura de banda de memória e eficiência o tornavam competitivo como uma CPU host para IA, mas os principais processadores x86 mantinham vantagens substanciais na maioria das outras cargas de trabalho. Esse desempenho desigual limitava os argumentos para escolher Grace como um substituto de uso geral para um servidor EPYC ou Xeon.
A Vera reduz significativamente essa diferença ao substituir os núcleos Neoverse V2 da Grace pelo design personalizado Olympus da NVIDIA e aumentar consideravelmente a largura de banda e a capacidade da memória. Ao fornecer uma CPU competitiva juntamente com suas GPUs, DPUs e soluções de rede, a NVIDIA consegue capturar uma fatia maior dos gastos com cada servidor. Isso também proporciona à empresa maior controle sobre seu ecossistema e sobre como os componentes interagem: os núcleos da CPU, o subsistema de memória, a interconexão e a GPU podem ser projetados em torno dos mesmos requisitos. O link coerente entre CPU e GPU da Vera, agora com velocidade de até 1.8 TB/s, é um exemplo concreto dessa integração.
Capturar uma parcela maior dos gastos de cada sistema é apenas parte da solução. O aprendizado por reforço (RL) e a IA agente oferecem à NVIDIA mais um motivo para disponibilizar um sistema de CPU independente. Um agente faz mais do que gerar uma resposta. Ele aciona ferramentas, recupera informações, executa código e verifica os resultados antes de decidir o que fazer em seguida. Grande parte dessa execução ocorre nas CPUs e, quando a próxima etapa do modelo depende do resultado de uma tarefa da CPU, a execução lenta atrasa toda a sequência. O desempenho por núcleo, a latência da memória e o comportamento previsível sob carga tornam-se, portanto, importantes para a capacidade de resposta do agente.
O núcleo do Olimpo
Esses requisitos estão em perfeita sintonia com o design dos 88 núcleos Olympus do Vera, que são construídos em torno de uma prioridade clara: alto desempenho de cada núcleo, mantido mesmo quando todo o soquete está ocupado. Olympus é a implementação da NVIDIA do conjunto de instruções Armv9.2, substituindo os núcleos Neoverse V2 usados no Grace. Essa distinção é importante: a Arm define as instruções que o processador executa, enquanto a NVIDIA projetou a infraestrutura que busca, agenda e executa essas instruções. Esse controle permite que a NVIDIA ajuste o núcleo para seu objetivo: concluir tarefas individuais rapidamente enquanto executa várias simultaneamente.
A primeira metade desse objetivo começa com instruções por ciclo, ou IPC: quantas instruções um núcleo completa, em média, em cada ciclo de clock. A velocidade do clock determina a frequência com que esses ciclos ocorrem; a microarquitetura determina a quantidade de trabalho útil que pode ser executada neles. A NVIDIA afirma uma melhoria de 1.5x no IPC em relação à geração anterior. O clock mais alto que observamos foi de 3.41 GHz, mas a arquitetura do Vera prioriza a extração de mais trabalho por ciclo e a manutenção desse progresso sob carga. Essa ênfase é importante porque, para um compilador, interpretador ou operação de banco de dados com uma longa sequência de etapas dependentes, núcleos adicionais por si só não conseguem acelerar a conclusão dessa sequência.
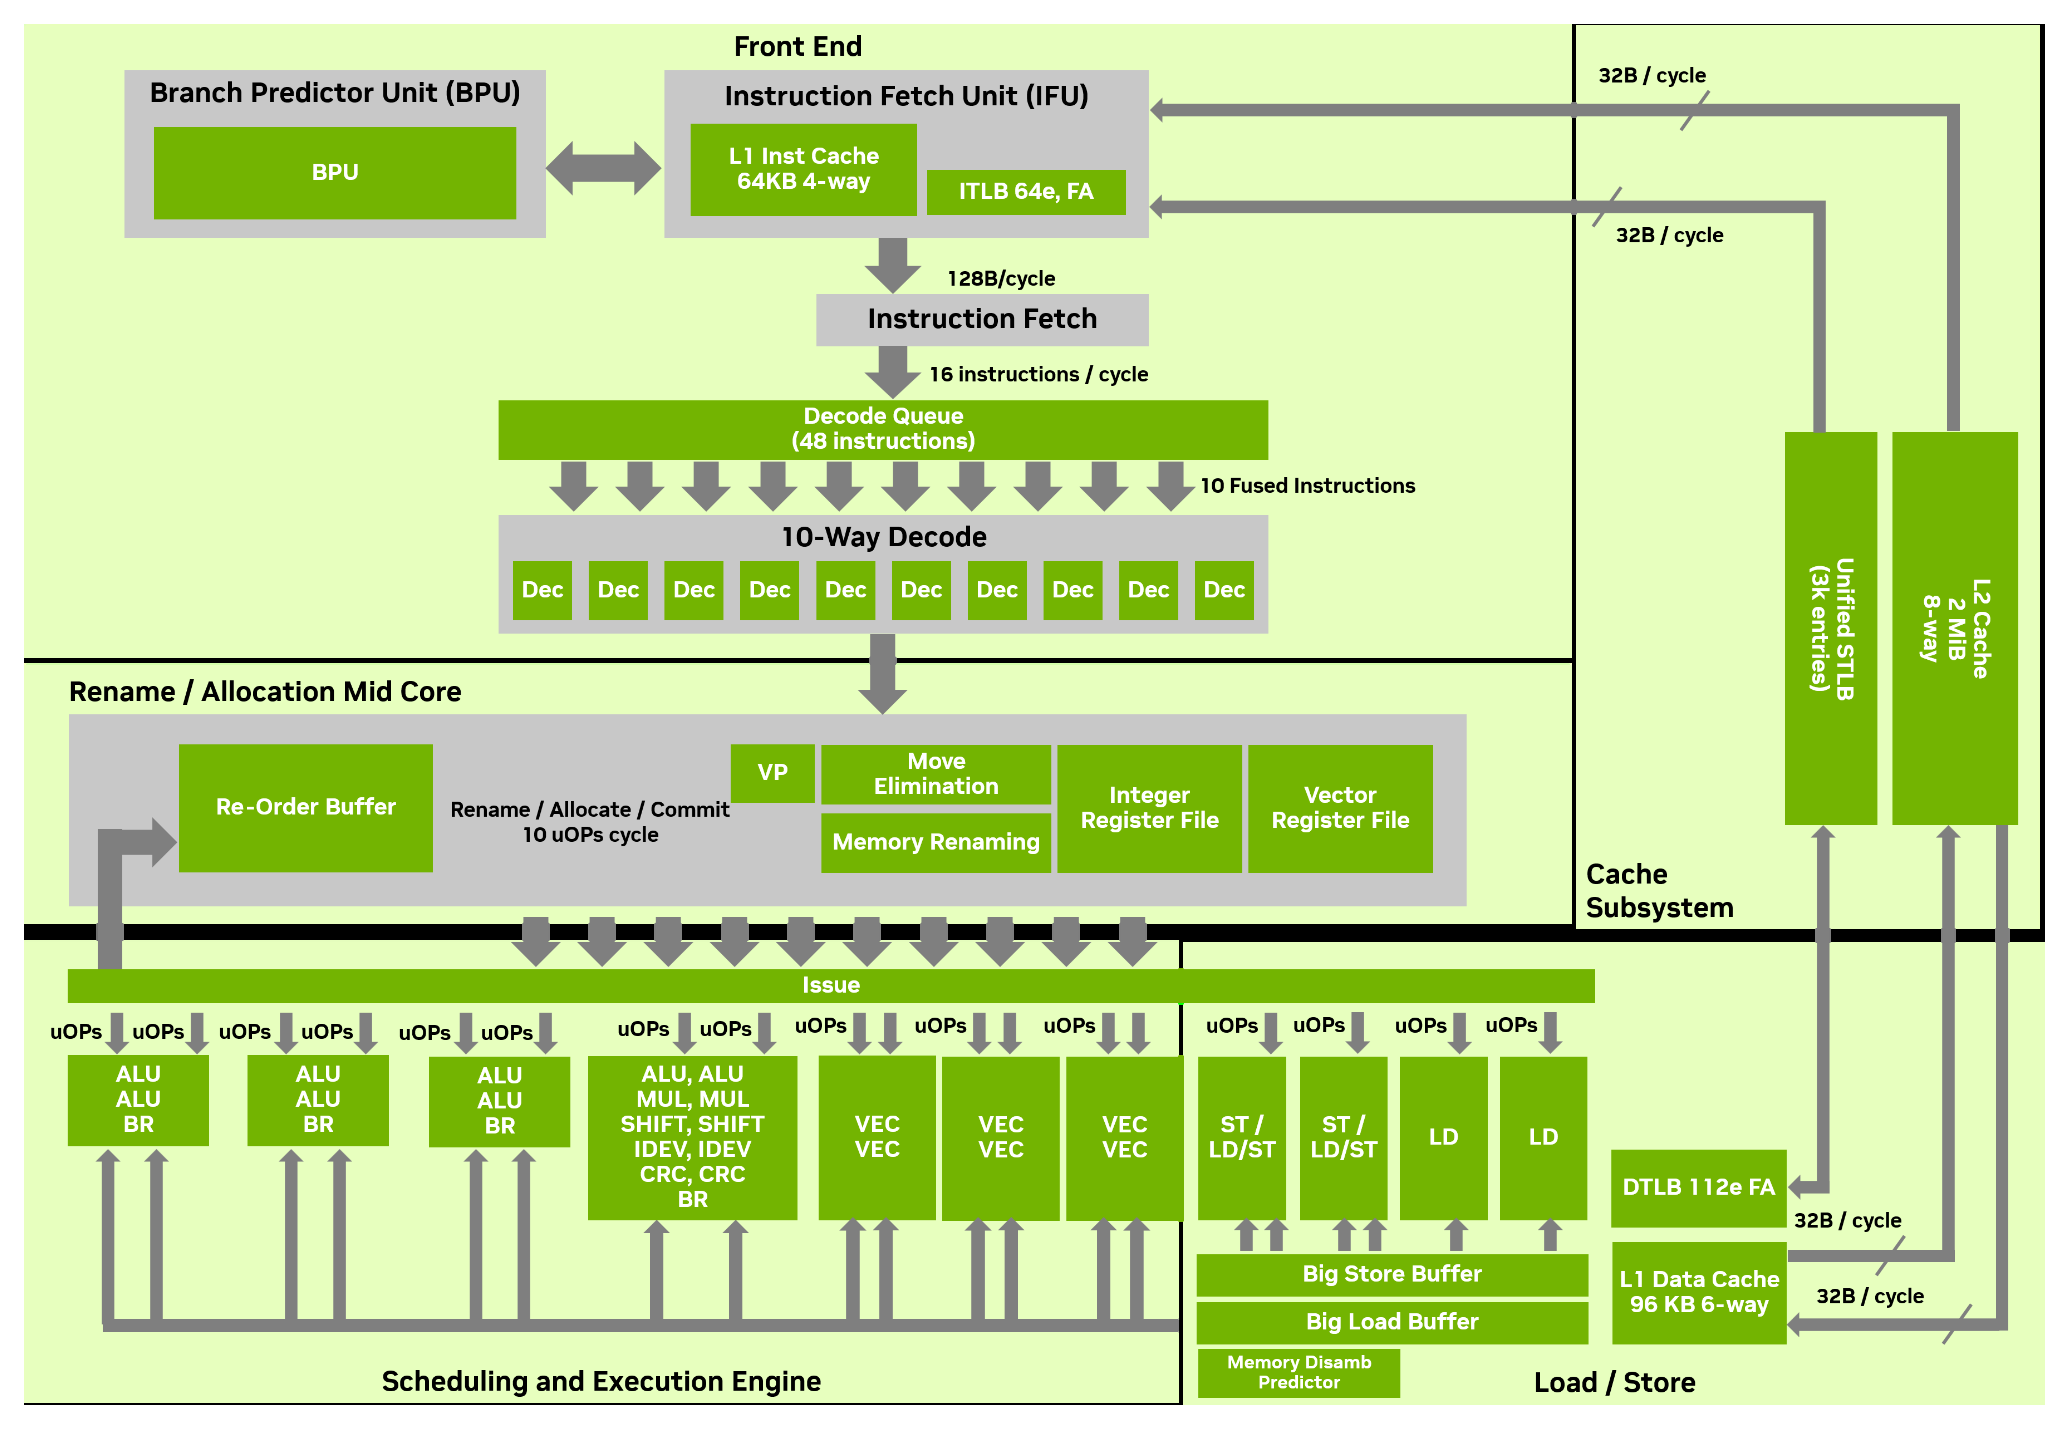
Para alcançar esse IPC, é fundamental um fornecimento constante de instruções úteis. O front-end do Olympus, a parte do núcleo que busca e decodifica as instruções do programa, pode decodificar até dez instruções por ciclo. Essa capacidade só é relevante se o fluxo de instruções for constante, o que se torna difícil quando o software frequentemente ramifica entre caminhos de código. Portanto, o Olympus combina um preditor de ramificação neural com outros preditores especializados e suporta até duas ramificações executadas por ciclo. Uma melhor previsão ajuda o núcleo a buscar as instruções necessárias, reduzindo o tempo gasto executando o caminho errado e reiniciando após um erro.
Uma vez que essas instruções são buscadas e decodificadas, o Olympus usa a execução fora de ordem para encontrar trabalho que possa prosseguir enquanto as instruções anteriores aguardam. Por exemplo, se uma operação estiver aguardando memória, um cálculo independente pode ser executado antes dela. Uma janela de instruções grande oferece ao processador mais oportunidades para encontrar esse trabalho independente.
Mesmo assim, algumas sequências, como as cadeias dependentes descritas acima, resistem a essa abordagem porque cada etapa precisa do resultado da etapa anterior. Para essas sequências, o Olympus também usa a previsão de valores para permitir que as operações dependentes comecem com um valor previsto e, em seguida, verifica esse valor quando o resultado real estiver disponível. Previsões corretas podem reduzir o tempo de espera efetivo ao longo dessas cadeias de dependência; previsões incorretas exigem que o trabalho especulativo seja corrigido e recalculado.
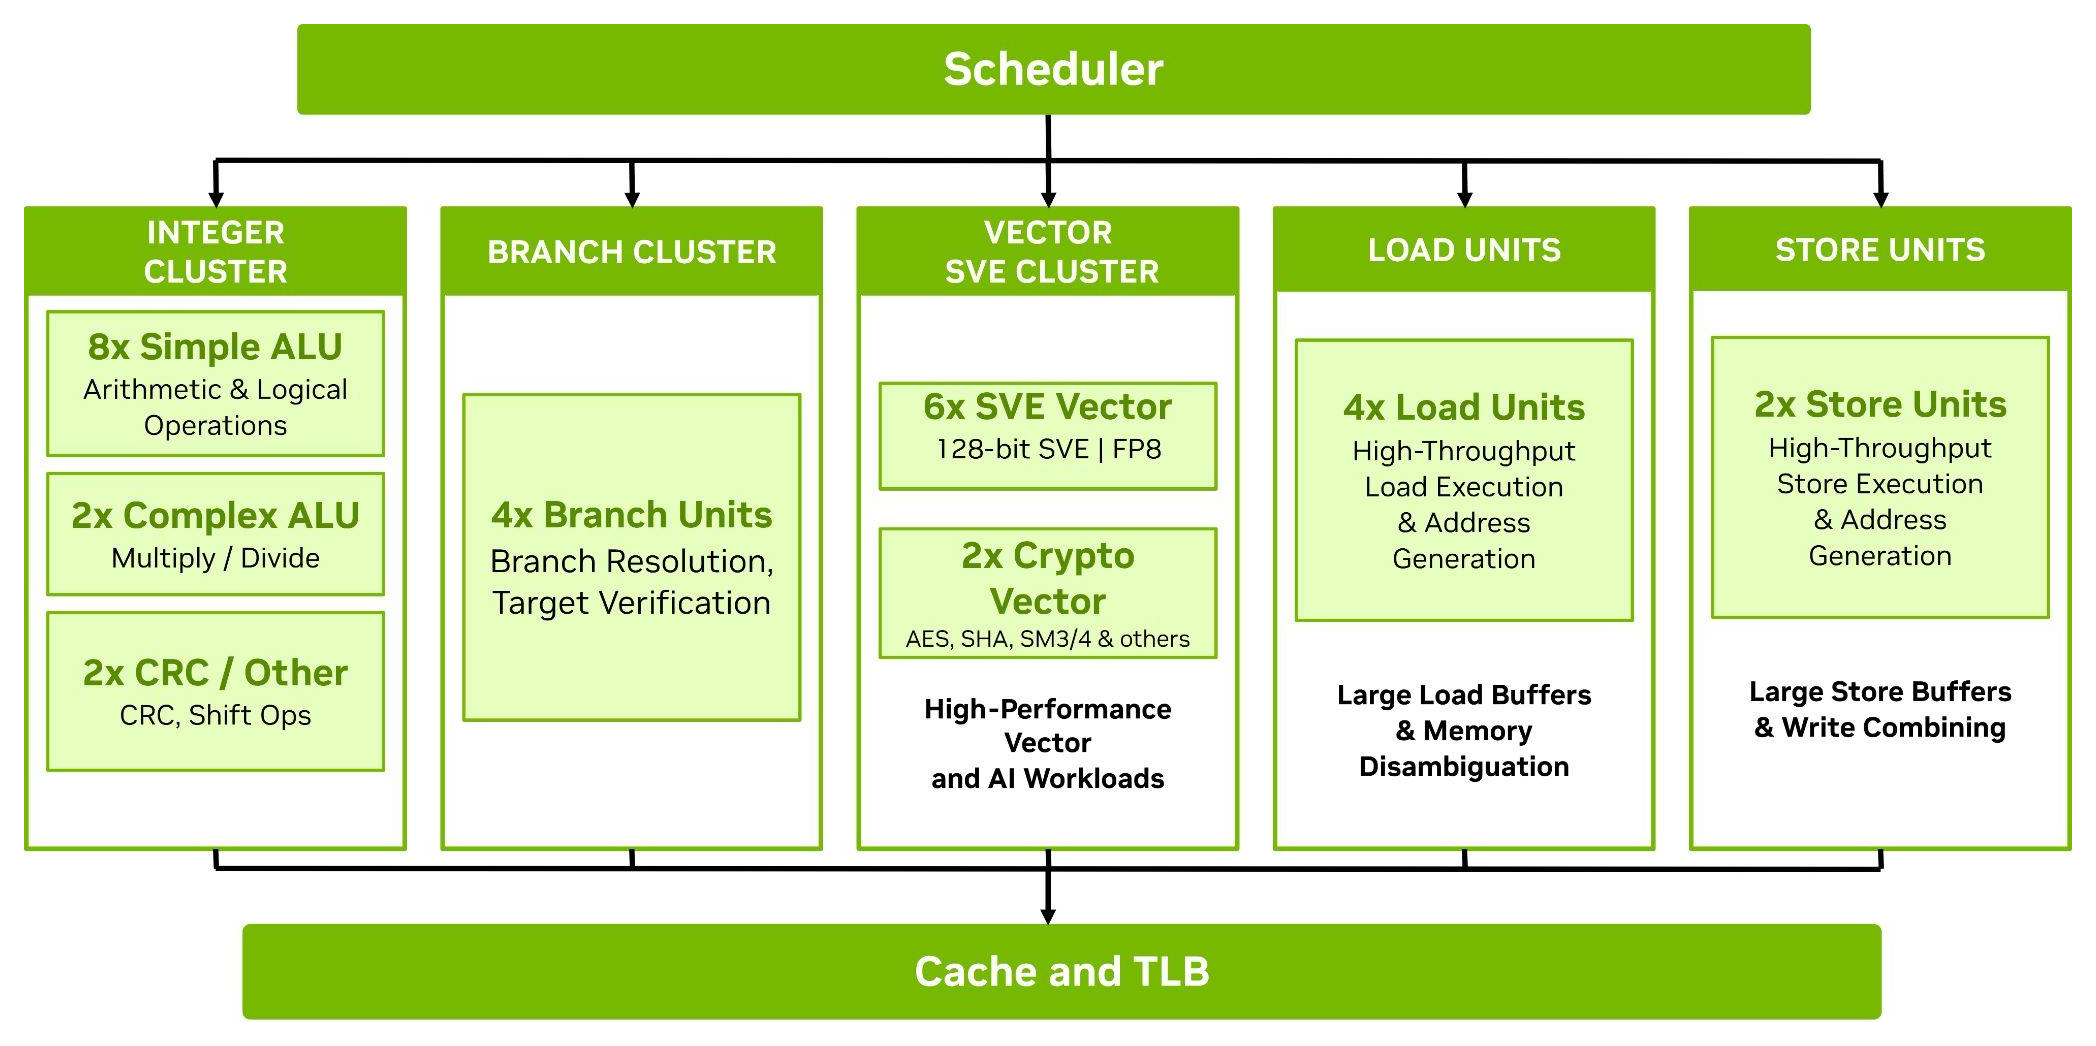
O mecanismo de execução precisa, então, de capacidade suficiente para transformar esse conjunto de instruções em trabalho concluído. O Olympus combina amplos recursos de execução de inteiros com unidades de desvio dedicadas, quatro pipelines de carregamento e dois pipelines de armazenamento. Esses recursos atendem a diferentes demandas: as unidades de inteiros lidam com aritmética, comparações e lógica; as unidades de desvio resolvem o fluxo de controle; e os pipelines de carregamento/armazenamento movem dados entre o núcleo e seus caches. O equilíbrio é importante porque um decodificador mais amplo ofereceria pouco benefício se as instruções simplesmente ficassem acumuladas devido a um gargalo de execução ou de memória.
Além desses recursos escalares, o Olympus possui seis pipelines vetoriais de 128 bits com suporte a SVE2, com suporte a FP8 e recursos criptográficos em dois pipelines. As instruções vetoriais aplicam uma operação a múltiplos elementos de dados, tornando-as úteis para cálculos numéricos, compressão e processamento de dados.
Esta é uma área em que a Olympus faz uma clara concessão: sua largura de vetor de 128 bits é menor que a largura de 512 bits disponível através do AVX-512 em processadores x86 concorrentes. A diferença é importante para kernels numéricos otimizados e até mesmo para tokenizadores, embora o desempenho da aplicação também dependa da taxa de transferência das instruções específicas, do código gerado e do fornecimento de dados. Aplicações científicas como o GROMACS, portanto, continuam sendo um teste à parte dos pontos fortes do projeto.
Cada um desses recursos de execução, escalares ou vetoriais, depende da chegada de dados em tempo hábil; portanto, manter os dados frequentemente usados próximos ao mecanismo de execução é igualmente importante. Cada núcleo possui um cache de instruções de 64 KB, um cache de dados de 96 KB e um cache L2 privado de 2 MB. Os pequenos caches de primeiro nível fornecem acesso rápido às instruções e aos dados mais imediatamente úteis; o cache L2, maior, retém uma porção maior do conjunto de trabalho do núcleo antes que um acesso precise percorrer o processador. Atribuir a cada núcleo um cache L2 privado substancial atende ao mesmo objetivo por núcleo: permitir que mais trabalho seja processado localmente, reduzindo a pressão sobre o cache compartilhado e a memória principal.
O pré-carregamento complementa esses caches, trazendo dados antes que uma instrução os solicite. Além dos pré-carregadores para padrões de acesso regulares, o Olympus inclui um pré-carregador de grafos para acessos indiretos, como A[B[i]], onde uma consulta fornece o índice para outra. Após aprender essa relação, o hardware pode começar a buscar o segundo dado antes que o programa o solicite. Isso ajuda a resolver um problema comum no processamento de grafos e outras cargas de trabalho irregulares: o processador tem ampla capacidade de execução, mas o progresso depende de encontrar o próximo dado.
A peça final do Olympus aborda a outra metade de seu objetivo: executar várias tarefas simultaneamente. Cada núcleo suporta dois threads de hardware, dando ao Vera 176 threads por soquete. A NVIDIA chama esse esquema de Multithreading Espacial. O núcleo pode dedicar seus recursos a um thread ativo ou dividir os recursos entre dois threads ativos, oferecendo a opção de concentrar a capacidade de execução em um fluxo de instruções ou suportar mais trabalho simultâneo.
O objetivo declarado da NVIDIA é reduzir a interferência entre as duas threads, tornando o desempenho mais previsível quando ambas estão ocupadas, que é a mesma previsibilidade da qual as cargas de trabalho com agentes dependem sob carga. As duas threads ainda compartilham um núcleo físico e o sistema de memória mais amplo, portanto, o particionamento de recursos não garante uma latência fixa para o aplicativo.
Tecido, memória e E/S
Além do núcleo individual, manter 88 núcleos de processamento em produção exige mais do que uma conexão rápida com a DRAM. Os núcleos também precisam trocar dados, acessar o cache compartilhado e se comunicar com os dispositivos conectados. O Vera conecta esses recursos por meio da segunda geração do Scalable Coherency Fabric da NVIDIA, uma malha interna que também mantém as cópias em cache dos dados compartilhados coerentes. Os núcleos, a malha e o cache de sistema de 164 MB estão localizados em um único chip de computação, com os controladores de memória e E/S em chiplets adjacentes. A NVIDIA classifica a malha com 3.4 TB/s de largura de banda de bisseção, uma medida da capacidade de tráfego na malha, separada da largura de banda da memória principal.
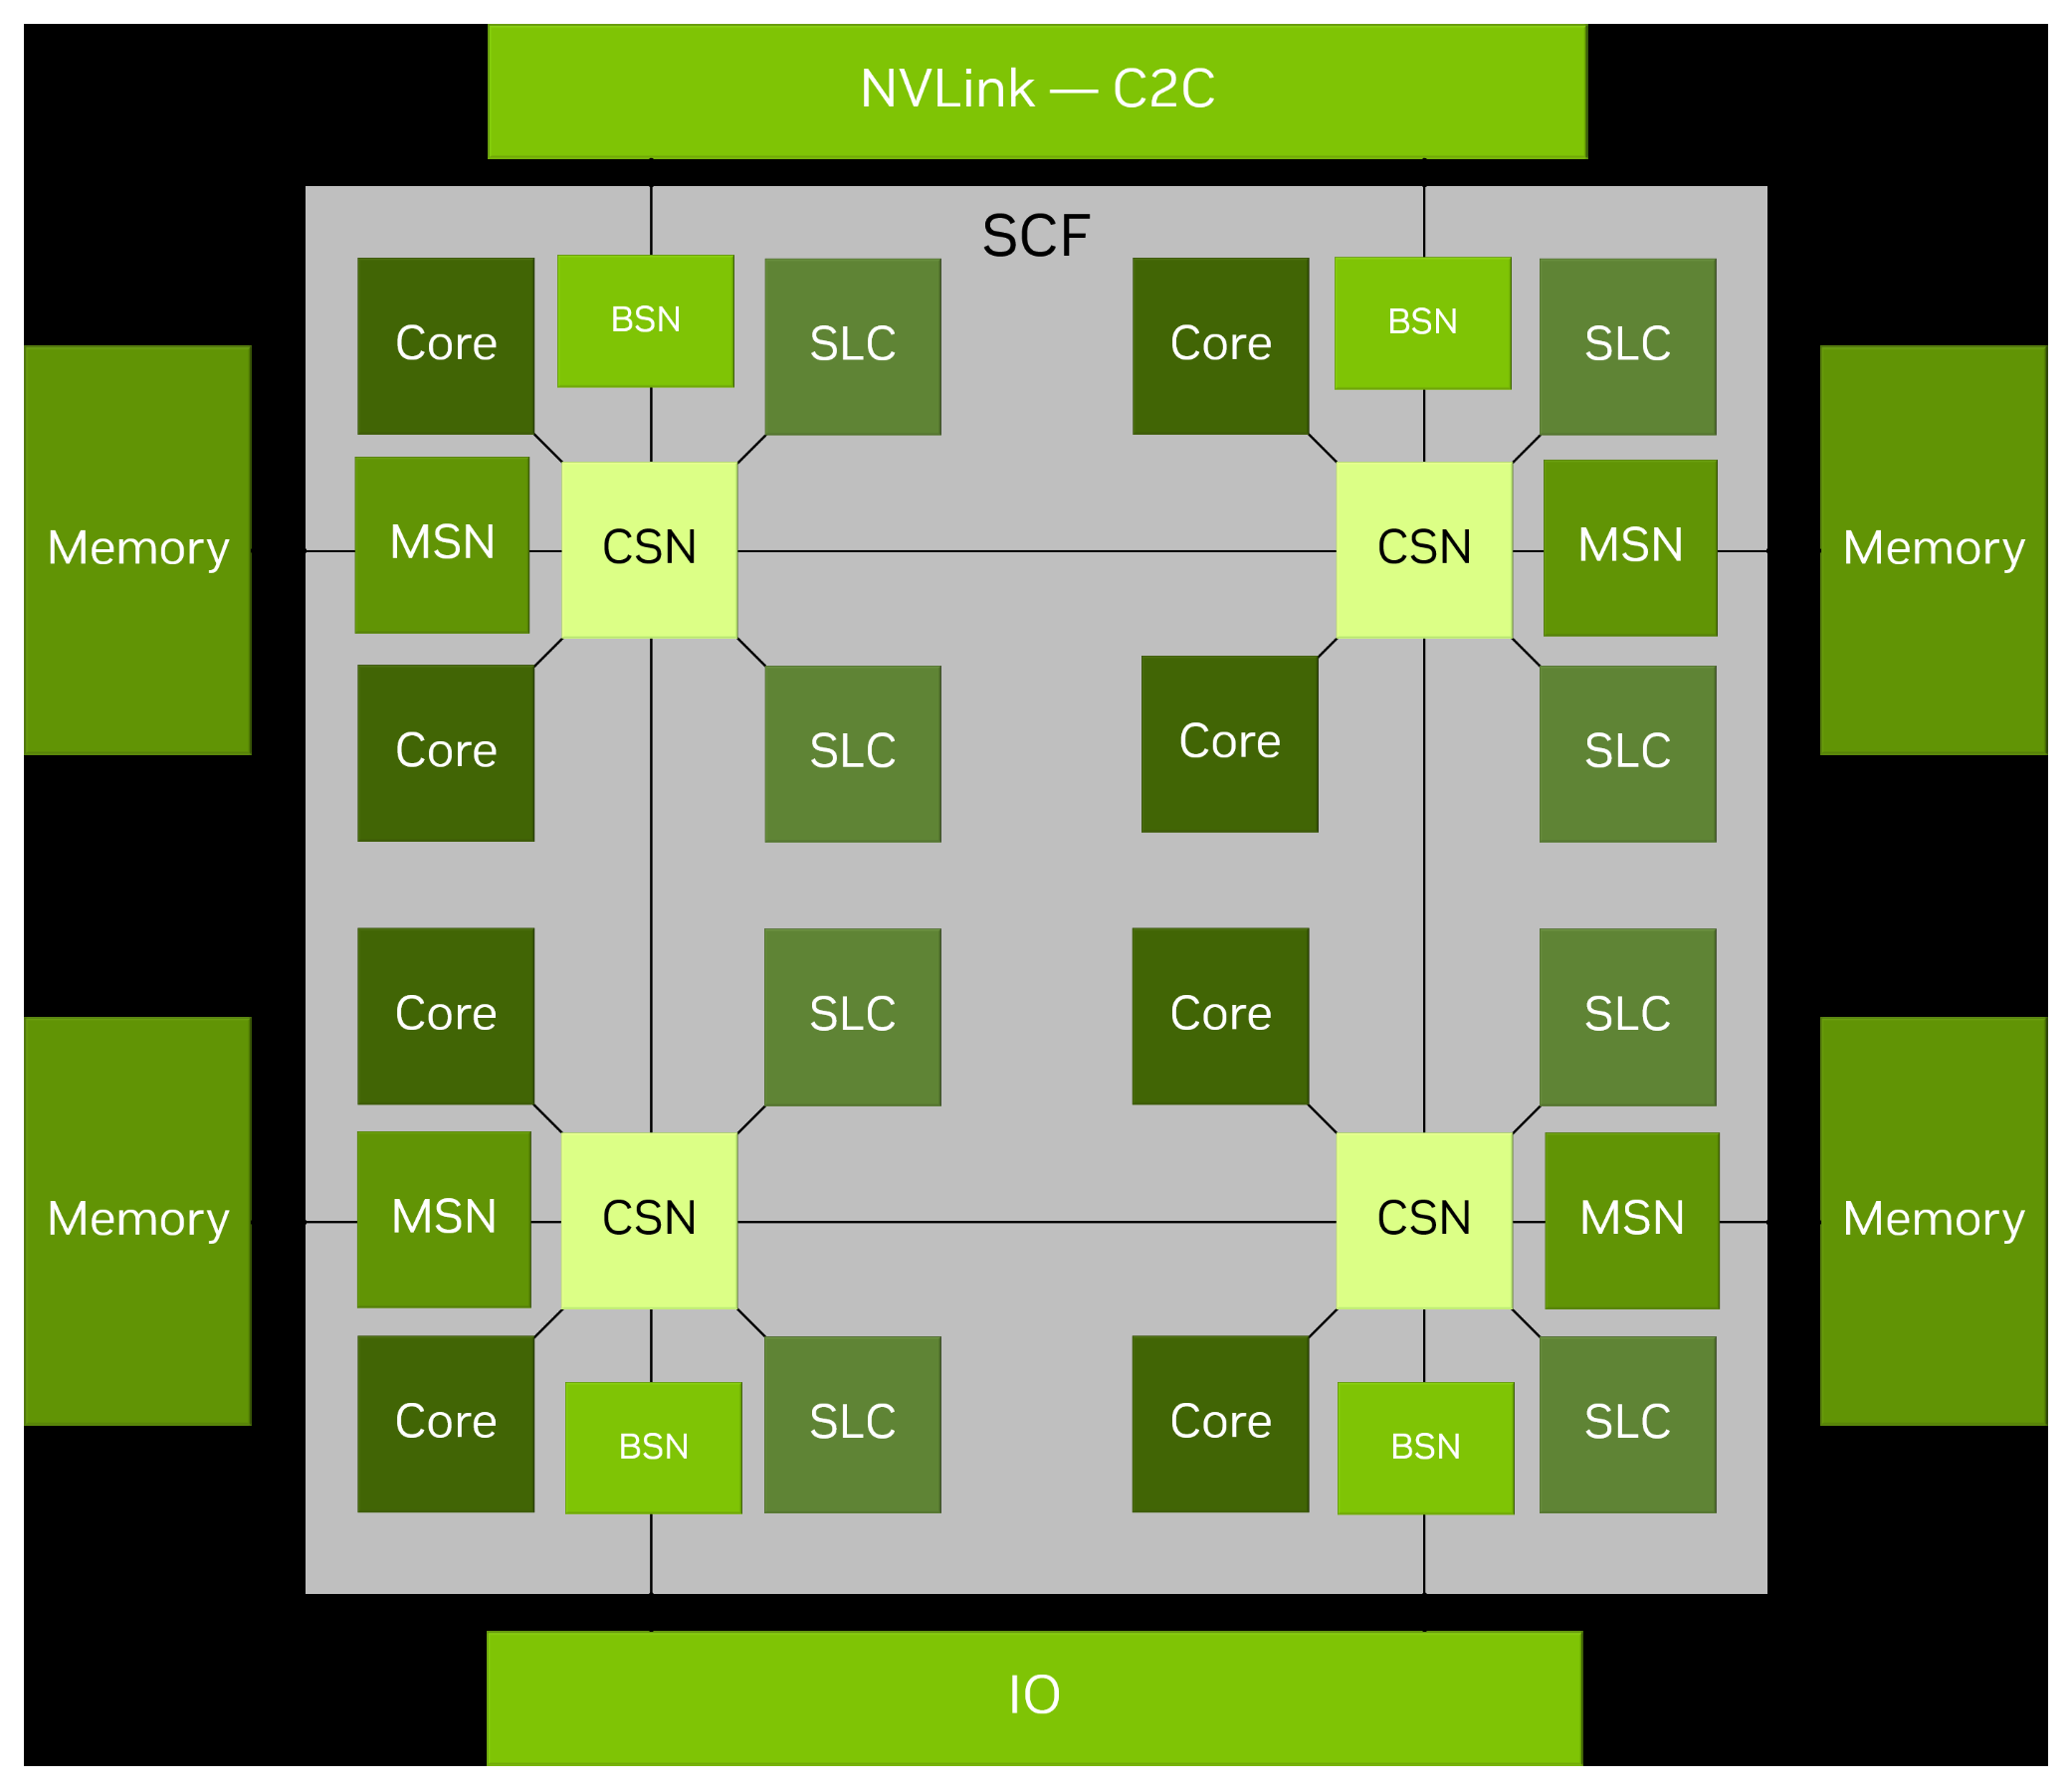
Esse layout de chip único evita transferências entre chips de computação separados quando os núcleos se comunicam ou acessam o cache compartilhado. Para o software, o Vera também apresenta um nó NUMA por soquete: o sistema operacional vê cada soquete como um grupo de núcleos e memória localmente conectada. Isso simplifica o posicionamento dentro do soquete, embora não signifique que todos os caminhos através da malha tenham latência idêntica. Um servidor com dois soquetes ainda possui dois nós NUMA, e o acesso à memória do outro soquete continua sendo diferente do acesso à memória local.
Dentro de cada soquete, o cache compartilhado em nível de sistema, ou L3, fica um nível acima dos caches L2 privados descritos anteriormente. Ele oferece aos núcleos outra oportunidade de reutilizar dados sem precisar acessar a DRAM e fornece capacidade compartilhada acessível em todo o soquete. Seus 164 MB são consideráveis, mas alguns processadores concorrentes oferecem L3 com muito mais capacidade. Isso é importante quando um conjunto de dados acessado repetidamente é grande demais para o L2 de um núcleo, mas cabe em um cache compartilhado maior. A alta largura de banda da DRAM ajuda quando os dados precisam vir da memória; ela não elimina a vantagem de evitar esse acesso em primeiro lugar.
Como essa capacidade é compartilhada, o Vera também oferece suporte ao Arm MPAM, permitindo que o software do sistema particione a capacidade de cache compartilhada e gerencie as alocações de largura de banda de memória entre as cargas de trabalho.
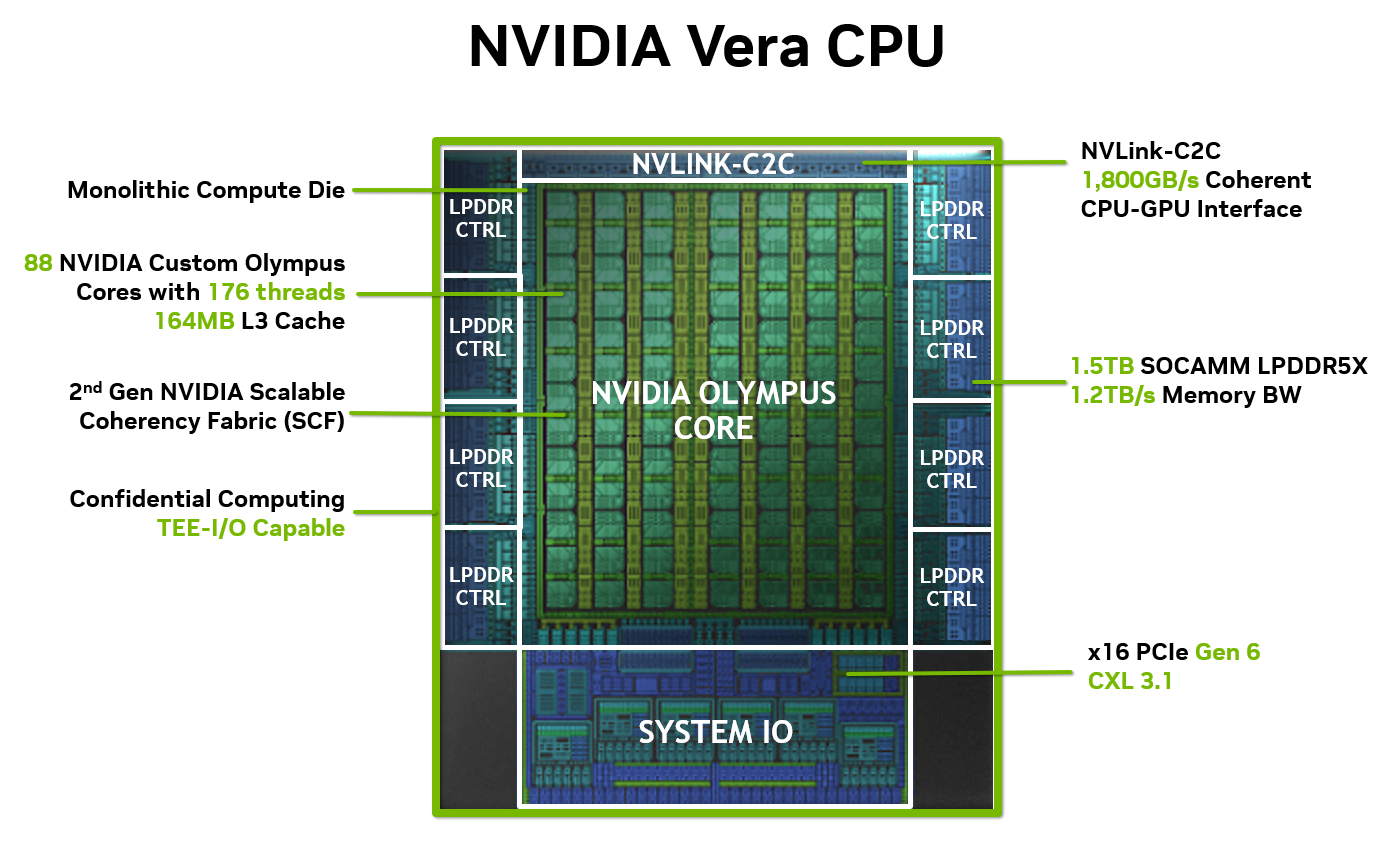
Quando os acessos atingem a memória principal, o Vera dispõe de uma largura de banda considerável. Oito controladores LPDDR5X de 128 bits fornecem uma interface agregada de 1,024 bits, com a memória operando a até 9,600 MT/s, resultando em uma taxa nominal de 1.2 TB/s por soquete. A memória é distribuída em oito módulos SOCAMM2 removíveis, combinando LPDDR5X com módulos substituíveis em campo. Isso confere ao Vera uma interface de memória ampla e rápida, sem a necessidade de soldar a memória diretamente na placa.
A largura de banda bruta é apenas parte da história. A relação mais útil é entre essa largura de banda e o número de núcleos que a compartilham. Dividindo os 1.2 TB/s nominais por 88 núcleos, obtemos cerca de 13.6 GB/s por núcleo físico. Essa é uma forma de descrever o equilíbrio do processador, não uma alocação dedicada ou uma garantia do que cada thread receberá. Aumentar o número de núcleos sem um aumento correspondente na largura de banda da memória reduziria essa proporção.
Dividindo a largura de banda STREAM medida pelo número de núcleos físicos, obtemos 11.8 GB/s por núcleo no Vera, em comparação com 3.8 GB/s no sistema Xeon 6978P de 240 núcleos. Este é um exemplo concreto de como o Vera oferece uma taxa de transferência de memória substancial em relação aos seus recursos computacionais.
A eficiência energética faz parte da mesma escolha de design. A NVIDIA estima um consumo de aproximadamente 30 W a 40 W para um subsistema de memória LPDDR5X totalmente preenchido, dependendo da capacidade. O atrativo do LPDDR5X é fornecer essa largura de banda, mantendo a contribuição da memória para o consumo total de energia do servidor baixa, liberando mais recursos de energia e refrigeração do sistema para computação.
A largura de banda e a eficiência ainda não dizem nada sobre a quantidade de dados que podem ser armazenados, e a capacidade continua sendo uma consideração à parte. A NVIDIA especifica até 1.5 TB de LPDDR5X conectado diretamente por soquete, ou 3 TB em dois soquetes. Para cargas de trabalho que precisam que seu conjunto de trabalho esteja residente na memória, taxas de transferência mais altas não compensam a capacidade insuficiente.
Quando a capacidade de conexão direta não for suficiente, a E/S do Vera oferece uma alternativa, juntamente com conexões para dispositivos. A plataforma de CPU independente fornece 88 pistas PCIe Gen6 por soquete para rede, armazenamento e aceleradores, enquanto a configuração Vera Rubin expõe 96. No lado da memória, o suporte a CXL 3.1 inclui dispositivos de memória Tipo 3 e agrupamento de memória, permitindo que a capacidade se estenda além dos módulos SOCAMM2. Essa memória expandida usa um caminho de acesso diferente da LPDDR5X conectada diretamente, portanto, seu desempenho deve ser avaliado separadamente.
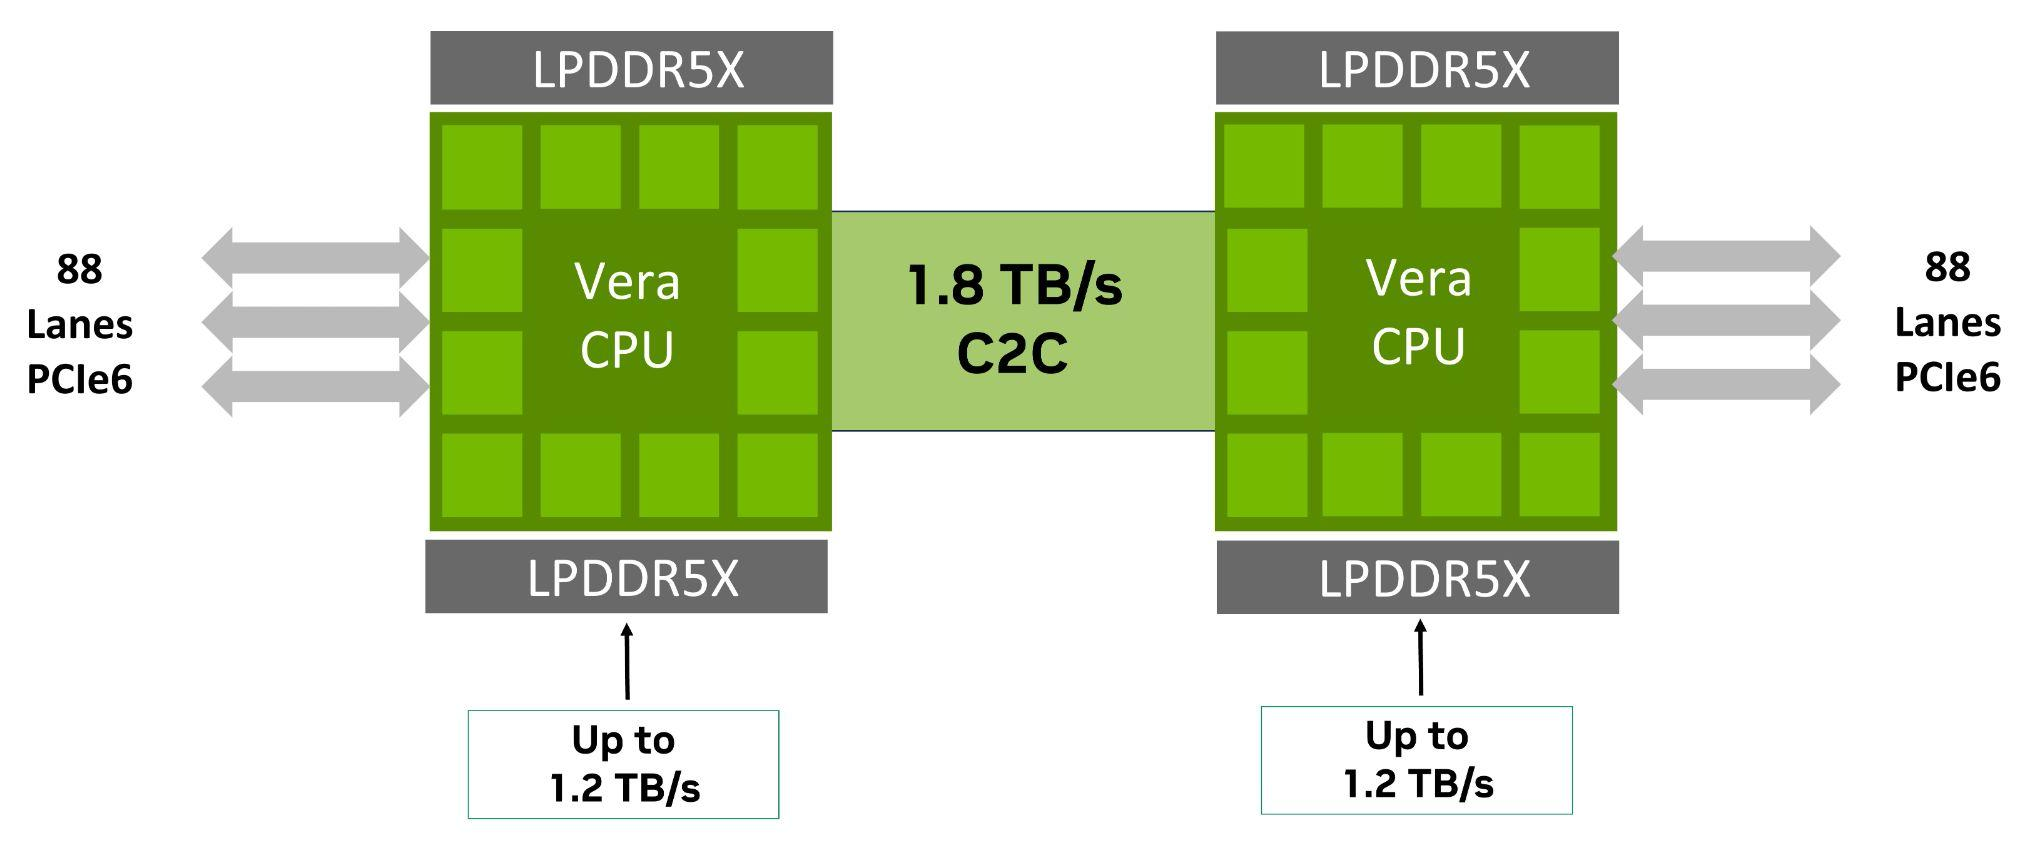
Por fim, para a comunicação entre processadores, o Vera utiliza a segunda geração do NVLink-C2C, sucessor da tecnologia introduzida com os superchips Grace. Ele conecta duas CPUs Vera em um servidor de dois soquetes ou liga o Vera a GPUs Rubin em um superchip. A conexão oferece até 1.8 TB/s de largura de banda bidirecional agregada, ou 900 GB/s em cada direção, e reflete a mesma integração estreita entre CPU e GPU que impulsionou a entrada da NVIDIA no mercado de CPUs.
Por dentro do servidor de referência MGX Vera C2
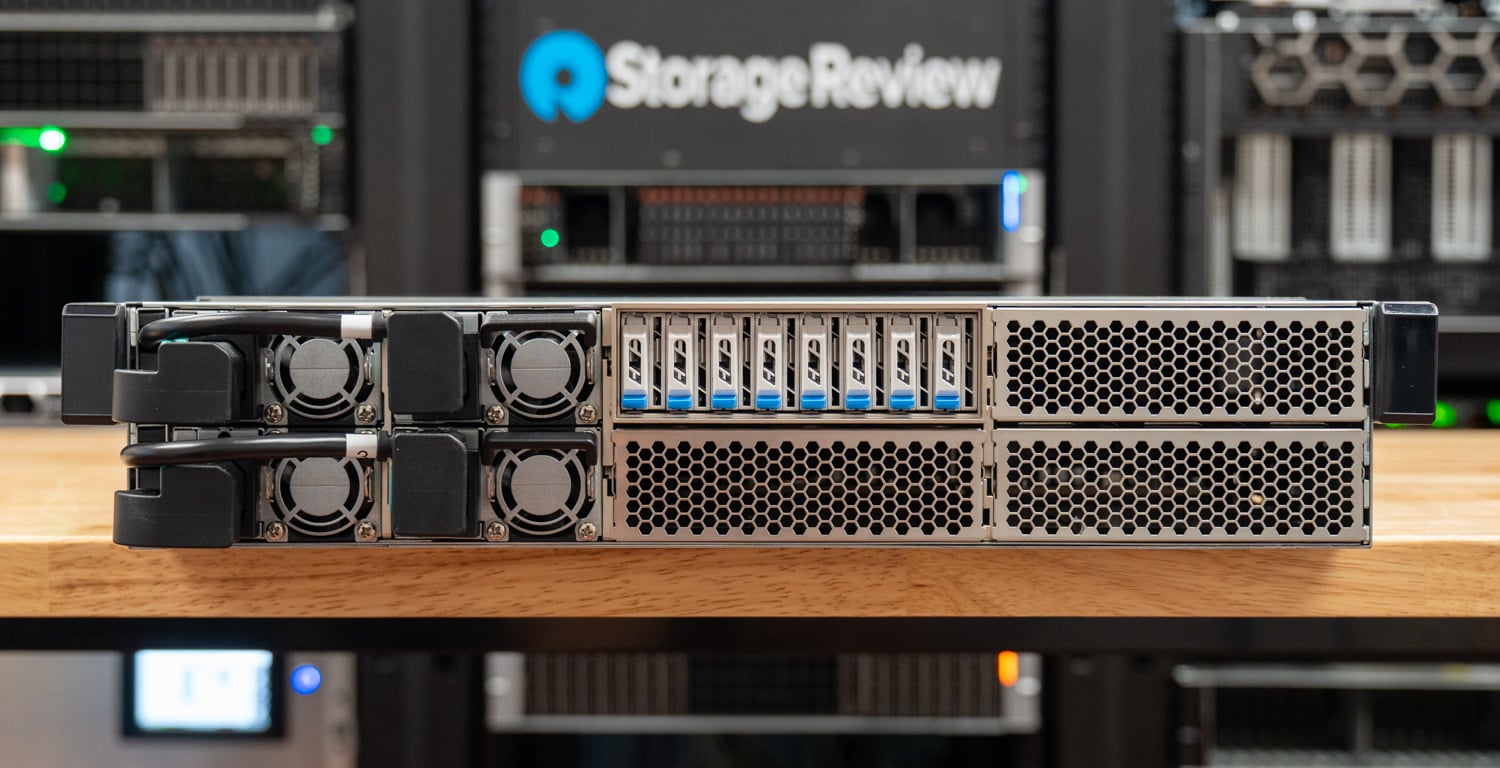
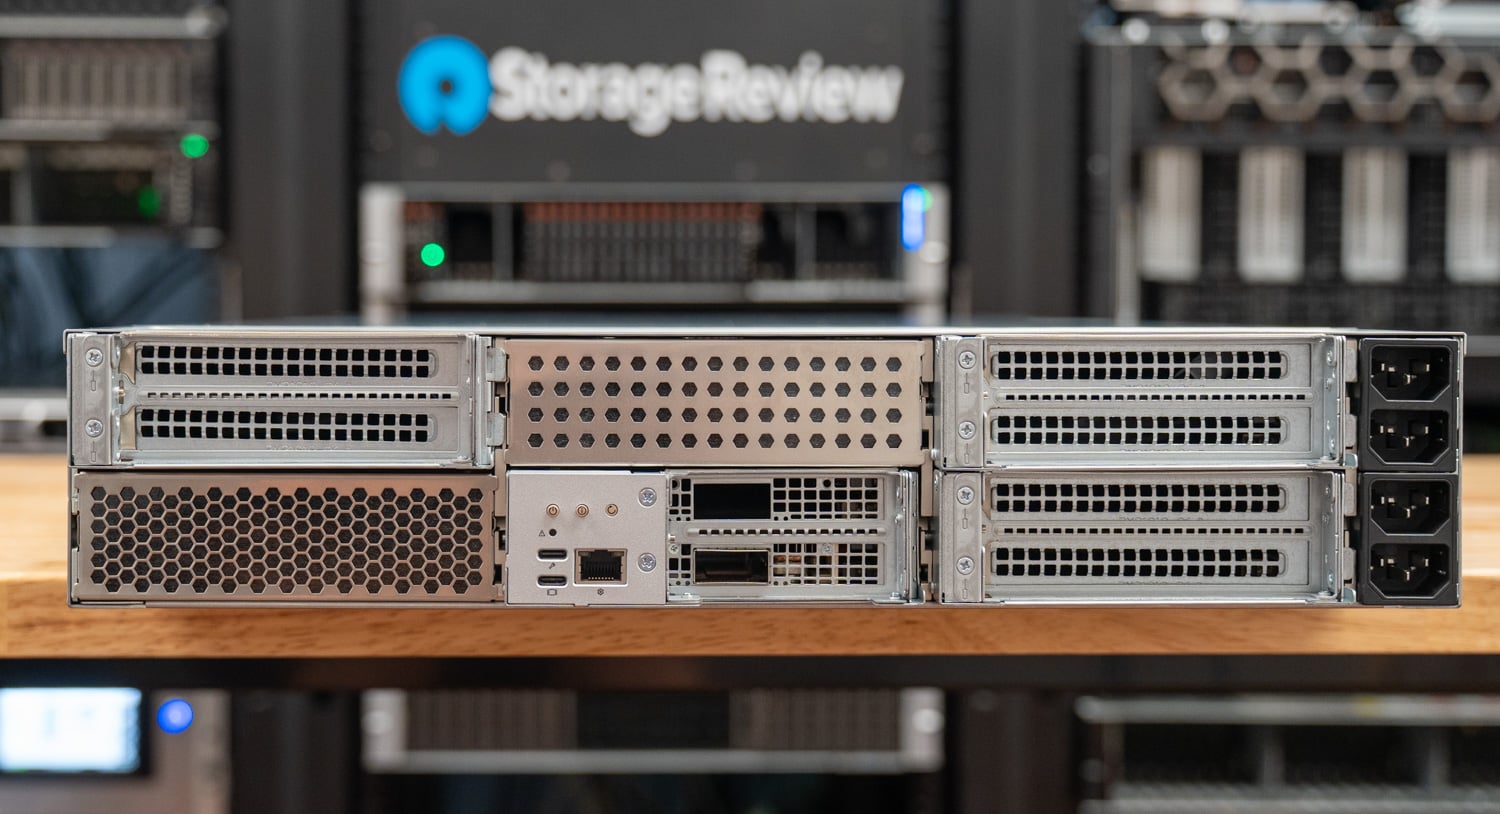
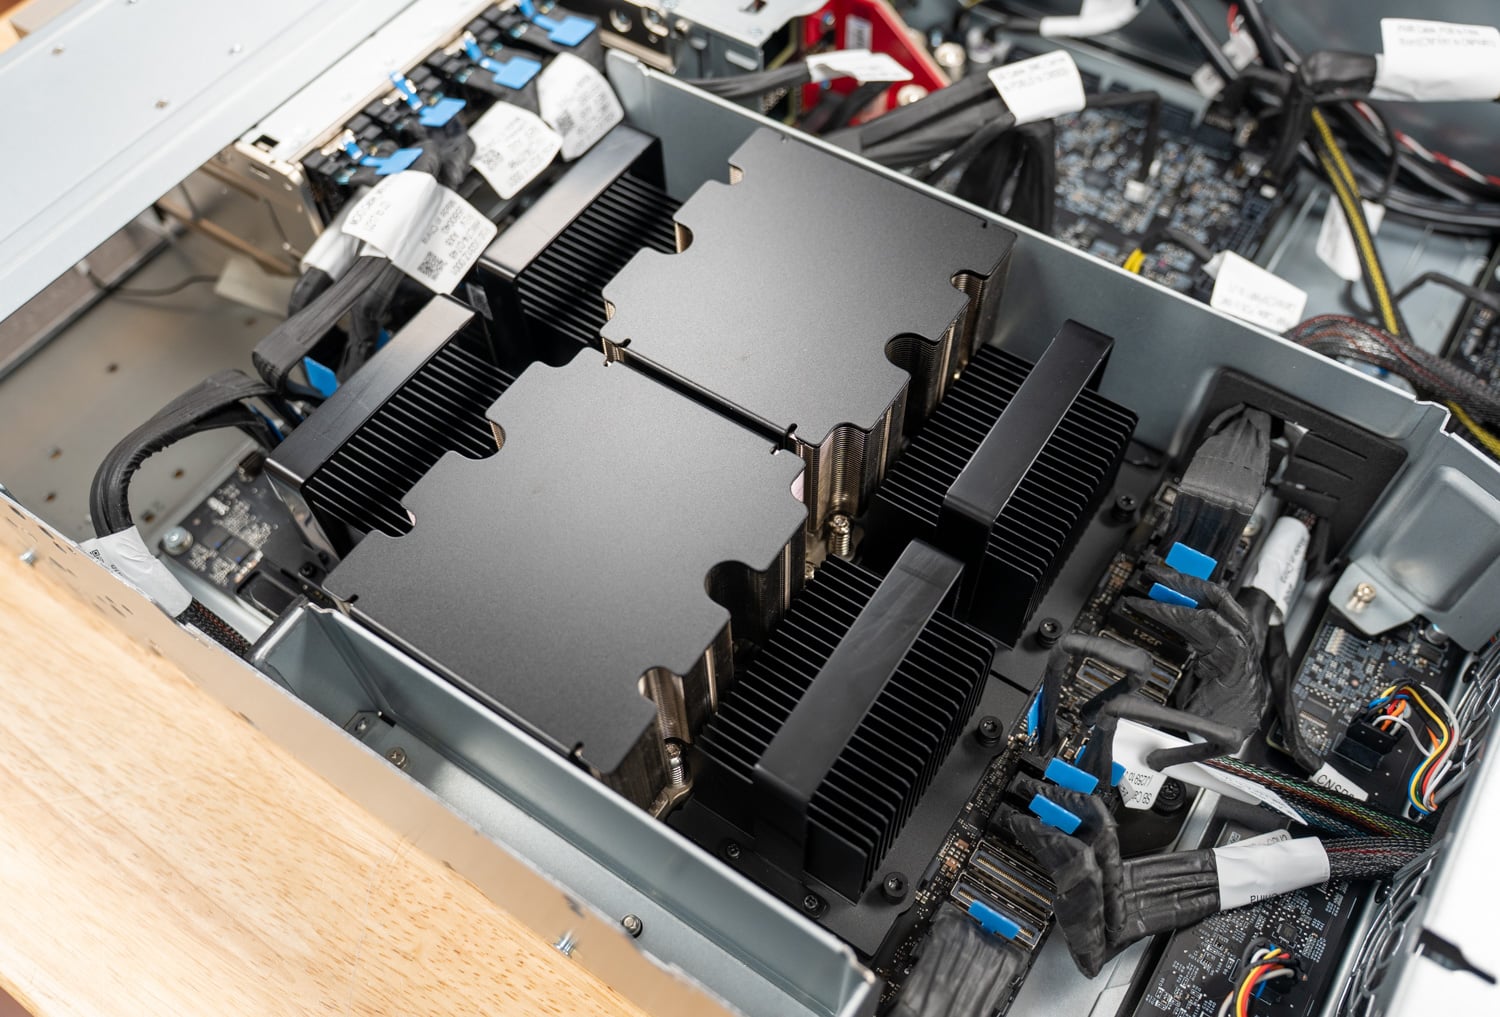
Nossa unidade de teste é o NVIDIA MGX Vera C2, um servidor de referência 2U com dois soquetes e refrigeração a ar, que os parceiros da NVIDIA estão usando como base para seus primeiros sistemas Vera. Oito baias E1.S ocupam a parte superior do painel frontal, ao lado de quatro fontes de alimentação Delta hot-swap, com entradas de ar em formato de colmeia preenchendo o restante da superfície. Como as fontes de alimentação são carregadas pela frente, a parte traseira permanece livre para cabeamento de E/S em um rack e é destinada aos risers PCIe e às portas de gerenciamento de E/S.
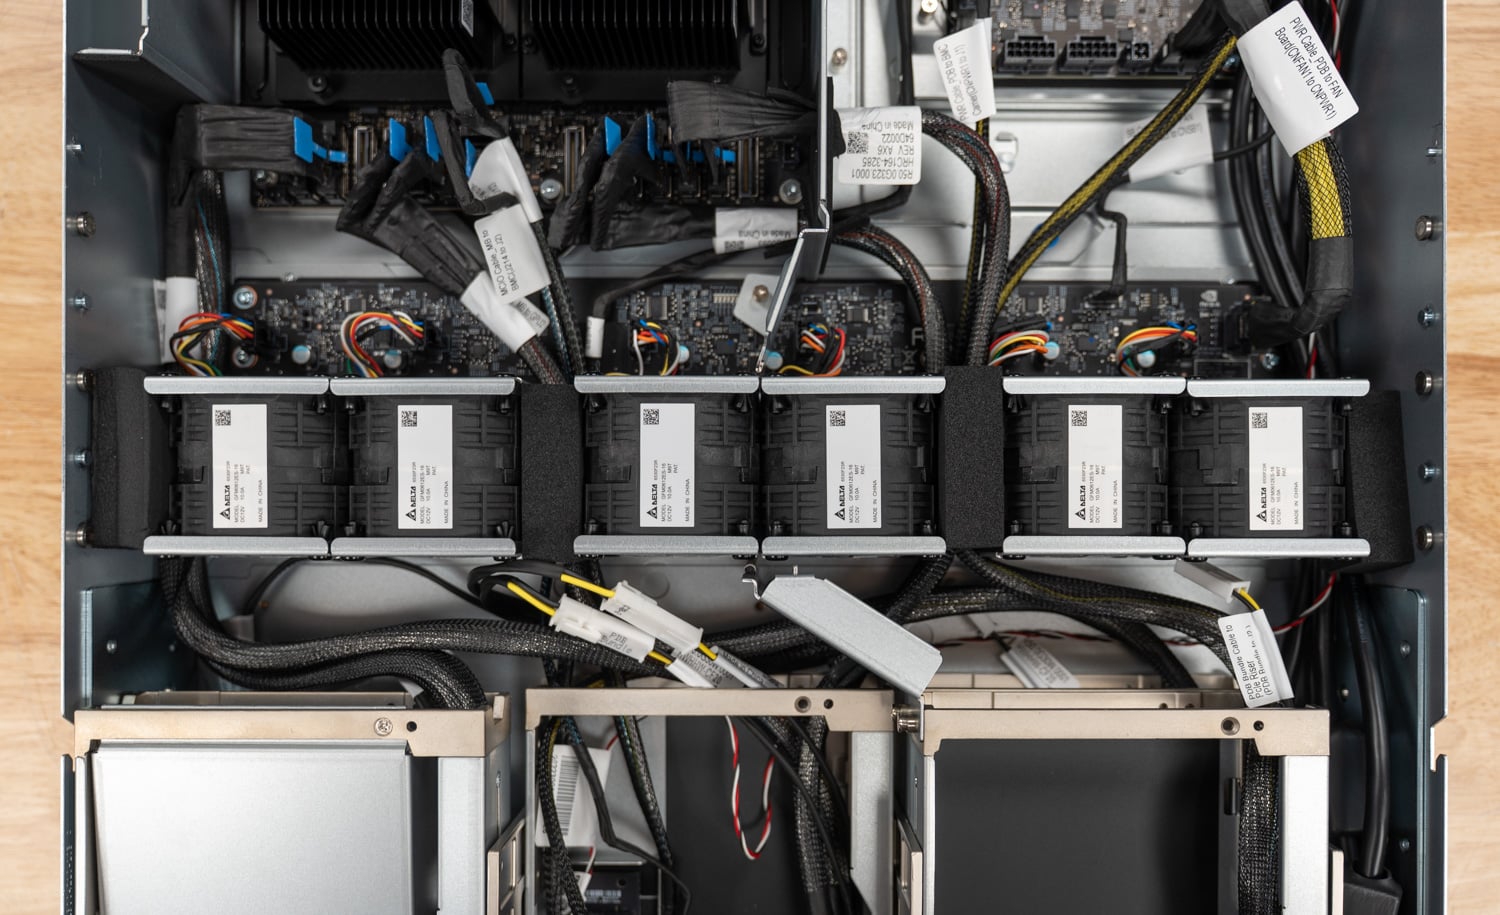
Por dentro, os dois processadores Vera ficam lado a lado sob dissipadores de calor passivos, com módulos SOCAMM2 em suas laterais. Uma parede de seis módulos de ventoinhas no centro do chassi, logo atrás das baias de unidade, puxa o ar através de ambos os soquetes, e blocos de espuma entre cada par de ventoinhas direcionam o fluxo de ar. Do ponto de vista da refrigeração, o layout é bem pensado.
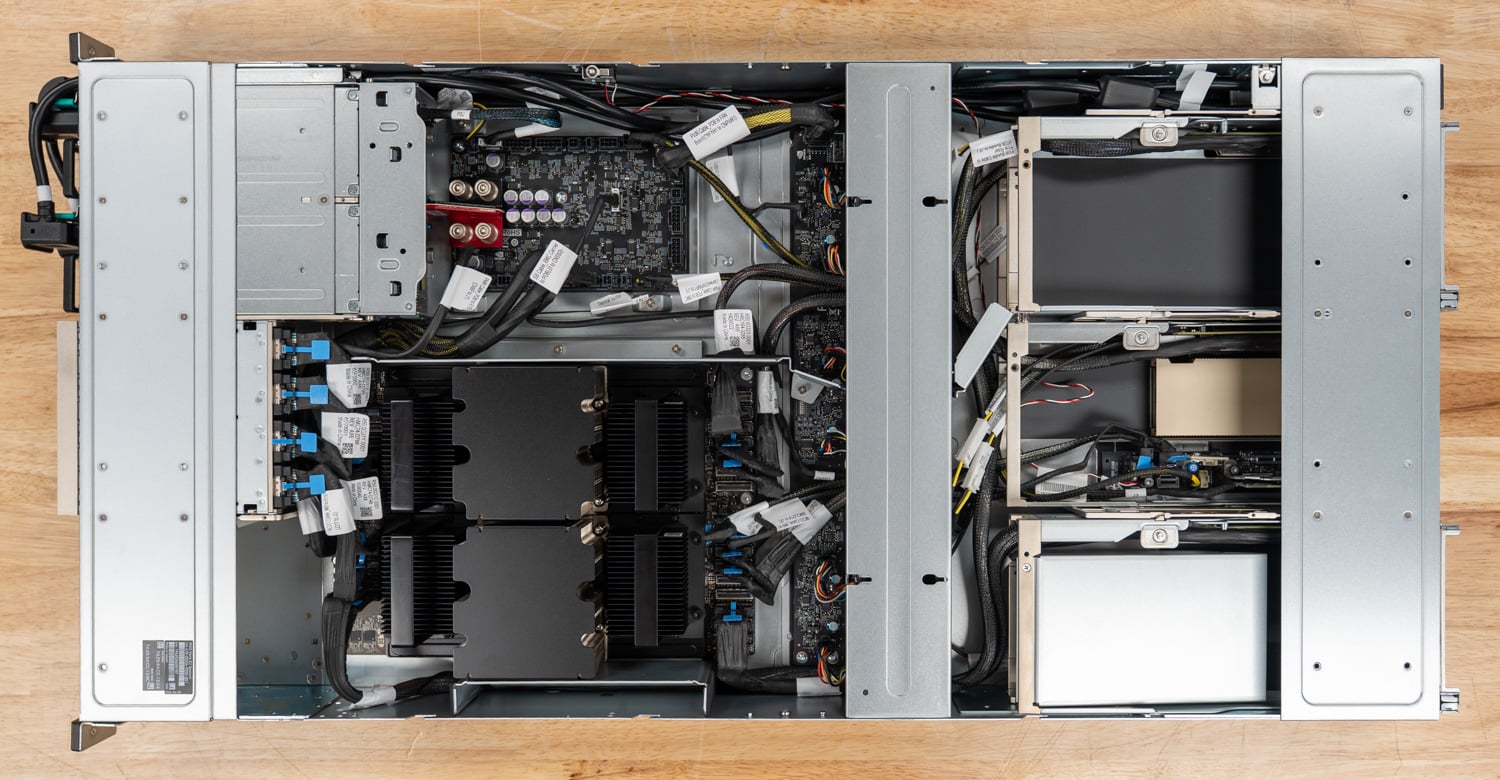
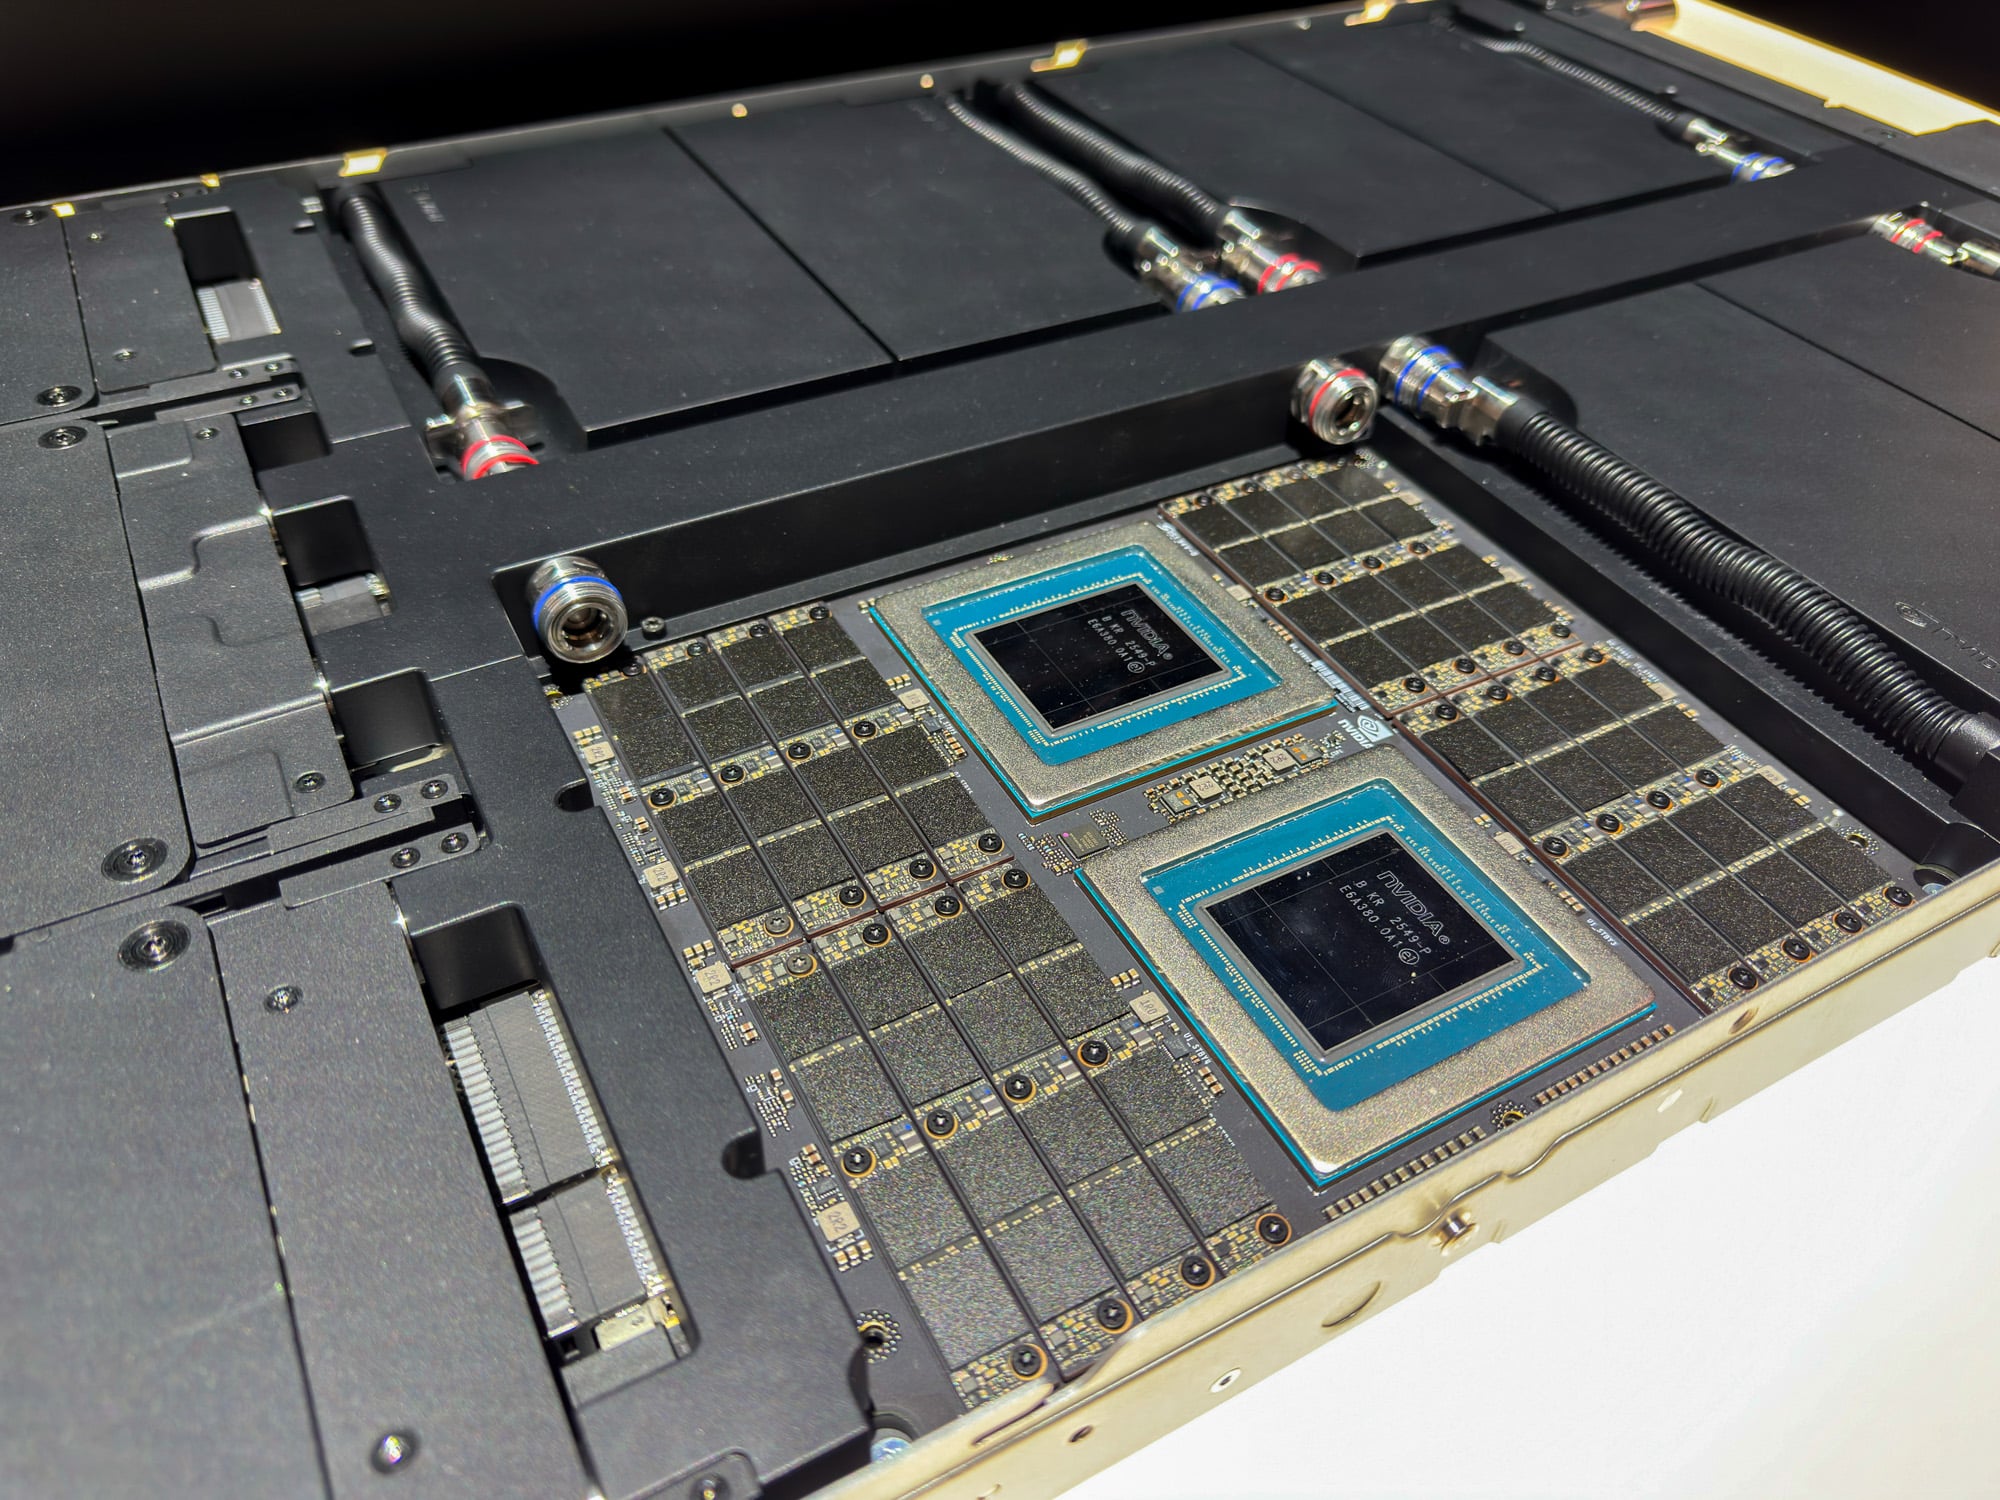
Ambos os processadores são montados diretamente na placa de circuito impresso (PCB), sem soquete, da mesma forma que a NVIDIA utiliza o Vera em seus superchips. Os 16 slots SOCAMM2 circundam os dois componentes, permitindo a substituição da memória em campo, mesmo que os processadores não o sejam; substituir uma CPU significa trocar a placa. Durante o verão, também analisamos a versão com refrigeração líquida da mesma placa, que utiliza tubos de refrigeração de desconexão rápida na parte superior da placa para conectar as placas frias dos processadores, enquanto os módulos SOCAMM2 são refrigerados a ar.
O painel central abriga um adaptador NVIDIA ConnectX-8 para redes de até 800G, e o painel traseiro possui portas USB, DisplayPort e uma porta de rede dedicada para gerenciamento fora da banda.
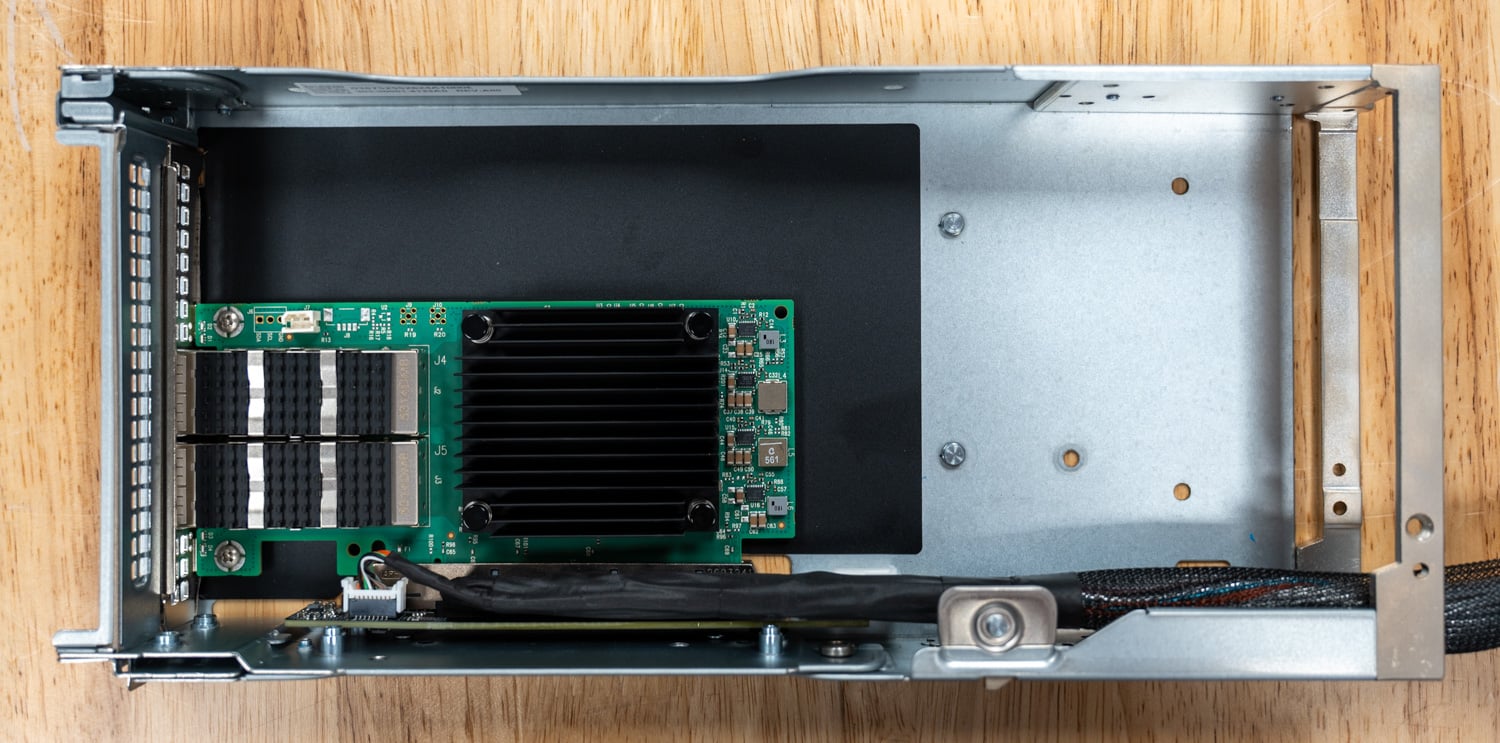
A plataforma é altamente modular e suporta uma variedade de configurações de armazenamento e PCIe traseiras, mas essa flexibilidade tem um custo: o tempo de manutenção. Seus três risers PCIe FHFL parecem fáceis de reparar à primeira vista. Em um servidor típico, trocar uma placa significa soltar o riser, levantar uma aba de suporte ou remover um parafuso e deslizar a placa para fora.
No servidor Vera, primeiro você retira a tampa do ventilador, remove um ou mais blocos de espuma e desconecta e levanta os cabos de alimentação e PCIe do riser. Só então todo o conjunto do riser pode ser deslizado para fora pela parte traseira do chassi. Uma vez que o conjunto esteja livre, ele precisa ser desmontado para acessar a placa e, em seguida, remontado após a troca. Uma tarefa que leva alguns segundos em um servidor convencional leva de 5 a 10 minutos por conjunto aqui.
Na prática, a manutenção no próprio rack está fora de questão, a menos que você esteja preparado para ficar movendo o servidor de um lado para o outro, então a maioria das trocas de componentes exige que o servidor seja levado para uma bancada para manutenção.
Desempenho e benchmarks
Os testes de desempenho examinam como o design do Vera se traduz em desempenho, desde threads individuais até cargas de trabalho que utilizam todo o sistema. Nossos testes abrangem largura de banda e latência de memória, computação científica, software de uso geral e bancos de dados, mostrando como o processador lida com diferentes demandas em seus núcleos e sistema de memória.
Sistemas de teste
| System | NVIDIA MGX Vera C2 | Dell Power Edge R7725 | Dell Power Edge R7725 | Dell PowerEdge R770AP | Dell Power Edge R770 | Dell Power Edge R760 |
|---|---|---|---|---|---|---|
| Processadores | ||||||
| CPU | NVIDIA Vera | AMD EPYC 9965 | AMD EPYC9175F | Intel Xeon 6978P | Intel Xeon 6787P | Intel Xeon Platina 8592+ |
| Sockets | 2 | |||||
| Núcleos/Threads por CPU | 88 / 176 | 192 / 384 | 16 / 32 | 120 / 240 | 86 / 172 | 64 / 128 |
| Relógio Base | 3.4 GHz | 2.25 GHz | 4.2 GHz | 2.1 GHz | 2.0 GHz | 1.9 GHz |
| Relógio máximo | 3.4 GHz | 3.7 GHz | 5.0 GHz | 3.9 GHz | 3.8 GHz | 3.9 GHz |
| Memória | ||||||
| Configuração | 16x 96GB Micron SOCAMM2 | 24x 128GB | 24x 64GB | 32x 64GB | 16x 64GB | |
| Tipo/Velocidade | LPDDR5X-9600 | DDR5-6400 | DDR5-5200 | DDR5-4800 | ||
| Capacidade total | 1.5TB | 3TB | 1.5TB | 2TB | 1TB | |
| Armazenamento | ||||||
| SSD | Solidigm D7-PS1010 7.68 TB | Solidigm D7-PS1030 12.8 TB | Micron 9550 PRO 7.68 TB | Solidigm D7-PS1010 7.68 TB | Samsung PM1745 6.4 TB | Solidigm D7-P5520 3.84 TB |
| Link SSD | PCIe Gen5 x4 | PCIe Gen5 x2 | PCIe Gen5 x4 | PCIe Gen4 x4 | ||
| firmware | ||||||
| BIOS do sistema | NV_SBIOS 06.07.01.06 | 1.5.3 | 1.2.1 | 1.8.5 | 2.8.2 | |
| Perfil da BIOS | Padrão | Desempenho | ||||
| Pilha de software | ||||||
| OS | Ubuntu LTS 26.04.1 | Ubuntu LTS 24.04.5 | ||||
| Núcleo | 7.0.0-2022-nvidia-bos | 6.8.0-142 / 6.8.0-146 | 6.8.0-147 | 6.8.0-138 | 6.8.0-142 / 6.8.0-146 | 6.8.0-142 / 6.8.0-146 |
| GCC | 15.2.0 | 13.3.0 | ||||
| glibc | 2.43 | 2.39 | ||||
| MPI aberto | 5.0.10 | 4.1.6 | ||||
| OpenJDK | 11.0.32 | |||||
Comparamos o Vera com cinco configurações Dell PowerEdge com configuração de memória ideal e os testamos com o mesmo conjunto de testes, abrangendo os processadores EPYC da AMD com maior número de núcleos e frequência otimizada, juntamente com Xeons de gerações atuais e anteriores.
Como o suporte para Olympus foi introduzido no GCC 15, o Vera executava uma pilha de software mais recente do que os sistemas x86, conforme listado acima. As versões de benchmark, entradas e flags de compilação eram idênticas em todos os sistemas.
Largura de banda de memória
A memória é o ponto em que o Vera mais se diferencia do x86, então começamos nossos testes por aí. Testamos o STREAM Triad, executado com uma thread OpenMP por núcleo físico em arrays de 16 GiB. O teste principal utiliza todos os núcleos do sistema, com os dados de cada thread alocados no mesmo socket. Em seguida, repetimos o teste com os núcleos do socket 0 lendo primeiro sua memória local e depois a memória do socket remoto, e com cada núcleo lendo páginas intercaladas entre os dois sockets. O gráfico abaixo mostra os resultados do Triad em todo o sistema para cada servidor com o SMT desativado.
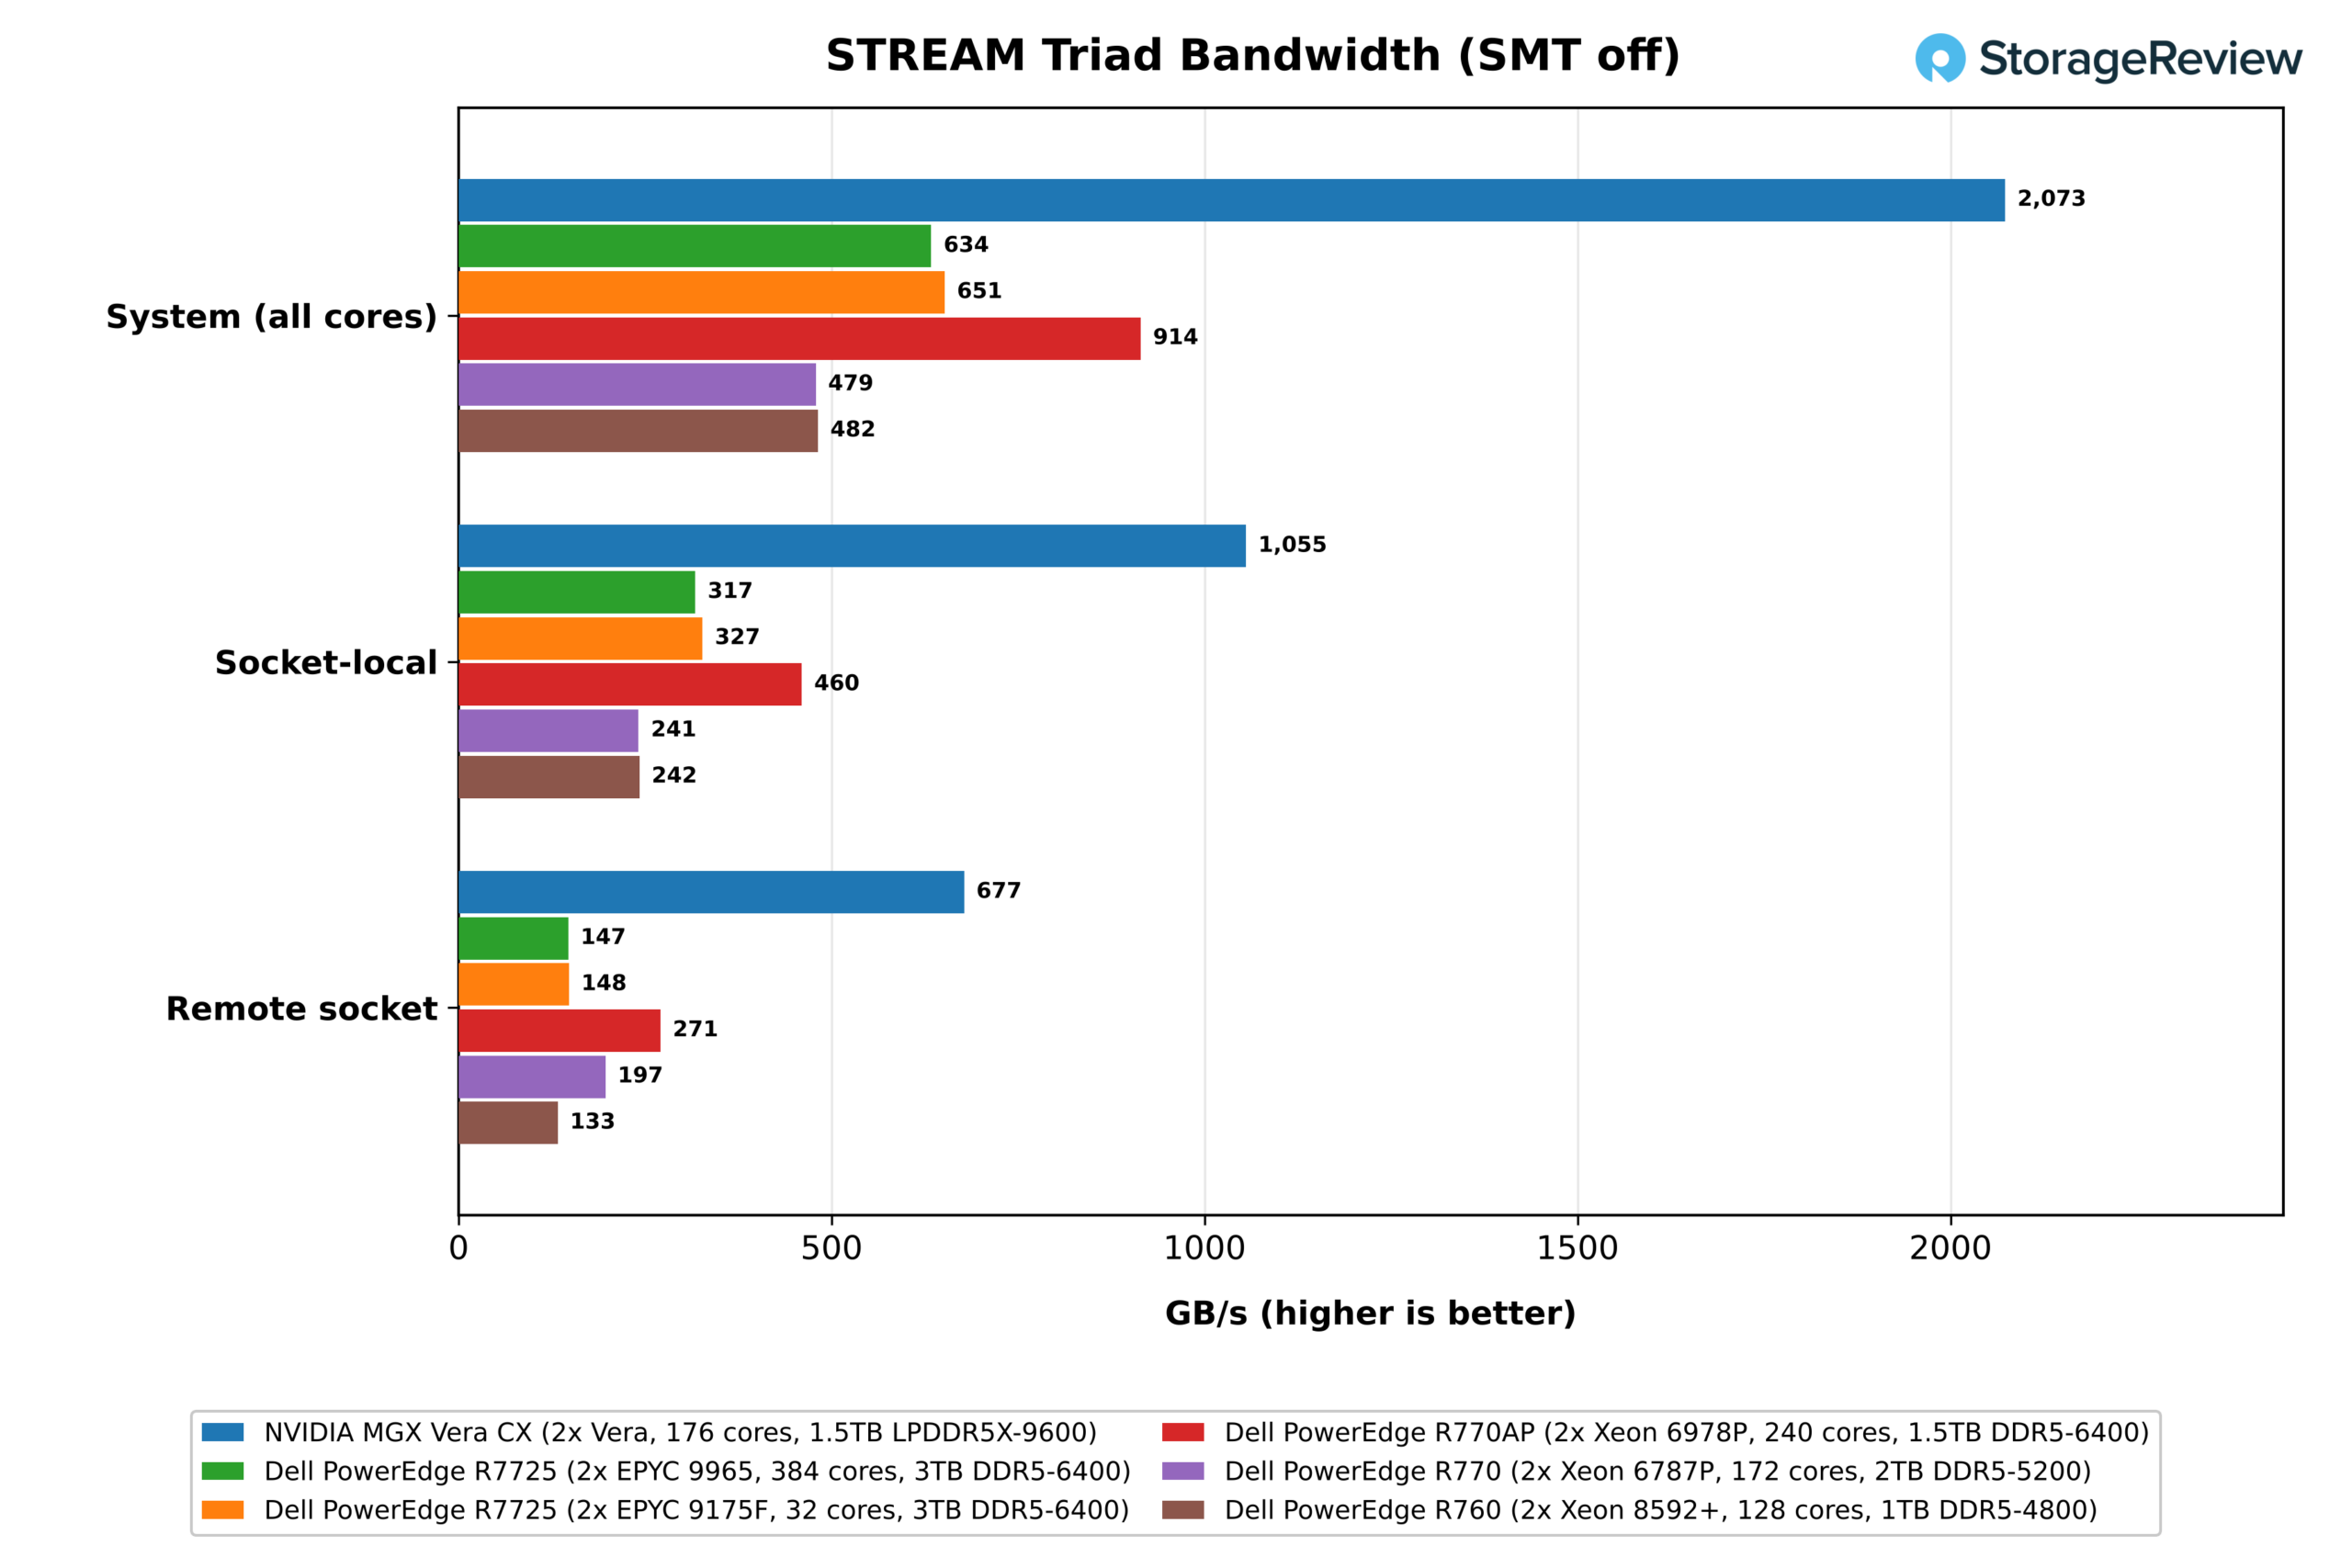
O Vera atingiu 2,073 GB/s, 86% de sua classificação de 2.4 TB/s para dois soquetes. O sistema x86 mais próximo foi o Xeon 6978P, cujos 24 canais de DDR5-6400 entregaram 914 GB/s, 74% de seu pico teórico de 1,229 GB/s, representando uma vantagem de 2.3 vezes sobre o Vera. Os dois sistemas EPYC também utilizam 24 canais de DDR5-6400, mas ficaram bem abaixo disso: 651 GB/s para o 9175F de 32 núcleos e 634 GB/s para o 9965 de 384 núcleos, apenas 52% do pico e uma vantagem de 3.3 vezes sobre o Vera. Por fim, o Xeon 6787P e o 8592+ ficaram para trás, utilizando memórias DDR5-5200 e DDR5-4800, mais lentas, atingindo 479 GB/s e 482 GB/s, respectivamente.
Parte da deficiência do EPYC vem da forma como o STREAM contabiliza o tráfego. O conjunto de testes compila o STREAM com GCC puro, que não gera operações de armazenamento em fluxo contínuo (streaming stores), portanto, uma operação de armazenamento que não encontra o cache primeiro lê a linha de destino da memória. O STREAM não contabiliza essa leitura, o que significa que o Triad subestima o tráfego movimentado em um quarto, independentemente de onde ele ocorra. Os núcleos Zen da AMD sofrem essa subestimação em cada operação de armazenamento. Núcleos ARM, como o Grace da NVIDIA (versão anterior), detectam escritas de linha completa e ignoram a leitura, e os Xeons recentes da Intel conseguem ignorar a maior parte do tráfego quando a memória está sobrecarregada.
A versão separada do Phoronix Test Suite do STREAM aponta na mesma direção. Com o SMT desativado, o resultado do teste de cópia atingiu 832 GB/s no 9965 e 873 GB/s no 9175F, cerca de 1.5 vezes os 551 GB/s e 570 GB/s da versão do conjunto de testes, e em linha com o ganho esperado para o teste de cópia quando a leitura extra for eliminada; nos Xeons, as duas versões apresentaram uma diferença de apenas 9%.
Ajustando para as leituras não contabilizadas, o 9965 transferiu cerca de 845 GB/s, aproximadamente 69% do pico, e a vantagem do Vera em bytes transferidos diminui para cerca de 2.5 vezes. O 6978P precisa de muito menos correção, o que torna seu valor de 2.3 vezes a comparação mais conservadora do conjunto.
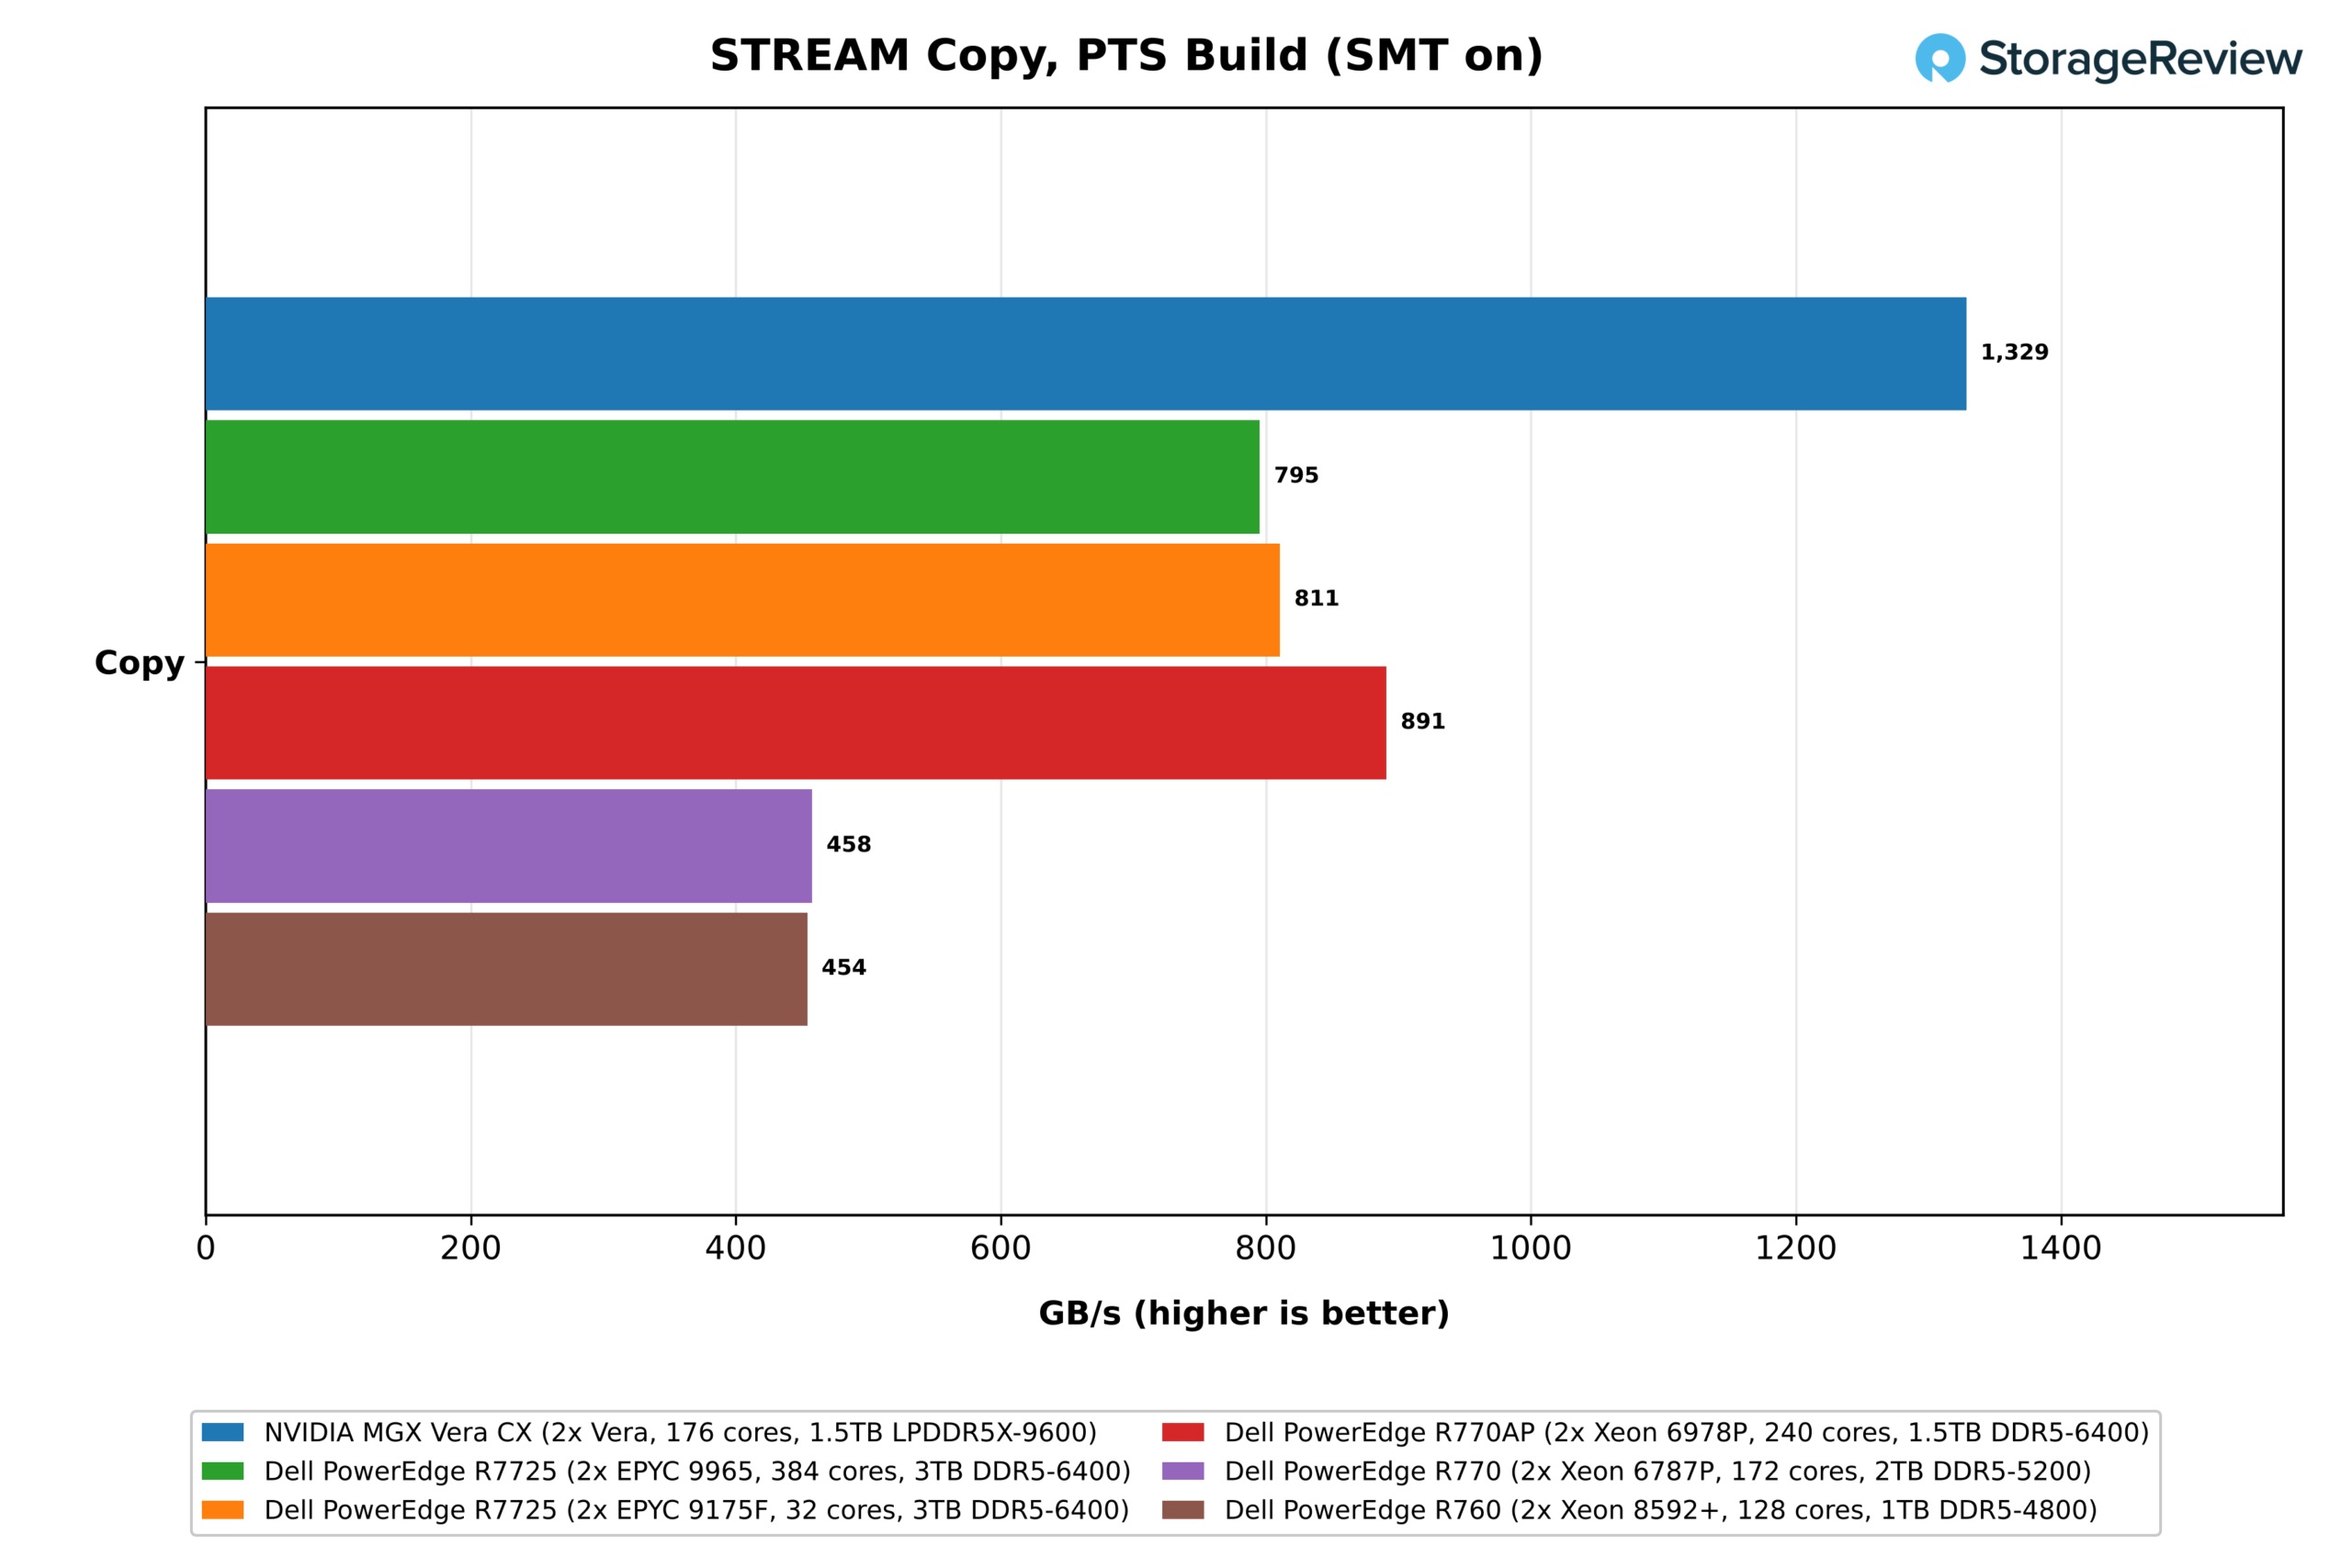
Dividir o teste por soquete mostra como a arquitetura lida com dados que não são locais aos núcleos. Os núcleos do soquete 0, ao lerem a memória local, atingiram 1,055 GB/s, 88% da classificação de 1.2 TB/s por soquete e mais do que qualquer servidor x86 inteiro no conjunto. Ao ler a memória do outro soquete via NVLink-C2C, os mesmos núcleos mantiveram 677 GB/s, 64% do valor local, contra 59% no Xeon 6978P e 45% no EPYC 9175F (148 GB/s remoto contra 327 GB/s local). Portanto, mesmo uma carga de trabalho colocada no soquete errado obtém mais largura de banda do que qualquer soquete x86 lê da memória local, que atinge o máximo de 460 GB/s no 6978P.
Como teste final para o Vera, realizamos testes com páginas intercaladas STREAM Triad em ambos os sockets, o caso que um aplicativo sem suporte a NUMA encontra, o que resultou em um desempenho de 1,372 GB/s para o Vera, 1.5 vezes o resultado de todo o sistema obtido pelo 6978P.
Latência
A largura de banda é apenas metade da história da memória. A latência determina quanto tempo um núcleo espera cada vez que encontra um valor no cache, e isso é especialmente importante para códigos que acessam ponteiros pela memória. Medimos a latência com o tinymembench, que mede o tempo de leituras aleatórias em um buffer de 1 GiB a partir de uma única thread no socket 0. O EPYC 9175F é o único sistema x86 em nosso conjunto com resultados deste teste, portanto, é ele que usamos como comparação aqui.
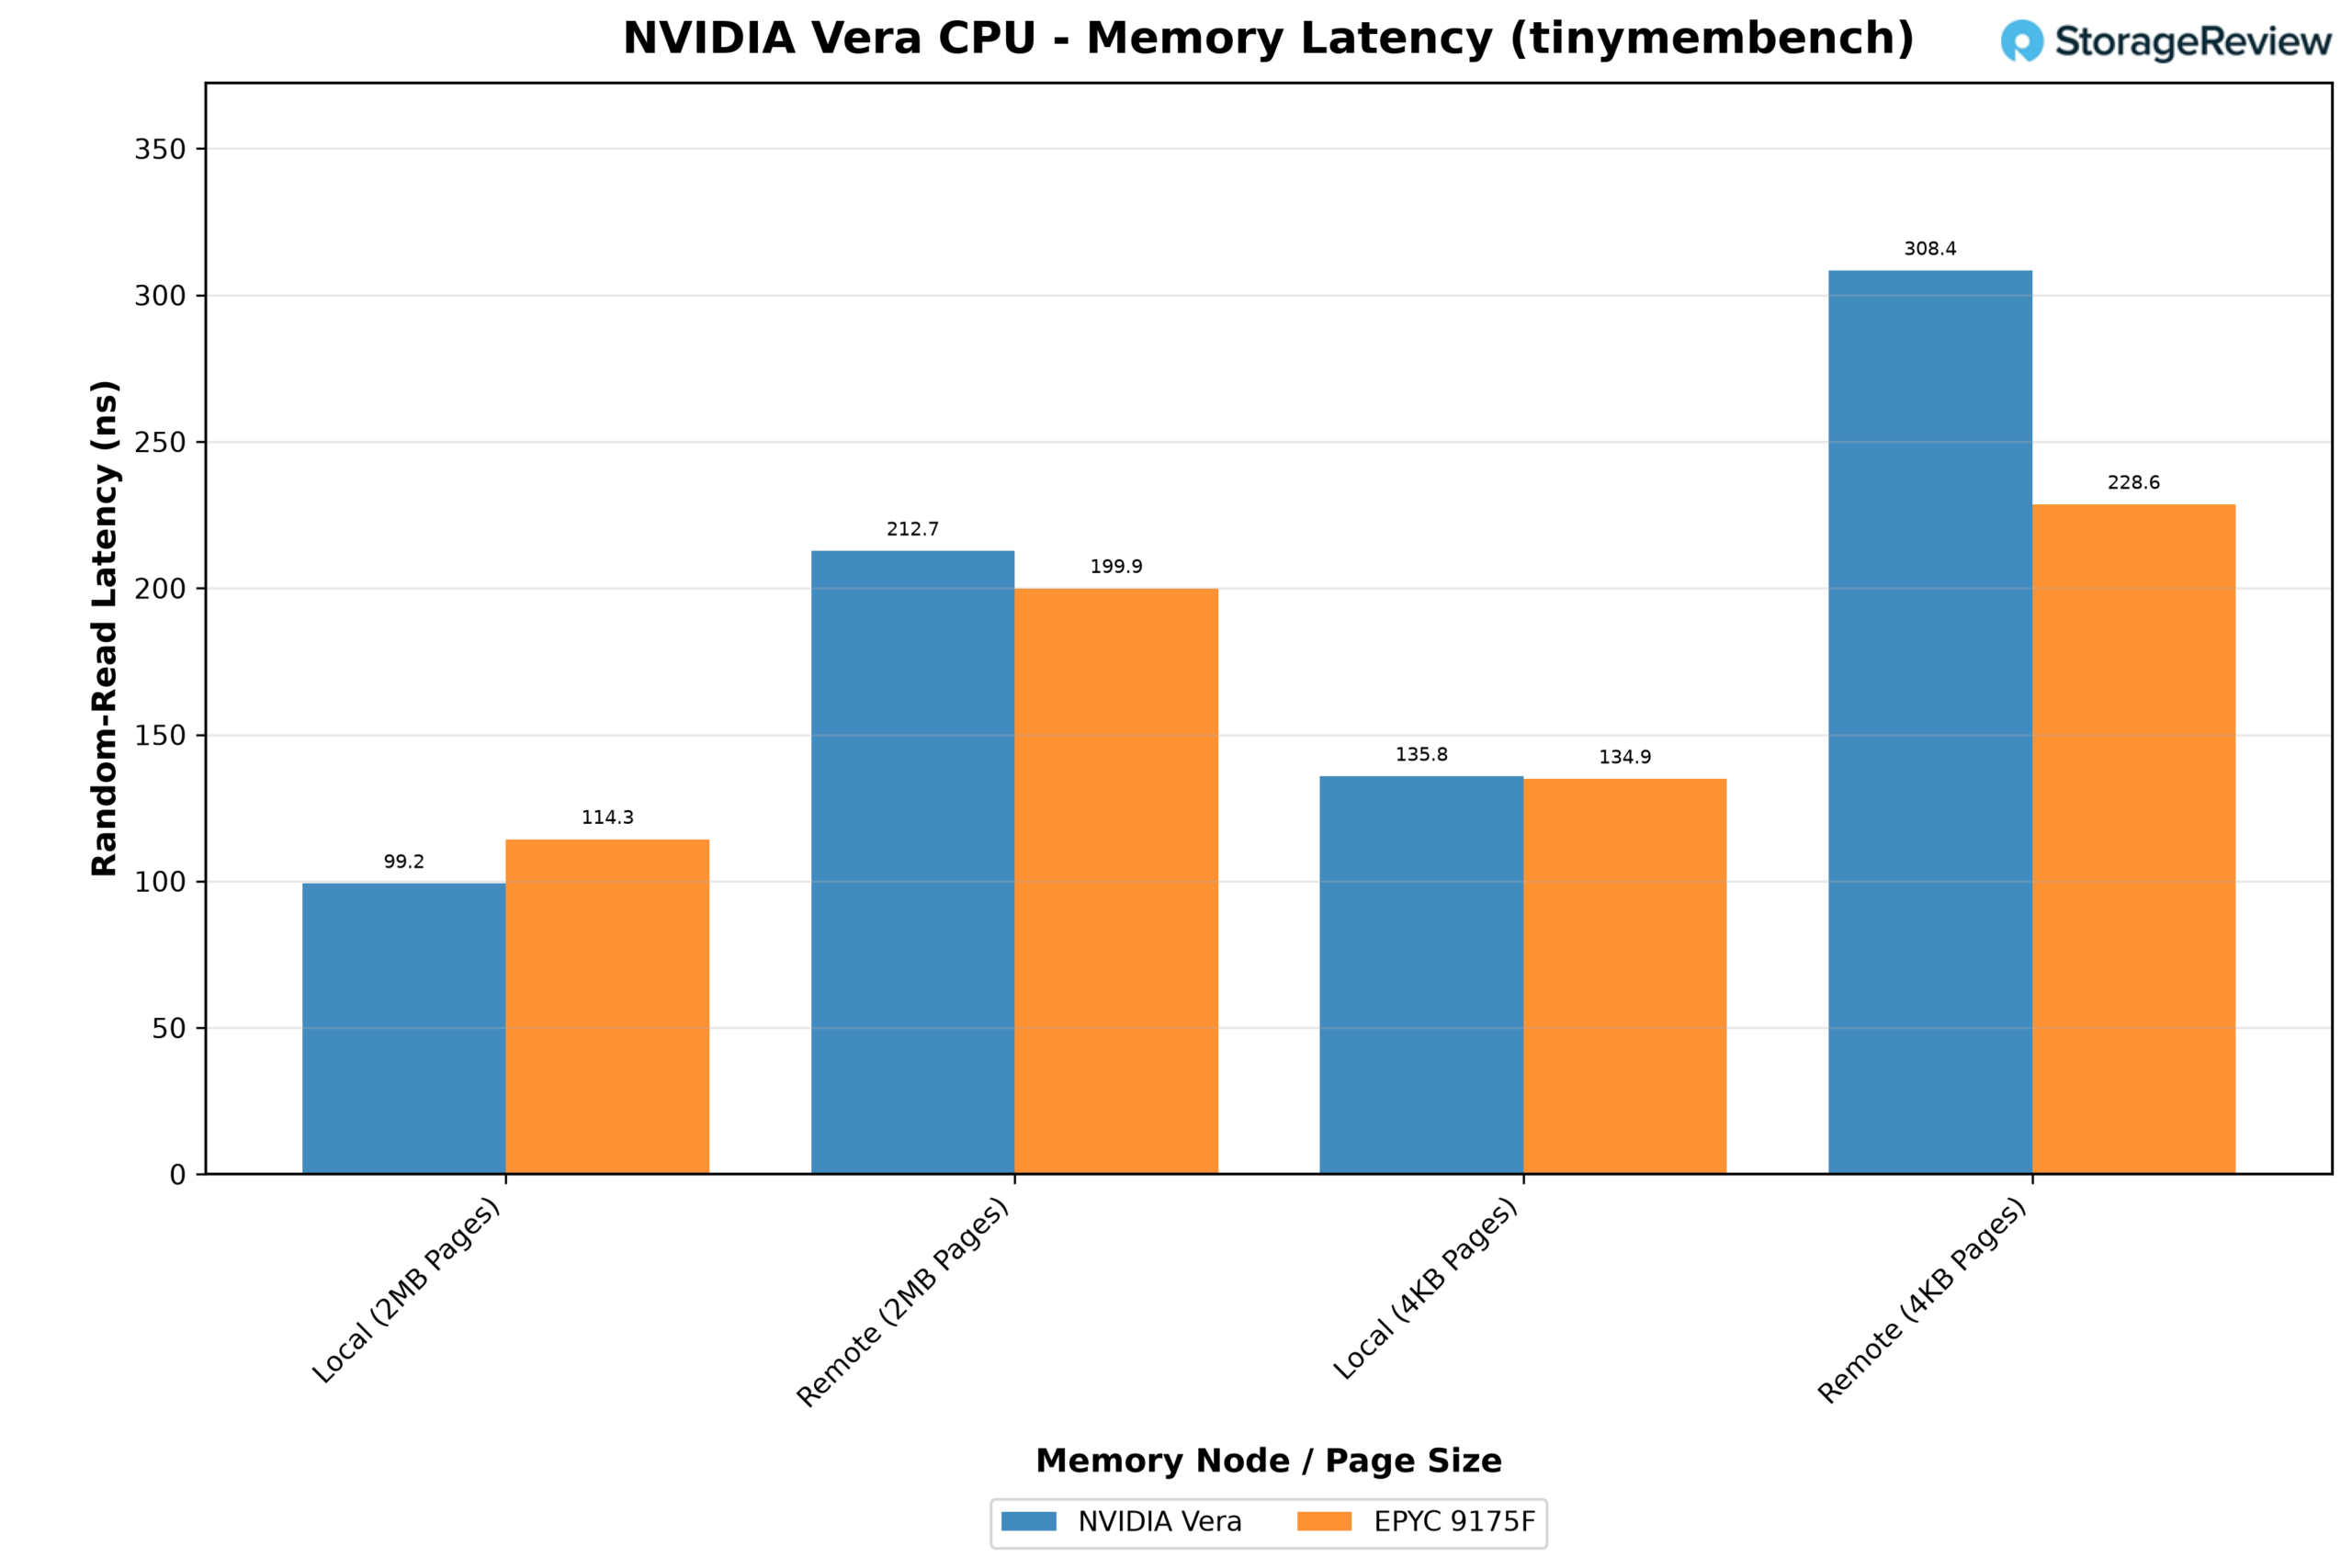
Na leitura da memória local, o Vera é mais rápido que o EPYC. Com hugepages de 2 MB, uma leitura local levou 99.2 ns no Vera contra 114.3 ns no 9175F, 13% mais rápido; com páginas padrão de 4 KB, os tempos foram equivalentes, em torno de 135 ns. A limitação do NVLink-C2C reside na leitura remota, em comparação com o outro socket. Uma leitura remota levou 212.7 ns no Vera, cerca de 2.1 vezes o tempo local, enquanto os 199.9 ns do EPYC representaram apenas 1.75 vezes o tempo local.
O Vera também é mais sensível ao tamanho da página. Com páginas de 4 KB, onde as falhas na tradução de endereços aumentam a latência a cada leitura, sua latência local aumentou 37% e sua latência remota atingiu 308.4 ns, contra um aumento de 18% e 228.6 ns no EPYC. No Vera, usaríamos hugepages.
HPC
A largura de banda e a latência descrevem o sistema de memória isoladamente. Aplicações científicas mostram o que acontece quando esse sistema de memória e os núcleos precisam trabalhar juntos, e nossos dois testes de HPC se baseiam em partes muito diferentes do projeto da CPU.
O GROMACS, um código de dinâmica molecular, passa a maior parte do tempo em aritmética vetorial, com loops críticos escritos manualmente para cada largura SIMD. Isso o torna o teste mais direto da relação de compromisso descrita na seção Olympus: seis pipelines SVE2 de 128 bits contra as unidades AVX-512 de 512 bits nos processadores x86. O OpenFOAM, um solucionador de dinâmica de fluidos computacional, trabalha com grandes matrizes esparsas e passa grande parte do tempo aguardando memória, demonstrando, portanto, se a largura de banda medida anteriormente se traduz em uma aplicação real.
GROMACS
Testamos o GROMACS 2025.3 com o benchPEP, um caso de 12 milhões de átomos executado em todos os núcleos físicos do servidor. A compilação usou ARM_SVE no Vera e AVX-512 em todos os sistemas x86, e as entradas fixas do conjunto de testes e o ajuste PME desativado garantiram que todas as plataformas executassem o mesmo trabalho.
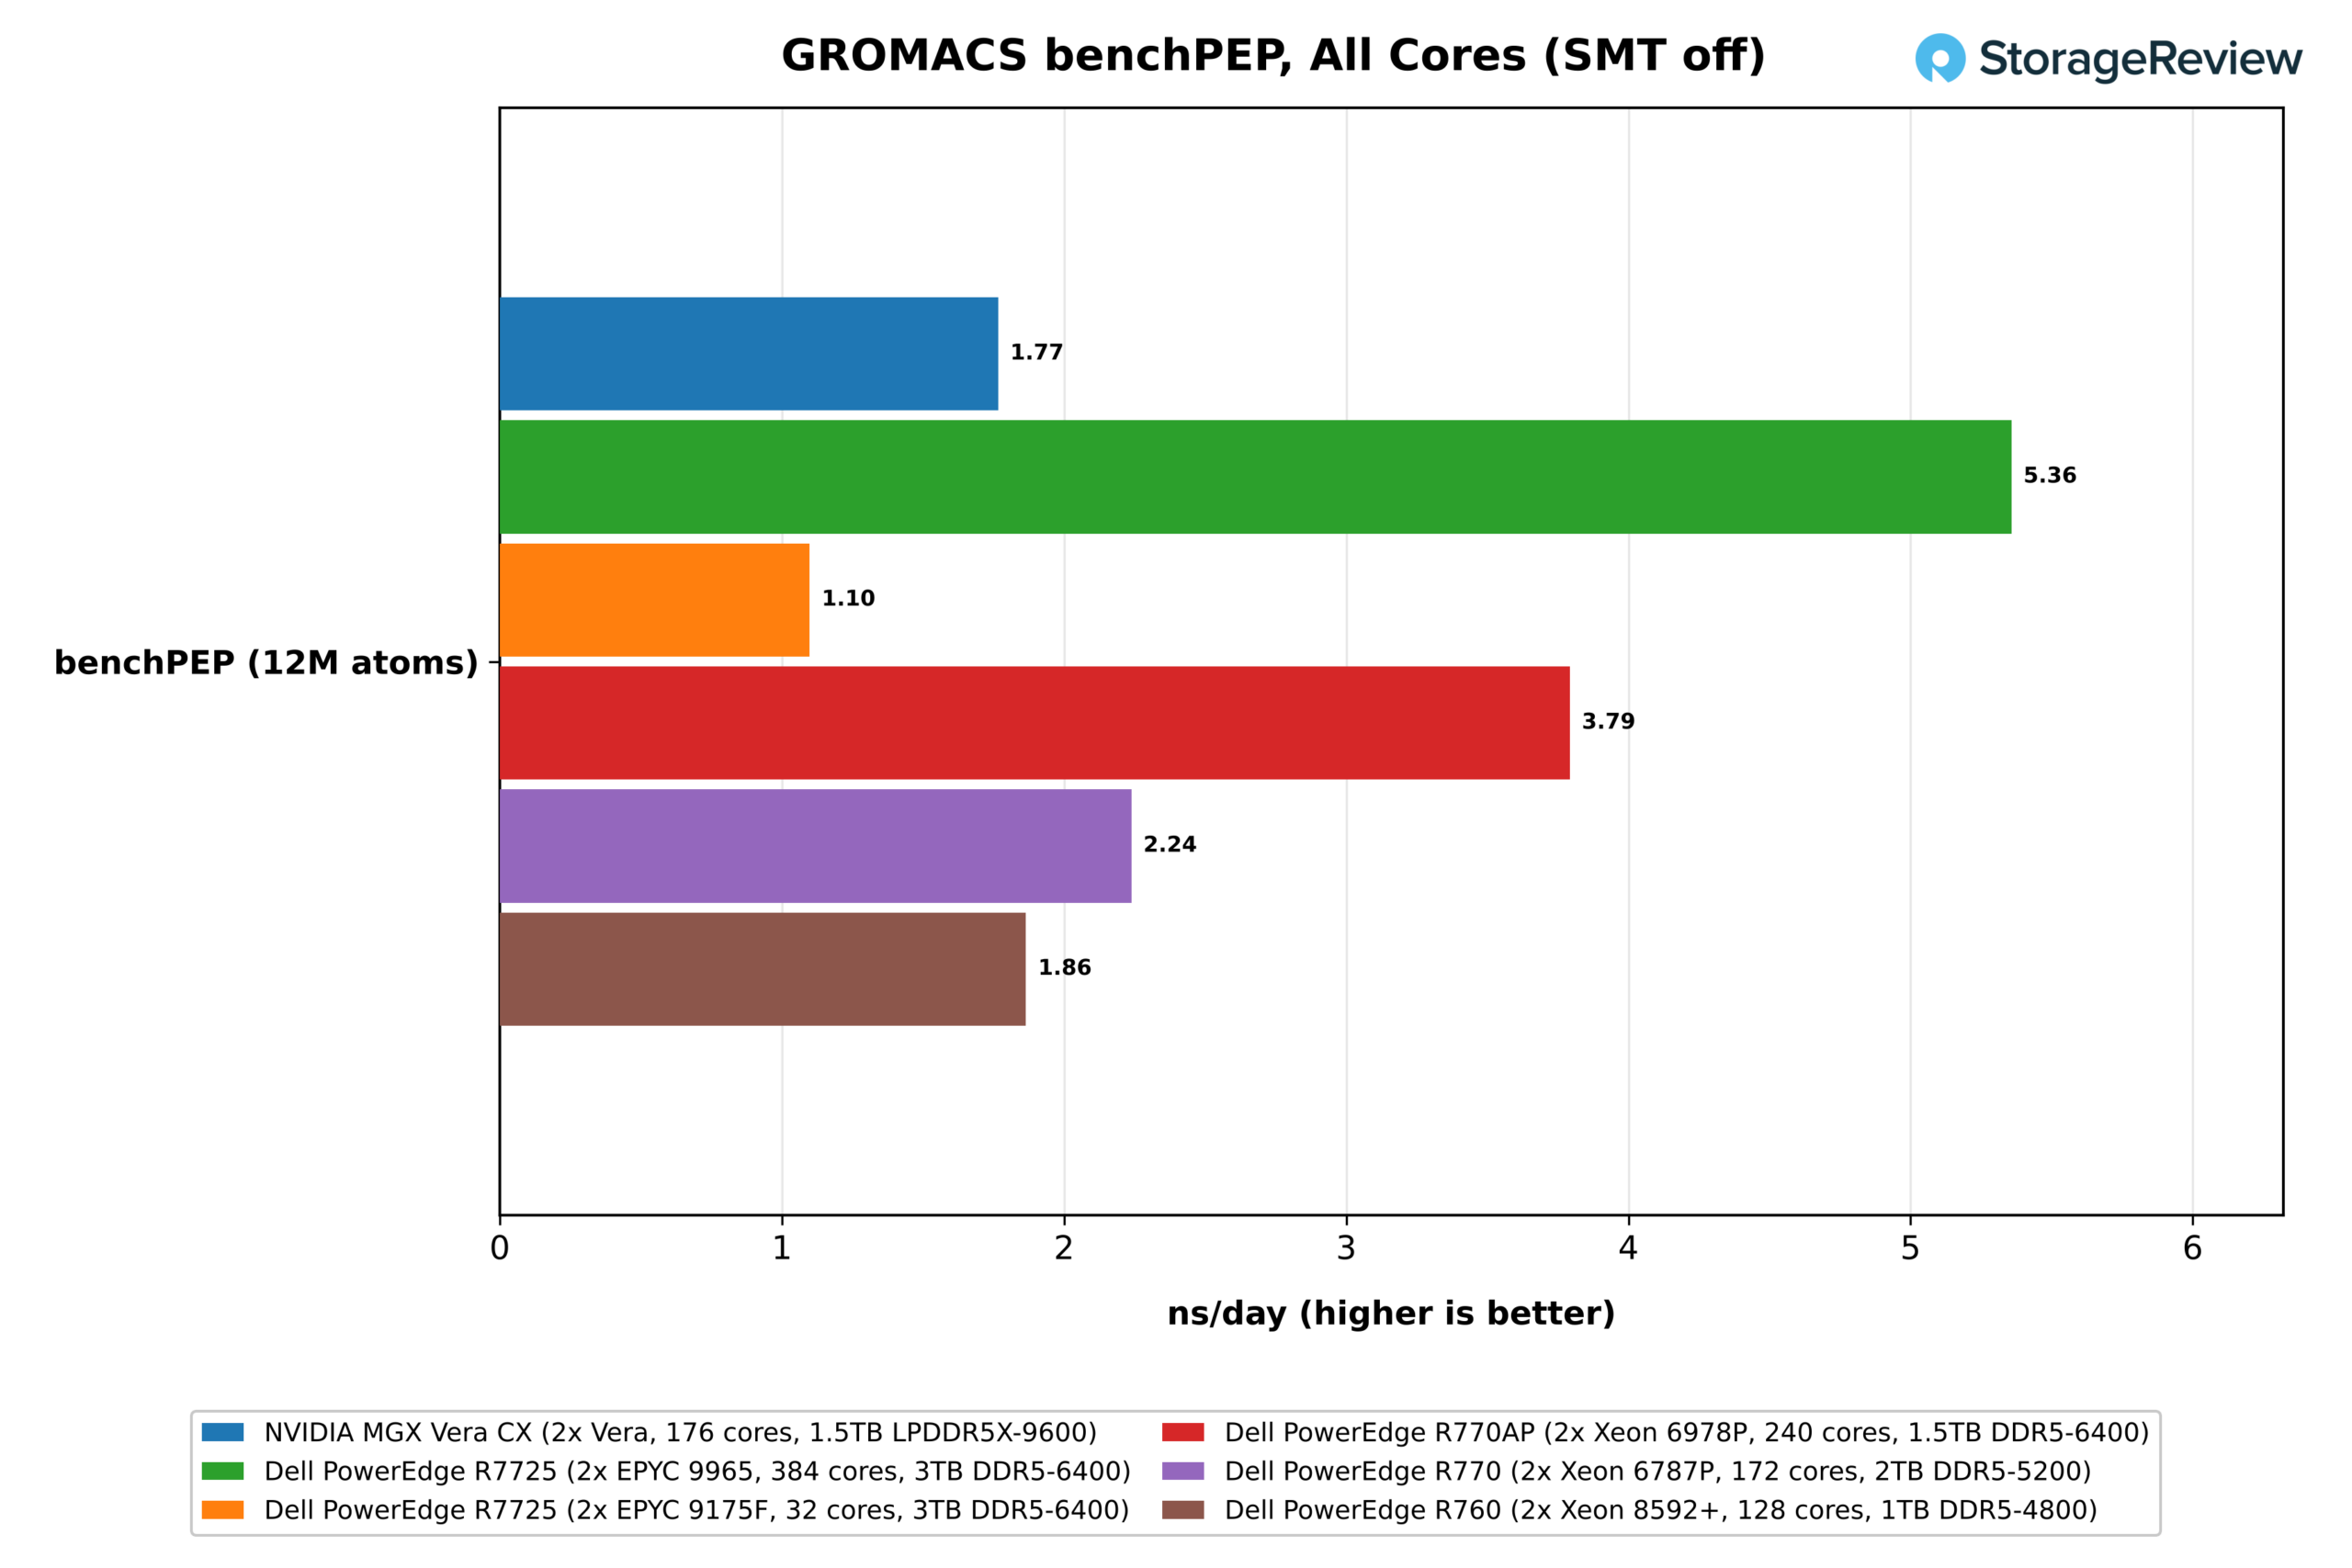
Com o SMT desativado, o Vera terminou o benchmark PEP em 1.77 ns/dia. O EPYC 9965 de 384 núcleos liderou com 5.36 ns/dia, 3.0 vezes o Vera, seguido pelo Xeon 6978P de 240 núcleos com 3.79 (2.1 vezes) e o Xeon 6787P de 172 núcleos com 2.24 (1.27 vezes). O Xeon 8592+ de 128 núcleos também ficou à frente com 1.87, deixando apenas o EPYC 9175F de 32 núcleos, com 1.10, atrás do Vera. A normalização pela contagem de núcleos mostra quanto dessa diferença se deve à arquitetura. O desempenho do Vera é de 0.0100 ns/dia por núcleo, contra 0.0130 no 6787P, 0.0140 no 9965, 0.0146 no 8592+ e 0.0158 no 6978P. Portanto, a desvantagem em relação aos processadores x86 de maior porte se deve em parte à quantidade de núcleos e em parte à taxa de transferência por núcleo.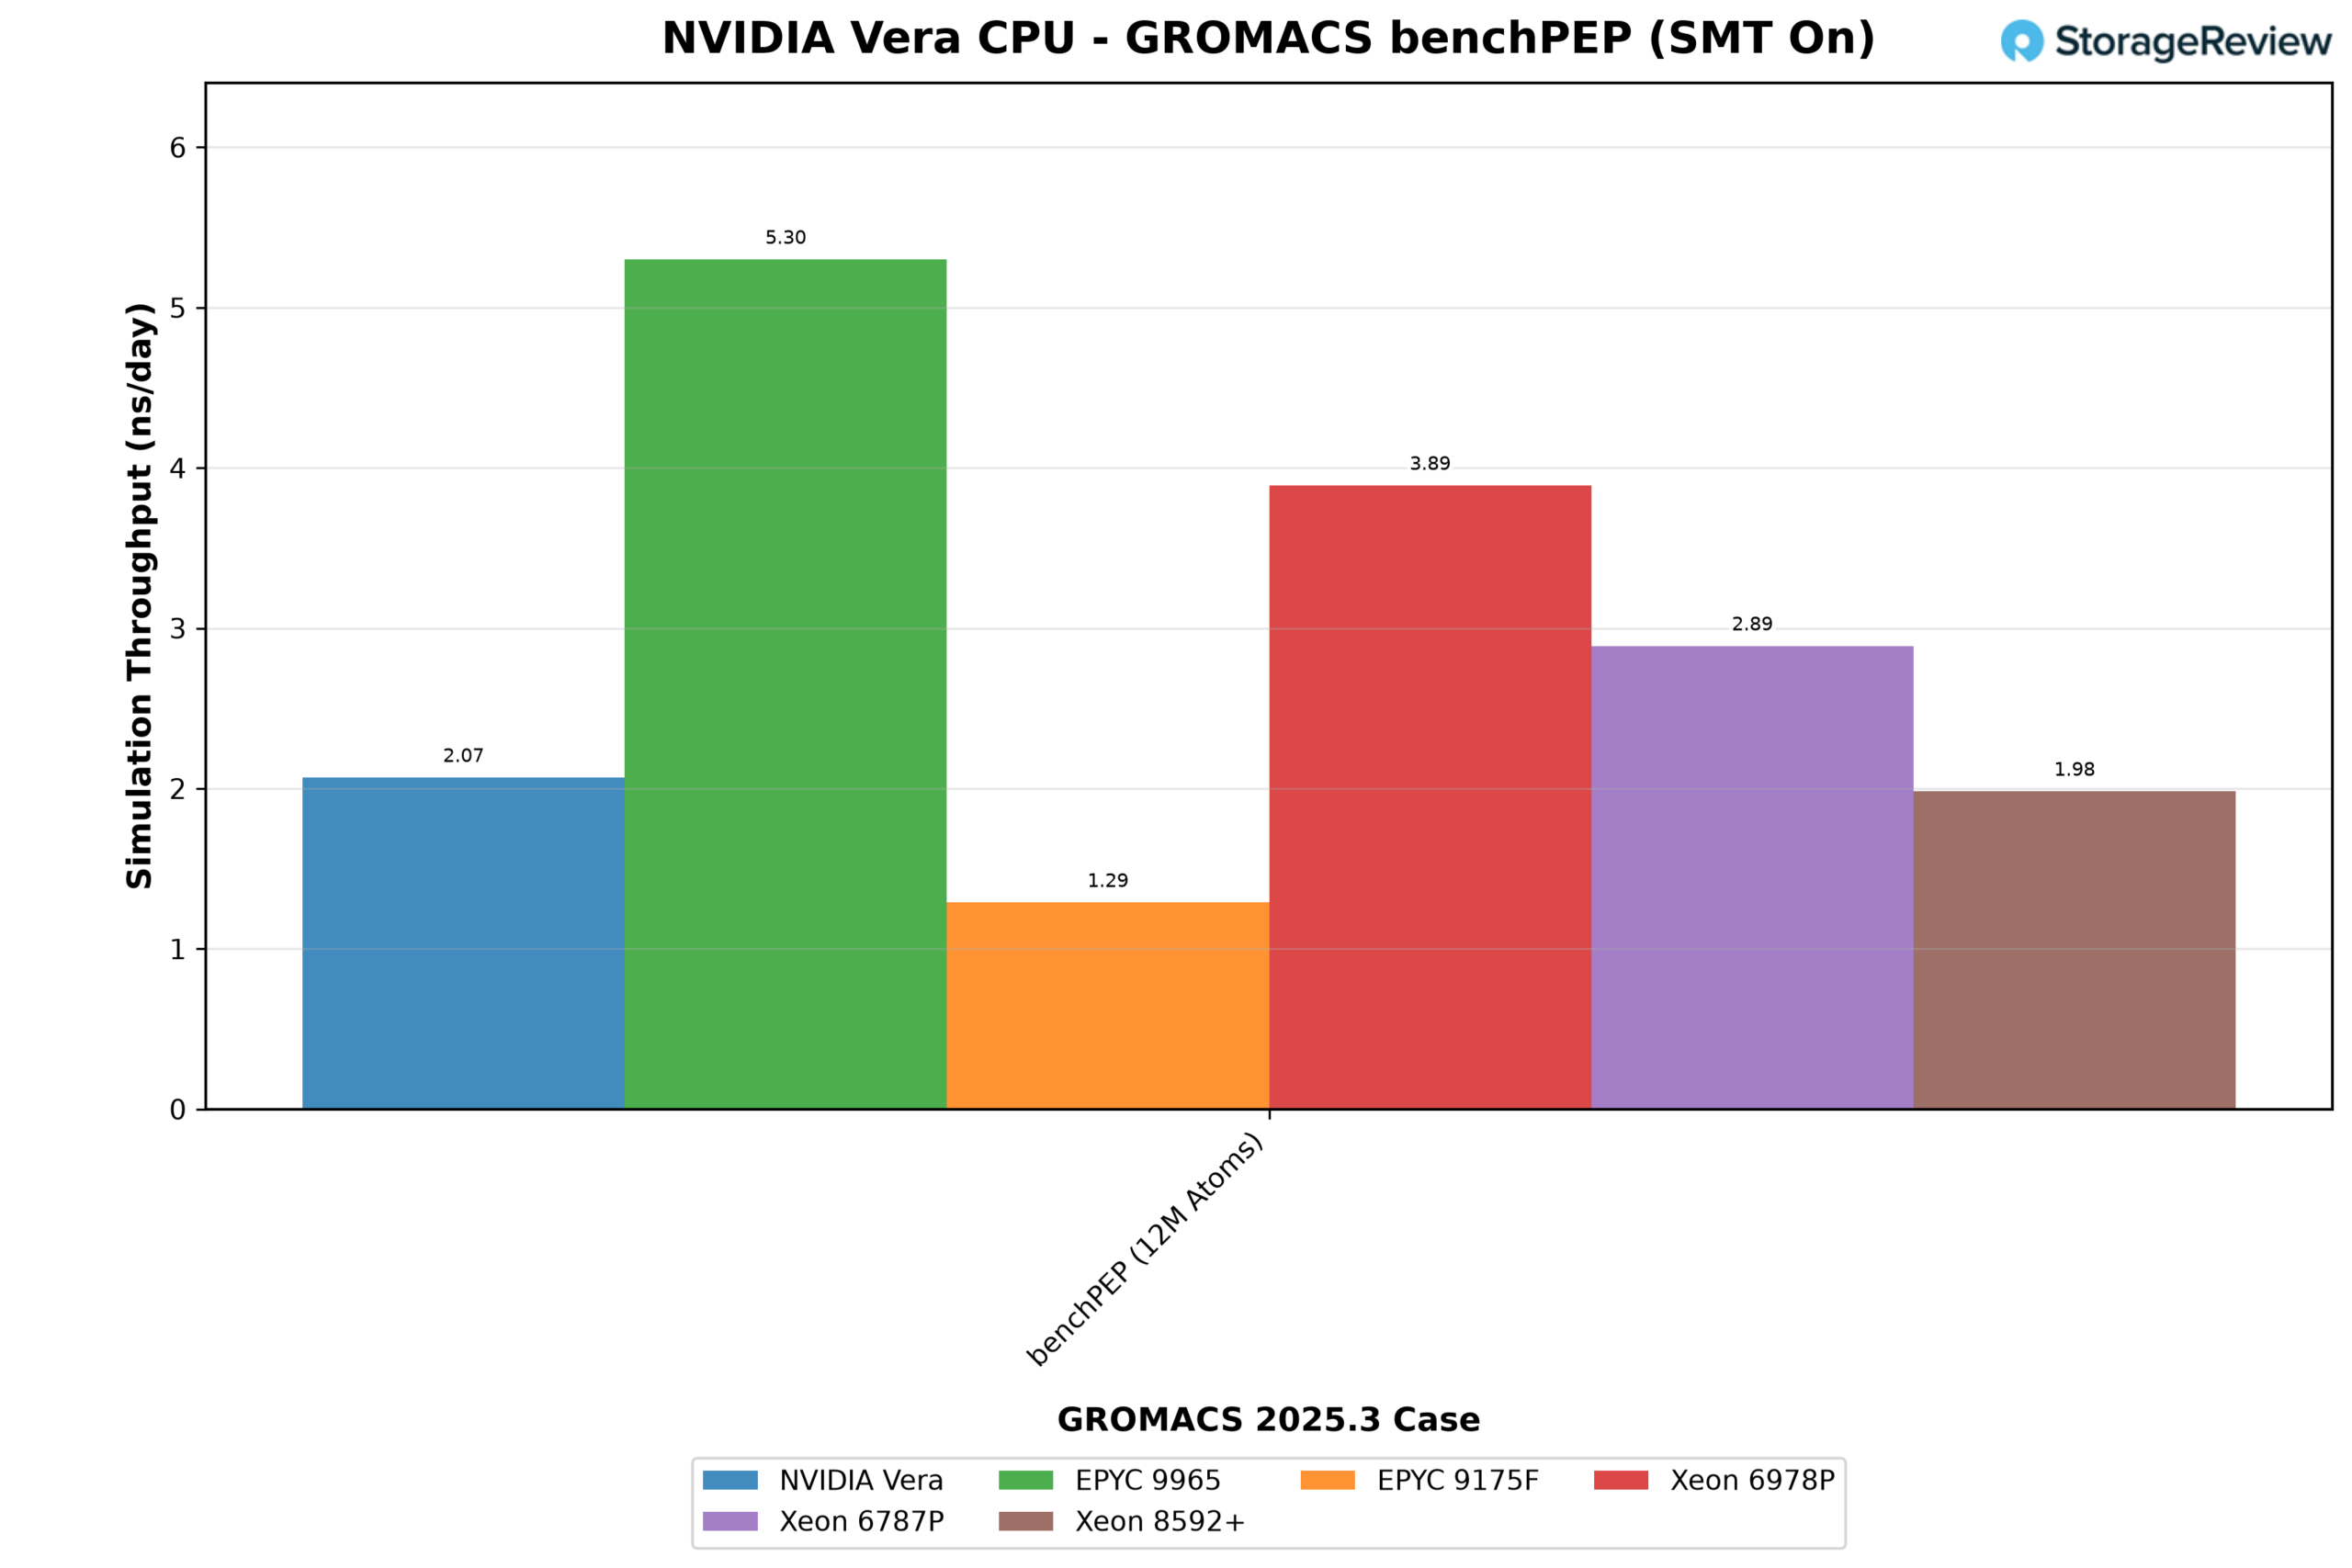
O Multithreading Espacial recupera parte desse terreno, já que habilitá-lo elevou o resultado do Vera em 17%, para 2.07 ns/dia, com o melhor layout executando todos os 352 threads de hardware como ranks thread-MPI. Esse ganho é maior do que o obtido com o SMT no Xeon 6978P (3%) ou no 8592+ (11%) em nossos testes anteriores, e o EPYC 9965 perdeu 3.5% com ele ativado. Com os recursos particionados entre os dois threads, cada rank recebe uma fatia do núcleo, e a combinação de matemática vetorial e pausas na memória do solucionador parece preencher essas fatias melhor do que um único rank.
O caso benchMEM isola a diferença por núcleo executando o sistema de 82,000 átomos em 16 núcleos físicos do soquete 0 em cada plataforma, de modo que a contagem de núcleos seja eliminada da equação, e o resultado reflita a taxa de transferência vetorial, o cache e a memória local.
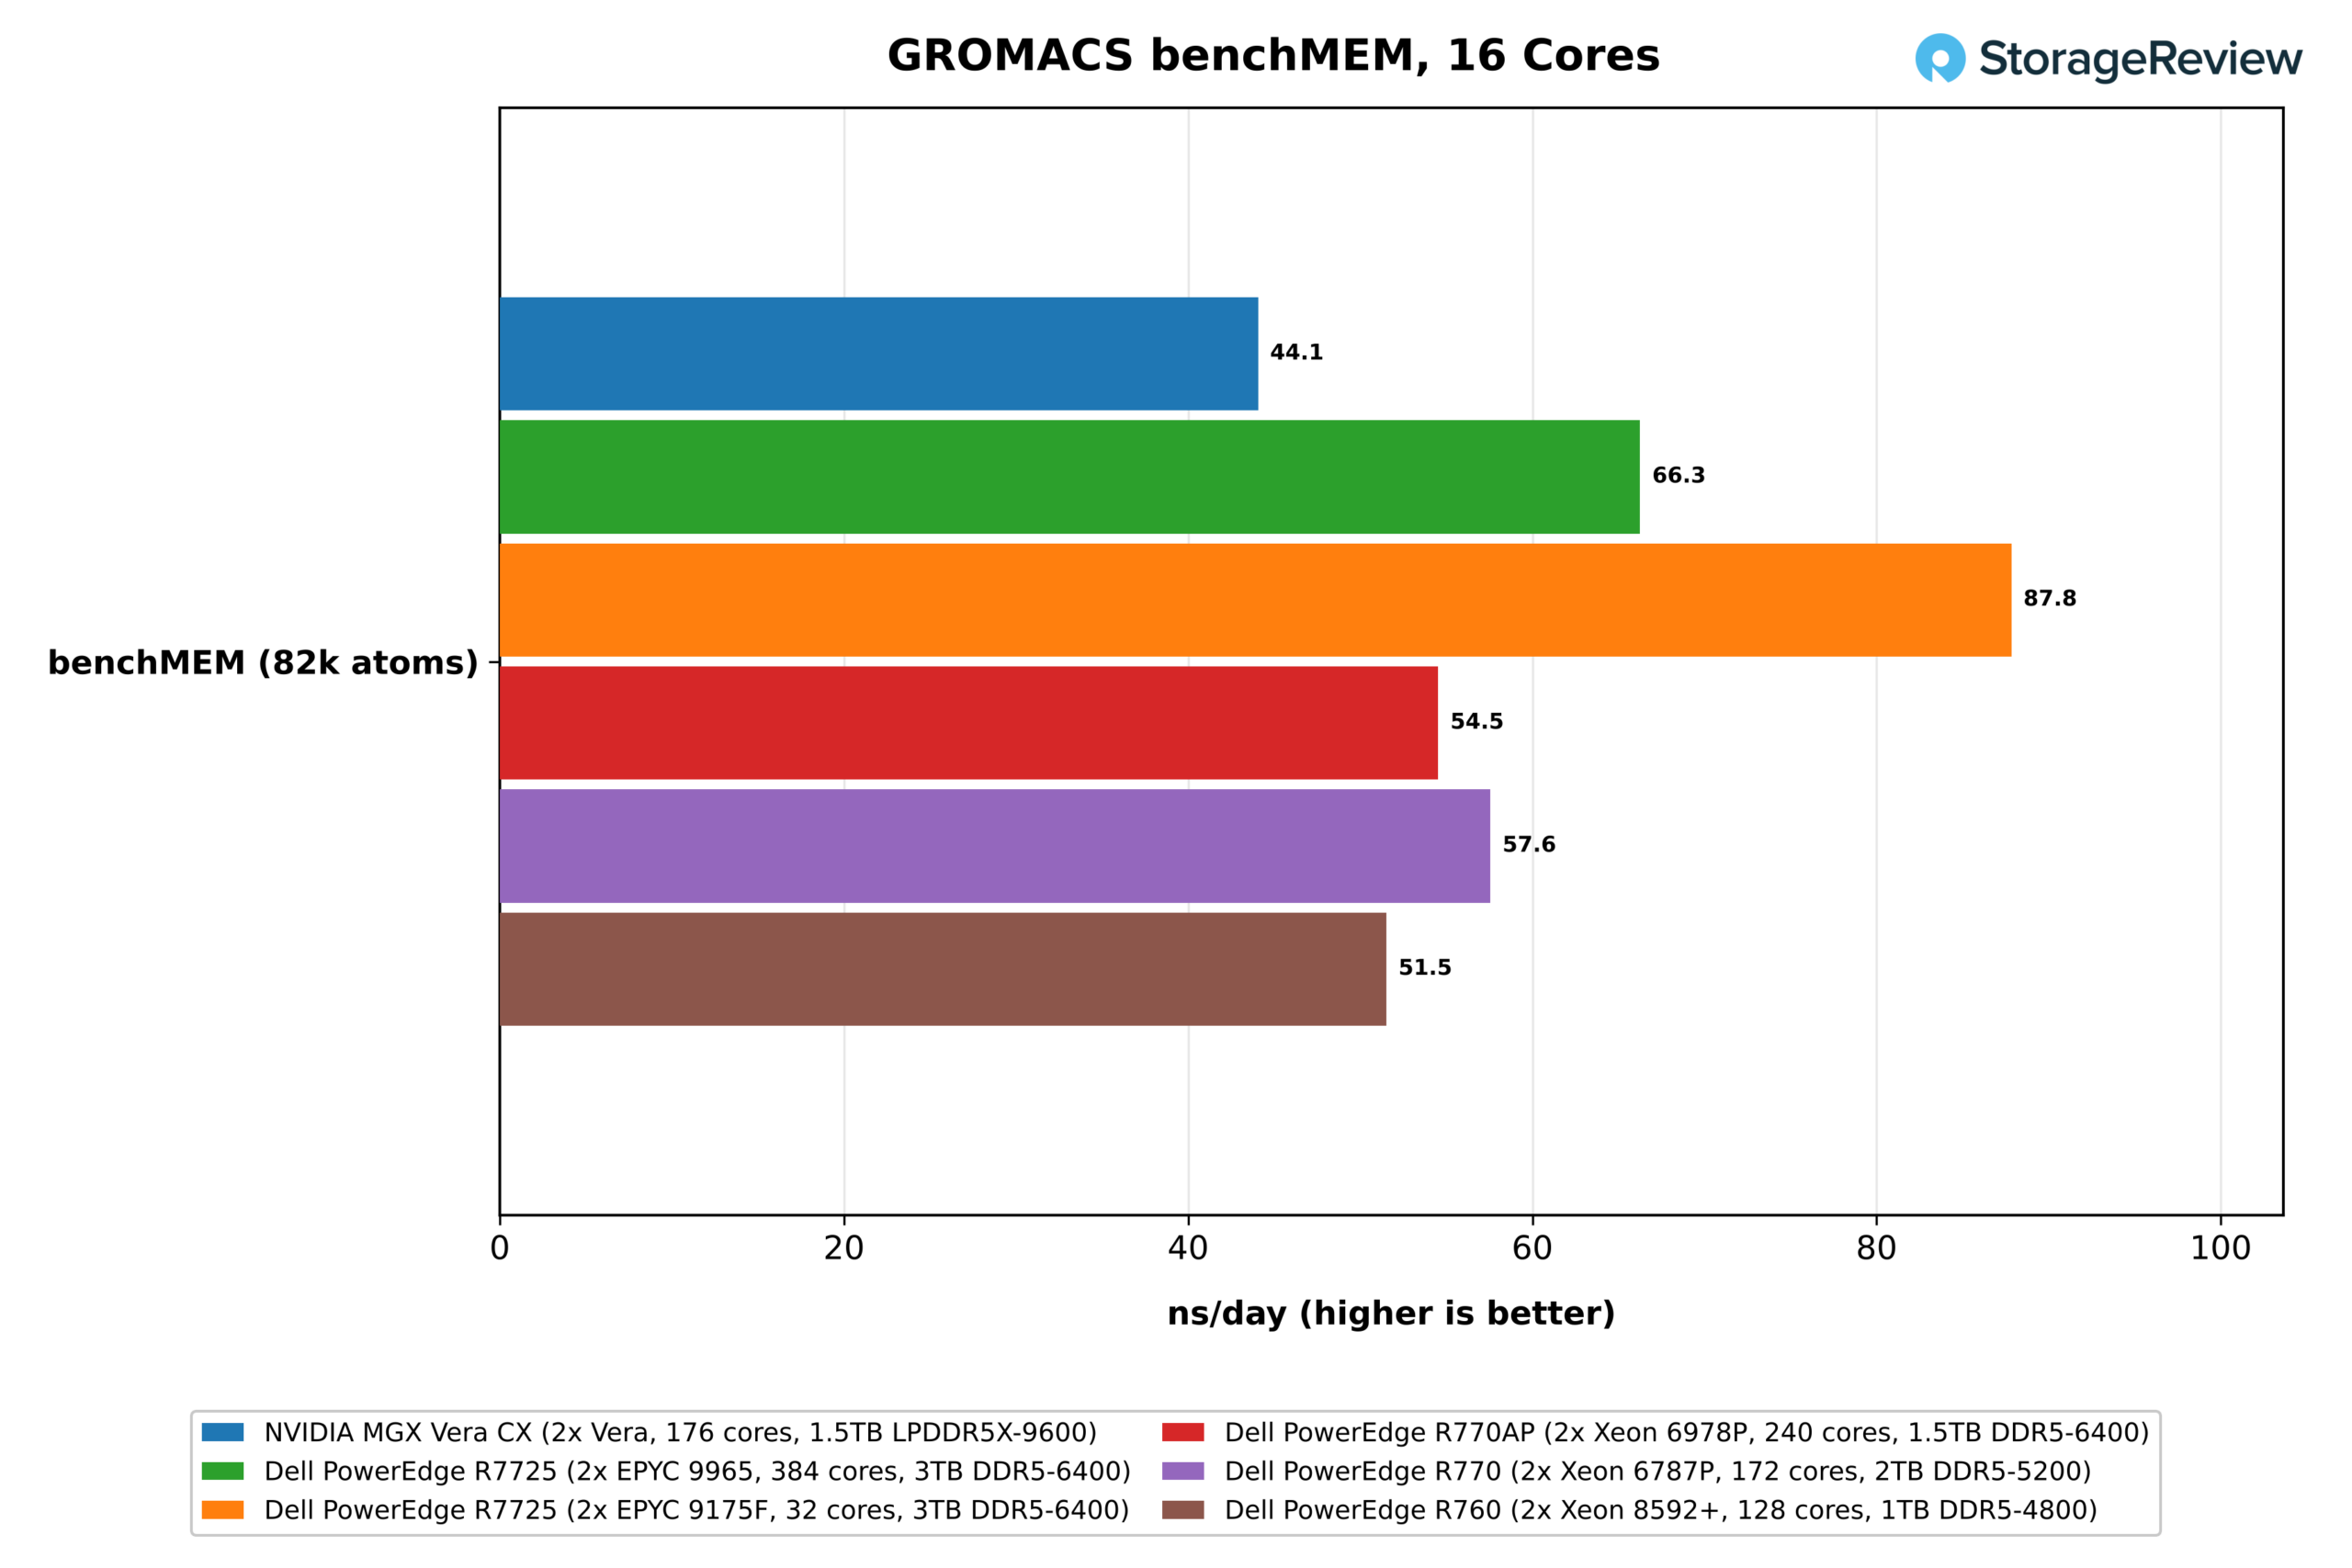
Aqui, o Vera registrou 44.1 ns/dia. O EPYC 9175F de 5.0 GHz dobrou esse valor, chegando a 87.8, e o EPYC 9965 alcançou 66.3, 1.5 vezes o Vera, à frente do Xeon 6787P com 57.6, do 6978P com 54.5 e do 8592+ com 51.5.
Um processador Vera de 16 núcleos, portanto, realiza cerca de dois terços do trabalho de um processador Zen 5c de 16 núcleos, mesmo que esses 16 núcleos Zen 5c compartilhem um único cache L3 de 32 MB, enquanto o Vera pode utilizar seu cache de sistema de 164 MB. Isso torna esta a medição mais clara que temos do custo de vetores de 128 bits em código escrito para vetores de 512 bits. A vantagem adicional do 9175F sobre o 9965 está aproximadamente em linha com sua vantagem de clock, 5.0 GHz contra 3.7 GHz.
OpenFOAM
O OpenFOAM transfere a pressão das unidades vetoriais para o sistema de memória. Executamos o OpenFOAM 13 no caso de aerodinâmica automotiva driverFastback, com um rank MPI por núcleo físico, em dois tamanhos de malha: uma malha média com 2.98 milhões de células e uma malha grande com 22.6 milhões de células.
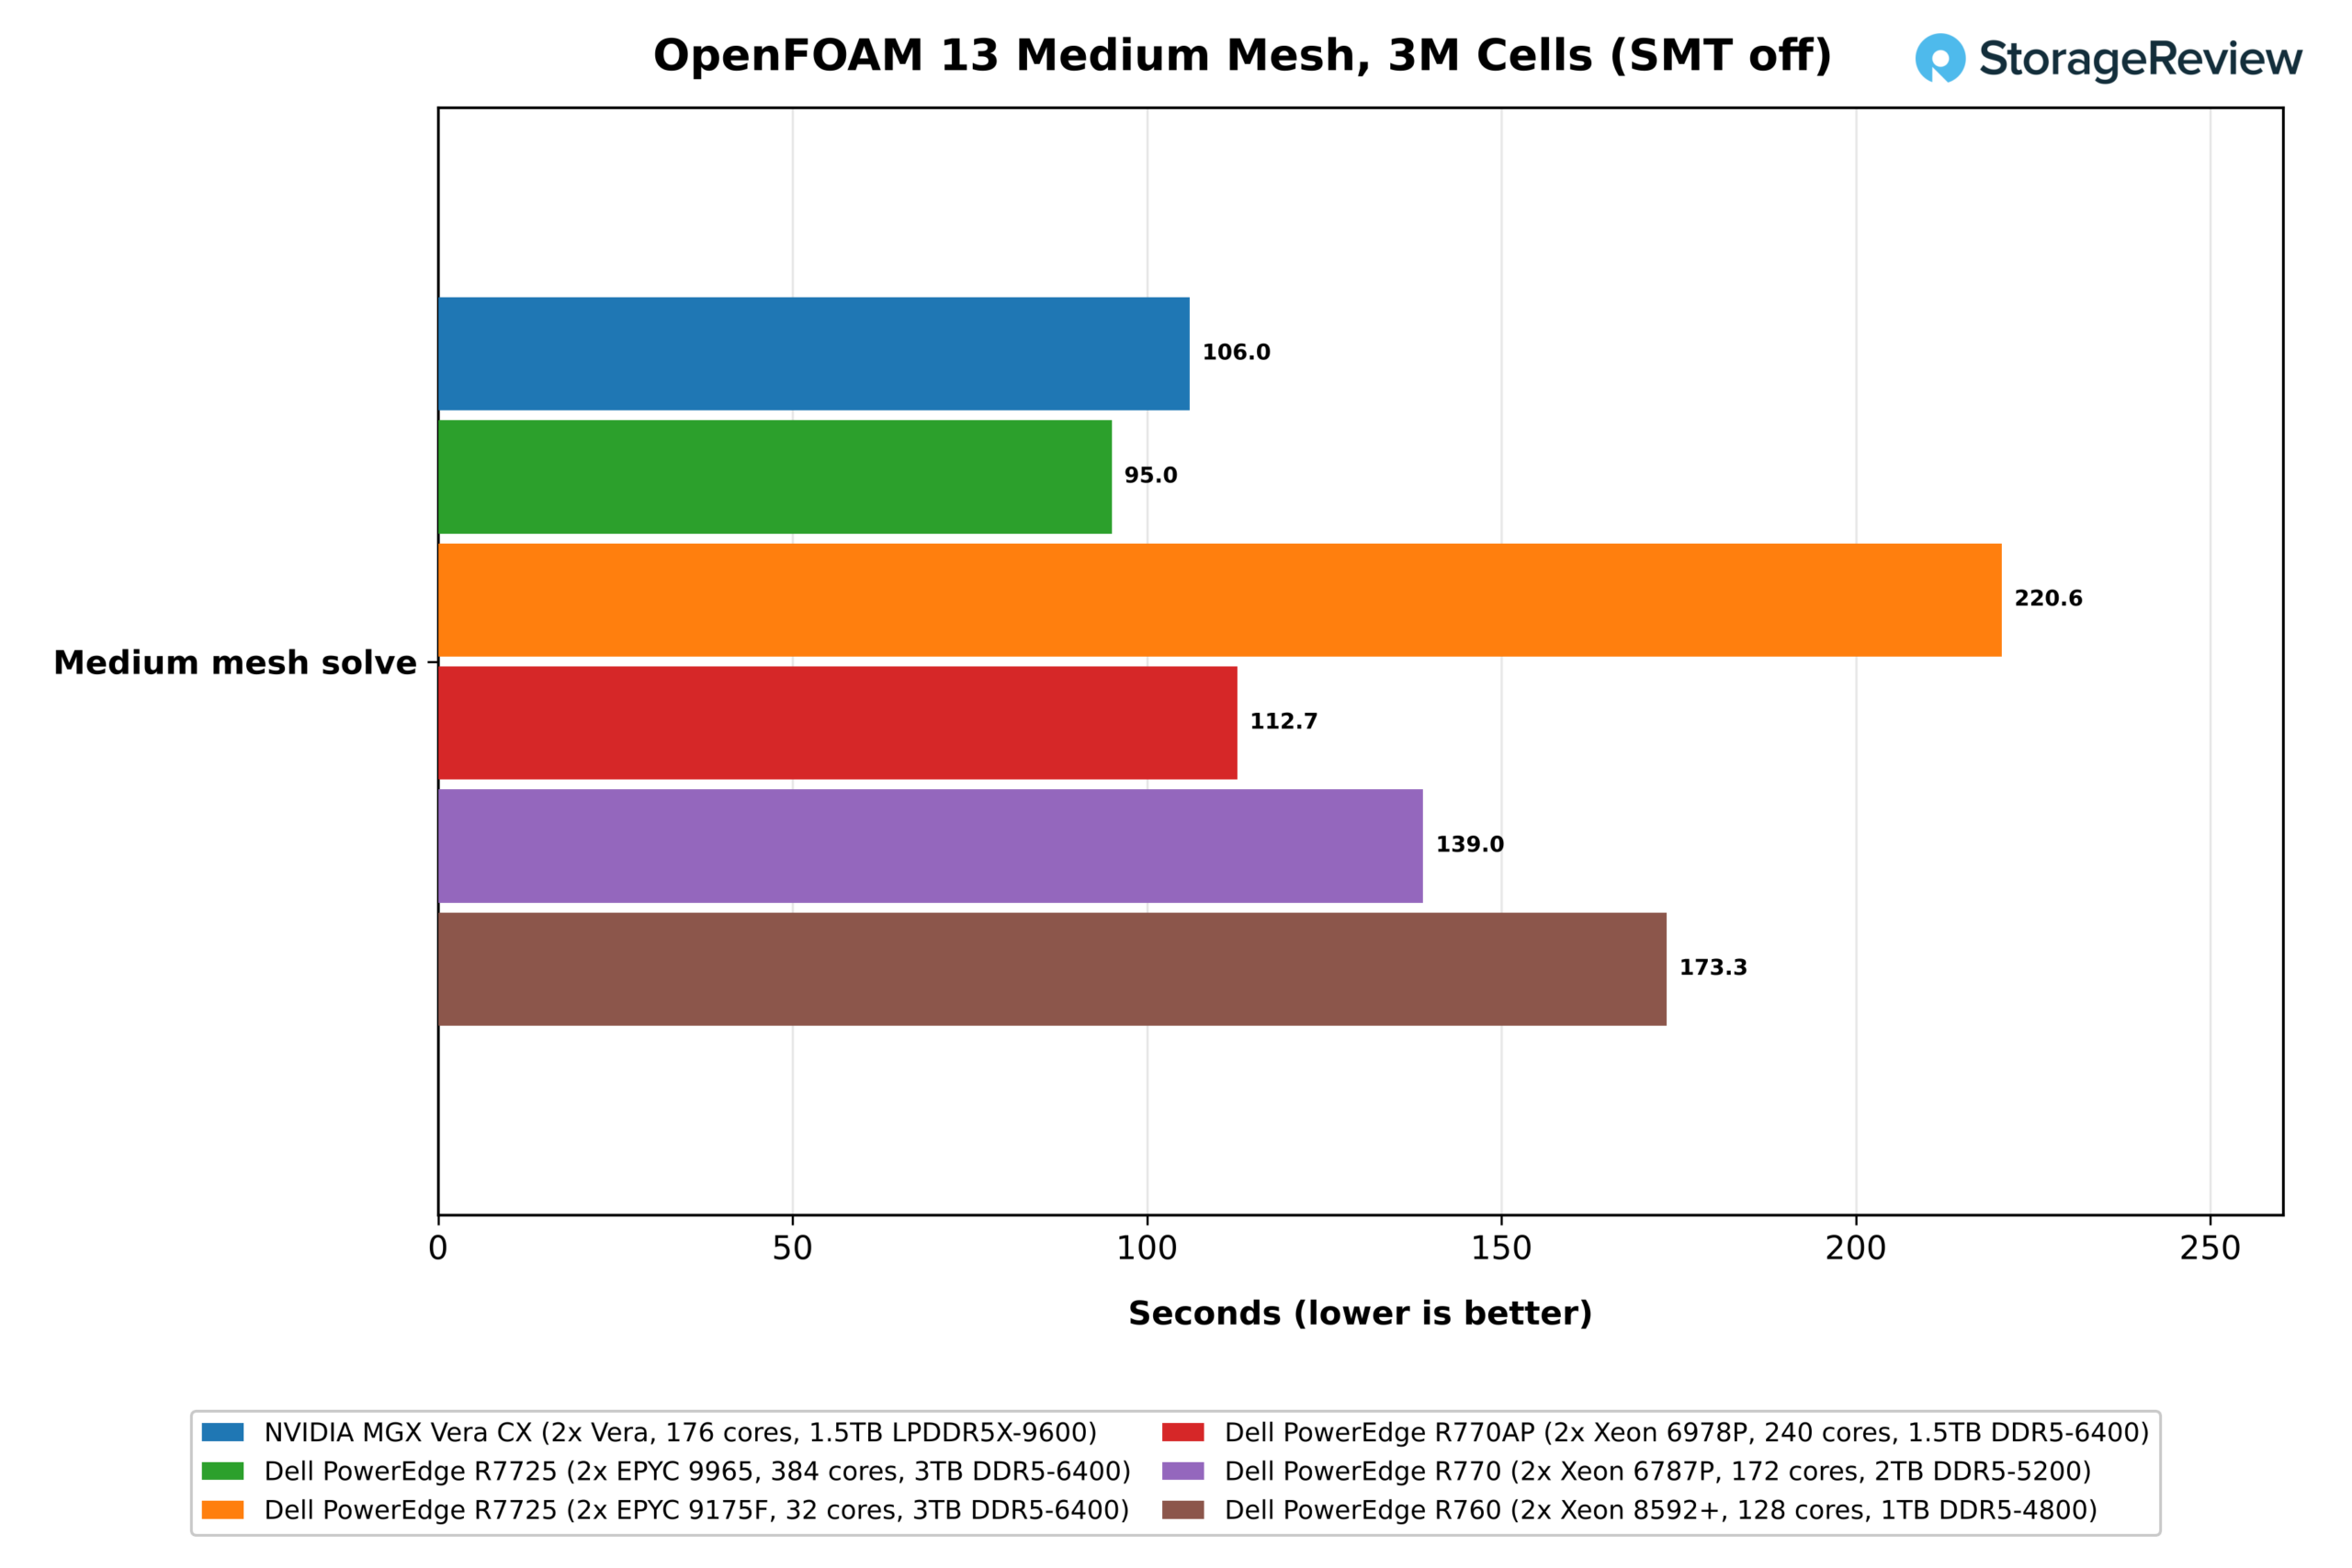
A malha média foi resolvida em 106.0 segundos no Vera, contra 95.0 no EPYC 9965, 112.7 no Xeon 6978P, 139.0 no 6787P, 173.3 no 8592+ e 220.6 no 9175F de 32 núcleos. Nesse tamanho, os 384 núcleos do 9965 levam a melhor, e o Vera leva 12% mais tempo, mas termina em segundo lugar, 6% à frente do Xeon de 240 núcleos. Com apenas 3 milhões de células, os caches L3 maiores dos processadores x86 provavelmente concentram a maior parte do problema, o que mantém a contagem de núcleos como fator determinante.
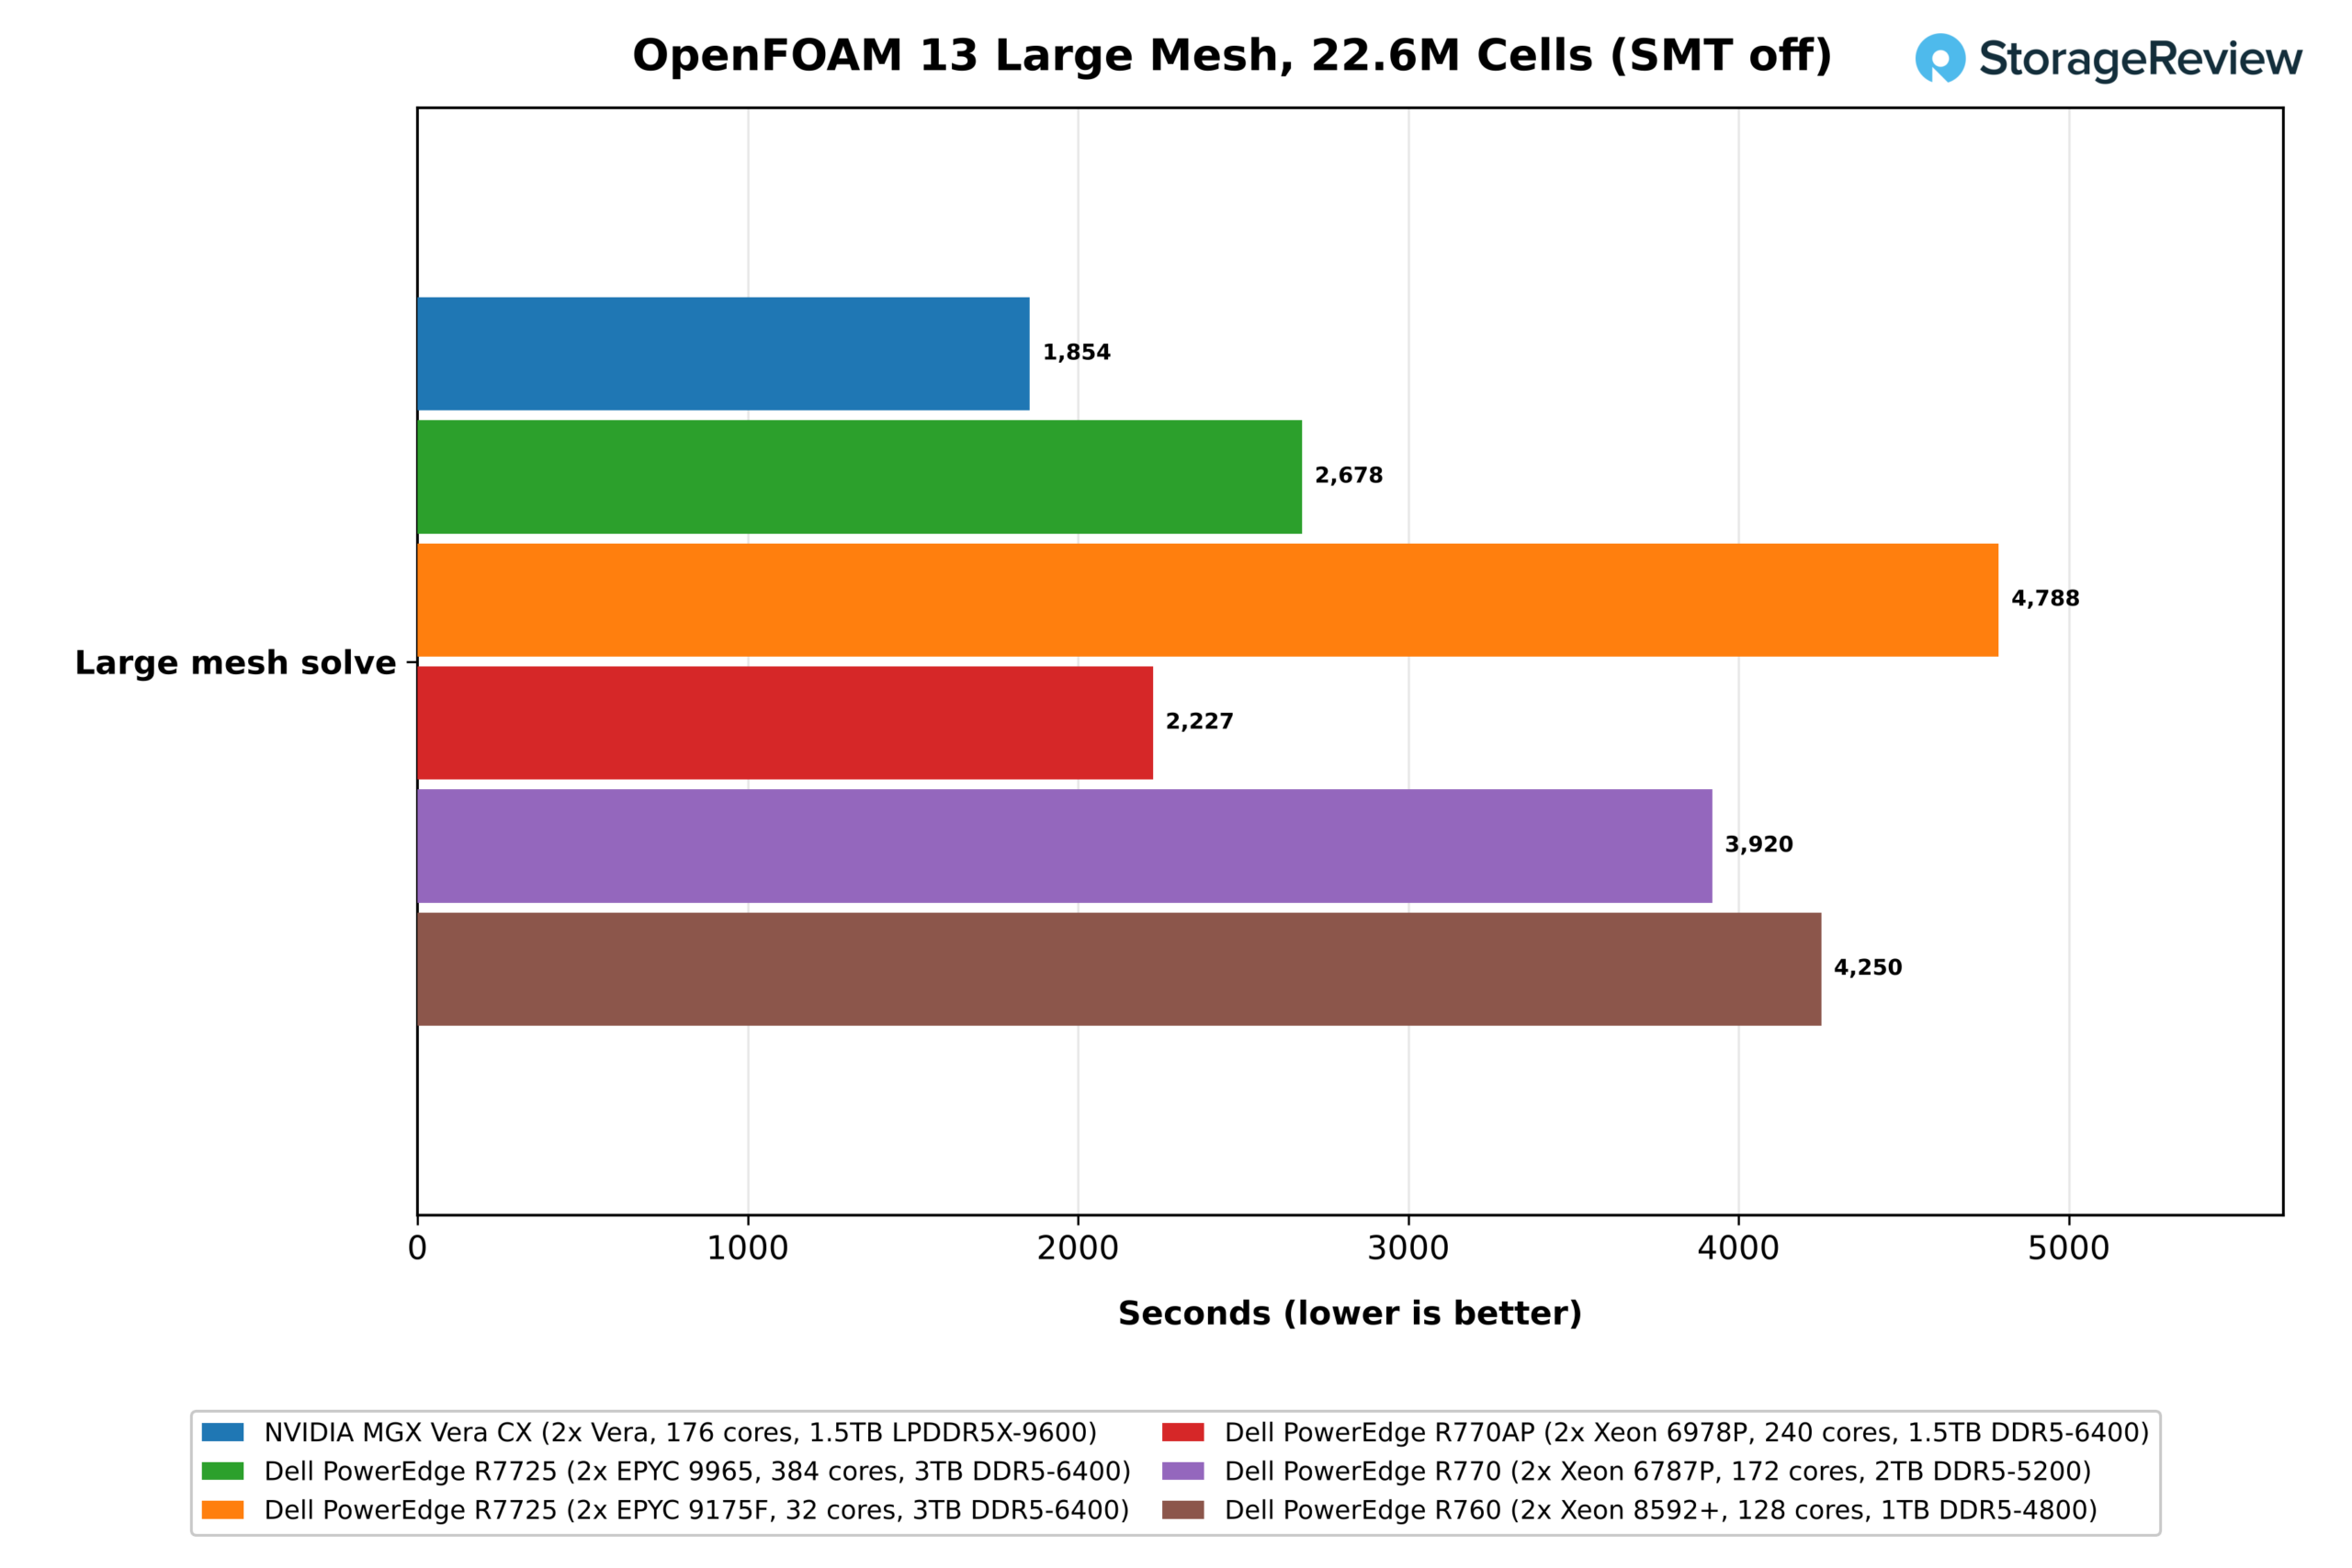
A malha grande inverte a ordem, com o Vera resolvendo o problema em 1,854 segundos, contra 2,227 segundos do Xeon 6978P, 2,678 do EPYC 9965, 3,920 do 6787P, 4,250 do 8592+ e 4,788 do 9175F, tornando-o 1.44 vezes mais rápido que o servidor AMD de 384 núcleos e 1.20 vezes mais rápido que o servidor Intel de 240 núcleos. O Vera também se mantém dentro do limite máximo de 450 W por soquete, em comparação com os 500 W do 9965.
Análise e dados em memória
Os resultados de HPC mostraram o impacto da largura de banda do Vera em um solucionador científico. Os serviços de dados utilizam o mesmo sistema de memória de maneiras diferentes, e nossos dois testes o exploram de perspectivas opostas. O ClickBench executa consultas analíticas que examinam e agregam grandes colunas de dados, distribuindo cada consulta por todos os núcleos, portanto, ele beneficia um sistema que combina muitos núcleos com a largura de banda necessária para alimentá-los. O Valkey, um armazenamento de chave-valor em memória, lida com milhões de pequenas solicitações, cada uma lendo ou gravando um único valor, dependendo, portanto, da rapidez com que um núcleo individual processa uma solicitação e, quando os dados ultrapassam a capacidade do cache, da latência e da largura de banda da memória.
ClickBench
Testamos o ClickBench com 43 consultas em uma tabela de análise da web com 100 milhões de linhas no ClickHouse 26.8. O cálculo de soma a quente, em que cada consulta lê do cache de páginas, mede quantos núcleos um sistema pode disponibilizar para varreduras colunares e agregações, e quão bem sua memória os alimenta. O cálculo de soma a frio adiciona uma reinicialização do servidor e leituras do SSD antes da primeira execução de cada consulta.
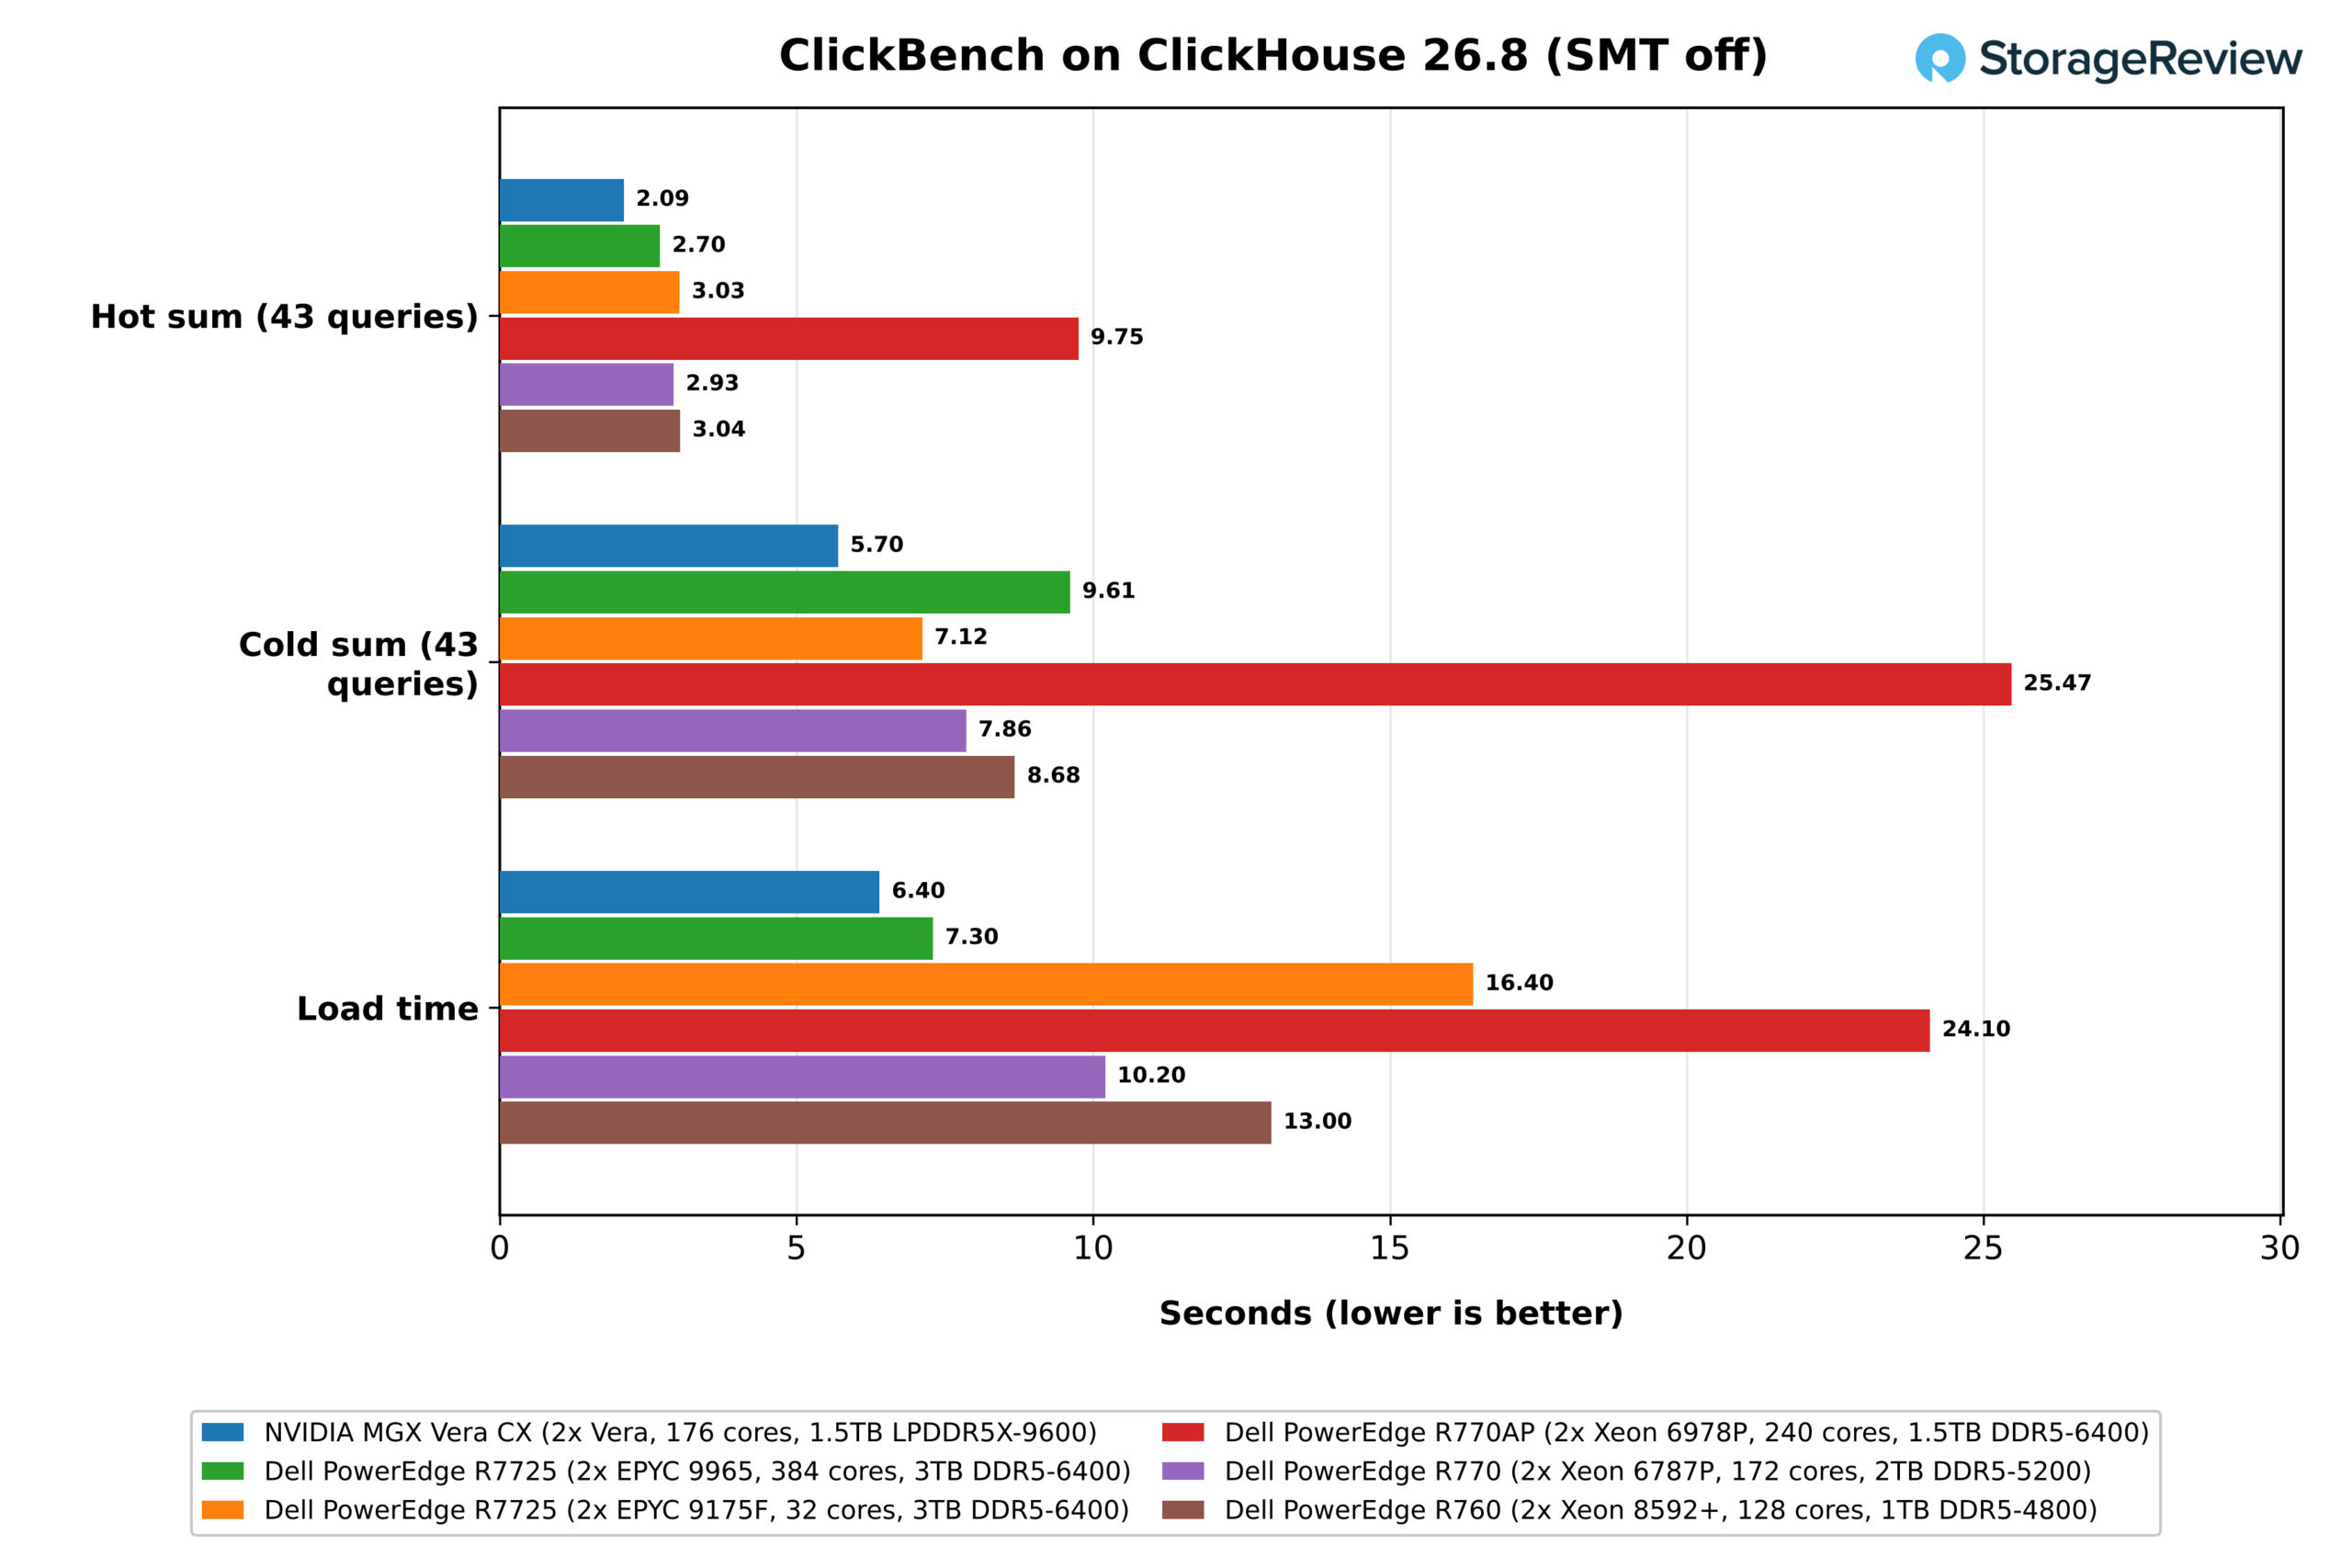
Com o SMT desativado, o Vera completou o teste a quente em 2.09 segundos, o resultado mais rápido em nosso conjunto de testes. O EPYC 9965 veio em seguida, com 2.70 segundos, levando 1.29 vezes mais tempo, enquanto o Xeon 6787P, o EPYC 9175F e o Xeon 8592+ ficaram praticamente empatados, com tempos entre 2.93 e 3.04 segundos. Essa diferença reflete o equilíbrio entre núcleos e largura de banda. O 9965, com 384 núcleos, tem núcleos de sobra, mas pouca largura de banda por núcleo; o 9175F, com 32 núcleos, tem o oposto; e o Vera combina 176 núcleos com mais de três vezes a largura de banda de ambos.
O Vera também liderou o teste a frio com 5.70 segundos, à frente do 9175F com 7.12, do 6787P com 7.86, do 8592+ com 8.68 e do 9965 com 9.61. O desempenho a frio depende mais do armazenamento, e as conexões dos discos rígidos diferem: Gen5 x4 no Vera e no 6787P, x2 em ambos os sistemas EPYC e Gen4 no 8592+.
O Vera também carregou o conjunto de dados de 15 GB mais rapidamente, em 6.4 segundos, em comparação com 7.3 segundos no 9965 e de 10.2 a 16.4 segundos nos demais. O Xeon 6978P, com 9.75 segundos em modo quente e 25.47 segundos em modo frio, ficou muito atrás dos outros Xeons por razões que não identificamos, portanto, o excluímos do ranking.
A ativação do Spatial Multithreading reduziu o tempo de execução do Vera para 2.31 segundos (soma quente) e 6.09 segundos (soma fria), uma penalidade de 10% na soma quente. Dividir os recursos de cada núcleo entre duas threads custou ao ClickHouse mais recursos do que trouxe benefícios.
Valkey
O Valkey executa comandos em uma única thread principal, com threads de E/S auxiliando apenas até certo ponto. Portanto, o crescimento das implementações é obtido com a adição de shards, já que fornecer mais núcleos a uma única instância tem pouco impacto. Assim, analisamos o Valkey sob duas perspectivas: o desempenho de um único shard com núcleos alocados e o desempenho de cada shard quando um socket é utilizado em conjunto. Em ambos os testes, os clientes são executados no outro socket da mesma máquina, sem o uso de placa de rede.
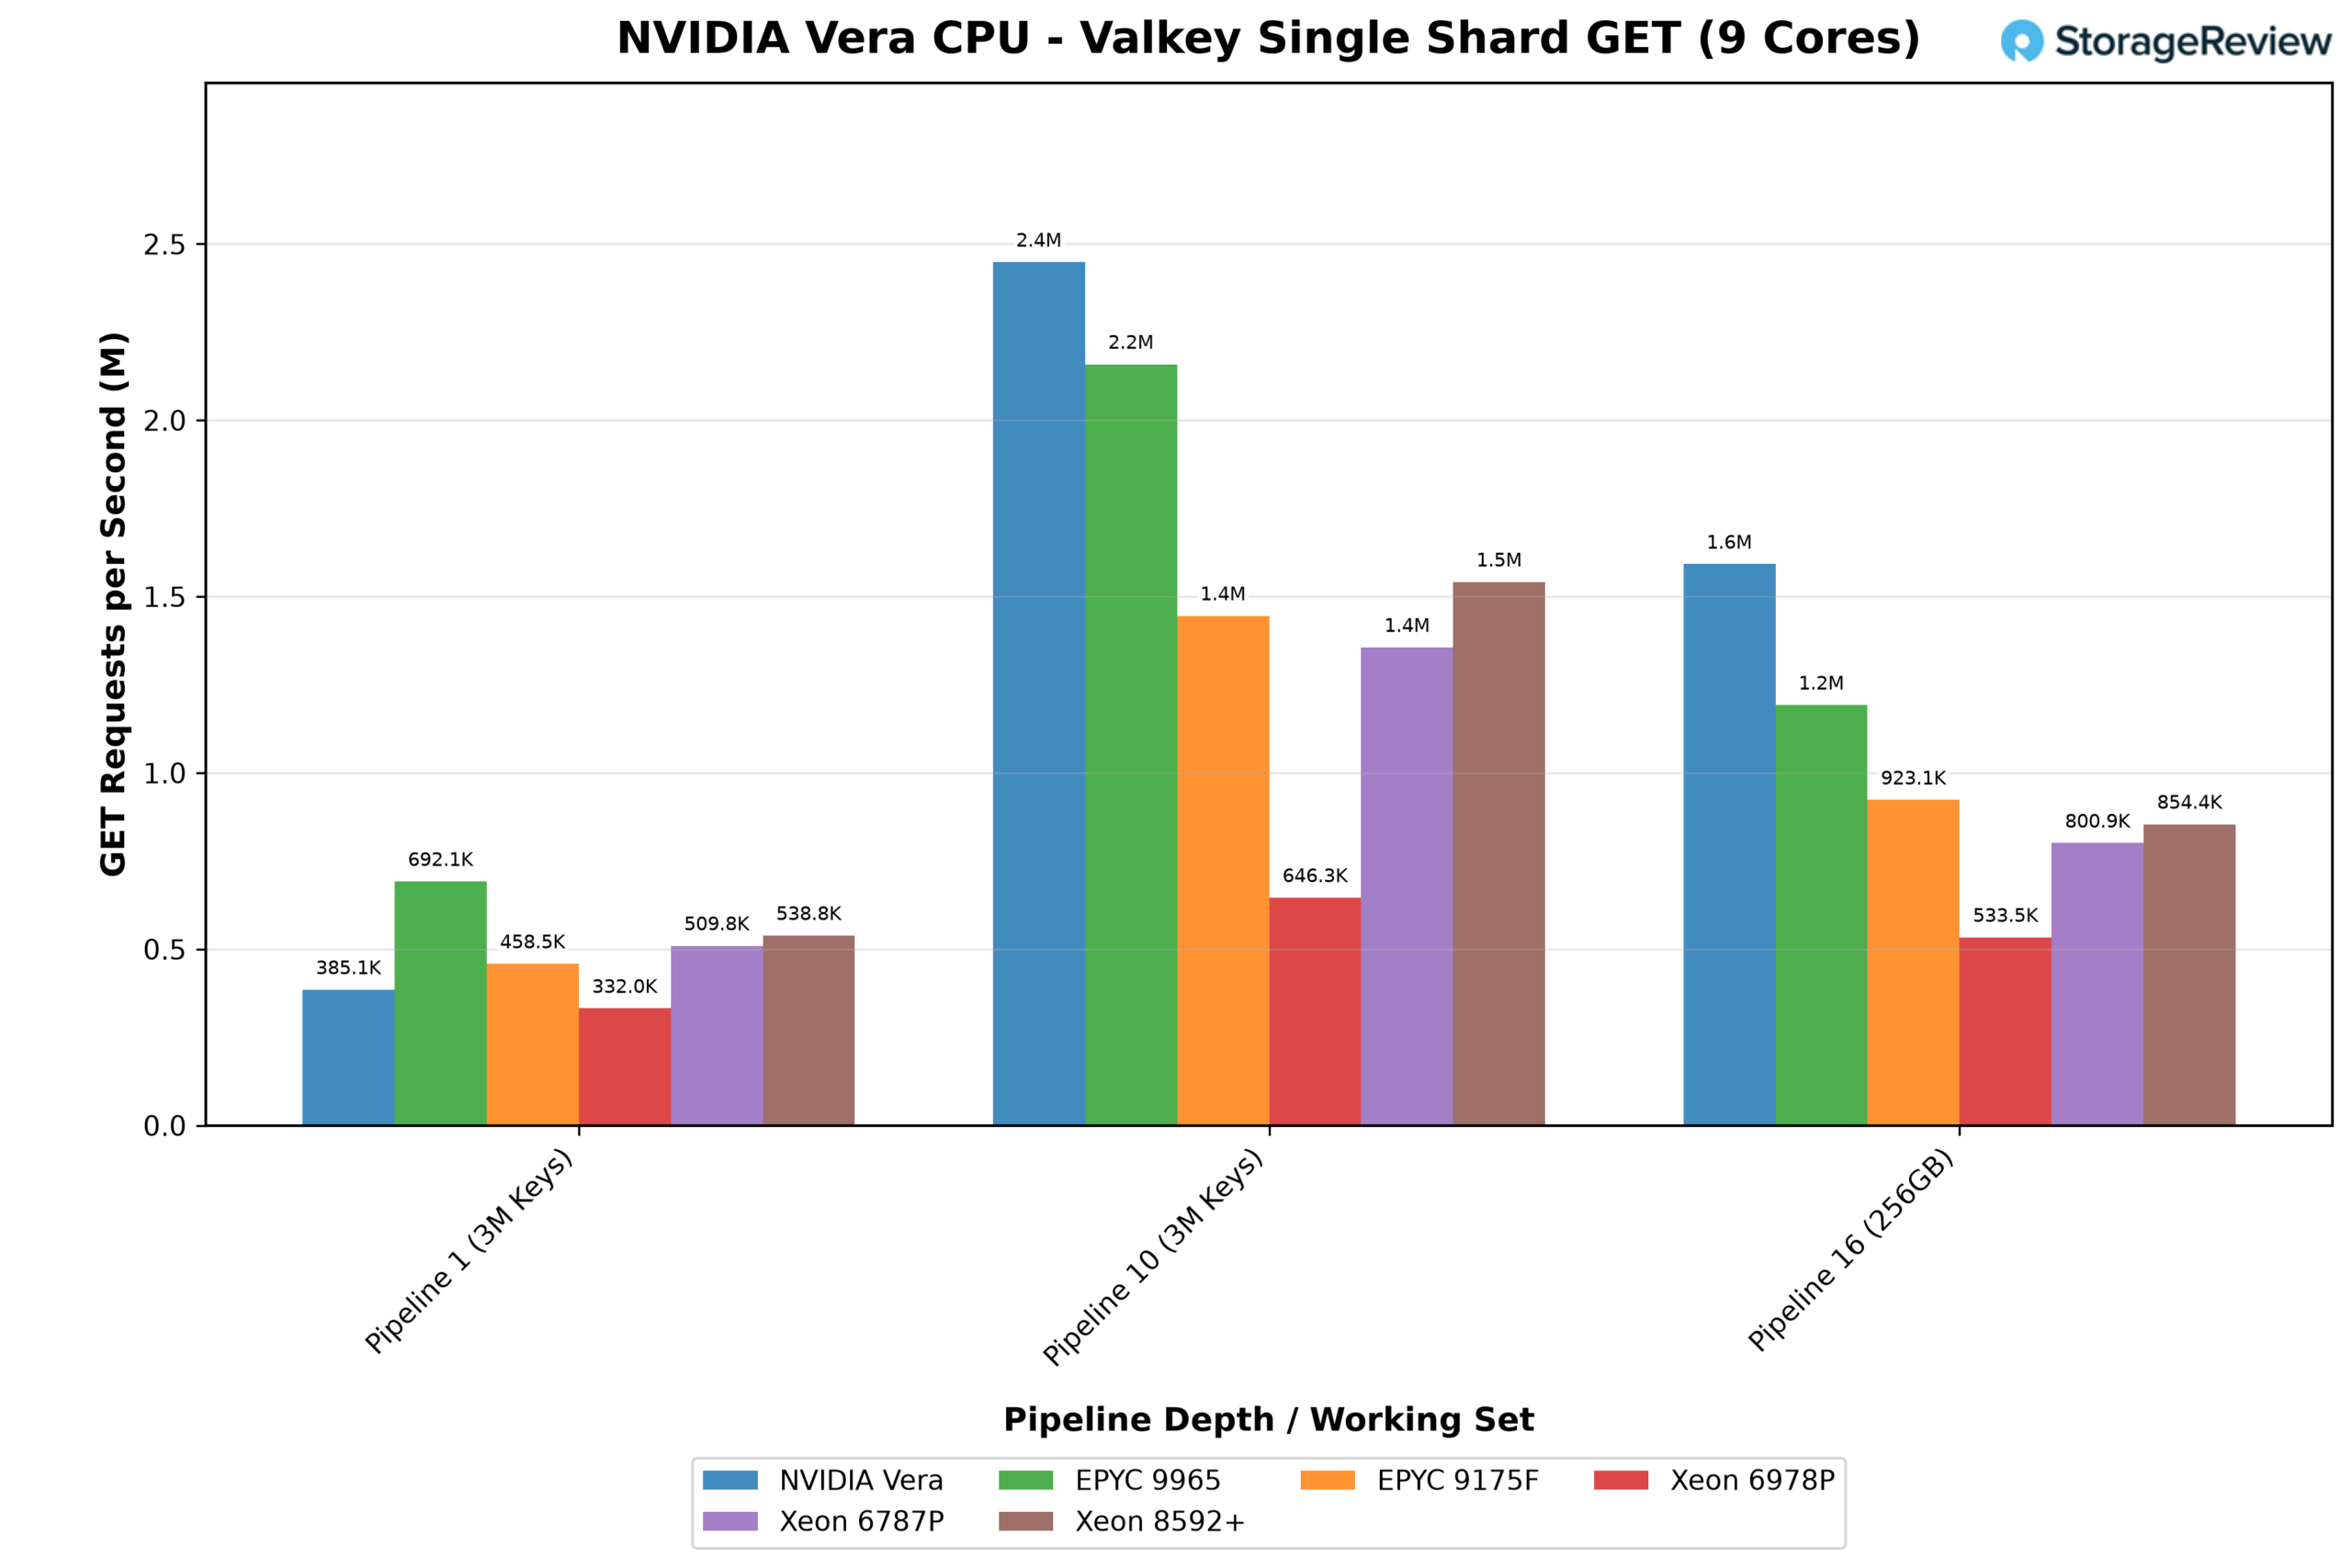
O teste de shard único atribui nove núcleos físicos a um servidor Valkey em cada plataforma. Ele processa um conjunto de dados de 3 milhões de chaves com solicitações enviadas uma de cada vez, depois em lotes de 10 e, em seguida, um conjunto de dados de 256 GB, grande demais para qualquer cache, em lotes de 16. Enviadas uma de cada vez, cada solicitação precisa completar sua ida e volta antes que a próxima seja enviada, e é aqui que o Vera apresenta sua maior desvantagem. Seu shard processou 385,000 solicitações GET por segundo, ficando à frente apenas do Xeon 6978P, enquanto o EPYC 9965 liderou com 692,000. A latência p99 do Vera também foi maior, com 1.76 ms contra 1.08 ms do 9965.
O processamento em lote elimina a maior parte desse custo de ida e volta, e o Vera assume a liderança. Com lotes de 10, seu shard processou 2.45 milhões de requisições GET por segundo, 13% a mais que o 9965 e bem à frente de todos os Xeon. O conjunto de dados de 256 GB ampliou ainda mais a diferença. Com quase todas as requisições direcionadas à memória, o Vera atendeu 1.59 milhão de requisições GET por segundo, 34% a mais que o 9965, enquanto o restante do conjunto de dados variou de 0.53 milhão a 0.92 milhão. Os resultados do SET seguiram o mesmo padrão em ambos os testes.
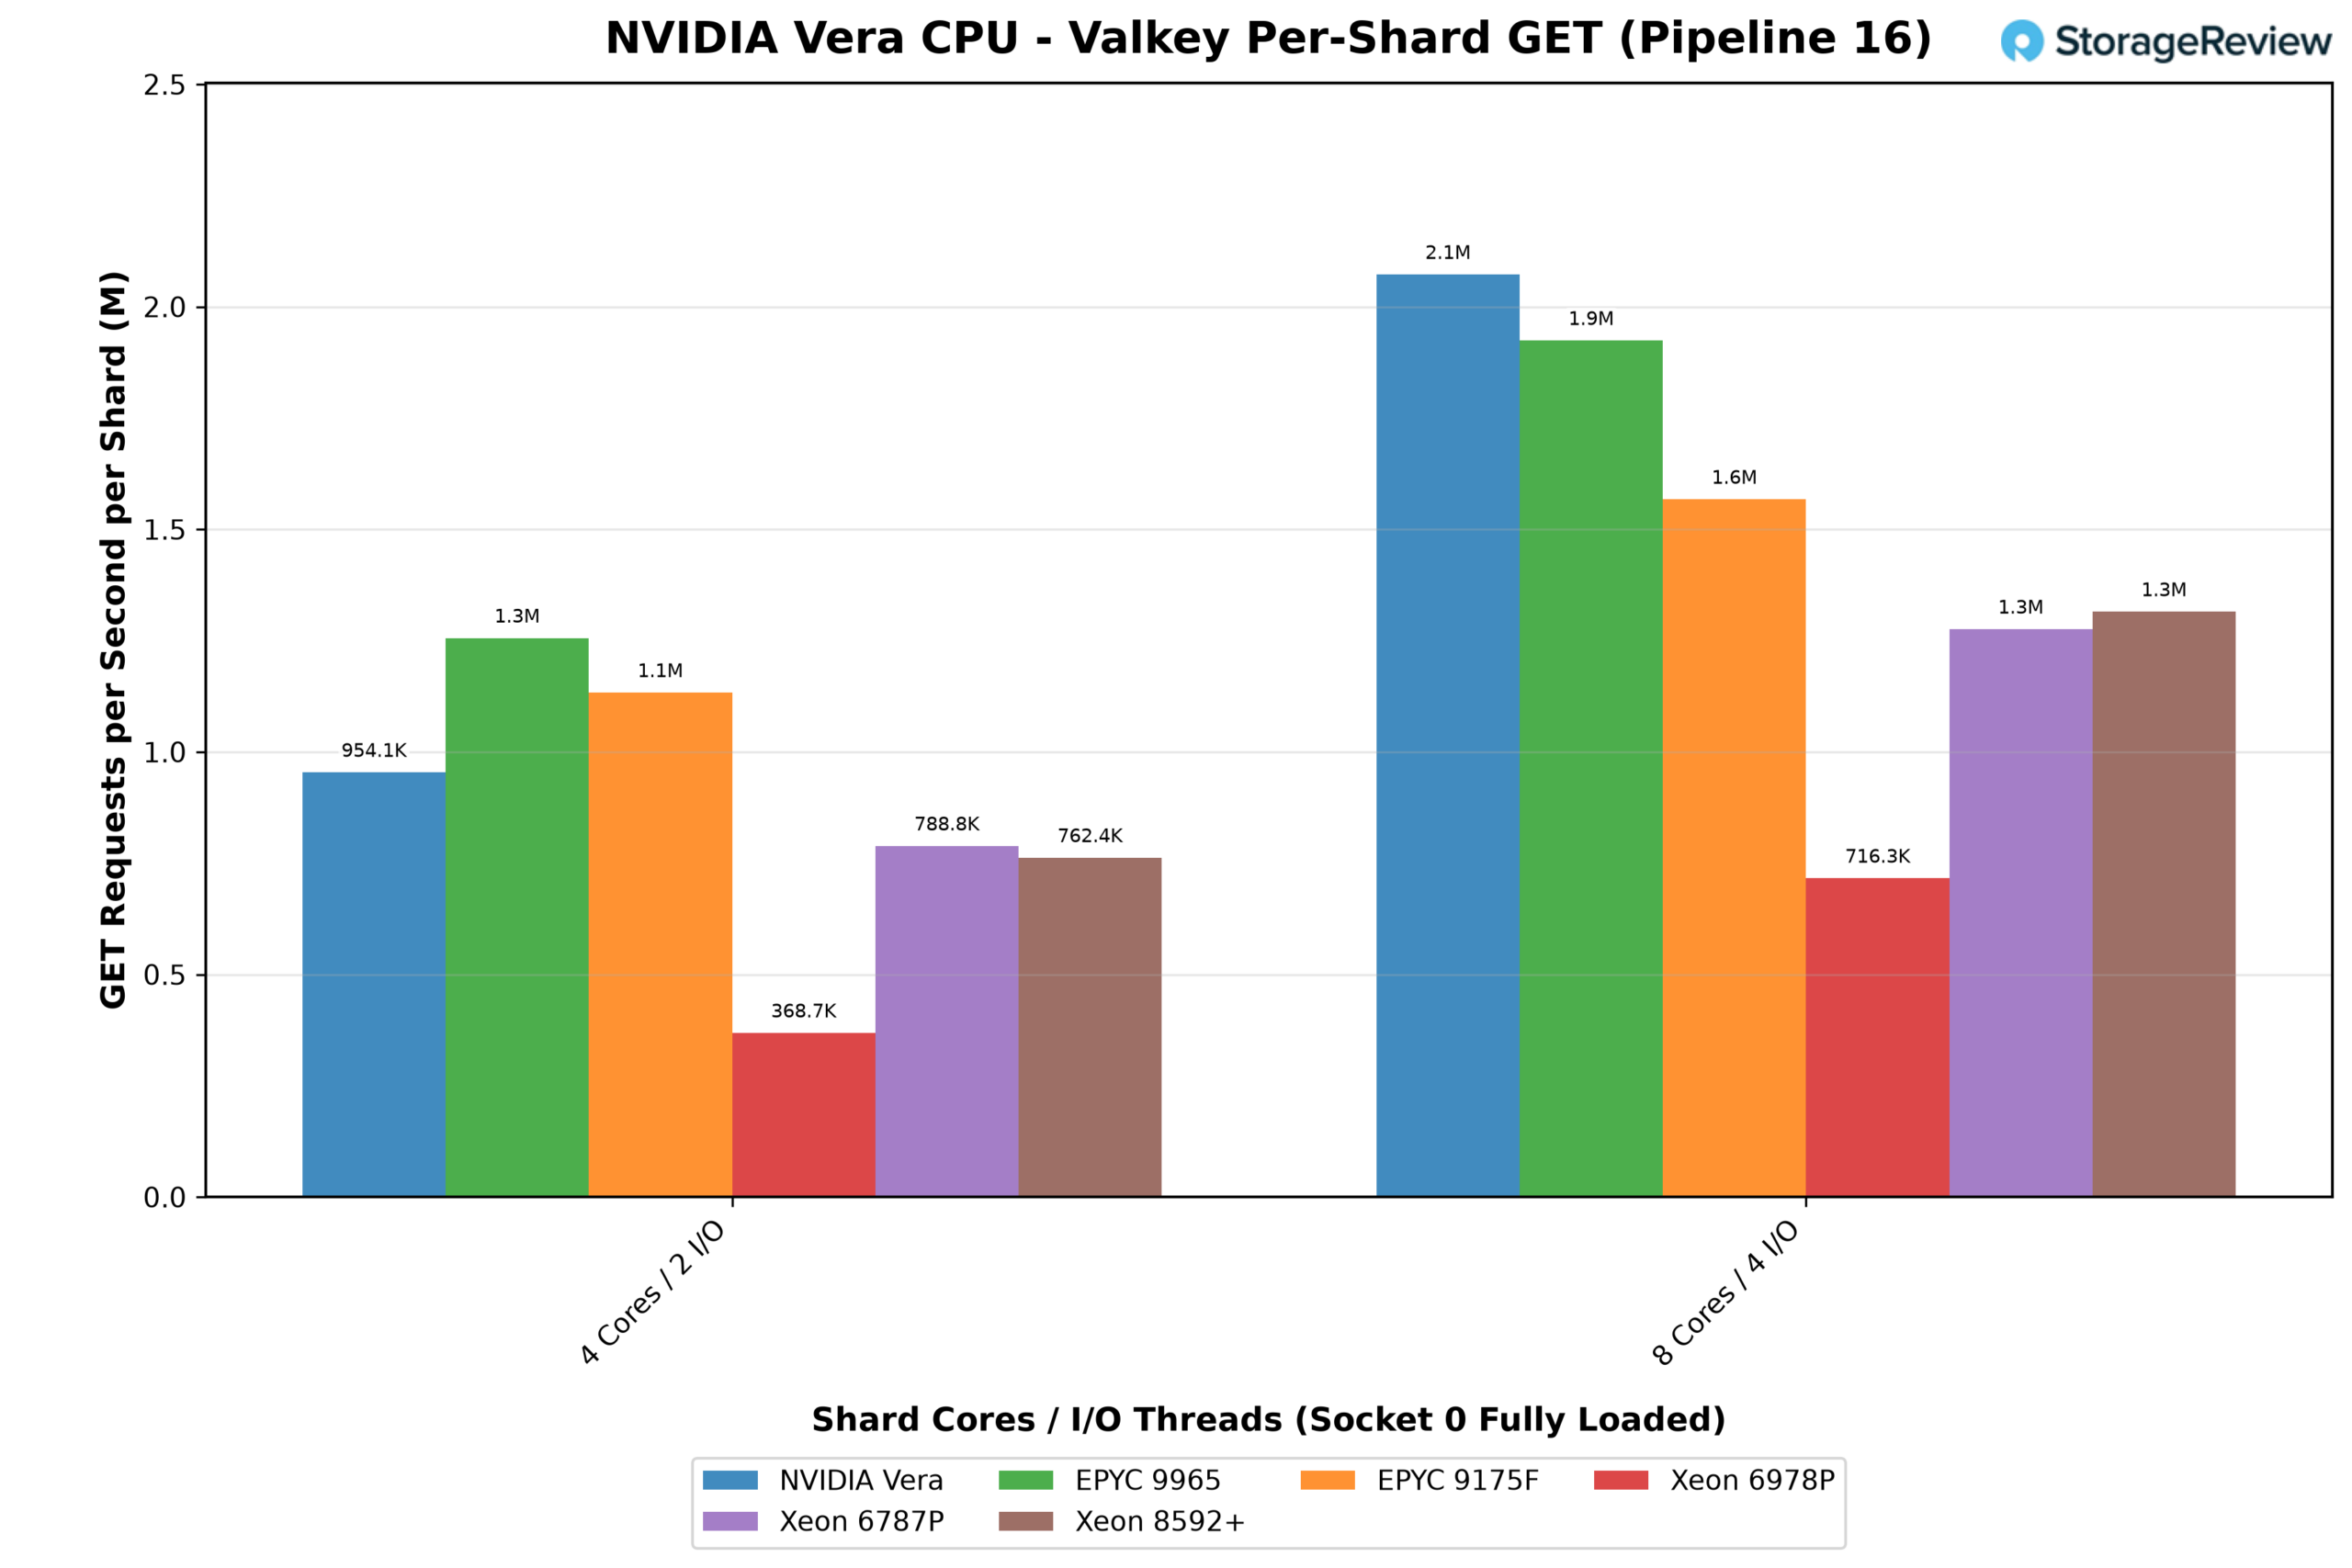
O modo de socket agrupa o socket 0 com shards idênticos de quatro ou oito núcleos, todos atendendo ao tráfego simultaneamente, o que se assemelha mais ao funcionamento de um host Valkey dedicado. Com shards de 8 núcleos e lotes de 16, cada shard do Vera entregou 2.07 milhões de requisições GET por segundo, superando os 1.92 milhão do 9965 e cerca de 1.6 vezes o Xeon 6787P e o 8592+, embora sua latência p99 tenha aumentado para 2.2 ms contra cerca de 0.5 ms no 9965.
Com shards menores de 4 núcleos, a AMD saiu na frente: o 9965 com 1.26 milhão de GETs por shard contra 0.95 milhão do Vera, embora o Vera ainda liderasse entre todos os Xeons. Com as requisições enviadas uma de cada vez, os shards do 9965 foram de 1.5 a 1.7 vezes mais rápidos que os do Vera em ambos os tamanhos, e o 6787P e o 8592+ também se destacaram em shards de 8 núcleos.
A densidade determina o número total de sockets: um socket Vera comporta 11 shards de oito núcleos e atendeu 22.8 milhões de requisições GET por segundo, enquanto os 192 núcleos do 9965 comportam 48 shards de quatro núcleos e atenderam 60.3 milhões. O Vera oferece os shards mais rápidos em nosso conjunto quando cada shard possui oito ou mais núcleos e as requisições são agrupadas, mas o 9965 comporta mais que o dobro de shards em um socket.
Processamento de um único núcleo e taxa de transferência
Valkey e ClickBench dependiam tanto do sistema de memória quanto dos núcleos. Esta seção se concentra nos próprios núcleos e nos dois objetivos por trás do Olympus descritos anteriormente: concluir tarefas individuais rapidamente e manter essa velocidade quando todo o socket estiver ocupado. O 7-Zip, o OpenSSL e o Python são executados como threads individuais alocadas a um núcleo, demonstrando o que um núcleo do Olympus pode fazer sozinho. Em seguida, o 7-Zip e o OpenSSL são executados novamente em todas as threads do sistema, mostrando quanta dessa velocidade por núcleo se mantém quando todos os núcleos estão competindo pelos mesmos caches e memória.
7-Zip
A compressão LZMA do 7-Zip utiliza código inteiro com muitas ramificações e acesso imprevisível à memória, exatamente o tipo de trabalho para o qual o front-end de 10 linhas e o pré-carregador de grafos do Olympus foram projetados.
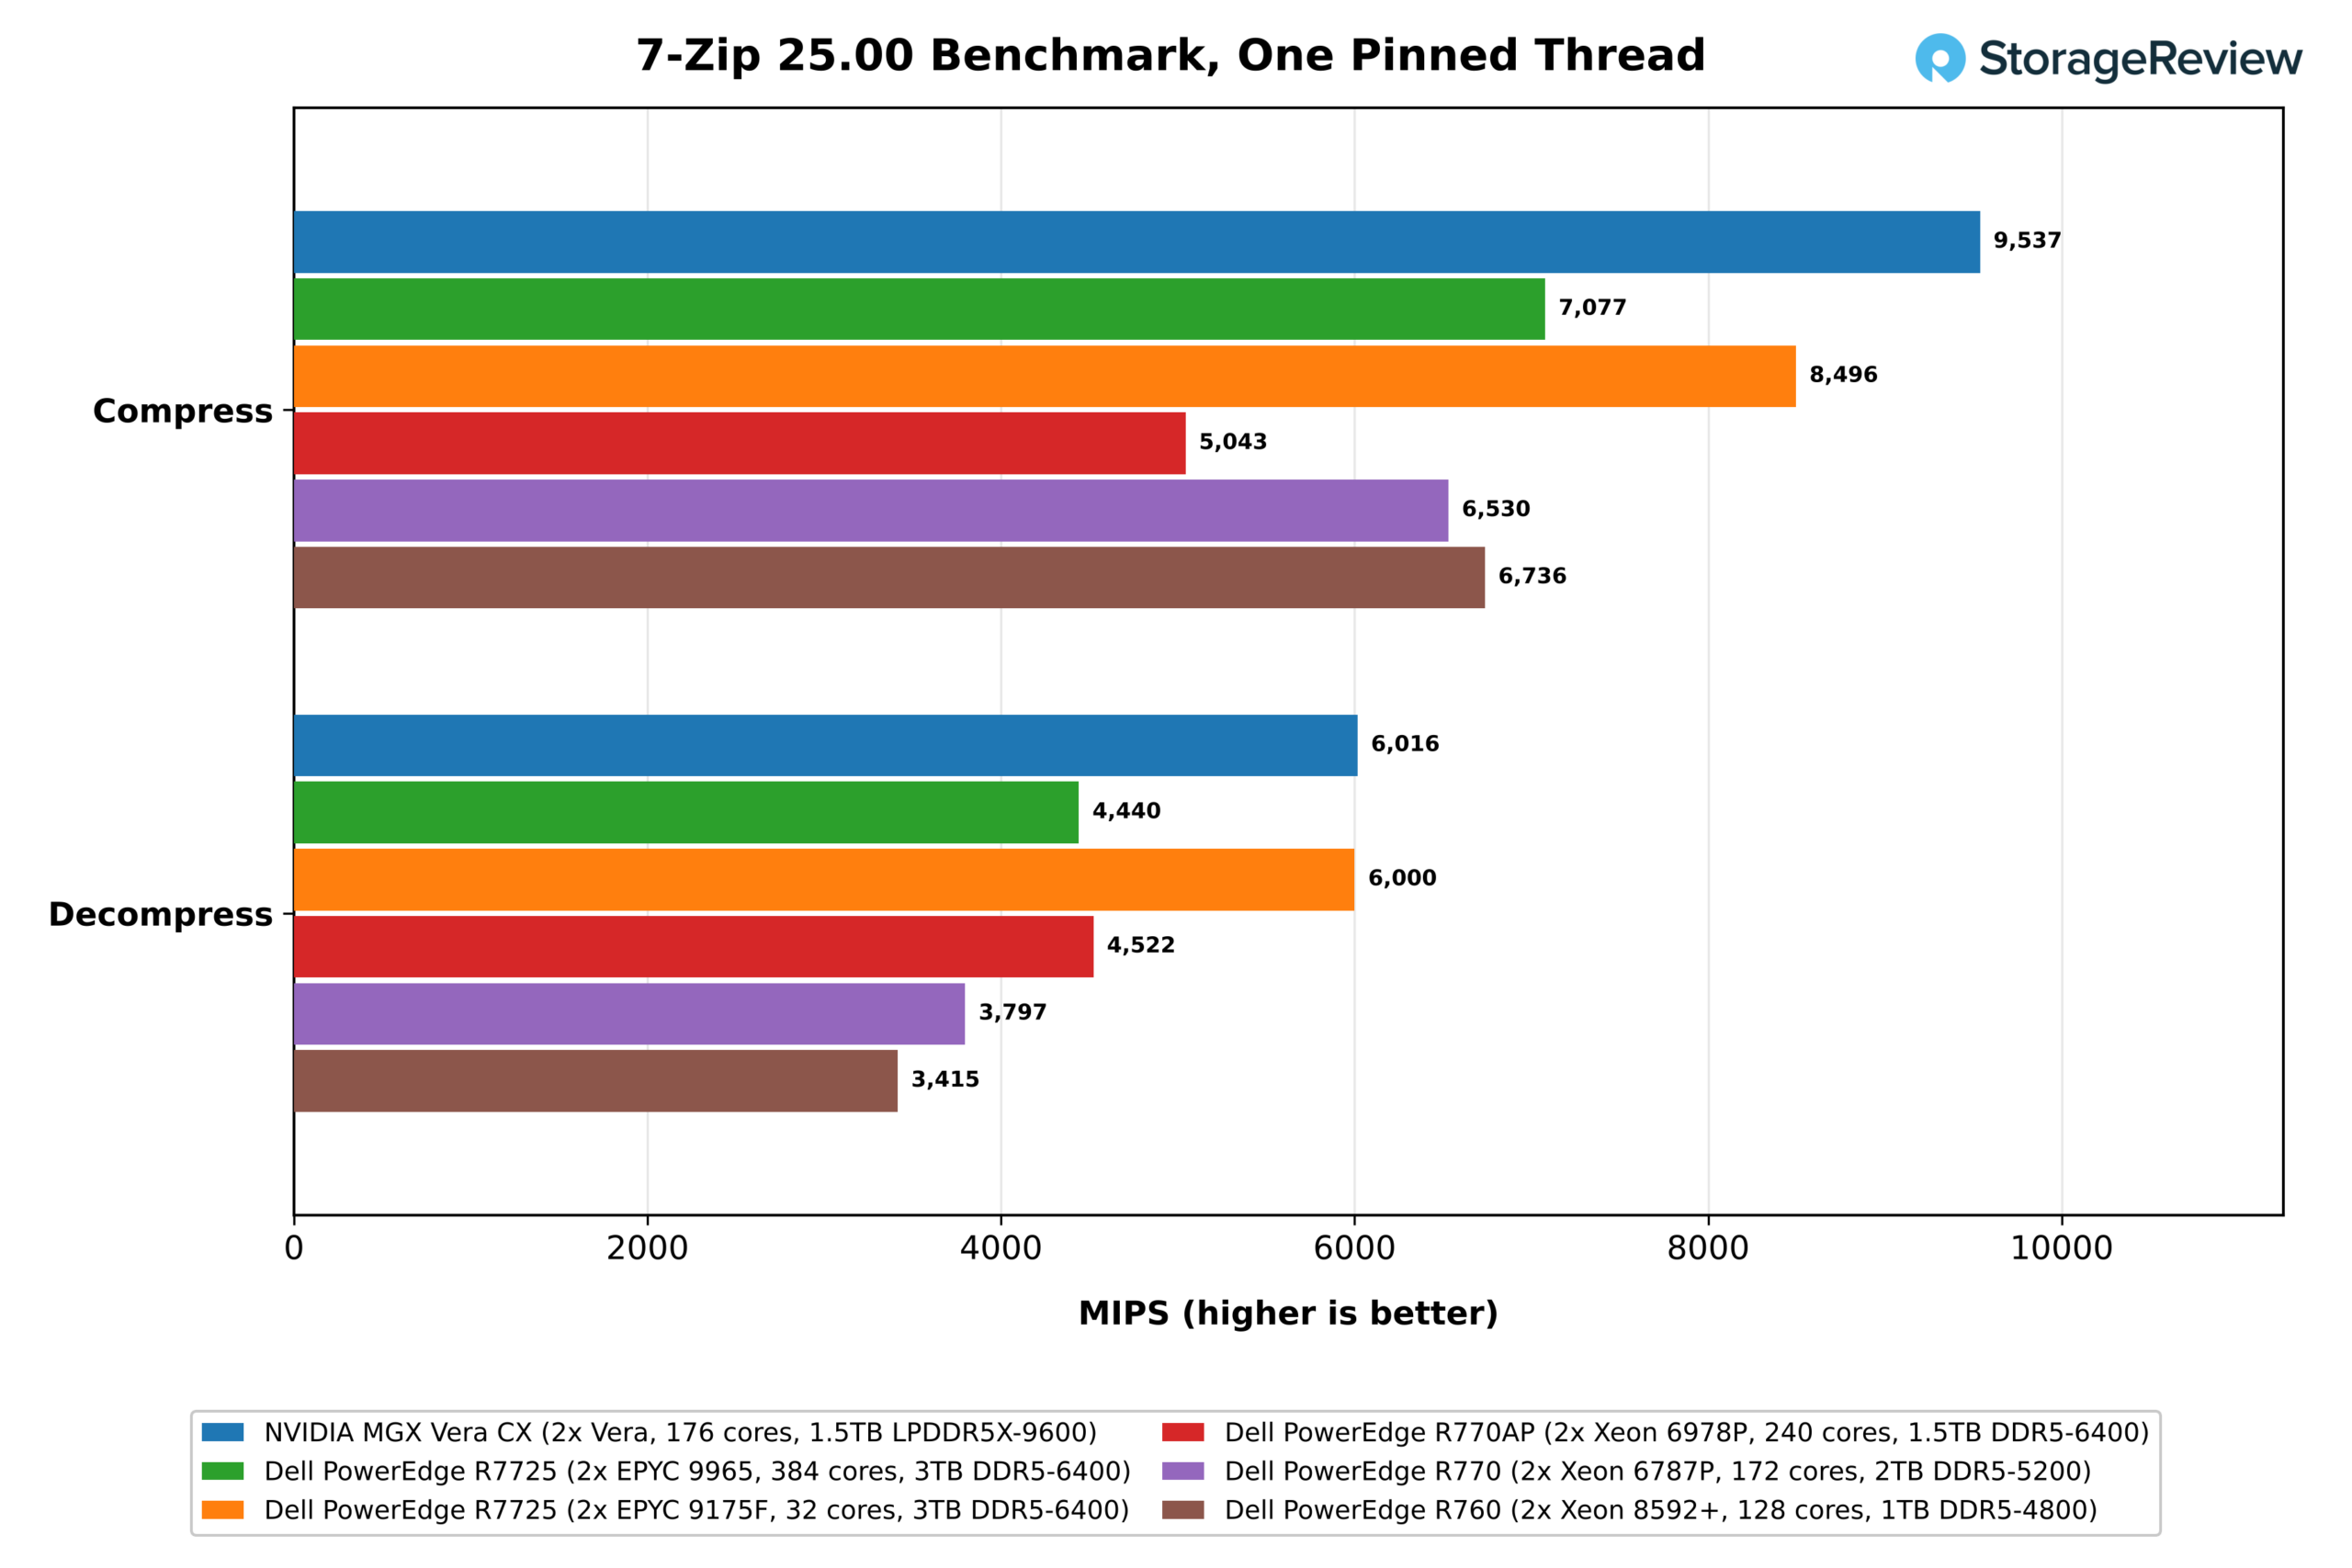
Em um único núcleo, o compressor da Olympus foi o mais rápido do nosso conjunto. Ele atingiu 9,537 MIPS, 12% à frente do EPYC 9175F de 5.0 GHz, o núcleo x86 mais rápido aqui, e bem à frente do EPYC 9965 e de todos os Xeon. A descompressão foi praticamente idêntica entre os dois: 6,016 MIPS para o Vera e 6,000 para o 9175F, sem nenhum outro sistema a menos de 20% de diferença.
Analisando cada thread, é possível ver quanto desse lead permanece disponível quando todo o sistema está ocupado.
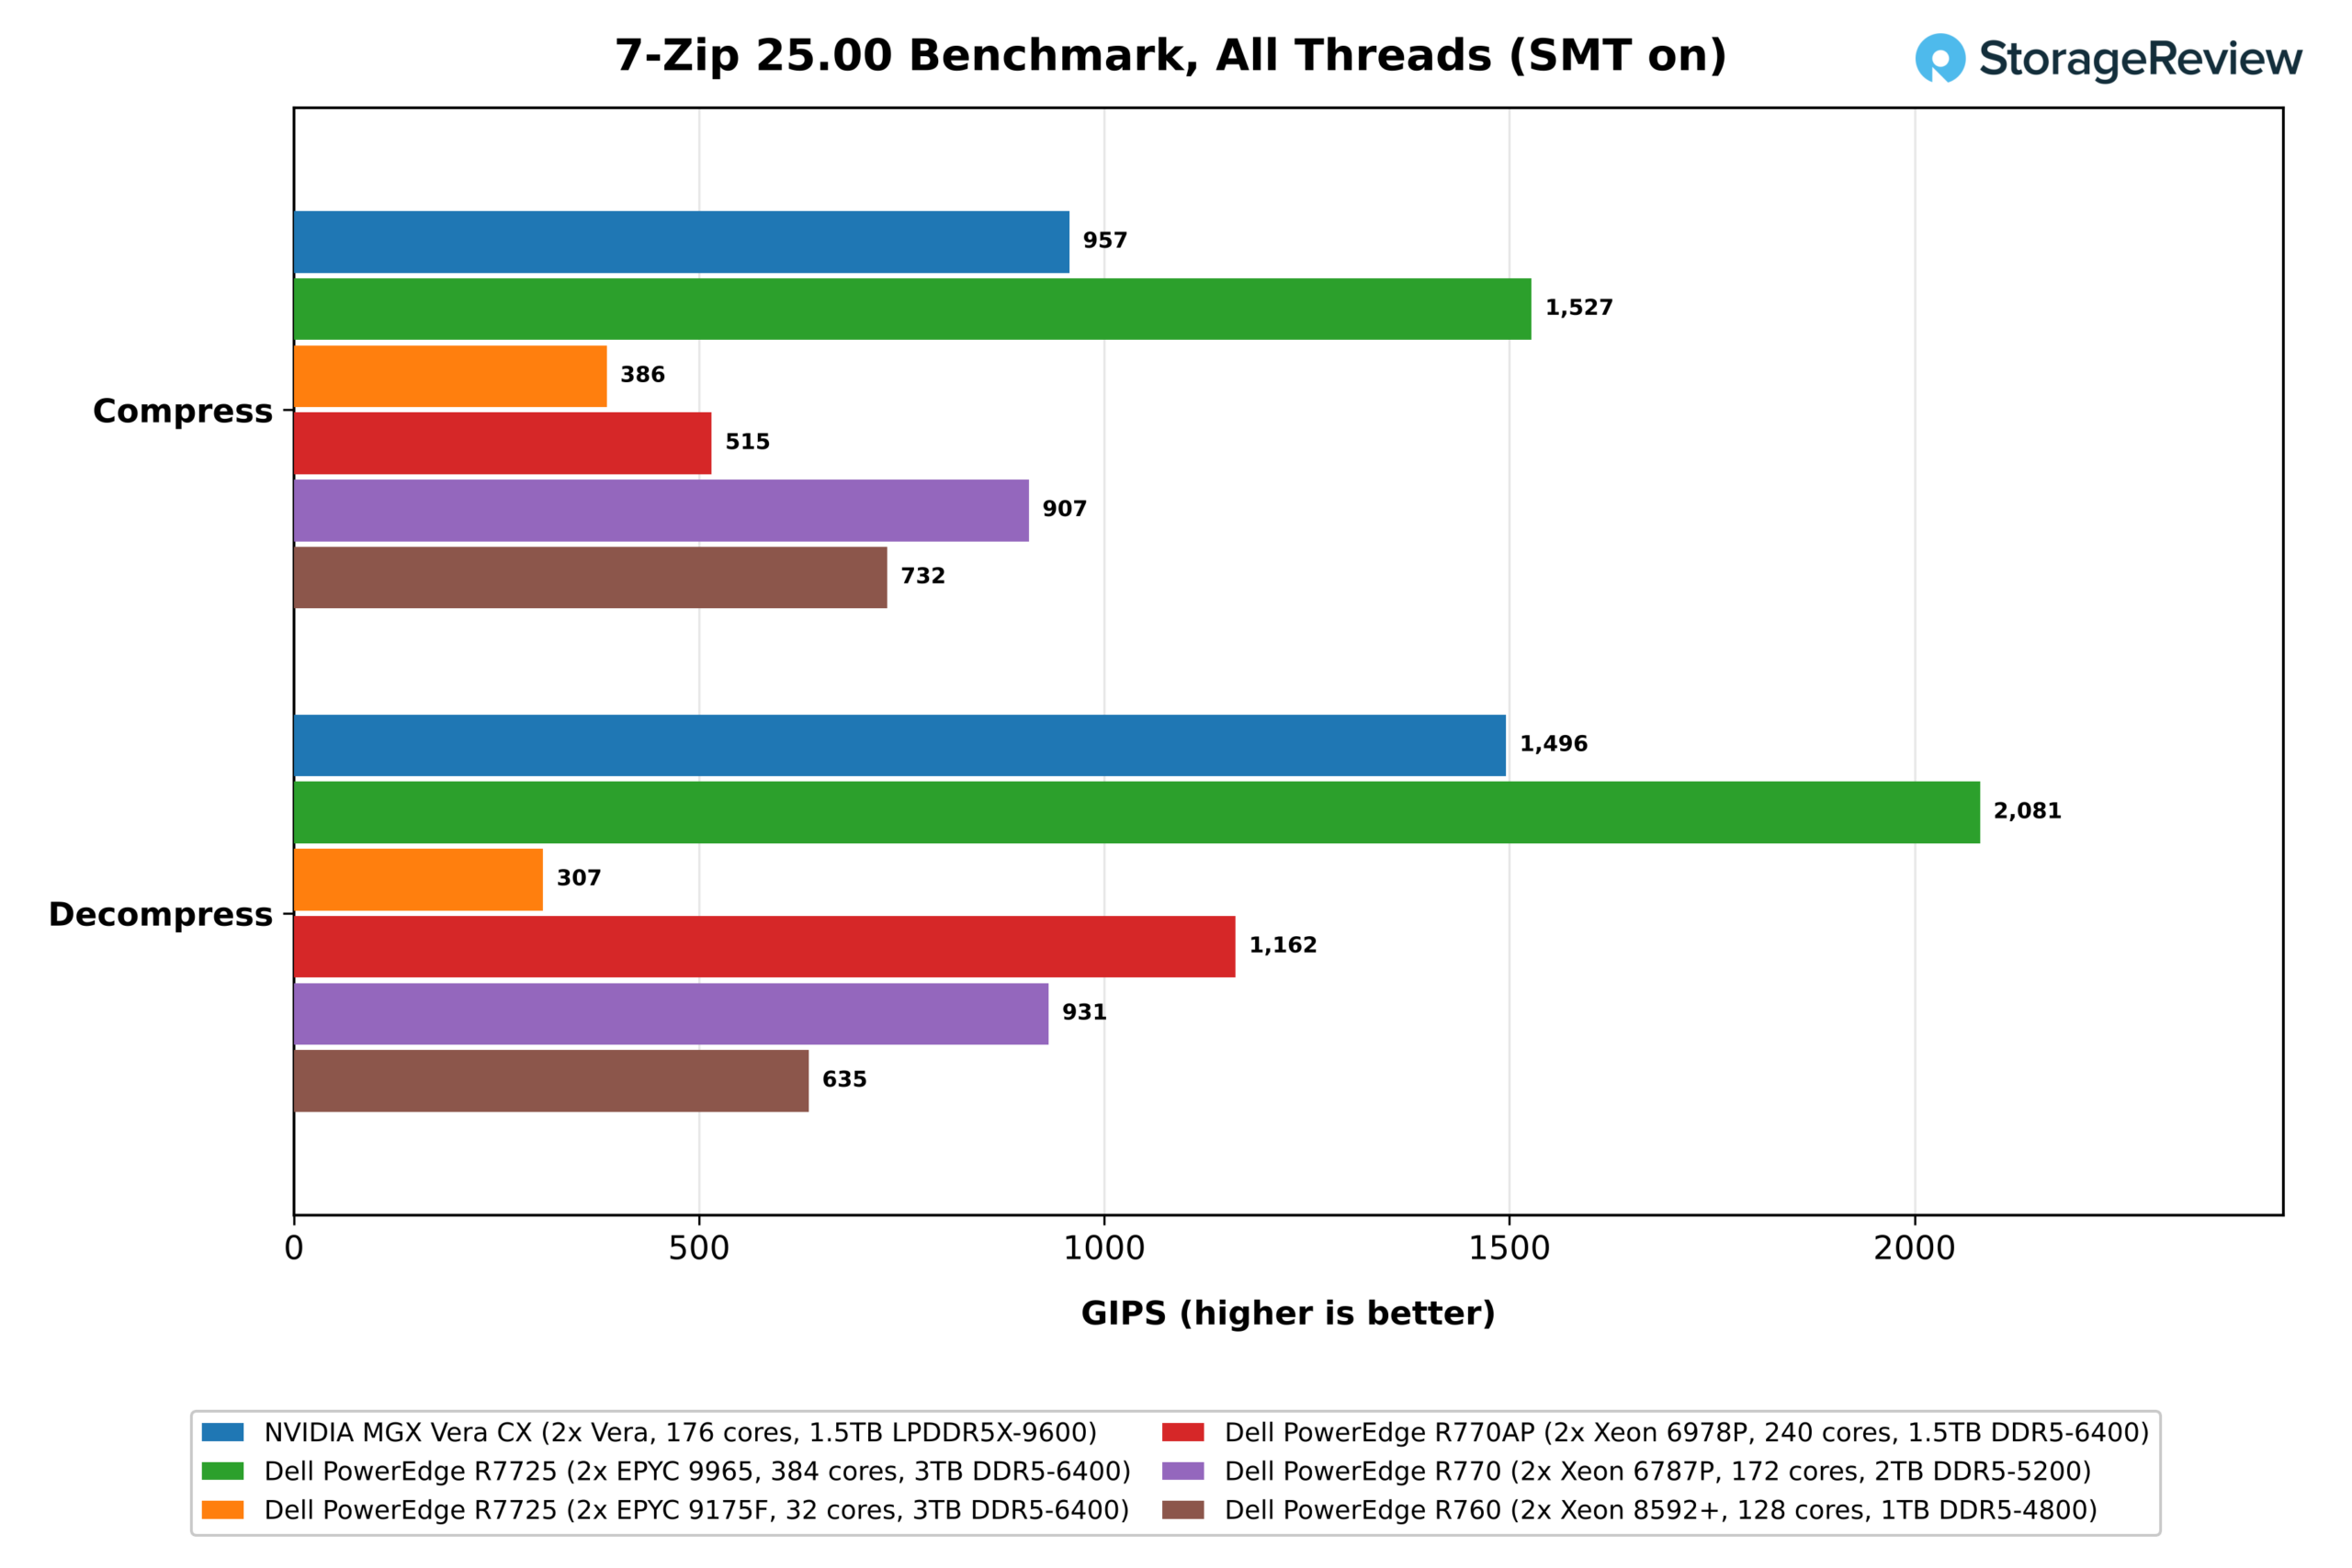
Com todos os threads em uso, os 768 threads do EPYC 9965 conquistaram o primeiro lugar com 1,527 GIPS em compressão e 2,081 GIPS em descompressão. Os 352 threads do Vera ficaram em segundo lugar com 957 e 1,496 GIPS, respectivamente, à frente de todos os Xeon, com o 6787P mais próximo, com 907 e 931. Medido por núcleo físico, o Vera se sai bem. Seus 5.4 GIPS de compressão por núcleo igualam os do 6787P e 8592+ e superam os 4.0 do 9965, e seus 8.5 GIPS de descompressão por núcleo são 57% maiores que os do 9965 e superam todos os Xeon. Apenas o 9175F de 32 núcleos, com muito menos núcleos compartilhando os caches e a memória de cada soquete, apresentou desempenho superior por núcleo em ambos os casos.
OpenSSL
O teste AES-256-GCM do OpenSSL é onde o Vera mais perde terreno. Apenas dois dos seis pipes SVE2 de 128 bits do Olympus conseguem executar instruções criptográficas, enquanto as partes x86 podem executar AES em registradores de 512 bits com VAES.
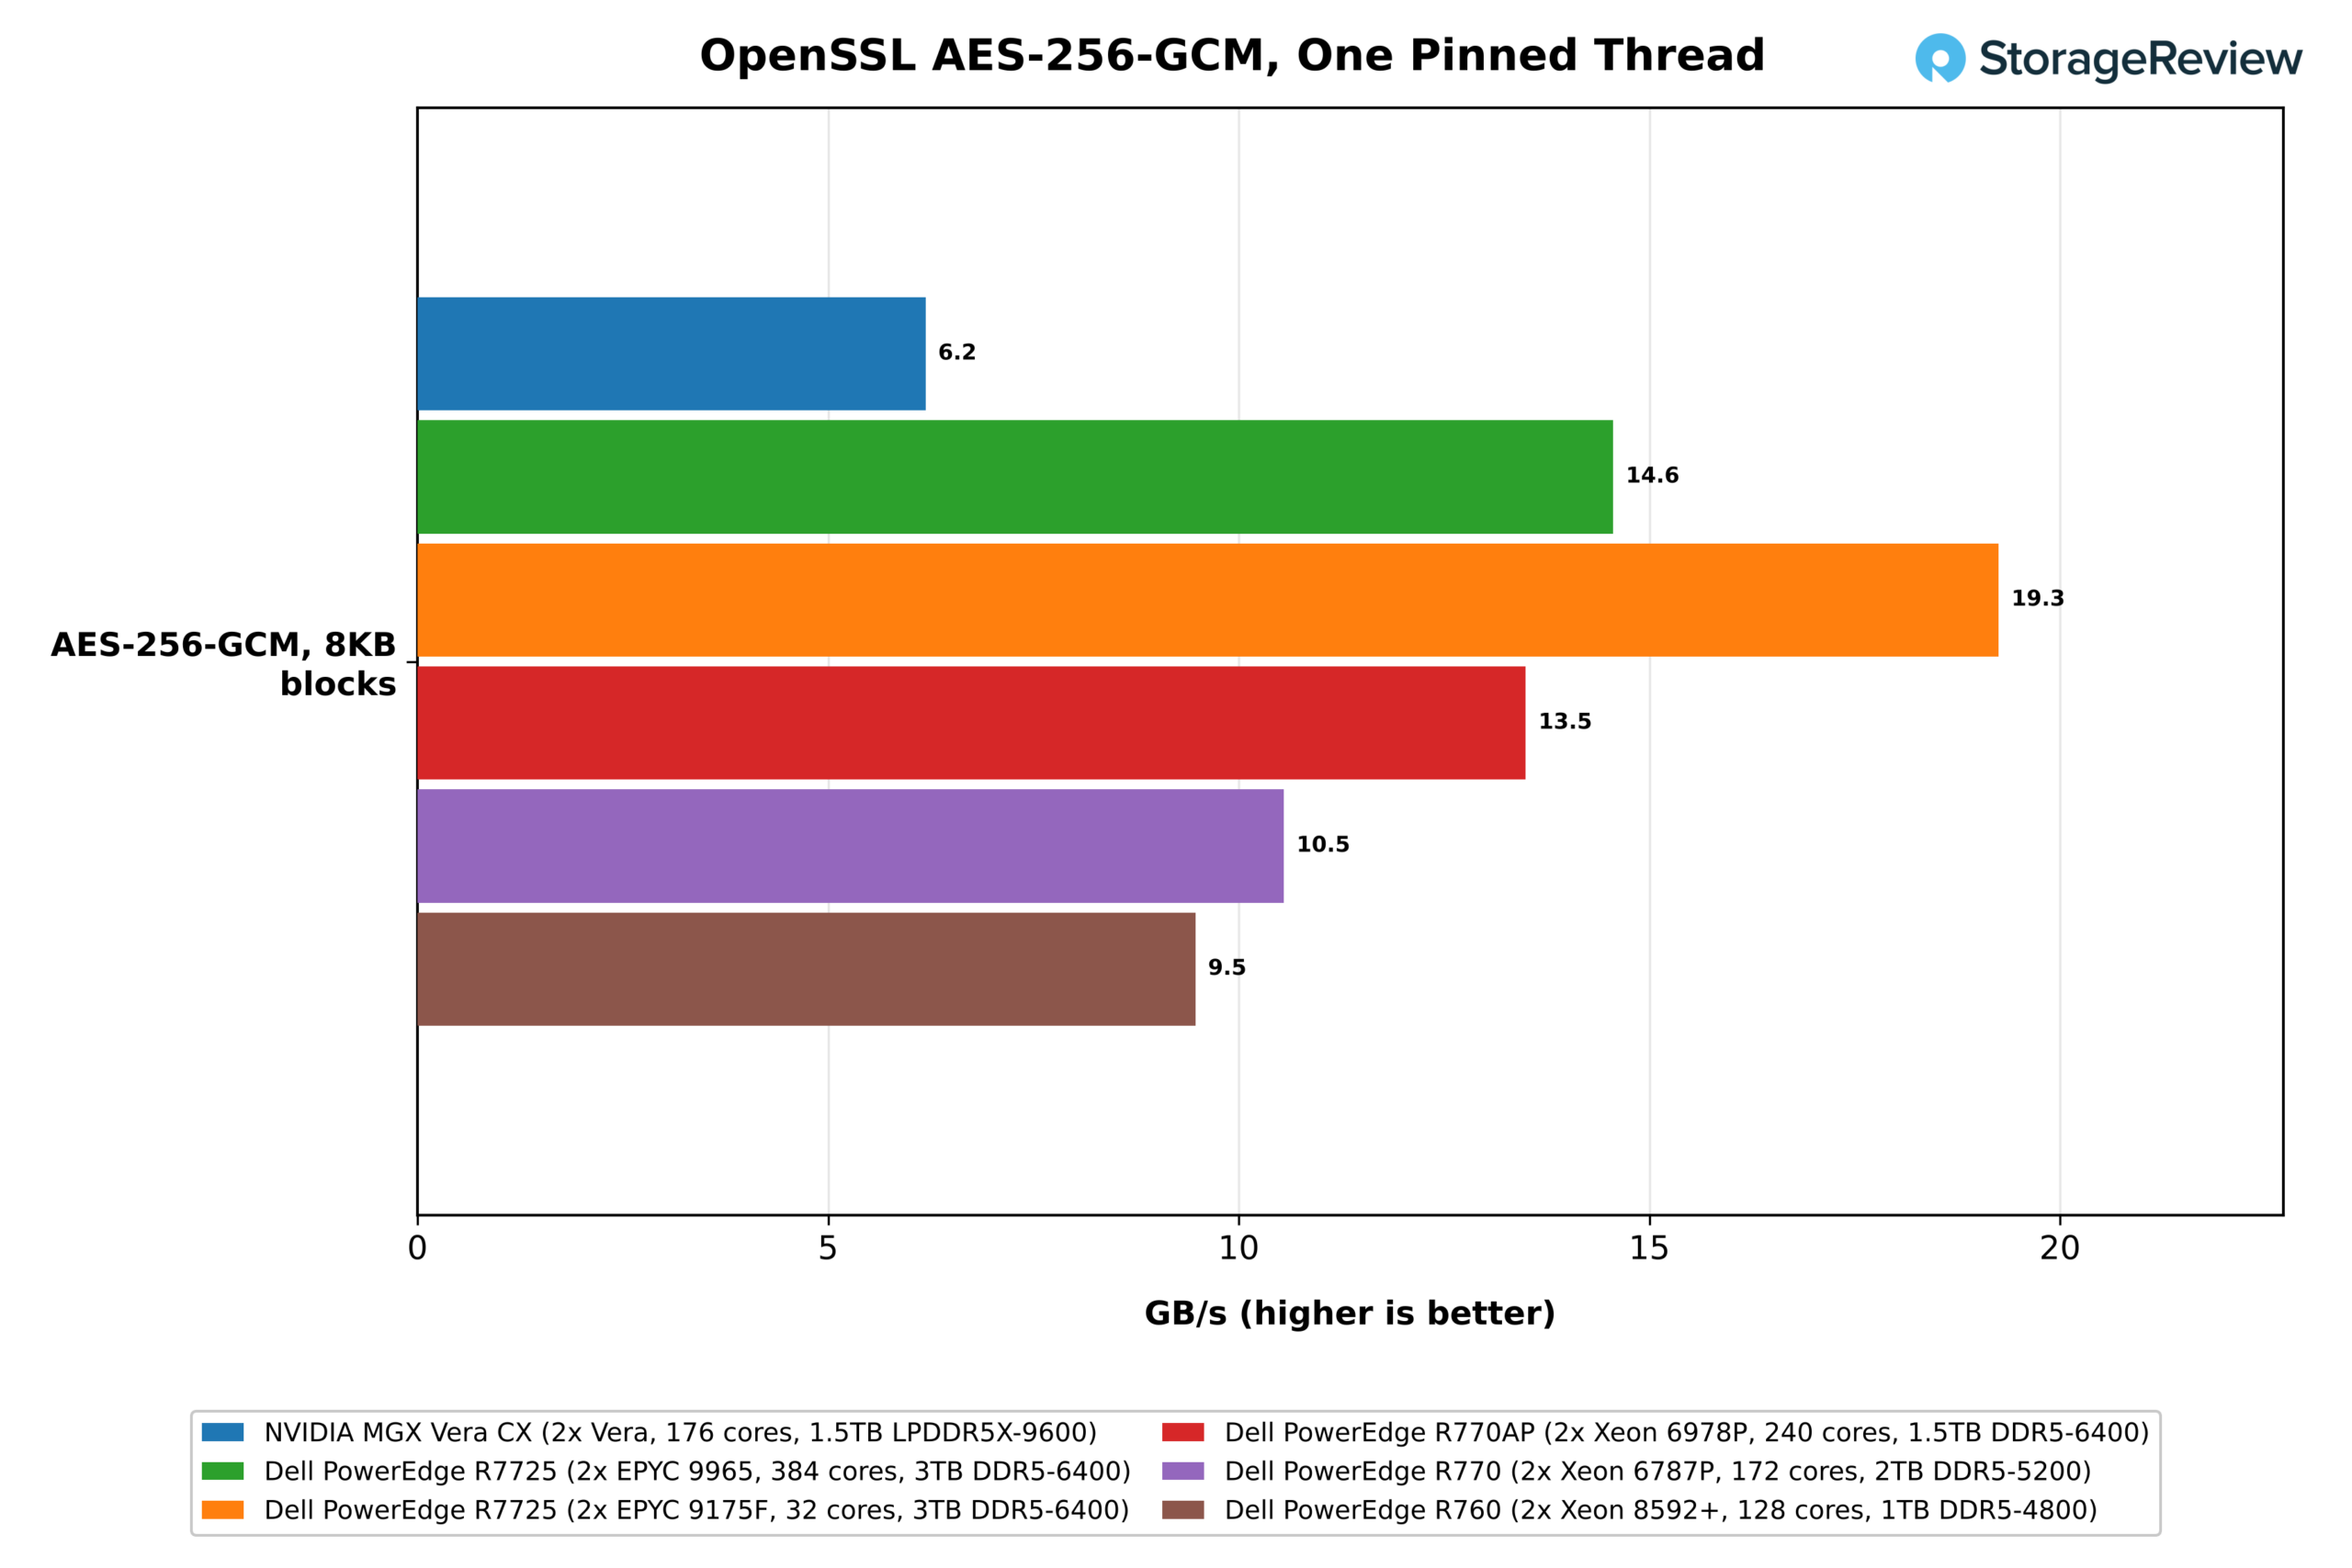
A diferença é mais evidente em um único núcleo. Um núcleo Olympus criptografou a 6.2 GB/s, cerca de um terço dos 19.3 GB/s do EPYC 9175F, e bem atrás do EPYC 9965 com 14.6 GB/s e do Xeon 6978P com 13.5 GB/s.
Em todos os aspectos, os sistemas x86 se alinham em termos de número de núcleos, o que mostra onde esse déficit por núcleo afeta o Vera.
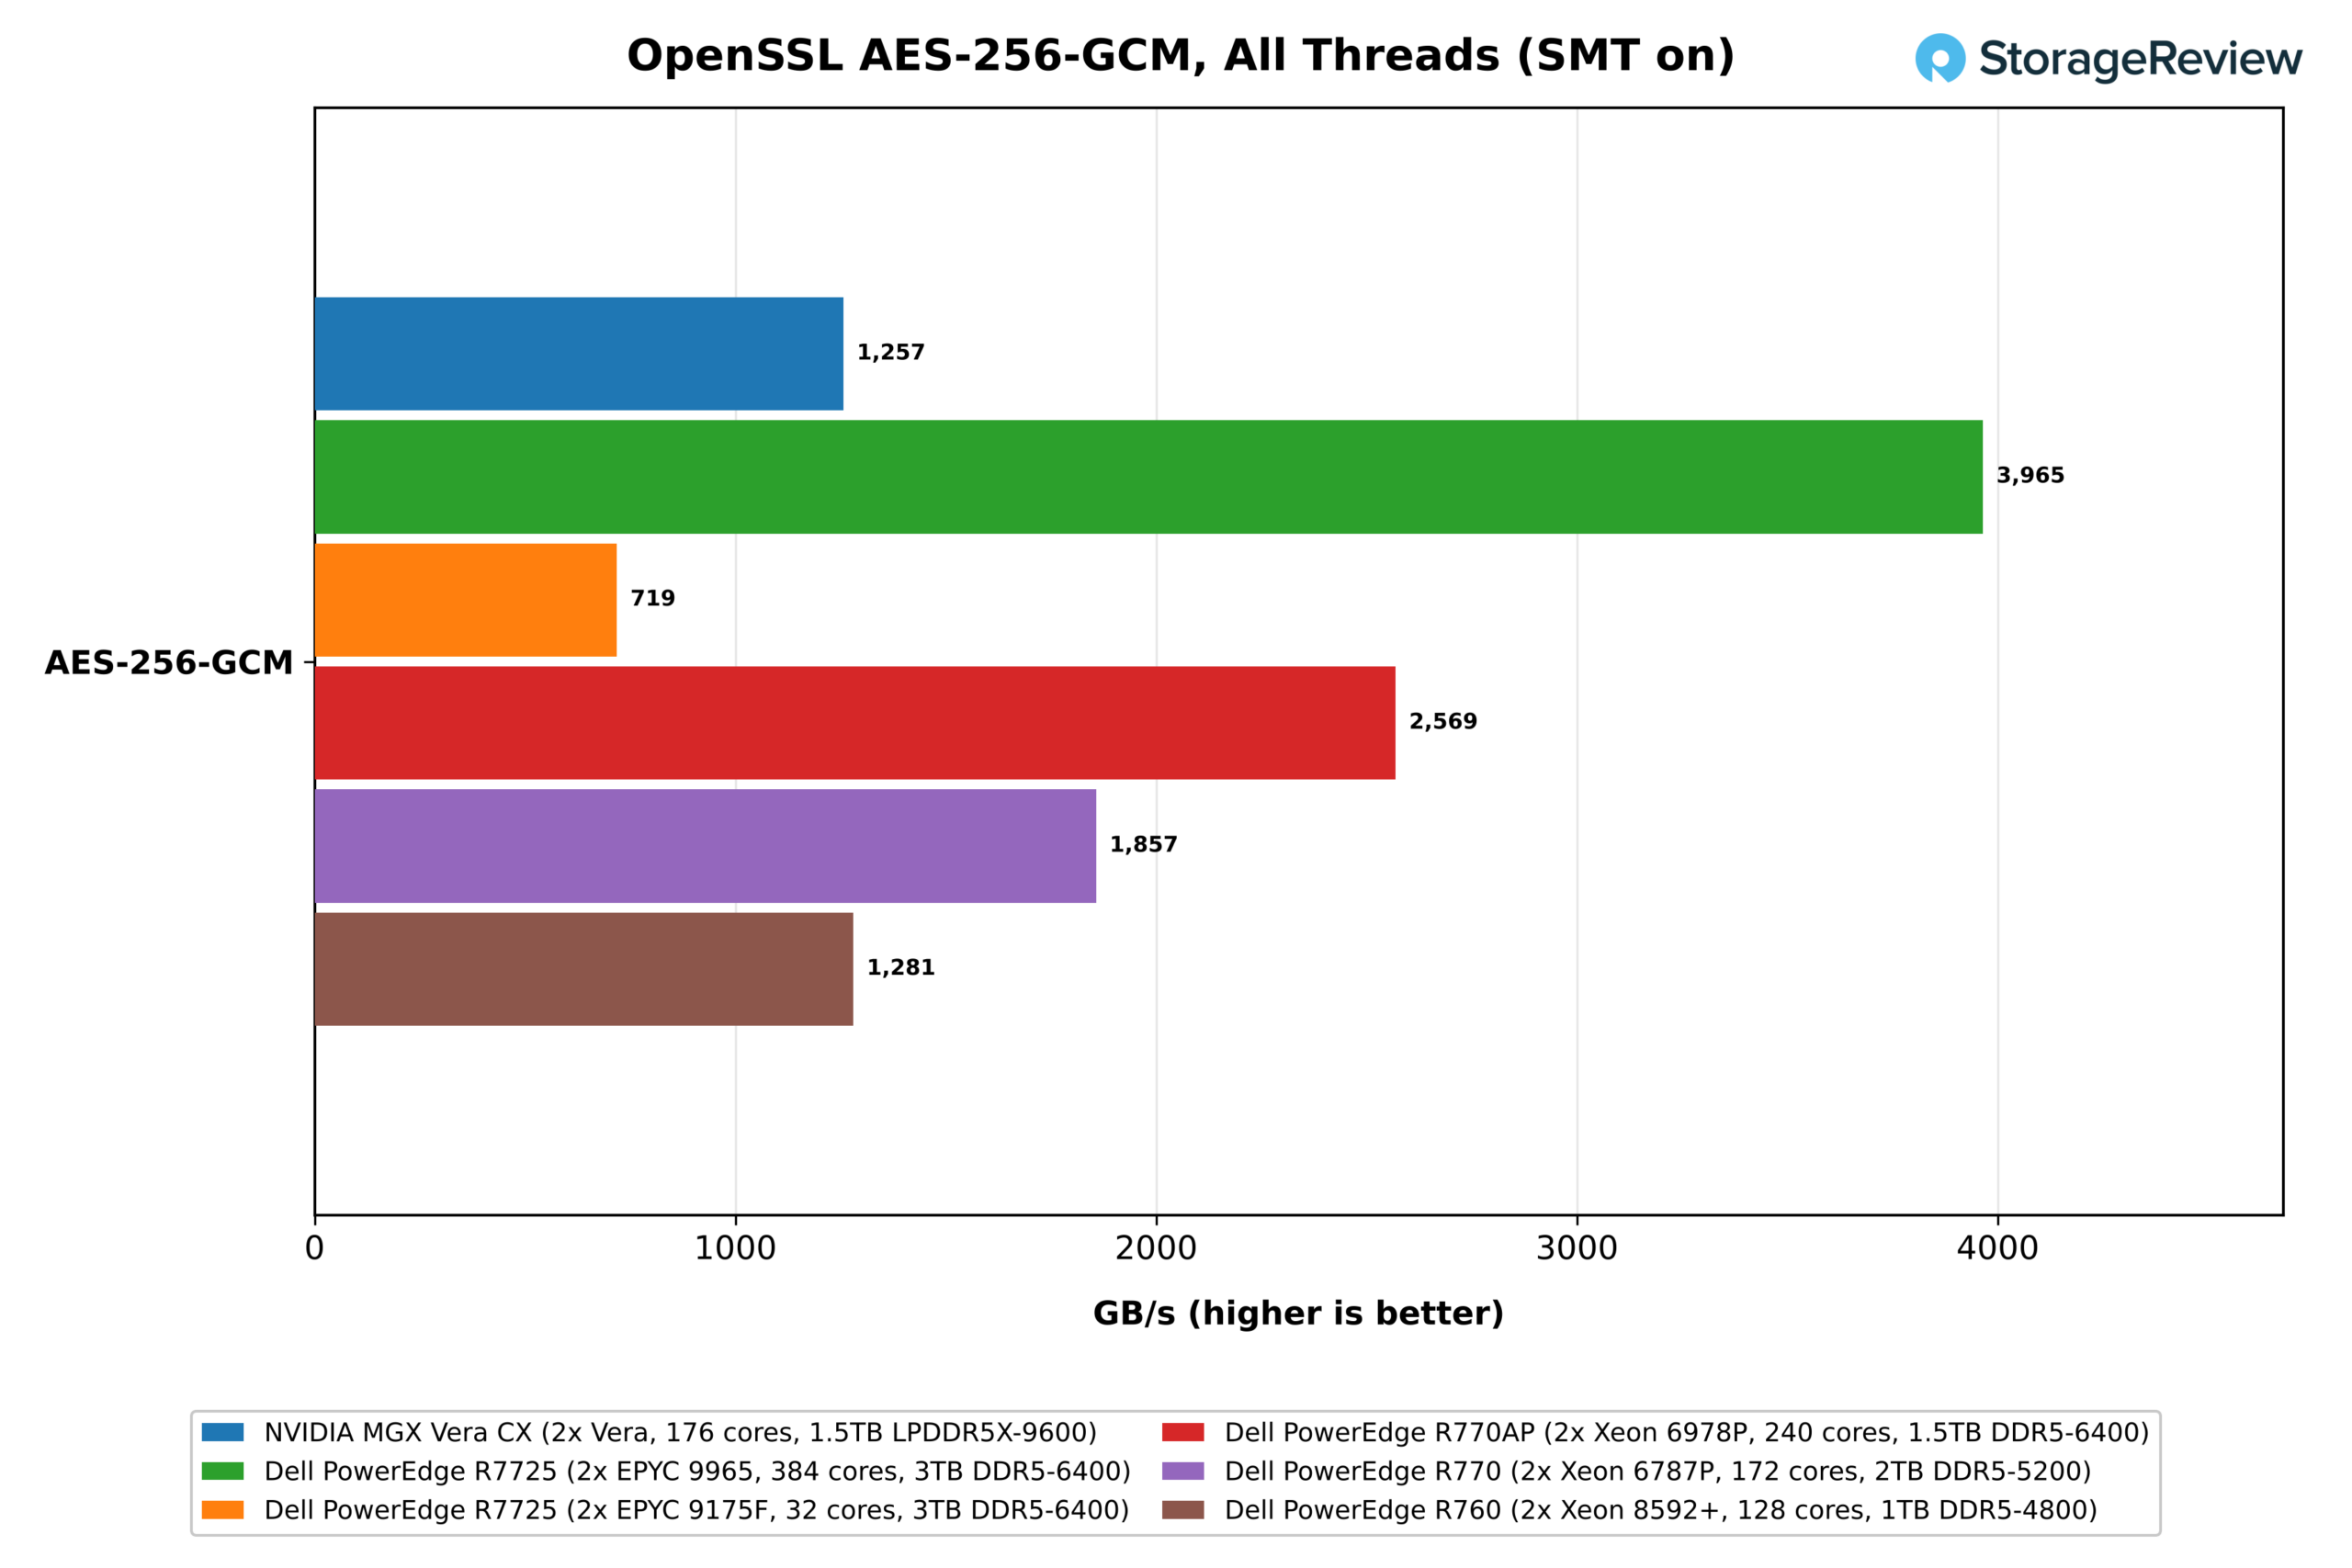
Com todos os 352 threads ocupados, o Vera atingiu 1.26 TB/s, empatando com o Xeon 8592+ de 128 núcleos, que alcançou 1.28 TB/s, e ficando à frente apenas do EPYC 9175F de 32 núcleos. O EPYC 9965 liderou com 3.96 TB/s, cerca de três vezes o resultado do Vera, seguido pelo Xeon 6978P com 2.57 TB/s e o 6787P com 1.86 TB/s.
Python
O Python é fundamental para os ambientes de teste (sandboxes) de agentes que a NVIDIA está visando com o Vera, e o pyperformance nos fornece três testes de thread única com desempenho otimizado: go, uma busca em árvore de jogos com grande volume de objetos; regex_compile, que compila expressões regulares; e nbody, uma simulação de física em ponto flutuante. Uma diferença de software se aplica aqui: o Vera executou o Python 3.14.4 do Ubuntu 26.04, enquanto os sistemas x86 executaram o 3.12.3 do Ubuntu 24.04, e a versão mais recente traz melhorias de desempenho do interpretador.
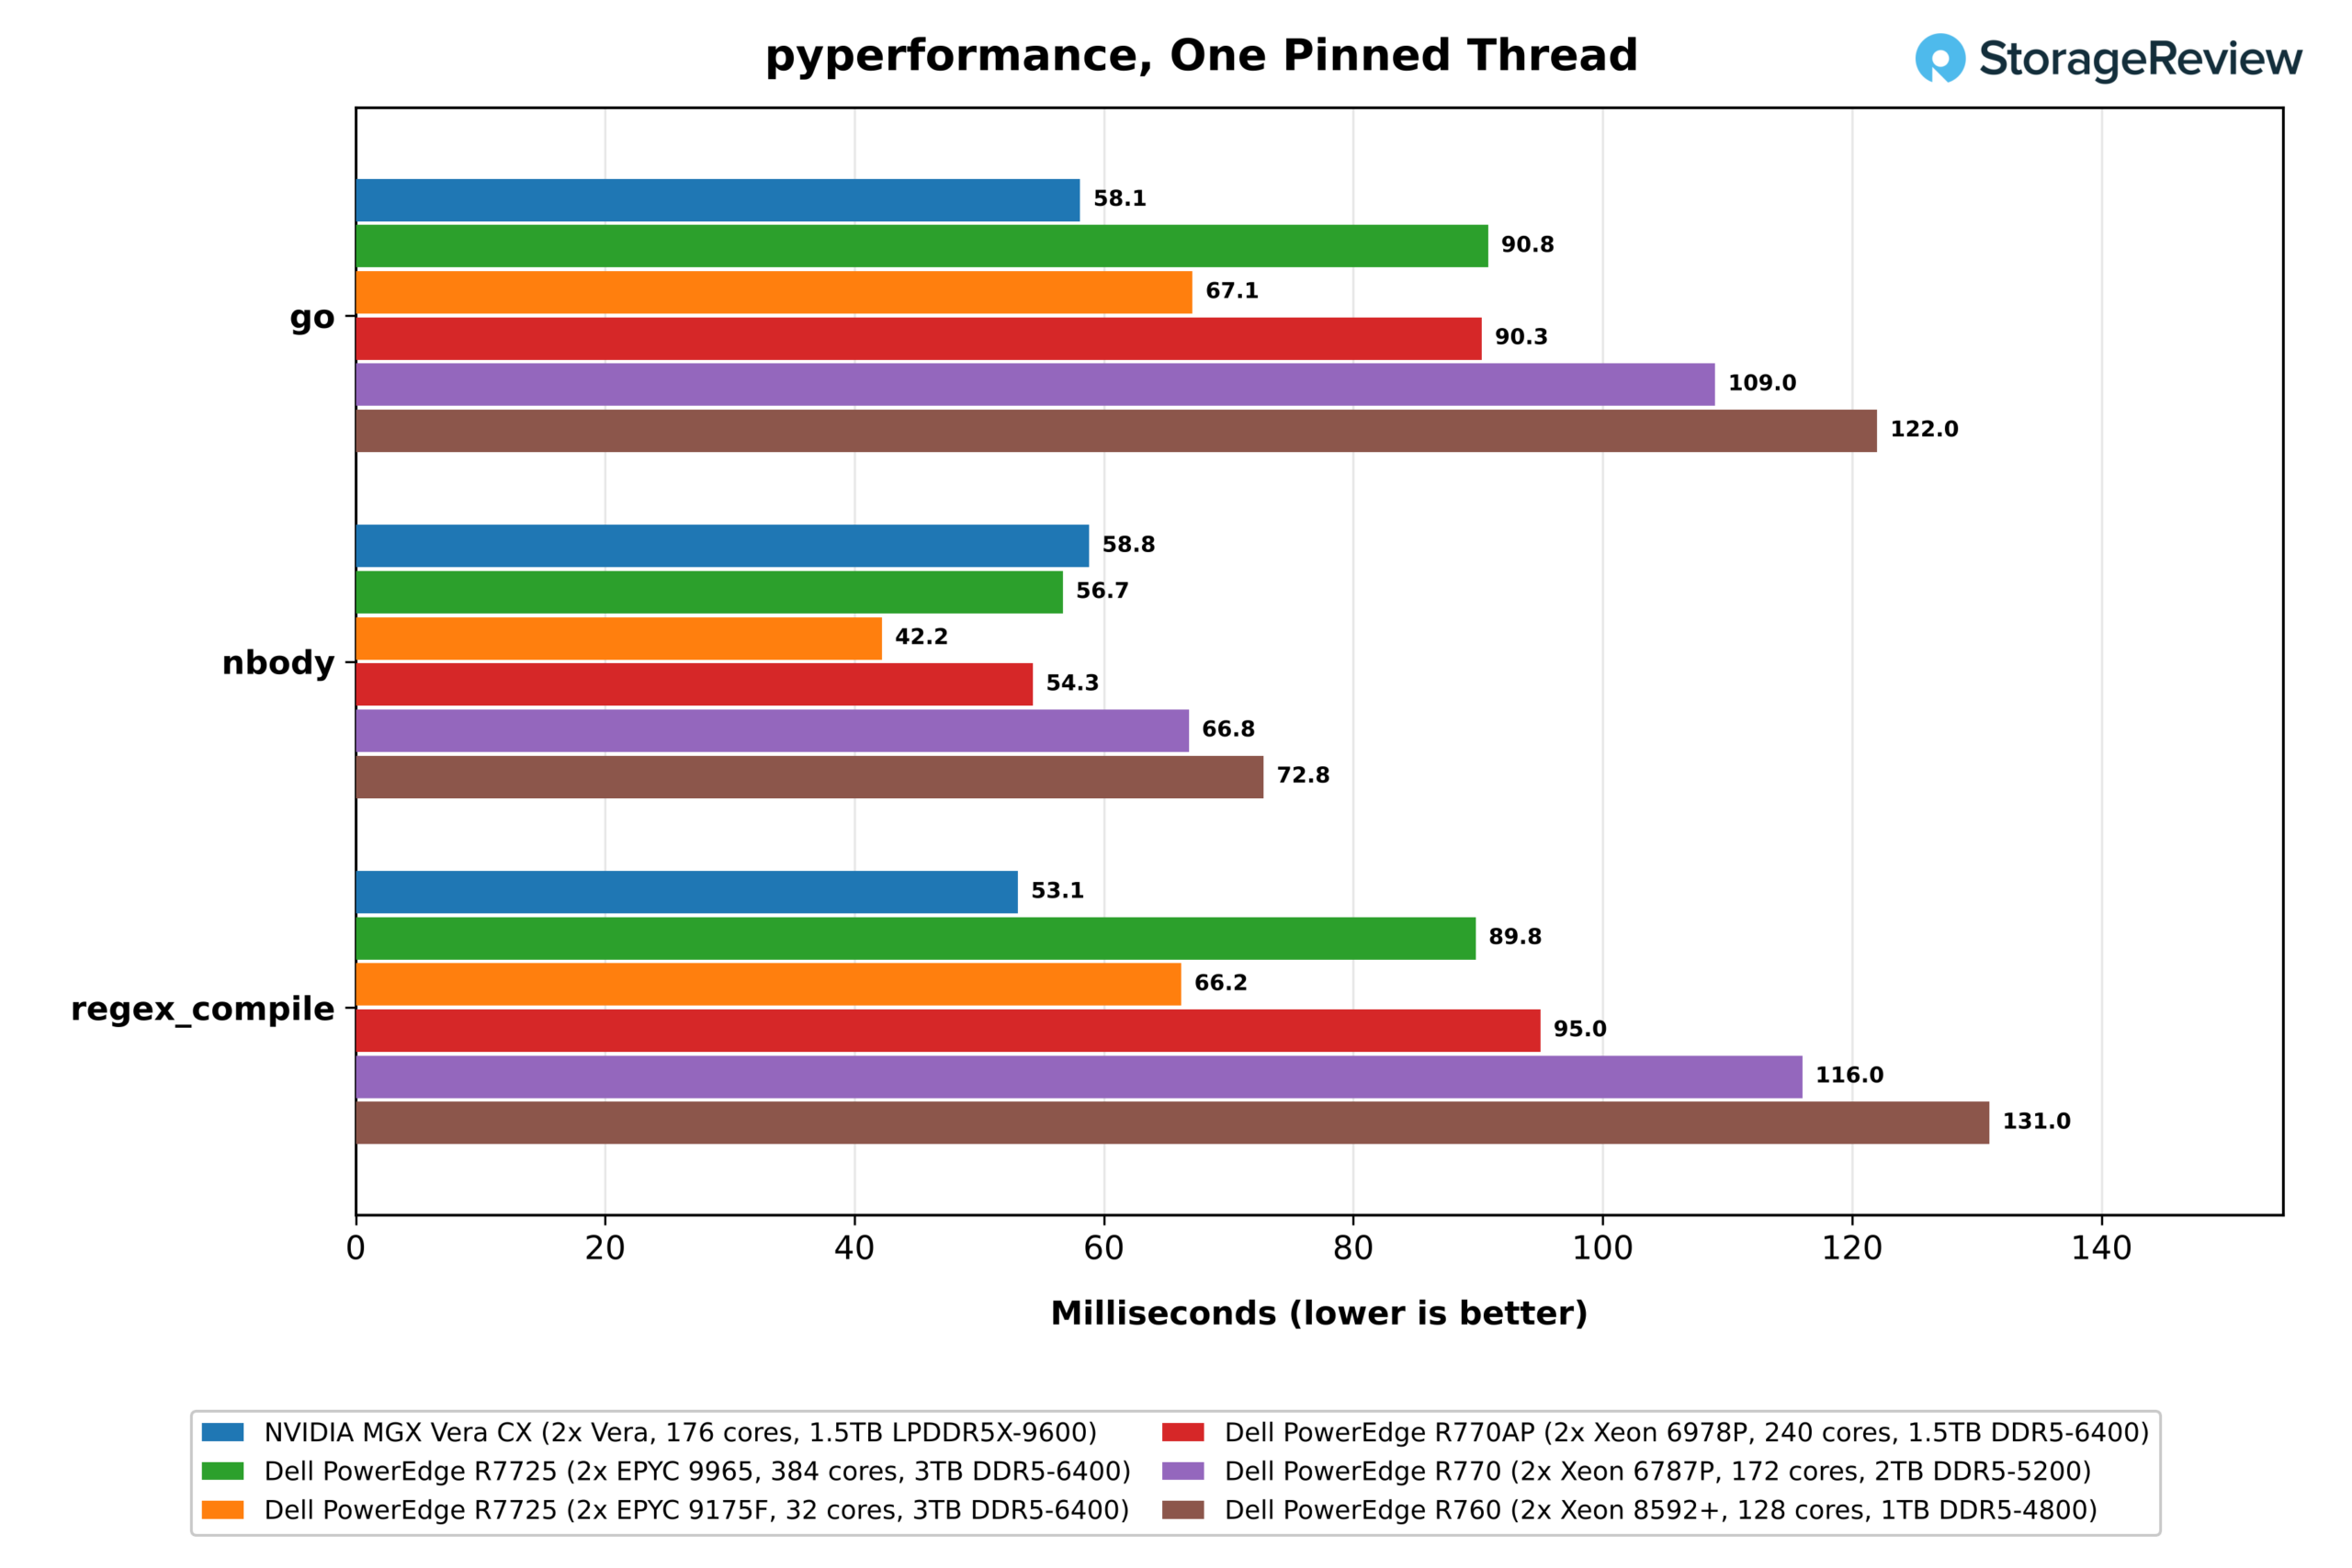
Vera venceu os dois testes baseados em código ramificado e com grande quantidade de objetos. O teste com `go` terminou em 58.1 ms, 15% mais rápido que o EPYC 9175F, o núcleo x86 mais rápido aqui, e de 1.6 a 2.1 vezes mais rápido que os demais. O teste com `regex_compile` apresentou uma margem ainda maior, terminando em 53.1 ms, 25% à frente do 9175F e 1.7 vezes à frente do EPYC 9965. Como Vera também possuía a versão mais recente do Python, considere ambas as margens como limites superiores.
O nbody seguiu o caminho oposto, já que seu curto loop de ponto flutuante e pequeno conjunto de trabalho tendem a favorecer clocks altos, e o 9175F de 5.0 GHz venceu com 42.2 ms, 39% mais rápido que os 58.8 ms do Vera. O Xeon 6978P e o EPYC 9965 também ficaram à frente do Vera, com 54.3 ms e 56.7 ms, respectivamente, mesmo com a versão mais recente do Python do Vera.
Servidor Web, JVM e Latência do Agendador
O último grupo de testes de desempenho abrange o software que envolve uma aplicação: a pilha web, a máquina virtual Java, o agendador do Linux e a cadeia de ferramentas do compilador. Esses resultados dependem tanto da quantidade de threads que cada sistema executa quanto da velocidade de cada núcleo, portanto, dizem menos sobre o próprio Olympus do que as seções anteriores, mas mostram como um servidor Vera se comporta em ambientes com software de servidor comuns.
NGINX
O NGINX encaminha solicitações HTTPS para o gerador de carga wrk em execução na mesma máquina, portanto, cliente e servidor competem pelos mesmos núcleos, e o resultado reflete a pilha TLS e HTTP mais do que a contagem bruta de núcleos.
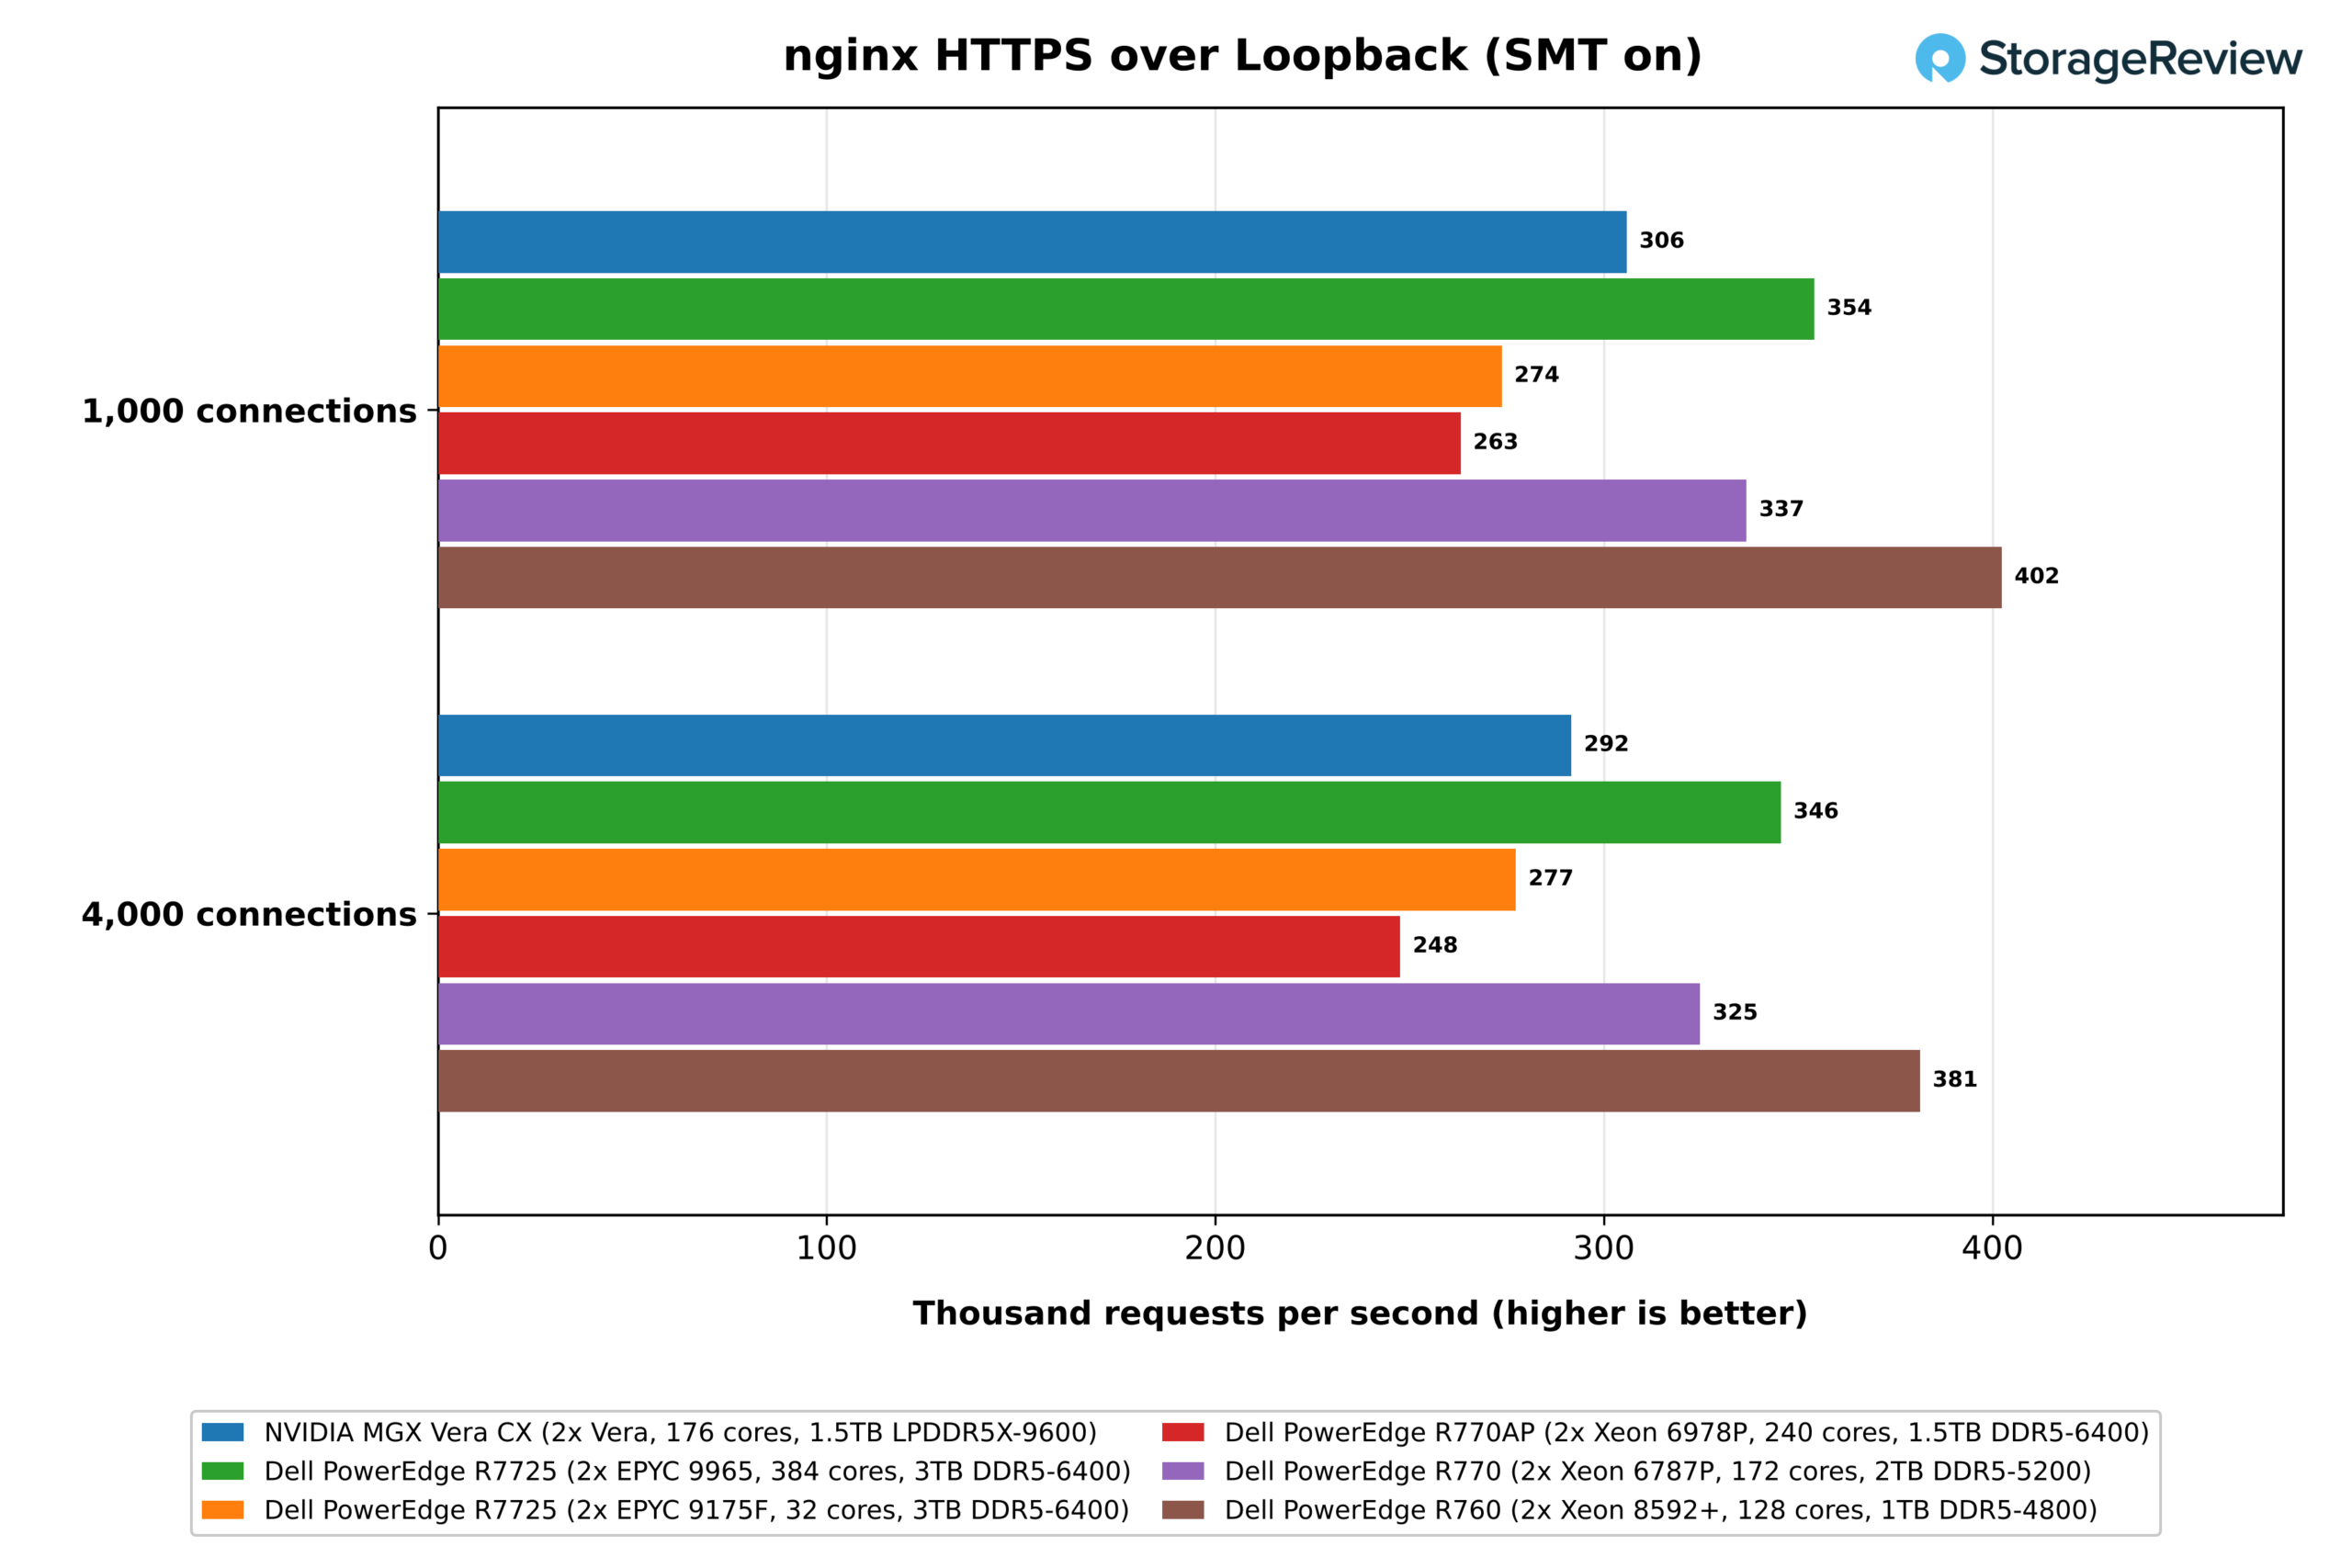
Com o SMT ativado, o Vera processou 306,000 requisições por segundo com 1,000 conexões e 292,000 com 4,000 conexões, situando-se em uma faixa que variava de 263,000 no Xeon 6978P a 402,000 no Xeon 8592+. O EPYC 9965 atingiu 354,000 e o Xeon 6787P 337,000, e desativar o SMT elevou o desempenho do Vera para 330,000. A pilha de rede do Vera se integra perfeitamente aos sistemas x86.
Renascimento
O Renaissance executa cargas de trabalho Java no OpenJDK 11. Seu teste HTTP com Finagle exercita uma pilha de rede Scala, e seu teste com Akka utiliza um framework de concorrência baseado em atores. Ambos distribuem o trabalho por todas as CPUs lógicas que a JVM consegue enxergar, então os executamos com SMT ativado e desativado.
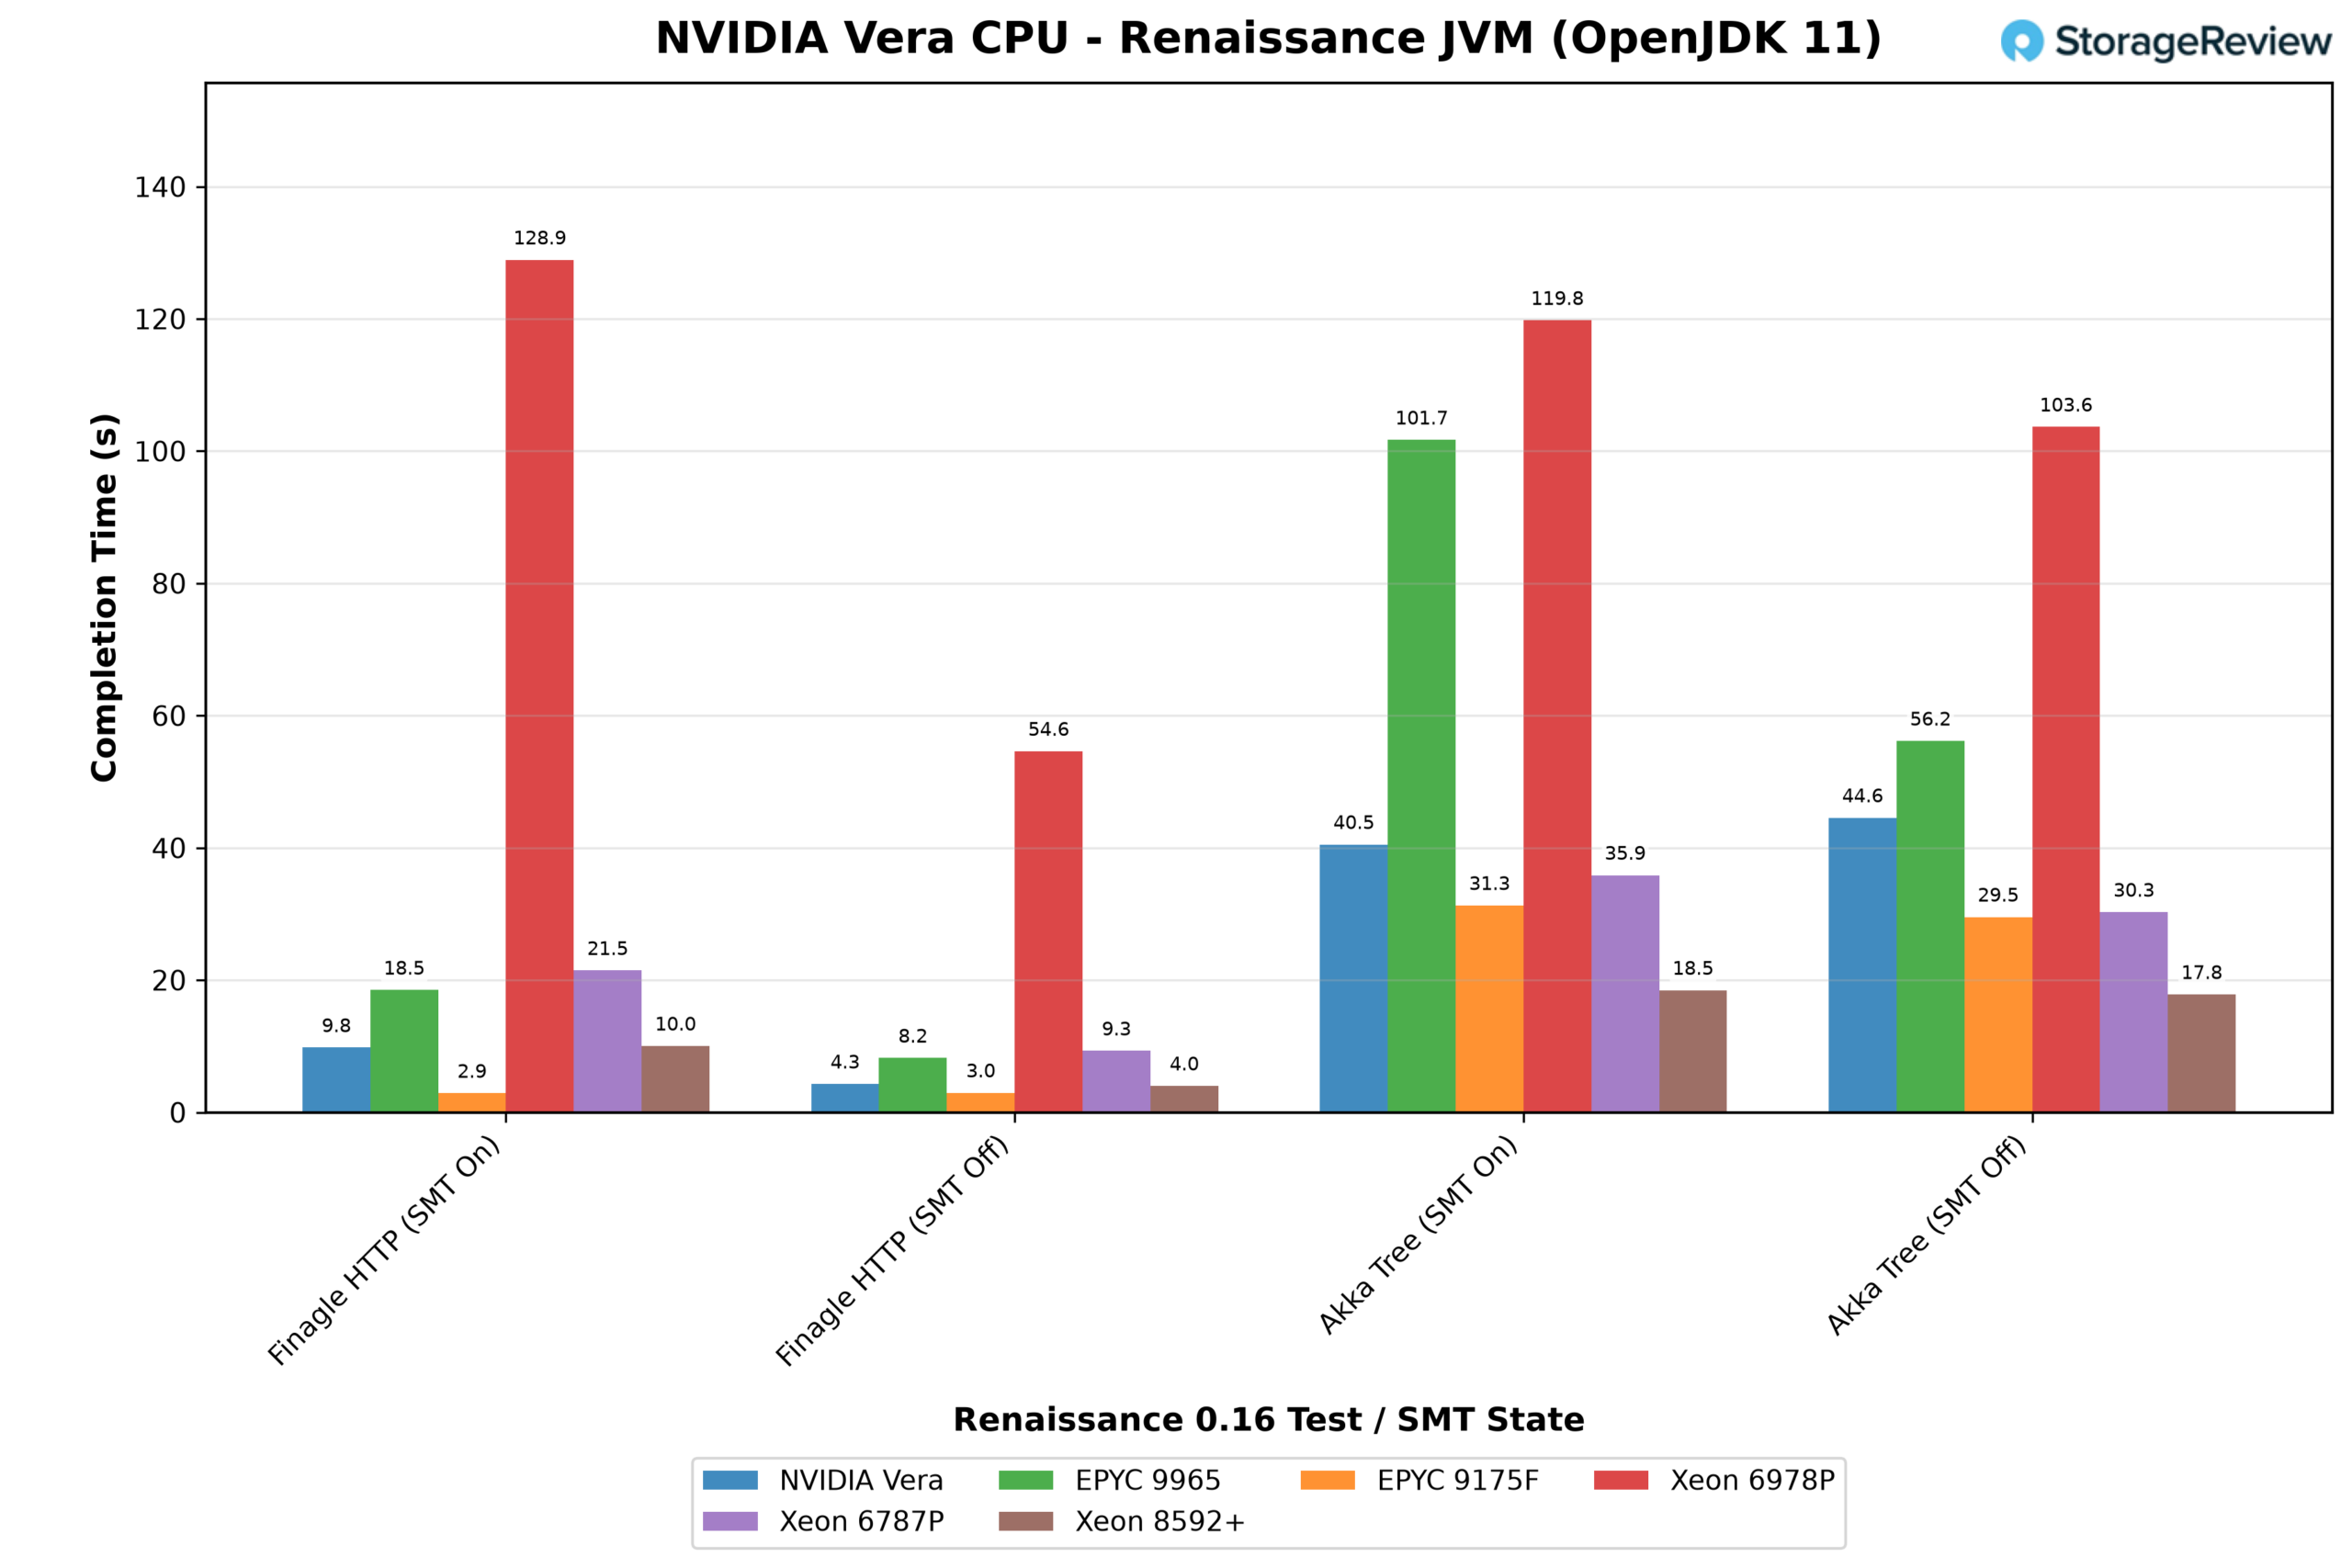
O Finagle roda mais rápido com menos threads. Desativar o SMT, que reduz pela metade o número de threads, diminuiu o tempo do Vera de 9.8 para 4.3 segundos, e os sistemas x86 maiores apresentaram uma melhora similar de 2.3 a 2.5 vezes. O EPYC 9175F de 32 núcleos, com poucas threads desde o início, liderou em ambos os casos com cerca de 3 segundos.
O Akka favoreceu o Xeon 8592+, que terminou em cerca de 18 segundos com SMT ativado ou desativado, enquanto o Vera levou 40.5 segundos com SMT ativado, e os dois sistemas maiores, o EPYC 9965 e o Xeon 6978P, foram os mais lentos, com 101.7 e 119.8 segundos, respectivamente. O terceiro teste Renaissance, um algoritmo genético, terminou entre 1.6 e 2.6 segundos com SMT ativado em todos os sistemas, exceto no 6978P, com o Vera em 2.6 segundos.
banco de sch
O schbench mede a rapidez com que o agendador do Linux ativa os threads de trabalho, executando cerca de um thread de trabalho por CPU lógica com 4 threads de mensagens e cerca de oito por CPU com 32. Como o número de threads de trabalho aumenta com o sistema, servidores maiores executam mais trabalho; portanto, esses resultados descrevem a latência sob carga máxima em cada máquina e não representam uma comparação direta.
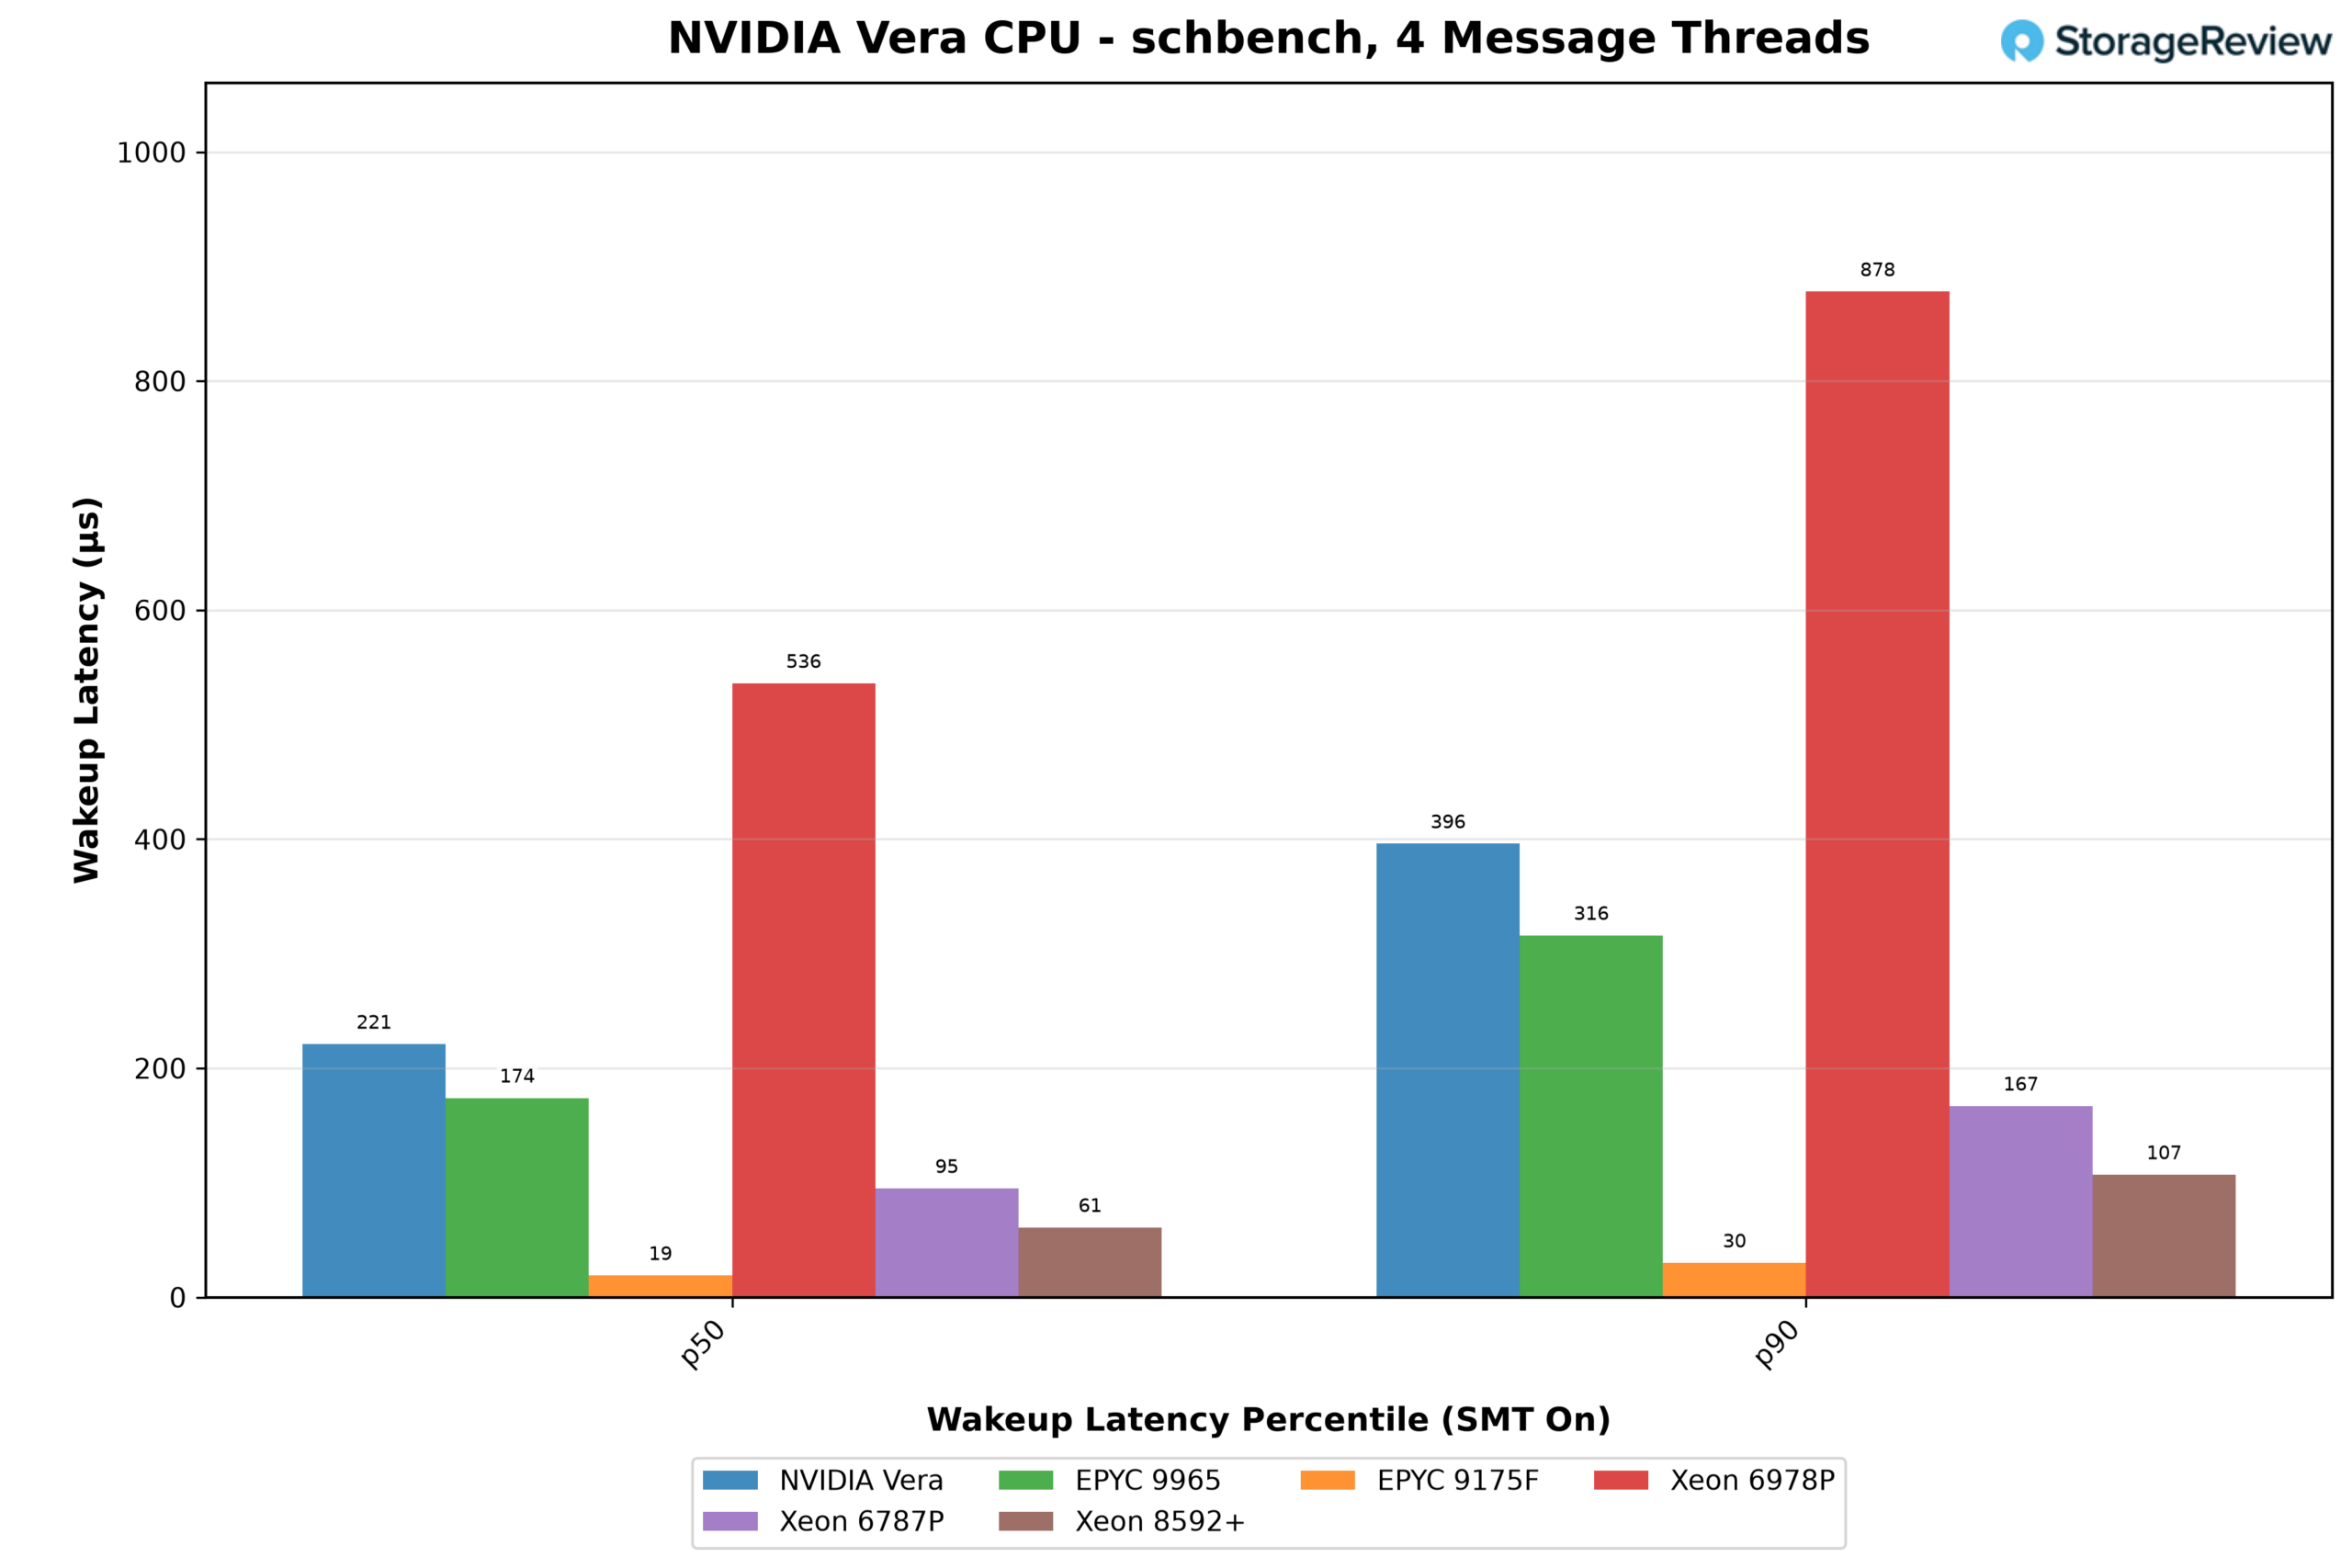
Com 4 threads de mensagens, a latência mediana de ativação do Vera foi de 221 µs e seu p90 de 396 µs, superior a todos os sistemas, exceto o Xeon 6978P, com 536 µs e 878 µs, respectivamente. As máquinas menores ativaram suas threads mais rapidamente, com o EPYC 9175F de 32 núcleos atingindo 19 µs e o Xeon 8592+ de 128 núcleos, 61 µs.
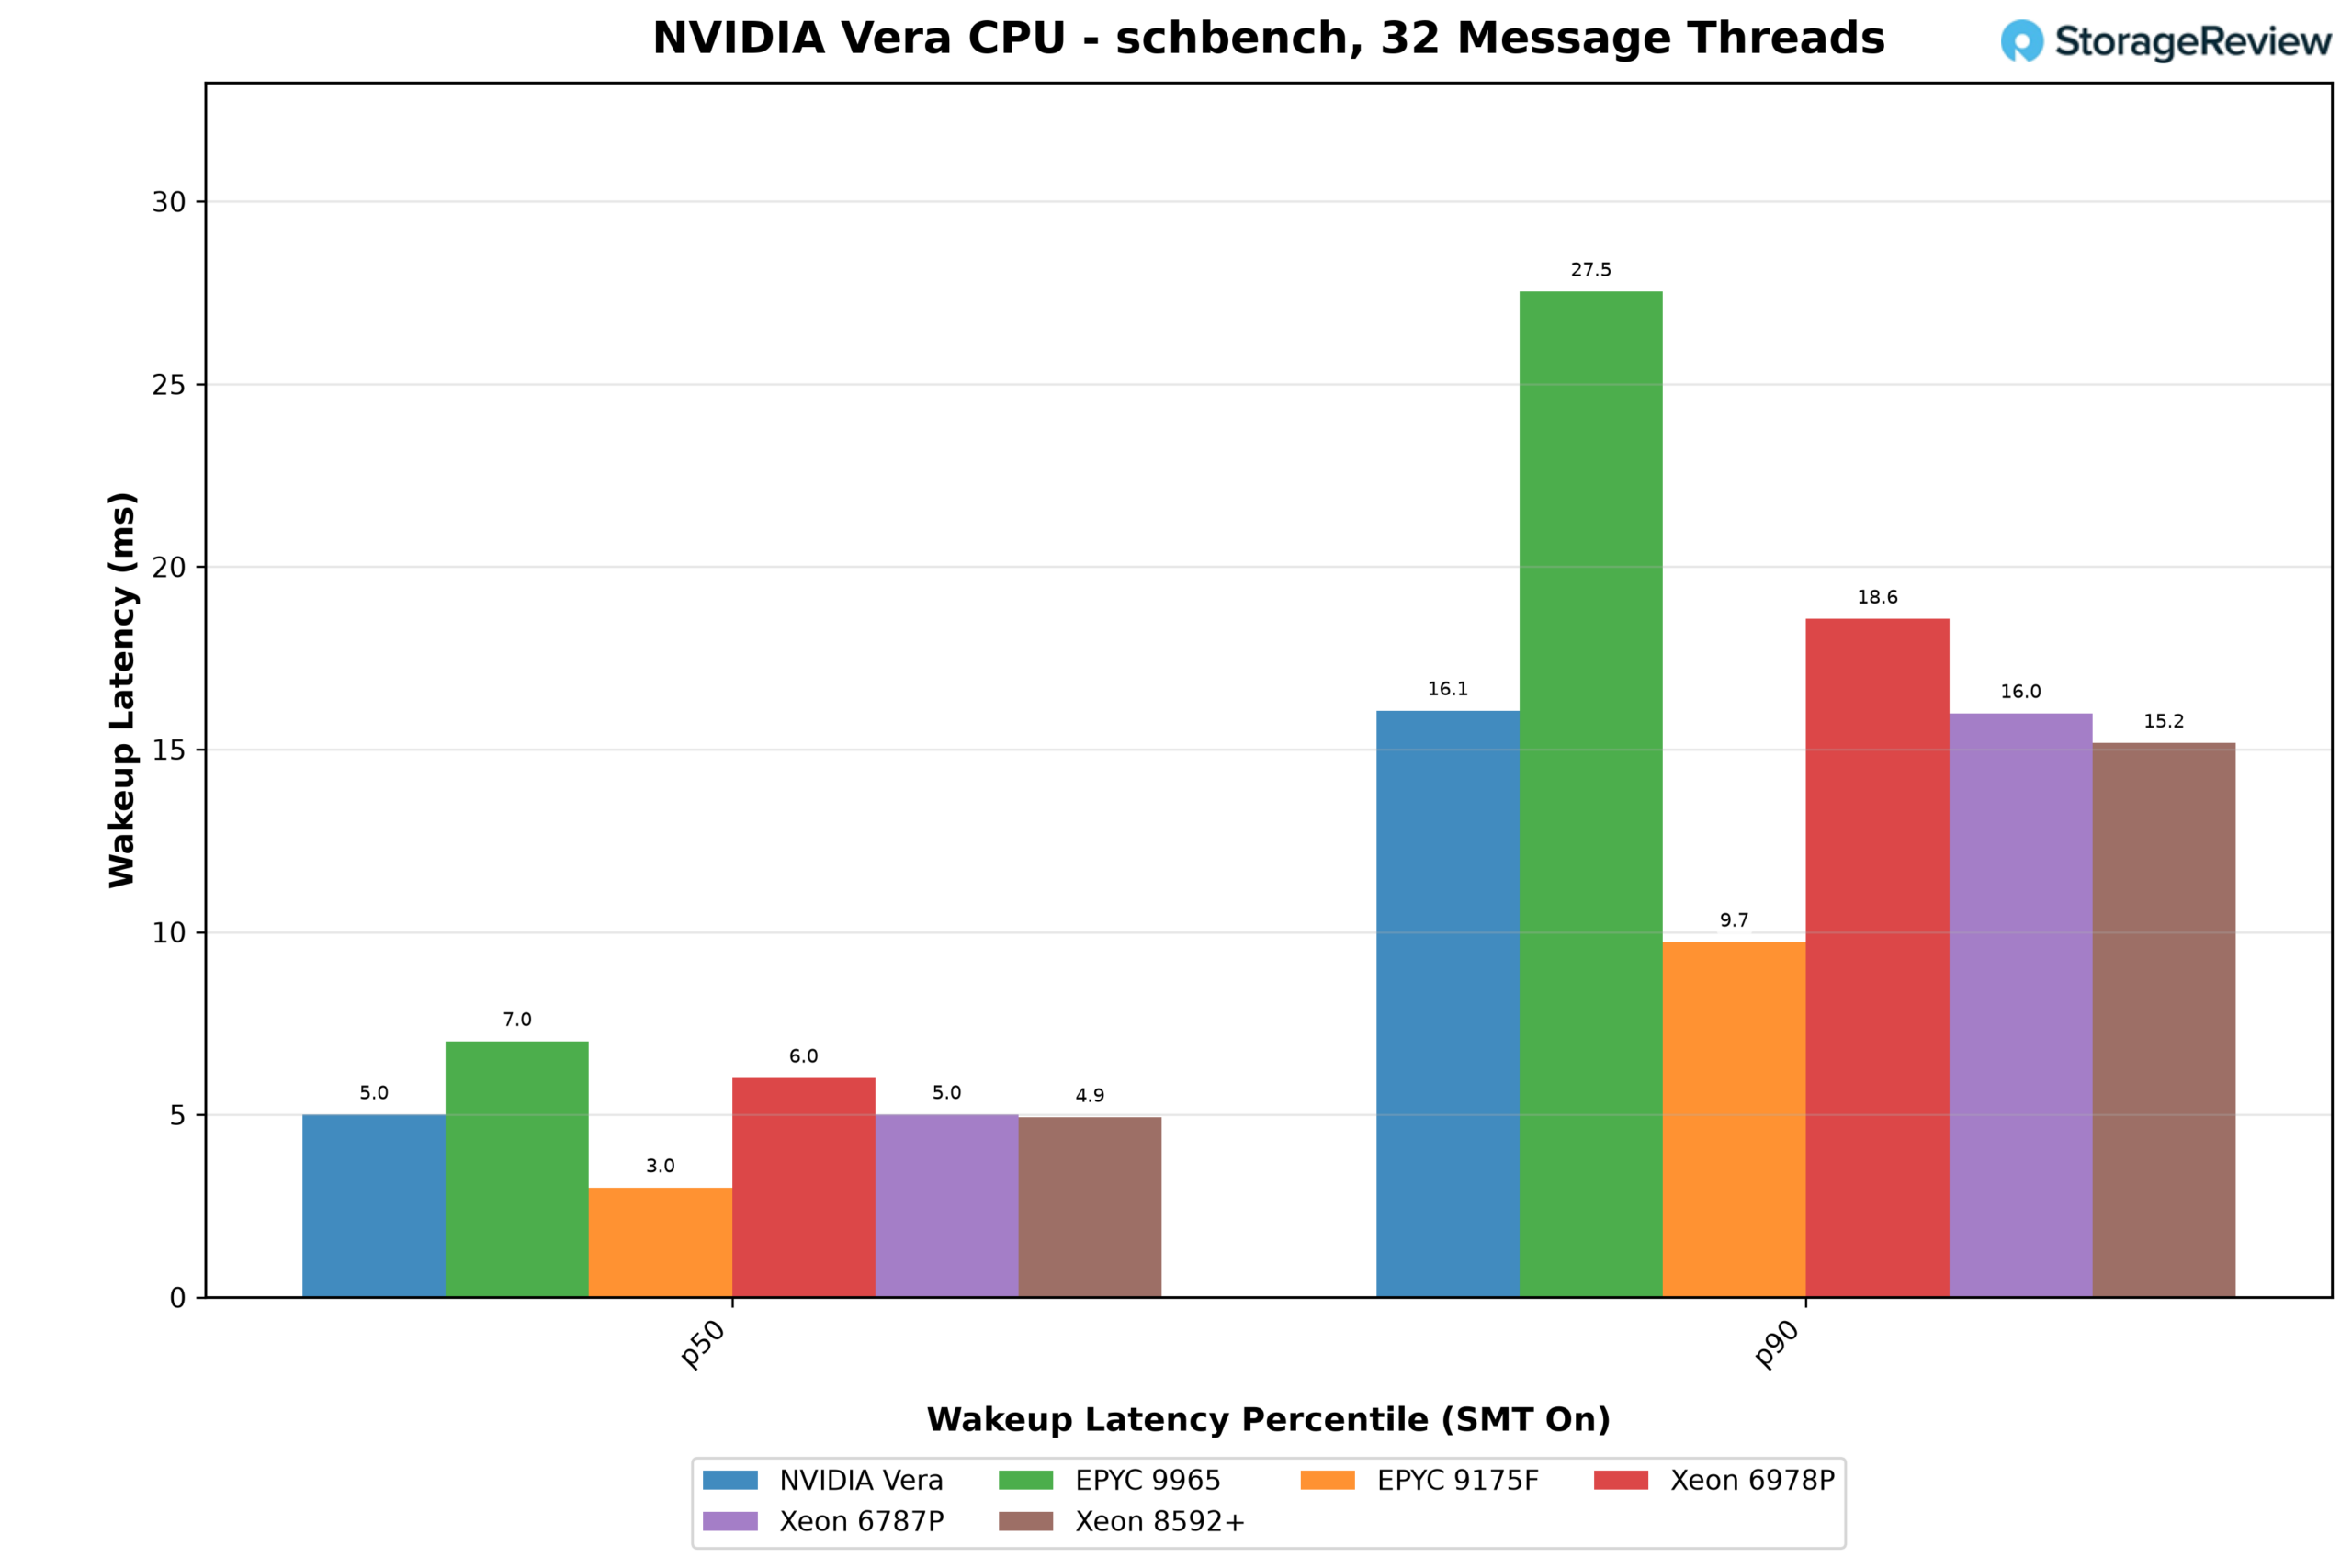
Com 32 threads de mensagens sobrecarregadas, o Vera ficou no meio do grupo. Sua mediana de 5.0 ms e p90 de 16.1 ms ficaram no mesmo nível do Xeon 6787P e do 8592+ e à frente tanto do Xeon 6978P quanto do EPYC 9965, que atingiu 27.5 ms em p90. Apenas o 9175F foi claramente mais rápido, com 3.0 ms e 9.7 ms, respectivamente.
Compilação do Kernel Linux
A compilação do kernel Linux com allmodconfig é o único resultado desta seção que não classificamos. O Vera compila a árvore do kernel arm64, que inclui um conjunto diferente de módulos e drivers da árvore x86-64 compilada pelos outros sistemas, e não tentamos uma compilação cruzada.
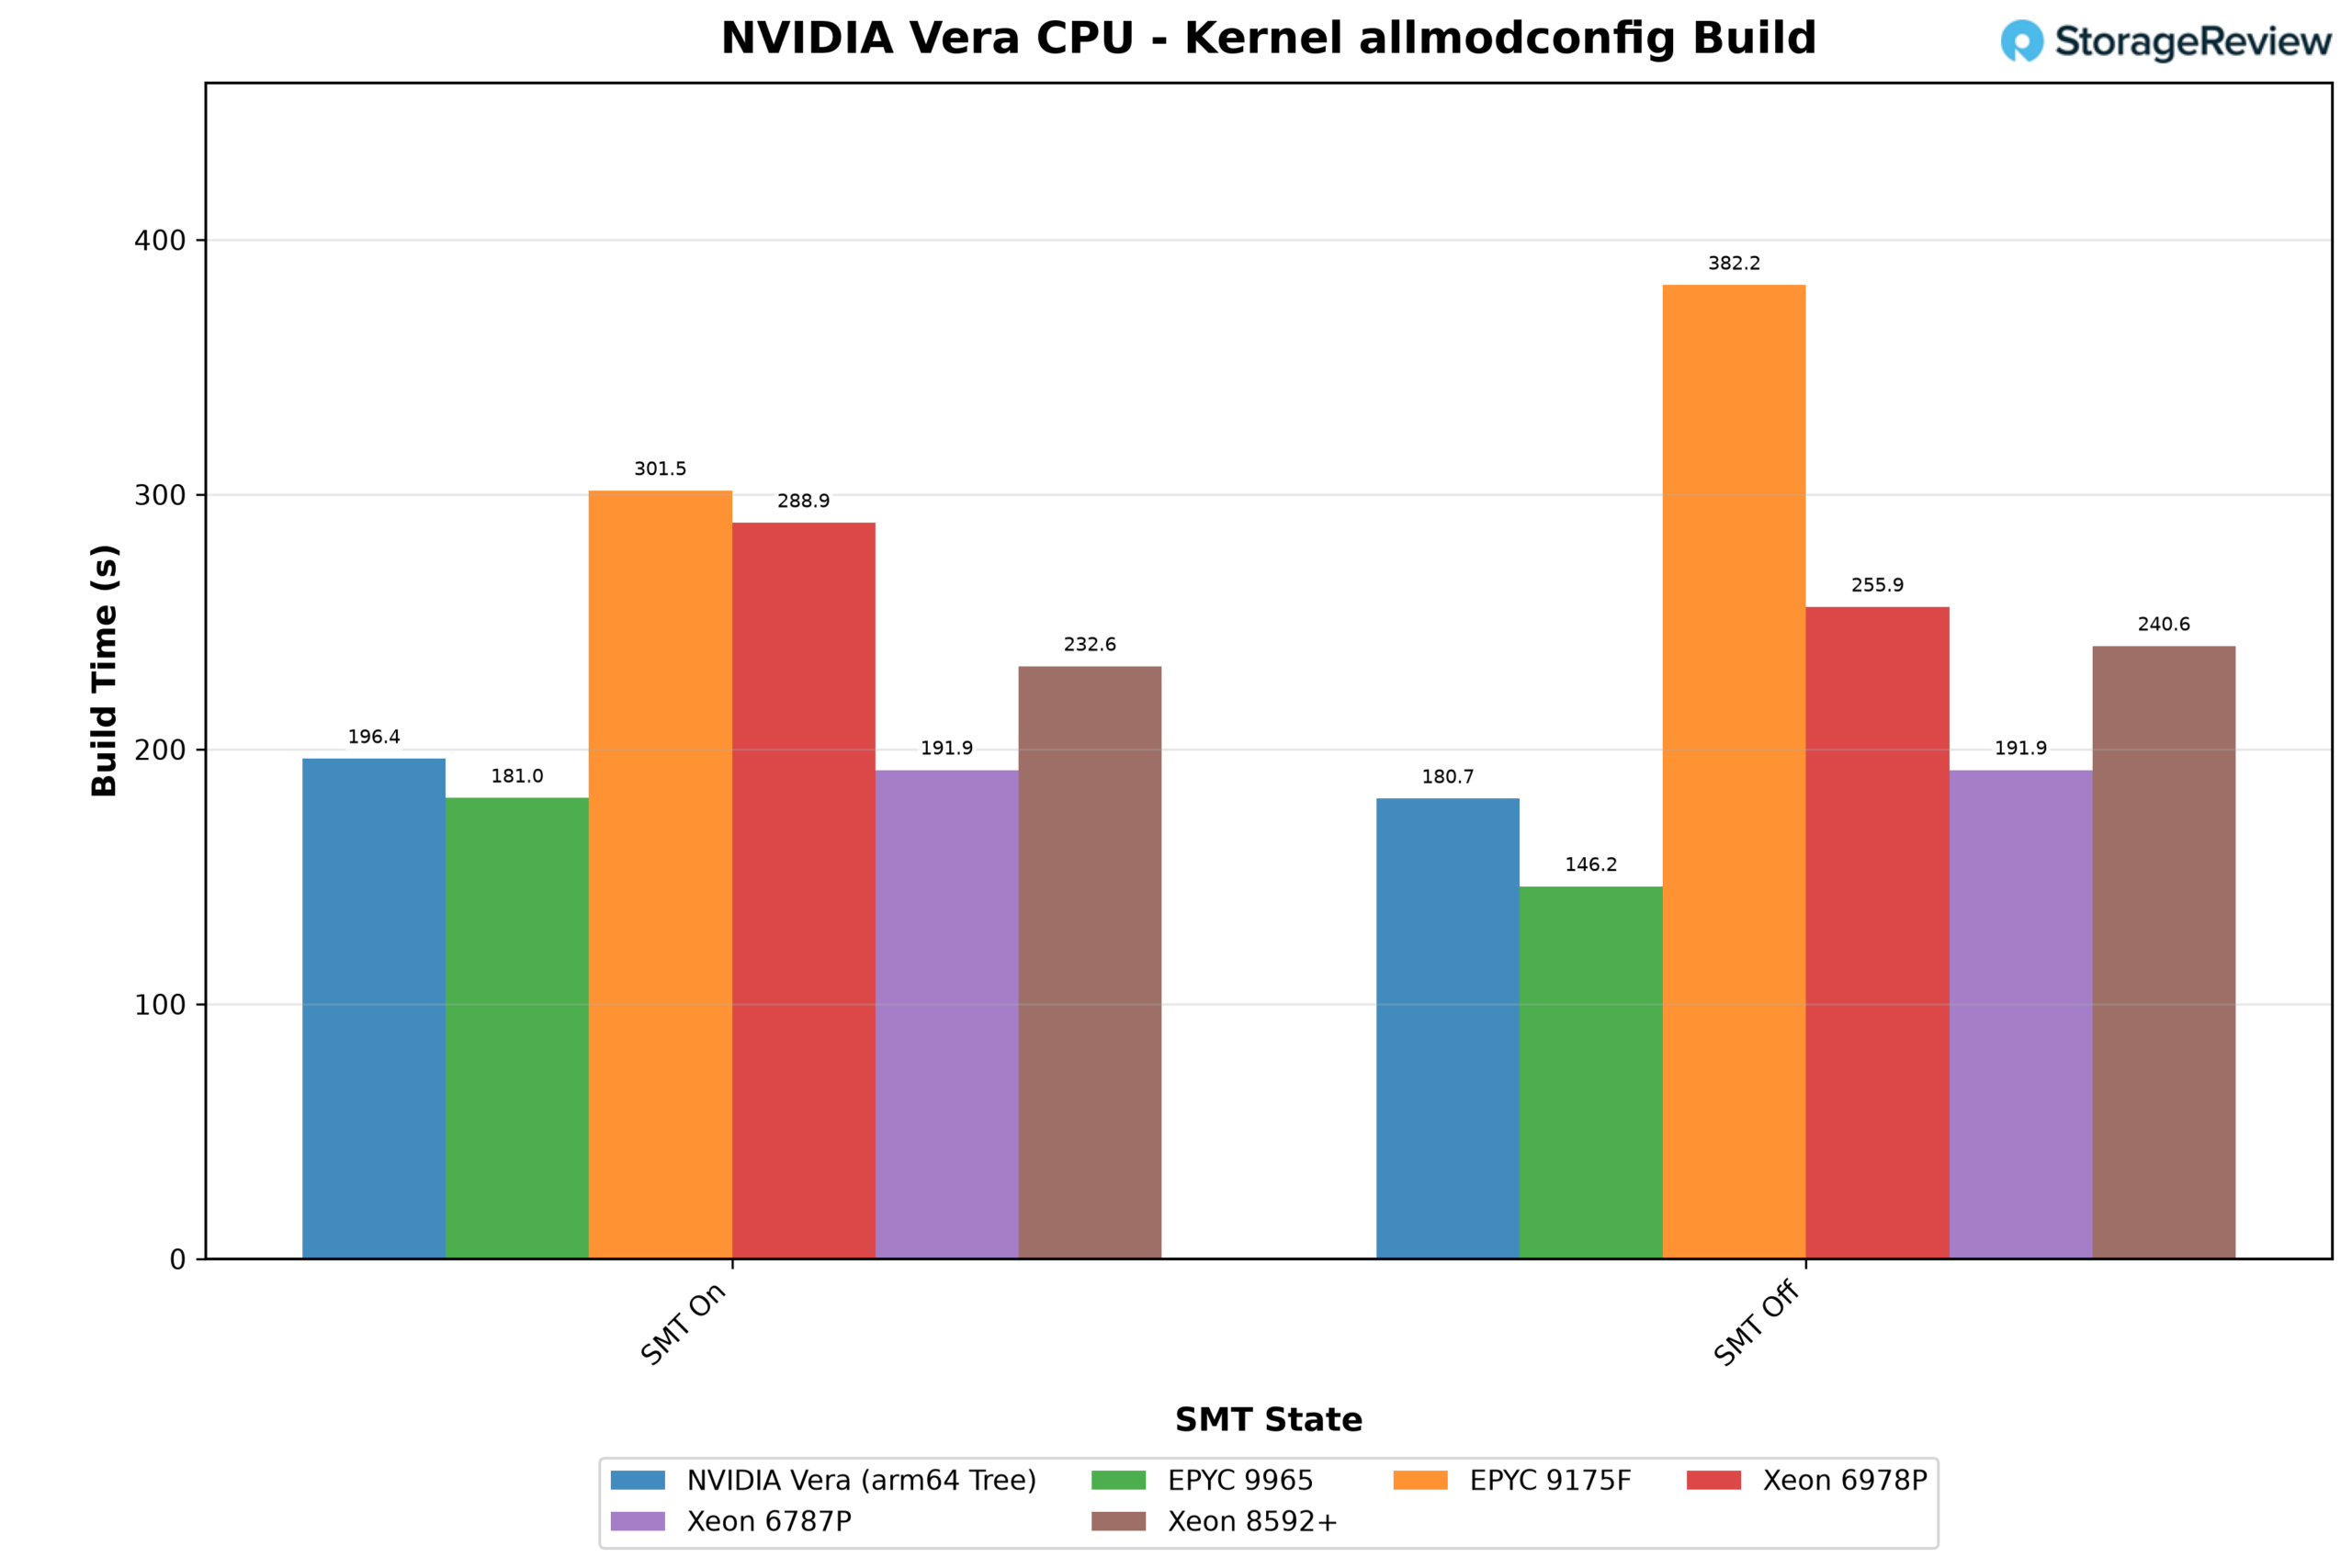
O Vera construiu sua árvore em 180.7 segundos com o SMT desativado e em 196.4 segundos com o SMT ativado, portanto, os threads extras tornaram a construção mais lenta. Nos sistemas x86, cada um construindo uma árvore nativa, os tempos variaram de 146.2 segundos no EPYC 9965 com o SMT desativado a 382.2 segundos no EPYC 9175F de 32 núcleos.
HammerDBName
Para os testes de banco de dados, contamos com Steve Shaw, criador e mantenedor do HammerDB. Shaw executou a carga de trabalho TPROC-C do HammerDB, um benchmark OLTP derivado do TPC-C, mas não comparável aos resultados publicados do TPC, no servidor Vera, no Dell PowerEdge R7725 com EPYC 9965 e no PowerEdge R770 com Xeon 6787P. Ele testou cinco mecanismos de código aberto em cada um: MariaDB 12.3.3 e 13.0.2, MySQL 26.7.0, VillageSQL 0.0.7 e PostgreSQL 18.6. O tamanho do banco de dados escalava com a quantidade de núcleos, com 16 warehouses por núcleo físico, ou 1,408 para um único socket do Vera.
Cada mecanismo foi executado em um soquete e em dois, com as CPUs do segundo soquete desativadas para as execuções em um único soquete, e todos os sistemas apresentaram melhor desempenho em um único soquete, o que é típico para o desempenho de bancos de dados. Em todos os 15 pares, adicionar o segundo soquete reduziu a taxa de transferência máxima em 23% a 47% e em 29% a 45% no Vera. Shaw já havia constatado que os bancos de dados de código aberto atingem um limite de escalabilidade antes de esgotarem os núcleos. Além desse ponto, manter os caches coerentes em dois soquetes custa mais do que os núcleos extras adicionados. Portanto, focamos nos resultados em um único soquete, mostrados no gráfico abaixo.
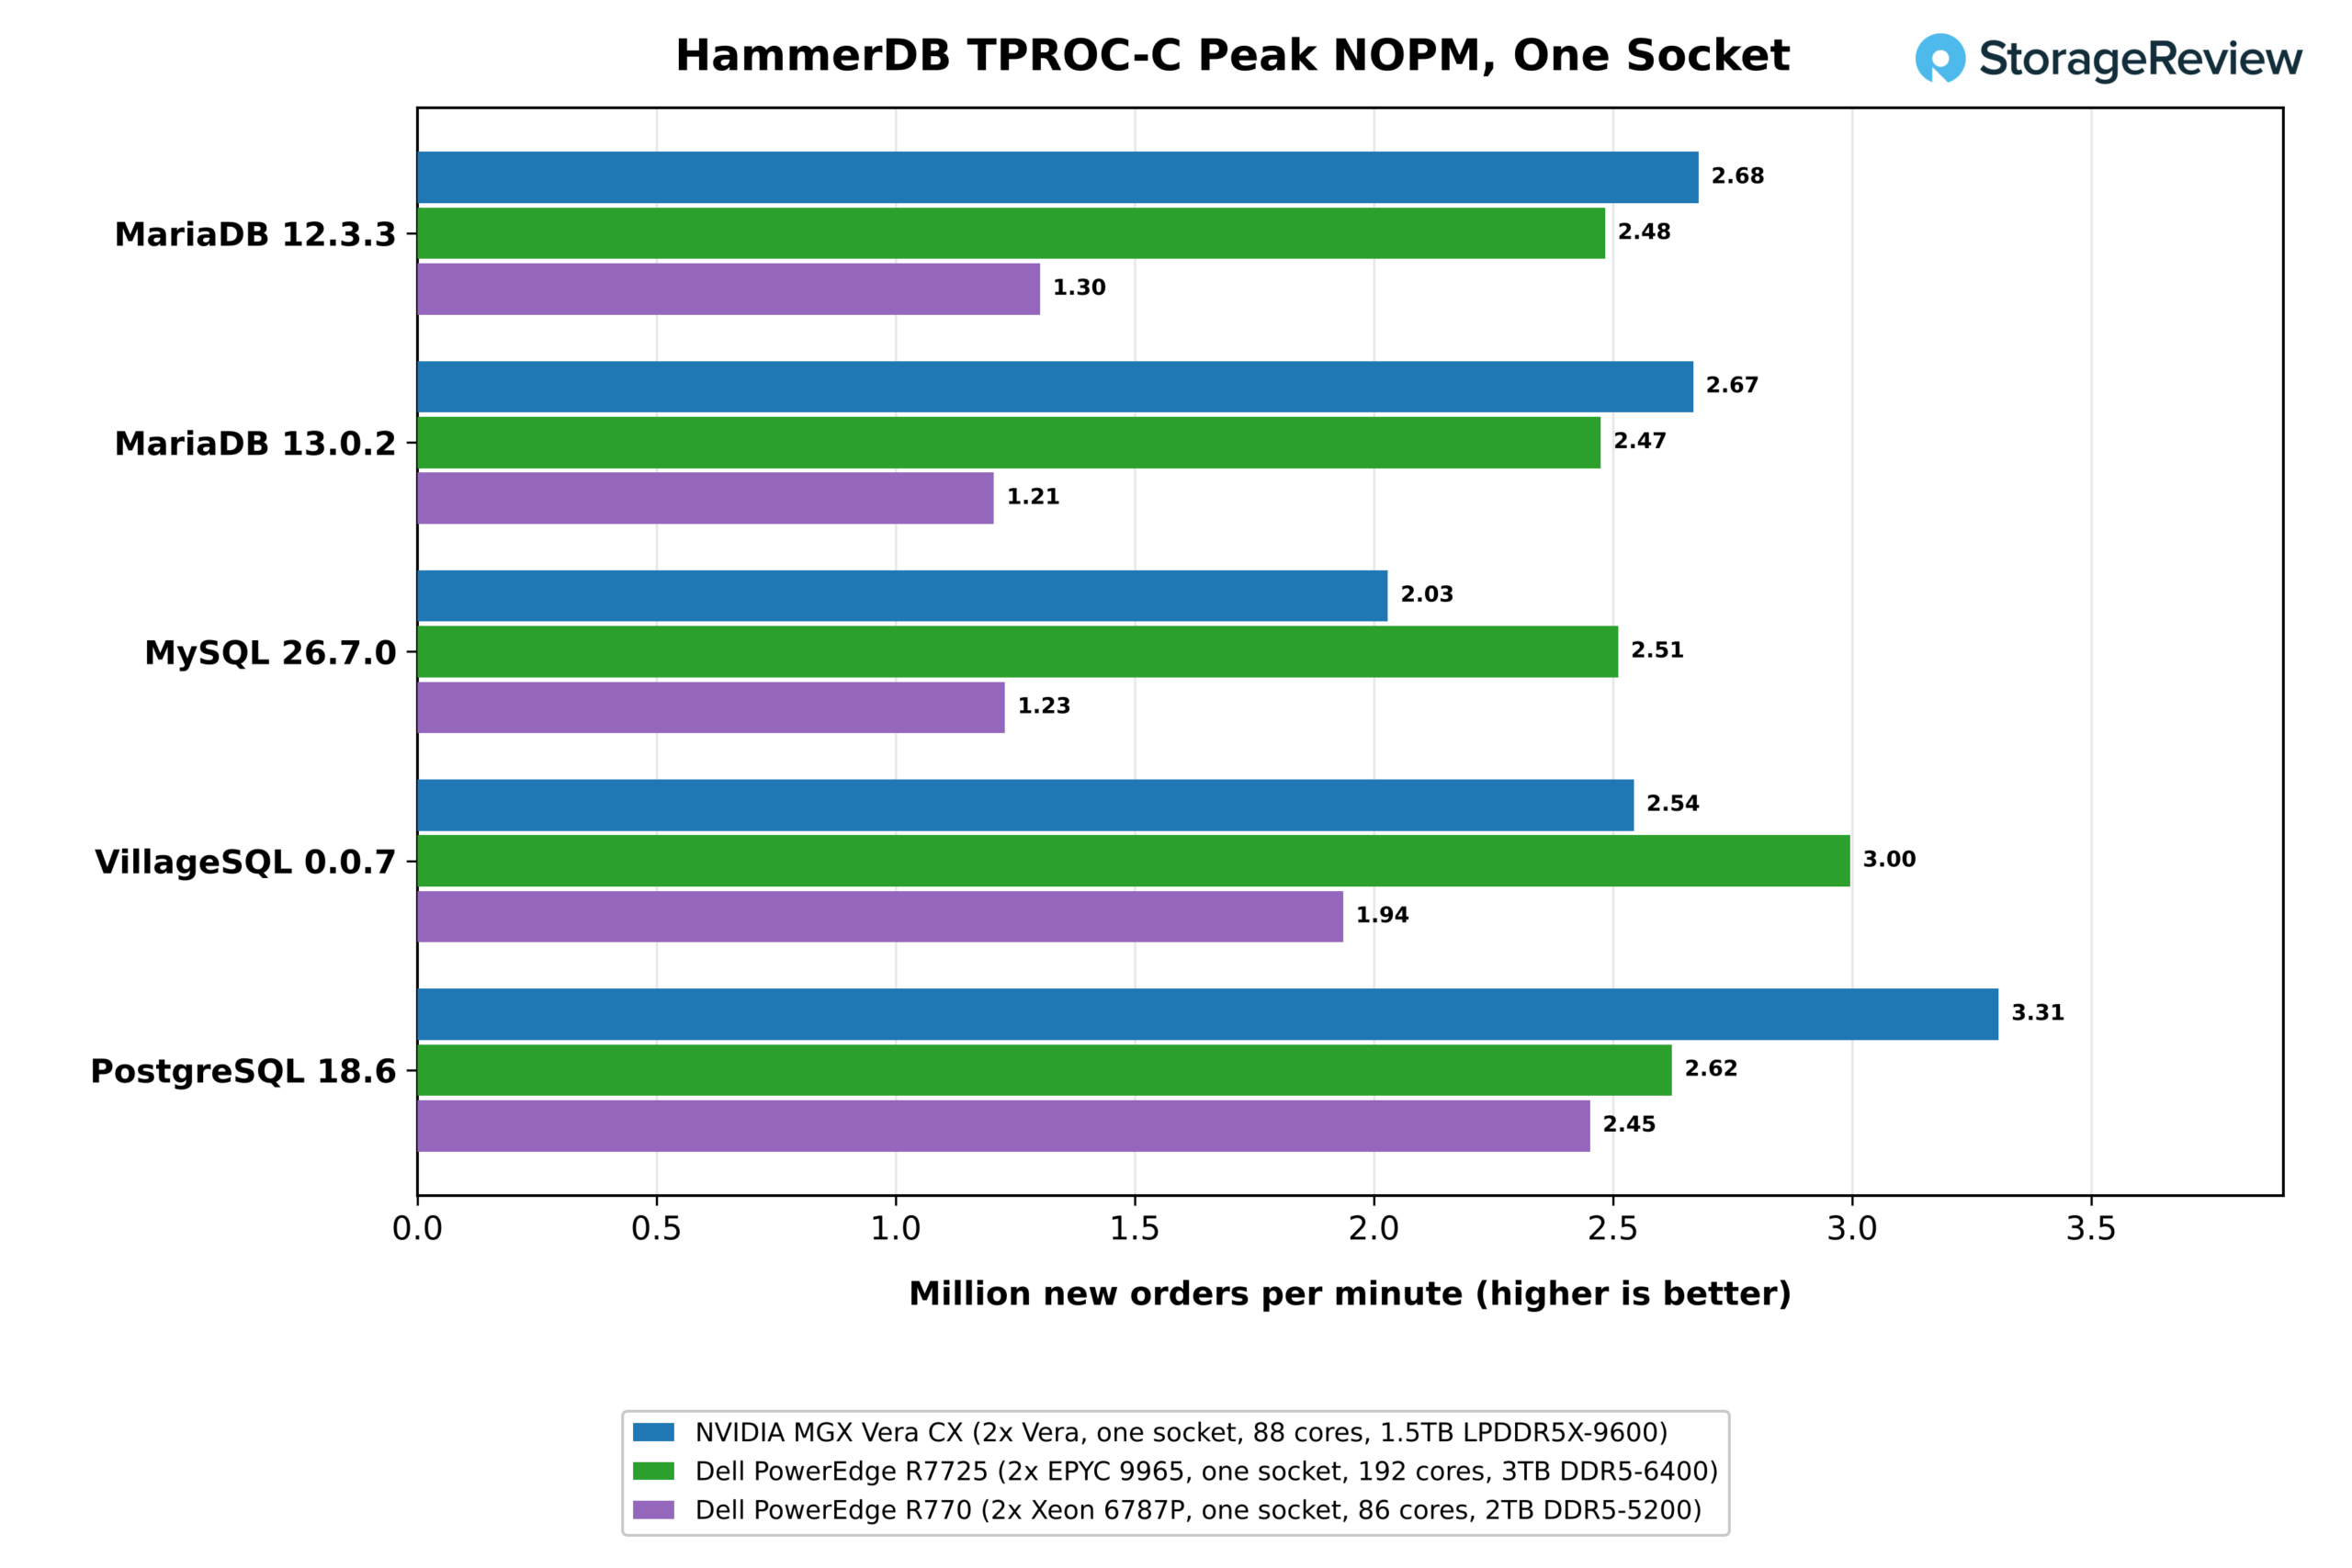
Em um soquete, os 88 núcleos do Vera lideraram em três dos cinco mecanismos. O PostgreSQL 18.6 deu ao Vera sua maior margem, com 3.31 milhões de novos pedidos por minuto (NOPM) com 128 usuários virtuais, em comparação com 2.62 milhões no soquete EPYC 9965 de 192 núcleos e 2.45 milhões no Xeon 6787P de 86 núcleos. Ambas as versões do MariaDB também foram bem-sucedidas no Vera, com 2.68 milhões e 2.67 milhões, em comparação com 2.48 milhões e 2.47 milhões no EPYC. A AMD manteve o MySQL 26.7.0 com 2.51 milhões contra 2.03 milhões do Vera, e o VillageSQL com 3.00 milhões contra 2.54 milhões. O Xeon ficou atrás em todos os cinco mecanismos por 1.21 milhão a 2.45 milhões, e seus resultados com o MariaDB foram menos da metade dos do Vera.
A divisão provavelmente se deve à forma como cada mecanismo escala. O modelo de um processo por conexão do PostgreSQL e o InnoDB do MariaDB distribuem o trabalho por vários núcleos com tráfego intenso de memória compartilhada, o que favorece a largura de banda local superior a 1 TB/s que cada socket Vera suportou no STREAM. O MySQL e o VillageSQL atingem a contenção de bloqueios internos mais cedo, portanto, seus resultados dependem mais da rapidez com que cada núcleo libera uma seção crítica, e é aí que o 9965 se destaca. Após a rodada de outubro, Shaw considerou o Arm a plataforma mais rápida no geral, afirmando que o Arm "definitivamente chegou como um servidor de banco de dados competitivo", embora tenha acrescentado que um EPYC de 96 núcleos com um único socket que ele havia testado anteriormente poderia superá-lo.
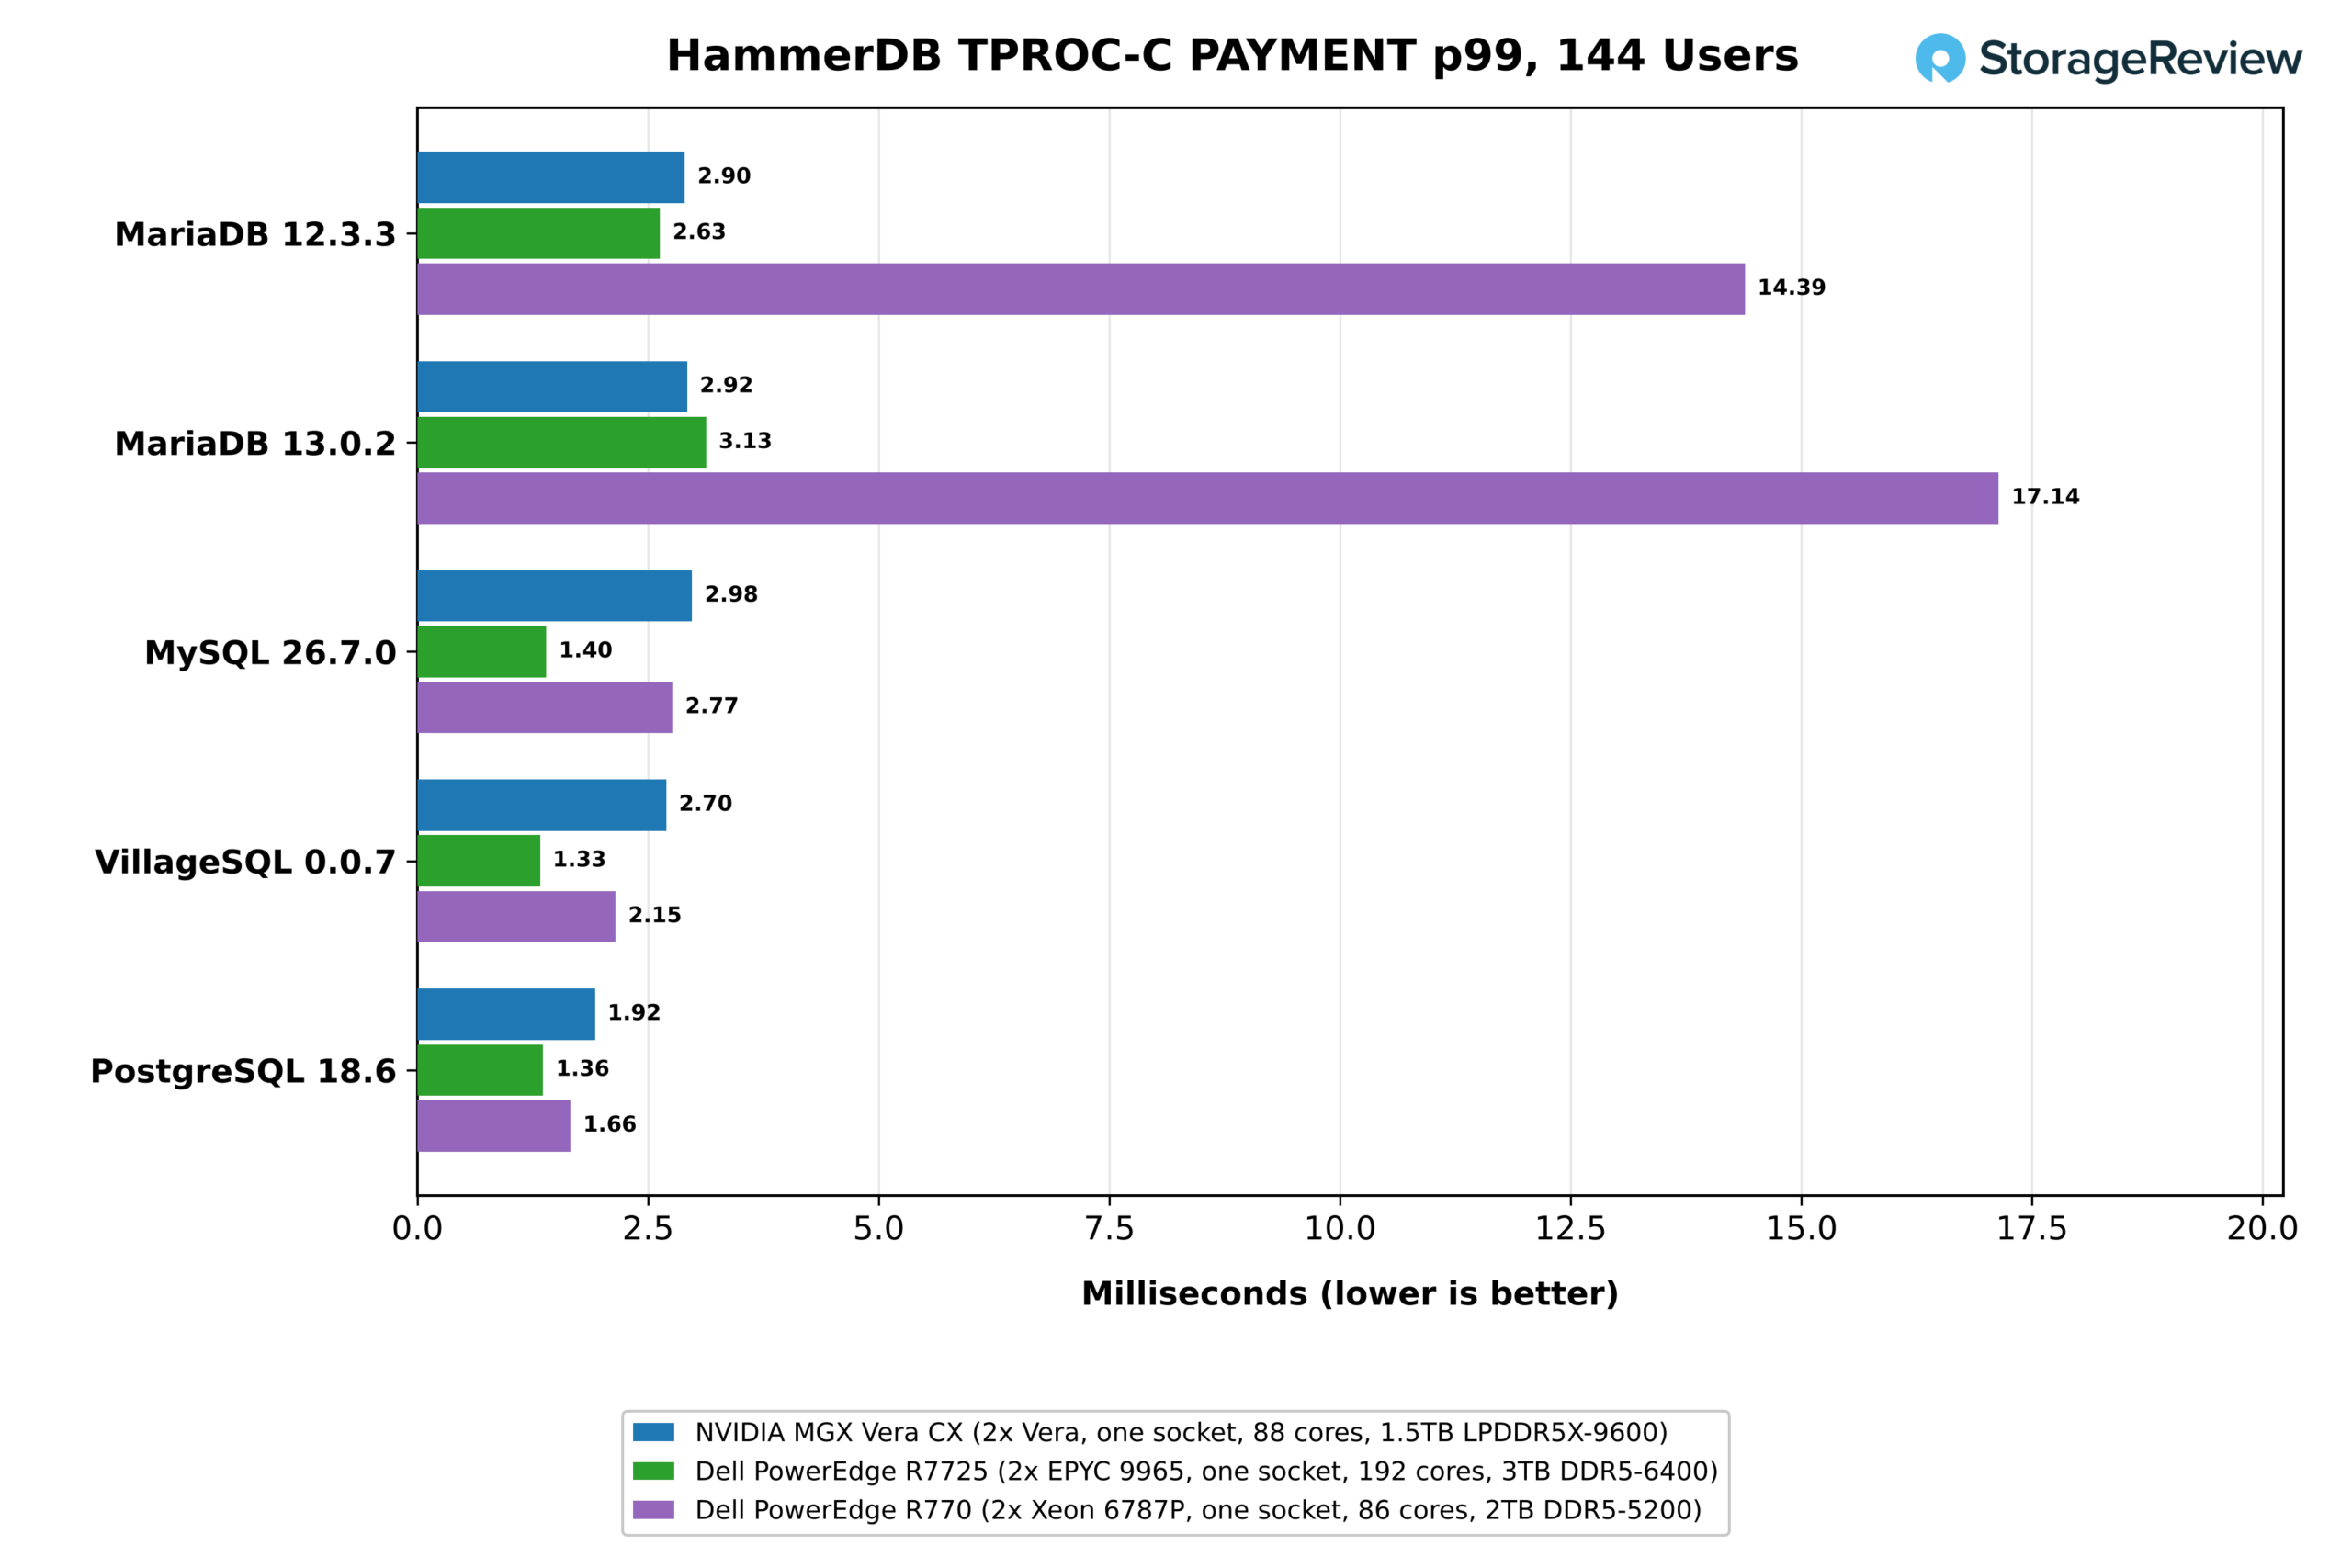
A latência de cauda com uma carga equivalente de 144 usuários virtuais mostra a mesma divisão. A latência PAYMENT p99 do Vera variou de 1.92 ms no PostgreSQL a 2.98 ms no MySQL. O EPYC 9965 manteve o MySQL, VillageSQL e PostgreSQL entre 1.33 ms e 1.40 ms, de 29% a 53% menor que o Vera, mas seus 3.13 ms no MariaDB 13.0.2 ficaram atrás dos 2.92 ms do Vera. As latências de cauda do Xeon 6787P no MariaDB, de 14.4 ms e 17.1 ms, foram várias vezes maiores que as de ambos, em consonância com sua taxa de transferência muito menor com a mesma carga. A transferência de bloqueios dentro dos mecanismos provavelmente impulsiona as latências de cauda mais altas do Vera, ecoando os resultados do Valkey, onde as solicitações enviadas uma de cada vez também favoreceram a AMD.
A rodada de novembro colocou a intuição de Shaw à prova. Ele executou a mesma carga de trabalho em um soquete do novo EPYC 9996 de 256 núcleos da AMD e em um EPYC 9686F de 96 núcleos, com o soquete do Vera na comparação. O 9996 e o Vera trocaram de processadores, com o Vera mantendo o PostgreSQL e o MariaDB, enquanto o EPYC apresentou melhor latência de cauda. O modelo de 96 núcleos superou o Vera no PostgreSQL. Os resultados completos estão em nossa análise do AMD EPYC Venice.
“Fiquei genuinamente impressionado com o desempenho dos bancos de dados de código aberto no NVIDIA Vera. É ótimo ver a Arm competindo no topo do desempenho de bancos de dados e trazendo uma alternativa atraente para o mercado corporativo”, disse Steve Shaw, criador e mantenedor do HammerDB, após a rodada de investimentos.
Conclusão
O Vera não é o processador mais rápido em todas as categorias porque a AMD atende a cada segmento de mercado com um componente dedicado. O EPYC 9175F, com frequência otimizada, foi projetado para velocidade por núcleo e ainda se destaca em cargas de trabalho que se beneficiam de um clock alto, desde o nbody do Python e AES de thread única até solicitações Valkey individuais. O EPYC 9965 foi projetado para alto desempenho e se destaca em tarefas que escalam com o número de núcleos, incluindo GROMACS, 7-Zip e AES com todas as threads, e o número de shards Valkey que cabem em um soquete.
O diferencial do Vera está no desempenho intermediário e na sua capacidade de se aproximar de cada um desses especialistas em seus respectivos campos de atuação. Em um único núcleo, ele igualou ou superou o 9175F em operações com números inteiros e em dois dos três testes em Python, comprimindo 12% mais rápido com o 7-Zip e executando as funções `go` e `regex_compile` 15% e 25% mais rápido, respectivamente, embora tenha ficado atrás em operações com ponto flutuante e criptografia.
Em todo o sistema, alcançou de 63% a 72% das taxas de desempenho do 9965 no teste 7-Zip com todos os núcleos, e terminou o teste OpenFOAM de média complexidade com uma diferença de apenas 12%, ultrapassando-o quando a memória assumiu o controle, tanto no teste de grande complexidade quanto no ClickBench. Manter-se tão próximo do líder em desempenho por núcleo em um único thread e do líder em desempenho geral em todo o sistema é o que torna o Vera um processador de uso geral tão robusto. Para compradores que desejam uma plataforma única para o amplo segmento intermediário do mercado sem abrir mão de grandes vantagens em nenhuma das extremidades, é uma opção extremamente forte.
O Vera oferece uma largura de banda de memória muito superior a qualquer sistema x86 que testamos. Dois sockets Vera mantiveram 2,073 GB/s no STREAM Triad, 2.3 vezes o melhor servidor DDR5 aqui, e o NVLink-C2C mantém essa largura de banda ao alcance entre os sockets: os núcleos do Vera leem a memória do outro socket a 677 GB/s, mais do que qualquer socket x86 lê da memória local.
Em seguida, vieram as cargas de trabalho com uso intensivo de memória: a grande malha OpenFOAM foi resolvida 1.44 vezes mais rápido do que no EPYC 9965, a execução a quente do ClickBench terminou em 2.09 segundos contra 2.70, o conjunto de trabalho Valkey de 256 GB foi executado 34% mais rápido e, em um único socket, o Vera superou o HammerDB no PostgreSQL e em ambas as versões do MariaDB. O custo da conexão é a latência: uma leitura remota leva cerca de 2.1 vezes mais tempo do que uma local, contra 1.75 vezes no EPYC 9175F, portanto, o posicionamento com reconhecimento de NUMA e as páginas enormes ainda são importantes no Vera.
As fragilidades são surpreendentemente sutis e decorrem diretamente do projeto. Seis pipelines SVE2 de 128 bits não correspondem às unidades AVX-512 de 512 bits no código escrito para elas, portanto, uma instância de 16 núcleos do Vera executou o benchmark GROMACS com metade da taxa de desempenho do 9175F e dois terços da taxa do 9965. Com apenas dois desses pipelines lidando com criptografia, um único núcleo Olympus criptografou AES-256-GCM a cerca de um terço da taxa de desempenho do 9175F.
O sucesso do Vera dependerá em grande parte dos parceiros OEM. O Dell PowerEdge R8822 começou a ser comercializado em outubro, com o Vera CPU Rack M9882 previsto para o primeiro trimestre de 2027. O HPE ProLiant Compute DL394 Gen12 chega neste outono (do hemisfério norte). A Supermicro já disponibilizou para orçamento seu Vera Rack de 256 CPUs, com sistemas Vera refrigerados a ar em formatos 1U e 2U. ASUS, ASRock Rack, QCT, GIGABYTE, MSI, Compal, Foxconn, Pegatron, Wistron e Lenovo já apresentaram designs para o Vera. A Oracle Cloud disponibiliza instâncias do Vera para o público em geral , com CoreWeave, Nebius, Lambda e outras soluções a seguir.
O Vera é o primeiro processador de servidor Arm que testamos que se compara aos principais processadores x86 em tarefas de uso geral, e o primeiro processador de qualquer fabricante a oferecer 2 TB/s de largura de banda de memória em um gabinete de dois soquetes com refrigeração a ar. Para a grande maioria do mercado, é uma opção viável atualmente, e a NVIDIA entra no mercado de CPUs com um subsistema de memória exclusivo. Para HPC com uso intensivo de vetores e serviços com criptografia, os especialistas em x86 mantêm a liderança. Submeteremos os sistemas OEM aos mesmos testes assim que chegarem ao laboratório, começando pela função de sandbox de agentes que a NVIDIA projetou para este processador.
Desde esta análise, o EPYC Venice da AMD chegou ao nosso laboratório, e nossas análises do AMD EPYC Venice SP7 e do Dell PowerEdge R9825 submeteram o EPYC 9996 de 256 núcleos ao mesmo conjunto de testes contra o Vera, com o Vera em seu firmware mais recente.
Classificação: O NVIDIA Vera detém o título de Melhor Implementação ARM em nossa classificação de Melhores Servidores.


 Amazon