

O programa JumpStart da Supermicro adota uma abordagem muito diferente para a avaliação de hardware. Em vez de uma demonstração curta e roteirizada em um ambiente de laboratório compartilhado, o JumpStart oferece aos clientes qualificados acesso gratuito e por tempo limitado a um catálogo de servidores de produção reais. De novas plataformas X14 com Intel Xeon 6 a sistemas H14 com AMD EPYC de 5ª geração e grandes configurações de GPU HGX, os clientes reservam sistemas, fazem login remotamente e executam suas próprias cargas de trabalho como se o hardware estivesse em seu próprio rack.
O valor comercial fica evidente ao tomar decisões rápidas e bem fundamentadas sobre a plataforma. Criar uma prova de conceito realista para IA ou computação de alto desempenho geralmente significa esperar por hardware de avaliação, coordenar com vários fornecedores e torcer para que a configuração de teste seja suficientemente próxima daquela que você planeja implantar. O JumpStart elimina esse atrito. As equipes podem validar o desempenho, verificar a compatibilidade do software, explorar o comportamento térmico e de energia e comparar arquiteturas sem sobrecarregar os laboratórios internos ou enviar um lote de servidores para o outro lado do país. Para a maioria das organizações, uma semana dedicada à configuração correta é suficiente para confirmar se uma plataforma atende às suas necessidades ou para descartá-la antes que se torne um compromisso.
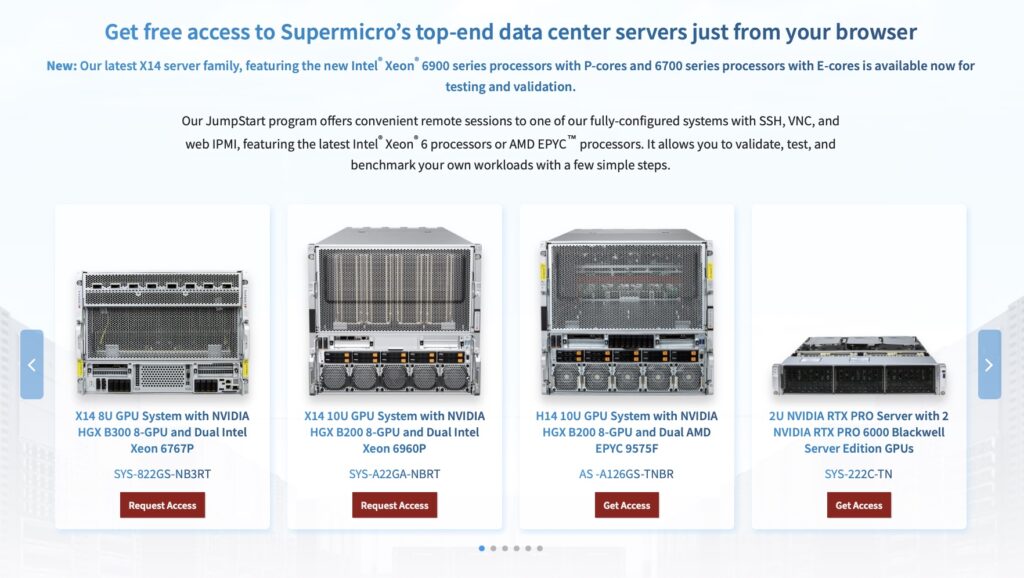
Página de lançamento do Supermicro JumpStart
O que torna o JumpStart particularmente atraente não é apenas o número de sistemas online, mas também a profundidade da tecnologia que a Supermicro está disposta a expor. As opções mais populares incluem servidores X14 com GPUs, equipados com Intel Xeon 6 e aceleradores NVIDIA, plataformas H14 otimizadas para computação de alta densidade com processadores AMD EPYC de 5ª geração e sistemas focados em armazenamento que combinam CPUs modernas com backends NVMe. No segmento de alto desempenho, a Supermicro já oferece acesso a sistemas HGX das classes B200 e B300 para treinamento e inferência de IA, e utiliza o JumpStart para proporcionar acesso antecipado, sob acordo de confidencialidade, a plataformas de próxima geração que ainda não estão amplamente disponíveis no mercado. Não vimos nenhum outro fabricante de equipamentos originais (OEM) tão proativo em transformar infraestrutura pré-lançamento em uma experiência de laboratório remoto estruturada e replicável.
A maioria dos ambientes de demonstração de fornecedores se limita a laboratórios de soluções guiadas ou ambientes de teste de produtos restritos. Esses recursos são úteis para aprender sobre ferramentas de gerenciamento e fluxos de trabalho de orquestração, mas raramente oferecem acesso root a um servidor de ponta ou a liberdade de instalar e executar sua própria infraestrutura. O JumpStart se comporta muito mais como um rack de empréstimo em um data center remoto. Ao reservar um sistema específico, você recebe controle total via SSH, VNC e IPMI durante o período da reserva, e a Supermicro formata e reconstrói o ambiente antes que o próximo cliente o utilize. Na prática, a experiência se assemelha menos a uma demonstração de marketing e mais a um engajamento curto e focado em um laboratório remoto bem gerenciado.
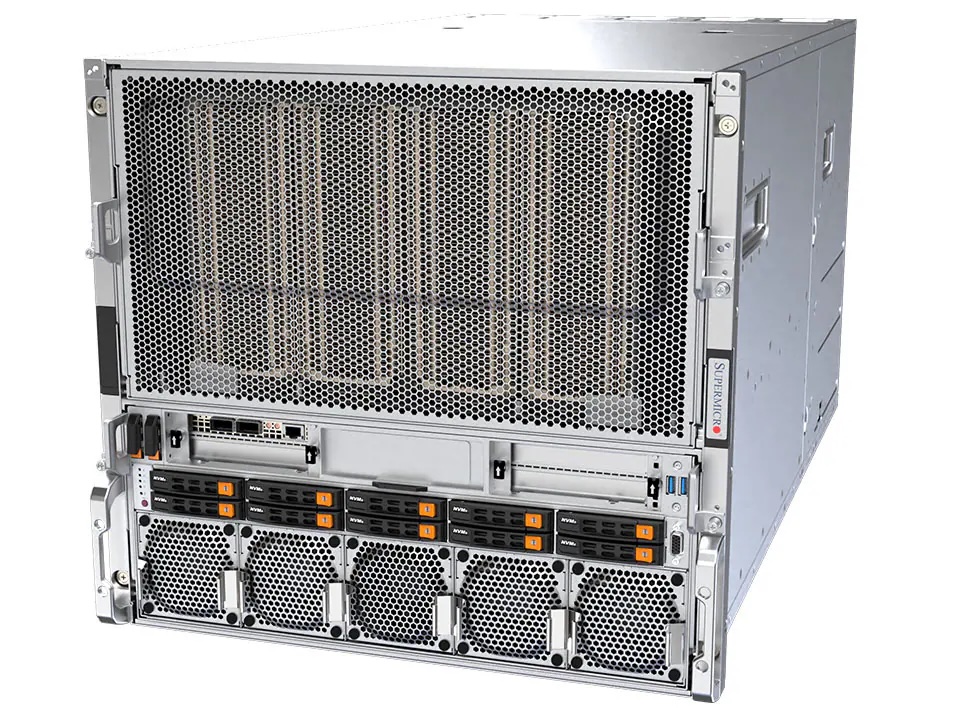
Sistema Supermicro JumpStart X14 B200
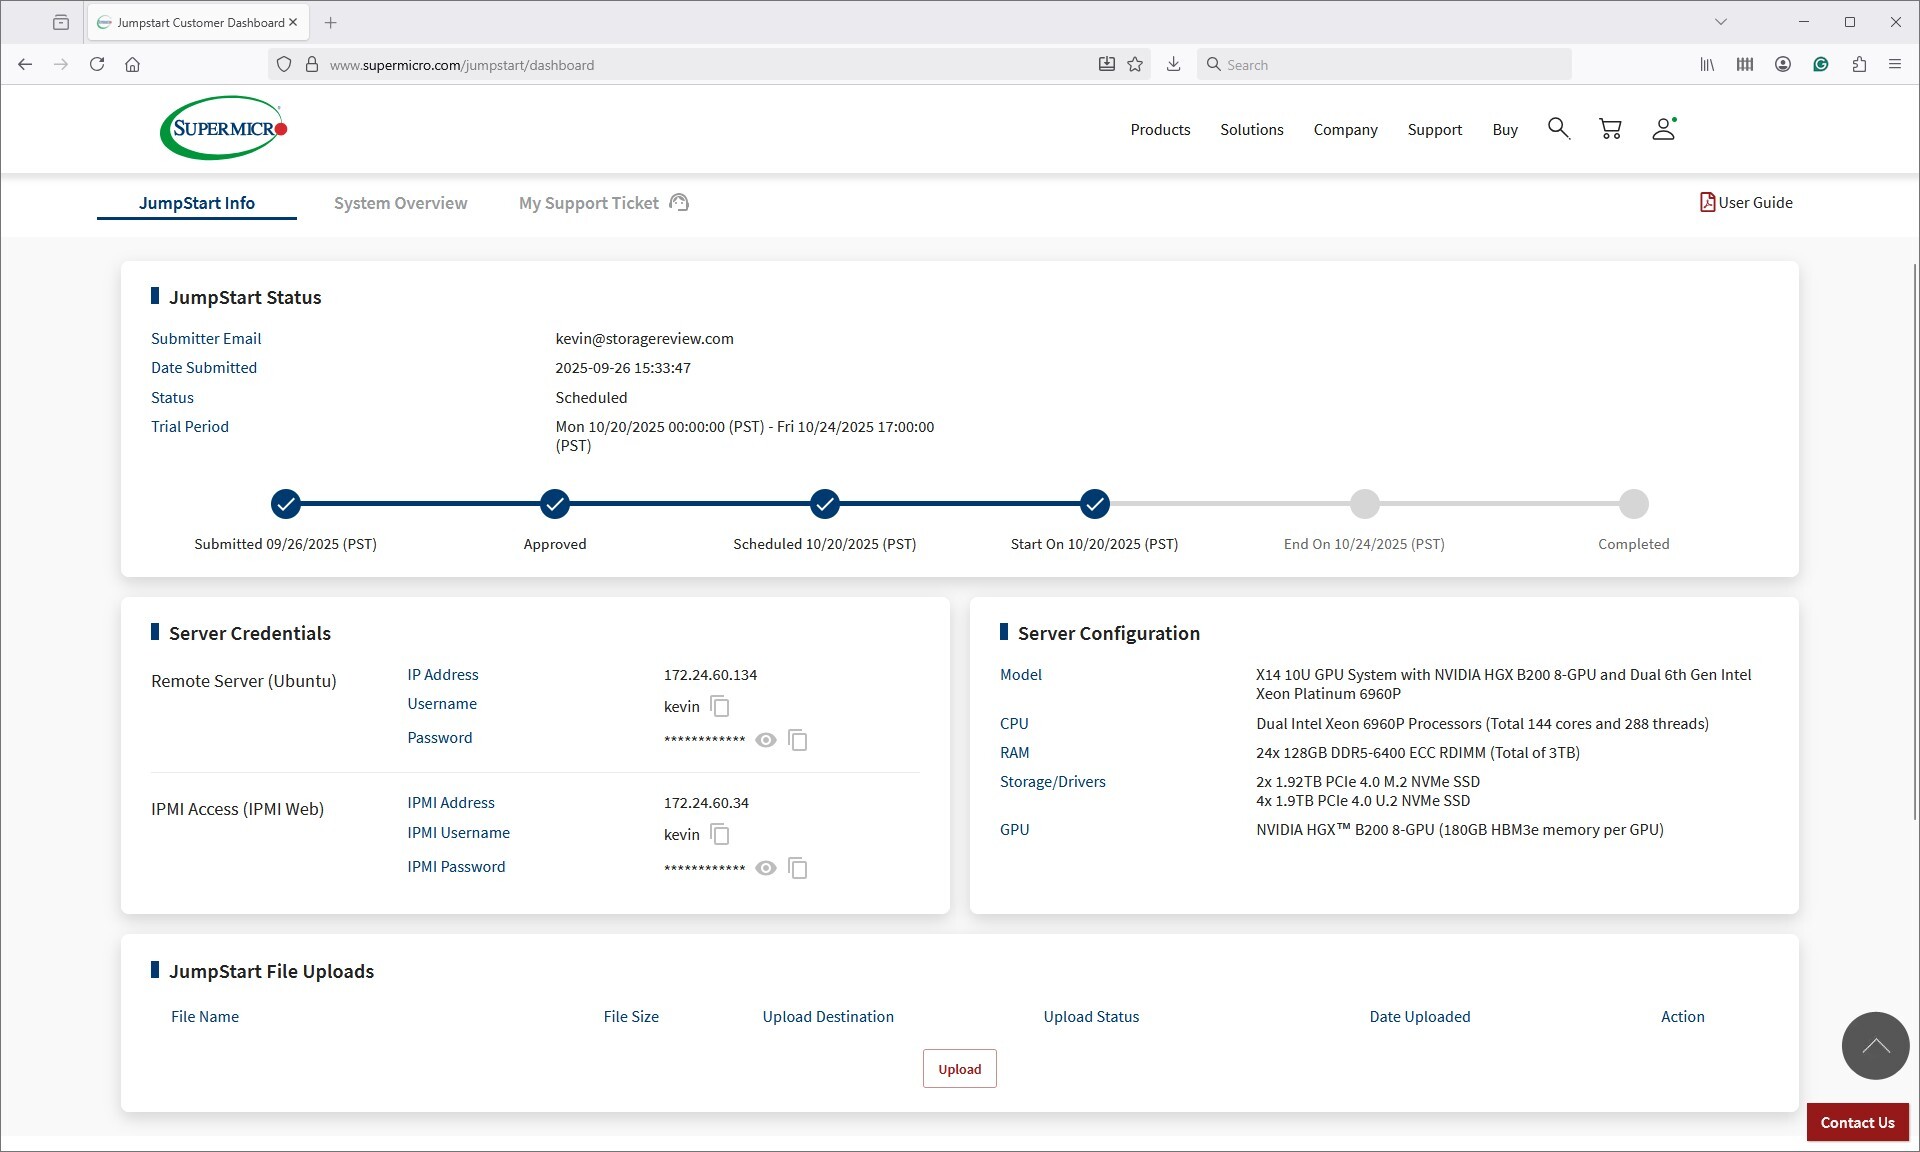
Para esta análise, a Supermicro forneceu ao StorageReview acesso ao JumpStart exatamente como um cliente o utilizaria. Agendamos um período de uso em um sistema X14 10U com GPUs, equipado com uma placa-mãe NVIDIA HGX B200 de 8 GPUs e dois processadores Intel Xeon Platinum 6960P de 6ª geração. O servidor estava configurado com 3 TB de memória DDR5-6400 ECC, uma combinação de SSDs NVMe M.2 e U.2 para armazenamento local e oito GPUs B200, cada uma com 180 GB de HBM3e. Ao longo de uma semana, utilizamos essa plataforma para verificar cargas de trabalho de IA e o comportamento do sistema, com foco nos tipos de perguntas que os compradores reais desejam ver respondidas antes de investir em uma nova geração de infraestrutura.
Nossa semana no programa Supermicro JumpStart
Assim que nossa janela de reservas foi aberta, o portal JumpStart tornou-se o ponto central para nossos testes. O painel inicial, mostrado abaixo, apresentava o cronograma da reserva e fornecia tudo o que era necessário para começar, incluindo credenciais SSH para o ambiente Ubuntu remoto e acesso IPMI completo. Ter ambas as interfaces disponíveis imediatamente significava que podíamos começar a validar o sistema em minutos, em vez de esperar pelo provisionamento ou pela intervenção do suporte.
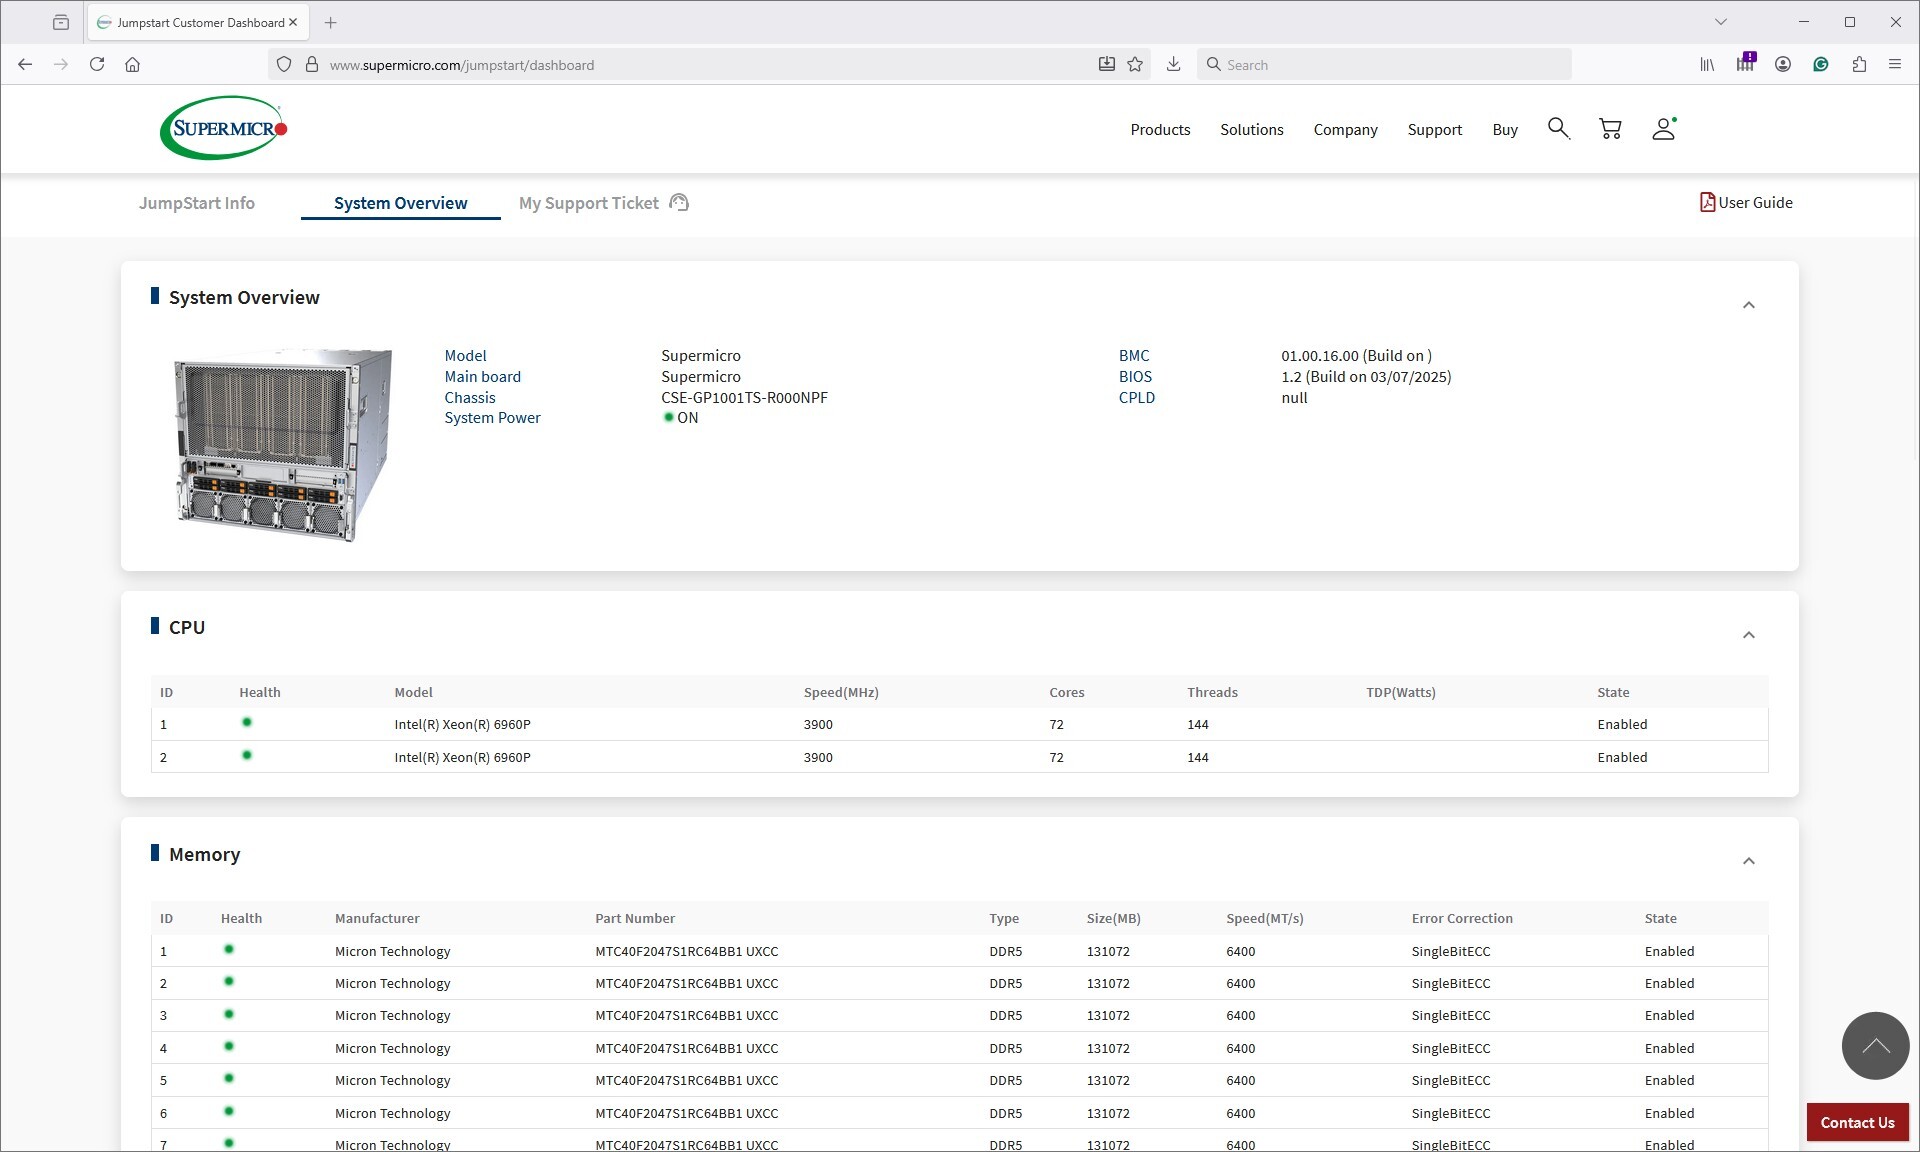
O primeiro passo em nosso fluxo de trabalho foi confirmar se o hardware estava pronto. Usando a página de Visão Geral do Sistema no portal (veja a captura de tela abaixo), verificamos se o chassi estava ligado, se ambas as CPUs foram detectadas, se a memória estava totalmente instalada e se o BMC reportava saúde do sistema (indicada como verde). Essa verificação rápida tornou-se uma prática padrão em nossas avaliações de laboratório, e ter visibilidade remota por meio do portal agilizou esse processo.
Com o sistema validado, passamos ao trabalho prático. O upload de arquivos para os ativos de teste foi feito diretamente pela interface do JumpStart, o que eliminou a dificuldade usual de preparar conjuntos de dados em uma plataforma remota. A partir daí, conectamos via SSH para a implantação das cargas de trabalho e usamos o console remoto via IPMI quando precisamos de acesso de baixo nível ou para observar o comportamento de inicialização.
O fluxo de trabalho ao longo da semana foi muito semelhante à operação de equipamentos em nosso próprio laboratório. Conseguimos iniciar, parar e iterar em cargas de trabalho rapidamente, reiniciar a plataforma quando necessário e monitorar o comportamento do hardware sem envolver o suporte da Supermicro. A combinação de acesso em nível de sistema operacional e controle total fora da banda tornou o ambiente previsível e eficiente para ciclos de teste curtos.
Ao final da reserva, o sistema era automaticamente recuperado e reiniciado, encerrando o engajamento de forma impecável. Essa estrutura previsível nos permitiu focar nos testes em vez da logística e garantiu que aproveitássemos ao máximo o período de acesso limitado.
Desempenho de armazenamento GPUDirect
Um dos testes que realizamos na plataforma Supermicro X14 foi o teste Magnum IO GPUDirect Storage (GDS). O GDS é um recurso desenvolvido pela NVIDIA que permite que as GPUs ignorem a CPU ao acessar dados armazenados em unidades NVMe ou outros dispositivos de armazenamento de alta velocidade. Em vez de rotear os dados pela CPU e pela memória do sistema, o GDS possibilita a comunicação direta entre a GPU e o dispositivo de armazenamento, reduzindo significativamente a latência e melhorando a taxa de transferência de dados.
Como funciona o armazenamento GPUDirect
Tradicionalmente, quando uma GPU processa dados armazenados em uma unidade NVMe, os dados precisam primeiro passar pela CPU e pela memória do sistema antes de chegar à GPU. Esse processo introduz gargalos, pois a CPU se torna intermediária, adicionando latência e consumindo recursos valiosos do sistema. O GPUDirect Storage elimina essa ineficiência, permitindo que a GPU acesse os dados diretamente do dispositivo de armazenamento por meio do barramento PCIe. Esse caminho direto reduz a sobrecarga de movimentação de dados, possibilitando transferências de dados mais rápidas e eficientes.
Cargas de trabalho de IA, especialmente aquelas que envolvem aprendizado profundo, exigem um alto consumo de dados. O treinamento de grandes redes neurais requer o processamento de terabytes de dados, e qualquer atraso na transferência de dados pode levar à subutilização de GPUs e a tempos de treinamento mais longos. O GPUDirect Storage aborda esse desafio garantindo que os dados sejam entregues à GPU o mais rápido possível, minimizando o tempo ocioso e maximizando a eficiência computacional.
Além disso, o GDS é particularmente benéfico para cargas de trabalho que envolvem streaming de grandes conjuntos de dados, como processamento de vídeo, processamento de linguagem natural ou inferência em tempo real. Ao reduzir a dependência da CPU, o GDS acelera a movimentação de dados e libera recursos da CPU para outras tarefas, aprimorando ainda mais o desempenho geral do sistema.
Além da largura de banda bruta, o GPUDirect com NVMe-oF (TCP/RDMA) também oferece E/S de latência ultrabaixa. Isso garante que as GPUs nunca fiquem sem dados, tornando o sistema ideal para inferência de IA em tempo real, pipelines de análise e reprodução de vídeo.
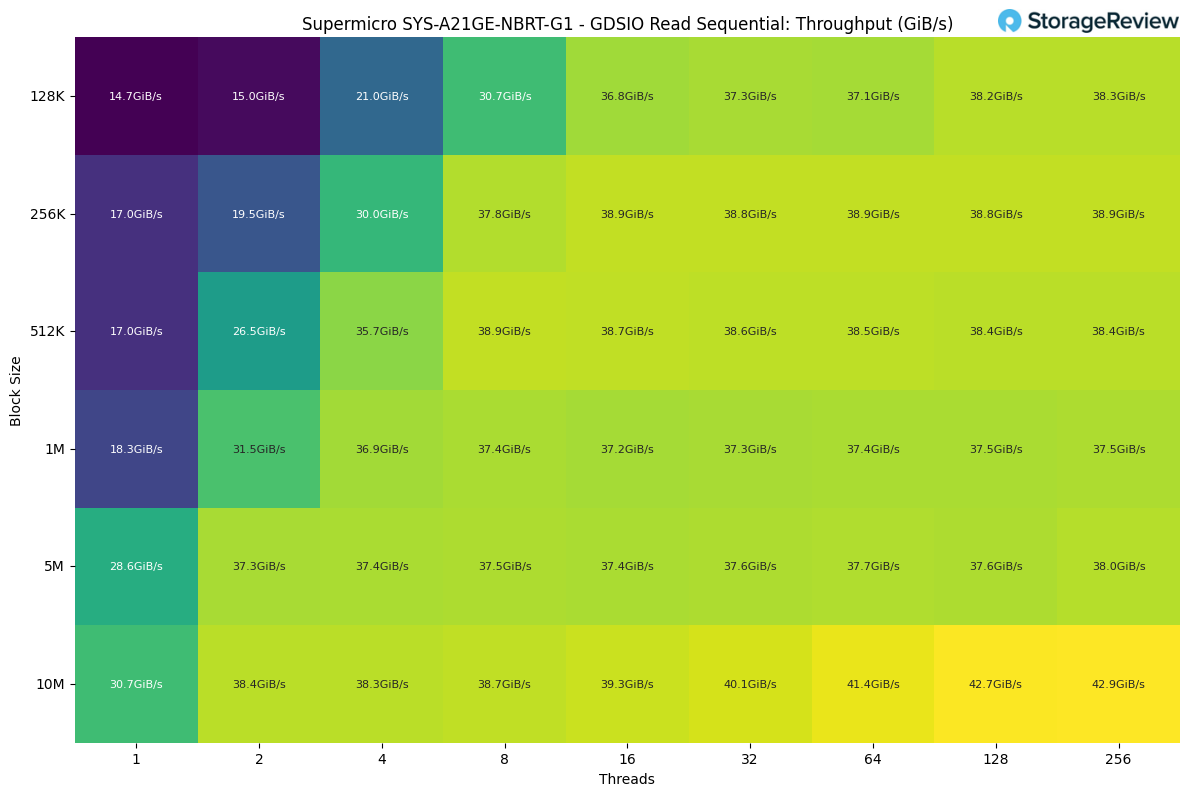
Taxa de transferência sequencial de leitura GDSIO
Para nossos testes de leitura sequencial GDSIO na plataforma B200, a carga de trabalho começou modestamente, com um único thread atingindo cerca de 14 a 15 GiB/s, dependendo do tamanho do bloco. Assim que aumentamos tanto o número de threads quanto o tamanho do bloco, o desempenho melhorou rapidamente. Ao passar para 2 e 4 threads, a taxa de transferência subiu para a faixa de 20 a 36 GiB/s, demonstrando a excelente escalabilidade do sistema após a introdução do paralelismo.
A aceleração real ocorreu quando atingimos oito ou mais threads, ponto em que a maioria das cargas de trabalho se estabilizou na faixa de 30 GiB/s. Blocos maiores foram os mais beneficiados, com tamanhos de 5M e 10M apresentando resultados consistentemente expressivos em todas as contagens de threads.
A taxa de transferência atingiu um máximo de aproximadamente 43 GiB/s com um tamanho de bloco de 10M em 256 threads, representando a maior taxa de leitura sequencial sustentada que observamos neste teste.
Latência sequencial de leitura GDSIO
Em termos de latência, a carga de trabalho começou muito responsiva, com leituras de thread única ficando na faixa de 0.06 a 0.1 ms para blocos menores. À medida que o número de threads aumentava, a latência diminuía gradualmente, permanecendo abaixo de 1 ms até o ponto de 8 threads para a maioria das cargas de trabalho.
Após ultrapassarmos 16 threads, tamanhos de bloco maiores começaram a atingir a faixa de vários milissegundos, à medida que o caminho de armazenamento ficava mais saturado. A maior latência ocorreu no final do teste, onde um tamanho de bloco de 10 MB com 256 threads atingiu um pico de pouco mais de 1.2 segundos (cerca de 1200 ms), refletindo uma carga extrema projetada para sobrecarregar o sistema.

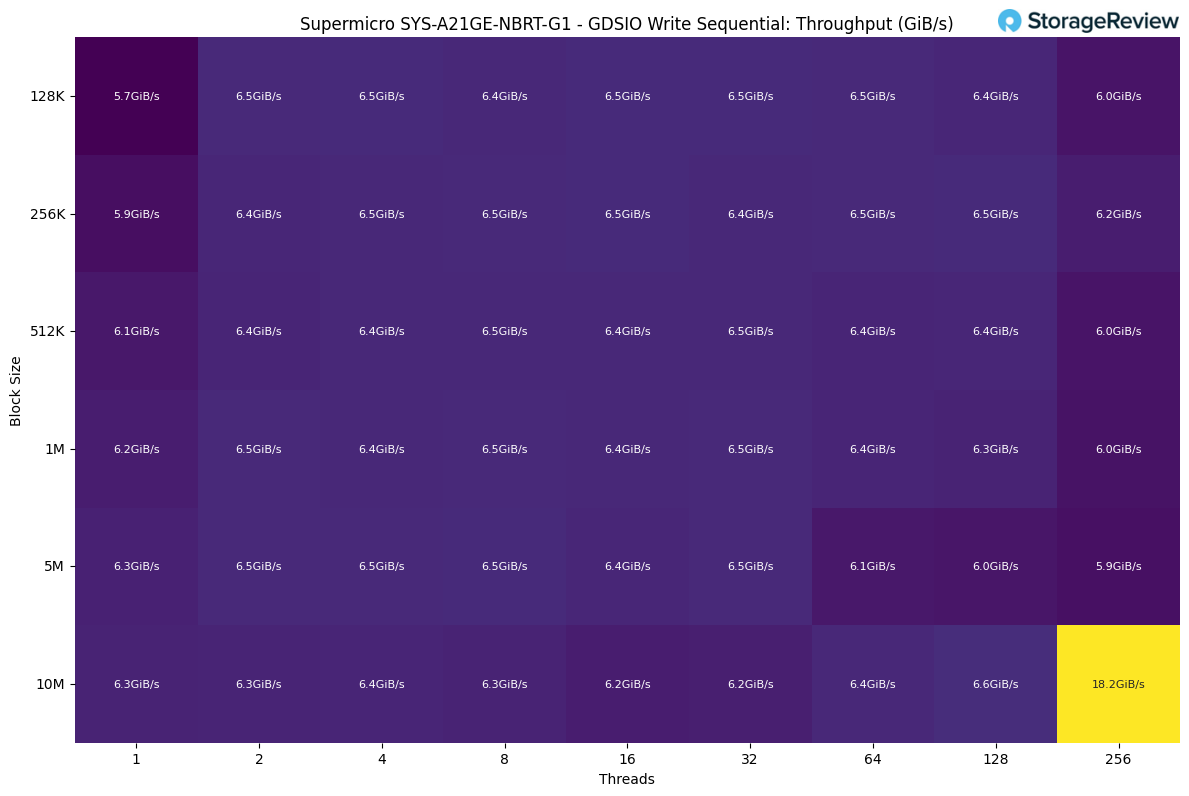
Taxa de transferência sequencial de gravação GDSIO
Para gravações sequenciais, o desempenho foi muito mais estável em comparação com as leituras. A carga de trabalho estabilizou rapidamente, com a maioria das combinações de threads e tamanhos de bloco atingindo cerca de 6.3 a 6.5 GiB/s. Isso indica que o caminho de gravação atinge um limite consistente logo no início, provavelmente relacionado à mídia de armazenamento e ao buffer, e não a limitações da GPU ou do PCIe.
Aumentar o número de threads não teve um impacto significativo, já que a taxa de transferência permaneceu essencialmente inalterada de 2 a 128 threads. O único resultado notável ocorreu no final, onde um tamanho de bloco de 10M com 256 threads atingiu um pico de 18.2 GiB/s, mostrando uma breve vantagem quando o sistema consegue aproveitar totalmente as filas profundas e a agregação de escrita.
Latência sequencial de gravação GDSIO
A latência de escrita começou relativamente baixa, com cargas de trabalho de thread única atingindo cerca de 0.15 a 0.5 ms em tamanhos de bloco menores. À medida que o número de threads aumentava, a latência escalava de forma muito mais agressiva do que na leitura, chegando à faixa de 1 a 4 ms com quatro threads e de 4 a 9 ms com oito threads.
Assim que atingimos 32 threads com tamanhos de bloco maiores, a latência aumentou drasticamente, com blocos de 5M e 10M saltando para a faixa de 170–350ms. O caso mais extremo foi o tamanho de bloco de 10M com 256 threads, que atingiu um pico de pouco menos de 3 segundos (cerca de 2900ms), mostrando claramente a rapidez com que o caminho de escrita fica saturado sob carga paralela pesada.

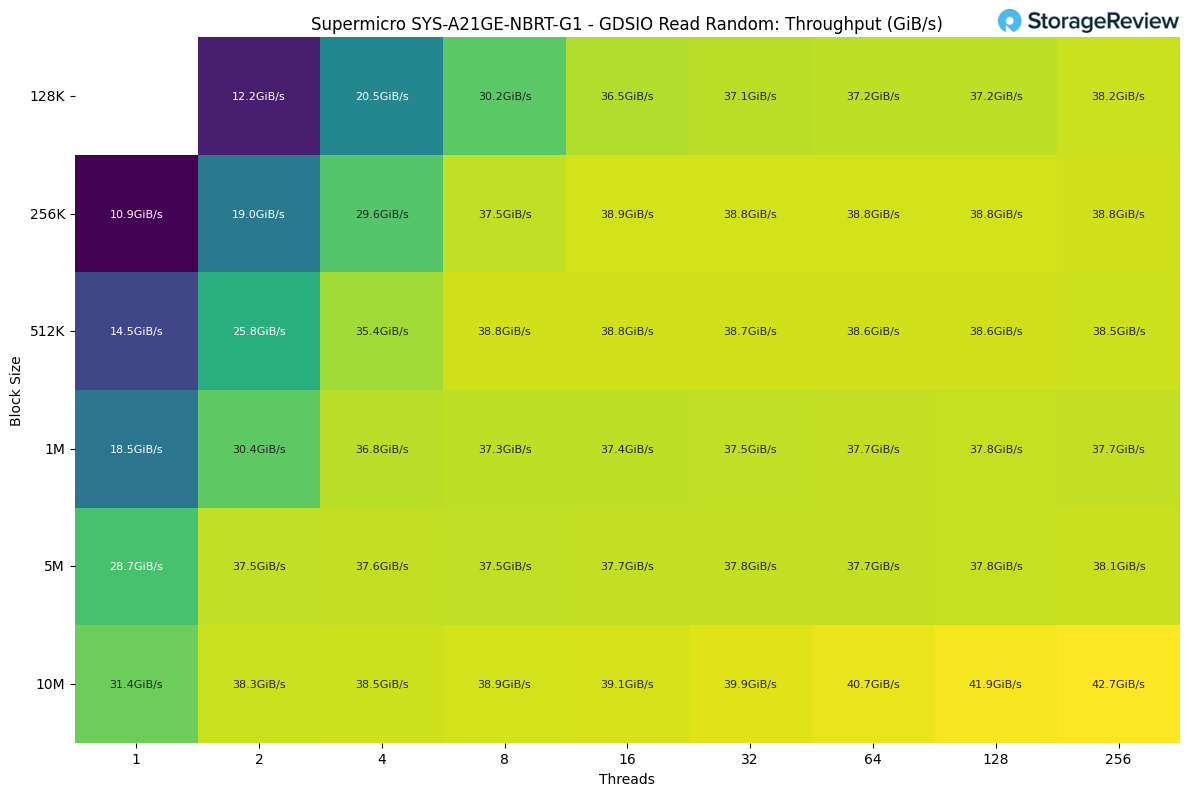
Taxa de transferência de leitura aleatória GDSIO
Para leituras aleatórias, a carga de trabalho aumentou rapidamente. O desempenho de um único núcleo variou de aproximadamente 11 a 31 GiB/s, dependendo do tamanho do bloco, com blocos maiores se beneficiando imediatamente de uma maior largura de banda. Assim que passamos para dois e quatro núcleos, a taxa de transferência subiu para a faixa de 20 a 36 GiB/s, demonstrando forte escalabilidade desde o início.
A partir de 8 threads, o sistema estabilizou-se em um patamar estável na faixa dos 30 GiB/s, muito semelhante ao que observamos no teste de leitura sequencial. O melhor resultado foi obtido com um tamanho de bloco de 10M e 256 threads, atingindo um pico de aproximadamente 42.7 GiB/s.
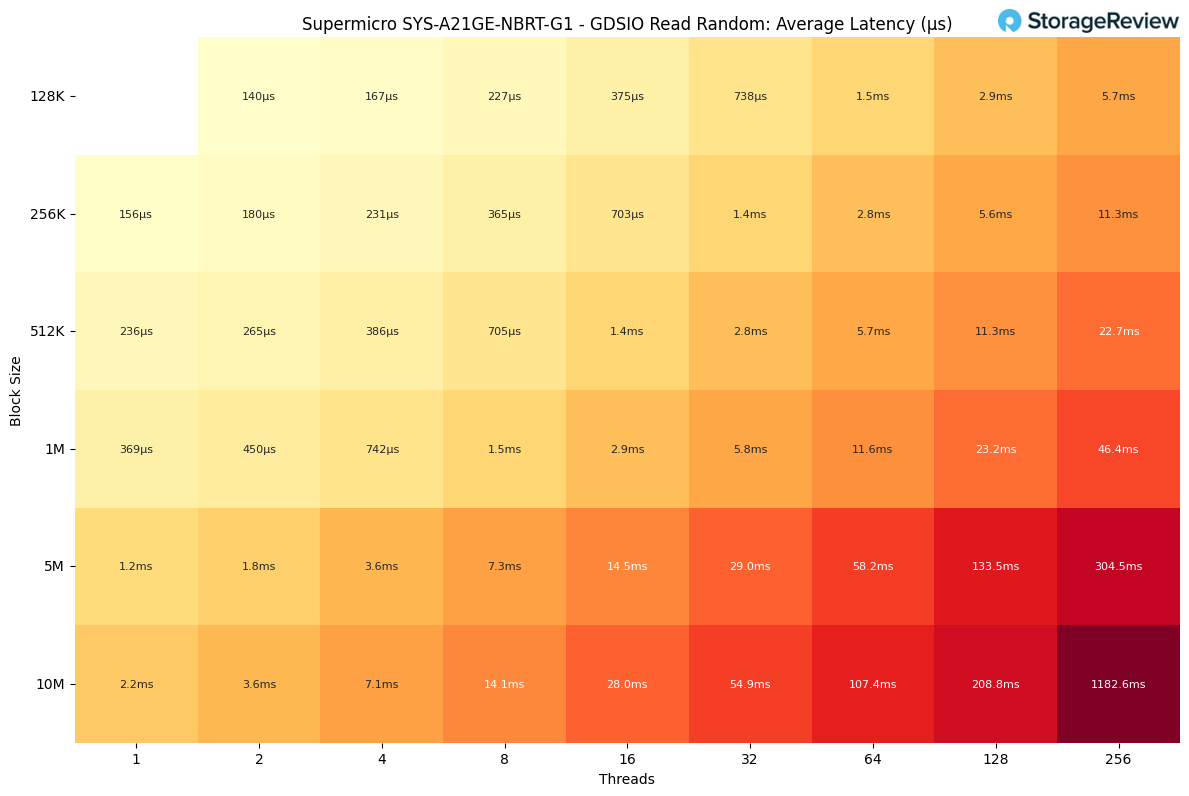
Latência de leitura aleatória GDSIO
A latência de leitura aleatória começou muito baixa, com cargas de trabalho de thread única atingindo cerca de 0.15 a 0.4 ms em tamanhos de bloco menores. À medida que o número de threads aumentava, a latência subia gradualmente, permanecendo abaixo de 1 ms até o ponto de 4 threads e atingindo aproximadamente 1 a 3 ms com oito threads.
Ao passarmos para 32 threads e blocos maiores, a latência aumentou mais acentuadamente, com transferências de 5M e 10M atingindo a faixa de 30 a 55 ms. O caso mais extremo ocorreu com 256 threads e um tamanho de bloco de 10M, onde a latência atingiu um pico de pouco mais de 1.1 segundos (cerca de 1180 ms).
Taxa de transferência de gravação aleatória GDSIO
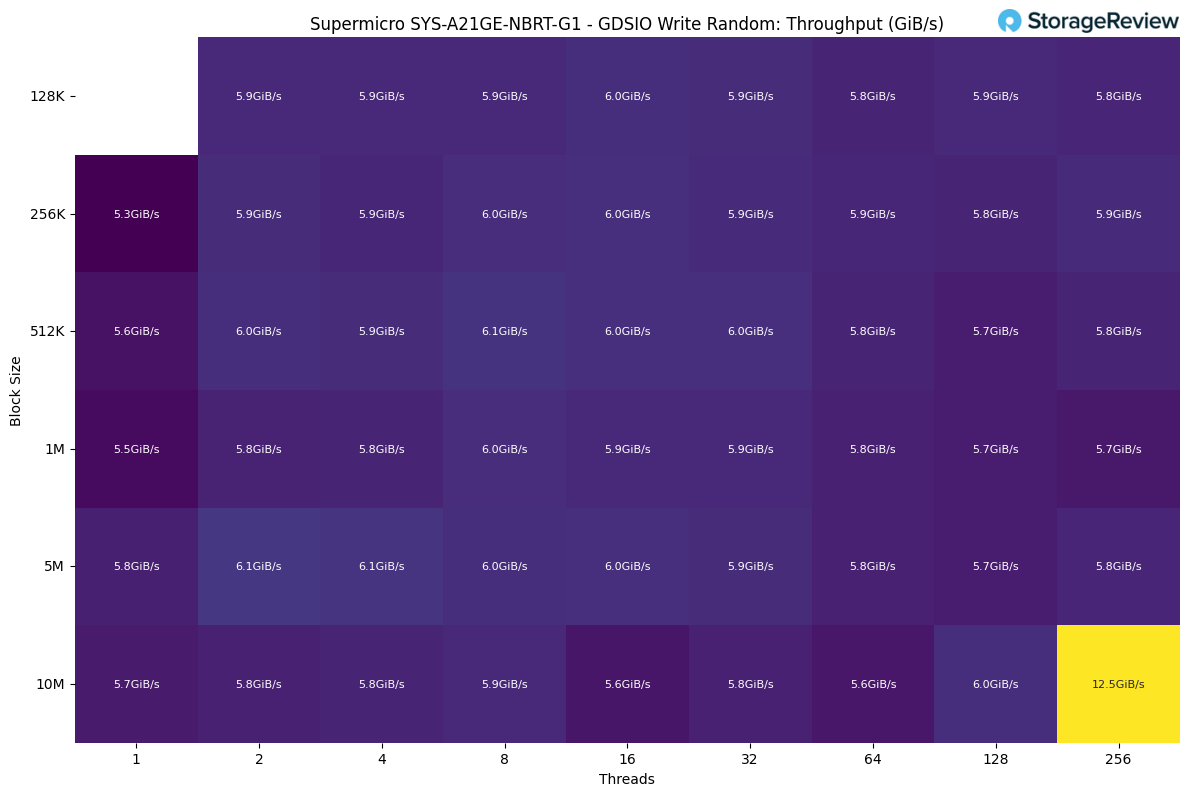
O desempenho de escrita aleatória foi muito consistente em todos os casos, com a maioria dos tamanhos de bloco e contagens de threads ficando em torno de 5.8–6.1 GiB/s. A carga de trabalho atingiu esse nível quase imediatamente e mostrou escalabilidade mínima com a introdução de threads adicionais, indicando que o caminho de escrita atinge seu limite precocemente.
O único valor discrepante notável ocorreu no final do teste, onde um tamanho de bloco de 10M com 256 threads atingiu brevemente um pico de 12.5 GiB/s, provavelmente se beneficiando de enfileiramento profundo e agregação de escrita sob carga paralela pesada.
Latência de escrita aleatória GDSIO
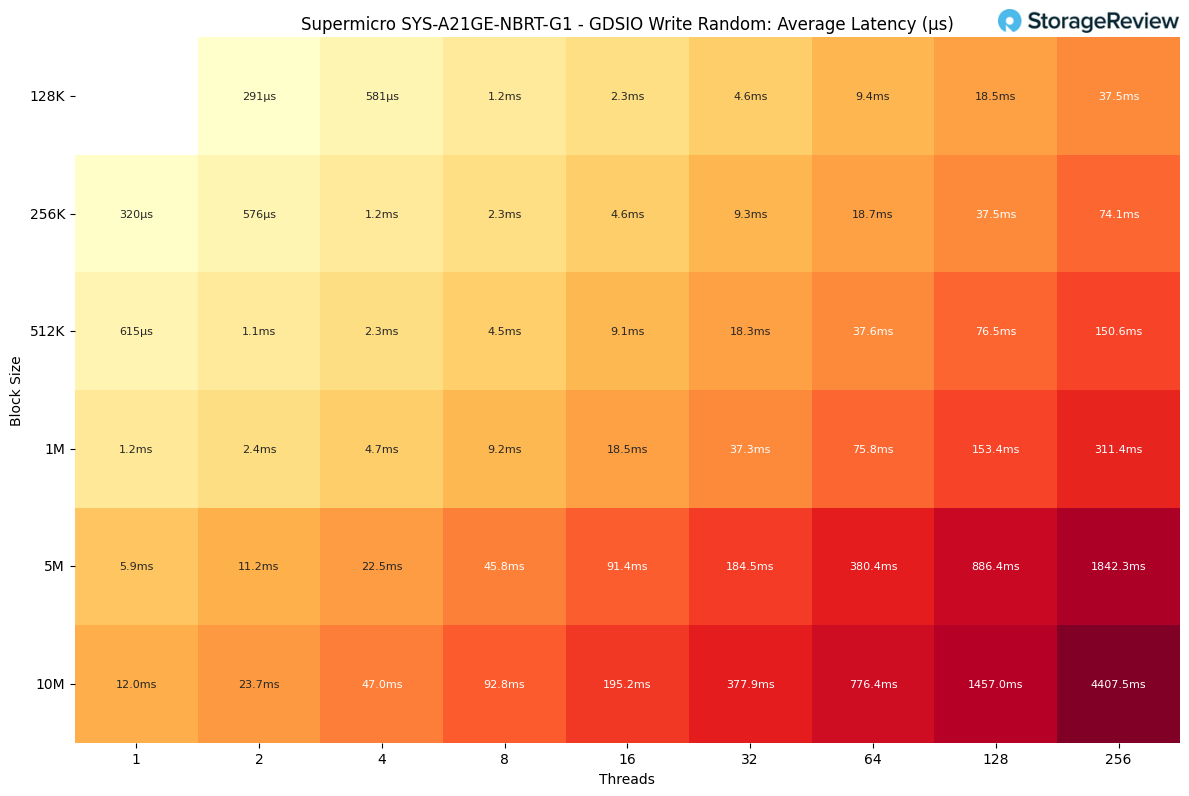
A latência de escrita aleatória começou relativamente baixa, com o desempenho de um único thread variando de cerca de 0.6 a 1.2 ms para tamanhos de bloco menores e de 5 a 12 ms para as maiores transferências. À medida que a concorrência aumentava, a latência escalava rapidamente, atingindo de 4 a 9 ms com oito threads e de 18 a 38 ms com 32 threads.
A partir desse ponto, o caminho de escrita ficou saturado. Tamanhos de bloco maiores saltaram para a faixa de 150–380 ms com 64 threads, e o escalonamento contínuo elevou a latência drasticamente. O pior caso foi o tamanho de bloco de 10 MB com 256 threads, atingindo um pico de aproximadamente 4.4 segundos.
Serviço online vLLM – Desempenho de inferência LLM
O vLLM é o mecanismo de inferência e serviço de alto desempenho mais popular para LLMs. O benchmark de serviço online do vLLM é uma ferramenta de avaliação de desempenho que mede as capacidades de serviço em situações reais desse mecanismo de inferência sob solicitações simultâneas. Ele simula cargas de trabalho de produção enviando solicitações para um servidor vLLM em execução com parâmetros configuráveis, incluindo taxa de solicitações, comprimentos de entrada/saída e o número de clientes simultâneos. O benchmark mede métricas importantes, incluindo taxa de transferência (tokens por segundo), tempo até o primeiro token e tempo por token de saída (TPOT), ajudando os usuários a entender o desempenho do vLLM sob diferentes condições de carga.
Testamos o desempenho de inferência em um conjunto abrangente de modelos que abrangem várias arquiteturas, escalas de parâmetros e estratégias de quantização para avaliar a taxa de transferência sob diferentes perfis de concorrência.
Desempenho do modelo denso
Os modelos densos seguem a arquitetura LLM convencional, onde todos os parâmetros e ativações são utilizados durante a inferência, resultando em um processamento computacional mais intensivo do que suas contrapartes esparsas. Para avaliar de forma abrangente as características de desempenho em diferentes escalas de modelo e estratégias de quantização, comparamos várias configurações de modelos densos da família Llama 3.1 8B.
Nosso conjunto de testes incluiu avaliações do Meta Llama 3.1 8B em três formatos de precisão: a configuração padrão, além de versões quantizadas em FP8 e FP4 utilizando o formato NVFP4 da NVIDIA. É importante observar que o vLLM atualmente utiliza o kernel Marlin para modelos quantizados em NVFP4, e os benefícios de desempenho totais desse formato de quantização ainda não foram totalmente aproveitados nesses benchmarks. Futuras otimizações do vLLM, visando operações nativas do núcleo tensorial NVFP4, podem gerar melhorias adicionais de desempenho. Essa estratégia de seleção de modelos permite a comparação direta de desempenho, isolando o impacto da quantização progressiva na taxa de transferência de inferência.
Desempenho Llama 3.1 8B
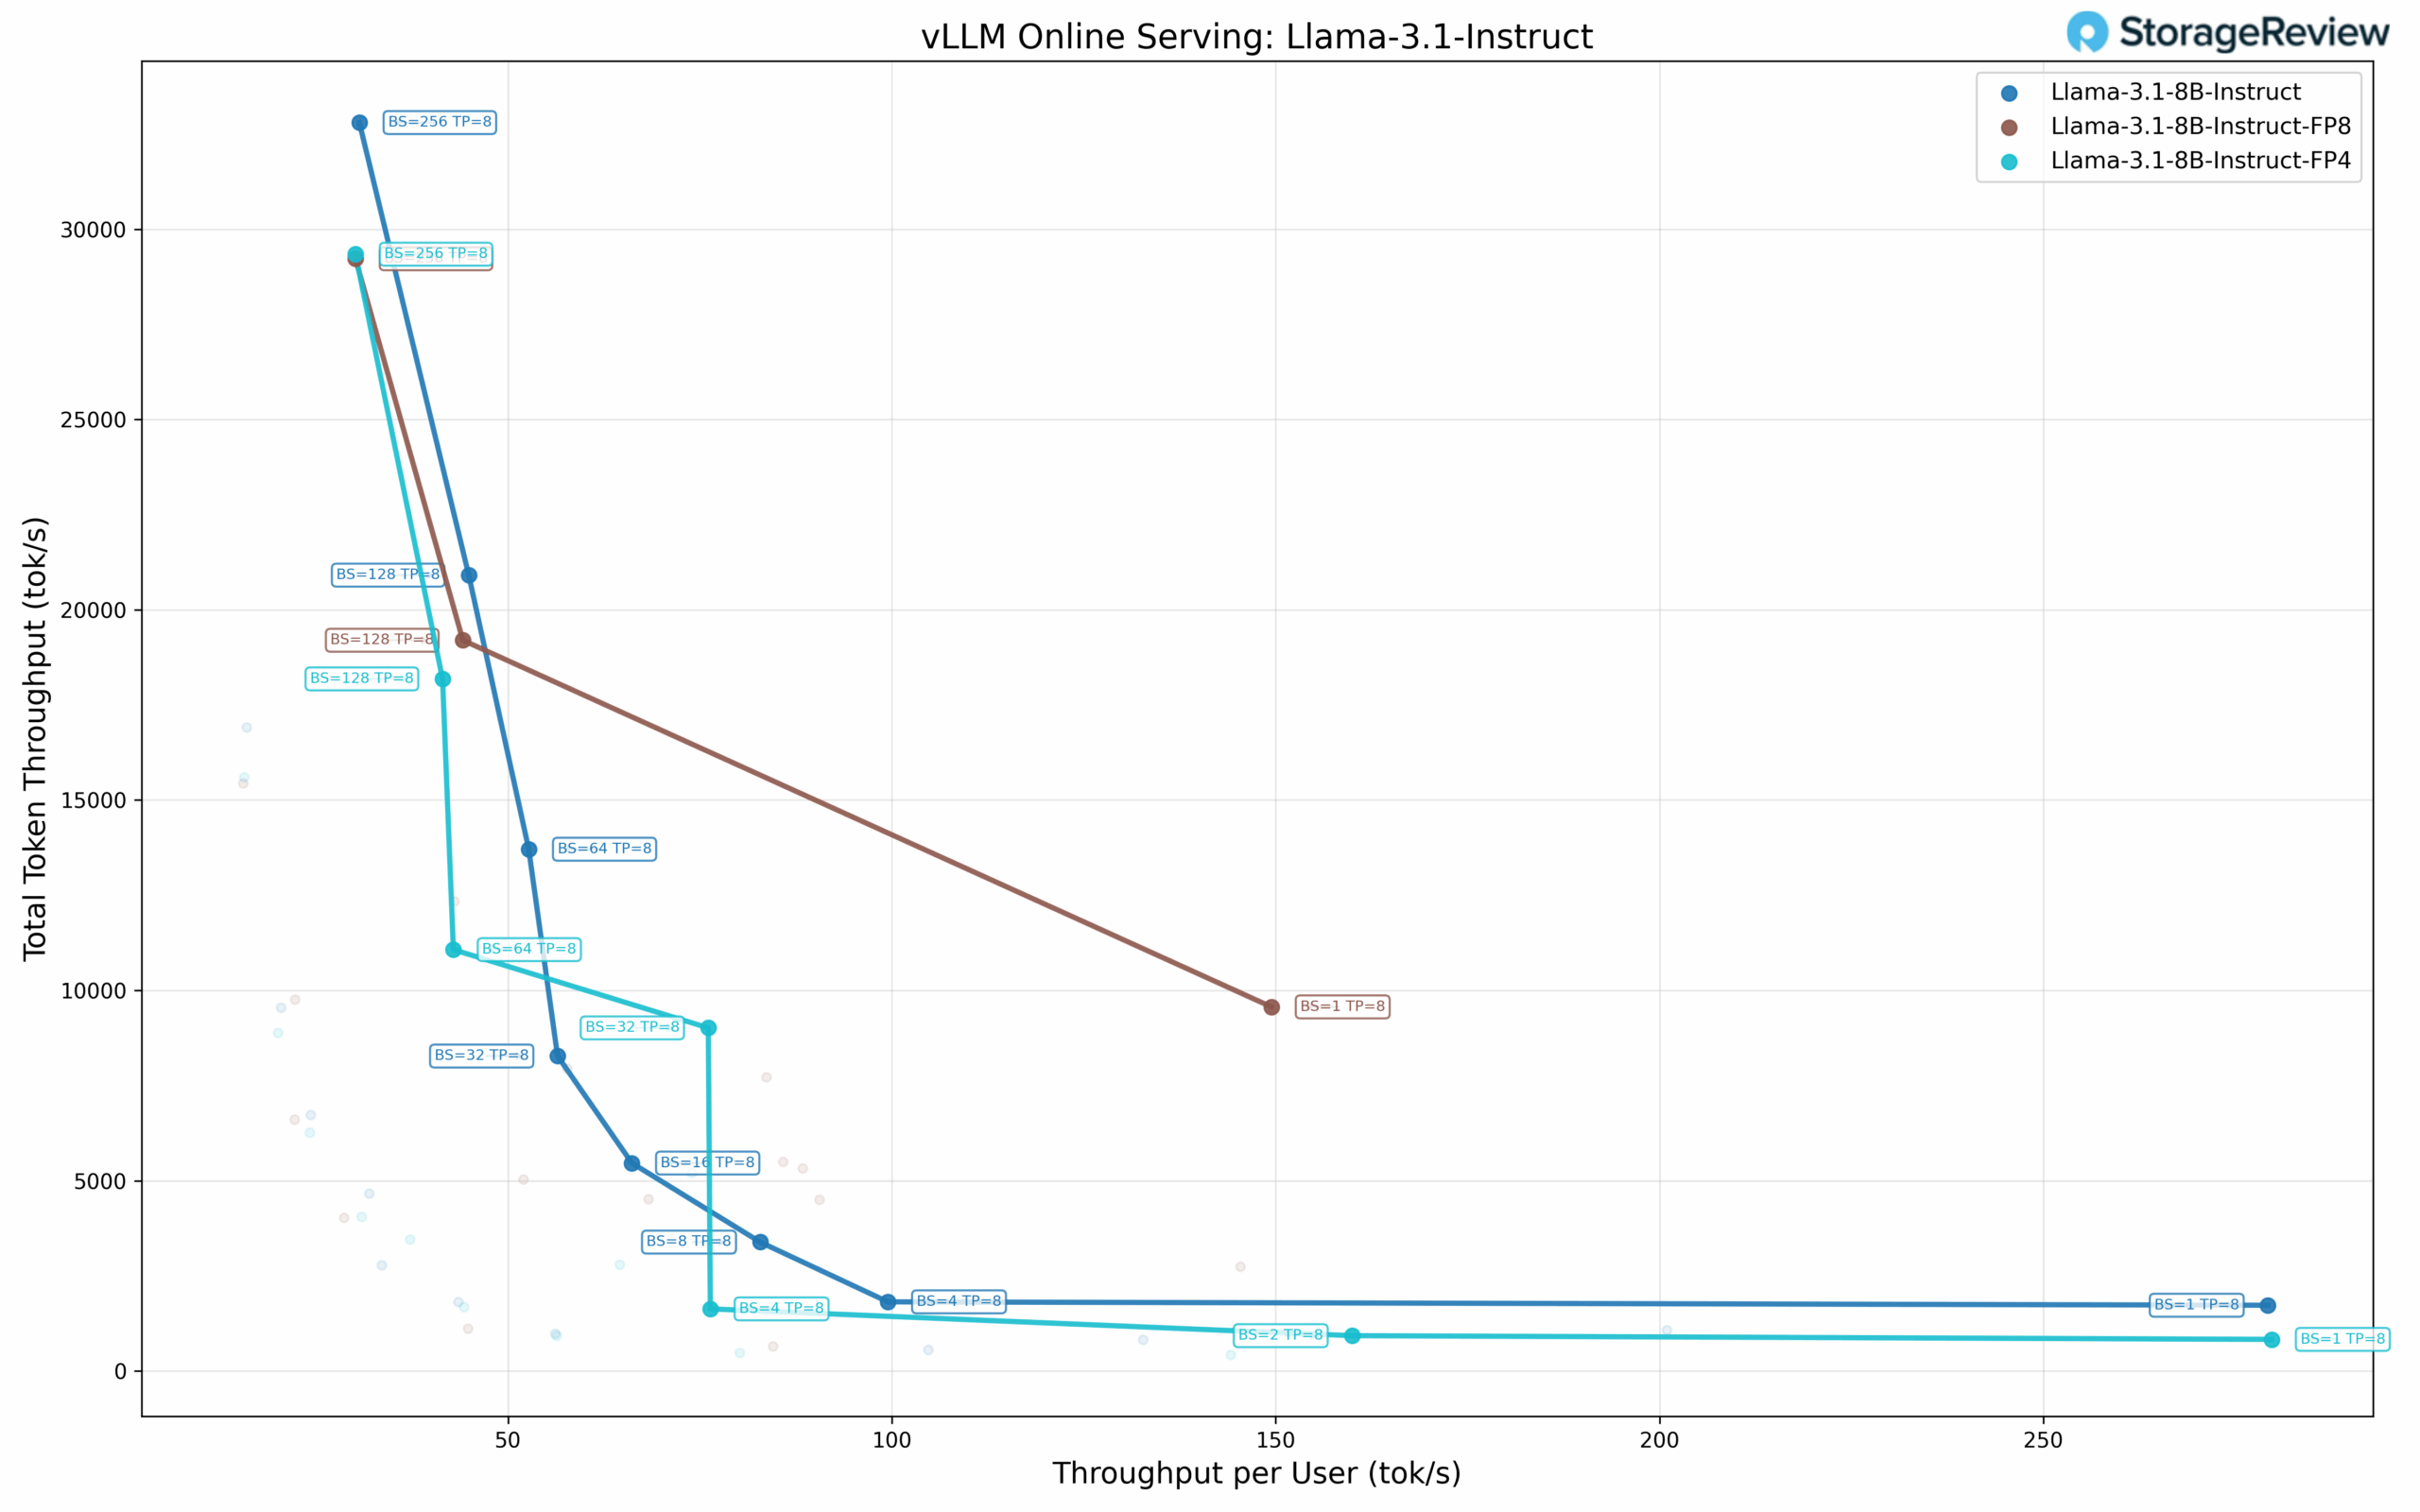
O modelo Llama 3.1 8B, com precisão padrão, demonstra as seguintes características de escalabilidade em diferentes níveis de concorrência. Com concorrência de usuário único (BS=1), o modelo atinge 279.27 tok/s por usuário, com uma taxa de transferência total de 1,727.62 tok/s e um TPOT de 3.37 ms. À medida que o tamanho do lote aumenta, a taxa de transferência por usuário diminui, enquanto a taxa de transferência total aumenta. Com BS=8, o modelo alcança 82.85 tok/s por usuário, com um total de 3,386.48 tok/s e um TPOT de 3.28 ms. O desempenho continua a escalar até BS=32 (56.46 tok/s por usuário, 8,274.66 tok/s no total) e BS=64 (52.70 tok/s por usuário, 13,707.66 tok/s no total).
O modelo atinge sua taxa de transferência total máxima em BS=256, fornecendo 32,797.67 tok/s, com 30.64 tok/s por usuário e um TPOT de 16.13 ms. Isso representa um aumento de 19 vezes na taxa de transferência total em comparação com o desempenho de usuário único. Os valores de TPOT permanecem na faixa de 3 a 4 ms até BS=64, aumentando para 16.13 ms em BS=256.
Desempenho do Llama 3.1 8B FP8
A variante quantizada FP8 apresenta características diferentes. Com BS=1, atinge 149.46 tok/s por usuário, com uma taxa de transferência total de 9,565.20 tok/s e um TPOT de 3.44 ms. A análise da fronteira de Pareto revela três pontos ótimos (BS=1, BS=128, BS=256).
Com BS=128, o modelo entrega 44.12 tok/s por usuário, com um total de 19,198.40 tok/s e 11.04 ms.
TPOT. A taxa de transferência total máxima ocorre em BS=256 com 29,219.67 tok/s no total, 30.13 tok/s por usuário e TPOT de 13.26 ms. A variante FP8 atinge uma taxa de transferência total máxima menor em comparação com a precisão padrão (29.2K vs 32.8K tok/s).
Desempenho do Llama 3.1 8B FP4
A configuração quantizada FP4 apresenta os seguintes resultados. Com concorrência de usuário único (BS=1), atinge 279.73 tok/s por usuário, taxa de transferência total de 830.46 tok/s e TPOT de 3.43 ms.
O modelo FP4 apresenta sete pontos na fronteira de Pareto. Com BS=2, ele entrega 159.95 tok/s por usuário, 928.60 tok/s no total e 3.43 ms de TPOT. O desempenho continua a escalar até BS=4 (76.36 tok/s por usuário, 1,631.69 tok/s no total) e BS=32 (76.09 tok/s por usuário, 9,014.29 tok/s no total). O modelo atinge a taxa de transferência total máxima em BS=256, com 29,340.89 tok/s no total, 30.13 tok/s por usuário e 16.18 ms de TPOT.
Desempenho do modelo esparso
Modelos esparsos, particularmente arquiteturas de Mistura de Especialistas (MoE), são uma abordagem emergente para escalar modelos de linguagem de forma eficiente. Essas arquiteturas mantêm um alto número total de parâmetros, ativando apenas um subconjunto de parâmetros por token, o que potencialmente oferece melhor desempenho por parâmetro ativo.
Avaliamos duas arquiteturas de Modelo de Emulação (MoE): DeepSeek-R1, um modelo focado em raciocínio, e Qwen3 Coder 30B-A3B, uma arquitetura esparsa especializada em geração de código. O DeepSeek-R1 é o modelo focado em raciocínio mais popular, demonstrando características de desempenho distintas em comparação com modelos de linguagem tradicionais. O modelo Qwen3 Coder mantém um tamanho completo de 30 bilhões de parâmetros, ativando apenas 3 bilhões de parâmetros por token gerado. Realizamos testes de desempenho do Qwen3 Coder em suas variantes padrão e quantizadas em FP8 para compreender as características de desempenho em diferentes estratégias de quantização.
Desempenho do DeepSeek-R1
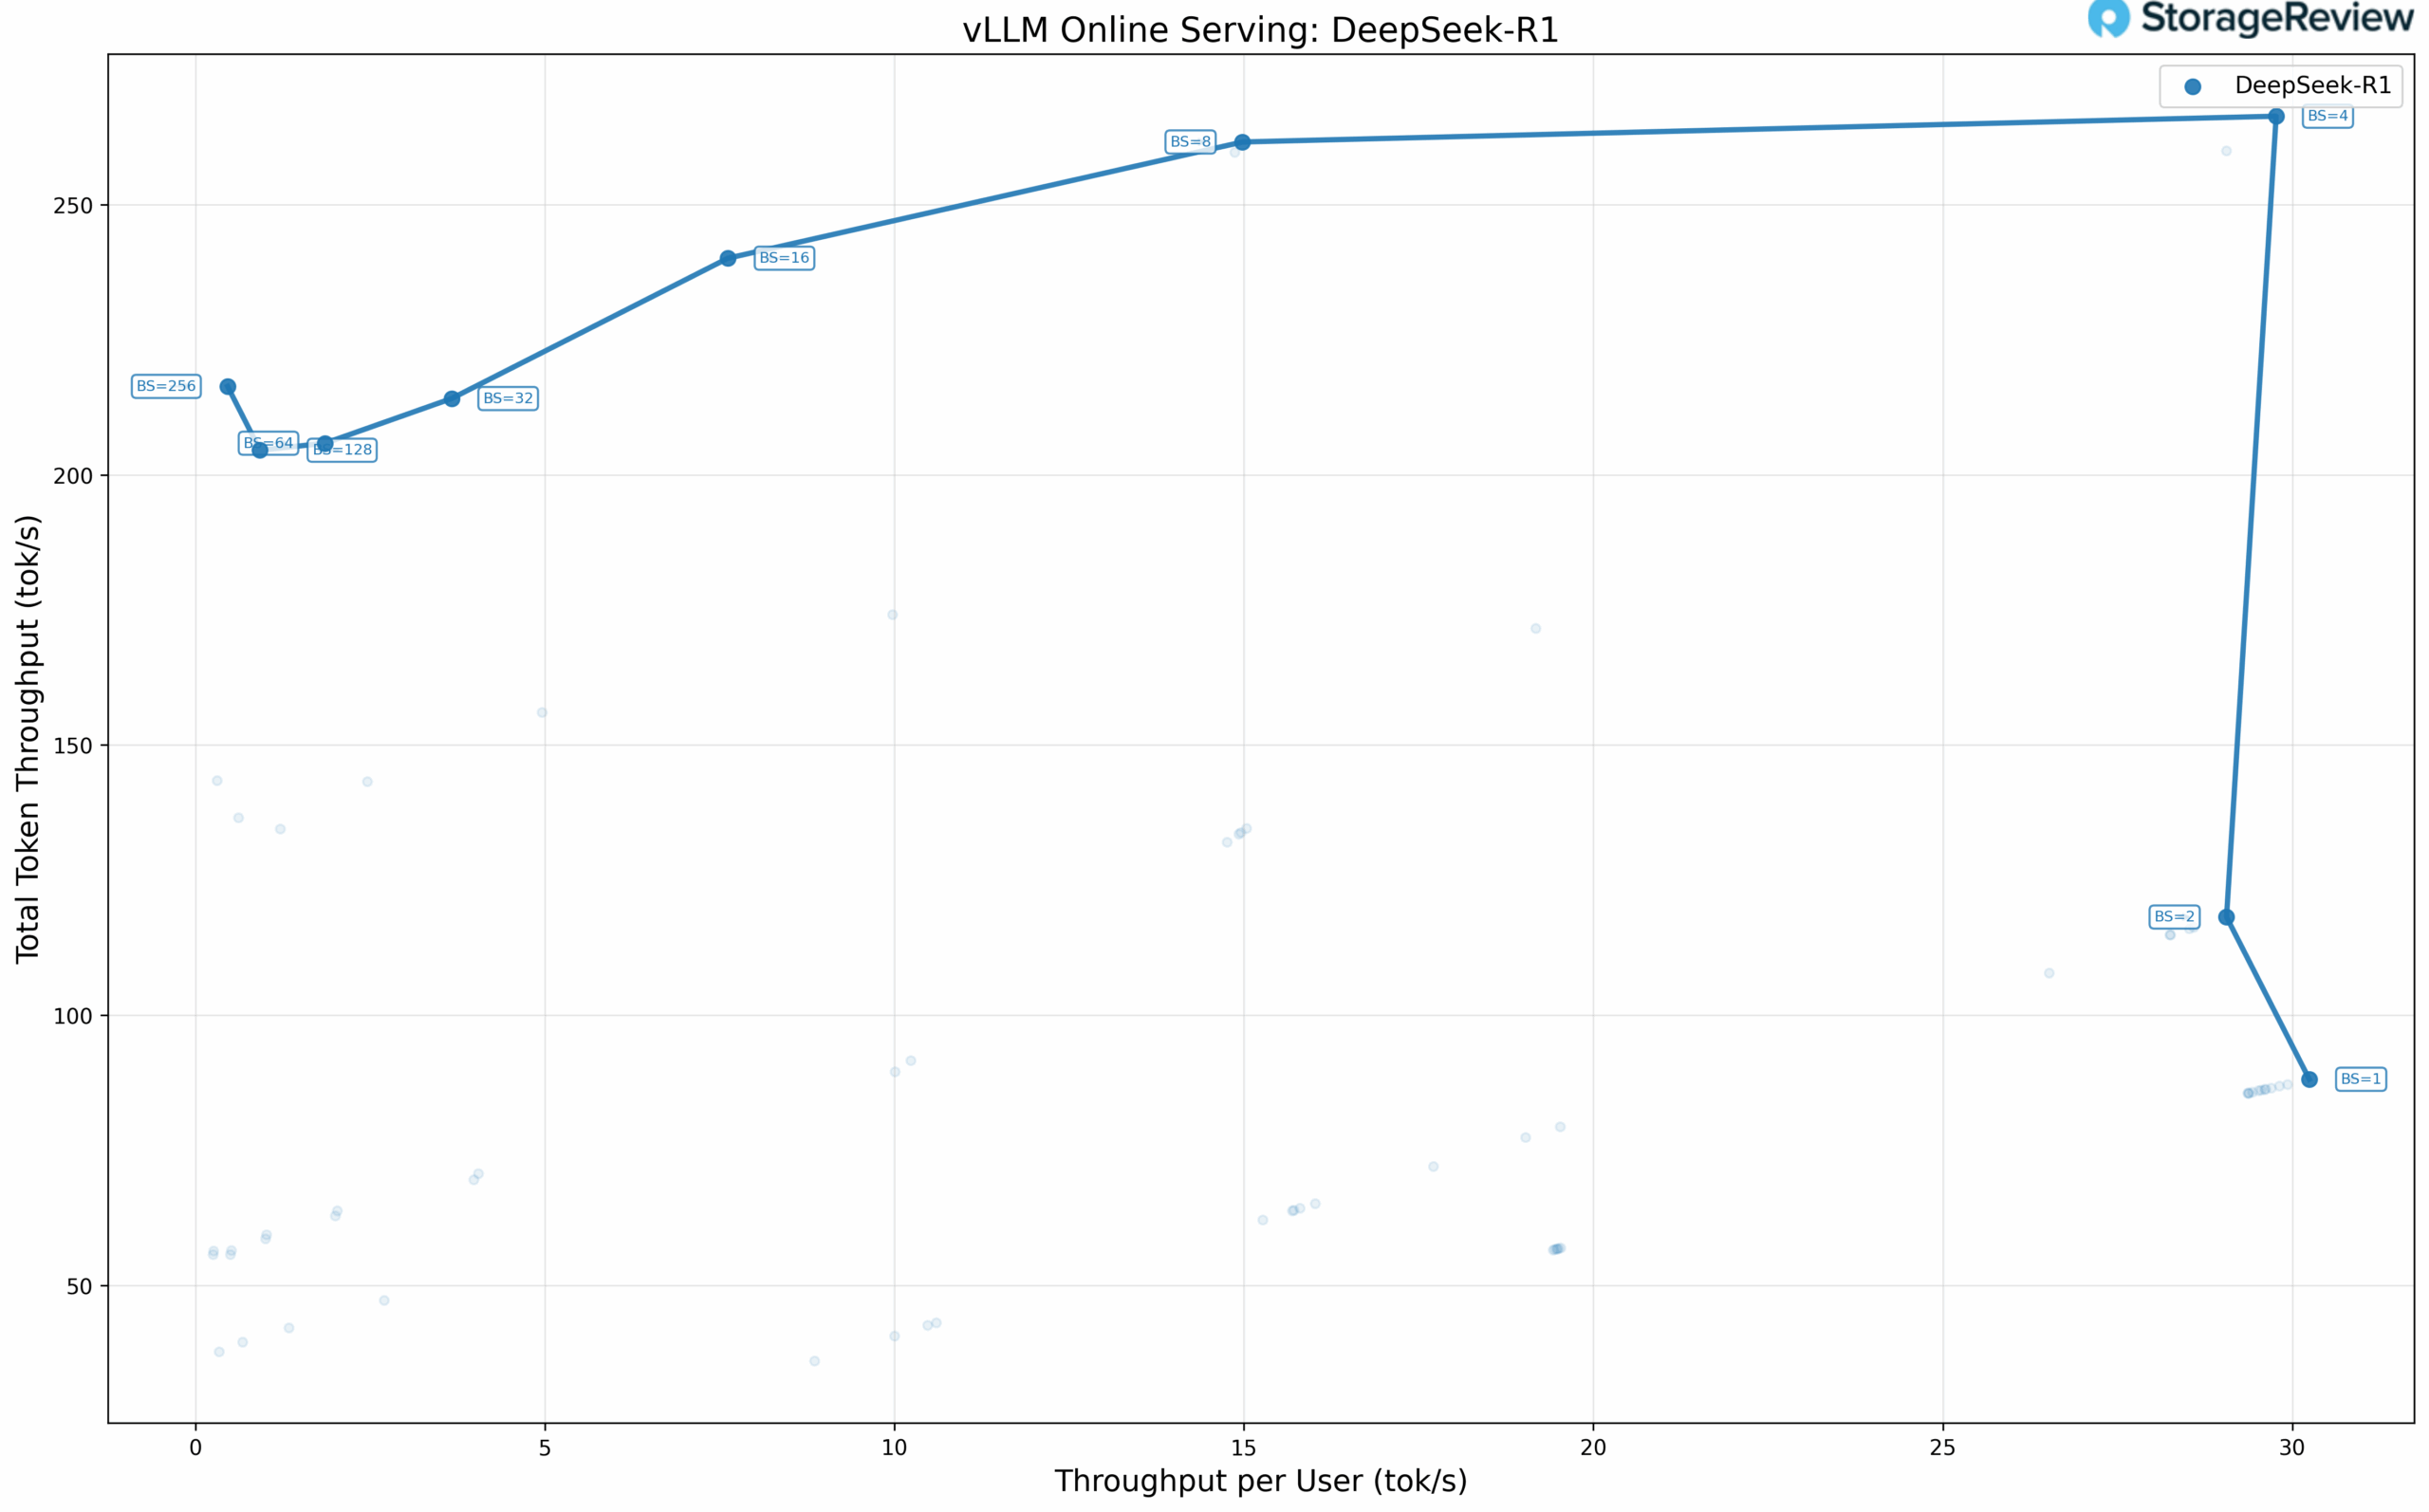
O modelo DeepSeek-R1 exibe um comportamento de escalabilidade interessante em relação aos tamanhos de lote. Com concorrência de usuário único (BS=1), o modelo atinge 30.24 tok/s por usuário, 88.13 tok/s de taxa de transferência total e TPOT de 29.85 ms. Ao escalar para BS=4, o desempenho alcança 29.77 tok/s por usuário, com uma taxa de transferência total de 266.40 tok/s e TPOT de 32.04 ms, representando a taxa de transferência total máxima alcançada em todas as configurações.
O desempenho do DeepSeek-R1 atinge um platô após BS=4. Em BS=8, a taxa de transferência por usuário cai drasticamente para 14.98 tok/s, e o declínio continua em tamanhos de lote maiores, chegando a apenas 0.46 tok/s por usuário em BS=256. A taxa de transferência total permanece relativamente estável entre 200 e 260 tok/s de BS=4 a BS=256, porque o modelo não consegue escalar com solicitações simultâneas adicionais em um único nó, o que leva a um aumento da latência sem ganhos significativos de taxa de transferência. É importante notar que o B200 DGX é uma das poucas soluções de servidor único capazes de executar esse modelo massivo.
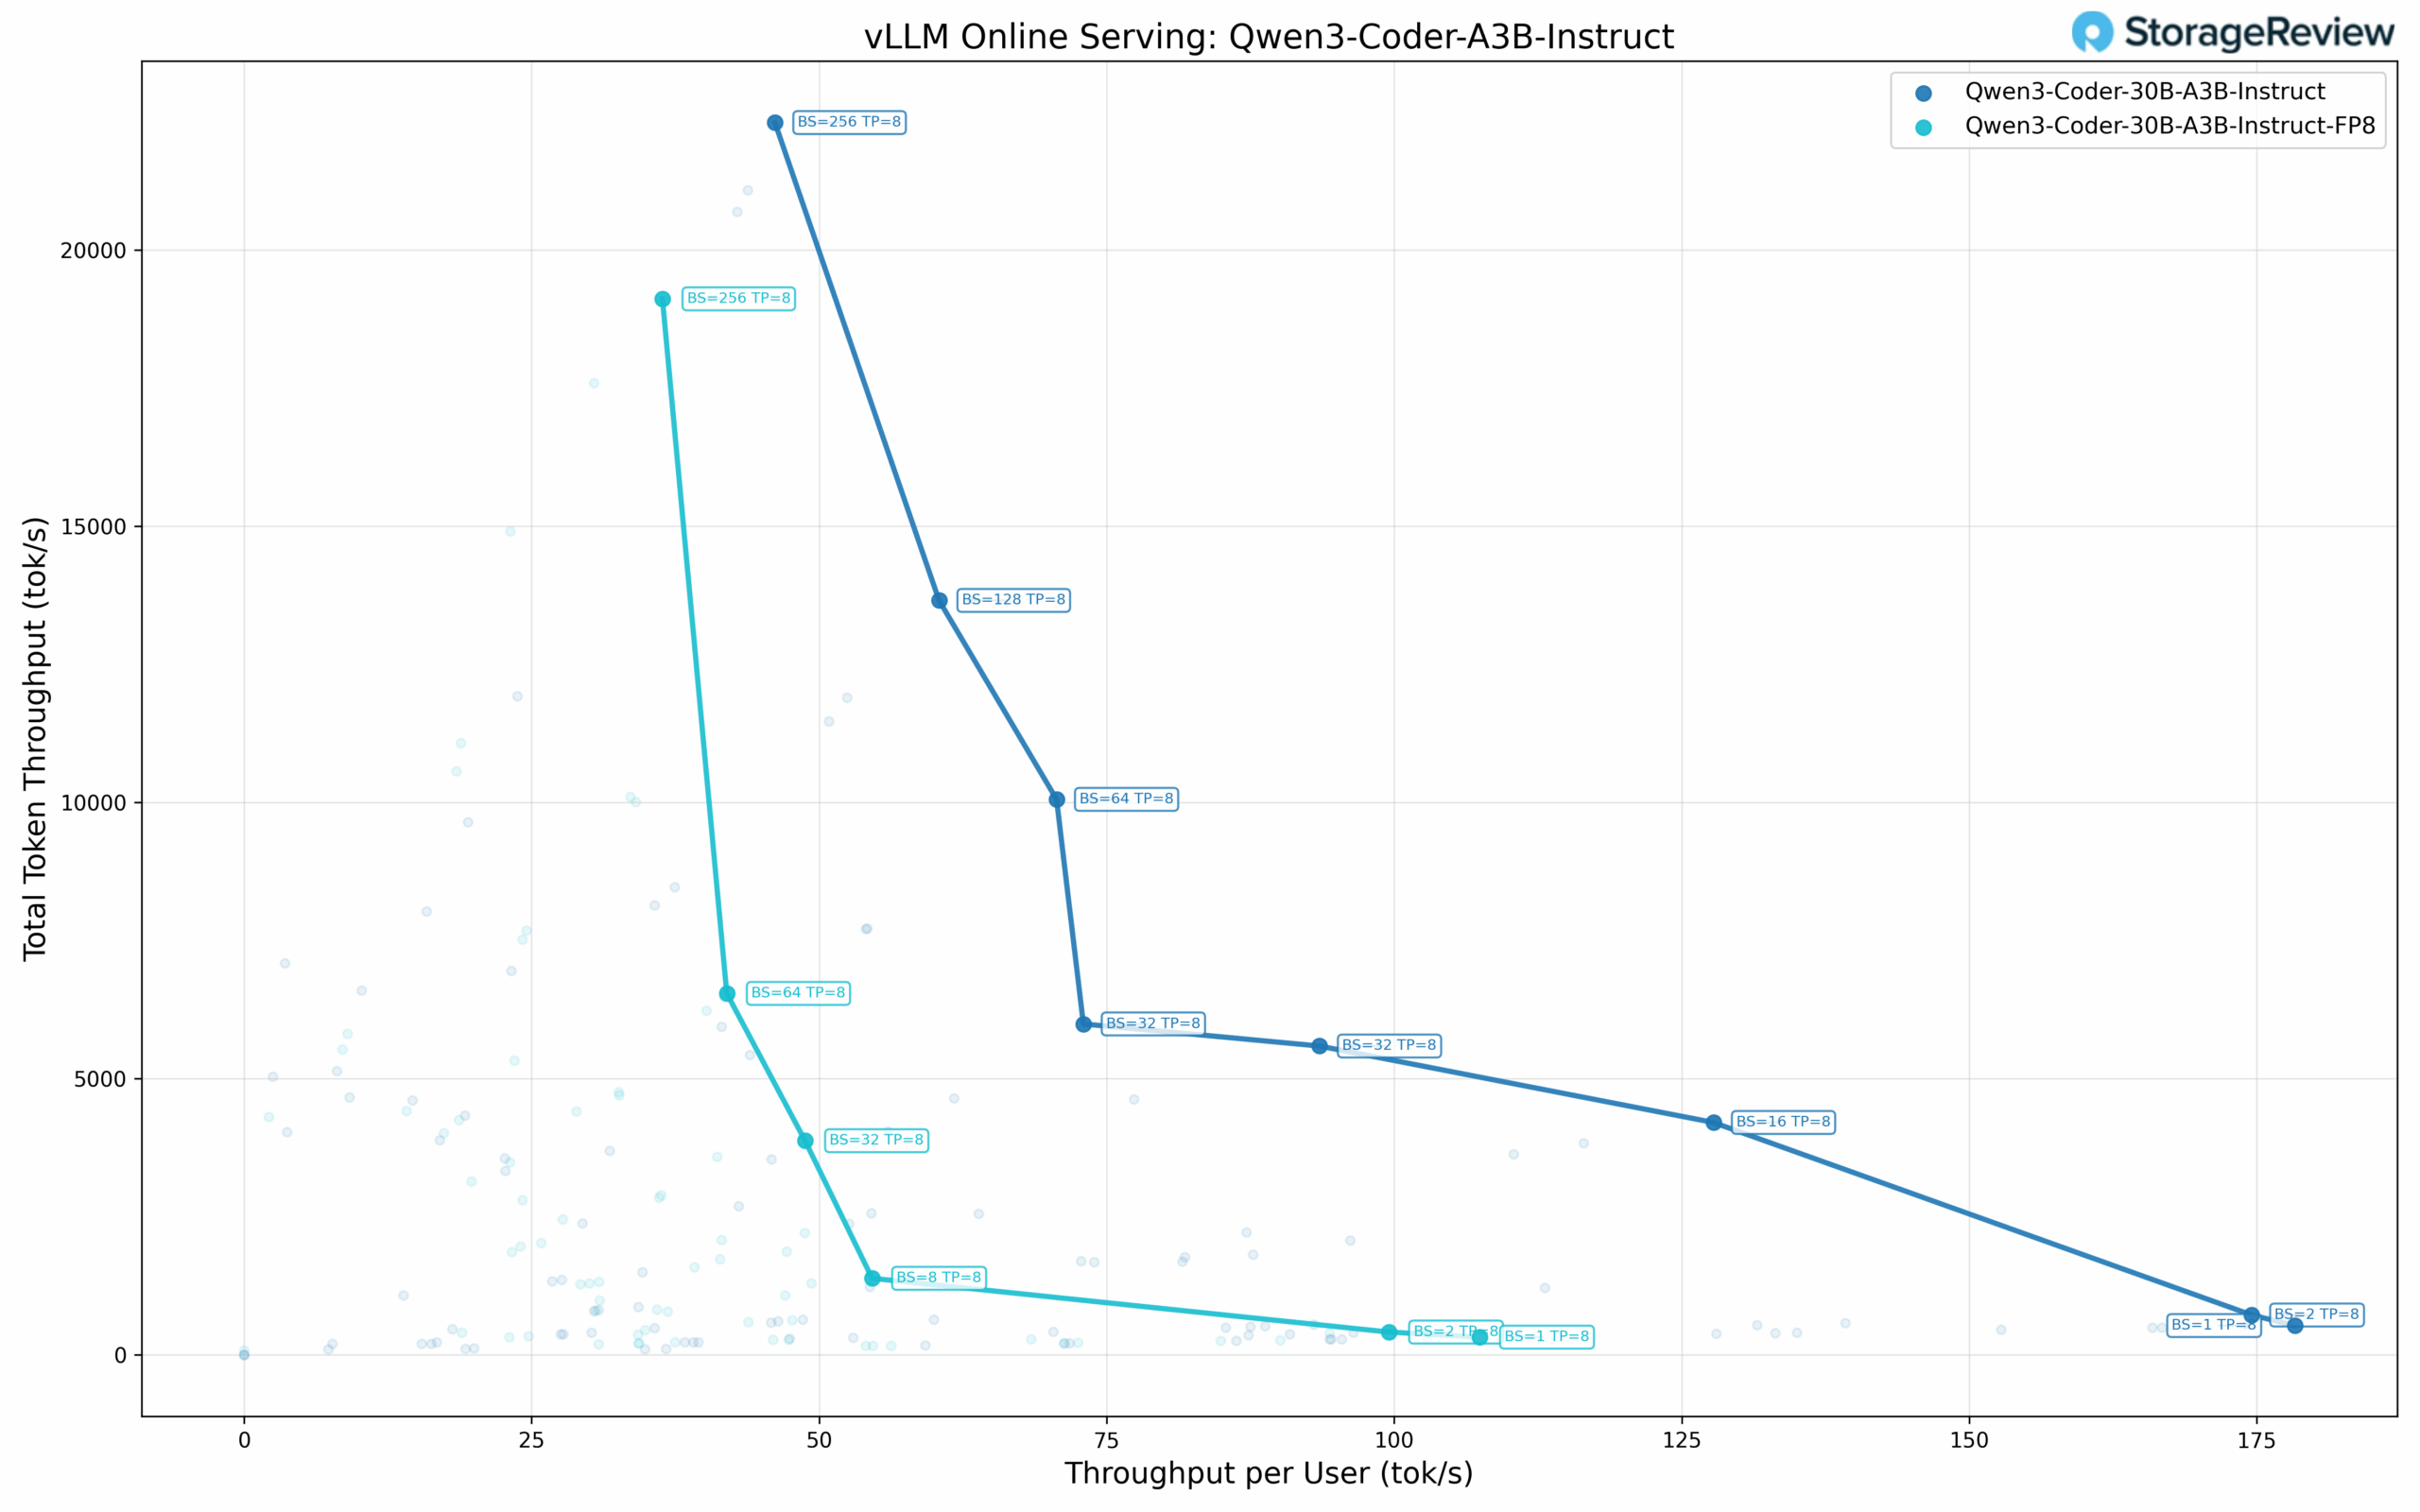
Desempenho do codificador Qwen3 30B-A3B
O modelo Qwen3 Coder de precisão padrão demonstra a seguinte escalabilidade em diferentes níveis de concorrência. Com concorrência de usuário único (BS=1), o modelo atinge 178.30 tok/s por usuário, 527.25 tok/s de taxa de transferência total e 5.46 ms de TPOT. Com BS=2, o desempenho alcança 174.56 tok/s por usuário, com 718.70 tok/s no total e 5.60 ms de TPOT. À medida que o tamanho do lote aumenta, a taxa de transferência por usuário diminui, enquanto a taxa de transferência total continua a escalar: BS=16 oferece 127.76 tok/s por usuário, 4,204.40 tok/s no total e 6.93 ms de TPOT.
O modelo atinge sua taxa de transferência total máxima em BS=256, alcançando 22,305.88 tok/s no total, com 46.16 tok/s por usuário e TPOT de 17.64 ms. A fronteira de Pareto inclui oito pontos distintos, com uma entrada duplicada em BS=32 (72.97 tok/s e 93.50 tok/s por usuário, provavelmente representando configurações diferentes). Os valores de TPOT permanecem na faixa de 5 a 9 ms até BS=64.
Desempenho do codificador Qwen3 30B-A3B FP8
A variante quantizada FP8 apresenta as seguintes características de desempenho. Com concorrência de usuário único (BS=1), ela oferece 107.46 tok/s por usuário, 317.75 tok/s de throughput total e 9.16 ms de TPOT. Com BS=2, o modelo atinge 99.55 tok/s por usuário, com 409.87 tok/s de throughput total e 9.86 ms de TPOT.
Escalando para tamanhos de lote maiores: BS=8 oferece 54.60 tok/s por usuário, com um total de 1,383.13 tok/s e um TPOT de 10.24 ms, enquanto BS=32 atinge 48.78 tok/s por usuário, com um total de 3,874.21 tok/s e um TPOT de 10.67 ms. A taxa de transferência total máxima ocorre em BS=256, com um total de 19,114.86 tok/s, 36.38 tok/s por usuário e um TPOT de 20.00 ms. Isso representa aproximadamente 86% da taxa de transferência máxima de precisão padrão.
Desempenho de tipo de dados em microescala
A microescala representa uma abordagem avançada de quantização que aplica fatores de escala de granularidade fina a pequenos blocos de pesos, em vez de uma quantização uniforme em grandes grupos de parâmetros. O formato NVFP4 da NVIDIA implementa essa técnica por meio de uma representação de ponto flutuante em blocos, onde cada bloco de microescala de 8 a 32 valores compartilha um expoente comum como fator de escala. Essa abordagem granular preserva a precisão numérica, alcançando uma representação de 4 bits, mantendo a faixa dinâmica crítica para arquiteturas de transformadores. O formato integra-se à arquitetura Tensor Core da NVIDIA, permitindo computação eficiente de precisão mista com descompressão instantânea durante operações de matriz.
Avaliamos os modelos GPT OSS da OpenAI em duas escalas de parâmetros usando a quantização NVFP4: a variante 20B e a variante maior 120B. Esses benchmarks demonstram o desempenho da quantização em microescala em diferentes tamanhos de modelo.
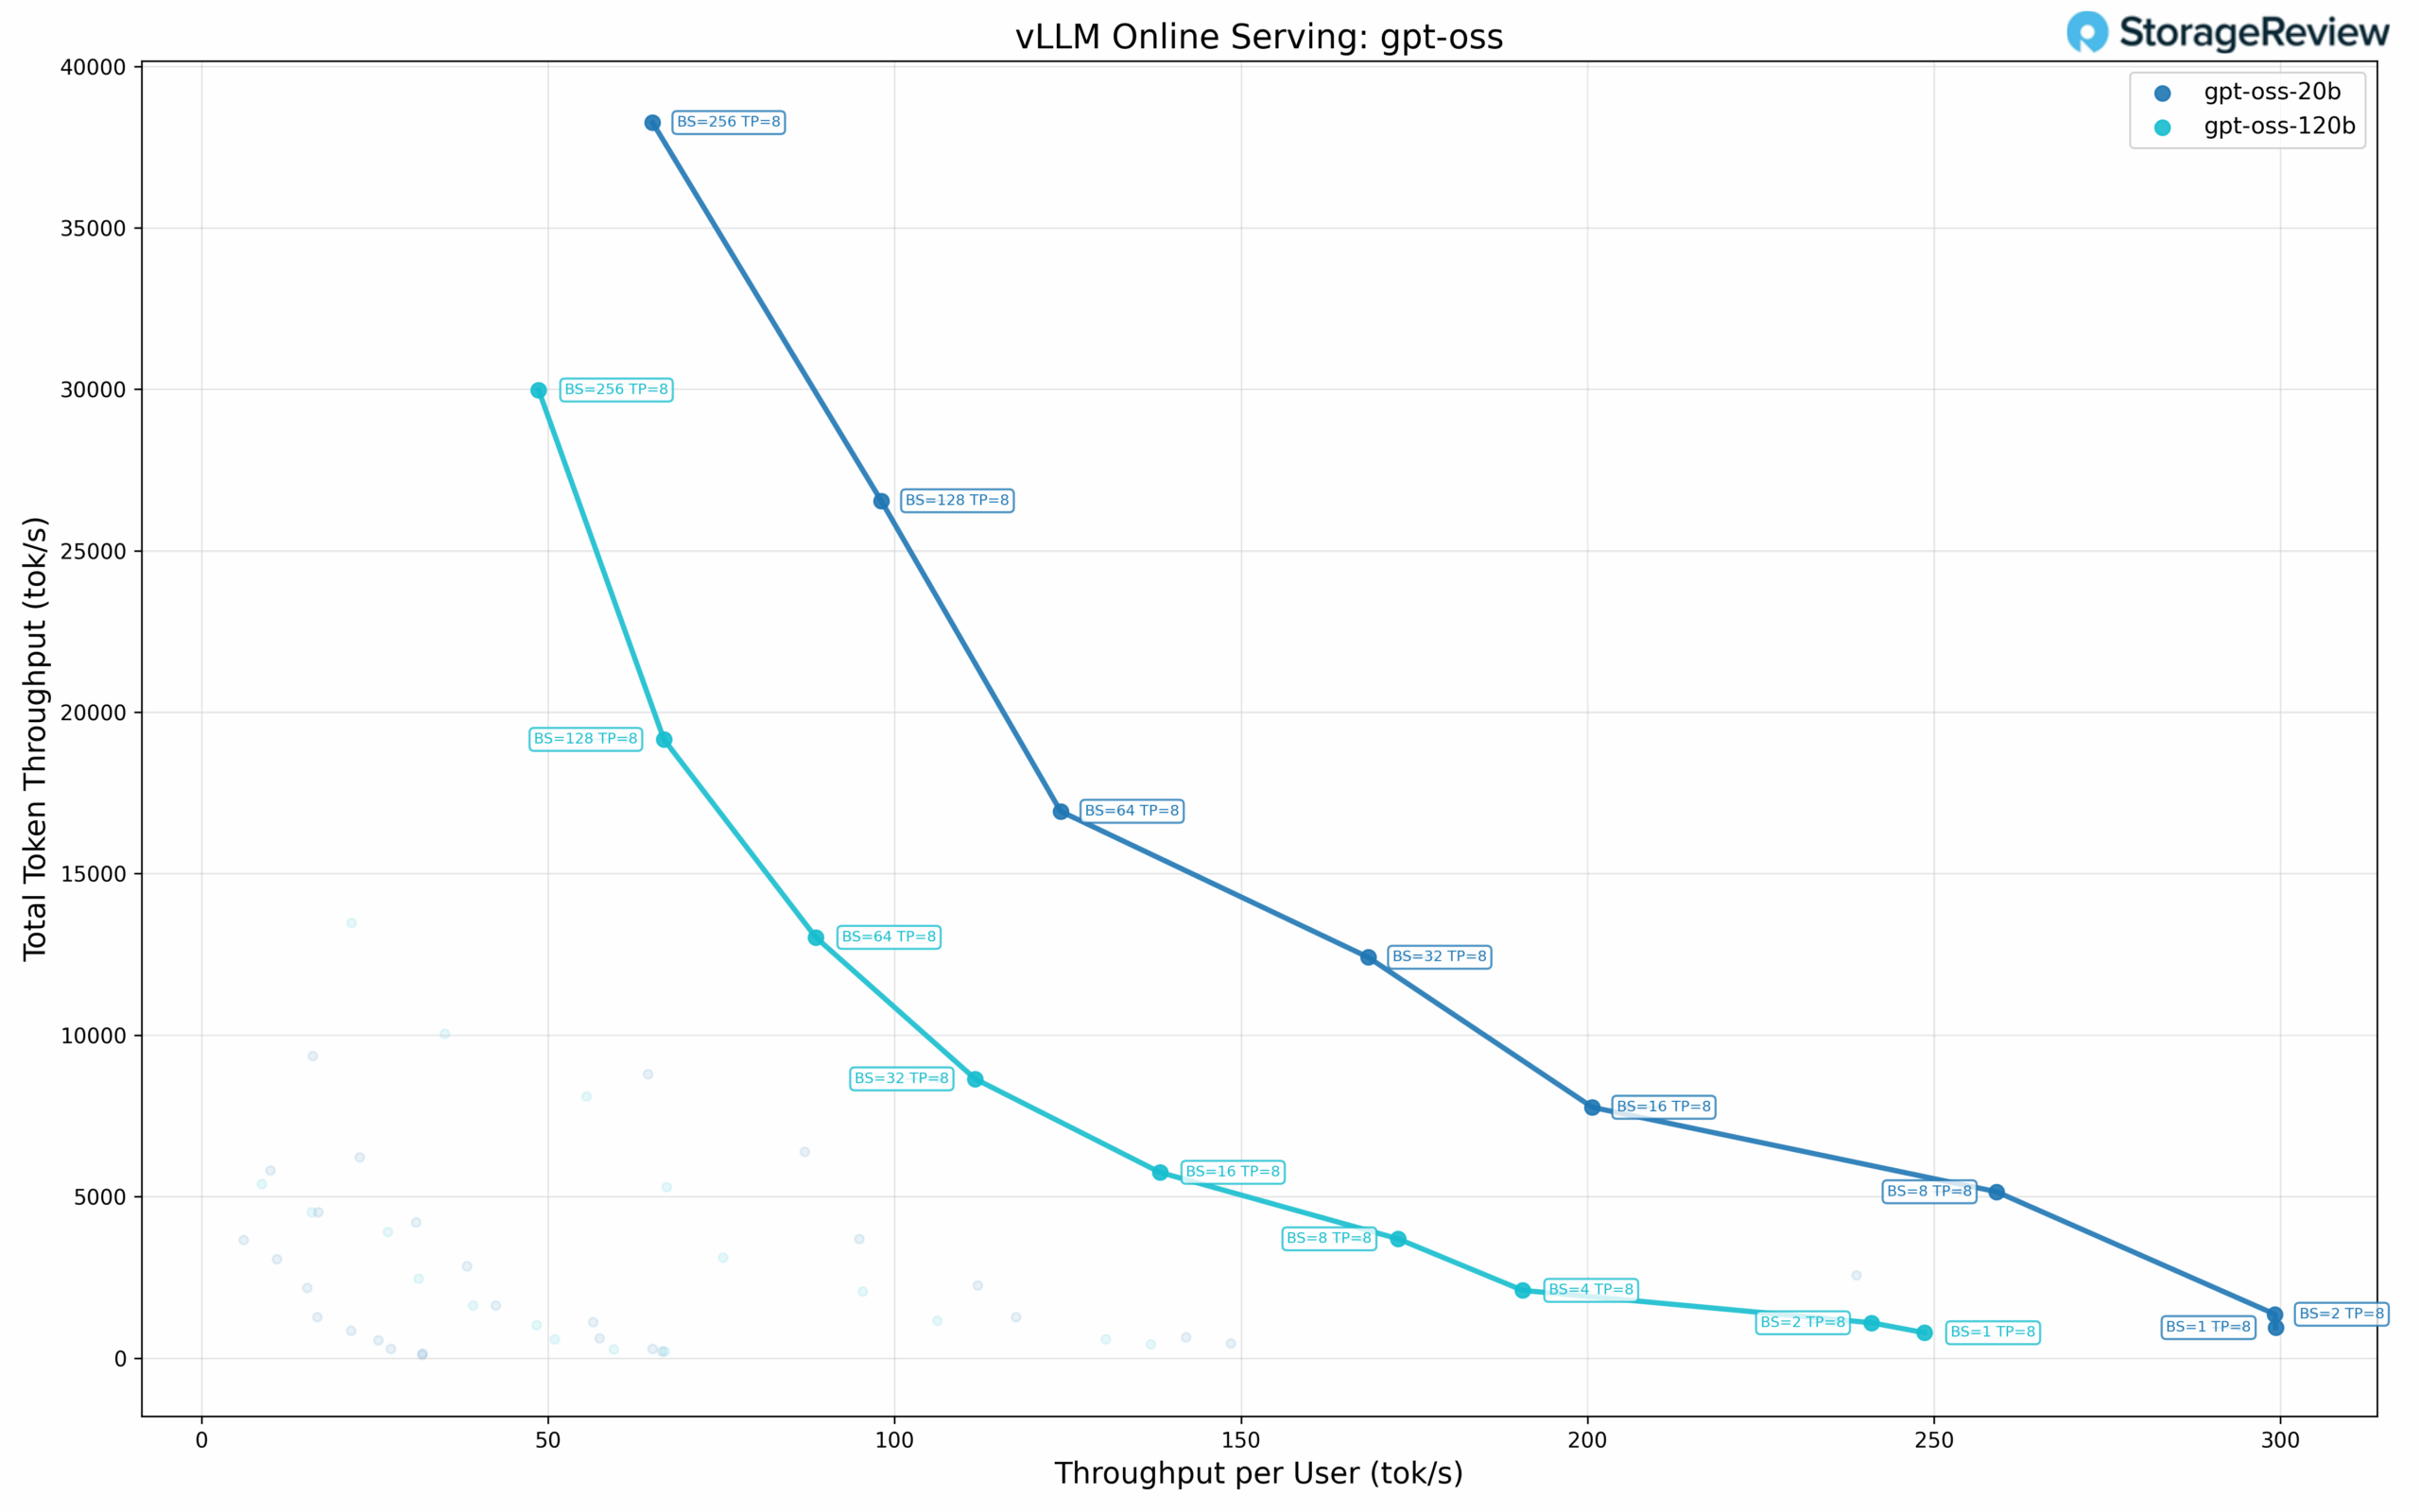
Desempenho GPT-OSS-20B
O modelo de 20B parâmetros alcança o seguinte desempenho em diferentes tamanhos de lote. Com concorrência de usuário único (BS=1), ele oferece 299.28 tok/s por usuário, 943.43 tok/s de taxa de transferência total e TPOT de 3.23 ms. Com BS=2, o modelo mantém 299.19 tok/s por usuário, com 1,356.87 tok/s de taxa de transferência total e TPOT de 3.19 ms.
Escalando para tamanhos de lote maiores: BS=8 atinge 259.02 tok/s por usuário com um total de 5,149.59 tok/s e TPOT de 3.42 ms, enquanto BS=16 oferece 200.69 tok/s por usuário com um total de 7,765.73 tok/s e TPOT de 3.77 ms. O modelo continua a escalar para BS=32 (168.34 tok/s por usuário, 12,411.72 tok/s no total) e BS=64 (123.96 tok/s por usuário, 16,931.47 tok/s no total).
A taxa de transferência total ocorre em BS=256, atingindo 38,258.50 tok/s no total, com 65.08 tok/s por usuário e TPOT de 9.39 ms. Isso representa um aumento de 40.5 vezes na taxa de transferência total em comparação com o desempenho de um único usuário. Os valores de TPOT permanecem na faixa de 3 a 5 ms até BS=32. A fronteira de Pareto inclui oito pontos distintos.
Desempenho GPT-OSS-120B
O modelo com 120 bits, de configuração maior, mantém o seguinte desempenho apesar do aumento no número de parâmetros. Com um único usuário simultâneo (BS=1), ele atinge 248.62 tok/s por usuário, 783.73 tok/s de throughput total e 3.89 ms de TPOT. Com BS=2, o modelo oferece 240.99 tok/s por usuário, 1,092.91 tok/s de throughput total e 3.99 ms de TPOT.
O desempenho continua a aumentar com tamanhos de lote maiores: BS=4 atinge 190.63 tok/s por usuário, com um total de 2,096.73 tok/s e um TPOT de 4.22 ms, enquanto BS=8 oferece 172.66 tok/s por usuário, com um total de 3,692.10 tok/s e um TPOT de 4.54 ms. A escalabilidade para BS=16 (138.28 tok/s por usuário, 5,751.41 tok/s no total), BS=32 (111.63 tok/s por usuário, 8,646.05 tok/s no total) e BS=64 (88.64 tok/s por usuário, 13,027.97 tok/s no total) mostra uma expansão consistente da taxa de transferência.
O modelo atinge sua taxa de transferência total máxima em BS=256, fornecendo 29,976.99 tok/s, com 48.64 tok/s por usuário e um TPOT de 12.53 ms. Isso representa um aumento de 38.2 vezes na taxa de transferência total em comparação com o desempenho de um único usuário. A taxa de transferência total máxima é aproximadamente 78% do pico do modelo 20B. A fronteira de Pareto inclui nove pontos distintos, o maior número entre todos os modelos testados.
Desempenho inesperado do modelo quantizado
Os resultados do modelo quantizado foram inesperados e justificam uma investigação mais aprofundada. Em vários casos, as versões quantizadas NVFP4 e FP8 dos modelos não alcançaram as melhorias de desempenho esperadas em relação às suas contrapartes de precisão nativa. Por exemplo, o modelo Llama 3.1 8B FP4 atingiu uma taxa de transferência total de apenas 830.46 tok/s com BS=1, em comparação com 1,727.62 tok/s para a variante de precisão padrão, apesar da taxa de transferência por usuário ser semelhante. Com tamanhos de lote maiores, embora os modelos quantizados tenham se aproximado da taxa de transferência de precisão padrão (29.2K-29.3K tok/s vs 32.8K tok/s com BS=256), os resultados gerais sugerem que a implementação atual do vLLM pode não estar totalmente otimizada para Blackwell.
Planejamos realizar testes adicionais no vLLM e também compará-lo com o TensorRT-LLM para verificar qual desempenho os usuários finais podem esperar atualmente.
O JumpStart da Supermicro revoluciona o cenário de provas de conceito em IA.
O programa JumpStart da Supermicro cumpre o que promete: acesso real e irrestrito a hardware de nível de produção, sem a logística, os atrasos de envio ou os custos de laboratório de uma prova de conceito tradicional. Nossa semana JumpStart na plataforma X14 HGX B200 começou rapidamente, transcorreu sem problemas e nos permitiu avaliar o desempenho da mesma forma que faríamos com equipamentos em nossos próprios racks.
Para organizações que precisam tomar decisões rápidas sobre infraestrutura de IA, esse tipo de acesso à plataforma pode reduzir semanas de planejamento a dias. Se o objetivo é validar o desempenho da GPU, o comportamento do armazenamento, o desempenho do modelo ou simplesmente confirmar a compatibilidade da pilha, o JumpStart fornece as respostas com o mínimo de atrito. É uma abordagem de avaliação de hardware que prioriza a confiança, e gostaríamos de ver mais fornecedores adotá-la.


 Amazon